首页 文章 精选 留言 我的

精选列表

搜索[趋势探讨],共10000篇文章
优秀的个人博客,低调大师

探讨求解:Android项目间如何实现资源复用?

我们开发项目时,通常不仅代码需要复用,很多资源也是经常重用的,比如: 按钮上的图标 交互时发出的声音 某种功能所需的Activity布局 控件样式 常见的文字及其对应的各语言版本 比如这样一个软件分享的布局: 其中的布局、标签及按钮文字都是可复用的,如果你分享的是作者软件列表链接,那么QR码图片也是可以复用的,每次调用时只需要传递进来不同的分享信息字符串就可以了。 现在问题就是我找不到办法在多项目间共享这些通用资源,目前只能很囧地在个项目间复制粘贴,总感觉很二啊…… 我尝试过将一个项目作为公共项目,存入资源,打包为Jar文件,其他项目引用,然后使用公共项目命名空间中的资源ID访问资源,但是这样做访问到的还是本项目中的和那个ID相同的(因为ID实际上只是一个int值)资源,这个问题肯定是因为上下文使用的仍然是本程序,所以就直接从本程序的资源里去找了。 那么我又尝试通过 this.createPackageContext("com.skyd.common", 0) 这样的形式获取公共项目的上下文,但是这样做是失败的,异常提示名称未找到,而这个办法在跨App调用时却是有效的。 大家有什么办法实现吗? 本文转自斯克迪亚博客园博客,原文链接:http://www.cnblogs.com/SkyD/archive/2011/01/09/1931048.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

观点:理性探讨 996 与员工工作效率问题

看到某人发所谓的帖子说什么反对996,还拿什么八小时工作制来作愰子,还有颇多的人支持,不知道这些人的脑子是做什么用的? 8小时工作的前提是完成企业的任务给企业带来八小时的价值,而不是混点。 不论是8小时还是12小时,只要能为企业创造相对应的价值,就足够了,而不是一味的去支持8小时或12小时的996。 全世界除了中国,多数的知名高科技企业都是弹性工作时间,如谷歌的OKR来管理,工作时间并不是固定的,以完成目标为主。 国内之所以多数公司要采用打卡考勤管理,我认为分两部分来说: 1.ATM这样的大公司996的意思很简单,待遇拉高了工作时间,即ATM用高薪抢到人才,但是这些人才所能创造的价值是恒定的。阿里、tx、有效美团工作1小时待遇最低是100元人民币,而一般的公司可能只有80。 2.ATM的1小时工作创造的价值未必比一般公司高但工资却多20%,那在市场竞争中自然优势下降。所以需要把工作时间延长以保证创造的价值抵减成本后的利润和一般公司相同。 3.所以ATM工作时间996才能抵消高工资带来的利润下降的问题。 别外一个问题就是工作效率和员工管理能力的问题,很多公司的员工管理非常差,很多所谓的管理岗都是技术人才转型,这样导致员工工作效率很低,单位小时创造的价值低,所以需要采用延长工作时间来达到与其支付的工资待遇相平衡。 996也好还是8小时,能为公司创造相对应的价值才是王道,高效率的工作6小时比低效率工作12小时要有用,而且后者还浪费了资源! 不谈工作价值,只说工作时间就是脑子进水的表现。

优秀的个人博客,低调大师

Python C扩展的引用计数问题探讨

Python GC机制 对于Python这种高级语言来说,开发者不需要自己管理和维护内存。Python采用了引用计数机制为主,标记-清除和分代收集两种机制为辅的垃圾回收机制。 首先,需要搞清楚变量和对象的关系: 变量:通过变量指针引用对象。变量指针指向具体对象的内存空间,取对象的值。 对象,类型已知,每个对象都包含一个头部信息(头部信息:类型标识符和引用计数器) 引用计数 python里每一个东西都是对象,它们的核心就是一个结构体:PyObject,其中ob_refcnt就是引用计数。当一个对象有新的引用时,ob_refcnt就会增加,当引用它的对象被删除,ob_refcnt就会减少。当引用计数为0时,该对象生命就结束了。 typedef struct_object { int ob_refcnt; struct_typeobject *ob_type; } PyObject; #define Py_INCREF(op) ((op)->ob_refcnt++) //增加计数 #define Py_DECREF(op) \ //减少计数 if (--(op)->ob_refcnt != 0) \ ; \ else \ __Py_Dealloc((PyObject *)(op)) 可以使用sys.getrefcount()函数获取对象的引用计数,需要注意的是,使用时会比预期的引用次数多1,原因是调用时会针对于查询的对象自动产生一个临时引用。 下面简单展现一下引用计数的变化过程。 一开始创建3个对象,引用计数分别是1。 之后将n1指向了新的对象"JKL",则之前的对象“ABC”的引用计数就变成0了。这时候,Python的垃圾回收器开始工作,将“ABC”释放。 接着,让n2引用n1。“DEF”不再被引用,“JKL”因为被n1、n2同时引用,所以引用计数变成了2。 >>> n1 = "ABC" >>> n2 = "DEF" >>> n3 = "GHI" >>> sys.getrefcount(n1) 2 >>> sys.getrefcount(n2) 2 >>> sys.getrefcount(n3) 2 >>> n1 = "JKL" >>> sys.getrefcount(n1) 2 >>> n2 = n1 >>> sys.getrefcount(n1) 3 >>> sys.getrefcount(n2) 3 >>> sys.getrefcount(n3) 2 优缺点:优点:实时性好。一旦没有引用,内存就直接释放了。实时性还带来一个好处:处理回收内存的时间分摊到了平时。 缺点:维护引用计数消耗资源;循环引用无法解决。 如下图,典型的循环引用场景。对象除了被变量引用n1、n2外,还被对方的prev或next指针引用,造成了引用计数为2。之后n1、n2设成null之后,引用计数仍然为1,导致对象无法被回收。 标记-清除、分代收集 Python采用标记-清除策略来解决循环引用的问题。但是该机制会导致应用程序卡住,为了减少程序暂停的时间,又通过“分代回收”(Generational Collection)以空间换时间的方法提高垃圾回收效率。详见Python垃圾回收机制!非常实用 Python C扩展的引用计数 Python提供了GC机制,保证对象不被使用的时候会被释放掉,开发者不需要过多关心内存管理的问题。但是当使用C扩展的时候,就不这么简单了,必须需要理解CPython的引用计数。 当使用C扩展使用Python时,引用计数会随着PyObjects的创建自动加1,但是当释放该PyObjects的时候,我们需要显示的将PyObjects的引用计数减1,否则会出现内存泄漏。 #include "Python.h" void print_hello_world(void) { PyObject *pObj = NULL; pObj = PyBytes_FromString("Hello world\n"); /* Object creation, ref count = 1. */ PyObject_Print(pLast, stdout, 0); Py_DECREF(pObj); /* ref count becomes 0, object deallocated. * Miss this step and you have a memory leak. */ } 有亮点尤其需要注意: PyObjects引用计数为0后,不能再访问。类似于C语言free后,不能再访问对象。 Py_INCREF、Py_DECREF必须成对出现。类似于C语言malloc、free的关系。 Python有三种引用形式,分别为 “New”, “Stolen” 和“Borrowed” 引用。 New引用 通过Python C Api创建出的PyObject,调用者对该PyObject具有完全的所有权。一般Python文档这样体现: PyObject* PyList_New(int len) Return value: New reference. Returns a new list of length len on success, or NULL on failure. 针对于New引用的PyObject,有如下两种选择。否则,就会出现内存泄漏。 使用完成后,调用Py_DECREF将其释放掉。 void MyCode(arguments) { PyObject *pyo; ... pyo = Py_Something(args); ... Py_DECREF(pyo); } 将引用通过函数返回值等形式传递给上层调用函数,但是接收者必须负责最终的Py_DECREF调用。 void MyCode(arguments) { PyObject *pyo; ... pyo = Py_Something(args); ... return pyo; } 使用样例: static PyObject *subtract_long(long a, long b) { PyObject *pA, *pB, *r; pA = PyLong_FromLong(a); /* pA: New reference. */ pB = PyLong_FromLong(b); /* pB: New reference. */ r = PyNumber_Subtract(pA, pB); /* r: New reference. */ Py_DECREF(pA); /* My responsibility to decref. */ Py_DECREF(pB); /* My responsibility to decref. */ return r; /* Callers responsibility to decref. */ } // 错误的例子,a、b两个PyObject泄漏。 r = PyNumber_Subtract(PyLong_FromLong(a), PyLong_FromLong(b)); Stolen引用 当创建的PyObject传递给其他的容器,例如PyTuple_SetItem、PyList_SetItem。 static PyObject *make_tuple(void) { PyObject *r; PyObject *v; r = PyTuple_New(3); /* New reference. */ v = PyLong_FromLong(1L); /* New reference. */ /* PyTuple_SetItem "steals" the new reference v. */ PyTuple_SetItem(r, 0, v); /* This is fine. */ v = PyLong_FromLong(2L); PyTuple_SetItem(r, 1, v); /* More common pattern. */ PyTuple_SetItem(r, 2, PyUnicode_FromString("three")); return r; /* Callers responsibility to decref. */ } 但是,需要注意PyDict_SetItem内部会引用计数加一。 Borrowed引用 Python文档中,Borrowed引用的体现: PyObject* PyTuple_GetItem(PyObject *p, Py_ssize_t pos) Return value: Borrowed reference. Borrowed 引用的所有者不应该调用 Py_DECREF(),使用Borrowed 引用在函数退出时不会出现内存泄露。。但是不要让一个对象处理未保护的状态Borrowed 引用,如果对象处理未保护状态,它随时可能会被销毁。 例如:从一个 list 获取对象,继续操作它,但并不递增它的引用。PyList_GetItem 会返回一个 borrowed reference ,所以 item 处于未保护状态。一些其他的操作可能会从 list 中将这个对象删除(递减它的引用计数,或者释放它),导致 item 成为一个悬垂指针。 bug(PyObject *list) { PyObject *item = PyList_GetItem(list, 0); PyList_SetItem(list, 1, PyInt_FromLong(0L)); PyObject_Print(item, stdout, 0); /* BUG! */ } no_bug(PyObject *list) { PyObject *item = PyList_GetItem(list, 0); Py_INCREF(item); /* Protect item. */ PyList_SetItem(list, 1, PyInt_FromLong(0L)); PyObject_Print(item, stdout, 0); Py_DECREF(item); }

优秀的个人博客,低调大师

DB 与 Elasticsearch 混合之应用系统场景分析探讨

作者介绍 李猛,Elastic Stack深度用户,通过Elastic工程师认证,2012年接触Elasticsearch,对Elastic Stack技术栈开发、架构、运维等方面有深入体验,实践过多种大中型项目;为企业提供Elastic Stack咨询培训以及调优实施;多年实战经验,爱捣腾各种技术产品,擅长大数据,机器学习,系统架构。 名词解释 DB:database,泛指关系型数据库,具有严格事务隔离机制的数据类库产品,如 mysql、sqlserver、postgresql、oracle、db2 等,db-engine 综合排名前面的全部是关系型数据库; ES:Elasticsearch,最好的开源搜索引擎产品,NoSQL 非关系型数据库,不具备严格事务隔离机制,当前 db-engine 综合排名第七; 应用:本文泛指业务应用系统,是

优秀的个人博客,低调大师

每日一博 | 开源软件商业模式的探讨

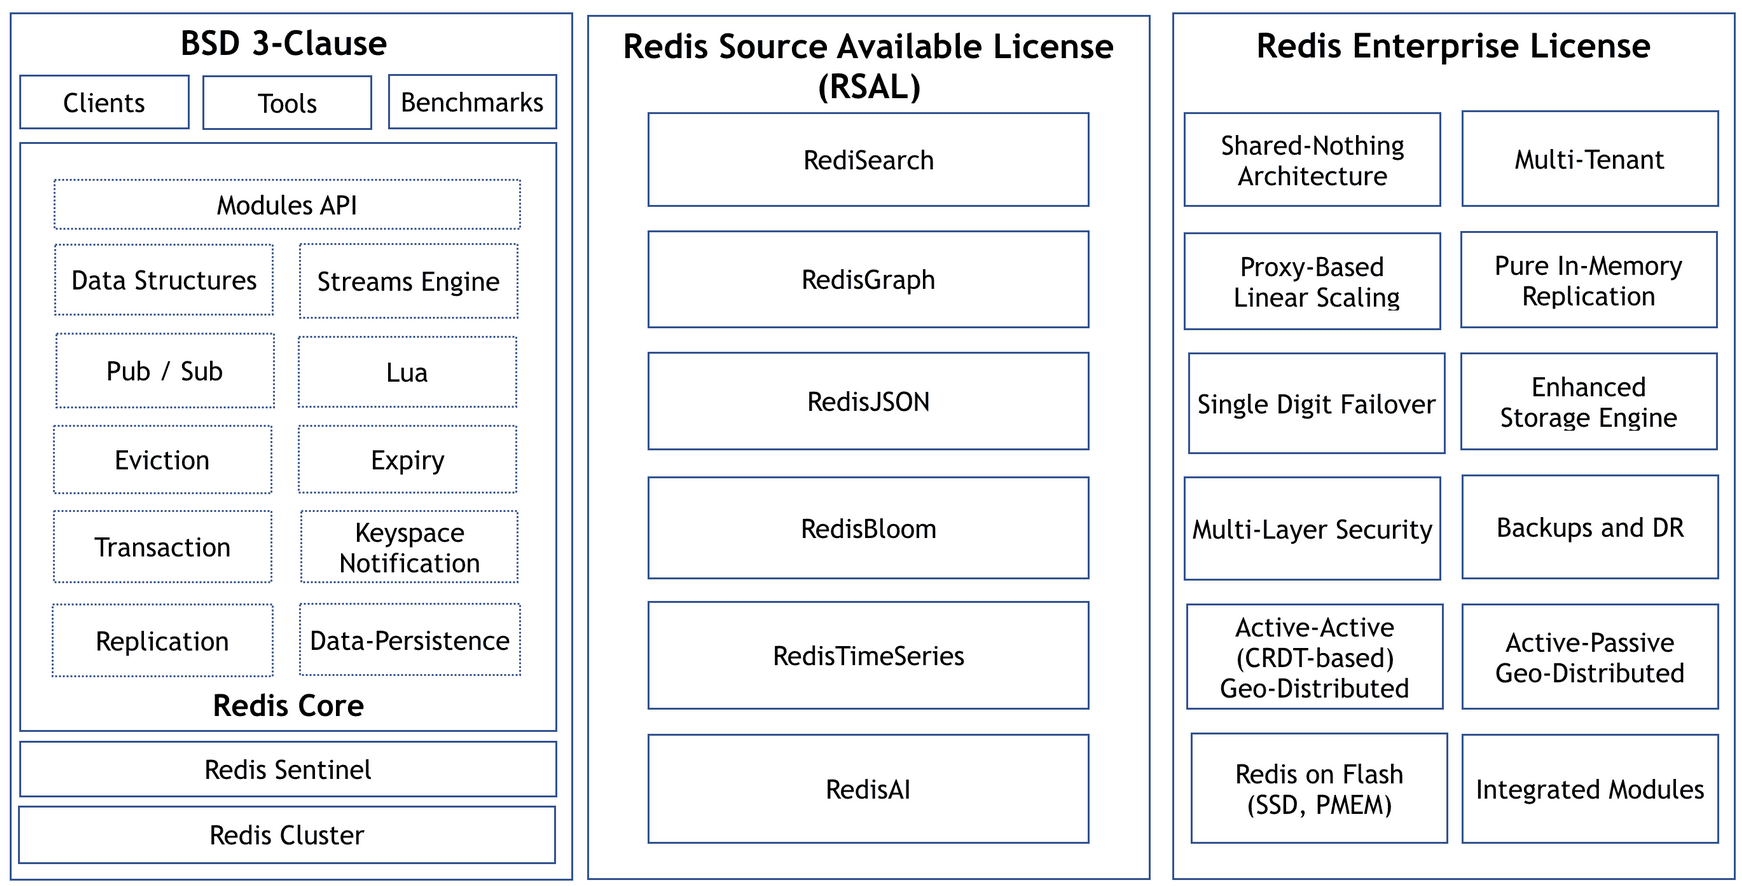
声明:我们的开源项目“ Milvus 向量搜索引擎”还处在社会主义初级阶段。以下内容是我们目前对开源工作的摸索,并非最佳实践。 开源许可证 既然我们决定了要开源,第一步便是要选择合适的开源许可证。虽然自由软件创始人 RMS 曾经倡导 Copyleft 概念,但 Copyleft 也是一种特殊的 Copyright 。 那么,什么是开源许可证?简单来说,一个许可证只要经过 OSI ( Open Source Initiative )认证,就可以被称之为开源许可证。 OSI 有专门的流程来审核一个许可证是否符合开源定义( Open Source Definition )。比如说, MongoDB 新设计的 SSPL ( Sever Side Public License )在完成 OSI 认证之前, MongoDB 只能说自己的许可证是源码可用( source available ),而不能说自己是开源(当然,这个限制属于行业惯例,没有强制性)。 目前主流的开源许可证,可以在 OSI 网站上查询到。网上也有很多文章去比较各个许可证之间的不同(可参考阮一峰老师的博客),我就不一一赘述了。这里主要结合我们的自身情况来谈一下开源许可证的选择。开源许可证简单来说,可以分为三档: 严格,以 GPL 2.0 许可证为代表,典型软件是 MySQL 适中,以 Apache 2.0 许可证为代表,目前使用最广泛 宽松,以 BSD,MIT , PostgreSQL 许可证为代表,典型软件是 PostgreSQL 熟悉数据库的朋友一定知道 MySQL 和 PostgreSQL 。 MySQL 是最流行的开源数据库,但 PostgreSQL 是衍生项目最多的开源数据库。现在的新项目很少使用 GPL 2.0 许可证,它的传染性应该是大家最有顾虑的地方。 对于推广基础技术来说,MIT/BSD 类的许可证是一个好选择。可能现在已经很少人使用 FreeBSD 。但它也还在不断的发展,因为采用非常宽松的 2-Clause-BSD 许可证, FreeBSD 被不少厂商用来开发自己的闭源系统。比如, Sony 的 Play Station 3 和 4 的系统都基于 FreeBSD , 还有任天堂的 Swtich 游戏机也是。 Redis 也采用宽松的 3-Clause-BSD 许可证(相比 2-Clause 多了对商标的使用限制)。不过, Redis 整个工具链的许可证情况十分复杂。以至于当 Redis 切换部分组件的许可证时,引起了业界很大的误解。因此中途将许可证变严格是件有点敏感的事情。 看起来颇为复杂的 Redis 许可矩阵。 如果上策太急,下策太缓。那么就选择中间的 Apache 2.0 。Apache 2.0 目前是 Apache 基金会与 CNCF 基金会推荐的默认开源许可证。 Github 网站对 Apache 2.0 许可证的简易说明 Apache 2.0 像其他开源许可证一样不限制商业使用,专利授权也默认包含其中。不过 Apache 2.0 也明确规定了在此开源许可证下软件厂商的免责条款。这也就是开源软件公司提供订阅增值服务的法律基础。 不过即使是 Apache 2.0 这么成熟的开源许可证,大家还是有一个担心:公有云。 需要防范公有云厂商吗 开源软件与公有云的关系这两年有点紧张,一个比较流行的观点是公有云插管吸血开源软件,而对开源社区没有太多贡献。不少开源项目开始寻找在公有云面前保护自己的方法。毕竟公有云的出现,一定程度上打乱了原有的开源商业模式。最终用户通过购买云服务,从公有云服务商那里的到了保障,开源厂商被绕开了。 于是, Common Clause 应运而生。 Common Clause 是一种附加条款,开源厂商依然需要选择一个基本的主许可证。最终的形式类似: Apache 2.0 + Common Clause 1.0 。 Common Clause 比较精炼,全文只有 3 句话,如下: The Software is provided to you by the Licensor under the License, as defined below, subject to the following condition. Without limiting other conditions in the License, the grant of rights under the License will not include, and the License does not grant to you, the right to Sell the Software. For purposes of the foregoing, "Sell" means practicing any or all of the rights granted to you under the License to provide to third parties, for a fee or other consideration (including without limitation fees for hosting or consulting/ support services related to the Software), a product or service whose value derives, entirely or substantially, from the functionality of the Software. Any license notice or attribution required by the License must also include this Commons Clause License Condition notice. Common Clause 主要禁止他人在不增加开源软件价值的情况下,利用开源软件牟利。它的限制性主要体现在以下三点: 禁止他人 对软件生态构建的影响 利用原软件进行 license 销售 非常小。目前主流观点是开源软件不收取 license 费用,软件收费以按年支付的订阅模式进行。 提供软件支持服务 比较小。尤其是产品初期,大家都不了解,需要依靠官方支持。官方提供订阅模式,大家比较容易接受。产品的订阅收费模式能够得到保障。不过将来等产品成熟以后,需要考虑参照 Oracle 的 OCP 方式,提供一些针对专业人士的产品能力认证,以缓和这一点可能的影响。 提供软件托管服务 防范云厂商。限制云厂商不能通过托管云服务( hosting )的方式,利用原软件进行盈利。但不代表用户不能在云环境里使用该软件。Apache 2.0 + Common Clause 1.0 不会限制用户运行软件的硬件环境,只要用户购买订阅服务,产品方一样会提供支持服务。 假设第三方在开源软件的基础上构建了一整套面向用户的应用,这套新应用增加了原开源软件的价值,那么这套新应用不会受到任何限制。这一点保证了开源厂商与合作伙伴之间的合作关系不会受到影响。 不过 Common Clause 没有经过 OSI 认证,因此添加了 Common Clause 以后建议只说自己是源码可用( source available )。虽然会引起一定的争议,不过初创开源项目选择添加 Common Clause 看起来正受到越来越多人的理解。 然而,我们的开源项目并不打算加上 Common Clause 。有两个重要的原因。 MongoDB 的启示 MongoDB 是开源项目成功的范例。 MongoDB 一开始就采用 AGPL 3.0 许可证。如果公有云要利用 MongoDB 提供服务,那么公有云厂商需要公布相关底层服务的源码。因此, AWS , Azure, Google Cloud 等一众美国公有云都选择自行开发文档型数据库。而在美国以外, MongoDB 却很难用法律武器保护自己。 2018 年 10 月 MongoDB 修改新版本的许可证时,再次抱怨了公有云厂商对 MongoDB 利益的侵害,主要指的就是美国以外的公有云厂商。因此,志在全球的开源基础软件厂商其实很难仅靠一个许可证来对自己进行全面的保护。 另一方面,当 AWS 有了 DynamoDB ; Azure 有了 Cosmos DB ; Google Cloud 有了 Cloud Firestore 之后,文档数据库不再是 MongoDB 一家独大。在之后的移动互联网浪潮中,移动端的 MongoDB Mobile 没有达到期待中的影响力。毕竟 Realm 这样的移动端文档数据库可以直接和多个公有云文档数据库同步,极大的方便了移动开发者。2019 年 4 月, MongoDB 以 3900 万美元收购了 Realm 。 防范别人的同时也部分影响了自己的发展空间,是否值得?答案因人而异,开源项目需要结合自身情况作出一个选择。 四爷的新策略 据咨询公司 Gartner 的统计, Google Cloud 2018 年占据公有云 IaaS 市场 4.0% 的份额,排行全球第四。依然不及老大 AWS 市场占有率( 47.8% )的一个零头。 Google Cloud 想迎头赶上,他该怎么办? 在今年的 Google Cloud Next 大会上,新上任的 Google Cloud CEO 一举请来了 Redis Lab CEO 与 MongoDB CEO 帮忙站台。大会上 Google Cloud 推出了 Redis 的托管服务, MongoDB 上了 Google Cloud Marketplace 。后续 MongoDB 的 Atlas 云服务还和 Google Cloud 展开了一系列合作。 Redis 和 MongoDB 在开源界与互联网行业有较大的技术影响力。而且他们是开源界对公有云厂商开炮比较多的两家。近期他们又先后针对公有云厂商修改了自己的许可证。因此 Google Cloud Next 大会上传达的信息很有意思。 与成熟的开源厂商合作,看起来正是 Google Cloud 的新策略。这条路值得一试。毕竟,老四恐怕很难用老大的方法来战胜老大。 “学我者生,似我者死。” —— 齐白石 Google Cloud 第一个想明白了。我相信会有越来越多的公有云厂商想明白这个问题,选择与成熟的开源厂商合作。所以对开源基础软件来说,当务之急是提升自身的成熟度,防范之心可以暂时放到一边。 商业设计 在上一篇文中,我们提到“ Apache 基金会拥有 1.9 亿行代码。根据 COCOMO II 模型估算,这些代码的开发成本超过 200 亿美元( 2019 年报)。”如此算来,每一行代码的开发成本超过 200 美元。所以千万别觉得开源软件就该免费使用。 典型的开源商业模式 目前比较成熟的开源软件商业模式有以下几种: 订阅服务:开源许可证免除了厂商对软件质量与软件缺陷修复的责任。而这些都是企业级应用所必须的。因此,最自然的商业模式就是提供软件订阅服务,从而向用户提供生产级的服务支持响应和 hotfix 修复。 高级功能:比如 Redis 。核心部分的组件是开源的。但工具类软件,进阶功能(如多租户,无共享分布式架构等)都是收费的。 云服务:比如 Databricks 。 Spark 是开源的,但收费版本仅提供 Azure 和 AWS 上的云服务。 生态收益(仅限超大型开源厂商):比如据华尔街分析师估算 Google 每年要支付近百亿美元给 Apple ,就为了 iPhone 上的默认搜索引擎入口。想想 Android 帮 Google 省了多少钱? 软件世界里有两个重大难题:一是大型软件系统的项目管理(人月神话),另一个是软件定价。关于项目管理,已经有了不少的研究与实践,大家多少有个参照物。而软件定价没有什么成熟的公式与模型。 但至少对于开源软件的定价,要避开下面两个坑: 定高价,打 1 折 不采用订阅模式 这些都是传统商业软件的模式。传统商业软件提供给客户的是资产,开源软件提供给用户的是服务。 如果大型用户要求对软件进行买断怎么办?大型用户倾向于一次性付费,并不是他们喜欢购买一堆软件资产。背后的原因在于大型用户内部的软硬件采购流程,需要采购人员与 IT 技术人员共同介入。而采购并不是技术人员的本职工作,以及事后的各种审计。因此技术人员更喜欢一次性买断,以省去未来的麻烦。请提醒他们,开源软件提供的是服务,服务是不能买断的,应该走更便捷的服务采购流程。 向 AWS 学习 基础软件的商业化是件很有挑战的事情。好在有很多成熟的企业可供我们参考。如果说 Oracle 是必须研究的传统商业软件公司,那么 AWS 毫无疑问就是必须好好学习的云服务公司。 刚才说软件定价没有什么成熟的公式与模型?其实 AWS 帮大家摸索了一个公有云上软件的定价方式。AWS Aurora 数据库据称是 AWS 上增长最快最赚钱的云服务。 Aurora 在技术上是非常创新的云原生数据库,带出了一众追随者。依据官方宣传: Amazon Aurora 的速度最高可以达到标准 MySQL 数据库的五倍、标准 PostgreSQL 数据库的三倍。它可以实现商用数据库的安全性、可用性和可靠性,而成本只有商用数据库的 1/10。(引用自 https://aws.amazon.com/cn/rds/aurora/ ) 那么这样一款技术如此先进的云上数据库是怎么定价的呢?以下对比 Aurora MySQL 所有可选的实例规格与 RDS MySQL 之间的定价: 云实例规格 RDS MySQL Aurora MySQL Aurora 溢价 db.t3.small 0.034 0.041 20.59% db.t3.medium 0.068 0.082 20.59% db.t2.small 0.034 0.041 20.59% db.t2.medium 0.068 0.082 20.59% db.r5.large 0.24 0.29 20.83% db.r5.xlarge 0.48 0.58 20.83% db.r5.2xlarge 0.96 1.16 20.83% db.r5.4xlarge 1.92 2.32 20.83% db.r5.12xlarge 5.76 6.96 20.83% db.r4.large 0.24 0.29 20.83% db.r4.xlarge 0.48 0.58 20.83% db.r4.2xlarge 0.96 1.16 20.83% db.r4.4xlarge 1.92 2.32 20.83% db.r4.8xlarge 3.84 4.64 20.83% db.r4.16xlarge 7.68 9.28 20.83% 单位:美元/小时 当然 Aurora MySQL 和 RDS MySQL 的技术实现不太一样,同样实例规格需要的硬件也不能简单划上等号。不过考虑到 AWS 本身的体量,两者间硬件差异的成本应该是微乎其微的。可以大致认为 20% 的溢价来自 Aurora MySQL 软件。 基础软件上公有云 Marketplace 的时候怎么定价,总算有个参照物了。 后记 虽然写了两篇文章,但也只是涉及了开源的一小部分。开源模式可一点也不比传统商业软件的模式要简单。 其中比较关键的社区运营和开发者生态构建,我们也还在不断的摸索。等有一天我们形成自己的方法与风格,届时一定与大家分享。希望国内的基础软件同行都能一起进步。

优秀的个人博客,低调大师

一次分表踩坑实践的探讨

前言 之前不少人问我“能否分享一些分库分表相关的实践”,其实不是我不分享,而是真的经验不多🤣;和大部分人一样都是停留在理论阶段。 不过这次多少有些可以说道了。 先谈谈背景,我们生产数据库随着业务发展量也逐渐起来;好几张单表已经突破亿级数据,并且保持每天 200+W 的数据量增加。 而我们有些业务需要进行关联查询、或者是报表统计;在这样的背景下大表的问题更加突出(比如一个查询功能需要跑好几分钟)。 可能很多人会说:为啥单表都过亿了才想方案解决?其实不是不想,而是由于历史原因加上错误预估了数据增长才导致这个局面。总之原因比较复杂,也不是本次讨论的重点。 临时方案 由于需求紧、人手缺的情况下,整个处理的过程分为几个阶段。 第一阶段应该是去年底,当时运维反应 MySQL 所在的主机内存占用很高,整体负载也居高不下,导致整个 MySQL 的吞吐量明显降低(写入、查询数据都明显减慢)。 为此我们找出了数据量最大的几张表,发现大部分数据量在7/8000W 左右,少数的已经突破一亿。 通过业务层面进行分析发现,这些数据多数都是用户产生的一些日志型数据,而且这些数据在业务上并不是强相关的,甚至两三个月前的数据其实已经不需要实时查询了。 因为接近年底,尽可能的不想去动应用,考虑是否可以在运维层面缓解压力;主要的目的就是把单表的数据量降低。 原本是想把两个月之前的数据直接迁移出来放到备份表中,但在准备实施的过程中发现一个大坑。 表中没有一个可以排序的索引,导致我们无法快速的筛选出一部分数据!这真是一个深坑,为后面的一些优化埋了个地雷;即便是加索引也需要花几个小时(具体多久没敢在生产测试)。 如果我们强行按照时间进行筛选,可能查询出 4000W 的数据就得花上好几个小时;这显然是行不通的。 于是我们便想到了一个大胆的想法:这部分数据是否可以直接不要了? 这可能是最有效及最快的方式了,和产品沟通后得知这部分数据真的只是日志型的数据,即便是报表出不来今后补上也是可以的。 于是我们就简单粗暴的做了以下事情: 修改原有表的表名,比如加上(_190416bak)。 再新建一张和原有表名称相同的表。 这样新的数据就写到了新表,同时业务上也是使用的这个数据量较小的新表。 虽说过程不太优雅,但至少是解决了问题同时也给我们做技术改造预留了时间。 分表方案 之前的方案虽说可以缓解压力,但不能根本解决问题。 有些业务必须得查询之前的数据,导致之前那招行不通了,所以正好我们就借助这个机会把表分了。 我相信大部分人虽说没有做过实际做过分表,但也见过猪跑;网上一搜各种方案层出不穷。 我认为最重要的一点是要结合实际业务找出需要 sharding 的字段,同时还有上线阶段的数据迁移也非常重要。 时间 可能大家都会说用 hash 的方式分配得最均匀,但我认为这还是需要使用历史数据的场景才用哈希分表。 而对于不需要历史数据的场景,比如业务上只查询近三个月的数据。 这类需求完成可以采取时间分表,按照月份进行划分,这样改动简单,同时对历史数据也比较好迁移。 于是我们首先将这类需求的表筛选出来,按照月份进行拆分,只是在查询的时候拼接好表名即可;也比较好理解。 哈希 刚才也提到了:需要根据业务需求进行分表策略。 而一旦所有的数据都有可能查询时,按照时间分表也就行不通了。(也能做,只是如果不是按照时间进行查询时需要遍历所有的表) 因此我们计划采用 hash 的方式分表,这算是业界比较主流的方式就不再赘述。 采用哈希时需要将 sharding 字段选好,由于我们的业务比较单纯;是一个物联网应用,所有的数据都包含有物联网设备的唯一标识(IMEI),并且这个字段天然的就保持了唯一性;大多数的业务也都是根据这个字段来的,所以它非常适合来做这个 sharding 字段。 在做分表之前也调研过 MyCAT 及 sharding-jdbc(现已升级为 shardingsphere),最终考虑到对开发的友好性及不增加运维复杂度还是决定在 jdbc 层 sharding 的方式。 但由于历史原因我们并不太好集成 sharding-jdbc,但基于 sharding 的特点自己实现了一个分表策略。 这个简单也好理解: int index = hash(sharding字段) % 分表数量 ; select xx from 'busy_'+index where sharding字段 = xxx; 其实就是算出了表名,然后路由过去查询即可。 只是我们实现的非常简单:修改了所有的底层查询方法,每个方法都里都做了这样的一个判断。 并没有像 sharding-jdbc 一样,代理了数据库的查询方法;其中还要做 SQL解析-->SQL路由-->执行SQL-->合并结果 这一系列的流程。 如果自己再做一遍无异于重新造了一个轮子,并且并不专业,只是在现有的技术条件下选择了一个快速实现达成效果的方法。 不过这个过程中我们节省了将 sharding 字段哈希的过程,因为每一个 IMEI 号其实都是一个唯一的整型,直接用它做 mod 运算即可。 还有一个是需要一个统一的组件生成规则,分表后不能再依赖于单表的字段自增了;方法还是挺多的: 比如时间戳+随机数可满足大部分业务。 UUID,生成简单,但没法做排序。 雪花算法统一生成主键ID。 大家可以根据自己的实际情况做选择。 业务调整 因为我们并没有使用第三方的 sharding-jdbc 组件,所有没有办法做到对代码的低侵入性;每个涉及到分表的业务代码都需要做底层方法的改造(也就是路由到正确的表)。 考虑到后续业务的发展,我们决定将拆分的表分为 64 张;加上后续引入大数据平台足以应对几年的数据增长。 这里还有个小细节需要注意:分表的数量需要为 2∧N 次方,因为在取模的这种分表方式下,即便是今后再需要分表影响的数据也会尽量的小。 再修改时只能将表名称进行全局搜索,然后加以修改,同时根据修改的方法倒推到表现的业务并记录下来,方便后续回归测试。 当然无法避免查询时利用非 sharding 字段导致的全表扫描,这是所有分片后都会遇到的问题。 因此我们在修改分表方法的底层查询时同时也会查看是否有走分片字段,如果不是,那是否可以调整业务。 比如对于一个上亿的数据是否还有必要存在按照分页查询、日期查询?这样的业务是否真的具有意义? 我们尽可能的引导产品按照这样的方式来设计产品或者做出调整。 但对于报表这类的需求确实也没办法,比如统计表中某种类型的数据;这种我们也可以利用多线程的方式去并行查询然后汇总统计来提高查询效率。 有时也有一些另类场景: 比如一个千万表中有某一特殊类型的数据只占了很小一部分,比如说几千上万条。 这时页面上需要对它进行分页查询是比较正常的(比如某种投诉消息,客户需要一条一条的单独处理),但如果我们按照 IMEI 号或者是主键进行分片后再分页查询那就比较蛋疼了。 所以这类型的数据建议单独新建一张表来维护,不要和其他数据混合在一起,这样不管是做分页还是 like 都比较简单和独立。 验证 代码改完,开发也单测完成后怎么来验证分表的业务是否正常也比较麻烦。 一个是测试麻烦,再一个是万一哪里改漏了还是查询的原表,但这样在测试环境并不会有异常,一旦上线产生了生产数据到新的 64 张表后想要再修复就比较麻烦了。 所以我们取了个巧,直接将原表的表名修改,比如加一个后缀;这样在测试过程中观察前后台有无报错就比较容易提前发现这个问题。 上线流程 测试验收通过后只是分表这个需求的80%,剩下如何上线也是比较头疼。 一旦应用上线后所有的查询、写入、删除都会先走路由然后到达新表;而老数据在原表里是不会发生改变的。 数据迁移 所以我们上线前的第一步自然是需要将原有的数据进行迁移,迁移的目的是要分片到新的 64 张表中,这样才会对原有的业务无影响。 因此我们需要额外准备一个程序,它需要将老表里的数据按照分片规则复制到新表中; 在我们这个场景下,生产数据有些已经上亿了,这个迁移过程我们在测试环境模拟发现耗时是非常久的。而且我们老表中对于 create_time 这样用于筛选数据的字段没有索引(以前的技术债),所以查询起来就更加慢了。 最后没办法,我们只能和产品协商告知用户对于之前产生的数据短期可能会查询不到,这个时间最坏可能会持续几天(我们只能在凌晨迁移,白天会影响到数据库负载)。 总结 这便是我们这次的分表实践,虽说不少过程都不优雅,但受限于条件也只能折中处理。 但我们后续的计划是,修改我们底层的数据连接(目前是自己封装的一个 jar 包,导致集成 sharding-jdbc 比较麻烦)最终逐渐迁移到 sharding-jdbc . 最后得出了几个结论: 一个好的产品规划非常有必要,可以在合理的时间对数据处理(不管是分表还是切入归档)。 每张表都需要一个可以用于排序查询的字段(自增ID、创建时间),整个过程由于没有这个字段导致耽搁了很长时间。 分表字段需要谨慎,要全盘的考虑业务情况,尽量避免出现查询扫表的情况。 最后欢迎留言讨论。 你的点赞与分享是对我最大的支持

优秀的个人博客,低调大师

探讨:SOA项目应用中的五大弊端

SOA刚刚经历了喧嚣的一年, 而这种刺激和变化才刚刚开始而已。各种机构团体继续对服务设计的多变的前景,服务总线,和服务管理甚至仅仅针对服务本身进行再次检测。这是由多方面的情绪引发的,很多人对于SOA在IT业中的成熟度与大致情况感到困惑。 但是,对于其在联合商业与技术方面的潜力,人们还是抱着毋庸置疑的兴奋。 今年许多SOA厂商带着各自的目标和期望值投放市场,有的一败涂地, 有的困难重重。在完成他们最初目标的决定性因素是学习那些已经在竞争中存活下来但是结果不怎么理想的项目经验。这些人留下来讲述他们的故事并警告他人在通向SOA的道路前方等待着他们的将是什么。 在我们的工作过程中将会看到不同完成程度的不同项目。我们可以看到一个好的SOA项目陷入困境, 不好的SOA项目变得更差。问题都是能够解决的,错误也可以纠正,但在将事情导向正途的过程总会有一些影响。因而最好的办法就是防患于未然。 理解了其他的缺陷之后,在你的SOA道路上构建一个安全路径将成为你的首要任务,你能达到的前景范围退居其次。为了让大家有一个领先他人的开始,我们收集了SOA应用中的五大弊端。 第一:不能理解SOA 性能需求 松散的连接是有代价的。当实现网络服务之后,SOA实现了数据处理层及架构于此基础上的相关性能。从小做起, 建立能按照预期运转的面向服务方案是较容易的。随着规模的扩大和新功能的增加,以信息为基础的沟通将会增长, 如此以来, 在预计之外的情况将开始经历一个重大的处理反应期。 建立成功的面向服务方案关键在于事先理解该方案性能需求及其基础架构的局限性。这就意味着要测试(如果必要的话, 加强)您的外部环境的信息处理能力并密切注意服务设计以达到在传送速度,传送量和能给方案性能带来负面影响的其他服务之间的平衡。 第二: 并非建立在XML基础上的架构 在今天的SOA世界中,一切皆始于网络服务。 这句话在某些机构当中已然成为了纲领, 但它却并不是完全正确的。其实, 在今天的SOA世界中, 一切始于XML.这个标准是由多层辅助标准演化而来的,目的在于形成既成事实数据的演示架构。这是促使形成今天驱动SOA一系列服务规范的一套核心标准。 我们投注了太多的注意在服务之间的数据传送上以至于经常忽略了这些数据是如何建构的,如果在服务线上生效的。这种疏忽将导致持续出现XML数据演示层的错误执行。XML数据演示层是SOA的基础, 它的缺陷将影响到建立在其基础上的所有方案。 第三: 缺乏过渡计划 没有全面的过渡计划, 成功转换的几率将大大降低。 由于企业内服务端点的范围将引起外部基础架构的重新定义,执行低质量的转换,其影响将是巨大的。有了过渡计划,你就可以在控制中逐步实现服务定位和SOA特性,从而使转换是在技术,架构及组织层面上进行的。 典型的SOA过渡计划包括: 效果分析(即预计SOA的改变对现有资源、程序、制订规则的影响范围),转换架构(即制订一系列混合进程计划以实现目标SOA)和一个投机分析(即考虑未来的网络服务增长及相应的配套技术发展)。 第四: 非标准化SOA 于其他架构一样,SOA需要内部设计标准的建立与实施来实现其优势。例如,如果一个项目建立一个与其他软件隔离开的面向服务方案,该方案的关键部分将不会符合临近应用程序,而需要内部操作或者与其他程序共享某种服务。 这就会引起许多问题,比如不兼容的数据演示,与不规则界面产生服务协议和非互补页面服务扩展名的应用(或者扩展名以不同形式安装)。 SOA 提倡使用抽取末端处理的发展环境以便能在一个应用程序里独立执行和发展。但是,标准化在保障其设计和与融入末端逻辑的其他服务互动的连贯性来说仍然是必要的。 第五: 按照传统结构分布建立SOA 在实现SOA的过程中面临的最大的障碍就是按照传统分布结构模式来建立SOA,并声称SOA的实现。 SOA 并不是简单的CORBA + XML,也不是ASP.NET + WSE。 服务导向并非目标导向,它们之间的联系也没有紧密到所有建立目标导向的组成逻辑在服务导向方案环境中都可以适用的地步。SOA是一种独特的建立在服务导向基础上的架构,一个独特的设计范例。理解其独特性对于建立真正的面向服务自动操作逻辑,使之与SOA全球发展方向一致是至关重要的。 本文转自 牛海彬 51CTO博客,原文链接:http://blog.51cto.com/newhappy/77121,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册