首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10011篇文章
优秀的个人博客,低调大师

Android笔记:stackview

stackview相关范例:(附件) 参考资料: 1.http://sampleprogramz.com/android/stackview.php 2.http://stackoverflow.com/questions/9997753/how-to-create-custom-stackview-for-android-2-2-or-2-3 3.http://stackoverflow.com/questions/5544112/alternative-views-instead-of-stackviews-for-android-versions-lower-to-android-3 4.http://stackoverflow.com/questions/12286506/simulate-stack-view-in-android2api-5 附件:http://down.51cto.com/data/2363570 本文转自 glblong 51CTO博客,原文链接:http://blog.51cto.com/glblong/1304103,如需转载请自行联系原作者

优秀的个人博客,低调大师

[old]wireless 笔记

AD Hoc network IBSS: Independent basic service set AP是解决无线客户端访问有线设备资源AP是什么?802.11<-----> 802.3 DS:分布系统==> Used for Infrastructure Mode BSA=wireless cell(basic service area)表示一个范围 BSS :基础服务集,由多个BSS组成的网络叫ESS扩展服务集 SSID service set identifier服务标示符,相当于一个VLAN,一个subnet BSSID:基础服务集标示符,一个48bit的MAC地址,无线客户端物理关联的标示符 多个BSSID组成MBSSID 漫游的条件:两AP必须要有交集覆盖 AP工作的角色(模式): HUB竞争信道 Repeater Outdoor Bridge (包括户外网桥,多用定向天线) Wireless只关心微波波段. 信号有Free-Spare path loss:自由空间路径损失,网络上有公式算. 信号有吸收,反射,穿透,散射最终我们可能会收到multipath信号,multipath会导致信号不好<出现信号抵消> SNR: signal to noise ratio,信噪比 Signal Strength / Noise Level = SNR Decibels分贝DB,是两次数据的对比 0dB = same power 3dB = twice the power -3dB=half the power 10dB=10* the power -10DB = 1 tenth of the power DBm used for AP transmitters ===>对等单位mw 0dbm = 1 mW 30dbm= 1W -20 dbm=0.01 mw 20dbm = 100 mw DBI used for dipole antenna Gain (偶极天线) 0dBd = + 2.14 dBi EIRP = TX power /dbm(天线发射功率)+ Antenna Gain /dbi (天线增益dbi)– Loss /DB Effectivelsotropic radiated power (等效全向辐射功率) 波的三要素:频率,倒数为波长,天线长度最好为1/4波长 振幅,经过任何物体都会吸收振幅. 相位,多天线来解决多路径问题 影响的因数就是上面三种 天线计量单位:瓦特和分贝 802.11设备最大100mW 80.211帧和CSMA/CA载波侦听多路访问/冲突避免 以太网使用的是CSMA/CD冲突检测 TO DS / From DS字段:这个两个字段用来描述包的去向 Frame Type: 1-Control (Request to send RTS, clear to send CTS, ACK,PS-Poll power save poll) 2-Data (simple data, null function) 3-Management: Beacon: 100s发一次,公告SSID BSSID等信息,隐藏的SSID的AP也会发Beacon Authentication request / response Association request / response Announcement traffic indication message (ATIM) 802.11 n的优点: 天线多,会有多径问题,有相位的错位 1分集(多天线技术,不等于MIMO) ,提高吞吐量 2 MIMO:空分复用,波束赋形(根据对方的信号找到最好的路径),最大比合并(按比值信号合并) AP的接口: AP型号上字母的意思 AIR-AP1131AG-A-K9 AIR-AP1131G-A-K9 AIR-LAP1131AG-A-K9 AIR = Aironet一种产品 AP/LAP =不带L表示出厂默认胖APIOS,带L表示默认瘦APIOS 1131= 1130系列 A=5GHZ, G=2.4HZ<3502不再有这个标示> -x=代表国家代码 -A:美国-C:中国 K9:代表安全特性 AIR-SAP3502i-A-K9 AIR-CAP3502e-A-K9 SAP/CAP = S表示出厂默认胖<stay alone > AP IOS, C表示默认瘦APIOS i/e= i表示内置天线,e表示外置天线 3501/3502 :代表单双频 =================================配置试验===================================== 配置胖AP单SSID Test PC xxxxxxAP----SW---Admin PC 配置管理胖AP管理地址: Interface bvi 1 Ip add 172.16.100.11 255.255.255.0 No shut 然后web登入,默认的是enablepassword ,用户名可以不用填 修改加密方法:security----encryption manager 创建SSID: secrirty-----SSID manager—single SSID 是否广播SSID Enable radiointerface开启2.4G/5.0G射频 ------>看summary可以看到结果 配置胖AP多SSID Test PC xxxxxxAP----SW---Admin PC Show ip int b 1-service-vlan 2-Security-Encryption manager ----CIPHER---AESCCMP 3-Security-SSID Manager---Multiple SSID ----Multiple bssidbeacon ----“set ssid as guest mode” 4- Enable radiointerface 查看有多少个链接:可以在ASSOCIATION中查看到 胖瘦AP的区别: IOS的区别, w7代表胖AP IOS, W8代表瘦AP IOS 胖AP转瘦AP叫升级, 瘦AP转胖AP叫降级 降级方法:1-断电mode建还原法,2-AP已注册在wlc上,使用wlc上降级命令 Config ap tftp-downgrade xxx.tar <APName> Show ap summary 升级方法: 1-命令行下载解压(不太老款的AP) Boot system flash:可以决定由哪个IOS启动 本文转自 bilinyee博客,原文链接: http://blog.51cto.com/ericfu/1753341 如需转载请自行联系原作者

优秀的个人博客,低调大师

swift 笔记2

swift交流群:342581988,欢迎增加。 今天真郁闷啊,把mac升级到10.10了。如今好了,曾经的程序都跑不了了。哎,不说了,让我郁闷会再。 说说条件推断吧,事实上这些基本的语法大家都知道肯定差点儿相同。好吧,我就自己写写看吧。 上代码 let individualScores = [78,32,32,53,23] var teamScore = 0 for score in individualScore{ if score > 50{ teamScore += 3 }else{ teamScore += 1 } } teamScore 这个事实上和曾经的oc差点儿相同了,我想大家都注意到了。就是这个Swift把曾经用圆弧括号的地方所有去掉,把分号也去掉。大概就是这样子 在这里。要说说这个if推断语句,这个if后面的条件必须是个Boolean表达式。换句话说,假设上面这样写 if score{ ... } 那就是错的了 由于score是一个非Boolean值,这个在曾经都是会自己主动与0相比較,非零值就会运行if后面语句。 这个地方if和let能够一起使用。let修饰变量时可选的,能够是一个值。也能够是nil。在类型后面加一个?表示他是可选的。 let v : int;已分配内存; let v : int ? 还没分配内存 以下if里面用来推断optionName是否存在。 var optionString:String? = "Hello" optionString == nil var optionName: String ? = "John Appleseed" var greeting = "Hello!" if let name = optionName{ greeting = "Hello, \(name)" } 假设上面optionName = nil;那么结果将会不一样,会运行你后面else部分。 以下说说switch吧,这个我也还没搞太懂,所以大家一定要拍砖 这个switch支持不论什么数据 的比較操作。不不过整形之类的, let vegetable = "red pepper" switch vegetable { case "celery": let vegetableComment = "Add some raisins and make ants on a log." case "cucumber","watercress": let vegetableComment = "That would make a good team sandwich." case let x where x.hasSuffix("pepper"): let vegetableComment = "Is it a spicy \(x)?" default: let vegetableComment = "Everything tastes good in soup." } 这个地方后面的default是不能少的,不然就会报错,只是这个地方有点变化的是,break不见了。对的。break不要了。 再说说for-in迭代循环吧 let interestingNumbers = [ "Prime": [2, 3, 5, 7, 11, 13], "Fibonacci": [1, 1, 2, 3, 5, 8], "Square": [1, 4, 9, 16, 25], ] var largest = 0 for (kind, numbers) in interestingNumbers { for number in numbers { if number > largest { largest = number } } } largest 事实上这个没什么可说的了,看看即可了, 然后在看看while和do...while吧 var n = 2; while n < 100{ n = n * 2 } n var m = 2 do{ m = m * 2 }while m < 100 m 注意确保循环进行至少一次 好吧,再写最后一个,应该算是一种新的写法吧 var firstForLoop = 0 for i in 0..3{ firstForLoop += i } firstForLoop var secondForLoop = 0 for var i = 0;i < 3; ++i{ secondForLoop += 1 } secondForLoop ..代表值递增。貌似包含端点值。 好吧,今天就写这点吧,感觉好慢啊,以后不能这样写了。必须 加速了,捡重点写点吧。 本文转自mfrbuaa博客园博客,原文链接:http://www.cnblogs.com/mfrbuaa/p/5112570.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

hive 权限笔记

启动权限,hive默认是禁止的。 Configuration For Hive 0.13.x Set the following in hive-site.xml: hive.server2.enable.doAs to false. hive.users.in.admin.role to the list of comma-separated users who need to be added toadminrole. Note thata user who belongs to theadminrole needs to run the "set role" command before getting the privileges of theadminrole, as this role is not in current roles by default. Start HiveServer2 with the following additional command-line options: -hiveconf hive.security.authorization.manager=org.apache.hadoop.hive.ql.security.authorization.plugin.sqlstd.SQLStdHiveAuthorizerFactory -hiveconf hive.security.authorization.enabled=true -hiveconf hive.security.authenticator.manager=org.apache.hadoop.hive.ql.security.SessionStateUserAuthenticator -hiveconf hive.metastore.uris=' ' For Hive 0.14 and Newer Set the following in hive-site.xml: hive.server2.enable.doAsto false. hive.users.in.admin.roleto the list of comma-separated users who need to be added toadminrole. Note thata user who belongs to theadminrole needs to run the "set role" command before getting the privileges of theadminrole, as this role is not in current roles by default. Add org.apache.hadoop.hive.ql.security.authorization.MetaStoreAuthzAPIAuthorizerEmbedOnly tohive.security.metastore.authorization.manager. (It takes a comma separated list, so you can add it along with StorageBasedAuthorization parameter, if you want to enable that as well). This setting disallows any of the authorization api calls to be invoked in a remote metastore. HiveServer2 can be configured to use embedded metastore, and that will allow it to invoke metastore authorization api. Hive cli and any other remote metastore users would be denied authorization when they try to make authorization api calls. This restricts the authorization api to privileged HiveServer2 process. You should also ensure that the metastore rdbms access is restricted to the metastore server and hiverserver2. hive.security.authorization.managerto org.apache.hadoop.hive.ql.security.authorization.plugin.sqlstd.SQLStdConfOnlyAuthorizerFactory.This will ensure that any table or views created by hive-cli have default privileges granted for the owner. Set the following in hiveserver2-site.xml: -hiveconf hive.security.authorization.manager=org.apache.hadoop.hive.ql.security.authorization.plugin.sqlstd.SQLStdHiveAuthorizerFactory -hiveconf hive.security.authorization.enabled=true -hiveconf hive.security.authenticator.manager=org.apache.hadoop.hive.ql.security.SessionStateUserAuthenticator -hiveconf hive.metastore.uris=' ' 角色管理: 说明:默认hive有public和admin角色,hive.users.in.admin.role中指定的用户为admin角色,多个用户以逗号分隔。 1、SET ROLE (role_name|ALL|NONE); 一个用户可以有多个用户组,SET ROLE命令会把当前用户切换到指定的角色组。 本文转自 yntmdr 51CTO博客,原文链接:http://blog.51cto.com/yntmdr/1749839,如需转载请自行联系原作者

优秀的个人博客,低调大师

dockerfile指令 笔记

Dockerfile指令 1、FROM 如果在同一Dockerfile中创建多个镜像时,可以使用多个FROM指令(每个镜像一次) 1 2 3 FROM<image> 或 FROM<image>:<tag> 2、MAINTAINER 维护者信息 1 MAINTAINER<name> 3、RUN 执行指定命令 1 2 3 RUN< command >(the command isrun in ashell-` /bin/sh -c`) 或 RUN[ "executable" , "param1" , "param2" ...]( exec form) 4、CMD:用于指定一个容器启动时要运行的命令,如果指定了多条命令,最有最后一条会被执行 1 2 CMD[ "executable" , "param1" , "param2" ](likean exec ,thisisthepreferredform) CMD command param1param2(asashell) 5、EXPOSE 暴露docker容器的端口 1 EXPOSE<port>[<port>...] 1 <br data-filtered= "filtered" > 6、ENV 指定一个环境变量,会被后续RUN指令使用,并在容器运行时保持 1 ENV<key><value> 7、ADD 复制本地主机的内容到容器目标容器的目录,如果源文件是gzip/bzip2/xz等归档文件,会自动解开并添加到目的地 8、COPY 复制本地主机的内容到容器目标容器的目录 1 ADD<src><dest> 9、ENTRYPOINT 每个Dockerfile中只能有一个ENTRYPOINT,当指定多个ENTRYPOINT时,只有最后一个生效 1 2 ENTRYPOINT[ "executable" , "param1" , "param2" ](likean exec ,thepreferredform) ENTRYPOINT command param1param2(asashell) 10、VOLUME 创建一个可以从本地或其他容器挂载的挂载点 1 VOLUME[ "<mountpoint>" ] 11、USER 使用指定用户运行命令 1 2 3 4 5 #指定memcached的运行用户 ENTRYPOINT[ "memcached" ] USERdaemon 或 ENTRYPOINT[ "memcached" , "-u" , "daemon" ] 12、WORKDIR 切换工作目录 1 WORKDIR /path/to/workdir 13、ONBUILD 1 2 ONBUILD<Dockerfile关键字> ONBUILD指定的命令在构建镜像时并不执行,而是在它的子镜像中执行。 创建镜像: docker build [ 选项 ] dockerfile路径 sudo docker build -t centos6-ssh . 笼统的收集了Dockerfile的指令 本文转自 yanconggod 51CTO博客,原文链接:http://blog.51cto.com/yanconggod/1883346

优秀的个人博客,低调大师

Spark SQL 笔记

官方参考文档: http://spark.apache.org/docs/2.1.0/sql-programming-guide.html#creating-dataframes DataFrame A DataFrame is a Dataset organized into named columns. It is conceptually equivalent to a table in a relational database or a data frame in R/Python, but with richer optimizations under the hood. DataFrames can be constructed from a wide array of sources such as: structured data files, tables in Hive, external databases, or existing RDDs. The DataFrame API is available in Scala, Java, Python, and R. 对于熟悉python的同学,Spark的DataFrame和python的DF很像。对于structured data files同学比较熟知的有xml、jason、parquet等。 关于parquet,请参考: http://blog.csdn.net/yu616568/article/details/50993491 具体的df的操作请参考官网: http://spark.apache.org/docs/2.1.0/sql-programming-guide.html#creating-dataframes python操作演示: >>> df = sqlContext.read.json("file:///home/zkpk/spark-1.5.2-bin-2.5.2/examples/src/main/resources/people.json") >>> df.show() +----+-------+ | age| name| +----+-------+ |null|Michael| | 30| Andy| | 19| Justin| +----+-------+ >>> df.printSchema() root |-- age: long (nullable = true) |-- name: string (nullable = true) >>> df.select("name").show() +-------+ | name| +-------+ |Michael| | Andy| | Justin| +-------+ >>> df.select(df['name'], df['age'] + 1).show() +-------+---------+ | name|(age + 1)| +-------+---------+ |Michael| null| | Andy| 31| | Justin| 20| +-------+---------+ >>> df.filter(df['age'] > 21).show() +---+----+ |age|name| +---+----+ | 30|Andy| +---+----+ scala在eclipse中的实现 import org.apache.spark.SparkConf import org.apache.spark.SparkContext import org.apache.spark.sql.SQLContext object DataFrameOperation { def main(args: Array[String]): Unit = { //create datarame //首先创建程序入口 val conf=new SparkConf().setAppName("DataFrameOperation") val sc=new SparkContext(conf); //create sqlcontext val sqlContext=new SQLContext(sc); val df=sqlContext.read.json("hdfs://hadoop1:9000/examples/src/main/resources/people.json") df.show(); //print schema df.printSchema() //name age df.select("name").show(); // df.select(df("name"),df("age")+1).show() //where df.filter(df("age") > 21).show() //groupby df.groupBy("age").count().show(); } } 关于代码的提交: 将上面的代码的代码文件(文件 即可不用导出工程) export成jar 提交请参考 Run on a YARN cluster 在上一篇的spark教程里 Interoperating with RDDs(和RDD交互) Spark SQL supports two different methods for converting existing RDDs into DataFrames. The first method uses reflection to infer the schema of an RDD that contains specific types of objects. This reflection based approach leads to more concise code and works well when you already know the schema while writing your Spark application. The second method for creating DataFrames is through a programmatic interface that allows you to construct a schema and then apply it to an existing RDD. While this method is more verbose, it allows you to construct DataFrames when the columns and their types are not known until runtime. 通过reflection的方式将RDD转换成dataframe 注意:RDD是读取非结构化数据 java版本 import org.apache.spark.SparkConf; import org.apache.spark.api.java.JavaRDD; import org.apache.spark.api.java.JavaSparkContext; import org.apache.spark.api.java.function.Function; import org.apache.spark.api.java.function.VoidFunction; import org.apache.spark.sql.DataFrame; import org.apache.spark.sql.Row; import org.apache.spark.sql.SQLContext; public class RDD2DataFrameReflection { public static void main(String[] args) { SparkConf conf = new SparkConf(); conf.setAppName("RDD2DataFrameReflection"); JavaSparkContext sc = new JavaSparkContext(conf); SQLContext sqlContext = new SQLContext(sc); //生成一个RDD JavaRDD<Person> PersonRDD = sc.textFile("hdfs://hadoop1:9000/examples/src/main/resources/people.txt") .map(new Function<String, Person>() { public Person call(String line) throws Exception { String[] strs = line.split(","); String name=strs[0]; int age=Integer.parseInt(strs[1].trim()); Person person=new Person(age,name); return person; } }); //生成一个df DataFrame personDF = sqlContext.createDataFrame(PersonRDD, Person.class); //将df注册成临时表,之后就可以像操作表一样 personDF.registerTempTable("person"); DataFrame resultperson = sqlContext.sql("select name,age from person where age > 13 and age <= 19"); //当想使用RDD的算子是,将df转换为RDD就可以使用类似foreach的操作了 resultperson.javaRDD().foreach(new VoidFunction<Row>() { /** * */ private static final long serialVersionUID = 1L; public void call(Row row) throws Exception { //把每一条数据都看成是一个row row(0)=name row(1)=age System.out.println("name"+row.getString(0)); System.out.println("age"+row.getInt(1)); } }); resultperson.javaRDD().saveAsTextFile("hdfs://hadoop1:9000/reflectionresult"); } } python版本(reflection.py): # sc is an existing SparkContext. from pyspark import SparkContext, SparkConf from pyspark.sql import SQLContext, Row appName= "reflection" master = "local" conf1 = SparkConf().setAppName(appName).setMaster(master) sc = SparkContext(conf=conf1) sqlContext = SQLContext(sc) # Load a text file and convert each line to a Row. lines = sc.textFile("file:///home/zkpk/spark-1.5.2-bin-2.5.2/examples/src/main/resources/people.txt") parts = lines.map(lambda l: l.split(",")) people = parts.map(lambda p: Row(name=p[0], age=int(p[1]))) # Infer the schema, and register the DataFrame as a table. schemaPeople = sqlContext.createDataFrame(people) schemaPeople.registerTempTable("people") # SQL can be run over DataFrames that have been registered as a table. teenagers = sqlContext.sql("SELECT name FROM people WHERE age >= 13 AND age <= 19") # The results of SQL queries are RDDs and support all the normal RDD operations. teenNames = teenagers.map(lambda p: "Name: " + p.name) for teenName in teenNames.collect(): print(teenName) 代码提交时,使用spark-submit reflection.py 用编程(programmatically)的方式将RDD转换成DF >>> lines = sc.textFile("file:///home/zkpk/spark-1.5.2-bin-2.5.2/examples/src/main/resources/people.txt") >>> parts = lines.map(lambda l: l.split(",")) >>> people = parts.map(lambda p: (p[0], p[1].strip())) >>> parts.collect() [[u'Michael', u' 29'], [u'Andy', u' 30'], [u'Justin', u' 19']] >>> people.collect() [(u'Michael', u'29'), (u'Andy', u'30'), (u'Justin', u'19')] >>> schemaString = "name age" >>> fields = [StructField(field_name, StringType(), True) for field_name in schemaString.split()] Traceback (most recent call last): File "<stdin>", line 1, in <module> NameError: name 'StructField' is not defined >>> from pyspark.sql.types import * >>> fields = [StructField(field_name, StringType(), True) for field_name in schemaString.split()] >>> fields.collect() Traceback (most recent call last): File "<stdin>", line 1, in <module> AttributeError: 'list' object has no attribute 'collect' >>> schema = StructType(fields) >>> schemaPeople = sqlContext.createDataFrame(people, schema) >>> schemaPeople.registerTempTable("people") >>> results = sqlContext.sql("SELECT name FROM people") >>> results.collect() [Row(name=u'Michael'), Row(name=u'Andy'), Row(name=u'Justin')] >>> names = results.map(lambda p: "Name: " + p.name) >>> names.collect() [u'Name: Michael', u'Name: Andy', u'Name: Justin'] >>> for name in names.collect(): ... print(name) ... Name: Michael Name: Andy Name: Justin >>> 不懂StructField和StructType的还请参考 http://spark.apache.org/docs/1.5.2/api/python/pyspark.sql.html?highlight=structfield#pyspark.sql.types.StructField DataFrame VS RDD 当生成DF的时候会返回schema类型(类似于postgresql的表结构),而RDD不会,仅仅返回的是一个Person,不知道里面具体的数据类型 数据的load以及save 参考: http://spark.apache.org/docs/2.1.0/sql-programming-guide.html#data-sources spark sql默认支持的是parquet文件格式,所以不制定load、save类型,默认都是parquet。关于parquet 参考 http://www.infoq.com/cn/articles/in-depth-analysis-of-parquet-column-storage-format Parquet是语言无关的,而且不与任何一种数据处理框架绑定在一起,适配多种语言和组件,能够与Parquet配合的组件有: 查询引擎: Hive, Impala, Pig, Presto, Drill, Tajo, HAWQ, IBM Big SQL 计算框架: MapReduce, Spark, Cascading, Crunch, Scalding, Kite 数据模型: Avro, Thrift, Protocol Buffers, POJOs 保存时是追加还是覆盖,请参考SaveModes parquet 文件操作 通用文件操作: df1 = sqlContext.read.load("file:///home/zkpk/spark-1.5.2-bin-2.5.2/examples/src/main/resources/users.parquet") >>> df1.show() +------+--------------+----------------+ | name|favorite_color|favorite_numbers| +------+--------------+----------------+ |Alyssa| null| [3, 9, 15, 20]| | Ben| red| []| +------+--------------+----------------+ df1.select("name", "favorite_color").show() +------+--------------+ | name|favorite_color| +------+--------------+ |Alyssa| null| | Ben| red| +------+--------------+ df1.select("name", "favorite_color").write.save("file:///home/zkpk/ecaoyng/input/namesAndFavColors.parquet") 自动推断分区(Partition Discovery) 看完下面的例子就知道什么是自动推断分区了 #在hdfs上新建一个目录country=US hadoop fs -mkdir -p /ecaoyng/country=US #将parquet文件上传到新建的目录 hadoop fs -put users.parquet /ecaoyng/country=US #之前读到的df1的内容 >>> df1.show() +------+--------------+----------------+ | name|favorite_color|favorite_numbers| +------+--------------+----------------+ |Alyssa| null| [3, 9, 15, 20]| | Ben| red| []| +------+--------------+----------------+ #在新建目录之后读取到的parquet文件,可以看出多了country这一列 >>> df2= sqlContext.read.parquet("hdfs:///ecaoyng/country=US/users.parquet") >>> df2.show() +------+--------------+----------------+-------+ | name|favorite_color|favorite_numbers|country| +------+--------------+----------------+-------+ |Alyssa| null| [3, 9, 15, 20]| US| | Ben| red| []| US| +------+--------------+----------------+-------+ schema的合并 >>> df3 = sqlContext.createDataFrame(sc.parallelize(range(1, 6)).map(lambda i : Row(single=i, double=i*2)) ... ) >>> df3.write.parquet("hdfs:///ecaoyng/test_table/key=1") >>> df4=sqlContext.createDataFrame(sc.parallelize(range(6,11)).map(lambda i : Row(single=i, triple=i*3))) >>> df4.write.parquet("hdfs:///ecaoyng/test_table/key=2") >>> df5 = sqlContext.read.option("mergeSchema", "true").parquet("hdfs:///ecaoyng/test_table") >>> df5.printSchema() root |-- double: long (nullable = true) |-- single: long (nullable = true) |-- triple: long (nullable = true) |-- key: integer (nullable = true) >>> df5.show() +------+------+------+---+ |double|single|triple|key| +------+------+------+---+ | null| 6| 18| 2| | null| 7| 21| 2| | null| 8| 24| 2| | null| 9| 27| 2| | null| 10| 30| 2| | 2| 1| null| 1| | 4| 2| null| 1| | 6| 3| null| 1| | 8| 4| null| 1| | 10| 5| null| 1| +------+------+------+---+ >>> 数据源之JDBC之mysql 以mysql为例,首先启动mysql. 遇到错误信息如下 nother MySQL daemon already running with the same unix socket. Starting mysqld: [FAILED] 解决方案,重命名/var/lib/mysql/mysql.sock 即可,重新启动mysql 其他的请参考如下链接 https://www.cnblogs.com/wwxbi/p/6978774.html http://spark.apache.org/docs/1.6.0/sql-programming-guide.html#jdbc-to-other-databases 注意,如果没有驱动包会报错: java.sql.SQLException: No suitable driver at java.sql.DriverManager.getDriver(DriverManager.java:278) 解决方法是: 下载驱动包 在spark-env.sh中设置 export SPARK_CLASSPATH=$SPARK_CLASSPATH:/usr/local/soft/hive/lib/mysql-connector-java-5.1.10.jar 那么在提交jdbc的脚本的时候就不可以设置--driver-class-path路径 如果在spark-env.sh脚本里没有设置MySQL驱动包的spark_classpath 那么需要在提交任务的时候在脚本里天如下内容: --driver-class-path /usr/local/soft/hive/lib/mysql-connector-java-5.1.10.jar 数据源之Hive 在spark开发中spark开发占了很大一部分,而基于hive的开发,又占了其中很大的比重。下面我们就来进行hive和spark集成

优秀的个人博客,低调大师

Docker入门笔记

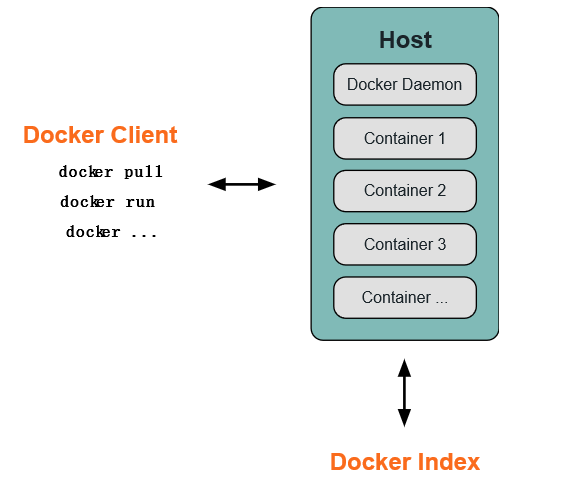
原文链接: http://yangbingdong.com/2017/docker-learning/ Preface 为什么选择Docker?网上已经给出了很多说法,总结而言就是,趋势(这不是废话吗) 哈哈,词穷 作为一种新兴的虚拟化方式,Docker跟传统的虚拟化方式相比具有众多的优势,这里也不详细列举了 Docker对于持续交付和部署的DevOps人员来说也有着重要的意义... 本篇主要记录Docker的基础学习(安装、简单使用) Concept 以下是Docker的三个基本概念。 Image(镜像) 官方而言,Docker 镜像是一个特殊的文件系统,除了提供容器运行时所需的程序、库、资源、配置等文件外,还包含了一些为运行时准备的一些配置参数(如匿名卷、环境变量、用户等)。镜像不包含任何动态数据,其内容在构建之后也不会被改变。 对博主而言,它相当于就是个Java Class(类)=.= 但它的存储结构类似Git,一层一层地网上盖,删除一个文件并不会真的删除,只是在那个文件上面做了一个标记为已删除。在最终容器运行的时候,虽然不会看到这个文件,但是实际上该文件会一直跟随镜像。因此,在构建镜像的时候,需要额外小心,每一层尽量只包含该层需要添加的东西,任何额外的东西应该在该层构建结束前清理掉。 Container(容器) 通俗来说,如果镜像是类,那么容器就是这个类的实例了,镜像是静态的定义,容器是镜像运行时的实体。容器可以被创建、启动、停止、删除、暂停等。 容器也有其特性,例如存储,不指定数据卷(Volume)的话,容器消亡数据也就跟着没了... 跟多特性请自行百度~ Repository(仓库) 仓库没啥好说的了,以 Ubuntu 镜像 为例,ubuntu 是仓库的名字,其内包含有不同的版本标签,如,14.04, 16.04。我们可以通过 ubuntu:14.04,或者 ubuntu:16.04 来具体指定所需哪个版本的镜像。如果忽略了标签,比如 ubuntu,那将视为 ubuntu:latest Install 这里以Ubuntu为例(当然是因为博主用的是Ubuntu= =),版本的话Docker目前支持的Ubuntu版本最低为12.04LTS,但从稳定性上考虑,推荐使用14.04LTS或更高的版本。 使用脚本自动安装 在测试或开发环境中 Docker 官方为了简化安装流程,提供了一套便捷的安装脚本,Ubuntu 系统上可以使用这套脚本安装: curl -fsSL get.docker.com -o get-docker.sh sudo sh get-docker.sh --mirror Aliyun 执行这个命令后,脚本就会自动的将一切准备工作做好,并且把 Docker 安装在系统中 使用 APT 镜像源 安装 sudo apt-get update sudo apt-get install \ apt-transport-https \ ca-certificates \ curl \ software-properties-common 鉴于国内网络问题,强烈建议使用国内源 国内源 curl -fsSL https://mirrors.aliyun.com/docker-ce/linux/ubuntu/gpg | sudo apt-key add - sudo add-apt-repository \ "deb [arch=amd64] https://mirrors.aliyun.com/docker-ce/linux/ubuntu \ $(lsb_release -cs) \ stable" 以上命令会添加 稳定 版本的 Docker CE APT 镜像源,如果需要最新版本的 Docker CE 请将 stable 改为 edge 或者 test 。从 Docker 17.06 开始,edge test 版本的 APT 镜像源也会包含稳定版本的 Docker 官方源 curl -fsSL https://download.docker.com/linux/ubuntu/gpg | sudo apt-key add - sudo add-apt-repository \ "deb [arch=amd64] https://download.docker.com/linux/ubuntu \ $(lsb_release -cs) \ stable" 安装 Docker CE sudo apt-get update sudo apt-get install docker-ce 启动 Docker CE sudo systemctl enable docker sudo systemctl start docker 建立 docker 用户组 默认情况下,docker 命令会使用 Unix socket 与 Docker 引擎通讯。而只有 root 用户和 docker 组的用户才可以访问 Docker 引擎的 Unix socket。出于安全考虑,一般 Linux 系统上不会直接使用 root 用户。因此,更好地做法是将需要使用 docker 的用户加入 docker 用户组。 建立 docker 组(貌似执行了自动安装脚本会自动建一个docker的用户组): sudo groupadd docker 将当前用户加入 docker 组: sudo usermod -aG docker $USER 加入docker 组之后要重启才能生效哦... Mirror Acceleration 没有代理的话国内访问Docker Hub的速度实在感人,但Docker官方和国内很多云服务商都提供了加速器服务: Docker 官方提供的中国registry mirror 阿里云加速器 DaoCloud 加速器 灵雀云加速器 如阿里,注册并申请后会得到加速域名如https://vioqnt8w.mirror.aliyuncs.com,然后正如官方说的一样,通过修改daemon配置文件/etc/docker/daemon.json来使用加速器: sudo mkdir -p /etc/docker sudo tee /etc/docker/daemon.json <<-'EOF' { "registry-mirrors": ["https://vioqnt8w.mirror.aliyuncs.com"] } EOF sudo systemctl daemon-reload sudo systemctl restart docker 查看生效: sudo docker info|grep "Registry Mirrors" -A 1 输出如下: Registry Mirrors: https://vioqnt8w.mirror.aliyuncs.com/ Use Image 获取 Docker Hub 上有大量的高质量的镜像可以用,我们可以通过以下的方式获取镜像: docker pull [选项] [Docker Registry地址]<仓库名>:<标签> 选项可以通过docker pull --help查看。 eg,从Docker Hub下载REPOSITORY为java的所有镜像: docker pull -a java 列出 使用docker images [OPTIONS] [REPOSITORY[:TAG]]列出已下载的镜像 列表包含了仓库名、标签、镜像 ID、创建时间以及所占用的空间 OPTIONS说明: -a :列出本地所有的镜像(含中间映像层,默认情况下,过滤掉中间映像层); --digests :显示镜像的摘要信息; -f :显示满足条件的镜像; --format :指定返回值的模板文件; --no-trunc :显示完整的镜像信息; -q :只显示镜像ID。 eg: # 看到在 mongo:3.2 之后建立的镜像,想查看某个位置之前的镜像也可以,只需要把 since 换成 before 即可 docker images -f since=mongo:3.2 虚悬镜像(dangling image) 举个例子:原来为 mongo:3.2,随着官方镜像维护,发布了新版本后,重新 docker pull mongo:3.2 时,mongo:3.2 这个镜像名被转移到了新下载的镜像身上,而旧的镜像上的这个名称则被取消,从而成为了 <none>。除了 docker pull 可能导致这种情况,docker build 也同样可以导致这种现象。由于新旧镜像同名,旧镜像名称被取消,从而出现仓库名、标签均为 <none> 的镜像。这类无标签镜像也被称为 虚悬镜像(dangling image) ,可以用下面的命令专门显示这类镜像: docker images -f dangling=true 一般来说,虚悬镜像已经失去了存在的价值,是可以随意删除的,可以用下面的命令删除: docker rmi $(docker images -q -f dangling=true) Commit 从容器创建一个新的镜像: docker commit [OPTIONS] CONTAINER [REPOSITORY[:TAG]] OPTIONS说明: -a :提交的镜像作者; -c :使用Dockerfile指令来创建镜像; -m :提交时的说明文字; -p :在commit时,将容器暂停。 eg: docker commit -a "ybd" -m "my apache" a404c6c174a2 mymysql:v1 当我们修改了镜像文件提交时候,可以使用docker diff [OPTIONS] CONTAINER查看修改了什么东西。 一般地,不推荐使用commit来构建镜像,之前也提过,镜像是特殊的文件系统,改了东西之后原来的基础之上叠加,使之变得越来越臃肿。此外,使用 docker commit 意味着所有对镜像的操作都是黑箱操作,生成的镜像也被称为黑箱镜像,换句话说,就是除了制作镜像的人知道执行过什么命令、怎么生成的镜像,别人根本无从得知。一般我们会使用Dockerfile定制镜像。 删除 删除镜像可以使用: docker rmi [OPTIONS] IMAGE [IMAGE...] OPTIONS说明: -f :强制删除; --no-prune :不移除该镜像的过程镜像,默认移除; 一般会组合使用: docker rmi $(docker images -q -f dangling=true) docker rmi $(docker images -q redis) docker rmi $(docker images -q -f before=mongo:3.2) 查看元数据 docker inspect : 获取容器/镜像的元数据。 docker inspect [OPTIONS] CONTAINER|IMAGE [CONTAINER|IMAGE...] OPTIONS说明: -f :指定返回值的模板文件。 -s :显示总的文件大小。 --type :为指定类型返回JSON。 实例 获取镜像mysql:5.6的元信息。 ~: docker inspect mysql:5.6 [ { "Id": "sha256:2c0964ec182ae9a045f866bbc2553087f6e42bfc16074a74fb820af235f070ec", "RepoTags": [ "mysql:5.6" ], "RepoDigests": [], "Parent": "", "Comment": "", "Created": "2016-05-24T04:01:41.168371815Z", "Container": "e0924bc460ff97787f34610115e9363e6363b30b8efa406e28eb495ab199ca54", "ContainerConfig": { "Hostname": "b0cf605c7757", "Domainname": "", "User": "", "AttachStdin": false, "AttachStdout": false, "AttachStderr": false, "ExposedPorts": { "3306/tcp": {} }, ... 获取正在运行的容器mymysql的 IP。 ~: docker inspect -f '' mymysql 172.17.0.3 Operating Container 开启 docker run :创建一个新的容器并运行一个命令 docker create :创建一个新的容器但不启动它 docker run [OPTIONS] IMAGE [COMMAND] [ARG...] docker create [OPTIONS] IMAGE [COMMAND] [ARG...] docker run OPTIONS说明: -a stdin: 指定标准输入输出内容类型,可选 STDIN/STDOUT/STDERR 三项; -d: 后台运行容器,并返回容器ID; -i: 以交互模式运行容器,通常与 -t 同时使用; -t: 为容器重新分配一个伪输入终端,通常与 -i 同时使用; -v: 挂载数据卷 --name="nginx-lb": 为容器指定一个名称; --restart=always: docker启动容器也跟着启动 --dns 8.8.8.8: 指定容器使用的DNS服务器,默认和宿主一致; --dns-search example.com: 指定容器DNS搜索域名,默认和宿主一致; -h "mars": 指定容器的hostname; -e username="ritchie": 设置环境变量; --env-file=[]: 从指定文件读入环境变量; --cpuset="0-2" or --cpuset="0,1,2": 绑定容器到指定CPU运行; -m :设置容器使用内存最大值; --net="bridge": 指定容器的网络连接类型,支持 bridge/host/none/container: 四种类型; --link=[]: 添加链接到另一个容器; --expose=[]: 开放一个端口或一组端口; <b>实例</b> 例如,启动一个 bash 终端,允许用户进行交互: docker run -t -i ubuntu:14.04 /bin/bash 当利用 docker run 来创建容器时,Docker 在后台运行的标准操作包括: 检查本地是否存在指定的镜像,不存在就从公有仓库下载 利用镜像创建并启动一个容器 分配一个文件系统,并在只读的镜像层外面挂载一层可读写层 从宿主主机配置的网桥接口中桥接一个虚拟接口到容器中去 从地址池配置一个 ip 地址给容器 执行用户指定的应用程序 执行完毕后容器被终止 停止 docker stop :停止一个运行中的容器: docker stop [OPTIONS] CONTAINER [CONTAINER...] 进入容器 使用docker exec : docker exec [OPTIONS] CONTAINER COMMAND [ARG...] OPTIONS说明: -d :分离模式: 在后台运行 -i :即使没有附加也保持STDIN 打开 -t :分配一个伪终端 例如进入ubuntu容器交互式模式: docker exec -it ubuntu /bin/sh 导出和导入容器 导出容器快照 docker export [OPTIONS] CONTAINER 例如: docker export 7691a814370e > ubuntu.tar 导入容器快照 docker import [OPTIONS] file|URL|- [REPOSITORY[:TAG]] OPTIONS说明: -c :应用docker 指令创建镜像; -m :提交时的说明文字; 例如: docker import ubuntu.tar ybd/ubuntu:v1 删除 docker rm [OPTIONS] CONTAINER [CONTAINER...] OPTIONS说明: -f :通过SIGKILL信号强制删除一个运行中的容器 -l :移除容器间的网络连接,而非容器本身 -v :-v 删除与容器关联的卷 删除所有容器: docker rm $(docker ps -a -q) 但这并不会删除运行中的容器 列出容器 docker ps [OPTIONS] OPTIONS说明: -a :显示所有的容器,包括未运行的。 -f :根据条件过滤显示的内容。 --format :指定返回值的模板文件。 -l :显示最近创建的容器。 -n :列出最近创建的n个容器。 --no-trunc :不截断输出。 -q :静默模式,只显示容器编号。 -s :显示总的文件大小。 例如列出最近创建的5个容器信息: docker ps -n 5 列出所有创建的容器ID: docker ps -a -q Dev Env In Docker mysql: docker run -p 6033:3306 --name mysql-master --restart=always -v $PWD/conf/my.cnf:/etc/mysql/my.cnf -v $PWD/logs:/var/log/mysql -v $PWD/data:/var/lib/mysql -e MYSQL_ROOT_PASSWORD=123456 -idt mysql:5.7.19 redis: docker run -p 6380:6379 --name redis-master --restart=always -v /home/ybd/docker/redis:/data -v /etc/redis/redis.conf:/usr/local/etc/redis/redis.conf -d redis:4.0.1 redis-server --appendonly yes Last 参考:Docker — 从入门到实践Docker命令大全

优秀的个人博客,低调大师

MessagePack 学习笔记

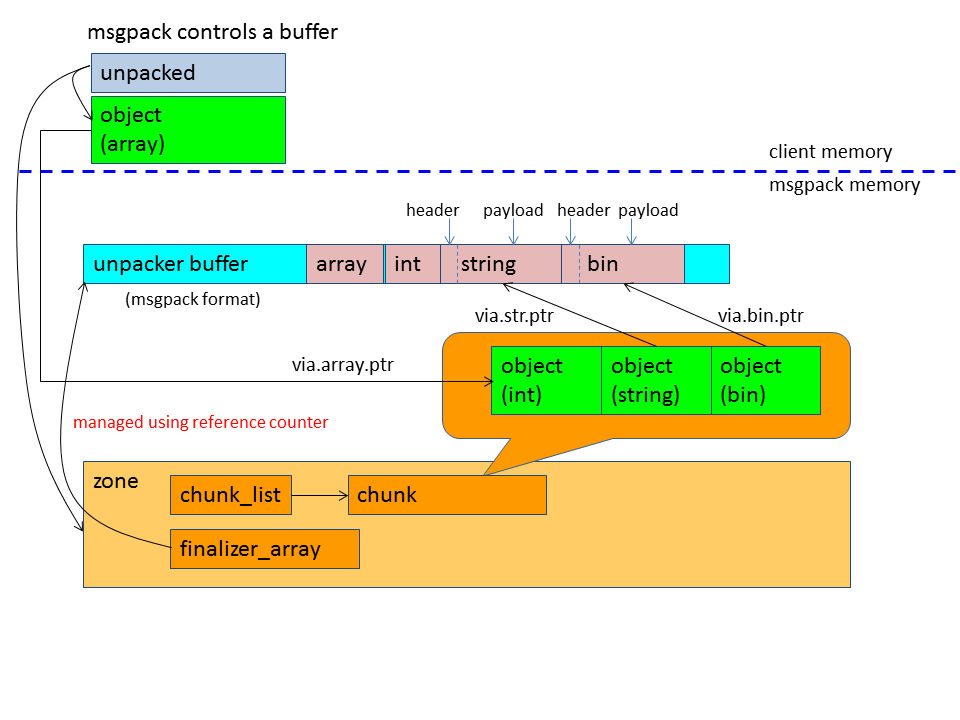
封装和解析类似json的 key-value 示例 {"ID" = 333,"name"="zds","3333"="ende"} msgpack::sbuffer sBuf; msgpack::packer<msgpack::sbuffer> pker(&sBuf); pker.pack_map(3); pker.pack(std::string("ID")); pker.pack(333); pker.pack(std::string("name")); pker.pack(std::string("zds")); pker.pack(std::string("333")); pker.pack(std::string("ende")); //unserilized msgpack::unpacked unpack; msgpack::unpack(unpack, sBuf.data(), sBuf.size()); msgpack::object obj = unpack.get(); std::cout << obj << std::endl; if (obj.type == msgpack::type::ARRAY) std::cout << "是array" << std::endl; else if (obj.type == msgpack::type::MAP) std::cout << "是map" << std::endl; if(obj.via.map.size > 0) { auto pkv = obj.via.map.ptr; auto pkv_end = obj.via.map.ptr + obj.via.map.size; do { auto key = pkv->key; auto val = pkv->val; std::cout << "key:" << key << " value:" << val << std::endl; ++pkv; } while (pkv < pkv_end); } 解析Socket示例 各类数据结构: msgpack::object 他是一个引用,拷贝他的代价少,因为他是浅拷贝msgpack::object_handle 他管理了一个对象的生命周期。他如果释放了,所有从他生成的object都是无效的引用 解析Socket示例 下列代码解析socke收包数据 unpacker.reserve_buffer 分配要收的数据的内存字节数unpacker..buffer() 返回数据地址unpacker.buffer_consumed() 设置实际收到的数据unpacker.next(object_handle& oh) 循环解析数据 int main() { boost::asio::io_service ios; std::uint16_t const port = 12345; // Server std::size_t const window_size = 10; boost::asio::ip::tcp::acceptor ac(ios, boost::asio::ip::tcp::endpoint(boost::asio::ip::tcp::v4(), port)); boost::asio::ip::tcp::socket ss(ios); std::function<void()> do_accept; std::function<void()> do_async_read_some; msgpack::unpacker unp; do_accept = [&] { ac.async_accept( ss, [&] (boost::system::error_code const& e) { if (e) { std::cout << __LINE__ << ":" << e.message() << std::endl; return; } unp.reserve_buffer(window_size); do_async_read_some = [&] { ss.async_read_some( boost::asio::buffer(unp.buffer(), window_size), [&](boost::system::error_code const& e, std::size_t bytes_transferred) { if (e) { std::cout << __LINE__ << ":" << e.message() << std::endl; return; } std::cout << bytes_transferred << " bytes read." << std::endl; unp.buffer_consumed(bytes_transferred); msgpack::object_handle oh; while (unp.next(oh)) { std::cout << oh.get() << std::endl; // In order to finish the program, // return if one complete msgpack is processed. // In actual server, don't return here. return; } do_async_read_some(); } ); }; do_async_read_some(); } ); }; do_accept(); // Client auto host = "localhost"; boost::asio::ip::tcp::resolver r(ios); boost::asio::ip::tcp::resolver::query q(host, boost::lexical_cast<std::string>(port)); auto it = r.resolve(q); boost::asio::ip::tcp::socket cs(ios); boost::asio::async_connect( cs, it, [&] (boost::system::error_code const& e, boost::asio::ip::tcp::resolver::iterator) { if (e) { std::cout << __LINE__ << ":" << e.message() << std::endl; return; } std::cout << __LINE__ << ":client connected" << std::endl; msgpack::sbuffer sb; msgpack::pack(sb, std::make_tuple(42, false, "hello world", 12.3456)); write(cs, boost::asio::buffer(sb.data(), sb.size())); } ); // Start ios.run(); } 详解: msgpack controls a buffer msgpack provides a buffer management functionality named msgpack::unpacker. msgpack::unpacker is sutable for the following motivations: msgpack data is chopped, and the client doesn't know when it will complete. This is a typical situation when you develop streaming applications. You want to minimize copy opperations without careful memory management. Here is the basic (not all) interface of msgpack::unpacker: #ifndef MSGPACK_UNPACKER_INIT_BUFFER_SIZE #define MSGPACK_UNPACKER_INIT_BUFFER_SIZE (64*1024) #endif #ifndef MSGPACK_UNPACKER_RESERVE_SIZE #define MSGPACK_UNPACKER_RESERVE_SIZE (32*1024) #endif class unpacker { public: unpacker(unpack_reference_func f = &unpacker::default_reference_func, void* user_data = nullptr, std::size_t init_buffer_size = MSGPACK_UNPACKER_INIT_BUFFER_SIZE, unpack_limit const& limit = unpack_limit()); void reserve_buffer(std::size_t size = MSGPACK_UNPACKER_RESERVE_SIZE); char* buffer(); void buffer_consumed(std::size_t size); bool next(unpacked& result); }; Here is a basic pattern using msgpack::unpacker: // The size may decided by receive performance, transmit layer's protocol and so on. std::size_t const try_read_size = 100; msgpack::unpacker unp; // Message receive loop while (/* block until input becomes readable */) { unp.reserve_buffer(try_read_size); // unp has at least try_read_size buffer on this point. // input is a kind of I/O library object. // read message to msgpack::unpacker's internal buffer directly. std::size_t actual_read_size = input.readsome(unp.buffer(), try_read_size); // tell msgpack::unpacker actual consumed size. unp.buffer_consumed(actual_read_size); msgpack::unpacked result; // Message pack data loop while(unp.next(result)) { msgpack::object obj(result.get()); // Use obj } // All complete msgpack message is proccessed at this point, // then continue to read addtional message. } msgpack::unpacker::next() returns true if one complete msgpack messege is proccessed. If msgpack message is correct but insufficient, it returns false. However, parsing proccess is proceeded and the context information is preserved in the msgpack::unpacker. It helps leveling the load of parse. When msgpack message contains binary data, string data, or ext data, they are not copied but referenced from msgpack::object by default. See the following implementation: inline bool unpacker::default_reference_func(type::object_type type, uint64_t len, void*) { return true; } You can also customize unpack_reference_func. Even if you use references, you don't need to control buffer's lifetime. The buffers' lifetime is controled by msgpack using msgpack::zone's finalizer_array and msgpack::unpacker's reference counting mechanism. So, in most cases, the default behavior is enough. If you want to control the peak of memory consumption when receiving msgpack data patterns are predictable, customizing unpack_reference_func might be useful. You can get a reference information from msgpack::unpacker::next() using the following function: bool next(unpacked& result, bool& referenced); However, mostly you don't need to use that version of next() because referenced memories are managed by unpacker.

优秀的个人博客,低调大师

YARN 笔记(一)

YARN是Yet Another Resource Negotiator的简称,它仍可认为采用了master/slave结构,总体上采用了双层调度架构,它主要以下几部分组成: ResourceManager:负责资源管理的主服务,整个系统只有一个,负责资源管理、调度和监控,它支持可插拔的资源调度器,自带了FIFO、Fair Scheduler和Capacity Scheduler三种调度器; NodeManager:负责单个节点的资源管理和监控,它定期将资源使用情况汇报给ResourceManager,并接收来自ApplicationMaster的命令以启动Container(YARN中对资源的抽象),回收Container ApplicationMaster:负责管理单个应用程序,它向ResourceManager申请资源,并使用这些资源启动内部的任务,同时负责任务的运行监控和容错等; Container:对资源的抽象,它封装了某个节点上的CPU、内存等资源,ApplicationMaster只有获得一个Container后才能启动任务,另外,ApplicationMaster本身也是运行在一个Container之中。 用户将应用程序提交到ResourceManager上 ResourceManager为应用程序ApplicationMaster申请资源,并与某个NodeManager通信,以启动ApplicationMaster; ApplicationMaster与ResourceManager通信,为内部要执行的任务申请资源,一旦得到资源后,将于NodeManager通信,以启动对应的任务。 所有任务运行完成后,ApplicationMaster向ResourceManager注销,整个应用程序运行结束。

优秀的个人博客,低调大师

RNACocktail安装笔记

前段时间,估计2个月之前了吧,Nature Commnication 上发了一篇史上最强RNA-Seq数据分析测评文章,本来一直想介绍一下的,但是尴尬的是实验室一直没来RNA-Seq数据让我分析,所以就一直没写文章提供的"RNACocktail",现在终于能够写一下如何布置RNACocktail的工作环境了。 官方地址:【https://bioinform.github.io/rnacocktail/】 如果你懂docker,并且有管理员权限,那你可以尝试他们提供的docker image, 也就是docker pull marghoob/rnacocktail.但这里,我们采用的是conda进行软件管理,为了保证环境的一致性和稳定性,我重新建立一个虚拟环境,国内用户可以需要添加清华镜像源提高下载速度(后面提到的配置文件里设置了清华镜像源)。 按照往常,我可能要把每一行下载的代码都要罗列出来才行,但是conda install有一个选项是-file, 通过已有的环境设置参数文件,一步搞定。我的配置文件放在我的GitHub上,下载后用conda install --file fileName.txt进行安装。 注意,RNACocktail是大杂烩的体系,下面不同步骤及其对应的主要软件 比对,align, HISAT2 转录本重建,reconstruct, StringTie 基因定量,quantify, Salmon-SMEM 差异表达,diff, DESeq2 短读长序列从头组装,denovo, Oases 长读长序列矫正,long_correct, loRDEC 长读长序列比对,long_align, STARlong 长读长序列转录本重建,long_reconstruct,IDP 长读长序列转录融合检测,long_fusion, IDP-fusion 变异位点识别,variant,GATK RNA编辑检测,editing, GIREMI RNA融合检测,fusion, FusionCatcher 并且,最后以上步骤最后都加入了all豪华套餐。 那么问题来了,我目前不需要三代测序,也不需要做RNA edit 和 fusion的分析,主要工作就是基因定量和差异表达分析,我不需要安装所有的软件。 安装方法: 我提供的requirement.txt文件安装的软件是RNACocktail流程的中配版本,而且我以身试坑,能够运行。大家可以根据需要,在此基础上添加不同口味的软件。 # 方法1,自定义环境名 conda env create -n rnacocktial(名字随意) -f=requiremment.txt # 方法2, 指定安装路径 crate env create -p $HOME/software/rnacocktail(路径自选) -f=requiremment.txt 如下是我将服务器导出环境配置文件,在我本地电脑上运行的示例图。 以身测坑 最后需要自己安装作者放在GitHub上最新版本的RNACocktial source activate rnacocktail pip install https://github.com/bioinform/RNACocktail/archive/v0.2.1.tar.gz 如果不需要可以一键删除, conda env remove -n rnacocktial 定量流程测试 由于安装的软件版本和官方的未必一样,需要先用quantify这一步探探雷。官方给的推荐命令如下: run_rnacocktail.py quantify --quantifier_idx salmon_fmd_idx # 使用salmon index -t reference.fa -i salmon_index_basename --type fmd 构建 --1 seq_1.fq.gz --2 seq_2.fq.gz #双端测序 --libtype IU # 无链特异性,双端 --salmon_k 19 # salmon教程75bp以上推荐31 --outdir out # --workdir work --salmon /path/to/salmon #salmon所在位置 --threads 10 #线程数 --sample A #表示样本A --unzip # 解压 之前写过是时候来一波RNA-Seq差异表达分析实操了 用的就是salmon,刚好能派上用场。 下载(拟南芥cDNA)序列,也就是转录组数据库,建立索引 # downlaod data from ensemblgenomes curl ftp://ftp.ensemblgenomes.org/pub/plants/release-28/fasta/arabidopsis_thaliana/cdna/Arabidopsis_thaliana.TAIR10.28.cdna.all.fa.gz -o athal.fa.gz # build quasi-mapping-based index salmon index -t athal.fa.gz -i Athaliana --type fmd 使用run_rancocktail对样本定量 for fn in ERR1698{194..209};ERR1698{194..209}; do samp=`basename ${fn}` echo "Processin sample ${sampe}" run_rnacocktail.py quantify \ --quantifier_idx /public1/wangjw/database/TAIR10/Athaliana/\ --1 ${samp}_1.fastq.gz \ --2 ${samp}_2.fastq.gz \ --libtype IU \ --salmon_k 31\ --workdir data \ --salmon $PATH/miniconda3/envs/rnacocktail/bin/salmon \ --threads 10 \ --sample ${sampe} \ --unzip 运行成功 最后结果会存放在 data/salmon-smem下(截图是目前分析的数据),说明配置没有问题。GITHUB地址:https://github.com/xuzhougeng/zgtoolkits/blob/master/requirement_of_rnacocktial.txt 一不小心被我删了。。尴尬

优秀的个人博客,低调大师

hiveql笔记(一)

1、创建表 create table if not exists mydb.employees{ name String COMMENT 'Employee name', salary FLOAT COMMENT 'Empolyee salary', subordinates APPAY<STRING> COMMENT 'Names of subordinates', deductions MAP<STRING,FLOAT> COMMENT 'Keys are deductions names,values are percentages' address STRUCT<street:STRING,city:String,state:STRING,zip:INT> COMMENT 'Home address') COMMENT 'Desription of the table' TBLPROPERITES ('creator '='me','created_at'='2012-01-02 10:00:00',...) LOCATION '/usr/hive/warehouse/mydb.db/employees'; Hive 会自动添加两个表属性:一个是last_modified_by,其保存着最后修改这个表的用户的用户名。另一个是last_modified_time,其保存着最后修改的新纪元时间秒。 2、查看表的详细表结构信息 DESCRIBE EXTENDED mydb.employees; //在表名后添加字段的名称,使用extended关键字也不会增加更多的输出信息。 DESCRIBE mydb.employees.salary; 3、外部表 CREATE EXTERNAL TABLE IF NOT EXISTS stocks ( exchange STRING, symbol STRING, ymd STRING, price_open FLOAT, price_high FLOAT, price_low FLOAT, price_close FLOAT, volume INT, price_adj_close FLOAT) ROW FORMAT DELIMITED FIELDS TERMINATED BY ‘,‘ LOCATION '/data/stocks'; 关键字EXTENAL告诉hive这个表是外部的,而后面的LOCATION..子句则用于告诉HIVE数据位于哪个路径下。 //还可以对一张存在的表进行结构复制(而不会复制数据) CREATE EXTERNAL TABLE IF NOT EXISTS mydb.employees3 LIKE mydb.employees LOCATION '/path/to/data'; 4、分区表、管理表 CREATE TABLE employees ( name String, salay FLOAT, subordinates APPAY<STRING>, deductions MAP<STRING,FLOAT>, address STRUCT<street:STRING,city:STRING,state:STRING,zip:INT> ) PARTITIONED BY (country STRING,state STRING); 分区表改变了Hive对数据存储的组织方式,这个表会有一个exployees目录与之对应,每个分区都有一个partXX //可以使用show partitions命令查看表中存在的所有分区: SHOW PARTITIONS employees; //如果表中存在很多的分区,而只想查看是否存储某个特定分区键的分区的话,还可以在命令上添加指定了一个或多个特定分区字段值的PARTITION子句: SHOW PARTITIONS employees PARTITION(country='US'); SHOW PARTITIONS employees PARTITION(country='US',state='AK'); 5、外部分区表 CREATE EXTERNAL TABLE IF NOT EXISTS log_messages ( hms INT, severity STRING, server STRING, porcess_id STRING, message STRING) PARTITIONED BY (year INT,month INT,day INT) ROW FORMAT DELIMITED FIELDS TERMINATED BY '\t'; ) //添加一个分区 ALTER TABLE log_messages ADD PARTITION(year = 2012,month = 1,day =2 ) LOCATITION 'hdfs://master_server/data/log_message/2012/01/02'; //将一个月前的分区数据拷贝到其他集群 hadoop distcp /data/log_message/2011/12/02 s3n://ourbucket/logs/2011/12/02 //修改表,将分区路径指向到S3路径: ALTER TABLE log_messages PARTITION(year = 2011,month = 12,day = 2) SET LOCATION 's3m://ourbucket/logs/2011/01/02'; //DESCRIBE EXTENDED log_message 语句会将分区键作为表的模式的一部分,和partitionKeys列表的内容同时进行显示: DESCRIBE EXTENDED log_messages; 6、删除表 DROP TABLE IF EXISTS employees; //这里有个知识点,如果开启了Hadoop回收站功能(默认是关闭),那么数据将会转移到用户在分布式文件系统中的用户跟目录下的.Trash目录下,也就是HDFS中的/usr/$USER/.Trash目录,如果要开启这个功能,需要配置fs.trash.internal的值。设置一个合理的整数,比如如果设置1440,那么就表示是24小时。 7、表重命名 ALTER TABLE log_messages RENAME TO logmsgs; 8、修改列信息 ALTER TABLE log_messages CHANGE COLUMN hms hours_minutes_seconds INT COMMENT 'The hours,minutes, and seconds part of the timestamp' AFTER severity; //这里说明,如果想将这个字段移动到第一个位置,需要使用FIRST关键字替代AFTER other_column子句即可。 9、增加列 ALTER TABLE log_messages ADD COLUMNS ( app_name STRING COMMENT 'Application name', session_id LONG COMMENT 'The current session id'); 10、删除或者替换列 //移除了之前所有的字段并重新指定了新的字段: ALTER TABLE log_messages REPLACE COLUMNS ( hours_mins_secs INT COMMENT 'hour,minute,seconds from timestamp', serverity STRING COMMENT 'The message severity' message STRING COMMENT 'The rest of the message'); 11、修改存储属性 ALTER TABLE log_messages PARTITION(year = 2012,month = 1,day = 1) SET FILEFORMAT SEQUENCEFILE; 12、通过查询语句向表中插入数据 INSERT OVERWRITE TABLE employees PARTITION (country = 'US' , state = 'OR' ) SELECT * FROM staged_employees se WHERE se.cnty = 'US' AND se.st = 'OR'; //如果是非分区表,之前表中的内容将会被覆盖掉 13、动态分区插入 //指定了country字段的值为静态的US,而分区字段state是动态值。 INSERT OVERWRITE TABLE employees PARTITION (country='US',state) SELECT ...,se.cnty,se.st FROM staged_employees se WHERE se.cnty = 'US'; (静态分区键必须出现在动态分区键之前) //延伸动态分区属性: hive.exec.dynamic.partition false 设置成true,表示开启动态分区功能 hive.exec.dynamic.partition.mode strict 设置成strict,表示允许所有分区都是动态的 hive.exec.max.dynamic.parition.pernode 100 每个mapper或reducer可以创建的最大动态分区个数。如果某个mapper或reducer尝试创建大于这个值得分区的话则会抛出一个致命错误信息。 hive.exec.max.dynamic.partitions +1000 一个动态分区创建语句可以创建的最大动态分区个数。如果超过这个值则会抛出一个致命错误信息。 hive.exec.max.created.files 100000 全局可以创建的最大文件个数。 eg: set hive.exec.dynamic.partition=true; set hive.exec.dynamic.partition.mode=nonstrct; set.hive.exec.max.dynamic.partitions.pernode=1000; INSERT OVERWRITE TABLE employees PARTITION (country,state) SELECT ...,se.cty,se.st FROM staged_employees se; 14、单个查询语句中创建表并加载数据 CREATE TABLE ca_employees as SELECT name,salary,address FROM employees WHERE se.state = 'CA'; 15、导出数据 hadoop fs -cp sorce_path target_path //也可以使用INSERT...DIRECTORY... INSERT OVERWRITE LOCAL DIRECTOR 'tmp/ca_employees' SELECT name,salary,address From employees WHERE se.state = 'CA'; 参考文献《Hive编程指南》

优秀的个人博客,低调大师

ISIS学习笔记

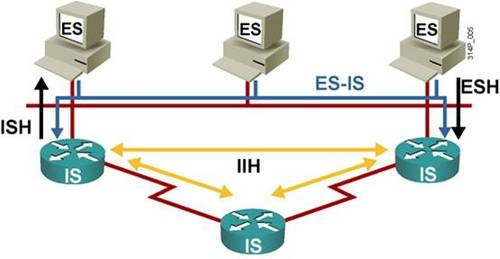
背景介绍 OSPF“表兄弟”,很另类,完全不同于OSI、TCP/IP协议栈,然而可以完全互相使用“双栈协议”。Intermediate system to intermediate system中间系统到中间系统 CLNS:ConnectionlessNetwork Service面向无连接的网络服务 IP ——àCLNS OSPF——àISIS ARP ——àESIS 链路状态路由协议,基于OSI七层模型设计 OSI参考模型确定了网络的标准,没有定义任何一个通信协议的细节但是提供了设计指导原则。 OSI网络层定义了两种服务:CONS与CLNS 基于CLNS的服务由以下网络层协议支持 – CLNP:无连接网络层协议 – ES-IS:终端系统-中间系统路由协议 – IS-IS :中间系统-中间系统路由协议 与OSPF拥有很多共同特性 – 维护一个链路状态数据库,使用SPF算法计算最短路径 – 使用Hello包形成和维护邻居关系 – 使用区域的概念来构建一个层次化的网络结构 – 支持手动汇总与VLSM – 在广播多路访问网络中都选举指定路由器 – 都具备认证功能 IS-IS基本术语 – IS:中间系统,相当于TCP/IP中的路由器 – ES:终端系统,相当于TCP/IP中的主机系统 – LSP:链路状态数据库报文 – NPDU:网络协议数据单元,ISO网络层报文,同IP包 – NSAP:网路服务接入点,即ISO中网络层地址 – (也称为CLNP地址) 地址格式 <8byte~20byte> DP:AFI、IDI DSP:High-order DSP、System-ID、NSEL Area:标识此IS端所在的区域 System:ID唯一标识次区域的IS 49.000x.0000.0000.000Y.00 AFI AreaID System-ID NSEI X->区域 Y->服务接口 基本原理 相同点 算法:SPF算法 特征:链路状态 无类:VLSM/CIDR 不相同 ①区域设计 OSPF:ABR链路两个区域 ISIS:没有明显的区域边界 ②分组类型 OSPF:非常多 ISIS:少,精简 ③路由器类型 OSPF 骨干路由器 常规路由器 ABR ISIS L1路由器 L2路由器 L1/2路由器 六种路由器是互相对应的 四种类型的路由 基本特征 属于网络层 链路状态协议 无类协议 最佳路径 AD:115àTCP/IP,115àOSI Metric:每跳,Metric为10 窄度量Narrow Metric接口2^6,总2^10 宽度量wide Metric接口2^24,总2^32 基本部署 接下去大都相同的,在开启clns路由,部署isis协议,在相应接口下部署isis 注意这个不同于osi模型,我们甚至查看不了路由 Ping的未知的地址回复也是不同的效果 然而仍然有表可查的 L1是常规区、L2骨干区 连通性测试 抓包之后发现不再是ICMP,这个也印证了ping不只是ICMP(其实TCP、ARP也可以~~) 修改区域类型 这里在L1,L1/2里面虽然都维护着R2的信息,但是对于R2来说根本没必要维护着R4的信息啊,所以就出现优化点。同理对于R4来说仅仅需要维护L2的信息即可 修改接口类型 我们知道R2是L1,R1、R3是L1/2,然而时不时R2会发送L2Hello包以维持R4的信息,所以需要相应的在接口下修改接口类型 结果 这里虽然没有路由信息竟然可以ping通!原因是什么?抓包可发现数据包的大小不同,但是在包里面却没有发现相应的路由信息啊。答案是,由于ISIS本身的算法,L1会寻找离它最近的L1/2(即默认路径)然后,通过该L1/2进行选路 修改度量值 双栈协议的体现 项目工程中很经常遇到的,集成ISIS,一般不会玩前面所说的纯ISIS。在这之前首先要给所有的路由器配上地址 结果 然而路由表、拓扑表中仍然没有信息 开始配置 根据拓扑,分别为其配置IP地址信息 不一一列举了,反正可以互相ping通就对了 提问 这两个命令意味着啥? ISIS路由分组 在R2与交换机之间进行抓包,可发现 从这个地方可以发现: 如果我们没有做优化,L1/2会向L1转发L2的hello事实上这些数据包对于R2来说是没有意义的,可以称之为垃圾包,这个就是需要进行链路优化的地方 Hello包发送非常密集,可以称之为”话痨“ Hello包 每3s发送一次,很消耗带宽,但可以很有效的报告当前的链路状态 CSNP包(DBD包) 每10s发送一次 PSNP 这个需要在串口状态下才能抓到,ISIS只认两种网络类型P2P、BMA ISIS DIS机制 vs OSPFDR机制 1、ISIS无备份机制 2、ISIS的DIS可抢占 3、ISIS默认优先级为64 4、ISIS的DIS hello间隔3.3s,Holdtime 10s R7R8一样的设置 LSP包 抓到这个包需要创建一个环回接口,然后才能抓到 虽然LSP是链路状态协议,但是完全可以说这个是EIGRP,因为几乎把所有的信息都公布出来了 ISIS路由算法 因为在OSPF的SPF算法的基础上多了PRC算法 ①算法优势:引入PRC,支持网络架构更大,网络更稳定; ②拓扑优势:区域设计不像OSPF有物理骨干区域的限制,ISIS的骨干区域相对比较灵活; ③分组优势:引入TLV 类型长度值的概念,可以更好的拓展新的特性和功能 ④迁移性:ISIS迁移到IPV4和IPV6,几乎无缝切换 路由汇总 汇总这个话题老生常谈~~ 汇总 需要在两个端口写,统一汇总信息,看效果 路由认证 跟EIGRP几乎没有区别 被动接口 跟前面的一样~~isis进程下使用passtive-interface 默认路由 ISIS路由泄露 根据ISIS的寻路算法,假如我们使用R2pingR7那么他们返回的路径是 因此需要相应的通过ACL人为的规定流量路径。哈?为啥要规定?不规定的话,路由拓扑就会被泄露啦 ISIS区域迁移 注意:由前面的配置经验可知,如果在相应进程下通告路由信息的话,原来的信息会被覆盖的,然而在ISIS里面却不会发生这样的情况 区域迁移的意义在于 OSPF与ISIS对比 共同之处 1 都是链路状态路由协议,都要求区域内的路由器交换链路状态信息,链路状态信息被收集到链路状态数据库中 2 都是用了一种实现路由选择信息交换相似机制 3 都在广播网络中选择指定路由器来控制扩散并降低这类介质中多对多邻接的系统资源需求 4 都是基于链路状态库中的信息,采用几乎相同的算法-SPF算法来计算最佳路由 5 都支持两个分层路由选择 6 都支持IP前缀的无类路由选择(支持VSLM) 7 都是共有协议 不同之处: ISIS OSPF 1 ISIS支持ISOCLNP和IP两种网络 仅支持IP网络 2 ISIS报文封装在数据链路层帧中 封装在IP包中 3 ISIS支持ISO无连接网络环境,注意数据链路是ISO协议(在以太网上数据链路类型为FEFE),在ISO协议栈中ISIS网络层协议ID是0x83 OSPF封装在IP报文当中,协议号89 4 ISIS路由器通告包含直连邻居及路由信息的TLV的LSP,使用LSP承载所有的路由选择信息 OSPF使用不同类型的LSA承载不同的路由信息,LSA被封装进LSU通告给邻居 5 ISIS数据包利用TLV字段承载所有易于扩散的信息 OSPF只有LSA可扩展,而LSA扩展性太差 6 ISIS可以忽略它所不支持的TLV 网络中的路由器为了进行适当的操作必须识别所有的LSA 7 ISIS数据包可以承载多个TLV,只有一个包头,节省带宽 1类,2类LSA可以承载多个IP前缀;3类,4类,5类LSA只能承载单个IP前缀,如果需要发送多个IP前缀信息,需要多个LSA 8 对于所有实际应用,ISIS仅支持广播和点对点链路。不支持NBMA链路。在NBMA环境下,可配置为p2p子接口或者广播链路(如果是全互联的连接方式)。 OSPF支持如下网络类型:p2p、广播、NMBA、点到多点和按需链路。 9 仅仅在广播链路实现3步邻接关系,IETF正在努力指定点到点链路的3步进程。 OSPF邻接关系的建立涉及到一个更加复杂的过程。 10 最初数据库同步在邻接关系建立后进行。 最初数据库同步在邻接关系形成前进行。 11 ISIS路由器只属于一个特定区域。 OSPF基于接口划分区域,路由器可属于不同的区域。 12 区域的边界在链路 区域的边界在路由器上。 13 默认情况下ISIS区域是stub区域,规定了level2到level1的路由泄漏 默认情况下,ospf区域不是stub,可以配置成为stub。 14 ISIS仅支持在点对点链路上可靠扩散,广播链路的扩散是不可靠的。然而通过DIS周期性的广播是可靠的。 OSPF确保所有链路上扩散的可靠性。 15 DIS无备份DIS,DIS可以被抢占,DIS以3被的频率发送HelloPDU 有BDR,DR不能被抢占,DR以正常的频率发送HelloPDU 16 默认情况下,ISIS的LSP最大生存时间为1200s刷新间隔为900s,而且定时器值可调。 OSPF的LSA的老化时间为3600s,刷新间隔为1800s,而且是固定值。 17 默认情况下,ISIS的接口cost值为10. 默认情况下,OSPF的保持时间(dead-interval)为40s,而且为了建立邻接关系,必须使双方的保持时间一致。 18 ISIS通过将HelloPDU的大小填充至接口MTU大小来检查双方MTU是否匹配。 OSPF通过在DBD报文中嵌入接口的MTU字段来检查MTU是否匹配。 19 由于ISIS区域中IP前缀是SPF数的叶子,故部分路由计算(PRC)较多,通常这就意味着在一个大的区域中路由处理器的负载较低。 部分SPF被限制用于域间和外部路由,任何要求较小的区域和分层拓扑扩展引起的域间链路动荡导致完全的SPF计算。 20 没有对IP组播路由选择的支持。 MOSPF扩展提供对IP组播路由选择的支持。

优秀的个人博客,低调大师

docker swarm笔记

1 准备节点: node-1 192.168.33.201 node-2 192.168.33.202 node-3 192.168.33.203 node-4 192.168.33.204 2 在每个节点分别安装docker服务。 sudo curl -sSL http://acs-public-mirror.oss-cn-hangzhou.aliyuncs.com/docker-engine/internet | sh - 安装后需要修改dockerd启动参数,增加: -H 0.0.0.0:2375 这个很重要,否则manager无法连接到节点。 docker 1.12以前,需要自己使用swarm镜像启动环境,这里整理一下。如果你已经是1.12+了,请直接跳到第4节。 3 Docker1.12以前的swarm-swarm container 3.1 在node-1启动swarm容器 docker pull warm 创建token $ docker run --rm swarm create 3445719bd06a6a19950c8a034f276cab 加入集群 docker run -d swarm join --addr=192.168.33.201:2375 token://3445719bd06a6a19950c8a034f276cab 3.2 在node-2启动swarm容器 重复node-1操作。记得修改IP地址。 3.3 查看集群节点 在其中一个节点查看集群 $ docker run --rm swarm list token://3445719bd06a6a19950c8a034f276cab 192.168.33.202:2375 192.168.33.201:2375 3.4 集群管理 3.4.1 启动管理节点 在测试机上开启管理程序。如果在node-1或node-2上,建议使用非2375端口,如:-p 5000:2375 $ docker run -d -p 2375:2375 swarm manage token://3445719bd06a6a19950c8a034f276cab 3eb0aec4c9917725c098d102aa12767803db59f869052c611d3be160971df534 3.4.2 查看集群状态 $ docker -H 192.168.33.203:2375 info Containers: 6 Running: 6 Paused: 0 Stopped: 0 Images: 4 Server Version: swarm/1.2.5 Role: primary Strategy: spread Filters: health, port, containerslots, dependency, affinity, constraint Nodes: 2 test1: 192.168.33.201:2375 └ ID: 52BN:6F2E:GMCP:4JYC:H3IW:VEUM:3ART:TAUE:4CLW:GR3I:S4KI:LKSR └ Status: Healthy └ Containers: 3 (3 Running, 0 Paused, 0 Stopped) └ Reserved CPUs: 0 / 1 └ Reserved Memory: 0 B / 1.018 GiB └ Labels: kernelversion=4.4.0-51-generic, operatingsystem=Ubuntu 16.04.1 LTS, storagedriver=aufs └ UpdatedAt: 2017-01-09T06:12:52Z └ ServerVersion: 1.12.5 test2: 192.168.33.202:2375 └ ID: I6N6:WJZH:B3S3:DW6E:MIPP:FIKF:EGIX:RAVH:XNKU:LHGL:WAE7:SBZ2 └ Status: Healthy └ Containers: 3 (3 Running, 0 Paused, 0 Stopped) └ Reserved CPUs: 0 / 1 └ Reserved Memory: 0 B / 1.018 GiB └ Labels: kernelversion=4.4.0-51-generic, operatingsystem=Ubuntu 16.04.1 LTS, storagedriver=aufs └ UpdatedAt: 2017-01-09T06:13:40Z └ ServerVersion: 1.12.5 Plugins: Volume: Network: Swarm: NodeID: Is Manager: false Node Address: Security Options: Kernel Version: 4.4.0-51-generic Operating System: linux Architecture: amd64 CPUs: 2 Total Memory: 2.035 GiB Name: cfa479ee8a5e Docker Root Dir: Debug Mode (client): false Debug Mode (server): false WARNING: No kernel memory limit support 其中Status: Healthy表示节点正常,如果前面提及的dockerd启动项未设置,这里将会是:Pending,服务不可用。 3.5 测试集群 3.5.1 查看容器 $ docker -H 192.168.33.203:2375 ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 3.5.2 设置命令别名 如果是2375,端口号可以省略。为了使用方便可以创建一个命令别名: alias docker-swarm='docker -H 192.168.33.203' 再测试: $ docker-swarm images REPOSITORY TAG IMAGE ID CREATED SIZE 3.5.3 启动容器 docker-swarm run -d --name web1 nginx docker-swarm run -d --name web2 nginx docker-swarm run -d --name web3 nginx docker-swarm run -d --name web4 nginx 3.5.4 查看整个集群的容器 $ docker-swarm ps -a CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 478206c91145 nginx "nginx -g 'daemon off" Less than a second ago Up Less than a second 80/tcp, 443/tcp test1/web4 07a70b5ba0c2 nginx "nginx -g 'daemon off" 4 seconds ago Up 4 seconds 80/tcp, 443/tcp test2/web3 dbd596f5464a nginx "nginx -g 'daemon off" 18 seconds ago Up 18 seconds 80/tcp, 443/tcp test2/web2 04c23c28bafb nginx "nginx -g 'daemon off" 54 seconds ago Up 54 seconds 80/tcp, 443/tcp test1/web1 查看NAMES数据,形如:test1/webx,其中test1表示节点名字 4 Docker1.12以后的swarmkit Docker 1.12 在 2016 年 7 月 28 日正式 GA,除了大量的在使用上的改进和 bug 修复外,最引人瞩目的是Docker原生支持了 Swarm 模式,而不是将Swarm作为一个容器对集群进行管理。而docker1.12的操作命令并不向下兼容,于是过去所有创建swarm集群的文档都不能参考了。 4.1 几个概念 4.1.1 节点类型 docker-swarm 把节点分为manager和worker,顾名思义,manager是管理节点,worker是工作节点。 4.1.2 service 区别于旧的swarm管理容器,新的docker-swarm抽象了一个service的概念,有点类似于kubernates的pod,它是管理的最小单元。 一个service是一个以上的容器的集合。 4.2 搭建swarm环境 仍然使用前面的节点服务来测试,第1、2节的工作还是需要有效的。 4.2.1 在node-1节点创建swarm环境 $ docker swarm init --advertise-addr 192.168.33.201 Swarm initialized: current node (9vpgoqj65y3kqo52jj3y6gcnj) is now a manager. To add a worker to this swarm, run the following command: docker swarm join \ --token SWMTKN-1-2at6h0j885ttz6zzxxdca7rerj0dkcnq5tbqv729u0ty2tvtzz-2g85bb2vug886wxit8rbpcisy \ 192.168.33.201:2377 To add a manager to this swarm, run 'docker swarm join-token manager' and follow the instructions. 他是使用Raft来管理节点的。事实上,如果你只有一个外网地址(即除了lo和docker网络等虚拟网络之外没有其他网络接口),可以直接执行:docker swarm init 4.2.2 将node-2节点加入到创建的swarm cluster 在node-2 执行: $ docker swarm join \ --token SWMTKN-1-2at6h0j885ttz6zzxxdca7rerj0dkcnq5tbqv729u0ty2tvtzz-2g85bb2vug886wxit8rbpcisy \ 192.168.33.201:2377 This node joined a swarm as a worker. 4.2.3 在更多节点加入swarm cluster token没有记录下来?没关系,在node-1执行如下命令查看完整的命令提示: $ docker swarm join-token worker To add a worker to this swarm, run the following command: docker swarm join \ --token SWMTKN-1-2at6h0j885ttz6zzxxdca7rerj0dkcnq5tbqv729u0ty2tvtzz-2g85bb2vug886wxit8rbpcisy \ 192.168.33.201:2377 如果要加入的是manager节点,则如下查看: $ docker swarm join-token manager To add a manager to this swarm, run the following command: docker swarm join \ --token SWMTKN-1-2at6h0j885ttz6zzxxdca7rerj0dkcnq5tbqv729u0ty2tvtzz-37rg2khjxgk1iis6dfds48b0s \ 192.168.33.201:2377 4.3 集群管理 4.3.1 查看集群节点 在manager节点: $ docker node list ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 9vpgoqj65y3kqo52jj3y6gcnj * test1 Ready Active Leader dc5t7rc04a69rzuahky6qh53x test2 Ready Active e4k1fjd93ukncipzy9cer0lcg test3 Ready Active 可以看到,一共有三个节点,node-1自身已经是一个worker了,他的MANAGER是Leader。 该命令只有在manager节点才有权限使用,如果你想在node-3上使用,则需要让node-3成为manager。。 一种方法是让node-3先从cluster重新以manager身份加入cluster。 $ docker swarm leave Node left the swarm. 注意:有时自己退出重新加入,反复操作,会让manager混乱,导致一些问题。如,test3已经leave,但manager看到它还是Reading状态,无法删除掉。docker node rm test3只能删除down状态的节点, 加上--force不是那么好使。 4.3.2 节点角色转换 接上,将node-3转换为manager最简单的方法是,角色提权:是在manager中把node-3的角色提升为manager: vagrant@test1:~$ docker node promote test3 Node test3 promoted to a manager in the swarm. vagrant@test1:~$ docker node ls ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 5awz4cd6auchp0knq0iljfudh test2 Ready Active a02rv4zuex14p03erer1h6zkz * test1 Ready Active Leader cq9q1su8ipkp9w80sabv16mmz test3 Ready Active Reachable 与之相反的就是降权: 一种方法是在manager中把node-3的角色提升为manager: vagrant@test1:~$ docker node ls ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 5awz4cd6auchp0knq0iljfudh test2 Ready Active a02rv4zuex14p03erer1h6zkz * test1 Ready Active Leader cq9q1su8ipkp9w80sabv16mmz test3 Ready Active 从安全性考虑,一个集群应该指定多个manager。但需要注意的是,如果一个manager宕机,那么另一个manager需要接管服务,需要至少有三个以上存活的节点。 4.3.3 删除节点 docker node rm [node_id] 如果节点状态是Down,可以直接删除,否则可以增加--force开关强制删除。 4.3.4 manager容灾测试 再增加一个node-4,并将node-3提权为manager。 vagrant@test1:~$ docker node ls ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 2n3x7y0oaez6pdoxq91r5lng9 test4 Ready Active 77pnoup6clbxgwfd58dp9reu4 test2 Ready Active 84n1fg849v49i2ezobmps5vwg * test1 Ready Active Leader 8v5r3wb9sujlluqda6jv981ut test3 Ready Active Reachable 关闭node-1,在node-3检查节点: vagrant@test3:~$ docker node ls ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 2n3x7y0oaez6pdoxq91r5lng9 test4 Ready Active 77pnoup6clbxgwfd58dp9reu4 test2 Ready Active 84n1fg849v49i2ezobmps5vwg test1 Ready Active Unreachable 8v5r3wb9sujlluqda6jv981ut * test3 Ready Active Leader 此时test3接管Leader了。 启动node-1,检查节点: vagrant@test1:~$ docker node ls ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS 2n3x7y0oaez6pdoxq91r5lng9 test4 Ready Active 77pnoup6clbxgwfd58dp9reu4 test2 Ready Active 84n1fg849v49i2ezobmps5vwg * test1 Ready Active Reachable 8v5r3wb9sujlluqda6jv981ut test3 Ready Active Leader node-1已经变成了Reachable。 4.4 使用入门 4.4.1 创建service 折腾了半天,办点正事吧。 vagrant@test1:~$ docker service create --name web1 nginx bojkn65bzwpv2az82y3p7qssv vagrant@test1:~$ docker ps -a CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 0/1 nginx #稍等片刻 vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 1/1 nginx REPLICAS 表示一共指定了1个副本,开始启动了0个,启动完成后,变成1/1。 4.4.2 查看服务中的容器 vagrant@test1:~$ docker service ps web1 ID NAME IMAGE NODE DESIRED STATE CURRENT STATE ERROR 3tu8qr42a74tzudu8xta46u9h web1.1 nginx test2 Running Running 3 minutes ago 4.4.3 调整容器副本 我们可以把web1服务中的容器多启动几个副本,如6个: vagrant@test1:~$ docker service scale web1=6 web1 scaled to 6 vagrant@test1:~$ docker service ps web1 ID NAME IMAGE NODE DESIRED STATE CURRENT STATE ERROR 3tu8qr42a74tzudu8xta46u9h web1.1 nginx test2 Running Running 4 minutes ago chy2qbqz3pbboyxxz90gb9vxb web1.2 nginx test3 Running Preparing 12 seconds ago 2ae4vz4lx8zcpacjepdzcxx5y web1.3 nginx test1 Running Preparing 13 seconds ago dfg1pul4brwa8xqutls2dddm1 web1.4 nginx test4 Running Preparing 13 seconds ago 2o39qlezex2ddk8ie0bzs9drv web1.5 nginx test4 Running Preparing 13 seconds ago bsduc9qvegikjs8fj94k4ogi8 web1.6 nginx test2 Running Running 6 seconds ago vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 2/6 nginx 其中的2/6以及前面看到的列表信息状态可以看出,我们指定了6个副本,目前web1.1和web1.6已经启动完成,其他还在Preparing。 6个副本中分别在test1启动了1个、test2启动了2个、test3启动了1个、test4启动了2个。 过一会再刷新: vagrant@test1:~$ docker service ps web1 ID NAME IMAGE NODE DESIRED STATE CURRENT STATE ERROR 3tu8qr42a74tzudu8xta46u9h web1.1 nginx test2 Running Running 7 minutes ago chy2qbqz3pbboyxxz90gb9vxb web1.2 nginx test3 Running Preparing 3 minutes ago 2ae4vz4lx8zcpacjepdzcxx5y web1.3 nginx test1 Running Preparing 3 minutes ago dfg1pul4brwa8xqutls2dddm1 web1.4 nginx test4 Running Running 9 seconds ago 2o39qlezex2ddk8ie0bzs9drv web1.5 nginx test4 Running Running 9 seconds ago bsduc9qvegikjs8fj94k4ogi8 web1.6 nginx test2 Running Running 3 minutes ago vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 4/6 nginx 最终会完全启动。 vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 6/6 nginx 处理scale子命令,还可以使用update子命令完成同样的工作: vagrant@test1:~$ docker service update web1 --replicas=3 web1 vagrant@test1:~$ docker service ls ID NAME REPLICAS IMAGE COMMAND bojkn65bzwpv web1 2/3 nginx 4.5 负载均衡 多个副本容器启动后, swarm集群的service: 公共的端口会暴露在每一个swarm集群中的节点服务器上. 请求公共端口时,会负载均衡到所有的sevice实例上. 负载均衡模式有两种,vip和dnsrr,可以在出啊构建服务时指定: vagrant@test1:~$ docker service create --name web1 --replicas=6 --endpoint-mode=dnsrr nginx 4dx616zii0vgrz4s5oi2rwgsp 如果使用vip模式,应该有VirtualIP: $ docker service inspect --format='{{.Endpoint.VirtualIPs}}' web1 [] 怎么木有?你可能忘记在创建服务时发布端口了。 vagrant@test1:~$ docker service create --name web1 --replicas=6 -p 8888:80 nginx 8qlkxx7v643z7aenfrmfnksxk vagrant@test1:~$ docker service inspect --format='{{.Endpoint.VirtualIPs}}' web1 [{9h4hrcm7bv1ijdpzpyezy4pld 10.255.0.6/16}] 可以直接访问”http://10.255.0.6:8080“吗?no,它只是为容器间通信的,你可以访问任一台节点的IP:http://192.168.33.201:8888 4.6 启动时指定副本数 vagrant@test1:~$ docker service create --name nginx1 --replicas 2 nginx c79881b02bd7zrfg74a9qp8ji vagrant@test1:~$ docker service ps nginx1 ID NAME IMAGE NODE DESIRED STATE CURRENT STATE ERROR 1ghmia00xkxucrisadlwyitv9 nginx1.1 nginx test3 Running Running 5 seconds ago 193mdx2xcja4qv8s9ssakt8w1 nginx1.2 nginx test4 Running Running 6 seconds ago 4.7 swarm网络 由于容器在不同的docker主机上,swarm是如何保证网络层的互通呢?swarm是使用overlay网络来解决这个问题的。 vagrant@test1:~$ docker network ls NETWORK ID NAME DRIVER SCOPE 180d624cf798 bridge bridge local 4d225a25b2b4 docker_gwbridge bridge local 6c1889cd666a host host local 9h4hrcm7bv1i ingress overlay swarm 839e8db03b09 none null local 其中的swarm是缺省创建的overlay网络。 你可以自己创建网络来管理一组服务的互通。 vagrant@test1:~$ docker network create --driver overlay test 17wzxz29pxdf6are8an6u0ep2 vagrant@test1:~$ docker network ls |grep test 17wzxz29pxdf test overlay swarm 在指定子网启动服务 vagrant@test1:~$ docker service create --network test --name myservice hello-world 5kz0imiep9fztvsev0c101568 vagrant@test1:~$ docker service ps myservice ID NAME IMAGE NODE DESIRED STATE CURRENT STATE ERROR 6zww5ci2jhnvy05aj68ohb3do myservice.1 hello-world test2 Running Preparing 5 seconds ago 通过docker service inspect myservice返回的json中Networks元素可以看到网络信息,Target正是前面创建的test接口的id: "Networks": [ { "Target": "17wzxz29pxdf6are8an6u0ep2" } ] 你只要保证你启动的多个服务在同一个网络接口,就可以保证他们之间互相通信。 4.8 小结 swarmkit的引入,在docker中引入了三个子命令: docker swarm——swarm集群搭建 docker service——服务管理 docker node——集群节点管理 4.8.1 docker swarm 子命令 查看子命令 vagrant@test1:~$ docker swarm –help init 初始化swarm集群 join 将当前节点加入到集群中 join-token 管理加入token update 动态更新swarm配置 leave 当前节点主动退出集群(仅限worker节点) 4.8.2 docker service 子命令 查看子命令 vagrant@test1:~$ docker service –help create 创建服务 inspect 显示服务详情 ps 列出服务中的容器 ls 列出所有服务及简介 rm 删除服务 scale 调整服务的副本数 update 动态更新服务配置 4.8.3 docker node 子命令 查看子命令 vagrant@test1:~$ docker node –help demote 管理节点为指定子节点降权 inspect 显示节点详情 ls 列出集群中的节点 promote 管理节点为指定子节点提权 rm 删除一个节点 ps 列出指定子节点中running的容器 update 动态更新节点配置 4.8 使用帮助 本节实际上只是给出了查看帮助的方法。想了解某个命令的使用,只需要在子命令后面加上--help即可,逐级深入。如想了解docker node的子命令rm,则是: vagrant@test1:~$ docker node rm --help Usage: docker node rm [OPTIONS] NODE [NODE...] Remove one or more nodes from the swarm Aliases: rm, remove Options: --force Force remove an active node --help Print usage 祝好运。

优秀的个人博客,低调大师

hadoop笔记一

Hadoop是Apache软件基金会旗下的一个开源分布式计算平台。 是 Apache 下的一个项目,由 HDFS 、 MapReduce 、 HBase 、 Hive 和 ZooKeeper 等成员组成。其中, HDFS 和 MapReduce 是两个最基础最重要的成员 Hadoop 由许多元素构成。其最底部是 Hadoop Distributed File System [3] (HDFS),它存储 Hadoop 集群中所有存储节点上的文件。HDFS(对于本文)的上一层是 MapReduce 引擎,该引擎由 JobTrackers 和 TaskTrackers 组成 ​hadoop两部分组成 1、分布式文件系统( HDFS Hadoop distributed FileSystem ) 2、MapReduce ​hadoop两大类角色: 1、master 主服务器 2、salve 子服务器 1、分布式文件系统 1、NameNode 作为主服务器,管理文件系统的命名空间和客户端对文件系统的访问操作(CRUD) 统计数据需要多大的空间,多少个DataNode块,进行存储数据 2、DataNode 管理存储的数据 数据真正储存的节点内容、或者物理地址 存储(blockID-块地址, data- 数据) hadoop启动时会将dataNode节点的数据主动上传到NameNode空间中,让所有的数据都让nameNode维护起来,DataNode与NameNode保持心跳(实时通信)实现数据共享、 ​2、 MapReduce 分布式计算 和 任务处理 JobTrackers 和 TaskTrackers 组成 ​1、Map 接受数据并且将数据抓换成key \ value形式保存 2、Reduce 对Map进行逻辑处理 排序 、 计算、处理的逻辑处理 同时又两个集中处理的子任务 1、 JobTracker、 分解任务的执行 2、TaskTracker、 任务的执行(分解出来的任务执行(存储在硬盘或DataNode)) 假设输入域是 one small step for man,one giant leap for mankind。在这个域上运行 Map 函数将得出以下的键/值对列表: (one,1) (small,1) (step,1) (for,1) (man,1) MapReduce 流程的概念流 (one,1) (giant,1) (leap,1) (for,1) (mankind,1) 如果对这个键/值对列表应用 Reduce 函数,将得到以下一组键/值对: (one,2) (small,1) (step,1) (for,2) (man,1)(giant,1) (leap,1) (mankind,1) ​ HDFS在MapReduce任务处理过程中提供了文件操作和存储等支持, MapReduce在HDFS的基础上实现了任务的分发、跟踪、执行等工作,并收集结果

优秀的个人博客,低调大师

Android学习笔记——文件路径、内容Uri学习笔记[转]

一、URI 通用资源标志符(Universal Resource Identifier, 简称"URI")。 Uri代表要操作的数据,Android上可用的每种资源 - 图像、视频片段等都可以用Uri来表示。 URI一般由三部分组成: 访问资源的命名机制。 存放资源的主机名。 资源自身的名称,由路径表示。 Android的Uri由以下三部分组成: "content://"、数据的路径、标示ID(可选) 举些例子,如: 所有联系人的Uri: content://contacts/people 某个联系人的Uri: content://contacts/people/5 所有图片Uri: content://media/external 某个图片的Uri:content://media/external/images/media/4 二、内部保存 首先我们来看一下android是如何管理多媒体文件(音频、视频、图片)的信息。通过DDMS,我们在/data/data/com.android.providers.media下找到数据库文件 打开external.db文件进一步查看:在media表格下,可以看到文件路径(_data)和Uri的标示ID(_id)的对应关系。 三、相互转换 1.从URI获得文件路径 1 string myImageUrl = "content://media/external/images/media/***"; 2 Uri uri = Uri.parse(myImageUrl); 3 4 5 String[] proj = { MediaStore.Images.Media.DATA }; 6 Cursor actualimagecursor = this.ctx.managedQuery(uri,proj,null,null,null); 7 int actual_image_column_index = actualimagecursor.getColumnIndexOrThrow(MediaStore.Images.Media.DATA); 8 actualimagecursor.moveToFirst(); 9 10 11 String img_path = actualimagecursor.getString(actual_image_column_index); 12 File file = new File(img_path); 13 Uri fileUri = Uri.fromFile(file); 2.由文件路径得到URI 1 Uri mUri = Uri.parse("content://media/external/images/media"); 2 Uri mImageUri = null; 3 4 Cursor cursor = managedQuery( 5 MediaStore.Images.Media.EXTERNAL_CONTENT_URI, null, null, 6 null, MediaStore.Images.Media.DEFAULT_SORT_ORDER); 7 cursor.moveToFirst(); 8 9 while (!cursor.isAfterLast()) { 10 String data = cursor.getString(cursor 11 .getColumnIndex(MediaStore.MediaColumns.DATA)); 12 if (picPath.equals(data)) { 13 int ringtoneID = cursor.getInt(cursor 14 .getColumnIndex(MediaStore.MediaColumns._ID)); 15 mImageUri = Uri.withAppendedPath(mUri, "" 16 + ringtoneID); 17 break; 18 } 19 cursor.moveToNext(); 20 } from:http://www.cnblogs.com/lingyun1120/archive/2012/04/18/2455212.html 欢迎加群互相学习,共同进步。QQ群:iOS: 58099570 | Android: 572064792 | Nodejs:329118122 做人要厚道,转载请注明出处! 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/sunshine-anycall/p/3544106.html ,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册