首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10011篇文章
优秀的个人博客,低调大师

HTML 学习笔记

基本框架 <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <meta name="viewport" content="width=device-width, initial-scale=1.0"> <meta http-equiv="X-UA-Compatible" content="ie=edge"> <title>标题</title> </head> <body> </body> </html> 可打开 .html 文件,直接输入 html:5 调出 语句 一些规范: 标签使用小写,元素必须闭合 空元素要加斜杠以闭合 eg. <br /> 不使用语义化,所有样式都存放于 CSS 中,内容与样式分离 <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <meta name="viewport" content="width=device-width, initial-scale=1.0"> <meta http-equiv="X-UA-Compatible" content="ie=edge"> <title>标题</title> </head> <body> <h1>一级标题</h1> <h2>二级标题</h2> <p>段落</p> <!--换行符--> <br /> <!--分割线--> <hr /> <!--列表,可嵌套--> <!--有序列表--> <ol> <li>第一项</li> <li>第二项</li> </ol> <!--无序列表--> <ul> <li>第一项</li> <li>第二项</li> </ul> <!--链接--> <a href="https://www.google.com/">链接显示的文本</a> <!--链接到页面特定位置,使用 ID 特性--> <a href="#top">回到顶部</a> <p id="top">顶部</p> <!--链接到其他页面的特定位置--> <a href="http://wiki-power.com/#top">跳转到站外页面的某个位置</a> <!--图像--> <img src="/xx.png" alt="无法加载时的文字说明" /> <!--表格--> <table> <!--第一行--> <tr> <!--第一列--> <th></th> <!--第二列--> <th scope="col">周六</th> <!--第三列--> <th scope="col">周日</th> </tr> <!--第二行--> <tr> <th scope="row">数量</th> <td>120</td> <td>135</td> </tr> <!--第三行--> <tr> <th scope="row">收益</th> <!--跨列 colspan,跨行 rowspan--> <td colspan="2">500</td> </tr> </table> <!--表单,待补充--> <!--iframe,待补充--> <!--flash/视频/音频,待补充--> </body> </html> 参考与致谢 HTML 教程 | 菜鸟教程 HTML 30 分钟入门教程 HTML - head 头部浅析 文章作者:Power Lin 原文地址:https://wiki-power.com 版权声明:文章采用 CC BY-NC-SA 4.0 协议,转载请注明出处。

优秀的个人博客,低调大师

Flink学习笔记

Flink 基础 Flink特性 流式计算是大数据计算的痛点,第1代实时计算引擎Storm对Exactly Once 语义和窗口支持较弱,使用的场景有限且无法支持高吞吐计算;Spark Streaming 采用“微批处理”模拟流计算,在窗口设置很小的场景中有性能瓶颈,Spark 本身也在尝试连续执行模式(Continuous Processing),但进展缓慢。 Flink是一个低延迟、高吞吐的实时计算引擎,其利用分布式一致性快照实现检查点容错机制,并实现了更好的状态管理,Flink可在毫秒级的延迟下处理上亿次/秒的消息或者事件,同时提供了一个Exactly-once的一致性语义,保证了数据的正确性,使得Flink可以提供金融级的数据处理能力,总结其高级特性包括CSTW(CheckPoint,Statue,Time,windows) Flink和Spark对比 设计思路 Spark的技术理念是基于批来模拟流,微批处理的延时较高(无法优化到秒以下的数量级),且无法支持基于event_time的时间窗口做聚合逻辑。Flink和spark相反,它基于流计算来模拟批计算,更切合数据的生成方式,技术上有更好的扩展性。 状态管理 流处理任务要对数据进行统计,如Sum, Count, Min, Max,这些值是需要存储的,因为要不断更新,这些值或者变量就可以理解为一种状态,如果数据源是在读取Kafka, RocketMQ,可能要记录读取到什么位置,并记录Offset,这些Offset变量都是要计算的状态。 Flink提供了内置的状态管理,可以把这些状态存储在Flink内部,而不需要把它存储在外部系统,这样做的好处: ① 降低了计算引擎对外部系统的依赖以及部署,使运维更加简单; ② 对性能带来了极大的提升:如果通过外部去访问如Redis , HBase 需要网络及RPC资源,如果通过Flink内部去访问,只通过自身的进程去访问这些变量。 同时Flink会定期将这些状态做Checkpoint持久化,把Checkpoint存储到一个分布式的持久化系统中,比如HDFS,这样当Flink的任务出现任何故障时,它都会从最近的一次Checkpoint将整个流的状态进行恢复,然后继续运行它的流处理,对用户没有任何数据上的影响。 Flink 初探 设计架构 Flink是一个分层的架构系统,每一层所包含的组件都提供了特定的抽象,用来服务于上层组件,Flink的分层体现有四层,分别是Deploy层、core层、API层/Libraries层,其中Deploy层主要涉及的是Flink的部署模式及同资源调度组件的交互模式,Core层提供了支持Flink计算的全部核心实现,API层/Libraries层提供了Flink的API接口和基于API接口的特定应用的计算框架; Deploy层:该层主要涉及了Flink的部署模式,Flink支持多种部署模式:本地、集群(Standalone/YARN)、云(GCE/EC2),Standalone 部署模式与Spark类似; Runtime层:Runtime层提供了支持Flink计算的全部核心实现,比如:支持分布式Stream处理、Job Graph到Execution Graph的映射、调度 等,为上层API层提供基础服务。 API层:API层主要实现了面向无界Stream的流处理和面向Batch的批处理API,其中面向流处理对应DataStream API,面向批处理对应DataSet API。 Libraries层:该层也可以称为Flink应用框架层,根据API层的划分,在API层之上构建的满足特定应用的实时计算框架,也分别对应于面向流处理 和面向批处理两类。面向流处理支持:CEP(复杂事件处理)、SQL-like的操作(基于Table的关系操作);面向批处理支持:FlinkML(机器学习库)、Gelly(图处理)。 Flink on yarn Flink支持增量迭代,具有对迭代自行优化的功能,因此在on yarn上提交的任务性能略好于 Spark,Flink提供2种方式在yarn上提交任务:启动1个一直运行的 Yarn session(分离模式)和在 Yarn 上运行1个 Flink 任务(客户端模式); 分离模式:通过命令yarn-session.sh的启动方式本质上是在yarn集群上启动一个flink集群,由yarn预先给flink集群分配若干个container,在yarn的界面上只能看到一个Flink session with X TaskManagers的任务,并且只有一个Flink界面,可以从Yarn的Application Master链接进入; 客户端模式:通过命令bin/flink run -m yarn-cluster启动,每次发布1个任务,本质上给每个Flink任务启动了1个集群,yarn在任务发布时启动JobManager(对应Yarn的AM)和TaskManager,如果一个任务指定了n个TaksManager(-yn n),则会启动n+1个Container,其中一个是JobManager,发布m个应用,则有m个Flink界面,不同的任务不可能在一个Container(JVM)中,实现了资源隔离。 进入Flink的bin目录下运行./yarn-session.sh –help 查看帮助验证yarn是否成功配置,使用./yarn-session.sh –q 显示yarn所有nodeManager节点资源;部署On yarn模式的Flink只需要修改配置conf/flink-conf.yaml ,详细参数请参考官网:通用配置:Configuration,HA配置:High Availability (HA) 采用分离模式来启动Flink Yarn Session,提交后提示该yarn application成功提交到yarn并返回id,使用yarn application –kill application_id 来停止yarn上提交的任务; yarn-session.sh -n 3 -jm 700 -tm 700 -s 8 -nm FlinkOnYarnSession -d –st 可以直接提交自带的词频统计用例,验证on yarn模式是否配置成功: ~/bin/flinkrun-myarn-cluster-yn4-yjm2048-ytm2048~/flink/examples/batch/WordCount.jar 流程分析 分离模式:通过命令yarn-session.sh先启动集群,然后再提交作业,接着会向yarn申请一块空间后,资源永远保持不变。如果资源满了,下一个作业就无法提交,只能等到yarn中的其中一个作业执行完成后,释放了资源,下个作业才会正常提交。所有作业共享Dispatcher和ResourceManager;共享资源;适合规模小执行时间短的作业。 客户端模式: 通过命令bin/flink run -m yarn-cluster提交任务,每提交一个作业会根据自身的情况,都会单独向yarn申请资源,直到作业执行完成,一个作业的失败与否并不会影响下一个作业的正常提交和运行,适合规模大长时间运行的作业; DataStream DataStream是Flink的较低级API,用于进行数据的实时处理任务,可以将该编程模型分为DataSource、Transformation、Sink三个部分; DataSource 源是程序读取输入数据的位置,可以使用 StreamExecutionEnvironment.addSource(sourceFunction) 将源添加到程序,Flink 有许多预先实现的源函数,也可以通过实现 SourceFunction 方法自定义非并行源 ,或通过实现 ParallelSourceFunction 或扩展 RichParallelSourceFunction 自定义并行源。 有几个预定义的流数据源可从 StreamExecutionEnvironment 访问: 基于文件: readTextFile(path)#逐行读取文本文件(文件符合 TextInputFormat 格式),并作为字符串返回每一行。readFile(fileInputFormat,path)#按指定的文件输入格式(fileInputFormat)读取指定路径的文件。readFile(fileInputFormat,path,watchType,interval,pathFilter)#前两个方法的内部调用方法。根据给定文件格式(fileInputFormat)读取指定路径的文件。根据 watchType,定期监听路径下的新数据(FileProcessingMode.PROCESS_CONTINUOUSLY),或者处理当前在路径中的数据并退出(FileProcessingMode.PROCESS_ONCE),使用 pathFilter,可以进一步排除正在处理的文件。 基于Socket:socketTextStream 从 Socket 读取,元素可以用分隔符分隔。 基于集合: fromCollection(Seq)#用 Java.util.Collection 对象创建数据流,集合中的所有元素必须属于同一类型;fromCollection(Iterator)#用迭代器创建数据流。指定迭代器返回的元素的数据类型;fromElements(elements:_*)#从给定的对象序列创建数据流。所有对象必须属于同一类型;fromParallelCollection(SplittableIterator)#并行地从迭代器创建数据流。指定迭代器返回的元素的数据类型;generateSequence(from,to)#并行生成给定间隔的数字序列。 自定义:addSource 附加新的源函数。例如从 Apache Kafka 中读取,可以使用 addSource(new FlinkKafkaConsumer08<>(...))。请详细查看 连接器。 Transformation Transformation操作将1个或多个DataStream转换为新的DataStream,多个转换组合成复杂的数据流拓扑,如下图所示,DataStream会由不同的Transformation操作、转换、过滤、聚合成其他不同的流,从而完成业务要求; Map:DataStream -> DataStream,一个数据元生成一个新的数据元。将输入流的元素翻倍:dataStream.map { x => x * 2 } FlatMap:DataStream -> DataStream,一个数据元生成多个数据元(可以为0)。将句子分割为单词: dataStream.flatMap{str=>str.split("")} Filter:DataStream -> DataStream,每个数据元执行布尔函数,只保存函数返回 true 的数据元。过滤掉零值的过滤器: dataStream.filter{_!=0} KeyBy :DataStream -> KeyedStream,将流划分为不相交的分区。具有相同 Keys 的所有记录在同一分区。指定 key 的取值: dataStream.keyBy("someKey")//Keybyfield"someKey"dataStream.keyBy(0)//KeybythefirstelementofaTuple Reduce :KeyedStream -> DataStream,KeyedStream 元素滚动执行 Reduce。将当前数据元与最新的一个 Reduce 值组合作为新值发送。创建 key 的值求和:keyedStream.reduce { _ + _ } Aggregations :KeyedStream -> DataStream,应用于 KeyedStream 上的滚动聚合。 Window:KeyedStream -> WindowedStream,Windows 可以在已经分区的 KeyedStream 上定义。Windows 根据某些特征(例如,在最近5秒内到达的数据)对每个Keys中的数据进行分组。更多说明参考 Windows 或 译版。 dataStream.keyBy(0).window(TumblingEventTimeWindows.of(Time.seconds(5))) WindowAll :DataStream -> AllWindowedStream,Windows 也可以在 DataStream 上定义。在许多情况下,这是非并行转换。所有记录将收集在 windowAll 算子的一个任务中。 dataStream.windowAll(TumblingEventTimeWindows.of(Time.seconds(5))) Window Apply :WindowedStream -> DataStream 或 AllWindowedStream -> DataStream,将函数应用于整个窗口。一个对窗口数据求和: windowedStream.apply{WindowFunction}allWindowedStream.apply{AllWindowFunction} Window Reduce:WindowedStream -> DataStream,Reduce 函数应用于窗口并返回结果值。windowedStream.reduce { _ + _ } Aggregations on windows:WindowedStream -> DataStream,聚合窗口内容; Union :DataStream* -> DataStream,两个或多个数据流的合并,创建包含来自所有流的所有数据元的新流。如果将数据流与自身联合,则会在结果流中获取两次数据元。 dataStream.union(otherStream1,otherStream2,...) Window Join :DataStream,DataStream -> DataStream,Join 连接两个流,指定 Key 和窗口。 dataStream.join(otherStream).where(<keyselector>).equalTo(<keyselector>).window(TumblingEventTimeWindows.of(Time.seconds(3))).apply{...} Window CoGroup :DataStream,DataStream -> DataStream,CoGroup 连接两个流,指定 Key 和窗口。 dataStream.coGroup(otherStream).where(0).equalTo(1).window(TumblingEventTimeWindows.of(Time.seconds(3))).apply{} CoGroup 与 Join 的区别:CoGroup 会输出未匹配的数据,Join 只输出匹配的数据 Connect :DataStream,DataStream -> ConnectedStreams,连接两个有各自类型的数据流。允许两个流之间的状态共享。 someStream:DataStream[Int]=...otherStream:DataStream[String]=...valconnectedStreams=someStream.connect(otherStream) 可用于数据流关联配置流; CoMap, CoFlatMap :ConnectedStreams -> DataStream,作用域连接数据流(connected data stream)上的 map 和 flatMap: Split :DataStream -> SplitStream,将数据流拆分为两个或更多个流。 Select :SplitStream -> DataStream,从 SpliteStream 中选择一个流或多个流。 valeven=splitselect"even"valodd=splitselect"odd"valall=split.select("even","odd") Iterate :DataStream -> IterativeStream -> DataStream,将一个算子的输出重定向到某个先前的算子,在流中创建 feedback 循环。这对于定义不断更新模型的算法特别有用。以下代码以流开头并连续应用迭代体。大于0的数据元将被发送回 feedback,其余数据元将向下游转发。 Project:DataStream -> DataStream,作用于元组的转换,从元组中选择字段的子集。 DataStream<Tuple3<Integer,Double,String>>in=//[...]DataStream<Tuple2<String,Integer>>out=in.project(2,0); Sink Data Sink 消费 DataStream 并转发到文件,套接字,外部系统或打印到页面。Flink 带有各种内置输出格式,封装在 DataStreams 上的算子操作后面: writeAsText() / TextOutputFormat:按字符串顺序写入文件。通过调用每个元素的 toString() 方法获得字符串。 writeAsCsv(...) / CsvOutputFormat:将元组写为逗号分隔的形式写入文件。行和字段分隔符是可配置的。每个字段的值来自对象的 toString() 方法。 print() / printToErr():在标准输出/标准错误流上打印每个元素的 toString() 值。可以定义输出前缀,这有助于区分不同的打印调用。如果并行度大于1,输出也包含生成输出的任务的标识符。 writeUsingOutputFormat() / FileOutputFormat:自定义文件输出的方法和基类。支持自定义对象到字节的转换。 writeToSocket:将元素写入 Socket,使用 SerializationSchema 进行序列化。 addSink:调用自定义接收器函数。请详细查看 连接器。 DataStream 的 write*() 方法主要用于调试目的。他们没有参与 Flink checkpoint,这意味着这些函数通常具有至少一次的语义。刷新到目标系统的数据取决于 OutputFormat 的实现,并非所有发送到 OutputFormat 的数据都会立即显示在目标系统中。此外,在失败的情况下,这些记录可能会丢失。 要将流可靠、准确地传送到文件系统,请使用 flink-connector-filesystem。通过 .addSink(...) 方法的自定义实现,可以实现在 checkpoint 中精确一次的语义。 Time 流式数据处理最大的特点是数据具有时间属性特征,Flink根据时间产生的位置不同,将时间区分为三种概念:数据生成时间(Event_time)、事件接入时间(Ingestion_time)、事件处理时间(Processing_time),用户可以根据需要选择事件类型作为流式数据的时间属性,极大增强了数据处理的灵活性和准确性; Event_time:独立事件在产生它的设备上的发生时间,这个时间通常在到达Flink之前已经嵌入到生产数据中,因此时间顺序取决于事件产生的地方,和下游的数据处理系统的事件无关,需要在Flink中指定事件的时间属性或者设定时间提取器提取事件时间; Processing_time:指在操作算子计算过程中获取到的所在主机的时间,用户选择了Processing_time后,所有和时间相关的计算算子都直接使用其所在主机的系统时间,使用Processing_time的程序性能相对较高,延时相对较低,因为其所有操作不需要做任何时间上的对比和协调; Ingestion_time:指数据接入Flink系统的时间,依赖于Source Operator所在主机的系统时钟; 一般场景中选择event_time作为事件时间戳是最贴近生产的,但大多数情况下由于数据的延迟和乱序使用processing_time; Window窗口 Windows定义和分类 在流式计算中,数据持续不断的流入计算引擎,需要一个窗口限定计算范围,比如监控场景的近2分钟或者精准计算的每隔2分钟计算一次,窗口定义了该范围,辅助完成有界范围的数据处理; Flink的DataStream API将窗口抽象成独立的Operator,且支持很多窗口算子,每个窗口算子包含Window Assigner 、Windows Function、触发器、剔除器、时延设定等部分属性,其中Window Assigner 和 Windows Function是必须要指定的属性; Window Assigner用来决定某个元素被分配到哪个/哪些窗口中去;Trigger触发器决定了一个窗口何时能够被计算或清除,每个窗口都会拥有一个自己的Trigger; Evictor驱逐者在Trigger触发之后,在窗口被处理之前,Evictor(如果有Evictor的话)会用来剔除窗口中不需要的元素,相当于一个filter。 Flink支持多种窗口类型,按照驱动类型分为:时间驱动的Time Window(如每30秒钟)和数据驱动的Count Window(如每100个事件),按照窗口的滚动方式又可以分成:翻滚窗口(Tumbling Window,无重叠),滚动窗口(Sliding Window,有重叠)和会话窗口(Session Window,活动间隙),下图可以看出分类区别: Time Window 是根据时间对数据流进行分组的,且窗口机制和时间类型是完全解耦的,也就是说当需要改变时间类型时(三种时间)不需要更改窗口逻辑相关的代码,Time Window 中常见的即为Tumbling Time Window和Sliding Time Window; Count Window 是根据元素个数对数据流进行分组的,也包括Tumbling Count Window和Sliding Count Window; Windows实现 上图中的组件都位于一个算子(window operator)中,数据流源源不断地进入算子,每一个到达的元素都会被交给 WindowAssigner,WindowAssigner 会决定元素被放到哪个或哪些窗口(window),Window本身是一个ID标识符,其内部可能存储了一些元数据,如TimeWindow中有开始和结束时间,但是并不会存储窗口中的元素。窗口中的元素实际存储在 Key/Value State 中,key为Window,value为元素集合(或聚合值)。为了保证窗口的容错性,该实现依赖了 Flink 的 State 机制。 每一个窗口都拥有一个属于自己的 Trigger,Trigger上会有定时器,用来决定一个窗口何时能够被计算或清除,每当有元素加入到该窗口,或者之前注册的定时器超时了,那么Trigger都会被调用。Trigger的返回结果可以是 continue(不做任何操作),fire(处理窗口数据),purge(移除窗口和窗口中的数据),或者 fire + purge。一个Trigger的调用结果只是fire的话,那么会计算窗口并保留窗口原样,也就是说窗口中的数据仍然保留不变,等待下次Trigger fire的时候再次执行计算。一个窗口可以被重复计算多次知道它被 purge 了。在purge之前,窗口会一直占用着内存。 当Trigger fire了,窗口中的元素集合就会交给Evictor(如果指定了的话)。Evictor 主要用来遍历窗口中的元素列表,并决定最先进入窗口的多少个元素需要被移除。剩余的元素会交给用户指定的函数进行窗口的计算。如果没有 Evictor 的话,窗口中的所有元素会一起交给函数进行计算。 计算函数收到了窗口的元素(可能经过了 Evictor 的过滤),并计算出窗口的结果值,并发送给下游。窗口的结果值可以是一个也可以是多个。DataStream API 上可以接收不同类型的计算函数,包括预定义的sum(),min(),max(),还有 ReduceFunction,FoldFunction,还有WindowFunction。WindowFunction 是最通用的计算函数,其他的预定义的函数基本都是基于该函数实现的。 Flink 对于一些聚合类的窗口计算(如sum,min)做了优化,因为聚合类的计算不需要将窗口中的所有数据都保存下来,只需要保存一个result值就可以了。每个进入窗口的元素都会执行一次聚合函数并修改result值。这样可以大大降低内存的消耗并提升性能。但是如果用户定义了 Evictor,则不会启用对聚合窗口的优化,因为 Evictor 需要遍历窗口中的所有元素,必须要将窗口中所有元素都存下来。 Windows Function 在运用窗口计算时,Flink根据上有数据集是否是KeyedStream类型(数据是否按照Key分区),如果上游数据未分组则调用window()方法指定Windows Assigner,数据会根据Key在不同Task实例中并行计算,最后得出针对每个Key的统计结果,如果是Non-Keyed类型则调用WindowsAll()方法指定Windows Assigner,所有的数据都会在窗口算子中路由得到一个Task中计算,并得到全局统计结果; 定义完窗口分配器后,需要为每一个窗口指定计算逻辑,也就是Windows Function,Flink提供了四种类型Window Function,分别是ReduceFunction、AggreateFunction、FoldFunction、ProcessWindowFunction,其中FoldFunction将逐渐不再使用;四种类型有分为增量聚合操作(ReduceFunction、AggreateFunction、FoldFunction)和全量聚合操作(ProcessWindowFunction); 增量聚合函数计算性能高,占用存储空间少,因为其只需要维护窗口的中间结果状态值,不需要缓存原始数据;全量聚合函数使用代价相对高,性能较弱,因为算子需要缓存该窗口的接入数据,然后等窗口触发后对所有原始数据进行汇总计算,若接入数据量大或窗口时间长容易导致计算性能下降; ReduceFunction和AggreateFunction相似,但前者的输出类型和输入类型一致(如使用tuple的某个字段聚合),后者更加灵活地提供3个复写方法,add()定义数据的添加逻辑,getResult()定义根据Accumulator计算结果的逻辑,merge()方法定义合并accumulator的逻辑; ProcessWindowFunction可以支撑更复杂的算子,其支持基于窗口全部数据元素的结果计算,当算子需要窗口的元数据或状态数据,或者算子不支持运算交换律和结合律(统计所有元素的中位数和众数),需要该函数中的Context对象,Context类定义了Window的元数据及可以操作的Window的状态数据包括GlobalState和WindowState; 大部分情况下,需要增量计算和全量计算结合,因为增量计算虽然一定程度能够提升窗口性能,但灵活性不及ProcessWindowFunction,两者整合使用,既可以得到增量算子又可以得到窗口的元数据(窗口开始、终止时间等),比如在计算TOP N的场景中,分窗口计算完数据的计算后需要根据商品ID汇聚总的点击数; Watermark 由于网络或系统等外部因素影响,事件数据不能及时传输到Flink系统中,导致数据乱序、延迟等问题,因此需要一种机制能够控制数据处理的过程和进度;基于event_time时间的Windows创建后,具体如何确定属于该Windows中的数据元素已经全部到达,如果确定全部到达就可以对所有数据进行窗口计算操作(汇总、分组),如果数据没有全部到达,则继续等待该窗口中的数据,但是又不能无限期的等下去,需要有机制来保证一个特定的时间后,必须触发window去进行计算了,此时watermark发挥作用了,它表示当达到watermark后,在watermark之前的数据已经全部达到(即使后面还有延迟的数据);Watermark是处理EventTime 窗口计算提出的机制,本质上是一种时间戳,可以在读取 Source时候指定或者在transformation操作之前,用自定义的Watermark生成器按照需求指定; 正常情况下,流式数据的到达时间是有序的,如下图: 一般情况存在数据的乱序(out-of-order)和延迟(late element),此时水位线机制能表明该时间戳之前到当前水位线时间戳的数据已经全部达到,没有比它(水位线)更早的数据了,并触发计算; Flink中生成水位线的方式有两种:Periodic Watermarks(周期性)和Punctuated Watermarks,前者假设当前时间戳减去固定时间,所有数据都能达到,后者要在特定事件指示后触发生成水位线; 举例说明Periodic Watermarks 工作方式:当前window为10s,设想理想情况下消息都没有延迟,那么eventTime等于系统当前时间,假如设置watermark等于eventTime的时候,当watermark = 00:00:10的时候,就会触发w1的计算,这个时后因为消息都没有延迟,watermark之前的消息(00:00:00~00:00:10)都已经落入到window中,所以会计算window中全量的数据。那么假如有一条消息eventTime是00:00:01 应该属于w1,在00:00:11才到达,因为假设消息没有延迟,那么watermark等于当前时间,00:00:11,这个时候w1已经计算完毕,那么这条消息就会被丢弃,没有加入计算,这样就会出现问题。这是已经可以理解,代码中为什么要减去一个常量作为watermark,假设每次提取eventTime的时减去2s,那么当data1在00:00:11到达的时候,watermark是00:00:09这个时候,w1还没有触发计算,那么data1会被加入w1,这个时候计算完全没有问题,所以减去一个常量是为了对延时的消息进行容错; Punctuated Watermarks提供自定义条件生成水位,例如判断某个数据元素的当前状态或tuple类型的某个值,如果接入事件中状态为0则触发生成watermark,如果状态不为0则不触发,需要分别复写extractTimestamp和checkAndGetNextWatermark方法; Flink允许提前预定义数据的提取器Timestamp Extractors,在读取source时候定义提取时间戳; 延迟数据 基于Event_time的窗口计算虽然可以使用warterMark机制容忍部分延迟,但只能一定程度的缓解该问题,无法应对某些延迟特别严重的场景。Flink默认丢失延迟数据,但用户可以自定义延迟数据的处理方式,此时需要Allowed Lateness机制近数据的额外处理; DataStream API提供Allowed Lateness方法指定是否对迟到数据进行处理,参数是Time类型的时间间隔大小,代表允许的最大延迟时间,Flink的窗口计算中会将Window的Endtime加上该时间作为窗口最后释放的结束时间(P),当接入的数据中Event time未超过该时间(P),但WaterMark已经超过Window的Event_Time时直接触发窗口计算,若Event_Time超过了时间P,则做丢弃处理; 通常情况下可以使用sideOutputLateData 方法对迟到数据进行标记,然后使用getSideOutput()方法得到被标记的延迟数据,分析延迟原因; 多流合并/关联 合并 Connect:Flink 提供connect方法实现两个流或多个流的合并,合并后生成ConnectedStreams,会对两个流的数据应用不同的处理方法,并且双流之间可以共享状态(比如计数);ConnectedStream提供的map()和flatMap()需要定义CoMapFunction和CoFlatMapFunction分别处理输入的DataStream数据集; Union:Union算子主要实现两个或者多个输入流合并成一个数据集,需要保证两个流的格式一致,输出的流与输入完全一致; 关联 Flink支持窗口的多流关联,即在一个窗口上按照相同条件对多个输入流进行join操作,需要保证输入的Stream构建在相同的Windows上,且有相同类型的Key做为关联条件; 数据集inputStream1通过join方法形成JoinedStreams类型数据集,调用where()方法指定inputStream1数据集的key,调用equalTo()方法指定inputStream2对应关联的key,通过window()方法指定Window Assigner,最后通过apply()方法中传入用户自定义的JoinFunction或者FlatJoinFunction对输入数据元素进行窗口计算; Windows Join过程中所有的Join操作都是Inner Join类型,也就是必须满足相同窗口中,每个Stream都有Key,且key相同才能完成关联操作并输出结果; 状态和容错 有状态计算是Flink重要特性,其内部存储计算产生的中间结果并提供给后续的Function或算子使用,状态数据维系在本地存储中,可以是Flink的堆内存或者堆外内存中,也可以借助于第三方的存储介质,同storm+ redis / hbase模式相比,Flink完善的状态管理减少了对外部系统的依赖,减少维护成本; State和类型 Flink根据数据集是否根据key分区将状态分为Keyed State和 Operator State两种类型,Keyed State只能用于KeyedStream类型数据集对应的Function和Operation上,它是Operator State的特例; Operator State只和并行的算子实例绑定,和数据元素中的key无关,支持当算子实例并行度发生变化后自动重新分配状态数据; Keyed State和 Operator State均有两种形式,一种是托管状态,一种是原始状态,前者有Flink Runtime控制和管理状态数据并将状态数据转换成内存Hash tables 或RocksDB的对象存储,后者由算子自己管理数据结构,当触发CheckPoint后,Flink并不知道状态数据内部的数据结构,只是将数据转换成bytes数据存储在CheckPoint中,当从Checkpoint恢复任务时,算子自己反序列化出状态的数据结构; CheckPoint 和SavePoint Flink基于轻量级分布式快照算法提供了CheckPoint机制,分布式快照可以将同一时间点的Task/Operator状态数据全局统一快照处理,包括Keyed State和Operator State Savepoints是检查点的一种特殊实现,底层使用CheckPoint机制,Savepoint是用户以手工命令方式触发CheckPoint,并将结果持久化到指定的存储路径中,其主要目的是帮助用户在升级和维护集群过程中保存系统的状态数据,避免因停机运维或者升级到知道正常终止的应用数据状态无法恢复。 参考内容: https://www.cnblogs.com/leesf456/p/11136344.html https://blog.csdn.net/a_drjiaoda/article/details/89357916 https://www.jianshu.com/p/9e92cefa9d4e http://wuchong.me/blog/2018/11/18/flink-tips-watermarks-in-apache-flink-made-easy/ - END - 欢迎加入 大数据 |数仓技术交流群 。 进群方式:请加微信(微信号:dataclub_bigdata),回复:数据,通过审核会拉你进群。 (备注:行业-职位-城市) 福利时刻 01. 后台回复「数据」,即可领取大数据经典资料。 02.后台回复「转型」,即可传统数据仓库转型大数据必学资料。 03. 后台回复「加群」,或添加一哥微信ID:dataclub_bigdata拉您入群(大数据|数仓|分析)或领取资料。 !关注不迷路~ 各种福利、资源定期分享! 你点的每个 在看 ,我都认真当成了喜欢 本文分享自微信公众号 - 数据社(DataClub)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

STL笔记1

顺序容器有vector、list、deque。关联容器有map、set。容器类自动申请和释放内存,无需new和delete操作。但是需要连接STL各个容器的内存管理 STL六大组件:容器,算法,迭代器,仿函数、适配器和空间配置器容器:容纳一组元素的对象迭代器:提供一种访问容器中每一个元素的方法适配器:用来修饰容器,比如queue和stack,底层借助了deque。空间适配器:负责空间配置和管理 空间配置器:对象构造前的空间配置和对象析构后的空间释放,由负责。设计哲学如下:先system heap要求空间考虑多线程状态考虑内存不足时的应变措施考虑碎片问题 对于碎片问题,有双层及配置器:第一级直接使用allocate()调用malloc()、deallocate()调用free(),使用类似new_handler机制解决内存不足(抛出异常),配置无法满足的问题(如果在申请动态内存时找不到足够大的内存块,malloc 和new 将返回NULL 指针,宣告内存申请失败)。 第二级视情况使用不同的策略,当配置区块大于128bytes时,调用第一级配置器,当配置区块小于128bytes时,采用内存池的整理方式:配置器维护16个(128/8)自由链表,负责16种小型区块的此配置能力。内存池以malloc配置而得,如果内存不足转第一级配置器处理。 1、第一级配置器详解 2、第二级空间配置器详解 第二级空间配置器实际上是一个内存池,维护了16个自由链表。自由链表是一个指针数组,有点类似与hash桶,它的数组大小为16,每个数组元素代表所挂的区块大小,比如free list[0]代表下面挂的是8bytes的区块,free list[1]代表下面挂的是16bytes的区块…….依次类推,直到free _ list[15]代表下面挂的是128bytes的区块。 3、空间配置器存在的问题自由链表所挂区块都是8的整数倍,因此当我们需要非8倍数的区块,往往会导致浪费。 由于配置器的所有方法,成员都是静态的,那么他们就是存放在静态区。释放时机就是程序结束,这样子会导致自由链表一直占用内存,自己进程可以用,其他进程却用不了。 各种容器的特点和适用情况:vector:可变大小的数组,支持快速随机访问,在尾部之外的位置插入或删除元素会较慢。deque:双端队列,支持快速随机访问,在头尾位置插入删除速度快。list:双向链表,只支持双向顺序访问,在list任何位置插入/删除速度都很快。forward_list:单向链表,只支持单向顺序访问array:固定大小的数组支持随机访问,不能添加或者删除元素。string:和vector相似,随机访问快,在尾位置插入/删除元素快。

优秀的个人博客,低调大师

Scala Symbol笔记

Symbol This class provides a simple way to get unique objects for equal strings. Since symbols are interned, they can be compared using reference equality. symbols可以作为一种快速比较字符串的方式,如果字符串的值相同,则返回的symbol变量具有相同的引用地址。Symbol内部维护了一个字符串池。 object SymbolDemo { def main(args: Array[String]): Unit = { val s = 'nihao val n = 'nihao // return true println(s == n) } } Compare to Java 在Java中创建String实例有两种方式:1、直接给一个变量赋值;2、用new关键创建String对象;(下文记作:方式1 和 方式2) 方式1 我们都知道 “方式1” 每次都会创建一个新变量(所以for循环内拼接字符串不建议用 “+” 操作符,因为每次都会开辟一个新的内存)。但Java其实对该操作做了优化,在String类内部维护了一个字符串池,每次通过 “方式1” 创建String实例时,首先检查字符串池中有没有相同的字符串,如果字符串池中不存在该字符串,则将字符串放入字符串池中(此处开辟新内存),同时将字符串的引用地址赋值给变量;如果字符串池中存在该字符串,则直接将原有引用地址赋值给新变量。 当创建 “str1” 时,字符串池中没有 “Hello Str”,此时将 “Hello Str” 放入字符串池中,并将内存地址赋值给 “str1”。当创建 “str2”时,字符串池中已经存在 “Hello Str”,直接将原有内存地址赋值给 “str2”,所以 “str1 == str2” 返回 true 。 方式2 每次都会创建一个新的对象,当调用 intern() 时逻辑过程跟 “方式1” 相同。当字符串池中存在 “Hello Str”时直接返回内存地址,否则将 “Hello Str” 放入字符串池中,并返回内存地址。 public class Demo { public static void main(String[] args) { String str1 = "Hello Str"; String str2 = "Hello Str"; String str3 = new String("Hello Str"); // return true System.out.println(str1 == str2); // return false System.out.println(str1 == str3); // return true System.out.println(str1 == str3.intern()); } } Refer from: https://www.scala-lang.org/api/2.12.1/scala/Symbol.htmlhttps://stackoverflow.com/questions/3554362/purpose-of-scalas-symbol

优秀的个人博客,低调大师

leetCode 编程笔记

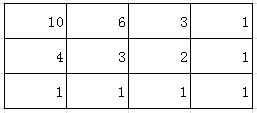
问:编写一个函数来查找字符串数组的最长公共前缀。如果不存在公共前缀,返回空字符串 “”。 示例输入:["flower", "flow", "flight"] 示例输出:"fl" 示例输入:["dog", "racecar", "car"] 示例输出:"" 解释:输入不存在公共前缀。 tips:所有的输入只包含小写字母 a-z 。 public class Solution { // 1. Method 1, start from the first one, compare prefix with next string, until end; // 2. Method 2, start from the first char, compare it with all string, and then the second char // I am using method 1 here public String longestCommonPrefix(String[] strs) { if (strs == null || strs.length == 0) { return ""; } String prefix = strs[0]; for(int i = 1; i < strs.length; i++) { int j = 0; while( j < strs[i].length() && j < prefix.length() && strs[i].charAt(j) == prefix.charAt(j)) { j++; } if( j == 0) { return ""; } prefix = prefix.substring(0, j); } return prefix; } } 有一个X x Y的网格,只能向右、向下移动,从(0, 0)走到(X - 1, Y - 1),中间某些位置有障碍物,打印一条路径(优化) 答:解题思路。 12.png 计算过程: 把底边和右边的每个格子标记为1 其余格子从右下角往右上角依次遍历 每个格子的值是其右边和下边格子值的和 遍历到右上角后求得最终结果 例如上图的结果为10。 这种解法依据的思路,由于每个格子只能向右或向下走,那么它的走法就由其右边格子的走法和下边格子的走法之和。而最下边和最右边的每个格子都只有唯一的走法。由此就能推导出其余格子的走法。 13.png tips:注意把握思想,把右下角右边和底部的边都设置为 1.之后向上推倒即可。最终结果是 10. 归并排序: //将有序数组a[]和b[]合并到c[]中 void MemeryArray(int a[], int n, int b[], int m, int c[]) { int i, j, k; i = j = k = 0; while (i < n && j < m) { if (a[i] < b[j]) c[k++] = a[i++]; else c[k++] = b[j++]; } // 当其中一个列表的所有数据都比另一个列表的所有数据小的时候,例如 i = n,j = 0; while (i < n) c[k++] = a[i++]; while (j < m) c[k++] = b[j++]; } tips: 解决了上面的合并有序数列问题,再来看归并排序,其的基本思路就是将数组分成二组A,B,如果这二组组内的数据都是有序的,那么就可以很方便的将这二组数据进行排序。如何让这二组组内数据有序了? 可以将A,B组各自再分成二组。依次类推,当分出来的小组只有一个数据时,可以认为这个小组组内已经达到了有序,然后再合并相邻的二个小组就可以了。这样通过先递归的分解数列,再合并数列就完成了归并排序。 构建 Hash 表的时候(散列函数的设计) f( key ) = key mod p ( p ≤ m ) mod ... 使用除留余数法的一个经验是,若散列表表长为m,通常p为小于或等于表 如何合理选取p值 使用除留余数法的一个经验是,若散列表表长为m,通常p为小于或等于表长(最好接近m)的最小质数或不包含小于20质因子的合数。 这句话怎么理解呢?要不这样吧,我再举个例子:某散列表的长度为100,散列函数H(k)=k%P,则P通常情况下最好选择哪个呢?A、91 B、93 C、97 D、99 实践证明,当P取小于哈希表长的最大质数时,产生的哈希函数较好。我选97,因为它是离长度值最近的最大质数。 可以盛最多水的容器 解法:我们可以循环遍历所有的两天边的乘积,取最大的值。 01.png 编程试题:求数列的和 使用语言:JAVA 参考正解代码如下: import java.util.*; class Main{ public static void main(String args[]){ int m; double sum,n; Scanner sc = new Scanner(System.in); while(sc.hasNext()){ n=sc.nextInt(); m=sc.nextInt(); sum=0; for(int i=0;i<m;i++){ sum=sum+n; n=Math.sqrt(n); } System.out.printf("%.2f",sum); System.out.println(); } } } 使用语言:C++ 参考正解代码如下: #include <math.h> #include <stdio.h> int main() { int n; double x, s; while (~scanf("%lf%d", &x, &n)) { for(s = 0.0; n--; x = sqrt(x)) s += x; printf("%.2lf\n", s); } return 0; } 使用语言:C# 参考正解代码如下: using System; namespace myApp { class Program { public static void Main() { string line; string[] p; int m, n; double nn; while (!string.IsNullOrEmpty(line = Console.ReadLine())) { p = line.Split(' '); n = int.Parse(p[0]); m = int.Parse(p[1]); double sum = 0; nn = n; for (int i = 0; i < m; i++) { sum = sum + nn; nn = Math.Sqrt(nn); } Console.WriteLine(string.Format("{0:f}", sum)); } } } } 使用语言:JavaScript 参考正解代码如下: var m; var sum,n; var sc while(sc = read_line()){ var arr = sc.split(' '); n=parseInt(arr[0]); m=parseInt(arr[1]); sum=0; for(var i=0;i<m;i++){ sum=sum+n; n=Math.sqrt(n); } print(sum.toFixed(2)); } 注意上面的三个代码有几点注意: 一:JavaScript 的输入和输出为 sc = read——line() 输出:print(); 精确到后两位:sum.toFixed(2) 二:C / C++ 精确到两位小数为:printf("%.2lf\n", s); 三:Java编写程序的时候精确到小数点后两位的写法:System.out.printf("%.2f",sum); 水仙花的求解 编程试题:水仙花 使用语言:JAVA 参考正解代码如下: import java.util.Scanner; public class Main{ public static void main(String args[]){ Scanner reader=new Scanner(System.in); while(reader.hasNextInt()){ int m=reader.nextInt(); int n=reader.nextInt(); if(100<=m&&m<=n&&n<=999){ int j=0; for(int i=m;i<=n;i++) { int geWei,shiWei,baiWei; baiWei=i/100; shiWei=(i-baiWei*100)/10; geWei=i-baiWei*100-shiWei*10; if(i==geWei*geWei*geWei+shiWei*shiWei*shiWei+baiWei*baiWei*baiWei) {j=j+1; if(j>1){ System.out.print(" "+i); } else{ System.out.print(i); } } } if(j==0){ System.out.print("no"); } System.out.println(); } } } } 使用语言:C++ 参考正解代码如下: #include<stdio.h> int main(){ int m,n; while(scanf("%d%d",&m,&n)!=EOF){ int t=0; for(int i=m; i<=n; i++){ int a=i/100; int b=i%100/10; int c=i%10; if(i==a*a*a+b*b*b+c*c*c && t==0){ printf("%d ",i); t++; } else if(i==a*a*a+b*b*b+c*c*c && t==1){ printf("%d ",i); } } if(t!=0){ printf("\n"); } if(t==0){ printf("no\n"); } } return 0; } 使用语言:C# 参考正解代码如下: using System; namespace myApp { class Program { public static void Main() { string line; string[] p; int m, n; while ((line = Console.ReadLine()) != null) { p = line.Split(' '); n = int.Parse(p[1]); m = int.Parse(p[0]); var j=0; for(var i=m;i<=n;i++) { int geWei,shiWei,baiWei; baiWei = (i/100); shiWei = ((i-baiWei*100)/10); geWei = i-baiWei*100-shiWei*10; if(i==geWei*geWei*geWei+shiWei*shiWei*shiWei+baiWei*baiWei*baiWei) { j=j+1; if(j>1) { Console.Write(" "+i); } else { Console.Write(i); } } } if(j==0) { Console.Write("no"); } Console.Write("\r\n"); } } } } 使用语言:JavaScript 参考正解代码如下: var sc; while(sc = read_line()){ var arr = sc.split(' '); n=parseInt(arr[1]); m=parseInt(arr[0]); if(100<=m&&m<=n&&n<=999){ var out = []; var j=0; for(var i=m;i<=n;i++) { var geWei,shiWei,baiWei; baiWei=parseInt(i/100); shiWei=parseInt((i-baiWei*100)/10); geWei=i-baiWei*100-shiWei*10; if(i==geWei*geWei*geWei+shiWei*shiWei*shiWei+baiWei*baiWei*baiWei) { j=j+1; if(j>1){ out.push(" "+i); } else{ out.push(i); } } } if(j==0){ out.push("no"); } print(out.join('')); } }

优秀的个人博客,低调大师

python基础笔记

python是跨平台的,它可以运行在Windows、Linux、Mac系统中,要开始学习python程序,首先需要把python安装到电脑上,从python的官网下载需要安装的软件版本,www.python.org,Windows系统下安装完毕后 通过cmd命令调取python,exit()退出 第一个python程序 通过python交互器执行程序,最后用exit()退出python,我们第一个python程序完成,唯一的缺憾是没有保存下来,下次运行还需要再输入一遍代码。 通过print()在括号中加入字符串就可以向屏幕上输出指定的文字 再python交互式命令行中写程序,好处是一下就能得到结果,坏处是没法保存,所以实际开发中我们会使用IDE或文本编辑器来写代码,写完后保存为一个python文件,这样程序就能反复运行,创建一个hello.py文件,并输入print("hello world") 进入指定目录通过python hello.py命令打开程序 变量 在python中变量的定义规则是 变量名只能是 字母、数字或下划线的任意组合 变量名的第一个字符不能是数字 python中的关键字不能声明为变量名 定义变量 name = "Zyy" 上面的代码声明了一个变量,变量名为: name,变量name的值为:"Zyy" python的输入和输出 用print()在括号中加入字符串,就可以向屏幕上输出指定的文字 print()可以接受多个字符串,用逗号","隔开,就可以连成一串,print()会依次打印每个字符串,遇到逗号会输出一个空格,print()也可以打印整数,或者计算结果,也可以组合使用。我刚整理了一套2018最新的0基础入门和进阶教程,无私分享,加Python学习q-u-n:(二二七),(四三五), (四五零)即可获取 print()输出 输入字符使用input() input()输入 python的数据类型 可以使用内部函数type()来查看数据的类型 字符串(str) 整数型(int) 布尔型(bool) 浮点型(float) 列表(list) 元组(tuple) 字典(dict) 集合(set) 空值(None) 运算符 算数运算 + 加法 - 减法 * 乘法 / 除(使用/除时,结果为float类型) //地板除(结果为整数int) % 取余数 ** 次幂(2**2 表示2的2次幂结果4) 比较运算,输出结果为bool == 等于 != 不等于(python3.0之后不可以写作<>) > 大于 < 小于 >= 大于等于 <=小于等于 赋值运算 = 简单的赋值运算符 +=加法赋值运算符 c+=a相当于c=c+a -=减法赋值运算符 c-=a相当于c=c-a *=乘法赋值运算符 c*=a相当于c=c*a /=除法赋值运算符 c/=a相当于c=c/a %=取余赋值运算符 c%=a相当于c=c%a 除此之外还有**= //= 逻辑运算符 and 布尔与 两者都是True才是True,否则为False or 布尔或 两者都是False才是False,否则为True not 布尔非 非True就是False,非False就是True 成员运算 in 如果在指定的序列找到值,则返回True,否则为False not in 如果在指定的序列中没有找到值,返回True,否则为False 身份运算 is is是判断两个标识符是不是引用一个对象 is not is not 是判断两个标识符是不是引用不同对象 判断语句和循环语句 python的语法比较简单,采用缩进方式;以#开头表示注释,批量注释使用'''。。。''',其他每一行都是一个语句,当语句以冒号:结尾时,缩进的语句视为代码块(不要tab键和空格混用,python是区分大小写的)。 判断语句 简单的if判断语句为 if 条件:#条件为True 执行结果 else: #否则 执行结果 if中还可以使用elif做更细致的判断,elif 是else if的缩写,if语句是从上往下判断,如果某个判断上是True,就会执行相应的结果,执行完毕后会忽略掉接下来的elif和else 循环语句for for...in....语句可以循环遍历list或tuple,又称作迭代,for x in ... 就是把每个元素带入变量x,然后执行缩进 循环语句while while循环是,只要条件满足,就不断循环,条件不满足时退出。在循环中,可以使用break和continue,需要配合if语句来使用,break是退出循环,continue是跳过当前循环

优秀的个人博客,低调大师

metaq学习笔记

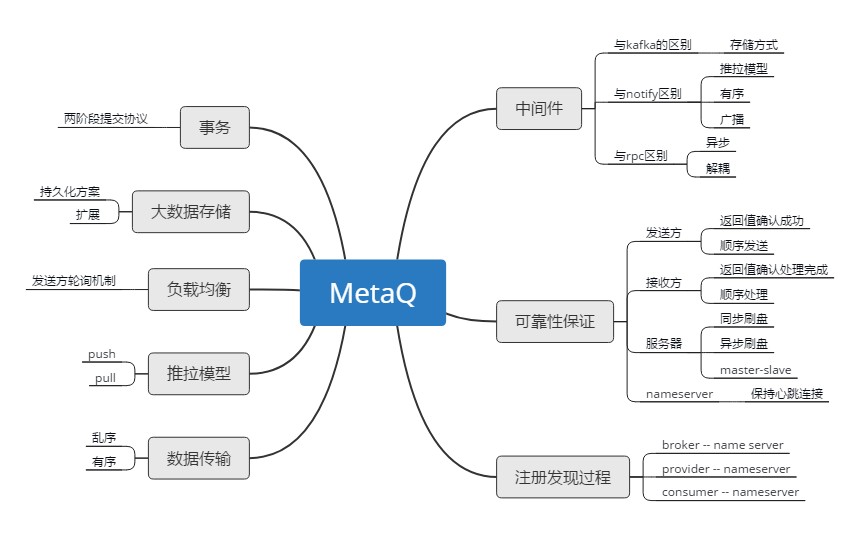
简介 metaq作为一款消息中间件,是支撑双11最为核心的系统之一,解耦收发双方,使得系统异步化,同时利用消息中间件堆积消息的功能,可以使得下游系统在可以慢慢消费消息,增强系统的缓冲能力,达到“削峰填谷”的目的 思维导图 在学习前先建立了思维导图,这样在学习过程中逐步深入,理解更加透彻 流程 发送端 1. UML图 2. 类 2.1 MetaProducer 发送端,可通过该类实例对象指定发送端分组(producerGroup),启动程序 2.2 Diamond 持久化配置中心,用于获取配置信息 2.3 MetaProducerImpl 用于初始化、注册埋点 2.4 DefaultMQProducerImpl 检查配置,注册发送方 2.5 MQClientInstance 若程序处于初始化状态,开启定时任务、拉取消息服务、负载平衡服务 2.6 MQClientAPIImpl 调用底层的 netty client 发送数据 metaq 的代码编写风格较为清爽,基本调用顺序为 MetaProducer --> MetaProducerImpl --> DefaultMQProducerImpl --> MQClientAPIImpl 3. 流程 具体流程见UML图中操作顺序,这里只列出重要的步骤 3.1 start 开启服务,程序入口 3.2 getConfig 获取配置信息,调用的是Diamond接口,本质是通过httpGet请求,使用netty从持久化配置中心下载配置文件,定位参数是指定的分组名(producerGroup) 3.3 addListener 添加监听,如果Diamond配置中心有数据变化,可获得新的数据 3.4 receive 通过设置AllowPushInterval变量,一分钟后再响应服务器配置变化 3.5 init 初始化,设置最大消息大小、埋点,这里设置的hook在最终发送消息时会依次调用 3.6 start DefaultMQProducerImpl 的 start 方法,根据serviceState决定执行流程;注意这里程序的入口包含参数 startFactory,boolean 类型判断是否需要开启服务,调用顺序为 DefaultMQProducerImpl.start( ) --> MQClientInstance.start( ) --> DefaultMQProducerImpl.start( ),只是在程序第二次调用时将标记位设为false 3.7 checkConfig 检查配置,判断分组名是否符合规范 3.8 start 开启MQClientInstance的服务,启动mqClientAPIImpl(底层netty通信客户端)、startScheduledTask(定时任务)、rebalanceService(负载均衡)、defaultMQProducerImpl 3.9 send 发送消息,此前需要对消息进行封装,指定消息主题topic、标签tag、内容body,其中通过topic即可实现收发双方的通信,接收方可以通过tag进行消息过滤 3.10 sendDefaultImpl 发送方法的默认实现,根据消息的发送方式选择不同的方法 3.11 sendKernelImpl 封装消息,执行之前设置的hook 3.1 sendMessage 调用底层的netty客户端发送消息,并返回SendResult 接收端 1. UML图 2. 类 2.1 MetaPushConsumer 接收方对象,程序入口,可订阅主题、设置监听、开启服务 2.2 DefaultMQPushConsumerImpl 默认实现方式,用于订阅和设置监听 2.3 MetaClientConfigChanged 用于获取配置 2.4 Diamond 调用接口,提供从持久化配置中心获取配置及设置监听的功能 2.5 MetaPushConsumerImpl 用于初始化服务 2.6 DefaultMQPushConusmerImpl 检查配置,开启服务 2.7 MQClientInstance 用于开启负载均衡、拉取消息等服务 可以看出,接收方和发送发的代码结构、类的命名方式极为相似,类的调用流程为 MetaPushConsumer --> DefaultMQPushConsumerImpl --> MetaPushConsumerImpl --> DefaultMQPushConsumerImpl --> MQClientInstance 3. 流程 具体流程见UML图中操作顺序,这里只列出重要的步骤 3.1 subscribe 程序入口,订阅相应主题,这里包含两个参数 3.1.1 topic:订阅主题,metaq发送发接收方通信的标识符,只要主题一致即可接收消息 3.1.2 subExpression:标记位tag,使用方式为“tag1 || tag2 || tag3”或者“*”,用于接收方过滤消息 3.2 registerMessageListener 注册消息监听,这里指定接受消息后的处理方式 3.3 getConfig 获取配置,与发送发方法一致 3.4 addListener 设置监听,当配置更新时获取新的信息 3.5 init 初始化,埋点 3.6 chechConfig 检查配置 3.7 mQClientAPIImpl.start( )、startScheduledtask( )、pullMessageService.start( )、rebalanceService.start( ) 与发送方类似 可以看出,metaq的代码编写风格极为规整,发送方接收方结构一致,方便阅读 broker broker的源代码暂无 源码解析 上述思维导图中,通过阅读源码,重点希望解决以下问题 1. 通讯建立 全网拓扑如下 各组件功能为: Name Server:注册服务器,需要将topic注册到上面,对应的操作是在metaq平台上发布topic(http://ons-api.taobao.net) Broker:存储转发服务器,每个broker需要与所有的name server建立长连接,从而获取topic信息;分为master和容灾的slaver Producer:消息发送方,需要与其中一个name server建立连接,获得路由信息,再与主题对应的broker建立长连接且定时向master发送心跳;消息由producer发送到master,再由master同步到所有broker Consumer:消息接收方,需要与其中一个name server建立连接,获得路由信息,再向提供服务的master、slaver建立长连接,具体接收消息时刻选择broker 这里需要建立的连接包括: Producer Consumer Name Server Broker Producer ---- 多对多 多对一 多对多 Consumer ---- 多对一 多对多 Name Server ---- 多对一 Broker ---- 1.1 producer <--> name server producer在初始化阶段需要与其中一个name server建立长连接,获得broker路由信息 1.1.1 获取name server 地址 源码提供了两种获取name server的地址,,默认地址为:http://jmenv.tbsite.net:8080/rocketmq/nsaddr MixAll //提供两种方式来指定获取name server地址:system environment variables 和 Java option //默认采用后者 public static String getWSAddr() { String wsDomainName = System.getProperty("rocketmq.namesrv.domain", DEFAULT_NAMESRV_ADDR_LOOKUP); String wsDomainSubgroup = System.getProperty("rocketmq.namesrv.domain.subgroup", "nsaddr"); String wsAddr = "http://" + wsDomainName + ":8080/rocketmq/" + wsDomainSubgroup; if (wsDomainName.indexOf(":") > 0) { wsAddr = "http://" + wsDomainName + "/rocketmq/" + wsDomainSubgroup; } return wsAddr; } producer在初始化时通过向固定地址发送httpGet请求,从而获得name server地址 TopAddressing public final String fetchNSAddr(boolean verbose, long timeoutMills) { String url = this.wsAddr; try { if (!UtilAll.isBlank(this.unitName)) { url = url + "-" + this.unitName + "?nofix=1"; } HttpTinyClient.HttpResult result = HttpTinyClient.httpGet(url, null, null, "UTF-8", timeoutMills); if (200 == result.code) { String responseStr = result.content; if (responseStr != null) { return clearNewLine(responseStr); } else { log.error("fetch nameserver address is null"); } } else { log.error("fetch nameserver address failed. statusCode=" + result.code); } } catch (IOException e) { if (verbose) { log.error("fetch name server address exception", e); } } if (verbose) { String errorMsg = "connect to " + url + " failed, maybe the domain name " + MixAll.getWSAddr() + " not bind in /etc/hosts"; errorMsg += FAQUrl.suggestTodo(FAQUrl.NAME_SERVER_ADDR_NOT_EXIST_URL); log.warn(errorMsg); } return null; } 1.1.2 与name server通信,获取主题路由信息,返回值为TopicRouteData,即主题对应的broker地址 在metaq中,所有请求的封装格式统一,区别在于请求码,最终通过netty client通信 MQClientAPIImpl public TopicRouteData getTopicRouteInfoFromNameServer(final String topic, final long timeoutMillis, boolean allowTopicNotExist) throws MQClientException, InterruptedException, RemotingTimeoutException, RemotingSendRequestException, RemotingConnectException { GetRouteInfoRequestHeader requestHeader = new GetRouteInfoRequestHeader(); requestHeader.setTopic(topic); RemotingCommand request = RemotingCommand.createRequestCommand(RequestCode.GET_ROUTEINTO_BY_TOPIC, requestHeader); RemotingCommand response = this.remotingClient.invokeSync(null, request, timeoutMillis); assert response != null; switch (response.getCode()) { case ResponseCode.TOPIC_NOT_EXIST: { if (allowTopicNotExist && !topic.equals(MixAll.DEFAULT_TOPIC)) { log.warn("get Topic [{}] RouteInfoFromNameServer is not exist value", topic); } break; } case ResponseCode.SUCCESS: { byte[] body = response.getBody(); if (body != null) { return TopicRouteData.decode(body, TopicRouteData.class); } } default: break; } throw new MQClientException(response.getCode(), response.getRemark()); } 1.2 producer <--> broker 遍历brokerAddrTable,对获取到的broker地址发送心跳sendHeartbeat建立长连接 MQClientInstance private void sendHeartbeatToAllBroker() { final HeartbeatData heartbeatData = this.prepareHeartbeatData(); final boolean producerEmpty = heartbeatData.getProducerDataSet().isEmpty(); final boolean consumerEmpty = heartbeatData.getConsumerDataSet().isEmpty(); if (producerEmpty && consumerEmpty) { log.warn("sending heartbeat, but no consumer and no producer"); return; } if (!this.brokerAddrTable.isEmpty()) { long times = this.sendHeartbeatTimesTotal.getAndIncrement(); Iterator<Entry<String, HashMap<Long, String>>> it = this.brokerAddrTable.entrySet().iterator(); while (it.hasNext()) { Entry<String, HashMap<Long, String>> entry = it.next(); String brokerName = entry.getKey(); HashMap<Long, String> oneTable = entry.getValue(); if (oneTable != null) { for (Map.Entry<Long, String> entry1 : oneTable.entrySet()) { Long id = entry1.getKey(); String addr = entry1.getValue(); if (addr != null) { if (consumerEmpty) { if (id != MixAll.MASTER_ID) continue; } try { int version = this.mQClientAPIImpl.sendHearbeat(addr, heartbeatData, 3000); if (!this.brokerVersionTable.containsKey(brokerName)) { this.brokerVersionTable.put(brokerName, new HashMap<String, Integer>(4)); } this.brokerVersionTable.get(brokerName).put(addr, version); if (times % 20 == 0) { log.info("send heart beat to broker[{} {} {}] success", brokerName, id, addr); log.info(heartbeatData.toString()); } } catch (Exception e) { if (this.isBrokerInNameServer(addr)) { log.info("send heart beat to broker[{} {} {}] failed", brokerName, id, addr); } else { log.info("send heart beat to broker[{} {} {}] exception, because the broker not up, forget it", brokerName, id, addr); } } } } } } } } consumer端连接建立过程和发送发相同,包含consumer <--> name server 和 consumer <--> broker,源码中consumer最终调用的是与producer相同的方法(MQClientInstance),这里就不再重复 broker需要与所有name server建立连接,从而获得topic信息,这里没有broker端源码,详细过程略 2. 存储方案 ata上不少文章都有对metaq物理存储的讲解,但这些内容大都混淆了metaq和kafka的存储结构,经过查阅相关资料,总结如下 2.1 kafka kafka采取的是分区+分段的方式,参考自Kafka设计解析(一)- Kafka背景及架构介绍 分区:partition,将物理broker映射为逻辑分区,实现了水平拓展,这样在传输时只需指定分区号即可,而broker可对应多个分区,这样就实现了分布式的存储 分段:segment,实际存储结构,包含数据文件和索引文件,顺序存储加快了速度,数据文件命名采用偏移量的方式,这样索引文件只需记录偏移量就可以二分查找快速定位 简单来说,kafka使用分区的方式实现了物理存储到逻辑分区的映射,能够轻松实现存储空间的扩展,而对用户透明;实际采用顺序存储的方式,用户只需指定索引(偏移量),就能快速查找;存储结构如下图所示 2.2 metaq metaq借鉴了kafka的思想(致敬kafka名作变形记),即一个topic对应一个顺序存储队列sequence,但是原有的分区的数量随着topic的增大而明显增大,本来高性能的顺序写文件会变成随机写,吞吐量会有较大的下降,因此在kafka的基础上进行了改进,取消 分区物理划分主题,而采用consume queue逻辑划分的方式,参考自阿里消息中间件架构演进之路:notify和metaq 2.1.1 commit log CommitLog属于物理队列,存储完整的消息数据,所有topic的消息都会写入到同一个CommitLog,这样就避免分区带来的影响,而划分主题的功能则交由consume queue实现 2.1.2 consume queue metaq对客户端暴露的主要是consume queue逻辑视图,提供队列访问接口,消费者通过指定consume queue的位点来读取消息,通过提交consume queue的位点来维护消费进度 2.1.3 改进 可以看出,kafka采用的是分区+分段的方式,即物理分区,分区划分主题、逻辑扩展,分段实际存储、索引查找;而metaq采取的是commitLog+consumeQueue,逻辑分区,即commitLog按照偏移量顺序存储,consumeQueue划分主题、索引查找,同时一个 broker对应多个队列,也可以达到存储拓展的功能;metaq的存储结构如下图所示 3. 推拉模式 3.1 pull 流程 程序初始化时启动pullMessageService服务,pullRequestQueue阻塞队列存储所有的pull任务,线程不停地从队列中获取新的任务并拉取消息 PullMessageService public void run() { log.info(this.getServiceName() + " service started"); while (!this.isStopped()) { try { PullRequest pullRequest = this.pullRequestQueue.take(); if (pullRequest != null) { this.pullMessage(pullRequest); } } catch (InterruptedException e) { } catch (Exception e) { log.error("Pull Message Service Run Method exception", e); } } log.info(this.getServiceName() + " service end"); } netty client 收到消息后,触发 processMessageReceived 方法,最终调用ConsumeConcurrentlyStatus status = this.messageListener.consumeMessage(msgs, content);这里的messageListener就是我们在main函数里设置的监听处理方法,同时在处理完一条消息后需要返回,只有确认正确处理才能继续传输,下面代码是处理和返回逻辑 ClientRemotingProcess private RemotingCommand consumeMessageDirectly(ChannelHandlerContext ctx, RemotingCommand request) throws RemotingCommandException { final RemotingCommand response = RemotingCommand.createResponseCommand(null); final ConsumeMessageDirectlyResultRequestHeader requestHeader = (ConsumeMessageDirectlyResultRequestHeader) request .decodeCommandCustomHeader(ConsumeMessageDirectlyResultRequestHeader.class); final MessageExt msg = MessageDecoder.decode(ByteBuffer.wrap(request.getBody())); ConsumeMessageDirectlyResult result = this.mqClientFactory.consumeMessageDirectly(msg, requestHeader.getConsumerGroup(), requestHeader.getBrokerName()); if (null != result) { response.setCode(ResponseCode.SUCCESS); response.setBody(result.encode()); } else { response.setCode(ResponseCode.SYSTEM_ERROR); response.setRemark(String.format("The Consumer Group <%s> not exist in this consumer", requestHeader.getConsumerGroup())); } return response; } 3.2 push 流程 metaq采用长轮询的方式模拟push,即在代码中将pull请求放入阻塞队列中,通过线程不停地从队列中take获取任务,达到push实时推送的功能;代码见3.1 pull 流程 4. 可靠性保证 4.1 producer可靠性保证 发送方与broker建立连接,使用netty传输消息message,同步传输确保消息能够到达服务器;源码如下,在得到response后需要调用processSendResponse方法对其进行分析,会根据response状态码更改responseCode,只有返回值的状态码正确才继续传输 private SendResult sendMessageSync( final String addr, final String brokerName, final Message msg, final long timeoutMillis, final RemotingCommand request ) throws RemotingException, MQBrokerException, InterruptedException { RemotingCommand response = this.remotingClient.invokeSync(addr, request, timeoutMillis); assert response != null; return this.processSendResponse(brokerName, msg, response); } 4.2 consumer可靠性保证 消费者顺序消费,只有在前一条消息成功后才会继续,如果持续失败(最多5次),则会将该条消息保存到本地,有后台进程继续尝试;具体消费流程见上述3.1 pull 流程 4.3 broker可靠性保证 notify服务器通过持久化保证消息的可靠性,但这样会带来io读写耗时大的问题,metaq对此进行了优化 4.3.1 master -- slaver 采用slaver的结构,一方面可以做到容灾,当master出现异常时可以自动顶替上去;另一方面,master--slaver的结构优化了读写操作,producer与master建立长连接,写操作进入master,再进行备份处理,而consumer与master和所有的slaver建立长连接,在读取时也可以对slaver的队列进行操作,优化了读取操作 4.3.2 持久化 metaq采用mmap(将一个文件或者其它对象映射到进程的地址空间,实现文件磁盘地址和进程虚拟地址空间中一段虚拟地址的一一对映关系)内存映射文件的方法,将消息持久到文件,提高了性能 4.4 总结 producer --> broker 、broker --> consumer 都依靠返回值的确认机制来保障,而broker端可靠性则依赖于本地文件持久化、容灾机制 5. 有序消息 metaq采用的是逻辑分区,即消息按序存储,但索引号是根据consumer queue决定,因此,只需保证producer单线程发送消息,且指定相同队列号即可保证消息的顺序性,源码中采用大小为1的semaphore信号量确保单线程传输 NettyRemotingAbstract public void invokeOnewayImpl(final Channel channel, final RemotingCommand request, final long timeoutMillis)throws InterruptedException, RemotingTooMuchRequestException, RemotingTimeoutException, RemotingSendRequestException { request.markOnewayRPC(); boolean acquired = this.semaphoreOneway.tryAcquire(timeoutMillis, TimeUnit.MILLISECONDS); if (acquired) { final SemaphoreReleaseOnlyOnce once = new SemaphoreReleaseOnlyOnce(this.semaphoreOneway); try { channel.writeAndFlush(request).addListener(new ChannelFutureListener() { @Override public void operationComplete(ChannelFuture f) throws Exception { once.release(); if (!f.isSuccess()) { log.warn("send a request command to channel <" + channel.remoteAddress() + "> failed."); } } }); } catch (Exception e) { once.release(); log.warn("write send a request command to channel <" + channel.remoteAddress() + "> failed."); throw new RemotingSendRequestException(RemotingHelper.parseChannelRemoteAddr(channel), e); } } else { if (timeoutMillis <= 0) { throw new RemotingTooMuchRequestException("invokeOnewayImpl invoke too fast"); } else { String info = String.format("invokeOnewayImpl tryAcquire semaphore timeout, %dms, waiting thread nums: %d semaphoreAsyncValue: %d", timeoutMillis, this.semaphoreOneway.getQueueLength(), this.semaphoreOneway.availablePermits() ); log.warn(info); throw new RemotingTimeoutException(info); } } } 6. 负载均衡 由于消费者只需根据topic从broker拉取消息即可,这里只讨论消生产者的负载均衡,broker端采用逻辑分区,在生产者看来所有的分区组成了分区列表依次使用,本质就是发送消息时合理选择分区的问题,metaq在初始化时从配置中心获取publish的topic对应的broker和分区列表,生产者在发送消息的时候必须选择一台broker上的一个分区来发送消息,默认的策略是一个轮询的路由规则,以此达到负载均衡的效果 代码演示 1. 发布topic 这里是将topic发布到name server上,便于构建TopicRouteData,为主题分配broker 2. 添加maven依赖 <dependency> <groupId>com.taobao.metaq.final</groupId> <artifactId>metaq-client</artifactId> <version>4.2.0.Final</version> </dependency> 3. Producer public class Producer { public static void main(String[] args) throws MQClientException, InterruptedException { MetaProducer producer = new MetaProducer("intern-metaq-demo-normal-consumer"); producer.start(); for (int i = 0; i < 1000; i++) { try { Message msg = new Message("intern-demo-sc",// topic "TagA",// tag ("sc " + i).getBytes()// body ); SendResult sendResult = producer.send(msg); System.out.println(sendResult.getSendStatus()); //Thread.sleep(1000); } catch (Exception e) { e.printStackTrace(); Thread.sleep(1000); } } producer.shutdown(); } } 4. Consumer public class Consumer { public static void main(String[] args) throws InterruptedException, MQClientException, MQClientException { MetaPushConsumer consumer = new MetaPushConsumer("CID-sc"); consumer.subscribe("intern-demo-sc", "*"); consumer.registerMessageListener(new MessageListenerConcurrently() { public ConsumeConcurrentlyStatus consumeMessage(List<MessageExt> msgs, //监听消息 ConsumeConcurrentlyContext context) { for (MessageExt msg : msgs) { //处理消息 System.out.println("ReceivedMsgId: " + new String(msg.getMsgId()) + " ReceivedMsgBody: " + new String(msg.getBody())); } return ConsumeConcurrentlyStatus.CONSUME_SUCCESS; } }); consumer.start(); System.out.println("Consumer Started."); } } 总结 1. 中间件与 rpc区别 1.1 业务逻辑层面 rpc:远程过程调用,强调的是解耦,将不同的功能模块拆分,但程序运行上还是作为一个整体,各个模块内部由不同平台根据具体业务场景开发,彼此之间通过rpc远程调用 中间件:解耦+异步,达到了1+1 > 2 的效果,遵循的主旨是最终一致性原则 参考自Notify和Metaq ——学习总结,以用户注册为例,需要的流程如下 在早期的业务处理流程中,会采用串行的执行方式,这样程序运行逻辑和业务处理流程相一致,但带来的问题很多,一方面程序总体耗时是单纯的线性叠加,另一方面,若果业务流程中某一环节出错,就不得不全部rollback,这样的代价太大;而中间件的着 眼点在于业务层面的解耦,仔细分析,我们可以发现该业务的主要逻辑是用户注册,而后续的准备支付宝,通知sns等操作虽然必须要完成,但却是不需要让用户等待的,经过分拆的流程如下 这样采取异步并行的方式来完成业务,极大的减少延迟,但带来的问题就是如果某一环节出错,整体流程不会因此rollback,比如用户注册成功但是却没有通过合法性验证,这样带来的就是数据上的危害,因此需要确保拆分模块运行的可靠性,经过中间件分 拆的最终模块如下 可以看出,中间件在业务逻辑优化的过程中起到了:1. 异步:解耦功能模块,并行执行缩短耗时;2. 可靠性保证:通过内部机制确保并行模块运行的可靠性 1.2 使用方式 在代码使用方面,hsf采用的是本地代理,最终通过invoke反射调用方法并返回结果;metaq则是producer -- broker、broker -- consumer 直接传输消息 2. metaq 与 notify 区别 最本质的区别就是notify采用push方式,broker不停地向consumer推送消息,这样确保了消息的可达性但却牺牲了服务器的性能,而metaq采用pull方式(pull模拟push),服务端只保存一定时间内的消息,提升了broker的性能,各方面对比见下表,可见在绝大 多数领域metaq性能更加优秀,因此notify正逐渐合并到metaq项目中 性能 metaq notify 消息推送方式 pull push 顺序性 局部有序 不提供 消息重复 部分避免 不提供 实时性 较高 高 消息堆积能力 强 较强 分布式 不支持 支持 过滤机制 单一 多种过滤机制 广播 支持 不支持 3. 削峰填谷 在metaq的介绍中,开始看到这个名词时感觉很高深,但随着深入学习,metaq的功能逐渐清晰起来。简单来说,削峰填谷是概括了中间件的功能,即异步并发,阻挡前端的数据洪峰,舒缓下游机器压力。试想这样的情景,在双11等业务场景下,用户瞬间的请 求量是爆炸式的,如果采用传统的同步顺序执行逻辑,所有的请求在没有完成前都需要挂载在服务端,服务器的压力可想而知,但采用中间件解耦业务逻辑,则用户请求在完成主体需求后可以直接退出,由中间件堆积消息并确保剩余业务的完成,这就可以容纳更多 的用户请求,因此,一个设计规范,运行良好的中间件系统对于公司业务的拓展骑着极为重要的作用 参考文章 http://www.jasongj.com/2015/03/10/KafkaColumn1/ https://www.atatech.org/articles/95456 https://www.atatech.org/articles/36160#5 https://www.atatech.org/articles/102577 https://www.atatech.org/articles/108048 https://www.atatech.org/articles/110786 https://www.cnblogs.com/huxiao-tee/p/4660352.html

优秀的个人博客,低调大师

JavaScript学习笔记

一:数组 //数组的构造的第一种方法 var arr=[1,2,3] var arr=[1,"2",true] //数组的构造的第二种方法 var arr1=new Array(5);//表示创建一个长度为5的数组 alert("arr1:"+arr1.length)//输出数组的长度 //数组的构造的第三种方法 var arr2=new Array(1,2,3); 二:方法的构造 //方法构造的第一种方法 function 方法名(参数列表){ 方法体; 返回值(可有可无) } //实例1 无参 function test(){ alert("aaa"); } //调用 test(); //实例2 有参 function test2(a,b){ var sum=a+b; alert(sum); } //调用 test(2,3); //方法构造的第二种方法 //匿名函数 var add=function(参数列表){ 方法体和返回值; } //实例 var add3= function(m,n){ alert(m+n); } //调用 add3(5,6); 三:js的全局变量和局部变量 **全局变量:在js页面标签中定义一个变量,这个变量在页面中的js部分都可以使用 - 在方法的外部使用,在方法的内部使用,在另一个Script标签使用 **局部变量:在方法内部定义一个变量,只能在方法内部使用 - 在方法外部调用这个变量会出错 【如果大家对程序员,web前端感兴趣,想要学习的,关注一下小编吧。加群:731771211。免费赠送web前端系统的学习资料!!前端学习必备公众号ID:mtbcxx】 四:js的重载 方法名相同,参数列表不同 function add1(a,b){ return (a+b); } function add2(a,b,c){ return (a+b+c); } add1(2,3); add2(2,3,4); 五:js的String对象 **创建String对象 ***var Str=""; **String属性 *** length 长度 **方法 (1)和html相关的方法 - bold();//加粗 var str1="sss"; document.write(Str1.blid); - fontcolor();//设置字符串的颜色 document.write(Str1.fontcolor("red")); - fontsize();//范围数字1-7,设置字体的大小 document.write(Str1.fontsize(2)); - link();//让字符串显示成超链接 document.write(Str1.link("hello.html")); - sub();//下标 document.write(Str1.sub()); //几次方 - sup();//上标 var str2="sss"; document.write(Str1.sup()); (2)与java相似的方法 var str1="abc"; var str2="def"; - concat();//连接字符串的方法 document.write(Str1.concat(str2));//abcdef - charAt();//返回指定位置的字符串 document.write(Str1.charAt(0));//a //字符串位置不存在,返回的是一个空的字符串 - indexOf();//返回字符串的位置 document.write(Str1.indexOf("a")); //字符串不存在返回-1 - split();//切分字符串,切分为数组 var str3="d-e-f"; var arr1=Str3.split("-"); document.write(Str3.length); - replace();//将指定得字符串替换成你将要换成的字符串 document.write(str1.replace("a","ttt")); - substr();和subString(); var str4="abcdefghuiop"; document.write(str4.sunstr(5,3));//fgh[5,3] //从第五位开始向后截取3位 document.write(str4.sunstrng(5,3));//fg //从第几位开始到第几位结束,但不包含最后一位[5,3) 六,js 的Array对象 **创建数组 -var arr1=[1,2,3]; -var arr2=new Array(3); -var arr3=new Array(1,32,3); **方法 -conact();//数组的连接 var arr1=[1,2,3]; var arr2=[4,5,6]; document.write(arr1.concat(arr2));//1,2,3,4,5,6 -join();//根据一个指定的字符进行数组分割 document.write(arr1.join("-"));//1-2-3 -push();//向数组的末尾添加一个或多个元素,返回新的数组长度 document.write(arr1.push("qwe"));//1,2,3,qwe document.write(arr1.push(arr2)); //把数组arr2添加到arr1之后,新的数组长度为四,因为是把数组arr2整体当成一个元素添加到了arr1中 -pop();//删除最后一个元素并返回 document.write(arr1.pop());//返回3 -reverse();//倒序 document.write(arr1.reverse()); 七.js的date对象 ** js获取当前时间 var date=new Date(); document.write(date);//未格式化的时间 document.write(date.toLocaleString());//格式化后的时间 -getFullYear();//获取当前的年份 document.write(date.getFullYear()); -getMonth();//获取当前月份,注意,获取的月份是(0-11) var month=date.getMonth(); document.write(month+1); -getDay();//获取当前的星期,注意,获取的星期是(0-6) -getDate();//获取当前的天 -getHours();//获取 当前的小时 -getMinutes();//获取当前的分钟 -getSeconds();//获取当前的秒 -getTime();//获取毫秒数,返回1970年1月1日至今的毫秒数 //应用场景 //使用毫秒数处理缓存http://www.baidu.com?毫秒数 八,js的Math对象 **数学 var mm=10.4; -cell(x);//向上舍入 document.write(Math.ceil(mm));//11 -floor(x);//向下舍入 document.write(Math.fllor(mm));//10 -round(x);//四舍五入 document.write(Math.round(mm));//10 -random();//得到随机数(0-1),是伪随机数 document.write(Math.random());//小数0.23131441 document.write(Math.floor(Math.random()*10));//0-9 -Max(x,y);//返回最大值 -pow(x,y);//返回x的y次方 九.js的全局函数 *由于不属于任何一个对象,直接写名称使用 -eval();//执行js代码 var str="alert('1234')"; eval(str);//1234 -encodeURI();// 对字符进行编码 var str="测试中文aaa1234"; var encode1=encodeURI(str); document.write(enocde1); -decodeURI();// 对字符进行解码 var encode2=encodeDRI(str); document.write(enocde2); -encodeURIComponent();// -decodeURIComponent();// -isNaN();//判断当前字符串是否为数字 var str="123";//false document.write(isNaN(str));//是数字返回false,如果不是数字返回的是true -parseInt();//类型转换 var str="123"; document.write(parseInt(str)+1);//124 十.js的重载 ** js的重载是否存在?不存在 **会调用最近的方法(面试题) (1)js里面不存在重载 (2)但是可以通过其他方法来模拟重载 arguments数组 十一.js的bom对象 ** broswer object model --对象 **navigater://获取浏览器的名称 document.write(navigater.appName); **screen:获取屏幕的信息 document.write(screen.height); document.write(screen.weight); **location:请求的URL地址 -href属性: ***获取请求的url地址 document.write(location.href); ***设置URL地址 一个页面中设置一个按钮,连接到另一个页面 鼠标点击事件 onclick="js的方法"; **history:请求URL的历史记录 // -到访问的上一个页面 function back(){ history.back(); //history.go(-1);//等同于back();方法 } -到访问的下一个页面 function next(){ history.forward(); //history.go(1);//等同于forward();方法 } **window(重点) *窗口对象 *顶层对象(所有的bom对象都是在window里面操作) **方法 -window.alert();//在窗口弹出一个页面 -window.confirm();//确认提示框 -var flag=window.confirm("是否删除"); alert(flag);//true -window.prompt();//输入对话框 window.prompt(text,defaulttext); window.prompt("显示输入提示","默认值"); window.prompt("请输入:","0"); -open();// window.open("连接到新的地址","","窗口特征,比如高和款等信息"); window.open("hello.html","","heigth=200,weight=300"); -close();//关闭窗口,兼容性比较差 -做定时器 ** setInterval("js代码",毫秒数); window.setInterval("alert('123')",3000);//每三秒就执行一次alert方法 ** setTimeout("js代码",毫秒数);//在指定的毫秒数之后去执行,但是只执行一次 window.setTimeout("alert('123')",3000);//在三秒之后执行alert,但是只执行一次 ** clearInterval();//清除setInterval的方法 var clear1=window.setInterval("alert('123')",3000);\ function clear1(){ clearInterval(clear1); } ** clearTimeout();//清除setTimeout的方法 var clear1=window.setTimeout("alert('123')",3000); function clear2(){ clearTimeout(clear1); } 十二.js的dom对象 * dom : document object model ** 文档 超文本标记文档 html xml ** 对象 提供了属性和方法 ** 模型 提供属性和方法操作超文本标记性文档 *** 可以使用js里面的dom对象进行操作 *** 想要对标记性超文本文档进行操作,首先需要对标记性超文本型文档里面所有的内容封装成对象 --需要把html里面的标签、属性、文本内容封装成对象 *** 解析过程 根据html的成绩结构,在内存中分配一个树形结构,需要把html中的每一个部分都封装成一个对象 -document对象:整个文档 -element对象:标签对象 -属性对象 -文本对象 --Node节点对象:这个对象时这些对象的父对象 *** 如果在这些对象里面找不到相对应的方法,这个时候需要到Node对象里面去找 * DHTML:是很多技术的简称 ** html:封装数据 ** css:使用属性和属性值设置样式 ** dom:操作html文档(标记性文档) ** JavaScript:专门指的是js的语法语句 十三.document对象:整个文档 * 表示整个文档 ** 常用方法 - write方法 (1)向页面输出变量值 document.write(str1); (2)向页面输出html代码 document.write(" "); - getElementById();//通过id得到标签,返回的是一个对象 var input=document.getElementById("nameid");//获取的是标签中的id值 //得到input里面的value值 alert(input.value); //向input里面设置一个value值 input.value="bbbb"; - getElementsByName();//通过标签的name属性值来得到标签,返回的是一个数组 var input=document.getElementsByName("name1"); alert(input.length); //遍历数组 for(var i=0;i var in=nput[i];//每次循环得到的是input的对象 alert(in.value);//得到每个input标签的value值 } - getElementsByTagName(“标签名称”);//返回的是一个数组 var in=document.getElementsByTagName("input");//传递的参数是标签名称 alert(in.length); //遍历集合,每次得一个input标签 for(var i=0;i var ip=in[i]; alert(ip.value); } *** 注意地方 //只有一个标签,这个标签智能通过name获取到,这个使用getElementByName返回的是一个数组 var in=document.getElementsByName("name1")[0]; alert(in.value); //通过input标签获取 var in=document.getElementsByName("input")[0]; alert(in.value); 十四.window弹窗案例 //实现s1的方法 //需要把num1和num2赋值到window页面 //跨页面操作 opener:创建这个窗口的窗口 得到window页面 function s1(num1,num2){ var pwin=window.opener;//得到window的页面 pwin.document.getElementById("nameId").value=num1; pwin.document.getElementById("pwdId").value=num2; window.close(); } 十五:元素对象(element) ** 要操作element对象,首先要获取element ** 方法 获取值 var input=document.getElementById("inid"); alert(input.getAttribute("value")); 设置值 input.setAttribute("参数名","haha"); input.setAttribute("class","haha"); 删除属性,但是不能删除value属性 input.removeAttribute("name"); ** 获取标签下面的子标签 childNodes()(兼容性差),getElementsByTagName()(兼容性高) 111 222 333 //获取ul标签 var ul1=document.getElementById("ulid"); //返回的是一个集合 //获取ul下面的子标签,兼容性差 var lis=ulid.childNodes; alert(lis.length); //获取ul下面的子标签,兼容性高 var lis1=ulid.getElementsByTagName("li") alert(lis.length); ** Node对象属性1 ***nodeName 节点名称 ***nodeType 节点类型 ***nodeValue 节点值 **标签节点对应的值 haha var span1=document.getElementById("spanid"); alert(span1.nodeName); // SPAN 大写标签名称 alert(span1.nodeType); // 1 alert(span1.nodeValue); // null //属性节点对应的值 var id1=spqn1.getAttributeNode("id"); alert(id1.nodeName); // id alert(id1.nodeType); // 2 alert(id1.nodeValue); // spanid //获取文本对象 var test1=span1.firstChild; //文本节点对应的值 alert(test1.nodeType); // 3 alert(test1.nodeName); // #text alert(test1.nodeValue); // haha ** Node对象属性2 111 222 333 var li1=document.getElementById("li1"); * 父节点 ul是li的父节点 parentNode:父节点 var ul1=li1.parentNode; //得到ul alert(ul1.id); * 子节点 li是ul的子节点 childNodes:得到所有的子节点,但是兼容性差 firstChild:第一个子节点 //获取ul的第一个子节点 //得到ul var ul1=document.getElementById("ulid"); var li1=ul1.firstChild; alert(li1.id); // li1 lastChild:最后一个子节点 //获取ul的最后一个子节点 //得到ul var ul1=document.getElementById("ulid"); var li4=ul1.lastChild; alert(li4.id); // li4 * 同辈对象 nextSibling:下一个兄弟节点 previousSibling:上一个兄弟节点 //获取li的id是li3的上个和先一个兄弟节点 var li=document.getElementById("li3"); alert(li.nextSibling.id); // li4 alert(li.previousSibling.id); // li2 十六.操作dom树 111 222 333 **apendChild方法 - 添加子节点到末尾,类似于剪切 //获取div2id的id var div2=document.getElementById("div2id"); //获取ulid的id var ul1=document.getElementById("ulid"); //把ulid中的li标签添加到div2中 ulid.apendChild(div2id); ** insertBefore(newNode,oldNode)方法 - 在么某个节点之前插入一个新的节点 //在 333 之前添加一个 000 111 222 333 function insert1(){ //获取li3的标签 var li3=document.getElementById("li3"); //获取ulid的标签 var ulid=document.getElementById("ulid"); //创建li标签 var li4=document.createElement("li"); //创建文本 var text4=document.createTextNode("000"); //把文本添加到ul标签里面(在 333 之前添加一个 000 ) ulid.insertBefore(li4,li3); } ** 不存在 insertAfter();方法 ** removeChild(); 删除节点 //删除li id="li3">333 //获取里标签 var li3=document.getElementById("li3"); //获取父节点 通过id获取或者是通过parentNode获取 var ulid=document.getElementById("ulid"); ulid.remove(li3); ** replaceChild(newNode,oldNode);//替换节点,通过父节点进行替换 //替换 333 为 444 111 222 333 function replace1(){ //获取li3的标签 var li3=document.getElementById("li3"); //创建新的标签 var li4=document.createElement("li"); //创建新的标签文本 var text4=document.createTextNode("444"); //把文本添加到标签 li4.apendChild(text4); //获取ulid标签 var uid=document.getElementById("ulid"); //执行替换方法 uid.replaceChild(li4,li3); } ** 赋值节点 ***cloneNode(boolean); 111 222 333 function cloneNode1(){ //复制 333 到div中 //获取ulid标签 var ulid=document.getElementById("ulid"); //执行复制方法 var copyul=ulid.cloneNode(true); //获取divv的标签 var divv=document.getElementById("divv"); //把复制的ul标签放在新的div里面 divv.apendChild(copyul); } ** 操作dom树的总结 * 获取节点使用方法 getElementById();//通过节点的id属性,查找相应的节点 getElementsByName();//通过节点的name属性,查找相应的节点 getElementsByTagName();//通过节点名称,查找相应的节点 *插入节点的方法 insertBefore方法: appendChild方法:添加到末尾 *删除方法 removeChild方法:通过父节点删除 * 替换节点的方法 replaceChild方法:通过父节点进行替换 十七.innerHTML属性 * 这个属性不是dom树的组成部分,但是大多数浏览器都支持的属性 第一个作用:获取文本的内容 haha //获取span标签 var span1=document.getElementById("spanid"); //获取标签的文本内容 alert(span1.innerHTML); 第二个作用:向标签里面设置内容(可以是HTML代码) haha //获取span标签 var span1=document.getElementById("spanid"); //获取div的标签 var div1=document.getElementById("divid"); //向div1标签里面设置内容(可以是HTML代码) div1.innerHTML=" hehehe "; * 案例 * 得到当前时间 var date =new date(); var d1= date.toLocaleString(); *需要每一秒获取时间 setInterval方法,定时器 *显示到页面上 每一秒向div写一次时间 * 使用innerHTML属性 function getd1(){ //获取当前时间 var date = new date(); //格式化当前时间 var d1 = date.toLocaleString(); //获取div的id var divv = document.getElementById("divid"); //添加到div中 divv.innerHTML = d1; } //使用定时器实现每一秒写一次时间 setInterval("getd1();",1000); 如果对你有帮助的话,可以点赞收藏哟! 【如果大家对程序员,web前端感兴趣,想要学习的,关注一下小编吧。加群:731771211。免费赠送web前端系统的学习资料!!前端学习必备公众号ID:mtbcxx】

优秀的个人博客,低调大师

Python进阶笔记

列表生成式 函数的参数类型 lambda函数 map, reduce, filter, sorted函数 eval, exec, join, zip函数 itertools中的函数 copy与deepcopy函数 模块 os、sys模块 迭代器 生成器 迭代器 参考网站: Python3教程: https://www.python-course.eu/python3_course.php Python之函数参数的使用:https://blog.csdn.net/jclian91/article/details/78309522 廖雪峰Python教程: https://www.liaoxuefeng.com/wiki/0014316089557264a6b348958f449949df42a6d3a2e542c000 Python之浅谈exec函数: https://blog.csdn.net/jclian91/article/details/80076512 Python官网的itertools说明: https://docs.python.org/3.6/library/itertools.html Python-copy()与deepcopy()区别: https://blog.csdn.net/qq_32907349/article/details/52190796 copy模块官网:https://docs.python.org/3.5/library/copy.html 列表生成式 列表生成式即List Comprehensions,是Python内置的非常简单却强大的可以用来创建list的生成式。一般是利用原有的数据结构来生成新的列表。 # 利用range()生成[1,2,...,9,10] list(range(1,11)) # 生成[1x1, 2x2, 3x3, ..., 10x10] [x * x for x in range(1, 11)] # 可以通过占位符_代表列表中的元素 [_*_ for _ in range(1,11)] # 筛选出仅偶数的平方, 在for循环后加上if判断语句 [x * x for x in range(1, 11) if x % 2 == 0] # 利用占位符简化 [_*_ for _ in range(1, 11) if not _%2] # 两层循环,三层循环,.... [m + n for m in 'ABC' for n in 'XYZ'] [x+y+z for x in 'ab' for y in 'cd' for z in 'ef'] # 遍历字典,生成列表 d = {'x': 'A', 'y': 'B', 'z': 'C' } [k + '=' + v for k, v in d.items()] 函数的参数类型 在Python中定义函数,其参数类型有: - 位置参数 - 默认参数 - 可变参数 - 关键字参数 这4种参数都可以一起使用,或者只用其中某些,但是请注意,参数定义的顺序必须是:位置参数、默认参数、可变参数和关键字参数。 可变参数以*开头,允许传入0个或任意个参数,这些可变参数在函数调用时自动组装为一个tuple。关键字参数以**开头,允许传入0个或任意个参数,这些可变参数在函数调用时自动组装为一个dict。若默认参数与可变参数放在一起,则接受完默认参数后,其后参数为可变参数。 位置参数 位置参数指定名称的必须放在未指定名称的后面 def person(name,age,city): s = "info: name=%s, age=%s, city=%s"%(name,age,city) return s print(person('Jack', 25, 'NY')) print(person(name='Jack', age=25, city='NY')) print(person('Jack', 25, city='NY')) # 下面的参数使用有误,位置参数指定名称的必须放在未指定名称的后面 print(person(name='Jack', 25, 'NY')) 默认参数 默认参数必须放在非默认参数的后面,可以该表默认参数的值 def person(name, city, age=18): s = "info: name=%s, age=%s, city=%s"%(name,age,city) return s print(person('Jack', 'NY')) print(person('Jack', 'NY', 20)) 可变参数 可变参数以*开头,允许传入0个或任意个参数,这些可变参数在函数调用时自动组装为一个tuple。函数参数的长度是可以变化的, 例如内置的sum, min, max等 def var_sum(*args): sum = 0 for i in args: sum += i return sum print(var_sum(1,2,3)) print(var_sum(1,2,3,4)) # 利用*号来分解参数 print(var_sum(*[1,2,3,4,5])) 若位置参数或默认参数与可变参数放在一起,则接受完位置参数或默认参数后,其后参数为可变参数。 def var_sum(a, *args): sum = 0 for i in args: sum += i print('a is %s, sum is %s'%(a,sum)) var_sum(1,2) var_sum(1,2,3) 关键字参数 关键字参数以**开头,允许传入0个或任意个参数,这些可变参数在函数调用时自动组装为一个dict。 def test_args(**kwargs): print('-'*20) for key in kwargs: print('key:', key, ',value:', kwargs[key]) print() test_args(a=1,b=2) test_args(a=1,b=2,c=3) lambda函数 lambda函数即为匿名函数,用关键字lambda表示,冒号(:)前面的为参数,后面为返回值,不用写return. 如: lambda x: x*x 匿名函数有个限制,就是只能有一个表达式,一般一行代码,不用写return,返回值就是该表达式的结果。 用匿名函数有个好处,因为函数没有名字,不必担心函数名冲突。此外,匿名函数也是一个函数对象,也可以把匿名函数赋值给一个变量,再利用变量来调用该函数,即函数也是变量,此为函数式编程(functional programming)思想。 f = lambda x: x*x f(5) map, reduce, filter, sorted函数 map函数 map()函数接收两个参数,一个是函数,一个是Iterable,map将传入的函数依次作用到序列的每个元素,并把结果作为新的Iterator返回。 可以直接作用于for循环的对象统称为可迭代对象:Iterable. 举例说明,比如我们有一个函数f(x)=x^2,要把这个函数作用在一个list [1, 2, 3, 4, 5, 6, 7, 8, 9]上,就可以用map()实现如下: # map函数: 一一映射 def f(x): return x * x r = map(f, [1, 2, 3, 4, 5, 6, 7, 8, 9]) list(r) # 利用lambda简化上述代码 list(map(lambda x: x*x, range(1, 11))) 再例如: 把list所有数字转为字符串: list(map(str, [1, 2, 3, 4, 5, 6, 7, 8, 9])) reduce函数 reduce把一个函数作用在一个序列[x1, x2, x3, …]上,这个函数必须接收两个参数,一个是函数,一个是Iterable. reduce把结果继续和序列的下一个元素做累积计算,其效果就是: reduce(f, [x1, x2, x3, x4]) = f(f(f(x1, x2), x3), x4) 比方说对一个序列求和,就可以用reduce实现: # 导入reduce, 这很重要 from functools import reduce def add(x, y): return x + y reduce(add, [1, 3, 5, 7, 9]) # 利用lambda函数简化 reduce(lambda x,y: x+y, range(1,10,2)) 作业: 利用reduce将序列[1, 3, 5, 7, 9]转化为整数13579. map, reduce的一个复杂例子: 将字符串列表[‘1’, ‘3’, ‘5’, ‘7’, ‘9’]转化为整数13579 from functools import reduce a = ['1', '3', '5', '7', '9'] t = reduce(lambda x,y: 10*x+y, map(int, a)) print(t) filter函数 Python内建的filter()函数用于过滤序列。 和map()类似,filter()也接收一个函数和一个序列。和map()不同的是,filter()把传入的函数依次作用于每个元素,然后根据返回值是True还是False决定保留还是丢弃该元素。 例如,在一个list中,删掉偶数,只保留奇数,可以这么写: list(filter(lambda x: x%2 == 1, [1, 2, 4, 5, 6, 9, 10, 15])) sorted函数 Python内置的sorted()函数就可以对list进行排序。 sorted([36, 5, -12, 9, -21]) 此外,sorted()函数还可以接收一个key函数来实现自定义的排序,例如按绝对值大小排序: sorted([36, 5, -12, 9, -21], key=abs) sorted(['bob', 'about', 'Zoo', 'Credit'], key=str.lower, reverse=True) 高阶函数,就是让函数的参数能够接收别的函数。map, reduce, filter, sorted都是高阶函数。 join, zip, eval, exec函数 join函数 Python中的join函数有两个,分别为: join()和os.path.join(),具体作用如下: join(): 连接字符串数组。将字符串、元组、列表中的元素以指定的字符(分隔符)连接生成一个新的字符串 os.path.join(): 将多个路径组合后返回 字符串中的join()函数的使用方法: ‘sep’.join(seq) sep:分隔符。可以为空。 seq:要连接的元素序列。 返回一个新的字符串。 seq = ['hello','good','boy','Dido'] print(' '.join(seq)) print('*'.join(seq)) zip函数 zip() 函数用于将可迭代的对象作为参数,将对象中对应的元素打包成一个个元组,然后返回由这些元组组成的列表。 如果各个迭代器的元素个数不一致,则返回列表长度与最短的对象相同,利用 * 号操作符,可以将元组解压为列表。 # basic use of zip x = [1, 2, 3] y = [4, 5, 6] zipped = zip(x, y) print(list(zipped)) # zip for loops for i,j in zip(x,y): print(i, "->", j) # unzip the list a = [(1,2,3), (3,4,5)] x2, y2, z2 = zip(*a) print(x2) print(y2) print(z2) # transpose a matrix mtx = [(1, 2), (3, 4), (5, 6)] print(list(zip(*mtx))) # clustering a data series into n-length groups idiom seq = range(1, 10) print(list(zip(*[iter(seq)]*3))) # dict and zip keys = ['spam', 'eggs'] vals = [42, 1729] d = dict(zip(keys, vals)) print(d) eval函数 eval函数用来计算字符串表达式的值 t = eval("23") print(t) print(type(t)) print(eval("(1+2)*(3+4)")) exec函数 exec()是Python的内置函数,不同于eval()函数只能执行计算数学表达式的结果的功能,exec()能够动态地执行复杂的Python代码,能够十分强大。 简单例子: # 执行简单的Python语句 i = 12 j = 13 exec("answer=i*j") print("Answer is %s"%answer) # 执行复杂的Python语句 func = "def fact(n):\n\treturn 1 if n==1 else n*fact(n-1)" exec(func) a = fact(5) print(a) exec函数还可以执行储存在其他文件中的Python代码,例如位于E盘的eg.txt,如下: def fact(n): if n==1: return 1 else: return n*fact(n-1) t = fact(6) print(t) 利用exec函数执行eg.txt中的代码: with open('E://eg.txt', 'r') as f: s = f.read() exec(s) 还可以在exec()函数中加入参数,参数的传递可以写成字典(dict)形式。 x = 10 expr = """ z = 30 sum = x + y + z print(sum) """ def func(): y = 20 exec(expr) exec(expr, {'x': 1, 'y': 2}) exec(expr, {'x': 1, 'y': 2}, {'y': 3, 'z': 4}) func() 输出结果为: 60 33 34 itertools模块中的函数 Python的内建模块itertools提供了非常有用的用于操作迭代对象的函数。 itertools模块提供的全部是处理迭代功能的函数,它们的返回值不是list,而是Iterator,只有用for循环迭代的时候才真正计算。 无穷迭代器 Iterator Arguments Results Example count() start, [step] start, start+step, start+2*step, … count(10) –> 10 11 12 13 14 … cycle() p p0, p1, … plast, p0, p1, … cycle(‘ABCD’) –> A B C D A B C D … repeat() elem [,n] elem, elem, elem, … endlessly or up to n times repeat(10, 3) –> 10 10 10 “有限”迭代器 Iterator Arguments Results Example accumulate() p [,func] p0, p0+p1, p0+p1+p2, … accumulate([1,2,3,4,5]) –> 1 3 6 10 15 chain() p, q, … p0, p1, … plast, q0, q1, … chain(‘ABC’, ‘DEF’) –> A B C D E F chain.from_iterable() iterable p0, p1, … plast, q0, q1, … chain.from_iterable([‘ABC’, ‘DEF’]) –> A B C D E F compress() data, selectors (d[0] if s[0]), (d[1] if s[1]), … compress(‘ABCDEF’, [1,0,1,0,1,1]) –> A C E F dropwhile() pred, seq seq[n], seq[n+1], starting when pred fails dropwhile(lambda x: x<5, [1,4,6,4,1]) –> 6 4 1 filterfalse() pred, seq elements of seq where pred(elem) is false filterfalse(lambda x: x%2, range(10)) –> 0 2 4 6 8 groupby() iterable[, keyfunc] sub-iterators grouped by value of keyfunc(v) islice() seq, [start,] stop [, step] elements from seq[start:stop:step] islice(‘ABCDEFG’, 2, None) –> C D E F G starmap() func, seq func(*seq[0]), func(*seq[1]), … starmap(pow, [(2,5), (3,2), (10,3)]) –> 32 9 1000 takewhile() pred, seq seq[0], seq[1], until pred fails takewhile(lambda x: x<5, [1,4,6,4,1]) –> 1 4 tee() it, n it1, it2, … itn splits one iterator into n zip_longest() p, q, … (p[0], q[0]), (p[1], q[1]), … zip_longest(‘ABCD’, ‘xy’, fillvalue=’-‘) –> Ax By C- D- groupby()函数 groupby()把迭代器中相邻的重复元素挑出来放在一起: for key, group in itertools.groupby('AAABBBCCAAA'): print(key, list(group)) A ['A', 'A', 'A'] B ['B', 'B', 'B'] C ['C', 'C'] A ['A', 'A', 'A'] 实际上挑选规则是通过函数完成的,只要作用于函数的两个元素返回的值相等,这两个元素就被认为是在一组的,而函数返回值作为组的key。 另一个例子 # 按身高归类 from itertools import * def height_class(h): if h>180: return 'tall' elif h<160: return 'short' else: return 'middle' friends = [191, 158, 159, 165, 170, 177, 181, 182, 190] for m,n in groupby(friends,key = height_class): print(m) print(list(n)) 作业: 对于一组身高的数据(list),利用上面代码给出的身高标准,将所以的tall, short, middle归为一类。注意与groupby()函数的区别。 tee()函数 把一个迭代器分为n个迭代器, 返回一个元组.默认是两个 from itertools import * a = "hello" c, d, e = tee(iter(a), 3) for i, j, k in zip(c, d, e): print(i, j, k) 组合生成器 Iterator Arguments Results product() p, q, … [repeat=1] cartesian product, equivalent to a nested for-loop permutations() p[, r] r-length tuples, all possible orderings, no repeated elements combinations() p, r r-length tuples, in sorted order, no repeated elements combinations_with_replacement() p, r r-length tuples, in sorted order, with repeated elements product(‘ABCD’, repeat=2) AA AB AC AD BA BB BC BD CA CB CC CD DA DB DC DD permutations(‘ABCD’, 2) AB AC AD BA BC BD CA CB CD DA DB DC combinations(‘ABCD’, 2) AB AC AD BC BD CD combinations_with_replacement(‘ABCD’, 2) AA AB AC AD BB BC BD CC CD DD copy与deepcopy函数 copy: 浅拷贝(shallow copy), deepcopy: 深拷贝(deep copy). 我们寻常意义的复制就是深复制,即将被复制对象完全再复制一遍作为独立的新个体单独存在。所以改变原有被复制对象不会对已经复制出来的新对象产生影响。 而浅复制并不会产生一个独立的对象单独存在,他只是将原有的数据块打上一个新标签,所以当其中一个标签被改变的时候,数据块就会发生变化,另一个标签也会随之改变。这就和我们寻常意义上的复制有所不同了。 对于简单的 object,用 shallow copy 和 deep copy 没区别 复杂的 object, 如 list 中套着 list 的情况,shallow copy 中的 子list,并未从原 object 真的「独立」出来。也就是说,如果你改变原 object 的子 list 中的一个元素,你的 copy 就会跟着一起变。这跟我们直觉上对「复制」的理解不同。 例子: from copy import copy, deepcopy #origin 里边有三个元素:1,2,[3, 4] origin = [1, 2, [3, 4]] # cop1为浅拷贝,cop2为深拷贝 cop1 = copy(origin) cop2 = deepcopy(origin) # cop1是否与cop2内容相同 print(cop1 == cop2) # cop1是否与cop2为同一个引用 print(cop1 is cop2) # 改变origin中嵌套列表中的元素 origin[2][0] = "hey" # 查看输出 print(origin) print(cop1) print(cop2) # 改变origin中嵌套列表中的元素 origin[1] = "hello" # 查看输出 print(origin) print(cop1) print(cop2) 输出结果: True False [1, 2, ['hey', 4]] [1, 2, ['hey', 4]] [1, 2, [3, 4]] [1, 'hello', ['hey', 4]] [1, 2, ['hey', 4]] [1, 2, [3, 4]] 模块 在Python中,一个Python文件就是一个模块。 模块让你能够有逻辑地组织你的 Python 代码段。 把相关的代码分配到一个模块里能让你的代码更好用,更易懂。 模块能定义函数,类和变量,模块里也能包含可执行的代码。 一个简单的模块例子: hello.py def say_hello(name): s = 'hello, %s!'%name return s 使用模块: import module from module import … import hello print(hello.say_hello("Lee")) from hello import say_hello print(say_hello("Jack")) os、sys模块 os模块 os模块包含普遍的操作系统功能。 os常用方法及属性 os.sep 可以取代操作系统特定的路径分隔符。windows下为 “\” os.name字符串指示你正在使用的平台。比如对于Windows,它是’nt’,而对于Linux/Unix用户,它是’posix’。 os.getcwd() 函数得到当前工作目录,即当前Python脚本工作的目录路径。 os.getenv() 获取一个环境变量,如果没有返回none os.putenv(key, value) 设置一个环境变量值 os.listdir(path) 返回指定目录下的所有文件和目录名。 os.remove(path) 函数用来删除一个文件。 os.system(command) 函数用来运行shell命令。 os.linesep 字符串给出当前平台使用的行终止符。例如,Windows使用’\r\n’,Linux使用’\n’而Mac使用’\r’。 os.curdir: 返回当前目录(’.’) os.chdir(dirname): 改变工作目录到dirname os.path常用方法: os.path.isfile()和os.path.isdir()函数分别检验给出的路径是一个文件还是目录。 os.path.existe()函数用来检验给出的路径是否真地存在 os.path.getsize(name):获得文件大小,如果name是目录返回0L os.path.abspath(name):获得绝对路径 os.path.normpath(path):规范path字符串形式 os.path.split(path) :将path分割成目录和文件名二元组返回。 os.path.splitext():分离文件名与扩展名 os.path.join(path,name):连接目录与文件名或目录;使用“\”连接 os.path.basename(path):返回文件名 os.path.dirname(path):返回文件路径 sys模块 sys模块提供了一系列有关Python运行环境的变量和函数。 sys模块的常用方法 sys.argv: 实现从终端向程序传递参数。 sys.exit([arg]): 程序中间的退出,arg=0为正常退出。 sys.getdefaultencoding(): 获取系统当前编码,一般默认为ascii。 sys.setdefaultencoding(): 设置系统默认编码,执行dir(sys)时不会看到这个方法,在解释器中执行不通过,可以先执行reload(sys),在执行 setdefaultencoding(‘utf8’),此时将系统默认编码设置为utf8。(见设置系统默认编码 ) sys.getfilesystemencoding(): 获取文件系统使用编码方式,Windows下返回’mbcs’,mac下返回’utf-8’. sys.path: 获取指定模块搜索路径的字符串集合,可以将写好的模块放在得到的某个路径下,就可以在程序中import时正确找到。 sys.platform: 获取当前系统平台。 sys.stdin, sys.stdout, sys.stderr: stdin , stdout , 以及stderr 变量包含与标准I/O 流对应的流对象. 如果需要更好地控制输出,而print 不能满足你的要求, 它们就是你所需要的. 你也可以替换它们, 这时候你就可以重定向输出和输入到其它设备( device ), 或者以非标准的方式处理它们 生成器 通过列表生成式,我们可以直接创建一个列表。但是,受到内存限制,列表容量肯定是有限的。而且,创建一个包含100万个元素的列表,不仅占用很大的存储空间,如果我们仅仅需要访问前面几个元素,那后面绝大多数元素占用的空间都白白浪费了。 所以,如果列表元素可以按照某种算法推算出来,那我们是否可以在循环的过程中不断推算出后续的元素呢?这样就不必创建完整的list,从而节省大量的空间。在Python中,这种一边循环一边计算的机制,称为生成器:generator。 创建generator的办法: 把一个列表生成式的[]改成() yield关键字 将列表的[]改成()的例子: # 列表生成式 L = [x * x for x in range(10)] print(type(L)) # 创建生成器 g = (x * x for x in range(10)) print(type(g)) # 获取下一个返回值 # 当没有更多元素时,会抛出StopIteration错误 print(next(g)) print(next(g)) print(next(g)) # for循环 for n in g: print(n) 通过yield创建生成器 # 普通方法生成斐波拉契数列 # 前几个斐波拉契数 def fib1(max): n, a, b = 0, 0, 1 while n < max: print(b) a, b = b, a + b n = n + 1 return 'done' fib1(6) # 通过yield创建生成器 # 注意yield的执行流程 def fib2(max): n, a, b = 0, 0, 1 while n < max: yield b a, b = b, a + b n = n + 1 return 'done' # 将生成器函数赋值给变量f f = fib2(6) print(type(f)) for n in f: print(n) generator和函数的执行流程不一样。函数是顺序执行,遇到return语句或者最后一行函数语句就返回。而变成generator的函数,在每次调用next()的时候执行,遇到yield语句返回,再次执行时从上次返回的yield语句处继续执行。 generator执行流程的理解: def odd(): print('step 1') yield 1 print('step 2') yield(3) print('step 3') yield(5) o = odd() print(next(o)) print(next(o)) print(next(o)) 迭代器 可以直接作用于for循环的数据类型有以下几种: 集合数据类型,如list、tuple、dict、set、str等; generator,包括生成器和带yield的generator function。 这些可以直接作用于for循环的对象统称为可迭代对象:==Iterable==。 可以使用isinstance()判断一个对象是否是Iterable对象: from collections import Iterable # 判断空列表是否为Iterable对象 # True print(isinstance([], Iterable)) # 判断空集合是否为Iterable对象 # True print(isinstance({}, Iterable)) # 判断字符是否为Iterable对象 # True print(isinstance('abc', Iterable)) # 判断生成器是否为Iterable对象 # True print(isinstance((x for x in range(10)), Iterable)) # 判断数字否为Iterable对象 # False print(isinstance(100, Iterable)) 可以被next()函数调用并不断返回下一个值的对象称为迭代器:Iterator。 可以使用isinstance()判断一个对象是否是Iterator对象: from collections import Iterator # 判断生成器是否为Iterator对象 # True print(isinstance((x for x in range(10)), Iterator)) # 判断空列表是否为Iterator对象 # False print(isinstance([], Iterator)) # 判断空集合是否为Iterator对象 # False print(isinstance({}, Iterator)) # 判断字符串是否为Iterator对象 # False print(isinstance('abc', Iterator)) 生成器都是Iterator对象,但list、dict、str虽然是Iterable,却不是Iterator。 把list、dict、str等Iterable变成Iterator可以使用iter()函数。

优秀的个人博客,低调大师

Java ClassLoader笔记

.java:保存需要执行的程序逻辑 编译  .class:保存java代码转换后的虚拟机指令要使用某个类时,虚拟机将加载.class文件,并创建对应的class对象。 将class文件加载到虚拟机的内存的过程叫类加载,过程如下:①加载Loading:利用class文件创建class对象②验证Verification:确保class文件的字节流中包含信息符合虚拟机要求,不会危害虚拟机本身安全,包括四种验证:文件格式验证;元数据验证;字节码验证;符号引用验证。③准备Preparation:为类变量(static修饰的变量)分配内存并设置该类变量的初始值0(static int i = 5;将只会把i初始化为0,5的值在初始化时赋值)。注意:智利不包含用final修饰的static,因为final在编译时就会分配了;这里不会为实例变量分配初始化,连变量会分配在方法区中,而实例变量是会随着对象一起分配到java堆中。④解析Resolution:将常量池中的符号引用替换为直接引用的过程。⑤初始化Initialization:执行静态初始化器和静态初始化成员变量。其中②③④被称为链接(Linking)过程。 符号引用:符号引用就是字符串,这个字符串包含足够的信息,以供实际使用时可以找到相应的位置。你比如说某个方法的符号引用,如:“java/io/PrintStream.println:(Ljava/lang/String;)V”。里面有类的信息,方法名,方法参数等信息。当第一次运行时,要根据字符串的内容,到该类的方法表中搜索这个方法。运行一次之后,符号引用会被替换为直接引用,下次就不用搜索了。直接引用就是偏移量,通过偏移量虚拟机可以直接在该类的内存区域中找到方法字节码的起始位置。直接引用:(1)直接指向目标的指针(比如,指向“类型”【Class对象】、类变量、类方法的直接引用可能是指向方法区的指针)(2)相对偏移量(比如,指向实例变量、实例方法的直接引用都是偏移量)(3)一个能间接定位到目标的句柄符号引用和直接引用的解释:https://www.zhihu.com/question/30300585https://blog.csdn.net/kkdelta/article/details/17752097启动(BootStrap)类加载器:加载JVM自身需要的类,是虚拟机自身的一部分,会将JAVA_HOME/lib下的核心类库或-Xbootclasspath参数指定路径下的jar包加载到内存中(出于安全考虑,bootstrap类加载器只加载包名为java、javax、sun等开头的类)。 扩展(Extension)类加载器:Sun公司实现的sum.misc.Luncher$ExtClassLoader类,是Luncher的静态内部类,负责加载JAVA_HOME/lib/ext下或由系统变量-Djava.ext.dir指定路径中的类库,开发者可以直接使用标准扩展类加载器。 系统(System)类加载器:也称应用程序加载器,指sun公司实现的sum.misc.Launcher$AppClassLoader。负责加载系统类路径java –classpath或 –Djava.class.path下的类库。一般情况下该类加载器是程序默认的类加载器,可以通过ClassLoader#getSystemClassLoader()方法获取到该类加载器。 双亲委派模式加载: 原理说明:一个类加载器收到了类加载请求,不会自己先加载,而是把这个请求委派给父类加载器去执行,如果父类还有父类则继续向上委托,最终达到顶层的启动类加载器,从启动类加载器开始进行加载,如果成功则返回,否则子加载器才会尝试自己加载。好处:①防止重复加载:如果父加载器已经加载了此类子加载器就没必要再加载了②安全考虑:如果运行时要加载一个java.lang.Integer类,会传递到启动类加载器,而启动类加载器发现在核心java API中有这个类已被加载,就直接返回已经加载了的Integer.class。再例如:要加载一个java.lang.FakeInteger,启动,扩展类加载器的路径下都没有该类,不会加载,会反向委托给系统类加载器加载,但是这样是不行的,因为java.lang是核心API包,需要访问权限,强制加载会报如下异常:java.lang.SecurityException: Prohibited package name: java.lang 类加载器常见类:通过上面的报错堆栈,可以看出几个ClassLoader相关类的关系如下: ①ClassLoader抽象类,定义了几个基本的类加载相关方法。②SecureClassLoader扩展了ClassLoader,新增了几个与使用相关的代码源和权限定义类验证。③URLClassLoader实现了ClassLoader没实现的几个方法,如findClass 等,有一个相关类URLClassPath负责获取Class字节码流,一般自定义类加载器继承URLClassLoader即可。这两个类的构造方法都有一个必填参数URL,该参数是一个路径,可能是文件或jar包,然后根据不同路径创建FileLoader或JarLoader或默认的Loader去加载相应路径下的class文件。 类加载器常用方法:①loadClass ②findClass③defineClass将byte字节流解析成JVM能够识别的Class对象,一般defineClass()方法通常与findClass()方法一起使用,一般在自定义类加载器时会覆盖ClassLoader类的findClass方法并编写加载规则,取的要加载类的字节码后转换成流,然后调用defineClass方法成成类的Class对象。④resolveClass(Class c)对Class对象进行解析。 ExtClassLoader和AppClassLoader他们都继承自URLClassLoader,是sun.misc.Launcher的静态内部类。类结构如下: 类加载器关系:①启动类加载器:由C++实现,没有父加载器②扩展类加载器(ExtClassLoader)由Java实现,父加载器为null③系统类加载器(AppClassLoader),父加载器为ExtClassLoader④自定义类加载器,父加载器为AppClassLoader 我们实现的自定义类加载器的父加载器都是AppClassLoader。Launcher类的源码如下: 如上:Launcher初始化时会创建ExtClassLoader,然后把ExtClassLoader作为parent入参构造AppClassLoader,然后将AppClassLoader默认设置为线程上下文加载器。而ExtClassLoader的parent为null,如下代码: 类与类加载器JVM中两个class对象是否是统一个类对象的必要条件为:①类的完整类名必须一致,包括包名②加载这个类的ClassLoader必须相同 实现自己的ClassLoaderpublic class MyClassLoader extends ClassLoader{ private String classPath; public MyClassLoader(){ super(); } public MyClassLoader(String classPath){ this.classPath = classPath; } public static void main(String[] args) { try { String path = "F:\\Learn\\Java\\workspace\\spring\\MyClassLoader\\bin"; MyClassLoader mcl1 = new MyClassLoader(path); // 自定义类加载器实例1 Class clazz1 = mcl1.findClass("com.classloader.MyClassLoader"); // 自定义类加载器加载自身类 MyClassLoader mcl2 = new MyClassLoader(path); // 自定义类加载器实例2 Class clazz2 = mcl2.findClass("com.classloader.MyClassLoader"); // 自定义类加载器加载自身类 Object inst = clazz1.newInstance(); //new一个自身类的实例 System.out.println(inst.toString()); System.out.println(mcl1.getClass().hashCode());//系统默认加载器加载的class类的实例是一样的 System.out.println(mcl2.getClass().hashCode());//系统默认加载器加载的class类的实例是一样的 System.out.println(clazz1.hashCode());//自定义加载器两次加载的class实例是不一样的(使用findClass) System.out.println(clazz2.hashCode());//自定义加载器两次加载的class实例是不一样的(使用findClass) System.out.println(mcl1.loadClass("com.classloader.MyClassLoader").hashCode());//loadClass和上面findClass的class对象实例是一样,因为loadClass时会先findClass,检查类是否已经被加载 System.out.println(mcl2.loadClass("com.classloader.MyClassLoader").hashCode());//loadClass和上面findClass的class对象实例是一样,因为loadClass时会先findClass,检查类是否已经被加载 System.out.println(mcl1.getSystemClassLoader());//系统类加载器是AppClassLoader System.out.println(mcl1.getParent());//自定义类加载器的父加载器是AppClassLoader System.out.println(mcl1.getSystemClassLoader().getParent());//系统类加载器的父加载器是ExtClassLoader System.out.println(mcl1.getSystemClassLoader().getParent().getParent());//ExtClassLoader的父加载器是null } catch (Exception e) { e.printStackTrace(); } } @Override public String toString() { return "MyClassLoader"; } public Class<?> findClass(String name) throws ClassNotFoundException { // 获取class文件的byte[]数组 try { byte[] classBytes = findClassBytes(name); if(null == classBytes){ throw new ClassNotFoundException(); } return defineClass(name,classBytes,0,classBytes.length); } catch (FileNotFoundException e) { e.printStackTrace(); } return null; } public byte[] findClassBytes(String className) throws FileNotFoundException { String path = this.classPath + File.separatorChar + className.replace('.', File.separatorChar) + ".class"; InputStream is = null; if(this.classPath.startsWith("http")){ try { /*URL u = new URL(path); is = u.openStream();*/ } catch (Exception e) { e.printStackTrace(); } }else{ is = new FileInputStream(path); } ByteArrayOutputStream baos = new ByteArrayOutputStream(); byte[] bs = new byte[1024]; int bytesNum = 0; try { while((bytesNum = is.read(bs)) != -1){ baos.write(bs,0,bytesNum); } return baos.toByteArray(); } catch (IOException e) { e.printStackTrace(); } finally{ try { is.close(); baos.close(); } catch (IOException e) { e.printStackTrace(); } } return null; } }

优秀的个人博客,低调大师

Python学习笔记

一:中文编码 1:指定编码 python-------》#!/usr/bin/python shell----------》#!/bin/bash 2:中文识别 # -*- coding: UTF-8 -*- 或 #coding=utf-8 3:多行语句 我们使用斜杠(/)将一行语句分成多行 如果是{},(),[]则直接可以进行换行 4.转义 \n表示换行、\t表示制表符、\\表示\、 如果有很多需要转义,则可使用r' ' ''' '''也可以表示换行 print('''line1 line2 line3''') 5:输出 print x,y print默认是换行的,如果再print末尾加个逗号“,”就回不换行 6.输入 shell:read -p "Please enter your age: " age python2:a = raw_input("请输入你的名字") python3:a = input("请输入你的名字") 二:变量和简单类型 python中数据类型分为5种:数字,字符串、列表、元组、字典 变量命名规则: python shell 文件名/模块名 小写,单词用“_”分割 ----->ad_stats.py 包名 小写,单词用“_”分割 类名 单词首字母大写----->ConfigUtil 全局变量名 大写字母,单词之间用_分割 ------->COLOR_WRITE 普通变量 小写字母,单词之间用_分割 ------->this_is_a_var 实例变量 以_开头,其他和普通变量一样 ----->_instance_var 普通函数 和普通变量一样-------------------->get_name() 2.1数字 整数:a=1 浮点数:a=1.234 2.2字符串 创:var1 = 'Hello World!' 查:print "var1[0]: ", var1[0] print "var2[1:5]: ", var2[1:5] 改:print "更新字符串 :- ", var1[:6] + 'Runoob!' rd()函数获取字符的整数表示,chr()函数把编码转换为对应的字符 占位符 'Hi, %s, you have $%d.' % ('Michael', 1000000) 如果你不太确定应该用什么,%s永远起作用,它会把任何数据类型转换为字符串 另外一种格式化字符串的方法是format(),他会将传入的参数依次替换{1},{2},{3}......,... 'Hello, {0}, 成绩提升了 {1:.1f}%'.format('小明', 17.125) 2.3布尔值 布尔值只有True、False两种值 2.4空值 2.5常量 10/3=3.3333 9/3=3.0 10//3=3 10%3=1 2.6除法 余数: >>> divmod(10,3) (3, 1) 四舍五入: >>> round(10/3,4) 3.0 >>> round(10.0/3,4) 3.3333 2.7数学函数与运算优先级 1.绝对值 abs(-10)=10 2.四舍五入 round(1.234)=1 三:高级特性 1.切片 L[0:3]表示,从索引0开始取,直到索引3为止,但不包括索引3。即索引0,1,2,正好是3个元素 如果第一个索引是0,还可以省略-------》L[:3] 前10个数,每两个取一个----------》L[:10:2] 所有数,每5个取一个--------------》L[::5] 什么都不写,只写[:]就可以原样复制一个list-----------》L[:] 2.迭代 3.列表生成器 [x * x for x in range(1, 11)]--------》[1, 4, 9, 16, 25, 36, 49, 64, 81, 100] 四:列表(List) list是一种有序的集合,可以随时添加和删除其中的元素。 list1 = ['Michael', 'Bob', 'Tracy'] 增:list1.append('adm')、 list1.insert(1,'jack') #插入元素到指定的位置 删:list1.pop(1) #不填则删除末尾元素 del list1[2] 查:list1[-1] 改:list1[1] ='Sarah',dellist1[2]; 附加:s = ['python','java', ['asp','php'],'scheme'],s[2][1] 五:元组 Python的元组与列表类似,不同之处在于元组的元素不能修改。 tup1 = ('physics', 'chemistry', 1997, 2000); 查:tup1[2] 较:cmp(tuple1, tuple2) 长:len(tup1) 六:字典 字典是另一种可变容器模型,且可存储任意类型对象。 d = {key1 : value1, key2 : value2 } 增: 删:del d['key1']; # 删除键是'key1'的条目 d.pop(key1) #删除对应的键值对 d.clear(); # 清空词典所有条目 del d; # 删除词典 查:d['key1'] d.get(key1)---------->value1 d..has_key(key1)-------->返回true或者false d.keys()-------------->返回所以键['key2','key1'] dict.values()---------->返回所以值[value1,value2] 改:d['key1']=value3 d.update(dict2)----------->将dict2添加到d后面 判:d.has_key(key1)---------->存在则返回true,否则为false 较:cmp(dict1, dict2) 长:len(dict) 七:运算符 python中运算符分为7种:1.算术运算符 2.比较(关系)运算符 3.赋值运算符 4.逻辑运算符 5.位运算符 6.成员运算符 7.身份运算符 1.算术运算符:+、-、*、%(求余)、**(次幂a**b)、//(取整) 2.比较运算符:==(比较是否相等)、!=、<>(比较两个数是否不相等)、>=、<= 3.赋值运算符:=、+=、-=、*=、/=(除法赋值运算符)、%=(取模赋值运算符)、**=(幂赋值运算符)、//=(取整运算符) 4.位运算符:&、|、^、 5.and(与)、or(或)、not 6.in(在)、not in(不在) 7.is(是)、is not(不是) 优先级 八:语句 python分为7种:条件语句,循环语句(while循环,for循环),break语句,continue循环语句,pass循环 python循环语句不用括号()括起来 1:条件语句 num = 5 if num == 3: # 判断num的值 print 'boss' elif num == 2:print 'user' elif num == 1:print 'worker' elif num < 0: # 值小于零时输出 print 'error' else:print 'roadman' # 条件均不成立时输出 2:循环语句 while...else循环 count = 0 while count < 5: print count, " is less than 5" count = count + 1 else: print count, " is not less than 5" for循环 for num in range(10,20): # 迭代 10 到 20 之间的数字 for i in range(2,num): # 根据因子迭代 if num%i == 0: # 确定第一个因子 j=num/i # 计算第二个因子 print '%d 等于 %d * %d' % (num,i,j) break # 跳出当前循环 else: # 循环的 else 部分 print num, '是一个质数' 九:函数 9.1函数规则 1:函数代码块以def关键字开头,后接函数标识符名称和圆括号() 2:任何传入参数和变量必须放在圆括号中间,圆括号中可以用于定义参数 3:函数第一行语句可以放文档字符串,用于存放函数说明 4:函数内容以冒号起始,并且缩进 #python函数 def printinfo( name, age ): "打印任何传入的字符串" print "Name: ", name; print "Age ", age; return; #调用printinfo函数 printinfo( age=50, name="miki" ); #shell函数 function RintedConfig(){ } 9.2函数参数 1.必备参数、2.关键字参数、3.默认参数、4.不定长参数 1:必备参数 必备参数须以正确的顺序传入函数。调用时的数量必须和声明时的一样。 2:关键字参数 使用关键字参数允许函数调用时参数的顺序与声明时不一致,因为 Python 解释器能够用参数名匹配参数值。 def printinfo( name, age ): printinfo( age=50, name="miki" ); 3:缺省参数 调用函数时,缺省参数的值如果没有传入,则被认为是默认值。 def printinfo( name, age = 35 ): printinfo( name="miki" ); 4:不定长参数 你可能需要一个函数能处理比当初声明时更多的参数。这些参数叫做不定长参数, def functionname([formal_args,] *var_args_tuple ): 加了星号(*)的变量名会存放所有未命名的变量参数 9.3高阶函数 1.map() map()可接受两个参数,一个是函数,一个是Iterable,map将传入的参数作用到序的每个元素,并把结果作为新的Iterable返回。 def f(x): return x*x map(f, [1,2,3,4]) >>[1,4,9,16] 2.return() return接收一个函数和两个参数,reduce把结果继续和序列的下一个元素做累积计算。 def f(x,y): return x+y >>map(f, [1,2,3,4]) >>25 3.filter() 用于过滤序列,filter()将元素作用于每个人元素,并根据返回值是true或者false来决定元素的去留。 def is_odd(n): return n % 2==1 filter(is_odd, [1,2,3,4,5,6]) 4.sorted() sorted()可将元素进行排序, def reversed_cmp(x, y): if x > y: return -1 if x < y: return 1 return 0 >>> sorted([36, 5, 12, 9, 21], reversed_cmp) [36, 21, 12, 9, 5] 9.4返回函数 高阶函数除了可以将函数作为参数,也可以将函数作为结果返回。 def lazy_sum(*args): def sum(): ax = 0 for n in args: ax = ax + n return ax return sum 9.5匿名函数 关键字lambda表示匿名函数, 匿名函数有个限制,就是只能使用一个表达式,返回值就是该表达式的结果。 map(lambda x: x*x, [1,2,3,4,5,6]) 使用匿名函数就不用担心名字冲突,同是匿名函数也是一个对象,可以将匿名函数作为参数。 ff = lambda x: x*x print ff(5) 9.6装饰器 有时候为了增强函数的功能,但又不改变函数的定义,这种在代码运行期间动态的增加函数的功能的方法叫装饰器。 def log(text): def decorator(func): def wrapper(*args, **kw): print('%s %s():' % (text, func.__name__)) return func(*args, **kw) return wrapper return decorator @log('execute') def now(): print('2015-3-25') >>> now() execute now(): 2015-3-25 9.7偏函数 十:模块 10.1作用域 有的函数和变量,我们仅仅希望在模块内使用,python中我们通过_前缀来实现。 正常的函数和变量都是被公开的,_xxx和__xxx这样的函数或变量就是非公开的(private),不应该被直接引用。 带下划线的函数,说明该函数不能根据 from * import来导入,明显在这个模块中你导入的还只是包,然后通过了这个导入的包去调用他内部存在的函数。 十一:面向对象编程 11.1类和实例 class Student (Object): class后面接的是类名,类名手写字母必须大写,紧接的是object,表示该类所继承的类,如果没有,则继承自object类。 class Student(object): def __init__(self, name, score): self.name = name self.score = score def print_score(self): print '%s: %s' % (self.name, self.score) 11.2访问限制 如果要让内部属性,不被外部访问,可以将属性的名称前面加两个下划线,python中变量以__开头的则为私有变量(private),只有内部可以访问,外部不能被访问。 外部要获取和改变,只能通过get和set方法来进行。 class Student(object): def __init__(self, name, score): self.__name = name self.__score = score def print_score(self): print '%s: %s' % (self.__name, self.__score) #外部直接获取 >>> bart = Student('Bart Simpson', 98) >>> bart.__name Traceback (most recent call last): File "<stdin>", line 1, in <module> AttributeError: 'Student' object has no attribute '__name'#必须使用getname和setname方法 class Student(object): ... def get_name(self): return self.__name def get_score(self): return self.__score 11.3基础多态 继承可以把父类的所有功能都直接拿过来,这样就不必重零做起,子类只需要新增自己特有的方法,也可以把父类不适合的方法覆盖重写; 有了继承,才能有多态。在调用类实例方法的时候,尽量把变量视作父类类型,这样,所有子类类型都可以正常被接收; 11.4获取对象信息 1.type() type可以判断一个变量、函数,类的类型。 2.isinstance() isinstance()判断的是一个对象是否是该类型本身,或者位于该类型的父继承链上。 3.dir() 如果要获得一个对象的所有属性和方法,可以使用dir()函数,它返回一个包含字符串的list。 11.5__slots__ 如果想对向前类进行限制只添加某几个属性,可以使用__slots__来进行限制。 __slots__只对当前类起作用,对继承的类不起作用。 class Student(object): __slots__=('name','age') s = Student() s.name = 'yaohong' s.age = 90 s.socre = 99 》》 s.socre = 99 AttributeError: 'Student' object has no attribute 'socre' 11.6@property Python内置的@property装饰器就是负责把一个方法变成属性调用的。 class Student(object): @property def birth(self): return self._birth @birth.setter def birth(self, value): self._birth = value @property def age(self): return 2014 - self._birth 11.7多继承 一个子类同时获得多个父类的所有功能。 由于Python允许使用多重继承,因此,Mixin就是一种常见的设计。 只允许单一继承的语言(如Java)不能使用Mixin的设计。 11.8定制类 __str__ class Student(object): def __init__(self, name): self.name = name def __str__(self): return self.name def __repr__(self): return self.name print Student('YAOHONG') print Student('YAOHONG') 11.9使用元类 十二:文件I/O 10.1打印到屏幕 print “”itnihao” 10.2读取输入 1.raw_input str = raw_input("请输入:"); print "你输入的内容是: ", str 2.input input可以接收一个函数表达式 str = input("请输入:"); print "你输入的内容是: ", str 3.open() file object = open(file_name [, access_mode][, buffering]) file_name:file_name变量是一个包含了你要访问的文件名称的字符串值。 access_mode:access_mode决定了打开文件的模式:只读,写入,追加等。所有可取值见如下的完全列表。这个参数是非强制的,默认文件访问模式为只读(r)。 buffering:如果buffering的值被设为0,就不会有寄存。如果buffering的值取1,访问文件时会寄存行。如果将buffering的值设为大于1的整数,表明了这就是的寄存区的缓冲大小。如果取负值,寄存区的缓冲大小则为系统默认。 4.close() close()方法刷新缓冲区里任何还没写入的信息,并关闭该文件,这之后便不能再进行写入。 5.write() write()方法可将任何字符串写入一个打开的文件 6.read() fo = open("foo.txt", "r+") str = fo.read(10); print "读取的字符串是 : ", str # 关闭打开的文件 fo.close() 7.rename() os.rename( "test1.txt", "test2.txt" ) 8.remove() os.remove("test2.txt") 8.mkdri() os.mkdir("test")在当前目录下创建新的test文件 9.chdir() os.chdir("/home/newdir")改变当前目录为/home/newdir目录 10.getcwd() os.getcwd()获取当前目录 11.rmdir() # 删除”/tmp/test”目录 os.rmdir( "/tmp/test" ) 十三:异常处理 1.捕获异常:try/except try: fh = open("testfile", "w") fh.write("这是一个测试文件,用于测试异常!!") except IOError: print "Error: 没有找到文件或读取文件失败" else: print "内容写入文件成功" fh.close() 2.try/finally try-finally 语句无论是否发生异常都将执行最后的代码。 3.触发异常 使用raise语句自己触发异常 def functionName( level ): if level < 1: raise Exception("Invalid level!", level) # 触发异常后,后面的代码就不会再执行 十四:file file使用open函数来创建 常用函数: file.close() file.flush() file.next() 返回下一行 file.read(size) 从文件读取指定的字节数,如果未给定或为负则读取所有。 file.readline(size) 读取整行 file.seek() 设置文件当前位置 file.tell() 返回文件当前位置 file.truncate() 截取文件,截取文件通过size指定 file.write() 将指定字符串写入文件 file.writelines() 向文件写入一个字符串列表 十五:OS os.access() 检测文件是否可读可写,文件是否存在,是否拥有执行权限 os.chdir(path) 切换到新的目录 os.chmod() 更改文件或者目录权限 os.chown() 更改文件所有者 os.close() 关闭文件 os.path.join('a','b')字符串拼接形成a/b os.system("ls") 执行shell命令,如assert os.system("rm -rf %s" % install_path) == 0, "卸载 失败" os.path.exists(BIN_PATH) 判断某个变量是否存在 os.unlink(path) 方法用于删除文件,如果文件是一个目录则返回一个错误。 os.remove() 删除文件 十六:open open(a.txt).read() 去取a.txt文件 十七:enumerate enumerate(list1) 枚举list,map等获取索引和元素for index, item in enumerate(list1): 十八:string str.strip("@") 去掉以@开头结尾的 str.startswith("#") 判断是否以#开头 十九:Python常见模块 python常见命令如下,点击链接查看详情 1.os 2.os.path 3.shutil 4.sys 5.inspect

优秀的个人博客,低调大师

Java synchronized笔记

1,造成线程安全问题的原因①存在线程间的共享数据(例如堆内存)②存在多个线程同时操作共享数据 2,锁类型互斥锁:(重量级锁)同一时刻有且仅有一个线程操作共享数据,当某个线程正在操作共享数据时,其他线程处于等待状态,必须等到该线程处理完后再进行.偏向锁:java1.6的新锁,针对多个线程竞争较少的场景,如果一个线程获得了锁,那么锁就进入偏向模式,对象头Mark Word里面的锁结构也编程偏向锁结构,这个线程再次请求锁时,无需做任何操作。轻量级锁:依据是大部分的锁,整个同步周期内不存在竞争,适用线程交替执行同步块的场景。自旋锁:依据是大部分线程持有锁的时间不会太长,因此自旋锁假设很快当前线程就会获得锁,所以虚拟机会让想要获取锁的线程执行几个空循环,如果循环完成后得到锁,则顺利进入。否则就会将线程在操作系统层面挂起。锁消除:指虚拟机在编译时消除无用的锁。 3,synchronized关键字作用:①保证同一时刻只有一个线程可以执行某个方法或者代码块②可以保证一个线程操作的共享数据变化能立即被其他线程所见(可替代volatile) 4,synchronized关键字用法:①修饰实例方法:作用于当前实例的方法(不包括静态方法),进入同步代码前要获取当前实例的锁(JVM通过常量池中的方法结构表的acc_synchronized标识区分一个方法是否是同步方法。)public class SynchronizedClass extends Thread{ static int share = 0; //①修饰实例方法 public synchronized void increase() { share++; } //②修饰静态方法 public synchronized static void increase4ClassLock(){ share++; } public void run() { for (int i = 0; i < 1000; i++) { increase(); } } /** * @param args */ public static void main(String[] args) { try { //场景1,t1,t2线程执行需要获得实例sc1的互斥锁 SynchronizedClass sc1 = new SynchronizedClass(); Thread t1 = new Thread(sc1); Thread t2 = new Thread(sc1); t1.start(); t2.start(); // join()方法:当前线程结束之后join()方法才返回,如果不试用join,打印出来的数据可能是0,1000,2000 t1.join(); t2.join(); System.out.println("scene1 share:" + share); //share = 0; //场景2,t3,t4线程执行各自获得实例sc2,sc3的锁,可能同时访问共享的静态资源share出现线程安全问题 SynchronizedClass sc2 = new SynchronizedClass(); SynchronizedClass sc3 = new SynchronizedClass(); Thread t3 = new Thread(sc2); Thread t4 = new Thread(sc3); t3.start(); t4.start(); t3.join(); t4.join(); System.out.println("scene2 share:" + share); } catch (Exception e) { e.printStackTrace(); } } }上面例子中:当前线程的锁是实例对象instance,java的线程同步锁可以是任意对象。注意:如果一个线程正在访问一个实例instance的synchronized方法A时,其他线程不能访问该实例的其他synchronized方法,因为一个对象实例只有一把锁,但其他线程可访问该实例的非synchronized方法。当然,如果其他线程要访问另外一个实例instance1的任何方法都是不受限制的,但是如果他们访问的是共享数据那么就会出问题,例如上面例子场景2中的静态变量share,这时候就需要使用②进行修饰。②修饰静态方法:作用于当前类对象,进入同步代码前要获得当前类(class)对象的锁。注意:两个线程可以同时分别访问static synchronized修饰的方法和non-static synchronized修饰的方法,因为他们一个是类对象的锁,一个是实例对象的锁,但是此时两个方法如果同时操作共享数据,也可能出现线程安全问题。例如上面例子中两个线程分别同时访问:increase4ClassLock()和increase()方法,就会出现线程安全问题。③修饰代码块:指定加锁对象,给指定对象家锁,进入同步代码块前要获取指定对象的锁(可以是类对象,也可以是实例对象),样例如下:static SynchronizedClass inst1 = new SynchronizedClass();public void increase2MethodBlock1(){ //使用实例锁,获取当前对象实例的锁,inst1也可用this(synchronized (inst1)) synchronized (inst1) { share++; } }public void increase2MethodBlock2(){ //使用类对象锁,获取当前class对象的锁 synchronized (SynchronizedClass.class) { share++; } } 5,sychronized实现原理jvm中synchronized的同步是通过管程(Monitor)实现的,在java的堆内存中,一个对象实例信息是按照如下方式存储的: 如上如所示结构,java对象头里面有锁信息,锁信息里有一个指向monitor(管程)对象的指针,管程对象在java虚拟机中是使用OjbectMonitor类实现的,类结构大致如下:ObjectMonitor(){_count = 0; //计数器_WaitSet = null; _EntryList = null;_owner = null; //指向拥有ObjectMonitor对象的线程……}说明:①多个线程进入同步代码时,会先进入_ EntryList队列,获取到monitor对象后修改owner指向为当前对象线程,计数器加1②线程调用wait()方法进入_WaitSet队列,owner置为空,count减1③当前线程执行完毕也会重置owner为空,复位变量 6,synchronized需要注意的点①可重入性一个线程在synchronized方法体内部可以调用另外一个synchronized方法,因为是同一个线程请求同一个锁。子类继承父类时,子类可通过重入锁调用父类的synchronized方法。②在线程sleep时调用interrupt方法会打断阻塞并抛出异常(对阻塞线程进行中断操作): ③处于非阻塞状态的线程需要我们手动进行中断检测并结束程序: 如上②和③两种情况(阻塞/和线程运行时中断中断的操作方法是不一样的[前者要捕捉异常,后者要手动判断中断状态并做中断处理]),可用下面代码兼顾两种场景: ④线程状态转换1)等待阻塞:等待阻塞(使用wait,notify/notifyAll方法进入和退出)(wait是Object类的方法)2)锁定阻塞:synchronized同步锁的获得和释放3)其他阻塞:sleep,join,IO操作等(sleep是Thread类的静态方法)4)就绪状态获得时间片就进入运行态,时间片用完或yield操作回到就绪状态5)sleep和wait的区别:sleep方法是Thread类的今天方法而wait是Object类的方法;sleep方法不会释放对象锁,sleep时其他线程任然不能访问同步块,而wait方法会释放对象锁。⑤线程中断操作对正在等待获取锁的synchronized方法或者代码块是不起作用的:一个正在等待锁的线程要么获得锁继续执行,要么继续等待。 ⑥wait(); notify(); notifyAll();方法必须放在synchronized中,否则会抛出IllegalMonitorStateException异常,因为:调用这几个方法必须获取管程(ObjectMonitor)对象,该对象放在对象头中,而synchronized可以获取到该对象。

优秀的个人博客,低调大师

Java学习笔记

代码点与代码单元 codePoint codeUnit 这里当字符串中有辅助字符时,代码点是两个代码单元,需要以下遍历: int cp = sentence.codePointAt(i); if(Character.isSupplementaryCodePoint(cp)){ i += 2; }else{ i++; } String类对象->不可变字符串 不能修改字符串中的字符:编译器可以将字符串共享,以此带来高效率。 当将一个字符串与一个非字符串的值进行拼接时,后者将被转换成字符串。 任何一个对象都可以转换成字符串。 检测两字符串是否相等,而不区分大小写,可用equalsIgnoreCase()方法 Java中允许一个数组长度为0,不同于null。 Java中的多维数组实际上是数组的数组。 一个对象变量实际上是一个对象指针。 用clone()方法获得对象的完整拷贝。 不能编写返回引用可变对象的访问器方法。 一个方法可以访问所属类的所有对象的私有数据。 Sytem类中有一个setOut方法是一个本地方法,不是用Java语言实现的,可以绕过Java的存取控制机制(out是final的)。 每个类都可以有一个main方法,可用来进行单元测试。 一个方法不能修改一个基本数据; 一个方法可以改变一个对象参数的状态; 一个方法不能让对象参数引用一个新的对象。 方法签名:方法名、参数类型。 初始化块机制 首先运行初始化快,然后才运行构造器的主体部分 静态域初始化块: static{ } 只能使用*导入一个包,如: import java.util.*; 静态导入:静态方法、静态域 import static java.lang.System.*; 如果没有指定public或private,那么这个部分(类、方法或者变量)可被同一个包中的所有方法访问 包作用域:默认情况下是包可见的 包密封:(package sealing) jar文件密封包 /*…/->文档注释 javadoc 标记+自由格式,其中标记由”@”开始 类设计技巧: 一定要将数据设为私有; 一定要对数据初始化; 不要在类中使用过多的基本数据类型; 不是所有的域都需要独立的域访问器和域更改器; 使用标准格式进行类的定义; 将职责过多的类进行分解; 类名和方法名要能够体现它们的职责。 Java中的所有继承都是公有继承:超类和子类 覆盖(Override)子类使用super调用超类的方法以及构造器 一个对象变量可以引用多种实际类型的现象叫做多态(Polymorphism) 运行能够自动地选择调用的适当方法的现象称为动态绑定 虚拟机预先为各个类创建了一个方法表 在覆盖一个方法时,子类方法不能低于超类方法的可见性 阻止继承的两种方法:final类的方法自动成为final方法(不包括域),final方法 内联的概念:如果一个方法没有被覆盖并且很短,编译器就能够对它进行优化处理。 强制类型转换: 只能在继承层次内进行类型转换; 在将超类转换成子类的前应使用instanceof进行检查 抽象类可以包含非抽象方法,也可以不包含抽象方法。抽象方法充当着占位的角色,具体实现在子类中。 抽象类不能被实例化 只有子类实现了所有抽象方法,子类才不是抽象的了 子类不能访问超类的私有域 hashcode: 由对象导出的一个整型值 每个对象都有一个默认的散列码,其值为对象的存储地址 两个相等的对象要求必须返回一个相等的散列码 自动打包规范要求boolean byte char=0:x; 四个基本的抽象流类:InputStream OutputStream Reader Writer(这些对象由其他方法返回) 注意流过滤器的运用 对象序列化:ObjectOutputstream ObjectInputStream writeObject() readObject() 类必须实现Serializable 接口 Java使用SHA编码的前8字节作为类的指纹 在序列化的过程中内存地址会被替换为序列号(唯一) 流类关注的是文件内容,而File类关注的是文件在磁盘上的存储 原文出处:后端技术杂谈 原文链接 转载请与作者联系,同时请务必标明文章原始出处和原文链接及本声明。

优秀的个人博客,低调大师

seaborn学习笔记

数据集的可视化展示对于分析数据集内在的规律有着很大帮助,因此我想着先学习一点matplotlib和seaborn的画图操作。 import numpy as np import pandas as pd import seaborn as sns from scipy import stats,integrate from sklearn.datasets import load_boston import matplotlib.pyplot as plt %matplotlib inline 加载数据集: Data = load_boston() X=pd.DataFrame(Data["data"]) y=pd.DataFrame(Data["target"]) Data=pd.DataFrame(np.hstack((X,y))) data=pd.read_csv("Desktop/creditcard.csv") iris_data = sns.load_dataset('iris') Data.columns=['a','b','c','d','e','f','g','h','i','j','k','l','m','n']#从数据集提取出的数据默认列名是自然数字,但是这样下面的lmplot函数会报错,所以手动修改了列名 print(list(Data))#打印列名 打印列名: ['a', 'b', 'c', 'd', 'e', 'f', 'g', 'h', 'i', 'j', 'k', 'l', 'm', 'n'] 中间取了几列做线性拟合: sns.lmplot(x='a',y='n',data=Data) sns.lmplot(x='c',y='n',data=Data) sns.lmplot(x='d',y='n',data=Data) sns.lmplot(x='sepal_length', y='sepal_width', hue='species', data=iris_data 可以看到,seaborn的lmpolt函数可以直接对数据线性回归拟合,还给出了置信区间。 lmplot中,参数x,y都是列名,data就是使用的数据集,hue是分类,按照鸢尾花的species类别进行分类 sns.distplot(data["V1"],bins=50,kde=False,fit=stats.gamma)#V1V2是数据集的列名 plt.show() sns.distplot(data["V2"],bins=20,kde=True,fit=stats.gamma)#bins为横轴等分数,kde是核分布 plt.show()#如果像lmplot一样不分开打印会导致图表重叠在一起``` 可视化结果如下: ![image](https://yqfile.alicdn.com/a0b90cef40f04e60263e7375698a9bb59ff935a4.png) ![image](https://yqfile.alicdn.com/a7c775b96a529532fb9c3d4ef53e39ee491cb90d.png) displot函数可以给出一个特征的分布情况,其中的fit=stats.gamma调用scipy中的计算高斯分布的函数,就是图上的黑色密度分布线。 类似的函数还有regplot。 sns.JointGrid(data=Data, x='e', y='n').plot(sns.regplot, sns.distplot)plt.show() 需要对图表设置样式,即加上.plot(sns.regplot, sns.distplot),否则不显示 这里默认选择了 seaborn 带有的回归拟合散点图以及单变量分布图 可视化结果为: ![image](https://yqfile.alicdn.com/5bd21401318668cf3ddda787eb5e909d7fb72d5b.png) JointGrid显示了回归结果的同时也给出边缘分布 多个特征相互比较,可以用PairGrid sns.PairGrid(data=iris_data,hue='species').map(plt.scatter) 同样也需要设置图表样式 结果的一部分: ![image](https://yqfile.alicdn.com/631f19541cdb4670ac74095096910c2100c968d7.png) 更多的还有像色彩矩阵,小提琴状图,箱形图等,不同的图适用不同的数据集。可视化的最终目的还是直观地了解数据集的嗯不状况,以方便做出最好的处理。

优秀的个人博客,低调大师

nignx笔记1

上图是单版的架构,理论一个tomcat并发就200到300,经过优化后的最多500,这很明显容量低,而且出现单点故障后应用服务就不可以访问了,比如tomcat,这样明显对于多并发是不行的。 那么如果我们从域名提供商哪里一个域名映射多个IP呢?下图,每一个IP对应一个tomcat,通过IP轮询来到底要访问哪个Tomcat,这样行不行呢?我们先看下面的图: 上图所示,这样虽然解决了单点故障,容量也提升了,但是又出现问题了,1.DNS服务器完全暴露在外网,造成不安全。2入口不集中。3.如果其中一个Tomcat挂了,那么用户通过对应的IP进入了那个坏的tomcat,还是不可以访问,这样很明显不行。 那么如果我们把用户的请求入口,集中管理起来,那么我们把所有用户的请求入口集中在nignx下,用nignx的反向代理/负载均衡的典型算法,如轮询或随机将请求分发到不同的Tomcat下,这样不就解决上面的问题了吗?如下图: 那么上图这个架构就没事了吗?明显出现了第一个架构出现的问题,还是出现单点故障了,因为如果nignx挂了,那么所有的应用就不能访问了,这样明显也是不可取的。那么我们就把nignx双机热备份,通过心跳检测,检测负载均衡服务器,如果一个挂了,立马切换虚拟IP到另外一台nignx备份机。如下图: 那么问题又来了,其实只有一台nignx在工作,另外一台只是待命,只有一台挂了,另外一台才工作,这明显利用率低。还有就是请求分发设备有流量并发上限。那么我们如何解决呢?试想,如果我们再到DNS动一下手脚呢?那么我们如果通过双击热备再加上DNS轮询 ,用户输入域名通过浏览器访问DNS服务器,得到一个虚拟IP,通过虚拟IP进入相应的双机热备份,下一个用户来了,就用过轮询,用下一个虚拟IP又进入了另外一个虚拟IP对应的双机热备份,这样不久解决了问题吗?如下图所示这样就解决了流量并发发问题

优秀的个人博客,低调大师

桥牌笔记:阻塞

7NT。 梅花有10张,看来完成很轻松,但小心明手没有进张,会发生阻塞。 正确的打法是飞西家的梅花Q,不管西家拿1、2、3张梅花,只要带Q,都成功。东家拿2张梅花带Q,一样会阻塞完不成。 唯一失败的情况是东家拿单张梅花Q ----==== Email: slofslb (GTD) qq.com 请将(GTD)换成@ ====---- 版权声明:自由转载-非商用-非衍生-保持署名( 创意共享3.0许可证) 作者: 申龙斌的程序人生 ---- 魔方、 桥牌、 象棋、游戏人生... ---- BASIC、C++、JAVA、 C#、 Haskell、 Objective-C、 Open Inventor、程序人生... ---- GTD伴我实现人生目标 ---- SeismicPro地震剖面显示程序 ---- Eclipse油藏数值模拟二进制文件格式解析和格式转换软件 本文转自申龙斌的程序人生博客园博文,原文链接:http://www.cnblogs.com/speeding/p/3539179.html,如需转载请自行联系原作者 http://www.cnblogs.com/speeding/

优秀的个人博客,低调大师

Android笔记:SlidingDrawer

一、概述 抽屉控件,官方已不建议用;但在某些需求下直接使用这个控件还是相当方便的。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 <SlidingDrawer android:id= "@+id/drawer" android:layout_width= "match_parent" android:layout_height= "match_parent" android:handle= "@+id/handle" android:content= "@+id/content" > <ImageView android:id= "@+id/handle" android:layout_width= "88dip" android:layout_height= "44dip" /> <GridView android:id= "@+id/content" android:layout_width= "match_parent" android:layout_height= "match_parent" /> </SlidingDrawer> 1.XML文件中的属性 属性名称 描述 android:allowSingleTap 是否可通过单击handle打开或关闭抽屉。默认是true。(如果是false,用户必须通过拖动,滑动或者使用轨迹球。) android:animateOnClick 顾名思义,点击的时候是否有动画。默认是true。 android:bottomOffset “手柄”距离SlidingDrawer底部的额外距离 。 android:content SlidingDrawer的内容。 android:handle SlidingDrawer的“手柄”。 android:orientation SlidingDrawer的方向。 android:topOffset “手柄”距离SlidingDrawer顶部的额外距离 。 2.一些重要的方法: voidsetOnDrawerCloseListener(SlidingDrawer.OnDrawerCloseListeneronDrawerCloseListener) 设置一个监听器,用来接收当抽屉被关闭时候的通知。 voidsetOnDrawerOpenListener(SlidingDrawer.OnDrawerOpenListeneronDrawerOpenListener) Since:API Level 3 设置一个监听器,用来接收当抽屉被打开的时候的通知。 voidsetOnDrawerScrollListener(SlidingDrawer.OnDrawerScrollListeneronDrawerScrollListener) 设置一个监听器,用来接收当抽屉处于正在打开或者正在结束的滚动时候的通知。 animateClose(): 使用动画关闭抽屉。 animateOpen(): 使用动画打开抽屉 getContent(): 获取内容 isMoving(): 指示SlidingDrawer是否在移动。 isOpened(): 指示SlidingDrawer是否已全部打开 lock(): 屏蔽触摸事件。 unlock(): 解除屏蔽触摸事件。 toggle(): 切换打开和关闭的抽屉SlidingDrawer。 3.一个简单的例子: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 public class SlidingDrawerDemoActivity extends Activity{ private SlidingDrawermyDrawer; private ImageViewmyImageView; private GridViewmyGridView; @Override protected void onCreate(BundlesavedInstanceState){ super .onCreate(savedInstanceState); setContentView(R.layout.main); myDrawer=(SlidingDrawer)findViewById(R.id.drawer); myImageView=(ImageView)findViewById(R.id.handle); myGridView=(GridView)findViewById(R.id.content); myDrawer.setOnDrawerOpenListener(newSlidingDrawer.OnDrawerOpenListener(){ @Override public void onDrawerOpened(){ myImageView.setImageResource(R.drawable.down); } }); myDrawer.setOnDrawerCloseListener(newSlidingDrawer.OnDrawerCloseListener(){ @Override public void onDrawerClosed(){ myImageView.setImageResource(R.drawable.up); } }); } } 二、可监听按钮点击事件的自定义SlidingDrawer 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 import android.content.Context; import android.graphics.Rect; import android.util.AttributeSet; import android.view.MotionEvent; import android.view.View; import android.view.ViewGroup; import android.widget.SlidingDrawer; /** *自定义SlidingDrawer:可监听按钮点击事件 *@authorzeng * */ public class ClickableSlidingDrawer extends SlidingDrawer { private ViewGroupmHandleLayout; private final RectmHitRect= new Rect(); public ClickableSlidingDrawer(Contextcontext,AttributeSetattrs, int defStyle) { super (context,attrs,defStyle); } public ClickableSlidingDrawer(Contextcontext,AttributeSetattrs) { super (context,attrs); } @Override protected void onFinishInflate() { super .onFinishInflate(); Viewhandle=getHandle(); if (handle instanceof ViewGroup) { mHandleLayout=(ViewGroup)handle; } } @Override public boolean onInterceptTouchEvent(MotionEventevent) { if (mHandleLayout!= null ) { int childCount=mHandleLayout.getChildCount(); int handleClickX=( int )(event.getX()-mHandleLayout.getX()); int handleClickY=( int )(event.getY()-mHandleLayout.getY()); RecthitRect=mHitRect; for ( int i= 0 ;i<childCount;i++) { ViewchildView=mHandleLayout.getChildAt(i); childView.getHitRect(hitRect); if (hitRect.contains(handleClickX,handleClickY)) { return false ; } } } return super .onInterceptTouchEvent(event); } } 三、控制SlidingDrawer在屏幕低端,而不会填满整个屏幕,同时handle按钮可点击的自定义SlidingDrawer 注:解决SlidingDrawer的高度设置为wrap_content时无法做到非全屏的问题。 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 import android.content.Context; import android.graphics.Rect; import android.util.AttributeSet; import android.view.MotionEvent; import android.view.View; import android.view.ViewGroup; import android.widget.SlidingDrawer; /** *自定义SlidingDrawer,控制SlidingDrawer在屏幕低端,而不会填满整个屏幕,同时handle按钮可点击 *@authorzeng * */ public class ClickableWrapSlidingDrawer extends SlidingDrawer { private ViewGroupmHandleLayout; private final RectmHitRect= new Rect(); private boolean mVertical; private int mTopOffset; public ClickableWrapSlidingDrawer(Contextcontext,AttributeSetattrs, int defStyle) { super (context,attrs,defStyle); int orientation=attrs.getAttributeIntValue( "android" , "orientation" ,ORIENTATION_VERTICAL); mTopOffset=attrs.getAttributeIntValue( "android" , "topOffset" , 0 ); mVertical=(orientation==SlidingDrawer.ORIENTATION_VERTICAL); } public ClickableWrapSlidingDrawer(Contextcontext,AttributeSetattrs) { super (context,attrs); int orientation=attrs.getAttributeIntValue( "android" , "orientation" ,ORIENTATION_VERTICAL); mTopOffset=attrs.getAttributeIntValue( "android" , "topOffset" , 0 ); mVertical=(orientation==SlidingDrawer.ORIENTATION_VERTICAL); } @Override protected void onMeasure( int widthMeasureSpec, int heightMeasureSpec) { int widthSpecMode=MeasureSpec.getMode(widthMeasureSpec); int widthSpecSize=MeasureSpec.getSize(widthMeasureSpec); int heightSpecMode=MeasureSpec.getMode(heightMeasureSpec); int heightSpecSize=MeasureSpec.getSize(heightMeasureSpec); final Viewhandle=getHandle(); final Viewcontent=getContent(); measureChild(handle,widthMeasureSpec,heightMeasureSpec); if (mVertical) { int height=heightSpecSize-handle.getMeasuredHeight()-mTopOffset; content.measure(widthMeasureSpec,MeasureSpec.makeMeasureSpec(height,heightSpecMode)); heightSpecSize=handle.getMeasuredHeight()+mTopOffset+content.getMeasuredHeight(); widthSpecSize=content.getMeasuredWidth(); if (handle.getMeasuredWidth()>widthSpecSize) widthSpecSize=handle.getMeasuredWidth(); } else { int width=widthSpecSize-handle.getMeasuredWidth()-mTopOffset; getContent().measure(MeasureSpec.makeMeasureSpec(width,widthSpecMode),heightMeasureSpec); widthSpecSize=handle.getMeasuredWidth()+mTopOffset+content.getMeasuredWidth(); heightSpecSize=content.getMeasuredHeight(); if (handle.getMeasuredHeight()>heightSpecSize) heightSpecSize=handle.getMeasuredHeight(); } setMeasuredDimension(widthSpecSize,heightSpecSize); } @Override protected void onFinishInflate() { super .onFinishInflate(); Viewhandle=getHandle(); if (handle instanceof ViewGroup) { mHandleLayout=(ViewGroup)handle; } } @Override public boolean onInterceptTouchEvent(MotionEventevent) { if (mHandleLayout!= null ) { int childCount=mHandleLayout.getChildCount(); int handleClickX=( int )(event.getX()-mHandleLayout.getX()); int handleClickY=( int )(event.getY()-mHandleLayout.getY()); RecthitRect=mHitRect; for ( int i= 0 ;i<childCount;i++) { ViewchildView=mHandleLayout.getChildAt(i); childView.getHitRect(hitRect); if (hitRect.contains(handleClickX,handleClickY)) { return false ; } } } return super .onInterceptTouchEvent(event); } } 本文转自 glblong 51CTO博客,原文链接:http://blog.51cto.com/glblong/1548354,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册