首页 文章 精选 留言 我的

精选列表

搜索[原理],共10002篇文章
优秀的个人博客,低调大师

Spark Streaming 原理剖析

通过源码呈现 Spark Streaming 的底层机制。 1. 初始化与接收数据 Spark Streaming 通过分布在各个节点上的接收器缓存接收到的流数据并将流数 据 包 装 成 Spark 能 够 处 理 的 RDD的格式 输入到Spark Streaming 之 后由Spark Streaming将作业提交到Spark集群进行执行如图1所示。 图 1 Spark Streaming 执行模型 初始化的过程主要可以概括为两点 1调度器的初始化。 调度器调度 Spark Streaming 的运行用户可以通过配置相关参数进行调优。 2将输入流的接收器转化为 RDD 在集群进行分布式分配然后启动接收器集合中的每个接收器。针对不同的数据源 Spark Streaming 提供了不同的数据接收器分布在各个节点上的每个接收器可以认为是一个特定的进程接收一部分流数据作为输入。 用户也可以针对自身生产环境状况自定义开发相应的数据接收器。 如图 2 所示接收器分布在各个节点上。通过下面代码创建并行的、在不同Worker 节点分布的 receiver 集合。 val tempRDD = if (hasLocationPreferences) { val receiversWithPreferences = receivers.map(r => (r, Seq(r.preferredLocation.get))) ssc.sc.makeRDD[Receiver[_]](receiversWithPreferences) } else { // 在这里创造 RDD 相当于进入 SparkContext.makeRDD // 此处将 receivers 的集合作为一个 RDD 进行分区 RDD[Receiver] // 即使是只有一个输入流按照这个分布式也是流的输入端在 worker 而不再 Master … // 将 receivers 的集合打散然后启动它们 … ssc.sparkContext.runJob(tempRDD, startReceiver) … } 图 2 Spark Streaming 接收器 2. 数据接收与转化 在上面的“初始化与接收数据”部分中已经介绍过 receiver 集合转换为 RDD在集群上分布式地接收数据流。那么每个 receiver 是怎样接收并处理数据流的呢读者可以通过图 3对输入流的处理有一个全面的了解。图 3为 Spark Streaming 数据接收与转化的示意图。 图 3 的主要流程如下。 1数据缓冲在 receiver 的 receive 函数中接收流数据将接收到的数据源源不断地放入到 BlockGenerator.currentBuffer。 2缓冲数据转化为数据块在 BlockGenerator 中有一个定时器RecurringTimer将 当 前 缓 冲 区 中 的 数 据 以 用 户 定 义 的 时 间 间 隔 封 装 为 一 个 数 据 块 Block 放 入 到 BlockGenerator 的 blocksForPush 队列中这个队列。 3数据块转化为 Spark 数据块在 BlockGenerator 中有一个 BlockPushingThread线程不断地将 blocksForPush 队列中的块传递给 BlockManager让 BlockManager 将 数据存储为块。 BlockManager 负责 Spark 中的块管理。 4元数据存储在 pushArrayBuffer 方法中还会将已经由 BlockManager 存储的元数据信息例如 Block 的 id 号传递给 ReceiverTracker ReceiverTracker 会将存储的 blockId 放到对应 StreamId 的队列中。 图 3 Spark Streaming 数据接收与转化 图中部分组件的作用如下 KeepPushingBlocks调用此方法持续写入和保持数据块。 pushArrayBuffer调用 pushArrayBuffer 方法将数据块存储到 BlockManager 中。 reportPushedBlock存储完成后汇报数据块信息到主节点。 receivedBlockInfo Meta Data已经接收到的数据块元数据记录。 streamId数据流 Id。 BlockInfo数据块元数据信息。 BlockManager.put数据块存储器写入备份数据块到其他节点。 Receiver数据块接收器接收数据块。 BlockGenerator数据块生成器将数据缓存生成 Spark 能处理的数据块。 BlockGenerator.currentBuffer缓存网络接收的数据记录等待之后转换为 Spark的数据块。 BlockGenerator.blocksForPushing将一块连续数据记录暂存为数据块待后续转换为 Spark 能够处理的 BlockManager 中的数据块A Block As a BlockManager’sBlock)。 BlockGenerator.blockPushingThread守护线程负责将数据块转换为 BlockManager中数据块。 ReceiveTracker输入数据块的元数据管理器负责管理和记录数据块。 BlockManager Spark 数据块管理器负责数据块在内存或磁盘的管理。 RecurringTimer时间触发器每隔一定时间进行缓存数据的转换。 上面的过程中涉及最多的类就是 BlockGenerator在数据转化的过程中其扮演者不可或缺的角色。 private[streaming] class BlockGenerator( listener: BlockGeneratorListener, receiverId: Int, conf: SparkConf ) extends Logging 3. 生成 RDD 与提交 Spark Job Spark Streaming 根据时间段将数据切分为 RDD然后触发 RDD 的 Action 提交 Job Job 被 提 交 到 Job Manager 中 的 Job Queue 中 由 Job Scheduler 调 度 之 后Job Scheduler 将 Job 提交到 Spark 的 Job 调度器然后将 Job 转换为大量的任务分发给 Spark 集群执行如图 4 所示。 图4 Spark Streaming 调度模型 Job generator 中通过下面的方法生成 Job 进行调度和执行。 从下面的代码可以看出 job 是从 outputStream 中生成的然后再触发反向回溯执行 整个 DStream DAG类似 RDD 的机制。 private def generateJobs(time: Time) { SparkEnv.set(ssc.env) Try(graph.generateJobs(time)) match { case Success(jobs) => // 获取输入数据块的元数据信息 val receivedBlockInfo = graph.getReceiverInputStreams.map { stream => . . . }.toMap jobScheduler.submitJobSet(JobSet(time, jobs, receivedBlockInfo)) case Failure(e) => jobScheduler.reportError("Error generating jobs for time " + time, e) } eventActor !DoCheckpoint(time) } // 下 面 进 入 JobScheduler 的 submitJobSet 方 法 一 探 究 竟 JobScheduler 是 整 个 Spark Streaming 调度的核心组件 def submitJobSet(jobSet: JobSet) { . . . jobSets.put(jobSet.time, jobSet) jobSet.jobs.foreach(job => jobExecutor.execute(new JobHandler(job))) . . . } // 进入 Graph 生成 job 的方法 Graph 本质是 DStreamGraph 类生成的对象 final private[streaming] class DStreamGraph extends Serializable with Logging { def generateJobs(time: Time): Seq[Job] = { . . . private val inputStreams = new ArrayBuffer[InputDStream[_]]() private val outputStreams = new ArrayBuffer[DStream[_]]() . . . val jobs = this.synchronized { outputStreams.flatMap(outputStream => outputStream.generateJob(time)) . . . } // outputStreams 中的对象是 DStream下面进入 DStream 的 generateJob 一探究竟 private[streaming] def generateJob(time: Time): Option[Job] = { getOrCompute(time) match { case Some(rdd) => { val jobFunc = () => { val emptyFunc = { (iterator: Iterator[T]) => {} } // 此处相当于针对每个时间段生成的一个 RDD会调用 SparkContext 的方法 runJob 提交 Spark 的一 个 Job context.sparkContext.runJob(rdd, emptyFunc) } Some(new Job(time, jobFunc)) } case None => None } } // 在 DStream 算是父类一些具体的 DStream 例如 SocketInputStream 等的类的父类可以通过 SocketInputDStream 看是如何通过上面的 getOrCompute 生成 RDD 的 private[streaming] def getOrCompute(time: Time): Option[RDD[T]] = { generatedRDDs.get(time) match { . . . case None => { if (isTimeValid(time)) { // Dstream 是个父类这里代表的是子类的 compute 方法 DStream 通过 compute 调用用户自定 义函数。当任务执行时同一个 stage 中的 DStream 函数会串联依次执行 compute(time) match { . . . generatedRDDs.put(time, newRDD) . . . } 在 SocketInputDStream 的 compute 方法中生成了对应时间片的 RDD override def compute(validTime: Time): Option[RDD[T]] = { if (validTime >= graph.startTime) { val blockInfo = ssc.scheduler.receiverTracker.getReceivedBlockInfo(id) receivedBlockInfo(validTime) = blockInfo val blockIds = blockInfo.map(_.blockId.asInstanceOf[BlockId]) Some(new BlockRDD[T](ssc.sc, blockIds)) } else { Some(new BlockRDD[T](ssc.sc, Array[BlockId]())) } } Spark Streaming 在保证实时处理的要求下还能够保证高吞吐与容错性。用户的数据分析中很多情况下也存在需要分析图数据运行图算法通过 GraphX 可以简便地开发分布式图分析算法。 本文转自大数据躺过的坑博客园博客原文链接http://www.cnblogs.com/zlslch/p/5725374.html如需转载请自行联系原作者

优秀的个人博客,低调大师

LeakCanary内存检测原理

LeakCanary介绍 LeakCanary内存检测工具是由squar公司开源的著名项目。此项目主要用于内存检测。开源鲜明的目录结构如下: leakcanary | |-leakcanary-analyzer |-leakcanary-android |-leakcanary-android-no-op |-leakcanary-watcher |-leakcanary-simple leakcanary-android,leakcanary-android-no-op是针对android的检查封装。leakcanary-analyzer:用于分析dump文件leakcanary-watcher:用于监控内存泄露leakcanary-a

优秀的个人博客,低调大师

Hadoop数据读写原理

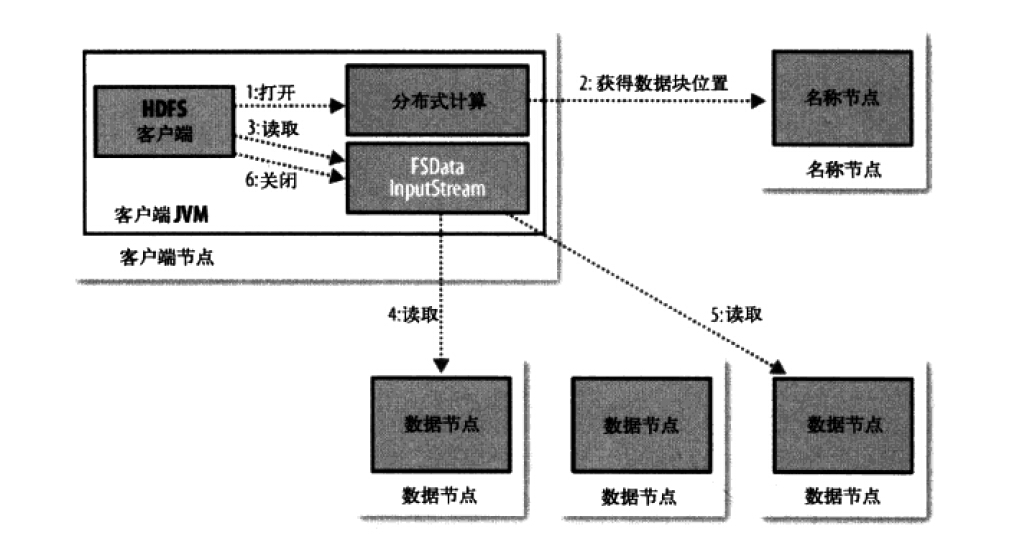
数据流 MapReduce作业(job)是客户端执行的单位:它包括输入数据、MapReduce程序和配置信息。Hadoop把输入数据划分成等长的小数据发送到MapReduce,称之为输入分片。Hadoop为每个分片创建一个map任务,由它来运行用户自定义的map函数来分析每个分片中的记录。 这里分片的大小,如果分片太小,那么管理分片的总时间和map任务创建的总时间将决定作业的执行的总时间。对于大数据作业来说,一个理想的分片大小往往是一个HDFS块的大小,默认是64MB(可以通过配置文件指定) map任务的执行节点和输入数据的存储节点是同一节点时,Hadoop的性能达到最佳。这就是为什么最佳分片的大小与块大小相同,它是最大的可保证存储在单个节点上的数据量如果分区跨越两个块,那么对于任何一个HDFS节点而言,基本不可能同时存储着两数据块,因此此分布的某部分必须通过网络传输到节点,这与使用本地数据运行map任务相比,显然效率很低。 reduce任务并不具备数据本地读取的优势,一个单一的reduce的任务的输入往往来自于所有mapper的输出。因此,有序map的输出必须通过网络传输到reduce任务运行的节点,并在哪里进行合并,然后传递到用户自定义的reduce函数中。 一般情况下,多个reduce任务的数据流成为"shuffle",因为每个reduce任务的输入都由许多map任务来提供。 Hadoop流 流适用于文字处理,在文本模式下使用时,它有一个面向行的数据视图。map的输入数据把标准输入流传输到map函数,其中是一行一行的传输,然后再把行写入标准输出。该框架调用mapper的map()方法来处理读入的每条记录,然而map程序可以决定如何处理输入流,可以轻松地读取和同一时间处理多行,用户的java map实现是压栈记录,但它仍可以考虑处理多行,具体做法是将mapper中实例变量中之前的行汇聚在一起(可用其他语言实现)。 HDFS的设计 HDFS是为以流式数据访问模式存储超大文件而设计的文件系统,在商用硬件的集群上运行。 流式数据访问:一次写入、多次读取模式是最高效的,一个数据集通常由数据源生成或复制,接着在此基础上进行各种各样的分析。 低延迟数据访问:需要低延迟访问数据在毫秒范围内的应用不适用于HDFS,HDFS是为达到高数据吞吐量而优化的,这有可能会以延迟为代价。(低延迟访问可以参考HBASE) 大量的小文件:namenode存储着文件系统的元数据,文件数量的限制也由namenode的内存量决定。每个文件,索引目录以及块占大约150个字节,因此,如果有一百万文件,每个文件占一个块,就至少需要300MB的内存。 多用户写入,任意修改文件:HDFS中的文件只有一个写入者。 HDFS的块比磁盘的块大,目的是为了减少寻址的开销。通过让一个块足够大,从磁盘转移数据的时间能够远远大于定位这个开始端的时间。因此,传送一个由多个块组成的文件的时间就取决于磁盘传送率。 文件读取与写入 HDFS中读取数据 客户端是通过调用fileSystem对象的open()来读取希望打开的文件的。对于HDFS,这个对象是分布式文件系统的一个实例。 (1)DistributedFileSystem通过使用RPC来调用namenode,以确定文件开头部分的块的位置,对于每一个块,namenode返回具有该块副本的数据节点地址。随后这些数据节点根据它们与客户端的距离来排序,如果该客户端本身就是一个数据节点,便从本地数据节点读取。(Distributed FileSystem返回一个FSData InputStream转而包装了一个DFSInputStream对象) (2)存储着文件开头部分的块的数据节点地址的DFSInputStream随机与这些块的最近的数据节点相连接,通过在数据流中重复调用read(),数据就会从数据节点返回客户端。到达块的末端时,DFSInputSteam会关闭与数据节点间的连接,然后为下一个块找到最佳的数据节点。 (3)客户端从流中读取数据时,块是按照DFSInputStream打开与数据节点的新连接的顺序读取的。它也会调用namenode来检索下一组需要的块的数据节点的位置。一旦客户端完成读取,就对文件系统数据输入调用close()。 这个设计的重点是,客户端直接联系数据节点去检索数据,通过namenode指引到每个块中最好的数据节点。因为数据流动在此集群中是在所有数据节点分散进行的,因此这种设计能使HDFS可扩展到最大的并发客户端数量。namenode提供块位置请求,其数据是存储在内存,非常的高效。 文件写入 客户端是通过在DistributedFilesystem中调用create()来创建文件,DistributedFilesystem一个RPC去调用namenode,在文件系统的命名空间中创建一个新文件。namenode执行各种不同的检查以确保这个文件不会已经存在,并且客户端有创建文件的权限。文件系统数据输出流控制一个DFSoutPutstream,负责datanode与namenode之间的通信。 客户端完成数据的写入后,会在流中调用clouse(),在向namenode发送完信息之前,此方法会将余下的所有包放入datanode管线并等待确认,namenode节点已经知道文件由哪些块组成(通过Data streamer询问块分配),所以它值需在返回成功前等待块进行最小量的复制。 一旦写入的数据超过一个块的数据,新的读取者就能看见第一个块,对于之后的块也是这样。总之,它始终是当前正在被写入的块,其他读取者是看不见的。HDFS提供一个方法来强制所有的缓存与datanode同步,即在文件系统数据输出流调用sync()方法,在syno()返回成功后,HDFS能保证文件中直至写入的最后的数据对所有新的读取者而言,都是可见且一致的。万一发生冲突(与客户端或HDFS),也不会造成数据丢失。 应用设计的重要性:如果不调用sync(),那么一旦客户端或系统发生故障,就可能失去一个块的数据,应该在适当的地方调用sync(). 通过distcp进行并行复制:Hadoop有一个叫distcp(分布式复制)的有用程序,能从Hadoop的文件系统并行复制大量数据。如果集群在Hadoop的同一版本上运行,就适合使用hdfs方案: hadoop distcp hdfs://namenode1/foo hdfs://namenode2/bar 将从第一个集群中复制/foo目录到第二个集群中的/bar目录下 参考:《Hadoop权威指南-第四版》

优秀的个人博客,低调大师

LangChain原理学习笔记

最新越发觉得AI的发展,对未来是一场革命,LangChain已经在工程设计上有了最佳实践,类似于AI时代的编程模型或编程框架,有点Spring框架的意思。之前在LangChain上也有些最佳实践,所以在这里分享记录下。 LangChain解决什么问题 LangChain是基于LLM之上的,在应用层和底层LLM之前的一个很好的编程框架,如果把LLM比喻为各种类型的数据库、中间件等这些基础设施,应用层是各种业务逻辑的组合之外,那么LangChain就负责桥接与业务层和底层LLM模型,让开发者可以快速地实现对接各种底层模型和快速实现业务逻辑的软件开发框架。 那么LangChain是如何做到的呢?试想一下,现在底层有一个大模型的推理能力,除了在对话框手动输入跟他聊天之外。如何用计算机方式跟它互动呢?如果把一次LLM调用当作一个原子能力,如何编排这些原子能力来解决一些业务需求呢?Langchain就是来解决这个事情的。 LangChain的几个核心概念 ▐Model I/O 这里重点把背后的LLM模型做了一层封装,开发者可以通过更改配置的方式快速切换底层LLM模型,比如chatgpt,chatGLM、通义千问等模型。 同时还有些高阶功能:比如提供了缓存等功能,这样对于语义上类似的query,如果缓存有,那么langchain可以快速返回结果,而不需要调用大模型。 ▐Retriver 检索是为了解决大模型打通用户的本身数据,做一些面向业务属性的东西。这里的检索并非传统的关系型数据库,更多的是与大模型的本身逻辑相似的,比如向量数据库。 一个经典的结合LLM和外部用户的文档进行智能答疑的场景 文档->分词->embedding->向量数据库 query->向量数据库查询->TOP N->上下文+ 用户提问 + prompt -> LLM -> 返回结果 一个经典的图如下: 关键技术:文档如何拆分、embedding过程、 TOPN 向量距离的选择 embedding技术选型 embedding是将现实中的物体通过向量化的方法转化为高维向量,可被机器学习模型所识别。他是一种映射,同时也保证了能清晰地表达现实物体的特征。基于此,可以进行一些归类分析、回归分析等。 现在市面上常见的embedding方法有通义千问的embedding等方法。 向量数据库: 向量数据库底层存储的是一堆向量,它提供了根据向量相似度进行查询的能力,一般情况下,向量相似度代表了现实世界中物体的相似度。比如”我的名字是小明“ 和“我叫小明”这两句话所代表的含义几乎是相同的,那么在embedding之后,基于向量数据库进行查询的时候,它们俩的相似度就会很近。 ▐Chain 各种类型的chain,chain代表了各种业务类型的组合,类似于工作流的编排。 ▐Memory LLM本身提供了记忆的能力,同时提供了接口,开发者可以将历史的对话记录传入给LLM。LangChain需要使用外部存储保存这些历史的会话和记忆。可以使用数据库、缓存等进行保存。 ▐Agent 重点是代理工具 代理工具可以让应用程序基于大模型的推理能力,然后进行代理工具或代理服务的调用。因为LLM是没有“联网”的能力的,如果想解决特定的应用场景,代理工具是个完美的选择。 代理工具通常包含三个方面:用户输入、prompt编排LLM思考与路由代理的过程、背后的代理服务。其中难点可能就在于prompt设计了。通常的“套路”是这样的: ReAct 模型 输入:用户的问题 思考过程:如果是情况1(这个是需要LLM进行意图识别进行思考的),那么推理和提取出一些关键参数,调用agent1,如果是情况2,那么推理和提取出一些关键参数,调用agent2 Act:调用agent1对应一个JSON格式化的输入,调用function1,返回结果。 观察:观察调用后的结果,再结合推理的能力,再进行循环思考。 LangChain的在实际场景中的实践 集团内部开发了一个JAVA版本的LangChain框架,以下实践基于此框架与开源大模型chatGLM-6B进行。 ▐淘宝开放平台智能问答 淘宝开放平台对内托管了上万个API,每天在内部群里都会有开发者咨询API发布问题,之前我们是通过NLP来实现智能问答的,现将它升级为基于大模型的智能问答,以下是具体的技术实现过程。 知识库Embedding过程 由于之前已经沉淀好了很多知识库,都是Question-Answer的这种形式,这里我们对Question,也就是问题进行Embedding,此处采用通义千问提供的Embedding方法。 知识库embedding: TongYiEmbeddings embeddings = new TongYiEmbeddings();embeddings.setServerAccessId(ALINLP_EMBEDDINGS_ACCESSID);embeddings.setServerUrl(ALINLP_EMBEDDINGS_SERVER_URL);embeddings.setServerUuid(ALINLP_EMBEDDINGS_UUID);Document document = new Document();document.setPageContent(rawText);List<Document> documents = embeddings.embedDocument(Arrays.asList(document));Document vecDocument= documents.get(0);// 向量化知识String embeddingString = JSON.toJSONString(vecDocument.getEmbedding()).replaceAll("\\[", "{").replaceAll("\\]", "}");return embeddingString; 向量数据库存储和查询 此处采用hologres向量数据库,图中红框表示知识库问题与回答在数据库中具体的向量化存储数据。 向量距离数据库查询: select origin_content as originContent, origin_title as originTitle, pm_approx_squared_euclidean_distance(embedding_title, #{embeddingTitle}) as distancefrom vs_knowledgeorder by distance asclimit #{limit} 大模型问答链路 问答chain的基本实现: //1. 初始化ChatGLM的参数ChatGLMV2Internal chatGLMV2Internal = new ChatGLMV2Internal();chatGLMV2Internal.setTemperature(0.01d);chatGLMV2Internal.setMaxLength(2048);//2. 提示词编写PromptTemplate prompt = new PromptTemplate();String template = "已知信息:\n" +"{context} \n" +"\n" +"根据上述已知信息,简洁和专业的来回答用户的问题。如果无法从中得到答案,请说 “根据已知信息无法回答该问题” 或 “没有提供足够的相关信息”,不允许在答案中添加编造成分,答案请使用中文。问题是:{question}";prompt.setTemplate(template);//3. 向量数据库检索配置,比如最大向量距离RetrievalQA qa = new RetrievalQA();qa.setRecommend(5);qa.setMaxDistanceValue(10000.0d);qa.setLlm(chatGLMV2Internal);qa.setPrompt(prompt);qa.setRetriever(holoRetriver.asRetriever());qa.init();//4. LLM大模型问答Map<String, Object> inputs = new HashMap<>();inputs.put("question", question);inputs.put("input", question);Map<String, Object> outputs = qa.run(inputs);llmKonwledgeDO.setContent(String.valueOf(outputs.get("text")));// 补充 doclistreturn llmKonwledgeDO; ▐AI Agent实践 以下实现了一个网关API调用日志解析的agent。 Agent工具注册: this.setName("ApiLogTool");this.setDescription("这是一个调用日志查询接口,如果[{question}]中包含requestId关键字,你可以请求这个工具与日志系统进行交互,调用这个工具。\n" + "请先提取出requestId的值,将它赋值为value。调用参数:[{\"requestId\": \"value\", \"type\": \"String\", \"description\": \"调用请求id\"}]。"); 工具解析: Map<String,Object> parse = (Map<String,Object>)JSON.parse(toolInput);if(parse.get("requestId")==null){ return new ToolExecuteResult("");}String requestId = parse.get("requestId").toString();ApiLogSearchQuery apiLogSearchQuery = new ApiLogSearchQuery();//日志查询解析处理 思考决策逻辑: public static final String FORMAT_INSTRUCTIONS_CH ="用户提出了一个问题: {question} \n" +"你可以选择使用下面这些工具:\n"+"{tool_list_description}"+"\n"+"同时你的思考过程如下:"+"Thought: 每一次你需要首先思考你应该做什么\n" +"Action: 你需要决定是否使用工具,应该是[{tool_names}] 中的一个Action,格式为JSON。如果匹配不到工具,就不要思考了,直接返回结果,请不要把思考过程返回给用户。\n" +"Input: 如果匹配到工具,使用的工具的输入参数,赋值给params\n" +"Observation: 如果匹配到工具,工具的输出结果 格式为[]。\n" +"Answer: 每一步回答问题的答案,格式为JSON。你可以多次使用Thought/Action/Input/Observation/Answer来一步一步的思考如何回答问题。\n"; 个人小思考 未来微服务HSF这种形式会向上往 agent工厂或者agent服务框架这种形式演进,因为这个框架搭好了后,后面各个业务方快速集成到agent服务上,可被上层AI应用层调用 如果多个agent联动了,才是真正的智能 如何定义agent? Agent体系架构可以分为慎思型、反应型和混合型。 慎思型构建负责规划和推理行为,反应型构建处理需要快速响应的重要事件。 信念-期望-意图(Belief-Desire-ltension, BDI) 体系架构是混合型体系架构的一个重要类型。 Agent的表示形式,Agent的行为可以被描述成好像拥有信念、期望和意图等思维状态。信念表示Agent拥有的知识,期望描述Agent追求的目标,意图说明Agent选择计划以实现哪些目标。 openai提供的agent概念 团队介绍 我们是淘天集团商家与开放平台团队,目前主要围绕商家的日常经营场景,为中小商家提供高效易用的电商工具。 ¤ 拓展阅读 ¤ 3DXR技术| 终端技术| 音视频技术 服务端技术|技术质量|数据算法 本文分享自微信公众号 - 大淘宝技术(AlibabaMTT)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册