首页 文章 精选 留言 我的

精选列表

搜索[AI原生解析],共10000篇文章
优秀的个人博客,低调大师

Redis radix tree源码解析

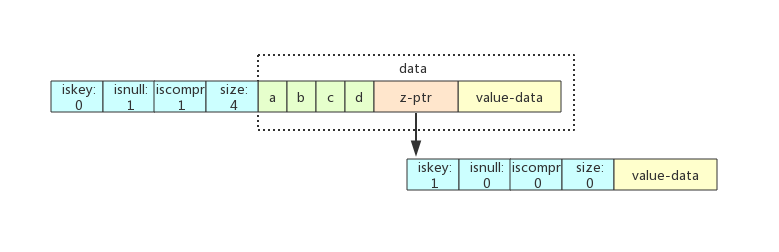
Redis实现了不定长压缩前缀的radix tree,用在集群模式下存储slot对应的的所有key信息。本文将详述在Redis中如何实现radix tree。 核心数据结构 raxNode是radix tree的核心数据结构,其结构体如下代码所示: typedef struct raxNode { uint32_t iskey:1; uint32_t isnull:1; uint32_t iscompr:1; uint32_t size:29; unsigned char data[]; } raxNode; iskey:表示这个节点是否包含key 0:没有key 1:表示从头部到其父节点的路径完整的存储了key,查找的时候按子节点iskey=1来判断key是否存在 isnull:是否有存储value值,比如存储元数据就只有key,没有value值。value值也是存储在data中 iscompr:是否有前缀压缩,决定了data存储的数据结构 size:该节点存储的字符个数 data:存储子节点的信息 iscompr=0:非压缩模式下,数据格式是:[header strlen=0][abc][a-ptr][b-ptr][c-ptr](value-ptr?),有size个字符,紧跟着是size个指针,指向每个字符对应的下一个节点。size个字符之间互相没有路径联系。 iscompr=1:压缩模式下,数据格式是:[header strlen=3][xyz][z-ptr](value-ptr?),只有一个指针,指向下一个节点。size个字符是压缩字符片段 Rax Insert 以下用几个示例来详解rax tree插入的流程。假设j是遍历已有节点的游标,i是遍历新增节点的游标。 场景一:只插入abcd z-ptr指向的叶子节点iskey=1,使用了压缩前缀。 场景二:在abcd之后插入abcdef 从abcd父节点的每个压缩前缀字符比较,遍历完所有abcd节点后指向了其空子节点,j = 0, i < len(abcded)。 查找到abcd的空子节点,直接将ef赋值到子节点上,成为abcd的子节点。ef节点被标记为iskey=1,用来标识abcd这个key。ef节点下再创建一个空子节点,iskey=1来表示abcdef这个key。 场景三:在abcd之后插入ab ab在abcd能找到前两位的前缀,也就是i=len(ab),j < len(abcd)。 将abcd分割成ab和cd两个子节点,cd也是一个压缩前缀节点,cd同时被标记为iskey=1,来表示ab这个key。 cd下挂着一个空子节点,来标记abcd这个key。 场景四:在abcd之后插入abABC abcABC在abcd中只找到了ab这个前缀,即i < len(abcABC),j < len(abcd)。这个步骤有点复杂,分解一下: step 1:将abcd从ab之后拆分,拆分成ab、c、d 三个节点。 step 2:c节点是一个非压缩的节点,c挂在ab子节点上。 step 3:d节点只有一个字符,所以也是一个非压缩节点,挂在c子节点上。 step 4:将ABC 拆分成了A和BC, A挂在ab子节点上,和c节点属于同一个节点,这样A就和c同属于父节点ab。 step 5:将BC作为一个压缩前缀的节点,挂在A子节点下。 step 6:d节点和BC节点都挂一个空子节点分别标识abcd和abcABC这两个key。 场景五:在abcd之后插入Aabc abcd和Aabc没有前缀匹配,i = 0,j = 0。 将abcd拆分成a、bcd两个节点,a节点是一个非压缩前缀节点。 将Aabc拆分成A、abc两个节点,A节点也是一个非压缩前缀节点。 将A节点挂在和a相同的父节点上。 同上,在bcd和abc这两个节点下挂空子节点来分别表示两个key。 Rax Remove 删除 删除一个key的流程比较简单,找到iskey的节点后,向上遍历父节点删除非iskey的节点。如果是非压缩的父节点并且size > 1,表示还有其他非相关的路径存在,则需要按删除子节点的模式去处理这个父节点,主要是做memove和realloc。 合并 删除一个key之后需要尝试做一些合并,以收敛树的高度。 合并的条件是: iskey=1的节点不能合并 子节点只有一个字符 父节点只有一个子节点(如果父节点是压缩前缀的节点,那么只有一个子节点,满足条件。如果父节点是非压缩前缀的节点,那么只能有一个字符路径才能满足条件) 结束语 云数据库Redis版(ApsaraDB for Redis)是一种稳定可靠、性能卓越、可弹性伸缩的数据库服务。基于飞天分布式系统和全SSD盘高性能存储,支持主备版和集群版两套高可用架构。提供了全套的容灾切换、故障迁移、在线扩容、性能优化的数据库解决方案。欢迎各位购买使用:云数据库 Redis 版 作者:羽洵 原文链接 本文为云栖社区原创内容,未经允许不得转载。

优秀的个人博客,低调大师

Android Handler原理实践解析

前言 Handler消息处理机制在Android开发中起着举足轻重的作用,我们有必要好好理解下其原理,下面我们先从一个简单的例子出发 一、日常使用 假设我们有这么一个需要,请求网络然后将图片展示出来,我们知道网络请求是不允许在主线程执行的,而UI是不能在子线程(具体是不允许在非创建UI的原始线程)更新的,因此我们需要在子线程请求网络获得了数据以后再切换回主线程更新UI,这个例子中Handler就是起着切换线程的作用,下面的代码演示了这个例子 classMainActivity : AppCompatActivity() { private lateinit var mImageView: ImageView override fun onCreate(savedInstanceState: Bundle?){

优秀的个人博客,低调大师

Helm源码解析 资料下载

Helm 是Kubernetes 集群的包管理器(charts), charts 是Kubernetes资源的一个打包集合。 Helm之于Kubernetes好比yum之于RHEL,或者apt-get之于Ubuntu。Helm使用Chart帮助我们管理应用,Chart就好像RPM一样,里面描述了应用及其依赖关系。这篇分享会简单介绍 Helm 的用法 以及chart 的介绍,随后会针对Helm 源码以一个简单的chart 创建为示例,从源码级别分析Helm 的创建流程。最后会简单介绍一下Helm v3的进展以及改变。 本次分享专家:阿里云技术专家 陈显鹭 直播视频全程链接:https://yq.aliyun.com/live/826 PPT精彩内容一览: PPT下载地址:https://yq.aliyun.com/download/32

优秀的个人博客,低调大师

应用基础框架全面解析

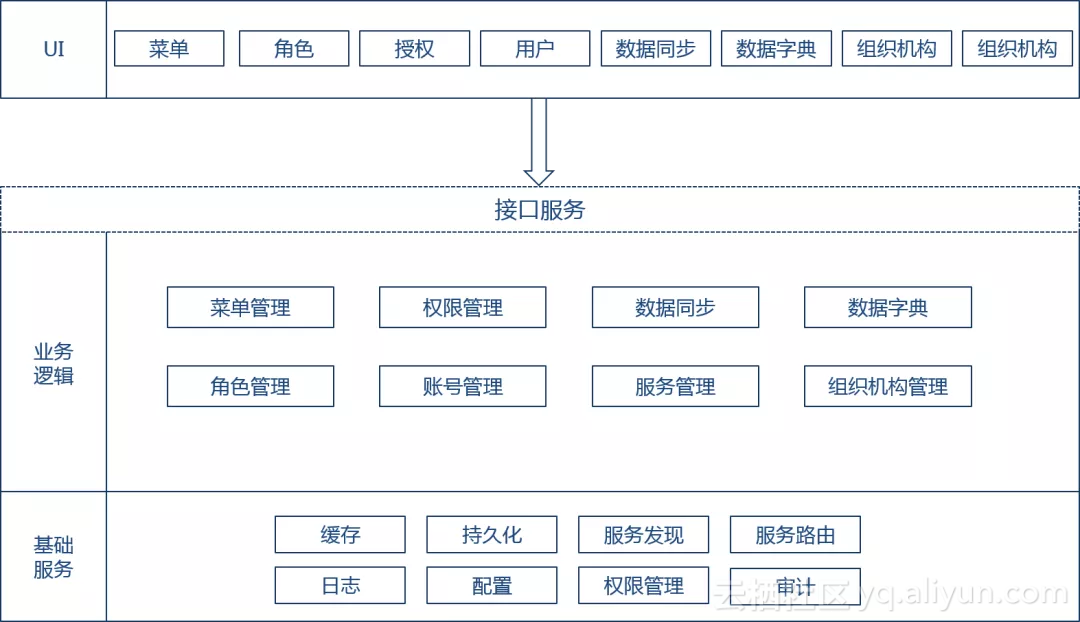
引言: 应用基础框架Coframe是EOS产品自带的开源应用基础框架,提供了资源管理、权限管理、用户以及角色管理等业务应用基础能力,用户可以根据自己的需要进行二次开发与扩展。本文向大家分享Coframe的主要功能和设计实现方案。 目录: 一、简介 二、系统资源 三、权限管理 四、组织管理 一、简介 应用基础框架也叫Coframe,是产品自带的开源应用基础框架,提供了一些基础功能,用户可以根据自己的需要进行二次开发与扩展。 Coframe提供3大核心功能: 系统资源:提供了功能菜单管理、字典码表、应用管理折几个应用框架基础能力。 权限管理:提供了基于Party(参与者) 的复杂权限计算模型和授权模型。 基于参与者、资源与授权等概念可扩展开发出符合用户个性化需求的参与者模型。 组织管理:提供了机构、岗位、员工、 用户、工作组等组织机构相关管理功能,支持与已有业务系统对接,使得基于普元EOS Platform 8.0开发的应用可方便地使用同一套组织机构。 逻辑架构逻辑架构图展示了基础应用框架的基本功能模块,前端Restful形式接口调用后端服务。进程架构应用基础框架有两种部署模式:微服务架构Coframe集成模式和单应用架构Coframe集成模式。 单应用架构很好理解,即直接使用Coframe源码或者jar包开发应用,后端只有一个server,而集成模式可以将应用要对外暴露的服务封装在Coframe中,这样Coframe可以对应用进行权限管理。前端使用VUE开发,可以很方便的使用源码进行二次开发。 数据模型应用基础框架的数据模型即DB表结构,展示了主要的一些表结构,包括权限表,用户表等。用户可以很方便的进行二次开发扩展应用。 二、系统资源 菜单管理 菜单框架支持两级菜单,用户可以自定义菜单的路径和打开方式等。应用基础框架提供了几个基础的菜单,用户可以在页面编辑菜单或者直接在数据库端编辑菜单。目前应用基础框架前端Ui支持二级菜单,用户可以根据自己的需求扩展到三级菜单。 字典码表 字典码表即为系统内部定义的具有业务属性的数据字典。系统管理员可以配置字典类型和字典项,用于管理系统中的枚举类型的基础数据,并且支持excel导入导出。字典类型和字典数据均支持一级子项。 字典类型:对数据进行分类管理 字典数据项:需要管理的枚举数据 应用管理 应用管理又叫服务权限控制,是指在多应用系统以及单应用系统下,实现对应用的服务功能的权限控制。实现角色、用户、功能的灵活绑定。在需要进行权限管理的功能接口方法定义上添加@TarestOperation注解,发布服务。 @RequestMapping("/say-hello") @TarestService(group = "SP1", displayName = "服务提供组1", version = "1.0.0.0", groupName = "服务提供组1", name = "ISampleAppHello") public interface ISampleAppHello { @GetMapping @TarestOperation(checkPermission=false,name="DEMO_001",displayName="功能1") String sayHello(); /** * @TarestOperation 在@TarestOperation中默认是不进行权限管理的 * 通过设置checkPermission = true,打开权限控制功能 * **/ @GetMapping(value = "/user") @TarestOperation(checkPermission =true,name="DEMO_002",displayName="功能2") String insertDemo(@RequestParam String name, @RequestParam Integer age); } 单应用系统即只有一个后端应用的系统,(直接以嵌入方式集成Coframe)无需新建应用。 多应用系统即有多个后端应用的系统,Coframe作为一个独立的应用部署的系统,需要在coframe中新建应用。如图所示: 三、权限管理 提供了基于Party(参与者) 的复杂权限计算模型和授权模型。 基于参与者、资源与授权等概念可扩展开发出符合用户个性化需求的参与者模型。 角色:角色是Coframe一个重要的对象,也可以成为权限集,表示系统中权限一个子集,用于控制用户可以使用的功能集合,赋予用户一个角色表示给用户一定功能的使用权限。Coframe中角色的分配本身赋予某些用户,员工,机构等之外,还要向角色授予可访问某些功能,模块,表单,视图等资源的权限。拥有某角色的用户可访问角色被授予的资源的权限。 用户:所有能登录系统的用户都是系统中的用户,需要增加登录账号有两种方式。一种是在用户管理中新增用户,第二种是在组织管理中新增员工时关联一个用户,如果用户的登录名不存在会创建一个新的用户。 用户管理所有能登录系统的用户都是系统中的用户,需要增加登录账号有两种方式。一种是在用户管理中新增用户,第二种是在组织管理中新增员工时关联一个用户,如果用户的登录名不存在会创建一个新的用户。当Coframe使用IAM的统一认证登录的时候能够同步IAM端的同一租户下的用户信息。 Coframe的用户账号由其登录认证方式决定是本地创建的还是又IAM即同一认真平台同步过来的用户信息。 本地登录:用户账号及其认证密码在本地存储,本地认证配置可以参考:http://t.cn/EUrzEtL 单点登录:即与IAM集成的sso方式登录,可以参考:http://t.cn/EUrZPOs 授权管理 目前提供了菜单授权与服务授权,授权管理即将资源与参与者之间建立关系。如下图所示,菜单和应用: 即可以视为资源,而账号、角色、组织机构、工作中等,即可以视为参与者。授权表结构如下图所示: 此注解用来标志一个数据实体为授权实体,授权实体需要指定类型:资源、授权主体,比如: @Entity // 此实体名称为order,类型为resource @AuthEntity(name = "order", type = AuthEntityType.RESOURCE) @Table(name = "SAMPLE_ORDER") public class SampleOrder { @Id @GeneratedValue private Long id; private String name; private Date date; } 四、组织管理 机构管理机构指企业的组织机构,一般包含机构、岗位、员工等信息。 机构管理通过对一棵机构人员树的维护把机构、岗位、人员等信息和关系维护好,并可设置这些组织对象的角色。工作组管理工作组与机构类似,是为了将项目组、工作组等临时性的组织机构管理起来,业务上通常工作组有一定的时效性,是一个非常设机构。 工作组是企业动态创建的组织机构分组,工作组下可以有子工作组、员工信息。总结: 以上介绍了应用基础框架的主要基础功能,以及设计过程中的一些理念,比如授权模型等。 作为开源应用基础框架会随着规划发展不断完善,用户可以根据自身的需求来更改适配。也非常欢迎大家能够更多参与使其更加健壮。 原文发布时间为:2018-12-19本文作者:许方杰本文来自云栖社区合作伙伴“ EAWorld”,了解相关信息可以关注“eaworld”微信公众号

优秀的个人博客,低调大师

Hystrix降级技术解析-Fallback

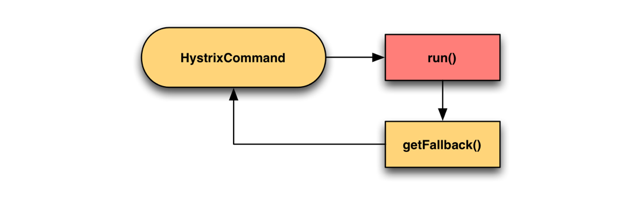
一、降级 所谓降级,就是指在在Hystrix执行非核心链路功能失败的情况下,我们如何处理,比如我们返回默认值等。如果我们要回退或者降级处理,代码上需要实现HystrixCommand.getFallback()方法或者是HystrixObservableCommand. HystrixObservableCommand()。 publicclassCommandHelloFailureextendsHystrixCommand<String>{ privatefinalStringname; publicCommandHelloFailure(Stringname){ super(HystrixCommandGroupKey.Factory.asKey("ExampleGroup")); this.name=name; } @Override protectedStringrun(){ thrownewRuntimeException("thiscommandalwaysfails"); } @Override protectedStringgetFallback(){ return"HelloFailure"+name+"!"; } } 二、Hystrix的降级回退方式 Hystrix一共有如下几种降级回退模式: 1、Fail Fast 快速失败 @Override protectedStringrun(){ if(throwException){ thrownewRuntimeException("failurefromCommandThatFailsFast"); }else{ return"success"; } } 如果我们实现的是HystrixObservableCommand.java则 重写 resumeWithFallback方法 @Override protectedObservable<String>resumeWithFallback(){ if(throwException){ returnObservable.error(newThrowable("failurefromCommandThatFailsFast")); }else{ returnObservable.just("success"); } } 2、Fail Silent 无声失败 返回null,空Map,空List fail silent.png @Override protectedStringgetFallback(){ returnnull; } @Override protectedList<String>getFallback(){ returnCollections.emptyList(); } @Override protectedObservable<String>resumeWithFallback(){ returnObservable.empty(); } 3、Fallback: Static 返回默认值 回退的时候返回静态嵌入代码中的默认值,这样就不会导致功能以Fail Silent的方式被清楚,也就是用户看不到任何功能了。而是按照一个默认的方式显示。 @Override protectedBooleangetFallback(){ returntrue; } @Override protectedObservable<Boolean>resumeWithFallback(){ returnObservable.just(true); } 4、Fallback: Stubbed 自己组装一个值返回 当我们执行返回的结果是一个包含多个字段的对象时,则会以Stubbed 的方式回退。Stubbed 值我们建议在实例化Command的时候就设置好一个值。以countryCodeFromGeoLookup为例,countryCodeFromGeoLookup的值,是在我们调用的时候就注册进来初始化好的。CommandWithStubbedFallback command = new CommandWithStubbedFallback(1234, "china");主要代码如下: publicclassCommandWithStubbedFallbackextendsHystrixCommand<UserAccount>{ protectedCommandWithStubbedFallback(intcustomerId,StringcountryCodeFromGeoLookup){ super(HystrixCommandGroupKey.Factory.asKey("ExampleGroup")); this.customerId=customerId; this.countryCodeFromGeoLookup=countryCodeFromGeoLookup; } @Override protectedUserAccountgetFallback(){ /** *Returnstubbedfallbackwithsomestaticdefaults,placeholders, *andaninjectedvalue'countryCodeFromGeoLookup'thatwe'lluse *insteadofwhatwewouldhaveretrievedfromtheremoteservice. */ returnnewUserAccount(customerId,"UnknownName", countryCodeFromGeoLookup,true,true,false); } 5、Fallback: Cache via Network 利用远程缓存 通过远程缓存的方式。在失败的情况下再发起一次remote请求,不过这次请求的是一个缓存比如redis。由于是又发起一起远程调用,所以会重新封装一次Command,这个时候要注意,执行fallback的线程一定要跟主线程区分开,也就是重新命名一个ThreadPoolKey。 Cache via Network.png publicclassCommandWithFallbackViaNetworkextendsHystrixCommand<String>{ privatefinalintid; protectedCommandWithFallbackViaNetwork(intid){ super(Setter.withGroupKey(HystrixCommandGroupKey.Factory.asKey("RemoteServiceX")) .andCommandKey(HystrixCommandKey.Factory.asKey("GetValueCommand"))); this.id=id; } @Override protectedStringrun(){ //RemoteServiceXClient.getValue(id); thrownewRuntimeException("forcefailureforexample"); } @Override protectedStringgetFallback(){ returnnewFallbackViaNetwork(id).execute(); } privatestaticclassFallbackViaNetworkextendsHystrixCommand<String>{ privatefinalintid; publicFallbackViaNetwork(intid){ super(Setter.withGroupKey(HystrixCommandGroupKey.Factory.asKey("RemoteServiceX")) .andCommandKey(HystrixCommandKey.Factory.asKey("GetValueFallbackCommand")) //useadifferentthreadpoolforthefallbackcommand //sosaturatingtheRemoteServiceXpoolwon'tprevent //fallbacksfromexecuting .andThreadPoolKey(HystrixThreadPoolKey.Factory.asKey("RemoteServiceXFallback"))); this.id=id; } @Override protectedStringrun(){ MemCacheClient.getValue(id); } @Override protectedStringgetFallback(){ //thefallbackalsofailed //sothisfallback-of-a-fallbackwill //failsilentlyandreturnnull returnnull; } } } 6、Primary + Secondary with Fallback 主次方式回退(主要和次要) 这个有点类似我们日常开发中需要上线一个新功能,但为了防止新功能上线失败可以回退到老的代码,我们会做一个开关比如使用zookeeper做一个配置开关,可以动态切换到老代码功能。那么Hystrix它是使用通过一个配置来在两个command中进行切换。 Primary + Secondary with Fallback.png /** *Sample{@linkHystrixCommand}patternusingasemaphore-isolatedcommand *thatconditionallyinvokesthread-isolatedcommands. */ publicclassCommandFacadeWithPrimarySecondaryextendsHystrixCommand<String>{ privatefinalstaticDynamicBooleanPropertyusePrimary=DynamicPropertyFactory.getInstance().getBooleanProperty("primarySecondary.usePrimary",true); privatefinalintid; publicCommandFacadeWithPrimarySecondary(intid){ super(Setter .withGroupKey(HystrixCommandGroupKey.Factory.asKey("SystemX")) .andCommandKey(HystrixCommandKey.Factory.asKey("PrimarySecondaryCommand")) .andCommandPropertiesDefaults( //wewanttodefaulttosemaphore-isolationsincethiswraps //2otherscommandsthatarealreadythreadisolated //采用信号量的隔离方式 HystrixCommandProperties.Setter() .withExecutionIsolationStrategy(ExecutionIsolationStrategy.SEMAPHORE))); this.id=id; } //通过DynamicPropertyFactory来路由到不同的command @Override protectedStringrun(){ if(usePrimary.get()){ returnnewPrimaryCommand(id).execute(); }else{ returnnewSecondaryCommand(id).execute(); } } @Override protectedStringgetFallback(){ return"static-fallback-"+id; } @Override protectedStringgetCacheKey(){ returnString.valueOf(id); } privatestaticclassPrimaryCommandextendsHystrixCommand<String>{ privatefinalintid; privatePrimaryCommand(intid){ super(Setter .withGroupKey(HystrixCommandGroupKey.Factory.asKey("SystemX")) .andCommandKey(HystrixCommandKey.Factory.asKey("PrimaryCommand")) .andThreadPoolKey(HystrixThreadPoolKey.Factory.asKey("PrimaryCommand")) .andCommandPropertiesDefaults( //wedefaulttoa600mstimeoutforprimary HystrixCommandProperties.Setter().withExecutionTimeoutInMilliseconds(600))); this.id=id; } @Override protectedStringrun(){ //performexpensive'primary'servicecall return"responseFromPrimary-"+id; } } privatestaticclassSecondaryCommandextendsHystrixCommand<String>{ privatefinalintid; privateSecondaryCommand(intid){ super(Setter .withGroupKey(HystrixCommandGroupKey.Factory.asKey("SystemX")) .andCommandKey(HystrixCommandKey.Factory.asKey("SecondaryCommand")) .andThreadPoolKey(HystrixThreadPoolKey.Factory.asKey("SecondaryCommand")) .andCommandPropertiesDefaults( //wedefaulttoa100mstimeoutforsecondary HystrixCommandProperties.Setter().withExecutionTimeoutInMilliseconds(100))); this.id=id; } @Override protectedStringrun(){ //performfast'secondary'servicecall return"responseFromSecondary-"+id; } } publicstaticclassUnitTest{ @Test publicvoidtestPrimary(){ HystrixRequestContextcontext=HystrixRequestContext.initializeContext(); try{ //将属性"primarySecondary.usePrimary"设置为true,则走PrimaryCommand;设置为false,则走SecondaryCommand ConfigurationManager.getConfigInstance().setProperty("primarySecondary.usePrimary",true); assertEquals("responseFromPrimary-20",newCommandFacadeWithPrimarySecondary(20).execute()); }finally{ context.shutdown(); ConfigurationManager.getConfigInstance().clear(); } } @Test publicvoidtestSecondary(){ HystrixRequestContextcontext=HystrixRequestContext.initializeContext(); try{ //将属性"primarySecondary.usePrimary"设置为true,则走PrimaryCommand;设置为false,则走SecondaryCommand ConfigurationManager.getConfigInstance().setProperty("primarySecondary.usePrimary",false); assertEquals("responseFromSecondary-20",newCommandFacadeWithPrimarySecondary(20).execute()); }finally{ context.shutdown(); ConfigurationManager.getConfigInstance().clear(); } } } } 三、总结 降级的处理方式,返回默认值,返回缓存里面的值(包括远程缓存比如redis和本地缓存比如jvmcache)。 但回退的处理方式也有不适合的场景: 1、写操作 2、批处理 3、计算 以上几种情况如果失败,则程序就要将错误返回给调用者。 参考资料:https://github.com/Netflix/Hystrix/wiki


优秀的个人博客,低调大师

Dubbo (二) ——- 项目结构解析

本文主要说明点 概述 背景 需求 架构 Dubbo源代码项目结构 概述 分享Dubbo 的项目结构,通过本文可以大致了解到Dubbo整个项目的结构 背景 将一个项目进行拆分, 进行分布式架构。 需要解决下面的问题 单一应用架构 网站流量少时单一架构,简化开发。此时,用于简化增删改查工作量的数据访问框架(ORM)是关键。 垂直应用架构 访问大时单一应用速度过小,需要进行应用拆分。此时,用于加速前端页面开发的Web框架(MVC)是关键。 分布式服务架构 当垂直应用过多,将核心业务独立服务。然后提供给其他项目内部调用。此时,用于提高业务复用及整合的分布式服务框架(RPC)是关键。 流动计算架构 当服务更多的时候,对流量的控制,服务的限流,熔断等操作。而且还需要管理集群容量,提供集群利用率。此时,用于提高机器利用率的资源调度和治理中心(SOA)是关键。 需求 dubbo解决下面几个需求 当服务越来越多时,服务 URL 配置管理变得非常困难,F5 硬件负载均衡器的单点压力也越来越大 服务间依赖关系变得错踪复杂,甚至分不清哪个应用要在哪个应用之前启动 服务的调用量越来越大,服务的容量问题就暴露出来机器管理,流量的控制等 架构 节点角色说明 节点角色说明 Provider暴露服务的服务提供方 Consumer调用远程服务的服务消费方 Registry服务注册与发现的注册中心 Monitor统计服务的调用次数和调用时间的监控中心 Container服务运行容器 调用关系说明 服务容器负责启动,加载,运行服务提供者 服务提供者在启动时,向注册中心注册自己提供的服务 服务消费者在启动时,向注册中心订阅自己所需的服务。 注册中心返回服务提供者地址列表给消费者,如果有变更,注册中心将基于长连接推送变更数据给消费者。 服务消费者,从提供者地址列表中,基于软负载均衡算法,选一台提供者进行调用,如果调用失败,再选另一台调用。 服务消费者和提供者,在内存中累计调用次数和调用时间,定时每分钟发送一次统计数据到监控中心。 Dubbo 架构 下面特点 连通性、健壮性、伸缩性、以及向未来架构的升级性 连通性 注册中心负责服务地址的注册与查找,相当于目录服务,服务提供者和消费者只在启动时与注册中心交互,注册中心不转发请求,压力较小 监控中心负责统计各服务调用次数,调用时间等,统计先在内存汇总后每分钟一次发送到监控中心服务器,并以报表展示 服务提供者向注册中心注册其提供的服务,并汇报调用时间到监控中心,此时间不包含网络开销 服务消费者向注册中心获取服务提供者地址列表,并根据负载算法直接调用提供者,同时汇报调用时间到监控中心,此时间包含网络开销 注册中心,服务提供者,服务消费者三者之间均为长连接,监控中心除外 注册中心通过长连接感知服务提供者的存在,服务提供者宕机,注册中心将立即推送事件通知消费者 注册中心和监控中心全部宕机,不影响已运行的提供者和消费者,消费者在本地缓存了提供者列表 注册中心和监控中心都是可选的,服务消费者可以直连服务提供者 健壮性 监控中心宕掉不影响使用,只是丢失部分采样数据 数据库宕掉后,注册中心仍能通过缓存提供服务列表查询,但不能注册新服务 注册中心对等集群,任意一台宕掉后,将自动切换到另一台 注册中心全部宕掉后,服务提供者和服务消费者仍能通过本地缓存通讯 服务提供者无状态,任意一台宕掉后,不影响使用 服务提供者全部宕掉后,服务消费者应用将无法使用,并无限次重连等待服务提供者恢复 伸缩性 注册中心为对等集群,可动态增加机器部署实例,所有客户端将自动发现新的注册中心 服务提供者无状态,可动态增加机器部署实例,注册中心将推送新的服务提供者信息给消费者 升级性 需要实现动态部署,进行流动计算 下图是未来可能的一种架构 节点角色说明 节点角色说明 Deployer自动部署服务的本地代理 Repository仓库用于存储服务应用发布包 Scheduler调度中心基于访问压力自动增减服务提供者 Admin统一管理控制台 Registry服务注册与发现的注册中心 Monitor统计服务的调用次数和调用时间的监控中心 Dubbo源代码项目结构 **模块分包 ** 每个模块都是相互隔离的,可插拔的。下面的这个图是模块引用图 下面对着这些模块做个简单介绍 **dubbo-common ** 公共逻辑模块:包括 Util 类和通用模型。 **dubbo-remoting ** 远程通讯模块:相当于 Dubbo 协议的实现,如果 RPC 用 RMI协议则不需要使用此包。 dubbo-rpc ** 远程调用模块**:抽象各种协议,以及动态代理,只包含一对一的调用,不关心集群的管理。 dubbo-cluster ** 集群模块**:将多个服务提供方伪装为一个提供方, 包括:负载均衡, 容错,路由等,集群的地址列表可以是静态配置的,也可以是由注册中心下发。 **dubbo-registry ** 注册中心模块:基于注册中心下发地址的集群方式,以及对各种注册中心的抽象 dubbo-monitor ** 监控模块**:统计服务调用次数,调用时间的,调用链跟踪的服务。 **dubbo-config ** 配置模块:是 Dubbo 对外的 API,用户通过 Config 使用D ubbo,隐藏 Dubbo 所有细节。 **dubbo-container ** 容器模块:是一个 Standlone 的容器,以简单的 Main 加载 Spring 启动, 因为服务通常不需要 Tomcat/JBoss 等 Web 容器的特性,没必要用 Web 容器去加载服务。 整体上按照分层结构进行分包,与分层的不同点在于: container 为服务容器,用于部署运行服务,没有在层中画出。 protocol 层和 proxy 层都放在 rpc 模块中,这两层是 rpc 的核心,在不需要集群也就是只有一个提供者时,可以只使用这两层完成 rpc 调用。 transport 层和 exchange 层都放在 remoting 模块中,为 rpc 调用的通讯基础。 serialize 层放在 common 模块中,以便更大程度复用。 依赖关系 图例说明: 图中小方块 Protocol, Cluster, Proxy, Service, Container, Registry, Monitor 代表层或模块,蓝色的表示与业务有交互,绿色的表示只对 Dubbo 内部交互。 图中背景方块 Consumer, Provider, Registry, Monitor 代表部署逻辑拓扑节点。 图中蓝色虚线为初始化时调用,红色虚线为运行时异步调用,红色实线为运行时同步调用。 图中只包含 RPC 的层,不包含 Remoting 的层,Remoting 整体都隐含在 Protocol 中。 下面对各个模块进行分解介绍 dubbo-common 公共逻辑模块:包括 Util 类和通用模型。 作用提供一些工具类和通用模型例如com.alibaba.dubbo.common.URL: dubbo-remoting 远程通讯模块:相当于 Dubbo 协议的实现,如果 RPC 用 RMI协议则不需要使用此包。 dubbo-remoting-zookeeper 相当于 Zookeeper 客户端,与ZK 服务器通信 dubbo-remoting-api 定义Dubbo CLient和 Dubbo Server的接口规则 实现dubbo-remoting-api dubbo-remoting-grizzly,基于Grizzly实现。 dubbo-remoting-http,基于Jetty或Tomcat实现。 dubbo-remoting-mina,基于Mina实现。 dubbo-remoting-netty,基于Netty 3实现。 dubbo-remoting-netty4,基于Netty 4实现。 dubbo-remoting-p2p,P2P 服务器。注册中心dubbo-registry-multicast项目的使用该项目。 dubbo-rpc 远程调用模块:抽象各种协议,以及动态代理,只包含一对一的调用,不关心集群的管理 集群相关的管理,由dubbo-cluster提供特性 dubbo-rpc-api 抽象各种协议以及动态代理,实现了一对一的调用。 其他模块,实现dubbo-rpc-api,提供对应的协议实现 协议参考手册 dubbo-rpc-default 对应dubbo://协议。 dubbo-cluster 集群模块:将多个服务提供方伪装为一个提供方,包括:负载均衡, 集群容错,路由,分组聚合等。集群的地址列表可以是静态配置的,也可以是由注册中心下发。 ​ 注册中心下发,由dubbo-registry提供特性。 容错 com.alibaba.dubbo.rpc.cluster.Cluster接口 +com.alibaba.dubbo.rpc.cluster.support包。 Cluster 将 Directory 中的多个 Invoker 伪装成一个 Invoker,对上层透明,伪装过程包含了容错逻辑,调用失败后,重试另一个。 拓展参见《Dubbo 用户指南 —— 集群容错》和《Dubbo 开发指南 —— 集群扩展》文档。 目录 com.alibaba.dubbo.rpc.cluster.Directory接口 +com.alibaba.dubbo.rpc.cluster.directory包。 Directory 代表了多个 Invoker ,可以把它看成 List ,但与 List 不同的是,它的值可能是动态变化的,比如注册中心推送变更。 路由 com.alibaba.dubbo.rpc.cluster.Router接口 +com.alibaba.dubbo.rpc.cluster.router包。 负责从多个Invoker中按路由规则选出子集,比如读写分离,应用隔离等。 拓展参见《Dubbo 用户指南 —— 路由规则》和《Dubbo 开发指南 —— 路由拓展》文档。 配置 com.alibaba.dubbo.rpc.cluster.Configurator接口 +com.alibaba.dubbo.rpc.cluster.configurator包。 拓展参见《Dubbo 用户指南 —— 配置规则》文档。 负载均衡 com.alibaba.dubbo.rpc.cluster.LoadBalance接口 +com.alibaba.dubbo.rpc.cluster.loadbalance包。 LoadBalance 负责从多个 Invoker 中选出具体的一个用于本次调用,选的过程包含了负载均衡算法,调用失败后,需要重选。 拓展参见《Dubbo 用户指南 —— 负载均衡》和《Dubbo 开发指南 —— 负载均衡拓展》文档。 合并结果 com.alibaba.dubbo.rpc.cluster.Merger接口 +com.alibaba.dubbo.rpc.cluster.merger包。 合并返回结果,用于分组聚合。 拓展参见《Dubbo 用户指南 —— 分组聚合》和《Dubbo 开发指南 —— 合并结果扩展》文档。 整体流程如下: dubbo-registry 注册中心模块:基于注册中心下发地址的集群方式,以及对各种注册中心的抽象。 dubbo-registry-api,抽象注册中心的注册与发现接口。 其他模块,实现dubbo-registry-api,提供对应的注册中心实现。在《用户指南 —— 注册中心参考手册》中,可以看到每种注册中心的介绍。 另外,dubbo-registry-default对应 Simple 注册中心。 拓展参见《Dubbo 开发指南 —— 注册中心扩展》文档。 dubbo-monitor 监控模块:统计服务调用次数,调用时间的,调用链跟踪的服务 拓展参见《Dubbo 开发指南 —— 监控中心扩展》。 dubbo-config 配置模块:是 Dubbo 对外的 API,用户通过 Config 使用Dubbo,隐藏 Dubbo 所有细节。 dubbo-config-api,实现了API 配置和属性配置功能。 dubbo-config-spring,实现了XML 配置和注解配置功能。 dubbo-container 容器模块:是一个 Standlone 的容器,以简单的 Main 加载 Spring 启动, 因为服务通常不需要 Tomcat/JBoss 等 Web 容器的特性,没必要用 Web 容器去加载服务。 dubbo-container-api:定义了com.alibaba.dubbo.container.Container接口,并提供 加载所有容器启动的 Main 类。 实现 dubbo-container-api dubbo-container-spring,提供了com.alibaba.dubbo.container.spring.SpringContainer。 dubbo-container-log4j,提供了com.alibaba.dubbo.container.log4j.Log4jContainer。 dubbo-container-logback,提供了com.alibaba.dubbo.container.logback.LogbackContainer。 拓展参考《Dubbo 用户指南 —— 服务容器》和《Dubbo 开发指南 —— 容器扩展》文档。 dubbo-filter 过滤器模块:提供了内置的过滤器。 dubbo-filter-cache ,缓存过滤器。 拓展参考《Dubbo 用户指南 —— 结果缓存》和《Dubbo 开发指南 —— 缓存拓展》文档。 dubbo-filter-validation ,参数验证过滤器。 拓展参考《Dubbo 用户指南 —— 参数验证》和《Dubbo 开发指南 —— 验证扩展》文档。 dubbo-plugin 过滤器模块:提供了内置的插件。 dubbo-qos ,提供在线运维命令。 拓展参考《Dubbo 用户指南 —— 新版本 telnet 命令使用说明》和《Dubbo 开发指南 —— Telnet 命令扩展》文档。 hessian-lite hessian-lite:Dubbo 对Hessian 2的序列化部分的精简、改进、BugFix 。 提交历史如下: dubbo-demo dubbo-demo快速启动示例。 参见《Dubbo 用户指南 —— 快速启动》文档。 dubbo-test dubbo-test测试模块。 在此我向大家推荐一个架构学习交流群。交流学习群号:821169538 里面会分享一些资深架构师录制的视频录像:有Spring,MyBatis,Netty源码分析,高并发、高性能、分布式、微服务架构的原理,JVM性能优化、分布式架构等这些成为架构师必备的知识体系。还能领取免费的学习资源,目前受益良多。 dubbo-test-benchmark ,性能测试。 dubbo-test-compatibility ,兼容性测试。 dubbo-test-spring3,测试对 Spring 3 的兼容性。 dubbo-test-example,使用示例。 Maven POM dubbo-dependencies-bom dubbo-dependencies-bom/pom.xml,Maven BOM(Bill Of Materials) ,统一定义了 Dubbo 依赖的三方库的版本号: dubbo-parent会引入该 BOM : dubbo-bom dubbo-bom/pom.xml,Maven BOM(Bill Of Materials) ,统一定义了 Dubbo 的版本号: dubbo-parent dubbo/pom.xml,Dubbo Parent Pom 。 Dubbo 的 Maven 模块,都会引入该 pom 文件。以dubbo-cluster举例子: 出处:http://wsccoder.top/2018/10/15/Dubb

优秀的个人博客,低调大师

深度解析volatile—底层实现

我们都知道,Java关键字volatile的作用 1、内存可见性 2、禁止指令重排序 可见性是指,在多线程环境,共享变量的操作对于每个线程来说,都是内存可见的,也就是每个线程获取的volatile变量都是最新值;并且每个线程对volatile变量的修改,都直接刷新到主存。 下面重点介绍指令重排序。 为什么要指令重排序? 为了提高程序执行的性能,编译器和执行器(处理器)通常会对指令做一些优化(重排序) 1、编译器重排序。编译器在不改变单线程程序语义的前提下,可以重新安排语句的执行顺序; 2、处理器重排序。如果不存在数据依赖性,处理器可以改变语句对应机器指令的执行顺序; 学过《编译原理》同学应该知道,现代高级编程语言的编译器,实现都很复杂。 编译器基本构造包括:语法分析、词法分析、语义分析、中间代码生成、指令优化、目标代码产生。 第一阶段:编译器优化,就是发生在编译阶段,就Java而言,就是java源码编译生成class字节码的时候,对编译生成的中间代码进行的一次指令优化。Java的编译器是javac.exe。 第二阶段:执行器(处理器)优化,和不同的处理器硬件厂商的实现有关,也和Java的执行器(java.exe,也称Java解释器)有关。执行器优化,是对于机器指令在目标平台的机器上运行,做的一层优化。 我们知道,现代高级编程语言,经过编译后,产生目标代码,如.java的源文件编译后生成.class字节码文件,.cpp源文件经过C++编译器编译后生成.o对象文件。 这些编译后生成的文件,不能直接在机器上运行,而是需要转化成特定平台的机器指令。机器能够运行的指令,是需要这个平台、这个机器能正确识别的。 相同的一份源码,最终转化成不同平台上的机器指令,是不同的。 这也更容易理解:汇编指令,并不是跨平台的。Windows下通常使用Intel汇编,而Linux下多用AT&T汇编,它们在语法上存在差异,运行效果也依赖于各自平台的实现。 在Java中,为了提高运行效率,javac编译器,和java解释器,在2个阶段分别对指令进行了优化,也就是重排序。 Java重排序的前提:在不影响 单线程运行结果的前提下进行重排序。也就是在单线程环境运行,重排序后的结果和重排序之前按代码顺序运行的结果相同。 指令重排序对单线程没有什么影响,它不会影响程序的运行结果,但是会影响多线程的正确性。 Java因为指令重排序,优化我们的代码,让程序运行更快,也随之带来了多线程下,指令执行顺序的不可控。既然指令重排序会影响到多线程执行的正确性,那么我们就需要某些情景下禁止重排序。Java提供给我们禁止重排序能力的操作——就是volatile。 那么JVM的volatile是如何禁止重排序的呢? 在具体探究之前,我们先看另一个原则happens-before,happen-before原则保证了程序的“有序性”,它规定如果两个操作的执行顺序无法从happens-before原则中推到出来,那么他们就不能保证有序性,可以随意进行重排序。其定义如下: 1、同一个线程中的,前面的操作 happen-before 后续的操作。(即单线程内按代码顺序执行。但是,在不影响在单线程环境执行结果的前提下,编译器和处理器可以进行重排序,这是合法的。换句话说,这一是规则无法保证编译重排和指令重排)。 2、监视器上的解锁操作 happen-before 其后续的加锁操作。(Synchronized 规则) 3、对volatile变量的写操作 happen-before 后续的读操作。(volatile 规则) 4、线程的start() 方法 happen-before 该线程所有的后续操作。(线程启动规则) 5、线程所有的操作 happen-before 其他线程在该线程上调用 join 返回成功后的操作。 6、如果 a happen-before b,b happen-before c,则a happen-before c(传递性)。 在JVM中,将Happens-Before的程序顺序规则与其他某个顺序规则(通常是监视器锁规则、volatile变量规则)结合起来,从而对某个未被锁保护的变量的访问操作进行排序。 我们着重看第三点volatile规则:对volatile变量的写操作 happen-before 后续的读操作。为了实现volatile内存语义,JMM会重排序,其规则如下: 是否重排序 第二个操作 第一个操作 普通读/写 volatile读 volatile写 普通读/写 volatile读 NO NO NO volatile写 NO NO 为了探究volatile底层的实现原理,进行了如下探究。 通过javap 命令,将字节码文件反编译。观察反编译的结果,对于volatile修饰的变量,发现反编译得到的代码并没有什么帮助,和不加volatile修饰的变量没有任何区别。也就是说,字节码层面volatile变量并没有什么不同。 下面通过查看Java的汇编指令,查看Java代码最真实的运行细节。 如何查看Java的汇编指令,可以阅读:https://www.jianshu.com/p/93821b08e774 通过使用-XX:+UnlockDiagnosticVMOptions -XX:+PrintAssembly IDEA打印出了源代码的汇编指令。我们看到红色线框里面的那行指令:putstatic a ,将静态变量a入栈,注意观察add指令前面有一个lock前缀指令。 加入volatile关键字和没有加入volatile关键字时所生成的汇编代码发现,加入volatile关键字时,会多出一个lock前缀指令。我们发现,volatile变量在字节码级别没有任何区别,在汇编级别使用了lock指令前缀。 lock是一个指令前缀,Intel的手册上对其的解释是: Causes the processor's LOCK# signal to be asserted during execution of the accompanying instruction (turns the instruction into an atomic instruction). In a multiprocessor environment, the LOCK# signal insures that the processor has exclusive use of any shared memory while the signal is asserted. 简单理解也就是说,lock后就是一个原子操作。原子操作是指不会被线程调度机制打断的操作;这种操作一旦开始,就一直运行到结束,中间不会有任何 context switch (切换到另一个线程)。 当使用 LOCK 指令前缀时,它会使 CPU 宣告一个 LOCK# 信号,这样就能确保在多处理器系统或多线程竞争的环境下互斥地使用这个内存地址。当指令执行完毕,这个锁定动作也就会消失。 是不是感觉有点像Java的synchronized锁。但volatile底层使用多核处理器实现的lock指令,更底层,消耗代价更小。 因此有人将Java的synchronized看作重量级的锁,而volatile看作轻量级的锁 并不是全无道理。 lock前缀指令其实就相当于一个内存屏障。内存屏障是一组CPU处理指令,用来实现对内存操作的顺序限制。volatile的底层就是通过内存屏障来实现的。 编译器和执行器 可以在保证输出结果一样的情况下对指令重排序,使性能得到优化。插入一个内存屏障,相当于告诉CPU和编译器先于这个命令的必须先执行,后于这个命令的必须后执行。正如去西藏途中各个站点的先后顺序在你心中都一清二楚。 内存屏障另一个作用是强制更新一次不同CPU的缓存。例如,一个写屏障会把这个屏障前写入的数据刷新到缓存,这样任何试图读取该数据的线程将得到最新值,而不用考虑到底是被哪个cpu核心或者哪个CPU执行的。这正是volatile实现内存可见性的基础。 内存屏障细说来有写屏障、读屏障、读写屏障,而且内存屏障的实现依赖于编译器和机器两部分。 编译器在编译过程中可能会对指令重排序,这样开发者通过显式地标注告知编译器,避免编译器最终生成的代码行为违背预期,对于 Java 而言,不光生成的 bytecode 需要保存 volatile 的语义,连运行时的 JIT 代码的行为也要遵守相应的约束;即插入内存屏障后,告诉CPU和编译器先于这个命令的必须先执行,后于这个命令的必须后执行,从而实现了禁止重排序。 关于内存屏障的一些具体细节,大佬Martin写了一篇文章《going into memory barriers》介绍,外网可以看看。 小结: 1、Java重排序的前提:在不影响 单线程运行结果的前提下进行重排序。也就是在单线程环境运行,重排序后的结果和重排序之前按代码顺序运行的结果相同。 2、指令重排序对单线程没有什么影响,它不会影响程序的运行结果,反而会优化执行性能,但会影响多线程的正确性。 3、Java因为指令重排序,优化我们的代码,让程序运行更快,也随之带来了多线程下,指令执行顺序的不可控。 4、volatile的底层是通过lock前缀指令、内存屏障来实现的。 存档文章 查看Java的汇编指令 终于有人把Java内存模型(JMM)说清楚了 JVM体系结构-----深入理解内存结构 从多核硬件架构,看Java内存模型

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册