首页 文章 精选 留言 我的

精选列表

搜索[AI原生解析],共10000篇文章
优秀的个人博客,低调大师

解析HetuEngine实现On Yarn原理

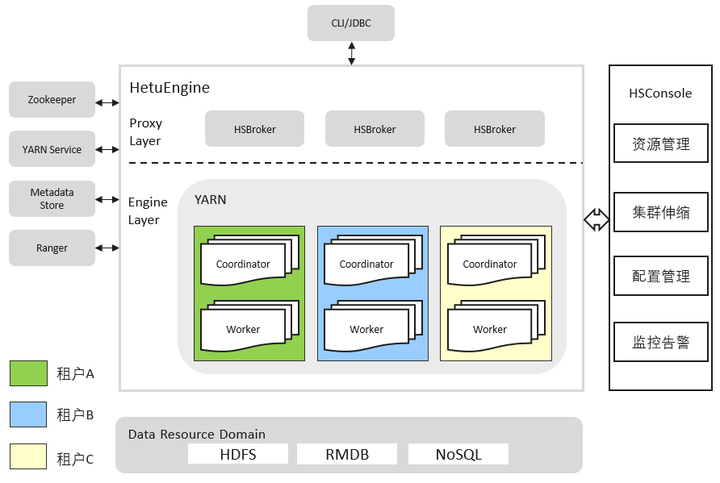
摘要:本文介绍HetuEngine实现On Yarn的原理,通过阅读本文,读者可以了解HetuEngine如何在资源使用方面融入Hadoop生态体系。 本文分享自华为云社区《MRS HetuEngine 特性之 On Yarn原理介绍》,作者:一颗柠檬。 HetuEngine是华为自研高性能分布式SQL查询&数据虚拟化引擎。与大数据生态无缝融合,实现海量数据秒级查询;支持多源异构协同,使能数据湖内一站式SQL融合分析。在整合开源能力的同时,MRS HetuEngine相较于开源社区也做了大量的优化,其中一个重要的特性就是On Yarn。 什么是On Yarn? 顾名思义,就是将进程运行在Yarn上,由Yarn进行资源的管理和调度。 不论是TrinoDB/PrestoDB还是openLooKeng,部署方式都是将coordinator和worker进程直接运行在主机上,与主机上的其他应用程序共享资源,无法做到资源隔离,并且难以扩展。 MRS HetuEngine借助Yarn Service提供的能力,将coordinator和worker进程以Yarn application的形式运行在Yarn container中,通过MRS集群的租户划分,可以将HetuEngine计算实例启动在特定租户队列里,从而实现资源隔离。 HetuEngine架构 下图是HetuEngine的拓扑图。HetuEngine向下可以对接各类数据源(比如Hive,GaussDB,HBASE,Elasticsearch等),对外向用户提供CLI/JDBC接口。在同一套MRS集群中,HetuEngine可以在不同租户队列中启动多个HetuEngine计算实例,支持一个租户队列上启动一个计算实例。由HetuEngine的HSBroker实例与Yarn Service交互,将租户队列与计算实例绑定,由HSConsole提供运维管理页面,对HetuEngine的多个计算实例进行运维管理操作,包括启动、停止、删除计算实例,对计算实例进行资源配置,扩缩容等。 HetuEngine On Yarn原理 如前所述,On Yarn就是把进程运行在了Yarn 的container中。HetuEngine 是如何实现将coordinator 和worker运行中Yarn中呢? Yarn Service提供了一系列API以及一个通用的AM,让用户可以调用API即可将任务提交到Yarn上,由Yarn实现任务的容器化,对容器进行资源和生命周期管理。详细请参考开源社区的介绍。https://hadoop.apache.org/docs/r3.1.0/hadoop-yarn/hadoop-yarn-site/yarn-service/Overview.html HetuEngine的 On Yarn实现正是借助了Yarn Service所提供的能力。在HetuEngine的HSBroker中,调用Yarn Service的API,拉起application,在container中运行HetuEngine自己的进程,也就是coordinator和worker。其中有以下几个关键点: Yarn Service API 创建一个Yarn Service服务的接口是/app/v1/services,参数json结构如下。 POST /app/v1/services { "name": "hello-world", "version": "1.0.0", "description": "hello world example", "components" : [ { "name": "hello", "number_of_containers": 1, "artifact": { "id": "nginx:latest", "type": "DOCKER" }, "launch_command": "./start_nginx.sh", "resource": { "cpus": 1, "memory": "256", "additional" : { "yarn.io/gpu" : { "value" : 4, "unit" : "" } } } } ] name:服务名称,显示在Yarn的resource manager WEB界面servicename; version:版本号 description:服务的描述 components:一个service中可以包含多个component,以运行不同的任务; components.name:component名称 number_of_containers:此component中container的数量; artifact:进程依赖的资源文件,包含id和type信息,type支持docker和tarball launch_command:进程启动命令 resource:此component所需的资源。 HetuEngine的HSBroker根据用户输入构造此json,然后调用Yarn Service API,实现On Yarn。此外Yarn Service还提供stop/delete等API,也由HSBroker调用,实现对HetuEngine计算实例的停止/删除等运维操作。 依赖文件 Yarn Service支持资源文件在HDFS上的形式启动进程,其提供的API可以接收tar包以及docker等形式的资源文件,由Yarn Service自行将HDFS上的文件进行资源本地化。因此,HetuEngine只需将依赖的jar包和资源文件提前部署在HDFS上的指定位置,在调用Yarn Service的API时指定资源文件即可。 租户绑定 HetuEngine支持将计算实例与Yarn的租户队列绑定,每个队列上都可以运行一套coordinator + worker的组合。基于前面Yarn Service能力,只需在构造json时,指定队列信息即可。除了队列,还可以设置container的放置策略(plecement policy),这里不进行详述,可以参考yarn的文档。 资源管理 HetuEngine支持用户自定义coordinator和worker的个数以及CPU内存大小。如下图,在HetuEngine的HSConsole页面,用户可以设置计算实例的CPU,内存,节点个数。内部实现是由HSBroker接收用户输入,将container运行所需的资源大小设置在json的resource段中。 当前HetuEngine支持横向扩展worker的个数,实现资源的弹性伸缩。即使在计算实例处于运行中时,也可以手动调整worker的个数,无需重启计算实例。这得益于Yarn Service的API中提供的flex接口,可以实现向一个运行中的application增加或者减少container的数量。 客户端使用 HetuEngine的计算实例创建完成后,用户可以通过hetu-cli或者JDBC程序进行访问,需要用户绑定对应的租户队列权限,才能向指定的队列提交任务。 Hetu CLI示例: hetu-cli --catalog hive --tenant tenantName --schema schemaName 租户名:(可选)租户名。指定HetuEngine启动的租户资源队列,不指定为租户的默认队列。使用此参数时,kinit的用户需要具有该租户对应角色的权限。 Hetu JDBC示例: Properties properties = new Properties(); ...… properties.setProperty("tenant", "default"); properties.setProperty("deploymentMode", "on_yarn"); …… connection = DriverManager.getConnection(url, properties); …… 本文主要介绍了HetuEngine On Yarn的原理,其实现主要是借助了Yarn Service提供的能力,感兴趣的读者可以深入阅读开源社区相关的介绍。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

@vue/composition-api 解析

前言 组合式 API 是 vue3 提出的一个新的开发方式,而在 vue2 中我们可以使用新的组合式 API 进行组件开发。本篇通过一个例子,来分析这个插件是如何提供功能。 关于该插件的安装、使用,可以直接阅读文档。 安装 我们从最开始安装分析,一探究竟。 vue.use 按照文档所提到的,我们必须通过 Vue.use() 进行安装: // vue.use 安装 import Vue from 'vue' import VueCompositionAPI from '@vue/composition-api' Vue.use(VueCompositionAPI) 复制代码 我们先看入口文件: // index.js import type Vue from 'vue' import { Data, SetupFunction } from './component' import { Plugin } from './install' export default Plugin // auto install when using CDN if (typeof window !== 'undefined' && window.Vue) { window.Vue.use(Plugin) } 复制代码 可以知道我们 Vue.use 时,传入的就是 install 文件中的 Plugin 对象。 // install.ts 折叠源码 export function install(Vue: VueConstructor) { if (isVueRegistered(Vue)) { if (__DEV__) { warn( '[vue-composition-api] already installed. Vue.use(VueCompositionAPI) should be called only once.' ) } return } if (__DEV__) { if (Vue.version) { if (Vue.version[0] !== '2' || Vue.version[1] !== '.') { warn( `[vue-composition-api] only works with Vue 2, v${Vue.version} found.` ) } } else { warn('[vue-composition-api] no Vue version found') } } Vue.config.optionMergeStrategies.setup = function ( parent: Function, child: Function ) { return function mergedSetupFn(props: any, context: any) { return mergeData( typeof parent === 'function' ? parent(props, context) || {} : undefined, typeof child === 'function' ? child(props, context) || {} : undefined ) } } setVueConstructor(Vue) mixin(Vue) } export const Plugin = { install: (Vue: VueConstructor) => install(Vue), } 复制代码 install 通过上面的代码和 Vue.use 可知,我们安装时其实就是调用了 install 方法,先分析一波 install。根据代码块及功能可以分成三个部分: 前两个大 if 的开发 check 部分 关于 setup 合并策略 通过 mixin 混入插件关于 组合式 API 的处理逻辑 第一部分中的第一个 if 是为了确保该 install 方法只被调用一次,避免浪费性能;第二个 if 则是确保vue版本为2.x。不过这里有个关于第一个if的小问题:多次注册插件时,Vue.use 自己本身会进行重复处理——安装过的插件再次注册时,不会调用 install 方法(Vue.use代码见下)。那么这个 if 的目的是啥? // Vue.use 部分源码 Vue.use = function (plugin: Function | Object) { const installedPlugins = (this._installedPlugins || (this._installedPlugins = [])) if (installedPlugins.indexOf(plugin) > -1) { return this } // additional parameters const args = toArray(arguments, 1) args.unshift(this) if (typeof plugin.install === 'function') { plugin.install.apply(plugin, args) } else if (typeof plugin === 'function') { plugin.apply(null, args) } installedPlugins.push(plugin) return this } 复制代码 根据上面代码可知 Vue.use 实际上还是传入 vue 并调用插件的 install 方法,那么如果有大神(或者是奇葩?)绕过 Vue.use 直接调用,那么这个 if 的判断就生效了。如下方代码,此时第二个 install 会判断重复后,抛出错误 // 直接调用 install import Vue from 'vue' import VueCompositionAPI from '@vue/composition-api' import App from './App.vue' Vue.config.productionTip = false VueCompositionAPI.install(Vue) VueCompositionAPI.install(Vue) 复制代码 报错: 第二部分的合并策略是“Vue.config.optionMergeStrategies”这个代码块。Vue 提供的这个能力很生僻,我们日常的开发中几乎不会主动接触到。先上文档: 这是用来定义属性的合并行为。比如例子中的 extend 在调用时,会执行 mergeOptions。 // Vue.extend Vue.extend = function (extendOptions) { const Super = this extendOptions = extendOptions || {} Sub.options = mergeOptions( Super.options, extendOptions ) } 复制代码 而 mergeOptions 里关于 _my_option的相关如下: const strats = config.optionMergeStrategies function mergeOptions (parent, child, vm){ for (key in parent) { mergeField(key) } for (key in child) { if (!hasOwn(parent, key)) { mergeField(key) } } function mergeField (key) { const strat = strats[key] || defaultStrat options[key] = strat(parent[key], child[key], vm, key) } } 复制代码 这里的 parent 就是 Super.options 也就是 Vue.options,而 child 就是 extendOptions 也就是我们传入的 { _my_option: 1 }。在这里使用了两个 for 循环,确保父子元素种所有的 key 都会执行到 mergeField,而第二个 for 循环中的 if 判断确保不会执行两次,保证了正确性及性能。而 mergeField 则是最终执行策略的地方。从 strats 中获取到我们定义的方法,把对应参数传入并执行,在这里就是: // demo执行 strat(undefined, 1, vm, '_my_option') // return 2 复制代码 顺便一提,Vue.mixin 的实现就是 mergeOptions,也就是说当我们使用了 mixin 且里面具有 setup 属性时,会执行到上述合并策略。 Vue.mixin = function (mixin) { this.options = mergeOptions(this.options, mixin) return this } 复制代码 而我们插件中相关的策略也很简单,获取好定义的父子 setup,然后合并成一个新的,在调用时会分别执行父子 setup,并通过 mergeData 方法合并返回: // optionMergeStrategies.setup Vue.config.optionMergeStrategies.setup = function ( parent: Function, child: Function ) { return function mergedSetupFn(props: any, context: any) { return mergeData( typeof parent === 'function' ? parent(props, context) || {} : undefined, typeof child === 'function' ? child(props, context) || {} : undefined ) } } 复制代码 第三部分则是通过调用 mixin 方法向 vue 中混入一些事件,下面是 mixin 的定义: function mixin(Vue) { Vue.mixin({ beforeCreate: functionApiInit, mounted(this: ComponentInstance) { updateTemplateRef(this) }, updated(this: ComponentInstance) { updateTemplateRef(this) } }) function functionApiInit() {} function initSetup() {} // 省略... } 复制代码 可以看到 mixin 内部调用了 Vue.mixin 来想 beforeCreate、mounted、updated 等生命周期混入事件。这样就完成 install 的执行, Vue.use(VueCompositionAPI) 也到此结束。 初始化 — functionApiInit functionApiInit 执行 我们知道在new Vue 时,会执行组件的 beforeCreate 生命周期。此时刚才通过 Vue.mixin 注入的函数 “functionApiInit”开始执行。 function Vue (options) { this._init(options) } Vue.prototype._init = function (options) { initLifecycle(vm) initEvents(vm) initRender(vm) callHook(vm, 'beforeCreate') // 触发 beforeCreate 生命周期,执行 functionApiInit initInjections(vm) // resolve injections before data/props initState(vm) initProvide(vm) // resolve provide after data/props callHook(vm, 'created') } 复制代码 该方法也很清晰,分别暂存了组件最开始的 render方法和 data方法(我们平常写的 data 是一个函数),然后在这基础上又扩展了一下这两个方法,达到类似钩子的目的。 function functionApiInit(this: ComponentInstance) { const vm = this const $options = vm.$options const { setup, render } = $options if (render) { // keep currentInstance accessible for createElement $options.render = function (...args: any): any { return activateCurrentInstance(vm, () => render.apply(this, args)) } } if (!setup) { return } if (typeof setup !== 'function') { if (__DEV__) { warn( 'The "setup" option should be a function that returns a object in component definitions.', vm ) } return } const { data } = $options // wrapper the data option, so we can invoke setup before data get resolved $options.data = function wrappedData() { initSetup(vm, vm.$props) return typeof data === 'function' ? (data as ( this: ComponentInstance, x: ComponentInstance ) => object).call(vm, vm) : data || {} } } 复制代码 虽然是先扩展的 render,但在 new Vue 的实际执行中会优先执行下方扩展的方法 “wrappedData”。因为 data 的执行是在 new Vue 时发生,而 render 的执行在 $mount 中。所以我们这里就按照执行顺序来看看如何扩展我们的 wrappedData。 wrappedData 这里只是简单执行了 initSetup 方法,对原先的 data 做了判断。这里是因为 Vue 执行时拿到的 data 已经是 wrappedData 这个函数而不是用户编写的 data,所以关于原 data 的处理移交在了 wrappedData 中。可以说 99%的逻辑都在 initSetup 中。我们接下来看这个方法。 setup 调用及处理 这块是通过 initSetup 函数实现的,代码很长且仅有几行是这里不用关心的(可自行研究),整体上可以跟着注释走一遍。 function initSetup(vm: ComponentInstance, props: Record<any, any> = {}) { // 获取定义好的 setup const setup = vm.$options.setup! // 创建 setup 方法接收的第二个参数 context,主流程中使用不上,先忽略 const ctx = createSetupContext(vm) // fake reactive for `toRefs(props)` // porps 相关,主流成可先忽略(毕竟可以不写 props...) def(props, '__ob__', createObserver()) // resolve scopedSlots and slots to functions // slots 相关,同 props 先忽略 // @ts-expect-error resolveScopedSlots(vm, ctx.slots) let binding: ReturnType<SetupFunction<Data, Data>> | undefined | null // 执行 setup activateCurrentInstance(vm, () => { // make props to be fake reactive, this is for `toRefs(props)` binding = setup(props, ctx) }) // 以下都是根据 setup 返回值,进行的一些处理 if (!binding) return if (isFunction(binding)) { // setup 可以返回一个渲染函数(render) // keep typescript happy with the binding type. const bindingFunc = binding // keep currentInstance accessible for createElement // 获取到渲染函数后,手动添加再 vue 实例上 vm.$options.render = () => { // @ts-expect-error resolveScopedSlots(vm, ctx.slots) return activateCurrentInstance(vm, () => bindingFunc()) } return } else if (isPlainObject(binding)) { // setup 返回的是一个普通对象 if (isReactive(binding)) { // 如果返回的是通过 reactive 方法定义的对象,需要通过 toRefs 结构 binding = toRefs(binding) as Data } // 用于 slots 及 $refs ,先忽略 vmStateManager.set(vm, 'rawBindings', binding) const bindingObj = binding // 遍历返回值,做一些处理 Object.keys(bindingObj).forEach((name) => { let bindingValue: any = bindingObj[name] if (!isRef(bindingValue)) { if (!isReactive(bindingValue)) { if (isFunction(bindingValue)) { bindingValue = bindingValue.bind(vm) } else if (!isObject(bindingValue)) { bindingValue = ref(bindingValue) } else if (hasReactiveArrayChild(bindingValue)) { // creates a custom reactive properties without make the object explicitly reactive // NOTE we should try to avoid this, better implementation needed customReactive(bindingValue) } } else if (isArray(bindingValue)) { bindingValue = ref(bindingValue) } } asVmProperty(vm, name, bindingValue) }) return } // 不是对象和方法时,在开发环境下抛错 if (__DEV__) { assert( false, `"setup" must return a "Object" or a "Function", got "${Object.prototype.toString .call(binding) .slice(8, -1)}"` ) } } 复制代码 我们先聚焦到 setup 的执行。setup 包裹在 activateCurrentInstance 方法中,activateCurrentInstance 目的是为了设置当前的实例。类似我们平常写的交换a、b变量的值。setup 在调用前,会先获取 currentInstance 变量并赋值给 preVm,最开始时currentInstance 为 null。接着再把 currentInstance 设置成当前的 vue 实例,于是我们变可以在 setup 通过 插件提供的 getCurrentInstance 方法获取到当前实例。在执行完毕后,又通过 setCurrentInstance(preVm) 把 currentInstance 重置为null。所以印证了文档中所说的,只能在 setup 及生命周期(不在本篇重点)中使用 getCurrentInstance 方法。 // setup执行 activateCurrentInstance(vm, () => { // make props to be fake reactive, this is for `toRefs(props)` binding = setup(props, ctx) }) function activateCurrentInstance(vm, fn, onError) { let preVm = getCurrentVue2Instance() setCurrentInstance(vm) try { return fn(vm) } catch (err) { if (onError) { onError(err) } else { throw err } } finally { setCurrentInstance(preVm) } } let currentInstance = null function setCurrentInstance(vm) { // currentInstance?.$scopedSlots currentInstance = vm } function getCurrentVue2Instance() { return currentInstance } function getCurrentInstance() { if (currentInstance) { return toVue3ComponentInstance(currentInstance) } return null } 复制代码 这里有个思考,为什么需要在最后把 currentInstance 设置为 null?我们写了一个点击事件,并在相关的事件代码里调用了getCurrentInstance 。如果在 setup 调用重置为 null ,那么在该事件里就可能导致获取到错误的 currentInstance。于是就置为null 用来避免这个问题。(个人想法,期待指正)。 setup 内部可能会执行的东西有很多,比如通过 ref 定义一个响应式变量,这块放在后续单独说。 当获取完 setup 的返回值 binding 后,会根据其类型来做处理。如果返回函数,则说明这个 setup 返回的是一个渲染函数,便把放回值赋值给 vm.$options.render 供挂载时调用。如果返回的是一个对象,则会做一些相应式处理,这块内容和响应式相关,我们后续和响应式一块看。 // setup 返回对象 if (isReactive(binding)) { binding = toRefs(binding) as Data } vmStateManager.set(vm, 'rawBindings', binding) const bindingObj = binding Object.keys(bindingObj).forEach((name) => { let bindingValue: any = bindingObj[name] if (!isRef(bindingValue)) { if (!isReactive(bindingValue)) { if (isFunction(bindingValue)) { bindingValue = bindingValue.bind(vm) } else if (!isObject(bindingValue)) { bindingValue = ref(bindingValue) } else if (hasReactiveArrayChild(bindingValue)) { // creates a custom reactive properties without make the object explicitly reactive // NOTE we should try to avoid this, better implementation needed customReactive(bindingValue) } } else if (isArray(bindingValue)) { bindingValue = ref(bindingValue) } } asVmProperty(vm, name, bindingValue) }) 复制代码 我们这里只看重点函数 “asVmProperty”。我们知道 setup 返回的是一个对象 (赋值给了 binding / bindingObj),且里面的所有属性都能在 vue 的其他选项中使用。那么这块是如何实现的呢? 访问 setup 返回值 — asVmProperty 实现 这个函数执行后,我们就可以在 template 模版及 vue 选项中访问到 setup 的返回值,的下面是“asVmProperty” 这个函数的实现: function asVmProperty(vm, propName, propValue) { const props = vm.$options.props if (!(propName in vm) && !(props && hasOwn(props, propName))) { if (isRef(propValue)) { proxy(vm, propName, { get: () => propValue.value, set: (val: unknown) => { propValue.value = val }, }) } else { proxy(vm, propName, { get: () => { if (isReactive(propValue)) { ;(propValue as any).__ob__.dep.depend() } return propValue }, set: (val: any) => { propValue = val }, }) } } } function proxy(target, key, { get, set }) { Object.defineProperty(target, key, { enumerable: true, configurable: true, get: get || noopFn, set: set || noopFn, }) } 复制代码 函数很短,这里有3个处理逻辑: 普通属性的 get 和 set 正常返回 如果是 ref 类型的属性(通过 ref 创建),通过 vm.xxx 访问/修改时,访问/修改 ref 的 value 属性 代理 reactive 类型的属性 (通过 reactive 创建),reactive 返回的是一个响应式对象。当访问这个对象时, 需要调用 响应式对象种的 depend 收集watcher(观察者),以便数据更新时通知 watcher 进行更新。 总之 asVmProperty 是拿到 setup 返回值中的一个键值对后,再通过 Object.defineProperty 劫持了 this(是vm,也就是组件实例)中访问改键值对的 get 和 set,这样我们便可以通过 this.xxx 访问到 setup 中return 出去的属性。 而模版访问也同理,因为 template 编译成 render 后,上面的变量都实际会编译成 _vm.xxx,而 _vm 就是 this ,也就是组件实例。 结语 创作不易,如果对大家有所帮助,希望大家点赞支持,有什么问题也可以在评论区里讨论😄~ 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star: http://github.crmeb.net/u/defu 不胜感激 ! 来自 “开源独尊 ” ,链接: https://ym.baisou.ltd/post/847.html
优秀的个人博客,低调大师

基本操作命令解析(续)

文章目录 1. 链接文件 (1)软链接: (2)硬链接: 2. 复制、删除、移动目录和文件 (1) cp (2)mv (3) rm 3. 查找目录和文件 (1) Which: (2) whereis (3)find 4. 查看文件内容 (1) cat (2) more (3) less (4) head (5) tail 5. 统计文件内容 6. 检索和过滤文件内容 (1) grep (2) cut (3) sort 7. 归档和压缩命令 (1) gzip命令、bzip2命令 (2)tar命令 8. 如何从linux 服务器上传/下载文件 9. vim 文档编辑 (1)vim工作模式 (2)vim光标操作: (3) vim编辑文档 (4)vim查找与替换 (5)vim保存并退出 (6)vim扩展小知识 1. 链接文件 (1)软链接: [root@rhcsa ~]# touch hello.txt [root@rhcsa ~]# ln -s /root/hello.txt /tmp/hi.txt //创建文件软链接 [root@rhcsa ~]# ll /tmp/hi.txt lrwxrwxrwx. 1 root root 15 Jan 27 17:36 /tmp/hi.txt -> /root/hello.txt [root@rhcsa ~]# mkdir test [root@rhcsa ~]# ln -s /root/test/ /var/test/ [root@rhcsa ~]# ll /var/test/ //创建目录软链接 total 0 lrwxrwxrwx. 1 root root 11 Jan 27 17:48 test -> /root/test/ (2)硬链接: [root@rhcsa ~]# ln /root/hello.txt /root/hello-1.txt //创建硬链接 [root@rhcsa ~]# rm -rf hello.txt //源文件删除后,链接文件仍可以正常使用 [root@rhcsa ~]# ll /root/hello-1.txt -rw-r--r--. 1 root root 0 Jan 27 17:34 /root/hello-1.txt 2. 复制、删除、移动目录和文件 (1) cp 功能描述:复制(copy)文件或目录 语法:cp [选项]… 源文件或目录… 目标文件或目录 选项: -r:递归复制整个目录树 -p:保持源文件的属性不变 -f:强制覆盖目标同名文件或目录 -i:需要覆盖文件或目录时进行提醒 (2)mv 功能描述:移动(move)文件或目录—若如果目标位置与源位置相同,则相当于改名 语法:mv [选项]... 源文件或目录... 目标文件或目录 [root@Gming ~]# mv file file.bak //将file改名为file.bak [root@Gming ~]# mv /tmp/vitest/ ./ //将/tmp/vitest/移动到当前目录 (3) rm 功能描述:删除(remove)文件或目录 语法:rm [选项] [文件或目录] 选项: -r 删除目录以及目录下的所有内容(递归删除) -f 不提示,强制删除 -I 删除前,提示是否删除 3. 查找目录和文件 (1) Which: 功能描述:查找linux命令文件并显示所在的位置----搜索范围由PATH环境变量指定 语法:which命令或程序名 [root@rhcsa tmp]# which cd /usr/bin/cd [root@rhcsa tmp]# which mkdir /usr/bin/mkdir [root@rhcsa tmp]# (2) whereis 功能描述:该指令会在特定目录中查找符合条件的文件。这些文件应属于原始代码、二进制文件,或是帮助文件。 该指令只会用于查找二进制文件、源代码文件和man手册页,一般文件的定位需使用locate命令。 语法:whereis 命令 选项: -b 只查找二进制文件 -m 只查找说明文件 [root@rhcsa tmp]# whereis bash bash: /usr/bin/bash /usr/share/man/man1/bash.1.gz /usr/share/info/bash.info.gz [root@rhcsa tmp]# whereis -b bash bash: /usr/bin/bash [root@rhcsa tmp]# whereis -m bash bash: /usr/share/man/man1/bash.1.gz /usr/share/info/bash.info.gz (3)find 功能描述:用于查找文件或目录 语法:find【path】-option 选项: -name 按文件名称查找 -size 按文件大小查找 -user 按文件属主查找 —用的不多 -type 按文件类型查找常用查找条件:  f:文件  d:目录  l:符号链接(软链接)高级查找条件: -perm 按权限进行查找 -ctime(-cmin) 按文件创建时间(天为单位)查找 -atime (-amin) 按访问时间查找 -mtime (-min) 修改时间查找 -maxdepth 限制find的递归层级 ! 取反操作 -exec 查找后再执行操作 find /etc -name "resol*.conf" # 查找/etc/下名字为resol开头以.conf结尾的文件 find / -type d -empty # 检索用户主目录下所有的空目录 find /usr -type f ! -name &apos;*.txt&apos; # 检索 /usr 下所有文件名不以 .txt 为后缀的文件。 按照时间相关 -mtime 2 :该文件 2 天前被修改过 -mtime -2:该文件 2 天以内被修改过 -mtime +2:该文件距离上次修改已经超过 2 天时间 find /usr -type f -mtime +50 -mtime -100 # 检索 /usr 下 50 到 100 天之前修改过的文件 find /usr -type f -mtime 2 -amin 5 # 检索 /usr 下两天前被修改过且 5 分钟前又读取过的文件 按照文件大小查找 find / -size +1G 检索文件大小高于 1 GB 的文件按照权限查找 find /usr -perm 644 # 搜索 /usr 目录下权限为 644(即 rw-r--r--)的文件 限制递归层级 find 命令默认是以递归的方式检索项目的,这有时候会导致得到的结果数量非常巨大。可以使用 -maxdepth 限制 find 命令递归的层数。 find / -maxdepth 3 # 搜索时向下递归的层数最大为 3 逻辑组合: find 命令支持 “and” 和 “or” 两种逻辑运算 find / -name *.log -a -type l #查找文件名有".log"并且类型为链接的文件 find / -name *.log -o -name "*.txt" #查找文件名为".log"或".txt"的文件 执行自定义命令 -exec 命令 {} ; find / -type f -exec grep -l root {} ; find /etc -name “*” | xargs grep -nH “root” # 查找/etc下 name所有 过滤出内容包含hello 的文件内容 4. 查看文件内容 (1) cat 功能描述:显示文件内容(文件内容全部显示出来) cat [选项] [文件] 选项: -b 显示行号,空白行不显示行号 -n 显示行号,包括空白行 [root@Gming ~]# cat -n passwd [root@Gming ~]# cat -b passwd (2) more 功能描述:全屏方式分页显示文件内容 语法:more [选项] 文件名… (空格)或f 显示下一页 (enter)显示下一行 Q或Q 退出 [root@Gming ~]# more /var/log/messages (3) less 功能描述:查看分页文件内容,空格(下一页)、方向键(上下回翻)、q键(推出查看) [root@Gming ~]# less /var/log/messages (4) head 功能描述:查看文件的前几行,默认显示前10行内容 语法:head [选项] [文件名] 语法: -c nk 显示文件前nkb的内容 -n 显示文件前n行的内容 [root@Gming ~]# head -c 2k /var/log/messages //查看文件的前2kb内容 [root@Gming ~]# head -5 /var/log/messages //查看文件前5行的内容 (5) tail 功能描述:查看文件的尾部内容 语法:tail [选项] [文件] 选项: -n 显示文件的后n行 -f 动态显示文件内容 -c nk 显示文件末尾nkb的内容 5. 统计文件内容 wc: 功能描述:统计文件中的单词数量(word count)等信息 语法:wc [选项]… 目标文件… 选项: -l 统计行数 -w 统计单词个数 -c 统计字节数 [root@Gming ~]# wc /etc/passwd 25 50 1229 /etc/passwd //依次显示文件的行数、单词数、字节数 [root@Gming ~]# wc -l < /etc/passwd 25 //显示文件的行数 [root@Gming ~]# wc -w < /etc/passwd 50 //显示文件的单词数 [root@Gming ~]# wc -c < /etc/passwd 1229 //显示文件的字节数 6. 检索和过滤文件内容 (1) grep 功能描述:在文件中查找并显示包含指定字符串的行 语法:grep [选项]… 查找条件 目标文件 常用命令选项: -i 查找时忽略大小写 -v 反转查找,输出与查找条件不相符的行 -l 列出文件内容符合指定的样式的文件名称 -An 搜索时显示匹配到的那一行以及下n行 -Bn 搜索时显示匹配到的那一行以及上n行 -Cn 搜索时显示匹配到的那一行以及上下n行 查找条件设置: 要查找的字符串用双引号括起来 “^……”表示以……开头 “……KaTeX parse error: Expected group after '^' at position 11: ”表示以……结尾 “^̲”表示空行 [root@Gming ~]# grep root /etc/passwd root: x:0:0:root:/root:/bin/bash //在/etc/passwd文件中过滤出包含root的行 operator:x11:0:operator:/root:/sbin/nologin [root@Gming ~]# grep --color root /etc/passwd //对匹配度的关键字高亮显示 [root@Gming ~]# grep -v root /etc/passwd //查找文件中不包含root的行 [root@Gming ~]# grep -v "^#" /etc/hosts //查找非注释行(不是以“#”开头的行) 显示/etc/passwd文件中以“lp”开头那一行以及上下4行内容: (2) cut 功能描述:命令用于显示每行从开头算起num1 到num2的文字 语法:cut [选项] 选项: -b 以字节为单位进行分割。这些字节位置将忽略多字节字符边界,除非也指定 -n标志 -c 以字符为单位进行分割 -d 自定义分隔符,默认为制定符 -f 与-d一起使用,指定显示哪个区域 -n 取消分割多字节字符。仅和-b标志一起使用 打印/etc/passwd文件中每一行以“:”为分隔符的第一个区域 [root@Gming ~]# cut -d':' -f1 /etc/passwd 在过滤/etc/passwd文件的’/bin/bash’后以“:”为分隔符打印第1,6行内容 [root@Gming ~]# grep '/bin/bash' /etc/passwd | cut -d':' -f1,6 root:/root redhat:/home/redhat (3) sort 功能描述:用于将文本文件内容加以排序 语法:sort [选项] [文件] 选项: -b 忽略每行前面开始处的空格字符 -c 检查文件是否已经按照顺序排序 -d 排序时,处理英文字母、数字及空格字符外,忽略其他的字符 -f 排序时,将小写字母视为大写字母 -m 将几个排序好的文件进行合并 -M 将前面的3个字母依照月份的缩写进行排序 -n 依照数值的大小排序 -r 以相反的顺序来排序 -u 以为这是唯一的(unique),输出结果是去掉重复值 -o<输出文件> 将排序后的结果存入指定的文件 -t<分隔字符> 指定分隔符 -k 与-t一起使用,定义排序数值区域 [root@Gming ~]# sort -t: -k3 -n /etc/passwd //以“:”为分隔符,按照第3行顺序排序 [root@Gming ~]# sort -u /etc/passwd //去掉连续重复的字符 [root@Gming ~]# sort -r /etc/passwd //反向排序 7. 归档和压缩命令 (1) gzip命令、bzip2命令 .gz :gzip程序压缩的⽂件 *.bz2 :bzip2程序压缩的⽂件 *.tar :tar程序打包的数据,并没有经过压缩 *.tar.gz :tar程序打包的⽂件,其中经过gzip的压缩 *.tar.bz2:tar程序打包的⽂件,其中经过bzip2的压缩 ⽤途:制作压缩⽂件、解开压缩⽂件 命令格式: gzip [-9] ⽂件名… bzip2 [-9] ⽂件名… gzip -d .gz格式的压缩⽂件 bzip2 -d *.bz2格式的压缩⽂件 常用命令选项: -9 表示高压缩比,多在创建压缩包时用 -d 用于解开已经压缩过的文件 (2)tar命令 用途:制作归档文件、释放归档文件 格式:tar [选项]… 归档文件名 源文件或目录 tar [选项]… 归档文件名 [-C 目标文件] 常用命令选项: -c 创建.tar格式的包文件 -x 解开.tar格式的包文件 -v 输出详细信息 -f 表示使用归档文件 -p 打包时保留原始文件及目录的权限 -t 列表查看包内的文件 -C解包时指定释放的目标文件夹 -z 调用gzip程序进行压缩或解压 -j 调用bzip2程序进行压缩或解压 创建: -czvf -cjvf 解压: -xzvf -xjvf 8. 如何从linux 服务器上传/下载文件 (1)客户端是linux的操作系统 服务器-服务器之间传输 从服务器下载普通文件: scp 用户名@目标IP地址:文件名 目录名 向服务器上传文件: srp 要上传文件的全路径 用户名@目标IP地址:文件名 (2)客户端是windows的操作系统 从windows向linux上传:rz或者xftp工具 从linux下载文件:sz 文件路径或者xftp工具 scp ./aaa.sh root@192.168.88.100:/tmp 从普通用户复制文件到root用户的/tmp/目录 scp root@192.168.88.100:/tmp/bbb.sh ./ 复制root用户文件到普通用户的当前位置 9. vim 文档编辑 (1)vim工作模式 vim编辑器默认会进⼊普通模式,插⼊模式可以通过以下按键进⼊: a 进⼊插⼊模式,后续输⼊的内容将插⼊⾄当前光标的后⾯ A 进⼊插⼊模式,后续输⼊的内容将插⼊⾄当前光标的断尾 i 进⼊插⼊模式,后续输⼊的内容将插⼊⾄当前光标的前⾯ I 进⼊插⼊模式,后续输⼊的内容将插⼊⾄当前光标的段⾸ o 进⼊插⼊模式并在当前⾏的后⾯创建新的空⽩⾏ O 进⼊插⼊模式并在当前⾏的前⾯创建新的空⽩⾏ (2)vim光标操作: h 光标向左移动⼀位 j 光标向下移动⼀⾏(以回⻋为换⾏符) k 光标向上移动⼀位 I 光标向右移动⼀位 gg 移动光标⾄⽂件⾸⾏ G 移动光标⾄⽂件末尾 nG 移动光标⾄第n⾏(n为数字,如n为10时表示第10⾏) ^ 光标移⾄当前⾏的⾸字符 $ 光标移⾄当前⾏的尾字符 fx 光标移⾄当前⾏的下⼀个x字符处(任意字符) Fx 光标移⾄当前⾏的上⼀个x字符处 w 光标向右移动⼀个单词 nw 光标向右移动n个单词(n为数字) b 光标向左移动⼀个单词 nb 光标向左移动n个单词(n为数组) (3) vim编辑文档 dd 删除⼀⾏ ndd 删除n⾏(n为数字) d$ 删除光标⾄⾏尾的内容 J 删除换⾏符,可以将两⾏合并为⼀⾏ u 撤销上⼀步操作,可以多次使⽤uu表示撤销两步操作 rx 将光标当前字符替换为x (x为任何键盘单个输⼊) yy 复制当前⾏ nyy 复制n⾏内容 p 粘贴⾄当前⾏之后 P 粘贴⾄当前⾏之前 (4)vim查找与替换 当⽂档很⻓时,我们可以通过查找快速定位要找的内容,在vim中通过“/” 关键词实现⾃上往下的查找功能: 如 /host 在当前⽂档的光标处向下查找host并显示,如果⼀个⽂档中有多个host,可以通过快捷键n 跳转⾄下⼀个匹配的关键词处, 快捷键 N 将跳转⾄上⼀个匹配的关键词处。 “?” 关键词实现了⾃下往上的查找功能: 如 ?host 从当前⽂档的光标处向上查找host并显示,此时快捷键n表示查看上⼀匹配, N 表示查找下⼀个匹配。 例如: [root@localhost ~]# cp /etc/passwd /root [root@localhost ~]# vim /root/passwd 通过上⾯两条命令复制⼀份临时测试⽂档并编辑,我们可以对该⽂件实现多种替换功能 : s/root/admin/ 将光标当前⾏中第⼀个出现的root替换为admin,没有则不替换 : s/root/admin/g 将光标当前⾏中所有的root替换为admin :3,5 s/sbin/bin/g 将第三⾏⾄第五⾏之间的所有sbin替换为bin :% s/nologin/fault/g 将所有⾏的nologin都替换为fault (5)vim保存并退出 :q! 不保存并退出(强制退出) :wq 保存并退出 :x 保存并退出 :w 保存(不退出) :w b.txt 另存为 b.txt (6)vim扩展小知识  显示行号::set number 或者简写为 :set nu  忽略大小写::set ignorecase  多窗口编辑 水平分割窗口 :split 垂直分割窗口 :vsplit Ctrl+w+h:快捷键表示跳转⾄左边⼀个窗⼝ Ctrl+w+I: 快捷键表示跳转⾄右边⼀个窗⼝ Ctrl+w+j: 快捷键表示跳转⾄上⾯⼀个窗⼝ Ctrl+w+k:快捷键表示跳转⾄下⾯⼀个窗⼝ 在命令模式下输⼊ :close 可以关闭当前窗⼝ 在命令模式下输⼊ :split second.txt 此命令会分割窗⼝并打开新的⽂件

优秀的个人博客,低调大师

PHP的面向对象解析

面向对象 早期编程由于受电脑硬件限制,程序都是追求效率,而忽略可理解性,扩充性,随着硬件技术的发展,编程越来越重视多人开发,程序员越来越重视程序的可靠性,可扩展性,可维护性,所以刺激了程序语言的发展 面向过程 程序员设计好程序代码流程图,辅助程序设计。优点:用什么功能就编写什么函数 缺点:数据管理上比较混乱 ,主要集中在函数成面上,面向对象把属性和方法进行封装,更好的可重用性和可扩展性 面向对象 万物皆对象,将构成问题的事务分解到各个对象上,建立对象的目的不是为了完成一个工作,而是为了描述某个事务在解决问题中的行为,更符合人的思维习惯,代码重用性高,可扩展性好 面向对象和面向过程的核心区别是如何分配职责。 类和对象 面向对象是由一系统具有属性和方法的对象构成,对象之间相互交互 ,从而实现业务需求。 属性 在类中定义的变量,即为成员属性,用于描述对象静态特性的数据。如人的姓名,性别,首字母小写 方法 函数定义在类中即为成员方法,用于描述对象动态特性的操作行为,方法名不区分大小写,不可重名,首字母小写 对象生命周期 创建后,生命周期开始,当程序结束后或程序员清除对象后即销毁,PHP会自动销毁对象 类是一种抽象的概念,是具有相同语义定义对象的集合(具有相同属性和方法的集体),使用具体的类是不可行的,只能实例化。拿汽车举例,汽车的设计图纸就是类,汽车是对象。设计中重点是类的创建 类名书写规范 类名首字母大写 一个类定义在一个文件中 $this 对象中使用 $this 指针可以访问属性或方法。 class Code { protected $len = 5; public function make() { return $this->len . $this->show(); } public function show() { return ' : is show'; } } echo (new Code)->make(); 继承 通过使用 extends 可以继承父类的属性与方法,在PHP中继承是单一的。 class Notify { public function message() { return 'notify message'; } } class User extends Notify { } echo (new User)->message(); 父类调用 子类可以使用 parent 关键字调用父类方法 ... public function message() { return parent::message(); } ... 方法重写 子类可以重写父类的方法,除非父类的方法没有使用 final 修饰。 class Notify { public function message() { return 'notify message'; } } class User extends Notify { public function message() { return 'user notify'; } } echo (new User)->message(); 禁止重写 使用final声明的方法,将禁止在子类中重写父类方法。 public final function message() { return 'notify message'; } 封装 public 公有 在类的内部与外部或子类都可以访问,是最开放的权限 private 私有 定义类的属性和方法,在类的内部可以访问,在类的外部或子类都不可以访问 protected 受保护 定义类的属性和方法,在类的内部或子类可以访问,类的外部不可以访问 模块设计 强内聚(功能尽量在类的内部完成),弱耦合(开放尽量少的方法给外部调用)。例:公司销售接项目,具体工作交给公司内部程序员,设计人员,服务器管理人员协同完成 trait 使用trait 机制可以变相的使用多重继承。 class Alipay { use Pay; } class WePay { use Pay; } trait Pay { public function sn() { return 'ABCDEF'; } } echo (new WePay)->sn(); 如果本类与 trait 中存在同名的属性和方法时,将使用本类中的属性与方法。 ... class WePay { use Pay; public function sn() { return __METHOD__; } } trait Pay { public function sn() { return 'ABCDEF'; } } ... 多个trait 可以使用多个 trait 用逗号连接 ... use Pay,Site; ... 解决冲突 class WePay { use Pay, Email { Pay::notify insteadof Email; Email::notify as EmailNotify; } trait Pay { public function notify() { return __METHOD__; } } trait Email { public function notify() { return __METHOD__; } } echo (new WePay)->notify(); Pay::notify insteadof Email 表示使用 Pay::notify 方法替代 Email::notify 方法。 Email::notify as EmailNotify` 将`Email:notify` 别名为 `EmailNotify 访问控制 可以为继承的 trait 方法重新定义访问控制 class WePay { use Pay, Email { Pay::notify insteadof Email; Email::notify as protected EmailNotify; ... } 多重trait 可以通过多个trait 组合来使用。 trait Notify { public function response() { return 'notify response'; } } trait Pay { use Notify; } class User { use Pay; } echo (new User)->response(); 抽象方法 trait Notify { public function response() { return 'notify response' . $this->sn(); } abstract protected function sn(); } trait Pay { use Notify; } class User { use Pay; protected function sn() { return 'SN999'; } } echo (new User)->response(); 静态方法 在 trait 中可以使用静态方法、抽象方法、静态属性。 ... trait Pay { public function sn() { return 'ABCDEF'; } public static function notify() { return __METHOD__; } } class WePay { use Pay; ... } echo WePay::notify(); static static: 需要一个数据对象只服务于类,即类内部可用,对外不可用时。建对象是极其耗费资源的,因此当一个方法具有比较强的公用性的时候,没有必要为了调用这个方法而重新再生成该类的实例。定义的方法或变量在程序第一次加载时即驻留内存,程序结束释放。 static变量: 通过static声明的成员变量为静态变量或叫类变量,是该类的公共变量,在第一次使用时即生成,对于该类的所有对象只有一份,是属于类的,不是属于对象的。static变量是属于类而不属于对象,可以在任何地方通地类来访问,是类的全局变量,类创建时即存入内存。对多个对象来说,静态数据成员只存储一处,可以节省内存。只要对静态数据成员的值更新一次,保证所有对象存取更新后的相同的值。 static方法: 用static声明的方法为静态方法或叫类方法,执行该方法时不会将对象引用传给函数,所以我们不能访问非静态成员,只能访问静态方法或静态变量。只能使用关于类的方式如self static parent等。使用时不用生成对象即可执行 类常量 使用 const 来定义类常量,常量使用 self::来调用。 class Model implements ArrayAccess, Iterator { use ArrayIterator, Relation, Validate, Auto, Filter; //----------自动验证---------- //有字段时验证 const EXIST_VALIDATE = 1; //值不为空时验证 const NOT_EMPTY_VALIDATE = 2; ... } $this self:: parent:: $this 是当前对象的引用, 一般出现在方法里,用于获取类的成员属性,或执行类的成员方法 self:: 对本类的引用 ,用于获取当前类的表态成员属性或静态成员方法self::run() parent:: 对父类的引用,调用父类的方法或属性。 魔术方法 构造方法&析构方法 构造方法__construct() 在创建对象时自动执行,没有返回值,用于执行类的一些初始化工作,如对象属性的初始化工作,构造方法为__construct()。 可以在构造方法中传递参数,用于定义属性,在父类和子类都定义构造方法时,执行子类的构造方法 析构方法__destruct(): 当所有对象的引用被销毁时执行。 __get 与__set 读取不可访问或不存在的属性时,__get() 会被调用,同理获取不可访问或不存的的属性时会执行 __set() 方法。 <?php abstract class Query { abstract protected function record(array $data); public function select() { return $this->record(['name' => '后盾人', 'age' => 33]); } } class Model extends Query { protected $field = [ 'name' ]; public function all(){ $this->select(); return $this->field; } protected function record(array $data) { $this->field = $data; } public function __get($name) { return $this->field[$name] ?? null; } public function __set($name, $value) { $this->field[$name] = $value; } } $user = new Model; $user->all(); echo $user->name; $user->name = '向军大叔'; echo $user->name;ry ### __isset() 与 __unset() 当使用 isset()函数或者empty()函数 判断属性是否存在或者是否为空的时候会自动触发。 当使用 unset() 函数判断属性时,如果存在__unset() 方法将会执行。 ... public function __unset($name) { if (!isset($this->field[$name]) || in_array($name, $this->deny)) { throw new Exception('禁止操作'); } } public function __isset($name) { return isset($this->field[$name]); } ... 抽象类&抽象方法 具有抽象方法的类为抽象类,抽象方法即为没有内容的空方法,要求子类进行完善内容,抽象类不能实例化,只能继承,通过extends来实现,抽象类中也可以定义普通方法 父类方法执行方式不确定,但子类还都有这个方法 例1:如交通工具类:定义抽象方法控制交通工具运行方式,这样每个交通工具如飞机,汽车都要重写父类方法。如果在父类工具类定义该方法(比如在地上走)没有任何意义,因为每个交通工具都要重写(飞机要重写方法,船要重写方法),所以针对你类方法的不确定性,我们需要抽象方法,实现多态。 例2:定义动物类,每个动物都有叫声方法,但是表面不同,所以要定义为抽象类,让每种动物类去实现功能。 当父类为抽象类时,子类必须重写父类的抽象方法 抽象类里不一定非要写抽象方法,但有抽象方法的类必须定义为抽象类 抽象类必须继承使用 抽象方法不能有主体即{} <?php abstract class AbstractClass { // 强制要求子类定义这些方法 abstract protected function getValue(); abstract protected function prefixValue($prefix); // 普通方法(非抽象方法) public function printOut() { print $this->getValue(); } } 接口 接口是一组成员声明方法的集合,包含空的成员方法和常量,空的方法要求继承类去具体实现。成员方法为public,属性为常量。 例如:现实中的电脑USB或PCI插槽,插线板等都有接口例子 继承是一级一级层次式,如果某一层出现问题,整个继承就会出现意外。而接口只影响实现接口的类,接口可以在破坏原来的继承基础上对类扩展。接口可以实现多继承。 例:电脑USB接口,规定各个厂商必须构造合适的接口方法,比如手机,数码相机,网银U盾。要让各个厂商写自己的方法如U盾插到USB上他会自动安装网银驱盾,弹出网页,手机装上后可以打开手机里的内容,同时可以充电 抽象类及普通类都可以实现接口,通过关键字implements 接口与抽象类的区别: 1 接口只能用implements实现 抽象类用extends继承实现 2 接口没有数据成员,可以定义常量,抽象类可以有 3 接口没有构造函数,抽象类可以定义构造函数 4 接口方法都是public 抽象类方法可以用protected private public来修饰 5 一个类可以实现多个接口,但只能继承一个抽象类 6 接口中不可以有成员方法,抽象类可以有成员方法 interface DbInterface { public function connectDb(); //获得连接 参数为表名 public function close(); //关闭数据库 public function exe($sql); //发送没有返回值的sql public function query($sql); //有返回值的sql } class Db implements DbInterface { public function exe($sql){ } public function query($sql{ } } 以上内容希望帮助到大家,更多PHP大厂PDF面试文档,PHP进阶架构视频资料,PHP精彩好文免费获取可以微信搜索关注公众号:PHP开源社区,或者访问: 2021金三银四大厂面试真题集锦,必看! 四年精华PHP技术文章整理合集——PHP框架篇 四年精华PHP技术文合集——微服务架构篇 四年精华PHP技术文合集——分布式架构篇 四年精华PHP技术文合集——高并发场景篇 四年精华PHP技术文章整理合集——数据库篇

优秀的个人博客,低调大师

Lock 解析,如何避免死锁?

Lock 前面聊了聊 synchronized,今天再聊聊 Lock。Lock 接口是 Java 5 引入的,最常见的实现类是 ReentrantLock、ReadLock、WriteLock,可以起到 “锁” 的作用。 PS:篇幅原因,这章不聊实现类,后面再聊,只专注于 Lock 以及它与 synchronized 的区别。 Lock.png Lock 和 synchronized 是 java 中两种最常见的锁,"锁" 是一种工具。它用于控制对共享资源的访问。需要注意的是 Lock 设计的初衷并不是为了取代 synchronized ,而是一种升级。当 synchronized 不合适或者不能满足需求时(后面会说两者区别),Lock 顶上。 一般情况下,Lock 同一时间只允许一个线程来访问这个共享资源。但是也有特殊的时候允许并发访问。比如读写锁(ReadWriteLock)里面的读锁(ReadLock)。PS:这就是其中一个 synchronized 不能满足的场景。 Lock 的方法 如下图所示,Lock 有 5 个方法,1 个条件: publicinterfaceLock{voidlock();voidlockInterruptibly()throwsInterruptedException;booleantryLock();booleantryLock(longtime,TimeUnitunit)throwsInterruptedException;voidunlock();ConditionnewCondition();} lock 加锁主要有 4 个方法:lock、lockInterruptibly、tryLock、tryLock (long time, TimeUnit unit) 。解锁只有一个 unlock 方法。此外,还有一个线程间通信的条件(Condition)。下面逐一讲解: lock Lock 有 4 种加锁方法,其中 lock 是最基础的。Lock 获取锁和释放锁都是显式的,不像 synchronized 是隐式的。所以 synchronized 会在抛异常时自动释放锁,而 Lock 只能是主动释放,加解锁都必须有显式的代码控制。所以就有了以下伪代码: Locklock=...;//代码显式加锁lock.lock();try{//获取到了被本锁保护的资源,处理任务//捕获异常}finally{//代码显式释放锁lock.unlock();} 这种 lock 的写法才是最安全的,先获取 lock,然后在 try 中操作资源,最后 finally 中释放锁,以保证绝对释放(这一步非常重要,它防止代码走不到这里,导致跳过了 unlock () 语句,使得这个锁永远不能被释放)。 此外,lock () 方法有个缺点就是它不能被中断,一旦陷入死锁,lock () 就会陷入永久等待。所以,一般来说我们会用 tryLock 来代替 lock。 tryLock tryLock 顾名思义是尝试获取锁的意思,返回值是 boolean,获取成功返回 true,获取失败返回 false*。使用方法如下: Locklock=...;if(lock.tryLock()){try{//操作资源}finally{//释放锁lock.unlock();}}else{//如果不能获取锁,则做其他事情} 使用 if 判断是否获取锁,成功获取则去操作共享资源,失败则去干别的事(比如,几秒之后重试,或者跳过此任务),最后还是记得要在 finally 中释放锁。 tryLock 解决死锁问题 想象这样一个场景:比如有两个线程同时调用以下这个方法,传入的 lock1 和 lock2 恰好是相反的。如果第一个线程获取了 lock1,第二个线程获取了 lock2,两个线程都需要获取对方的锁才能工作。如果用 lock 这就很容易陷入死锁,原因前面也说了。 这个时候 tryLock 就发挥作用了:其中一个线程尝试获取锁 lock1,获取不到,则去隔段时间重试(这样做的目的在于等另一个获取到锁的线程在这段时间内完成任务,释放锁)。获取到了,则继续获取 lock2 ,获取到就操作共享资源,获取不到则释放 lock1,继续进入重试。 publicvoidtryLock(Locklock1,Locklock2)throwsInterruptedException{while(true){if(lock1.tryLock()){try{if(lock2.tryLock()){try{System.out.println("获取到了两把锁,完成业务逻辑");return;}finally{lock2.unlock();}}}finally{lock1.unlock();}}else{Thread.sleep(newRandom().nextInt(1000));}}} tryLock(long time, TimeUnit unit) 这个方法是 tryLock 的重载,区别在于 tryLock (long time, TimeUnit unit) 方法会有一个超时时间。在拿不到锁时会等待指定的时间,在指定时间内获取不到锁返回 false;获取到锁或者等待期间内获取到锁,返回 true。 此外,超时之后,它将放弃主动获取锁。它还可以响应中断,抛出 InterruptException,避免死锁的产生。 lockInterruptibly lockInterruptibly 去获取锁,获取到了马上返回 true。它非常执拗,如果获取不到锁就会一直尝试获取直到获取到为止,除非当前线程在获取锁期间被中断。可以把它理解为不限时的 tryLock (long time, TimeUnit unit)。 publicvoidlockInterruptibly()throwsInterruptException{lock.lockInterruptibly();try{System.out.println("操作资源");}finally{lock.unlock();}} unlock unlock 顾名思义就是释放锁。就 ReentrantLock 而言,调用 unlock 方法时,内部会把锁的 “被持有计数器” 减 1,减到 0 代表当前线程已经完全释放这把锁。 newCondition() Condition 的用法就不说了,不会的看之前这篇文章:线程之生产者消费者模式。它有两个主要的方法 await 和 signal 分别用于阻塞线程和唤醒线程。对应于 Object 的 wait 和 notify。 -END- 如果看到这里,喜欢这篇文章的话,请帮点个好看。微信搜索「一个优秀的废人」,关注后回复「1024」送你一套完整的 java 教程(包括视频)。回复「电子书」送你全编程领域电子书(不只Java)。 教程节选 本文分享自微信公众号 - 一个优秀的废人(feiren_java)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

AnalyticDB for MySQL技术架构解析

企业数据需求不断变化,近年来变化趋势日益明显,从数据的3V特性看:体积,速度和变化;Big Data强调数据量,PB级以上,是静态数据。而Fast Data在数据量的基础上,意味着速度和和变化,意味着客户可以更加实时化、更加快速地进行数据处理。 在Forrester最近的一项研究中,超过75%的受访公司已经使用Fast Data解决方案。 在接受调查的人中,88%表示他们需要近乎实时地对数据执行分析。 AnalyticDB是阿里巴巴自主研发、唯一经过超大规模以及核心业务验证的PB级实时数据仓库,是FastData的最佳代表。自2012年第一次在集团发布上线以来,至今已累计迭代发布近百个版本,支撑起集团内的电商、广告、菜鸟、文娱、飞猪等众多在线分析业务。AnalyticDB于2014年在阿里云开始正式对外输出,支撑行业既包括传统的大中型

优秀的个人博客,低调大师

ConcurrentHashMap 1.8原理解析

JDK 1.8中,Hash家族有这么一些存在,HashMap,HashTable,LinkedHashMap,ConcurrentHashMap。这里面支持线程安全的有HashTable以及ConcurrentHashMap。对Hash有一个基本了解可以参考本人的从Hash到一致性Hash原理(深度好文) 。 那既然说到ConcurrentHashMap,自然要讨论的就是它的线程安全性和效能。我们先来看一下HashTable的线程安全性以及效能的低下。 public synchronized V put(K key, V value) { // Make sure the value is not null if (value == null) { throw new NullPointerException(); } // Makes sure the key is not already in the hashtable. Entry<?,?> tab[] = table; int hash = key.hashCode(); int index = (hash & 0x7FFFFFFF) % tab.length; @SuppressWarnings("unchecked") Entry<K,V> entry = (Entry<K,V>)tab[index]; for(; entry != null ; entry = entry.next) { if ((entry.hash == hash) && entry.key.equals(key)) { V old = entry.value; entry.value = value; return old; } } addEntry(hash, key, value, index); return null; } public synchronized V get(Object key) { Entry<?,?> tab[] = table; int hash = key.hashCode(); int index = (hash & 0x7FFFFFFF) % tab.length; for (Entry<?,?> e = tab[index] ; e != null ; e = e.next) { if ((e.hash == hash) && e.key.equals(key)) { return (V)e.value; } } return null; } 我们对比一下HashMap 1.7的这两个方法(因为1.8点HashMap会生成红黑树,我们暂时先不考虑红黑树的问题) public V put(K key, V value) { if (key == null) return putForNullKey(value); int hash = hash(key); int i = indexFor(hash, table.length); for (Entry<K,V> e = table[i]; e != null; e = e.next) { Object k; if (e.hash == hash && ((k = e.key) == key || key.equals(k))) { V oldValue = e.value; e.value = value; e.recordAccess(this); return oldValue; } } modCount++; addEntry(hash, key, value, i); return null; } public V get(Object key) { if (key == null) return getForNullKey(); Entry<K,V> entry = getEntry(key); return null == entry ? null : entry.getValue(); } final int hash(Object k) { int h = 0; if (useAltHashing) { if (k instanceof String) { return sun.misc.Hashing.stringHash32((String) k); } h = hashSeed; } h ^= k.hashCode(); // This function ensures that hashCodes that differ only by // constant multiples at each bit position have a bounded // number of collisions (approximately 8 at default load factor). //一种算法,进行4次位移,得到相对比较分散的链表 h ^= (h >>> 20) ^ (h >>> 12); return h ^ (h >>> 7) ^ (h >>> 4); } 在这里我们可以看到,他们除了key的hash算法不同,HashTable的比较简单,只是用key的哈希值与0x7FFFFFFF(十进制2147483647,二进制1111111111111111111111111111111)进行一次与运算,即为只要相同二进制位上不论0,1全部都变成1,再对table数组的长度取模。而HashMap 1.7则为key的哈希值进行各位无符号位移加异或运算,取得最终哈希值。然后是HashTable不接收null的key,而HashMap接受。他们最大的区别就在于synchronized显示器锁了。 synchronized的本质是所有对象的字节码中有一个monitor的对象头,任何线程拿到了这个monitor的对象头就可以对这个对象进行操作,而拿不到monitor对象头的线程就只能等待,直到拿到了monitor的线程放弃,其他线程才能争夺这个对象头来对对象进行操作。那么问题来了,当大量线程高并发的时候,只要有一个线程拿到了这个对象头,其他线程对这个对象是既不能读也不能写。而对于HashMap来说,如果多线程对其进行操作,那么任意线程都可以胡乱修改里面值的内容造成脏读,所以HashMap是线程不安全的。 那么我们今天的主角登场了ConcurrentHashMap。我们同样来看一下这两个方法。以下是1.8的源码,首先我们要清楚的是1.8跟1.7已经完全不同,1.7是使用segements(16个segement),每个segement都有一个table(Map.Entry数组),相当于16个HashMap,同步机制为分段锁,每个segment继承ReentrantLock;而1.8只有1个table(Map.Entry数组),同步机制为CAS + synchronized保证并发更新。如果不搞清楚这个问题,那么你看1.8的源码可能会很懵逼。 public V put(K key, V value) { return putVal(key, value, false); } final V putVal(K key, V value, boolean onlyIfAbsent) { //无论key还是value,不允许空 if (key == null || value == null) throw new NullPointerException(); //此处获取hash值的方法与HashTable类似 int hash = spread(key.hashCode()); int binCount = 0; //无限循环 for (Node<K,V>[] tab = table;;) { Node<K,V> f; int n, i, fh; //如果节点数组为null,或者长度为0,初始化节点数组 if (tab == null || (n = tab.length) == 0) tab = initTable(); //如果节点数组的某个节点为null,则put的时候就会采用无锁竞争来获取该节点的头把交椅 else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) { if (casTabAt(tab, i, null, new Node<K,V>(hash, key, value, null))) break; // no lock when adding to empty bin } //需要扩容的时候先扩容,再写入 else if ((fh = f.hash) == MOVED) tab = helpTransfer(tab, f); else { //如果hash冲突的时候,即多线程操作时,大家都有一样的hash值 V oldVal = null; synchronized (f) { //锁定节点数组的该节点 if (tabAt(tab, i) == f) { //如果当前该节点为链表形态 if (fh >= 0) { binCount = 1; for (Node<K,V> e = f;; ++binCount) { K ek; //找链表中找到相同的key,把新value替代老value if (e.hash == hash && ((ek = e.key) == key || (ek != null && key.equals(ek)))) { oldVal = e.val; if (!onlyIfAbsent) e.val = value; break; } Node<K,V> pred = e; //如果找不到key,就添加到链表到末尾 if ((e = e.next) == null) { pred.next = new Node<K,V>(hash, key, value, null); break; } } } //如果当前为红黑树形态,进行红黑树到查找和替代(存在相同的key),或者放入红黑树到新叶节点上(key不存在) else if (f instanceof TreeBin) { Node<K,V> p; binCount = 2; if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key, value)) != null) { oldVal = p.val; if (!onlyIfAbsent) p.val = value; } } } } if (binCount != 0) { //如果链表长度超过了8,链表转红黑树 if (binCount >= TREEIFY_THRESHOLD) treeifyBin(tab, i); if (oldVal != null) return oldVal; break; } } } //统计节点个数,检查是否需要扩容 addCount(1L, binCount); return null; } public V get(Object key) { Node<K,V>[] tab; Node<K,V> e, p; int n, eh; K ek; int h = spread(key.hashCode()); if ((tab = table) != null && (n = tab.length) > 0 && (e = tabAt(tab, (n - 1) & h)) != null) { if ((eh = e.hash) == h) { if ((ek = e.key) == key || (ek != null && key.equals(ek))) return e.val; } else if (eh < 0) return (p = e.find(h, key)) != null ? p.val : null; while ((e = e.next) != null) { if (e.hash == h && ((ek = e.key) == key || (ek != null && key.equals(ek)))) return e.val; } } return null; } 读取的时候,我们没有看见锁到存在,说明读不受多线程影响。 对比ConcurrentHashMap和HashTable,我们可以明显的看到,ConcurrentHashMap在写的时候,并没有锁住整个节点数组,在新节点上使用的是无锁竞争,在老节点上锁住的仅仅是一个节点,读的时候如果不是恰好读到写线程写入相同Hash值的位置,不受影响(可以认为我们的操作一般是读多写少,这种几率也比较低)。而HashTable是对整个节点数组进行锁定,读到时候不能写,写的时候不能读,这么一对比就可以明显感觉到性能差距是巨大的。 虽然ConcurrentHashMap的并发性能还算比较优异,但在亿级计算中,却依然会成为性能瓶颈,具体可以参考本人的Fork/Join框架原理和使用探秘 至于这里为什么会慢,我认为在这种超高并发下,节点数组的单节点的的写写竞争是互斥的,其次,由于红黑树具有读快写慢的特性,它要不断保持树的平衡而不断返转,所以才会使得高并发写的性能急剧下降。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册