首页 文章 精选 留言 我的

精选列表

搜索[orm框架],共10000篇文章
优秀的个人博客,低调大师

Qt之Concurrent框架

简述 QtConcurrent 命名空间提供了高级 API,使得可以在不使用低级线程原语(例如:互斥、读写锁、等待条件或信号量)的情况下编写多线程程序,使用 QtConcurrent 编写的程序根据可用的处理器核心数自动调整所使用的线程数。这意味着,当在未来部署多核系统时,现在编写的应用程序将继续适应。 简述 用法 Qt Concurrent 单词统计 更多参考 用法 在 C++ API changes 有关于 Qt Concurrent 的更改说明: Qt Concurrent has been moved from Qt Core to its own module 意思是说,Qt Concurrent 已经被从 Qt Core 中移到自己的模块中了。所以,要链接到 Qt Concurrent 模块,需要在 qmake 项目文件中添加: QT += concurrent 注意: QtConcurrent::Exception 类被重命名为 QException,并且 QtConcurrent::UnhandledException 类被重命名为 QUnhandledException,他们仍然位于 Qt Core 中。 Qt Concurrent QtConcurrent 包含了函数式编程风格 APIs 用于并行列表处理,包括用于共享内存(非分布式)系统的 MapReduce 和 FilterReduce 实现,以及用于管理 GUI 应用程序异步计算的类: Concurrent Map 和 Map-Reduce QtConcurrent::map():将一个函数应用于一个容器中的每一项,就地修改 items。 QtConcurrent::mapped():和 map() 类似,只是它返回一个包含修改内容的新容器。 QtConcurrent::mappedReduced():和 mapped() 类似,只是修改后的结果减少或组合成一个单一的结果。 Concurrent Filter 和 Filter-Reduce QtConcurrent::filter():从一个容器中删除所有 items,基于一个 filter 函数的结果。 QtConcurrent::filtered():和 filter() 类似,只是它返回一个包含过滤内容的新容器。 QtConcurrent::filteredReduced():和 filtered() 类似,只是过滤后的结果减少或组合成一个单一的结果。 Concurrent Run QtConcurrent::run():在另一个线程中运行一个函数。 QFuture:表示异步计算的结果 QFutureIterator:允许通过 QFuture 遍历可用的结果 QFutureWatcher:允许使用信号槽来监控一个 QFuture QFutureSynchronizer:是一个方便的类,用于一些 QFutures 的自动同步 Qt Concurrent 支持多种兼容 STL 的容器和迭代器类型,但是最好使用具有随机访问迭代器的 Qt 容器,例如:QList 或 QVector。map 和 filter 函数都接受容器和 begin/end 迭代器。 STL 迭代器支持概述: 迭代器类型 示例类 支持状态 Input Iterator 不支持 Output Iterator 不支持 Forward Iterator std::slist 支持 Bidirectional Iterator QLinkedList, std::list 支持 Random Access Iterator QList, QVector, std::vector 支持和推荐 在 Qt Concurrent 迭代大量轻量级 items 的情况下,随机访问迭代器可以更快,因为它们允许跳过容器中的任何点。此外,使用随机访问迭代器允许 Qt Concurrent 通过 QFuture::progressValue() 和 QFutureWatcher::progressValueChanged() 来提供进度信息。 非就地修改的函数(例如:mapped() 和 filtered()),在调用时会创建容器的副本。如果正在使用的是 STL 容器,此复制操作可能需要一段时间,在这种情况下,建议为容器指定 begin 和 end 迭代器。 单词统计 厉害了 Concurrent,来看一个单词统计的示例: #include <QList> #include <QMap> #include <QTextStream> #include <QString> #include <QStringList> #include <QDir> #include <QTime> #include <QApplication> #include <QDebug> #include <qtconcurrentmap.h> using namespace QtConcurrent; // 递归搜索文件 QStringList findFiles(const QString &startDir, QStringList filters) { QStringList names; QDir dir(startDir); foreach (QString file, dir.entryList(filters, QDir::Files)) names += startDir + '/' + file; foreach (QString subdir, dir.entryList(QDir::AllDirs | QDir::NoDotAndDotDot)) names += findFiles(startDir + '/' + subdir, filters); return names; } typedef QMap<QString, int> WordCount; // 单线程单词计数器函数 WordCount singleThreadedWordCount(QStringList files) { WordCount wordCount; foreach (QString file, files) { QFile f(file); f.open(QIODevice::ReadOnly); QTextStream textStream(&f); while (textStream.atEnd() == false) foreach (const QString &word, textStream.readLine().split(' ')) wordCount[word] += 1; } return wordCount; } // countWords 计算单个文件的单词数,该函数由多个线程并行调用,并且必须是线程安全的。 WordCount countWords(const QString &file) { QFile f(file); f.open(QIODevice::ReadOnly); QTextStream textStream(&f); WordCount wordCount; while (textStream.atEnd() == false) foreach (const QString &word, textStream.readLine().split(' ')) wordCount[word] += 1; return wordCount; } // reduce 将 map 的结果添加到最终结果,该函数只能由一个线程一次调用。 void reduce(WordCount &result, const WordCount &w) { QMapIterator<QString, int> i(w); while (i.hasNext()) { i.next(); result[i.key()] += i.value(); } } int main(int argc, char** argv) { QApplication app(argc, argv); qDebug() << "finding files..."; QStringList files = findFiles("../../", QStringList() << "*.cpp" << "*.h"); qDebug() << files.count() << "files"; int singleThreadTime = 0; { QTime time; time.start(); // 单线程统计,与 mapreduce 机制实现的作对比 WordCount total = singleThreadedWordCount(files); singleThreadTime = time.elapsed(); // 打印出所耗费的时间 qDebug() << "single thread" << singleThreadTime; } int mapReduceTime = 0; { QTime time; time.start(); // mappedReduced 方式进行统计 WordCount total = mappedReduced(files, countWords, reduce); mapReduceTime = time.elapsed(); qDebug() << "MapReduce" << mapReduceTime; } // 输出 mappedReduced 方式比单线程处理方式要快的倍数 qDebug() << "MapReduce speedup x" << ((double)singleThreadTime - (double)mapReduceTime) / (double)mapReduceTime + 1; } 输出如下: finding files… 2185 files single thread 5221 MapReduce 2256 MapReduce speedup x 2.31427 可以看出,共查找了 2185 个文件,单线程使用了 5221 毫秒,MapReduce 方式使用了 2256 毫秒,比单线程要快 2.31427 倍。经过反复尝试,基本都在 2 倍以上。 更多参考 Qt之Concurrent Map和Map-Reduce Qt之Concurrent Filter和Filter-Reduce Qt之Concurrent Run Qt之QFuture Qt之QFutureWatcher
优秀的个人博客,低调大师

Storm Ack框架笔记

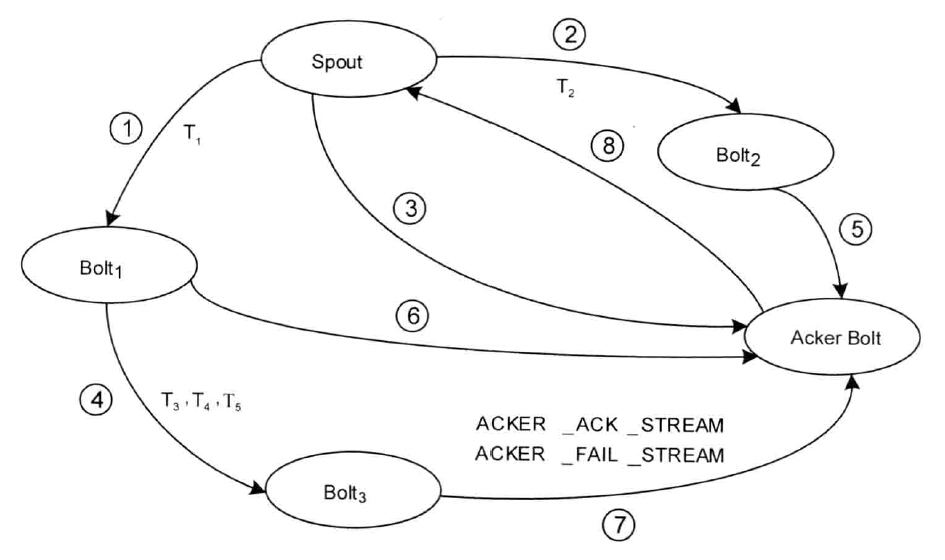
Storm利用Acker Bolt节点跟踪消息,当Spout发送出去的消息以及这些消息所衍生出来的消息均被处理后,Spout将受到对应于该消息的Ack。实现要点: 1、Storm中每条发送出去的消息都会对应一个随机的消息ID。 2、Spout发送消息后,将向Acker Bolt发送一条消息,该消息内容为<RootId,消息ID>,Acker bolt将为该消息创建一条跟踪项。 3、Bolt产生要发送的消息时,会计算每条新消息的消息ID,并将消息ID发送至Acker Bolt,Acker Bolt对消息ID进行异或后存储。于是,Storm对新发送的消息进行了跟踪。 4、Blot对输入的消息进行Ack时,也会将该消息ID发送到Acker Bolt,Acker Bolt对每条消息ID进行异或存储,由于该消息在被发送时,已经向Acker Bolt发送过消息ID,之后再被Acker时又再次发送该消息ID。根据异或的语义,这相当于对该消息的跟踪结束。 5、Acker Bolt在更新某一个消息的跟踪值时,若发现其跟踪值变为零,则向Spout节点发送消息,表明Spout发送的这条消息已经被成功处理。 6、若Spout在发送消息时未指定用于消息跟踪的ID,系统则不对消息进行跟踪,Blot新产生的消息并不会被单独跟踪。 7、Spout的每条消息以及由该消息演化而来的所有消息的跟踪负载为16个字节,8个字节的根消息ID以及8个字节的消息跟踪值AckValue.但是,由于Storm中采用HashMap对其进行存储,在32位的JVM中,每条消息至少需要20个字节的额外负载,故一条消息的跟踪需要40个字节左右的负载。 (一)1与2中,Spout发送T1到Bolt1,发送T2到Bolt2.T1和T2具有相同的内容,但表示不同的备份,每条消息都会对应一个ID,消息T1的anchors为<RootId,T1>,消息T2的anchors为<RootId,T2> (二)3中,Spout在Acker Bolt中注册了一条记录RootId=T1^T2。 (三)4与6中,Bolt1发送新的消息T3、T4、T5到Blot3,同时对输入的消息进行Ack操作,消息内容为<RootId,T1^T3^T4^T5>,此时,Acker Bolt中的跟踪项为<RootId,T1^T2^T1^T3^T4^T5=>T2^T3^T4^T5>。 (四)在5中,Bolt2对输入的消息T2进行Ack操作,它没有产生新的消息,发送到Acker Bolt的消息为<RootId,T2>,T2异或后消失。 (五)在7中,Blot3对输入的消息进行Ack操作,发送的消息为<RootId,T3^T4^T5>,此时Acker Bolt中的跟踪项为<RootId,T3^T4^T5^T3^T4^T5 =>0> (六)Acker Bolt发现RootId对应的值为零,它认为该RootId对应的消息以及所有衍生出来的消息均已经被成功处理,于是它向Spout发送消息,而Spout将调用Ack回调方法。 那么每条被处理的消息必须进行Ack或者Fail操作,否则,虽然有超时机制可以对过期消息进行清空,但可能导致消息不断重传。(所以项目中每次进入bolt都有唯一性过滤?) 参考:《Storm 源码分析》

优秀的个人博客,低调大师

以替代 MyBatis 为己任,融合 JPA 和超强 SQL 功能 sqltoy-orm 5.6.26 发版了

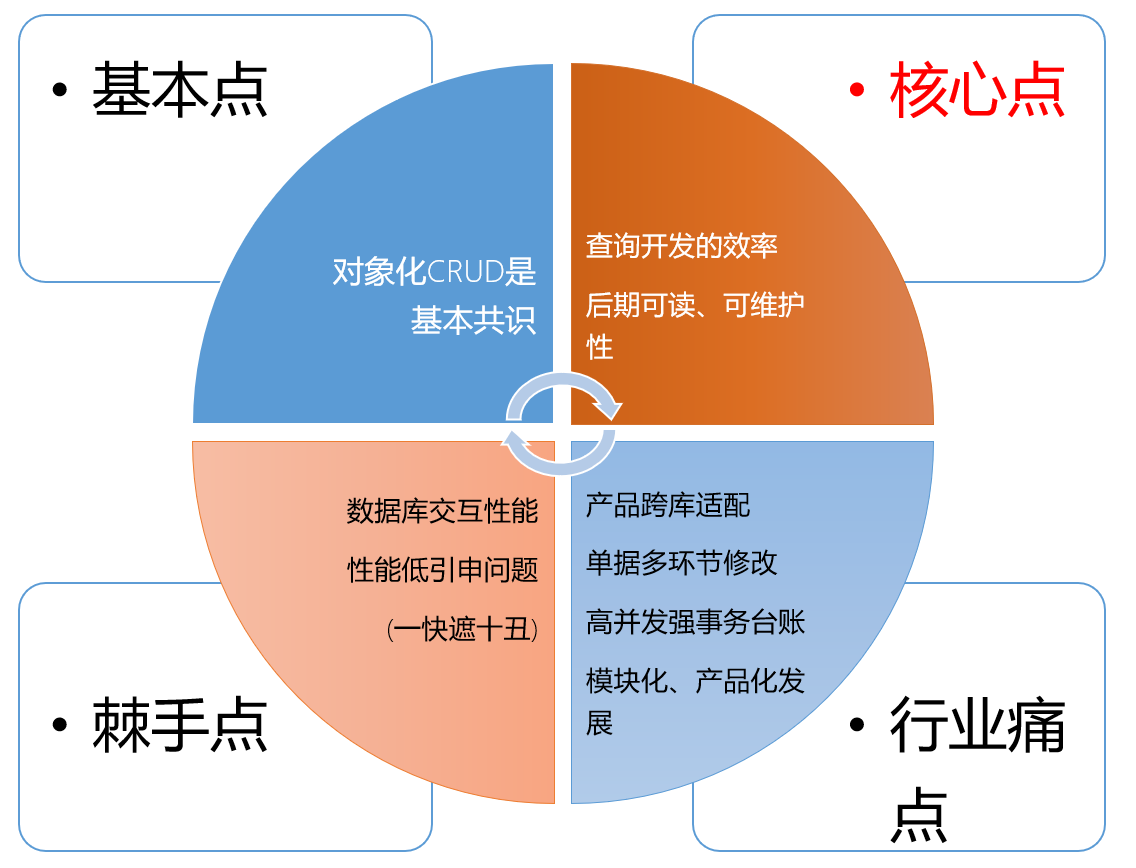
兄弟们,让mybatis退出历史舞台吧,mybatis的存在引发了反xml之争、反sql之争,产生了成百个的plus系列,无尽的争吵、无尽的后来者开发plusplus! 开源地址: github:https://github.com/sagframe/sagacity-sqltoy gitee:https://gitee.com/sagacity/sagacity-sqltoy idea 插件 (可直接在 idea 中检索安装):https://github.com/imyuyu/sqltoy-idea-plugin sqltoy 脚手架项目:https://gitee.com/momoljw/sss-rbac-admin sqltoy lambda 项目:https://gitee.com/gzghde/sqltoy-plus 更新内容 1、针对batchUpdate、saveAll、updateAll、saveOrUpdateAll、loadAll等批量操作,针对超大数据集场景提供并行执行机制 @Test public void testDeleteAll() { List entites = new ArrayList(); for (int i = 1; i < 3000; i++) { entites.add(new ComplexpkHeadVO(LocalDateTime.parse("2020-09-08T12:11:20"), "S000" + i)); } // 最小1000作为一个并行分组,并行度10、最大等待时间120秒 lightDao.delete().parallelConfig(ParallelConfig.create().groupSize(1000) .maxThreads(10).maxWaitSeconds(120)).many(entites); //批量修改 //lightDao.update().parallelConfig(ParallelConfig.create().groupSize(1000)).many(entites); //批量保存 //lightDao.save().parallelConfig(ParallelConfig.create().groupSize(1000)).many(entites); //批量saveOrUpdate,saveMode(SaveMode.UPDATE)存在则修改 //lightDao.save().saveMode(SaveMode.UPDATE).parallelConfig(ParallelConfig.create() // .groupSize(1000)).many(entites); //lightDao.batch().sql(sql).dataSet(batchDataSet).parallelConfig(ParallelConfig.create().groupSize(1000)).submit() } 2、sql支持if\elseif\else 逻辑 String sql = """ select * from table where 1=1 #[@if(:flag==1) and status=:status #[@if(:operateType==2) and saleType is not :saleType] #[@else and saleType is :saleType] ] #[@elseif(:flag==2) and name like :name] #[@else and orderType=:orderType] #[@if(:tenantId==4) and tenant=1] #[@elseif(:tenantId==3) and tenant=3] """; SqlToyResult result = SqlConfigParseUtils.processSql(sql,new String[] { "flag", "status", "name", "orderType", "saleType", "operateType", "tenantId" },new Object[] { 1, 1, "张", "SALE", null, 4, 3 }); JPA 部分 类似 JPA 的对象化 CRUD、对象级联加载和新增、更新 支持通过 POJO 生成 DDL 以及直接向数据库创建表 强化 update 操作,提供弹性字段修改能力,不同于 hibernate 先 load 后修改,而是一次数据库交互完成修改,确保了高并发场景下数据的准确性 改进了级联修改,提供了先删除或者先置无效,再覆盖的操作选项 增加了 updateFetch、updateSaveFetch 功能,强化针对强事务高并发场景的处理,类似库存台账、资金台账,实现一次数据库交互,完成锁查询、不存在则插入、存在则修改,并返回修改后的结果 增加了树结构封装,便于统一不同数据库树型结构数据的递归查询 支持分库分表、支持多种主键策略 (额外支持基于 redis 的产生特定规则的业务主键)、加密存储、数据版本校验 提供了公共属性赋值 (创建人、修改人、创建时间、修改时间、租户)、扩展类型处理等 提供了多租户统一过滤和赋值、提供了数据权限参数带入和越权校验 查询部分 极为直观的 sql 编写方式,便于从客户端 <--> 代码 双向快速迁移,便于后期变更维护 支持缓存翻译、反向缓存匹配 key 代替 like 模糊查询 提供了跨数据库支持能力:不同数据库的函数自动转换适配,多方言 sql 根据实际环境自动匹配、多数据库同步测试,大幅提升了产品化能力 提供了取 top 记录、随机记录等特殊场景的查询功能 提供了最强大的分页查询机制:1) 自动优化 count 语句;2) 提供基于缓存的分页优化,避免每次都执行 count 查询;3) 提供了独具特色的快速分页;4) 提供了并行分页 提供了分库分表能力 提供了在管理类项目中极为价值的:分组汇总计算、行列转换 (行转列、列转行)、同比环比、树形排序、树形汇总 相关算法自然集成 提供了基于查询的层次化数据结构封装 提供了大量辅助功能:数据脱敏、格式化、条件参数预处理等 支持多种数据库 常规的 mysql、oracle、db2、postgresql、 sqlserver、dm、kingbase、sqlite、h2、 oceanBase、polardb、guassdb、tidb 支持分布式 olap 数据库: clickhouse、StarRocks、greenplum、impala (kudu) 支持 elasticsearch、mongodb 所有基于 sql 和 jdbc 各类数据库查询 sqltoy 特点介绍: sqltoy 的核心构建思想 sqltoy 的对比 mybatis (plus) 的核心点:查询语句编写、可阅读性、可维护性 对象化 crud 是基础,但 sqltoy 有针对性的改进:update、updateSaveFetch、updateFetch 等 sqltoy 的缓存翻译,大幅减少表关联简化 sql,让你的查询性能成几何级提升 极致的分页,同样帮助你实现查询的性能大幅提升 快速分页:@fast () 实现先取单页数据然后再关联查询,极大提升速度 分页优化器:page-optimize 让分页查询由两次变成 1.3~1.5 次 (用缓存实现相同查询条件的总记录数量在一定周期内无需重复查询 sqltoy 的分页取总记录的过程不是简单的 select count (1) from (原始 sql);而是智能判断是否变成:select count (1) from 'from 后语句 ', 并自动剔除最外层的 order by sqltoy 支持并行查询:parallel="true",同时查询总记录数和单页数据,大幅提升性能 便利的跨数据库统计计算:数据旋转 便利的跨数据库统计计算:无限极分组统计 (含汇总求平均) 便利的跨数据库统计计算:同比环比 5、树形表排序汇总 6、扩展集成

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册