首页 文章 精选 留言 我的

精选列表

搜索[腾讯混元生3D],共10000篇文章
优秀的个人博客,低调大师

移动归因数据“罗生门”:你的IP归属地和AppsFlyer为何总是对不上?

在移动广告归因和数据分析的日常工作中,许多开发者可能都遇到过这样一个“玄学”问题:明明用户就在A城,但无论是自己后端通过IP解析的地理位置,还是广告平台(如Google Ads)显示的数据,都与AppsFlyer等移动归因平台(MMP)报告中的用户国家/城市结果不一致。这种数据“打架”的现象,轻则干扰日常报表解读,重则可能误导广告预算的投放策略。

优秀的个人博客,低调大师

一个 Bean 就这样走完了它的一生之 Bean 的出生

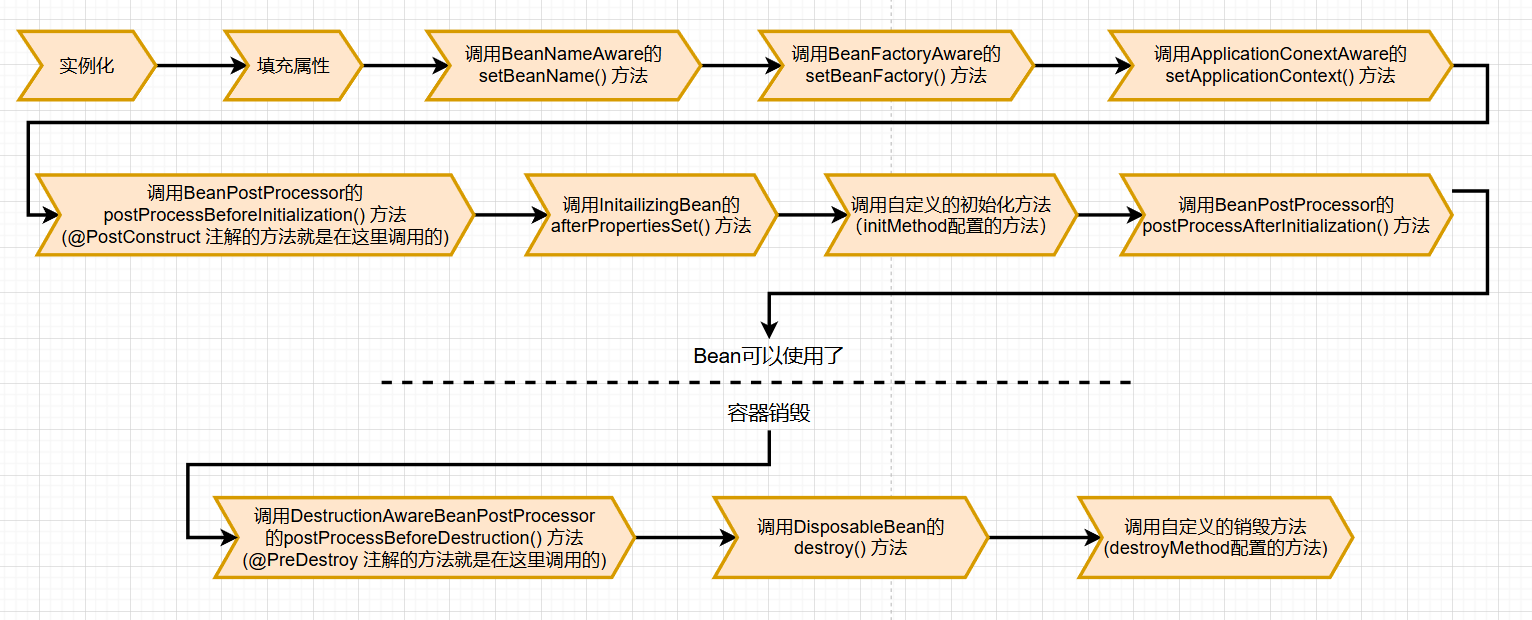
生命周期流程 Spring 中的一个 Bean 从被创建到被销毁,需要经历很多个阶段的生命周期,下图是一个 Bean 从创建到销毁的生命周期流程: 在 Bean 的各个生命周期流程点,Spring 都提供了对应的接口或者注解,以便开发者在各个生命周期的流程点能够做一些自己的操作。 案例解析 定义 Spring 上下文工具类 Spring 中生命周期最常见的应用可能是定义一个 Spring 上下文的工具类。这个工具类也使用 @Component 注解修饰,表明它也是一个 Bean ,其次它实现了 ApplicationContextAware 接口,则说明它作为一个 Bean 被创建以及初始化的过程中需要调用 setApplicationContext() 方法,设置它所在的 Spring 上下文。代码如下: @Component public class SpringContextUtils implements ApplicationContextAware { private static ApplicationContext applicationContext; /** * Spring会自动调用这个方法,注入ApplicationContext */ @Override public void setApplicationContext(ApplicationContext applicationContext) throws BeansException { SpringContextUtils.applicationContext = applicationContext; } /** * 获取ApplicationContext * @return ApplicationContext */ public static ApplicationContext getApplicationContext() { if (applicationContext == null) { throw new IllegalStateException("ApplicationContext is not set. Make sure SpringContextUtils is properly initialized."); } return applicationContext; } /** * 通过名称获取Bean * @param name Bean的名称 * @return Bean实例 */ public static Object getBean(String name) { return getApplicationContext().getBean(name); } /** * 通过名称和类型获取Bean * @param name Bean的名称 * @param requiredType Bean的类型 * @param <T> Bean的类型 * @return Bean实例 */ public static <T> T getBean(String name, Class<T> requiredType) { return getApplicationContext().getBean(name, requiredType); } /** * 通过类型获取Bean * @param requiredType Bean的类型 * @param <T> Bean的类型 * @return Bean实例 */ public static <T> T getBean(Class<T> requiredType) { return getApplicationContext().getBean(requiredType); } } 在 Bean 的依赖注入之后执行初始化操作 比如下面的案例中,MyService 这个 Bean 需要在它的依赖 MyRepository 这个 Bean 注入完成之后,调用依赖的 loadInitialData() 方法加载初始数据。代码如下: @Service public class MyService { private MyRepository myRepository; private List<String> initialData; @Autowired public void setMyRepository(MyRepository myRepository) { this.myRepository = myRepository; } // 依赖注入完成后执行的初始化方法 @PostConstruct public void init() { this.initialData = myRepository.loadInitialData(); } public void doBusinessLogic() { } } @Service class MyRepository { public List<String> loadInitialData() { } } @PostConstruct 注解是 JSR-250 标准定义的注解,它与 Spring 框架的耦合度比较低。除此之外还可以实现 InitializingBean 接口,在它的 afterPropertiesSet() 方法中来完成初始化;通过 XML 配置 init-method 或者 @Bean 注解的 initMethod 属性来指定任意的方法作为初始化方法来完成初始化。 Bean 创建源码解析 在 Spring 源码实现中实际上分为了三个大的步骤:实例化 -> 填充属性 -> 初始化 。填充属性可以看前面的文章[Spring 中@Autowired,@Resource,@Inject 注解实现原理](https://mp.weixin.qq.com/s/WVpWDU2JXFbpl-hgsywUXQ)。在上面生命周期图片中的从 XXXAware 的 setXXXAware() 方法到 postProcessAfterInitialization() 都属于初始化的这个步骤中。 在 AbstractAutowireCapableBeanFactory 中提供的 doCreateBean() 方法中提现了这三个大的步骤,其中的 createBeanInstance() 方法完成 Bean 的实例化;populateBean() 方法完成 Bean的属性填充;initializeBean() 方法完成 Bean 的初始化。代码如下: protected Object doCreateBean(String beanName, RootBeanDefinition mbd, @Nullable Object[] args) throws BeanCreationException { // Instantiate the bean. BeanWrapper instanceWrapper = null; if (instanceWrapper == null) { //实例化Bean instanceWrapper = createBeanInstance(beanName, mbd, args); } Object bean = instanceWrapper.getWrappedInstance(); // Eagerly cache singletons to be able to resolve circular references // even when triggered by lifecycle interfaces like BeanFactoryAware. boolean earlySingletonExposure = (mbd.isSingleton() && this.allowCircularReferences && isSingletonCurrentlyInCreation(beanName)); if (earlySingletonExposure) { addSingletonFactory(beanName, () -> getEarlyBeanReference(beanName, mbd, bean)); } // Initialize the bean instance. Object exposedObject = bean; try { //填充Bean的属性,比如处理@Autowired,@Resource,@Inject注解 populateBean(beanName, mbd, instanceWrapper); //初始化Bean exposedObject = initializeBean(beanName, exposedObject, mbd); } catch { } } initializeBean()方法流程 在 initializeBean() 方法中又分为:调用 invokeAwareMethods() 方法 -> 调用 applyBeanPostProcessorsBeforeInitialization() 方法 -> 调用 invokeInitMethods() 方法 -> 调用 applyBeanPostProcessorsAfterInitialization() 方法,代码如下: protected Object initializeBean(String beanName, Object bean, @Nullable RootBeanDefinition mbd) { //调用Aware()方法 invokeAwareMethods(beanName, bean); Object wrappedBean = bean; if (mbd == null || !mbd.isSynthetic()) { //调用BeanPostProcessor的postProcessBeforeInitialization()方法 wrappedBean = applyBeanPostProcessorsBeforeInitialization(wrappedBean, beanName); } try { //调用初始化方法 invokeInitMethods(beanName, wrappedBean, mbd); } catch (Throwable ex) { throw new BeanCreationException( (mbd != null ? mbd.getResourceDescription() : null), beanName, ex.getMessage(), ex); } if (mbd == null || !mbd.isSynthetic()) { //调用BeanPostProcessor的postProcessAfterInitialization()方法 wrappedBean = applyBeanPostProcessorsAfterInitialization(wrappedBean, beanName); } return wrappedBean; } invokeAwareMethods()方法流程 需要注意的是 invokeAwareMethods() 方法中仅仅只调用实现了 BeanNameAware,BeanClassLoaderAware,BeanFactoryAware 接口的方法。而常见的 ApplicationContextAware 接口的 setApplicationContext() 方法则是在 ApplicationContextAwareProcessor 的 postProcessBeforeInitialization() 方法中调用的。代码如下: public abstract class AbstractAutowireCapableBeanFactory { private void invokeAwareMethods(String beanName, Object bean) { if (bean instanceof Aware) { if (bean instanceof BeanNameAware beanNameAware) { //调用setBeanName()方法 beanNameAware.setBeanName(beanName); } if (bean instanceof BeanClassLoaderAware beanClassLoaderAware) { ClassLoader bcl = getBeanClassLoader(); if (bcl != null) { //调用setBeanClassLoader()方法 beanClassLoaderAware.setBeanClassLoader(bcl); } } if (bean instanceof BeanFactoryAware beanFactoryAware) { //调用setBeanFactory()方法 beanFactoryAware.setBeanFactory(AbstractAutowireCapableBeanFactory.this); } } } } class ApplicationContextAwareProcessor { public Object postProcessBeforeInitialization(Object bean, String beanName) throws BeansException { if (bean instanceof Aware) { this.invokeAwareInterfaces(bean); } return bean; } private void invokeAwareInterfaces(Object bean) { if (bean instanceof EnvironmentAware environmentAware) { environmentAware.setEnvironment(this.applicationContext.getEnvironment()); } if (bean instanceof EmbeddedValueResolverAware embeddedValueResolverAware) { embeddedValueResolverAware.setEmbeddedValueResolver(this.embeddedValueResolver); } if (bean instanceof ResourceLoaderAware resourceLoaderAware) { resourceLoaderAware.setResourceLoader(this.applicationContext); } if (bean instanceof ApplicationEventPublisherAware applicationEventPublisherAware) { applicationEventPublisherAware.setApplicationEventPublisher(this.applicationContext); } if (bean instanceof MessageSourceAware messageSourceAware) { messageSourceAware.setMessageSource(this.applicationContext); } if (bean instanceof ApplicationStartupAware applicationStartupAware) { applicationStartupAware.setApplicationStartup(this.applicationContext.getApplicationStartup()); } if (bean instanceof ApplicationContextAware applicationContextAware) { //这里调用的setApplicationContext()方法 applicationContextAware.setApplicationContext(this.applicationContext); } } } applyBeanPostProcessorsBeforeInitialization() 方法流程 在该方法中主要就是查找所有实现了 BeanPostProcessor 接口的对象,然后循环调用其 postProcessBeforeInitialization() 方法。代码如下: public Object applyBeanPostProcessorsBeforeInitialization(Object existingBean, String beanName) throws BeansException { Object result = existingBean; for (BeanPostProcessor processor : getBeanPostProcessors()) { Object current = processor.postProcessBeforeInitialization(result, beanName); if (current == null) { return result; } result = current; } return result; } 在 Spring 中提供了 CommonAnnotationBeanPostProcessor(@Resource 注解也是它处理的) 实现了 BeanPostProcessor 接口,在它的构造函数里面初始化了要处理 @PostConstruct 注解。代码如下: public CommonAnnotationBeanPostProcessor() { setOrder(Ordered.LOWEST_PRECEDENCE - 3); // Jakarta EE 9 set of annotations in jakarta.annotation package addInitAnnotationType(loadAnnotationType("jakarta.annotation.PostConstruct")); addDestroyAnnotationType(loadAnnotationType("jakarta.annotation.PreDestroy")); // Tolerate legacy JSR-250 annotations in javax.annotation package addInitAnnotationType(loadAnnotationType("javax.annotation.PostConstruct")); addDestroyAnnotationType(loadAnnotationType("javax.annotation.PreDestroy")); } 然后在它的子类 InitDestroyAnnotationBeanPostProcessor 的 postProcessBeforeInitialization() 实现了查找 @PostConstruct 注解修饰的方法,然后调用的逻辑。代码如下: public Object postProcessBeforeInitialization(Object bean, String beanName) throws BeansException { LifecycleMetadata metadata = findLifecycleMetadata(bean.getClass()); try { metadata.invokeInitMethods(bean, beanName); } catch (InvocationTargetException ex) { throw new BeanCreationException(beanName, "Invocation of init method failed", ex.getTargetException()); } catch (Throwable ex) { throw new BeanCreationException(beanName, "Failed to invoke init method", ex); } return bean; } invokeInitMethods() 方法流程 在该方法中会先判断 Bean 是否实现了 InitializingBean 接口,如果实现了则调用其 afterPropertiesSet() 方法,然后查看 Bean 定义中是否有自定义的初始化方法,如果有的话,则调用自定义的初始化方法。代码如下: protected void invokeInitMethods(String beanName, Object bean, @Nullable RootBeanDefinition mbd) throws Throwable { boolean isInitializingBean = (bean instanceof InitializingBean); if (isInitializingBean && (mbd == null || !mbd.hasAnyExternallyManagedInitMethod("afterPropertiesSet"))) { if (logger.isTraceEnabled()) { logger.trace("Invoking afterPropertiesSet() on bean with name '" + beanName + "'"); } //调用afterPropertiesSet()方法 ((InitializingBean) bean).afterPropertiesSet(); } if (mbd != null && bean.getClass() != NullBean.class) { String[] initMethodNames = mbd.getInitMethodNames(); if (initMethodNames != null) { for (String initMethodName : initMethodNames) { if (StringUtils.hasLength(initMethodName) && !(isInitializingBean && "afterPropertiesSet".equals(initMethodName)) && !mbd.hasAnyExternallyManagedInitMethod(initMethodName)) { //调用自定义初始化方法 invokeCustomInitMethod(beanName, bean, mbd, initMethodName); } } } } } protected void invokeCustomInitMethod(String beanName, Object bean, RootBeanDefinition mbd, String initMethodName) throws Throwable { Class<?> beanClass = bean.getClass(); MethodDescriptor descriptor = MethodDescriptor.create(beanName, beanClass, initMethodName); String methodName = descriptor.methodName(); Method initMethod = (mbd.isNonPublicAccessAllowed() ? BeanUtils.findMethod(descriptor.declaringClass(), methodName) : ClassUtils.getMethodIfAvailable(beanClass, methodName)); //省略代码 Method methodToInvoke = ClassUtils.getPubliclyAccessibleMethodIfPossible(initMethod, beanClass); try { ReflectionUtils.makeAccessible(methodToInvoke); //这里通过反射的方式调用初始化方法 methodToInvoke.invoke(bean); } catch (InvocationTargetException ex) { throw ex.getTargetException(); } } applyBeanPostProcessorsBeforeInitialization() 方法流程 在该方法中主要就是查找所有实现了 BeanPostProcessor 接口的对象,然后循环调用其 postProcessAfterInitialization() 方法。代码如下: public Object postProcessBeforeInitialization(Object bean, String beanName) throws BeansException { LifecycleMetadata metadata = findLifecycleMetadata(bean.getClass()); try { metadata.invokeInitMethods(bean, beanName); } catch (InvocationTargetException ex) { throw new BeanCreationException(beanName, "Invocation of init method failed", ex.getTargetException()); } catch (Throwable ex) { throw new BeanCreationException(beanName, "Failed to invoke init method", ex); } return bean; }

优秀的个人博客,低调大师

化学工程毕业生教你如何转行

大数据文摘出品 来源:medium 编译:张大笔茹 作为一名最近毕业于化学工程专业的学生,我第一份工作是在一家科技公司担任数据分析师。我曾在这里记录了从化学工程到数据科学的转变。从那时起,每当我与学校的学生谈论这一举动时,许多人表达了相同的兴趣和疑问…… “你是如何从工程学转向数据科学的?” 这也是我问自己的问题-我是怎么实现这个转变的?一年多以前,我就一直想着去分享关于数据科学家技能掌握的旅程。 并非缺乏信息使学习变得困难。相反,学习数据科学的大量资源使得很难从普通资源中找到最佳资源。 如此多的选择,如此少的时间… 但是首先,让我们先明白… 什么是数据科学? 额…这是一个很难回答的问题。不同的公司对数据科学的定义不同,这使其变得模棱两可,有些难以捉摸。一些人认为是编程,另一些人认为是数学,还有一些人认为和理解数据相关,它们在某种程度上来说都是正确的。对我来说,我最同意的定义是: 数据科学是一个跨学科领域,它是综合数学,计算机科学,领域知识领域中的技术和理论。 对我来说,这就是数据科学的样子。我以模糊的方式表示各个领域部分之间的界限,即来自各领域的知识融合在一起形成了所谓的“数据科学”。 好,那我该如何学习数据科学? 这一系列博客将重点介绍在自学中参加的一些课程以及它们的优缺点。希望能借此帮助你规划数据科学领域的自学之旅。包括: 第1部分-使用SQL,Python和R进行数据处理(本文) 第2部分-数学,概率论和统计 第3部分-计算机科学基础 第4部分-机器学习 在这篇文章中,我将重点介绍如何学习数据科学家所需的数据处理知识。学习处理数据,通常需要: 使用SQL(标准查询语言)从数据库中提取数据 清理,整合,分析数据(通常用Python和/或R) 有效地可视化数据 1. 使用SQL进行数据提取 SQL是一种数据库查询和程序设计语言,用于存取数据以及查询、更新和管理关系数据库系统。如果把数据比作埋在地下的宝藏,那SQL则是挖掘宝藏原始形式的工具。更具体地说,它可以从数据库中的一个表或多个表的组合中提取信息。 精通SQL并不难。 SQL有很多不同的“风格”,如SQL Server,PostgreSQL,Oracle,MySQL和SQLite。每种方法都有细微的差别,但是语法大致相似,因此不必担心要学习哪种SQL。 要学习一种语言,首先要学习单词,然后再将它们组合成句子和段落。学SQL也是一样的。 我用Datacamp(SQL入门)和Dataquest(SQL基础)学习最基本的概念(SQL的单词或句子)。(稍后,我将介绍Datacamp和Dataquest的优缺点。)通常这些站点里包括讲解练习和示例来学习基本的SQL技能。涵盖的一些概念是: 过滤和选择功能SELECT和WHERE COUNT,SUM,MAX,GROUP BY,HAVING用于汇总数据 DISTINCT,COUNT DISTINCT用于生成有用的不同列表和不同集合 OUTER(例如LEFT)和INNER JOIN何时/何地使用它们 字符串和时间转换 完成这些练习并不能使我变成分析师。就像我能够理解单词和句子,但无法写完整的段落一样。尤其是缺少一些重要的中级和高级概念,例如子查询和窗口功能,这些已经在数次技术访谈中进行了测试,并且对于作为分析师的角色来说是必不可少的。这些技能包括: 使用COALESCE处理NULL 子查询及其对查询效率的影响 临时表 自加入 窗口功能,例如PARTITION,LEAD,LAG 用户定义的功能 在查询中使用索引以使操作更快 学习这些技能,我主要用免费的SQLZoo.net,它通过设置有挑战性的联系来巩固学习每个概念。我最喜欢的SQLZoo功能是它的在一个综合问题中测试不同概念的练习。例如,提供以下实体关系图,并要求其基于该关系图创建复杂的查询。 实体关系图示例。图片来源:Ottomachin,根据知识共享许可 这与我们在分析师工作中遇到的情况相似,即使用了已学到的不同技术从同一数据库中提取信息。 以下是SQLZoo问题“帮助台”的实体关系图。系统要求您显示经理和2017–08–12一天中每小时的已接电话数量。(在这里自己尝试!) 我使用的其他资源包括Zachary Thomas的SQL Questions和Leetcode。 2. 使用R和Python进行数据处理 开始学习数据科学所需的编程和工具是总是躲不过R和/或Python。它们都是非常流行的编程语言,用于数据处理,可视化和调整。R 还是 Python是一个古老的问题,值得单独写一篇文章。我的意见? 选择R还是python都没关系:精通它俩之一,你就可以轻松驾驭另一个。 我使用python和R进行编码开始于与CodeAcademy,Datacamp,Dataquest,SoloLearn和Udemy等一起写代码的网站。这些网站提供按语言或程序包组织的自定进度课程。每种方法都将概念分解为易于消化的部分,并为用户提供了入门代码。通常是先引导你完成一个简单的演示,随后将有机会通过练习立即练习该概念。一些人随后提供基于项目的练习。 今天我介绍自己最喜欢的两个:Datacamp 和 Dataquest。 (1) Datacamp DataCamp在线提供由专业人士讲授的视频讲座和空白练习,视频讲座大多简洁有效。 我喜欢DataCamp的一个原因是它的最新的课程,以SQL,R和python的形式组成。这消除了计划课程的痛苦-现在只需要遵循自己感兴趣的选择即可,内容包括: Python / R相关的数据科学 Python / R / SQL相关的数据分析 R相关的统计 Python / R相关的机器学习 Python / R相关的编程 我个人是从R的Data Science开始学习的,该课程对R的tidyverse提供了相当详细的介绍,R tidyverse是一个非常有用的数据包的集合,这些数据包用于清洗,操作和可视化数据,其中最著名的是ggplot2 可视化),dplyr(用于数据操作)和stringr(用于字符串操作)。 我最喜欢的R语言包,作者提供 但DataCamp也有缺点——完成DataCamp之后信息保存能力很差。使用空白填充格式,很容易猜测空白处的内容,而无需真正理解该概念。在平台上学习时,我努力在尽可能短的时间内完成尽可能多的课程。我浏览了一下代码,并在不了解大局的情况下填补了空白。如果我可以重新开始在DataCamp上学习,那么我将花时间在整体上更好地消化和理解代码,而不仅是要求我填写的部分。 (2) Dataquest Dataquest与DataCamp非常相似,着重于使用代码练习来阐明编程概念。与Datacamp一样,它提供了R,Python和SQL方面的各种课程,尽管范围比DataCamp中的要少。与Datacamp不同,Dataquest不提供视频讲座。 Dataquest提供的一些曲目包括: R / Python中的λ数据分析师 Python中的数据科学 数据工程 通常,DataQuest的内容要比DataCamp的难得多。“填空”格式练习也更少。尽管花费了更长的时间,但DataQuest的知识保留却更好。 DataQuest的另一个重要功能是每月与导师通话,导师将浏览你的简历并提供技术指导。虽然我个人没有与导师联系,但事后回想,它肯定可以帮助我更快地进步。 3. 数据可视化 数据可视化是呈现数据信息的关键, 学完用python和R创建图表的技能后,我通过Cole Knaflic的《用数据讲故事》一书中学习了数据可视化的原理。 这本书是平台性的。换句话说,它不关注任何特定的软件,而是通过启发性的示例来阐述数据可视化的一般原理。可以从这本书中学到的一些关键信息包括: 了解背景 选择有效的方式 清理杂质 注意你所关注的地方 像设计师一样思考 讲一个故事 读这本书之前,我以为自己是很了解数据可视化的。 消化完这本书后,我可以画一个看起来还不错的图表了,来展示警察对黑人的残酷行为。这本书对我最大的启发之一是注意你所关注的地方。通过这条明亮的黄色突出显示非裔美国人的线条(使人联想起BLM颜色),同时在背景中保留图表的其余部分,并带有白色和灰色等暗淡的阴影,来突出我所关注的点。 数据可视化技术应用于强调警察野蛮行为的图表。图片由作者提供。 接下来… 在这篇文章中,我介绍了自己从头开始学习编程的步骤。通过学习这些课程,你应该已经具备了处理数据的必要技能!但还有很长的路要走。在接下来的帖子中,我将介绍: 第2部分:数学,概率论和统计 第3部分:计算机科学基础 第4部分:机器学习 如有更新,文摘菌定会第一时间传递给各位读者~ 相关报道: https://towardsdatascience.com/how-to-teach-yourself-data-science-in-2020-f674ec036965 【本文是51CTO专栏机构大数据文摘的原创译文,微信公众号“大数据文摘(id: BigDataDigest)”】 戳这里,看该作者更多好文 【责任编辑: 赵宁宁 TEL:(010)68476606】 点赞 0

优秀的个人博客,低调大师

意法半导体于引:希望打造STM32生态系统

物联网被广泛认为是接替互联网的下一个“风口”,IoT设备连年高速增长正在印证这一判断。日前在“第五届EEVIA年度中国ICT媒体论坛”北京站上,意法半导体微控制器北方区市场经理于引认为,IoT的应用其实非常广泛,整个IoT生态系统包括三个组成部分,一个是数据,一个是传输,还有一个是后端的服务。 意法半导体拥有很强的传感器部门,据透露2015年前三季度出货量达到了100亿片,其中嵌入式上半年有20亿片的出货量。从产品线看,意法的MCU主要分为两大类,一类是8位MCU,是由意法自主的内核来做的,那么另外一个就是32位MCU,即STM32,全线使用了ARMCortex系列。“我们希望搭建一个通用平台,为用户做产品节省设计周期。” 目前意法半导体STM32已经占到了其MCU一半的份额。于引举了几个例子,例如无人机,是2015年大热的产品,意法半导体2015年最新推出的高性能的MCU——F7,基于cortex M7内核,主要做的就是图像控制,以及无人机的平衡控制,帮助无人机在悬浮状态保持稳定的场景应用。另外在无人机里面还有到F4,主要做飞机控制和无线定位控制,此外包括M3和F0系列。“在整个无人机系统里,我们会有不同的产品做一个对应,包括处理能力更强的,或者功能更简单,成本更低的,这种完美的组合会让我们产品更有竞争力。” 据介绍,意法半导体主流产品里面是基于M0、M3和M4的内核做的区分。F0是入门级的,F1系列是最早07年第一款基于corte M系列的产品,到现在将近10年时间,也是目前市场主流的产品线。基于M4的内核增加了浮点运算和模拟外设,包括AD增加M3系列的产品等三个系列。 此外,意法半导体还包括低功耗产品、高性能产品系列,高性能产品采用用M3、M4,以及最新的基于M7的内核所做的。单纯来评价一下内核的性能,F7应该是业界跑的最快的MCU。“后续我们还会在M7的基础上增加H7的产品,甚至于MPU的产品。在高性能这条产品线上,我们会不断投入研发资源,希望能够扩展市场份额。” “整个IoT生态系统包括三个组成部分,作为芯片的供应商,只做芯片很难更好地服务于整个市场。我们希望建立一个生态系统,成为合作伙伴最信任的一个搭档,一起基于我们的硬件搭建平台,软件厂商跟我们一起合作,能够把更好的方案推到终端用户。”于引说,生态系统的核心是MCU,还会扩展一些增值服务商,代理商,包括设计公司提供相应的方案,除此之外还有做推广,包括一些创客社区的服务,还有一些在线的论坛。在2015年,意法半导体也开创了本地化的网站www.stmcu.com.cn。 本文转自d1net(转载)

优秀的个人博客,低调大师

1分钟完成MySQL5.6生产库自动化安装部署

1分钟完成MySQL5.6安装部署 简介 Part1:写在最前 自动化运维是一个DBA应该掌握的技术,其中,自动化安装数据库是一项基本的技能,本文中的安装脚本已通过测试,作为生产库来说没有问题,鉴于每个公司存储规划要求不同,可以按需自行修改脚本。 由于源码安装费时费力,rpm包可定制性差,生产库一般采用二进制安装包,本文的安装包为二进制安装文件,本文使用的是mysql-5.6.25-linux-glibc2.5-x86_64.tar.gz,如版本不同,替换第109、110行的tar命令后的mysql安装包名即可 Part2:新特性简介 本脚本默认启用5.6部分新特性 innodb_buffer_pool_dump_at_shutdown=1 它dump的不是数据,是Id号 innodb_buffer_pool_load_at_startup=1 开启这个两个参数当数据库重启后把这些热数据重新加载回去 只有正常关库才会dump热数据块,宕机和kill -9不会 部分参数按需整改,例如innodb_buffer_pool_size,本文给的512M,一般为内存的50%-80% 来看一下脚本的具体情况 实战 Part1:自动化脚本 [root@HE3 ~]# cat mysql_auto_install.sh ######二进制自动安装数据库脚本root密码MANAGER将脚本和安装包放在/root目录即可############### ######数据库目录/usr/local/mysql############ ######数据目录/data/mysql############ ######日志目录/log/mysql############ ######端口号默认3306其余参数按需自行修改############ ################## #author:rrhelei@126.com# ################## #!/bin/bash PATH=/bin:/sbin:/usr/bin:/usr/sbin:/opt/bin:/opt/sbin:~/bin exportPATH #Checkifuserisroot if[$(id-u)!="0"];then echo"Error:Youmustberoottorunthisscript,pleaseuseroottoinstall" exit1 fi clear echo"=========================================================================" echo"Atooltoauto-compile&installMySQL5.6.25onRedhat/CentOSLinux" echo"=========================================================================" cur_dir=$(pwd) #setmysqlrootpassword echo"===========================" mysqlrootpwd="MANAGER" echo-e"Pleaseinputtherootpasswordofmysql:" read-p"(Defaultpassword:MANAGER):"mysqlrootpwd if["$mysqlrootpwd"=""];then mysqlrootpwd="MANAGER" fi echo"===========================" echo"MySQLrootpassword:$mysqlrootpwd" echo"===========================" #whichMySQLVersiondoyouwanttoinstall? echo"===========================" isinstallmysql56="n" echo"InstallMySQL5.6.25,Pleaseinputy" read-p"(Pleaseinputy,n):"isinstallmysql56 case"$isinstallmysql56"in y|Y|Yes|YES|yes|yES|yEs|YeS|yeS) echo"YouwillinstallMySQL5.6.25" isinstallmysql56="y" ;; *) echo"INPUTerror,YouwillexitinstallMySQL5.6.25" isinstallmysql56="n" exit esac get_char() { SAVEDSTTY=`stty-g` stty-echo sttycbreak #ddif=/dev/ttybs=1count=12>/dev/null stty-raw sttyecho stty$SAVEDSTTY } echo"" echo"Pressanykeytostart...orPressCtrl+ctocancel" char=`get_char` #Initializetheinstallationrelatedcontent. functionInitInstall() { cat/etc/issue uname-a MemTotal=`free-m|grepMem|awk'{print$2}'` echo-e"\nMemoryis:${MemTotal}MB" #Settimezone #rm-rf/etc/localtime #ln-s/usr/share/zoneinfo/Asia/Shanghai/etc/localtime #DeleteOldMysqlprogram rpm-qa|grepmysql rpm-emysql #yum-yremovemysql-servermysqlmysql-libs #yum-yremovephp-mysql #yum-yinstallyum-fastestmirror #yum-yupdate #DisableSeLinux if[-s/etc/selinux/config];then sed-i's/SELINUX=enforcing/SELINUX=disabled/g'/etc/selinux/config fi setenforce0 } #Installationofdependonandoptimizationoptions. functionInstallDependsAndOpt() { cd$cur_dir cat>>/etc/security/limits.conf<<EOF *softnproc65535 *hardnproc65535 *softnofile65535 *hardnofile65535 EOF echo"fs.file-max=65535">>/etc/sysctl.conf } #InstallMySQL functionInstallMySQL56() { echo"============================InstallMySQL5.6.22==================================" cd$cur_dir #Backupoldmy.cnf #rm-f/etc/my.cnf if[-s/etc/my.cnf];then mv/etc/my.cnf/etc/my.cnf.`date+%Y%m%d%H%M%S`.bak fi #mysqldirectoryconfiguration groupaddmysql-g512 useradd-u512-gmysql-s/sbin/nologin-d/home/mysqlmysql tarxvf/root/mysql-5.6.25-linux-glibc2.5-x86_64.tar.gz mv/root/mysql-5.6.25-linux-glibc2.5-x86_64/usr/local/mysql mkdir-p/data/mysql mkdir-p/log/mysql chown-Rmysql:mysql/data/mysql chown-Rmysql:mysql/usr/local/mysql chown-Rmysql:mysql/log #edit/etc/my.cnf SERVERID=`ifconfigeth0|grep"inetaddr"|awk'{print$2}'|awk-F.'{print$3$4}'` cat>>/etc/my.cnf<<EOF [client] port=3306 socket=/tmp/mysql.sock default-character-set=utf8 [mysql] default-character-set=utf8 [mysqld] port=3306 socket=/tmp/mysql.sock basedir=/usr/local/mysql datadir=/data/mysql open_files_limit=3072 back_log=103 max_connections=800 max_connect_errors=100000 table_open_cache=512 external-locking=FALSE max_allowed_packet=32M sort_buffer_size=2M join_buffer_size=2M thread_cache_size=51 query_cache_size=32M tmp_table_size=96M max_heap_table_size=96M slow_query_log=1 slow_query_log_file=/log/mysql/slow.log log-error=/log/mysql/error.log long_query_time=1 server-id=$SERVERID log-bin=mysql-bin sync_binlog=1 binlog_cache_size=4M max_binlog_cache_size=4096M max_binlog_size=1024M expire_logs_days=60 key_buffer_size=32M read_buffer_size=1M read_rnd_buffer_size=16M bulk_insert_buffer_size=64M character-set-server=utf8 default-storage-engine=InnoDB binlog_format=row innodb_buffer_pool_dump_at_shutdown=1 innodb_buffer_pool_load_at_startup=1 binlog_rows_query_log_events=1 explicit_defaults_for_timestamp=1 #log_slave_updates=1 #gtid_mode=on #enforce_gtid_consistency=1 #innodb_write_io_threads=8 #innodb_read_io_threads=8 #innodb_thread_concurrency=0 transaction_isolation=REPEATABLE-READ innodb_additional_mem_pool_size=16M innodb_buffer_pool_size=512M #innodb_data_home_dir= innodb_data_file_path=ibdata1:1024M:autoextend innodb_flush_log_at_trx_commit=1 innodb_log_buffer_size=16M innodb_log_file_size=512M innodb_log_files_in_group=2 innodb_max_dirty_pages_pct=50 innodb_file_per_table=1 innodb_locks_unsafe_for_binlog=0 wait_timeout=14400 interactive_timeout=14400 skip-name-resolve [mysqldump] quick max_allowed_packet=32M EOF /usr/local/mysql/scripts/mysql_install_db--basedir=/usr/local/mysql--datadir=/data/mysql--defaults-file=/etc/my.cnf--user=mysql cp/usr/local/mysql/support-files/mysql.server/etc/init.d/mysqld chmod700/etc/init.d/mysqld chkconfig--addmysqld chkconfig--level2345mysqldon cat>>/etc/ld.so.conf.d/mysql-x86_64.conf<<EOF /usr/local/mysql/lib EOF ldconfig if[-d"/proc/vz"];then ulimit-sunlimited fi /etc/init.d/mysqldstart cat>>/etc/profile<<EOF exportPATH=$PATH:/usr/local/mysql/bin exportLD_LIBRARY_PATH=$LD_LIBRARY_PATH:/usr/local/mysql/lib EOF source/etc/profile /usr/local/mysql/bin/mysqladmin-urootpassword$mysqlrootpwd cat>/tmp/mysql_sec_script<<EOF usemysql; deletefrommysql.userwhereuser!='root'orhost!='localhost'; grantallprivilegeson*.*to'sys_admin'@'%'identifiedby'MANAGER'; flushprivileges; EOF /usr/local/mysql/bin/mysql-uroot-p$mysqlrootpwd-hlocalhost</tmp/mysql_sec_script #rm-f/tmp/mysql_sec_script /etc/init.d/mysqldrestart echo"============================MySQL5.6.25installcompleted=========================" } functionCheckInstall() { echo"=====================================Checkinstall===================================" clear ismysql="" echo"Checking..." if[-s/usr/local/mysql/bin/mysql]&&[-s/usr/local/mysql/bin/mysqld_safe]&&[-s/etc/my.cnf];then echo"MySQL:OK" ismysql="ok" else echo"Error:/usr/local/mysqlnotfound!!!MySQLinstallfailed." fi if["$ismysql"="ok"];then echo"InstallMySQL5.6.25completed!enjoyit." echo"=========================================================================" netstat-ntl else echo"Sorry,FailedtoinstallMySQL!" echo"Youcantail/root/mysql-install.logfromyourserver." fi } #Theinstallationlog InitInstall2>&1|tee/root/mysql-install.log CheckAndDownloadFiles2>&1|tee-a/root/mysql-install.log InstallDependsAndOpt2>&1|tee-a/root/mysql-install.log InstallMySQL562>&1|tee-a/root/mysql-install.log CheckInstall2>&1|tee-a/root/mysql-install.log Part2:安装 下载完毕安装包,将脚本和安装文件放在/root目录下,执行上述脚本即可(如不是5.6.25版本,需修改脚本132、133行为对应版本号) [root@HE3 ~]# sh -x mysql_auto_install.sh 如首次安装,请再次执行source /etc/profile [root@HE3 ~]#source /etc/profile 验证 执行脚本后,输入用户名密码(默认MANAGER)后登录数据库成功。 至此,MySQL5.6安装完成。

优秀的个人博客,低调大师

混圈子!双十二拼团大咖灰太狼教你如何流量变现!

大家好,我叫灰太狼,在一家互联网公司担任程序员一职,但是正不正经我就不大清楚了。比起最近在群内接触到的称霸拼团赛榜首的大佬们,我只是一枚刚入门云大使两三个月的萌新,但在这次双十一和双十二拼团赛中,我结合自身的优势,也找到了最适合自己的推广方式,成为云大使这段时间也有不少的感悟,现在就来与大家分享一下。 我也像很多其他程序员小伙伴一样,平时没有什么特别花时间的爱好,对于闲暇时间针对专业知识和工作的思考,我喜欢用写文章的方式记录下来,在个人公众号中与志同道合的小伙伴们分享交流技术,当然也有一些时事热点(欢迎大家去公众号关注我,与我多多交流,公众号ID:Python乱炖)。在我看来,写技术文章不仅可以不断为自己沉淀经验与知识,还可以帮助到不少渴望知识渴望成长的人,这是一件十分有意义的事情。 在了解到这个云计算普惠全国的阿里云大使项目前,也有不少同学来咨询我,问我服务器该怎么买,结合他们的具体情况,我都很耐心一一为他们解答,推荐产品。还是一个偶然的机会,阿里云官方运营同学发现了我的公众号,邀请我加入阿里云大使,在此之前我也是阿里云的用户,对阿里云的产品十分信任,并且推荐新人购买还有不菲的佣金可以拿,我便欣然的接受了这份邀请。 在推广前,我认认真真做了一波战略分析,如果上来就盲目的推广必然是费时费力还没有较好成果的,所以我的方针是“普遍撒网,重点捕捞”,首先我们要找到有意向购买阿里云产品的用户,我当机立断,写了一篇如何制作个人网站的教程并顺便推广了阿里云产品,随后发布到了自己的公众号,果不其然,随着文章浏览量的增多,越来越多的朋友和粉丝向我咨询服务器该怎么选购,在这个时候作为推广者需要从各个纬度分析,了解清楚他们的需求、他们的身份和预算以及他们想要解决的案例等等,得知了这些消息之后,我便可以根据自己的专业知识以及经验,为他们推荐了最适合他们的产品,本着自己平时刻苦钻研的知识和对阿里云品牌的信赖,我相信我推荐的产品是最好、最适合来咨询我的人的。 在双十一前期,我推广了一段时间后,发现用户中夹杂着一些阿里云老用户,这部分用户购买阿里云产品在当时是不计入返利,但还好因为我准备的教程偏基础,接触的用户还是新用户偏多的,这在无形中帮助我了不少。好在双十一拼团赛后期以及双十二,阿里云听到了我们云大使的心声,推出了老用户新购也可以返佣的政策,返佣条件变得宽松了特别多,对于我来说又是有一部分资源可以利用了,希望以后阿里云还可以出更多有利于云大使的规则,感谢! 从开始推广阿里云产品的这段时间以来,我感觉自己的生活变得更加充实了,虽然比起以前忙碌了不少,但我也确实帮助到了不少的人。双十一和双十二的拼团赛我都取得了让自己满意的成绩,不过我并不满足于此,我会选择稳扎稳打,在慢慢积累流量的过程中探寻更多变现模式,抓住更多推广阿里云产品的机会,为云计算普惠全国贡献一份力量!不管你是想要学习Python知识还是想要交流推广心得,都可以来公众号戳我~

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册