首页 文章 精选 留言 我的

精选列表

搜索[前端性能],共10000篇文章
优秀的个人博客,低调大师

Android 性能优化 - APK 瘦身

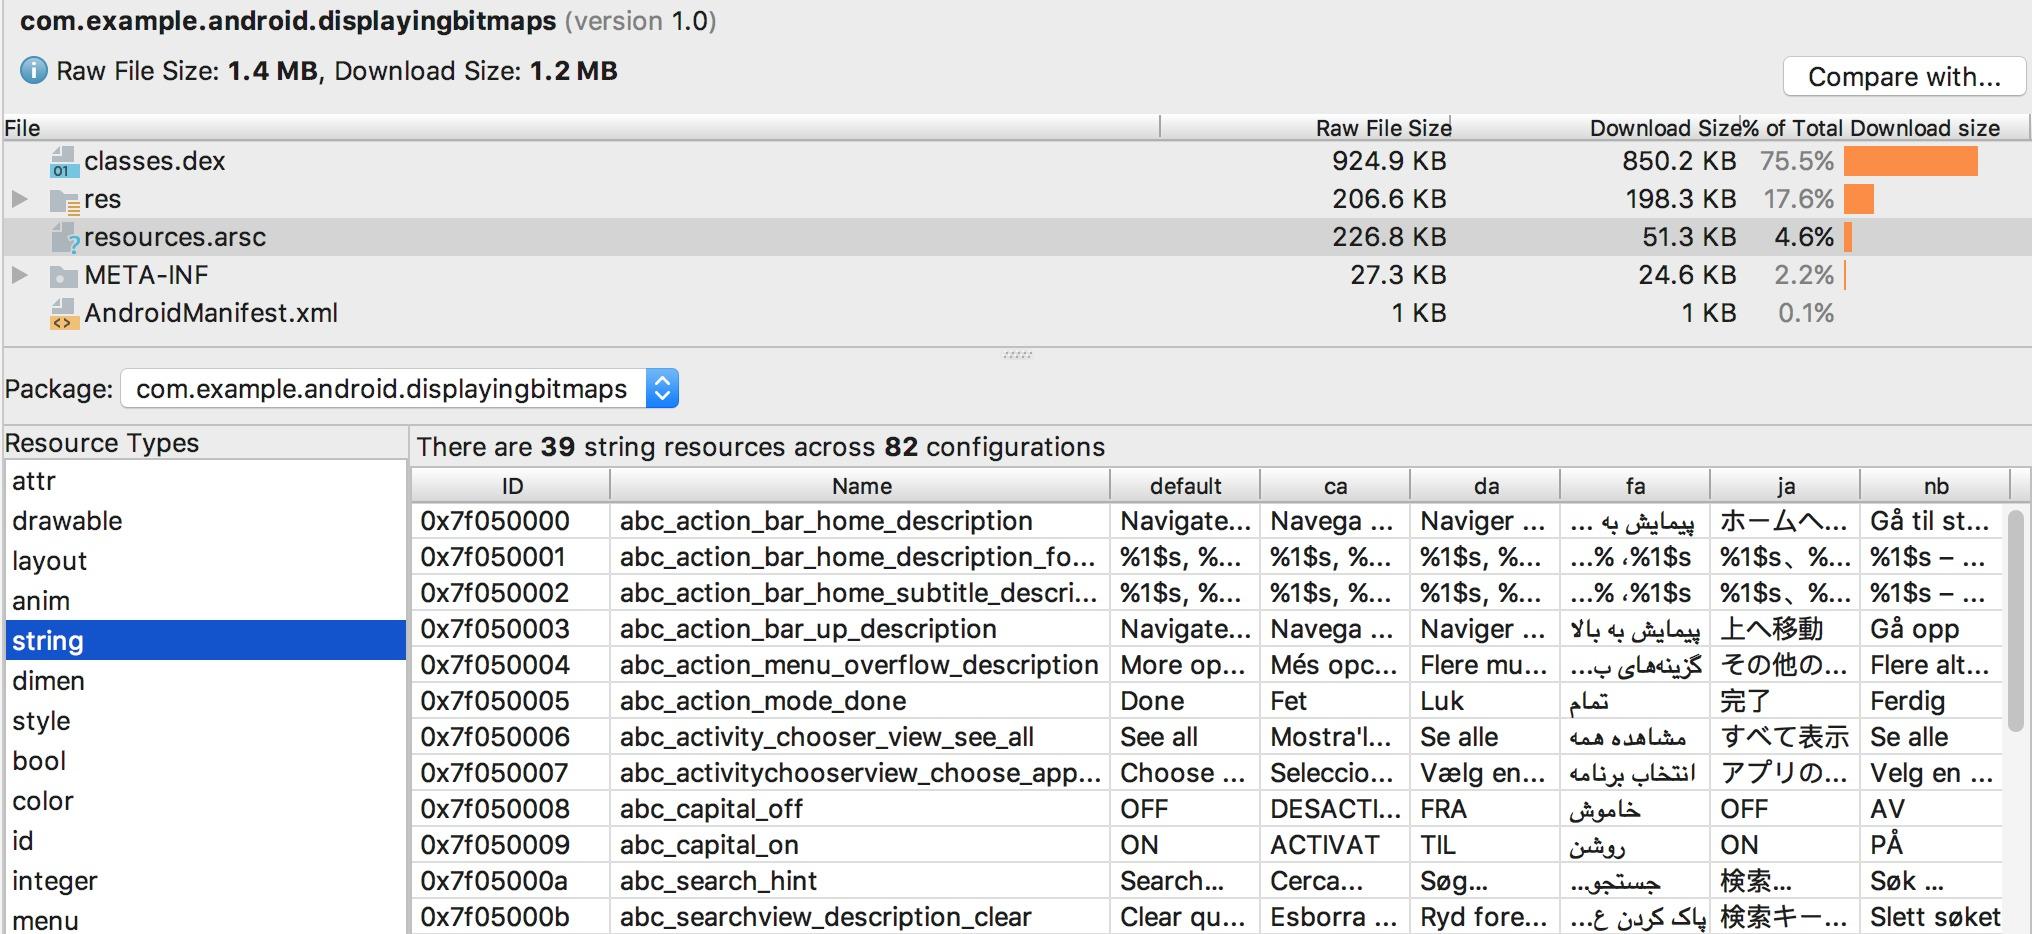
如何查看 apk 的组成 如果要优化 apk 的大小,我们首先需要知道我们编译出来的 apk 都包含哪些东西,然后针对占用大的做裁剪,或者删除不需要的东西,从而达到瘦身的目的。 查看 apk 的内容占用情况很简单,打开 AS ,把 apk 拖到 AS 里面就可以查看 apk 包含的内容了。 可以看到占大头的是 res 代码等,所以瘦身可以从这几个方面来考虑。 如何减少 res 资源大小 删除冗余的资源 一般随着项目的迭代,部分图片等资源不再使用了,但是可能仍然被编译到了 apk 里面,所以可以删除这部分不再使用的资源,可以使用 lint 工具来搜索项目中不再使用的图片等资源。 重复资源的优化 除了有冗余资源,还有些是文件名不一样,但是内容一样的图片,可以通过比较 md5 值来判断是不是一样的资源,然后编辑 resources.arsc 来重定向。 图片压缩 未压缩的图片文件占用空间较大,可以考虑压缩未压缩过的图片来瘦身。常用的工具是 tinypng 网站。 同时也可以借助 TinyPngPlugin 等插件或者其他开源工具来帮助压缩图片。 资源混淆 通过将资源路径 res/drawable/wechat 变为 r/d/a 的方式来减少 apk 的大小,当 apk 有较多资源项的时候,效果比较明显,这是一款微信开源的工具,详细地址是:AndResGuard 指定语言 如果没有特殊的需求的话,可以只编译中文,因为其他的语言用不上,如果用不上的语言编译了,会在 resource 的表里面占用大量的空间,故 android { defaultConfig { ... // 仅支持 中文 resConfigs "zh" } } 如何减少 so 库资源大小 自己编译的 so release 包的 so 中移除调试符号。可以使用 Android NDK 中提供的 arm-eabi-strip 工具从原生库中移除不必要的调试符号。 如果是 cmake 来编译的话,可以再编辑脚本添加如下代码 set(CMAKE_C_FLAGS_RELEASE "${CMAKE_C_FLAGS_RELEASE} -s") set(CMAKE_CXX_FLAGS_RELEASE "${CMAKE_CXX_FLAGS_RELEASE} -s") 别人编译的 so 联系作者修改,一般很难联系到。 动态下发 so 可以通过服务器下发 so , 下载完后再进入应用,但是体验不好,但是是一个思路。 只编译指定平台的 so 一般我们都是给 arm 平台的机器开发,如果没有特殊情况,我们一般只需要考虑 arm 平台的。具体的方法是 app 下的 build.gradle 添加如下代码 android { defaultConfig { ndk { abiFilter "armeabi" } } } 各个平台的差别如下: 平台 说明 armeabi-v7a arm 第 7 代及以上的处理器,2011 年后的设备基本都是 arm64-v8a arm 第 8 代 64 位处理器设备 armeabi arm 第 5、6 代处理器,早期的机器都是这个平台 x86 x86 32 位平台,平板和模拟器用的多 x86_64 x86 64 位平台 如何减少代码资源大小 一个功能尽量用一个库 比如加载图片库,不要 glide 和 fresco 混用,因为功能是类似的,只是使用的方法不一样,用了多个库来做类似的事情,代码肯定就变多了。 混淆 混淆的话,减少了生成的 class 大小,这样积少成多,也可以从一定层度减少 apk 的大小。 R 文件内联 通过把 R 文件里面的资源内联到代码中,从而减少 R 文件的大小。 可以使用 shrink-r-plugin 工具来做 R 文件的内联 参考文档 Android App包瘦身优化实践 联系我 Github: https://github.com/XanderWang Mail: 420640763@qq.com Blog: https://xander_wang.gitee.io/android-note/

优秀的个人博客,低调大师

Android MEM性能数据获取

查看内存使用情况使用adb dumpsys 命令 adb shell dumpsys meminfo 其中,package_name 也可以换成程序的pid,pid可以通过 adb shell top | grep app_name 来查找,下图是滴滴主端的内存使用情况 应用级内存 didi@bogon  ~  adb shell dumpsys meminfo com.sdu.didi.psnger Applications Memory Usage (in Kilobytes): Uptime: 180975 Realtime: 180975 ** MEMINFO in pid 7914 [com.sdu.didi.psnger] ** Pss Private Private SwapPss Heap Heap Heap Total Dirty Clean Dirty Size Alloc Free ------ ------ ------ ------ ------ ------ ------ Native Heap 32081 31972 92 294 59904 41985 17918 Dalvik Heap 26859 26764 0 318 27257 16354 10903 Dalvik Other 6354 6348 0 0 Stack 1424 1424 0 0 Ashmem 1558 1544 0 0 Gfx dev 4942 1636 8 0 Other dev 27 0 24 0 .so mmap 13066 384 8904 199 .apk mmap 19677 80 16676 0 .ttf mmap 11 0 0 0 .dex mmap 48628 24 37604 0 .oat mmap 12470 0 3128 0 .art mmap 2754 1872 44 15 Other mmap 2227 8 1256 0 EGL mtrack 41100 41100 0 0 GL mtrack 6984 6984 0 0 Unknown 5939 5924 12 99 TOTAL 227026 126064 67748 925 87161 58339 28821 App Summary Pss(KB) ------ Java Heap: 28680 Native Heap: 31972 Code: 66800 Stack: 1424 Graphics: 49728 Private Other: 15208 System: 33214 TOTAL: 227026 TOTAL SWAP PSS: 925 Objects Views: 121 ViewRootImpl: 1 AppContexts: 3 Activities: 1 Assets: 4 AssetManagers: 3 Local Binders: 75 Proxy Binders: 35 Parcel memory: 37 Parcel count: 131 Death Recipients: 1 OpenSSL Sockets: 7 SQL MEMORY_USED: 945 PAGECACHE_OVERFLOW: 263 MALLOC_SIZE: 62 DATABASES pgsz dbsz Lookaside(b) cache Dbname 4 88 135 16/40/7 /storage/emulated/0/Android/data/com.sdu.didi.psnger/files/im/im_database_282680000258050.db 4 28 45 171/107/4 /data/user/0/com.sdu.didi.psnger/databases/dns_record.db 4 32 84 10/24/7 /data/user/0/com.sdu.didi.psnger/databases/ad 4 20 37 46/22/5 /data/user/0/com.sdu.didi.psnger/databases/location_info.db 4 24 41 5/19/2 /data/user/0/com.sdu.didi.psnger/databases/download_file.db 4 100 149 58/44/25 /data/user/0/com.sdu.didi.psnger/databases/DIDI_DATABASE 4 20 19 0/23/2 /data/user/0/com.sdu.didi.psnger/databases/audio_record_2 4 12 0/0/0 (attached) temp 4 20 56 3/15/3 /data/user/0/com.sdu.didi.psnger/databases/audio_record_2 (1) 重点关注如下几个字段: (1) 私有(Clean and Dirty)内存 进程独占的内存,也就是应用进程销毁时系统可以直接回收的内存容量。 通常来说,“private dirty”内存是其最重要的部分,因为只被自己的进程使用。它只在内存中存储,因此不能做分页存储到外存(Android不支持swap)。 所有分配的Dalvik堆和本地堆都是“private dirty”内存;Dalvik堆和本地堆中和Zygote进程共享的部分是共享dirty内存。 (2) Total 的 PSS 信息 实际使用内存,这是另一种应用内存使用的计算方式,这个值就是我们应用真正占据的内存大小。 PSS会把跨进程的共享页也计算在内。任何独占的内存页直接计算它的PSS值,而和其它进程共享的页则按照共享的比例计算PSS值。例如,在两个进程间共享的页,计算进每个进程PPS的值是它的一半大小。 PSS计算方式的一个好处是:把所有进程的PSS值加起来就可以确定所有进程总共占用的内存。这意味着用PSS来计算进程的实际内存使用、进程间对比内存使用和总共剩余内存大小是很好的方式。 通常来说,只需关心Pss Total列和Private Dirty列就可以了。在一些情况下,Private Clean列和Heap Alloc列也会提供很有用的信息。 代码示例 /** * 获取进程内存Private Dirty数据 * * @param context * @param pid * 进程ID * @return nativePrivateDirty、dalvikPrivateDirty、 TotalPrivateDirty */ public static long[] getPrivDirty(Context context, int pid) { ActivityManager mAm = (ActivityManager) context .getSystemService(Context.ACTIVITY_SERVICE); int[] pids = new int[1]; pids[0] = pid; MemoryInfo[] memoryInfoArray = mAm.getProcessMemoryInfo(pids); MemoryInfo pidMemoryInfo = memoryInfoArray[0]; long[] value = new long[3]; // Natvie Dalvik Total value[0] = pidMemoryInfo.nativePrivateDirty; value[1] = pidMemoryInfo.dalvikPrivateDirty; value[2] = pidMemoryInfo.getTotalPrivateDirty(); return value; } /** * 获取进程内存PSS数据 * * @param context * @param pid * @return nativePss、dalvikPss、TotalPss */ public static long[] getPSS(Context context, int pid) { long[] value = new long[3]; // Natvie Dalvik Total if (pid >= 0) { int[] pids = new int[1]; pids[0] = pid; ActivityManager mAm = (ActivityManager) context .getSystemService(Context.ACTIVITY_SERVICE); MemoryInfo[] memoryInfoArray = mAm.getProcessMemoryInfo(pids); MemoryInfo pidMemoryInfo = memoryInfoArray[0]; value[0] = pidMemoryInfo.nativePss; value[1] = pidMemoryInfo.dalvikPss; value[2] = pidMemoryInfo.getTotalPss(); } else { value[0] = 0; value[1] = 0; value[2] = 0; } return value; } 获取手机总内存和可用内存信息 “/proc/meminfo”文件记录了android手机的一些内存信息,通过读取文件”/proc/meminfo”的信息能够获取手机Memory的总量。 # cat /proc/meminfo cat /proc/meminfo MemTotal: 94096 kB 所有可用RAM大小。 MemFree: 1684 kB LowFree与HighFree的总和,被系统留着未使用的内存。 Buffers: 16 kB 用来给文件做缓冲大小 Cached: 27160 kB 被高速缓冲存储器(cache memory)用的内存的大小(等于diskcache minus SwapCache)。 SwapCached: 0 kB 被高速缓冲存储器(cache memory)用的交换空间的大小。已经被交换出来的内存,仍然被存放在swapfile中,用来在需要的时候很快的被替换而不需要再次打开I/O端口。 Active: 35392 kB 在活跃使用中的缓冲或高速缓冲存储器页面文件的大小,除非非常必要,否则不会被移作他用。 Inactive: 44180 kB 在不经常使用中的缓冲或高速缓冲存储器页面文件的大小,可能被用于其他途径。 Active(anon): 26540 kB Inactive(anon): 28244 kB Active(file): 8852 kB Inactive(file): 15936 kB Unevictable: 280 kB Mlocked: 0 kB SwapTotal: 0 kB 交换空间的总大小。 SwapFree: 0 kB 未被使用交换空间的大小。 Dirty: 0 kB 等待被写回到磁盘的内存大小。 Writeback: 0 kB 正在被写回到磁盘的内存大小。 AnonPages: 52688 kB 未映射页的内存大小。 Mapped: 17960 kB 设备和文件等映射的大小。 Slab: 3816 kB 内核数据结构缓存的大小,可以减少申请和释放内存带来的消耗。 SReclaimable: 936 kB 可收回Slab的大小。 SUnreclaim: 2880 kB 不可收回Slab的大小(SUnreclaim+SReclaimable=Slab)。 PageTables: 5260 kB 管理内存分页页面的索引表的大小。 NFS_Unstable: 0 kB 不稳定页表的大小。 Bounce: 0 kB WritebackTmp: 0 kB CommitLimit: 47048 kB Committed_AS: 1483784 kB VmallocTotal: 876544 kB VmallocUsed: 15456 kB VmallocChunk: 829444 kB 要获取android手机总内存大小,只需读取”/proc/meminfo”文件的第1行,并进行简单的字符串处理即可。 代码示例 /** * 获取空闲内存和总内存拼接字符串 * * @return 总内存 */ public static String getFreeAndTotalMem() { long[] memInfo = getMemInfo(); return Long.toString(memInfo[1] + memInfo[2] + memInfo[3]) + "M/" + Long.toString(memInfo[0]) + "M"; } /** * 获取内存信息:total、free、buffers、cached,单位MB * * @return 内存信息 */ public static long[] getMemInfo() { long memInfo[] = new long[4]; try { Class<?> procClazz = Class.forName("android.os.Process"); Class<?> paramTypes[] = new Class[] { String.class, String[].class, long[].class }; Method readProclines = procClazz.getMethod("readProcLines", paramTypes); Object args[] = new Object[3]; final String[] memInfoFields = new String[] { "MemTotal:", "MemFree:", "Buffers:", "Cached:" }; long[] memInfoSizes = new long[memInfoFields.length]; memInfoSizes[0] = 30; memInfoSizes[1] = -30; args[0] = new String("/proc/meminfo"); args[1] = memInfoFields; args[2] = memInfoSizes; if (null != readProclines) { readProclines.invoke(null, args); for (int i = 0; i < memInfoSizes.length; i++) { memInfo[i] = memInfoSizes[i] / 1024; } } } catch (Exception e) { e.printStackTrace(); } return memInfo; } 总结 1)Pss/SharedDirty/Private Dirty三列是读取了/proc/process-id/smaps文件获取的,可以通过adb shell cat /proc/process-id/smaps来查看(需要root)。这是个普通的linux文件,描述了进程的虚拟内存区域的具体信息。 2)Native HeapSize/Alloc/Free三列是使用C函数mallinfo得到的。 3)Dalvik HeapSize/Alloc/Free并非该cpp文件产生,而是android的Debug类生成。 meminfo结果详细分析 Pss对应的TOTAL值:内存所实际占用的值。 Dalvik Heap Size:从RuntimetotalMemory()获得,DalvikHeap总共的内存大小。 Dalvik HeapAlloc:RuntimetotalMemory()-freeMemory() ,Dalvik Heap分配的内存大小。 Dalvik Heap Free:从RuntimefreeMemory()获得,DalvikHeap剩余的内存大小。 Dalvik Heap Size 约等于Dalvik HeapAlloc+ Dalvik HeapFree。 Cursor:/dev/ashmem/Cursor Cursor消耗的内存(KB)。 Ashmem:/dev/ashmem,匿名共享内存用来提供共享内存通过分配一个多个进程可以共享的带名称的内存块。 Other dev:/dev/,内部driver占用的在 “Otherdev”。 .so mmap:C 库代码占用的内存。 .jar mmap:Java 文件代码占用的内存。 .apk mmap:apk代码占用的内存。 .ttf mmap:ttf 文件代码占用的内存。 .dex mmap:Dex 文件代码占用的内存。 Other mmap:其他文件占用的内存。 私有(Clean and Dirty)内存: 进程独占的内存。也就是应用进程销毁时系统可以直接回收的内存容量。通常来说,“private dirty”内存是其最重要的部分,因为只被自己的进程使用。它只在内存中存储,因此不能做分页存储到外存(Android不支持swap)。所有分配的Dalvik堆和本地堆都是“private dirty”内存;Dalvik堆和本地堆中和Zygote进程共享的部分是共享dirty内存。 实际使用内存 (PSS): 这是另一种应用内存使用的计算方式,把跨进程的共享页也计算在内。任何独占的内存页直接计算它的PSS值,而和其它进程共享的页则按照共享的比例计算PSS值。例如,在两个进程间共享的页,计算进每个进程PPS的值是它的一半大小。PSS计算方式的一个好处是:把所有进程的PSS值加起来就可以确定所有进程总共占用的内存。这意味着用PSS来计算进程的实际内存使用、进程间对比内存使用和总共剩余内存大小是很好的方式。 通常来说,只需关心Pss Total列和Private Dirty列就可以了。在一些情况下,Private Clean列和Heap Alloc列也会提供很有用的信息。下面是一些应该查看的内存分配类型(行中列出的类型): Dalvik Heap: 应用中Dalvik分配使用的内存。Pss Total包含所有的Zygote分配(如上面PSS定义所描述的,共享跨进程的加权)。Private Dirty是应用堆独占的内存大小,包含了独自分配的部分和应用进程从Zygote复制分裂时被修改的Zygote分配的内存页。注意:新平台版本有Dalvik Other这一项。Dalvik Heap中的Pss Total和Private Dirty不包括Dalvik的开销,例如即时编译(JIT)和垃圾回收(GC),然而老版本都包含在Dalvik的开销里面。 Heap Alloc: 是应用中Dalvik堆和本地堆已经分配使用的大小。它的值比Pss Total和Private Dirty大,因为进程是从Zygote中复制分裂出来的,包含了进程共享的分配部分。 .so mmap和.dex mmap: mmap映射的.so(本地) 和.dex(Dalvik)代码使用的内存。Pss Total 包含了跨应用共享的平台代码;Private Clean是应用独享的代码。通常来说,实际映射的内存大小要大一点——这里显示的内存大小是执行了当前操作后应用使用的内存大小。然而,.so mmap 的private dirty比较大,这是由于在加载到最终地址时已经为本地代码分配好了内存空间。 Unknown: 无法归类到其它项的内存页。目前,这主要包含大部分的本地分配,就是那些在工具收集数据时由于地址空间布局随机化(Address Space Layout Randomization ,ASLR)不能被计算在内的部分。和Dalvik堆一样, Unknown中的Pss Total把和Zygote共享的部分计算在内,Unknown中的Private Dirty只计算应用独自使用的内存。 TOTAL: 进程总使用的实际使用内存(PSS),是上面所有PSS项的总和。它表明了进程总的内存使用量,可以直接用来和其它进程或总的可以内存进行比较。Private Dirty和Private Clean是进程独自占用的总内存,不会和其它进程共享。当进程销毁时,它们(特别是Private Dirty)占用的内存会重新释放回系统。Dirty内存是已经被修改的内存页,因此必须常驻内存(因为没有swap);Clean内存是已经映射持久文件使用的内存页(例如正在被执行的代码),因此一段时间不使用的话就可以置换出去。 ViewRootImpl: 进程中活动的根视图的数量。每个根视图与一个窗口关联,因此可以帮助确定涉及对话框和窗口的内存泄露。 AppContexts和Activities: 当前驻留在进程中的Context和Activity对象的数量。可以很快的确认常见的由于静态引用而不能被垃圾回收的泄露的 Activity对象。这些对象通常有很多其它相关联的分配,因此这是追查大的内存泄露的很好办法。 注意:View 和 Drawable 对象也持有所在Activity的引用,因此,持有View 或 Drawable 对象也可能会导致应用Activity泄露。

优秀的个人博客,低调大师

Android CPU性能数据获取

总体CPU 获取CPU信息思路 Android系统是基于Linux内核的,所以系统文件的结构和Linux下一样,系统总体CPU使用信息放在/proc/stat文件下,/proc/cpuinfo文件存放CPU的其它信息,包括CPU名称,直接读取即可。 通过proc获取CPU信息: Linux CPU 九元组参数解析(单位:jiffies): (jiffies是内核中的一个全局变量,用来记录自系统启动一来产生的节拍数,在linux中,一个节拍大致可理解为操作系统进程调度的最小时间片,不同linux内核可能值有不同,通常在1ms到10ms之间) user 从系统启动开始累计到当前时刻,处于用户态的运行时间,不包含 nice值为负进程。 nice 从系统启动开始累计到当前时刻,nice值为负的进程所占用的CPU时间 system 从系统启动开始累计到当前时刻,处于核心态的运行时间 idle 从系统启动开始累计到当前时刻,除IO等待时间以外的其它等待时间 iowait 从系统启动开始累计到当前时刻,IO等待时间(since 2.5.41) irq 从系统启动开始累计到当前时刻,硬中断时间(since 2.6.0-test4) softirq 从系统启动开始累计到当前时刻,软中断时间(since 2.6.0-test4) 可以每1s获取一次CPU信息,分析整机CPU占用率。总的cpu时间totalCpuTime = user + nice + system + idle + iowait + irq + softirq + stealstolen +guest 计算方法 1、 采样两个足够短的时间间隔的Cpu快照,分别记作t1,t2,其中t1、t2的结构均为: (user、nice、system、idle、iowait、irq、softirq、stealstolen、guest)的9元组; 2、 计算总的Cpu时间片totalCpuTime a) 把第一次的所有cpu使用情况求和,得到s1; b) 把第二次的所有cpu使用情况求和,得到s2; c) s2 - s1得到这个时间间隔内的所有时间片,即totalCpuTime = s2 - s1 ; 3、计算空闲时间idle idle对应第四列的数据,用第二次的idle - 第一次的idle即可 idle = idle2 - idle1 4、计算cpu使用率 CPU总使用率(%) = 100*((totalCputime2- totalCputime1)-(idle2-idle1))/(totalCputime2-totalCputime1) 示例代码 public static long getTotalCpuTime() { // 获取系统总CPU使用时间 String[] cpuInfos = null; BufferedReader reader = null; try { reader = new BufferedReader(new InputStreamReader( new FileInputStream("/proc/stat")), 1000); String load = reader.readLine(); cpuInfos = load.split(" "); } catch (IOException ex) { ex.printStackTrace(); } finally { if (reader != null) { try { reader.close(); } catch (IOException e) { e.printStackTrace(); } } } long totalCpu = Long.parseLong(cpuInfos[2]) + Long.parseLong(cpuInfos[3]) + Long.parseLong(cpuInfos[4]) + Long.parseLong(cpuInfos[6]) + Long.parseLong(cpuInfos[5]) + Long.parseLong(cpuInfos[7]) + Long.parseLong(cpuInfos[8]); return totalCpu; } 应用级CPU 单个应用CPU监控 Emmagee是将选中应用的PID传入,读取/proc/PID/stat文件信息及可获取该PID对应程序的CPU信息。 计算方法 1、首先获取应用的进程id: adb shell ps | grep com.package | awk '{print $2}' > tmp 2、根据进程id,通过proc获取CPU信息 while read line; do adb shell cat /proc/$line/stat | awk '{print $14,$15,$16,$17}' >> appcpu0; done < tmp 说明:以下只解释对我们计算Cpu使用率有用相关参数(14-17列) 参数解释 pid 进程号 utime 该任务在用户态运行的时间,单位为jiffies stime 该任务在核心态运行的时间,单位为jiffies cutime 所有已死线程在用户态运行的时间,单位为jiffies cstime 所有已死在核心态运行的时间,单位为jiffies 结论:进程的总Cpu时间processCpuTime = utime + stime + cutime + cstime,该值包括其所有线程的cpu时间。 之后可以每1s获取一次CPU信息,分析获得app的CPU占用率等信息 单个程序的CPU使用率(%) = 100*(processCpuTime2-processCpuTime1)/(totalCpuTime2-totalCpuTime1) 示例代码 public static long getAppCpuTime(int pid) { // 获取应用占用的CPU时间 String[] cpuInfos = null; BufferedReader reader = null; try { reader = new BufferedReader(new InputStreamReader( new FileInputStream("/proc/" + pid + "/stat")), 1000); String load = reader.readLine(); cpuInfos = load.split(" "); } catch (IOException ex) { ex.printStackTrace(); } finally { if (reader != null) { try { reader.close(); } catch (IOException e) { e.printStackTrace(); } } } long appCpuTime = Long.parseLong(cpuInfos[13]) + Long.parseLong(cpuInfos[14]) + Long.parseLong(cpuInfos[15]) + Long.parseLong(cpuInfos[16]); return appCpuTime; } }

优秀的个人博客,低调大师

Android 性能篇 - 内存优化

内存优化是一个程序员的基本功。有时也要切合项目的实际需求来做选择。一、解决所有的内存泄漏 内存泄漏概念:不再使用的对象没有被回收,就是内存泄露。 单利泄漏 主要原因还是因为一般情况下单例都是全局的,有时候会引用一些实际生命周期比较短的变量,导致其无法释放。 例如 : activity 的 content 赋值到单利对象里面的成员量变量code: private static volatile ClassXX instance; private Context context; private ClassXX(Context context) { this.context = context; } public static ClassXX getInstance(Context context) { if (instance == null) { synchronized (instance) { if(instance == null) { instance = new ClassXX(context); } } } return instance; } 如果这个Context是 Activity 的 Context ,当你的 Activity finish(); 之后Activity 这个对象的内存还是在堆中,没有释放。因为单利对象持有Activity 的引用,jvm 认为你这个对象还是在使用中,不敢去 回收掉你的 Activity。那单例什么时候被回收?那就只有等到整个进程被回收了,单例才会被回收。 进程杀死(回收):Process.killProcess(Process.myPid())用户手动卡片式摧毁 (亲测可行)解决方法: 传入和单例一样生命周期的对象,如context.getApplication(); 不将 context保存在单例的成员变量里面。 Handler AsyncTask 等内部类的内存泄漏 主要原因是内部类默认持有外部类的引用大家应该很喜欢吧 Handler写成一个内部类譬如: private Handler mMainActivityHandler = new Handler(){ @Override public void handleMessage(Message msg) { super.handleMessage(msg); } }; 其实包括我也很喜欢,而且一个Activity 对应一个 Handler,每一个 Handler 负责更新本 Activity 的 UI,一对一关系,分工明确。好用到爆炸。然而 java 内部类是默认持有一个外部类的引用,因为 jvm 在把.java 源文件编译成 .class 字节码的时候,会在默认的构造函数加入外部类的引用。所以我们在内部类中也能访问外部类的引用。然后问题就发生了,当前 Handler 持有当前 Activity 的引用,Handler 不释放,Activity 也别想释放了。MMP(为什么 Handler 有时候会不会被释放?) 解决方法: 构造函数传入Activity 并用 WeakReferencemActivity;弱引用保存下来。 GC 的时候会不计入Handler 对Activity的引用,可以被回收。Activity OnDestroy 的时候 ,把所有的相关请求终止,并且把消息队列清空 removeCallbacksAndMessages(null); 防止有数据回调到 UI 层。(当然如果不这么做,Activity 照样被回收,但是 Handler 不及时回收而已)(什么叫 强引用 软引用 弱引用 虚引用 ,以及 Handler 的消息驱动模型是怎么样子的,这里就不展开讲,本文着重内存泄漏)当然 AsyncTask 和其它对象内部类也是有这种问题,解决方法同上。 资源使用完未关闭 主要是: 广播(BraodcastReceiver)动态注册之后要反注册,推荐在onStart onStop 对应的生命周期执行。服务(Service)Start 之后 记得 Stop。启动服务时机看需求。一般不建议在 Application 启动(启动 Service 耗时基本要100ms+)。io Cursor 流要记得 close,一定要在 finally 去 close,防止抛异常没执行 close ,那就泄漏了。Bitmap 内存大户,要记得回收 recycle 一下,当然 90% 的场景 Glide 已经帮我们处理的。4.检测内存泄漏的工具 当然有时候不能完全在写代码的时候规避掉所有的内存泄漏,就要用一些工具检测一下:LeakCanaryAndroid Studio profileMAT选自己喜欢的工具,去研究一下。(网上很多教程) 二、图片压缩 bitmap 压缩 大家都知道 bitmap 占用内存很大,用完之后要 recycle 一下。不知道大家有没有用过,图片加载出来内存就爆掉了(OOM)情况,本宝宝就遇到过了(心中一千万头草拟吗奔腾而过)。首先一张图片从网络获下来,从 InputStream 转成 Bitmap,这个 bitmap 占了多少内存怎么计算?献上代码:Bitmap.getAllocationByteCount();其实就是 ByteCount = 长 宽 4(假设这里每一个像素点是是RGB888) 那就是 4 个字节。也有一个像素点 RGB565 占 3 个字节,当然占更多字节的 RGB888 更加高清无码。起初版本 Glide 使用 RGB565,目前 Glide 4.XX 的默认都是 RGB888,当然自己可以配置一下。为了解决这个问题一般都是通过下面代码: BitmapFactory.Options options = new BitmapFactory.Options(); options.inJustDecodeBounds = true; // 通过这个bitmap获取图片的宽和高 Bitmap bitmap = BitmapFactory.decodeFile("/sdcard/MTXX/3.jpg", options); float realWidth = options.outWidth; float realHeight = options.outHeight; //计算出scale options.inSampleSize = scale; options.inJustDecodeBounds = false; // 注意这次要把options.inJustDecodeBounds 设为 false,这次图片是要读取出来的。 bitmap = BitmapFactory.decodeFile("/sdcard/MTXX/3.jpg", options); 先获取他的图片大小,根据自己需要的大小计算出缩放比例。(图片大小都是放在图片的头部,这时候不会去加载整张图片)进行缩放,得出符合自己的控件尺寸的大小。(当然还有些非法的图片头部是获取不出 长* 宽。这时候记得搞个默认的缩放率,防止 OOM)有时候为了优化内存,还不如压缩一张图片 所节约的内存来的更快。譬如 一张 1080 * 1920 图片再乘以 4 等于 7.9 M。我压缩到 一张缩略图 200*200 等于 156KB。瞬间节约了7M 空间。区别真的太大了,顿时内心 一句 MMP 。三、解决内存抖动 1.String VS StringBuffer VS StringBuilder 大家应该对着三个类都非常熟悉。那就先看代码: long time = System.currentTimeMillis(); String s = new String("JAVA"); for(int i = 0 ;i<10000; i++) { s = s+"VERSION"; } Log.d("TestString","Time consumption:"+(System.currentTimeMillis() - time)); time = System.currentTimeMillis(); StringBuilder s1 = new StringBuilder("JAVA"); for(int i = 0 ;i<10000; i++) { s1.append("VERSION"); } Log.d("TestString","Time consumption:"+(System.currentTimeMillis() - time)); D/TestString: Time consumption:3786 D/TestString: Time consumption:2 很明显使用 StringBuilder 去拼接字符,效率大大快于用加号,我们带着问题来找原因。那我们看一下用 + 号去拼接的字节码: 使用+号去拼接字符,jvm 会创建一个临时的 StringBuilder25 new #24 然后把上次的结果集,通过构造函数传入, 29 invokespecial #25 <java/lang/StringBuilder.<init>> //调用构造函数,这串符号引用类似 jni 中反调 java的类查找写法 32 aload_3 //将局变量表Slot 3的元素入栈 再拼接本次需要拼接的字符。然后存到局部变量表中,等待下次循环操作。 44 astore_3 然后跳转编号17 去继续循环。这时候又重新创建了一个 StringBulider 去拼接。真是啃爹啊。。。 48 goto 17 (-31) 那我们看一下用 StringBuilder 去拼接的字节码: 这个很明显 new StringBulider 字节码在循环体外面,所以并没有循环新建对象。总结: 通过上面的例子,String 的拼接通过一个 for 循环创建了 10000 个 StringBulider,而且用完就抛弃。特别浪费,在内存吃紧的情况下,很容易引起 gc ,导致 App 卡顿。也许有同学要问 一个 StringBuilder 的空对象才占堆内存多大?我们来算一算一个对象 = 对象头 + 成员属性对象头 = MardWord + Klass= 12个字节 (数组除外)上图: MardWord 字段大全(出自网上扣得): 这个 MardWord 怎么有这么多锁状态,这些锁状态又是什么?这就要涉及到 synchronized 同步锁的知识,这个不在本文讨论范围之内。那么 StringBulider 的成员属性有哪些?清单: static final long serialVersionUID = 4383685877147921099L; char[] value; int count; 对象结构图 计算下来:12+8+8+4+24 = 56 个字节 10000 个对象 那就是要 560KB 内存。不小吧。当然我们实际需求不可能一次搞这么多个对象,但是多个地方都用 String 去玩的话,积少成多,到时候 APP 内存比别人的高出一大截。那就尴尬了.. 四、尽量使用 “池” 我们常见的池有 线程池Lrucache 缓存池okhttp 里面的 ConnectionPool (socket 复用池)okio SegmentPool (buffer 复用池)池的功能:可以重复利用对象,并且减少内存开销,内存抖动,cpu 开销。线程池 public ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue, ThreadFactory threadFactory, RejectedExecutionHandler handler) 尽量使用线程池去跑任务,而不是动不动就先 new Thread 去跑,这样子线程是得不到复用的。当任务量一大,使用线程池的效率会超乎你想象(具体自己看源码),毕竟 开启一个线程 cpu 内存都是有开销的。这里推荐 Rxjava 的第三方库,一个将 装饰者模式 玩到上天的 框架,切换线程方便,支持函数式编程 杜绝回调地狱 等等: Observable.create(new Action1<Emitter<Integer>>() { @Override public void call(Emitter<Integer> subscriber) {} }, Emitter.BackpressureMode.BUFFER) .subscribeOn(Schedulers.io()) //切换到 io 线程池 .subscribeOn(Schedulers.computation()) //切换 到计算 线程池 .subscribeOn(Schedulers.immediate()) // 使用当前线程 .observeOn(AndroidSchedulers.mainThread()) //切换到 android UI 主线程 .subscribe(); Lrucache 缓存池 Lrucache 缓存池:最近最少使用缓存池,底层原理是用 LinkHashMap 实现。 谷歌的 Glide 图片加载库,就是使用了 Lrucache,和 LruDiskCache 对图片进行缓存,进而提高用户体验。 ConnectionPool 缓存池 ConnectionPool 缓存池 :复用 tcp socket 套接字,进行网络通讯,每一次 HTTP 请求结束后,并不结束链接,可复用于下次的请求。把网络传输速度极致化。 一次 http 请求分:tcp 三次握手数据传输tcp 四次分手如果每一次请求都经历整个流程,可能别人所有数据都加载完毕了,我还在握手中… 这就不能忍。(当然 http 1.1+ 才支持这个链接复用,具体详细源码 看 OKhttp,本文不做详细展开) okio SegmentPool (buffer 复用池) SegmentPool:同上。 总结: 对于一些需要 大量频繁生成和回收的对象,建议使用池,如果没有轮子,也是可以手动写一个。五、其他 常用数据结构优化xml 层级 和 view1.常用数据结构优化 内存大用户 : HashMap (及其子类)HashMap 是一个典型的 空间换时间,时间复杂度趋近 o(1)占用空间 是大于 size / 0.75(负载因子), /** * hashMap put 部分源码, * size 当前已存入数据数目 * threshold = 容量 *0.75 */ if (++size > threshold) resize(); 通俗点就是 存入100个数据,要占用 133 个数据内存(及以上),所在数据量较小,或者对速度没有那么要求的时候可用 SparseArray(二叉树实现) 代替。 2.xml 层级 和 view xml 层级最好控制在 5 层以内。 view 的使用多用: ViewStubIncludemerge 原文发布时间为:2018-07-05本文作者:Overried本文来自云栖社区合作伙伴“安卓巴士Android开发者门户”,了解相关信息可以关注“安卓巴士Android开发者门户”。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册