首页 文章 精选 留言 我的

精选列表

搜索[k8s],共4083篇文章
优秀的个人博客,低调大师

K8S集群入门:运行一个应用程序究竟需要多少集群?

云栖号:https://yqh.aliyun.com第一手的上云资讯,不同行业精选的上云企业案例库,基于众多成功案例萃取而成的最佳实践,助力您上云决策! 如果你使用Kubernetes作为应用程序的操作平台,那么你应该会遇到一些有关使用集群的方式的基本问题: 你应该有多少集群? 它们应该多大? 它们应该包含什么? 本文将深入讨论这些问题,并分析你所拥有的一些选择的利弊。 问题所在 作为一个软件创建者,你应该开发并运行了多个应用程序。而且,你应该在不同的环境中运行这些应用程序的多个实例——例如,你应该有开发、测试以及生产环境。那么,不同的环境和应用程序的组合,我们可以得到一个“矩阵”: 在以上例子中,有3个应用程序和3个环境,两两组合为9个应用程序实例。每个应用程序实例是一个独立的部署单位,可以独立运行。 请注意,一个应用程序实例可能由多个组件组成,如前端、后端、数据库等。在一个微服务应用程序中,一个应用程序实例将由所有微服务构成。 那么作为一个Kubernetes用户,此时会遇到一些问题: 应该在一个集群中运行所有应用程序实例吗? 或者每个应用程序实例都应该有一个单独的集群吗? 或者应该以上两者相结合? 以上这些都是行之有效的方法——Kubernetes是一个灵活的系统,它并不会直接告诉你某一条指定的使用方法。 关于集群的搭配你有以下选择: 一个大型的共享集群 许多小型的一次性集群 每个应用程序有一个集群 每个环境中有一个集群 前两种方法分别是大型集群和小型集群的极端,其规模大小关系如下: 总而言之,如果一个集群包含了大量的节点和Pod,那么它就可以被定义为大于另一个集群。例如,一个有10个节点和100Pod的集群大于有1个节点和10个Pod的集群。 厘清了概念和选项,那么我们现在开始吧! 一个大型共享集群 这个方法是指将你所有的工作负载都运行在一个集群中: 通过这种方法,我们可以像通用基础架构平台一样使用该集群——无论你需要运行什么,都可将其部署到现有的Kubernetes集群中。 Kubernetes中有一个命名空间的概念,可以 在逻辑上将集群的各个部分彼此分开。在上述情况下,你可以为每个应用程序实例创建单独的命名空间。 接下来,我们来看看这个方法的优劣势。 云栖号:https://yqh.aliyun.com第一手的上云资讯,不同行业精选的上云企业案例库,基于众多成功案例萃取而成的最佳实践,助力您上云决策! 原文发布时间:2020-02-29本文作者:Rancher本文来自:“Dockone.io”,了解相关信息可以关注“Dockone.io”

优秀的个人博客,低调大师

从认证到调度,K8s 集群上运行的小程序到底经历了什么?

作者 | 声东 阿里云售后技术专家 导读:不知道大家有没有意识到一个现实:大部分时候,我们已经不像以前一样,通过命令行,或者可视窗口来使用一个系统了。 前言 现在我们上微博、或者网购,操作的其实不是眼前这台设备,而是一个又一个集群。通常,这样的集群拥有成百上千个节点,每个节点是一台物理机或虚拟机。集群一般远离用户,坐落在数据中心。为了让这些节点互相协作,对外提供一致且高效的服务,集群需要操作系统。Kubernetes 就是这样的操作系统。 比较 Kubernetes 和单机操作系统,Kubernetes 相当于内核,它负责集群软硬件资源管理,并对外提供统一的入口,用户可以通过这个入口来使用集群,和集群沟通。 而运行在集群之上的程序,与普通程序有很大的不同。这样的程序,是“关在笼子里”的程序。它们从被制作,到被部署,再到被使用,都不寻常。我们只有深挖根源,才能理解其本质。 “关在笼子里”的程序 代码 我们使用 go 语言写了一个简单的 web 服务器程序 app.go,这个程序监听在 2580 这个端口。通过 http 协议访问这个服务的根路径,服务会返回 "This is a small app for kubernetes..." 字符串。 package main import ( "github.com/gorilla/mux" "log" "net/http" ) func about(w http.ResponseWriter, r *http.Request) { w.Write([]byte("This is a small app for kubernetes...\n")) } func main() { r := mux.NewRouter() r.HandleFunc("/", about) log.Fatal(http.ListenAndServe("0.0.0.0:2580", r)) } 使用 go build 命令编译这个程序,产生 app 可执行文件。这是一个普通的可执行文件,它在操作系统里运行,会依赖系统里的库文件。 # ldd app linux-vdso.so.1 => (0x00007ffd1f7a3000) libpthread.so.0 => /lib64/libpthread.so.0 (0x00007f554fd4a000) libc.so.6 => /lib64/libc.so.6 (0x00007f554f97d000) /lib64/ld-linux-x86-64.so.2 (0x00007f554ff66000) “笼子” 为了让这个程序不依赖于操作系统自身的库文件,我们需要制作容器镜像,即隔离的运行环境。Dockerfile 是制作容器镜像的“菜谱”。我们的菜谱就只有两个步骤,下载一个 centos 的基础镜像,把 app 这个可执行文件放到镜像中 /usr/local/bin 目录中去。 FROM centos ADD app /usr/local/bin 地址 制作好的镜像存再本地,我们需要把这个镜像上传到镜像仓库里去。这里的镜像仓库,相当于应用商店。我们使用阿里云的镜像仓库,上传之后镜像地址是: registry.cn-hangzhou.aliyuncs.com/kube-easy/app:latest 镜像地址可以拆分成四个部分:仓库地址/命名空间/镜像名称:镜像版本。显然,镜像上边的镜像,在阿里云杭州镜像仓库,使用的命名空间是 kube-easy,镜像名:版本是 app:latest。至此,我们有了一个可以在 Kubernetes 集群上运行的、“关在笼子里”的小程序。 得其门而入 入口 Kubernetes 作为操作系统,和普通的操作系统一样,有 API 的概念。有了 API,集群就有了入口;有了 API,我们使用集群,才能得其门而入。Kubernetes 的 API 被实现为运行在集群节点上的组件 API Server。这个组件是典型的 web 服务器程序,通过对外暴露 http(s) 接口来提供服务。 这里我们创建一个阿里云 Kubernetes 集群。登录集群管理页面,我们可以看到 API Server 的公网入口。 API Server 内网连接端点: https://xx.xxx.xxx.xxx:6443 双向数字证书验证 阿里云 Kubernetes 集群 API Server 组件,使用基于 CA 签名的双向数字证书认证来保证客户端与 api server 之间的安全通信。这句话很绕口,对于初学者不太好理解,我们来深入解释一下。 从概念上来讲,数字证书是用来验证网络通信参与者的一个文件。这和学校颁发给学生的毕业证书类似。在学校和学生之间,学校是可信第三方 CA,而学生是通信参与者。如果社会普遍信任一个学校的声誉的话,那么这个学校颁发的毕业证书,也会得到社会认可。参与者证书和 CA 证书可以类比毕业证和学校的办学许可证。 这里我们有两类参与者,CA 和普通参与者;与此对应,我们有两种证书,CA 证书和参与者证书;另外我们还有两种关系,证书签发关系以及信任关系。这两种关系至关重要。 我们先看签发关系。如下图,我们有两张 CA 证书,三个参与者证书。 其中最上边的 CA 证书,签发了两张证书,一张是中间的 CA 证书,另一张是右边的参与者证书;中间的 CA 证书,签发了下边两张参与者证书。这六张证书以签发关系为联系,形成了树状的证书签发关系图。 然而,证书以及签发关系本身,并不能保证可信的通信可以在参与者之间进行。以上图为例,假设最右边的参与者是一个网站,最左边的参与者是一个浏览器,浏览器相信网站的数据,不是因为网站有证书,也不是因为网站的证书是 CA 签发的,而是因为浏览器相信最上边的 CA,也就是信任关系。 理解了 CA(证书),参与者(证书),签发关系,以及信任关系之后,我们回过头来看“基于 CA 签名的双向数字证书认证”。客户端和 API Server 作为通信的普通参与者,各有一张证书。而这两张证书,都是由 CA 签发,我们简单称它们为集群 CA 和客户端 CA。客户端信任集群 CA,所以它信任拥有集群 CA 签发证书的 API Server;反过来 API Server 需要信任客户端 CA,它才愿意与客户端通信。 阿里云 Kubernetes 集群,集群 CA 证书,和客户端 CA 证书,实现上其实是一张证书,所以我们有这样的关系图。 KubeConfig 文件 登录集群管理控制台,我们可以拿到 KubeConfig 文件。这个文件包括了客户端证书,集群 CA 证书,以及其他。证书使用 base64 编码,所以我们可以使用 base64 工具解码证书,并使用 openssl 查看证书文本。 首先,客户端证书的签发者 CN 是集群 id c0256a3b8e4b948bb9c21e66b0e1d9a72,而证书本身的 CN 是子账号 252771643302762862; Certificate: Data: Version: 3 (0x2) Serial Number: 787224 (0xc0318) Signature Algorithm: sha256WithRSAEncryption Issuer: O=c0256a3b8e4b948bb9c21e66b0e1d9a72, OU=default, CN=c0256a3b8e4b948bb9c21e66b0e1d9a72 Validity Not Before: Nov 29 06:03:00 2018 GMT Not After : Nov 28 06:08:39 2021 GMT Subject: O=system:users, OU=, CN=252771643302762862 其次,只有在 API Server 信任客户端 CA 证书的情况下,上边的客户端证书才能通过 API Server 的验证。kube-apiserver 进程通过 client-ca-file 这个参数指定其信任的客户端 CA 证书,其指定的证书是 /etc/kubernetes/pki/apiserver-ca.crt。这个文件实际上包含了两张客户端 CA 证书,其中一张和集群管控有关系,这里不做解释,另外一张如下,它的 CN 与客户端证书的签发者 CN 一致; Certificate: Data: Version: 3 (0x2) Serial Number: 787224 (0xc0318) Signature Algorithm: sha256WithRSAEncryption Issuer: O=c0256a3b8e4b948bb9c21e66b0e1d9a72, OU=default, CN=c0256a3b8e4b948bb9c21e66b0e1d9a72 Validity Not Before: Nov 29 06:03:00 2018 GMT Not After : Nov 28 06:08:39 2021 GMT Subject: O=system:users, OU=, CN=252771643302762862 再次,API Server 使用的证书,由 kube-apiserver 的参数 tls-cert-file 决定,这个参数指向证书 /etc/kubernetes/pki/apiserver.crt。这个证书的 CN 是 kube-apiserver,签发者是 c0256a3b8e4b948bb9c21e66b0e1d9a72,即集群 CA 证书; Certificate: Data: Version: 3 (0x2) Serial Number: 2184578451551960857 (0x1e512e86fcba3f19) Signature Algorithm: sha256WithRSAEncryption Issuer: O=c0256a3b8e4b948bb9c21e66b0e1d9a72, OU=default, CN=c0256a3b8e4b948bb9c21e66b0e1d9a72 Validity Not Before: Nov 29 03:59:00 2018 GMT Not After : Nov 29 04:14:23 2019 GMT Subject: CN=kube-apiserver 最后,客户端需要验证上边这张 API Server 的证书,因而 KubeConfig 文件里包含了其签发者,即集群 CA 证书。对比集群 CA 证书和客户端 CA 证书,发现两张证书完全一样,这符合我们的预期。 Certificate: Data: Version: 3 (0x2) Serial Number: 786974 (0xc021e) Signature Algorithm: sha256WithRSAEncryption Issuer: C=CN, ST=ZheJiang, L=HangZhou, O=Alibaba, OU=ACS, CN=root Validity Not Before: Nov 29 03:59:00 2018 GMT Not After : Nov 24 04:04:00 2038 GMT Subject: O=c0256a3b8e4b948bb9c21e66b0e1d9a72, OU=default, CN=c0256a3b8e4b948bb9c21e66b0e1d9a72 访问 理解了原理之后,我们可以做一个简单的测试:以证书作为参数,使用 curl 访问 api server,并得到预期结果。 # curl --cert ./client.crt --cacert ./ca.crt --key ./client.key https://xx.xx.xx.xxx:6443/api/ { "kind": "APIVersions", "versions": [ "v1" ], "serverAddressByClientCIDRs": [ { "clientCIDR": "0.0.0.0/0", "serverAddress": "192.168.0.222:6443" } ] } 择优而居 两种节点,一种任务 如开始所讲,Kubernetes 是管理集群多个节点的操作系统。这些节点在集群中的角色,却不必完全一样。Kubernetes 集群有两种节点:master 节点和 worker 节点。 这种角色的区分,实际上就是一种分工:master 负责整个集群的管理,其上运行的以集群管理组件为主,这些组件包括实现集群入口的 api server;而 worker 节点主要负责承载普通任务。 在 Kubernetes 集群中,任务被定义为 pod 这个概念。pod 是集群可承载任务的原子单元,pod 被翻译成容器组,其实是意译,因为一个 pod 实际上封装了多个容器化的应用。原则上来讲,被封装在一个 pod 里边的容器,应该是存在相当程度的耦合关系。 择优而居 调度算法需要解决的问题,是替 pod 选择一个舒适的“居所”,让 pod 所定义的任务可以在这个节点上顺利地完成。 为了实现“择优而居”的目标,Kubernetes 集群调度算法采用了两步走的策略: 第一步,从所有节点中排除不满足条件的节点,即预选; 第二步,给剩余的节点打分,最后得分高者胜出,即优选。 下面我们使用文章开始的时候制作的镜像,创建一个 pod,并通过日志来具体分析一下,这个 pod 怎么样被调度到某一个集群节点。 Pod 配置 首先,我们创建 pod 的配置文件,配置文件格式是 json。这个配置文件有三个地方比较关键,分别是镜像地址,命令以及容器的端口。 { "apiVersion": "v1", "kind": "Pod", "metadata": { "name": "app" }, "spec": { "containers": [ { "name": "app", "image": "registry.cn-hangzhou.aliyuncs.com/kube-easy/app:latest", "command": [ "app" ], "ports": [ { "containerPort": 2580 } ] } ] } } 日志级别 集群调度算法被实现为运行在 master 节点上的系统组件,这一点和 api server 类似。其对应的进程名是 kube-scheduler。kube-scheduler 支持多个级别的日志输出,但社区并没有提供详细的日志级别说明文档。查看调度算法对节点进行筛选、打分的过程,我们需要把日志级别提高到 10,即加入参数 --v=10。 kube-scheduler --address=127.0.0.1 --kubeconfig=/etc/kubernetes/scheduler.conf --leader-elect=true --v=10 创建 Pod 使用 curl,以证书和 pod 配置文件等作为参数,通过 POST 请求访问 api server 的接口,我们可以在集群里创建对应的 pod。 # curl -X POST -H 'Content-Type: application/json;charset=utf-8' --cert ./client.crt --cacert ./ca.crt --key ./client.key https://47.110.197.238:6443/api/v1/namespaces/default/pods -d@app.json 预选 预选是 Kubernetes 调度的第一步,这一步要做的事情,是根据预先定义的规则,把不符合条件的节点过滤掉。不同版本的 Kubernetes 所实现的预选规则有很大的不同,但基本的趋势,是预选规则会越来越丰富。 比较常见的两个预选规则是 PodFitsResourcesPred 和 PodFitsHostPortsPred。前一个规则用来判断,一个节点上的剩余资源,是不是能够满足 pod 的需求;而后一个规则,检查一个节点上某一个端口是不是已经被其他 pod 所使用了。 下图是调度算法在处理测试 pod 的时候,输出的预选规则的日志。这段日志记录了预选规则 CheckVolumeBindingPred的执行情况。某些类型的存储卷(PV),只能挂载到一个节点上,这个规则可以过滤掉不满足 pod 对 PV 需求的节点。 从 app 的编排文件里可以看到,pod 对存储卷并没有什么需求,所以这个条件并没有过滤掉节点。 优选 调度算法的第二个阶段是优选阶段。这个阶段,kube-scheduler 会根据节点可用资源及其他一些规则,给剩余节点打分。 目前,CPU 和内存是调度算法考量的两种主要资源,但考量的方式并不是简单的,剩余 CPU、内存资源越多,得分就越高。 日志记录了两种计算方式:LeastResourceAllocation 和 BalancedResourceAllocation。 前一种方式计算 pod 调度到节点之后,节点剩余 CPU 和内存占总 CPU 和内存的比例,比例越高得分就越高; 第二种方式计算节点上 CPU 和内存使用比例之差的绝对值,绝对值越大,得分越少。 这两种方式,一种倾向于选出资源使用率较低的节点,第二种希望选出两种资源使用比例接近的节点。这两种方式有一些矛盾,最终依靠一定的权重来平衡这两个因素。 除了资源之外,优选算法会考虑其他一些因素,比如 pod 与节点的亲和性,或者如果一个服务有多个相同 pod 组成的情况下,多个 pod 在不同节点上的分散程度,这是保证高可用的一种策略。 得分 最后,调度算法会给所有的得分项乘以它们的权重,然后求和得到每个节点最终的得分。因为测试集群使用的是默认调度算法,而默认调度算法把日志中出现的得分项所对应的权重,都设置成了 1,所以如果按日志里有记录得分项来计算,最终三个节点的得分应该是 29,28 和 29。 之所以会出现日志输出的得分和我们自己计算的得分不符的情况,是因为日志并没有输出所有的得分项,猜测漏掉的策略应该是 NodePreferAvoidPodsPriority,这个策略的权重是 10000,每个节点得分 10,所以才得出最终日志输出的结果。 结束语 在本文中,我们以一个简单的容器化 web 程序为例,着重分析了客户端怎么样通过 Kubernetes 集群 API Server 认证,以及容器应用怎么样被分派到合适节点这两件事情。 在分析过程中,我们弃用了一些便利的工具,比如 kubectl,或者控制台。我们用了一些更接近底层的小实验,比如拆解 KubeConfig 文件,再比如分析调度器日志来分析认证和调度算法的运作原理。希望这些对大家进一步理解 Kubernetes 集群有所帮助。 架构师成长系列直播 “阿里巴巴云原生关注微服务、Serverless、容器、Service Mesh 等技术领域、聚焦云原生流行技术趋势、云原生大规模的落地实践,做最懂云原生开发者的技术圈。”

优秀的个人博客,低调大师

蚂蚁金服万级规模 K8s 集群管理系统如何设计?

作者 | 蚂蚁金服技术专家 沧漠 关注『阿里巴巴云原生』公众号,回复关键词“1024”,可获取本文 PPT。 前言 Kubernetes 以其超前的设计理念和优秀的技术架构,在容器编排领域拔得头筹。越来越多的公司开始在生产环境部署实践 Kubernetes,在阿里巴巴和蚂蚁金服 Kubernetes 已被大规模用于生产环境。Kubernetes 的出现使得广大开发同学也能运维复杂的分布式系统,它大幅降低了容器化应用部署的门槛,但运维和管理一个生产级的高可用 Kubernetes 集群仍十分困难。本文将分享蚂蚁金服是如何有效可靠地管理大规模 Kubernetes 集群的,并会详细介绍集群管理系统核心组件的设计。 系统概览 Kubernetes 集群管理系统需要具备便捷的集群生命周期管理能力,完成集群的创建、升级和工作节点的管理。在大规模场景下

优秀的个人博客,低调大师

Rancher + VMware PKS实现全球数百站点的边缘K8S集群管理

Sovereign Systems是一家成立于2007年的技术咨询公司,帮助客户将传统数据中心技术和应用程序转换为更高效的、基于云的技术平台,以更好地应对业务挑战。曾连续3年提名CRN,并且在2012年到2016年均被评为美国增长最快的私营公司之一。 本文由Sovereign Systems的解决方案架构师Chip Zoller根据客户的使用案例撰写而成 Rancher是一个容器编排管理平台,它已经在这一领域深耕几年并且具备很多简单易用的实用功能。近几年,它经过重构已经完全拥抱Kubernetes。在本文中,我将着重介绍如何在VMware Enterprise PKS之上构建一个企业级、高可用和安全的Rancher Server安装。同时,我将回答“为什么要在PKS上使用Rancher”这一问题。此外,本文将包括整个构建流程、架构以及完整的安装指南。涉及的内容十分丰富,赶紧开始吧! 把Rancher部署在PKS上? 我知道这并不是一个普遍的搭配,特别是这两个解决方案还存在某种竞争关系。它们都能够在不同的云提供商部署Kubernetes集群,并可以在本地部署到诸如vSphere之类的堆栈。它们分别都有自己的长处和短处,但是在管理空间中两者没有重叠的地方。Enterprise PKS使用BOSH部署Kubernetes集群,并且继续将其用于生命周期的事件——扩展、修复、升级等。而Rancher则是将自己的驱动程序用于各种云PaaS解决方案,甚至使用vSphere进行本地部署来执行类似的任务。但Rancher能够导入外部配置的集群并且为其提供可见性,至今PKS还没有实现这样的功能。而在VMware 2019大会上,VMware宣布推出一款名为Tanzu Mission Control的产品,该产品在未来或许能实现Rancher现有的这些功能。但是,在那之前,Rancher依旧代表着优秀的技术,它可以管理并且聚合不同的Kubernetes集群到单一的系统中。 这个案例从何而来? 和我之前写过的很多文章一样,这篇文章也是从客户项目中衍生出来的。而且由于找不到关于这个主题的Enterprise PKS指南,我决定自己写一个。这个客户计划使用裸机、小型硬件将在边缘的Kubernetes部署到全球数百个站点。他们需要将所有集群统一到一个工具中,从而方便管理、监控以及应用程序部署。他们在主要的数据中心运行Enterprise PKS,来为其他业务需求部署Kubernetes集群。由于这些站点都与他们在世界各地的各个数据中心相连接,因此它们需要聚集在一个可以在本地运行的工具中,同时必须具有高可用性、安全性和高性能。将Enterprise PKS用于底层、专用的Kubernetes集群,然后在该集群上以HA模式在Rancher Server上分层,这样操作为我们两个方面的绝佳功能——通过NSX-T进行网络和安全性,通过BOSH进行集群生命周期维护,通过Harbor复制镜像仓库并且通过Rancher在边缘范围内对分散的Kubernetes集群在单一窗格进行统一管理。 架 构 我们先来看看架构图。 理论上说,我们在底部有一个vSphere栈,它在我们本地的SDDC中托管这个环境。接下来,我们通过PKS构建了一个3-master和3-worker的Kubernetes集群。除了许多其他系统容器(未在上图显示)之外,worker还托管Rancher pod和Nginx pod。基于以上,我们使用NSX-T提供的负载均衡器来提供两个主要虚拟的服务器:一个用于控制平面访问,另一个用于ingress访问。 然而,经过反复的试验并最终失败之后,我发现NSX-T的L7负载均衡器并不支持Rancher正常运行所需的必要请求头。具体来说,Rancher需要在HTTP请求中传递4个请求头到pod。这些请求头用于识别入站请求的来源,并确保在应用程序外部已经发生适当的TLS终止。其中一个请求头X-Forwarded-Proto,它可以告诉Rancher用于与负载均衡器进行通信的协议,但NSX-T的负载均衡器无法传递这些请求头。基于此,我们必须使用第三方ingress controller——nginx,它是目前最流行的解决方案之一,它对大部分的客户端选项提供了广泛的支持,并且可以直接发送请求头。 我们接着往下一个层次看,进入Kubernetes内部(如下图所示)。请记住,我们正在专门研究worker,但正在抽象化诸如节点之类的物理层。 外部请求通过Nginx controller中的LoadBalance服务类型进入集群。从该服务构建的端点列表中选择一个nginx controller,进而匹配ingress controller中的规则。该请求将转发到Rancher Service,最后到与该服务上的标签selector匹配的pod。 我们接下来一步一步完成安装过程,看完之后你将会有更深的理解。 安 装 请记住上文提到的架构,我们将开始将这些碎片拼在一起。一共有6个大步骤,每个步骤下都有详细的小步骤,我会详细说明。 1、 配置新的自定义PKS集群 第一步,我们将专门为Rancher制定一个plan,然后构建一个专门用于在HA模式下运行Rancher的集群。我们还将制作一个自定义的负载均衡器配置文件,以供构建中参考。 2、 使用Helm准备集群 集群构建完成之后,我们需要进行准备,以便可以使用Helm的软件包,因为我们将使用它来安装ingress controller和Rancher。 3、 生成证书和secret 这是一个企业级的部署,这意味着要使用自定义证书。所以我们需要创建那些证书并且使它们可供Kubernetes的各种API资源使用。 4、 创建并配置Ingress 既然我们无法使用NSX-T作为Ingress controller,那么我们必须配置另一种类型并适当地配置它。然后我们将使用一个NSX-T的Layer-4负载均衡器来发送流量到ingress。 5、 安装Rancher 接下来,我们使用Helm安装Rancher。 6、 配置基础架构 一切都就位之后,我们需要执行一些部署后的配置任务,然后才完成所有的步骤。 接下来,我将详细解释每一个步骤具体如何操作。 配置新的自定义PKS集群 首先我们需要做的是设置PKS基础架构,以便我们可以将Kubernetes集群部署在任意地方。需要做两件最基础的事情:创建一个新plan,创建中型负载均衡器。我们的plan需要指定3个master以使控制平面级别高可用,并且3个worker在工作负载级别高可用。在本例中,由于我们正在准备将大量集群安装到Rancher中,因此我们可能要继续进行操作,并指定一个中型负载均衡器,否则PKS会给我们一个很小的负载均衡器。这个负载均衡器将为控制平面/API访问提供虚拟服务器并将traffic发送到Rancher。 在PKS tile中,我使用以下配置创建一个新plan。 根据你自己的需求来创建plan,但记住master和worker的数量。如果想要将其放入生产环境中,我建议你增加master永久磁盘的规格。既然每个主节点都是一个包含控制平面组件和etcd的组合节点,并且Rancher将充分利用Kubernetes集群的etcd安装作为其数据存储,因此我们要确保有足够的空间。 你可以使用底部的附加组件部分来自动加载任意Kubernetes Manifest,使其可以在集群构建过程中运行。我将使用pks-dns,它可以在控制平面启动后自动为其创建DNS记录。如果你之前尚未使用过,我强烈建议你试用一下。 最后,为了让Rancher agent能够正确运行,请务必在此集群上启动“允许特权”模式。 现在,使用之前保存的plan和提交的更改,你应该能够运行一个pks plans并且显示这个新的plan。 $ pks plans Name ID Description dev-small 8A0E21A8-8072-4D80-B365-D1F502085560 1 master; 2 workers (max 4) dev-large 58375a45-17f7-4291-acf1-455bfdc8e371 1 master; 4 workers (max 8) prod-large 241118e5-69b2-4ef9-b47f-4d2ab071aff5 3 masters; 10 workers (20 max) dev-tiny 2fa824527-318d-4253-9f8e-0025863b8c8a 1 master; 1 worker (max 2); auto-adds DNS record upon completion. rancher fa824527-318d-4253-9f8e-0025863b8c8a Deploys HA configuration with 3 workers for testing Rancher HA builds. 有了这个,我们现在可以创建一个自定义负载均衡器plan。目前,实现这个方法的唯一方式是通过pks CLI工具或通过创建自定义JSON规范文件创建API。保存一下信息到名为lb-medium.json.的文件中,根据自己的需求替换“name”和”description”的值。 { "name": "lb-medium", "description": "Network profile for medium NSX-T load balancer", "parameters": { "lb_size": "medium" } } 运行以下命令来创建一个新的网络配置文件: $ pks create-network-profile lb-medium.json 再次检查,确保plan是存在的。 $ pks network-profiles Name Description lb-medium Network profile for medium NSX-T load balancer 现在使用你的plan和中型负载均衡器创建一个新的PKS集群。 $ pks create-cluster czpksrancher05 -e czpksrancher05.sovsystems.com -p rancher --network-profile lb-medium 构建集群将会花费几分钟的时间,可以趁机休息一下。你可以监视集群创建过程,以了解什么时候创建完成。 $ watch -n 5 pks cluster czpksrancher05 Every 5.0s: pks cluster czpksrancher05 Name: czpksrancher05 Plan Name: rancher UUID: 3373eb33-8c8e-4c11-a7a8-4b25fe17722d Last Action: CREATE Last Action State: in progress Last Action Description: Instance provisioning in progress Kubernetes Master Host: czpksrancher05.sovsystems.com Kubernetes Master Port: 8443 Worker Nodes: 3 Kubernetes Master IP(s): In Progress Network Profile Name: lb-medium 集群创建完成之后,如果你之前使用了我推荐的pls-dns工具,那么你的DNS记录现在也应该已经创建好了。 $ nslookup czpksrancher05 Server: 10.10.30.13 Address: 10.10.30.13#53 Name: czpksrancher05.sovsystems.com Address: 10.50.0.71 现在,所有必要的工作都完成了,我们可以访问这个集群。首先让我们先配置kubeconfig。 $ pks get-credentials czpksrancher05 然后确认我们是否具有访问权限。 $ kubectl cluster-info Kubernetes master is running at https://czpksrancher05.sovsystems.com:8443 CoreDNS is running at https://czpksrancher05.sovsystems.com:8443/api/v1/namespaces/kube-system/services/kube-dns:dns/proxy 使用Helm准备集群 既然现在我们已经可以访问我们的集群,我需要使用Helm来准备它。Helm是一个用chart的打包格式来将整个应用程序部署到Kubernetes的一个工具。这些chart打包了完整部署应用程序所需的各种Kubernetes manifest。网络上已经有大量的文章介绍了Helm及其入门,所以我将不再赘述。我假设你已经了解了这些,并将Helm二进制文件添加到了PATH中。我们需要在Kubernetes创建一个必要的对象,以供Tiller(Helm的服务器端组件)运行。这包括了一个ServiceAccount、ClusterRoleBinding,然后初始化Helm。 $ kubectl -n kube-system create serviceaccount tiller serviceaccount/tiller created 创建Tiller帐户的绑定作为集群管理员。当你完成安装之后,你就可以解除绑定了。通常来说,绑定service account到集群管理员角色并不是一个好主意,除非它们真的需要集群范围的访问。如果你想的话,可以限制Tiller部署到单个命名空间中。幸运的是,在Helm3中将不会有Tiller,这将进一步简化Helm chart的部署并提高了安全性。 $ kubectl create clusterrolebinding tiller --clusterrole cluster-admin --serviceaccount=kube-system:tiller clusterrolebinding.rbac.authorization.k8s.io/tiller created 接下来,使用service account初始化Helm,这将在kube-system命名空间创建一个Tiller pod。 $ helm init --service-account tiller $HELM_HOME has been configured at /home/chip/.helm. Tiller (the Helm server-side component) has been installed into your Kubernetes Cluster. 你现在应该能够检查并看到一个新的Tiller pod已经创建完成并且正在运行。 $ kubectl -n kube-system get po -l app=helm NAME READY STATUS RESTARTS AGE tiller-deploy-5d6cc99fc-sv6z6 1/1 Running 0 5m25s helm version要能确保客户端的helm二进制文件能够与新创建的Tiller pod通信。 $ helm version Client: &version.Version{SemVer:"v2.14.3", GitCommit:"0e7f3b6637f7af8fcfddb3d2941fcc7cbebb0085", GitTreeState:"clean"} Server: &version.Version{SemVer:"v2.14.3", GitCommit:"0e7f3b6637f7af8fcfddb3d2941fcc7cbebb0085", GitTreeState:"clean"} 第二个步骤就完成,接下来我们需要做一些证书工作。 生成证书和secret 现在,我们不得不创建我们的自定义证书并使它们可供Kubernetes使用。在本例中,我使用由内部企业证书颁发机构(CA)签名的证书,但是你可以只使用由第三方根签名的通用证书。Rancher可以使用以上两种证书,也可以使用自签名证书。由于这是一个企业级部署,我们需要一个已经建立的信任链,因此我们将使用企业CA。 创建证书的过程可能会有所不同,因此我无法一一列出所有情况,我只会简单介绍与本例所需证书创建和生成过程相同的证书。但是无论如何,我们都需要一个主机名,通过它可以访问集群中运行的Rancher应用程序。不要将之前我们在创建PKS集群时使用的外部主机名混淆,它们时两个单独的地址,并且作用也不一样。我将这个Rancher安装命名为“czrancherblog”,以便正确地生成并签名我的证书。 通过Internet的魔力,我们可以快速完成生成过程,直到获得证书,secret和根CA证书文件。 确保运行kubectl的系统可以访问这些文件,然后继续。 我们将为Rancher创建一个新的命名空间,在命名空间内,我们需要创建2个secret:一个用于签署我们的主机证书的根CA证书,以及实际生成的证书及其对应的私钥。 $ kubectl create ns cattle-system namespace/cattle-system created 在创建第一个secret之前,确保根CA证书命名为cacerts.pem,必须准确地使用这个名字,否则Rancher pod将启动失败。 $ kubectl -n cattle-system create secret generic tls-ca --from-file=cacerts.pem secret/tls-ca created 接下来,创建TLS secret,该secret将保存czrancherblog站点的主机证书。此外,在下一步创建的nginx ingress controllerPod也会需要这个secret,以便正确认证客户请求。 $ kubectl -n cattle-system create secret tls czrancherblog-secret --cert=czrancherblog.cer --key=czrancherblog.key secret/czrancherblog-secret created 验证已经创建的两个secret $ kubectl -n cattle-system get secret NAME TYPE DATA AGE czrancherblog-secret kubernetes.io/tls 2 2m7s default-token-4b7xj kubernetes.io/service-account-token 3 5m1s tls-ca Opaque 1 3m26s 你会注意到,创建了这些secret,实际上只是创建两种不同类型的secret而已。tls-ca这个secret是Opaque类型的secret,而czrancherblog-secret是一个TLS secret。如果你两相比较,你会注意到tls-ca secret会在数据部分为cacerts.pem列出一个base64-encoded 证书。而czrancherblog-secret将会列出其中的两个,每个文件分配一个。你同时还会注意到无论你提供哪种输入文件,都已经为tls.crt和tls.key列出它们的值(经过base64编码以使它们模糊之后)。 现在我们已经完成证书的生成了,现在应该到nginx ingress的部分。 创建和配置Ingress 既然secret和命名空间都已经创建,现在让我们来安装nginx-ingress controller。如上文所提到的,尽管Enterprise PKS可以并且将使用NSX-T作为现成的Ingress controller,但是Rancher有些特殊需求是这一controller无法满足的。因此在这一情况下,我们将使用其他的controller。Nginx有一个被广泛使用并且技术成熟的ingress controller,恰好符合我们的需求。请注意在本例中,我使用的是kubernetes/ingress-nginx,而不是nginxinc/Kubernetes-ingress。尽管它们有些许差异,但其实在本例中两者都能使用。 在您的终端上,运行以下Helm命令以从稳定版本中安装kubernetes / ingress-nginx controller: helm install stable/nginx-ingress --name nginx --namespace cattle-system --set controller.kind=DaemonSet 在这个命令中,我们让Helm把nginx对象放入cattle-system命名空间中,并且将pod作为DaemonSet而不是Deployment来运行。我们希望每个Kubernetes节点都有一个controller,进而节点故障不会消除通往Rancher Pod的入口数据路径。Rancher将完成类似的任务,但将使用具有pod反关联规则的deployment(这与vSphere DRS的工作原理相似)。 命令完成之后,你将会从Helm获得一连串的返回,包括所有它创建的对象。需要指出的是,几个API对象是ConfigMap,它存储nginx controller的配置以及服务。 ==> v1/Service NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE nginx-nginx-ingress-controllern LoadBalancer 10.100.200.48 <pending> 80:32013/TCP,443:32051/TCP 0s nginx-nginx-ingress-default-backend ClusterIP 10.100.200.45 <none> 80/TCP 0s 第一个称为nginx-nginx-ingress-controller的类型为LoadBalancer。从应用程序的角度来看,这实际上将是Rancher集群的切入点。如果你看到External-IP栏,你将会注意到它最初只报告了<pending>状态。这时候需要给你的Kubernetes集群一些时间来拉取镜像,然后再次检查命名空间的服务。 # kubectl -n cattle-system get svc NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE nginx-nginx-ingress-controller LoadBalancer 10.100.200.48 10.50.0.79,100.64.128.125 80:32013/TCP,443:32051/TCP 6m35s nginx-nginx-ingress-default-backend ClusterIP 10.100.200.45 <none> 80/TCP 6m35s 这一次,你将会发现它分配了两个IP,因为NSX容器插件(NCP)注意到该对象的创建,并已与NSX-T进行通信,以使用为此集群指定的中型负载均衡器为我们创建新的虚拟服务器。 如果你跳到NSX-T管理器界面中的Server Pool选项卡,并找到此处引用的选项卡,那么可以检查Pool Member选项卡,并查看它已自动添加了该服务引用的端点。 Name栏被截断了,但是IP栏依旧可见。让我们再次检查一下Kubernetes。 $ kubectl -n cattle-system get po -o wide -L app NAME READY IP NODE APP nginx-nginx-ingress-controller-wjn2x 1/1 10.11.54.2 9aa90453-2aff-4655-a366-0ea8e366de4a nginx-ingress nginx-nginx-ingress-controller-wkgms 1/1 10.11.54.3 f35d32a0-4dd3-42e4-995b-5daffe36dfee nginx-ingress nginx-nginx-ingress-controller-wpbtp 1/1 10.11.54.4 e832528a-899c-4018-8d12-a54790aa4e15 nginx-ingress nginx-nginx-ingress-default-backend-8fc6b98c6-6r2jh 1/1 10.11.54.5 f35d32a0-4dd3-42e4-995b-5daffe36dfee nginx-ingress 输出的内容被稍微修改了一点点,去除了不必要的栏,但除了正在运行的节点之外,你还可以清晰地看到pod、它们的状态以及IP地址。 有了新虚拟服务器的IP地址,我们接下来需要创建一个DNS记录,可以与我们的Rancher HA安装的主机名对应。我决定将其命名为“czrancherblog”,因此我将在DNS中创建一个A记录,将在czrancherblog指向10.50.0.79。 $ nslookup czrancherblog Server: 10.10.30.13 Address: 10.10.30.13#53 Name: czrancherblog.sovsystems.com Address: 10.50.0.79 这一阶段的最后一步是在Kubernetes上创建ingress controller。尽管我们已经有LoadBalancer这一服务类型,我们依旧需要ingress资源来路由流量到Rancher service。但该服务尚不存在,但很快就可以创建。 使用以下代码创建一个新的manifest,命名为ingress.yaml,并且使用kubectl create -f ingress.yaml对其进行应用: apiVersion: extensions/v1beta1 kind: Ingress metadata: annotations: kubernetes.io/ingress.class: nginx namespace: cattle-system name: rancher-ingress spec: rules: - host: czrancherblog.sovsystems.com http: paths: - backend: serviceName: rancher servicePort: 80 tls: - hosts: - czrancherblog.sovsystems.com secretName: czrancherblog-secret 现在我来解释一下这个manifest。首先,我们的类型是Ingress,接下来我们有一个注释。这一行实际上在做两件事:指示NCP不要告诉NSX-T创建和配置任何对象,并告诉Nginx controller将流量路由到端口80上尚未创建的名为rancher的服务。最后,当来自主机值为czrancherblog.sovsystems.com的请求中的任何流量进入系统时,它使用我们创建的包含证书及密钥的TLS secret应用到controller上。 尽管我们希望不会出错,但是我们仍然要将该地址放入网络浏览器中,以查看返回的内容。 我们将获得一些重要的信息。首先,非常明显的大字“503 Service Temporarily Unavailable”,考虑到目前尚无流量经过nginx controller,这样的返回结果是符合期望的。其次, 在地址栏我们看到了一个绿色锁的图标,这意味着我们创建的包含证书的TLS secret已经被接受并且应用于主机规则。 到目前为止,都在向预想的方向进行,让我们进行下一步。 安装Rancher 终于到了期待已久的一刻——安装Rancher。现在我们一切都准备好了,开始安装吧! 添加Rancher stable仓库到Helm,然后进行更新并拉取最新chart。 $ helm repo add rancher-stable https://releases.rancher.com/server-charts/stable "rancher-stable" has been added to your repositories $ helm repo list NAME URL stable https://kubernetes-charts.storage.googleapis.com local http://127.0.0.1:8879/charts rancher-stable https://releases.rancher.com/server-charts/stable $ helm repo update Hang tight while we grab the latest from your chart repositories... ...Skip local chart repository ...Successfully got an update from the "rancher-stable" chart repository ...Successfully got an update from the "stable" chart repository Update Complete. 为什么在安装nginx ingress之前我们不需要添加一个仓库呢?因为那个chart实际上来自由谷歌托管的默认”stable”仓库,因此没有自定义仓库可以添加。对于Rancher,我们必须添加stable或latest仓库以访问其管理的chart。 如果你已经成功更新了,那么赶紧激活Rancher吧。从stable repo中安装最新的chart,并检查输出。 $ helm install rancher-stable/rancher --name rancher --namespace cattle-system --set hostname=czrancherblog.sovsystems.com --set ingress.tls.source=secret --set privateCA=true NAME: rancher LAST DEPLOYED: Sun Sep 8 18:11:18 2019 NAMESPACE: cattle-system STATUS: DEPLOYED RESOURCES: ==> v1/ClusterRoleBinding NAME AGE rancher 1s ==> v1/Deployment NAME READY UP-TO-DATE AVAILABLE AGE rancher 0/3 0 0 1s ==> v1/Pod(related) NAME READY STATUS RESTARTS AGE rancher-6b774d9468-2svww 0/1 ContainerCreating 0 0s rancher-6b774d9468-5n8n7 0/1 Pending 0 0s rancher-6b774d9468-dsq4t 0/1 Pending 0 0s ==> v1/Service NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE rancher ClusterIP 10.100.200.15 <none> 80/TCP 1s ==> v1/ServiceAccount NAME SECRETS AGE rancher 1 1s ==> v1beta1/Ingress NAME HOSTS ADDRESS PORTS AGE rancher czrancherblog.sovsystems.com 80, 443 1s NOTES: Rancher Server has been installed. NOTE: Rancher may take several minutes to fully initialize. Please standby while Certificates are being issued and Ingress comes up. Check out our docs at https://rancher.com/docs/rancher/v2.x/en/ Browse to https://czrancherblog.sovsystems.com Happy Containering! 很好,现在chart为我们部署了大量的Kubernetes对象。然而,注意一下最后一个对象,它是另一个ingress。我们不需要它,所以直接将其删除。 $ kubectl -n cattle-system delete ing rancher ingress.extensions "rancher" deleted 检查pod以确保它们现在正在运行。 $ kubectl -n cattle-system get po -l app=rancher NAME READY STATUS RESTARTS AGE rancher-6b774d9468-2svww 1/1 Running 2 5m32s rancher-6b774d9468-5n8n7 1/1 Running 2 5m32s rancher-6b774d9468-dsq4t 1/1 Running 0 5m32s 非常棒,一切都起来了。如果你在RESTARTS列中看到的值不是零,也不要惊慌,Kubernetes最终会与其controller和监控循环保持一致,因此只要采取适当的措施,就可以使得实际状态达到所需状态为止。 现在,这些工作都完成之后,让我们再次检查我们的网页,看看发生了什么。 正如我们所希望的那样,我们现在进入我们的Rancher集群了!让我们设置初始密码以及在下一页面中设置server URL。如果不进行设置,它将自动填充我们的主机名。 这一步骤就算完成啦,接下来让我们进入最后一步。 配置基础架构 既然我们已经让一切都起来了并且正在运行,让我们做些事情。 首先,你可能已经注意到你的“local”集群卡在Provisioning的状态,正在等待设置主机名。通常这几分钟之后就会自动解决,但在本例中,则需要执行几个简单的步骤。 最快的修复步骤是点击最右边的设置按钮来编辑这个集群。 现在不做任何更改,直接点击保存。 然后回到主页,它应该已经起来了。 再次进入集群,确保你的节点正在汇报状态。 接下来,我们需要在主机之间分配我们的基础PKS Kubernetes节点。如果你的plan包括多个可用空间,你可能已经完成这一步了。但如果你像我一样,没有多个可用空间,你将需要某种方法来确保你的master和你的worker分布在ESXi主机上。如果你听说过我的Optimize-VMwarePKS项目,我强烈建议你使用它,该项目可以自动为你处理master,但我们依旧需要手动把worker分开。请记住,我们不仅需要API和控制平面的高可用,我们也需要Rancher 数据平面的高可用。这意味着任何管理程序的故障都不会影响我们应用程序的可访问性。 你使用-ProcessDRSRules标志运行Optimize-VMware-PKS之后,它应该检测到该集群的master并创建DRS反关联性规则。现在,你需要为worker节点手动创建一个新的节点。 为worker创建一个新的反关联规则,并添加所有规则。由于BOSH会使用UUID而不是实际名称来部署它们,因此在列表中找到它们十分困难,但是你可以在vSphere VM和模板清单视图中找到它们(如果你使用-ProcessDRSRules标志运行Optimize-VMware-PKS),或者你可以在引用部署后,从BOSH CLI获取名称。 $ bosh -d service-instance_3373eb33-8c8e-4c11-a7a8-4b25fe17722d vms Using environment 'czpcfbosh.sovsystems.com' as client 'ops_manager' Task 55540. Done Deployment 'service-instance_3373eb33-8c8e-4c11-a7a8-4b25fe17722d' Instance Process State AZ IPs VM CID VM Type Active master/00be5bab-649d-4226-a535-b2a8b15582ee running AZ1 10.50.8.3 vm-a8a0c53e-3358-46a9-b0ff-2996e8c94c26 medium.disk true master/1ac3d2df-6a94-48d9-89e7-867c1f18bc1b running AZ1 10.50.8.2 vm-a6e54e16-e216-4ae3-8a99-db9100cf40c8 medium.disk true master/c866e776-aba3-49c5-afe0-8bf7a128829e running AZ1 10.50.8.4 vm-33eea584-ff26-45ed-bce3-0630fe74f88a medium.disk true worker/113d6856-6b4e-43ef-92ad-1fb5b610d28d running AZ1 10.50.8.6 vm-5508aaec-4253-4458-b2de-26675a1f049f medium.disk true worker/c0d00231-4afb-4a4a-9a38-668281d9411e running AZ1 10.50.8.5 vm-e4dfc491-d69f-4404-8ab9-81d2f1f4bd0d medium.disk true worker/ff67a937-8fea-4c13-8917-3d92533eaade running AZ1 10.50.8.7 vm-dcc29000-16c2-4f5a-b8f4-a5420f425400 medium.disk true 6 vms Succeeded 无论你选择哪种方法,只要能保证规则创建即可。 现在你已经有了master和worker的反关联规则,那么请确保你在多个方面都具备高可用性。如果你愿意进行测试,那么让工作节点(或与此相关的主节点)发生故障,或删除Rancher Pod,然后查看Kubernetes创建的新pod。此时,Rancher应该还保持工作状态。 结 语 你已经看到了我们如何从零开始创建了一个具备高可用性以及完整功能的Rancher Server,并且你也应该采取了一些措施确保将其安全地分布在底层架构上。你需要牢记一个重要的考虑因素:当在Enterprise PKS上运行Rancher的时候,与Kubernetes命名空间有关。当在Kubernetes上安装Rancher时,通过创建CRD和其他对象,Rancher从平台的角度将与Kubernetes深度集成。当用户创建一个新项目或导入一个新集群时,Kubernetes将会在后台创建一个新的命名空间。在其他Kubernetes环境中,这样的操作流程会非常完美,但在Enterprise PKS中,一个新的命名空间则意味着新的Tier-1 router、新的逻辑网段、新的pod IP块等。在PKS没有预先设置好的情况下,如果大量导入集群和创建项目,那么这些命名空间很快会耗尽诸如pod IP块之类的NSX-T对象。如果你正在考虑在生产环境中采用这样的架构,那么需要牢记这一点。现在,无法告诉NCP忽略这些命名空间创建命令,因此它不会在NSX-T内部生成对象。

优秀的个人博客,低调大师

CNCF 发布 K8s 项目历程报告,35k 贡献者有你吗?

云原生计算基金会 CNCF 首次发布了Kubernetes 项目历程报告。 Kubernetes 托管于 CNCF,它是目前使用最广泛的容器编排平台,通常被称为“云端 Linux”,CNCF 介绍此报告旨在客观地评估 Kubernetes 项目的状态以及 CNCF 如何影响 Kubernetes 的发展和增长。 Kubernetes 项目的首次 commit 发生在 2014 年 6 月 6 日,自 2016 年 3 月 10 日加入 CNCF,到目前为止,Kubernetes 共有 35k contributor 做了 110 万次贡献、148k 次 commit 与 83k PR,并且有超过2000 家公司参与贡献开源。 数据显示,目前在参与贡献的公司中,排名前两位的是 Google 和 Red Hat。三年前 Kubernetes 加入 CNCF 之前,两家公司所做贡献占了所有贡献的 83%,目前占比为 35%,这是整个生态在发展的原因,因为有越来越多人参与进来贡献,稀释了份额,但两家公司的贡献量仍然在不断增加。 值得注意的是,国内的华为贡献量排在第 4 位。 公司的累计贡献量 公司贡献占比 贡献者方面,从 Kubernetes 项目诞生开始,就有大约 20 名积极参与的开发人员参与贡献,而今天已经有超过 3000 位活跃贡献者,自创立以来增加超过 14000%。 这些贡献者来自数十个国家,其贡献的地理多样性随着时间的推移而不断扩大。在 Kubernetes 的整个生命周期中,11 个国家里平均有超过10 个贡献者。下图显示了按时间划分的贡献数量以及按国家/地区划分的贡献者的百分比。 我们可以看到,中国在这些贡献数据中有不错的成绩。 Kubernetes 是历史上发展得极快的开源软件项目,并且它的发展速度越来越快,从下边这些增长数据可以看得出来这一点。 CNCF 还表示,这是首次发布该系列报告,其将专注于已毕业项目,所以接下来应该会陆续有其它 CNCF 项目历程报告出炉。 报告详情查看:https://www.cncf.io/cncf-kubernetes-project-journey

优秀的个人博客,低调大师

云原生生态周报 Vol. 15 | K8s 安全审计报告发布

业界要闻 CNCF 公布 Kubernetes的安全审计报告,报告收集了社区对 Kubernetes、CoreDNS、Envoy、Prometheus 等项目的安全问题反馈,包含从一般弱点到关键漏洞。报告帮项目维护人员解决已识别的漏洞,并给出了一系列最佳实践。 技术监督委员会(TOC)已投票决定将 rkt 项目归档。尽管rkt 在2014年12月创建后最初很受欢迎,并在2017年3月贡献给CNCF,但其采纳程度已严重下降,很多用户已经从rkt转向了如containerd、CRI-O等其它项目。 上游重要进展 Kubernetes 项目 支持readonly的接口指定不同的网卡 https://github.com/kubernetes/enhancements/issues/1208 在Kubectl中进行pod问题定位分析: https

优秀的个人博客,低调大师

K8S从懵圈到熟练:读懂这一篇,集群节点不下线

排查完全陌生的问题,完全不熟悉的系统组件,是售后工程师的一大工作乐趣,当然也是挑战。今天借这篇文章,跟大家分析一例这样的问题。排查过程中,需要理解一些自己完全陌生的组件,比如systemd和dbus。但是排查问题的思路和方法基本上还是可以复用了,希望对大家有所帮助。 问题一直在发生 I'm NotReady 阿里云有自己的Kubernetes容器集群产品。随着Kubernetes集群出货量的剧增,线上用户零星的发现,集群会非常低概率地出现节点NotReady情况。据我们观察,这个问题差不多每个月,就会有一两个客户遇到。在节点NotReady之后,集群Master没有办法对这个节点做任何控制,比如下发新的Pod,再比如抓取节点上正在运行Pod的实时信息。 需要知道的Kubernetes知识 这里我稍微补充一点Kubernetes集群的基本知识

优秀的个人博客,低调大师

通过阿里云容器服务K8S Ingress Controller实现应用服务的灰度发布

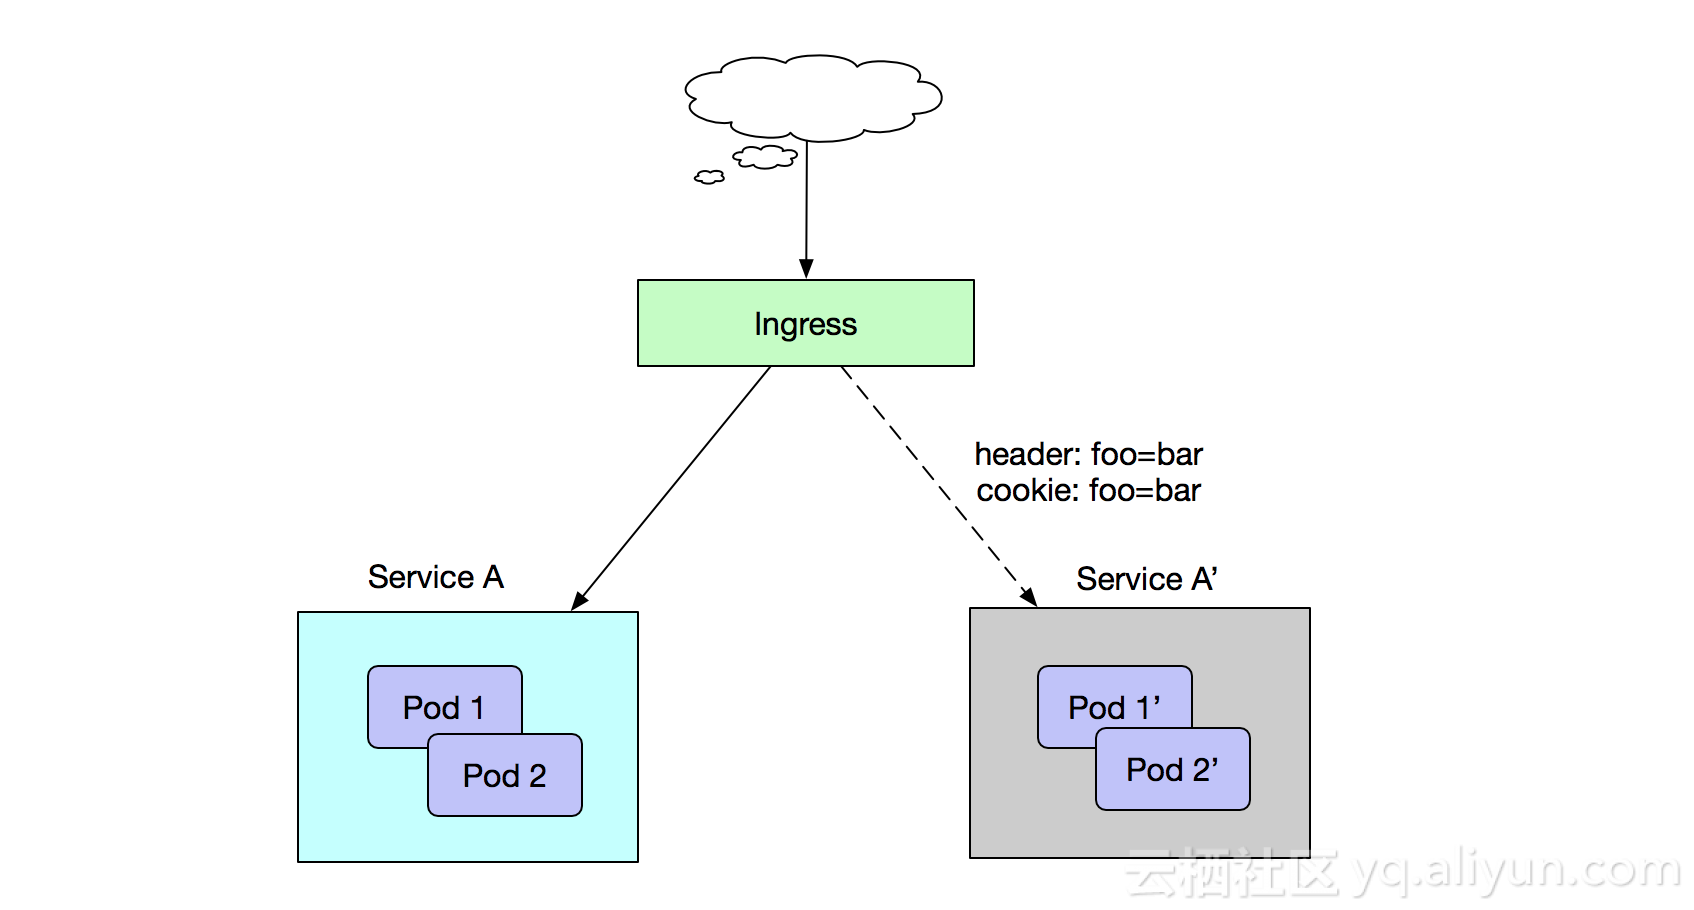
简介 日常工作中我们经常需要对服务进行版本更新升级,为此我们经常使用到的发布方式有滚动升级、分批暂停发布、蓝绿发布以及灰度发布,今天主要跟大家分享下在阿里云容器服务Kubernetes集群中如何通过Ingress Controller来实现应用服务的灰度发布及AB测试。 发布场景 场景一 假设当前线上环境我们已经有一套服务Service A对外提供7层服务,此时我们新开发了一些新的特性,需要灰度发布上线一个新的版本Service A',但是我们暂时又不希望简单地直接替换掉Service A服务,而是希望将请求头中包含foo=bar或者cookie中包含foo=bar的客户端请求转发到Service A'服务中,待运行一段时间稳定,将所有的流量切换到Service A'服务中后,再平滑地下线掉Service A服务: 场景二 假设当前线上环境我

优秀的个人博客,低调大师

Shell脚本快速部署Kubernetes(K8S v1.1版本)集群系统

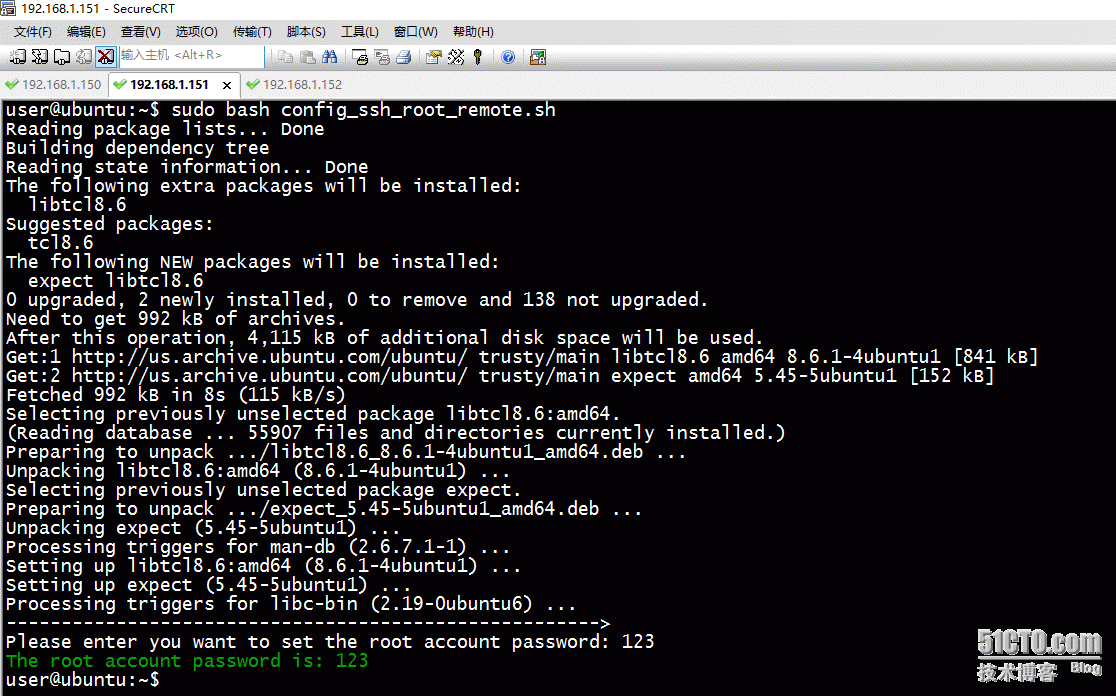
提醒:即使按照本篇文章一步一步做,也不一定部署成功。原因你懂得!如果失败,也建议你仔细看看脚本内容,从中寻找解决办法。同时,相信你也会从脚本中获取到其他有价值的信息。 实验环境: 操作系统:Ubuntu14.04_x64 master:192.168.1.150 minion01: 192.168.1.151 容器网段:172.17.1.0/24 minion02: 192.168.1.152 容器网段:172.17.2.0/24 安装包下载: etcd:http://pan.baidu.com/s/1c1wITMw kubernetes:http://pan.baidu.com/s/1kUoxgYb 相关脚本下载:http://pan.baidu.com/s/1o7nEaca 脚本说明: config_ssh_root_remote.sh #配置root SSH登录(默认ubuntu系统禁止root SSH登录) ssh_keypair_auth.sh #配置master主机与minion主机SSH免交互认证 kubernetes-install.sh #安装kubernetes的master端与minion端 config_gre_channel.sh #配置两台Docker主机容器实现跨主机访问(OVS) 安装步骤(请按照步骤做): 1)在minion主机root权限开启root允许SSH远程登录 操作命令:$ sudo bash config_ssh_root_remote.sh 脚本内容:$ cat config_ssh_root_remote.sh 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 #!/bin/bash #Description:configurationrootaccountsshremotelogin if [$USER!= "root" ]; then echo "Pleaseuserootaccountoperationorsudo!" exit 1 fi function color_echo(){ if [$1== "green" ]; then echo -e "\033[32;40m$2\033[0m" elif [$1== "red" ]; then echo -e "\033[31;40m$2\033[0m" fi } function check_pkg(){ if !$(dpkg-l$PKG_NAME> /dev/null 2>&1); then echo no else echo yes fi } function install_pkg(){ local PKG_NAME=$1 if [$(check_pkg$PKG_NAME)== "no" ]; then apt-get install $PKG_NAME-y if [$(check_pkg$PKG_NAME)== "no" ]; then color_echogreen "$PKG_NAMEinstallationfailure!Trytoinstallagain." apt-getautoremove&&apt-getupdate apt-get install $PKG_NAME--force- yes -y [$(check_pkg$PKG_NAME)== "no" ]&&color_echored "The$PKG_NAMEinstallationfailure!" && exit 1 fi fi } install_pkgexpect #modifysshconfigfile sed -r-i 's/(PermitRootLogin).*/\1yes/' /etc/ssh/sshd_config service ssh restart> /dev/null #setrootaccountpassword echo "------------------------------------------------------>" while true ; do read -p "Pleaseenteryouwanttosettherootaccountpassword:" ROOT_PASS if [-n "$ROOT_PASS" ]; then break else color_echored "Passwordcannotbeempty!" continue fi done expect-c" spawn passwd root expect{ \"EnternewUNIXpassword:\"{send\"$ROOT_PASS\r\";exp_continue} \"RetypenewUNIXpassword:\"{send\"$ROOT_PASS\r\"} } expecteof "> /dev/null color_echogreen "Therootaccountpasswordis:$ROOT_PASS" 2)在master主机切换到root用户执行脚本与minion主机root用户建立SSH免交互登录 操作命令:# bashssh_keypair_auth.sh root@192.168.1.151-152@123 脚本内容:# catssh_keypair_auth.sh 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 #!/bin/bash #Description:configurationlocalhostandremotehostsshkeypairauthentication,SupportUbuntuandCentOSoperationsystem. function color_echo(){ if [$1== "green" ]; then echo -e "\033[32;40m$2\033[0m" elif [$1== "red" ]; then echo -e "\033[31;40m$2\033[0m" fi } function os_version(){ local OS_V=$( cat /etc/issue | awk 'NR==1{print$1}' ) if [$OS_V== "\S" -o$OS_V== "CentOS" ]; then echo "CentOS" elif [$OS_V== "Ubuntu" ]; then echo "Ubuntu" fi } function check_ssh_auth(){ if $( grep "Permissiondenied" $EXP_TMP_FILE> /dev/null ); then color_echored "Host$IPSSHauthenticationfailure!Loginpassworderror." exit 1 elif $( ssh $INFO 'echoyes>/dev/null' ); then color_echogreen "Host$IPSSHauthenticationsuccessfully." fi rm $EXP_TMP_FILE> /dev/null } function check_pkg(){ local PKG_NAME=$1 if [$(os_version)== "CentOS" ]; then if !$(rpm-ql$PKG_NAME> /dev/null 2>&1); then echo no else echo yes fi elif [$(os_version)== "Ubuntu" ]; then if !$(dpkg-l$PKG_NAME> /dev/null 2>&1); then echo no else echo yes fi fi } function install_pkg(){ local PKG_NAME=$1 if [$(os_version)== "CentOS" ]; then if [$(check_pkg$PKG_NAME)== "no" ]; then yum install $PKG_NAME-y if [$(check_pkg$PKG_NAME)== "no" ]; then color_echogreen "The$PKG_NAMEinstallationfailure!Trytoinstallagain." yummakecache yum install $PKG_NAME-y [$(check_pkg$PKG_NAME)== "no" ]&&color_echored "The$PKG_NAMEinstallationfailure!" && exit 1 fi fi elif [$(os_version)== "Ubuntu" ]; then if [$(check_pkg$PKG_NAME)== "no" ]; then apt-get install $PKG_NAME-y if [$(check_pkg$PKG_NAME)== "no" ]; then color_echogreen "$PKG_NAMEinstallationfailure!Trytoinstallagain." apt-getautoremove&&apt-getupdate apt-get install $PKG_NAME--force- yes -y [$(check_pkg$PKG_NAME)== "no" ]&&color_echored "The$PKG_NAMEinstallationfailure!" && exit 1 fi fi fi } function generate_keypair(){ if [!-e~/. ssh /id_rsa .pub]; then color_echogreen "Thepublic/privatersakeypairnotexist,startGenerating..." expect-c" spawn ssh -keygen expect{ \" ssh /id_rsa ):\"{send\"\r\";exp_continue} \"passphrase):\"{send\"\r\";exp_continue} \"again:\"{send\"\r\";exp_continue} } "> /dev/null 2>&1 if [-e~/. ssh /id_rsa .pub]; then color_echogreen "Generatingpublic/privatersakeypairsuccessfully." else color_echored "Generatingpublic/privatersakeypairfailure!" exit 1 fi fi } EXP_TMP_FILE= /tmp/expect_ssh .tmp if [[$1=~^[a-z]+@[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}@.*]]; then install_pkgexpect;generate_keypair for i in $@; do USER=$( echo $i| cut -d@-f1) IP=$( echo $i| cut -d@-f2) PASS=$( echo $i| cut -d@-f3) INFO=$USER@$IP expect-c" spawn ssh -copy- id $INFO expect{ \"( yes /no )?\"{send\" yes \r\";exp_continue} \"password:\"{send\"$PASS\r\";exp_continue} } ">$EXP_TMP_FILE #ifloginfailed,loginerrorinfoappendtempfile check_ssh_auth done elif [[$1=~^[a-z]+@[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}-[0-9]{1,3}@.*]]; then install_pkgexpect;generate_keypair START_IP_NUM=$( echo $1| sed -r 's/.*\.(.*)-(.*)@.*/\1/' ) END_IP_NUM=$( echo $1| sed -r 's/.*\.(.*)-(.*)@.*/\2/' ) for ((i=$START_IP_NUM;i<=$END_IP_NUM;i++)); do USER=$( echo $1| cut -d@-f1) PASS=$( echo $1| cut -d@-f3) IP_RANGE=$( echo $1| sed -r 's/.*@(.*\.).*/\1/' ) IP=$IP_RANGE$i INFO=$USER@$IP_RANGE$i expect-c" spawn ssh -copy- id $INFO expect{ \"( yes /no )?\"{send\" yes \r\";exp_continue} \"password:\"{send\"$PASS\r\";exp_continue} } ">$EXP_TMP_FILE check_ssh_auth done else echo "Example1:$0<root@192.168.1.10-15@password>" echo "Example2:$0<root@192.168.1.10@password>" echo "Example3:$0[root@192.168.1.10@passwordroot@192.168.1.11@passwordroot@192.168.1.12@password...]" fi 3)在master主机root权限执行脚本安装master端服务 操作命令:$ sudo bash kubernetes-install.sh master 脚本内容:$ cat kubernetes-install.sh 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 205 206 207 208 209 210 211 212 213 214 215 216 217 218 219 220 221 222 223 224 225 226 227 228 229 230 231 232 233 234 235 236 237 238 239 240 241 242 243 244 245 246 247 248 249 250 251 252 253 254 255 256 257 258 259 260 261 262 263 264 265 266 267 268 269 270 271 272 273 274 275 276 277 278 279 280 281 282 283 284 #!/bin/bash #Description:InstallationKubernetes1.1.3 #EtcdDownload:https://github.com/coreos/etcd/releases/download/v2.2.2/etcd-v2.2.2-linux-amd64.tar.gz #K8SDownload:https://storage.googleapis.com/kubernetes-release/release/v1.1.3/kubernetes.tar.gz . /lib/lsb/init-functions if [$( cat /etc/issue | awk '{print$1}' )!= "Ubuntu" ]; then echo "Onlysupportubuntuoperatingsystem!" exit 1 fi if [$USER!= "root" ]; then echo "Pleaseuserootaccountoperation!" exit 1 fi function color_echo(){ if [$1== "green" ]; then echo -e "\033[32;40m$2\033[0m" elif [$1== "red" ]; then echo -e "\033[31;40m$2\033[0m" fi } function check_install_pkg(){ if [!-e$ETCD_FILE-a!-e$K8S_FILE]; then color_echored "$ETCD_FILEand$K8S_FILEfilenotexist!" exit 1 elif [!-e$ETCD_FILE]; then color_echored "$ETCD_FILEfilenotexist!" exit 1 elif [!-e$K8S_FILE]; then color_echored "$K8S_FILEfilenotexist!" exit 1 fi } function local_ip(){ local NUMARRAY_LENGTH NUM=0 for NIC_NAME in $( ls /sys/class/net | grep -vE "lo|docker0" ); do NIC_IP=$( ifconfig $NIC_NAME| awk -F '[:]+' '/inetaddr/{print$4}' ) if [-n "$NIC_IP" ]; then NIC_IP_ARRAY[$NUM]= "$NIC_NAME:$NIC_IP" let NUM++ fi done ARRAY_LENGTH=${ #NIC_IP_ARRAY[*]} if [$ARRAY_LENGTH- eq 1]; then LOCAL_IP=${NIC_IP_ARRAY[0] #*:} return 0 elif [$ARRAY_LENGTH- eq 0]; then color_echored "Noavailablenetworkcard!" exit 1 else #multinetworkcardselect for NIC in ${NIC_IP_ARRAY[*]}; do echo $NIC done while true ; do read -p "Pleaseenterlocalusetonetworkcardname:" INPUT_NIC_NAME for NIC in ${NIC_IP_ARRAY[*]}; do NIC_NAME=${NIC%:*} if [$NIC_NAME== "$INPUT_NIC_NAME" ]; then LOCAL_IP=${NIC_IP_ARRAY[0] #*:} return 0 fi done echo "Notmatch!Pleaseinputagain." done fi } function check_ip(){ local IP=$1 VALID_CHECK=$( echo $IP| awk -F. '$1<=255&&$2<=255&&$3<=255&&$4<=255{print"yes"}' ) if echo $IP| grep -E "^[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}$" > /dev/null ; then if [${VALID_CHECK:-no}== "yes" ]; then return 0 else echo "IP$IPnotavailable!" return 1 fi else echo "IPformaterror!" return 1 fi } function cluster_ip(){ if [$1== "master" ]; then while true ; do read -p "PleaseentermasterIP:" MASTER_IP check_ip$MASTER_IP [$?- eq 0]&& break done elif [$1== "minion" ]; then while true ; do local MINION_NUM read -p "Pleaseenterclusterminionnodenumber:" MINION_NUM if [[$MINION_NUM=~^[0-9]+$]]; then break else color_echored "Formaterror!" fi done NUM=1 while [$NUM- le $MINION_NUM]; do local MINION_IP read -p "Pleaseenterminionhost$NUMIP:" MINION_IP check_ip$MINION_IP if [$?- eq 0]; then let NUM++ MINION_IP_ARRAY+=($MINION_IP) fi done fi } function modify_init_script(){ if [$1== "master" ]; then cd $MASTER_MODULE_INIT_SCRIPT_DIR elif [$1== "minion" ]; then cd $MINION_MODULE_INIT_SCRIPT_DIR fi for MODULE_INIT_SCRIPT in $( ls | grep - v etcd); do if [-x$MODULE_INIT_SCRIPT]; then sed -r-i '/\/sbin\/initctl/{s/(if)(.*)/\1false\&\&\2/}' $MODULE_INIT_SCRIPT fi done } function check_service_status(){ sleep 1 if [$( ps -ef| grep - v grep | grep -c "$BIN_DIR/$MODULE_INIT_SCRIPT" )- eq 1]; then log_begin_msg "Starting$MODULE_INIT_SCRIPT" log_end_msg0 #0istherightcommandexecutionstatus else log_failure_msg "$(color_echored" Starting$MODULE_INIT_SCRIPT ")" log_end_msg1 #1isthewrongcommandexecutionstatus fi } function check_exec_status(){ if [$?- ne 0]; then color_echogreen "Pleasetrytorunthescript!" exit 1 fi } BASE_DIR=$PWD ETCD_FILE=$BASE_DIR /etcd-v2 .2.2-linux-amd64. tar .gz K8S_FILE=$BASE_DIR /kubernetes . tar .gz BIN_DIR= /opt/bin INIT_SCRIPT_DIR= /etc/init .d OPTS_FILE_DIR= /etc/default MODULE_BIN_DIR=$BASE_DIR /kubernetes/server/bin MASTER_MODULE_INIT_SCRIPT_DIR=$BASE_DIR /kubernetes/cluster/ubuntu/master/init_scripts MINION_MODULE_INIT_SCRIPT_DIR=$BASE_DIR /kubernetes/cluster/ubuntu/minion/init_scripts case $1 in master) check_install_pkg pkilletcd;pkillkube cluster_ipminion #Createbinaryfiledirectory [!-d$BIN_DIR]&& mkdir $BIN_DIR #Installationstoragesystemetcd log_action_msg "Unzipthe$ETCD_FILE" tar zxf$ETCD_FILE;check_exec_status cp $BASE_DIR /etcd-v2 .2.2-linux-amd64 /etc *$BIN_DIR;check_exec_status echo " ETCD_OPTS=\"\ --listen-client-urlshttp: //0 .0.0.0:4001\ --advertise-client-urlshttp: //0 .0.0.0:4001\ --data- dir /var/lib/etcd/default .etcd\" ">$OPTS_FILE_DIR /etcd #Installationmodulekube-apiserverkube-schedulerandkube-controller-manager log_action_msg "Unzipthe$K8S_FILE" tar zxf$BASE_DIR /kubernetes . tar .gz;check_exec_status tar zxf$BASE_DIR /kubernetes/server/kubernetes-server-linux-amd64 . tar .gz;check_exec_status cd $MODULE_BIN_DIR&& cp -akubectlkube-apiserverkube-schedulerkube-controller-manager$BIN_DIR;check_exec_status #Configureinitscripts modify_init_scriptmaster cp -aetcdkube-*$INIT_SCRIPT_DIR;check_exec_status sed -i '63s/.*/"/' $INIT_SCRIPT_DIR /etcd #Removetheappendlogfile,Otherwiseetcdmaycannotbestarted #ModuleConfigureoption log_action_msg "Create$OPTS_FILE_DIR/kube-apiserverstartupoptionsfile..." echo " KUBE_APISERVER_OPTS=\"\ --insecure-bind-address=0.0.0.0\ --insecure-port=8080\ --service-cluster-ip-range=10.0.0.0 /16 \ --etcd_servers=http: //127 .0.0.1:4001\ --logtostderr= true \" ">$OPTS_FILE_DIR /kube-apiserver check_exec_status log_action_msg "Create$OPTS_FILE_DIR/kube-controller-managerstartupoptionsfile..." echo " KUBE_CONTROLLER_MANAGER_OPTS=\"\ --master=127.0.0.1:8080\ --logtostderr= true \" ">$OPTS_FILE_DIR /kube-controller-manager log_action_msg "Create$OPTS_FILE_DIR/kube-schedulerstartupoptionsfile..." echo " KUBE_SCHEDULER_OPTS=\"\ --master=127.0.0.1:8080\ --logtostderr= true \" ">$OPTS_FILE_DIR /kube-scheduler #Startingmodule for MODULE_INIT_SCRIPT in $( ls $INIT_SCRIPT_DIR| grep -E "(etcd|kube.*)" ); do service$MODULE_INIT_SCRIPTstart> /dev/null check_service_status done #setvariable echo "exportPATH=$PATH:$BIN_DIR" >> /etc/profile . /etc/profile #Copymodulekubeletandkube-proxytominion SSH_OPTS= "-oConnectTimeout=1-oConnectionAttempts=3" cd $MODULE_BIN_DIR for MINION_IP in ${MINION_IP_ARRAY[*]}; do log_action_msg "Copymoduleto$MINION_IP:$BIN_DIR..." ssh $SSH_OPTSroot@$MINION_IP "mkdir$BIN_DIR2>/dev/null" ;check_exec_status scp $SSH_OPTSkubeletkube-proxyroot@$MINION_IP:$BIN_DIR done #Copymoduleinitscriptstominion modify_init_scriptminion cd $MINION_MODULE_INIT_SCRIPT_DIR for MINION_IP in ${MINION_IP_ARRAY[*]}; do log_action_msg "Copymoduleinitscriptsto$MINION_IP:$INIT_SCRIPT_DIR..." scp $SSH_OPTSkubeletkube-proxyroot@$MINION_IP:$INIT_SCRIPT_DIR;check_exec_status done color_echogreen "Kubernetesmasterinstallationcomplete." ;; minion) cluster_ipmaster #Noticeinputmasterip local_ip pkillkube #InstallDocker if !$(dpkg-ldocker-engine> /dev/null 2>&1)&&!$(dockerinfo> /dev/null 2>&1); then log_action_msg "StarttheinstallationDocker..." apt-keyadv--keyserverhkp: //p80 .pool.sks-keyservers.net:80--recv-keys58118E89F3A912897C070ADBF76221572C52609D> /dev/null 2>&1 [$?- ne 0]&& echo "Dockersourcesecretkeyregisterfailure!" DOCKER_U_SOURCE= /tmp/docker_source .tmp echo " debhttps: //apt .dockerproject.org /repo ubuntu-precisemain debhttps: //apt .dockerproject.org /repo ubuntu-trustymain debhttps: //apt .dockerproject.org /repo ubuntu-vividmain debhttps: //apt .dockerproject.org /repo ubuntu-wilymain ">$DOCKER_U_SOURCE OS_CODE_V=$(lsb_release-cs) DOKER_SOURCE=$( grep $OS_CODE_V$DOCKER_U_SOURCE) echo "$DOKER_SOURCE" > /etc/apt/sources .list.d /docker .list rm $DOCKER_U_SOURCE apt-getupdate apt-get install docker-engine-y if $(dpkg-ldocker-engine> /dev/null )&&$(dockerinfo> /dev/null ); then color_echogreen "Dockerinstallationsuccessfully." else apt-getremove;apt-get install docker-engine--force- yes -y if !$(dpkg-ldocker-engine> /dev/null )&&!$(dockerinfo> /dev/null ); then color_echored "Dockerinstallationfailure!" exit 1 fi fi fi #ModuleConfigureoption log_action_msg "Create$OPTS_FILE_DIR/kubeletstartupoptionsfile..." echo " KUBELET_OPTS=\"\ --address=0.0.0.0\ --port=10250\ --hostname_override=$LOCAL_IP\ --api_servers=http: // $MASTER_IP:8080\ --pod-infra-container-image=docker.io /kubernetes/pause :latest\ --logtostderr= true \" ">$OPTS_FILE_DIR /kubelet log_action_msg "Create$OPTS_FILE_DIR/kube-proxystartupoptionsfile..." echo " KUBE_PROXY_OPTS=\"\ --master=http: // $MASTER_IP:8080\ --proxy-mode=iptables\ --logtostderr= true \" ">$OPTS_FILE_DIR /kube-proxy #Startingmodule for MODULE_INIT_SCRIPT in $( ls $INIT_SCRIPT_DIR| grep kube.*); do service$MODULE_INIT_SCRIPTstart> /dev/null check_service_status done color_echogreen "Kubernetesminioninstallationcomplete." ;; *) echo "Usage:$0{master|minion}" exit 1 ;; esac 4)在minion主机root权限执行脚本安装minion端服务 操作命令:$ sudo bashkubernetes-install.shminion 脚本内容:同上 5)在minion主机root权限执行脚本创建GRE通道 操作命令:$ sudo bashconfig_gre_channel.sh 脚本内容:$ cat config_gre_channel.sh 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 #!/bin/bash #Description:configurationdockerhostbetweenGREChannel if [$( cat /etc/issue | awk '{print$1}' )!= "Ubuntu" ]; then echo "Onlysupportubuntuoperatingsystem!" exit 1 fi if [$USER!= "root" ]; then echo "Pleaseuserootaccountoperation!" exit 1 fi function color_echo(){ if [$1== "green" ]; then echo -e "\033[32;40m$2\033[0m" elif [$1== "red" ]; then echo -e "\033[31;40m$2\033[0m" fi } function check_ip(){ local IP=$1 local VALID_CHECK=$( echo $IP| awk -F. '$1<=255&&$2<=255&&$3<=255&&$4<=255{print"yes"}' ) if echo $IP| grep -E "^[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}$" > /dev/null ; then if [${VALID_CHECK:-no}== "yes" ]; then return 0 else echo "IP$IPnotavailable!" return 1 fi else echo "IPformaterror!" return 1 fi } function docker_host_ip(){ color_echogreen "Notice:OnlysupporttwoDockerhostconfigurationGREChannel!" NUM=1 while [$NUM- le 2]; do local DOCKER_IP read -p "PleaseenterDockerhost$NUMIP:" DOCKER_HOST_IP check_ip$DOCKER_HOST_IP if [$?- eq 0]; then let NUM++ DOCKER_HOST_IP_ARRAY+=($DOCKER_HOST_IP) fi done } function local_nic_info(){ local NUMARRAY_LENGTH NUM=0 for NIC_NAME in $( ls /sys/class/net | grep -vE "lo|docker0" ); do NIC_IP=$( ifconfig $NIC_NAME| awk -F '[:]+' '/inetaddr/{print$4}' ) if [-n "$NIC_IP" ]; then NIC_IP_ARRAY[$NUM]= "$NIC_NAME:$NIC_IP" let NUM++ fi done ARRAY_LENGTH=${ #NIC_IP_ARRAY[*]} if [$ARRAY_LENGTH- eq 1]; then LOCAL_NIC=${NIC_IP_ARRAY[0]%:*} LOCAL_IP=${NIC_IP_ARRAY[0] #*:} return 0 elif [$ARRAY_LENGTH- eq 0]; then color_echored "Noavailablenetworkcard!" exit 1 else #multinetworkcardselect for NIC in ${NIC_IP_ARRAY[*]}; do echo $NIC done while true ; do read -p "Pleaseenterlocalusetonetworkcardname:" INPUT_NIC_NAME for NIC in ${NIC_IP_ARRAY[*]}; do NIC_NAME=${NIC%:*} if [$NIC_NAME== "$INPUT_NIC_NAME" ]; then LOCAL_NIC=${NIC_IP_ARRAY[0]%:*} LOCAL_IP=${NIC_IP_ARRAY[0] #*:} return 0 fi done echo "Notmatch!Pleaseinputagain." done fi } function check_pkg(){ if !$(dpkg-l$PKG_NAME> /dev/null 2>&1); then echo no else echo yes fi } function install_pkg(){ local PKG_NAME=$1 if [$(check_pkg$PKG_NAME)== "no" ]; then apt-get install $PKG_NAME-y if [$(check_pkg$PKG_NAME)== "no" ]; then color_echogreen "The$PKG_NAMEinstallationfailure!Trytoinstallagain." apt-getautoremove&&apt-getupdate apt-get install $PKG_NAME--force- yes -y [$(check_pkg$PKG_NAME)== "no" ]&&color_echored "The$PKG_NAMEinstallationfailure!" && exit 1 fi fi } function config_gre_channel(){ install_pkgopenvswitch-switch install_pkgbridge-utils if [${DOCKER_HOST_IP_ARRAY[0]}== "$LOCAL_IP" ]; then REMOTE_HOST_IP=${DOCKER_HOST_IP_ARRAY[1]} #remotehostip REMOTE_DOCKER_IP= "172.17.2.0/24" #remotedockerhostdefaultcontaineriprange LOCAL_DOCKER_IP= "172.17.1.0" #kbr0gateway elif [${DOCKER_HOST_IP_ARRAY[1]}== "$LOCAL_IP" ]; then REMOTE_HOST_IP=${DOCKER_HOST_IP_ARRAY[0]} REMOTE_DOCKER_IP= "172.17.1.0/24" LOCAL_DOCKER_IP= "172.17.2.0" else echo "IPnotmatch!Pleaseinputagain." exit 1 fi ovs-vsctladd-brobr02> /dev/null ovs-vsctladd-portobr0gre0-- set Interfacegre0 type =greoptions:remote_ip=$REMOTE_HOST_IP2> /dev/null brctladdbrkbr02> /dev/null brctladdifkbr0obr02> /dev/null iplink set devkbr0up if [$( grep -cE "kbr0" /etc/network/interfaces )- ne 2]; then echo " autokbr0 ifacekbr0inetstatic address$( echo $LOCAL_DOCKER_IP| sed 's/0$/1/' ) netmask255.255.255.0 gateway$LOCAL_DOCKER_IP bridge_portsobr0 ">> /etc/network/interfaces fi if $( ls /sys/class/net | grep docker0> /dev/null ); then servicedockerstop> /dev/null iplink set devdocker0down iplinkdeletedevdocker0 echo "DOCKER_OPTS=\"-b=kbr0\"" > /etc/default/docker servicedockerstart> /dev/null fi ifdownkbr0> /dev/null 2>&1;ifupkbr0> /dev/null 2>&1 #rebootinvalid #iprouteadd$REMOTE_DOCKER_IPvia$REMOTE_HOST_IPdev$LOCAL_NIC2>/dev/null #permanentvalid if !$( grep "$REMOTE_DOCKER_IPvia$REMOTE_HOST_IP" /etc/rc . local > /dev/null ); then sed -i "$i\iprouteadd$REMOTE_DOCKER_IPvia$REMOTE_HOST_IPdev$LOCAL_NIC" /etc/rc . local fi } #main docker_host_ip echo "--------------------------------------------" local_nic_info config_gre_channel color_echogreen "GREChannelconfigurationcomplete." brctlshow echo "-------------------------------------------------" ovs-vsctlshow 1、配置minion主机root SSH登录 先将config_gre_channel.sh、config_ssh_root_remote.sh和kubernetes-install.sh这三个文件上传各自的minion主机,以备后用。 说明:操作成功,root密码为123 2、配置master主机与minion主机SSH免交互认证 将kubernetes-install.sh、ssh_keypair_auth.sh和etcd-v2.2.2-linux-amd64.tar.gz、kubernetes.tar.gz安装包上传到master主机 3、安装master端 说明:先解压文件,在创建启动选项文件,再启动服务,最后将minion相关包通过scp工具拷贝过去。通过ps工具看到服务进程已经启动。 4、安装minion端 说明:Docker源秘钥注册失败,没关系,一般不会影响安装。当提示安装docker成功后才能继续,否则报错退出。通过ps 工具看到服务进程都已经启动。 5、配置GRE通道 说明:目前配置GRE通道脚本只支持两台Docker主机 6、查看集群是否配置成功 # 通过kubectl命令创建一个pod 说明:在master端可以看到两台minion端状态是Ready,并且创建的Pod已经成功运行。 注意:如果没有kubectl命令,先尝试执行source /etc/profile下看看,如果还没有,直接使用/opt/bin/kubectl 本文转自 李振良OK 51CTO博客,原文链接:http://blog.51cto.com/lizhenliang/1738807,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册