首页 文章 精选 留言 我的

精选列表

搜索[k8s],共4083篇文章
优秀的个人博客,低调大师

通过例子理解 k8s 架构 - 每天5分钟玩转 Docker 容器技术(122)

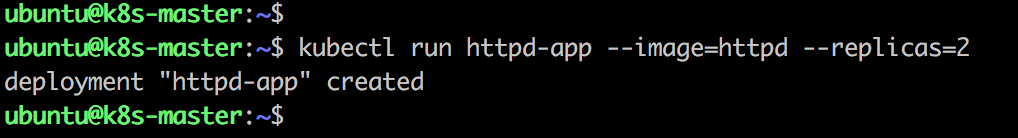
为了帮助大家更好地理解 Kubernetes 架构,我们部署一个应用来演示各个组件之间是如何协作的。 执行命令 kubectlrunhttpd-app--image=httpd--replicas=2 等待一段时间,应用部署完成。 Kubernetes 部署了 deploymenthttpd-app,有两个副本 Pod,分别运行在k8s-node1和k8s-node2。 详细讨论整个部署过程。 ① kubectl 发送部署请求到 API Server。 ② API Server 通知 Controller Manager 创建一个 deployment 资源。 ③ Scheduler 执行调度任务,将两个副本 Pod 分发到 k8s-node1 和 k8s-node2。 ④ k8s-node1 和 k8s-node2 上的 kubectl 在各自的节点上创建并运行 Pod。 补充两点: 应用的配置和当前状态信息保存在 etcd 中,执行kubectl get pod时 API Server 会从 etcd 中读取这些数据。 flannel 会为每个 Pod 都分配 IP。因为没有创建 service,目前 kube-proxy 还没参与进来。 Kubernetes 架构就讨论到这里。从下节开始,我们将通过实践深入学习 Kubernetes 的各种特性。作为容器编排引擎,最重要也是最基本的功能当然是运行容器化应用。下节见。 书籍: 1.《每天5分钟玩转Docker容器技术》https://item.jd.com/16936307278.html2.《每天5分钟玩转OpenStack》https://item.jd.com/12086376.html 本文转自CloudMan6 51CTO博客,原文链接:http://blog.51cto.com/cloudman/2063499

优秀的个人博客,低调大师

5 秒创建 k8s 集群 - 每天5分钟玩转 Docker 容器技术(115)

据说 Google 的数据中心里运行着超过 20 亿个容器,而且 Google 十年前就开始使用容器技术。 最初,Google 开发了一个叫 Borg 的系统(现在命令为 Omega)来调度如此庞大数量的容器和工作负载。在积累了这么多年的经验后,Google 决定重写这个容器管理系统,并将其贡献到开源社区,让全世界都能受益。 这个项目就是 Kubernetes。简单的讲,Kubernetes 是 Google Omega 的开源版本。 从 2014 年第一个版本发布以来,Kubernetes 迅速获得开源社区的追捧,包括 Red Hat、VMware、Canonical 在内的很多有影响力的公司加入到开发和推广的阵营。目前 Kubernetes 已经成为发展最快、市场占有率最高的容器编排引擎产品。 Kubernetes 一直在快速地开发和迭代。本章我们将以 v1.7 和 v1.8 为基础学习 Kubernetes。我们会讨论 Kubernetes 重要的概念和架构,学习 Kubernetes 如何编排容器,包括优化资源利用、高可用、滚动更新、网络插件、服务发现、监控、数据管理、日志管理等。 下面就让我们开始 Kubernetes 的探险之旅。 先跑起来 按照一贯的学习思路,我们会在最短时间内搭建起一个可用系统,这样就能够尽快建立起对学习对象的感性认识。先把玩起来,快速了解基本概念、功能和使用场景。 越是门槛高的知识,就越需要有这么一个最小可用系统。如果直接上来就学习理论知识和概念,很容易从入门到放弃。 当然,要搭建这么一个可运行的系统通常也不会太容易,不过很幸运,Kubernetes 官网已经为大家准备好了现成的最小可用系统。 kubernetes.io 开发了一个交互式教程,通过 Web 浏览器就能使用预先部署好的一个 kubernetes 集群,快速体验 kubernetes 的功能和应用场景,下面我就带着大家去玩一下。 打开https://kubernetes.io/docs/tutorials/kubernetes-basics/ 页面左边就能看到教程菜单: 教程会指引大家完成创建 kubernetes 集群、部署应用、访问应用、扩展应用、更新应用等最常见的使用场景,迅速建立感性认识。 创建 Kubernetes 集群 点击教程菜单1. Create a Cluster->Interactive Tutorial - Creating a Cluster 显示操作界面。 左边部分是操作说明,右边是 Terminal,命令终端窗口。 按照操作说明,我们在 Terminal 中执行minikube start,然后执行kubectl get nodes,这样就创建好了一个单节点的 kubernetes 集群。 集群的唯一节点为host01,需要注意的是当前执行命令的地方并不是host01。我们是在通过 Kubernetes 的命令行工具kubectl远程管理集群。 执行kubectl cluster-info查看集群信息: heapster、kubernetes-dashboard都是集群中运行的服务。 注:为节省篇幅,在后面的演示中,我将简化操作步骤,详细的说明和完整步骤请参考官网在线文档。 集群创建好了,下一节我将带领大家快速体验 Kubernetes 的核心功能。 书籍: 1.《每天5分钟玩转Docker容器技术》https://item.jd.com/16936307278.html2.《每天5分钟玩转OpenStack》https://item.jd.com/12086376.html 本文转自CloudMan6 51CTO博客,原文链接:http://blog.51cto.com/cloudman/2057612

优秀的个人博客,低调大师

【官宣】简化 k8s 上大数据集群的运维管理 CloudEon 加入 Dromara 社区

随着云原生技术的发展,越来越多的业务场景需要使用容器来部署和管理应用程序,而Kubernetes作为容器编排平台的事实标准,自然也受到了越来越多的关注和使用。 但是如果想在Kubernetes上部署和运维大数据服务是有比较高的学习成本,需要专业的运维人员来进行管理和维护,在这种情况下,我们开发出CloudEon平台,致力于简化多种大数据服务在Kubernetes上的部署和管理,同时还能更好地利用Kubernetes的资源调度和管理能力,使用户更加简单、方便、高效地搭建和管理大数据集群。 快速搭建大数据集群: 在Kubernetes上快速搭建部署大数据集群,省去了手动安装和配置的繁琐过程**容器化运行大数据服务**:大数据服务以容器方式运行,服务的部署和管理更加灵活和便捷,更好地利用Kubernetes的资源调度和管理能力 支持监控告警等功能:帮助用户实时监控集群运行状态,及时发现和解决问题 支持配置修改等功能:使用户能够更加灵活地管理和配置自己的大数据集群 ****自动化运维:降低集群管理的难度和人力成本,提高集群的可用性和稳定性 ****可视化管理界面:用户能够更加直观地管理和监控自己的大数据集群 灵活的扩展性:提供插件机制,让用户可以自定义拓展和安装更多的大数据服务 使用前置条件: Kubernetes环境,可以使用 kubekey 快速搭建 SSH服务,CloudEon需要访问Kubernetes集群中节点的SSH服务 CloudEon使用: 创建集群 https://www.bilibili.com/video/BV1Qc411p7tG/?share_source=copy_web&vd_source=46aa1a26d3bb8ed1a9a8a815d67fc1dd 添加节点 https://www.bilibili.com/video/BV1Zh411M7mY/?share_source=copy_web&vd_source=46aa1a26d3bb8ed1a9a8a815d67fc1dd 安装服务 https://www.bilibili.com/video/BV1vL411f7rw/?share_source=copy_web&vd_source=46aa1a26d3bb8ed1a9a8a815d67fc1dd 管理服务 https://www.bilibili.com/video/BV1zX4y1r7En/?share_source=copy_web&vd_source=46aa1a26d3bb8ed1a9a8a815d67fc1dd CloudEon是一款基于Kubernetes的云原生大数据平台,旨在为用户提供一种简单、高效、可扩展的大数据解决方案。如果CloudEon项目对您有帮助,请在github搜索CloudEon支持一下,点击star加关注。CloudEon遵循 Apache-2.0 开源协议,代码完全开源,如果您想为开源社区做出贡献,非常欢迎加入CloudEon项目,与其他开发者一起共同推动项目的发展。 Github:https://github.com/dromara/CloudEon Gitee:https://gitee.com/dromara/CloudEon 官网:https://cloudeon.top/ 欢迎加入社区技术交流公众号:CloudEon开源微信社区

优秀的个人博客,低调大师

用更云原生的方式做诊断|大规模 K8s 集群诊断利器深度解析

本文约 3500字,预计阅读时间:9 分钟 背景 通常而言,集群的稳定性决定了一个平台的服务质量以及对外口碑,当一个平台管理了相当规模数量的 Kubernetes 集群之后,在稳定性这件事上也许会“稍显被动”。 我们可能经常会遇到这样的场景:客户一个电话,火急火燎地说业务出现问题了,你们平台快帮忙查询一下是不是哪里出了问题呀?技术同学连忙放下手头工作,上去一通操作加安抚客户……看似专业且厉害,急用户之所急,细想之后实则无章无法,一地鸡毛。 通常我们依赖监控系统来提前发现问题,但是监控数据作为一个正向链路,很难覆盖到所有场景,经常会有因为集群配置的不一致性或者一些更底层资源的异常,即使监控数据完全正常,但是整个系统依然会有一些功能不可用。对此,我们做了一套巡检系统,针对系统中一些薄弱点以及一致性做诊断,但是这套系统的扩展性不是很好,对集群跟巡检项的管理也相对粗暴了一点。 最后我们决定做一个更加云原生的诊断工具,使用 operator 实现集群跟诊断项的管理,抽象出集群跟诊断项的资源概念,以此来解决大规模 Kubernetes 集群的诊断问题,通过在中心下发诊断项到其他集群,并统一收集其他集群的诊断结果,实现任何时刻都可以从中心获取到其他所有集群的运行状态,做到对大规模 Kubernetes 集群的有效管理以及诊断。 Talk is cheap, show me the demo : Kubeprober 项目介绍 项目地址: https://github.com/erda-project/kubeprober 官网地址: https://k.erda.cloud Kubeprober 是一个针对大规模 Kubernetes 集群设计的诊断工具,用于在 Kubernetes 集群中执行诊断项以证明集群的各项功能是否正常,Kubeprober 有如下特点: 支持大规模集群 支持多集群管理,支持在管理端配置集群跟诊断项的关系以及统一查看所有集群的诊断结果。 云原生 核心逻辑采用 operator 来实现,提供完整的 Kubernetes API 兼容性。 可扩展 支持用户自定义巡检项。 其核心架构如下: 区别于监控系统,Kubeprober 从巡检的角度来验证集群的各项功能是否正常,监控作为正向链路,无法覆盖系统中的所有场景,即使系统中各个环境的监控数据都正常,也无法保证系统是 100% 可用的,因此我们就需要一个工具从反向来证明系统的可用性,根本上做到先于用户发现集群中不可用的点,比如: 集群中的所有节点是否均可以被调度,有没有特殊的污点存在等; pod 是否可以正常的创建,销毁,验证从 Kubernetes,Kubelet 到 Docker 的整条链路; 创建一个 service,并测试连通性,验证 kube-proxy 的链路是否正常; 解析一个内部或者外部的域名,验证 CoreDNS 是否正常工作; 访问一个 ingress 域名,验证集群中的 ingress 组件是否正常工作; 创建并删除一个 namespace,验证相关的 webhook 是否正常工作; 对 Etcd 执行 put/get/delete 等操作,用于验证 Etcd 是否正常运行; 通过 mysql-client 的操作来验证 MySQL 是否正常运行; 模拟用户对业务系统进行登录,操作,验证业务的主流程是否正常; 检查各个环境的证书是否过期; 云资源的到期检查; …… 组件介绍 Kubeprober 整体采用 Operator 来实现核心逻辑,集群之间的管理使用 remotedialer 来维持被纳管集群跟管理集群之间的心跳链接,被纳管集群通过 RBAC 赋予 probe-agent 最小所需权限并且通过心跳链接实时上报被纳管集群元 信息以及访问 apiserver 的 token,实现在管理集群可以对被管理集群的相关资源进行操作的功能。 probe-master 运行在管理集群上的 operator 维护着两个 CRD:一个是 Cluster,用于管理被纳管的集群;另一个是 Probe,用于管理内置的以及用户自己编写的诊断项。probe-master 通过 watch 这两个 CRD,将最新的诊断配置推送到被纳管的集群,同时 probe-master 提供接口用于查看被纳管集群的诊断结果。 probe-agent 运行在被纳管集群上的 operator,这个 operator 维护两个 CRD:一个是跟 probe-master 完全一致的 Probe,probe-agent 按照 probe 的定义去执行该集群的诊断项;另一个是 ProbeStatus,用于记录每个 Probe 的诊断结果,用户可以在被纳管的集群中通过 kubectl get probestatus 来查看本集群的诊断结果。 什么是 Probe Kubeprobe 中运行的诊断计划我们称之为 Probe,一个 Probe 为一个诊断项的集合,我们建议将统一场景下的诊断项作为一个 Probe 来运行,probe-agent 组件会 watch probe 资源,执行 Probe 中定义的诊断项,并且将结果写在 ProbeStatus 的资源中。 我们期望有一个输出可以清晰地看到当前集群的运行状态,因此我们建议所有的 Probe 都尽可能属于应用、中间件、Kubernetes 以及基础设置这四大场景,这样我们可以在展示状态的时候,清晰且自上而下地查看究竟是系统中哪个层面引起的问题。 目前的 Probe 还比较少,我们还在继续完善,也希望跟大家一起共建。欢迎广大爱好者一起来共建: 自定义Probe https://github.com/erda-project/kubeprober/blob/master/probers/README.md 对比其他诊断工具 目前社区已经有 Kuberhealthy 以及 Kubeeye 来做 Kubernetes 集群诊断这件事情。 Kuberheathy 提供一套比较清晰的框架可以让你轻松编写自己的诊断项,将诊断项 CRD 化,可以轻松地使用Kubernetes 的方式来对单个 Kubernetes 进行体检。 Kubeeye 同样是针对单个集群,主要通过调用 Kubernetes 的 event api 以及 Node-Problem-Detector 来检测集群控制平面以及各种节点问题,同时也支持自定义诊断项。 其实,Kubeprober 做的也是诊断 Kubernetes 集群这件事情,提供框架来编写自己的诊断项。除此之外,Kubeprober 主要解决了大规模 Kubernetes 集群的诊断问题,通过中心化的思路,将集群跟诊断项抽象成 CRD,可以实现在中心 Kubernetes 集群管理其他 Kubernetes 诊断项配置,诊断结果收集,未来也会解决大规模 Kubernetes 集群的运维问题。 如何使用 Kubeprober 主要解决大规模 Kubernetes 集群的诊断问题,通常我们选择其中一个集群作为 master 集群,部署probe-master,其他集群作为被纳管集群,部署 probe-agent,详细的使用说明可参考官方文档。 官方文档 https://docs.erda.cloud/2.0/manual/eco-tools/kubeprober/guides/introduction.html 可视化 Kubeprober 在多集群中根据 probe 的策略执行诊断项,会产生大量的诊断事件。由此,对这些诊断项进行可视化的展示就显得尤为重要,此时如果有一个全局的 dashboard 对大规模集群的海量诊断项进行统一查看分析,将会更有利于我们掌握这些集群的运行状态。 Kubeprober 支持将诊断项事件写入 influxdb,通过 grafana 配置图表来统一展示诊断结果,比如:我们将 ERROR 事件统一展示出来作为最高优先级进行关注。 同时,我们也可以通过扩展 probe-agent 上报的集群信息,展示一张详尽的集群列表: 结语 随着数字化的逐渐发展,企业的 IT 架构也变得越来越复杂,如何在复杂环境中保证业务连续性及稳定性?相信这是每一个 IT 从业者都会面临的问题,如果大家对稳定性的话题或者是对 Kuberprober 项目感兴趣,欢迎联系我们一起深入探讨,同时也欢迎广大开源爱好者一起参与,共同打造一个大规模的 Kubernetes 集群的管理神器。 ContributingtoKubeprober https://github.com/erda-project/kubeprober/blob/master/CONTRIBUTING.md 我们致力于解决社区用户在实际生产环境中反馈的问题和需求,如果您有任何疑问或建议,欢迎添加小助手微信: Erda202106 ,加入 Erda 用户群参与交流或在 Github 上与我们讨论! Erda Github 地址 : https://github.com/erda-project/erda Erda Cloud 官网 : https://www.erda.cloud/ 戳原文,了解更多! 本文分享自微信公众号 - 尔达 Erda(gh_0f507c84dfb0)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Kubernetes迎来7周年,VMware简化K8s部署与应用的成就与挑战

作为基于容器的分布式管理系统,Kubernetes历经七年发展,生态系统不断壮大,被越来越多的企业投入到生产环境中。Craig McLuckie和Joe Beda是Kubernetes的主要创始人,当初在谷歌内部Kubernetes起步的时候,它的项目名称叫Project 7(七号项目),这个名字来自于科幻电影Star Trek(星际迷航)提供的灵感,所以在上个月为Kubernetes庆祝的7岁生日,这个“7”是非常有特殊意义的。2016年Craig McLuckie和Joe Beda离开谷歌并创办Heptio,2018年12月,VMware完成了对Heptio的收购,同时两位加入VMware,分别担任VMware应用现代化业务部门研发副总裁和VMware首席工程师。 VMware应用现代化业务部门研发副总裁Craig McLuckie近期在接受记者采访时表示,企业在使用Kubernetes时,通常会遇到来自两个方面的挑战:一是如何能够以一种可扩展的方式迅速运行操作Kubernetes;二是如何让广大开发人员能够轻而易举地用上Kubernetes。基于此,VMware推出了Tanzu Kubernetes Grid(TKG),很好地帮助用户改善了使用Kubernetes的复杂性。 VMware应用现代化业务部门研发副总裁 Craig McLuckie 应用Kubernetes面临的主要挑战 虽然越来越多的企业开始使用Kubernetes,但在用户使用过程当中,仍然存在一些不友好的地方。 在VMware看来,Kubernetes无论是在部署还是使用过程中,都或多或少地存在着一些问题。Craig McLuckie表示,大部分企业都是以一种更加精细粒度的方式来部署Kubernetes,例如构建很多小规模Kubernetes集群。这种部署模式带来的最大挑战是当企业有了自建Kubernetes集群之后,由于自身技术能力跟不上,不能够对这些集群进行实时升级,无法通过Kubernetes上游项目中的各种创新来进行更新,这就带来了较大的安全隐患。 除此之外,很多开发人员也反映Kubernetes在使用过程中出现了一些复杂性,尤其是Spring方面。Craig McLuckie表示,VMware一直都在支持Spring社区的发展,通过最新调查发现,目前已经有75%的Spring开发者在Kubernetes平台之下运行应用。如果把Kubernetes和Spring结合在一起,不仅能够带来运维方面的便利,而且能够让开发者只需要专注于代码开发,而不需要去关注代码的运行环境,更不需要关注基础架构层面的各种问题。 “我们看到,目前Kubernetes使用者呈现出指数级的增长,与VMware合作的每一个企业都在以某种方式部署Kubernetes,但是很多企业在部署和使用Kubernetes时都会遇到一些问题。”Craig McLuckie表示,借助VMware推出的Tanzu Kubernetes Grid(TKG),能够让用户更加易于获得和运维。 以Tanzu Kubernetes Grid简化Kubernetes部署与应用 VMware Tanzu Kubernetes Grid(TKG)是VMware Tanzu产品组合的首批产品之一,不仅支持私有云以及VMware Cloud,同时也能够支持目前主流的公有云环境,且支持IaaS环境。 当然,随着越来越多集群运行在不同的云环境中,或者网络边缘之上,VMware还提供了统一的管理工具:Tanzu Mission Control(Tanzu任务控制),对运行在不同环境中的集群实现统一的管理。 Craig McLuckie表示,Tanzu Mission Control(Tanzu任务控制)是Tanzu技术中非常关键的组成部分,在其全生命周期管理的一系列工具中,包括身份管理、安全能力、配置管理、审计管理、数据保护等等,都能够直接用于支持Kubernetes运维,而且能够通过API实现接入。这样的优势在于,智能化的管理工具让开发者能够如使用Linux一样,轻松应用Kubernetes,使得开发者能够对各种集群进行整合化管理,在整合化集群之上部署应用。 Craig McLuckie强调,通过Tanzu Advanced提供的丰富技术和能力,让Kubernetes更加简单易用,且功能变得更加强大,帮助用户在对现有应用进行现代化管理的同时,更加高效地构建新型应用。 实际上,VMware还在致力于推出容器本地的虚拟化。VMware首席工程师 Joe Beda表示,VMware正在通过不同的方法来实现容器本地的虚拟化。据介绍,在vSphere 7当中已经内置了VMware本地PODs,通过hypervisor来支持Kubernetes Pods,这样能够与部分云供应商提供的容器本地虚拟化是相同的。 VMware首席工程师 Joe Beda “虽然Kubernetes已经走过了七年,但作为一个社区,仍然处于早期发展阶段,在VMware前方还有大量且非常精彩的工作去做,不仅要让Kubernetes的操作运维更加简单易用,而且还要通过Kubernetes,把基于Kubernetes的开源社群创新充分释放出来。”Craig McLuckie表示,VMware Tanzu能够让客户根据现有阶段的能力部署Kubernetes,用Kubernetes补充和增强他们在技术上已经作出的投资,帮助他们对现有应用程序进行现代化改造,按照自己选定的速度和步骤,使得数据中心能够更好地应对各种创新。 可信云原生制品仓库:Harbor 在本场采访活动中,VMware中国研发技术总监、CNCF Harbor开源项目创建人张海宁还详细介绍了来自VMware中国研发中心原创的开源项目:Harbor。实际上,这个项目已经拥有7年的发展历程。 VMware中国研发技术总监、CNCF Harbor开源项目创建人 张海宁 据介绍,Harbor是一个可信云原生制品仓库的产品,最早在2016年开源,是中国原创的第一个CNCF开源项目,也是最早从CNCF毕业的中国开源项目。 张海宁表示,CNCF最新用户调查数据反馈,Harbor在全国生产系统中的用户使用率达到了47%,在所有中国原创CNCF项目中排名第一,得到了用户的高度认可。 虽然是一个开源的项目,但在VMware Tanzu Advanced的产品当中,就包括了很多Harbor的源代码。张海宁告诉记者,在vSphere7中的vRegistry service,能够使用Harbor原生内置的支持容器镜像管理,用户在使用vSphere Kubernetes平台时,可以用vRegistry service自动去获得镜像管理能力,包括镜像扫描、镜像安全保护等等一系列策略。 除此之外,诸如TKG Registry Service企业级Kubernetes产品镜像仓库管理、TMC artifact management service中基于公有云上的Tanzu Mission Control,都是基于Harbor管理能力去实现的。此外,基于中央平台管理多个Kubernetes集群能力的SaaS服务,在国外已经落地,在国内正在尝试今年落地。 张海宁告诉记者,VMware利用Harbor搭建了一个对外使用的容器镜像仓库,能够让合作伙伴快速使用Harbor。同时,在产品和商业化过程中,也加入了Harbor的产品理念,构建了很多对外的服务,取得了非常不错的成绩。 【责任编辑:张诚 TEL:(010)68476606】

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册