首页 文章 精选 留言 我的

精选列表

搜索[k8s],共4083篇文章
优秀的个人博客,低调大师

每日一博 | 一通百通,实现灵活的 K8s 基础架构

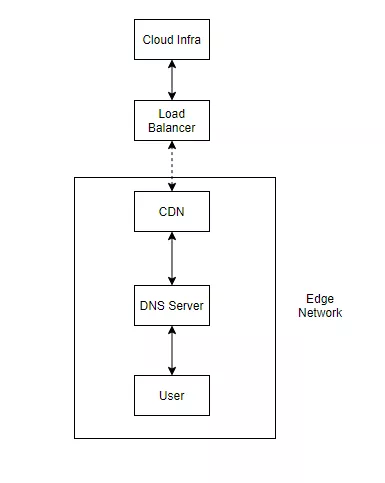
作者简介 VIGNESH T.V.,Timecampus CEO、CTO及创始人。 Kubernetes是当前最为流行的开源容器编排平台,成为众多企业构建基础架构的首选。在本文中,我们将探讨针对你的用例构建基础设施的最佳方式,以及你可能要根据各种限制条件做出的各种决定。 架构设计 你的架构应该在很大程度上围绕你的用例来设计,因此在设计过程中你需要非常仔细以确保该基础架构能够支撑你的用例,在必要的时候也可以寻求外部专业团队的帮助。在架构设计的开始保证方向正确十分重要,但是这并不意味着不会发生错误,而且随着每天都有新的技术或研究横空出世,你可以看到变革已经成为常态,并且你的架构设计思维有可能过时。 这就是为什么我强烈建议你采用Architect for Chang的原则,让你的架构成为一个模块化的架构以便在未来有需要的时候你可以灵活地在内部进行改变。 让我们看看在考虑client-server模型的情况下如何实现系统架构的目标。 切入点:DNS 在任何典型的基础架构中(无论是否是云原生架构),一个消息请求必须先由DNS服务器解析,并返回服务器的IP地址。设置你的DNS应该基于你所需要的可用性。如果你需要更高的可用性,你可能想要将你的服务器分布到多个区域或者云提供程序上,具体的实现要基于你想要达到的可用性等级。 内容分发网络(CDN) 在某些情况下,你可能需要尽可能地以最小的延迟为用户提供服务,同时减少服务器的负载。这就是内容分发网络(CDN)发挥重要作用的地方。 Client是否经常从服务器上请求一组静态资产?你是否希望提高向用户交付内容的速度,同时减少服务器的负载?在这种情况下,采用边缘的CDN为一组静态资产提供服务,实际上可能有助于降低用户的延迟和服务器的负载。 你所有的内容都是动态的吗?你是否可以在一定程度上为用户提供延迟的内容,以减少复杂性?或者你的应用程序接收很低的流量吗?在这种情况下,使用CDN可能没有太大的意义,你可以将所有的流量直接发送到全局负载均衡器。但要注意的是,拥有CDN也确实有分配流量的优势,这在你的服务器受到DDOS攻击时是很有帮助的。 CDN提供程序包括Cloudfare CDN、Fastly、Akamai CDN、Stackpath,此外你的云提供商也有可能会提供CDN服务,比如谷歌云平台的Cloud CDN、AWS的CloudFront、微软Azure的Azure CDN等。 Load Balancer 如果有一个请求不能被你的CDN服务,这个请求下一步会传送到你的负载均衡器上。而这些可以是区域性的IP,也可以是全局性的Anycast IP。在某些情况下,你也可以使用负载均衡器来管理内部流量。 除了路由和代理流量到合适的后端服务,负载均衡还能够承担SSL终止、与CDN集成,甚至管理网络流量的某些方面等职责。 虽然存在硬件负载均衡器,但软件负载均衡器提供了强大的灵活性、减少了成本开支以及弹性伸缩性。 与CDN类似,你的云提供程序应该也能够为你提供一个负载均衡器(如GCP的GLB、AWS的ELB、Azure的ALB等),但更有趣的是你可以直接从Kubernetes中调配这些负载均衡器。例如,在GKE中创建一个Ingress也会在后端为你创建一个GLB来接收流量,其他功能如CDN、SSL重定向等也可以通过配置你的ingress来设置,访问以下链接查看详情: https://cloud.google.com/kubernetes-engine/docs/how-to/ingress-features 虽然一开始总是从小开始,但是负载均衡器可以让你逐步扩展至具有以下规模的架构: 网络及安全架构 下一件需要关注的事情是网络。如果你想要提高安全性,你可能需要一个私有集群。在那里,你可以调节入站和出站流量,在NATs后面屏蔽IP地址,在多个VPC上隔离多个子网的网络等。 如何设置网络通常取决于你所追求的灵活性程度以及如何实现它。设置正确的网络就是要尽可能地减少攻击面,同时还能保持正常的运转。 通过设置正确的网络来保护你的基础设施通常还涉及到使用正确规则和限制条件设置的防火墙,以便限制来自各后端服务的流量的进出,包括入站和出站。 在很多情况下,可以通过设置堡垒主机并通过隧道进行集群中的所有操作来保护这些私有集群,因为你需要向公共网络公开的就是堡垒(又称Jump host),通常是在与集群相同的网络中设置。 一些云提供商在实现零信任安全的方法上也提供了定制化的解决方案。例如,GCP为其用户提供身份意识代理(IAP),可用于代替典型的VPN实现。 所有都处理好之后,下一步是根据你的用例在集群本身内设置网络。 这牵涉到以下任务: 设置集群内的服务发现(可由CoreDNS处理) 如果需要的话,设置一个服务网格(如LinkerD、Istio、Consul等) 设置Ingress controller和API网关(例如:Nginx、Ambassador、Kong、Gloo等) 设置使用CNI的网络插件,方便集群内的联网 设置网络策略,调节服务间的通信,并根据需要使用各种服务类型暴露服务 使用GRPC、Thrift或HTTP等协议和工具,设置不同服务之间的服务间通信 设置A/B测试,如果你使用像Istio或Linkerd这样的服务网格,实现起来可以更容易 如果你想看一些示例实现,我建议你看看这个repo(https://github.com/terraform-google-modules/cloud-foundation-fabric),它可以帮助用户在GCP中设置所有这些不同的网络模型,包括通过VPN的hub和spoke、用于内部的DNS和Google Private Access、支持GKE的共享VPC等等,所有这些都使用Terraform。 而云计算中网络的有趣之处在于,它不局限于你所在地区的云服务商,而是可以根据需要跨越多个地区的多个服务商。这就是Kubefed或Crossplane这样的项目可以提供帮助的地方。 如果你想探索更多关于设置VPC、子网和整体网络时的一些最佳实践,我建议你访问下方网页,同样的概念也适用于你加入的任何云提供商: https://cloud.google.com/solutions/best-practices-vpc-design Kubernetes 如果你使用的是GKE、EKS、AKS这样的托管集群,Kubernetes是自动管理的,从而降低了用户操作的复杂程度。 如果你自己管理Kubernetes,你需要处理很多事情,比如,备份和加密etcd存储,在集群中的各个节点之间建立网络,定期为你的节点打上最新版本的操作系统补丁,管理集群升级以与上游的Kubernetes版本保持一致。基于此,只有当你拥有一个专门的团队来维护这些事情的时候,才建议这样做。 Site Reliability Engineering (SRE) 当你维护一个复杂的基础设施时,拥有合适的可观察性堆栈是非常重要的,这样你就可以在用户注意到错误之前就检测到错误以及预测可能的变化,进而识别异常,并有余力深入钻研问题到底在哪里。 现在,这就需要你有代理,将指标暴露为特定的工具或应用来收集分析(可以遵循pull或push机制)。而如果你使用的是带有sidecars的服务网格,它们往往会自带指标,而不需要自定义配置。 在任意场景下,都可以使用Prometheus这样的工具作为时序数据库,为你收集所有的指标,以及借助类似于OpenTelemetry的工具,使用内置的exporter从应用程序和各种工具中公开指标。借助Alertmanager之类的工具可以向多个渠道发送通知和告警, Grafana将提供可视化仪表板,给用户提供整个基础设施的完整可见性。 综上,这就是Prometheus的可观察性的解决方案: 来源:https://prometheus.io/docs/introduction/overview/ 拥有这样复杂的系统,还需要使用日志聚合系统,这样所有的日志就可以流到一个地方,便于调试。大部分企业倾向于使用ELK或EFK堆栈,Logstash或FluentD根据你的限制条件为你做日志聚合和过滤。但日志领域也有新的玩家,比如Loki和Promtail。 下图说明了类似FluentD的日志聚合系统如何简化你的架构: 来源:https://www.fluentd.org/architecture 但是,如果要追踪跨越多个微服务和工具的请求呢?这是分布式跟踪开始发挥作用的地方,特别是考虑到微服务的复杂性。像Zipkin和Jaeger这样的工具一直是这个领域的先驱,最近进入这个领域的新兴工具是Tempo。 虽然日志聚合会给出各种来源的信息,但它不一定能给出请求的上下文,这才是做跟踪真正有帮助的地方。但是请记住,在你的堆栈中添加跟踪会给你的请求增加很大的开销,因为上下文必须和请求一起在服务之间传播。 下图是一个典型的分布式跟踪架构: 来源:https://www.jaegertracing.io/docs/1.21/architecture/ 但是,网站的可靠性并不仅仅止于监控、可视化和告警。你必须准备好处理系统任何部分的任何故障,并定期进行备份和故障切换,这样至少可以将数据损失的程度降到最低。你可以借助类似Velero的工具实现。 Velero通过利用你使用的相同Kubernetes架构,帮助你维护集群中各种组件的定期备份,包括你的工作负载、存储等。Velero的架构如下: 正如你所观察到的,有一个备份controller,它定期对对象进行备份,根据你设置的计划将它们推送到特定的目的地,其频率是基于你设置的计划。这可以用于故障转移和迁移,因为几乎所有的对象都有备份。 存 储 有许多不同的存储程序和文件系统可用,这在云提供程序之间可能存在很大的不同。这就需要像容器存储接口(CSI)这样的标准,该标准可以帮助大部分volume的外置插件,从而使其易于维护和发展而不会成为核心瓶颈。 下图是CSI架构,通常可以支持各种volume插件: 来源:https://kubernetes.io/blog/2018/08/02/dynamically-expand-volume-with-csi-and-kubernetes/ 分布式存储带来的集群、扩展等各种问题怎么办?这时Ceph这样的文件系统已经证明了自己的能力,不过考虑到Ceph并不是以Kubernetes为中心构建的,部署和管理起来存在一些难度,此时可以考虑Rook这样的项目。 虽然Rook没有和Ceph耦合,也支持其他文件系统,比如EdgeFS、NFS等,但Rook与Ceph CSI就像是天作之合。Rook与Ceph的架构如下: 来源:https://rook.io/docs/rook/v1.5/ceph-storage.html 如你所见,Rook承担了Kubernetes集群中的Ceph安装、配置和管理的功能。根据用户的喜好,自动分配下面的存储。这一切的发生,都不会让应用暴露在任何复杂的情况下。 镜像仓库 镜像仓库为你提供了一个用户界面,你可以在这里管理各种用户账户、推送/拉取镜像、管理配额、通过webhook获得事件通知、进行漏洞扫描、签署推送的镜像,还可以处理镜像或在多个镜像仓库中复制镜像等操作。 如果你使用的是云提供商,他们很有可能已经提供了镜像仓库作为一项服务(例如GCR、ECR、ACR等),这就消除了很多复杂性。如果你的云提供商没有提供,你也可以选择第三方的镜像仓库,比如Docker Hub、Quay等。 但如果你想托管自己的镜像仓库呢? 如果你想在企业内部部署镜像仓库,想对其本身有更多的控制权,或者想降低漏洞扫描等操作的相关成本,那么可能需要进行托管。 如果是这种情况,那么选择像Harbor这样的私有镜像仓库会对你有所帮助。Harbor架构如下: 来源:https://goharbor.io/docs/1.10/install-config/harbor-ha-helm/ Harbor是一个符合OCI的镜像仓库,由各种开源组件组成,包括Docker镜像仓库V2、Harbor UI、Clair和Notary。 CI/CD架构 Kubernetes可以在任何规模下托管所有的工作负载,但这也需要一个标准的方式来部署应用程序,并采用精简的CI/CD工作流程。下图为典型的CI/CD流水线: 一些第三方服务如Travis CI、Circle CI、Gitlab CI或Github Actions都包含了自己的CI运行器。你只需定义你要构建的流水线中的步骤。这通常包括:构建镜像,扫描镜像以查找可能的漏洞,运行测试并将其推送到镜像仓库,在某些情况下还需要提供一个预览环境以进行审批。 现在,虽然如果你管理自己的CI运行器,步骤通常保持不变,但你需要将它们配置为在集群内部或外部设置,并具有适当的权限,以便将资产推送到镜像仓库。 总 结 我们已经介绍了基于Kubernetes的云原生基础设施的架构。正如我们上面所看到的,各种工具解决了基础设施的不同问题。它们就像乐高积木一样,每一个都专注于当前的一个特定问题,为你抽象掉了很多复杂的东西。 这使得用户可以以渐进的方式逐渐上手Kubernetes。并且你可以根据你的用例,只使用整个堆栈中你需要的工具。

优秀的个人博客,低调大师

一通百通,一文实现灵活的K8S基础架构!

作者简介 VIGNESH T.V.,Timecampus CEO、CTO及创始人。 Kubernetes是当前最为流行的开源容器编排平台,成为众多企业构建基础架构的首选。在本文中,我们将探讨针对你的用例构建基础设施的最佳方式,以及你可能要根据各种限制条件做出的各种决定。 架构设计 你的架构应该在很大程度上围绕你的用例来设计,因此在设计过程中你需要非常仔细以确保该基础架构能够支撑你的用例,在必要的时候也可以寻求外部专业团队的帮助。在架构设计的开始保证方向正确十分重要,但是这并不意味着不会发生错误,而且随着每天都有新的技术或研究横空出世,你可以看到变革已经成为常态,并且你的架构设计思维有可能过时。 这就是为什么我强烈建议你采用Architect for Chang的原则,让你的架构成为一个模块化的架构以便在未来有需要的时候你可以灵活地在内部进行改变。 让我们看看在考虑client-server模型的情况下如何实现系统架构的目标。 切入点:DNS 在任何典型的基础架构中(无论是否是云原生架构),一个消息请求必须先由DNS服务器解析,并返回服务器的IP地址。设置你的DNS应该基于你所需要的可用性。如果你需要更高的可用性,你可能想要将你的服务器分布到多个区域或者云提供程序上,具体的实现要基于你想要达到的可用性等级。 内容分发网络(CDN) 在某些情况下,你可能需要尽可能地以最小的延迟为用户提供服务,同时减少服务器的负载。这就是内容分发网络(CDN)发挥重要作用的地方。 Client是否经常从服务器上请求一组静态资产?你是否希望提高向用户交付内容的速度,同时减少服务器的负载?在这种情况下,采用边缘的CDN为一组静态资产提供服务,实际上可能有助于降低用户的延迟和服务器的负载。 你所有的内容都是动态的吗?你是否可以在一定程度上为用户提供延迟的内容,以减少复杂性?或者你的应用程序接收很低的流量吗?在这种情况下,使用CDN可能没有太大的意义,你可以将所有的流量直接发送到全局负载均衡器。但要注意的是,拥有CDN也确实有分配流量的优势,这在你的服务器受到DDOS攻击时是很有帮助的。 CDN提供程序包括Cloudfare CDN、Fastly、Akamai CDN、Stackpath,此外你的云提供商也有可能会提供CDN服务,比如谷歌云平台的Cloud CDN、AWS的CloudFront、微软Azure的Azure CDN等。 Load Balancer 如果有一个请求不能被你的CDN服务,这个请求下一步会传送到你的负载均衡器上。而这些可以是区域性的IP,也可以是全局性的Anycast IP。在某些情况下,你也可以使用负载均衡器来管理内部流量。 除了路由和代理流量到合适的后端服务,负载均衡还能够承担SSL终止、与CDN集成,甚至管理网络流量的某些方面等职责。 虽然存在硬件负载均衡器,但软件负载均衡器提供了强大的灵活性、减少了成本开支以及弹性伸缩性。 与CDN类似,你的云提供程序应该也能够为你提供一个负载均衡器(如GCP的GLB、AWS的ELB、Azure的ALB等),但更有趣的是你可以直接从Kubernetes中调配这些负载均衡器。例如,在GKE中创建一个Ingress也会在后端为你创建一个GLB来接收流量,其他功能如CDN、SSL重定向等也可以通过配置你的ingress来设置,访问以下链接查看详情: https://cloud.google.com/kubernetes-engine/docs/how-to/ingress-features 虽然一开始总是从小开始,但是负载均衡器可以让你逐步扩展至具有以下规模的架构: 网络及安全架构 下一件需要关注的事情是网络。如果你想要提高安全性,你可能需要一个私有集群。在那里,你可以调节入站和出站流量,在NATs后面屏蔽IP地址,在多个VPC上隔离多个子网的网络等。 如何设置网络通常取决于你所追求的灵活性程度以及如何实现它。设置正确的网络就是要尽可能地减少攻击面,同时还能保持正常的运转。 通过设置正确的网络来保护你的基础设施通常还涉及到使用正确规则和限制条件设置的防火墙,以便限制来自各后端服务的流量的进出,包括入站和出站。 在很多情况下,可以通过设置堡垒主机并通过隧道进行集群中的所有操作来保护这些私有集群,因为你需要向公共网络公开的就是堡垒(又称Jump host),通常是在与集群相同的网络中设置。 一些云提供商在实现零信任安全的方法上也提供了定制化的解决方案。例如,GCP为其用户提供身份意识代理(IAP),可用于代替典型的VPN实现。 所有都处理好之后,下一步是根据你的用例在集群本身内设置网络。 这牵涉到以下任务: 设置集群内的服务发现(可由CoreDNS处理) 如果需要的话,设置一个服务网格(如LinkerD、Istio、Consul等) 设置Ingress controller和API网关(例如:Nginx、Ambassador、Kong、Gloo等) 设置使用CNI的网络插件,方便集群内的联网 设置网络策略,调节服务间的通信,并根据需要使用各种服务类型暴露服务 使用GRPC、Thrift或HTTP等协议和工具,设置不同服务之间的服务间通信 设置A/B测试,如果你使用像Istio或Linkerd这样的服务网格,实现起来可以更容易 如果你想看一些示例实现,我建议你看看这个repo(https://github.com/terraform-google-modules/cloud-foundation-fabric),它可以帮助用户在GCP中设置所有这些不同的网络模型,包括通过VPN的hub和spoke、用于内部的DNS和Google Private Access、支持GKE的共享VPC等等,所有这些都使用Terraform。 而云计算中网络的有趣之处在于,它不局限于你所在地区的云服务商,而是可以根据需要跨越多个地区的多个服务商。这就是Kubefed或Crossplane这样的项目可以提供帮助的地方。 如果你想探索更多关于设置VPC、子网和整体网络时的一些最佳实践,我建议你访问下方网页,同样的概念也适用于你加入的任何云提供商: https://cloud.google.com/solutions/best-practices-vpc-design Kubernetes 如果你使用的是GKE、EKS、AKS这样的托管集群,Kubernetes是自动管理的,从而降低了用户操作的复杂程度。 如果你自己管理Kubernetes,你需要处理很多事情,比如,备份和加密etcd存储,在集群中的各个节点之间建立网络,定期为你的节点打上最新版本的操作系统补丁,管理集群升级以与上游的Kubernetes版本保持一致。基于此,只有当你拥有一个专门的团队来维护这些事情的时候,才建议这样做。 Site Reliability Engineering (SRE) 当你维护一个复杂的基础设施时,拥有合适的可观察性堆栈是非常重要的,这样你就可以在用户注意到错误之前就检测到错误以及预测可能的变化,进而识别异常,并有余力深入钻研问题到底在哪里。 现在,这就需要你有代理,将指标暴露为特定的工具或应用来收集分析(可以遵循pull或push机制)。而如果你使用的是带有sidecars的服务网格,它们往往会自带指标,而不需要自定义配置。 在任意场景下,都可以使用Prometheus这样的工具作为时序数据库,为你收集所有的指标,以及借助类似于OpenTelemetry的工具,使用内置的exporter从应用程序和各种工具中公开指标。借助Alertmanager之类的工具可以向多个渠道发送通知和告警, Grafana将提供可视化仪表板,给用户提供整个基础设施的完整可见性。 综上,这就是Prometheus的可观察性的解决方案: 来源:https://prometheus.io/docs/introduction/overview/ 拥有这样复杂的系统,还需要使用日志聚合系统,这样所有的日志就可以流到一个地方,便于调试。大部分企业倾向于使用ELK或EFK堆栈,Logstash或FluentD根据你的限制条件为你做日志聚合和过滤。但日志领域也有新的玩家,比如Loki和Promtail。 下图说明了类似FluentD的日志聚合系统如何简化你的架构: 来源:https://www.fluentd.org/architecture 但是,如果要追踪跨越多个微服务和工具的请求呢?这是分布式跟踪开始发挥作用的地方,特别是考虑到微服务的复杂性。像Zipkin和Jaeger这样的工具一直是这个领域的先驱,最近进入这个领域的新兴工具是Tempo。 虽然日志聚合会给出各种来源的信息,但它不一定能给出请求的上下文,这才是做跟踪真正有帮助的地方。但是请记住,在你的堆栈中添加跟踪会给你的请求增加很大的开销,因为上下文必须和请求一起在服务之间传播。 下图是一个典型的分布式跟踪架构: 来源:https://www.jaegertracing.io/docs/1.21/architecture/ 但是,网站的可靠性并不仅仅止于监控、可视化和告警。你必须准备好处理系统任何部分的任何故障,并定期进行备份和故障切换,这样至少可以将数据损失的程度降到最低。你可以借助类似Velero的工具实现。 Velero通过利用你使用的相同Kubernetes架构,帮助你维护集群中各种组件的定期备份,包括你的工作负载、存储等。Velero的架构如下: 正如你所观察到的,有一个备份controller,它定期对对象进行备份,根据你设置的计划将它们推送到特定的目的地,其频率是基于你设置的计划。这可以用于故障转移和迁移,因为几乎所有的对象都有备份。 存 储 有许多不同的存储程序和文件系统可用,这在云提供程序之间可能存在很大的不同。这就需要像容器存储接口(CSI)这样的标准,该标准可以帮助大部分volume的外置插件,从而使其易于维护和发展而不会成为核心瓶颈。 下图是CSI架构,通常可以支持各种volume插件: 来源:https://kubernetes.io/blog/2018/08/02/dynamically-expand-volume-with-csi-and-kubernetes/ 分布式存储带来的集群、扩展等各种问题怎么办?这时Ceph这样的文件系统已经证明了自己的能力,不过考虑到Ceph并不是以Kubernetes为中心构建的,部署和管理起来存在一些难度,此时可以考虑Rook这样的项目。 虽然Rook没有和Ceph耦合,也支持其他文件系统,比如EdgeFS、NFS等,但Rook与Ceph CSI就像是天作之合。Rook与Ceph的架构如下: 来源:https://rook.io/docs/rook/v1.5/ceph-storage.html 如你所见,Rook承担了Kubernetes集群中的Ceph安装、配置和管理的功能。根据用户的喜好,自动分配下面的存储。这一切的发生,都不会让应用暴露在任何复杂的情况下。 镜像仓库 镜像仓库为你提供了一个用户界面,你可以在这里管理各种用户账户、推送/拉取镜像、管理配额、通过webhook获得事件通知、进行漏洞扫描、签署推送的镜像,还可以处理镜像或在多个镜像仓库中复制镜像等操作。 如果你使用的是云提供商,他们很有可能已经提供了镜像仓库作为一项服务(例如GCR、ECR、ACR等),这就消除了很多复杂性。如果你的云提供商没有提供,你也可以选择第三方的镜像仓库,比如Docker Hub、Quay等。 但如果你想托管自己的镜像仓库呢? 如果你想在企业内部部署镜像仓库,想对其本身有更多的控制权,或者想降低漏洞扫描等操作的相关成本,那么可能需要进行托管。 如果是这种情况,那么选择像Harbor这样的私有镜像仓库会对你有所帮助。Harbor架构如下: 来源:https://goharbor.io/docs/1.10/install-config/harbor-ha-helm/ Harbor是一个符合OCI的镜像仓库,由各种开源组件组成,包括Docker镜像仓库V2、Harbor UI、Clair和Notary。 CI/CD架构 Kubernetes可以在任何规模下托管所有的工作负载,但这也需要一个标准的方式来部署应用程序,并采用精简的CI/CD工作流程。下图为典型的CI/CD流水线: 一些第三方服务如Travis CI、Circle CI、Gitlab CI或Github Actions都包含了自己的CI运行器。你只需定义你要构建的流水线中的步骤。这通常包括:构建镜像,扫描镜像以查找可能的漏洞,运行测试并将其推送到镜像仓库,在某些情况下还需要提供一个预览环境以进行审批。 现在,虽然如果你管理自己的CI运行器,步骤通常保持不变,但你需要将它们配置为在集群内部或外部设置,并具有适当的权限,以便将资产推送到镜像仓库。 总 结 我们已经介绍了基于Kubernetes的云原生基础设施的架构。正如我们上面所看到的,各种工具解决了基础设施的不同问题。它们就像乐高积木一样,每一个都专注于当前的一个特定问题,为你抽象掉了很多复杂的东西。 这使得用户可以以渐进的方式逐渐上手Kubernetes。并且你可以根据你的用例,只使用整个堆栈中你需要的工具。

优秀的个人博客,低调大师

云原生五大趋势预测,K8s 安卓化位列其一

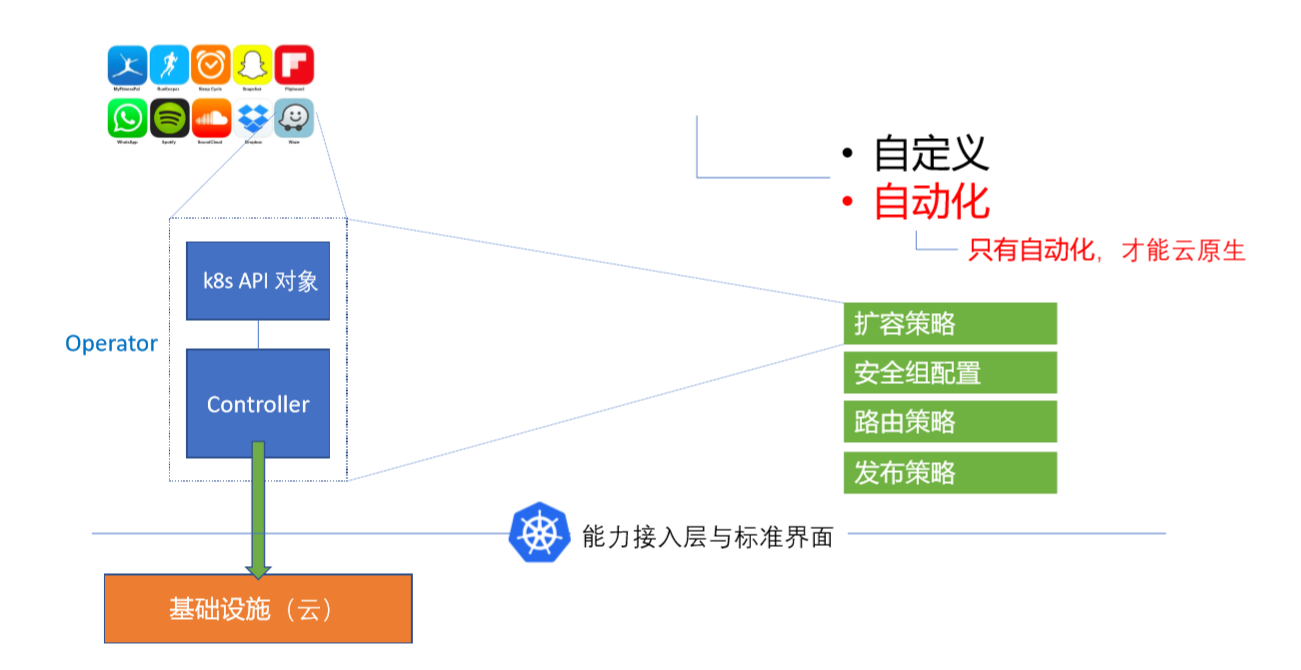
作者 |李响、张磊 Kubernetes 本身并不直接产生商业价值,你不会花钱去购买 Kubernetes 。这就跟安卓一样,你不会直接掏钱去买一个安卓系统。Kubernetes 真正产生价值的地方也在于它的上层应用生态。 “未来的软件一定是生长于云上的”,这是云原生理念的最核心假设。而所谓“云原生”,实际上就是在定义一条能够让应用最大程度利用云的能力、发挥云的价值的最佳路径。因此,云原生其实是一套指导软件架构设计的思想。按照这样的思想而设计出来的软件:首先,天然就“生在云上,长在云上”;其次,能够最大化地发挥云的能力,使得我们开发的软件和“云”能够天然地集成在一起,发挥出“云”的最大价值。 云原生的概念大家并不陌生,很多企业也已经基于云原生的架构和技术理念落地相关实践。那么,这么多企业和开发者热衷和推崇的云原生,未来的发展趋势如何?如何才能顺应云原生的主流方向去发展? 我们邀请到阿里云资深技术专家、CNCF 技术监督委员会代表,etcd 作者李响和阿里云高级技术专家、CNCF 应用交付领域 co-chair 张磊分享云原生的理念、发展以及未来趋势,为大家打开新的思路和眼界。 以下内容共享给大家。 Kubernetes 项目的安卓化 云原生里有一个非常关键的项目,就是 Kubernetes。Kubernetes 的发展非常迅速,它是整个云原生体系发展的基石。今天我们来观察 Kubernetes 项目的发展特点,首先,Kubernetes 无处不在,无论是在云上,还是用户自建的数据中心里,甚至一些我们想象不到的场景里,都有 Kubernetes 的存在。 第二,所有云原生的用户使用 Kubernetes 的目的,都是为了交付和管理应用。当然这个应用是一个泛化的概念,可以是一个网站,也可以是淘宝这样非常庞大的电商主站,或者是 AI 作业、计算任务、函数、甚至虚拟机等,这些都是用户可以使用 Kubernetes 去交付和管理的应用类型。 第三,今天我们来看 Kubernetes 所处的位置,实际上是承上启下。Kubernetes 对上暴露基础设施能力的格式化数据抽象,比如 Service、Ingress、Pod、Deployment,这些都是 Kubernetes 本身原生 API 给用户暴露出来的能力。而对下,Kubernetes 提供的是基础设施能力接入的标准接口,比如说 CNI、CSI、DevicePlugin、CRD,让云能够作为一个能力提供商,以一个标准化的方式把能力接入到 Kubernetes 的体系中。 这一点其实跟安卓非常类似,安卓虽然装在你的设备里,但是它能够让你的硬件、手机、电视、汽车等都能接入到一个平台里。对上则暴露统一的一套应用管理接口,让你能够基于安卓系统来编写应用,去访问或者享受到这些基础设施能力,这也是 Kubernetes 和安卓的相似之处。 最后, Kubernetes 本身并不直接产生商业价值,你不会花钱去购买 Kubernetes。这就跟安卓一样,你不会直接掏钱去买一个安卓系统。Kubernetes 真正产生价值的地方也在于它的上层应用生态。对安卓来说,它今天已经具备了一个庞大的移动端或设备端应用的开发生态,而对于 Kubernetes 来说也是类似的,只不过现在还在于比较早的阶段。但我们已经能够看到,今天在 Kubernetes 上构建的商业层很多是垂直解决方案,是面向用户、面向应用这一侧真正能够产生商业价值的东西,而不是 Kubernetes 本身这一层。这就是为什么我说 Kubernetes 发展跟安卓很像,当然这可能也是谷歌比较擅长的一个“打法”:全力地去免费推广一个“操作系统”,真正获取商业价值的方式则是是去“收割”操作系统上层的生态价值而不是操作系统本身。 基于这些现象,我们将 Kubernetes 的发展趋势概括为以下几点: 1. 云的价值回归到应用本身 用户使用 Kubernetes 的本质目的是去交付和管理应用。从这个现象来看,如果 Kubernetes 发展下去,那么世界上所有的数据中心和基础设施上面都会有一层 Kubernetes ,自然而然用户就会开始以 Kubernetes 为基础去编写和交付以及管理其应用,就跟现在我们会以安卓这样一个操作系统为基础去编写移动应用是类似的。 这就会导致云上的大多数软件和云产品都是第三方开发的。第三方开发是指所有人都可以面向一个标准界面去开发和交付软件,这个软件本身既可以是自己的软件,也可以是一个云产品。未来,越来越多的第三方开源项目,如 MongoDB、Elasticsearch 等,都会以云原生理念去开发、部署和运维,最后直接演进成为一种云服务。 2. 云端“豌豆荚”的出现 有了 Kubernetes 这样一个标准,开发者面对的就是一个类似于操作系统的界面。由于有更多的应用是面向 Kubernetes 诞生的,或者说面向 Kubernetes 去交付的,那么就需要有一个类似于“豌豆荚”的产品,来作为云上的应用商店或者云上的应用分发系统,它的关键能力在于把应用无差别地交付给全世界任何一个 Kubernetes 上面,就跟用豌豆荚把任何一个安卓应用交付在任何一个安卓设备上的原理是一样的。 其实今天谷歌已经在做这类产品的尝试了,比如 Anthos (面向混合云的应用交付平台),虽然是一款混合云产品,但它本质上是把谷歌云的服务,比如数据库服务、大数据服务,去直接交付于任何一个基于 Kubernetes 的混合云环境里面去,其实就相当于一款云端的“豌豆荚”。 3. 基于 Kubernetes 可扩展能力的开放应用平台会取代 PaaS 成为主流 由于未来整个应用生态会面向 Kubernetes 去构建,那么基于 Kubernetes 可扩展能力的开放应用平台会逐渐取代传统 PaaS 而成为主流。基于 Kubernetes 可扩展能力去构建一个开放的应用平台,其能力是可插拔的,能够去交付和管理的应用类型是多样化的,这才更符合 Kubernetes 所构建的趋势和生态,所以一些真正高可扩展的平台层项目会大量产生。 另外,今天我们看到的 Kubernetes ,跟“理想”中的云原生应用生态之间其实还有很多路要走,这也是阿里云原生团队一直在做的事情,基于 Kubernetes 在应用层构建更丰富的应用生态,帮助用户实现多样化的需求。 应用与能力的“ Operator 化” 纵观云原生时代应用或者云的能力的发展方向,你会发现另一个趋势,就是 Operator 化。Operator 是 Kubernetes 的一个概念,是指 Kubernetes 交付的一个实体,这个实体有一个基础模型存在,这个模型分为两部分:一部分是 Kubernetes 的 API 对象(CRD),另一部分是一个控制器(Controller),如下图所示: 这里要区分两个概念,自定义和自动化。很多人会说 Operator 可以帮助我做自定义,因为很多人都会觉得 Kubernetes 内置的能力是不够用的,所以用户会利用它的可扩展能力去写一个 Controller ,从而实现跟多自定义的需求。但自定义只是 Operator 中很小的一部分价值,我们今天对应用和能力做 Operator 化的核心动力在于其实是为了实现自动化,而且只有自动化了,我们才能讲云原生。 这是因为,云原生带来的最大的红利是可以让我们最大限度、最高效地使用云的能力,二这种最高效、最大化的方式一定没办法通过人工来实现的。换句话说,只有通过自动化的方式去开发、运维应用以及与云进行交互,才能真正把云原生的价值发挥出来。 而如果要通过自动化的方式跟云进行交互,那么在云原生生态里,必须有一个类似于Controller 或者 Operator 这样的插件的存在。今天阿里巴巴在云上交付的 PolarDB、OceanBase 等,其实都有一个跟 Kubernetes 衔接的 Controller 的存在。通过 Controller 与基础设施、云进行交互,把云的能力输入到产品里面去。 在未来,会有大量的云上的应用和对应的运维能力、管理能力都会以 Kubernetes Operator 的方式交付。在这个背景下, Kubernetes 真正扮演的一个角色就是能力的接入层和标准界面。如下图所示,这是一个非常典型的用户侧 Kubernetes 集群的样子。 一个用户的 Kubernetes 只有红框里面这部分是 Kubernetes 原生提供的 API ,而大量的能力都是以插件化或者说 Operator 化的方式存在。就比如上图右边所有这些自定义的资源和能力全部来自于第三方开发,通过 Operator 这样一个标准的形态开发出来的能力来服务最终用户的。这就意味着在未来云原生的生态里面,基于 CRD Operator 的而非 Kubernetes 原生 API 的应用和能力会占到绝大多数。 随着这个趋势的不断演进,越来越多的软件和能力通过 Kubernetes Operator 去描述和定义,云产品也会开始默认以 Kubernetes 为底座,基于 Operator 进行交付。 正是因为越来越多的 Operator 的出现,这里就会逐步需要一个中心化的方式去解决 Operator 潜在的稳定性、可发现性和性能问题,也就是说在未来很可能会有一个横向的 Operator 管理平台出现,对所有基于 Kubernetes Operator 开发的应用和能力进行统一管理,从而更好、更专业地服务用户。 此外,由于未来每一个能力、每一个应用都需要去编写 Operator ,所以说对开发者友好的 Operator 编写框架也是未来一个很重要的趋势。这个编写框架可以支持不同语言,如 Go、Java、C、Rust 语言等,并且编写过程是专注于运维逻辑和应用的管理、能力的管理,而不是专注在 Kubernetes 的语义和细节上面。 最后,随着云原生生态的普及,云服务也将实现 Operator 化,并且面向多集群/混合云场景出现面向应用层的云服务标准化定义与抽象,并在云原生领域逐渐取代 IaC 项目(比如 Terraform 等)成为云服管理与消费的主流方式。 应用中间件能力进一步下沉 随着云原生以及整个生态的发展,我们看到应用中间件领域也随之发生了很多改变。从原先最开始的中心化 ESB ,到后来的胖客户端,逐步演化到今天我们经常提到的 Service Mesh 这样一种 Sidecar 化的方式。 其实今天你会发现,无论是云的能力还是基础设施的能力,都在不断丰富,很多原先只能通过中间件做的事情,现在可以很容易通过云服务来实现。应用中间件不再是能力的提供方,而是能力接入的标准界面,并且这个标准界面的构建不再基于胖客户端,而是通过非常普通的 HTTP 协议、 gRPC 协议去做,然后通过 Sidecar 方式把整个服务的接入层跟应用业务逻辑做一个解耦,这其实就是 Service Mesh 的思想。 目前 Service Mesh 只做了传统中间件里面的流量治理、路由策略、访问控制这一层的事情。而实际上, Sidecar 这个模型可以应用到所有中间件的场景里,实现中间件逻辑跟应用业务逻辑完全解耦,让应用中间件能力“下沉”,变成 Kubernetes 能力的一部分。这样应用本身会更加专一化,更多的关注业务逻辑本身。 伴随着这个趋势,在 Kubernetes 这一层还会有另外一个趋势出现,就是 Sidecar 的自动化的、规模化的运维能力会成为一个必选项。因为 Sidecar 的数量会极其庞大,应用中间件很可能会演化成 Sidecar 集群,那么这些 Sidecar 的管理和规模化的运维能力,会是集群或者云产品的一个必备选项。 下一代 DevOps 模型与体系 随着云原生生态的不断发展,云原生理念的不断普及, DevOps 的思想很可能也会发生一个本质的变化,即下一代 DevOps 模型与体系。随着 Kubernetes 的能力越来越多、越来越强大,基础设施也会变得越来越复杂,那么基于这样一个强大的基础设施去构建一个应用平台就会非常简单,并且这个应用平台最终会取代传统的PaaS平台。 我们现在之所以在用 DevOps 这一套思想,实际上是由于基础设施本身不够强大,不够标准化,不够好用,所以我们需要在业务研发侧做一套工具去黏合研发人员和基础设施。例如,基础设施提供的能力是一个虚拟机,怎么能让虚拟机变成研发侧想要的蓝绿发布或者一个渐进式的应用交付系统呢?这就需要一系列的 DevOps 的工具、 CI/CD 的流水线来完成。 但是现在的情况已经发生了变化。基于 Kubernetes 的基础设施本身的能力已经非常丰富,像蓝绿发布这些能力本身就是 Kubernetes 可以提供的能力。在这样的背景下, DevOps 的发展趋势也会发生很大的改变: 1. 关注点分离 在 Kubernetes 的背景下,“软件”不再是一个由应用 Owner 掌控的单一交付物,而是多个 Kubernetes 对象的集合,而这一堆 Kubernetes 里面的对象只有很少一部分其实才跟研发有关,所以说有很多对象会不在应用 Owner 的认知范围内,这就导致平台必须去做关注点分离,研发侧的关注点和运维侧、系统侧的关注点是完全不一样的东西。也就是研发不用再考虑运维方面的细节,比如蓝绿发布怎么做,水平扩容什么策略,只要把业务代码写完交付就好。 伴随着 Kubernetes 和基础设施越来越复杂,概念越来越多,作为平台层是不大可能让研发了解所有的概念,因此未来云原生生态一定会做抽象和分层。每一层的角色只跟属于自己的数据抽象去交互,研发侧有一套自己的声明式 API 对象,运维侧有一套自己的声明式 API 对象,每一层的关注点也是不一样的,这会是未来整个 DevOps 体系里发展的一个重要的背景。 2. Serverless 泛化 云原生本身的关注点就是应用,在这样一个背景下,Serverless 本身不再是一个独立场景,不再局限在某几个非常垂直的领域,而会变成云原生应用管理体系的一种泛化思想和天然组成部分。我从两个层面解释一下:一是在能力侧,“轻运维”“ NoOps ”以及“自助式运维能力”会成为应用运维的主流方式。云原生生态上的应用管理会体现出一种轻运维的状态,就是说应用运维不再是一个人工的、非常复杂的过程,而是一组开箱即用的、非常简单的模块化操作。无论是通过 Kubernetes 还是通过云原生能力,都是对下层基础设施的一个模块化的分装,这跟 Serverless 所提倡的 NoOps 理念非常类似。 二是在应用侧,应用描述会广泛地进行用户侧的抽象,事件驱动和 Serverless 理念被拆分和泛化,可以被应用于多样化的场景中而不仅仅是今天狭义的 Serverless 场景比如 FaaS 或者 Container Instance,未来所有的应用都可以实现 scale-to-zero 。 3. 基于 Infrastructure as Data(IaD)思想的应用层技术渐成主流 第一,基于 Infrastructure as Data(IaD)的思想会成为一个主流技术,IaD 实际就是 Kubernetes 的声明式 API ,声明式 API 的核心在于把基础设施、应用、能力以一个声明式的文件、声明式的对象去描述,那么这个文件或者对象本身就是“数据”。而 Kubernetes 或者基础设施这一层是通过数据去驱动的,这就是 Infrastructure as Data。这样的思想会延伸出很多技术和前沿的思想,比如 GitOps 、管道型 YAML 操作工具(Kustomize/kpt)等。这样的管道型应用管理会成为云原生生态里面一个非常主流的应用管理方式。 第二,声明式应用定义模型(比如 OAM),以及声明式的 CI/CD 系统和 Pipeline 会成为一个新的应用交付的模式。比如传统的 Jenkins 是一个命令式的组织方式,而随着声明式的 Pipeline 的出现,加上云原生生态、Kubernetes 的普及,基于 Infrastructure as Data 思想的流水线和下一代的 CI/CD 系统也会成为业界的主流。这跟以前的 CI/CD 和流水线有本质的区别,因为这个 CI/CD 系统里面所有的操作都是一个声明式描述。正因为是声明式描述,所有这些操作以及 CI/CD 里面的环节都可以托管到 Git 上,哪怕一个人工审核(Manual Approve)这样的动作都可以托管在 Git 里面,通过 Git 去审计和做版本管理等。 Infrastructure as Data 的出现就是告诉我们,未来云原生的系统。一切皆对象,一切皆数据。随着对象和数据越来越多,对他们的管理、审计、验证等就变得越来越复杂,那么围绕它们的策略引擎(Policy Engine)会成为一个非常重要的需求。策略引擎会成为一个非常重要的组件,未来 Kubernetes 所有的应用平台可能都需要一个策略引擎的存在,帮助用户处理不同场景下对数据的操作策略。 4. 构建于 IaD 之上的最终用户体验层 需要注意的一点是,虽然 Infrastructure as Data 会成为应用层的主流技术,但是它有一个“硬伤”,就是对最终用户并不友好。因为人的大脑比较容易去处理流程化的、规则化的事情,而不是去处理一个静态的数据,所以说在 IaD 之上会有一层面向最终用户的体验层的存在。这就意味着 Kubernetes 不会把声明式的数据直接交给最终用户,而是通过其他方式来操作这些数据,比如通过一种能够理解 Kubernetes 数据模型的动态配置语言(DSL)来完成,或者通过基于 API 对象的 CLI 或者 dashboard 来完成,也可能是通过一种以应用为中心的交互与协作流程来完成。而最终用户体验层会决定产品有没有黏性,这是云原生的这套体系有没有黏性,是不是用户友好的一个关键环节。 5. DevSecOps 随着如前所述的下一代 DevOps 体系的发展,安全会从一开始就变成应用交付的一部分。在业界大家称之为 DevSecOps ,就是从 day zero 开始就把安全策略、对安全的考量、安全配置作为应用的一部分,而不是等到应用交付出去了甚至应用已经上线了再去做事后的安全审计和管理。 底层基础设施的 Serverless 云原生化 随着云原生体系的发展,云的价值逐渐走向应用层,不断向基于声明式 API 、基于 IaD 的理念去发展,那么下层的基础设施也会发生相应的变化。第一个变化是基础设施能力声明式 API 化、自助化。今天的云是基础设施能力的集大成者,可以认为是一个无限的能力层,今天我们能想象到的基础设施上所有的能力,云都可以提供,这跟以前的基础设施完全不一样。以前云的能力很薄弱,基础设施的能力也很薄弱,所以才需要一个庞大的中间件体系和精密的 DevOps 体系来做一个“胶水层”,去弥补基础设施跟应用、研发、运维人员之间的鸿沟。 而未来,应用才是整个云原生生态的主角。应用需要使用某个能力,那么云就会提供这个能力,并且是通过一个标准化的接入层来提供,而不是直接跟基础设施打交道。云原生生态的发展会使得用户侧的视角发生很大的改变,从面向基础设施变为面向应用,从基础设施有什么用户才能用什么,变成用户要什么,基础设施就可以提供什么。以应用为中心的基础设施会是未来基础设施的一个基本形态。 这个理念跟 Serverless 理念非常类似,我们可以将它称为底层基础设施的 Serverless 原生化,这意味着基础设施会在未来也逐渐的声明式 API 化,而声明式 API 化带来的一个直接结果就是他会变成一个自助化的基础设施。 另外,由于基础设施能够实现声明式 API 化,实现自助化,那么打造更加智能化的基础设施就成为一个重要方向。因为基础设施系统的模块化能力变成了一个数据化的定义方式,那么就可以和容易的通过监控数据、历史数据来驱动基础设施的运转,也就是“自动驾驶的基础设施”。数据驱动的智能化基础设施会在未来成为可能,当然其前提是基础设施本身实现声明式 API 化和自助化。 与此同时,由于应用层本身会 Serverless 泛化,像 “scale to 0” 和 “pay as you go” 这些功能,会成为应用的一个基础的假设,导致资源层也会走向极致弹性+无限资源池的方向。作为一个智能化的基础设施,可以去做更加智能的调度与混部,从而提供极致的资源利用效能,实现成本的极低化。 与此同时,由于要实现极致的资源效能,就意味着底层一定是一个强多租架构,并且这个强多租架构是面向 Kubernetes 的,跟 Kubernetes 有一个天然的、非常融合的集成。这体现在两个方面:第一,在运行时这一层,这个基础设施会倾向走基于硬件虚拟化的容器运行时而非传统虚拟机的方向,比如 Kata Container ,并且认为神龙裸金属服务器更适合做宿主机。伴随着这套技术的发展,轻量化的 VMM(虚拟化管理技术)会成为优化容器运行时、优化整个基础设施敏捷度的一个关键技术和关键链路。 第二,强多租的控制面会针对不同租户做物理隔离,而不只是逻辑隔离,这是 Kubernetes 数据模型的要求,即租户的控制面板之间需要有强的物理隔离,这就是为什么我们讲未来的强多租架构一定会面向 Kubernetes 来构建。阿里内部也是看到了这样的趋势,在不断做一些尝试,去更好地响应未来 Serverless 原生化的基础设施的发展趋势。 另外,我们团队正在招聘2021年毕业的应届生,欢迎各位同学加入我们: 简历投递:yaowei.cyw@alibaba-inc.com 邮件标题:云原生-岗位名称 详情可点击查看:https://mp.weixin.qq.com/s/aMGMme2-p296798wlGQQfQ。 “阿里巴巴云原生关注微服务、Serverless、容器、Service Mesh 等技术领域、聚焦云原生流行技术趋势、云原生大规模的落地实践,做最懂云原生开发者的公众号。”

优秀的个人博客,低调大师

云原生的五大趋势,K8s安卓化位列其一

“未来的软件一定是生长于云上的”,这是云原生理念的最核心假设。而所谓“云原生”,实际上就是在定义一条能够让应用最大程度利用云的能力、发挥云的价值的最佳路径。因此,云原生其实是一套指导软件架构设计的思想。按照这样的思想而设计出来的软件:首先,天然就“生在云上,长在云上”;其次,能够最大化地发挥云的能力,使得我们开发的软件和“云”能够天然地集成在一起,发挥出“云”的最大价值。 云原生的概念大家并不陌生,很多企业也已经基于云原生的架构和技术理念落地相关实践。那么,这么多企业和开发者热衷和推崇的云原生,未来的发展趋势如何?如何才能顺应云原生的主流方向去发展?怎么在云原生时代“乘风破浪”? 我们邀请到阿里云原生资深技术专家、CNCF技术监督委员会代表,etcd作者李响和阿里云高级技术专家、CNCF 应用交付领域联席主席张磊分享云原生的理念、发展以及未来趋势,为大家打开新的思路和眼界。 以下内容共享给大家。 一、Kubernetes项目的安卓化 云原生里有一个非常关键的项目,就是Kubernetes。Kubernetes的发展非常迅速,它是整个云原生体系发展的基石。今天我们来观察Kubernetes项目的发展特点,首先,Kubernetes无处不在,无论是在云上,还是用户自建的数据中心里,甚至一些我们想象不到的场景里,都有Kubernetes的存在。 第二,所有云原生的用户使用Kubernetes的目的,都是为了交付和管理应用。当然这个应用是一个泛化的概念,可以是一个网站,也可以是淘宝这样非常庞大的电商主站,或者是AI作业、计算任务、函数,甚至虚拟机等,这些都是用户可以使用Kubernetes去交付和管理的应用类型。 第三,今天我们来看Kubernetes所处的位置,实际上是承上启下。Kubernetes对上暴露基础设施能力的格式化数据抽象,比如Service、Ingress、Pod、Deployment,这些都是Kubernetes本身原生API给用户暴露出来的能力。而对下,Kubernetes提供的是基础设施能力接入的标准接口,比如说CNI、CSI、DevicePlugin、CRD,让云能够作为一个能力提供商,以一个标准化的方式把能力接入到Kubernetes的体系中。 这一点其实跟安卓非常类似,安卓虽然装在你的设备里,但是它能够让你的硬件、手机、电视、汽车等都能接入到一个平台里。对上则暴露统一的一套应用管理接口,让你能够基于安卓系统来编写应用,去访问或者享受到这些基础设施能力,这也是Kubernetes和安卓的相似之处。 最后,Kubernetes本身并不直接产生商业价值,你不会花钱去购买Kubernetes。这就跟安卓一样,你不会直接掏钱去买一个安卓系统。而类似的,Kubernetes真正产生价值的地方也在于它的上层应用生态。对安卓来说,它今天已经具备了一个庞大的移动端或设备端应用的开发生态,而对于Kubernetes来说也是类似的,只不过现在还在于比较早的阶段。但我们已经能够看到,今天在Kubernetes上构建的商业层很多是垂直解决方案,是面向用户、面向应用这一侧真正能够产生商业价值的东西,而不是Kubernetes本身这一层。这就是为什么我说Kubernetes发展跟安卓很像,当然这可能也是谷歌比较擅长的一个“打法”:全力地去免费推广一个“操作系统”,真正获取商业价值的方式则是是去“收割”操作系统上层的生态价值而不是操作系统本身。 基于这些现象,我们将Kubernetes的发展趋势概括为以下几点: 1、云的价值回归到应用本身 用户使用Kubernetes的本质目的是去交付和管理应用。从这个现象来看,如果Kubernetes 发展下去,那么世界上所有的数据中心和基础设施上面都会有一层Kubernetes,自然而然用户就会开始以Kubernetes为基础去编写和交付以及管理其应用,就跟现在我们会以安卓这样一个操作系统为基础去编写移动应用是类似的。 这就会导致云上的大多数软件和云产品都是第三方开发的。第三方开发是指所有人都可以面向一个标准界面去开发和交付软件,这个软件本身既可以是自己的软件,也可以是一个云产品。未来,越来越多的第三方开源项目,如MongoDB、Elasticsearch等,都会以云原生理念去开发、部署和运维,最后直接演进成为一种云服务。 2、云端“豌豆荚”的出现 有了Kubernetes这样一个标准,开发者面对的就是一个类似于操作系统的界面。由于有更多的应用是面向Kubernetes诞生的,或者说面向Kubernetes去交付的,那么就需要有一个类似于“豌豆荚”的产品,来作为云上的应用商店或者云上的应用分发系统,它的关键能力在于把应用无差别地交付给全世界任何一个Kubernetes上面,就跟用豌豆荚把任何一个安卓应用交付在任何一个安卓设备上的原理是一样的。 其实今天谷歌已经在做这类产品的尝试了,比如Anthos(面向混合云的应用交付平台),虽然是一款混合云产品,但它本质上是把谷歌云的服务,比如数据库服务、大数据服务,去直接交付于任何一个基于Kubernetes的混合云环境里面去,其实就相当于一款云端的“豌豆荚”。 3、基于Kubernetes可扩展能力的开放应用平台会取代PaaS成为主流 由于未来整个应用生态会面向Kubernetes去构建,那么基于Kubernetes可扩展能力的开放应用平台会逐渐取代传统PaaS 而成为主流。基于Kubernetes可扩展能力去构建一个开放的应用平台,其能力是可插拔的,能够去交付和管理的应用类型是多样化的,这才更符合Kubernetes所构建的趋势和生态,所以一些真正高可扩展的平台层项目会大量产生。 另外,今天我们看到的Kubernetes,跟“理想”中的云原生应用生态之间其实还有很多路要走,这也是阿里云原生团队一直在做的事情,基于Kubernetes在应用层构建更丰富的应用生态,帮助用户实现多样化的需求。 二、应用与能力的“Operator化” 纵观云原生时代应用或者云的能力的发展方向,你会发现另一个趋势,就是Operator化。Operator是Kubernetes的一个概念,是指Kubernetes交付的一个实体,这个实体有一个基础模型存在,这个模型分为两部分:一部分是Kubernetes的 API 对象(CRD),另一部分是一个控制器(Controller),如下图所示。这里要区分两个概念,自定义和自动化。很多人会说 Operator 可以帮助我做自定义,因为很多人都会觉得Kubernetes内置的能力是不够用的,所以用户会利用它的可扩展能力去写一个Controller,从而实现跟多自定义的需求。但自定义只是Operator 中很小的一部分价值,我们今天对应用和能力做Operator化的核心动力在于其实是为了实现自动化,而且只有自动化了,我们才能讲云原生。 这是因为,云原生带来的最大的红利是可以让我们最大限度、最高效地使用云的能力,二这种最高效、最大化的方式一定没办法通过人工来实现的。换句话说,只有通过自动化的方式去开发、运维应用以及与云进行交互,才能真正把云原生的价值发挥出来。 而如果要通过自动化的方式跟云进行交互,那么在云原生生态里,必须有一个类似于Controller或者Operator这样的插件的存在。今天阿里巴巴在云上交付的PolarDB、OceanBase等,其实都有一个跟Kubernetes衔接的Controller的存在。通过Controller与基础设施、云进行交互,把云的能力输入到产品里面去。 在未来,会有大量的云上的应用和对应的运维能力、管理能力都会以Kubernetes Operator 的方式交付。在这个背景下,Kubernetes真正扮演的一个角色就是能力的接入层和标准界面。如下图所示,这是一个非常典型的用户侧Kubernetes集群的样子。 一个用户的Kubernetes只有红框里面这部分是Kubernetes原生提供的API,而大量的能力都是以插件化或者说Operator化的方式存在。就比如上图右边所有这些自定义的资源和能力全部来自于第三方开发,通过Operator 这样一个标准的形态开发出来的能力来服务最终用户的。这就意味着在未来云原生的生态里面,基于CRD Operator的而非Kubernetes原生API的应用和能力会占到绝大多数。 随着这个趋势的不断演进,越来越多的软件和能力通过Kubernetes Operator去描述和定义,云产品也会开始默认以Kubernetes为底座,基于Operator进行交付。 正是因为越来越多的Operator的出现,这里就会逐步需要一个中心化的方式去解决Operator潜在的稳定性、可发现性和性能问题,也就是说在未来很可能会有一个横向的Operator管理平台出现,对所有基于Kubernetes Operator开发的应用和能力进行统一管理,从而更好、更专业地服务用户。 此外,由于未来每一个能力、每一个应用都需要去编写Operator,所以说对开发者友好的Operator编写框架也是未来一个很重要的趋势。这个编写框架可以支持不同语言,如Go、Java、C、Rust语言等,并且编写过程是专注于运维逻辑和应用的管理、能力的管理,而不是专注在Kubernetes的语义和细节上面。 最后,随着云原生生态的普及,云服务也将实现Operator化,并且面向多集群/混合云场景出现面向应用层的云服务标准化定义与抽象,并在云原生领域逐渐取代IaC项目(比如 Terraform 等)成为云服管理与消费的主流方式。 三、应用中间件能力进一步下沉 随着云原生以及整个生态的发展,我们看到应用中间件领域也随之发生了很多改变。从原先最开始的中心化ESB,到后来的胖客户端,逐步演化到今天我们经常提到的Service Mesh这样一种Sidecar化的方式。 其实今天你会发现,无论是云的能力还是基础设施的能力,都在不断丰富,很多原先只能通过中间件做的事情,现在可以很容易通过云服务来实现。应用中间件不再是能力的提供方,而是能力接入的标准界面,并且这个标准界面的构建不再基于胖客户端,而是通过非常普通的HTTP协议、gRPC协议去做,然后通过Sidecar方式把整个服务的接入层跟应用业务逻辑做一个解耦,这其实就是Service Mesh的思想。 目前Service Mesh只做了传统中间件里面的流量治理、路由策略、访问控制这一层的事情。而实际上,Sidecar 这个模型可以应用到所有中间件的场景里,实现中间件逻辑跟应用业务逻辑完全解耦,让应用中间件能力“下沉”,变成Kubernetes能力的一部分。这样应用本身会更加专一化,更多的关注业务逻辑本身。 伴随着这个趋势,在Kubernetes这一层还会有另外一个趋势出现,就是Sidecar的自动化的、规模化的运维能力会成为一个必选项。因为Sidecar的数量会极其庞大,应用中间件很可能会演化成Sidecar集群,那么这些Sidecar的管理和规模化的运维能力,会是集群或者云产品的一个必备选项。 四、下一代DevOps模型与体系 随着云原生生态的不断发展,云原生理念的不断普及,DevOps的思想很可能也会发生一个本质的变化,即下一代DevOps模型与体系。随着Kubernetes的能力越来越多、越来越强大,基础设施也会变得越来越复杂,那么基于这样一个强大的基础设施去构建一个应用平台就会非常简单,并且这个应用平台最终会取代传统的PaaS平台。 我们现在之所以在用DevOps这一套思想,实际上是由于基础设施本身不够强大,不够标准化,不够好用,所以我们需要在业务研发侧做一套工具去黏合研发人员和基础设施。例如,基础设施提供的能力是一个虚拟机,怎么能让虚拟机变成研发侧想要的蓝绿发布或者一个渐进式的应用交付系统呢?这就需要一系列的DevOps的工具、CI/CD的流水线来完成。但是现在的情况已经发生了变化。基于Kubernetes的基础设施本身的能力已经非常丰富,像蓝绿发布这些能力本身就是Kubernetes可以提供的能力。在这样的背景下,DevOps的发展趋势也会发生很大的改变: 1、关注点分离 在 Kubernetes 的背景下,“软件”不再是一个由应用Owner掌控的单一交付物,而是多个Kubernetes对象的集合,而这一堆Kubernetes里面的对象只有很少一部分其实才跟研发有关,所以说有很多对象会不在应用Owner的认知范围内,这就导致平台必须去做关注点分离,研发侧的关注点和运维侧、系统侧的关注点是完全不一样的东西。也就是研发不用再考虑运维方面的细节,比如蓝绿发布怎么做,水平扩容什么策略,只要把业务代码写完交付就好。 伴随着 Kubernetes和基础设施越来越复杂,概念越来越多,作为平台层是不大可能让研发了解所有的概念,因此未来云原生生态一定会做抽象和分层。每一层的角色只跟属于自己的数据抽象去交互,研发侧有一套自己的声明式API对象,运维侧有一套自己的声明式API对象,每一层的关注点也是不一样的,这会是未来整个DevOps体系里发展的一个重要的背景。 2、Serverless 泛化 云原生本身的关注点就是应用,在这样一个背景下,Serverless本身不再是一个独立场景,不再局限在某几个非常垂直的领域,而会变成云原生应用管理体系的一种泛化思想和天然组成部分。我从两个层面解释一下:一是在能力侧,“轻运维”“NoOps”以及“自助式运维能力”会成为应用运维的主流方式。云原生生态上的应用管理会体现出一种轻运维的状态,就是说应用运维不再是一个人工的、非常复杂的过程,而是一组开箱即用的、非常简单的模块化操作。无论是通过Kubernetes还是通过云原生能力,都是对下层基础设施的一个模块化的分装,这跟Serverless所提倡的NoOps理念非常类似。 二是在应用侧,应用描述会广泛地进行用户侧的抽象,事件驱动和Serverless 理念被拆分和泛化,可以被应用于多样化的场景中而不仅仅是今天狭义的 Serverless 场景比如 FaaS 或者 Container Instance,未来所有的应用都可以实现scale-to-zero。 3、基于Infrastructure as Data(IaD)思想的应用层技术渐成主流 第一,基于Infrastructure as Data(IaD)的思想会成为一个主流技术,IaD实际就是Kubernetes的声明式API,声明式API的核心在于把基础设施、应用、能力以一个声明式的文件、声明式的对象去描述,那么这个文件或者对象本身就是“数据”。而Kubernetes或者基础设施这一层是通过数据去驱动的,这就是Infrastructure as Data。这样的思想会延伸出很多技术和前沿的思想,比如GitOps、管道型YAML操作工具(Kustomize/kpt)等。这样的管道型应用管理会成为云原生生态里面一个非常主流的应用管理方式。 第二,声明式应用定义模型(比如 OAM),以及声明式的CI/CD系统和Pipeline会成为一个新的应用交付的模式。比如传统的Jenkins是一个命令式的组织方式,而随着声明式的Pipeline的出现,加上云原生生态、Kubernetes的普及,基于Infrastructure as Data思想的流水线和下一代的CI/CD系统也会成为业界的主流。这跟以前的CI/CD和流水线有本质的区别,因为这个CI/CD系统里面所有的操作都是一个声明式描述。正因为是声明式描述,所有这些操作以及CI/CD里面的环节都可以托管到Git上,哪怕一个人工审核(Manual Approve)这样的动作都可以托管在Git里面,通过Git去审计和做版本管理等。 Infrastructure as Data的出现就是告诉我们,未来云原生的系统。一切皆对象,一切皆数据。随着对象和数据越来越多,对他们的管理、审计、验证等就变得越来越复杂,那么围绕它们的策略引擎(Policy Engine)会成为一个非常重要的需求。策略引擎会成为一个非常重要的组件,未来Kubernetes所有的应用平台可能都需要一个策略引擎的存在,帮助用户处理不同场景下对数据的操作策略。 4、构建于IaD之上的最终用户体验层 需要注意的一点是,虽然Infrastructure as Data会成为应用层的主流技术,但是它有一个“硬伤”,就是对最终用户并不友好。因为人的大脑比较容易去处理流程化的、规则化的事情,而不是去处理一个静态的数据,所以说在IaD之上会有一层面向最终用户的体验层的存在。这就意味着Kubernetes不会把声明式的数据直接交给最终用户,而是通过其他方式来操作这些数据,比如通过一种能够理解Kubernetes数据模型的动态配置语言(DSL)来完成,或者通过基于API对象的CLI或者dashboard来完成,也可能是通过一种以应用为中心的交互与协作流程来完成。而最终用户体验层会决定产品有没有黏性,这是云原生的这套体系有没有黏性,是不是用户友好的一个关键环节。 5、DevSecOps 随着如前所述的下一代DevOps体系的发展,安全会从一开始就变成应用交付的一部分。在业界大家称之为DevSecOps,就是从day zero开始就把安全策略、对安全的考量、安全配置作为应用的一部分,而不是等到应用交付出去了甚至应用已经上线了再去做事后的安全审计和管理。 五、底层基础设施的Serverless云原生化 随着云原生体系的发展,云的价值逐渐走向应用层,不断向基于声明式API、基于IaD的理念去发展,那么下层的基础设施也会发生相应的变化。第一个变化是基础设施能力声明式API化、自助化。今天的云是基础设施能力的集大成者,可以认为是一个无限的能力层,今天我们能想象到的基础设施上所有的能力,云都可以提供,这跟以前的基础设施完全不一样。以前云的能力很薄弱,基础设施的能力也很薄弱,所以才需要一个庞大的中间件体系和精密的DevOps体系来做一个“胶水层”,去弥补基础设施跟应用、研发、运维人员之间的鸿沟。 而未来,应用才是整个云原生生态的主角。应用需要使用某个能力,那么云就会提供这个能力,并且是通过一个标准化的接入层来提供,而不是直接跟基础设施打交道。云原生生态的发展会使得用户侧的视角发生很大的改变,从面向基础设施变为面向应用,从基础设施有什么用户才能用什么,变成用户要什么,基础设施就可以提供什么。以应用为中心的基础设施会是未来基础设施的一个基本形态。 这个理念跟Serverless理念非常类似,我们可以将它称为底层基础设施的Serverless原生化,这意味着基础设施会在未来也逐渐的声明式API化,而声明式API化带来的一个直接结果就是他会变成一个自助化的基础设施。 另外,由于基础设施能够实现声明式API化,实现自助化,那么打造更加智能化的基础设施就成为一个重要方向。因为基础设施系统的模块化能力变成了一个数据化的定义方式,那么就可以和容易的通过监控数据、历史数据来驱动基础设施的运转,也就是“自动驾驶的基础设施”。数据驱动的智能化基础设施会在未来成为可能,当然其前提是基础设施本身实现声明式API化和自助化。 与此同时,由于应用层本身会Serverless泛化,像“scale to 0 ”和“pay as you go”这些功能,会成为应用的一个基础的假设,导致资源层也会走向极致弹性+无限资源池的方向。作为一个智能化的基础设施,可以去做更加智能的调度与混部,从而提供极致的资源利用效能,实现成本的极低化。 与此同时,由于要实现极致的资源效能,就意味着底层一定是一个强多租架构,并且这个强多租架构是面向Kubernetes 的,跟Kubernetes有一个天然的、非常融合的集成。这体现在两个方面:第一,在运行时这一层,这个基础设施会倾向走基于硬件虚拟化的容器运行时而非传统虚拟机的方向,比如Kata Container,并且认为神龙裸金属服务器更适合做宿主机。伴随着这套技术的发展,轻量化的VMM(虚拟化管理技术)会成为优化容器运行时、优化整个基础设施敏捷度的一个关键技术和关键链路。 第二,强多租的控制面会针对不同租户做物理隔离,而不只是逻辑隔离,这是Kubernetes数据模型的要求,即租户的控制面板之间需要有强的物理隔离,这就是为什么我们讲未来的强多租架构一定会面向Kubernetes来构建。阿里内部也是看到了这样的趋势,在不断做一些尝试,去更好地响应未来Serverless原生化的基础设施的发展趋势。 云计算的下一站,就是云原生;IT架构的下一站,就是云原生架构,这是属于所有开发者最好的时代。阿里云将于7月上线《云原生架构白皮书》,助力所有的开发者、架构师和技术决策者们,共同定义云原生,拥抱云原生。

优秀的个人博客,低调大师

每日一博 | 更新应用时,如何实现 K8s 零中断滚动更新?

作者 | 子白(阿里云开发工程师)、溪恒(阿里云技术专家) <关注阿里巴巴云原生公众号,回复排查即可下载电子书> 《深入浅出 Kubernetes》一书共汇集 12 篇技术文章,帮助你一次搞懂 6 个核心原理,吃透基础理论,一次学会 6 个典型问题的华丽操作! Kubernetes集群中,业务通常采用Deployment + LoadBalancer类型Service的方式对外提供服务,其典型部署架构如图1所示。这种架构部署和运维都十分简单方便,但是在应用更新或者升级时可能会存在服务中断,引发线上问题。今天我们来详细分析下这种架构为何在更新应用时会发生服务中断以及如何避免服务中断。 图1 业务部署图 为何会发生服务中断 Deployment滚动更新时会先创建新pod,等待新pod running后再删除旧pod。 新建Pod 图2 服务中断示意图 中断原因:Pod running后被加入到Endpoint后端,容器服务监控到Endpoint变更后将Node加入到SLB后端。此时请求从SLB转发到Pod中,但是Pod业务代码还未初始化完毕,无法处理请求,导致服务中断,如图2所示。 解决方法:为pod配置就绪检测,等待业务代码初始化完毕后后再将node加入到SLB后端。 删除Pod 在删除旧pod过程中需要对多个对象(如Endpoint、ipvs/iptables、SLB)进行状态同步,并且这些同步操作是异步执行的,整体同步流程如图3所示。 图3 Deployment更新时序图 Pod pod状态变更:将Pod设置为Terminating状态,并从所有Service的Endpoints列表中删除。此时,Pod停止获得新的流量,但在Pod中运行的容器不会受到影响; 执行preStop Hook:Pod删除时会触发preStop Hook,preStop Hook支持bash脚本、TCP或HTTP请求; 发送SIGTERM 信号:向Pod中的容器发送SIGTERM信号; 等待指定的时间:terminationGracePeriodSeconds字段用于控制等待时间,默认值为30秒。该步骤与preStop Hook同时执行,因此terminationGracePeriodSeconds需要大于preStop的时间,否则会出现preStop未执行完毕,pod就被kill的情况; 发送SIGKILL信号:等待指定时间后,向pod中的容器发送SIGKILL信号,删除pod。 中断原因:上述1、2、3、4步骤同时进行,因此有可能存在Pod收到SIGTERM信号并且停止工作后,还未从Endpoints中移除的情况。此时,请求从slb转发到pod中,而Pod已经停止工作,因此会出现服务中断,如图4所示。 图4 服务中断示意图 解决方法:为pod配置preStop Hook,使Pod收到SIGTERM时sleep一段时间而不是立刻停止工作,从而确保从SLB转发的流量还可以继续被Pod处理。 iptables/ipvs 中断原因:当pod变为termintaing状态时,会从所有service的endpoint中移除该pod。kube-proxy会清理对应的iptables/ipvs条目。而容器服务watch到endpoint变化后,会调用slb openapi移除后端,此操作会耗费几秒。由于这两个操作是同时进行,因此有可能存在节点上的iptables/ipvs条目已经被清理,但是节点还未从slb移除的情况。此时,流量从slb流入,而节点上已经没有对应的iptables/ipvs规则导致服务中断,如图5所示。 图5 服务中断示意图 解决方法: Cluster 模式:Cluster模式下kube-proxy会把所有业务Pod写入Node的iptables/ipvs中,如果当前Node没有业务pod,则该请求会被转发给其他Node,因此不会存在服务中断,如6所示; 图6 Cluster模式请求转发示意图 Local模式:Local模式下,kube-proxy仅会把Node上的pod写入iptables/ipvs。当Node上只有一个pod且状态变为terminating时,iptables/ipvs会将该pod记录移除。此时请求转发到这个node时,无对应的iptables/ipvs记录,导致请求失败。这个问题可以通过原地升级来避免,即保证更新过程中Node上至少有一个Running Pod。原地升级可以保障Node的iptables/ipvs中总会有一条业务pod记录,因此不会产生服务中断,如图7所示; 图7 Local模式原地升级时请求转发示意图 ENI 模式 Service:ENI模式绕过kube-proxy,将Pod直接挂载到SLB后端,因此不存在因为iptables/ipvs导致的服务中断。 图 8 ENI模式请求转发示意图 SLB 图 9服务中断示意图 中断原因:容器服务监控到Endpoints变化后,会将Node从slb后端移除。当节点从slb后端移除后,SLB对于继续发往该节点的长连接会直接断开,导致服务中断。 解决方法:为SLB设置长链接优雅中断(依赖具体云厂商)。 如何避免服务中断 避免服务中断可以从Pod和Service两类资源入手,接下来将针对上述中断原因介绍相应的配置方法。 Pod配置 apiVersion: v1 kind: Pod metadata: name: nginx namespace: default spec: containers: - name: nginx image: nginx # 存活检测 livenessProbe: failureThreshold: 3 initialDelaySeconds: 30 periodSeconds: 30 successThreshold: 1 tcpSocket: port: 5084 timeoutSeconds: 1 # 就绪检测 readinessProbe: failureThreshold: 3 initialDelaySeconds: 30 periodSeconds: 30 successThreshold: 1 tcpSocket: port: 5084 timeoutSeconds: 1 # 优雅退出 lifecycle: preStop: exec: command: - sleep - 30 terminationGracePeriodSeconds: 60 注意:需要合理设置就绪检测(readinessProbe)的探测频率、延时时间、不健康阈值等数据,部分应用启动时间本身较长,如果设置的时间过短,会导致 POD 反复重启。 livenessProbe为存活检测,如果失败次数到达阈值(failureThreshold)后,pod会重启,具体配置见官方文档; readinessProbe为就绪检查,只有就绪检查通过后,pod才会被加入到Endpoint中。容器服务监控到Endpoint变化后才会将node挂载到slb后端; preStop时间建议设置为业务处理完所有剩余请求所需的时间,terminationGracePeriodSeconds时间建议设置为preStop的时间再加30秒以上。 Service配置 Cluster模式(externalTrafficPolicy: Cluster) apiVersion: v1 kind: Service metadata: name: nginx namespace: default spec: externalTrafficPolicy: Cluster ports: - port: 80 protocol: TCP targetPort: 80 selector: run: nginx type: LoadBalancer 容器服务会将集群中所有节点挂载到SLB的后端(使用BackendLabel标签配置后端的除外),因此会快速消耗SLB quota。SLB限制了每个ECS上能够挂载的SLB的个数,默认值为50,当quota消耗完后会导致无法创建新的监听及SLB。 Cluster模式下,如果当前节点没有业务pod会将请求转发给其他Node。在跨节点转发时需要做NAT,因此会丢失源IP。 Local模式(externalTrafficPolicy: Local) apiVersion: v1 kind: Service metadata: name: nginx namespace: default spec: externalTrafficPolicy: Local ports: - port: 80 protocol: TCP targetPort: 80 selector: run: nginx type: LoadBalancer # 需要尽可能的让每个节点在更新的过程中有至少一个的Running的Pod # 通过修改UpdateStrategy和利用nodeAffinity尽可能的保证在原地rolling update # * UpdateStrategy可以设置Max Unavailable为0,保证有新的Pod启动后才停止之前的pod # * 先对固定的几个节点打上label用来调度 # * 使用nodeAffinity+和超过相关node数量的replicas数量保证尽可能在原地建新的Pod # 例如: apiVersion: apps/v1 kind: Deployment ...... strategy: rollingUpdate: maxSurge: 50% maxUnavailable: 0% type: RollingUpdate ...... affinity: nodeAffinity: preferredDuringSchedulingIgnoredDuringExecution: - weight: 1 preference: matchExpressions: - key: deploy operator: In values: - nginx 容器服务默认会将Service对应的Pod所在的节点加入到SLB后端,因此SLB quota消耗较慢。Local模式下请求直接转发到pod所在node,不存在跨节点转发,因此可以保留源IP地址。Local模式下可以通过原地升级的方式避免服务中断,yaml文件如上。 ENI模式(阿里云特有模式) apiVersion: v1 kind: Service metadata: annotations: service.beta.kubernetes.io/backend-type: "eni" name: nginx spec: ports: - name: http port: 30080 protocol: TCP targetPort: 80 selector: app: nginx type: LoadBalancer Terway网络模式下,通过设置service.beta.kubernetes.io/backend-type: "eni" annotation可以创建ENI模式的SLB。ENI模式下,pod会直接挂载到SLB后端,不经过kube-proxy,因此不存在服务中断的问题。请求直接转发到pod,因此可以保留源IP地址。 三种svc模式对比如下表所示。 图 10 Service对比 结论 Terway 网络模式 (推荐方式) 选用ENI模式的svc + 设定Pod优雅终止 + 就绪检测。 Flannel 网络模式 如果集群中slb数量不多且不需要保留源ip:选用cluster模式 + 设定Pod优雅终止 + 就绪检测; 如果集群中slb数量较多或需要保留源ip:选用local模式 + 设定Pod优雅终止 + 就绪检测 + 原地升级(保证更新过程中每个节点上至少有一个Running Pod)。 Reference 容器生命周期钩子 Configure Liveness, Readiness and Startup Probes 通过负载均衡访问服务 Kubernetes 最佳实践:优雅的中止 Kubernetes社区相关讨论:Create ability to do zero downtime deployments when using externalTrafficPolicy: Local,Graceful Termination for External Traffic Policy Local 容器服务 kubernetes(ACK)中应用优雅上下线 课程推荐 为了更多开发者能够享受到 Serverless 带来的红利,这一次,我们集结了 10+ 位阿里巴巴 Serverless 领域技术专家,打造出最适合开发者入门的 Serverless 公开课,让你即学即用,轻松拥抱云计算的新范式——Serverless。 点击即可免费观看课程:https://developer.aliyun.com/learning/roadmap/serverless “阿里巴巴云原生关注微服务、Serverless、容器、Service Mesh 等技术领域、聚焦云原生流行技术趋势、云原生大规模的落地实践,做最懂云原生开发者的公众号。”

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册