首页 文章 精选 留言 我的

精选列表

搜索[k8s],共4786篇文章
优秀的个人博客,低调大师

大模型推理服务化:从 Embedding 到 LLM 的 K8s 部署全流程

## **摘要**: 大模型推理是 AI 应用提供服务的最终环节,通常表现为大规模、高并发、请求突发性强的在线服务。腾讯云容器服务 TKE 围绕模型推理场景提供推理加速框架 TACO、GPU 共享技术 qGPU、超级节点预创沙箱等能力,支持从 Embedding 模型到大语言模型的完整部署流程。 ## 一、大模型推理服务化的核心挑战 模型推理作为 AI 应用面向用户的最后一环,承载着将训练成果转化为实际价值的关键使命。与离线训练不同,推理服务直接面对终端用户的实时请求,对响应延迟、吞吐能力和资源效率有着极为严苛的要求。一个典型的推理服务需要在毫秒级别内完成从接收请求到返回结果的全过程,同时还要应对不可预测的流量波动。 延迟和吞吐之间的矛盾是推理服务面临的首要挑战。降低单次推理的延迟往往意味着减少批处理的大小,这会直接影响 GPU 的利用率和整体吞吐量。反之,增大批处理规模虽然提升了吞吐效率,却会增加单个请求的等待时间。在实际生产中,需要根据业务特点在这两者之间找到最佳平衡点。 资源成本是另一个不可忽视的因素。高性能 GPU 的价格昂贵且供应紧张,而大模型的推理又高度依赖 GPU 算力。如何在保证服务质量的前提下最大化 GPU 的利用率,直接关系到推理服务的经济可行性。许多企业在推理集群上的投入占据了 AI 项目总成本的相当大比例,资源优化空间巨大。 ## 二、TKE 推理加速的核心能力 ### 2.1 TACO 推理加速框架 TACO 是腾讯云自研的大语言模型推理加速框架,针对推理场景的全链路进行了深度优化。该框架在注意力计算、内存管理、调度策略等多个层面引入了创新设计,能够显著提升推理性能。在实际应用中,TACO 为不同类型的推理任务提供了针对性的优化方案。 对于文本生成类任务,TACO 通过改进的连续批处理机制,动态调整每个迭代步中的活跃请求集合,有效减少了 GPU 的空闲等待时间。对于多模态理解场景,框架优化了图像编码器和文本解码器之间的流水线并行策略,降低了端到端的处理延迟。这些底层优化对于用户而言是透明的,只需通过标准的接口调用即可享受到性能提升带来的收益。 ### 2.2 GPU 共享与异构算力支持 深度集成的 qGPU 共享技术使得多个推理实例可以安全地共享同一张 GPU 卡。传统的 GPU 分配方式是以整卡为单位,即使推理负载只需要一小部分显存和算力,也必须独占整张 GPU。qGPU 通过在驱动层实现算力和显存的精细化切分,将 GPU 资源的分配粒度从整卡降低到了更精细的水平,大幅提升了 GPU 的利用效率。 除了 NVIDIA GPU 之外,TKE 还广泛兼容业界主流的 AI 芯片,包括多家国产加速卡厂商的产品。这种异构算力的支持为企业提供了更多的硬件选择空间,降低了对单一供应商的依赖风险。在实际部署中,可以根据不同模型的特性和成本要求,灵活选择最适合的硬件平台。 ### 2.3 极致弹性与快速响应 超级节点预创沙箱技术结合 HPA 和 VPA 实现了推理资源的毫秒级响应。当推理请求量突然增加时,系统可以在秒级时间内启动新的推理实例,确保服务质量不受影响。这种弹性能力对于应对突发流量具有重要的保障作用。 预创沙箱的核心思路是在业务低峰期预先准备好轻量级的运行环境。当需要扩容时,直接将推理工作负载注入已就绪的沙箱中,跳过了传统容器从零启动的漫长过程。配合按量计费的付费模式,企业只需为实际运行的 Pod 资源付费,在获得弹性能力的同时控制了成本支出。 ## 三、从 Embedding 到 LLM 的部署实践 ### 3.1 Embedding 模型的部署要点 Embedding 模型是将文本转换为向量表示的基础组件,广泛应用于语义搜索、推荐系统、知识图谱等场景。这类模型的特点是参数量相对较小但请求频率极高,对延迟和吞吐都有较高要求。在 Kubernetes 上部署 Embedding 推理服务时,需要特别关注以下几个方面。 首先是副本数量的规划。由于 Embedding 请求通常具有较短的处理时间和较高的并发度,需要通过足够的副本数来分散负载。HPA 配置应基于请求队列长度或自定义的业务指标进行扩缩容决策,而非仅仅依赖 CPU 或内存使用率。其次是模型加载的优化。通过将模型文件缓存在高速存储上,可以显著缩短新实例的启动时间,加快弹性扩容的响应速度。 ### 3.2 大语言模型的部署策略 大语言模型的部署相比 Embedding 模型更为复杂。数百亿参数的模型需要多卡甚至多机协同才能完成推理。在 TKE 上部署满血版大模型时,可以使用 LeaderWorkerSet 组件来管理多机部署的拓扑结构。Leader Pod 负责协调工作流,Worker Pod 承担实际的计算任务,这种架构确保了分布式推理的高效执行。 对于需要使用 RDMA 高性能网络的场景,如 HCCPNV 系列机型,应当启用 HostNetwork 模式以确保 RDMA 设备在 Pod 内部正常生效。存储方面,挂载 CFS 共享存储可以实现模型权重在多节点间的快速分发,避免每个节点独立下载造成的带宽浪费和启动延迟。 ### 3.3 推理服务的灰度发布 模型版本的迭代是推理服务的常态。TKE 支持服务的滚动更新和快速更新策略,可以实现模型版本的平滑切换。在更新过程中,新旧版本的实例会并存一段时间,流量按照预设的策略逐步从旧版本迁移到新版本。如果在灰度阶段发现新版本存在问题,可以快速回滚到之前的稳定版本。 对于大型模型的更新,还可以采用蓝绿部署的策略。先部署一套完整的新版本实例,验证无误后一次性切换全部流量。这种方式虽然需要额外的资源开销,但提供了最安全的发布保障。 ## 四、推理服务的运维与优化 ### 4.1 监控指标体系 完善的监控是推理服务稳定运行的基础。TKE 支持查看服务详细的监控指标,包括请求量、响应延迟、错误率等关键数据。对于推理服务而言,还应当关注 GPU 利用率、显存占用、KV Cache 命中率等模型特有的指标。通过这些数据的持续采集和分析,可以及时发现性能瓶颈和异常状况。 ### 4.2 成本优化路径 推理服务的成本优化可以从多个维度展开。在资源层面,通过 qGPU 共享提高单卡利用率,利用竞价模式的超级节点处理可中断的推理任务。在架构层面,采用 Prefill 和 Decode 分离的设计,将计算密集和解码密集的环节分别调度到最优的硬件资源上。在缓存层面,利用前缀缓存复用公共提示词的 KV Cache,减少重复计算带来的资源消耗。 从 Embedding 到 LLM,从单模型到多模型路由——**TKE 配合 TACO 推理加速框架,提供从部署到弹性伸缩再到灰度发布的完整推理服务化方案** → [https://cloud.tencent.com/product/tke](https://cloud.tencent.com/product/tke)

优秀的个人博客,低调大师

API Server 全挂,k8s 集群还能活多久?用一个实践

> 内容有点长,可收藏后续查看。 **可能的场景** 凌晨三点,你被 PagerDuty 吵醒。告警面板一片飘红:`kubectl get nodes`返回 `Unable to connect`。 你的第一反应可能是:**整个集群完蛋了。** 但事实是——业务 Pod 依然在跑,用户流量依然在转发。 API Server 挂了,集群并没有你想的那么脆弱。 --- 这是 **「Kubernetes Cluster HA 故障演练」**系列的第四篇。前几篇我们验证了单 Master 宕机、LB 节点故障、ETCD 多数派失效,这一篇我们玩个更狠的——**直接停掉所有 API Server 实例**,看看集群到底会怎样。 ### **故障演练系列** - **EP.1**一台 Master 宕机 —— 集群无感知 - **EP.2LB 节点整机宕机 —— VIP 漂移验证** - **EP.3**ETCD 多数派失效 —— 控制面瘫痪 - **EP.4**API Server 全挂(本文)—— 各组件降级行为验证 --- ## **一、"API Server 挂了"到底是什么意思?** 在深入实验之前,先厘清一个关键概念:"API Server 挂了"并不只有一种情况。 ### **场景一:单个实例故障 → 用户无感** 三 Master 高可用部署中,如果 `master01`上的 API Server 进程异常退出,但负载均衡器健康检查正常且其余两个实例正常,`kubectl`请求会自动转发到 `master02`或 `master03`——用户几乎无感知。 ### **场景二:所有实例不可用 → 本文实验场景** Kubernetes API 入口完全消失: ``` kubectl get nodes # Unable to connect to the server: EOF ``` 集群进入"失聪失明"状态。 ### **场景三:进程在跑,但连不上 etcd** API Server 仍在监听 `6443`,但与 etcd 之间链路出问题。写操作全部失败,部分只读请求可能短暂成功。这种场景更"诡异"。(EP.3 已验证) 本文重点讨论 **场景二**——最能帮助我们理解控制面与数据面边界的极端场景。 > **核心认知纠正:**API Server 是集群的"控制入口",不是"运行时执行者"。它负责认证、鉴权、写入 etcd,但**不负责让容器活着**。 ### **各组件对 API Server 的依赖关系** |组件|主要依赖|全宕后影响| | --- | --- | --- | |kubectl|CRUD 所有资源|完全无法操作| |Controller Manager|Watch 资源变化、更新状态|停止调谐,自愈停摆| |Scheduler|Watch Pending Pod、写入绑定|新 Pod 永远 Pending| |kubelet|获取 Pod 清单、上报状态|已有容器继续运行| |kube-proxy|Watch Service/Endpoint|转发规则仍生效| |etcd|被动被 API Server 访问|不受影响| --- ## **二、原理推演:各组件会怎样?** 实验之前,先理解每个组件的工作机制,观察现象时才能知其所以然。 ### **1. Controller Manager:不退出,但调谐完全停止** Controller Manager 的设计哲学:**持续观察集群当前状态,驱动至用户声明的期望状态。** 它并非不断轮询 API Server,而是通过 **Informer 机制**建立长连接 Watch。全宕后: - **Watch 连接中断**——不再收到任何新增/修改事件 - **本地缓存定格**——内存中的资源快照停留在故障前最后一刻 - **Reconcile 全部失败**——即使发现需要创建 Pod,调用 API 也会 connection refused - **进程不崩溃**——持续输出 lease 续约失败日志,等待恢复 **各控制器的具体影响:** - **Deployment / ReplicaSet Controller**:无法创建或删除 Pod,即使 Pod 被手动 kill 也无法补足副本数 - **StatefulSet Controller**:无法创建新的 Stateful Pod - **Node Controller(关键)**:正常情况下 kubelet 每 10 秒上报心跳,超过 40 秒未收到会标记 NotReady。但 API Server 全宕时,Node Controller 自身也无法更新 Node 对象——**节点状态永远定格,即便某节点真的宕机,外部也看不到变化** > **结论:**Controller Manager 进程保持运行,但完全丧失获取新状态和修改资源的能力。已有 Pod 不会被主动删除,也不会被恢复。 ### **2. Scheduler:无法调度,但不会崩溃** Scheduler 的工作很简单:找到 `spec.nodeName`为空的 Pod(Pending),挑一个最优 Node,写回 Binding。 API Server 全宕后,调度决策无法写入 etcd,所有调度行为停滞。但 Scheduler 进程保持运行,持续尝试重连。 实际上,由于 kubectl 创建 Deployment 这一步就已经失败,**根本不会有新 Pod 对象产生**。但故障前已处于 Pending 的 Pod 会一直等下去。 > **结论:**Scheduler 自身不崩溃,但无法获取新任务也无法写回调度结果。已运行的 Pod 不受影响。 ### **3. kubelet:已有 Pod 会不会停?——最关键的误解** 很多人直觉认为:kubelet 失去了与集群的联络,Pod 应该会停止。 **事实恰恰相反——不会停止。** kubelet 不是"远程遥控"的代理,它是运行在每个节点上的**自主管理进程**,拥有独立的本地状态和对容器运行时的直接控制权。 一旦某个 Pod 被调度到该节点并且 kubelet 成功启动了对应容器,这个 Pod 的运行状态就存在于一条**完全的本地链路**中,不再需要与 API Server 实时通信即可维持容器存活。 kubelet 内部有一个关键组件——**PLEG (Pod Lifecycle Event Generator)**。它通过定期调用 CRI 检查容器状态,只要容器运行时正常,PLEG 就能独立工作,不依赖 API Server。 **API Server 全宕后,kubelet 受影响的功能:** 1. **节点心跳无法上报**——Lease 续约失败 1. **新 Pod 无法被分配**——创建链路依赖 API Server 1. **Pod 状态无法同步**——外部看到的状态永远定格在故障前 但最关键的是:**容器崩溃了,kubelet 仍然能在本地重新拉起。**只要 Pod 的 `restartPolicy`为 `Always`或 `OnFailure`,kubelet 通过 PLEG 检测到退出事件后会在本地重新启动容器,整个过程无需 API Server 参与。 > **结论:**API Server 故障期间,kubelet 仍能维护已运行容器,执行探针与重启策略。节点上的业务容器不会因 API Server 宕机而终止。 ### **4. kube-proxy:已有网络规则不消失** 已刷入内核的 iptables/IPVS 规则仍然存在,Linux 内核不会主动删除。**已有 Service 的流量转发不受影响。** 但任何 Service/Endpoint 变化都无法同步,可能导致部分新 Pod 无法接收流量。 ### **5. etcd:完全不受影响** etcd 只与 API Server 通信,不感知上层的 Kubernetes 资源。API Server 只是 etcd 的一个客户端——**API Server 宕机不会导致 etcd 停止。**只要 etcd 集群满足 quorum,它就会继续运行。 > etcd 的 Raft 共识和多数派机制,是整篇集群"扛住"的根本。 ### **6. 为什么已有的 Pod 不会被杀?** Pod 的删除需要经历完整的请求链路: ``` 用户/控制器 → API Server 接收请求 → 写入 deletionTimestamp → kubelet 收到事件 → 执行清理 ``` API Server 全宕时,**删除请求根本无法被接收和处理**。已在运行的 Pod 永远不会收到删除指令。 --- ## **三、实验:直接停掉所有 API Server** ### **实验环境** - Kubernetes v1.36 | 3 Master + 3 Worker - 容器运行时:containerd - CNI:Calico - 负载均衡:HAProxy(VIP 方式访问 API Server) ### **实验前检查:建立健康基线** 所有节点 Ready,核心组件 Running,部署 nginx 测试业务,验证访问正常。 ![实验前集群状态](https://developer.qcloudimg.com/http-save/yehe-12454170/5df265b5d79eb21305d3bcfae3a5f97d.png) 实验前集群状态 ![核心组件 Pod 状态](https://developer.qcloudimg.com/http-save/yehe-12454170/20e2ef79170ea0c56ad8204d126e5cc3.png) 核心组件 Pod 状态 ![测试业务创建及访问](https://developer.qcloudimg.com/http-save/yehe-12454170/726dfbfa54bbac0927fb4152f42c0c6d.png) 测试业务创建及访问 ### **停掉所有 API Server 实例** kubeadm 将 API Server 作为静态 Pod 运行,停止方法是将清单文件移出监控目录: ``` # 在所有 Master 节点上执行 mv /etc/kubernetes/manifests/kube-apiserver.yaml /tmp/ ``` kubelet 几秒内检测到文件消失,停止对应容器。验证: ``` kubectl get nodes --request-timeout=5s # client rate limiter Wait returned an error: # context deadline exceeded - error from a previous attempt: EOF kubectl get nodes # Unable to connect to the server: EOF ``` > **⚠️ 排障提示:**看到 `EOF`不要误以为是网络配置问题!本实验中 kubectl 经过 HAProxy LB,后端容器停止后 TLS 握手阶段就断开了,LB 把这个 EOF 透传给 kubectl。直连或等 LB 健康检查更新后,才会看到 `connection refused`。 ![kubectl 连接被拒](https://developer.qcloudimg.com/http-save/yehe-12454170/b4b9e670242adc9db18394631587db8a.png) kubectl 连接被拒 ### **确认:业务容器还在跑** 登录 Worker 节点直接查看容器运行时: ``` sudo crictl ps | grep nginx # e6cac9a74deae nginx 41 minutes ago Running nginx-f79c7c654-kfb52 ``` 容器仍在运行,启动时间停在 41 分钟前——**API Server 的消失对已运行的容器没有任何影响。** ![](https://developer.qcloudimg.com/http-save/yehe-12454170/33533cee5ef9a194c0cde52a62d01ac3.png) nginx 容器仍在运行 验证业务流量: ``` curl http://: # Welcome to nginx! ``` 已有 Service 转发规则依然有效。 ![curl 访问成功](https://developer.qcloudimg.com/http-save/yehe-12454170/d7c4583036ad7ea69f498434c5094d61.png) curl 访问成功 ### **控制面组件:冻结而非崩溃** **Controller Manager 日志**中高频出现 Leader Election 租约获取失败: ``` E0715 06:59:22 leaderelection.go:461] "Error retrieving lease lock" err="dial tcp 192.168.114.145:6443: connect: connection refused" lock="kube-system/kube-controller-manager" ...(每 2-3 秒一条,持续输出) ``` 注意:**不是 Watch 失败,而是 Lease 续约失败。**当前 leader 仍会在租期内尝试履职,但所有需要访问 API Server 的操作全部失败。进程从未退出。 **Scheduler 日志**显示它卡在启动阶段的缓存同步: ``` I0715 06:22:02 shared_informer.go:402] "Waiting for caches to sync" ``` Informer 需要从 API Server List 全量资源完成初始缓存同步,这一步永远无法完成。Scheduler 卡在启动流程中,既没有完成缓存同步,也没有进入正常调度循环。 ![Scheduler 与 Controller 真实日志](https://developer.qcloudimg.com/http-save/yehe-12454170/d341fc07ab37f59ee643ab91535b4ff0.png) Scheduler 与 Controller 真实日志 尝试扩容和创建新 Pod 均失败: ``` kubectl scale deployment nginx --replicas=5 # Unable to connect to the server: EOF kubectl run test-nginx --image=nginx # Unable to connect to the server: EOF ``` ![](https://developer.qcloudimg.com/http-save/yehe-12454170/8cdd0ff04d7de6454c0db613989833e2.png) ### **kubelet 心跳失败与节点状态冻结** kubelet 与 API Server 的交互远不止心跳上报,至少涉及**四类请求**: ``` # 1. Lease 续约失败(节点心跳) E0715 15:31:14 controller.go:201] "Failed to ensure lease exists" err="...EOF" interval="7s" # 2. Node Status 上报失败 E0715 15:31:16 kubelet_node_status.go:479] "Error updating node status" err="...EOF" # 3. Webhook 认证失败 E0715 15:31:10 webhook.go:154] Failed to make webhook authenticator request err="...EOF" # 4. Event 写入失败 E0715 15:31:11 event.go:368] "Unable to write event" err="...EOF" ``` > **⚠️ 关键点:**由于 Node Controller 自身也无法通过 API Server 更新节点状态,所以节点**不会被标记为 NotReady**,基于 NotReady 触发的 Pod 驱逐也不会发生。整个集群对节点状态的观察是"冻结"的。 ### **核心验证:kubelet 能否独立重启容器?** 这是本次实验最关键的验证——**手动停掉一个容器,看 kubelet 能否自行拉起。** **步骤 1**:查看 nginx 容器,记录 ID ``` sudo crictl ps | grep nginx ``` **步骤 2**:手动停止该容器 ``` sudo crictl stop ``` **步骤 3**:再次查看——**全新容器 ID,启动时间在几秒内** ``` sudo crictl ps | grep nginx # 全新的容器 ID,刚刚启动 ``` ![容器重启前后 ID 对比](https://developer.qcloudimg.com/http-save/yehe-12454170/7e66e420d96a9b0487f6ee761961902d.png) 容器重启前后 ID 对比 > **✅ 这直接证明了:**kubelet 对已调度到本节点的 Pod 拥有完整的本地自治能力。容器的存活与 API Server 无关,完全由节点上的 kubelet 和容器运行时决定。 --- ## **四、恢复 API Server,集群如何自愈?** 将清单文件移回原位: ``` mv /tmp/kube-apiserver.yaml /etc/kubernetes/manifests/ ``` kubelet 检测到文件变化,约 30 秒至 1 分钟后 API Server 完全就绪。 ![API Server 容器恢复](https://developer.qcloudimg.com/http-save/yehe-12454170/82eb9c178689c19acd90d3e4afa4b0ad.png) API Server 容器恢复 恢复后,各组件迅速重新建立 Watch 连接: - **Controller Manager**:重新 List/Watch 所有资源,发现副本数不足立即创建 Pod - **Scheduler**:重新 Watch Pending Pod,立即执行调度 - **kubelet**:重新上报节点和 Pod 状态,获取新分配的 Pod ![恢复后集群状态](https://developer.qcloudimg.com/http-save/yehe-12454170/25c55da310abd658890e1a4f30969ea1.png) 恢复后集群状态 --- ## **五、实验结果总结** |组件/资源|故障期间|恢复后| | --- | --- | --- | |API Server|完全不可用|容器重建后恢复| |etcd|正常运行,数据完整|无影响| |Controller Manager|Watch 中断,调谐停止|重新同步,继续 Reconcile| |Scheduler|无法调度新 Pod|立即处理积压 Pending Pod| |kubelet|本地维护容器,可重启|恢复上报,获取新 Pod| |已有 Pod|正常运行,不受影响|无影响| |已有 Service 流量|转发规则仍在内核中|同步最新规则变更| |新 Pod 创建|完全失败|控制器按需创建| |Node 状态|冻结,不标 NotReady|心跳恢复,状态更新| --- ## **六、为什么 Kubernetes 能做到"控制面挂了,业务不停"?** 这背后是四个核心设计原则的集中体现: 1. **控制面与数据面严格分离**——控制面负责全局调度和状态管理,数据面负责本地容器运行。两者通过异步 API 调用解耦,而非实时心跳强关联。 1. **声明式模型**——用户只声明期望状态,控制器持续驱动实际状态向期望状态靠拢。短暂中断只暂停驱动过程,不破坏状态本身。 1. **Informer 与本地缓存**——各组件维护从 API Server 同步的本地缓存,Watch 中断后缓存依然保留全量快照,重连后有上下文可循。 1. **etcd 独立持久化**——所有期望状态安全保存在 etcd 中,与 API Server 生命周期完全解耦。只要 etcd 存活,集群就拥有"恢复记忆"的能力。 --- ## **七、生产环境启示** - **部署高可用 API Server**——至少 3 个 Master,前端 LB 使用 `/healthz`或 `/readyz`做健康检查 - **监控关键指标**——请求延迟、错误率、etcd 延迟、API Server 内存/CPU(防 OOM) - **防范常见诱因**——etcd 性能下降、证书过期、准入 Webhook 阻塞、资源竞争 - **定期故障演练**——只有真实演练才能确认集群承受能力 --- ## **八、常见问题** **Q:API Server 全宕后,Pod 会被杀掉吗?** A:不会。Pod 删除需要 API Server 下发 `deletionTimestamp`。API Server 不可用时,删除命令根本无法生成。 **Q:API Server 挂了还能创建 Pod 吗?** A:不能。创建 Pod 的第一步就是访问 API Server,不可达则整个流程中断。 **Q:挂多久才算危险?** A:没有绝对阈值。短期中断业务通常无感,但随着时间拉长,自动扩容、故障自愈、状态同步全部丧失。建议 5 分钟内恢复,超过 15 分钟需人工介入。 **Q:恢复后数据会丢失吗?** A:不会。期望状态完整保存在 etcd 中,恢复后控制器根据 etcd 数据进行 Reconcile,使集群恢复一致。 **Q:故障期间节点重启了怎么办?** A:节点重启后 kubelet 需从 API Server 获取 Pod 清单。如果 API Server 仍不可用,Pod 无法恢复,直到 API Server 恢复后由控制器在其他节点重建。 --- ## **九、总结** 1. API Server 是控制面的唯一入口,但**不是容器运行时的依赖** 1. API Server 全宕后,业务 Pod 不会停止,数据面继续运行 1. Controller Manager 和 Scheduler 不会退出,但暂停所有控制能力 1. kubelet 能独立维护已调度 Pod,甚至本地重启崩溃的容器 1. 已有 Service 网络规则不受影响,流量转发正常 1. API Server 恢复后,集群通过声明式模型自动修复所有偏差 > 理解这些行为,也就掌握了 Kubernetes 高可用架构设计的核心思想: **控制面可以短暂"失聪失明",但只要 etcd 数据完好、数据面组件健壮,业务就能持续运行,系统终将自愈。** --- > 如果这篇文章帮你真正理解了 Kubernetes 控制面与数据面的边界,欢迎关注 「一根头发丝的宽度」。 这里不会只讲概念,而是坚持用 真实实验 + 源码原理 + 架构图解,拆开 Kubernetes 每一个容易误解的知识点。 本文完整实验过程、所有命令、日志截图、组件时序图,以及 API Server 故障实验 EP.1~EP.3 已整理到个人站点。 📖 点击「阅读原文」,查看完整版。

优秀的个人博客,低调大师

基于 CoreDNS 和 K8s 构建云原生场景下的企业级 DNS

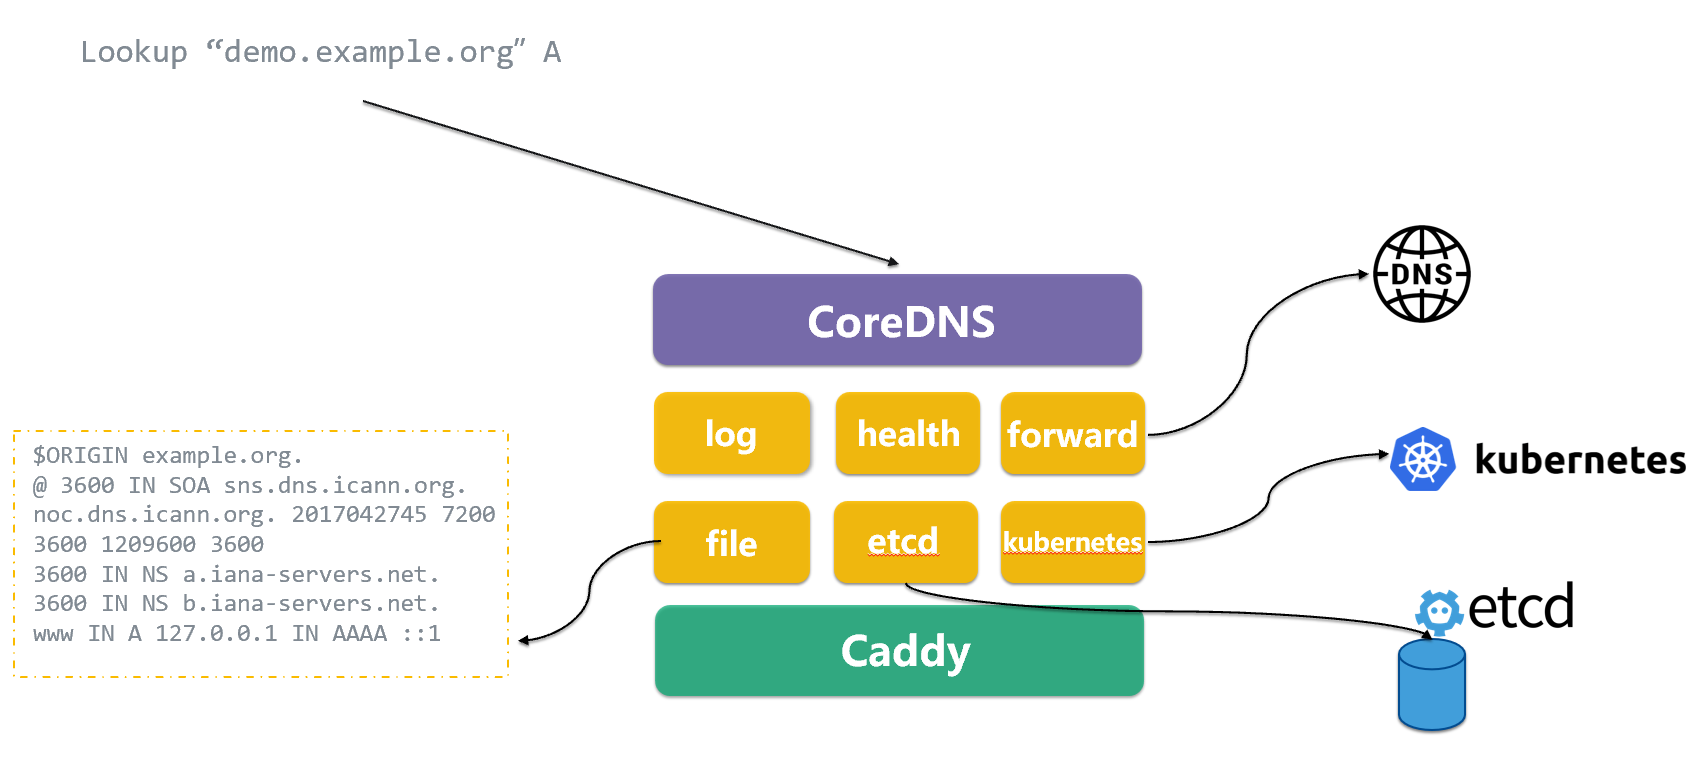
容器作为近些年最火热的后端技术,加快了很多企业的数字化转型进程。目前的企业,不是在使用云原生技术,就是在转向云原生技术的过程中。在容器化进程中,如何保持业务的平稳迁移,如何将现有的一些服务设施一并进行容器化迁移,也是众多企业较为关注的点。 以 DNS 为例,如何构建一个云原生的企业 DNS 系统? CoreDNS 简介 CoreDNS 是一个 Go 语言编写的灵活可扩展的 DNS 服务器,在 Kubernetes 中,作为一个服务发现的配置中心,在 Kubernetes 中创建的 Service 和 Pod 都会在其中自动生成相应的 DNS 记录。Kubernetes 服务发现的特性,使 CoreDNS 很适合作为企业云原生环境的 DNS 服务器,保障企业容器化和非容器化业务服务的稳定运行。 构建企业 DNS 服务器时,一般会有以下需求: 用户外网域名访问服务; 混合云业务迁移、数据共享、容灾; 开发代码 IP 写死导致架构可用性、弹性无法实现; 统一 DNS 管理需求,含上下级平台对接; DNS 劫持等网络安全风险; 存量代码固定域名访问; 集群外域名访问; 相比于 Bind 开源方案或 Windows Server DNS 商业 DNS 服务器,CoreDNS 有以下优势: 无商业许可要求,降低投资成本; 轻量化,通过插件实现功能添加; 支持 DNS,DNS over TLS,DNS over HTTP/2,DNS over gRPC 协议; 提供 kubernetes 服务发现; 支持对接 Route53/Google Cloud DNS/AzureDNS; 支持集成 Prometheus, OpenTracing,OPA,带来更全面的运维体验; 支持整合容器管理平台,提供统一 DNS 系统运维。 构建企业云原生 DNS 前,对 CoreDNS 做一个更深入的了解。 CoreDNS 运行原理与插件介绍 CoreDNS 基于 Caddy 框架实现模块化设计,每个插件承载相应的具体功能,对于 DNS 系统而言,CoreDNS 使用 File,ETCD 插件等加载 DNS 记录,使用 Kubernetes 插件实现集群服务发现,外部 DNS 请求到达 CoreDNS 后,根据插件调用链依次处理 DNS 请求。 CoreDNS 社区官方提供了 50 多种插件,开发者亦可根据需求开发个性化的外部插件。CoreDNS 常用插件如下图,根据使用场景,可分为运维、DNS 处理、后端数据存储等三个类别。 CoreDNS 定义 Corefile 配置文件,服务器在加载 Corefile 后处理 DNS 请求,对于以下插件,只需在 Corefile 中引用即可,之后 CoreDNS 会使用插件链进行调用,插件链可参考以下链接: https://github.com/coredns/coredns/blob/master/plugin.cfg 设计一个基于 CoreDNS 的分层 DNS 架构 在熟悉 CoreDNS 特性后,可设计企业的 DNS 架构: DNS 架构以外网 DNS、内网 DNS、分区 DNS 组成: 外网 DNS: 使用 DNSSEC、DOT、DOH 等保障 DNS 安全; 缓存 DNS 记录; 构建 DNS 实例自动伸缩,应对高 QPS 需求; 内网 DNS: Kubernetes 服务发现; 构建上游 DNS 区域; 分区 DNS: 建立开发、测试、UAT、生产等区域 DNS; NodeLocalDNS 提高性能; 设置转发器处理递归 DNS 请求; KubeSphere 部署 CoreDNS 由于 CoreDNS 是一个 CNCF 毕业的云原生项目,是目前支持云原生最好的一个 DNS 服务器,用户可直接在 KubeSphere 应用商店一键安装。KubeSphere 提供了基于 Helm 模板的应用商店,支持云原生应用的生命周期管理,提供开发人员应用上传、测试,版本提交,应用管理人员进行审核、发布等流程管理。用户在应用商店选择 CoreDNS 应用后,可按需部署于不同集群的不同项目中,并自定义应用模板配置: 服务发现与 DNS 配置 部署 CoreDNS 后,对于运维人员来说,CoreDNS 的配置大体分为两类:一类为 Kubernetes 配置,一类为 DNS 配置。CoreDNS 提供了 Kubernetes 插件,支持在 kubernetes 集群中读取区域数据,并根据 Pod 和 Service 的域名记载相应的 A 记录和 PTR 记录。 这是一个 Kubernetes 集群中的 CoreDNS corefile 默认配置,CoreDNS 会在 53 端口读取 cluster.local 后缀的 Kubernetes 集群 A 记录和 PTR 记录。并将 CoreDNS 收集到的监控指标通过 9153 端口输出到集群内的 Prometheus。而 Kubernetes 不同类型 Service 的 DNS 记录格式,CoreDNS 也有相应标准进行记录。 设置完 Kubernetes 后,可以设置其他业务需求的 DNS 配置,如: 设置不同的存根域; 设置存根域静态 DNS 条目; 面对存量代码,设置域名重写; 面对集群外服务,设置 DNS 转发; 设置日志和监控集成; 设置缓存、健康、就绪检查及链路追踪; 根据以上配置,就构建了一个基础的企业云原生 DNS 系统: DNS 服务暴露 对于集群外的服务而言,存量业务可能还是一些虚拟化和裸机的应用,若和集群网络无法互联,如何在业务迁移时访问新的 DNS 服务? KubeSphere 提供了一个开源项目——OpenELB 来解决云原生环境下的服务暴露问题,这是一个 CNCF 的沙箱项目。OpenELB 通过物理环境的交换机使用 BGP 协议将 LoadBalancer 类型服务的 ExternalIP 宣告出去,在 IP 可达的环境下集群外部业务即可通过 EIP 访问 Kubernetes 服务资源。 对于集群外需要设置 DNS 服务器的服务资源,可通过 OpenELB 使用 EIP 暴露 CoreDNS ,即可访问 DNS 服务 。 在 KubeSphere 3.3 版本,用户可在开启集群网关 / 项目网关时,在网关访问 LoadBalancer 模式下,选择“OpenELB”负载均衡提供商,之后创建的 LoadBalancer 服务都会从 OpenELB 建立的 EIP Pool 中分配 EIP,供集群外部访问。 DNS 监控运维 为保障 CoreDNS 稳定运行,运维人员还需在基础设施侧完善 DNS 系统的日志、监控、告警、通知功能,KubeSphere 提供了简单易用的监控面板、日志管理与落盘,多维度的告警策略和消息,以及对接多个企业应用(邮件,钉钉, 企业微信)的通知系统,时刻关注业务运行状态。 此处以一个系统管理员视角,展示了在 KubeSphere 日志系统搜寻 NXDOMAIN 类型 DNS 回复的结果。 通过 KubeSphere 自定义监控面板,设置一个基于 CoreDNS 指标的监控面板,KubeSphere 内置了众多监控面板,用户可直接使用模板构建亦可使用 PromQL 创建面板: 通过 KubeSphere 告警和通知组件,用户可基于预置规则模板(CPU、内存、磁盘、网络、异常率)或使用 PromQL 语句自定义告警规则,此处定义当 CoreDNS CPU 用量大于等于 0.1Core 系统触发告警: KubeSphere 针对租户设计了通知模板,包含多种通知系统集成,此处使用邮件将“重要告警”,“危险告警”条件的告警消息发送给邮件接收人。 当告警触发后,即可在告警消息和通知历史处查看到相应的条目,此时用户也会收到一封告警邮件了: 在高并发 DNS 请求场景中,还需对 CoreDNS 进行自动伸缩设计,通常考虑到服务高可用性和性能考量,可参考以下计算规格和调度策略设计: 副本打散,跨可用区 / 节点。 避免所在节点 CPU、内存过高。 通常设计副本数为 2。QPS 与 CPU 消耗正相关,单 CPU——1w+QPS Kubernetes 集群下,CoreDNS 副本数与集群节点配置 1:8。 业务峰值 CPU 占用 >1Core,水平扩容。 通过 KubeSphere 自动伸缩机制,可设置基于 CPU 用量的自动伸缩策略,保障 CoreDNS 在瞬时高并发场景稳定运行。 总结 以上就是建设一个云原生的 DNS 系统的全部内容了,可以看出,在云原生时代,新的技术层出不穷,IT 系统的部门和人员也越发趋于协同作战,以往构建一个 DNS 系统可能只需要安装一套稳定能进行 DNS 解析的系统,并实现主备切换即可。在应用驱动基础架构转型的云原生时代,基础服务应用还更需要考虑异构系统的连接,灵活简便的安装升级管理,更强大的可靠性和自愈能力,日志监控通知系统的完善,还有更适合实际业务需求的弹性设计,来加速应用现代化,推动业务应用持续转型。 本文由博客一文多发平台 OpenWrite 发布!

优秀的个人博客,低调大师

面对大规模 K8s 集群,这款诊断利器必须要“粉一波”!

作者|段超 来源|尔达 Erda 公众号 背景 我们是一家做商业软件的公司,从一开始我们就把软件交付流程做的非常标准且简单,所有的软件都是基于我们的企业数字化平台 Erda(现已开源)来交付,底层基于 Kubernetes,为企业提供 DevOps、微服务治理、多云管理以及快数据管理等云厂商无绑定的 IT 服务。 ​ 随着我们服务的客户数量越来越多,如今我们管理着相当规模数量的 Kubernetes 集群,集群的稳定性决定了服务质量以及对外口碑,很长一段时间内我们在这件事情上都显得很被动,经常会出现 Erda 支持同学或者客户将问题反馈到我们说:有业务出现了问题,需要我们协助查询一下是不是平台导致的,然后我们上去一顿操作最后解决问题,答复客户。看似专业且厉害,急用户之所急,实则无章无法,一地鸡毛。 通常我们依赖监控系统来提前发现问题,但是监控数据作为一个正向链路,很难覆盖到所有场景,经常会有因为集群配置的不一致性或者一些更底层资源的异常,导致即使监控数据完全正常,但是整个系统依然会有一些功能不可用。对此,我们做了一套巡检系统,针对系统中一些薄弱点以及一致性做诊断,美中不足的是,这套系统的扩展性不是很好,对集群跟巡检项的管理也相对粗暴了一点。 ​ 最后,我们决定做一个更加云原生的诊断工具,使用 operator 来实现集群跟诊断项的管理,抽象出集群跟诊断项的资源概念,来解决大规模 Kubernetes 集群的诊断问题,通过在中心下发诊断项到其他集群,并统一收集其他集群的诊断结果,来实现任何时刻都可以从中心获取到其他所有集群的运行状态,做到对大规模 Kubernetes 集群的有效管理以及诊断。 ​ Kubeprober 项目介绍 项目地址: https://github.com/erda-project/kubeprober ​ KubeProber 是一个针对大规模 Kubernetes 集群设计的诊断工具,用于在 Kubernetes 集群中执行诊断项以证明集群的各项功能是否正常,KubeProber 有如下特点: ​ 支持大规模集群:支持多集群管理,支持在管理端配置集群跟诊断项的关系以及统一查看所有集群的诊断结。 云原生:核心逻辑采用 operator 来实现,提供完整的 Kubernetes API 兼容性。 可扩展:支持用户自定义巡检项。 ​ 其核心架构如下: ​ 区别于监控系统,kubeProber 从巡检的角度来证明集群的各项功能是否正常,监控作为正向链路,无法覆盖系统中的所有场景,系统中各个环境的监控数据都正常,也不能保证系统是 100% 可以用的,因此需要一个工具从反向来证明系统的可用性、从根本上做到先于用户发现集群中不可用的点,比如: ​ 集中的所有节点是否均可以被调度,有没有特殊的污点存在等。 pod 是否可以正常的创建、销毁,验证从 Kubernetes,Kubelet 到 Docker 的整条链路。 创建一个 Service,并测试连通性,验证 kube-proxy 的链路是否正常。 解析一个内部或者外部的域名,验证 CoreDNS 是否正常工作。 访问一个 ingress 域名,验证集群中的 ingress 组件是否正常工作。 创建并删除一个 namespace,验证相关的 webhook 是否正常工作。 对 Etcd 执行 put/get/delete 等操作,用于验证 Etcd 是否正常运行。 通过 mysql-client 的操作来验证 MySQL 是否正常运行。 模拟用户对业务系统进行登录、操作,验证业务的主流程是否常常。 检查各个环境的证书是否过期。 云资源的到期检查。 更多... ​ 组件介绍 Kubeprober 整体采用 Operator 来实现核心逻辑,集群之间的管理使用 remotedialer 来维持被纳管集群跟管理集群之间的心跳链接,被纳管集群通过 RBAC 赋予 probe-agent 最小所需权限,并且通过心跳链接实时上报被纳管集群元信息,以及访问 apiserver 的 token,实现在管理集群可以对被管理集群的相关资源进行操作的功能。 ​ probe-master 运行在管理集群上的 operator,这个 operator 维护两个 CRD,一个是 Cluster,用于管理被纳管的集群;另一个是 Probe,用于管理内置的以及用户自己编写的诊断项,probe-master 通过 watch 这两个 CRD,将最新的诊断配置推送到被纳管的集群,同时 probe-master 提供接口用于查看被纳管集群的诊断结果。 ​ probe-agent 运行在被纳管集群上的 operator,这个 operator 维护两个 CRD,一个是跟 probe-master 完全一致的 Probe,probe-agent 按照 probe 的定义去执行该集群的诊断项,另一个是 ProbeStatus,用于记录每个 Probe 的诊断结果,用户可以在被纳管的集群中通过 kubectl get probestatus 来查看本集群的诊断结果。 ​ 什么是 Probe kubeprobe 中运行的诊断计划我们称之为 Probe,一个 Probe 为一个诊断项的集合,我们建议将统一场景下的诊断项作为一个 Probe 来运行,probe-agent 组件会 watch probe 资源,执行 Probe 中定义的诊断项,并且将结果写在 ProbeStatus 的资源中。 我们期望有一个输出可以清晰的看到当前集群的运行状态,因此,我们建议所有的 Probe 都尽可能属于应用、中间件、Kubernets、基础设置这四大场景,这样我们可以在展示状态的时候,自上而下清楚地查看究竟是系统中哪个层面引起的问题。 ​ 目前的 Probe 还比较少,我们还在继续完善,也希望跟大家一起共建。 ​ 自定义 Probe ​ 对比其他诊断工具 目前社区已经有 Kuberhealthy 以及 kubeeye 来做 Kubernetes 集群诊断这件事情。 ​ kuberheathy 提供一套比较清晰的框架可以让你轻松编写自己的诊断项,将诊断项 CRD 化,可以轻松地使用 Kubernetes 的方式来对单个 Kubernetes 进行体检。 ​ kubeeye 同样是针对单个集群,主要通过调用 Kubernetes 的 event api 以及 Node-Problem-Detector 来检测集群控制平面以及各种节点问题,同时也支持自定义诊断项。 ​ kubeprober 做的也是诊断 Kubernetes 集群这件事情,提供框架来编写自己的诊断项。除此之外,kubeprober 主要解决了大规模 Kubernetes 集群的诊断问题,通过中心化的思路,将集群跟诊断项抽象成 CRD,可以实现在中心 Kubernetes 集群管理其他 Kubernetes 诊断项配置、诊断结果收集,未来也会解决大规模 Kubernetes 集群的运维问题。 ​ 如何使用 kubeprober 主要解决大规模 Kubernetes 集群的诊断问题,通常我们选择其中一个集群作为 master 集群,部署 probe-master,其他集群作为被纳管集群,部署 probe-agent。 ​ 安装 probe-master probe-master 使用了 webhook,webhook 的运行需要校验证书,需要先部署一下 cert-manager 的服务: ​ kubectl apply -f https://github.com/jetstack/cert-manager/releases/download/v1.3.1/cert-manager.yaml ​ 然后安装 probe-master: ​ APP=probe-master make deploy 安装 probe-agent 在逻辑上,一个 cluster 资源对应一个 probe-agent,在部署 probe-agent 之前,需要先创建一个 cluster 资源,probe-master 会给每一个 cluster 生成一个 secreykey,用于跟 probe-master 交互的唯一凭证。 ​ kubectl apply -f config/samples/kubeprobe_v1_cluster.yaml kubectl get cluster -o wide #可以获取到集群的secretkey ​ 部署 probe-agent 前,需要先修改 probe-agent 的 configmap: ​ vim config/manager-probe-agent/manager.yaml --- apiVersion: v1 kind: ConfigMap metadata: name: probeagent namespace: system data: probe-conf.yaml: | probe_master_addr: http://kubeprober-probe-master.kubeprober.svc.cluster.local:8088 cluster_name: moon secret_key: 2f5079a5-425c-4fb7-8518-562e1685c9b4 ​ 最后安装 probe-agent: ​ APP=probe-agent make deploy ​ 安装好 probeagent 后我们就可以在 master 集群中看到 cluster 信息。 配置 probe 有了 cluster,我们还需要在 master 集群中创建 probe 资源,比如: ​ kubectl apply -f config/samples/kubeprobe_v1_cron_probe.yaml ​ 使用 kubectl get probe 来查看 probe 列表,使用 kubectl label 来将一个 probe 跟 cluster 关联起来,则对用的 probe-agent 会在本集群内执行相关的诊断项。 ​ kubectl label cluster moon probe/probe-link-test1=true kubectl label cluster moon probe/probe-cron-sample=true ​ 最后,我们可以在被诊断的集群中使用 kubectl get probestatus 来查看诊断本集群的诊断结果。 ​ 欢迎参与开源 当前 kubeprobe 已经发布了第一个版本 0.0.1,还有许多功能不太完善,probe-master 的管理能力还可以进一步的被放大挖掘,probe 的编写也需要更加的简单易用。我们希望跟社区一起共建,共同打造一个大规模 Kubernetes 集群的管理神器。欢迎大家关注、贡献代码和 Star! ​ Erda Github 地址:https://github.com/erda-project/erda Erda Cloud 官网:https://www.erda.cloud/ Contributing to KubeProber:https://github.com/erda-project/kubeprober/blob/master/CONTRIBUTING.md

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册
修改密码
忘记密码