首页 文章 精选 留言 我的

精选列表

搜索[centos],共5663篇文章
优秀的个人博客,低调大师

Centos6-防火墙的基本配置

1.iptables 启动指令: service iptables start 重启指令: service iptables restart 关闭指令: service iptables stop 保存指令: service iptables save 相关配置: /etc/sysconfig/iptables 2.操作: vim /etc/sysconfig/iptables # Firewall configuration written by system-config-firewall # Manual customization of this file is not recommended. *filter :INPUT ACCEPT [0:0] :FORWARD ACCEPT [0:0] :OUTPUT ACCEPT [0:0] -A INPUT -m state --state ESTABLISHED,RELATED -j ACCEPT -A INPUT -p icmp -j ACCEPT -A INPUT -i lo -j ACCEPT -A INPUT -m state --state NEW -m tcp -p tcp --dport 22 -j ACCEPT -A INPUT -m state --state NEW -m tcp -p tcp --dport 80 -j ACCEPT -A INPUT -j REJECT --reject-with icmp-host-prohibited -A FORWARD -j REJECT --reject-with icmp-host-prohibited COMMIT 启动: service iptables start 重启: service iptables restart 保存: service iptables save 注意: 先service iptables restart,然后才调用/etc/rc.d/init.d/iptables save 因为/etc/rc.d/init.d/iptables save会在iptables服务启动时重新加载, 要是在重启之前直接先调用了/etc/rc.d/init.d/iptables save 那么你的/etc/sysconfig/iptables 配置就回滚到上次启动服务的配置了,这点必须注意!!!

优秀的个人博客,低调大师

0025-CENTOS6.5安装CDH5.12.1(二)

温馨提示:要看高清无码套图,请使用手机打开并单击图片放大查看。 5.快速组件服务验证 5.1HDFS验证(mkdir+put+cat+get) mkdir操作: _[root@ip-172-31-6-148_~]# hadoop fs -mkdir -p /fayson/test [root@ip-172-31-6-148 ~]# hadoop fs -ls / Found 3 items drwxr-xr-x - root supergroup 0 2017-09-0506:16 /fayson drwxrwxrwt - hdfs supergroup 0 2017-09-0504:24 /tmp drwxr-xr-x - hdfs supergroup 0 2017-09-0504:24 /user [root@ip-172-31-6-148 ~]# put操作: _[root@ip-172-31-6-148_~]# vim a.txt 1,test 2,fayson 3.zhangsan [root@ip-172-31-6-148 ~]#hadoop fs -put a.txt /fayson/test [root@ip-172-31-6-148 ~]# hadoop fs -ls /fayson/test Found 1 items -rw-r--r-- 3 root supergroup 27 2017-09-05 06:20 /fayson/test/a.txt [root@ip-172-31-6-148 ~]# cat操作: [root@ip-172-31-6-148 ~]# hadoop fs -cat /fayson/test/a.txt 1,test 2,fayson 3.zhangsan [root@ip-172-31-6-148 ~]# get操作: _[root@ip-172-31-6-148_~]# rm -rf a.txt [root@ip-172-31-6-148 ~]# hadoop fs -get /fayson/test/a.txt [root@ip-172-31-6-148 ~]# cat a.txt 1,test 2,fayson 3.zhangsan [root@ip-172-31-6-148 ~]# 5.2Hive验证 使用hive命令行操作 _[root@ip-172-31-6-148_~]# hive ... hive> create external table test_table( > s1 string, > s2 string > ) row formatdelimited fields terminated by ',' > stored as textfile location '/fayson/test'; OK Time taken: 1.933 seconds hive_>_ select * from test_table; OK 1 test 2 fayson 3 zhangsan Time taken: 0.44 seconds, Fetched: 3row(s) hive> insert into test_table values("4"_,_"lisi"); ... OK Time taken: 18.815 seconds hive_>_ select * from test_table; OK 4 lisi 1 test 2 fayson 3 zhangsan Time taken: 0.079 seconds, Fetched: 4row(s) hive_>_ Hive MapReduce操作 hive_>_ select count(*) from test_table; Query ID = root_20170905064545_100f033c-49b9-488b-9920-648a2e1c7285 ... OK 4 Time taken: 26.428 seconds, Fetched: 1 row(s) hive_>_ 5.3MapReduce验证 [root@ip-172-31-6-148 hadoop-mapreduce]# pwd /opt/cloudera/parcels/CDH/lib/hadoop-mapreduce [root@ip-172-31-6-148 hadoop-mapreduce]#hadoop jar hadoop-mapreduce-examples.jar pi 5 5 Number of Maps = 5 Samples per Map = 5 Wrote input for Map #0 Wrote input for Map #1 Wrote input for Map #2 Wrote input for Map #3 Wrote input for Map #4 Starting Job 17/09/05 06:48:53 INFO client.RMProxy: Connecting to ResourceManager atip-172-31-6-148.fayson.com/172.31.6.148:8032 17/09/05 06:48:53 INFO input.FileInputFormat: Total input paths to process : 5 17/09/05 06:48:53 INFO mapreduce.JobSubmitter: number of splits:5 17/09/05 06:48:54 INFO mapreduce.JobSubmitter: Submitting tokens for job:job_1504585342848_0003 17/09/05 06:48:54 INFO impl.YarnClientImpl: Submitted applicationapplication_1504585342848_0003 17/09/05 06:48:54 INFO mapreduce.Job: The url to track the job:http://ip-172-31-6-148.fayson.com:8088/proxy/application_1504585342848_0003/ 17/09/05 06:48:54 INFO mapreduce.Job: Running job: job_1504585342848_0003 17/09/05 06:49:01 INFO mapreduce.Job: Job job_1504585342848_0003 running in ubermode : false 17/09/05 06:49:01 INFO mapreduce.Job: map0% reduce 0% 17/09/05 06:49:07 INFO mapreduce.Job: map20% reduce 0% 17/09/05 06:49:08 INFO mapreduce.Job: map60% reduce 0% 17/09/05 06:49:09 INFO mapreduce.Job: map100% reduce 0% 17/09/05 06:49:15 INFO mapreduce.Job: map100% reduce 100% 17/09/05 06:49:16 INFO mapreduce.Job: Job job_1504585342848_0003 completedsuccessfully 17/09/05 06:49:16 INFO mapreduce.Job: Counters: 49 File System Counters FILE: Numberof bytes read=64 FILE: Numberof bytes written=875624 FILE: Numberof read operations=0 FILE: Numberof large read operations=0 FILE: Number of writeoperations=0 HDFS: Numberof bytes read=1400 HDFS: Numberof bytes written=215 HDFS: Numberof read operations=23 HDFS: Numberof large read operations=0 HDFS: Number of writeoperations=3 Job Counters Launched map tasks=5 Launched reduce tasks=1 Data-local map tasks=5 Total time spent by all maps in occupiedslots (ms)=_27513_ _Total_ **time** spentby all reduces **in** occupied slots (ms)=_3803_ _Total_ **time** spentby all map tasks (ms)=_27513_ _Total_ **time** spentby all reduce tasks (ms)=_3803_ _Total_ vcore-milliseconds taken by all map tasks=27513 Total vcore-millisecondstaken by all reduce tasks=3803 Total megabyte-millisecondstaken by all map tasks=28173312 Total megabyte-millisecondstaken by all reduce tasks=3894272 Map-Reduce Framework Map inputrecords=5 Map outputrecords=10 Map outputbytes=90 Map outputmaterialized bytes=167 Input splitbytes=810 Combine input records=0 Combine output records=0 Reduce input groups=2 Reduce shuffle bytes=167 Reduce input records=10 Reduce output records=0 Spilled Records=20 Shuffled Maps =5 Failed Shuffles=0 Merged Map outputs=5 GC timeelapsed (ms)=_273_ _CPU_ **time** spent(ms)=_4870_ _Physical_ memory (bytes) snapshot=2424078336 Virtual memory (bytes) snapshot=9435451392 Total committedheap usage (bytes)=_2822766592_ _Shuffle_ Errors BAD\_ID=0 CONNECTION=0 IO_ERROR=0 WRONG_LENGTH=0 WRONG_MAP=0 WRONG_REDUCE=0 File Input FormatCounters Bytes Read=590 File Output FormatCounters Bytes Written=97 Job Finished in 23.453 seconds Estimated value of Pi is 3.68000000000000000000 [root@ip-172-31-6-148 hadoop-mapreduce]# 5.4Spark验证 _[root@ip-172-31-6-148_~]# spark-shell Setting default log level to "WARN". To adjust logging level use sc.setLogLevel(newLevel). Welcome to _\_\_\_\__ \_\_ / __/__ ___ _____/ /__ \_\ \/ \_ \/ \_ _`_/\_\_/ '\_/ /___/ .__/_,_/_//_/_ version 1.6.0 /_/ ... Spark context available as sc (master = yarn-client, app id = application_1504585342848_0004). 17/09/05 06:51:59 WARN metastore.ObjectStore: Version information not found in metastore.hive.metastore.schema.verification is not enabled so recording the schemaversion 1.1.0-cdh5.12.1 17/09/05 06:51:59 WARN metastore.ObjectStore: Failed to get database default,returning NoSuchObjectException SQL context available as sqlContext. scala> val textFile=sc.textFile("hdfs://ip-172-31-6-148.fayson.com:8020/fayson/test/a.txt") textFile: org.apache.spark.rdd.RDDString =hdfs://ip-172-31-6-148.fayson.com:8020/fayson/test/a.txt MapPartitionsRDD1 at textFileat :27 _scala> textFile.count_() res0: Long = 3 scala_>_ 醉酒鞭名马,少年多浮夸! 岭南浣溪沙,呕吐酒肆下!挚友不肯放,数据玩的花!温馨提示:要看高清无码套图,请使用手机打开并单击图片放大查看。 欢迎关注Hadoop实操,第一时间,分享更多Hadoop干货,喜欢请关注分享。 原创文章,欢迎转载,转载请注明:转载自微信公众号Hadoop实操

优秀的个人博客,低调大师

centos7临时修改IP、永久修改IP

临时修改IP ifconfig eno16777736 192.168.1.101 注意(eno16777736)是默认第一个网络接口名称 永久修改IP 第一步:查看网络接口 ifconfig 第二步:去对应的网络接口配置文件修改配置,注意文件名称是(ifcfg-默认第一个网络接口名称),文件路径是/etc/sysconfig/network-scripts/ vim /etc/sysconfig/network-scripts/ifcfg-网络接口名称 修改以下配置 TYPE=Ethernet BOOTPROTO=static DEFROUTE=yes IPV4_FAILURE_FATAL=no IPV6INIT=yes IPV6_AUTOCONF=yes IPV6_DEFROUTE=yes IPV6_FAILURE_FATAL=no NAME=eno16777736 UUID=9e8d604f-d991-4aa2-88a3-4c679e6f139c DEVICE=eno16777736 ONBOOT=yes PEERDNS=yes PEERROUTES=yes IPV6_PEERDNS=yes IPV6_PEERROUTES=yes HWADDR=00:0c:29:ce:3f:3c#MAC地址 IPADDR=192.168.1.104#静态IP GATEWAY=192.168.1.2#默认网关 NETMASK=255.255.255.0#子网掩码 DNS1=192.168.1.2#DNS配置 第三步:重启网络服务 servicenetwork restart 其他 DEVICE=物理设备名 IPADDR=IP地址 NETMASK=掩码值 NETWORK=网络地址 BROADCAST=广播地址 GATEWAY=网关地址 ONBOOT=[yes|no](引导时是否激活设备) USERCTL=[yes|no](非root用户是否可以控制该设备) BOOTPROTO=[none|static|bootp|dhcp](引导时不使用协议|静态分配|BOOTP协议|DHCP协议) HWADDR= 你的MAC地址

优秀的个人博客,低调大师

Centos yum一键安装NMP默认版本

首先,更新yum:yum update 然后,查看准备yum安装的php版本,命令如下:yum list php* 确保版本合适之后,安装NMP及相关组件,命令如下:yum -y install php nginx mysql mysql-server php-cli php-pdo php-tidy php-pecl-memcache php-eaccelerator php-mysql php-gd libjpeg* php-imap php-ldap php-odbc php-pear php-xml php-xmlrpc php-mbstring php-mcrypt php-bcmath php-mhash libmcrypt libmcrypt-devel php-fpm 以上配置和组件能基本满足国内外常用CMS的需要!

优秀的个人博客,低调大师

CentOS7.X生成免费SSL通配符证书

安装前的准备 原文地址https://note.so1234.top 查看python版本(要求版本大于2.7.0) python -V 如果python版本低于2.7.0建议不要随意更新python,会影响yum的正常使用 安装库支持 yum install yum-utils -y yum-config-manager \ --enable \ rhui-REGION-rhel-server-extras \ rhui-REGION-rhel-server-optional \ 安装certbot-nginx cd /root wget https://dl.eff.org/certbot-auto cp /root/certbot-auto /usr/local/bin/ chmod -R 755 /usr/local/bin/certbot-auto 生成证书(*.xxx.com为通配符域名) certbot-auto --server https://acme-v02.api.letsencrypt.org/directory -d "*.xxx.com" -d "xxx.com" --manual --preferred-challenges dns-01 certonly # 1.执行过程中输入邮箱 # 2.执行过程中输入A同意 # 3.执行过程中输入Y确认 # 4.执行过程中输入Y确认 # 5.执行过程中添加DNS的TXT解析记录,以阿里云DNS为例 # 1.记录类型TXT # 1.主机记录_xxx-xxx.xxx.com # 1.解析线路默认 # 1.记录值xxxxxx # 1.TTL 10分钟 # 6.按下回车,提示成功! 按照成功后的提示,记下证书文件的路径,提示信息类似如下 IMPORTANT NOTES: - Congratulations! Your certificate and chain have been saved at: /etc/letsencrypt/live/xxx.com/fullchain.pem Your key file has been saved at: /etc/letsencrypt/live/xxx.com/privkey.pem Your cert will expire on 2xxx-xx-xx. To obtain a new or tweaked version of this certificate in the future, simply run certbot-auto again. To non-interactively renew *all* of your certificates, run "certbot-auto renew" - If you like Certbot, please consider supporting our work by: Donating to ISRG / Let's Encrypt: https://letsencrypt.org/donate Donating to EFF: https://eff.org/donate-le # 生成的文件放在: /etc/letsencrypt/live/xxx.com/fullchain.pem /etc/letsencrypt/live/xxx.com/privkey.pem # 该证书到期的时间是 2xxx-xx-xx # 所以要设置自动更新证书 自动更新 # 测试是否支持自动更新 certbot-auto renew --dry-run # 使用自动更新 certbot-auto renew # 在crontab配置:每5天尝试自动更新(频率小于90天即可) crontab -e 0 0 */5 * * root -c certbot-auto renew ESC :wq 配置nginx 完成 领支付宝红包支持作者

优秀的个人博客,低调大师

Centos安装Python3(自带pip和setuptools)

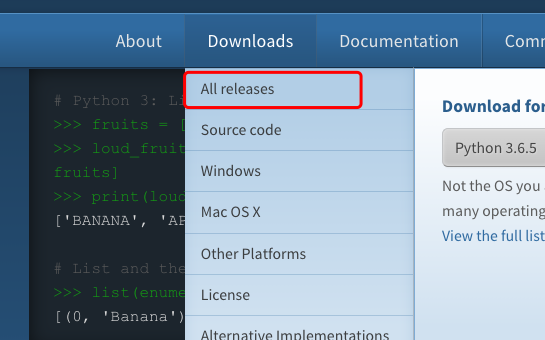
安装zlib相关依赖 解决zipimport.ZipImportError: can’t decompress data和pip3 ssl证书问题 sudo yum -y install zlib* sudo yum install openssl-devel 找到Python3下载链接 进入官网 选择对应版本 选一个你喜欢的Python3版本, 建议3.4以后(这里我选择3.6) 选择压缩包 右键赋值链接地址 比如这里是https://www.python.org/ftp/python/3.6.5/Python-3.6.5.tar.xz 下载 wget https://www.python.org/ftp/python/3.6.5/Python-3.6.5.tar.xz 解压 tar xvf Python-3.6.5.tar.xz 进入目录编译 configure sudo ./configure make sudo make install sudo make install 安装完成

优秀的个人博客,低调大师

CentOS下cpu信息和网卡等信息查看

1、查看物理CPU的个数 #cat /proc/cpuinfo |grep "physical id"|sort |uniq|wc –l 2、查看逻辑CPU的个数 #cat /proc/cpuinfo |grep "processor"|wc –l 3、查看CPU是几核 #cat /proc/cpuinfo |grep "cores"|uniq 4、查看CPU的主频 #cat /proc/cpuinfo |grep MHz|uniq 5、#uname -a 6、Linux euis1 2.6.9-55.ELsmp #1 SMP Fri Apr 20 17:03:35 EDT 2007 i686 i686 i386 GNU/Linux (查看当前操作系统内核信息) 7、#cat /etc/issue | grep Linux 8、Red Hat Enterprise Linux AS release 4 (Nahant Update 5(查看当前操作系统发行版信息) 9、#cat /proc/cpuinfo | grep name | cut -f2 -d: | uniq -c 8Intel(R) Xeon(R) CPUE5410@ 2.33GHz (看到有8个逻辑CPU, 也知道了CPU型号) 9#cat /proc/cpuinfo | grep physical | uniq -c 4physical id: 0 4physical id: 1 (说明实际上是两颗4核的CPU) 10、#getconf LONG_BIT 32 (说明当前CPU运行在32bit模式下, 但不代表CPU不支持64bit) 11、#cat /proc/cpuinfo | grep flags | grep ' lm ' | wc –l 8(结果大于0, 说明支持64bit计算. lm指long mode, 支持lm则是64bit) 12、如何获得CPU的详细信息: linux命令:cat /proc/cpuinfo 13、用命令判断几个物理CPU,几个核等: 逻辑CPU个数: # cat /proc/cpuinfo | grep "processor" | wc -l 物理CPU个数: # cat /proc/cpuinfo | grep "physical id" | sort | uniq | wc -l 14、每个物理CPU中Core的个数: # cat /proc/cpuinfo | grep "cpu cores" | wc -l 15、是否为超线程?如果有两个逻辑CPU具有相同的”core id”,那么超线程是打开的。每个物理CPU中逻辑CPU(可能是core, threads或both)的个数: # cat /proc/cpuinfo | grep "siblings" 1.查看CPU信息命令 cat /proc/cpuinfo 2.查看内存信息命令 cat /proc/meminfo 3.查看硬盘信息命令 fdisk -l 测试机器的硬件信息: 查看CPU信息(型号) # cat /proc/cpuinfo | grep name | cut -f2 -d: | uniq -c 8 Intel(R) Xeon(R) CPU E5410 @ 2.33GHz (看到有8个逻辑CPU, 也知道了CPU型号) # cat /proc/cpuinfo | grep physical | uniq -c 4 physical id : 0 4 physical id : 1 (说明实际上是两颗4核的CPU) # getconf LONG_BIT 32 (说明当前CPU运行在32bit模式下, 但不代表CPU不支持64bit) # cat /proc/cpuinfo | grep flags | grep ' lm ' | wc -l 8 (结果大于0, 说明支持64bit计算. lm指long mode, 支持lm则是64bit) 再完整看cpu详细信息, 不过大部分我们都不关心而已. # dmidecode | grep 'Processor Information' 查看内 存信息 # cat /proc/meminfo # uname -a Linux euis1 2.6.9-55.ELsmp #1 SMP Fri Apr 20 17:03:35 EDT 2007 i686 i686 i386 GNU/Linux (查看当前操作系统内核信息) # cat /etc/issue | grep Linux Red Hat Enterprise Linux AS release 4 (Nahant Update 5) (查看当前操作系统发行版信息) 查看机器型号 # dmidecode | grep "Product Name" 查看网卡信息 # dmesg | grep -i eth 查看操作系统版本 #lsb_release -a

优秀的个人博客,低调大师

Centos7 更换内核到4.16的尝试

背景: 特殊需求,需要使用kernel 4.x版本,在云上ECS如何更换呢? 怂一下先: 请对生产环境,保持敬畏之心,务必做好快照备份! 请对生产环境,保持敬畏之心,务必做好快照备份! 请对生产环境,保持敬畏之心,务必做好快照备份! 1,看下内核先 # uname -r 3.10.0-514.26.2.el7.x86_64 2,升级内核需要先导入elrepo的key,然后安装elrepo的yum源: # rpm -import https://www.elrepo.org/RPM-GPG-KEY-elrepo.org # rpm -Uvh http://www.elrepo.org/elrepo-release-7.0-2.el7.elrepo.noarch.rpm Retrieving http://www.elrepo.

优秀的个人博客,低调大师

centos7 hadoop 单机模式安装配置

版权声明:本文由董可伦首发于https://dongkelun.com,非商业转载请注明作者及原创出处。商业转载请联系作者本人。 https://blog.csdn.net/dkl12/article/details/80232782 我的原创地址:https://dongkelun.com/2018/03/23/hadoopConf/ 前言 由于现在要用spark,而学习spark会和hdfs和hive打交道,之前在公司服务器配的分布式集群,离开公司之后,自己就不能用了,后来用ambari搭的三台虚拟机的集群太卡了,所以就上网查了一下hadoop+hive的单机部署,以便自己能进行简单的学习,这里记录一下,本来想把hadoop和hive的放在一起写,由于太多,就分成两篇写了。 1、首先安装配置jdk(我安装的1.8) 2、下载hadoop 下载地址:http://mirror.bit.edu.cn/apache/hadoop/common/,我下载的是hadoop-2.7.5.tar.gz (由于我之前用的2.7.1是几年前下载保存在本地的,现在发现之前在配置spark那篇写的那个hadoop下载地址较慢,所以改成这个地址) 3、解压到/opt目录下(目录根据自己习惯) tar -zxvf hadoop-2.7.5.tar.gz -C /opt/ 4、配置hadoop环境变量 vim /etc/profile export HADOOP_HOME=/opt/hadoop-2.7.5 export PATH=$PATH:$HADOOP_HOME/bin source /etc/profile 5、配置hadoop 5.1 配置hadoop-env.sh vim /opt/hadoop-2.7.5/etc/hadoop/hadoop-env.sh 找到# The java implementation to use.将其下面的一行改为: export JAVA_HOME=/opt/jdk1.8.0_45 5.2 配置core-site.xml (5.2和5.3中配置文件里的文件路径和端口随自己习惯配置) 其中的IP:192.168.44.128为虚拟机ip,不能设置为localhost,如果用localhost,后面在windows上用saprk连接服务器(虚拟机)上的hive会报异常(win读取的配置也是localhost,这样localhost就为win本地ip了~也可以给ip加个映射,不过因为单机的我就没加)。 vim /opt/hadoop-2.7.5/etc/hadoop/core-site.xml <configuration> <property> <name>hadoop.tmp.dir</name> <value>file:///opt/hadoop-2.7.5</value> <description>Abase for other temporary directories.</description> </property> <property> <name>fs.defaultFS</name> <value>hdfs://192.168.44.128:8888</value> </property> </configuration> 5.3 配置hdfs-site.xml vim /opt/hadoop-2.7.5/etc/hadoop/hdfs-site.xml <configuration> <property> <name>dfs.replication</name> <value>1</value> </property> <property> <name>dfs.namenode.name.dir</name> <value>file:///opt/hadoop-2.7.5/tmp/dfs/name</value> </property> <property> <name>dfs.datanode.data.dir</name> <value>file:///opt/hadoop-2.7.5/tmp/dfs/data</value> </property> </configuration> 6、SSH免密码登录 参考:linux ssh 免密登录 7、启动与停止 第一次启动hdfs需要格式化: cd /opt/hadoop-2.7.5 ./bin/hdfs namenode -format Re-format filesystem in Storage Directory /opt/hadoop-2.7.5/tmp/dfs/name ? (Y or N) 输入:Y (出现询问输入Y or N,全部输Y即可) 启动: ./sbin/start-dfs.sh 停止: ./sbin/stop-dfs.sh 验证,浏览器输入:http://192.168.44.128:50070 简单的验证hadoop命令: hadoop fs -mkdir /test 在浏览器查看,出现如下图所示,即为成功 8、配置yarn 8.1 配置mapred-site.xml cd /opt/hadoop-2.7.5/etc/hadoop/ cp mapred-site.xml.template mapred-site.xml vim mapred-site.xml <configuration> <!-- 通知框架MR使用YARN --> <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> </configuration> 8.2 配置yarn-site.xml vim yarn-site.xml <configuration> <!-- reducer取数据的方式是mapreduce_shuffle --> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> </configuration> 8.3 yarn启动与停止 启动: cd /opt/hadoop-2.7.5 ./sbin/start-yarn.sh ./sbin/stop-yarn.sh 浏览器查看:http://192.168.44.128:8088 jps查看进程 到此,hadoop单机模式就配置成功了! 参考资料 https://blog.csdn.net/cafebar123/article/details/73500014

优秀的个人博客,低调大师

CentOS探索之路3---安装python3

安装Python3 总述 ​ 一般来说Linux类型的操作系统都会自带安装python,但是系统默认安装的python都是2.x的版本。而现在一般使用的是python3.x版本,相比于python2.x版本,python3.x教之前版本有较大升级,且不向下兼容python2.x版本。因此我们需要安装python3.x版本。 具体安装步骤 安装依赖包: 直接执行下面的命令: yum -y groupinstall "Development tools" yum -y install zlib-devel bzip2-devel openssl-devel ncurses-devel sqlite-devel readline-devel tk-devel gdbm-devel db4-devel libpcap-devel xz-devel 新建安装目录: 我这里直接安装到 /home/KiDe/dev/python路径下,执行下面命令: mkdir /home/KiDe/dev/python3 下载对应python包: 直接取python官网https://www.python.org/ftp/python/找到对应的版本,我这里进入到上一步创建的目录之后,直接执行: wget https://www.python.org/ftp/python/3.7.0/Python-3.7.0a4.tar.xz 解压python包: 直接在当前目录下输入以下命令进行解压: tar -xvJf Python-3.7.0a4.tar.xz 添加配置文件前缀: 直接执行: cd Python-3.7.0a4 ./configure --prefix=/home/KiDe/dev/python3 安装: 本来直接执行make && make install 就能安装,结果在安装的时候报了错:ModuleNotFoundError: No module named '_ctypes'网上搜发现这个链接说的很详细(https://blog.csdn.net/qq_36416904/article/details/79316972)。最终我的安装分两个步骤,分别执行的命令如下: yum install libffi-devel -y make && make install 创建软链接: 直接执行下面命令,将python3和pip3链接到python3安装目录: ln -s /home/KiDe/dev/python3/bin/python3 /usr/bin/python3 ln -s /home/KiDe/dev/python3/bin/pip3 /usr/bin/pip3 ​ ​ 好了,大功告成,可以畅游在python3的世界了~~~~ 黎明前最黑暗,成功前最绝望!

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册