首页 文章 精选 留言 我的

精选列表

搜索[智能推荐],共10000篇文章
优秀的个人博客,低调大师

推荐 10 个 NB 的 IDEA 插件,代码能自动生成的绝不手写

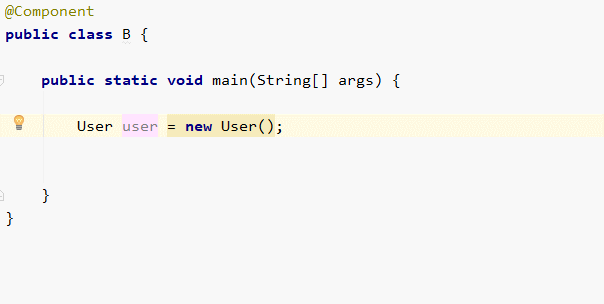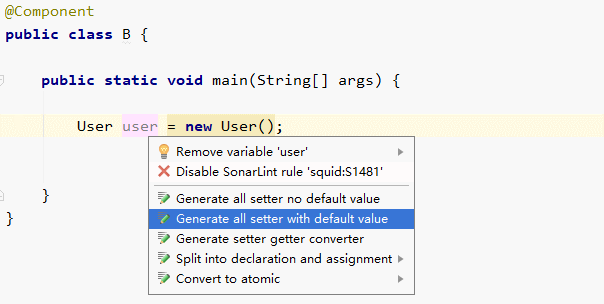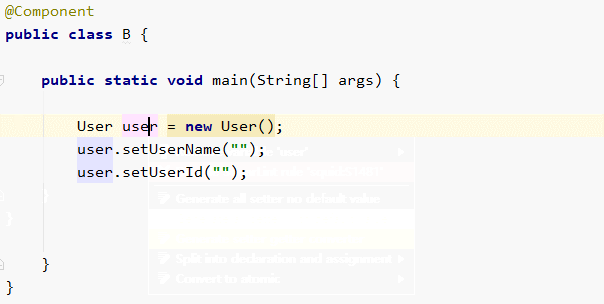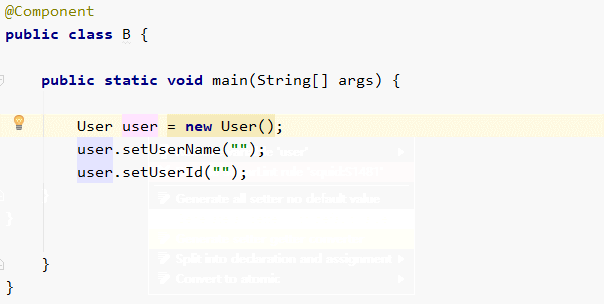
本文收录在 GitHub 地址 https://github.com/chengxy-nds/Springboot-Notebook 友情提示:插件虽好,可不要贪装哦,装多了会 卡 、卡 、卡 ~ 正经干活用的 分享一点自己工作中得心应手的IDEA插件,可不是在插件商店随随便便搜的,都经过实战检验,用过的都说好。可能有一些大家用过的就快速划过就行了。 1、GenerateAllSetter 实际的开发中,可能会经常为某个对象中多个属性进行 set 赋值,尽管可以用BeanUtil.copyProperties()方式批量赋值,但这种方式有一些弊端,存在属性值覆盖的问题,所以不少场景还是需要手动 set。如果一个对象属性太多 set 起来也很痛苦,GenerateAllSetter可以一键将对象属性都 set 出来。 快捷键:Alt+Enter 2、Alibaba Java Coding Guidelines 阿里出品的《Java 开发手册》时下已经成为了很多公司新员工入职必读的手册,前一段阿里发布了《Java 开发手册(泰山版)》, 又一次对Java开发规范做了完善。不过,又臭又长的手册背下来是不可能的,但集成到IDEA开发工具中就方便很多。 举个栗子:开发手册上不允许用Executors去创建线程池,而是通过ThreadPoolExecutor的方式。 集成插件后会再去使用Executors去创建线程池会有如下的提示。 3、GsonFormat GsonFormat 个人觉得是一个非常非常实用的插件,它可以将JSON字符串自动转换成Java实体类。特别是在和其他系统对接时,往往以JSON格式传输数据,而我们需要用Java实体接收数据入库或者包装转发,如果字段太多一个一个编写那就太麻烦了。 快捷键:Alt+ S 4、Maven Helper Maven Helper 是解决Maven依赖冲突的利器,可以快速查找项目中的依赖冲突。安装后打开pom文件,底部有 Dependency Analyzer 视图。显示红色表示存在依赖冲突,点进去直接在包上右键Exclude排除,pom文件中会做出相应排除包的操作。 Conflicts(冲突) All Dependencies as List(列表形式查看所有依赖) All Dependencies as Tree(树结构查看所有依赖),并且这个页面还支持搜索。 5、Codota 用了Codota 后不再怕对API不会用,举个栗子:当我们用stream().filter()对List操作,可是对filter()用法不熟,按常理我们会百度一下,而用Codota 会提示很多filter()用法,节省不少查阅资料的时间。 6、Free MyBatis Plugin 在使用MyBatis 作为持久框架时有一个尴尬的问题:SQL xml文件和定义的Java接口无法相互跳转,不能像Java接口间调用那样,只能全局搜索稍显麻烦。Free MyBatis Plugin将两者之间进行关联。 7、IntelliJad IntelliJad是一个Java class文件的反编译工具,需要在 setting 中设置本地Java jad.exe工具的地址。 随便找个Jar架包选择class文件右键Decompile,会出现反编译的结果。 8、Properties to YAML Converter 将Properties 配置文件一键转换成YAML 文件,很实用的一个插件。注意:要提前备份原Properties 文件 9、Lombok Lombok 插件应该比较熟,它替我们解决了那些繁琐又重复的代码,比如Setter、Getter、toString、equals等方法。 10、CodeGlance CodeGlance 是一款代码编辑区迷你缩放图插件,可以很方便的知道我们方法大致在什么位置。 IDEA还有不少的开发小技巧,有助于我们少些代码,不知道大家有没有发现?变量后.可以联想提示,而在联想列表的最后边有很多简洁的命令。 例如: list.sout = System.out.println(list); list.var = List<User> list1 = list list.nn = list.if (list != null) ...... 装X用的 下边这些就属于装X神器了,可以根据个人的喜好来耍一下。 1、Material Theme UI 使用插件后界面图标样式都会变的很漂亮。 2、activate-power-mode 这个震动的效果看似很是酷炫,可写了十分钟代码我就快被它晃悠吐了。 3、Nyan progress bar 会让IDEA所有进度条都变得萌萌的,但我并不建议你安装因为会很卡,不知道是不是只有我这样。 4、Rainbow Brackets 彩虹颜色的括号,看着很舒服,有点赏心悦目的感觉。 整理了几百本各类技术电子书,送给小伙伴们。关注公号回复【666】自行领取。和一些小伙伴们建了一个技术交流群,一起探讨技术、分享技术资料,旨在共同学习进步,如果感兴趣就加入我们吧! 无论你是刚入行、还是已经有几年经验的程序员,相信这份面试提纲都会给你不少助力,长按二维码关注 『 程序员内点事 』 ,回复 『 offer 』 自行领取,祝大家 offer 拿到手软

优秀的个人博客,低调大师

KTV 歌曲推荐-PCA 降维+逻辑回归-性别预测及过拟合处理

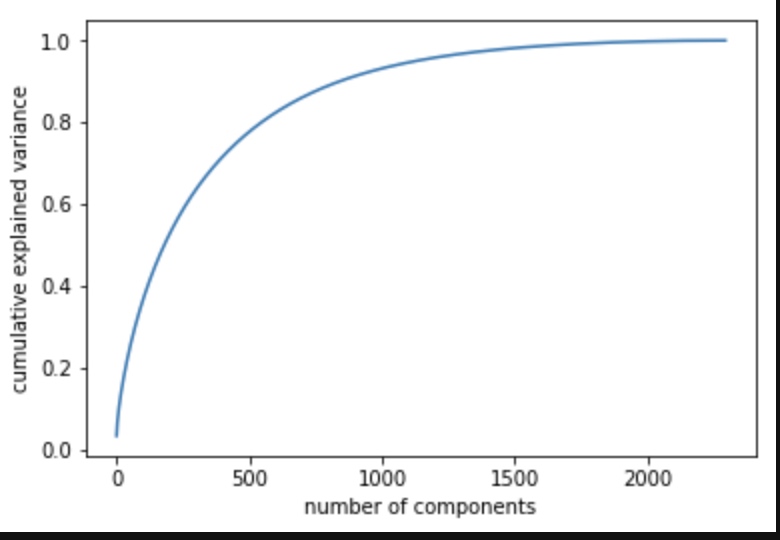
前言 上一篇使用逻辑回归预测了用户性别,由于矩阵比较稀疏所以会影响训练速度。所以考虑降维,降维方案有很多,本次只考虑PCA和SVD。 PCA和SVD原理 有兴趣的可以自己去研究一下 https://medium.com/@jonathan_hui/machine-learning-singular-value-decomposition-svd-principal-component-analysis-pca-1d45e885e491 我简述一下: PCA是将高维数据映射到低维坐标系中,让数据尽量稀疏 SVD就是非方阵的PCA 实际使用中SVD和PCA并无太大区别 如果特征大于数据记录数,并不能有好的效果,具体原因自己可以去看。 代码 数据获取和处理 以前文章写过很多次,这里略过 原数据shape为:2000*1900 PCA和矩阵转换 查看最佳维度数 %matplotlib inline import numpy as np import matplotlib.pyplot as plt from sklearn.decomposition import PCA pca = PCA().fit(song_hot_matrix) plt.plot(np.cumsum(pca.explained_variance_ratio_)) plt.xlabel('number of components') plt.ylabel('cumulative explained variance'); 从图中可以看出大概1500维度已经可以达到90+解释性 保留99%矩阵解释性 pca = PCA(n_components=0.99, whiten=True) song_hot_matrix_pca = pca.fit_transform(song_hot_matrix) 得到压缩后特征为: 2000*1565 并没有压缩多少 模型训练 import os os.environ["CUDA_DEVICE_ORDER"] = "PCI_BUS_ID" # see issue #152 os.environ["CUDA_VISIBLE_DEVICES"] = "" import numpy as np from keras.models import Sequential from keras.layers import Dense, Activation, Embedding,Flatten,Dropout import matplotlib.pyplot as plt from keras.utils import np_utils from sklearn import datasets from sklearn.model_selection import train_test_split n_class=user_decades_encoder.get_class_count() song_count=song_label_encoder.get_class_count() print(n_class) print(song_count) train_X,test_X, train_y, test_y = train_test_split(song_hot_matrix_pca, decades_hot_matrix, test_size = 0.2, random_state = 0) train_count = np.shape(train_X)[0] # 构建神经网络模型 model = Sequential() model.add(Dense(input_dim=song_hot_matrix_pca.shape[1], units=n_class)) model.add(Activation('softmax')) # 选定loss函数和优化器 model.compile(loss='categorical_crossentropy', optimizer='sgd', metrics=['accuracy']) # 训练过程 print('Training -----------') for step in range(train_count): scores = model.train_on_batch(train_X, train_y) if step % 50 == 0: print("训练样本 %d 个, 损失: %f, 准确率: %f" % (step, scores[0], scores[1]*100)) print('finish!') 训练结果: 训练样本 4750 个, 损失: 0.371499, 准确率: 83.207470 训练样本 4800 个, 损失: 0.381518, 准确率: 82.193959 训练样本 4850 个, 损失: 0.364363, 准确率: 83.763909 训练样本 4900 个, 损失: 0.378466, 准确率: 82.551670 训练样本 4950 个, 损失: 0.391976, 准确率: 81.756759 训练样本 5000 个, 损失: 0.378810, 准确率: 83.505565 测试集验证: # 准确率评估 from sklearn.metrics import classification_report scores = model.evaluate(test_X, test_y, verbose=0) print("%s: %.2f%%" % (model.metrics_names[1], scores[1]*100)) Y_test = np.argmax(test_y, axis=1) y_pred = model.predict_classes(song_hot_matrix_pca.transform(test_X)) print(classification_report(Y_test, y_pred)) accuracy: 50.20% 很明显已经过拟合 处理过拟合-增加Dropout 这里使用加Dropout,随机丢弃特征的方式处理过拟合,代码: # 构建神经网络模型 model = Sequential() model.add(Dropout(0.5)) model.add(Dense(input_dim=song_hot_matrix_pca.shape[1], units=n_class)) model.add(Activation('softmax')) accuracy:70% 处理过拟合-L1L2正则 这里给权重增加正则 # 构建神经网络模型 model = Sequential() model.add(Dense(input_dim=song_hot_matrix_pca.shape[1], units=n_class, kernel_regularizer=regularizers.l2(0.01))) model.add(Activation('softmax')) accuracy:62% Well Done 其实SVD的做法与PCA类似,这里不再演示。经过我测试发现,在我的数据集上,PCA虽然加快了训练速度,但是丢弃了太多特征,导致数据很容易过拟合。加入Dropout或者增加正则相可以改善过拟合的情况,下一篇会分享自编码降维。

优秀的个人博客,低调大师

码云推荐 | 微信读书开源的跨平台 UI 开发框架 QMUI

QMUI 是腾讯微信读书开发团队开源的一套致力于提高项目 UI 开发效率的跨平台解决方案,项目有iOS、Android 与 Web 三端支持。 QMUI Web QMUI Web 是一个专注 Web UI 开发,帮助开发者快速实现特定的一整套设计的框架。框架主要由一个强大的 SASS 方法合集与内置的工作流构成。通过 QMUI Web,开发者可以很轻松地提高 Web UI 开发的效率,同时保持了项目的高可维护性与稳健。如果你需要方便地控制项目的整体样式,或者需要应对频繁的界面变动,那么 QMUI Web 框架将会是你最好的解决方案。 它具有以下特性: 基础配置与组件。通过内置的公共组件和对应的 SASS 配置表,你只需修改简单的配置即可快速实现所需样式的组件。 SASS 增强支持。包含 70 个 SASS mixin/function/extend,涉及布局、外观、动画、设备适配、数值计算以及 SASS 原生能力增强等多个方面,可以大幅提升开发效率。 完善的内置工作流。内置的工作流拥有从初始化项目到变更文件的各种自动化处理,包含了模板引擎,雪碧图处理,图片集中管理与自动压缩,静态资源合并、压缩与变更以及冗余文件清理等功能。 扩展组件。除了内置的公共组件外,还通过扩展的方式提供了常用的扩展组件,如等高左右双栏,文件上传按钮,树状选择菜单。 QMUI Android​​​​​​​ QMUI Android 的设计目的是用于辅助快速搭建一个具备基本设计还原效果的 Android 项目,同时利用自身提供的丰富控件及兼容处理,让开发者能专注于业务需求而无需耗费精力在基础代码的设计上。不管是新项目的创建,或是已有项目的维护,均可使开发效率和项目质量得到大幅度提升。 特性包括: 全局 UI 配置。只需要修改一份配置表就可以调整 App 的全局样式,包括组件颜色、导航栏、对话框、列表等。一处修改,全局生效。 丰富的 UI 控件。提供丰富常用的 UI 控件,例如 BottomSheet、Tab、圆角 ImageView、下拉刷新等,使用方便灵活,并且支持自定义控件的样式。 高效的工具方法。提供高效的工具方法,包括设备信息、屏幕信息、键盘管理、状态栏管理等,可以解决各种常见场景并大幅度提升开发效率。 QMUI iOS QMUI iOS 与 QMUI Android 出发点一致,都是辅助开发者完成移动 UI 开发。除了拥有前边提到的 QMUI Android 功能特性外,它还支持UIKit 拓展及版本兼容:拓展多个 UIKit 的组件,提供更加丰富的特性和功能,提高开发效率;解决不同 iOS 版本常见的兼容性问题。 项目详情可以查看主页: https://gitee.com/QMUI

优秀的个人博客,低调大师

推荐 :手把手教你用Python创建简单的神经网络

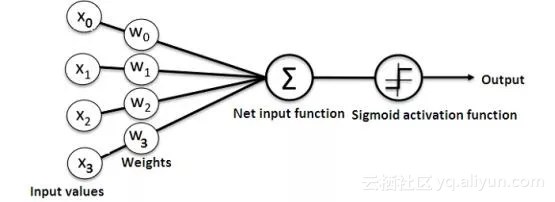
了解神经网络工作方式的最佳途径莫过于亲自创建一个神经网络,本文将演示如何做到这一点。 神经网络(NN)又称人工神经网络(ANN),是机器学习领域中基于生物神经网络概念的学习算法的一个子集。 拥有五年以上经验的德国机器学习专家Andrey Bulezyuk声称:“神经网络正在彻底改变机器学习,因为它们能够在广泛的学科和行业中为抽象对象高效建模。” 人工神经网络基本上由以下组件组成: 输入层:接收并传递数据 隐藏层 输出层 各层之间的权重 每个隐藏层都有一个激活函数。在这个简单的神经网络Python教程中,我们将使用Sigmoid激活函数。 神经网络有多种类型。在本项目中,我们将创建前馈或感知神经网络。这种类型的ANN直接将数据从前向后传递。 前馈神经元的训练往往需要反向传播,它为网络提供了相应的输入和输出集。当输入数据被传送到神经元时,经过处理后,产生一个输出。 下面的图表显示了一个简单的神经网络的结构:了解神经网络如何工作的最佳方法是学习如何从头开始构建神经网络(而不是采用任何库)。 在本文中,我们将演示如何利用Python编程语言创建一个简单的神经网络。 问题 如下是一个展示问题的表格。 我们将提供一个新的数据集,利用它训练神经网络,从而能够预测正确的输出值。 正如上表所示,输出值总是等于输入部分中的第一个值。因此,我们期望输出的值为1。 让我们看看是否可以使用Python代码来得出相同的结果(你可以在本文末尾仔细阅读这个项目的代码,然后再继续阅读本文)。 创建一个NeuralNetwork类 我们将用Python创建一个NeuralNetwork类来训练神经元,以期给出准确的预测。这个类还会有其他的帮助函数。 即使我们不会在这个简单的神经网络示例中使用神经网络库,我们也将导入numpy库来辅助计算。 numpy库提供了以下四种重要方法: exp—用于生成自然指数 array—用于生成矩阵 dot—用于矩阵相乘 random—用于生成随机数。请注意,我们将生成随机数,以确保它们的有效分布。 应用Sigmoid函数 我们将使用Sigmoid函数,来绘制一个特征“S”型曲线,作为神经网络的激活函数。此函数可以将任何值映射到0到1之间的值,它将有助于我们对输入的加权和归一化。 此后,我们将创建Sigmoid函数的导数,以帮助计算权重的调整参数。 可以利用Sigmoid函数的输出来生成它的导数。例如,如果输出变量为“x”,则其导数为x*(1-x)。 训练模型 这是我们教神经网络做出准确预测的阶段。每个输入都有一个权重-可为正值或负值。这意味着:有较大的正权重或负权重的输入会对结果的输出产生更大的影响。请记住,我们最初是通过为每个随机数分配一个权重后开始的。 下面是这个神经网络示例的训练过程: 第一步:从训练数据集中提取输入,根据训练数据集的权重进行调整,并通过一种计算神经网络输出的方法对其进行筛选。 第二步:计算反向传播错误率。在这种情况下,它是神经元的预测输出与训练数据集的期望输出之间的差异。 第三步:利用误差加权导数公式,根据所得到的误差范围,进行了一些较小的权值调整。 第四步:对这一过程进行15000次迭代。在每次迭代中,整个训练集被同时处理。 我们使用“.T”函数将矩阵从水平位置转换为垂直位置。因此,数字将以如下方式存储: 最终,神经元的权重将根据所提供的训练数据进行优化。随后,如果让神经元考虑一个新的状态,与先前的状态相同,它便可以作出一个准确的预测。这就是反向传播的方式。 打包运行 最后,NeuralNetwork类初始化成功后,可以运行代码了。 下面是如何在Python项目中创建神经网络的完整代码: import numpy as np class NeuralNetwork(): def __init__(self): # seeding for random number generation np.random.seed(1) #converting weights to a 3 by 1 matrix with values from -1 to 1 and mean of 0 self.synaptic_weights = 2 * np.random.random((3, 1)) - 1 def sigmoid(self, x): #applying the sigmoid function return 1 / (1 + np.exp(-x)) def sigmoid_derivative(self, x): #computing derivative to the Sigmoid function return x * (1 - x) def train(self, training_inputs, training_outputs, training_iterations): #training the model to make accurate predictions while adjusting weights continually for iteration in range(training_iterations): #siphon the training data via the neuron output = self.think(training_inputs) #computing error rate for back-propagation error = training_outputs - output #performing weight adjustments adjustments = np.dot(training_inputs.T, error * self.sigmoid_derivative(output)) self.synaptic_weights += adjustments def think(self, inputs): #passing the inputs via the neuron to get output #converting values to floats inputs = inputs.astype(float) output = self.sigmoid(np.dot(inputs, self.synaptic_weights)) return output if __name__ == "__main__": #initializing the neuron class neural_network = NeuralNetwork() print("Beginning Randomly Generated Weights: ") print(neural_network.synaptic_weights) #training data consisting of 4 examples--3 input values and 1 output training_inputs = np.array([[0,0,1], [1,1,1], [1,0,1], [0,1,1]]) training_outputs = np.array([[0,1,1,0]]).T #training taking place neural_network.train(training_inputs, training_outputs, 15000) print("Ending Weights After Training: ") print(neural_network.synaptic_weights) user_input_one = str(input("User Input One: ")) user_input_two = str(input("User Input Two: ")) user_input_three = str(input("User Input Three: ")) print("Considering New Situation: ", user_input_one, user_input_two, user_input_three) print("New Output data: ") print(neural_network.think(np.array([user_input_one, user_input_two, user_input_three]))) print("Wow, we did it!") 运行代码之后的输出:这样,我们便成功地创建了一个简单的神经网络。 神经元首先给自己分配一些随机权重,接着,利用训练实例进行了自我训练。 之后,如果出现新的状态[1,0,0],则它得出的数值为0.9999584。 还记得我们想要的正确答案是1吗? 这个数值非常接近,Sigmoid函数输出值在0到1之间。 当然,在这个例子中,我们只使用一个神经元网络来完成简单的任务。如果我们把几千个人工神经网络连接在一起,情况将会是怎样呢?我们能不能完全模仿人类的思维方式呢? 原文发布时间为:2018-12-18本文作者:Michael Garbade本文来自云栖社区合作伙伴“ 数据分析 ”,了解相关信息可以关注“ecshujufenxi”微信公众号

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册