首页 文章 精选 留言 我的

精选列表

搜索[行业样板间],共10000篇文章
优秀的个人博客,低调大师

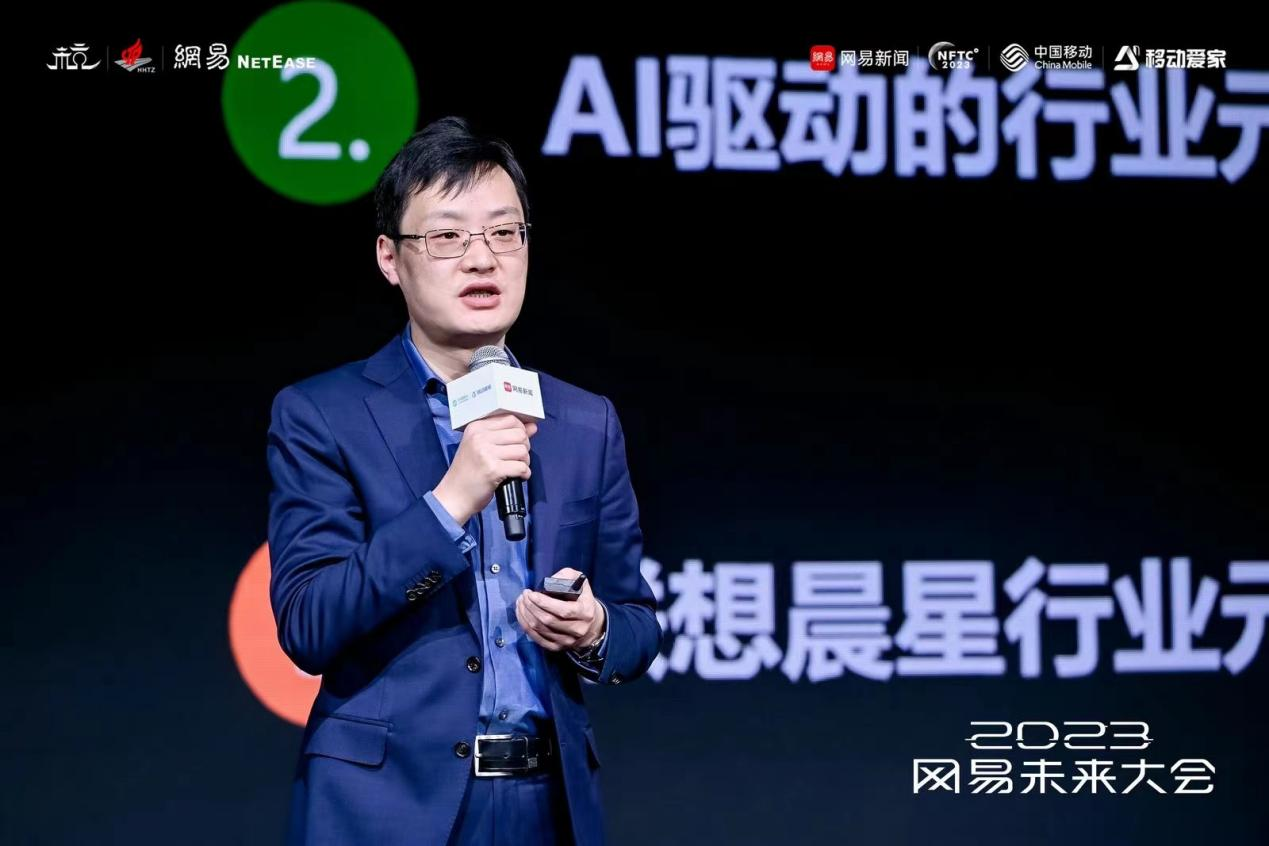
联想毛世杰:行业元宇宙愿景需要分阶段实现

“满足人和机器的协同效率,为现实世界提供服务,这是元宇宙的愿景”,12月22日,联想集团副总裁、联想研究院上海分院院长毛世杰在网易未来大会上表示,“而这个愿景需要分阶段实现。” “之所以我们需要元宇宙,需要数字空间,是因为在虚拟空间里可以实现真实世界难以实现,或者是实现成本很高的事情。”毛世杰强调,但是在构建虚拟空间以后,最终的目的仍然是要回到现实世界,一步一步赋能现实世界变得更加美好和高效。 以工业元宇宙为例,毛世杰指出,第一步是要构建元宇宙产线。在元宇宙产线中,工业产线叠加虚拟世界的信息与感知能力,可以提升人与机器人的决策能力和协作效率;在人、机器、数据等关键要素融合的产线数字孪生体和工业元宇宙虚拟装配空间中,非接触式检测手段可以实现三维自动化、智能化质检;工艺仿真模型库可以引导规范产线操作,提供专家远程协同指导等。 第二步是要构建元宇宙工厂。在元宇宙工厂中,通过低时延、高保真、智能决策的工厂级元宇宙平台可以实现多类型工业软件集成、沉浸交互设备实现智能巡检、远程协作等应用,工厂生产运营各环节信息可以全面感知和实时反馈。 第三步是打造元宇宙园区。在元宇宙园区中,虚实结合的新型园区建设模式和运营模式可以提升工业园区产业规划和布局能力,优化园区空间布局、设施配套、资源调配等协同服务能力和运营效率。此外,还可以建立基于工业元宇宙的科技创新和招商引资平台,创新园区服务模式。 “未来,联想将把持续打造成熟的工业元宇宙,开拓虚实互促的制造业增长新模式作为长期目标。”毛世杰强调。

优秀的个人博客,低调大师

某物联网数智化园区行业基于 KubeSphere 的云原生实践

公司简介 作为物联网 + 数智化园区一体化解决方案提供商,我们致力于为大中型园区、停车场提供软硬件平台,帮助园区运营者实现数字化、智能化运营。 在使用 K8s 之前我们使用传统的方式部署上线,使用 spug(一款轻量级无 Agent 的自动化运维平台) 自动化在单节点完成代码部署上线,也没有进行容器化,随着产品上线提上日程,对稳定性要求提高,以及私有化部署环境管理问题,我们开始使用 Docker 以及 K8s。 背景介绍 降本增效是每个企业的目标,而 DevOps、容器化、云原生就是研发团队降本增效的方法论。在这个趋势下,使用 Docker、K8s 几乎是每个开发团队的必经之路。 物联网平台对稳定性要求非常高,一旦停机,所有设备都将掉线重连,因此保证服务的稳定性,减少停机时间就非常重要。 在使用 K8s 之前,我们很多时间都要人工处理各种繁琐重复的服务维护问题,这种枯燥且毫无技术含量琐碎极大的消磨开发团队的激情。为了将人力从大量重复的环境配置、服务维护中解放出来从而提高开发迭代效率,我们就决定全面容器化,拥抱云原生。 总结来说就是: 服务稳定性,自动化运维,减少停机时间; 分布式部署,弹性伸缩; DevOps 规范的部署上线流程。 这些问题迫使我们开始调研容器化、Docker、K8s 的应用。 选型说明 由于没有相关经验,因此一开始我们就希望找到一款能够帮助快速上手 K8s 的工具,在调研 KubeSphere、Zadig、Rancher、KubeVela、Kubeadm 等多款工具后,我们最终选择了 KubeSphere。 选择 KubeSphere 最主要的原因首先是它的社区活跃,有问题能够找到解决方案。同时它集成了很多开箱即用的插件如 DevOps,这正是我们所需要的。当然第一眼就选中 KubeSphere 还是因为它的颜值,能看得出来 KubeSphere 的 UI 是经过精心设计过的,这在开发工具领域中是极为难得的,从这点上就能够看出背后的开发团队对于打造一款基于 K8s 的云原生操作系统的理念与决心。 使用 KubeSphere 让我们立马就拥有了成熟 DevOps 工作流了,而无需额外的搭建成本,这对于我们毫无 K8s 经验的团队来说太重要了,极大的降低了上手门槛。 目前我们将所有无状态应用全部容器化,使用 K8s 负载,提交代码 Webhook 触发 KubeSphere 流水线自动发布,对于不习惯命令行操作的用户,KubeSphere 后台能满足所有需求。 实践过程 容器化及迁移到 K8s、KubeSphere 第一步就是将应用全部 Docker 容器化,然后使用 K8s 的 deployment 进行部署。实现分布式高可用的服务部署。 K8s 让我们轻易的就拥有了一个分布式高可靠的架构了,分布式部署从未如此简单。 创建 DevOps 项目流水线 KubeSphere 的 DevOps 项目不同于常规项目,这是 KubeSphere 中独有的概念,和 K8s 的命名空间没关系,流水线可以直接用 Jenkinsfile,也可以用可视化的方式创建,非常方便。 配置好发布流水线后,对于开发来说只用提交代码就行了,KubeSphere 会自动帮我们按照预期把应用部署到集群中,上线前的最后一公里问题被彻底解决了。 管理 Pod 在 KubeSphere 后台可以直接管理 Pod ,容器信息一目了然,还可以直接进入容器,查看容器实时日志。负载也能一键伸缩,轻点鼠标就能够快速部署和回滚。 日志和监控方案 由于我们之前就有了 ELK 和 Prometheus、Grafana 了,因此日志我们只需要将容器内的应用日志采集到集中的 ELK 上去就可以了。监控也是如此,只需要采集 node_exporter 和业务指标就行了。 如果之前没有相关方案,也可以直接使用 KubeSphere 开箱即用的日志监控方案,同样也是基于 Elasticsearch 和 Prometheus 的。 多租户资源可视化 企业空间完美契合了多租户管理,这样对于私有化部署、资源利用统计都非常方便,同时企业空间下的项目 刚好就对应 K8s 中的命名空间,这让人非常惊喜,KubeSphere 是紧贴 K8s 标准的,不会增加任何学习使用成本。 集群状态和资源用量排行可以直观看到各节点资源使用情况,方便为未来资源预算做好规划。还可以对企业空间进行配额限制,满足了不同租户资源控制需求。 存储 由于我们目前主要是无状态应用,对储存要求不高,所以用的是最简单的方案集中式 NFS,由于是单节点存储,所以存在单点问题,这个后面可以使用云厂商的 NAS 存储或者其它分布式存储。 使用过程中遇到的困难及其解决方案 CI 构建节点配置问题 节点配置至少在 4C·16G ,否则 DevOps Jenkins 可能无法正常运行,这个还是有些占资源的,建议 使用特定节点充当 CI 节点:为依赖项缓存设置 CI 节点 流水线不响应问题 有时会出现流水线一直等待运行,或者卡住的问题,这通常是构建节点资源问题,我们遇到过前端 node 打包 cpu 占满问题,出现这种情况时应该首先检查打包节点的资源情况,kill 掉占用高的打包进程就行了。或尝试重新创建 DevOps-jenkins 负载通常能够解决问题。有时还需要进入 Jenkins 后台查看问题(密码与 KubeSphere 后台密码相同)。 构建缓存问题 由于 git 缓存问题,所以我们将 jenkins-casc-config.yaml 中定义的 Agent 配置 idleMinutes 改为一个较大的值,以实现打包 Pod 在构建后不会被删除。 之所以只能这样,是因为 base-n8qkj 的卷 workspace-volume,卷类型是 EmptyDir 临时的,如果是 HostPath 类型的就好了,这点不知道官方是怎么考虑的。 configmap 更新问题 在 K8s 中 configmap 的更新会自动生效,并同步到各个挂载了 volumes configMap 的 Pod 上去,这样就可以实现配置更新后自动生效而不用重新发布应用。 但是在使用中我们发现存在一个问题,这种生效机制是通过软连接实现的(改变软连接指向,删除旧的文件),而某些应用可能会出现在更新配置时,短暂的找不到文件报错的问题(phpfpm),所以针对这个情况我们额外做了处理,原理是应用不直接挂载 configMap 了,而是通过另一个容器去挂载 configMap 并处理好稳定的文件后再供目标应用使用。 使用效果 使用 KubeSphere 后我们几乎就没再关注过服务是否在线等运维的琐碎事情了,因为 K8s 会保证一切按照预期进行,这使得我们的迭代发布速度大大提高,开发要做的只是提交代码,其它的一切都不用操心,极大的提高了开发编码的幸福度和对保障服务稳定的信心。 无状态应用分布式部署,弹性伸缩; 自动发布,自动化运维,故障自愈; 一次构建到处运行,无惧环境搭建。 未来规划 由于还在逐步学习应用中,目前对 K8s 的应用场景还比较简单,未来还有很多探索的点,如: 存储上,目前为了解决 web 无状态应用 可能也会有临时文件上传等需求,使用了 NFS 存储,这样多节点 Pod 可以共享存储,后面可以尝试使用其它更为可靠的分布式存储。 应用上,目前主要是将无状态应用部署了上来,随着学习的深入,后面可以将更多的有状态应用也部署上来。 最后希望 KubeSphere 能够越来越普及,紧跟 K8s 官方标准,在降低上手门槛、社区、文档建设等方面不断取得突破,让更多的人能够更快速的享受到 K8s 的好处。 本文由博客一文多发平台 OpenWrite 发布!

优秀的个人博客,低调大师

Google 漏洞悬赏金额创下新记录,Chrome 修复速度行业领先

Google 近日发布官方博客表示,他们的漏洞奖励计划(VRP)在 2021 年继续得到增长,共发放了 870 万美元的漏洞奖励,其中这些找到漏洞的研究人员还将他们奖励中的 30 万美元捐赠给了慈善机构。 Android: 对于 Android 系统的漏洞奖励而言,2021 年与 2020 年相比,研究人员获得的报酬翻了一番。落到具体数字上的话,研究人员在 2021 年获得了近 300 万美元的奖励。Google 还发放了有史以来最大的单笔 Android 系统漏洞赏金 —— 15.7 万美元(研究员 gzobqq@gmail.com 在 Android 中发现了一个关键的漏洞利用链 CVE-2021-39698)。 漏洞奖励金额一览: 代码执行漏洞 Pixel Titan M:最高 100 万美元 安全元件:最高 25 万美元 可信执行环境:最高 25 万美元 内核:最高 25 万美元 特权进程:最高 10 万美元 数据泄露 由 Titan M 保护的高价值数据:最高 50 万美元 由安全元件保护的高价值数据:最高 25 万美元 Google 在去年还推出了 Android 芯片组安全奖励计划(Android Chipset Security Reward Program),这是 Google 与 Android 芯片制造商合作提供的漏洞奖励计划。2021 年,研究人员单单为这一个计划就提交了 220 多份安全报告,Google 为此共奖励了 29.6 万美元。 Chrome: 谈到 Chrome,Google 发放的奖励也创造了一个新纪录。他们向发现的 333 个 Chrome 安全漏洞,共 115 名研究人员发放了 330 万美元的奖励。这些贡献不仅可以帮助 Google 改进 Chrome,还能改进所有基于 Chromium 的浏览器。 在这 330 万美元中,有 310 万美元用于奖励 Chrome 浏览器中所发现的安全漏洞,另外的 20 多万美元则是用于奖励 Chrome OS 中的漏洞,其中对单个 Chrome OS 安全漏洞发放的最高奖金达到 4.5 万美元(在 Chrome OS 中实现 root 权限提升的问题),对单个 Chrome 浏览器安全漏洞发放的最高奖金则是 2.7 万美元。 其中 Chrome 在接收错误报告和向用户提供修复程序之间的间隔最短,平均时间为 30 天,而 Chrome 的竞争对手 Firefox 则需要 38天,Safari 甚至需要 73天。 Google Play: Google Play 向 60 多名安全研究人员支付了 55 万美元的奖励。 Bug Hunters: Google 在去年 7 月推出了一个全新的漏洞悬赏平台(我们对此也有报道),该平台为研究人员提供了一个提交 Google、Android、Chrome、Google Play 等漏洞的统一入口,简化了流程。该平台还通过提供各种维度的排行榜、奖励金额、徽章等功能,将提交漏洞的过程游戏化,进一步激发了研究人员的热情。未来 Google 还会积极听取研究人员的意见,持续改进这个平台。

优秀的个人博客,低调大师

基于深度学习的短文本相似度学习与行业测评

2 --> 文本相似度计算作为NLP的热点研究方向之一,在搜索推荐、智能客服、闲聊等领域得到的广泛的应用。在不同的应用领域,也存在着一定的差异,例如在搜索领域大多是计算query与document的相似度;而在智能客服、聊天领域更注重的是query与query之间的匹配,即短文本之间的相似度计算。 不同的文本长度,相似度的计算方案也存在差异,长文本匹配更多注重文本的关键词或者主题的匹配,业界使用的较多的算法如:TF-IDF、LSA、LDA;而短文本匹配更多的是句子整体的语义一致性,业界较为主流的算法有:word2vec、esim、abcnn、bert等深度模型。 相比于长文本的相似度计算,短文本的相似度计算存在更大的挑战。其一,短文本可以利用的上下文信息有限,语义刻画不够全面;其二,短文本通常情况下,口语化程度更高,存在缺省的可能性更大;第三,短文本更注重文本整体语义的匹配,对文本的语序、句式等更为敏感。 query1 query2 我要打给你 我要打你 你叫什么 你叫我什么 我叫小布 我不叫小布 你有男票吗 你是单身狗吗 你真搞笑 你是个逗比啊 我喜欢看动漫 你不知道我喜欢看动漫吗 不同文本相似度算法的得分分布不一致,无法通过评分来对算法进行评估。因此对于不同的算法方案,可以设定特定的得分门限,得分高于门限,可判断为语义相同;否则,判断为语义不同。对于一个给定标签的数据集,可以通过准确率来衡量相似度计算的效果。常用的中文评估语料有:LCQMC、BQ Corpus、PAWS-X (中文)、afqmc等。 1. 主流方案 业界常用的短文本相似度计算方案大致可以分为两类:监督学习与无监督学习,通常情况下,监督学习效果相对较好。在没有足够的训练数据需要冷启动的情况下,可优先考虑使用无监督学习来进行上线。 1.1 无监督学习 最简单有效的无监督学习方案就是预训练的方式,使用word2vec或者bert等预训练模型,对任务领域内的无标签数据进行预训练。使用得到的预训练模型,获取每个词以及句子的语义表示,用于相似度的计算。 Word2vec是nlp领域一个划时代的产物,将word的表征从离散的one-hot的方式转化成连续的embedding的形式,不仅降低了计算维度,各个任务上的效果也取得了质的飞跃。Word2vec通过对大规模语料来进行语言模型(language model)的建模,使得语义相近的word,在embedding的表示上,也具有很强的相关性。 通过cbow或者max-pooling的方式,使用句子中每个词的word embedding计算得到sentence embedding,可以使得语义相似的句子在sentence embedding的表示上也具备较高的相关性,相比于传统的TF-IDF等相似度计算具有更好的泛化性。但是cbow的方式来计算sentence embedding,句子中所有word使用相同的权重,无法准确获取句子中的keyword,导致语义计算的准确率有限,难以达到上线标准。 虽然Word2vec提供了一定的泛化性,但其最大的弱点是在不同的语境下,同一个word的表征完全相同,无法满足丰富的语言变化。gpt、bert等大规模预训练模型的出现,彻底解决了这个问题,做到了word的表征与上下文相关,同时也不断刷新了各个领域任务的榜单。 但实验证明直接使用bert输出的token embedding来计算句子的sentence embedding,无论使用cbow的方式对所有token embedding求平均或者直接使用[CLS] token的embedding来表示,语义计算的效果都不佳,甚至不如GloVe。究其原因,在bert的预训练过程中,高频词之间共现概率更大,MLM任务训练使得它们之间语义表征更加接近,而低频词之间的分布更为稀疏。语义空间分布的不均匀,导致低频词周围中存在很多语义的“hole”,由于这些“hole”的存在,导致语义计算的相似度存在偏差。 为了解决bert语义空间不均匀的问题,CMU与字节跳动合作的bert-flow提出将bert的语义空间映射到一个标准的高斯隐空间,由于标准高斯分布满足各向同性,区域内不存在“hole”,不会破坏语义空间的连续性。 Bert-flow的训练过程就是学习一个可逆的映射f,把服从高斯分布的变量z映射到BERT编码的u,那就可以把u映射到均匀的高斯分布,这时我们最大化从高斯分布中产生BERT表示的概率,就学习到了这个映射: 实验表明,通过bert-flow的方式来进行语义表征与相似度计算的效果,要远远优于word2vec以及直接使用bert的方式。 1.2 监督学习 Bert-flow的出现使得无监督学习在文本相似度计算方面取得了较大进步,但是在特定任务上相比于监督学习,效果还存在一定的差距。监督学习常用的相似度计算模型大致可以分为两类:语义表征模型,语义交互式模型。语义表征模型常用于海量query召回,交互式模型更多使用于语义排序阶段。 DSSM是搜索领域最常用的语义表征模型之一,而在短文本匹配领域,使用最多的网络结构是孪生网络,常用的孪生网络包括:siamese cbow,siamese cnn,siamese lstm等。孪生网络训练时,所有query使用相同模型来进行语义表征,通过余弦相似度等方式来计算query间的相似度,不断最大化正样本之间的相关性,抑制负样本之间的相关性。预测时,每个query通过语义模型单独获取语义向量,用来计算query之间的相似度得分。由于query 语义表征仅与本身有关,因此在进行query检索时,可以提前对语料库中query构建语义索引,大大提升系统的检索效率。 相比于语义表征模型,交互式语义模型具有更好的匹配效果,模型结构往往也更加复杂,常用的交互式语义模型有ABCNN、ESIM等。交互式模型在计算query之间的语义相似度时,不仅对单个query的语义特征进行建模,还需要query之间的交互特征。交互式模型通常使用二分类的任务来进行训练,当模型输入的两个query语义一致,label为“1”,反之,label为“0”。在预测时,可通过logits来作为置信度判断。 大规模预训练模型的出现,也横扫了文本相似度任务的各项榜单。Bert将lcqmc数据集的SOTA带到了86%的水平。随后,Roberta、albert、ernie等新的预训练模型层出不穷,也不断刷新着匹配准确率的SOTA水平。 2. 业务应用 在语义问答的业务中,通常会使用召回+排序的算法架构,在我们的闲聊业务中,我们也使用了类似的架构。使用siamese cnn语义表征模型来进行语义召回,用蒸馏后的transformer语义交互模型来做排序。 在语义表征模型的loss构建上,我们参考了人脸识别领域的损失函数设计。这个两个任务在本质上是相似的,人脸识别是将人脸图片用向量表示,而文本检索式将文本用向量来进行表示,都期望正样本之间有足够高的相关性,负样本之间足够好区分。 在使用Siamese cnn进行语义建模时,我们使用了1个标准query,1个正样本,5个负样本(尝试过其他负样本数量,在我们的数据上效果不如5个负样本),训练过程其实是在这6个样本中,识别出对应正样本的位置,因此可将其转化为分类任务来进行训练,每个正负样本分别对应一个类别。使用每个样本与标准query之间的相似度,来作为对应类别的logits,对logits进行归一化并构建loss函数。传统的softmax归一化构建的分类边界使得类别之间可分,为了更好的语义表征效果,需要使得类内更加汇聚,类间更加分散。ASoftmax、AMSoftmax、ArcFace等归一化方式,提出将所有query映射到一个球面,query之间的相似度通过他们之间的夹角来计算,夹角越小相似度越高,通过在角度域添加margin的方式,使得类内更汇聚,类间更可分,达到更好的语义表征效果。 我们对比了softmax、Asoftmax、AMSoftmax、Arcface等不同归一化方式,其中,Softmax没有添加任何margin,ASoftmax通过倍角的方式在角度域添加margin,AMSoftmax则是在余弦域添加margin,而Arcface则是直接在角度域添加固定margin。 我们使用30W的语料库来构建索引,使用12900条线上query(语料库中不包含完全相同的query)来进行召回测试,使用相同的向量索引工具,对比发现AMSoftmax、Arcface召回效果上有很大提升,在我们的业务中得到了应用。 在排序模型方面,我们尝试了ABCNN、ESIM、transformer等交互式语义模型,但效果相比于bert等预训练模型,还存在一定的差距。我们团队自研的预训练模型Xbert,在与Roberta large同规模的情况下,融入了自研知识图谱数据,添加了WWM(whole word MLM)、DAE、Entity MLM等任务,使用LAMB优化器进行优化。我们使用XBert在业务数据上进行了测试,相比于同规模的Roberta large准确率有接近0.9%的提升。为了满足上线需求,我们参考tiny bert的方式,用Xbert蒸馏了一个4层的transformer model用于线上推断。 我们在内部的问答数据集上对不同排序方案做了的效果对比,使用12900条线上用户真实query,进行全链路的效果对比测试。用语义召回top1的准确率来评估语义表征模型的效果,并且通过消歧模块进一步提升应答准确率;测试排序模型效果时,我们使用了多路召回,共召回30个候选,使用排序模型对候选排序,选择排序后的top1作为最终答案。若经过消歧模块,所有候选均被消歧掉,或排序后的top1候选排序得分不满足应答门限时,则该query系统无应答。因此,我们使用应答率与应答准确率来作为系统最终的评测指标,来评估不同方案的效果。 为了测试自研的Xbert在公开的语义相似度数据集上的效果,在lcqmc数据集上,单模型准确率88.96%,较Roberta large单模型87.9%的准确率,提升了1%;通过使用正样本之间的传递性以及负样本采样的方式,来进行数据增强以及FGM对抗训练的方式,准确率提升至89.23%;通过ensemble的方式,将准确率进一步提升至90.47%。通过相同的方式,在bq_corpus上达到了87.17%,在paws-x任务上达到了88%,在afqmc数据集上也达到了77.234%,在百度举办的千言文本相似度比赛中完成登顶。 3. 总结与展望 短文本相似度在我们的闲聊领域得到了应用,使用语义表征学习来进行召回+交互模型排序的算法架构,在保证系统性能的前提下,取得了不错的业务效果。在语义表征模型上,我们使用人脸识别领域的loss来提升召回效果;在语义排序方面,我们也利用了大规模预训练模型以及模型蒸馏,来进一步提升业务效果。在大规模预训练语言模型方面,我们积极探索与改进,相比于现有开源预训练模型,我们的Xbert在业务上以及公开数据集上的评测效果,都有了进一步的提升。 在今后的工作中,我们会利用好预训练模型这个核武器,在我们Xbert的基础上努力优化突破,将文本的相似度匹配任务带新的台阶。在解决单轮相似度匹配的情况下,我们也会继续探索结合上下文的多轮匹配以及多轮生成等任务,来进一步提升我们闲聊业务的体验。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册