首页 文章 精选 留言 我的

精选列表

搜索[文智公众趋势分析],共10000篇文章
优秀的个人博客,低调大师

告别DNS劫持,一文读懂DoH

如果评选一个差评服务器榜单,除去育碧高居榜首外,一定也少不了 Nintendo Switch 让人头秃的联网服务。尽管任天堂已经架设了香港 CDN 服务器用于加速,但是更新安装的速度也没有什么大幅改变。一般这种时候大家都会选择更改 DNS 来提高 NS 下载速度。 DNS(域名系统)是工作生活中很常见的名词,用户只需要在浏览器中输入一个可识别的网址,系统便会在很短的时间内找到相应的 IP 地址。在解析过程中,DNS 会访问各种名称服务器,从这些名称服务器中获取存储着的与 URL 对应的数字地址。截止到现在,DNS 已经发展了几十年,虽然使用广泛,却很少引起人们对其安全性的关注。 从安全角度来看,请求传输时通常不进行任何加密,任何人都可以读取的 DNS 其实是不安全的。这意味着网络罪犯可以很容易地使用自己的服务器拦截受害者的 DNS,将用户的请求跳转到钓鱼网站上,这些网站发布恶意软件,或在正常网站上投放大量广告吸引用户,这种行为我们称之为 DNS 劫持。为了减少这类情况的发生,业界专家目前在挣扎讨论基于 HTTPS 的 DNS(DoH)的可行性选择。那么什么是通过 HTTPS 的 DNS,它可以使 Internet 更安全吗?我们一起来看看吧。 为什么需要通过 HTTPS 的 DNS? 在日常上网中,如果用户输入无法解析的网址(例如,由于输入错误),则某些 Internet 提供商(ISP)会故意使用 DNS 劫持技术来提供错误消息。一旦 ISP 拦截了此内容,就会将用户定向到自己的网站,在该网站宣传自己或第三方的产品。虽然这并不违法,也不会直接损害用户,但是该类重定向仍会让用户反感。因此,单独使用 DNS 协议并不是非常可靠的。 而 DoH (DNS over HTTPS)即使用安全的 HTTPS 协议运行 DNS ,主要目的是增强用户的安全性和隐私性。通过使用加密的 HTTPS 连接,第三方将不再影响或监视解析过程。因此,欺诈者将无法查看请求的 URL 并对其进行更改。如果使用了基于 HTTPS 的 DNS ,数据在传输过程中发生丢失时,DoH 中的传输控制协议(TCP)会做出更快的反应。 目前,DoH 尚未成为 Internet 上的全球标准,大多数连接仍依赖基本的 DNS。到目前为止,仅 Google 和 Mozilla 两家公司涉足了这一领域。Google 现正在与部分用户一起测试该功能。此外,还有用于移动设备的应用程序,这些应用程序也可以通过 DoH 进行网上冲浪。Android Pie 也提供了通过网络设置启用基于 HTTPS 的 DNS 选项。 通过 HTTPS 的 DNS 如何工作? 通常一些域名解析会直接从用户的客户端进行,相应的域名信息被保存在浏览器或路由器的缓存中。而期间传输的所有内容都需要通过 UDP 连接,因为这样可以更快速地交换信息。但是我们都知道,UDP 既不安全也不可靠。使用该协议时,数据包可能会随时丢失,因为没有任何机制可以保证传输的可靠性。 而 DoH 依赖于 HTTPS,因此也依赖于 TCP,一种在 Internet 上使用频率更高的协议。这样既可以对连接进行加密, TCP 协议也可以确保完整的数据传输。另外,使用了基于 HTTPS 的 DNS,通信始终通过 443 端口进行,并在 443 端口传输实际的网络流量(例如,访问网站)。因此,外人无法区分 DNS 请求和其他通信,这也保障了更高级别的用户隐私。 DoH 的优点和缺点 DoH 的优点是显而易见的,该技术提高了安全性并保护了用户隐私。与传统的 DNS 相比,DoH 提供了加密措施。它利用 HTTPS 这种行业通用的安全协议,将 DNS 请求发往 DNS 服务器,这样运营商或第三方在整个传输过程中,只能知道发起者和目的地,除此以外别的什么都知道,甚至都不知道我们发起了 DNS 请求。 DoH 的加密措施可防止窃听或拦截 DNS 查询,但这也会带来了一些潜在的风险。多年以来实施的一些互联网安全措施都要求 DNS 请求过程可见。例如,家长控制需要依靠运营商为一些用户阻止访问某些域名。执法部门可能希望通过 DNS 数据来跟踪罪犯,并且许多组织都会使用安全系统来保护其网络,这些安全系统也会使用 DNS 信息来阻止已知的恶意站点。引入 DoH 可能会严重影响上述这些情况。因此,目前 DoH 还处于自主配置的时期。用户需要清楚谁可以看到数据,谁可以访问数据以及在什么情况下可以访问。 DoH 与 DoT 除了基于 HTTPS 的 DNS 外,目前还有另一种用于保护域名系统的技术:基于 TLS 的 DNS(DoT)。这两个协议看起来很相似,它们也都承诺了更高的用户安全性和隐私性。但是这两项标准都是单独开发的,并且各有各的 RFC 文档。DoT 使用了安全协议 TLS,在用于 DNS 查询的用户数据报协议(UDP)的基础上添加了 TLS 加密。DoT 使用 853 端口,DoH 则使用 HTTPS 的 443 端口。 由于 DoT 具有专用端口,因此即使请求和响应本身都已加密,但具有网络可见性的任何人都可以发现来回的 DoT 流量。DoH 则相反,DNS 查询和响应在某种程度上伪装在其他 HTTPS 流量中,因为它们都是从同一端口进出的。 关于 DoT 和 DoH 究竟哪个更好?这个还有待商榷。不过从网络安全的角度来看,DoT 可以说是更好的。它使网络管理员能够监视和阻止 DNS 查询,这对于识别和阻止恶意流量非常重要。另一方面,DoH 查询隐藏在常规 HTTPS 流量中。这意味着,若不阻止所有其他的 HTTPS 流量,就很难阻止它们。 推荐阅读 最容易被盗的密码,你中了么? 聊聊 DNS 的那些小知识

优秀的个人博客,低调大师

一文总结GaussDB通信原理知识

摘要:从发展历程到通信模型设计,到你了解一下GaussDB通信原理知识。 MPPDB通信库发展历程 Postgres-XC 方法:采用libpq通信库实现CN和DN之间的连接,CN负责计算,DN仅进行数据存储。 缺点:随着计算任务的不断增大,CN计算出现瓶颈,且白白浪费DN的计算能力。 V1R3 方法:提出分布式执行框架,将计算下推到DN上执行,DN不仅作为存储同时承担计算任务。由于每个DN只存储有一部分数据,因此DN间也需要进行通信,采用stream线程TCP直连,每个连接都需要一个TCP端口。 缺点:随着集群规模的增加,DN之间的连接数不断增加,在大并发场景下需要大量的TCP端口,而实际情况是由于单机TCP端口只有65535个,TCP端口数严重限制了数据库的集群规模和并发规模。 V1R5-V1R7C00 方法:结合SCTP协议的多流优点,DN间的通信采用SCTP通信库架构,使用逻辑连接来代替物理连接,用来解决DN之间连接太多的问题。 缺点:SCTP协议本身存在的内核BUG,通信报错。 V1R7C10 方法:TCP代理通信库。 缺点:CN和DN之间的物理连接数也会暴涨。 V1R8C00 方法:CN和DN之间也采用逻辑连接实现,即CN多流。 问题1:DN间是查询结果的通信还是原始数据的通信? 解:既有查询结果,也有原始数据;DN之间的数据交流是Hash之后,各个DN根据所需获取。 通信模型的设计 1. Pooler通信模型 问题2:连接池上的CN、DN是否存在交集,即poolA中的DN在poolB中也存在? 解:不存在。 问题3:CN和CN的连接是做什么的?为什么设计连接池连接CN上的PG线程?CN上为什么有多个PG线程,有什么用途? 解:CN和CN之间连接是为了数据同步等,包括建表之后的信息交汇。CN上的PG线程也是为了用户查询建立。 问题4:DN上为什么有多个PG线程,有什么用途? 解:一个查询操作就是创建一个新的PG线程。 问题5:如何理解gsql客户端退出时,只退出PG线程和agent代理线程,而取到的slot连接会还回database pool? 解:slot连接退回到pooler,下次连接可以直接获取,若不存在,则重新创建。 问题6:DN间的TCP连接数:C = (H * D * Q * S)* D,为什么最后乘以D,而不是(D - 1)/ 2 ? 此外,这个公式是否存在高重复,每次查询都要建立DN间的通信,而不考虑重复性?DN间的通信线程数量是否有限制? 解:数据是双向通信,但执行算子是单向的,所以不能除以2。数量有限制,但可以调整。 2. DN间stream线程通信模型 执行计划需要使用多个线程进行执行,包括1个CN线程和每个DN上3个线程t1-t3。每个DN节点都有3个线程是因为数据是分布到每个DN上的,在执行查询过程中,查询的每个阶段每个DN都要参与。自下而上是数据流,自上而下是控制流。具体执行过程如下: 每个DN的t3顺序扫描table表,将表数据广播到所有DN的t2线程; 每个DN的t2接收t3的数据,建立hash表,然后扫描store_sales数据与customer表进行hashjoin,join结果进行哈希聚集后,重分布发送到对应DN的t1线程; 每个DN的t1线程将收到的数据进行第二次哈希聚集, 排序后将结果传输到CN; CN收集所有DN的返回数据,作为结果集返回。 问题7:DN上是否执行查询操作?DN广播的数据是否属于同一个数据表?每个DN都广播数据,那最后所有DN的数据是否相同?图中t2发送给所有DN的t1?、 解:执行,DN上存的数据是表的几分之几,不是整个表,也不是一个表的部分,是所有表的一部分,这样做是为了并发。DN数据不相同,因为各取所需。 SCTP通信库设计 1. 概要 SCTP 协议:一种可靠、保序协议,支持message-based模式,单个通道支持65535个流,且多流之间互不阻塞,利用该特性,可以打破设备物理连接数对大规模集群节点间通信的限制,支持更大规模的节点规模。 通道共享:每两个节点之间有一个数据传输单向SCTP物理通道,在这条物理通道内部有很多逻辑通道(inner Stream),每个stream流由producer发送到consumer,利用SCTP内部支持多流的特性,不同的producer & consumer对使用通道中不同的流(SCTP流),因此每两个点之间仅需要两个数据连接通道。 通道复用:查询完成后,物理通道中的逻辑连接关闭,物理连接不关闭,后面的查询继续使用建好的物理连接。 流量控制:采用pull模式,因为SCTP通道的所有流共享内核的socket buffer, 为了避免一个连接发的数据量过大,consumer端却不接收,导致kernel的buffer被填满,阻塞了其他流的发送,增加了流控,给每个流设置一个quota, 由接收端分配,当有quota时,告知发送端可发送数据,发送端根据发来的quota值,发送quota大小的数据量,实现接收端与发送端同步控制;为了保证控制信息的可靠性,将控制信息和数据通道分离,流控信息走单独的一条双向TCP控制通道。 2. 架构 TCP Channels:TCP控制通道,控制流走此通道; SCTP Channels:SCTP数据通道,包含很多stream流,数据流走此通道; Send Controller发送端流控线程:gs_senders_flow_controller(),收发控制消息; Recv Controller接收端流控线程:gs_receivers_flow_controller(),接收端用于发送和接收控制报文,与代理接收线程不同,代理接收线程接收的是数据,而接收流控线程接收的是报文; Receiver代理接收线程:gs_receivers_loop(),用于接收数据的线程,从sctp数据通道中接收数据,将数据放到不同逻辑连接的不同cmailbox报箱中,并通知执行层的consumer工作线程来取,取走后,有空闲的buffer时,接收端流控线程会通过tcp控制通道通知发送端还有多少空闲内存,即还有多少quota可用于继续接收数据; Auxiliary辅助线程:gs_auxiliary(),由top consumer,每个两秒检查一下,处理公共事务,如DFX消息,Cancel信号响应等; 数据PULL模型:每个逻辑连接有quota大小的buffer,需要数据时将空闲buffer的大小(即quota)发送给发送端,发送端即可以发送quota大小的数据,quota不足时阻塞发送,直到接收端的buffer被应用取走。 TCP多流实现 TCP代理在现有的逻辑连接、代理分发、quota流控等实现的基础上,将数据通道从SCTP协议替换成TCP协议,TCP代理逻辑连接的实现基于head+data的数据包收发模型,在head中写入逻辑连接id及后续data的长度。 问题8:单机TCP只有65535个端口,SCTP呢?TCP多流和TCP在端口上的区别?TCP的三次握手是否依旧? SCTP是基于消息流传输,数据收发的最小单位是消息包(chunk),一个SCTP连接(Association)同时可以支持多个流(stream),每个流包含一系列用户所需的消息数据(chunk)。而TCP协议本身只能支持一个流,因此我们需要在这一个流中区分不同逻辑连接的数据,通过在TCP报文的head中写入逻辑连接id及后续data的长度来区分,这样虽然TCP只有一个数据包组成,但每个数据包包含多个块,实现了TCP的多流。同时发送时需保证整包原子发送。 问题9:如何多流?是多个通道同时发送head+data吗? 解:一个流发送完整的数据。多流是并发。 TCP代理通信库的发送端实现,producerA和producerB分别给DN1发送数据,为保证发送端head+data发送的完整性,producerA首先需要对单个物理连加锁,此时producerB处于等锁状态,producerA将数据完整发送到本地协议栈后返回,并释放锁,producerB获得锁后发送数据。节点数越多冲突越少。 问题10:加锁等待是否影响效率?SCTP的实现也是如此? 解:不影响,因为有缓存buffer。 问题11:数据丢失,永远无法达到head怎么办?一直缓存? 解:不会丢失,TCP协议有保证。 CN多流实现 在V1R8C00版本中,CN和DN之间的链接使用libcomm通信库,即两个节点间仅存在一条物理通道,在该物理通道上使用逻辑连接通道实现并行通信。 CN端流程: 建立连接:CN调用Libcomm的gs_connect与DN建立连接,入参中指明建立双向逻辑通道,使用相同的nidx,sidx同时初始化发送和接受的mailbox,通过发送流控线程通知接收端; 等待DN返回结果:通过判断发送mailbox的状态,确认DN端已成功建立的逻辑连接(发送流控线程收到DN端的CTRL_READY报文); 发送startuppacket:通过PQbuildPGconn,初始化libpq的pg_conn结构体,生成startuppacket,随后通过gs_send发送startuppacket给DN端; 等待DN PG线程初始化:通过LIBCOMMgetResult,等待DN端返回ready for query报文,之后认为连接建立成功。 DN端流程: 初始化发送、接收mailbox:DN端接收流控线程识别到连接请求来自CN后,调用gs_build_reply_conntion,注册CN的信息,初始化发送mailbox,随后初始化接收mailbox,最终通过流控线程返回CTRL_READY报文,表示逻辑通道建立成功; 创建unix domain sock:DN端接收流控线程,创建一个unix domain sock,将生成的逻辑连接地址通过该通道发给postmaster主线程; fork postgres子线程:postmaster主线程的serverloop监听到unix domain sock后,接收逻辑连接地址,保存到port结构体中,随后fork postgres子线程(沿用原有逻辑); postgres线程初始化完毕:在pg线程完成初始化后,首先给CN回复ready for query报文,随后进入ReadCommand函数,等待CN发来的下一个Query。 本文分享自华为云社区《GaussDB通信原理总结》,原文作者:Caesar.D 发。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

一文终结SQL 子查询优化

子查询(Subquery)的优化一直以来都是 SQL 查询优化中的难点之一。关联子查询的基本执行方式类似于 Nested-Loop,但是这种执行方式的效率常常低到难以忍受。当数据量稍大时,必须在优化器中对其进行去关联化(Decoorelation 或 Unnesting),将其改写为类似于 Semi-Join 这样的更高效的算子。 前人已经总结出一套完整的方法论,理论上能对任意一个查询进行去关联化。本文结合 SQL Server 以及 HyPer 的几篇经典论文,由浅入深地讲解一下这套去关联化的理论体系。它们二者所用的方法大同小异,基本思想是想通的。 本文的例子都基于 TPC-H 的表结构,这里 有一份供你参考。 子查询简介 子查询是定义在 SQL 标准中一种语法,它可以出现在 SQL 的几乎任何地方,包括 SELECT, FROM, WHERE 等子句中。 总的来说,子查询可以分为关联子查询(Correlated Subquery)和非关联子查询(Non-correlated Subquery)。后者非关联子查询是个很简单的问题,最简单地,只要先执行它、得到结果集并物化,再执行外层查询即可。下面是一个例子: SELECTc_count,count(*)AScustdist FROM( SELECTc_custkey,count(o_orderkey)ASc_count FROMCUSTOMER LEFTOUTERJOINORDERSONc_custkey=o_custkey ANDo_commentNOTLIKE'%pending%deposits%' GROUPBYc_custkey )c_orders GROUPBYc_count ORDERBYcustdistDESC,c_countDESC; ▲ TPCH-13 是一个非关联子查询 非关联子查询不在本文讨论范围之列,除非特别声明,以下我们说的子查询都是指关联子查询。 关联子查询的特别之处在于,其本身是不完整的:它的闭包中包含一些外层查询提供的参数。显然,只有知道这些参数才能运行该查询,所以我们不能像对待非关联子查询那样。 根据产生的数据来分类,子查询可以分成以下几种: 标量(Scalar-valued)子查询:输出一个只有一行一列的结果表,这个标量值就是它的结果。如果结果为空(0 行),则输出一个 NULL。但是注意,超过 1 行结果是不被允许的,会产生一个运行时异常。 标量子查询可以出现在任意包含标量的地方,例如 SELECT、WHERE 等子句里。下面是一个例子: SELECTc_custkey FROMCUSTOMER WHERE1000000<( SELECTSUM(o_totalprice) FROMORDERS WHEREo_custkey=c_custkey ) ▲ Query 1: 一个出现在 WHERE 子句中的标量子查询,关联参数用红色字体标明了 SELECTo_orderkey,( SELECTc_name FROMCUSTOMER WHEREc_custkey=o_custkey )ASc_nameFROMORDERS ▲ Query 2: 一个出现在 SELECT 子句中的标量子查询 存在性检测(Existential Test)子查询:特指 EXISTS 的子查询,返回一个布尔值。如果出现在 WHERE 中,这就是我们熟悉的 Semi-Join。当然,它可能出现在任何可以放布尔值的地方。 SELECTc_custkey FROMCUSTOMER WHEREc_nationkey=86ANDEXISTS( SELECT*FROMORDERS WHEREo_custkey=c_custkey ) ▲ Query 3: 一个 Semi-Join 的例子 集合比较(Quantified Comparision)子查询:特指 IN、SOME、ANY 的查询,返回一个布尔值,常用的形式有:x = SOME(Q)(等价于x IN Q)或X <> ALL(Q)(等价于x NOT IN Q)。同上,它可能出现在任何可以放布尔值的地方。 SELECTc_name FROMCUSTOMER WHEREc_nationkey<>ALL(SELECTs_nationkeyFROMSUPPLIER) ▲ Query 4: 一个集合比较的非关联子查询 原始执行计划 我们以 Query 1 为例,直观地感受一下,为什么说关联子查询的去关联化是十分必要的。 下面是 Query 1 的未经去关联化的原始查询计划(Relation Tree)。与其他查询计划不一样的是,我们特地画出了表达式树(Expression Tree),可以清晰地看到:子查询是实际上是挂在 Filter 的条件表达式下面的。 img实际执行时,查询计划执行器(Executor)在执行到 Filter 时,调用表达式执行器(Evaluator);由于这个条件表达式中包含一个标量子查询,所以 Evaluator 又会调用 Executor 计算标量子查询的结果。 这种 Executor - Evaluator - Executor 的交替调用十分低效!考虑到 Filter 上可能会有上百万行数据经过,如果为每行数据都执行一次子查询,那查询执行的总时长显然是不可接受的。 Apply 算子 上文说到的 Relation - Expression - Relation 这种交替引用不仅执行性能堪忧,而且,对于优化器也是个麻烦的存在——我们的优化规则都是在匹配并且对 Relation 进行变换,而这里的子查询却藏在 Expression 里,令人无从下手。 为此,在开始去关联化之前,我们引入 Apply 算子: Apply 算子(也称作 Correlated Join)接收两个关系树的输入,与一般 Join 不同的是,Apply 的 Inner 输入(图中是右子树)是一个带有参数的关系树。 Apply 的含义用下图右半部分的集合表达式定义:对于 Outer Relation RR 中的每一条数据 rr,计算 Inner Relation E(r)E(r),输出它们连接(Join)起来的结果 r⊗E(r)r⊗E(r)。Apply 的结果是所有这些结果的并集(本文中说的并集指的是 Bag 语义下的并集,也就是 UNION ALL)。 “ Apply 是 SQL Server 的命名,它在 HyPer 的文章中叫做 Correlated Join。它们是完全等价的。考虑到 SQL Server 的文章发表更早、影响更广,本文中都沿用它的命名。 根据连接方式(⊗⊗)的不同,Apply 又有 4 种形式: Cross ApplyA×A×:这是最基本的形式,行为刚刚我们已经描述过了; Left Outer ApplyALOJALOJ:即使 E(r)E(r) 为空,也生成一个 r∘{NULLs}r∘{NULLs}。 Semi ApplyA∃A∃:如果 E(r)E(r) 不为空则返回 rr,否则丢弃; Anti-Semi ApplyA∄A∄:如果 E(r)E(r) 为空则返回 rr,否则丢弃; 我们用刚刚定义的 Apply 算子来改写之前的例子:把子查询从 Expression 内部提取出来。结果如下: 上面的例子中,我们可以肯定 Scalar Agg 子查询有且只有一行结果,所以可以直接转成 Apply。但某些情况下,可能无法肯定子查询一定能返回 0 或 1 行结果(例如,想象一下 Query 2 如果 c_custkey 不是唯一的),为了确保 SQL 语义,还要在 Apply 右边加一个 Max1RowMax1Row 算子: Max1Row(E)=⎧⎩⎨⎪⎪Null,E,error,if |E|=0if |E|=1otherwiseMax1Row(E)={Null,if |E|=0E,if |E|=1error,otherwise 理论上,我们可以将所有的子查询转换成 Apply 算子,一个通用的方法如下: 如果某个算子的表达式中出现了子查询,我们就把这个子查询提取到该算子下面(留下一个子查询的结果变量),构成一个 ALOJALOJ 算子。如果不止一个子查询,则会产生多个 ALOJALOJ。必要的时候加上 Max1RowMax1Row 算子。 然后应用其他一些规则,将 ALOJALOJ 转换成 A×A×、A∃A∃、A∄A∄。例如上面例子中的子查询结果 XX 被用作 Filter 的过滤条件,NULL 值会被过滤掉,因此可以安全地转换成 A×A×。 下面这个例子中,Filter 条件表达式中包含 Q1Q1、Q2Q2 两个子查询。转换之后分别生成了对应的 Apply 算子。其中 Q2Q2 无法确定只会生成恰好一条记录,所以还加上了 Max1RowMax1Row 算子。 基本消除规则 第一组规则是最基本的规则,等式中的 ⊗⊗ 说明它不限制连接类型,可以是 {×,LOJ,∃,∄}{×,LOJ,∃,∄} 中的任意一个。 这两条规则是非常显而易见的,翻译成大白话就是:如果 Apply 的右边不包含来自左边的参数,那它就和直接 Join 是等价的。 下面是对 Query 3 应用规则 (2) 的例子: Project 和 Filter 的去关联化 第二组规则描述了如何处理子查询中的 Project 和 Filter,其思想可以用一句话来描述:尽可能把 Apply 往下推、把 Apply 下面的算子向上提。 注意这些规则仅处理 Cross Apply 这一种情况。其他 3 种 Apply 的变体,理论上都可以转换成 Cross Apply,暂时我们只要知道这个事实就可以了。 你可能会问:通常我们都是尽可能把 Filter、Project 往下推,为什么这里会反其道而行呢?关键在于:Filter、Project 里面原本包含了带有关联变量的表达式,但是把它提到 Apply 上方之后,关联变量就变成普通变量了!这正是我们想要的。 我们稍后就会看到这样做的巨大收益:当 Apply 被推最下面时,就可以应用第一组规则,直接把 Apply 变成 Join,也就完成了子查询去关联化的优化过程。 下面是对 Query 2 应用规则 (3) 的例子。之后再应用规则 (1),就完成了去关联化过程。 Aggregate 的去关联化 第三组规则描述如何处理子查询中的 Aggregate(即 Group By)。和上一组一样,我们的指导思想仍然是:尽可能把 Apply 往下推、把 Apply 下面的算子向上提。 下面等式中,GA,FGA,F 表示带有 Group By 分组的聚合(Group Agg),其中 AA 表示分组的列,FF 表示聚合函数的列;G1FGF1 表示不带有分组的聚合(Scalar Agg)。 img这一组规则不像之前那么简单直白,我们先看一个例子找找感觉。下面是对 Query 1 运用规则 (9) 的结果: 规则 (9) 在下推 Apply 的同时,还将 ScalarAgg 变成了 GroupAgg,其中,分组列就是 R 的 key,在这里也就是 CUSTOMER 的主键 c_custkey。 “ 如果 R 没有主键或唯一键,理论上,我们可以在 Scan 时生成一个。 为什么变换前后是等价的呢?变换前,我们是给每个 R 的行做了一次 ScalarAgg 聚合计算,然后再把聚合的结果合并起来;变换后,我们先是将所有要聚合的数据准备好(这被称为 augment),然后使用 GroupAgg 一次性地做完所有聚合。 这也解释了为什么我们要用 ALOJALOJ 而不是原本的 A×A× :原来的 ScalarAgg 上,即使输入是空集,也会输出一个 NULL。如果我们这里用 ALOJALOJ,恰好也会得到一样的行为(*);反之,如果用 A×A× 就有问题了——没有对应 ORDERS 的客户在结果中消失了! 规则 (8) 处理的是 GroupAgg,道理也是一样的,只不过原来的分组列也要留着。 ScalarAgg 转换中的细节* 细心的读者可能注意到,规则 (9) 右边产生的聚合函数是 F′F′,多了一个单引号,这暗示它和原来的聚合函数 FF 可能是有些不同的。那什么情况下会不同呢?这个话题比较深入了,不感兴趣的同学可以跳过。 首先我们思考下,GroupAgg 以及 ALOJALOJ 的行为真的和变换前一模一样吗?其实不然。举个反例: SELECT c_custkey, ( SELECT COUNT(*) FROM ORDERS WHERE o_custkey = c_custkey ) AS count_orders FROM CUSTOMER 设想一下:客户 Eric 没有任何订单,那么这个查询应当返回一个['Eric', 0]的行。但是,当我们应用了规则 (9) 做变换之后,却得到了一个['Eric', 1]的值,结果出错了! 为何会这样呢?变换之后,我们是先用 LeftOuterJoin 准备好中间数据(augment),然后用 GroupAgg 做聚合。LeftOuterJoin 为客户 Eric 生成了一个['Eric', NULL, NULL, ...]的行;之后的 GroupAgg 中,聚合函数COUNT(*)认为 Eric 这个分组有 1 行数据,所以输出了['Eric', 1]。 下面是个更复杂的例子,也有类似的问题: SELECT c_custkey FROM CUSTOMER WHERE 200000 < ( SELECT MAX(IF_NULL(o_totalprice, 42)) -- o_totalprice may be NULL FROM ORDERS WHERE o_custkey = c_custkey ) 作为总结,问题的根源在于:F(∅)≠F({NULL})F(∅)≠F({NULL}),这样的聚合函数 FF 都有这个问题。 变换后的 GroupAgg 无法区分它看到的 NULL 数据到底是 OuterJoin 产生的,还是原本就存在的,有时候,这两种情形在变换前的 ScalarAgg 中会产生不同的结果。 幸运的是,SQL 标准中定义的聚合函数 F(col)F(col) 都是 OK 的——它们都满足 F(∅)=F({NULL})F(∅)=F({NULL}),我们只要对 FF 稍加变换就能解决这个问题。 对于例子一,将COUNT(*)替换成一个对非空列(例如主键)的 Count 即可,例如:COUNT(o_orderkey); 对于例子二,需要把MIN(IF_NULL(o_totalprice, 42))分成两步来做:定义中间变量X,先用 Project 计算X = IF_NULL(o_totalprice, 42),再对聚合函数MIN(X)进行去关联化即可。 集合运算的去关联化 最后一组优化规则用来处理带有 Union(对应UNION ALL)、Subtract(对应EXCEPT ALL) 和 Inner Join 算子的子查询。再强调一遍,我们的指导思想是:尽可能把 Apply 往下推、把 Apply 下面的算子向上提。 下面的等式中,×× 表示 Cross Join,⋈R.key⋈R.key 表示按照 RR 的 Key 做自然连接:r∘e1∘e2r∘e1∘e2 。和之前一样,我们假设 RR 存在主键或唯一键,如果没有也可以在 Scan 的时候加上一个。 注意到,这些规则与之前我们见过的规则有个显著的不同:等式右边 RR 出现了两次。这样一来,要么我们把这颗子树拷贝一份,要么做成一个 DAG 的执行计划,总之会麻烦许多。 事实上,这一组规则很少能派上用场。在 [2] 中提到,在 TPC-H 的 Schema 下甚至很难写出一个带有 Union All 的、有意义的子查询。 其他 有几个我认为比较重要的点,用 FAQ 的形式列在下面。 ► 是否任意的关联子查询都可以被去关联化? 可以说是这样的,在加上少量限定之后,理论上可以证明:任意的关联子查询都可以被去关联化。 证明方法在 [1]、[3] 中都有提及。以 [1] 中为例,思路大致是: 对于任意的查询关系树,首先将关联子查询从表达式中提取出来,用 Apply 算子表示; 一步步去掉其中非基本关系算子,首先,通过等价变换去掉 Union 和 Subtract; 进一步缩小算子集合,去掉 OuterJoin、ALOJALOJ、A∃A∃、A∄A∄; 最后,去掉所有的 A×A×,剩下的关系树仅包含基本的一些关系算子,即完成了去关联化。 另一方面,现实世界中用户使用的子查询大多是比较简单的,本文中描述的这些规则可能已经覆盖到 99% 的场景。虽然理论上任意子查询都可以处理,但是实际上,没有任何一个已知的 DBMS 实现了所有这些变换规则。 ► HyPer 和 SQL Server 的做法有什么异同? HyPer 的理论覆盖了更多的去关联化场景。例如各种 Join 等算子,[3] 中都给出了相应的等价变换规则(作为例子,下图是对 Outer Join 的变换)。而在 [1] 中仅仅是证明了这些情况都可以被规约到可处理的情形(实际上嘛,可想而知,一定是没有处理的)。 另一个细节是,HyPer 中还存在这样一条规则: 其中,D=ΠF(T2)∩A(T1)(T1)D=ΠF(T2)∩A(T1)(T1),表示对 T1T1 的 Distinct Project 结果(所谓的 _Magic Set_)。直接看等式比较晦涩,看下面的例子就容易理解了: 图中,在做 Apply 之前,先拿到需要 Apply 的列的 Distinct 值集合,拿这些值做 Apply,之后再用普通的 Join 把 Apply 的结果连接上去。 这样做的好处是:如果被 Apply 的数据存在大量重复,则 Distinct Project 之后需要 Apply 的行数大大减少。这样一来,即使之后 Apply 没有被优化掉,迭代执行的代价也会减小不少。 ► 本文说的这些变换规则,应该用在 RBO 还是 CBO 中呢?换句话说,去关联化后之后的执行计划一定比去关联化之前更好吗? 答案是,不一定。 直观的看,如果 Apply 的左边数据量比较少(例如,仅有 1 条数据),那直接带入 Apply 的右边计算反而是更好的方式。另一种情况是,右边有合适的索引,这种情况下,多次 Apply 的代价也并非不可接受。 所以把这些规则放进一个 CBO 的优化器是更合适的,优化器根据代价估计选出最优的计划来。甚至,在某些情况下,我们还会自右向左地运用这些等式,做“加关联化”。 这和用 HashJoin 还是 NestedLoopJoin 是同样的道理。事实上,NestedLoopJoin 就是 Apply 的一个特例。如果存在合适的索引,NestedLoopJoin 效率高于 HashJoin 是很常见的事情。

优秀的个人博客,低调大师

一文了解Kubernetes的前世今生

近十几年来,IT领域新技术、新概念层出不穷,例如DevOps、微服务(Microservice)、容器(Container)、云计算(Cloud Computing)和区块链(Blockchain)等,直有“乱花渐欲迷人眼”之势。另外,出于业务的需要,IT应用模型也在不断地变革,例如,开发模式从瀑布式(Waterfall)到敏捷(Agile)再到精益(Lean),甚至是与QA和Operations融合的DevOps,应用程序架构从单体(monolithic)模型到分层模型再到微服务,部署及打包方式从面向物理机到虚拟机再到容器,应用程序的基础架构从自建机房到托管再到云计算,等等,这些变革使得IT技术应用的效率大大提升,同时却以更低的成本交付更高质量的产品。尤其是以Docker为代表的容器技术的出现,终结了DevOps中交付和部署环节

优秀的个人博客,低调大师

一文看懂存储虚拟化技术

【大咖・来了 第7期】10月24日晚8点观看《智能导购对话机器人实践》 这次,我们一起学习—存储虚拟化技术。 数据在整个计算机系统是最重要的一部分,也是最珍贵的。数据的存储一直是一个热议的话题,在没有云计算之前数据存储已经发展了很久,可以说和云计算没有特别关系,我这边将的云计算存储通常指的是亚马逊的 S3 存储或者 EBS 存储等,将统一的资源池划分给多个用户。 什么是存储 存储,历史悠久,无处不在。 存储是 Storage,注意和内存 (记忆体)Memory 区分; 本质的差异是 Storage 要持久化,Memory 一般认为是 RAM,掉电易失,主要作用是 XIP(eXecute In Place) 。人的记忆要能存储起来就好了。存储,不同的介质千差万别,种类繁多…… 什么是存储虚拟化 存储虚拟化是在存储设备上加入一个逻辑层,通过逻辑层访问存储资源 对管理员来说,可以很方便的调整存储资源,提高存储利用率 对终端用户来说,集中的存储设备可以提供更好的性能和易用性 存储虚拟化的实现方式 裸设备+逻辑卷: 存储设备虚拟化 主机存储虚拟化+文件系统 存储虚拟化的原理 裸设备+逻辑卷的方式是最直接的存储控制方式,直接在通用块层之上划分成以 1 G 为单元的存储块,通过管理这些单元,实现卷的维护操作 存储设备虚拟化是指通过存储设备的能力,实现卷的维护操作,并且存储设备还可以提供一些存储高级业务,例如精简配置、快照和链接克隆 主机存储虚拟化+文件系统是指主机通过文件系统管理虚拟机磁盘文件,并通过虚拟化层提供很多高级业务,业务能力不依赖存储设备 裸设备+逻辑卷虚拟化结构 裸设备+逻辑卷的方式是最直接的存储控制方式,直接在通用块层之上划分成以 1 G 为单元的存储块,通过管理这些单元,实现卷的维护操作; IO 路径简单,读写性能***,但不支持高级业务; 术语解释: 主机内核空间:Dom-0 Kernel Space 用户虚拟机:Guest OS 前段驱动:blkfront 后端驱动:blkback 通用块层:Generic Block Layer 存储设备虚拟化的结构 存储设备虚拟化是指通过存储设备的能力,实现卷的维护操作,并且存储设备还可以提供一些存储高级业务,例如精简配置、快照和链接克隆 该技术的优点:与主机无关,不占用主机资源,数据管理功能丰富。 该技术的缺点:一般只能实现对本设备内磁盘的虚拟化。不同厂商间的数据管理功能不能互操作。多套存储设备需要配置多套数据管理软件,成本较高。 存储虚拟化+文件系统的结构 主机存储虚拟化+文件系统是指主机通过文件系统管理虚拟机磁盘文件,并通过虚拟化层提供很多高级业务,这也是目前业界采用较多的虚拟化方式。 支持异构存储和异构服务器 高级功能丰富,且不依赖于硬件设备 IO 路径较长,性能有损耗 存储虚拟化类型 几种存储虚拟化技术的比较

优秀的个人博客,低调大师

独家 | 一文带你读懂特征工程!

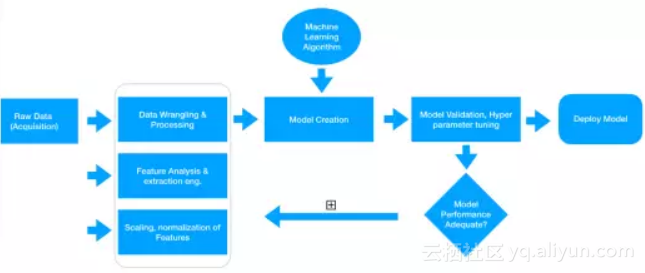
无论它的规模和大小如何,数据已经成为现代企业、公司和组织的一流资产。任何一个智能系统都需要数据驱动,无论它多复杂。每个智能系统的核心,均有一个或多个基于某种数据学习方法的算法,例如机器学习、深度学习或统计方法,它们利用这些数据来生成知识,并在一段时间内提供智能洞察。 算法本身是非常通用的,但无法在普通原始数据上有效发挥作用。因此,需要从原始数据中提取有意义的特征,我们才能够理解和使用这些数据。 任何一个智能数据洞察系统基本上都由端到端的管道组成: •先是 获取原始数据 ; •然后利用数据处理技术,从这些数据中 获取、处理和提取有意义的特征和属性 ; •最后,通常利用统计模型或机器学习模型等技术 对这些特征进行 建模 。 如果有必要的话,还需要根据手头要解决的问题部署该模型以供将来使用。 获取原始数据后,直接在数据之上构建模型是鲁莽的,因为我们无法从普通

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册