首页 文章 精选 留言 我的

精选列表

搜索[文智公众趋势分析],共10000篇文章
优秀的个人博客,低调大师

一文简单了解并构建DockerFile

GreatSQL社区原创内容未经授权不得随意使用,转载请联系小编并注明来源。 GreatSQL是MySQL的国产分支版本,使用上与MySQL一致。 作者: 蟹黄瓜子 文章来源:GreatSQL社区投稿 Docker是一个开源的应用容器引擎,让开发者可以打包他们的应用以及依赖包到一个可抑制的容器中,然后发布到任何流行的Linux机器上,也可以实现虚拟化。 那么今天要介绍的DockerFile是什么呢?简单来说DockerFile用来描述Docker镜像的文件,而且是类似源码的描述。 假设现有一台机器,docker容器中有镜像如下: [root@localhost ~]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE redis latest 7614ae9453d1 12 months ago 113MB mysql 5.7 c20987f18b13 12 months ago 448MB mysql 8.0 3218b38490ce 12 months ago 516MB greatsql/greatsql latest 2390016ed67a 16 months ago 550MB consul 1.9.4 28efe5fcc049 21 months ago 120MB 我们可以简单看看greatsql/greatsql:latest的dockerfile: [root@localhost ~]# docker history --format {{.CreatedBy}} --no-trunc=true 2390016ed67a|sed "s/\/bin\/sh\ -c\ \#(nop)\ //g"|sed "s/\/bin\/sh\ -c/RUN/g" | tac ADD file:bd7a2aed6ede423b719ceb2f723e4ecdfa662b28639c8429731c878e86fb138b in / LABEL org.label-schema.schema-version=1.0 org.label-schema.name=CentOS Base Image org.label-schema.vendor=CentOS org.label-schema.license=GPLv2 org.label-schema.build-date=20201204 CMD ["/bin/bash"] MAINTAINER greatsql@greatdb.com ENV LANG=en_US.utf8 ENV MYSQL_DATA_DIR=/data/GreatSQL ENV MYSQL_USER=mysql ENV MYSQL_UID_GID=3306 ENV MYSQL_EXTRACT_DIR=/usr/local ENV TMP_DIR=/tmp ENV MYSQL_PORT=3306 ENV GREATSQL=GreatSQL-8.0.25-15-Linux-glibc2.28-x86_64-minimal ENV MYSQL_BASEDIR=/usr/local/GreatSQL-8.0.25-15-Linux-glibc2.28-x86_64-minimal ENV DEP_LIBS=numactl-libs libaio readline-devel ncurses-devel ENV JEMALLOC_RPM=jemalloc-3.6.0-1.el8.x86_64.rpm ENV GREATSQL_INIT=greatsql-init.sh RUN groupadd -g ${MYSQL_UID_GID} ${MYSQL_USER}; useradd -u ${MYSQL_UID_GID} -r -g ${MYSQL_UID_GID} -s /sbin/nologin -c "MySQL User" ${MYSQL_USER} COPY dir:39057b483c2d76e9f0001cb84ed6603761599e330b2e714a6ee5941a4332cd97 in /usr/local/GreatSQL-8.0.25-15-Linux-glibc2.28-x86_64-minimal COPY file:fe881a5e38a8821b0a03018241b9e51c6f815bd0733a73b8ff95c0cb23e53df9 in /tmp RUN yum install -y ${TMP_DIR}/${JEMALLOC_RPM} RUN yum install -y ${DEP_LIBS} RUN cd ${MYSQL_BASEDIR}/support-files && cp -f my.cnf /etc/my.cnf ; echo "LD_PRELOAD=/usr/lib64/libjemalloc.so.1" >> /etc/sysconfig/mysql ; echo "THP_SETTING=never" >> /etc/sysconfig/mysql ; echo "export PATH=\$PATH:${MYSQL_BASEDIR}/bin" >> /etc/profile.d/mysql.sh ; source /etc/profile.d/mysql.sh RUN PATH="\$PATH:${MYSQL_BASEDIR}/bin" RUN export PATH RUN mkdir -p ${MYSQL_DATA_DIR} && chown -R ${MYSQL_USER}:${MYSQL_USER} ${MYSQL_BASEDIR} ; chmod -R ug+rwX ${MYSQL_BASEDIR} ; chmod -R ug+rwX /etc/my.cnf RUN rm -f ${TMP_DIR}/${JEMALLOC_RPM} COPY file:246cf23778cd1862e366d7b64f51aaf616c480874560e8f1ed0992ba7f6e4273 in /docker-entrypoint.sh ENTRYPOINT ["/docker-entrypoint.sh"] EXPOSE 3306 33060 33061 CMD ["mysqld"] 1.Dockerfile介绍 官方网站:https://hub.docker.com/ 现在我们简单介绍一下dockerfile: Dockerfile 是一个文本文件,其内包含了一条条的指令(Instruction),用于构建镜像。每一条指令构建一层镜像,因此每一条指令的内容,就是描述该层镜像应当如何构建。dockerfile 用于指示 docker image build 命令自动构建Image的源代码 # 对该目录下的dockerfile进行镜像的构建 docker build -f Dockerfile 通过dockerfile创建镜像大致上分为三步:写Dockerfile ——>docker build——>docker run Dockerfile 可以大致分为4个部分: 基础镜像信息 维护者信息 镜像操作指令 容器启动时执行指令 dockerfile也有一些需要注意的地方: dockerfile是通过从上到下的顺序运行指令的。其中第一条指令是 FROM,表示源镜像是基于什么镜像,因此也就有了所有镜像的源镜像:scratch。 每条保留字指令都必须是大写字母, 并且后面要跟随至少一个参数。 每条指令可用 # 添加注释。 每条指令都会创建一个新镜像层, 并对镜像进行提交。 2.Dockerfile指令解析 指令 解析 FROM 指定基础镜像,必须为第一个命令 MAINTAINER 维护者邮箱等信息 RUN 构建镜像docker build时执行的命令 ADD 将本地文件添加到容器中,tar 类型文件会自动解压 COPY 功能类似ADD,但是是不会自动解压文件,也不能访问网络资源 CMD 在docker run时会执行的命令,如果存在多个则仅最后一个生效,例如一个镜像的dockerfile的结尾是“ CMD ["/bin/bash"] ”,那么进入容器可以使用docker exec -it imageName或docker exec -it imageName /bin/bash,后者是在“ CMD ["/bin/bash"] ”的指令下面多加了一个“ CMD ["/bin/bash"] ”,根据CMD的特性,存在多个时,只让最后一个CMD生效,因此不影响 ENTRYPOINT 可执行化 LABEL 用于为镜像添加元数据 ENV 设置环境变量 EXPOSE 指定于外界交互的端口 VOLUME 用于指定持久化目录 WORKDIR 工作目录 ARG 用于指定传递给构建运行时的变量 ONBUILD 用于设置镜像触发器 2.1 FROM # 格式 FROM <image> FROM <image>:<tag> FROM <image>@<digest> # 例子 FROM mysql:5.6 2.2 MAINTAINER # 格式 MAINTAINER <name> # 例子 MAINTAINER xiehgz@foxmail.com 2.3 RUN # 格式 RUN <command> # 例子 RUN yum install -y mysql 2.4 ADD # 格式 ADD <src>... <dest> # 例子,添加 "name" 到 `WORKDIR`/dir/ ADD name Dir/ 2.5 COPY # 格式 COPY <src>... <dest> # 例子 COPY name in /dir 2.6 CMD # 格式 CMD ["executable","param1","param2"] # 例子 CMD ["mysqld"] 2.7 ENTRYPOINT # 格式 ENTRYPOINT ["executable", "param1", "param2"] # 例子:让什么可执行化 ENTRYPOINT ["ls", "/usr/local"] 2.8 LABEL # 格式 LABEL <key>=<value> <key>=<value> ... # 例子 LABEL version="1.0" 2.9 ENV # 格式 ENV <key> <value> ENV <key>=<value> ... # 例子 ENV name guazi ENV name=guazi 2.10 EXPOSE # 格式 EXPOSE <port> [<port>...] # 例子 EXPOSE 3306 2.11 VOLUME # 格式 VOLUME ["/path"] # 例子 VOLUME ["/mydata"] 2.12 WORKDIR # 格式 WORKDIR /path # 例子 WORKDIR /mydata 2.13 ARG # 格式 ARG <name>[=<default value>] # 例子,外部传入一参数testparm,默认值为1 ARG testparm=1 2.14 ONBUILD # 格式 ONBUILD [INSTRUCTION] # 例子 ONBUILD ADD . /app/src 3.制作镜像 以自定义一个centos镜像为例,在官方镜像的基础上添加vim和net-tools工具 首先创建dockerfile: [root@localhost dockerfile]# cat Dockerfile FROM centos:7 MAINTAINER xiehgz ENV MYPATH /usr/local WORKDIR $MYPATH RUN yum -y install vim net-tools EXPOSE 80 CMD /bin/bash 构建镜像: [root@localhost dockerfile]# docker build -t mycentos:3.0 . Sending build context to Docker daemon 2.048kB Step 1/7 : FROM centos:7 7: Pulling from library/centos 2d473b07cdd5: Pull complete Digest: sha256:9d4bcbbb213dfd745b58be38b13b996ebb5ac315fe75711bd618426a630e0987 Status: Downloaded newer image for centos:7 ---> eeb6ee3f44bd Step 2/7 : MAINTAINER xiehgz ---> Running in a43782764a07 Removing intermediate container a43782764a07 ---> ba42beb587ed Step 3/7 : ENV MYPATH /usr/local ---> Running in 9a7b0fab77b6 ........... vim-filesystem.x86_64 2:7.4.629-8.el7_9 which.x86_64 0:2.20-7.el7 Complete! 查看镜像: [root@localhost dockerfile]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE mycentos 3.0 b2d59a130341 About a minute ago 453MB 检验是否正常启动: [root@localhost dockerfile]# docker run -it mycentos:3.0 [root@0b8baab6a633 local]# 构建成功 最后,也可以测试阅读GreatSQL官方的dockerfile:https://gitee.com/GreatSQL/GreatSQL-Docker/blob/master/GreatSQL/Dockerfile,这里就不展开了。 Enjoy GreatSQL :) 关于 GreatSQL GreatSQL是由万里数据库维护的MySQL分支,专注于提升MGR可靠性及性能,支持InnoDB并行查询特性,是适用于金融级应用的MySQL分支版本。 相关链接: GreatSQL社区 Gitee GitHub Bilibili GreatSQL社区: 社区有奖建议反馈: https://greatsql.cn/thread-54-1-1.html 社区博客有奖征稿详情: https://greatsql.cn/thread-100-1-1.html 社区2022年度勋章获奖名单: https://greatsql.cn/thread-184-1-1.html (对文章有疑问或者有独到见解都可以去社区官网提出或分享哦~) 技术交流群: 微信&QQ群: QQ群:533341697 微信群:添加GreatSQL社区助手(微信号:wanlidbc )好友,待社区助手拉您进群。

优秀的个人博客,低调大师

一文详解Java日志框架JUL

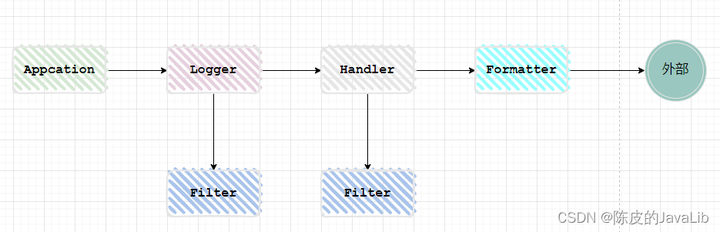
摘要:JUL(Java util logging),Java原生日志框架,不需要引入第三方依赖包,使用简单方便。 本文分享自华为云社区《Java 日志框架 JUL 详解大全》,作者: 陈皮的JavaLib 。 JUL 简介 JUL(Java util logging),Java 原生日志框架,不需要引入第三方依赖包,使用简单方便,一般在小型应用中使用,主流项目中现在很少使用了。 JUL 架构 Application:Java 应用程序。 Logger:记录器,Java 应用程序通过调用记录器的方法来发布日志记录。 Handler:处理器,每一个 Logger 都可以关联一个或多个 Handler,Handler 从 Logger 获取日志并将日志输出到某个目的地,目的地可以是控制台,本地文件,或网络日志服务,或将它们转发到操作系统日志等等。通过Handler.setLevel(level.off)方法可以禁用一个 Handler,也可以设置其他级别来开启此 Handler。 Filter:过滤器,根据条件过滤哪些日志记录。每一个 Logger 和 Handler 都可以关联一个 Filter。 Formatter :格式化器,负责对日志事件中的日志记录进行转换和格式化。 Level:每一条日志记录都有一个关联的日志级别,表示此条日志的重要性和紧急程度。也可以对 Logger 和 Handler 设置关联的日志级别。 入门示例 package com.chenpi; import java.util.logging.Level; import java.util.logging.Logger; import org.junit.Test; /** * @author 陈皮 * @version 1.0 * @description * @date 2022/3/2 */ public class ChenPiJULMain { // JUL 日志框架演示 @Test public void testLog() { // 获取日志记录器对象 Logger logger = Logger.getLogger("com.chenpi.ChenPiJULMain"); // 日志记录输出 logger.severe(">>>>> Hello ChenPi!!"); logger.warning(">>>>> Hello ChenPi!!"); logger.info(">>>>> Hello ChenPi!!"); // 默认日志级别 logger.config(">>>>> Hello ChenPi!!"); logger.fine(">>>>> Hello ChenPi!!"); logger.finer(">>>>> Hello ChenPi!!"); logger.finest(">>>>> Hello ChenPi!!"); // 输出指定日志级别的日志记录 logger.log(Level.WARNING, ">>>>> Hello Warning ChenPi!!"); // 占位符形式 String name = "ChenPi"; int age = 18; logger.log(Level.INFO, ">>>>> Hello {0},{1} years old!", new Object[]{name, age}); // 异常堆栈信息 logger.log(Level.SEVERE, ">>>>> Hello NPE!", new NullPointerException()); } } JUL 默认将日志信息输出到控制台,默认日志级别是 info。控制台输出结果如下: Logger 父子继承关系 在 JUL 中,Logger 有父子继承关系概念,会根据 Logger 对象的名称的包含关系,划分父子继承关系。对于某个 Logger 对象,如果找不到显性创建的父 Logger 对象,那么它的父 Logger 是根 Logger,即 RootLogger。 子代 Logger 对象会继承父 Logger 的配置,例如日志级别,关联的 Handler,日志格式等等。对于任何 Logger 对象,如果没对其做特殊配置,那么它最终都会继承 RootLogger 的配置。 package com.chenpi; import java.util.logging.Logger; import org.junit.Test; /** * @author 陈皮 * @version 1.0 * @description * @date 2022/3/2 */ public class ChenPiJULMain { @Test public void testLog() { // logger1的父Logger是RootLogger Logger logger1 = Logger.getLogger("com.chenpi.a"); // logger2的父Logger是logger1 Logger logger2 = Logger.getLogger("com.chenpi.a.b.c"); Logger logger1Parent = logger1.getParent(); System.out.println("logger1Parent:" + logger1Parent + ",name:" + logger1Parent.getName()); Logger logger2Parent = logger2.getParent(); System.out.println("logger1:" + logger1 + ",name:" + logger1.getName()); System.out.println("logger2Parent:" + logger2Parent + ",name:" + logger2Parent.getName()); } } // 输出结果如下 logger1Parent:java.util.logging.LogManager$RootLogger@61e717c2,name: logger1:java.util.logging.Logger@66cd51c3,name:com.chenpi.a logger2Parent:java.util.logging.Logger@66cd51c3,name:com.chenpi.a 日志配置 我们可以通过2种方式调整 JUL 默认的日志行为(设置日志级别,日志输出目的地,日志格式等等),一种是通过在程序中硬编码形式(不推荐),另一种是通过单独的配置文件形式。 硬编码日志配置 在 JUL 中,Logger 是有父子继承关系的,所以当我们需要对某一个 Logger 对象进行单独的配置时,需要将它设置为不继承使用父 Logger 的配置。 以下演示名称为com.chenpi.ChenPiJULMain的 Logger 对象单独进行配置,并且关联两个 Handler。 package com.chenpi; import java.io.IOException; import java.util.logging.*; import org.junit.Test; /** * @author 陈皮 * @version 1.0 * @description * @date 2022/3/2 */ public class ChenPiJULMain { @Test public void testLog() throws IOException { // 获取日志记录器对象 Logger logger = Logger.getLogger("com.chenpi.ChenPiJULMain"); // 关闭默认配置,即不使用父Logger的Handlers logger.setUseParentHandlers(false); // 设置记录器的日志级别为ALL logger.setLevel(Level.ALL); // 日志记录格式,使用简单格式转换对象 SimpleFormatter simpleFormatter = new SimpleFormatter(); // 控制台输出Handler,并且设置日志级别为INFO,日志记录格式 ConsoleHandler consoleHandler = new ConsoleHandler(); consoleHandler.setLevel(Level.INFO); consoleHandler.setFormatter(simpleFormatter); // 文件输出Handler,并且设置日志级别为FINE,日志记录格式 FileHandler fileHandler = new FileHandler("./jul.log"); fileHandler.setLevel(Level.FINE); fileHandler.setFormatter(simpleFormatter); // 记录器关联处理器,即此logger对象的日志信息输出到这两个Handler进行处理 logger.addHandler(consoleHandler); logger.addHandler(fileHandler); // 日志记录输出 logger.severe(">>>>> Hello ChenPi!!"); logger.warning(">>>>> Hello ChenPi!!"); logger.info(">>>>> Hello ChenPi!!"); logger.config(">>>>> Hello ChenPi!!"); logger.fine(">>>>> Hello ChenPi!!"); logger.finer(">>>>> Hello ChenPi!!"); logger.finest(">>>>> Hello ChenPi!!"); } } 因为 Logger 设置的日志级别是 ALL,即所有级别的日志记录都可以通过。但是 ConsoleHandler 设置的日志级别是 INFO,所以控制台只输出 INFO 级别以上的日志记录。而 FileHandler 设置的日志级别是 FINE,所以日志文件中输出的是 FINE 级别以上的日志记录。 以下是控制台输出的日志结果: 以下是日志文件jul.log中输出的日志结果: 日志配置文件 通过 debug 调试,按以下方法顺序,可以发现,如果我们没有配置 JUL 的配置文件,系统默认从 JDK 的安装目录下的 lib 目录下读取默认的配置文件logging.properties。 getLogger() -> demandLogger() -> LogManager.getLogManager() -> ensureLogManagerInitialized() -> owner.readPrimordialConfiguration() -> readConfiguration() 以下是 JDK 自带的 JUL 默认日志配置文件内容: 对于配置选项有哪些,其实可以通过相应类的源码找出,例如 Logger 类的源码如下: FileHandler 类的源码如下: 所以我们可以拷贝默认的配置文件到我们工程的 resources 目录下,自定义修改配置信息。 ############################################################ # 全局属性 ############################################################ # 顶级RootLogger关联的Handler,多个Handler使用逗号隔开 # 对于其他Logger,如果没有指定自己的Handler,则默认继承此 handlers= java.util.logging.FileHandler, java.util.logging.ConsoleHandler # 默认全局日志级别,Logger和Handler都可以设置自己的日志级别来覆盖此级别 .level= ALL ############################################################ # Handler 配置 ############################################################ # FileHandler定义 # 日志文件存储位置 java.util.logging.FileHandler.pattern = ./jul%u.log # 单个文件的最大字节数,0代表不限制 java.util.logging.FileHandler.limit = 50000 # 文件数量上限,多个文件为jul0.log.0,jul0.log.1 ... java.util.logging.FileHandler.count = 5 # 日志级别 java.util.logging.FileHandler.level = SEVERE # 日志追加方式 java.util.logging.FileHandler.append = true # Handler对象采用的字符集 java.util.logging.FileHandler.encoding = UTF-8 # 日志格式,使用系统默认的简单格式 java.util.logging.FileHandler.formatter = java.util.logging.SimpleFormatter # ConsoleHandler定义 # 日志级别 java.util.logging.ConsoleHandler.level = INFO # Handler对象采用的字符集 java.util.logging.ConsoleHandler.encoding = UTF-8 # 日志格式,使用系统默认的简单格式 java.util.logging.ConsoleHandler.formatter = java.util.logging.SimpleFormatter ############################################################ # Logger 配置 ############################################################ # 设置名称为com.chenpi.person的Logger对象的日志级别为WARNING com.chenpi.person.level = WARNING 然后我们应用中加载我们类路径中自定义的配置文件。 package com.chenpi; import java.io.IOException; import java.io.InputStream; import java.util.logging.LogManager; import java.util.logging.Logger; import org.junit.Test; /** * @author 陈皮 * @version 1.0 * @description * @date 2022/3/2 */ public class ChenPiJULMain { // JUL 日志框架演示 @Test public void testLog() throws IOException { // 读取配置文件 // 也可以通过使用java.util.logging.config.file系统属性指定文件名 // 例如 java -Djava.util.logging.config.file=myfile InputStream resourceAsStream = ChenPiJULMain.class.getClassLoader() .getResourceAsStream("logging.properties"); // 获取LogManager LogManager logManager = LogManager.getLogManager(); // 记载配置文件 logManager.readConfiguration(resourceAsStream); // 获取日志记录器对象 Logger logger = Logger.getLogger("com.chenpi.ChenPiJULMain"); // 日志记录输出 logger.severe(">>>>> Hello ChenPi!!"); logger.warning(">>>>> Hello ChenPi!!"); logger.info(">>>>> Hello ChenPi!!"); logger.config(">>>>> Hello ChenPi!!"); logger.fine(">>>>> Hello ChenPi!!"); logger.finer(">>>>> Hello ChenPi!!"); logger.finest(">>>>> Hello ChenPi!!"); // 获取日志记录器对象 Logger personLogger = Logger.getLogger("com.chenpi.person"); // 日志记录输出 personLogger.severe(">>>>> Hello Person!!"); personLogger.warning(">>>>> Hello Person!!"); personLogger.info(">>>>> Hello Person!!"); personLogger.config(">>>>> Hello Person!!"); personLogger.fine(">>>>> Hello Person!!"); personLogger.finer(">>>>> Hello Person!!"); personLogger.finest(">>>>> Hello Person!!"); } } 控制台和文件中输出内容如下: 自定义 Logger 我们可以针对某一个 Logger 进行单独的配置,例如日志级别,关联的 Handler 等,而不默认继承父级的。 当然我们也可以为以包名为名称的 Logger 进行配置,这样这个包名下的所有子代 Logger 都能继承此配置。 ############################################################ # 全局属性 ############################################################ # 顶级RootLogger关联的Handler,多个Handler使用逗号隔开 # 对于其他Logger,如果没有指定自己的Handler,则默认继承此 handlers= java.util.logging.FileHandler, java.util.logging.ConsoleHandler # 默认全局日志级别,Logger和Handler都可以设置自己的日志级别来覆盖此级别 .level= ALL ############################################################ # Handler 配置 ############################################################ # FileHandler定义 # 日志文件存储位置 java.util.logging.FileHandler.pattern = ./jul%u.log # 单个文件的最大字节数,0代表不限制 java.util.logging.FileHandler.limit = 50000 # 文件数量上限 java.util.logging.FileHandler.count = 5 # 日志级别 java.util.logging.FileHandler.level = SEVERE # 日志追加方式 java.util.logging.FileHandler.append = true # Handler对象采用的字符集 java.util.logging.FileHandler.encoding = UTF-8 # 日志格式,使用系统默认的简单格式 java.util.logging.FileHandler.formatter = java.util.logging.SimpleFormatter # ConsoleHandler定义 # 日志级别 java.util.logging.ConsoleHandler.level = INFO # Handler对象采用的字符集 java.util.logging.ConsoleHandler.encoding = UTF-8 # 日志格式,使用系统默认的简单格式 java.util.logging.ConsoleHandler.formatter = java.util.logging.SimpleFormatter ############################################################ # Logger 配置 ############################################################ # 设置名称为com.chenpi.person的Logger对象的日志级别为WARNING com.chenpi.person.level = WARNING # 只关联FileHandler com.chenpi.person.handlers = java.util.logging.FileHandler # 关闭默认配置 com.chenpi.person.useParentHandlers = false package com.chenpi; import java.io.IOException; import java.io.InputStream; import java.util.logging.LogManager; import java.util.logging.Logger; import org.junit.Test; /** * @author 陈皮 * @version 1.0 * @description * @date 2022/3/2 */ public class ChenPiJULMain { // JUL 日志框架演示 @Test public void testLog() throws IOException { // 读取配置文件 InputStream resourceAsStream = ChenPiJULMain.class.getClassLoader() .getResourceAsStream("logging.properties"); // 获取LogManager LogManager logManager = LogManager.getLogManager(); // 记载配置文件 logManager.readConfiguration(resourceAsStream); // 获取日志记录器对象 Logger logger = Logger.getLogger("com.chenpi.ChenPiJULMain"); // 日志记录输出 logger.severe(">>>>> Hello ChenPi!!"); logger.warning(">>>>> Hello ChenPi!!"); logger.info(">>>>> Hello ChenPi!!"); logger.config(">>>>> Hello ChenPi!!"); logger.fine(">>>>> Hello ChenPi!!"); logger.finer(">>>>> Hello ChenPi!!"); logger.finest(">>>>> Hello ChenPi!!"); // 获取日志记录器对象 Logger personLogger = Logger.getLogger("com.chenpi.person"); // 日志记录输出 personLogger.severe(">>>>> Hello Person!!"); personLogger.warning(">>>>> Hello Person!!"); personLogger.info(">>>>> Hello Person!!"); personLogger.config(">>>>> Hello Person!!"); personLogger.fine(">>>>> Hello Person!!"); personLogger.finer(">>>>> Hello Person!!"); personLogger.finest(">>>>> Hello Person!!"); } } 上述例子中,对于名称为com.chenpi.person的 Logger,只将日志输出到文件中,其他 Logger 则会同时输出到控制台和文件中。 自定义日志格式 以SimpleFormatter类源码为例,再到LoggingSupport类源码,发现首先判断我们是否通过java.util.logging.SimpleFormatter.format属性配置了格式,如果没有则使用默认的日志格式。 所以我们可以在配置文件中自定义日志记录的格式。 ############################################################ # 全局属性 ############################################################ # 顶级RootLogger关联的Handler,多个Handler使用逗号隔开 # 对于其他Logger,如果没有指定自己的Handler,则默认继承此 handlers= java.util.logging.FileHandler, java.util.logging.ConsoleHandler # 默认全局日志级别,Logger和Handler都可以设置自己的日志级别来覆盖此级别 .level= ALL ############################################################ # Handler 配置 ############################################################ # FileHandler定义 # 日志文件存储位置 java.util.logging.FileHandler.pattern = ./jul%u.log # 单个文件的最大字节数,0代表不限制 java.util.logging.FileHandler.limit = 1024 # 文件数量上限 java.util.logging.FileHandler.count = 5 # 日志级别 java.util.logging.FileHandler.level = FINE # 日志追加方式 java.util.logging.FileHandler.append = true # Handler对象采用的字符集 java.util.logging.FileHandler.encoding = UTF-8 # 日志格式,使用系统默认的简单格式 java.util.logging.FileHandler.formatter = java.util.logging.SimpleFormatter # 自定义SimpleFormatter的日志格式 java.util.logging.SimpleFormatter.format = %4$s: %5$s [%1$tc]%n # ConsoleHandler定义 # 日志级别 java.util.logging.ConsoleHandler.level = INFO # Handler对象采用的字符集 java.util.logging.ConsoleHandler.encoding = UTF-8 # 日志格式,使用系统默认的简单格式 java.util.logging.ConsoleHandler.formatter = java.util.logging.SimpleFormatter ############################################################ # Logger 配置 ############################################################ # 设置名称为com.chenpi.person的Logger对象的日志级别为WARNING com.chenpi.person.level = WARNING 这样,所有绑定了 SimpleFormatter 的 Handler 的所有日志记录就使用了自定义的格式。 当然通过源码发现,日志格式类还有其他几个实现,如下所示: 日志过滤器 Filter,日志过滤器,用来对输出的日志记录进行过滤。我们可以根据多个维度进行过滤,例如只输出 message 包含某段文本信息的日志,只输出某个方法中记录的日志,某个级别的日志等等。 Logger 对象将日志信息包装成一个 LogRecord 对象,然后将该对象传给 Handler 进行处理。每一个 Logger 和 Handler 都可以关联一个 Filter。LogRecord 中包含了日志的文本信息、日志生成的时间戳、日志来自于哪个类、日志来自于哪个方法、日志来自于哪个线程等等信息。 Filter 源码如下所示,我们只需要创建一个 Filter 的实现类,重写方法即可。 package java.util.logging; /** * A Filter can be used to provide fine grain control over * what is logged, beyond the control provided by log levels. * <p> * Each Logger and each Handler can have a filter associated with it. * The Logger or Handler will call the isLoggable method to check * if a given LogRecord should be published. If isLoggable returns * false, the LogRecord will be discarded. * * @since 1.4 */ @FunctionalInterface public interface Filter { /** * Check if a given log record should be published. * @param record a LogRecord * @return true if the log record should be published. */ public boolean isLoggable(LogRecord record); } 我们实现一个 Filter ,如果日志消息包含暴力两个字,则不予放行,即不记录此条日志。 package com.chenpi; import java.util.logging.Filter; import java.util.logging.LogRecord; /** * @author 陈皮 * @version 1.0 * @description * @date 2022/3/2 */ public class MyLoggerFilter implements Filter { private static final String SENSITIVE_MESSAGE = "暴力"; @Override public boolean isLoggable(LogRecord record) { String message = record.getMessage(); return null == message || !message.contains(SENSITIVE_MESSAGE); } } 然后我们将此过滤器对象设置绑定到 Logger 中即可。 package com.chenpi; import java.io.IOException; import java.io.InputStream; import java.util.logging.LogManager; import java.util.logging.Logger; import org.junit.Test; /** * @author 陈皮 * @version 1.0 * @description * @date 2022/3/2 */ public class ChenPiJULMain { // JUL 日志框架演示 @Test public void testLog() throws IOException { // 读取配置文件 InputStream resourceAsStream = ChenPiJULMain.class.getClassLoader() .getResourceAsStream("logging.properties"); // 获取LogManager LogManager logManager = LogManager.getLogManager(); // 记载配置文件 logManager.readConfiguration(resourceAsStream); // 获取日志记录器对象 Logger logger = Logger.getLogger("com.chenpi.ChenPiJULMain"); // Logger关联过滤器 logger.setFilter(new MyLoggerFilter()); // 日志记录输出 logger.info(">>>>> Hello ChenPi!!"); logger.info(">>>>> 暴力小孩!!"); } } // 输出结果如下 信息: >>>>> Hello ChenPi!! [星期三 三月 02 15:31:06 CST 2022] 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

一文了解MySQL的Buffer Pool

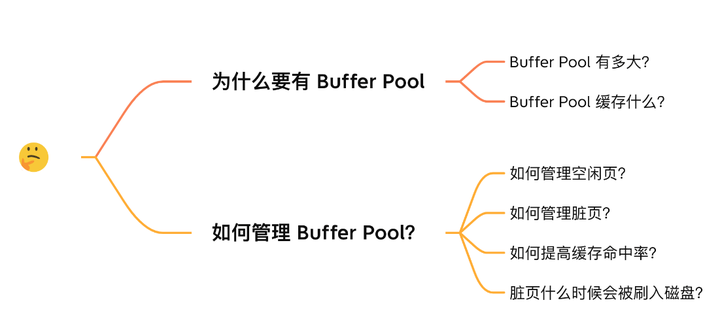
摘要:Innodb 存储引擎设计了一个缓冲池(Buffer Pool),来提高数据库的读写性能。 本文分享自华为云社区《MySQL 的 Buffer Pool,终于被我搞懂了》,作者:小林coding 。 今天就聊 MySQL 的 Buffer Pool,发车! 为什么要有 Buffer Pool? 虽然说 MySQL 的数据是存储在磁盘里的,但是也不能每次都从磁盘里面读取数据,这样性能是极差的。 要想提升查询性能,加个缓存就行了嘛。所以,当数据从磁盘中取出后,缓存内存中,下次查询同样的数据的时候,直接从内存中读取。 为此,Innodb 存储引擎设计了一个缓冲池(Buffer Pool),来提高数据库的读写性能。 有了缓冲池后: 当读取数据时,如果数据存在于 Buffer Pool 中,客户端就会直接读取 Buffer Pool 中的数据,否则再去磁盘中读取。 当修改数据时,首先是修改 Buffer Pool 中数据所在的页,然后将其页设置为脏页,最后由后台线程将脏页写入到磁盘。 Buffer Pool 有多大? Buffer Pool 是在 MySQL 启动的时候,向操作系统申请的一片连续的内存空间,默认配置下 Buffer Pool 只有 128MB 。 可以通过调整 innodb_buffer_pool_size 参数来设置 Buffer Pool 的大小,一般建议设置成可用物理内存的 60%~80%。 Buffer Pool 缓存什么? InnoDB 会把存储的数据划分为若干个「页」,以页作为磁盘和内存交互的基本单位,一个页的默认大小为 16KB。因此,Buffer Pool 同样需要按「页」来划分。 在 MySQL 启动的时候,InnoDB 会为 Buffer Pool 申请一片连续的内存空间,然后按照默认的16KB的大小划分出一个个的页, Buffer Pool 中的页就叫做缓存页。此时这些缓存页都是空闲的,之后随着程序的运行,才会有磁盘上的页被缓存到 Buffer Pool 中。 所以,MySQL 刚启动的时候,你会观察到使用的虚拟内存空间很大,而使用到的物理内存空间却很小,这是因为只有这些虚拟内存被访问后,操作系统才会触发缺页中断,接着将虚拟地址和物理地址建立映射关系。 Buffer Pool 除了缓存「索引页」和「数据页」,还包括了 undo 页,插入缓存、自适应哈希索引、锁信息等等。 为了更好的管理这些在 Buffer Pool 中的缓存页,InnoDB 为每一个缓存页都创建了一个控制块,控制块信息包括「缓存页的表空间、页号、缓存页地址、链表节点」等等。 控制块也是占有内存空间的,它是放在 Buffer Pool 的最前面,接着才是缓存页,如下图: 上图中控制块和缓存页之间灰色部分称为碎片空间。 为什么会有碎片空间呢? 你想想啊,每一个控制块都对应一个缓存页,那在分配足够多的控制块和缓存页后,可能剩余的那点儿空间不够一对控制块和缓存页的大小,自然就用不到喽,这个用不到的那点儿内存空间就被称为碎片了。 当然,如果你把 Buffer Pool 的大小设置的刚刚好的话,也可能不会产生碎片。 查询一条记录,就只需要缓冲一条记录吗? 不是的。 当我们查询一条记录时,InnoDB 是会把整个页的数据加载到 Buffer Pool 中,因为,通过索引只能定位到磁盘中的页,而不能定位到页中的一条记录。将页加载到 Buffer Pool 后,再通过页里的页目录去定位到某条具体的记录。 关于页结构长什么样和索引怎么查询数据的问题可以在这篇找到答案:换一个角度看 B+ 树 如何管理 Buffer Pool? 如何管理空闲页? Buffer Pool 是一片连续的内存空间,当 MySQL 运行一段时间后,这片连续的内存空间中的缓存页既有空闲的,也有被使用的。 那当我们从磁盘读取数据的时候,总不能通过遍历这一片连续的内存空间来找到空闲的缓存页吧,这样效率太低了。 所以,为了能够快速找到空闲的缓存页,可以使用链表结构,将空闲缓存页的「控制块」作为链表的节点,这个链表称为Free 链表(空闲链表)。 Free 链表上除了有控制块,还有一个头节点,该头节点包含链表的头节点地址,尾节点地址,以及当前链表中节点的数量等信息。 Free 链表节点是一个一个的控制块,而每个控制块包含着对应缓存页的地址,所以相当于 Free 链表节点都对应一个空闲的缓存页。 有了 Free 链表后,每当需要从磁盘中加载一个页到 Buffer Pool 中时,就从 Free链表中取一个空闲的缓存页,并且把该缓存页对应的控制块的信息填上,然后把该缓存页对应的控制块从 Free 链表中移除。 如何管理脏页? 设计 Buffer Pool 除了能提高读性能,还能提高写性能,也就是更新数据的时候,不需要每次都要写入磁盘,而是将 Buffer Pool 对应的缓存页标记为脏页,然后再由后台线程将脏页写入到磁盘。 那为了能快速知道哪些缓存页是脏的,于是就设计出Flush 链表,它跟 Free 链表类似的,链表的节点也是控制块,区别在于 Flush 链表的元素都是脏页。 有了 Flush 链表后,后台线程就可以遍历 Flush 链表,将脏页写入到磁盘。 如何提高缓存命中率? Buffer Pool 的大小是有限的,对于一些频繁访问的数据我们希望可以一直留在 Buffer Pool 中,而一些很少访问的数据希望可以在某些时机可以淘汰掉,从而保证 Buffer Pool 不会因为满了而导致无法再缓存新的数据,同时还能保证常用数据留在 Buffer Pool 中。 要实现这个,最容易想到的就是 LRU(Least recently used)算法。 该算法的思路是,链表头部的节点是最近使用的,而链表末尾的节点是最久没被使用的。那么,当空间不够了,就淘汰最久没被使用的节点,从而腾出空间。 简单的 LRU 算法的实现思路是这样的: 当访问的页在 Buffer Pool 里,就直接把该页对应的 LRU 链表节点移动到链表的头部。 当访问的页不在 Buffer Pool 里,除了要把页放入到 LRU 链表的头部,还要淘汰 LRU 链表末尾的节点。 比如下图,假设 LRU 链表长度为 5,LRU 链表从左到右有 1,2,3,4,5 的页。 如果访问了 3 号的页,因为 3 号页在 Buffer Pool 里,所以把 3 号页移动到头部即可。 而如果接下来,访问了 8 号页,因为 8 号页不在 Buffer Pool 里,所以需要先淘汰末尾的 5 号页,然后再将 8 号页加入到头部。 到这里我们可以知道,Buffer Pool 里有三种页和链表来管理数据。 图中: Free Page(空闲页),表示此页未被使用,位于 Free 链表; Clean Page(干净页),表示此页已被使用,但是页面未发生修改,位于LRU 链表。 Dirty Page(脏页),表示此页「已被使用」且「已经被修改」,其数据和磁盘上的数据已经不一致。当脏页上的数据写入磁盘后,内存数据和磁盘数据一致,那么该页就变成了干净页。脏页同时存在于 LRU 链表和 Flush 链表。 简单的 LRU 算法并没有被 MySQL 使用,因为简单的 LRU 算法无法避免下面这两个问题: 预读失效; Buffer Pool 污染; 什么是预读失效? 先来说说 MySQL 的预读机制。程序是有空间局部性的,靠近当前被访问数据的数据,在未来很大概率会被访问到。 所以,MySQL 在加载数据页时,会提前把它相邻的数据页一并加载进来,目的是为了减少磁盘 IO。 但是可能这些被提前加载进来的数据页,并没有被访问,相当于这个预读是白做了,这个就是预读失效。 如果使用简单的 LRU 算法,就会把预读页放到 LRU 链表头部,而当 Buffer Pool空间不够的时候,还需要把末尾的页淘汰掉。 如果这些预读页如果一直不会被访问到,就会出现一个很奇怪的问题,不会被访问的预读页却占用了 LRU 链表前排的位置,而末尾淘汰的页,可能是频繁访问的页,这样就大大降低了缓存命中率。 怎么解决预读失效而导致缓存命中率降低的问题? 我们不能因为害怕预读失效,而将预读机制去掉,大部分情况下,局部性原理还是成立的。 要避免预读失效带来影响,最好就是让预读的页停留在 Buffer Pool 里的时间要尽可能的短,让真正被访问的页才移动到 LRU 链表的头部,从而保证真正被读取的热数据留在 Buffer Pool 里的时间尽可能长。 那到底怎么才能避免呢? MySQL 是这样做的,它改进了 LRU 算法,将 LRU 划分了 2 个区域:old 区域 和 young 区域。 young 区域在 LRU 链表的前半部分,old 区域则是在后半部分,如下图: old 区域占整个 LRU 链表长度的比例可以通过 innodb_old_blocks_pc 参数来设置,默认是 37,代表整个 LRU 链表中 young 区域与 old 区域比例是 63:37。 划分这两个区域后,预读的页就只需要加入到 old 区域的头部,当页被真正访问的时候,才将页插入 young 区域的头部。如果预读的页一直没有被访问,就会从 old 区域移除,这样就不会影响 young 区域中的热点数据。 接下来,给大家举个例子。 假设有一个长度为 10 的 LRU 链表,其中 young 区域占比 70 %,old 区域占比 20 %。 现在有个编号为 20 的页被预读了,这个页只会被插入到 old 区域头部,而 old 区域末尾的页(10号)会被淘汰掉。 如果 20 号页一直不会被访问,它也没有占用到 young 区域的位置,而且还会比 young 区域的数据更早被淘汰出去。 如果 20 号页被预读后,立刻被访问了,那么就会将它插入到 young 区域的头部,young 区域末尾的页(7号),会被挤到 old 区域,作为 old 区域的头部,这个过程并不会有页被淘汰。 虽然通过划分 old 区域 和 young 区域避免了预读失效带来的影响,但是还有个问题无法解决,那就是 Buffer Pool 污染的问题。 什么是 Buffer Pool 污染? 当某一个 SQL 语句扫描了大量的数据时,在 Buffer Pool 空间比较有限的情况下,可能会将Buffer Pool 里的所有页都替换出去,导致大量热数据被淘汰了,等这些热数据又被再次访问的时候,由于缓存未命中,就会产生大量的磁盘 IO,MySQL 性能就会急剧下降,这个过程被称为Buffer Pool 污染。 注意, Buffer Pool 污染并不只是查询语句查询出了大量的数据才出现的问题,即使查询出来的结果集很小,也会造成 Buffer Pool 污染。 比如,在一个数据量非常大的表,执行了这条语句: select * from t_user where name like "%xiaolin%"; 可能这个查询出来的结果就几条记录,但是由于这条语句会发生索引失效,所以这个查询过程是全表扫描的,接着会发生如下的过程: 从磁盘读到的页加入到 LRU 链表的 old 区域头部; 当从页里读取行记录时,也就是页被访问的时候,就要将该页放到 young 区域头部; 接下来拿行记录的 name 字段和字符串 xiaolin 进行模糊匹配,如果符合条件,就加入到结果集里; 如此往复,直到扫描完表中的所有记录。 经过这一番折腾,原本 young 区域的热点数据都会被替换掉。 举个例子,假设需要批量扫描:21,22,23,24,25 这五个页,这些页都会被逐一访问(读取页里的记录)。 在批量访问这些数据的时候,会被逐一插入到 young 区域头部。 可以看到,原本在 young 区域的热点数据 6 和 7 号页都被淘汰了,这就是 Buffer Pool 污染的问题。 怎么解决出现 Buffer Pool 污染而导致缓存命中率下降的问题? 像前面这种全表扫描的查询,很多缓冲页其实只会被访问一次,但是它却只因为被访问了一次而进入到 young 区域,从而导致热点数据被替换了。 LRU 链表中 young 区域就是热点数据,只要我们提高进入到 young 区域的门槛,就能有效地保证 young 区域里的热点数据不会被替换掉。 MySQL 是这样做的,进入到 young 区域条件增加了一个停留在 old 区域的时间判断。 具体是这样做的,在对某个处在 old 区域的缓存页进行第一次访问时,就在它对应的控制块中记录下来这个访问时间: 如果后续的访问时间与第一次访问的时间在某个时间间隔内,那么该缓存页就不会被从 old 区域移动到 young 区域的头部; 如果后续的访问时间与第一次访问的时间不在某个时间间隔内,那么该缓存页移动到 young 区域的头部; 这个间隔时间是由 innodb_old_blocks_time 控制的,默认是 1000 ms。 也就说,只有同时满足「被访问」与「在 old 区域停留时间超过 1 秒」两个条件,才会被插入到 young 区域头部,这样就解决了 Buffer Pool 污染的问题 。 另外,MySQL 针对 young 区域其实做了一个优化,为了防止 young 区域节点频繁移动到头部。young 区域前面 1/4 被访问不会移动到链表头部,只有后面的 3/4被访问了才会。 脏页什么时候会被刷入磁盘? 引入了 Buffer Pool 后,当修改数据时,首先是修改 Buffer Pool 中数据所在的页,然后将其页设置为脏页,但是磁盘中还是原数据。 因此,脏页需要被刷入磁盘,保证缓存和磁盘数据一致,但是若每次修改数据都刷入磁盘,则性能会很差,因此一般都会在一定时机进行批量刷盘。 可能大家担心,如果在脏页还没有来得及刷入到磁盘时,MySQL 宕机了,不就丢失数据了吗? 这个不用担心,InnoDB 的更新操作采用的是 Write Ahead Log 策略,即先写日志,再写入磁盘,通过 redo log 日志让 MySQL 拥有了崩溃恢复能力。 下面几种情况会触发脏页的刷新: 当 redo log 日志满了的情况下,会主动触发脏页刷新到磁盘; Buffer Pool 空间不足时,需要将一部分数据页淘汰掉,如果淘汰的是脏页,需要先将脏页同步到磁盘; MySQL 认为空闲时,后台线程回定期将适量的脏页刷入到磁盘; MySQL 正常关闭之前,会把所有的脏页刷入到磁盘; 在我们开启了慢 SQL 监控后,如果你发现**「偶尔」会出现一些用时稍长的 SQL**,这可能是因为脏页在刷新到磁盘时可能会给数据库带来性能开销,导致数据库操作抖动。 如果间断出现这种现象,就需要调大 Buffer Pool 空间或 redo log 日志的大小。 总结 Innodb 存储引擎设计了一个缓冲池(Buffer Pool),来提高数据库的读写性能。 Buffer Pool 以页为单位缓冲数据,可以通过 innodb_buffer_pool_size 参数调整缓冲池的大小,默认是 128 M。 Innodb 通过三种链表来管理缓页: Free List (空闲页链表),管理空闲页; Flush List (脏页链表),管理脏页; LRU List,管理脏页+干净页,将最近且经常查询的数据缓存在其中,而不常查询的数据就淘汰出去。; InnoDB 对 LRU 做了一些优化,我们熟悉的 LRU 算法通常是将最近查询的数据放到 LRU 链表的头部,而 InnoDB 做 2 点优化: 将 LRU 链表 分为young 和 old 两个区域,加入缓冲池的页,优先插入 old 区域;页被访问时,才进入 young 区域,目的是为了解决预读失效的问题。 当「页被访问」且「 old 区域停留时间超过 innodb_old_blocks_time 阈值(默认为1秒)」时,才会将页插入到 young 区域,否则还是插入到 old 区域,目的是为了解决批量数据访问,大量热数据淘汰的问题。 可以通过调整 innodb_old_blocks_pc 参数,设置 young 区域和 old 区域比例。 在开启了慢 SQL 监控后,如果你发现「偶尔」会出现一些用时稍长的 SQL,这可因为脏页在刷新到磁盘时导致数据库性能抖动。如果在很短的时间出现这种现象,就需要调大 Buffer Pool 空间或 redo log 日志的大小。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

一文带你认识LPWA通信技术

摘要:为了满足越来越多的远距离物联网设备的连接需求,LPWA应用而生。 本文分享自华为云社区《常见物联网通信技术之LPWA通信技术》,作者:爱吃面包的猫。 如果你比较关注物联网圈的话,想必对LPWA这一名词有所耳闻。即使没有见过,也在科技媒体上扫见过LoRa、SigFox、NB-IoT这些技术关键词。 为了满足越来越多的远距离物联网设备的连接需求,LPWA应用而生。LPWAN(Low Power Wide Area Network)低功耗广域网络,专为低带宽、低功耗、远距离、大量连接的物联网应用而设计的。下面我们就来进入今天的正题,为大家全面介绍LPWA技术。 1 SigFox SigFox 是一家法国的物联网技术创业公司,它的公司叫 SigFox,它的这项技术的名字也叫 SigFox。SigFox 这项技术专门为那些吞吐率很低的项目所设计,它的传输功耗很低,只有 50-100 微瓦,但是仍然能维持比较稳定的数据连接。但是呢,因为物联网设备会产生大量的 数据,并且这些数据由 SigFox 公司自己来进行存储。但是 SigFox 毕竟是一家小公司,自己 保存着这些数据公信力不足,同样在信息安全方面也存在疑问,所以它的使用并没有像 LoRa 一样非常广泛。 2 LoRa 是 Long Range 的缩写,它跟 SigFox 不一样的是他由 LoRa 联盟维护管理。LoRa 技术 由 Semtech 公司开发,之后经过 LoRa 联盟的共同努力,他们开发出了应用于 LPWA 领域的 网络,叫做 LoRaWAN。它是一项基于扩频技术的超远距离无线传输方案,以此来达到长距 离和低功耗的要求,这项技术主要在未授权频段来支撑。Lora 可以应用于自动抄表、智能家 居和楼宇自动化、无线预警和安全系统、工业监测和控制以及远程灌溉系统等等。 3 NB-IoT NB-IoT 最早是由华为和沃达丰主导提出来的,之后加入了爱立信和高通等一些公司。它的特 点就在于 NB-IoT 叫窄带蜂窝物联网,所以它构建于现有的蜂窝网络。同时因为它是窄带,所 以他只消耗大约 180KHz 的带宽,可直接部署于 GSM 网络、UMTS 网络或 LTE 网络,以降 低部署成本、实现平滑升级。 4 eMTC 在 LPWA 技术当中最后一个要描述的就是爱立信基于 4G 网络提出的解决方案 eMTC,它主 要面向深度覆盖、大连接的应用场景。与 NB-IoT 相比,它的速率更高但是覆盖范围要更小, 并且功耗也比较大。但是,虽然与 NB-IoT 相比它的覆盖范围更小,功耗也更大,但是它具备 语音通信的能力。所以相较于 NB-IoT,它可以被应用于一些需要使用语音通信功能的场景之 下。 5 LPWA 技术对比 接下来本文同样也会对上述的 LPWA 技术做一个简单的对比,除了 NB-IoT 和 eMTC,其他的 两种网络都运行在 SubG 免授权频段上。SubG 的意思是频率在 1GHz 以下,主要是指 27MHz 到 960MHz 的频段。SubG 是长距离、低功耗通信的理想选择。因为在功率相同的情 况下,网络的频率越高,穿透能力就越差,但是 LPWA 场景下的设备如电表、水表等,他们 经常被放在比较深的位置当中,通常有非常多的阻碍在上面,所以选择低频段就显得非常有必 要了。 在表中也可以看到对于 NB-IoT 的描述当中,它的频段主要部署在 SubG 授权频段之上,这是 因为有一部分 NB-IoT 网络部署于 SubG 授权频段之外,具体的原因将在本文之后的章节中进 行说明。 由于应用于免授权频段的 LoRa 与授权频段上的 NB-IoT 都是比较热门的 LPWA 技术,所以经 常被用来作对比。两者之间的差别就在于: 1) 阵容不同 LoRa 是由美国个体户 Semtech 研究出来的,NB-IoT 是由 3GPP 官方移动通信协会制定的标 准。LoRa 基本上是由 Semtech 一家公司包办上下游产业链,但 NB-IoT 则是整个通信产业上 下游公司在合力运营,比如 NB-IoT 芯片模组现在华为、高通、三星、联发科等公司都在做。 2) 频段使用不同 NB-IoT 使用的频段是授权频段,而 LoRa 使用的则是非授权频段。 授权频段,就是工信部授予的,除了被授予的运营商能用,其他所有个人企业机构都不能使用 的频段,用了就违法,无线电管理部门会上门查水表。 而非授权频段,就是工信部没说给谁用,谁都可以用的频段。因此,如果有个人或者企业使用 LoRa 的工作频段做别的事,那么就会对这个区域的 LoRa 设备产生严重的干扰,导致网络无 法使用。 因此,有官方背景的 NB-IoT 网络质量肯定更好,更高质。 3) LoRa 需要企业自建,NB-IoT 运营商早已建好 运营商并不运营 LoRa 网络,如果企业想使用 LoRa,需要自己购买基站、网络设备、服务器 等等全套网络运营软硬件,并完成网络搭建,自己运营。 而 NB-IoT 目前三大运营商已经在国内完成了基站的建设与网络开通,像使用手机 SIM 卡一 样,企业只需要从运营商采买 NB-IoT 的 SIM 卡,随后插入带有 NB-IoT 模组的设备内,就可 以缴费使用啦。 4) LoRa 的优势在哪里? 其实对于 90%的企业来说,LoRa 确实没啥优势。除非企业想使用物联网的位置在农村、偏远 山区、独立的厂区等(比如智慧农场、智慧工厂),确实没有运营商 NB-IoT 网络的覆盖,无 可奈何才会想到自建 LoRa。 再就是非常大的企业,或者政府,怕使用运营商的网络不安全,比如出现数据窃取,因此宁愿 自己建设网络自己维护,也不相信运营商。 以上就是 NB-IoT 与 LoRa 之间比较大的区别。 6 无线通信技术对比 上述三类无线通信技术当中包含了非常多不同的网络通信技术,并且这三类都能应用在物联网 领域,开发者该怎么去选择呢,怎么样去权衡使用呢? 图 4-6 就能很好的回答这个问题,通过这张图就知道具体什么样的情形下应该使用什么样的网 络。 这张图的两个坐标轴分别是传输速率和传输距离,它也跟物联网的不同场景的需求相对应。根 据不同的数据速率要求可以将场景大概分成三类,一类是数据速率要求最高的比如视频监控、 车联网,第二类速率要求比较高的像智能物流、车辆管理等等,第三类是速率要求不太高的例 如抄表之类的行业。那么当然,如果具体到传播距离上的话这些场景还可以再细分,所以大概 可以分成这六种针对不同的需求的不同的网络。在上文中也提到过,最合适的网络才是最好的 网络,除了从传输距离和传输速率上进行考虑之外,还需要从成本上进行考虑,以此来选择最 合适的网络应用于解决方案中,从而获得最大的利益。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

一文彻底弄懂cookie、session、token

前言 作为一个JAVA开发,之前有好几次出去面试,面试官都问我,JAVAWeb掌握的怎么样,我当时就不知道怎么回答,Web,日常开发中用的是什么?今天我们来说说JAVAWeb最应该掌握的三个内容。 发展历程 1、很久很久以前,Web 基本上就是文档的浏览而已, 既然是浏览,作为服务器, 不需要记录谁在某一段时间里都浏览了什么文档,每次请求都是一个新的HTTP协议, 就是请求加响应, 尤其是我不用记住是谁刚刚发了HTTP请求, 每个请求对我来说都是全新的。 2、但是随着交互式Web应用的兴起,像在线购物网站,需要登录的网站等等,马上就面临一个问题,那就是要管理会话,必须记住哪些人登录系统, 哪些人往自己的购物车中放商品, 也就是说我必须把每个人区分开,这就是一个不小的挑战,因为HTTP请求是无状态的,所以想出的办法就是给大家发一个会话标识(session id), 说白了就是一个随机的字串,每个人收到的都不一样, 每次大家向我发起HTTP请求的时候,把这个字符串给一并捎过来, 这样我就能区分开谁是谁了。 3、这样大家很嗨皮了,可是服务器就不嗨皮了,每个人只需要保存自己的session id,而服务器要保存所有人的session id ! 如果访问服务器多了, 就得由成千上万,甚至几十万个。 这对服务器说是一个巨大的开销 , 严重的限制了服务器扩展能力, 比如说我用两个机器组成了一个集群, 小F通过机器A登录了系统, 那session id会保存在机器A上, 假设小F的下一次请求被转发到机器B怎么办? 机器B可没有小F的 session id啊。 有时候会采用一点小伎俩: session sticky , 就是让小F的请求一直粘连在机器A上, 但是这也不管用, 要是机器A挂掉了, 还得转到机器B去。 那只好做session 的复制了, 把session id 在两个机器之间搬来搬去, 快累死了。 后来有个叫Memcached的支了招: 把session id 集中存储到一个地方, 所有的机器都来访问这个地方的数据, 这样一来,就不用复制了, 但是增加了单点失败的可能性, 要是那个负责session 的机器挂了, 所有人都得重新登录一遍, 估计得被人骂死。 也尝试把这个单点的机器也搞出集群,增加可靠性, 但不管如何, 这小小的session 对我来说是一个沉重的负担 4 于是有人就一直在思考, 我为什么要保存这可恶的session呢, 只让每个客户端去保存该多好? 可是如果不保存这些session id , 怎么验证客户端发给我的session id 的确是我生成的呢? 如果不去验证,我们都不知道他们是不是合法登录的用户, 那些不怀好意的家伙们就可以伪造session id , 为所欲为了。 嗯,对了,关键点就是验证 ! 比如说, 小F已经登录了系统, 我给他发一个令牌(token), 里边包含了小F的 user id, 下一次小F 再次通过Http 请求访问我的时候, 把这个token 通过Http header 带过来不就可以了。 不过这和session id没有本质区别啊, 任何人都可以可以伪造, 所以我得想点儿办法, 让别人伪造不了。 那就对数据做一个签名吧, 比如说我用HMAC-SHA256 算法,加上一个只有我才知道的密钥, 对数据做一个签名, 把这个签名和数据一起作为token , 由于密钥别人不知道, 就无法伪造token了。 这个token 我不保存, 当小F把这个token 给我发过来的时候,我再用同样的HMAC-SHA256 算法和同样的密钥,对数据再计算一次签名, 和token 中的签名做个比较, 如果相同, 我就知道小F已经登录过了,并且可以直接取到小F的user id , 如果不相同, 数据部分肯定被人篡改过, 我就告诉发送者: 对不起,没有认证。 Token 中的数据是明文保存的(虽然我会用Base64做下编码, 但那不是加密), 还是可以被别人看到的, 所以我不能在其中保存像密码这样的敏感信息。 当然, 如果一个人的token 被别人偷走了, 那我也没办法, 我也会认为小偷就是合法用户, 这其实和一个人的session id 被别人偷走是一样的。 这样一来, 我就不保存session id 了, 我只是生成token , 然后验证token , 我用我的CPU计算时间获取了我的session 存储空间 ! 解除了session id这个负担, 可以说是无事一身轻, 我的机器集群现在可以轻松地做水平扩展, 用户访问量增大, 直接加机器就行。 这种无状态的感觉实在是太好了! Cookie 1.什么是Cookie Cookie翻译成中文的意思是‘小甜饼’,是由W3C组织提出,最早由Netscape社区发展的一种机制。目前Cookie已经成为标准,所有的主流浏览器如IE、Netscape、Firefox、Opera等都支持Cookie。 服务器单从网络连接上无从知道客户身份。怎么办呢?就给客户端们颁发一个通行证吧,每人一个,无论谁访问都必须携带自己通行证。这样服务器就能从通行证上确认客户身份了。这就是Cookie的工作原理。 Cookie是客户端保存用户信息的一种机制,用来记录用户的一些信息,也是实现Session的一种方式。Cookie存储的数据量有限,且都是保存在客户端浏览器中。不同的浏览器有不同的存储大小,但一般不超过4KB。因此使用Cookie实际上只能存储一小段的文本信息(key-value格式)。 2.Cookie的机制 当用户第一次访问并登陆一个网站的时候,cookie的设置以及发送会经历以下4个步骤: 客户端发送一个请求到服务器; 服务器发送一个HttpResponse响应到客户端,其中包含Set-Cookie的头部; 客户端保存cookie,之后向服务器发送请求时,HttpRequest请求中会包含一个Cookie的头部; 服务器返回响应数据。 为了探究这个过程,写了代码进行测试,如下: 我在doGet方法中,new了一个Cookie对象并将其加入到了HttpResponse对象中 @RestController public class TestController { @GetMapping(value = "/doGet") public void doGet(HttpServletRequest req, HttpServletResponse resp) throws ServletException, IOException { Cookie cookie = new Cookie("jiangwang",System.currentTimeMillis()+""); // 设置生命周期为MAX_VALUE cookie.setMaxAge(Integer.MAX_VALUE); resp.addCookie(cookie); } } 复制代码 浏览器输入地址进行访问,结果如图所示: 可见Response Headers中包含Set-Cookie头部,而Request Headers中包含了Cookie头部。name和value正是上述设置的。 3.Cookie的属性 Expires 该属性用来设置Cookie的有效期。Cookie中的maxAge用来表示该属性,单位为秒。Cookie中通过getMaxAge()和setMaxAge(int maxAge)来读写该属性。maxAge有3种值,分别为正数,负数和0。 如果maxAge属性为正数,则表示该Cookie会在maxAge秒之后自动失效。浏览器会将maxAge为正数的Cookie持久化,即写到对应的Cookie文件中(每个浏览器存储的位置不一致)。无论客户关闭了浏览器还是电脑,只要还在maxAge秒之前,登录网站时该Cookie仍然有效。下面代码中的Cookie信息将永远有效。 Cookie cookie = new Cookie("jiangwang",System.currentTimeMillis()+""); // 设置生命周期为MAX_VALUE,永久有效 cookie.setMaxAge(Integer.MAX_VALUE); resp.addCookie(cookie); 复制代码 当maxAge属性为负数,则表示该Cookie只是一个临时Cookie,不会被持久化,仅在本浏览器窗口或者本窗口打开的子窗口中有效,关闭浏览器后该Cookie立即失效。 Cookie cookie = new Cookie("jiangwang",System.currentTimeMillis()+""); // 设置生命周期为MAX_VALUE,永久有效 cookie.setMaxAge(-1); resp.addCookie(cookie); 复制代码 当maxAge为0时,表示立即删除Cookie。 Cookie[] cookies = req.getCookies(); Cookie cookie = null; // get Cookie for (Cookie ck : cookies) { if ("jiangwang".equals(ck.getName())) { cookie = ck; break; } } if (null != cookie) { // 删除一个cookie cookie.setMaxAge(0); resp.addCookie(cookie); } 复制代码 修改或者删除Cookie HttpServletResponse提供的Cookie操作只有一个addCookie(Cookie cookie),所以想要修改Cookie只能使用一个同名的Cookie来覆盖原先的Cookie。如果要删除某个Cookie,则只需要新建一个同名的Cookie,并将maxAge设置为0,并覆盖原来的Cookie即可。 新建的Cookie,除了value、maxAge之外的属性,比如name、path、domain都必须与原来的一致才能达到修改或者删除的效果。否则,浏览器将视为两个不同的Cookie不予覆盖。 Cookie的域名 Cookie是不可以跨域名的,隐私安全机制禁止网站非法获取其他网站的Cookie。 正常情况下,同一个一级域名下的两个二级域名也不能交互使用Cookie,比如a1.jiangwang.com和a2.jiangwang.com,因为二者的域名不完全相同。如果想要jiangwnag.com名下的二级域名都可以使用该Cookie,需要设置Cookie的domain参数为.jiangwang.com,这样使用a1.jiangwang.com和a2.jiangwang.com就能访问同一个cookie 一级域名又称为顶级域名,一般由字符串+后缀组成。熟悉的一级域名有baidu.com,qq.com。com,cn,net等均是常见的后缀。 二级域名是在一级域名下衍生的,比如有个一级域名为abc.com,则blog.abc.com和www.abc.com均是其衍生出来的二级域名。 Cookie的路径 path属性决定允许访问Cookie的路径。比如,设置为"/"表示允许所有路径都可以使用Cookie 4.应用 Cookies最典型的应用是判定注册用户是否已经登录网站,用户可能会得到提示,是否在下一次进入此网站时保留用户信息以便简化登录手续,这些都是Cookies的功用。另一个重要应用场合是“购物车”之类处理。用户可能会在一段时间内在同一家网站的不同页面中选择不同的商品,这些信息都会写入Cookies,以便在最后付款时提取信息。 Session 1.什么是Session 在WEB开发中,服务器可以为每个用户浏览器创建一个会话对象(session对象),注意:一个浏览器独占一个session对象(默认情况下)。因此,在需要保存用户数据时,服务器程序可以把用户数据写到用户浏览器独占的session中,当用户使用浏览器访问其它程序时,其它程序可以从用户的session中取出该用户的数据,为用户服务。 2.Session实现原理 服务器创建session出来后,会把session的id号,以cookie的形式回写给客户机,这样,只要客户机的浏览器不关,再去访问服务器时,都会带着session的id号去,服务器发现客户机浏览器带session id过来了,就会使用内存中与之对应的session为之服务。可以用如下的代码证明: @RestController public class TestController { @GetMapping(value = "/doGet") public void doGet(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException { response.setCharacterEncoding("UTF-8"); response.setContentType("text/html;charset=UTF-8"); //使用request对象的getSession()获取session,如果session不存在则创建一个 HttpSession session = request.getSession(); //将数据存储到session中 session.setAttribute("mayun", "马云"); //获取session的Id String sessionId = session.getId(); //判断session是不是新创建的 if (session.isNew()) { response.getWriter().print("session创建成功,session的id是:"+sessionId); }else { response.getWriter().print("服务器已经存在该session了,session的id是:"+sessionId); } } } 复制代码 第一次访问时,服务器会创建一个新的sesion,并且把session的Id以cookie的形式发送给客户端浏览器,如下图所示: 再次请求服务器,此时就可以看到浏览器再请求服务器时,会把存储到cookie中的session的Id一起传递到服务器端了,如下图所示: 3.session创建和销毁 在程序中第一次调用request.getSession()方法时就会创建一个新的Session,可以用isNew()方法来判断Session是不是新创建的 //使用request对象的getSession()获取session,如果session不存在则创建一个 HttpSession session = request.getSession(); //获取session的Id String sessionId = session.getId(); //判断session是不是新创建的 if (session.isNew()) { response.getWriter().print("session创建成功,session的id是:"+sessionId); }else { response.getWriter().print("服务器已经存在session,session的id是:"+sessionId); } 复制代码 session对象默认30分钟没有使用,则服务器会自动销毁session,也可以手工配置session的失效时间,例如: session.setMaxInactiveInterval(10*60);//10分钟后session失效 复制代码 当需要在程序中手动设置Session失效时,可以手工调用session.invalidate方法,摧毁session。 HttpSession session = request.getSession(); //手工调用session.invalidate方法,摧毁session session.invalidate(); 复制代码 面试题:浏览器关闭,session就销毁了? 不对. Session生成后,只要用户继续访问,服务器就会更新Session的最后访问时间,并维护该Session。为防止内存溢出,服务器会把长时间内没有活跃的Session从内存删除。这个时间就是Session的超时时间。如果超过了超时时间没访问过服务器,Session就自动失效了。 Token 1.什么是Token token的意思是“令牌”,是服务端生成的一串字符串,作为客户端进行请求的一个标识。 当用户第一次登录后,服务器生成一个token并将此token返回给客户端,以后客户端只需带上这个token前来请求数据即可,无需再次带上用户名和密码。 简单token的组成;uid(用户唯一的身份标识)、time(当前时间的时间戳)、sign(签名,token的前几位以哈希算法压缩成的一定长度的十六进制字符串。为防止token泄露)。 2.Token的原理 用户通过用户名和密码发送请求 程序校验 程序返回一个Token给客户端 客户端存储Token,并且每次发送请求携带Token 服务端验证Token,并返回数据 3.Token的使用 Spring Boot和Jwt集成示例 项目依赖 pom.xml <dependency> <groupId>com.alibaba</groupId> <artifactId>fastjson</artifactId> <version>1.2.47</version> </dependency> <dependency> <groupId>com.auth0</groupId> <artifactId>java-jwt</artifactId> <version>3.10.3</version> </dependency> 复制代码 自定义注解 //需要登录才能进行操作的注解LoginToken @Target({ElementType.METHOD, ElementType.TYPE}) @Retention(RetentionPolicy.RUNTIME) public @interface LoginToken { boolean required() default true; } 复制代码 //用来跳过验证的PassToken @Target({ElementType.METHOD, ElementType.TYPE}) @Retention(RetentionPolicy.RUNTIME) public @interface PassToken { boolean required() default true; } 复制代码 用户实体类、及查询service public class User { private String userID; private String userName; private String passWord; public String getUserID() { return userID; } public void setUserID(String userID) { this.userID = userID; } public String getUserName() { return userName; } public void setUserName(String userName) { this.userName = userName; } public String getPassWord() { return passWord; } public void setPassWord(String passWord) { this.passWord = passWord; } } 复制代码 @Service public class UserService { public User getUser(String userid, String password){ if ("admin".equals(userid) && "admin".equals(password)){ User user=new User(); user.setUserID("admin"); user.setUserName("admin"); user.setPassWord("admin"); return user; } else{ return null; } } public User getUser(String userid){ if ("admin".equals(userid)){ User user=new User(); user.setUserID("admin"); user.setUserName("admin"); user.setPassWord("admin"); return user; } else{ return null; } } } 复制代码 Token生成 @Service public class TokenService { /** * 过期时间10分钟 */ private static final long EXPIRE_TIME = 10 * 60 * 1000; public String getToken(User user) { Date date = new Date(System.currentTimeMillis() + EXPIRE_TIME); String token=""; token= JWT.create().withAudience(user.getUserID()) // 将 user id 保存到 token 里面 .withExpiresAt(date) //十分钟后token过期 .sign(Algorithm.HMAC256(user.getPassWord())); // 以 password 作为 token 的密钥 return token; } } 复制代码 拦截器拦截token package com.jw.interceptor; import com.auth0.jwt.JWT; import com.auth0.jwt.JWTVerifier; import com.auth0.jwt.algorithms.Algorithm; import com.auth0.jwt.exceptions.JWTDecodeException; import com.auth0.jwt.exceptions.JWTVerificationException; import com.jw.annotation.LoginToken; import com.jw.annotation.PassToken; import com.jw.entity.User; import com.jw.service.UserService; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.web.method.HandlerMethod; import org.springframework.web.servlet.HandlerInterceptor; import org.springframework.web.servlet.ModelAndView; import javax.servlet.http.HttpServletRequest; import javax.servlet.http.HttpServletResponse; import java.lang.reflect.Method; public class JwtInterceptor implements HandlerInterceptor{ @Autowired private UserService userService; @Override public boolean preHandle(HttpServletRequest httpServletRequest, HttpServletResponse httpServletResponse, Object object) throws Exception { String token = httpServletRequest.getHeader("token");// 从 http 请求头中取出 token // 如果不是映射到方法直接通过 if(!(object instanceof HandlerMethod)){ return true; } HandlerMethod handlerMethod=(HandlerMethod)object; Method method=handlerMethod.getMethod(); //检查是否有passtoken注释,有则跳过认证 if (method.isAnnotationPresent(PassToken.class)) { PassToken passToken = method.getAnnotation(PassToken.class); if (passToken.required()) { return true; } } //检查有没有需要用户权限的注解 if (method.isAnnotationPresent(LoginToken.class)) { LoginToken loginToken = method.getAnnotation(LoginToken.class); if (loginToken.required()) { // 执行认证 if (token == null) { throw new RuntimeException("无token,请重新登录"); } // 获取 token 中的 user id String userId; try { userId = JWT.decode(token).getAudience().get(0); } catch (JWTDecodeException j) { throw new RuntimeException("401"); } User user = userService.getUser(userId); if (user == null) { throw new RuntimeException("用户不存在,请重新登录"); } // 验证 token JWTVerifier jwtVerifier = JWT.require(Algorithm.HMAC256(user.getPassWord())).build(); try { jwtVerifier.verify(token); } catch (JWTVerificationException e) { throw new RuntimeException("401"); } return true; } } return true; } @Override public void postHandle(HttpServletRequest httpServletRequest, HttpServletResponse httpServletResponse, Object o, ModelAndView modelAndView) throws Exception { } @Override public void afterCompletion(HttpServletRequest httpServletRequest, HttpServletResponse httpServletResponse, Object o, Exception e) throws Exception { } } 复制代码 注册拦截器 package com.jw.config; import com.jw.interceptor.JwtInterceptor; import org.springframework.context.annotation.Bean; import org.springframework.context.annotation.Configuration; import org.springframework.web.servlet.config.annotation.InterceptorRegistry; import org.springframework.web.servlet.config.annotation.WebMvcConfigurer; @Configuration public class InterceptorConfig implements WebMvcConfigurer{ @Override public void addInterceptors(InterceptorRegistry registry) { registry.addInterceptor(jwtInterceptor()) .addPathPatterns("/**"); // 拦截所有请求,通过判断是否有 @LoginRequired 注解 决定是否需要登录 //注册TestInterceptor拦截器 // InterceptorRegistration registration = registry.addInterceptor(jwtInterceptor()); // registration.addPathPatterns("/**"); //添加拦截路径 // registration.excludePathPatterns( //添加不拦截路径 // "/**/*.html", //html静态资源 // "/**/*.js", //js静态资源 // "/**/*.css", //css静态资源 // "/**/*.woff", // "/**/*.ttf", // "/swagger-ui.html" // ); } @Bean public JwtInterceptor jwtInterceptor() { return new JwtInterceptor(); } } 复制代码 登录Controller @RestController public class LoginController { @Autowired private UserService userService; @Autowired private TokenService tokenService; @PostMapping("login") public Object login(String username, String password){ JSONObject jsonObject=new JSONObject(); User user=userService.getUser(username, password); if(user==null){ jsonObject.put("message","登录失败!"); return jsonObject; }else { String token = tokenService.getToken(user); jsonObject.put("token", token); jsonObject.put("user", user); return jsonObject; } } @LoginToken @GetMapping("/getMessage") public String getMessage(){ return "你已通过验证"; } } 复制代码 配置全局异常捕获 @RestControllerAdvice public class GlobalExceptionHandler { @ResponseBody @ExceptionHandler(Exception.class) public Object handleException(Exception e) { String msg = e.getMessage(); if (msg == null || msg.equals("")) { msg = "服务器出错"; } JSONObject jsonObject = new JSONObject(); jsonObject.put("code", 1000); jsonObject.put("message", msg); return jsonObject; } } 复制代码 postman测试 获取token 无token登录 有token登录 错误token登录 4.Token的优缺点 优点: 支持跨域访问: Cookie是不允许垮域访问的,token支持; 无状态: token无状态,session有状态的; 去耦: 不需要绑定到一个特定的身份验证方案。Token可以在任何地方生成,只要在 你的API被调用的时候, 你可以进行Token生成调用即可; 更适用于移动应用: Cookie不支持手机端访问的; 性能: 在网络传输的过程中,性能更好; 基于标准化: 你的API可以采用标准化的 JSON Web Token (JWT). 这个标准已经存在 多个后端库(.NET, Ruby, Java,Python, PHP)和多家公司的支持(如: Firebase,Google, Microsoft)。 缺点: 占带宽,正常情况下要比 session_id 更大,需要消耗更多流量,挤占更多带宽,假如你的网站每月有 10 万次的浏览器,就意味着要多开销几十兆的流量。听起来并不多,但日积月累也是不小一笔开销。实际上,许多人会在 JWT 中存储的信息会更多; 无法在服务端注销,那么久很难解决劫持问题; 性能问题,JWT 的卖点之一就是加密签名,由于这个特性,接收方得以验证 JWT 是否有效且被信任。但是大多数 Web 身份认证应用中,JWT 都会被存储到 Cookie 中,这就是说你有了两个层面的签名。听着似乎很牛逼,但是没有任何优势,为此,你需要花费两倍的 CPU 开销来验证签名。对于有着严格性能要求的 Web 应用,这并不理想,尤其对于单线程环境。 结尾 创作不易,如果对大家有所帮助,希望大家点赞支持,有什么问题也可以在评论区里讨论😄~ 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star: http://github.crmeb.net/u/defu 不胜感激 ! 来自 “开源独尊 ” ,链接: https://ym.baisou.ltd/post/785.html

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册