首页 文章 精选 留言 我的

精选列表

搜索[鸿蒙实践],共10000篇文章
优秀的个人博客,低调大师

MAPREDUCE实践篇(1)

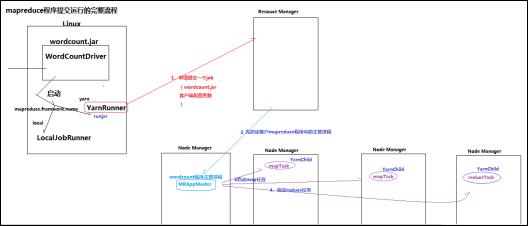
2.1MAPREDUCE示例编写及编程规范 2.1.1编程规范 (1)用户编写的程序分成三个部分:Mapper,Reducer,Driver(提交运行mr程序的客户端) (2)Mapper的输入数据是KV对的形式(KV的类型可自定义) (3)Mapper的输出数据是KV对的形式(KV的类型可自定义) (4)Mapper中的业务逻辑写在map()方法中 (5)map()方法(maptask进程)对每一个<K,V>调用一次 (6)Reducer的输入数据类型对应Mapper的输出数据类型,也是KV (7)Reducer的业务逻辑写在reduce()方法中 (8)Reducetask进程对每一组相同k的<k,v>组调用一次reduce()方法 (9)用户自定义的Mapper和Reducer都要继承各自的父类 (10)整个程序需要一个Drvier来进行提交,提交的是一个描述了各种必要信息的job对象 1.7.2 wordcount示例编写 需求:在一堆给定的文本文件中统计输出每一个单词出现的总次数 (1)定义一个mapper类 //首先要定义四个泛型的类型 //keyin: LongWritable valuein: Text //keyout: Text valueout:IntWritable public class WordCountMapper extends Mapper<LongWritable, Text, Text, IntWritable>{ //map方法的生命周期: 框架每传一行数据就被调用一次 //key : 这一行的起始点在文件中的偏移量 //value:这一行的内容 @Override protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException { //拿到一行数据转换为string String line = value.toString(); //将这一行切分出各个单词 String[] words = line.split(" "); //遍历数组,输出<单词,1> for(String word:words){ context.write(new Text(word), new IntWritable(1)); } } } (2)定义一个reducer类 //生命周期:框架每传递进来一个kv组,reduce方法被调用一次 @Override protected void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException { //定义一个计数器 int count = 0; //遍历这一组kv的所有v,累加到count中 for(IntWritable value:values){ count += value.get(); } context.write(key, new IntWritable(count)); } } (3)定义一个主类,用来描述job并提交job public class WordCountRunner { //把业务逻辑相关的信息(哪个是mapper,哪个是reducer,要处理的数据在哪里,输出的结果放哪里……)描述成一个job对象 //把这个描述好的job提交给集群去运行 public static void main(String[] args) throws Exception { Configuration conf = new Configuration(); Job wcjob = Job.getInstance(conf); //指定我这个job所在的jar包 //wcjob.setJar("/home/hadoop/wordcount.jar"); wcjob.setJarByClass(WordCountRunner.class); wcjob.setMapperClass(WordCountMapper.class); wcjob.setReducerClass(WordCountReducer.class); //设置我们的业务逻辑Mapper类的输出key和value的数据类型 wcjob.setMapOutputKeyClass(Text.class); wcjob.setMapOutputValueClass(IntWritable.class); //设置我们的业务逻辑Reducer类的输出key和value的数据类型 wcjob.setOutputKeyClass(Text.class); wcjob.setOutputValueClass(IntWritable.class); //指定要处理的数据所在的位置 FileInputFormat.setInputPaths(wcjob, "hdfs://hdp-server01:9000/wordcount/data/big.txt"); //指定处理完成之后的结果所保存的位置 FileOutputFormat.setOutputPath(wcjob, new Path("hdfs://hdp-server01:9000/wordcount/output/")); //向yarn集群提交这个job boolean res = wcjob.waitForCompletion(true); System.exit(res?0:1); } 2.2MAPREDUCE程序运行模式 2.2.1本地运行模式 (1)mapreduce程序是被提交给LocalJobRunner在本地以单进程的形式运行 (2)而处理的数据及输出结果可以在本地文件系统,也可以在hdfs上 (3)怎样实现本地运行?写一个程序,不要带集群的配置文件(本质是你的mr程序的conf中是否有mapreduce.framework.name=local以及yarn.resourcemanager.hostname参数) (4)本地模式非常便于进行业务逻辑的debug,只要在eclipse中打断点即可 如果在windows下想运行本地模式来测试程序逻辑,需要在windows中配置环境变量: %HADOOP_HOME% = d:/hadoop-2.6.1 %PATH% = %HADOOP_HOME%\bin 并且要将d:/hadoop-2.6.1的lib和bin目录替换成windows平台编译的版本 2.2.2集群运行模式 (1)将mapreduce程序提交给yarn集群resourcemanager,分发到很多的节点上并发执行 (2)处理的数据和输出结果应该位于hdfs文件系统 (3)提交集群的实现步骤: A、将程序打成JAR包,然后在集群的任意一个节点上用hadoop命令启动 $ hadoop jar wordcount.jar cn.itcast.bigdata.mrsimple.WordCountDriver inputpath outputpath B、直接在linux的eclipse中运行main方法 (项目中要带参数:mapreduce.framework.name=yarn以及yarn的两个基本配置) C、如果要在windows的eclipse中提交job给集群,则要修改YarnRunner类 mapreduce程序在集群中运行时的大体流程: 附:在windows平台上访问hadoop时改变自身身份标识的方法之二: 3. MAPREDUCE中的Combiner (1)combiner是MR程序中Mapper和Reducer之外的一种组件 (2)combiner组件的父类就是Reducer (3)combiner和reducer的区别在于运行的位置: Combiner是在每一个maptask所在的节点运行 Reducer是接收全局所有Mapper的输出结果; (4) combiner的意义就是对每一个maptask的输出进行局部汇总,以减小网络传输量 具体实现步骤: 1、自定义一个combiner继承Reducer,重写reduce方法 2、在job中设置: job.setCombinerClass(CustomCombiner.class) (5) combiner能够应用的前提是不能影响最终的业务逻辑 而且,combiner的输出kv应该跟reducer的输入kv类型要对应起来 本文转自yushiwh 51CTO博客,原文链接:http://blog.51cto.com/yushiwh/1913043,如需转载请自行联系原作者

优秀的个人博客,低调大师

MAPREDUCE实践篇(2)

4.1. Mapreduce中的排序初步 4.1.1需求 对日志数据中的上下行流量信息汇总,并输出按照总流量倒序排序的结果 数据如下: 13631579850661372623050300-FD-07-A4-72-B8:CMCC120.196.100.822427248124681200 1363157995052138265441015C-0E-8B-C7-F1-E0:CMCC120.197.40.4402640200 13631579910761392643565620-10-7A-28-CC-0A:CMCC120.196.100.99241321512200 1363154400022139262511065C-0E-8B-8B-B1-50:CMCC120.197.40.4402400200 4.1.2分析 基本思路:实现自定义的bean来封装流量信息,并将bean作为map输出的key来传输 MR程序在处理数据的过程中会对数据排序(map输出的kv对传输到reduce之前,会排序),排序的依据是map输出的key 所以,我们如果要实现自己需要的排序规则,则可以考虑将排序因素放到key中,让key实现接口:WritableComparable 然后重写key的compareTo方法 4.1.3实现 1、自定义的bean public class FlowBean implements WritableComparable<FlowBean>{ long upflow; long downflow; long sumflow; //如果空参构造函数被覆盖,一定要显示定义一下,否则在反序列时会抛异常 public FlowBean(){} public FlowBean(long upflow, long downflow) { super(); this.upflow = upflow; this.downflow = downflow; this.sumflow = upflow + downflow; } public long getSumflow() { return sumflow; } public void setSumflow(long sumflow) { this.sumflow = sumflow; } public long getUpflow() { return upflow; } public void setUpflow(long upflow) { this.upflow = upflow; } public long getDownflow() { return downflow; } public void setDownflow(long downflow) { this.downflow = downflow; } //序列化,将对象的字段信息写入输出流 @Override public void write(DataOutput out) throws IOException { out.writeLong(upflow); out.writeLong(downflow); out.writeLong(sumflow); } //反序列化,从输入流中读取各个字段信息 @Override public void readFields(DataInput in) throws IOException { upflow = in.readLong(); downflow = in.readLong(); sumflow = in.readLong(); } @Override public String toString() { return upflow + "\t" + downflow + "\t" + sumflow; } @Override public int compareTo(FlowBean o) { //自定义倒序比较规则 return sumflow > o.getSumflow() ? -1:1; } } 2、mapper和reducer public class FlowCount { static class FlowCountMapper extends Mapper<LongWritable, Text, FlowBean,Text > { @Override protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException { String line = value.toString(); String[] fields = line.split("\t"); try { String phonenbr = fields[0]; long upflow = Long.parseLong(fields[1]); long dflow = Long.parseLong(fields[2]); FlowBean flowBean = new FlowBean(upflow, dflow); context.write(flowBean,new Text(phonenbr)); } catch (Exception e) { e.printStackTrace(); } } } static class FlowCountReducer extends Reducer<FlowBean,Text,Text, FlowBean> { @Override protected void reduce(FlowBean bean, Iterable<Text> phonenbr, Context context) throws IOException, InterruptedException { Text phoneNbr = phonenbr.iterator().next(); context.write(phoneNbr, bean); } } public static void main(String[] args) throws Exception { Configuration conf = new Configuration(); Job job = Job.getInstance(conf); job.setJarByClass(FlowCount.class); job.setMapperClass(FlowCountMapper.class); job.setReducerClass(FlowCountReducer.class); job.setMapOutputKeyClass(FlowBean.class); job.setMapOutputValueClass(Text.class); job.setOutputKeyClass(Text.class); job.setOutputValueClass(FlowBean.class); // job.setInputFormatClass(TextInputFormat.class); FileInputFormat.setInputPaths(job, new Path(args[0])); FileOutputFormat.setOutputPath(job, new Path(args[1])); job.waitForCompletion(true); } } 4.2. Mapreduce中的分区Partitioner 4.2.1需求 根据归属地输出流量统计数据结果到不同文件,以便于在查询统计结果时可以定位到省级范围进行 4.2.2分析 Mapreduce中会将map输出的kv对,按照相同key分组,然后分发给不同的reducetask 默认的分发规则为:根据key的hashcode%reducetask数来分发 所以:如果要按照我们自己的需求进行分组,则需要改写数据分发(分组)组件Partitioner 自定义一个CustomPartitioner继承抽象类:Partitioner 然后在job对象中,设置自定义partitioner:job.setPartitionerClass(CustomPartitioner.class) 4.2.3实现 /** *定义自己的从map到reduce之间的数据(分组)分发规则 按照手机号所属的省份来分发(分组)ProvincePartitioner *默认的分组组件是HashPartitioner * * @author * */ public class ProvincePartitioner extends Partitioner<Text, FlowBean> { static HashMap<String, Integer> provinceMap = new HashMap<String, Integer>(); static { provinceMap.put("135", 0); provinceMap.put("136", 1); provinceMap.put("137", 2); provinceMap.put("138", 3); provinceMap.put("139", 4); } @Override public int getPartition(Text key, FlowBean value, int numPartitions) { Integer code = provinceMap.get(key.toString().substring(0, 3)); return code == null ? 5 : code; } } 4.3. mapreduce数据压缩 4.3.1概述 这是mapreduce的一种优化策略:通过压缩编码对mapper或者reducer的输出进行压缩,以减少磁盘IO,提高MR程序运行速度(但相应增加了cpu运算负担) 1、Mapreduce支持将map输出的结果或者reduce输出的结果进行压缩,以减少网络IO或最终输出数据的体积 2、压缩特性运用得当能提高性能,但运用不当也可能降低性能 3、基本原则: 运算密集型的job,少用压缩 IO密集型的job,多用压缩 4.3.2 MR支持的压缩编码 4.3.3 Reducer输出压缩 在配置参数或在代码中都可以设置reduce的输出压缩 1、在配置参数中设置 mapreduce.output.fileoutputformat.compress=false mapreduce.output.fileoutputformat.compress.codec=org.apache.hadoop.io.compress.DefaultCodec mapreduce.output.fileoutputformat.compress.type=RECORD 2、在代码中设置 Job job = Job.getInstance(conf); FileOutputFormat.setCompressOutput(job, true); FileOutputFormat.setOutputCompressorClass(job, (Class<? extends CompressionCodec>) Class.forName("")); 4.3.4 Mapper输出压缩 在配置参数或在代码中都可以设置reduce的输出压缩 1、在配置参数中设置 mapreduce.map.output.compress=false mapreduce.map.output.compress.codec=org.apache.hadoop.io.compress.DefaultCodec 2、在代码中设置: conf.setBoolean(Job.MAP_OUTPUT_COMPRESS, true); conf.setClass(Job.MAP_OUTPUT_COMPRESS_CODEC, GzipCodec.class, CompressionCodec.class); 4.3.5压缩文件的读取 Hadoop自带的InputFormat类内置支持压缩文件的读取,比如TextInputformat类,在其initialize方法中: public void initialize(InputSplit genericSplit, TaskAttemptContext context) throws IOException { FileSplit split = (FileSplit) genericSplit; Configuration job = context.getConfiguration(); this.maxLineLength = job.getInt(MAX_LINE_LENGTH, Integer.MAX_VALUE); start = split.getStart(); end = start + split.getLength(); final Path file = split.getPath(); // open the file and seek to the start of the split final FileSystem fs = file.getFileSystem(job); fileIn = fs.open(file); //根据文件后缀名创建相应压缩编码的codec CompressionCodec codec = new CompressionCodecFactory(job).getCodec(file); if (null!=codec) { isCompressedInput = true; decompressor = CodecPool.getDecompressor(codec); //判断是否属于可切片压缩编码类型 if (codec instanceof SplittableCompressionCodec) { final SplitCompressionInputStream cIn = ((SplittableCompressionCodec)codec).createInputStream( fileIn, decompressor, start, end, SplittableCompressionCodec.READ_MODE.BYBLOCK); //如果是可切片压缩编码,则创建一个CompressedSplitLineReader读取压缩数据 in = new CompressedSplitLineReader(cIn, job, this.recordDelimiterBytes); start = cIn.getAdjustedStart(); end = cIn.getAdjustedEnd(); filePosition = cIn; } else { //如果是不可切片压缩编码,则创建一个SplitLineReader读取压缩数据,并将文件输入流转换成解压数据流传递给普通SplitLineReader读取 in = new SplitLineReader(codec.createInputStream(fileIn, decompressor), job, this.recordDelimiterBytes); filePosition = fileIn; } } else { fileIn.seek(start); //如果不是压缩文件,则创建普通SplitLineReader读取数据 in = new SplitLineReader(fileIn, job, this.recordDelimiterBytes); filePosition = fileIn; } 4.4.更多MapReduce编程案例 4.4.1 reduce端join算法实现 1、需求: 订单数据表t_order: id date pid amount 1001 20150710 P0001 2 1002 20150710 P0001 3 1002 20150710 P0002 3 商品信息表t_product id name category_id price P0001 小米5 C01 2 P0002 锤子T1 C01 3 假如数据量巨大,两表的数据是以文件的形式存储在HDFS中,需要用mapreduce程序来实现一下SQL查询运算: select a.id,a.date,b.name,b.category_id,b.price from t_order a join t_product b on a.pid = b.id 2、实现机制: 通过将关联的条件作为map输出的key,将两表满足join条件的数据并携带数据所来源的文件信息,发往同一个reduce task,在reduce中进行数据的串联 public class OrderJoin { static class OrderJoinMapper extends Mapper<LongWritable, Text, Text, OrderJoinBean> { @Override protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException { //拿到一行数据,并且要分辨出这行数据所属的文件 String line = value.toString(); String[] fields = line.split("\t"); //拿到itemid String itemid = fields[0]; //获取到这一行所在的文件名(通过inpusplit) String name = "你拿到的文件名"; //根据文件名,切分出各字段(如果是a,切分出两个字段,如果是b,切分出3个字段) OrderJoinBean bean = new OrderJoinBean(); bean.set(null, null, null, null, null); context.write(new Text(itemid), bean); } } static class OrderJoinReducer extends Reducer<Text, OrderJoinBean, OrderJoinBean, NullWritable> { @Override protected void reduce(Text key, Iterable<OrderJoinBean> beans, Context context) throws IOException, InterruptedException { //拿到的key是某一个itemid,比如1000 //拿到的beans是来自于两类文件的bean // {1000,amount} {1000,amount} {1000,amount} --- {1000,price,name} //将来自于b文件的bean里面的字段,跟来自于a的所有bean进行字段拼接并输出 } } } 缺点:这种方式中,join的操作是在reduce阶段完成,reduce端的处理压力太大,map节点的运算负载则很低,资源利用率不高,且在reduce阶段极易产生数据倾斜 解决方案:map端join实现方式 4.4.2 map端join算法实现 1、原理阐述 适用于关联表中有小表的情形; 可以将小表分发到所有的map节点,这样,map节点就可以在本地对自己所读到的大表数据进行join并输出最终结果,可以大大提高join操作的并发度,加快处理速度 2、实现示例 --先在mapper类中预先定义好小表,进行join --引入实际场景中的解决方案:一次加载数据库或者用distributedcache public class TestDistributedCache { static class TestDistributedCacheMapper extends Mapper<LongWritable, Text, Text, Text>{ FileReader in = null; BufferedReader reader = null; HashMap<String,String> b_tab = new HashMap<String, String>(); String localpath =null; String uirpath = null; //是在map任务初始化的时候调用一次 @Override protected void setup(Context context) throws IOException, InterruptedException { //通过这几句代码可以获取到cache file的本地绝对路径,测试验证用 Path[] files = context.getLocalCacheFiles(); localpath = files[0].toString(); URI[] cacheFiles = context.getCacheFiles(); //缓存文件的用法——直接用本地IO来读取 //这里读的数据是map task所在机器本地工作目录中的一个小文件 in = new FileReader("b.txt"); reader =new BufferedReader(in); String line =null; while(null!=(line=reader.readLine())){ String[] fields = line.split(","); b_tab.put(fields[0],fields[1]); } IOUtils.closeStream(reader); IOUtils.closeStream(in); } @Override protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException { //这里读的是这个map task所负责的那一个切片数据(在hdfs上) String[] fields = value.toString().split("\t"); String a_itemid = fields[0]; String a_amount = fields[1]; String b_name = b_tab.get(a_itemid); //输出结果 100198.9banan context.write(new Text(a_itemid), new Text(a_amount + "\t" + ":" + localpath + "\t" +b_name )); } } public static void main(String[] args) throws Exception { Configuration conf = new Configuration(); Job job = Job.getInstance(conf); job.setJarByClass(TestDistributedCache.class); job.setMapperClass(TestDistributedCacheMapper.class); job.setOutputKeyClass(Text.class); job.setOutputValueClass(LongWritable.class); //这里是我们正常的需要处理的数据所在路径 FileInputFormat.setInputPaths(job, new Path(args[0])); FileOutputFormat.setOutputPath(job, new Path(args[1])); //不需要reducer job.setNumReduceTasks(0); //分发一个文件到task进程的工作目录 job.addCacheFile(new URI("hdfs://hadoop-server01:9000/cachefile/b.txt")); //分发一个归档文件到task进程的工作目录 //job.addArchiveToClassPath(archive); //分发jar包到task节点的classpath下 //job.addFileToClassPath(jarfile); job.waitForCompletion(true); } } 4.4.3 web日志预处理 1、需求: 对web访问日志中的各字段识别切分 去除日志中不合法的记录 根据KPI统计需求,生成各类访问请求过滤数据 2、实现代码: a)定义一个bean,用来记录日志数据中的各数据字段 public class WebLogBean { private String remote_addr;//记录客户端的ip地址 private String remote_user;//记录客户端用户名称,忽略属性"-" private String time_local;//记录访问时间与时区 private String request;//记录请求的url与http协议 private String status;//记录请求状态;成功是200 private String body_bytes_sent;//记录发送给客户端文件主体内容大小 private String http_referer;//用来记录从那个页面链接访问过来的 private String http_user_agent;//记录客户浏览器的相关信息 private boolean valid = true;//判断数据是否合法 public String getRemote_addr() { return remote_addr; } public void setRemote_addr(String remote_addr) { this.remote_addr = remote_addr; } public String getRemote_user() { return remote_user; } public void setRemote_user(String remote_user) { this.remote_user = remote_user; } public String getTime_local() { return time_local; } public void setTime_local(String time_local) { this.time_local = time_local; } public String getRequest() { return request; } public void setRequest(String request) { this.request = request; } public String getStatus() { return status; } public void setStatus(String status) { this.status = status; } public String getBody_bytes_sent() { return body_bytes_sent; } public void setBody_bytes_sent(String body_bytes_sent) { this.body_bytes_sent = body_bytes_sent; } public String getHttp_referer() { return http_referer; } public void setHttp_referer(String http_referer) { this.http_referer = http_referer; } public String getHttp_user_agent() { return http_user_agent; } public void setHttp_user_agent(String http_user_agent) { this.http_user_agent = http_user_agent; } public boolean isValid() { return valid; } public void setValid(boolean valid) { this.valid = valid; } @Override public String toString() { StringBuilder sb = new StringBuilder(); sb.append(this.valid); sb.append("\001").append(this.remote_addr); sb.append("\001").append(this.remote_user); sb.append("\001").append(this.time_local); sb.append("\001").append(this.request); sb.append("\001").append(this.status); sb.append("\001").append(this.body_bytes_sent); sb.append("\001").append(this.http_referer); sb.append("\001").append(this.http_user_agent); return sb.toString(); } } b)定义一个parser用来解析过滤web访问日志原始记录 public class WebLogParser { public static WebLogBean parser(String line) { WebLogBean webLogBean = new WebLogBean(); String[] arr = line.split(" "); if (arr.length > 11) { webLogBean.setRemote_addr(arr[0]); webLogBean.setRemote_user(arr[1]); webLogBean.setTime_local(arr[3].substring(1)); webLogBean.setRequest(arr[6]); webLogBean.setStatus(arr[8]); webLogBean.setBody_bytes_sent(arr[9]); webLogBean.setHttp_referer(arr[10]); if (arr.length > 12) { webLogBean.setHttp_user_agent(arr[11] + " " + arr[12]); } else { webLogBean.setHttp_user_agent(arr[11]); } if (Integer.parseInt(webLogBean.getStatus()) >= 400) {//大于400,HTTP错误 webLogBean.setValid(false); } } else { webLogBean.setValid(false); } return webLogBean; } public static String parserTime(String time) { time.replace("/", "-"); returntime; } } c) mapreduce程序 public class WeblogPreProcess { static class WeblogPreProcessMapper extends Mapper<LongWritable, Text, Text, NullWritable> { Text k = new Text(); NullWritable v = NullWritable.get(); @Override protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException { String line = value.toString(); WebLogBean webLogBean = WebLogParser.parser(line); if (!webLogBean.isValid()) return; k.set(webLogBean.toString()); context.write(k, v); } } public static void main(String[] args) throws Exception { Configuration conf = new Configuration(); Job job = Job.getInstance(conf); job.setJarByClass(WeblogPreProcess.class); job.setMapperClass(WeblogPreProcessMapper.class); job.setOutputKeyClass(Text.class); job.setOutputValueClass(NullWritable.class); FileInputFormat.setInputPaths(job, new Path(args[0])); FileOutputFormat.setOutputPath(job, new Path(args[1])); job.waitForCompletion(true); } } 本文转自yushiwh 51CTO博客,原文链接:http://blog.51cto.com/yushiwh/1913046,如需转载请自行联系原作者

优秀的个人博客,低调大师

Docker实践:搭建wordpress

①查看docker版本信息 先查看docker版本等信息,输入获取版本信息: [root@docker1 ~]#docker version Client: Version: 1.12.6 API version: 1.24 Package version: docker-1.12.6-61.git85d7426.el7.centos.x86_64 Go version: go1.8.3 Git commit: 85d7426/1.12.6 Built: Tue Oct 24 15:40:21 2017 OS/Arch: linux/amd64 Server: Version: 1.12.6 API version: 1.24 Package version: docker-1.12.6-61.git85d7426.el7.centos.x86_64 Go version: go1.8.3 Git commit: 85d7426/1.12.6 Built: Tue Oct 24 15:40:21 2017 OS/Arch: linux/amd64 [root@docker1 ~]#docker info Containers: 12 Running: 1 Paused: 0 Stopped: 11 Images: 133 Server Version: 1.12.6 Storage Driver: devicemapper Pool Name: docker-253:0-25843-pool Pool Blocksize: 65.54 kB Base Device Size: 10.74 GB Backing Filesystem: xfs Data file: /dev/loop0 Metadata file: /dev/loop1 Data Space Used: 11.53 GB Data Space Total: 107.4 GB Data Space Available: 1.073 GB Metadata Space Used: 15.47 MB Metadata Space Total: 2.147 GB Metadata Space Available: 1.073 GB Thin Pool Minimum Free Space: 10.74 GB Udev Sync Supported: true Deferred Removal Enabled: true Deferred Deletion Enabled: true Deferred Deleted Device Count: 0 Data loop file: /var/lib/docker/devicemapper/devicemapper/data WARNING: Usage of loopback devices is strongly discouraged for production use. Use `--storage-opt dm.thinpooldev` to specify a custom block storage device. Metadata loop file: /var/lib/docker/devicemapper/devicemapper/metadata Library Version: 1.02.140-RHEL7 (2017-05-03) Logging Driver: journald Cgroup Driver: systemd Plugins: Volume: local Network: null overlay bridge host Swarm: inactive Runtimes: docker-runc runc Default Runtime: docker-runc Security Options: seccomp selinux Kernel Version: 3.10.0-693.5.2.el7.x86_64 Operating System: CentOS Linux 7 (Core) OSType: linux Architecture: x86_64 Number of Docker Hooks: 3 CPUs: 1 Total Memory: 472.3 MiB Name: docker1 ID: 7WA2:LZJV:R2X2:EV57:DFTD:4TOC:CT26:DRLS:PTMU:RE4W:SX5P:FQ4E Docker Root Dir: /var/lib/docker Debug Mode (client): false Debug Mode (server): false Registry: https://index.docker.io/v1/ WARNING: bridge-nf-call-iptables is disabled WARNING: bridge-nf-call-ip6tables is disabled Insecure Registries: 127.0.0.0/8 Registries: docker.io (secure) docker信息可以输出表示docker运行成功 ②下载mysql镜像 我们先拉下来mysql镜像,然后设定mysql密码(我设的123456),指定mysql版本为最新版(latest) [root@docker1 ~]# docker pull mysql Using default tag: latest Trying to pull repository docker.io/library/mysql ... latest: Pulling from docker.io/library/mysql f49cf87b52c1: Pull complete 78032de49d65: Pull complete 837546b20bc4: Pull complete 9b8316af6cc6: Pull complete 1056cf29b9f1: Pull complete 86f3913b029a: Pull complete 4cbbfc9aebab: Pull complete 8ffd0352f6a8: Pull complete 45d90f823f97: Pull complete ca2a791aeb35: Pull complete Digest: sha256:1f95a2ba07ea2ee2800ec8ce3b5370ed4754b0a71d9d11c0c35c934e9708dcf1 [root@docker1 ~]# docker run --name some-mysql -e MYSQL_ROOT_PASSWORD=my-secret-pw -p 4406:3306 -d mysql:latest 4710c01635048e6255348d40c706b93975c2bc73d8db8747ce98f8d7be82e858 [root@docker1 ~]# docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 4710c0163504 mysql:latest "docker-entrypoint.sh" 4 seconds ago Up 3 seconds 0.0.0.0:4406->3306/tcp some-mysql 7、启动WordPress博客系统 输入一下命令,表示使用mysql来启动WordPress,且把宿主机端口8088与ubuntu端口80进行绑定。 [root@docker1 ~]# docker run --name some-wordpress --link some-mysql:mysql -p 8088:80 -d wordpress d80930fe7ad5ea3ddf8513117541140685759b4e5f22d70783acdf802504a272 [root@docker1 ~]# docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES d80930fe7ad5 wordpress "docker-entrypoint.sh" 5 seconds ago Up 4 seconds 0.0.0.0:8088->80/tcp some-wordpress 4710c0163504 mysql:latest "docker-entrypoint.sh" 2 minutes ago Up 2 minutes 0.0.0.0:4406->3306/tcp some-mysql 此时,WordPress项目就跑起来了。 在本机输入localhost:8088,效果如下,是不是很酷!: 本文转自 Mr_sheng 51CTO博客,原文链接:http://blog.51cto.com/sf1314/2050682

优秀的个人博客,低调大师

MaxScale Binlog Server实践

简介 Part1:写在最前 在之前的博文中有说到MaxScale,作为中间件,配合MHA使用或者主从使用可实现读写分离和负载均衡,今天简单介绍下MaxScale作为Binlog Server来减少主从延迟的问题;MySQL的主从架构中,链式拓扑的架构比较容易出现主从延迟的问题。本文着重介绍MaxScale作为Binlog Server是如何降低主从延迟的。 MaxScale配合MHA请移步至: http://suifu.blog.51cto.com/9167728/1869520 Part2:本文环境 HE1:192.168.1.248 slave HE3:192.168.1.250 master HE4:192.168.1.251maxscale 架构演示 效果对比 实战 Part1:安装maxscale [root@HE4 ~]#yum -y install maxscale-2.0.1-2.centos.6.x86_64.rpm [root@HE4 ~]# mkdir -p /data/binlog [root@HE4 ~]# useradd maxscale [root@HE4 ~]# chown -R maxscale. /data/binlog [root@HE4 ~]# cat /etc/maxscale.cnf 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 [maxscale] threads=1 ##根据CPU核数设置 [Replication] type =service router=binlogrouter user=mysync passwd =MANAGER #使用主库上的repl复制账号 #权限: #GRANTREPLICATIONSLAVE,REPLICATIONCLIENTON*.*TO'repl'@'%'IDENTIFIEDBY'repl'; router_options=server_id=1251,heartbeat=30,binlogdir= /data/binlog ,transaction_safety=1,mariadb10-compatibility=1,send_slave_heartbeat=1 #server_id设置maxscale的,记得不能与主和从库重复,要唯一 #heartbeat=30秒,意思为当maxscale在30秒内没有接收到主库推送的binlog日志,发送心跳检查 #binlogdir设置接收binlog的存放路径,目录属性chown-Rmaxscale.maxscale/data/binlog #transaction_safety=1此参数用于启用binlog日志中的不完整事务检测。当MariaDBMaxScale启动时,如果当前binlog文件已损坏或找到不完整的事务,则可能会出现错误消息。在正常工作期间,binlog事件不会分配到从库,直到事务已经提交。默认值为off,设置transaction_safety=on以启用不完全事务检测。 #send_slave_heartbeat=1开启心跳检查 [ReplicationListener] type =listener service=Replication protocol=MySQLClient port=5308 #后端的从库CHANGEMASTERTO这个端口,默认5308 [CLI] type =service router=cli [CLIListener] type =listener service=CLI protocol=maxscaled port=6603 Part2:启动Maxscale [root@HE4 ~]# /etc/init.d/maxscale start Starting MaxScale: maxscale (pid 16680) is running... [ OK ] [root@HE4 ~]# /etc/init.d/maxscale status Checking MaxScale status: MaxScale (pid 16680) is running.[ OK ] Part3:从库配置 1 2 3 4 5 6 7 8 9 10 11 [root@HE1~] #mysql-umysync-pMANAGER-h192.168.1.251-P5308 WelcometotheMariaDBmonitor.Commandsendwith;or\g. YourMySQLconnection id is3196 Serverversion:10.0.02.0.1-maxscale Copyright(c)2000,2016,Oracle,MariaDBCorporationAbandothers. Type 'help;' or '\h' for help.Type '\c' to clear thecurrentinputstatement. MySQL[(none)]>CHANGEMASTERTOMASTER_HOST= '192.168.1.250' ,MASTER_USER= 'mysync' ,MASTER_PASSWORD= 'MANAGER' ,MASTER_PORT=3306,MASTER_LOG_FILE= 'mysql-bin.000005' ,MASTER_LOG_POS=20; ERROR1234(42000):Cannot set MASTER_LOG_POSto20:Permittedbinlogposis4.Specifiedmaster_log_file=mysql-bin.000005 MySQL[(none)]>CHANGEMASTERTOMASTER_HOST= '192.168.1.250' ,MASTER_USER= 'mysync' ,MASTER_PASSWORD= 'MANAGER' ,MASTER_PORT=3306,MASTER_LOG_FILE= 'mysql-bin.000005' ,MASTER_LOG_POS=4; MySQL[(none)]>startslave; QueryOK,0rowsaffected(0.00sec) 这里可以看出,Maxscale binlog server只能从位置4开始配置 配置好后,在/data/binlog下生成的binlog文件 [root@HE4 ~]# cd /data/binlog/ [root@HE4 binlog]# ls cache master.ini mysql-bin.000003 Part4:主库配置 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 [root@HE3~] #mysql-uroot-p Enterpassword: WelcometotheMariaDBmonitor.Commandsendwith;or\g. YourMariaDBconnection id is7 Serverversion:10.1.16-MariaDBMariaDBServer Copyright(c)2000,2016,Oracle,MariaDBCorporationAbandothers. Type 'help;' or '\h' for help.Type '\c' to clear thecurrentinputstatement. MariaDB[(none)]>showmasterstatus; +------------------+----------+--------------+------------------+ |File|Position|Binlog_Do_DB|Binlog_Ignore_DB| +------------------+----------+--------------+------------------+ |mysql-bin.000005|652||| +------------------+----------+--------------+------------------+ 1row in set (0.00sec) MariaDB[(none)]>grantreplicationclient,replicationslaveon*.*to 'mysync' @ '192.168.1.%' identifiedby 'MANAGER' ; MariaDB[(none)]>flushprivileges; Part5:主从配置 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 从库指向binlogserver [root@HE1~] #mysql-uroot-pMANAGER WelcometotheMariaDBmonitor.Commandsendwith;or\g. YourMariaDBconnection id is5 Serverversion:10.1.16-MariaDBMariaDBServer Copyright(c)2000,2016,Oracle,MariaDBCorporationAbandothers. Type 'help;' or '\h' for help.Type '\c' to clear thecurrentinputstatement. MariaDB[(none)]>CHANGEMASTERTOMASTER_HOST= '192.168.1.251' ,MASTER_USER= 'mysync' ,MASTER_PASSWORD= 'MANAGER' ,MASTER_PORT=5308,MASTER_LOG_FILE= 'mysql-bin.000005' ,MASTER_LOG_POS=652; QueryOK,0rowsaffected(0.02sec) MariaDB[(none)]>startslave; QueryOK,0rowsaffected(0.00sec) MariaDB[(none)]>showslavestatus\G ***************************1.row*************************** Slave_IO_State:Waiting for mastertosendevent Master_Host:192.168.1.251 Master_User:mysync Master_Port:5308 Connect_Retry:60 Master_Log_File:mysql-bin.000005 Read_Master_Log_Pos:652 Relay_Log_File:mysql-relay-bin.000002 Relay_Log_Pos:537 Relay_Master_Log_File:mysql-bin.000005 Slave_IO_Running:Yes Slave_SQL_Running:Yes Replicate_Do_DB: Replicate_Ignore_DB: Replicate_Do_Table: Replicate_Ignore_Table: Replicate_Wild_Do_Table: Replicate_Wild_Ignore_Table: Last_Errno:0 Last_Error: Skip_Counter:0 Exec_Master_Log_Pos:652 Relay_Log_Space:835 Until_Condition:None Until_Log_File: Until_Log_Pos:0 Master_SSL_Allowed:No Master_SSL_CA_File: Master_SSL_CA_Path: Master_SSL_Cert: Master_SSL_Cipher: Master_SSL_Key: Seconds_Behind_Master:0 Master_SSL_Verify_Server_Cert:No Last_IO_Errno:0 Last_IO_Error: Last_SQL_Errno:0 Last_SQL_Error: Replicate_Ignore_Server_Ids: Master_Server_Id:1250 Master_SSL_Crl: Master_SSL_Crlpath: Using_Gtid:No Gtid_IO_Pos: Replicate_Do_Domain_Ids: Replicate_Ignore_Domain_Ids: Parallel_Mode:conservative 1row in set (0.00sec) ——总结—— 生产环境中,大多采用的是一主多从架构,例如星状拓扑和链式拓扑,星状拓扑在从库过多的情况下,会增加主库的io压力,而链式拓扑虽然缓解了主库的网络IO压力,但其缺点是:二级Slave得到最新的数据,需要再经过一层的复制才到达,期间的延迟比一主多从架构要大。而采用maxscale binlog server则避免了这类问题。由于笔者的水平有限,编写时间也很仓促,文中难免会出现一些错误或者不准确的地方,不妥之处恳请读者批评指正。 本文转自 dbapower 51CTO博客,原文链接:http://blog.51cto.com/suifu/1878847,如需转载请自行联系原作者

优秀的个人博客,低调大师

Oracle备份还原实践

一、项目背景: 1.1 客户需求: 将物理机房生产环境的Oracle/MySQL及阿里云的RDS数据库备份出来,存储到一个集中数据库存储服务器,实现异地备份,并且在还原环境内要将MySQL/Oracle以及阿里云RDS备份数据还原到测试环境,并判断还原数据库是否存在异常,检验数据的一致性,如有异常邮件或微信告警,每周生成Excel报表发送给负责人。 1.2 需求要点: 网络通信:阿里金融云/公有云/物理机房环境网络须在固定网段互通。 网络安全:各个网段隔离,有需求通信的网段开放通信,需实现端口级别控制。 数据备份:MySQL/Oracle/RDS实现数据库备份。 数据传输:采用定时crond+scp+rsync配合传输。 数据校验:保障数据库还原成功的可靠性。 监控告警:***网络中断,或数据库备份失败等需要发送通知到管理员。 报表生成:将数据库还原的信息生成报表统一发送给管理员。 1.3 解决方案: 网络通信:在阿里云端,采用深信服IPSec ***与物理机房Cisco设备隧道互通。开通传输网段,将此网段作为网络传输中转网段。 网络安全:各个网段隔离,如有跨地区或机房相互通信的需求,需将此环境下的数据传输到中转网段,再实现数据传输。使用阿里云安全组deny any,开通需要通信的白名单端口。 数据备份:MySQL及RDS采用mysqldump逻辑备份,Oracle采用expdp备份。 数据传输:采用定时crond+scp+rsync配合传输。 数据校验:导入文件存在日志,查看日志与比对库数目。 监控告警:采用smarteye自定义监控,监控***状况,同事采用自定义脚本+数据库还原异常告警。如果***中断或数据库恢复异常发送短信,邮件,微信消息通知管理员。 报表生成:每日脚本将数据库还原日志文件进行处理,最终打包统一传输到一个Python环境下,利用自编写Python脚本处理文件数据,生成报表,每周发送给管理员。 二、逻辑拓扑: 2.1 Oracle数据库备份还原: 2.1 Oracle数据库备份还原: 三、技术细节: 3.1 Oracle数据库备份还原: 创建Oracle数据库备份用户: createuserbackuseridentifiedbypwdbackuser; 默认情况下用户创建好后系统会默认给该用户分配一个表空间(users); 查看用户表空间: selectusername,default_tablespacefromdba_users; 需要为创建的用户创建自己的表空间: createtablespacebaktablesdatafile'/data/bakdir/baktab_data.dbf'size200M; 分配了表空间,此用户还无法登录,因此需要为用户授权: grantcreatesession,createtable,createview,createsequence,unlimitedtablespacetobackuser; 将创建好的表空间分配给用户: alteruserbackuserdefaulttablespacebaktables; 创建Oracle数据库备份目录: createdirectorydump_diras'/backup/backup_dir'; 查看备份目录: select*fromdba_directories; 授权备份用户对备份目录具有读写权限: Grantread,writeondirectorydump_dirtobackuser; 使用expdp导出数据库: expdpbackuser/pwdbackuserSCHEMAS=DB1dumpfile=DB1.dmpdirectory=dump_dirlog=DB1.log 查看备份日志: Oracle自动备份脚本示例: #!/bin/bash exportORACLE_BASE=/u01/app/oracle exportORACLE_HOME=$ORACLE_BASE/product/11.2.0/db_1 exportORACLE_SID=ORCL exportPATH=$ORACLE_HOME/bin:$PATH filename=`date+%Y-%m-%d`'.dmp' logname=`date+%Y-%m-%d`'.log' dump_dir="/backup/backup_dir/" backdir="dump_dir" forSchameinDB1....DB2 do /u01/app/oracle/product/11.2.0/db_1/bin/expdpbackuser/pwdbackuserSCHEMAS=${Schame}dumpfile=${Schame}-${filename}directory=${backdir}log=${Schame}-${logname} find${dump_dir}-mtime+7-name"*.dmp"-execrm-rf{}\; find${dump_dir}-mtime+7-name"*.log"-execrm-rf{}\; done Oracle 备份检查脚本: #!/bin/bash DATE=`date+%F` MON=`date+%Y-%m` M_date=`date+%Y/%m/%d` DIR='/backup/backup_dir/' FDIR='/backup/Oracle_Excel/' if[!-d${FDIR}];then mkdir-p${FDIR} fi O_FILE='/backup/Oracle_Excel/tmp_OracleB.txt' #Oracle END_TIME=`find${DIR}-name"*-${DATE}.dmp"-execls-l{}\;|awk'{print$8}'|sort-r|head-1` FILE=`find${DIR}-name"*-${DATE}.dmp"-execls{}\;|awk'{printf("%s",$1)}'` #O_SIZE=`find${DIR}-name"*-${DATE}.dmp"-execdu{}\;|awk'{sum+=$1}END{printsum/1024"M"}'` O_SIZE=`find${DIR}-name"*-${DATE}.dmp"-execdu-sh{}\;|awk'{printf("%s",$1)}'` #writefile echo-e"${M_date},ORACLE,分库备份,(逻辑)每天,22:00:00,${END_TIME},成功,${FILE},否,${O_SIZE},否\n\c">>${O_FILE} Week=`date+%w` if[${Week}-eq0];then if[!-d${FDIR}${DATE}];then mkdir-p${FDIR}${DATE} fi mv${O_FILE}${FDIR}${DATE} /usr/bin/zip-r${FDIR}OracleB_${DATE}.zip${FDIR}${DATE}/* if[$?-eq0];then /usr/bin/scp${FDIR}OracleB_${DATE}.ziproot@192.168.11.11:/user/backup/oracle/Oracle_Excel fi rm-rf${FDIR}OracleB_${DATE}.zip fi 查看数据存储服务器: 脚本拆分开,在那个步失败,可以单独进行恢复统一进行调用: SCP传输 #!/bin/bash fdate=`date+%Y-%m-%d-d'-1day'` /usr/bin/scp-P2621root@172.16.84.12:/backup/backup_dir/*-${fdate}.dmp/user/backup/oracle/oraclebak 分类归档压缩: #!/bin/bash fdate=`date+%Y-%m-%d-d'-1day'` filename=`date+%Y-%m-%d-d'-1day'`'.dmp' dump_dir="/user/backup/oracle/oraclebak" I=`ls/user/backup/oracle/oraclebak/|grep$filename|awk-F'-''{print$1}'|uniq` cd${dump_dir} forSchamein${I[*]} do tarzcf${Schame}-$filename.tar.gz${Schame}-$filename done find${dump_dir}-name"*.dmp"-execrm-rf{}\; find${dump_dir}-mtime+7-name"*.dmp.tar.gz"-execrm-rf{}\; rsync进行断点传输: #!/bin/bash #Data=`date+%Y-%m-%d""%H:%m` dir="/user/backup/oracle/" fdate=`date+%Y-%m-%d-d'-1day'` filename=`date+%Y-%m-%d-d'-1day'`'.dmp' /usr/bin/rsync-rP--timeout=3600--rsh=ssh/user/backup/oracle/oraclebak/DB1-${fdate}.dmp.tar.gzroot@172.17.130.130:/DATA/oracle/oracle_bak&&echo"$DataDB1rsyncissuccess!">>${dir}Logdir/oracle-rsync.log if["$?"=="0"];then Data=`date+%Y-%m-%d""%H:%m` /usr/bin/rsync-rP--timeout=3600--rsh=ssh/user/backup/oracle/oraclebak/DB2-${fdate}.dmp.tar.gzroot@172.17.130.130:/DATA/oracle/oracle_bak&&echo"$DataDB2rsyncissuccess!">>${dir}Logdir/oracle-rsync.log if["$?"=="0"];then unsetData Data=`date+%Y-%m-%d""%H:%m` /usr/bin/rsync-rP--timeout=3600--rsh=ssh/user/backup/oraclebak/DB3-${fdate}.dmp.tar.gzroot@172.17.130.130:/DATA/oracle/oracle_bak&&echo"$DataDB3rsyncissuccess!">>${dir}Logdir/oracle-rsync.log if["$?"=="0"];then unsetData Data=`date+%Y-%m-%d""%H:%m` echo"$Datarsyncissuccess!">>${dir}Logdir/oracle-rsync.log fi fi fi 总体调用: #!/bin/bash #Data=`date+%Y-%m-%d""%H:%m` dir="/user/backup/oracle/" /bin/bash${dir}1_oracle_scp.sh if["$?"=="0"];then Data=`date+%Y-%m-%d""%H:%m` echo"$Data1_oracle_scp.shisexecsuccess!">>${dir}Logdir/oracle-back.log&&/bin/bash${dir}2_oracle_tar.sh if["$?"=="0"];then unsetData Data=`date+%Y-%m-%d""%H:%m` echo"$Data2_oracle_tar.shisexecsuccess!">>${dir}Logdir/oracle-back.log&&/bin/bash${dir}3_oracle_rsync.sh if["$?"=="0"];then unsetData Data=`date+%Y-%m-%d""%H:%m` echo"$Data3_oracle_rsync.shisexecsuccess!">>${dir}Logdir/oracle-back.log fi fi fi 在还原服务器进行Oracle数据库还原: 首先初步核查传输过来的库数目及文件大小是否异常,如果异常可以进行重新拉取: #!/bin/bash oracle_path="/DATA/oracle/oracle_bak/" Data=`date+%Y-%m-%d""%H:%M` dir="/user/backup/oracle/" fdate=`date+%Y-%m-%d-d'-1day'` check_data=`date+%Y-%m-%d-d'-3day'` check_size=`du-sh/DATA/oracle/oracle_bak/${check_data}/|awk'{print$1}'|cut-dM-f1|awk-F.'{print$1}'` filename=`date+%Y-%m-%d-d'-1day'`'.dmp' NUM=`ls${oracle_path}*.tar.gz|wc-l` SIZE=`du-sh/DATA/oracle/oracle_bak/${fdate}/|awk'{print$1}'|cut-dM-f1|awk-F.'{print$1}'` if["$NUM"!="3"]||[$SIZE-lt${check_size}];then /usr/bin/rsync-ravP--timeout=3600--rsh=sshroot@10.199.75.14:/user/backup/oracle/oraclebak/DB1-${fdate}.dmp.tar.gz${oracle_path} if["$?"=="0"];then /usr/bin/rsync-ravP--timeout=3600--rsh=sshroot@10.199.75.14:/user/backup/oracle/oraclebak/DB2-${fdate}.dmp.tar.gz${oracle_path} if["$?"=="0"];then /usr/bin/rsync-ravP--timeout=3600--rsh=sshroot@10.199.75.14:/user/backup/oracle/oraclebak/DB3-${fdate}.dmp.tar.gz${oracle_path} fi fi fi 解压传输过来的数据库: #!/bin/bash #数据库存储文件 oracle_path="/DATA/oracle/oracle_bak/" #数据库恢复目录 repath="/DATA/oracle/oracle_restore/" #数据库导入目录 backdir="/home/oracle/app/backup_dir/" #数据库归档文件命名 dadir=`date+%Y-%m-%d-d-1day` #数据库导入日志目录 implogdir="/DATA/oracle/implogdir/" oraclecmd="/home/oracle/app/oracle/product/12.1.0/dbhome_1/bin/sqlplus" if[!-d${implogdir}${dadir}];then mkdir-p${implogdir}${dadir} fi if[!-d${repath}];then mkdir-p${repath} fi if[!-d${oracle_path}${dadir}];then mkdir${oracle_path}${dadir} fi if[!-d${repath}${dadir}];then mkdir${repath}${dadir} fi #把压缩文件存放在日期目录 sudochown-Roracle:dba${oracle_path}* cd${oracle_path} mv*-"$dadir".dmp.tar.gz$dadir #把压缩文件解压到还原目录 cd${oracle_path}${dadir} oracle=`ls` forIin${oracle[*]} do /bin/tarzxf$I-C${repath}${dadir} done cp${repath}${dadir}/*${backdir} 进行Oracle还原库用户初始化:(此处列两个库做说明) #!/bin/bash exportORACLE_BASE=/home/oracle/app exportORACLE_HOME=$ORACLE_BASE/oracle/product/12.1.0/dbhome_1 exportORACLE_SID=ORCL exportPATH=$PATH:$HOME/bin:$ORACLE_HOME/bin #数据库恢复目录 repath="/DATA/oracle/oracle_restore/" #数据库导入目录 backdir="/home/oracle/app/backup_dir/" #数据库归档文件命名 dadir=`date+%Y-%m-%d-d-1day` #数据库导入日志目录 implogdir="/DATA/oracle/implogdir/" oraclecmd="/home/oracle/app/oracle/product/12.1.0/dbhome_1/bin/sqlplus" cd${backdir} fordbinDB1...DBn do if["$db"=="DB1"];then sqlplus-S/nolog<<EOF conn/assysdba dropuser${db}cascade; createuser${db}identifiedbyDBuser1; alteruserDB_user1defaulttablespacetab1; grantcreatesession,createtable,createview,createprocedure,createsequence,unlimitedtablespaceto${db}; Grantread,writeondirectorydump_dirto${db}; exit; else["$db"=="GPSUSER"]; sqlplus-S/nolog<<EOF conn/assysdba dropuser${db}cascade; createuser${db}identifiedbyDBuser2; alteruserDBdefaulttablespacetab2; grantcreatesession,createtable,createview,createprocedure,createsequence,unlimitedtablespaceto${db}; Grantread,writeondirectorydump_dirto${db}; exit; EOF fi done Oracle数据库采用impdp进行导入: #!/bin/bash exportORACLE_BASE=/home/oracle/app exportORACLE_HOME=$ORACLE_BASE/oracle/product/12.1.0/dbhome_1 exportORACLE_SID=glpfin exportPATH=$PATH:$HOME/bin:$ORACLE_HOME/bin #数据库存储文件 oracle_path="/DATA/oracle/oracle_bak/" #数据库恢复目录 repath="/DATA/oracle/oracle_restore/" #数据库导入目录 backdir="/home/oracle/app/backup_dir/" #数据库归档文件命名 dadir=`date+%Y-%m-%d-d'-1day'` #数据库导入日志目录 implogdir="/DATA/oracle/implogdir/" oraclecmd="/home/oracle/app/oracle/product/12.1.0/dbhome_1/bin/sqlplus" I=`ls/DATA/oracle/oracle_restore/$dadir/|grep$dadir|awk-F'-''{print$1}'|uniq` cd${backdir} fordbin${I[*]} do impdpsystem/51idc.comdirectory=dump_dirdumpfile=${db}-${dadir}.dmplogfile=import-${db}-${dadir}.log rm-rf${backdir}${db}-${dadir}.dmp&&mvimport-${db}-${dadir}.log${implogdir}${dadir} /bin/mail-rxuel@anchnet.com-s"Oracle-${db}-backup-mail"oraclebak@anchnet.com<${implogdir}${dadir}/import-${db}-${dadir}.log done find${oracle_path}-mtime+30-name"*.tar.gz"-execrm-rf{}\; find${implogdir}-ctime+30-typed-execrm-rf{}\; find${repath}-mtime+7-name"*.dmp"-execrm-rf{}\; find${repath}-typed-mtime+7-execrm-rf{}\; 分析导入log,处理后写入文件 #!/bin/bash date=`date+%Y/%m/%d""%H:%M` Logdir="/DATA/oracle/Logdir/" dadir=`date+%Y-%m-%d-d'-1day'` implogdir="/DATA/oracle/implogdir/" if[-d${implogdir}${dadir}];then File=`ls${implogdir}${dadir}|grep${dadir}|awk-F'-''{print$2}'|uniq` forIin${File[*]} do echo${date}>>${Logdir}${I}-import.log tail-1${implogdir}${dadir}/import-${I}-${dadir}.log>>${Logdir}${I}-import.log done fi ***监控脚本: #!/bin/bash IP=10.199.75.14 dir="/DATA/oracle/netdir/" if[!-d${dir}];then mkdir-p${dir} fi echo1>${dir}ping.lock whiletrue do Time=`date+%F` TIME="${Time}23:59" if["${data}"=="${TIME}"];then mkdir${dir}${Time}&&mv${dir}ping2.log${dir}${Time}-ping2.log mv${dir}${Time}-ping2.log${dir}${Time} fi find${dir}-mtime+7-name"*-ping2.log"-execrm-rf{}\; find${dir}-mtime+7-typed-execrm-rf{}\; data=`date+%F''%H:%M` data1=`date+%F''%H:%M:%S` echo"------------${data1}---------------">>${dir}ping2.log ping-c10${IP}>>${dir}ping2.log if[$?-eq1];then STAT=`cat${dir}ping.lock` if[${STAT}-eq1];then /usr/bin/python/DATA/oracle/netdir/GFweixin.pyxuel***-monitor"GLPfromPDC(192.168.11.11)ping金融云(10.75.128.8)中断,请检查深信服***!\nTIME:${ data1}"echo0>${dir}ping.lock else continue fi else STAT=`cat${dir}ping.lock` if[${STAT}-eq0];then /usr/bin/python/DATA/oracle/netdir/GFweixin.pyxuel***-monitor"***monitorfrom物理机(192.168.11.11)ping金融云(10.199.75.14)恢复!\nTIME:${data1}" echo1>${dir}ping.lock else continue fi fi done 如有异常会发送告警: 微信告警: 短信告警: 日志收集脚本: #!/bin/bash DATE=`date+%F` MON=`date+%Y-%m` FDIR='/user/backup/mysql/MySQL_Excel/' if[!-d${FDIR}];then mkdir-p${FDIR} fi DIR='/user/backup/mysql/sub-treasury/' MySQL_FILE='/user/backup/mysql/MySQL_Excel/tmp_MySQLB.txt' M_date=`date+%Y/%m/%d` M_SIZE=`find${DIR}-name"*-${DATE}.sql.tar.gz"-execdu{}\;|awk'{sum+=$1}END{printsum/1024"M"}'` #writefile echo-e"${M_date},MySQL,分库备份(逻辑),每天,22:00:00,22:02:00,成功,${DIR}*-${DATE}.sql.tar.gz,是,${M_SIZE},否\n\c">>${MySQL_FILE} Week=`date+%w` if[${Week}-eq0];then if[!-d${FDIR}${DATE}];then mkdir-p${FDIR}${DATE} fi mv${MySQL_FILE}${FDIR}${DATE} /usr/bin/zip-r${FDIR}MySQLB_${DATE}.zip${FDIR}${DATE}/* if[$?-eq0];then /usr/bin/scp${FDIR}MySQLB_${DATE}.ziproot@172.16.6.150:/DATA/oracle/Excel/MySQL_ZIP fi rm-rf${FDIR}MySQLB_${DATE}.zip fi 集中处理文件脚本: #!/bin/bash DATE=`date+%F` LDATE=`date+%F-d'-1day'` MON=`date+%Y-%m` DIR='/DATA/oracle/Excel/' tmp_dir='/DATA/oracle/Excel/Tmp_restore/' res_dir='/DATA/oracle/Excel/Totle_restore/' ZIP='/usr/bin/unzip' zipfunction(){ $ZIP$1-d${tmp_dir} TXT=`find${tmp_dir}-nametmp_*.txt` cp$TXT${res_dir} rm-rf${tmp_dir}* } foriin`find${DIR}-name*_${LDATE}.zip-execls{}\;` do zipfunction$i done cd${DIR}scripts/ if[$?-eq0];then /bin/python34${DIR}scripts/GLP_excel.py fi if[!-d${DIR}scripts/${MON}];then mkdir-p${DIR}scripts/${MON} fi mv${DIR}scripts/Oralce_bak.xlsx${DIR}scripts/${MON}/GLP_${DATE}.xlsx cd${DIR}scripts/${MON}/ /bin/mailx-rxuel@anchnet.com-s"Oracle-Excel-report"-a${DIR}scripts/${MON}/GLP_${DATE}.xlsxOraclebak@anchnet.com<${DIR}scripts/${MON}/GLP_${DATE}.xlsx rm-rf${DIR}Totle_restore/* Python脚本将文件集中处理生成Excel:(python写的不是很好,初步完成生成报表功能。) #!/bin/envpython34 importxlsxwriter #定义excel对象workbook workbook=xlsxwriter.Workbook("Oracle.xlsx") #MySQLsheet格式定义 worksheet_M=workbook.add_worksheet('MySQL备份详情表') worksheet_M.set_column('A:K',12) worksheet_M.set_row(0,17) worksheet_M.set_column('C:C',20) worksheet_M.set_column('H:H',58) #MySQLDWsheet格式定义 worksheet_MDW=workbook.add_worksheet('MySQL-DW备份详情表') worksheet_MDW.set_column('A:K',12) worksheet_MDW.set_row(0,17) worksheet_MDW.set_column('C:C',20) worksheet_MDW.set_column('H:H',58) #Oraclesheet格式定义 worksheet_O=workbook.add_worksheet('ORACLE备份详情表') worksheet_O.set_column('A:K',12) worksheet_O.set_row(0,17) worksheet_O.set_column('G:H',40) worksheet_O.set_column('C:C',16) #NFSsheet格式定义 worksheet_N=workbook.add_worksheet('NFS备份详情表') worksheet_N.set_column('A:K',14) worksheet_N.set_row(0,17) worksheet_N.set_column('H:H',59) #定义表头格式 merge_format=workbook.add_format({ 'bold':1, 'border':1, 'align':'center', 'valign':'vcenter', 'fg_color':'#FAEBD7' }) #表各项目名称格式 name_format=workbook.add_format({ 'bold':1, 'border':1, 'align':'center', 'valign':'vcenter', 'fg_color':'#E0FFFF' }) #表内容格式 normal_format=workbook.add_format({ 'align':'center' }) #写入个表项目名称函数 defset_title(file_list,row,col,worksheet): foriinfile_list: worksheet.write(row,col,i,name_format) col+=1 #写入表内容函数 defset_content(file_content,row,worksheet): withopen(file_content,'r')asF: foriinF: listnum=list(i.split(',')) col=0 forjinlistnum: worksheet.write(row,col,j,normal_format) col+=1 row+=1 #写入MySQLsheet表头 worksheet_M.merge_range('A1:K1','MySQL备份详情表',merge_format) worksheet_M.merge_range('A12:K12','MySQL还原详情表',merge_format) #写入MySQLDWsheet表头 worksheet_MDW.merge_range('A1:K1','MySQL-DW备份详情表',merge_format) worksheet_MDW.merge_range('A12:K12','MySQL-DW还原详情表',merge_format) #写入Oraclesheet表头 worksheet_O.merge_range('A1:K1','ORACLE备份详情表',merge_format) worksheet_O.merge_range('A11:K11','ORACLE传输详情表',merge_format) worksheet_O.merge_range('A21:K21','ORACLE还原详情表',merge_format) #写入NFSsheet表头 worksheet_N.merge_range('A1:J1','NFS备份详情表',merge_format) worksheet_N.merge_range('A12:J12','vsftp备份详情表',merge_format) #定义MySQL表各项目名称 MySQL_Baklist=['备份日期','备份对象','备份类型','备份周期','备份开始时间','备份结束时间','备份状态','备份文件','是否压缩','备份文件大小','是否补备'] MySQL_Reslist=['还原日期','还原对象','还原类型','还原周期','还原开始时间','还原状态','库数目','库数目对比、还原详情','补还原'] #定义MySQL-DW表各项目名称 MySQLDW_Baklist=['备份日期','备份对象','备份类型','备份周期','备份开始时间','备份结束时间','备份状态','备份文件','是否压缩','备份文件大小','是否补备'] MySQLDW_Reslist=['还原日期','还原对象','还原类型','还原周期','还原开始时间','还原状态','库数目','库数目对比、还原详情','补还原'] #定义Oracle表各项目名称 Oracle_Baklist=['备份日期','备份对象','备份类型','备份周期','备份开始时间','备份结束时间','备份状态','备份文件','是否压缩','备份文件大小','是否补备'] Oracle_Tralist=['传输日期','传输对象','类型','传输周期','开始时间','scp传输打包状态','rsync状态','rsync文件','rsync重传'] Oracle_Reslist=['还原日期','还原对象','还原类型','还原周期','开始时间','还原状态','还原详情','补还原'] #定义NFS表各项目名称 Rsync_list=['备份日期','备份对象','备份类型','备份周期','备份开始时间','备份结束时间','备份状态','日志文件','是否压缩','是否补备'] Vsftp_list=['备份日期','备份对象','备份类型','备份周期','备份开始时间','备份结束时间','备份状态','日志文件','是否压缩','是否补备'] #写入MySQL表项目名称 set_title(MySQL_Baklist,row=1,col=0,worksheet=worksheet_M) set_title(MySQL_Reslist,row=12,col=0,worksheet=worksheet_M) #写入MySQL-DW表项目名称 set_title(MySQLDW_Baklist,row=1,col=0,worksheet=worksheet_MDW) set_title(MySQLDW_Reslist,row=12,col=0,worksheet=worksheet_MDW) #写入Oracle表项目名称 set_title(Oracle_Baklist,row=1,col=0,worksheet=worksheet_O) set_title(Oracle_Tralist,row=11,col=0,worksheet=worksheet_O) set_title(Oracle_Reslist,row=21,col=0,worksheet=worksheet_O) #写入NFS表项目名称 set_title(Rsync_list,row=1,col=0,worksheet=worksheet_N) set_title(Vsftp_list,row=12,col=0,worksheet=worksheet_N) #定义MySQL内容数据文件路径 MySQLB_file='/DATA/oracle/Excel/Totle_restore/tmp_MySQLB.txt' MySQLR_file='/DATA/oracle/Excel/Totle_restore/tmp_MySQLR.txt' #定义MySQL-DW内容数据文件路径 MySQLDWB_file='/DATA/oracle/Excel/Totle_restore/tmp_MySQLDWB.txt' MySQLDWR_file='/DATA/oracle/Excel/Totle_restore/tmp_MySQLDWR.txt' #定义Oracle内容数据文件路径 OracleB_file='/DATA/oracle/Excel/Totle_restore/tmp_OracleB.txt' OracleT_file='/DATA/oracle/Excel/Totle_restore/tmp_OracleT.txt' OracleR_file='/DATA/oracle/Excel/Totle_restore/tmp_OracleR.txt' #定义NFS内容数据文件路径 Rsync_file='/DATA/oracle/Excel/Totle_restore/tmp_rsync.txt' Vsftp_file='/DATA/oracle/Excel/Totle_restore/tmp_vsftpd.txt' #写入MySQL数据内容 set_content(MySQLB_file,row=2,worksheet=worksheet_M) set_content(MySQLR_file,row=13,worksheet=worksheet_M) #写入MySQL数据内容 set_content(MySQLDWB_file,row=2,worksheet=worksheet_MDW) set_content(MySQLDWR_file,row=13,worksheet=worksheet_MDW) #写入Oracle数据内容 set_content(OracleB_file,row=2,worksheet=worksheet_O) set_content(OracleT_file,row=12,worksheet=worksheet_O) set_content(OracleR_file,row=22,worksheet=worksheet_O) #写入NFS数据内容 set_content(Rsync_file,row=2,worksheet=worksheet_N) set_content(Vsftp_file,row=13,worksheet=worksheet_N) #关闭workbook workbook.close() 报表查看:
优秀的个人博客,低调大师

Greenplum 模糊查询 实践

标签 PostgreSQL , Greenplum , orafunc , 阿里云HybridDB for PostgreSQL , reverse , like , 模糊查询 背景 文本搜索的需求分为: 1、全匹配,如: select * from table where column = 'xxxx'; 2、后模糊,如: select * from table where column like 'xxxx%'; 3、前模糊,如: select * from table where column like '%xxxx'; 4、前后模糊,如: select * from table where column like '%xxxx%'; 《中文模糊查询性能优化 by PostgreSQL trgm》 5、正则,如: select

优秀的个人博客,低调大师

Android开发实践小结

作为一名搬运工,应该懂得避免重复创建轮子。 配置keystore密码信息 通常在app/build.gradle中我们会使用以下方式配置: signingConfigs { release { storeFile file("myapp.keystore") storePassword "mystorepassword" keyAlias "mykeyAlias" keyPassword "mykeypassword" } } 但这种方法不是特别好,因为如果你把代码分享到github,你的密码就泄露了。 推荐的做法应该是在Androd项目中gradle.properties(如果没有则手动创建一个)文件中创建以下变量,这个文件是不会被版本控制系统提交的,所以不用担心密码泄露。 KEYSTORE_PASSWORD=mystorepassword KEY_PASSWORD=mykeypassword 那么在app/build.gradle中的配置就应该是 signingConfigs { release { try { storeFile file("myapp.keystore") storePassword KEYSTORE_PASSWORD keyAlias "mykeyAlias" keyPassword KEY_PASSWORD } catch (ex) { throw new InvalidUserDataException("You should define KEYSTORE_PASSWORD and KEY_PASSWORD in gradle.properties.") } } } 这里在打包的时候,如果没有在gradle.properties配置相关变量,那么就会在messages窗口中提示 Error:(16, 0) You should define KEYSTORE_PASSWORD and KEY_PASSWORD in gradle.properties. 包引用尽可能使用dependency而不是直接导入jar包 dependencies { compile 'com.squareup.retrofit2:retrofit:2.1.0' } 以下方式也是不推荐使用的 dependencies { compile 'com.squareup.retrofit2:retrofit:2.1.0+' } 这种方式每次编译时都会去联网检测最新的包,影响性能,还可能会下载跟你不符合需求的jar包。 为release版本和debug版本指定不同的包名 同一个应用而不同的包名可以同时安装在同一个手机里面。 可以参考以下配置 android { buildTypes { debug { applicationIdSuffix '.debug' versionNameSuffix '-DEBUG' } ​ release { // ... } } } 分别为包名和版本号加上debug和DEBUG后缀。 如果想要在版本号添加时间信息,有利于区分,可以这样处理: 1、首先在app/build.gralde中定义一个buildTime()函数 //定义build 时间 def buildTime() { Date date = new Date() String build = date.format("yyMMddHHmm", TimeZone.getDefault()) return build } 2、然后再修改versionNameSuffix参数 buildTypes { debug { //配置这包名后缀下可以同时安装release包和debug包 applicationIdSuffix ".debug" //配置versionName后缀 versionNameSuffix '_' + (buildTime()) + '-DEBUG' ... } release { ... } } 在debug包中定义了版本号 开发调试工具 Stetho Stetho是facebook开源的Android调试工具,可以使用Chrome开发工具来对Android应用进行调试、抓包、查看Sqlite数据库等功能。可以在debug版本中集成Stetho,方便开发调试。 集成Stetho也是非常简单,只需要在app/build.gradle中配置 dependencies { compile 'com.facebook.stetho:stetho:1.4.1' } 然后在Application里面初始化Stetho public class MyApplication extends Application { public void onCreate() { super.onCreate(); Stetho.initializeWithDefaults(this); } } 这样就配置好了,AS连接手机跑起来后。打开Chrome,在地址栏输入 chrome://inspect/#devices 这时候就看到手机调试的信息 查看设备 查看sqlite数据库 View Hierarchy 调试网络 目前Steho支持okhttp网络库,同样的在gradle里面配置 dependencies { compile 'com.facebook.stetho:stetho:1.4.1' compile 'com.facebook.stetho:stetho-okhttp3:1.4.1' compile 'com.facebook.stetho:stetho-urlconnection:1.4.1' } 对OkHttp2.x版本 OkHttpClient client = new OkHttpClient(); client.networkInterceptors().add(new StethoInterceptor()); 对OkHttp3.x版本 new OkHttpClient.Builder() .addNetworkInterceptor(new StethoInterceptor()) .build(); 对于其他网络需要修改Stetho现在还没有支持,如果是HttpURLConnection,可以使用StethoURLConnectionManager来集成,详情可以参考Steho官网。 网络抓包 LeakCanary LeakCanary可以在应用运行时检测应用是否有OOM风险的一个工具库。同样的可只在debug版本中集成。 在app/build.gradle中 dependencies { debugCompile 'com.squareup.leakcanary:leakcanary-android:1.5' releaseCompile 'com.squareup.leakcanary:leakcanary-android-no-op:1.5' testCompile 'com.squareup.leakcanary:leakcanary-android-no-op:1.5' } 在Application中 public class ExampleApplication extends Application { ​ @Override public void onCreate() { super.onCreate(); if (LeakCanary.isInAnalyzerProcess(this)) { // This process is dedicated to LeakCanary for heap analysis. // You should not init your app in this process. return; } LeakCanary.install(this); // Normal app init code... } } 这样就配置好了。连接手机AS跑完后就会在手机桌面上生成一个LeakCanary图标,点击进入可以方便查看变量在内存中的引用链。如果LeakCanary检测到有内存泄露,也会发送一个通知栏消息来提醒。 AS常用插件 很多App都会使用UI注解框架来初始化UI控件其中最有名的估计就是ButterKnife了。 class ExampleActivity extends Activity { @BindView(R.id.user) EditText username; @BindView(R.id.pass) EditText password; ​ @BindString(R.string.login_error) String loginErrorMessage; ​ @OnClick(R.id.submit) void submit() { // TODO call server... } ​ @Override public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.simple_activity); ButterKnife.bind(this); // TODO Use fields... } } 但是经常写@BindView也是一件令人枯燥和烦恼的事情。 Android Butterknife Zelezny 这个插件可以极大的解放程序猿的双手,提高搬砖效率。 安装好插件后,把光标定位到layout文件的引用处,例如setContentView(R.layout.simple_activity);的R.layout.simple_activity末尾处,按下快捷键command+N(windows是Altt+Insert)将弹出以下对话框。 so easy! 关注我们,可以获取更多

优秀的个人博客,低调大师

Kylin-实践OLAP

OLAP的历史与基本概念 OLAP全称为在线联机分析应用,是一种对于多维数据分析查询的解决方案。典型的OLAP应用场景包括销售、市场、管理等商务报表,预算决算,经济报表等等。 最早的OLAP查询工具是发布于1970年的Express,然而完整的OLAP概念是在1993年由关系数据库之父EdgarF.Codd 提出,伴随而来的是著名的“twelvelaws of online analytical processing”. 1998年微软发布MicrosoftAnalysis Services,并且在早一年通过OLE DB for OLAP API引入MDX查询语言,2001年微软和Hyperion发布的XML forAnalysis 成为了事实上的OLAP查询标准。如今,MDX已成为与SQL旗鼓相当的OLAP 查询语言,被各家OLAP厂商先后支持。 OLAPCube是一种典型的多维数据分析技术,Cube本身可以认为是不同维度数据组成的dataset,一个OLAP Cube 可以拥有多个维度(Dimension),以及多个事实(Factor Measure)。用户通过OLAP工具从多个角度来进行数据的多维分析。通常认为OLAP包括三种基本的分析操作:上卷(rollup)、下钻(drilldown)、切片切块(slicingand dicing),原始数据经过聚合以及整理后变成一个或多个维度的视图。 ROLAP和MOLAP 传统OLAP根据数据存储方式的不同分为ROLAP(Relational OLAP)以及MOLAP(Multi-dimensionOLAP) ROLAP 以关系模型的方式存储用作多维分析用的数据,优点在于存储体积小,查询方式灵活,然而缺点也显而易见,每次查询都需要对数据进行聚合计算,为了改善短板,ROLAP使用了列存、并行查询、查询优化、位图索引等技术 MOLAP 将分析用的数据物理上存储为多维数组的形式,形成CUBE结构。维度的属性值映射成多维数组的下标或者下标范围,事实以多维数组的值存储在数组单元中,优势是查询快速,缺点是数据量不容易控制,可能会出现维度爆炸的问题。 大数据时代OLAP的挑战 近二十年内,ROLAP技术随着MPP并行数据库技术的发展,尤其是列存技术的支持下,实现了分析能力大幅度的跨越提升,同时伴随着内存成本的进一步降低,单节点内存扩展性增强,集群单节点的查询性能实现了飞跃,内存数据库的实用性跨上了一个新台阶,这些技术进步共同作用的结果是类似的技术基本覆盖了TB级别的数据分析需求。 Hadoop以及相关大数据技术的出现提供了一个几近无限扩展的数据平台,在相关技术的支持下,各个应用的数据已突破了传统OLAP所能支持的容量上界。每天千万、数亿条的数据,提供若干维度的分析模型,大数据OLAP最迫切所要解决的问题就是大量实时运算导致的响应时间迟滞。 2. Apache Kylin 大数据下的OLAP解决方案 Apache Kylin的背景 Apache Kylin 是一个Hadoop生态圈下的MOLAP系统,是eBay大数据部门从2014年开始研发并开源的支持TB到PB级别数据量的分布式OLAP分析引擎。其特点包括: 可扩展的超快的OLAP引擎 提供ANSI-SQL接口 交互式查询能力 MOLAP Cube 的概念 与BI工具可无缝整合 Apache Kylin典型的应用场景如下: 用户数据存在于Hadoop HDFS中,利用Hive将HDFS文件数据以关系数据方式存取,数据量巨大,在500G以上 每天有数G甚至数十G的数据增量导入 有10个左右为固定的分析维度 ApacheKylin的核心思想是利用空间换时间,由于查询方面制定了多种灵活的策略,进一步提高空间的利用率,使得这样的平衡策略在应用中是值得采用的。 Apache Kylin的总体架构 Apache Kylin 作为一个OLAP引擎完成了从数据源抓取数据,ETL到自己的存储引擎,提供REST服务等一系列工作,其架构如图所示: Apache Kylin 的生态圈包括: Kylin Core: Kylin 引擎的框架,查询、任务、以及存储引擎都集中于此,除此之外还包括一个REST 服务器来响应各种客户端请求。 扩展插件: 各种提供额外特性的插件,如安全认证、SSO等 完整性组件: Job管理器,ETL、监控以及报警 交互界面: 基于Kylin Core之上的用户交互界面 驱动: 提供了JDBC以及ODBC的连接方式 Apache kylin Cube 多维数据的计算 Apache Kylin的多维计算主要是体现在OLAPCube的计算。Cube由多个Cuboid组合而成,Cuboid上的数据是原始数据聚合的数据,因此创建Cube可以看作是在原始数据导入时做的一个预计算预处理的过程。Kylin的强大之处在于充分利用了Hadoop的MapReduce并行处理的能力,高效处理导入的数据。 Apache Kylin的数据来自于Hive,并作为一个Hive的加速器希望最终的查询SQL类似于直接在Hive上查询。因此Kylin在建立Cube的时候需要从Hive获取Hive表的元数据。虽然有建立Cube的过程,但是并不想对普通的查询用户暴露Cube的存在。 Apache Kylin创建Cube的过程如下图所示: 根据Cube定义的事实表以及维度表,利用Hive创建一张宽表 抽取事实表上的维度的distinct值,将事实表上的维度以字典树方式压缩编码成目录,将维度表以字典树的方式编码 利用MapReduce从第一步得到的宽表文件作为输入,创建 N-Dimension cuboid,然后每次根据前一步的结果串行生成 N-1 cuboid, N-2 cuboid … 0-Cuboid 根据生成的Cuboid数据量计算HTable的Region分割策略,创建HTable,将HFile导入进来 Apache Kylin与传统的OLAP一样,无法应对数据Update的情况(更新数据会导致Cube的失效,需要重建整个Cube)。面对每天甚至每两个小时这样固定周期的增量数据,Kylin使用了一种增量Cubing技术来进行快速响应。 Apache Kylin的Cube可以根据时间段划分成多个Segment。在Cube第一次Build完成之后会有一个Segment,在每次增量Build后会产生一个新的Segment。增量Cubing依赖已有的CubeSegments和增量的原始数据。增量Cubing的步骤和新建 Cube的步骤类似,Segment之间以时间段进行区分。 增量Cubing所需要面对的原始数据量更小,因此增量Cubing的速度是非常快的。然而随着CubeSegments的数目增加,一定程度上会影响到查询的进行,所以在Segments数目到一定数量后可能需要进行CubeSegments的合并操作,实际上MergeCube是合成了一个新的大的CubeSegment来替代,Merge操作是一个异步的在线操作,不会对前端的查询业务产生影响。 合并操作步骤如下: 遍历指定的Cube Segment 合并维度字典目录和维度表快照 利用MapReduce合并他们的 N-Dimension cuboid 将cuboid转换成HFile,生成新的HTable,替代原有的多个HTable Apache Kylin对传统MOLAP的改进 计算Cube的存储代价以及计算代价都是比较大的, 传统OLAP的维度爆炸的问题Kylin也一样会遇到。 Kylin提供给用户一些优化措施,在一定程度上能降低维度爆炸的问题: Cube 优化: Hierachy Dimension Derived Dimension Aggregation Group Hierachy Dimension, 一系列具有层次关系的Dimension组成一个Hierachy, 比如年、月、日组成了一个Hierachy, 在Cube中,如果不设置Hierarchy, 会有 年、月、日、年月、年日、月日 6个cuboid, 但是设置了Hierarchy之后Cuboid增加了一个约束,希望低Level的Dimension一定要伴随高Level的Dimension 一起出现。设置了Hierachy Dimension 能使得需要计算的维度组合减少一半。 Derived Dimension, 如果在某张维度表上有多个维度,那么可以将其设置为Derived Dimension, 在Kylin内部会将其统一用维度表的主键来替换,以此来达到降低维度组合的数目,当然在一定程度上Derived Dimension 会降低查询效率,在查询时,Kylin使用维度表主键进行聚合后,再通过主键和真正维度列的映射关系做一次转换,在Kylin内部再对结果集做一次聚合后返回给用户 Aggregation Group, 这是一个将维度进行分组,以求达到降低维度组合数目的手段。不同分组的维度之间组成的Cuboid数量会大大降低,维度组合从2的(k+m+n)次幂至多能降低到 2的k次幂加2的m次幂加2的n次幂。Group的优化措施与查询SQL紧密依赖,可以说是为了查询的定制优化。 如果查询的维度是夸Group的,那么Kylin需要以较大的代价从N-Cuboid中聚合得到所需要的查询结果,这需要Cube构建人员在建模时仔细地斟酌。 数据压缩: ApacheKylin针对维度字典以及维度表快照采用了特殊的压缩算法,对于Hbase中的聚合计算数据利用了Hadoop的LZO或者是Snappy,从而保证存储在Hbase以及内存中的数据尽可能的小。其中维度字典以及维度表快照的压缩考虑到DataCube中会出现非常多的重复的维度成员值,最直接的处理方式就是利用数据字典的方式将维度值映射成ID, Kylin中采用了Trie树的方式对维度值进行编码 distinct count聚合查询优化: Apache Kylin 采用了HypeLogLog的方式来计算DistinctCount。好处是速度快,缺点是结果是一个近似值,会有一定的误差。在非计费等通常的场景下DistinctCount的统计误差应用普遍可以接受。 具体的算法可见Paper,本文不再赘述: http://algo.inria.fr/flajolet/Publications/FlFuGaMe07.pdf Apache kylin SQL查询的实现 ANSI SQL查询是Apache Kylin 非常明显的优势。Kylin的SQL语法解析依赖于另一个开源数据管理框架 ApacheCalcite, Calcite即之前的Optiq,是一个没有存储模块的数据库,即不管理数据存储、不包含数据处理的算法,不包含元信息的存储。因此它非常适合来做一个应用到存储引擎之间的中间层。在Calcite的基础之上只要为存储引擎写一个专用的适配器(Adapter)即可形成一个功能丰富的支持DML甚至DDL的“类数据库”。 Kylin完成了一个定制的Adapter,在Calcite完成SQL解析,形成语法树(AST)之后,由Kylin定义语法树各个节点的执行规则来进行查询。Calcite在遍历语法树节点后生成一个Kylin描述查询模型的Digest, Kylin会为此Digest去判断是否有匹配的Cube。如果有与查询匹配的Cube,即选择一个查询代价最小的Cube进行查询(KylinCube的查询代价计算目前是一个开放接口,可以根据维度数目,可以根据数据量大小来计算Cost) Kylin目前的多维数据存储引擎是HBase, Kylin利用了HBase的Coprocessor机制在HBase的RegionServer完成部分聚合以及全部过滤操作,在HbaseScan时提前进行计算,利用HBase多个Region Server的计算能力加速Kylin的SQL查询。目前Kylin仍然有部分查询语法不支持,特别是过滤器Where部分的约束较多、对SQL有一定的要求,但是如果有针对性的对Coprocessor部分进行改造相信SQL兼容度可以有大幅的提升。 Apache kylin 与 RTOLAP ApacheKylin 可以说是与市面上流行的Presto、SparkSQL、Impala等直接在原始数据上查询的系统(暂且归于RTOLAP)走了一条完全不同的道路。前者在如何快速求得预计算结果,以及优化查询解析使得更多的查询能用上预计算结果方面在优化。后续Kylin的版本会改进预计算引擎,优化预计算速度,使得Kylin可以变成一个近似实时的分析引擎。而像Presto,SparkSQL等是着重于优化查询数据的过程环节,像一些其它的数据仓库一样,使用列存、压缩、并行查询等技术,优化查询。这种方案的好处就在于扩展性强、能适配更广泛的查询。但是在查询速度上,可以说Apache Kylin 要比ROLAP 至少快上一个数量级,所以对与查询响应时间要求较高的应用,ApacheKylin是最好的选择。 3. Apache Kylin在网易 Kylin服务化 在网易,Apache Kylin作为大数据平台的OLAP查询模块,可以为公司的各种分析类需求以及应用提供服务。所有数据存在Hadoop Hive 上的数据都能够通过Kylin OLAP 引擎进行加速查询。在公司内部Kylin作为一个统一平台,与各产品的数据仓库进行接驳。 目前Kylin的部署架构如下: Kylin集群由多个查询节点以及控制节点组成。 控制节点唯一,负责集群项目、任务调度与Cube增删查改。 多个查询节点前用Nginx做负载均衡,后段节点可按需水平扩容。前端可同时支持JDBC与ODBC的客户端查询。 Kylin性能表现 在Kylin上线前,我们选取了公司内部原有的一些报表业务进行过性能对比,对比内容在相同的数据下、Kylin查询与Mondrian 结合Oracle的查询比较。 测试结果通过数据量较大的DataStream报表来进行比较: 再看Kylin的吞吐量,利用Haproxy进行请求转发后随着Kylin服务器的增加吞吐量的表现: 网易对Kylin的改进 原生的社区版Aapche Kylin 是需要部署在一个统一底层的Hadoop、Hive、HBase集群之上的。而网易内部的大数据平台由于各种原因,分为了多个Hadoop集群、各应用会在不同的Hadoop集群上建立Hive数据仓库。最原始而自然的想法就是在每一个Hadoop环境上部署一套Kylin服务来满足不同的需求,但是集群资源管理、计算资源调度、管理运维的复杂性都会是一个比较突出的问题。例如用户数据在A机房的Hive上,而A机房的Hadoop集群并没有足够的计算资源来保证KylinOLAP的高效运行。因此根据公司内部实际的大数据平台分布情况及机房建设情况,将Kylin打造成一个公司内统一的服务平台是一个更好的选择。OLAP小组对开源版本的Kylin进行了二次开发,并将改进补丁提交给了社区并受到了积极反馈。 目前的改进主要包括: Kylin对Kerberos认证的支持 Kylin非Hadoop节点的部署支持 多数据源的支持 在公司内,由于性能以及安全性方面的考量,不同部门的应用会搭建各自的Hive进行数据分析,并且由于公司内还没有跨机房的Hadoop集群,因此会出现用户数据在A地方的Hive上,而A机房的Hadoop集群并没有足够的计算资源来保证KylinOLAP的高效运行。 综合分析现实的场景之后,我们选择了公司内最大的hadoop集群作为KylinOLAP的计算引擎集群,保证有充足的存储以及计算资源。 HBase采用一个独立的集群,避免Hbase查询和Hadoop集群任务之间的互相干扰。数据源Hive允许用户自定义,目前已支持同Hadoop集群下不同Hive 以及不同Hadoop集群下的不同Hive节点使用KylinOLAP服务。根据用户数据仓库的实际配置情况可能会出现跨集群的数据源抽取计算,由于公司同城机房有专线网络,数据仓库Hive里的源数据量也远小于Kylin实际的聚合后的数据存储(存于Hbase,数据量大小一般为数据源Hive中的10倍以上),因此可认为这样的开销可以认为带来的影响不大,并且在我们的测试中得到了印证。 Kylin OLAP与猛犸以及有数的结合 猛犸是网易内部的统一大数据入口平台,为了让Kylin更快更好的融入到大平台中,OLAP小组已计划在不久之后全面与猛犸大数据平台进行打通和整合, Kylin OLAP将深度内嵌于猛犸,用户可以基于猛犸平台完成KylinOLAP的简化管理工作。猛犸平台对接控制节点,作为专业数据建模师的操作入口 Kylin将利用猛犸的用户管理功能 猛犸将接管用户项目的创建以及Cube的管理 猛犸将原有的Hive数据源彻底与Kylin打通,便于Kylin管理用户的数据源 Kylin原生的用户管理是基于LDAP的,如果不使用LDAP服务需要利用SpringSecurity重新开发一套,网易的内部的猛犸大数据平台有一套成熟且完善的用户权限访问控制体系,因此可以利用现成的机制对Kylin的访问、修改做保护性的限制。 Kylin的Data Cube建模,特别是一些高级的Cube优化功能如RowKey顺序、维度分组、分层等需要较高的学习成本,所以认为不适合让一般的数据分析师来直接操作,我们设计了一套简化版的Cube 建模流程,以用户申请——运维审批的方式进行数据的接入。 有数是网易内部重要的报表分析平台,有数将KylinOLAP作为一个单独的数据源进行支持。已有的以及潜在的Hive查询客户可以轻松的将报表迁移到KylinOLAP,使得大数据量下的交互式报表分析成为可能。 有数能基于在猛犸上创建的Cube创建报表 有数主动识别Kylin Cube定义的维度和度量 用户在Kylin OLAP允许的范围内自由操作,完成报表的编辑和查询。 与有数结合后的Kylin 查询结果可以用更多更丰富的图表的方式展示给数据分析人员:

优秀的个人博客,低调大师

Spark实践-日志查询

环境 win 7 jdk 1.7.0_79 (Oracle Corporation) scala version 2.10.5 spark 1.6.1 详细配置: Spark Properties spark.app.id local-1461891171126 spark.app.name JavaLogQuery spark.driver.host 10.170.26.123 spark.driver.port 34998 spark.executor.id driver spark.externalBlockStore.folderName spark-5242ec5b-3653-42e4-9ba2-da3ef515a1d5 spark.master local[1] spark.scheduler.mode FIFO 任务 完成对如下日志的查询: "10.10.10.10 - \"FRED\" [18/Jan/2013:17:56:07 +1100] \"GET http://images.com/2013/Generic.jpg " + "HTTP/1.1\" 304 315 \"http://referall.com/\" \"Mozilla/4.0 (compatible; MSIE 7.0; " + "Windows NT 5.1; GTB7.4; .NET CLR 2.0.50727; .NET CLR 3.0.04506.30; .NET CLR 3.0.04506.648; " + ".NET CLR 3.5.21022; .NET CLR 3.0.4506.2152; .NET CLR 1.0.3705; .NET CLR 1.1.4322; .NET CLR " + "3.5.30729; Release=ARP)\" \"UD-1\" - \"image/jpeg\" \"whatever\" 0.350 \"-\" - \"\" 265 923 934 \"\" " + "62.24.11.25 images.com 1358492167 - Whatup", "10.10.10.10 - \"FRED\" [18/Jan/2013:18:02:37 +1100] \"GET http://images.com/2013/Generic.jpg " + "HTTP/1.1\" 304 306 \"http:/referall.com\" \"Mozilla/4.0 (compatible; MSIE 7.0; Windows NT 5.1; " + "GTB7.4; .NET CLR 2.0.50727; .NET CLR 3.0.04506.30; .NET CLR 3.0.04506.648; .NET CLR " + "3.5.21022; .NET CLR 3.0.4506.2152; .NET CLR 1.0.3705; .NET CLR 1.1.4322; .NET CLR " + "3.5.30729; Release=ARP)\" \"UD-1\" - \"image/jpeg\" \"whatever\" 0.352 \"-\" - \"\" 256 977 988 \"\" " + "0 73.23.2.15 images.com 1358492557 - Whatup" 思路: 1.利用正则表达式提取出日志特征,然后map在分片后的RDD上。 JavaPairRDD<Tuple3<String, String, String>, Stats> extracted 2.执行reducebykey,merge相同的Stats package org.apache.spark.examples; import com.google.common.collect.Lists; import scala.Tuple2; import scala.Tuple3; import org.apache.commons.logging.impl.Log4JLogger; import org.apache.log4j.Level; import org.apache.log4j.Logger; import org.apache.spark.SparkConf; import org.apache.spark.api.java.JavaPairRDD; import org.apache.spark.api.java.JavaRDD; import org.apache.spark.api.java.JavaSparkContext; import org.apache.spark.api.java.function.Function2; import org.apache.spark.api.java.function.PairFunction; import java.io.Serializable; import java.util.Collections; import java.util.List; import java.util.regex.Matcher; import java.util.regex.Pattern; /** * 日志查询 * @author jinhang * */ public final class JavaLogQuery { //模拟日志 exampleApacheLogs public static final List<String> exampleApacheLogs = Lists.newArrayList( "10.10.10.10 - \"FRED\" [18/Jan/2013:17:56:07 +1100] \"GET http://images.com/2013/Generic.jpg " + "HTTP/1.1\" 304 315 \"http://referall.com/\" \"Mozilla/4.0 (compatible; MSIE 7.0; " + "Windows NT 5.1; GTB7.4; .NET CLR 2.0.50727; .NET CLR 3.0.04506.30; .NET CLR 3.0.04506.648; " + ".NET CLR 3.5.21022; .NET CLR 3.0.4506.2152; .NET CLR 1.0.3705; .NET CLR 1.1.4322; .NET CLR " + "3.5.30729; Release=ARP)\" \"UD-1\" - \"image/jpeg\" \"whatever\" 0.350 \"-\" - \"\" 265 923 934 \"\" " + "62.24.11.25 images.com 1358492167 - Whatup", "10.10.10.10 - \"FRED\" [18/Jan/2013:18:02:37 +1100] \"GET http://images.com/2013/Generic.jpg " + "HTTP/1.1\" 304 306 \"http:/referall.com\" \"Mozilla/4.0 (compatible; MSIE 7.0; Windows NT 5.1; " + "GTB7.4; .NET CLR 2.0.50727; .NET CLR 3.0.04506.30; .NET CLR 3.0.04506.648; .NET CLR " + "3.5.21022; .NET CLR 3.0.4506.2152; .NET CLR 1.0.3705; .NET CLR 1.1.4322; .NET CLR " + "3.5.30729; Release=ARP)\" \"UD-1\" - \"image/jpeg\" \"whatever\" 0.352 \"-\" - \"\" 256 977 988 \"\" " + "0 73.23.2.15 images.com 1358492557 - Whatup"); public static final Pattern apacheLogRegex = Pattern.compile( "^([\\d.]+) (\\S+) (\\S+) \\[([\\w\\d:/]+\\s[+\\-]\\d{4})\\] \"(.+?)\" (\\d{3}) ([\\d\\-]+) \"([^\"]+)\" \"([^\"]+)\".*"); public static class Stats implements Serializable { private final int count; private final int numBytes; public Stats(int count, int numBytes) { this.count = count; this.numBytes = numBytes; } public Stats merge(Stats other) { return new Stats(count + other.count, numBytes + other.numBytes); } public String toString() { return String.format("bytes=%s\tn=%s", numBytes, count); } } public static Tuple3<String, String, String> extractKey(String line) { Matcher m = apacheLogRegex.matcher(line); if (m.find()) { String ip = m.group(1); String user = m.group(3); String query = m.group(5); if (!user.equalsIgnoreCase("-")) { return new Tuple3<String, String, String>(ip, user, query); } } return new Tuple3<String, String, String>(null, null, null); } public static Stats extractStats(String line) { Matcher m = apacheLogRegex.matcher(line); if (m.find()) { int bytes = Integer.parseInt(m.group(7)); return new Stats(1, bytes); } else { return new Stats(1, 0); } } public static void main(String[] args) { Logger.getLogger(JavaLogQuery.class).setLevel(Level.FATAL); SparkConf sparkConf = new SparkConf().setAppName("JavaLogQuery").setMaster("local[1]"); JavaSparkContext jsc = new JavaSparkContext(sparkConf); JavaRDD<String> dataSet = (args.length == 1) ? jsc.textFile(args[0]) : jsc.parallelize(exampleApacheLogs); JavaPairRDD<Tuple3<String, String, String>, Stats> extracted = dataSet.mapToPair(new PairFunction<String, Tuple3<String, String, String>, Stats>() { @Override public Tuple2<Tuple3<String, String, String>, Stats> call(String s) { return new Tuple2<Tuple3<String, String, String>, Stats>(extractKey(s), extractStats(s)); } }); JavaPairRDD<Tuple3<String, String, String>, Stats> counts = extracted.reduceByKey(new Function2<Stats, Stats, Stats>() { @Override public Stats call(Stats stats, Stats stats2) { return stats.merge(stats2); } }); List<Tuple2<Tuple3<String, String, String>, Stats>> output = counts.collect(); //遍历结果 for (Tuple2<?,?> t : output) { System.out.println(t._1() + "\t" + t._2()); } jsc.stop(); } } 分析下执行过程: 加载SLF4J Using Spark's default log4j profile: org/apache/spark/log4j-defaults.properties SLF4J: Class path contains multiple SLF4J bindings. SLF4J: Found binding in [jar:file:/D:/JavaProject/spark-demo/lib/spark-assembly-1.6.1-hadoop2.0.0-mr1-cdh4.2.0.jar!/org/slf4j/impl/StaticLoggerBinder.class] SLF4J: Found binding in [jar:file:/D:/JavaProject/spark-demo/lib/spark-examples-1.6.1-hadoop2.0.0-mr1-cdh4.2.0.jar!/org/slf4j/impl/StaticLoggerBinder.class] SLF4J: See http://www.slf4j.org/codes.html#multiple_bindings for an explanation. SLF4J: Actual binding is of type [org.slf4j.impl.Log4jLoggerFactory] 初始化sparkcontext上下文 16/04/29 09:36:22 INFO SparkContext: Running Spark version 1.6.1 //-Djava.library.path=$HADOOP_HOME/lib/native/Linux-amd64-64/*.jar可以解决 16/04/29 09:36:23 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable 16/04/29 09:36:23 INFO SecurityManager: Changing view acls to: hp 16/04/29 09:36:23 INFO SecurityManager: Changing modify acls to: hp 16/04/29 09:36:23 INFO SecurityManager: SecurityManager: authentication disabled; ui acls disabled; users with view permissions: Set(hp); users with modify permissions: Set(hp) 16/04/29 09:36:23 INFO Utils: Successfully started service 'sparkDriver' on port 36010. 16/04/29 09:36:23 INFO Slf4jLogger: Slf4jLogger started 16/04/29 09:36:24 INFO Remoting: Starting remoting 16/04/29 09:36:24 INFO Remoting: Remoting started; listening on addresses :[akka.tcp://sparkDriverActorSystem@10.170.26.123:36023] 16/04/29 09:36:24 INFO Utils: Successfully started service 'sparkDriverActorSystem' on port 36023. 16/04/29 09:36:24 INFO SparkEnv: Registering MapOutputTracker 16/04/29 09:36:24 INFO SparkEnv: Registering BlockManagerMaster 16/04/29 09:36:24 INFO DiskBlockManager: Created local directory at C:\Users\hp\AppData\Local\Temp\blockmgr-84667505-0018-439b-9627-a4360d872118 16/04/29 09:36:24 INFO MemoryStore: MemoryStore started with capacity 517.4 MB 16/04/29 09:36:24 INFO SparkEnv: Registering OutputCommitCoordinator 16/04/29 09:36:24 INFO Utils: Successfully started service 'SparkUI' on port 4040. 16/04/29 09:36:24 INFO SparkUI: Started SparkUI at http://10.170.26.123:4040 16/04/29 09:36:24 INFO Executor: Starting executor ID driver on host localhost 16/04/29 09:36:24 INFO Utils: Successfully started service 'org.apache.spark.network.netty.NettyBlockTransferService' on port 36030. 16/04/29 09:36:24 INFO NettyBlockTransferService: Server created on 36030 16/04/29 09:36:24 INFO BlockManagerMaster: Trying to register BlockManager 16/04/29 09:36:24 INFO BlockManagerMasterEndpoint: Registering block manager localhost:36030 with 517.4 MB RAM, BlockManagerId(driver, localhost, 36030) 16/04/29 09:36:24 INFO BlockManagerMaster: Registered BlockManager SecurityManager ‘sparkDriver’ on port 36010 Remoting: Remoting started; listening on addresses :[akka.tcp://sparkDriverActorSystem@10.170.26.123:36023] MapOutputTracker BlockManagerMaster DiskBlockManager: Created local directory at C:\Users\hp\AppData\Local\Temp\blockmgr-84667505-0018-439b-9627- OutputCommitCoordinator Executor org.apache.spark.network.netty.NettyBlockTransferService 这几个是几个主要过程。 开始执行job 16/04/29 10:12:31 INFO SparkContext: Starting job: collect at JavaLogQuery.java:112 16/04/29 10:12:31 INFO DAGScheduler: Registering RDD 1 (mapToPair at JavaLogQuery.java:98) 16/04/29 10:12:31 INFO DAGScheduler: Got job 0 (collect at JavaLogQuery.java:112) with 1 output partitions 16/04/29 10:12:31 INFO DAGScheduler: Final stage: ResultStage 1 (collect at JavaLogQuery.java:112) 16/04/29 10:12:31 INFO DAGScheduler: Parents of final stage: List(ShuffleMapStage 0) 16/04/29 10:12:31 INFO DAGScheduler: Missing parents: List(ShuffleMapStage 0) 16/04/29 10:12:31 INFO DAGScheduler: Submitting ShuffleMapStage 0 (MapPartitionsRDD[1] at mapToPair at JavaLogQuery.java:98), which has no missing parents 16/04/29 10:12:31 WARN SizeEstimator: Failed to check whether UseCompressedOops is set; assuming yes 16/04/29 10:12:31 INFO MemoryStore: Block broadcast_0 stored as values in memory (estimated size 3.1 KB, free 3.1 KB) 16/04/29 10:12:31 INFO MemoryStore: Block broadcast_0_piece0 stored as bytes in memory (estimated size 1897.0 B, free 5.0 KB) 16/04/29 10:12:31 INFO BlockManagerInfo: Added broadcast_0_piece0 in memory on localhost:36394 (size: 1897.0 B, free: 517.4 MB) 16/04/29 10:12:31 INFO SparkContext: Created broadcast 0 from broadcast at DAGScheduler.scala:1006 16/04/29 10:12:31 INFO DAGScheduler: Submitting 1 missing tasks from ShuffleMapStage 0 (MapPartitionsRDD[1] at mapToPair at JavaLogQuery.java:98) 16/04/29 10:12:31 INFO TaskSchedulerImpl: Adding task set 0.0 with 1 tasks 16/04/29 10:12:31 INFO TaskSetManager: Starting task 0.0 in stage 0.0 (TID 0, localhost, partition 0,PROCESS_LOCAL, 3033 bytes) 16/04/29 10:12:31 INFO Executor: Running task 0.0 in stage 0.0 (TID 0) 16/04/29 10:12:32 INFO Executor: Finished task 0.0 in stage 0.0 (TID 0). 1158 bytes result sent to driver 16/04/29 10:12:32 INFO TaskSetManager: Finished task 0.0 in stage 0.0 (TID 0) in 320 ms on localhost (1/1) 16/04/29 10:12:32 INFO TaskSchedulerImpl: Removed TaskSet 0.0, whose tasks have all completed, from pool 16/04/29 10:12:32 INFO DAGScheduler: ShuffleMapStage 0 (mapToPair at JavaLogQuery.java:98) finished in 0.349 s 16/04/29 10:12:32 INFO DAGScheduler: looking for newly runnable stages 16/04/29 10:12:32 INFO DAGScheduler: running: Set() 16/04/29 10:12:32 INFO DAGScheduler: waiting: Set(ResultStage 1) 16/04/29 10:12:32 INFO DAGScheduler: failed: Set() 16/04/29 10:12:32 INFO DAGScheduler: Submitting ResultStage 1 ***(ShuffledRDD[2] at reduceByKey at JavaLogQuery.java:105), which has no missing parents*** 16/04/29 10:12:32 INFO MemoryStore: Block broadcast_1 stored as values in memory (estimated size 2.9 KB, free 7.9 KB) 16/04/29 10:12:32 INFO MemoryStore: Block broadcast_1_piece0 stored as bytes in memory (estimated size 1746.0 B, free 9.6 KB) 16/04/29 10:12:32 INFO BlockManagerInfo: Added broadcast_1_piece0 in memory on localhost:36394 (size: 1746.0 B, free: 517.4 MB) 16/04/29 10:12:32 INFO SparkContext: Created broadcast 1 from broadcast at DAGScheduler.scala:1006 16/04/29 10:12:32 INFO DAGScheduler: Submitting 1 missing tasks from ResultStage 1 (ShuffledRDD[2] at reduceByKey at JavaLogQuery.java:105) 16/04/29 10:12:32 INFO TaskSchedulerImpl: Adding task set 1.0 with 1 tasks 16/04/29 10:12:32 INFO TaskSetManager: Starting task 0.0 in stage 1.0 (TID 1, localhost, partition 0,NODE_LOCAL, 1894 bytes) 16/04/29 10:12:32 INFO Executor: Running task 0.0 in stage 1.0 (TID 1) 16/04/29 10:12:32 INFO ShuffleBlockFetcherIterator: Getting 1 non-empty blocks out of 1 blocks 16/04/29 10:12:32 INFO ShuffleBlockFetcherIterator: Started 0 remote fetches in 16 ms 16/04/29 10:12:32 INFO Executor: Finished task 0.0 in stage 1.0 (TID 1). 1449 bytes result sent to driver 16/04/29 10:12:32 INFO TaskSetManager: Finished task 0.0 in stage 1.0 (TID 1) in 107 ms on localhost (1/1) 16/04/29 10:12:32 INFO TaskSchedulerImpl: Removed TaskSet 1.0, whose tasks have all completed, from pool 16/04/29 10:12:32 INFO DAGScheduler: ResultStage 1 (collect at JavaLogQuery.java:112) finished in 0.108 s 16/04/29 10:12:32 INFO DAGScheduler: Job 0 finished: collect at JavaLogQuery.java:112, took 0.850227 s (10.10.10.10,"FRED",GET http://images.com/2013/Generic.jpg HTTP/1.1) bytes=621 n=2 16/04/29 10:12:56 INFO BlockManagerInfo: Removed broadcast_1_piece0 on localhost:36394 in memory (size: 1746.0 B, free: 517.4 MB) 结束 16/04/29 10:12:56 INFO BlockManagerInfo: Removed broadcast_1_piece0 on localhost:36394 in memory (size: 1746.0 B, free: 517.4 MB) 16/04/29 10:16:13 INFO ContextCleaner: Cleaned accumulator 2 16/04/29 10:16:13 INFO BlockManagerInfo: Removed broadcast_0_piece0 on localhost:36394 in memory (size: 1897.0 B, free: 517.4 MB) 16/04/29 10:16:13 INFO ContextCleaner: Cleaned accumulator 1 16/04/29 10:24:29 WARN QueuedThreadPool: 5 threads could not be stopped 16/04/29 10:24:29 INFO SparkUI: Stopped Spark web UI at http://10.170.26.123:4040 16/04/29 10:24:29 INFO MapOutputTrackerMasterEndpoint: MapOutputTrackerMasterEndpoint stopped! 16/04/29 10:24:29 INFO MemoryStore: MemoryStore cleared 16/04/29 10:24:29 INFO BlockManager: BlockManager stopped 16/04/29 10:24:29 INFO BlockManagerMaster: BlockManagerMaster stopped 16/04/29 10:24:30 INFO OutputCommitCoordinator$OutputCommitCoordinatorEndpoint: OutputCommitCoordinator stopped! 16/04/29 10:24:30 INFO SparkContext: Successfully stopped SparkContext 16/04/29 10:24:30 INFO RemoteActorRefProvider$RemotingTerminator: Shutting down remote daemon. 16/04/29 10:24:30 INFO RemoteActorRefProvider$RemotingTerminator: Remote daemon shut down; proceeding with flushing remote transports. 16/04/29 10:24:30 INFO RemoteActorRefProvider$RemotingTerminator: Remoting shut down. 总结 java的代码实现spark API虽然代码冗余很多,但是很清楚显示了spark的执行过程,先比于scala的代码,较为清楚,而且java的代码和其他的项目结合效果可能好些。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册