首页 文章 精选 留言 我的

精选列表

搜索[监督学习],共10000篇文章
优秀的个人博客,低调大师

android studio 学习之一

一、简介 Android Studio 是一个Android集成开发工具,基于IntelliJ IDEA. 类似 Eclipse ADT,Android Studio 提供了集成的 Android 开发工具用于开发和调试。 官网:http://www.android-studio.org/ 二、安装问题 1.Unable to access Android SDK add-on list 如果是第一安装完之后出现这个界面,在这个目录下 C:\Program Files\Android\Android Studio\bin\idea.properties 最后面添加上这句话 disable.android.first.run=true 2.汉化教程 提示:resources_en.jar拷贝出来改名为resources_cn.jar,使用解压软件打开,然后把中文版的文件拷进去,保存后再考回lib下 http://www.imgeek.org/article/825308169

优秀的个人博客,低调大师

Material Design学习之 Camera

转载请注明出处:王亟亟的大牛之路 年后第一篇,自从来了某司产量骤减,这里批评下自己,这一篇的素材来源于老牌Material Design控件写手afollestad的 https://github.com/afollestad/material-camera 开篇前,继续安利,你懂的:https://github.com/ddwhan0123/Useful-Open-Source-Android (最近把 6.0授权部分单独罗列出来了) 介绍代码之前先贴下效果图 如何使用 先是添加依赖让maven去下代码 maven部分 repositories { jcenter() maven { url "https://dl.bintray.com/drummer-aidan/maven" } } 然后在build.gradle里添加 compile 'com.afollestad:material-camera:0.4.4' 当然你要下源码也行,就是一个java代码和布局文件,截图如下 依赖加好,代码下好,还需要做一件事,注册Activity 需要在项目的main文件里加 <activity android:name="com.afollestad.materialcamera.CaptureActivity" android:theme="@style/MaterialCamera.CaptureActivity" /> <activity android:name="com.afollestad.materialcamera.CaptureActivity2" android:theme="@style/MaterialCamera.CaptureActivity" /> 用于注册library的activity OK,配置大致就是如下 自定义设置 在使用拍摄功能前肯定,一定会有多多少少的设置,最通常的诸如,图片储存地址,图片大小,画质压缩等等,原作者也提供了强大的api,这里做下翻译。 .allowRetry(true) //是否显示重拍按钮 .autoSubmit(false) //是否允许用户在录制后播放视频 .saveDir(saveFolder) //拍摄的内容的储存地址 .primaryColorAttr(R.attr.colorPrimary) //相机配色,建议遵从app style .showPortraitWarning(true) //如果用户按纵向方向的记录,是否显示警告 .defaultToFrontFacing(false) //是否默认为前置摄像头 .allowChangeCamera(true) //允许用户更改相机 .retryExits(false) //如果为true,播放屏幕中的“重试”按钮将退出相机,而不是返回录音机 .restartTimerOnRetry(false) //如果为true,则当用户在播放中轻按“重试”时,倒计时器将重置为0 .continueTimerInPlayback(false) //如果为true,倒计时器将在播放过程中继续向下,而不是暂停。 .videoEncodingBitRate(1024000) //设置视频大小 .audioEncodingBitRate(50000) // 设置音频大小 .videoFrameRate(24) //设置视频fps值 .qualityProfile(MaterialCamera.QUALITY_HIGH) //设置质量配置文件,手动设置比特率或帧速率与其他设置将覆盖单个质量配置文件设置 .videoPreferredHeight(720) //设置录制视频的首选高度 .videoPreferredAspect(4f / 3f) //为录制的视频输出设置首选宽高比 .maxAllowedFileSize(1024 * 1024 * 5) //将最大文件大小设置为5MB,如果文件达到此限制,录制将停止。请记住,FAT文件系统的文件大小限制为4GB。 .iconRecord(R.drawable.mcam_action_capture) //设置用于开始录制的按钮的自定义图标 .iconStop(R.drawable.mcam_action_stop) //为用于停止录制的按钮设置自定义图标 .iconFrontCamera(R.drawable.mcam_camera_front) //设置用于切换到前置摄像头的按钮的自定义图标 .iconRearCamera(R.drawable.mcam_camera_rear) //设置用于切换到后置摄像头的按钮的自定义图标 .iconPlay(R.drawable.evp_action_play) //设置用于开始播放的自定义图标 .iconPause(R.drawable.evp_action_pause) // 设置用于暂停播放的自定义图标 .iconRestart(R.drawable.evp_action_restart) //设置用于重新开始播放的自定义图标 .labelRetry(R.string.mcam_retry) //为用于重试记录的按钮设置自定义按钮标签(如果可用) .labelConfirm(R.string.mcam_use_video) //为用于确认/提交录音的按钮设置自定义按钮标签 .autoRecordWithDelaySec(5) //摄像机将在5秒倒计时后自动开始录制。这将最初禁用前后摄像头之间的切换。 .autoRecordWithDelayMs(5000) //与上面相同,用毫秒而不是秒表示。 .audioDisabled(false) //设置为true可记录没有任何音频的视频 .start(CAMERA_RQ); //启动相机活动,结果将被发回当前活动 这都是api提供的设置的方法,通俗易懂,建议写成一个工厂方法然后调用,省得每次构造一个新的MaterialCamera对象 控件调用 作者在适配方面还是做的很用心的,高低版本的Fragment和通常的Activity都有做。兼容方面我分别在 华为,nexus,小米部分机型做过测试没有明显的差异和bug出现,我们来看下具体是如何调用的。 MaterialCamera materialCamera = new MaterialCamera(this) .saveDir(saveDir) .showPortraitWarning(true) .allowRetry(true) .defaultToFrontFacing(true) .allowRetry(true) .autoSubmit(false) .labelConfirm(R.string.mcam_use_video); materialCamera.stillShot() .labelConfirm(R.string.mcam_use_stillshot); materialCamera.start(CAMERA_RQ); 按钮啊或者其他地方调用下就好了,然后和使用普通相机一样在onActivityResult里找结果就行 @Override protected void onActivityResult(int requestCode, int resultCode, Intent data) { super.onActivityResult(requestCode, resultCode, data); // Received recording or error from MaterialCamera if (requestCode == CAMERA_RQ) { if (resultCode == RESULT_OK) { final File file = new File(data.getData().getPath()); Toast.makeText(this, String.format("Saved to: %s, size: %s", file.getAbsolutePath(), fileSize(file)), Toast.LENGTH_LONG).show(); } else if (data != null) { Exception e = (Exception) data.getSerializableExtra(MaterialCamera.ERROR_EXTRA); if (e != null) { e.printStackTrace(); Toast.makeText(this, "Error: " + e.getMessage(), Toast.LENGTH_LONG).show(); } } } } 首先判断是否是自己之前预设的requestCode值是的话去读取data里面的值只要能读到data值那就走正常的业务逻辑就好。整体使用体验和厂商自带的相机相机功能没有什么区别。 区别在于存储部分帮你做了,常用功能帮你封了,长得很MD,还有很强的拓展性 一些补充 1.暂时只支持android.support.v4.app.Fragmentandroid.app.FragmentActivity调用相机,特殊场景的话自己得转Context 2.manifest里面加的2个Activity节点不能漏,lib裤自己没有存货的进程,都依附于调用者(我没试过不加会怎么样,八成是找不到那个类)那为什么需要有2个呢? 兼容看看2个类的注解就知道了 @TargetApi(Build.VERSION_CODES.LOLLIPOP) public class Camera2Fragment extends BaseCameraFragment implements View.OnClickListener 以及 @TargetApi(Build.VERSION_CODES.JELLY_BEAN) public class CameraFragment extends BaseCameraFragment implements View.OnClickListener 这个库暂时就介绍到这里,这篇没去拆源码,我对这个库的理解感觉这是一个实用性大于教学性的开源库,类似功能的库实现都是大同小异都是对自带的照相机外面套了层ui,套了层功能强化,当然感兴趣可以自己去读读,不是很难。 如果觉得部分功能自己需要拓展,继承BaseCameraFragment 这部分开始自己实现我觉得也很方便。 项目地址:https://github.com/afollestad/material-camera

优秀的个人博客,低调大师

虚拟化技术学习笔记

ECS 用的KVM。 任何计算机的问题都可以通过另一层的重定向解决。 虚拟技术:Xen, KVM, Hyper-V, Vmware ESX Server, VMware workstation, VirtualBox Binary Translation: 因为一开始X86不支持虚拟化, 实现复杂,性能损失 硬件辅助虚拟化:2004年 Intel和AMD 发布新的CPU规范,支持虚拟化。 问题: 1,ECS主要就是用的虚拟化技术吧,ECS产品本身和盘古有什么关系呢?这张图感觉有点需要推敲。 2,一个特定的ECS在阿里云里面,如果相应的物理机发生故障,如何切换?

优秀的个人博客,低调大师

Learning ELK stack 学习笔记

不错的入门书Learning ELK stack 第三章: Logstash插件类型分为四类: Input Filter Output Codec Logstash input类的file插件维护了一个sincedb文件追踪监控操作文件的当前位置。默认写入$HOME/.sincedb*,游标及读取频率可以通过配置修改。 file的两个配置属性:sincedb_path,sincedb_write_interval(默认15秒读取一次文件) 这里还涉及另一个配置 start_position => "beginning" 或"end"(默认),使用beginning,如果移除了.sincedb,将重新读取历史数据,造成数据重复。 lumberjack和logstash forwarder(轻量化的logstash)使用lumberjack协议打包日志 redis经常做为logstash forwarder 与logstash的中间人角色,在高负载系统上提供获取日志的服务。 Logstash outpu类型插件: 重点是elasticsearch,email,kafka,lumberjack,redis, Logstash filter类型插件: date,drop,grok解析非结构化的日志转换成结构化,mutate重命名,移除,替换,修改字段,转换字段类型,合并字段等 Logstash codec类型插件:编码解码日志 json,mutliline 第五章节: elasticsearch > indices > documents(json) > fields(_type,mapping) pattern=>"logstash-%{+YYYY.MM.dd}"(默认index) shard:index的物理存储位置,支持Primary shard and replica shard, 默认每个document使用5个shard replica shard分布在各个节点上,可以failover与平均负载 cluster > nodes :三种角色 =>data node =>master node =>routing node & load banlancer node elasticsearch api $curl -X '://://?'d '' VERB:GET, POST, PUT,DELETE, HEAD PROTOCAL:http,https PATH:/index/type/id OPERATION_NAME:_search, _count, and so on QUERY_STRING:?pretty for pretty print of JSON documents BODY:This makes a request for body text. 查看指定index的document thinkt@linux-pw37:~> curl -XGET 'http://192.168.56.101:9200/logstash-2016.09.09/_search?pretty' { "took" : 107, "timed_out" : false, "_shards" : { "total" : 5, "successful" : 5, "failed" : 0 }, "hits" : { "total" : 1, "max_score" : 1.0, "hits" : [ { "_index" : "logstash-2016.09.09", "_type" : "logs", "_id" : "AVf3tVjYndkMLGPlmtnx", "_score" : 1.0, "_source" : { "message" : "2016-09-09,770.099976,773.244995,759.659973,759.659973,1812200,759.659973", "@version" : "1", "@timestamp" : "2016-09-09T00:00:00.000Z", "path" : "/home/vagrant/table.csv", "host" : "localhost.localdomain", "Date" : "2016-09-09", "Open" : 770.099976, "High" : 773.244995, "Low" : 759.659973, "Close" : 759.659973, "Volume" : 1812200, "Adj_close" : 759.659973 } } ] } } 查看所有index thinkt@linux-pw37:~> curl -XGET 'http://192.168.56.101:9200/_cat/indices?v' health status index pri rep docs.count docs.deleted store.size pri.store.size yellow open logstash-2016.03.18 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.03.17 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.03.16 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.03.15 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.06.07 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.06.08 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.06.09 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.08.31 5 1 1 0 8kb 8kb yellow open logstash-2016.09.01 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.08.30 5 1 1 0 8kb 8kb yellow open logstash-2016.03.21 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.06.14 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.09.08 5 1 1 0 8kb 8kb yellow open logstash-2016.06.15 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.09.09 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.06.16 5 1 1 0 7.9kb 7.9kb yellow open logstash-2016.09.06 5 1 1 0 7.9kb 7.9kb 查看集群中所有nodes thinkt@linux-pw37:~> curl -XGET 'http://192.168.56.101:9200/_cat/nodes?v' host ip heap.percent ram.percent load node.role master name 10.0.2.15 10.0.2.15 13 56 0.00 d * node-1 logstash 的elasticsearch 插件会自动创建index kibana4特性: 搜索关键字高亮 聚合类型:桶,度量 可脚本化的字段 动态展示 kibana的主项: discover,visualize,dashboard,settings discover的search box搜索记录默认最多显示500条index documents time filter支持quick,absolute,relative三种时间过滤方式,并支持定义自动刷新间隔,也可以使用histogram直方图拖动选择时间。 查询语法使用lucene语法 Lucene n. Lucene是一个非常优秀的开源的全文搜索引擎; 我们可以在它的上面开发出各种全文搜索的应用来。Lucene在国外有很高的知名度; 现在已经是Apache的顶级项目; 在国内; 搜索方式:search box 文本查询,field查询 visualize,dashboard 阻止数据丢失 logs > borker(redis,rabbit mq,amqp,zeroMQ) > logstash > elasticsearch > kibana > nginx 加固数据访问 elasticsearch,kibana使用SSL认证访问elasticsearch browser-(ssl_key_file,ssl_cert_file)->kibana->elasticsearch Elasticsearch shield(收费) Search guard(free) 系统伸缩性 horizontally scalable fast,quick,realtime inexpensive便宜的 flexable弹性灵活的 用户量及支持力度 开源的 数据保留策略 elasticsearch curator管理indeices

优秀的个人博客,低调大师

Hbase 学习(十) HBase Snapshots

HBase Snapshots允许你对一个表进行快照(即可用副本),它不会对Region Servers产生很大的影响,它进行复制和 恢复操作的时候不包括数据拷贝。导出快照到另外的集群也不会对Region Servers产生影响。 下面告诉你如何使用Snapshots功能。 1. 开启快照支持功能,在0.95+之后的版本都是默认开启的,在0.94.6+是默认关闭。 <property> <name>hbase.snapshot.enabled</name> <value>true</value> </property>2. 给表建立快照,不管表是启用或者禁用状态,这个操作不会进行数据拷贝。 $ ./bin/hbase shell hbase> snapshot 'myTable', 'myTableSnapshot-122112'3. 列出已经存在的快照 $ ./bin/hbase shell hbase> list_snapshots4. 删除快照 $ ./bin/hbase shell hbase> delete_snapshot 'myTableSnapshot-122112' 5. 从快照复制生成一个新表 $ ./bin/hbase shell hbase> clone_snapshot 'myTableSnapshot-122112', 'myNewTestTable' 6. 用快照恢复数据,它需要先禁用表,再进行恢复 $ ./bin/hbase shell hbase> disable 'myTable' hbase> restore_snapshot 'myTableSnapshot-122112' 提示:因为备份(replication)是系统日志级别的,而快照是文件系统级别的,当使用快照恢复之后,副本会和master出于不同的状态,如果你需要使用恢复的话,你要停止备份,并且重置bootstrap。 如果是因为不正确的客户端行为导致数据丢失,全表恢复又需要表被禁用,可以采用快照生成一个新表,然后从新表中把需要的数据用map-reduce拷贝到主表当中。 7. 复制到别的集群当中 该操作要用hbase的账户执行,并且在hdfs当中要有hbase的账户建立的临时目(hbase.tmp.dir参数控制),采用16个mappers来把一个名为MySnapshot的快照复制到一个名为srv2的集群当中。 $ bin/hbase class org.apache.hadoop.hbase.snapshot.tool.ExportSnapshot -snapshot MySnapshot -copy-to hdfs://srv2:8020/hbase -mappers 16

优秀的个人博客,低调大师

Hbase 学习(二)各种filter

各种filter 今天的主题是 Filter,hbase客户端查询的时候,自定义查询filter。 直接上例子吧,不多说别的了,第一个例子是RowFilter的。 Scan scan = new Scan(); scan.addColumn(Bytes.toBytes("colfam1"), Bytes.toBytes("col-0")); Filter filter1 = new RowFilter(CompareFilter.CompareOp.LESS_OR_EQUAL, new BinaryComparator(Bytes.toBytes("row-22"))); scan.setFilter(filter1); ResultScanner scanner1 = table.getScanner(scan); for (Result res : scanner1) { System.out.println(res); } scanner1.close(); Filter filter2 = new RowFilter(CompareFilter.CompareOp.EQUAL, new RegexStringComparator(".*-.5")); scan.setFilter(filter2); ResultScanner scanner2 = table.getScanner(scan); for (Result res : scanner2) { System.out.println(res); } scanner2.close(); Filter filter3 = new RowFilter(CompareFilter.CompareOp.EQUAL, new SubstringComparator("-5")); scan.setFilter(filter3); ResultScanner scanner3 = table.getScanner(scan); for (Result res : scanner3) { System.out.println(res); } scanner3.close();第二个例子是 QualifierFilter的 Filter filter = new QualifierFilter(CompareFilter.CompareOp.LESS_OR_EQUAL, new BinaryComparator(Bytes.toBytes("col-2"))); Scan scan = new Scan(); scan.setFilter(filter); ResultScanner scanner = table.getScanner(scan); for (Result result : scanner) { System.out.println(result); } scanner.close(); Get get = new Get(Bytes.toBytes("row-5")); get.setFilter(filter); Result result = table.get(get);第三个例子是 ValueFilter Filter filter = new ValueFilter(CompareFilter.CompareOp.EQUAL, new SubstringComparator(".4")); Scan scan = new Scan(); scan.setFilter(filter); ResultScanner scanner = table.getScanner(scan); for (Result result : scanner) { for (KeyValue kv : result.raw()) { System.out.println("KV: " + kv + ", Value: " + Bytes.toString(kv.getValue())); } } scanner.close(); Get get = new Get(Bytes.toBytes("row-5")); get.setFilter(filter); Result result = table.get(get); for (KeyValue kv : result.raw()) { System.out.println("KV: " + kv + ", Value: " + Bytes.toString(kv.getValue())); }第四个例子是 PageFilter,分页的filter Filter filter = new PageFilter(15); int totalRows = 0; byte[] lastRow = null; while (true) { Scan scan = new Scan(); scan.setFilter(filter); if (lastRow != null) { byte[] startRow = Bytes.add(lastRow, POSTFIX); System.out.println("start row: " +Bytes.toStringBinary(startRow)); scan.setStartRow(startRow); } ResultScanner scanner = table.getScanner(scan); int localRows = 0; Result result; while ((result = scanner.next()) != null) { System.out.println(localRows++ + ": " + result); totalRows++; lastRow = result.getRow(); } scanner.close(); if (localRows == 0) break; } System.out.println("total rows: " + totalRows);第五个例子是 InclusiveStopFilter,它是什么意思呢,就是扫描到某个rowkey就停止,下面的例子是从row-3开始扫描,一直扫描到row-5结束。 Filter filter = new InclusiveStopFilter(Bytes.toBytes("row-5")); Scan scan = new Scan(); scan.setStartRow(Bytes.toBytes("row-3")); scan.setFilter(filter); ResultScanner scanner = table.getScanner(scan); for (Result result : scanner) { System.out.println(result); } scanner.close();第六个 SingleColumnValueFilter,这个是我们最常用的filter,我觉得很好用。 SingleColumnValueFilter filter = new SingleColumnValueFilter(Bytes.toBytes("colfam1"), Bytes.toBytes("col-5"), CompareFilter.CompareOp.NOT_EQUAL, new SubstringComparator("val-5")); filter.setFilterIfMissing(true); Scan scan = new Scan(); scan.setFilter(filter); ResultScanner scanner = table.getScanner(scan); for (Result result : scanner) { for (KeyValue kv : result.raw()) { System.out.println("KV: " + kv + ", Value: " + Bytes.toString(kv.getValue())); } } scanner.close(); Get get = new Get(Bytes.toBytes("row-6")); get.setFilter(filter); Result result = table.get(get); System.out.println("Result of get: "); for (KeyValue kv : result.raw()) { System.out.println("KV: " + kv + ", Value: " + Bytes.toString(kv.getValue())); }第七个 FilterList,它有两个选项,需要全部通过,还是一个通过就行,MUST_PASS_ALL,MUST_PASS_ONE。 public class CustomFilter extends FilterBase { private byte[] value = null; private boolean filterRow = true; public CustomFilter() { super(); } public CustomFilter(byte[] value) { this.value = value; } @Override public void reset() { this.filterRow = true; } @Override public ReturnCode filterKeyValue(KeyValue kv) { if (Bytes.compareTo(value, kv.getValue()) == 0) { filterRow = false; } return ReturnCode.INCLUDE; } @Override public boolean filterRow() { return filterRow; } @Override public void write(DataOutput dataOutput) throws IOException { Bytes.writeByteArray(dataOutput, this.value); } @Override public void readFields(DataInput dataInput) throws IOException { this.value = Bytes.readByteArray(dataInput); } }这里要讲的是 自定义filter,从FilterBase继承。 public class CustomFilter extends FilterBase { private byte[] value = null; private boolean filterRow = true; public CustomFilter() { super(); } public CustomFilter(byte[] value) { this.value = value; } @Override public void reset() { this.filterRow = true; } @Override public ReturnCode filterKeyValue(KeyValue kv) { if (Bytes.compareTo(value, kv.getValue()) == 0) { filterRow = false; } return ReturnCode.INCLUDE; } @Override public boolean filterRow() { return filterRow; } @Override public void write(DataOutput dataOutput) throws IOException { Bytes.writeByteArray(dataOutput, this.value); } @Override public void readFields(DataInput dataInput) throws IOException { this.value = Bytes.readByteArray(dataInput); } } 然后打成jar包,要在hbase-env.sh中指明路径。 export HBASE_CLASSPATH="/hbase/target/hbase-customfilter.jar",然后就可以在客户端中使用它了。

优秀的个人博客,低调大师

Hbase 学习(五) 调优

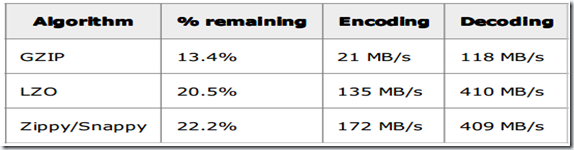
1.垃圾回收器调优 当我们往hbase写入数据,它首先写入memstore当中,当menstore的值大于hbase.hregion.memstore.flush.size参数中设置的值后,就会写入硬盘。 在hbase-env.sh文件中,我们可以设置HBASE_OPTS或者HBASE_REGIONSERVER_OPTS,后者只影响region server进程。 export HBASE_REGIONSERVER_OPTS="-Xmx8g -Xms8g -Xmn128m -XX:+UseParNewGC -XX:+UseConcMarkSweepGC -XX:CMSInitiatingOccupancyFraction=70 -verbose:gc -XX:+PrintGCDetails -XX:+PrintGCTimeStamps -Xloggc:$HBASE_HOME/logs/gc-$(hostname)-hbase.log" 《hbase权威指南》推荐了上述的写法,下面是从网上搜的,原书中为什么要这么设置的解释真心看不懂。 -Xmx8g -Xms8g –Xmn128m :最大堆内存8G,最小堆内存8G,新生代内存-Xmn128m。 -XX:+UseParNewGC : 设置对于新生代的垃圾回收器类型,这种类型是会停止JAVA进程,然后再进行回收的,但由于新生代体积比较小,持续时间通常只有几毫秒,因此可以接受。 -XX:+UseConcMarkSweepGC :设置老生代的垃圾回收类型,如果用新生代的那个会不合适,即会导致JAVA进程停止的时间太长,用这种不会停止JAVA进程,而是在JAVA进程运行的同时,并行的进行回收。 -XX:CMSInitiatingOccupancyFraction :设置CMS回收器运行的频率,避免前两个参数引起JAVA进程长时间停止,设置了这个之后,不需要停止JAVA进程,但是会提高CPU使用率。 最后两句是输出详细的日志。 2.MemStore-Local Allocation Buffer MemStore-Local Allocation Buffer,是Cloudera在HBase 0.90.1时提交的一个patch里包含的特性。它基于Arena Allocation解决了HBase因Region flush导致的内存碎片问题。 MSLAB的实现原理(对照Arena Allocation,HBase实现细节): MemstoreLAB为Memstore提供Allocator。 创建一个2M(默认)的Chunk数组和一个chunk偏移量,默认值为0。 当Memstore有新的KeyValue被插入时,通过KeyValue.getBuffer()取得data bytes数组。将data复制到Chunk数组起始位置为chunk偏移量处,并增加偏移量=偏移量+data.length。 当一个chunk满了以后,再创建一个chunk。 所有操作lock free,基于CMS原语。 优势: KeyValue原始数据在minor gc时被销毁。 数据存放在2m大小的chunk中,chunk归属于memstore。 flush时,只需要释放多个2m的chunks,chunk未满也强制释放,从而为Heap腾出了多个2M大小的内存区间,减少碎片密集程度。 开启MSLAB hbase.hregion.memstore.mslab.enabled=true // 开启MSALB hbase.hregion.memstore.mslab.chunksize=2m // chunk的大小,越大内存连续性越好,但内存平均利用率会降低,要比插入的单元格的数据大一些。 hbase.hregion.memstore.mslab.max.allocation=256K // 通过MSLAB分配的对象不能超过256K,否则直接在Heap上分配,256K够大了。 3.压缩存储 直接上图吧,说多了没用。 推荐使用Snappy,性能最好,但是Snappy要单独安装,安装教程等我装成功了,再发一个文档出来吧。 4.优化Splits and Compactions 对于实时性要求稳定的系统来说,不定时的split和compact会使集群的响应时间出现比较大的波动,因此建议把split和compact关闭,手动进行操作,比如我们把hbase.hregion.max.filesize设置成100G(major compaction大概需要一小时,设置太大了,compaction会需要更多的时间),major compaction是必须要做的,群里有个网友给数据设置了过期时间,数据被逻辑删除了,但是没有释放硬盘空间,why?没有进行major compaction,最后是手动进行的合并。 5.平衡分布 在我们设计rowkey的时候,在前面加上随机数,比如0rowkey-1,1rowkey-2,0rowkey-3,1rowkey-4,去前面加上个随机数,就会有负载均衡的效果,但是如果这样做了,某个机器的数据还是比别的机器要多很多,这个怎么办呢?我们可以手动调用move()方法,通过shell或者HBaseAdmin类,或者调用unassign()方法,数据就会转移了。

优秀的个人博客,低调大师

Hbase 学习(七) rowkey设计

一直以来对rowkey的设计都比较迷茫,《hbase权威指南》倒是给出了个还算靠谱的例子。 下面这个例子有点儿像帖子表结构,它的rowkey设计是这样的,可以简单的理解为,什么人在什么时间发了什么信息,信息包括什么附件,它是用户为主线的一个设计。 <userId>-<date>-<messageId>-<attachmentId> 如果我们想查某个用户发的信息,我们可以设置scan的start rowkey 为该userId,end rowkey为userId+1即可。 当我们要查某个用户某天发了什么信息,我们可以使用<userId>-<date>来搜索该用户所有的帖子。 当我们要查某个具体的帖子的内容,rowkey过滤<userId>-<date>-<messageId>即可。 所以rowkey的设计是要看具体的应用的。 上面这个例子没有考虑热点的问题,实际上每个用户的帖子被访问的热度是不一样的,有些帖子被大量访问,有的无人问津。 那怎么办呢?有的书上写,在前面加0-n的随机数,random % 机器数 。但是这样子的话,以后你想取某个用户的userId的时候只能开多线程去访问了,因为你不能逆推出来它的rowkey。在和支付宝的工程狮聊了一下,他们是这样处理的取md5(userId)的前4位+reverse(userId)这个样子来处理userId,这样子的话,能解决热点的问题,也可以逆推出来rowkey。

优秀的个人博客,低调大师

MapReduce编程实现学习

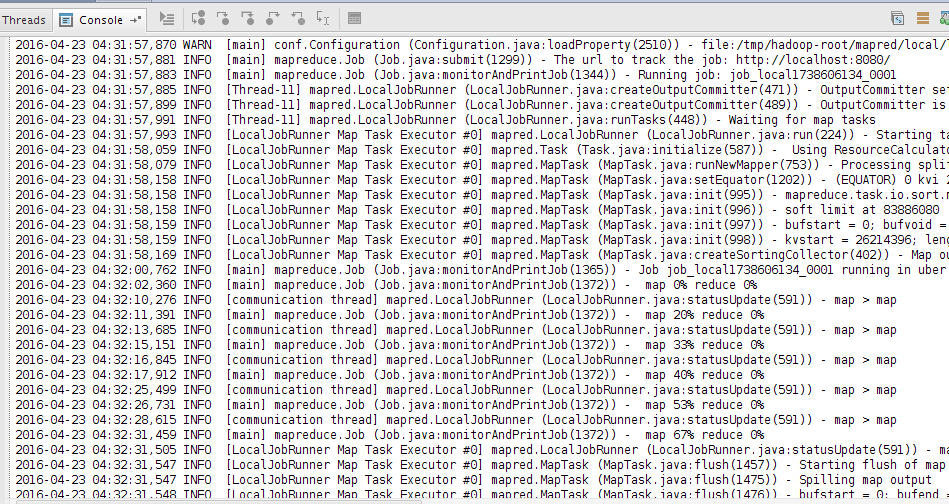
MapReduce主要包括两个阶段:一个是Map,一个是Reduce. 每一步都有key-value对作为输入和输出。 Map阶段的key-value对的格式是由输入的格式决定的,如果是默认的TextInputFormat,则每行作为一个记录进程处理,其中key为此行的开头相对文件的起始位置,value就是此行的字符文本。Map阶段的输出的key-value对的格式必须同reduce阶段的输入key-value对的格式相对应。 下面开始尝试,假设我们需要处理一批有关天气的数据,其格式如下:按照ASCII码存储,每行一条记录每一行字符从0开始计数,第15个到第18个字符为年第25个到第29个字符为温度,其中第25位是符号+/- Text文本样例: 0067011990999991950051507+0000+ 0043011990999991950051512+0022+ 0043011990999991950051518-0011+ 0043012650999991949032412+0111+ 0043012650999991949032418+0078+ 0067011990999991937051507+0001+ 0043011990999991937051512-0002+ 0043011990999991945051518+0001+ 0043012650999991945032412+0002+ 0043012650999991945032418+0078+ 上代码啦: package Hadoop; import java.io.IOException; import java.util.StringTokenizer; import org.apache.hadoop.conf.Configured; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.IntWritable; import org.apache.hadoop.io.LongWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.mapreduce.Mapper; import org.apache.hadoop.mapreduce.Reducer; import org.apache.hadoop.mapreduce.Reducer.Context; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.input.TextInputFormat; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat; import org.apache.hadoop.util.Tool; import org.apache.hadoop.util.ToolRunner; import java.io.IOException; import java.util.StringTokenizer; /** * Created by root on 4/23/16. */ public class hadoopTest extends Configured implements Tool{ //map将输入中的value复制到输出数据的key上,并直接输出 public static class Map extends Mapper<LongWritable, Text, Text, IntWritable> { //实现map函数 @Override public void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException { String line = value.toString(); String year = line.substring(15, 19); int airTemperature; if (line.charAt(25) == '+') { airTemperature = Integer.parseInt(line.substring(26, 30)); } else { airTemperature = Integer.parseInt(line.substring(25, 30)); } context.write(new Text(year), new IntWritable(airTemperature)); } } //reduce将输入中的key复制到输出数据的key上,并直接输出 public static class Reduce extends Reducer<Text, IntWritable, Text, IntWritable> { public void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException { int maxValue = Integer.MIN_VALUE; for (IntWritable sorce : values) { maxValue = Math.max(maxValue, sorce.get()); } context.write(key, new IntWritable(maxValue)); } } @Override public int run(String[] arg0) throws Exception { //这里测试用,传入的路径直接赋值 String InputParths = "/usr/local/hadooptext.txt"; String OutputPath = "/usr/local/hadoopOut"; //声明一个job对象,这里的getConf是获取hadoop的配置信息,需要继承Configured. Job job = new Job(getConf()); //设置job名称 job.setJobName("AvgSorce"); //设置mapper输出的key-value对的格式 job.setOutputKeyClass(Text.class); //设置Mapper,默认为IdentityMapper,这里设置的代码中的Mapper job.setMapperClass(hadoopTest.Map.class); //Combiner可以理解为小的Reducer,为了降低网络传输负载和后续Reducer的计算压力 可以单独写一个方法进行调用 job.setCombinerClass(Reduce.class); //设置reduce输出的key-value对的格式 job.setOutputValueClass(IntWritable.class); //设置输入格式 job.setInputFormatClass(TextInputFormat.class); //设置输入输出目录 FileInputFormat.setInputPaths(job, new Path(InputParths)); FileOutputFormat.setOutputPath(job, new Path(OutputPath)); boolean success = job.waitForCompletion(true); return success ? 0 : 1; } public static void main(String[] args) throws Exception { int ret = ToolRunner.run(new hadoopTest(), args); System.exit(ret); } } Map函数继承自MapReduceBase,它实现了Mapper接口,此接口是一个范型类型,它有4种形式的参数,分别用来指定map的输入key值类型、输入value值类型、输出key值类型和输出value值类型。这里使用的是TextInputFormat,它的输出key值是LongWritable类型,输出value是Text类型。因为需要输出<word,1>形式,因此输出的key值类型是Text,输出的value值类型是IntWritable InputFormat()和inputSplit InputSplit是Hadoop定义的用来传输给每个单独的map的数据,InputSplit存储的并非数据本身,而是一个分片长度和一个记录数据位置的数组。生成InputSplit的方法可以通过InputFormat()来设置。当数据传输给map时,map会将输入分片传送到InputFormat上,InputFormat调用getRecordReader()方法生成RecordReader,RecordReader再通过creatKey()、creatValue()方法创建可供map处理的<key,value>对,即<k1,v1>,InputFormat()方法是用来生成可供map处理的<key,value>对的。 TextInputFormat是Hadoop默认的输入方法,在TextInputFormat中,每个文件都会单独地作为map的输入,而这是继承自FileInputFormat的,之后,每行数据都会生成一条记录,每条记录则表示成<key,value>形式。 这里的key是每个数据的记录在数据分片中的字节偏移量,数据类型是LongWritable. value值是每行的内容,数据类型是Text. 执行结果:

优秀的个人博客,低调大师

hadoop学习笔记--集群搭建

注:大家常说的ssh其实就是一个免密码访问的东西,为了简化操作的,不用每次访问其他节点重新输入密码。但是要想配置如下: 1.在每台机器上执行 ssh-keygen -t rsa,连敲三次回车键(即设置空密码) 2.然后在每台机器上都执行cd ~/.ssh,并分别把id_rsa.pub复制到authorized_keys中, 即执行 cp id_rsa.pub authorized_keys 3.然后分别把slave0,slave1的authorized_keys都复制到master主节点的authorized_keys中, 即分别在两个从节点slave0和slave1中执行 ssh-copy-id -i master 4.再分别复制到slave0,slave1中(即每一个节点的authorized_keys中都有这三个节点的密钥) 即在主节点master上执行 scp -r ~/.ssh/authorized_keys slave0:~/.ssh/ scp -r ~/.ssh/authorized_keys slave1:~/.ssh/ 此时成功。 简单测试:比如说在master上执行ssh slave0,这时候发现不需要输入密码即可转 到slave0从节点上,这时成功 hadoop-0.20.2的配置文件 hadoop-0.20.0的配置文件: core-site.xml <property> <name>fs.default.name</name> <value>hdfs://cMaster:9000</value> </property> <property> <name>hadoop.tmp.dir</name> <value>/home/joe/cloudData</value> </property> hdfs-site.xml <property> <name>dfs.name.dir</name> <value>/home/joe/hdfs/name</value> </property> <property> <name>dfs.data.dir</name> <value>/home/joe/hdfs/data</value> </property> <property> <name>dfs.replication</name> <value>1</value> </property> mapred-site.xml <property> <name>mapred.job.tracker</name> <value>cMaster:9001</value> </property> hadoop-0.20.2集群操作命令: hadoop-0.20.2的集群操作命令 上传本地文件至hdfs:[rio@cMaster hadoop-0.20.2]#bin/hadoop dfs -put /home/rio/input/* /in 用WordCount计算数据:[rio@cMaster hadoop-2.2.0]#bin/hadoop jar hadoop-0.20.2-examples.jar wordcount /in /out/wc-01 hadoop-2.2.0的配置文件: hadoop-2.2.0的配置文件: core-site.xml <property> <name>fs.defaultFS</name> <value>hdfs://cMaster:8020</value> </property> <property> <name>hadoop.tmp.dir</name> <value>/home/joe/cloudData</value> </property> yarn-site.xml <property> <name>yarn.resourcemanager.hostname</name> <value>cMaster</value> </property> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> mapred-site.xml(注:将mapred-site.xml.template重命名为mapred-site.xml) <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> hadoop-2.2.0进程启动命令: 启动(或关闭)全部服务:[rio@cMaster hadoop-2.2.0]#sbin/start-all.sh [rio@cMaster hadoop-2.2.0]#sbin/stop-all.sh 格式化主节点:[rio@cMaster hadoop-2.2.0]#bin/hdfs namenode -format(注:仅格式化一次) 启动主节点上的namenode:[rio@cMaster hadoop-2.2.0]#sbin/hadoop-daemon.sh start namenode 启动主节点上的resourcemanager:[rio@cMaster hadoop-2.2.0]#sbin/yarn-daemon.sh start resourcemanager 启动从节点上的datanode:[rio@cMaster hadoop-2.2.0]#sbin/hadoop-daemon.sh start datanode 启动从节点上的nodemanager:[rio@cMaster hadoop-2.2.0]#sbin/yarn-daemon.sh start nodemanager 启动日志历史查询:[rio@cMaster hadoop-2.2.0]#sbin/mr-jobhistory-daemon.sh start historyserver 查看服务是否启动:[rio@cMaster hadoop-2.2.0]#/usr/java/jdk1.8.0_71/bin/jps hadoop-2.2.0集群操作命令: 创建目录:[rio@cMaster hadoop-2.2.0]#bin/hdfs dfs -mkidr /in 删除文件及目录:[rio@cMaster hadoop-2.2.0]#bin/hdfs dfs -rmr /out/input 上传本地文件至hdfs:[rio@cMaster hadoop-2.2.0]#bin/hdfs dfs -put /home/rio/input/* /in 查看hdfs里的文件:[rio@cMaster hadoop-2.2.0]#bin/hdfs dfs -cat /in/* [rio@cMaster hadoop-2.2.0]#bin/hdfs dfs -cat /out/wc-01/* 用WordCount计算数据:[rio@cMaster hadoop-2.2.0]#bin/hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-example-2.2.0.jar wordcount /in /out/wc-01 当神已无能为力,那便是魔渡众生

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册