首页 文章 精选 留言 我的

精选列表

搜索[监督学习],共10000篇文章
优秀的个人博客,低调大师

Dockerfile学习And构建Hexo镜像

原文链接: http://yangbingdong.com/2017/note-of-dockefile-and-build-hexo-docker-image/ Preface 制作一个镜像可以使用docker commit和定制Dockerfile,但推荐的是写Dockerfile。 因为docker commit是一个暗箱操作,除了制作镜像的人知道执行过什么命令、怎么生成的镜像,别人根本无从得知,而且会加入一些没用的操作导致镜像臃肿。 此篇记录构建Hexo的镜像踩坑~ Build Images 首先在当前空目录创建一个Dockerfile: FROM ubuntu:latest ENV BLOG_PATH /root/blog ENV NODE_VERSION 6 MAINTAINER yangbingdong <yangbingdong1994@gmail.com> RUN \ apt-get update -y && \ apt-get install -y git curl libpng-dev && \ curl -sL https://deb.nodesource.com/setup_$NODE_VERSION.x | bash - && \ apt-get install -y nodejs && \ apt-get clean && \ apt-get autoclean && \ rm -rf /var/lib/apt/lists/* /tmp/* /var/tmp/* && \ npm install -g hexo-cli WORKDIR $BLOG_PATH VOLUME ["$BLOG_PATH", "/root/.ssh"] EXPOSE 4000 CMD ['/bin/bash'] 然后在当前目录打开终端: docker build -t <repo-name>/<image-name>:<tag> . 其中<repo-name>表示仓库名,与远程仓库(如docker hub)名字要一致,<tag>表示标签,不给默认latest,都是可选项,例如可以写成这样: docker build -t <image-name> . 看到Successfully built就表示构建成功了 注意docker build 命令最后有一个 .表示构建的上下文,镜像构建需要把上下文的东西上传到Docker引擎去构建。 Dockerfile 指令 From 指定基础镜像 所谓定制镜像,那一定是以一个镜像为基础,在其上进行定制。而 FROM 就是指定基础镜像,因此一个 Dockerfile 中 FROM 是必备的指令,并且必须是第一条指令。 在 Docker Hub上有非常多的高质量的官方镜像, 有可以直接拿来使用的服务类的镜像,如 nginx、redis、mongo、mysql、httpd、php、tomcat 等; 也有一些方便开发、构建、运行各种语言应用的镜像,如 node、openjdk、python、ruby、golang 等。 可以在其中寻找一个最符合我们最终目标的镜像为基础镜像进行定制。 如果没有找到对应服务的镜像,官方镜像中还提供了一些更为基础的操作系统镜像,如 ubuntu、debian、centos、fedora、alpine 等,这些操作系统的软件库为我们提供了更广阔的扩展空间。 除了选择现有镜像为基础镜像外,Docker 还存在一个特殊的镜像,名为 scratch。这个镜像是虚拟的概念,并不实际存在,它表示一个空白的镜像。 RUN 执行命令 RUN 指令是用来执行命令行命令的。由于命令行的强大能力,RUN 指令在定制镜像时是最常用的指令之一。其格式有两种: shell 格式:RUN <命令>,就像直接在命令行中输入的命令一样。刚才写的 Dockrfile 中的 RUN 指令就是这种格式。 RUN echo '<h1>Hello, Docker!</h1>' > /usr/share/nginx/html/index.html exec 格式:RUN ["可执行文件", "参数1", "参数2"],这更像是函数调用中的格式。 注意: RUN命令尽量精简,也就是像上面一样一个RUN(使用$$ \),如果分开写很多个RUN会导致镜像铺了很多层从而臃肿。 RUN最后记住清理掉没用的垃圾,很多人初学 Docker 制作出了很臃肿的镜像的原因之一,就是忘记了每一层构建的最后一定要清理掉无关文件。 COPY 复制文件 格式: COPY <源路径>... <目标路径> COPY ["<源路径1>",... "<目标路径>"] 和 RUN 指令一样,也有两种格式,一种类似于命令行,一种类似于函数调用。 COPY 指令将从构建上下文目录中 <源路径> 的文件/目录复制到新的一层的镜像内的 <目标路径> 位置。比如: COPY package.json /usr/src/app/ ADD 更高级的复制文件 ADD 指令和 COPY 的格式和性质基本一致。但是在 COPY 基础上增加了一些功能。 比如 <源路径> 可以是一个 URL,这种情况下,Docker 引擎会试图去下载这个链接的文件放到 <目标路径> 去。下载后的文件权限自动设置为 600,如果这并不是想要的权限,那么还需要增加额外的一层 RUN进行权限调整,另外,如果下载的是个压缩包,需要解压缩,也一样还需要额外的一层 RUN 指令进行解压缩。所以不如直接使用 RUN 指令,然后使用 wget 或者 curl 工具下载,处理权限、解压缩、然后清理无用文件更合理。因此,这个功能其实并不实用,而且不推荐使用。 如果 <源路径> 为一个 tar 压缩文件的话,压缩格式为 gzip, bzip2 以及 xz 的情况下,ADD 指令将会自动解压缩这个压缩文件到 <目标路径> 去。 在某些情况下,这个自动解压缩的功能非常有用,比如官方镜像 ubuntu 中: FROM scratch ADD ubuntu-xenial-core-cloudimg-amd64-root.tar.gz / ... 但在某些情况下,如果我们真的是希望复制个压缩文件进去,而不解压缩,这时就不可以使用 ADD 命令了。 在 Docker 官方的最佳实践文档中要求,尽可能的使用 COPY,因为 COPY 的语义很明确,就是复制文件而已,而 ADD 则包含了更复杂的功能,其行为也不一定很清晰。最适合使用 ADD 的场合,就是所提及的需要自动解压缩的场合。 另外需要注意的是,ADD 指令会令镜像构建缓存失效,从而可能会令镜像构建变得比较缓慢。 因此在 COPY 和 ADD 指令中选择的时候,可以遵循这样的原则,所有的文件复制均使用 COPY 指令,仅在需要自动解压缩的场合使用 ADD。 CMD 容器启动命令 CMD 指令就是用于指定默认的容器主进程的启动命令的。 CMD 指令的格式和 RUN 相似,也是两种格式: shell 格式:CMD <命令> exec 格式:CMD ["可执行文件", "参数1", "参数2"...] 参数列表格式:CMD ["参数1", "参数2"...]。在指定了 ENTRYPOINT 指令后,用 CMD 指定具体的参数。 在运行时可以指定新的命令来替代镜像设置中的这个默认命令,比如,ubuntu 镜像默认的 CMD 是 /bin/bash,如果我们直接 docker run -it ubuntu 的话,会直接进入 bash。我们也可以在运行时指定运行别的命令,如 docker run -it ubuntu cat /etc/os-release。这就是用 cat /etc/os-release 命令替换了默认的 /bin/bash 命令了,输出了系统版本信息。 在指令格式上,一般推荐使用 exec 格式,这类格式在解析时会被解析为 JSON 数组,因此一定要使用双引号 ",而不要使用单引号。 如果使用 shell 格式的话,实际的命令会被包装为 sh -c 的参数的形式进行执行。比如: CMD echo $HOME 在实际执行中,会将其变更为: CMD [ "sh", "-c", "echo $HOME" ] 所以如果使用shell格式会导致容器莫名退出,因为实际上执行的事sh命令,而sh命令执行完时候容器也就没有存在的意义。 ENTRYPOINT 入口点 ENTRYPOINT 的格式和 RUN 指令格式一样,分为 exec 格式和 shell 格式。 ENTRYPOINT 的目的和 CMD 一样,都是在指定容器启动程序及参数。ENTRYPOINT 在运行时也可以替代,不过比 CMD 要略显繁琐,需要通过 docker run 的参数 --entrypoint 来指定。 当指定了 ENTRYPOINT 后,CMD 的含义就发生了改变,不再是直接的运行其命令,而是将 CMD 的内容作为参数传给 ENTRYPOINT 指令,换句话说实际执行时,将变为: <ENTRYPOINT> "<CMD>" 这个指令非常有用,例如可以把命令后面的参数传进来或启动容器前准备一些环境然后执行启动命令(通过脚本exec "$@")。 ENV 设置环境变量 格式有两种: ENV <key> <value> ENV <key1>=<value1> <key2>=<value2>... 这个指令很简单,就是设置环境变量而已,无论是后面的其它指令,如 RUN,还是运行时的应用,都可以直接使用这里定义的环境变量。 ex: ENV NODE_VERSION 6 ... RUN curl -sL https://deb.nodesource.com/setup_$NODE_VERSION.x | bash - && \ ... ARG 构建参数 格式:ARG <参数名>[=<默认值>] 构建参数和 ENV 的效果一样,都是设置环境变量。所不同的是,ARG 所设置的构建环境的环境变量,在将来容器运行时是不会存在这些环境变量的。但是不要因此就使用 ARG 保存密码之类的信息,因为 docker history 还是可以看到所有值的。 Dockerfile 中的 ARG 指令是定义参数名称,以及定义其默认值。该默认值可以在构建命令 docker build 中用 --build-arg <参数名>=<值> 来覆盖。 在 1.13 之前的版本,要求 --build-arg 中的参数名,必须在 Dockerfile 中用 ARG 定义过了,换句话说,就是 --build-arg 指定的参数,必须在 Dockerfile 中使用了。如果对应参数没有被使用,则会报错退出构建。从 1.13 开始,这种严格的限制被放开,不再报错退出,而是显示警告信息,并继续构建。这对于使用 CI 系统,用同样的构建流程构建不同的 Dockerfile 的时候比较有帮助,避免构建命令必须根据每个 Dockerfile 的内容修改。 VOLUME 定义匿名卷 格式为: VOLUME ["<路径1>", "<路径2>"...] VOLUME <路径> 之前我们说过,容器运行时应该尽量保持容器存储层不发生写操作,对于数据库类需要保存动态数据的应用,其数据库文件应该保存于卷(volume)中,后面的章节我们会进一步介绍 Docker 卷的概念。为了防止运行时用户忘记将动态文件所保存目录挂载为卷,在 Dockerfile 中,我们可以事先指定某些目录挂载为匿名卷,这样在运行时如果用户不指定挂载,其应用也可以正常运行,不会向容器存储层写入大量数据。 VOLUME /data 这里的 /data 目录就会在运行时自动挂载为匿名卷,任何向 /data 中写入的信息都不会记录进容器存储层,从而保证了容器存储层的无状态化。当然,运行时可以覆盖这个挂载设置。比如: docker run -d -v mydata:/data xxxx 在这行命令中,就使用了 mydata 这个命名卷挂载到了 /data 这个位置,替代了 Dockerfile 中定义的匿名卷的挂载配置。 EXPOSE 声明端口 格式为 EXPOSE <端口1> [<端口2>...]。EXPOSE 指令是声明运行时容器提供服务端口,这只是一个声明,在运行时并不会因为这个声明应用就会开启这个端口的服务。在 Dockerfile 中写入这样的声明有两个好处,一个是帮助镜像使用者理解这个镜像服务的守护端口,以方便配置映射;另一个用处则是在运行时使用随机端口映射时,也就是 docker run -P时,会自动随机映射 EXPOSE 的端口。 此外,在早期 Docker 版本中还有一个特殊的用处。以前所有容器都运行于默认桥接网络中,因此所有容器互相之间都可以直接访问,这样存在一定的安全性问题。于是有了一个 Docker 引擎参数 --icc=false,当指定该参数后,容器间将默认无法互访,除非互相间使用了 --links 参数的容器才可以互通,并且只有镜像中 EXPOSE 所声明的端口才可以被访问。这个 --icc=false 的用法,在引入了 docker network后已经基本不用了,通过自定义网络可以很轻松的实现容器间的互联与隔离。 要将 EXPOSE 和在运行时使用 -p <宿主端口>:<容器端口> 区分开来。-p,是映射宿主端口和容器端口,换句话说,就是将容器的对应端口服务公开给外界访问,而 EXPOSE 仅仅是声明容器打算使用什么端口而已,并不会自动在宿主进行端口映射。 WORKDIR 指定工作目录 格式为 WORKDIR <工作目录路径>。 使用 WORKDIR 指令可以来指定工作目录(或者称为当前目录),以后各层的当前目录就被改为指定的目录,如该目录不存在,WORKDIR 会帮你建立目录。 之前提到一些初学者常犯的错误是把 Dockerfile 等同于 Shell 脚本来书写,这种错误的理解还可能会导致出现下面这样的错误: RUN cd /app RUN echo "hello" > world.txt 如果将这个 Dockerfile 进行构建镜像运行后,会发现找不到 /app/world.txt 文件,或者其内容不是 hello。原因其实很简单,在 Shell 中,连续两行是同一个进程执行环境,因此前一个命令修改的内存状态,会直接影响后一个命令;而在 Dockerfile 中,这两行 RUN 命令的执行环境根本不同,是两个完全不同的容器。这就是对 Dokerfile 构建分层存储的概念不了解所导致的错误。 之前说过每一个 RUN 都是启动一个容器、执行命令、然后提交存储层文件变更。第一层 RUN cd /app 的执行仅仅是当前进程的工作目录变更,一个内存上的变化而已,其结果不会造成任何文件变更。而到第二层的时候,启动的是一个全新的容器,跟第一层的容器更完全没关系,自然不可能继承前一层构建过程中的内存变化。 因此如果需要改变以后各层的工作目录的位置,那么应该使用 WORKDIR 指令。 USER 指定当前用户 格式:USER <用户名> USER 指令和 WORKDIR 相似,都是改变环境状态并影响以后的层。WORKDIR 是改变工作目录,USER则是改变之后层的执行 RUN, CMD 以及 ENTRYPOINT 这类命令的身份。 当然,和 WORKDIR 一样,USER 只是帮助你切换到指定用户而已,这个用户必须是事先建立好的,否则无法切换。 RUN groupadd -r redis && useradd -r -g redis redis USER redis RUN [ "redis-server" ] 踩坑 Dockerfile里也需要注意权限问题(nodejs7版本以上不能正常安装hexo,需要创建用户并制定权限去安装) 在docker容器里如果是root用户对挂载的文件进行了操作,那么实际上挂载文件的权限也变成了root的 使用attach进入容器,退出的时候容器也跟着退出了。。。囧 每一个RUN是一个新的shell su -之前在启动脚本加了-,导致环境变量以及工作目录都变了 Hexo-Docker 最后献上踩坑写的Hexo Dockerfile: # 使用Ubuntu官方镜像 FROM ubuntu:latest # 作者信息 MAINTAINER yangbingdong <yangbingdong1994@gmail.com> # 设置环境变量,使用${变量名}取值 ENV \ USER_NAME=hexo \ NODE_VERSION=8.5.0 \ NODE_DIR=/home/${USER_NAME}/nodejs # 需要执行的命令,使用 `$$ \` 分割多行多个命令 RUN \ # 安装基本的依赖以及工具 apt-get update -y && \ apt-get upgrade -y && \ apt-get install -y git && \ apt-get install -y curl && \ apt-get install -y libpng-dev && \ # 清理不必要的垃圾 apt-get clean && \ apt-get autoclean && \ rm -rf /var/lib/apt/lists/* /tmp/* /var/tmp/* && \ # 创建hexo用户去安装hexo useradd -m -U ${USER_NAME} && \ # 创建nodejs目录 mkdir ${NODE_DIR} && \ # 将nodejs下载解压到对应目录 curl -L https://nodejs.org/dist/v${NODE_VERSION}/node-v${NODE_VERSION}-linux-x64.tar.gz | tar xvzf - -C ${NODE_DIR} --strip-components=1 && \ # 把nodejs文件赋权给hexo用户 chown -R ${USER_NAME}.${USER_NAME} ${NODE_DIR} && \ # 把node相关命令软连接到/usr/local/bin目录下以便我们使用 ln -s ${NODE_DIR}/bin/node /usr/local/bin/node && \ ln -s ${NODE_DIR}/bin/npm /usr/local/bin/npm && \ # 以hexo用户身份安装hexo-cli su - ${USER_NAME} -c "npm install -g hexo-cli" && \ # 同样把hexo命令放到/usr/local/bin下 ln -s ${NODE_DIR}/bin/hexo /usr/local/bin/hexo && \ # 使用淘宝镜像 npm config set registry https://registry.npm.taobao.org/ # 切换到此目录 WORKDIR /home/${USER_NAME}/blog # 可以挂载进来的卷(文件夹) VOLUME ["/home/${USER_NAME}/blog", "/home/${USER_NAME}/.ssh"] # 暴露端口 EXPOSE 4000 # 把上下文中的docker-entrypoint.sh复制进来 COPY docker-entrypoint.sh /docker-entrypoint.sh # 执行脚本 ENTRYPOINT ["/docker-entrypoint.sh"] # 这个...鸡肋操作 CMD ['/bin/bash'] docker-entrypoint.sh : #!/bin/sh # 发生异常回滚 set -e # 设置git相关信息,不设置默认为博主的=.= GIT_USER_NAME=${GIT_USER_NAME:-yangbingdong} GIT_USER_MAIL=${GIT_USER_MAIL:-yangbingdong1994@gmail.com} # 你想要的用户名 NEW_USER_NAME=${NEW_USER_NAME:-ybd} # 由于每次启动容器都会执行这个脚本,但这个只需要执行一次,在此标志一下 if [ $(git config --system user.name)x = ${GIT_USER_NAME}x ] then su ${NEW_USER_NAME} else # 修改用户名 /usr/sbin/usermod -l ${NEW_USER_NAME} ${USER_NAME} /usr/sbin/usermod -c ${NEW_USER_NAME} ${NEW_USER_NAME} /usr/sbin/groupmod -n ${NEW_USER_NAME} ${USER_NAME} chown -R ${NEW_USER_NAME}.${NEW_USER_NAME} /home/${USER_NAME}/blog chmod -R 766 /home/${USER_NAME}/blog # 设置git全局信息 git config --system user.name $GIT_USER_NAME git config --system user.email $GIT_USER_MAIL su ${NEW_USER_NAME} fi # 执行脚本之后的命令 exec "$@" 源码:https://github.com/masteranthoneyd/docker-hexo Last 参考:Docker从入门到实践

优秀的个人博客,低调大师

Android Architecture Componets BasicSample学习

1.创建工程 所有模块依赖于Google,jencenter,maven仓库 allprojects { repositories { jcenter() maven { url 'https://maven.google.com' } mavenCentral() } } gradle版本:gradle-4.1-milestone-1-all gradle 的Android插件版本在3.0.0-beta7 distributionUrl=https\://services.gradle.org/distributions/gradle-4.1-milestone-1-all.zip classpath 'com.android.tools.build:gradle:3.0.0-alpha7' 工程根目录的gradle设置一些变量,表示模块依赖的框架的版本号,方便以后改动,例如 ext { buildToolsVersion = "26.0.1" supportLibVersion = "26.0.2" runnerVersion = "1.0.1" rulesVersion = "1.0.1" espressoVersion = "3.0.1" archLifecycleVersion = "1.0.0-alpha9" archRoomVersion = "1.0.0-alpha9" constrantLayoutVersion="1.0.2" } Module的gradle里 compile 'com.android.support:design:' + rootProject.supportLibVersion compile 'com.android.support:cardview-v7:' + rootProject.supportLibVersion compile 'com.android.support:recyclerview-v7:' + rootProject.supportLibVersion compile 'com.android.support.constraint:constraint-layout:' + rootProject.constrantLayoutVersion 需求分析,效果展示 这个应用就两个界面,打开应用进入首页,刚开始会加载产品数据,数据是从本地数据库查询而来,然后点击任意一项可以进入产品的详情页,详情页包含对产品的评论 效果展示 主目录 src主目录 db db目录 converter 里面放着一个日期转换器,用了TypeConverter注解 /** * 时间转换 * @param timestamp * @return Date */ @TypeConverter public static Date toDate(Long timestamp){ return timestamp==null?null:new Date(timestamp); } /** * 时间转换 * @param date * @return long */ @TypeConverter public static Long toTimestamp(Date date) { return date == null ? null : date.getTime(); } model 模型,里面都是接口,包含的都是获取数据实体成员的方法,它们都是抽象的。 例:一个Comment的,一个Product的 public interface Comment { int getId();//获取ID int getProductId();//获取产品ID String getText();//获取评论内容 Date getPostedAt();//获取发布时间 } public interface Product { int getId(); String getName(); String getDescription(); int getPrice(); } entity 这个数据库就两张表,一个使产品表,一个使评论表,所以分别对应着各自的实体类 例如一个产品的实体类,它是实现了model里的抽象方法 //Entity注解,设置表名为products @Entity(tableName = "products") public class ProductEntity implements Product{//实现了模型的抽象方法 @PrimaryKey private int id;//id 为主键 private String name;//产品名 private String description;//产品描述 private int price;//产品价格 @Override public String getDescription() { return description; } public void setDescription(String description) { this.description = description; } @Override public int getId() { return id; } public void setId(int id) { this.id = id; } @Override public String getName() { return name; } public void setName(String name) { this.name = name; } @Override public int getPrice() { return price; } public void setPrice(int price) { this.price = price; } public ProductEntity() { } public ProductEntity(Product product){ this.id=product.getId(); this.name=product.getName(); this.description=product.getDescription(); this.price=product.getPrice(); } } @Entity(tableName = "comments" ,foreignKeys = { @ForeignKey(entity = ProductEntity.class, parentColumns = "id", childColumns = "productId", onDelete = ForeignKey.CASCADE) },indices = { @Index(value = "productId") }) public class CommentEntity implements Comment{ @PrimaryKey(autoGenerate = true) private int id; private int productId; private String text; private Date postedAt; @Override public int getId() { return id; } public void setId(int id) { this.id = id; } @Override public int getProductId() { return productId; } public void setProductId(int productId) { this.productId = productId; } @Override public String getText() { return text; } public void setText(String text) { this.text = text; } @Override public Date getPostedAt() { return postedAt; } public void setPostedAt(Date postedAt) { this.postedAt = postedAt; } public CommentEntity() { } public CommentEntity(Comment comment) { this.id = comment.getId(); this.productId = comment.getProductId(); this.text = comment.getText(); this.postedAt = comment.getPostedAt(); } } dao 里面是各个表的操作接口,都是抽象的,很像Retrofit那个带注解的接口,只不过这里是操作数据库 @Dao public interface CommentDao { @Query("SELECT * FROM comments where productId = :productId") LiveData<List<CommentEntity>> loadComments(int productId); @Query("SELECT * FROM comments where productId = :productId") List<CommentEntity> loadCommentsSync(int productId); @Insert(onConflict = OnConflictStrategy.REPLACE) void insertAll(List<CommentEntity> products); } @Dao public interface ProductDao { @Query("SELECT * FROM products") LiveData<List<ProductEntity>> loadAllProducts(); @Insert(onConflict = OnConflictStrategy.REPLACE) void insertAll(List<ProductEntity> products); @Query("SELECT * FROM products WHERE id=:productId") LiveData<ProductEntity> loadProduct(int productId); @Query("SELECT * FROM products WHERE id =:productId") ProductEntity loadProductSync(int productId); } AppDatabase.java AppDatabase继承RoomDatabase,这个类的作用就是数据库类,通过这个对象可以获取各个表的Dao和数据库设置,@Database注解设置了实体类和数据库版本,@TypeConverters指定了类型转换,就是上面的日期转换,因为数据库没有Data这种类型,但可以用long表示 @Database(entities = {ProductEntity.class, CommentEntity.class},version = 1) @TypeConverters(DateConverter.class) public abstract class AppDataBase extends RoomDatabase { public static final String DATABASENAME="basesample-db";//数据库名 public abstract ProductDao productDao();//获取Dao public abstract CommentDao commentDao();//获取Dao } DatabaseCreator.java 这个是一个辅助类,也是一个单例,用于获取AppDatabase实例,因为很多地方都要用AppDatabase实例嘛,而且数据库还没创建啊,这个类设计到一些知识 实现单例 这里应该用的是双重检查锁,保证创建实例是也是在一个线程里创建 // For Singleton instantiation private static DatabaseCreator sInstance; private static final Object LOCK = new Object(); public synchronized static DatabaseCreator getInstance(Context context) { if (sInstance == null) { synchronized (LOCK) { if (sInstance == null) { sInstance = new DatabaseCreator(); } } } return sInstance; } 原子操作 这里用到了AtomicBoolean,原来看到这里我都很懵逼,后来查查资料,才知道这个叫原子操作,就是compareAndSet(boolean expect, boolean update)。 比较AtomicBoolean和expect的值,如果一致,执行方法内的语句。其实就是一个if语句 把AtomicBoolean的值设成update 这连个操作一气呵成,中间没有人能够阻止,这样的话可以进行多线程控制,比如这里的创建数据库,因为后期可能多个地方会用到creatDb方法,所以要保证数据库只能创建一次且只能在一个线程中创建,当然这里没用SharePreferences,所以这里的"数据库只能创建一次"是指在应用不被杀死的情况下。 private final MutableLiveData<Boolean> mIsDatabaseCreated = new MutableLiveData<>(); private AppDataBase mDb; private final AtomicBoolean mInitializing = new AtomicBoolean(true); public void createDb(Context context) { Log.d("DatabaseCreator", "Creating DB from " + Thread.currentThread().getName()); if (mInitializing.compareAndSet(false, true)) { return; // Already initializing 已经创建了数据库 } mIsDatabaseCreated.setValue(false);//开始创建数据库,观察这个数据可以显示loading new AsyncTask<Context,Void,Void>(){ @Override protected Void doInBackground(Context... contexts) { Log.d("DatabaseCreator", "Starting bg job " + Thread.currentThread().getName()); Context context = contexts[0].getApplicationContext(); // Reset the database to have new data on every run. context.deleteDatabase(DATABASENAME); AppDataBase db= Room.databaseBuilder(context.getApplicationContext(),AppDataBase.class, DATABASENAME).build(); addDelay(); // Add a delay to simulate a long-running operation模拟耗时操作 // Add some data to the database 加一些数据进去 DatabaseInitUtil.initializeDb(db); Log.d("DatabaseCreator", "DB was populated in thread " + Thread.currentThread().getName()); mDb=db; return null; } @Override protected void onPostExecute(Void aVoid) { mIsDatabaseCreated.setValue(true);//创建数据库完毕 Log.d(TAG, "onPostExecute:"); } }.execute(context.getApplicationContext()); } viewmodel viewmodel目录 viewmodel就是提供一个连接model和view的桥梁,只不过提供的是可被观察的数据对象,而且是liveData,可以判断观察者的状态进行通知.如下面的ProductListViewModel,mObservableProducts是一个LiveData,viewmodel获取它是通过database得到,但如果database未初始化的情况也要考虑,所以用了一个Transformations.switchMap(),就是在databaseCreator.isDatabaseCreated()这个liveData为FALSE时返回值为空的liveData,为True时返回database查询到的liveData,这里可能有点绕,但是慢慢想又觉得很妙,因为这个观察模式在一定的生命周期内一直生效,完全是响应式的。 public class ProductListViewModel extends AndroidViewModel{ private static final String TAG = "ProductListViewModel>>>"; private static final MutableLiveData ABSENT=new MutableLiveData(); { ABSENT.setValue(null); } private final LiveData<List<ProductEntity>> mObservableProducts; public ProductListViewModel(@Nullable Application application) { super(application); final DatabaseCreator databaseCreator=DatabaseCreator.getInstance(application); mObservableProducts= Transformations.switchMap(databaseCreator.isDatabaseCreated(), new Function<Boolean, LiveData<List<ProductEntity>>>() { @Override public LiveData<List<ProductEntity>> apply(Boolean input) { if (!Boolean.TRUE.equals(input)){ Log.d(TAG, "apply: 空数据!"); return ABSENT; }else { return databaseCreator.getDatabase().productDao().loadAllProducts(); } } }); databaseCreator.createDb(this.getApplication()); } public LiveData<List<ProductEntity>> getmObservableProducts() { return mObservableProducts; } }

优秀的个人博客,低调大师

MongoDB学习笔记(一)--基础

Insert MongoDB在执行插入时,首先会将插入的数据转换成BSON格式。然后MongoDB数据库会对BSON进行解剖,并检查是否存在_id建。 >doc = { "_id" : 1, "author" : "yyd", "title" : "MongoDB Test", "text" : "this is a test", "tags" : [ "love", "test" ], "comments" : [ { "author" : "yyd_guest", "comment" : "yes" }, { "author" : "yyd_admin", "comment" : "no" } ] } > db.yyd.insert(doc); Query 全部查找 返回除了 tags 字段外的所有字段 返回 tags = test 除了 comments 的所有列 返回 id=1 的 title 字段 <, <=, >, >= 大于 $gt、小于 $lt、大于等于 $gte、小于等于 $lte $all $all 操作类似$in 操作,但是不同的是,$all 操作要求数组里面的值全部被包含在返回的记录里面。 $exists $exists 操作检查一个字段是否存在。 $exists:true代表返回存在这个键的值。 $exists:false代表返回不存在这个键的值。 $mod > db.user.find("this._id%2==1"); > db.user.find({_id:{$mod:[2,1]}}); 两句话一样的效果。 $ne $ne 意思是 not equal,不等于。 $in $in 操作类似于传统关系数据库中的 IN。 $nin $nin 跟$in 操作相反。 $or $nor $nor 跟$or 相反。 $size $size 操作将会查询数组长度等于输入参数的数组。 skip 跳过前 2 条记录。 limit 每页返回 3 条记录 sort() sort()方法对返回记录集按照指定字段进行排序返回,1 表示升序,-1 表示降序。 count() count()方法返回查询记录的总数目。 Remove Update update() db.collection.update( criteria, objNew, upsert, multi ) 参数说明: Criteria:用于设置查询条件的对象 Objnew:用于设置更新内容的对象 Upsert:如果记录已经存在,更新它,否则新增一个记录 Multi:如果有多个符合条件的记录,全部更新 注意:默认情况下,只会更新第一个符合条件的记录 save() 如果存在更新它,如果不存在,新增记录。 $inc 增加1,对int等有效。 对一个_id=3 的 user 的年龄进行加 1,两种方法。 $set { $set : { field : value } } 把 field 的值设置成 value,当 field 不存在时,增加一个字段,类似 SQL 的 set 操作,value 支持所有类型。 $unset { $unset : { field : 1} } 删除给定的字段 field。 $push { $push : { field : value } } 如果 filed 是一个已经存在的数组,那么把 value 追加给 field; 如果 field 原来不存在,那么新增 field 字段,把 value 的值赋给 field; 如果 field 存在,但是不是一个数组,将会出错。 $pushAll { $pushAll : { field : value_array } } 功能同$push,只是这里的 value 是数组,相当于对数组里的每一个值进行$push操作。 $addToSet { $addToSet : { field : value } } 如果 filed 是一个已经存在的数组,并且 value 不在其中,那么把 value 加入到数组; 如果 filed 不存在,那么把 value 当成一个数组形式赋给 field;$pop 如果 field 是一个已经存在的非数组类型,那么将会报错。 $pop { $pop : { field : 1 } } 删除数组中最后一个元素 { $pop : { field : -1 } } 删除数组中第一个元素 $pull { $pull : { field : _value } } 如果 field 是一个数组,那么删除符合_value 检索条件的记录; 如果 field 是一个已经存在的非数组,那么会报错。 $pullAll { $pullAll : { field : value_array } } $rename { $rename : { old_field_name : new_field_name } 重命名指定的字段名称。 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/3557414.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

深度学习的IR“之争”

熟悉编译器的同学应该对上图并不陌生。它就是大名鼎鼎的LLVM的logo。Google Tensorflow XLA (Accelerated Linear Algebra)就使用了LLVM IR(Intermediate Representation)。而它的“竞争对手”,刚刚发布的TVM/NNVM,则是“Tensor IR Stack for Deep Learning Systems”。IR是什么?为什么重要?我们一起来看看。 上周,我们看到这样的新闻“Facebook and Microsoft introduce new open ecosystem for interchangeable AI frameworks”。这也让Framework之争更加热闹。简单来说,ONNX也是为了解决目前多个Framework互操作的问题

优秀的个人博客,低调大师

Log stash学习笔记(一)

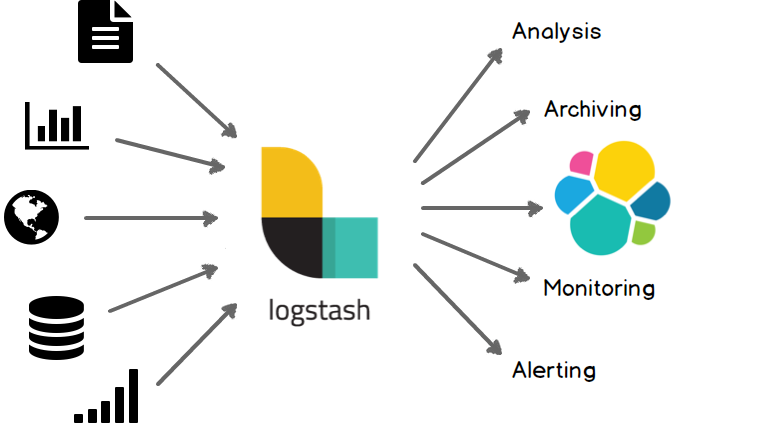
Logstash是一款开源的数据收集引擎,具备实时管道处理能力。简单来说,logstash作为数据源与数据存储分析工具之间的桥梁,结合 ElasticSearch以及Kibana,能够极大方便数据的处理与分析。通过200多个插件,logstash可以接受几乎各种各样的数据。包括日志、网络请求、关系型数据库、传感器或物联网等等。 安装 之前我有一篇文章ElasticSearch + Logstash + Kibana 搭建笔记记录了ELK环境的搭建过程,只是简单介绍了一种安装方式,本文记录更多的细节。 logstash 要求Java8的支持。Java9暂时不支持,本文使用的logstash版本为5.5.1。 在Linux环境中,我们可以通过包管理进行安装,例如Unbuntu中的apt、以及CentOS中的yum。也可以从这里下载对应环境的二进制版本。 体验Pipeline Logstatsh最基本的Pipeline模式如下图所示,其需要两个必需参数input、output,以及一个可选参数filter。 cd logstash-5.5.1 bin/logstash -e 'input { stdin { } } output { stdout {} }' [2017-08-09T15:40:03,303][INFO ][logstash.pipeline ] Pipeline main started hello world 2017-08-09T07:40:46.397Z iZ627x15h6pZ hello world -e参数允许我们在命令行中直接输入配置,而不同通过-f参数指定配置文件。看到Pipeline main started表示logstash已经启动成功,在命令行输入一些文字后,logstash会加上日期和主机名(IP)输出到终端。这就是Logstash最基本的工作模式,接受输入,然后将信息加工后放入到输出。 处理日志 Logstash收购了Filebeat加入到自己的生态系统中用来处理日志,Filebeat是一个轻量化的日志收集工具,还可以感知后台logstash的繁忙程度来决定日志发送的速度。 首先下载 Filebeat,解压后就可以使用。找到filebeat.yml修改如下: filebeat.prospectors: - input_type: log paths: - /path/to/file/logstash-tutorial.log output.logstash: hosts: ["localhost:5043"] 配置完成后等logstash启动后再启动Filebeat。 sudo ./filebeat -e -c filebeat.yml -d "publish" 接下来配置logstash,按照如下配置编写一个 filebeat.conf 文件 input { beats { port => "5043" } } output { stdout { codec => rubydebug } } 配置文件可以用下面的命令验证是否有问题 bin/logstash -f filebeat.conf --config.test_and_exit 如果验证没有问题,就可以用这个配置文件启动 logstash 了。 bin/logstash -f filebeat.conf 之后再启动Filebeat,就可以在Filebeat终端窗口看到日志信息的输出,同时在logstash这边也能看到有日志输出。这就说明此时logstash已经能够正常接收beats送来的文件了。 参考资料: 1、Logstash Reference 2、Filebeat

优秀的个人博客,低调大师

网络及Web学习笔记

IT人一提到说到网络,必定且首先就要提到的就是TCP/IP协议了。这是基本的网络通信层的协议。而这个协议,是网路平台七层网络协议中的一个点。网路协议定义了从用户数据和请求的处理打包/解包的TCP,UDP协议,到分包发送数据的IP协议,再到物理层的实现。一大堆的概念,一本本大砖头般的书,就是学这方面的人都受不了,更不用说只是想了解下网络过程的一般用户了。而更为人熟知的,该是伯纳斯李及其万维网了。万维网乃是现在最大的网络了,而一开始,网络是一点点连接起来的。 那么网络到底是什么呢?计算机刚兴起时,其主要工作就是用来做大规模计算的。其服务方式也是由大型服务机To客户机的形式。客户端进行数据请求,服务机响应处理然后再由客户机显示结果。后来,才有了机器与机器之间需要数据共享的问题。如果就那么几台机器,那么拷贝一份数据也没什么。但是当一个集群的机器需要共享数据,特别是涉及到实时数据时,显然,用拷贝的方式不能满足需求了。所以才有了计算机之间的通信。 而在一开始,不同硬件厂商——IBM, HP, SUN都定义了自己的通信协议和实现。同一个硬件厂商的硬件通信没问题,但是不同厂商的硬件却不能通信。所以才有了后来的标准化的通信协议。而万维网的兴起是在个人计算机兴起后,伯纳斯李的创造性发明。由此,计算机不再是一个个单独的存在,而是通过网络互通互联在一起的一个网络了。 首次接触到通信协议这种东西,往往茫然不知其所谓。记得我第一次了解到这些协议的时候就总是想不通,通过这些协议性的规定就可以实现数据的传输了吗?这是莫名其妙。后来才理解了,传输数据是由物理层的介质——光纤、无线网络——来实现的。而协议是通信双方约定好的,数据传输的格式。以约定好的格式来传输,双方都方便。数据发送方按照协议规定格式进行数据打包然后发送,而接收方就可以按照这个格式进行快速解包了。或者,可以这么去理解,协议就是一个双方都知道的其格式的空表格,发送方往表格空白处填充数据,而接收方,从表格中取出数据。由于双方都知道表格的格式,所以,要发什么数据,要取什么数据,直接去找所需的栏目就可以了。 现在的网络,是一个去中心化的网络。网络中的一个个节点通过IP地址定位。主要通信则发生在服务器与普通网络入口(pc机,手机)之间。所谓网络应用程序就是客户端(Client)软件与服务器端(Server)的通信了。这就是所谓的CS架构模型。而当下大热的Web,提倡用浏览器(Browser)代替客户端(Client)的新模型——BS架构模型。其中,最主要的通信就是浏览器与服务器程序的通信。也就是HTTP通信协议。这些整个过程中,HTTP协议负责对请求和响应的打包与解包。TCP协议负责的是机器与机器之间的通信连接,即用户端机器与服务器端机器的连接。而IP协议负责了用户机器与客户端机器见通信路径的选择,数据的分包发送等。TCP协议是建立在IP协议的基础上的。 作者:何妍 来源:51CTO

优秀的个人博客,低调大师

MySQL Group Replication 学习笔记

作者简介 刘伟 云和开创高级顾问 题记:group replication作为mysql官方,在5.7版本阶段开发的,innodb的分布式数据库架构,从发布开始就有很多关注,下文是我对目前为止的材料以及实验的一些总结。 主要资料来源是官方blog:http://mysqlhighavailability.com/ group replication架构 group replication(后文简称GR)实现的分布式数据库架构,底层的分布式基础是Paxos(出于行文限制,此处不单独交代Paxos)。通过Paxos来保证分布式数据库系统中,事务的提交顺序。 每次一个事务在一个节点提交的时候,就会发送所修改的数据到所有节点,检查期间是否有修改冲突(比如修改了别的节点已经修改并提交成功的事务的数据),如果发现冲突,本事务回滚。如果没有冲突,则可以直接提交成功。 对于非执行事务的远程节点,如果事务判断为执行成功,远程发送过来的数据,会被保存在本地的一个relay log里面(注意,与常规主从同步使用的relay log不是同一组),之后由从库的applier线程采用正常主从同步(目前已经支持LOGICAL_CLOCK并行执行)的方式执行掉对应的relay log。 这里有一个临界点,如果一个事务刚刚被写入relay log,还没有来得及执行掉,这时候有一个事务的执行涉及了相关的数据,那么后来的这个事务在执行阶段可以执行成功,但是必定会在提交阶段失败的。 使用建议 根据目前的状况看,GR使用的时候,应该做到以下几点以对性能优化以及减少分布式冲突。 节点分区 虽然是分布式,但并非采用纯粹的随机或者轮询来对节点访问,而是采用一些分区算法,保证指定的主键必定发生指定的实例上。 这点主要目的是避免出现事务在分布式系统中的冲突,导致不可控的事务回滚。 建议的分区算法是一致性哈希,方便节点的添加删除,以及负载均衡。 控制单次事务操作数据量 即控制事务所涉及修改(增,删,改)的数据,主要原因有两点: 一是,多节点之间的冲突检验需要传输相关的数据,如果单次事务量过大,会导致单次事务的检查时间增长,由于分布式事务的全局序列性,单个慢事务会导致全局的低速。 二是,由于最终多节点的同步,还是通过每个节点自己的relay线程来执行的,如果有大事务,会导致relay线程执行不到后面的事务,导致事务延迟,并导致可能会产生的分布式事务回滚。 周边功能介绍 主要组件简介 capture 追踪当前正在执行的事务的上下文 applier 执行远程事务传输到本地的日志到本地数据库 recovery 负责分布式环境下的节点恢复,以及相关的数据回追,失败处理等 失败节点检测 只有认为无法连接的节点才会从集群中自动踢走。 机制如下: 不可用本身的发觉,是依赖消息通讯的超时决定的。即如果节点对另外的节点的消息发送超时,则认为远程节点不可用。 对于正常节点,如果认为一个其他节点不可用了,首先会标记为不可用,之后与其他节点沟通,如果确认这个节点确实其他节点都认为不可用,则实际设置为不可用节点。 如果一个节点发现自生连接不到其他所有的实例(认为其他节点全部死亡),则这个节点本身之后的事务执行,就不会采用分布式算法而是退回传统的单节点事务模式。 另外,如果同时失败节点数过多(超过一半),为了避免脑裂,分布式算法会拒绝运行,需要人工介入恢复,这也是需要注意的一点。 节点状态 ONLINE 节点状态正常,可以正常执行事务 RECOVERING 正在接收种子节点的日志 OFFLINE 节点之前注册了,但并不属于当前集群(可能节点已经失败) ERROR 恢复阶段,阶段1或者阶段2失败 UNREACHABLE 节点不可达,一般出现在通讯超时的情况 失败恢复 这里说的,主要把一个节点,加入到已有集群的过程,而非单实例的崩溃恢复。 -->阶段1 第一阶段,新实例选择集群中的一个实例作为种子实例,这个种子实例会发送所有新实例到加入集群为止缺失的日志数据到新实例,这个的执行,是通过简单的主从同步日志的方式做的。 执行阶段1的期间,新实例还会一直持续接收当前正在活跃(实例加入集群后)的事务的日志,补全从种子实例没有传输的增量日志。 当种子实例传输日志完成之后,第一阶段就完毕了。 这一阶段,如果种子实例出现问题崩溃或者失败了,新实例会自动选取实例里面别的实例替代。 -->阶段2 这一阶段,新实例合并之前的活跃事务到当前数据库,当残余的事务量接近0(新事务一直在别的实例发生,只能非常接近0而很难完全追上)的时候,实例在集群中的状态,就会被修改为ONLINE了。 流量控制 mysql的GR,全局所有的实例都拥有所有的数据,也实际上需要运行所有的写入流量,如果有某一个实例相对较慢,如果时间持续下去,这个节点可能出现延迟,极端情况下,可能越追越远。 流量控制试图做到的事情是,保障整个集群节点之间,最快的节点和最慢的节点之间的事务差距不要太大。 实际需要控制的,有两个队列,一个是事务提交时候的冲突检查队列,一个是事务实际执行的relay日志队列 DDL执行 DDL先天上并不支持事务化,也就是多节点执行的时候,如果有几个节点失败,并不会导致已经执行成功的节点回滚DDL,对于DDL的执行结果需要单独验证,以避免多节点表不一致。 IP白名单 这个主要是安全方面的考虑,之允许指定来源的ip作为复制节点与集群通讯。 一些限制 使用group replication有以下一些限制。 所有涉及的数据都必须发生在InnoDB存储引擎的表内。 所有的表必须有明确的主键定义。 网络地址只支持IPv4。 需要低延迟,高带宽的网络。 目前集群限制最多允许9个节点。 必须启用binlog。 binlog 格式必须是row格式。 必须打开gtid模式。 复制相关信息必须使用表存储。 事务写集合(Transaction write set extraction)必须打开。(这个目前与savepoint冲突,这也是导致mysqldump无法备份GR实例的原因) log slave updates必须打开。 binlog的checksum目前不支持。 由于事务写集合的干扰,无法使用savepoint。 SERIALIZABLE 隔离级别目前不支持。 对同一个对象,在集群中不同的实例上,并行地执行DDL(哪怕是相互冲突的DDL)是可行的,但会导致数据一致性等方面的错误,目前阶段不支持在多节点同时执行同一对象的DDL。 外键的级联约束操作目前的实现并不完全支持,不推荐使用。 几个名词 Donor:用于节点恢复时候,传输历史binlog的节点。Group Configuration:集群里已经配置的实例列表。Group Membership Service:维护一致性view变更的服务,作用于节点的新增,退出,以及当前视图的维护工作。Joiner:将要加入到集群但状态尚未恢复到ONLINE的新节点。Seed:负责触发新节点加入集群动作的实例。View:当前集群活跃实例的列表。 本文出自数据和云公众号,原文链接

优秀的个人博客,低调大师

Android Drawable绘图学习笔记

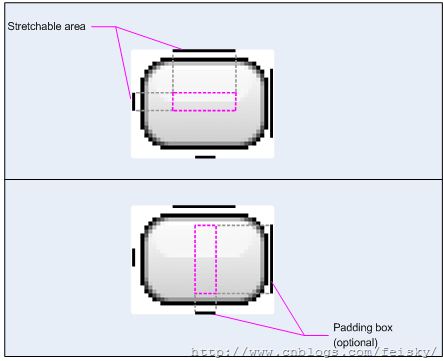
如何获取 res 中的资源 数据包package:android.content.res 主要类:Resources Android SDK中的简介:Class for accessing an application’s resources.Class for accessing an application’s resources. This sits on top of the asset manager of the application (accessible through getAssets()) and provides a higher-level API for getting typed data from the assets. 其主要接口按照功能,划分为以下三部分: getXXXX() 例如: int getColor(int id) Drawable getDrawable(int id) String getString(int id) 直接获取res中存放的资源 InputStream openRawResource(int id) 获取资源的数据流,读取资源数据 void parseBundleExtras(XmlResourceParser parser, Bundle outBundle) 从XML文件中获取数据 Resource为每种资源提供了相应的接口来获取这种资源,除了可以直接获取资源外,还额外提供了以数据流的方式获取资源,这在以后的应用程序开发中会经常使用,那么如何获取Resources了,如下:Resources r = this.getContext().getResources(); 如何获取资源中的画图对象 数据包package:android.graphics.drawable 主要类:Drawable Android SDK中的简介:A Drawable is a general abstraction for “something that can be drawn.” Most often you will deal with Drawable as the type of resource retrieved for drawing things to the screen; the Drawable class provides a generic API for dealing with an underlying visual resource that may take a variety of forms. 看了以上简介,发现Drawable是个virtual class,具体如何画图,需要具体分析Drawable的子类,例如:BitmapDrawable Android SDK中的简介:A Drawable that wraps a bitmap and can be tiled, stretched, or aligned. You can create a BitmapDrawable from a file path, an input stream, through XML inflation, or from a Bitmap object. It can be defined in an XML file with the<bitmap>element. 其主要接口如下: BitmapDrawable() BitmapDrawable(Bitmap bitmap) BitmapDrawable(String filepath) BitmapDrawable(InputStream is) void draw(Canvas canvas) Draw in its bounds (set via setBounds) respecting optional effects such as alpha (set via setAlpha) and color filter (set via setColorFilter). final Bitmap getBitmap() final Paint getPaint() Drawable是个抽象类,在BitmapDrawable中我们就看到位图的具体操作,在仔细看下BitmapDrawable的构造函数,我们就会发现与Resource中的openRawResource()接口是相对应的,就可以通过以下方法来获取位图: Resources r = this.getContext().getResources(); Inputstream is = r.openRawResource(R.drawable.my_background_image); BitmapDrawable bmpDraw = new BitmapDrawable(is); Bitmap bmp = bmpDraw.getBitmap(); Paint 数据包package:android.graphics Android SDK中的简介:The Paint class holds the style and color information about how to draw geometries, text and bitmaps. 主要就是定义:画刷的样式,画笔的大小/颜色等。 Typeface 数据包 package:android.graphics Android SDK中的简介:The Typeface class specifies the typeface and intrinsic style of a font. 主要就是定义:字体。 核心类显示资源 数据包package:android.graphics 主要类:Canvas Android SDK中的简介:The Canvas class holds the “draw” calls. To draw something, you need 4 basic components: A Bitmap to hold the pixels, a Canvas to host the draw calls (writing into the bitmap), a drawing primitive (e.g. Rect, Path, text, Bitmap), and a paint (to describe the colors and styles for the drawing). 按照结构的功能,将主要接口分为以下3部分: boolean clipXXXX() Region区域操作:DIFFERENCE INTERSECT REPLACE REVERSE_DIFFERENCE UNION XOR void drawXXXX()画图函数 void rotate() void scale() void skew() void translate() 画布操作函数 Region在这里需要特殊说明下:Region就是一个区域,也就是画布(Canvas)中的有效区域,在无效区域上draw,对画布没有任何改变。 Drawable类 Drawable是一个通用的抽象类,它的目的是告诉你什么东西是可以画的。你会发现基于Drawable类扩展出各种绘图的类,见下面的表格,当然你可以继承它来创建你自己的绘图类. Interfaces Animatable Interface that drawables suporting animations should implement. Drawable.Callback Implement this interface if you want to create an animated drawable that extendsDrawable. Classes AnimationDrawable An object used to create frame-by-frame animations, defined by a series of Drawable objects, which can be used as a View object's background. BitmapDrawable A Drawable that wraps a bitmap and can be tiled, stretched, or aligned. ClipDrawable A Drawable that clips another Drawable based on this Drawable's current level value. ColorDrawable A specialized Drawable that fills the Canvas with a specified color, with respect to the clip region. Drawable A Drawable is a general abstraction for "something that can be drawn." Most often you will deal with Drawable as the type of resource retrieved for drawing things to the screen; the Drawable class provides a generic API for dealing with an underlying visual resource that may take a variety of forms. Drawable.ConstantState DrawableContainer DrawableContainer.DrawableContainerState GradientDrawable A Drawable with a color gradient for buttons, backgrounds, etc. InsetDrawable A Drawable that insets another Drawable by a specified distance. LayerDrawable A Drawable that manages an array of other Drawables. LevelListDrawable A resource that manages a number of alternate Drawables, each assigned a maximum numerical value. NinePatchDrawable A resizeable bitmap, with stretchable areas that you define. PaintDrawable Drawable that draws its bounds in the given paint, with optional rounded corners. PictureDrawable Drawable subclass that wraps a Picture, allowing the picture to be used whereever a Drawable is supported. RotateDrawable A Drawable that can rotate another Drawable based on the current level value. ScaleDrawable A Drawable that changes the size of another Drawable based on its current level value. ShapeDrawable A Drawable object that draws primitive shapes. ShapeDrawable.ShaderFactory Base class defines a factory object that is called each time the drawable is resized (has a new width or height). StateListDrawable Lets you assign a number of graphic images to a single Drawable and swap out the visible item by a string ID value. TransitionDrawable An extension of LayerDrawables that is intended to cross-fade between the first and second layer. 有三种方法可以定义和实例化一个Drawable:保存一个图片到你工程资源中,使用XML文件来描述Drawable属性或者用一个正常的类去构造。下面我们将讨论两种技术(对一个有开发经验的开发者来说构造并不是最新的技术)。 从资源图像文件中创建 一个比较简单的方法是添加一个图片到你的程序中,然后通过资源文件引用这个文件,支持的文件类型有PNG(首选的) JPG(可接受的)GIF(不建议),显然这种对于显示应用程序的图标跟来说是首选的方法,也可以用来显示LOGO,其余的图片可以用在例如游戏中。 把一个图片资源,添加你的文件到你工程中res/drawable/目录中去,从这里,你就可以引用它到你的代码或你的XML布局中,也就是说,引用它也可以用资源编号,比如你选择一个文件只要去掉后缀就可以了(例如:my_image.png 引用它是就是my_image)。 注意:SDK指出,为了缩小图片的存储空间,在Build的时候又可能对图片进行压缩,如果不想被压缩,可以将图片放在res/raw/目录中。 SDK给出的例子: LinearLayout mLinearLayout; protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); // Create a LinearLayout in which to add the ImageView mLinearLayout = new LinearLayout(this); // Instantiate an ImageView and define its properties ImageView i = new ImageView(this); i.setImageResource(R.drawable.my_image); i.setAdjustViewBounds(true); // set the ImageView bounds to match the Drawable's dimensions i.setLayoutParams(new Gallery.LayoutParams(LayoutParams.WRAP_CONTENT, LayoutParams.WRAP_CONTENT)); // Add the ImageView to the layout and set the layout as the content view mLinearLayout.addView(i); setContentView(mLinearLayout); } 获取Drawable对象: Resources res = mContext.getResources(); Drawable myImage = res.getDrawable(R.drawable.my_image); 注意:保持每个资源类型的一至,可以保证你项目状态的一致性,就不用担心有许多不同类型的对象来实例化它。例如:如果使用相同的图像资源来实例化两个Drawable对象。然后修改一个Drawables的属性(例如alpha),然后不幸得是这个效果也会出现在另一个对象上去。所以当处理同一个资源的多个实例对象时,不是直接转换为Drawable,而是应该执行tween animation 如何添加资源到ImageView: <ImageView android:layout_width="wrap_content" android:layout_height="wrap_content" android:tint="#55ff0000" android:src="@drawable/my_image"/> 从XML文件中创建 到如今,你应该比较熟悉按Android的原则去开发一个用户接口,因此,你也应该理解了定义一个XML文件对于对象的作用与灵活的重要性。这个理念无数次用于Drawables. 如果你想创建一个Drawable对象,而这个对象并不依赖于变量或用户的交换,把它定义到XML中去应该是一个不错的方法。即使你期望在你的应用程序中改变其属性来增加用户体验。你应该考虑把对象放入XML中,因为你可以随时修改其属性。 当你在你的XML中定义了一个Drawable,保存这个XML文件到你工程目录下res/drawable目录中,然后通过调用Resource.getDrawable()来检索并实例化,传递给它XML文件中的资源ID号。任何Drawable的子类都支持inflate这个方法,这个方法会通过XML来实例化你的程序。任何Drawable都支持XML的扩展来利用特殊的XML属性来帮助定义对象的属性,可以查看任何Drawable子类文档来看如何定义XML文件。 如下定义了一个TransitionDrawable:An extension of LayerDrawables that is intended to cross-fade between the first and second layer. It can be defined in an XML file with the<transition>element. Each Drawable in the transition is defined in a nested<item>. 有关TransitionDrawable的详细信息查看http://androidappdocs.appspot.com/reference/android/graphics/drawable/TransitionDrawable.html。 将其定义在res/drawable/expand_collapse.xml: <?xml version="1.0" encoding="utf-8"?> <transition xmlns:android="http://schemas.android.com/apk/res/android"> <item android:drawable="@drawable/pic1"/> <item android:drawable="@drawable/pic2"/> </transition> 下面实例化并处理: public class MainActivity extends Activity { /** Called when the activity is first created. */ @Override public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.main); Resources res=getResources(); TransitionDrawable trans=(TransitionDrawable )res.getDrawable(R.drawable.expand_collapse); ImageView image = (ImageView)findViewById(R.id.ImageView01); image.setImageDrawable(trans); trans.startTransition(3000); } } ShapeDrawable 当你想去画一些动态的二维图片,一个ShapeDrawable对象可能会对你有很大的帮助。通过ShapeDrawable,你可以通过编程画出任何你想到的图像与样式。 ShapeDrawable继承了Drawable, 所以你可以调用Drawable里有的函数,比如视图的背景,通过setBackgroundDrawable()设置。当然,你可以在自定义的视图布局中画你的图形,因为ShapeDrawable有自己的draw()方法。你可以在View.OnDraw()方法期间创建一个视图的子类去画ShapeDrawable。 ShapeDrawable类(像很多其他Drawable类型在android.graphics.drawable包)允许你定义drawable公共方法的各种属性。有些属性你可以需要调整,包括透明度,颜色过滤,不透明度,颜色。 例子: public class CustomDrawableView extends View { private ShapeDrawable mDrawable; public CustomDrawableView(Context context) { super(context); int x = 10; int y = 10; int width = 300; int height = 50; mDrawable = new ShapeDrawable(new OvalShape()); mDrawable.getPaint().setColor(0xff74AC23); mDrawable.setBounds(x, y, x + width, y + height); } protected void onDraw(Canvas canvas) { mDrawable.draw(canvas); } 显示: CustomDrawableView mCustomDrawableView;protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); mCustomDrawableView = new CustomDrawableView(this); setContentView(mCustomDrawableView);} 在XML中定义方法:如果你想用XML文件配置来取代原有布局来画自定义的drawable,于是你自定义的Drawable类必须重载view (Context, AttributeSet) 构造函数。 <com.example.shapedrawable.CustomDrawableView android:layout_width="fill_parent" android:layout_height="wrap_content" /> NinePatchDrawable NinePatchDrawable 绘画的是一个可以伸缩的位图图像,Android会自动调整大小来容纳显示的内容。一个例子就是NinePatch为背景,使用标准的Android按钮,按钮必须伸缩来容纳长度变化的字符 NinePatchDrawable是一个标准的PNG图像,它包括额外的1个像素的边界,你必须保存它后缀为.9.png,并且保持到工程的res/drawable目录中。 这个边界是用来确定图像的可伸缩和静态区域。你可以在左边和上边的线上画一个或多个黑色的1个像素指出可伸缩的部分(你可以需要很多可伸缩部分),它的相对位置在可伸缩部分相同,所以大的部分总是很大的。 你还有可以在图像的右边和下边画一条可选的drawable区域(有效的,内边距线)。如果你的视图对象设置NinePath为背景然后指定特殊的视图字体,它将自行伸缩使所有的文本来适应根据右线与底部线设计好的区域(如果有的话),当然内边距线不包括其中,Android可以使用左边的线与上面的线来定义一个drawable区域。 我们来澄清一下这两条不同的线,左边跟顶部的线来定义哪些图像的像素允许在伸缩时被复制。底部与右边的线用来定义一个相对位置内的图像,视图的内容就放入其中。 使用方法: <Button id="@+id/tiny" android:layout_width="wrap_content" android:layout_height="wrap_content" android:layout_alignParentTop="true" android:layout_centerInParent="true" android:text="Tiny" android:textSize="8sp" android:background="@drawable/my_button_background"/><Button id="@+id/big" android:layout_width="wrap_content" android:layout_height="wrap_content" android:layout_alignParentBottom="true" android:layout_centerInParent="true" android:text="Biiiiiiig text!" android:textSize="30sp" android:background="@drawable/my_button_background"/> 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/archive/2010/01/08/1642567.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android学习进阶和IoC

1.成为Android高手一般分为六个阶段: 第一阶段:熟练掌握Java SE,尤其是对其内部类、线程、并发、网络编程等需要深入研究;熟练掌握基于HTTP协议的编程,清楚POST和GET等请求方式流程和细节;能够进行基本的Java Web编程,如果能够使用Java EE则更好; 第二阶段:精通Android的核心API的使用,例如四大组件所涉及的API、Context等,精通核心界面的编程,例如ListView的编程;到达这个阶段已经能够做大部分基本的应用开发了; 第三阶段:精通应用框架的原理,尤其是对IoC的理解及其在Android应用框架中的应用,精通基本的23种设计模式在Android中的应用; 第四阶段:精通JNI,熟练Android类库中C/C++组件开发;并能够使用JNI机制把现有的C/C++组件移植成为应用框架的核心组件;具备修改和编写自己的应用框架的能力; 第五阶段:做出自己的Android系统,无论是底层还是上层都能够了如指掌;能够根据实际需要设计和实现比较大Android系统,例如带领比较大的团队做出自己的Android手机产品等; 第六阶段:势。一切的思考均进入“势”的思考,一切都是思路问题,判断和预测Android的形势,引领市场,通往自由的天堂。 2. Android之IoC (Inversion of Control) 1)概念 一种设计思想。使调用者和被调用者解耦和分离,便于更改和代码重用,便于移植。 许多应用都是由多个类通过彼此合作来实现业务逻辑,每个对象之间都相互依赖,这将导致代码高度耦合并且难以测试、难以修改难以重用。 IoC很好的解决了该问题,它将实现组件间关系从程序内部提到外部容器来管理。也就是说由容器在运行期将组件间的某种依赖关系动态的注入组件中。控制程序间关系的实现交给了外部容器来完成。 2)案例 为了实现调用者和被调用者解耦,分离,一般是通过工厂模式实现的,下面将通过比较工厂模式和Ioc模式不同,加深理解Ioc模式。 假设有两个类B 和 C:B作为调用者,C是被调用者。一般的做法是: public class B{private C comp=new C(); ...... } 工厂模式实现如下: public class B{private C comp; private final static MyFactory myFactory = MyFactory.getInstance();public B(){this.comp = myFactory.createInstanceOfC(); }public void someMethod(){this.comp.sayHello(); } } 使用Ioc依赖性注射实现Picocontainer如下: public class B{private C comp; public B(C comp){this.comp = comp; }public void someMethod(){this.comp.sayHello(); } } //外部容器实现,控制程序间的关系。CImp类为C接口/类的一个具体实现。public class client{public static void main( String[] args ) { DefaultPicoContainer container = new DefaultPicoContainer(); container.registerComponentImplementation(CImp.class); //向B类实现注射C类具体实现 container.registerComponentImplementation(B.class); B b = (B) container.getComponentInstance(B.class); b.someMethod(); } } 3)工厂模式和Ioc不同的特点和区别: 如上,主要区别体现在B类的代码,如果使用Ioc,在B类代码中将不需要嵌入任何工厂模式等的代码,因为这些工厂模式其实还是与C有些间接的联系,这样,使用Ioc彻底解耦了B和C之间的联系。 使用Ioc带来的代价是:需要在客户端或其它某处进行B和C之间联系的组装。 所以,Ioc并没有消除B和C之间这样的联系,只是转移了这种联系。 总之,使用Ioc模式,可以不管将来具体实现,完全在一个抽象层次进行描述和技术架构。 分类: Android 本文转自快乐就好博客园博客,原文链接:http://www.cnblogs.com/happyday56/p/3611800.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

IoT Kaa平台学习(二)

版权声明:您好,转载请留下本人博客的地址,谢谢 https://blog.csdn.net/hongbochen1223/article/details/73115338 在这片文章中,主要讨论在Kaa架构和逻辑设计下的功能性概念。 Kaa IoT平台由Kaa server,Kaa扩展和端点SDKs组成。 kaa服务器是平台的后端部分。他被用于去管理租户,应用,用户和设备。Kaa服务器暴露了集成接口并且提供了管理能力。 kaa扩展是独立的软件模块,他提升了平台的功能性。 端点SDK是为多种多样的Kaa平台特征提供客户端的API并且处理通信,数据编集,持久性等的一个库。Kaa SDK被设计区促进客户端应用的创造性来运行在各种各样连接的设备上。然而,不使用Kaa端点SDK的客户端应用也是有可能的。以不同的编程语言有多种不同的端点SDK。 Kaa集群 Kaa服务器节点使用Apache的ZooKeeper来与服务合作。互相连接的节点和特别的Kaa实例组成了一个Kaa集群。Kaa集群需要Nosql和SQL数据库实例来保存端点数据和原语。 位于集群中的Kaa节点运行了Control,Operation和Bootstrap服务的组合。 Control服务 Kaa控制服务管理所有的系统数据,处理来自Web UI和外部集成系统的API请求,并且向Operaion服务发送通知。控制服务通过持续的接收来自ZooKeeper的信息来维持一个最新的可操作服务列表。除此之外,控制服务运行嵌入的使用控制服务API的管理web UI组件,来想用户提供方便的基于web的接口来管理租户,用户账户,应用数据等。 为了支持高可用性,一个Kaa集群至少有两个节点是使能控制服务的。在高可用性模式中,其中的一个控制服务是活动的,另外一个是待机模式。一旦活动的控制服务失效了,ZooKeeper会唤醒其中一个待机控制服务并且将它升级成为活动控制服务。 操作服务 操作服务最基础的角色就是与当前多个端点进行通信。操作服务处理端点请求并且把数据发送给他们。 为了横向扩展,你可以设置一个Kaa集群的每一个几点都是操作服务使能的。在这个情况下,所有的操作服务的实例当前都是在运行的。如果一个操作服务意外终止了,之前连接端点自动转换到其他可用的操作服务中去。Kaa服务器在运行时可以重新负载均衡,所以在集群中路由端点到低负载的节点中的效率是非常高的。 引导程序服务 Kaa Bootstrap服务发送关于操作服务连接参数的信息到端点中。取决于配置的协议栈,连接参数可能包括IP地址,TCP端口,安全证书等。Kaa SDK包含一个在集群中预生成的Bootstrao可用列表,他被用于生成SDK库。在这个列表中的端点查询Bootstrap服务为当前可用操作服务取回连接。Bootstrap服务通过和ZooKeeper服务合作来维持他们的可用操作服务的列表。 第三方组件 Zookeeper Apache ZooKeeper使能在Kaa集群节点之间高可靠性分布式合作。每一个Kaa节点持续的推送关于连接参数,使能的服务和回应的服务负载的信息,其他Kaa节点使用这个信息去获取他们兄弟的列表并且与他们进行通信。活动的控制服务在SDK生成期间使用关于可用Bootstrap服务和他们连接参数的信息。 SQL database SQL数据库实例被用于存储租户,应用,端点组合其他原语,他们不随着端点的增加而增长。 一个Kaa集群的高可用性通过在HA模式下部署SQL数据库被实现了。Kaa现在官方支持MariaDB和PostgreSQL最为嵌入的SQL数据库。 NoSQL database NoSql数据库实例被用于存储端点关系数据,这些数据随着端点的增加成线性增长。 NoSQL数据库节点可以和Kaa节点一样放在相同的为或虚拟机上,并且为了这个系统的高可用性,他应该在HA模式下被部署。Kaa官方支持Apache Cassandra和MongoDB作为嵌入的NoSQL数据库。 Internode communications Kaa服务使用Apache Thirft来进行进程和节点之间的通信。每一个服务使用ZooKeeper包含关于他的兄弟的元数据。这个元数据包含关于Thrift主机和端口的信息。 高可用性和伸缩性 Kaa集群可以横向和线性扩展;在Kaa集群架构中没有单一故障点。Kaa操作和Bootstrap服务是独一无二的并且工作在主动-主动的HA模式下。其中一个集群节点包含一个活动的控制服务。一旦节点发生故障,位于另外一个节点的待机控制服务被提升变成活动的。Kaa集群的高可用性也依赖于SQL和NoSQL数据库的HA。 主动负载均衡 Kaa SDK在初始化期间伪随机选择Bootstrap和操作服务实例。依赖于对Kaa集群的请求发起者两个负载均衡的方法被使用:Kaa端点SDK或者是REST API。 端点SDK请求 Kaa SDK在初始化过程中伪随机选择Bootstrap和操作服务。然而,如果集群负载太重,端点的随机分发可能是效率不高的。当一个新的节点加入集群的时候,他在更新拓扑的时候,为了更好的性能,被要求重新均衡负载。 Kaa服务使用主动负载均衡方法来构建一些端点来重新连接一个不同的操作服务,因此平衡了节点之间的负载。使用算法来使服务器加载数据(连接的端点的数量,加载平均值等),该算法被kaa节点公布作为输入,并且定期的重新计算每一个节点的权重值。然后,超负荷的节点被要求重定向到一个不同的节点,一些端点被要求连接。 一个相似的方法可以被采用,通过预定服务的方式来加载进一个节点中,或者是在物理或虚拟机上逐渐的移植集群。为了实现,你需要通过实现重新均衡负载借口来设置一个自定义的负载均衡策略。 REST API请求 对于REST API负载均衡,你可以使用现成的HTTP负载均衡解决方案,例如Nginx,AWS Elastic负载均衡,Google Cloud LB。 Kaa实例 Kaa实例是Kaa平台一个特殊的安装,特也可以是单节点的,也可以是集群部署。 在Kaa中的一个应用定义了一系列数据模型,端点和Kaa服务之间的通信的类型和运行规则。Kaa应用对特定的平台,操作系统或客户端软件实现是不具体的。例如,针对一个压力传感器的两个固件实现在Arduino和STM32平台上是不一样的,但是在kaa中可以被看做是相同的应用,只要他们报告相同结构的遥测数据。 Kaa平台是多租户的。一个单一的Kaa实例可以支持多个独立的商务实体。应用属于租户,但是端点注册在应用中。(看下图) 一个端点(EP)是一个抽象,他代表着在一个Kaa部署中一个分离的管理实体。通俗的将,一个端点是在一个Kaa实例中的特别注册的Kaa客户端。基于用户实例,不同层的物理实例被认为是端点。在一个个人设置中,一个位于船队追踪应用中的单一的空气质量传感器,一个火车(尽管写到这多个报告数据的传感器)可能只是一个实体被认为是一个端点。 为了通过不同的属性区分端点,而不是使用一个ID,Kaa使用端点配置文件。 端点配置文件是一个自定义的结构化的数据集合,他描述了位于一个应用中的一个特定端点的特征。每一个端点配置文件包括客户端,服务端和系统部分。客户端部分的初始化值是被客户端开发者使用数据模式指定的。接着,客户端端点配置文件在一个新的端点被注册的时候生成。端点配置文件的服务器和系统部分数据是由Kaa服务管理的。 配置文件数据被用于将端点放到端点组中 - 由配置文件适配器定义的独立的管理实体。配置文件符合配置文件适配器的端点被自动变成这个组的成员。一个端点可以同时位于无限个组中。 端点也与拥有者相关。基于应用,应有着可以是人,组或者是组织。

优秀的个人博客,低调大师

Kaa IoT平台学习(一)

版权声明:您好,转载请留下本人博客的地址,谢谢 https://blog.csdn.net/hongbochen1223/article/details/72964894 kaa IoT开发平台概览 Kaa是一个用于物联网的多功能的中间件平台,他允许构建完全端到端IoT解决方案,连接的应用和智能产品。Kaa平台为IoT产品开发提供了一个开放的,功能丰富的工具组件,因此有效的降低了相关的费用,风险和面向市场的时间。为了快速开始,kaa提供了一套开箱即用的企业级物联网功能,其能够被简单的插入并实现大量的IoT用户实例。 kaa上有很多架构特征使得IoT开发更加快速和简单。首先,kaa是与硬件无关的,因此 kaa与虚拟化的任何类型的连接的设备,传感器和网关是相兼容的。他也提供了一个清澈的IoT特征和延伸的架构用于不同种类的应用。在开发上,他们可以使用最小额外的代码,被用于即插即用的模块。和用于连接协议和整体分析的无限选项结合在一块,这些能力使得Kaa成为了用于创新性IoT开发的恰当的比喻。 Kaa可以管理你的设备的能力有: 管理无限数量的连接设备 设置跨设备的协同工作的能力 运行A/B服务测试 运行远程设备供应和配置 运行实时设备监控 发布OTA固件更新 为智能产品创建云服务 收集和分析传感器数据 分析用户行为,发送目标提醒 Kaa如何工作 Kaa为连接的对象使能数据管理,并且通过提供服务器和末端SDK组件来使能你的后端基础建设。SDKs被嵌入到你连接的设备上并且实现与服务器的实时双流向的数据交换。Kaa SDKs能被集成在虚拟的任何连接的设备或芯片上。 Kaa服务器提供了所有的后端功能,这些功能需要操作甚至是大规模和关键任务的IoT解决方案。他处理所有通过连接对象的交流,包括数据一致性和安全性,设备协同工作能力和失败证明连接性。 Kaa服务器特征非常好的被构建了接口用于数据管理和分析系统和你的产品专属服务的集成。他为你的后端系统扮演一个功能,便是你可以非常简便的扩展和定制来满足你的产品的特殊的需求。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册