首页 文章 精选 留言 我的

精选列表

搜索[AIOps最佳实践],共10001篇文章
优秀的个人博客,低调大师

赢得 Docker 挑战最佳实践

难怪Docker正在迅速发展。Docker,一个开源项目。仅仅两年,Docker价值近10亿美元,最近获得了9500万美元的资金。令人激动的是,我们看到有这么多开发者对这个项目的热情。然而,我将在下面讨论企业使用Docker本身是不够的。 现代IT问题 许多企业IT团队解决这两个问题:首先,开发者和运维者在优先级上并不能总是达成一致。企业必须应对的挑战将来自开发人员的代码和运维团队的代码切换。这两个团队之间的关系很难和谐相处。 第二,将代码从一个地方迁移到另一个可以是很困难的。因为你没有简单的方法打包应用程序代码,包括你的系统依赖性。你在不同的操作系统,不同的虚拟机或不同的IaaS上处理代码。 Docker的好处 Docker最激动人心之处就是可以解决企业的这两个问题。第一个问题似乎是确定的,因为开发人员和运维人员之间有着清楚的界限。开发人员考虑Docker容器内部发生的一切,运维人员思考容器外面发生了什么。Docker让这一切变得更加简单和方便,这是一个非常便携式的解决方案。 至于第二个问题,Docker通过使你在单个应用程序进程打包一切与你相关的应用程序。但这只是部分解决了这些问题。 Docker缺少什么 Docker可以形象化的比喻为像可叠起堆放的乐高积木。每个容器是一个乐高。乐高玩具的美丽之处是可以组装的砖块和建立各种各样的奇妙的东西。同样的概念也适用于Docker的容器中。利用Docker,诸如编排、监控、日志记录和扩展可能成为企业关注的问题。Docker容器可以为企业运行几个容器,但如果你运行成百上千的呢?这些都是需要考虑的一些问题,它们超出了Docker容器本身可以提供的范围,为什么PaaS平台是对Docker的补充。 让我们看看容器本身三个特定的缺陷: 1. 装载容器 应用程序开发人员如何让一款应用进入容器?对于开发者来说构建Docker image也有一些负担,谁需要关注代码,不依赖于不同的系统的操作系统。这个问题的解决方案被称为buildpacks——对于PaaS是最好和最便携的选择。大多数PaaS生态系统正在让其标准化。Buildpacks允许你建立你的栈,包括在容器内部的所有系统依赖关系,以及配置应用程序的环境。开发人员只需要考虑他们的应用程序代码。他们不需要担心什么。Buildpacks配置你的应用程序。 2. 编排运输过程 假设开发人员创建大量的Docker的容器。然后他们与运维团队通信:“Ship these. Deploy these to production”。IT运维人员如何传输这些容器并且以系统的方法来管理这些容器性能、安全性和遵从性?容器有很多乐高积木。他们如何管理? 这个问题的答案是Docker Schedulers。如今在市场上有大量的调度器,它们为你编排和运行的容器并且跨集群分发它们——而不用考虑你的云计算集群是什么。调度器是有弹性的,所以如果一个容器或机器或应用程序宕机,它会重新分配这些容器。从用户的角度来看,根本感觉没有停机时间。虽然这些调度器解决一部分运输问题是有帮助的,但是还有另一个重要的问题,企业仍然面临一个调度器不能解决的问题。 3. 开发自助服务 企业文化当中对于自助服务似乎有着天然的缺陷。开发人员和IT运维之间也存在的天然的鸿沟。在某些方面,你可以说他们之间存在着一堵墙。经常发生的是,开发人员将构建一个应用程序,然后把它扔在墙那边给运维人员,并且希望应用能够一切运行正常。因此,将应用程序部署到生产需要数周或数月。所以听到开发者抱怨他们需要多长多长时间在生产环境中部署应用就不难理解了。 这种文化上的差异遭遇到破旧的基础设施时,后果就会更严重,因为一些企业仍使用过时的票务系统获取虚拟机,计算周期可能需要数周时间。 开发人员可以解决这个分歧,但他们需要特殊的工具。他们需要一种自助的方式为企业工作。给开发人员自由的部署在他们的应用,但是这些工具也必须满足安全性和遵企业的需求,包括多租户管理。开发人员可以专注于他或她的应用程序,但是企业需要考虑所有由不同的开发人员提交的应用程序。怎么处理这个?如何打破这堵存在与开发者和运维者之间的墙? PaaS平台也有闪光的地方,它提供了一个介于你的应用程序和基础设施之间的平台。这个平台是一样的,从开发到生产,提供一个无缝应用交付体验。 一个新的开发方法 Docker的承诺是真正伟大的,帮助开发人员解决构建新应用时的重大问题。它将改变应用程序开发过程,但某些挑战必须克服从而使得企业获得最大好处。PaaS平台将促进Docker的发展,并且帮助其履行自己的承诺。 本文作者:张鹏程编译 来源:51CTO

优秀的个人博客,低调大师

混合IT架构的最佳实践

传统IDC跟云服务的关系 传统IDC作为互联网的基础平台为其服务了几十年,可是对IDC的使用从来没有像今天这样使用了互联网思维。云时代,服务商卖给企业的不只是场地,机柜,电。。还有一整套采用互联网思维来使用它们的解决方案,所以通常我们会觉得云服务“哪儿哪儿都要花钱“,所以有实力的公司会搞“私有云“。 混合IT架构的尴尬地位 随着云服务的逐渐完善,如果我要做一个产品,必然会去选择云服务提供商,因此也就不会有混合IT架构这个概念了,因为这个概念通常存在于使用传统 IDC的公司向云服务过度的一个中间状态。也对运维部门是一个极大的考验,因为要在一个新的环境建立产品运行环境,还要保障产品速度,各种转换率不会因此降低。 数据一致性 混合架构有两种方式,一种是备份机房,机主机房出现比较大的故障,可以将流量切至备用机房,一种则是双活,即两个机房同时为用户提供服务。无论是哪种方案,都需要两个机房之间的网络延迟在可以接受的范围内,一般通过专有光纤来解决,云服务商通常会提供这种专有光纤的接入(比如AWS的Direct Connect服务)来打通实体机房与云服务的网络环境,我们可以利用它来做到数据的同步。 有了良好的网络环境,如何实现数据同步同样是一件及其困难的事情,比如数据库,就需要用户写数据的时候往两个机房各写一份,比较普遍的做法是采用消息队列,将用户写的数据先排进队列,然后在开启两个队列对不同机房的数据库进行写操作。 另外是缓存,如果用户访问新的机房,由于新的机房没有缓存,则会出现新的机房数据库被打爆的风险,比较简单的做法是通过在请求包设置cookie用以标记是否是老用户然后负载均衡层判断,含有次cookie的转发至老机房,没有此cookie的新用户则转发至新机房,然后再将老用户按照逐渐递增的方式将流量迁移至新机房,直到新机房缓存完全建立。 做到敏捷 使用云服务的一大优势便是资源到位速度快,一般情况下,我们可认为云的资源时无限大的(如需求特别的,需要跟云服务商单独谈),许多的云服务商(比如AWS)都会给用户提供api接口用于开启资源,并配合cloud-int服务实现资源的初始化,比如我们可以通过脚本的方式调用api快速开启一台 webserver,一台memcache,一台mysql,并使他们处于不同的集群以及不同的监控组中。 尽可能多的使用服务 云服务商提供的服务不仅仅有虚拟服务器,也会提供诸如负载均衡,分布式存储,cache,消息队列等其他的公共服务,将他们恰当的运用到自己的项目中是很有必要的,因为你将在短期内不用担心他们的扩容问题,比如可以使用AWS的ELB作为负载均衡器对外提供服务,使用S3存储静态资源以及log文件 (有个叫s3fuse的项目可以实现将s3作为文件系统挂载到服务器上,可以向访问本地文件一样访问s3上的文件)。 监控一切 在企业架构还处于混合架构的状态中,我们要对产品的性能做两套监控系统,另外一个用来专门监控处在云服务上的产品的性能数据,包括性能指标以及业务指标。我们可以通过在前端分流层对流向IDC以及云服务的流量打上cookie或者标记Etag,然后再log分析的时候便可以出两套数据,用于对比,随时对云服务进行优化或者技术决策,可以采用grafana做成类似如下的图标用来实时观测数据。 本文作者:兰亭集势-段超 来源:51CTO

优秀的个人博客,低调大师

HBase最佳实践-集群规划

HBase自身具有极好的扩展性,也因此,构建扩展集群是它的天生强项之一。在实际线上应用中很多业务都运行在一个集群上,业务之间共享集群硬件、软件资源。那问题来了,一个集群上面到底应该运行哪些业务可以最大程度上利用系统的软硬件资源?另外,对于一个给定业务来说,应该如何规划集群的硬件容量才能使得资源不浪费?最后,一个给定的RegionServer上到底部署多少Region比较合适?想必这些问题都曾经困惑过很多HBaser,那本文将结合前人的分享以及笔者的经验简单的对这三个问题分别进行解析,抛砖引玉,希望大家能够针对这几个话题进行深入的交流! 集群业务规划 一般而言,一个HBase集群上很少只跑一个业务,大多数情况都是多个业务共享集群,实际上就是共享系统软硬件资源。这里通常涉及两大问题,其一是业务之间资源隔离问题,就是将各个业务在逻辑上隔离开来,互相不受影响,这个问题产生于业务共享场景下一旦某一业务一段时间内流量猛增必然会因为过度消耗系统资源而影响其他业务;其二就是共享情况下如何使得系统资源利用率最高,理想情况下当然希望集群中所有软硬件资源都得到最大程度利用。前者本次并不讨论,后期会开’专场’讨论,本节主要就后者进行探讨。 使得集群系统资源最大化利用,那首先要看业务对系统资源的需求情况。经过对线上业务的梳理,通常可将这些业务分为如下几类: 1. 硬盘容量敏感型业务:这类业务对读写延迟以及吞吐量都没有很大的要求,唯一的需要就是硬盘容量。比如大多数离线读写分析业务,上层应用一般每隔一段时间批量写入大量数据,然后读取也是定期批量读取大量数据。特点:离线写、离线读,需求硬盘容量 2. 带宽敏感型业务:这类业务大多数写入吞吐量很大,但对读取吞吐量没有什么要求。比如日志实时存储业务,上层应用通过kafka将海量日志实时传输过来,要求能够实时写入,而读取场景一般是离线分析或者在上次业务遇到异常的时候对日志进行检索。特点:在线写、离线读,需求带宽 3. IO敏感型业务:相比前面两类业务来说,IO敏感型业务一般都是较为核心的业务。这类业务对读写延迟要求较高,尤其对于读取延迟通常在100ms以内,部分业务可能要求更高。比如在线消息存储系统、历史订单系统、实时推荐系统等。特点:在(离)线写、在线读,需求内存、高IOPS介质 (而对于CPU资源,HBase本身就是CPU敏感型系统,主要用于数据块的压缩/解压缩,所有业务都对CPU有共同的需求) 一个集群想要资源利用率最大化,一个思路就是各个业务之间‘扬长避短’,合理搭配,各取所需。实际上就是上述几种类型的业务能够混合分布,建议不要将同一种类型的业务太多分布在同一个集群。因此一个集群理论上资源利用率比较高效的配置为:硬盘敏感型业务 + 带宽敏感型业务 + IO敏感型业务。 另外,集群业务规划的时候除了考虑资源使用率最大化这个问题之外,还需要考虑实际运维的需求。建议将核心业务和非核心业务分布在同一个集群,强烈建议不要将太多核心业务同时分布在同一个集群。这主要有两方面的考虑: 1. 一方面是因为‘一山不容二虎’,核心业务共享资源必然会产生竞争,一旦出现竞争无论哪个业务’落败’都不是我们愿意看到的; 2. 另一方面在特殊场景下方便运维童鞋进行降级处理,比如类似于淘宝双十一这类大促活动,某个核心业务预期会有很大的流量涌入,为了保证核心业务的平稳,在资源共享的情况下只能牺牲其他非核心业务,在和非核心业务方充分交流沟通的基础上限制这些业务的资源使用,在流量极限的时候甚至可以直接停掉这些非核心业务。试想,如果是很多核心业务共享集群的话,哪个核心业务愿意轻易让路? 那有些同学就说了:如果按照你这样设计,那岂不是会产生很多小集群。的确,这种设计会产生很多小集群,相信如果没有资源隔离的话,小集群是没法避免的。有些使用’rsgroup’进行业务资源隔离的集群会做的很大,大集群通过隔离会将业务独立分布到很多独立的RS上,这样实际上就产生了很多逻辑上的小集群,那么,这些小集群同样适用上面提出的规划思路。 集群容量规划 每个季度公司都会要求采购新机器,一般情况下机器的规格(硬盘总容量、内存大小、CPU规格)都是固定的。假如现在一台RegionServer的硬盘规格是3.6T * 12,总内存大小为128G,从理论上来说这样的配置是否会有资源浪费?如果有的话是硬盘浪费还是内存浪费?那合理的硬盘/内存搭配应该是什么样?和哪些影响因素有关? 这里需要提出一个’Disk / Java Heap Ratio’的概念,意思是说一台RegionServer上1bytes的Java内存大小需要搭配多大的硬盘大小最合理。在给出合理的解释在前,先把结果给出来: Disk Size / Java Heap = RegionSize / MemstoreSize * ReplicationFactor * HeapFractionForMemstore * 2 按照默认配置,RegionSize = 10G,对应参数为hbase.hregion.max.filesize;MemstoreSize = 128M,对应参数为hbase.hregion.memstore.flush.size;ReplicationFactor = 3,对应参数为dfs.replication;HeapFractionForMemstore = 0.4,对应参数为hbase.regionserver.global.memstore.lowerLimit; 计算为:10G / 128M * 3 * 0.4 * 2 = 192,意思是说RegionServer上1bytes的Java内存大小需要搭配192bytes的硬盘大小最合理,再回到之前给出的问题,128G的内存总大小,拿出96G作为Java内存用于RegionServer,那对应需要搭配96G * 192 = 18T硬盘容量,而实际采购机器配置的是36T,说明在默认配置条件下会有几乎一半硬盘被浪费。 计算公式是如何’冒’出来的? 再回过头来看看那个计算公式是怎么’冒’出来的,其实很简单,只需要从硬盘容量纬度和Java Heap纬度两方面计算Region个数,再令两者相等就可以推导出来,如下: 硬盘容量纬度下Region个数:Disk Size / (RegionSize *ReplicationFactor) Java Heap纬度下Region个数:Java Heap * HeapFractionForMemstore / (MemstoreSize / 2 ) Disk Size / (RegionSize *ReplicationFactor) =Java Heap * HeapFractionForMemstore / (MemstoreSize / 2 ) =>Disk Size / Java Heap = RegionSize / MemstoreSize * ReplicationFactor * HeapFractionForMemstore * 2 这样的公式有什么具体意义? 1. 最直观的意义就是判断在当前给定配置下是否会有资源浪费,内存资源和硬盘资源是否匹配。 2. 那反过来,如果已经给定了硬件资源,比如硬件采购部已经采购了当前机器内存128G,分配给Java Heap为96G,而硬盘是40T,很显然两者是不匹配的,那能不能通过修改HBase配置来使得两者匹配?当然可以,可以通过增大RegionSize或者减少MemstoreSize来实现,比如将默认的RegionSize由10G增大到20G,此时Disk Size / Java Heap = 384,96G * 384 = 36T,基本就可以使得硬盘和内存达到匹配。 3. 另外,如果给定配置下内存硬盘不匹配,那实际场景下内存’浪费’好呢还是硬盘’浪费’好?答案是内存’浪费’好,比如采购的机器Java Heap可以分配到126G,而总硬盘容量只有18T,默认配置下必然是Java Heap有浪费,但是可以通过修改HBase配置将多余的内存资源分配给HBase读缓存BlockCache,这样就可以保证Java Heap并没有实际浪费。 另外,还有这些资源需要注意… 带宽资源:因为HBase在大量scan以及高吞吐量写入的时候特别耗费网络带宽资源,强烈建议HBase集群部署在万兆交换机机房,单台机器最好也是万兆网卡+bond。如果特殊情况交换机是千兆网卡,一定要保证所有的RegionServer机器部署在同一个交换机下,跨交换机会导致写入延迟很大,严重影响业务写入性能。 CPU资源:HBase是一个CPU敏感型业务,无论数据写入读取,都会因为大量的压缩解压操作,特别耗费计算资源。因此对于HBase来说,CPU越多越好。 参考: http://hadoop-hbase.blogspot.com/2013/01/hbase-region-server-memory-sizing.html Region规划 Region规划主要涉及到两个方面:Region个数规划以及单Region大小规划,这两个方面并不独立,而是相互关联的,大Region对应的Region个数少,小Region对应的Region个数多。Region规划相信是很多HBase运维同学比较关心的问题,一个给定规格的RegionServer上运行多少Region比较合适,在刚开始接触HBase的时候,这个问题也一直困扰着笔者。在实际应用中,Region太多或者太少都有一定的利弊: 优点 缺点 大量小Region 1.更加有利于集群之间负载分布 2.有利于高效平稳的Compaction,这是因为小Region中HFile相对较小,Compaction代价小,详情可见:Stripe Compaction 1. 最直接的影响:在某台RegionServer异常宕机或者重启的情况下大量小Region重分配以及迁移是一个很耗时的操作,一般一个Region迁移需要1.5s~2.5s左右,Region个数越多,迁移时间越长。直接导致failover时间很长。 2. 大量小Region有可能会产生更加频繁的flush,产生很多小文件,进而引起不必要的Compaction。特殊场景下,一旦Region数超过一个阈值,将会导致整个RegionServer级别的flush,严重阻塞用户读写。 3. RegionServer管理维护开销很大 少量大Region 1. 有利于RegionServer的快速重启以及宕机恢复 2. 可以减少总的RCP数量 3. 有利于产生更少的、更大的flush 1. Compaction效果很差,会引起较大的数据写入抖动,稳定性较差 2. 不利于集群之间负载均衡 可以看出来,在HBase当前工作模式下,Region太多或者太少都不是一件太好的事情,在实际线上环境需要选择一个折中点。官方文档给出的一个推荐范围在20~200之间,而单个Region大小控制在10G~30G,比较符合实际情况。 然而,HBase并不能直接配置一台RegionServer上的Region数,Region数最直接取决于RegionSize的大小配置hbase.hregion.max.filesize,HBase认为,一旦某个Region的大小大于配置值,就会进行分裂。 hbase.hregion.max.filesize默认为10G,如果一台RegionServer预期运行100个Region,那单台RegionServer上数据量预估值就为:10G * 100 * 3 = 3T。反过来想,如果一台RegionServer上想存储12T数据量,那按照单Region为10G计算,就会分裂出400个Region,很显然不合理。此时就需要调整参数hbase.hregion.max.filesize,将此值适度调大,调整为20G或者30G。而实际上当下单台物理机所能配置的硬盘越来越大,比如36T已经很普遍,如果想把所有容量都用来存储数据,依然假设一台RegionServer上分布100个Region,那么每个Region的大小将会达到可怕的120G,一旦执行Compaction将会是一个灾难。 可见,对于当下的HBase,如果想让HBase工作的更加平稳(Region个数控制在20~200之间,单Region大小控制在10G~30G之间),最多可以存储的数据量差不多为200 * 30G * 3= 18T。如果存储的数据量超过18T,必然会引起或多或少的性能问题。所以说,从Region规模这个角度讲,当前单台RegionServer能够合理利用起来的硬盘容量上限基本为18T。 然而随着硬件成本的不断下降,单台RegionServer可以轻松配置40T+的硬盘容量,如果按照上述说法,越来越多的硬盘其实只是’镜中月,水中花’。社区也意识到了这样的问题,在当前Region的概念下提出了Sub-Region的概念,可以简单理解为将当前的Region切分为很多逻辑上小的Sub-Region。Region还是以前的Region,只是所有之前以Region为单位进行的Compaction将会以更小的Sub-Region粒度执行。这样,单Region就可以配置的很大,比如50G、100G,此时单台RegionServer上也就可以存储更多的数据。个人认为Sub-Region功能将会是HBase开发的一个重点。 总结 本文结合HBase相关理论知识以及笔者的实际经验,对HBase集群规划中最常见的三个问题 - 业务规划、容量规划以及Region规划做了简单的解析,希望给大家一些启发和思考。线上集群规划是一个经验积累的过程,相信每个HBase运维同学或多或少都会碰到一些坑,也肯定会有自己的思考和见解,希望大家能够更多的在评论区或者邮件交流,谢谢! 本文转载自:http://hbasefly.com 原文链接

优秀的个人博客,低调大师

Hive Tunning(三) 最佳实践

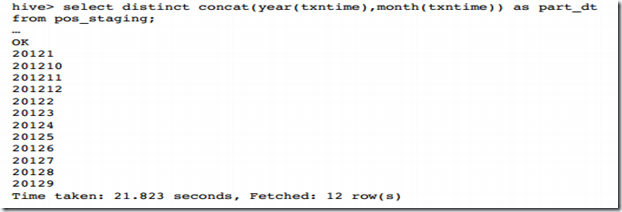
在上一讲的基础上,我们来做来一个实际的例子来展示如何在实操中进行高效的hive查询作业。 (1)首先我们建立一个表 CREATE EXTERNAL TABLE pos_staging( txnid STRING, txntime STRING, givenname STRING, lastname STRING, postalcode STRING, storeid STRING, indl STRING, productid STRING, purchaseamount FLOAT, creditcard STRING )ROW FORMAT DELIMITED FIELDS TERMINATED BY '|' LOCATION '/user/hdfs/staging_data/pos_staging'; 我们建立一张外部表是为了初始化或者加载mapreduce或者pig作业产生的元数据,然后我们自己建立一张优化的表。 (2)建立调优表的时候,我们就要考虑使用哪种分区模式,比如按时间分区。 以下是两个关于动态分区的参数: 所有节点的动态分区的最大数以及每个节点的动态分区的最大数 hive.exec.max.dynamic.partitions=1000 hive.exec.max.dynamic.partitions.pernode=100 (3)建立调优表 CREATE TABLE fact_pos ( txnid STRING, txntime STRING, givenname STRING, lastname STRING, postalcode STRING, storeidSTRING, indl STRING, productid STRING, purchaseamountFLOAT, creditcardSTRING ) PARTITIONED BY (part_dt STRING)! CLUSTERED BY (txnid) SORTED BY (txnid) INTO 24 BUCKETS STORED AS ORC tblproperties("orc.compress"="SNAPPY"); CLUSTERED 和SORTED 使用都是同一个字段,它就是连接的时候需要使用的字段。 BUCKETS也出现了,前面一直不理解的概念,现在出现了还分了24个。 (4)把数据插入到调优表中 FROM pos_staging INSERT OVERWRITE TABLE fact_pos PARTITION (part_dt) SELECT txnid, txntime, givenname, lastname, postalcode, storeid, indl, productid, purchaseamount, creditcard, concat(year(txntime),month(txntime)) as part_dt SORT BY productid; 语句中使用了前面教的自动分区的语句,按照年月自动分区。 hadoop fs-setrep-R –w 5 /apps/hive/warehouse/fact_pos 上面的命令当中是个hdfs中存数的fact_pos表增加备份,因为hdfs的数据是存得很分散的,增加备份因为会使得节点上的数据增多,然后查询的时候,hive 从本地直接就可以获取到的数据的几率提高,增快查询速度。 当然考虑到空间的问题,可以减少一下备份的数量。 上述流程我们也可以把它放到oozie中自动执行。 。。。又一个熟悉的词出现了。 在hdfs-site.xml或者Ambari settings for HDFS, 设置完要重启。 dfs.block.local-path-access.user=hdfs dfs.client.read.shortcircuit=true dfs.client.read.shortcircuit.skip.checksum=false 开启了这个东东有什么作用呢?当数据块在本地的时候,它可以不需要开启一个端口来读,可以直接访问,就像图中的闪电那样。 (5)执行查询 set hive.mapred.reduce.tasks.speculative.execution=false; set io.sort.mb=300; set mapreduce.reduce.input.limit=-1; select productid, ROUND(SUM(purchaseamount),2) as total from fact_pos where part_dt between ‘201210’ and ‘201212’ group by productid order by total desc limit 100; 查询之前先对查询设置相应的运行参数。

优秀的个人博客,低调大师

MySQL VARCHAR 最佳长度评估实践

你的 VARCHAR 长度合适么? 作者:官永强,爱可生 DBA 团队成员,擅长 MySQL 运维方面的技能。热爱学习新知识,亦是个爱打游戏的宅男。 作者:李富强,爱可生 DBA 团队成员,熟悉 MySQL,TiDB,OceanBase 等数据库。相信持续把对的事情做好一点,会有不一样的收获。 爱可生开源社区出品,原创内容未经授权不得随意使用,转载请联系小编并注明来源。 本文约 2200 字,预计阅读需要 8 分钟。 背景描述 有客户反馈,他们对一个 VARCHAR 类型的字段进行长度扩容。第一次可以很快就可以修改好,但是第二次却需要执行很久。比较疑惑明明表中的数据量是差不多的,为什么从 VARCHAR(20) 调整为 VARCHAR(50) 就比较快,但是从 VARCHAR(50) 调整为 VARCHAR(100) 就需要执行很久呢? 于是我们对该情况进行场景复现并进行问题分析。 环境信息 本次验证涉及到的产品及版本信息如下: 产品 版本 MySQL 5.7.25-log MySQL Community Server (GPL) Sysbench sysbench 1.0.17 场景复现 3.1 数据准备 mysql> show create table test.sbtest1; +---------+----------------------------------------+ | Table | Create Table | +---------+----------------------------------------+ | sbtest1 | CREATE TABLE `sbtest1` ( `id` int(11) NOT NULL AUTO_INCREMENT, `k` int(11) NOT NULL DEFAULT '0', `c` varchar(20) COLLATE utf8mb4_bin NOT NULL DEFAULT '', `pad` varchar(20) COLLATE utf8mb4_bin NOT NULL DEFAULT '', PRIMARY KEY (`id`), KEY `k_1` (`k`) ) ENGINE=InnoDB AUTO_INCREMENT=1000001 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_bin | +---------+----------------------------------------+ 1 row in set (0.00 sec) mysql> select count(*) from test.sbtest1; +----------+ | count(*) | +----------+ | 1000000 | +----------+ 1 row in set (0.10 sec) 3.2 问题验证 模拟客户的描述,我们对字段 c 进行修改,将 VARCHAR(20) 修改为 VARCHAR(50) 后再修改为 VARCHAR(100),并观察其执行所需时间,以下是相关的操作命令以及执行结果: mysql> ALTER TABLE test.sbtest1 MODIFY c VARCHAR(50); Query OK, 0 rows affected (0.01 sec) Records: 0 Duplicates: 0 Warnings: 0 mysql> show create table test.sbtest1; +---------+-------------------------------+ | Table | Create Table | +---------+-------------------------------+ | sbtest1 | CREATE TABLE `sbtest1` ( `id` int(11) NOT NULL AUTO_INCREMENT, `k` int(11) NOT NULL DEFAULT '0', `c` varchar(50) COLLATE utf8mb4_bin DEFAULT NULL, `pad` varchar(20) COLLATE utf8mb4_bin NOT NULL DEFAULT '', PRIMARY KEY (`id`), KEY `k_1` (`k`) ) ENGINE=InnoDB AUTO_INCREMENT=1000001 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_bin | +---------+--------------------------------------------------------+ 1 row in set (0.00 sec) mysql> ALTER TABLE test.sbtest1 MODIFY c VARCHAR(100); Query OK, 1000000 rows affected (4.80 sec) Records: 1000000 Duplicates: 0 Warnings: 0 mysql> show create table test.sbtest1; +---------+---------------------------+ | Table | Create Table | +---------+---------------------------+ | sbtest1 | CREATE TABLE `sbtest1` ( `id` int(11) NOT NULL AUTO_INCREMENT, `k` int(11) NOT NULL DEFAULT '0', `c` varchar(100) COLLATE utf8mb4_bin DEFAULT NULL, `pad` varchar(20) COLLATE utf8mb4_bin NOT NULL DEFAULT '', PRIMARY KEY (`id`), KEY `k_1` (`k`) ) ENGINE=InnoDB AUTO_INCREMENT=1000001 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_bin | +---------+------------------------------------------------------------------------+ 1 row in set (0.00 sec) 通过验证发现,该问题会稳定复现,故继续尝试去修改,最终发现在修改 VARCHAR(63) 为 VARCHAR(64) 时需要执行很久,但在 64 之后继续进行长度扩容发现可以很快完成。 mysql> ALTER TABLE test.sbtest1 MODIFY c VARCHAR(63); Query OK, 0 rows affected (0.01 sec) Records: 0 Duplicates: 0 Warnings: 0 mysql> ALTER TABLE test.sbtest1 MODIFY c VARCHAR(64); Query OK, 1000000 rows affected (4.87 sec) Records: 1000000 Duplicates: 0 Warnings: 0 mysql> show create table test.sbtest1; +---------+---------------+ | Table | Create Table | +---------+---------------+ | sbtest1 | CREATE TABLE `sbtest1` ( `id` int(11) NOT NULL AUTO_INCREMENT, `k` int(11) NOT NULL DEFAULT '0', `c` varchar(64) COLLATE utf8mb4_bin DEFAULT NULL, `pad` varchar(20) COLLATE utf8mb4_bin NOT NULL DEFAULT '', PRIMARY KEY (`id`), KEY `k_1` (`k`) ) ENGINE=InnoDB AUTO_INCREMENT=1000001 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_bin | +---------+------------------------------------------------------------------------+ 1 row in set (0.00 sec) mysql> ALTER TABLE test.sbtest1 MODIFY c VARCHAR(65); Query OK, 0 rows affected (0.01 sec) Records: 0 Duplicates: 0 Warnings: 0 mysql> ALTER TABLE test.sbtest1 MODIFY c VARCHAR(66); Query OK, 0 rows affected (0.01 sec) Records: 0 Duplicates: 0 Warnings: 0 3.3 问题分析 对于 VARCHAR(63) 修改为 VARCHAR(64) 需要执行很久的这个情况进行分析。通过查阅官方文档 发现,由于 VARCHAR 字符类型在字节长度为 1 时可存储的字符为 0~255。当前字符集类型为 UTF8MB4,由于 UTF8MB4 为四字节编码字符集,即一个字节长度可存储 63.75(255/4)个字符,所以当我们将 VARCHAR(63) 修改为 VARCHAR(64) 时,需要增加一个字节去进行数据的存储,就要通过建立临时表的方式去完成本次长度扩容,故需要花费大量时间。 拓展验证 4.1 数据准备 mysql> show create table test_utf8.sbtest1; +---------+----------------------------------------+ | Table | Create Table | +---------+----------------------------------------+ | sbtest1 | CREATE TABLE `sbtest1` ( `id` int(11) NOT NULL AUTO_INCREMENT, `k` int(11) NOT NULL DEFAULT '0', `c` varchar(20) NOT NULL DEFAULT '', `pad` varchar(20) NOT NULL DEFAULT '', PRIMARY KEY (`id`), KEY `k_1` (`k`) ) ENGINE=InnoDB AUTO_INCREMENT=1000001 DEFAULT CHARSET=utf8 | +---------+------------------+ 1 row in set (0.00 sec) mysql> select count(*) from test_utf8.sbtest1; +----------+ | count(*) | +----------+ | 1000000 | +----------+ 1 row in set (0.10 sec) 4.2 UTF8 场景验证 由于 UTF8 为三字节编码字符集,即一个字节可存储 85(255/3=85)个字符。 本次修改顺序:VARCHAR(20)→VARCHAR(50)→VARCHAR(85),并观察其执行所需时间,以下是相关的操作命令以及执行结果: mysql> ALTER TABLE test_utf8.sbtest1 MODIFY c VARCHAR(50) ,algorithm=inplace,lock=none; Query OK, 0 rows affected (0.01 sec) Records: 0 Duplicates: 0 Warnings: 0 mysql> ALTER TABLE test_utf8.sbtest1 MODIFY c VARCHAR(85) ,algorithm=inplace,lock=none; Query OK, 0 rows affected (0.00 sec) Records: 0 Duplicates: 0 Warnings: 0 mysql> show create table test_utf8.sbtest1; +---------+-------------------------------+ | Table | Create Table | +---------+-------------------------------+ | sbtest1 | CREATE TABLE `sbtest1` ( `id` int(11) NOT NULL AUTO_INCREMENT, `k` int(11) NOT NULL DEFAULT '0', `c` varchar(85) DEFAULT NULL, `pad` varchar(20) NOT NULL DEFAULT '', PRIMARY KEY (`id`), KEY `k_1` (`k`) ) ENGINE=InnoDB AUTO_INCREMENT=1000001 DEFAULT CHARSET=utf8 | +---------+--------------------------------------------------+ 1 row in set (0.00 sec) 修改顺序:VARCHAR(85)→VARCHAR(86)→VARCHAR(100),此时我们会观察到执行的 SQL 语句直接返回报错。于是我们删除 algorithm=inplace ,lock=none 这两个参数,即允许本次 SQL 创建临时表以及给目标表上锁,然后重新执行 SQL,以下是相关的操作命令以及执行结果: mysql> ALTER TABLE test_utf8.sbtest1 MODIFY c VARCHAR(86) ,algorithm=inplace,lock=none; ERROR 1846 (0A000): ALGORITHM=INPLACE is not supported. Reason: Cannot change column type INPLACE. Try ALGORITHM=COPY. mysql> ALTER TABLE test_utf8.sbtest1 MODIFY c VARCHAR(86); Query OK, 1000000 rows affected (4.94 sec) Records: 1000000 Duplicates: 0 Warnings: 0 mysql> show create table test_utf8.sbtest1; +---------+-------------------------------+ | Table | Create Table | +---------+-------------------------------+ | sbtest1 | CREATE TABLE `sbtest1` ( `id` int(11) NOT NULL AUTO_INCREMENT, `k` int(11) NOT NULL DEFAULT '0', `c` varchar(86) DEFAULT NULL, `pad` varchar(20) NOT NULL DEFAULT '', PRIMARY KEY (`id`), KEY `k_1` (`k`) ) ENGINE=InnoDB AUTO_INCREMENT=1000001 DEFAULT CHARSET=utf8 | +---------+--------------------------------------------------+ 1 row in set (0.00 sec) mysql> ALTER TABLE test_utf8.sbtest1 MODIFY c VARCHAR(100) ,algorithm=inplace,lock=none; Query OK, 0 rows affected (0.00 sec) Records: 0 Duplicates: 0 Warnings: 0 4.3 UTF8MB4 场景验证 由于 UTF8MB4 为四字节编码字符集,即一个字节长度可存储 63(255/4=63.75)个字符。 本次修改顺序:VARCHAR(20)→VARCHAR(50)→VARCHAR(63),并观察其执行所需时间,以下是相关的操作命令以及执行结果: mysql> ALTER TABLE test.sbtest1 MODIFY c VARCHAR(50) ,algorithm=inplace,lock=none; Query OK, 0 rows affected (0.00 sec) Records: 0 Duplicates: 0 Warnings: 0 mysql> ALTER TABLE test.sbtest1 MODIFY c VARCHAR(63) ,algorithm=inplace,lock=none; Query OK, 0 rows affected (0.00 sec) Records: 0 Duplicates: 0 Warnings: 0 mysql> show create table test.sbtest1; +---------+-------------------------+ | Table | Create Table | +---------+-------------------------+ | sbtest1 | CREATE TABLE `sbtest1` ( `id` int(11) NOT NULL AUTO_INCREMENT, `k` int(11) NOT NULL DEFAULT '0', `c` varchar(63) COLLATE utf8mb4_bin DEFAULT NULL, `pad` varchar(20) COLLATE utf8mb4_bin NOT NULL DEFAULT '', PRIMARY KEY (`id`), KEY `k_1` (`k`) ) ENGINE=InnoDB AUTO_INCREMENT=1000001 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_bin | +---------+-------------------------------------------------------------------------+ 1 row in set (0.00 sec) 本次修改顺序:VARCHAR(63)→VARCHAR(64)→VARCHAR(100),此时我们会观察到执行的 SQL 语句直接返回报错。于是我们删除 algorithm=inplace, lock=none 这两个参数,即允许本次 SQL 创建临时表以及给目标表上锁,然后重新执行 SQL,以下是相关的操作命令以及执行结果: mysql> ALTER TABLE test.sbtest1 MODIFY c VARCHAR(64) ,algorithm=inplace,lock=none; ERROR 1846 (0A000): ALGORITHM=INPLACE is not supported. Reason: Cannot change column type INPLACE. Try ALGORITHM=COPY. mysql> ALTER TABLE test.sbtest1 MODIFY c VARCHAR(64) ; Query OK, 1000000 rows affected (4.93 sec) Records: 1000000 Duplicates: 0 Warnings: 0 mysql> show create table test.sbtest1; +---------+--------------------------+ | Table | Create Table | +---------+--------------------------+ | sbtest1 | CREATE TABLE `sbtest1` ( `id` int(11) NOT NULL AUTO_INCREMENT, `k` int(11) NOT NULL DEFAULT '0', `c` varchar(64) COLLATE utf8mb4_bin DEFAULT NULL, `pad` varchar(20) COLLATE utf8mb4_bin NOT NULL DEFAULT '', PRIMARY KEY (`id`), KEY `k_1` (`k`) ) ENGINE=InnoDB AUTO_INCREMENT=1000001 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_bin | +---------+-------------------------------------------------------------------------+ 1 row in set (0.00 sec) mysql> ALTER TABLE test.sbtest1 MODIFY c VARCHAR(100) ,algorithm=inplace,lock=none; Query OK, 0 rows affected (0.00 sec) Records: 0 Duplicates: 0 Warnings: 0 4.4 对比分析 字符长度修改 UTF8(MB3) UTF8MB4 20->50 online ddl (inplace) online ddl (inplace) 50->100 online ddl (copy) online ddl (copy) X->Y 当Y*3<256 时,inplace <br> 当X*3>=256,inplace 当 Y*4<256 时,inplace <br> 当 X*4>=256,inplace 备注 一个字符最大占用 3 个字节 一个字符最大占用 4 个字节 结论 当一个字段的最大字节长度 >=256 字符时,需要 2 个字节来表示字段长度。 使用 UTF8MB4 举例: 对于字段的最大字节长度在 256 字符内变化 (即 x*4<256 且 Y*4<256),online ddl 走 inplace 模式,效率高。 对于字段的最大字节长度在 256 字符外变化 (即 x*4>=256 且 Y*4>=256) ,online ddl 走 inplace 模式,效率高。 否则,online ddl 走 copy 模式,效率低. UTF8(MB3) 同理。 建议 为避免由于后期字段长度扩容,online ddl 走效率低的 copy 模式,建议: 对于 UTF8(MB3) 字符类型: 字符个数小于 50 个,建议设置为 VARCHAR(50) 或更小的字符长度。 字符个数接近 84(256/3=83.33)个,建议设置为varchar(84)或更大的字符长度。 对于 UTF8MB4 字符类型: 字符个数小于 50 个,建议设置为 VARCHAR(50),或更小的字符长度。 字符个数接近 64(256/4=64)个,建议设置为 VARCHAR(64) 或更大的字符长度。 本次验证结果仅供参考,若您需要在生产环境中进行操作,请结合实际情况合理定义 VARCHAR 的长度,避免造成经济损失。 更多技术文章,请访问:https://opensource.actionsky.com/ 关于 SQLE SQLE 是一款全方位的 SQL 质量管理平台,覆盖开发至生产环境的 SQL 审核和管理。支持主流的开源、商业、国产数据库,为开发和运维提供流程自动化能力,提升上线效率,提高数据质量。 SQLE 获取 类型 地址 版本库 https://github.com/actiontech/sqle 文档 https://actiontech.github.io/sqle-docs/ 发布信息 https://github.com/actiontech/sqle/releases 数据审核插件开发文档 https://actiontech.github.io/sqle-docs/docs/dev-manual/plugins/howtouse

优秀的个人博客,低调大师

PostgreSQL Huge Page使用最佳实践

对于重度依赖于内存的应用数据库而言,hugepage是经常会被使用的。例如在Oracle中我们一般建议当SGA大于8GB时使用hugepage,而在postgresql中我们也建议当内存较大的时候开启hugepage。 为什么呢?这是因为Linux需要维护虚拟内存地址与物理内存的映射关系,为了提升转换性能,最好这部分能够cache在cpu的cache里面。页越大,映射表就越小。使用huge page可以减少页表大小。 接下来我们来看看pg中hugepage的设置方法。 设置方法: 1、首先我们需要看看数据库使用了多少内存。 获得PID $ head -1 $PGDATA/postmaster.pid 4170 计算数据库启动用了多少内存,指定进程ID $ pmap 4170 | awk ‘/rw-s/ && /zero/ {print $2}’ 6490428K 2、计算需要使用多少hugepage 查看hugepage页大小 grep ^Hugepagesize /proc/meminfo Hugepagesize: 2048 kB 计算需要多少hugepage(或者直接使用shared_buffer/hugepage页大小) 6490428 / 2048 = 3169.15 一般建议设置大于内存数,因为这里我们取整为:3170 3、分配hugepage vi /etc/sysctl.conf vm.nr_hugepages = 3170 sysctl -p 4、设置数据库参数 huge_pages = on # 或者try shared_buffers = 64GB # 使用64G内存 5、重启数据库并查看hugepage使用情况 cat /proc/meminfo |grep -i huge AnonHugePages: 6144 kB HugePages_Total: 3170 ## 设置的HUGE PAGE HugePages_Free: 3170 ## 这个是当前剩余的,但是实际上真正可用的并没有这么多,因为被PG锁定了3170个大页 HugePages_Rsvd: 3170 ## 启动PG时申请的HUGE PAGE HugePages_Surp: 0 Hugepagesize: 2048 kB ## 当前大页2M 注意事项: 1、当配置参数huge_pages设置为on时,若PG启动时需要注册的共享内存大于操作系统提供的Huge Page大小时,数据库将无法启动。推荐将huge_pages参数设置为try,在此种场景下,PostMaster将会改为申请普通内存。 2、如果连接数较少时,使用HUGE PAGE性能不如不使用。因此我们可以尽量使用连接池,减少连接数,提升性能。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册