首页 文章 精选 留言 我的

精选列表

搜索[AIOps最佳实践],共10001篇文章
优秀的个人博客,低调大师

PikiwiDB(Pika) 3.5 最佳实践

PikiwiDB(Pika) 是 360 技术中台中间件团队基于 RocksDB 开发的大容量类 Redis 存储系统,力求在完全兼容 Redis 协议、继承 Redis 便捷运维设计的前提下通过持久化存储方式解决 Redis 在大容量场景下主从同步代价高、恢复时间慢、单线程相对脆弱、内存成本高等问题。 我们根据 360 内部的 PikiwiDB(Pika) 使用经验及社区用户的问题反馈,整理了本文并在这里分享给大家。 之一 在微信群(群管理员微信号:PikiwiDB)中提问时,请主动带上版本号,可大幅度加快问题解决速度。 之二 PikiwiDB(Pika) 已在 2024 年 5 月更新至 3.5.4,但仍然有大量用户停留在 3.3.6 或3.3.2,我们建议使用 3.5.4 的最新版(预计本周内发布 v4.0.0),你会发现你遇到的很多问题都在我们的 bug 修复列表中。 之三 PikiwiDB(Pika) 的线程数量 thread-num 建议设置为 CPU core 数目的 80% 左右,如果是单机多实例的部署,每个 PikiwiDB(Pika) 实例的线程数量可以酌情降低,但不建议低于 CPU core 数的 1/2。 之四 PikiwiDB(Pika) 的工作线程池数量 thread-pool-size 建议和 CPU core 数目一致,如果是单机多实例的部署,每个 PikiwiDB(Pika) 实例的线程数量可以酌情降低,但不建议低于 1/2 CPU core 数。 之五 PikiwiDB(Pika) 的性能和 IO 性能息息相关,如果对耗时非常敏感,建议使用 NVMe SSD。另外,主从服务器的硬件规格应当尽量一致。 之六 在使用 PikiwiDB(Pika) 复合数据结构(hash,list,zset,zset)时,尽量确保每个 key 中的二级 key(或者成为 field)不要太多(不要超过 1 万个),在业务层或者代理层对大 key 符合数据结构进行拆分(类似于分库分表), 这样可以避免超大 key 带来很多潜在的性能风险。 之七 root-connection-num 参数非常有用,意为“允许通过 127.0.0.1 登录 PikiwiDB(Pika) 的连接数”,它不会被算进客户端最大连接数配置项 maxclients,因此在发生异常 maxclients 被用尽的场景中,管理员仍然可以登录 PikiwiDB(Pika) 所在服务器并通过 127.0.0.1 登入 PikiwiDB(Pika) 处理问题,可以认为是超级管理员通道。 之八 client kill 命令被加强了,如果你想一次性杀掉当前 PikiwiDB(Pika) 的所有客户端连接,只需要执行 client kill all 命令即可。注意,主从同步的网络连接不受影响。 之九 适当地调整 timeout 参数,PikiwiDB(Pika) 会主动断开不活跃时间超过 timeout 值的连接,避免连接数耗尽。由于网络连接会占用主机内存,因此合理的配置 timeout 参数也能够在一定程度上降低 PikiwiDB(Pika) 的内存使用量。 之十 PikiwiDB(Pika) 的内存占用主要集中在 SST 文件的 cache 和网络连接内存占用量,通常网络连接内存量会比 SST 的 cache 大,PikiwiDB(Pika) 目前已支持连接申请内存的动态调整与回收,因此连接占用的总内存大小是可以粗略估算的,如果你的 PikiwiDB(Pika) 内存占用远超预估(如大于 10GiB),那么可能为你当前使用的版本存在内存泄漏问题,尝试依次执行命令 client kill all 对连接内存进行强制回收,或者升级到最新版本。 之十一 非常不建议单副本运行 PikiwiDB(Pika),单副本的数据安全性无法保障,诸如 RocksDB Bug 或者资源不够(如:ERR IO error: While fdatasync: /data1/db/zsets/16566747.log: Cannot allocate memory)导致 RocksDB 存储数据被污染,此时无法全量恢复数据。 最简集群状态应为一主一从。 之十二 如果 PikiwiDB(Pika) 单副本运行(非主从集群),只在乎性能,且不在乎数据安全性(如缓存场景),可以考虑通过关闭 binlog(将 write-binlog 参数设置为 no)来提高写入性能。 之十三 PikiwiDB(Pika) v3.5.2 以及之后的版本提供了关闭 RocksDB WAL (DisableWAL true) 的命令,如果你的 PikiwiDB(Pika) 实例出现间断性的写性能阻塞的情况,你可以通过关闭 WAL 命令暂时关闭 WAL,这种方式有断电情况下数据丢失的风险,待性能恢复时,请及时再打开。对数据完整性要求不高时,建议关闭 WAL。 之十四 PikiwiDB(Pika) 的数据目录中有大量的 SST 文件,这些文件随着 PikiwiDB(Pika) 数据量的增加而增加,建议为 PikiwiDB(Pika) 配置一个较大的 open_file_limit ,以避免 fd 不够用,如果不希望 Pika 占用太多的文件描述符,可以通过适当增大单个 SST 的体积来降低 SST 的总数量,对应参数为 target-file-size-base。 之十五 不要修改 log 目录中的 write2file 文件和 manifest。write2file 记录了 binlog 文件列表等关键信息,而 manifest 则记录了 RocksDB 的 version 信息,二者关乎 PikiwiDB(Pika) 实例重启后的 binlog 续写及 slave 断点续传时的数据正确性。 之十六 自 PikiwiDB(Pika) v3.5.0 之后的版本摒弃了用 rsync 进程进行全量同步,PikiwiDB(Pika) 进程内部重新实现了一套新的全量同步机制(通过名称为 rsync 的线程传输)。PikiwiDB(Pika) 提供了 rsync 的总传输限速参数 throttle-bytes-per-second 和并发 rsync 线程数 max-rsync-parallel-num,throttle-bytes-per-second 参数的单位是 MiB,建议在千兆环境中该参数设置不应高于 45,而在万兆环境中不应高于 500,以避免 PikiwiDB(Pika) 在全量同步的时候将所在服务器网卡流量用尽而影响到 PikiwiDB(Pika) 服务客户端。 之十七 在 PikiwiDB(Pika) 中执行 “ key * ” 并不会造成 Pika 阻塞(PikiwiDB(Pika) 是多线程的),但在存在巨量 key 的场景下可能会造成临时占用巨量内存(这些内存用于该连接存放 key *的执行结果,会在 “ key * ”执行完毕后释放),因此使用 “ key * ” 一定要小心谨慎。 之十八 如果发现 PikiwiDB(Pika) 有数据但 info keyspace 的显示均为 0,这是因为 Pika 并没有像 Redis 那样对 key 的数量进行实时统计,PikiwiDB(Pika) 中 key 的统计需要人工触发,执行 info keyspace 1,注意执行 info keyspace 是不会触发统计的,没有带上最后的参数 1 将会仅仅展示上一次的统计结果,key 的统计是需要时间的,执行状态可以通过 info stats 中的 is_scaning_keyspace 进行查看,该项值为 yes 表明统计正在进行,为 no 时表明没有正在进行的统计/上一次统计已结束,在统计执行完毕前 info keyspace 不会更新,info keyspace 的数据是存放在内存里的,重启将清零。 之十九 不要在 PikiwiDB(Pika) 执行全量 compact 的时候触发 key 统计(info keyspace 1)或执行 keys *,否则会造成数据体积暂时膨胀直到 key 统计、keys *执行结束。 之二十 对存在大量过期数据的 PikiwiDB(Pika) 实例,compact-cron 配置项可以在固定时段(一般配置为低峰流量时间段)进行过期数据清理。自 PikiwiDB(Pika) v3.5.0 之后还提供了 auto_compact 配置型,启用后 PikiwiDB(Pika) 会自动周期性执行 compact。 异常的数据体积(大于估算值 10%以上),可以通过执行 compact 命令,在 compact 执行完毕后观察数据体积是否恢复正常。 请求耗时突然异常增大,可以通过执行 compact 命令,在 compact 执行完毕后观察请求耗时是否恢复正常。 之二十一 自 PikiwiDB(Pika) v3.5.0 之后可统计过期 key(可通过 info keyspace 1 来触发统计,通过 info keyspace 查看统计结果),统计结果中的 invaild_keys 的值为“已删除/过期但还未被物理删除的 key 的数量”,PikiwiDB(Pika) 会在后台逐步地对已删除/过期的 key 进行物理清理,由于这是一个后台行为,因此在存在大规模过期 key 的场景下这些 key 可能无法被及时清理,因此建议关注该值,若发现无效 key 数量过多可通过 compact 命令进行全面清理,这样能够将未物理清理的无效数据控制在一个较好的程度从而确保 Pika 的性能稳定,如果 PikiwiDB(Pika) 中存储的数据是规律性过期的,例如每个 key 的过期时间为 7 天,那么建议通过配置 compact-cron 参数来实现每天的定时自动进行全量 compact,compact 会占用一定的 IO 资源,因此如果磁盘 IO 压力过大,建议将其配置为业务低峰期执行,例如深夜。 之二十二 write2file 的角色相当于 binlog,建议 write2file 保留周期/数量不低于 48 小时,足够的 write2file 有利于 大数据集群的从库扩容、从库服务器关机维修、从库迁移 等工作,不会因为主库 write2file 过期而被迫全量重传。 之二十三 PikiwiDB(Pika) 的备份生成为快照式,通过硬链接存放在 dump 目录下,以日期为后缀,每天只生成一份,多次生成备份时新的备份会覆盖之前的旧文件。在生成备份快照的时,为了确保数据的一致性 PikiwiDB(Pika) 会暂时阻塞写入,阻塞时间与实际数据量相关,根据测试PikiwiDB(Pika) 生成 500GiB 备份快照仅需 50ms。在写入阻塞的过程中连接不会中断,但 client 会感觉到 “在那一瞬间请求耗时增加了一些”。由于PikiwiDB(Pika)Pika 的快照是 db 目录中 sst 文件的硬连接,因此最初这个目录是不会占用磁盘空间的。 但在 PikiwiDB(Pika) db 目录中的 SST 文件发生了合并、删除后,硬链接的旧文件并不删除,这会导致 PikiwiDB(Pika) 占用的磁盘空间超出预估,所以请根据实际的磁盘空间调整备份保留天数,避免备份太多而造成磁盘空间用尽。 之二十四 如果写入量巨大且磁盘性能不足以满足 RocksDB memtable 的及时刷盘需求,那么 RocksDB 很可能会进入写保护模式(write stall,写入将被全部阻塞),建议更换性能更好的存储系统来支撑,或者降低写入频率(例如将集中写数据的 2 小时拉长到 4 小时),也可适当加大 write-buffer-size 的值来提高 memtable 的总容量从而降低整个 memtable 被写满的可能。 之二十五 PikiwiDB(Pika) 对数据进行了压缩,默认压缩算法为 snappy,并允许改为 zlib,因此每一次数据的存入、读出都需要经过压缩、解压,这对 CPU 有一定的消耗,建议像使用 Redis 一样使用 PikiwiDB(Pika):在 PikiwiDB(Pika) 中关闭压缩,而在 client 中完成数据的压缩、解压,这样不仅能够降低数据体积,还能有效降低 Pikiw。注意关闭和开启压缩后,需要重启 PikiwiDB(Pika) 实例。 之二十六 读写分离很重要,PikiwiDB(Pika) 在常见的主从集群中由于写入是单点的(仅 master 支持写),因此写入性能是有极限的。可通过多个 slave 来共同支撑读流量,因此 PikiwiDB(Pika) 集群的读性能是随着 slave 数量的增加而增加的,所以对于读量很大的场景,建议在业务层代码加入读写分离策略,同时在 PikiwiDB(Pika) 层增加 slave 数量。 之二十七 全量 compact 的原理是逐步对 RocksDB 的每一层做数据合并、清理工作,在这个过程中会新增、删除大量的 SST 文件,因此在执行全量 compact 的时候可以发现数据体积先增大后减小并最终减小到一个稳定值(无效、重复数据合并、清理完毕仅剩有效数据),建议在执行 compact 前确保磁盘空余空间不低于 30%,以避免新增 SST 文件时将磁盘空间耗尽,另外 PikiwiDB(Pika) 支持对指定数据结构进行 compact,例如一个实例中已知 hashtable 结构的无效数据很少但 hashtable 结构数据量很大,set 结构数据量很大且无效数据很多,在这个例子中 hashtable 结构的 compaction(命令是 compact hash) 是没有必要的,你可以通过 compact set 实现只对 set 结构进行 compaction。 注意:在 PikiwiDB v4.0.0 版本之后,不再支持对特定类型的 compaction。因为 PikiwiDB v3.x 使用的存储引擎是 Blackwidow,每个数据类型使用一个 RocksDB,而 v4.0.0 的存储引擎升级为 Floyd,可以在单个 RocksDB 中存储所有类型的数据。 之二十八 PikiwiDB(Pika) 3.5.0 以后的版本支持通过 rate-limiter-bandwidth 配置项以限制磁盘 IO 速率,可以通过调整该配置参数来调整读写速度。在 v4.0.0 之前只支持写限速,在 v4.0.0 之后支持读写限速,可以通过调整配置参数中的 rate-limiter-mode 来设置限速模式。 之二十九 PikiwiDB(Pika) 和 Redis 一样支持慢日志功能,可通过 slowlog 命令查看。slowlog 的原始内容只存于内存中,内存空间有上限,且这个上限可配置,当然如果配置过大会造成 slowlog 占用太多内存。PikiwiDB(Pika) 也允许将 slowlog-write-errorlog 设置为 yes,以把慢日志记录到 pika.ERROR 日志中,用于追溯、分析。 之三十 PikiwiDB(Pika) v3.5.2 以后的版本支持冷热数据分离,并在 Pika 磁盘存储之上增加了内存缓存层(称之为 RedisCache),将用户访问的热数据放在缓存层,冷数据放在磁盘,可减少查询磁盘的次数,提升服务的读性能,不论 PikiwiDB(Pika) 使用的是主从复制模式还是集群模式,可以配置 cache-mode 为 1 ,并设置缓存的大小和个数,以提升读性能。如果实例内存较小,不足以支撑缓存层的资源耗费,你可以选择将 cache-mode 设置成为 0 将缓存层关闭掉。 之三十一 PikiwiDB(Pika) 3.5.3 以后的版本支持了 Redis ACL 功能,设置用户密码的方式发生了变化,ACL的认证方式和 Redis 保持一致,在 config 文件中按照 ACL 规则对 user 进行配置。PikiwiDB(Pika) 3.5.3 仍然兼容以前旧版本的认证方式。 之三十二 PikiwiDB(Pika) 3.5.3 以后的版本支持快、慢命令分离,有快、慢两个线程池,可以防止慢命令对快命令线程池阻塞的影响。可以通过 slow-cmd-list 配置项设置慢命令列表,通过设置 slow-cmd-thread-pool-size 设置慢命令线程池个数。 之三十三 欲知后事如何,且待微信群里分解。请添加 PikiwiDB 小助手【微信号: PikiwiDB】为好友,它会拉您加入官方微信群。

优秀的个人博客,低调大师

Pgbouncer最佳实践:系列三

作者:王志斌,曾获得中国PostgreSQL数据库管理工程师(PGCE),是PostgreSQL官方认证讲师,盘古云课堂特邀金牌讲师。 PgBouncer具有三种可用的池模式:事务池,会话池和语句池: 事务连接池 数据库客户端很少在不间断的情况下执行连续的事务。而是通常在事务之间执行非数据库工作。这意味着服务器连接在等待新工作到达时会花费大量时间空闲。 事务池模式试图减少服务器连接的空闲时间,如下所示: 池程序在开始事务时将服务器连接分配给客户端。 客户端的事务完成后,池程序将释放连接分配。 注意事项: 如果客户端运行多个事务,则每个事务可以在不同的服务器连接上执行。 单个服务器连接可以在其生命周期内运行由不同客户端发出的事务。 图 6 事务连接池 与服务器所允许的连接相比,允许活动客户端的数量要多得多。尽管取决于给定的工作负载,但经常会看到10倍或更多的活动客户端连接与服务器连接比率。 这确实带来了一个重要的警告:客户端不再期望对数据库会话状态所做的更改在同一客户端进行的连续事务中继续存在,因为这些事务可能在不同的服务器连接上运行。此外,如果客户端进行会话状态更改,它们可能并且很可能会影响其他客户端。 以下是一些使用上面的事务池示例: 如果客户端1在T1中的第一个服务器连接上将会话设置为只读,而客户端2的T3是写事务,则T3将失败,因为它在现在的只读服务器连接上运行。 如果客户端1运行PREPARE a1 AS ...在T1上运行EXECUTE a1 ...,在T2上,则T2将失败,因为预编译语句对于运行T1的服务器连接是本地的。 如果客户端2在T3中创建了一个临时表并尝试在T4中使用它,则T4将失败,因为该临时表对于运行T3的服务器连接是本地的。 有关使用事务池时不支持的会话状态功能和操作的完整列表,请参见PgBouncer的列表 会话连接池 分配给客户端的服务器连接在客户端连接的整个生命周期内持续。这看起来好像根本不使用连接池一样,但是有一个重要的区别:当分配的客户端断开连接时,服务器连接不会被破坏。当客户端断开连接时,池管理器将: 清除客户端所做的任何会话状态更改。 将服务器连接返回到池中,以供其他客户端使用。 图 7 会话连接池 语句连接池 在此,服务器连接分配仅在单个语句的持续时间内持续。这具有与事务池模式相同的会话状态限制,同时还破坏了事务语义。 图 8 语句连接池 这使得所有客户端连接的行为就像在“自动提交”模式下一样。如果客户端尝试开始多语句事务,则合并程序将返回错误。尽管这是 表 3 连接池模式对比 从上述对比情况来看,在连接池的选择上,需要依据业务环境特点来进行选择,默认情况下推荐使用事务连接池,它兼顾了执行事务的特性,尤其多语句的支持,并且不会像会话连接池那样,尝尝处于等待状态。当然事务模式并不支持预编译语句。而根据具体业务场景的特殊需要,有些时候需要客户端与服务器端保持连接,或者支持预编译语句,这样只能选择会话池模式。还有一些特例情况,某些业务场景只是单语句执行,那么语句池模式可能更适合。因此对比这三种模式,可以发现从对客户端操作的支持程度来讲,会话池支持度最高,其次是事务池,最后是语句池模式。但是从支持的连接数来讲,可能刚好是相反的顺序。 表 4 SQL特性对照表 上表为会话连接池和事务连接池的SQL特性对比情况,可以通过对比具体业务场景与SQL特性的符合度,来对连接池模式进行选型。 下面列举了一些示例场景: 有些只运行快速查询,因此在没有事务的情况下可以共享一个会话来处理上百个并发查询。 一些角色成员对于会话级并发是安全的,并且总是使用事务。因此,他们可以安全地共享数百个并发事务的多个会话。 有些角色过于复杂,无法与其他人共享会话。因此,您对它们使用会话池模式可以避免当所有“插槽”都已占用时连接错误。 不要使用它代替HAProxy或其他负载均衡器。尽管pgbouncer具有一些可配置的功能来解决负载均衡器要解决的问题,例如dns_max_ttl,并且可以为其设置DNS配置,但是大多数产品环境都使用HAProxy或其他用于HA的负载均衡器。这是因为HAProxy确实擅长以循环方式在服务器之间实现负载平衡,而不是pgbouncer。尽管pgbouncer对于postgres连接池更好,但最好使用一个小型守护程序来完美地执行一项任务,而不是使用较大的守护程序来完成两项任务,那样效果更糟。 在对于连接数的建议值来讲,上文也给出了一个大致的结果,就是一般情况下设置为CPU核数的3-4倍左右,当然这个不是绝对值,应该是在与业务场景类似的硬件环境中充分进行测试后,才能够得出具体的数值。 还有一点需要注意的是连接Pgbouncer的连接方式,网络连接和unix socket连接方式,较网络连接,unix socket方式可能更加节省网络通信的开销,因此如果pgbouncer和数据库在一台机器部署,可以优选该方式;如果处于不同服务器上,则选择网络连接。 了解更多PostgreSQL热点资讯、新闻动态、精彩活动,请访问中国PostgreSQL官方网站 解决更多PostgreSQL相关知识、技术、工作问题,请访问中国PostgreSQL官方问答社区 下载更多PostgreSQL相关资料、工具、插件问题,请访问中国PostgreSQL官方下载网站

优秀的个人博客,低调大师

Phoenix索引构建最佳实践

用户福利 阿里云发布业界首款云原生多模数据库Lindorm,新用户可享9.9元/3个月优惠,技术交流钉钉群:35977898,更多内容请参考链接 背景 Phoenix的索引构建有两类方法: 同步构建,直接通过sqlline.py create index构建 在云HBase Phoenix 5.x之后,同步构建可以通过轻客户端或重客户端来构建。 异步构建,先create index ... async, 然后通过MR提交build索引job。 因此我们有三种方式构建索引:轻客户端、重客户端、MR异步构建,我们依次介绍下各种方案的优缺点、适用场景和使用方法。 同步构建-轻客户端 适用与数据量比较小,一般构建耗时在10分钟以内。使用方式: 直接使用轻客户端, sqlline-thin.py , create index 即可。 如果数据量较大,我们很可能会遇到索引build超时,我们释放调整Phoenix hbase.rpc.timeout、hbase.client.scanner.timeout.period、phoenix.query.timeoutMs 配置,重启Queryserver生效。 优点: 简单,不占用客户端资源,整个build过程是在服务端完成的。 缺点: 调整参数需要重启queryserver生效,重启过程会导致线上服务临时中断 调整参数会对线上服务造成影响如果有异常SQL导致的大请求会导致服务端负载高,调整了RPC超时时间, 一旦遇到这种请求,无法及时中断,可能对线上业务产生的影响。 无法控制并发,可能因为索引构建打爆服务器 同步构建-重客户端 重客户端适用于中小规模的数据构建,一般索引构建时间在10小时以内。 使用方式: 下载重客户端工具 部署在用户VPC下,机器配置大于等于4c8g;重客户端构建索引的过程中流量会经过这个节点,如果需要更快的索引构建,可以升级节点配置。 调整配置 bin/hbase-site.xml后,使用bin/sqline.py 集群地址 hbase.zookeeper.quorumzk 连接地址,注意使用VPC链接地址。 并发数 phoenix.query.threadPoolSize并发数,越大对目标集群读写压力,可以从1开始逐步增加 超时配置 phoenix.query.keepAliveMs hbase.rpc.timeout hbase.client.scanner.timeout.period phoenix.query.timeoutMs超时时间单位是ms, 可以按需调整。 for ex: <property> <name>hbase.zookeeper.quorum</name> <value>master1-1,master2-1,master3-1:2181</value> </property> <property> <name>phoenix.query.threadPoolSize</name> <value>1</value> </property> <property> <name>phoenix.query.keepAliveMs</name> <value>60000000</value> </property> <property> <name>hbase.rpc.timeout</name> <value>60000000</value> </property> <property> <name>hbase.client.scanner.timeout.period</name> <value>60000000</value> </property> <property> <name>phoenix.query.timeoutMs</name> <value>60000000</value> </property> 优点: 灵活,并发、超时时间可以按需调整,无需重启Phoenix集群,对线上服务影响小 缺点: 需要单独build索引的资源机器 受制于build索引机器的单机性能,扩展性差。 异步构建-MR MR索引构建适用于超大规模数据的情况。 使用方式: 异步索引构建方案 创建异步索引 CREATE INDEX async_index ON my_schema.my_table (v) ASYNC 提交MR JOB build 索引 hadoop --config /mr-phoenix-conf jar \ /mr-phoenix-conf/ali-phoenix-5.2.4.1-HBase-2.x-client.jar \ org.apache.phoenix.mapreduce.index.IndexTool \ --data-table {DATA_TABLE_XXXX} \ --index-table {INDEX_XXX} \ --output-path hdfs://hbase-cluster/ASYNC_INDEX_TMP ps: ali-phoenix-client获取,先下载重客户端包,解压后,取ali-phoenix-xxxx-HBase-2.x-client.jar 索引Build MR环境准备 自建Hadoop或者购买EMR Hadoop集群 在MR环境中创建mr-phoenix-conf目录 配置云HBASE的zk到hbase-site.xml,并此配置文件添加到mr-phoenix-conf目录 云HBase的zk地址可以从控制台获取。 拷贝以下hadoop配置文件到mr-phoenix-conf目录下,包括: core-site.xml、mapred-site.xml、yarn-site.xml、hdfs-site.xml 修改hdfs-site.xml(mr-phoenix-conf目录下) 增加hbase hdfs访问能力。 云HBase HDFS开端口和NN地址获取,找@云HBase答疑协助。 修改dfs.nameservices 增加hbase-cluster 增加hbase-cluster hdfs相关配置 EMR集群打通HBase集群参考配置 <property> <name>dfs.nameservices</name> <value>emr-cluster,hbase-cluster</value> </property> <property> <name>dfs.client.failover.proxy.provider.hbase-cluster</name> <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value> </property> <property> <name>dfs.ha.automatic-failover.enabled.hbase-cluster</name> <value>true</value> </property> <property> <name>dfs.ha.namenodes.hbase-cluster</name> <value>nn1,nn2</value> </property> <property> <name>dfs.namenode.rpc-address.hbase-cluster.nn1</name> <value>${nn1-host}:8020</value> </property> <property> <name>dfs.namenode.rpc-address.hbase-cluster.nn2</name> <value>${nn2-host}:8020</value> </property> 优点: 可以对任意规模数据进行索引构建, 扩展性强 缺点: 需要准备单独build资源 相对复杂 总结 适用数据量 优点 缺点 轻客户端 0~10GB 简单,无需额外资源 配置参数调整会影响线上服务 重客户端 10GB-512GB 可以灵活配置并发、超时参数,无需重启Phoenix集群 需要单独的构建索引的机器,受制于单机性能 MR异步构建 512GB~TB级 适用于任意规模索引构建,扩展性强 额外MR资源、MR集群配置复杂 一般少量数据直接用轻客户端来做索引构建,对于中小规模的数据推荐用重客户端来构建索引,而大规模数据则推荐用MR进行索引构建。 参考文档: Phoenix 二级索引:http://phoenix.apache.org/secondary_indexing.html AliPhoenix重客户端下载地址:https://hbase-opt.oss-cn-hangzhou.aliyuncs.com/ali-phoenix-5.2.4.1-HBase-2.x-all.tar.gz

优秀的个人博客,低调大师

Spark最佳实践-项目规范

前言 大数据开发的日常工作中,开发人员经常需要使用 Spark、Flink 等计算引擎作为工具来实现一些 业务逻辑 的计算。 以 Spark 为例,开发人员会使用 SparkSQL、DataFrame、RDD 等不同形式的API来实现业务需求。 通常情况下,简单的需求都可以通过 SparkSQL、DataFrame 很方便的实现,其简洁的API也是其深受数据分析师青睐的原因之一。 但是正是因为 SparkSQL、DataFrame 的高层次封装,在 复杂度较高的计算需求 实现中,可能会出现 实现复杂或者API的功能性无法满足,或者千方百计实现需求之后 性能表现低下,代码段复杂而庞大 的情况。 尽管Spark允许开发人员通过UDF、UDAF等形式提供自定义的函数功能,但是此时很多人会选择使用较为底层的RDD接口进行开发:可控性好、开发与调试方便、性能强劲。 但是使用RDD接口来开发业务需求时,很多小的项目团队并没有一个统一的项目规范,需求开发完全由开发人员个人自己发挥。 各个业务项目的大致流程基本是相同的: 创建SparkSession 用 spark.table or spark.textFile 等API读取数据源 进行RDD的各种 Transformation 和 Action 操作 得到数据结果之后再调用 saveAsTable or saveAsTextFile 写入外部数据源中 虽然看起来流程挺一致的,但是其中仍然存在以下问题: 业务代码混乱 团队成员代码风格不一,有的喜欢一长串一长串的写,有的喜欢将过程封装 即使将过程封装了,但是封装的边界没有明确定义,仍然会有人不小心“越界” 读写数据源的API使用不统一 各个计算引擎对各个数据源都有不同的读写API接口提供使用,一些比较繁杂的API可能会被人“错误”使用 同时也会有人时常忘记对应接口如何使用,反复查阅资料 重复的编码工作 理论上所有业务项目,除了业务逻辑是变化的之外,其余应该都是一个不变的模板 开发人员应该专注于变化的业务逻辑,而不是每次都要分一些精力出来处理其他“边边角角”的事情 没有规范任由团队成员发挥的话,尽管有些成员能写一手漂亮的代码,但是你并不能保证所有人都这么优秀。 时间一久项目中代码的 坏味道 会越来越多,最后混乱的程度可能会超出你的想象。 为了解决以上问题,我们建议:定义一个项目规范,所有业务项目都需要遵守这个规范。 俗话说,有规矩成方圆。 有了项目规范,所有人都遵守这个标准来开发。 有了这个标准,我们就可以在标准化的基础上做很多事情,比如 定义自动化工具来帮助开发人员解放双手。 本文讨论的项目规范可以作为一种参考,以供读者与相关开发人员翻阅。 一、项目规范 和Java项目规范类似,以 模块化项目 的结构来定义项目规范可以为业务项目提供 结构化标准,其可以规整所有 混乱的业务项目结构。 项目结构标准化的重要性: 项目统一管理与生成 方便快速搭框架 所有开发人员遵守相同的编码规范 易于交接与维护 以下模块划分和Java项目类似,略微有些细节差异。 1.1 api模块 业务计算逻辑模块,不应该出现任何 Spark等执行框架的API 以 保持模块独立性与可移植。 理论上该模块可以独立构成一个单机程序执行,这样可以将最重要的业务逻辑根据需要迁移到任意计算引擎中,如 Spark 到 Spark Streaming、Flink 甚至 Hive UDF 等。 对外只提供接口调用,不可直接在外部实例化具体类(工厂模式) 所有service业务逻辑需要有对应的测试用例 事务控制、所有异常捕获和处理 依赖common 1.2 common模块 项目内通用的常量、枚举、POJO实体类、工具函数等,视情况分离,可集成到 context 中 不包含任何业务逻辑 不依赖其他模块 相关工具保持单例 1.3 context模块 Spark或者其他程序 执行入口,负责初始化各种计算引擎的环境变量。 系统 全局配置(conf)与脚本(bin) 集中管理 依赖server、api、common 程序关键点需要打印日志以便后续debug使用 1.4 server模块 整个项目中整合了业务逻辑调用、数据源读写等操作的模块,需求简单的情况下可以直接集成到 context 中。 该模块中根据不同的接口操作类,还划分了 dal、service与manager三个包。 1.4.1 dal包 主要是对数据进行操作,如读写常用的库:Hive、MySQL、HBase;以及读写文件系统:HDFS。 dal中的所有使用都由接口来定义,不同的接口实现使用不同的应用框架API,如Spark、Flink应该为两个独立的dal实现,在后续service使用过程中可以自由切换。 需要遵循以下原则: 所有bean对象,定义在dal 不得在dal写各种业务逻辑、数据清洗逻辑 一张表对应一个dal接口、一个bean,对应多个独立的dao实现 不允许在1个dao中同时操作多个表 包结构如下: basic: basic包下主要放一些基础对象,如BaseDao,所有dao都需要完善 TABLE_NAME bean: 定义数据源表结构,不同的数据源可以定义在不同的包中,如hive、hbase、mysql等 dao: 接口具体实现,用来操作数据表。如:增删改查 1.4.2 service包 和dao对接,一个service对应一个dao,service的使用都由接口来定义。 一个service下有两个实现包: 正常实现包:直接对接dao,简单处理一些判断:如参数不合法校验等。 测试实现包:模拟数据,可以不通过dao获取,从本地文件生成或代码中生成。 不同的计算框架有不同的service实现,如spark、flink等(需要传入其环境变量)。 1.4.3 manager包 调用service包实现数据增删改查 调用api模块进行业务逻辑组合 提供函数接口给context模块调用执行 二、代码框架 基于以上项目模块的划分,我们可以看到,api、common是 每次都会变化的业务逻辑和通用属性的抽取,而 context 是根据业务需要的计算引擎和运行环境设置的 执行入口。 以上三个模块都是 根据业务需求变化比较大的,而server模块则是负责对 其他各个模块的调用与整合,最后通过 manager 提供统一的函数接口给 context 入口调用执行。 所以 server 模块是这个项目规范中可以 自动化 起来的重点目标。 基于这个目标,我们开发了一个 大数据业务开发 基准项目的雏形,开发人员能够做到开箱即用,不必再花太多精力在研究计算引擎与各个数据源的接口和API如何调用,专注于业务逻辑的实现,提升开发效率。 项目地址:https://github.com/chubbyjiang/aisql-bigdata-base 使用介绍 org.aisql.bigdata.base.framework包中提供了几种常见大数据项目需要用到的数据源。 framework 以 模块化项目 的结构提供了 各个数据源基础的Dao、Service接口与默认实现。 配合自动化的代码生成工具,可以一键生成 server 模块的代码文件直接使用。 现在我们来看一下规范+自动化的威力,例如现有 default.t_users 表需要读取。 开发人员仅需要生成代码文件并复制到项目中,写代码如下: val service = new UsersService //读取整个表 val allRdd:RDD[Users] = service.selectAll() //字段筛选 val allRdd:RDD[Users] = service.selectAllWithCols(Seq("name","age")) //条件过滤 val allRdd:RDD[Users] = service.selectAllByWhere("age>10") //读取1000条数据 val demoRdd:RDD[Users] = service.selectDemo() //写入表 service.insertInto(demoRDD) service.createTable(demoRDD) 是不是 so easy? 其实所做的内容也就是在 server 模块中封装了 常用的不同计算引擎对不同数据源的读写操作API,并 自动化了 bean、dal、service 三个部分的代码生成。 使得开发人员可以直接使用 service 提供的数据操作接口 读出数据源 后 调用业务计算逻辑 处理完毕后 写入数据源 中。 通过对项目模块的标准化规范,我们可以以一个 比较统一和简单易懂的开发方式 来进行需求落地。 虽然刚开始使用规范的时候会有人觉得繁琐与不耐烦,如果是手动开发的话谁都会烦,都是一些重复性的苦力活儿,这就是框架规范的缺点:特别繁琐。 但是配套做一些自动化工具来使用的话,相信大部分开发人员都会觉得很酸爽,某种程度上标准化项目就是这么来提升开发效率的。

优秀的个人博客,低调大师

ADB日志分析最佳实践

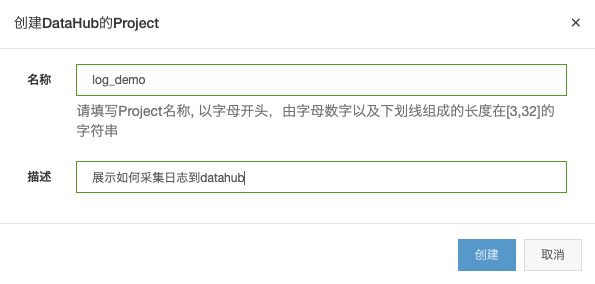
背景 利用服务器日志做分析是很多公司进入大数据分析的第一步,也是很关键的一步。大部分情况下,这些公司在考虑进行大数据分析的时候,都会遇到以下问题: 团队里面缺乏了解大数据技术栈的工程师 都听过Hadoop,想要学习Hadoop,但是不知道从何入手 从市面上寻找大数据人才效果不理想 不愿意一下子投入过多的资金去组建一个专门的大数据团队 虽然Hadoop没有办法一下子搭起来,但是其实在刚开始进入大数据的时候完全可以用MPP数据库来快速满足需求。但是你可能会有疑问,MPP能够代替Hadoop吗?要回答这个问题,首先要理解Hadoop的出现到底解决了什么问题: 传统的单节点关系型数据库,要提升性能,只能通过scale up的方式,即增加cpu/内存/硬盘。到后面提升5%的计算能力可能是前面10倍的成本投入。Hadoop利用分布式的思想,通过shared-nothing的架构,实现了scale out的能力。在这样的架构下面,加入同样性能的机器,可以达到线性提升处理性能的效果,投入产出成正比。 关系型数据库对于非/半结构化数据不是特别友好,主要表现在关系型数据库是以行列为结构存储数据的,无法直接把json,xml这类型的数据插入进去。Hadoop的优势是可以通过编写特定的input reader,来解释这些数据格式,从而达到处理非结构数据的能力。但是不能忘记的一点是,为了提升处理性能,即使使用Hadoop,最后也是要将数据结构化的。 通过上面的描述,其实思路就很清晰了。如果可以有一个shared-nothing架构的关系型数据库,将要导入的数据预先进行结构化处理,那么我们还是可以在关系型数据库(MPP)里面做大数据分析。显然ADB就是这么一个场景下最合适的选择。 组件介绍 这一章介绍一下本方案使用到的各种组件 名称 介绍 Nginx 反向代理,一般被用来做负载均衡。作为网络流量的总入口,会沉淀所有的用户行为。利用这里的日志作为分析可以得到最全面的数据视图。 Logstash 日志采集工具,可以对采集到的数据进行一定的预处理,通过配置文件进行格式化改造。 DataHub 数据管道,提供对数据的发布和订阅。支持直接导出到一些常用的数据存储包括MaxCompute,OSS,ADB等。 ADB for MySQL 高并发低延时的PB级别数据仓库,MPP架构,完全兼容MySQL协议。 搭建步骤 安装Nginx 在CentOS下面,安装Nginx yum install nginx 成功安装的话,会看到如下内容 已安装: nginx.x86_64 1:1.12.2-3.el7 作为依赖被安装: nginx-all-modules.noarch 1:1.12.2-3.el7 nginx-mod-http-geoip.x86_64 1:1.12.2-3.el7 nginx-mod-http-image-filter.x86_64 1:1.12.2-3.el7 nginx-mod-http-perl.x86_64 1:1.12.2-3.el7 nginx-mod-http-xslt-filter.x86_64 1:1.12.2-3.el7 nginx-mod-mail.x86_64 1:1.12.2-3.el7 nginx-mod-stream.x86_64 1:1.12.2-3.el7 完毕! 完成安装之后,需要定义Nginx打印日志的格式。在这个例子中,因为我们想要统计网站访问的UV和每个请求的响应时长,所以我们需要把 $request_time 和 $http_cookie 添加进去。另外,Nginx日期的默认打印方式是 07/Jul/2019:03:02:59, 对于我们后面做分析时候查询不是十分友好,所以要把它们统一改成 2019-07-11T16:32:09 的格式。 找到/etc/nginx/nginx.conf,用vi打开,将log_format更改如下: log_format main '$remote_addr - [$time_iso8601] "$request" ' '$status $body_bytes_sent $request_time "$http_referer" ' '"$http_user_agent" "$http_x_forwarded_for" "$http_cookie"' ; 执行下面命令,重启Nginx使配置生效: service nginx restart 这时去看一下日志(位于/var/log/nginx/access.log),会发现日志打印格式如下 119.35.6.17 - [2019-07-14T16:39:17+08:00] "GET / HTTP/1.1" 304 0 0.000 "-" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_5) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36" "-" "-" 由于默认的Nginx主页不会记录cookie,建议后面挂一个带登陆的系统来做验证 部署DataHub DataHub的控制台地址 https://datahub.console.aliyun.com/datahub 首先要创建一个Project,取名为log_demo: 进入到这个log_demo 项目之后,要创建一个Topic, 我们可以取名topic_nginx_log : Topic的类型选择Tuple,这是一种带schema的组织形式,更方便我们查看和后面的处理。Schema的定义跟我们要从日志中取得的字段是强相关的,所以建立的时候需要确保没有错误,否则可能导致后面日志写入的时候出错。 字段名称 意义 类型 对应Nginx日志的字段 remote_ip 请求的来源IP STRING $remote_addr date 请求发生的日期 BIGINT $time_iso8601 的日期部分 time 请求发生的时间,24小时制,精确到秒 STRING $time_iso8601 的时间部分 method Http请求的方法 STRING $request 的请求动作部分,例如GET request 请求的uri和param部分 STRING $request的uri和param部分 http_version Http版本号 STRING $request的http版本号部分 status 请求的返回状态码 STRING $status bytes 请求体的大小 BIGINT $body_bytes_sent request_time 请求的耗时 DOUBLE $request_time referer 发出这个请求之前,用户在哪个页面 STRING $http_referer agent 客户端使用的操作系统和浏览器 STRING $http_user_agent xforward 请求经过的代理 STRING $http_x_forwarded_for cookie 用户的标识 STRING $http_cookie 成功创建之后,可以在这个Topic的Schema里面看到如下图展示 安装Logstash 官方的Logstash没有提供DataHub的兼容工具,所以建议到DataHub的官网上面去下载最新的兼容版本,减少中间融合操作成本。具体的介绍页面在这里。 回到控制台,输入下面命令,下载和解压Logstash到你想要的目录 ##注意,这里的版本号和下载链接可能因为更新缘故有区别,建议到介绍页面去获取最新链接 wget http://aliyun-datahub.oss-cn-hangzhou.aliyuncs.com/tools/logstash-with-datahub-6.4.0.tar.gz?spm=a2c4g.11186623.2.17.60f73452tHbnZQ&file=logstash-with-datahub-6.4.0.tar.gz tar -zxvf logstash-with-datahub-6.4.0.tar.gz 安装完成之后需要配置Logstash,这里有两个工作需要完成。第一,由于我们需要将日志处理成结构化的数据,所以在抓取的过程中,还需要做一点加工。Logstash的grok可以帮我们轻松地完成这个任务。第二,我们需要告诉Logstash从哪里(Nginx的日志存放位置)抓起日志文件,最后要同步到哪里(DataHub)去。 配置grok 我们需要让grok能够理解日志文件并进行转换,需要往grok-pattern文件里面添加一个新格式。这个文件存放在刚刚下载的Logstash目录里面,具体路径如下 : logstash/vendor/bundle/jruby/1.9/gems/logstash-patterns-core-xxx/patterns/grok-patterns 用vi打开这个文件,把下面的新pattern填到文件最末端即可 DATE_CHS %{YEAR}\-%{MONTHNUM}\-%{MONTHDAY} NGINXACCESS %{IP:remote_ip} \- \[%{DATE_CHS:date}T%{TIME:time}\+08:00\] "%{WORD:method} %{URIPATHPARAM:request} HTTP/%{NUMBER:http_version}" %{NUMBER:status} %{NUMBER:bytes} %{NUMBER:request_time} %{QS:referer} %{QS:agent} %{QS:xforward} %{QS:cookie} 配置Logstash 在Logstash的目录里面,有一个config文件夹,里面有一个logstash-sample.conf文件。打开它,把它改成 input { file { path => "/var/log/nginx/access.log" #nginx的日志位置,默认在这里。 start_position => "beginning" #从什么位置开始读起日志文件,beginning表示从最开始。 } } filter { grok { match => {"message" => "%{NGINXACCESS}"} #当grok获取到一个消息时,怎么去转换格式 } mutate { gsub => [ "date", "-", ""] #因为日期在后面要用作ADB表的二级分区,所以需要把非数字字符去掉 } } output { datahub { access_id => "<access-key>" #从RAM用户获取access key access_key => "<access-secrect>" #从RAM用户获取access secret endpoint => "http://dh-cn-shenzhen-int-vpc.aliyuncs.com" #DataHub的endpoint,取决于把project建立在哪个区域 project_name => "log_demo" #刚刚在DataHub上面创建的项目名称 topic_name => "topic_nginx_log" #刚刚在DataHub上面创建的Topic名称 dirty_data_continue => true #脏数据是否继续运行 dirty_data_file => "/root/dirty_file" #脏数据文件名称,脏数据会被写入到这里 dirty_data_file_max_size => 1000 #脏数据的文件大小 } } 完成这个配置之后,我们可以启动Logstash来验证是否有日志被写入到DataHub里面了。在Logstash的根目录里面,执行如下命令 bin/logstash -f config/logstash-sample.conf 看到这个如下日志代表启动成功 ending Logstash logs to /root/logstash-with-datahub-6.4.0/logs which is now configured via log4j2.properties [2019-07-12T13:36:49,946][WARN ][logstash.config.source.multilocal] Ignoring the 'pipelines.yml' file because modules or command line options are specified [2019-07-12T13:36:51,000][INFO ][logstash.runner ] Starting Logstash {"logstash.version"=>"6.4.0"} [2019-07-12T13:36:54,756][INFO ][logstash.pipeline ] Starting pipeline {:pipeline_id=>"main", "pipeline.workers"=>2, "pipeline.batch.size"=>125, "pipeline.batch.delay"=>50} [2019-07-12T13:36:55,556][INFO ][logstash.outputs.datahub ] Init datahub success! [2019-07-12T13:36:56,663][INFO ][logstash.inputs.file ] No sincedb_path set, generating one based on the "path" setting {:sincedb_path=>"/root/logstash-with-datahub-6.4.0/data/plugins/inputs/file/.sincedb_d883144359d3b4f516b37dba51fab2a2", :path=>["/var/log/nginx/access.log"]} [2019-07-12T13:36:56,753][INFO ][logstash.pipeline ] Pipeline started successfully {:pipeline_id=>"main", :thread=>"#<Thread:0x445e23fb run>"} [2019-07-12T13:36:56,909][INFO ][logstash.agent ] Pipelines running {:count=>1, :running_pipelines=>[:main], :non_running_pipelines=>[]} [2019-07-12T13:36:56,969][INFO ][filewatch.observingtail ] START, creating Discoverer, Watch with file and sincedb collections [2019-07-12T13:36:57,650][INFO ][logstash.agent ] Successfully started Logstash API endpoint {:port=>9600} 这时候可以开始去刷一下Nginx代理的页面了。默认Nginx自带一个静态的网页,可以通过访问80端口打开。产生日志的话,Logstash的日志会马上打印如下信息 [2019-07-12T13:36:58,740][INFO ][logstash.outputs.datahub ] [2010]Put data to datahub success, total 10 然后在DataHub上,可以看到抽样数据如下 配置ADB 先到ADB的控制台去创建一个新的集群,数据库的名字取nginx_logging。需要注意的是,当ADB创建好之后,在控制台那边看不到数据库的名字,转而变成了集群名称。目前看来称谓不一样,但是其实是一回事。 新的集群初始化会需要一点时间。待初始化完成之后,可以通过控制台的登陆数据库按钮跳转到DMS(数据管理)去创建用于存放日志的数据库。在创建数据库之前,需要先理解ADB的几个核心概念,这样设计出来的表性能才会更佳。 一级分区 要理解一级分区,需要先理解MPP数据库是怎么提升性能的。本文的背景中说到,MPP是可以线性扩展的,但是有一个前提,数据要均匀分布。这样在一个Query过来的时候,才能让尽量多的磁盘被利用起来。在ADB中,数据是否均匀分布,主要取决选择哪个列作为一级分区。千万不要选择数据倾斜的列作为分区列,例如日期,性别,或者存在大量空值的列。在本例中,比较适合的应该是remote_ip这一列。 二级分区 二级分区是在一级分区的基础上做二次切分,可以理解为隐性地帮用户把一个表切成了多个表,从而提升全表查询的性能。此外,二级分区还有一个优点,就是可以设置分区个数。在超过分区个数的时候,ADB会自动将历史最久的一个二级分区删除,实现历史数据自动清楚的效果。在本例中,date这个列特别时候做二级分区。假如我们想保留30天的日志数据,我们只需要将二级分区设置成30个即可。注意,二级分区的列一定要是整数类型,例如bigint或者long。 下面是创建表nginx的SQL CREATE TABLE nginx_logging.nginx( remote_ip varchar NOT NULL COMMENT '', date bigint NOT NULL COMMENT '', time varchar NOT NULL COMMENT '', method varchar NOT NULL COMMENT '', request varchar COMMENT '', http_version varchar COMMENT '', status varchar COMMENT '', bytes bigint COMMENT '', request_time double COMMENT '', referer varchar COMMENT '', agent varchar COMMENT '', xforward varchar COMMENT '', cookie varchar COMMENT '', PRIMARY KEY (remote_ip,date,time) ) PARTITION BY HASH KEY (remote_ip) PARTITION NUM 128 -- remote_ip作为一级分区 SUBPARTITION BY LIST KEY (date) -- date作为二级分区 SUBPARTITION OPTIONS (available_partition_num = 30) -- 二级分区30个,代表保留30天的数据 TABLEGROUP logs OPTIONS (UPDATETYPE='realtime') -- 由于要被DataHub更新,所以一定要选择是realtime的表 COMMENT '''' 成功配置创建表之后,ADB这边的准备任务就算完成了。需要提示一下,默认ADB的网络连接信息只有公有网络和经典网络的连接。专有网络的连接地址需要通过配置打开。因为ADB完全兼容MySQL协议,所以我们要从本地登陆的话,可以利用公有网络的地址。而DataHub访问ADB,目前使用的是经典网络的连接。 配置DataConnector 回到刚刚创建的Topic, topic_nginx_log, 下面。右上角有一个按钮叫+DataConnector。这里需要输入几个关于ADB的信息: Host : #ADB集群经典网络的连接地址 Port : #ADB集群经典网络的端口 Database : nginx_logging #之前建立ADB集群时候输入的名字,同时也是这个ADB集群的名字 Table : nginx #上面建立的表名 Username : <access-key> #RAM用户的access key Password : <access-secret> #RAM用户的access secret 模式 : replace into #如果主键冲突,会覆盖掉记录 成功配置之后,在DataConnectors下面就可以看到相关的信息了。如果之前DataHub上面已经有数据,现在查询ADB里面的nginx表就可以将这些记录查出来。 至此,整个数据链路就算搭建完成了。

优秀的个人博客,低调大师

ECS应用管理最佳实践

前言 即使在CloudNative发展如火如荼的当下,ECS应用(直接将应用部署在ECS上,不使用容器)仍然占了相当大的比重,原因主要在于相对容器化应用,ECS应用由于不需要容器的运行时环境和类似K8S的调度层软件,因此存在一些天然优势,比如: 更低的Overhead,可以更充分发挥硬件的处理能力,适合用于工作负载比较高的组件或应用 更高的单元可靠性,结合高可用方案,可以实现很好的整体可用性 更好的安全性,因为隔离在虚拟化层面 更易用的运维界面,对运维的技能要求更低 对于既存系统,无改造成本 当然,对比于容器化的应用,ECS应用的劣势也很明显,因为缺少统一的部署标准和调度系统,需要用户通过脚本或配管工具才能实现自动化管理,而这些附加手段由于本身缺乏标准,如果用户没有良好的运维能力,其本身的功能完整性和可靠性都有可能成为制约业务发展的不利因素。 拿

优秀的个人博客,低调大师

jackson-databind最佳实践

给出一个简单的POJO 使用databind,我们需要一个最基础的对象com.fasterxml.jackson.databind.ObjectMapper这里我们构造一个: 注意:这个objectMapper是可以复用的 ObjectMapper 该映射器(或数据绑定器或编解码器)为Java对象之间和匹配的JSON结构的转换提供功能 属性(为序列化过程定义基本的全局设置的配置对象) _serializationConfig _deserializationConfig image.png Inclusion 需要的传参 用于定义Java Bean的哪些属性将被包含在序列化中的枚举 ALWAYS 指示属性始终被包含 独立于值 NON_NULL 该值指示仅包含具有非空值的属性 NON_DEFAULT 只包含没有默认值的属性(意味着当它使用无参数构造函数构造Bean时的值) Map通常无用,因为它们没有默认值,如果使用,则与ALWAYS NON_EMPTY 属性值为null或被认为是空的属性不包括在内 Feature 定义了可引导序列化功能的可触发功能的枚举 WRITE_DATES_AS_TIMESTAMPS(true) 确定Date以及基于日期的东西如Calendar是否要序列化为时间戳 FAIL_ON_EMPTY_BEANS(true) 确定在找到某个类型没有访问者时会发生什么的功能 如果启用(默认),则抛出异常以将它们指示为不可序列化的类型 如果禁用,则它们被序列化为空的对象,即没有任何属性。 简单的把JSON反序列化成Object的用法如下: 简单的把Object序列化成JSON的用法如下: 其实到这一步,对于很多读者来说已经足够了。因为大部分时候我们要的就是这些。但是不妨继续看下去,还有一些你可能会用到的。 集合 如果你使用的不是简单的POJO,而是List,Map: 思考:为什么需要指定类型?(类型擦除) 注意:序列化的时候不需要指定,只有反序列化的时候需要。

优秀的个人博客,低调大师

restful-api最佳实践

Best-practices-for-a-pragmatic-restful-api 先阅读文档:http://www.oschina.net/translate/best-practices-for-a-pragmatic-restful-api 理解restful api设计理念 我们公司的所有微服务接口都放在 "api.998jk.com/微服务名"下 微服务内部api设计规范为:业务域/访问级别, 与best-practices-for-a-pragmatic-restful-api的区别是加入了一级访问级别,例如: 简单列表接口 /chatMessage/pb GET方式,提交参数page,pageSize,total 复杂查询接口 /chatMessage/pb/search POST方式,提交参数为json RequestBody,根据各个接口不同自行定义 查询单条接口 /chatMessage/pb/123 GET方式,123为id 删除单条接口 /chatMessage/pt/123 DELETE方式,123为id 更新单条接口 /chatMessage/pt/123 PUT方式,提交参数为json RequestBody,根据各个接口不同自行定义 上述示例 完整路径为:api.998jk.com/微服务名/chatMessage/xxx 访问级别: pb(public) 公开,对外对内没有任何限制; pt(protected)受保护,对外受保护,对内没有任何限制。需要header中含有authorization 值为"Bearer token令牌"。在api gateway会获取该token, 并且在header中设置uid 值为该令牌的用户id。 df(default) 默认,对外加密,对内没有任何限制。继承protected限制。并且在api gateway会对返回结果加密,客户端需要对结果解密后使用。加密后json如下: {"encrypted":"返回结果加密后的字符串"} pv(private) 私有的,对外无法访问,对内没有任何限制。继承default限制。 暴露的restful服务需采用JAX-RS标准注解,无需springMVC controller 直接暴露service,需要使用swagger注解以便自动产生restful api文档。示例如下 packagecharles.sc.provider.service; importcharles.sc.provider.entity.ChatMessage; importcom.jztey.framework.mvc.Paging; importcom.jztey.framework.mvc.RestfulPagingResult; importcom.jztey.framework.mvc.RestfulResult; importio.swagger.annotations.Api; importio.swagger.annotations.ApiOperation; importio.swagger.annotations.ApiParam; importorg.springframework.cloud.netflix.feign.FeignClient; importjavax.validation.Valid; importjavax.ws.rs.*; importjavax.ws.rs.core.MediaType; /** *CreatedbyCharleson2016/8/15. */ @FeignClient(value="provider-service") @Path("/chatMessage") @Produces(MediaType.APPLICATION_JSON) @Api(tags={"聊天消息接口"}) publicinterfaceChatMessageService{ @Path("/pb") @GET @ApiOperation(value="聊天记录列表",response=RestfulPagingResultChatMessage.class) RestfulPagingResult<ChatMessage>findPage(@QueryParam("id")intpage,@QueryParam("pageSize")intpageSize,@QueryParam("total")inttotal); @Path("/pt/{id:\\d+}") @GET @ApiOperation(value="按id查询聊天记录",response=RestfulResultChatMessage.class) RestfulResult<ChatMessage>find(@PathParam("id")Longid); @Path("/pb/search") @POST @ApiOperation(value="搜索聊天记录",response=RestfulPagingResultChatMessage.class) RestfulPagingResult<ChatMessage>search(Paging<ChatMessage>paging); @Path("/pt") @POST @ApiOperation(value="添加聊天记录",response=RestfulResultChatMessage.class) RestfulResult<ChatMessage>insert(@HeaderParam("uid")Longuid,@ApiParam@ValidChatMessagechatMessage); @Path("/pt/{id:\\d+}") @DELETE @ApiOperation(value="按id删除聊天记录",response=RestfulResultChatMessage.class) RestfulResult<ChatMessage>delete(@HeaderParam("uid")Longuid,@PathParam("id")Longid); @Path("/pt/{id:\\d+}") @PUT @ApiOperation(value="修改聊天记录",response=RestfulResultChatMessage.class) RestfulResult<ChatMessage>update(@HeaderParam("uid")Longuid,@PathParam("id")Longid,@ApiParam@ValidChatMessagechatMessage); classRestfulResultChatMessageextendsRestfulResult<ChatMessage>{ } classRestfulPagingResultChatMessageextendsRestfulPagingResult<ChatMessage>{ } } packagecharles.sc.provider.service; importcharles.sc.provider.entity.ChatMessage; importcom.jztey.framework.mvc.Paging; importcom.jztey.framework.mvc.RestfulPagingResult; importcom.jztey.framework.mvc.RestfulResult; importorg.springframework.stereotype.Service; importjava.util.ArrayList; importjava.util.List; /** *CreatedbyCharleson2016/8/16. */ @com.alibaba.dubbo.config.annotation.Service @Service publicclassChatMessageServiceImplextendsBaseService<ChatMessage>implementsChatMessageService{ @Override publicRestfulPagingResult<ChatMessage>findPage(intpage,intpageSize,inttotal){ System.out.println("get"); //统一使用查询接口 Paging<ChatMessage>paging=newPaging<>(page,pageSize); paging.setTotal(total); returnthis.search(paging); } @Override publicRestfulResult<ChatMessage>find(Longid){ System.out.println("getById"); returnnewRestfulResult(newChatMessage(id,"fu","tu","msg","mi",System.currentTimeMillis(),System.currentTimeMillis(),ChatMessage.STATUS_NO_PROCESS)); } @Override publicRestfulPagingResult<ChatMessage>search(Paging<ChatMessage>paging){ System.out.println("search"); List<ChatMessage>entityList=newArrayList<>(); entityList.add(newChatMessage(1L,"fu","tu","msg","mi",System.currentTimeMillis(),System.currentTimeMillis(),ChatMessage.STATUS_NO_PROCESS)); entityList.add(newChatMessage(2L,"fu2","tu2","msg2","mi2",System.currentTimeMillis(),System.currentTimeMillis(),ChatMessage.STATUS_NO_PROCESS)); if(-1==paging.getTotal()){//total没有传上来 //查询total paging.setTotal(100); } returnnewRestfulPagingResult(entityList,paging.getTotal()); } @Override publicRestfulResult<ChatMessage>insert(Longuid,ChatMessagechatMessage){ System.out.println("insertuid:"+uid); returnnewRestfulResult<>(chatMessage); } @Override publicRestfulResult<ChatMessage>delete(Longuid,Longid){ System.out.println("deleteuid:"+uid); returnnewRestfulResult(newChatMessage(id,"fu","tu","msg","mi",System.currentTimeMillis(),System.currentTimeMillis(),ChatMessage.STATUS_NO_PROCESS)); } @Override publicRestfulResult<ChatMessage>update(Longuid,Longid,ChatMessagechatMessage){ System.out.println("updateuid:"+uid); returnnewRestfulResult<>(chatMessage); } } 完整代码参考:http://gitlab.998jk.com/heying/spring-cloud 本文转自yushiwh 51CTO博客,原文链接:http://blog.51cto.com/yushiwh/1942254,如需转载请自行联系原作者

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册