首页 文章 精选 留言 我的

精选列表

搜索[离线安装],共10029篇文章
优秀的个人博客,低调大师

Bytom Java版本离线签名

比原项目仓库: Github地址:https://github.com/Bytom/bytom Gitee地址:https://gitee.com/BytomBlockchain/bytom tx_signer Java implementation of signing transaction offline to bytomd. Pre Get the source code $ git clone https://github.com/Bytom/bytom.git $GOPATH/src/github.com/bytom git checkout $ git checkout dev Why need dev branch? Because you could call decode transaction api from dev branch and obtain tx_id and some inputs ids. Build $ cd $GOPATH/src/github.com/bytom $ make bytomd # build bytomd $ make bytomcli # build bytomcli When successfully building the project, the bytom and bytomcli binary should be present in cmd/bytomd and cmd/bytomcli directory, respectively. Initialize First of all, initialize the node: $ cd ./cmd/bytomd $ ./bytomd init --chain_id solonet launch $ ./bytomd node --mining Usage Build jar first get source code git clone https://github.com/successli/tx_signer.git get jar package $ mvn assembly:assembly -Dmaven.test.skip=true You can get a jar with dependencies, and you can use it in your project. Test cases Need 3 Parameters: Private Keys Array Template Object After call build transaction api return a Template json object. build transaction api use bytom java sdk return a Template object. Raw Transaction call decode raw-transaction api from dev branch. decode raw-transaction api Call method: // return a Template object signed offline basically. Template result = signatures.generateSignatures(privates, template, rawTransaction); // use result's raw_transaction call sign transaction api to build another data but not need password or private key. Single-key Example: @Test // 使用 SDK 来构造 Template 对象参数, 单签 public void testSignSingleKey() throws BytomException { Client client = Client.generateClient(); String asset_id = "ffffffffffffffffffffffffffffffffffffffffffffffffffffffffffffffff"; String address = "sm1qvyus3s5d7jv782syuqe3qrh65fx23lgpzf33em"; // build transaction obtain a Template object Template template = new Transaction.Builder() .addAction( new Transaction.Action.SpendFromAccount() .setAccountId("0G0NLBNU00A02") .setAssetId(asset_id) .setAmount(40000000) ) .addAction( new Transaction.Action.SpendFromAccount() .setAccountId("0G0NLBNU00A02") .setAssetId(asset_id) .setAmount(300000000) ) .addAction( new Transaction.Action.ControlWithAddress() .setAddress(address) .setAssetId(asset_id) .setAmount(30000000) ).build(client); logger.info("template: " + template.toJson()); // use Template object's raw_transaction id to decode raw_transaction obtain a RawTransaction object RawTransaction decodedTx = RawTransaction.decode(client, template.rawTransaction); logger.info("decodeTx: " + decodedTx.toJson()); // need a private key array String[] privateKeys = new String[]{"10fdbc41a4d3b8e5a0f50dd3905c1660e7476d4db3dbd9454fa4347500a633531c487e8174ffc0cfa76c3be6833111a9b8cd94446e37a76ee18bb21a7d6ea66b"}; logger.info("private key:" + privateKeys[0]); // call offline sign method to obtain a basic offline signed template Signatures signatures = new SignaturesImpl(); Template basicSigned = signatures.generateSignatures(privateKeys, template, decodedTx); logger.info("basic signed raw: " + basicSigned.toJson()); // call sign transaction api to calculate whole raw_transaction id // sign password is None or another random String Template result = new Transaction.SignerBuilder().sign(client, basicSigned, ""); logger.info("result raw_transaction: " + result.toJson()); // success to submit transaction } Multi-keys Example: Need an account has two or more keys. @Test // 使用 SDK 来构造 Template 对象参数, 多签 public void testSignMultiKeys() throws BytomException { Client client = Client.generateClient(); String asset_id = "ffffffffffffffffffffffffffffffffffffffffffffffffffffffffffffffff"; String address = "sm1qvyus3s5d7jv782syuqe3qrh65fx23lgpzf33em"; // build transaction obtain a Template object // account 0G1RPP6OG0A06 has two keys Template template = new Transaction.Builder() .setTtl(10) .addAction( new Transaction.Action.SpendFromAccount() .setAccountId("0G1RPP6OG0A06") .setAssetId(asset_id) .setAmount(40000000) ) .addAction( new Transaction.Action.SpendFromAccount() .setAccountId("0G1RPP6OG0A06") .setAssetId(asset_id) .setAmount(300000000) ) .addAction( new Transaction.Action.ControlWithAddress() .setAddress(address) .setAssetId(asset_id) .setAmount(30000000) ).build(client); logger.info("template: " + template.toJson()); // use Template object's raw_transaction id to decode raw_transaction obtain a RawTransaction object RawTransaction decodedTx = RawTransaction.decode(client, template.rawTransaction); logger.info("decodeTx: " + decodedTx.toJson()); // need a private key array String[] privateKeys = new String[]{"08bdbd6c22856c5747c930f64d0e5d58ded17c4473910c6c0c3f94e485833a436247976253c8e29e961041ad8dfad9309744255364323163837cbef2483b4f67", "40c821f736f60805ad59b1fea158762fa6355e258601dfb49dda6f672092ae5adf072d5cab2ceaaa0d68dd3fe7fa04869d95afed8c20069f446a338576901e1b"}; logger.info("private key 1:" + privateKeys[0]); logger.info("private key 2:" + privateKeys[1]); // call offline sign method to obtain a basic offline signed template Signatures signatures = new SignaturesImpl(); Template basicSigned = signatures.generateSignatures(privateKeys, template, decodedTx); logger.info("basic signed raw: " + basicSigned.toJson()); // call sign transaction api to calculate whole raw_transaction id // sign password is None or another random String Template result = new Transaction.SignerBuilder().sign(client, basicSigned, ""); logger.info("result raw_transaction: " + result.toJson()); // success to submit transaction } Multi-keys and Multi-inputs Example: @Test // 使用 SDK 来构造 Template 对象参数, 多签, 多输入 public void testSignMultiKeysMultiInputs() throws BytomException { Client client = Client.generateClient(); String asset_id = "ffffffffffffffffffffffffffffffffffffffffffffffffffffffffffffffff"; String address = "sm1qvyus3s5d7jv782syuqe3qrh65fx23lgpzf33em"; // build transaction obtain a Template object Template template = new Transaction.Builder() .setTtl(10) // 1 input .addAction( new Transaction.Action.SpendFromAccount() .setAccountId("0G1RPP6OG0A06") // Multi-keys account .setAssetId(asset_id) .setAmount(40000000) ) .addAction( new Transaction.Action.SpendFromAccount() .setAccountId("0G1RPP6OG0A06") .setAssetId(asset_id) .setAmount(300000000) ) // 2 input .addAction( new Transaction.Action.SpendFromAccount() .setAccountId("0G1Q6V1P00A02") // Multi-keys account .setAssetId(asset_id) .setAmount(40000000) ) .addAction( new Transaction.Action.SpendFromAccount() .setAccountId("0G1Q6V1P00A02") .setAssetId(asset_id) .setAmount(300000000) ) .addAction( new Transaction.Action.ControlWithAddress() .setAddress(address) .setAssetId(asset_id) .setAmount(60000000) ).build(client); logger.info("template: " + template.toJson()); // use Template object's raw_transaction id to decode raw_transaction obtain a RawTransaction object RawTransaction decodedTx = RawTransaction.decode(client, template.rawTransaction); logger.info("decodeTx: " + decodedTx.toJson()); // need a private key array String[] privateKeys = new String[]{"08bdbd6c22856c5747c930f64d0e5d58ded17c4473910c6c0c3f94e485833a436247976253c8e29e961041ad8dfad9309744255364323163837cbef2483b4f67", "40c821f736f60805ad59b1fea158762fa6355e258601dfb49dda6f672092ae5adf072d5cab2ceaaa0d68dd3fe7fa04869d95afed8c20069f446a338576901e1b", "08bdbd6c22856c5747c930f64d0e5d58ded17c4473910c6c0c3f94e485833a436247976253c8e29e961041ad8dfad9309744255364323163837cbef2483b4f67"}; logger.info("private key 1:" + privateKeys[0]); logger.info("private key 2:" + privateKeys[1]); // call offline sign method to obtain a basic offline signed template Signatures signatures = new SignaturesImpl(); Template basicSigned = signatures.generateSignatures(privateKeys, template, decodedTx); logger.info("basic signed raw: " + basicSigned.toJson()); // call sign transaction api to calculate whole raw_transaction id // sign password is None or another random String Template result = new Transaction.SignerBuilder().sign(client, basicSigned, ""); logger.info("result raw_transaction: " + result.toJson()); // success to submit transaction }

优秀的个人博客,低调大师

sparkcore离线性能调优

1.常规调优 1.1 最优资源配置 Spark 性能调优的第一步,就是为任务分配更多的资源,在一定范围内,增加资源的分配与性能的提升是成正比的,实现了最优的资源配置后,在此基础上再考虑进行后面论述的性能调优策略。 资源的分配在使用脚本提交Spark任务时进行指定,标准的Spark任务提交脚本如代码清单: /usr/opt/modules/spark/bin/spark-submit --class com.atguigu.spark.Analysis --num-executors 80 --driver-memory 6g --executor-memory 6g --executor-cores 3 /usr/opt/modules/spark/jar/spark.jar \ *名称* *说明* *–num-executors* 配置Executor的数量 *–driver-memory* 配置Driver内存(影响不大) *–executor-memory* 配置每个Executor的内存大小 *–executor-cores* 配置每个Executor的CPU core数量 调节原则:尽量将任务分配的资源调节到可以使用的资源的最大限度。 对于具体资源的分配,我们分别讨论 Spark 的两种 Cluste 运行模式: • 第一种是Spark Standalone模式,你在提交任务前,一定知道或者可以从运维部门获取到你可以使用的资源情况,在编写submit脚本的时候,就根据可用的资源情况进行资源的分配,比如说集群有15台机器,每台机器为8G内存,2个CPU core,那么就指定15个Executor,每个Executor分配8G内存,2个CPU core。 • 第二种是Spark Yarn模式,由于Yarn使用资源队列进行资源的分配和调度,在表写 submit 脚本的时候,就根据Spark作业要提交到的资源队列,进行资源的分配,比如资源队列有400G内存,100个CPU core,那么指定50个Executor,每个Executor分配8G内存,2个CPU core。 资源调节后的性能提升 *名称* *解析* *增加Executor·个数* 在资源允许的情况下,增加Executor的个数可以提高执行task的并行度。比如有4个Executor,每个Executor有2个CPU core,那么可以并行执行8个task,如果将Executor的个数增加到8个(资源允许的情况下),那么可以并行执行16个task,此时的并行能力提升了一倍。 *增加每个Executor的CPU core个数* 在资源允许的情况下,增加每个Executor的Cpu core个数,可以提高执行task的并行度。比如有4个Executor,每个Executor有2个CPU core,那么可以并行执行8个task,如果将每个Executor的CPU core个数增加到4个(资源允许的情况下),那么可以并行执行16个task,此时的并行能力提升了一倍。 *增加每个Executor的内存量* 在资源允许的情况下,增加每个Executor的内存量以后,对性能的提升有三点: 1. 可以缓存更多的数据(即对RDD进行cache),写入磁盘的数据相应减少,甚至可以不写入磁盘,减少了可能的磁盘IO; 2. 可以为shuffle操作提供更多内存,即有更多空间来存放reduce端拉取的数据,写入磁盘的数据相应减少,甚至可以不写入磁盘,减少了可能的磁盘IO; 3. 可以为task的执行提供更多内存,在task的执行过程中可能创建很多对象,内存较小时会引发频繁的GC,增加内存后,可以避免频繁的GC,提升整体性能。 1.2 RDD优化 1.2.1 RDD复用 在对RDD进行算子时,要避免相同的算子和计算逻辑之下对 RDD 进行重复的计算 1.2.2 RDD持久化 在Spark中,当多次对同一个 RDD 执行算子操作时,每一次都会对这个 RDD 的祖先 RDD 重新计算一次,这种情况是必须要避免的,对同一个RDD的重复计算是对资源的极大浪费,因此,必须对多次使用的RDD进行持久化,通过持久化将公共RDD的数据缓存到内存/磁盘中,之后对于公共RDD的计算都会从内存/磁盘中直接获取RDD数据。 对于RDD的持久化,有两点需要说明: 1. ,RDD的持久化是可以进行序列化的,当内存无法将RDD的数据完整的进行存放的时候,可以考虑使用序列化的方式减小数据体积,将数据完整存储在内存中。 如果对于数据的可靠性要求很高,并且内存充足,可以使用副本机制,对RDD数据进行持久化。当持久化启用了复本机制时,对于持久化的每个数据单元都存储一个副本,放在其他节点上面,由此实现数据的容错,一旦一个副本数据丢失,不需要重新计算,还可以使用另外一个副本。 1.2.3 对于RDD尽可能早的做filter 获取到初始RDD后,应该考虑尽早地过滤掉不需要的数据,进而减少对内存的占用,从而提升Spark作业的运行效率。 1.3 并行度的调节 Spark作业中的并行度指各个stage 的 task 的数量。 如果并行度设置不合理而导致并行度过低,会导致资源的极大浪费,例如,20个 Executor,每个 Executor 分配 3 个CPU core,而Spark作业有 40 个task,这样每个Executor分配到的task个数是2个,这就使得每个Executor有一个CPU core空闲,导致资源的浪费。 理想的并行度设置,应该是让并行度与资源相匹配,简单来说就是在资源允许的前提下,并行度要设置的尽可能大,达到可以充分利用集群资源。合理的设置并行度,可以提升整个 Spark 作业的性能和运行速度。 Spark官方推荐,task数量应该设置为Spark作业总CPU core数量的2~3倍。之所以没有推荐task数量与CPU core总数相等,是因为task的执行时间不同,有的task执行速度快而有的task执行速度慢,如果task数量与CPU core总数相等,那么执行快的task执行完成后,会出现CPU core空闲的情况。*如果task数量设置为CPU core总数的**2~3**倍,那么一个task执行完毕后,CPU core会立刻执行下一个task,降低了资源的浪费,同时提升了Spark作业运行的效率。* Spark作业并行度的设置如代码: new SparkConf() .set("spark.default.parallelism", "500") 1.4 广播大变量 默认情况下,task 中的算子中如果使用了外部的变量,每个 task 都会获取一份变量的复本,这就造成了内存的极大消耗。 - 一方面,如果后续对 RDD 进行持久化,可能就无法将 RDD 数据存入内存,只能写入磁盘,磁盘IO将会严重消耗性能; - 另一方面,task在创建对象的时候,也许会发现堆内存无法存放新创建的对象,这就会导致频繁的GC,GC会导致工作线程停止,进而导致Spark暂停工作一段时间,严重影响Spark性能。 假设当前任务配置了20个Executor,指定500个task,有一个20M的变量被所有task共用,此时会在500个task中产生500个副本,耗费集群10G的内存,如果使用了广播变量, 那么每个Executor保存一个副本,一共消耗400M内存,内存消耗减少了5倍。 广播变量在每个Executor保存一个副本,此Executor的所有task共用此广播变量,这让变量产生的副本数量大大减少。 1.5 修改序列化方式 默认情况下,Spark 使用 Java 的序列化机制。Java的序列化机制使用方便,不需要额外的配置,在算子中使用的变量实现Serializable接口即可,但是,Java 序列化机制的效率不高,序列化速度慢并且序列化后的数据所占用的空间依然较大。 Kryo序列化机制比Java序列化机制性能提高10倍左右,Spark之所以没有默认使用Kryo作为序列化类库,是因为它不支持所有对象的序列化,同时Kryo需要用户在使用前注册需要序列化的类型,不够方便,但从Spark 2.0.0版本开始,简单类型、简单类型数组、字符串类型的Shuffling RDDs 已经默认使用Kryo序列化方式了。 public class MyKryoRegistrator implements KryoRegistrator{ @Override public void registerClasses(Kryo kryo){ kryo.register(StartupReportLogs.class); } } //创建SparkConf对象 val conf = new SparkConf().setMaster(…).setAppName(…) //使用Kryo序列化库,如果要使用Java序列化库,需要把该行屏蔽掉 conf.set("spark.serializer", "org.apache.spark.serializer.KryoSerializer"); //在Kryo序列化库中注册自定义的类集合,如果要使用Java序列化库,需要把该行屏蔽掉 conf.set("spark.kryo.registrator", "atguigu.com.MyKryoRegistrator"); 1.6 调节本地化等待时间 Spark 作业运行过程中,Driver 会对每一个 stage 的 task 进行分配。根据 Spark 的 task 分配算法,Spark希望task能够运行在它要计算的数据所在的节点(数据本地化思想),这样就可以避免数据的网络传输。 通常来说,task可能不会被分配到它处理的数据所在的节点,因为这些节点可用的资源可能已经用尽,此时,Spark会等待一段时间,默认3s,如果等待指定时间后仍然无法在指定节点运行,那么会自动降级,尝试将task分配到比较差的本地化级别所对应的节点上,比如将task分配到离它要计算的数据比较近的一个节点,然后进行计算,如果当前级别仍然不行,那么继续降级。 当task要处理的数据不在task所在节点上时,会发生数据的传输。task会通过所在节点的BlockManager获取数据,BlockManager发现数据不在本地时,会通过网络传输组件从数据所在节点的BlockManager处获取数据。 网络传输数据的情况是我们不愿意看到的,大量的网络传输会严重影响性能,因此,我们希望通过调节本地化等待时长,如果在等待时长这段时间内,目标节点处理完成了一部分task,那么当前的task将有机会得到执行,这样就能够改善Spark作业的整体性能。 表2-3 Spark本地化等级 *名称* *解析* *PROCESS_LOCAL* 进程本地化,task和数据在同一个Executor中,性能最好。 *NODE_LOCAL* 节点本地化,task和数据在同一个节点中,但是task和数据不在同一个Executor中,数据需要在进程间进行传输。 *RACK_LOCAL* 机架本地化,task和数据在同一个机架的两个节点上,数据需要通过网络在节点之间进行传输。 *NO_PREF* 对于task来说,从哪里获取都一样,没有好坏之分。 *ANY* task和数据可以在集群的任何地方,而且不在一个机架中,性能最差。 在Spark项目开发阶段,可以使用client模式对程序进行测试,此时,可以在本地看到比较全的日志信息,日志信息中有明确的task数据本地化的级别,如果大部分都是PROCESS_LOCAL,那么就无需进行调节,但是如果发现很多的级别都是NODE_LOCAL、ANY,那么需要对本地化的等待时长进行调节,通过延长本地化等待时长,看看task的本地化级别有没有提升,并观察Spark作业的运行时间有没有缩短。 注意,过犹不及,不要将本地化等待时长延长地过长,导致因为大量的等待时长,使得Spark作业的运行时间反而增加了。 val conf = new SparkConf() .set("spark.locality.wait", "6")//配置这一个,就都有了相当于 2.算子调优 2.1 mapPartitions 普通的 map 算子对 RDD 中的每一个元素进行操作,而 mapPartitions 算子对 RDD 中每一个分区进行操作。 2.2 foreachPartition 优化数据库操作 使用了foreachPartition算子后,可以获得以下的性能提升: 1.对于我们写的function函数,一次处理一整个分区的数据; 2.对于一个分区内的数据,创建唯一的数据库连接; 3.只需要向数据库发送一次SQL语句和多组参数; 在生产环境中,全部都会使用foreachPartition算子完成数据库操作。foreachPartition算子存在一个问题,与mapPartitions算子类似,如果一个分区的数据量特别大,可能会造成OOM,即内存溢出。 2.3 filter 与 coalesce 的配合使用 在Spark任务中我们经常会使用filter算子完成RDD中数据的过滤,在任务初始阶段,从各个分区中加载到的数据量是相近的,但是一旦进过filter过滤后,每个分区的数据量有可能会存在较大差异 repartition与coalesce都可以用来进行重分区,其中repartition只是coalesce接口中shuffle为true的简易实现,coalesce默认情况下不进行shuffle,但是可以通过参数进行设置。 2.4 repartition解决 SparkSQL 低并行度问题 在第一节的常规性能调优中我们讲解了并行度的调节策略,但是,并行度的设置对于Spark SQL是不生效的,用户设置的并行度只对于Spark SQL以外的所有Spark的stage生效。 Spark SQL的并行度不允许用户自己指定,Spark SQL自己会默认根据 hive 表对应的 HDFS 文件的 split 个数自动设置 Spark SQL 所在的那个 stage 的并行度,用户自己通spark.default.parallelism参数指定的并行度,只会在没Spark SQL的stage中生效。 由于Spark SQL所在stage的并行度无法手动设置,如果数据量较大,并且此stage中后续的transformation操作有着复杂的业务逻辑,而Spark SQL自动设置的task数量很少,这就意味着每个task要处理为数不少的数据量,然后还要执行非常复杂的处理逻辑,这就可能表现为第一个有 Spark SQL 的 stage 速度很慢,而后续的没有 Spark SQL 的 stage 运行速度非常快。 为了解决Spark SQL无法设置并行度和 task 数量的问题,我们可以使用repartition算子。 2.5 reduceByKey 预聚合 类似于mapreduce的combiner,可以实现本地预聚合,降低shuffle传输的数据量,提升性能。 3.shuffle调优 3.1 调节map端缓冲区大小 在 Spark 任务运行过程中,如果 shuffle 的map端处理的数据量比较大,但是map端缓冲的大小是固定的,可能会出现map端缓冲数据频繁spill溢写到磁盘文件中的情况,使得性能非常低下,通过调节map端缓冲的大小,可以避免频繁的磁盘 IO 操作,进而提升 Spark 任务的整体性能。 map端缓冲的默认配置是32KB,如果每个task处理640KB的数据,那么会发生640/32 = 20次溢写,如果每个task处理64000KB的数据,机会发生64000/32=2000此溢写,这对于性能的影响是非常严重的。 val conf = new SparkConf() .set("spark.shuffle.file.buffer", "64") 3.2 调节reduce端拉取数据缓冲区大小 Spark Shuffle 过程中,shuffle reduce task 的 buffer缓冲区大小决定了reduce task 每次能够缓冲的数据量,也就是每次能够拉取的数据量,如果内存资源较为充足,适当增加拉取数据缓冲区的大小,可以减少拉取数据的次数,也就可以减少网络传输的次数,进而提升性能。 reduce端数据拉取缓冲区的大小可以通过spark.reducer.maxSizeInFlight参数进行设置,默认为48MB, val conf = new SparkConf() .set("spark.reducer.maxSizeInFlight", "96") 3.3 调节reduce端拉取数据重试次数 Spark Shuffle 过程中,reduce task 拉取属于自己的数据时,如果因为网络异常等原因导致失败会自动进行重试。对于那些包含了特别耗时的 shuffle 操作的作业,建议增加重试最大次数(比如60次),以避免由于 JVM 的full gc 或者网络不稳定等因素导致的数据拉取失败。在实践中发现,对于针对超大数据量(数十亿~上百亿)的shuffle 过程,调节该参数可以大幅度提升稳定性。 reduce 端拉取数据重试次数可以通过spark.shuffle.io.maxRetries参数进行设置,该参数就代表了可以重试的最大次数。如果在指定次数之内拉取还是没有成功,就可能会导致作业执行失败,默认为3, val conf = new SparkConf() .set("spark.shuffle.io.maxRetries", "6") 3.4 调节reduce端拉取数据等待间隔 Spark Shuffle 过程中,reduce task 拉取属于自己的数据时,如果因为网络异常等原因导致失败会自动进行重试,在一次失败后,会等待一定的时间间隔再进行重试,可以通过加大间隔时长(比如60s),以增加shuffle操作的稳定性。 reduce端拉取数据等待间隔可以通过spark.shuffle.io.retryWait参数进行设置,默认值为5s, val conf = new SparkConf() .set("spark.shuffle.io.retryWait", "60s") 3.5 调节SortShuffle排序操作阈值 对于SortShuffleManager,如果shuffle reduce task的数量小于某一阈值则shuffle write过程中不会进行排序操作,而是直接按照未经优化的HashShuffleManager的方式去写数据,但是最后会将每个task产生的所有临时磁盘文件都合并成一个文件,并会创建单独的索引文件。 当你使用SortShuffleManager时,如果的确不需要排序操作,那么建议将这个参数调大一些,大于shuffle read task的数量,那么此时map-side就不会进行排序了,减少了排序的性能开销,但是这种方式下,依然会产生大量的磁盘文件,因此shuffle write性能有待提高。 SortShuffleManager排序操作阈值的设置可以通过spark.shuffle.sort. bypassMergeThreshold这一参数进行设置,默认值为200, val conf = new SparkConf() .set("spark.shuffle.sort.bypassMergeThreshold", "400") 4.jvm调优 4.1 降低cache操作的内存占比 4.1.1 静态内存管理机制 根据 Spark 静态内存管理机制,堆内存被划分为了两块,Storage 和 Execution。 Storage 主要用于缓存 RDD数据和 broadcast 数据,Execution主要用于缓存在shuffle过程中产生的中间数据,Storage占系统内存的60%,Execution占系统内存的20%,并且两者完全独立。 在一般情况下,Storage的内存都提供给了cache操作,但是如果在某些情况下cache操作内存不是很紧张,而task的算子中创建的对象很多,Execution内存又相对较小,这回导致频繁的minor gc,甚至于频繁的full gc,进而导致Spark频繁的停止工作,性能影响会很大。 在Spark UI中可以查看每个stage的运行情况,包括每个task的运行时间、gc时间等等,如果发现gc太频繁,时间太长,就可以考虑调节Storage的内存占比,让task执行算子函数式,有更多的内存可以使用。 Storage内存区域可以通过spark.storage.memoryFraction参数进行指定,默认为0.6,即60%,可以逐级向下递减, val conf = new SparkConf() .set("spark.storage.memoryFraction", "0.4") 4.1.2 统一内存管理机制 根据Spark统一内存管理机制,堆内存被划分为了两块,Storage 和 Execution。Storage 主要用于缓存数据,Execution 主要用于缓存在 shuffle 过程中产生的中间数据,两者所组成的内存部分称为统一内存,Storage和Execution各占统一内存的50%,由于动态占用机制的实现,shuffle 过程需要的内存过大时,会自动占用Storage 的内存区域,因此无需手动进行调节。 4.2 调节Executor堆外内存 Executor 的堆外内存主要用于程序的共享库、Perm Space、 线程Stack和一些Memory mapping等, 或者类C方式allocate object。 有时,如果你的Spark作业处理的数据量非常大,达到几亿的数据量,此时运行 Spark 作业会时不时地报错,例如shuffle output file cannot find,executor lost,task lost,out of memory等,这可能是Executor的堆外内存不太够用,导致 Executor 在运行的过程中内存溢出。 stage 的 task 在运行的时候,可能要从一些 Executor 中去拉取 shuffle map output 文件,但是 Executor 可能已经由于内存溢出挂掉了,其关联的 BlockManager 也没有了,这就可能会报出 shuffle output file cannot find,executor lost,task lost,out of memory等错误,此时,就可以考虑调节一下Executor的堆外内存,也就可以避免报错,与此同时,堆外内存调节的比较大的时候,对于性能来讲,也会带来一定的提升。 默认情况下,Executor 堆外内存上限大概为300多MB,在实际的生产环境下,对海量数据进行处理的时候,这里都会出现问题,导致Spark作业反复崩溃,无法运行,此时就会去调节这个参数,到至少1G,甚至于2G、4G。 Executor堆外内存的配置需要在spark-submit脚本里配置, --conf spark.executor.memoryOverhead=2048 以上参数配置完成后,会避免掉某些JVM OOM的异常问题,同时,可以提升整体 Spark 作业的性能。 4.3 调节连接等待时长 在 Spark 作业运行过程中,Executor 优先从自己本地关联的 BlockManager 中获取某份数据,如果本地BlockManager没有的话,会通过TransferService远程连接其他节点上Executor的BlockManager来获取数据。 如果 task 在运行过程中创建大量对象或者创建的对象较大,会占用大量的内存,这会导致频繁的垃圾回收,但是垃圾回收会导致工作现场全部停止,也就是说,垃圾回收一旦执行,Spark 的 Executor 进程就会停止工作,无法提供相应,此时,由于没有响应,无法建立网络连接,会导致网络连接超时。 在生产环境下,有时会遇到file not found、file lost这类错误,在这种情况下,很有可能是Executor的BlockManager在拉取数据的时候,无法建立连接,然后超过默认的连接等待时长120s后,宣告数据拉取失败,如果反复尝试都拉取不到数据,可能会导致 Spark 作业的崩溃。这种情况也可能会导致 DAGScheduler 反复提交几次 stage,TaskScheduler 返回提交几次 task,大大延长了我们的 Spark 作业的运行时间。 此时,可以考虑调节连接的超时时长,连接等待时长需要在spark-submit脚本中进行设置 --conf spark.core.connection.ack.wait.timeout=300 调节连接等待时长后,通常可以避免部分的XX文件拉取失败、XX文件lost等报错。

优秀的个人博客,低调大师

React Native 离线包/图片资源

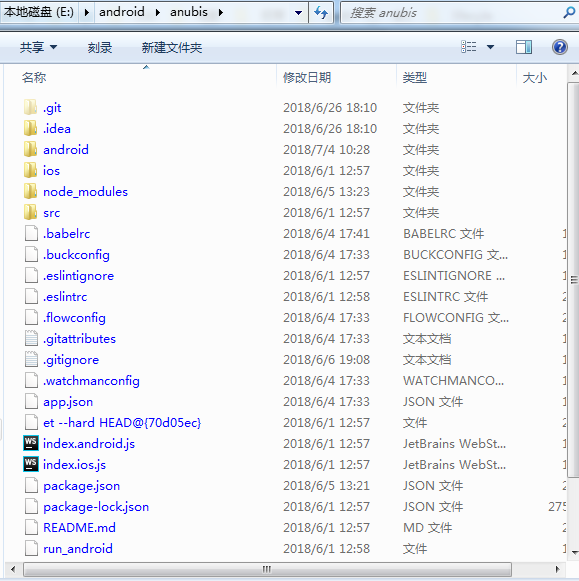
1). 打包 进入项目根目录(如图1,anubis为项目名)执行命令 react-native bundle --platform android --dev false --entry-file index.android.js --bundle-output android/app/src/main/assets/index.android.bundle --assets-dest android/app/src/main/assets/ 图1.png 注:打包时一定要确保"android/app/src/main/路径下存在assets文件夹,如果不存在,创建即可 2). 打包文件 进入"android/app/src/main/assets/"全部打包 图2.png 并将压缩包推送到手机内存卡中, 并在手机中解压 adb push bundle.zip /mnt/sdcard/ 其中bundle.zip文件在桌面,"/mnt/sdcard/"是手机内存卡路径 图3.png 3). 打包App 修改app/build.gradle文件 project.ext.react = [ // false: 不将index.android.bundle文件打包进assets文件夹 // true: 将index.android.bundle文件打包进assets文件夹 bundleInDebug: false, bundleInUat : false, bundleInRelease: true ] 直接使用Android Studio运行项目, 即可成功出现app界面

优秀的个人博客,低调大师

Delta Lake 平台化实践(离线篇)

原文链接:https://blog.csdn.net/lsshlsw/article/details/103553289 博客主:breeze_lsw 01 SQL 支持 1.1 DML 背景 delta lake 0.4 只支持以 api 的方式使用 Delete/Update/Merge Into 等 DML,对习惯了使用 sql 的终端用户会增加其学习使用成本。 解决方式 下文通过 spark sql extension 以插件化的方式扩展 sql parser ,增加 DML 语法的支持。在 spark 推出 sql extension 功能前,也可以用通过 aspectj 通过拦截 sql 的方式实现增加自定义语法的功能。 1.在自定义扩展 g4 文件中相应的 antlr4 DML 语法,部分参考了 databricks 商业版的语法 st

优秀的个人博客,低调大师

以太坊PHP离线交易开发包

EthTool开发包适用于希望采用裸交易的PHP以太坊应用开发,主要包含以下特性: 支持裸交易部署/调用合约 内置etherscan和infura支持 keystore生成与读取,兼容geth/parity 采用裸交易的一个好处是开发者不必自己部署以太坊节点 —— 同步区块是很痛苦的过程。使用EthTool构造 好裸交易之后,只需要使用第三方(etherscan/infura/...)提供的服务来广播交易即可。 下载地址:http://sc.hubwiz.com/codebag/eth-php-lib/ EthTool运行在**Php 7.1+**环境下,当前版本1.0.0,主要代码文件清单如下: 代码文件 说明 ethtool/src/Callback.php RPC回调类 ethtool/src/Credential.php 身份标识类 ethtool/src/KeyStore.php Keystore类,V3算法 ethtool/src/EthApi.php 以太坊交易接口基类 ethtool/src/EthApiEtherscan.php Etherscan交易接口类 ethtool/src/EthApiWeb3.php Infura/Web3交易接口类 ethtool/src/RawContract.php 裸交易合约类 ethtool/src/RawTxBuilder.php 裸交易构造器 test/demo-etherscan.php 裸交易演示代码,使用etherscan提交 test/demo-infura.php 裸交易演示代码,使用infura提交 test/demo-keystore.php keystore演示代码 vendor 第三方依赖包目录 composer.json composer配置文件 使用说明 代码包的主要类如下: RawTxBuilder: 裸交易构造器 Credential: 账户私钥与交易签名封装 EthApi: 以太坊交易接口封装 KeyStore: V3版本的keystore,兼容geth/parity 裸交易构造 使用RawTxBuilder的create()静态方法获取一个构造器实例,例如: $rtb = RawTxBuilder::create(); 裸交易构造器需要绑定一个账户对象,使用credential()方法: $crendetial = Crendetial::fromKey('...'); $rtb->credential($credential); RawTxBuilder目前支持三种裸交易的构造: 普通裸交易,例如以太币转账交易。使用getPlaintx()方法获取。 合约部署裸交易,使用getDeployTx()方法获取。 合约方法调用裸交易,使用getSendTx()方法获取。 例如,下面的代码生成合约部署裸交易: $rawtx = RawTxBuilder::create() ->credential($credential) ->gasLimit('4000000') ->gasPrice('10000000000') ->chainId($chainId) ->nonce($nonce) ->contract($abi) //创建合约对象,一个RawContract实例 ->bytecode($bin) //设置合约对象的字节码 ->getDeployTx(1000000,'HAPPY COIN',0,'HAPY'); //获取部署裸交易码流 裸交易广播 EthApi基类目前定义以下方法,可以根据自己的需要扩充 getTransactionCount sendRawTransaction getTransactionReceipt EthApiEtherscan是基于Etherscan服务的EthApi实现,EthApiWeb3是基于以太坊RPC的EthApi 实现。例如,下面的代码使用Etherscan在rinkeby测试链部署前面获得的裸交易: $eth = new EthApiEtherscan($your_api_key/*etherscan api key*/,4/*rinkeby*/); $txid = $eth->sendRawTransaction($rawtx); KeyStore读写 KeyStore类可以读取geth/parity生成的keystore文件,其生成的 keystore文件也可以被geth/parity读取。 使用KeyStore类的静态方法save()将私钥转化为keystore格式写入指定目录: $credential = Credential::new(); $prv = $credential->getPrivateKey(); $fileName = KeyStore::save($prv,'123','./keystore') 使用KeyStore类的静态方法load()载入指定的keystore文件并解密私钥: $fileName = './keystore/....' $prv = KeyStore::load($fileName,'123');

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册