首页 文章 精选 留言 我的

精选列表

搜索[搜索引擎],共3933篇文章
优秀的个人博客,低调大师

Apache Lucene 7.7.3 发布,Java 全文搜索引擎

Apache Lucene 7.7.3 已发布,Lucene 是一个全文检索引擎的架构,提供了完整的查询引擎和索引引擎、部分文本分析引擎。目的是为软件开发人员提供一个简单易用的工具包,以方便地在目标系统中实现全文检索的功能,或者是以此为基础建立起完整的全文检索引擎。 此版本修复了一个 bug: LUCENE-9300:修复当 doc 值更新应用于外部创建的 segment 上并使用 IndexWriter#addIndexes(Directory) 添加到索引中时,新的 gen 字段信息损坏的问题 下载地址https://lucene.apache.org/core/downloads.html

优秀的个人博客,低调大师

Apache Lucene 8.5.1 发布,Java 全文搜索引擎

Apache Lucene 8.5.1已发布,Lucene 是一个全文检索引擎的架构,提供了完整的查询引擎和索引引擎、部分文本分析引擎。目的是为软件开发人员提供一个简单易用的工具包,以方便地在目标系统中实现全文检索的功能,或者是以此为基础建立起完整的全文检索引擎。 此版本修复了 doc 值更新和 addIndexes 时出现的索引损坏问题。 LUCENE-9300:修复当 doc 值更新应用于外部创建的 segment 上并使用 IndexWriter#addIndexes(Directory) 添加到索引中时,新的 gen 字段信息损坏的问题 下载地址https://lucene.apache.org/core/downloads.html

优秀的个人博客,低调大师

Apache Lucene 8.5.0 发布,Java 全文搜索引擎

Apache Lucene 8.5.0 发布了,Lucene 是一个全文检索引擎的架构,提供了完整的查询引擎和索引引擎、部分文本分析引擎。目的是为软件开发人员提供一个简单易用的工具包,以方便地在目标系统中实现全文检索的功能,或者是以此为基础建立起完整的全文检索引擎。 新版本的亮点包括: XYPointField 允许在平面 X,Y 空间中建立点索引,并有效地查找边界框、距离或任意多边形内的文档 LatLonShape 上的新查询构建器可以有效地查找与点或多边形具有特定关系的文档 可以在“点”字段中存储多达 16 个数据维度 KoreanTokenizer 支持自定义词典 二进制 doc 值现在已压缩,并且术语词典已改进压缩 如果所有文档值更新都将单个字段更新为相同的值,则索引刷新速度最高可提高 20% 现在,存储的字段和术语向量的索引是堆外存储的 基于 QueryBuilder 的查询解析器可以通过在令牌流上设置 BoostAttribute 值来提升特定术语或同义词 间隔查询可正确处理有序和无序源中的重复子项 发布公告

优秀的个人博客,低调大师

Apache Lucene 8.4.0 发布,Java 全文搜索引擎

Apache Lucene 8.4.0 发布了,Lucene 是一个全文检索引擎的架构,提供了完整的查询引擎和索引引擎、部分文本分析引擎。目的是为软件开发人员提供一个简单易用的工具包,以方便地在目标系统中实现全文检索的功能,或者是以此为基础建立起完整的全文检索引擎。 新版本的亮点包括: LatLonShape 现在支持 “CONTAINS” 关系,该关系可以查找包含查询形状的所有索引形状 并发搜索通过允许收集器跨线程共享信息,以更有效地跳过非竞争性命中,从而变得更加高效 在密集节点上更快的 FST 查找 现在可以使用 SIMD 指令解码贴子 LRUQueryCache 包括新的试探法,可防止缓存过多地影响延迟 LatLonShape 构建了更高效的树,有望提高搜索速度 BaseDirectoryReader 可以更有效地隐藏文档的子集的阅读器视图 BKD 树顶部的索引现在通过 MMapDirectory 进行了堆外存储 简单间隔查询支持高亮 超过时间时,可能会中断 DocValues 的读取 发布公告

优秀的个人博客,低调大师

Milvus 向量搜索引擎 0.6.0 新功能介绍

Gitee:https://gitee.com/milvus-io/milvus 发布时间:2019-12-07 版本兼容 Milvus 版本 pymilvus 版本 Java SDK 版本 0.6.0 0.2.6 0.4.0 ✨新增功能 仅需 CPU 的 Milvus 在之前的版本,我们只提供了 GPU 版本的 Milvus。为了降低用户使用门槛,从 v0.6.0 开始,Milvus 提供仅需 CPU 和支持 GPU 两个版本的 Docker 镜像。CPU 版适合百万级数据的查询,而 GPU 版在超大数据集搜索情况下性能优势更明显。 您也可以源码编译,但考虑到编译环境复杂多变,有可能会增加编译困难,我们在新版本提供了 Ubuntu 18.04 的 Docker 镜像,便于大家直接在 Docker 容器中编译 Milvus。 更多信息,请参阅 PR#192: https://github.com/milvus-io/milvus/pull/192 Milvus 安装步骤: https://www.milvus.io/docs/zh-CN/userguide/install_milvus/ CPU 版镜像下载:milvusdb/milvus:cpu-latest GPU 版镜像下载:milvusdb/milvus:latest 分区表 随着单张表的数据量不断增长,查询性能也会不断下降。单张表的数据变得很臃肿的时候,就要考虑将这张表拆分。v0.6.0 新增了分区表功能以确保增量数据的高性能查询。Milvus 的表基于标签分区,通过定义partition_tag,您可以指定某张分区表,每张分区表的索引继承自母表。Python,Java 和 C++ SDK 中也分别增加了表分区功能的相关接口,目前支持创建/删除分区表,向量插入指定分区表,查看指定分区表,以及指定分区表的查询。 更多信息,请参阅 PR#245:https://github.com/milvus-io/milvus/pull/245 实验功能 v0.6.0还推出了一些实验功能,代表了 Milvus 未来版本可能发展的方向。这些实验功能仍在持续开发和更新中,可能包含已知问题和未发现的错误。现阶段这些功能主要用于测试和用户反馈收集,欢迎大家积极试用。 Mishards Milvus 旨在帮助用户实现海量非结构化数据的近似检索和分析。单个 Milvus 实例可处理十亿级数据规模,而对于百亿或者千亿级数据,则需要一个 Milvus 集群实例。v0.6.0 推出的 Mishards 正是 Milvus 集群分片处理的中间件,主要负责将上游请求拆分,并路由到内部各细分子服务,最后将子服务结果汇总,返回给上游。Mishards 内部处理请求转发、读写分离、水平扩展、动态扩容,为用户提供内存和算力可以无限扩容的 Milvus 集群实例。 更多信息,请参阅PR#232: https://github.com/milvus-io/milvus/pull/232 新的索引类型 支持新的索引类型如SPTAG-KDT,SPTAG-BKT,RNSG和IVFPQ。Milvus 集成了微软的 SPTAG 算法库,包含两种索引类型。RNSG是 Milvus 在 NSG 基础上自研的基于图的索引算法,它可以 a) 降低图的平均出度;b) 缩短搜索路径;c) 缩减索引大小;d) 降低索引复杂度。IVF_PQ是在倒排索引的基础上进一步利用笛卡儿积(PQ)对每一个倒排文件中的向量进行编码的索引技术。这样的方法称之为非对称距离计算。向量大小可以缩减至原来大小的1/8甚至1/16。该索引方式虽然会损失精度,但内存占用会进一步下降,适用于低内存环境下的大规模向量搜索。 目前看来,这几种新的索引类型的搜索性能表现并不令人满意,具体原因还有待进一步发掘,也欢迎感兴趣的小伙伴一起加入研究讨论。 更多信息,请参阅 SPTAG-PR#438:https://github.com/milvus-io/milvus/pull/438 RNSG-PR#554:https://github.com/milvus-io/milvus/pull/554 IVFPQ-PR#324:https://github.com/milvus-io/milvus/pull/324 SPTAG 索引介绍:https://github.com/Microsoft/SPTAG NSG 索引论文:https://arxiv.org/abs/1707.00143 Milvus 性能测试报告 Milvus 支持多种类型的索引,各个索引的查询性能会随着数据集和调参的变化而改变。新版本提供了针对IVFFLAT,IVFSQ8和IVFSQ8H的性能测试报告。随着 Milvus 支持的索引类型不断增加,测试报告也会持续更新。 具体性能测试报告,请参阅索引性能测试:https://github.com/milvus-io/milvus/tree/master/docs ✨主要改进 Milvus 优化过的 FAISS 在原有 FAISS 的基础上, Milvus 做了一些深层代码的优化以获得更优的查询性能和支持更多类型的索引类型,比如IVFSQ8H。现在,我们将这部分针对 FAISS 进行优化的代码开源了。 更多信息,请参阅PR#585: https://github.com/milvus-io/milvus/pull/585 多张 GPU 创建索引 支持使用多张 GPU 来创建索引以减少创建索引和整体查询的时间。在使用支持 GPU 的 Milvus 时,您可以通过对 Milvus 配置文件中的参数build_index_resources来指定多张 GPU 卡用于索引创建。 更多信息,请参阅 PR#414:https://github.com/milvus-io/milvus/pull/414 ✨Bug 修复 进一步解决了随查询次数增加,内存占用持续增加的问题。 更多信息,请参阅 PR#335: https://github.com/milvus-io/milvus/pull/335 如果还想了解 v0.6.0 更具体的更新改动,请参阅Milvus CHANGELOG:https://github.com/milvus-io/milvus/blob/master/CHANGELOG.md 欢迎加入Milvus社区 主页:milvus.io GitHub:github.com/milvus-io/milvus 知乎:zhuanlan.zhihu.com/milvus Slack:milvusio.slack.com Twitter:twitter.com/milvusio Facebook:www.facebook.com/io.milvus.5

优秀的个人博客,低调大师

Solr搜索引擎 — SolrCloud介绍和环境准备

搞定了一切的一切之后下一步就是正式使用了,但是之前介绍的都是在单台服务器上进行的部署,如果在生产环境出现了单台故障怎么办呢?提供稳定性和性能的最直观的方式就是集群,solr官方提供了cloud的集群方式 附上: 喵了个咪的博客:http://w-blog.cn Solr官网:http://lucene.apache.org/solr/ PS:8.0.0版本已经发布,本文使用此时较为稳定的7.7.1版本 一,SolrCloud介绍 SolrCloud是基于Solr和Zookeeper的分布式搜索方案。它的主要思想是使用Zookeeper作为SolrCloud集群的配置信息中心,统一管理solrcloud的配置,比如solrconfig.xml和schema.xml。 SolrCloud(solr集群)是Solr提供的分布式搜索方案,一下场景能够比较好的使用SolrCloud 当你需要大规模,容错,分布式索引和检索能力时使用SolrCloud。 当索引量很大,搜索请求并发很高时,同样需要使用SolrCloud来满足这些需求。 不过当一个系统的索引数据量少的时候是没有必要使用SolrCloud的。 Solrcloud特点功能: 集中式的配置信息 自动容错 近实时搜索 查询时自动负载均衡 Solrcloud的结构: solrcloud为了降低单机的处理压力,需要由多台服务器共同来完成索引和搜索任务。实现的思路是将索引数据进行Shard分片,每个分片由多台服务器共同完成,当一个索引或搜索请求过来时会分别从不同的Shard的服务器中操作索引。solrcloud是基于solr和zookeeper部署,zookeeper是一个集群管理软件,solrcloud需要由多台solr服务器组成,然后由zookeeper来进行协调管理。 物理结构: 三个Solr实例( 每个实例包括两个Core),组成一个SolrCloud。 逻辑结构: 索引集合包括两个Shard(shard1和shard2),shard1和shard2分别由三个Core组成,其中一个Leader两个Replication,Leader是由zookeeper选举产生,zookeeper控制每个shard上三个Core的索引数据一致,解决高可用问题。用户发起索引请求分别从shard1和shard2上获取,解决高并发问题。 core: 每个Core是Solr中一个独立运行单位,提供 索引和搜索服务。一个shard需要由一个Core或多个Core组成。由于collection由多个shard组成所以collection一般由多个core组成。 Master&Slave: Master是master-slave构中的主结点(通常说主服务器),Slave是master-slave结构中的从结点(通常说从服务器或备服务器)。同一个Shard下master和slave存储的数据是一致的,这是为了达到高可用目的 二、环境准备 准备三台centos 7服务器 , 并且对主机名进行改写 hostname solr-1 hostname solr-2 hostname solr-3 修改三台机器hosts文件通过hostname可以互相访问,使用ping命令验证可以互相通讯 > vim /etc/hosts 172.16.2.75 solr-1 172.16.2.74 solr-2 172.16.2.72 solr-3 安装JAVA,可以自行安装或oneinstack一键命令安装,这里安装了java和tomcat > wget -c http://mirrors.linuxeye.com/oneinstack-full.tar.gz && tar xzf oneinstack-full.tar.gz && ./oneinstack/install.sh --tomcat_option 2 --jdk_option 2 --reboot 三、Zookeeper安装 > cd /app/install/ > wget http://mirrors.hust.edu.cn/apache/zookeeper/zookeeper-3.4.13/zookeeper-3.4.13.tar.gz > tar -zxvf zookeeper-3.4.13.tar.gz > mv zookeeper-3.4.13 /usr/local/ 修改配置文件 > cd /usr/local/zookeeper-3.4.13/conf/ > cp zoo_sample.cfg zoo.cfg > vim zoo.cfg tickTime=2000 dataDir=/usr/local/zookeeper-3.4.13/data clientPort=2181 initLimit=10 syncLimit=5 server.1=solr-1:2888:3888 server.2=solr-2:2888:3888 server.3=solr-3:2888:3888 所有节点修改环境变量 > vim /etc/profile # zookeeper export ZOOKEEPER_HOME=/usr/local/zookeeper-3.4.13 export PATH=$ZOOKEEPER_HOME/bin:$PATH > source /etc/profile 将zookeeper目录复制到其他节点上 > scp -r /usr/local/zookeeper-3.4.13/ root@solr-2:/usr/local/zookeeper-3.4.13 > scp -r /usr/local/zookeeper-3.4.13/ root@solr-3:/usr/local/zookeeper-3.4.13 添加myid文件(每节点都需要) > cd /usr/local/zookeeper-3.4.13 > mkdir data > echo "1" > data/myid 注意,每个节点myid文件要不一致 启动并测试 # 在三台机器上分别执行 > zkServer.sh start # 查看状态 [root@solr-1 zookeeper-3.4.13]# zkServer.sh status ZooKeeper JMX enabled by default Using config: /usr/local/zookeeper-3.4.13/bin/../conf/zoo.cfg Mode: follower [root@solr-2 zookeeper-3.4.13]# zkServer.sh status ZooKeeper JMX enabled by default Using config: /usr/local/zookeeper-3.4.13/bin/../conf/zoo.cfg Mode: leader [root@solr-3 zookeeper-3.4.13]# zkServer.sh status ZooKeeper JMX enabled by default Using config: /usr/local/zookeeper-3.4.13/bin/../conf/zoo.cfg Mode: follower

优秀的个人博客,低调大师

【Elasticsearch全文搜索引擎实战】之Kibana搭建

1. Kibana介绍 Kibana是一个针对Elasticsearch的开源分析及可视化平台,用来搜索、查看交互存储在Elasticsearch索引中的数据。使用Kibana,可以通过各种图表进行高级数据分析及展示。 Kibana让海量数据更容易理解。它操作简单,基于浏览器的用户界面可以快速创建仪表板(dashboard)实时显示Elasticsearch查询动态。 设置Kibana非常简单。无需编码或者额外的基础架构,几分钟内就可以完成Kibana安装并启动Elasticsearch索引监测。 2. Kibana特性 2.1 丰富的数据报表 Kibana 核心搭载了一批经典功能:柱状图、线状图、饼图、环形图,等等。它们充分利用了 Elasticsearch 的聚合功能。 2.2 将地理数据融入任何地图 利用 Elastic Maps Services 来实现地理空间数据的可视化,或者发挥创意,在您自己的地图上实现自定义位置数据的可视化。 2.3 时间序列 可以利用 Timelion,对Elasticsearch 中的数据执行高级时间序列分析。您可以利用功能强大、简单易学的表达式来描述查询、转换和可视化。 2.4 用机器学习探索异常 借助 X-Pack 里面的非监督型 machine learning 功能 来检测隐藏在 Elasticsearch 数据中的异常和探索那些对它们有显著影响的属性。 2.5 与Elasticsearch REST API实现可视化交互 Console 等 Kibana 开发工具提供多种方法帮助您开发 Elastic Stack。借助 Console,可以跳过在终端键入的过程直接处理 Elasticsearch 数据。 Search Profiler 可让您轻松查看搜索请求期间花费的时间。并且在Logstash配置中创建复杂的 Grok 模式,使 Grok Debugger 变得轻而易举。 3. 下载安装 OS Kibana CentOS 6.0.1 wget https://artifacts.elastic.co/downloads/kibana/kibana-6.0.1-linux-x86_64.tar.gz sha1sum kibana-6.0.1-linux-x86_64.tar.gz tar -xzf kibana-6.0.1-linux-x86_64.tar.gz cd kibana-6.0.1-linux-x86_64/ 3.1 配置 #修改配置 vi config/kibana.yml #增加以下内容 server.port: 5601 server.host: "192.168.1.31" elasticsearch.url: "http://192.168.1.31:9200" 3.2 运行 #进入kibana根目录 /kibana-6.0.1-linux-x86_64 #启动 ./bin/kibana 4. 访问 浏览器访问: 192.168.1.31:5601 此时会提示: Configure an index pattern 浏览器访问:192.168.1.31:5601/app/kibana#/discover 即可查看日志 参考资料: [1] Kibana使用教程:https://segmentfault.com/a/1190000002972420 [2] Kibana User Guide:https://www.elastic.co/guide/en/kibana/current/index.html

优秀的个人博客,低调大师

全文搜索引擎Elasticsearch的安装过程

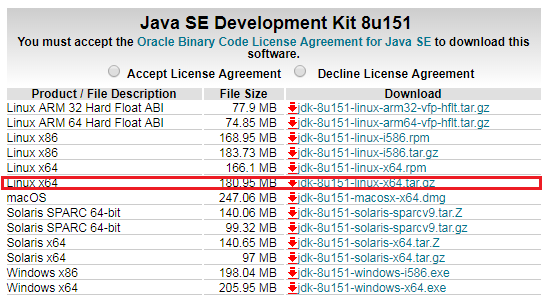
Elasticsearch是目前为止比较屌炸天的一款大数据日志收集工具,而且在很多知名大公司比如360、蚂蚁金服、京东、腾讯等都急需这方面的研究人才,在https://elasticsearch.cn/explore/category-12官方网站就有N多Elasticsearch招聘贴。 要安装Elasticsearch,需要在机器里先有java1.8+的环境,我这2个机器都是阿里云centos 7.4 64位纯净系统,配置是2核2G。 首先#yum -y update一波,更新一下最新的yum,在更新的时候呢,也不要干坐着,登陆http://www.oracle.com/technetwork/java/javase/downloads/jdk8-downloads-2133151.html ,下载最新的java安装包,我为了省事直接就选择的tar包,如图: 下载完并且上传之后,执行一下#rpm -qa | grep java,看一下有没有以前老的java,比如: 1 2 3 4 5 6 7 [root@chen-elk-001usr] #rpm-qa|grepjava java-1.7.0-openjdk-headless-1.7.0.51-2.4.5.5.el7.x86_64 python-javapackages-3.4.1-5.el7.noarch tzdata-java-2014b-1.el7.noarch javapackages-tools-3.4.1-5.el7.noarch java-1.7.0-openjdk-1.7.0 [root@chen-elk-001usr] # 如果有的话就#rpm -e --nodeps加上查询出的java名逐一删除掉java,比如: 1 2 [root@chen-elk-001usr] #rpm-e--nodepsjava-1.7.0-openjdk-headless-1.7.0.51-2.4.5.5.el7.x86_64 [root@chen-elk-001usr] #rpm-e--nodepsjava-1.7.0-openjdk-1.7.0 删除完毕之后,要#java -version检查一下是否已经不会出现版本了。 现在更新也更新完了,以前老的java也干掉了,那么就把jdk-8u151-linux-x64.tar.gz 拆包解压缩到/usr/local里,如图: 然后就#vim /etc/profile,在全文的末尾加上这样的内容: 1 2 3 4 5 6 #java1.8config JAVA_HOME= /usr/local/jdk1 .8.0_151#这里就是jdk1.8的那个路径,根据解压缩的位置而定 JRE_HOME=$JAVA_HOME /jre CLASSPATH=:$JAVA_HOME /lib/dt .jar:$JAVA_HOME /lib/tools .jar:$JRE_HOME /lib/dt .jar PATH=$PATH:$JAVA_HOME /bin :$JRE_HOME /bin export JAVA_HOMEJRE_HOMECLASSPATHPATH 保存退出之后,#source /etc/profile,然后#java -version看一下版本: java 1.8安装完毕,下面就是安装Elasticsearch,直接下载压缩包吧,比较简单暴力。 1 2 3 4 #wgethttps://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-5.5.1.zip #unzipelasticsearch-5.5.1.zip #cdelasticsearch-5.5.1/bin #./elasticsearch 启动之后,发现爆了一个错误,"Java HotSpot(TM) 64-Bit Server VM warning: INFO: os::commit_memory(0x000000008a660000, 1973026816, 0) failed; error='Cannot allocate memory' (errno=12)",如图: vim打开elasticsearch会看到下面这句话 1 #ES_JAVA_OPTS="-Xms8g-Xmx8g"./bin/elasticsearch 这个错误代表8G内存才可以启动elasticsearch,于是就升级到8G,这玩意的确是有钱人玩的东西。 升级之后,再次启动,出现了"can not run elasticsearch as root"这个错误: 既然不让root,那就建立一个新的用户吧: 1 2 3 4 5 roupaddelsearch useradd elsearch-gelsearch-pelasticsearch chown -Relsearch:elsearch/安装路径 /elasticsearch-5 .5.1 cd /安装路径 /elasticsearch-5 .5.1 /bin su elsearch. /elasticsearch 这样就看到正确启动的样子: 如果要后台启动的话,命令就是#su elsearch ./elasticsearch -d。如果你非要用root用户去启动的话,也不是不可以,命令是#./安装路径/bin/elasticsearch -Des.insecure.allow.root=true。 如果启动的时候,爆“max virtual memory areas vm.maxmapcount [65530] is too low”这个错误,那么就先运行如下命令:#sudo sysctl -w vm.max_map_count=262144。 如果启动的时候,爆“max file descriptors [65535] for elasticsearch process is too low, increase to at least [65536]”,那么#vim /etc/security/limits.conf,把文末内容改成这样,改完了之后#sysctl -p即可: 1 2 3 4 5 6 7 #Endoffile rootsoftnofile65535 roothardnofile65535 *softnofile165536 *hardnofile165536 *softnproc2048 *hardnproc4096 启动之后,在命令行里输入#curl localhost:9200,就会返回JSON 对象,包含当前节点、集群、版本等信息。 我这个Elasticsearch版本是5.11,中文教程https://elasticsearch.cn/book/elasticsearch_definitive_guide_2.x/ 已经有点老了,所以研究之路不仅充满荆棘还充满各种墙和英语... 参考资料:http://www.yiibai.com/elasticsearch/ 参考资料:http://www.cnblogs.com/Wolfmanlq/p/5984376.html 最后的最后,如果您觉得本文对您升职加薪有帮助,那么请不吝赞助之手,刷一下下面的二维码,赞助本人继续写更多的博文! 本文转自 苏幕遮618 51CTO博客,原文链接:http://blog.51cto.com/chenx1242/2043924

优秀的个人博客,低调大师

mapreduce实现搜索引擎简单的倒排索引

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq1010885678/article/details/44458825 使用hadoop版本为2.2.0 倒排索引简单的可以理解为全文检索某个词 例如:在a.txt 和b.txt两篇文章分别中查找统计hello这个单词出现的次数,出现次数越多,和关键词的吻合度就越高 现有a.txt内容如下: hello tom hello jerry hello kitty hello world hello tom b.txt内容如下: hello jerry hello tom hello world 在hadoop平台上编写mr代码分析统计各个单词在两个文本中出现的次数 其实也只是WordCount程序的改版而已~ 将两个文本上传到hdfs根目录的ii文件夹下(mr直接读取ii文件夹,会读取所有没有以_(下划线)开头的文件) 编写mr代码 首先分析,map输入的格式为 该行偏移量 该行文本 如: 0 hello 我们知道,map的输出之后会根据相同的key来进行合并 而每个单词都不是唯一的,它可能在两个文本中都出现,使用单词作为key的话无法分辨出该单词属于哪个文本 而使用文本名字作为key的话,那么将达到我们原来的目的,因为map的输出就会变成a.txt->单词..单词..单词 这显然不是我们想要的结果 所以map输出的格式应该为 单个单词->所在文本 1 如: hello->a.txt 1 这里用->作为单词和所在文本的分隔 这样就可以在根据key进行合并的时候不会影响到我们的结果 map代码如下: public static class MyMapper extends Mapper<LongWritable, Text, Text, Text> { private Text k = new Text(); private Text v = new Text(); protected void map( LongWritable key, Text value, org.apache.hadoop.mapreduce.Mapper<LongWritable, Text, Text, Text>.Context context) throws java.io.IOException, InterruptedException { String[] data = value.toString().split(" "); //FileSplit类从context上下文中得到,可以获得当前读取的文件的路径 FileSplit fileSplit = (FileSplit) context.getInputSplit(); //文件路径为hdfs://hadoop:9000/ii/a.txt //根据/分割取最后一块即可得到当前的文件名 String[] fileNames = fileSplit.getPath().toString().split("/"); String fileName = fileNames[fileNames.length - 1]; for (String d : data) { k.set(d + "->" + fileName); v.set("1"); context.write(k, v); } }; } 在map执行完毕之后 我们需要一个combiner来帮助完成一些工作 注意,combiner的输入格式和输出格式是一致的,也就是map的输出格式,否则会出错 再次分析,根据key合并value之后的键值对是这个样子的: (hello->a.txt,{1,1,1,1,1}) combiner要做的工作就是讲values统计累加 并将key的单词和文本分隔开,将文本名和统计之后的values组合在一起形成新的value 如: (hello,a.txt->5) 为什么要这么做? 因为在combiner执行完毕之后 还会根据key进行一次value的合并,跟map之后的是一样的 将key相同的value组成一个values集合 如此一来,在经过combiner执行之后,到达reduce的输入就变成了 (hello,{a.txt->5,b.txt->3}) 这样的格式,然后在reduce中循环将values输出不就是我们想要的结果了吗~ combiner代码如下: public static class MyCombiner extends Reducer<Text, Text, Text, Text> { private Text k = new Text(); private Text v = new Text(); protected void reduce( Text key, java.lang.Iterable<Text> values, org.apache.hadoop.mapreduce.Reducer<Text, Text, Text, Text>.Context context) throws java.io.IOException, InterruptedException { //分割文件名和单词 String[] wordAndPath = key.toString().split("->"); //统计出现次数 int counts = 0; for (Text t : values) { counts += Integer.parseInt(t.toString()); } //组成新的key-value输出 k.set(wordAndPath[0]); v.set(wordAndPath[1] + "->" + counts); context.write(k, v); }; } 接下来reduce的工作就简单了 代码如下: public static class MyReducer extends Reducer<Text, Text, Text, Text> { private Text v = new Text(); protected void reduce( Text key, java.lang.Iterable<Text> values, org.apache.hadoop.mapreduce.Reducer<Text, Text, Text, Text>.Context context) throws java.io.IOException, InterruptedException { String res = ""; for (Text text : values) { res += text.toString() + "\r"; } v.set(res); context.write(key, v); }; } main方法代码: public static void main(String[] args) throws Exception { Configuration conf = new Configuration(); FileSystem fs = FileSystem.get(conf); Path inPath = new Path("hdfs://hadoop:9000" + args[0]); Path outPath = new Path("hdfs://hadoop:9000" + args[1]); if (fs.exists(outPath)) { fs.delete(outPath, true); } Job job = Job.getInstance(conf); job.setJarByClass(InverseIndex.class); FileInputFormat.setInputPaths(job, inPath); job.setInputFormatClass(TextInputFormat.class); job.setMapperClass(MyMapper.class); job.setMapOutputKeyClass(Text.class); job.setMapOutputValueClass(Text.class); job.setCombinerClass(MyCombiner.class); job.setReducerClass(MyReducer.class); job.setOutputKeyClass(Text.class); job.setOutputValueClass(Text.class); FileOutputFormat.setOutputPath(job, outPath); job.setOutputFormatClass(TextOutputFormat.class); job.waitForCompletion(true); } 在hadoop上运行jar包执行结果如图: 初学hadoop,仅作笔记之用,其中如有错误望请告知^-^

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册