首页 文章 精选 留言 我的

精选列表

搜索[告别],共1802篇文章
优秀的个人博客,低调大师

用 Python 批量生成销售日报,告别每天复制粘贴

销售日报需要汇总各渠道的订单数、销售额和客单价。渠道超过十个以后,手工把数据从各平台抄进同一张 Excel 就成了明显负担:耗时、易错、且无法追溯数据来源。以 11 个渠道、日均 42 分钟手工汇总估算,每月仅此一项就占用约 15 个小时。本文用一个可落地的 Python 脚本,把这份日报改成每天定时自动生成。流程拆成取数、归一化、算指标、写 Excel、调度五步,代码可直接复用,数据源与代理配置集中管理,渠道字段变动时只改对应函数。先说清日报的结构:左侧各渠道一行,右侧是当日订单数、销售额、客单价,末尾合计并附环比。格式稳定是自动化的前提,若格式频繁变动,脚本反而增加维护成本。先把事情拆开一份"日报"其实就三件事。第一,数据从哪儿来。第二,拿回来怎么算。第三,算完怎么落盘成 Excel 并发出去。这三步我分开写,后面渠道改字段或者老板要加指标,都不用动全身。有人会问,为什么不直接用 pandas 一口气读库写表完事。因为我们的情况是混合数据源,没法一刀切。公司自有订单系统在公司内网,直接连库拉就行。另外两个渠道的销量要走平台开放接口,而这个接口按出口 IP 限流,办公室那条固定 IP 请求两轮就被封半小时。这两类数据源的取数逻辑完全不同,硬塞一个函数里只会越写越乱。也有人推荐直接用 Excel 的 Power Query。试过,图形化界面点起来爽,但渠道一多,每个查询的刷新顺序、依赖关系全藏在界面背后,出了错没法 diff,也没法进版本库。脚本丑是丑,但每一行都在眼前,新人接手看代码就行,不用我坐在旁边讲半小时。抓数据,并且要能重试网络这种事你控制不了,别指望一次就通。接口超时、平台抖一下、代理偶尔抽风,都是常态。我用了 tenacity 做重试,最多试三次,失败之间退避等待,避免一拥而上把接口打挂。报表自动化为什么绕不开代理先把背景讲透。日报要拉十几个渠道,其中有几个是淘宝、抖音这类开放平台,它们的订单接口都带反爬。办公室那条固定出口 IP,请求两轮就被限流半小时。我一开始加了 sleep 退避,没用,平台认的是 IP 不是频率。后来接了亿牛云的动态转发代理(隧道代理)。它背后是一个很大的 IP 池,只配一个固定入口,每次转发自动换出口 IP,对目标平台来说每次请求都来自不同地方,而且是匿名的,拉数据跟正常访问没两样。我不用自己维护 IP 池,某个 IP 被封也不会全盘停摆。日报一天几十兆流量,动态转发按月付,成本比自己租服务器搭池子低很多,这也是我没自己养 IP 的原因。代理的鉴权是用户名加密码,格式是 http://用户名:密码@入口域名:端口。用户名里通常带订单号和地区参数,具体以后台接入串为准,别照抄网上的例子。动态转发一般要求把调用方出口 IP 加进白名单,否则拒绝连接。我第一次配完连不上,查了半天是忘绑白名单,这种坑踩一次就记住了。 ``` from dataclasses import dataclass from datetime import date from typing import Optional import httpx from tenacity import retry, stop_after_attempt, wait_exponential @dataclass class YiniuProxy: """动态转发代理配置,集中管理鉴权与入口。""" order_id: str secret: str host: str = "dynamic.ynyun-proxy.com" port: int = 8000 region: str = "cn" @property def tunnel(self) -> str: # 用户名里带订单号与地区是代理的鉴权约定,按后台接入串填 user = f"{self.order_id}-region-{self.region}" return f"http://{user}:{self.secret}@{self.host}:{self.port}" PROXY = YiniuProxy(order_id="YOUR_ORDER", secret="YOUR_SECRET").tunnel @retry(stop=stop_after_attempt(3), wait=wait_exponential(multiplier=1, max=10)) def fetch_channel_orders(channel: str, day: date) -> list[dict]: """拉取单个渠道某天的订单原始数据。 Args: channel: 渠道标识,例如 "taobao" 或 "douyin" day: 统计日期 Returns: 平台返回的原始订单字典列表 Raises: httpx.HTTPError: 三次重试后仍失败 """ resp = httpx.get( f"https://api.example.com/{channel}/orders", params={"date": day.isoformat()}, headers={"User-Agent": "Mozilla/5.0 (compatible; daily-report/1.0)"}, proxies={"http://": PROXY, "https://": PROXY}, timeout=15, ) resp.raise_for_status() return resp.json()["data"] ``` 抓取我用的是 httpx 而不是 requests,看中的就是它的异步能力。渠道一多,十几个请求串行太慢,改成 asyncio 并发之后,隧道代理给每个请求分配不同出口 IP,天然适合并发跑,日报生成时间从一分钟压到了十秒出头。有个坑得提醒:平台的开放接口大多校验 User-Agent,不带就直接返回 403,第一次跑不通我查了半小时才定位到。还有一件事要提前想:十几个渠道里只要有一个挂了,整份日报就废了吗?我的做法是每个渠道单独 try,失败的记进日志并跳过,最后如果全部失败才整体告警。这样某个平台凌晨维护,不影响其他渠道的日报照常出来。 ``` def fetch_all(channels: list[str], day: date) -> list[SalesRecord]: records: list[SalesRecord] = [] for ch in channels: try: raw = fetch_channel_orders(ch, day) records.extend(normalize(raw, ch, day)) except Exception as exc: # 单渠道失败不应拖垮整份日报 logging.error("渠道 %s 拉取失败: %s", ch, exc) return records ``` 用 dataclass 把一行日报钉死拿到原始数据先别急着算,先定义清楚"一行日报长什么样"。我习惯用 dataclass 把字段和类型钉死,后面无论是存库还是出 Excel,都围绕这个结构转。类型不对解释器当场报错,比跑起来才发现某列是 None 强太多。比起直接用 dict,dataclass 还有个好处:你能把客单价这种派生字段写成 property,调用方拿到的永远是算好的值,不用到处重复那段除法。 ``` @dataclass class SalesRecord: channel: str order_date: date order_count: int total_amount: float customer_count: int @property def avg_order_value(self) -> float: if self.customer_count == 0: return 0.0 return self.total_amount / self.customer_count ``` 不同渠道返回的字段名天差地别,有的叫 order_cnt,有的叫 pay_count,金额字段有的带单位后缀。这一步是纯体力活,但集中在一个归一化函数里,以后改起来不头疼。 ``` def normalize(raw: list[dict], channel: str, day: date) -> list[SalesRecord]: """把平台原始订单转成统一的 SalesRecord。""" records: list[SalesRecord] = [] for item in raw: records.append( SalesRecord( channel=channel, order_date=day, order_count=int(item["order_cnt"]), total_amount=float(item["pay_amount"]), customer_count=int(item["buyer_cnt"]), ) ) return records ``` 算指标,逻辑摊开在眼前总销售额求和,客单价用总额除以人数,环比拿今天和昨天的差额除昨天。数据量小的时候我更偏向手写而不是上 pandas,逻辑摊开在眼前,新人也能一眼看懂。等哪天单渠道一天几万单,再考虑换 pandas 也不迟。除以昨天那段一定要先判断昨天是不是零,否则新渠道上线第一天就会抛除零异常,我踩过这个坑。 落盘成 Excel出文件用 openpyxl。样式最容易写成一坨,我把它单独抽成一个函数,只负责写数据和设置表头加粗、列宽自适应。这样哪天要把日报改成横向排版,只动这个函数。金额这类字段,openpyxl 默认按浮点存,Excel 里会显示成一长串小数或者科学计数法。我在写之前用 round 保留两位小数,需要千分位的话再套一个 f"{x:,.2f}"。老板看报表不爱看 12345.6789,他要看 12,345.68。这种细节代码不会替你想,得你自己定。日报我按日期命名存本地,顺手也传一份到共享盘,三个月攒下九十多个文件,哪天要拉趋势直接读回来,连数据库都不用碰。 上线前先测一遍脚本写完别直接丢服务器上。我本地用 pytest 写了三个用例:一个造几条假 SalesRecord 验 aggregate 的环比计算,一个验 normalize 在字段缺失时不崩,一个验 write_report 产出的文件能被 openpyxl 重新打开。跑通再上线,比凌晨被告警叫起来改 bug 舒服得多。这三个用例加起来不到四十行,但每次改归一化逻辑之前跑一遍,心里有底。 ``` from datetime import date import pytest from openpyxl import load_workbook def test_aggregate_mom(): today = [SalesRecord("self", date(2026, 8, 1), 10, 1000.0, 8)] prev = [SalesRecord("self", date(2026, 7, 31), 10, 500.0, 8)] result = aggregate(today, prev) assert result["mom"] == 100.0 def test_normalize_missing_field(): raw = [{"order_cnt": "3", "pay_amount": "300", "buyer_cnt": "2"}] assert len(normalize(raw, "self", date(2026, 8, 1))) == 1 def test_write_report_readable(tmp_path): recs = [SalesRecord("self", date(2026, 8, 1), 3, 300.0, 2)] p = tmp_path / "r.xlsx" write_report(str(p), recs, aggregate(recs)) assert load_workbook(p)["销售日报"]["A1"].value == "渠道" ``` 串起来,并留好日志main 里就四步:拉数据、归一化、算指标、写文件。再加一层 logging,哪天报表没出来,能回看是卡在抓取还是卡在写盘。我真实遇到过一次:某渠道接口凌晨升级,返回的字段改了名,归一化函数直接抛错。多亏有日志,我早上看了一眼就知道是哪一个渠道,十分钟修完补跑,没耽误早会。光写日志不够,失败了得有人知道。我在 main 外层包了一层 try,任何渠道连续失败就发一条钉钉告警到运维群。第一次收到告警是某个渠道证书过期,我比平台客服早发现,挺有成就感的。代理侧也不是永远稳,有回代理入口做了维护,日志里一排连接拒绝,我看了一眼就知道不是我代码的问题,等它恢复就行,没白折腾去查自己的脚本。 ``` import logging logging.basicConfig(filename="report.log", level=logging.INFO, format="%(asctime)s %(levelname)s %(message)s") def main() -> None: day = date.today() all_records: list[SalesRecord] = fetch_all(["taobao", "douyin", "self"], day) if not all_records: logging.error("全部渠道拉取失败,终止生成") return summary = aggregate(all_records) write_report(f"sales_{day.isoformat()}.xlsx", all_records, summary) logging.info("日报已生成:%s", summary) ``` 定时跑我用 schedule 库,比 crontab 好懂,部署在 Windows 上也零配置。要是跑在 Linux 服务器上,我更推荐直接交给 crontab,不用常驻一个进程占着内存。 ``` import schedule import time schedule.every().day.at("07:00").do(main) while True: schedule.run_pending() time.sleep(30) ``` 发出去那步我接了公司 SMTP,日报作为附件发到指定邮箱。你们团队用钉钉或者企业微信也行,把写文件换成调对应的机器人接口即可,改动很小。三个月下来的体会脚本上线三个月,日报没漏过一天。我估摸每天省下至少半小时,更值钱的是不再有抄错行的低级事故,老板追问某个数字时我也能从日志里翻出来源。以前那种"这个数字好像不太对但又说不清哪不对"的心虚感,没了。这脚本第一版其实很丑,所有逻辑堆在一个文件里,连配置文件都没有。它能跑,我就先让它跑了三个月。等真的稳定了,才把渠道列表、代理配置挪进一个 config 文件。我建议大家都这么干:先让能用的版本上线,再谈优雅。追求一步到位容易卡在抽象设计上,最后啥也没上线。也不是所有报表都该自动化。那种只出一次的季度复盘、字段随时在变的临时分析,写脚本的维护成本可能比手工还高。判断标准很简单:这份报表接下来三个月还会不会以同样的格式出现。会,就值得自动化;不会,老老实实复制粘贴。维护成本真实存在,渠道字段平均两个月变一次,每次十分钟,对比每天省下的半小时,这笔账怎么算都划算。如果团队不止你一个人要看,把脚本和 config 一起丢进 git,谁改了什么一目了然,比把 Excel 传来传去强。

优秀的个人博客,低调大师

告别云端压缩:Docker部署开源图片处理神器Mazanoke指南

# 一、Mazanoke介绍 ## 1.1 Mazanoke简介 >`Mazanoke `是一款在浏览器中运行的本地图像优化工具,支持离线使用,提供图像压缩、格式转换与隐私保护功能,所有操作均在设备端完成,无需上传数据。 ## 1.2 Mazanoke主要特点 - 浏览器内直接运行,无需安装额外软件。 - 调整图像质量(0-100%)、目标文件大小及最大宽高限制。 - 支持 JPG、PNG、WebP、ICO 格式互转,并兼容 HEIC、AVIF、TIFF、GIF、SVG 等格式转换。 - 支持剪贴板直接粘贴图像进行优化。 - 完全离线工作,所有处理数据不离开设备。 - 自动移除 EXIF 元数据(如位置、拍摄时间等隐私信息)。 - 无用户跟踪,严格保护用户隐私。 - 可安装为渐进式网页应用(PWA),支持多设备使用。 # 二、本次实践规划 ## 2.1 本地环境规划 >本次实践为个人测试环境,操作系统版本为 Ubuntu 24.04.2 LTS。 |hostname| IP地址 | 操作系统版本 |Docker版本 |部署项目|备注 |--|--| --| --|--|--| |jeven |192.168.3.88 | Ubuntu 24.04.2 LTS| 28.5.0 |mazanoke | —— ## 2.2 本次实践介绍 >1.本次实践部署环境为个人测试环境,生产环境请谨慎; >2.在Docker环境下部署mazanoke简单图像优化工具。 # 三、本地环境检查 ## 3.1 检查Docker服务状态 >检查Docker服务是否正常运行,确保Docker正常运行。 ```bash root@jeven:~# systemctl status docker ● docker.service - Docker Application Container Engine Loaded: loaded (/usr/lib/systemd/system/docker.service; enabled; preset: enabled) Active: active (running) since Tue 2025-12-02 00:51:31 CST; 1min 11s ago TriggeredBy: ● docker.socket Docs: https://docs.docker.com Main PID: 75393 (dockerd) Tasks: 32 Memory: 34.1M (peak: 34.8M) CPU: 1.248s CGroup: /system.slice/docker.service ``` ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-4995888/abb255efc952dabcb17c36c31c1cd133.png) ## 3.2 检查Docker版本 >检查Docker版本 ```bash root@jeven:~# docker -v Docker version 28.5.0, build 887030f ``` ## 3.3 检查docker compose 版本 >检查Docker compose版本,确保2.0以上版本。 ```bash root@jeven:~# docker compose version Docker Compose version v2.39.4 ``` # 四、拉取mazanoke镜像 >下载mazanoke镜像,镜像名称为:`ghcr.io/civilblur/mazanoke:latest`。 ```bash docker pull ghcr.io/civilblur/mazanoke:latest ``` ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-4995888/2e5f13f678c4abfe4f66f961de1ddb6b.png) # 五、部署mazanoke服务 ## 5.1 创建部署目录 - 创建部署目录 ```bash mkdir -p /data/mazanoke && cd /data/mazanoke ``` ## 5.2 docker compose方式部署 >使用docke-cli方式部署,可参考如下命令: ```bash docker run -d \ --restart always \ --name mazanoke \ -p 6630:80 \ ghcr.io/civilblur/mazanoke:latest ``` >新建及编辑docker-compose.yaml文件,宿主机映射端口可自行设置,注意防止端口冲突。 ```bash vim docker-compose.yaml ``` ```yaml version: '3' services: mazanoke: image: ghcr.io/civilblur/mazanoke:latest container_name: mazanoke restart: always ports: - "6630:80" ``` ## 5.3 创建mazanoke容器 >执行以下命令,创建mazanoke容器。 ```bash docker compose up -d ``` ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-4995888/75ec04d898573bfd780203924d64275c.png) ## 5.4 查看mazanoke容器状态 >检查mazanoke容器运行状态,确保mazanoke容器正常启动。 ```bash root@jeven:/data/mazanoke# docker compose ps WARN[0000] /data/mazanoke/docker-compose.yaml: the attribute `version` is obsolete, it will be ignored, please remove it to avoid potential confusion NAME IMAGE COMMAND SERVICE CREATED STATUS PORTS mazanoke ghcr.io/civilblur/mazanoke:latest "/docker-entrypoint.…" mazanoke 32 seconds ago Up 32 seconds 0.0.0.0:6630->80/tcp, [::]:6630->80/tcp ``` ## 5.5 检查mazanoke容器日志 >检查容器运行日志,确保mazanoke服务正常运行。 ```bash docker compose logs ``` ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-4995888/9023b65aee4f7dec2011d854dc6a0c20.png) # 六、访问mazanoke服务 ## 6.1 访问mazanoke首页 >浏览器地址: `http://:6630`,访问mazanoke初始页。如果无法访问,请确保宿主机的防火墙已关闭或已放行相关端口,对于云服务器还需配置相应的安全组规则。 ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-4995888/4db302a2f8b82a4c8ddd0f946d2c8276.png) ## 6.2 压缩图片 >可根据需要,自行调整压缩参数,如下所示: ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-4995888/4d4ed4d16424be50a9cbc95420e9054e.png) ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-4995888/132922297c44e4611ead64f1424f522d.png) # 七、总结 >本次实践成功完成了 Mazanoke 本地图像优化工具的 Docker 部署与功能验证,整个流程顺畅高效。通过 docker compose 方式部署,服务快速启动并稳定运行,无需依赖外部网络或后端服务。实际使用中,Mazanoke 能在浏览器中完成图片压缩、格式转换及 EXIF 数据清除,充分体现了其离线处理与隐私保护的优势。该工具轻量、安全、易用,非常适合注重数据隐私的个人用户或开发团队本地部署使用。

优秀的个人博客,低调大师

告别手动运维!Kubernetes Deployment 保姆级实操指南

![](https://developer.qcloudimg.com/http-save/yehe-11081884/1c93470795634286b8f1fb34111171cf.jpg) 你有没有遇到过这样的情况? 半夜收到告警,说某个服务挂了。赶紧爬起来登录服务器,手动重启应用。 结果刚睡着,告警又来了。 反复折腾,直到天亮。 说实话,我之前也是这样。 从手动部署到自动化运维,从反复重启到零宕机更新,这条路我走了很久。 今天,我想把这套 **Kubernetes Deployment** 的实战经验,毫无保留地分享给你。 ## **为什么选择 Deployment?** 手动创建 Pod,就像在没有空调的房间里装电风扇。 能用,但不可靠。 节点故障时 Pod 不会自动恢复,版本更新更是噩梦。 > Deployment 给你三个超能力: - **自愈能力**Pod 挂了自动重建,节点故障自动迁移 - **滚动更新**零停机发布,自动管理新旧版本切换 - **版本回滚**支持回滚到任意历史版本 ## **生产级配置长什么样?** 先给你看一个完整的配置文件,覆盖了 90% 的常见场景。 ``` apiVersion: apps/v1 kind: Deployment metadata: name: nginx-deployment namespace: prod labels: app: nginx version: v1 spec: replicas: 3 revisionHistoryLimit: 10 selector: matchLabels: app: nginx strategy: type: RollingUpdate rollingUpdate: maxSurge: 1 maxUnavailable: 0 progressDeadlineSeconds: 600 template: metadata: labels: app: nginx spec: imagePullSecrets: - name: regcred containers: - name: nginx image: nginx:1.25.3 imagePullPolicy: IfNotPresent ports: - containerPort: 80 env: - name: TZ value: "Asia/Shanghai" - name: APP_ENV valueFrom: configMapKeyRef: name: app-config key: environment resources: requests: cpu: "100m" memory: "256Mi" limits: cpu: "500m" memory: "512Mi" livenessProbe: httpGet: path: /healthz port: 80 initialDelaySeconds: 30 periodSeconds: 10 timeoutSeconds: 5 failureThreshold: 3 readinessProbe: httpGet: path: /ready port: 80 initialDelaySeconds: 5 periodSeconds: 5 timeoutSeconds: 3 failureThreshold: 2 volumeMounts: - name: config-volume mountPath: /etc/nginx/conf.d readOnly: true - name: cache-volume mountPath: /var/cache/nginx volumes: - name: config-volume configMap: name: nginx-config - name: cache-volume emptyDir: {} affinity: podAntiAffinity: preferredDuringSchedulingIgnoredDuringExecution: - weight: 100 podAffinityTerm: labelSelector: matchLabels: app: nginx topologyKey: kubernetes.io/hostname ``` 看起来有点长? 别担心,我帮你拆解一下。 ## **关键字段详解** ### **1. 副本与选择器** ``` replicas: 3 selector: matchLabels: app: nginx ``` **注意:**`selector.matchLabels` 必须与 `template.metadata.labels` 完全一致,这是 Deployment 管理 Pod 的依据。 ### **2. 滚动更新策略** ``` strategy: type: RollingUpdate rollingUpdate: maxSurge: 1 # 最多额外创建 1 个 Pod maxUnavailable: 0 # 不允许任何 Pod 不可用 ``` **maxSurge**:更新期间允许超出 replicas 的 Pod 数量。设置为 1 意味着 3 副本时最多有 4 个 Pod 同时运行。 **maxUnavailable**:最多允许多少个 Pod 不可用。设置为 0 实现真正的零宕机更新。 **推荐配置:**生产环境 maxSurge: 1, maxUnavailable: 0;测试环境可以适当放宽加速更新。 ### **3. 资源限制** ``` resources: requests: cpu: "100m" # 保证分配 100 毫核 CPU memory: "256Mi" # 保证分配 256Mi 内存 limits: cpu: "500m" # 最多使用 500 毫核 CPU memory: "512Mi" # 最多使用 512Mi 内存 ``` 为什么两个都要设置? **requests** 影响调度决策,保证 Pod 能被调度到有足够资源的节点。 **limits** 防止 Pod 占用过多资源影响其他应用。 设置合理的 limits 能避免 OOMKilled,设置 requests 能避免资源争抢。 ### **4. 健康检查** ``` livenessProbe: httpGet: path: /healthz port: 80 initialDelaySeconds: 30 periodSeconds: 10 failureThreshold: 3 readinessProbe: httpGet: path: /ready port: 80 initialDelaySeconds: 5 ``` **livenessProbe**:容器"活"不活,不活就重启。initialDelaySeconds 要给足应用启动时间。 **readinessProbe**:容器能不能接流量,不能接就从 Service 摘除。这个检查要轻量快速。 **常见坑:**initialDelaySeconds 设置太短,应用还没启动就被反复重启。 ### **5. 节点亲和性** ``` affinity: podAntiAffinity: preferredDuringSchedulingIgnoredDuringExecution: - weight: 100 podAffinityTerm: labelSelector: matchLabels: app: nginx topologyKey: kubernetes.io/hostname ``` 这个配置让同一个应用的 Pod 尽量分散到不同节点,提升高可用性。 ## **常用运维命令** ### **创建与更新** ``` # 创建 Deployment kubectl apply -f deployment.yaml # 更新镜像触发滚动更新 kubectl set image deployment/nginx-deployment nginx=nginx:1.26.0 # 查看 Deployment 状态 kubectl get deployments kubectl describe deployment nginx-deployment ``` ### **查看更新进度** ``` # 实时查看滚动更新状态 kubectl rollout status deployment/nginx-deployment # 查看 Pod 变化 kubectl get pods -l app=nginx -w ``` ### **版本管理** ``` # 查看历史版本 kubectl rollout history deployment/nginx-deployment # 回滚到上一版本 kubectl rollout undo deployment/nginx-deployment # 回滚到指定版本 kubectl rollout undo deployment/nginx-deployment --to-revision=3 ``` ### **扩缩容** ``` # 手动扩容到 5 个副本 kubectl scale deployment/nginx-deployment --replicas=5 # 自动扩容(需要先安装 Metrics Server) kubectl autoscale deployment/nginx-deployment --min=3 --max=10 --cpu-percent=80 ``` ## **常见问题排查** ### **问题 1:Pod 一直处于 Pending 状态** **现象**:`kubectl get pods` 显示 STATUS 为 Pending **排查**: ``` kubectl describe pod ``` **常见原因**: - 节点资源不足(CPU/内存) - 污点和容忍度不匹配 - PVC 无法绑定 **解决**:调整资源请求,增加节点,检查 PVC 状态 ### **问题 2:CrashLoopBackOff 反复重启** **现象**:Pod 启动后立即崩溃 **排查**: ``` kubectl logs --previous ``` **常见原因**: - 应用启动失败 - 配置错误(环境变量/ConfigMap) - 依赖服务未就绪 **解决**:检查应用日志,确认依赖服务可用 ### **问题 3:滚动更新卡住** **现象**:`kubectl rollout status` 一直显示等待 **排查**: ``` kubectl describe deployment ``` **常见原因**: - 新 Pod 无法就绪 - ReadinessProbe 失败 - 资源不足无法创建新 Pod **解决**:检查新 Pod 日志,调整探针配置,增加节点资源 ### **问题 4:ImagePullBackOff 镜像拉取失败** **现象**:镜像拉取失败,Pod 无法启动 **排查**: ``` kubectl describe pod ``` **常见原因**: - 镜像名称或 tag 错误 - 私有仓库认证失败 - 网络问题 **解决**:确认镜像名称和 tag,创建 imagePullSecrets ``` kubectl create secret docker-registry regcred \ --docker-server= \ --docker-username= \ --docker-password= ``` ## **生产环境最佳实践** ### **1. 版本控制** 所有 YAML 文件纳入 Git 管理,使用 GitOps 工具(如 ArgoCD)自动部署。 ### **2. 资源配额** 在 Namespace 级别设置 ResourceQuota,防止单个应用占用过多资源。 ``` apiVersion: v1 kind: ResourceQuota metadata: name: compute-quota spec: hard: requests.cpu: "10" requests.memory: 20Gi limits.cpu: "20" limits.memory: 40Gi ``` ### **3. 监控告警** 配置 Prometheus 监控关键指标: - Deployment 副本数可用性 - Pod 重启次数 - 资源使用率 - 滚动更新耗时 ### **4. 灾备测试** 定期进行故障演练,验证自愈能力: - 手动杀 Pod 观察自动重建 - 模拟节点故障观察 Pod 迁移 - 发布错误版本测试回滚 ### **5. 安全加固** - 使用非 root 用户运行容器 - 配置 NetworkPolicy 限制网络访问 - 定期扫描镜像漏洞 - 启用 Pod Security Policy ## **进阶技巧** ### **金丝雀发布** ``` # 暂停滚动更新,只更新部分 Pod kubectl rollout pause deployment/nginx-deployment # 验证新版本无误后继续 kubectl rollout resume deployment/nginx-deployment ``` ### **蓝绿部署** ``` # 创建新的 Deployment(如 nginx-deployment-blue) # 更新 Service 的 selector 指向新的 Deployment # 验证通过后删除旧 Deployment ``` ### **配置热更新** 使用 ConfigMap 的挂载方式,更新 ConfigMap 后重启 Pod 即可生效: ``` kubectl create configmap nginx-config --from-file=nginx.conf # 修改 ConfigMap kubectl create configmap nginx-config --from-file=nginx.conf --dry-run=client -o yaml | kubectl apply -f - # 触发 Pod 重启 kubectl rollout restart deployment/nginx-deployment ``` --- Kubernetes Deployment 的核心价值在于**声明式管理**和**自动化运维**。 掌握本文的内容,你已经能够处理 90% 的生产场景。 记住三个关键: - **配置要规范**YAML 语法、标签一致性、资源设置缺一不可 - **探针要合理**给应用足够的启动时间,区分存活和就绪检查 - **监控要到位**实时关注 Deployment 状态,问题早发现早处理 **“无他,惟手熟尔”!**有需要的用起来! **如果你觉得这篇文章有用,欢迎点赞、转发、收藏、留言、推荐**❤!

优秀的个人博客,低调大师

从零吃透HVV情报&溯源工具,告别低效研判

按**实战优先级**分类,覆盖IOC研判、IP/域名拓线、样本沙箱、资产测绘、备案Whois、漏洞、历史快照、社工溯源,全部护网值守、攻击溯源、写报告高频工具,国内直连优先。 ## 一、国内综合威胁情报平台(护网核心,优先用) 用于恶意IP/域名/Hash/URL研判、攻击团伙画像、PDNS、历史攻击记录、IOC导出,蓝队溯源第一站 1. **微步在线X情报社区**https://x.threatbook.cn/ 护网最常用,国内数据最全;支持IP/域名/文件/邮箱/证书全维度查询,PDNS历史、子域名、关联恶意样本、APT团伙标签、运营商溯源、可导出情报报告。 ![](https://developer.qcloudimg.com/http-save/yehe-11249421/5a93bfa79f2ee609e2eb6b79173f5e38.png) 1. **360威胁情报中心**https://ti.360.net/ 国内黑产、挖矿、远控IP库丰富,攻击时间线清晰,适合国内IDC、家用宽带恶意IP研判,联动360补天漏洞。 ![](https://developer.qcloudimg.com/http-save/yehe-11249421/e1a481fa2e3b4551a62f7cdf07e5ac9d.png) 1. **启明星辰VenusEye(维纳斯之眼)**https://www.venuseye.com.cn/ APT深度报告、TTP战术链、境外组织溯源强,关基护网研判高级攻击必备。 ![](https://developer.qcloudimg.com/http-save/yehe-11249421/74866f4b0728504764d3fbc09914ca76.png) 1. **绿盟威胁分析中心**https://poma.nsfocus.com/ 边界流量、暴力破解、扫描类恶意IP情报精准,匹配绿盟防火墙日志。 ![](https://developer.qcloudimg.com/http-save/yehe-11249421/87f779bb3cc25606818b565ded48001f.png) ## 二、全球多源情报&样本沙箱(境外IOC、恶意文件深度分析) 1. **VirusTotal(VT)** https://www.virustotal.com/ 全球40+杀毒引擎沙箱;查IP/域名/文件Hash,看全球标记恶意记录、关联C2、历史样本,溯源境外远控木马核心工具。 1. **URLScan.io** https://urlscan.io/ 网页动态沙箱,抓取钓鱼页面加载资源、JS后门、跳转链,还原钓鱼攻击链路。 1. **AbuseIPDB** https://www.abuseipdb.com/ 全球举报恶意IP库,扫描、暴力破解、垃圾邮件标记,可导出黑名单用于防火墙封禁。 ## 三、网络空间资产测绘(反向溯源红队攻击基础设施) 通过攻击IP反查其名下所有域名、端口、设备、旁站,拓线攻击者全部资产 ### 国内(护网首选,合规可商用) 1. **FOFA** https://fofa.info/ 全网资产检索,语法强大;`ip="x.x.x.x"`反查同IP所有站点、设备、CMS指纹,溯源红队VPS、钓鱼站。 1. **奇安信鹰图Hunter** https://hunter.qianxin.com/ 国内IDC、IoT、摄像头资产覆盖广,国内备案站点匹配度高。 1. **360 Quake** https://quake.360.cn/quake/#/index 端口、协议、漏洞资产检索,适合批量扫描IP段排查关联资产。 1. **ZoomEye钟馗之眼** https://www.zoomeye.org/ 老牌测绘,设备指纹丰富,工控、网络设备溯源优势。 ### 境外补充 - Shodan https://www.shodan.io/ 全球设备测绘 - Censys https://search.censys.io/ 证书+端口资产检索 ## 四、IP精准溯源、旁站反查(定位IP归属、同IP域名) ### 1. IP归属/高精度定位 - IPIP.NET https://www.ipip.net/ip.html 运营商、地市、机房精准划分 - IP138 https://site.ip138.com/ 快速查IP省市、ISP - ipplus360 https://www.ipplus360.com/ 高精度IP地理定位 - CNNIC官方IP Whois https://ipwhois.cnnic.cn/ 国内IP段AS、运营商注册信息(官方权威) ### 2. 反向IP(同IP所有域名/旁站) - 站长工具反向IP https://tool.chinaz.com/ipdomain - ViewDNS https://viewdns.info/reverseip/ 境外IP旁站查询 - WebScan https://www.webscan.cc/ 批量旁站、子域名扫描 ## 五、域名溯源:Whois/ICP备案/PDNS(追注册人、企业、历史域名) ### 1. 工信部官方ICP备案(国内域名溯源必备,权威无篡改) - 工信部备案查询 https://beian.miit.gov.cn/ - 站长之家备案 https://icp.chinaz.com/ - 爱站备案 https://icp.aizhan.com/ 作用:恶意域名查企业法人、联系方式、服务器接入商,护网溯源写报告强制要求备案证据。 ### 2. Whois历史/实时查询(域名注册人、邮箱、电话、注册商) 国内: - 站长之家Whois https://whois.chinaz.com/ - 微步自带Whois历史(最优,含多年变更记录) 境外: - Who.is https://who.is/ 全球后缀域名完整Whois - DomainTools https://domaintools.com/ 付费,完整PDNS、Whois历史拓线 ### 3. PDNS历史解析(域名历年绑定的所有IP,攻击链路关键) 微步在线、DomainTools均内置,可查域名多年切换的VPS IP,串联攻击时间线。 ## 六、漏洞库平台(匹配攻击载荷、漏洞利用溯源) 1. **CNVD国家信息安全漏洞库** http://www.cnnvd.org.cn/ 国内官方漏洞库,护网报告标准引用源 1. **360补天漏洞平台** https://www.butian.net/ 国内厂商漏洞、红队利用案例库 1. **Seebug知道创宇漏洞库** https://paper.seebug.org/ 漏洞复现、POC、攻击流量特征 1. **Exploit-DB** https://www.exploit-db.com/ 全球EXP、POC库,追溯漏洞利用工具来源 ## 七、历史网页快照(域名删站、隐藏页面溯源) 1. **Wayback Machine(Archive.org)** https://archive.org/web/抓取域名多年前页面,找回删除的后门页面、社工信息、黑产联系方式;护网溯源钓鱼站、仿冒站点必备。 1. 国内备用:网页时光机、站长历史快照 ## 八、社工溯源辅助(从邮箱/手机号/企业拓攻击者身份) 1. 企业信息(备案企业匹配法人、电话) 天眼查 https://www.tianyancha.com/ 爱企查 https://aiqicha.baidu.com/ 企查查 https://www.qcc.com/ 1. 证书反向查询(SSL证书邮箱反查所有域名) SSLMate、微步证书检索 1. 邮箱反查 微步情报社区输入邮箱,查其注册所有恶意域名 ## 九、护网溯源标准使用流程(蓝队实操步骤) ![](https://developer.qcloudimg.com/http-save/yehe-11249421/3f08168f970338376e1fb24cbac50ee5.png) ## 补充说明 1. 合规提醒:护网仅用于**防守溯源、攻击取证**,禁止使用工具对无关资产主动扫描探测; 1. 优先级:国内平台优先(访问稳定、境内黑产数据更全、报告采信度高),境外平台仅用于境外APT/木马补充研判; 1. 报告素材:微步、CNNVD、工信部备案、FOFA截图为护网溯源报告四大权威佐证来源。 ***另:点击下方工具可免费使用阿祥自制的ICT随身工具箱↓*** ***常用厂商指令查找、故障码查询、快捷脚本生成,一网打尽。***

优秀的个人博客,低调大师

LiteFlow v2.15.0 发布:拥抱虚拟线程,告别JVM参数!

概述 各位 LiteFlow 的使用者,大家好! 历经四个月的持续迭代,LiteFlow v2.15.0 正式发布!这是一个里程碑式的版本,共包含了 4 个新特性、7 项重要增强以及 7 个问题修复,累计解决了 18 个 issue。 至于为何版本号从 2.13.2 直接跳到了 2.15.0。其实也没啥特别的原因,可能是因为风水问题吧。 言归正传,对于正在使用 2.13.X 版本的用户,新版本在绝大多数场景下都能做到无缝兼容。我们对从 JDK 8 到 JDK 25 的所有主流版本进行了严苛测试,超过 2000 个测试用例确保了 LiteFlow 框架在各种 JDK 环境下的稳定运行。 平滑支持JDK8~JDK25的所有版本 在旧版本中,LiteFlow 虽然支持 JDK 8 至 17,但在 JDK 9 以上环境中运行时,需要用户额外添加 JVM 参数。其根本原因在于 LiteFlow 底层对 sun.* 包的部分反射调用,而这些内部 API 在高版本 JDK 中受到了严格的封装限制。 在新版本中,我们通过替换底层实现,彻底解决了这一问题。现在,无论您使用哪个 JDK 版本,运行 LiteFlow 都再也无需添加任何额外的 JVM 参数,体验更加平滑顺畅。 全面拥抱 JDK 21 虚拟线程 作为 JDK 21 中最核心的特性之一,虚拟线程能以极低的调度开销,显著提升高 I/O 密集型应用的性能。针对社区中大家高度关注的 JDK 21 及虚拟线程支持问题,我们在此版本中给出了完整的回应。 当您的应用运行在 JDK 21 及以上环境时,LiteFlow 内部的所有异步线程都将自动切换为虚拟线程,充分释放新版 JDK 的性能红利。而在 JDK 21 以下版本,框架则会平稳地回退至使用传统的平台线程。 更棒的是,无论您使用哪个 JDK 版本,都只需引入同一套依赖,无需任何版本区分。 支持 EL 表达式的即时执行 我们收到了许多社区反馈:对于一些简单的动态规则,通过 XML 定义 chain 显得过于繁琐,而每次都用代码动态构建又存在性能开销和手动清理的麻烦。 为此,2.15.0 版本引入了直接执行 EL 规则的新能力。 LiteflowResponse response = flowExecutor.execute2RespWithEL("THEN(a, b, c)", requestData, CustomContext.class); 现在,您可以直接执行一个 EL 表达式来完成流程编排,无需预先创建 chain。并且您完全不必担心性能问题——对于相同的 EL 表达式,框架只会在首次执行时编译一次,后续调用将直接复用缓存,高效可靠。 引入活跃规则的缓存策略 对于拥有海量规则(例如上万条)的复杂系统,此特性将带来显著的内存优化。 我们引入了一套全新的缓存策略。当系统中的规则过多时,该策略会自动维持 N 条最活跃规则的缓存,并将不活跃的规则从内存中卸载,从而有效避免堆内存的持续增长。当被卸载的规则再次被调用时,框架会自动重新编译并将其纳入活跃队列。 整个过程对用户完全透明。该策略默认关闭,您可以通过以下配置开启并调整: # 是否开启保活策略 liteflow.chain-cache.enabled=true # 保持活跃chain的数目,默认为10000 liteflow.chain-cache.capacity=10000 # 模式一定得为PARSE_ONE_ON_FIRST_EXEC liteflow.parse-mode=PARSE_ONE_ON_FIRST_EXEC 隐式子流程的改版 我们必须承认,旧版的隐式子流程在设计上存在诸多局限。为了兼容该特性,框架的许多核心功能不得不做出妥协,导致部分实现变得复杂且不够优雅,这一直是我们维护者心中的一个痛点。 因此,我们曾考虑彻底移除该功能。但考虑到这会给现有用户带来较大的迁移成本,我们最终选择了一条更优的路径:在保留原有调用方式的基础上,对其底层实现进行了彻底重构。 这次重构不仅理顺了内部逻辑,也为未来的功能扩展扫清了障碍。对于正在使用隐式子流程的用户,迁移过程非常简单,仅需将获取子流程请求数据的方法名从 getSubRequestData 统一更改为 getDataRequest 即可。 关于社区答疑 我们始终珍视社区的力量,并长期致力于为开发者提供免费的技术支持。随着 LiteFlow 社区的不断壮大(目前已拥有16个微信交流群),我们发现难以确保每一位开发者的问题都能得到及时和深入的解答。 为了提供更高效、更专注的答疑服务, 您可以选择加入LF CLUB知识星球。在星球里: 每一个问题都会得到详尽的解答。 沉淀了大量高质量的知识库文章、案例实践和深度解析。 具体加入方式请查看 LiteFlow 官方网站。 完整更新列表 特性#ICUMKV 全面支持jdk21,以及支持jdk21中的虚拟线程 https://gitee.com/dromara/liteFlow/issues/ICUMKV 特性#IBQCWB Liteflow的执行器FlowExecutor支持执行EL表达式,而不需要传入chainId https://gitee.com/dromara/liteFlow/issues/IBQCWB 特性#IAY66T 建立一种机制保证在过多的规则下只维持前N条最活跃的规则缓存 https://gitee.com/dromara/liteFlow/issues/IAY66T 特性#ICM6TX WHEN 并行编排增加关键字实现完成任务达到百分比阈值时方可放行 https://gitee.com/dromara/liteFlow/issues/ICM6TX 增强#ICO3IK 在switch节点中,希望能拿到target的列表信息 https://gitee.com/dromara/liteFlow/issues/ICO3IK 增强#ICUEG9 JDK支持度更加平滑 https://gitee.com/dromara/liteFlow/issues/ICUEG9 增强#ICANTH 隐式子流程改版 https://gitee.com/dromara/liteFlow/issues/ICANTH 增强#IC9GTV 脚本ScriptValidator新增返回ValidationResp的API https://gitee.com/dromara/liteFlow/issues/IC9GTV 增强#ICGGAW redis数据源支持集群模式 https://gitee.com/dromara/liteFlow/issues/ICGGAW 增强#ICR1PL AND关键字的逻辑和语意明确点 https://gitee.com/dromara/liteFlow/issues/ICR1PL 增强#ICU7Z4 升级liteflow的一些依赖 https://gitee.com/dromara/liteFlow/issues/ICU7Z4 修复#ICPDU7 Slot的conditionStack在多线程并发时无法保证Condition的弹栈压栈顺序 https://gitee.com/dromara/liteFlow/issues/ICPDU7 修复#ICO23A Spring设置BeanFactory的cacheBeanMetadata属性为false时,Liteflow项目无法注册声明式组件,后续解析EL失败,项目无法启动 https://gitee.com/dromara/liteFlow/issues/ICO23A 修复#ICJGIK PARSE_ONE_ON_FIRST_EXEC 模式下 Node 对象执行 Java 脚本 最终 instance.isEnd() 判断空指针问题 https://gitee.com/dromara/liteFlow/issues/ICJGIK 修复#IC9ZZ8 reids poll模式代码问题 https://gitee.com/dromara/liteFlow/issues/IC9ZZ8 修复#IC8UPJ 规则EL校验在liteflow.parse-mode=PARSE_ONE_ON_FIRST_EXEC时失效 https://gitee.com/dromara/liteFlow/issues/IC8UPJ 修复#IC71HA 在线程1的执行过程中线程2去remove chain导致的线程1无法平滑继续执行的bug https://gitee.com/dromara/liteFlow/issues/IC71HA 修复#IC2F4F 模糊文件路径的监听,添加新的规则文件没有自动加载 https://gitee.com/dromara/liteFlow/issues/IC2F4F

优秀的个人博客,低调大师

Eurynome Cloud 2.7.0.20 发布,告别 Java 8,正式开启 17 之旅

Eurynome Cloud 是一款企业级微服务架构和服务能力开发平台。首个全面拥抱 Spring Authorization Server 的版本,基于Spring Boot 2.7.0、Spring Cloud 2021.0.3、Spring Cloud Alibaba 2021.0.1.0、 Spring Authorization Server 0.3.0、Nacos 2.1.0 等最新版本开发,遵循SpringBoot编程思想,高度模块化和可配置化。具备服务发现、配置、熔断、限流、降级、监控、多级缓存、分布式事务、工作流等功能 平台定位 构建成熟的、完善的、全面的,基于 OAuth2 的、前后端分离的微服务架构解决方案。 面向企业级应用和互联网应用设计开发,既兼顾传统项目的微服务化,又满足互联网应用开发建设、快速迭代的使用需求。 平台架构使用微服务领域及周边相关的各类新兴技术或主流技术进行建设,是帮助快速跨越架构技术选型、研究探索阶段的利器。 代码简洁规范、结构合理清晰,是新技术开发应用的典型的、综合性案例,助力开发人员对新兴技术的学习和掌握。 [1]、发布背景 2021年11月8日 Spring 官方已经强烈建议使用 Spring Authorization Server 替换已经过时的 Spring Security OAuth2.0。 在 Spring Security OAuth2 彻底停止维护、Spring Boot 2.7.0 正式发布之时,又恰逢 Eurynome Cloud 开源一周年之际,推出基于 Spring Authorization Server 0.2.3、Spring Boot 2.7.0、Spring Cloud 2021.0.2、Spring Cloud Alibaba 2021.0.1.0 和 Nacos 2.1.0 的全新正式版本。该版本基于 Spring Authorization Server 0.2.3 和 Spring Boot 2.7.0 全新定制开发,细节满满,欢迎品鉴。 [2]、重要说明 Eurynome Cloud 自 v2.7.0.20 版本,开始全面使用 JDK 17。自该版本以后,系统代码将不再兼容 JDK 8,敬请悉知! 升级使用 JDK 17 的主要原因: Spring Authorization Server 0.3.0 版本,已经开始使用 JDK 11 进行代码编译。该版本在 JDK 8 下已无法编译成功,想要使用必须要升级 JDK 版本。 2022 年 11 月,Spring Boot 3 将会发布,最低版本要求 JDK 17。因此,直接将 JDK 版本升级至 17,为升级至 Spring Boot 3 提前做铺垫准备。 [3]、本次更新内容 重要更新 Eurynome Cloud 版本使用 JDK 从 8 升级至 17 (注意:现有版本不再兼容 JDK 8) 主要更新 Spring Cloud 版本升级至 2021.0.3 Spring Authorization Server 版本升级至 0.3.0 其它更新 根据 Spring Authorization Server 0.3.0 代码的变化,修改和调整现有系统代码 为支持 JDK 17,同时解决老旧依赖包安全漏洞问题,临时删除现有 baidu 短信模块 升级 Kryo 版本至 5.3.0,增加自定义拓展代码,解决 Kryo 现有版本与 JDK 17 不兼容问题而导致的 Jetcache 无法使用问题。 升级 Xnio 版本,解决 Undertow 在 JDK 17 环境下运行,抛出 `Could not initialize class org.xnio.channels.Channels` 错误,导致服务无法运行问题。 修复 docker-compose脚本配置错误。 修复现有工程中残留的 FastJson 使用代码。 依赖更新 JetCache 版本升级至 2.6.5 Tencentcloud-sdk-java 版本升级至 3.1.516 [4]、Eurynome Cloud 2.7.X 主要变化 基于 Spring Authorization Server 深度定制: 基于 Spring Data JPA,重新构建 Spring Authorization Server 基础数据存储代码,替代原有 JDBC 数据访问方式,破除 Spring Authorization Server 原有数据存储局限,扩展为更符合实际应用的方式和设计。 基于 Spring Authorization Server,在 OAuth 2.1 规范基础之上,增加自定义“密码”认证模式,以兼容现有基于 OAuth 2 规范的、前后端分离的应用。 基于 Spring Authorization Server,在 OAuth 2.1 规范基础之上,增加自定义Social Credentials 认证模式,支持手机短信验证码、微信小程序、第三方应用登录。 遵照 Spring Security 5 以及 Spring Authorization Server 的代码规范,进行 OAuth2 认证服务器核心代码的开发,遵照其使用 Jackson 反序列化的方式, 增加大量自定义 Jackson Module。 支持 Spring Authorization Server 的标准的Token加密校验方式外,还了增加支持自定义证书的 Token 加密方式,可通过配置动态修改 支持 OAuth2 OIDC 认证模式,补充前端 OIDC 认证相关配置操作,以及对应的 /userinfo 接口调用支持 和 客户端注册支持 支持 OAuth2 Authorization Code PKCE 认证模式 扩展 Spring Authorization Server 默认的 Client Credentials 模式,实现 Refresh Token 的创建。 扩展 Spring Authorization Server 默认的 Client Credentials 模式,实现真正的使用 Scope 权限对接口进行验证。 增加客户端 Scope 的权限配置功能,并与已有的用户权限体系解耦 自定义 Spring Authorization Server 授权码模式登录认证页面和授权确认页面,授权码模式登录采用数据加密传输。支持多种验证码类型,暂不支持行为验证码。 代码结构的大规模调整和优化: 对原有代码进行了深度的“庖丁解牛”,严格遵照“单一职责”原则,根据各个组件的职责以及用途,将整个工程拆解细化为多个各自独立组件模块,在最大程度上降低代码间的耦合,也更容易聚焦和定位问题。 将通用化组件提取为独立工程,独立编译、按需选用,极大的降低系统主工程代码量。相关组件也已上传至 Maven 中央仓库,降低系统主工程工程代码编译耗时,改进和提升 CICD 效率, 原有主工程代码结构也进行了深化调整,代码分包更加合理,代码逻辑也更加清晰。 [5]、额外说明 本项目以后将主要维护 Spring Authorization Server 版本,原有基于 Spring Security OAuth2 的版本已经移至 spring-security-oauth2 分支,可以从该分支或发行版页面获取历史版本继续使用。后期会根据 ISSUE 以及使用用户反馈情况,再行决定是否继续维护 Spring Security OAuth2 版本。 原有基于Java 8的SpringAuthorizationServer版本,已经移至spring-authorization-server-jdk8分支。可以从该分支或发行版页面获取历史版本继续使 最新版本代码,暂时继续沿用原有基于 Vue2、Vuetify2、Typescript开发的前端系统。基于 Vue3、Vite2、Vuetify3、Pinia 等新版前端正在加进开发中,由于 Vuetify3 版本发布跳票以及部分已有组件的缺失,导致新版前端开发延后。 原有基于 Vue2、Vuetify2、Typescript 开发的前端,由于使用了过渡性 Typescript IOC 组件,以及依赖组件版本限制等问题,初次接触该项目在编译过程中会出现一些问题,请移步至本项目在线文档,详见“常见问题”章节。

优秀的个人博客,低调大师

研究称芯片业已告别低迷期 迎来小幅复苏

7月28日消息,据国外媒体Venturebeat报道,致力于芯片市场分析的知名公司VLSI Research指出,种种迹象表明,芯片业持续了一年的低迷期已结束,目前正迎来复苏期。 芯片产业一直处在起起伏伏的经济周期中。芯片几乎被用于所有电子产品中,因此芯片业的销售预测是所有电子产品销量的风向标,如,传感器、引入先进技术的汽车以及智能手机。 这张分析图表显示形势已开始好转。图中可以看出,VLSI公司着重分析了芯片销量(蓝线)和订单活动之间的关系。VLSI指出,第二季度的供给和需求已从第一季度的饱和状态转变为更加平衡的状态。如今根据截止7月13日收集的数据,形势已出现回升迹象。VLSI指出,对于芯片涉及的不同领域,如内存、合同制造(代工)、集成设备制造、系统级芯片制造和物联网市场,价格环境已经改善。中国智能手机市场对芯片的需求尤其火爆。VLSI预计今年第三季度芯片销量将同比增长4%。尽管增长幅度不算很大,但很有希望会实现。 ====================================分割线================================ 本文转自d1net(转载)

优秀的个人博客,低调大师

告别1人年,教你21天搭建推荐系统!

免费开通大数据服务:https://www.aliyun.com/product/odps href="https://www.aliyun.com/product/odps" target="_blank"> 活动预告:为了让大家更好的了解如何在21天快速搭建推荐系统,特邀请本文作者、阿里云技术专家郑重(卢梭)开展一场线上课程,报名地址:https://yq.aliyun.com/webinar/join/14,时间6月16日晚20点直播。 本文作者为阿里云技术专家郑重(卢梭),主要分享内容是如何在21天内快速搭建推荐系统。推荐系统的搭建是个复杂工程,涉及到实时计算、离线计算,以及各种数据采集、流转等,对自建推荐系统来说,1人年是跑不掉的。 本文介绍的内容还包括如何搭建一个个性化推荐系统所需的环境准备、基本配置和离线技术等基本功

优秀的个人博客,低调大师

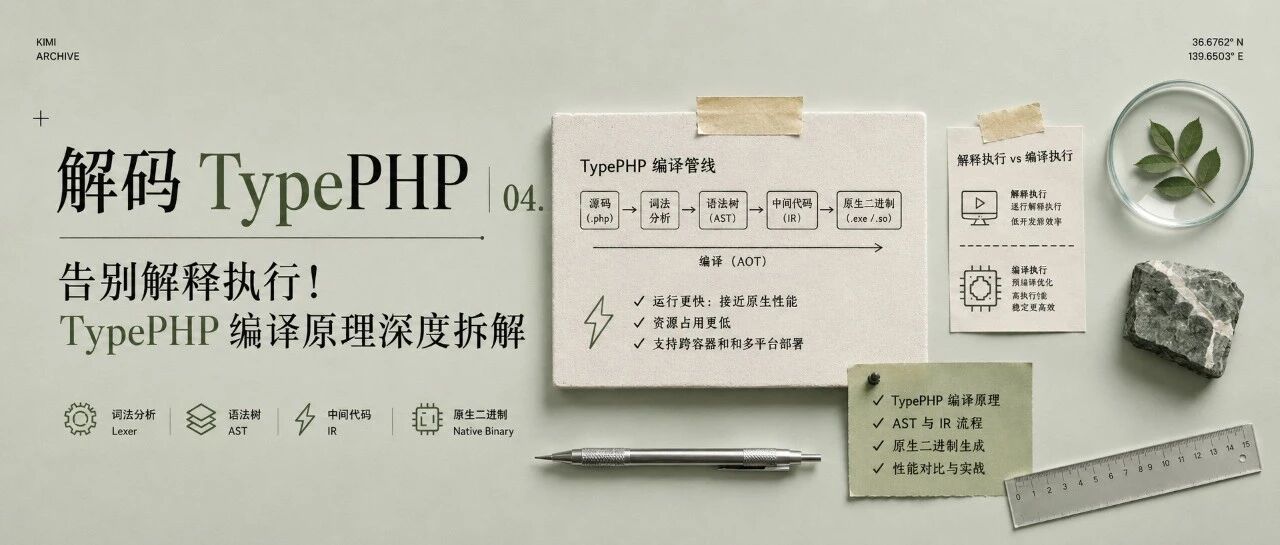
告别解释执行!TypePHP 编译原理深度拆解

# **TypePHP 编译原理深度拆解** > **写在前面**|前两篇装好了环境、编出了第一个二进制,但 tpc 对我们来说还是个黑盒:PHP 进去,二进制出来,中间发生了什么? 这篇拆盒。TypePHP 官方文档里有一篇《执行过程》,把编译器内部讲得相当透,我结合 `--dry` 参数带你看一遍完整流水线。 ## **01. 全景:官方定义的四阶段流水线** 官方文档把编译过程定义为四个阶段,全部离线完成: ``` ┌───────────────────────────────────────┐ │ 输入:PHP 源码(.php / project.yml) │ └───────────────────┬───────────────────┘ ▼ ┌───────────────────────────────────────┐ │ ① prepare() 预处理 │ │ 扫描、收集、排序全部源文件 │ │ 产出:完整符号表 │ └───────────────────┬───────────────────┘ ▼ ┌───────────────────────────────────────┐ │ ② convert() 转换 │ │ PHP AST → 等价的 C++ 源码 │ │ (tpc --dry 可看到这一层产物) │ └───────────────────┬───────────────────┘ ▼ ┌───────────────────────────────────────┐ │ ③ compile() 编译 │ │ 交给 GCC / Clang / MSVC │ │ 产出:目标文件(-O2/-O3 在此生效) │ └───────────────────┬───────────────────┘ ▼ ┌───────────────────────────────────────┐ │ ④ build() 链接 │ │ 链接 libphp + libphpx 运行时库 │ └───────────────────┬───────────────────┘ ▼ ┌───────────────────────────────────────┐ │ 原生二进制:ELF / Mach-O / PE │ └───────────────────────────────────────┘ ``` 注意这条流水线的分工边界:TypePHP 自己只实现 ①② 两个阶段,③④ 完全交给系统里的 C++ 工具链。 1. **预处理 prepare()** :扫描、收集、排序所有源文件,构建完整的符号表 1. **转换 convert()** :把 PHP 翻译成等价的 C++ 源码 1. **编译 compile()** :交给 GCC/Clang/MSVC 生成目标文件 1. **链接 build()** :链接运行时库,产出可执行文件(ELF/PE)或动态库(.so/.dll) 这个分工是理解整个项目的一把钥匙:TypePHP 专注于"把 PHP 语义正确翻译成 C++"这件最难的事,优化和代码生成全部委托给几十年功力的 C++ 编译器。 ## **02. 转换阶段:PHP 到 C++ 的映射规则** 这是最有意思的一步。TypePHP 把每个 PHP 函数、类翻译成 C++ 代码,类型处理分两个层次: |类型层次|启用方式|C++ 类型| | --- | --- | --- | |原生类型|use native_types|php::Int/php::Float/php::Bool,即 int64_t/double/bool| |动态类型|默认(未声明)|php::Var(zval 包装)、php::Array、php::String、php::Object| 也就是说,同一个 int,开不开 native_types 是两种命运:开了就是裸的 int64_t 直接运算,不开就还是 zval 装箱拆箱。 映射规则大致是: - PHP 函数 → C++ 函数,用户函数之间是直接 C++ 调用(存在子类覆盖时编译器会尝试去虚化) - PHP 类 → C++ class,属性按固定偏移布局(第三篇说的 C Struct 式优化) - 内置函数 → 通过 ZendAPI 的 `zend_call_function()` 直调底层 C 函数指针 - 无法静态确定的部分 → 保留运行时动态能力 想看真实产物?用 `--dry`: ``` tpc hello.php --dry ``` 它只生成 C++ 文件,不调用 C++ 编译器和链接器。去 build 目录里翻翻,就能看到你的 PHP 被翻译成的 C++ 源码。第一次看会有点震撼:一个 echo 语句背后是 phpx 运行时的输出调用,一个类型明确的循环就是干净的 C++ while。 指定生成目录也行: ``` tpc project.yml --dry --build-dir /tmp/typephp-build ``` 学编译原理、排查"为什么这段代码没被优化",都靠这个参数。 ## **03. 第三阶段:C++ 编译** 翻译出来的 C++ 交给系统编译器。这里有一组关键参数: **优化级别**。`-O0` 到 `-O3`,对应 `tpc` 的 `--debug`(-O0)到 `-O2`/`-O3`。跑分用的就是 -O3。日常开发用 --debug 编译快,发布用 -O2 起步。 **并行编译**。`-j8` 开多任务,大项目提速明显: ``` tpc project.yml -O2 -j8 ``` **编译器选择**。GCC、Clang、MSVC 都行,project.yml 里可以指定: ``` cpp-compiler: clang++ ``` **C++ 标准**。默认 c++20,可配置: ``` cxx-std: c++20 ``` Hot/Cold 注解就是在这一阶段生效的——它们被翻译成 `__attribute__((hot/cold))`,影响 C++ 编译器的优化决策。 ## **04. 第四阶段:链接** C++ 目标文件和两个核心库链接: - **libphp.so**:PHP Embed,提供内置函数、ZendVM 兜底执行能力 - **libphpx.so**:TypePHP 运行时,提供原生类型、容器、高精度数学等基础设施 这就是为什么部署要带 libphpx、为什么安装时 ldd 检查那么重要。链接完,产物就是最终的原生二进制:ELF(Linux)、Mach-O(macOS)或 PE(Windows)。 ## **05. 运行时:三种执行模式协同** 很多人以为编译后 ZendVM 就退场了,其实不是。官方文档说得很清楚:TypePHP 程序运行在**混合执行环境**中,有三种模式: **模式 1:静态编译执行**。AOT 编译过的用户代码,直接机器指令执行,无 zval 装箱、无 Opcode,接近原生 C++ 性能。 **模式 2:ZendAPI 直接调用**。PHP 内置函数(explode、preg_match)和扩展函数(json_decode、curl_init),通过 `zend_call_function()` 直调底层 C 函数指针,不生成 Opcode。开销只有函数指针查找和参数的 zval 包装。 **模式 3:ZendVM 解释执行**。`include()`/`require()`、`eval()`、`create_function()`、动态类定义,这些只能运行时走完整的"解析→编译→解释"管线,效率和标准 PHP 一样。 注意 include/require 也在模式 3 里——这点容易被忽略。所以官方给的最佳实践是:核心业务逻辑放静态编译文件,只把配置加载、路由分发这类必要场景留给动态加载。 还有个冷知识:TypePHP 定义的 Trait 只作为编译期 AST 模板存在,不注册到 ZendVM,所以动态代码里 use 不了 TypePHP 的 Trait。 这个设计的代价是每个二进制都带着 ZendVM(所以部署要 libphp),收益是兼容性——你不需要把代码改成"编译器喜欢的样子"才能跑起来,只是跑得快慢的区别。 ## **06. 执行入口的约定** 还记得 main() 约定吗?现在能解释清楚了:原生程序不经过 PHP 的脚本加载流程,需要一个明确的 C 风格入口。TypePHP 把你的全局 main() 翻译成二进制的真正入口点,argc/argv 可以直接拿到命令行参数: ``` function main(int $argc, array $argv): void { echo "参数数量: $argc\n"; } ``` 这也是为什么 TypePHP 特别适合写 CLI 工具——入口模型和 C 完全一致,启动没有 PHP 运行时的引导开销。 ## **07. 缓存与增量编译** tpc 有编译缓存,改一个文件不会全量重编。需要强制重编时: ``` tpc project.yml --force ``` 注意 --profile 参数会强制重编 main.cc,因为要注入 ProfilerStart/ProfilerStop 调用(第二篇讲过)。 ## **08. 小结** - 四段流水线:prepare 预处理 → convert 翻译 C++ → compile 系统编译器 → build 链接,产出原生二进制 - TypePHP 只管翻译,优化交给 GCC/Clang/MSVC - `--dry` 是学习利器,能看到翻译出的真实 C++ 代码 - 编译与解释双形态共存,ZendVM 负责兜底,兼容性优先 - main() 是原生入口,CLI 场景启动零引导开销 下一篇进入类型系统:TypePHP 只给了三种原生类型,它是怎么用这么少的类型撑起 PHP 的动态世界的?`use native_types` 背后的完整规则一次讲清。 ## **参考资料** 1. 执行过程:https://www.swoole.com/aot/docs/execution 1. 编译项目:https://www.swoole.com/aot/docs/compile 1. Printer:https://www.swoole.com/aot/docs/printer 1. 命令行参数:https://www.swoole.com/aot/docs/options --- **—— 如果这篇对你有帮助 ——** 点赞 · 在看 · 转发 关注「开源技术小栈」,第一时间见证 TypePHP 的每一次关键进化

优秀的个人博客,低调大师

告别桌面混乱:用 WorkBuddy 批量整理文件,效率翻 10 倍

## **前言** 作为一枚电脑重度用户,我的桌面和下载文件夹常年处于「灾难状态」——几百个文件按时间堆在一起,找一个东西要翻半天。手动整理一次至少 30 分钟,整理完维持不到一周又乱了。 直到我把 WorkBuddy 用到了文件整理场景,才发现这件事原来可以这么简单。批量归类、智能重命名、自动归档——以前一上午的活儿,现在 30 秒搞定。 ## **效果展示** 我现在的工作流是这样的:每天下班前花 10 秒在 WorkBuddy 里说「整理一下桌面和下载文件夹」,它就会按我的规则自动处理: · 把图片、视频、文档、压缩包按类型自动归类到对应子文件夹 · 文件名加日期前缀(如 2026-07-30_项目方案.docx) · 半年没动过的文件自动归档到 _Archives 文件夹 · 空的子文件夹自动删除 · 重复文件(同名同大小)保留最新版本,其余移到 _Duplicates 连续用了一个月,桌面常年保持「不超过 10 个文件」的状态,找东西的效率直线上升。 ## **操作步骤** 整个整理过程不需要写脚本,纯粹靠自然语言驱动: 第一步:扫描并出方案。告诉 WorkBuddy「扫描桌面和下载文件夹,给我一个整理方案,但不要直接执行」。它会先用「计划模式」分析当前文件分布,输出一份方案——哪些文件会被移到哪儿、哪些会重命名、哪些会归档。 第二步:审阅方案。方案里会标注每个操作的「风险等级」:纯移动是低风险,删除重复文件是中风险,永久删除是大风险。建议第一次用的时候仔细看看,避免误操作。 第三步:执行。确认方案没问题后回复「开始执行」,WorkBuddy 就会按方案批量处理。处理过程实时反馈进度,完成后给出总结报告:处理了多少文件、跳过了多少、有没有失败。 第四步(可选):回滚。WorkBuddy 会把执行记录保存到一份日志里,万一整理结果不满意,可以让它「回滚到上一步」。 ## **踩坑记录** **坑一:规则太模糊会让 AI 自由发挥:**我第一次用的时候说「把桌面整理一下」,结果它把所有文件一股脑全归到一个叫「桌面文件」的文件夹里——等于没整理。后来学会了把规则写具体:「按文件扩展名归类,图片放 Images、文档放 Documents、压缩包放 Archives、代码放 Code、其余保留原位」。规则越细,结果越可控。 **坑二:千万别让 AI 直接删文件:**我一开始图省事,跟 WorkBuddy 说「重复文件直接删掉」,结果它真删了——虽然备份里有,但还是要花时间恢复。安全做法是分两步:第一步先让重复文件移到 _Duplicates 文件夹,确认无误后再手动删除。WorkBuddy 本身有这个安全机制,但指令里明确写出来更稳妥。 **坑三:文件名包含特殊字符会导致重命名失败:**某些从网上下载的文件名带 / \ : * ? 等 Windows 不允许的字符,WorkBuddy 重命名时会报错。解决方法是在指令里加一条规则:「文件名中的非法字符自动替换为下划线」。我后来把这个规则加到默认整理模板里,再没遇到过这类问题。 ## **进阶玩法** 文件整理用熟了之后,可以探索一些更高级的玩法: 1. 定时自动整理:把整理命令做成每天 18:00 的自动化任务,下班时自动执行,不用每天手动触发。 2. 临时文件清理:每周日定时清理系统临时目录、浏览器缓存、回收站,保持磁盘空间健康。 3. 智能归档策略:可以根据文件大小、修改时间、扩展名组合出更精细的归档规则。比如「3 个月前的视频文件自动压缩,超过 100MB 的旧文件提示我手动决定」。 4. 项目文件夹结构生成:告诉 WorkBuddy「帮我建一个标准的前端项目文件夹结构」,它会自动创建 src、docs、tests、assets 等子文件夹,省去手动建目录的麻烦。

优秀的个人博客,低调大师

告别重复性劳动,Python让你效率提升10倍!
![](https://developer.qcloudimg.com/http-save/yehe-11081884/46d54d0bd585a61be2d334caf609a874.jpg) 你有没有这样的体验? 每天下班前的1小时,都在做重复又耗时的工作? 整理文件、处理数据、发送邮件... 这些工作不复杂,但特别耗费时间。 明明这些都可以自动完成,为什么我们还要花大量时间做重复的事? 我曾经也每天花2小时做这些琐事,直到我发现了Python自动化的魅力。 今天,我就来分享30个职场必备的Python自动化脚本,帮助你把宝贵的时间用在更重要的事情上。 ## **💡 自动化的本**质 你是不是觉得Python很难学? 别担心,这些脚本都是我精心挑选的实用脚本,很多都是**复制粘贴**就能用的。 > ***自动化**:让程序代替人,完成重复、耗时的任务。简单来说,就是用代码解决日常问题。* 你不需要懂太多Python语法,只需要根据自己的需求修改一下配置参数,就能实现自动化。 ## **📂 文件管理类脚**本 ![文件自动化过程](https://developer.qcloudimg.com/http-save/yehe-11081884/bed5ceba97ff63f1882933c644cb38c4.jpg) ### **1. CSV文件数据清洗工具** 从网上下载的CSV文件总是有很多重复数据和格式问题? 这个脚本可以帮你自动清洗CSV文件,让数据更干净易处理。 ``` import csv def clean_csv(input_file, output_file): with open(input_file, mode='r', newline='', encoding='utf-8') as infile, \ open(output_file, mode='w', newline='', encoding='utf-8') as outfile: reader = csv.reader(infile) writer = csv.writer(outfile) for row in reader: cleaned_row = [cell.strip() for cell in row] writer.writerow(cleaned_row) input_file = '/path/to/input.csv' output_file = '/path/to/cleaned_output.csv' clean_csv(input_file, output_file) ``` ### **2. 文件夹内容统计工具** 想知道一个文件夹里有多少文件和子文件夹? 这个脚本可以帮你快速统计文件夹的详细信息。 ``` import os def count_files_and_dirs(directory): total_files = 0 total_dirs = 0 for root, dirs, files in os.walk(directory): total_files += len(files) total_dirs += len(dirs) return total_files, total_dirs directory = '/path/to/your/directory' files, dirs = count_files_and_dirs(directory) print(f"Total files: {files}, Total directories: {dirs}") ``` ### **3. 文件类型分类工具** 想了解文件夹里都有哪些类型的文件? 这个脚本可以按文件扩展名统计文件数量。 ``` import os def classify_files_by_type(directory): file_types = {} for filename in os.listdir(directory): if os.path.isfile(os.path.join(directory, filename)): extension = os.path.splitext(filename)[1] if extension in file_types: file_types[extension] += 1 else: file_types[extension] = 1 return file_types directory = '/path/to/your/directory' file_types = classify_files_by_type(directory) for ext, count in file_types.items(): print(f"Files with extension '{ext}': {count}") ``` ### **4. 图像识别标签生成** 需要从图片中提取文字? 这个脚本可以帮你使用OCR技术从图片中识别文字内容。 ``` from PIL import Image from pytesseract import pytesseract def image_to_text(image_path): img = Image.open(image_path) text = pytesseract.image_to_string(img) return text image_path = '/path/to/your/image.png' text = image_to_text(image_path) print(f"Text from image: {text}") ``` ### **5. 视频转音频工具** 需要从视频中提取音频? 这个脚本可以帮你快速将视频文件转换为MP3音频格式。 ``` from moviepy.editor import VideoFileClip def convert_video_to_audio(video_path, audio_path): clip = VideoFileClip(video_path) clip.audio.write_audiofile(audio_path) video_path = '/path/to/your/video.mp4' audio_path = '/path/to/converted/audio.mp3' convert_video_to_audio(video_path, audio_path) ``` ### **6. 从网页提取图片** 想批量下载网页上的所有图片? 这个脚本可以帮你自动抓取网页中的所有图片并保存到本地。 ``` import requests from bs4 import BeautifulSoup import os def extract_images_from_webpage(url, output_dir): response = requests.get(url) soup = BeautifulSoup(response.text, 'html.parser') images = soup.find_all('img') os.makedirs(output_dir, exist_ok=True) for image in images: src = image.get('src') if src and src.startswith('http'): image_data = requests.get(src).content filename = os.path.join(output_dir, os.path.basename(src)) with open(filename, 'wb') as f: f.write(image_data) url = 'https://example.com' output_dir = '/path/to/output/images' extract_images_from_webpage(url, output_dir) ``` ### **7. 文本文件翻译工具** 需要翻译大量文档? 这个脚本可以帮你自动翻译文本文件。 ``` from deep_translator import GoogleTranslator def translate_text(input_file, output_file, target_language): with open(input_file, 'r', encoding='utf-8') as file: text = file.read() translated_text = GoogleTranslator(source='auto', target=target_language).translate(text) with open(output_file, 'w', encoding='utf-8') as file: file.write(translated_text) input_file = '/path/to/your/text.txt' output_file = '/path/to/translated_text.txt' target_language = 'es' translate_text(input_file, output_file, target_language) ``` ### **8. 文本摘要生成工具** 长篇文章读不完? 这个脚本可以帮你自动生成文章摘要,快速了解核心内容。 ``` from transformers import pipeline def generate_summary(text): summarizer = pipeline("summarization") summary = summarizer(text, max_length=130, min_length=30, do_sample=False) return summary[0]['summary_text'] text = """Lorem ipsum dolor sit amet, consectetur adipiscing elit. Sed non risus. Suspendisse lectus tortor, dignissim sit amet, adipiscing nec, ultricies sed, dolor.""" summary = generate_summary(text) print(f"Summary: {summary}") ``` ### **9. 文件夹内容同步工具** 需要在多个文件夹之间同步内容? 这个脚本可以帮你将源文件夹的内容同步到目标文件夹。 ``` import shutil import os def sync_folders(src_folder, dst_folder): for item in os.listdir(src_folder): s = os.path.join(src_folder, item) d = os.path.join(dst_folder, item) if os.path.isdir(s): shutil.copytree(s, d, dirs_exist_ok=True) else: shutil.copy2(s, d) src_folder = '/path/to/source/folder' dst_folder = '/path/to/destination/folder' sync_folders(src_folder, dst_folder) ``` ### **10. 数据备份到云存储服务** 需要将数据备份到云存储? 这个脚本可以帮你将文件自动上传到AWS S3等云存储服务。 ``` import boto3 def upload_to_s3(bucket_name, local_file_path, remote_file_path): s3 = boto3.client('s3') s3.upload_file(local_file_path, bucket_name, remote_file_path) bucket_name = 'your-bucket-name' local_file_path = '/path/to/your/local/file' remote_file_path = 'path/to/remote/file' upload_to_s3(bucket_name, local_file_path, remote_file_path) ``` ### **11. 批量重命名文件工具** 每天都在处理一堆文件,文件名杂乱无章? 这个脚本可以帮你批量重命名文件,统一添加项目前缀。 ``` import os def batch_rename(directory, prefix): for i, filename in enumerate(os.listdir(directory)): os.rename( os.path.join(directory, filename), os.path.join(directory, f"{prefix}_{i}{os.path.splitext(filename)[1]}") ) directory = '/path/to/files' prefix = 'new_name' batch_rename(directory, prefix) ``` ## **⏰ 定时与任务管理类脚本** ![自动任务时钟](https://developer.qcloudimg.com/http-save/yehe-11081884/8ca5306812e9d10f3d1893faff50120f.jpg) ### **12. 自动发送电子邮件** 需要每周定时发送周报? 这个脚本可以帮你自动发送邮件。 ``` import smtplib from email.mime.text import MIMEText def send_email(subject, body, to_email): msg = MIMEText(body) msg['Subject'] = subject msg['From'] = 'your_email@example.com' msg['To'] = to_email with smtplib.SMTP('smtp.example.com', 587) as server: server.starttls() server.login('your_email@example.com', 'your_password') server.send_message(msg) send_email('Test Subject', 'This is the email body', 'recipient@example.com') ``` ### **13. 网页内容监控工具** 需要监控某个网页是否有更新? 这个脚本可以帮你实时监控网页内容变化。 ``` import requests import time def monitor_website(url, check_interval=60): previous_content = requests.get(url).text while True: time.sleep(check_interval) current_content = requests.get(url).text if current_content != previous_content: print("Website content has changed!") previous_content = current_content monitor_website('https://example.com') ``` ### **14. 自动填写表单工具** 需要填写大量表单? 这个脚本可以帮你自动填写网页表单。 ``` from selenium import webdriver def auto_fill_form(url, form_data): driver = webdriver.Chrome() driver.get(url) for field_name, value in form_data.items(): element = driver.find_element_by_name(field_name) element.send_keys(value) submit_button = driver.find_element_by_xpath("//input[@type='submit']") submit_button.click() form_data = { 'username': 'your_username', 'password': 'your_password' } auto_fill_form('https://example.com/login', form_data) ``` ### **15. 自动生成报告工具** 需要定期生成Word报告? 这个脚本可以帮你自动生成格式化的Word文档。 ``` from docx import Document def generate_report(title, content, output_file): doc = Document() doc.add_heading(title, level=1) doc.add_paragraph(content) doc.save(output_file) generate_report('Monthly Report', 'This is report content...', 'monthly_report.docx') ``` ### **16. 社交媒体自动发布工具** 需要在Twitter上自动发布内容? 这个脚本可以帮你自动发布推文。 ``` import tweepy def tweet_message(api_key, api_secret, access_token, access_token_secret, message): auth = tweepy.OAuthHandler(api_key, api_secret) auth.set_access_token(access_token, access_token_secret) api = tweepy.API(auth) api.update_status(message) tweet_message('your_api_key', 'your_api_secret', 'your_access_token', 'your_access_token_secret', 'Hello from Python!') ``` ### **17. 自动会议记录生成器** 需要把会议录音转换成文字记录? 这个脚本可以帮你使用语音识别技术自动转写会议录音。 ``` import speech_recognition as sr def transcribe_meeting(audio_file): r = sr.Recognizer() with sr.AudioFile(audio_file) as source: audio = r.record(source) try: return r.recognize_google(audio) except Exception as e: return f"Error: {str(e)}" transcription = transcribe_meeting('meeting_recording.wav') with open('meeting_transcript.txt', 'w') as f: f.write(transcription) ``` ### **18. 自动数据可视化工具** 数据都准备好了,但是需要花时间做图表? 这个脚本可以自动从数据文件生成可视化图表。 ``` import pandas as pd import matplotlib.pyplot as plt def auto_visualize(data_file): df = pd.read_csv(data_file) df.plot(kind='bar') plt.savefig('visualization.png') auto_visualize('data.csv') ``` ### **19. 密码管理器** 担心密码不安全? 这个脚本可以帮你加密和管理密码。 ``` from cryptography.fernet import Fernet import json def generate_key(): return Fernet.generate_key() def encrypt_password(key, password): f = Fernet(key) return f.encrypt(password.encode()).decode() def decrypt_password(key, encrypted_password): f = Fernet(key) return f.decrypt(encrypted_password.encode()).decode() key = generate_key() encrypted = encrypt_password(key, "my_secret_password") print(decrypt_password(key, encrypted)) ``` ### **20. 系统资源监控工具** 需要实时监控系统资源使用情况? 这个脚本可以帮你监控CPU和内存使用率。 ``` import psutil import time def monitor_resources(interval=5): while True: cpu = psutil.cpu_percent() memory = psutil.virtual_memory().percent print(f"CPU Usage: {cpu}%, Memory Usage: {memory}%") time.sleep(interval) monitor_resources() ``` ### **21. 批量文件重命名工具** 需要给文件添加统一前缀? 这个脚本可以批量重命名文件夹中的所有文件。 ``` import os def rename_files(directory, prefix): for filename in os.listdir(directory): file_path = os.path.join(directory, filename) if os.path.isfile(file_path): new_filename = f"{prefix}_{filename}" new_file_path = os.path.join(directory, new_filename) os.rename(file_path, new_file_path) print(f"Renamed '{filename}' to '{new_filename}'") # 示例用法 rename_files('/path/to/your/files', 'project') ``` ### **22. 文件分类整理工具** 下载文件夹总是乱糟糟的? 这个脚本可以自动将文件按类型分类到不同子文件夹。 ``` import os import shutil def organize_folder(folder_path): file_types = { "Images": [".jpg", ".jpeg", ".png", ".gif"], "Documents": [".pdf", ".docx", ".txt"], "Spreadsheets": [".xlsx", ".csv"], "Videos": [".mp4", ".mov", ".avi"] } for file_name in os.listdir(folder_path): file_path = os.path.join(folder_path, file_name) if os.path.isfile(file_path): file_ext = os.path.splitext(file_name)[1].lower() for folder, extensions in file_types.items(): if file_ext in extensions: target_folder = os.path.join(folder_path, folder) os.makedirs(target_folder, exist_ok=True) shutil.move(file_path, os.path.join(target_folder, file_name)) break ``` ### **23. 自动化数据备份脚本** 需要定期备份重要文件? 这个脚本将指定文件夹压缩备份,并添加时间戳。 ``` import os import shutil import datetime import zipfile def backup_files(src_dir, backup_dir): current_time = datetime.datetime.now().strftime("%Y%m%d_%H%M%S") backup_name = f"backup_{current_time}" backup_path = os.path.join(backup_dir, backup_name) if not os.path.exists(backup_dir): os.makedirs(backup_dir) with zipfile.ZipFile(backup_path + '.zip', 'w', zipfile.ZIP_DEFLATED) as zipf: for root, _, files in os.walk(src_dir): for file in files: file_path = os.path.join(root, file) arc_name = os.path.relpath(file_path, src_dir) zipf.write(file_path, arc_name) print(f"备份完成!文件保存在: {backup_path}.zip") ``` ### **24. 邮件自动发送工具** 需要发送带附件的邮件? 这个脚本可以自动发送带附件的邮件。 ``` import smtplib from email.mime.multipart import MIMEMultipart from email.mime.text import MIMEText def send_email(subject, body, recipient): sender_email = "your_email@gmail.com" sender_password = "your_password" message = MIMEMultipart() message["From"] = sender_email message["To"] = recipient message["Subject"] = subject message.attach(MIMEText(body, "plain")) with smtplib.SMTP("smtp.gmail.com", 587) as server: server.starttls() server.login(sender_email, sender_password) server.send_message(message) print("Email sent!") ``` ### **25. 网页数据抓取工具** 需要获取网页上的新闻头条? 这个脚本可以抓取网页头条新闻,保持信息更新。 ``` import requests from bs4 import BeautifulSoup def fetch_headlines(url): response = requests.get(url) soup = BeautifulSoup(response.text, 'html.parser') headlines = soup.find_all('h2') for i, headline in enumerate(headlines[:5]): print(f"{i+1}. {headline.text.strip()}") # 示例用法 fetch_headlines("https://news.ycombinator.com/") ``` ### **26. 自动打开常用网页** 每天都要打开同样的网页? 这个脚本可以一键打开工作所需的所有网页。 ``` import webbrowser def open_websites(): urls = [ "https://mail.google.com", "https://www.jira.com", "https://www.github.com" ] for url in urls: webbrowser.open(url) # 示例用法 open_websites() ``` ### **27. 文本替换工具** 需要批量替换文本文件中的内容? 这个脚本可以批量替换文本文件中的内容。 ``` def replace_text_in_file(file_path, old_text, new_text): with open(file_path, 'r+') as file: content = file.read() new_content = content.replace(old_text, new_text) file.seek(0) file.write(new_content) file.truncate() # 示例用法 replace_text_in_file('/your/text.txt', 'old_word', 'new_word') ``` ### **28. 实时文件监控备份** 需要实时监控文件夹变化并自动备份? 这个脚本可以实时监控文件夹变化并自动备份重要文件。 ``` import os import shutil from watchdog.observers import Observer from watchdog.events import FileSystemEventHandler from datetime import datetime class FileBackupHandler(FileSystemEventHandler): def __init__(self, source_dir, backup_dir): self.source_dir = source_dir self.backup_dir = backup_dir def on_modified(self, event): if not event.is_directory: self.copy_file(event.src_path) def copy_file(self, src): timestamp = datetime.now().strftime("%Y-%m-%d_%H-%M-%S") backup_path = os.path.join(self.backup_dir, f"backup_{timestamp}") os.makedirs(backup_path, exist_ok=True) shutil.copy2(src, backup_path) def monitor_folder(source_dir, backup_dir): event_handler = FileBackupHandler(source_dir, backup_dir) observer = Observer() observer.schedule(event_handler, source_dir, recursive=True) observer.start() try: while True: time.sleep(1) except KeyboardInterrupt: observer.stop() observer.join() ``` ### **29. 定时任务调度器** 需要灵活安排定时任务? 这个脚本可以灵活安排定时任务,如每日报表生成、定期数据备份等。 ``` import schedule import time def job(): print("Job running...") # 设置定时任务 schedule.every(1).minutes.do(job) schedule.every().day.at("10:30").do(job) while True: schedule.run_pending() time.sleep(1) ``` ### **30. 社交媒体自动发布工具** 需要在Twitter上自动发布内容? 这个脚本可以自动发布社交媒体内容,适用于品牌营销和内容运营。 ``` import tweepy def post_tweet(api_key, api_secret, access_token, access_secret, message): auth = tweepy.OAuthHandler(api_key, api_secret) auth.set_access_token(access_token, access_secret) api = tweepy.API(auth) api.update_status(message) # 示例用法 post_tweet("API_KEY", "API_SECRET", "ACCESS_TOKEN", "ACCESS_SECRET", "Hello, Twitter!") ``` ## **🎯 如何开始使**用 看完这些脚本,你是不是觉得Python自动化其实没那么难? **第一步**:选择合适的脚本。根据你的工作需求,选择上面的脚本。 **第二步**:修改配置参数。把脚本中的路径和配置改成你自己的。 **第三步**:运行脚本。保存为Python文件,点击运行按钮。 ## **💡 为什么要学Python自动**化 你可能觉得,学习Python要花很多时间,但是相比之下,我们每天花在重复性工作上的时间更多。 > ***时间成本**:如果每天花1小时在重复性工作上,一年就是365小时,也就是46个工作日。* 通过学习Python自动化,你可以把这些时间省下来,用来做更有价值的事情。 ## **📌 我的建**议 **1. 从简单的开始** 先从文件处理类的脚本开始,比如批量重命名、文件分类等,这些脚本修改参数就能用,容易上手。 **2. 记录日常重复性工作** 在工作中,把你觉得**浪费时间**的事情记录下来,然后搜索对应的Python解决方案,慢慢积累自己的自动化工具箱。 **3. 养成自动化思维** 遇到新的任务,先思考:这个任务可以用自动化完成吗?然后再动手做。 ## **✨ 自动化后的变化** 这些脚本虽然看起来很简单,但它们能带来的变化是巨大的。 你不用再担心下班前的文件整理工作,不用再担心错过某个定时任务,也不用再为复制粘贴数据而烦恼。 更重要的是,你可以把节省下来的时间用在更有创造性的工作上,提升自己的价值。 ## **🎉 写在最**后 我曾经也是一个每天花2小时做重复性工作的人,但Python自动化帮我把这些时间都省了下来。 现在,我可以把更多时间用在思考问题和解决问题上,效率提升了不止10倍。 > ***自动化不是为了替代人,而是为了让人有更多时间去做更有价值的事情。*** 希望今天分享的30个脚本能帮助你节省时间,提升效率。 ---
优秀的个人博客,低调大师

一键让网站从此告别攻击

> 如今网络安全风险早已不是早年中个木马、泄露点信息的小打小闹。勒索加密攻击愈发泛滥,不少攻击者将目光对准暴露在公网的各类线上服务:一旦 Web 站点防护不足,SQL 注入、远程代码执行等攻击可直接拿下服务器权限,进而加密核心业务数据、拖走用户信息,造成的业务中断、数据资产损失往往难以估量。 很多个人站长、中小团队开发者会觉得,自己体量小,攻击不会找上门,就算中招也无所谓。但真正遭遇安全事故后,业务停摆的营收损失、核心数据丢失的代价,往往远高于提前做好防护的成本。 ![](https://developer.qcloudimg.com/http-save/yehe-8683001/497668cd015e25e0162ae8b3c0167c6a.png) 对开发者和运维人员来说,更值得思考的是:如何提前筑牢防线,保护线上服务的安全?这就需要添加一套防火墙了。但是专业级的防火墙可是一笔不少的开支。 ![某平台基础web防火墙包年费用](https://developer.qcloudimg.com/http-save/yehe-8683001/122e8761400926ff628b16e926388a25.png) 某平台基础web防火墙包年费用面对以上各种困难,我们如何破局呢?有没有低成本、易部署、防护能力还靠谱的方案?不妨试试长亭雷池(SafeLine)WAF。 **关于** 作为一款主打简单高效的 WAF 产品,雷池 (SafeLine) 核心搭载长亭自研的智能语义分析引擎,和传统依赖规则匹配的 WAF 相比,跳出了逐条规则匹配的局限:通过对 HTTP 流量的语义解析识别攻击行为,不仅对 SQL 注入、XSS 跨站脚本、命令注入等常见 Web 攻击的识别精度更高,还能有效应对绕过规则的变形攻击。 > **雷池官网**:https://waf-ce.chaitin.cn/ **GitHub 仓库**:https://github.com/chaitin/SafeLine ![](https://developer.qcloudimg.com/http-save/yehe-8683001/71e0015ed6cc13ca2620f4a26b90d607.png) **部署** 雷池 SafeLine 最大的优势之一就是部署门槛极低,无需复杂的环境配置,一行命令即可启动安装。 ``` bash -c "$(curl -fsSLk https://waf-ce.chaitin.cn/release/latest/manager.sh)" ``` ![输入1开始安装](https://developer.qcloudimg.com/http-save/yehe-8683001/87bf205655f591b3f4d5a7ea62650276.png) 输入1开始安装傻瓜式一路狂点`y`就行了。 ![](https://developer.qcloudimg.com/http-save/yehe-8683001/39e1a9fb08a6c4c2a422af01d8a884c4.png) ![完成安装](https://developer.qcloudimg.com/http-save/yehe-8683001/503d8cd303bf7db597eec1faa21a4c12.png) 完成安装 **注意:** 部署前需要在服务器安全组 / 防火墙中放行 `9443` 端口,否则无法访问管理后台。 **开箱体验** 访问`ip:9443`输入账号和密码,登录控制台。 ![](https://developer.qcloudimg.com/http-save/yehe-8683001/5d70a52ebe00838ce6f32be69f180c3c.png) 后台界面清晰直观,首页统计报表可以直接看到近 24 小时的请求量、拦截次数、攻击类型分布等数据,防护状态一目了然。 ![程序首页](https://developer.qcloudimg.com/http-save/yehe-8683001/76ec08604c4491eb7232947412ff5d08.png) 程序首页 **保护第一个应用** 接下来,我们创建一个实例,保护你的站点。雷池基于 Nginx 进行开发, 作为 反向代理 接入网络。 因此,在使用之前我们需要提前做好以下准备工作。 - • 将域名解析到雷池WAF对应的服务器IP。 - • 确定要保护的站点。 - • 相关SSL证书。 接下来进入 `防护应用` 页面, 点击右上角的 `添加应用` 按钮进行配置。 ![](https://developer.qcloudimg.com/http-save/yehe-8683001/d407b95742d9668cef867dbb0157ff5e.png) 添加完成后,返回`防护应用` 页面,访问域名检查访问是否正常。 ![目标网站能访问 并有请求数说明添加成功](https://developer.qcloudimg.com/http-save/yehe-8683001/c007afac1dc71bdaf8d0403ca3dd517d.png) 目标网站能访问 并有请求数说明添加成功 接下来,可以根据实际情况,开启`CC防护Bot防护`等。 ### **配置CC攻击** CC 攻击是最常见的攻击方式之一,通过大量并发请求打垮站点服务。雷池的 CC 防护支持「等候室」与「频率限制」双重能力。 ![](https://developer.qcloudimg.com/http-save/yehe-8683001/ca70d8fb0ca8cbd1a067122ff93f66c1.png) ### **配置Bot防护** 针对自动化爬虫、漏洞扫描器这类 Bot 攻击,雷池提供了完整的防护方案。支持人机验证、动态防护、提供 HTML 动态加密、JS 动态混淆、图片动态水印等功能。 ![](https://developer.qcloudimg.com/http-save/yehe-8683001/28735679977cbf537c51590bd98233b9.png) ### **身份验证** 如果是内部系统、测试站点这类不希望公开访问的应用,可以开启雷池的身份认证功能。 ![](https://developer.qcloudimg.com/http-save/yehe-8683001/1ead38531dd067c894a64761df9d0e1e.png) 完成后,效果如下: ![](https://developer.qcloudimg.com/http-save/yehe-8683001/5fd0a6f3cd17655bcaf21ad3d659673f.png) 点击详细信息,可查看路由等信息。 ![](https://developer.qcloudimg.com/http-save/yehe-8683001/a16a9635a1a6502e4f986b380621800d.png) **小试牛刀** 接下来,我们对目标设备进行一次简单的压力测试,来看看它的防护效果吧!轻轻勾选,应对各种防护。 ![借助AI进行全面测试](https://developer.qcloudimg.com/http-save/yehe-8683001/220adea33dc123425a9adbba2f3e6e29.png) 借助AI进行全面测试 ![刚开始扫描,就提示拦截了](https://developer.qcloudimg.com/http-save/yehe-8683001/a2461f33948f0d8fc4f82490b6cfd817.png) 刚开始扫描,就提示拦截了 ![很多攻击都以失败告终](https://developer.qcloudimg.com/http-save/yehe-8683001/815a919b72dd9232d3b506a727854c78.png) 很多攻击都以失败告终 测试过程中,常规的端口扫描、漏洞探测、头部绕过、HTTP 走私等攻击尝试,全部被雷池拦截,返回 468 状态码,攻击载荷根本无法触达后端站点。接下来,我们返回到雷池,看看防护日志。 ![概览统计](https://developer.qcloudimg.com/http-save/yehe-8683001/e8403a8a988a8584fb41965414c59dbd.png) 概览统计 ![攻击日志](https://developer.qcloudimg.com/http-save/yehe-8683001/72900827247dd24cb9f7a23855208c52.png) 攻击日志 ![详细信息](https://developer.qcloudimg.com/http-save/yehe-8683001/e92afd90774cc471cd3fc7ad8f38405f.png) 详细信息 ![CC防护](https://developer.qcloudimg.com/http-save/yehe-8683001/c43ac12b34d3cb3dd1c3fab2a26346ca.png) CC防护 ![人机验证](https://developer.qcloudimg.com/http-save/yehe-8683001/1443f5505fab5ebe2898b16195a07c95.png) 人机验证 为了保障防护效果,需要我们定期更新情报库,点击`通用设置`对相关指纹库和情报组进行更新。 ![](https://developer.qcloudimg.com/http-save/yehe-8683001/0ddd000a317f359e1732326ce9d1464f.png) **总结** 总的来说,雷池(SafeLine)WAF很好地平衡了易用性与防护能力:一行命令即可部署,后台配置简单直观,没有复杂的规则编写门槛,新手也能快速上手;同时核心防护能力扎实,能够覆盖 SQL 注入、XSS、CC 攻击、恶意爬虫等绝大多数 Web 攻击场景,对个人站长、中小团队、开发测试环境来说,是性价比极高的防护方案。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册