首页 文章 精选 留言 我的

精选列表

搜索[告别],共1801篇文章
优秀的个人博客,低调大师

🎉smart-servlet v3.1 发布,告别传统 Servlet 容器

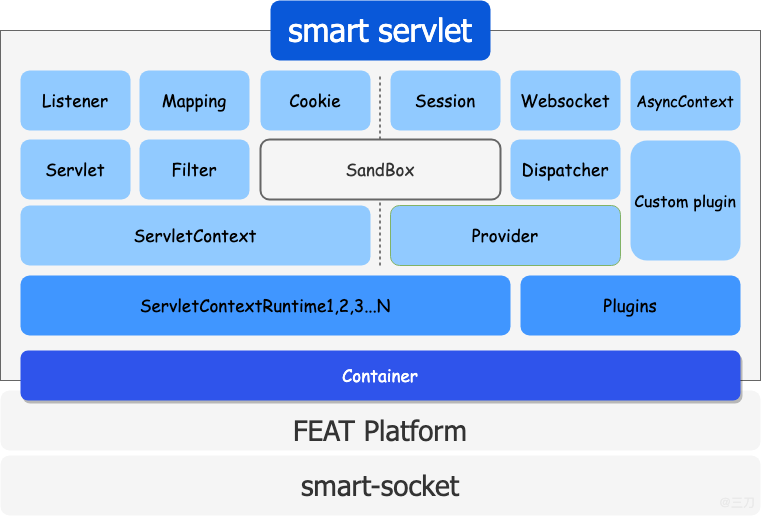
前言 我们很高兴地宣布 smart-servlet v3.1 正式发布!作为基于 Jakarta Servlet 6.0 标准的国产轻量级 Servlet 容器,本次更新的核心亮点是底层HTTP服务模块 Feat 的全面升级,带来更卓越的性能表现和更稳定的运行体验。 伴随着AI技术带来的产业变革,我们深刻认识到:传统技术架构的臃肿已成为企业智能化转型的桎梏。 因此,本次版本在技术上全面升级的同时,更在授权策略上做出了重大调整——我们将授权门槛直接"打下来"了! 只要您手里有 Feat 的授权,smart-servlet 直接开箱即用,零额外成本! 什么是 smart-servlet? smart-servlet 是一个适用于 Java 17+ 环境的轻量级 Servlet 容器,完全遵循 Jakarta Servlet 6.0 规范。作为国产Web服务器,smart-servlet具有以下核心特色: 国产血统:核心技术100%全栈自研,从底层通信框架到上层应用接口,实现了完全自主可控 性能优越:搭载最新版通信微内核 smart-socket,配合全新升级的 Feat HTTP服务模块 安全可靠:严格遵循协议规范,支持 HTTP/2、TLS/SSL 加密传输方式 简洁易用:支持 War 包、SpringBoot、Maven-plugin等多种运行模式,使用体验100%兼容 Tomcat v3.1 版本核心更新 🚀 Feat 底层HTTP服务模块全面升级 Feat 作为 smart-servlet 的底层HTTP通信核心,承载着所有HTTP请求的解析与响应工作。此次从早期版本升级至 v1.5.3,带来了多项关键改进: 更高效的请求解析引擎:优化HTTP协议解析算法,降低CPU占用率 增强的内存管理机制:减少内存分配频次,提升高并发场景下的GC表现 完善的异常处理机制:增强边界条件处理,提升服务稳定性 应用场景 smart-servlet v3.1 适用于以下场景: 1. 信创替代 作为完全自主研发的Servlet容器,smart-servlet是替换Tomcat/Jetty等国外产品的理想选择,特别适用于: 金融、政务、能源、教育、医疗等信创领域 对核心技术自主可控有要求的国企和央企 2. 高性能Web服务 基于 Feat 的高性能HTTP引擎,smart-servlet特别适合: 高并发API网关 微服务基础设施 实时通信服务 3. 云原生部署 配合 Feat Cloud 组件,smart-servlet完美支持: Kubernetes 容器化部署 Serverless 无服务器架构 弹性伸缩场景 🎉 关于授权调整 在AI技术蓬勃发展的当下,我们清醒地认识到:Servlet、Spring 等传统技术方案正在加剧企业智能化战略实施的系统性臃肿。企业深陷于复杂的技术栈、繁重的维护成本和缓慢的创新节奏中,难以快速响应市场变化。 与此同时,Feat 作为代表云原生、智能原生的新一代解决方案,有望成为这一困局的破局者。它以其轻量、高效、智能的特性,为企业数字化转型提供了全新的技术路径。 更关键的是,在AI的加持下,我们已将产品的建设成本降低到极致。由此创造的技术红利,足以覆盖传统Java生态的高昂成本,让企业以更少的投入获得更优的技术能力。 基于以上洞察,smart-servlet 自 v3.1 版本起大幅降低授权门槛:Feat 在册授权企业无需额外成本,可直接使用 smart-servlet。这一举措旨在帮助企业实现系统架构的"去肥增瘦"——通过统一的技术授权体系,简化技术栈管理,降低架构臃肿度,逐步完成轻量化、智能化的转型。 💡 建议:如果您正在评估 smart-servlet,欢迎同时了解 Feat 产品。 拿下 Feat,smart-servlet 白送!没接触过 Feat 的小伙伴别犹豫,先去瞅瞅,这波绝对不亏~ 相关链接 官方网站:https://smartboot.tech/smart-servlet/ GitHub仓库:https://github.com/smartboot/smart-servlet Gitee仓库:https://gitee.com/smartboot-x/smart-servlet Feat项目:https://gitee.com/smartboot/feat smart-servlet v3.1,国产Servlet容器的新里程碑,期待您的使用与反馈!

优秀的个人博客,低调大师

告别跑断腿!这套系统让所有流程在线上跑通了!

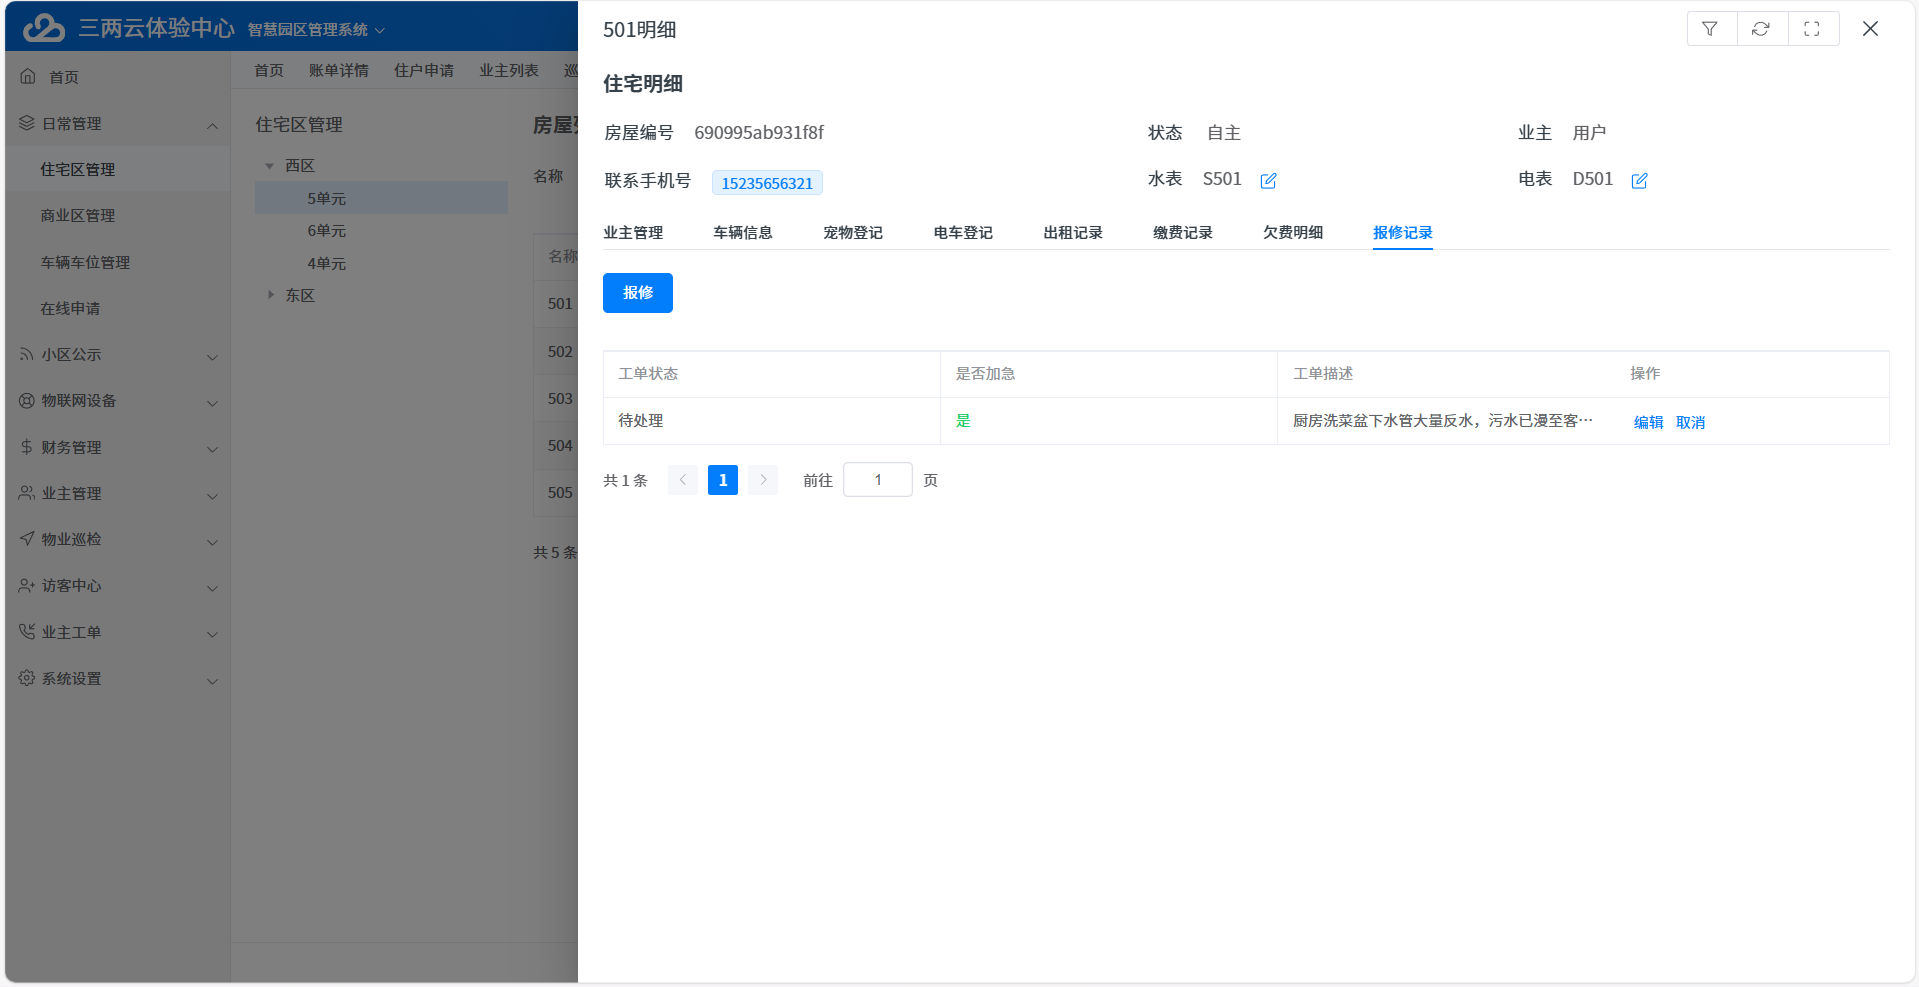
在日益复杂的社区服务与运营场景中,物业团队需要的是一个能够无缝连接各方、灵活响应需求的轻捷智能平台。三两云智慧物业系统正是以此为核心理念,构建了一个社区服务与管理的“一体化数字基座”。 系统将社区中的核心模块——包括收费核算、设备维护、工单分发、公告通知及社区活动等,通过一个平台、两端协同的模式,重构了传统物业服务流程。运营端作为管理的“智慧大脑”,移动端则作为服务的“敏捷触手”,二者数据同源、实时联动,共同构建了管理高效、服务便捷、体验智慧的现代化社区。 版本信息 版本日期: 2025-11-21 运营管理端升级 1. 基础管理 资产与人员管理:可集中维护业主、住户、宠物、车辆及报修记录等,形成完整的社区资产与业主档案。 2. 运营服务 工单闭环处理:可添加工单日志,实现从派单、处理、验收到归档的全流程在线跟踪与闭环管理。 标准化巡检:支持自定义巡检路线与巡检记录、任务的添加,任务可派发至保安端,确保园区设施与安全状况的受控状态。 智能安防联动:道闸管理与门禁、道闸系统打通,支持访客线上预约、保安端登记核验的安全高效流程。 3. 财务管理 计费与催缴:支持个性化费率配置,支持线上推送与催缴,极大提升收缴效率。 多元化经营:通过商业租赁管理等模块,助力物业企业拓展收入渠道,构建多元盈利生态。 4. 物联网与设备 设备全生命周期监控:对电梯、摄像头、水电表等园区设备进行在线管理,实时监控运行状态。 ​5. 社区运营 信息发布与精准触达:社区信息支持精准、及时地传达至目标业主,提升沟通效率与社区活力。 新增移动应用端 移动端分为业主端与保安端,将服务与管理能力延伸至现场,确保信息与任务的无缝落地。 业主端:掌上智慧生活 业主端产品图 服务一键触达:集成“联系物业、维修上报、访客预约、缴费清单”等核心功能,业主足不出户即可办理各项业务,并可实时跟踪进度。 活跃社区生态:设有“社区动态、活动中心、邻里集市”等板块,促进邻里交流与资源共享,营造温暖、活跃的社区氛围。 个人事务中心:集中管理“我的房屋、我的车位、我的工单、我的账单”等,实现个人资产与社区事务的线上闭环。 保安端:移动工作平台 保安端产品图 移动化巡检:在手机端接收巡检任务,按预设路线与标准完成打卡与状态记录,异常情况可一键上报生成工单。 高效门岗管理:快速登记与核验访客信息,联动道闸系统实现精准放行,保障园区安全。 现场工单处理:实时接收并处理业主报修或自主发现的园区问题工单,实现任务的快速响应与闭环。 专项作业支持:支持移动端完成水表抄表、宠物信息登记等专项工作,数据实时回传至运营端,确保准确高效。 协同价值:数据驱动的闭环生态 本系统的核心价值在于运营端与移动端的高效协同,形成一个完整的数字生态。 任务闭环:业主在手机上报修,工单在运营端生成并派发,保安在移动端接单处理,结果反馈至运营端归档,并通知业主,实现全流程透明化。 数据联动:保安端巡检采集的数据,实时同步至运营端,成为管理者决策和生成数据看板的基础。 服务体验升级:通过两端协作,让物业服务响应更迅速、管理更精细、体验更人性化。 相关链接 未来社区智慧物业系统运营端的详细介绍:点击查看 未来社区智慧物业系统运营端的下载地址:https://gitee.com/yimiyisu/house 未来社区智慧物业系统移动端的下载地址:https://gitee.com/yimiyisu/landlord​​​​​​​

优秀的个人博客,低调大师

GitHub 告别独立时代,Gitee 12 年坚守开启 AI 新程

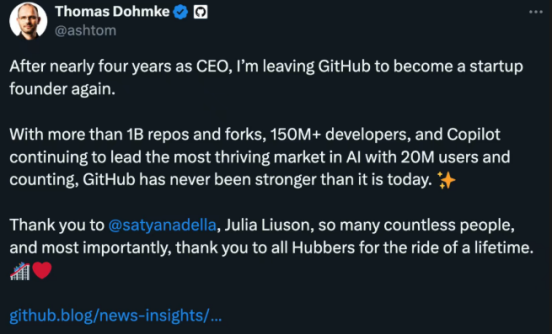
深圳北科大厦,几位外国客人,专注地盯着屏幕上 Gitee 的实操演示,不时还向一旁的中国工程师询问功能细节,转眼一小时过去——这一幕发生在 2018 年 10 月开源中国的深圳办公室,来访者正是 GitHub 的前两任 CEO :Nat Friedman 与 Thomas Dohmke 。 而如今,这两位熟人走了,开源中国仍在,开启 AI 新程...... GitHub 两任 CEO 的东方足迹 2018 年 10 月,在中国开源年会 COSCon'18 的活动现场,开源中国 COO 徐勇(现任开源中国 CEO )第一次见到了 Nat Friedman 。“衣着随意,一看就是程序员”,是徐勇对这位 GitHub 掌门人的第一印象。 可能是身处一个圈子的好感,徐勇与 Nat Friedman 在第二天讨论中国开源生态的闭门会上,聊得格外投机。当 Nat Friedman 得知开源中国也有一款类似 GitHub 的软件后,顿时来了兴趣,当即便和徐勇约定了第二天到开源中国拜访,于是就出现了开头的一幕。 那是 2018 年的一个凉爽的上午,一高一矮两个老外走进了开源中国办公室。徐勇回忆,上午十点,Nat Friedman 一行就来了。寒暄一阵之后,徐勇作为东道主,向 Nat Friedman 一行讲解起了当时的 Gitee 。 “ Nat 大高个儿嘛,看屏幕就比较费劲,全程都是勾着腰。但看得出,他对 Gitee 很感兴趣,特别是一些功能上的创新——或者说,是中国的开发者市场。” 彼时,开源历史上的一个里程碑事件引发全球瞩目:GitHub 被微软以 75 亿美元全资收购。GitHub 作为全球最知名且中立的开源协作平台,被科技巨头收购之后该何去何从?Nat Friedman 被任命为 CEO 未来又有何动作?外界众说纷纭。 但我们可以知道的是,Nat Friedman 官宣上任后的第一件事,并没有出现在 GitHub 的办公室,反而是来到了中国,特别是出现在了开源中国的办公室,一起观摩 Gitee 的演示。 拜访的最后,Nat Friedman 团队其中一人向徐勇递出了名片,直白地问:“如果我们出钱收购,开源中国卖不卖?” 此人,正是当时 GitHub 的 CTO,也就是后来的第二任 CEO 的 Thomas Dohmke。 对此,徐勇内心坚定,但周全考虑并没有明确拒绝。而在这次深圳会面不久,微软全球 CEO Satya Nadella 来华,又特地安排了与开源中国马越(现开源中国董事长)的会面,依旧提及收购事宜。 面对行业巨头抛来的橄榄枝,开源中国始终坚定选择独立发展。徐勇后来回忆道:“虽然 2018 年,开源中国也处于业务转型的阵痛期,在资本市场四处化缘,但将本土唯一的代码托管平台拱手让人,中国未来的开源生态又谈何自强呢?Gitee 得坚持走自己的路,中国特色的路。” 正如 Gitee 一开始就定下的基调:致敬 GitHub ,但绝不照搬,始终聚焦“开发者为本”,走出一条贴合中国开发者需求的特色之路。 2 个人,7 年,“他们都离开了”,我们依然前行 2025 年 8 月 11 日,一则消息震动全球开发者社区:GitHub CEO Thomas Dohmke 宣布辞职,而 GitHub 将结束独立运营,整体并入微软 CoreAI 部门,且微软不再为其寻找新 CEO。 Thomas Dohmke 在内部邮件中提及:如今 GitHub 已有超过 10 亿个代码库与分支,开发者数量突破 1.5 亿,以及 Copilot 持续引领蓬勃发展的 AI 市场,拥有 2000 万用户并不断增长...... 如此成绩的背后,是微软与 GitHub 以开放的方式续写开源生态的共生故事: 开源开放上,微软开源 WSL ( Windows Subsystem for Linux ),打破了 Windows 与 Linux 长期以来的生态壁垒,成为连接千万开发者的技术桥梁; GitHub 产品功能上,开放地收购了 NPM 等工具厂商,使得 Actions 能力变强。GitHub Actions 于微软时期推出,甚至免费私有仓库也是在微软时期才开始提供; 数据开放,GitHub 上的公开数据,成为开发者打磨工具、挖掘趋势、创造新方案的 “原始素材库”。而在大模型时代,无数聚焦代码生成、漏洞检测、自动化开发的大模型与工具,正是以 GitHub 的公开数据为训练基底; 对开发者生态来说,“开放”是微软收购 GitHub 之后的一个极为重要的关键词,并且以这样的开放实现了众多创举,其中就有 Copilot 。 2021 年,随着生成式 AI 的崛起,微软与 OpenAI 合作推出 GitHub Copilot ,正式开启 AI 编程时代。如今,Copilot 已从代码补全工具,发展成拥有 Copilot Chat&Voice 的对话式编程助手,再到能审查与修复代码、用GitHub Spark 构建全栈应用的多模态智能体系统, 但,乱世何妨缺英豪?尽管 GitHub Copilot 算是第一个在 AI 编程领域颠覆大家认知的产品,但过去这一年多,微软一定也意识到:在这波 AI 编程浪潮下,旗下的 GitHub 并没有发挥出其应有的影响力,而 Copilot 则更多地是在给旁人做嫁衣。 正如开源中国 CTO 红薯评价:“不仅是 GitHub 还包括 VSCode 。GitHub 的价值体现在其不止有 1.5 亿用户和 10 亿仓库上,还有巨大的流量和用户惯性。但很明显,很多人已经不买 Copilot 的账了,说得更夸张一点就是 GitHub 在 AI 编程时代从一开始的首发到现在暂时落后。微软希望改变现在的这个局面,其核心思路不再GitHub+AI,而是 All In AI。” 结合微软与 GitHub 目前遇到的危机,曾经的“开放”,也在步入“缩紧”。相较于 GitHub 在巨头体系下的战略调整,Gitee 的发展路径始终聚焦 “开发者为本”。没有大厂的资金狂投,却凭借 “草根” 式的坚韧,筑牢了中国开源创新的基础设施;没有急于追逐全球扩张,却深耕本土土壤,让每一个功能都贴合中国开发者的工作场景。这种扎根本土的坚守,让 Gitee 在开源浪潮中站稳了脚跟。 开源中国 12 年坚守,开启 AI 新程 看到卸任的新闻,回顾 Nat Friedman 、 Thomas Dohmke 与开源中国 2018 年的这段缘分,不禁令人唏嘘。7 年时间,他们已经离开。这一变动让不少人感慨开源平台的命运流转,而在中国,另一个名字却始终稳健前行 —— Gitee 正以扎根本土的坚守与创新,书写着属于中国开源的独特篇章。 如今的 Gitee ,依托对中国开发者协作习惯的深刻理解,已进化为一站式软件工程平台,支撑起 1350w+开发者、36w+ 企业、2000+ 高校的高效协作。从代码托管到项目管理,再到DevOps 工具链,Gitee 的每一次迭代、升级都紧扣本土开发者的真实需求 —— 让每一行代码,都有改变世界的力量。 当下,AI 浪潮席卷全球,软件开发正迎来智能化变革。面对这一时代呼唤,开源中国以“与时俱进”的姿态开启 AI 新程,推出面向开发者、终端用户与产业场景的 AI 应用共创平台——模力方舟( ai.gitee.com )。 模力方舟以全栈技术能力降低 AI 应用门槛,构建三大核心体系:技术基座通过多模态模型库、国产化算力优化和智能调度实现 “模型即服务”,配合低代码工具链加速开发;服务体系覆盖全链路商业化支持,提供安全合规的存储认证系统与企业级私有部署方案,推动金融、工业等垂直领域快速落地;开放生态通过 AI 审核分级、开发者收益倾斜和算力补贴机制,形成 "开发 - 反馈 - 迭代" 的创新闭环。 100层高楼已完成90层,模力方舟建立在OSChina与Gitee之上 12 载的坚守,有心酸、亦光荣!在中国这片开源生态的土地上,其实并没有如微软这样的顶级大厂,于资金上的猛烈加持,更多是如 Gitee 、模力方舟这样的“草根”搭台,一步一个脚印,深耕本土土壤,肩负起了中国软件工程基础设施建设的重任,筑牢了中国开源创新的根基。 过去十二年,Gitee 以学习为起点,在开源路上步步扎实;未来,Gitee 将以模力方舟为支点,在 AI 工程的新赛道上持续创新。从软件工程平台到 AI 工程平台,变的是技术形态,不变的是 “全心全意为开发者服务” 的初心。 在开源与 AI 交织的新远征中,Gitee 将继续扎根本土、拥抱世界,以自主创新的中国特色之路,为全球开发者贡献属于中国的开源力量。

优秀的个人博客,低调大师

告别SQL卡顿与混乱!AI如何赋能实时计算?

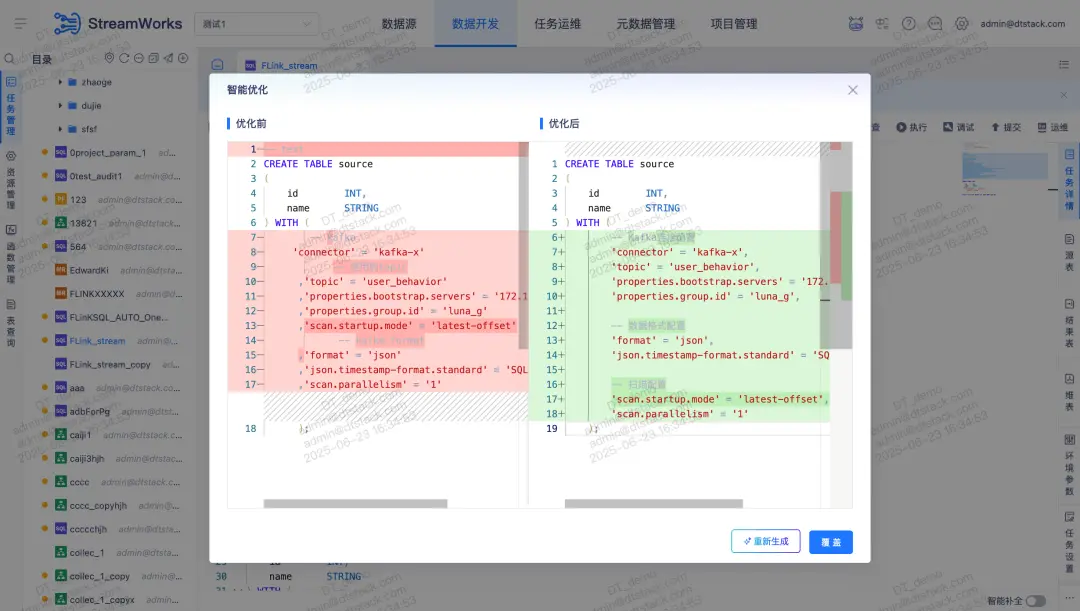
在当今数据驱动的商业环境中,SQL作为与数据库交互的核心语言,其编写效率和质量直接影响着企业的数据决策速度和系统性能。然而,我们在长期的企业服务实践中发现,数据库开发人员普遍面临以下痛点: SQL性能问题频发:约65%的性能问题源于低效SQL,但开发人员缺乏专业的优化指导 知识传承困难:复杂的业务SQL往往缺乏文档说明,新成员理解成本高 错误诊断耗时:平均每个SQL错误需要45分钟排查,严重影响开发效率 这些痛点导致企业SQL开发效率低下,平均每个开发人员每天要花费2-3小时在SQL相关问题的处理上。 基于以上问题,袋鼠云实时开发平台引入了智能AI,深度集成于企业数据库开发环境,提供从SQL编写、优化到运维的全生命周期智能支持。助力企业开发效率提升40%+、性能问题减少60%、有效缩短新人上手时间。 重点功能介绍 智能优化 平台提供SQL语句性能优化建议,并支持一键替换原SQL。 智能注释 对SQL语句添加注释,方便理解表的作用及SQL的作用。其中注释内容包含:各数据表的业务含义、SQL的总体功能描述、关键操作步骤说明。 智能解释 平台支持解析选中SQL的业务逻辑。其中解释内容包括:SQL的预期输出结果、各关键操作步骤的业务含义、涉及数据表的关系说明。 日志解析 解析SQL执行错误并提供解决方案。其中支持场景包含:语法错误定位与修正建议、运行时错误原因分析、资源不足等系统级问题诊断。 灵瞳(AI助手)对话 元数据智能检索 支持查询平台存储的元数据信息 可展示表结构、字段说明等详细信息 示例查询:"显示customer表的所有字段" ​ 知识库智能应答 自动匹配知识库中的解决方案 支持多轮对话上下文理解 知识来源:历史问题库、最佳实践文档 SQL智能补全 该功能可以基于当前编辑的SQL上下文提供建议,支持表名、字段名、函数名等智能补全,学习用户习惯提供个性化建议。 典型应用场景 场景一:金融行业复杂报表开发 用户痛点:某银行数据分析团队需要每日生成20+张监管报表,SQL平均长度超过500行,维护困难。 平台解决方案: 使用智能注释自动生成报表SQL的业务说明 通过执行计划分析识别全表扫描等性能问题 新人通过"解释"功能快速理解复杂业务逻辑 场景二:某公司数据仓库建设 用户痛点:某公司建设企业数据仓库,涉及300+数据表的关联查询。 平台解决方案: 通过元数据检索快速查找所需表结构 字段智能补全避免记忆大量表名 袋鼠云实时开发平台通过深度集成AI能力,致力于解决SQL开发中的核心痛点,平台提供从编写、注释、解释到诊断的全流程智能支持,显著提升开发效率,降低维护成本。袋鼠云始终坚持帮助企业数据团队释放潜能,让数据价值高效兑现! ​

优秀的个人博客,低调大师

OCAI + DeepSeek 满血版双 buff 加成,OS 运维从此告别焦虑

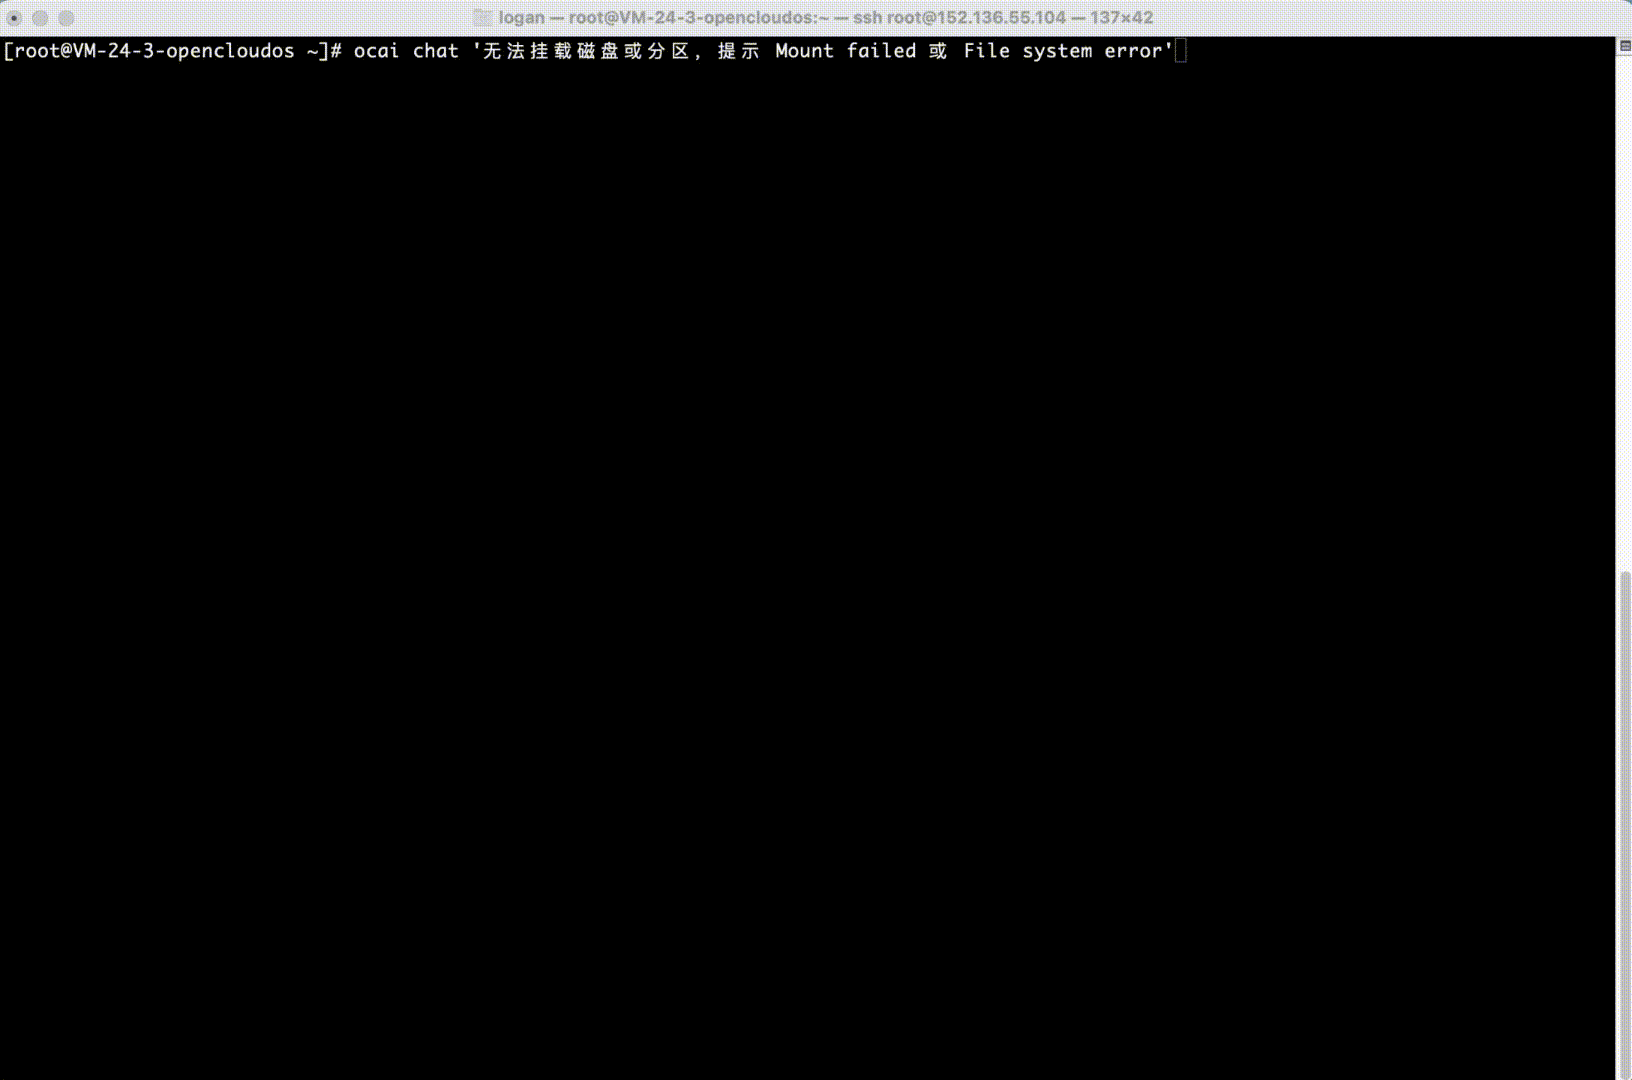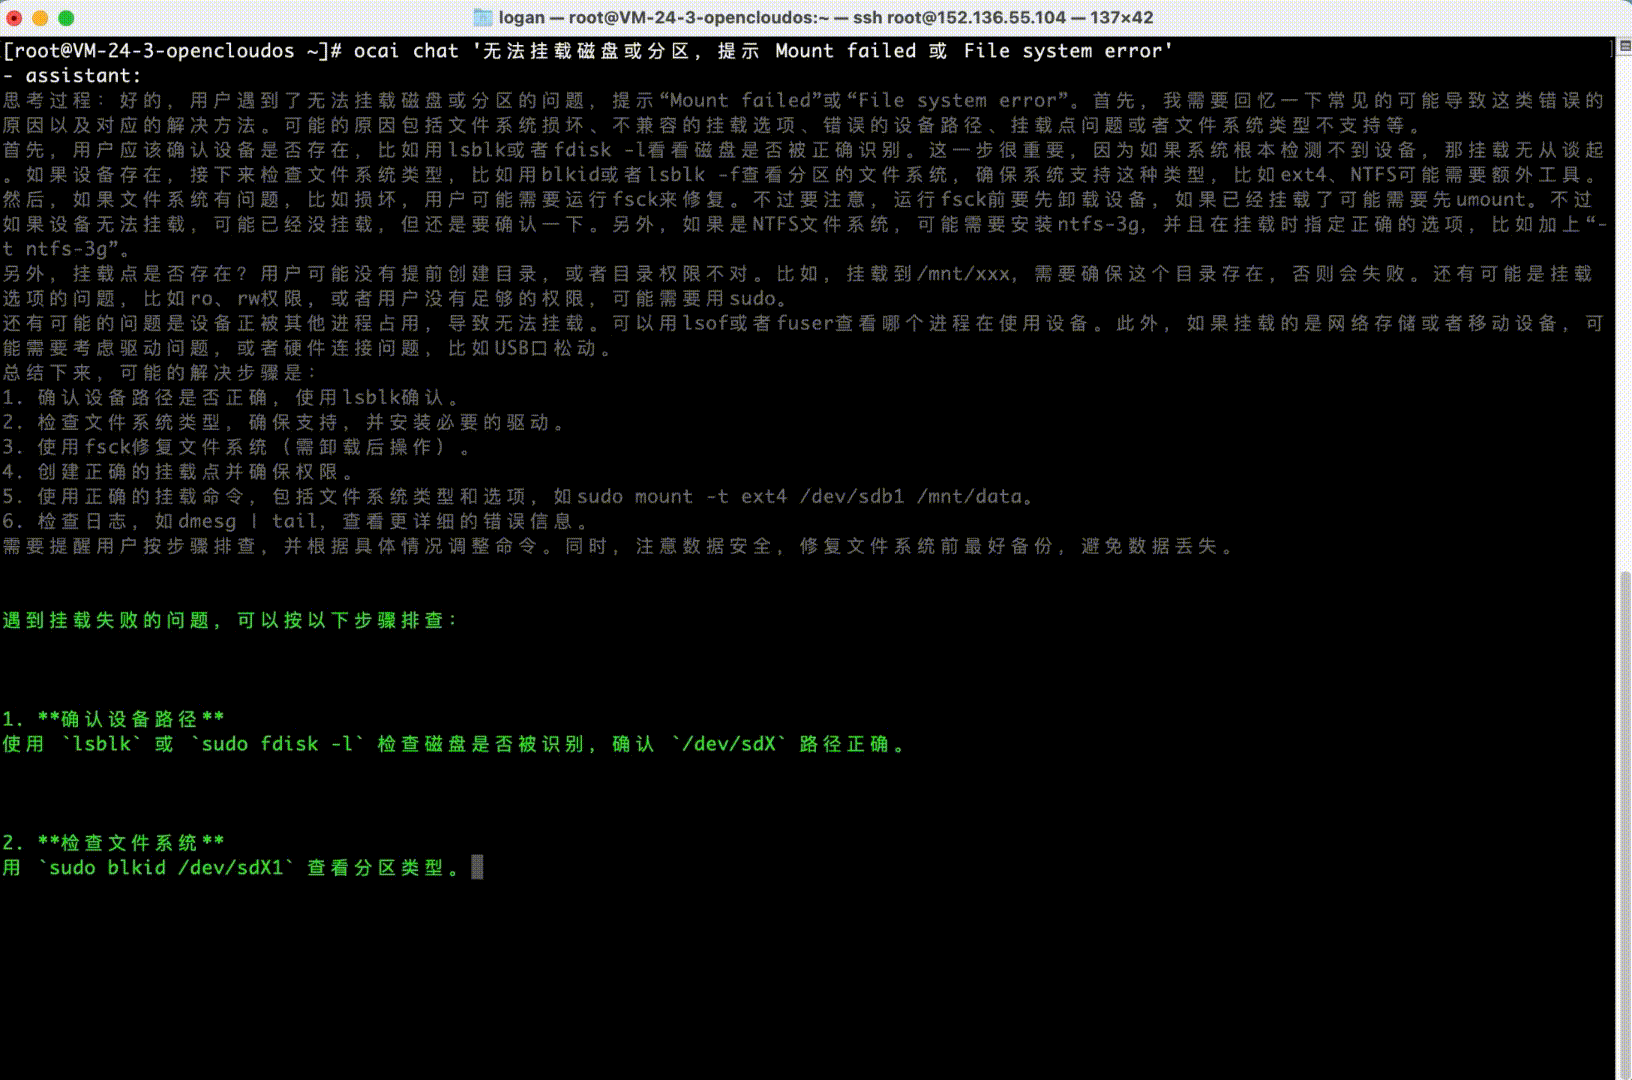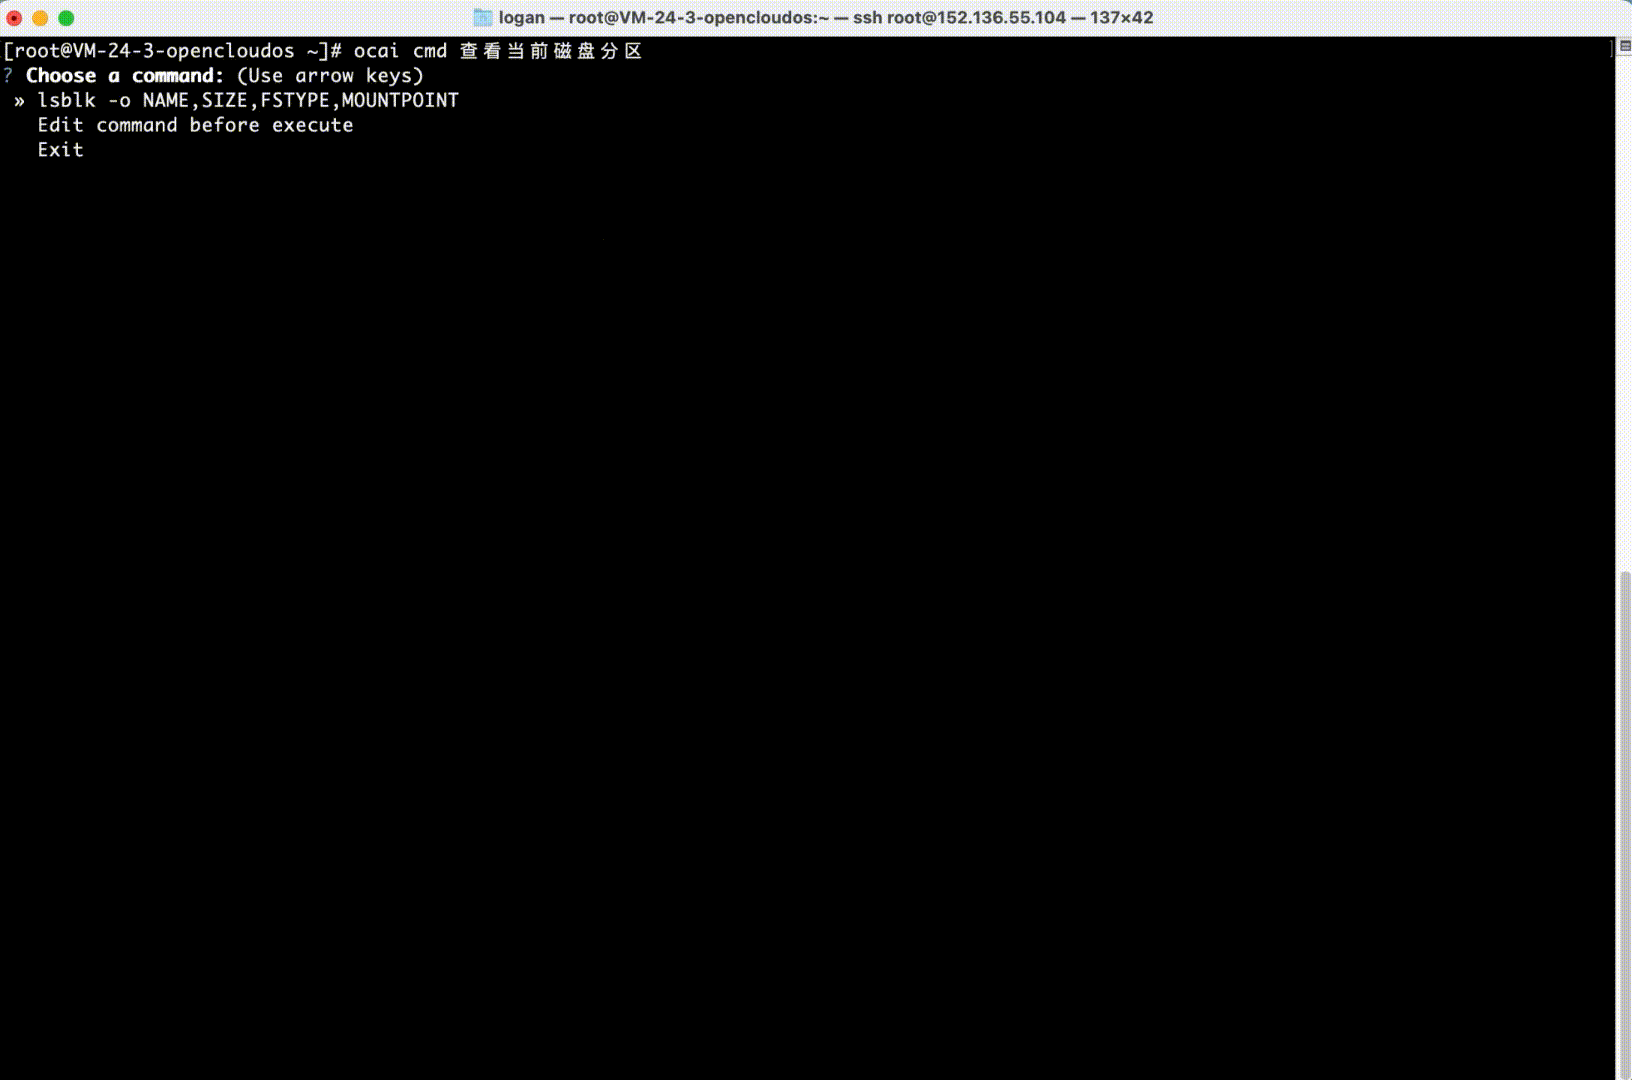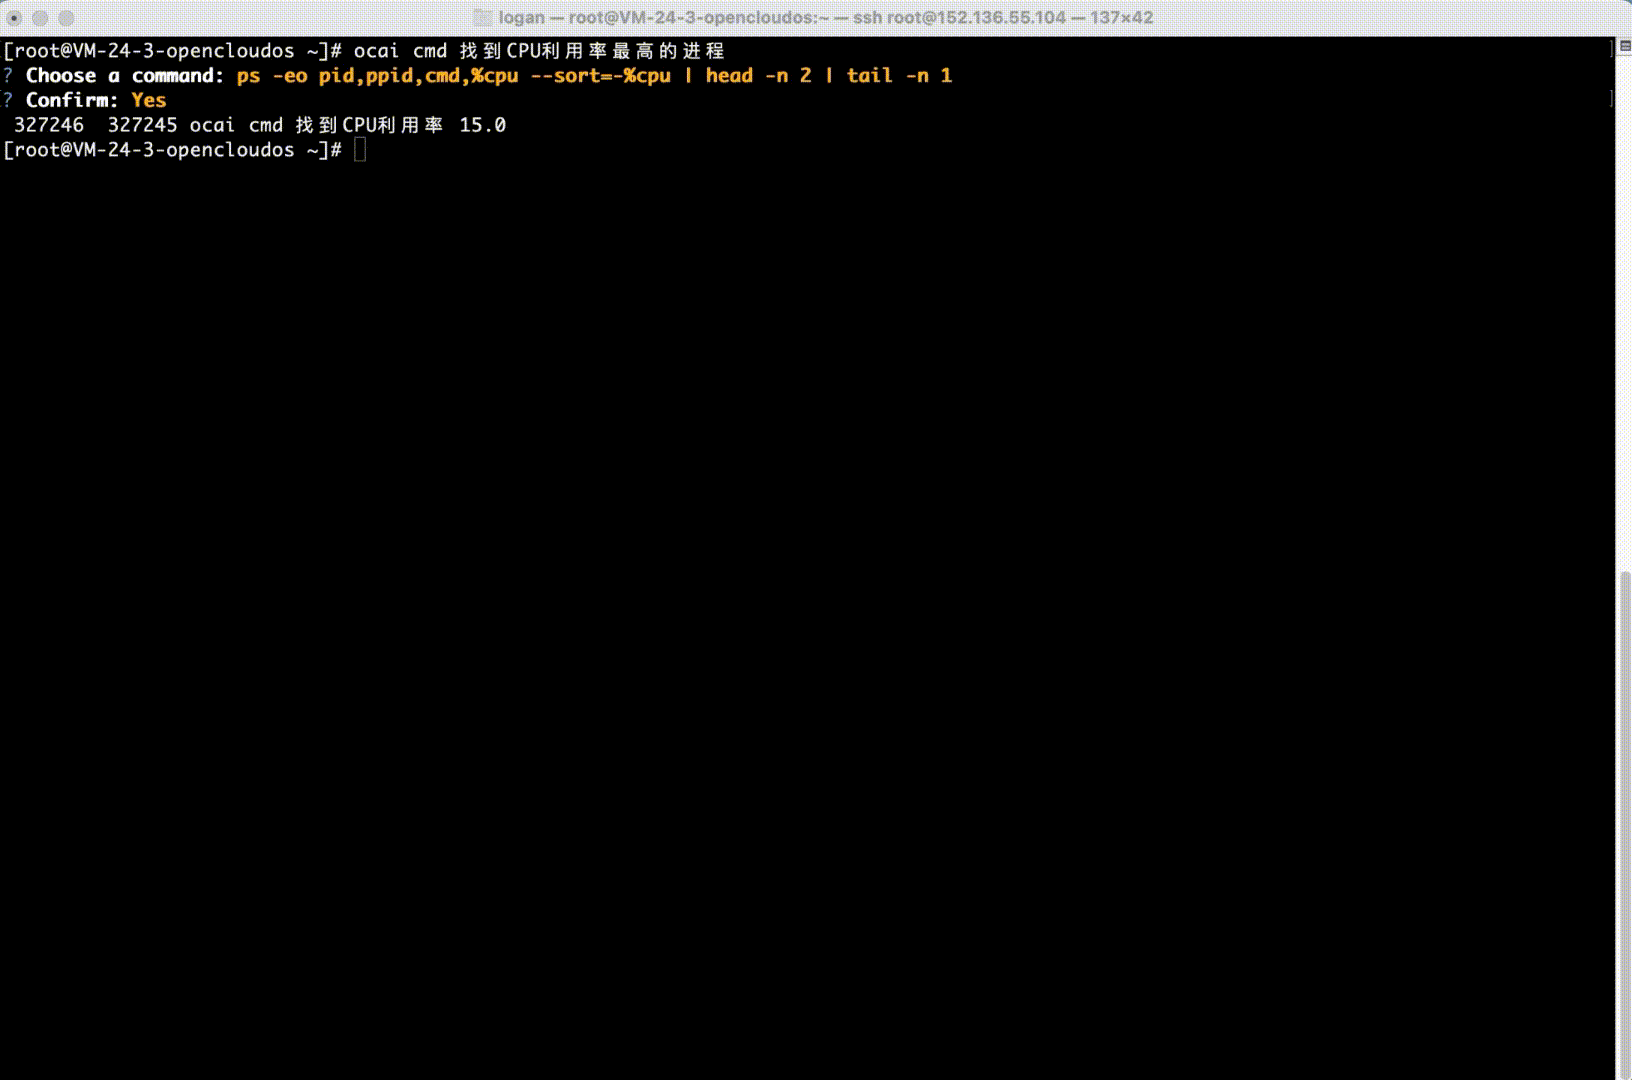
作者丨黄敏杰、李强 编辑丨cherry 审稿丨林青、郑力博 当遇到忘记的Shell命令参数,你是否还在使用“xxxx --help”查询使用帮助?当你遇到OS的疑难问题,是否还在全网苦苦搜索解决方案?今天,OpenCloudOS 社区重磅推出新一代OS智能助手OCAI-Agent,它集代码生成、场景化指南输出于一体,通过接入满血版 DeepSeek R1模型,让你通过简单的中文指令,即可实现秒级AI Agent调用。 一、OCAI工具概览 很多OS运维工程师常陷于「文档迷宫」:面对上千页的官方手册、散落全网的技术贴、版本迭代带来的参数变更,每一次故障排查都可能演变成耗时数小时的文档检索工程。但 OCAI 的诞生,可能一切都变了…… 先看一下这个,好像小白也可以实现对OS的运维: (划至文章底部可查看未加速操作版) 目前,OCAI已接入满血版 DeepSeek R1 模型,并将OpenCloudOS全量文档、社区运维案例、Gitee技术方案等异构数据,经向量化处理后形成动态知识图谱。 也就是说,针对OpenCloudOS的使用、运维管理操作等场景,OCAI可以帮为用户总结提炼并生成具体场景下的使用指南、命令、甚至代码,从而实现极大程度上的智能提效。 OCAI当前版本主要分为三种模式: Chat模式:通过提问,开始调用OCAI问答系统,并让系统进入思考、推理及结果输出过程。 Cmd模式:直接执行的Shell命令,并根据用户指示执行相应任务。 Code模式:生成执行代码。 1、Chat模式 安装完成并使配置生效后,在命令窗口中直接输入相关问题,无需加入任何命令前缀,即可方便调用OCAI智能助手的问答能力。 也可通过ocai chat <question>命令形式对问答能力进行调用。 2、Cmd模式 Cmd模式支持根据用户指示生成可直接执行的Shell命令,用户确认后可立即执行获取结果。 3、Code模式 Code模式下支持根据用户指示生成不同编程语言下的代码。 二、OCAI背后的技术实现原理 当前 OCAI 智能助手针对不同场景设计了多个 Agent 分别处理请求,采用RAG方式导入OpenCloudOS特有知识库信息,通过OCAI-Service与客户端进行交互,使用不同的底座模型对数据进行推理、总结和润色,最终输出给用户。 1、多Agents编排 OCAI智能助手针对不同场景和数据源创建了多个不同的 Agents,每个Agent负责特定的一个领域的处理逻辑(如对话、命令生成、代码生成),并通过指定逻辑将多个Agents组合编排,从而使使用入口得以统一,多个Agents可以协同工作。 2、RAG 针对通用模型缺少特定领域知识的情况,OCAI智能助手采用 RAG(Retrieval Augmented Generation) 方式,将特定领域的知识库(如 OpenCloudOS 文档库)数据进行处理清洗和切分后,计算成向量形式并存入向量数据库。用户提问将先从向量数据库中检索出相关程度较高的资料,再统一拼接成 prompt 提交给大模型进行总结和回答。 3、OCAI-Service OCAI-Service 是OCAI智能助手的接口层服务。在直接提供服务调用接口的同时,还支持了上下文管理、接口转发、用户识别、身份鉴权、配置管理、反馈收集、统计日志等真实使用情况下必不可少的基础能力。 OCAI-Service 也为多模型选择及函数调用提供了通道。 4、底座模型 OCAI智能助手在处理逻辑的各个阶段使用了 DeepSeek 和混元的各类大模型,包括但不限于 DeepSeek-R1、DeepSeek-V3、混元T1、混元Turbo等。 三、如何使用 当前 OCAI-Agent RPM包已在OpenCloudOS 8/9 软件源上线,使用上述版本的用户可直接执行yum install ocai-agent先进行安装。 RPM包安装链接: OC9:https://mirrors.opencloudos.tech/opencloudos/9.2/AppStream/x86_64/os/Packages/ocai-agent-1.0.0-2.oc9.x86_64.rpm OC8:https://mirrors.opencloudos.tech/opencloudos/8.10/Extras/x86_64/os/Packages/ocai-agent-1.0.0-2.oc8.x86_64.rpm 完成安装后,请在该网址(https://opencloudos.org/ospages/learnmore/ocai)内输入您的邮箱进行注册,并按照邮件中的指引配置访问密钥,即可开始使用。 为了确保服务的稳定性,OCAI-Agent 每天最多可调用 50 次。请合理安排您的使用频率,以免达到调用上限。如有更多需求,请关注后续更新或联系我们获取帮助。感谢您的理解与支持! OpenCloudOS 开源社区是由操作系统、云平台、软硬件厂商与个人携手打造中立开放、安全稳定且高性能的 Linux 操作系统及生态。欢迎上下游厂商、高校及组织加入社区,共建开放共享的安全生态。 扫码添加社区助手进群,添加时备注「OCAI」

优秀的个人博客,低调大师

告别 Kafka,拥抱 Databend:构建高效低成本的用户行为分析体系

用户行为数据埋点指标是数据仓库中不可或缺的重要数据源之一,同时也是企业最宝贵的资产之一。通常情况下,用户行为数据分析包含两大数据源:用户行为分析日志和上游关系型数据库(如 MySQL)。基于这些数据,企业可以进行用户增长分析、用户行为研究,甚至通过用户行为分析精准排查用户问题。 用户行为数据分析的挑战 用户行为数据分析的特点决定了要构建一套可扩展、灵活且低成本的分析架构并非易事,具体表现在以下几个方面: 高流量和大容量:用户行为数据的产生量非常大,对存储和分析能力要求高; 兼顾多种分析需求:既需支持 BI 报表的静态展示,也需满足灵活的 Adhoc 查询; 多样化 数据格式:用户行为数据通常包含结构化数据与半结构化数据(如 JSON); 实时性要求:需要对用户行为快速响应,实现及时反馈。 由于这些复杂性,大多数初创企业和中小型公司通常会选择通用埋点系统(如 Google Analytics、Mixpanel)作为用户行为分析的起点。这些系统只需在网站中插入 JSON 代码,或在 APP 中嵌入 SDK,即可自动采集并上传埋点数据,生成访问量、停留时间、转化漏斗等指标。 然而,通用埋点系统虽然简单易用,但在实际使用中存在以下不足: 数据 明细 的缺失。 通用埋点系统往往不会提供用户具体的访问明细日志,只能在 UI 中查询预设的报表; 自定义查询能力不足。 通用埋点系统的查询模式并非标准 SQL 查询接口,当数据科学家希望构建复杂的 adhoc 查询时,由于缺少 SQL 能力,难以支持复杂的自定义查询; 成本快速上升。 通用埋点系统一般采用阶梯计费模式,往往到了一个阶梯时,费用会翻倍。随着企业流量的持续增长,如果要查询更大范围的用户行为数据时,成本会迅速增加。 自建用户行为分析体系的复杂性 为了应对通用埋点系统的局限性,不少企业在业务增长到一定阶段后,往往都会选择自建一套用户行为埋点数据分析体系。通常情况下,传统自建架构多基于 Hadoop 大数据生态,典型实现流程如下: 在客户端(APP、网站)中埋入 SDK,采集用户行为日志 activity logs; 使用 Activity gateway 埋点指标网关,收集客户端发来的日志,并将日志转到 Kafka 消息总线; 利用 Kafka 将日志 logs 落到 Hive 或 Spark 等计算引擎; 通过 ETL 工具将数据导入数据仓库,生成用户行为分析报表。 虽然这一架构在功能上能够满足需求,但其复杂性和维护成本极高: Kafka 需要依赖 Zookeeper ,还需要配备 SSD 硬盘保障性能。 从 Kafka 到 Data Warehouse 需要 kafka-connect ; Spark 要运行在 YARN 上,ETL 需要 Airflow 管理; 当 Hive 存储达到上限,可能还需要将 MySQL 换成 TiDB 等分布式数据库。 这种架构不仅需要大量的技术团队投入,还极大增加了运维负担。而在企业不断追求降本增效的背景下,传统 Hadoop 架构已不再适合需要简单、高效的业务场景。 新选择:基于 Databend Cloud 的轻量化用户行为分析 随着技术的演进,企业在设计用户行为数据埋点架构时有了新的选择。Databend Cloud 凭借简洁的架构和灵活性,提供了一种高效且低成本的用户行为分析解决方案。 Databend Cloud 的架构特性 100% 面向对象存储,完全存储计算分离,显著降低存储成本; Rust 编写的 Query 引擎性能高,价格低廉。在计算资源闲置时自动休眠,不产生额外费用; 支持 100% ANSI SQL ,支持半结构化数据分析(JSON 和自定义 UDF)。当用户有一些比较复杂的 JSON,可以用内置的 JSON 分析能力或自定义的 UDF,分析半结构化数据; 内置 Task 调度驱动 ETL,完全无状态,自动弹性伸缩。 典型架构实现 企业可以通过以下流程快速搭建用户行为数据分析体系: 日志采集与存储:不再需要 Kafka,用户直接将埋点日志通过 vector 以 ndjson 格式落到 S3。 数据摄入与处理:在 Databend Cloud 中创建一个 copy task 任务,自动把日志拉出来,落到 S3。很多时候,S3 在 Databend Cloud 中可以当做一个 stage,落到 stage 里面的东西就可以被 Databend Cloud 自动吸进来,然后在 Databend Cloud 中进行处理,再从 S3 转出去。 查询与报表分析:通过自动休眠的 Warehouse 运行 BI 报表/即席查询,休眠时不产生任何费用。 通过上述方式,Databend Cloud 能够以最简化的方式实现企业对高效用户行为分析的需求。 案例:Databend Cloud 在用户行为分析的应用实践 某互联网应用公司有一个典型的用户行为分析场景,在做架构选型时选择了 Databend Cloud 进行用户行为数据分析体系的搭建。在使用 Databend Cloud 后,该用户放弃了 Kafka,直接用 Databend Cloud 建了一个 stage ,把用户行为日志落在 S3 中,再用 task 导进 Databend Cloud 中。最终,该公司仅用一个下午便完成了 POC,从复杂的 Hadoop 架构切换到 Databend Cloud,极大简化了运维和操作成本。 用户所需要的准备工作非常简单。首先,准备两个 Warehouse,一个用于 Task 摄入数据,一个用于 BI 报表查询。一般来说,摄入数据的时候可以用一个规格小点的 Warehouse,查询的 Warehouse 规格高一点,因为查询不会一直查,可以节省更多成本。 然后点击 connect 获得一个连接串,这个连接串可以放在 BI 报表用于查询。Databend 提供了各种语言的 Driver。 接下来的准备工作只有三步,一是建表,其中的字段与 NDJSON 格式的日志一致。然后创建一个 stage,将存放用户行为日志的 S3 目录录进来,然后再创建一个 task ,每一分钟或者十秒钟执行一次。它会自动把 stage 里的文件导进来,然后自动把它清理掉。准备工作完成后,就可以源源不断地把用户行为日志录进来。 架构对比与收益 通过对比通用埋点系统、传统 Hadoop 架构和 Databend Cloud,Databend Cloud 的优势显而易见: 架构简洁性:摆脱了复杂的大数据生态,无需 Kafka、Airflow 等组件。 成本优化:利用对象存储和弹性计算实现低成本的存储与分析。 灵活性与性能:支持高性能 SQL 查询,满足多样化的业务场景。 此外,Databend Cloud 提供了快照机制,支持数据的时点回溯(Timetravel),确保数据安全性和可恢复性。 在构建用户行为数据埋点系统时,除了存储、计算方面的成本,维护成本也是架构选型的重要因子。Databend Cloud 通过对象存储与计算分离的架构革新,彻底改变了传统用户行为数据分析体系的复杂性。企业可以轻松搭建一套高性能、低成本的埋点分析架构,实现从数据采集到分析的全流程优化。这一方案无疑为企业在降本增效的同时释放了数据的最大价值。 关于 Databend Databend 是一款开源、弹性、低成本,基于对象存储也可以做实时分析的新式数仓。期待您的关注,一起探索云原生数仓解决方案,打造新一代开源 Data Cloud。 👨‍💻‍ Databend Cloud:databend.cn 📖 Databend 文档:docs.databend.cn/ 💻 Wechat:Databend ✨ GitHub:github.com/databendlab... 询问AI

优秀的个人博客,低调大师

一文搞懂 Vue3 defineModel 双向绑定:告别繁琐代码!

前言 随着vue3.4版本的发布,defineModel也正式转正了。它可以简化父子组件之间的双向绑定,是目前官方推荐的双向绑定实现方式。 vue3.4以前如何实现双向绑定 大家应该都知道v-model只是一个语法糖,实际就是给组件定义了modelValue属性和监听update:modelValue事件,所以我们以前要实现数据双向绑定需要给子组件定义一个modelValue属性,并且在子组件内要更新modelValue值时需要emit出去一个update:modelValue事件,将新的值作为第二个字段传出去。 我们来看一个简单的例子,父组件的代码如下: <template> <CommonInput v-model="inputValue" /> </template> <script setup lang="ts"> import { ref } from "vue"; const inputValue = ref(); </script> 子组件的代码如下: <template> <input :value="props.modelValue" @input="emit('update:modelValue', $event.target.value)" /> </template> <script setup lang="ts"> const props = defineProps(["modelValue"]); const emit = defineEmits(["update:modelValue"]); </script> 上面的例子大家应该很熟悉,以前都是这样去实现v-model双向绑定的。但是存在一个问题就是input输入框其实支持直接使用v-model的,我们这里却没有使用v-model而是在input输入框上面添加value属性和input事件。 原因是因为从vue2开始就已经是单向数据流,在子组件中是不能直接修改props中的值。而是应该由子组件中抛出一个事件,由父组件去监听这个事件,然后去修改父组件中传递给props的变量。如果这里我们给input输入框直接加一个v-model="props.modelValue",那么其实是在子组件内直接修改props中的modelValue。由于单向数据流的原因,vue是不支持直接修改props的,所以我们才需要将代码写成上面的样子。 使用defineModel实现数据双向绑定 defineModel是一个宏,所以不需要从vue中import导入,直接使用就可以了。这个宏可以用来声明一个双向绑定 prop,通过父组件的v-model来使用。 基础demo 父组件的代码和前面是一样的,如下: <template> <CommonInput v-model="inputValue" /> </template> <script setup lang="ts"> import { ref } from "vue"; const inputValue = ref(); </script> 子组件的代码如下: <template> <input v-model="model" /> </template> <script setup lang="ts"> const model = defineModel(); model.value = "xxx"; </script> 在上面的例子中我们直接将defineModel的返回值使用v-model绑定到input输入框上面,无需定义 modelValue 属性和监听 update:modelValue 事件,代码更加简洁。defineModel的返回值是一个ref,我们可以在子组件中修改model变量的值,并且父组件中的inputValue变量的值也会同步更新,这样就可以实现双向绑定。 那么问题来了,从vue2开始就变成了单向数据流。这里修改子组件的值后,父组件的变量值也被修改了,那这不就变回了vue1的双向数据流了吗?其实并不是这样的,这里还是单向数据流,我们接下来会简单讲一下defineModel的实现原理。 实现原理 defineModel其实就是在子组件内定义了一个叫model的ref变量和modelValue的props,并且watch了props中的modelValue。当props中的modelValue的值改变后会同步更新model变量的值。并且当在子组件内改变model变量的值后会抛出update:modelValue事件,父组件收到这个事件后就会更新父组件中对应的变量值。 实现原理代码如下: <template> <input v-model="model" /> </template> <script setup lang="ts"> import { ref, watch } from "vue"; const props = defineProps(["modelValue"]); const emit = defineEmits(["update:modelValue"]); const model = ref(); watch( () => props.modelValue, () => { model.value = props.modelValue; } ); watch(model, () => { emit("update:modelValue", model.value); }); </script> 看了上面的代码后你应该了解到了为什么可以在子组件内直接修改defineModel的返回值后父组件对应的变量也会同步更新了吧。我们修改的其实是defineModel返回的ref变量,而不是直接修改props中的modelValue。实现方式还是和vue3.4以前实现双向绑定一样的,只是defineModel这个宏帮我们将以前的那些繁琐的代码给封装到内部实现了。 其实defineModel的源码中是使用 customRef 和 watchSyncEffect 去实现的,我这里是为了让大家能够更容易的明白defineModel的实现原理才举的ref和watch的例子。如果大家对defineModel的源码感兴趣,请在评论区留言,如果感兴趣的小伙伴比较多,我会在下一期出一篇defineModel源码的文章。 defineModel如何定义type、default等 既然defineModel是声明了一个prop,那同样也可以定义prop的type、default。具体代码如下: const model = defineModel({ type: String, default: "20" }); 除了支持type和default,也支持required和validator,用法和定义prop时一样。 defineModel如何实现多个 v-model 绑定 同样也支持在父组件上面实现多个 v-model 绑定,这时我们给defineModel传的第一个参数就不是对象了,而是一个字符串。 const model1 = defineModel("count1"); const model2 = defineModel("count2"); 在父组件中使用v-model时代码如下: <CommonInput v-model:count1="inputValue1" /> <CommonInput v-model:count2="inputValue2" /> 我们也可以在多个v-model中定义type、default等 const model1 = defineModel("count1", { type: String, default: "aaa", }); defineModel如何使用内置修饰符和自定义修饰符 如果要使用系统内置的修饰符比如trim,父组件的写法还是和之前是一样的: <CommonInput v-model.trim="inputValue" /> 子组件也无需做任何修改,和上面其他的defineModel例子是一样的: const model = defineModel(); defineModel也支持自定义修饰符,比如我们要实现一个将输入框的字母全部变成大写的uppercase自定义修饰符,同时也需要使用内置的trim修饰符。 我们的父组件代码如下: <CommonInput v-model.trim.uppercase="inputValue" /> 我们的子组件需要写成下面这样的: <template> <input v-model="modelValue" /> </template> <script setup lang="ts"> const [modelValue, modelModifiers] = defineModel({ // get我们这里不需要 set(value) { if (modelModifiers.uppercase) { return value?.toUpperCase(); } }, }); </script> 这时我们给defineModel传进去的第一个参数就是包含get和set方法的对象,当对modelValue变量进行读操作时会走到get方法里面去,当对modelValue变量进行写操作时会走到set方法里面去。如果只需要对写操作进行拦截,那么可以不用写get。 defineModel的返回值也可以解构成两个变量,第一个变量就是我们前面几个例子的ref对象,用于给v-model绑定。第二个变量是一个对象,里面包含了有哪些修饰符,在这里我们有trim和uppercase两个修饰符,所以modelModifiers的值为: { trim: true, uppercase: true } 在输入框进行输入时,就会走到set方法里面,然后调用value?.toUpperCase()就可以实现将输入的字母变成大写字母。 总结 这篇文章介绍了如何使用defineModel宏实现双向绑定以及defineModel的实现原理。 在子组件内调用defineModel宏会返回一个ref对象,在子组件内可以直接对这个ref对象进行赋值,父组件内的相应变量也会同步修改。 defineModel其实就是在子组件内定义了一个ref变量和对应的prop,然后监听了对应的prop保持ref变量的值始终和对应的prop是一样的。在子组件内当修改ref变量值时会抛出一个事件给父组件,让父组件更新对应的变量值,从而实现双向绑定。 使用defineModel({ type: String, default: "20" })就可以定义prop的type和default等选项。 使用defineModel("count")就可以实现多个v-model绑定。 通过解构defineModel()的返回值拿到modelModifiers修饰符对象,配合get和set转换器选项实现自定义修饰符。 关注公众号:【前端欧阳】,解锁我更多vue原理文章。还可以加我微信,让你的朋友圈多一位对vue有深入理解的人。也可以通过微信给我说你想看哪些vue原理文章,我会根据大家的反馈进行创作。

优秀的个人博客,低调大师

智能运维应用之道,告别企业数字化转型危机

云智慧 AIOps 社区是由云智慧发起,针对运维业务场景,提供算法、算力、数据集整体的服务体系及智能运维业务场景的解决方案交流社区。该社区致力于传播 AIOps 技术,旨在与各行业客户、用户、研究者和开发者们共同解决智能运维行业技术难题,推动 AIOps 技术在企业中落地,建设健康共赢的AIOps 开发者生态。 面临的问题及挑战 数据中心发展历程 2000年中国数据中心始建,至今已经历以下3大阶段。早期:离散型数据中心IT因以项目建设为导向,故缺乏规划且无专门运维管理体系,此外,开发建设完的项目均是独立运维维护,因此效率低下。中期:各行各业进行了应用大集中,逐步按照标准化体系建设了生产中心、灾备中心,且引入“两第三中心”的模式。此外,该阶段开始有了系统规范的运维体系,具有代表性的建立了IT服务体系、监控体系等运维框架。另一方面,也通过流程实现跨部门的运维协,有了清晰的开发、测试、运维的边界,各专业领域内的运维工具蓬勃发展。后期:自2015年后,由于IT技术的高速发展,业务需求的不断变化,数据中心逐步向多活混合云环境进行演进,从金融行业逐步扩展到运营商、能源、政府、军工等行业。数据中心开始围绕服务和资源的供给提供运维保证,运维工作逐步走向一体化、自动化,最终向着智能化演进。本篇文章表述的解决方案则主要是针对自动化运维场景。 数据中心现状分析 因当前大部分数据中心运维环境较为复杂,且IT技术栈具有多样性,故而导致运维对象愈发庞大,运维人员每日的运维工作越来越复杂繁琐。经统计,上述复杂的运维工作中的70%均是规律且重复性的,因此导致人力投入成本越来越大。此外,因缺乏标准化运维工作流程,所以运维工作质量只能通过技术人员个人主观因素来判定。另一方面,大部分企业运维工作人员沉底下来的知识无法有效复用,交接工作流于形式,因此导致运维工作效果一般。 除上述70%的重复性运维工作外,还有30%的运维工作是属于复杂且操作风险高的。企业经常会因为技术人员个人因素造成了业务的隐患。整体运维工作效率偏低,带来了业务中断时间长,应急处置效果低的问题。 自动化运维挑战与最佳实践 基于以上数据中心的运维问题,云智慧根据自身在自动化运维的多年经验,总结以往在进行自动化运维项目建设时遇到的挑战。如云智慧很多客户建设了自动化运维平台,但平台本身缺少开箱即用的场景;此外,部分客户项目的建设周期过长,且缺少行业最少实践的参考。 云智慧的Automation平台在各行各业都有交付,且将各行各业常用的自动化运维业务场景沉淀成了标准产品组件,真正做到了开箱即用。如海量的巡检指标,应用发布的标准化编排,灾切的最佳实践等,均能大幅缩短自动化平台建设周期情况下,给出最佳实践供企业参考选择。 传统的自动化平台大部分以脚本调度功能为主,缺少了各种无代理协议的远程采控机制。云智慧基于运维中台化的理解,打造了专门的全栈采控中心cdc,在支撑脚本类的调度功能以及开机即用的功能下,还支持了各种硬件、虚拟化、容器、微服务、业务类等封装好的采控API接口。如各类虚拟化的创建、扩缩容接口,硬件IPMI的采控协议,K8S的接口等。 云智慧采用分布式大数据架构和智能化调度引擎解决了高并发处理能力问题,支持百万级管理节点高效率高文档的工作状态。 以往的自动化工具缺少标准化和开箱即用的服务调用接口,现今其他运维工具很多缺少场景联通,容易形成自动化数据孤岛。云智慧依托自身的运维中台,具备开箱即用的标准化服务接口,不管是其他运维工具调用自动化工具,还是自动化工具接入第三方运维工具的数据,均可以满足。 解决方案与功能场景介绍 自动化运维平台架构图 下图为云智慧自动化运维平台的架构图,分为以下几个纬度: 纳管对象层:包含数据中心日常运维的全栈对象,例如操作系统、数据库、中间件、物理服务器、业务应用、网络设备、存储、云以及虚拟化资源等。 执行通道层:针对下图被管理的对象,云智慧采控中心cdc提供了agent代理模式,以及像ssh、ipmi、snmp、jdbc、smi-s、jmx和各类api等的无代理采控协议。 服务管理层:云智慧具有标准化的流程管理功能,如统一脚本管理、操作编排、脚本执行管理、定时任务、各类查询功能。上述通用化功能均会为上层自动化运维场景提供底层支撑能力。 运维场景层:该层包括应用发布管理、自动化巡检、软件安装、合规建立、运维工具箱、应急处置等。 互联互通:该模块中的运维工具可以是第3方的工具。云智慧作为智能化全栈运维的厂商,除了自动化模块外,同时也具备IT服务管理、监控、配置、可视化等运维通用化工具。因此可以帮助企业客户建立一整套的运维中台最佳实践。 功能场景介绍 高效的应用发布管理 由于传统的应用发布大部分依靠手工进行,所以发布一个系统大概需花费1-2个小时。使用云智慧的自动化应用发布发布后时间可缩短至10-30分钟有效的提高发布效率。云智慧自动化运维平台整体是基于DevOps理念,目的是加强开发、测试和运维之间沟通、协作和集成,实现应用发布交付的标准化。此外,平台整体发布模型采用“环境”+“组件”的设计,同时提供可视化的编排功能。云智慧可视化编排引擎使用的是自身运维中台中服务编排的通用化能力,支持复杂的串并行,节点可调用不同环境和组件,具有全局参数化等能力,同时支撑完全自动以及半自动化等不同场景。最后,平台支持节点处跳过、重复执行、暂停等通用化细节处理能力。 另一方面,云智慧自动化运维管理平台还提供发布驾驶舱功能、各种数据看板,可进行全局概览。云智慧借助自动化平台通用化能力,如命令、脚本集中管理等,支持有代理和无代理模式,细粒度、全方位的进行权限管理控制,来确保所有运维操作安全可控。 便捷的 自动化 巡检 云智慧自动化平台中内置了全栈式巡检模版,从常用的操作系统、数据库、中间件到网络、硬件、存储、云、容器、微服务等,完全地做到了开箱即用。依托云智慧运维中台指标体系能力,企业也可以自行维护编辑。 巡检执行可以手工触发,也可以依靠定时任务自动触发。传统巡检依靠人工进行,每次巡检时间30-60分钟不等,自动化巡检可将巡检时间降低至1-2分钟,此外,巡检报告还可以自动发送给管理或者领导,并将问题巡检项标注出来。巡检指标与基准值的比对设置是依托云智慧运维中台中指标管理下面的阈值管理。该项支持传统的静态阈值、动态阈值和巡检指标相结合,还支持巡检结果单人/双人复合,可按照业务系统纬度或者设备类型纬度进行自动巡检工作。此外,还可结合云智慧知识库,给出异常巡检项处理办法参考。 巡检还支持异常巡检项生成工单功能,企业可按需进行使用。云智慧运维中台指标体系拥有良好的高并发能力,可以同时支持百万级管理对象同时并行巡检。 灵活的运维工具箱 运维工具箱的关键技术在于开箱即用的原子工具沉淀。云智慧拥有10多年自动化运维经验,具有丰富的内置开箱即用原子化工具集。 企业运维管理人员通过云智慧提供的工具集,只需要输入指定的参数(如IP地址,文件系统目录等)自动化工具便可自动执行,还可同时并行调用多个工具或并行执行多个对象。此外,上述工具集后期是可以编辑维护的,企业可根据自身需求补充常用原子化工具集,经过审批后方能发布上线使用。所有自动化操作调度的执行过程都有日志留痕,所有的操作都支持后期审计,还可与企业堡垒机进行对接。可减少人工直接与生产环境进行交互,降低由人工误操作产生的生产风险。 安全稳健的批量 自动化 批量自动化主要应用于银行日间、日终的跑批业务,因此需要时刻保证整个自动化平台安全稳健的运行。并且在整个跑批过程中,需要全程监控,出现极端系统灾难后,要有灾难恢复机制。云智慧的自动化平台是可以取代control-m的功能的,除了常用的功能外,还支持批量的拓扑分析。在做control-m迁移时,可以将control-m导出xml文件中的关键要素字段与云智慧平台进行比对映射,然后将其转化成exl字段文件。此外,平台支持承接使用原系统上的脚本,将转化过的exl文件导入到云智慧的自动化平台里,可以自动生成批量调度的拓扑视图,再进行后期的参数化调整,便可以完成迁移工作。 一键式灾备切换 灾备切换的业务场景因涉及预案、灾切模型、签到等,故较为复杂。关键点在于数据中心级的灾备切换和灾切演练,一键式灾切是为应对突发事件时提升应急处理能力。自动化编排能力可以支撑复杂灾切流程编排。像灾切里面涉及到的环境、数据一致性、网络连通性、配置一致性检查,云智慧都有相关的功能做支撑。此外,云智慧额外提供沙盘演练的功能,整体的灾备模型可以与目标解耦,满足流程复用的要求。还有单独的移动pad作为灾切的控制端,体现一键切换,切换过程中的各项数据都会实时监控,反馈到灾切大屏上。 安全合规审计 云智慧提供开箱即用的行业基准,例如CIS、PCI DSS、SOX等,一套平台即可提供不仅仅是物理服务器和虚拟机,还包括数据库、中间件和网络等数据中心资源的合规审计。此外,还提供当前和历史的漏洞风险趋势详细报告,建立配置标准并监视变更情况,通过8,000多个开箱即用的自动化操作流程在问题修复时大大缩短修复时间。与此同时,还支持数以千计的设备类型、型号组合。 一键开闭市(券商) 对于证券行业,每天需要定时执行一系列业务操作,如开市流程、闭市流程。上述业务场景便要求运维人员需要根据业务规则在不同设备上的应用系统进行操作运行。此业务流程比较复杂,同时具有串行、分支、判断、并行、聚合、循环,为了降低流程的复杂性,需要各种子流程;此外,业务规则判断也比较复杂,需要根据业务数据来判断流程执行是否有错误;与此同时,在中间步骤执行错误时,需通过人工修复错误或者有管理员角色确认后,方能继续进行。云智慧提供的自动化运维平台对对流程执行有严格的安全控制,如权限控制、时间控制等。除了一键开闭市,还能为券商清算业务提供清算前准备工的自动化业务能力。除了日常运维工作,还有一部分业务操作也可以使用自动化工具来实现。 软件 自动化 管理 云智慧自动化运维平台中自带软件介质管理平台,可上传管理各类软件的介质版本,支持并行在多个目标对象上执行安装部署步骤。与此同时,平台提供丰富的交互参数,文件参数、加密参数等。除了安装功能,平台也支持卸载启动等等,依托云智慧运维中台中采控中心的通用化能力。 补丁 自动化 管理 为预防系统漏洞带来的安全隐患,系统运维人员必须定期为操作系统安装补丁。但在传统的运维模式下,系统运维人员很难直观了解每台机器的补丁安装情况,因此需要针对每一台机器执行漏洞扫描并根据扫描结果为每台机器安装补丁。这种手动操作的方式,不仅耗费大量时间,还容易出错。自动化作业产品提供补丁管理、主机扫描、补丁安装等功能,不仅能让运维人员了解服务器的健康状态,还能够根据扫描结果为服务器安装缺失的补丁,及时解决安全隐患。 云智慧的补丁自动化管理功能可以和合规审计功能一起使用,修复一些缺少的补丁问题。重点是在批量并发执行,主动扫描并发现当前主机操作系统、数据库、中间件补丁安装情况。与此同时,云智慧会定期更新补丁库。 应用发布一体化场景 应用发布的一体化场景是自动化运维的融合场景,主要出现在实际的发布场景中,场景包含了ITSM工具、配置管理工具、自动化发布工具、统一监控工具等多种工具。应用发布的一体化场景是典型的一体化协同联动场景。任务由导入生产排期信息同步到ITSM系统,经过ITSM审批,确定发布任务;修改任务状态(从待审批到待发布)时,ITSM会通知监控系统在发布期略过该业务系统的监控,等待发布时间后,可以由人工触发或者自动触发进行自动化发布;发布过程中,监控系统会过滤掉该业务系统的告警,发布完成后,发布任务状态同步回传给ITSM系统,ITSM结束发布流程发起配置流程,经过一系列的请求、采集、比对最终更新完该系统的最终配置信息到配置库里,一体化流程结束。 流程即服务应用场景 流程即服务的联动场景主要体现的是各类服务请求可以通过自动化平台进行自动交付的场景。企业通过服务门户选择各类服务请求,服务请求的工单经过审批后,按照不同业务场景触发自动化平台的API服务接口,ITSM工单中的参数同步到自动化平台中,自动化平台按照业务场景进行自动交付,自动交付完成后回传结果至ITSM平台,可以大幅缩短交付时间。像日常虚拟化资源扩缩容服务请求,标准化数据变更,标准化环境变更等。 故障处置一体化场景 故障处置一体化的场景里面涉及预案、处置流程编排、以及与ITSM联动。正常触发故障处置一体化的场景可以由管理员手工触发,也可以由监控告警自动触发,触发之后根据系统内置的预案(如进程启停、清理空间等)生成一张ITSM处置类或者变更类的工单,根据紧急度、影响度多种因素来影响ITSM流程流转的节点分级,包含紧急变更、一般变更、标准变更,每种类型涉及到审批人及审批流程均有不同。审批也可以包含自动审批、人工审批等,最终审批结束后触发处置工具进行自动化处置工作,调度结束后回传结果到ITSM工单进行审核。 案例分享 典型案例-某银行 企业背景:该企业由于数据中心的运维对象被管设备对象大概有3000多个,企业运维技术人员每天都要做多次完整的巡检,每次完整的巡检要花费1个小时以上,巡检完的结果也没有特别好的展现形式,都是填到一些制式的表里,他们的需求特别清晰,都是自动化巡检。 解决方案:云智慧经过3个月的项目建设,纳管了全行3000多的软硬件运维对象,用云智慧的自动化系统1分钟之内就可以完成1次完整的巡检工作,巡检完的结果,通过云智慧的巡检大屏幕以及数据看版,还可生成完整的巡检报告。如果在巡检过程中发现异常的点,还会推送到该企业的一体化告警平台,进行告警。这个项目是一个短平快的项目,依托云智慧内置的开箱即用的巡检指标,在极短的周期完成测试上线工作,而且直接提升了日常运维的效率。 典型案例-某制造业集团公司 企业背景:该企业在数字化转型过程中,发现缺乏体系化、规范化的运维流程。日常的运维工作过度依赖运维人员的能力和态度,风险比较高,有新的运维人员进来,如果技能不达标,会造成极高的业务风险。为了解决上述问题,该企业打算利用自动化平台来减少对运维人员技术能力的依赖,包含降低由于运维人员态度造成的风险。 解决方案:云智慧经过大概半年的建设,该企业整体运维工作效率提升了70%,降低了30%日常运维的的操作风险。企业应用发布纳管了56套应用系统,应用发布的自动化率在90%以上,每月常规发版次数超过80次。网络自动化模块,纳管了500多台网络设备,交换机、防火墙、路由器、负载均衡等都均被纳管,自动化率达到了95%,月均常规网络变更40多次。除了网络设备,该企业还纳管了2000多个像操作系统、数据库、中间件的运维对象,自动率达到了98%,运维工具内的原子化工具集超过2000种,每个月运维工具箱使用次数超过4000次。此外,该企业还做了灾备切换,将最重要的30套系统纳管进来了,灾切的自动化率在55%,在60分钟内就可以完成数据中心级的灾备切换。这30套重要的业务系统,还做了超过100套的应急处置预案,主要是固化下来一些日常的故障自愈场景。自动化平台内包含超过100种以上的软件版本介质包,日常软件安装的自动化率超过99% 。 价值与优势 自动化 运维全栈式采控能力 依托云智慧运维中台中全栈的采控能力,不光可以对各类平台设备,像操作系统、数据库、中间件进行采控调度,还支持各类异构的自动化作业,比如除了常见的各类脚本,还支持http作业、c/s架构的软件、as400的作业,像400属于金融行业比较老的系统了,但是这些都可以支持,还有像数据库的SQL、存储过程的作业、邮件的、FTP等等这些类型的作业都可以完美支持。 成熟的开箱即用 自动化 业务场景 云智慧提供的自动化平台,拥有成熟的开箱即用的业务场景,能极大的缩短项目的建设周期。下图常见的9个场景,加一体化的场景,都能比较好的支持,像应用发布、自动巡检、运维工具箱、灾切、批量、网络、应用处置、安全合规、软件安装。 安全可信的技术平台 云智慧提供安全可信的技术平台,云智慧的全栈产品都是自主研发的,规避了安全缺陷隐患。可以在国产化信创环境上运行,像国产化的cpu(鲲鹏)、国产化的操作系统(麒麟、统信)、数据库(人大金仓、达梦)、中间件(东方通、宝兰德)等等。国家近期发布了最新的数据安全法,云智慧的自动化平台符合国家的各项数据安全法规,不管是数据传输、存储、解析等等环节,都安全合规。这个平台经过了10年以上的长期迭代,稳定率超过了5个9,支持各类异常熔断、极端情况下的灾难恢复。 开源福利 云智慧已开源数据可视化编排平台 FlyFish 。通过配置数据模型为用户提供上百种可视化图形组件,零编码即可实现符合自己业务需求的炫酷可视化大屏。 同时,飞鱼也提供了灵活的拓展能力,支持组件开发、自定义函数与全局事件等配置, 面向复杂需求场景能够保证高效开发与交付。 点击下方地址链接,欢迎大家给 FlyFish 点赞送 Star。参与组件开发,更有万元现金等你来拿。 GitHub 地址: https://github.com/CloudWise-OpenSource/FlyFish Gitee 地址:https://gitee.com/CloudWise/fly-fish 万元现金活动: http://bbs.aiops.cloudwise.com/t/Activity 微信扫描识别下方二维码,备注【飞鱼】加入AIOps社区飞鱼开发者交流群,与 FlyFish 项目 PMC 面对面交流~

优秀的个人博客,低调大师

JustAuth v1.16.3 发布,新增 Builder 模式,告别 if 享受极致的体验!

更新内容 发布 v1.16.3 新增 集成“企业微信的第三方应用”平台登录 PR AuthRequst增加Builder构建方式,使用起来更简单。 (gitee *27) 使用 Github Action 添加发布快照的 workflow。 (#126) 新增了企业微信的第三方应用登录,AuthWeChatEnterpriseThirdQrcodeRequest。 (#127) 添加快照版本对应更详细的文档。 (#128) 修改 在 Gitee PR (*27) 的基础上重构代码,增加 Builder 方式创建 AuthRequest 解决 Line 登录的错误。#122 Builder 方式使用介绍 Builder 方式一 静态配置AuthConfig AuthRequest authRequest = AuthRequestBuilder.builder() .source("github") .authConfig(AuthConfig.builder() .clientId("clientId") .clientSecret("clientSecret") .redirectUri("redirectUri") .build()) .build(); Builder 方式二 动态获取并配置AuthConfig AuthRequest authRequest = AuthRequestBuilder.builder() .source("gitee") .authConfig((source) -> { // 通过 source 动态获取 AuthConfig // 此处可以灵活的从 sql 中取配置也可以从配置文件中取配置 return AuthConfig.builder() .clientId("clientId") .clientSecret("clientSecret") .redirectUri("redirectUri") .build(); }) .build(); Builder 方式支持自定义的平台 AuthRequest authRequest = AuthRequestBuilder.builder() // 关键点:将自定义实现的 AuthSource 配置上 .extendSource(AuthExtendSource.values()) // source 对应 AuthExtendSource 中的枚举 name .source("other") // ... 其他内容不变,参考上面的示例 .build();

优秀的个人博客,低调大师

告别祖传代码 -Java 8 语境下模板模式的再审视

点击上方“蓝字”关注我们 作者 | 乔迟,武汉事业群 编辑 | 陈婷 《设计模式:可复用面向对象软件的基础》这本书自 1994 年问世以来一直被视为面向对象理论的经典著作,尤其在 Java 世界,无数 Java 程序员将其视为软件开发架构设计的金科玉律。26 年以来,对于这本书里 23 种设计模式讨论与解读的书籍出版了一本又一本。令人遗憾的是,从 1994 年出版时算起,Java 已经从 1.0 版本迭代到了 14,而设计模式再版了几十次也并没有在内容上和 Java 技术的发展相适应。 老祖宗 26 年前留下的代码,在今天函数式编程满天飞的时代还能呼风唤雨经久不衰吗?在软件编程这个快速迭代的领域里,答案无疑是否定的,大神 Joshua Bloch 在近年最新的 Effective Java 第三版中就对常用的模板模式提出了批评: The Template Method pattern [..] is far less attractive. The modern alternative is to provide a static factory or constructor that accepts a function object to achieve the same effect. 本文就试图在 Java 8 语境下重新审视模板模式的设计与实现。 模板模式回顾 在经典的 GOF 23 种设计模式中,模板模式(或 称 模板方法模式)因为简单明了、实现方便,很快就成为了在日常开发中最受欢迎的设计模式之一,在各种系统实现中被广泛使用。 模板模式最常见的应用场景在处理流程算法相对固定的一类业务中,提炼出算法骨架和原子动作集合,通过骨架代码(模板模式中成为模板方法)对原子动作进行组装,形成最终的业务逻辑实现。在面对后续不同的子业务场景时,只需要继承实现不同的子类,覆盖对应的差异性原子动作,即可很快的完成对一个子业务场景的封装实现。 模板模式类图如下: 例如,一个业务可以分成三步,那么可以提炼出父类 AbstractProcessor public abstract class AbstractProcessor { public final void process() { step1(); step2(); step3(); } public abstract void step1(); public abstract void step2(); public abstract void step3();} 流程逻辑被封装在父抽象类的 process 方法中,客户端只需要调用父类的 process 骨架方法即可实现对应的业务逻辑: public class ClientLogic { private AbstractProcessor processor; public void foo() { processor.process(); }} 接着,根据某个实际场景开发对应的实体类,例如 public class ConcreteProcessor1 extends AbstractProcessor { @Override public void step1() { System.out.println("Step1 Logic in ConcreteProcessor1"); } @Override public void step2() { System.out.println("Step2 Logic in ConcreteProcessor1"); } @Override public void step3() { System.out.println("Step3 Logic in ConcreteProcessor1"); }} 假设现在有新的业务场景,第一步和第二步依然和 ConcreteProcessor1 的逻辑一致,仅第三步略有不同,此时就可以通过继承的方式编写 ConcreteProcessor2 覆盖 step3 方法: public class ConcreteProcessor2 extends ConcreteProcessor1{ @Override public void step3() { System.out.println("Step3 Logic in ConcreteProcessor2"); }} 这样一来,所有流程逻辑和相对稳定的原子动作都可以进行复用,在应对不同的业务场景时,只需要覆盖对应的原子动作就可以快速实现,提高了代码复用率,降低了维护成本。 老祖宗的代码看起来确实很香,然而在实际开发使用过程中模板模式有什么问题呢? 现实的问题 以我参与过的一个项目为例。 该项目需要对接上千家外部单位,虽然对接单位众多,但是业务流程相对固定,设计开发人员很快就意识到可以通过模板模式对整个业务流程进行封装,通过对业务流程的梳理提炼,很快设计了一个父类(示例代码): public abstract class AbstractProcessor { public final void process() { step1(); step2(); step3(); step4(); step5(); } public abstract void step1(); public abstract void step2(); public abstract void step3(); public abstract void step4(); public abstract void step5();} 并且开发了对应的默认实现类: public class DefaultProcessor extends AbstractProcessor { @Override public void step1() { System.out.println("default step1"); } @Override public void step2() { System.out.println("default step2"); } @Override public void step3() { System.out.println("default step3"); } @Override public void step4() { System.out.println("default step4"); } @Override public void step5() { System.out.println("default step5"); }} 于是形成了这样的树状类图关系: 接下来对于第一家外部对接单位 A,分析其业务逻辑发现只需要修改默认实现的第一步即可,于是类图变成下面这样: 接着开始实现外部单位 B,发现只需要修改默认实现的第二步,于是类图变成: 在对接外部单位 C 时发现,其第一步逻辑与外部单位 A 类似,因此可以进一步继承复用,于是形成如下的类图结构: 对接了几十家外部单位后,类图结构变成了一颗茁壮的树: 这时问题出现了,开发人员很快发现随着对接单位的增多,模板树状结构越来越复杂,随之而来的问题是: 1.对于任意一个叶子节点的模板,它的 5 个步骤原子方法逻辑分散在整个继承逻辑的父类之上,单独阅读叶子节点的代码根本无法理解完整的模板逻辑。 2.要加入一家新的外部单位,如果想要正确实现逻辑复用,就必须全面分析模板树,找到对应的继承挂载点。 3.如果交付时间紧张,很难完成对模板树的梳理,取而代之的是从一个最熟悉的叶子节点开始挂载,这样就产生了破窗效应,后续的模板大量倾斜挂载在某个叶子模板之下,完全背离了原有设计。 那么问题到底出在哪呢? 问题 回顾一下 GOF 的设计模式,其中有两条最为重要的原则: 1.Program to interface, not implementation 面向接口编程 2.Favor object composition over inheritance 聚合优于继承 而恰恰是 GOF 的模板模式,从一开始就违背了自己定下的原则,通过抽象类继承的方式进行实现。模板模式的这种实现方式在小规模的模板复用时尚且可以接受,一旦模板数量上升,整个模板继承的可维护性就会严重下降。在上面实际项目的实践中,正是违反了聚合优于继承的原则,导致整个设计在模板数量增长时,失去了可维护性,背离了设计目标。 观察一下现实生活就很容易发现聚合优于继承的情况。例如去西餐店吃饭,点餐时服务员会拿出菜单让顾客在前菜、主菜、饮料、甜点上分别选择,这就是一种典型的聚合实现的模板模式,前菜、主菜、饮料、甜点对应模板模式的原子方法,最终形成的菜单对应模板模式的模板方法。没有西餐店会提供一个基于继承的菜单服务,告诉客户如果您要将饮料从威士忌换成葡萄酒就需要选取套餐 5 而不是套餐 4。 那么聚合到底为什么优于继承呢?这就需要从面向对象理论中的耦合度计算说起。 理论 一个有趣的经验是,在我参与的很多面试中,如果问面试者为什么使用设计模式,对方会很快告诉你这是为了“解耦”,但是如果进一步追问”这两个相关的类,耦合到底有多紧”时,绝大部分面试者都是以下两种表情: 耦合度成为了开发者口中皇帝的新装式的概念,所有人都知道需要松耦合,但是耦合如何度量、到底如何松耦合、一个代码修改是消除耦合还是增加耦合这类问题大家往往一知半解。事实上,面向对象基础理论中对于耦合度是有公式可以度量的。 对于任意两个存在关联关系的类 A 和 B,它们的关系无外乎下面五种: 两个类 A、B,它们之间耦合度的计算公式为: 表示类 A 和类 B 之间共享代码的行数, 表示类 B 的代码总行数, 表示类 A 和类 B 的关系系数。 对于系数 ,取值范围从 0 到 1,0 表示没有关系,1 表示最大关系,可以将取值对应到 Dependency、Association、Aggregation、Composition、Inheritance 五类关系中,取值从小到大。 对于共享代码行数,如果类 A 被类 B 继承,那么等于类 A 所有非 private 修饰的代码行数;如果类 A 只是作为引用被类 B 调用,那么 等于类 A 所有 public 方法签名的行数。 从以上公式可以看出,在继承关系中,两个类的耦合度不仅关系系数取值更大,而且 取值也更大,从而导致耦合度更高。 解决方案 根据上面的理论分析可以看出,要优化现有的模板模式实现,其主要思想是降低耦合度。 可以通过将继承改为聚合的方式实现第一版的优化: public class TemplatePattern1 { private Step1Processor step1Processor; private Step2Processor step2Processor; private Step3Processor step3Processor; private Step4Processor step4Processor; private Step5Processor step5Processor; public interface Step1Processor { void step1(); } public interface Step2Processor { void step2(); } public interface Step3Processor { void step3(); } public interface Step4Processor { void step4(); } public interface Step5Processor { void step5(); } public void templateMethod() { step1Processor.step1(); step2Processor.step2(); step3Processor.step3(); step4Processor.step4(); step5Processor.step5(); }} 在上面的代码中,将原有以继承方式实现的模板各原子方法变为通过聚合方式引入的各个处理器接口引用,注入不同的原子方法处理器就可以很容易的改变模板方法的逻辑。 通过这种实现解决前面的实际问题,对于任意一个需要对接的外部单位,只需要明确该单位在模板每个步骤中具体应该采用的处理器类型,然后简单配置组合就可以快速形成新的模板处理逻辑。 进一步的,根据前面耦合度计算的公式,如果使用方法参数而非成员变量的方式传入各步骤处理器,将会进一步降低耦合度,这样就形成了第二版优化代码: public class TemplatePattern2 { public interface Step1Processor { void step1(); } public interface Step2Processor { void step2(); } public interface Step3Processor { void step3(); } public interface Step4Processor { void step4(); } public interface Step5Processor { void step5(); }public void templateMethod(Step1Processor step1Processor,Step2Processor step2Processor, Step3Processor step3Processor,Step4Processor step4Processor,Step5Processor step5Processor) { step1Processor.step1(); step2Processor.step2(); step3Processor.step3(); step4Processor.step4(); step5Processor.step5(); }} 接着,通过 Java 8 引入的接口静态方法实现静态工厂模式(这里也可以看作是函数式编程中高阶函数模式),并通过 Lambda 表达式进一步完善可读性后得到第三版代码: public interface TemplatePattern3 { void templateMethod(Step1Processor step1Processor, Step2Processor step2Processor, Step3Processor step3Processor, Step4Processor step4Processor, Step5Processor step5Processor); static TemplatePattern3 getTemplate(Step1Processor step1Processor, Step2Processor step2Processor, Step3Processor step3Processor, Step4Processor step4Processor, Step5Processor step5Processor){ return (step1Processor1, step2Processor1, step3Processor1, step4Processor1, step5Processor1) -> { step1Processor1.step1(); step1Processor1.step1(); step1Processor1.step1(); step1Processor1.step1(); step1Processor1.step1(); }; }} 这里需要补充的是,从前面的理论分析可以看出,要想尽量降低耦合度,接口的设计者就应该抛弃继承改为使用方法参数传值的方式,而承载这个思想最好的实现正是 Java 8 引入的 Lambda 表达式,因为 Lambda 表达式不拥有任何成员变量,所有的逻辑引用来源都必须是参数传入,从这个意义上来说,尽量选择 Lambda 表达式作为业务逻辑承载的主体是一种能够显著降低系统耦合度的最佳实践。 总结 1.《设计模式》中模板模式的原始实现存在缺陷,应通过聚合优于继承的思想进行改造; 2.类耦合度可以通过公式计量,最低的耦合关系是 Dependency,最高的耦合关系是继承; 3.Lambda 表达式天然适合实现 Dependency 关系,应该尽量选择作为业务逻辑封装的实现主体。 猜你喜欢 OCR数据处理(下篇) 政务服务体验设计背后的故事 | 云南办事通 APP 2.0 设计(文末招聘!!!) 首屏加载速度慢?试试这 6 个技巧 Docs as Code | (文末招聘!!!) 近期活动:金科大咖 云讲坛 如何融汇科技,打造数字化转型引擎? 如何共享资源,主动赋能同业与社会? 如何共建生态,构建无界多维的生态空间? 如何创新引领,成为新金融的实践者和先行者? 38位金融科技大咖应邀云端,与你探索未来科技前沿方向。豪华专家师资队伍,精选38项高端课程,尽在优源汇! 参与方式:关注公众号,点击“金科大咖”进入直播间 本文分享自微信公众号 - 金科优源汇(jkyyh2020)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

DataQL 4.1.3 发布,支持 SQL 执行,从此告别 Mapper、BO、VO、DO、DAO

新增 新增 Dataway 框架 dataway 通过数据库探测机制来实现确定 SQL 执行方案。 DataQL 增加可以构建多个独立的环境。其中 dataway 使用独立的环境。 DataQL 新增 SQL 代码片段执行器,开启 DataQL + SQL 模式。支持分页模式,并兼容多种数据库。 CorsFilter web框架增加一个跨域的 Filter 工具类。 DataQL-fxDataQL FragmentProcess 接口新增批量处理能力。 DataQL-fx增加完成事物函数库,完整支持 7种事务传播属性。 DataQL-fx增加 web 相关的 函数库 DataQL-fx增加 加密解密 udf 工具。 优化 DataQL 语法解析器新增支持 标识符可以通过 `` 来囊括特殊字符例如:+、-、*、/ 等符号 DataQL QueryApiBinder 的 bindFinder 支持 Supplier了。 修复 ApiBinderCreater 拼写错误 ApiBinderCreator。 2.mapjoin 函数名改为 mapJoin。 修复 Hasor-web:InvokerSupplier,修复 npe 问题。 ------------------------------------------------------------------------------------------------ SQL执行器的一些一些内容 关于SQL执行器 配置数据源 SQL方言 执行 SQL SQL 参数化 SQL 注入 Ognl 表达式 批量操作 执行结果拆包 分页查询 分页信息 数据库事务 作为Dao层 配置 Maven 插件 编写QL文件 执行QL查询 消息来源:https://www.hasor.net/web/dataql/index.html#sql

优秀的个人博客,低调大师

苹果彻底告别“芯片门” 安卓N最终预览版发布

1. iPhone 6s发生的“芯片门”时间让人记忆犹新,不过好消息是,根据台媒《电子时报》消息,苹果已经在今年处理器生产合作伙伴名单中花掉了三星的名字,也就是说今年所有的A10芯片都将由台积电生产。另外值得注意的是,报道还指出苹果的这一计划很可能还将延长至明年的iPhone 7s(或名为iPhone 8),因此台积电最早将在2017年第二季度开始进行A11芯片的小规模量产。 2. 尽管我们都知道Android N应该就是Android 7.0,不过在开发者预览阶段,谷歌当前仍然以Nougat牛轧糖代号来称呼它。今天早些时候,谷歌发布了Android N第5个开发者预览版,这也是新系统正式发布前的最后一个预览版本。Android N本身进行了大量改进,比如加入了原生多窗口模式,支持通知消息直接回复,优化续航和性能等。最新预览版并没有加入太多的新特性,主要还是集中于bug修复(最明显的体现在快捷设置菜单),唯一的新特性就是隐藏了一个彩蛋。 3. 日前有消息称索尼将在今年的IFA 2016柏林消费电子展上推出两款新机,型号为分别为Sony F8331 以及 F8332,而且预计隶属于Xperia Z系列。继此前F8331配置现身GFXBench基准测试数据库之后,现在GSMArena首次曝光了该机的真机照。 从谍照来看,我们可以发现索尼这次明显在手机的外观设计上下了更大的功夫,手机屏幕侧边微微弯曲,向机身有一个完美的过渡,另外索尼也首次尝试加入了Type-C接口。 4. 在几年前,苹果的MacBook Air的确给人留下了深刻的印象,但不可否认的是,如今MacBook Air的地位正变的越来越尴尬,一方面其便携性不如12英寸MacBook,而另一方面性能又比不上MacBook Pro。此前有消息称苹果正打算彻底放弃这一产品线,现在著名苹果分析师凯基证券郭明表达了相同的观点从,称苹果将放弃11英寸的MacBook Air系列,由12英寸的新版MacBook代替,而13英寸版本则会继续保留。 ====================================分割线================================ 本文转自d1net(转载)

优秀的个人博客,低调大师

微软这场告别,走了十年

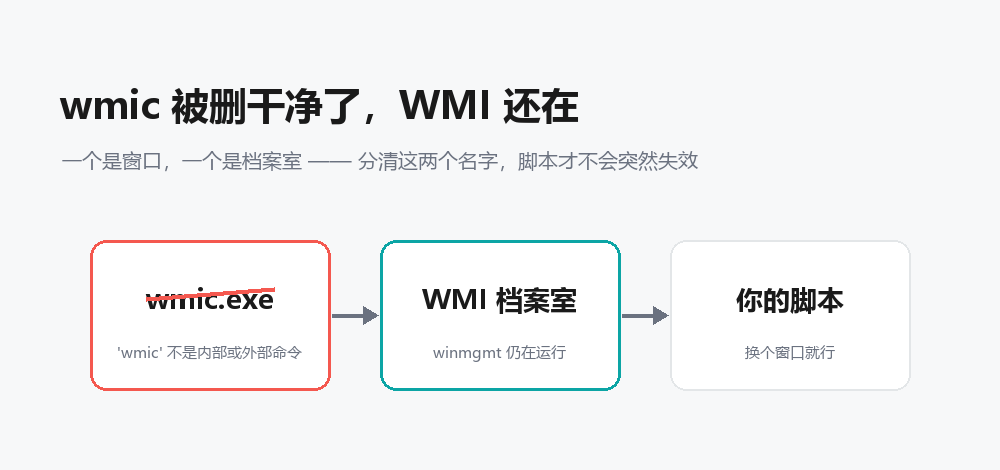
前几天一段用了好几年的老 bat 翻车了。它靠 `wmic baseboard get serialnumber` 读主板序列号做机器指纹,跑在一台新装的 Win11 24H2 上返回空值,授权校验跟着全挂。手动一跑,根因就一行: ``` 'wmic' 不是内部或外部命令,也不是可运行的程序或批处理文件。 ``` wmic.exe 不在机器上了。很多人到这一步就得出"微软把 WMI 删了"的结论——错就错在把两个名字当成了一个东西。 先把结论放在最前面:**WMI 是 Windows 的管理机制,wmic 只是操作它的一个命令行工具。被删的是工具,机制一点没伤。** 这篇文章就把这两个名字分开,说清楚 wmic 是什么时候被废弃的、官方的替代方案是什么、你的代码要改哪里。 ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-2726701/f9c0f27e62ff052ab98753b90d72f694.png) - 一句话说清:WMI 是 Windows 的"管理机制"(底层基础设施),WMIC 只是访问它的其中一个命令行工具。​ 下面这张图展示了它们的关系: ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-2726701/0af6c7e4c64d78092957fb856faeab52.png) **WMI(Windows Management Instrumentation)** —— 是"机制" - 微软对 WBEM/CIM 标准的实现,一套**系统管理框架**,本身不是一个可执行的命令 - 由 `Winmgmt` 常驻服务驱动,核心组件是 **CIM 仓库**(存数据)+ **Provider**(连系统组件) - 用统一的 WMI 类描述系统资源,比如 `Win32_Process`、`Win32_Service`、`Win32_LogicalDisk` 需要注意的一点 不只是 WMIC 被弃用了,PowerShell 里的老 cmdlet `Get-WmiObject` **同样被弃用**,官方推荐统一改用 **`Get-CimInstance`**: |写法|状态| |:-:|:-:| |`wmic process list`|已弃用| |`Get-WmiObject Win32_Process`|已弃用| |`Get-CimInstance Win32_Process`|官方推荐(走新的 CIM/WinRM 通道)| 顺手记住一个实用对比: ``` # 旧写法(不推荐) wmic process where "name='chrome.exe'" get processid # 新写法(推荐) Get-CimInstance Win32_Process -Filter "name='chrome.exe'" | Select ProcessId ``` 简单类比:**WMI 相当于一台"管理数据库 + 服务",WMIC 只是其中一个过时的查询客户端**。以后写脚本统一用 `Get-CimInstance`,跨 PowerShell 7 / Windows 11 都更稳。 ## WMI 是档案室,wmic 只是它的一个窗口 **WMI(Windows Management Instrumentation)是 Windows 里的一套管理机制,从 NT 4 时代就在。** 你可以把它想成一个档案室:系统里所有能被查询的东西——进程、服务、主板、BIOS、磁盘——都被整理成一份份标准档案,存在里面。 档案室里有两样东西值得认识: - **Winmgmt 服务**:看门的人,任何查询都得经过它; - **Provider**:真正跑腿的组件,比如 `cimwin32.dll`,去问内核、驱动、注册表,把答案翻译成统一的格式。 档案按柜子分,最常用的那个柜子叫 `root\cimv2`。你见过的 `Win32_Process`、`Win32_Service`、`Win32_BIOS`,都是一份份档案的名字。查档案用一种长得像 SQL 的话,叫 WQL。 不过档案室本身没有"在命令行敲一行"这回事——得有窗口。 **wmic.exe 就是其中一个窗口。** 它躺在 `C:\Windows\System32\wbem\` 里,卖点是省事:`process` 就是 `Win32_Process`,`bios` 就是 `Win32_BIOS`,`baseboard` 就是 `Win32_BaseBoard`。这些简称定义在 WMI 的 `root\cli` 柜子里。 它的地位也没那么特殊:PowerShell 的 CIM cmdlet、VBScript 的 GetObject、C# 的 System.Management,都跟它平级,都是窗口。所以 **wmic 被删,档案室一份没少**——微软官方原话是"此弃用仅适用于 WMIC 实用工具,WMI 本身不受影响"。 |WMI|wmic| |:-:|:-:| |全称|Windows Management Instrumentation|WMI Command-line| |身份|系统级管理机制|调用 WMI 的命令行工具| |落地形态|Winmgmt 服务 + Provider 组件|System32\wbem\wmic.exe| |现状|一直受支持|2021 年弃用,2026 年彻底移除| ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-2726701/f2ccdc5cd1481da1240db4eb2914f882.png) ## wmic 是什么时候被废弃的 不是突然消失的,官方支持文档(KB5067470)里有一张明确的退场时间线。先分清两个词:**弃用**是"还能用,但微软不再投入",**移除**才是"真没了"。wmic 从标记弃用到彻底移除,前后走了十年。 ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-2726701/08f8636c29a10fc65bd4c618260a1ac6.png) - **2016 年**,Windows Server 2012 上标记弃用; - **2021 年**,Windows 10 21H2 上标记弃用——这就是大多数资料说的"wmic 被废弃"的起点; - **2022 年**,Win11 22H2 把它改成"按需功能",默认还预装; - **2024 年**,Win11 23H2 / 24H2 默认不装了,但能手动加回; - **2025 年**,升到 25H2 时已装的会被移除,仍然能加回; - **2026 年 8 月起**,24H2 / 25H2 更新后不再包含 wmic,功能包同步下架——到这一步就**加不回来了**。 关键在最后一行。8 月之前,网上那些"Win11 找回 wmic"的教程教你 `Add-WindowsCapability`,当时全对;8 月之后,包没了,这条路断了。 还有两个容易看错的地方: - 这次删除的适用范围是"仍在支持的 Windows 11 客户端版本"。Windows Server 各版本不在删除范围里,Windows 10 普通版 22H2 则在 2025 年 10 月就停止了支持。所以"我服务器上 wmic 还能跑"是真的,但它救不了你手上的 Win11 客户机。 - 微软两份文档的口径差一个小版本:WMIC 功能页写"Windows 10 21H1 起弃用",支持文档的时间线写 21H2。不影响结论,对照时别以为看错了。 ## 还想用 wmic,能装回来吗 能不能装回来,只取决于一件事:这台机器打没打 2026 年 8 月及之后的更新。 ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-2726701/c7cde177a9a2f8b57458142302742d0e.png) **没打 8 月更新**——功能包在本地还在,管理员 PowerShell 直接装: ``` Get-WindowsCapability -Online -Name "WMIC~~~~" # 先查状态 ``` 官方文档注明这个功能包带卫星组件,安装得走 DISM(`Add-WindowsCapability` 对它不保证好使): ``` DISM /Online /Add-Capability /CapabilityName:WMIC~~~~ ``` 图形界面的入口是设置 → 系统 → 可选功能 → 添加可选功能,搜 WMIC。装完记得新开一个终端,老窗口的环境变量不刷新。 **打了 8 月及之后的更新**——上面那条会直接失败。微软在支持文档里留了最后一个包 `wmic_dlc.zip`:解压到本地文件夹,管理员 PowerShell 进到解压目录,先跑 `Set-ExecutionPolicy Bypass -Scope Process`,再执行 `install.ps1`,它把文件复制回 `System32\wbem` 并重新注册简称。官方措辞很直白:**这不是安全的长久方案,只是给你留出改脚本的时间**。 图上三条路,前两条是缓冲,第三条才是正解。改代码按场景分两种,下面两节分别说。 ## 官方替代方案:换成 PowerShell 的 CIM cmdlet 微软指定的替代品是 PowerShell 的 CIM cmdlet,官方迁移博客的标题就叫"WMIC 弃用的下一步"。**档案还是那些档案,类名一个字不用变,换的只是窗口。** |原来(wmic)|现在(PowerShell)| |:-:|:-:| |`wmic bios get serialnumber`|`(Get-CimInstance Win32_BIOS).SerialNumber`| |`wmic baseboard get serialnumber`|`(Get-CimInstance Win32_BaseBoard).SerialNumber`| |`wmic csproduct get uuid`|`(Get-CimInstance Win32_ComputerSystemProduct).UUID`| |`wmic cpu get name,numberofcores`|`Get-CimInstance Win32_Processor~s| Select Name,NumberOfCores`| |`wmic logicaldisk get caption,freespace`|`Get-CimInstance Win32_LogicalDisk -Filter "DriveType=3"~s| Select Caption,FreeSpace`| |`wmic process where "name='chrome.exe'" get processid`|`Get-CimInstance Win32_Process -Filter "Name='chrome.exe'"~s| Select ProcessId`| 名字之外有四个差异,照抄要出事: - 参数不叫 `-Class` 了,叫 `-ClassName`,别只换 cmdlet 名字; - `-Filter` 里写的是 WQL 字符串:等号就是 `=`,字符串用单引号包,多条件用 `AND`,它不接受 PowerShell 脚本块; - 拿回来的是 CIM 实例——一份数据快照,不是能直接下命令的活动对象。`$obj.StopService()` 不能再写,要改成 `Invoke-CimMethod -InputObject $obj -MethodName StopService`; - `LastBootUpTime` 这类时间字段从字符串变成了真正的 `DateTime`。老脚本里的手工转换可以一并删掉,前提是确认没人依赖字符串格式。 bat 没有对象概念,只能套一层 PowerShell 拿文本: ``` for /f "usebackq delims=" %%i in (`powershell -NoProfile -Command "(Get-CimInstance Win32_ComputerSystemProduct).UUID"`) do set UUID=%%i echo 机器指纹: %UUID% ``` 一句性能提醒:`powershell -Command` 每次冷启动要几百毫秒。要连着取主板、BIOS、磁盘好几个字段,别开四五个进程,一条命令取完、用分隔符拼成一行输出,回 bat 里拆。 ## 程序里怎么改 先分清是哪种取法:用 `Process.Start` / `ProcessBuilder` 去执行 `wmic` 再解析文本的,一定会断;通过 WMI 的 API 直接查的,不受影响。 ![在这里插入图片描述](https://developer.qcloudimg.com/http-save/yehe-2726701/c2d69a99cec73d7929969cd300672332.png) C# 用 `System.Management`,它连的是 WMI 的 COM 接口,不经过 wmic.exe: ``` using var searcher = new ManagementObjectSearcher("SELECT SerialNumber FROM Win32_BaseBoard"); foreach (var mo in searcher.Get()) Console.WriteLine(mo["SerialNumber"]); ``` .NET Core / .NET 5 之后要单独引 `System.Management` NuGet 包,目标框架得带 `-windows`,否则运行时会报 "only supported for Windows desktop applications"。 Java 用 OSHI,JNA 直接调系统接口,Windows 上底层照样是 WMI,但全程不落命令行: ``` com.github.oshi oshi-core 7.3.2 ``` ``` var hal = new SystemInfo().getHardware(); String boardSerial = hal.getComputerSystem().getBaseboard().getSerialNumber(); ``` ## 四个容易踩的坑 **Get-WmiObject 不是替代品。** 它在 PowerShell 7 里根本不存在(不是"弃用",是整个移除了),只有 Windows PowerShell 5.1 里还有。微软的迁移文档把它列进替代清单有点误导——照着改完,脚本进了 pwsh 7 一样报错。要写就写 `Get-CimInstance`,5.1 和 7 都能跑。 **远程查询换了协议。**`wmic /node:xxx` 走 DCOM(TCP 135 + 一段动态端口),`Get-CimInstance -ComputerName` 默认走 WinRM(5985/5986)。本地好好的、一远程就报错,先用 `Test-WSMan 目标机` 探一下,八成是 WinRM 没开。要连只开 DCOM 的老机器,用 `New-CimSessionOption -Protocol Dcom` 建会话再查。 **别把 `wmic product` 照抄成 `Get-CimInstance Win32_Product`。** 这个类一被查询就触发 MSI 重新校验,慢得离谱,还可能让已装的软件自己"重修"一遍。想列装了什么软件,去读注册表的 Uninstall 键。 **扫描工具不认识 bat。** PSScriptAnalyzer 的 AvoidUsingWMICmdlet 规则只查 PowerShell 脚本,bat 里的 wmic.exe 它看不见。存量脚本得自己来:把 .bat / .cmd / .vbs 全搜一遍 `wmic `,比等客户报障便宜得多。 ## 回到开头 那台 24H2 上翻车的指纹脚本,改法很直接:wmic 调用换成 `Get-CimInstance`,算法、字段、值全都不用动。 真正要当心的是另一件事:主板和 BIOS 序列号在不少虚拟机、组装机上本来就是空串或全 0。这是数据源的问题,换工具解决不了。授权这种死磕机器指纹的场景,空值分支永远得有。 wmic 走了,WMI 还在。下次再看到这两个词,先问一句:说的是档案室,还是那个窗口。

优秀的个人博客,低调大师

『NAS』告别付费和广告,在群晖部署PDF工具箱-bentopdf

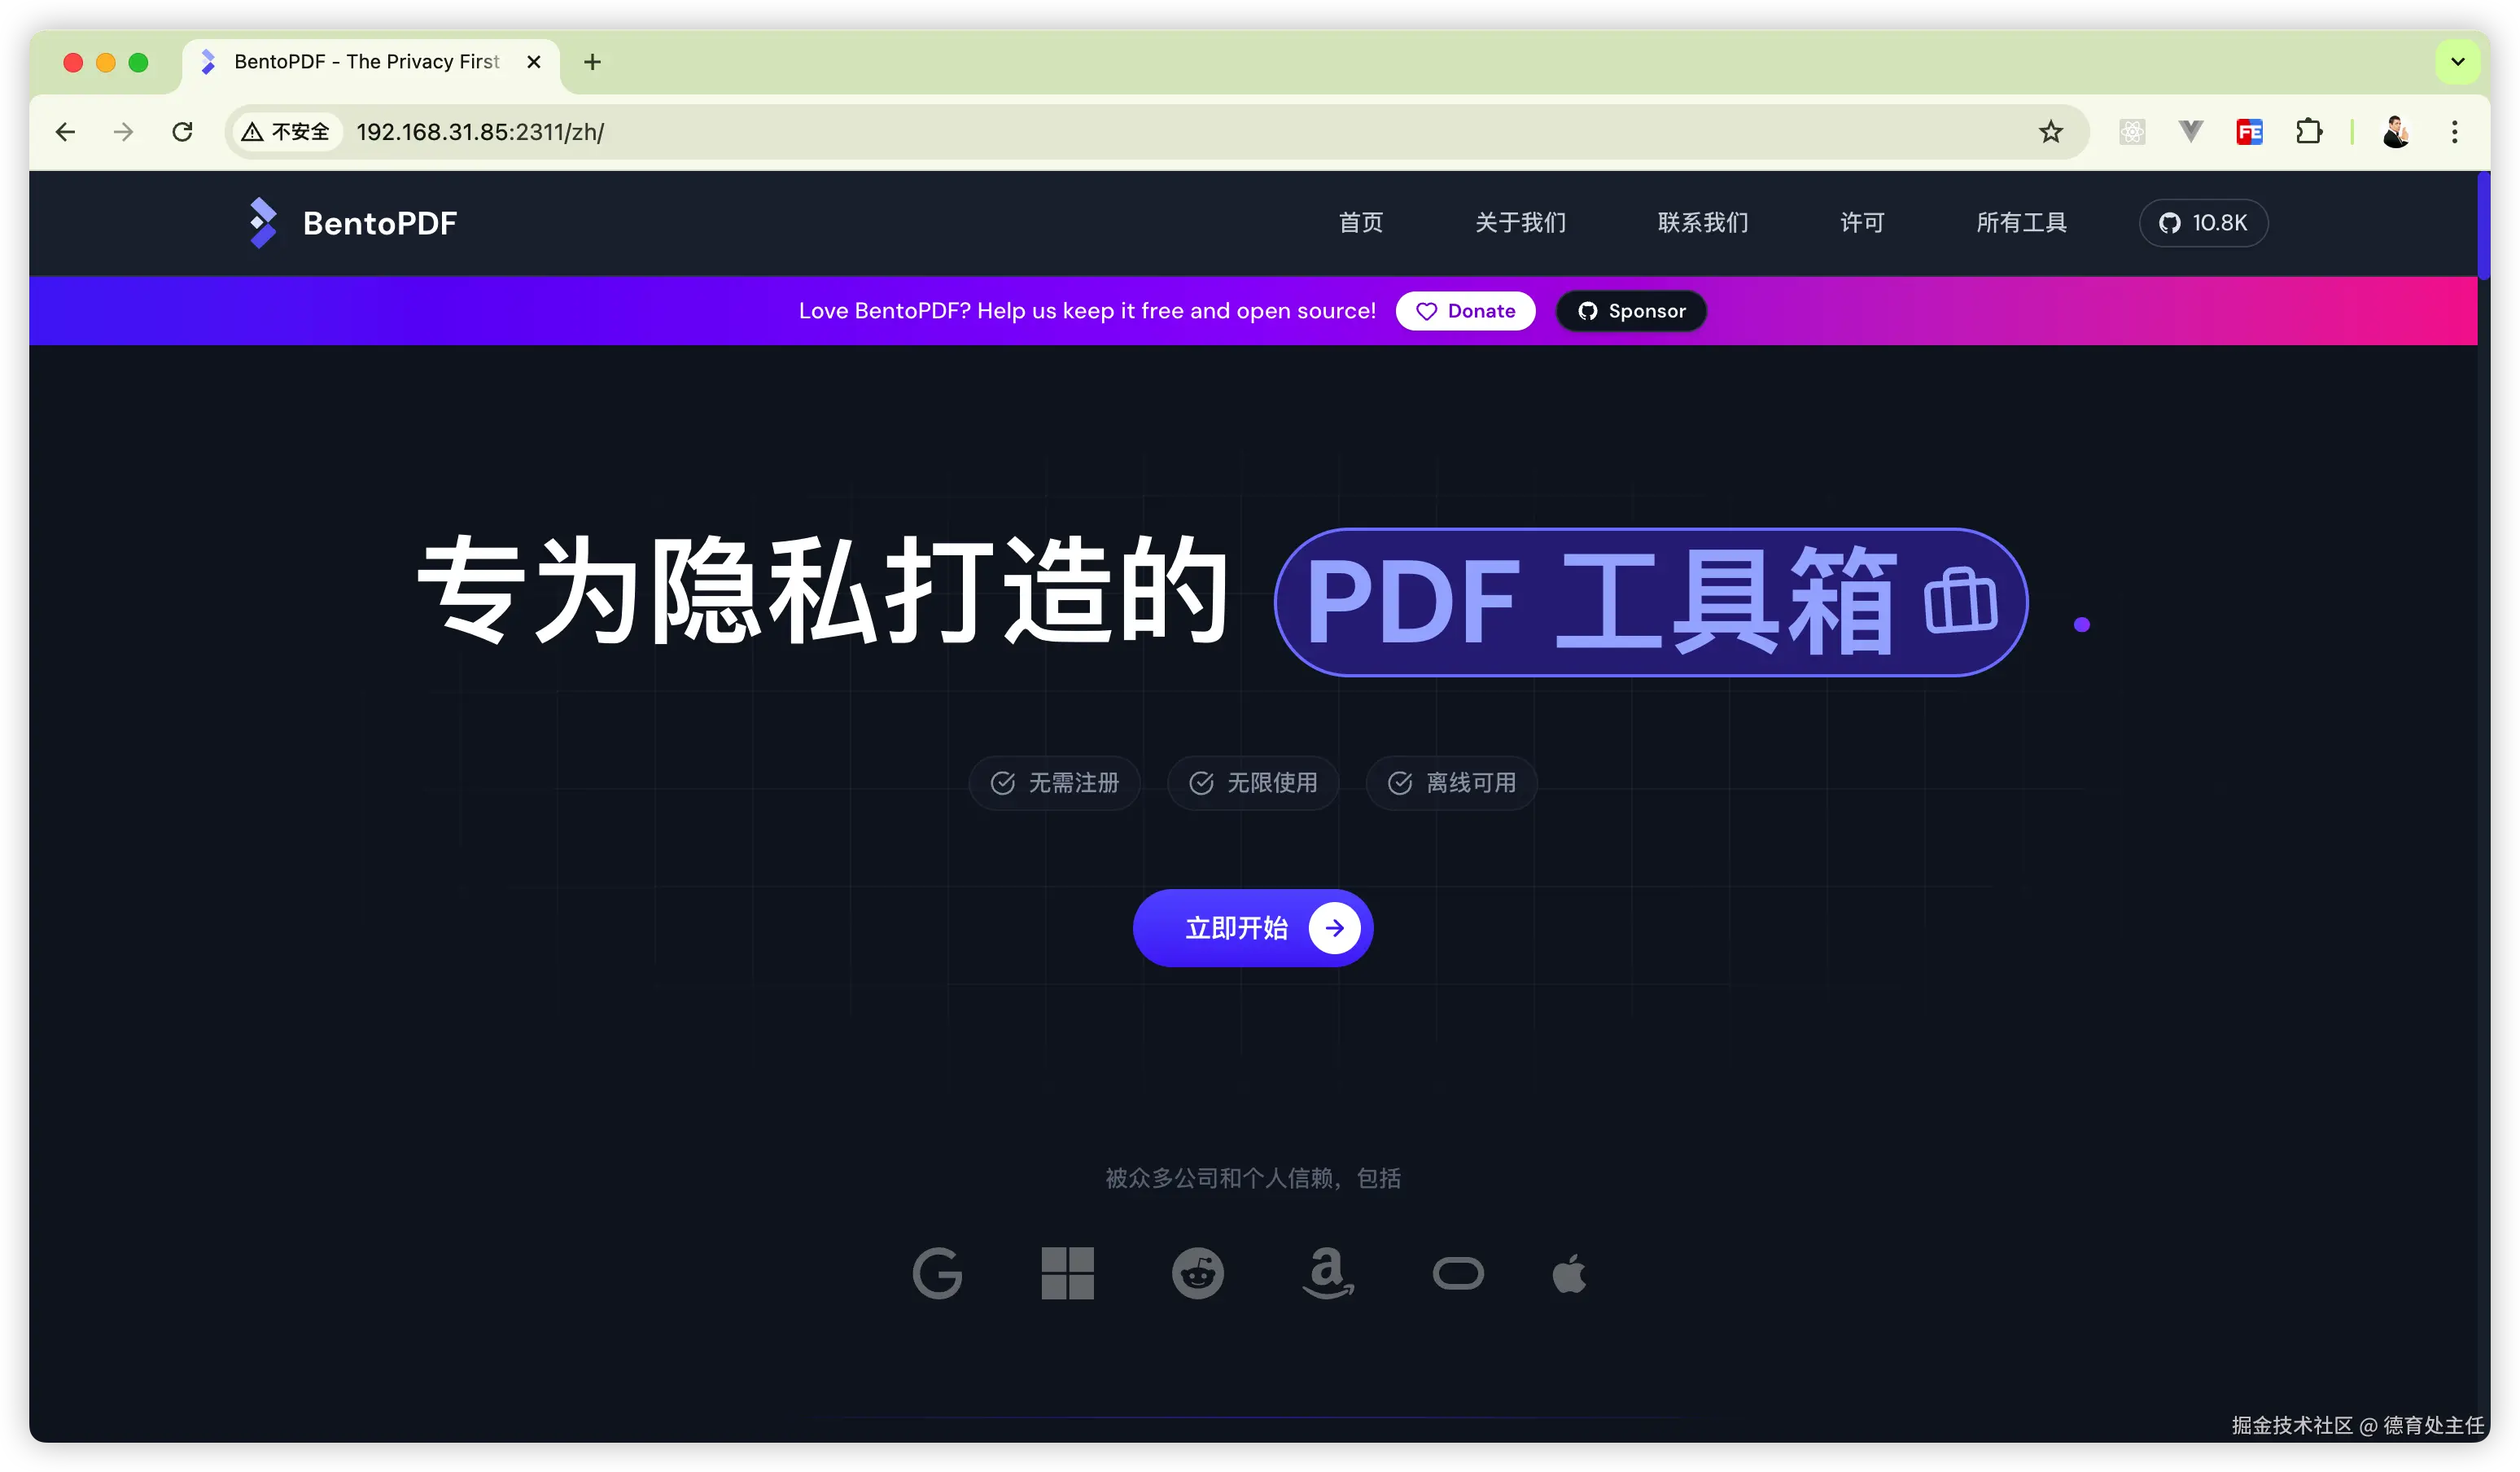
**点赞 + 关注 + 收藏 = 学会了** > 整理了一个NAS小专栏,有兴趣的工友可以关注一下 👉 《NAS邪修》 BentoPDF 是一款**隐私优先、纯浏览器端运行的 PDF 全能工具箱**,可通过 Docker 轻松部署到 NAS。提供数十种处理 PDF 功能,所有文件处理均在本地完成,无大小 / 数量限制、无水印、完全开源免费,无需担心隐私安全与付费套路。 ![01.png](https://developer.qcloudimg.com/http-save/yehe-9556244/aa211a3562cd5505807daed7f1b2931b.webp) 本次使用群晖 NAS 部署 BentoPDF。 首先在“File Station”的“docker”里创建一个“bentopdf”文件夹。 ![02.png](https://developer.qcloudimg.com/http-save/yehe-9556244/912cfd60a73b83348ec1a347e533ffd6.webp) 然后打开“Container Manager”,新增一个项目,填入以下内容。 ![03.png](https://developer.qcloudimg.com/http-save/yehe-9556244/67f6091b7a728fbeb7385357f58ac3fd.webp) 填入下面这份代码拉取「BentoPDF」镜像。 ``` services: bentopdf: image: bentopdf/bentopdf:latest container_name: bentopdf ports: - 8001:8080 restart: unless-stopped ``` 在「网页门户设置」里勾选”通过 Web Station 设置网页门户“。 然后点击”下一步“,开始拉取「BentoPDF」镜像。 ![04.png](https://developer.qcloudimg.com/http-save/yehe-9556244/e8c46eb84aac2e781cad3b08aee1d825.webp) 接下来打开”Web Station“新增一个”网络门户“。 填入以下内容。如果发现部分功能无法使用,可以勾选 `HTTPS`,给它创建要给端口,在浏览器就使用 `https` 的方式访问。我这里只给 `http` 设置了 `2311` 端口,你根据自己需求配置。 ![05.png](https://developer.qcloudimg.com/http-save/yehe-9556244/d0e2cd627d29933515c86d4685511a22.webp) 完成上面的操作后,打开浏览器,输入你 `NAS的IP + BentoPDF端口`,就能使用 BentoPDF 了。 比如我的是 `http://192.168.31.85:2311`。 ![06.png](https://developer.qcloudimg.com/http-save/yehe-9556244/4c4e7d5eff27a44c329ce73922a44215.webp) 页面往下滚动就可以看到一堆 PDF 相关的工具,但都是全英的。 ![07.png](https://developer.qcloudimg.com/http-save/yehe-9556244/46ba1fb46aeb9215ad2a279afa3e6ae7.webp) 想设置成中文的话,需要滚动到页面底部,在箭头所指的地方修改。 ![08.png](https://developer.qcloudimg.com/http-save/yehe-9556244/3a22a5ee01b25ec1bd22001ad3868608.webp) 调整成中文后的样子。 ![09.png](https://developer.qcloudimg.com/http-save/yehe-9556244/242d370f63c48e8fcd4eb60056f02759.webp) 我测试了一下,将「JSP转PDF」,速度还挺快的。 ![10.png](https://developer.qcloudimg.com/http-save/yehe-9556244/3cd6eb3062e05e5ee314e6b4669cb390.webp) 这是转换出来的结果。 ![11.png](https://developer.qcloudimg.com/http-save/yehe-9556244/963f31b61f8ee3ca7112c332259d23ed.webp) --- 以上就是本文的全部内容啦,**有疑问可以在评论区讨论~** **想了解更多NAS玩法可以关注《NAS邪修》?**? **点赞 + 关注 + 收藏 = 学会了**

优秀的个人博客,低调大师

告别滚动割裂:HarmonyOS Web 组件自适应布局实战与避坑指南

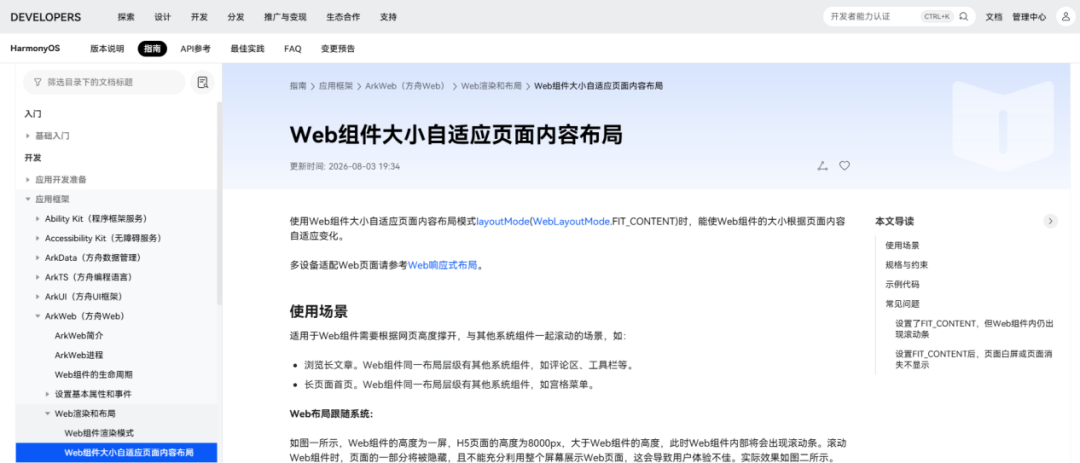
在 HarmonyOS ArkWeb 开发场景中,Web 组件为应用提供 H5 页面嵌入能力。默认状态下 Web 组件高度固定为一屏尺寸,当内部 H5 页面内容较长时,Web 组件会生成独立内部滚动区域。若页面同时存在 ArkUI 原生组件(如评论区、功能菜单等),Web 内部滚动与外层页面滚动相互割裂,会造成分段滑动、页面展示不完整等体验缺陷。 针对该业务痛点,HarmonyOS 开发者官网梳理的《Web 组件大小自适应页面内容布局》技术文档展示了ArkWeb网页渲染引擎的layoutMode(WebLayoutMode.FIT_CONTENT)自适应布局模式,该模式可实现 Web 组件高度跟随 H5 内容自动撑开,消除 Web 内部独立滚动条,实现 Web 与原生组件统一联动滚动,为混合原生+H5 页面开发提供标准化参考。 一、能力适用场景 FIT_CONTENT 自适应布局模式适用于 Web 组件与其他 ArkUI 系统组件处于同一层级、需要共用外层滚动容器整体滑动的业务场景,典型业务包含两类: 1. 长文章浏览页面:Web 承载文章 H5 内容,页面下方搭配原生评论区、操作工具栏; 2. 混合布局首页:Web 展示运营 H5 模块,页面内并存原生宫格功能菜单。 两种布局模式效果对比: 1. 默认固定高度布局(非 FIT_CONTENT) Web 组件高度固定为一屏,若 H5 页面总高度(如 8000px)超出组件尺寸,Web 内部生成独立滚动条。滑动 Web 区域仅滚动网页内容,页面上下原生组件无法同步移动,页面展示完整性与交互流畅度较差。 2. FIT_CONTENT 自适应内容布局 Web 组件高度自动匹配完整 H5 页面高度,Web 内部不再生成滚动区域。页面滑动时,Web 内容、评论、菜单等所有组件同步联动滚动,全屏一体化展示页面内容。 二、规格与约束规范 使用 WebLayoutMode.FIT_CONTENT 模式时,需遵循明确的配置约束,规避白屏、布局错乱、滚动冲突等异常问题,全部规范如下: ▪ 渲染模式建议配置为同步渲染模式,避免因为组件大小超出限制导致的白屏、布局错乱问题; ▪ 建议将 overScrollMode过滚动模式设置为关闭状态。若开启过滚动,Web 滑动至边缘的弹性回弹动画会与外层 Scroll 组件回弹逻辑冲突,引发滚动卡顿; ▪ 若 Web 组件 keyboardAvoidMode键盘避让属性配置为 RESIZE_CONTENT,自适应高度能力将失效; ▪ 该模式不支持 H5页面双指缩放操作; ▪ 不支持通过 Web 组件的 height 属性修改组件高度; ▪ 仅支持根据页面内容自适应组件高度,不支持自适应宽度; ▪ 不支持瀑布流类型 H5 页面使用该自适应模式。 三、常见问题及解决方案 技术文档还描述了使用 FIT_CONTENT 自适应布局过程中易出现的各类问题,以下是高频问题的针对性解决方法,可以助力开发者快速定位并修复问题: 1. 设置了 FIT_CONTENT,但 Web 组件内仍出现滚动条: (1)可能原因:内部 H5 页面高度超过了 7680px(物理像素),但没有设置渲染模式为同步渲染模式;未配置 metaviewport 属性。 (2)解决方案:更改渲染模式为同步渲染模式;在 H5 页面增加 meta 配置<meta name="viewport" content="width=device-width, initial-scale=1.0"> 2. 设置 FIT_CONTENT 后,页面白屏或页面消失不显示: (1)可能的原因:核心内容 DOM 节点高度为 0;CSS 样式 height <number> vh 和 Web 组件大小自适应页面布局存在计算冲突,需检查 height <number> vh 是否是由 body 节点以内的第一个高度 CSS 样式。 (2)解决方案:在使用vh 的子 DOM 内部增加固定高度元素,撑开 DOM 容器;父容器直接配置固定像素高度,规避顶层 vh 布局冲突。 总而言之,WebLayoutMode.FIT_CONTENT 自适应布局作为 HarmonyOS 混合原生+ H5 页面开发的核心能力,能够解决多组件分层滚动割裂的用户体验问题。开发落地时需严格遵循同步渲染、关闭过滚动、规范 H5 viewport 三大基础配置,同时避开 vh 顶层布局、手动设置 Web 高度、搭配 RESIZE_CONTENT 键盘避让等约束场景。遇到页面滚动条、白屏等异常时,可对照本文故障定位方案快速修复,保障混合页面滚动交互流畅稳定。 想了解更多技术细节,请登录 HarmonyOS 开发者官网,按照“指南→应用框架→ArkWeb(方舟 Web)→Web 渲染和布局→Web 组件大小自适应页面内容布局”路径获取详细文档。

优秀的个人博客,低调大师

告别 ELK 账单刺客:用 ClickHouse + 隧道代理搭建百亿级爬虫观测底座

去年年中,我们团队负责的一套分布式爬虫集群单日抓取量突破了 8000 万次。随之而来的不是业务增长的喜悦,而是基础设施层面的全面告警。 当时为了排查目标站的风控阻断和代理链路抖动,我们搭建了一套常规的 ELK 集群,同时将请求产生的 HTML 页面快照存放在对象存储中。跑了不到两个月,痛点集中爆发: 1. **Elasticsearch 成为账单刺客**:海量爬虫日志把 8 节点 ES 集群的 JVM 堆内存和 SSD 磁盘迅速吃满,倒排索引膨胀严重,单月机器预算直接超标。 2. **关系库写入性能见底**:早期的部分核心元数据放在 MySQL,单表过亿后,高并发写入导致连接池经常被打满,B+ 树索引频繁分裂带来严重的 IO 抖动。 3. **日志与页面快照割裂**:排查一次反爬改版或解析异常,需要先在日志系统查到请求 ID,再去对象存储拉取对应的 HTML 快照,跨系统关联耗时费力。 在经历了两次线上复盘后,我们对整个采集链路的可观测架构做了重构,将日志度量数据与页面快照统一收拢至 **ClickHouse**。实测下来,整体存储成本下降了近 75%,单机写入吞吐和多维聚合查询性能也得到了数量级的提升。 本文结合这套方案的设计细节,分享我们在日志压缩、批量落盘、TTL 分层管理以及结合高并发隧道代理的完整实践。 ## 一、主流存储方案的横向对标 在爬虫工程中,日志和快照数据具备非常典型的特征:写入吞吐要求极高、极少单条更新、强时间局部性、分析查询多为大范围聚合,且 HTML 快照包含大量重复的文本结构。 我们在选型阶段针对几种主流方案做了实测对比: | 评估维度 | MySQL / PostgreSQL | MongoDB | Elasticsearch (ELK) | ClickHouse | | :--- | :--- | :--- | :--- | :--- | | **单节点写入吞吐** | 5k ~ 2w 行/秒 | 2w ~ 5w 行/秒 | 1w ~ 3w 行/秒(吃 CPU/内存) | **15w ~ 50w 行/秒(批量追加)** | | **快照压缩比** | 1.3:1 ~ 2:1 | 2:1 ~ 3:1 | 约 1.5:1(索引开销大) | **6:1 ~ 10:1(ZSTD 列式压缩)** | | **百亿级聚合延迟** | 分钟级甚至超时 | 秒级到十秒级 | 秒级(受限于堆内存) | **亚秒级(SIMD 向量化执行)** | | **冷热生命周期** | 依赖业务分表与外置清理 | 基础 TTL 索引(删除慢) | ILM 生命周期策略 | **原生表级/列级 TTL + 分层卷挂载** | | **硬件成本** | 较高(依赖高 IOPS) | 中等 | 高昂(大内存 + SSD 标配) | **低(高压缩 + 支持 HDD/对象存储冷归档)** | 关系型数据库无法应付千万级以上的日志追加,Elasticsearch 的倒排索引在非全文检索场景下纯属资源浪费,而 ClickHouse 的列式存储与分析型引擎正好覆盖了爬虫监控的痛点。 ## 二、ClickHouse 契合爬虫观测的关键特性 ### 1. 列式存储与 ZSTD 高效压缩 爬虫日志中存在大量低基数或高重复字段,比如请求方法、状态码、目标域名、出口 IP、异常分类等。即便是 HTML 快照本身,也包含大量的重复标签(如 ``、``、`` 及 CSS 类名)。 行存数据库将整行数据打包在一起,无法利用字段间的数据相似性。ClickHouse 将同一列的数据连续存放: * 对于低基数字符串,使用 `LowCardinality(String)` 字典编码; * 对于时间戳与耗时浮点数,使用 `DoubleDelta` 和 `Gorilla` 编码; * 对于 HTML 快照长文本列,配置 `CODEC(ZSTD(6))`。 在我们真实的测试集中,1TB 原始抓取日志与 HTML 快照,落盘后仅占用约 130GB 空间,综合压缩比达到 7.7:1。 ### 2. MergeTree 追加写支撑高并发数据流 ClickHouse 的 `MergeTree` 引擎只进行顺序追加写(Append-only),并在后台异步合并数据分片(Parts)。只要客户端做好批量聚合(例如每 1000~5000 条或每 2~3 秒提交一次),单台普通的 8 核 16G 机器即可稳定承载 20 万行/秒的写入压力,不会发生行级锁竞争。 ### 3. 原生 TTL 自动化分层与数据生命周期 爬虫排障具有明显的时效特征: * 最近 3~7 天的数据:高频访问,用于线上告警排查、反爬拦截分析及解析模板纠错; * 7 天以上的数据:访问频率极低,仅用于离线统计与样本回溯。 ClickHouse 支持在建表时直接指定 TTL 策略,无需额外维护定时清理脚本: ```sql ALTER TABLE crawler_dw.crawler_access_log MODIFY TTL created_at + INTERVAL 7 DAY TO VOLUME 'cold_disks', created_at + INTERVAL 30 DAY DELETE; ``` ## 三、生产实战:ClickHouse + 隧道代理 采集与落盘 在大规模采集任务中,高并发网络请求通常依托于稳定的隧道代理服务。在本次方案中,我们选用 **爬虫代理(隧道版)** 作为出口代理基础设施。 隧道代理通过统一的网关入口自动在云端轮换高匿出口 IP,爬虫客户端无需维护本地 IP 池,直接在 Python 异步协程中发起请求,并同步完成链路耗时度量与 ClickHouse 批量落盘。 ### 1. ClickHouse DDL 建表设计 ```sql CREATE DATABASE IF NOT EXISTS crawler_dw; CREATE TABLE IF NOT EXISTS crawler_dw.crawler_access_log ( request_id UUID DEFAULT generateUUIDv4(), task_name LowCardinality(String), -- 任务名称(字典编码) target_domain LowCardinality(String), -- 目标域名(字典编码) target_url String, -- 完整URL proxy_provider LowCardinality(String) DEFAULT 'yiniuyun', -- 代理商标识 proxy_ip String, -- 代理出口IP http_status UInt16 CODEC(T64, ZSTD(1)), -- HTTP状态码 tcp_handshake_ms Float32 CODEC(Gorilla, ZSTD(1)), -- TCP建连耗时 ttfb_ms Float32 CODEC(Gorilla, ZSTD(1)), -- 首字节到达耗时 total_cost_ms Float32 CODEC(Gorilla, ZSTD(1)), -- 请求总耗时 retry_count UInt8 CODEC(T64, ZSTD(1)), -- 重试次数 is_success UInt8 CODEC(T64, ZSTD(1)), -- 业务成功标记(1/0) error_reason LowCardinality(String), -- 错误类型(timeout/403/block等) html_snapshot String CODEC(ZSTD(6)), -- HTML快照(ZSTD Level 6) snapshot_size UInt32, -- 快照字节数 created_at DateTime DEFAULT now() CODEC(DoubleDelta, LZ4) ) ENGINE = MergeTree() PARTITION BY toYYYYMMDD(created_at) ORDER BY (task_name, target_domain, is_success, created_at) SETTINGS index_granularity = 8192; ``` ### 2. 异步数据采集与批量写入 Pipeline 以下为结合 aiohttp 与 clickhouse-connect 的可执行完整代码: ```python # -*- coding: utf-8 -*- """ ClickHouse 爬虫日志与快照存储方案 集成亿牛云隧道代理与异步批量写入器 """ import asyncio import time import uuid import aiohttp from typing import List, Dict, Any from clickhouse_connect import get_client # 亿牛云爬虫代理(隧道版)配置信息 PROXY_HOST = "proxy.16yun.cn" # 代理服务器域名 PROXY_PORT = "3100" # 隧道端口 PROXY_USER = "16YUN_USER_DEMO" # 账号用户名 PROXY_PASS = "16YUN_PASS_DEMO" # 账号密码 # 构建标准 HTTP Basic 认证代理连接串 PROXY_URL = f"http://{PROXY_USER}:{PROXY_PASS}@{PROXY_HOST}:{PROXY_PORT}" # ClickHouse 实例连接配置 CH_HOST = "127.0.0.1" CH_PORT = 8123 CH_USER = "default" CH_PASS = "" CH_DATABASE = "crawler_dw" class ClickHouseBatchWriter: """ClickHouse 异步批量写入缓冲区,平滑突发写入峰值""" def __init__(self, batch_size: int = 500, flush_interval: float = 2.0): self.batch_size = batch_size self.flush_interval = flush_interval self.buffer: List[Dict[str, Any]] = [] self.lock = asyncio.Lock() self.ch_client = get_client( host=CH_HOST, port=CH_PORT, username=CH_USER, password=CH_PASS, database=CH_DATABASE ) self.is_running = True async def add_log(self, record: Dict[str, Any]): async with self.lock: self.buffer.append(record) if len(self.buffer) >= self.batch_size: await self._flush_unlocked() async def _flush_unlocked(self): if not self.buffer: return records_to_insert = self.buffer.copy() self.buffer.clear() columns = list(records_to_insert[0].keys()) data = [[r[col] for col in columns] for r in records_to_insert] try: await asyncio.to_thread( self.ch_client.insert, table="crawler_access_log", data=data, column_names=columns ) print(f"[{time.strftime('%X')}] 写入 ClickHouse 成功:{len(records_to_insert)} 条记录") except Exception as e: print(f"ClickHouse 批量写入异常: {e}") async def start_auto_flush(self): """定时刷盘协程""" while self.is_running: await asyncio.sleep(self.flush_interval) async with self.lock: await self._flush_unlocked() async def close(self): self.is_running = False async with self.lock: await self._flush_unlocked() self.ch_client.close() async def fetch_and_record( session: aiohttp.ClientSession, url: str, task_name: str, writer: ClickHouseBatchWriter ): """通过亿牛云隧道代理发起请求,度量耗时并记录页面快照""" start_time = time.perf_counter() ttfb_ms, total_ms = 0.0, 0.0 status_code = 0 html_content = "" error_reason = "none" is_success = 0 proxy_ip = "auto_tunnel" try: req_start = time.perf_counter() async with session.get( url, proxy=PROXY_URL, timeout=aiohttp.ClientTimeout(total=10, connect=3) ) as resp: ttfb_ms = (time.perf_counter() - req_start) * 1000 status_code = resp.status proxy_ip = resp.headers.get("X-Forwarded-For", "tunnel_auto") # 读取快照(截取前 512KB 避免异常大体积响应) raw_bytes = await resp.content.read(512 * 1024) html_content = raw_bytes.decode("utf-8", errors="ignore") total_ms = (time.perf_counter() - start_time) * 1000 # 业务内容有效性三层校验 if status_code == 200: block_keywords = ["验证码", "访问限制", "waf", "robot check", "滑块验证"] if any(kw in html_content.lower() for kw in block_keywords): is_success = 0 error_reason = "anti_spider_blocked" else: is_success = 1 error_reason = "none" elif status_code in (403, 429): is_success = 0 error_reason = f"http_{status_code}_rate_limit" else: is_success = 0 error_reason = f"http_{status_code}" except asyncio.TimeoutError: error_reason = "network_timeout" total_ms = (time.perf_counter() - start_time) * 1000 except Exception as exc: error_reason = f"exception_{type(exc).__name__}" total_ms = (time.perf_counter() - start_time) * 1000 record = { "request_id": str(uuid.uuid4()), "task_name": task_name, "target_domain": url.split("//")[-1].split("/")[0], "target_url": url, "proxy_provider": "yiniuyun", "proxy_ip": proxy_ip, "http_status": status_code, "tcp_handshake_ms": 0.0, "ttfb_ms": round(ttfb_ms, 2), "total_cost_ms": round(total_ms, 2), "retry_count": 0, "is_success": is_success, "error_reason": error_reason, "html_snapshot": html_content, "snapshot_size": len(html_content.encode("utf-8")), } await writer.add_log(record) async def main(): writer = ClickHouseBatchWriter(batch_size=50, flush_interval=2.0) flush_task = asyncio.create_task(writer.start_auto_flush()) target_urls = [ "https://httpbin.org/ip", "https://httpbin.org/headers", "https://httpbin.org/user-agent", ] * 15 connector = aiohttp.TCPConnector(limit=50, ssl=False) async with aiohttp.ClientSession(connector=connector) as session: tasks = [ fetch_and_record(session, url, "news_crawling_job", writer) for url in target_urls ] await asyncio.gather(*tasks) await writer.close() flush_task.cancel() if __name__ == "__main__": asyncio.run(main()) ``` ## 四、排障实战:常用分析查询 统一收敛到 ClickHouse 后,日常的集群治理与风控溯源可以通过直接执行 SQL 完成。 ### 1. 实时分析各站点的抓取成功率与耗时分位数 ```sql SELECT target_domain, count() AS total_requests, round(countIf(is_success = 1) * 100.0 / count(), 2) AS success_rate_pct, round(quantile(0.50)(ttfb_ms), 1) AS p50_ttfb_ms, round(quantile(0.95)(ttfb_ms), 1) AS p95_ttfb_ms, round(quantile(0.99)(total_cost_ms), 1) AS p99_total_ms FROM crawler_dw.crawler_access_log WHERE created_at >= now() - INTERVAL 1 HOUR GROUP BY target_domain ORDER BY total_requests DESC; ``` > 在千万级日志记录下,该聚合查询在单机环境下通常在 **30~60 毫秒** 内返回结果。 ### 2. 定位风控拦截并提取现场快照 当特定目标站成功率出现异常滑落时,可以快速下钻异常分布,并调取被拦截时的 HTML 结构: ```sql -- 1. 统计最近 30 分钟拦截类型分布 SELECT error_reason, count() AS fail_count, topK(3)(http_status) AS top_statuses FROM crawler_dw.crawler_access_log WHERE target_domain = 'target-ecommerce.com' AND is_success = 0 AND created_at >= now() - INTERVAL 30 MINUTE GROUP BY error_reason; -- 2. 提取最新一条被拦截的真实页面快照 SELECT request_id, http_status, html_snapshot FROM crawler_dw.crawler_access_log WHERE target_domain = 'target-ecommerce.com' AND error_reason = 'anti_spider_blocked' ORDER BY created_at DESC LIMIT 1; ``` ## 五、总结 ClickHouse 在大规模爬虫可观测场景下的核心价值,在于同时兼顾了**高吞吐日志度量**与**高压缩长文本快照**两种不同类型的数据存储需求: 1. **架构收敛**:避免了在生产环境中同时运维 ES、MySQL 与对象存储的多组件负担,降低了系统运维复杂度和排障链路。 2. **存储成本可控**:依靠列式存储与 ZSTD 压缩编码,将原本庞大的 HTML 快照存储体积压缩至原来的 15% 左右,配合 TTL 机制实现冷热自动流转。 3. **结合隧道代理提升效率**:在底层配合**隧道代理**这类自动轮换出口 IP 的网络基础设施后,爬虫侧可以将重心放在采集逻辑与风控对抗上,实时将质量指标沉淀至 ClickHouse,形成可快速回溯的观测闭环。
优秀的个人博客,低调大师

告别系统崩溃!ARM工控机 + OverlayFS,系统一键还原

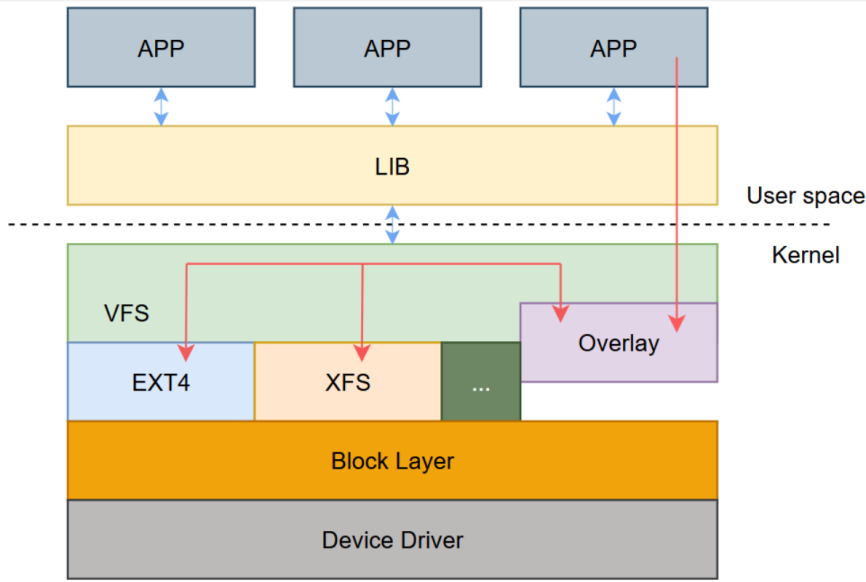
# **▍**OverlayFS如何保护系统? OverlayFS是Linux内核中的一种联合挂载文件系统服务,通过合并多个目录最终实现分层存储管理。 ![](https://developer-private-1258344699.cos.ap-guangzhou.myqcloud.com/column/article/8546319/20260826-07914bea.png?x-cos-security-token=jU68plXgF9W2J2H1S65dWj5M92L4MYMa95382b909ab56ea69a28e4196a8aa86eIxPyig0XjCfH5AbOjCDICCAr1btKgyEiRuoH38992EAj_XE4KI3JID5hjihmM_l-9Lr7POaXYWkBv3hJrYKF3qKmHpC6NmsScWduQn8-emcXif6T8ph-YXlBerNgAVVacSvxp2ADk0YuAx74lLmiCK-Y4I4qpiRtvjSzoSfxBUYX0N96aGo90egkEr0NCqDug6wfhjDmWm7SqYdTS65-vWa6rYCrJDjferTo6uIA9nyKrzFrVAcb-zrws0XTqPlHMMdd67qttUnWwuPrKYuYEtmi9rGii56NzqhHhcKOT-6w1AfrazItFwxJnp3p9uYrdzFSd3p4smuSdQywl886F1eZgD_-Uo1biLx3Q_AQT6aLQciJE8sI-VDDC1w3uzI1A3uGlBJ5JiKJnxc9EQs1MQ&q-sign-algorithm=sha1&q-ak=AKIDDd0ZjKzC4VBizJ1IdftYzU5WGhOy4plIlZfO8yojfFSUqM8Toonjs6M_Nulzz1VD&q-sign-time=1789034148%3B1789034748&q-key-time=1789034148%3B1789034748&q-header-list=host&q-url-param-list=x-cos-security-token&q-signature=9a7a6817ac459375b4b5c9963bfc710a2f43b4e0) 添加描述 OverlayFS文件系统由下层目录(Lowerdir)、上层目录(Upperdir)、工作目录(Workdir)和合并目录(Merged)构成。通过写时复制机制优先展示上层文件,利用whiteout机制和opaque目录实现文件删除功能。 ![](https://developer-private-1258344699.cos.ap-guangzhou.myqcloud.com/column/article/8546319/20260826-2eb5906b.png?x-cos-security-token=jU68plXgF9W2J2H1S65dWj5M92L4MYMafd3c09184ee06edce35d4057e28b9961IxPyig0XjCfH5AbOjCDICCAr1btKgyEiRuoH38992EAj_XE4KI3JID5hjihmM_l-9Lr7POaXYWkBv3hJrYKF3qKmHpC6NmsScWduQn8-emcXif6T8ph-YXlBerNgAVVacSvxp2ADk0YuAx74lLmiCK-Y4I4qpiRtvjSzoSfxBUYX0N96aGo90egkEr0NCqDug6wfhjDmWm7SqYdTS65-vQ06rXt6vbQbub4M1IUEd-5grUisKDmXC9JLdowAplTBxd2EfSj9vETrlZJF0SBbRXra1E90ZeDC8atYS-8jmnXOJ3y4cl-loLAS79arPTBmqH-09uU1baMWlqaZ1tEXOLVC94N6jekFb76jGShdIvUjZm1zyjsJy1uxUZA5_eI3vqusbjVVrT5jni-oB-dHWA&q-sign-algorithm=sha1&q-ak=AKIDcUIF86snRH6HOH9RjpBsqIXTbSygyyk-oUnGHYrJCjrTiX-nIwYZRgNf56NYXKff&q-sign-time=1789034148%3B1789034748&q-key-time=1789034148%3B1789034748&q-header-list=host&q-url-param-list=x-cos-security-token&q-signature=1f73a13ed61bf81cf7df3765fe832d956183c7ec) 添加描述 Overlay通过联合挂载技术将lower层和upper层合并为一个视图(merge层)。当修改文件时,系统自动执行写时复制机制,若文件存在于lower层,系统会先将其复制到upper层,随后仅对upper层的副本进行修改;若文件仅存在于upper层(如用户新增文件),则直接在该层操作。 在支持OverlayFS的设备上,系统采用分层存储机制保护根文件系统分区(rootfs分区),rootfs分区以只读方式挂载至lower层,确保原始系统镜像免受意外修改或损坏。并且,所有用户修改均定向写入的upper层(userdata分区),而非直接操作rootfs分区。 若在"/root-ro/"(lower层)目录中创建文件,会提示只读,无法写入。 若在用户目录(merge层)中,则可以创建,写入文件。 # **▍系统恢复功能演示** 以下基于RK3576嵌入式工控机演示通过Overlayrs实现恢复出厂设置功能,将文件系统恢复至初始状态。此操作可彻底清除用户数据及自定义配置,使系统重置为最近一次完成系统镜像固化的状态。 请先参考产品资料,配置任意网口的静态IP。以下以配置LAN1网口静态IP作为演示。配置完成后,可以看到LAN1网口的IP地址被修改为192.168.11.195。当恢复出厂设置后,该配置将失效,恢复为初始的动态获取IP。 执行如下命令,可查看到单板机文件系统分别在"/etc/NetworkManager/system-connections"(merge层)目录与"/userdata/rootfs_overlay/etc/NetworkManager/system-connections"(upper层)目录下会自动生成静态IP配置文件。 执行如下命令查看,在"/root-ro/etc/NetworkManager/system-connections"(lower层)下,该文件没有生成。 执行如下命令,进行恢复出厂设置。在这个过程中,单板机将进入recovery模式,进行格式化处理,其中lower层的内容将得到保留,格式化完成之后系统将自动引导进入文件系统。 进入系统后,可查看到静态IP配置修改已清除,"/userdata/rootfs_overlay"(upper层)相关文件消失,且IP地址成功恢复成初始状态。

优秀的个人博客,低调大师

告别背命令:Pragmatic AI Shell 把自然语言带进日常终端操作

用自然语言驱动终端,Pragmatic AI Shell 让运维排障"说话就行" 还在为记不住lsof、awk、find的参数写法头疼?还在ps+netstat+文档之间来回切换?Pragmatic AI Shell(smartcli)试图改变这一切——你只需要用自然语言描述意图,它替你生成命令,安全过滤后确认执行,全程可审计。 一句话介绍 你说人话,它出命令,确认后执行。 🤖 > 找出占用 8080 端口的进程 ➜ 建议执行: lsof -i :8080 确认执行?[y/N] y java 12345 user 45u IPv6 0x1234 ... TCP *:http-alt (LISTEN) (退出码 0) 🤖 > 杀掉这个进程 ➜ 建议执行: kill -9 12345 核心特性 🧠 语义模式:自然语言 → LLM 生成 shell 命令 → 二次确认 → 执行;支持 Ctrl+C 取消,超时或服务异常自动降级直通模式,不中断会话。 💬 多轮对话上下文:保留最近 10 轮对话与命令执行结果(直通!命令同样入史),模型可引用上一步输出完成后续操作;/context查看、/clear清空,退出会话即清空,不跨会话持久化;密钥类信息(sk-、token=等)入史前自动脱敏。 🛡️ 三层安全防线:模型自审(UNSAFE)→ 黑名单与风险分级过滤 → 危险命令强制人工确认;默认拦截内网地址扫描类请求。被安全策略拒绝的命令会入史,模型不会被诱导生成规避安全策略的命令。 ⚡ 直通模式:!前缀或/mode direct,命令原样执行,与原生终端无异。 📂 会话状态 REPL 级处理:cd/export/source等状态命令在 REPL 层模拟,跨命令持久生效,弥补子进程隔离带来的状态丢失问题。 📋 全量审计日志:每条命令的来源、原文、执行结果、耗时,JSON 落盘,事后复盘一目了然。 🔌 真终端体验:JLine REPL、Tab 路径补全、命令历史、等待动画;ssh/vim/top等交互命令直连终端,可正常分配伪终端。 和 AI 编程助手(Claude Code / CodeBuddy 等)有什么区别? 它们是“AI 程序员”——面向代码仓库,自主读写文件、重构、跑测试;Pragmatic AI Shell 是“AI 终端”——面向命令本身,专注运维排障与日常终端操作。核心差异: 人主导,AI 辅助:每条命令强制人工确认后才执行,配合三层安全防线,AI 生成的命令敢在真实生产环境里跑; 会话状态真实持久:cd/export/source在 REPL 层模拟,跨命令生效(对子进程隔离的补偿设计); 上下文围绕“命令 + 结果”:多轮历史包含命令执行输出,直通!命令同样入史,密钥自动脱敏; 无 Key 也能用:不配置 LLM 就退化为纯直通终端,交互命令(ssh/vim/top)直连终端。 技术亮点 多模型支持:基于 LangChain4j,兼容任意 OpenAI 协议(DeepSeek / OpenAI / 智谱 / Ollama 等),本地模型同样可用; 多轮消息组装:每轮历史按「用户输入 → 命令 → 执行结果块」组装为结构化消息,让模型"看得见"上一步发生了什么; 输出回流:命令实时打印的同时收集尾部摘要(默认 2000 字符,超出保留最新),供上下文引用; 健壮的进程管理:命令超时递归销毁整棵进程树,不残留孤儿进程; 跨平台:macOS / Linux / Windows 均可运行,配置中心化(config.yaml),支持只读模式(适合生产环境排障)。 快速上手 git clone https://github.com/pragmatic-lee/pragmatic-ai-shell.git cd pragmatic-ai-shell cp config.example.yaml config.yaml # 填入 LLM 配置bin/smartcli 未配置 LLM 时程序自动降级为纯直通模式,即使没有 API Key 也能当普通终端用。 结语 Pragmatic AI Shell 面向"想用终端但不想背命令"的开发者与运维,以安全为底线,把 AI 能力做进最常用的工具里。项目开源,欢迎体验与共建。

优秀的个人博客,低调大师

5分钟学会用AI批量处理Excel——告别重复劳动

你有没有被重复的数据处理工作折磨过? 每月要汇总几十张表格,复制粘贴到手指发麻;领导突然要某个筛选条件的数据,翻遍Excel也找不到;数据清洗去重,盯着屏幕看到眼睛酸…… 今天分享一个我亲测有效的方法:用AI批量处理Excel,效率提升10倍不止。 ## 我的真实经历 上个月,我需要从一份3000+行的销售数据里,按地区和产品类别做交叉统计。 手动操作?预计4小时。 用AI辅助?15分钟搞定,剩下的时间摸鱼。 ## 具体怎么做 **第一步:把需求说清楚** 不要只说帮我整理数据,要说清楚: - 源文件是什么格式 - 要筛选哪些条件 - 输出格式是什么 - 有没有特殊统计逻辑 比如:我的Excel里A列是日期,B列是地区,C列是金额。请帮我统计每个地区的月度销售总额,输出成新表格。 **第二步:让AI生成处理脚本** 现在的AI工具可以帮你写Python数据分析代码。你只需要: 1. 把表格列名告诉AI 1. 说明处理逻辑 1. 让它生成可运行的代码 1. 本地运行即可 核心代码其实就几行,关键是让AI帮你写。 **第三步:验证结果** 重要!AI处理完后一定要抽查几条数据确认无误,再交给领导。 ## 适合AI处理的场景 数据清洗去重、格式统一;多表合并汇总;条件筛选分类;生成统计报表;异常值检测。 不适合的场景:需要主观判断的数据、涉及隐私敏感信息、需要实时数据。 ## 工具推荐 Python加pandas最灵活,适合重复任务;AI对话工具适合一次性分析;Excel内置函数可以先试试简单统计。 --- 用AI处理数据不是偷懒,而是把时间花在真正需要思考的地方。那些机械重复的工作,就让机器去做吧。 你平时有哪些重复性的数据处理工作?有没有想过用AI来帮忙?欢迎分享交流。 --- *你有什么Excel处理的小技巧?欢迎在评论区交流!*

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册