首页 文章 精选 留言 我的

精选列表

搜索[面试],共5090篇文章
优秀的个人博客,低调大师

面试请不要再问我Spring Cloud底层原理了!

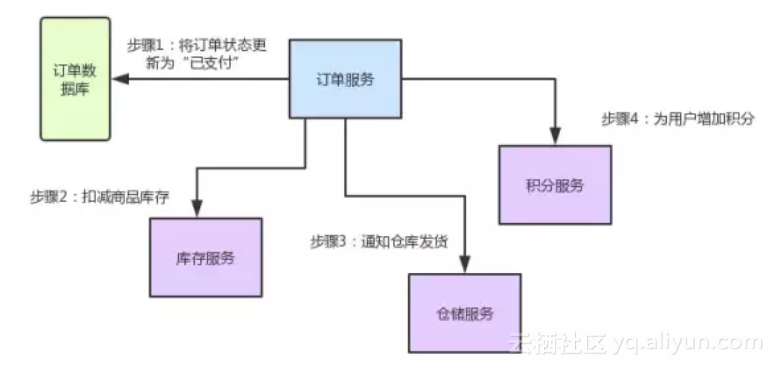
毫无疑问,Spring Cloud是目前微服务架构领域的翘楚,无数的书籍博客都在讲解这个技术。不过大多数讲解还停留在对Spring Cloud功能使用的层面,其底层的很多原理,很多人可能并不知晓。因此本文将通过大量的手绘图,给大家谈谈Spring Cloud微服务架构的底层原理。 实际上,Spring Cloud是一个全家桶式的技术栈,包含了很多组件。本文先从其最核心的几个组件入手,来剖析一下其底层的工作原理。也就是Eureka、Ribbon、Feign、Hystrix、Zuul这几个组件。 一、业务场景介绍 先来给大家说一个业务场景,假设咱们现在开发一个电商网站,要实现支付订单的功能,流程如下: ●创建一个订单后,如果用户立刻支付了这个订单,我们需要将订单状态更新为“已支付” ●扣减相应的商品库存 ●通知仓储中心,进行发货 ●给用户的这次购物增加相应的积分 针对上述流程,我们需要有订单服务、库存服务、仓储服务、积分服务。整个流程的大体思路如下: ●用户针对一个订单完成支付之后,就会去找订单服务,更新订单状态 ●订单服务调用库存服务,完成相应功能 ●订单服务调用仓储服务,完成相应功能 ●订单服务调用积分服务,完成相应功能 至此,整个支付订单的业务流程结束! 下图这张图,清晰表明了各服务间的调用过程: 好!有了业务场景之后,咱们就一起来看看Spring Cloud微服务架构中,这几个组件如何相互协作,各自发挥的作用以及其背后的原理。 二、Spring Cloud核心组件:Eureka 咱们来考虑第一个问题:订单服务想要调用库存服务、仓储服务,或者积分服务,怎么调用? ●订单服务压根儿就不知道人家库存服务在哪台机器上啊!他就算想要发起一个请求,都不知道发送给谁,有心无力! ●这时候,就轮到Spring Cloud Eureka出场了。 Eureka是微服务架构中的注册中心,专门负责服务的注册与发现。 咱们来看看下面的这张图,结合图来仔细剖析一下整个流程: 如上图所示,库存服务、仓储服务、积分服务中都有一个Eureka Client组件,这个组件专门负责将这个服务的信息注册到Eureka Server中。说白了,就是告诉Eureka Server,自己在哪台机器上,监听着哪个端口。而Eureka Server是一个注册中心,里面有一个注册表,保存了各服务所在的机器和端口号。 订单服务里也有一个Eureka Client组件,这个Eureka Client组件会找Eureka Server问一下:库存服务在哪台机器啊?监听着哪个端口啊?仓储服务呢?积分服务呢?然后就可以把这些相关信息从Eureka Server的注册表中拉取到自己本地缓存起来。 这时如果订单服务想要调用库存服务,不就可以找自己本地的Eureka Client问一下库存服务在哪台机器?监听哪个端口吗?收到响应后,紧接着就可以发送一个请求过去,调用库存服务扣减库存的那个接口!同理,如果订单服务要调用仓储服务、积分服务,也是如法炮制。 总结一下: ●Eureka Client:负责将这个服务的信息注册到Eureka Server中 ●Eureka Server:注册中心,里面有一个注册表,保存了各个服务所在的机器和端口号 三、Spring Cloud核心组件:Feign 现在订单服务确实知道库存服务、积分服务、仓库服务在哪里了,同时也监听着哪些端口号了。但是新问题又来了:难道订单服务要自己写一大堆代码,跟其他服务建立网络连接,然后构造一个复杂的请求,接着发送请求过去,最后对返回的响应结果再写一大堆代码来处理吗? 这是上述流程翻译的代码片段,咱们一起来看看,体会一下这种绝望而无助的感受!!! 友情提示,前方高能! 看完上面那一大段代码,有没有感到后背发凉、一身冷汗?实际上你进行服务间调用时,如果每次都手写代码,代码量比上面那段要多至少几倍,所以这个事压根儿就不是地球人能干的。 既然如此,那怎么办呢?别急,Feign早已为我们提供好了优雅的解决方案。来看看如果用Feign的话,你的订单服务调用库存服务的代码会变成啥样? 看完上面的代码什么感觉?是不是感觉整个世界都干净了,又找到了活下去的勇气!没有底层的建立连接、构造请求、解析响应的代码,直接就是用注解定义一个 FeignClient接口,然后调用那个接口就可以了。人家Feign Client会在底层根据你的注解,跟你指定的服务建立连接、构造请求、发起靕求、获取响应、解析响应,等等。这一系列脏活累活,人家Feign全给你干了。 那么问题来了,Feign是如何做到这么神奇的呢?很简单,Feign的一个关键机制就是使用了动态代理。咱们一起来看看下面的图,结合图来分析: ●首先,如果你对某个接口定义了@FeignClient注解,Feign就会针对这个接口创建一个动态代理; ●接着你要是调用那个接口, 本质就是会调用 Feign创建的动态代理,这是核心中的核心; ●Feign的动态代理会根据你在接口上的@RequestMapping等注解,来动态构造出你要请求的服务的地址; ●最后针对这个地址,发起请求、解析响应; 四、Spring Cloud核心组件:Ribbon 说完了Feign,还没完。现在新的问题又来了,如果人家库存服务部署在了5台机器上,如下所示: ●192.168.169:9000 ●192.168.170:9000 ●192.168.171:9000 ●192.168.172:9000 ●192.168.173:9000 这下麻烦了!人家Feign怎么知道该请求哪台机器呢? ●这时Spring Cloud Ribbon就派上用场了。Ribbon就是专门解决这个问题的。 它的作用是负载均衡,会帮你在每次请求时选择一台机器,均匀的把请求分发到各个机器上 ; ●Ribbon的负载均衡默认使用的最经典的Round Robin轮询算法。这是啥?简单来说,就是如果订单服务对库存服务发起10次请求,那就先让你请求第1台机器、然后是第2台机器、第3台机器、第4台机器、第5台机器,接着再来—个循环,第1台机器、第2台机器。。。以此类推。 此外,Ribbon是和Feign以及Eureka紧密协作,完成工作的,具体如下: ●首先Ribbon会从 Eureka Client里获取到对应的服务注册表,也就知道了所有的服务都部署在了哪些机器上,在监听哪些端口号。 ●然后Ribbon就可以使用默认的Round Robin算法,从中选择一台机器 ●Feign就会针对这台机器,构造并发起请求。 对上述整个过程,再来一张图,帮助大家更深刻的理解: 五、Spring Cloud核心组件:Hystrix 在微服务架构里,一个系统会有很多的服务。以本文的业务场景为例:订单服务在一个业务流程里需要调用三个服务。现在假设订单服务自己最多只有100个线程可以处理请求,然后呢,积分服务不幸的挂了,每次订单服务调用积分服务的时候,都会卡住几秒钟,然后抛出—个超时异常。 咱们一起来分析一下,这样会导致什么问题? ●如果系统处于高并发的场景下,大量请求涌过来的时候,订单服务的100个线程都会卡在请求积分服务这块。导致订单服务没有一个线程可以处理请求; ●然后就会导致别人请求订单服务的时候,发现订单服务也挂了,不响应任何请求了; 上面这个,就是微服务架构中恐怖的服务雪崩问题,如下图所示: 如上图,这么多服务互相调用,要是不做任何保护的话,某一个服务挂了,就会引起连锁反应,导致别的服务也挂。比如积分服务挂了,会导致订单服务的线程全部卡在请求积分服务这里,没有一个线程可以工作,瞬间导致订单服务也挂了,别人请求订单服务全部会卡住,无法响应。 但是我们思考一下,就算积分服务挂了,订单服务也可以不用挂啊!为什么? ●我们结合业务来看:支付订单的时候,只要把库存扣减了,然后通知仓库发货就OK了 ●如果积分服务挂了,大不了等他恢复之后,慢慢人肉手工恢复数据!为啥一定要因为一个积分服务挂了,就直接导致订单服务也挂了呢?不可以接受! 现在问题分析完了,如何解决? 这时就轮到Hystrix闪亮登场了。Hystrix是隔离、熔断以及降级的一个框架。啥意思呢?说白了,Hystrix会搞很多个小小的线程池,比如订单服务请求库存服务是一个线程池,请求仓储服务是一个线程池,请求积分服务是一个线程池。每个线程池里的线程就仅仅用于请求那个服务。 打个比方:现在很不幸,积分服务挂了,会咋样? 当然会导致订单服务里那个用来调用积分服务的线程都卡死不能工作了啊!但由于订单服务调用库存服务、仓储服务的这两个线程池都是正常工作的,所以这两个服务不会受到任何影响。 这个时候如果别人请求订单服务,订单服务还是可以正常调用库存服务扣减库存,调用仓储服务通知发货。只不过调用积分服务的时候,每次都会报错。但是如果积分服务都挂了,每次调用都要去卡住几秒钟干啥呢?有意义吗?当然没有!所以我们直接对积分服务熔断不就得了,比如在5分钟内请求积分服务直接就返回了,不要去走网络请求卡住几秒钟,这个过程,就是所谓的熔断! 那人家又说,兄弟,积分服务挂了你就熔断,好歹你干点儿什么啊!别啥都不干就直接返回啊?没问题,咱们就来个降级:每次调用积分服务,你就在数据库里记录一条消息,说给某某用户增加了多少积分,因为积分服务挂了,导致没增加成功!这样等积分服务恢复了,你可以根据这些记录手工加一下积分。这个过程,就是所谓的降级。 为帮助大家更直观的理解,接下来用一张图,梳理一下Hystrix隔离、熔断和降级的全流程: 六、Spring Cloud核心组件:Zuul 说完了Hystrix,接着给大家说说最后一个组件:Zuul,也就是微服务网关。这个组件是负责网络路由的。不懂网络路由?行,那我给你说说,如果没有Zuul的日常工作会怎样? 假设你后台部署了几百个服务,现在有个前端兄弟,人家请求是直接从浏览器那儿发过来的。打个比方:人家要请求一下库存服务,你难道还让人家记着这服务的名字叫做inventory-service?部署在5台机器上?就算人家肯记住这一个,你后台可有几百个服务的名称和地址呢?难不成人家请求一个,就得记住一个?你要这样玩儿,那真是友谊的小船,说翻就翻! 上面这种情况,压根儿是不现实的。所以一般微服务架构中都必然会设计一个网关在里面,像android、ios、pc前端、微信小程序、H5等等,不用去关心后端有几百个服务,就知道有一个网关,所有请求都往网关走,网关会根据请求中的一些特征,将请求转发给后端的各个服务。 而且有一个网关之后,还有很多好处,比如可以做统一的降级、限流、认证授权、安全,等等。 七、总结: 最后再来总结一下,上述几个Spring Cloud核心组件,在微服务架构中,分别扮演的角色: ●Eureka:各个服务启动时,Eureka Client都会将服务注册到Eureka Server,并且Eureka Client还可以反过来从Eureka Server拉取注册表,从而知道其他服务在哪里 ●Ribbon:服务间发起请求的时候,基于Ribbon做负载均衡,从一个服务的多台机器中选择一台 ●Feign:基于Feign的动态代理机制,根据注解和选择的机器,拼接请求URL地址,发起请求 ●Hystrix:发起请求是通过Hystrix的线程池来走的,不同的服务走不同的线程池,实现了不同服务调用的隔离,避免了服务雪崩的问题 ●Zuul:如果前端、移动端要调用后端系统,统一从Zuul网关进入,由Zuul网关转发请求给对应的服务 以上就是我们通过一个电商业务场景,阐述了Spring Cloud微服务架构几个核心组件的底层原理。 文字总结还不够直观?没问题!我们将Spring Cloud的5个核心组件通过一张图串联起来,再来直观的感受一下其底层的架构原理: 原文发布时间为:2018-11-20本文作者:中华石杉本文来自云栖社区合作伙伴“ Java后端技术”,了解相关信息可以关注“ Java后端技术”。

优秀的个人博客,低调大师

[算法总结] 3 道题搞定 BAT 面试——堆栈和队列

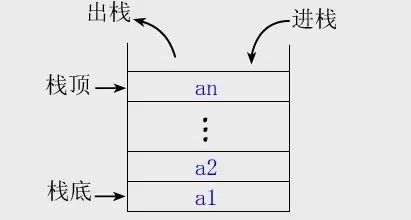
本文首发于我的个人博客:尾尾部落 0. 基础概念 栈:后进先出(LIFO) image 队列:先进先出(FIFO) image 1. 栈的 java 实现 import java.util.Arrays; public class Stack { private int size = 0; //栈顶位置 private int[] array; public Stack(){ this(10); } public Stack(int init) { if(init <= 0){ init = 10; } array = new int[init]; } /** * 入栈操作 * @param item 入栈的元素 */ public void push(int item){ if(size == array.length){ array = Arrays.copyOf(array, size*2); //扩容操作 } array[size++] = item; } /** * 获取栈顶元素,但栈顶元素不出栈 * @return 栈顶元素 */ public int peek(){ if(size == 0){ //空栈 throw new IndexOutOfBoundsException("栈是空的"); } return array[size-1]; } /** * 出栈,同时获取栈顶元素 * @return */ public int pop(){ int item = peek(); //获取栈顶元素 size--; //直接使元素个数减1,不用清除元素,下次入栈会覆盖旧元素的值 return item; } /** * 判断栈是否已满 * @return */ public boolean isFull(){ return size == array.length; } /** * 判断栈是否为空 * @return */ public boolean isEmpty(){ return size == 0; } public int getSize(){ return size; } } 2. 队列的 java 实现 public class ArrayQueue { private final Object[] queue; //声明一个数组 private int head; private int tail; /** * 初始化队列 * @param capacity 队列长度 */ public ArrayQueue(int capacity){ this.queue = new Object[capacity]; } /** * 入队 * @param o 入队元素 * @return 入队成功与否 */ public boolean put(Object o){ if(head == (tail+1)%queue.length){ //说明队满 return false; } queue[tail] = o; tail = (tail+1)%queue.length; //tail标记后移一位 return true; } /** * 返回队首元素,但不出队 * @return */ public Object peak() { if(head==tail){ //队空 return null; } return queue[head]; } /** * 出队 * @return 出队元素 */ public Object pull(){ if(head==tail){ return null; } Object item = queue[head]; queue[head] = null; return item; } /** * 判断是否为空 * @return */ public boolean isEmpty(){ return head == tail; } /** * 判断是否为满 * @return */ public boolean isFull(){ return head == (tail+1)%queue.length; } /** * 获取队列中的元素个数 * @return */ public int getsize(){ if(tail>=head){ return tail-head; }else{ return (tail+queue.length)-head; } } } 3. 用两个栈实现队列 剑指offer:用两个栈实现队列 LeetCode:Implement Queue using Stacks class MyQueue { Stack<Integer> input = new Stack<Integer>(); Stack<Integer> output = new Stack<Integer>(); /** Push element x to the back of queue. */ public void push(int x) { input.push(x); } /** Removes the element from in front of queue and returns that element. */ public int pop() { peek(); return output.pop(); } /** Get the front element. */ public int peek() { if(output.isEmpty()){ while(!input.isEmpty()) output.push(input.pop()); } return output.peek(); } /** Returns whether the queue is empty. */ public boolean empty() { return input.isEmpty() && output.isEmpty(); } } 4. 用队列实现栈 LeetCode:Implement Stack using Queues class MyStack { Queue<Integer> q1 = new LinkedList<Integer>(); Queue<Integer> q2 = new LinkedList<Integer>(); /** Push element x onto stack. */ public void push(int x) { if(q1.isEmpty()){ q1.add(x); for(int i = 0; i < q2.size(); i++){ q1.add(q2.poll()); } }else{ q2.add(x); for(int i = 0; i < q1.size(); i++){ q2.add(q1.poll()); } } } /** Removes the element on top of the stack and returns that element. */ public int pop() { return q1.isEmpty() ? q2.poll() : q1.poll(); } /** Get the top element. */ public int top() { return q1.isEmpty() ? q2.peek() : q1.peek(); } /** Returns whether the stack is empty. */ public boolean empty() { return q1.isEmpty() && q2.isEmpty(); } } 5. 包含min函数的栈 剑指offer:包含min函数的栈 定义栈的数据结构,请在该类型中实现一个能够得到栈最小元素的min函数。 class MinStack { Stack<Integer> stack = new Stack<Integer>(); Stack<Integer> temp = new Stack<Integer>(); public void push(int x) { stack.push(x); if(temp.isEmpty() || temp.peek() >= x) temp.push(x); } public void pop() { int x = stack.pop(); int min = temp.peek(); if(x == min) temp.pop(); } public int top() { return stack.peek(); } public int getMin() { return temp.peek(); } } 6. 栈的压入、弹出序列 剑指offer:栈的压入、弹出序列 输入两个整数序列,第一个序列表示栈的压入顺序,请判断第二个序列是否为该栈的弹出顺序。假设压入栈的所有数字均不相等。例如序列1,2,3,4,5是某栈的压入顺序,序列4,5,3,2,1是该压栈序列对应的一个弹出序列,但4,3,5,1,2就不可能是该压栈序列的弹出序列。(注意:这两个序列的长度是相等的) import java.util.ArrayList; import java.util.Stack; public class Solution { public boolean IsPopOrder(int [] pushA, int [] popA) { if(pushA.length != popA.length || pushA.length == 0 || popA.length == 0) return false; Stack<Integer> stack = new Stack<>(); int index = 0; for(int i = 0; i < pushA.length; i++){ stack.push(pushA[i]); while(!stack.empty() && stack.peek() == popA[index]){ stack.pop(); index++; } } return stack.empty(); } }

优秀的个人博客,低调大师

2018 年最常见的 Python 面试题 & 答案

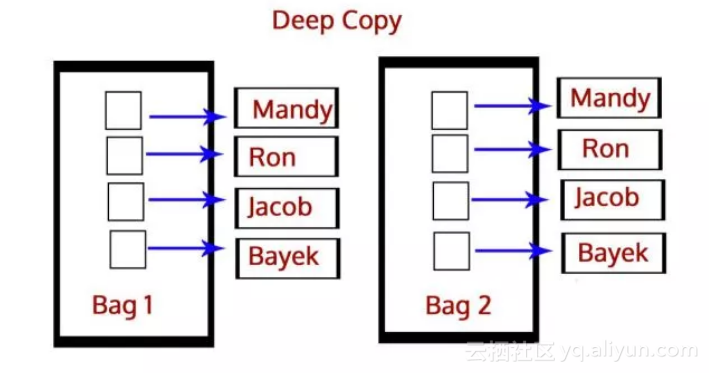
Q 1:Python 有哪些特点和优点? 作为一门编程入门语言,Python 主要有以下特点和优点: 可解释 具有动态特性 面向对象 简明简单 开源 具有强大的社区支持 当然,实际上 Python 的优点远不止如此,可以阅读该文档,详细了解: https://data-flair.training/blogs/python-tutorial/ Q 2:深拷贝和浅拷贝之间的区别是什么? 答:深拷贝就是将一个对象拷贝到另一个对象中,这意味着如果你对一个对象的拷贝做出改变时,不会影响原对象。在 Python 中,我们使用函数 deepcopy() 执行深拷贝,导入模块 copy,如下所示: 1 >> > import copy 2 >> > b=copy.deepcopy(a) 而浅拷贝则是将一个对象的引用拷贝到另一个对象上,所以如果我

优秀的个人博客,低调大师

9道前端面试题及答案,赶紧收藏!

1、什么是W3C标准? WEB标准不是某一个标准,而是一系列标准的集合。网页主要由三部分组成:结构(Structure)、表现(Presentation)和行为(Behavior)。对应的标准也分三方面:结构化标准语言主要包括XHTML和XML,表现标准语言主要包括CSS,行为标准主要包括对象模型(如W3C DOM)、ECMAScript等。 2、bootstrap响应式原理 是通过栅格系统和媒体查询实现的 // 小屏幕(平板,大于等于 768px)@media (min-width: @screen-sm-min) { ... }// 中等屏幕(桌面显示器,大于等于 992px)@media (min-width: @screen-md-min) { ... }// 大屏幕(大桌面显示器,大于等于 1200... 3、HTML/XHTM的区别 XHTML 与 HTML 4.01 标准没有太多的不同。 XHTML 元素必须被正确地嵌套。 XHTML 元素必须被关闭。 标签名必须用小写字母。 XHTML 文档必须拥有根元素。 【如果大家对程序员,web前端感兴趣,想要学习的,关注一下小编吧。我是一名前端开发程序员,现在在网上授课教前端,每晚都会在群内免费直播。从最基础的HTML+CSS+JS到移动端HTML5到各种框架都有整理,送给每一位前端小伙伴,这里是小白聚集地,欢迎初学和进阶中的小伙伴。加群:731771211。前端学习必备公众号ID:mtbcxx】 4、页面构架和布局 布局可以是编码方面的,也可以是视觉方面的。 编码方面的涉及到语义化标签(也包含了div+css)布局、iframe框架(特殊地方使用)布局和表格布局(只用于一些特殊的地方,不推荐全站使用),具体你可以百度下了解学习下相关知识。 如果是视觉交互方面的,就比较多了,每年都会有新的设计布局,高级一点的比如视差类型布局,全屏布局,瀑布流,无缝拼图布局等,这些都不局限于传统的布局方式;传统电子商务、信息类的大多采用单栏、两栏或者三栏布局,还有更多栏布局;分辨率相关的宽屏布局和窄屏布局,感应式布局。太多的选择了,要学习的东西也比较多,要慢慢了解啦。还有更多的布局需要慢慢摸索和体验。我把我知道的说了。 至于手机端,例举一些:竖排列表、横排方块、九宫格、TAB切换式、手风琴布局(有多个分类及其内容同时展示)、抽屉/侧边栏、标签场景式),因为屏幕小,要增加用户体验都可以根据具体情况用不同的布局方式。 5、BootStrap学习笔记,优缺点总结 优点: BT的优势之一就是可以根据用户屏幕尺寸调整页面,使其在各个尺寸上都表现良好。 BT预先定义了很多CSS类,使用的时候直接给class赋予对应的类名即可,如text-left,text-align,.table等。最有代表性的就是btn类,BT定义了一个.bt的基础类,如果还想要其他样式可以在这个基础类上进行扩展,实现不同的视觉效果。 BT的JavaScript插件非常丰富,既可以用现成的也可以自己扩充,BT提供了一个集成板的BT.js您可以直接拿过来使用也可以单个使用引入*.js即可。 不足: 对IE兼容也存在不小的问题,BT将所有的元素盒模型都设置成了border-box,这是IE混杂模式下的盒模型,光这点就导致了不能兼容IE。此外还用到了大量的H5标签以及CSS3语法,这些语法标签兼容性方面同样存在不小的问题,当然网上存在很多兼容IE的办法,但需要引入其他文件,有些还不小,势必导致加载速度变慢,影响用户体验。 BT对IE6,7的兼容性肯定不好,对IE8的支持也需要一些额外的文件。 IE8的媒体查询需要response.js的配合才能实现 BT 不支持 IE 古老的兼容模式。为了让 IE 浏览器运行最新的渲染模式下,建议将此 标签加入到你的页面中: 按 F12 键打开 IE 的调试工具,就可以看到 IE 当前的渲染模式是什么。 BT属于前端UI库,可以快速搭建前端页面,以及设计响应式界面,还可以使用saas重新设计组件, 【如果大家对程序员,web前端感兴趣,想要学习的,关注一下小编吧。我是一名前端开发程序员,现在在网上授课教前端,每晚都会在群内免费直播。从最基础的HTML+CSS+JS到移动端HTML5到各种框架都有整理,送给每一位前端小伙伴,这里是小白聚集地,欢迎初学和进阶中的小伙伴。加群:731771211。前端学习必备公众号ID:mtbcxx】 6、JQeury学习笔记,优缺点总结 优点: jQuery实现脚本与页面的分离,是操作DOM的首选js库。 最少的代码做最多的事情 最少的代码做最多的事情,这是jQuery的口号,而且名副其实。使用它的高级selector,开发者只需编写几行代码就能实现令人惊奇的效果。开发者无需过于担忧浏览器差异,它除了还完全支持Ajax,而且拥有许多提高开发者编程效率的其它抽象概念。jQuery把JavaScript带到了一个更高的层次。以下是一个非常简单的示例: 代码如下: $("p.neat").addClass("ohmy").show("slow"); 通过以上简短的代码,开发者可以遍历“neat”类中所有的 元素,然后向其增加“ohmy”类,同时以动画效果缓缓显示每一个段落。开发者无需检查客户端浏览器类型,无需编写循环代码,无需编写复杂的动画函数,仅仅通过一行代码就能实现上述效果。 性能 在大型JavaScript框架中,jQuery对性能的理解最好。尽管不同版本拥有众多新功能,其最精简版本只有18KB大小,这个数字已经很难再减少。jQuery的每一个版本都有重大性能提高。 插件 基于jQuery开发的插件目前已经有大约数千个。开发者可使用插件来进行表单确认、图表种类、字段提示、动画、进度条等任务。 节省开发者学习时间 当然要想真正学习jQuery,开发者还是需要投入一点时间,尤其是如果你要编写大量代码或自主插件的话,更是如此。但是,开发者可以采取“各个击破”的方式,而且jQuery提供了大量示例代码,入门是一件非常容易的事情。 不足: 不能向后兼容 插件兼容性。 jQuery的稳定性 在大型框架中,jQuery核心代码库对动画和特效的支持相对较差。 7、”高内聚 ,低耦合“到底是什么意思? ‘高内聚,低耦合’是相对于代码而言,一个项目中: 每个模块之间相互联系的紧密程度,模块之间联系越紧密,则耦合性越高,模块的独立性就越差!反之同理; 一个模块中各个元素之间的联系的紧密程度,如果各个元素(语句、程序段)之间的联系程度越高,则内聚性越高,即‘高内聚’ ! 如:一个项目中有20个方法调用良好,但是要修改了其中一个,另外的19个都要进行修改,这就是高耦合!独立性太差! 现在的软件结构设计,都会要求“高内聚,低耦合”,来保证软件的高质量!mark! 8、对前后端联合开发 的技术原理(Ajax、Json)有一定认识,理解DOM、Xml概念, 熟悉前后台交互方式。 Ajax异步交互原理:Ajax其核心有JavaScript、XMLHTTPRequest、DOM对象组成,通过XmlHttpRequest对象来向服务器发异步请求,从服务器获得数据,然后用JavaScript来操作DOM而更新页面。 Json:一般我用的比较多的是通过AJAX异步来获取JSON数据。 DOM:文档对象模型,一个网页中所有的东西都是dom节点,根节点是,它可以无线嵌套。用来获取或设置文档中标签的属性,例如获取或者设置input表单的value值。 BOM:浏览器对象模型。用来获取或设置浏览器的属性、行为,例如:新建窗口、获取屏幕分辨率、浏览器版本号等。 XML:被设计用来传输和存储数据,被设计用来格式化和显示数据。仅仅是纯文本。 -前后台交互方式: 9、GET和POST请求的区别 GET提交的数据会放在URL之后,以?分割URL和传输数据,参数之间以&相连,如EditPosts.aspx?name=test1&id=123456. POST方法是把提交的数据放在HTTP包的Body中. GET提交的数据大小有限制(因为浏览器对URL的长度有限制),而POST方法提交的数据没有限制. GET方式需要使用Request.QueryString来取得变量的值,而POST方式通过Request.Form来获取变量的值。 GET方式提交数据,会带来安全问题,比如一个登录页面,通过GET方式提交数据时,用户名和密码将出现在URL上,如果页面可以被缓存或者其他人可以访问这台机器,就可以从历史记录获得该用户的账号和密码. 【如果大家对程序员,web前端感兴趣,想要学习的,关注一下小编吧。我是一名前端开发程序员,现在在网上授课教前端,每晚都会在群内免费直播。从最基础的HTML+CSS+JS到移动端HTML5到各种框架都有整理,送给每一位前端小伙伴,这里是小白聚集地,欢迎初学和进阶中的小伙伴。加群:731771211。前端学习必备公众号ID:mtbcxx】

优秀的个人博客,低调大师

学习Java基础知识,打通面试关~十三锁机制

静态创建线程池 我们平常使用的大部分还是依靠java中自带的静态工厂产生的线程池。先了解下自带的线程池。 newFixedThreadPool(int numThreads) 该线程池会在初始化的指定线程数量。具有以下的特点1.在任何时刻都是最多有numThreads的线程数量活动。如果超过限制会在LinkedBlockingQueue中等待。 2.当达到核心线程数的时候,线程数不在继续增加。3.有工作线程退出,新的工作线程被创建来达到设置的线程数。 Executors.newFixedThreadPool(1); //源码实现 public static ExecutorService newFixedThreadPool(int nThreads) { return new ThreadPoolExecutor(nThreads, nThreads, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>()); } newCachedThreadPool 该线程池是一个可以用来缓存的线程池。1.尝试缓存使用过的线程。2.没有缓存的线程池时,就会使用工厂方法创建线程池,最大的容量理论上是Integer.MAX_VALUE。这个跟服务器的配置有关。所以如果过来大量的线程任务,那么该线程池会在瞬间创建多个线程来执行工作。3.时间上多余的线程超过60秒会被终止移除缓存中。4.内部使用的SynchronousQueue实现的队列,该队列在实现的时候没有容量。适合来做交换的工作。 Executors.newCachedThreadPool(); //源码实现 public static ExecutorService newCachedThreadPool() { return new ThreadPoolExecutor(0, Integer.MAX_VALUE, 60L, TimeUnit.SECONDS, new SynchronousQueue<Runnable>()); } newSingleThreadExecutor 该线程池是用来设置单个的线程池,使用的队列是无界队列。因为提交的任务只要一个是能活动的,剩下的是放到无界队列中。队列是先进先出的。那么执行顺序是有序的。 Executors.newSingleThreadExecutor(); //源码 public static ExecutorService newSingleThreadExecutor() { return new FinalizableDelegatedExecutorService (new ThreadPoolExecutor(1, 1, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>())); } newWorkStealingPool 工作线程,该线程是在jdk1.8以后新增加的.使用的是ForkJoinPool创建线程池。该任务执行没有顺序。需要考虑到硬件的cpu核心数。 Executors.newWorkStealingPool(); public static ExecutorService newWorkStealingPool() { return new ForkJoinPool (Runtime.getRuntime().availableProcessors(), //默认使用的是硬件的cpu数目 ForkJoinPool.defaultForkJoinWorkerThreadFactory, null, true); } Executors.newWorkStealingPool(10); public static ExecutorService newWorkStealingPool(int parallelism) { return new ForkJoinPool (parallelism, // 使用的是自定义的核心数 ForkJoinPool.defaultForkJoinWorkerThreadFactory, null, true); } newSingleThreadScheduledExecutor()与newScheduledThreadPool(int poolSize) 周期性的调度执行任务的线程池。 单个执行。 Executors.newSingleThreadScheduledExecutor(); public static ScheduledExecutorService newSingleThreadScheduledExecutor() { return new DelegatedScheduledExecutorService (new ScheduledThreadPoolExecutor(1)); } //核心周期执行的线程数 Executors.newScheduledThreadPool(10); public static ScheduledExecutorService newScheduledThreadPool(int corePoolSize) { return new ScheduledThreadPoolExecutor(corePoolSize); } 了解其java内部的静态线程池,并且在程序中使用其策略。当然在这种我们没有看到的是线程池的拒绝策略。无界队列和有界队列,核心数的与最大的核心数的设置,这些不同。那么我们的执行拒绝策略也是不同的。在接下里的文章我们会具体了解拒绝策略。 原文发布时间为:2018-07-09本文作者:mengrui本文来自云栖社区合作伙伴“LuckQI”,了解相关信息可以关注“LuckQI”。
资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册