首页 文章 精选 留言 我的

精选列表

搜索[面试],共5090篇文章
优秀的个人博客,低调大师

关于Java锁机制面试官会怎么问

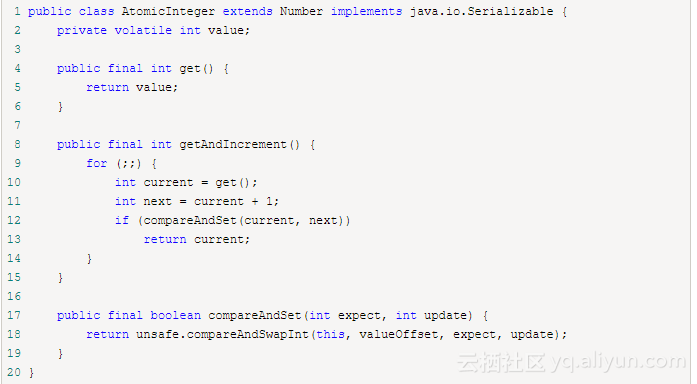
乐观锁与悲观锁 悲观锁:总是假设最坏的情况,每次去拿数据的时候都认为别人会修改,所以每次在拿数据的时候都会上锁,这样别人想拿这个数据就会阻塞直到它拿到锁。传统的关系型数据库里边就用到了很多这种锁机制,比如行锁,表锁等,读锁,写锁等,都是在做操作之前先上锁。再比如Java里面的同步原语synchronized关键字的实现也是悲观锁。 乐观锁:顾名思义,就是很乐观,每次去拿数据的时候都认为别人不会修改,所以不会上锁,但是在更新的时候会判断一下在此期间别人有没有去更新这个数据,可以使用版本号等机制。乐观锁适用于多读的应用类型,这样可以提高吞吐量,像数据库提供的类似于write_condition机制,其实都是提供的乐观锁。在Java中java.util.concurrent.atomic包下面的原子变量类就是使用了乐观锁的一种实现方式CAS实现的。 乐观锁的一种实现方式-CAS(Compare and Swap 比较并交换): 锁存在的问题 Java在JDK1.5之前都是靠synchronized关键字保证同步的,这种通过使用一致的锁定协议来协调对共享状态的访问,可以确保无论哪个线程持有共享变量的锁,都采用独占的方式来访问这些变量。这就是一种独占锁,独占锁其实就是一种悲观锁,所以可以说 synchronized 是悲观锁。 悲观锁机制存在以下问题: 在多线程竞争下,加锁、释放锁会导致比较多的上下文切换和调度延时,引起性能问题。 一个线程持有锁会导致其它所有需要此锁的线程挂起。 如果一个优先级高的线程等待一个优先级低的线程释放锁会导致优先级倒置。 对比于悲观锁的这些问题,另一个更加有效的锁就是乐观锁。其实乐观锁就是:每次不加锁而是假设没有并发冲突而去完成某项操作,如果因为并发冲突失败就重试,直到成功为止。 乐观锁 乐观锁( Optimistic Locking)在上文已经说过了,其实就是一种思想。相对悲观锁而言,乐观锁假设认为数据一般情况下不会产生并发冲突,所以在数据进行提交更新的时候,才会正式对数据是否产生并发冲突进行检测,如果发现并发冲突了,则让返回用户错误的信息,让用户决定如何去做。 上面提到的乐观锁的概念中其实已经阐述了它的具体实现细节:主要就是两个步骤:冲突检测和数据更新。其实现方式有一种比较典型的就是 Compare and Swap ( CAS )。 CAS CAS是乐观锁技术,当多个线程尝试使用CAS同时更新同一个变量时,只有其中一个线程能更新变量的值,而其它线程都失败,失败的线程并不会被挂起,而是被告知这次竞争中失败,并可以再次尝试。 CAS 操作中包含三个操作数 —— 需要读写的内存位置(V)、进行比较的预期原值(A)和拟写入的新值(B)。如果内存位置V的值与预期原值A相匹配,那么处理器会自动将该位置值更新为新值B。否则处理器不做任何操作。无论哪种情况,它都会在 CAS 指令之前返回该位置的值。(在 CAS 的一些特殊情况下将仅返回 CAS 是否成功,而不提取当前值。)CAS 有效地说明了“ 我认为位置 V 应该包含值 A;如果包含该值,则将 B 放到这个位置;否则,不要更改该位置,只告诉我这个位置现在的值即可。 ”这其实和乐观锁的冲突检查+数据更新的原理是一样的。 这里再强调一下,乐观锁是一种思想。CAS是这种思想的一种实现方式。 JAVA对CAS的支持:在JDK1.5 中新增 java.util.concurrent (J.U.C)就是建立在CAS之上的。相对于对于 synchronized 这种阻塞算法,CAS是非阻塞算法的一种常见实现。所以J.U.C在性能上有了很大的提升。 以 java.util.concurrent 中的 AtomicInteger 为例,看一下在不使用锁的情况下是如何保证线程安全的。主要理解 getAndIncrement 方法,该方法的作用相当于 ++i 操作。 在没有锁的机制下,字段value要借助volatile原语,保证线程间的数据是可见性。这样在获取变量的值的时候才能直接读取。然后来看看 ++i 是怎么做到的。getAndIncrement 采用了CAS操作,每次从内存中读取数据然后将此数据和 +1 后的结果进行CAS操作,如果成功就返回结果,否则重试直到成功为止。而 compareAndSet 利用JNI(Java Native Interface)来完成CPU指令的操作: 那么比较this == expect,替换this = update,compareAndSwapInt实现这两个步骤的原子性呢? 参考CAS的原理。 CAS原理:CAS通过调用JNI的代码实现的。而compareAndSwapInt就是借助C来调用CPU底层指令实现的。下面从分析比较常用的CPU(intel x86)来解释CAS的实现原理。下面是sun.misc.Unsafe类的compareAndSwapInt()方法的源代码: 如上面源代码所示,程序会根据当前处理器的类型来决定是否为cmpxchg指令添加lock前缀。如果程序是在多处理器上运行,就为cmpxchg指令加上lock前缀(lock cmpxchg)。反之,如果程序是在单处理器上运行,就省略lock前缀(单处理器自身会维护单处理器内的顺序一致性,不需要lock前缀提供的内存屏障效果)。 CAS缺点: ABA问题:比如说一个线程one从内存位置V中取出A,这时候另一个线程two也从内存中取出A,并且two进行了一些操作变成了B,然后two又将V位置的数据变成A,这时候线程one进行CAS操作发现内存中仍然是A,然后one操作成功。尽管线程one的CAS操作成功,但可能存在潜藏的问题。如下所示: 现有一个用单向链表实现的堆栈,栈顶为A,这时线程T1已经知道A.next为B,然后希望用CAS将栈顶替换为B:head.compareAndSet(A,B);在T1执行上面这条指令之前,线程T2介入,将A、B出栈,再pushD、C、A,此时堆栈结构如下图,而对象B此时处于游离状态: 此时轮到线程T1执行CAS操作,检测发现栈顶仍为A,所以CAS成功,栈顶变为B,但实际上B.next为null,所以此时的情况变为: 其中堆栈中只有B一个元素,C和D组成的链表不再存在于堆栈中,平白无故就把C、D丢掉了。从Java1.5开始JDK的atomic包里提供了一个类AtomicStampedReference来解决ABA问题。这个类的compareAndSet方法作用是首先检查当前引用是否等于预期引用,并且当前标志是否等于预期标志,如果全部相等,则以原子方式将该引用和该标志的值设置为给定的更新值。 循环时间长开销大: 自旋CAS(不成功,就一直循环执行,直到成功)如果长时间不成功,会给CPU带来非常大的执行开销。如果JVM能支持处理器提供的pause指令那么效率会有一定的提升,pause指令有两个作用,第一它可以延迟流水线执行指令(de-pipeline),使CPU不会消耗过多的执行资源,延迟的时间取决于具体实现的版本,在一些处理器上延迟时间是零。第二它可以避免在退出循环的时候因内存顺序冲突(memory order violation)而引起CPU流水线被清空(CPU pipeline flush),从而提高CPU的执行效率。 只能保证一个共享变量的原子操作: 当对一个共享变量执行操作时,我们可以使用循环CAS的方式来保证原子操作,但是对多个共享变量操作时,循环CAS就无法保证操作的原子性,这个时候就可以用锁,或者有一个取巧的办法,就是把多个共享变量合并成一个共享变量来操作。比如有两个共享变量i=2,j=a,合并一下ij=2a,然后用CAS来操作ij。从Java1.5开始JDK提供了AtomicReference类来保证引用对象之间的原子性,你可以把多个变量放在一个对象里来进行CAS操作。 CAS与Synchronized的使用情景 1、对于资源竞争较少(线程冲突较轻)的情况,使用synchronized同步锁进行线程阻塞和唤醒切换以及用户态内核态间的切换操作额外浪费消耗cpu资源;而CAS基于硬件实现,不需要进入内核,不需要切换线程,操作自旋几率较少,因此可以获得更高的性能。 2、对于资源竞争严重(线程冲突严重)的情况,CAS自旋的概率会比较大,从而浪费更多的CPU资源,效率低于synchronized。 补充:synchronized在jdk1.6之后,已经改进优化。synchronized的底层实现主要依靠Lock-Free的队列,基本思路是自旋后阻塞,竞争切换后继续竞争锁,稍微牺牲了公平性,但获得了高吞吐量。在线程冲突较少的情况下,可以获得和CAS类似的性能;而线程冲突严重的情况下,性能远高于CAS。 concurrent包的实现 由于java的CAS同时具有 volatile 读和volatile写的内存语义,因此Java线程之间的通信现在有了下面四种方式: A线程写volatile变量,随后B线程读这个volatile变量。 A线程写volatile变量,随后B线程用CAS更新这个volatile变量。 A线程用CAS更新一个volatile变量,随后B线程用CAS更新这个volatile变量。 A线程用CAS更新一个volatile变量,随后B线程读这个volatile变量。 Java的CAS会使用现代处理器上提供的高效机器级别原子指令,这些原子指令以原子方式对内存执行读-改-写操作,这是在多处理器中实现同步的关键(从本质上来说,能够支持原子性读-改-写指令的计算机器,是顺序计算图灵机的异步等价机器,因此任何现代的多处理器都会去支持某种能对内存执行原子性读-改-写操作的原子指令)。同时,volatile变量的读/写和CAS可以实现线程之间的通信。把这些特性整合在一起,就形成了整个concurrent包得以实现的基石。如果我们仔细分析concurrent包的源代码实现,会发现一个通用化的实现模式: 首先,声明共享变量为volatile; 然后,使用CAS的原子条件更新来实现线程之间的同步; 同时,配合以volatile的读/写和CAS所具有的volatile读和写的内存语义来实现线程之间的通信。 AQS,非阻塞数据结构和原子变量类(java.util.concurrent.atomic包中的类),这些concurrent包中的基础类都是使用这种模式来实现的,而concurrent包中的高层类又是依赖于这些基础类来实现的。从整体来看,concurrent包的实现示意图如下: JVM中的CAS(堆中对象的分配) Java调用new object()会创建一个对象,这个对象会被分配到JVM的堆中。那么这个对象到底是怎么在堆中保存的呢? 首先,new object()执行的时候,这个对象需要多大的空间,其实是已经确定的,因为java中的各种数据类型,占用多大的空间都是固定的(对其原理不清楚的请自行Google)。那么接下来的工作就是在堆中找出那么一块空间用于存放这个对象。 在单线程的情况下,一般有两种分配策略: 指针碰撞:这种一般适用于内存是绝对规整的(内存是否规整取决于内存回收策略),分配空间的工作只是将指针像空闲内存一侧移动对象大小的距离即可。 空闲列表:这种适用于内存非规整的情况,这种情况下JVM会维护一个内存列表,记录哪些内存区域是空闲的,大小是多少。给对象分配空间的时候去空闲列表里查询到合适的区域然后进行分配即可。 但是JVM不可能一直在单线程状态下运行,那样效率太差了。由于在给一个对象分配内存的时候不是原子性的操作,至少需要以下几步:查找空闲列表、分配内存、修改空闲列表等等,这是不安全的。解决并发时的安全问题也有两种策略: CAS:实际上虚拟机采用CAS配合上失败重试的方式保证更新操作的原子性,原理和上面讲的一样。 TLAB:如果使用CAS其实对性能还是会有影响的,所以JVM又提出了一种更高级的优化策略:每个线程在Java堆中预先分配一小块内存,称为本地线程分配缓冲区(TLAB),线程内部需要分配内存时直接在TLAB上分配就行,避免了线程冲突。只有当缓冲区的内存用光需要重新分配内存的时候才会进行CAS操作分配更大的内存空间。 虚拟机是否使用TLAB,可以通过-XX:+/-UseTLAB参数来进行配置(jdk5及以后的版本默认是启用TLAB的)。 原文发布时间为:2018-07-05本文来自云栖社区合作伙伴“Java架构沉思录”,了解相关信息可以关注“Java架构沉思录”。

优秀的个人博客,低调大师

java面试-深入理解JVM(八)——类加载的时机

类的生命周期 一个类从加载进内存到卸载出内存为止,一共经历7个阶段:加载——>验证——>准备——>解析——>初始化——>使用——>卸载 其中,类加载包括5个阶段:加载——>验证——>准备——>解析——>初始化 在类加载的过程中,以下3个过程称为连接:验证——>准备——>解析 因此,JVM的类加载过程也可以概括为3个过程:加载——>连接——>初始化 C/C++在运行前需要完成预处理、编译、汇编、链接;而在Java中,类加载(加载、连接、初始化)是在程序运行期间完成的。在程序运行期间进行类加载会稍微增加程序的开销,但随之会带来更大的好处——提高程序的灵活性。Java语言的灵活性体现在它可以在运行期间动态扩展,所谓动态扩展就是在运行期间动态加载和动态连接。 类加载的时机 1. 类加载过程中每个步骤的顺序 我们已经知道,类加载的过程包括:加载、连接、初始化,连接又分为:验证、准备、解析,所以说类加载一共分为5步:加载、验证、准备、解析、初始化。 其中加载、验证、准备、初始化的开始顺序是依次进行的,这些步骤开始之后的过程可能会有重叠。而解析过程会发生在初始化过程中。 2. 类加载过程中“初始化”开始的时机 JVM规范中只定义了类加载过程中初始化过程开始的时机,加载、连接过程都应该在初始化之前开始(解析除外),这些过程具体在何时开始,JVM规范并没有定义,不同的虚拟机可以根据具体的需求自定义。 初始化开始的时机: 在运行过程中遇到如下字节码指令时,如果类尚未初始化,那就要进行初始化:new、getstatic、putstatic、invokestatic。这四个指令对应的Java代码场景是: 通过new创建对象; 读取、设置一个类的静态成员变量(不包括final修饰的静态变量); 调用一个类的静态成员函数。 使用java.lang.reflect进行反射调用的时候,如果类没有初始化,那就需要初始化; 当初始化一个类的时候,若其父类尚未初始化,那就先要让其父类初始化,然后再初始化本类; 当虚拟机启动时,虚拟机会首先初始化带有main方法的类,即主类; 3. 主动引用 与 被动引用 JVM规范中要求在程序运行过程中,“当且仅当”出现上述4个条件之一的情况才会初始化一个类。如果间接满足上述初始化条件是不会初始化类的。其中,直接满足上述初始化条件的情况叫做主动引用;间接满足上述初始化过程的情况叫做被动引用。那么,只有当程序在运行过程中满足主动引用的时候才会初始化一个类,若满足被动引用就不会初始化一个类。 4. 被动引用的场景示例 示例一 public class Fu{ public static String name = "柴毛毛"; static{ System.out.println("父类被初始化!"); } } public class Zi{ static{ System.out.println("子类被初始化!"); } } public static void main(String[] args){ System.out.println(Zi.name); } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 输出结果:父类被初始化!柴毛毛原因分析:本示例看似满足初始化时机的第一条:当要获取某一个类的静态成员变量的时候如果该类尚未初始化,则对该类进行初始化。但由于这个静态成员变量属于Fu类,Zi类只是间接调用Fu类中的静态成员变量,因此Zi类调用name属性属于间接引用,而Fu类调用name属性属于直接引用,由于JVM只初始化直接引用的类,因此只有Fu类被初始化。 示例二 public class A{ public static void main(String[] args){ Fu[] arr = new Fu[10]; } } 1 2 3 4 5 输出结果:并没有输出“父类被初始化!”原因分析:这个过程看似满足初始化时机的第一条:遇到new创建对象时若类没被初始化,则初始化该类。但现在通过new要创建的是一个数组对象,而非Fu类对象,因此也属于间接引用,不会初始化Fu类。 示例三 public class Fu{ public static final String name = "柴毛毛"; static{ System.out.println("父类被初始化!"); } } public class A{ public static void main(String[] args){ System.out.println(Fu.name); } } 1 2 3 4 5 6 7 8 9 10 11 12 输出结果:柴毛毛原因分析:本示例看似满足类初始化时机的第一个条件:获取一个类静态成员变量的时候若类尚未初始化则初始化类。但是,Fu类的静态成员变量被final修饰,它已经是一个常量。被final修饰的常量在Java代码编译的过程中就会被放入它被引用的class文件的常量池中(这里是A的常量池)。所以程序在运行期间如果需要调用这个常量,直接去当前类的常量池中取,而不需要初始化这个类。 5. 接口的初始化 接口和类都需要初始化,接口和类的初始化过程基本一样,不同点在于:类初始化时,如果发现父类尚未被初始化,则先要初始化父类,然后再初始化自己;但接口初始化时,并不要求父接口已经全部初始化,只有程序在运行过程中用到当父接口中的东西时才初始化父接口。

优秀的个人博客,低调大师

java面试-深入理解JVM(三)——垃圾收集策略详解

Java虚拟机的内存模型分为五个部分,分别是:程序计数器、Java虚拟机栈、本地方法栈、堆、方法区。 这五个区域既然是存储空间,那么为了避免Java虚拟机在运行期间内存存满的情况,就必须得有一个垃圾收集者的角色,不定期地回收一些无效内存,以保障Java虚拟机能够健康地持续运行。 这个垃圾收集者就是平常我们所说的“垃圾收集器”,那么垃圾收集器在何时清扫内存?清扫哪些数据?这就是接下来我们要解决的问题。 程序计数器、Java虚拟机栈、本地方法栈都是线程私有的,也就是每条线程都拥有这三块区域,而且会随着线程的创建而创建,线程的结束而销毁。那么,垃圾收集器在何时清扫这三块区域的问题就解决了。 此外,Java虚拟机栈、本地方法栈中的栈帧会随着方法的开始而入栈,方法的结束而出栈,并且每个栈帧中的本地变量表都是在类被加载的时候就确定的。因此以上三个区域的垃圾收集工作具有确定性,垃圾收集器能够清楚地知道何时清扫这三块区域中的哪些数据。 然而,堆和方法区中的内存清理工作就没那么容易了。堆和方法区所有线程共享,并且都在JVM启动时创建,一直得运行到JVM停止时。因此它们没办法根据线程的创建而创建、线程的结束而释放。 堆中存放JVM运行期间的所有对象,虽然每个对象的内存大小在加载该对象所属类的时候就确定了,但究竟创建多少个对象只有在程序运行期间才能确定。方法区中存放类信息、静态成员变量、常量。类的加载是在程序运行过程中,当需要创建这个类的对象时才会加载这个类。因此,JVM究竟要加载多少个类也需要在程序运行期间确定。因此,堆和方法区的内存回收具有不确定性,因此垃圾收集器在回收堆和方法区内存的时候花了一些心思。 堆内存的回收 1. 如何判定哪些对象需要回收? 在对堆进行对象回收之前,首先要判断哪些是无效对象。我们知道,一个对象不被任何对象或变量引用,那么就是无效对象,需要被回收。一般有两种判别方式: 引用计数法每个对象都有一个计数器,当这个对象被一个变量或另一个对象引用一次,该计数器加一;若该引用失效则计数器减一。当计数器为0时,就认为该对象是无效对象。 可达性分析法所有和GC Roots直接或间接关联的对象都是有效对象,和GC Roots没有关联的对象就是无效对象。GC Roots是指: Java虚拟机栈所引用的对象(栈帧中局部变量表中引用类型的变量所引用的对象) 方法区中静态属性引用的对象 方法区中常量所引用的对象 本地方法栈所引用的对象PS:注意!GC Roots并不包括堆中对象所引用的对象!这样就不会出现循环引用。 两者对比:引用计数法虽然简单,但存在一个严重的问题,它无法解决循环引用的问题。因此,目前主流语言均使用可达性分析方法来判断对象是否有效。 2. 回收无效对象的过程 当JVM筛选出失效的对象之后,并不是立即清除,而是再给对象一次重生的机会,具体过程如下: 判断该对象是否覆盖了finalize()方法 若已覆盖该方法,并该对象的finalize()方法还没有被执行过,那么就会将finalize()扔到F-Queue队列中; 若未覆盖该方法,则直接释放对象内存。 执行F-Queue队列中的finalize()方法虚拟机会以较低的优先级执行这些finalize()方法们,也不会确保所有的finalize()方法都会执行结束。如果finalize()方法中出现耗时操作,虚拟机就直接停止执行,将该对象清除。 对象重生或死亡如果在执行finalize()方法时,将this赋给了某一个引用,那么该对象就重生了。如果没有,那么就会被垃圾收集器清除。 注意:强烈不建议使用finalize()函数进行任何操作!如果需要释放资源,请使用try-finally。因为finalize()不确定性大,开销大,无法保证顺利执行。 方法区的内存回收 我们知道,如果使用复制算法实现堆的内存回收,堆就会被分为新生代和老年代,新生代中的对象“朝生夕死”,每次垃圾回收都会清除掉大量的对象;而老年代中的对象生命较长,每次垃圾回收只有少量的对象被清除掉。 由于方法区中存放生命周期较长的类信息、常量、静态变量,因此方法区就像是堆的老年代,每次垃圾收集的只有少量的垃圾被清除掉。 方法区中主要清除两种垃圾:1. 废弃常量2. 废弃的类 1. 如何判定废弃常量? 清除废弃的常量和清除对象类似,只要常量池中的常量不被任何变量或对象引用,那么这些常量就会被清除掉。 2. 如何废弃废弃的类? 清除废弃类的条件较为苛刻:1. 该类的所有对象都已被清除2. 该类的java.lang.Class对象没有被任何对象或变量引用只要一个类被虚拟机加载进方法区,那么在堆中就会有一个代表该类的对象:java.lang.Class。这个对象在类被加载进方法区的时候创建,在方法区中该类被删除时清除。3. 加载该类的ClassLoader已经被回收 垃圾收集算法 现在我们知道了判定一个对象是无效对象、判定一个类是废弃类、判定一个常量是废弃常量的方法,也就是知道了垃圾收集器会清除哪些数据,那么接下来介绍如何清除这些数据。 1. 标记-清除算法 首先利用刚才介绍的方法判断需要清除哪些数据,并给它们做上标记;然后清除被标记的数据。 分析:这种算法标记和清除过程效率都很低,而且清除完后存在大量碎片空间,导致无法存储大对象,降低了空间利用率。 2. 复制算法 将内存分成两份,只将数据存储在其中一块上。当需要回收垃圾时,也是首先标记出废弃的数据,然后将有用的数据复制到另一块内存上,最后将第一块内存全部清除。 分析:这种算法避免了碎片空间,但内存被缩小了一半。而且每次都需要将有用的数据全部复制到另一片内存上去,效率不高。 解决空间利用率问题:在新生代中,由于大量的对象都是“朝生夕死”,也就是一次垃圾收集后只有少量对象存活,因此我们可以将内存划分成三块:Eden、Survior1、Survior2,内存大小分别是8:1:1。分配内存时,只使用Eden和一块Survior1。当发现Eden+Survior1的内存即将满时,JVM会发起一次MinorGC,清除掉废弃的对象,并将所有存活下来的对象复制到另一块Survior2中。那么,接下来就使用Survior2+Eden进行内存分配。 通过这种方式,只需要浪费10%的内存空间即可实现带有压缩功能的垃圾收集方法,避免了内存碎片的问题。 但是,当一个对象要申请内存空间时,发现Eden+Survior中剩下的空间无法放置该对象,此时需要进行Minor GC,如果MinorGC过后空闲出来的内存空间仍然无法放置该对象,那么此时就需要将对象转移到老年代中,这种方式叫做“分配担保”。 什么是分配担保?当JVM准备为一个对象分配内存空间时,发现此时Eden+Survior中空闲的区域无法装下该对象,那么就会触发MinorGC,对该区域的废弃对象进行回收。但如果MinorGC过后只有少量对象被回收,仍然无法装下新对象,那么此时需要将Eden+Survior中的所有对象都转移到老年代中,然后再将新对象存入Eden区。这个过程就是“分配担保”。 3. 标记-整理算法 在回收垃圾前,首先将所有废弃的对象做上标记,然后将所有未被标记的对象移到一边,最后清空另一边区域即可。 分析:它是一种老年代的垃圾收集算法。老年代中的对象一般寿命比较长,因此每次垃圾回收会有大量对象存活,因此如果选用“复制”算法,每次需要复制大量存活的对象,会导致效率很低。而且,在新生代中使用“复制”算法,当Eden+Survior中都装不下某个对象时,可以使用老年代的内存进行“分配担保”,而如果在老年代使用该算法,那么在老年代中如果出现Eden+Survior装不下某个对象时,没有其他区域给他作分配担保。因此,老年代中一般使用“标记-整理”算法。 4. 分代收集算法 将内存划分为老年代和新生代。老年代中存放寿命较长的对象,新生代中存放“朝生夕死”的对象。然后在不同的区域使用不同的垃圾收集算法。 Java中引用的种类 Java中根据生命周期的长短,将引用分为4类。 1. 强引用 我们平时所使用的引用就是强引用。A a = new A();也就是通过关键字new创建的对象所关联的引用就是强引用。只要强引用存在,该对象永远也不会被回收。 2. 软引用 只有当堆即将发生OOM异常时,JVM才会回收软引用所指向的对象。软引用通过SoftReference类实现。软引用的生命周期比强引用短一些。 3. 弱引用 只要垃圾收集器运行,软引用所指向的对象就会被回收。弱引用通过WeakReference类实现。弱引用的生命周期比软引用短。 4. 虚引用 虚引用也叫幽灵引用,它和没有引用没有区别,无法通过虚引用访问对象的任何属性或函数。一个对象关联虚引用唯一的作用就是在该对象被垃圾收集器回收之前会受到一条系统通知。虚引用通过PhantomReference类来实现。

优秀的个人博客,低调大师

Java中方法重写的两个面试题

1:方法重写和方法重载的区别?方法重载能改变返回值类型吗? 方法重写: 在子类中,出现和父类中一模一样的方法声明的现象。(包含方法名、参数列表和返回值类型都一样) 方法重载: 同一个类中,出现的方法名相同,参数列表不同,与返回值类型无关的现象。 方法重载能改变返回值类型,因为它和返回值类型无关。 Override:方法重写 Overload:方法重载 2:this关键字和super关键字分别代表什么?以及他们各自的使用场景和作用。 this: 代表当前类的对象引用。 super:代表父类存储空间的标识。(可以理解为父类的引用,通过这个东西可以访问父类的成员。) 应用场景: 成员变量: this.成员变量 super.成员变量 构造方法: this(...) super(...) 成员方法: this.成员方法 super.成员方法我的GitHub地址: https://github.com/heizemingjun 我的博客园地址: http://www.cnblogs.com/chenmingjun 我的蚂蚁笔记博客地址: http://blog.leanote.com/chenmingjun Copyright ©2018 黑泽明军 【转载文章务必保留出处和署名,谢谢!】

优秀的个人博客,低调大师

Android面试,View绘制流程以及invalidate()等相关方法分析

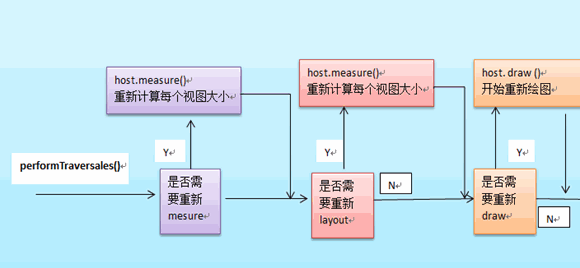
整个View树的绘图流程是在ViewRoot.java类的performTraversals()函数展开的,该函数做的执行过程可简单概况为 根据之前设置的状态,判断是否需要重新计算视图大小(measure)、是否重新需要安置视图的位置(layout)、以及是否需要重绘 (draw),其框架过程如下: measure()过程 主要作用:为整个View树计算实际的大小,即设置实际的高(对应属性:mMeasuredHeight)和宽(对应属性:mMeasureWidth),每个View的控件的实际宽高都是由父视图和本身视图决定的。 具体的调用链如下: ViewRoot根对象地属性mView(其类型一般为ViewGroup类型)调用measure()方法去计算View树的大小,回调View/ViewGroup对象的onMeasure()方法,该方法实现的功能如下: 1、设置本View视图的最终大小,该功能的实现通过调用setMeasuredDimension()方法去设置实际的高(对应属性:mMeasuredHeight)和宽(对应属性:mMeasureWidth) ; 2 、如果该View对象是个ViewGroup类型,需要重写该onMeasure()方法,对其子视图进行遍历的measure()过程。 2.1 对每个子视图的measure()过程,是通过调用父类ViewGroup.java类里的measureChildWithMargins()方法去实现,该方法内部只是简单地调用了View对象的measure()方法。(由于measureChildWithMargins()方法只是一个过渡层更简单的做法是直接调用View对象的measure()方法)。 整个measure调用流程就是个树形的递归过程 measure函数原型为 View.java 该函数不能被重载 public final void measure(int widthMeasureSpec, int heightMeasureSpec) { //.... //回调onMeasure()方法 onMeasure(widthMeasureSpec, heightMeasureSpec); //more } 为了大家更好的理解,采用“二B程序员”的方式利用伪代码描述该measure流程 //回调View视图里的onMeasure过程 private void onMeasure(int height , int width){ //设置该view的实际宽(mMeasuredWidth)高(mMeasuredHeight) //1、该方法必须在onMeasure调用,否者报异常。 setMeasuredDimension(h , l) ; //2、如果该View是ViewGroup类型,则对它的每个子View进行measure()过程 int childCount = getChildCount() ; for(int i=0 ;i<childCount ;i++){ //2.1、获得每个子View对象引用 View child = getChildAt(i) ; //整个measure()过程就是个递归过程 //该方法只是一个过滤器,最后会调用measure()过程 ;或者 measureChild(child , h, i)方法都 measureChildWithMargins(child , h, i) ; //其实,对于我们自己写的应用来说,最好的办法是去掉框架里的该方法,直接调用view.measure(),如下: //child.measure(h, l) } } //该方法具体实现在ViewGroup.java里 。 protected void measureChildWithMargins(View v, int height , int width){ v.measure(h,l) } layout布局过程 主要作用 :为将整个根据子视图的大小以及布局参数将View树放到合适的位置上 具体的调用链如下: host.layout()开始View树的布局,继而回调给View/ViewGroup类中的layout()方法。具体流程如下 1 、layout方法会设置该View视图位于父视图的坐标轴,即mLeft,mTop,mLeft,mBottom(调用setFrame()函数去实现)接下来回调onLayout()方法(如果该View是ViewGroup对象,需要实现该方法,对每个子视图进行布局) ; 2、如果该View是个ViewGroup类型,需要遍历每个子视图chiildView,调用该子视图的layout()方法去设置它的坐标值。 layout函数原型为 ,位于View.java /* final 标识符 , 不能被重载 , 参数为每个视图位于父视图的坐标轴 * @param l Left position, relative to parent * @param t Top position, relative to parent * @param r Right position, relative to parent * @param b Bottom position, relative to parent */ public final void layout(int l, int t, int r, int b) { boolean changed = setFrame(l, t, r, b); //设置每个视图位于父视图的坐标轴 if (changed || (mPrivateFlags & LAYOUT_REQUIRED) == LAYOUT_REQUIRED) { if (ViewDebug.TRACE_HIERARCHY) { ViewDebug.trace(this, ViewDebug.HierarchyTraceType.ON_LAYOUT); } onLayout(changed, l, t, r, b);//回调onLayout函数 ,设置每个子视图的布局 mPrivateFlags &= ~LAYOUT_REQUIRED; } mPrivateFlags &= ~FORCE_LAYOUT; } 同样地, 将上面layout调用流程,用伪代码描述如下: // layout()过程 ViewRoot.java // 发起layout()的"发号者"在ViewRoot.java里的performTraversals()方法, mView.layout() private void performTraversals(){ //... View mView ; mView.layout(left,top,right,bottom) ; //.... } //回调View视图里的onLayout过程 ,该方法只由ViewGroup类型实现 private void onLayout(int left , int top , right , bottom){ //如果该View不是ViewGroup类型 //调用setFrame()方法设置该控件的在父视图上的坐标轴 setFrame(l ,t , r ,b) ; //-------------------------- //如果该View是ViewGroup类型,则对它的每个子View进行layout()过程 int childCount = getChildCount() ; for(int i=0 ;i<childCount ;i++){ //2.1、获得每个子View对象引用 View child = getChildAt(i) ; //整个layout()过程就是个递归过程 child.layout(l, t, r, b) ; } } draw()绘图过程 由ViewRoot对象的performTraversals()方法调用draw()方法发起绘制该View树,值得注意的是每次发起绘图时,并不会重新绘制每个View树的视图,而只会重新绘制那些“需要重绘”的视图,View类内部变量包含了一个标志位DRAWN,当该视图需要重绘时,就会为该View添加该标志位。 调用流程 : mView.draw()开始绘制,draw()方法实现的功能如下: 1 、绘制该View的背景 2 、为显示渐变框做一些准备操作(大多数情况下,不需要改渐变框) 3、调用onDraw()方法绘制视图本身 (每个View都需要重载该方法,ViewGroup不需要实现该方法) 4、调用dispatchDraw ()方法绘制子视图(如果该View类型不为ViewGroup,即不包含子视图,不需要重载该方法)值得说明的是,ViewGroup类已经为我们重写了dispatchDraw ()的功能实现,应用程序一般不需要重写该方法,但可以重载父类函数实现具体的功能。 4.1 dispatchDraw()方法内部会遍历每个子视图,调用drawChild()去重新回调每个子视图的draw()方法(注意,这个 地方“需要重绘”的视图才会调用draw()方法)。值得说明的是,ViewGroup类已经为我们重写了dispatchDraw()的功能实现,应用程序一般不需要重写该方法,但可以重载父类函数实现具体的功能。 绘制滚动条 伪代码: // draw()过程 ViewRoot.java // 发起draw()的"发号者"在ViewRoot.java里的performTraversals()方法, 该方法会继续调用draw()方法开始绘图 private void draw(){ //... View mView ; mView.draw(canvas) ; //.... } //回调View视图里的onLayout过程 ,该方法只由ViewGroup类型实现 private void draw(Canvas canvas){ //该方法会做如下事情 //1 、绘制该View的背景 //2、为绘制渐变框做一些准备操作 //3、调用onDraw()方法绘制视图本身 //4、调用dispatchDraw()方法绘制每个子视图,dispatchDraw()已经在Android框架中实现了,在ViewGroup方法中。 // 应用程序程序一般不需要重写该方法,但可以捕获该方法的发生,做一些特别的事情。 //5、绘制渐变框 } //ViewGroup.java中的dispatchDraw()方法,应用程序一般不需要重写该方法 @Override protected void dispatchDraw(Canvas canvas) { // //其实现方法类似如下: int childCount = getChildCount() ; for(int i=0 ;i<childCount ;i++){ View child = getChildAt(i) ; //调用drawChild完成 drawChild(child,canvas) ; } } //ViewGroup.java中的dispatchDraw()方法,应用程序一般不需要重写该方法 protected void drawChild(View child,Canvas canvas) { // .... //简单的回调View对象的draw()方法,递归就这么产生了。 child.draw(canvas) ; //......... } invalidate()方法 说明:请求重绘View树,即draw()过程,假如视图发生大小没有变化就不会调用layout()过程,并且只绘制那些“需要重绘的”视图,即谁(View的话,只绘制该View ;ViewGroup,则绘制整个ViewGroup)请求invalidate()方法,就绘制该视图。 一般引起invalidate()操作的函数如下: 1、直接调用invalidate()方法,请求重新draw(),但只会绘制调用者本身。 2、setSelection()方法 :请求重新draw(),但只会绘制调用者本身。 3、setVisibility()方法 : 当View可视状态在INVISIBLE转换VISIBLE时,会间接调用invalidate()方法,继而绘制该View。 4 、setEnabled()方法 : 请求重新draw(),但不会重新绘制任何视图包括该调用者本身。 requestLayout()方法 会导致调用measure()过程 和 layout()过程 。 说明:只是对View树重新布局layout过程包括measure()和layout()过程,不会调用draw()过程,但不会重新绘制任何视图包括该调用者本身。 一般引起invalidate()操作的函数如下: 1、setVisibility()方法: 当View的可视状态在INVISIBLE/ VISIBLE 转换为GONE状态时,会间接调用requestLayout() 和invalidate方法。 同时,由于整个个View树大小发生了变化,会请求measure()过程以及draw()过程,同样地,只绘制需要“重新绘制”的视图。 requestFocus() 说明:请求View树的draw()过程,但只绘制“需要重绘”的视图。 View中的draw和onDraw的区别 1.大概扫一下源码就可以明白,draw()这个函数本身会做很多事情, * 1. Draw the background * 2. If necessary, save the canvas' layers to prepare for fading * 3. Draw view's content * 4. Draw children * 5. If necessary, draw the fading edges and restore layers * 6. Draw decorations (scrollbars for instance)在第三步的时候,它就会调用onDraw()方法,来绘制view的内容。也就是draw会调用onDraw。所以看需要,一般情况下,直接用onDraw绘制view的content就可以了,如果绘制多一点的内容,可以调用draw(),不过Android官方推荐用只用onDraw就可以了。“When implementing a view, do not override this method; instead, you should implement onDraw” 2.View组件的绘制会调用draw(Canvas canvas)方法,draw过程中主要是先画Drawable背景,对drawable调用setBounds(),然后是draw(Canvas c)方法.有点注意的是背景drawable的实际大小会影响view组件的大小,drawable的实际大小通过getIntrinsicWidth()和getIntrinsicHeight()获取,当背景比较大时view组件大小等于背景drawable的大小,画完背景后,draw过程会调用onDraw(Canvas canvas)方法,然后就是dispatchDraw(Canvas canvas)方法, dispatchDraw()主要是分发给子组件进行绘制,我们通常定制组件的时候重写的是onDraw()方法。值得注意的是ViewGroup容器组件的绘制,当它没有背景时直接调用的是dispatchDraw()方法, 而绕过了draw()方法,当它有背景的时候就调用draw()方法,而draw()方法里包含了dispatchDraw()方法的调用。因此要在ViewGroup上绘制东西的时候往往重写的是dispatchDraw()方法而不是onDraw()方法,或者自定制一个Drawable,重写它的draw(Canvas c)和 getIntrinsicWidth(),getIntrinsicHeight()方法,然后设为背景。 3.ondraw() 和dispatchdraw()的区别 绘制VIew本身的内容,通过调用View.onDraw(canvas)函数实现 绘制自己的孩子通过dispatchDraw(canvas)实现 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/3960826.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android面试,BroadCastReceiver的两种注册方式的异同

在Android手机应用程序中开发中,需要用到BroadcastReceiver来监听广播的消息。在自定义好BroadcastReceiver ,需要对其进行注册,注册有两种方法: 一种是在代码当中注册,注册的方法是registerReceiver(receiver,filter)(用Activity的实例来调用),取消注册的方法:unregisterReceiver(receiver),如果一个BroadcastReceiver用于更新UI(User Interface),那么通常会使用这种方法进行注册,在Activity启动的时候进行注册,在Activity不可见后取消注册; 另一种就是在AndroidManifest当中进行注册。 使用代码进行注册 IntentFilter filter = new IntentFilter("android.provider.Telephony.SMS_RECEIVED"); IncomingSMSReceiver receiver = new IncomingSMSReceiver(); registerReceiver(receiver, filter); 在AndroidManifest.xml文件中的<application>节点里进行注册 <receiver android:name=".IncomingSMSReceiver"> <intent-filter> <action android:name="android.provider.Telephony.SMS_RECEIVED"/> </intent-filter> </receiver> 注册完之后即可以发送广播,使用Context.sendBroadcast()、Context.sendOrderedBroadcast()或者Context.sendStickyBroadcast()来实现,接收端代码: public class IncomingSMSReceiver extends BroadcastReceiver { @Override public void onReceive(Context context, Intent intent) { //todo...接收广播,做自己的业务 } } 区别 在AndroidManifest中进行注册后,不管改应用程序是否处于活动状态,都会进行监听,比如某个程序时监听 内存 的使用情况的,当在手机上安装好后,不管改应用程序是处于什么状态,都会执行改监听方法中的内容。 在代码中进行注册后,当应用程序关闭后,就不再进行监听。我们读知道,应用程序是否省电,决定了该应用程序的受欢迎程度,所以,对于那些没必要在程序关闭后仍然进行监听的Receiver,在代码中进行注册,无疑是一个明智的选择。 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/3909619.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

面试官:spring中定义bean的方法有哪些? 我一口气说完12种,彻底征服面试官.

2 --> 前言 在庞大的java体系中,spring有着举足轻重的地位,它给每位开发者带来了极大的便利和惊喜。我们都知道spring是创建和管理bean的工厂,它提供了多种定义bean的方式,能够满足我们日常工作中的多种业务场景。 那么问题来了,你知道spring中有哪些方式可以定义bean? 最近无意间获得一份BAT大厂大佬写的刷题笔记,一下子打通了我的任督二脉,越来越觉得算法没有想象中那么难了。 BAT大佬写的刷题笔记,让我offer拿到手软 我估计很多人会说出以下三种: 没错,但我想说的是以上三种方式只是开胃小菜,实际上spring的功能远比你想象中更强大。 各位看官如果不信,请继续往下看。 1. xml文件配置bean 我们先从xml配置bean开始,它是spring最早支持的方式。后来,随着springboot越来越受欢迎,该方法目前已经用得很少了,但我建议我们还是有必要了解一下。 1.1 构造器 如果你之前有在bean.xml文件中配置过bean的经历,那么对如下的配置肯定不会陌生: <bean > </bean> 这种方式是以前使用最多的方式,它默认使用了无参构造器创建bean。 当然我们还可以使用有参的构造器,通过<constructor-arg>标签来完成配置。 <bean > <constructor-arg index="0" value="susan"></constructor-arg> <constructor-arg index="1" ref="baseInfo"></constructor-arg> </bean> 其中: index表示下标,从0开始。 value表示常量值 ref表示引用另一个bean 1.2 setter方法 除此之外,spring还提供了另外一种思路:通过setter方法设置bean所需参数,这种方式耦合性相对较低,比有参构造器使用更为广泛。 先定义Person实体: @Data public class Person { private String name; private int age; } 它里面包含:成员变量name和age,getter/setter方法。 然后在bean.xml文件中配置bean时,加上<property>标签设置bean所需参数。 <bean > <property name="name" value="susan"></constructor-arg> <property name="age" value="18"></constructor-arg> </bean> 1.3 静态工厂 这种方式的关键是需要定义一个工厂类,它里面包含一个创建bean的静态方法。例如: public class SusanBeanFactory { public static Person createPerson(String name, int age) { return new Person(name, age); } } 接下来定义Person类如下: @AllArgsConstructor @NoArgsConstructor @Data public class Person { private String name; private int age; } 它里面包含:成员变量name和age,getter/setter方法,无参构造器和全参构造器。 然后在bean.xml文件中配置bean时,通过factory-method参数指定静态工厂方法,同时通过<constructor-arg>设置相关参数。 <bean factory-method="createPerson"> <constructor-arg index="0" value="susan"></constructor-arg> <constructor-arg index="1" value="18"></constructor-arg> </bean> 1.4 实例工厂方法 这种方式也需要定义一个工厂类,但里面包含非静态的创建bean的方法。 public class SusanBeanFactory { public Person createPerson(String name, int age) { return new Person(name, age); } } Person类跟上面一样,就不多说了。 然后bean.xml文件中配置bean时,需要先配置工厂bean。然后在配置实例bean时,通过factory-bean参数指定该工厂bean的引用。 <bean > </bean> <bean factory-bean="susanBeanFactory" factory-method="createPerson"> <constructor-arg index="0" value="susan"></constructor-arg> <constructor-arg index="1" value="18"></constructor-arg> </bean> 1.5 FactoryBean 不知道大家有没有发现,上面的实例工厂方法每次都需要创建一个工厂类,不方面统一管理。 这时我们可以使用FactoryBean接口。 public class UserFactoryBean implements FactoryBean<User> { @Override public User getObject() throws Exception { return new User(); } @Override public Class<?> getObjectType() { return User.class; } } 在它的getObject方法中可以实现我们自己的逻辑创建对象,并且在getObjectType方法中我们可以定义对象的类型。 然后在bean.xml文件中配置bean时,只需像普通的bean一样配置即可。 <bean > </bean> 轻松搞定,so easy。 注意:getBean("userFactoryBean");获取的是getObject方法中返回的对象。而getBean("&userFactoryBean");获取的才是真正的UserFactoryBean对象。 我们通过上面五种方式,在bean.xml文件中把bean配置好之后,spring就会自动扫描和解析相应的标签,并且帮我们创建和实例化bean,然后放入spring容器中。 虽说基于xml文件的方式配置bean,简单而且非常灵活,比较适合一些小项目。但如果遇到比较复杂的项目,则需要配置大量的bean,而且bean之间的关系错综复杂,这样久而久之会导致xml文件迅速膨胀,非常不利于bean的管理。 2. Component注解 为了解决bean太多时,xml文件过大,从而导致膨胀不好维护的问题。在spring2.5中开始支持:@Component、@Repository、@Service、@Controller等注解定义bean。 如果你有看过这些注解的源码的话,就会惊奇得发现:其实后三种注解也是@Component。 @Component系列注解的出现,给我们带来了极大的便利。我们不需要像以前那样在bean.xml文件中配置bean了,现在只用在类上加Component、Repository、Service、Controller,这四种注解中的任意一种,就能轻松完成bean的定义。 @Component系列注解的出现,给我们带来了极大的便利。我们不需要像以前那样在bean.xml文件中配置bean了,现在只用在类上加Component、Repository、Service、Controller,这四种注解中的任意一种,就能轻松完成bean的定义。 @Service public class PersonService { public String get() { return "data"; } } 不过,需要特别注意的是,通过这种@Component扫描注解的方式定义bean的前提是:需要先配置扫描路径。 目前常用的配置扫描路径的方式如下: 在applicationContext.xml文件中使用<context:component-scan>标签。例如: <context:component-scan base-package="com.sue.cache" /> 在springboot的启动类上加上@ComponentScan注解,例如: @ComponentScan(basePackages = "com.sue.cache") @SpringBootApplication public class Application { public static void main(String[] args) { new SpringApplicationBuilder(Application.class).web(WebApplicationType.SERVLET).run(args); } } 直接在SpringBootApplication注解上加,它支持ComponentScan功能: @SpringBootApplication(scanBasePackages = "com.sue.cache") public class Application { public static void main(String[] args) { new SpringApplicationBuilder(Application.class).web(WebApplicationType.SERVLET).run(args); } } 当然,如果你需要扫描的类跟springboot的入口类,在同一级或者子级的包下面,无需指定scanBasePackages参数,spring默认会从入口类的同一级或者子级的包去找。 @SpringBootApplication public class Application { public static void main(String[] args) { new SpringApplicationBuilder(Application.class).web(WebApplicationType.SERVLET).run(args); } } 此外,除了上述四种@Component注解之外,springboot还增加了@RestController注解,它是一种特殊的@Controller注解,所以也是@Component注解。 @RestController还支持@ResponseBody注解的功能,即将接口响应数据的格式自动转换成json。 @Component系列注解已经让我们爱不释手了,它目前是我们日常工作中最多的定义bean的方式。 3. JavaConfig @Component系列注解虽说使用起来非常方便,但是bean的创建过程完全交给spring容器来完成,我们没办法自己控制。 spring从3.0以后,开始支持JavaConfig的方式定义bean。它可以看做spring的配置文件,但并非真正的配置文件,我们需要通过编码java代码的方式创建bean。例如: @Configuration public class MyConfiguration { @Bean public Person person() { return new Person(); } } 在JavaConfig类上加@Configuration注解,相当于配置了<beans>标签。而在方法上加@Bean注解,相当于配置了<bean>标签。 此外,springboot还引入了一些列的@Conditional注解,用来控制bean的创建。 @Configuration public class MyConfiguration { @ConditionalOnClass(Country.class) @Bean public Person person() { return new Person(); } } @ConditionalOnClass注解的功能是当项目中存在Country类时,才实例化Person类。换句话说就是,如果项目中不存在Country类,就不实例化Person类。 这个功能非常有用,相当于一个开关控制着Person类,只有满足一定条件才能实例化。 spring中使用比较多的Conditional还有: ConditionalOnBean ConditionalOnProperty ConditionalOnMissingClass ConditionalOnMissingBean ConditionalOnWebApplication 如果你对这些功能比较感兴趣,可以看看《》,这是我之前写的一篇文章,里面做了更详细的介绍。 下面用一张图整体认识一下@Conditional家族: 恭喜你,这是个好问题,因为@Import注解也支持。 4. Import注解 通过前面介绍的@Configuration和@Bean相结合的方式,我们可以通过代码定义bean。但这种方式有一定的局限性,它只能创建该类中定义的bean实例,不能创建其他类的bean实例,如果我们想创建其他类的bean实例该怎么办呢? 这时可以使用@Import注解导入。 4.1 普通类 spring4.2之后@Import注解可以实例化普通类的bean实例。例如: 先定义了Role类: @Data public class Role { private Long id; private String name; } 接下来使用@Import注解导入Role类: @Import(Role.class) @Configuration public class MyConfig { } 然后在调用的地方通过@Autowired注解注入所需的bean。 @RequestMapping("/") @RestController public class TestController { @Autowired private Role role; @GetMapping("/test") public String test() { System.out.println(role); return "test"; } } 聪明的你可能会发现,我没有在任何地方定义过Role的bean,但spring却能自动创建该类的bean实例,这是为什么呢? 这也许正是@Import注解的强大之处。 此时,有些朋友可能会问:@Import注解能定义单个类的bean,但如果有多个类需要定义bean该怎么办呢? 恭喜你,这是个好问题,因为@Import注解也支持 @Import({Role.class, User.class}) @Configuration public class MyConfig { } 甚至,如果你想偷懒,不想写这种MyConfig类,springboot也欢迎。 @Import({Role.class, User.class}) @SpringBootApplication(exclude = {DataSourceAutoConfiguration.class, DataSourceTransactionManagerAutoConfiguration.class}) public class Application { public static void main(String[] args) { new SpringApplicationBuilder(Application.class).web(WebApplicationType.SERVLET).run(args); } } 可以将@Import加到springboot的启动类上。 这样也能生效? springboot的启动类一般都会加@SpringBootApplication注解,该注解上加了@SpringBootConfiguration注解。 而@SpringBootConfiguration注解,上面又加了@Configuration注解 所以,springboot启动类本身带有@Configuration注解的功能。 意不意外?惊不惊喜? 4.2 Configuration类 上面介绍了@Import注解导入普通类的方法,它同时也支持导入Configuration类。 先定义一个Configuration类: @Configuration public class MyConfig2 { @Bean public User user() { return new User(); } @Bean public Role role() { return new Role(); } } 然后在另外一个Configuration类中引入前面的Configuration类: @Import({MyConfig2.class}) @Configuration public class MyConfig { } 这种方式,如果MyConfig2类已经在spring指定的扫描目录或者子目录下,则MyConfig类会显得有点多余。因为MyConfig2类本身就是一个配置类,它里面就能定义bean。 但如果MyConfig2类不在指定的spring扫描目录或者子目录下,则通过MyConfig类的导入功能,也能把MyConfig2类识别成配置类。这就有点厉害了喔。 其实下面还有更高端的玩法。 swagger作为一个优秀的文档生成框架,在spring项目中越来越受欢迎。接下来,我们以swagger2为例,介绍一下它是如何导入相关类的。 众所周知,我们引入swagger相关jar包之后,只需要在springboot的启动类上加上@EnableSwagger2注解,就能开启swagger的功能。 其中@EnableSwagger2注解中导入了Swagger2DocumentationConfiguration类。 该类是一个Configuration类,它又导入了另外两个类: SpringfoxWebMvcConfiguration SwaggerCommonConfiguration SpringfoxWebMvcConfiguration类又会导入新的Configuration类,并且通过@ComponentScan注解扫描了一些其他的路径。 SwaggerCommonConfiguration同样也通过@ComponentScan注解扫描了一些额外的路径。 4.3 ImportSelector 还有什么好说的,狂起点赞,简直完美。 4.3 ImportSelector 上面提到的Configuration类,它的功能非常强大。但怎么说呢,它不太适合加复杂的判断条件,根据某些条件定义这些bean,根据另外的条件定义那些bean。 那么,这种需求该怎么实现呢? 这时就可以使用ImportSelector接口了。 首先定义一个类实现ImportSelector接口: public class DataImportSelector implements ImportSelector { @Override public String[] selectImports(AnnotationMetadata importingClassMetadata) { return new String[]{"com.sue.async.service.User", "com.sue.async.service.Role"}; } } 重写selectImports方法,在该方法中指定需要定义bean的类名,注意要包含完整路径,而非相对路径。 然后在MyConfig类上@Import导入这个类即可: @Import({DataImportSelector.class}) @Configuration public class MyConfig { } 朋友们是不是又发现了一个新大陆? 不过,这个注解还有更牛逼的用途。 @EnableAutoConfiguration注解中导入了AutoConfigurationImportSelector类,并且里面包含系统参数名称:spring.boot.enableautoconfiguration。 AutoConfigurationImportSelector类实现了ImportSelector接口。 除此之外,spring还提供了专门注册bean的接口:BeanDefinitionRegistryPostProcessor。 该方法会根据ENABLED_OVERRIDE_PROPERTY的值来作为判断条件。 而这个值就是spring.boot.enableautoconfiguration。 换句话说,这里能根据系统参数控制bean是否需要被实例化,优秀。 我个人认为实现ImportSelector接口的好处主要有以下两点: 把某个功能的相关类,可以放到一起,方便管理和维护。 重写selectImports方法时,能够根据条件判断某些类是否需要被实例化,或者某个条件实例化这些bean,其他的条件实例化那些bean等。我们能够非常灵活的定制化bean的实例化。 4.4 ImportBeanDefinitionRegistrar 我们通过上面的这种方式,确实能够非常灵活的自定义bean。 但它的自定义能力,还是有限的,它没法自定义bean的名称和作用域等属性。 有需求,就有解决方案。 接下来,我们一起看看ImportBeanDefinitionRegistrar接口的神奇之处。 先定义CustomImportSelector类实现ImportBeanDefinitionRegistrar接口: public class CustomImportSelector implements ImportBeanDefinitionRegistrar { @Override public void registerBeanDefinitions(AnnotationMetadata importingClassMetadata, BeanDefinitionRegistry registry) { RootBeanDefinition roleBeanDefinition = new RootBeanDefinition(Role.class); registry.registerBeanDefinition("role", roleBeanDefinition); RootBeanDefinition userBeanDefinition = new RootBeanDefinition(User.class); userBeanDefinition.setScope(ConfigurableBeanFactory.SCOPE_PROTOTYPE); registry.registerBeanDefinition("user", userBeanDefinition); } } 重写registerBeanDefinitions方法,在该方法中我们可以获取BeanDefinitionRegistry对象,通过它去注册bean。不过在注册bean之前,我们先要创建BeanDefinition对象,它里面可以自定义bean的名称、作用域等很多参数。 然后在MyConfig类上导入上面的类 @Import({CustomImportSelector.class}) @Configuration public class MyConfig { } 我们所熟悉的fegin功能,就是使用ImportBeanDefinitionRegistrar接口实现的: 5. PostProcessor 除此之外,spring还提供了专门注册bean的接口:BeanDefinitionRegistryPostProcessor。 该接口的方法postProcessBeanDefinitionRegistry上有这样一段描述: 修改应用程序上下文的内部bean定义注册表标准初始化。所有常规bean定义都将被加载,但是还没有bean被实例化。这允许进一步添加在下一个后处理阶段开始之前定义bean。 如果用这个接口来定义bean,我们要做的事情就变得非常简单了。只需定义一个类实现BeanDefinitionRegistryPostProcessor接口。 @Component public class MyRegistryPostProcessor implements BeanDefinitionRegistryPostProcessor { @Override public void postProcessBeanDefinitionRegistry(BeanDefinitionRegistry registry) throws BeansException { RootBeanDefinition roleBeanDefinition = new RootBeanDefinition(Role.class); registry.registerBeanDefinition("role", roleBeanDefinition); RootBeanDefinition userBeanDefinition = new RootBeanDefinition(User.class); userBeanDefinition.setScope(ConfigurableBeanFactory.SCOPE_PROTOTYPE); registry.registerBeanDefinition("user", userBeanDefinition); } @Override public void postProcessBeanFactory(ConfigurableListableBeanFactory beanFactory) throws BeansException { } } 重写postProcessBeanDefinitionRegistry方法,在该方法中能够获取BeanDefinitionRegistry对象,它负责bean的注册工作。 不过细心的朋友可能会发现,里面还多了一个postProcessBeanFactory方法,没有做任何实现。 这个方法其实是它的父接口:BeanFactoryPostProcessor里的方法。 在应用程序上下文的标准bean工厂之后修改其内部bean工厂初始化。所有bean定义都已加载,但没有bean将被实例化。这允许重写或添加属性甚至可以初始化bean。 @Component public class MyPostProcessor implements BeanFactoryPostProcessor { @Override public void postProcessBeanFactory(ConfigurableListableBeanFactory beanFactory) throws BeansException { DefaultListableBeanFactory registry = (DefaultListableBeanFactory)beanFactory; RootBeanDefinition roleBeanDefinition = new RootBeanDefinition(Role.class); registry.registerBeanDefinition("role", roleBeanDefinition); RootBeanDefinition userBeanDefinition = new RootBeanDefinition(User.class); userBeanDefinition.setScope(ConfigurableBeanFactory.SCOPE_PROTOTYPE); registry.registerBeanDefinition("user", userBeanDefinition); } } 既然这两个接口都能注册bean,那么他们有什么区别? BeanDefinitionRegistryPostProcessor 更侧重于bean的注册 BeanFactoryPostProcessor 更侧重于对已经注册的bean的属性进行修改,虽然也可以注册bean。 此时,有些朋友可能会问:既然拿到BeanDefinitionRegistry对象就能注册bean,那通过BeanFactoryAware的方式是不是也能注册bean呢? 从下面这张图能够看出DefaultListableBeanFactory就实现了BeanDefinitionRegistry接口。 这样一来,我们如果能够获取DefaultListableBeanFactory对象的实例,然后调用它的注册方法,不就可以注册bean了? 说时迟那时快,定义一个类实现BeanFactoryAware接口: @Component public class BeanFactoryRegistry implements BeanFactoryAware { @Override public void setBeanFactory(BeanFactory beanFactory) throws BeansException { DefaultListableBeanFactory registry = (DefaultListableBeanFactory) beanFactory; RootBeanDefinition rootBeanDefinition = new RootBeanDefinition(User.class); registry.registerBeanDefinition("user", rootBeanDefinition); RootBeanDefinition userBeanDefinition = new RootBeanDefinition(User.class); userBeanDefinition.setScope(ConfigurableBeanFactory.SCOPE_PROTOTYPE); registry.registerBeanDefinition("user", userBeanDefinition); } } 重写setBeanFactory方法,在该方法中能够获取BeanFactory对象,它能够强制转换成DefaultListableBeanFactory对象,然后通过该对象的实例注册bean。 当你满怀喜悦的运行项目时,发现竟然报错了: spring中bean的创建过程顺序大致如下: BeanFactoryAware接口是在bean创建成功,并且完成依赖注入之后,在真正初始化之前才被调用的。在这个时候去注册bean意义不大,因为这个接口是给我们获取bean的,并不建议去注册bean,会引发很多问题。 最近无意间获得一份BAT大厂大佬写的刷题笔记,一下子打通了我的任督二脉,越来越觉得算法没有想象中那么难了。 BAT大佬写的刷题笔记,让我offer拿到手软

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册