首页 文章 精选 留言 我的

精选列表

搜索[面试],共5090篇文章
优秀的个人博客,低调大师

分布式系统架构,回顾2020年常见面试知识点梳理(每次面试都会问到其中某一块知识点)

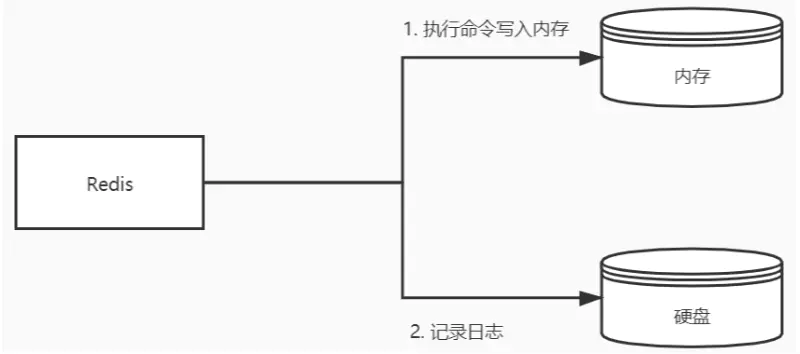
分布式分为分布式缓存(Redis)、分布式锁(Redis 或 Zookeeper)、分布式服务(Dubbo 或 SpringCloud)、分布式服务协调(Zookeeper)、分布式消息队列(Kafka 、RabbitMq)、分布式 Session 、分布式事务、分布式搜索(Elasticsearch)等。不可能所有分布式内容都熟悉,一定要在某个领域有所专长。 分布式理论 问:分布式有哪些理论? CAP 、BASE。分布式 CAP 理论,任何一个分布式系统都无法同时满足 Consistency(一致性)、Availability(可用性)、Partition tolerance(分区容错性) 这三个基本需求。最多只能满足其中两项。而 Partition tolerance(分区容错性) 是必须的,因此一般是 CP ,或者 AP。 问:你怎么理解分布式一致性? 数据一致性通常指关联数据之间的逻辑关系是否正确和完整。在分布式系统中,数据一致性往往指的是由于数据的复制,不同数据节点中的数据内容是否完整并且相同。 一致性还分为强一致性,弱一致性,还有最终一致性。强一致性就是马上就保持一致。 最终一致性是指经过一段时间后,可以保持一致。 分布式事务 问:你怎么理解分布式事务?分布式事务的协议有哪些? 分布式事务是指会涉及到操作多个数据库的事务。目的是为了保证分布式系统中的数据一致性。分布式事务类型:二阶段提交 2PC ,三阶段提交 3PC。 2PC :第一阶段:准备阶段(投票阶段)和第二阶段:提交阶段(执行阶段)。 3PC :三个阶段:CanCommit 、PreCommit 、DoCommit。 问:分布式事务的解决方案有哪些? 分布式事务解决方案:补偿机制 TCC 、XA 、消息队列 MQ。 问:讲一下 TCC。 T(Try)锁资源:锁定某个资源,设置一个预备类的状态,冻结部分数据。 比如,订单的支付状态,先把状态修改为"支付中(PAYING)"。 比如,本来库存数量是 100 ,现在卖出了 2 个,不要直接扣减这个库存。在一个单独的冻结库存的字段,比如 prepare _ remove _ stock 字段,设置一个 2。也就是说,有 2 个库存是给冻结了。 积分服务的也是同理,别直接给用户增加会员积分。你可以先在积分表里的一个预增加积分字段加入积分。 比如:用户积分原本是 1190 ,现在要增加 10 个积分,别直接 1190 + 10 = 1200 个积分啊!你可以保持积分为 1190 不变,在一个预增加字段里,比如说 prepare _ add _ credit 字段,设置一个 10 ,表示有 10 个积分准备增加。 C(Confirm):在各个服务里引入了一个 TCC 分布式事务的框架,事务管理器可以感知到各个服务的 Try 操作是否都成功了。假如都成功了, TCC 分布式事务框架会控制进入 TCC 下一个阶段,第一个 C 阶段,也就是 Confirm 阶段。此时,需要把 Try 阶段锁住的资源进行处理。 比如,把订单的状态设置为“已支付(Payed)”。 比如,扣除掉相应的库存。 比如,增加用户积分。 C(Cancel):在 Try 阶段,假如某个服务执行出错,比如积分服务执行出错了,那么服务内的 TCC 事务框架是可以感知到的,然后它会决定对整个 TCC 分布式事务进行回滚。 TCC 分布式事务框架只要感知到了任何一个服务的 Try 逻辑失败了,就会跟各个服务内的 TCC 分布式事务框架进行通信,然后调用各个服务的 Cancel 逻辑。也就是说,会执行各个服务的第二个 C 阶段, Cancel 阶段。 比如,订单的支付状态,先把状态修改为" closed "状态。 比如,冻结库存的字段, prepare _ remove _ stock 字段,将冻结的库存 2 清零。 比如,预增加积分的字段, prepare _ add _ credit 字段,将准备增加的积分 10 清零。 问:事务管理器宕掉了,怎么办? 做冗余,设置多个事务管理器,一个宕掉了,其他的还可以用。 问:怎么保证分布式系统的幂等性? 状态机制。版本号机制。 Redis 问:Redis 有哪些优势? 速度快,因为数据存在内存中。 支持丰富数据类型,支持 string、list、set 、sorted set、hash。 支持事务,操作都是原子性,所谓的原子性就是对数据的更改要么全部执行,要么全部不执行。 丰富的特性:可用于缓存,消息,按 key 设置过期时间,过期后将会自动删除。 单线程,单进程,采用 IO 多路复用技术。 问:Redis 的存储结构是怎样的? key-value 键值对。 问:Redis 支持哪些数据结构? string(字符串), hash(哈希), list(队列), set(集合)及 zset(sorted set 有序集合)。 问:Redis 的数据结构,有哪些应用场景? string:简单地 get / set 缓存。 hash:可以缓存用户资料。比如命令:hmset user1 name "lin" sex "male" age "25" ,缓存用户 user1 的资料,姓名为 lin ,性别为男,年龄 25。 list:可以做队列。往 list 队列里面 push 数据,然后再 pop 出来。 zset:可以用来做排行榜。 问:Redis 的数据结构,底层分别是由什么实现的? Redis 字符串,却不是 C 语言中的字符串(即以空字符 ’\0’ 结尾的字符数组),它是自己构建了一种名为 简单动态字符串(simple dynamic string , SDS)的抽象类型,并将 SDS 作为 Redis 的默认字符串表示。 Redi List ,底层是 ZipList ,不满足 ZipList 就使用双向链表。ZipList 是为了节约内存而开发的。和各种语言的数组类似,它是由连续的内存块组成的,这样一来,由于内存是连续的,就减少了很多内存碎片和指针的内存占用,进而节约了内存。 问:Redis 怎么保证可靠性?Redis 的持久化方式有哪些?有哪些优缺点? 一个可靠安全的系统,肯定要考虑数据的可靠性,尤其对于内存为主的 Redis ,就要考虑一旦服务器挂掉,启动之后,如何恢复数据的问题,也就是说数据如何持久化的问题。 AOF 就是备份操作记录。AOF 由于是备份操作命令,备份快、恢复慢。 AOF 的优点:AOF 更好保证数据不会被丢失,最多只丢失一秒内的数据。另外重写操作保证了数据的有效性,即使日志文件过大也会进行重写。AOF 的日志文件的记录可读性非常的高。 AOF 的缺点:对于相同数量的数据集而言, AOF 文件通常要大于 RDB 文件。 RDB 就是备份所有数据,使用了快照。RDB 恢复数据比较快。 问:AOF 文件过大,怎么处理? 会进行 AOF 文件重写。 随着 AOF 文件越来越大,里面会有大部分是重复命令或者可以合并的命令。 重写的好处:减少 AOF 日志尺寸,减少内存占用,加快数据库恢复时间。 执行一个 AOF 文件重写操作,重写会创建一个当前 AOF 文件的体积优化版本。 问:讲一下 Redis 的事务。 先以 MULTI 开始一个事务, 然后将多个命令入队到事务中, 最后由 EXEC 命令触发事务, 一并执行事务中的所有命令。如果想放弃这个事务,可以使用 DISCARD 命令。 问:Redis 事务无法回滚,那怎么处理? 问:怎么设置 Redis 的 key 过期时间? key 的的过期时间通过 EXPIRE key seconds 命令来设置数据的过期时间。返回 1 表明设置成功,返回 0 表明 key 不存在或者不能成功设置过期时间。 问:Redis 的过期策略有哪些? 惰性删除:当读/写一个已经过期的 key 时,会触发惰性删除策略,直接删除掉这个过期 key ,并按照 key 不存在去处理。惰性删除,对内存不太好,已经过期的 key 会占用太多的内存。 定期删除:每隔一段时间,就会对 Redis 进行检查,主动删除一批已过期的 key。 问:为什么 Redis 不使用定时删除? 定时删除,就是在设置 key 的过期时间的同时,创建一个定时器,让定时器在过期时间来临时,立即执行对 key 的删除操作。 定时删会占用 CPU ,影响服务器的响应时间和性能。 问:Redis 的内存回收机制都有哪些? 当前已用内存超过 maxmemory 限定时,会触发主动清理策略,也就是 Redis 的内存回收策略。 LRU 、TTL。 noeviction :默认策略,不会删除任何数据,拒绝所有写入操作并返回客户端错误信息,此时 Redis 只响应读操作。 volatitle - lru :根据 LRU 算法删除设置了超时属性的键,知道腾出足够空间为止。如果没有可删除的键对象,回退到 noeviction 策略。 allkeys - lru :根据 LRU 算法删除键,不管数据有没有设置超时属性,直到腾出足够空间为止。 allkeys - random :随机删除所有键,知道腾出足够空间为止。 volatitle - random :随机删除过期键,知道腾出足够空间为止。 volatitle - ttl :根据键值对象的 ttl 属性,删除最近将要过期数据。如果没有,回退到 noeviction 策略。 问:手写一下 LRU 算法。 问:Redis 的搭建有哪些模式? 主从模式、哨兵模式、Cluster(集群)模式。最好是用集群模式。 问:你用过的 Redis 是多主多从的,还是一主多从的?集群用到了多少节点?用到了多少个哨兵? 集群模式。三主三从。 问:Redis 采用多主多从的集群模式,各个主节点的数据是否一致? 问:Redis 集群有哪些特性 master 和 slaver。主从复制。读写分离。哨兵模式。 问:Redis 是怎么进行水平扩容的? 问:Redis 集群数据分片的原理是什么? Redis 数据分片原理是哈希槽(hash slot)。 Redis 集群有 16384 个哈希槽。每一个 Redis 集群中的节点都承担一个哈希槽的子集。 哈希槽让在集群中添加和移除节点非常容易。例如,如果我想添加一个新节点 D ,我需要从节点 A 、B、C 移动一些哈希槽到节点 D。同样地,如果我想从集群中移除节点 A ,我只需要移动 A 的哈希槽到 B 和 C。当节点 A 变成空的以后,我就可以从集群中彻底删除它。因为从一个节点向另一个节点移动哈希槽并不需要停止操作,所以添加和移除节点,或者改变节点持有的哈希槽百分比,都不需要任何停机时间(downtime)。 问:讲一下一致性 Hash 算法。 一致性 Hash 算法将整个哈希值空间组织成一个虚拟的圆环, 我们对 key 进行哈希计算,使用哈希后的结果对 2 ^ 32 取模,hash 环上必定有一个点与这个整数对应。依此确定此数据在环上的位置,从此位置沿环顺时针“行走”,第一台遇到的服务器就是其应该定位到的服务器。 一致性 Hash 算法对于节点的增减都只需重定位环空间中的一小部分数据,具有较好的容错性和可扩展性。 比如,集群有四个节点 Node A 、B 、C 、D ,增加一台节点 Node X。Node X 的位置在 Node B 到 Node C 直接,那么受到影响的仅仅是 Node B 到 Node X 间的数据,它们要重新落到 Node X 上。 所以一致性哈希算法对于容错性和扩展性有非常好的支持。 问:为什么 Redis Cluster 分片不使用 Redis 一致性 Hash 算法? 一致性哈希算法也有一个严重的问题,就是数据倾斜。 如果在分片的集群中,节点太少,并且分布不均,一致性哈希算法就会出现部分节点数据太多,部分节点数据太少。也就是说无法控制节点存储数据的分配。 问:集群的拓扑结构有没有了解过?集群是怎么连接的? 无中心结构。Redis-Cluster 采用无中心结构,每个节点保存数据和整个集群状态,每个节点都和其他所有节点连接。 问:讲一下 Redis 主从复制的过程。 从机发送 SYNC(同步)命令,主机接收后会执行 BGSAVE(异步保存)命令备份数据。 主机备份后,就会向从机发送备份文件。主机之后还会发送缓冲区内的写命令给从机。 当缓冲区命令发送完成后,主机执行一条写命令,就会往从机发送同步写入命令。 问:讲一下 Redis 哨兵机制。 下面是 Redis 官方文档对于哨兵功能的描述: 监控(Monitoring):哨兵会不断地检查主节点和从节点是否运作正常。 自动故障转移(Automatic Failover):当主节点不能正常工作时,哨兵会开始自动故障转移操作,它会将失效主节点的其中一个从节点升级为新的主节点,并让其他从节点改为复制新的主节点。 配置提供者(Configuration Provider):客户端在初始化时,通过连接哨兵来获得当前 Redis 服务的主节点地址。 通知(Notification):哨兵可以将故障转移的结果发送给客户端。 问:讲一下布隆过滤器。 布隆过滤器的主要是由一个很长的二进制向量和若干个(k 个)散列映射函数组成。因为每个元数据的存储信息值固定,而且总的二进制向量固定。所以在内存占用和查询时间上都远远超过一般的算法。当然存在一定的不准确率(可以控制)和不容易删除样本数据。 布隆过滤器的优点:大批量数据去重,特别的占用内存。但是用布隆过滤器(Bloom Filter)会非常的省内存。 布隆过滤器的特点:当布隆过滤器说某个值存在时,那可能就不存在,如果说某个值不存在时,那肯定就是不存在了。 布隆过滤器的应用场景:新闻推送(不重复推送)。解决缓存穿透的问题。 缓存 问:缓存雪崩是什么? 如果缓存数据设置的过期时间是相同的,并且 Redis 恰好将这部分数据全部删光了。这就会导致在这段时间内,这些缓存同时失效,全部请求到数据库中。这就是缓存雪崩。 问:怎么解决缓存雪崩? 解决方法:在缓存的时候给过期时间加上一个随机值,这样就会大幅度的减少缓存在同一时间过期。 问:缓存穿透是什么? 缓存穿透是指查询一个一定不存在的数据。由于缓存不命中,并且出于容错考虑,如果从数据库查不到数据则不写入缓存,这将导致这个不存在的数据每次请求都要到数据库去查询,失去了缓存的意义。 问:怎么解决缓存穿透? 问:什么是缓存与数据库双写一致问题? 问:如何保证缓存与数据库的一致性? 读的时候,先读缓存,缓存没有的话,就读数据库,然后取出数据后放入缓存,同时返回响应。 先删除缓存,再更新数据库。 问:为什么是先删除缓存,而不是先更新缓存? 问:先更新数据库,再删除缓存,会有什么问题? 先更新数据库,再删除缓存。可能出现以下情况: 如果更新完数据库, Java 服务提交了事务,然后挂掉了,那 Redis 还是会执行,这样也会不一致。 如果更新数据库成功,删除缓存失败了,那么会导致数据库中是新数据,缓存中是旧数据,数据就出现了不一致。 先删除缓存,再更新数据库。 如果删除缓存失败,那就不更新数据库,缓存和数据库的数据都是旧数据,数据是一致的。 如果删除缓存成功,而数据库更新失败了,那么数据库中是旧数据,缓存中是空的,数据不会不一致。因为读的时候缓存没有,所以去读了数据库中的旧数据,然后更新到缓存中。 问:先删除缓存,在写数据库成功之前,如果有读请求发生,可能导致旧数据入缓存,引发数据不一致,怎么处理? 分布式锁 问:Redis 如何实现分布式锁? 使用 set key value ex nx 命令。 当 key 不存在时,将 key 的值设为 value ,返回 1。若给定的 key 已经存在,则 setnx 不做任何动作,返回 0。 当 setnx 返回 1 时,表示获取锁,做完操作以后 del key ,表示释放锁,如果 setnx 返回 0 表示获取锁失败。 详细的命令如下: set key value [EX seconds] [PX milliseconds] [NX|XX]EX seconds:设置失效时长,单位秒PX milliseconds:设置失效时长,单位毫秒NX:key不存在时设置value,成功返回OK,失败返回(nil)XX:key存在时设置value,成功返回OK,失败返回(nil)。 复制代码 示例如下: set name fenglin ex 100 nx 复制代码 问:为什么不先 set nx ,然后再使用 expire 设置超时时间? 我们需要保证 setnx 命令和 expire 命令以原子的方式执行,否则如果客户端执行 setnx 获得锁后,这时客户端宕机了,那么这把锁没有设置过期时间,导致其他客户端永远无法获得锁了。 问:使用 Redis 分布式锁, key 和 value 分别设置成什么? value 可以使用 json 格式的字符串,示例: { "count":1, "expireAt":147506817232, "jvmPid":22224, "mac":"28-D2-44-0E-0D-9A", "threadId":14} 复制代码 问:Redis 实现的分布式锁,如果某个系统获取锁后,宕机了怎么办? 系统模块宕机的话,可以通过设置过期时间(就是设置缓存失效时间)解决。系统宕机时锁阻塞,过期后锁释放。 问:设置缓存失效时间,那如果前一个线程把这个锁给删除了呢? 问:如果加锁和解锁之间的业务逻辑执行的时间比较长,超过了锁过期的时间,执行完了,又删除了锁,就会把别人的锁给删了。怎么办? 这两个属于锁超时的问题。 可以将锁的 value 设置为 Json 字符串,在其中加入线程的 id 或者请求的 id ,在删除之前, get 一下这个 key ,判断 key 对应的 value 是不是当前线程的。只有是当前线程获取的锁,当前线程才可以删除。 问:Redis 分布式锁,怎么保证可重入性? 可以将锁的 value 设置为 Json 字符串,在其中加入线程的 id 和 count 变量。 当 count 变量的值为 0 时,表示当前分布式锁没有被线程占用。 如果 count 变量的值大于 0 ,线程 id 不是当前线程,表示当前分布式锁已经被其他线程占用。 如果 count 变量的值大于 0 ,线程 id 是当前线程的 id ,表示当前线程已经拿到了锁,不必阻塞,可以直接重入,并将 count 变量的值加一即可。 这种思路,其实就是参考了 ReentrantLock 可重入锁的机制。 问:Redis 做分布式锁, Redis 做了主从,如果设置锁之后,主机在传输到从机的时候挂掉了,从机还没有加锁信息,如何处理? 可以使用开源框架 Redisson ,采用了 redLock。 问:讲一下 Redis 的 redLock。 问:Zookeeper 是怎么实现分布式锁的? 分布式锁:基于 Zookeeper 一致性文件系统,实现锁服务。锁服务分为保存独占及时序控制两类。 保存独占:将 Zookeeper 上的一个 znode 看作是一把锁,通过 createznode 的方式来实现。所有客户端都去创建 / distribute _ lock 节点,最终成功创建的那个客户端也即拥有了这把锁。用完删除自己创建的 distribute _ lock 节点就释放锁。 时序控制:基于/ distribute _ lock 锁,所有客户端在它下面创建临时顺序编号目录节点,和选 master 一样,编号最小的获得锁,用完删除,依次方便。 更详细的回答如下: 其实基于 Zookeeper ,就是使用它的临时有序节点来实现的分布式锁。 原理就是:当某客户端要进行逻辑的加锁时,就在 Zookeeper 上的某个指定节点的目录下,去生成一个唯一的临时有序节点, 然后判断自己是否是这些有序节点中序号最小的一个,如果是,则算是获取了锁。如果不是,则说明没有获取到锁,那么就需要在序列中找到比自己小的那个节点,并对其调用 exist() 方法,对其注册事件监听,当监听到这个节点被删除了,那就再去判断一次自己当初创建的节点是否变成了序列中最小的。如果是,则获取锁,如果不是,则重复上述步骤。 当释放锁的时候,只需将这个临时节点删除即可。 Zookeeper 问:Zookeeper 的原理是什么? 问:Zookeeper 是怎么保证一致性的? zab 协议。 zab 协议有两种模式,它们分别是恢复模式(选主)和广播模式(同步)。当服务启动或者在领导者崩溃后, zab 就进入了恢复模式,当领导者被选举出来,且大多数 server 完成了和 leader 的状态同步以后,恢复模式就结束了。状态同步保证了 leader 和 server 具有相同的系统状态。 问:Zookeeper 有哪些应用场景? Zookeeper 可以作为服务协调的注册中心。还可以做分布式锁(如果没有用过分布式锁就不要说)。 问:Zookeeper 为什么能做注册中心? Zookeeper 的数据模型是树型结构,由很多数据节点组成, zk 将全量数据存储在内存中,可谓是高性能,而且支持集群,可谓高可用。另外支持事件监听(watch 命令)。 Zookeeper 可以作为一个数据发布/订阅系统。 问:Zookeeper 的节点有哪些类型?有什么区别? 临时节点,永久节点。更加细分就是临时有序节点、临时无序节点、永久有序节点、永久无序节点。 临时节点:当创建临时节点的程序停掉之后,这个临时节点就会消失,存储的数据也没有了。 问:Zookeeper 做为注册中心,主要存储哪些数据?存储在哪里? IP、端口、还有心跳机制。数据存储在 Zookeeper 的节点上面。 问:心跳机制有什么用? 问:Zookeeper 的广播模式有什么缺陷? 广播风暴。 问:讲一下 Zookeeper 的读写机制。 Leader 主机负责读和写。 Follower 负责读,并将写操作转发给 Leader。Follower 还参与 Leader 选举投票,参与事务请求 Proposal 投票。 Observer 充当观察者的角色。Observer 和 Follower 的唯一区别在于:Observer 不参与任何投票。 问:讲一下 Zookeeper 的选举机制。 Leader 不可用时,会重新选举 Leader。超过半数的 Follower 选举投票即可,Observer 不参与投票。 问:你们的 Zookeeper 集群配置了几个节点? 3 个节点。注意:Zookeeper 集群节点,最好是奇数个的。 集群中的 Zookeeper 节点需要超过半数,整个集群对外才可用。 这里所谓的整个集群对外才可用,是指整个集群还能选出一个 Leader 来, Zookeeper 默认采用 quorums 来支持 Leader 的选举。 如果有 2 个 Zookeeper,那么只要有 1 个死了 Zookeeper 就不能用了,因为 1 没有过半,所以 2 个 Zookeeper 的死亡容忍度为 0 ;同理,要是有 3 个 Zookeeper,一个死了,还剩下 2 个正常的,过半了,所以 3 个 Zookeeper 的容忍度为 1 ;同理你多列举几个:2 -> 0 ; 3 -> 1 ; 4 -> 1 ; 5 -> 2 ; 6 -> 2 会发现一个规律, 2n 和 2n - 1 的容忍度是一样的,都是 n - 1 ,所以为了更加高效,何必增加那一个不必要的 Zookeeper 呢。 问:Zookeeper 的集群节点,如果不是奇数可能会出现什么问题? 可能会出现脑裂。 假死:由于心跳超时(网络原因导致的)认为 master 死了,但其实 master 还存活着。 脑裂:由于假死会发起新的 master 选举,选举出一个新的 master ,但旧的 master 网络又通了,导致出现了两个 master ,有的客户端连接到老的 master 有的客户端链接到新的 master。 消息队列 问:为什么使用消息队列?消息队列有什么优点和缺点?Kafka 、ActiveMQ 、RabbitMq 、RocketMQ 都有什么优点和缺点? 消息队列解耦,削峰,限流。 问:如何保证消息队列的高可用?(多副本) 问:如何保证消息不被重复消费?(如何保证消息消费的幂等性) 问:如何保证消息的可靠性传输?(如何处理消息丢失的问题) 问:如何保证消息的顺序性? 问:如何解决消息队列的延时以及过期失效问题?消息队列满了以后该怎么处理?有几百万消息持续积压几小时,说说怎么解决? 问:如果让你写一个消息队列,该如何进行架构设计啊?说一下你的思路。 答案 Kafka 问:讲一下 Kafka。 Kafka 的简单理解 问:Kafka 相对其他消息队列,有什么特点? 持久化:Kafka 的持久化能力比较好,通过磁盘持久化。而 RabbitMQ 是通过内存持久化的。 吞吐量:Rocket 的并发量非常高。 消息处理:RabbitMQ 的消息不支持批量处理,而 RocketMQ 和 Kafka 支持批量处理。 高可用:RabbitMQ 采用主从模式。Kafka 也是主从模式,通过 Zookeeper 管理,选举 Leader ,还有 Replication 副本。 事务:RocketMQ 支持事务,而 Kafka 和 RabbitMQ 不支持。 问:Kafka 有哪些模式? 如果一个生产者或者多个生产者产生的消息能够被多个消费者同时消费的情况,这样的消息队列称为"发布订阅模式"的消息队列。 问:Kafka 作为消息队列,有哪些优势? 分布式的消息系统。 高吞吐量。即使存储了许多 TB 的消息,它也保持稳定的性能。 数据保留在磁盘上,因此它是持久的。 问:Kafka 为什么处理速度会很快?kafka 的吞吐量为什么高? 零拷贝:Kafka 实现了"零拷贝"原理来快速移动数据,避免了内核之间的切换。 消息压缩、分批发送:Kafka 可以将数据记录分批发送,从生产者到文件系统(Kafka 主题日志)到消费者,可以端到端的查看这些批次的数据。 批处理能够进行更有效的数据压缩并减少 I / O 延迟。 顺序读写:Kafka 采取顺序写入磁盘的方式,避免了随机磁盘寻址的浪费。 问:讲一下 Kafka 中的零拷贝。 数据的拷贝从内存拷贝到 kafka 服务进程那块,又拷贝到 socket 缓存那块,整个过程耗费的时间比较高, kafka 利用了 Linux 的 sendFile 技术(NIO),省去了进程切换和一次数据拷贝,让性能变得更好。 问:Kafka 的偏移量是什么? 消费者每次消费数据的时候,消费者都会记录消费的物理偏移量(offset)的位置。等到下次消费时,他会接着上次位置继续消费 问:Kafka 的生产者,是如何发送消息的? 生产者的消息是先被写入分区中的缓冲区中,然后分批次发送给 Kafka Broker。 生产者的消息发送机制,有同步发送和异步发送。 同步发送消息都有个问题,那就是同一时间只能有一个消息在发送,这会造成许多消息。 无法直接发送,造成消息滞后,无法发挥效益最大化。 异步发送消息的同时能够对异常情况进行处理,生产者提供了 Callback 回调。 问:Kafka 生产者发送消息,有哪些分区策略? Kafka 的分区策略指的就是将生产者发送到哪个分区的算法。有顺序轮询、随机轮询、key - ordering 策略。 key - ordering 策略:Kafka 中每条消息都会有自己的 key ,一旦消息被定义了 Key ,那么你就可以保证同一个 Key 的所有消息都进入到相同的分区里面,由于每个分区下的消息处理都是有顺序的,故这个策略被称为按消息键保序策略。 问:Kafka 为什么要分区? 实现负载均衡和水平扩展。Kafka 可以将主题(Topic)划分为多个分区(Partition),会根据分区规则选择把消息存储到哪个分区中,只要如果分区规则设置的合理,那么所有的消息将会被均匀的分布到不同的分区中,这样就实现了负载均衡和水平扩展。另外,多个订阅者可以从一个或者多个分区中同时消费数据,以支撑海量数据处理能力。 问:Kafka 是如何在 Broker 间分配分区的? 在 broker 间平均分布分区副本。 假设有 6 个 broker ,打算创建一个包含 10 个分区的 Topic ,复制系数为 3 ,那么 Kafka 就会有 30 个分区副本,它可以被分配给这 6 个 broker ,这样的话,每个 broker 可以有 5 个副本。 要确保每个分区的每个副本分布在不同的 broker 上面: 假设 Leader 分区 0 会在 broker1 上面, Leader 分区 1 会在 broker2 上面, Leder 分区 2 会在 broker3 上面。 接下来会分配跟随者副本。如果分区 0 的第一个 Follower 在 broker2 上面,第二个 Follower 在 broker3 上面。分区 1 的第一个 Follower 在 broker3 上面,第二个 Follower 在 broker4 上面。 问:Kafka 如何保证消息的顺序性? Kafka 可以保证同一个分区里的消息是有序的。也就是说消息发送到一个 Partition 是有顺序的。 问:Kafka 的消费者群组 Consumer Group 订阅了某个 Topic ,假如这个 Topic 接收到消息并推送,那整个消费者群组能收到消息吗? Kafka 官网中有这样一句" Consumers label themselves with a consumer group name , and each record published to a topic is delivered to one consumer instance within each subscribing consumer group . " 表示推送到 topic 上的 record ,会被传递到已订阅的消费者群组里面的一个消费者实例。 问:如何提高 Kafka 的消费速度? 问:Kafka 出现消息积压,有哪些原因?怎么解决? 出现消息积压,可能是因为消费的速度太慢。 扩容消费者。之所以消费延迟大,就是消费者处理能力有限,可以增加消费者的数量。 扩大分区。一个分区只能被消费者群组中的一个消费者消费。消费者扩大,分区最好多随之扩大。 问:Kafka 消息消费者宕机了,怎么确认有没有收到消息? ACK 机制,如果接收方收到消息后,会返回一个确认字符。 问:讲一下 Kafka 的 ACK 机制。 acks 参数指定了要有多少个分区副本接收消息,生产者才认为消息是写入成功的。此参数对消息丢失的影响较大。 如果 acks = 0 ,就表示生产者也不知道自己产生的消息是否被服务器接收了,它才知道它写成功了。如果发送的途中产生了错误,生产者也不知道,它也比较懵逼,因为没有返回任何消息。这就类似于 UDP 的运输层协议,只管发,服务器接受不接受它也不关心。 如果 acks = 1 ,只要集群的 Leader 接收到消息,就会给生产者返回一条消息,告诉它写入成功。如果发送途中造成了网络异常或者 Leader 还没选举出来等其他情况导致消息写入失败,生产者会受到错误消息,这时候生产者往往会再次重发数据。因为消息的发送也分为 同步 和 异步, Kafka 为了保证消息的高效传输会决定是同步发送还是异步发送。如果让客户端等待服务器的响应(通过调用 Future 中的 get() 方法),显然会增加延迟,如果客户端使用回调,就会解决这个问题。 如果 acks = all ,这种情况下是只有当所有参与复制的节点都收到消息时,生产者才会接收到一个来自服务器的消息。不过,它的延迟比 acks = 1 时更高,因为我们要等待不只一个服务器节点接收消息。 问:Kafka 如何避免消息丢失? 1、生产者丢失消息的情况 生产者(Producer) 调用 send 方法发送消息之后,消息可能因为网络问题并没有发送过去。 所以,我们不能默认在调用 send 方法发送消息之后消息消息发送成功了。为了确定消息是发送成功,我们要判断消息发送的结果。可以采用为其添加回调函数的形式,获取回调结果。 如果消息发送失败的话,我们检查失败的原因之后重新发送即可!可以设置 Producer 的 retries(重试次数)为一个比较合理的值,一般是 3 ,但是为了保证消息不丢失的话一般会设置比较大一点。 设置完成之后,当出现网络问题之后能够自动重试消息发送,避免消息丢失。 2、消费者丢失消息的情况 当消费者拉取到了分区的某个消息之后,消费者会自动提交了 offset。自动提交的话会有一个问题,试想一下,当消费者刚拿到这个消息准备进行真正消费的时候,突然挂掉了,消息实际上并没有被消费,但是 offset 却被自动提交了。手动关闭闭自动提交 offset ,每次在真正消费完消息之后之后再自己手动提交 offset 。 3 、Kafka 丢失消息 a、假如 leader 副本所在的 broker 突然挂掉,那么就要从 follower 副本重新选出一个 leader ,但是 leader 的数据还有一些没有被 follower 副本的同步的话,就会造成消息丢失。因此可以设置 ack = all。 b、设置 replication . factor >= 3 。为了保证 leader 副本能有 follower 副本能同步消息,我们一般会为 topic 设置 replication . factor >= 3。这样就可以保证每个 分区(partition) 至少有 3 个副本。虽然造成了数据冗余,但是带来了数据的安全性。 问:Kafka 怎么保证可靠性? 多副本以及 ISR 机制。 在 Kafka 中主要通过 ISR 机制来保证消息的可靠性。 ISR(in sync replica):是 Kafka 动态维护的一组同步副本,在 ISR 中有成员存活时,只有这个组的成员才可以成为 leader ,内部保存的为每次提交信息时必须同步的副本(acks = all 时),每当 leader 挂掉时,在 ISR 集合中选举出一个 follower 作为 leader 提供服务,当 ISR 中的副本被认为坏掉的时候,会被踢出 ISR ,当重新跟上 leader 的消息数据时,重新进入 ISR。 问:什么是 HW ? HW(high watermark):副本的高水印值, replica 中 leader 副本和 follower 副本都会有这个值,通过它可以得知副本中已提交或已备份消息的范围, leader 副本中的 HW ,决定了消费者能消费的最新消息能到哪个 offset。 问:什么是 LEO ? LEO(log end offset):日志末端位移,代表日志文件中下一条待写入消息的 offset ,这个 offset 上实际是没有消息的。不管是 leader 副本还是 follower 副本,都有这个值。 问:Kafka 怎么保证一致性?(存疑) 一致性定义:若某条消息对 client 可见,那么即使 Leader 挂了,在新 Leader 上数据依然可以被读到。 HW - HighWaterMark : client 可以从 Leader 读到的最大 msg offset ,即对外可见的最大 offset , HW = max(replica . offset) 对于 Leader 新收到的 msg , client 不能立刻消费, Leader 会等待该消息被所有 ISR 中的 replica 同步后,更新 HW ,此时该消息才能被 client 消费,这样就保证了如果 Leader fail ,该消息仍然可以从新选举的 Leader 中获取。 对于来自内部 Broker 的读取请求,没有 HW 的限制。同时, Follower 也会维护一份自己的 HW , Folloer . HW = min(Leader . HW , Follower . offset). 问:Kafka 怎么处理重复消息?怎么避免重复消费? 偏移量 offset :消费者每次消费数据的时候,消费者都会记录消费的物理偏移量(offset)的位置。等到下次消费时,他会接着上次位置继续消费。 一般情况下, Kafka 重复消费都是由于未正常提交 offset 造成的,比如网络异常,消费者宕机之类的。 使用的是 spring-Kafka ,所以把 Kafka 消费者的配置 enable.auto. commit 设为 false ,禁止 Kafka 自动提交 offset ,从而使用 spring-Kafka 提供的 offset 提交策略。 sprin-Kafka 中的 offset 提交策略可以保证一批消息数据没有完成消费的情况下,也能提交 offset ,从而避免了提交失败而导致永远重复消费的问题。 问:怎么避免重复消费? 将消息的唯一标识保存起来,每次消费时判断是否处理过即可。 问:如何保证消息不被重复消费?(如何保证消息消费的幂等性) 怎么保证消息队列消费的幂等性?其实还是得结合业务来思考,有几个思路: 比如你拿个数据要写库,你先根据主键查一下,如果这数据都有了,你就别插入了, update 一下好吧。 比如你是写 Redis ,那没问题了,反正每次都是 set ,天然幂等性。 如果是复杂一点的业务,那么每条消息加一个全局唯一的 id ,类似订单 id 之类的东西,然后消费到了之后,先根据这个 id 去比如 Redis 里查一下,之前消费过吗? 如果没有消费过,你就处理,然后这个 id 写 Redis。如果消费过了,那你就别处理了,保证别重复处理相同的消息即可。 问:Kafka 消息是采用 pull 模式,还是 push 模式? pull 模式。 问:pull 模式和 push 模式,各有哪些特点? pull 模式,准确性?可以较大保证消费者能获取到消息。 push 模式,即时性?可以在 broker 获取消息后马上送达消费者。 问:Kafka 是如何存储消息的? Kafka 使用日志文件的方式来保存生产者和发送者的消息,每条消息都有一个 offset 值来表示它在分区中的偏移量。 Kafka 中存储的一般都是海量的消息数据,为了避免日志文件过大, 一个分片并不是直接对应在一个磁盘上的日志文件,而是对应磁盘上的一个目录。 数据存储设计的特点在于以下几点: Kafka 把主题中一个分区划分成多个分段的小文件段,通过多个小文件段,就容易根据偏移量查找消息、定期清除和删除已经消费完成的数据文件,减少磁盘容量的占用; 采用稀疏索引存储的方式构建日志的偏移量索引文件,并将其映射至内存中,提高查找消息的效率,同时减少磁盘 IO 操作; Kafka 将消息追加的操作逻辑变成为日志数据文件的顺序写入,极大的提高了磁盘 IO 的性能; 问:讲一下 Kafka 集群的 Leader 选举机制。 Kafka 在 Zookeeper 上针对每个 Topic 都维护了一个 ISR(in - sync replica ---已同步的副本)的集合,集合的增减 Kafka 都会更新该记录。如果某分区的 Leader 不可用, Kafka 就从 ISR 集合中选择一个副本作为新的 Leader。 分库分表 问:数据库如何处理海量数据? 分库分表,主从架构,读写分离。 问:数据库分库分表,何时分?怎么分? 水平分库/分表,垂直分库/分表。 水平分库/表,各个库和表的结构一模一样。 垂直分库/表,各个库和表的结构不一样。 问:读写分离怎么做? 主机负责写,从机负责读。 系统设计 1、分布式、高并发场景 遇到高并发场景,可以使用 Redis 缓存、Redis 限流、MQ 异步、MQ 削峰等。 问:在实践中,遇到过哪些并发的业务场景? 秒杀。比如抢商品,抢红包。 2、秒杀 问:如何设计一个秒杀/抢券系统? 可以通过队列配合异步处理实现秒杀。 使用 redis 的 list ,将商品 push 进队列, pop 出队列。 异步操作不会阻塞,不会消耗太多时间。 问:如何提高抢券系统的性能? 使用多个 list。 使用多线程从队列中拉取数据。 集群提高可用性。 MQ 异步处理,削峰。 问:秒杀怎么避免少卖或超卖? redis 是单进程单线程的,操作具有原子性,不会导致少卖或者超卖。另外,也可以设置一个版本号 version ,乐观锁机制。 问:考勤打卡,假如高峰期有几万人同时打卡,那么怎么应对这种高并发? 使用 Redis 缓存。员工点击签到,可以在缓存中 set 状态。将工号作为 key ,打卡状态作为 value ,打卡成功为 01 ,未打卡或者打卡失败为 00 ,然后再将数据异步地写入到数据库里面就可以了。 问:如何应对高峰期的超高并发量? Redis 限流。Redis 可以用计数器限流。使用 INCR 命令,每次都加一,处理完业务逻辑就减一。然后设置一个最大值,当达到最大值后就直接返回,不处理后续的逻辑。 Redis 还可以用令牌桶限流。使用 Redis 队列,每十个数据中 push 一个令牌桶,每个请求进入后会先从队列中 pop 数据,如果是令牌就可以通行,不是令牌就直接返回。 3、短链接 问:如何将长链接转换成短链接,并发送短信? 短 URL 从生成到使用分为以下几步: 有一个服务,将要发送给你的长 URL 对应到一个短 URL 上.例如 www.baidu.com -> www.t.cn/1。 把短 url 拼接到短信等的内容上发送。 用户点击短 URL ,浏览器用 301 / 302 进行重定向,访问到对应的长 URL。 展示对应的内容。 问:长链接和短链接如何互相转换? 思路是建立一个发号器。每次有一个新的长 URL 进来,我们就增加一。并且将新的数值返回.第一个来的 url 返回"www.x.cn/0",第二个返回"www.x.cn/1". 问:长链接和短链接的对应关系如何存储? 如果数据量小且 QPS 低,直接使用数据库的自增主键就可以实现。 还可以将最近/最热门的对应关系存储在 K-V 数据库中,这样子可以节省空间的同时,加快响应速度。 系统架构与设计 问:如何提高系统的并发能力? 使用分布式系统。 部署多台服务器,并做负载均衡。 使用缓存(Redis)集群。 数据库分库分表 + 读写分离。 引入消息中间件集群。 问:设计一个红包系统,需要考虑哪些问题,如何解决?(本质上也是秒杀系统) 问:如果让你设计一个消息队列,你会怎么设计? 项目经验及数据量 问:这个项目的亮点、难点在哪里? 问:如果这个模块挂掉了怎么办? 问:你们的项目有多少台机器? 问:你们的项目有多少个实例? 4 个实例。 问:你们的系统 QPS(TPS)是多少? QPS ,每秒查询量。QPS 为几百/几千,已经算是比较高的了。 TPS ,每秒处理事务数。TPS 即每秒处理事务数,包括:”用户请求服务器”、”服务器自己的内部处理”、”服务器返回给用户”,这三个过程,每秒能够完成 N 个这三个过程, TPS 也就是 3。 问:一个接口,多少秒响应才正常? 快的话几毫秒。慢的话 1-2 秒。异常情况可能会 10 几秒;最好保证 99 %以上的请求是正常的。 问:这个接口的请求时间,大概多久?主要耗时在哪里? 问:系统的数据量多少?有没有分库分表? 正常情况下,几百万的数据量没有必要分库分表。只有超过几千万才需要分库分表。 问:插入/更新一条数据要多久?更新十万/百万条数据要多久? 插入/更新一条数据一般要几毫秒;更新十万条数据最好在 10 秒以内; 百万条数据最好在 50-100 秒以内。

优秀的个人博客,低调大师

面试题解答:Spring Lifecycle 和 SmartLifecycle 有何区别?

当我们想在 Spring 容器启动或者关闭的时候,做一些初始化操作或者对象销毁操作,我们可以怎么做? 注意我这里说的是容器启动或者关闭的时候,不是某一个 Bean 初始化或者销毁的时候~ 1. Lifecycle 对于上面提到的问题,如果小伙伴们稍微研究过 Spring,应该是了解其里边有一个 Lifecycle 接口,通过这个接口,我们可以在 Spring 容器启动或者关闭的时候,做一些自己需要的事情。 我们先来看下 Lifecycle 接口: public interface Lifecycle { void start(); void stop(); boolean isRunning(); } 这个接口一共就三个方法: start:启动组件,该方法在执行之前,先调用 isRunning 方法判断组件是否已经启动了,如果已经启动了,就不重复启动了。 stop:停止组件,该方法在执行之前,先调用 isRunning 方法判断组件是否已经停止运行了,如果已经停止运行了,就不再重复停止了。 isRunning:这个是返回组件是否已经处于运行状态了,对于容器来说,只有当容器中的所有适用组件都处于运行状态时,这个方法返回 true,否则返回 false。 如果我们想自定义一个 Lifecycle,方式如下: @Component public class MyLifeCycle implements Lifecycle { private volatile boolean running; @Override public void start() { running = true; System.out.println("start"); } @Override public void stop() { running = false; System.out.println("stop"); } @Override public boolean isRunning() { return running; } } 需要自定义一个 running 变量,该变量用来描述当前组件是否处于运行/停止状态,因为系统在调用 start 和 stop 方法的时候,都会先调用 isRunning 方法,用以确认是否需要真的调用 start/stop 方法。 接下来创建配置类,扫描上述组件: @Configuration @ComponentScan public class JavaConfig { } 最后我们启动容器: public class Demo { public static void main(String[] args) { AnnotationConfigApplicationContext ctx = new AnnotationConfigApplicationContext(JavaConfig.class); ctx.start(); ctx.stop(); } } 启动之后,我们就可以看到控制台打印出来的信息: [外链图片转存中...(img-jWhjCQzV-1697683960574)] 可以看到,在容器启动和停止的时候,相应的方法会被触发。 不过 Lifecycle 有一个问题,就是必须显式的调用 start 或者 stop 方法才会触发 Lifecycle 中的方法。当然,如果你没有调用 stop 方法,而是调用了 close 方法,那么在 close 方法内部也会触发 stop 方法。 如果我们想要 start 方法被自动触发呢?那就得一个更加智能的 Lifecycle 了--- SmartLifecycle。 2. SmartLifecycle 相比于 LifeCycle,SmartLifecycle 中多了几个方法: public interface SmartLifecycle extends Lifecycle, Phased { int DEFAULT_PHASE = Integer.MAX_VALUE; default boolean isAutoStartup() { return true; } default void stop(Runnable callback) { stop(); callback.run(); } @Override default int getPhase() { return DEFAULT_PHASE; } } 大家看一下,这里首先多了一个 isAutoStartup 方法,这个方法就表示是否自动执行 startup 方法,这个方法返回 true,则 startup 方法会被自动触发,这个方法要是返回 false,则 startup 方法就不会被自动触发(那么效果就等同于 LifeCycle 了)。 这里多了一个重载的 stop 方法,这个重载的 stop 方法会传入一个线程对象,然后在 stop 中触发,这个 callback 回调是为了告诉容器,我们销毁组件的工作已经完成了。如果使用了 SmartLifecycle,那么 Lifecycle 中的 stop 方法就不会被直接触发了,除非我们在 SmartLifecycle#stop 中手动去触发 Lifecycle#stop 方法。 另外这里还有一个 getPhase 方法,这个当存在多个 SmartLifecycle 实例的时候,我们需要为其执行顺序排序,getPhase 方法就是返回执行顺序,数字越小,优先级越高,默认优先级最小。 我们来写一个 SmartLifecycle 的案例来试下: @Component public class MyLifeCycle implements SmartLifecycle { private volatile boolean running; @Override public void start() { running = true; System.out.println("start"); } @Override public void stop() { running = false; System.out.println("stop"); } @Override public boolean isRunning() { return running; } @Override public boolean isAutoStartup() { return SmartLifecycle.super.isAutoStartup(); } @Override public void stop(Runnable callback) { stop(); callback.run(); } @Override public int getPhase() { return 0; } } 3. 原理分析 那么 Lifecycle 到底是如何被触发的呢?我们来分析一下源码。 由于系统中可能存在多个 Lifecycle,因此这多个 Lifecycle 需要一个统一的管理,这个管理者就是 LifecycleProcessor,这也是一个接口,这个接口中只有两个方法: public interface LifecycleProcessor extends Lifecycle { void onRefresh(); void onClose(); } onRefresh:这个是在上下文刷新的时候被触发,例如在容器启动的时候这个方法被触发。 onClose:这个是在上下文关闭的时候被触发,例如在容器停止运行的时候这个方法被触发。 LifecycleProcessor 只有一个实现类 DefaultLifecycleProcessor,所以很好分析,这个 DefaultLifecycleProcessor 中,重写了上面的 onRefresh 和 onClose 两个方法: @Override public void onRefresh() { startBeans(true); this.running = true; } @Override public void onClose() { stopBeans(); this.running = false; } 3.1 start 小伙伴们看到,在容器启动的时候,这里会去调用 startBeans 方法,在这个方法中就会触发 Lifecycle#start 方法: private void startBeans(boolean autoStartupOnly) { Map<string, lifecycle> lifecycleBeans = getLifecycleBeans(); Map<integer, lifecyclegroup> phases = new TreeMap&lt;&gt;(); lifecycleBeans.forEach((beanName, bean) -&gt; { if (!autoStartupOnly || (bean instanceof SmartLifecycle smartLifecycle &amp;&amp; smartLifecycle.isAutoStartup())) { int phase = getPhase(bean); phases.computeIfAbsent( phase, p -&gt; new LifecycleGroup(phase, this.timeoutPerShutdownPhase, lifecycleBeans, autoStartupOnly) ).add(beanName, bean); } }); if (!phases.isEmpty()) { phases.values().forEach(LifecycleGroup::start); } } 在这个方法中,首先调用 getLifecycleBeans 方法,这个方法的作用是去 Spring 容器中查找所有 Lifecycle 类型的 Bean,并把查找结果封装到一个 Map 集合中返回。 接下来就去遍历这个 Map,遍历的时候由于 autoStartupOnly 变量传进来的时候是 true,取反之后就是 false 了,所以就会去判断这个 Bean 是否为 SmartLifecycle 类型,如果是该类型并且 isAutoStartup 方法返回 true,就表示要自动执行 start 方法。 如果确定是 SmartLifecycle 类型的 Bean,那么就调用 getPhase 方法获取其 phase,这个表示执行的优先级,然后将之存入到 phases 集合中,存储的时候,phase 是 key,value 则是一个 LifecycleGroup,phases 是一个 TreeMap,小伙伴们知道,TreeMap 是有序的,也就是存入进去的数据,会自动按照 phase 进行排序。LifecycleGroup 是将 phase 相同的 SmartLifecycle 分组之后的对象。 > 经过上面的分析,相信大家已经明白了为什么直接实现 Lifecycle 接口,就一定需要手动调用 start 方法(因为上面 if 中的条件不满足)。 最后就是遍历 phases,调用每一个 LifecycleGroup 中的 start 方法。 public void start() { if (this.members.isEmpty()) { return; } Collections.sort(this.members); for (LifecycleGroupMember member : this.members) { doStart(this.lifecycleBeans, member.name, this.autoStartupOnly); } } private void doStart(Map<string, ? extends lifecycle> lifecycleBeans, String beanName, boolean autoStartupOnly) { Lifecycle bean = lifecycleBeans.remove(beanName); if (bean != null &amp;&amp; bean != this) { String[] dependenciesForBean = getBeanFactory().getDependenciesForBean(beanName); for (String dependency : dependenciesForBean) { doStart(lifecycleBeans, dependency, autoStartupOnly); } if (!bean.isRunning() &amp;&amp; (!autoStartupOnly || !(bean instanceof SmartLifecycle smartLifecycle) || smartLifecycle.isAutoStartup())) { bean.start(); } } } 在 doStart 方法中,从集合中取出来 Lifecycle,然后查找一下该 Lifecycle 是否有依赖的 Bean,如果有,就继续递归调用 doStart 方法。否则,在 isRunning 返回 false(即该组件还没有运行),且 bean 不是 SmartLifecycle 类型(那就只能是 Lifecycle 类型)或者 bean 是 SmartLifecycle 类型且 isAutoStartup 方法为 true 的情况下,调用 bean 的 start 方法。 > 小伙伴们注意,上面的分析是从 onRefresh 方法开始的,该方法中调用 startBeans 的时候,传入的参数是 true,也就是上面这个判断里边 autoStartupOnly 为 true,取反之后这个条件就不满足了,如果是我们手动调用 start 方法的话,这个参数默认传入的是 false,取反之后上面这个条件就满足了,也就是无论是手动还是自动,最终都是在这个地方触发 start 方法的。 3.2 stop 再来看 stop 方法的逻辑。从 onClose 方法开始,也是先调用 stopBeans 方法: private void stopBeans() { Map<string, lifecycle> lifecycleBeans = getLifecycleBeans(); Map<integer, lifecyclegroup> phases = new HashMap&lt;&gt;(); lifecycleBeans.forEach((beanName, bean) -&gt; { int shutdownPhase = getPhase(bean); LifecycleGroup group = phases.get(shutdownPhase); if (group == null) { group = new LifecycleGroup(shutdownPhase, this.timeoutPerShutdownPhase, lifecycleBeans, false); phases.put(shutdownPhase, group); } group.add(beanName, bean); }); if (!phases.isEmpty()) { List<integer> keys = new ArrayList&lt;&gt;(phases.keySet()); keys.sort(Collections.reverseOrder()); for (Integer key : keys) { phases.get(key).stop(); } } } 这块的逻辑跟 start 差不多,就是排序的方案有一些差别。这里用了 HashMap,没有用 TreeMap,然后在具体调用的时候,再去给 key 排序的。 这里调用到的也是 LifecycleGroup 的 stop 方法,我们来看下: public void stop() { if (this.members.isEmpty()) { return; } this.members.sort(Collections.reverseOrder()); CountDownLatch latch = new CountDownLatch(this.smartMemberCount); Set<string> countDownBeanNames = Collections.synchronizedSet(new LinkedHashSet&lt;&gt;()); Set<string> lifecycleBeanNames = new HashSet&lt;&gt;(this.lifecycleBeans.keySet()); for (LifecycleGroupMember member : this.members) { if (lifecycleBeanNames.contains(member.name)) { doStop(this.lifecycleBeans, member.name, latch, countDownBeanNames); } else if (member.bean instanceof SmartLifecycle) { // Already removed: must have been a dependent bean from another phase latch.countDown(); } } try { latch.await(this.timeout, TimeUnit.MILLISECONDS); if (latch.getCount() &gt; 0 &amp;&amp; !countDownBeanNames.isEmpty() &amp;&amp; logger.isInfoEnabled()) { logger.info("Failed to shut down " + countDownBeanNames.size() + " bean" + (countDownBeanNames.size() &gt; 1 ? "s" : "") + " with phase value " + this.phase + " within timeout of " + this.timeout + "ms: " + countDownBeanNames); } } catch (InterruptedException ex) { Thread.currentThread().interrupt(); } } 大家看一下,这里的 doStop 方法,最终就会触发到 Lifecycle 的 stop,这个里边的代码简单,我们就不去细看了。需要提醒大家的时候,这里使用到了这样一个计数器,初始值就是 members 的数量,每当调用一个 member 的 stop 方法之后,这个计数器减一,这样,到下面调用 await 的时候,就刚刚好不用等。 await 方法的等待时间是 this.timeout,这个属性默认值是 30s,也就是如果 stop 方法在子线程中执行,那么执行时间不能超过 30s,否则就会抛出异常。 如果我们想要自定义这个超时时间,可以自己在 Spring 容器中提供如下 Bean: @Configuration @ComponentScan public class JavaConfig { @Bean DefaultLifecycleProcessor lifecycleProcessor() { DefaultLifecycleProcessor processor = new DefaultLifecycleProcessor(); processor.setTimeoutPerShutdownPhase(2000); return processor; } } 上面这个案例中设置了超时时间为 2s。 好啦,这就是关于 Lifecycle 的整体触发流程。 接下来我们来看下自动触发和手动触发分别是在哪里触发的。 3.3 自动触发 先来看自动触发。 经过前面的讲解,现在小伙伴们都知道,Spring 容器初始化的时候,会调用到 refresh 方法,这个刷新要做的事情比较多,其中最后一件事情是调用 finishRefresh 方法,如下: protected void finishRefresh() { // Clear context-level resource caches (such as ASM metadata from scanning). clearResourceCaches(); // Initialize lifecycle processor for this context. initLifecycleProcessor(); // Propagate refresh to lifecycle processor first. getLifecycleProcessor().onRefresh(); // Publish the final event. publishEvent(new ContextRefreshedEvent(this)); } 这里有两个方法跟本文相关,一个是 initLifecycleProcessor,这个是初始化 LifecycleProcessor,就是去 Spring 容器中查找 LifecycleProcessor,找到就用,没找到就创建新的。 然后就是 getLifecycleProcessor().onRefresh(); 方法,这个就是触发了 DefaultLifecycleProcessor#onRefresh 方法,而关于该方法的逻辑,松哥在前面已经介绍过了。 来看下 initLifecycleProcessor 方法是如何做初始化操作的: protected void initLifecycleProcessor() { ConfigurableListableBeanFactory beanFactory = getBeanFactory(); if (beanFactory.containsLocalBean(LIFECYCLE_PROCESSOR_BEAN_NAME)) { this.lifecycleProcessor = beanFactory.getBean(LIFECYCLE_PROCESSOR_BEAN_NAME, LifecycleProcessor.class); } else { DefaultLifecycleProcessor defaultProcessor = new DefaultLifecycleProcessor(); defaultProcessor.setBeanFactory(beanFactory); this.lifecycleProcessor = defaultProcessor; beanFactory.registerSingleton(LIFECYCLE_PROCESSOR_BEAN_NAME, this.lifecycleProcessor); } } 大家注意,LIFECYCLE_PROCESSOR_BEAN_NAME 常量的值是 lifecycleProcessor,为什么要强调这个,如果我们是自定义 DefaultLifecycleProcessor,那么 beanName 必须是 lifecycleProcessor,否则系统会以为我们没有自定义 DefaultLifecycleProcessor。 那么这里的逻辑就是如果用户自定义了 DefaultLifecycleProcessor,那么就使用用户自定义的 DefaultLifecycleProcessor,否则就创建一个新的 DefaultLifecycleProcessor,并注册到 Spring 容器中。 这就是自动触发的逻辑。 3.4 手动触发 手动触发需要我们自己调用 start 方法,start 方法如下: @Override public void start() { getLifecycleProcessor().start(); publishEvent(new ContextStartedEvent(this)); } 相当于直接调用了 DefaultLifecycleProcessor 的 start 方法: @Override public void start() { startBeans(false); this.running = true; } 这个跟 DefaultLifecycleProcessor 的 onRefresh 方法内容基本一致,唯一的区别在于调用 startBeans 的时候,传入的参数为 false,这个参数带来的变化,这个松哥在前面的内容中已经分析过了,这里就不再啰嗦啦。 4. 小结 好啦,这就是松哥和大家分享的 Spring Lifecycle 和 SmartLifecycle 的区别。老实说,我们自己开发需要自定义这两个的场景其实并不多,但是在 Spring Boot 中,SmartLifecycle 的应用还是比较多的,有了今天这个内容作基础,将来小伙伴们分析 Spring Boot 的时候就会容易很多了。</string></string></integer></integer,></string,></string,></integer,></string,>
优秀的个人博客,低调大师

软件测试面试:拿到一个产品(版本)如何开展测试?

产品提测后,如何开展测试? 我们都了解软件测试的执行流程,......提测-冒烟测试-详细测试-提交缺陷报告-回归测试,但软件测试并不总是线性过程,它甚至可能是螺旋结构,不断地试错,不断地迭代,不断地回归,直至最终的可用版本。 那么测试人员拿到提测版本后,如何开展测试?如何进行第一轮、第二轮测试? 第一轮测试: 1、从冒烟测试开始,也就是最简单的测试,如果不是特别复杂的项目,可以直接由基本流+备用流的方式来进行快速测试,也可以认为是可用性测试,能否继续进行下一步取决于冒烟测试结果是否通过,如基本流未通,则可以直接退回。否则,继续下一步 2、在快速测试过程中,可能激发了某些灵感,这时一定要记录下来,或者遇到一个新的问题可能引发其他的问题时,也做好记录;做记录的同时可以去补充测试用例,也可以暂时放在待测试想法列表中,通过后续的步骤时,来决定这些想法是否有进一步测试的必要 3、开始执行用例,测试用例一般情况下会区分正向反向用例的,在这个步骤中,先执行正向用例,若未通过数没有超过规定的比例,再执行反向用例;同时在这个过程中,很可能开发人员已提交过N个版本,那么仍需要不定期进行可用性测试 4、确保版本可用的情况下,且已执行完所有用例(部分阻碍用例除外),此时可以对第一轮测试做一个小结。小结内容包括:是否需要调整测试策略;是否存在重复出现的问题;以及自己经过一轮测试后对版本建立的初步认识等等 第二轮测试: 1、整理一轮测试中的缺陷报告,如果有测试管理平台,可以很方便地通过筛选条件来查看缺陷类型和原因,以及缺陷增长趋势;多数开发人员不会主动分析缺陷,需要测试人员来评估哪些区域或模块需要深度测试,如果有修改过公共代码,哪些模块需要重复测试等等 2、结合一轮测试中的测试小结,及评估所有被退回测试或拒绝的Bug,分析拒绝原因并再次测试,记录好二次测试的结果 3、交叉测试,这一步可以灵活调整,视测试时间充分与否,交叉测试人员可以是同组的,也可以是外组测试,可以重点测试Bug聚集的模块 ,也可以探索测试,但测试完成后要做好小结,以便与第一位测试人员的小结做比对。查漏补缺。 4、回归测试,对所有提交的未关闭缺陷进行回归测试 5、可用性测试+大回归测试,在开发多次迭代的基础上,要进行最后一轮的可用性测试,在走流程的过程中,要重点关注Bug集中的模块或语句,以及重新打开频率较高Bug的代码逻辑,在最后一轮的大回归测试中,建议结对测试效果会更好。 最后,将每个步骤中的测试检查点形成文档,再归结到测试报告中。 以上,即是一般性软件产品的测试步骤,实际工作中,可以根据软件版本的大小,及测试团队的规模来具体规划测试流程。(更多软件测试干货可关注公众号“木蚂蚁”了解)

优秀的个人博客,低调大师

面试官问我:如何减少客户对交付成果的质疑

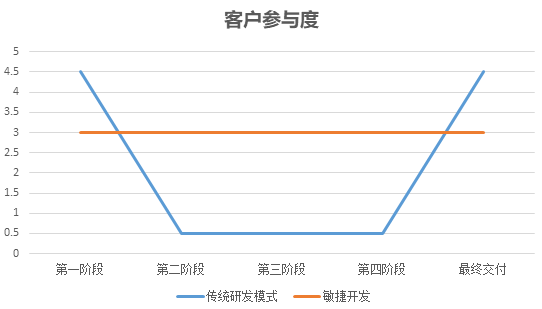
摘要:对标市面主流产品,更新差异特性,让产品跟随市场变化。 本文分享自华为云社区《项目上线后,如何减少客户对交付成果的质疑》,原文作者:敏捷的小智。 背景 背景描述 早些年前,软件行业刚刚兴起,当时的软件产品功能简单,用途单一,软件研发方法也都遵循“计划-->需求分析-->设计-->编码-->测试-->运维”这样一个流程按部就班的开发,最后产品基本能满足客户的需求。这种研发方法被很多公司沿用至今,可与之前不同的是,客户对项目交付成果的质疑越来越多。 有家公司就问了类似的问题:“项目上线后客户提出质疑,导致交付出现问题,项目管理上如何操作可以避免或减少这种情况的发生?”在交流过程中,我们了解到该公司在使用传统的瀑布模型进行研发,同时也了解了客户主要有哪些方面的质疑。 质疑描述 客户质疑大致有三方面,一方面:交付成果和合同要求对不上:客户认为合同明明说的是A,可是产品做出来的功能却是B,比如地处西北的客户吃饺子,想蘸点老陈醋,签了份合同让公司提供“饺子蘸料”,接单的是东北人,根据“蘸料”开发了一瓶酱油,于是客户认为自己表述的足够清晰,是公司内部管理不善造成功能开发错误;另一方面,产品按需求研发,但是整个研发过程中,客户一直没有接收到研发团队关于产品或研发进度的信息,导致客户对项目的焦虑,从而对产品产生质疑;还有一方面,有的产品按需求正确开发,也定时向客户汇报进度,可交付时客户认为功能不够,在当下市场没有竞争力就像当下做电商不支持移动支付;这些质疑让公司很头疼。 你是否也经历着同样的问题?如何减少客户对交付成果的质疑? 问题分析 上文提到的质疑可以概括为:双方对需求理解不一致,产品功能规划没有随市场变化而刷新和沟通不足引发客户不了解情况而焦虑。接下来我们推测下产生这些质疑的原因。 双方对需求理解不一致 需求被制定后,可能没有做进一步澄清,导致开发人员理解有误,照着自己的想法开发出偏离预想的产品;或者客户想表达的意思是A,但是由于自己表述有问题,需求描述成了B,那自然无法开发出令人满意的交付成果。 还有一种情况更要命:客户在制定需求的时候自己只有一个模糊的想法,具体要做的自己也不清楚,这种情况按计划做出的产品想令客户满意就只能靠运气了。 沟通不足,客户因不了解情况而焦虑 我们试想一种场景:小张在网上买了个手机想要送给女朋友作为生日礼物,眼看生日快到了,商品显示已发货,却始终看不到详细的物流信息,客服也不告知小张商品目前是啥情况,换做你是小张,你急不急,就算商品按时到达,也会因为物流过程不可见而而很难获得好评。 实际生产中也是一样,客户下了订单之后,研发团队一直闷头干活,不与客户沟通项目进度,客户一样会因为不了解项目进展而焦虑,最终对交付成果产生质疑。 产品功能规划没有随市场变化而刷新 正所谓计划不如变化,传统研发模式是计划驱动,而市场是瞬息万变的,想要占领市场,需求变更在所难免。计划就像一张地图,一条路经历世事变迁会发生很多变化,按照一张两年前的地图找上面标注的店铺很可能走了半天也找不到地方;同样,照着两年前制定的计划做出的产品,按交付时的背景去审视它,会给人一种“乃不知有汉,无论魏晋”的感觉,客户难免会对产品提出质疑。 解决措施 传统研发模式的交付类似流水作业:做完计划和需求,就可以按照计划进行开发,然后交付验收。在这种研发模式中,客户参与度类似U型:客户在计划阶段和定义需求阶段参与较多;之后项目进入研发阶段,客户参与度骤降甚至不参与;最后交付阶段客户参与进来,进行验收工作。客户在研发阶段参与度降低,很容易造成双方对产品沟通不到位:比如需求被错误理解没人引导;市场上出现新功能,产品想不到变通等,这些“不到位”最后都会转化成对交付成果的质疑。为避免这种情况,可以尝试做敏捷转型,客户对交付成果的质疑在所难免,但敏捷可以大大减少客户的质疑。 敏捷开发的价值观是:“个体和互动重于流程和工具;可工作的软件重于面面俱到的文档;客户合作重于合同谈判;响应变化重于遵循计划,尽管右侧重要,但左侧更重要”。敏捷按迭代进行交付,每个迭代持续时间不会很长;同时敏捷更注重给客户带来的价值,客户(或客户代表)可以全生命周期的参与并影响整个项目。下图是传统开发和敏捷开发客户在不同生命周期参与度对比。 敏捷具体可以从哪几个方面减少客户对交付成果的质疑呢? 使用标准的用户故事方法分析和记录需求,确保双方理解一致 传统研发模式以计划为导向,使用详细的文档比如:概要设计、详细设计记录需求,这种方法有他的优点,但是缺点也比较明显:首先制作计划需要花费很长的时间,其次需求描述过于产品化,不易解读。 敏捷开发以价值为导向,区别于传统研发模式的文档,敏捷开发使用用户故事记录需求:用户故事是站在用户的角度去描述需求,并且给出用户期待实现的价值,这样开发人员更容易开发出客户真正想要的功能(用户故事细节详见 《 “用户故事等于需求说明”——你一定没有写好用户故事》 )。 举个例子,使用用户故事描述需求:客户吃饺子想要一瓶蘸料,用户故事可以写成:“作为生长在山西的小王,我想要一瓶饺子蘸料,以便于让饺子吃起来更美味”。通过用户故事可以看出,客户是“生长在山西的”,所以饺子蘸料可能是老陈醋而不是酱油,交付起来会比“客户想要一瓶蘸料”准确很多。 另外用户故事并不是写好之后就一成不变的。用户故事的“INVEST”原则中的“N(可商议的)”原则要求用户故事是可以商议的。当开发人员不理解用户故事中的需求,可以将问题抛出来,由产品负责人进行澄清,直到双方对需求的理解达成共识。下图是使用DevCloud编写的用户故事,以及需求分析讨论。 综上所述,使用标准的用户故事记录需求,可以解决双方对需求理解不一致的问题,从而减少客户对交付成果的质疑。 通过评审会等方式与客户保持定期或不定期的沟通交流 敏捷开发方法众多,Scrum是最主流的敏捷方法之一。Scrum中有四个活动:计划会议,每日站会,评审会议,回顾会议,每个活动都帮助着团队更好的践行敏捷,更高质量的交付,各活动详细信息如下: 从表中可以看出,计划会议,每日站会,评审会议都是围绕产品开展的。评审会议在每个迭代即将结束时开展,定期邀请客户参加评审会议是最直接有效的与客户沟通的方法:会上团队向客户演示迭代交付成果,客户通过演示了解产品已经具备哪些功能,哪些功能没有完成,哪些功能和理想中有偏差,对于偏差部分可以和开发团队沟通,后续迭代进行改进。 如果客户很忙或者时间不稳定,不能参与每次评审会议,那么可不定期邀请客户参加每日站会,站会每天早晨都进行,客户可以在有空或有兴趣的时候参与。每日站会不是必须和客户一起开展,但是通过站会客户能了解到小部分交付成果以及团队工作状态,减少焦虑。客户不参加会议的话,可由产品负责人在评审会议结束后整理评审会议纪要,通过拜访,电话,邮件等形式告知客户,让客户了解当前项目进度,减少焦虑,从而减少对交付成果的质疑。 对标市面主流产品,更新差异特性,让产品跟随市场变化 除了澄清需求、增强与客户的沟通等手段之外,我们还可以带着客户,用产品对标市面上其他主流产品,找到差异并更新,减少客户的质疑。比如一款电商产品的结算功能在计划时未考虑移动支付,只支持网银支付,按传统模式运作项目的话,最终交付时产品不会支持移动支付,使用起来会很麻烦;如果使用Scrum运作项目,可以在项目进行过程中,或者评审产品的支付功能时,对标主流电商产品,这时候会发现移动支付是目前最主流的在线支付方式,产品需要支持移动支付,所以可将“结算功能支持移动支付”作为一个优先级高的新需求加入项目,并与产品负责人协商下个迭代或尽可能快的完成这个需求,让产品的支付功能跟随市场变化,增加产品的竞争力。 参考附录 Kenneth S.Rubin:Scrum精髓. 北京:清华大学出版社 Scrum Guide 点击关注,第一时间了解华为云新鲜技术~

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册