首页 文章 精选 留言 我的

精选列表

搜索[权限提升],共10000篇文章
优秀的个人博客,低调大师

DLang 2.091.1 发布,修复版本提升可靠性

DLang 2.091.1 有 9 个固定的Bugzilla问题修复,更多开发者投入到 2.092.0 的大版本开发中,对苹果 iOS 平台的支持也加入了更多的测试用例。 DMD 编译器回归 Bugzilla 20130: ICE 在从字符串转换到其他数组类型时,由于__ArrayCast 没有写入的问题 Bugzilla 20730: [REG 2.091] __traits(compiles) 如果编译中出现任何未标记错误就会失败 DMD编译器错误修复 Bugzilla 18651: ice: 当构建这三个琐碎的文件时在 glue.d:777 会出现断言 Bugzilla 20610: 忽略 .tupleof 循环中的 const Bugzilla 20656: 未指定 -preview=dip1021 时不能编译方法 Bugzilla 20692: 嵌套别名声明和获取成员特性会使 dmd 崩溃 Bugzilla 20700: 正向引用导到 extern(C++, class|struct) 被忽略 运行时回归 Bugzilla 20649: Trait 方法 isZeroInit 不准确? 运行时错误修复 Bugzilla 20731: checkaction=context 失败,因为结构具有 'alias this'

优秀的个人博客,低调大师

Scheme 实现 GNU Guile 3.0.0 发布,性能大幅提升

GNU Guile 3.0.0 发布了,这是新的稳定 3.0 版本系列中的第一个版本。 Guile 是 Scheme 编程语言的一种实现,除了实现R5RS、R6RS 和 R7RS Scheme 标准外,Guile 还有包括以下能力:POSIX 系统调用、网络支持、多线程、动态链接、外部函数调用接口、强大的字符串处理与 HTTP 客户端/服务器实现。Guile 可以作为脚本解释器、转换VM 字节码的编译器与Scheme 交互运行。同时它还被打包为一个库,这样可以让应用程序轻松地包含完整的 Scheme 解释器/VM。 Guile 3.0 的主要新特性是 JIT 本地代码生成,其可以提高所有程序的性能。与 2.2 相比,微基准测试的性能总体上高出一倍左右,在某些基准测试情况下速度高达 32 倍。 值得注意的是,对于较大的用例,这一特性最终使Scheme 中编写的“eval”性能快于Guile 1.8 时代使用 C 语言编写的“ eval”的性能。 3.0 的其它新特性包括支持词汇上下文中的交错定义和表达式、结构化异常的原生支持,更好地支持 R6RS 和 R7RS Scheme标准,同时做了不少优化。 同时,Guile 3.0.0 与 3.0 系列中其它所有接下来发布的版本(如 2.2)都可以与其它稳定版本并行安装。 详情查看: https://www.gnu.org/software/guile/news/gnu-guile-300-released.html https://lists.gnu.org/archive/html/guile-devel/2020-01/msg00080.html

优秀的个人博客,低调大师

JVM优化-Java架构师能力提升必学

想要成为一名出色的Java架构师,必须要彻底了解Java的一个重要的特点那就JVM 动力节点Java学院寄语 前些天面试了阿里的实习生,问到关于Dalvik虚拟机能不能执行class文件,我当时的回答是不能,但是它执行的是class转换的dex文件。 当面试官继续问,为什么不能执行class文件时,我却只能回答Dalvik虚拟机内部的优化原因,却不能正确回答具体的原因。 其实周志明的这本书就有回答:Dakvik并不是一个Java虚拟机,它没有遵循Java虚拟机规范,不能执行Java的class文件,使用的是寄存器架构而不是JVM中常见的栈架构,但是它与Java又有着千丝万缕的关系,它执行的dex文件可以通过class文件转化而来。 其实在本科期间,就有接触过《深入理解Java虚拟机》,但是一直以来都没去仔细研读,现在回头想想实在是觉得可惜!研一期间花了不少时间研读,现在准备找工作了,发现好多内容看了又忘。索性写一篇文章,把这本书的知识点做一个总结。当然了,如果你想看比较详细的内容,可以翻看《深入理解Java虚拟机》。 JVM内存区域我们在编写程序时,经常会遇到OOM(out of Memory)以及内存泄漏等问题。为了避免出现这些问题,我们首先必须对JVM的内存划分有个具体的认识。JVM将内存主要划分为:方法区、虚拟机栈、本地方法栈、堆、程序计数器。JVM运行时数据区如下: 程序计数器程序计数器是线程私有的区域,很好理解嘛~,每个线程当然得有个计数器记录当前执行到那个指令。占用的内存空间小,可以把它看成是当前线程所执行的字节码的行号指示器。如果线程在执行Java方法,这个计数器记录的是正在执行的虚拟机字节码指令地址;如果执行的是Native方法,这个计数器的值为空(Undefined)。此内存区域是唯一一个在Java虚拟机规范中没有规定任何OutOfMemoryError情况的区域。Java虚拟机栈与程序计数器一样,Java虚拟机栈也是线程私有的。其生命周期与线程相同。如何理解虚拟机栈呢?本质上来讲,就是个栈。里面存放的元素叫栈帧,栈帧好像很复杂的样子,其实它很简单!它里面存放的是一个函数的上下文,具体存放的是执行的函数的一些数据。执行的函数需要的数据无非就是局部变量表(保存函数内部的变量)、操作数栈(执行引擎计算时需要),方法出口等等。执行引擎每调用一个函数时,就为这个函数创建一个栈帧,并加入虚拟机栈。换个角度理解,每个函数从调用到执行结束,其实是对应一个栈帧的入栈和出栈。注意这个区域可能出现的两种异常:一种是StackOverflowError,当前线程请求的栈深度大于虚拟机所允许的深度时,会抛出这个异常。制造这种异常很简单:将一个函数反复递归自己,最终会出现栈溢出错误(StackOverflowError)。另一种异常是OutOfMemoryError异常,当虚拟机栈可以动态扩展时(当前大部分虚拟机都可以),如果无法申请足够多的内存就会抛出OutOfMemoryError,如何制作虚拟机栈OOM呢,参考一下代码: 1.publicvoidstackLeakByThread(){2.while(true){3.newThread(){4.publicvoidrun(){5.while(true){6.}7.}8.}.start()9.}10.} ``这段代码有风险,可能会导致操作系统假死,请谨慎使用~~~本地方法栈本地方法栈与虚拟机栈所发挥的作用很相似,他们的区别在于虚拟机栈为执行Java代码方法服务,而本地方法栈是为Native方法服务。与虚拟机栈一样,本地方法栈也会抛出StackOverflowError和OutOfMemoryError异常。 Java堆Java堆可以说是虚拟机中最大一块内存了。它是所有线程所共享的内存区域,几乎所有的实例对象都是在这块区域中存放。当然,睡着JIT编译器的发展,所有对象在堆上分配渐渐变得不那么“绝对”了。Java堆是垃圾收集器管理的主要区域。由于现在的收集器基本上采用的都是分代收集算法,所有Java堆可以细分为:新生代和老年代。在细致分就是把新生代分为:Eden空间、From Survivor空间、To Survivor空间。当堆无法再扩展时,会抛出OutOfMemoryError异常。方法区方法区存放的是类信息、常量、静态变量等。方法区是各个线程共享区域,很容易理解,我们在写Java代码时,每个线程度可以访问同一个类的静态变量对象。由于使用反射机制的原因,虚拟机很难推测那个类信息不再使用,因此这块区域的回收很难。另外,对这块区域主要是针对常量池回收,值得注意的是JDK1.7已经把常量池转移到堆里面了。同样,当方法区无法满足内存分配需求时,会抛出OutOfMemoryError。制造方法区内存溢出,注意,必须在JDK1.6及之前版本才会导致方法区溢出,原因后面解释,执行之前,可以把虚拟机的参数-XXpermSize和-XX:MaxPermSize限制方法区大小。1.Listlist=newArrayList();2.inti=0;3.while(true){4.list.add(String.valueOf(i).intern());5.}运行后会抛出java.lang.OutOfMemoryError:PermGen space异常。解释一下,String的intern()函数作用是如果当前的字符串在常量池中不存在,则放入到常量池中。上面的代码不断将字符串添加到常量池,最终肯定会导致内存不足,抛出方法区的OOM。下面解释一下,为什么必须将上面的代码在JDK1.6之前运行。我们前面提到,JDK1.7后,把常量池放入到堆空间中,这导致intern()函数的功能不同,具体怎么个不同法,且看看下面代码:1.Stringstr1=newStringBuilder("hua").append("chao").toString();2.System.out.println(str1.intern()==str1);3.Stringstr2=newStringBuilder("ja").append("va").toString();4.System.out.println(str2.intern()==str2);这段代码在JDK1.6和JDK1.7运行的结果不同。JDK1.6结果是:false,false ,JDK1.7结果是true, false。原因是:JDK1.6中,intern()方法会吧首次遇到的字符串实例复制到常量池中,返回的也是常量池中的字符串的引用,而StringBuilder创建的字符串实例是在堆上面,所以必然不是同一个引用,返回false。在JDK1.7中,intern不再复制实例,常量池中只保存首次出现的实例的引用,因此intern()返回的引用和由StringBuilder创建的字符串实例是同一个。为什么对str2比较返回的是false呢?这是因为,JVM中内部在加载类的时候,就已经有"java"这个字符串,不符合“首次出现”的原则,因此返回false。垃圾回收(GC)JVM的垃圾回收机制中,判断一个对象是否死亡,并不是根据是否还有对象对其有引用,而是通过可达性分析。对象之间的引用可以抽象成树形结构,通过树根(GC Roots)作为起点,从这些树根往下搜索,搜索走过的链称为引用链,当一个对象到GC Roots没有任何引用链相连时,则证明这个对象是不可用的,该对象会被判定为可回收的对象。那么那些对象可作为GC Roots呢?主要有以下几种:1.虚拟机栈(栈帧中的本地变量表)中引用的对象。2.方法区中类静态属性引用的对象。3.方法区中常量引用的对象4.本地方法栈中JNI(即一般说的Native方法)引用的对象。另外,Java还提供了软引用和弱引用,这两个引用是可以随时被虚拟机回收的对象,我们将一些比较占内存但是又可能后面用的对象,比如Bitmap对象,可以声明为软引用货弱引用。但是注意一点,每次使用这个对象时候,需要显示判断一下是否为null,以免出错。 三种常见的垃圾收集算法1.标记-清除算法首先,通过可达性分析将可回收的对象进行标记,标记后再统一回收所有被标记的对象,标记过程其实就是可达性分析的过程。这种方法有2个不足点:效率问题,标记和清除两个过程的效率都不高;另一个是空间问题,标记清除之后会产生大量的不连续的内存碎片。2.复制算法为了解决效率问题,复制算法是将内存分为大小相同的两块,每次只使用其中一块。当这块内存用完了,就将还存活的对象复制到另一块内存上面。然后再把已经使用过的内存一次清理掉。这使得每次只对半个区域进行垃圾回收,内存分配时也不用考虑内存碎片情况。但是,这代价实在是让人无法接受,需要牺牲一般的内存空间。研究发现,大部分对象都是“朝生夕死”,所以不需要安装1:1比例划分内存空间,而是将内存分为一块较大的Eden空间和两块较小的Survivor空间,每次使用Eden空间和一块Survivor空间,默认比例为Eden:Survivor=8:1.新生代区域就是这么划分,每次实例在Eden和一块Survivor中分配,回收时,将存活的对象复制到剩下的另一块Survivor。这样只有10%的内存会被浪费,但是带来的效率却很高。当剩下的Survivor内存不足时,可以去老年代内存进行分配担保。如何理解分配担保呢,其实就是,内存不足时,去老年代内存空间分配,然后等新生代内存缓过来了之后,把内存归还给老年代,保持新生代中的Eden:Survivor=8:1.另外,两个Survivor分别有自己的名称:From Survivor、To Survivor。二者身份经常调换,即有时这块内存与Eden一起参与分配,有时是另一块。因为他们之间经常相互复制。3.标记-整理算法标记整理算法很简单,就是先标记需要回收的对象,然后把所有存活的对象移动到内存的一端。这样的好处是避免了内存碎片。类加载机制类从被加载到虚拟机内存开始,到卸载出内存为止,整个生命周期包括:加载、验证、准备、解析、初始化、使用和卸载七个阶段。其中加载、验证、准备、初始化、和卸载这5个阶段的顺序是确定的。而解析阶段不一定:它在某些情况下可以在初始化阶段之后再开始,这是为了支持Java的运行时绑定。关于初始化:JVM规范明确规定,有且只有5中情况必须执行对类的初始化(加载、验证、准备自然再此之前要发生):1.遇到new、getstatic、putstatic、invokestatic,如果类没有初始化,则必须初始化,这几条指令分别是指:new新对象、读取静态变量、设置静态变量,调用静态函数。2.使用java.lang.reflect包的方法对类进行反射调用时,如果类没初始化,则需要初始化3.当初始化一个类时,如果发现父类没有初始化,则需要先触发父类初始化。4.当虚拟机启动时,用户需要制定一个执行的主类(包含main函数的类),虚拟机会先初始化这个类。5.但是用JDK1.7启的动态语言支持时,如果一个MethodHandle实例最后解析的结果是REF_getStatic、REF_putStatic、Ref_invokeStatic的方法句柄时,并且这个方法句柄所对应的类没有进行初始化,则要先触发其初始化。另外要注意的是:通过子类来引用父类的静态字段,不会导致子类初始化:1.publicclassSuperClass{2.publicstaticintvalue=123;3.static{4.System.out.printLn("SuperClassinit!");5.}6.}7.publicclassSubClassextendsSuperClass{8.static{9.System.out.println("SubClassinit!");10.}11.}12.publicclassTest{13.publicstaticvoidmain(String[]args){14.System.out.println(SubClass.value);15.}16.}最后只会打印:SuperClass init!对应静态变量,只有直接定义这个字段的类才会被初始化,因此通过子类类引用父类中定义的静态变量只会触发父类初始化而不会触发子类初始化。通过数组定义来引用类,不会触发此类的初始化:1.publicclassTest{2.publicstaticvoidmain(String[]args){3.SuperClass[]sca=newSuperClass[10];4.}5.}常量会在编译阶段存入调用者的常量池,本质上并没有直接引用到定义常量的类,因此不会触发定义常量的类初始化,示例代码如下:1.publicclassConstClass{2.publicstaticfinalStringHELLO_WORLD="helloworld";3.static{4.System.out.println("ConstClassinit!");5.}6.}7.publicclassTest{8.publicstaticvoidmain(String[]args){9.System.out.print(ConstClass.HELLO_WORLD);10.}11.}上面代码不会出现ConstClass init!加载加载过程主要做以下3件事1.通过一个类的全限定名称来获取此类的二进制流2.强这个字节流所代表的静态存储结构转化为方法区的运行时数据结构3.在内存中生成一个代表这个类的java.lang.Class对象,作为方法区这个类的各种数据访问入口。验证这个阶段主要是为了确保Class文件字节流中包含信息符合当前虚拟机的要求,并且不会出现危害虚拟机自身的安全。准备准备阶段是正式为类变量分配内存并设置类变量初始值的阶段,这些变量所使用的内存都在方法区中分配。首先,这个时候分配内存仅仅包括类变量(被static修饰的变量),而不包括实例变量。实例变量会在对象实例化时随着对象一起分配在java堆中。其次这里所说的初始值“通常情况下”是数据类型的零值,假设一个类变量定义为1.publicstaticintvalue=123;那变量value在准备阶段后的初始值是0,而不是123,因为还没有执行任何Java方法,而把value赋值为123是在程序编译后,存放在类构造函数()方法中。解析解析阶段是把虚拟机中常量池的符号引用替换为直接引用的过程。初始化类初始化时类加载的最后一步,前面类加载过程中,除了加载阶段用户可以通过自定义类加载器参与以外,其余动作都是虚拟机主导和控制。到了初始化阶段,才是真正执行类中定义Java程序代码。准备阶段中,变量已经赋过一次系统要求的初始值,而在初始化阶段,根据程序员通过程序制定的主观计划初始化类变量。初始化过程其实是执行类构造器()方法的过程。()方法是由编译器自动收集类中所有类变量的赋值动作和静态语句块中的语句合并产生的。收集的顺序是按照语句在源文件中出现的顺序。静态语句块中只能访问定义在静态语句块之前的变量,定义在它之后的变量可以赋值,但不能访问。如下所示:1.publicclassTest{2.static{3.i=0;4.System.out.print(i);5.}6.staticinti=1;7.}()方法与类构造函数(或者说实例构造器())不同,他不需要显式地调用父类构造器,虚拟机会保证子类的()方法执行之前,父类的()已经执行完毕。类加载器关于自定义类加载器,和双亲委派模型,这里不再提,写了几个小时了,该洗洗睡了~动力节点Java架构师班深度剖析Java底层原理,热门技术深入探讨,前沿技术深入解读,大项目实战重构,从0到1做架构,从全局思维出发,带你把控大型项目中别人忽略的重要细节节点,站在巨人肩膀上学习架构师,带你领会架构师不一样的视野

优秀的个人博客,低调大师

揭秘Android开发效率提升多倍的利器;Gradle

Gradle是什么? Gradle是一种构建语言,目前是Android的默认构建工具,我们编写的编译脚本,其实就是玩Gradle的API,所以从它更底层的意义上看,是一个编程框架。 因为涉及的内容很多没法一两篇文章就介绍详细清楚,方便起见我用PPT图片的形式简单介绍一下。如果需要更详细了解学习的朋友可以看文末。 一.Gradle介绍 二.Gradle 之语言基础 Groovy ; 三.Gradle的重要概念; 1.Gradle Wrapper介绍; 2.Closure; 3.带有闭包的方法调用; 4.闭包重要知识点; 5.Gradle tasts 6.Gradle 插件 四.多维度打包 五.Gradle 的工作流程 详细的讲解介绍; 上面截图中的视频可以免费分享,加Android高级开发群;701740775 备注csdn领取Gradle教程

优秀的个人博客,低调大师

有经验JAVA程序员如何提升自己?

具有一到五年开发经验 需要学习内容很多JVM/分布式/高并发/性能优化/Spring MVC/Spring Boot/Spring Cloud/MyBatis/Netty源码分析等等等 01、透彻理解Tomcat原理手写动静态资源的实现 02、分享能源领域的分布式监测系统架构 03、分布式系统关键技术Rpc框架详解与实现 04、自己写一个SpringMVC框架 05、使用Jsoup实现网页爬虫功能 06、JAVA高级进阶之NIO通信架构原理详解 07、高手必过之路透彻理解Spring容器IOC的原理分析 08、并发编程之深入业务隔离场景原理详解 09、深入浅出Java虚拟机 10、源码分析之手写MyBatis 11、大型分布式服务治理技术-Dubbo企业级实战 12、大流量高并发之限流特技 13、深入分析热部署机制的原理实现 14、高性能反向代理服务器Nginx-动静分离实战 15、架构师必备技能之Spring MVC框架原理解析 16、大家可以点击加入群:468897908【Java架构/分布式/高并发】 下面为系统的学习方向01、maven的使用 maven的使用入门 maven私服的搭建及部署 maven坐标分析/父控设置 02、git版本管理及jenkins自动化构建 git使用入门培训 git常用命令分析和使用 jenkins环境搭建及插件配置 git+jenkins实现自动化构建 03、NoSql专题-redis高性能缓存 redis使用入门 redis常用命令及客户端的使用 redis高可用集群搭建 04、NoSql专题-mongodb mongodb使用入门 mongodb高可用集群搭建 mongodb常用命令及客户端的使用 05、分布式专题-zookeeper+dubbo服务协调 zookeeper安装部署及命令分析 zookeeper客户端的使用 zookeeper实现原理分析 dubbo的使用入门及配置分析 zookeeper+dubbo实现服务注册和发现 06、分布式专题-消息中间件 activeMq-jms规范及使用 activeMq消息分发机制分析 kafka实现原理剖析 kafka的数据传输事务性及实践练习 07、分布式缓存分析对比 memcache的原理分析及使用 memcache和redis的横向对比分析 分布式接口技术 webservice/RMI/restful的使用 09、高并发专题-数据库层面优化 分库分表的原理及规则讲解 数据库主备及高可用 10、性能调优专题-jvm调优 JVM原理剖析 jvm内存模型及垃圾回收器的分析 11、性能调优专题-容器性能优化 nginx性能优化 tomcat性能优化 12、性能调优专题-数据库优化 mysql常见优化手段分析及实践 13、高性能容器的使用 nginx使用入门 nginx负载均衡/反向代理实现 14、双十一专题-九阳真经 太极聚气之分布式压测平台 氤氲紫气之分布式缓存体系 盘龙真诀之分布式消息系统 金刚之躯之分布式跟踪系统 外功辅助之分布式配置系统 15、微服务架构技术栈分析 springboot的使用 16、分布式协调服务zookeeper zookeeper集群及相关概念分析 zookeeper java api的使用及实践 17、从集中式到分布式架构 分布式架构的演进过程 分布式架构的基石-TCP/UDP 18、分布式通信协议 分布式通信协议-HTTP及RESTful 分布式通信协议-webservice详解 分布式通信协议-RMI 分布式通信协议-序列化技术 19、分布式服务治理 dubbo控制台及监控中心的安装部署 dubbo常用配置分析 dubbo实战演练 20、NIO技术之-Netty NIO基本概念及BIO、AIO的对比分析 NIO核心设计思想剖析(Buffer/Channel..) Netty产生的背景及优缺点分析 Netty实现IM聊天系统 21、分布式缓存技术-Redis redis的安装及数据类型分析 Redis客户端的使用 Redis高可用方案实战 Redis+Lua脚本实现原子操作 22、高性能之道-MongoDB MongoDB高可用部署 MongoDB动态查询及索引剖析 MongoDB集成spring应用 23、数据库高性能之道-Mysql 分库分表深入分析 Mysql主从模型配置/Mycat的使用 24、分布式通信技术 JMS基本概念和模型 ActiveMQ结合Spring开发 ActiveMQ静态网络和**络链接 Kafka的高可用方案及原理分析 25、SOA架构及微服务架构 什么是SOA架构/为什么需要SOA 领域驱动设计方法/典型SOA架构设计 spring boot深入剖析 spring boot+dubbo企业实战 26、Docker虚拟化技术 Docker虚拟化技术(镜像/仓库/容器) Docker整合spring boot Docker 服务编排 27、导流技术 Nginx反向代理、负载均衡 Nginx进程模型分析 Nginx+keepalived高可用方案 28、微服务技术 spring boot(mvc) spring boot(REST) spring boot(验证) 29、spring cloud spring cloud config client spring cloud config server spring cloud netflix eureka spring cloud netflix ribbon spring cloud hystrix spring cloud feign spring cloud stream spring cloud bus spring cloud sleuth 30、分布式消息技术-kafka kafka高可用集群及介绍 kafka底层实现原理分析 31、分布式缓存-redis redis的数据类型分析 redis高可用集群方案 lua脚本在redis中的应用 32、高性能之道-MongoDB MongoDB的基本原理 MongoDB常用命令及客户端使用 手写基于MongoDB的ORM框架 MongoDB高可用解决方案 33、数据库高性能-Mysql 分库分表深入分析及主从模型 数据库中间件Mycat介绍 34、性能优化专题 从测试的角度解读如何衡量性能 了解Linux系统 35、虚拟机-JVM 内存模型、运行时数据 垃圾回收、GC日志 调优实战 36、容器优化-Tomcat tomcat架构分析 线程模型分析 tomcat调优实战 37、mysql数据库调优 Mysql底层存储分析 面试技巧之SQL执行计划及优化手段 工作一到五年的程序员朋友面对目前的技术无从下手,感到很迷茫可以加群744677563,里面有阿里Java高级大牛直播讲解知识点,分享知识,课程内容都是各位老师多年工作经验的梳理和总结,带着大家全面、科学地建立自己的技术体系和技术认知!

优秀的个人博客,低调大师

ARM强势收购Sansa 以提升物联网安全

芯片制造商ARM公司敲定一项购买以色列物联网(IoT)安全网络专家Sansa的协议,该交易于本周四宣布,涉及的财务条款还未正式对外披露。不过据华尔街日报此前的报道,涉及金额为7500万到8500万美元。 全球大多数智能手机使用的芯片是由ARM制造的,收购Sansa之举可令ARM有能力在芯片上加入基于硬件和软件的安全功能,能提高在连接设备上保护敏感数据和内容的能力。 Sansa技术已经被部署到一系列的智能连接设备和企业系统里,该公司的前身是Discretix,于去年10月更名,专攻嵌入式安全技术。该收购可互补ARM的安全产品组合,包括ARM TrustZone技术和SecurCore处理器版权。 ARM首席技术官Mike Muller在声明中表示,“任何连接设备都可能成为恶意攻击的目标,所以我们必须在每一个潜在的攻击点嵌入安全性。多层次的防御是防御黑客效果最好的手段,所以我们正在将我们的安全技术功能扩大整合到硬件子系统和可信软件里,这意味着我们的合作伙伴将来能够从单一源获取整个安全套件的许可证。” Sansa提供一套完整的硬件子系统,可用于将安全敏感操作与主应用处理器隔离。Sansa的物联网安全平台拥有移动部件,并具有跨基于云的系统协同工作的功能。 鉴于已经认识到的物联网设备安全问题,ARM和Sansa可以说是在肥沃的土壤播种。目前已经确认的物联网设备的安全缺陷绝大部分涉及到诸如弱密码、多设备的共用默认证书以及太烂的认证等东西。这些都是基本错误,在安全性一事上亡羊补牢的做法远非最佳的办法。 但回过头来说,启用安全和物联网互联肯定有其市场,针对这样的市场Sansa的技术所处的位置还是十分有利的。 ARM和Sansa去年12月都加入了一个名为Thread Group的业界组织,Thread Group旨在推进Thread,Thread是一种低功耗、无线网状网络协议,目标是简化数以百计的家庭设备的安全连接。Thread Group的其他成员包括三星电子、Nest Labs和Freescale等。 原文发布时间为:2015年07月31日 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。

优秀的个人博客,低调大师

新的内存技术提升了带宽和容量

DDR4内存在2014年推出时,其性能是DDR3内存的1.5倍,而内存接口的功耗却令人印象深刻,与DDR3内存相比,降低了25%的功耗。此外,DDR4支持每个模块的最大容量为512 GB,并且具有比其DDR3内存更多的存储空间,以及更快的循环和增加的引脚数(284),以支持更高的寻址能力。 根据IC Insights的说法,DDR4内存标准包括一些功能,可以加快内存操作,并增加服务器,笔记本和台式机,平板电脑以及各种消费电子产品的SDRAM存储。更具体地说,DDR4支持多达8个器件的堆叠存储器芯片,向存储器控制器提供单个信号负载。事实上,与DDR3内存相比,DDR4内存提供了双模块密度和双倍速度的潜力,同时降低了功耗,并延长了未来64位平板电脑和智能手机的电池寿命。 DDR4内存预计今年将成为DRAM的主导产品,其市场份额将达到58%,而DDR3内存的市场份额为39%。 变得更好 虽然DDR4的时钟频率为1.6Gbps至3.2Gbps,但标准化机构固态技术协会(JEDEC)最近公布的下一代DRAM-DDR5内存将实现双倍的带宽,从而实现3.2Gbps至6.4Gbps的时钟频率,以满足数据中心在物联网的时代(IoT)不断增长的带宽需求。事实上,普遍连接的新时代已经产生了数字海啸般的数据,这正在推动DDR4内存突破容量和内存带宽的限制。 虽然DDR5标准制定的工作仍在进行中,但早期公开发布的信息显示出了许多进化的改进。这些包括更高的密度,新的命令结构和新的省电功能。 DDR5内存还可能引入信号均衡和纠错功能。 引入高带宽内存(HBM)是提高服务器内存性能的另一种方法。本质上,高带宽内存(HBM)通过将低延迟DRAM内存放置在更加靠近CPU的位置来支持本地可用内存。 此外,高带宽内存(HBM)通过为1024位的SoC提供非常宽的接口来增加存储器带宽。这意味着HBM2的最大速度为2Gbps,总带宽为256GB / s。虽然其比特率与2.1Gbps的DDR3内存类似,但8位128位通道为HBM提供了大约15倍的带宽。此外,与现有架构相比,四个HBM存储器堆栈邻近CPU,每个具有256GB /s(例如)的存储速率,显著地提高了存储器密度和带宽。 除了DDR5内存和高带宽内存(HBM)之外,正在部署混合DIMM技术,如NVDIMM(非易失性DIMM),以满足不断增长的内存容量和带宽需求。据JEDEC称,NVDIMM-P将为计算机系统的新型高容量持久存储器模块提供针对成本,功耗和性能优化的新内存解决方案。事实上,DIMM的持久内存使用支持超大规模,高性能和高容量数据中心的多种用例。这些应用包括减少延迟,降低功耗,元数据存储,内存数据库,软件定义的服务器RAID以及意外故障期间的处理负载减少。 应该注意的是,NVDIMM-P可以在DIMM上实现完全可访问的闪存,从而允许系统利用非易失性存储器作为附加的高速存储器。同时,NVDIMM-N旨在使闪存作为DRAM的持久存储器备份。实际上,这意味着DRAM数据本地存储在闪存上,从而在减少CPU负载的同时,并产生持久性(在停电的情况下)。 总而言之,日益相连的世界激励了行业巨头在数据中心实施和创新新架构,以消除各种瓶颈。这其中包括DDR4内存和DDR5缓冲芯片,第二代高带宽内存(HBM2)和混合DIMM技术,如NVDIMM-P和NVDIMM-N。相信存储行业厂商需要共同开发下一代存储解决方案,同时坚持以最小的变化加快当前研发速度。 作者:HERO译 来源:51CTO

优秀的个人博客,低调大师

提升云NFV基础设施的运营效率

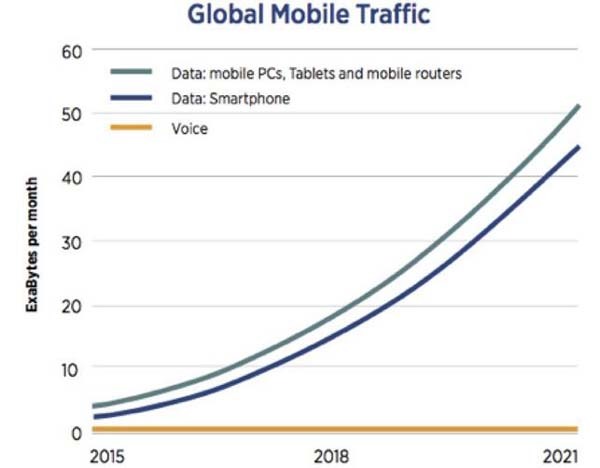
从2015年到2021年,移动数据流量将增长高达10倍以上。数据和新服务的需求大量涌现,数据和需求的来源不仅来自智能手机,还保留物联网(IoT)设备。电信运营商需要通过提供更快更新的服务来增强竞争力,尤其是随着5G的采用,电信运营商目前正在着手构建的网络功能虚拟化(NFV)基础设施必须满足这种迫在眉睫的需求。电信运营商目前面临的一个根本挑战是,以最低的NFV基础设施成本提供最多的创新服务。 Figure 1 – Mobile data traffic growth driven primarily by video, gaming, data, and IoT applications 敏捷高效的服务器基础设施是关键 服务器是NFV基础设施的核心模块,它承载了虚拟机(VM)中运行的web、业务逻辑、网络和安全的应用程序。他们是运营商向移动设备和IoT设备以及用户提供的服务和获取收入来源,每个月有超过60%的数据中心的成本花费在这些服务器以及相关的电力和冷却上。因此,提高NFV基础设施中每个服务器的效率是电信运营商首要关注的,其次是使用云编排工具(如OpenStack)管理服务器相关的运营效率。 Figure 2 – Server monthly costs based on 3-year server and 10-year infrastructure amortization. 影响服务器性能的因素 为了提供必要的服务,VM以及其中运行的应用程序,需要在服务器中访问足够的资源,例如CPU核心、内存、存储、安全策略规则、网络带宽和分析处理等。基于它们在NFV基础设施中托管的应用程序,VM根据其资源需求有不同的配置文件,一些VM是计算密集型的,一些是内存密集型的,另外一些是I/O密集型的。 VM需要安全和网络服务,这些服务是通过OpenStack网络管理的虚拟交换机(如Open vSwitch,OVS)或虚拟路由(如Contrail vRouter)提供的。他们需要报告实时分析,在大多数情况下,虚拟交换机或虚拟路由代表VM收集分析数据,并将数据报告给中央分析处理引擎。 当使用传统的服务器网络技术(如10/25/40 Gb以太网网卡(NIC))时,使用虚拟交换机或虚拟路由提供安全、网络和分析服务可消耗高达12个CPU内核。对于互联网混合(IMIX)流量,向VM传输的I/O吞吐量被限制到低于6 Gb/s。来自移动和物联网设备的流量在到达数据中心服务器时转变为连接和连接建立速率(connection setup rates)。在这些情况下,连接建立速率(connection setup rates)被限制到每秒5000个,消耗12个额外CPU核心,在服务器软件中处理连接建立逻辑。因此,计算密集型虚拟机无法获得所需的CPU核心,而网络密集型虚拟机无法获得他们所需的I/O吞吐量。结果是服务器效率很差,其中每个服务器的输出减少到预期值的六分之一。 服务器基础设施运营效率 有一个常识是管理很多相同的事物比管理不同事物的孤岛容易的多,OpenStack管理的同构服务器是NFV基础设施或任何数据中心基础设施的理想选择。使用服务器中的传统NIC(或商用NIC),可以实现整个数据中心服务器的同质性目标。然而,这样做的后果是每个服务器的效率被降到最低。当传统网卡与基于软件的虚拟交换机或虚拟路由搭配使用时,只能使用专用网络配置满足特定虚拟机配置文件的需求。 例如,一个需要低I/O吞吐量的VM可以用来实现网络配置,在其内核中执行基于软件的虚拟交换机或虚拟路由器,并且为这样的处理分配四到六个CPU核心。在另一种情况下,使用DPDK在用户空间中执行基于软件的虚拟交换机或虚拟路由器,并且可以为这样的处理分配八到十个CPU核心以向VM提供更高的I/O吞吐量。第三种情况是,可以使用诸如SR-IOV技术将最高I/O吞吐量传输到某些简档的VM。这样做的优势是,服务器可以为满足VM的配置文件需求而配置,缺陷是我们要有不同的服务器配置。VM不能自由放置和移动,这些缺陷影响了NFV服务器基础设施的运营效率。 Figure 3 – Network configuration silos resulting in significantly reduced operational efficiencies 智能NIC时代到来 无论是为了提高每个服务器的效率,还是整个数据中心和NFV基础设施的运营效率,智能网卡(SmartNIC)都能为这些问题提供解决方案。智能网卡(SmartNIC)是可编程的网卡,针对COTS(common off-the-shelf)服务器和基于开源部署进行了优化,使用最新版本的Open vSwitch(OVS)和Contrail vRouter提供完整的OpenStack管理解决方案。 在单个服务器效率方面,智能网卡可以将每台服务器的输出提高6倍,从而带来以下优势: 节省10个以上CPU核心 5倍以上I/O吞吐量,同时保持OVS和Contrail vRouter提供的丰富的联网服务 20多倍的连接建立速率 提高10倍以上的实时分析的价格/性能 此外,智能网卡还支持统一的OpenStack管理的COTS服务器基础架构,实现用户虚拟机和第三方虚拟网络功能(VNF)的无缝和快速入门,同时保持完整的虚拟机移动性。因此,使用智能网卡可显著提高整个数据中心的服务器基础设施运营效率。 作者:佚名 来源:51CTO

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册