首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10000篇文章
优秀的个人博客,低调大师

JUC中的原子变量内部解析

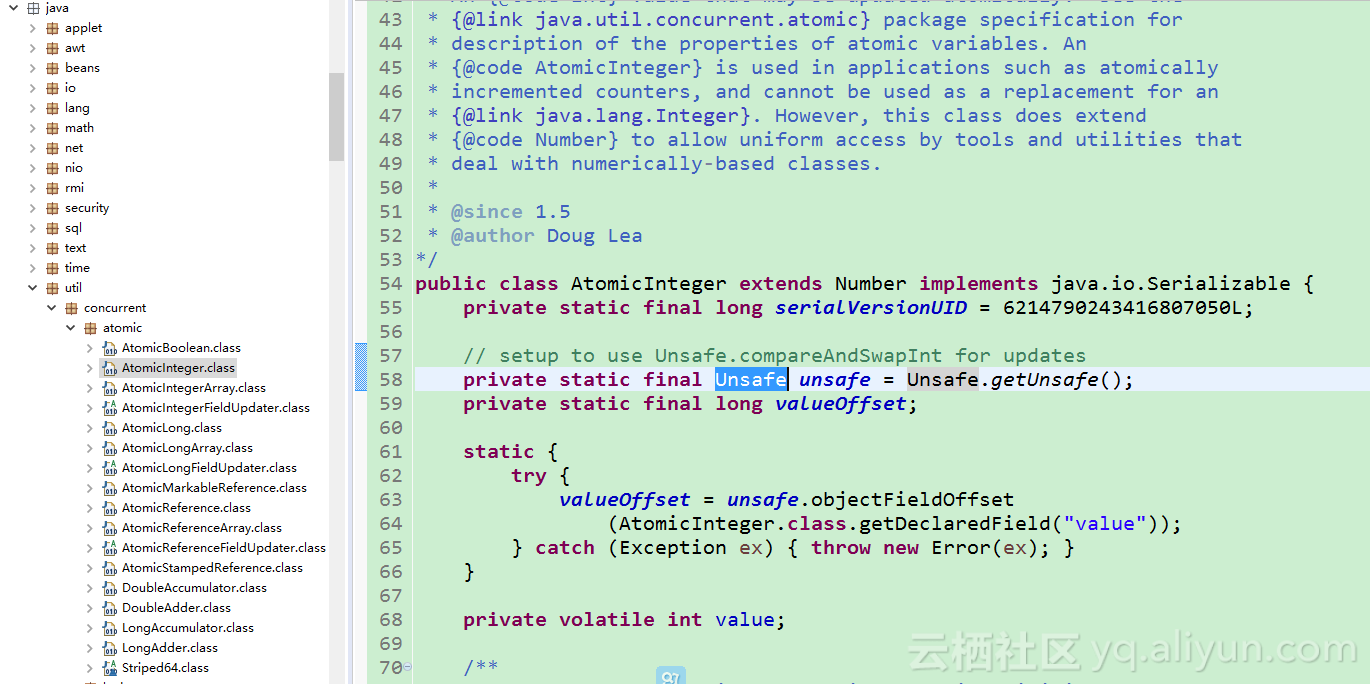
前言 工作中用到的一些原子操作类,查看一下它们的源码,顺便复习学习和梳理一下之前遗忘的知识点。 在Java中的java.util.concurrent.atomic包下面的原子操作类截图: 主要知识点 1.原子变量 在Java代码中保证线程安全一般分成两种方式:锁和原子变量,这次的主题是原子变量。 原子变量能够保证原子性的操作,意思是某个任务在执行过程中,要么全部成功,要么全部失败回滚,恢复到执行之前的初态,不存在初态和成功之间的中间状态。例如CAS(Compare and Swap)操作,要么比较并交换成功,要么比较并交换失败。由CPU保证原子性。 通过原子变量可以实现线程安全。执行某个任务的时候,先假定不会有冲突,若不发生冲突,则直接执行成功;当发生冲突的时候,则执行失败,回滚再重新操作,直到不发生冲突。 2.CAS CAS(Compare and Swap),一种无锁(lock-free)的非阻塞算法,翻译为:比较和交换。并且是CPU指令,在大多数处理器架构,包括IA32、Space中采用的都是CAS指令。 CAS是项乐观锁技术,当多个线程尝试使用CAS同时更新同一个变量时,只有其中一个线程能更新变量的值,而其它线程都失败,失败的线程并不会被挂起,而是被告知这次竞争中失败,并可以再次尝试。CAS有3个操作数,内存值V,旧的预期值A,要修改的新值B。当且仅当预期值A和内存值V相同时,将内存值V修改为B,否则什么都不做。 CAS无锁算法的C实现: int compare_and_swap (int* reg, int oldval, int newval) { ATOMIC(); int old_reg_val = *reg; if (old_reg_val == oldval) *reg = newval; END_ATOMIC(); return old_reg_val; } JVM对CAS的支持体现从JDK1.5中引入了底层的支持,在int、long和对象的引用等类型上都公开了CAS的操作,并且JVM把它们编译为底层硬件提供的最有效的方法。 3.魔法类:sun.misc.Unsafe 在原子变量中的方法底层实现的是利用Unsafe的CAS来实现原子操作的,其中Unsafe.compareAndSwap()用来实现高效的无锁数据结构。 这个类的提供了一些绕开JVM的更底层功能,直接申请和操作物理内存,基于它的实现可以提高效率。它所分配的内存需要手动free(不被GC回收)。 Unsafe的简单介绍: (1)Unsafe类设计只提供给JVM信任的启动类加载器所使用,是一个典型的单例模式类; (2)在Java中,可以用Unsafe绕过安全检查器。

优秀的个人博客,低调大师

源码解析Flask的配置文件

在flask里,我们常在主文件中定义某些配置,比如: app.debug = True app.secret_key = 'helloworld!!' 实际上,flask中默认可以进行可选的配置项有很多。 如果在开发的过程中,把所有需要的配置项都定义在主文件中,就会造成整个程序的目录结构不合理, 如果需要重写的flask配置项很多的时候,就可以把配置项用别的方式进行定义,然后导入使用 flask的配置文件是一个flask.config.Config对象 导入Config对象,可以发现Config对象继承字典, Config默认的配置有: default_config = ImmutableDict({ 'DEBUG': get_debug_flag(default=False), 'TESTING': False, 'PROPAGATE_EXCEPTIONS': None, 'PRESERVE_CONTEXT_ON_EXCEPTION': None, 'SECRET_KEY': None, 'PERMANENT_SESSION_LIFETIME': timedelta(days=31), 'USE_X_SENDFILE': False, 'LOGGER_NAME': None, 'LOGGER_HANDLER_POLICY': 'always', 'SERVER_NAME': None, 'APPLICATION_ROOT': None, 'SESSION_COOKIE_NAME': 'session', 'SESSION_COOKIE_DOMAIN': None, 'SESSION_COOKIE_PATH': None, 'SESSION_COOKIE_HTTPONLY': True, 'SESSION_COOKIE_SECURE': False, 'SESSION_REFRESH_EACH_REQUEST': True, 'MAX_CONTENT_LENGTH': None, 'SEND_FILE_MAX_AGE_DEFAULT': timedelta(hours=12), 'TRAP_BAD_REQUEST_ERRORS': False, 'TRAP_HTTP_EXCEPTIONS': False, 'EXPLAIN_TEMPLATE_LOADING': False, 'PREFERRED_URL_SCHEME': 'http', 'JSON_AS_ASCII': True, 'JSON_SORT_KEYS': True, 'JSONIFY_PRETTYPRINT_REGULAR': True, 'JSONIFY_MIMETYPE': 'application/json', 'TEMPLATES_AUTO_RELOAD': None, }) 通过查看Config对象的源码,可以知道flask的配置可以有以下几种方式 1.在主文件中定义(通常使用的方式) app.debug = True app.secret_key = 'helloworld!!' 由于Config对象继承了dict的方法和属性,所以还可以使用app.config.update(配置项)的方式导入配置项 2.从环境变量中导入配置项 导入配置项的方式: app.config.from_envvar("环境变量名称") from_envvar方法的源码: def from_envvar(self, variable_name, silent=False): rv = os.environ.get(variable_name) if not rv: if silent: return False raise RuntimeError('The environment variable %r is not set ' 'and as such configuration could not be ' 'loaded. Set this variable and make it ' 'point to a configuration file' % variable_name) return self.from_pyfile(rv, silent=silent) 可以看到,从环境变量中导入配置项的方法,就是从环境变量中找到并读取对应的py文件名称,然后内部调用from_pyfile方法处理读取到的内容得到配置 3.从python文件中导入 从python文件中获取配置项的方式: app.config.from_pyfile("python文件名称") 例如,创建一个名为setting.py的文件 setting.py文件的内容为: DEBUG=True 然后使用app.config.from_pyfile("setting.py")的方式导入配置项 from_pyfile方法的源码: def from_pyfile(self, filename, silent=False): filename = os.path.join(self.root_path, filename) d = types.ModuleType('config') d.__file__ = filename try: with open(filename, mode='rb') as config_file: exec(compile(config_file.read(), filename, 'exec'), d.__dict__) except IOError as e: if silent and e.errno in (errno.ENOENT, errno.EISDIR): return False e.strerror = 'Unable to load configuration file (%s)' % e.strerror raise self.from_object(d) return True 从py文件中导入配置项的过程中,读取参数中的python文件的内容,进行编译后exec方法执行,就得到所需要的配置项 需要注意的是: python文件可以是绝对路径或者相对路径,如果是相对路径,则py文件必须放在root_path目录下, 4.从对象中导入配置项 from_object方法的源码: def from_object(self, obj): if isinstance(obj, string_types): obj = import_string(obj) for key in dir(obj): if key.isupper(): self[key] = getattr(obj, key) 从对象中导入配置项的过程中,首先判断所传入的对象名是否是字符串,然后调用import_string方法处理字符串形式的对象名 import_string方法的源码: def import_string(import_name, silent=False): import_name = str(import_name).replace(':', '.') try: try: __import__(import_name) except ImportError: if '.' not in import_name: raise else: return sys.modules[import_name] module_name, obj_name = import_name.rsplit('.', 1) try: module = __import__(module_name, None, None, [obj_name]) except ImportError: module = import_string(module_name) try: return getattr(module, obj_name) except AttributeError as e: raise ImportError(e) except ImportError as e: if not silent: reraise( ImportStringError, ImportStringError(import_name, e), sys.exc_info()[2]) 可以看到,import_string方法,实际上是对字符串形式的对象名执行rsplit方法,得到模块名和对象名 在模块可以被正常导入之前,不停执行import_string方法,最后执行getattr方法从模块中获取对象名 5.from_json:从json字符串中获取配置项 from_json方法的源码: def from_json(self, filename, silent=False): filename = os.path.join(self.root_path, filename) try: with open(filename) as json_file: obj = json.loads(json_file.read()) except IOError as e: if silent and e.errno in (errno.ENOENT, errno.EISDIR): return False e.strerror = 'Unable to load configuration file (%s)' % e.strerror raise return self.from_mapping(obj) 从json文件中获取配置项,实际上就是对json文件执行json.loads方法,得到对象 然后内部调用from_mapping方法处理所得到的对象 6.from_mapping:从dict字典中获取配置项 from_mapping方法的源码: def from_mapping(self, *mapping, **kwargs): mappings = [] if len(mapping) == 1: if hasattr(mapping[0], 'items'): mappings.append(mapping[0].items()) else: mappings.append(mapping[0]) elif len(mapping) > 1: raise TypeError( 'expected at most 1 positional argument, got %d' % len(mapping) ) mappings.append(kwargs.items()) for mapping in mappings: for (key, value) in mapping: if key.isupper(): self[key] = value return True 把参数字典中的所有键值对添加到列表串,循环遍历列表,读取列表中每个元素的键和值 如果键为大写,则key为配置选项,value为配置选项的值 7.get_namespace:从名称空间中获取配置选项 get_namespace源码: def get_namespace(self, namespace, lowercase=True, trim_namespace=True): rv = {} for k, v in iteritems(self): if not k.startswith(namespace): continue if trim_namespace: key = k[len(namespace):] else: key = k if lowercase: key = key.lower() rv[key] = v return rv get_namespace方法,是从指定的名称空间或前缀中进行匹配,返回包含配置项的子集的字典 迭代当前对象,获取key和v,把key转换为小写格式,然后把key和v包含在一个字典中

优秀的个人博客,低调大师

摩拜单车爬虫源码及解析

为什么爬摩拜的数据 摩拜是最早进入成都的共享单车,每天我从地铁站下来的时候,在APP中能看到很多单车,但走到那里的时候,才发现车并不在那里。有些车不知道藏到了哪里;有些车或许是在高楼的后面,由于有GPS的误差而找不到了;有些车被放到了小区里面,一墙之隔让骑车人无法获得到车。 那么有没有一个办法通过获得这些单车的数据,来分析这些车是否变成了僵尸车?是否有人故意放到小区里面让人无法获取呢? 带着这些问题,我开始了研究如何获取这些数据。 从哪里获得数据 如果你能够看到数据,那么我们总有办法自动化的获取到这些数据。只不过获取数据的方式方法决定了获取数据的效率,对于摩拜单车的数据分析这个任务而言,这个爬虫要能够在短时间内(通常是10分钟左右)获取到更多的数据,对于数据分析才有用处。那么数据来源于哪里? 最直接的来源是摩拜单车的APP。现代的软件设计

优秀的个人博客,低调大师

Unity加载模块深度解析(纹理篇)

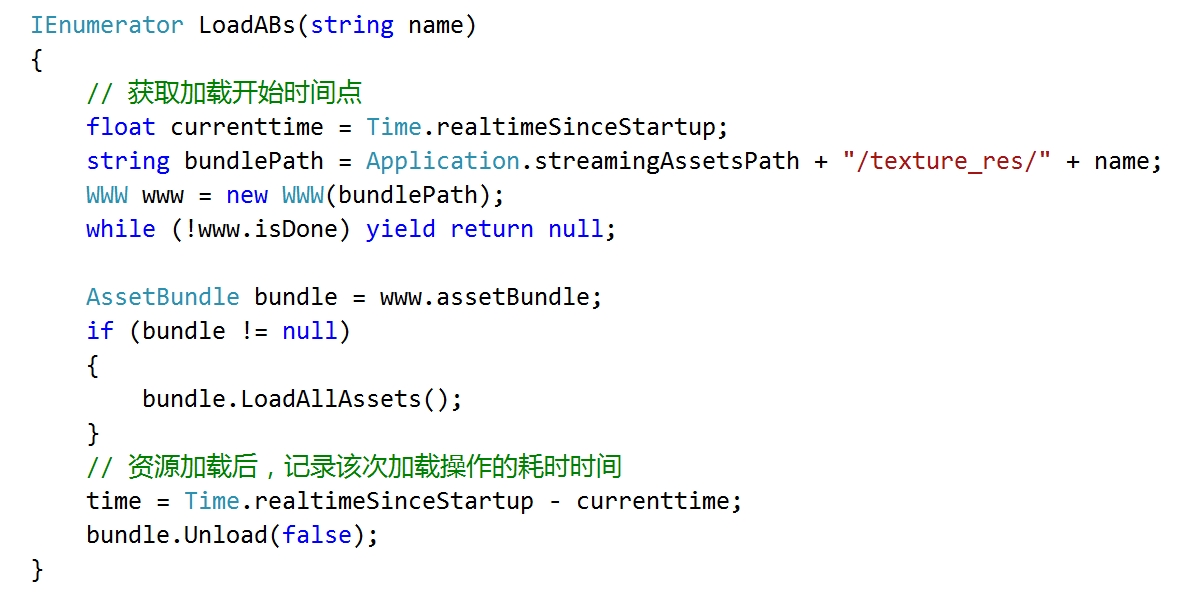
资源加载 资源加载是加载模块中最为耗时的部分,其CPU开销在Unity引擎中主要体现在Loading.UpdatePreloading和Loading.ReadObject两项中,相信经常查看Profiler的朋友对这两项肯定毫不陌生了。 Loading.UpdatePreloading,这一项仅在调用类似LoadLevel(Async)的接口处出现,主要负责卸载当前场景的资源,并且加载下一场景中的相关资源和序列化信息等。下一场景中,自身所拥有的GameObject和资源越多,其加载开销越大。 在很多项目中,存在另外一种加载方式,即场景为空场景,绝大部分资源和GameObject都是通过OnLevelWasLoaded回调函数中进行加载、实例化和拼合的。对于这种情况,Loading.UpdatePreloading的加载开销会很小。 Loading.ReadObject,这一项记录的则是资源加载时的真正资源读取性能开销,基本上引擎的主流资源(纹理资源、网格资源、动画片段等等)读取均是通过该项来进行体现。可以说,这一项很大程度上决定了项目场景的切换效率。正因如此,我们就当前项目中所用的主流资源进行了大量的测试和分析,下面我们将分析结果与大家一起分享,希望可以帮到正在进行开发的你。 注意事项:本篇文章的资源性能分析主要是针对移动项目而言,因为目前UWA所测评的项目中,移动游戏/应用占比在90%以上。所以,我们选择首先在移动设备上针对每种资源的加载性能进行分析和总结。 资源加载性能测试代码 以下为我们测试时所使用的测试代码,我们将每种资源均制作成一定大小的AssetBundle文件,并逐一通过以下代码在不同设备上进行加载,以期得到不同硬件设备上的资源加载性能比较。 测试环境 引擎版本:Unity 5.2版本 测试设备:五台不同档次的移动设备(Android:红米2、红米Note2和三星S6,iOS:iPhone 5 和 iPhone 6) 纹理资源 纹理资源是项目加载过程中开销占用最大的资源之一,其加载效率由其自身大小决定。目前,决定纹理资源大小的因素主要有三种:分辨率、格式和Mipmap是否开启。 1. 分辨率 & 格式 分辨率和格式是影响纹理资源加载效率的重要因素,因为这两项的设置对纹理资源的大小影响很大。因此,我们对这两种因素进行了详细的测试: 测试1:相同格式、不同分辨率的加载效率测试 我们选取了两张分辨率为2048x2048的普通纹理资源,并在打成AssetBundle时,将其分辨率最大值分别设置为512x512、1024x1024和2048x20248,纹理格式均设置为ETC1(Android)和PVRTC(iOS)、且关闭Mipmap功能。所以,三组纹理的内存占用分别为256KB、1MB和4MB,其对应AssetBundle大小为156KB、531KB和1.92MB(对于Android平台)、175KB、628KB和2.4MB(对于iOS平台)。Unity 版本为5.2,压缩格式为默认的LZMA压缩。 Android平台测试纹理: 我们在五种不同档次的机型上加载这些纹理资源,为降低偶然性,每台设备上重复进行十次加载操作并将取其平均值作为最终性能开销。具体测试结果如下表所示。 通过上述测试,我们可以得到以下结论: 1、纹理资源的分辨率对加载性能影响较大,分辨率越高,其加载越为耗时。设备性能越差,其耗时差别越为明显; 2、设备越好,加载效率确实越高。但是,对于硬件支持纹理(ETC1/PVRTC)来说,中高端设备的加载效率差别已经很小,比如图中的红米Note2和三星S6设备,差别已经很不明显。 测试2:不同格式、相同分辨率的加载效率测试 我们选取了两张分辨率为1024x1024的普通纹理资源,并在打成AssetBundle时,根据不同平台将其纹理格式分别设置不同格式用于打包。对于Android平台,我们使用ETC1、ETC2、RGBA16和RGBA32四种格式,对于iOS平台,我们使用PVRTC 4BPP、RGBA16和RGBA32三种格式,同时,对于每张纹理均关闭Mipmap功能。所以,三组纹理的内存占用分别为1MB、1MB、4MB 和 8MB(Android平台)/1MB、4MB 和 8MB(iOS平台)。 Android平台测试纹理: 与测试1相同,我们在五种不同档次的机型上重复进行十次加载操作并将取其平均值作为最终性能开销。具体测试结果如下图所示。Android设备:iOS设备: 通过上述测试,我们可以得到以下结论: 1、纹理资源的格式对加载性能影响同样较大,Android平台上,ETC1和ETC2的加载效率最高。同样,iOS平台上,PVRTC 4BPP的加载效率最高。 2、RGBA16格式纹理的加载效率同样很高,与RGBA32格式相比,其加载效率与ETC1/PVRTC非常接近,并且设备越好,加载开销差别越不明显; 3、RGBA32格式纹理的加载效率受硬件设备的性能影响较大,ETC/PVRTC/RGBA16受硬件设备的影响较低。 注意事项:这里需要指出的是测试中所使用的ETC1和ETC2纹理均为RGB 4Bit格式,所以对于半透明纹理贴图,需要两张ETC1格式的纹理进行支持(一张RGB通道,一张Alpha通道)。逐一加载两张ETC1格式的纹理,其加载效率要低于RGBA16格式,但可以通过加载方式来进行弥补。这一点我们将在后续文章中进行详细说明。 2. 开启Mipmap功能 开启Mipmap功能同样会增大一部分纹理大小,一般来说,其内存会增加至原始大小的1.33倍。因此,我们对开启Mipmap功能前后的加载性能进行了详细的测试: 测试3:开启/关闭Mipmap功能的加载效率测试 我们仍然使用两张分辨率为1024x1024的普通纹理资源,分别使用ETC1格式、PVRTC格式、RGBA16格式和RGBA32格式(测试所用纹理与测试2相同),并在打成AssetBundle时,一组开启Mipmap功能,一组关闭Mipmap功能。 与测试1相同,我们在五种不同档次的机型上重复进行十次加载操作并将取其平均值作为最终性能开销。具体测试结果如下图所示。Android平台:iOS平台: 通过上述测试,我们可以看出:开启Mipmap功能会导致资源加载更为耗时,且设备性能越差,其加载效率影响越大。 通过以上性能测试,我们对于纹理资源的加载建议如下: 1、严格控制RGBA32和ARGB32纹理的使用,在保证视觉效果的前提下,尽可能采用“够用就好”的原则,降低纹理资源的分辨率,以及使用硬件支持的纹理格式。 2、在硬件格式(ETC、PVRTC)无法满足视觉效果时,RGBA16格式是一种较为理想的折中选择,既可以增加视觉效果,又可以保持较低的加载耗时。 3、严格检查纹理资源的Mipmap功能,特别注意UI纹理的Mipmap是否开启。在UWA测评过的项目中,有不少项目的UI纹理均开启了Mipmap功能,不仅造成了内存占用上的浪费,同时也增加了不小的加载时间。 4、ETC2对于支持OpenGL ES3.0的Android移动设备来说,是一个很好的处理半透明的纹理格式。但是,如果你的游戏需要在大量OpenGL ES2.0的设备上进行运行,那么我们不建议使用ETC2格式纹理。因为不仅会造成大量的内存占用(ETC2转成RGBA32),同时也增加一定的加载时间。下图为测试2中所用的测试纹理在三星S3和S4设备上加载性能表现。可以看出,在OpenGL ES2.0设备上,ETC2格式纹理的加载要明显高于ETC1格式,且略高于RGBA16格式纹理。因此,建议研发团队在项目中谨慎使用ETC2格式纹理。 正是由于以上加载效率问题,我们在UWA测评报告中加入了对每个检测到的纹理资源参数的详细展示,以方便开发团队可以快速查看资源的使用情况,只需对相关信息列进行排序,即可定位引发性能问题的具体资源。 说明:以上测试数据为我们所用的测试纹理加载数据,需要指出的是,不同纹理的加载效率是不相同的,因为其内容的不同会造成AssetBundle压缩包大小的不同,进而造成最终加载效率的不同。这里我们给出的具体性能比较,其本意是让大家通过数据直观了解到纹理格式、分辨率和Mipmap功能对加载性能的影响。另外,我们后续会进行更多的测试,以期为大家提供更为普遍的测试结果。 以上为纹理资源在加载时的性能测试。关于加载模块的性能问题,我们会不断推出网格、音频等其他资源的加载性能分析、资源卸载性能分析、资源实例化性能分析、不同加载方式的性能分析等一系列技术文章,并对目前UWA所检测过项目的共性问题进行总结,以期让大家对项目的加载效率有更加深入的认知,并提升对加载模块的掌控能力。 原文出处:侑虎科技 转载请与作者联系,同时请务必标明文章原始出处和原文链接及本声明。

优秀的个人博客,低调大师

C++ 虚函数表解析

转自:http://blog.csdn.net/haoel/article/details/1948051 本人修改部分(添加了代码验证) 在此感谢原作者 ,写出这么好的文章 (虽然转的,但是文章确实不错,所以还是脸皮厚点发到首页......,管理员,你看着办吧!!!) 前言 C++中的虚函数的作用主要是实现了多态的机制。关于多态,简而言之就是用父类型别的指针指向其子类的实例,然后通过父类的指针调用实际子类的成员函数。这种技术可以让父类的指针有“多种形态”,这是一种泛型技术。所谓泛型技术,说白了就是试图使用不变的代码来实现可变的算法。比如:模板技术,RTTI技术,虚函数技术,要么是试图做到在编译时决议,要么试图做到运行时决议。 关于虚函数的使用方法,我在这里不做过多的阐述。大家可以看看相关的C++的书籍。在这篇文章中,我只想从虚函数的实现机制上面为大家 一个清晰的剖析。 当然,相同的文章在网上也出现过一些了,但我总感觉这些文章不是很容易阅读,大段大段的代码,没有图片,没有详细的说明,没有比较,没有举一反三。不利于学习和阅读,所以这是我想写下这篇文章的原因。也希望大家多给我提意见。 言归正传,让我们一起进入虚函数的世界。 虚函数表 C++ 了解的人都应该知道虚函数(Virtual Function)是通过一张虚函数表(Virtual Table)来实现的。简称为V-Table。在这个表中,主是要一个类的虚函数的地址表,这张表解决了继承、覆盖的问题,保证其容真实反应实际的函数。这样,在有虚函数的类的实例中这个表被分配在了这个实例的内存中,所以,当我们用父类的指针来操作一个子类的时候,这张虚函数表就显得由为重要了,它就像一个地图一样,指明了实际所应该调用的函数。 这里我们着重看一下这张虚函数表。C++的编译器应该是保证虚函数表的指针存在于对象实例中最前面的位置(这是为了保证取到虚函数表的有最高的性能——如果有多层继承或是多重继承的情况下)。 这意味着我们通过对象实例的地址得到这张虚函数表,然后就可以遍历其中函数指针,并调用相应的函数。 听我扯了那么多,我可以感觉出来你现在可能比以前更加晕头转向了。 没关系,下面就是实际的例子,相信聪明的你一看就明白了。 假设我们有这样的一个类: class Base { public: virtual void f() { cout << "Base::f" << endl; } virtual void g() { cout << "Base::g" << endl; } virtual void h() { cout << "Base::h" << endl; } }; 按照上面的说法,我们可以通过Base的实例来得到虚函数表。 下面是实际例程: typedef void(*Fun)(void); Base b; Fun pFun = NULL; cout << "虚函数表地址:" << (int*)(&b) << endl; cout << "虚函数表 — 第一个函数地址:" << (int*)*(int*)(&b) << endl; // Invoke the first virtual function pFun = (Fun)*((int*)*(int*)(&b)); pFun(); 实际运行经果如下:(Windows XP+VS2003, Linux 2.6.22 + GCC 4.1.3) 虚函数表地址:0012FED4 虚函数表 — 第一个函数地址:0044F148 Base::f 通过这个示例,我们可以看到,我们可以通过强行把&b转成int *,取得虚函数表的地址,然后,再次取址就可以得到第一个虚函数的地址了,也就是Base::f(),这在上面的程序中得到了验证(把int*强制转成了函数指针)。通过这个示例,我们就可以知道如果要调用Base::g()和Base::h(),其代码如下: (Fun)*((int*)*(int*)(&b)+0); // Base::f() (Fun)*((int*)*(int*)(&b)+1); // Base::g() (Fun)*((int*)*(int*)(&b)+2); // Base::h() 这个时候你应该懂了吧。什么?还是有点晕。也是,这样的代码看着太乱了。没问题,让我画个图解释一下。如下所示: 注意:在上面这个图中,我在虚函数表的最后多加了一个结点,这是虚函数表的结束结点,就像字符串的结束符“/0”一样,其标志了虚函数表的结束。这个结束标志的值在不同的编译器下是不同的。在WinXP+VS2003下,这个值是NULL。而在Ubuntu 7.10 + Linux 2.6.22 + GCC 4.1.3下,这个值是如果1,表示还有下一个虚函数表,如果值是0,表示是最后一个虚函数表。 下面,我将分别说明“无覆盖”和“有覆盖”时的虚函数表的样子。没有覆盖父类的虚函数是毫无意义的。我之所以要讲述没有覆盖的情况,主要目的是为了给一个对比。在比较之下,我们可以更加清楚地知道其内部的具体实现。 一般继承(无虚函数覆盖) 下面,再让我们来看看继承时的虚函数表是什么样的。假设有如下所示的一个继承关系: 请注意,在这个继承关系中,子类没有重载任何父类的函数。那么,在派生类的实例中,其虚函数表如下所示: 对于实例:Derive d; 的虚函数表如下: 代码验证如下: // CppTest.cpp : 定义控制台应用程序的入口点。 // #include "stdafx.h" #include <iostream> using namespace std; class Base{ public: virtual void f(){cout<<"Base::f\n";} virtual void g(){cout<<"Base::g\n";} virtual void h(){cout<<"Base::h\n";} }; class Derive:public Base{ public: virtual void f1(){cout<<"Derive:f1\n";} virtual void g1(){cout<<"Derive:g1\n";} virtual void h1(){cout<<"Derive:h1\n";} }; int _tmain(int argc, _TCHAR* argv[]) { typedef void(*FUN)(void); Base b; FUN pFun=NULL; cout<<"虚函数表的地址为:"<<(int*)(&b)<<endl; cout << "虚函数表 — 第一个函数地址:" << (int*)*(int*)(&b) << endl; for (int i=0;i<3;++i) { pFun = (FUN)*((int*)*(int*)(&b)+i); pFun(); } cout<<"-----------------------------------------"<<endl; Derive d; pFun=NULL; cout<<"虚函数表的地址为:"<<(int*)(&d)<<endl; cout<<"虚函数表 — 第一个函数地址:"<<(int*)*(int*)(&d)<<endl; for (int i=0;i<6;++i) { pFun=(FUN)*((int*)*(int*)(&d)+i); pFun(); } return 0; } 程序的输出为: 我们可以看到下面几点: 1)虚函数按照其声明顺序放于表中。 2)父类的虚函数在子类的虚函数前面。 一般继承(有虚函数覆盖) 覆盖父类的虚函数是很显然的事情,不然,虚函数就变得毫无意义。下面,我们来看一下,如果子类中有虚函数重载了父类的虚函数,会是一个什么样子?假设,我们有下面这样的一个继承关系。 为了让大家看到被继承过后的效果,在这个类的设计中,我只覆盖了父类的一个函数:f()。那么,对于派生类的实例,其虚函数表会是下面的一个样子: 代码验证如下: #include <iostream> using namespace std; class Base{ public: virtual void f(){cout<<"Base::f\n";} virtual void g(){cout<<"Base::g\n";} virtual void h(){cout<<"Base::h\n";} }; class Derive:public Base{ public: virtual void f(){cout<<"Derive:f\n";} virtual void g1(){cout<<"Derive:g1\n";} virtual void h1(){cout<<"Derive:h1\n";} }; int _tmain(int argc, _TCHAR* argv[]) { typedef void(*FUN)(void); Base b; FUN pFun=NULL; cout<<"虚函数表的地址为:"<<(int*)(&b)<<endl; cout << "虚函数表 — 第一个函数地址:" << (int*)*(int*)(&b) << endl; for (int i=0;i<3;++i) { pFun = (FUN)*((int*)*(int*)(&b)+i); pFun(); } cout<<"-----------------------------------------"<<endl; Derive d; pFun=NULL; cout<<"虚函数表的地址为:"<<(int*)(&d)<<endl; cout<<"虚函数表 — 第一个函数地址:"<<(int*)*(int*)(&d)<<endl; for (int i=0;i<5;++i) { pFun=(FUN)*((int*)*(int*)(&d)+i); pFun(); } return 0; } 我们从表中可以看到下面几点, 1)覆盖的f()函数被放到了虚表中原来父类虚函数的位置。 2)没有被覆盖的函数依旧。 这样,我们就可以看到对于下面这样的程序: Base *b = new Derive(); b->f(); 由b所指的内存中的虚函数表的f()的位置已经被Derive::f()函数地址所取代,于是在实际调用发生时,是Derive::f()被调用了。这就实现了多态。 多重继承(无虚函数覆盖) 下面,再让我们来看看多重继承中的情况,假设有下面这样一个类的继承关系。注意:子类并没有覆盖父类的函数。 对于子类实例中的虚函数表,是下面这个样子: 代码验证如下: #include <iostream> using namespace std; class Base1{ public: virtual void f(){cout<<"Base1::f\n";} virtual void g(){cout<<"Base1::g\n";} virtual void h(){cout<<"Base1::h\n";} }; class Base2{ public: virtual void f(){cout<<"Base2::f\n";} virtual void g(){cout<<"Base2::g\n";} virtual void h(){cout<<"Base2::h\n";} }; class Base3{ public: virtual void f(){cout<<"Base3::f\n";} virtual void g(){cout<<"Base3::g\n";} virtual void h(){cout<<"Base3::h\n";} }; class Derive:public Base1,Base2,Base3{ public: virtual void f1(){cout<<"Derive:f1\n";} virtual void g1(){cout<<"Derive:g1\n";} virtual void h1(){cout<<"Derive:h1\n";} }; int _tmain(int argc, _TCHAR* argv[]) { typedef void(*FUN)(void); Derive d; FUN pFun=NULL; cout<<"虚函数表的地址为:"<<(int*)(&d)<<endl; cout << "虚函数表 — 第一个函数地址:" << (int*)*(int*)(&d) << endl; for (int i=0;i<6;++i) { pFun = (FUN)*((int*)*(int*)(&d)+i); pFun(); } cout<<"----------------------------"<<endl; for (int i=0;i<3;++i) { pFun = (FUN)*((int*)*((int*)(&d)+1)+i); pFun(); } cout<<"----------------------------"<<endl; for (int i=0;i<3;++i) { pFun = (FUN)*((int*)*((int*)(&d)+2)+i); pFun(); } cout<<"----------------------------"<<endl; return 0; } 结果如下: 多重继承(有虚函数覆盖) 下面我们再来看看,如果发生虚函数覆盖的情况。 下图中,我们在子类中覆盖了父类的f()函数。 下面是对于子类实例中的虚函数表的图: 代码验证如下: #include <iostream> using namespace std; class Base1{ public: virtual void f(){cout<<"Base1::f\n";} virtual void g(){cout<<"Base1::g\n";} virtual void h(){cout<<"Base1::h\n";} }; class Base2{ public: virtual void f(){cout<<"Base2::f\n";} virtual void g(){cout<<"Base2::g\n";} virtual void h(){cout<<"Base2::h\n";} }; class Base3{ public: virtual void f(){cout<<"Base3::f\n";} virtual void g(){cout<<"Base3::g\n";} virtual void h(){cout<<"Base3::h\n";} }; class Derive:public Base1,Base2,Base3{ public: virtual void f(){cout<<"Derive::f\n";} virtual void g1(){cout<<"Derive::g1\n";} virtual void h1(){cout<<"Derive::h1\n";} }; int _tmain(int argc, _TCHAR* argv[]) { typedef void(*FUN)(void); Derive d; FUN pFun=NULL; cout<<"虚函数表的地址为:"<<(int*)(&d)<<endl; cout << "虚函数表 — 第一个函数地址:" << (int*)*(int*)(&d) << endl; for (int i=0;i<5;++i) { pFun = (FUN)*((int*)*(int*)(&d)+i); pFun(); } cout<<"----------------------------"<<endl; for (int i=0;i<3;++i) { pFun = (FUN)*((int*)*((int*)(&d)+1)+i); pFun(); } cout<<"----------------------------"<<endl; for (int i=0;i<3;++i) { pFun = (FUN)*((int*)*((int*)(&d)+2)+i); pFun(); } cout<<"----------------------------"<<endl; return 0; } 结果为: 我们可以看见,三个父类虚函数表中的f()的位置被替换成了子类的函数指针。这样,我们就可以任一静态类型的父类来指向子类,并调用子类的f()了。如: Derive d; Base1 *b1 = &d; Base2 *b2 = &d; Base3 *b3 = &d; b1->f(); //Derive::f() b2->f(); //Derive::f() b3->f(); //Derive::f() b1->g(); //Base1::g() b2->g(); //Base2::g() b3->g(); //Base3::g( 安全性 每次写C++的文章,总免不了要批判一下C++。这篇文章也不例外。通过上面的讲述,相信我们对虚函数表有一个比较细致的了解了。水可载舟,亦可覆舟。下面,让我们来看看我们可以用虚函数表来干点什么坏事吧。 一、通过父类型的指针访问子类自己的虚函数 我们知道,子类没有重载父类的虚函数是一件毫无意义的事情。因为多态也是要基于函数重载的。虽然在上面的图中我们可以看到Base1的虚表中有Derive的虚函数,但我们根本不可能使用下面的语句来调用子类的自有虚函数: Base1 *b1 = new Derive(); b1->f1(); //编译出错 任何妄图使用父类指针想调用子类中的未覆盖父类的成员函数的行为都会被编译器视为非法,所以,这样的程序根本无法编译通过。但在运行时,我们可以通过指针的方式访问虚函数表来达到违反C++语义的行为。(关于这方面的尝试,通过阅读后面附录的代码,相信你可以做到这一点) 二、访问non-public的虚函数 另外,如果父类的虚函数是private或是protected的,但这些非public的虚函数同样会存在于虚函数表中,所以,我们同样可以使用访问虚函数表的方式来访问这些non-public的虚函数,这是很容易做到的。 #include <iostream> using namespace std; class Base { private: virtual void f() { cout << "Base::f" << endl; } }; class Derive : public Base{ }; int _tmain(int argc, _TCHAR* argv[]) { typedef void(*Fun)(void); Derive d; Fun pFun = (Fun)*((int*)*(int*)(&d)+0); pFun(); return 0; } 结束语 C++这门语言是一门Magic的语言,对于程序员来说,我们似乎永远摸不清楚这门语言背着我们在干了什么。需要熟悉这门语言,我们就必需要了解C++里面的那些东西,需要去了解C++中那些危险的东西。不然,这是一种搬起石头砸自己脚的编程语言。 附录一:VC中查看虚函数表 我们可以在VC的IDE环境中的Debug状态下展开类的实例就可以看到虚函数表了(并不是很完整的) ============================================================================== 本文转自被遗忘的博客园博客,原文链接:http://www.cnblogs.com/rollenholt/archive/2012/04/26/2472050.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

视频监控业务上云方案解析

行业痛点 由于视频监控能最大的记录和还原当被监控的场景,近年来,视频监控逐步从专业领域的应用普及到了各个民用、家用领域,各个摄像相机厂家也纷纷推出各种型号的摄像机和解决方案。由于视频监控数据量大,也会遇到各种问题: 存储资源消耗大且增长迅速。视频监控业务极度消耗存储资源,一个成规模的互联网视频监控服务往往需要PB级甚至更多存储资源,普通IDC或小云服务提供商有限的基础设施很容易成为云视频监控业务爆发增长的瓶颈,一旦出现存储瓶颈,扩容难度大,迁移成本高。 对数据可靠性要求高。监控视频数据是安防监控业务的核心价值数据,必须不能丢失。尤其是在互联网业务模式下,如果能做到视频数据不丢失,安防监控服务提供商就能向其终端用户提供可靠的视频存储服务。 带宽资源消耗巨大,且上行、下行流量不对称。7*24小时写入视频流的视频监控业务是重资产的业务,数万级别

优秀的个人博客,低调大师

sql server中filegroup与partition解析

0.参考文献: SQL SERVER 分区表的总结 SQL Server 2005 分区表实践——建立分区表(partition table) SQL Server中数据库文件的存放方式,文件和文件组(fromCareySon) T-SQL查询进阶--理解SQL SERVER中的分区表(fromCareySon) 1.基础知识 一直对于表分区和filegroup的概念不是很清晰,今天通过具体的实例来学习什么事filegroup和partition,以及他们的作用。 1.1通过文件组来管理文件的特性 对于用户角度来说,需对创建的对象指定存储的文件组只有三种数据对象:表,索引和大对象(LOB) 使用文件组可以隔离用户和文件,使得用户针对文件组来建立表和索引,而不是实际磁盘中的文件。也就是可以指定将表和索引存储在不同的文件上面。 使用文件组来管理文件可以使得同一文件组内的不同文件分布在不同的硬盘中,极大的提高了IO性能. SQL SERVER会根据每个文件设置的初始大小和增长量会自动分配新加入的空间,假设在同一文件组中的文件A设置的大小为文件B的两倍,新增一个数据占用三页(Page),则按比例将2页分配到文件A中,1页分配到文件B中. 1.2文件的分类 首要文件:这个文件是必须有的,而且只能有一个。这个文件额外存放了其他文件的位置等信息.扩展名为.mdf 次要文件:可以建任意多个,用于不同目的存放.扩展名为.ndf,用于存放数据,而不是日志。 日志文件:存放日志,扩展名为.ldf 在SQL SERVER 2008之后,还新增了文件流数据文件和全文索引文件. 我们可以通过sys.database_files这个视图查看数据库中的文件情况: select * from sys.database_files 1.3创建filegroup,并将索引创建在指定的filegroup中 可以通过TSQL语句来创建文件组,也可以通过SSMS来创建文件组,这个在后面会提到。这里不再重复。下面我们重点来介绍如何将索引创建在指定的filegroup中,而不跟数据放在一起。首先来看我创建好的filegroup,已经这些filegroup所对应的files,如下图所示: 然后我们通过如下TSQL语句来测试 View Code 总结: 在分区上创建聚集索引,聚集索引不要放在IndexStorage这个filegroup当中,因为聚集索引就是数据本身。如果将聚集索引on IndexStorage的话,那么所有数据都将会在IndexStorage这个filegroup所对应的文件上。 在创建非聚集索引的时候,通过在创建索引语句的最后加上on [filegroup]指定需要将这个索引放在哪一个filegroup当中,如果不加的话会使用默认filegroup,我们这里的默认filegroup是priamry。 1.4使用多个文件的好处 使用多个文件分布数据到多个硬盘中可以极大的提高IO性能.放在一个磁盘中基本没有效果。 场景描述 应用程序发来大量的并发语句在修改同一张表格里的记录,而表格架构设计以及用户业务逻辑使得这些修改都集中在同一个页面,或者数量不多的几个页面上。这些页面有的时候也被称为Hot Page。这样的瓶颈通常只会发生在并发用户比较多的、典型的OLTP系统上。这种瓶颈是无法通过提高硬件配置解决的,只有通过修改表格设计或者业务逻辑,让修改分散到尽可能多的页面上,才能提高并发性能。 在现实环境里,可以试想下面的情形。一个股票交易系统,每一笔交易都会有一个流水号,是递增且不可重复的。而客户发过来的交易请求,都要存储在同一张交易表里。每一个新的交易,都要插入一条新记录。如果设计者选择在流水号上建聚集索引(这也是很自然的),就容易遇到Hot Page的PAGELATCH资源瓶颈。在同一时间,只能有一个用户插入一笔交易。 怎样才能解决或者缓解这种瓶颈呢? 最简单的方法,是换一个数据列建聚集索引,而不要建在Identity的字段上。这样表格里的数据就按照其他方式排序,同一时间的插入就有机会分散在不同的页面上。 如果实在是一定要在Identity的字段上建聚集索引,建议根据其他某个数据列在表格上建立若干个分区(Partition)。把一个表格分成若干个分区,可以使得接受新数据的页面数目增加。 还是以上面那个股票交易系统为例子。不同的股票属于不同的行业。开发者可以根据股票的行业属性,将一张交易表分成若干个分区。在SQL Server里,已分区表(Partitioned Table)的每个分区都是一个独立的存储单位。分属不同分区的数据行是严格分开存储的。所以同一个时间发生的交易记录,因其行业不同,也会被分别保存在不同的分区里。这样,在同一个时间点,可以插入不同行业的交易记录。每个分区上的Hot Page(接受新数据插入的page)就不那么hot了。 在我的事例中,是有一张SalesOrderDetail表,其数据量很大,我希望按照UnitPrice这个字段进行分区。下面来看具体步骤。 step1:创建filegroup 在sql server中好像没有create filegroup的说法,只是在现成的数据库中添加filegroup而已。下面的代码中首先创建数据库,然后添加四个filegroup,tsql代码如下所示: View Code 执行完以后我们可以在TEST数据库的properties中看到我们添加的四个filegroup,如下图所示: step2:为filegroup添加数据文件 在创建完filegroup以后,我们为每一个filegroup创建一个次要数据文件,因为每一个数据库只能有一个primary datafile,也就是mdf文件,但是可以有多个次要数据文件,也就是.ndf文件。为filegroup创建ndf数据文件的TSQL语句如下图所示: View Code 执行完上述语句以后,我们可以查看TEST数据库的file properties,如下图所示: 我们可以看到四个文件的大小都是2MB。 step3:创建分区函数 在当前数据库中创建一个函数,该函数可根据指定列的值将表或索引的各行映射到分区。使用 CREATE PARTITION FUNCTION 是创建已分区表或索引的第一步。在 SQL Server 2012 中,一张表或一个索引最多可以有 15,000 个分区。 创建分区函数的具体如法如下: View Code 在本事例中,需要有5个分区,本实例创建的分区函数如下所示: View Code 其中RANGE LEFT|RIGHT表示当间隔值由 数据库引擎 按升序从左到右排序时,boundary_value[,...n] 属于每个边界值间隔的哪一侧(左侧还是右侧,就是等于号在哪一边)。如果未指定,则默认值为 LEFT。比如在我的分区函数中指定的间隔是(500,1000,1500,2000),并且是RANGE RIGHT,那么我的范围就是 分区 1 2 3 4 5 值 <500 >=500 and <1000 >=1000 and <1500 >=1500 and <2000 >=2000 step4:建分区架构 创建分区架构的TSQL如下所示: View Code 从上述TSQL中我们可以发现,在创建分区架构的时候关联了分区函数以及具体的5个filegroup。 注意:这里并不一定必须要求有5个filegroup,我们可以填写相同的filegroup,但是需要填写5次filegroup,因为有5个分区。 step5:创建分区表并填充数据 View Code 需要注意的是分区列UnitPrice必须有唯一约束或者是聚集索引。所以在这里我创建聚集索引的时候将UnitPrice列也添加进去了。如果不讲UnitPrice设为聚集索引,也就是让此列唯一,那么在执行上述命令的时候会报如下错误: Msg 1908, Level 16, State 1, Line 2Column 'UnitPrice' is partitioning column of the index 'PK_SalesOrderDetail_SalesOrderID_SalesOrderDetailID'. Partition columns for a unique index must be a subset of the index key.Msg 1750, Level 16, State 0, Line 2Could not create constraint. See previous errors. 在执行完上面的操作以后我们再去看看ndf文件有没有变化,如下图所示,我们发现ndf文件大小有增长,这表明已经往这几个分区中写入了数据。 上边的表结构是通过select * into语句来创建表的,这种方式没有普遍性,下面我们通过create table来创建表结构: View Code step5':创建分区表并填充数据 在上面语句中,我们发现: 创建主键约束的时候我们指定使用的是nonclustered index,如果不指明的话那么默认创建的是聚集索引。但是一张表只能有一个聚集索引,而分区列上又必须有聚集索引,所以我们这里要显式声明primary key为nonclustered index。 然后在UnitPrice列上面创建聚集索引,并且指明分区架构,也就是ON [Sch_SalesOrderDetail_UnitPrice]([UnitPrice])。 在创建好表结构以后,我们往里面插入数据。如果一条一条插入数据比较慢的话,我们可以在AdventureWorks2008R2.Sales.SalesOrderDetail表中导入,导入语句如下: View Code 6.查看分区表各分区数据情况(数据行数,最大最小 UnitPrice值) 执行如下查询命令 View Code 其中fn_Partition_SalesOrderDetail_UnitPrice(UnitPrice)是分区函数,UnitPrice是列名。 使用第一种方法,也就是select * into的方法导入数据,其查询结果为: partition rows minval maxval ----------- ----------- --------------------- --------------------- 1 88053 1.3282 469.794 2 12243 539.99 986.5742 3 9582 1000.4375 1466.01 4 939 1700.99 1971.9942 5 10500 2024.994 3578.27 我们可以看到每一个分区上面都有数据。有些总数据量小于2MB,所以ndf文件大小没有改变。如果ndf文件文件大小变化不大,我们可以多执行几次上面的数据导入语句。 使用第二种方法插入数据,一共执行了三次,其最后文件大小如下图所示: 分区上存储的数据统计信息如下: partition rows minval maxval ----------- ----------- --------------------- --------------------- 1 264159 1.3282 469.794 2 36729 539.99 986.5742 3 28746 1000.4375 1466.01 4 2817 1700.99 1971.9942 5 31500 2024.994 3578.27 从上述查询结果我们可以发现在partition4(对应FG_TEST_SalesOrderDetail_UnitPrice_3_data_1.ndf这个次要数据文件)中,数据行只有2817条,这也说明了为什么在上图中只有FG_TEST_SalesOrderDetail_UnitPrice_3_data_1.ndf这个文件大小没有增长,依然是2048KB。 查看partition状态的的四个视图 View Code 本文转自xwdreamer博客园博客,原文链接:http://www.cnblogs.com/xwdreamer/archive/2012/08/30/2664671.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android启动过程深入解析【转】

转自:http://www.open-open.com/lib/view/open1403250347934.html 当按下Android设备电源键时究竟发生了什么? Android的启动过程是怎么样的? 什么是Linux内核? 桌面系统linux内核与Android系统linux内核有什么区别? 什么是引导装载程序? 什么是Zygote? 什么是X86以及ARM linux? 什么是init.rc? 什么是系统服务? 当我们想到Android启动过程时,脑海中总是冒出很多疑问。本文将介绍Android的启动过程,希望能帮助你找到上面这些问题的答案。 Android是一个基于Linux的开源操作系统。x86(x86是一系列的基于intel 8086 CPU的计算机微处理器指令集架构)是linux内核部署最常见的系统。然而,所有的Android设备都是运行在ARM处理器(ARM 源自进阶精简指令集机器,源自ARM架构)上,除了英特尔的Xolo设备(http://xolo.in/xolo-x900-features)。Xolo来源自凌动1.6GHz x86处理器。Android设备或者嵌入设备或者基于linux的ARM设备的启动过程与桌面版本相比稍微有些差别。这篇文章中,我将解释Android设备的启动过程。深入linux启动过程是一篇讲桌面linux启动过程的好文。 当你按下电源开关后Android设备执行了以下步骤。 第一步:启动电源以及系统启动 当电源按下,引导芯片代码开始从预定义的地方(固化在ROM)开始执行。加载引导程序到RAM,然后执行。 第二步:引导程序 引导程序是在Android操作系统开始运行前的一个小程序。引导程序是运行的第一个程序,因此它是针对特定的主板与芯片的。设备制造商要么使用很受欢迎的引导程序比如redboot、uboot、qi bootloader或者开发自己的引导程序,它不是Android操作系统的一部分。引导程序是OEM厂商或者运营商加锁和限制的地方。 引导程序分两个阶段执行。第一个阶段,检测外部的RAM以及加载对第二阶段有用的程序;第二阶段,引导程序设置网络、内存等等。这些对于运行内核是必要的,为了达到特殊的目标,引导程序可以根据配置参数或者输入数据设置内核。 Android引导程序可以在\bootable\bootloader\legacy\usbloader找到。 传统的加载器包含的个文件,需要在这里说明: init.s初始化堆栈,清零BBS段,调用main.c的_main()函数; main.c初始化硬件(闹钟、主板、键盘、控制台),创建linux标签。 更多关于Android引导程序的可以在这里了解。 第三步:内核 Android内核与桌面linux内核启动的方式差不多。内核启动时,设置缓存、被保护存储器、计划列表,加载驱动。当内核完成系统设置,它首先在系统文件中寻找”init”文件,然后启动root进程或者系统的第一个进程。 第四步:init进程 init是第一个进程,我们可以说它是root进程或者说有进程的父进程。init进程有两个责任,一是挂载目录,比如/sys、/dev、/proc,二是运行init.rc脚本。 init进程可以在/system/core/init找到。 init.rc文件可以在/system/core/rootdir/init.rc找到。 readme.txt可以在/system/core/init/readme.txt找到。 对于init.rc文件,Android中有特定的格式以及规则。在Android中,我们叫做Android初始化语言。 Android初始化语言由四大类型的声明组成,即Actions(动作)、Commands(命令)、Services(服务)、以及Options(选项)。 Action(动作):动作是以命令流程命名的,有一个触发器决定动作是否发生。 语法 1 2 3 4 on < trigger > < command > < command > < command > Service(服务):服务是init进程启动的程序、当服务退出时init进程会视情况重启服务。 语法 1 2 3 4 service < name > < pathname > [< argument >]* < option > < option > ... Options(选项) 选项是对服务的描述。它们影响init进程如何以及何时启动服务。 咱们来看看默认的init.rc文件。这里我只列出了主要的事件以及服务。 Table Action/Service 描述 on early-init 设置init进程以及它创建的子进程的优先级,设置init进程的安全环境 on init 设置全局环境,为cpu accounting创建cgroup(资源控制)挂载点 on fs 挂载mtd分区 on post-fs 改变系统目录的访问权限 on post-fs-data 改变/data目录以及它的子目录的访问权限 on boot 基本网络的初始化,内存管理等等 service servicemanager 启动系统管理器管理所有的本地服务,比如位置、音频、Shared preference等等… service zygote 启动zygote作为应用进程 在这个阶段你可以在设备的屏幕上看到“Android”logo了。 第五步 在Java中,我们知道不同的虚拟机实例会为不同的应用分配不同的内存。假如Android应用应该尽可能快地启动,但如果Android系统为每一个应用启动不同的Dalvik虚拟机实例,就会消耗大量的内存以及时间。因此,为了克服这个问题,Android系统创造了”Zygote”。Zygote让Dalvik虚拟机共享代码、低内存占用以及最小的启动时间成为可能。Zygote是一个虚拟器进程,正如我们在前一个步骤所说的在系统引导的时候启动。Zygote预加载以及初始化核心库类。通常,这些核心类一般是只读的,也是Android SDK或者核心框架的一部分。在Java虚拟机中,每一个实例都有它自己的核心库类文件和堆对象的拷贝。 Zygote加载进程 加载ZygoteInit类,源代码:/frameworks/base/core/java/com/android/internal/os/ZygoteInit.java registerZygoteSocket()为zygote命令连接注册一个服务器套接字。 preloadClassed “preloaded-classes”是一个简单的包含一系列需要预加载类的文本文件,你可以在<Android Source>/frameworks/base找到“preloaded-classes”文件。 preloadResources() preloadResources也意味着本地主题、布局以及android.R文件中包含的所有东西都会用这个方法加载。 在这个阶段,你可以看到启动动画。 第六步:系统服务或服务 完成了上面几步之后,运行环境请求Zygote运行系统服务。系统服务同时使用native以及java编写,系统服务可以认为是一个进程。同一个系统服务在Android SDK可以以System Services形式获得。系统服务包含了所有的System Services。 Zygote创建新的进程去启动系统服务。你可以在ZygoteInit类的”startSystemServer”方法中找到源代码。 核心服务: 启动电源管理器; 创建Activity管理器; 启动电话注册; 启动包管理器; 设置Activity管理服务为系统进程; 启动上下文管理器; 启动系统Context Providers; 启动电池服务; 启动定时管理器; 启动传感服务; 启动窗口管理器; 启动蓝牙服务; 启动挂载服务。 其他服务: 启动状态栏服务; 启动硬件服务; 启动网络状态服务; 启动网络连接服务; 启动通知管理器; 启动设备存储监视服务; 启动定位管理器; 启动搜索服务; 启动剪切板服务; 启动登记服务; 启动壁纸服务; 启动音频服务; 启动耳机监听; 启动AdbSettingsObserver(处理adb命令)。 第七步:引导完成 一旦系统服务在内存中跑起来了,Android就完成了引导过程。在这个时候“ACTION_BOOT_COMPLETED”开机启动广播就会发出去。 原文链接:kpbird翻译:伯乐在线-云海之巅 译文链接:http://blog.jobbole.com/67931/ 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/sky-heaven/p/5687411.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册