首页 文章 精选 留言 我的

精选列表

搜索[参考文献管理],共10000篇文章
优秀的个人博客,低调大师

浅谈MaxCompute资源规划管理及评估

一、MaxCompute资源规划背景介绍 MaxCompute资源主要有两类:存储资源、计算资源(包含cpu和内存)。存储资源用于存储MaxCompute的库表数据,计算资源用于运行sql、mr等任务。最佳的MaxCompute资源规划方案能够达到以下几个目的: • 数据存储资源足够,既能够存储当前的所有存量库表数据,也能够存储未来一段时间的增量数据;• 计算资源充足,但是不能浪费。计算资源量能够满足所有数据计算任务,且尽可能减少资源浪费情况。这样耗费的资源费用最少;• 被处理的数据量巨大、耗费计算资源较多的大型任务,可能会将quota group资源组耗尽,造成其他任务无法获取到计算资源而阻塞。MaxCompute资源规划方案必须能够尽量避免这种情况;• 不同优先级的计算任务能够尽量互不干扰,有限保证高优先级的任务获取到足够计算资源;• 能够满足时段的差异化资源需求,满足对资源隔离(生产/开发/自助分析)不同工作负载的能力,避免相互干扰,同时更大化提高资源使用率。 MaxCompute资源规划的最终目标就是能够满足上述几点需求,企业客户消耗最低资源费用的情况下,满足数据存储需求,以及数据处理任务对计算资源的需求。 本文内容主要基于阿里公有云MaxCompute环境。公有云和专有云环境的MaxCompute资源规划有比较大的差异,比如:在公有云环境,存储资源和计算资源是使用整个阿里云区域的资源池,几乎不用担心底层到底有多少台服务器进行支撑,可以近乎认为公有云底层的资源池是无限的;但是在专有云环境,整个专有云都是企业客户独享的资源,必须根据存储资源和计算资源量规划服务器数量&&服务器规格。本文主要探讨公有云MaxCompute的资源规划。 二、MaxCompute存储资源规划 2.1 计存比在介绍存储方案选择之前,先说一个常用的概念:“计存比”。计存比就是计算CU数量和实际存储数量TB的比值。比如资源分配:50CU计算资源,存储数据量是10TB。那么,50CU/10TB=5,计存比=5。 2.2 存储资源规划建议对于存储资源,MaxCompute提供两种计费方式:• 按量付费:MaxCompute以小时级别采集每个项目空间下当前的存储,并以 project 项目空间为基本单位,计算项目空间当天的存储平均值。然后再乘以单价(元/GB/天),最后的得到每天的存储费用。 • 套餐资源:MaxCompute包年包月套餐包含预留的计算资源和存储资源,每种套餐固定计算资源CU量和存储资源。套餐中的存储资源是指每天固定的存储资源,超过的部分另外按量计费。套餐资源目前只支持固定的几个套餐,见下图所示: 阿里云提供的第二种方案,三种套餐的计存比是固定的,而且计存比都在1左右。这种固定资源套餐的计存比偏低,适合存储量大、计算任务较少的企业客户。固定资源套餐的计算资源CU量是固定的,无法应对计算资源需求量猛增的情况。比如企业平时的数据批量处理任务可以正常运行,在双11、618等大促活动期间的数据批量处理任务就会出现严重阻塞。 对于存储资源规划,笔者建议:• 当预估企业客户未来一段时间的数据存储总量比较大(100TB以上)、计算任务少(计存比小于1.5),选择阿里云的固定套餐资源;• 当客户需要更加灵活的存储资源空间,同时计算资源CU量不受存储空间限制,建议选择按量付费方式。使用多少存储空间,消耗多少存储费用。至于计算资源CU规划,按照企业客户的实际需求,单独进行规划。 三、MaxCompute计算资源规划 3.1 MaxCompute计算资源简介对于计算资源规划,笔者首先建议:在项目测试阶段,全部都采用按量付费方式。因为开发测试阶段,消耗的计算资源CU数量不多,采用按量付费方式更加便宜。关于MaxCompute计算资源按量付费的计费规则,读者可以详细参考官网文档:https://help.aliyun.com/document_detail/112752.html项目开发完成,正式进入到上线阶段,建议购买包年包月的计算资源CU配额,因为是固定的CU配额,不会在阿里云公共计算资源池去抢占计算资源,可以顺利地为企业客户预留足够的CU资源。计费方式如下所示: 本章节主要介绍项目上线之后,如何购买合适的包年包月固定CU数量。对于计算资源规划,本文介绍在项目实践中常用的两种方案:方法1:按照以往经验先确定计存比,然后预估数据容量,最后得到计算计算资源CU量;方法2:选择在项目正式上线前、或者在项目正式上线运行一小段时间之后,评估计算资源CU消耗的CPU总时长,然后再根据不同任务单独消耗的CPU时长、任务的优先级、企业客户要求每天所有任务必须在哪个时间段运行完成,综合考虑这几个因素,最后得到计算资源CU量的最小最大值,用数学表达式表示就是: 本文分两个章节分别介绍这两种常用的计算资源预估方法。 3.2按照计存比方法预估计算资源第一步:评估存储容量按照3年项目周期计算:存储容量 = 当前数据存量 + 每月预估数据增量*月数。当前数据存量很容易得到,在数据上云完成之后就可以得到当前数据存量。每月预估数据增量需要在数据上云之后两三个月,根据增量总值除以月数,得到每月预估增量平均值。当然,如果还要考虑未来数据中台承载更多业务、每月数据增量会变大等因素,可以将当前计算得到的每月预估数据增量值乘以倍数。建议每半年预估一次存储总容量,然后每半年调整一次计算资源CU量。 第二步:预估计存比按照项目开发测试阶段、以及上线运行一两个月的情况,可以大概预估计存比。根据实际情况,计存比一般配置2-10。如果客户每天运行的数据批量处理任务很多,且sql程序计算复杂度高,计存比可以选择10;如果客户每天运行的数据批量处理任务比较少,且sql程序计算复杂度不高,计算比可以选择2;如果客户每天运行的数据批量处理任务适中,sql程序计算复杂度也适中,计存比可以选择2-10之间的合适值。建议每半年评估一次计存比,然后每半年调整一次计算资源CU量。 第三步:预估计算资源CU量按照第一步预估的每半年存储资源总量,结合每半年评估的计存比值,存储资源总量 *计存比 = 计算资源CU总量。 预估得到计算资源CU总量,进而每半年利用该企业主账号调整一次MaxCompute计算资源CU总量。 按照计存比预估企业项目需要消耗的计算资源CU总量,有很多需要预估的变量,包括数据存储总量、计存比,很可能预估不准确。因此,该方法要求项目的技术负责人拥有较多的项目实施经验,能够在每一步预估都尽可能准确。 3.3按照项目实际消耗CU量进行资源划分选择在项目正式上线前、或者在项目正式上线运行一小段时间之后,评估计算资源CU消耗的CPU总时长,然后再根据不同任务单独消耗的CPU时长、任务的优先级、企业客户要求每天所有任务必须在哪个时间段运行完成,综合考虑这几个因素,最后得到计算资源消耗费用最少的最佳CU数量。 3.3.1查看计算资源消耗情况在进行资源规划之前,需要首先搞清楚过去一段时间MaxCompute计算资源的消耗情况。读者可以参考https://help.aliyun.com/document_detail/135432.html 详细介绍如何开通和查看MaxCompute的information_schema信息。MaxCompute元数据表有很多,本文只需要利用到一张表:TASKS_HISTORY。这张元数据表记录了所有MaxCompute 计算任务的资源消耗情况。读者可以参考https://help.aliyun.com/document_detail/135433.html#title-r2c-tak-zfi详细介绍元数据表TASKS_HISTORY的字段信息,其中最重要的字段信息是:cost_cpu 和 cost_mem,分别表示: 本文主要借助CPU消耗量(也就是上图的cost_cpu字段对应的每个任务消耗的cpu数量)进行计算资源CU数量的规划。需要注意的是,cost_cpu字段的含义:MaxCompute计算任务作业的CPU消耗量。100表示1 cores,比如官网的例子:10 core运行5s,cost_cpu为101005=5000)。那么cost_cpu字段表示的是“cpu核数消耗量 100 任务运行时间秒”。因为cost_cpu按照秒统计,对于实际项目评估太过于精细,我们通常将cost_cpu 除以 100、然后再除以3600,得到cores h (cpu核数 *小时)。这样方便评估实际项目在规定时间段内运行完所有任务需要quota group资源组的最少计算资源CU数量。 如下如所示某个MaxCompute project 的MaxCompute计算任务的资源消耗情况: 3.3.2 规划计算资源CU数量通过3.3.1章节的内容,我们可以查看到MaxCompute project某一天运行的所有计算任务消耗的CPU核数*小时。计算资源CU数量规划的细则:Step1:首先,计算得到平均每天运行所有任务消耗的cost_cpu总和(需要除以100,才能得到真正的cpu核数 秒,然后再除以 3600,得到消耗的 “cpu核数 小时”)。举个例子:MaxCompute project平均每天需要运行1000个任务,这些任务消耗的cost_cpu分别是 W1、W2 …… W1000。那么需要将W1 + W2+ …… + W1000 得到每天运行所有任务消耗的cost_cpu总和Wz。注意:数据中台一般会划分6个MaxCompute project,分别是:• ods_dev:贴源层开发测试project;• ods_prod:贴源层生产project;• cdm_dev:公共层开发测试project;• cdm_prod:公共层生产project;• ads_dev:应用层开发测试project;• ads_prod:应用层生产project;需要将这6个MaxCompute project的所有数据计算任务的cost_cpu相加得到cost_cpu总和Wz。当然,大部分读者使用MaxCompute进行数据处理,并非需要建设数据中台。任何需要使用MaxCompute进行数据处理的应用场景,都可以按照实际划分的MaxCompute project,将这些MaxCompute project涵盖的所有数据处理任务消耗的cost_cpu相加得到总和Wz。Step2:按照上述介绍的阿里云官网详情介绍,cost_cpu需要除以100才是真正消耗的CPU核数。同时,cost_cpu按照秒进行度量,我们一般会按照小时进行度量。因此,需要将cost_cpu总和Wz除以100、再除以3600,最后得到平均每天运行所有任务消耗 “cpu核数 *小时”,本文假设这个值为W。Step3:咨询客户数据批量处理任务需要在每天的哪些时间段运行完成。举个例子:客户要求在深夜零点之后、凌晨6点之前必须将所有数据批量处理任务运行完成。那么每天能够运行的总时长都是6个小时。本文假设所有任务必须在N个小时运行完成。Step4:利用上述得到的每天所有任务[cpu核数 *小时 / 任务运行时长N个小时],就可以得到该客户的MaxCompute project需要分配的计算资源CU数量的最小值:W/N。W/N的前提是数据处理任务的cost_cpu很稳定,而且在这N个小时内,所有任务都随时在运行,不存在任何空闲的时间。但是,实际项目可能会因为某些原因导致数据计算任务运行时间延长(比如参与计算的数据量增加),相当于W会变大;同时,由于DataWorks/Dataphin调度任务还会产生很多延迟时间、任务获取CU资源也会耽误很多时间,这部分延迟时间会加大任务之间运行的时间间隔,真正用于运行任务的时间会小于N。W/N的分母实际变大、分子实际变小,进而变相地要求增加计算资源,以便让任务获取更多资源进而运行地更加快速。因此一般情况下,会在上述得到的W/N结果基础上增加一倍。按照上述4个步骤,可以预估计算得到企业可以需要购买的CU数量。 3.3.3举例规划计算资源CU数量某企业实施数据中台项目,划分8个MaxCompute project。除了3.3.2章节介绍的6个MaxCompute project之外,还单独规划了两个专门做数据清洗的MaxCompute project。当然,正如前文所述,读者需要按照实际规划的若干个MaxCompute project进行计算。Step1 和 Step2:按照3.3.1章节介绍的方法统计过去15天,平均每天8个MaxCompute project消耗的“cpu核数 小时”的总量为:202 CPU核数 小时。Step3:因为客户的业务系统空闲时间在晚上1点到早上6点,而且每天早上7点之前需要出每天数据批量任务的运行结果。在6点到7点之间,主要产出报表,因此只有5个小时可以运行批量任务。Step4:得到MaxCompute计算资源CU数量:202 CPU核数 小时 / 5小时 = 40.2 cores核数,也就是至少需要41 CU。因此建议客户购买计算资源CU量为 412 = 82 CU数量。根据预估计算结果,我们为客户推荐购买的包年包月固定CU量为82个。先开通MaxCompute 计算资源quota group 资源组的包年包月固定CU资源: 然后配置总CU量为82个。 四、浅谈MaxCompute group quota 资源划分方法 笔者在第3章节详细介绍如何根据最近一段时间的CU消耗情况,预估得到MaxCompute 计算资源CU数量。购买的MaxCompute quota group资源属于“默认预付费Quota”,类似于开源hadoop yarn的root资源队列。在实际项目开发过程中,还需要将“默认预付费Quota”再细分为若干个“子quota group资源组”。当然,一般情况下建议1个MaxCompute project 划分1个子quota group资源组。如何将“默认预付费Quota”划分为若干个子quota group资源组?这是本章节需要详细介绍的内容。 4.1 fuxi伏羲资源调度系统原理简介为了便于读者理fuxi调度系统关于资源组的资源分配和资源抢占机制,本文以开源hadoop yarn资源队列进行类比。MaxCompute的“默认预付费Quota”类似于yarn的root资源队列,这部分计算资源属于“总计算资源组”,需要将总资源组进行细分。假设我们购买的“默认预付费Quota”包含Dt个CU资源,然后“默认预付费Quota”被划分了n个子资源组D1、D2 …… Dn 。这n个资源组必须设置两个重要参数:资源组的“预留CU最小配额”minD1、minD2……minDn,以及“预留CU最大配额” maxD1、maxD2……maxDn。这n个资源组必须满足以下条件:•** minD1 + minD2 + …… + minDn = Dt• 对于任意的子资源组的maxDi,maxDi <= Dt**我们划分子资源组必须满足上述两个条件。其中,每个MaxCompute project的min资源量表示该子资源组最低预留的CU数量,无论是否有任务提交,这个子资源组就会占用这么多CU量;每个MaxCompute project的max资源量表示该子资源组能够获取到的最大CU数量,哪怕其他资源组全部都没有任务运行,这个子资源组最多也只能占用max的CU量。如下图所示,170个CU资源量的“默认预付费Quota”划分了两个子资源组: 从上图我们看到,划分的两个子资源组yong_quota_group 和 fixed_quota_group设置的最小CU配额、最大CU配额,满足上述两个条件。 4.2 MaxCompute计算资源抢占机制按照4.1介绍的内容,若干个子资源组的max最大CU配额都可以设置为“默认预付费Quota”,那么一旦所有资源组对应的MaxCompute project都疯狂地运行任务,那么必然存在资源抢占的问题。按照默认规则,MaxCompute资源组的资源抢占按照“fair scheduling”公平调度机制,先提交的任务优先获取CU资源。那么,如果某个MaxCompute project提交超大型任务,必然将会把CU资源消耗殆尽。此时,其他资源组对应的MaxCompute project提交的任务将会因为无法获取到CU资源而被阻塞。如何更加完美地划分quota group资源组,并且为每个资源组分配最合理的 min资源配额、max资源配额? 如何结合实际项目需求,合理安排任务运行的先后顺序、以及任务运行调度的依赖关系?这是划分子quota group资源组需要考虑的重点因素。 4.3 quota group资源组划分在第3章节详细介绍如何预估计算企业客户需要购买的包年包月预留CU量,也就是 “默认预付费Quota”,比如3.3.3章节的实际案例里面介绍的170个CU。下一步就是创建子quota group资源组,并为每个quota group分配 min、max资源量。笔者结合多年hadoop yarn资源分配经验,以及使用MaxCompute的一些经验,总结了一些实际的经验。 第1条方法:每个MaxCompute project 对应1个独立的quota group子资源组; 第2条方法:每个quota group子资源组的min 资源量不小于 “默认预付费Quota”的5%,建议也不大于“默认预付费Quota”的20%。具体原因:如果将子资源组的min资源量设置太大,比如超过20%,那么各个资源组的min资源量之和就会接近或者超过“默认预付费Quota”,那么划分子资源组将会失去意义,最终造成资源大量浪费。 第3条方法:每个quota group子资源组的max 资源量不小于“默认预付费Quota”的40%,当然最大可以设置到“默认预付费Quota”。如果子资源组的max 资源量设太小,在集群运行任务空闲的时候,资源会造成极大浪费。除了上述三条基本方法之外,还有几个比较实用的方法: 第4条方法:对于企业客户划分的多个MaxCompute project,需要统计每个project 的cost_cpu消耗量“cpu核数 *小时”,并按照消耗量进行排序。消耗量最大的MaxCompute project对应的子资源组的max资源量可以设置为“默认预付费Quota”的80%以上,其他project对应的子资源组按照排序,设置的max资源量以此减少,直到最后的子资源组的max资源量不小于“默认预付费Quota”的40%。 第5条方法:考虑任务调度与依赖关系对于很多企业客户,使用DataWorks/Dataphin需要做任务调度。任务调度就必然有父子任务关系。比如笔者在本文列举的实际案例,对于数据中台项目,划分了8个MaxCompute project,分别是:数据清洗的两个project、ods贴源层的两个project、cdm公共层的两个project、ads应用层的两个project。每个project分配一个独立的quota group子资源组。数据分层有严格的先后顺序:数据清洗的任务是ods层任务的父任务;ods层任务是cdm层任务的父任务;cdm层任务是ads层任务的父任务,他们之间的任务调度关系如下所示: 对于这类常见的不同MaxCompute project的任务之间有严格的调度依赖关系,不能简单的按照上述的方法设置资源组的min资源量和max资源量。因为上一个层次有几百个任务需要运行、下一个层次也有几百个任务需要运行,而且这些任务之间是混合运行的。比如:某个工作流的几十个ods层任务运行完成,那么接下来将会运行对应的几十个cdm层任务;与此同时,数据清洗层和ods层还会运行新的任务;cdm层和ads层也会运行所有上游都运行完成的任务。这些任务之间混合在一起运行,为资源组划分资源量添加了很多变数。此时需要根据实际项目经验,为这些资源组分配min资源量和max资源量。 比如笔者这边的项目情况如下:数据清洗层因为涉及很多业务系统原始数据表的join操作,非常消耗CU资源;ods层经常是导入清洗之后的数据即可,不需要消耗太多资源;cdm层规范建模,任务运行方法比较固定,因为我们在数据清洗层已经将数据做规范化处理,因此cdm层消耗的CU资源也很少;最后,将cdm的派生指标融合进ads层,需要做很多复杂的join操作,因此消耗的CU资源非常多。并且,从晚上1点到凌晨7点之间,这四个层次对应的项目运行消耗的资源量呈现“错峰”情况。下图是我们在进行测试环节统计的情况: 可以明显看出来,四个层次运行任务的数量呈现“错峰”情况,每个层次出现的任务高峰会以此延后一段时间,该层次MaxCompute project消耗的资源量也是呈现错峰。鉴于上述场景分析,我们考虑在第4条方法的基础上,将不同层次“错峰”高峰运行的因素也考虑在内。尽可能让消耗资源多的项目分配的max资源量更大,但是因为“错峰”运行因素,消耗资源少的项目分配的max资源量也不能太小,尽可能分配大一些,让资源得到合理应用。笔者为该项目设计4个quota 资源组: • 数据清洗层project对应的quota 资源组:min资源量为“默认预付费Quota”的10%,max资源量为“默认预付费Quota”的70%;• ods贴源层project对应的quota 资源组:min资源量为“默认预付费Quota”的10%,max资源量为“默认预付费Quota”的50%;• cdm公共层project对应的quota 资源组:min资源量为“默认预付费Quota”的10%,max资源量为“默认预付费Quota”的50%;• ads应用层project对应的quota 资源组:min资源量为“默认预付费Quota”的10%,max资源量为“默认预付费Quota”的80%。 五、总结 当然,实际如何为MaxCompute project划分资源组?每个资源组的min/max资源量占据“默认预付费Quota”的百分比多少?需要综合考虑不同MaxCompute project内部的数据处理任务的优先级、任务之间依赖关系、任务错峰运行情况,还需要特别考虑某些超大型数据计算任务是否有必要与其他普通任务进行资源组隔离。 关于更多包年包月计算资源规划建议:1.包年包月资源分时设置:https://developer.aliyun.com/article/7689842.包年包月项目作业使用按量付费资源:https://help.aliyun.com/document_detail/171280.html3.包年包月作业优先级功能:https://help.aliyun.com/document_detail/175617.html

优秀的个人博客,低调大师

FlutterDojo设计之道—状态管理之路(七)

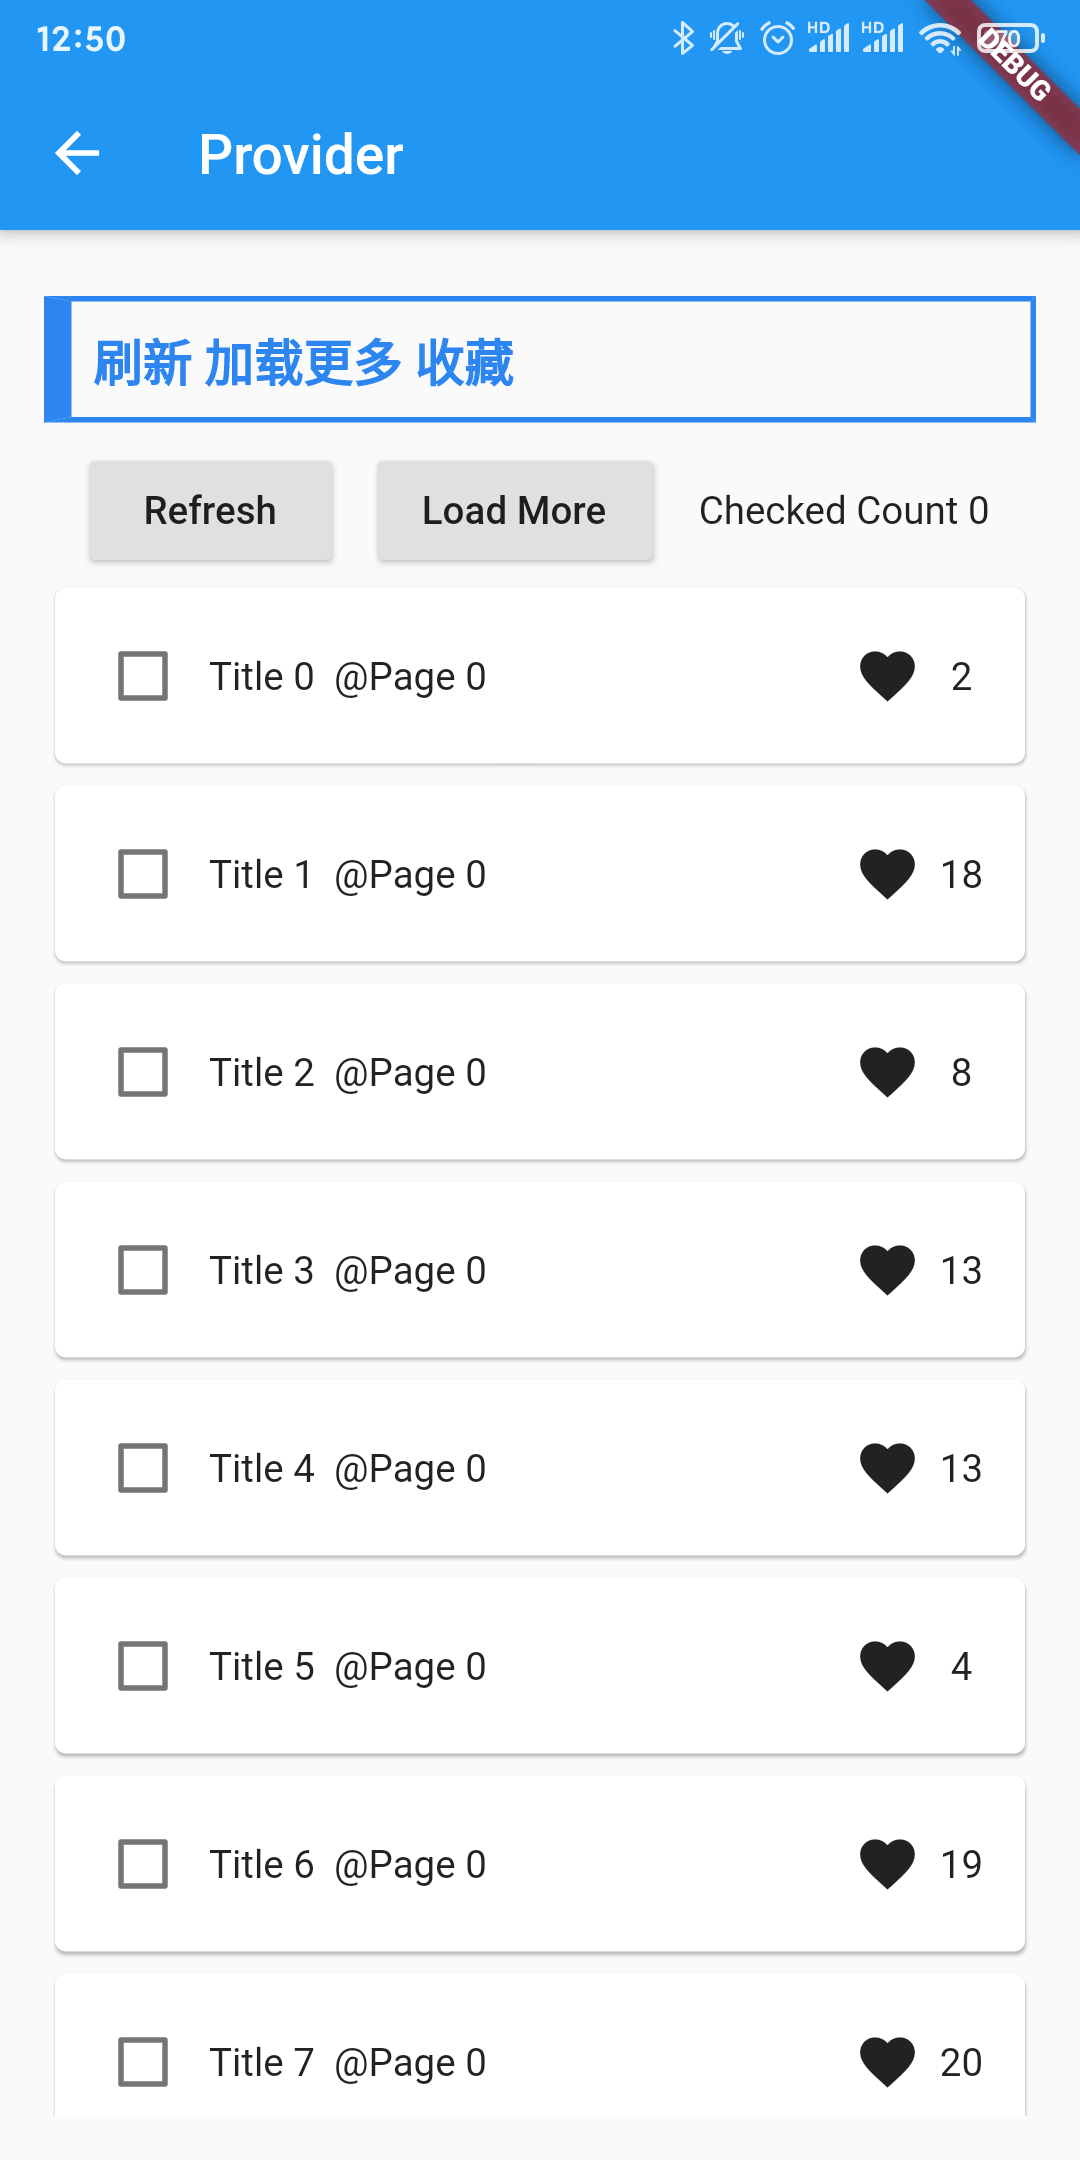
Provider在列表中使用 在前面的讲解中,我们大部分的场景都是在普通的Box布局中,相信大家对Provider的使用已经非常清楚了,下面来看下在List中的使用场景,相信对于很多App来说,列表应该是大部分页面的核心UI,所以,到底如何在列表的「下拉刷新」、「上拉加载更多」、「Item点击修改状态」这几种场景下来使用Provider呢?官方并没有给出很好的建议,官方的Demo也都是在静态的列表中做的演示,并不涉及到列表的修改,所以下面,我将和大家一起讨论下如何在列表中使用Provider。 当然,这只是我的探索,希望读者能给出更好的方案。 首先,先创建本例的Demo界面。 为了简化Demo,让读者专注于Provider的使用,这里并没有使用下拉刷新和上拉加载的框架,而是通过两个Button来模拟这两个操作,同时,每个Item都提供了一个CheckBox,用于演示单个Item的刷新。 为了尽可能还原场景,这里还提供了Mock数据的获取,代码如下所示。 classItemModel{Stringtitle;boolisCheck;intlikeCount;ItemModel(this.title,this.isCheck,this.likeCount);}classDataModel{List<ItemModel>dataList=List();Future<List<ItemModel>>getData(intpageIndex)async{List<ItemModel>items=awaitapi.getListDataOfIndex(pageIndex);dataList.addAll(items);returndataList;}}classAPI{Future<List<ItemModel>>getListDataOfIndex(intpageIndex)async{List<ItemModel>data=List();awaitFuture.delayed(Duration(seconds:3));List.generate(10,(index)=>(data.add(ItemModel('Title$index@Page$pageIndex',false,Random().nextInt(20)+1))),);returndata;}}varapi=API(); 其它的UI代码,大家可以参考Dojo的源码,如下所示。 flutter_dojo/category/backend/providerstate4widget.dart 使用Setstate 首先来看下最基本的方式。通过setState来更新数据,其原理就是在Future完成之后,使用setState刷新UI。核心代码如下所示。 获取数据。 data.getData(pageIndex).then((value){setState(()=>data.dataList=value);}); 刷新选中。 Checkbox(value:itemModel.isCheck,onChanged:(flag){setState((){varisCheck=itemModel.isCheck;if(isCheck){checkedCount--;}else{checkedCount++;}returnitemModel.isCheck=!isCheck;});}), 下拉刷新与上拉加载。 RaisedButton(onPressed:(){setState(()=>data.dataList.clear());data.getData(0).then((value){setState(()=>data.dataList=value);});},child:Text('Refresh'),),RaisedButton(onPressed:(){data.getData(++pageIndex).then((value){setState(()=>data.dataList=value);});},child:Text('LoadMore'),),Text('CheckedCount$checkedCount'), 这种方式并没有什么问题,特别是当List占据当整个UI界面时,这样其实最简单也不太会影响效率。只有当页面比较复杂的时候,才需要考虑采用Provider来降低刷新带来的效率问题。 下面我们来考虑下如何通过Selector来改造整个Demo,完成数据刷新、数据加载更多、显示Checked数量几个功能。 改造Model Model是Provider的数据处理对象,封装了数据模型和对数据的处理操作。这里的改造和前面讲解的使用Provider的Model的处理方式基本相同,代码如下所示。 classItemModel{Stringtitle;boolisCheck;intlikeCount;ItemModel(this.title,this.isCheck,this.likeCount);}classDataModelwithChangeNotifier{List<ItemModel>dataList=List();intcheckedCount=0;boolshouldListRebuild=true;getData(intpageIndex)async{List<ItemModel>items=awaitapi.getListDataOfIndex(pageIndex);shouldListRebuild=true;dataList.addAll(items);notifyListeners();}refreshData(){dataList.clear();checkedCount=0;shouldListRebuild=true;notifyListeners();}updateChecked(intindex,boolisChecked){shouldListRebuild=false;varitem=dataList[index];if(isChecked){checkedCount++;}else{checkedCount--;}dataList[index]=ItemModel(item.title,isChecked,item.likeCount);notifyListeners();}} 新增了几个函数,分别用于获取分页数据,刷新数据,更新Item的Checked状态。 改造ListItem选中的刷新逻辑 在之前的方案中,当我们点击一个Item做修改时,整个List都将Rebuild,通过Selector,可以根据属性筛选,过滤出需要刷新的Item。 当List内容固定时,不需要刷新整个List,只需要更新改变的Item。 在List的ItemBuilder中,我们做一个Selector筛选,筛选内容为dataList中的ItemModel,当在指定的Item中点击CheckBox后,model被更新,所以Selector的shouldRebuild被判断为true,所以这个Item就会被更新,而其它未点击的Item则因为没有改变所以不会被更新,这样就控制了List的刷新范围为被更新的Item,代码如下所示。 returnListView.builder(itemBuilder:(context,index){returnSelector<DataModel,ItemModel>(selector:(context,value)=>value.dataList[index],builder:(BuildContextcontext,data,Widgetchild){debugPrint(('Item$indexrebuild'));returnCard(child:Padding(padding:constEdgeInsets.all(8.0),child:Row(children:[Checkbox(value:data.isCheck,onChanged:(flag){dataModel.updateChecked(index,!data.isCheck);}),Text(data.title),Spacer(),Icon(Icons.favorite),ConstrainedBox(constraints:BoxConstraints(minWidth:30),child:Center(child:Text(data.likeCount.toString())),),],),),);},);},itemCount:dataModel.dataList.length,); Item的刷新控制其实比较简单,也是Selector的通用解决方案,但是Selector的使用场景是固定数据的List。如果List的数据会发生改变,则Selector的使用则会存在问题,举个例子,我们大部分APP的List使用场景都包含刷新数据、加载分页数据这样两个过程,所以List的数据源是一直在变化的,当首页数据加载时,还可能需要展示一个Loading界面,因此,这些场景下,整个List是一定需要Rebuild的,这时候,一个Selector就无能为力了,但是,我们可以再增加一个Selector,用于控制List是否需要刷新,这样就可以在不同的场景下,精细控制List的刷新范围。 当列表数据不固定时,刷新整个List 当列表数据固定时,只刷新更新的Item 有了这样的思路,就可以理解前面的Model中为什么需要一个shouldListRebuild变量了吧,剩下的代码如下所示。 Expanded(child:Selector<DataModel,DataModel>(shouldRebuild:(pre,next)=>pre.shouldListRebuild,selector:(context,dataModel)=>dataModel,builder:(BuildContextcontext,DataModeldataModel,Widgetchild){if(dataModel.dataList.length>0){returnListView.builder(itemBuilder:(context,index){returnSelector<DataModel,ItemModel>(selector:(context,value)=>value.dataList[index],builder:(BuildContextcontext,data,Widgetchild) 这里一个技巧是Selector<DataModel, DataModel>,这里只借助了Selector的shouldRebuild功能,所以并没有对数据做筛选,完整的代码大家请参考Dojo中的实现。 flutter_dojo/category/backend/providerstate4widget.dart 实际上的操作就是在刷新和加载分页数据这些操作的时候,让shouldRebuild为true,而当只修改Item数据的时候,让shouldRebuild为false,这样就完整的控制了List的刷新范围。 综上 当然,这样的处理只针对于对性能极致要求的场景,大部分情况下,并不太需要考虑的这么细,对List的Rebuild并不会产生多大的性能开销,开发者需要针对不同的场景采用不同的方案,没有必要太过严苛的控制刷新。 更多内容,请访问 https://xuyisheng.top 点击阅读原文,一键直达 本文分享自微信公众号 - Android群英传(android_heroes)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

FlutterDojo设计之道—状态管理之路(四)

在Flutter中,跨Widget的数据共享,可以如下图这样表示。 当Child Widget想要跨Widget拿到其它Widget的数据时,通常就需要使用构造函数,将数据一层层传递到Child Widget,这显然不是一个好的解决方案,不仅让Widget之间有了很大的耦合,也产生很多的冗余数据。 为了解决这个问题,Flutter SDK提供了InheritedWidget这个Widget,InheritedWidget是除了StatefulWidget和StatelessWidget之外的第三个常用的Widget。当把InheritedWidget作为Widget Tree的根节点时,这个Widget Tree就具有了一些新的功能,例如,Child Widget可以根据BuildContext找到最近的指定类型的InheritedWidget,而不是通过Widget Tree的构造函数一层层进行传递,如下图所示。 InheritedWidget的使用其实非常简单,即共享数据给Child。所以它的核心点,其实就是两个。 需要共享的数据 重新updateShouldNotify的条件 通过BuildContext的dependOnInheritedWidgetOfExactType函数,就可以直接获取父Widget中的InheritedWidget。所以在InheritedWidget内部,通常会有一个of函数,用过调用BuildContext的dependOnInheritedWidgetOfExactType函数来获取对应的父InheritedWidget。 只读的InheritedWidget InheritedWidget默认情况下都是只读的,即只能将某个数据共享给Child Widget,而不能让Child Widget对数据做更新。下面这个例子演示了一个最基本的InheritedWidget是如何共享数据的。 classInheritedWidgetReadOnlyWidgetextendsStatelessWidget{@overrideWidgetbuild(BuildContextcontext){returnReadOnlyRoot(count:1008,child:ChildReadOnly(),);}}classChildReadOnlyextendsStatelessWidget{@overrideWidgetbuild(BuildContextcontext){debugPrint('build');ReadOnlyRootroot=ReadOnlyRoot.of(context);returnColumn(children:<Widget>[SubtitleWidget('InheritedWidget本身不具有写数据的功能,需要结合State来获取数据修改的能力'),Text('show${root.count}',style:TextStyle(fontSize:20),),],);}}//仅支持读取属性classReadOnlyRootextendsInheritedWidget{staticReadOnlyRootof(BuildContextcontext)=>context.dependOnInheritedWidgetOfExactType<ReadOnlyRoot>();finalintcount;ReadOnlyRoot({Keykey,@requiredthis.count,@requiredWidgetchild,}):super(key:key,child:child);@overrideboolupdateShouldNotify(ReadOnlyRootoldWidget)=>count!=oldWidget.count;} 给InheritedWidget增加读写功能 数据的状态通常情况下都是保存在StatefulWidget的State中的,所以,InheritedWidget必须要结合StatefulWidget才能具有修改数据的能力,因此,思路就是在InheritedWidget中持有一个StatefulWidget的State实例,同时,使用一个StatefulWidget,将原本的Child Widget之上,插入这个InheritedWidget,这样就可以借助StatefulWidget来完成数据的修改能力,通过InheritedWidget来实现数据的共享能力。 classRootContainerextendsStatefulWidget{finalWidgetchild;RootContainer({Keykey,this.child,}):super(key:key);@override_RootContainerStatecreateState()=>_RootContainerState();static_RootContainerStateof(BuildContextcontext)=>context.dependOnInheritedWidgetOfExactType<Root>().state;}class_RootContainerStateextendsState<RootContainer>{intcount=0;voidincrementCounter()=>setState(()=>count++);@overrideWidgetbuild(BuildContextcontext){returnRoot(state:this,child:widget.child);}}//同时支持读取和写入classRootextendsInheritedWidget{final_RootContainerStatestate;Root({Keykey,@requiredthis.state,@requiredWidgetchild,}):super(key:key,child:child);//判断是否需要更新@overrideboolupdateShouldNotify(RootoldWidget)=>true;} 在这种写法中,InheritedWidget(Root)是在StatefulWidget(RootContainer)中初始化的,当使用StatefulWidget(RootContainer)的setState函数时,InheritedWidget(Root)重建了,但是其child并不会重建,因为它是widget.child,并不会因为State的重建而重建。 要注意的是,虽然这里的StatefulWidget通过setState来修改数据了,但其子Widget并不会全部重绘,因为InheritedWidget的存在,Child Widget会有选择性的进行重绘。 在这基础上,使用就比较简单了,代码如下所示。 classInheritedWidgetWidgetextendsStatelessWidget{@overrideWidgetbuild(BuildContextcontext){returnRootContainer(child:Column(children:<Widget>[Widget1(),Widget2(),Widget3(),],),);}}classWidget1extendsStatelessWidget{@overrideWidgetbuild(BuildContextcontext){debugPrint('buildWidget1');returnSubtitleWidget('InheritedWidget本身不具有写数据的功能,需要结合State来获取数据修改的能力');}}classWidget2extendsStatelessWidget{@overrideWidgetbuild(BuildContextcontext){debugPrint('buildWidget2');returnText('show${RootContainer.of(context).count}',style:TextStyle(fontSize:20),);}}classWidget3extendsStatelessWidget{@overrideWidgetbuild(BuildContextcontext){debugPrint('buildWidget3');returnRaisedButton(onPressed:(){RootContainer.of(context).incrementCounter();},child:Text('Add'),);}} 相关代码 Flutter Dojo-Widgets-Async-InheritedWidget 在上面这个Demo中,Widget2、3分别获取和修改了InheritedWidget中的共享数据,实现了跨Widget的数据共享。 通过Log我们可以发现,初始化的时候,Widget1、2、3都执行了build,但点击的时候,只有Widget2、3重新build了,但是Widget1并不会重新build。 这是什么原因呢? 其实这就是RootContainer.of(context)导致的。 当我们执行RootContainer.of(context)这个函数的时候,实际上调用的是context.dependOnInheritedWidgetOfExactType函数,这个函数不仅仅会返回指定类型的InheritedWidget,同时也会将Context对应的Widget添加到订阅者列表中,也就是说,即使你调用这个函数,只是为了执行某个函数,并不是想刷新UI,但是系统依然认为你需要刷新,从而导致Widget2、3都会执行rebuild。而Widget1,由于没有调用过of函数,所以不会被添加到订阅者列表中,所以不会执行rebuild。 要想解决这个问题也非常简单,那就是在不需要监听的时候,使用findAncestorWidgetOfExactType即可,这个函数只会返回指定类型的Widget,而不会将监听加入订阅者列表中。 static_RootContainerStateofNoBuild(BuildContextcontext)=>context.findAncestorWidgetOfExactType<Root>().state; 点击按钮的函数,只需要调用上面的这个函数,在点击的时候,Widget3就不会执行rebuild了。 除了这种方式以外,还有一个方式,那就是通过const关键字,将一个Widget设置为常量Widget,即不会发生改变,这个时候rebuild的时候,系统会发现const Widget并没有发生改变,就不会rebuild了,这也是为什么在Flutter中,很多不需要改变的Padding、Margin、Theme、Size等参数需要尽可能设置为const的原因,这样可以在rebuild的时候,提高效率。 在Flutter中,Theme的实现,就是采用的这种方式。 Widget Tree的遍历 前面提到了两种方式来获取Widget Tree中的InheritedWidget,dependOnInheritedWidgetOfExactType和findAncestorWidgetOfExactType,从调用结果上来看,一种是会被加入订阅者名单,一种只是单纯的查找。 下面再来继续仔细的看看这两个函数的区别。 findAncestorWidgetOfExactType 首先来看下这个函数的注释。 从中我们可以提取几个关键信息。 不会触发rebuild O(n)复杂度 最好在didChangeDependencies中调用 所以findAncestorWidgetOfExactType有几个比较常用的使用场景。 在断言中判断父Widget的使用条件 获取父Widget对象,调用其方法 例如在一些Widget中,可以通过Assert来判断当前是否有使用该Widget的条件,例如Hero Widget。 dependOnInheritedWidgetOfExactType 首先也来看下这个函数的注释。 会触发rebuild O(1)复杂度 最好在didChangeDependencies中调用 可以发现,其实他跟findAncestorWidgetOfExactType是非常类似的,主要的区别还是在于是否会rebuild,另外,dependOnInheritedWidgetOfExactType的效率很高。 项目地址 Flutter Dojo 本文分享自微信公众号 - Android群英传(android_heroes)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册