首页 文章 精选 留言 我的

精选列表

搜索[声明式],共10000篇文章
优秀的个人博客,低调大师

分布式系统学习共性总结:

1.归纳法: 对标与参考 适配与裁剪 2..术法道,深入源码体系 先分析该系统是数据存储还是计算系统。 如果是数据存储系统,从数据分布和副本策略开始入手 哈希:ElasticSearch 范围:HBase 数据量:HDFS 一致性:Cassan 副本读取 副本更新 副本切换 如果是数据处理问题,从数据投递策略入手。 离线 实时 微批 at most once at least once exactly once 2 .读对应系统架构图,对应着常用的架构模型,每个组件和已有的系统进行类比,想一下这个组件类似于hdfs的namenode等等,最后在脑海里梳理下数据流的整个流程。 3.在了解了系统的大概,着重看下文档中fault tolerence章节,看系统如何容错,或者自己可以预先问些问题,比如如果一个节点挂了、一个任务挂了系统是如何处理这些异常的,带着问题看文档。 4.文档详细读了一遍,就可以按照官方文档写些hello world的例子了,详细查看下系统配置项,随着工作的深入就可以看些系统的细节和关键源码了。 转自:https://blog.csdn.net/tg229dvt5i93mxaq5a6u/article/details/78266424

优秀的个人博客,低调大师

蚂蚁搬家式迁移mysql数据库

乘机房搬迁的机会,打算做一次业务整合。现有的架构是在2010年规划并运营起来的,随着时间的推移,项目也越来越多。打开nginx配置文件,有四十多行include包含存在,每一个包含就是一个项目(有些是web,有些是app)。一整个机柜,老旧的设备,负载均衡高可用架构。为保证业务一致性和降低成本,业务数据(开发的应用程序及用户上传数据)共享一套NFS;各业务共享同一套物理数据库(一台物理服务器mysql创建多个库)。随着业务和访问量的增长,这种隐患越来越令人担忧,主要表现在以下几个方面: ◆安全问题 数十个站点共享目录,以nfs方式共享给各物理服务器,这几十个项目,只要任何一个有安全漏洞存在,有心人都能进来为所欲为,让站点全部沦陷。时不时的,被人注入恶意代码,针对性的进行清除,但没多久又被注入篡改。大家心里都有数,存在漏洞的地方,不一定是被篡改的那个。但站点太多,又没有隔离,根本无法用安全工具扫描(一个站点进行扫描,平均花费一天)。 [root@web57 ~]# more /usr/local/nginx/conf/nginx.confuser www www;worker_processes 6;worker_rlimit_nofile 51200;events {use epoll;#use kqueue; #FreeBSD systemworker_connections 51200;}http {include mime.types;default_type application/octet-stream;#charset gb2312;server_names_hash_bucket_size 256;client_header_buffer_size 256k;large_client_header_buffers 4 256k;client_max_body_size 500m;…………………………………………省略若干…………………………………include vhosts/faxian.quanzhen.com.conf;include vhosts/www.quanzhen.com.conf;include vhosts/news.quanzhen.com.conf;include vhosts/s.quanzhen.com.conf;include vhosts/down.quanzhen.com.conf;include vhosts/static.quanzhen.com.conf;include vhosts/image.quanzhen.com.conf;include vhosts/3g.quanzhen.com.conf;include vhosts/mini.quanzhen.com.conf;include vhosts/xml.quanzhen.com.conf;include vhosts/mayiapi.quanzhen.com.conf;include vhosts/www.android77.com.conf;include vhosts/fahongbao.android77.com.conf;include vhosts/update.android77.com.conf;include vhosts/dev.quanzhen.com.conf;include vhosts/qr.110.cc.conf;include vhosts/110.cc.conf;include vhosts/eggserver.quanzhen.com.conf;include vhosts/apkegg.quanzhen.com.conf;include vhosts/eggserver.yidong7.cn.conf;include vhosts/www.yidong7.cn.conf;include vhosts/down.yidong7.cn.conf;include vhosts/wan.quanzhen.com.conf;include vhosts/open.quanzhen.com.conf;include vhosts/bakdown.yidong7.cn.conf ;include vhosts/hanhua.quanzhen.com.conf;include vhosts/mpk.quanzhen.com.conf;include vhosts/android.quanzhen.com.conf;include vhosts/pay.quanzhen.com.conf;include vhosts/cmstop.quanzhen.cn.conf;include vhosts/news.quanzhen.cn.conf;include vhosts/pingce.quanzhen.cn.conf;include vhosts/gonglue.quanzhen.cn.conf;include vhosts/hao.quanzhen.cn.conf;include vhosts/all.quanzhen.cn.conf;include vhosts/s.quanzhen.cn.conf;include vhosts/apkz.quanzhen.com.conf;include vhosts/ajax.quanzhen.com.conf;include vhosts/union.quanzhen.com.conf;include vhosts/mai.quanzhen.com.conf;include vhosts/blog.quanzhen.com.conf;include vhosts/guazi.quanzhen.com.conf;include vhosts/lockscreen.yidong7.cn.conf;include vhosts/dsp.pujia8.com.conf;include vhosts/3svx4haii9.quanzhen.com.conf;include vhosts/u.quanzhen.com.conf;include vhosts/bianji.quanzhen.com.conf;include vhosts/default.conf;} ◆性能问题 主要集中在数据库上边,只要有一个库出现问题,引起锁表或者其它竞争,全部相关业务都会挂起,烦不胜烦啊。想进行拆分,决策人认为,本来就满机柜了,如果再新家机器,得另租机柜,考虑到成本等其它问题,只求不出事即可。 整合的计划是,迁移部分业务到公有云上,腾出服务器后,对现有的设备进行扩充配置(拼内存、硬盘等,古旧的机器直接下架)。留下配置高的,进行虚拟化,既能减少设备数量(托管费降低),又有利于日常维护。 前边说了这么多,似乎与技术关系不大,但对于一些有遗留问题的项目,还是具有参考意义。接下来,我们就进入正题,看看我们要迁移的项目状况。要往云上迁移的数据包括网站数据及数据库数据,网站数据比较好办,rsync同步到对应的目录,而数据库相对而言,要麻烦不少。两个数据库,一个容量38G,另一个29G,不算太大,但公用的ibdata1文件却有123G,最初是尝试把这两个库,直接导入到阿里云的RDS,在进行数次操作失败后,咨询客服得到的答复是RDS暂时不支持分表的数据库。为节省成本,购买一个配置高一点的云主机(cpu 8core,内存32G,1T高效云盘),部署上mysql5.6,供两个数据库使用。 第一次尝试 预估了一下,200G的数据,贪心一把,看一次性能不能迁移完。提前几天,把云上的环境全部准备妥当(能出来测试页),运营部门把通知发下去,然后某天夜里0:30分,一些人在办公室,一些人在家里,眯着眼,庄重地在键盘敲入“screen”这几个字符。在qq群里得到一致许可,可以进行数据库导出操作以后,小弟小心翼翼地发来一条指令: [root@db-209 ~]# innobackupex --user=root --passwor='i%=KGb76' \--defaults-file=/etc/my.cnf \ --databases=“quanzhen_mobile7lockscreen quanzhen_equipment” /data/bakmysql/InnoDB Backup Utility v1.5.1-xtrabackup; Copyright 2003, 2009 Innobase Oyand Percona Ireland Ltd 2009-2012. All Rights Reserved.This software is published underthe GNU GENERAL PUBLIC LICENSE Version 2, June 1991.180618 00:30:31 innobackupex: Starting mysql with options: --defaults-file='/etc/my.cnf' --password=xxxxxxxx --user='root' --unbuffered --180618 00:30:31 innobackupex: Connected to database with mysql child process (pid=20090)180618 00:30:37 innobackupex: Connection to database server closedIMPORTANT: Please check that the backup run completes successfully. At the end of a successful backup run innobackupex prints "completed OK!".innobackupex: Using mysql Ver 14.12 Distrib 5.0.95, for redhat-linux-gnu (x86_64) using readline 5.1innobackupex: Using mysql server version Copyright (c) 2000, 2011, Oracle and/or its affiliates. All rights reserved.innobackupex: Created backup directory /data/bakmysql/2018-06-18_00-30-37180618 00:30:37 innobackupex: Starting mysql with options: --defaults-file='/etc/my.cnf' --password=xxxxxxxx --user='root' --unbuffered --180618 00:30:37 innobackupex: Connected to database with mysql child process (pid=20123)180618 00:30:39 innobackupex: Connection to database server closed180618 00:30:39 innobackupex: Starting ibbackup with command: xtrabackup_55 --defaults-file="/etc/my.cnf" --defaults-group="mysqld" --backup --suspend-at-end --target-dir=/data/bakmysql/2018-06-18_00-30-37 --tmpdir=/tmpinnobackupex: Waiting for ibbackup (pid=20132) to suspendinnobackupex: Suspend file '/data/bakmysql/2018-06-18_00-30-37/xtrabackup_suspended'xtrabackup_55 version 2.0.7 for Percona Server 5.5.16 Linux (x86_64) (revision id: 552)xtrabackup: uses posix_fadvise().xtrabackup: cd to /data/mysql_dbxtrabackup: Target instance is assumed as followings.xtrabackup: innodb_data_home_dir = ./xtrabackup: innodb_data_file_path = ibdata1:10M:autoextendxtrabackup: innodb_log_group_home_dir = ./xtrabackup: innodb_log_files_in_group = 2xtrabackup: innodb_log_file_size = 5242880>> log scanned up to (601191481892)[01] Copying ./ibdata1 to /data/bakmysql/2018-06-18_00-30-37/ibdata1>> log scanned up to (601191481892)>> log scanned up to (601191481892)>> log scanned up to (601191481892)>> log scanned up to (601191481892)>> log scanned up to (601191481892)>> log scanned up to (601191481892)>> log scanned up to (601191481892)…………………………………省略…………………………………………… 乐观估计,上午7点前,能完成整个迁移,几个人商量轮流监看进展程度,等进行完一步后叫醒休息的人,以便进行下一步。结果,到凌晨六点多,才执行完这个innobackupex,还差好几步呢,每一步都同样耗时,只能宣告迁移暂时失败,选个黄道吉日,分两次进行迁移。 第二次分拆迁移 万年历排除近期诸事不宜的日子,再摇卦选利用用神的地支,选定日志,约上相关人等,继续进行迁移。有了上一次的教训,在迁移前又对要迁移的库做了清理,删掉了一些无用的数据,省出来好几个G的空间。在源数据库,执行指令: [root@db-209 ~]#innobackupex --user=root --passwor='i%=KGb76' \ --defaults-file=/etc/my.cnf --databases=“quanzhen_equipment” /data/bakmysql/ 我交到好以后,就躺下睡觉,到凌晨三点电话响了,告知第一步完成。 [root@db-209 ~]#innobackupex --apply-log /data/bakmysql/2018-06-18_00-30-37 日志应用倒是执行的很快,回车即完。然后进行tar 打包和复制文件到目标服务器,由于租赁的出口带宽太小(总带宽30M,现在读者知道为什么要夜间访问低谷进行迁移了吧?),复制文件到目标服务花了一些时间。 目标服务器,仅仅需要安装好mysql软件,创建好目录/data/mysql_db,不需要执行数据库初始化操作,因为innobackupex导入时,要求数据目录必须为空。阿里云的配置,远比源服务器配置高,解压文件很快就完成。 检查一下mysql选项文件/etc/my.cnf,注意是选项文件。设定“—datadir=/data/mysql_db”,就可执行导入操作,指令如下: [root@msyql mysql_db]# innobackupex --defaults-file=/etc/my.cnf \ --copy-back /data/db_bk/2018-06-18_00-30-37 源数据导出时,没有把库mysql一并导出,这倒不是什么要紧的事情,反正只有一个账户需要创建。接下来,初始化数据库并创建应用帐号,具体操做如下: [root@msyql mysql_db]#cd /usr/local/mysql/[root@msyql ~]#scripts/mysql_install_db --user=mysql --datadir=/data/mysql_db[root@msyql ~]#mysqlmysql>grant all on quanzhen_equipment.* to …… 还要记得给mysql空密码消除掉。 源库与目标库,比对一下表的数量,以及随机抽取一些大表,对记录数进行比较。确认数据完整以后,一帮去调试应用,后续工作不表,没我什么事。 第三次分拆迁移 有了上一次的成功经验,这次信心满满了,不过担心还是有的,就是那个目标库导入时,要求数据目录为空。小弟在未开始时,就来征求我的意见,我担心可能会有障碍,就对他说,你只要把源站数据导出准备好,放到目标数据库,余下的我亲自搞定。 自己的选择有两个,一个是使用选项“--force-non-empty-directories”,如果不行,就再弄一个mysql实例,启用3307端口,双实例运行。先尝试第一个选项,看能不能进行下去,具体指令为: [root@msyql db_bk]# pwd/data/db_bk[root@msyql db_bk]#innobackupex --defaults-file=/etc/my.cnf --copy-back \ --force-non-empty-directories 2018-06-22_00-24-52180623 23:31:57 innobackupex: Starting the copy-back operationIMPORTANT: Please check that the copy-back run completes successfully. At the end of a successful copy-back run innobackupex prints "completed OK!".innobackupex version 2.4.11 based on MySQL server 5.7.19 Linux (x86_64) (revision id: b4e0db5)innobackupex: Can't create/write to file '/data/mysql_db/ib_logfile0' (Errcode: 17 - File exists)[01] error: cannot open the destination stream for ib_logfile0[01] Error: copy_file() failed. 悲催了,有同名文件存在,不行!直接终止运行。好吧,我把文件“ib_logfile0、ib_logfile1”挪走,再执行,还是不行,提示文件“ibdata1”存在,这可是个大家伙。虽然担心新导入的ibdata1可能不包含现有数据库相关信息,但忍不住想试一把。可能有读者会问,这样搞可能把数据库原有的数据破坏掉了,其实我想到这一层来,老早我就把整个库做了备份,买了保险的。 正全神贯注盯着屏幕查看输出,希望进展顺利,突然,qq群有消息传来,问进展如何,啥时能完成。一看时间,六点了,北方大地已经一片光明。时间来不及了,停掉进程,试试直接复制文件,不使用innobuckupex。心中没底,就去仔细比较了数据库目录与导出数据目录中的三个文件“ibdata1、ib_logfile0、ib_logfile1”,发现其大小完全相同。不管了,把现有数据库里的这几个文件搬走,从导出目录cp来着三个文件。复制完,执行mysqld_safe启动服务,失败,提示ib_logfile0无写入权限;这好办,一条chown指令而已。再执行启动mysql服务,正常。 那么数据对不对呢?我不能确定,万一不对,就再配一个mysql,导入数据,以双实例启动,后边再想法整合;阿里云购买的服务器,相互通信是内网,不会在传输上浪费太多时间。 既然服务正常,就对一下数据吧,万一运气爆棚(前几天夜里梦到自己能飞,抓住一只巨型天鹅,我美美地搂着天鹅的脖子…),数据完整可用呢!我自己悄悄对比了一阵,没差异呢,又到qq群呼叫其它人,说导入有障碍,数次不成功,后边采取了一些不确定的手段,mysql服务是起来了,请大家核实一下数据,看是否完整可用。几个程序员一阵忙碌,得到答复,数据是完整可用的。到此,我的工作完成了。 有人可能要鄙视我一番,为什么不先测试?不制定完善的流程?这个问题问得好!我数次建议决策人,准备点资源,说白了就是准备1台空闲服务器,再内网演练,就算白天也能能进行(复制数据走内网,不在用户访问的带宽),但是,没有资源给我啊,但事情又不得不做。虽然累点,折腾一番,翻过来想,咱玩悬的也获得经验,不然也没有这个文章问世,你们觉得觉呢? 道长有话说最近受邀在51CTO博客专栏出版《负载均衡高手炼成记》,依托自己十余年的IT运维经验,以实际工作经验为基础,介绍不同场景下,负载均衡的实现方式,以及负载均衡的日常维护。本专栏适合于一直徘徊在运维初级未找到入佳境之门的运维工程师,也适合对负载均衡有兴趣了解和学习的技术爱好者。跟着田道长学完这个系列课程,不仅学知识,更是涨薪、升职、进心仪公司的一大捷径!负载均衡高手炼成记

优秀的个人博客,低调大师

分布式--Redis 内存数据库

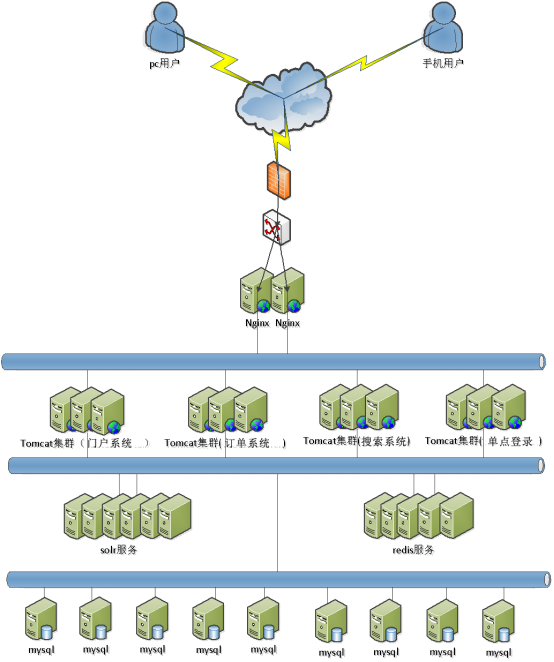
1. Redis 内存数据库 1). Redis Redis是一个开源的,高性能,C语言开发的 ,键值对(key-value)存储数据的NOSQL数据库。 2). 基本概念 NOSQL :Not Only Sql 泛指非关系型数据库 Redis MongoDB Hbase 关系型数据库: mysql oracle sybase sqlServer 3). 数据库应用的发展历史 1:在互联网时代来临之前 ,企业的一些内部信息管理系统,一个单个的数据库的实例就可以应付系统的功能需求单数据库实例 2:随着系统访问用户的增多 ,数据量的增大,单个数据库的实例已经满足不了系统频繁读取数据(权限的验证,系统的默认配置)的需求 。缓存 (ehCache/MemCached)+ 数据库实例 3: 缓存虽然可以缓解数据库的读取压力 ,但是数据量的写入压力持续增大 ,这个时候我们需要采取数据库主从机制进行读写分离缓存 (ehCache/MemCached)+ 主从数据库 + 读写分离 4: 数据量再次增大,读写分离以后,主数据库的写库的压力出现瓶颈缓存 (ehCache/MemCached)+ 主从数据库 + 读写分离 +分库分表 5:互联网和大数据的时代的来林,关系型数据库已经不能很好的存储一些并发性大,实时性高,而且格式不固定的数据Nosql数据库+主从数据库 + 读写分离 +分库分表 4). 系统架构中的位置 图1.png 2. 安装 3. Redis的五大数据类型以及应用 String/Hash/List/Set/sorted set 字符串类型 String 列表类型 list 集合类型 set 有序集合类型 sorted set 散列类型 hash 1). K-V格式中 V是一个字符串对象 set k1 v1 get k1 del k1 incr num (自增1 如果没有设置值默认为1) decr num (自减1) incrby num 5 (自增5) decrby num 5 (自减 5) Append num 4 (追加4)返回字符串长度位数,不是数学+ 是拼接 应用场景: 秒杀商品/商品点赞 2). Hash K-V格式中 V是一个Hash类型 其实java里面的Map<String,object> 赋值命令 hset student id 1 hset student name mazaiting hset student sex boy hmset myhash username admin age 20 取值命令 hget myhash username hget myhash username age hgetall myhash 删除命令 hdel myhash username age del myhash (删除myhash) hincrby myhash age 5 (增加5) 其他命名 hexists myhash username 判断myhash中是否包含username包含返回1否则返回0 hlen myhash 获取myhash中的字段数 hkeys myhash 获取所有的 key hvals myhash 获取所有的值 应用场景: 电商网站的商品详细信息 3). list K-V格式中 V是一个list类型 其实java里面的LinkedList 把他看成一个竹子,两边是打通了 从左插入记录 lpush book 1 2 3 从右插入记录 rpush book 4 5 6 从左弹出记录 lpop book 1 从右弹出记录 lpush book 1 列表里面的记录顺序(竹子)-- 3 2 1 4 5 6 应用场景: 商品的评论 lpush mylist 1 2 3 从左插入记录 rpush mylist a b c 从右插入记录 lrange mylist 开始索引位置 结束索引位置(-1最后一个) lpop mylist 左侧弹出(相当于删除) rpop mylist 右侧弹出(相当于删除) lpush mylist 左侧插入 rpush mylist 右侧插入 lrem mylist 删除几个元素 删除哪个元素 lset mylist 索引位置 插入的值 linsert mylist before 哪个值前面 要插入的值 linsert mylist after 哪个值后面 要插入的值 rpoplpush 集合1 集合2 把集合1中取出的值放在集合2中 4). Set K-V格式中 V是一个set类型 set是无序的/set里面的元素具有唯一性、 sadd summer_friends sky big mo mike sadd maybe_friends sky big tdd world oky 应用场景: 独立IP进行网站投票 /微信朋友圈的共同好友 sadd myset a b c 添加 a b c 不能添加重复的值 srem myset a c 移除a c smembers myset 查看所有值 sismember myset a 查看集合里面是否包含a包含返回1 否则返回0 sadd myset2 a b c sadd myset3 a c 1 sdiff myset2 myset3 myset2 和myset3相差的是b 差集运算 sinter myset2 myset3 myset2 和myset3相交的是a c 交集运算 sunion myset2 myset3 并集运算 合并集合 相同的会去掉(值不能重复) scard myset 获取集合数量 srandmember myset 随机获取集合中的一个值 sdiffstore myset4 myset2 myset3 将myset2 和myset3中相差的值放到myset4里面 sinterstore myset4 myset2 myset3 将myset2 和myset3中相交的值放到myset4里面 sunionstore myset4 myset2 myset3 将myset2 和myset3中相并的值放到myset4里面 5). sorted-set 游戏排名 热点话题中应用 K-V格式中 V是一个Zset类型 zset是有序的? 怎么做到有序 应用场景: 商品的销售排行榜 zadd sales 100 huawei 99 iphone 98 vivo 97 oppo Zrange sales 0 -1 withscores 从小到大 Zrevrange sales 0 -1 withscores 从大到小 4. Java 使用Redis 1). 工具下载 Jedis下载 此处使用windows下的redis工具包,因为虚拟机连接会出现很多问题。 1). Redis-win下载 下载后解压,如下图 图3.png 2). 在上方地址栏输入cmd然后回车,这时会打开命令提示符窗口,然后输入redis-server.exe redis.windows.conf 开启redis服务器. 图4.png 3). 在上方地址栏继续输入cmd回车,输入命令``打开redis客户端 图5.png 2). 连接 public class RedisJava { public static void main(String[] args) { Jedis jedis = new Jedis("127.0.0.1", 6379); System.out.println("服务正在运行: " + jedis.ping()); jedis.close(); } } 3). 测试 public class RedisJava { public static void main(String[] args) { Jedis jedis = new Jedis("127.0.0.1", 6379); System.out.println("服务正在运行: " + jedis.ping()); jedis.set("name", "linghaoyu"); System.out.println(jedis.get("name"));; jedis.close(); } } 打印结果: 图6.png 5. 其他 1). Redis HyperLogLog命令 Redis HyperLogLog 是用来做基数统计的算法,HyperLogLog 的优点是,在输入元素的数量或者体积非常非常大时,计算基数所需的空间总是固定 的、并且是很小的。基数:数据集 {1, 3, 5, 7, 5, 7, 8}, 那么这个数据集的基数集为 {1, 3, 5 ,7, 8}, 基数(不重复元素)为5。 基数估计就是在误差可接受的范围内,快速计算基数。 图7.png 2). Redis 订阅 I. Redis 发布订阅(pub/sub)是一种消息通信模式:发送者(pub)发送消息,订阅者(sub)接收消息。Redis 客户端可以订阅任意数量的频道。 下图展示了频道 channel1 , 以及订阅这个频道的三个客户端 —— client2 、 client5 和 client1 之间的关系: 图8.png 当有新消息通过 PUBLISH 命令发送给频道 channel1 时, 这个消息就会被发送给订阅它的三个客户端: 图9.png II. 实例 订阅 subscribe redisChat 图10.png 发布消息 publish redisChat "Redis is a great caching technique" 图11.png 3). Redis 事务 Redis 事务可以一次执行多个命令, 并且带有以下两个重要的保证: 事务是一个单独的隔离操作:事务中的所有命令都会序列化、按顺序地执行。事务在执行的过程中,不会被其他客户端发送来的命令请求所打断。 事务是一个原子操作:事务中的命令要么全部被执行,要么全部都不执行。 一个事务从开始到执行会经历以下三个阶段: 开始事务。 命令入队。 执行事务。 示例: 127.0.0.1:6379> multi OK 127.0.0.1:6379> set book-name "Mastering C++ in 21 days" QUEUED 127.0.0.1:6379> get book-name QUEUED 127.0.0.1:6379> sadd tag "C++" "Programming" "Matering Series" QUEUED 127.0.0.1:6379> smembers tag QUEUED 127.0.0.1:6379> exec 1) OK 2) "Mastering C++ in 21 days" 3) (integer) 3 4) 1) "Matering Series" 2) "C++" 3) "Programming" 图12.png 序号 命令及描述 1 DISCARD 取消事务,放弃执行事务块内的所有命令。 2 EXEC 执行所有事务块内的命令。 3 MULTI 标记一个事务块的开始。 4). Redis 桌面管理 代码下载

优秀的个人博客,低调大师

python函数式编程之生成器

在前面的学习过程中,我们知道,迭代器有两个好处: 一是不依赖索引的统一的迭代方法 二是惰性计算,节省内存 但是迭代器也有自己的显著的缺点,那就是 不如按照索引取值方便 一次性,只能向后取值,不能向前取值 所以我们还需要学习另外一种对象,那已经生成器 1.什么是生成器 如果一个函数体内部包含yield关键字,该函数就是生成器函数,执行该函数就得到一个生成器对象 2.得到生成器 先来看下面的代码 def foo(): print("first...") yield print("second...") yield print("third...") g=foo() print(g) 根据上面生成器的定义:函数体内部包含yield关键字,则该函数就是生成器函数,则上面的函数执行结果就是一个生成器对象 执行上面的代码,查看程序执行结果 <generator object foo at 0x0000000001DF2BF8> 可以看出:上面的函数执行的结果g就是一个生成器对象,上面的函数foo就是一个生成器函数 3.生成器的内置方法 修改上面的代码,调用dir方法查看生成器中包含的方法 def foo(): print("first...") yield print("second...") yield print("third...") g=foo() print(dir(g)) 打印生成器内部的方法,可以看到打印的结果 ['__class__', '__del__', '__delattr__', '__dir__', '__doc__', '__eq__', '__format__', '__ge__', '__getattribute__', '__gt__', '__hash__', '__init__', '__init_subclass__', '__iter__', '__le__', '__lt__', '__name__', '__ne__', '__new__', '__next__', '__qualname__', '__reduce__', '__reduce_ex__', '__repr__', '__setattr__', '__sizeof__', '__str__', '__subclasshook__', 'close', 'gi_code', 'gi_frame', 'gi_running', 'gi_yieldfrom', 'send', 'throw'] 在这些结果中,可以看到有__iter__方法和__next__方法,由此可以判断出生成器的本质就是迭代器 ,生成器是迭代器的一种 4.判断生成器是否是迭代器 修改上面的代码 def foo(): print("first...") yield print("second...") yield print("third...") g=foo() from collections import Iterable print(isinstance(g,Iterable)) 查看打印结果 True 上面的两个例子都可以证明:生成器的本质是迭代器,生成器就是迭代器的一种 5.生成器的 __iter__方法和__next__方法 既然生成器的本质是迭代器,那么调用生成器的 __iter__方法和__next__方法,得到的结果会是什么呢 修改上面的代码 def foo(): print("first...") yield print("second...") yield print("third...") g=foo() print(g) print(g.__iter__()) g.__next__() 程序执行结果 <generator object foo at 0x0000000001DF2BF8> <generator object foo at 0x0000000001DF2BF8> first... 从上面的程序的执行结果可以看出:直接打印生成器g和调用生成器g.__iter__方法,得到的结果都是生成器对象g 在内存中的地址 调用g.__next__方法,实际上就是从生成器g中取出一个值,执行一次g.__next__方法,触发一次生成器的取值操作,这个过程在上面的代码中表现为foo函数的向下执行过程 从上面的程序的执行结果中可以看到,只执行了foo函数的第一个print函数,并没有执行第二个和第三个print函数。 通常对函数来说,函数开始执行以后直到return语句,函数才会停止执行 在这里执行一次g.__next__方法,foo函数中执行了一行代码,遇到yield就停止了,在这里yield好像起到了return的作用。 实际上,yield关键字的功能之一就是起到返回的作用 上面的程序执行遇到yield,本次g.__next__方法执行完毕。 在函数的执行过程中,如果函数的return语句有返回值,则函数的执行完成就得到return语句的返回值, 如果return没有定义返回值或者函数中没有定义return语句,则函数的执行结果默认为None 修改上面的代码,打印__next__方法的执行结果 def foo(): print("first...") yield print("second...") yield print("third...") g=foo() print(g.__next__()) 程序执行结果 first... None 可以看到,调用__next__方法时,yield后没接任何参数时,yield默认的返回值也是None 6.yield后面接返回值 那如果在yield关键字后接一个返回值,程序执行结果会是怎么样的呢 修改上面的代码,在yield关键字后接一个返回值,看程序的执行结果 def foo(): print("first...") yield 1 print("second...") yield 2 print("third...") g=foo() print(g.__next__()) 程序执行结果 first... 1 从上面的程序的执行结果可以看出,yield会把其后面接的数返回,作为__next__方法的执行结果 7.yield与return的不同点 在函数中,不管一个函数中定义了多少个return语句,函数在执行到第一个return语句的时候就会中止,其后面的语句将不会被继续执行 而对于yield来说,每调用一次__next__方法,程序会从开始向下执行,直到遇到yield语句,程序暂停,等到第二次调用__next__方法,程序会从上次暂停的地方继续向下执行,直到遇到下一个yield或者程序执行完成 在上面的例子里,是使用yield把函数foo变成一个生成器,执行foo函数时,并不会立即执行foo函数,而是先得到生成器g,当调用一次`g.__next__`方法时,函数foo开始向下执行,遇到yield时,程序暂停,当下一次调用`g.__next__`方法时,函数foo继续从上一次暂停的地方开始向下执行,直到遇到yield暂停 8.生成器的StopIteration 修改程序,多次调用__next__方法,查看程序的执行结果 def foo(): print("first...") yield print("second...") yield print("third...") g=foo() print(g) print(g.__iter__()) g.__next__() print('*'*30) g.__next__() print('#'*30) g.__next__() 程序执行结果 <generator object foo at 0x0000000001DF2BF8> <generator object foo at 0x0000000001DF2BF8> first... ****************************** second... ############################## third... Traceback (most recent call last): File "E:/py_code/test.py", line 28, in <module> g.__next__() StopIteration 从上面程序的执行结果可以看出,每调用一次生成器的__next__方法,会得到一个返回值,就相当于从迭代器中取一个值。 如果程序在执行过程中,没有得到返回值,这就说明迭代器的最后一个值已经被遍历完成了,所以此时再调用__next__方法,程序就会抛出异常 9.生成器的for循环遍历 在前面的学习中已经知道,生成器本质上就是一个迭代器。既然是迭代器,那么当然可以使用for循环来遍历生成器 修改上面的例子,使用for循环来遍历生成器 def foo(): print("first...") yield 1 print("second...") yield 2 print("third...") g=foo() for i in g: print(i) print("*"*30) 查看程序的执行结果 first... 1 ****************************** second... 2 ****************************** third... 在上面的例子里,每执行一次for循环,就相当于是执行一次g.__next__方法,yield会返回其后所接的数字,所以for循环前两次的执行结果都是print函数和yield后接的数字 for循环执行到第三次的时候,执行完print函数,程序会抛出StopIteration异常,但是StopIteration的异常会被for循环捕捉到,所以for循环执行第三次只执行了print语句 10.总结: yield关键字的功能: 与return的功能类似,都可以返回值,但不一样的地方在于一个函数中可以多次调用yield来返回值 为函数封装好了`__iter__方法`和`__next__方法`,把函数的执行结果变成了迭代器 `遵循迭代器的取值方式(obj.__next__())`,触发的函数的执行,函数暂停与再继续都由yield保存 11.示例:使用yield模拟linux中的命令:tail -f | grep 'error' | grep '404' 代码如下: import time def tail(file_path, encoding='utf-8'): with open(file_path, encoding=encoding) as f: f.seek(0, 2) while True: line = f.readline() if line: yield line else: time.sleep(0.5) def grep(lines, pattern): for line in lines: if pattern in line: yield line g1 = tail('a.txt') g2 = grep(g1, 'error') g3 = grep(g2, '404') for i in g3: print(i)


资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册