首页 文章 精选 留言 我的

精选列表

搜索[文档解析],共10000篇文章
优秀的个人博客,低调大师

Redis radix tree源码解析

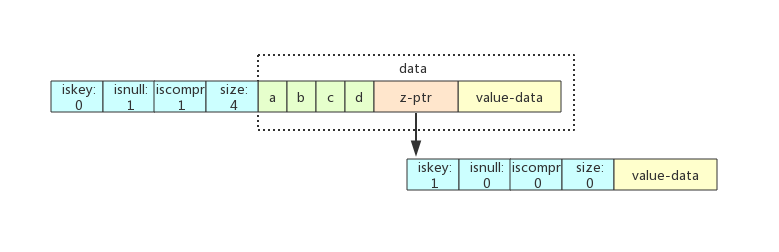
Redis实现了不定长压缩前缀的radix tree,用在集群模式下存储slot对应的的所有key信息。本文将详述在Redis中如何实现radix tree。 核心数据结构 raxNode是radix tree的核心数据结构,其结构体如下代码所示: typedef struct raxNode { uint32_t iskey:1; uint32_t isnull:1; uint32_t iscompr:1; uint32_t size:29; unsigned char data[]; } raxNode; iskey:表示这个节点是否包含key 0:没有key 1:表示从头部到其父节点的路径完整的存储了key,查找的时候按子节点iskey=1来判断key是否存在 isnull:是否有存储value值,比如存储元数据就只有key,没有value值。value值也是存储在data中 iscompr:是否有前缀压缩,决定了data存储的数据结构 size:该节点存储的字符个数 data:存储子节点的信息 iscompr=0:非压缩模式下,数据格式是:[header strlen=0][abc][a-ptr][b-ptr][c-ptr](value-ptr?),有size个字符,紧跟着是size个指针,指向每个字符对应的下一个节点。size个字符之间互相没有路径联系。 iscompr=1:压缩模式下,数据格式是:[header strlen=3][xyz][z-ptr](value-ptr?),只有一个指针,指向下一个节点。size个字符是压缩字符片段 Rax Insert 以下用几个示例来详解rax tree插入的流程。假设j是遍历已有节点的游标,i是遍历新增节点的游标。 场景一:只插入abcd z-ptr指向的叶子节点iskey=1,使用了压缩前缀。 场景二:在abcd之后插入abcdef 从abcd父节点的每个压缩前缀字符比较,遍历完所有abcd节点后指向了其空子节点,j = 0, i < len(abcded)。 查找到abcd的空子节点,直接将ef赋值到子节点上,成为abcd的子节点。ef节点被标记为iskey=1,用来标识abcd这个key。ef节点下再创建一个空子节点,iskey=1来表示abcdef这个key。 场景三:在abcd之后插入ab ab在abcd能找到前两位的前缀,也就是i=len(ab),j < len(abcd)。 将abcd分割成ab和cd两个子节点,cd也是一个压缩前缀节点,cd同时被标记为iskey=1,来表示ab这个key。 cd下挂着一个空子节点,来标记abcd这个key。 场景四:在abcd之后插入abABC abcABC在abcd中只找到了ab这个前缀,即i < len(abcABC),j < len(abcd)。这个步骤有点复杂,分解一下: step 1:将abcd从ab之后拆分,拆分成ab、c、d 三个节点。 step 2:c节点是一个非压缩的节点,c挂在ab子节点上。 step 3:d节点只有一个字符,所以也是一个非压缩节点,挂在c子节点上。 step 4:将ABC 拆分成了A和BC, A挂在ab子节点上,和c节点属于同一个节点,这样A就和c同属于父节点ab。 step 5:将BC作为一个压缩前缀的节点,挂在A子节点下。 step 6:d节点和BC节点都挂一个空子节点分别标识abcd和abcABC这两个key。 场景五:在abcd之后插入Aabc abcd和Aabc没有前缀匹配,i = 0,j = 0。 将abcd拆分成a、bcd两个节点,a节点是一个非压缩前缀节点。 将Aabc拆分成A、abc两个节点,A节点也是一个非压缩前缀节点。 将A节点挂在和a相同的父节点上。 同上,在bcd和abc这两个节点下挂空子节点来分别表示两个key。 Rax Remove 删除 删除一个key的流程比较简单,找到iskey的节点后,向上遍历父节点删除非iskey的节点。如果是非压缩的父节点并且size > 1,表示还有其他非相关的路径存在,则需要按删除子节点的模式去处理这个父节点,主要是做memove和realloc。 合并 删除一个key之后需要尝试做一些合并,以收敛树的高度。 合并的条件是: iskey=1的节点不能合并 子节点只有一个字符 父节点只有一个子节点(如果父节点是压缩前缀的节点,那么只有一个子节点,满足条件。如果父节点是非压缩前缀的节点,那么只能有一个字符路径才能满足条件) 结束语 云数据库Redis版(ApsaraDB for Redis)是一种稳定可靠、性能卓越、可弹性伸缩的数据库服务。基于飞天分布式系统和全SSD盘高性能存储,支持主备版和集群版两套高可用架构。提供了全套的容灾切换、故障迁移、在线扩容、性能优化的数据库解决方案。欢迎各位购买使用:云数据库 Redis 版 作者:羽洵 原文链接 本文为云栖社区原创内容,未经允许不得转载。

优秀的个人博客,低调大师

Android Handler原理实践解析

前言 Handler消息处理机制在Android开发中起着举足轻重的作用,我们有必要好好理解下其原理,下面我们先从一个简单的例子出发 一、日常使用 假设我们有这么一个需要,请求网络然后将图片展示出来,我们知道网络请求是不允许在主线程执行的,而UI是不能在子线程(具体是不允许在非创建UI的原始线程)更新的,因此我们需要在子线程请求网络获得了数据以后再切换回主线程更新UI,这个例子中Handler就是起着切换线程的作用,下面的代码演示了这个例子 classMainActivity : AppCompatActivity() { private lateinit var mImageView: ImageView override fun onCreate(savedInstanceState: Bundle?){

优秀的个人博客,低调大师

Helm源码解析 资料下载

Helm 是Kubernetes 集群的包管理器(charts), charts 是Kubernetes资源的一个打包集合。 Helm之于Kubernetes好比yum之于RHEL,或者apt-get之于Ubuntu。Helm使用Chart帮助我们管理应用,Chart就好像RPM一样,里面描述了应用及其依赖关系。这篇分享会简单介绍 Helm 的用法 以及chart 的介绍,随后会针对Helm 源码以一个简单的chart 创建为示例,从源码级别分析Helm 的创建流程。最后会简单介绍一下Helm v3的进展以及改变。 本次分享专家:阿里云技术专家 陈显鹭 直播视频全程链接:https://yq.aliyun.com/live/826 PPT精彩内容一览: PPT下载地址:https://yq.aliyun.com/download/32

优秀的个人博客,低调大师

应用基础框架全面解析

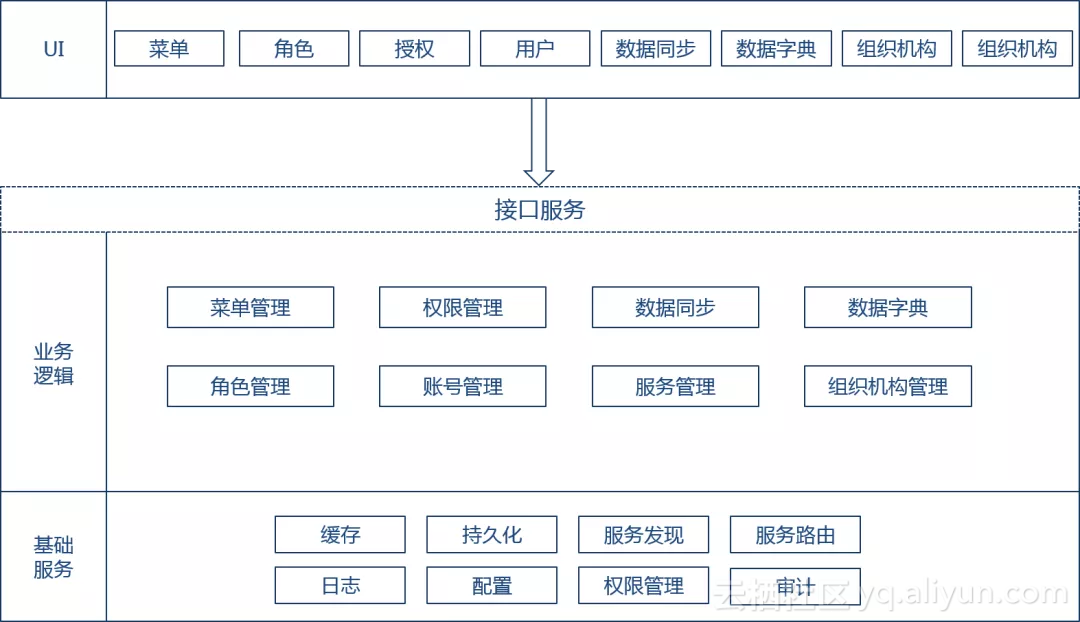
引言: 应用基础框架Coframe是EOS产品自带的开源应用基础框架,提供了资源管理、权限管理、用户以及角色管理等业务应用基础能力,用户可以根据自己的需要进行二次开发与扩展。本文向大家分享Coframe的主要功能和设计实现方案。 目录: 一、简介 二、系统资源 三、权限管理 四、组织管理 一、简介 应用基础框架也叫Coframe,是产品自带的开源应用基础框架,提供了一些基础功能,用户可以根据自己的需要进行二次开发与扩展。 Coframe提供3大核心功能: 系统资源:提供了功能菜单管理、字典码表、应用管理折几个应用框架基础能力。 权限管理:提供了基于Party(参与者) 的复杂权限计算模型和授权模型。 基于参与者、资源与授权等概念可扩展开发出符合用户个性化需求的参与者模型。 组织管理:提供了机构、岗位、员工、 用户、工作组等组织机构相关管理功能,支持与已有业务系统对接,使得基于普元EOS Platform 8.0开发的应用可方便地使用同一套组织机构。 逻辑架构逻辑架构图展示了基础应用框架的基本功能模块,前端Restful形式接口调用后端服务。进程架构应用基础框架有两种部署模式:微服务架构Coframe集成模式和单应用架构Coframe集成模式。 单应用架构很好理解,即直接使用Coframe源码或者jar包开发应用,后端只有一个server,而集成模式可以将应用要对外暴露的服务封装在Coframe中,这样Coframe可以对应用进行权限管理。前端使用VUE开发,可以很方便的使用源码进行二次开发。 数据模型应用基础框架的数据模型即DB表结构,展示了主要的一些表结构,包括权限表,用户表等。用户可以很方便的进行二次开发扩展应用。 二、系统资源 菜单管理 菜单框架支持两级菜单,用户可以自定义菜单的路径和打开方式等。应用基础框架提供了几个基础的菜单,用户可以在页面编辑菜单或者直接在数据库端编辑菜单。目前应用基础框架前端Ui支持二级菜单,用户可以根据自己的需求扩展到三级菜单。 字典码表 字典码表即为系统内部定义的具有业务属性的数据字典。系统管理员可以配置字典类型和字典项,用于管理系统中的枚举类型的基础数据,并且支持excel导入导出。字典类型和字典数据均支持一级子项。 字典类型:对数据进行分类管理 字典数据项:需要管理的枚举数据 应用管理 应用管理又叫服务权限控制,是指在多应用系统以及单应用系统下,实现对应用的服务功能的权限控制。实现角色、用户、功能的灵活绑定。在需要进行权限管理的功能接口方法定义上添加@TarestOperation注解,发布服务。 @RequestMapping("/say-hello") @TarestService(group = "SP1", displayName = "服务提供组1", version = "1.0.0.0", groupName = "服务提供组1", name = "ISampleAppHello") public interface ISampleAppHello { @GetMapping @TarestOperation(checkPermission=false,name="DEMO_001",displayName="功能1") String sayHello(); /** * @TarestOperation 在@TarestOperation中默认是不进行权限管理的 * 通过设置checkPermission = true,打开权限控制功能 * **/ @GetMapping(value = "/user") @TarestOperation(checkPermission =true,name="DEMO_002",displayName="功能2") String insertDemo(@RequestParam String name, @RequestParam Integer age); } 单应用系统即只有一个后端应用的系统,(直接以嵌入方式集成Coframe)无需新建应用。 多应用系统即有多个后端应用的系统,Coframe作为一个独立的应用部署的系统,需要在coframe中新建应用。如图所示: 三、权限管理 提供了基于Party(参与者) 的复杂权限计算模型和授权模型。 基于参与者、资源与授权等概念可扩展开发出符合用户个性化需求的参与者模型。 角色:角色是Coframe一个重要的对象,也可以成为权限集,表示系统中权限一个子集,用于控制用户可以使用的功能集合,赋予用户一个角色表示给用户一定功能的使用权限。Coframe中角色的分配本身赋予某些用户,员工,机构等之外,还要向角色授予可访问某些功能,模块,表单,视图等资源的权限。拥有某角色的用户可访问角色被授予的资源的权限。 用户:所有能登录系统的用户都是系统中的用户,需要增加登录账号有两种方式。一种是在用户管理中新增用户,第二种是在组织管理中新增员工时关联一个用户,如果用户的登录名不存在会创建一个新的用户。 用户管理所有能登录系统的用户都是系统中的用户,需要增加登录账号有两种方式。一种是在用户管理中新增用户,第二种是在组织管理中新增员工时关联一个用户,如果用户的登录名不存在会创建一个新的用户。当Coframe使用IAM的统一认证登录的时候能够同步IAM端的同一租户下的用户信息。 Coframe的用户账号由其登录认证方式决定是本地创建的还是又IAM即同一认真平台同步过来的用户信息。 本地登录:用户账号及其认证密码在本地存储,本地认证配置可以参考:http://t.cn/EUrzEtL 单点登录:即与IAM集成的sso方式登录,可以参考:http://t.cn/EUrZPOs 授权管理 目前提供了菜单授权与服务授权,授权管理即将资源与参与者之间建立关系。如下图所示,菜单和应用: 即可以视为资源,而账号、角色、组织机构、工作中等,即可以视为参与者。授权表结构如下图所示: 此注解用来标志一个数据实体为授权实体,授权实体需要指定类型:资源、授权主体,比如: @Entity // 此实体名称为order,类型为resource @AuthEntity(name = "order", type = AuthEntityType.RESOURCE) @Table(name = "SAMPLE_ORDER") public class SampleOrder { @Id @GeneratedValue private Long id; private String name; private Date date; } 四、组织管理 机构管理机构指企业的组织机构,一般包含机构、岗位、员工等信息。 机构管理通过对一棵机构人员树的维护把机构、岗位、人员等信息和关系维护好,并可设置这些组织对象的角色。工作组管理工作组与机构类似,是为了将项目组、工作组等临时性的组织机构管理起来,业务上通常工作组有一定的时效性,是一个非常设机构。 工作组是企业动态创建的组织机构分组,工作组下可以有子工作组、员工信息。总结: 以上介绍了应用基础框架的主要基础功能,以及设计过程中的一些理念,比如授权模型等。 作为开源应用基础框架会随着规划发展不断完善,用户可以根据自身的需求来更改适配。也非常欢迎大家能够更多参与使其更加健壮。 原文发布时间为:2018-12-19本文作者:许方杰本文来自云栖社区合作伙伴“ EAWorld”,了解相关信息可以关注“eaworld”微信公众号

优秀的个人博客,低调大师

Hystrix降级技术解析-Fallback

一、降级 所谓降级,就是指在在Hystrix执行非核心链路功能失败的情况下,我们如何处理,比如我们返回默认值等。如果我们要回退或者降级处理,代码上需要实现HystrixCommand.getFallback()方法或者是HystrixObservableCommand. HystrixObservableCommand()。 publicclassCommandHelloFailureextendsHystrixCommand<String>{ privatefinalStringname; publicCommandHelloFailure(Stringname){ super(HystrixCommandGroupKey.Factory.asKey("ExampleGroup")); this.name=name; } @Override protectedStringrun(){ thrownewRuntimeException("thiscommandalwaysfails"); } @Override protectedStringgetFallback(){ return"HelloFailure"+name+"!"; } } 二、Hystrix的降级回退方式 Hystrix一共有如下几种降级回退模式: 1、Fail Fast 快速失败 @Override protectedStringrun(){ if(throwException){ thrownewRuntimeException("failurefromCommandThatFailsFast"); }else{ return"success"; } } 如果我们实现的是HystrixObservableCommand.java则 重写 resumeWithFallback方法 @Override protectedObservable<String>resumeWithFallback(){ if(throwException){ returnObservable.error(newThrowable("failurefromCommandThatFailsFast")); }else{ returnObservable.just("success"); } } 2、Fail Silent 无声失败 返回null,空Map,空List fail silent.png @Override protectedStringgetFallback(){ returnnull; } @Override protectedList<String>getFallback(){ returnCollections.emptyList(); } @Override protectedObservable<String>resumeWithFallback(){ returnObservable.empty(); } 3、Fallback: Static 返回默认值 回退的时候返回静态嵌入代码中的默认值,这样就不会导致功能以Fail Silent的方式被清楚,也就是用户看不到任何功能了。而是按照一个默认的方式显示。 @Override protectedBooleangetFallback(){ returntrue; } @Override protectedObservable<Boolean>resumeWithFallback(){ returnObservable.just(true); } 4、Fallback: Stubbed 自己组装一个值返回 当我们执行返回的结果是一个包含多个字段的对象时,则会以Stubbed 的方式回退。Stubbed 值我们建议在实例化Command的时候就设置好一个值。以countryCodeFromGeoLookup为例,countryCodeFromGeoLookup的值,是在我们调用的时候就注册进来初始化好的。CommandWithStubbedFallback command = new CommandWithStubbedFallback(1234, "china");主要代码如下: publicclassCommandWithStubbedFallbackextendsHystrixCommand<UserAccount>{ protectedCommandWithStubbedFallback(intcustomerId,StringcountryCodeFromGeoLookup){ super(HystrixCommandGroupKey.Factory.asKey("ExampleGroup")); this.customerId=customerId; this.countryCodeFromGeoLookup=countryCodeFromGeoLookup; } @Override protectedUserAccountgetFallback(){ /** *Returnstubbedfallbackwithsomestaticdefaults,placeholders, *andaninjectedvalue'countryCodeFromGeoLookup'thatwe'lluse *insteadofwhatwewouldhaveretrievedfromtheremoteservice. */ returnnewUserAccount(customerId,"UnknownName", countryCodeFromGeoLookup,true,true,false); } 5、Fallback: Cache via Network 利用远程缓存 通过远程缓存的方式。在失败的情况下再发起一次remote请求,不过这次请求的是一个缓存比如redis。由于是又发起一起远程调用,所以会重新封装一次Command,这个时候要注意,执行fallback的线程一定要跟主线程区分开,也就是重新命名一个ThreadPoolKey。 Cache via Network.png publicclassCommandWithFallbackViaNetworkextendsHystrixCommand<String>{ privatefinalintid; protectedCommandWithFallbackViaNetwork(intid){ super(Setter.withGroupKey(HystrixCommandGroupKey.Factory.asKey("RemoteServiceX")) .andCommandKey(HystrixCommandKey.Factory.asKey("GetValueCommand"))); this.id=id; } @Override protectedStringrun(){ //RemoteServiceXClient.getValue(id); thrownewRuntimeException("forcefailureforexample"); } @Override protectedStringgetFallback(){ returnnewFallbackViaNetwork(id).execute(); } privatestaticclassFallbackViaNetworkextendsHystrixCommand<String>{ privatefinalintid; publicFallbackViaNetwork(intid){ super(Setter.withGroupKey(HystrixCommandGroupKey.Factory.asKey("RemoteServiceX")) .andCommandKey(HystrixCommandKey.Factory.asKey("GetValueFallbackCommand")) //useadifferentthreadpoolforthefallbackcommand //sosaturatingtheRemoteServiceXpoolwon'tprevent //fallbacksfromexecuting .andThreadPoolKey(HystrixThreadPoolKey.Factory.asKey("RemoteServiceXFallback"))); this.id=id; } @Override protectedStringrun(){ MemCacheClient.getValue(id); } @Override protectedStringgetFallback(){ //thefallbackalsofailed //sothisfallback-of-a-fallbackwill //failsilentlyandreturnnull returnnull; } } } 6、Primary + Secondary with Fallback 主次方式回退(主要和次要) 这个有点类似我们日常开发中需要上线一个新功能,但为了防止新功能上线失败可以回退到老的代码,我们会做一个开关比如使用zookeeper做一个配置开关,可以动态切换到老代码功能。那么Hystrix它是使用通过一个配置来在两个command中进行切换。 Primary + Secondary with Fallback.png /** *Sample{@linkHystrixCommand}patternusingasemaphore-isolatedcommand *thatconditionallyinvokesthread-isolatedcommands. */ publicclassCommandFacadeWithPrimarySecondaryextendsHystrixCommand<String>{ privatefinalstaticDynamicBooleanPropertyusePrimary=DynamicPropertyFactory.getInstance().getBooleanProperty("primarySecondary.usePrimary",true); privatefinalintid; publicCommandFacadeWithPrimarySecondary(intid){ super(Setter .withGroupKey(HystrixCommandGroupKey.Factory.asKey("SystemX")) .andCommandKey(HystrixCommandKey.Factory.asKey("PrimarySecondaryCommand")) .andCommandPropertiesDefaults( //wewanttodefaulttosemaphore-isolationsincethiswraps //2otherscommandsthatarealreadythreadisolated //采用信号量的隔离方式 HystrixCommandProperties.Setter() .withExecutionIsolationStrategy(ExecutionIsolationStrategy.SEMAPHORE))); this.id=id; } //通过DynamicPropertyFactory来路由到不同的command @Override protectedStringrun(){ if(usePrimary.get()){ returnnewPrimaryCommand(id).execute(); }else{ returnnewSecondaryCommand(id).execute(); } } @Override protectedStringgetFallback(){ return"static-fallback-"+id; } @Override protectedStringgetCacheKey(){ returnString.valueOf(id); } privatestaticclassPrimaryCommandextendsHystrixCommand<String>{ privatefinalintid; privatePrimaryCommand(intid){ super(Setter .withGroupKey(HystrixCommandGroupKey.Factory.asKey("SystemX")) .andCommandKey(HystrixCommandKey.Factory.asKey("PrimaryCommand")) .andThreadPoolKey(HystrixThreadPoolKey.Factory.asKey("PrimaryCommand")) .andCommandPropertiesDefaults( //wedefaulttoa600mstimeoutforprimary HystrixCommandProperties.Setter().withExecutionTimeoutInMilliseconds(600))); this.id=id; } @Override protectedStringrun(){ //performexpensive'primary'servicecall return"responseFromPrimary-"+id; } } privatestaticclassSecondaryCommandextendsHystrixCommand<String>{ privatefinalintid; privateSecondaryCommand(intid){ super(Setter .withGroupKey(HystrixCommandGroupKey.Factory.asKey("SystemX")) .andCommandKey(HystrixCommandKey.Factory.asKey("SecondaryCommand")) .andThreadPoolKey(HystrixThreadPoolKey.Factory.asKey("SecondaryCommand")) .andCommandPropertiesDefaults( //wedefaulttoa100mstimeoutforsecondary HystrixCommandProperties.Setter().withExecutionTimeoutInMilliseconds(100))); this.id=id; } @Override protectedStringrun(){ //performfast'secondary'servicecall return"responseFromSecondary-"+id; } } publicstaticclassUnitTest{ @Test publicvoidtestPrimary(){ HystrixRequestContextcontext=HystrixRequestContext.initializeContext(); try{ //将属性"primarySecondary.usePrimary"设置为true,则走PrimaryCommand;设置为false,则走SecondaryCommand ConfigurationManager.getConfigInstance().setProperty("primarySecondary.usePrimary",true); assertEquals("responseFromPrimary-20",newCommandFacadeWithPrimarySecondary(20).execute()); }finally{ context.shutdown(); ConfigurationManager.getConfigInstance().clear(); } } @Test publicvoidtestSecondary(){ HystrixRequestContextcontext=HystrixRequestContext.initializeContext(); try{ //将属性"primarySecondary.usePrimary"设置为true,则走PrimaryCommand;设置为false,则走SecondaryCommand ConfigurationManager.getConfigInstance().setProperty("primarySecondary.usePrimary",false); assertEquals("responseFromSecondary-20",newCommandFacadeWithPrimarySecondary(20).execute()); }finally{ context.shutdown(); ConfigurationManager.getConfigInstance().clear(); } } } } 三、总结 降级的处理方式,返回默认值,返回缓存里面的值(包括远程缓存比如redis和本地缓存比如jvmcache)。 但回退的处理方式也有不适合的场景: 1、写操作 2、批处理 3、计算 以上几种情况如果失败,则程序就要将错误返回给调用者。 参考资料:https://github.com/Netflix/Hystrix/wiki

优秀的个人博客,低调大师

深度解析volatile—底层实现

我们都知道,Java关键字volatile的作用 1、内存可见性 2、禁止指令重排序 可见性是指,在多线程环境,共享变量的操作对于每个线程来说,都是内存可见的,也就是每个线程获取的volatile变量都是最新值;并且每个线程对volatile变量的修改,都直接刷新到主存。 下面重点介绍指令重排序。 为什么要指令重排序? 为了提高程序执行的性能,编译器和执行器(处理器)通常会对指令做一些优化(重排序) 1、编译器重排序。编译器在不改变单线程程序语义的前提下,可以重新安排语句的执行顺序; 2、处理器重排序。如果不存在数据依赖性,处理器可以改变语句对应机器指令的执行顺序; 学过《编译原理》同学应该知道,现代高级编程语言的编译器,实现都很复杂。 编译器基本构造包括:语法分析、词法分析、语义分析、中间代码生成、指令优化、目标代码产生。 第一阶段:编译器优化,就是发生在编译阶段,就Java而言,就是java源码编译生成class字节码的时候,对编译生成的中间代码进行的一次指令优化。Java的编译器是javac.exe。 第二阶段:执行器(处理器)优化,和不同的处理器硬件厂商的实现有关,也和Java的执行器(java.exe,也称Java解释器)有关。执行器优化,是对于机器指令在目标平台的机器上运行,做的一层优化。 我们知道,现代高级编程语言,经过编译后,产生目标代码,如.java的源文件编译后生成.class字节码文件,.cpp源文件经过C++编译器编译后生成.o对象文件。 这些编译后生成的文件,不能直接在机器上运行,而是需要转化成特定平台的机器指令。机器能够运行的指令,是需要这个平台、这个机器能正确识别的。 相同的一份源码,最终转化成不同平台上的机器指令,是不同的。 这也更容易理解:汇编指令,并不是跨平台的。Windows下通常使用Intel汇编,而Linux下多用AT&T汇编,它们在语法上存在差异,运行效果也依赖于各自平台的实现。 在Java中,为了提高运行效率,javac编译器,和java解释器,在2个阶段分别对指令进行了优化,也就是重排序。 Java重排序的前提:在不影响 单线程运行结果的前提下进行重排序。也就是在单线程环境运行,重排序后的结果和重排序之前按代码顺序运行的结果相同。 指令重排序对单线程没有什么影响,它不会影响程序的运行结果,但是会影响多线程的正确性。 Java因为指令重排序,优化我们的代码,让程序运行更快,也随之带来了多线程下,指令执行顺序的不可控。既然指令重排序会影响到多线程执行的正确性,那么我们就需要某些情景下禁止重排序。Java提供给我们禁止重排序能力的操作——就是volatile。 那么JVM的volatile是如何禁止重排序的呢? 在具体探究之前,我们先看另一个原则happens-before,happen-before原则保证了程序的“有序性”,它规定如果两个操作的执行顺序无法从happens-before原则中推到出来,那么他们就不能保证有序性,可以随意进行重排序。其定义如下: 1、同一个线程中的,前面的操作 happen-before 后续的操作。(即单线程内按代码顺序执行。但是,在不影响在单线程环境执行结果的前提下,编译器和处理器可以进行重排序,这是合法的。换句话说,这一是规则无法保证编译重排和指令重排)。 2、监视器上的解锁操作 happen-before 其后续的加锁操作。(Synchronized 规则) 3、对volatile变量的写操作 happen-before 后续的读操作。(volatile 规则) 4、线程的start() 方法 happen-before 该线程所有的后续操作。(线程启动规则) 5、线程所有的操作 happen-before 其他线程在该线程上调用 join 返回成功后的操作。 6、如果 a happen-before b,b happen-before c,则a happen-before c(传递性)。 在JVM中,将Happens-Before的程序顺序规则与其他某个顺序规则(通常是监视器锁规则、volatile变量规则)结合起来,从而对某个未被锁保护的变量的访问操作进行排序。 我们着重看第三点volatile规则:对volatile变量的写操作 happen-before 后续的读操作。为了实现volatile内存语义,JMM会重排序,其规则如下: 是否重排序 第二个操作 第一个操作 普通读/写 volatile读 volatile写 普通读/写 volatile读 NO NO NO volatile写 NO NO 为了探究volatile底层的实现原理,进行了如下探究。 通过javap 命令,将字节码文件反编译。观察反编译的结果,对于volatile修饰的变量,发现反编译得到的代码并没有什么帮助,和不加volatile修饰的变量没有任何区别。也就是说,字节码层面volatile变量并没有什么不同。 下面通过查看Java的汇编指令,查看Java代码最真实的运行细节。 如何查看Java的汇编指令,可以阅读:https://www.jianshu.com/p/93821b08e774 通过使用-XX:+UnlockDiagnosticVMOptions -XX:+PrintAssembly IDEA打印出了源代码的汇编指令。我们看到红色线框里面的那行指令:putstatic a ,将静态变量a入栈,注意观察add指令前面有一个lock前缀指令。 加入volatile关键字和没有加入volatile关键字时所生成的汇编代码发现,加入volatile关键字时,会多出一个lock前缀指令。我们发现,volatile变量在字节码级别没有任何区别,在汇编级别使用了lock指令前缀。 lock是一个指令前缀,Intel的手册上对其的解释是: Causes the processor's LOCK# signal to be asserted during execution of the accompanying instruction (turns the instruction into an atomic instruction). In a multiprocessor environment, the LOCK# signal insures that the processor has exclusive use of any shared memory while the signal is asserted. 简单理解也就是说,lock后就是一个原子操作。原子操作是指不会被线程调度机制打断的操作;这种操作一旦开始,就一直运行到结束,中间不会有任何 context switch (切换到另一个线程)。 当使用 LOCK 指令前缀时,它会使 CPU 宣告一个 LOCK# 信号,这样就能确保在多处理器系统或多线程竞争的环境下互斥地使用这个内存地址。当指令执行完毕,这个锁定动作也就会消失。 是不是感觉有点像Java的synchronized锁。但volatile底层使用多核处理器实现的lock指令,更底层,消耗代价更小。 因此有人将Java的synchronized看作重量级的锁,而volatile看作轻量级的锁 并不是全无道理。 lock前缀指令其实就相当于一个内存屏障。内存屏障是一组CPU处理指令,用来实现对内存操作的顺序限制。volatile的底层就是通过内存屏障来实现的。 编译器和执行器 可以在保证输出结果一样的情况下对指令重排序,使性能得到优化。插入一个内存屏障,相当于告诉CPU和编译器先于这个命令的必须先执行,后于这个命令的必须后执行。正如去西藏途中各个站点的先后顺序在你心中都一清二楚。 内存屏障另一个作用是强制更新一次不同CPU的缓存。例如,一个写屏障会把这个屏障前写入的数据刷新到缓存,这样任何试图读取该数据的线程将得到最新值,而不用考虑到底是被哪个cpu核心或者哪个CPU执行的。这正是volatile实现内存可见性的基础。 内存屏障细说来有写屏障、读屏障、读写屏障,而且内存屏障的实现依赖于编译器和机器两部分。 编译器在编译过程中可能会对指令重排序,这样开发者通过显式地标注告知编译器,避免编译器最终生成的代码行为违背预期,对于 Java 而言,不光生成的 bytecode 需要保存 volatile 的语义,连运行时的 JIT 代码的行为也要遵守相应的约束;即插入内存屏障后,告诉CPU和编译器先于这个命令的必须先执行,后于这个命令的必须后执行,从而实现了禁止重排序。 关于内存屏障的一些具体细节,大佬Martin写了一篇文章《going into memory barriers》介绍,外网可以看看。 小结: 1、Java重排序的前提:在不影响 单线程运行结果的前提下进行重排序。也就是在单线程环境运行,重排序后的结果和重排序之前按代码顺序运行的结果相同。 2、指令重排序对单线程没有什么影响,它不会影响程序的运行结果,反而会优化执行性能,但会影响多线程的正确性。 3、Java因为指令重排序,优化我们的代码,让程序运行更快,也随之带来了多线程下,指令执行顺序的不可控。 4、volatile的底层是通过lock前缀指令、内存屏障来实现的。 存档文章 查看Java的汇编指令 终于有人把Java内存模型(JMM)说清楚了 JVM体系结构-----深入理解内存结构 从多核硬件架构,看Java内存模型

优秀的个人博客,低调大师

Java LinkedHashMap类源码解析

LinkedHashMap继承了HashMap,他在HashMap的基础上增加了一个双向链表的结构,链表默认维持key插入的顺序,重复的key值插入不会改变顺序,适用于使用者需要返回一个顺序相同的map对象的情况。还可以生成access-order顺序的版本,按照最近访问顺序来存储,刚被访问的结点处于链表的末尾,适合LRU,put get compute merge都算作一次访问,其中put key值相同的结点也算作一次访问,replace只有在换掉一个键值对的时候才算一次访问,putAll产生的访问顺序取决于原本map的迭代器实现。 在插入键值对时,可以通过对removeEldestEntry重写来实现新键值对插入时自动删除最旧的键值对 拥有HashMap提供的方法,迭代器因为是通过遍历双向链表,所以额外开销与size成正比与capacity无关,因此选择过大的初始大小对于遍历时间的增加没有HashMap严重,后者的遍历时间依赖与capacity。 同样是非线程安全方法,对于LinkedHashMap来说,修改结构的操作除了增加和删除键值对外,还有对于access-order时进行了access导致迭代器顺序改变,主要是get操作,对于插入顺序的来说,仅仅修改一个已有key值的value值不是一个修改结构的操作,但对于访问顺序,put和get已有的key值会改变顺序。迭代器也是fail-fast设计,但是fail-fast只是一个调试功能,一个设计良好的程序不应该出现这个错误 因为HashMap加入了TreeNode,所以现在LinkedHashMap也有这个功能 以下描述中的链表,若无特别说明都是指LinkedHashMap的双向链表 先来看一下基本结构,每个键值对加入了前后指针,集合加入了头尾指针来形成双向链表,accessOrder代表链表是以访问顺序还是插入顺序存储 static class Entry<K,V> extends HashMap.Node<K,V> { Entry<K,V> before, after;//增加了先后指针来形成双向链表 Entry(int hash, K key, V value, Node<K,V> next) { super(hash, key, value, next); } } /** * The head (eldest) of the doubly linked list.头部 */ transient LinkedHashMap.Entry<K,V> head; /** * The tail (youngest) of the doubly linked list.尾部 */ transient LinkedHashMap.Entry<K,V> tail; //true访问顺序 false插入顺序 final boolean accessOrder; 然后是几个内部方法。linkNodeLast将p连接到链表尾部 private void linkNodeLast(LinkedHashMap.Entry<K,V> p) { LinkedHashMap.Entry<K,V> last = tail; tail = p; if (last == null) head = p;//原本链表为空则p同时为头部 else { p.before = last; last.after = p; } } transferLinks用dst替换src private void transferLinks(LinkedHashMap.Entry<K,V> src, LinkedHashMap.Entry<K,V> dst) { LinkedHashMap.Entry<K,V> b = dst.before = src.before; LinkedHashMap.Entry<K,V> a = dst.after = src.after; if (b == null) head = dst; else b.after = dst; if (a == null) tail = dst; else a.before = dst; } reinitialize在调用HashMap方法的基础上,将head和tail设为null void reinitialize() { super.reinitialize(); head = tail = null; } newNode生成一个LinkedHashMap结点,next指向e,插入到LinkedHashMap链表末端 Node<K,V> newNode(int hash, K key, V value, Node<K,V> e) { LinkedHashMap.Entry<K,V> p = new LinkedHashMap.Entry<K,V>(hash, key, value, e);//新建一个键值对,next指向e linkNodeLast(p);//p插入到LinkedHashMap链表末端 return p; } replacementNode根据原结点生成一个LinkedHashMap结点替换原结点 Node<K,V> replacementNode(Node<K,V> p, Node<K,V> next) { LinkedHashMap.Entry<K,V> q = (LinkedHashMap.Entry<K,V>)p; LinkedHashMap.Entry<K,V> t = new LinkedHashMap.Entry<K,V>(q.hash, q.key, q.value, next);//生成一个新的键值对next是给出的next参数 transferLinks(q, t);//用t替换q return t; } newTreeNode生成一个TreeNode结点,next指向next,插入到LinkedHashMap链表末端 TreeNode<K,V> newTreeNode(int hash, K key, V value, Node<K,V> next) { TreeNode<K,V> p = new TreeNode<K,V>(hash, key, value, next);//生成一个TreeNode,next指向参数next linkNodeLast(p);//p插入到LinkedHashMap链表末端 return p; } replacementTreeNode根据结点p生成一个新的TreeNode,next设为给定的next,替换原本的p TreeNode<K,V> replacementTreeNode(Node<K,V> p, Node<K,V> next) { LinkedHashMap.Entry<K,V> q = (LinkedHashMap.Entry<K,V>)p; TreeNode<K,V> t = new TreeNode<K,V>(q.hash, q.key, q.value, next); transferLinks(q, t);//根据结点p生成一个新的TreeNode,next设为给定的next,替换原本的p return t; } afterNodeRemoval从LinkedHashMap的链上移除结点e void afterNodeRemoval(Node<K,V> e) { LinkedHashMap.Entry<K,V> p = (LinkedHashMap.Entry<K,V>)e, b = p.before, a = p.after; p.before = p.after = null; if (b == null) head = a; else b.after = a; if (a == null) tail = b; else a.before = b; } afterNodeInsertion可能移除最旧的结点,需要evict为true同时链表不为空同时removeEldestEntry需要重写 void afterNodeInsertion(boolean evict) { LinkedHashMap.Entry<K,V> first; if (evict && (first = head) != null && removeEldestEntry(first)) {//removeEldestEntry需要重写才从发挥作用,否则一定返回false K key = first.key;//移除链表头部的结点 removeNode(hash(key), key, null, false, true); } } afterNodeAccess在访问过后将结点e移动到链表尾部,需要Map是access-order,若移动成功则增加modCount void afterNodeAccess(Node<K,V> e) { LinkedHashMap.Entry<K,V> last; if (accessOrder && (last = tail) != e) {//Map是access-order同时e不是链表的尾部 LinkedHashMap.Entry<K,V> p = (LinkedHashMap.Entry<K,V>)e, b = p.before, a = p.after; p.after = null; if (b == null)//将结点e从链表中剪下 head = a; else b.after = a; if (a != null) a.before = b; else last = b; if (last == null) head = p; else { p.before = last; last.after = p; } tail = p;//结点e移动到链表尾部 ++modCount;//因为有access-order下结点被移动,所以增加modCount } } 构造函数方面,accessOrder默认是false插入顺序,初始大小为16,负载因子为0.75,这里是同HashMap。复制构造也是调用了HashMap.putMapEntries方法 containsValue遍历链表寻找相等的value值,这个操作一定不会造成结构改变 public boolean containsValue(Object value) { for (LinkedHashMap.Entry<K,V> e = head; e != null; e = e.after) {//检查同样是根据LinkedHashMap提供的链表顺序进行遍历 V v = e.value; if (v == value || (value != null && value.equals(v))) return true; } return false; } get方法复用HashMap的getNode方法,若找到结点且Map是访问顺序时,要将访问的结点放到链表最后,若没找到则返回null。而getOrDefault仅有的区别是没找到时返回defaultValue public V get(Object key) { Node<K,V> e; if ((e = getNode(hash(key), key)) == null)//复用HashMap的getNode方法 return null; if (accessOrder) afterNodeAccess(e);//access-order时将e放到队尾 return e.value; } public V getOrDefault(Object key, V defaultValue) { Node<K,V> e; if ((e = getNode(hash(key), key)) == null) return defaultValue;//复用HashMap的getNode方法,若没有找到对应的结点则返回defaultValue if (accessOrder) afterNodeAccess(e);//access-order时将e放到队尾 return e.value; } clear方法在HashMap的基础上要把head和tail设为null public void clear() { super.clear(); head = tail = null; } removeEldestEntry在put和putAll插入键值对时调用,原本是一定返回false的,如果要自动删除最旧的键值对要返回true,需要进行重写。比如下面这个例子,控制size不能超过100 private static final int MAX_ENTRIES = 100; protected boolean removeEldestEntry(Map.Entry eldest) { return size() > MAX_ENTRIES; } 下面两个方法和HashMap相似,返回key的Set和value的Collection还有返回键值对的Set,这个是直接引用,所以对它们的remove之类的修改会直接反馈到LinkedHashMap上 public Set<K> keySet() { Set<K> ks = keySet; if (ks == null) { ks = new LinkedKeySet(); keySet = ks; } return ks;//返回key值的set } public Collection<V> values() { Collection<V> vs = values; if (vs == null) { vs = new LinkedValues(); values = vs; } return vs;//返回一个包含所有value值的Collection } public Set<Map.Entry<K,V>> entrySet() { Set<Map.Entry<K,V>> es; return (es = entrySet) == null ? (entrySet = new LinkedEntrySet()) : es;//返回一个含有所有键值对的Set } 检查HashMap的putVal方法,我们可以看到在找到了相同key值并修改value值时会调用afterNodeAccess,对于access-order会改变结点顺序 if (e != null) { // 找到了相同的key则修改value值并返回旧的value V oldValue = e.value; if (!onlyIfAbsent || oldValue == null) e.value = value; afterNodeAccess(e); return oldValue; }

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册