首页 文章 精选 留言 我的

精选列表

搜索[文档滚动],共10000篇文章
优秀的个人博客,低调大师

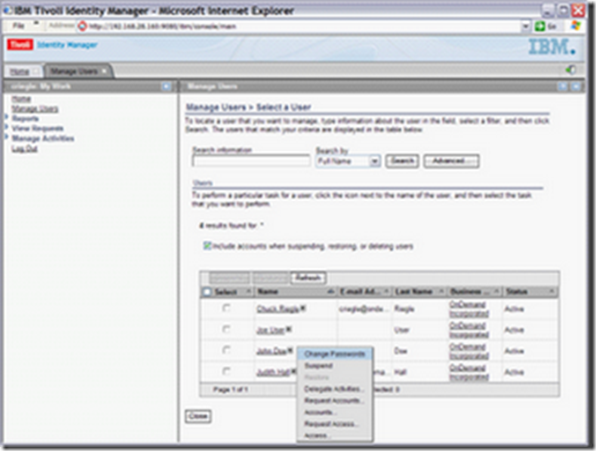
【IBM Tivoli Identity Manager 学习文档】1 简介

IBM Tivoli Identity Manager, 简称 TIM, 是IBM身份的生命周期的管理工具。 它提供了集成化的身份生存周期管理,可以自动的创建、管理删除用户对于不同系统资源(如文件、服务器、应用程序、及其他基于角色或需求的系统资源)的进入权限。 IBM在2002年并购了Access360 将其拳头产品命名为TIM 4.4.以后该产品都是基于这个版本的代码进行开发的。 TIM 4.5.1 在2003年9月份发布. TIM 4.6 在 2005年7月发布最新版本的TIM, 5.0在2007年12月发布 IBM 在2006年发布了IBM Tivoli Identity Manager Express.瞄准了服务器信息块(SMB)市场。 其特点是: 在TIM所连接的资源上为授权用户提供账户。 在WAS上运行,可以是单服务器的,也可以是集群式的。 在数据库服务器上存储历史和等待数据。 在LDAP服务器上存储用户账户及其组织的数据。 在数据库内存储TIM审核和报告的数据。 提供HTTP式的管理服务。 安装部署要求: 一个数据库服务器:这个服务器上要有JDBC,用于与其数据通信, 一个LDAP服务器 一个IBM TDI(可选):用于同步在不同目录、数据库和应用程序的身份数据。TDI同步和管理在应用程序间或目录资源间的信息交互。 WAS:提供了JVM,为企业应用程序代码提供了运行环境。并且提供了为特定Java程序组建运行所需的容器。 一个HTTP服务器:为TIM提供由浏览器进行管理的客户端界面,TIM要求安装带有HTTP服务器的WebSphere Web Server plug-in。 一个TIM服务器:使你可以对不同的资源给予身份。 一个TIM adapters:使你可以将TIM服务器连接到不同的资源上。 TIM5.0的新功能: 1.新的管理员界面和新的End-User界面。 2.自动化流程,并增强了审计功能。 3.访问权限控制。 4.手动服务(这是指某个服务没有 adapter,必须有手工介入,比如设定办公室和电话号码),工作流和重新鉴权等都可以用手工服务进行)。 5.基于供应的请求(Request Based Provisioning)。 要想真正学习一个东西就需要对其设计初衷有所了解 TIM5.0的设计初衷: a.方便安装和部署,b.方便使用和管理,c.遵循自动化并提供审计功能。 我们看看这些初衷在功能中怎么体现的: 初衷a—— 提供了中间件自动配置的功能,并且可以将DB2和TDS这两个中间件部署在单一的服务器或集群环境; 从TIM4.6(含express版本)的迁移; 支持静默安装选项,输入可以从响应文件中获取。 LDAP和Unix/Linux的Adapter是安装的服务器的一部分。安装的Adapters的服务类型有: LDAP POSIX Solaris POSIX Linux POSIX HP-UX POSIX AIX 初衷b—— 全新设计的管理者界面,提供了多任务特性,对于不同的用户类型(TIM administrators、help desk assistants、service owners 、managers、auditors )有优化的预定义的组、视图、安全设置(ACIS),并且可以对上述进行个性化定制。 对于服务和策略,有生成向导和模板,大大提高了效率。 对于使用Self Service的End-User,用户可以方便的管理他们的档案、账户和访问权限。管理员可以在这个界面中自己定制用户视图、安全设置、界面风格、配置选项。 提供了基于需求的帐户供应模式( Request-Based Account Provisioning)和基于角色的帐户供应模式( Role-based account provisioning),以及二者的混合模式。 权限管理是依赖于帐户所属的组。像服务一样,访问权限的界定也可以付给某个用户,它来管理访问权限。 初衷c—— 支持定义相关策略和工作流来定期的收集为了自动审查而进行的重新鉴权的信息,无需进行脚本编程或写代码。 本文转自gnuhpc博客园博客,原文链接:http://www.cnblogs.com/gnuhpc/archive/2012/01/16/2323698.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

发布在线文档【软件=业务+架构+流程+组织.pptx】

0年的技术工作,软件这个词对我来说一点都不陌生,但是当我问自己如何理解软件的?我却不知道如何回答。软件=业务+架构+流程+组织,其中公式是借用软件产品线工程BAPO的概念,我觉得不错,这个ppt就是我去年思考的一个理解,希望大家看后对软件也有一个更清晰的认识。 在线查看地址:软件=业务+架构+流程+组织.pptx 上周我发布的在线电子书列表,只能在线查看,不提供免费下载 本文转自 jingen_zhou 51CTO博客,原文链接:http://blog.51cto.com/zhoujg/519466,如需转载请自行联系原作者

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 多语言接口协议

本文描述了 Storm (0.7.1 版本以上)的多语言接口协议。 Storm 多语言协议 Shell 组件 Storm 的多语言支持主要通过 ShellBolt,ShellSpout 和 ShellProcess 类来实现。这些类实现了 IBolt 接口、ISpout 接口,并通过使用 Java 的 ProcessBuilder 类调用 shell 进程实现了执行脚本的接口协议。 输出域 输出域是拓扑的 Thrift 定义的一部分。也就是说,如果你在 Java 中使用了多语言接口,那么你就需要创建一个继承自 ShellBolt 并实现 IRichBolt 接口的 bolt,这个 bolt 还需要在declareOutputFields方法中声明输出域(ShellSpout 也有类似的问题)。 你可以在基础概念一文中了解更多相关信息。 协议报头 最简单的协议是通过执行脚本或程序的标准输入输出(STDIN/STDOUT)来实现的。在这个过程中传输的数据都是以 JSON 格式编码的,这样可以支持很多种语言。 打包 为了在集群上运行壳组件,执行的外壳脚本必须和待提交的 jar 包一起置于resources/目录下。 但是,在本地开发测试时,resources 目录只需要保持在 classpath 中即可。 协议 注意: 输入输出协议的结尾都使用行读机制,所以,必须要修剪掉输入中的新行并将他们添加到输出中。 所有的 JSON 输入输出都由一个包含 “end” 的行结束标志。注意,这个定界符并不是 JSON 的一部分。 下面的几个标题就是从脚本作者的 STDIN 与 STDOUT 的角度出发的。 初始握手 两种类型壳组件的初始握手过程都是相同的: STDIN: 设置信息。这是一个包含 Storm 配置、PID 目录、拓扑上下文的 JSON 对象: { "conf": { "topology.message.timeout.secs": 3, // etc }, "pidDir": "...", "context": { "task->component": { "1": "example-spout", "2": "__acker", "3": "example-bolt1", "4": "example-bolt2" }, "taskid": 3, // 以下内容仅支持 Storm 0.10.0 以上版本 "componentid": "example-bolt" "stream->target->grouping": { "default": { "example-bolt2": { "type": "SHUFFLE"}}}, "streams": ["default"], "stream->outputfields": {"default": ["word"]}, "source->stream->grouping": { "example-spout": { "default": { "type": "FIELDS", "fields": ["word"] } } } "source->stream->fields": { "example-spout": { "default": ["word"] } } } } 你的脚本应该在这个目录下创建一个以 PID 命名的空文件。比如,PID 是 1234 的时候,在目录中创建一个名为 1234 的空文件。这个文件可以让 supervisor 了解到进程的 PID,这样,supervisor 在需要的时候就可以关闭该进程。 Storm 0.10.0 加强了发送到壳组件的上下文的功能,现在的上下文中包含了兼容 JVM 组件的拓扑上下文中的所有内容。新增的一个关键因素是确定拓扑中某个壳组件的源与目标(也就是输入与输出)的功能,这是通过stream->target->grouping和source->stream->grouping字典实现的。在这些关联字典的底层,分组是以字典的形式表示的,至少包含有一个type键,并且也可以含有一个fields键,该键可以用于指定在FIELDS分组中所涉及的域。 STDOUT: 你的 PID,以 JSON 对象的形式展现,比如{"pid": 1234}。这个壳组件将会把 PID 记录到它自己的日志中。 接下来怎么做就要取决于组件的具体类型了。 Spouts Shell Spouts 都是同步的。以下内容是在一个 while(true) 循环中实现的: STDIN: 一个 next、ack 或者 fail 命令。 “next” 与 ISpout 的nextTuple等价,可以这样定义 “next”: {"command": "next"} 可以这样定义 “ack”: {"command": "ack", "id": "1231231"} 可以这样定义 “fail”: {"command": "fail", "id": "1231231"} STDOUT: 前面的命令对你的 spout 作用产生的结果。这个结果可以是一组 emits 和 logs。 emit 大概是这样的: { "command": "emit", // tuple 的 id,如果是不可靠 emit 可以省略此值,该 id 可以为字符串或者数字 "id": "1231231", // tuple 将要发送到的流 id,如果发送到默认流,将该值留空 "stream": "1", // 如果是一个直接型 emit,需要定义 tuple 将要发送到的任务 id "task": 9, // 这个 tuple 中的所有值 "tuple": ["field1", 2, 3] } 如果不是直接型 emit,你会立即在 STDIN 上收到一条表示 tuple 发送到的任务的 id 的消息,这个消息是以 JSON 数组形式展现的。 “log” 会将消息记录到 worker log 中,“log” 大概是这样的: { "command": "log", // 待记录的消息 "msg": "hello world!" } STDOUT: “sync” 命令会结束 emits 与 logs 的队列,“sync” 是这样使用的: {"command": "sync"} 在 sync 之后, ShellSpout 不会继续读取你的输出,直到它发送出新的 next,ack 或者 fail。 注意,与 ISpout 类似,worker 中的所有 spouts 都会在调用 next,ack 或者 fail 之后锁定,直到你调用 sync。同样,如果没有需要发送的 tuple,你也应该在 sync 之前 sleep 一小段时间。ShellSpout 不会自动 sleep。 Bolts Shell Bolts 的协议是异步的。你会在有 tuple 可用时立即从 STDIN 中获取到 tuple,同时你需要像下面的示例这样调用 emit,ack,fail,log 等操作写入 STDOUT: STDIN: 就是一个 tuple!这是一个 JSON 编码的结构: { // tuple 的 id,为了兼容缺少 64 位数据类型的语言,这里使用了字符串 "id": "-6955786537413359385", // 创建该 tuple 的 id "comp": "1", // tuple 将要发往的流 id "stream": "1", // 创建该 tuple 的任务 "task": 9, // tuple 中的所有值 "tuple": ["snow white and the seven dwarfs", "field2", 3] } STDOUT: 一个 ack,fail,emit 或者 log。例如,emit 是这样的: { "command": "emit", // 标记这个输出 tuple 的 tuples 的 ids "anchors": ["1231231", "-234234234"], // tuple 将要发送到的流 id,如果发送到默认流,将该值留空 "stream": "1", // 如果是一个直接型 emit,需要定义 tuple 将要发送到的任务 id "task": 9, // 这个 tuple 中的所有值 "tuple": ["field1", 2, 3] } 如果不是直接型 emit,你会立即在 STDIN 上收到一条表示 tuple 发送到的任务的 id 的消息,这个消息是以 JSON 数组形式展现的。注意,由于 shell bolt 协议的异步特性,如果你在 emit 之后立即接收数据,有可能不会收到对应的任务 id,而是收到上一个 emit 的任务 id,或者是一个待处理的新 tuple。然而,最终接收到的任务 id 序列仍然是和 emit 的顺序完全一致的。 ack 是这样的: { "command": "ack", // 待 ack 的 tuple "id": "123123" } fail 是这样的: { "command": "fail", // 待 fail 的 tuple "id": "123123" } “log” 会将消息记录到 worker log 中,“log” 是这样的: { "command": "log", // 待记录的消息 "msg": "hello world!" } 注意:对于 0.7.1 版本,shell bolt 不再需要进行“同步”。 处理心跳(0.9.3 及以上版本适用) Storm 0.9.3 通过在 ShellSpout/ShellBolt 与他们的多语言子进程之间使用心跳来检测子进程是否处于挂起或僵死状态。所有通过多语言接口与 Storm 交互的库都必须使用以下步骤来…… Spout Shell Spouts 是同步的,所有子进程会在next()的结尾发送sync命令。因此,你不需要为 spouts 做过多的处理。也就是说,在next()过程中不能够让子进程的 sleep 时间超过 worker 的延时时间。 Bolt Shell Bolts 是异步的,所以 ShellBolt 会定期向它的子进程发送心跳 tuple。心跳 tuple 是这样的: { "id": "-6955786537413359385", "comp": "1", "stream": "__heartbeat", // 这个 shell bolt 的系统任务 id "task": -1, "tuple": [] } 在子进程收到心跳 tuple 之后,它必须向 ShellBolt 发送一个sync命令。 转载自并发编程网 - ifeve.com


优秀的个人博客,低调大师

Apache Storm 官方文档 —— 使用 Maven 构建 Storm 应用

在开发拓扑的时候,你需要在 classpath 中包含 Storm 的相关 jar 包。你可以将各个 jar 包直接包含到你的项目的 classpath 中,也可以使用 Maven 将 Storm 添加到依赖项中。Storm 已经集成到 Maven 的中心仓库中。你可以在项目的 pom.xml 中添加以下依赖来将 Storm 包含进项目中: <dependency> <groupId>org.apache.storm</groupId> <artifactId>storm-core</artifactId> <version>0.9.3</version> <scope>provided</scope> </dependency> 这里有一个 Storm 项目的 pom.xml 文件的例子(依赖中的版本号与实际 Storm 发行版相关,目前最新的正式版本为 0.9.5 —— 译者注)。 Storm 开发 如果对 Storm 的开发很感兴趣,请参考DEVELOPER一文。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— Storm 集群安装配置

本文详细介绍了 Storm 集群的安装配置方法。如果需要在 AWS 上安装 Storm,你应该先了解一下storm-deploy项目。storm-deploy可以自动完成 E2 上 Storm 集群的准备、配置、安装的全部过程,同时还设置好了 Ganglia,方便监控 CPU、磁盘以及网络的使用信息。 如果你在使用 Storm 集群时遇到问题,请先查看“问题与解决”一文中是否已有相应的解决方案。如果检索不到有效的解决方法,请向社区的邮件列表发送关于问题的邮件。 以下是安装 Storm 的步骤: 安装 ZooKeeper 集群; 在各个机器上安装运行集群所需要的依赖组件; 下载 Storm 安装程序并解压缩到集群的各个机器上; 在 storm.yaml 中添加集群配置信息; 使用 “storm” 脚本启动各机器后台进程。 安装 ZooKeeper 集群 Storm 使用 ZooKeeper 来保证集群的一致性。集群中 ZooKeeper 并不是用来进行消息传递的,所以 Storm 对 ZooKeeper 的负载相当低。虽然在大部分场景下单点 ZooKeeper 也勉强够用,但是如果你需要更可靠的 HA 机制或者需要部署大规模 Storm 集群,你最好配置一个 ZooKeeper 集群。ZooKeeper 集群的部署说明请参考此文。 关于 ZooKeeper 部署的几点说明: ZooKeeper 必须在监控模式下运行。因为 ZooKeeper 是个快速失败系统,如果遇到了故障,ZooKeeper 服务会主动关闭。更多详细信息请参考此文。 需要设置一个 cron 服务来定时压缩 ZooKeeper 的数据与事务日志。因为 ZooKeeper 的后台进程不会处理这个问题,如果不配置 cron,ZooKeeper 的日志会很快填满磁盘空间。更多详细信息请参考此文。 安装必要的依赖组件 接下来你需要在集群中的所有机器上安装必要的依赖组件,包括: Java 6(推荐使用 JDK 7 以上版本 —— 译者注) Python 2.6.6(推荐使用 Python 2.7.x 版本 —— 译者注) 以上均为在 Storm 上测试通过的版本。Storm 并不保证对其他版本的 Java 或 Python 的支持。 下载 Storm 安装程序并解压 接下来就要下载需要的 Storm 发行版,并将 zip 安装文件解压缩到集群中的各个机器上。Storm 的发行版可以在这里下载(推荐在 Storm 官方网站的下载页面使用 Apache 的镜像服务下载 —— 译者注)。 配置 storm.yaml Storm 的安装包中包含一个在 conf 目录下的storm.yaml文件,该文件是用于配置 Storm 集群的各种属性的。你可以在这里查看各个配置项的默认值。storm.yaml 会覆盖 defaults.yaml 中各个配置项的默认值。以下是几个在安装集群时必须配置的选项: 1)storm.zookeeper.servers:这是 Storm 关联的 ZooKeeper 集群的地址列表,此项的配置是如下所示: storm.zookeeper.servers: - "111.222.333.444" - "555.666.777.888" 注意,如果你使用的 ZooKeeper 集群的端口不是默认端口,你还需要相应地配置storm.zookeeper.port。 2)storm.local.dir:Nimbus 和 Supervisor 后台进程都需要一个用于存放一些状态数据(比如 jar 包、配置文件等等)的目录。你可以在每个机器上创建好这个目录,赋予相应的读写权限,并将该目录写入配置文件中,如下所示: storm.local.dir: "/mnt/storm" 3)nimbus.host:集群的工作节点需要知道集群中的哪台机器是主机,以便从主机上下载拓扑以及配置文件,如下所示: nimbus.host: "111.222.333.44" 4)supervisor.slots.ports:你需要通过此配置项配置每个 Supervisor 机器能够运行的工作进程(worker)数。每个 worker 都需要一个单独的端口来接收消息,这个配置项就定义了 worker 可以使用的端口列表。如果你在这里定义了 5 个端口,那么 Storm 就会在该机器上分配最多 5 个worker。如果定义 3 个端口,那 Storm 至多只会运行三个 worker。此项的默认值是 6700、6701、6702、6703 四个端口,如下所示: supervisor.slots.ports: - 6700 - 6701 - 6702 - 6703 配置外部库与环境变量(可选) 如果你需要使用某些外部库或者定制插件的功能,你可以将相关 jar 包放入extlib/与extlib-daemon目录下。注意,extlib-daemon目录仅仅用于存储后台进程(Nimbus,Supervisor,DRPC,UI,Logviewer)所需的 jar 包,例如,HDFS 以及定制的调度库。另外,可以使用STORM_EXT_CLASSPATH和STORM_EXT_CLASSPATH_DAEMON两个环境变量来配置普通外部库与“仅用于后台进程”外部库的 classpath。 使用 “storm” 脚本启动后台进程 最后一步是启动所有的 Storm 后台进程。注意,这些进程必须在严格监控下运行。因为 Storm 是个与 ZooKeeper 相似的快速失败系统,其进程很容易被各种异常错误终止。之所以设计成这种模式,是为了确保 Storm 进程可以在任何时刻安全地停止并且在进程重新启动之后恢复征程。这也是 Storm 不在处理过程中保存任何状态的原因 —— 在这种情况下,如果有 Nimbus 或者 Supervisor 重新启动,运行中的拓扑不会受到任何影响。下面是启动后台进程的方法: Nimbus:在 master 机器上,在监控下执行bin/storm nimbus命令。 Supervisor:在每个工作节点上,在监控下执行bin/storm supervisor命令。Supervisor 的后台进程主要负责启动/停止该机器上的 worker 进程。 UI:在 master 机器上,在监控下执行bin/storm ui命令启动 Storm UI(Storm UI 是一个可以在浏览器中方便地监控集群与拓扑运行状况的站点)后台进程。可以通过http://{nimbus.host}:8080来访问 UI 站点。 可以看出,启动后台进程非常简单。同时,各个后台进程也会将日志信息记录到 Storm 安装程序的 logs/ 目录中(这是 Storm 的默认设置,日志文件的路径与相关配置信息可以在 {STORM_HOME}/logback/cluster.xml 文件中修改 —— 译者注)。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

docker官方文档中的dns,link,expose,publish

link是过时的了,尽量不要用。 dns内部集成,也可以用外部。 expose只是用于记录,并不真的。 publish是否起作用,也要看情况,是否被占用端口。 -------------------------------------- Embedded DNS server Docker daemon runs an embedded DNS server which provides DNS resolution among containers connected to the same user-defined network, so that these containers can resolve container names to IP addresses. If the embedded DNS server is unable to resolve the request, it will be forwarded to any external DNS servers configured for the container. To facilitate this when the container is created, only the embedded DNS server reachable at127.0.0.11will be listed in the container’sresolv.conffile. For more information on embedded DNS server on user-defined networks, seeembedded DNS server in user-defined networks Exposing and publishing ports In Docker networking, there are two different mechanisms that directly involve network ports: exposing and publishing ports. This applies to the default bridge network and user-defined bridge networks. You expose ports using theEXPOSEkeyword in the Dockerfile or the--exposeflag todocker run. Exposing ports is a way of documenting which ports are used, but does not actually map or open any ports. Exposing ports is optional. You publish ports using thePUBLISHkeyword in the Dockerfile or the--publishflag todocker run. This tells Docker which ports to open on the container’s network interface. When a port is published, it is mapped to an available high-order port (higher than30000) on the host machine, unless you specify the port to map to on the host machine at runtime. You cannot specify the port to map to on the host machine in the Dockerfile, because there is no way to guarantee that the port will be available on the host machine where you run the image. This example publishes port 80 in the container to a random high port (in this case,32768) on the host machine. $ docker run -it -p 80 nginx $ docker ps 64879472feea nginx "nginx -g 'daemon ..." 43 hours ago Up About a minute 443/tcp, 0.0.0.0:32768->80/tcp blissful_mclean The next example specifies that port 80 should be mapped to port 8080 on the host machine. It will fail if port 8080 is not available. $ docker run -it -p 80:8080 nginx $ docker ps b9788c7adca3 nginx "nginx -g 'daemon ..." 43 hours ago Up 3 seconds 80/tcp, 443/tcp, 0.0.0.0:80->8080/tcp goofy_brahmagupta Links Before Docker included user-defined networks, you could use the Docker--linkfeature to allow a container to resolve another container’s name to an IP address, and also give it access to the linked container’s environment variables. Where possible, you should avoid using the legacy--linkflag. When you create links, they behave differently when you use the defaultbridgenetwork or when you use user-defined bridge networks. For more information, seeLegacy Linksfor link feature in defaultbridgenetwork and thelinking containers in user-defined networksfor links functionality in user-defined networks.

优秀的个人博客,低调大师

Spark Streaming Dynamic Resource Allocation 文档(非官方特性)

必要配置 通过下面参数开启DRA spark.streaming.dynamicAllocation.enabled=true 设置最大最小的Executor 数目: spark.streaming.dynamicAllocation.minExecutors=0 spark.streaming.dynamicAllocation.maxExecutors=50 可选配置 这些参数可以不用配置,都已经提供了一个较为合理的默认值 开启日志: spark.streaming.dynamicAllocation.debug=true 设置DRA 生效延时: spark.streaming.dynamicAllocation.delay.rounds=10 设置DRA 计算资源量时参考的周期数: spark.streaming.dynamicAllocation.rememberBatchSize=1 设置DRA 释放资源的步调: spark.streaming.dynamicAllocation.releaseRounds=5 设置DRA 资源额外保留比例: spark.streaming.dynamicAllocation.reserveRate=0.2 DRA 算法说明 减少资源时,采用启发式算法。根据之前周期的处理时间,计算需要保留的资源量(A),然后尝试分多轮试探性的减少(B),每个计算周期都会重复A,B动作,最后会收敛到一个具体的数值。 如果一旦发生延时,则会立马向Yarn申请spark.streaming.dynamicAllocation.maxExecutors 个Executor,以保证可以最快速度消除延时。富余出来的资源会通过减少资源的动作慢慢进行减少,让程序趋于稳定。 发生减少资源的动作,则剔除的掉的Executor 会被立刻(几毫秒/纳秒)屏蔽,并且不再分配Task,之后再由Yarn异步移除。 添加资源的动作,则由Yarn决定 注意事项 请务必保证你Package 的App包不包含spark 相关的组件。否则你会看到自己的设置并不生效,因为运行的时候用了你的App里的spark-core,spark-streaming jar包了。 一些可以参考的调整 如果系统趋向稳定后,经过人工观察发现其实还可以再降资源,则可以尝试调低 spark.streaming.dynamicAllocation.releaseRounds=5 spark.streaming.dynamicAllocation.reserveRate=0.2 建议releaseRounds 不低于2,reserveRate 不低于0.05。避免系统发生颠簸。 测试代码 object IamGod { def main(args: Array[String]): Unit = { def createContext = { val conf = new SparkConf().setAppName("DRA Test") val ssc = new StreamingContext(conf, Seconds(30)) val items1 = Seq.fill(30)(Seq((10 + scala.util.Random.nextInt(10)) * 1000)) val items2 = Seq.fill(30)(Seq((30 + scala.util.Random.nextInt(10)) * 1000)) val items3 = Seq.fill(30)(Seq((20 + scala.util.Random.nextInt(10)) * 1000)) val fileInput = new TestInputStream[Int](ssc, items1 ++ items2 ++ items3, 10) val logs = fileInput.map(f => Thread.sleep(f)) logs.foreachRDD { rdd => rdd.count() } ssc } val ssc = createContext ssc.start() ssc.awaitTermination() } } 前面引用了一个测试类: class TestInputStream[T: ClassTag](_ssc: StreamingContext, input: Seq[Seq[T]], numPartitions: Int) extends InputDStream[T](_ssc) { def start() {} def stop() {} def compute(validTime: Time): Option[RDD[T]] = { logInfo("Computing RDD for time " + validTime) val index = ((validTime - zeroTime) / slideDuration - 1).toInt val selectedInput = if (index < input.size) input(index) else Seq[T]() // lets us test cases where RDDs are not created if (selectedInput == null) { return None } // Report the input data's information to InputInfoTracker for testing val inputInfo = StreamInputInfo(id, selectedInput.length.toLong) ssc.scheduler.inputInfoTracker.reportInfo(validTime, inputInfo) val rdd = ssc.sc.makeRDD(selectedInput, numPartitions) logInfo("Created RDD " + rdd.id + " with " + selectedInput) Some(rdd) } }

优秀的个人博客,低调大师

微信公众平台开发文档 语音识别

开通语音识别功能,用户每次发送语音给公众号时,微信会在推送的语音消息XML数据包中,增加一个Recongnition字段。 注:由于客户端缓存,开发者开启或者关闭语音识别功能,对新关注者立刻生效,对已关注用户需要24小时生效。开发者可以重新关注此帐号进行测试。 开启语音识别后的语音XML数据包如下: <xml> <ToUserName><![CDATA[toUser]]></ToUserName> <FromUserName><![CDATA[fromUser]]></FromUserName> <CreateTime>1357290913</CreateTime> <MsgType><![CDATA[voice]]></MsgType> <MediaId><![CDATA[media_id]]></MediaId> <Format><![CDATA[Format]]></Format> <Recognition><![CDATA[腾讯微信团队]]></Recognition> <MsgId>1234567890123456</MsgId> </xml> 参数说明: 参数 描述 ToUserName 开发者微信号 FromUserName 发送方帐号(一个OpenID) CreateTime 消息创建时间 (整型) MsgType 语音为voice MediaID 语音消息媒体id,可以调用多媒体文件下载接口拉取该媒体 Format 语音格式:amr Recognition 语音识别结果,UTF8编码 MsgID 消息id,64位整型

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册