首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | nginx http 模块数据存储结构

从本节开始,我们将进入http模块实现原理的讲解,关于http模块,有一个非常重要的点就是其是如何存储http块、server块和location块的数据的,而且nginx有的配置项是可以在多个配置块中使用的,当http块、server块和location块中两个或者两个以上的配置块都配置了该配置项的时候,就会有一个问题是,nginx是如何处理这些配置项的。本文主要讲解http块中的各个模块数据的存储方式,这将是理解nginx的http模块的工作方式的重要基石。 1. 核心模块的存储方式 在nginx运行过程中,有一个全局配置结构体ngx_cycle_t,其有一个属性conf_ctx,这个属性是存储nginx所有模块配置的一个数组,这个数组的长度与nginx模块的个数相同。不过需要注意的是,conf_ctx数组的第一维只会存储核心模块的配置,而其他模块对应的位置处的数组元素其实是为NULL。在conf_ctx中,各个核心模块配置结构体的存储位置与该模块在所有模块(包括非核心模块)中的相对位置是一致的,如下图所示为nginx存储核心模块的一个结构示意图: 这里标注的events和http只是为了展示方便而添加的,本质上这个数组的元素的类型是void*的指针,至于该指针指向的具体结构体的类型,则是根据各个核心模块自身的定义来的。 在http模块下,其指向了一个ngx_http_conf_ctx_t类型的结构体,这个结构体的作用就是用来存储http配置块中各个配置项的数据的。如下是这个结构体的定义: typedef struct { // 存储MAIN级别配置 void **main_conf; // 存储SRV级别配置 void **srv_conf; // 存储LOC级别配置 void **loc_conf; } ngx_http_conf_ctx_t; 我们知道,在nginx.conf配置文件中,在http块下还配置有server块,而server块下也是可以有location块,更有甚者,在location块下可以有子location块,如此往复,而这里的ngx_http_conf_ctx_t结构体的作用就是存储所有的这些配置所对应的结构体数据。首先,我们需要明确的一点是,在nginx.conf配置文件中,配置项都是由一个个模块定义的,一个模块可以定义多个配置项,对于这些配置项的解析工作都是由这个模块所定义的方法进行的。但是,一般的,一个模块一般都只会定义一个结构体,这个结构体中的各个属性则对应于该模块所定义的各个配置项的数据,也就是说,通过各个模块所定义的方法,其会将其所定义的配置项对应的配置转换为该模块所定义的结构体。这里所说的结构体就对应于上面的main_conf、srv_conf和loc_conf中的配置。从上面的定义就可以看出,这三个属性的类型都是指针类型的数组,而数组的长度就对应于模块的个数,准确来讲,是对应于http模块的各个。在解析各个http模块的配置之前,nginx会对各个http模块在当前类型的模块(http模块)中进行相对位置进行标记,每个http模块的相对位置就对应于上面的三个属性的数组下标。前面已经讲到,每个http模块都只会有一个配置结构体存储该模块所定义的所有配置数据,而这些配置结构体就是存储在上面的三个数组中的。这样,我们就能够理解了,其实上面的结构体的三个属性,每一个属性的数组都对应了一个http模块的配置结构体。 既然这里每个模块都有一个结构体存储在数组的对应索引位置,那这里为什么需要三个数组呢?比如说,对于ngx_http_core_module,其相对位置在http模块是第一个,也就是说main_conf[0]、srv_conf[0]和loc_conf[0]存储的都是ngx_http_core_module的配置结构体,为什么需要三个结构体。这里我们需要说明的是,对于每个http模块,其会根据需要将配置项按照可使用范围划分为三类:仅用于http块,可以用于http块和server块,以及可以用于http块、server块和location块。每一类配置项都使用的是一个不同的结构体,比如ngx_http_core_module就定义了ngx_http_core_main_conf_t用于存储仅用于http块的配置项,定义了ngx_http_core_srv_conf_t用于存储用于http块和server块的配置项,定义了ngx_http_core_loc_conf_t用于存储用于http块、server块和location块的配置项。对应于上面的数组就是,main_conf[0]的结构体类型为ngx_http_core_main_conf_t,srv_conf[0]的结构体类型为ngx_http_core_srv_conf_t,loc_conf[0]对应的结构体类型为ngx_http_core_loc_conf_t。说到这里,我们就必须要厘清一个问题了,比如,对于某个配置项,其配置在了http块中,但是其类型是可以用于http块、server块和location块的,那么其就会被存储在loc_conf[0]中,也就是说,上面的一整个结构体,从目前来看,存储的都是在http块中解析出来的各个配置项的数据。那么nginx是如何标记一个配置项是这三种类型中的哪一种呢?这主要是通过ngx_command_t结构体来定义的,如下所示为三个典型的配置: { ngx_string("variables_hash_max_size"), NGX_HTTP_MAIN_CONF | NGX_CONF_TAKE1, ngx_conf_set_num_slot, NGX_HTTP_MAIN_CONF_OFFSET, offsetof(ngx_http_core_main_conf_t, variables_hash_max_size), NULL }, { ngx_string("listen"), NGX_HTTP_SRV_CONF | NGX_CONF_1MORE, ngx_http_core_listen, NGX_HTTP_SRV_CONF_OFFSET, 0, NULL }, { ngx_string("root"), NGX_HTTP_MAIN_CONF | NGX_HTTP_SRV_CONF | NGX_HTTP_LOC_CONF | NGX_HTTP_LIF_CONF | NGX_CONF_TAKE1, ngx_http_core_root, NGX_HTTP_LOC_CONF_OFFSET, 0, NULL }, 这里我们以variables_hash_max_size、listen和root三个指令为例,这三个指令都是ngx_http_core_module模块定义的配置项,但是它们存储的位置则是完全不同的。我们需要注意的就是每个指令的第四个属性的定义:NGX_HTTP_MAIN_CONF_OFFSET、NGX_HTTP_SRV_CONF_OFFSET和NGX_HTTP_LOC_CONF_OFFSET。这三个类型的定义有两重含义,一个是表示这个配置项是仅用于http块,还是可以用于http块和server块,再或者是可以用于http块、server块和location块;另一重含义是定义了这个配置项在上面讲的ngx_http_conf_ctx_t中的偏移量,所谓的偏移量指的就是,在知道ngx_http_conf_ctx_t结构体对象的指针地址时,通过这里的偏移量就可以计算出当前配置项所存储的数组。这里我们就需要展示一段代码,即在ngx_conf_parse()方法中,其主要是用于解析nginx.conf配置文件的,在解析了某个配置项之后,就会在所有的模块中,找到该配置项的定义,如果找到了配置项,就会尝试获取存储该配置项所对应的结构体,并且会调用该配置项指定的方法进行配置项数据的解析。这里尝试获取该配置项所对应的结构体时,就需要用上上面的偏移量。如下是获取该配置项的方法: // 查找配置对象,NGX_DIRECT_CONF常量单纯用来指定配置存储区的寻址方法,只用于core模块 if (cmd->type & NGX_DIRECT_CONF) { conf = ((void **) cf->ctx)[cf->cycle->modules[i]->index]; // NGX_MAIN_CONF常量有两重含义,其一是指定指令的使用上下文是main(其实还是指core模块), // 其二是指定配置存储区的寻址方法。 } else if (cmd->type & NGX_MAIN_CONF) { conf = &(((void **) cf->ctx)[cf->cycle->modules[i]->index]); // 除开core模块,其他类型的模块都会使用第三种配置寻址方式,也就是根据cmd->conf的值 // 从cf->ctx中取出对应的配置。举http模块为例,cf->conf的可选值是NGX_HTTP_MAIN_CONF_OFFSET、 // NGX_HTTP_SRV_CONF_OFFSET、NGX_HTTP_LOC_CONF_OFFSET, // 分别对应“http{}”、“server{}”、“location{}”这三个http配置级别。 // 这个if判断的作用主要是,cf->ctx的类型是ngx_http_conf_ctx_t,而cmd->conf主要的值可选 // NGX_HTTP_MAIN_CONF_OFFSET、NGX_HTTP_SRV_CONF_OFFSET、NGX_HTTP_LOC_CONF_OFFSET, // 可以看到ngx_http_conf_ctx_t的属性有main_conf、srv_conf和loc_conf, // 其实这里就是在计算当前的配置对象是存储在这三个数组中的哪一个数组中,以default_type指令为例, // 其ngx_command_t的配置为: // {ngx_string("default_type"), // NGX_HTTP_MAIN_CONF | NGX_HTTP_SRV_CONF | NGX_HTTP_LOC_CONF | NGX_CONF_TAKE1, // ngx_conf_set_str_slot, // NGX_HTTP_LOC_CONF_OFFSET, // offsetof(ngx_http_core_loc_conf_t, default_type), // NULL}, // 可以看到,其conf属性的值为NGX_HTTP_LOC_CONF_OFFSET,则说明其是存储在loc_conf数组中的, // 而该数组中的元素类型为ngx_http_core_loc_conf_t,因而可以看到,后面ngx_command_t // 中offset属性的值就指定为了offsetof(ngx_http_core_loc_conf_t, default_type), // 这就是在计算default_type属性在ngx_http_core_loc_conf_t结构体中的位置。 // 通过下面的if判断第一步confp = *(void **) ((char *) cf->ctx + cmd->conf);,就可以 // 计算出当前所使用的结构体是在main_conf、srv_conf // 和loc_conf的哪一个数组中,而通过第二步conf = confp[cf->cycle->modules[i]->ctx_index]; // 的计算,就可以计算出该结构体在数组中的具体位置,并且获取该结构体数据。 // 需要注意的是,这种计算方式只适用于http模块的配置项获取,因为只有http模块的配置结构体是 // ngx_http_conf_ctx_t类型的 } else if (cf->ctx) { confp = *(void **) ((char *) cf->ctx + cmd->conf); if (confp) { conf = confp[cf->cycle->modules[i]->ctx_index]; } } 这里我们需要重点关注最后一个else if分支,这里就表明了http模块是如何根据配置项的定义来计算该配置项所对应的结构体的存储位置的。下面的图就展示了包含有http块配置的整体结构: 2. server块的存储方式 上面我们讲到,使用ngx_http_conf_ctx_t结构体就可以存储所有的http块中的配置项,那么server块中的配置项是如何存储的呢?其主要存储在ngx_http_core_module模块的main_conf中,也即上面的main_conf[0]所对应的ngx_http_core_main_conf_t结构体中,该结构体有一个属性servers,这个属性的类型为ngx_array_t,也即一个数组。也就是说,在每个http配置块下,每个server配置块都对应于servers数组的一个元素,而数组的元素类型与http块的一致,还是ngx_http_conf_ctx_t。不过区别在于,由于当前的配置项一定是可用于server块或者location块中的,而不是仅仅只能用于http块中的,因而配置项的类型一定是上面讲到的NGX_HTTP_SRV_CONF_OFFSET和NGX_HTTP_LOC_CONF_OFFSET之一,而不可能是NGX_HTTP_MAIN_CONF_OFFSET。因而这里虽然每个server配置块对应的配置结构体还是ngx_http_conf_ctx_t,但是其main_conf数组是不会有对应的配置项的,而只能从http块中继承配置项。既然是继承,nginx的处理方式是直接将该数组的指针指向http块对应的ngx_http_conf_ctx_t的main_conf数组。如下所示为两个server块配置的示意图: 这个图稍微看起来有点复杂,但实际上并不复杂,按照配置块划分,上面的ngx_http_conf_ctx_t中存储的就是http块的配置,而下面的两个ngx_http_conf_ctx_t存储的就是两个server块中的配置,中间的引用过程是通过http块的ngx_http_core_module模块对应的ngx_http_core_main_conf_t.servers进行的。需要注意的一点是,上面的server块的配置中,main_conf指针都是指向的http块的对应ngx_http_conf_ctx_t的main_conf属性。 3. location块的存储方式 对于location块的存储,其存储结构也还是ngx_http_conf_ctx_t,并且由于当前配置项在location块中的,因而其类型一定不会是NGX_HTTP_MAIN_CONF_OFFSET和NGX_HTTP_SRV_CONF_OFFSET,也就是说,解析location配置项得到的数据一定是存储在loc_conf数组中的。因而,与server块一样,location块对应的ngx_http_conf_ctx_t结构体中的main_conf和srv_conf指向的则是当前location所在的http块的main_conf和所在的server块的srv_conf数组。 另外,一个server块下会有多个location块,在存储结构上,这些location块是以队列的方式进行组织的,与server块类似,这个队列则是存储在其所在的server块对应的ngx_http_conf_ctx_t的loc_conf[0]中的。这里的loc_conf[0]的结构体类型为ngx_http_core_loc_conf_s,其有一个ngx_queue_t类型的属性locations就是该location队列。最后需要注意的是,这里的locations属性表征的不仅仅只是server块下的多个location块,因为在location配置块下还可以继续配置多个location块,如此不断递归下去。这些子location块的类型其实还是ngx_http_core_loc_conf_s,因而也是可以通过locations属性进行表征的。如下是加入location配置块的结构体示意图: 图中展示了两个location并列组织的情形,其main_conf和srv_conf分别指向了http块的main_conf和当前location块所在的server块的srv_conf,并且两个location块对应的结构体是以队列的方式组织在ngx_http_core_loc_conf_t中的。 4. 小结 本文从ngx_cycle_t结构体开始,介绍了http块的配置项是如何存储在ngx_cycle_t中的,并且依次介绍了http块、server块和location块的存储方式,以及相互之间的组织方式。
优秀的个人博客,低调大师

每日一博 | Unicode 字符集的由来

本文起源于行走在阳光下的那些不可见字符中的知识边界,因为涉及到字符相关,而我也不能很清楚的描述Unicode的前世今生,故而有了此文。 计算机技术的革命极大地方便了人们的工作与生活,使得人类生活前进了一大步,可是在计算机发展进程中,世界各地由于语言文字不一,有过那么一段混乱难受的日子... 字符世界的起源 由于计算机在美国诞生,因此字符集最初也只考虑了美国人当时的需求,诞生了大家熟知的ASCII(American Standard Code for Information Interchange),它由26个基本拉丁字母、阿拉伯数字、英式标点符号和一些控制字符组成。 随着世界的发展,各国人民也开始接触计算机,然而各国人民也有自己独特的文化需求,最开始的字符集满足不了人们日益增长的需求,各国出现了不同的字符集标准,比如国内早期的Java程序员熟知的GBK、GB18030等,我曾经实习的时候接触的用JSP的老系统里就有相关的编码设定,如果用错误编码设定了文档解析格式,可能就会看到乱码,再想想世界上那么多个国家,会有多少编码标准啊,这也是互联网早期乱码比较多的原因吧。 各种编码的字符互不兼容,相互之间的通信可能由于编码的不同,而导致对方看到的是乱码,这就如中国历史中的大秦统一文字和度量单位之前的华夏文明一样,语言不通、货币不通,交流困难。时间的车轮滚滚向前,推动着历史的发展,于是Unicode(Universal Coded Character Set)出现了,它对世界上大部分的文字系统进行了整理、编码,使得计算机能够以更简单的方式来呈现和处理字符,它的目的就是为所有的字符提供统一的编码,任何的平台、系统、设备、应用或者语言都能兼容且无风险使用。 至今Unicode仍在不断的增修,当前最新版本为2019年5月公布的12.1,包含137994个字符,不仅包括当今世界上150种语言模型和历史性的手写码和符号,还包括多种符号集与表情符号。 Unicode 九层之台,起于累土。这样世界性的标准绝不是一蹴而就,必有其坚实的基础,设计原则就是Unicode的一大基础,在《The Unicode Standard Version 6.2 - Core Specification》有提到Unicode的设计原则, 我们熟知的UTF-8其实是Unicode的一种实现方式,即Unicode 转换格式(Unicode Transform Format),是一种为了减少传输数据的大小而设计的变长编码,每个字符使用1/2/3字节按照一定算法进行转换识别。此外,Unicode的实现方式还包括UTF-7、UTF-16、UTF-32、punycode、GB18030等。 总的来说,Unicode于乱世出生逐渐成为标准统一字符世界,至今仍持续发展,造福了社会,极大的提升了生产效率,虽未与ASCII并列与IEEE里程碑,但也是计算机科学史中一件举足轻重的大事记。 本次探索到此结束,全文本着追溯Unicode是什么为什么产生等问题,进行了一系列追寻,大致理清了Unicode的一些“前世今生”,基本对Unicode能够有个大概的认知,需要更加深入的探索的小伙伴可以留言一起探讨~ 冬至快乐哦~ ps: 及时总结,静心沉淀;如风少年,砥砺前行。 欢迎关注我的公众号 "和F君一起xx" reference: Unicode Zh Unicode En Unicode Charts Index Unicode Character Database IEEE里程碑列表 ENIAC ASCII Unicode Script

优秀的个人博客,低调大师

每日一博 | 由 AnnotatedElementUtils 想到如何阅读源码

这篇博客的两个主题: spring的AnnotatedElementUtils 个人源码阅读方法论分享 为什么要分享AnnotatedElementUtils这个类呢,这个类看起来就是一个工具类,听起来很像apache的StringUtils,CollectionUtils。 原因是,它包含着spring对java注解的另类理解,和运用。 java的是怎样支撑注解的? Class<TestAnnotation> clazz = TestAnnotation.class; // 获取类注解 MyClassAnnotation myClassAnnotation = clazz.getAnnotation(MyClassAnnotation.class); // 获得构造方法注解 Constructor<TestAnnotation> cons = clazz.getConstructor(new Class[] {}); MyConstructorAnnotation Constructor = cons.getAnnotation(MyConstructorAnnotation.class); // 获得方法注解 Method method = clazz.getMethod("setId", new Class[] { String.class }); MyMethodAnnotation myMethodAnnotation = method.getAnnotation(MyMethodAnnotation.class); // 获得字段注解 Field field = clazz.getDeclaredField("id"); MyFieldAnnotation myFieldAnnotation = field.getAnnotation(MyFieldAnnotation.class); 以及@Inherited,它可以将父类的注解,带到继承体系上的子类中去。 这套注解体系有什么问题? 面向对象语言之所以被冠以“面向对象”这样的名字,是因为它具有多态的能力。有了多态的能力,我们才有了面向接口编程的能力,有了这个能力,依赖反转才有立足点;所有的设计模式才有立足点(工厂模式,装饰器模式,策略模式...)。可以说多态是java这样的强类型,面向对象语言的灵魂。 那么多态这种能力是怎么来的? 父类与接口。弱类型的语言其实天然就支持多态,但强类型的语言则不是。而java在语言层面支持了"父类与接口",体现在java程序可以自动的向上转型,并且可以安全的向下转型。向上,向下转型这两件事,就实现了所谓的“多态”语义。 我们再向问题的本质进一步,看看java是怎么实现上下转型的? 当把class文件加载进内存(方法区)时,方法在真正运行之前就有一个确定的调用版本,且该版本在运行期不可变的一类,将会被解析,符号引用将被替换为实在的内存地址,成为该方法的入口地址。静态方法,私有方法,构造器,父类方法符合这个要求。这类方法也被称为非虚方法。 public class Test { public void test() { // 实例和方法都是确定的(Human的静态方法run) Human.run(); } } 而虚方法和静态分派则是: // 实例不确定,方法也不确定。 // 此处唯一能确定的是,方法的重载版本。可见这个方法的版本是无参数的,它确定了执行器在调用run时, // 一定不会去调用一个带任何参数的版本的run方法。这就是静态分派。 public class Test { public void test(Human human) { human.run(); } } 上面提到了重载,而静态分派就是用以确定重载版本的,下面我要说的是覆写。覆写会导致不同实例的覆写版本,方法体不一样,所以虚拟机只能在运行期通过对象的实际类型来决定调用哪个版本的覆写方法。这被称为动态分派。 public class Test { public void test() { System.out.println("i'm Test"); } } public class SubTest extends Test { public void test() { System.out.println("i'm SubTest"); } } public class TestTest { public static void main(String[] args) { Test t = new Test(); t.test(); t = new SubTest(); t.test(); } } 发现没有,覆写是多态的原理!动态分派是覆写的原理!那么,动态分派也就是多态的原理,进而,动态分派也就是java是面向对象语言的根本原理,或者说根本原因! 而目前,java的注解,并不支持动态分派,就是说它并不支持覆写!这就是目前java这套注解体系的一个重要的问题,它使得注解不易使用。 举例: java的注解之间没有继承关系。注意@Inherited表达的不是注解间有继承关系,而是子类可以获得父类的注解。这导致注解的语义不能传递,类似于Man属于Human这样的逻辑它无法表达。 Java的注解之间没有多态关系,你就是你,我就是我。这导致你可能要将某些相似的处理逻辑放到多个不同的annotation processor里。例:@Component和@Service都有注册bean的能力,则这个能力将在这两个注解的处理器中分别实现。 在深入探究Spring解决方案前,还有一个问题有待解决 在阐述AnnotatedElementUtils前,我要引出今天这次分享的第二个主题:源码阅读方法论。 我问过好多朋友,也在各社区搜索过,如何阅读开源代码这件事情。得到的答案往往是一些“放之四海而皆准”的指导性建议,始终没有得到一个切实可行的方法论,后来我自己总结,摸索了一套。 首先问一个问题:当我们说“读源码”时,我们究竟是要做一件什么事情? 以前我对这个问题的回答是:读懂它的逻辑,或叫流程。这个答案背后的含义是,我在乎的是代码中的判断,分支。但是我经常在读源码时有很强的挫败感,因为我很努力的去读,却发现,我读懂了一个方法,而这个类有好几十个方法,我对这个类还是不理解,方法和方法间的关系还是不明朗,类的抽象还是很模糊。 也就是在这个阶段,我请教过很多朋友,以及论坛,甚至每当遇到新的程序员朋友时,我都会问对方这个问题——怎么阅读源码。 直到后来,我看到《人月神话》中有这样一句话:让我看你的流程图不让我看表,我会仍然搞不明白。给我看你的表,一般我就不用看你的流程图了,表能让人一目了然。 这里的表指的是数据,以及数据的结构,例如一个类的成员变量就是它的表;我们写业务的时候,mysql中的数据就是表。《人月神话》的这句话让我突然一惊,难道我一直以来在理解代码的时候,所关注的点是错的,我不应该关注逻辑,而应该关注表? 验证这个道理的最好办法,就是运用它,实验它! 在这里我可以告诉大家,它是对的!我的方法论就是建立在它之上的。 源码阅读方法论——原则 以类为最小理解单位(指的是聚合类) 当你要读源码时,将一个类看作一个整体去理解,这个类有些什么方法,其实并不是很重要,重要的是,这个类是个什么东西,或者说抽象是什么(这里仅指聚合类,聚合类指的是它的方法和表是为同一件事情而存在的。举个例子,apache的StringUtils是一个非聚合类,它的方法之间没有必然联系,是各自为正的;而spring的AnnotationTypeMapping则是一个聚合类,它的表和方法都围绕着某个注解而工作,这个类后面会重点介绍)。 以表为支点 理解一个类,就是去理解这个类的表(而不是它的业务方法)!理解表有多种途径:通过注释,通过表的设值函数,通过表的使用函数,通过其他文章等等。在理解表的这些途径中,表的设值函数通常来说是能提供最多信息的地方,所以类的构造函数和设值方法是我们首先应该关注的东西。 源码阅读方法论——技巧 打锚点,协助思维跳跃 在读源码的时候,经常遇到你要跨越很多次方法调用的情况,人脑的栈是比较小的,所以我通过打锚点的方式,来协助大脑记忆调用栈。 打锚点是通过在关键代码上标注 todo 注释实现的。例如下图中的“// todo wanxm 1.15.1”。配合这个正则表达式: todo wanxm (1.15)\.?\d+.?( |$) 这里相当于列出了一条1.15.x的链,x可以是增量的,表示着某种你想要的先后顺序(比如方法调用顺序,逻辑点顺序等)。前缀1.15也是可变的,例如你在图中看到的这条1.15.x的链,其实是我在读一条1.x的链,读到1.15这个点上时,我发现它后面有挺多内容,于是我在1.15这个点上使用1.15.0开了一条嵌套链。当我使用Idea的Ctrl + Shift + F 搜索时,使用“todo wanxm (1).?\d+.?( |$)”我就能看到那条1.x的链,使用“todo wanxm (1.15).?\d+.?( |$)”时,就能看到那条1.15.x的链。 使用idea的Ctrl + Alt + H,来跟踪类的初始化链。 使用“设”,来简化描述语言。例如后面的文章我将会展示的一段“设”: /** * 设AnnotationTypeMapping的某个实例为M,M所映射的注解为A。 * A中有5个属性(方法):H0,H1,H2,H3,H4。(H后面的数字表示方法的行文索引) */ 源码阅读方法论——步骤 开始之前先定目的 目的,在我们读源码的过程中,是非常重要的,其一:如果没有一个清晰明确的目的,你很可能被程序中纷繁的细节所包围,抓不住重点,搞不清楚自己要干什么,有了明确的目的,可以让你在深陷细节泥潭时跳脱出来,重新寻找支点。其二:要确定目的则你必需对你所要阅读的代码有一定的了解,这能促使你在阅读前,先去做一定的准备工作,从侧面先对代码有一个概念性的,笼统的认识。 构建依赖图 依赖图的构建方法有很多,你可以是从其他文章中看来的,也可以是自己找一个切入点,速读代码构建依赖图。 根据依赖图,自底向上,逐个理解类以及接口 理解类的时候,先以类的构造函数(或设值函数)为主,功能方法为辅理解类的表;后以表为支点,理解类。 有一些类,其表很简单甚至没有,而其功能方法决定了类的能力,这种类就以功能方法为支点来理解,通常这种类,读懂了功能方法,也就明了了 有时,会因为我们不理解构造函数的参数的用意而导致我们无法有效的通过构造函数去理解表,此时从依赖图中找到最底层,最接近该类的一处实例化过程去阅读,以搞清楚构造函数中参数的语义。 带着方法论,探索Spring 到这里,今天的主角AnnotatedElementUtils就要登场了,它虽然名字叫做utils,但它可不是一个工具类那么简单,它蕴含着spring对注解这种语法的思考。 我是通过阅读《Spring Boot 编程思想》这本书了解到AnnotatedElementUtils的,书中没有详细展开介绍它,但是通过书中的描述,我知道了spring对注解的处理,是不同于java反射的语义的。我们就来读一读,看看有什么奥秘。我的阅读目的就是:spring怎样让注解实现属性覆写? 先展示一下AnnotatedElementUtils的作用 @TestA @Retention(RetentionPolicy.RUNTIME) @Target({ElementType.TYPE}) public @interface TestRoot { } @TestB @Retention(RetentionPolicy.RUNTIME) @Target({ElementType.TYPE}) public @interface TestA { @AliasFor(value = "c1", annotation = TestC.class) String bb() default "testA"; } @TestC @Retention(RetentionPolicy.RUNTIME) @Target({ElementType.TYPE}) public @interface TestB { @AliasFor(value = "c2", annotation = TestC.class) String cc() default "testB"; } @Retention(RetentionPolicy.RUNTIME) @Target({ElementType.TYPE}) public @interface TestC { @AliasFor(value = "c2") String c1() default "testC"; @AliasFor(value = "c1") String c2() default "testC"; } 从AnnotatedElementUtils开始构建依赖图 AnnotatedElementUtils这个类没有表,显然它只是某些其他类的代理,既然没有表,按照我们的方法论,它就没有什么太多可理解的了,我们读一读它的注释: AnnotatedElementUtils(类) 查找注释通用方法。就是从AnnotatedElement上获取注释信息。 它和jdk提供的原生反省不一样。 它提供了两类查找,一类是get语义的查找,一类是find语义的查找 get语义的查找可查找到直接定义在AnnotatedElement上的,或继承来的注解。 find则比get要广 AnnotatedElement是类,则搜索这个类的超类,和接口 AnnotatedElement是方法,则搜索这个方法的桥接方法,以及超类和接口中的方法。(桥接方法:https://blog.csdn.net/alex_xfboy/article/details/86609055) get和find都支持@Inherited 在组合注解中的元注解的属性复写功能被以下方法(及其重载方法)支持 getMergedAnnotationAttributes getMergedAnnotation getAllMergedAnnotations getMergedRepeatableAnnotations findMergedAnnotationAttributes findMergedAnnotation findAllMergedAnnotations findMergedRepeatableAnnotations 从注释里我们知道,它有一堆get和find方法,find方法的语义看起来更接近我所提出的问题,所以我选择了findMergedAnnotationAttributes来作为切入点。迅速的阅读一下这个方方法,找出它当中依赖了些什么。 (下面给出依赖图) 从底层开始阅读 在这个依赖图中,最底层的类是:AttributeMethods,RepeatableContainers的实现类,AnnotationsScanner的实现类,AnnotationFilter,这几个底层类是比较简单的,所以今天我不讲他们,我讲AnnotationTypeMapping,按照正常的顺序,你应该是先去读它们的。 阅读注释 现在让我们聚焦到AnnotationTypeMapping这个类上,它的注释是这样写的: Provides mapping information for a single annotation (or meta-annotation) in the context of a root annotation type. 以根注解为上下文,提供单个注解的映射信息。第一次读这句话我觉得没有几个中国人能理解,好在注释只是理解的手段之一。 阅读构造函数 source, root,distance 构造函数第一句就遇到麻烦了,只看前三行,大家能看出来什么逻辑吗? 不理解没关系,根据方法论,我们应该从依赖图中找到最底层,最接近该类的一处实例化过程去阅读,如果你严格画出了依赖图,并且从依赖图的底部着手去阅读,那么当你去寻找最近的实例化过程时,你会发现,它就在隔壁。 进入实例化点,利用Idea的功能, 得到调用层级 好了,现在你已经拥有一条实例化链了,注意scope选this class,实例化链的阅读要小心,不要被太多细节干扰,我们的目标仅仅是搞清楚构造函数参数的含义,一旦你在阅读的过程中理解了,就可以立刻停下,回到最初的那个类了,不要在此有多余的停留。 通过实例化链的阅读,我们明白了,AnnotationTypeMapping的实例是由AnnotationTypeMappings创建的,创建的过程是根据注解的注释体系从下往上进行的,可以参考“展示AnnotatedElementUtils的作用”那一节的示例(TestRoot -> TestA -> TestB -> TestC,它们将会串起来,后者的source指向前者,而所有的root都指向TestRoot)。这样前三个成员变量的含义是不是就清晰了。 metaTypes,annotationType,annotation,attributeMethods,aliasMappings,aliasedBy 在这里我就不赘述所有成员变量(也就是这个类的表)的阅读过程了,总之它们都是通过读AnnotationTypeMapping的构造函数而理解的,下面我直接贴图,展示了我如何对已经搞清楚的成员变量进行注释的。 mirrorSets,conventionMappings,annotationValueMappings,annotationValueSource 这几个则是依赖MirrorSet这个类的逻辑。MirrorSet是一个内部类,内部类和普通类的一个重要区别就是,当它被实例化的时候,所使用的数据不全来自构造函数的参数,还会来自其外部类的表,所以在阅读内部类的构造函数时,要先将它所使用的外部类的表理解了。 我面对内部类的策略是,尽量推迟阅读内部类的时间,也就是说,如果不是它阻碍了流程,那么就先将其搁置。(你掌握越多的外部类信息,则理解内部类时就越少会遇到卡壳的情况,避免在两个类之间反复切换的情况发生) 在不理会MirrorSets及其相关逻辑的情况下,我们已经疏通了上面那部分数据表的逻辑,根据那些信息,我可以比较容易的得出MirrorSets以及MirrorSet的表。 这两内部类就属于,表很简单,其功能更多由功能方法决定的类。我们去读一读它的各个功能方法(如果功能方法的参数你无法理解,有两种策略,1:使用类似阅读构造函数的方法;2:先不理他,等以后阅读其他代码时,发现调用到了这个功能方法,那时你带着相关参数的含义再来读这个功能方法)(我在这使用了第二种方法)。 这里贴出展现这两个内部类核心能力的代码注释: MirrorSets的: MirrorSet的: 读完MirrorSets的相关逻辑后,整个AnnotationTypeMapping的表的信息就有了。这里贴出它的全部表信息。 到这里,AnnotationTypeMapping这个类其实已经读的差不多了,总结一下,spring引入了如下层级属性概念: 别名属性 直接通过@AliaseFor关联起来的属性 镜像属性 由于直接或间接的@AliaseFor关系,使得某些属性实际上一定拥有相同的值,这些属性被称为镜像属性。 惯例属性 位于注解A中的和Root中同名的属性,被称为惯例属性,并且,同一注解中的惯例属性的镜像属性也是惯例属性。如,A中的H0和H1互为镜像属性,Root中的某个方法Hr和A中的H0名字相同,则Hr是Ho的惯例属性,Hr也是H1的惯例属性。 最低阶属性 A的最接近Root的有效属性。相当于,对A的某个属性来说,当低阶上存在它的镜像时,就取低阶的值,否则取它自己的值。由于低阶具有高优先级,所以我将它称作“最低阶属性”。 看了AnnotationTypeMapping的表,你的脑袋里是否已经有了它的概念了呢? AnnotationTypeMapping提供了三个关键功能方法,分别是 getAliasMapping 用以获取root中的别名属性行文索引 getConventionMapping 用以获取root中的惯例属性的行文索引 getMappedAnnotationValue 获取最低阶属性的值 这三个方法就形成了spring获取注解属性的基础能力。 回到开篇——spring是如何赋予注解覆写能力的? 在spring中,注解之间具有多种关系,并且存在层级概念。使用者输入“别名关系”,spring则将这种关系深化,最终落到“惯例关系”与“最低阶关系”上,从而赋予低阶注解属性影响高阶注解属性的能力,实现低阶对高阶的覆写,就像子类对父类的覆写一样。并且,值得注意的是,spring并没有真的去修改高阶注解的属性值,而是通过类似指针的方式,将获取高阶注解属性值的操作指向它的低阶镜像,从而在外部看来,像是高阶属性被低阶属性覆写。 这种能力可以为我们带来什么优势? 以spring的@Service注解为例,它被@Component注解元标注,并且其value属性被标识了是@Component的value属性的别名。spring在为我们提供@Service注解的时候,并不需要专门去写一个注解处理器来将被@Service标注的类注册成Bean,spring只需要一个@Component的注解处理器就可以,因为它可以从任何被@Service标注的类上获取到@Component,并且获取到被覆写的value值。这是不是很像向上转型,很像多态? 对于广大的互联网开发人员来说,我们的基础工作栈之一就是spring,当我们在spring应用中开发时,何不使用spring已经搭建好的脚手架呢,当我们需要开发一些注解处理器的时候,完全可以使用spring封装好的AnnotatedElementUtils。 题外话 大家有没有注意到MirrorSet的resolve方法有问题? 问题出在:“如果所有属性都是默认值,则result = -1”(参看前文对MirrorSet的resolve方法的注释截图)。 -1表示的是它在某组镜像属性中没有找到有效属性,如果没有找到有效属性,那么某个高层注解的“最低阶属性”就不可能定位到这组镜像上来。 举个例子说明它会导致的问题: @TestB @Retention(RetentionPolicy.RUNTIME) @Target({ElementType.TYPE}) public @interface TestA { @AliasFor(value = "b1", annotation = TestB.class) String a1() default "testA"; } @Retention(RetentionPolicy.RUNTIME) @Target({ElementType.TYPE}) public @interface TestB { @AliasFor(value = "b2") String b1() default "testB"; @AliasFor(value = "b1") String b2() default "testB"; } @TestA public class Test { public static void main(String[] args) { // 这里你得到的实例b有两个key,b1和b2,值都是"testA" AnnotationAttributes b = AnnotatedElementUtils.findMergedAnnotationAttributes(Test.class, TestB.class, false, true); } } 但是当你将TestA修改成这样,使得a1和a2成为镜像属性时,得到的结果就比较奇怪了 @TestB @Retention(RetentionPolicy.RUNTIME) @Target({ElementType.TYPE}) public @interface TestA { @AliasFor(value = "b1", annotation = TestB.class) String a1() default "testA"; @AliasFor(value = "b2", annotation = TestB.class) String a2() default "testA"; } @TestA public class Test { public static void main(String[] args) { // 这里你得到的实例b有两个key,b1和b2,值都是"testB" AnnotationAttributes b = AnnotatedElementUtils.findMergedAnnotationAttributes(Test.class, TestB.class, false, true); } } 注解TestB中的属性并没有被TestA中的属性覆盖,但TestA确实是TestB的低层级属性,它理应具有覆写上层属性的能力,当TestA中的属性没有形成镜像时,它确实表现出了这种能力,但当TestA中的属性形成镜像时,这种能力消失了(这个bug在spring-framework5.2.x版本下存在,将可能于5.2.3版本修复)。 比较幸运,我们发现了一个spring的bug。也从侧面证明了,我们的源码阅读方法论是有效的。给spring提一个PR,我们就能收到几个感谢。 结语 AnnotatedElementUtils的能力其实并不是一个AnnotationTypeMapping可以概括的,还有其他一些类在整个逻辑中发挥重要作用,我会继续更新博客,慢慢将完整的AnnotatedElementUtils展现出来,而面对今天的AnnotationTypeMapping,你在看了表的注释后,有一个概括性的认识就可以了。 希望我的方法能对大家有所帮助,也期望大家和我分享你们的方法,让我们取长补短,最后能得出一套高效的方法论。

优秀的个人博客,低调大师

每日一博 | RBAC 权限控制概念的理解

1. 前言 欢迎阅读 Spring Security 实战干货系列文章 。截止到上一篇我们已经能够简单做到用户主体认证到接口的访问控制了,但是依然满足不了实际生产的需要。 如果我们需要一个完整的权限管理系统就必须了解一下 RBAC (Role-Based Access Control 基于角色的访问控制) 的权限控制模型。 2. 为什么需要 RBAC? 在正式讨论 RBAC 模型之前,我们要思考一个问题,为什么我们要做角色权限系统? 答案很明显,一个系统肯定具有不同访问权限的用户。比如付费用户和非付费用户的权限,如果你是 QQ音乐的会员那么你能听高音质的歌曲,如果不是就不能享受某些便利的、优质的服务。那么这是一成不变的吗?又时候为了流量增长或者拉新的需要,我们又可能把一些原来充钱才能享受的服务下放给免费用户。如果你有了会员等级那就更加复杂了,VIP1 跟 VIP2 具有的功能肯定又有所差别了。主流的权限管理系统都是 RBAC 模型的变形和运用,只是根据不同的业务和设计方案,呈现不同的显示效果。 下图展示了用户和角色以及资源的简单关系: 那为什么不直接给用户分配权限,还多此一举的增加角色这一环节呢?当然直接给用户具体的资源访问控制权限也不是不可以。只是这样做的话就少了一层关系,扩展性弱了许多。如果你的系统足够简单就不要折腾 RBAC 了,怎么简单就怎么玩。如果你的系统需要考虑扩展性和权限控制的多样性就必须考虑 RBAC 。 如果你有多个具有相同权限的用户,再分配权限的时候你就需要重复为用户去 Query (查询) 和 Add (赋予) 权限,如果你要修改,比如上面的 VIP1 增加一个很 Cool 的功能,你就要遍历 VIP1 用户进行修改。有了角色后,我们只需要为该角色制定好权限后,将相同权限的用户都指定为同一个角色即可,便于权限管理。 对于批量的用户权限调整,只需调整该用户关联的角色权限,无需遍历,既大幅提升权限调整的效率,又降低了漏调权限的概率。这样用户和资源权限解除了耦合性,这就是 RBAC 模型的优势所在。 3. RBAC 模型的分类 RBAC 模型可以分为:RBAC0、RBAC1、RBAC2、RBAC3 四种。其中 RBAC0 是基础,其它三种都是在 RBAC0 基础上的变种。大部分情况下,使用 RBAC0 模型就可以满足常规的权限管理系统设计了。不过一定不要拘泥于模型,要以业务需要为先导。接下来简单对四种模型进行简单的介绍一下。 3.1 RBAC0 RBAC0 是基础,定义了能构成 RBAC 权限控制系统的最小的集合,RBAC0 由四部分构成: 用户(User) 权限的使用主体 角色(Role) 包含许可的集合 会话(Session)绑定用户和角色关系映射的中间通道。而且用户必须通过会话才能给用户设置角色。 许可(Pemission) 对特定资源的特定的访问许可。 3.2 RBAC1 RBAC1 在 RBAC0 的基础之上引入了角色继承的概念,有了继承那么角色就有了上下级或者等级关系。父角色拥有其子角色所有的许可。通俗讲就是来说: 你能干的,你的领导一定能干,反过来就不一定能行。 3.3 RBAC2 在体育比赛中,你不可能既是运动员又是裁判员! 这是很有名的一句话。反应了我们经常出现的一种职务(其实也就是角色)冲突。有些角色产生的历史原因就是为了制约另一个角色,裁判员就是为了制约运动员从而让运动员按照规范去比赛。如果一个人兼任这两个角色,比赛必然容易出现不公正的情况从而违背竞技公平性准则。还有就是我们每个人在不同的场景都会充当不同的角色,在公司你就是特定岗位的员工,在家庭中你就是一名家庭成员。随着场景的切换,我们的角色也在随之变化。 所以 RBAC2 在 RBAC0 的基础上引入了静态职责分离(Static Separation of Duty,简称SSD)和动态职责分离(Dynamic Separation of Duty,简称DSD)两个约束概念。他们两个作用的生命周期是不同的; SSD 作用于约束用户和角色绑定时。 1.互斥角色:就像上面的例子你不能既是A又是B,互斥的角色只能二选一 ; 2. 数量约束:用户的角色数量是有限的不能多于某个基数; 3. 条件约束:只能达到某个条件才能拥有某个角色。经常用于用户等级体系,只有你充钱成为VIP才能一刀999。 DSD 作用于会话和角色交互时。当用户持有多个角色,在用户通过会话激活角色时加以条件约束,根据不同的条件执行不同的策略。 图就不画了就是在 RBAC0 加了上述两个约束。 3.4 RBAC3 我全都要! RBAC1 和 RBAC2 各有神通。当你拿着这两个方案给产品经理看时,他给了你一个坚定的眼神:我全都要! 于是 RBAC3 就出现了。也就是说 RBAC3 = RBAC1 + RBAC2 。 4. RBAC 中一些概念的理解 四个模型说完,我们来简单对其中的一些概念进行进一步的了解。 4.1 用户(User) 对用户的理解不应该被局限于单个用户,也可以是用户组(类似 linux 的 User Group), 或许还有其它的名字比如部门或者公司;也可以是虚拟的账户,客户,甚至说第三方应用也可以算用户 。所以对用户的理解要宽泛一些,只要是有访问资源需求的主体都可以纳入用户范畴。 4.2 角色(Role) 角色是特定许可的集合以及载体。一个角色可以包含多个用户,一个用户同样的也可以属于多个角色;同样的一个角色可以包含多个用户组,一个用户组也可以具有多个角色,所以角色和用户是多对多的关系。角色是可以细分的,也就是可以继承、可以分组的。 4.3 许可(Permission) 许可一般称它为权限。通常我们将访问的目标统称为资源,不管是数据还是静态资源都是资源。我们访问资源基本上又通过 api 接口来访问。所以一般权限都体现在对接口的控制上。再细分的话我将其划分为菜单控制,具体数据增删改查功能控制(前台体现为按钮)。另外许可具有原子性,不可再分。我们将许可授予角色时就是粒度最小的单元。 5. 总结 基于角色的访问控制(RBAC)已成为高级访问控制的主要方法之一。通过RBAC,您可以控制最终用户在广义和精细级别上可以做什么。您可以指定用户是管理员,专家用户还是最终用户,并使角色和访问权限与组织中员工的职位保持一致。仅根据需要为员工完成工作的足够访问权限来分配权限。通过上面的介绍相信一定会让你有所收获。对我接下来的 Spring Security 实战干货 集成 RBAC 也是提前预一下热。其实不管你使用什么安全框架, RBAC 都是必须掌握的。如果你有什么问题可以留言讨论。也可以通过关注公众号 Felordcn 与我联系。 关注公众号:Felordcn获取更多资讯 个人博客:https://felord.cn

优秀的个人博客,低调大师

每日一博 | Gitee 存储库体积控制策略

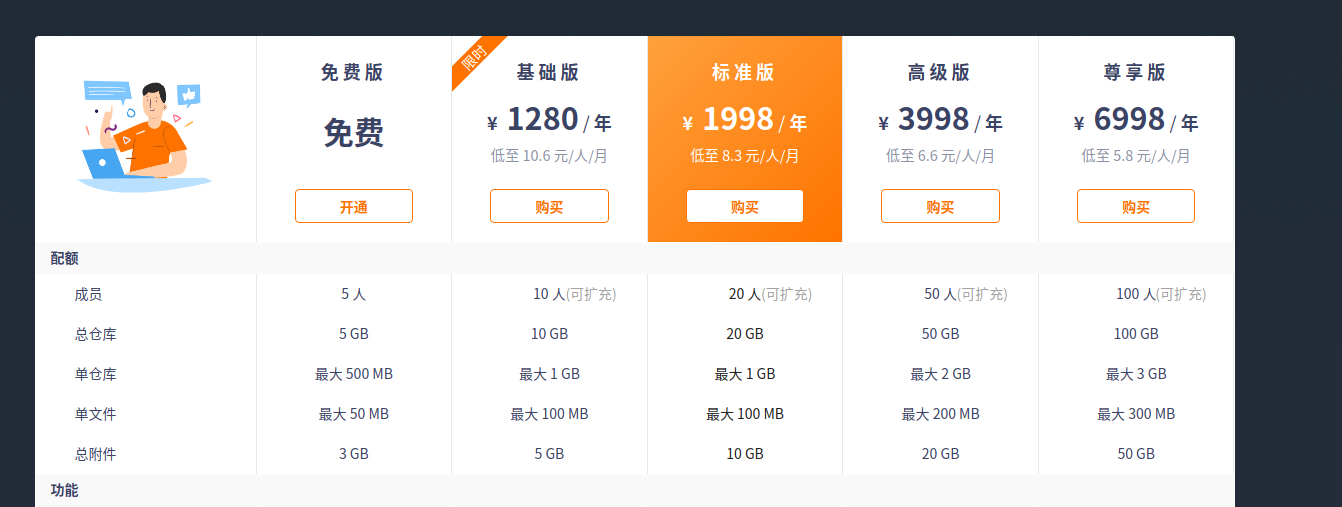
前言 作为全球第二大的代码托管平台,Gitee 拥有350W 用户和 600W 存储库,海量的存储库对 Gitee 的硬件设施提出了更高的要求,以 600W 存储库为例,如果按照平均 1GB 的大小磁盘体积,这些存储库将需要总共 5860 TB 的空间,按照 Gitee 每台存储磁盘 14TB,则需要 419 台存储设备。实际上在 Gitee 中,绝大多数存储库的体积都小于 100 M,超过 100 M 的存储库通常都是未合理使用 git。尽管如此,Gitee 仍然需要投入大量的存储设备来支撑用户的接入。为了能够让更多的人能够免费使用 Gitee,我们迫不得已只能限制大存储库的访问。近期,Gitee 存储库路由架构改造第一阶段已经到了收尾截断,在此期间,我们将陆续将服务端的钩子切换到 GNK (Gitee Native Hook),GNK 基于 C++ 编写,使用了 Git 环境隔离等高级特定,意味着大文件检测和存储库体积检测不会再有漏网之鱼。一些用户的存储库体积已经超过了 Gitee 配额限制,而之前的钩子检测存在缺陷,无法实时拦截大存储库和大文件,当切换到 GNK 后,这些用户修改他们的存储库却无法推送到 Gitee,这让他们产生了困扰,本文就这一困扰解答若干问题。当然如果用户有其他问题也可以在本文下留言。 Gitee 套餐信息 Gitee 分为普通用户,和企业用户,个人的套餐实际和企业免费版一致,最新的套餐信息 如下: 大存储库的产生 Git 是基于文件快照的,但并不是所有时候都存储快照,当对象被打包到 .pack 文件中时,则有可能存储对象的差异,即 OBJ_OFS_DELTA/OBJ_REF_DELTA。这种机制使得在文件大小不变的情况下,每次修改文件都会导致存储库体积按大于文件压缩后体积增长,以一个 Zip 压缩文件为例,每次修改后大小为 50 MB,提交 20次便能够超过 1000 MB。当用户将项目中的构建文件诸如 .exe,.pdb,.so,.jar 或者依赖文件/文件夹 node_modules,packages 以及资源文件 .psd,.raw,.avi,.jpg 添加到版本控制中后,很容易使得存储库体积超出限制。 大文件除了容易让存储库超出限制,而且也会降低用户拉取代码的体验,git 在处理二进制文件时需要花费更多的 CPU。 GNK 的拦截 随着存储服务器陆续切换到 GNK,超出配额的报告也可能会更多。GNK 的拦截是实时的,即用户将代码推送到服务器后,git-receive-pack 将调用 GNK 中的 pre-receive 钩子,这个钩子将统计存储库的 objects 目录,将所有文件和目录所占用的磁盘空间大小累加就获得了存储库的体积,这和 du -sh 机制一致,特别的,我们这里说的存储库体积包含其附带的 wiki 存储库的目录,这也是为了避免个别用户使用 wiki 存储大文件。 GNK 目前会给大存储库推送提供三次机会,如果三次读没有减小存储库体积,则便无法继续修改远程存储库,以 Linux 内核 1.4 G 为例,如下所示: 第三次时如果存储库体积依然超出限制,则会告知用户,已经耗尽所有机会,无法重试。 无法尝试时,输出如下: GNK 还会拦截用户推送的大文件,但已经存在于存储库的大文件,GNK 不会去检测。基于 Git 环境隔离机制实现的 GNK,拦截大文件不会像之前一样反复推送大文件失败导致存储库体积变大,环境隔离目录在 pre-receive 执行失败后会被删除。 存储库的精简方案 在开发的时候,我们可以使用包管理工具管理项目依赖,比如 dotnet core 使用 NuGet,Java 使用 Maven,完全没有必要将依赖二进制纳入版本控制。 如果不慎将大文件纳入了版本控制中,可以去访问 Gitee 帮助:仓库体积过大,如何减小?。在修改本地存储库后,通过 git push -f 的方式推送到 Gitee,然后在项目配置页面运行 Git GC 待 GC 运行后,通常能够发现存储库体积变小。 如果项目使用 PR 机制参与协作开发,强制推送后运行 git gc 可能不会减小存储库的体积(这是因为存储库需要使用内部引用保持 PR 相应的 commit 的可用性,不被 GC),这个时候用户可以升级套餐,获得更大的存储库容量,或者在 Gitee 上新建一个空存储库,将修改历史记录的存储库推送到新的存储库。使用新的存储库即可。 一些大文件无法用版本控制可以将其使用 Git LFS 管理,用户需要使用 Git LFS 可以查看 Gitee LFS。 对于一些用户由于疏忽已经用完重试次数则可以联系官方团队重置重试次数 最后 无论如何,给用户带来困扰,我们很抱歉,但 Gitee 也是需要不断改进,不断的完善。随着 GNK 迁移完成和前端切换,Gitee 的路由架构改造第一阶段也将完成,这使得用户改名,存储库改名,存储库忽略大小写,fork 能够更容易实现或者更加快速。

优秀的个人博客,低调大师

每日一博 | 聊聊 Vue 3.0 响应式数据

"别再更新了,实在是学不动了"这句话道出了多少前端开发者的心声,"不幸"的是 Vue 的作者在国庆区间发布了 Vue3.0 的 pre-Aplha 版本,这意味着 Vue3.0 快要和我们见面了。既来之则安之,扶我起来我要开始讲了。Vue3.0 为了达到更快、更小、更易于维护、更贴近原生、对开发者更友好的目的,在很多方面进行了重构: 使用 Typescript 放弃 class 采用 function-based API 重构 complier 重构 virtual DOM 新的响应式机制 今天咱就聊聊重构后的响应式数据。 尝鲜 重构后的 Vue3.0 和之前在写法上有很大的差别,早前在网络上对于 Vue3.0 这种激进式的重构方式发起了一场讨论,见仁见智。不多说先看看 Vue3.0 在写法上激进到什么程度。 <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <title>Document</title> <script src="../packages/vue/dist/vue.global.js"></script> </head> <body> <div id="app"></div> <script> const { reactive, computed, effect, createApp } = Vue const App = { template: ` <div id="box"> <button @click="add">{{ state.count }}</button> </div> `, setup() { const state = reactive({ count: 0 }) function add() { state.count++ } effect(() => { console.log('count改变', state.count); }) return { state, add } } } createApp().mount(App, '#app') </script> </body> </html> 确实写法上和 Vue2.x 差别有点大,还整出了个 setup。不过我的第一感觉倒不是写法上的差异,毕竟写过 React,这种写法也没啥特别的。关键是这种响应式数据的写法好像在哪里见过有没有?写过 React 项目的人可能一眼就能看出来,没错就是它mobx,一种 React 的响应式状态管理插件 import {observable,computed,autorun} from "mobx" var numbers = observable([1,2,3]); var sum = computed(() => numbers.reduce((a, b) => a + b, 0)); var disposer = autorun(() => console.log(sum.get())); // 输出 '6' numbers.push(4); // 输出 '10' numbers.push(5); 再看看 Vue3.0 暴露的这几个和响应式数据相关的方法: reactive(value) 创建可观察的变量,参数可以是 JS 原始类型、引用、纯对象、类实例、数组、集合(Map|Set)。 effect(fn) effect 意思是副作用,此方法默认会先执行一次。如果 fn 中有依赖的可观察属性变化时,会再次触发此回调函数 computed(()=>expression) 创建一个计算值,computed实现也是基于effect来实现的,特点是computed中的函数不会立即执行,多次取值是有缓存机制的,expression不应该有任何副作用,而仅仅是返回一个值。当这个expression依赖的可观察属性变化时,这个表达式会重新计算。 和mobx有异曲同工之妙。 Vue3.0 把创建响应式对象从组件实例初始化中抽离了出来,通过暴露 API 的方式将响应式对象创建的权利交给开发者,开发者可以自由的决定何时何地创建响应式对象,就冲这点 Vue3.0 我先粉了。 重构后的响应式机制带来了哪些改变? 每一个大版本的发布都意味着新功能、新特性的出现,那么重构后的响应式数据部分相比 3.0 之前的版本有了哪些方面的改变呢?下面听我娓娓道来: 对数组的全面监听 Vue2.x 中被大家吐槽的最多的一点就是针对数组只实现了push,pop,shift,unshift,splice,sort,reverse'这七个方法的监听,以前通过数组下标改变值的时候,是不能触发视图更新的。这里插一个题外话,很多人认为 Vue2.x 中数组不能实现全方位监听是 Object.defineProperty 不能监听数组下标的改变,这可就冤枉人家了,人家也能侦听数组下标变化的好吗,不信你看 const arr = ["2019","云","栖","音","乐","节"]; arr.forEach((val,index)=>{ Object.defineProperty(arr,index,{ set(newVal){ console.log("赋值"); }, get(){ console.log("取值"); return val; } }) }) let index = arr[1]; //取值 arr[0] = "2050"; //赋值 没毛病,一切变化都在人家的掌握中。上面这段代码,有没有人没看懂,我假装你们都不懂,贴张图 从数组的数据结构来看,数组也是一个 Key-Value 的键值对集合,只是 Key 是数字罢了,自然也可以通过Object.defineProperty 来实现数组的下标访问和赋值拦截了。其实 Vue2.x 没有实现数组的全方位监听主要有两方面原因: 数组和普通对象相比,JS 数组太"多变"了。比如:arr.length=0,可以瞬间清空一个数组;arr[100]=1又可以瞬间将一个数组的长度变为 100(其他位置用空元素填充),等等骚操作。对于一个普通对象,我们一般只会改变 Key 对应的 Value 值,而不会连key都改变了,而数组就不一样了 Key 和 Value 都经常增加或减少,因此每次变化后我们都需要重新将整个数组的所有 key 递归的使用 Object.defineProperty 加上 setter 和 getter,同时我们还要穷举每一种数组变化的可能,这样势必就会带来性能开销问题,有的人会觉得这点性能开销算个 x 呀,但是性能问题都是由小变大的,如果数组中存的数据量大而且操作频繁时,这就会是一个大问题。React16.x 在就因为在优化 textNode 的时候,移除了无意义的 span 标签,性能据说都提升了多少个百分点,所以性能问题不可小看。 数组在应用中经常会被操作,但是通常push,pop,shift,unshift,splice,sort,reverse这 7 种操作就能达到目的。因此,出于性能方面的考虑 Vue2.x 做出了一定的取舍。 那么 Vue3.0 怎么又走回头路去实现了数组的全面监听了呢?答案就是 Proxy 和 Reflet 这一对原生 CP 的出现,Vue3.0 使用 Proxy 作为响应式数据实现的核心,用 Proxy 返回一个代理对象,通过代理对象来收集依赖和触发更新。大概的原理像这段代码一样: const arr = ["2019","云","栖","音","乐","节"]; let ProxyArray = new Proxy(arr,{ get:function(target, name, value, receiver) { console.log("取值") return Reflect.get(target,name); }, set: function(target, name, value, receiver) { console.log("赋值") Reflect.set(target,name, value, receiver);; } }) const index = ProxyArray[0]; //取值 ProxyArray[0]="2050" //赋值 效果和 Object.defineProperty 一样一样的,又显得清新脱俗有没有?而且 Proxy 只要是对象都能代理,后面还会提到。当然 Vue3.0 是虽然有了新欢,但也没忘记旧爱,对于在之前版本中数组的几种方法的监听还是照样支持的。 惰性监听 什么是"惰性监听"? 简单讲就是"偷懒",开发者可以选择性的生成可观察对象。在平时的开发中常有这样的场景,一些页面上的数据在页面的整个生命周期中是不会变化的,这时这部分数据不需要具备响应式能力,这在 Vue3.0 以前是没有选择余地的,所有在模板中使用到的数据都需要在 data 中定义,组件实例在初始化的时候会将 data 整个对象变为可观察对象。 惰性监听有什么好处? 提高了组件实例初始化速度 Vue3.0 以前组件实例在初始化的时候会将 data 整个对象变为可观察对象,通过递归的方式给每个 Key 使用Object.defineProperty 加上 getter 和 settter,如果是数组就重写代理数组对象的七个方法。而在 Vue3.0 中,将可响应式对象创建的权利交给了开发者,开发者可以通过暴露的 reactive, compted, effect 方法自定义自己需要响应式能力的数据,实例在初始化时不需要再去递归 data 对象了,从而降低了组件实例化的时间。 降低了运行内存的使用 Vue3.0 以前生成响应式对象会对对象进行深度遍历,同时为每个 Key 生成一个 def 对象用来保存 Key 的所有依赖项,当 Key 对应的 Value 变化的时候通知依赖项进行 update。但如果这些依赖项在页面整个生命周期内不需要更新的时候,这时 def 对象收集的依赖项不仅没用而且还会占用内存,如果可以在初始化 data 的时候忽略掉这些不会变化的值就好了。Vue3.0 通过暴露的 reactive 方法,开发者可以选择性的创建可观察对象,达到减少依赖项的保存,降低了运行内存的使用。 Map、Set、WeakSet、WeakMap的监听 前面提到 Proxy 可以代理所有的对象,立马联想到了 ES6 里面新增的集合 Map、Set, 聚合类型的支持得益于 Proxy 和 Reflect。讲真的这之前还真不知道 Proxy 这么刚啥都能代理,二话不说直接动手用 Proxy 代理了一个 map 试试水 let map = new Map([["name","zhengcaiyun"]]) let mapProxy = new Proxy(map, { get(target, key, receiver) { console.log("取值:",key) return Reflect.get(target, key, receiver) } }) mapProxy.get("name") Uncaught TypeError: Method Map.prototype.get called on incompatible receiver [object Object] 一盆凉水泼来,报错了。原来Map、Set对象赋值、取值和他们内部的 this 指向有关系,但这里的 this 指向的是其实是 Proxy 对象,所以得这样干 let map = new Map([['name','wangyangyang']]) let mapProxy = new Proxy(map, { get(target, key, receiver) { var value = Reflect.get(...arguments) console.log("取值:",...arguments) return typeof value == 'function' ? value.bind(target) : value } }) mapProxy.get("name") 当获取的是一个函数的时候,通过作用域绑定的方式将原对象绑定到Map、Set对象上就好了。 Vue3.0 是如何实现集合类型数据监听的? 眼尖的同学看完上面这段代码会发现一个问题,集合是没有 set 方法,集合赋值用的是 add 操作,那咋办呢?来看看那么 Vue3.0 是怎么处理的,上一段简化后的源码 function reactive(target: object) { return createReactiveObject( target, rawToReactive, reactiveToRaw, mutableHandlers, mutableCollectionHandlers ) } function createReactiveObject( target: any, toProxy: WeakMap<any, any>, toRaw: WeakMap<any, any>, baseHandlers: ProxyHandler<any>, collectionHandlers: ProxyHandler<any> ) { //collectionTypes = new Set<Function>([Set, Map, WeakMap, WeakSet]) const handlers = collectionTypes.has(target.constructor) ? collectionHandlers : baseHandlers //生成代理对象 observed = new Proxy(target, handlers) toProxy.set(target, observed) toRaw.set(observed, target) if (!targetMap.has(target)) { targetMap.set(target, new Map()) } return observed } 根据 target 类型适配不同的 handler,如果是集合 (Map、Set)就使用 collectionHandlers,是其他类型就使用 baseHandlers。接下来看看 collectionHandlers export const mutableCollectionHandlers: ProxyHandler<any> = { get: createInstrumentationGetter(mutableInstrumentations) } export const readonlyCollectionHandlers: ProxyHandler<any> = { get: createInstrumentationGetter(readonlyInstrumentations) } 没有意外只有 get,骚就骚在这儿: // 可变数据插桩对象,以及一系列相应的插桩方法 const mutableInstrumentations: any = { get(key: any) { return get(this, key, toReactive) }, get size() { return size(this) }, has, add, set, delete: deleteEntry, clear, forEach: createForEach(false) } // 迭代器相关的方法 const iteratorMethods = ['keys', 'values', 'entries', Symbol.iterator] iteratorMethods.forEach(method => { mutableInstrumentations[method] = createIterableMethod(method, false) readonlyInstrumentations[method] = createIterableMethod(method, true) }) // 创建getter的函数 function createInstrumentationGetter(instrumentations: any) { return function getInstrumented( target: any, key: string | symbol, receiver: any ) { target = hasOwn(instrumentations, key) && key in target ? instrumentations : target return Reflect.get(target, key, receiver) } } 由于 Proxy 的 traps 跟Map|Set集合的原生方法不一致,因此无法通过 Proxy 劫持 set,所以作者在在这里进行了"偷梁换柱",这里新创建了一个和集合对象具有相同属性和方法的普通对象,在集合对象 get 操作时将 target 对象换成新创建的普通对象。这样,当调用 get 操作时 Reflect 反射到这个新对象上,当调用 set 方法时就直接调用新对象上可以触发响应的方法,是不是很巧妙?所以多看源码好处多多,可以多学学人家的骚操作。 IE 怎么办? 这是个实在不想提但又绕不开的话题,IE 在前端开发者眼里和魔鬼没什么区别。在 Vue3.0 之前,响应式数据的实现是依赖 ES5 的 Object.defineProperty,因此只要支持 ES5 的浏览器都支持 Vue,也就是说 Vue2.x 能支持到 IE9。Vue3.0 依赖的是 Proxy 和 Reflect 这一对出生新时代的 CP,且无法被转译成 ES5,或者通过 Polyfill 提供兼容,这就尴尬了。开发者技术前线获悉的信息,官方在发布最终版本之前会做到兼容 IE11,至于更低版本的 IE 那就只有送上一曲凉凉了。 其实也不用太纠结IE的问题,因为连微软自己都已经放弃治疗 IE 拥抱 Chromium 了,我们又何必纠结呢? 结语 在使用开源框架时不要忘了,我们之所以能免费试用他,靠的维护者投入的大量精力。希望我们多去发现它带来的优点和作者想通过它传递的编程思想。最后期待 Vue3.0 正式版本的早日到来。

优秀的个人博客,低调大师

每日一博 | 详解浏览器跨域

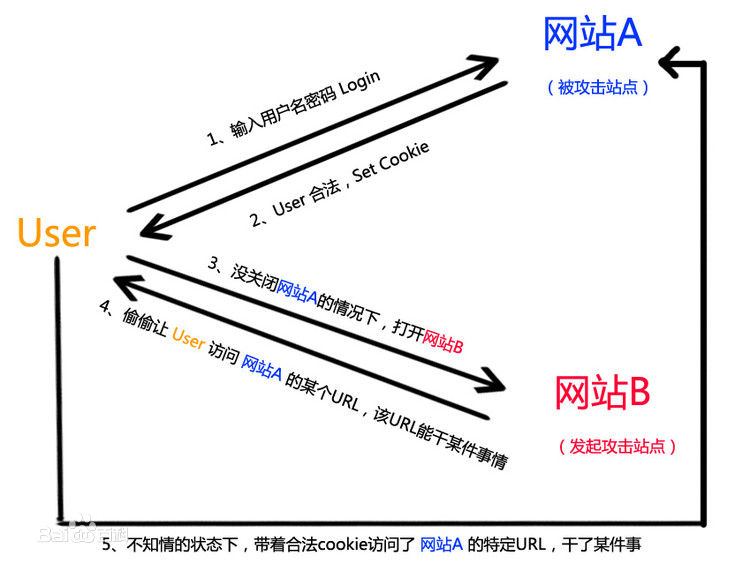
一、什么是跨域? JavaScript出于安全方面的考虑做的同源策略的限制,不允许跨域访问其他资源。通常跨域请求成功后,浏览器会拒绝响应服务器端返回的结果。 1.出于哪些方面的安全考虑? 同源政策的目的是为了防止恶意网站窃取用户数据信息冒充用户做一些操作。同源限制只是提高攻击成本。如果没有JavaScript同源限制: (1)CSRF攻击 (2)XSS攻击 2.什么是同源? 域名、协议、端口均相同。举例来说,http://www.example.com/dir/page.html这个网址,协议是http://,域名是www.example.com,端口是80(默认端口可以省略) 3.做了哪些限制? (1)Window对象之间的跨源通信:无法读取Cookie(cookie是只会区分域名,不会区分端口的,所以在处理cookie 的时候必须首先你自己为cookie加上端口的标示以便区分。这里要感谢评论区指正的道友)、LocalStorage 、IndexDB 和获取DOM,但通过以下标签可以跨域访问资源: <imgsrc="URL"> <linkhref="URL"> <scriptsrc="URL"> <iframe src="URL"> <form action="URL" method="get/post"> First name: <input type="text" name="fname"><br> Last name: <input type="text" name="lname"><br> <input type="submit" value="提交"> </form> 另外,如果是非同源的网页,目前允许通过 JavaScript 脚本可以拿到其他窗口/网页的window对象的九个属性和四个方法。 window.closed window.frames window.length window.location window.opener window.parent window.self window.top window.window window.blur() window.close() window.focus() window.postMessage() 其中,只有window.location是可读写(非同源的情况下,也只允许调用location.replace方法和写入location.href属性)的,其他八个全部都是只读。 (3)客户端服务器间:浏览器拒绝接受AJAX 请求的响应。 4.怎么样算是跨域? 如下相对http://store.company.com/dir/page.html同源检测的示例: URL 结果 原因 http://store.company.com/dir2/other.html 成功 只有路径不同 http://store.company.com/dir/inner/another.html 成功 只有路径不同 https://store.company.com/secure.html 失败 不同协议 ( https和http ) http://store.company.com:81/dir/etc.html 失败 不同端口 ( http:// 80是默认的) http://news.company.com/dir/other.html 失败 不同域名( news和store ) 注意:域名与其对应的ip也不能成功访问 二、如何解决跨域限制? 1.Window对象之间的跨源通信 (1)如果两个网页只是二级域名不同,一级域名相同 ① 浏览器允许通过设置document.domain共享 Cookie,拿到 DOM。 /****A网页:http://t1.example.com/a.html*/ document.domain = 'example.com'; //设置cookie document.cookie = "test1=hello"; /****B网页:http://t2.example.com/b.html,设置相同的document.domain*/ document.domain = 'example.com'; //访问A网页的cookie console.log(document.cookie); /*注意:A 和 B 两个网页都需要设置document.domain属性,才能达到同源的目的。因为设置document.domain的同时,会把端口重置为null,因此如果只设置一个网页的document.domain,会导致两个网址的端口不同,还是达不到同源的目的*/ ② 另外,服务器也可以在设置Cookie的时候,指定Cookie的所属域名为一级域名,二/三级域名不用做任何设置,就可以读取这个Cookie Set-Cookie: key=value; domain=.example.com; path=/ 缺点:这种方法只适用于共享 Cookie 和 iframe 窗口,LocalStorage 和 IndexDB 无法通过这种方法跨域共享 (2)对于完全不同源的网站,可以通过以下三种解决跨域窗口的通信问题: ①片段识别符(URL的#号后面的部分) 只是改变url的片段标识符,页面不会重新刷新,父窗口可以把信息,写入子窗口的片段标识符。 //****父窗口把要共享的信息添加到子窗口url的#后 var src = originURL + '#' + data; document.getElementById('myIFrame').src = src; //****子窗口监听窗口变化 window.onhashchange = ()=>{ //获取url的#后的数据 var data= window.location.hash; } //子窗口也可以通过这种方式向父窗口共享信息 parent.location.href= target + "#" + hash; ②window.name 浏览器窗口的window.name属性,只要在同一个窗口里无论是否同源,前一个网页设置了这个属性,后一个网页可以读取它,且容量很大,可以放置非常长的字符串。 //****子窗口:http://child.url.com/xxx.html,将信息写入window.name属性: window.name = data; location = 'http://parent.url.com/other.html';//接着,子窗口跳回一个与父窗口同域的网址。 //****父窗口:http://parent.url.com/xxx.html,先打开不同源的子窗口网页: var iframe = document.createElement('iframe'); iframe.id='myFrame'; iframe.src = 'http://child.url.com/xxx.html';//iframe可以跨域加载资源 document.body.appendChild(iframe); //然后,父窗口就可以读取子窗口的window.name了。 var data = document.getElementById('myFrame').contentWindow.name; 缺点:必须监听子窗口window.name属性的变化,影响网页性能。 ③window.postMessage HTML5为了解决Window对象之间的跨源通信问题(例如:在页面和它的弹出窗口之间,或嵌入其中的iframe之间,具体参见:https://www.w3cschool.cn/fetch_api/fetch_api-lx142x8t.html),引入了——跨文档通信 API。这个API为window对象新增了一个window.postMessage方法,允许跨窗口通信,不论这两个窗口是否同源。 /*语法:otherWindow.postMessage(message, targetOrigin, [transfer]); message:要发送的数据信息 targetOrigin:接收消息的窗口的源(origin),即"协议 + 域名 + 端口"。也可以设为*,表示不限制域名,向所有窗口发送。 */ //****父窗口"http://aaa.com"向子窗口"http://bbb.com"发消息 var popup = window.open('http://bbb.com', 'title'); popup.postMessage('Hello World!', 'http://bbb.com'); //****子窗口通过message事件,监听发送者的消息 window.addEventListener('message', function(event) { console.log(event.source);//发送源自的窗口:popup (子窗口可以通过event.source属性引用父窗口,然后发送消息) console.log(event.origin);//发送源自的域:"http://aaa.com"(通过event.origin验证发送者,分派事件的origin属性的值不受调用窗口中document.domain的当前值的影响) console.log(event.data);//消息内容:'Hello World!' },false); 安全问题 ①如果您不希望从其他网站接收message,请不要为message事件添加任何事件侦听器,这是一个完全万无一失的方式来避免安全问题 ②如果您确实希望从其他网站接收message,请始终使用origin和source属性验证发件人的身份,以免收到恶意网站发送的恶意信息。 ③当您使用postMessage将数据发送到其他窗口时,始终指定精确的目标origin,而不是*,以免被恶意网站中间拦截postMessage发送的信息。 详情查看:https://developer.mozilla.org/zh-CN/docs/Web/API/Window/postMessage 2.AJAX 同源政策规定,AJAX请求只能发给同源的网址,否则就报错。三种解决方案: (1)架设服务器代理 浏览器请求同源服务器,再由后者请求外部服务 (2)JSONP JSONP是服务器与客户端跨源通信的常用方法,简单适用,兼容性好。 基本原理: ①网页添加一个<script>元素,向服务器请求一个脚本,直接作为代码运行,这不受同源政策限制,可以跨域请求。 ②服务器收到请求后,拼接一个字符串,将 JSON 数据放在函数名里面,作为字符串返回(bar({...})) ③客户端会将服务器返回的字符串,作为代码解析,因为浏览器认为,这是<script>标签请求的脚本内容。这时,客户端只要定义了bar()函数,就能在该函数体内,拿到服务器返回的 JSON 数据。 //请求的脚本网址有一个callback参数(?callback=bar),用来告诉服务器,客户端的回调函数名称(bar) <script src="http://api.foo.com?callback=bar"></script> //定义bar()函数,在该函数体内,拿到服务器返回的 JSON 数据 function foo(data) { console.log('服务器返回:' + data.id); }; //服务器收到这个请求以后,会将数据放在回调函数的参数位置返回。 foo({ 'ip': '8.8.8.8' }); 缺点:只能get请求 (3)WebSocket WebSocket协议是一种基于TCP的网络协议,取代用HTTP作为传输层的双向通讯技术——允许服务器主动发送信息给客户端。使用ws://(非加密)和wss://(加密)作为协议前缀。 ①服务器根据WebSocket请求头的Origin字段(表示:请求源自哪个域名),判断是否许可本次通信 ②如果该域名在白名单内,服务器就会做出回应,所以没有同源限制 //websocket请求头(摘自网络) GET /chat HTTP/1.1 Host: server.example.com Upgrade: websocket Connection: Upgrade Sec-WebSocket-Key: x3JJHMbDL1EzLkh9GBhXDw== Sec-WebSocket-Protocol: chat, superchat Sec-WebSocket-Version: 13 Origin: http://example.com //判断为白名单后,服务端做出回应 HTTP/1.1 101 Switching Protocols Upgrade: websocket Connection: Upgrade Sec-WebSocket-Accept: HSmrc0sMlYUkAGmm5OPpG2HaGWk= Sec-WebSocket-Protocol: chat (3)CORS CORS是跨源资源分享(Cross-Origin Resource Sharing)的缩写,是W3C标准,是跨源AJAX请求的根本解决方法。 相比JSONP只能发GET请求,CORS允许任何类型的请求。 CORS 需要浏览器和服务器同时支持,实现 CORS 通信的关键是服务器。只要服务器实现了 CORS 接口,就可以跨域通信。 CORS 请求分成两类,划分的原因是,表单在历史上一直可以跨域发出请求。简单请求就是表单请求,浏览器沿袭了传统的处理方式,不把行为复杂化,否则开发者可能转而使用表单,规避 CORS 的限制。对于非简单请求,浏览器会采用新的处理方式: ①简单请求:简单的 HTTP 方法(head,get,post)与简单的 HTTP 头信息(Accept,Accept-Language,Content-Language,Last-Event-ID,Content-Type:只限于三个值application/x-www-form-urlencoded、multipart/form-data、text/plain)的结合。 浏览器发现跨域 AJAX 请求是简单请求,直接发出 CORS 请求,自动在头信息之中,添加一个Origin字段。 如果Origin指定的源,不在许可范围内,服务器会返回一个正常的 HTTP 回应,头信息Access-Control-Allow-Origin没有包含Origin。浏览器收到后从而抛出一个错误,被XMLHttpRequest的onerror回调函数捕获。注意,这种错误无法通过状态码识别,因为 HTTP 回应的状态码有可能是200。 如果Origin指定的域名在许可范围内,服务端响应头之中Access-Control-Allow-Origin字段包含请求头中Origin字段的值。 //****JavaScript脚本: var url = 'http://api.alice.com/cors'; var xhr = new XMLHttpRequest(); xhr.open('GET', url, true); xhr.withCredentials = true;/*在 AJAX 请求中打开withCredentials属性,从而向服务器发送 Cookies。但是,如果服务器端的响应中未携带 Access-Control-Allow-Credentials: true ,浏览器将不会把响应内容返回给请求的发送者。*/ xhr.send(); //***请求头: GET /cors HTTP/1.1 Origin: http://api.bob.com /*表示请求来自哪个域(协议 + 域名 + 端口)。服务器根据这个值,决定是否同意这次请求*/ Host: api.alice.com Accept-Language: en-US Connection: keep-alive User-Agent: Mozilla/5.0... //****如果Origin指定的域名在许可范围内,服务端响应头之中,会多出几个头信息字段,有三个与 CORS 请求相关的字段,都以Access-Control-开头。 Access-Control-Allow-Origin: http://api.bob.com /*必须字段。值可以是请求头Origin字段的值(如果服务端指定了具体的Origin域名,则响应头中的 Vary 字段的值必须包含 “Origin”,告诉客户端:服务器对不同的源站返回不同的内容),对于不需要携带身份凭证的请求(请求头没有携带cookie信息),服务器可以指定该字段的值为一个*,表示接受任意域名的请求。*/ Access-Control-Allow-Credentials: true /*可选字段。表示服务器明确许可浏览器可以把 Cookie 包含在请求中,一起发给服务器。但,须 AJAX 请求中打开withCredentials属性才起作用*/ Access-Control-Expose-Headers: FooBar /*在跨域访问时,XMLHttpRequest对象的getResponseHeader()方法只能拿到一些最基本的响应头,Cache-Control、Content-Language、Content-Type、Expires、Last-Modified、Pragma,如果要访问其他头,则需要服务器设置本响应头,把允许浏览器访问的头放入白名单*/ Content-Type: text/html; charset=utf-8 ②非简单请求:非简单请求是那种对服务器提出特殊要求的请求,比如:请求方法是PUT或DELETE,或者Content-Type字段的类型是application/json。 非简单请求的 CORS 请求,会在正式通信之前,增加一次 HTTP 查询请求,称为“预检”请求(preflight)。"预检请求“的使用,可以避免跨域请求对服务器的用户数据产生未预期的影响。 服务器收到“预检”请求以后,检查了Origin、Access-Control-Request-Method和Access-Control-Request-Headers字段以后,确认允许跨源请求,就可以做出回应。 如果服务器否定了“预检”请求,会返回一个正常的 HTTP 回应,但是没有任何 CORS 相关的头信息字段,或者明确表示请求不符合条件。 一旦服务器通过了“预检”请求,以后每次浏览器正常的 CORS 请求,就都跟简单请求一样,会有一个Origin头信息字段。服务器的回应,也都会有一个Access-Control-Allow-Origin头信息字段。 //****JavaScript脚本: var url = 'http://api.alice.com/cors'; var xhr = new XMLHttpRequest(); xhr.open('PUT', url, true); xhr.setRequestHeader('X-Custom-Header', 'value'); xhr.send(); //****“预检”请求头 OPTIONS /cors HTTP/1.1 /*“预检”请求用的请求方法是OPTIONS,表示这个请求是用来询问的*/ Origin: http://api.bob.com /*表示请求来自哪个源*/ Access-Control-Request-Method: PUT /*该字段是必须的,用来列出浏览器的 CORS 请求会用到哪些 HTTP 方法,本例是PUT*/ Access-Control-Request-Headers: X-Custom-Header /*该字段是一个逗号分隔的字符串,指定浏览器 CORS 请求会额外发送的头信息字段,本例是X-Custom-Header*/ Host: api.alice.com Accept-Language: en-US Connection: keep-alive User-Agent: Mozilla/5.0... ①//****服务器否定了“预检”请求的响应头: OPTIONS http://api.bob.com HTTP/1.1 Status: 200 Access-Control-Allow-Origin: https://notyourdomain.com/*明确不包括发出请求的http://api.bob.com*/ Access-Control-Allow-Method: POST //****浏览器发现服务器不同意预检请求,触发一个错误,被XMLHttpRequest对象的onerror回调函数捕获。控制台报错信息: XMLHttpRequest cannot load http://api.alice.com. Origin http://api.bob.com is not allowed by Access-Control-Allow-Origin. ②//****服务器允许了“预检”请求的回应头: HTTP/1.1 200 OK Date: Mon, 01 Dec 2008 01:15:39 GMT Server: Apache/2.0.61 (Unix) Access-Control-Allow-Origin: http://api.bob.com /*表示http://api.bob.com可以请求数据。该字段也可以设为星号,表示同意任意跨源请求。*/ Access-Control-Allow-Methods: GET, POST, PUT /*该字段必需,它的值是逗号分隔的一个字符串,表明服务器支持的所有跨域请求的方法。注意,返回的是所有支持的方法,而不单是浏览器请求的那个方法。这是为了避免多次“预检”请求。*/ Access-Control-Allow-Headers: X-Custom-Header /*如果浏览器请求包括Access-Control-Request-Headers字段,则Access-Control-Allow-Headers字段是必需的。它也是一个逗号分隔的字符串,表明服务器支持的所有头信息字段,不限于浏览器在“预检”中请求的字段。*/ Content-Type: text/html; charset=utf-8 Content-Encoding: gzip Content-Length: 0 Keep-Alive: timeout=2, max=100 Connection: Keep-Alive Content-Type: text/plain Access-Control-Max-Age: 1728000 /*该字段可选,用来指定本次预检请求的有效期,单位为秒。这里有效期是20天(1728000秒),即允许缓存该条回应1728000秒(即20天),在此期间,不用发出另一条预检请求。*/ //****“预检”请求通过之后,浏览器的会再发一个正常 CORS 请求: PUT /cors HTTP/1.1 Origin: http://api.bob.com Host: api.alice.com X-Custom-Header: value Accept-Language: en-US Connection: keep-alive User-Agent: Mozilla/5.0... //****然后,服务器正常的回应: Access-Control-Allow-Origin: http://api.bob.com Content-Type: text/html; charset=utf-8 缺点:兼容性不好(>ie10) 具体参见:https://wangdoc.com/javascript/bom/cors.html 详情查看:https://wangdoc.com/javascript/bom/same-origin.html 其他相关链接:https://developer.mozilla.org/zh-CN/docs/Web/API/Window/postMessage、https://developer.mozilla.org/zh-CN/docs/Web/HTTP/Access_control_CORS

优秀的个人博客,低调大师

每日一博 | DevOps 落地实践及案例分享

转载本文需注明出处:微信公众号EAWorld,违者必究。 引言: 银行业为了应对业务的快速变化、互联网层面不穷的业务形态和交易压力,IT“双态(或双模)化”无可避免,开始探索部分业务参考互联网的方式引入分布式架构,但对于银行业独特的强监管、高安全、强一致性的行业要求前提下,如何在业务发展、合规、IT革新之间找到平衡? 而DevOps被越来越多的金融企业所采用,来支撑软件生产过程的数字化转型,本文主要和大家分享在金融行业落地DevOps的一些坑,如何填坑以及一些心得体会!希望大家能够在自己企业中,找到适合自己企业的DevOps实践之路! 目录: 一、关于DevOps实践的一些问题 二、DevOps在金融行业落地都有哪些姿势 三、DevOps在金融行业落地的套路 四、DevOps将软件生产线数字化 五、总结一些DevOps最佳实践 六、DevOps项目落地过程中一些心得体会 1.关于DevOps实践的一些问题 来源:DevOps咖啡馆 我们从国际信息科学考试学会(EXIN)关于DevOps认证体系来分析,DevOps Pre-Master(DOPM)中包含了敏捷、精益、ITSM和测试相关的内容,也就是说这四项其实是作为了DevOps知识体系的基础,其中敏捷、精益和测试是和软件生产、开发工作Dev强相关,ITSM则与Ops运维工作强相关。所以DevOps知识体系更像是对于以往IT知识的再次提炼和融合,不是一门新的技术。 DevOps是什么?又不是什么? DevOps是个开放的体系,从实践中而来,并且还在不断的发展,具体到某个组织也并没有一致的套路,所以DevOps落地更多是因组织而异、因目标而异、因人而异 大家越来越意识到IT是个系统工程,要提高IT组织的绩效,有很多好的通用的实践,好的DevOps落地实践会涵盖DevOps最核心原则和模式,避免走不必要的弯路,有效地缩短个人和组织的学习曲线 在DevOps项目落地过程中需要培养和训练全局的、系统性的思维认知能力,而非某些工具和命令的用法(原因是:原则和实践是相对稳定的,而工具和命令的变化是非常快的),DevOps落地不是单纯的CI/CD,也不是单纯的Jenkins + Ansible DevOps是自动化运维吧?不是做运维的为什么要学DevOps? DevOps是跨部门的合作,里面涉及的部门和角色远不止开发和运维(其他包括产品、需求、架构、测试、安全、项目管理等),所以DevOps不是自动化运维 但DevOps项目落地需要服务于组织目标,可以从自动化运维开始 讲DevOps还是在讲理论,会不会太虚了? 所谓DevOps落地本质上就是定义问题、识别问题可能的最优解、然后不断实验该解的循环过程。这里不存在一个通用的落地框架,重要的是能理解问题的本质,培养自主解决问题的能力。任何别人家的落地都只是别人家的,企业需要发展出独有的、属于自己的落地实践,没人能替代(就像家长嘴里的别人家的孩子,永远无法成为自己的孩子) DevOps是高绩效IT企业实践的有机集合体。任何企业的IT都需要在竞争的环境下不断提升自身的绩效,以便有效创造客户价值、最大化业务产出、减少浪费、提升交付速度和交付质量,并使企业在数字化时代拥有市场领先的IT能力。那么,从这个意义上来讲,只要是IT从业人员,学习和了解DevOps对组织和个人都是有非常有意义的 2.DevOps在金融行业落地都有哪些姿势 我们先看看我们对于CICD的定义: CI持续集成,我们通常定义为从代码提交到编译打包,再到SIT的过程 CD中的持续交付,我们通常定义为从代码提交到UAT的过程 但项目里,没有用DevOps做CI的项目,也可变相为从编译打包到UAT的过程 CD中的持续部署,我们通常定义为从代码提交到最后生产部署的全过程 但项目中,有可能变通为从编译打包到生产部署的过程 总结来看,项目结果不同,或者接入DevOps应用系统也有可能处于不同的阶段,这造成了,CI/CD的过程随项目实际情况会有些差异。 DevOps项目在售前、招标或前期阶段,我们通常看到是小圈里面的内容:CI/CD、自动化部署及回滚、与现有云平台的接口、流程的图形化编排调度等,但这些只是DevOps的内核,真正去落地一个DevOps项目的时候,其实你会看到外面大圈的这些内容,换句话讲,需要梳理组织整个软件生产的全过程! 姿势一:小范围CI+CD,再全公司推广 先看看Capital one的案例,美国第一资本金融公司,美国排名前十的银行。 痛点: 2014年当时,Capital One的软件开发实践和很多传统做法没有什么不同:大量外包,瀑布模型,季度发布,手工流程,变更请求。在某次代码检查会上,大家发现一个测试失败是由于某个XML文件里的tag不配对造成的。按理说,这么小的问题改了再提交就可以了。但是:开发工作是由另外一家公司负责,他们需要发起漫长的变更请求;代码修改后的构建流程(编译、测试、部署等)就需要至少2天时间。这个小小的问题让Capital One的技术团队开始反思他们的构建流程,并决定从这里下手。他们从一个小的团队开始实践DevOps,最终把时间从2天缩短到几分钟。于是,这个实践逐渐在Capital One蔓延开来,所谓星星之火,可以燎原。 2015年的成绩: 代码提交频率:从之前的不固定到每天100多次的提交 代码集成频率:从每月1次到每15分钟一次 部署流程:手工变成自动化 部署到QA和Perf(性能)环境频率:从每月1次到每天4次 部署到生产环境频率:从每月或每个季度1次到每个迭代1次 单元测试覆盖:从没概念到>90% 2016年的成绩: 发布到产品环境的频率:从每个迭代一次到每天至少1次 自动发布的应用软件数量达20个 一个应用软件每天最多可以发布34次 总结DevOps在Capital one的落地姿势:先小范围做全套,再全公司大范围推广。 某寿险也是用的姿势一:他们是与基于Spring cloud的微服务体系架构一起引入DevOps的,原来的想法只是对于这些新的微服务的应用适用DevOps,经过半年的时间之后,感觉还不错,就将DevOps逐步向传统单体架构的应用中去推广了。表中的系统是目前已经接入到DevOps中的系统。对接的代码库有svn/gitlab/bitbucket,介质库是Nexus,CI和CD的流程目前还是做手工触发,CI集成了Sonar和maven test单元测试,cd已包含测试和生产环境。组件包含:springboot、shell脚本和tomcat 3类,主要是全量的部署方式。 再总结一下:先小范围适用CI+CD,它是现在微服务架构适用的,取得经验积累之后,再大范围的推广。 姿势二:先CI,后CD 我们看看中国银行的案例 在项目之初,中国银行首先对软件生产的全流程进行了重新梳理和规划,其中包含流程、规范、度量体系和反馈机制。 在实践阶段分了三步走,研发层面的持续集成、运维层面的持续交付,最终打通研发和运维实现DevOps全流程。 从试点效果来看,单就自动化部署层面就比之前提高了2-5倍的效率。并且在软件质量和规范落实层面有了长足的进步。 再来一个以姿势二落地的,某国家政策性银行。 它的科技局下属研发中心和运行中心是分开的两个大部门,两个部门之间的纽带就是介质,但之前代码基线与生产环境的介质版本一直对不上,这对生产的BUG修复、灾备部署都形成了很大困扰,所以它的研发中心引入DevOps是希望能形成统一的软件出口,能够将需求、代码、配置、介质控制在同一个基线上。所以他们做法是先做CI,并且并行配合maven的框架推广及CMMI4的落地实施。但项目到了二期,它要引进建行建银科技的新核心,一是新核心短时间内的多版本在多个测试环境的部署,二是配合改造的69个业务系统短时间内也会有很多版本要快速部署,进行集成测试,这就要求必须有自动化部署的工具才行。所以DevOps二期的重点就定在了CD,主要是配合核心及配套改造系统提测后的快速自动化部署。 所以总结一下,DevOps落地的第二个姿势:通常都是先由研发部门主导做CI,之后再推广CD,最后将两个流程串起来形成CI和CD的全流程。 姿势三:先CD,后CI 这是一家地方商业银行,也是因为今年要上新核心,并且伴随新核心,有5个系统要重新建设,110套系统要配套改造,行领导提出的目标:在9月8日上线时,利用DevOps做一键式的统一部署!所以项目一期的重点就放在了CD上,短期目标是满足110多套系统的短期大量版本的提测后的自动化部署,最终目标,是要将1+5+110这些系统能够可视化的一键式部署。项目的二期重点,是在CI,配合诸多研发管理的落地实施,全流程的应用和推广以及自动化测试的接入。 3.DevOps在金融行业落地的套路 套路我总结了五步:确定目标、选好姿势、梳理全流程、制定规范、最后分步实施。我们细看一下这五步: 第一步:确定目标 示例一: 这是农行对于DevOps设定的目标:1个平台、能够连接开发、测试、运维3个角色,打通需求、开发、测试、部署、运维5个环节。 示例二: 我们再看看招商银行设定的目标:DevOps是作为打造精益研发体系的一个重要组成部分。 第二步:选好姿势 第一种姿势:小范围CI+CD,之后全公司推广CI+CD , 并打通全流程 第二种姿势:先CI,后CD,打通全流程 第三种姿势:先CD,后CI ,打通全流程 第三步:梳理全流程 示例一: 这是对一家商业银行全流程的梳理,以及DevOps需要集成的IT系统,如项目管理系统、JIRA以及测试管理系统。 示例二: 这是招商银行的全流程梳理,将DevOps平台切成了两个平台协同工作平台和持续交付流水线平台。 示例三: 以上是农行的全流程梳理方式。 第四步:制定规范 在将整个软件生产全流程梳理完之后,会很对DevOps及各原有IT系统的集成界面和分工非常清晰。接下来就要进行第四步规范的梳理和制定,规范包含哪些呢? 开发规范 持续集成规范 持续部署规范 持续交付规范 介质管理规范 文档命名规范 开发分支管理策略 测试管理规范 运维管理规范 …… 那规范制定的目的是什么呢? 有效管控软件生产线上的各个活动和环节 建立统一质量和衡量标准 软件生产活动能被持续度量、反馈、优化 通过DevOps进行有效落实 简单来讲,没有规范的制约,没有统一标准,大家各做各的,DevOps项目不可能成功。 第五步:分步实施 接下来,就是第五步,要具体的落地实施了,但也要有前有后,分轻重缓急。我们建议调些试点项目来,如何来调呢,原则是啥? DevOps试点项目的选择建议原则: 基于互联网渠道,需要快速迭代的项目 需求、产品、开发、测试、运维都在一个团队的项目 有一定脚本化或CI/CD积累的项目 基于JAVA Maven的项目 DevOps试点项目执行原则: 制定规范与试点项目执行并行,来验证规范可落地、可实施,而非空中楼阁 通过试点项目总结出类似项目推行DevOps的规定动作,如:Demo脚本、CI/CD流程、自动化测试脚本、Maven二方库和三方库的管理经验等等 DevOps与试点项目团队混编,定期举行回顾会,巩固成果,总结教训,关键——肯定成绩和收获 DevOps试点项目执行的苦恼:一个巴掌拍不响: 需要坚持对目标的执念 “两口子过日子”理论 4.DevOps将软件生产线数字化 从横向角度来看,DevOps产生的数据可以分3个部分: 管理数据、开发数据和运营数据,其实这些数据是涵盖了软件生产的全过程,我们可以通过这些数据或直播,来反哺到我们的生产过程,优化我们的不足。 我们从另一个角度DevOps的质量视图、从纵向角度来看,我们也可以从周期、效率、治理和技术的角度来去制定指标考核。 5.总结一些DevOps最佳实践 持续集成的原则 鼓励开发人员在开发分支上频繁的提交代码,随后触发CI流程,在CI过程中可以加入单元测试和代码质量检查等动作,这样产生代码冲突的几率会下降,并且代码质量也会提高的; 在下班之前,构建必须处于成功状态,原因是你的代码在第二天有可能是其它同事开发工作的基础,如何无法保证构建成功,会影响其它的人工作质量和效率,团队氛围也会产生坏的影响; 让开发环境上快速体现最新程序包 让程序、配置、数据分离,其实现在好多的单体应用开发时,是将程序、配置、数据裹在一起的,改一处,要解决一堆的依赖,改一处,牵扯到很多地方都要做更新,这些降低了版本迭代的效率,并且很可能会出现遗漏 maven模式下,pom依赖尽量不要用system本地依赖模式,而是将二方库和三方库依赖到统一的类似Nexus介质库,整个组织一份,来屏蔽本地jar依赖差异导致的编译错误。 持续集成的最佳实践 构建过程,建议等待构建的结果,不要同时做其它的事情,尤其是构建失败之后不要提交新代码,这样很可能会错上加错,最后不知道到底是谁的错,这些错误的回溯会产生很大的成本。 提交之前在本地运行所有的提交测试 提交之前请更新本地代码,保证代码是最新的,冲突解决了,再提交 记得更新数据库、配置文件等 等构建成功后再继续其他工作 下班之前,构建必须处于成功状态 以十分钟为界限,如果代码提交后构建错误,十分钟之内无法解决问题,需要将新代码撤回,否则可能会影响其它同事的工作。 自动化部署的原则 原则1:确保从开发、各类测试到生产,使用相同版本的中间件和操作系统,保证从操作系统、到补丁包、到应用运行环境基线是一致的 原则2:同一套脚本,解决各类环境的部署问题,不要试图通过脚本来解决环境的差异性,因为环境的差异性本应该是不存在的,否则改了脚本,之前的各个环境还需要做脚本的回归测试 原则3:部署之前,事先设计回滚与零停机发布的策略 原则4:全量发布优先,尽量不要用增量发布,因为引入增量发布,就会引入手工操作,人工去选择哪些做增量 原则5:详细记录部署活动的整个过程 自动化部署的最佳实践 要做到自动化部署,要确保自动化部署的成功,最最重要的关键为:保障一致性!将要部署的各个环境一致;在各个环境执行的部署脚本一致;要部署的安装包也要一致! 从提测之后,所有环境运行的是同一个介质包,不要在SIT、UAT、准生产和生产等环节重复的打包 保证各个环境的操作系统、补丁和软件运行环境的基线一致; 保证使用同一的二方和三方库依赖,推荐Nexus 关于配置文件,建议: 配置文件与代码的版本保持一致 配置项清晰、规范、统一命名 配置项模块化、且封闭 每个配置项都是唯一的,避免顾此失彼 避免过分设计,尽量简单 建议逐步过渡到Apollo这样的统一配置中心,以key/value的形式管理各环境的配置项 6.DevOps项目落地过程中一些心得体会 关于DevOps项目的复杂度,我画了一个矩阵图,希望与大家形成共鸣: 图的X轴是软件生产的全流程,Y轴是DevOps要集成的各类IT系统,Z轴是要推广的各个项目,从这个图可以看出,要做好DevOps落地,复杂度还是相当高的。 DevOps项目落地,我自己总结了一套扁担理论: 这条扁担就是软件生产的全流程,是整个项目的骨架,需要事先梳理全流程,并打通工具链,制定各类规划和规范 扁担一头挑着自动化持续集成,各项目组件构建的调研、设计、开发、适配,从标注化到脚本化,最后自动化,并落实开发规范 扁担另一头挑着自动化部署,各项目组件部署的调研、设计、开发、适配,从标注化到脚本化,最后自动化,并落实部署和运维规范 但DevOps项目虽然落地困难,无论从管理者层面和一线人员层面也确确实实能给金融起来带来价值: 对于管理者: 将软件生产的各个管理环节前置,尽早发现软件质量问题,从而降低缺陷的解决成本和对生产带来的影响;提高软件产品的质量 缩短软件产品的生产周期,软件产品尽早的投产使用,给业务带来价值 实现从业务需求到产品上线的里程碑管理和成本统计 实现需求、开发任务、代码之间的闭环关联 对于一线人员: 引入流程化和自动化等手段,提高软件产品的生产效率 保证环境一致性、脚本一致性、介质一致性,缩短各环境的发布部署时间 在软件产品的生产过程中,引入标准和规范,从而规避手工操作带来的混乱和风险 希望大家能够通过本文,了解一些DevOps在金融行业落地的套路和最佳实践,能够找到适合自己组织的DevOps落地经验。 关于作者:八爷,普元架构师,擅长DevOps、基础架构层IaaS/PaaS/虚拟化、系统分析和架构分析;参与九江银行持续集成项目、国家开发银行CDP二期项目、中投移动办公平台项目、山东城商联盟服务治理项目咨询工作。 关于EAWorld:微服务,DevOps,数据治理,移动架构原创技术分享。长按二维码关注!

优秀的个人博客,低调大师

每日一博 | 从 PaaS 平台到 aPaaS 平台

互联网行业喜欢搞一些单词的缩写,最近一个朋友换工作,说是去搞aPaaS平台了,那么aPaaS平台是什么呢? 了解下云计算 aPaas是衍生在云平台之上的,如果开发一款应用,需要涉及大量基础技术或者基础设置。 如果从技术层次上划分来说,分为以下几层: application层 data层 runtime层 middleware层 OS层 virtualization层 servers层 storage层 networking层 在以前软件开发及维护过程中需要购买并维护这9层设施,而一些公司可以将这9层基础技术或者基础设施打包起来出售,就是云计算了。 慢慢云计算,云服务就变成了我们服务底层的水电煤,我们每个月交钱就可以了,比自己维护这9层来说简单了很多。 针对这9层的打包方式分为以下几种方式: IaaS:基础即服务 PaaS:平台即服务 SaaS:软件即服务 aPaaS是什么 可以将aPaaS理解为PaaS的一种形式,aPaaS(application Platform as a service,应用程序即服务)。基于aPaaS的解决方案,支持应用程序在云端开发,部署和运行,提供软件开发中基础工具用户,数据对象,权限管理,用户界面等功能。 介于PaaS和SaaS之间。 aPaaS的特点: 提供应用的快速开发环境,用户在几个小时内就可以完成应用开发,测试,部署,并可以随时调整和更新代码。 低代码或者零代码,非技术人员可以完成开发。 PaaS和aPaaS之间的区别 两者都支持软件的开发和部署,支持云端访问,差异主要体现在用户和使用人群不一样。 PaaS:是平台即服务,需要专业的技术人员在本地完成代码编写和应用开发及数据提供,之后部署到PaaS平台,之后分发应用。 aPaaS:面对非技术人员可以直接在云端完成应用程序的搭建,部署,使用和更新管理。 aPaaS主要特点是快速,低成本开发,非技术人员可以自行开发一套商业系统,开发过程所见即所得,便于快速调整。 国内外有一些面向中小企业市场的企业开发平台的厂商已经推出了aPaaS平台。 aPaaS特点 低代码侵入 aPaaS平台为解决快速开发,低代码甚至零代码的侵入,一般通过对所需要的基础能力,比如权限,界面,交互,流程进行抽象,通过提供配置化页面进行组装。用户无需专业的编程能力就可以随意编排创建出自己的aPaaS应用。 通过降低代码侵入,减少人员学习成本使用aPaaS可以大大节省人力成本。 提供元数据是用来描述数据的数据。譬如一条客户信息,包括名称、行业、地址、联系电话等,这些用来描述客户信息的数据就是元数据。 而元数据架构规范了元数据的功能、格式设计、语法规则等方面,实现了可规范、可校验、可分析的数据结构,有利于数据的互通互联,从而实现少量代码或零代码的开发。 以元数据框架为基础构建的aPaaS平台,可帮助企业实现高效开发。譬如通过使用aPaaS平台高效开发工具:自定对象生成器、工作流程设置、翻译工作台、AI+BI的建模等,无需代码,系统管理员只需通过简单的拖拽就可完成业务配置。 可扩展性 为了面向不同的应用需求,可扩展性是aPaaS平台所需要具备的。同时为具备更强的扩展能力,平台需要可以提供一系列OpenAPI接口,便于技术人员进行更高级别的功能开发,比如和其他系统进行对接。 aPaaS平台能够提供沙盒环境,为产品全生命周期研发从产品开发、单独测试、联动测试到产品培训、生产上线等各阶段提供独立的测试环境,保障产品高质、高效的交付。同时,环境之间可以一键自动迁移部署,实现“持续交付”和“持续集成”的自动化部署流程。 云能力 aPaaS需要具备天生的云能力,在任何设备,任何时间,任何地点可以随意访问,解决多租户问题,保证数据可靠。 通过容器(Docker)等技术建立先进的微服务架构,此架构犹如一个个集装箱的集合。在保持代码统一开发的前提下,能够满足企业数据安全合规性,实现指定云端部署的特殊要求。可以一键部署到云端。 灵活UI支持 通过Breeze UI全新的设计理念,在网页端、移动端和小程序端进行开放和创新的UI框架设计,为用户体验带来如清风般(Breeze)的感觉。 如通过Breeze视觉语言设计和更多的“千人千面”设计配置,实现高效的开发工具——移动端的APP设计器,可根据不同角色在手机端设计出不同的首页布局、详情页布局等,无论从视觉还是内容上,让企业员工聚焦更有用信息,屏蔽无用内容,提升工作效率。 从技术平台到aPaaS平台 目前很多公司都在搞平台化,在进行业务收敛,能力内聚之后,由之前提供服务化接口,API的能力将会慢慢演化去提供服务能力的aPaaS平台方向。整合第三方客户数据进行全面的企业运营数据分析等。以及与企业官网、电子邮件、工商数据等等实现联通,全面打破数据孤岛,让数据成为企业真正的生产力。 对于平台化团队来说,aPaaS方向是个值得探索的方向和机会。

优秀的个人博客,低调大师

每日一博 | 从技术平台到 aPaaS 平台

互联网行业喜欢搞一些单词的缩写,最近一个朋友换工作,说是去搞aPaaS平台了,那么aPaaS平台是什么呢? 了解下云计算 aPaas是衍生在云平台之上的,如果开发一款应用,需要涉及大量基础技术或者基础设置。 如果从技术层次上划分来说,分为以下几层: application层 data层 runtime层 middleware层 OS层 virtualization层 servers层 storage层 networking层 在以前软件开发及维护过程中需要购买并维护这9层设施,而一些公司可以将这9层基础技术或者基础设施打包起来出售,就是云计算了。 慢慢云计算,云服务就变成了我们服务底层的水电煤,我们每个月交钱就可以了,比自己维护这9层来说简单了很多。 针对这9层的打包方式分为以下几种方式: IaaS:基础即服务 PaaS:平台即服务 SaaS:软件即服务 aPaaS是什么 可以将aPaaS理解为PaaS的一种形式,aPaaS(application Platform as a service,应用程序即服务)。基于aPaaS的解决方案,支持应用程序在云端开发,部署和运行,提供软件开发中基础工具用户,数据对象,权限管理,用户界面等功能。 介于PaaS和SaaS之间。 aPaaS的特点: 提供应用的快速开发环境,用户在几个小时内就可以完成应用开发,测试,部署,并可以随时调整和更新代码。 低代码或者零代码,非技术人员可以完成开发。 PaaS和aPaaS之间的区别 两者都支持软件的开发和部署,支持云端访问,差异主要体现在用户和使用人群不一样。 PaaS:是平台即服务,需要专业的技术人员在本地完成代码编写和应用开发及数据提供,之后部署到PaaS平台,之后分发应用。 aPaaS:面对非技术人员可以直接在云端完成应用程序的搭建,部署,使用和更新管理。 aPaaS主要特点是快速,低成本开发,非技术人员可以自行开发一套商业系统,开发过程所见即所得,便于快速调整。 国内外有一些面向中小企业市场的企业开发平台的厂商已经推出了aPaaS平台。 aPaaS特点 低代码侵入 aPaaS平台为解决快速开发,低代码甚至零代码的侵入,一般通过对所需要的基础能力,比如权限,界面,交互,流程进行抽象,通过提供配置化页面进行组装。用户无需专业的编程能力就可以随意编排创建出自己的aPaaS应用。 通过降低代码侵入,减少人员学习成本使用aPaaS可以大大节省人力成本。 提供元数据是用来描述数据的数据。譬如一条客户信息,包括名称、行业、地址、联系电话等,这些用来描述客户信息的数据就是元数据。 而元数据架构规范了元数据的功能、格式设计、语法规则等方面,实现了可规范、可校验、可分析的数据结构,有利于数据的互通互联,从而实现少量代码或零代码的开发。 以元数据框架为基础构建的aPaaS平台,可帮助企业实现高效开发。譬如通过使用aPaaS平台高效开发工具:自定对象生成器、工作流程设置、翻译工作台、AI+BI的建模等,无需代码,系统管理员只需通过简单的拖拽就可完成业务配置。 可扩展性 为了面向不同的应用需求,可扩展性是aPaaS平台所需要具备的。同时为具备更强的扩展能力,平台需要可以提供一系列OpenAPI接口,便于技术人员进行更高级别的功能开发,比如和其他系统进行对接。 aPaaS平台能够提供沙盒环境,为产品全生命周期研发从产品开发、单独测试、联动测试到产品培训、生产上线等各阶段提供独立的测试环境,保障产品高质、高效的交付。同时,环境之间可以一键自动迁移部署,实现“持续交付”和“持续集成”的自动化部署流程。 云能力 aPaaS需要具备天生的云能力,在任何设备,任何时间,任何地点可以随意访问,解决多租户问题,保证数据可靠。 通过容器(Docker)等技术建立先进的微服务架构,此架构犹如一个个集装箱的集合。在保持代码统一开发的前提下,能够满足企业数据安全合规性,实现指定云端部署的特殊要求。可以一键部署到云端。 灵活UI支持 通过Breeze UI全新的设计理念,在网页端、移动端和小程序端进行开放和创新的UI框架设计,为用户体验带来如清风般(Breeze)的感觉。 如通过Breeze视觉语言设计和更多的“千人千面”设计配置,实现高效的开发工具——移动端的APP设计器,可根据不同角色在手机端设计出不同的首页布局、详情页布局等,无论从视觉还是内容上,让企业员工聚焦更有用信息,屏蔽无用内容,提升工作效率。 从技术平台到aPaaS平台 目前很多公司都在搞平台化,在进行业务收敛,能力内聚之后,由之前提供服务化接口,API的能力将会慢慢演化去提供服务能力的aPaaS平台方向。整合第三方客户数据进行全面的企业运营数据分析等。以及与企业官网、电子邮件、工商数据等等实现联通,全面打破数据孤岛,让数据成为企业真正的生产力。 对于平台化团队来说,aPaaS方向是个值得探索的方向和机会。

优秀的个人博客,低调大师

每日一博 | 初学者也说 TARS

作为一个应届毕业生,进入阅文集团,加入到通用平台中心之后,随着日常工作的逐步深入,我渐渐了解阅文的技术体系,其中尤其以腾讯TARS平台最为重要。目前TARS平台承载了阅文内部绝大多数的服务,每日接口调用最大值近百亿,单业务峰值可在数万每秒,近300个业务服务。作为一个新人,我来讲下我从TARS小白到熟练工的历程中整理的一些知识点。 TARS文件 TARS作为一个服务治理框架,最基础的还是要解决服务间调用的问题,这样就引入一个问题:如何在多个服务之间发布接口协议。TARS创新性的设计了一种接口描述语言,即TARS文件,在TARS文件中,可以编写模型、接口、枚举等。在服务提供方,我们可以通过tars-maven-plugin解析TARS文件,生成对应的模型、接口、枚举代码,然后就可以在接口实现类中进行业务逻辑的编写。在对外提供服务时,调用方只需要拿到服务提供方的TARS文件,就能了解服务提供的所有接口及相关描述,从而生成客户端调用代码,进行服务接口调用。 module TestApp { interface Hello { string hello(int no, string name); }; }; 在阅文内部,我们也提供了统一的TARS管理中心,在这里我们可以找到所有已经上传到管理中心的TARS文件,从而避免了通过线下传递TARS文件带来的不便;管理中心支持将TARS文件自动打包成jar包并发布到公司的Maven镜像上,省去了自己编译带来的麻烦。 服务部署 在TARS平台上进行服务部署,只需把代码仓库地址配置到TARS平台,选择分支、选择编译器、编译、打包、分批发布一条龙部署到TARS平台上。目前TARS平台支持物理机部署、Docker部署、物理机和Docker混合部署,极大地提升了使用的体验及满足了服务发布的多样性。同时,TARS平台还支持对每台服务器做特殊化处理,比如可以选择某台服务器设置为无流量做线上接口测试,可以修改某台服务器的私有模板进行服务设置、JVM设置、日志设置等配置的修改。这些都为日常工作中的开发、测试、问题排查提供了更多的方法及可能性。 在发布线上服务时,TARS平台只支持指定tag进行编译打包,从而在流程上规范了服务发布的操作。而且发布是可以自定义选择分批发布、无损发布,最大限度的降低因服务重启引起的线上服务抖动。 服务监控 TARS平台提供了多维度、多样化的服务监控及特性监控。服务监控选项包含了流量、平均耗时、异常率、超时率等,可以自由选择时间范围、主调方业务名、主调方IP、被调方IP、接口名,从而缩小监控范围,方便定位问题。特性监控则针对每一台服务器提供了对JVM内存、堆使用情况、线程、请求队列等特性的监控,从而实现从服务器JVM级别进行问题定位。这些监控目前都是以5分钟为间隔,期待未来TARS平台可以提供更细粒度的时间间隔的监控。 服务监控还提供了实时数据的功能,实现实时观测服务的秒级运行状况,在定位线上问题上发挥了重要的作用。 日志 TARS-JAVA自带一套日志系统,提供了日志类的基础功能。它支持异步输出,支持多种日志级别,并且日志级别可以直接在TARS的管理平台通过修改私有模板或者给TARS服务发送设置日志级别命令来进行实时修改,实现平台一致性。它还支持异常输出,可以方便地打印异常日志。该日志系统不用额外的配置文件,不需要重写加载配置(在services.xml的应用中使用sl4j日志系统时,需要将日志系统的初始化安排到配置文件加载之后;在springboot的应用中使用sl4j日志系统时,需要写重新加载配置文件的逻辑)。目前TARS提供的日志系统在很多项目中都作为唯一日志系统使用。 不过需要注意的是默认的日志系统输出的日志编码是GBK格式的,当你使用以UTF-8解析的远程shell工具查看日志时经常会发现有些日志内容丢失或者时乱码。则可以根据需要,将远程工具的编码格式调整为与GBK兼容的编码,或者使用iconv等工具转换日志编码进行查看。 # encoding converting cat xx.log | iconv -f=gbk 配置文件 TARS平台提供了服务配置中心来管理配置文件,在这里可以添加多个配置文件。在TARS平台上部署服务时,每台服务器会自动将所有配置文件加载到本地(前提是在服务代码中配置了加载配置文件),放在Classpath路径下,供JAVA服务读取解析。对于每个配置文件,TARS平台还提供了文件内容变更时触发的回调函数。通过回调函数机制,我们可以在修改完一个配置文件之后,在TARS平台上进行配置文件推送,从而触发代码中预先设定的回调函数,达到配置文件热更新的效果。当然,对于数据库连接信息、Redis连接信息这些需要重建连接的配置信息还是推荐通过重启服务来更新。 接口测试 TARS平台提供了对TARS接口进行测试的页面。在测试页面,我们可以为每个接口添加多个测试用例数据,可以任意选择服务所在的一台机器进行测试用例调用。这种调用方式方便、快捷,但是对于自动化脚本不甚友好。针对这种情况,阅文内部提供了使用HTTP接口调用TARS接口的方式,更方便地进行自动化接口测试。期待TARS平台后续能对自动化接口测试提供更多的支持。 编码问题 在开发TARS服务时,尤其需要注意各种编码问题,这里整理了一些可能出现的编码问题以及解决方案。 服务配置文件编码 上面提到TARS平台提供了服务配置中心来管理配置文件,服务配置默认的编码是GBK,并且不支持修改,但阅文这边部署服务所使用的的机器(包括物理机和Docker)一般使用的编码是UTF-8。GBK和UTF-8都对ASCII码兼容,所以当配置文件不涉及中文或其他超过ASCII码覆盖范围的字符时,部署的微服务程序中采用系统默认编码读取配置文件时不会发生问题;但是当配置文件中涉及中文字符时,可能由于操作系统默认编码不与GBK兼容时,程序会读到错误的信息。 解决办法: 在自己写的服务代码中使用GBK编码打开配置文件;使用Unicode编码过的字符串代替原中文字符串。 TARS-JAVA的编码 你想尝试一下TARS,于是你把TARS-Java部署在刚刚调教好的Linux上(把本地语言设置成了zh_CN.UTF-8时),当你发布应用时,你会遇到一些奇怪的错误。当你查找原因时,你会发现原来在发布程序使用了GBK去读取Linux的命令行输出。这个时候你只需要改一下TARS-JAVA的源码,将读取命令行输出的编码改成UTF-8,然后重新编译一下即可,非常快捷。当然,也可以不将操作系统的编码设置成zh_CN.UTF-8,很多工具可能无法正确显示中文字符。 服务器文件编码 服务器默认文件编码有时候会出现不是UTF-8的诡异的现象(往往是locale没有配置对UTF-8的支持),这个时候如果代码中使用了默认编码,就会出现乱码的现象。 解决方法:不要使用默认编码,在需要使用编码的时候,一定手动指定编码。 一些Trick分享 在实践TARS服务开发的过程中,积累了一些小技巧,挑选一些献丑。 系统关闭钩子 在TARS平台管理中可以将特定服务的选中实例设置为无流量,以方便做发布、线上验证等操作。不过可惜的是,在TARS服务中无法感知平台的无流量配置,这也就意味着自己编写的TARS服务无法在无流量状态配置前后做一些特别的动作,比如在无流量开启时同时去屏蔽队列消费操作等。但是,TARS服务支持系统的关闭钩子,可以在系统退出前对申请资源进行清理以及确保某些任务完成后再退出。退出TARS服务只需要通过平台对服务的AdminObj发送shutdown命令来完成,然后通过System.exit退出系统。于是可以利用Runtime.getRuntime().addShutdownHook方法,给TARS服务增加系统关闭的钩子。 获取调用方的IP 有时候需要记录调用方的IP,但由于TARS为了高效等目的,没有办法从服务端获取到客户端的标识信息。我们可以从TCP/UDP连接获取调用方的IP和端口信息。 Session session = ContextManager.getContext().request().getIoSession(); String remoteIp = session.getRemoteIp(); int remotePort = session.getRemotePort(); 如何规避Communicator实例重用所带来的问题 在TARS服务的实现中,不可避免地会去调用其他现成的服务,并且绝大多数情况下会调用多个服务。这些被调服务可能会要求在调用时使用不同的编码,有的需要使用UTF-8,而有的需要使用GBK。当多种不同编码的客户端混合调用时,可能会遇到编码问题。追本溯源,发现在获取Communicator实例时,会对其使用Map进行缓存,Map的键为locator或者CommunicatorConfig实例,而CommunicatorConfig只使用了locator和moduleName作为hashCode和equals方法的计算要素。于是当使用locator和moduleName相同的CommunicatorConfig实例去获取Communicator实例时,会得到同一个实例,即便charsetName并不一致。 解决的办法一般有两种: 继承CommunicatorConfig,并重写hashCode和equals方法,加入charsetName作为计算要素,再由这个派生类得到的实例去获取Communicator实例; 为需要特别配置其他属性的CommunicatorConfig实例设置不同的moduleName。 小编有话说 感谢这位同学的精彩分享,看完这位同学从TARS小白到熟练工的进阶过程中积攒的经验,你是否也想分享一下自己的经验?欢迎向 tarscloud@qq.com 投稿。 如果你还没有了解过TARS,欢迎到GitHub上围观、交流,觉得好的话请给TARS点个star哦~! GitHub地址:https://github.com/TarsCloud 作者丨唐靖凯 编辑丨TARS小助手

优秀的个人博客,低调大师

每日一博 | 如何同步多个 git 远程仓库

日常需求 以前源码是托管在 github 的, 现在想要同步托管在 gitee, 一做备份分发, 二方便国内下载使用(网速可观), 三防特色墙... 方式一 使用 gitee 的强制同步 之前在 github 托管了这么一个项目 mirrors-in-china, 后来国内出了 gitee, 那么想着把项目同步一份到 gitee, 方便大家查看... 正巧 gitee 提供强制同步功能, 方便操作... 我还是只用维护 github 那份源码, gitee 这边没忘记的话, 手搓点击下强制同步按钮即可. 但是容易忘记, 造成两边不完全同步. 不过我这个项目本身就非常简单, 这点同步时差完全没大问题, 够用, 并且没有其他任何多余的操作. 方式二 手搓 push 多次 换另一个项目来说, 我之前在 github 托管了这么一个项目 GlobalScanner.Sdk, 应广大小伙伴需求, 希望把项目在国内同步一份, 方便下载/参考/使用. 那么不外乎就是配置多个远程库地址, 多次推送咯, 那么我们先来看看现有远程库的情况: $ git remote --verbose origin git@github.com:taadis/GlobalScanner.Sdk.git (fetch) origin git@github.com:taadis/GlobalScanner.Sdk.git (push) 可以看到目前仅有 git@github.com:taadis/GlobalScanner.Sdk.git 这个远程库地址. 我们来加一个 gitee 的远程地址, 首先在 gitee 建好同步仓库, 然后我们在本地添加一个新的远程库地址: $ git remote add giteeorigin git@gitee.com:taadis/GlobalScanner.Sdk.git 添加完成后我们查看一下: $ git remote --verbose giteeorigin git@gitee.com:taadis/GlobalScanner.Sdk.git (fetch) giteeorigin git@gitee.com:taadis/GlobalScanner.Sdk.git (push) origin git@github.com:taadis/GlobalScanner.Sdk.git (fetch) origin git@github.com:taadis/GlobalScanner.Sdk.git (push) 可以查看到以下2个远程库地址: giteeorigin: 是我们新加的 gitee 的远程库地址 origin: 是我们之前在 github 的远程库地址 接下来同步: git add . git commit -m "add gitee" git push -u origin master git push -u giteeorigin master 有链接有真相: github: add gitee gitee: add gitee 比之前多个一次 git push 操作...其他和之前没有太大区别...没有更多的心智负担. 但是经常容易忘记... 方式三 最多跑一次 不想着法偷懒的 coder 不是好程序员, 秉承 "最多跑一次" 的理念, 让我们试试怎么一次 push 统统搞定. 在本地 git 仓库里找到这个文件 .git/config, 内容如下: [core] repositoryformatversion = 0 filemode = false bare = false logallrefupdates = true symlinks = false ignorecase = true [remote "origin"] url = git@github.com:taadis/GlobalScanner.Sdk.git fetch = +refs/heads/*:refs/remotes/origin/* [branch "master"] remote = origin merge = refs/heads/master [remote "giteeorigin"] url = git@gitee.com:taadis/GlobalScanner.Sdk.git fetch = +refs/heads/*:refs/remotes/giteeorigin/* 改为如下: 合并2个 remote 配置 [core] repositoryformatversion = 0 filemode = false bare = false logallrefupdates = true symlinks = false ignorecase = true [remote "origin"] url = git@github.com:taadis/GlobalScanner.Sdk.git url = git@gitee.com:taadis/GlobalScanner.Sdk.git fetch = +refs/heads/*:refs/remotes/origin/* [branch "master"] remote = origin merge = refs/heads/master 上面这个手动配置是为了更好的说明而已, 其实可以用以下命令简化操作, 在 origin 节点下补充了一个新的远程地址. $ git remote set-url --add origin git@gitee.com:taadis/GlobalScanner.Sdk.git 看看补充后的远程地址情况 git remote --verbose origin git@github.com:taadis/GlobalScanner.Sdk.git (fetch) origin git@github.com:taadis/GlobalScanner.Sdk.git (push) origin git@gitee.com:taadis/GlobalScanner.Sdk.git (push) 注意看后面的 (fetch)(push), 相信你会明白点什么. 然后我们可以继续这样使用来实现 github & gitee 的同步推送和分发: git add . git commit -m "github & gitee 同步推送和分发" git push origin master 有链接有真相: github: github & gitee 同步推送和分发 gitee: github & gitee 同步推送和分发 可以看到, 使用上和最初没有任何区别, 只是多配置了一次, 算是实现了 "最多配(跑)一次". 总而言之 几种方式, 各取所需咯.

优秀的个人博客,低调大师

每日一博 | 金融行业微服务架构解析

转载本文需注明出处:微信公众号EAWorld,违者必究。 引言: 对于微服务,每个人都有自己的理解,与互联网企业的大量落地相比,微服务在传统金融行业还没有普及,这首先是传统金融行业线上系统需求更新和版本迭代没有互联网公司那么频繁;其次是技术能力约束了新技术的落地;再者传统金融行业对系统可用性和稳定性的要求非常高。 如何理解微服务架构?微服务能够给金融行业带来什么?金融行业微服务架构如何选型?这些都需要我们对微服务架构进行深入的剖析。 目录: 一、什么是微服务 二、主流微服务框架 三、微服务架构关键技术 一、什么是微服务? 微服务架构定义 微服务的定义源于 2014 年 3 月 Martin Fowler 所写的一篇文章“Microservices”,微服务的四个特性定义抽象为“小、独、轻、松”。 微服务的感性认识 转型之前: 紧耦合组件 慢的部署周期,等待集成测试 转型之后: 松耦合组件 自动化部署,无需等待独立组件 微服务优势 可伸缩性:服务的承载能力在设计之初并不能完全符合后来业务发展的要求,随着业务量增大,服务要通过服务器集群方式进行扩展,各个微服务的扩展数量也是按需求扩展,承载量大的微服务扩展节点多,承载量小的微服务扩展节点少,从而实现资源有效配置。 降低风险:准备好部署各个阶段的工件,包括:构建工件,测试脚本,配置文件和部署清单文件。 a) 从负载均衡列表中移除掉“金丝雀”服务器。 b) 升级“金丝雀”应用(排掉原有流量并进行部署)。 c) 对应用进行自动化测试。 d) 将“金丝雀”服务器重新添加到负载均衡列表中(连通性和健康检查)。 e) 如果“金丝雀”在线使用测试成功,升级剩余的其他服务器。(否则就回滚) 弹性系统:在理想的设计中,一旦某一非核心微服务启动失败,其他微服务仍然可用,用户在没有使用到异常模块所提供的服务时,对这一异常完全无感知,大大增强了用户体验。 敏捷:开发成本降低,响应速度加快。各个开发团队的人员不必耗费大量时间了解整个服务端架构,主要通过了解某个微服务的金融业务需求和技术体系即可参与开发,从而降低了学习成本以及改动代码带来的风险,代码审查流程的简化也相应地加快了开发响应速度。 灵活:不要求所有的微服务都使用同一种技术和平台来实现。 微服务架构带来的问题 依赖服务变更很难跟踪,其他团队的服务接口文档过期怎么办?依赖的服务没有准备好,如何验证我开发的功能。 部分模块重复构建,跨团队、跨系统、跨语言会有很多的重复建设。 微服务放大了分布式架构的系列问题,如分布式事务怎么处理?依赖服务不稳定怎么办? 运维复杂度陡增,如:部署物数量多、监控进程多导致整体运维复杂度提升。 这些解决方案折腾到最后就会明白,原来我们要有一个微服务应用平台才能整体性的解决这些问题。 微服务架构适用场景 微服务架构并不是万能的,有它适合采用的系统,这些系统包括: 对于业务流程较为复杂,且业务会逐渐变得更加复杂的系统,单体应用将十分庞大,后期难以修改和维护,应考虑使用微服务架构。 为了满足业务需求,项目中引入了众多的技术栈,中间件,单体应用会给开发者带来很大的困扰,应考虑将应用拆分成多个独立部署的采用最优技术栈实施的微服务。 高并发的,有高可用和弹性伸缩需求的系统,往往是那些面向庞大数量互联网用户的平台类、交易类系统,应考虑利用微服务架构便于横向扩展和弹性伸缩的特性。 单体应用版本发布成本高,而单个微服务的变更和发布都很容易,那些有高频率版本发布需求的系统,应使用微服务架构。 没有数据实时强一致要求,可接受数据最终一致的系统,可使用微服务架构。 在银行系统中: OA、HR、绩效等管理类系统并不需要微服务架构; 信贷、CRM等管理类应用如果体积庞大(几十万行代码以上),要使用微服务改造; 中间业务、核心账务、网银由于系统压力大,可以采用微服务架构。 微服务架构在互联网金融方面的应用 第三方支付包括以支付宝、财付通、盛付通为代表的互联网支付企业,也包括快钱、汇付天下为代表的金融型支付企业。 P2P小额信贷是一种个人对个人的直接信贷模式。 大数据金融是指集合海量非结构化数据,通过对其进行实时分析,可以为互联网金融机构提供客户全方位信息。 众筹融资指用团购+预购的形式,向网友募集项目资金的模式。众筹利用互联网传播的特性,让小企业、艺术家或个人对公众展示他们的创意,争取大家的关注和支持,进而获得所需要的资金援助。 所谓信息化金融机构,是指通过采用信息技术,对传统运营流程进行改造活重构,实现经营、管理全面电子化的银行、证券和保险等金融机构。 互联网金融门户是指利用互联网进行金融产品的销售以及为金融产品销售提供第三方服务的平台。它的核心就是“搜索+比价”的模式。 二、主流微服务框架 业界开源微服务框架方案比较 综合来看,SpringCloud是首选。为什么选择SpringCloud? 不只是解决微服务的某一个问题,而是一个解决微服务架构实施的综合性解决框架; 整合了诸多被广泛实践和证明过的框架作为实施的基础部件,又在该体系基础上创建了一些非常优秀的边缘组件 ; 大量的兼容性测试,保证了更好的稳定性; 极高的社区活跃度; SpringCloud之于其他微服务框架就好比是:品牌机 VS DIY电脑 三、微服务架构关键技术 微服务平台技术图谱 微服务技术桟: API Doc: Swagger UI API Mock: Swagger Mock API AOP基础框架:Spring framework 微服务容器:Spring Boot 服务发布:Spring Web MVC 服务注册中心:Spring Cloud - Eureka 服务路由:Spring Cloud – Ribbon 服务调用:Spring Cloud – Feign 服务熔断器:Spring Cloud – Hystrix 安全认证:Spring Cloud - Security 服务配置中心:Apollo , Spring Cloud – Config 服务监控:Spring Boot Admin 关键技术架构与设计 我们从这9个方面来解析微服务关键技术架构与设计。 1、前端UI框架 兼容性 Vue是流行的前端框架,其对浏览器的兼容性较好,主流的操作系统和浏览器都支持。 vue响应式双向数据绑定实现自动同步 vue.js采用数据劫持结合发布者-订阅者的方式,通过Object.defineProperty()来劫持各个属性的setter,getter,在数据变动时,发布消息给订阅者,触发相应的监听回调。 具体的来讲,Vue.js通过Directives指令去对DOM做封装,当数据发生变化,会通知指令去修改对应的DOM,数据驱动DOM的变化。vue.js还会对操作做一些监听(DOM Listener),当我们修改视图的时候,vue.js监听到这些变化,从而改变数据。这样就形成了数据的双向绑定。 2、微服务容器 微服务运行的容器环境 我们来看一下微服务运行容器,要做可靠高效的微服务架构应用,实际上我们需要做的事情还是非常多的。如果没有一个统一的微服务容器,这些能力在每个微服务组件中都需要建设一遍,而且会五花八门,也很难集成到一起。 微服务容器:负载均衡 微服务容器的基础服务能力之一就是支持负载均衡。 通常所说的负载均衡都指的是服务端负载均衡,其中分为硬件负载均衡和软件负载均衡。硬件负载均衡主要通过在服务器节点之间安装专门用于负载均衡的设备,比如F5等;而软件负载均衡则是通过在服务器上安装一些具有负载均衡功能或模块的软件来完成请求分发工作,比如Nigix等。 硬件负载均衡的设备或是软件负载均衡的软件模块都会维护一个下挂可用的服务端清单,通过心跳检测来剔除故障的服务端节点以保证清单中都是可以正常访问的服务端节点。当客户端发送请求到负载均衡设备时,该设备按照某种算法(比如线性轮询、按权重负载、按流量负载等)从维护的可用服务端清单中取出一台服务端的地址,然后进行转发。 客户端负载均衡和服务器负载均衡最大的不同点在于上面所提到的服务清单所存储的位置。在客户端负载均衡中,所有客户端节点都维护着自己要访问的服务端清单,而这些服务端的清单来自于服务注册中心,建议使用Spring Cloud Netflix 的Ribbon组件。 微服务容器:服务熔断、容错、升降级、限流 微服务容器的基础服务能力之二就是服务熔断、容错、升降级、限流,在系统出现异常时提供故障恢复能力。 3、注册中心 服务注册与发现 接下来我们聊一下注册发现,以前的单块应用之间互相调用时配置个IP就行了,但在微服务架构下,服务提供者会有很多,手工配置IP地址又变成了一个不可行的事情。那么服务自动注册发现的方案就解决了这个问题。 我们的服务注册发现能力是依赖SpringCloud Eureka组件实现的。服务在启动的时候,会将自己要发布的服务注册到服务注册中心,运行时,如果需要调用其他微服务的接口,那么就要先到注册中心获取服务提供者的地址,拿到地址后,通过微服务容器内部的简单负载均衡器进行路由。 一般情况,系统内微服务的调用都通过这种客户端负载均衡的模式进行,否则就需要有很多的负载均衡进程。跨业务系统的服务调用,也可以采用这种去中心化的路由方式。当然采用SOA的模式,由中心化的服务网管来管理系统间的调用也是另一种选择,要结合企业的IT现状和需求来决定。 4、配置中心 集中配置管理 微服务分布式环境下,一个系统拆分为很多个微服务,一定要告别投产或运维手工修改配置的方式。需要采用集中配置管理的方式来提升运维的效率。 配置文件主要有运行前的静态配置和运行期的动态配置两种。静态配置通常是在编译部署包之前设置好。动态配置则是系统运行过程中需要调整的系统变量或者业务参数。 要想做到集中的配置管理,那么需要注意以下几点: 配置与介质分离,这个就需要通过制定规范的方式来控制。千万别把配置放在Jar包里。 配置的方式要统一,格式、读写方式、变更热更新的模式尽量统一,要采用统一的配置框架 运行时需要有个配置中心来统一管理业务系统中的配置信息,这个就需要平台来提供配置中心服务和配置管理门户。 配置修改同步交互 配置修改后通过推送或者定时拉取的方式更新并缓存到应用程序所在的微服务容器中供应用程序使用。 高可用运行架构设计 配置中心有两种部署模式 高可用模式,见上图,支撑大规模微服务访问时根据负载情况可以对“配置查询同步服务”进行横向扩展 ALL-IN-ONE模式,配置变更服务、配置查询服务合并为一个进程。适合支撑少量系统的场景使用。 配置中心可以支持高可用模式部署,满足金融行业的要求。 5、监控中心 基于Skywalking定制实现 SkyWalking主要就是通过收集各种格式的数据进行存储,然后展示。所以我们需要关注的是 SkyWalking Collecter、SkyWalking UI 和 存储设备。 APM探针 JavaAgent 是JDK 1.5 以后引入的,也可以叫做Java代理。 JavaAgent 是运行在 main方法之前的拦截器,它内定的方法名叫 premain ,也就是说先执行 premain 方法然后再执行 main 方法。 使用agent技术构建一个独立于应用程序的代理程序(即为Agent),用来协助监测、运行甚至替换其他JVM上的程序。使用它可以实现虚拟机级别的AOP功能。 APM全链路运行监控 调用链跟踪分析:把同一TraceID的Span收集起来,按时间排序就是timeline。把ParentID串起来就是调用栈。 实时分析:对单条日志直接分析,不做汇总,重组。得到当前QPS,延迟。 离线分析:按TraceID汇总,通过Span的ID和ParentID还原调用关系,分析链路形态。 6、日志中心 日志中心架构 日志分析是运维工程师解决系统故障,发现问题的主要手段。日志主要包括系统日志、应用程序日志和安全日志。系统运维和开发人员可以通过日志了解服务器软硬件信息、检查配置过程中的错误及错误发生的原因。经常分析日志可以了解服务器的负荷,性能安全性,从而及时采取措施纠正错误。 通常,日志被分散的储存在不同的设备上。如果你管理数十上百台服务器,你还在使用依次登录每台机器的传统方法查阅日志,即繁琐又效率低下。为此,我们使用集中化的日志管理,将所有服务器上的日志收集汇总。 集中化管理日志后,日志的统计和检索又成为一件比较麻烦的事情,这时实时日志分析ELK平台能够完美的解决上述的问题,ELK由ElasticSearch、Logstash和Kiabana三个开源工具组成。 规范日志与流水,问题追根溯源 作为一个微服务应用平台除了提供支撑开发和运行的技术组件和框架之外,还应该提供一些运维友好的经验总结,我们推荐的日志与流水实现如下: 先来看日志,平台应提供的日志主要有三种,系统日志,引擎日志还有跟踪日志。有了这些日志,在出问题的时候能够帮助我们获取一些关键信息进行问题定位。 要想做到出了问题能够追根溯源,那么右边的这些流水号的设计也是非常重要的,日志与各种流水号配合,能够让我们快速定位问题发生的具体时间地点以及相关信息,能够快速还原业务交易全链路。对这些日志与流水的细节处理,对于系统运维问题定位有非常大的帮助,没有这些有用的日志内容,ELK日志收集套件搭建的再漂亮,收一堆垃圾日志也是没用的。 通常开源框架只是提供个框架有开发人员自由发挥,而设计一个平台则一定要考虑直接提供统一规范的基础能力。 7、API Gateway 基于Spring Cloud Netflix的Zuul组件定制实现 异步非阻塞模式启动的线程很少,基本上一个CPU core上只需启一个处理线程,它使用的线程资源就很少,上下文切换(Context Switch)开销也少。非阻塞模式可以接受的连接数大大增加,可以简单理解为请求来了只需要进队列,这个队列的容量可以设得很大,只要不超时,队列中的请求都会被依次处理。 API Gateway逻辑架构 API网关就像整个系统的门面一样,所有的外部访问都经过它实现调度、过滤、请求路由、负载均衡、校验等等。 API Gateway 功能 API网关上还可以实现更多更复杂的功能。 8、IAM(Identity and Access Management) IAM架构 IAM为企业提供统一的账号管理视角,对所有基于账号的管理、认证、授权、审计进行集中的统一管理,提高了账号管理的安全,帮助系统管理员提高了工作效率,降低了管理负担,同时改善了普通用户在不同资源中登录认证的重复繁琐过程,为日常工作提供了更高的安全性。 统一用户中心 IAM可以为企业所有的资源使用人员如普通用户、系统管理人员、驻场代维人员、合作伙伴、临时工作人员等定义主账号,按照公司的组织方式对人员进行管理。通过一对一的主账号管理模式,可以在该平台实现对所有资源使用人员进行集中定义、集中维护等生命周期管理。 统一认证与鉴权 安全认证方面,我们基于Spring Security结合Auth2再加上JWT(Json web token)做安全令牌,实现统一的安全认证与鉴权,使得微服务之间能够按需隔离和安全互通。认证鉴权一定是个公共的服务,而不是多个系统各自建设。 9、微服务管理 服务管理机制 服务提供者: 服务注册 在服务注册时,需要确认下eureka.client.register-with-eureka=true参数是否正确,默认为true,若设置为false将不会启动注册操作。 服务同步 由于服务注册中心之间因互相注册为服务,当服务提供者发送注册请求到一个服务注册中心,它会将该请求转发给集群中相连的其他注册中心,从而实现注册中心之间的服务同步。 服务续约 eureka.instance.lease-renewal-interval-in-seconds参数用于定义服务续约任务的调用间隔时间默认30秒。 eureka.instance.lease-exptration-duration-in-seconds参数用于定义服务失效时间,默认为90秒。 服务消费者: 获取服务 当我们启动服务消费者时候,它会发送一个REST请求给服务注册中心,来获取上面注册的服务清单。为了性能考虑,Eureka Server会维护一份只读的服务清单来返回给客户端,同时该缓存清单会每隔30秒更新一次。 服务调用 服务消费者在获取服务清单后,通过服务名可以获得具体提供服务的实例名和该实例的元数据。因为有这些服务实例的详细信息,所以客户端可以根据自己的需要决定具体调用哪个实例。 单服务异常导致雪崩 采用微服务架构后,服务之间会有错综复杂的依赖关系,例如,一个前端请求一般会依赖于多个后端服务。 在微服务架构中,存在着那么多的服务单元,若一个单元出现故障,就很容易因依赖关系而引发故障的蔓延,最终导致整个系统的瘫痪,造成所谓的雪崩效应,这样的架构较传统架构更加不稳定。 自我保护 当网络分区故障发生时,微服务与Eureka Server之间无法正常通信,而微服务本身是正常运行的,此时不应该移除这个微服务,所以引入了自我保护机制。 服务注册到Eureka Server之后,会维护一个心跳连接,告诉Eureka Server自己还活着。Eureka Server在运行期间,会统计心跳失败的比例在15分钟之内是否低于85%,如果出现低于的情况,Eureka Server会将当前的实例注册信息保护起来,让这些实例不会过期,尽可能保护这些注册信息。 服务容错处理 资源隔离:包括线程池隔离和信号量隔离,限制调用分布式服务的资源使用,某一个调用的服务出现问题不会影响其他服务调用 降级机制:超时降级、资源不足时(线程或信号量)降级,降级后可以配合降级接口返回托底数据。 熔断:当失败率达到阀值自动触发降级(如因网络故障/超时造成的失败率高),熔断器触发的快速失败会进行快速恢复。 缓存:提供了请求缓存、请求合并实现。 关于作者:黄豆,数字化金融研究院研究员,擅长系统分析和架构设计、金融三级密钥安全体系及信息安全保障、虚拟化和云计算技术、JavaEE技术;参与研发的神州商桥电子商务平台获得“全国电子商务示范单位”称号;带领团队研发的国电通云终端系统在国网多个省公司推广应用。 关于EAWorld:微服务,DevOps,数据治理,移动架构原创技术分享。长按二维码关注!

优秀的个人博客,低调大师

抢占式实例在小博无线的应用

背景 抢占式实例是什么 抢占式实例是阿里云提供的一种低价短期实例。其价格受阿里云ECS资源存量的影响,浮动不定,最低时只有包月实例价格的三分之一。阿里云只保证抢占式实例一小时的可用时间,一小时后随时可能被释放。 抢占式实例如何创建 创建抢占式时需要指定类型和最高价格。 举例来说,我们创建时指定类型ecs.c5.xlarge,最高价格0.27元。如果该实例当前价格低于我们的出价,假如是0.15元,则抢占式实例创建成功。一小时后实例价格随时可能变化,变化之前实例的运行费用为每小时0.15。如果价格变为0.25元,之后实例按每小时0.25元计费。直到价格高于我们出价,实例就会被释放。如果创建时实例价格高于我们的出价,抢占式实例不会创建创建,阿里云返回错误”LowerThanPublicPrice”。某些时候,一些类型可能没有抢占式实例资源可用,即出价再高也无法创建成功。 除了价格低廉,后文还会提到抢占式实例的其他优势。 CI环境试用抢占式实例 大规模应用之前,我们先在CI环境中试用了抢占式实例。CI环境的特点非常适合使用这种临时短期实例: 大部分实例只在测试、发布代码时才会工作,其余时间都是闲置的 大部分代码的测试和构建任务不需要很长时间,一个小时的生命周期完全足够 我们的运维机器人实时监控Jenkins任务队列,如果有正在等待资源的任务立即创建抢占式实例并加入CI集群。开发时有两个问题需要注意: 初始化实例虽然很多步骤可以预置到ECS镜像中,但还是有些操作需要在实例启动后进行。最初我们使用ssh,待实例启动后登陆实例执行初始化脚本。实际应用后发现,实例启动后到ssh端口可用这段时间很不确定,有时实例启动后几秒钟ssh端口就通了,有时却长达一分钟。所以不得不在代码中重复尝试直到成功登陆。之后我们发现阿里云支持Cloud Init,可以在创建实例时指定实例启动后自动执行的脚本(CreateInstance接口的UserData字段)。使用Cloud Init相当于将阻塞的初始化任务变成异步非阻塞,应用程序的代码更简单,其可靠性经我们测试也非常高。 抢占式实例创建失败受阿里云策略的影响,抢占式实例价格浮动不定,甚至可能无货。为了保证CI系统正常运转,如果抢占式实例创建失败需要继续尝试创建按量实例。 试用结果 最终我们的CI系统只保留了一台包月实例运行Jenkins Web UI和git server,构建各种服务的发布包和容器镜像的任务都运行在按需创建的实例上。产品发布高峰期CI集群中有十几台抢占式实例。实例加入集群的速度控制在五分钟内,在CI系统中这样的延迟是完全可以接受的。 小规模应用到生产环境 由于在CI环境中试用很顺利,创建成功率很高加入集群的流程也很稳定,我们进一步将抢占式应用到生产环境。 我们设置了集群节点数,由运维机器人保证集群内始终有足够的节点,如果不够则尝试创建抢占式实例。设置集群节点数量的好处是,如果抢占式实例应用顺利可以继续推进,只需要删除一台包月实例运维机器人就会自动补上一台抢占式实例加入集群。 和CI环境类似,生产环境中使用抢占式实例也包括创建实例和初始化实例两个步骤。不同于CI环境对实例的需求是短期的,生产环境中的实例会一直运行业务,如果创建到按量实例就很不划算。所以当抢占式实例应用到生产环境后我们作了一些尝试来提高创建成功率: 加入更多类型每种类型的资源状态不同,一种类型当前无货可能其他类型还能够创建到。 实例分散在不同类型上我们推测阿里云的资源池是以类型来划分的,所有类型资源同时波动的概率相对小些。尽量创建不同类型的抢占式实例,避免集群中全是同一种类型的实例,可以降低集群内所有抢占实例被同时释放的风险。实现上,实例类型是一个有序数组,初始顺序以价格从低到高排序,创建时从第一个类型开始尝试。如果一种类型创建成功,降低权重使其排序靠后,下次创建时优先使用其他类型。 扩大抢占式实例规模 随着生产环境中使用规模的增,抢占式实例负担了越来越多的业务服务,释放抢占式实例带来的风险也越来越大。 这个阶段我们的目标是,在实例被释放前创建新实例并妥善处理待释放实例上的服务。阿里云在释放实例前五分钟会将实例标注为待释放状态,运维机器人检测到有实例将被释放,执行以下动作: 立即创建等量实例 被释放实例移出白名单当实例被移出白名单后,已有服务不受影响,之后新启动的服务将不会再分配到这台实例上。 迁移待释放实例上的服务我们使用mesos+marathon运行服务,如果一个容器退出,marathon会新启动一个容器保证服务的节点数量不变。即使不做额外的操作这个模型也可以保证服务最终恢复到正常状态,但这样的波动对服务质量还是很有影响的。比如某个高流量的服务少了一个节点,其它节点流量会相应升高;某个服务一共两个节点且两个节点所在的实例全部被释放,那么该服务将短暂地处于无节点状态。抢占式实例的释放相对高频,频繁的波动必定会严重影响服务质量。因此在实例被释放前应该先迁移上面的服务。既然知道服务节点将会减少,我们就提前给服务增加节点。例如data-api一共五个节点,其中两个节点所在的实例即将释放,则将data-api服务扩展至七个节点。 关闭待释放实例阿里云在释放实例前会使用”强制停止”停止实例,强制停止相当于断电,这会带来两个问题: 如果机器正在处理请求,断电会造成该请求被中断 断电会使mesos-slave与master失联,从而引起marathon上短暂的服务状态异所以在阿里云释放实例之前,我们会主动停止服务并关闭实例,保证服务和集群状态正常。因为第3步增加了节点数量,这一步在停止服务时使用scale=true参数将节点数调回到初始状态。 这4个步骤需要注意的是,执行第1步后不能立即执行后续步骤,因为新实例需要一段时间才能加入集群,如果立即将待释放实例移出白名单,第3步新增的节点可能没有足够的资源运行,第4步又将旧节点停止最终服务的节点就会变少。所以我们在第1步之后会等待3分钟,保证有足够的时间让新实例加入集群,并让第3步新增的节点在新实例上面运行起来。 实例级伸缩 我们之前的运维系统实现了服务级别的伸缩,运维机器人会根据服务的负载增加或减少服务节点。当时没有做实例级别的伸缩主要是因为阿里云的价格策略,按量实例的价格约是包月实例的三倍,如果频繁使用按量实例,成本上毫无优势。 抢占式实例价格低且按小时计价,非常适合用来实现实例级伸缩。如果集群内资源使用率过高,运维机器人创建抢占式实例,较低则尝试移除一台实例。 之前我们为集群设置了节点个数的限制,保证集群中始终有足够的实例。现在我们将节点个数改为了CPU核数,增加实例时也是按CPU数量增加。例如增加8个CPU,8个CPU可能是一台实例也可能是四台实例。当集群内多台实例将被释放时,运维机器人会计算其CPU总数,创建与之等量的实例,可能是多台也可能是一台。 关注CPU数量而非节点个数,屏蔽了不同类型的差异,简化内部实现。而且只关注计算资源本身也更符合mesos框架的思想。我们业务服务的内存CPU比值大约为二比一,而阿里云的绝大多数机器的内存CPU比值都大于二,所以使用CPU一个指标就足够,不用再考虑内存。 运维机器人的判断逻辑: 所有实例按资源使用率排序,若最低的实例超过了70%,增加8个CPU 如果最低两个实例的使用率之和低于20%,尝试删除一台实例理论上,增加的阈值设置为70%,那么删除时只要保证最低两个实例之和低于70%即可,这样就不会出现删除实例之后又达到增加的阈值。但是我们的集群中还有很多定时任务,这些短任务随时有可能被启动占用集群资源。如果删除的阈值刚好是70%,有可能在删除后某些定时任务又被启动了,这时就会达到增加实例的触发条件。所以我们将删除的阈值设为20%,给这些定时任务留出空间,防止集群内实例伸缩抖动。 尝试移除实例的策略: 优先删除按量实例 优先删除低CPU实例,每台实例上都会运行一些基础服务,所以大实例的资源利用率更高 抢占式实例尽可能保留到整数小时。抢占式实例是按小时计费的,我们对其创建分钟数取模,大于50分钟时才正真删除 单个实例上是否有足够的资源除了考虑资源使用率,还应该考虑单个实例上是否有足够的资源运行服务。某些情况下当所有大实例都不可用,创建到的抢占式实例都是小实例(2核或4核),如果只判断使用率就有可能出现所有实例的资源使用率都低于70%,但单个实例上没有足够的资源运行某些资源占用较多的服务。 给集群设置CPU下限与上限。下限是为了防止集群在业务低谷缩得太小,从而不能应付突发流量;上限是防止某些极端情况,比如代码或数据库的问题导致负载升高,这时增加再多的节点也无济于事。 提升动态实例的创建效率 经过长时间的应用,我们集群中的抢占式实例已经占了大半,期间遇到过多次所有实例被同时释放。至此我们改变了思路,将抢占式实例被释放当成随时可能会发生的常态,我们能做的就是在收到释放通知后尽可能快的创建新实例。 创建抢占式实例的时间 在谈优化之前,先量化一下创建一台实例所需的时间。 调用阿里云创建接口调用创建接口失败大概需要1秒,成功需要4秒。假设尝试了6种类型都失败,第7种类型成功,那么耗时为6 * 1 + 4,一共10秒。在没有任何预判随机选取类型依次尝试,平均需要尝试7次,这个概率大致符合实际情况。这也是后文量化数据的一个前提假设。 初始化动态实例当创建接口调用成功,会返回实例的InstanceId。我们发现接口调用成功后使用该InstanceId立即去查询有可能会查不到,而且实例创建后会短暂地处于”Pending”状态,该状态无法做任何操作,所以创建成功后需要sleep 15秒。实例启动需要30秒左右。启动之后会设置数据库白名单、SLS机器组,加上mesos相关属性的一些设置,初始化实例一共需要50秒。 创建一台实例一共需要60秒。 实例类型尝试策略改进 如前所述,调用创建接口时即使失败也需要1秒左右,在可尝试类型很多的时候,大批量的失败调用也非常浪费时间。要提高创建效率,首先需要提高创建时的成功率。 只尝试有可能成功的类型最初在代码里hardcode了几个常用的类型,可尝试类型很少,失败的概率也很高。后来导入了所有实例的类型依次尝试,不仅效率很低而且还触发了阿里云的接口调用频率的限制,可见也不能盲目加入过多类型。 最终的方案是使用阿里云的历史价格接口DescribeSpotPriceHistory,这个接口返回抢占式实例近期的价格变化。我们抓取所有最近价格低于出价的2核到12核类型,在创建时只尝试这些类型。虽然这个接口的数据并不是实时的,但也大幅提高了创建成功率。 失败后移除实例之前为了防止创建相同类型的实例,一个类型创建成功后会降低其权重,避免下一次再创建该类型的实例。也就是说,我们宁愿多几次失败的尝试也不希望集群中出现相同类型的实例。但从多次抢占式实例全部被释放的情况来看,这种防御措施用处不大。后来我们改为只要某个类型失败则半小时内不再尝试该类型。这样可以大大减少(半小时内)二次创建时的失败次数。 并发创建模型的演进 创建一个实例需要一分钟,一次创建大量实例时,不得不使用并发模型。我们的并发模型经历了四次演进。 1. 按节点数创建的简单并行 最初按实例数量创建,创建5个则由5个worker并行创建。模型如图: 创建总时间为60秒。但这种使用实例个数作为创建指标的方案只适用于仅使用单一类型实例的小型测试集群。由于创建单一类型实例失败的概率很大,这样的方案无法应用于生产环境中。为了将多种实例类型统一起来,我们后面改为使用CPU数量作为创建指标。 2. 按最大CPU核数拆分子worker 改为按CPU数量创建后带来的问题:应该按多大的粒度(CPU个数)拆分子woker?假设需要创建48核,如果分为24子worker每个子woker创建一个2核的实例,顺利的话24个子worker一次并发就能成功,创建时间为60秒。但可能会遇到没有2核实例的情况。如果拆分的粒度太大,假设每个子worker创建24个核,由于我们设置最大的类型为12核,所以每个子worker至少会创建2次。总时间为2 * 60 = 120秒。 我们采取了一种折中的方案,采用最大CPU核数(12)拆分为4个子worker,理想情况下1次并发就能创建完成,耗时60秒。如果12核资源不可用,那么子worker会尝试其他其他资源,创建时间也会相应延长。 3. MapReduce模型 上一种模型的效率很大程度上取决于阿里云的资源池状态。例如一个子worker创建12核,尝试12核实例不成功,转而尝试8核实例,8核不成功再一次尝试4核、2核。最坏的情况,每个子worker都只能创建2核实例,需要串行6次才能将12核创建完成。总时间为6 * 60 = 360秒。 继续优化模型,上一种模型的问题在于,以最大CPU核数(12核)拆分子worker,但有可能当前所有12核实例都不可用,所以在子worker中又不得不继续串行创建。 理论上,我们将失败的类型标记为半小时之内不再尝试,那么可尝试的第一个类型应该就是最有可能创建成功的。我们以这个类型的CPU来拆分子worker,一次并行的成功率应该会很高。问题是,创建抢占式实例的频率远低于失败类型过期的时间(半小时),于是,在创建第一组实例时,所有类型会被认为是可用的,无法达到有效过滤的目的。 因此,我们引入了MapReduce模型,子worker只创建一个实例,成功后立即返回告知主worker,不再继续创建。主worker汇总每个子worker的创建结果,如果还需要创建,则再进行拆分。如果第一次拆分使用的CPU数量不可靠,第二次使用的CPU数量是一分钟前成功创建的,再次创建成功的概率就非常高了。 例如,第一次按12核拆分了4个子worker,每个子worker都创建了一个4核实例,reduce之后还剩32核需要创建。第二次拆分就会按4核拆分出8个子worker,这8个子worker创建4核实例的成功率非常高,几乎不会进行第三次拆分。 这个模型绝大多数情况都不会多过两次map,总时间为 60 + 55 = 115秒。第二次不会再遇到错误尝试,所以会快5秒。 4. 异步初始化 上一种模型还有改进的空间,实例创建后子worker需等到实例启动并加入集群才认为实例创建成功,大部分的时间是在等待实例初始化。 初始化步骤调试稳定后,几乎没有出过错。既然出错的概率很低,我们完全可以认为只要实例创建成功那么一定会加入集群运行业务,所以子worker不用等到实例初始化完毕才返回。只要实例创建成功,子worker立即fork一个新的worker初始化实例,然后返回通知主worker实例创建完毕。 这也是我们现在使用的最终方案,创建效率提高了将近一倍。两次map的初始化动作是并行的,总时间为65秒。 最终方案耗时65秒,实际线上运行的创建成功率100%,并且效率很接近第一种全并发的方案。 有了创建效率的保证,才能抵抗抢占式实例被释放的风险,在旧实例被释放前,新实例已经加入了集群接过之前运行在旧实例上的服务,旧实例释放后对服务没有丝毫影响。我们有时一天能遇到好几次实例全部被释放的情况,但运维机器人每次都能做到平滑过渡,业务层面无感知。 改进空间 当前使用的最终模型仍有继续优化的空间。 1. 主动替换实例 当所有抢占式实例都不可用,就会创建到按量实例。目前对按量实例的处理仅体现在删除上,删除时优先删除按量实例。 如果1:00创建了三台按量实例,2:00抢占式实例可用了,但系统可能分别在3:00、4:00、5:00才将三台按量实例删除。我们可以加入主动替换的模型,只要集群中存在按量实例,运维机器人就会周期性地尝试创建抢占式实例,创建成功则移除按量实例。 更进一步,除了主动替换按量实例,还可以主动用低价实例替换高价实例,以及用高配置实例替换低配实例。 因为创建按量实例的概率很低,所以这种改进暂时不是很有必要。 2,主动将服务压缩至一台机器 运维机器人在动态伸缩实例时,会判断每个实例的资源使用率。服务在每台实例上的分布没有人为干预,有可能出现两台实例上的资源使用率分别是40%,这种情况将两台实例的服务迁移到一台实例上,就能释放一台实例。 遇到的问题 在抢占式实例的应用过程中,有下面几个值得注意的问题。 1. 实例不存在成为常态,需要更大的错误容忍度 之前集群内节点几乎不会变化,引入抢占式实例后,集群内节点变动非常频繁,一个节点下一秒可能就被释放,任何对该节点的引用都会产生错误。系统各处需要妥善处理这里错误: zabbix host unreachable实例只要被移除,zabbix便会出现unreachable错误,以往这种出现这种情况需要人为干预,现在需要将实例从zabbix配置中移除 服务发现不要求注册成功之前部署一个nginx的后端服务,需要通知对应的nginx服务注册后端到upstream中,只有确认注册成功后后端服务才会通过健康检查。现在nginx服务所处的实例很有可能已经被释放了,所以我们在部署后端服务时,发送注册请求后不用再等待其返回。 使用nginx健康检查插件nginx默认只支持被动的健康检查,即使某个backend不可用,实际的请求至少会错误一次。实例频繁被释放,nginx backend节点不可用的概率也会增大,使用nginx默认的健康检查就会影响服务质量。我们采用了淘宝的nginx健康检查插件nginx_upstream_check_module,支持主动模式,可以很好的解决backend不可用的问题。 2. 优先保证抢占式实例创建业务线的运行资源 在抢占式实例的应用初期,我们遇到过新实例没有创建起来,旧实例被释放后大量服务没有资源运行。其中包括我们的运维机器人和创建抢占式实例的一些运维服务,结果造成集群资源已经非常紧张了但是新实例无法被创建。 我们为抢占式实例相关的运维线服务分配了独占资源,以保证其运行资源不受影响。 3. docker pull直连OSS 大量新实例加入集群后,一时间会全量拉取很多image。由于我们的docker registry没有开启直连OSS,所有请求都会走registry中转,受registry所在ECS带宽限制,多节点同时拉取大量image速度非常慢。 阿里云有为docker registry提供一个官方的OSS driver,设置一个启动参数即可开启直连OSS。之前没有开启是因为我们有跨区拉取image的需要。我们的docker registry位于杭州区,但CI环境部署在上海区,无法访问杭州区的OSS,所以需要走docker registry中转。 我们最终在杭州区部署两个docker registry指向同一个OSS,一个registry开启直连OSS供产生环境使用,一个不直连OSS供CI环境使用。 4. 创建实例不指定InstanceName 最初我们在创建抢占式实例时会指定InstanceName,形如”service-1020074503”,用以标识实例的用途和创建时间,系统中多处使用InstanceName来判断实例的用途。结果时常出现创建两台甚至三台同名实例的情况,深入分析调查发现是因为阿里云创建接口超时SDK内部重试造成了连续发起了多个创建请求。 我们将系统改造为不依赖InstanceName,创建实例时不指定Instancename,由阿里云生成随机Instancename。 5. 阿里云接口限流 由于不知道阿里云创建接口的限流规则,我们曾导入过超过150种类型到尝试列表中,期望通过尝试更多机型以提高抢占式实例的创建成功率。实际工作时由于并发执行在一分钟调用了400多次创建接口,之后所有创建接口都返回错误。工单咨询得知是调用太频繁被阿里云限制访问了,阿里云要求每分钟不超过200次。 增值点: 1. 资源灵活伸缩 使用抢占式实例,我们实现了实例级别的伸缩。业务高峰期,集群会自动扩大规模;低谷期会收缩到最小。 2. 降低成本 抢占式实例成本低于包月实例,加上实例都是按需创建,成本进一步被降低。 CI环境、测试环境只有发布代码时才创建实例,平时不需要常备实例 生产环境:实例级伸缩加持,业务低谷期只保有最小规模 抢占式实例的资源池每个区域不一样,我们的生产环境部署在杭州区,CI环境在上海区。经过半年的使用发现,上海区的资源相对充足,抢占式创建成功率非常高,创建成功后持有的时间相当长(最长到一个多星期),被同时释放的概率也很低。杭州区资源相对紧张,实例平均持有时间不到一天,被全部释放的概率也较高。即便如此,我们在杭州区创建按量实例的次数也很少。 3. 简化运维工作 对于包月实例有很多问题需要处理: 磁盘不足 日志目录太大,做log rotate docker目录太大,删除docker数据后重启docker 如果是某个还没有自动化的目录,就得开发、测试、部署一套新逻辑 负载过高重启实例,问题依旧再深入调查,无果则提交工单申请迁移物理机 ...... 使用抢占式实例后,所有这些问题都不存在了。只要实例出现这些异常状态,运维机器人会将其删除,之后会根据情况自动创建新实例。这就好比长进程和短进程的区别,长进程运行时间长难免出现内存泄漏,短进程执行完毕就退出,下次再执行就是一个新的进程。又好比系统太复杂,运行时间长了总会出现各种奇怪的问题,与其花费时间精力调查不如直接重启来的经济。而删除实例再新建,则是更为彻底的重启,运行时是新的,文件系统是新的,网络配置是新的。 期望阿里云的支持 抢占式实例的总体效果符合甚至超出我们的预期,但仍有几个方面我们觉得阿里云可以做得更好。 1,优化接口响应时间 调用创建接口需要4秒左右,即使失败也需要1秒左右才能返回,在一个规模不算太大的集群里,这个时间还是可以接受的。让人头痛的是,创建接口偶尔会超时,超时不严重会造成之前提到过的创建多台同名实例的问题。之所以说不严重,是因为SDK在重试的时候最后一次成功返回了,应用层认为这次调用是成功的,后续的流程可以继续走下去。12月1日晚八点半到九点半我们遇到了一次严重的超时,每一次调用的每一次重试都超时,在应用层看来创建接口全部失败,然而实例却被创建了。最终创建了100多台按量实例,达到了我们设置的上限才没有继续创建。这些按量实例因为没有被初始化无法运行业务,还白白占用了配额使运维机器人无法继续创建新的可用实例。 2,精确的询价接口 创建模型中相当一部分工作就是猜测当前什么类型可用。如果阿里云能提供一个精确的询价接口,返回当前每个类型的准确价格,不仅能提高创建效率还能大幅简化创建模型。 3,数据读写一致性 之前提到的因为超时导致创建多台同名实例的问题,在使用随机InstanceName之前,我们还尝试过这种workround方案:创建之后再查询,发现同名实例就重命名多余的实例。例如,发现名为”service-1020074503”的实例有两台,将其中一台重命名为”service-1020074503-deprecated”,另一台实例继续走初始化流程。在测试过程中,我们发现重命名后立即使用”service-1020074503”去查询仍然有可能查询到”service-1020074503-deprecated”这台实例的信息,即短时间内系统中仍然存在两台重名实例。另外我们在初始化实例时会等待15秒,其中一个原因是返回的InstanceId短时间内有可能查询不到。我们猜测这些问题都是因为写操作同步到阿里云内部的所有数据节点需要一定时间,在这之前读到的可能是修改前的数据。如果阿里云的API系统能实现对于同一个客户端的读写一致性的话,用户使用起来会方便不少。

优秀的个人博客,低调大师

Android开发精选博文推荐(12.3-12.9)

silverlight C#委托与事件 我们都知道,C#中有“接口”这个概念,所谓的“接口”就是定义一套标准,然后由实现类来具体实现其中的方法,所以说“接口,是一组类的抽象”。同样道理,我们可以将“委托”理解为“方法的抽象”,也就是说定义一个方法的模板,至于这个方法具体是怎么样的,就由方法自己去实现。http://www.apkbus.com/blog-109557-45420.htmlandroid 混淆文件proguard.cfg详解 proguard是一个java代码混淆的工具,通过proguard,别人即使反编译你的apk包,也只会看到一些让人很难看懂的代码,从而达到保护代码的作用。http://www.apkbus.com/blog-56077-45418.htmlAndroid中TextView中加图片,超链接 对一个TextView中添加图片或者本身文字颜色或者背景色变化的demo:http://www.apkbus.com/blog-134192-45409.htmlandroid opengl es 绘制位图字体 Android中绘制字体,用到了canvas,下面代码里面为我写的实例,几乎每行代码都有注释。http://www.apkbus.com/blog-55942-45401.htmlandroid 程序锁 某些人有时候会有这样一种需求,小A下载了个软件,只是软件中的美女过于诱惑与暴露,所以他不想让别人知道这是个什么软件,起码不想让别人打开浏览。而这款软件又没有锁,任何人都可以打开,肿么办呢?如果打开它的时候需要输入密码,那该多好阿!于是,程序锁这种应用就产生了http://www.apkbus.com/blog-66575-45396.htmlandroid静音拍照 之前写过一些android手机root之后的安全问题的(文章列表见末尾),其实我是想到哪就写到了,今天整理硬盘,发现一年之前写过一段代码,所以今天我们就一起来讨论一下。http://www.apkbus.com/blog-66575-45394.htmlSQLite数据库的创建增删改查等问题 很多朋友刚接触安卓,对安卓里SQLite数据库还不是很了解,下面是我做的一个小程序,程序里能实现数据库的创建、增加、修改、删除、查询等,程序非常简单,希望能对初学者有帮助。http://www.apkbus.com/blog-127136-45390.htmlandroid ViewFlipper的使用 屏幕切换指的是在同一个Activity内屏幕见的切换,最长见的情况就是在一个FrameLayout内有多个页面,比如一个系统设置页面;一个个性化设置页面。http://www.apkbus.com/blog-85308-45385.html简单易懂的Android ROM定制与修改教程 每个人对手机都有不同的要求,这里我想谈谈我的修改ROM的方法,其中大部分是总结于论坛中其他帖子,有一小部分是自己总结的经验。玩Android手机可为个层次:http://www.apkbus.com/blog-83782-45383.html利用pull解析器读写XML文件 对XML解析有SAX和DOM等多种方式,Android中极力推荐xmlpull方式解析xml。xmlpull不仅可用在Android上同样也适用于javase,但在javase环境中需自己获取xmlpull所依赖的类库,kxml2-2.3.0.jar,xmlpull_1_1_3_4c.jar。http://www.apkbus.com/blog-83703-45382.htmlActivity的跳转与传值 Activity跳转与传值,主要是通过Intent类,Intent的作用是激活组件和附带数据。http://www.apkbus.com/blog-83703-45380.html数据存取之SQLite SQLite是一款轻型的数据库,是遵守ACID的关联式数据库管理系统,它的设计目标是嵌入 式的,而且目前已经在很多嵌入式产品中使用了它,它占用资源非常的低,在嵌入式设备中,可能只需要几百K的内存就够了。http://www.apkbus.com/blog-17085-45379.htmlLibgdx camera 介绍 Camera 是libgdx中很重要的一个类。api中有关介绍如下:http://www.apkbus.com/blog-20705-45377.html基于Android Fragment功能的例子 通过最近空闲时候对Fragment的学习,尝试着写了一个小Demo,将在开发的时候能常用到的Fragment知识放在一起,写过了这个Demo对Android Fragment的了解更加深入了,以后做起有关的项目也会顺手很多,下面先贴上几张实现之后的图片http://www.apkbus.com/blog-83782-45375.htmlAndroid 查看内存 方式一,Running services 通过手机上Running services的Activity查看,可以通过Setting->Applications->Running services进。http://www.apkbus.com/blog-83591-45357.htmlandroid 文件读写 从resource中的raw文件夹中获取文件并读取数据(资源文件只能读不能写)http://www.apkbus.com/blog-17085-45351.htmlsql where 1=1和 0=1 的作用 举个例子,如果您做查询页面,并且,可查询的选项有多个,同时,还让用户自行选择并输入查询关键词,那么,按平时的查询语句的动态构造,代码大体如下:http://www.apkbus.com/blog-120032-45350.htmlANDROID 产生弹出菜单方法 先对某一个控件注册,使得他能够产生菜单registerForContextMenu(this.gallery); //注册一个gallery空间的的菜单http://www.apkbus.com/blog-83591-45343.htmlAndroid 菜单(OptionMenu)大全 建立你自己的菜单 菜单是用户界面中最常见的元素之一,使用非常频繁,在Android中,菜单被分为如下三种,选项菜单(OptionsMenu)、上下文菜单(ContextMenu)和子菜单(SubMenu),今天这讲是OptionsMenuhttp://www.apkbus.com/blog-130933-45337.htmlandroid文件存储的4种方式 Context.MODE_PRIVATE:为默认操作模式,代表该文件是私有数据,只能被应用本身访问,在该模式下,写入的内容会覆盖原文件的内容,如果想把新写入的内容追加到原文件中。http://www.apkbus.com/blog-56077-45333.htmlSimpleCursorAdapter 在许多时候需要将数据库表中的数据显示在ListView、Gallery等组件中。虽然可以直接使用Adapter对象处理,但工作量很大。为此,Android SDK提供了一个专用于数据绑定的Adapter类:SimpleCursorAdapter。http://www.apkbus.com/blog-17085-45328.htmlGallery和GridView浅析 Gallery(画廊)是一个锁定中心条目并且拥有水平滚动列表的视图,一般用来浏览图片,并且可以响应事件显示信息。Gallery还可以和ImageSwitcher组件结合使用来实现一个通过缩略图来浏览图片的效果。http://www.apkbus.com/blog-17085-45327.html一个简易的音乐播放器 因为第一次发表博客,很多地方还不会,以后会好好改进的,希望能和大家交流学习,android还在学习当中,以后有好东西会第一时间和大家分享的。。。http://www.apkbus.com/blog-138234-45326.htmlandroid service 实现Binder类 如果你的service仅被自己的应用使用并且不需跨进程工作,那么你可以实现你自己的Binder类使得你的客户端能直接使用service的公开接口方法.http://www.apkbus.com/blog-85308-45324.htmlAndroid Service的用法 Service就是一个应用程序组件,用来执行一些长时间的操作,然而不与用户交互或者为其他应用程序提供一些功能。每一个Service类都必须定义在AndroidManifest.xml中,以<service>tag开头。http://www.apkbus.com/blog-85308-45321.html采用MQTT协议实现android消息推送 MQ 遥测传输 (MQTT) 是轻量级基于代理的发布/订阅的消息传输协议,设计思想是开放、简单、轻量、易于实现。这些特点使它适用于受限环境。http://www.apkbus.com/blog-85308-45319.htmlAndroid游戏框架Libgdx使用入门(转) Libgdx是一款支持2D与3D游戏开发的游戏类库,兼容大多数微机平台(标准JavaSE实现,能运行在Mac、Linux、Windows等系统)与Android平台(Android1.5以上即可使用,Android2.1以上可满功率发挥)http://www.apkbus.com/blog-20705-45318.htmlSurface、SurfaceView、SurfaceHolder及SurfaceHolder.Callback之间的关系 Surface就是“表面”的意思。在SDK的文档中,对Surface的描述是这样的:“Handle onto a raw buffer that is being managed by the screen compositor”,翻译成中文就是“由屏幕显示内容合成器(screen compositor)所管理的原生缓冲器的句柄”,这句话包括下面两个意思http://www.apkbus.com/blog-130933-45313.htmlAndroid支持HTML标签 目前android不支持全部的html的标签,目前只支持与文本显示和段落等标签,对于图片和其他的多媒体,还有一些自定义标签不能识别。http://www.apkbus.com/blog-144026-45311.htmlAsyncTask的用法 在开发Android应用时必须遵守单线程模型的原则: Android UI操作并不是线程安全的并且这些操作必须在UI线程中执行。在单线程模型中始终要记住两条法则:http://www.apkbus.com/blog-124243-45310.htmlAndroid开发中多线程及异步处理 由于内核并没有对多线程进程的支持,因此,内核中只有单线程进程的概念, 而多线程进程是通过一个和应用程序连接的函数库实现的。由于内核没有轻量 级进程(线程)的概念,因此它不能独立的对之进行调度,而是由一个线程运 行库来组织线程的调度,其主要工作在于在各个线程的栈之间调度。http://www.apkbus.com/blog-124243-45309.htmlAndroid Socket编程 Socket Programming on AndroidSocket 编程基础知识:主要分服务器端编程和客户端编程。http://www.apkbus.com/blog-76214-45306.htmlViewPager在ScrollView中无法正常滑动的问题 ——问题解决 ScrollView中嵌入ViewPager,ViewPager的滑动出现问题在网上找到两种方法,都是自定义scrollview,主要作用于多重嵌套,复杂布局,我最近正在做的大家可以试试。http://www.apkbus.com/blog-24118-45304.htmlandroid 监听电话状态 以上代码是对电话进行状态改变的监听。这里需要理解监听器的机制。 Android的事件处理机制有两种:监听和回调。http://www.apkbus.com/blog-105036-45262.htmlandroid_handle消息机制 默认情况下,Handler接受的是当前线程下的消息循环实例(使用Handler(Looper looper)、Handler(Looper looper, Handler.Callback callback)可以指定线程),同时一个消息队列可以被当前线程中的多个对象进行分发、处理(在UI线程中,系统已经有一个Activity来处理了,你可以再起若干个Handler来处理)。http://www.apkbus.com/blog-98964-45259.html中国国家气象局天气预报信息接口 想在自己的android应用中获得当天的天气情况,这该怎么做呢?不用担心。中国国家气象局提供了获取所在城市天气预报信息接口。通过这个接口,我们就可以获取天气信息了。http://www.apkbus.com/blog-56077-45150.htmlAndroid 国际化 多语言适配 nternationalization (国际化)简称 i18n,因为在i和n之间还有18个字符,localization(本地化 ),简称L10n。一般用 语言_地区的形式表示一种语言,如zh_CN, zh_TW.http://www.apkbus.com/blog-24118-45137.htmllibgdx 三维旋转立方体(原创)http://www.apkbus.com/blog-20705-45381.html 本文转自qianqianlianmeng博客园博客,原文链接:http://www.cnblogs.com/aimeng/archive/2012/12/10/2811601.html ,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册