首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 我在阿里实习做开源

我在阿里实习做开源 3月19日,初春的杭州,依旧阴雨朦胧。透过 EFC 健身房的落地窗往外看,远处的楼宇、青山、整齐的街道和稀疏的车辆在水雾中若隐若现。 午后的小憩时光,我拿了瓶咖啡回到工位,看着刚刚提交的PR通过了CI check,这或许是我人生中作为实习生的最后一天了。 成长的过程就是不断经历和体验的过程,一段又一段不同心境的开始和结束。我希望三个月后,那个过了22岁生日的年轻人会如愿顺利拿到毕业证,再次出现在这里,我想那时的他一定更熟悉 java 了吧。 本科时光 循规蹈矩的大学生涯大概是是四年本科和三年硕士,而我属于校园的时光,只有两年半。在外实习到现在已经整整一年了,从北京到深圳再到杭州,我也非常庆幸能拥有这样的经历。 三段不同方向的实习,从最一开始在学校里的 GoOnline 在线 IDE 项目,让我对真正落地的开发项目充满了向往;到 “互享“ 平台运维开发,让我对企业落地的日常开发运维流程有所了解;再到看点业务开发与需求上线,让我对拥有百万用户的项目和技术充满了激情;再到中间件研发,专注于云原生领域的探索和落地。 第一段实习是在北京图森科技,期间充满了懵懂和纠结的,纠结于是选择研发还是科研,懵懂与对从没见过的花里胡哨的各种工具的胆怯,但很幸运最终习惯了自己的选择。 第二段实习是在深圳腾讯,整个过程充满了刺激和危机感,危机来源于在社会上和技术上如何站住脚跟,惊险刺激于一连串从没料到的事情。很感谢我能冷静对待遇到的各种突发情况,来自就业的压力,来自转正的压力,都不足以压垮一个有梦想的年轻人。至今依旧怀念当时带领我成长的导师 Steven【见链接 1】。 去年秋天开始在阿里集团中间件团队开始了我的第三段实习经历,相比前两次,这次实习舒服了很多。当看清前路的时候,活的还是比较滋润的,所要做的就是积累、沉淀和享受来自研发的快乐。很幸运,实习经历中遇到的导师、同事和领导们都非常 nice,都可以遇到一起聊天交心、一起吃饭喝酒的前辈们,或许对于初入社会的年轻人,是一盏盏指向未来散发光满的灯塔。 dubbogo 社区 拿到阿里实习 offer 后还未入职西厂前,便被大 Boss 引入了 dubbogo 社区,被告知实习的任务就是推动 dubbo-go 在内部的落地和 dubbo-go 3.0 的开发。这是一个有技术的组织,更是一个有人情味的地方。 时光到回到去年刚拿到 offer 的10月份,第一次将 dubbo-go clone 到本地,成功实现了 RPC 调用,心情是无比激动的。因为这个场景陌生中带着熟悉。第一次 bug fix,第一次贡献feature,写源码解读,再到后面成为 dubbo committer,投入 Dubbo-go 3.0 的贡献中。专属于年轻 IT 工程师的快乐,莫非于让自己和项目一起成长。 在阿里的实习过程,2021 年的重大版本 dubbo-go 3.0 贯穿了整条时间线。从我尚未入职还在石家庄的时候,便开始一边在按摩店洗脚一边开周会接任务,到后面熟识了社区中的领导们、技术大佬们,很多次被前辈的技术和精神所感动,说社区充满了人情味毫不为过。 马上就要到了三月底,我也希望 dubbo-go 3.0 可以成为实习过程中属于我的一份期末答卷,而 3.0 版本一定不是终点,而是国内开源 RPC 框架发展的过程所在,因为有了每一个阶段的创新,才成就了在未来长河中的丰富的云原生发展史。 比起项目本身,我更爱这种技术氛围: 很多技术人员可以凝聚在一起,各尽所长为了一个目标而努力; 一种“有我在项目就在”的责任心; 一种在贯彻于编码中的开源项目的严谨; 一种聚会时可以快乐吹水和交流的默契。 就在上周六晚上,dubbogo 社区负责 dubbo-go-pixiu 项目的负责人铁城大哥,为了庆祝自己成功从阿里外围公司转到盒马,召集了社区杭州的网友们成功小聚。觥筹交错间从技术八卦到社区秘闻,无所不谈,并纷纷“讨伐”图中某位马上从杭州某 IoT 公司离职要投奔蚂蚁的大佬 ^_^。 很感激在前行路上遇到的许多优秀又充满情怀的前辈! Triple-go 实习当然不可能只有周末的风月,更多的是期间的工作经历和成长。整个实习期间个人主要负责 dubbo-go 3.0 的 Triple 协议和新路由规则实现。 开源 Triple 协议作为 dubbo-go 3.0 的重要 feature,简单来说,就是扩展 gRPC 协议,在gRPC 的基础上引入 dubbo 的服务治理能力和扩展空间。 刚开始想的很简单,在 HTTP2 之上实现 Triple,并兼容 gRPC。但难点在于既要和 gRPC 在 普通/流式/状态码 上完全兼容,又要具有 dubbo 服务治理能力 --- 在 dubbo-go 已有基础上扩展,还要扩展的优雅。 手撕 HTTP2 只借助数据帧层的 SDK 手撕 HTTP2 协议,首先需要解决发包逻辑的正确性。搞了一两个星期。实现了调用打通。 但自己实现的总会有问题... 除了数据帧发送正确,还要考虑滑动窗口流控、上下线、数据帧的拆包合包等等一系列流式场景下的问题。我的解决方法很直接,抓包看grpc怎么做的(没时间看源码了),然后按照它的逻辑去实现。 当问题一个在掉头发的过程中解决,看似美好,实则陷入死胡同 --- 手撕真的比不上官方库,无论是稳定性还是速度。 改官方库 一开始没有选择官方库,因为 gRPC 并不是这么做的。调研的过程中感觉困难重重,Go 语言官方库只给了少的可怜的接口,怎么自定义 Header 和 Trailer?怎么流式调用?给官方库提交 issue 后被回复:“想法不错,你自己实现个贡献出来吧”... 在这一点上,隔壁java的实现就舒服了很多,功能强大的java-http2库直接信手拈来。后来对于大型项目的贡献已经有点恐惧了,条条框框太多,跟师兄学聪明点,干脆fork个分支自己改,改的自己都觉得骚,但是能实现需求。 很感谢经验丰富的领导提醒我,官方库可以试试用。 丝滑体验 花了两天时间换了底层网络库,体验丝滑了很多,尤其是几兆的大个儿数据包,跟社区前辈一起测了一下,最后 2-3MiB 的双向数据包单机压测可达到 1.5k qps。 当然没考虑到的问题还有很多,但沉浸在开发的快乐和成就感中真的很爽。 未来的云原生 实习期虽然只有短短地三个月,但到后来我越来越发现,中间件研发已经承包了我的太多快乐,我越来越发觉了对编程的热爱,对专业的敬畏,对云原生技术的信仰。 我认为任何一位IT工程师,无论技术深度如何,无论经验是否丰富,都应该拥有自己的技术信仰。我希望技术信仰于我而言,始于对于编程的喜爱和强烈的项目成就感,成长于与前辈的交流和源码的学习中,希望在未来将落实于在 “落地” 和 “创新” 两个词中。 我认为,任何的技术,如果不落地生产,将不具有太多意义。而将“形而上学”的架构观念,突破层层阻碍和壁垒,例如和已有服务/语言/设计理念相悖,不断推进落地,这过程是伟大的,这个过程中付出过努力的人都是站在浪潮之巅的弄潮儿。 中间件的未来是什么? sidecar 架构真正优雅落地是什么样子? Java 和 Go以后的关系又是如何? RPC 又能被什么替代,或者是以一种新形态出现? 很多东西就像年初的股市一样扑朔迷离,但未来一定会有一个唯一的答案。未来在杭州,我在技术上又会经历什么变化,业内技术栈又回产生什么样的突破和进展。 难以想象未来三年后,我的技术栈将会变成什么样?毕竟从测试、运维、业务开发、再到基础架构,唯一不变的是变化。 最后的话 配上实习最后一天离开西厂前的纪念照,纪念一段人生路程的结束。祝福开源的 dubbo/dubbogo/dapr,在未来将会变得越来越强大,越来越多的开发者可以使用它们,创造云原生更大的价值。 Dubbo 3.0 将于近期正式发布,敬请期待!如有兴趣,可到 dubbogo 社区钉钉群 31363295 找我聊聊。 谨以此文致敬我的三段实习经历中帮助我成长的各位导师和技术前辈们,并以此纪念我即将逝去的大学生涯! 相关链接 1 我在腾讯看点的导师 Steven https://blog.csdn.net/forevermoonlight/article/details/108644085 2 dubbo-go https://github.com/apache/dubbo-go 3 Triple-go https://github.com/dubbogo/triple

优秀的个人博客,低调大师

每日一博 | gorm 乐观锁插件的实现

前言 最近在用 Go 写业务的时碰到了并发更新数据的场景,由于该业务并发度不高,只是为了防止出现并发时数据异常。 所以自然就想到了乐观锁的解决方案。 实现 乐观锁的实现比较简单,相信大部分有数据库使用经验的都能想到。 UPDATE `table` SET `amount`=100,`version`=version+1 WHERE `version` = 1 AND `id` = 1 需要在表中新增一个类似于 version 的字段,本质上我们只是执行这段 SQL,在更新时比较当前版本与数据库版本是否一致。 如上图所示:版本一致则更新成功,并且将版本号+1;如果不一致则认为出现并发冲突,更新失败。 这时可以直接返回失败,让业务重试;当然也可以再次获取最新数据进行更新尝试。 我们使用的是 gorm 这个 orm 库,不过我查阅了官方文档却没有发现乐观锁相关的支持,看样子后续也不打算提供实现。 不过借助 gorm 实现也很简单: type Optimistic struct { Id int64 `gorm:"column:id;primary_key;AUTO_INCREMENT" json:"id"` UserId string `gorm:"column:user_id;default:0;NOT NULL" json:"user_id"` // 用户ID Amount float32 `gorm:"column:amount;NOT NULL" json:"amount"` // 金额 Version int64 `gorm:"column:version;default:0;NOT NULL" json:"version"` // 版本 } func TestUpdate(t *testing.T) { dsn := "root:abc123@/test?charset=utf8&parseTime=True&loc=Local" db, err := gorm.Open(mysql.Open(dsn), &gorm.Config{}) var out Optimistic db.First(&out, Optimistic{Id: 1}) out.Amount = out.Amount + 10 column := db.Model(&out).Where("id", out.Id).Where("version", out.Version). UpdateColumn("amount", out.Amount). UpdateColumn("version", gorm.Expr("version+1")) fmt.Printf("#######update %v line \n", column.RowsAffected) } 这里我们创建了一张 t_optimistic 表用于测试,生成的 SQL 也满足乐观锁的要求。 不过考虑到这类业务的通用性,每次需要乐观锁更新时都需要这样硬编码并不太合适。对于业务来说其实 version 是多少压根不需要关心,只要能满足并发更新时的准确性即可。 因此我做了一个封装,最终使用如下: var out Optimistic db.First(&out, Optimistic{Id: 1}) out.Amount = out.Amount + 10 if err = UpdateWithOptimistic(db, &out, nil, 0, 0); err != nil { fmt.Printf("%+v \n", err) } 这里的使用场景是每次更新时将 amount 金额加上 10。 这样只会更新一次,如果更新失败会返回一个异常。 当然也支持更新失败时执行一个回调函数,在该函数中实现对应的业务逻辑,同时会使用该业务逻辑尝试更新 N 次。 func BenchmarkUpdateWithOptimistic(b *testing.B) { dsn := "root:abc123@/test?charset=utf8&parseTime=True&loc=Local" db, err := gorm.Open(mysql.Open(dsn), &gorm.Config{}) if err != nil { fmt.Println(err) return } b.RunParallel(func(pb *testing.PB) { var out Optimistic db.First(&out, Optimistic{Id: 1}) out.Amount = out.Amount + 10 err = UpdateWithOptimistic(db, &out, func(model Lock) Lock { bizModel := model.(*Optimistic) bizModel.Amount = bizModel.Amount + 10 return bizModel }, 3, 0) if err != nil { fmt.Printf("%+v \n", err) } }) } 以上代码的目的是: 将 amount 金额 +10,失败时再次依然将金额+10,尝试更新 3 次;经过上述的并行测试,最终查看数据库确认数据并没有发生错误。 面向接口编程 下面来看看具体是如何实现的;其实真正核心的代码也比较少: func UpdateWithOptimistic(db *gorm.DB, model Lock, callBack func(model Lock) Lock, retryCount, currentRetryCount int32) (err error) { if currentRetryCount > retryCount { return errors.WithStack(NewOptimisticError("Maximum number of retries exceeded:" + strconv.Itoa(int(retryCount)))) } currentVersion := model.GetVersion() model.SetVersion(currentVersion + 1) column := db.Model(model).Where("version", currentVersion).UpdateColumns(model) affected := column.RowsAffected if affected == 0 { if callBack == nil && retryCount == 0 { return errors.WithStack(NewOptimisticError("Concurrent optimistic update error")) } time.Sleep(100 * time.Millisecond) db.First(model) bizModel := callBack(model) currentRetryCount++ err := UpdateWithOptimistic(db, bizModel, callBack, retryCount, currentRetryCount) if err != nil { return err } } return column.Error } 具体步骤如下: 判断重试次数是否达到上限。 获取当前更新对象的版本号,将当前版本号 +1。 根据版本号条件执行更新语句。 更新成功直接返回。 更新失败 affected == 0 时,执行重试逻辑。 重新查询该对象的最新数据,目的是获取最新版本号。 执行回调函数。 从回调函数中拿到最新的业务数据。 递归调用自己执行更新,直到重试次数达到上限。 这里有几个地方值得说一下;由于 Go 目前还不支持泛型,所以我们如果想要获取 struct 中的 version 字段只能通过反射。 考虑到反射的性能损耗以及代码的可读性,有没有更”优雅“的实现方式呢? 于是我定义了一个 interface: type Lock interface { SetVersion(version int64) GetVersion() int64 } 其中只有两个方法,目的则是获取 struct 中的 version 字段;所以每个需要乐观锁的 struct 都得实现该接口,类似于这样: func (o *Optimistic) GetVersion() int64 { return o.Version } func (o *Optimistic) SetVersion(version int64) { o.Version = version } 这样还带来了一个额外的好处: 一旦该结构体没有实现接口,在乐观锁更新时编译器便会提前报错,如果使用反射只能是在运行期间才能进行校验。 所以这里在接收数据库实体的便可以是 Lock 接口,同时获取和重新设置 version 字段也是非常的方便。 currentVersion := model.GetVersion() model.SetVersion(currentVersion + 1) 类型断言 当并发更新失败时affected == 0,便会回调传入进来的回调函数,在回调函数中我们需要实现自己的业务逻辑。 err = UpdateWithOptimistic(db, &out, func(model Lock) Lock { bizModel := model.(*Optimistic) bizModel.Amount = bizModel.Amount + 10 return bizModel }, 2, 0) if err != nil { fmt.Printf("%+v \n", err) } 但由于回调函数的入参只能知道是一个 Lock 接口,并不清楚具体是哪个 struct,所以在执行业务逻辑之前需要将这个接口转换为具体的 struct。 这其实和 Java 中的父类向子类转型非常类似,必须得是强制类型转换,也就是说运行时可能会出问题。 在 Go 语言中这样的行为被称为类型断言;虽然叫法不同,但目的类似。其语法如下: x.(T) x:表示 interface T:表示 向下转型的具体 struct 所以在回调函数中得根据自己的需要将 interface 转换为自己的 struct,这里得确保是自己所使用的 struct ,因为是强制转换,编译器无法帮你做校验,具体能否转换成功得在运行时才知道。 总结 有需要的朋友可以在这里获取到源码及具体使用方式: https://github.com/crossoverJie/gorm-optimistic 最近工作中使用了几种不同的编程语言,会发现除了语言自身的语法特性外大部分知识点都是相同的; 比如面向对象、数据库、IO操作等;所以掌握了这些基本知识,学习其他语言自然就能触类旁通了。

优秀的个人博客,低调大师

每日一博 | 给 DPVS 加上 SESSION 同步功能

给DPVS加上SESSION同步功能 前言 DPVS是一款爱奇艺开源的基于DPDK的优秀软件(https://github.com/iqiyi/dpvs)。利用DPDK工作在用户空间的特性,相比于内核空间的LVS,我们可以使用用户空间的一系列工具/中间件等完成很多在内核空间很难完成的功能。 Just for fun 虽然笔者日常工作中是搞Java中间件开发的,但一直都对底层技术尤其是在网络层面抱有很大的激情与好奇心。偶然接触到DPDK这个用户态数据平面开发套件,看了其官方文档和源码后,不禁技痒难耐,于是就尝试在DPVS上增加一个Session同步功能。虽然和工作关系不大,但搞技术的乐趣不就在于不停的折腾么,Just For Fun!当然,由于精力原因,只是写出了原型并测试成功,距离生产环境还有很大的距离,毕竟不靠这个吃饭^_^。 DPVS DPVS事实上就是一个负载均衡软件,源于LVS,我们常说的Virtual IP(VIP)就可以使用DPVS来支持,如下图所示: 这次笔者就是在DPVS在FullNAT模式下对于主从模式增加了Session同步功能。如下图所示: 没有SESSION同步功能会如何 由于DPVS的数据转发是通过内部的session表来分发数据包的,如果没有Session同步功能,那么对应的数据库由于找不到对应的Session进而被丢弃。如果Client端是通过tcp进行连接的话: 那么将会在配置的tcp重传超时之后报错。 TCP Client RealServer 如果SESSION同步会如何 如果Session同步后,由于新晋升的DPVS2 Master依旧能够知道将这个Packet发送到后面哪台RealServer,如果是采用TCP连接的话,在一次重传之后,依旧能够保证连接的稳定。 SESSION同步方法 笔者这次尝试的是主从模式下FullNat的Session同步,事实上只需要将FullNat下的两张Session表(Session_IN和Session_OUT)从Master同步到Slave即可。 如果工作在内核态的LVS如何同步 由于LVS这一类的软件工作在内核态,那么就需要使用比较复杂且难于调试的问题进行主从之间的通信,如下图所示: 内核态的调试由于比起用户态来说相对复杂,而且没什么好用的中间件,笔者就没有做这方面的尝试。 在用户态笔者采用Redis Pub/Sub同步 而在用户态,可用的工具就太多了,于是笔者就选择了使用Redis的订阅/发布(Pub/Sub)功能将Session表信息从Master同步到Slave,如下图所示: 由于FullNat采用五元组,所以笔者在Redis中Pub的Key为: session_key_(af协议簇) _(proto协议) _(client源地址) _(client端口号) _(vip地址) _(vip端口号) _(localIP) _(localPort) _(RealServer目的地址) _(RS目的端口号) _(当前session所在CPUID) SESSION同步工作线程 首先,笔者在DPVS启动的main函数除了DPVS的线程之外用pthread新建了两个线程,用于reids的Send(Pub)和Receive(Sub)。 线程间通信 发布信息到Redis DPDK线程与Send/Recv线程间,同时ring_buffer进行通信。所以一开始创建的时候,就给每个DPDK线程创建了一个rte_ring(session_rings)。当每有新建连接动作时候,DPDK线程就会将新建连接的动作封装成一个消息扔到里面,然后由SendPub线程去消费。如下图所示: 由于ring_buffer是有限的,可能出现消息丢失的现象。 新建连接的DPVS运行栈为: __dp_vs_in |->conn_sched |->tcp_conn_sched (tcp协议) /* only TCP-SYN without other flag can be scheduled */ /* 即只有TCP-SYN包才会走新建连接的逻辑 */ |->dp_vs_schedule |->dp_vs_snat_schedule (FullNAT模式) 在最终的dp_vs_snat_schedule代码中,加入一段代码: static struct dp_vs_conn *dp_vs_snat_schedule(......) { conn = dp_vs_conn_new(mbuf,iph,&param,dest,0); ...... // 加入把conn信息放入session_buffer的逻辑 session_info_enqueue(conn); return conn; } 放入逻辑,其实就是将conn的信息组装成一个sesion_msg结构体,然后将之前session_key的9个信息从conn中提取: void session_info_enqueue(struct dp_vs_conn* conn){ ...... int cid = rte_lcore_id(); struct session_msg* msg; if(rte_mempool_get(message_pool,(void**)&msg) < 0){ ...... return; } copy_conn_to_msg(conn,msg); if(rte_ring_enqueue(session_rings[cid],msg) != 0){ ... rete_mempool_put(message_pool,msg); return; } } 从Redis订阅消息 同样的,有一个Recv(Sub)线程从Redis订阅信息,然后Recv(Sub)线程和DPDK间的线程也用ring_buffer来同步,不过另用了一个session_subscribe_buffer。 如图中所示,从Redis订阅到信息之后,将消息重新塞到session_subscribe_buffer(每个线程都有)里面。然后利用DPVS的job回调方法在每个线程中处理subscribe消息并通过此消息重建session表: lcore_job_recv_fwd |->lcore_process_session_subscribe_ring void lcore_process_session_subscribe_ring(...){ struct rte_ring* ring = session_subscribe_rings[cid]; ... struct session_msg* msg; if(rte_ring_dequeue(ring,(void**)&msg) < 0){ return; } new_dpvs_conn(msg); rte_mempool_put(message_pool,msg); } 笔者在new_dpvs_conn里面做了FullNAT的两张session表同步操作。 void dp_vs_conn_new_from_session(struct session_msg* msg){ ...... /*init inbound conn tuple hash*/ // SESSION IN 表项构建 t->af = msg->af; t->proto = msg->proto; ...... /*init outbound conn tuple hash*/ // SESSION OUT 表项构建 new->af = msg->af; new->proto = msg->proto; ...... // 绑定dest err = dp_vs_conn_bind_dest(new,dest); ...... // 绑定hash表 dp_vs_conn_hash(new); } MQ消费重放 用Redis做Pub/Sub只是笔者为了保持编码简单而做的选择。如果正式用在产线,笔者觉得还是要把这种Session发到Kafka这种queue里面,那么就可以将Session的变化落到本地。这样,在主备都宕机的情况下,可以通过消费Kafka中已有的消息重建Session表。 遇到的小坑 在笔者进行测试的时候,遇到的一个问题时,在Session同步之后,虽然Session表项同步无误,但始终tcp连接被断开,在加了各种Print判断和TCP dump了一堆之后。才发现,DPVS本身会对TCP的sequence进行重写以增加toa字段,所以导致TCP sequence对不上,进而连接被断开。为了简单起见,笔者注掉了这段代码,然后终于成功了! static int tcp_fnat_in_handle(...) { struct tcphdr *th; ...... // tcp_in_add_toa(conn,mbuf,th); // tcp_in_adjust_seq(conn,th); th->source = conn->lport; th->dest = conn->dport; return tcp_send_csum(af,iphdrlen,th,conn,mbuf); } 不足之处 当前笔者只做了Session新建动作的同步,Session删除等其它动作还需要慢慢斟酌。 另外,由于时间精力所限,笔者对DPVS的编码只相当于做了一次简单的原型验证,还远远达不到产线高可用的要求。 不过,当测试成功,Master宕机后另一台Slave立马接上后,长连接(用的MySQL Client做测试)保持不断,查询数据依旧丝滑,仿佛什么都没发生过的时候(如果没有这个功能,只能坐等25s左右的卡主超时了,tcp_retries2=5),就感觉非常的有成就感! 总结 笔者爱折腾、喜欢做有挑战的事。笔者在玩只狼的时候,在挑战蝴蝶夫人70多次败北终于成功后,那种喜悦难以言喻。这次玩DPVS也一样,在Debug了大半天之后,终于成功的感觉和只狼如出一辙,这也是我乐此不疲的原因,Just For Fun! 关注笔者公众号,获取更多干货文章:

优秀的个人博客,低调大师

每日一博 | Shell 编程之软硬链接 ln

在 Windows 里面我们经常通过快捷方式来创建链接以方便我们使用电脑。而 Linux 中有两种方式创建链接,分别为软链接和硬链接。下面我们就来详细说下二者的区别。 定义 ln (link file 的简称)是 GNU 核心工具包中的基本工具。该命令是为某个文件在另外一个位置建立一个同步链接。当我们需要在不同的目录用到相同的文件时,我们不需要在每一个需要的目录下都放一个必须相同的文件,此时只需用 ln 创建对应文件的链接,不必重复的占用磁盘空间。 命令格式 # 硬链接(source只能是文件) ln source target # 软链接(source可以是文件也可以是目录) ln -s source target 软链接 软链接 symbolic link 跟 Windows 里面的快捷方式等价。它的内容是指向另一个文件的位置。所以可以创建某个目录的软链接,也可以对一个不存在的文件进行链接。除此之外,它可以跨文件系统。这三点硬链接都无法实现。 硬链接 硬链接 hard link 可以理解为文件的别名,而且别名可以有多个。 原理 对于 Linux 而言,文件的结构与 Windows 有点类似,由文件名,inode(类似于 Windows 下的 FCB 文件控制块,保存文件的一些信息)和数据组成。比如创建 origin 文件,会得到下面的信息。 注意 Inode 和硬链接,下面创建 origin 的硬链接 hardlink。 比对发现,创建硬链接的文件 hardlink 与原文件 origin 之间除了名称不同之外其他完全相同,就像同一个人它有个正式的名称也可能会有小名。它们的数据显然完全一样。 接下来,我们创建 origin 的软链接 softlink。 对比发现,origin 和 softlink 是完全不同的文件,有着不同的 size,不同的块,不同的 Inode,不同的 type。唯一的联系是 softlink 文件指向 origin 文件(有点文件指针的味道)。 用例 删除源文件对软硬链接的影响 由上图可以看出 hardlink 中硬链接的个数少了一个,而 softlink 还是安然无恙的存在着。接着我们通过两个链接来打开文件。 由上图发现,hardlink 依旧能打开文件,而软链接却无法查看原文件。 参考文献 GUN核心工具包 维基百科ln ln源码 如果该文章对您产生了帮助,或者您对技术文章感兴趣,可以关注微信公众号: 技术茶话会, 能够第一时间收到相关的技术文章,谢谢! 本篇文章由一文多发平台ArtiPub自动发布

优秀的个人博客,低调大师

【争做优秀博主】大话MySQL之爱恨情仇

在数据库的发展过程中,安全-->稳定-->高效-->低成本四个有序的要点一直如影随形,后者离开前者就是空谈。10月19日晚上MySQL发布了8.0.22版本,其中一个新功能(Automatic connection failover for Async Replication Channels)引起我的注意,也很感兴趣,作为一个DBA老兵,百感交集,在过去的20多年,故障切换功能一直是三方后娘工具在主导,是几代DBA的痛,互联网最流行的数据库,在这块一直为人诟病。此功能还没有测试,不管如何,至少在这块官方终于开始出手解决了。夜深人静,整理了一下思路,对于MySQL产品截至目前的发展情况,做了一下总结,基本走以下几个方向发展:1、主从同步方向:异步同步到半同步,在到增强半同步,再到组复制;走同步的安全策略,到提升同步的效率,走单线程复制到并行复制,致力于降低主从延迟问题,但相对的同步绝对的延迟伴随其发展全过程至今。2、性能优化方向:多线程,线程池(原版MySQL的企业版支持,社区版不支持);各种日志各种独立,截止8.0.22版本,保证安全与问题记录的日志基本全部独立了,可以动态调整参数单独控制关闭和打开;重构核心引擎Innodb,优化各种锁,独立锁,优化事务操作等。各种的一顿骚操作优化,使得最新版的MySQL性能也达到了前所未有的高度。3、多模数据库方向:关系型数据、JSON半结构化数据、对象数据、内存型以及全文检索引擎等等多个数据引擎,走支持OLTP业务开始拓展至OLAP业务(Oracle云上支持的Analytics Service),虽然只有它自己的云上支持。4、借鉴其他数据库方向:最大的借鉴为ORACLE数据库,现在的各种语法和一些用法越来越ORACLE了;借鉴了MongoDB的一些功能,如MIC中的相关设置、自动搭建从节点的克隆功能等,不过在使用中确实有点复杂。5、智能化运维方向:支持各类在线DDL,对业务几乎无感知,这个为以后智能自助动态优化索引打下坚实的基础;重点的性能参数差不多都支持在线修改;支持持久化动态调整参数,保证重启后参数与重启前一致;关闭MySQL时可以把内存的热数据持久化到硬盘,启动时重新由硬盘加载到内存,减少了数据库预热,使数据库重启后快速进入之前的战时状态;SQL语句的重写功能,不变更业务代码情况下重写SQL;可以支持根据硬件配置,启动时自动调整部分参数配置,虽然可自动调整的参数有限,结合前几项,为未来MySQL在智能参数调优与自我优化方面、自治数据库的发展奠定了基础。6、提升安全性方向:健全的日志,保证在各种异常状态下不丢失数据,这也是数据库最基本的要求,MySQL也一直在努力增强再增强,努力打造金融级数据库;增强的用户验证方式caching_sha2_password,强化认证模式,增加用户认证串被暴力破解的难度。但最大的安全功能failove却一直没有。7、降低成本方向:这个路线进度有点慢,目前在innodb的压缩上有所发力,压缩比有所改进;在增强用户使用体验,简化使用操作等人力成本上一直在努力,不过有些操作比较畸形,操作配置使用复杂,比如MySQL innodb cluster的配置。固然MySQL深受广大人民喜爱,装机量也很大,其本身也特别优秀,但爱之深恨之切,依然有许多不足:1、自动创建从节点:组复制刚自动增加新节点竟然必须要有数据库初始化开始全部的Binlog日志才行(感觉设计这个方案的产品脑仁有点小),否则就需要使用mysqldump手动搞定,至今增加新节点的操作依然很骚,依然不方便,操作依然复杂,反观MongoDB就简单多了,不管是操作还是运维成本都很低。2、故障切换:MySQL经过20多年的发展,至今故障切换依然依赖三方工具,故障自愈方面好好改进一下,不过至今为止,不是很理想。其实在MySQL的JDBC中很早就类似MongoDB支持链接多数据库多节点配置,但是自身没有故障自动检测和切换功能,这个功能一直是个摆设。MySQL8.0.22版本终于支持故障启动切换,走配置参数来看,节操碎一地,估计差MongoDB的这个功能不是一星半点。期待官方在这块投入更多的人力物力,使MySQL结束这种原始操作状态,提升一下运维人员SLA和业务的不可用时间。3、drop table/database删除操作的优化:目前删除大表和库的时候对数据库性能影响巨大,甚至能把数据库给干挂了。4、假删除或延时删除库表,做数据库的删除回收站,给数据库定制后悔药。5、MySQL的MySQL Innodb Cluster目前是个鸡肋,估计也没啥人用,router和shell组件完全可以集成进MySQL中,组件越多运维等成本越高,这种管理模式用中间件不也挺好,还能私人订制(毕竟修改中间件的成本没有MySQL源码的高),配置管理复杂,向MongoDB复制集看齐不香嘛?6、不务正业:每个产品都有其核心竞争力,MySQL现在的产品有忘记初心(安全、稳定、高效、低成本)的嫌疑,花活太多,想做的东西太多,想要参考其他数据库功能也很多,all database in MySQL行的通嘛?真的能一统数据库江湖唯吾独尊嘛?传说中的MySQL存储与计算分离官方是否会支持?数据库的存储与计算分离架构这两年很火,这也是数据库发展的一个方向,一方面硬件技术的进步,支持弹性伸缩,合理利用资源,降低成本,二来高并发大数据量的业务需求,特别是万物皆为云的当下,这种架构的出现确实应时应景。MySQL如果支持这种架构,必然要对MySQL-Innodb的存储引擎做大量的修改,而且还要有自己对应的分布式文件系统,当前的MySQL架构可能要做大量的调整。MySQL官方为了进一步降低主从同步延迟,可能会支持物理复制来优化延迟问题。至于存储与计算分离个人感觉官方不会支持,至少在在短时间内不会支持,也许在MySQL13中会支持,因为我河南老乡王守义说过十三香^-^集多种数据库优点之大成,不忘初心,海乃百川,有容乃大,感觉MySQL还是不够包容和开放。很多现成的成功案例和方案思路,借鉴过来即可,何况官方的研发人员也是全球顶级的,咋就学不会呢?很多事情咱也看不懂,咱也不知道,咱也不敢问,谁知道哪,说不定明天一觉醒来MySQL来个华丽转身,穿个新娘妆跑步进入智能化、自治化数据库时代呢?

优秀的个人博客,低调大师

每日一博 | Docker 搭建 Redis Cluster 集群环境

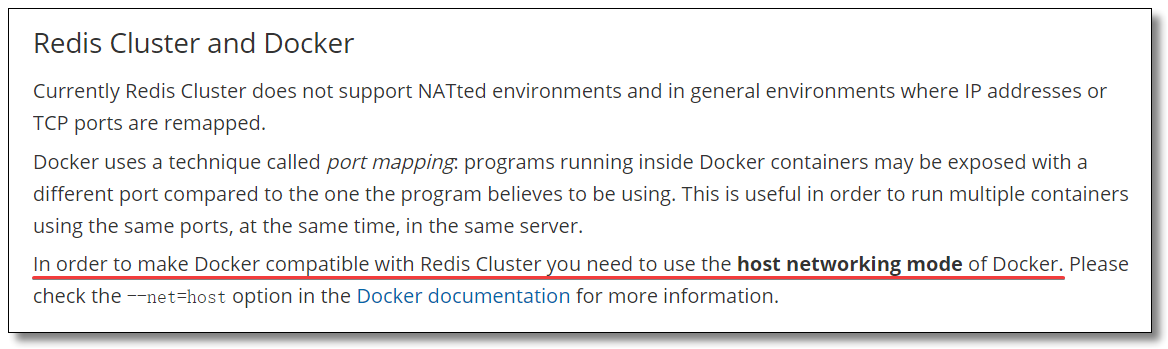
使用 Docker 搭建 Redis Cluster,最重要的环节就是容器通信的问题,这一块我们在之前的文章中已经给大家解决了《Docker 网络模式详解及容器间网络通信》,本篇文章主要练习使用多个容器完成 Redis Cluster 集群环境的搭建,顺便为学习 Docker Compose 铺铺路。俗话说没有对比就没有伤害,通过对比才能感受到 Docker Compose 的好处 😄。 关于 Redis Cluster 集群更多的内容请阅读《最通俗易懂的 Redis 架构模式详解》。 按照 Redis 官网:https://redis.io/topics/cluster-tutorial 的提示,为了使 Docker 与 Redis Cluster 兼容,您需要使用 Docker 的 host 网络模式。 host 网络模式需要在创建容器时通过参数 --net host 或者 --network host 指定,host 网络模式可以让容器共享宿主机网络栈,容器将不会虚拟出自己的网卡,配置自己的 IP 等,而是使用宿主机的 IP 和端口。 环境 为了让环境更加真实,本文使用多机环境: 192.168.10.10 192.168.10.11 每台机器所使用的基础设施环境如下: CentOS 7.8.2003 Docker version 19.03.12 搭建 整体搭建步骤主要分为以下几步: 下载 Redis 镜像(其实这步可以省略,因为创建容器时,如果本地镜像不存在,就会去远程拉取); 编写 Redis 配置文件; 创建 Redis 容器; 创建 Redis Cluster 集群。 编写 Redis 配置文件 创建目录及文件 分别在 192.168.10.10 和 192.168.10.11 两台机器上执行以下操作。 # 创建目录 mkdir -p /usr/local/docker-redis/redis-cluster # 切换至指定目录 cd /usr/local/docker-redis/redis-cluster/ # 编写 redis-cluster.tmpl 文件 vi redis-cluster.tmpl 编写配置文件 192.168.10.10 机器的 redis-cluster.tmpl 文件内容如下: port ${PORT} requirepass 1234 masterauth 1234 protected-mode no daemonize no appendonly yes cluster-enabled yes cluster-config-file nodes.conf cluster-node-timeout 15000 cluster-announce-ip 192.168.10.10 cluster-announce-port ${PORT} cluster-announce-bus-port 1${PORT} 192.168.10.11 机器的 redis-cluster.tmpl 文件内容如下: port ${PORT} requirepass 1234 masterauth 1234 protected-mode no daemonize no appendonly yes cluster-enabled yes cluster-config-file nodes.conf cluster-node-timeout 15000 cluster-announce-ip 192.168.10.11 cluster-announce-port ${PORT} cluster-announce-bus-port 1${PORT} port:节点端口; requirepass:添加访问认证; masterauth:如果主节点开启了访问认证,从节点访问主节点需要认证; protected-mode:保护模式,默认值 yes,即开启。开启保护模式以后,需配置 bind ip 或者设置访问密码;关闭保护模式,外部网络可以直接访问; daemonize:是否以守护线程的方式启动(后台启动),默认 no; appendonly:是否开启 AOF 持久化模式,默认 no; cluster-enabled:是否开启集群模式,默认 no; cluster-config-file:集群节点信息文件; cluster-node-timeout:集群节点连接超时时间; cluster-announce-ip:集群节点 IP,填写宿主机的 IP; cluster-announce-port:集群节点映射端口; cluster-announce-bus-port:集群节点总线端口。 每个 Redis 集群节点都需要打开两个 TCP 连接。一个用于为客户端提供服务的正常 Redis TCP 端口,例如 6379。还有一个基于 6379 端口加 10000 的端口,比如 16379。 第二个端口用于集群总线,这是一个使用二进制协议的节点到节点通信通道。节点使用集群总线进行故障检测、配置更新、故障转移授权等等。客户端永远不要尝试与集群总线端口通信,与正常的 Redis 命令端口通信即可,但是请确保防火墙中的这两个端口都已经打开,否则 Redis 集群节点将无法通信。 在 192.168.10.10 机器的 redis-cluster 目录下执行以下命令: for port in `seq 6371 6373`; do \ mkdir -p ${port}/conf \ && PORT=${port} envsubst < redis-cluster.tmpl > ${port}/conf/redis.conf \ && mkdir -p ${port}/data;\ done 在 192.168.10.11 机器的 redis-cluster 目录下执行以下命令: for port in `seq 6374 6376`; do \ mkdir -p ${port}/conf \ && PORT=${port} envsubst < redis-cluster.tmpl > ${port}/conf/redis.conf \ && mkdir -p ${port}/data;\ done 上面两段 shell for 语句,意思就是循环创建 6371 ~ 6376 相关的目录及文件。 在 192.168.10.10 机器执行查看命令结果如下,如果没有 tree 命令先安装 yum install -y tree。 在 192.168.10.11 机器执行查看命令结果如下。 以下内容为每个节点的配置文件详细信息。 ============================== 192.168.10.10 ============================== [root@localhost redis-cluster]# cat /usr/local/docker-redis/redis-cluster/637{1..3}/conf/redis.conf port 6371 requirepass 1234 masterauth 1234 protected-mode no daemonize no appendonly yes cluster-enabled yes cluster-config-file nodes.conf cluster-node-timeout 15000 cluster-announce-ip 192.168.10.10 cluster-announce-port 6371 cluster-announce-bus-port 16371 port 6372 requirepass 1234 masterauth 1234 protected-mode no daemonize no appendonly yes cluster-enabled yes cluster-config-file nodes.conf cluster-node-timeout 15000 cluster-announce-ip 192.168.10.10 cluster-announce-port 6372 cluster-announce-bus-port 16372 port 6373 requirepass 1234 masterauth 1234 protected-mode no daemonize no appendonly yes cluster-enabled yes cluster-config-file nodes.conf cluster-node-timeout 15000 cluster-announce-ip 192.168.10.10 cluster-announce-port 6373 cluster-announce-bus-port 16373 ============================== 192.168.10.10 ============================== ============================== 192.168.10.11 ============================== [root@localhost redis-cluster]# cat /usr/local/docker-redis/redis-cluster/637{4..6}/conf/redis.conf port 6374 requirepass 1234 masterauth 1234 protected-mode no daemonize no appendonly yes cluster-enabled yes cluster-config-file nodes.conf cluster-node-timeout 15000 cluster-announce-ip 192.168.10.11 cluster-announce-port 6374 cluster-announce-bus-port 16374 port 6375 requirepass 1234 masterauth 1234 protected-mode no daemonize no appendonly yes cluster-enabled yes cluster-config-file nodes.conf cluster-node-timeout 15000 cluster-announce-ip 192.168.10.11 cluster-announce-port 6375 cluster-announce-bus-port 16375 port 6376 requirepass 1234 masterauth 1234 protected-mode no daemonize no appendonly yes cluster-enabled yes cluster-config-file nodes.conf cluster-node-timeout 15000 cluster-announce-ip 192.168.10.11 cluster-announce-port 6376 cluster-announce-bus-port 16376 ============================== 192.168.10.11 ============================== 创建 Redis 容器 创建容器 将宿主机的 6371 ~ 6376 之间的端口与 6 个 Redis 容器映射,并将宿主机的目录与容器内的目录进行映射(目录挂载)。记得指定网络模式,使用 host 网络模式。 在 192.168.10.10 机器执行以下命令: for port in $(seq 6371 6373); do \ docker run -di --restart always --name redis-${port} --net host \ -v /usr/local/docker-redis/redis-cluster/${port}/conf/redis.conf:/usr/local/etc/redis/redis.conf \ -v /usr/local/docker-redis/redis-cluster/${port}/data:/data \ redis redis-server /usr/local/etc/redis/redis.conf; \ done 在 192.168.10.11 机器执行以下命令: for port in $(seq 6374 6376); do \ docker run -di --restart always --name redis-${port} --net host \ -v /usr/local/docker-redis/redis-cluster/${port}/conf/redis.conf:/usr/local/etc/redis/redis.conf \ -v /usr/local/docker-redis/redis-cluster/${port}/data:/data \ redis redis-server /usr/local/etc/redis/redis.conf; \ done 在 192.168.10.10 机器执行 docker ps -n 3 查看容器是否创建成功。 在 192.168.10.11 机器执行 docker ps -n 3 查看容器是否创建成功。 创建 Redis Cluster 集群 随便进入一个容器节点,并进入 /usr/local/bin/ 目录: # 进入容器 docker exec -it redis-6371 bash # 切换至指定目录 cd /usr/local/bin/ 接下来我们就可以通过以下命令实现 Redis Cluster 集群的创建。 redis-cli -a 1234 --cluster create 192.168.10.10:6371 192.168.10.10:6372 192.168.10.10:6373 192.168.10.11:6374 192.168.10.11:6375 192.168.10.11:6376 --cluster-replicas 1 出现选择提示信息,输入 yes,结果如下所示: 集群创建成功如下: 以下内容是创建集群时返回的详细信息,也就是上两幅图中的所有内容。 root@localhost:/usr/local/bin# redis-cli -a 1234 --cluster create 192.168.10.10:6371 192.168.10.10:6372 192.168.10.10:6373 192.168.10.11:6374 192.168.10.11:6375 192.168.10.11:6376 --cluster-replicas 1 Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe. >>> Performing hash slots allocation on 6 nodes... Master[0] -> Slots 0 - 5460 Master[1] -> Slots 5461 - 10922 Master[2] -> Slots 10923 - 16383 Adding replica 192.168.10.11:6376 to 192.168.10.10:6371 Adding replica 192.168.10.10:6373 to 192.168.10.11:6374 Adding replica 192.168.10.11:6375 to 192.168.10.10:6372 M: 299cf79ddafc83dced27f628f1f82dac483fbc4e 192.168.10.10:6371 slots:[0-5460] (5461 slots) master M: ac805b90b6e20e26dc4268454bb2855beea6cc19 192.168.10.10:6372 slots:[10923-16383] (5461 slots) master S: db35494fcc5db0c88d27da7885c817e6cdcc9373 192.168.10.10:6373 replicates 7013270480d37eeab79b9cd0272e934d4548136a M: 7013270480d37eeab79b9cd0272e934d4548136a 192.168.10.11:6374 slots:[5461-10922] (5462 slots) master S: 8435e1b0d51f2690c5f94f9a5682a4ac34e94326 192.168.10.11:6375 replicates ac805b90b6e20e26dc4268454bb2855beea6cc19 S: 7b13c16fa6fe8e13cdc0b4846b87edffed55c62e 192.168.10.11:6376 replicates 299cf79ddafc83dced27f628f1f82dac483fbc4e Can I set the above configuration? (type 'yes' to accept): yes >>> Nodes configuration updated >>> Assign a different config epoch to each node >>> Sending CLUSTER MEET messages to join the cluster Waiting for the cluster to join . >>> Performing Cluster Check (using node 192.168.10.10:6371) M: 299cf79ddafc83dced27f628f1f82dac483fbc4e 192.168.10.10:6371 slots:[0-5460] (5461 slots) master 1 additional replica(s) S: 8435e1b0d51f2690c5f94f9a5682a4ac34e94326 192.168.10.11:6375 slots: (0 slots) slave replicates ac805b90b6e20e26dc4268454bb2855beea6cc19 S: db35494fcc5db0c88d27da7885c817e6cdcc9373 192.168.10.10:6373 slots: (0 slots) slave replicates 7013270480d37eeab79b9cd0272e934d4548136a S: 7b13c16fa6fe8e13cdc0b4846b87edffed55c62e 192.168.10.11:6376 slots: (0 slots) slave replicates 299cf79ddafc83dced27f628f1f82dac483fbc4e M: 7013270480d37eeab79b9cd0272e934d4548136a 192.168.10.11:6374 slots:[5461-10922] (5462 slots) master 1 additional replica(s) M: ac805b90b6e20e26dc4268454bb2855beea6cc19 192.168.10.10:6372 slots:[10923-16383] (5461 slots) master 1 additional replica(s) [OK] All nodes agree about slots configuration. >>> Check for open slots... >>> Check slots coverage... [OK] All 16384 slots covered. 至此一个高可用的 Redis Cluster 集群搭建完成,如下图所示,该集群中包含 6 个 Redis 节点,3 主 3 从。三个主节点会分配槽,处理客户端的命令请求,而从节点可用在主节点故障后,顶替主节点。 查看集群状态 我们先进入容器,然后通过一些集群常用的命令查看一下集群的状态。 # 进入容器 docker exec -it redis-6371 bash # 切换至指定目录 cd /usr/local/bin/ 检查集群状态 redis-cli -a 1234 --cluster check 192.168.10.11:6375 查看集群信息和节点信息 # 连接至集群某个节点 redis-cli -c -a 1234 -h 192.168.10.11 -p 6376 # 查看集群信息 cluster info # 查看集群结点信息 cluster nodes SET/GET 在 6371 节点中执行写入和读取,命令如下: # 进入容器并连接至集群某个节点 docker exec -it redis-6371 /usr/local/bin/redis-cli -c -a 1234 -h 192.168.10.10 -p 6371 # 写入数据 set name mrhelloworld set aaa 111 set bbb 222 # 读取数据 get name get aaa get bbb 别着急,让我来解释一下上图中的操作过程: 首先进入容器并连接至集群某个节点; 然后执行第一个 set 命令 set name mrhelloworld,name 键根据哈希函数运算以后得到的值为 [5798]。当前集群环境的槽分配情况为:[0-5460] 6371节点,[5461-10922] 6374节点,[10923-16383] 6372节点,所以该键的存储就被分配到了 6374 节点上; 再来看第二个 set 命令 set aaa,这里大家可能会有一些疑问,为什么看不到 aaa 键根据哈希函数运算以后得到的值?因为刚才重定向至 6374 节点插入了数据,此时如果还有数据插入,正好键根据哈希函数运算以后得到的值也还在该节点的范围内,那么直接插入数据即可; 接着是第三个 set 命令 set bbb,bbb 键根据哈希函数运算以后得到的值为 [5287],所以该键的存储就被分配到了 6371 节点上; 然后是读取操作,第四个命令 get name,name 键根据哈希函数运算以后得到的值为 [5798],被重定向至 6374 节点读取; 第五个命令 get aaa,aaa 键根据哈希函数运算以后得到的值也在 6374 节点,直接读取; 第六个命令 get bbb,bbb 键根据哈希函数运算以后得到的值为 [5287],被重定向至 6371 节点读取。 通过以上操作我们得知 name 键的存储被分配到了 6374 节点,如果直接连接 6374 节点并获取该值会怎么样?没错,不需要重定向节点,因为数据就在该节点,所以直接读取返回。 客户端连接 最后来一波客户端连接操作,随便哪个节点,看看可否通过外部访问 Redis Cluster 集群。 至此使用多机环境多个容器搭建 Redis Cluster 集群环境就到这里,其实整体搭建过程不算特别麻烦,因为: 创建 Redis 集群需要用到 Ruby,否则就得自己关联节点构建集群,自己分配槽; 如果使用 Ruby 构建 Redis 集群,就需要安装 Ruby 环境; 而 Redis 从 5 版本开始可以直接使用 redis-cli 命令创建集群了,就省去了很多麻烦事; 我们还使用了 shell for 循环语句简化了构建过程,否则那些语句一条条执行也够你闹心的。 综上所述,有没有更简单的办法呢?当然有了,不然我在这跟你卖什么关子。 Docker Compose 就可以解决这个问题。后面我们先学习一下什么是 Docker Compose,然后使用 Docker Compose 再来搭建一遍 Redis Cluster 集群环境,感受感受这前后的区别。 本文采用 知识共享「署名-非商业性使用-禁止演绎 4.0 国际」许可协议。 大家可以通过 分类 查看更多关于 Docker 的文章。 🤗 您的点赞和转发是对我最大的支持。 📢 扫码关注 哈喽沃德先生「文档 + 视频」每篇文章都配有专门视频讲解,学习更轻松噢 ~

优秀的个人博客,低调大师

每日一博 | Linux 是如何管理内存的?

点击蓝色“Java建设者”关注我哟 加个“星标”,及时阅读最新技术文章 这是Java建设者第 106 篇原创文章 Linux 内存管理模型非常直接明了,因为 Linux 的这种机制使其具有可移植性并且能够在内存管理单元相差不大的机器下实现 Linux,下面我们就来认识一下 Linux 内存管理是如何实现的。 基本概念 每个 Linux 进程都会有地址空间,这些地址空间由三个段区域组成:text 段、data 段、stack 段。下面是进程地址空间的示例。 数据段(data segment) 包含了程序的变量、字符串、数组和其他数据的存储。数据段分为两部分,已经初始化的数据和尚未初始化的数据。其中尚未初始化的数据就是我们说的 BSS。数据段部分的初始化需要编译就期确定的常量以及程序启动就需要一个初始值的变量。所有 BSS 部分中的变量在加载后被初始化为 0 。 和 代码段(Text segment) 不一样,data segment 数据段可以改变。程序总是修改它的变量。而且,许多程序需要在执行时动态分配空间。Linux 允许数据段随着内存的分配和回收从而增大或者减小。为了分配内存,程序可以增加数据段的大小。在 C 语言中有一套标准库 malloc 经常用于分配内存。进程地址空间描述符包含动态分配的内存区域称为 堆(heap)。 第三部分段是 栈段(stack segment)。在大部分机器上,栈段会在虚拟内存地址顶部地址位置处,并向低位置处(向地址空间为 0 处)拓展。举个例子来说,在 32 位 x86 架构的机器上,栈开始于 0xC0000000,这是用户模式下进程允许可见的 3GB 虚拟地址限制。如果栈一直增大到超过栈段后,就会发生硬件故障并把页面下降一个页面。 当程序启动时,栈区域并不是空的,相反,它会包含所有的 shell 环境变量以及为了调用它而向 shell 输入的命令行。举个例子,当你输入 cpcxuanlx 时,cp 程序会运行并在栈中带着字符串 cp cxuan lx ,这样就能够找出源文件和目标文件的名称。 当两个用户运行在相同程序中,例如编辑器(editor),那么就会在内存中保持编辑器程序代码的两个副本,但是这种方式并不高效。Linux 系统支持共享文本段作为替代。下面图中我们会看到 A 和 B 两个进程,它们有着相同的文本区域。 数据段和栈段只有在 fork 之后才会共享,共享也是共享未修改过的页面。如果任何一个都需要变大但是没有相邻空间容纳的话,也不会有问题,因为相邻的虚拟页面不必映射到相邻的物理页面上。 除了动态分配更多的内存,Linux 中的进程可以通过内存映射文件来访问文件数据。这个特性可以使我们把一个文件映射到进程空间的一部分而该文件就可以像位于内存中的字节数组一样被读写。把一个文件映射进来使得随机读写比使用 read 和 write 之类的 I/O 系统调用要容易得多。共享库的访问就是使用了这种机制。如下所示 我们可以看到两个相同文件会被映射到相同的物理地址上,但是它们属于不同的地址空间。 映射文件的优点是,两个或多个进程可以同时映射到同一文件中,任意一个进程对文件的写操作对其他文件可见。通过使用映射临时文件的方式,可以为多线程共享内存提供高带宽,临时文件在进程退出后消失。但是实际上,并没有两个相同的地址空间,因为每个进程维护的打开文件和信号不同。 Linux 内存管理系统调用 下面我们探讨一下关于内存管理的系统调用方式。事实上,POSIX 并没有给内存管理指定任何的系统调用。然而,Linux 却有自己的内存系统调用,主要系统调用如下 如果遇到错误,那么 s 的返回值是 -1,a 和 addr 是内存地址,len 表示的是长度,prot 表示的是控制保护位,flags 是其他标志位,fd 是文件描述符,offset 是文件偏移量。 brk 通过给出超过数据段之外的第一个字节地址来指定数据段的大小。如果新的值要比原来的大,那么数据区会变得越来越大,反之会越来越小。 mmap 和 unmap 系统调用会控制映射文件。mmp 的第一个参数 addr 决定了文件映射的地址。它必须是页面大小的倍数。如果参数是 0,系统会分配地址并返回 a。第二个参数是长度,它告诉了需要映射多少字节。它也是页面大小的倍数。prot 决定了映射文件的保护位,保护位可以标记为 可读、可写、可执行或者这些的结合。第四个参数 flags 能够控制文件是私有的还是可读的以及 addr 是必须的还是只是进行提示。第五个参数 fd 是要映射的文件描述符。只有打开的文件是可以被映射的,因此如果想要进行文件映射,必须打开文件;最后一个参数 offset 会指示文件从什么时候开始,并不一定每次都要从零开始。 Linux 内存管理实现 内存管理系统是操作系统最重要的部分之一。从计算机早期开始,我们实际使用的内存都要比系统中实际存在的内存多。内存分配策略克服了这一限制,并且其中最有名的就是 虚拟内存(virtual memory)。通过在多个竞争的进程之间共享虚拟内存,虚拟内存得以让系统有更多的内存。虚拟内存子系统主要包括下面这些概念。 大地址空间 操作系统使系统使用起来好像比实际的物理内存要大很多,那是因为虚拟内存要比物理内存大很多倍。 保护 系统中的每个进程都会有自己的虚拟地址空间。这些虚拟地址空间彼此完全分开,因此运行一个应用程序的进程不会影响另一个。并且,硬件虚拟内存机制允许内存保护关键内存区域。 内存映射 内存映射用来向进程地址空间映射图像和数据文件。在内存映射中,文件的内容直接映射到进程的虚拟空间中。 公平的物理内存分配 内存管理子系统允许系统中的每个正在运行的进程公平分配系统的物理内存。 共享虚拟内存 尽管虚拟内存让进程有自己的内存空间,但是有的时候你是需要共享内存的。例如几个进程同时在 shell 中运行,这会涉及到 IPC 的进程间通信问题,这个时候你需要的是共享内存来进行信息传递而不是通过拷贝每个进程的副本独立运行。 下面我们就正式探讨一下什么是 虚拟内存 虚拟内存的抽象模型 在考虑 Linux 用于支持虚拟内存的方法之前,考虑一个不会被太多细节困扰的抽象模型是很有用的。 处理器在执行指令时,会从内存中读取指令并将其解码(decode),在指令解码时会获取某个位置的内容并将他存到内存中。然后处理器继续执行下一条指令。这样,处理器总是在访问存储器以获取指令和存储数据。 在虚拟内存系统中,所有的地址空间都是虚拟的而不是物理的。但是实际存储和提取指令的是物理地址,所以需要让处理器根据操作系统维护的一张表将虚拟地址转换为物理地址。 为了简单的完成转换,虚拟地址和物理地址会被分为固定大小的块,称为 页(page)。这些页有相同大小,如果页面大小不一样的话,那么操作系统将很难管理。Alpha AXP系统上的 Linux 使用 8 KB 页面,而 Intel x86 系统上的 Linux 使用 4 KB 页面。每个页面都有一个唯一的编号,即页面框架号(PFN)。 上面就是 Linux 内存映射模型了,在这个页模型中,虚拟地址由两部分组成:偏移量和虚拟页框号。每次处理器遇到虚拟地址时都会提取偏移量和虚拟页框号。处理器必须将虚拟页框号转换为物理页号,然后以正确的偏移量的位置访问物理页。 上图中展示了两个进程 A 和 B 的虚拟地址空间,每个进程都有自己的页表。这些页表将进程中的虚拟页映射到内存中的物理页中。页表中每一项均包含 有效标志(valid flag) :表明此页表条目是否有效 该条目描述的物理页框号 访问控制信息,页面使用方式,是否可写以及是否可以执行代码 要将处理器的虚拟地址映射为内存的物理地址,首先需要计算虚拟地址的页框号和偏移量。页面大小为 2 的次幂,可以通过移位完成操作。 如果当前进程尝试访问虚拟地址,但是访问不到的话,这种情况称为 缺页异常,此时虚拟操作系统的错误地址和页面错误的原因将通知操作系统。 通过以这种方式将虚拟地址映射到物理地址,虚拟内存可以以任何顺序映射到系统的物理页面。 按需分页 由于物理内存要比虚拟内存少很多,因此操作系统需要注意尽量避免直接使用低效的物理内存。节省物理内存的一种方式是仅加载执行程序当前使用的页面(这何尝不是一种懒加载的思想呢?)。例如,可以运行数据库来查询数据库,在这种情况下,不是所有的数据都装入内存,只装载需要检查的数据。这种仅仅在需要时才将虚拟页面加载进内中的技术称为按需分页。 交换 如果某个进程需要将虚拟页面传入内存,但是此时没有可用的物理页面,那么操作系统必须丢弃物理内存中的另一个页面来为该页面腾出空间。 如果页面已经修改过,那么操作系统必须保留该页面的内容,以便以后可以访问它。这种类型的页面被称为脏页,当将其从内存中移除时,它会保存在称为交换文件的特殊文件中。相对于处理器和物理内存的速度,对交换文件的访问非常慢,并且操作系统需要兼顾将页面写到磁盘的以及将它们保留在内存中以便再次使用。 Linux 使用最近最少使用(LRU)页面老化技术来公平的选择可能会从系统中删除的页面,这个方案涉及系统中的每个页面,页面的年龄随着访问次数的变化而变化,如果某个页面访问次数多,那么该页就表示越 年轻,如果某个呃页面访问次数太少,那么该页越容易被换出。 物理和虚拟寻址模式 大多数多功能处理器都支持 物理地址模式和虚拟地址模式的概念。物理寻址模式不需要页表,并且处理器不会在此模式下尝试执行任何地址转换。Linux 内核被链接在物理地址空间中运行。 Alpha AXP 处理器没有物理寻址模式。相反,它将内存空间划分为几个区域,并将其中两个指定为物理映射的地址。此内核地址空间称为 KSEG 地址空间,它包含从 0xfffffc0000000000 向上的所有地址。为了从 KSEG 中链接的代码(按照定义,内核代码)执行或访问其中的数据,该代码必须在内核模式下执行。链接到 Alpha 上的 Linux内核以从地址 0xfffffc0000310000 执行。 访问控制 页面表的每一项还包含访问控制信息,访问控制信息主要检查进程是否应该访问内存。 必要时需要对内存进行访问限制。例如包含可执行代码的内存,自然是只读内存;操作系统不应允许进程通过其可执行代码写入数据。相比之下,包含数据的页面可以被写入,但是尝试执行该内存的指令将失败。大多数处理器至少具有两种执行模式:内核态和用户态。你不希望访问用户执行内核代码或内核数据结构,除非处理器以内核模式运行。 访问控制信息被保存在上面的 Page Table Entry ,页表项中,上面这幅图是 Alpha AXP的 PTE。位字段具有以下含义 V 表示 valid ,是否有效位 FOR 读取时故障,在尝试读取此页面时出现故障 FOW 写入时错误,在尝试写入时发生错误 FOE 执行时发生错误,在尝试执行此页面中的指令时,处理器都会报告页面错误并将控制权传递给操作系统, ASM 地址空间匹配,当操作系统希望清除转换缓冲区中的某些条目时,将使用此选项。 GH 当在使用单个转换缓冲区条目而不是多个转换缓冲区条目映射整个块时使用的提示。 KRE 内核模式运行下的代码可以读取页面 URE 用户模式下的代码可以读取页面 KWE 以内核模式运行的代码可以写入页面 UWE 以用户模式运行的代码可以写入页面 页框号 对于设置了 V 位的 PTE,此字段包含此 PTE 的物理页面帧号(页面帧号)。对于无效的 PTE,如果此字段不为零,则包含有关页面在交换文件中的位置的信息。 除此之外,Linux 还使用了两个位 _PAGE_DIRTY 如果已设置,则需要将页面写出到交换文件中 _PAGE_ACCESSED Linux 用来将页面标记为已访问。 缓存 上面的虚拟内存抽象模型可以用来实施,但是效率不会太高。操作系统和处理器设计人员都尝试提高性能。但是除了提高处理器,内存等的速度之外,最好的方法就是维护有用信息和数据的高速缓存,从而使某些操作更快。在 Linux 中,使用很多和内存管理有关的缓冲区,使用缓冲区来提高效率。 缓冲区缓存 缓冲区高速缓存包含块设备驱动程序使用的数据缓冲区。 还记得什么是块设备么?这里回顾下 块设备是一个能存储固定大小块信息的设备,它支持以固定大小的块,扇区或群集读取和(可选)写入数据。每个块都有自己的物理地址。通常块的大小在 512 - 65536 之间。所有传输的信息都会以连续的块为单位。块设备的基本特征是每个块都较为对立,能够独立的进行读写。常见的块设备有 硬盘、蓝光光盘、USB 盘 与字符设备相比,块设备通常需要较少的引脚。 缓冲区高速缓存通过设备标识符和块编号用于快速查找数据块。如果可以在缓冲区高速缓存中找到数据,则无需从物理块设备中读取数据,这种访问方式要快得多。 页缓存 页缓存用于加快对磁盘上图像和数据的访问 它用于一次一页地缓存文件中的内容,并且可以通过文件和文件中的偏移量进行访问。当页面从磁盘读入内存时,它们被缓存在页面缓存中。 交换区缓存 仅仅已修改(脏页)被保存在交换文件中 只要这些页面在写入交换文件后没有修改,则下次交换该页面时,无需将其写入交换文件,因为该页面已在交换文件中。可以直接丢弃。在大量交换的系统中,这节省了许多不必要的和昂贵的磁盘操作。 硬件缓存 处理器中通常使用一种硬件缓存。页表条目的缓存。在这种情况下,处理器并不总是直接读取页表,而是根据需要缓存页的翻译。这些是转换后备缓冲区 也被称为 TLB,包含来自系统中一个或多个进程的页表项的缓存副本。 引用虚拟地址后,处理器将尝试查找匹配的 TLB 条目。如果找到,则可以将虚拟地址直接转换为物理地址,并对数据执行正确的操作。如果处理器找不到匹配的 TLB 条目, 它通过向操作系统发信号通知已发生 TLB 丢失获得操作系统的支持和帮助。系统特定的机制用于将该异常传递给可以修复问题的操作系统代码。操作系统为地址映射生成一个新的 TLB 条目。清除异常后,处理器将再次尝试转换虚拟地址。这次能够执行成功。 使用缓存也存在缺点,为了节省精力,Linux 必须使用更多的时间和空间来维护这些缓存,并且如果缓存损坏,系统将会崩溃。 Linux 页表 Linux 假定页表分为三个级别。访问的每个页表都包含下一级页表 图中的 PDG 表示全局页表,当创建一个新的进程时,都要为新进程创建一个新的页面目录,即 PGD。 要将虚拟地址转换为物理地址,处理器必须获取每个级别字段的内容,将其转换为包含页表的物理页的偏移量,并读取下一级页表的页框号。这样重复三次,直到找到包含虚拟地址的物理页面的页框号为止。 Linux 运行的每个平台都必须提供翻译宏,这些宏允许内核遍历特定进程的页表。这样,内核无需知道页表条目的格式或它们的排列方式。 页分配和取消分配 对系统中物理页面有很多需求。例如,当图像加载到内存中时,操作系统需要分配页面。 系统中所有物理页面均由 mem_map 数据结构描述,这个数据结构是 mem_map_t 的列表。它包括一些重要的属性 count :这是页面的用户数计数,当页面在多个进程之间共享时,计数大于 1 age:这是描述页面的年龄,用于确定页面是否适合丢弃或交换 map_nr :这是此mem_map_t描述的物理页框号。 页面分配代码使用 free_area向量查找和释放页面,free_area 的每个元素都包含有关页面块的信息。 页面分配 Linux 的页面分配使用一种著名的伙伴算法来进行页面的分配和取消分配。页面以 2 的幂为单位进行块分配。这就意味着它可以分配 1页、2 页、4页等等,只要系统中有足够可用的页面来满足需求就可以。判断的标准是nr_free_pages> min_free_pages,如果满足,就会在 free_area 中搜索所需大小的页面块完成分配。free_area 的每个元素都有该大小的块的已分配页面和空闲页面块的映射。 分配算法会搜索请求大小的页面块。如果没有任何请求大小的页面块可用的话,会搜寻一个是请求大小二倍的页面块,然后重复,直到一直搜寻完 free_area 找到一个页面块为止。如果找到的页面块要比请求的页面块大,就会对找到的页面块进行细分,直到找到合适的大小块为止。 因为每个块都是 2 的次幂,所以拆分过程很容易,因为你只需将块分成两半即可。空闲块在适当的队列中排队,分配的页面块返回给调用者。 如果请求一个 2 个页的块,则 4 页的第一个块(从第 4 页的框架开始)将被分成两个 2 页的块。第一个页面(从第 4 页的帧开始)将作为分配的页面返回给调用方,第二个块(从第 6 页的页面开始)将作为 2 页的空闲块排队到 free_area 数组的元素 1 上。 页面取消分配 上面的这种内存方式最造成一种后果,那就是内存的碎片化,会将较大的空闲页面分成较小的页面。页面解除分配代码会尽可能将页面重新组合成为更大的空闲块。每释放一个页面,都会检查相同大小的相邻的块,以查看是否空闲。如果是,则将其与新释放的页面块组合以形成下一个页面大小块的新的自由页面块。每次将两个页面块重新组合为更大的空闲页面块时,页面释放代码就会尝试将该页面块重新组合为更大的空闲页面。通过这种方式,可用页面的块将尽可能多地使用内存。 例如上图,如果要释放第 1 页的页面,则将其与已经空闲的第 0 页页面框架组合在一起,并作为大小为 2页的空闲块排队到 free_area 的元素 1 中 内存映射 内核有两种类型的内存映射:共享型(shared) 和私有型(private)。私有型是当进程为了只读文件,而不写文件时使用,这时,私有映射更加高效。但是,任何对私有映射页的写操作都会导致内核停止映射该文件中的页。所以,写操作既不会改变磁盘上的文件,对访问该文件的其它进程也是不可见的。 按需分页 一旦可执行映像被内存映射到虚拟内存后,它就可以被执行了。因为只将映像的开头部分物理的拉入到内存中,因此它将很快访问物理内存尚未存在的虚拟内存区域。当进程访问没有有效页表的虚拟地址时,操作系统会报告这项错误。 页面错误描述页面出错的虚拟地址和引起的内存访问(RAM)类型。 Linux 必须找到代表发生页面错误的内存区域的 vm_area_struct 结构。由于搜索 vm_area_struct 数据结构对于有效处理页面错误至关重要,因此它们以 AVL(Adelson-Velskii和Landis)树结构链接在一起。如果引起故障的虚拟地址没有 vm_area_struct 结构,则此进程已经访问了非法地址,Linux 会向进程发出 SIGSEGV 信号,如果进程没有用于该信号的处理程序,那么进程将会终止。 然后,Linux 会针对此虚拟内存区域所允许的访问类型,检查发生的页面错误类型。如果该进程以非法方式访问内存,例如写入仅允许读的区域,则还会发出内存访问错误信号。 现在,Linux 已确定页面错误是合法的,因此必须对其进行处理。 往期精彩回顾 最棒 Spring Boot 干货总结 ! 删库后如何优雅的恢复数据? 换人!这些算法都不会还学什么操作系统 计算机网络基础知识总结 本文分享自微信公众号 - Java建设者(javajianshe)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 理解 Snowflake 算法的实现原理

前提 Snowflake(雪花)是Twitter开源的高性能ID生成算法(服务)。 上图是Snowflake的Github仓库,master分支中的REAEMDE文件中提示:初始版本于2010年发布,基于Apache Thrift,早于Finagle(这里的Finagle是Twitter上用于RPC服务的构建模块)发布,而Twitter内部使用的Snowflake是一个完全重写的程序,在很大程度上依靠Twitter上的现有基础架构来运行。 而2010年发布的初版Snowflake源码是使用Scala语言编写的,归档于scala_28分支。换言之,「大家目前使用的Snowflake算法原版或者改良版已经是十年前(当前是2020年)的产物,不得不说这个算法确实比较厉害」。scala_28分支中有介绍该算法的动机和要求,这里简单摘录一下: 「动机:」 Cassandra中没有生成顺序 ID的工具, Twitter由使用 MySQL转向使用 Cassandra的时候需要一种新的方式来生成 ID(印证了架构不是设计出来,而是基于业务场景迭代出来)。 「要求:」 高性能:每秒每个进程至少产生 10K个 ID,加上网络延迟响应速度要在 2ms内。 顺序性:具备按照时间的自增趋势,可以直接排序。 紧凑性:保持生成的 ID的长度在 64 bit或更短。 高可用: ID生成方案需要和存储服务一样高可用。 下面就Snowflake的源码分析一下他的实现原理。 Snowflake方案简述 Snowflake在初版设计方案是: 时间: 41 bit长度,使用毫秒级别精度,带有一个自定义 epoch,那么可以使用大概 69年。 可配置的机器 ID: 10 bit长度,可以满足 1024个机器使用。 序列号: 12 bit长度,可以在 4096个数字中随机取值,从而避免单个机器在 1 ms内生成重复的序列号。 但是在实际源码实现中,Snowflake把10 bit的可配置的机器ID拆分为5 bit的Worker ID(这个可以理解为原来的机器ID)和5 bit的Data Center ID(数据中心ID),详情见IdWorker.scala: 也就是说,支持配置最多32个机器ID和最多32个数据中心ID: 由于算法是Scala语言编写,是依赖于JVM的语言,返回的ID值为Long类型,也就是64 bit的整数,原来的算法生成序列中只使用了63 bit的长度,要返回的是无符号数,所以在高位补一个0(占用1 bit),那么加起来整个ID的长度就是64 bit: 其中: 41 bit毫秒级别时间戳的取值范围是: [0, 2^41 - 1] => 0 ~ 2199023255551,一共 2199023255552个数字。 5 bit机器 ID的取值范围是: [0, 2^5 - 1] => 0 ~ 31,一共 32个数字。 5 bit数据中心 ID的取值范围是: [0, 2^5 - 1] => 0 ~ 31,一共 32个数字。 12 bit序列号的取值范围是: [0, 2^12 - 1] => 0 ~ 4095,一共 4096个数字。 那么理论上可以生成2199023255552 * 32 * 32 * 4096个完全不同的ID值。 Snowflake算法还有一个明显的特征:「依赖于系统时钟」。41 bit长度毫秒级别的时间来源于系统时间戳,所以必须保证系统时间是向前递进,不能发生「时钟回拨」(通说来说就是不能在同一个时刻产生多个相同的时间戳或者产生了过去的时间戳)。一旦发生时钟回拨,Snowflake会拒绝生成下一个ID。 位运算知识补充 Snowflake算法中使用了大量的位运算。由于整数的补码才是在计算机中的存储形式,Java或者Scala中的整型都使用补码表示,这里稍微提一下原码和补码的知识。 原码用于阅读,补码用于计算。 正数的补码与其原码相同。 负数的补码是除最高位其他所有位取反,然后加 1(反码加 1),而负数的补码还原为原码也是使用这个方式。 +0的原码是 0000 0000,而 -0的原码是 1000 0000,补码只有一个 0值,用 0000 0000表示,这一点很重要,补码的 0没有二义性。 简单来看就是这样: *[+11]原码=[00001011]补码=[00001011]*[-11]原码=[10001011]补码=[11110101]*[-11]的补码计算过程:原码10001011除了最高位其他位取反11110100加111110101(补码) 使用原码、反码在计算的时候得到的不一定是准确的值,而使用补码的时候计算结果才是正确的,记住这个结论即可,这里不在举例。由于Snowflake的ID生成方案中,除了最高位,其他四个部分都是无符号整数,所以四个部分的整数「使用补码进行位运算的效率会比较高,也只有这样才能满足Snowflake高性能设计的初衷」。Snowflake算法中使用了几种位运算:异或(^)、按位与(&)、按位或(|)和带符号左移(<<)。 异或 异或的运算规则是:0^0=0 0^1=1 1^0=1 1^1=0,也就是位不同则结果为1,位相同则结果为0。主要作用是: 特定位翻转,也就是一个数和 N个位都为 1的数进行异或操作,这对应的 N个位都会翻转,例如 0100 & 1111,结果就是 1011。 与 0项异或,则结果和原来的值一致。 两数的值交互: a=a^b b=b^a a=a^b,这三个操作完成之后, a和 b的值完成交换。 这里推演一下最后一条: *[+11]原码=[00001011]补码=[00001011]a*[-11]原码=[10001011]补码=[11110101]ba=a^b0000101111110101---------^11111110b=b^a11110101---------^00001011(十进制数:11)ba=a^b11111110---------^11110101(十进制数:-11)a 按位与 按位与的运算规则是:0^0=0 0^1=0 1^0=0 1^1=1,只有对应的位都为1的时候计算结果才是1,其他情况的计算结果都是0。主要作用是: 清零,如果想把一个数清零,那么和所有位为 0的数进行按位与即可。 取一个数中的指定位,例如要取 X中的低 4位,只需要和 zzzz...1111进行按位与即可,例如取 1111 0110的低 4位,则 11110110 & 00001111即可得到 00000110。 按位或 按位与的运算规则是:0^0=0 0^1=1 1^0=1 1^1=1,只要有其中一个位存在1则计算结果是1,只有两个位同时为0的情况下计算结果才是0。主要作用是: 对一个数的部分位赋值为 1,只需要和对应位全为 0的数做按位或操作就行,例如 1011 0000如果低 4位想全部赋值为 1,那么 10110000 | 00001111即可得到 1011 1111。 带符号左移 带符号左移的运算符是<<,一般格式是:M << n。作用如下: M的二进制数(补码)向左移动 n位。 左边(高位)移出部分直接舍弃,右边(低位)移入部分全部补 0。 移位结果:相当于 M的值乘以 2的 n次方,并且0、正、负数通用。 移动的位数超过了该类型的最大位数,那么编译器会对移动的位数取模,例如 int移位 33位,实际上只移动了 33 % 2 = 1位。 推演过程如下(假设n = 2): *[+11]原码=[00001011]补码=[00001011]*[-11]原码=[10001011]补码=[11110101]*[+11<<2]的计算过程补码00001011左移2位00001011舍高补低00101100十进制数2^2+2^3+2^5=44*[-11<<2]的计算过程补码11110101左移2位11110101舍高补低11010100原码10101100(补码除最高位其他所有位取反再加1)十进制数-(2^2+2^3+2^5)=-44 可以写个main方法验证一下: publicstaticvoidmain(String[]args){System.out.println(-11<<2);//-44System.out.println(11<<2);//44} 组合技巧 利用上面提到的三个位运算符,相互组合可以实现一些高效的计算方案。 「计算n个bit能表示的最大数值:」 Snowflake算法中有这样的代码: //机器ID的位长度privatevalworkerIdBits=5L;//最大机器ID->31privatevalmaxWorkerId=-1L^(-1L<<workerIdBits); 这里的算子是-1L ^ (-1L << 5L),整理运算符的顺序,再使用64 bit的二进制数推演计算过程如下: *[-1]的补码1111111111111111111111111111111111111111111111111111111111111111左移5位1111111111111111111111111111111111111111111111111111111111100000[-1]的补码1111111111111111111111111111111111111111111111111111111111111111异或-----------------------------------------------------------------------^结果的补码0000000000000000000000000000000000000000000000000000000000011111(十进制数2^0+2^1+2^2+2^3+2^4=31) 这样就能计算出5 bit能表示的最大数值n,n为整数并且0 <= n <= 31,即0、1、2、3...31。Worker ID和Data Center ID部分的最大值就是使用这种组合运算得出的。 「用固定位的最大值作为Mask避免溢出:」 Snowflake算法中有这样的代码: varsequence=0L......privatevalsequenceBits=12L//这里得到的是sequence的最大值4095privatevalsequenceMask=-1L^(-1L<<sequenceBits)......sequence=(sequence+1)&sequenceMask 最后这个算子其实就是sequence = (sequence + 1) & 4095,假设sequence当前值为4095,推演一下计算过程: *[4095]的补码0000000000000000000000000000000000000000000000000000011111111111[sequence+1]的补码0000000000000000000000000000000000000000000000000000100000000000按位与-----------------------------------------------------------------------&计算结果0000000000000000000000000000000000000000000000000000000000000000(十进制数:0) 可以编写一个main方法验证一下: publicstaticvoidmain(String[]args){intmask=4095;System.out.println(0&mask);//0System.out.println(1&mask);//1System.out.println(2&mask);//2System.out.println(4095&mask);//4095System.out.println(4096&mask);//0System.out.println(4097&mask);//1} 也就是x = (x + 1) & (-1L ^ (-1L << N))能保证最终得到的x值不会超过N,这是利用了按位与中的"取指定位"的特性。 Snowflake算法实现源码分析 Snowflake虽然用Scala语言编写,语法其实和Java差不多,当成Java代码这样阅读就行,下面阅读代码的时候会跳过一些日志记录和度量统计的逻辑。先看IdWorker.scala的属性值: //定义基准纪元值,这个值是北京时间2010-11-0409:42:54,估计就是2010年初版提交代码时候定义的一个时间戳valtwepoch=1288834974657L//初始化序列号为0varsequence=0L//TODOafter2.8makethisaconstructorparamwithadefaultof0//机器ID的最大位长度为5privatevalworkerIdBits=5L//数据中心ID的最大位长度为5privatevaldatacenterIdBits=5L//最大的机器ID值,十进制数为为31privatevalmaxWorkerId=-1L^(-1L<<workerIdBits)//最大的数据中心ID值,十进制数为为31privatevalmaxDatacenterId=-1L^(-1L<<datacenterIdBits)//序列号的最大位长度为12privatevalsequenceBits=12L//机器ID需要左移的位数12privatevalworkerIdShift=sequenceBits//数据中心ID需要左移的位数=12+5privatevaldatacenterIdShift=sequenceBits+workerIdBits//时间戳需要左移的位数=12+5+5privatevaltimestampLeftShift=sequenceBits+workerIdBits+datacenterIdBits//序列号的掩码,十进制数为4095privatevalsequenceMask=-1L^(-1L<<sequenceBits)//初始化上一个时间戳快照值为-1privatevarlastTimestamp=-1L//下面的代码块为参数校验和初始化日志打印,这里不做分析if(workerId>maxWorkerId||workerId<0){exceptionCounter.incr(1)thrownewIllegalArgumentException("workerIdcan'tbegreaterthan%dorlessthan0".format(maxWorkerId))}if(datacenterId>maxDatacenterId||datacenterId<0){exceptionCounter.incr(1)thrownewIllegalArgumentException("datacenterIdcan'tbegreaterthan%dorlessthan0".format(maxDatacenterId))}log.info("workerstarting.timestampleftshift%d,datacenteridbits%d,workeridbits%d,sequencebits%d,workerid%d",timestampLeftShift,datacenterIdBits,workerIdBits,sequenceBits,workerId) 接着看算法的核心代码逻辑: //同步方法,其实就是protectedsynchronizedlongnextId(){......}protected[snowflake]defnextId():Long=synchronized{//获取系统时间戳(毫秒)vartimestamp=timeGen()//高并发场景,同一毫秒内生成多个IDif(lastTimestamp==timestamp){//确保sequence+1之后不会溢出,最大值为4095,其实也就是保证1毫秒内最多生成4096个ID值sequence=(sequence+1)&sequenceMask//如果sequence溢出则变为0,说明1毫秒内并发生成的ID数量超过了4096个,这个时候同1毫秒的第4097个生成的ID必须等待下一毫秒if(sequence==0){//死循环等待下一个毫秒值,直到比lastTimestamp大timestamp=tilNextMillis(lastTimestamp)}}else{//低并发场景,不同毫秒中生成ID//不同毫秒的情况下,由于外层方法保证了timestamp大于或者小于lastTimestamp,而小于的情况是发生了时钟回拨,下面会抛出异常,所以不用考虑//也就是只需要考虑一种情况:timestamp>lastTimestamp,也就是当前生成的ID所在的毫秒数比上一个ID大//所以如果时间戳部分增大,可以确定整数值一定变大,所以序列号其实可以不用计算,这里直接赋值为0sequence=0}//获取到的时间戳比上一个保存的时间戳小,说明时钟回拨,这种情况下直接抛出异常,拒绝生成ID//个人认为,这个方法应该可以提前到vartimestamp=timeGen()这段代码之后if(timestamp<lastTimestamp){exceptionCounter.incr(1)log.error("clockismovingbackwards.Rejectingrequestsuntil%d.",lastTimestamp);thrownewInvalidSystemClock("Clockmovedbackwards.Refusingtogenerateidfor%dmilliseconds".format(lastTimestamp-timestamp));}//lastTimestamp保存当前时间戳,作为方法下次被调用的上一个时间戳的快照lastTimestamp=timestamp//度量统计,生成的ID计数器加1genCounter.incr()//X=(系统时间戳-自定义的纪元值)然后左移22位//Y=(数据中心ID左移17位)//Z=(机器ID左移12位)//最后ID=X|Y|Z|计算出来的序列号sequence((timestamp-twepoch)<<timestampLeftShift)|(datacenterId<<datacenterIdShift)|(workerId<<workerIdShift)|sequence}//辅助方法:获取系统当前的时间戳(毫秒)protecteddeftimeGen():Long=System.currentTimeMillis()//辅助方法:获取系统当前的时间戳(毫秒),用死循环保证比传入的lastTimestamp大,也就是获取下一个比lastTimestamp大的毫秒数protecteddeftilNextMillis(lastTimestamp:Long):Long={vartimestamp=timeGen()while(timestamp<=lastTimestamp){timestamp=timeGen()}timestamp} 最后一段逻辑的位操作比较多,但是如果熟练使用位运算操作符,其实逻辑并不复杂,这里可以画个图推演一下: 四个部分的整数完成左移之后,由于空缺的低位都会补充了0,基于按位或的特性,所有低位只要存在1,那么对应的位就会填充为1,由于四个部分的位不会越界分配,所以这里的本质就是:「四个部分左移完毕后最终的数字进行加法计算」。 Snowflake算法改良 Snowflake算法有几个比较大的问题: 低并发场景会产生连续偶数,原因是低并发场景系统时钟总是走到下一个毫秒值,导致序列号重置为 0。 依赖系统时钟,时钟回拨会拒绝生成新的 ID(直接抛出异常)。 Woker ID和 Data Center ID的管理比较麻烦,特别是同一个服务的不同集群节点需要保证每个节点的 Woker ID和 Data Center ID组合唯一。 这三个问题美团开源的Leaf提供了解决思路,下图截取自com.sankuai.inf.leaf.snowflake.SnowflakeIDGenImpl: 对应的解决思路是(不进行深入的源码分析,有兴趣可以阅读以下Leaf的源码): 序列号生成添加随机源,会稍微减少同一个毫秒内能产生的最大 ID数量。 时钟回拨则进行一定期限的等待。 使用 Zookeeper缓存和管理 Woker ID和 Data Center ID。 Woker ID和Data Center ID的配置是极其重要的,对于同一个服务(例如支付服务)集群的多个节点,必须配置不同的机器ID和数据中心ID或者同样的数据中心ID和不同的机器ID(「简单说就是确保Woker ID和Data Center ID的组合全局唯一」),否则在高并发的场景下,在系统时钟一致的情况下,很容易在多个节点产生相同的ID值,所以一般的部署架构如下: 管理这两个ID的方式有很多种,或者像Leaf这样的开源框架引入分布式缓存进行管理,再如笔者所在的创业小团队生产服务比较少,直接把Woker ID和Data Center ID硬编码在服务启动脚本中,然后把所有服务使用的Woker ID和Data Center ID统一登记在团队内部知识库中。 自实现简化版Snowflake 如果完全不考虑性能的话,也不考虑时钟回拨、序列号生成等等问题,其实可以把Snowflake的位运算和异常处理部分全部去掉,使用Long.toBinaryString()方法结合字符串按照Snowflake算法思路拼接出64 bit的二进制数,再通过Long.parseLong()方法转化为Long类型。编写一个main方法如下: publicclassMain{privatestaticfinalStringHIGH="0";/***2020-08-0100:00:00*/privatestaticfinallongEPOCH=1596211200000L;publicstaticvoidmain(String[]args){longworkerId=1L;longdataCenterId=1L;longseq=4095;StringtimestampString=leftPadding(Long.toBinaryString(System.currentTimeMillis()-EPOCH),41);StringworkerIdString=leftPadding(Long.toBinaryString(workerId),5);StringdataCenterIdString=leftPadding(Long.toBinaryString(dataCenterId),5);StringseqString=leftPadding(Long.toBinaryString(seq),12);Stringvalue=HIGH+timestampString+workerIdString+dataCenterIdString+seqString;longnum=Long.parseLong(value,2);System.out.println(num);//某个时刻输出为3125927076831231}privatestaticStringleftPadding(Stringvalue,intmaxLength){intdiff=maxLength-value.length();StringBuilderbuilder=newStringBuilder();for(inti=0;i<diff;i++){builder.append("0");}builder.append(value);returnbuilder.toString();}} 然后把代码规范一下,编写出一个简版Snowflake算法实现的工程化代码: //主键生成器接口publicinterfacePrimaryKeyGenerator{longgenerate();}//简易Snowflake实现publicclassSimpleSnowflakeimplementsPrimaryKeyGenerator{privatestaticfinalStringHIGH="0";privatestaticfinallongMAX_WORKER_ID=31;privatestaticfinallongMIN_WORKER_ID=0;privatestaticfinallongMAX_DC_ID=31;privatestaticfinallongMIN_DC_ID=0;privatestaticfinallongMAX_SEQUENCE=4095;/***机器ID*/privatefinallongworkerId;/***数据中心ID*/privatefinallongdataCenterId;/***基准纪元值*/privatefinallongepoch;privatelongsequence=0L;privatelonglastTimestamp=-1L;publicSimpleSnowflake(longworkerId,longdataCenterId,longepoch){this.workerId=workerId;this.dataCenterId=dataCenterId;this.epoch=epoch;checkArgs();}privatevoidcheckArgs(){if(!(MIN_WORKER_ID<=workerId&&workerId<=MAX_WORKER_ID)){thrownewIllegalArgumentException("Workeridmustbein[0,31]");}if(!(MIN_DC_ID<=dataCenterId&&dataCenterId<=MAX_DC_ID)){thrownewIllegalArgumentException("Datacenteridmustbein[0,31]");}}@Overridepublicsynchronizedlonggenerate(){longtimestamp=System.currentTimeMillis();//时钟回拨if(timestamp<lastTimestamp){thrownewIllegalStateException("Clockmovedbackwards");}//同一毫秒内并发if(lastTimestamp==timestamp){sequence=sequence+1;if(sequence==MAX_SEQUENCE){timestamp=untilNextMillis(lastTimestamp);sequence=0L;}}else{//下一毫秒重置sequence为0sequence=0L;}lastTimestamp=timestamp;//41位时间戳字符串,不够位数左边补"0"StringtimestampString=leftPadding(Long.toBinaryString(timestamp-epoch),41);//5位机器ID字符串,不够位数左边补"0"StringworkerIdString=leftPadding(Long.toBinaryString(workerId),5);//5位数据中心ID字符串,不够位数左边补"0"StringdataCenterIdString=leftPadding(Long.toBinaryString(dataCenterId),5);//12位序列号字符串,不够位数左边补"0"StringseqString=leftPadding(Long.toBinaryString(sequence),12);Stringvalue=HIGH+timestampString+workerIdString+dataCenterIdString+seqString;returnLong.parseLong(value,2);}privatelonguntilNextMillis(longlastTimestamp){longtimestamp;do{timestamp=System.currentTimeMillis();}while(timestamp<=lastTimestamp);returntimestamp;}privatestaticStringleftPadding(Stringvalue,intmaxLength){intdiff=maxLength-value.length();StringBuilderbuilder=newStringBuilder();for(inti=0;i<diff;i++){builder.append("0");}builder.append(value);returnbuilder.toString();}publicstaticvoidmain(String[]args){longepoch=LocalDateTime.of(1970,1,1,0,0,0,0).toInstant(ZoneOffset.of("+8")).toEpochMilli();PrimaryKeyGeneratorgenerator=newSimpleSnowflake(1L,1L,epoch);for(inti=0;i<5;i++){System.out.println(String.format("第%s个生成的ID:%d",i+1,generator.generate()));}}}//某个时刻输出如下第1个生成的ID:6698247966366502912第2个生成的ID:6698248027448152064第3个生成的ID:6698248032162549760第4个生成的ID:6698248033076908032第5个生成的ID:6698248033827688448 通过字符串拼接的写法虽然运行效率低,但是可读性会比较高,工程化处理后的代码可以在实例化时候直接指定Worker ID和Data Center ID等值,并且这个简易的Snowflake实现没有第三方库依赖,拷贝下来可以直接运行。上面的方法使用字符串拼接看起来比较低端,其实最后那部分的按位或,「可以完全转化为加法」: publicclassMain{/***2020-08-0100:00:00*/privatestaticfinallongEPOCH=1596211200000L;publicstaticvoidmain(String[]args){longworkerId=1L;longdataCenterId=1L;longseq=4095;longtimestampDiff=System.currentTimeMillis()-EPOCH;longnum=(long)(timestampDiff*Math.pow(2,22))+(long)(dataCenterId*Math.pow(2,17))+(long)(workerId*Math.pow(2,12))+seq;System.out.println(num);//某个时刻输出为3248473482862591}} 这样看起来整个算法都变得简单,不过这里涉及到指数运算和加法运算,效率会比较低。 小结 Snowflake算法是以高性能为核心目标的算法,基于这一点目的巧妙地大量使用位运算,这篇文章已经把Snowflake中应用到的位运算和具体源码实现彻底分析清楚。最后,基于Twitter官方的Snowflake算法源码,修订出了一版Java实现版本,并且应用前面提到的改良方式,修复了低并发场景下只产生偶数的问题,「并且已经应用于生产环境一段时间」,代码仓库如下(代码没有任何第三方库依赖,拷贝出来就直接可用): Github: https://github.com/zjcscut/framework-mesh/tree/master/java-snowflake 参考资料: 美团Leaf源码 Twitter Snowflake (本文完 c-3-d e-a-20200809 封面图来源于国漫《灵笼》) 本文分享自微信公众号 - Throwable文摘(throwable-doge)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 2020 年 Service Mesh 技术展望

背景 有外文指出,2020 年 Service Mesh 技术将有以下三大发展: 快速增长的服务网格需求; Istio 很难被打败,很可能成为服务网格技术的事实标准; 出现更多的服务网格用例,WebAssembly 将带来新的可能。 针对 Service Mesh 技术,ServiceMesher 社区治理委员会成员在 2020 新年伊始发表了他们各自的看法,并邀请云原生与服务网格领域业界大牛抒发各自的见解,汇总成文,希望能给读者们带来一些思考和启发。 正文 宋净超(蚂蚁金服) 用一句话概括 Service Mesh 近几年的发展——道阻且长,行则将至。这几年来我一直在探寻云原生之道,从容器、Kubernetes 再到 Service Mesh,从底层的基础设施到越来越趋向于业务层面,Service Mesh 肯定不是云原生的终极形式,其复杂性依然很高,且业界标准也尚未形成,它的发展也远没有同期的 Kubernetes 那么顺利,但是很多人都已意识到了服务网格价值,现在它正在远离最初市场宣传时的喧嚣,走向真正的落地。 罗广明(百度) 据了解,2020 年的 Kubecon EU 的提案中,很少有涉及服务网格落地场景,由此来看,服务网格技术离大规模生产落地还有很远的路要走。当前 Istio 架构体现出来的性能问题迟迟没有得到优化,使用原生的 Istio 大规模上生产还不太靠谱,有的公司选择将 mixer 功能下层至自研的数据面,有的公司通过向容器注入探针解决可观察性。总的来看,在当前服务网格部分落地场景中,大多都是基于 Istio 和 envoy,但对其或多或少都有改动,以满足公有云/私有云的需求。 此外,在 Service Mesh 落地的过程中,现有传统微服务应用(Spring Cloud/Dubbo 应用)如何平滑迁移到 Service Mesh,也是一个至关重要的话题。“双模微服务”的互联互通、共同治理有望成为 2020 年服务网格落地的关键技术之一,这也是国内几家典型云厂商力求打造的亮点产品。 马若飞(FreeWheel) 我个人认为 Service Mesh 想要真正发展成熟并大规模落地还有很长的一段路要走。一方面业界基于微服务构建的一系列服务治理框架和产品相当稳定和成熟,在功能上和 Service Mesh 有很多重合的地方,使得开发者对 Service Mesh 的需求并不迫切;另一方面,目前 Service Mesh 领域产品的成熟度还有待提高,冒险迁移过于激进,也容易面临兼容性的问题,这也制约了 Service Mesh 的落地。 从近半年厂商的动作来看,主要方向是提供托管的控制平面,并整合成熟的数据面(如 Envoy);同时提供多环境支持(如多云、混合云、VM 等)。这也和目前应用复杂多样的的部署现状有关,厂商的目的是先让你上云,再 Mesh 化。这也是一个相对稳妥且折中的方案。我司作为一个重度使用 AWS 服务的公司,选择了 AWS App Mesh 托管服务作为 mesh 的解决方案,使得和现有服务能更容易的整合,减少维护和迁移成本。 邱世达 (BoCloud) 目前来看,Kubernetes 已经逐步在企业中落地,服务上云已然是大势所趋。而随着云计算基础设施层的日益完备,在可以预见的未来,应用层服务治理必然成为新的焦点,也是在大规模微服务场景下必须要解决的问题。在 Service Mesh 领域,Istio 无疑是明星项目,除了具备一定自研能力的科技公司会定制开发自己的服务治理工具,大多数中小型企业通常会选择以 Istio 为代表的开源服务治理方案进行初步试水。实践过程中遇到问题并不可怕,我认为这反而是一种正向推动力,作为一种良性反馈,能更加积极地促使 Service Mesh 技术趋于成熟和稳定。拥抱服务网格,拥抱云原生,让我们期待 Service Mesh 在新的一年取得更大的发展! 孙海洲(中国科学院计算技术研究所) 对于 Service Mesh 来说,2019 年是极不平凡的一年,也是从观望走向生产落地的一年。在这一年里,以 Istio 为代表的 Service Mesh 开始加快发布周期,可以看到社区从以优雅架构到开始追求性能。最近社区里大家积极地参与到 Istio 文档的本地化工作中。在业界可以看到国内各个大厂开始有所举动,蚂蚁在双十一的成功大规模落地为 Service Mesh 走向生产打下了坚实的基础,同时也为大家提供了很多宝贵的经验,腾讯、百度、华为等云服务提供商也都纷纷发布相关的产品。关于 Service Mesh 的图书在今年也出版了几本,社区多次组织线下的 Service Mesh Meetup 场场爆满,可见大家对 Service Mesh 的热情与日俱增。2020年应该可以看到会有更多的 Service Mesh 的成功落地,但是当前还有很多企业还处于过渡时期,如何更好更便捷地解决向云原生迁移依赖值得关注。Service Mesh 社区的推广和布道工作依然任重而道远,需要我们更加积极努力地投入到 Service Mesh 事业中去。 赵化冰(中兴通讯) 在 2019 年里,我看到的一个有趣的现象是出现了各种各样的开源 Service Mesh 项目,基于开源 Service Mesh 项目的初创公司,以及各大云厂商的闭源 Service Mesh 实现。和 2018 年大部分项目围绕 Istio 搭建生态有所不同(至少大部分项目声称自己兼容 Istio),2019年整个 Service Mesh 生态出现了百花齐放,百家争鸣的趋势。这也许和 Istio 项目的进度有一定关系。Istio 在项目最开始发布时搭建了一个非常漂亮的架构,但实际开发的进展较慢。目前 Mixer V2 还没有能够正式发布(处于 alpha 版本), 其安全模型也在近期进行了较大的变动,导致除了流量管控之外的其他功能基本无法在生产中使用;除此之外,Istio 对于非 Kubernetes 环境的支持也非常有限。所有这些因素在一定程度上给其他 Service Mesh 项目留出了较大的发展空间。 在 Service Mesh 的不同实现纷纷涌现的情况下,要最大化利用 Service Mesh 提供了服务通信和管控能力,必须统一 Service Mesh 的标准接口。通过一个标准北向接口,对 Service Mesh 提供的流量控制,安全策略,拓扑信息、性能指标等基本能力进行组合,并加以创新,可以创建大量端到端的高附加值业务,例如支持业务平滑升级的灰度发布,测试微服务系统健壮性的混沌测试,微服务的监控系统等等。而采用一个标准的南向接口,则可以构建一个良好的数据面代理生态,甚至可能将一些传统的硬件代理设备纳入 Service Mesh 控制面进行统一管理。 在 2020 年里,我希望 Istio 项目在 telemetry 和 security 方面取得更多实际性的进展,并出现更多的商用案例。希望能够制定一个 Service Mesh 的标准接口,或者出现一个足够强大的事实标准,并看到建立在标准北向接口上的更多应用,这是 Service Mesh 的核心价值所在,也许会成为 Service Mesh 的下一个热点。 钟华(腾讯云) 还记得 2019 年初,我们对打磨半年之久的 Istio 新版本翘首以盼,大家对 Istio 的高度抽象模型褒贬不一,社区里偶尔会看到朋友问「到底有没有公司在生产环境落地了 Istio?」 在过去的一年里,Istio 持续发力,核心功能迭代更加稳定,发布了四个子版本,同时也更注重用户体验的优化。各大云厂商在 2019 年陆续实现了对 Istio 的支持,业界也出现了越来越多的 Service Mesh 生产实践,其中典型的是蚂蚁双十一大规模落地案例;笔者所在的腾讯云 TKE Mesh 团队,支持了数十个团队的 Service Mesh 改造过程,其中不乏一些场景复杂、体量庞大的核心系统。 Service Mesh 技术前景广阔,但远未成熟。展望 2020, 作为 Service Mesh 头号玩家的, Istio 还会持续快速发展,我个人很期待的一些演进: 支持 webassembly 扩展的数据面,真正生产可用的 Mixer V2,更易安装和运维的单体控制面 istiod,更容易理解和操纵的用户接口,以及提升 Istio 自身的可观测性。 Service Mesh 技术本质上是各种最佳实践的组合运用。Istio 试图运用精巧的模型,去联结各种平台、观测系统和用户应用。未来的 Istio,一定会更加复杂,这些「复杂」的目的,是让用户能更「简单」地使用 Service Mesh 领域的最佳实践。 William Morgan Buoyant CEO, author of Linkerd,the originator of the concept Service Mesh. 今天的服务网格处于有点不幸的状态:虽然有真实和重要的价值,但市场营销已经超过了技术本身。云供应商特别利用服务网格作为区分他们的容器产品的一种方式,而由此产生的狂热的市场推广给终端用户带来了实质性的损害。 然而,如果应用正确,服务网格确实能提供一些真正变革性的功能。从 Linkerd 的角度来看,创建服务网格的项目,我们仍然认为最小化服务网格的成本,特别是由复杂性引起的长期运营成本是最重要的。 在2020年,Linkerd 将继续专注于提供“可观察的安全性”的目标,同时最小化复杂性和使用成本 — Linkerd 的超轻、超快 Rust 代理、极简控制平面,以及“少做,而不是多做”的理念已经在这里得到了鲜明的体现。最重要的是,Linkerd 对开放治理和中立基础的承诺将确保 Linkerd 将继续成为一个为所有工程师服务的项目,而不是为某个特定云供应商的客户服务。 Christian Posta Field CTO at solo.io, author Istio in Action and Microservices for Java Developers, open-source enthusiast, cloud application development, committer @ Apache, Serverless, Cloud, Integration, Kubernetes, Docker, Istio, Envoy blogger, blog https://blog.christianposta.com/. 回顾2019 更多的Service Mesh产品发布了!API/软件网络领域的每个人都正在实践自己的服务网格。我认为这对市场来说是一件好事,因为它表明这是有价值的,并且应该探索不同的实现方式。这也将指引我们在未来殊途同归。 越来越多的组织参与到服务网格技术中(从去年的架构讨论开始)可用性是关键!像linkerd这样的网格技术展示了如何简化使用和操作,其他产品也注意到了这一点,并尝试提高它们的可用性。 Istio已经持续的进行定期发布,这证明了它开始走向稳定并具有可预测性。 Consul推出了和consul模型无缝结合的L7路由特性。 不可忽视,虽然更多的人开始着手服务网格技术的实践,但依然有很多争议: 谁来支持? 多租户支持的不好 对现有应用不总是透明的 VM+容器支持不够好 暴露什么样的API给用户 2020年展望 服务网格在2019年引领了潮流,我期待它能变得更加强大。2020年,会有更多的组织落地服务网格,继续与现有的网格技术集成,如Istio和其他产品: 多网格的存在!虽然现在已经有很多网格实现,但最终还是会收敛的。然而,有趣的是,我不认为融合会像kubernetes那样发生(我们都落在一件事情上)。我怀疑总会有多种服务网格实现会成为主流。每个云提供商都有自己的托管网格产品,这可能与本地网格不同。因此,多集群和网格的多分布将成为主要的部署实现。 Web assembly正在流行:它提供了一种在类似Envoy这样的代理中安全地运行用户代码的方法,我们将很快看到服务网格和API网关,如istio和gloo对它提供支持。Web assembly将允许用户/供应商/组织提供功能模块,用以定制化代理并改变其默认行为。Web assembly 工具集将开始出现并对其进行管理。对于那些努力将服务网格集成到现有环境并维护组织兼容性的人来说,这将是令人兴奋的。 优化服务网格数据平面:去年我在第一个ServiceMeshCon演讲(PPT:https://www.slideshare.net/ceposta/the-truth-about-the-service-mesh-data-plane)讨论了如何在服务网格数据平面进行调优,就像直接运行你的代码一样。作为代理,和共享的代理。例如,gRPC最近增加了对xDS API的支持, CNCF也有一个工作组来帮助将这个“通用数据平面API”标准化以用于其他用途:https://github.com/cncf/udpa。 Service Mesh 终端用户调查 为了增加大家对 Service Mesh的了解,促进社区更好的发展,我们发起了 Service Mesh 终端用户问卷调查,请访问链接 https://wj.qq.com/s2/5258418/d5d8 ,或者扫码下面图片中的二维码,花几分钟的时间填写下这份问卷。谢谢! 关于 ServiceMesher 社区 ServiceMesher 社区是由一群拥有相同价值观和理念的志愿者们共同发起,于 2018 年 4 月正式成立。 社区关注领域有:容器、微服务、Service Mesh、Serverless,拥抱开源和云原生,致力于推动 Service Mesh 在中国的蓬勃发展。 社区官网:https://www.servicemesher.com

优秀的个人博客,低调大师

每日一博|保护 Kafka 环境的最佳实践

对于许多企业来说,Kafka是整个企业数据系统的中枢和源泉,因此保护事件流平台对于数据安全至关重要,并且通常是管理层要求的。本文会讲述五个安全类别以及Kafka和Confluent平台的基本功能,这些功能可以帮助用户保护事件流平台。 认证方式 认证机制会验证接入Kafka和Confluent平台的用户和应用的身份。需要关注的与认证相关的主要领域有三个:Kafka的Broker或Confluent的服务端,Apache ZooKeeper的服务端以及基于HTTP的服务。HTTP服务包括Kafka Connect工作节点、ksqlDB服务端、Confluent REST代理、模式注册表和Control Center。验证与这些服务的所有连接是安全的基础。 Kafka Broker和Confluent服务端 Kafka Broker和Confluent服务端使用简单认证和安全层(SASL)或mutual TLS(mTLS)对来自客户端和其他Broker的连接进行身份验证。 SASL是用于身份验证的框架,提供了多种身份验证机制。当前支持的SASL机制包括PLAIN、SCRAM、GSSAPI(Kerberos)和OAUTHBEARER(注意:OAUTHBEARER的开发者必须提供代码以获取和验证凭据)。Kafka Broker可以同时启用多种机制,然后客户端可以选择用于身份验证的机制。Kafka监听器大致是Broker接受连接的IP、端口和安全协议。每种机制的SASL配置略有不同,但通常包括启用所需机制的列表并配置代理监听器,以下是GSSAPI配置的摘要: sasl.enabled.mechanisms=GSSAPI sasl.mechanism.inter.broker.protocol=GSSAPI listeners=SASL_SSL://kafka1:9093 advertised.listeners=SASL_SSL://localhost:9093 详细的信息,请参见SASL文档。 使用mTLS进行认证时,SSL/TLS证书在服务端和客户端之间提供基本的信任关系,但是mTLS不能与任何SASL机制结合使用,为特定的监听器启用SASL后,将禁用SSL/TLS客户端认证。 在支持的认证方法中,mTLS、SASL SCRAM和SASL GSSAPI是当前的KafkaBroker建议的认证方法。对于Confluent服务端,当与Confluent提供的LDAP回调和SSL/TLS配对时,还可以使用PLAIN机制。使用这些方法可为企业生产提供更好的安全性实践。强烈建议始终集成SSL/TLS以保护网络上的身份验证凭据,下面的加密部分在保护传输中的数据方面将进一步展开介绍。 ZooKeeper服务端 Kafka利用ZooKeeper来执行各种关键的集群管理任务。防止在ZooKeeper中进行未经授权的修改对于维护稳定和安全的Kafka集群至关重要。Kafka的2.5版本开始附带了支持mTLS认证的ZooKeeper,通过启用/禁用SASL认证可以启用ZooKeeper的身份验证。在2.5版之前,仅支持DIGEST-MD5和GSSAPI SASL机制。 要为ZooKeeper启用mTLS身份验证,必须同时配置ZooKeeper和Kafka。 以下是启用mTLS的ZooKeeper配置片段示例: zookeeper.connect=zk1:2182,zk2:2182,zk3:2182 zookeeper.ssl.client.enable=true zookeeper.clientCnxnSocket=org.apache.zookeeper.ClientCnxnSocketNetty zookeeper.ssl.keystore.location=<path-to-kafka-keystore> zookeeper.ssl.keystore.password=<kafka-keystore-password> zookeeper.ssl.truststore.location=<path-to-kafka-trustore> zookeeper.ssl.truststore.password=<kafka-truststore-password> zookeeper.set.acl=true HTTP服务 Kafka Connect、Confluent模式注册表、REST代理、MQTT代理、ksqlDB和Control Center,在HTTP(S)监听器、REST API和用户界面上都支持身份验证。Kafka和Confluent平台支持Basic身份验证和mTLS,不过Confluent平台还提供了通过HTTP Basic身份验证对LDAP进行认证的选项。 授权 身份验证验证用户和应用的身份,而授权则定义连接后允许其执行的操作。 ACLs Apache Kafka带有现成的授权机制来建立ACL配置,以保护特定的Kafka资源。Kafka ACL存储在ZooKeeper中,并通过kafka-acls命令进行管理。对于Kafka ACL,可以使用SimpleAclAuthorizer,以验证在身份验证过程中确定的主体。可以使用SCRAM用户名、Kerberos主体或客户端证书来标识客户端。Confluent平台还提供了旧版LDAP授权器及其替代者Confluent服务端授权器,可用于与现有LDAP基础架构集成。 Kafka ACL提供了细粒度的方法来管理对单个Kafka集群的访问,但没有扩展到Kafka Connect、Confluent模式注册表、Control Center或ksqlDB等其他服务。基于ZooKeeper的ACL也是面向集群的,因此如果要管理多个集群,需要独立管理所有集群中的ACL。最后,由于没有角色的概念,使用大量的主体(用户、组或应用)和控件可能难以管理ACL。 Confluent平台通过集中式ACL可以帮助解决其中一些ACL管理缺陷,通过基于角色的访问控制,从一个集中的权威集群管理多个集群的ACL。 基于角色的访问控制(RBAC) Confluent平台提供了基于角色的访问控制(RBAC),可解决上面列出的问题。RBAC和ACL功能类似,但处理问题的方式不同,可以独立使用也可协同使用。RBAC由Confluent的元数据服务(MDS)提供支持,该元数据服务与LDAP集成在一起,并充当授权和身份验证数据的核心协调者。RBAC利用角色绑定来确定哪些用户和组可以访问特定资源,以及可以在这些资源(角色)中执行哪些操作。RBAC通过Confluent服务端在Kafka集群上获得授权,Confluent服务端是完全兼容的Kafka Broker,集成了RBAC等商业安全功能。 管理员为各种资源上的用户和组分配预定义的角色,每个用户可以在每个资源上分配多个角色。资源就是诸如Kafka集群,消费者组或仅是主题之类的东西。管理员创建角色绑定,将主体、角色和资源映射在一起,可以使用Control Center或者Confluent CLI中的iam rolebinding子命令管理角色绑定,例如: confluent iam rolebinding create --principal User:ConnectAdmin --role ResourceOwner --resource Topic:connect-statuses --kafka-cluster-id abc123 RBAC还与Confluent平台中的许多其他应用紧密集成,以提供面向特定应用量身定制的集群级和资源级绑定。例如,带RBAC的Kafka Connect可以将连接器作为资源进行控制,并通过集群级角色绑定管理对整个分布式Kafka Connect集群的访问。RBAC模式注册表集成还允许将模式主题视为资源,从而将一组模式注册表视为集群并绑定角色。 加密 保护传输中的数据 对Broker与应用之间传输的数据进行加密可减轻跨网络意外拦截数据的风险。身份验证和加密是在Kafka中的每个监听器上定义的。Kafka监听器默认使用PLAINTEXT这样的不安全协议,这适用于开发环境,但是所有的生产环境都应启用加密。使用listener配置以及管理信任库和密钥库来配置Broker上的加密,下面的代码片段显示了两个监听器,其在Broker上一起使用SSL和SASL_SSL: listeners=SSL://:9093,SASL_SSL://:9094 使用ssl配置键来配置密钥和可信证书,例如: ssl.truststore.location=/var/private/ssl/kafka.server.truststore.jks ssl.truststore.password=test1234 ssl.keystore.location=/var/private/ssl/kafka.server.keystore.jks ssl.keystore.password=test1234 ssl.key.password=test1234 SSL/TLS还可以通过在客户端和服务端之间分配可信证书来用于客户端身份验证,有关此方法的更多详细信息,请参见Confluent的相关文档。 为了将不受保护的集群迁移到受保护的集群,Kafka支持多个监听器,只需配置一个新的受保护的监听器并迁移客户端应用即可。迁移所有客户端后,就可以停用不受保护的监听器。 Broker受保护后,还必须配置客户端的安全性。按照与Broker类似的过程,为所有客户端(包括ksqlDB、Kafka Connect和Kafka Streams)配置加密。 机密保护 启用加密和安全功能需要配置机密值,包括密码、密钥和主机名。Kafka没有提供任何保护这些值的方法,开发者经常将它们存储在明文配置文件和源代码控制系统中,通常会看到这样的机密配置: ssl.key.password=test1234 通用安全实践规定,机密不应该以明文形式存储在配置文件中,也不应体现在应用日志的输出中,以防止机密无意泄漏。Confluent平台提供了机密保护功能,它利用了信封加密,这是一种通过高度安全的方法保护加密机密的行业标准。 应用此功能将导致配置文件中包含用于ConfigProvider获取机密值而非实际明文值的指令: ssl.key.password=${securepass:secrets.file:server.properties/ssl.key.password} 可监测性 监测安全事件和服务指标并对之做出反应有助于维护可靠和安全的集群。服务中断可能是由于配置错误、应用有故障等原因导致,Confluent平台提供了相关的核心功能,使运维人员可以监控平台内发生的事件。 审计日志 Kafka没有直接提供维护授权决定记录的机制,运维人员需要从Broker那里捕获和解析非结构化的日志,以便建立有关ACL决策的监测结果。 Confluent平台通过结构化的审计日志对Kafka进行了补充,该日志提供了一种捕获、保护的机制,并将授权活动保存到主题中。具体来说,审计日志记录权限检查的运行时决策,这些权限检查是在用户/应用尝试执行受ACL和RBAC保护的操作时发生的。虽然消费者可能会无序地消费审计日志消息,但是可审计的事件是按时间顺序记录的。这些结构化事件使运维人员可以在其集群上实时调查可操作的安全事件。审计日志是使用CloudEvents构建的,CloudEvents是与供应商无关的规范,用于定义事件数据的模式,并可以与各种行业工具集成。 监控 监控和跟踪集群指标是监控异常(包括安全漏洞)的关键,在Kafka中可以配置JMX端口并实现自定义指标和监控解决方案,或者与各种第三方监控解决方案集成。 借助Confluent平台,监控功能可以直接在各个组件之间紧密集成。Confluent Metrics Reporter会收集来自Kafka Broker的各种指标然后将数据输出到Kafka主题。Confluent Metrics Reporter可以将数据输出到与其监测的集群不同的集群,从而减少生产集群上的操作负载。Confluent Metrics Reporter与Confluent Control Center集成在一起,可以提供多集群,仪表盘风格的视图。 Confluent Control Center是与RBAC集成的,后者使用户可以查看自己的权限,在拥有其他权限的情况下管理其他用户的角色绑定,并完全保持对关键运营指标的可见性,这简化了整个企业的安全管理。 Confluent Monitoring Interceptors是客户端插件,可捕获客户端性能统计信息并将其转发给Kafka主题。和Confluent Metrics Reporter一样,监控拦截器可以将这些记录转发到其他集群,以减少生产集群上的操作负载。Confluent Control Center与Confluent Monitoring Interceptors集成在一起,可以提供客户端状态以及Broker数据的完整视图。 报警 指标和数据是了解集群的运行状况和安全性的关键,但是如果不采取任何措施,它们就会失效。Confluent Control Center提供了报警功能,这是提高集群状态感知能力的关键。报警是通过定义触发器和动作来工作的,触发器是与条件配对的指标,这些条件定义了何时应触发触发器。动作与触发器相关联,并定义触发触发器时发生的活动。操作可以与电子邮件,Slack或流行的PagerDuty事件响应平台集成。 数据治理 数据治理包括企业的策略和控制措施,以确保高可用和高质量的数据系统。数据系统中的消费端应用依赖于格式良好的数据记录和可靠的连接,Confluent平台扩展了Kafka,以在此领域提供增强的功能。 数据质量 Confluent Schema Validation通过为数据生产者强制执行模式合规性,从而提供记录级数据完整性。使用模式验证,如果无法从中央模式注册表中获得有效模式标识,就可以阻止生产者写入数据。这种策略通常称为写模式,除了保护数据完整性外,还使消费者应用免于在读取时验证模式的负担。为了构建灵活的系统,模式验证支持模式进化的概念,允许消费者和生产者跨版本进行通信。使用Confluent服务端,可以在Confluent Control Center或命令行中按主题启用模式验证: kafka-topics --create --bootstrap-server localhost:9092 --replication-factor 1 --partitions 1 --topic test-validation-true --config confluent.value.schema.validation=true 在Confluent平台5.5版本中,现在支持Protobuf和JSON Schema格式,以及现有的Apache Avro™支持,模式验证完全支持这些新格式。 配额 客户端应用可能以很高的速率生产或消费数据,从而占满了集群资源,从而导致剩余客户端资源不足。Kafka配额通过限制有问题的应用的资源利用率来为所有客户端提供资源保护。当Broker检测到超过配额时,会试图通过引入人为延迟以使违规客户端低于阈值来减慢他的速度,这些配置可以保护集群避免遇到流量高峰的客户端带来的资源不足。在Broker级别设置的默认配额还可以保护Broker免受恶意客户端的拒绝服务攻击。可以向下面这样在Broker中配置默认​​配额,它将默认的生产者和消费者速率设置为10MBps: quota.producer.default=10485760 quota.consumer.default=10485760 在集群运行时,可以为每个客户端ID或用户分配自定义配额。下面的示例将客户端clientA的生产者和消费者速率阈值分别设置为1KB和2KB: bin/kafka-configs --bootstrap-server localhost:9092 --alter --add-config 'producer_byte_rate=1024,consumer_byte_rate=2048' --entity-name clientA --entity-type clients 合规性 许多行业要求政府强制执行其他法规。Confluent平台支持HIPAA和SSAE 18 SOC2合规性认证,Confluent Cloud支持GDPR,ISO 27001,PCI 2级,SOC 1、2和3标准,并且Confluent Cloud企业版还支持HIPAA合规性。

优秀的个人博客,低调大师

每日一博 | 不可忽视的 Dubbo 线程池

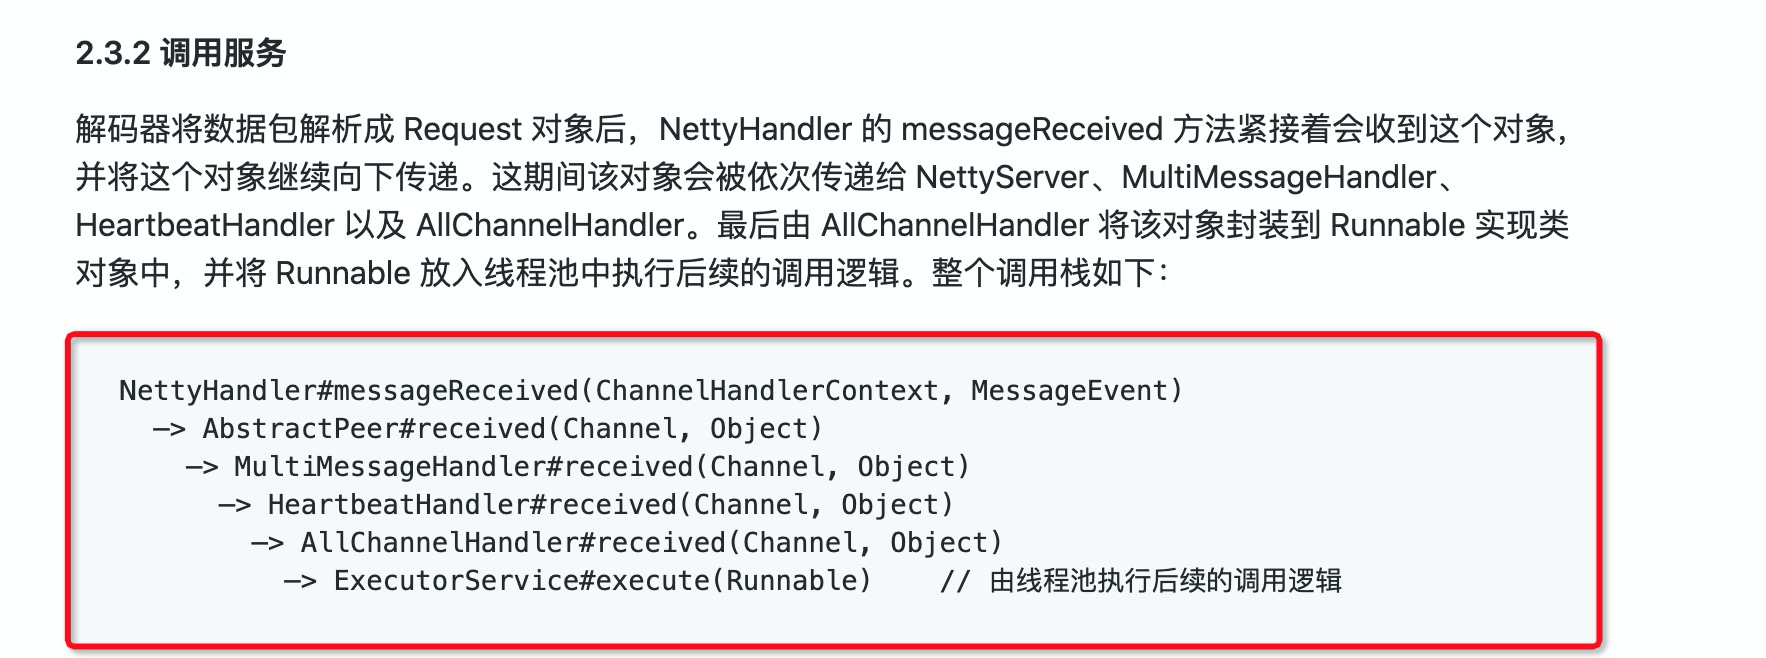
问题描述 线上突然出现Dubbo超时调用,时间刚好为Consumer端设置的超时时间。 有好几个不同的接口都报超时了 第1次调用超时,第2次(或第3次)重试调用非常快(正常水平) Dubbo调用超时的情况集中出现了3次,每次都是过一会自动恢复 排查 排查日志 看到调用超时,首先就拿着traceId去服务提供方查日志。 奇怪的是,在服务提供方的业务日志里面,只有正常的调用日志(耗时正常),没有超时调用的日志。 从正常的调用日志里面看,一切都是正常的,看不出所以然。 给人的感觉就是超时那次请求的调用没有达到服务提供方。 此时系统活动情况 通过系统历史监控,我们发现除了gc比平时稍微高一点外(也在正常水位),没有其他的异常;CPU、内存、网络等指标都在正常范围。 查看Dubbo线程活动情况 第2次系统集中超时报警的做的第一件事就是登录到那台服务器查看dubbo线程活动情况:看下能不能找到阻塞在哪一行代码。很遗憾,所有的dubbo线程都没有阻塞,都是正常的WAITING状态。 并没有明显表明阻塞在某段代码,这可难倒我们了:如果没有阻塞的话,为什么dubbo调用方会报超时?继续看代码 该接口是否存在阻塞的代码? 硬着头皮重新看代码每一个分支,突然发现底层的一个方法中有http调用!会不会是这个http调用导致的超时?如果是的话,那么不同的接口调用超时的情况就说的通了,因为上层大部分接口都会调用这个底层方法。 怀揣着激动的心,仔细看了http调用的逻辑:用的是JDK提供的HttpURLConnection,其中只用了HttpURLConnection#getContentLength方法,并且也在finally代码块中将这个连接关闭了。好像也不是这个引起的,起初还以为getContentLength会把文件给下载下来,但是看了接口文档以后发现只会去读头信息中的ContentLength。 /** * Returns the value of the {@code content-length} header field. * <p> * <b>Note</b>: {@link #getContentLengthLong() getContentLengthLong()} * should be preferred over this method, since it returns a {@code long} * instead and is therefore more portable.</p> * * @return the content length of the resource that this connection's URL * references, {@code -1} if the content length is not known, * or if the content length is greater than Integer.MAX_VALUE. */ public int getContentLength() { long l = getContentLengthLong(); if (l &gt; Integer.MAX_VALUE) return -1; return (int) l; } 代码阻塞的情况可能性也不大,因为重试请求不会超时:如果代码阻塞,那么重试请求大概率也会超时。 数据访问层是否有异常情况 既然代码没有阻塞,那么有没有可能是数据访问层的异常造成的呢?毕竟不止一个接口存在超时的问题,如果是底层数据访问层的异常导致,那么也说得通。 重点排查了mysql,但结果是令人失望的:并没有慢SQL;并且dubbo超时期间,mysql实例的CPU和内存水位都是正常的。 除了mysql、redis实例本身指标正常外,基于上面同样的理由:如果数据访问层有问题,那么重试基本上也会超时。所以数据访问层导致超时的线索也被排除。 有没有可能是Dubbo层面的问题 排查再次陷入僵局,逼迫着我们重新梳理排查思路: 除了代码阻塞 除了数据访问层异常 除了超时请求,其他请求的日志都是正常的 那么还有可能会导致超时呢?会不会是Dubbo本身异常导致的? 此时有一个关键的线索进入我们的视野:超时的那次请求去哪儿了? 在服务提供方的日志里面没有超时请求的的日志,只有重试请求成功的业务日志。太奇怪了,就算超时总的留下日志的吧,日志都不留,欺负我胖虎吗?! 到这里想到超时的请求可能是一个突破口,于是开始看Dubbo的相关的源码和文档。 从官方文档中的服务端调用链一层层往下查 在AllChannelHandler源码中看到了令人兴奋的注释: 兴奋之余,为了避免理解偏差,还特地用百度翻译了一下 没错,如果线程池已经满了,那么服务端不会返回,直到客户端超时!这不是正式我们碰到的问题吗?! 并且此时还没有进入业务代码,所以没有打印业务日志,这样就可以解释为什么没有服务提供方没有超时请求的日志了。 别激动,这里明明有返回threadpool is exhausted异常信息,怎么能说没有返回呢? 别急,这是另外一个项目引用的dubbo,版本是2.6.2。 回到出问题的那个项目,查看dubbo版本:2.8.6,查看AllChannelHandler源码:是的在2.8.6版本中,并没有返回这个错误 问题好像找到了,OK,剩下的就是验证了。 验证 准备 将DubboServerHandler线程池的最大线程数调到5 使用Apache Bench进行压测:200请求、并发10个线程 case1:复现问题 Dubbo使用2.8.6版本 预期:部分请求超时报错,重试耗时正常 压测结果符合预期:部分接口报错超时,并且重试请求耗时正常 case2:验证猜想 Dubbo使用2.6.2版本 预期:部分请求报错线程池耗尽threadpool is exhausted,并且重试大概率也会报该错误 压测结果符合预期 至此,基本判定线上Dubbo调用超时的问题就是因为线程池耗尽引起的。 这个超时问题前前后后查了一周左右,排查过程中试了很多排查方向,为了叙述方便就没有展开。 避坑指南 合理设置Dubbo线程池大小。默认是200 合理设置超时时间。如果真出现了Dubbo调用超时的情况,合理的超时时间能够避免服务调用方被打爆 Dubbo接口必须有返回值。从AllChannelHandler#received的源码和注释中可以看到只有有返回值的接口才会返回线程池耗尽的错误信息;其它的情况则不会将错误信息返回给调用方,直到调用方超时。

优秀的个人博客,低调大师

每日一博 | Redis 集群演进探讨和总结

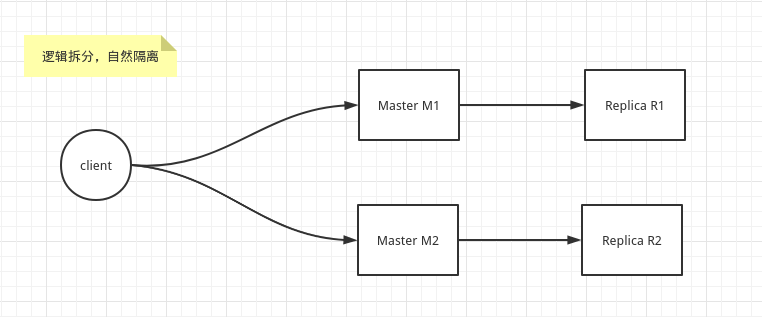
Redis为什么需要集群? 首先Redis单实例主要有单点,容量有限,流量压力上限的问题。 Redis单点故障,可以通过主从复制replication,和自动故障转移sentinel哨兵机制。 但Redis单Master实例提供读写服务,仍然有容量和压力问题,因此需要数据分区,构建多个Master实例同时提供读写服务(不仅限于从replica节点提供读服务)。 那么就需要一定的机制保证数据分区。这样能充分把容量分摊到多台计算机,或能充分利用多核计算机的性能。 并且数据在各个主Master节点间不能混乱,当然最好还能支持在线数据热迁移的特性。 探讨数据分区方案 针对数据分区,一般来说,分为两个大类: 逻辑拆分: 逻辑上能拆分,比如 Redis 中的 M1 节点 存储 A服务需要的业务数据,而 Redis 中的 M2 节点存储 B服务需要的业务数据。 数据分区: 当逻辑上不能拆分,那么只能按数据来拆分,需要保证客户端读和写数据一致。 因此需要一个高效快速的数据结构来路由对应的Master节点。 最容易想到的就是类比 Java 中的 HashMap, 采用 哈希算法,快速找到,快速设置。 这里有四种方式,分别是固定取模,随机,哈希一致性,哈希槽。 固定取模 假设有三个 Master,配置IP 和权重如下: Real Server IP weight 10.0.2.21 1 10.0.2.22 2 10.0.2.23 3 那么会根据每一个real Server 及其权重虚拟出对应权重 weight 个的虚拟vritual server节点,映射关系会是: Real Server IP virtual server 10.0.2.21 1 10.0.2.22 2,3 10.0.2.23 4,5,6 一个 key 存储在那个虚拟vritual server节点,通过哈希hash算法: virtual_server_index = hash(key) % (total_virtual_weight) 假设某个key,它的 hash 值是 10,那么以上: 10%6=4,将落到 10.0.2.23 这个真实的 Master上。 缺点 因为取模的模数是固定的,当新增或删除 master节点时,所有的数据几乎要全部洗牌,几乎需要重新迁移数据(而且相当麻烦),无法做到在线数据热迁移。 意味着Redis在此种用法下,只能当缓存,不能当存储数据库! 随机 随机选取一个存储和访问。 一般结合 list,用于非顺序性要求的消息队列场景。 缺点: 使用场景比较单一。 并且由于随机性问题,导致持久化存在不可靠性。Redis在此种用法下,也只能当缓存,不能当存储数据库! 一致性哈希 一致性哈希算法(Consistent Hashing)最早在论文《Consistent Hashing and Random Trees: Distributed Caching Protocols for Relieving Hot Spots on the World Wide Web》中被提出。 简单来说,一致性哈希将整个哈希值空间组织成一个虚拟的圆环,如假设某哈希函数H的值空间为0-2^32-1(即哈希值是一个32位无符号整形),整个哈希空间环如下: 1.有一个HASH环,环上每个节点都是一个自然数,从0开始顺时针递增,直到2^32-1,最后回到0 2.真实节点 M1 M2 M3 通过 hash(IP 或主机名)确定在哈希环上的位置 3.当客户端请求时,首先 hash(key) 确定在哈希环上的位置,然后顺时针往后找,找到的第一个真实节点,就是客户端需要请求访问的真实主机 优点: 哈希一致性其实是对固定取模的一种优化。 (1)扩展性:当增加节点时,只会影响顺时针的真实节点(此部分数据比较难迁移),而不是影响全部的节点。 (2)容错性:当节点宕机或删除节点时,只会影响逆时针的真实节点,而不是影响全部的节点。 (3)平衡性:当哈希算法的节点过少时,会可能造成某些服务器的数据存储较多,而另外一些存储较少,造成数据倾斜,当节点足够多时,这种现象得以缓解。 因此虚拟节点个数较大的时候,数据的平衡性得以保证。 缺点: 因为当增删节点时,需要重新计算受影响部分的节点中的key全部找出来,才能迁移,这个很麻烦!!! Redis在此种用法下,也只能当缓存,不能当存储数据库! 哈希槽(PreSharding) 这个跟哈希一致性很相似。 区别在于,它预先分配好真实节点管理的哈希槽(slot),并存储管理起来,我们可以预先知道哪个master主机拥有哪些哈希槽(slot),这里总数是16384。 127.0.0.1:7001> cluster nodes 2aaf59558f1b9f493a946a695e51711eb03d15f9 127.0.0.1:7002@17002 master - 0 1590126183862 2 connected 5461-10922 6439c3e9468fd2c545a63b3b9bfe658c5fc14287 127.0.0.1:7003@17003 master - 0 1590126181856 3 connected 10923-16383 340d985880c23de9816226dff5fd903322e44313 127.0.0.1:7001@17001 myself,master - 0 1590126182000 1 connected 0-5460 我们可以清晰看到Redis Cluster中的每一个master节点管理的哈希槽。 比如 127.0.0.1:7001 拥有哈希槽 0-5460, 127.0.0.1:7002 拥有哈希槽 5461-10922, 127.0.0.1:7003 拥有哈希槽 10923-16383。 ➜ redis-cli -p 7001 127.0.0.1:7001> set a 1 (error) MOVED 15495 127.0.0.1:7003 ➜ redis-cli -p 7001 -c 127.0.0.1:7001> set a 1 -> Redirected to slot [15495] located at 127.0.0.1:7003 OK 我们看到的是master节点在 Redis Cluster中的实现时,都存有所有的路由信息。 当客户端的key 经过hash运算,发送slot 槽位不在本节点的时候。 (1)如果是非集群方式连接,则直接报告错误给client,告诉它应该访问集群中那个IP的master主机。 (2)如果是集群方式连接,则将客户端重定向到正确的节点上。 注意这里并不是127.0.0.1:7001 帮client去连接127.0.0.1:7003获取数据的,而是将客户端请求重定向了。 优点: 继承并增强一致性哈希的容错性,扩展性,以及平衡性。 Redis在此种用法下,可以当缓存,也能当存储数据库! 这里Redis给出更详细的说明:https://redis.io/topics/partitioning 具体方案 以下列表为按照出现的先后顺序排列: 方案 描述 数据分区支持策略 分布式 在线数据热迁移 twemproxy twitter 开源的redis代理中间件,不修改redis源码 https://github.com/twitter/twemproxy 存在modula(固定取模)、 random (随机)、ketama(哈希一致性)三种可选的配置 本身是单点的,可以通过keepalived等保证高可用 不支持,无法平滑地扩容/缩容 Redis Cluster 官方提供的集群方案 采用预先分片(PreSharding),即哈希槽方式,存储在每一个master节点上 没有proxy代理层,客户端可以连接集群中的任意master节点 提供客户端命令redis-cli --cluster reshard ip port按哈希槽迁移指定节点的数据 codis 豌豆荚开源的redis代理中间件,修改了redis源码 https://github.com/CodisLabs/codis 采用预先分片(PreSharding),即哈希槽方式,存储在ZooKeeper上 集群部署,部署相对复杂 支持数据热迁移 Redis Cluster :一般生产环境量不大,且采用 Spring 提供的 RedisTemplate 之类封装好的 fat client ,可以采用 redis6.0后,官方也推出Redis Cluster的proxy方案 (https://github.com/RedisLabs/redis-cluster-proxy),只是尚为新,且处于beta阶段(2020.5处于1.0beta版本),不成熟。但未来可期,毕竟是官方支持的。) 目前如果生产环境量大,但尚无研发能力,可以选用 codis @SvenAugustus(https://www.flysium.xyz/) 更多请关注微信公众号【编程不离宗】,专注于分享服务器开发与编程相关的技术干货:

优秀的个人博客,低调大师

每日一博 | 自己动手写 SQL 执行引擎

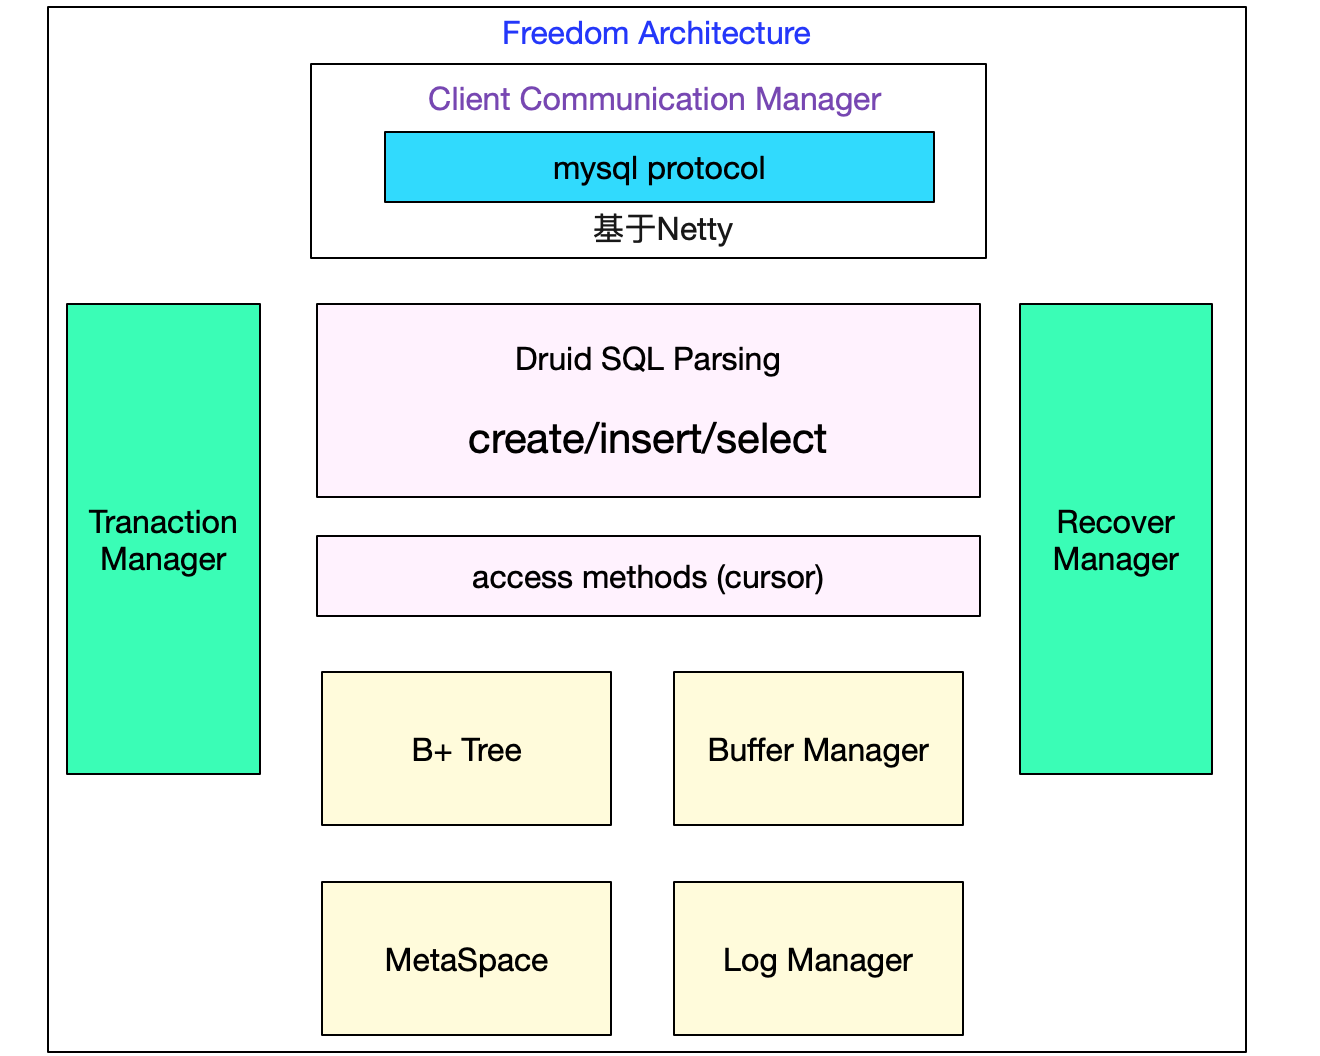
自己动手写SQL执行引擎 前言 在阅读了大量关于数据库的资料后,笔者情不自禁产生了一个造数据库轮子的想法。来验证一下自己对于数据库底层原理的掌握是否牢靠。在笔者的github中给这个database起名为Freedom。 整体结构 既然造轮子,那当然得从前端的网络协议交互到后端的文件存储全部给撸一遍。下面是Freedom实现的整体结构,里面包含了实现的大致模块: 最终存储结构当然是使用经典的B+树结构。当然在B+树和文件系统block块之间的转换则通过Buffer(Page) Manager来进行。当然了,为了完成事务,还必须要用WAL协议,其通过Log Manager来操作。 Freedom采用的是索引组织表,通过DruidSQL Parse来将sql翻译为对应的索引操作符进而进行对应的语义操作。 MySQL Protocol结构 client/server之间的交互采用的是MySQL协议,这样很容易就可以和mysql client以及jdbc进行交互了。 query packet mysql通过3byte的定长包头去进行分包,进而解决tcp流的读取问题。再通过一个sequenceId来再应用层判断packet是否连续。 result set packet mysql协议部分最复杂的内容是其对于result set的读取,在NIO的方式下加重了复杂性。 Freedom通过设置一系列的读取状态可以比较好的在Netty框架下解决这一问题。 row packet 还有一个较简单的是对row格式进行读取,如上图所示,只需要按部就班的解析即可。 由于协议解析部分较为简单,在这里就不再赘述。 SQL Parse Freedom采用成熟好用的Druid SQL Parse作为解析器。事实上,解析sql就是将用文本表示 的sql语义表示为一系列操作符(这里限于篇幅原因,仅仅给出select中where过滤的原理)。 对where的处理 例如where后面的谓词就可以表示为一系列的以树状结构组织的SQL表达式,如下图所示: 当access层通过游标提供一系列row后,就可以通过这个树状表达式来过滤出符合where要求的数据。Druid采用了Parse中常用的visitor很方便的处理上面的表达式计算操作。 对join的处理 对join最简单处理方案就是对两张表进行笛卡尔积,然后通过上面的where condition进行过滤,如下图所示: Freedom对于缩小笛卡尔积的处理 由于Freedom采用的是B+树作为底层存储结构,所以可以通过where谓词来界定B+树scan(搜索)的范围(也即最大搜索key和最小搜索key在B+树种中的位置)。考虑sql select a.*,b.* from t_archer as a join t_rider as b where a.id>=3 and a.id<=11 b.id and b.id>=19 b.id<=31 那么就可以界定出在id这个索引上,a的scan范围为[3,11],如下图所示: b的scan范围为[19,31],如下图所示(假设两张表数据一样,便于绘图): scan少了从原来的15*15(一共15个元素)次循环减少到4*4次循环,即循环次数减少到7.1% 当然如果存在join condition的话,那么Freedom在底层cursor递归处理的过程中会预先过滤掉一部分数据,进一步减少上层的过滤。 B+Tree的磁盘结构 leaf磁盘结构 Freedom的B+Tree是存储到磁盘里的。考虑到存储的限制以及不定长的key值,所以会变得非常复杂。Freedom以page为单位来和磁盘进行交互。叶子节点和非叶子节点都由page承载并刷入磁盘。结构如下所示: 一个元组(tuple/item)在一个page中分为定长的ItemPointer和不定长的Item两部分。 其中ItemPointer里面存储了对应item的起始偏移和长度。同时ItemPointer和Item如图所示是向着中心方向进行伸张,这种结构很有效的组织了非定长Item。 leaf和node节点在Page中的不同 虽然leaf和node在page中组织结构一致,但其item包含的项确有区别。由于Freedom采用的是索引组织表,所以对于leaf在聚簇索引(clusterIndex)和二级索引(secondaryIndex)中对item的表示也有区别,如下图所示: 其中在二级索引搜索时通过secondaryIndex通过index-key找到对应的clusterId,再通过 clusterId在clusterIndex中找到对应的row记录。 由于要落盘,所以Freedom在node节点中的item里面写入了index-key对应的pageno, 这样就可以容易的从磁盘恢复所有的索引结构了。 B+Tree在文件中的组织 有了Page结构,我们就可以将数据承载在一个个page大小的内存里面,同时还可以将page刷新到对应的文件里。有了node.item中的pageno,我们就可以较容易的进行文件和内存结构之间的互相映射了。 B+树在磁盘文件中的组织如下图所示: B+树在内存中相对应的映射结构如下图所示: 文件page和内存page中的内容基本是一致的,除了一些内存page中特有的字段,例如dirty等。 每个索引一个B+树 在Freedom中,每个索引都是一颗B+树,对记录的插入和修改都要对所有的B+树进行操作。 B+Tree的测试 笔者通过一系列测试case,例如随机变长记录对B+树进行插入并落盘,修复了其中若干个非常诡异的corner case。 B+Tree的todo 笔者这里只是完成了最简单的B+树结构,没有给其添加并发修改的锁机制,也没有在B+树做操作的时候记录log来保证B+树在宕机等灾难性情况下的一致性,所以就算完成了这么多的工作量,距离一个高并发高可用的bptree还有非常大的距离。 Meta Data table的元信息由create table所创建。创建之后会将元信息落盘,以便Freedom在重启的时候加载表信息。每张表的元信息只占用一页的空间,依旧复用page结构,主要保存的是聚簇索引和二级索引的信息。元信息对应的Item如下图所示: 如果想让mybatis可以自动生成关于Freedom的代码,还需实现一些特定的sql来展现Freedom的元信息。这个在笔者另一个项目rider中有这样的实现。原理如下图所示: 实现了上述4类SQL之后,mybatis-generator就可以通过jdbc从Freedom获取元信息进而自动生成代码了。 事务支持 由于当前Freedom并没有保证并发,所以对于事务的支持只做了最简单的WAL协议。通过记录redo/undolog从而实现原子性。 redo/undo log协议格式 Freedom在每做一个修改操作时,都会生成一条日志,其中记录了修改前(undo)和修改后(redo)的行信息,redo用来回滚,redo用来宕机recover。结构如下图所示: WAL协议 WAL协议很好理解,就是在事务commit前将当前事务中所产生的的所有log记录刷入磁盘。 Freedom自然也做了这个操作,使得可以在宕机后通过log恢复出所有的数据。 回滚的实现 由于日志中记录了undo,所以对于一个事务的回滚直接通过日志进行undo即可。如下图所示: 宕机恢复 Freedom如果在page全部刷盘之后关机,则可以由通过加载page的方式获取原来的数据。 但如果突然宕机,例如kill -9之后,则可以通过WAL协议中记录的redo/undo log来重新 恢复所有的数据。由于时间和精力所限,笔者并没有实现基于LSN的检查点机制。 Freedom运行 git clone https://github.com/alchemystar/Freedom.git // 并没有做打包部署的工作,所以最简单的方法是在java编辑器里面 run alchemystar.freedom.engine.server.main 以下是笔者实际运行Freedom的例子: join查询 delete回滚 Freedom todo Freedom还有很多工作没有完成,例如有层次的锁机制和MVCC等,由于工作忙起来就耽搁了。 于是笔者就看了看MySQL源码的实现理解了一下锁和MVCC实现原理,并写了两篇博客。比起 自己动手撸实在是轻松太多了^_^。 MVCC https://my.oschina.net/alchemystar/blog/1927425 二阶段锁 https://my.oschina.net/alchemystar/blog/1438839 尾声 在造轮子的过程中一开始是非常有激情非常快乐的。但随着系统越来越庞大,复杂性越来越高,进度就会越来越慢,还时不时要推翻自己原来的设想并重新设计,然后再协同修改关联的所有代码,就如同泥沼,越陷越深。至此,笔者才领悟了软件工程最重要的其实是控制复杂度!始终保持简洁的接口和优雅的设计是实现一个大型系统的必要条件。 收获与遗憾 这次造轮子的过程基本满足了笔者的初衷,通过写一个数据库来学习数据库。不仅仅是加深了理解,最重要的是笔者在写的过程中终于明白了数据库为什么要这么设计,为什么不那样设计,仅仅对书本的阅读可能并不会有这些思考与领悟。 当然,还是有很多遗憾的,Freedom并没有实现锁机制和MVCC。由于只能在工作闲暇时间写,所以断断续续写了一两个月,工作一忙就将这个项目闲置了。现在将Freedom的设计写出来,希望大家能有所收获。 学习MySQL视频课程 github链接 https://github.com/alchemystar/Freedom 码云链接 https://gitee.com/alchemystar/Freedom

优秀的个人博客,低调大师

每日一博 | 大规格文件的上传优化

作者:凹凸曼 - TJ 在开发过程中,收到这样一个问题反馈,在网站上传 100 MB 以上的文件经常失败,重试也要等老半天,这就难为需要上传大规格文件的用户了。那么应该怎么做才能快速上传,就算失败了再次发送也能从上次中断的地方继续上传呢?下文为你揭晓答案~ 温馨提示:配合 Demo 源码一起阅读效果更佳 整体思路 第一步是结合项目背景,调研比较优化的解决方案。 文件上传失败是老生常谈的问题,常用方案是将一个大文件切片成多个小文件,并行请求接口进行上传,所有请求得到响应后,在服务器端合并所有的分片文件。当分片上传失败,可以在重新上传时进行判断,只上传上次失败的部分,减少用户的等待时间,缓解服务器压力。这就是分片上传文件。 大文件上传 那么如何实现大文件分片上传呢? 流程图如下: 分为以下步骤实现: 1. 文件 MD5 加密 MD5 是文件的唯一标识,可以利用文件的 MD5 查询文件的上传状态。 根据文件的修改时间、文件名称、最后修改时间等信息,通过 spark-md5 生成文件的 MD5。需要注意的是,大规格文件需要分片读取文件,将读取的文件内容添加到 spark-md5 的 hash 计算中,直到文件读取完毕,最后返回最终的 hash 码到 callback 回调函数里面。这里可以根据需要添加文件读取的进度条。 实现方法如下: // 修改时间+文件名称+最后修改时间-->MD5 md5File (file) { return new Promise((resolve, reject) => { let blobSlice = File.prototype.slice || File.prototype.mozSlice || File.prototype.webkitSlice let chunkSize = file.size / 100 let chunks = 100 let currentChunk = 0 let spark = new SparkMD5.ArrayBuffer() let fileReader = new FileReader() fileReader.onload = function (e) { console.log('read chunk nr', currentChunk + 1, 'of', chunks) spark.append(e.target.result) // Append array buffer currentChunk++ if (currentChunk < chunks) { loadNext() } else { let cur = +new Date() console.log('finished loading') // alert(spark.end() + '---' + (cur - pre)); // Compute hash let result = spark.end() resolve(result) } } fileReader.onerror = function (err) { console.warn('oops, something went wrong.') reject(err) } function loadNext () { let start = currentChunk * chunkSize let end = start + chunkSize >= file.size ? file.size : start + chunkSize fileReader.readAsArrayBuffer(blobSlice.call(file, start, end)) } loadNext() }) } 2. 查询文件状态 前端得到文件的 MD5 后,从后台查询是否存在名称为 MD5 的文件夹,如果存在,列出文件夹下所有文件,得到已上传的切片列表,如果不存在,则已上传的切片列表为空。 // 校验文件的MD5 checkFileMD5 (file, fileName, fileMd5Value, onError) { const fileSize = file.size const { chunkSize, uploadProgress } = this this.chunks = Math.ceil(fileSize / chunkSize) return new Promise(async (resolve, reject) => { const params = { fileName: fileName, fileMd5Value: fileMd5Value, } const { ok, data } = await services.checkFile(params) if (ok) { this.hasUploaded = data.chunkList.length uploadProgress(file) resolve(data) } else { reject(ok) onError() } }) } 3. 文件分片 文件上传优化的核心就是文件分片,Blob 对象中的 slice 方法可以对文件进行切割,File 对象是继承 Blob 对象的,因此 File 对象也有 slice 方法。 定义每一个分片文件的大小变量为 chunkSize,通过文件大小 FileSize 和分片大小 chunkSize 得到分片数量 chunks,使用 for 循环和 file.slice() 方法对文件进行分片,序号为 0 - n,和已上传的切片列表做比对,得到所有未上传的分片,push 到请求列表 requestList。 async checkAndUploadChunk (file, fileMd5Value, chunkList) { let { chunks, upload } = this const requestList = [] for (let i = 0; i < chunks; i++) { let exit = chunkList.indexOf(i + '') > -1 // 如果已经存在, 则不用再上传当前块 if (!exit) { requestList.push(upload(i, fileMd5Value, file)) } } console.log({ requestList }) const result = requestList.length > 0 ? await Promise.all(requestList) .then(result => { console.log({ result }) return result.every(i => i.ok) }) .catch(err => { return err }) : true console.log({ result }) return result === true } 4. 上传分片 调用 Promise.all 并发上传所有的切片,将切片序号、切片文件、文件 MD5 传给后台。 后台接收到上传请求后,首先查看名称为文件 MD5 的文件夹是否存在,不存在则创建文件夹,然后通过 fs-extra 的 rename 方法,将切片从临时路径移动切片文件夹中,结果如下: 当全部分片上传成功,通知服务端进行合并,当有一个分片上传失败时,提示“上传失败”。在重新上传时,通过文件 MD5 得到文件的上传状态,当服务器已经有该 MD5 对应的切片时,代表该切片已经上传过,无需再次上传,当服务器找不到该 MD5 对应的切片时,代表该切片需要上传,用户只需上传这部分切片,就可以完整上传整个文件,这就是文件的断点续传。 // 上传chunk upload (i, fileMd5Value, file) { const { uploadProgress, chunks } = this return new Promise((resolve, reject) => { let { chunkSize } = this // 构造一个表单,FormData是HTML5新增的 let end = (i + 1) * chunkSize >= file.size ? file.size : (i + 1) * chunkSize let form = new FormData() form.append('data', file.slice(i * chunkSize, end)) // file对象的slice方法用于切出文件的一部分 form.append('total', chunks) // 总片数 form.append('index', i) // 当前是第几片 form.append('fileMd5Value', fileMd5Value) services .uploadLarge(form) .then(data => { if (data.ok) { this.hasUploaded++ uploadProgress(file) } console.log({ data }) resolve(data) }) .catch(err => { reject(err) }) }) } 5. 上传进度 虽然分片批量上传比大文件单次上传会快很多,也还是有一段加载时间,这时应该加上上传进度的提示,实时显示文件上传进度。 原生 Javascript 的 XMLHttpRequest 有提供 progress 事件,这个事件会返回文件已上传的大小和总大小。项目使用 axios 对 ajax 进行封装,可以在 config 中增加 onUploadProgress 方法,监听文件上传进度。 const config = { onUploadProgress: progressEvent => { var complete = (progressEvent.loaded / progressEvent.total * 100 | 0) + '%' } } services.uploadChunk(form, config) 6. 合并分片 上传完所有文件分片后,前端主动通知服务端进行合并,服务端接受到这个请求时主动合并切片,通过文件 MD5 在服务器的文件上传路径中找到同名文件夹。从上文可知,文件分片是按照分片序号命名的,而分片上传接口是异步的,无法保证服务器接收到的切片是按照请求顺序拼接。所以应该在合并文件夹里的分片文件前,根据文件名进行排序,然后再通过 concat-files 合并分片文件,得到用户上传的文件。至此大文件上传就完成了。 Node 端代码: // 合并文件 exports.merge = { validate: { query: { fileName: Joi.string() .trim() .required() .description('文件名称'), md5: Joi.string() .trim() .required() .description('文件md5'), size: Joi.string() .trim() .required() .description('文件大小'), }, }, permission: { roles: ['user'], }, async handler (ctx) { const { fileName, md5, size } = ctx.request.query let { name, base: filename, ext } = path.parse(fileName) const newFileName = randomFilename(name, ext) await mergeFiles(path.join(uploadDir, md5), uploadDir, newFileName, size) .then(async () => { const file = { key: newFileName, name: filename, mime_type: mime.getType(`${uploadDir}/${newFileName}`), ext, path: `${uploadDir}/${newFileName}`, provider: 'oss', size, owner: ctx.state.user.id, } const key = encodeURIComponent(file.key) .replace(/%/g, '') .slice(-100) file.url = await uploadLocalFileToOss(file.path, key) file.url = getFileUrl(file) const f = await File.create(omit(file, 'path')) const files = [] files.push(f) ctx.body = invokeMap(files, 'toJSON') }) .catch(() => { throw Boom.badData('大文件分片合并失败,请稍候重试~') }) }, } 总结 本文讲述了大规格文件上传优化的一些做法,总结为以下 4 点: Blob.slice 将文件切片,并发上传多个切片,所有切片上传后告知服务器合并,实现大文件分片上传; 原生 XMLHttpRequest 的 onprogress 对切片上传进度的监听,实时获取文件上传进度; spark-md5 根据文件内容算出文件 MD5,得到文件唯一标识,与文件上传状态绑定; 分片上传前通过文件 MD5 查询已上传切片列表,上传时只上传未上传过的切片,实现断点续传。 参照 Demo 源码 可快速上手上述功能,希望本文能对你有所帮助,感谢阅读 ❤️ 欢迎关注凹凸实验室博客:aotu.io 或者关注凹凸实验室公众号(AOTULabs),不定时推送文章:

优秀的个人博客,低调大师

每日一博 | 谈谈大数据的文件存储

上一次我们谈到了各种类型的数据库,今天我们来谈谈在大数据,尤其是Hadoop栈下的数据和文件的存储。 我们知道为了解决大数据的存储和处理问题,google最先设计了推出了Map/Reduce的算法,而hadoop就是Google的map/reduce的开源实现。Hadoop主要由分布式的文件系统HDFS(参考Google的GFS)和Map/Reduce计算这两块。但随着Spark等更强大的计算引擎的出现,很少再有人使用Hadoop的Map/Reduce来做计算了,但是对于海量数据/文件的存储,除了HDFS,还真没有更多更好的选择。所以我们就来看看在Hadoop下,文件存储的各种选项。 原始文本文件 首先,我们什么都不需要做,HDFS提供分布式的文件存储,那么我们就直接把原始的文本文件存储在HDFS上就好了。通常我们会使用诸如txt,csv,json,xml等文本格式的文件存储在HDFS上,然后由各种计算引擎加载,计算。 HDFS是按照块来存储文件的,缺省的设置一个块的大小是64M,那么假定我的文本文件是1G,它会被分成16个分区,由计算引擎(Spark,Map/Reduce)来并行的处理,计算。 使用文本格式的主要问题是: 占用空间大 处理时有额外的序列化反序列化的开销,例如把日志中的文本‘12’转化为数字的12 所以这里就引入了两个解决方案: 压缩。 压缩是使用计算资源来换取存储/IO的资源。因为压缩后的体积小,存储和传输的效率就变高了,当然,压缩和解压缩都会消耗系统的计算资源。常见的压缩算法有:snappy,gzip,bzip,LZO,zlib等 压缩方式 压缩效率 压缩速度 是否可分割 Gzip 中高 中 否 bzip2 高 慢 是 Snappy 低 快 否 LZO 低 快 是(但是要求建立索引) Zlib 低 快 是 使用二进制的序列化格式 使用二进制的序列化格式,本身就占存储空间比文本小,而且也有比较好的序列化和反序列化的支持。 支持压缩的SequenceFile 为了解决文本文件存储和传输效率不高的问题,Hadoop提供了SequenceFile格式, SequenceFile是Hadoop API 提供的一种二进制文件, 它将数据(Key/Value形式)序列化到文件中。这种二进制文件内部使用Hadoop 的标准的Writable 接口实现序列化和反序列化。 支持三种记录存储方式,无压缩,记录压缩和块压缩。SequenceFile只支持Java, SequenceFile一般用来作为小文件的容器使用, 防止小文件占用过多的NameNode内存空间来存储其在DataNode位置的元数据。 语言无关的序列化文件 SequenceFile虽然解决了本文文件的空间占用问题,但是它支持Java,而我们程序员都觉得PHP才是最好的语言,于是我们需要与语言无关的序列化文件格式。Facebook推出了thrift,用于实现跨语言提供服务和接口, 满足跨平台通信. 但是Thrift不支持分片, 且缺少MapReduce的原生支持。 Avro是一个语言无关的支持数据密集型的二进制文件格式和数据序列化的系统, 它的出现主要是为了解决Writables API缺少跨语言移植的缺陷。Avro将模式存储在文件头中, 所以每个文件都是自描述的, 而且Avro还支持模式演进(schema evolution), 也就是说, 读取文件的模式不需要与写入文件的模式严格匹配, 当有新需求时, 可以在模式中加入新的字段。Avro的文件格式更为紧凑,若要读取大量数据时, Avro能够提供更好的序列化和反序列化性能。Avro支持分片, 即使是进行Gzip压缩之后。 Avro是Hadoop的基于行的存储格式,已广泛用作序列化平台。Avro将模式Schema存储为JSON格式,使任何程序均可轻松读取和解释。数据本身以二进制格式存储,从而使其紧凑高效。Avro是与语言无关的数据序列化系统。 它可以由多种语言(当前为C,C ++,C#,Java,Python和Ruby)处理。Avro的一项关键功能是对数据架构的强大支持,该架构会随时间变化,即架构演变。 Avro处理架构更改,例如缺少字段,添加的字段和更改的字段。Avro提供了丰富的数据结构。 例如,您可以创建一个包含数组,枚举类型和子记录的记录。 这种格式是在数据湖着陆区中存储数据的理想选择,因为:1。 通常将从登陆区读取的数据整体读取,以供下游系统进行进一步处理(在这种情况下,基于行的格式更有效)2。 下游系统可以轻松地从文件中检索表模式(无需将Schema分别存储在外部元存储中)3。 任何源模式更改都易于处理(模式Schema演变)。 面向行/列的存储格式 之前的文件格式都是面向行的,同一行的数据存储在一起,即连续存储。采用这种方式,如果只需要访问行的一小部分数据,亦需要将整行读入内存,推迟序列化一定程度上可以缓解这个问题,但是从磁盘读取整行数据的开销却无法避免。面向行的存储适合于整行数据需要同时处理的情况。在大数据分析的场景下,我们常常对针对不同的列来做分析,大部分的分析计算,只会使用到少数的列,这个时候,行存储的效率就不高了,因为会读入并不需要的整行的数据。 为了解决行存储对分析应用效率不高的问题,程序猿们发明了面向列的存储格式。 RC文件 Hive的Record Columnar File(记录列文件),这种类型的文件首先将数据按行划分为行组,然后在行组内部将数据存储在列中。 它遵循“先按列划分,再垂直划分”的设计理念。当查询过程中,针对它并不关心的列时,它会在IO上跳过这些列。需要说明的是,RCFile在map阶段从 远端拷贝仍然是拷贝整个数据块,并且拷贝到本地目录后RCFile并不是真正直接跳过不需要的列,并跳到需要读取的列, 而是通过扫描每一个row group的头部定义来实现的,但是在整个HDFS Block 级别的头部并没有定义每个列从哪个row group起始到哪个row group结束。所以在读取所有列的情况下,RCFile的性能反而没有SequenceFile高。它的结构如下: ORC文件 ORC是一种专为Hadoop工作负载设计的自我描述类型感知列式文件格式。它针对大型流读取进行了优化,但具有集成支持,可快速查找所需的行。以列格式存储数据使阅读器仅可以读取,解压缩和处理当前查询所需的值。由于ORC文件可识别类型,因此编写器为该类型选择最合适的编码,并在写入文件时建立内部索引。 ORC文件格式提供了一种高效的数据存储方式。 提供了比RCFile更有效的文件格式。它旨在克服其他文件格式的限制。 它理想地存储紧凑的数据,并且无需大型,复杂或手动维护的索引就可以跳过不相关的部分。 ORC文件格式解决了所有这些问题。 ORC文件格式具有许多优点,例如: 一个文件作为每个任务的输出,从而减轻了NameNode的负担 支持Hive类型,包括DateTime,十进制和复杂类型(结构,列表,映射和联合) 使用单独的RecordReader并发读取同一文件 无需扫描标记即可分割文件的能力 根据文件页脚中的信息,估计读取器/写入器在堆内存分配上的上限。 使用协议缓冲区存储的元数据,允许添加和删除字段 Parquet文件 Apache Parquet是Hadoop生态系统中任何项目均可使用的列式存储格式,而与数据处理框架,数据模型或编程语言的选择无关。 Parquet的独特功能之一是它也可以以列形式存储具有嵌套结构的数据。 这意味着在Parquet文件格式中,即使嵌套字段也可以单独读取,而无需读取嵌套结构中的所有字段。 Parquet格式使用记录粉碎和组装算法以列形式存储嵌套结构。 要了解Hadoop中的Parquet文件格式,您应该注意以下术语: 行组:将数据逻辑地水平划分为行。 行组由数据集中每个列的列块组成。 列块:特定列的数据块。 这些列块位于特定的行组中,并保证在文件中是连续的。 页面:列块分为重新写回的页面。 这些页面共享一个公共标题,读应用可以跳过他们不感兴趣的页面。 Apache Arrow Apache Arrow是用于内存数据的跨语言开发平台。它为平面和分层数据指定了一种与语言无关的标准化列式存储格式,该格式组织用于在现代硬件上进行有效的分析操作。它还提供计算库和零复制流式消息传递和进程间通信。当前支持的语言包括C,C ++,C#,Go,Java,JavaScript,MATLAB,Python,R,Ruby和Rust。 简而言之,它促进了许多组件之间的通信,例如,使用Python Pandas 读取Parquet文件并转换为Spark数据框,Falcon Data Visualization或Cassandra,而无需担心转换。 Apache Arrow利用列缓冲区来减少IO并加快分析处理性能。 如上图所示,我们可以理解它是面向列的存储,但是实在内存内实现的。它可以用于优化在计算系统之间的数据交换。 CarbonData Apache CarbonData是带有多维索引的列式数据格式,用于在大数据平台上进行快速分析。 CarbonData是华为开源,将使您能够使用单个副本访问整个数据。 查询处理中的挑战是我们有不同类型的查询: OLAP查询和详细查询。 大扫描查询和小扫描查询:您可能有需要比较大扫描的查询,也可能有在较小区域内扫描的查询。 点查询:消耗大表的很少部分。 因此,统一的文件格式使您可以拥有不同类型的查询(导致不同类型的数据访问)。 CarbonData文件格式是基于列式存储的,并存储在HDFS之上;其包含了现有列式存储文件格式的许多优点,比如:可分割、可压缩、支持复杂数据类型等。CarbonData为了解决前面提到的几点要求,加入了许多独特的特性,主要概括为以下四点: (1)数据及索引:在有过滤的查询中,它可以显著地加速查询性能,减少I/O和CPU资源;CarbonData的索引由多级索引组成,计算引擎可以利用这些索引信息来减少调度和一些处理的开销;扫描数据的时候可以仅仅扫描更细粒度的单元(称为blocklet),而不再是扫描整个文件; (2)可操作的编码数据:通过支持高效的压缩和全局编码模式,它可以直接在压缩或者编码的数据上查询,仅仅在需要返回结果的时候才进行转换,更好的查询下推; (3)列组:支持列组,并且使用行格式进行存储,减少查询时行重建的开销; (4)多种使用场景:顺序存取、随机访问、类OLAP交互式查询等。 一个CarbonData文件是由一系列被称为blocklet组成的,除了blocklet,还有许多其他的元信息,比如模式、偏移量以及索引信息等,这些元信息是存储在CarbonData文件中的footer里。 当在内存中建立索引的时候都需要读取footer里面的信息,因为可以利用这些信息优化后续所有的查询。 每个blocklet又是由许多Data Chunks组成。Data Chunks里面的数据可以按列或者行的形式存储;数据既可以是单独的一列也可以是多列。文件中所有blocklets都包含相同数量和类型的Data Chunks。CarbonData文件格式如下图所示。 每个Data Chunk又是由许多被称为Pages的单元组成。总共有三种类型的pages: (1)Data Page:包含一列或者列组的编码数据; (2)Row ID Page:包含行id的映射,在Data Page以反向索引的形式存储时会被使用; (3)RLE Page:包含一些额外的元信息,只有在Data Page使用RLE编码的时候会被使用。 在一些给出的测试报告中,CarbonData的查询性能要优与Parquet和Orc (作为列村格式一起比较)。 CarbonData的问题是它对于Spark的依赖比较重。 Apache Kudu Apache Kudu是一种数据存储技术,可以对快速数据进行快速分析。 Cloudera启动了该项目,但它是完全开源的。 Kudu提供快速插入和更新功能以及快速搜索功能,以加快分析速度。 它位于带有Parquet的HBase和Impala之间,试图消除快速扫描和快速随机访问之间的折衷。 我们直到列存储对于分析优化,而HBase之类的数据库是对随机访问优化,Kudu希望在这两者中取得折衷,当然折衷的结果也可能是两者都不是最优。 像传统的关系数据库模型一样,Kudu需要在表上使用主键。 表具有列和原始数据类型,并支持更新。 如果要将关系数据库迁移到Hadoop集群,维护更新/删除可能是一个挑战。 这是由于"数据库"工具直接位于HDFS之上。 由于HDFS是一次写入的架构,因此更新行可能会很困难,因为您必须通过重写基础数据来复制此功能。 它不使用HDFS。 但是,它可以与HDFS在同一群集上共存。 您可以在Kudu常见问题解答页面上找到做出此设计决定的多种原因。 每个表必须具有一个唯一的主键。 这充当索引,以允许快速访问更新和删除。 表由平板电脑组成,就像分区一样。 平板电脑可跨多个节点复制,以实现弹性。 数据以列形式存储。 这意味着由于每个列中的所有数据都按顺序存储,因此列式聚合更快。 这也意味着可以更轻松地对数据进行矢量化和压缩,因为每列的所有数据都是同一类型。 尽管Kudu位于HDFS之外,但它仍然是Hadoop集群上的"好公民"。 它可以与HDFS节点共享数据磁盘,并且占用的内存很少。 它还允许您透明地将Kudu表与Hadoop中其他位置(包括HBase表)存储的数据连接在一起。 总结 在你的大数据应用中,文件存储是不可少的部分,如何选择最适合的存储格式是很重要的。 为了节省存储空间和I/O,你需要考虑支持压缩和二进制的序列化的格式,同时需要考虑是否有多语言和Schema的支持。这里Avro是不错的选择。 为了更好的支持分析类的查询,使用列存储格式例如Parquet,Orc。你也可以选择CarbonData和Apache Kudu Apache Arrow能有效的在计算系统之间交换数据 谢谢阅读,欢迎和我交流相关的话题。

优秀的个人博客,低调大师

每日一博 | 解 Bug 之路-中间件

前言 我们的分库分表中间件在线上运行了两年多,到目前为止还算稳定。在笔者将精力放在处理各种灾难性事件(例如中间件物理机宕机/数据库宕机/网络隔离等突发事件)时。竟然发现还有一些奇怪的corner case。现在就将排查思路写成文章分享出来。 Bug现场 应用拓扑 应用通过中间件连后端多个数据库,sql会根据路由规则路由到指定的节点,如下图所示: 错误现象 应用在做某些数据库操作时,会发现有比较大的概率失败。他们的代码逻辑是这样: int count = updateSql(sql1); ... // 伪代码 int count = updateSql("update test set value =1 where id in ("100","200") and status = 1; if( 0 == count ){ throw new RuntimeException("更新失败"); } ...... int count = updateSql(sql3); ... 即每做一次update之后都检查下是否更新成功,如果不成功则回滚并抛异常。 在实际测试的过程中,发现经常报错,更新为0。而实际那条sql确实是可以更新到的(即报错回滚后,我们手动执行sql可以执行并update count>0)。 中间件日志 笔者根据sql去中间件日志里面搜索。发现了非常奇怪的结果,日志如下: 2020-03-13 11:21:01:440 [NIOREACTOR-20-RW] frontIP=>ip1;sqlID=>12345678;rows=>0;sql=>update test set value =1 where id in ("1","2") and status = 1;start=>11:21:01:403;time=>24266; 2020-03-13 11:21:01:440 [NIOREACTOR-20-RW] frontIP=>ip1;sqlID=>12345678;rows=>2;sql=>update test set value =1 where id in ("1","2") and status = 1;start=>11:21:01:403;time=>24591; 由于中间件对每条sql都标识了唯一的一个sqlID,在日志表现看来就好像sql执行了两遍!由于sql中有一个in,很容易想到是否被拆成了两条执行了。如下图所示: 这条思路很快被笔者否决了,因为笔者explain并手动执行了一下,这条sql确实只路由到了一个节点。真正完全否决掉这条思路的是笔者在日志里面还发现,同样的SQL会打印三遍!即看上去像执行了三次,这就和仅仅只in了两个id的sql在思路上相矛盾了。 数据库日志 那到底数据真正执行了多少条呢?找DBA去捞一下其中的sql日志,由于线下环境没有日志切割,日志量巨大,搜索时间太慢。没办法,就按照现有的数据进行分析吧。 日志如何被触发 由于当前没有任何思路,于是笔者翻看中间件的代码,发现在update语句执行后,中间件会在收到mysql okay包后打印上述日志。如下图所示: 注意到所有出问题的update出问题的时候都是同一个NIOREACTOR线程先后打印了两条日志,所以笔者推断这两个okay大概率是同一个后端连接返回的。 什么情况会返回多个okay? 这个问题笔者思索了很久,因为在笔者的实际重新执行出问题的sql并debug时,永远只有一个okay返回。于是笔者联想到,我们中间件有个状态同步的部分,而这些状态同步是将set auto_commit=0等sql拼接到应用发送的sql前面。即变成如下所示: sql可能为 set auto_commit=0;set charset=gbk;>update test set value =1 where id in ("1","2") and status = 1; 于是笔者细细读了这部分的代码,发现处理的很好。其通过计算出前面拼接出的sql数量,再在接收okay包的时候进行递减,最后将真正执行的那条sql处理返回。其处理如下图所示: 但这里确给了笔者一个灵感,即一条sql文本确实是有可能返回多个okay包的。 真相大白 在笔者发现(sql1;sql2;)这样的拼接sql会返回多个okay包后,就立刻联想到,该不会业务自己写了这样的sql发给中间件,造成中间件的sql处理逻辑错乱吧。因为我们的中间件只有在对自己拼接(同步状态)的sql做处理,明显是无法处理应用传过来即为拼接sql的情况。 由于看上去有问题的那条sql并没有拼接,于是笔者凭借这条sql打印所在的reactor线程往上搜索,发现其上面真的有拼接sql! 2020-03-1311:21:01:040[NIOREACTOR-20RW]frontIP=>ip1;sqlID=>12345678;rows=>1; sql=>update test_2 set value =1 where id=1 and status = 1;update test_2 set value =1 where id=2 and status = 1; 如上图所示,(update1;update2)中update1的okay返回被驱动认为是所有的返回。然后应用立即发送了update3。前脚刚发送,update2的okay返回就回来了而其刚好是0,应用就报错了(要不是0,这个错乱逻辑还不会提前暴露)。那三条"重复执行"也很好解释了,就是之前的拼接sql会有三条。 为何是概率出现 但奇怪的是,并不是每次拼接sql都会造成update3"重复执行"的现象,按照笔者的推断应该前面只要是多条拼接sql就会必现才对。于是笔者翻了下jdbc驱动源码,发现其在发送命令之前会清理下接收buffer,如下所示: MysqlIO.java final Buffer sendCommand(......){ ...... // 清理接收buffer,会将残存的okay包清除掉 clearInputStream(); ...... send(this.sendPacket, this.sendPacket.getPosition()); ...... } 正是由于clearInputStream()使得错误非必现(暴露),如果okay(update2)在应用发送第三条sql前先到jdbc驱动会被驱动忽略! 让我们再看一下不会让update3"重复执行"的时序图: 即根据okay(update2)返回的快慢来决定是否暴露这个问题,如下图所示: 同时笔者观察日志,确实这种情况下"update1;update2"这条语句在中间件里面日志有两条。 临时解决方案 让业务开发不用这些拼接sql的写法后,再也没出过问题。 为什么不连中间件是okay的 业务开发这些sql是就在线上运行了好久,用了中间件后才出现问题。 既然不连中间件是okay的,那么jdbc必然有这方面的完善处理,笔者去翻了下mysql-connect-java(5.1.46)。由于jdbc里面存在大量的兼容细节处理,笔者这边只列出一些关键代码路径: MySQL JDBC 源码 MySQLIO stack; executeUpdate |->executeUpdateInternel |->executeInternal |->execSQL |->sqlQueryDirect |->readAllResults (MysqlIO.java) readAllResults: //核心在这个函数的处理里面 ResultSetImpl readAllResults(......){ ...... while (moreRowSetsExist) { ...... // 在返回okay包的保中其serverStatus字段中如果SERVER_MORE_RESULTS_EXISTS置位 // 表明还有更多的okay packet moreRowSetsExist = (this.serverStatus & SERVER_MORE_RESULTS_EXISTS) != 0; } ...... } 正确的处理流程如下图所示: 而我们中间件的源码确实这么处理的: @Override public void okResponse(byte[] data, BackendConnection conn) { ...... // 这边仅仅处理了autocommit的状态,没有处理SERVER_MORE_RESULTS_EXISTS // 所以导致了不兼容拼接sql的现象 ok.serverStatus = source.isAutocommit() ? 2 : 1; ok.write(source); ...... } select也"重复执行"了 解决完上面的问题后,笔者在日志里竟然发现select尽然也有重复的,这边并不会牵涉到okay包的处理,难道还有问题?日志如下所示: 2020-03-13 12:21:01:040[NIOREACTOR-20RW]frontIP=>ip1;sqlID=>12345678;rows=>1;select abc; 2020-03-13 12:21:01:045[NIOREACTOR-21RW]frontIP=>ip2;sqlID=>12345678;rows=>1;select abc; 从不同的REACTOR线程号(20RW/21RW)和不同的frontIP(ip1,ip2)来看是两个连接执行了同样的sql,但为何sqlID是一样的?任何一个诡异的现象都必须一查到底。于是笔者登录到应用上看了下应用日志,确实应用有两个不同的线程运行了同一条sql。 那肯定是中间件日志打印的问题了,笔者很快就想通了其中的关窍,我们中间件有个对同样sql缓存其路由节点结构体的功能(这样下一次同样sql就不必解析,降低了CPU),而sqlID信息正好也在那个路由节点结构体里面。如下图所示: 这个缓存功能感觉没啥用(因为线上基本是没有相同sql的),于是笔者在笔者优化的闪电模式下(大幅度提高中间件性能)将这个功能禁用掉了,没想到为了排查问题而开启的详细日志碰巧将这个功能开启了。 总结 任何系统都不能说百分之百稳定可靠,尤其是不能立flag。在线上运行了好几年的系统也是如此。只有对所有预料外的现象进行细致的追查与深入的分析并解决,才能让我们的系统越来越可靠。 公众号 关注笔者公众号,获取更多干货文章: 原文链接 https://my.oschina.net/alchemystar/blog/3208851

优秀的个人博客,低调大师

每日一博 | 进程无故消失的破案历程

概述 前段时间公司有个系统的进程老是无故退出,在客户那边好好的,在家里服务器上老是出现,而且出现的时间也没啥规律,当然最终查出来还是有规律的,不过这个规律比较特别。大家看了后面的内容之后就明白了,真的很特殊! 初步分析 进程Crash? 当同事找到我的时候,我第一反应是是不是进程Crash了,如果是crash,那通常情况下会有crash的日志,检查了一遍,什么日志都没有留下,当然有时候Crash了,JVM也确实也不会留下Crash日志,不过这个特别罕见了,绝大部分是人为操作了。 被OS Kill? 既然不是Crash,那是不是系统存在内存泄露,被OS Kill了,不过很快通过dmesg也排除了,因为没有看到任何kill的迹象。 System.exit? 排除掉以上两个因素之后,接着马上就怀疑是否有什么代码执行过System.exit,于是重新编译了一把JDK,在System的exit方法处打印了些日志,于是坐等奇迹的发生。 令人兴奋的是,进程真的消失了,可是令人遗憾的是,我们埋点的日志并没有出现。这让我再次陷入沉思。 回归源码 从日志看确实是调用了ShutdownHook 于是找到addShutdownHook源码的位置 再次翻了一下JDK的源码,除了正常退出,System.exit等之外还有哪些情况会调用这个Shutdown的Hook,于是将埋点埋到了Shutdown.runHooks方法里。 继续等待事情再次发生,果然没多久,当天下午又发生了,打印了如下日志 也就是说当时是收到了一个SIGHUP的信号,这个信号最终会让进程退出,JVM对这个信号确实是没有特殊处理的,因此没有我们看到的Crash日志。 那接下来就是要找到为什么会收到这个信号了,这个信号又是谁发出的。 找出信号源 SIGHUP这个信号,最主要发生的场景是Shell终端关闭一个Session的时候会对该Session关联的进程发送一个SIGHUP信号,这个信号默认是会退出进程的。为此我还特地下载了ITerm2(我和同事都是mac,用的iTerm2的终端)的源码,还真找到了几个发送SIGHUP信号的代码 看名字PTYTask就能猜到了,这应该是一个seesion任务,于是进到代码里看到主要是有两个方法有发送SIGHUP信号给子进程,分别是dealloc和stop,其中stop会通过sendSignal函数给子进程发送SIGHUP信号。 对于我这种比较喜欢自虐的人,一般会想怎么就确定这个就是我要找的代码,之前从没有写过Object-C的代码,想着是否有个类似java的jmap的工具可以让我看内存里的对象的情况,然而临时没找到,不过偶然发现mac自带的Activity工具就能看到一些迹象,于是在Activity里找到了iTerm2进程,然后对其内存数据进行了采样,看能否抓到类似PTYTask. dealloc或者stop的调用栈,可是比较难模拟,因为存在时间差,点击采样的时候,很快就结束了,我还没来得及关闭session。在看采样报告的时候偶然看到了/usr/bin/sample的命令,原来Activity是采用这个命令进行采样的,于是摸索了一把,真能搞起来,采样的时间可以自定义,间隔是1ms一次,这样可以让我有充足的时间来操作了,于是在采样开启之后,不断地开一个session,起一个进程,然后close,重复做了好几次,结束采样之后看采样的输出,还真的就抓到了PTYTask.stop的调用栈 这也就验证了我close session的时候确实会给对应的子进程发送SIGHUP的信号。 那到此为止我们可以确认的是 进程退出是因为收到了信号SIGHUP 而SIGHUP的发生是因为终端Session Close 那到底是不是这种情况呢? 重新复盘问题现场 这个貌似不太可能,因为我们的shell脚本里执行java的时候都会带上&,这样进程就会后台运行,不会出现这种session的问题。看了下脚本,确实是带上了&的,自己也模拟了几遍,在一个shell里调用带有&的java命令,关闭终端java进程并不会退出。难道是因为同事的终端配置和我的不一样?后来要同事发了它的iTerm2里的seesion的配置给我看了下,和我的完全一样,这就挺奇怪了。 于是再回过来看看之前的几次进程消失时候的日志(我要同事有保留),看到那几个进程退出的时间点,分别是 2019-01-14 20:42:52* 2019-01-15 18:34:00* 2019-01-18 00:57:58* 2019-01-18 17:34:30 这几个时间点完全没有规律看起来,不过我突然想起2019-01-18那天是周五,同事是在上海出差,而17:34:30那会应该是快下班了,或者那会正好从上海赶车回杭州,于是问了下那个点同事是不是准备回杭州了,同事说那会确实合上电脑准备赶车回杭州,于是我接着问其他几个时间是不是差不多也是合上电脑的时间,结果还真是那么巧,既然这样,那说明我们的判断方向是正确的了。 水落石出 后面突然发现同事修改过这个启动脚本,在脚本的最后加了行命令 java xxxx &cd $DIR_LOG && tail -f common-*.log 难道是这个命令搞的鬼? 突然想起一个问题来,父子进程的问题,假如说当我们在shell里加了&跑的话,当父进程跑完之后,会直接将其挂到init进程下面,也就是你通过ps -ef去看它的父进程会是1号进程,但是如果原来的父进程没有跑完,那其父进程仍然会是原来的进程,所以当我们执行这个脚本的时候,一直被执行tail等待日志输出,这样一来,如果我们将当前窗口关闭了,那就意味着父进程会退出,然后给子进程发送SIGHUP的信号,于是导致java进程退出,但是如果我们在tail日志过程中ctrl c了,那java进程会过继给init进程,因此此时当我们再关闭窗口的时候也不会给其发送SIGHUP的信号了。 经过验证果然如此,至此这个消失的进程终于得到了解释,嗯,好在不是我们代码的问题,值得欣慰,毕竟我们的代码是要在客户那边运行的,必须要保证好稳定性。 欢迎关注 PerfMa 社区,推荐阅读: 小心踩雷,一次Java内存泄漏排查 跟Kafka学技术系列之时间轮

优秀的个人博客,低调大师

每日一博 | 一小时搞定 Eureka

一、什么是Eureka Eureka是Netflix公司开源的产品,它是一种基于REST( Representational State Transfer )的服务,主要用于AWS云。 Eureka提供了完整的Service Registry和Service Discovery实现实现,也是Spring Cloud体系中最重要的组件之一。 简单来说Eureka就是Netflix开源的一款提供服务注册和发现的产品,并且提供了java客户端。当然,springcloud大力优化后的Eureka,可以应用在任何需要使用注册中心的场景。 Eureka由两个组件组成:Eureka服务端和Eureka客户端。Eureka服务端就是注册中心。Eureka客户端是一个java客户端,用来简化与服务端的交互、作为轮询负载均衡器,并提供服务的故障切换支持。 下面是Eureka的使用场景 从上面看Eureka Server担任注册中心的角色,提供了服务的发现和注册功能。 Service Provider服务提供者,将自身的服务注册到Eureka Server,同时通过心跳检查服务的运行状态。 Service Consumer服务调用者,从Eureka Server得到注册的服务列表,找到对应的服务地址调用并使用。 二、Eureka核心概念 1、Eureka Server:注册中心服务端 注册中心服务端主要对外提供了三个功能: (1)服务注册 服务提供者启动时,会通过Eureka Client向Eureka Server注册信息,Eureka Server会存储该服务的信息,Eureka Server内部有二层缓存机制来维护整个注册表。 (2)提供注册表 服务消费者在调用服务时,如果Eureka Client没有缓存注册表的话,会从Eureka Server获取最新的注册表。 (3)同步状态 Eureka Client通过注册、心跳机制和Eureka Server同步当前客户端的状态。 2、Eureka Client:注册中心客户端 Eureka Client是一个java客户端,用于简化与Eureka Server的交互。Eureka Client会拉取、更新、缓存Eureka Server中的信息。因此当所有的Eureka Server节点都宕掉,服务消费者依然可以使用缓存中的信息找到服务的提供者,但是当服务有更改的时候会出现信息不一致。 3、Register:服务注册 服务的提供者,将自身注册到注册中心,服务提供者也是一个Eureka Client。当Eureka Client向Eureka Server注册时,它提供自身的元数据,比如IP地址、端口、运行状况指示符URL、主页等。 4、Renew:服务续约 Eureka Client会每隔30秒发送一次心跳来续约。通过续约来告知Eureka Server该Eureka Client运行正常,没有出现问题。默认情况下,如果Eureka Server在90秒内没有收到Eureka Client的续约,Server端会将实例从其注册表中删除,此事件可配置,一般情况不建议更改。 5、Eviction服务剔除 当Eureka Client和Eureka Server不再有心跳时,Eureka Server会将服务实例从服务注册列表中删除,即服务剔除。 6、Cancel:服务下线 Eureka Client在程序关闭时想Eureka Server发送取消请求,发送请求后,该客户端实例信息将从Eureka Server的实例注册表中删除。该下线请求不会自动完成,它需要调用一下内容: DiscoveryManager.getInstance().shutdownComponent(); 7、GetRegistry:获取注册列表信息 Eureka Client从服务器获取注册表信息,并将其缓存在本地。客户端会使用该信息查找其他服务,从而进行远程调用。该注册列表信息定期(每30秒)更新一次。每次返回注册列表信息可能与Eureka Client的缓存信息不同,Eureka Client自动处理。 如果由于某种原因导致注册信息列表信息不能及时匹配,Eureka Client则会重新获取整个注册表信息。Eureka Server缓存注册列表信息,整个注册表以及每个应用程序的信息进行了压缩,压缩内容和没有压缩的内容完全相同。Eureka Client和Eureka Server可以使用JSON/XML格式进行通讯。在默认情况下Eureka Client使用压缩JSON形式来获取注册列表的信息。 8、Remote Call:远程调用 当Eureka Client从注册中心获取到服务提供者信息后,就可以通过HTTP请求调用对应的服务;服务提供者有多个时,Eureka Client客户端会自动通过Ribbon自动进行负载均衡。 三、自我保护机制 默认请款下,如果Eureka Server在90秒内没有接收到某个微服务实例的心跳,会注销该实例。但是在微服务架构下服务之间通常都是跨进程调用,网络通信往往面临很多问题,比如微服务状态正常,网络分区故障,导致此实例被注销。 固定时间内大量实例被注销,可能会严重威胁某个微服务架构的可用性,为了解决这个问题,Eureka开发了自我保护机制,那么什么是自我保护机制呢? Eureka Server在运行期间会去统计心跳失败比例在15分钟之内是否低于85%,如果低于85%,Eureka Server即进入自我保护机制。 Eureka Server触发自我保护机制后,页面会出现提示: Eureka Server进入自我保护机制,会出现以下几种情况: (1)Eureka不再从注册列表中移除因为长时间没收到心跳而应该过期的服务。 (2)Eureka仍然能够接受新服务的注册和查询,但是不会被同步到其它节点上(即保证当前节点依然可用)。 (3)当网络稳定后,当前实例新的注册信息会被同步到其它节点上。 Eureka自我保护机制是为了防止误杀服务而提供的一种机制。当个别客户端出现心跳失联时,则认为是客户端的问题,剔除客户端;当Eureka 捕获到大量的心跳失败时,则认为可能是网络问题,进入自我保护机制;当客户端心跳恢复时,Eureka会自动退出自我保护机制。 如果在保护期内刚好这个服务提供者非正常下线了,此时服务消费者就会拿到一无效的服务实例,则会调用失败。对于这个问题需要服务消费者要有一些容错机制,比如重试,断路器等。 四、Eureka高可用集群 理论上来讲,服务消费者本地缓存了服务提供者的地址,即使Eureka Server宕机,也不会影响服务之间的调用,但是一旦涉及到服务的上下线,本地的缓存信息将会出现偏差,影响整个微服务的稳定性,因此搭建Eureka Server集群来提高整个架构的高可用性,是非常必要的。 从图中可以看出Eureka Server集群相互之间通过Replicate来同步数据,相互之间不区分主节点和从节点,所有的节点都是平等的。在这种架构中,节点通过彼此互相注册提高可用性,每个节点需要添加一个或多个有效的serviceURL指向其他节点。 如果某台 Eureka Server 宕机,Eureka Client 的请求会自动切换到新的 Eureka Server 节点。当宕机的服务器重新恢复后,Eureka 会再次将其纳入到服务器集群管理之中。当节点开始接受客户端请求时,所有的操作都会进行节点间复制,将请求复制到其它 Eureka Server 当前所知的所有节点中。 另外 Eureka Server 的同步遵循着一个非常简单的原则:只要有一条边将节点连接,就可以进行信息传播与同步。所以,如果存在多个节点,只需要将节点之间两两连接起来形成通路,那么其它注册中心都可以共享信息。每个 Eureka Server 同时也是 Eureka Client,多个 Eureka Server 之间通过 P2P 的方式完成服务注册表的同步。 Eureka Server 集群之间的状态是采用异步方式同步的,所以不保证节点间的状态一定是一致的,不过基本能保证最终状态是一致的。 五、 Eureka分区 Eureka提供了Region和Zone两个概念来进行分区: Region:可以理解为地理上的不同区域,比如亚洲地区,中国地区,大连地区等等。没有具体大小的限制。根据项目具体的情况,可以自行合理划分Region。 Zone:可以简单理解为region内的具体机房,比如说region划分为大连,大连有两个机房,就可以再次region之下划分出zone1,zone2两个zone。 六、Eureka保证AP Eureka Server 各个节点都是平等的,几个节点挂掉不会影响正常节点的工作,剩余的节点依然可以提供注册和查询服务。而 Eureka Client 在向某个 Eureka 注册时,如果发现连接失败,则会自动切换至其它节点。只要有一台 Eureka Server 还在,就能保证注册服务可用(保证可用性),只不过查到的信息可能不是最新的(不保证强一致性)。 七、Eureka工作流程 1、Eureka Server启动成功,等待服务端注册。 在启动过程中如果配置了集群,集群之间定时通过Replicate同步注册表,每个Eureka Server都存在独立完整的服务注册表信息。 2、Eureka Client启动时根据配置的Eureka Server地址去注册中心注册服务。 3、Eureka Client会每30秒向Eureka Server发送一次心跳,证明客户端服务正常。 4、当Eureka Server90秒内没有收到Eureka Client的心跳,注册中心则认为该节点失效,会注销该实例。 5、单位时间内Eureka Server统计到大量的Eureka Client没有发送心跳,则认为可能为网络异常,进入自我保护机制,不再剔除没有发送心跳的客户端。 6、当Eureka Client心跳恢复正常后,Eureka Server自动退出自我保护机制。 7、Eureka Client定时全量或者增量从注册中心获取服务注册表,并且将获取到的信息缓存在本地。 8、服务调用时,Eureka Client会先从本地缓存找寻调取的服务。如果获取不到,先从注册中心刷新注册表,再同步到本地缓存。 9、Eureka Client获取到目标服务器信息,发起服务调用。 10、Eureka Client程序关闭时向Eureka Server发送取消请求,Eureka Server将实例从注册表中剔除。 八、 Eureka Server数据存储 Eureka Server的数据存储分为两层:数据存储层和缓存层。 数据存储层记录注册到 Eureka Server上的服务信息,缓存层是经过包装后的数据,可以直接在 Eureka Client调用时返回。 Eureka Server的数据存储层是双层的ConcurrentHashMap,我们知道 ConcurrentHashMap 是线程安全高效的Map集合。 private final ConcurrentHashMap<String, Map<String, Lease<InstanceInfo>>> registry= new ConcurrentHashMap<String, Map<String, Lease<InstanceInfo>>>(); 第一层的ConcurrentHashMap的key=spring.application.name也就是客户端实例注册的应用名;value为嵌套的ConcurrentHashMap。 第二层嵌套的ConcurrentHashMap的key=instanceId也就是服务的唯一实例id,value为Lease对象,Lease对象存储着这个实例的所有注册信息,包括IP、端口、属性等。 根据这个存储结构我们可以发现,Eureka Server 第一层都是存储着所有的服务名,以及服务名对应的实例信息,也就是说第一层都是按照服务应用名这个维度来切分存储: 应用名1:应用1实例 Map 应该名2:应用2实例 Map ... 第二层是根据实例的唯一 ID 来存储的,那么按照这个结构最终的存储数据格式为: : 应用1实例A:实例A的注册信息 应用名1:应用1实例: 应用1实例B:实例B的注册信息 : 应用1实例C:实例C的注册信息 : .... ----------------- : 应用2实例F:实例F的注册信息 应该名2:应用2实例: 应用2实例G:实例G的注册信息 : ... ... 数据存储层数据结构如下图所示: 当如服务的状态发生变更时,会同步 Eureka Server 中的 registry 数据信息,比如服务注册、剔除服务时。 九、 Eureka的缓存机制 Eureka Server 为了提供响应效率,提供了两层的缓存结构,将 Eureka Client 所需要的注册信息,直接存储在缓存结构中。 第一层缓存:readOnlyCacheMap,本质上是 ConcurrentHashMap,依赖定时从 readWriteCacheMap 同步数据,默认时间为 30 秒。 readOnlyCacheMap: 是一个 CurrentHashMap的只读缓存,这个主要为了供客户端获取注册信息时使用,其缓存更新,依赖于定时器的更新,通过和 readWriteCacheMap 的值做对比,如果数据不一致,则以 readWriteCacheMap 的数据为准。 第二层缓存: readWriteCacheMap ,本质上是Guava缓存。 readWriteCacheMap:readWriteCacheMap 的数据主要同步于存储层。当获取缓存时判断缓存中是否没有数据, 如果不存在此数据,则通过 CacheLoader 的 load 方法去加载,加载成功之后将数据放入缓存,同时返回数据。 readWriteCacheMap 缓存过期时间,默认为 180 秒,当服务下线、过期、注册、状态变更,都会来清除此缓存中的数据。 Eureka Client 获取全量或者增量的数据时,会先从一级缓存中获取;如果一级缓存中不存在,再从二级缓存中获取;如果二级缓存也不存在,这时候先将存储层的数据同步到缓存中,再从缓存中获取。 通过 Eureka Server 的二层缓存机制,可以非常有效地提升 Eureka Server 的响应时间,通过数据存储层和缓存层的数据切割,根据使用场景来提供不同的数据支持。 十、代码实例 1、项目架构: 2、Eureka服务端application.yml server: port: 9000 eureka: instance: hostname: localhost client: register-with-eureka: false fetch-registry: false service-url: defaultZone: http://${eureka.instance.hostname}:${server.port}/eureka/ instance: prefer-ip-address: true 3、客户端启动类 package cn.itcast.product; ... @SpringBootApplication @EntityScan("cn.itcast.product.entity") @EnableEurekaClient public class ProductServiceApplication { public static void main(String[] args) { SpringApplication.run(ProductServiceApplication.class, args); } } 4、一些基本的controller、service、bean就不写了,使用的是spring data jpa方式查询的数据库。 5、启动服务 Eureka Server -->Eureka Providor -->Eureka Consumer Eureka Server 6、Eureka Consumer调用服务 十一、总结 讲解了 Eureka核心概念、 Eureka自我保护机制、 Eureka高可用集群。通过分析 Eureka工作原理,可以明显地感受到 Eureka设计之巧妙,通过一系列的机制,完美的解决了注册中心的稳定性和高可用性。 Eureka为了保障注册中心的高可用性,容忍了数据的非强一致性,服务节点的数据可能不一致, Eureka Client间的数据可能不一致。比较适合跨越多机房、对注册中心服务可用性要求较高的使用场景。 更多精彩内容,首发公众号【素小暖】,欢迎关注。

优秀的个人博客,低调大师

每日一博 | 深入理解JVM - 方法调用

方法调用并不等同于方法中的代码被执行,方法调用阶段唯一的任务就是确定被调用方法的版本(即调用哪一个方法),暂时还未涉及方法内部的具体运行过程。一切方法调用在Class文件里面存储的都只是符号引用,而不是方法在实际运行时内存布局中的入口地址(也就是之前说的直接引用)。 解析 所有方法调用的目标方法在Class文件里面都是一个常量池中的符号引用,在类加载的解析阶段,会将其中的一部分符号引用转化为直接引用,这种解析能够成立的前提是:方法在程序真正运行之前就有一个可确定的调用版本,并且这个方法的调用版本在运行期是不可改变的。换句话说,调用目标在程序代码写好、编译器进行编译那一刻就已经确定下来。这类方法的调用被称为解析(Resolution),在Java语言中符合这种要求的主要有静态方法和私有方法。 方法调用指令 invokestatic:用于调用静态方法。 invokespecial:用于调用实例构造器<init>()方法、私有方法和父类中的方法。 invokevirtual:用于调用所有的虚方法。 invokeinterface:用于调用接口方法,会在运行时再确定一个实现该接口的对象。 invokedynamic:先在运行时动态解析出调用点限定符所引用的方法,然后再执行该方法。 前面4条调用指令,分派逻辑都固化在Java虚拟机内部,而invokedynamic指令的分派逻辑是由用户设定的引导方法来决定的。 方法分类 在java语言中方法主要分为“虚方法”和“非虚方法”。 非虚方法:在类加载的时候就可以把符号引用解析为该方法的直接引用。比如:静态方法、私有方法、实例构造器、父类方法和被final修饰的方法。 虚方法:需要在运行时才能将符号引用转换成直接引用,如,分派。 分派 分派(Dispatch)它可能是静态的也可能是动态的,按照分派依据的宗量数可分为单分派和多分派。这两类分派方式两两组合就构成了静态单分派、静态多分派、动态单分派、动态多分派4种分派组合情况。 静态分派 依赖静态类型来决定方法执行版本的分派动作,都称为静态分派。静态分派的最典型应用表现就是方法重载,虚拟机(或者准确地说是编译器)在重载时是通过参数的静态类型来作为判定依据的。 public class StaticDispatch { static abstract class Human { } static class Man extends Human { } static class Woman extends Human { } public void sayHello(Human guy) { System.out.println("hello,guy!"); } public void sayHello(Man guy) { System.out.println("hello,gentleman!"); } public void sayHello(Woman guy) { System.out.println("hello,lady!"); } public static void main(String[] args) { Human man = new Man(); Human woman = new Woman(); StaticDispatch sr = new StaticDispatch(); sr.sayHello(man); sr.sayHello(woman); } } 运行结果: hello,guy! hello,guy! Human man = new Man(); 这里的Human 就是变量的“静态类型”(Static Type),或者叫“外观类型”(Apparent Type);Man就是变量的“实际类型”(Actual Type)或者叫“运行时类型”(Runtime Type)。 动态分派 我们把在运行期根据实际类型确定方法执行版本的分派过程称为动态分派。最典型的表现就是重写。 public class DynamicDispatch { static abstract class Human { abstract void sayHello(); } static class Man extends Human { public void sayHello() { System.out.println("hello,Man!"); } } static class Woman extends Human { public void sayHello() { System.out.println("hello,Woman!"); } } public static void main(String[] args) { Human man = new Man(); Human woman = new Woman(); man.sayHello(); woman.sayHello(); } } 运行结果: hello,Man! hello,Woman! 我们通过javap命令看下main方法的字节码: ... public static void main(java.lang.String[]); descriptor: ([Ljava/lang/String;)V flags: ACC_PUBLIC, ACC_STATIC Code: stack=2, locals=3, args_size=1 0: new #2 // class com/xiaolyuh/DynamicDispatch$Man 3: dup 4: invokespecial #3 // Method com/xiaolyuh/DynamicDispatch$Man."<init>":()V 7: astore_1 8: new #4 // class com/xiaolyuh/DynamicDispatch$Woman 11: dup 12: invokespecial #5 // Method com/xiaolyuh/DynamicDispatch$Woman."<init>":()V 15: astore_2 16: aload_1 17: invokevirtual #6 // Method com/xiaolyuh/DynamicDispatch$Human.sayHello:()V 20: aload_2 21: invokevirtual #6 // Method com/xiaolyuh/DynamicDispatch$Human.sayHello:()V 24: return LineNumberTable: line 27: 0 line 28: 8 line 29: 16 line 30: 20 line 31: 24 LocalVariableTable: Start Length Slot Name Signature 0 25 0 args [Ljava/lang/String; 8 17 1 man Lcom/xiaolyuh/DynamicDispatch$Human; 16 9 2 woman Lcom/xiaolyuh/DynamicDispatch$Human; } ... 通过字节码我们发现:在main方法中,sayHello()方法的调用对应的符号引用是一样的,com/xiaolyuh/DynamicDispatch$Human.sayHello:()V 。在这里我们可以得出一个结论:在动态分派的情况下,在编译时期我们是无法确定方法的直接引用的,那么它是怎么实现重载方法的调用的呢?问题关键是在invokevirtual指令上,在执行invokevirtual指令时,invokevirtual指令会去确定方法的调用版本。 invokevirtual指令的运行过程 找到操作数栈顶的第一个元素所指向的对象的实际类型,记作C。 如果在类型C中找到与常量中的描述符和简单名称都相符的方法,则进行访问权限校验,如果通过则返回这个方法的直接引用,查找过程结束;不通过则返回java.lang.IllegalAccessError异常。 否则,按照继承关系从下往上依次对C的各个父类进行第二步的搜索和验证过程。4. 如果始终没有找到合适的方法,则抛出java.lang.AbstractMethodError异常。 正是因为invokevirtual指令执行的第一步就是在运行期确定接收者的实际类型,所以两次调用中的invokevirtual指令并不是把常量池中方法的符号引用解析到直接引用上就结束了,还会根据方法接收者的实际类型来选择方法版本,这个过程就是Java语言中方法重写的本质。 当子类声明了与父类同名的字段时,虽然在子类的内存中两个字段都会存在,但是子类的字段会遮蔽父类的同名字段 动态分派的实现 因为动态方法执行非常频繁,并且动态分派的方法版本选择需要在运行时,在实际接受者类型的方法元数据中搜索合适的目标方法,因此,Java虚拟机实现基于执行性能的考虑,虚拟机会为类型在方法区中建立一个虚方法表(Virtual Method Table,也称为vtable,与此对应的,在invokeinterface执行时也会用到接口方法表——Interface Method Table,简称itable),使用虚方法表索引来代替元数据查找以提高性能。 虚方法表中存放着各个方法的实际入口地址。如果某个方法在子类中没有被重写,那子类的虚方法表中的地址入口和父类相同方法的地址入口是一致的,都指向父类的实现入口。如果子类中重写了这个方法,子类虚方法表中的地址也会被替换为指向子类实现版本的入口地址。在图中,Son重写了来自Father的全部方法,因此Son的方法表没有指向Father类型数据的箭头。但是Son和Father都没有重写来自Object的方法,所以它们的方法表中所有从Object继承来的方法都指向了Object的数据类型。 虚方法表一般在类加载的连接阶段进行初始化,准备了类的变量初始值后,虚拟机会把该类的虚方法表也一同初始化完毕。 单分派与多分派 方法的接收者与方法的参数统称为方法的宗量。分派基于多少种宗量,可以将分派划分为单分派和多分派两种。单分派是根据一个宗量对目标方法进行选择,多分派则是根据两个及以上的宗量对目标方法进行选择。 静态分派需要根据静态类型和方法参数两个宗量来确定方法调用,所以属于多分派。 动态分派只需要根据实际类型一个宗量来确定方法的调用,所以属于单分派。 在动态分派的过程中,方法签名是确定的,所以方法参数就不会变,方法调用就取决于参数的实际类型。 总结 解析调用一定是个静态的过程,在编译期间就完全确定,在类加载的解析阶段就会把涉及的符号引用全部转变为明确的直接引用,不必延迟到运行期再去完成。分派(Dispatch)调用则要复杂许多,它可能是静态的也可能是动态的,按照分派依据的宗量数可分为单分派和多分派。这两类分派方式两两组合就构成了静态单分派、静态多分派、动态单分派、动态多分派4种分派组合情况。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册