首页 文章 精选 留言 我的

精选列表

搜索[产品策略],共10000篇文章
优秀的个人博客,低调大师

Databend 产品月报(2025年4月)

很高兴为您带来 Databend 2025 年 4 月的最新更新、新功能和改进!我们希望这些增强功能对您有所帮助,并期待您的反馈。 BendDeploy:安装 Databend 的新方式 BendDeploy 是由 Databend 开发的一款基于 Kubernetes 的平台,旨在简化和标准化 Databend 集群的部署与管理。它提供可视化、用户友好的界面,支持多集群、多租户操作,显著提升了运维效率、系统可靠性以及管控能力。 多租户管理:为不同租户提供隔离的环境,并支持基于角色的用户访问控制。 一键集群部署:只需几次点击即可轻松启动并管理 Databend 集群。 生命周期管理操作:支持滚动升级、版本回滚、水平扩展和集群重启等功能。 可视化监控与日志:集成节点状态视图、日志(如查询日志、性能分析日志)以及外部 Prometheus 指标。 网页 SQL 工作台:可在 UI 中直接执行 SQL 查询,并可指定目标租户集群。 BendSave:一条命令完成数据备份与恢复 BendSave 是一款命令行工具,用于备份和恢复 Databend 中的元数据及实际数据文件。它将备份内容存储在兼容 S3 的对象存储中,非常适合用于灾难恢复场景。 export AWS_ACCESS_KEY_ID=minioadmin export AWS_SECRET_ACCESS_KEY=minioadmin # Backup ./databend-bendsave backup \ --from ../configs/databend-query.toml \ --to 's3://backupbucket?endpoint=http://127.0.0.1:9000/&region=us-east-1' # Restore ./databend-bendsave restore \ --from "s3://backupbucket?endpoint=http://127.0.0.1:9000/&region=us-east-1" \ --to-query ../configs/databend-query.toml \ --to-meta ../configs/databend-meta.toml \ --confirm 查询结果缓存 查询结果缓存是 Databend 的一项性能优化功能,用于存储先前查询的结果。对于重复执行的查询,系统可直接从缓存中返回结果,而无需重新计算,从而降低查询延迟并提升整体系统效率,尤其适用于重复的分析型工作负载。 有关如何启用和配置查询结果缓存的详细信息,请参阅查询结果缓存。 动态列默认值:NEXTVAL() 您现在可以在创建表时,使用来自序列的动态值作为列的默认值。通过 NEXTVAL(<seq>),每次插入新行时,该列将自动获取序列生成的下一个值。 CREATE SEQUENCE staff_id_seq; CREATE TABLE staff ( staff_id INT DEFAULT NEXTVAL(staff_id_seq), -- Assigns the next number from the sequence 'staff_id_seq' if no value is provided name VARCHAR(50), department VARCHAR(50) DEFAULT 'Marketing' -- Defaults to 'Marketing' if no value is provided ); 查询文件级元数据 您现在可以从暂存文件中查询文件级别的元数据信息,例如文件名和行号。 -- Querying Metadata Fields SELECT metadata$filename, metadata$file_row_number, * FROM @my_internal_stage/iris.parquet LIMIT 5; -- Using Metadata in COPY INTO COPY INTO iris_with_meta FROM (SELECT metadata$filename, metadata$file_row_number, $1, $2, $3, $4, $5 FROM @my_internal_stage/iris.parquet) FILE_FORMAT=(TYPE=parquet); 新文件格式:Avro Apache Avro™ 是领先的记录数据序列化格式,也是流式数据管道的首选格式。Databend 现已支持将 Avro 作为加载数据的文件格式。 COPY INTO userdata FROM 'https://raw.githubusercontent.com/Teradata/kylo/master/samples/sample-data/avro/userdata1.avro' FILE_FORMAT = (type = avro); 新函数 LISTAGG:将多行中的值连接成一个字符串,并用指定的分隔符分隔。 -- Aggregate Function LISTAGG([DISTINCT] <expr> [, <delimiter>]) [WITHIN GROUP (ORDER BY <order_by_expr>)] -- Window Function LISTAGG([DISTINCT] <expr> [, <delimiter>]) [WITHIN GROUP (ORDER BY <order_by_expr>)] OVER ([PARTITION BY <partition_expr>]) DATE_BETWEEN:计算两个日期或时间戳之间的时间间隔,以指定的单位返回差值,正值表示第一个时间早于第二个时间,负值表示相反。 DATE_BETWEEN( YEAR | QUARTER | MONTH | WEEK | DAY | HOUR | MINUTE | SECOND | DOW | DOY | EPOCH | ISODOW | YEARWEEK | MILLENNIUM, <start_date_or_timestamp>, <end_date_or_timestamp> ) GLOB:使用通配符执行区分大小写的模式匹配。 GLOB(<string>, <pattern>) 关于 Databend Databend 是一款开源、弹性、低成本,基于对象存储也可以做实时分析的新式湖仓。期待您的关注,一起探索云原生数仓解决方案,打造新一代开源 Data Cloud。 👨‍💻‍ Databend Cloud:databend.cn 📖 Databend 文档:docs.databend.cn 💻 Wechat:Databend ✨ GitHub:github.com/databendlab...

优秀的个人博客,低调大师

Databend 产品月报(2025年3月)

很高兴为您带来 Databend 2025 年 3 月的最新更新、新功能和改进!我们希望这些增强功能对您有所帮助,并期待您的反馈。 仪表盘共享 您现在可以在 Databend Cloud 上与组织内的所有人或特定个人共享您的仪表盘,并选择以下权限级别之一来控制他人对其的访问方式: 只读 (Read Only) :查看仪表盘,但无法进行更改或运行查询以获取最新结果。 执行(Execute) :运行查询以获取最新结果或与仪表盘交互,但无法修改它。 编辑(Edit) :修改仪表盘,包括更改查询和仪表盘如何反映结果。 使用来自另一个表的值更新表 UPDATE 命令已增强,允许使用来自另一个表的值更新表。 UPDATE bookstore SET book_name = book_updates.new_book_name FROM book_updates WHERE bookstore.book_id = book_updates.book_id; 最小日期和时间戳调整 我们已更新日期和时间戳数据类型的最小值: 最小日期:0001-01-01 最小时间戳:0001-01-01 00:00:00.00000 对用户名称和角色名称的限制 Databend 不允许 SQL 用户或角色名称包含以下特殊字符: 单引号(') 双引号(") 退格符(\b) 换页符(\f) 使用 enable_expand_roles 管理角色继承 enable_expand_roles 设置确定 SHOW_GRANTS 函数是否显示来自角色的继承权限。默认设置为 1,它递归地扩展所有权限;当设置为 0 时,它仅显示直接权限和角色授予。例如: 当 enable_expand_roles=1 时: SELECT grants FROM show_grants('role', 'a') ORDER BY object_id; ┌──────────────────────────────────────────────────────┐ │ grants │ ├──────────────────────────────────────────────────────┤ │ GRANT SELECT ON 'default'.'default'.'t1' TO ROLE `a` │ │ GRANT SELECT ON 'default'.'default'.'t2' TO ROLE `a` │ └──────────────────────────────────────────────────────┘ 当 enable_expand_roles=0 时: SELECT grants FROM show_grants('role', 'a') ORDER BY object_id; ┌──────────────────────────────────────────────────────┐ │ grants │ ├──────────────────────────────────────────────────────┤ │ GRANT SELECT ON 'default'.'default'.'t1' TO ROLE `a` │ │ GRANT ROLE b to ROLE `a` │ │ GRANT ROLE public to ROLE `a` │ └──────────────────────────────────────────────────────┘ 日志级别配置更新 databend-query.toml 配置文件中的 [log.file] 和 [log.stderr] 设置现在使用 env_logger 语法(error, warn, info, debug, trace, off),默认设置为 warn,databend_=info,openraft=info,以实现灵活的日志控制。 Iceberg 表函数 Databend 引入了以下表函数用于查询 Iceberg 元数据,允许用户高效地检查快照和清单: ICEBERG_MANIFEST:返回 Iceberg 表的清单文件的元数据,包括文件路径、分区详细信息和快照关联。 SELECT * FROM ICEBERG_MANIFEST('tpcds', 'catalog_returns'); ╭───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────╮ │ content │ path │ length │ partition_spec │ added_snapshot │ added_data_fil │ existing_data_ │ deleted_data_ │ added_delete_ │ existing_dele │ deleted_delet │ partition_sum │ │ Int32 │ String │ Int64 │ _id │ _id │ es_count │ files_count │ files_count │ files_count │ te_files_coun │ e_files_count │ maries │ │ │ │ │ Int32 │ Nullable(Int64 │ Nullable(Int32 │ Nullable(Int32 │ Nullable(Int3 │ Nullable(Int3 │ t │ Nullable(Int3 │ Array(Nullabl │ │ │ │ │ │ ) │ ) │ ) │ 2) │ 2) │ Nullable(Int3 │ 2) │ e(Tuple(Nulla │ │ │ │ │ │ │ │ │ │ │ 2) │ │ ble(Boolean), │ │ │ │ │ │ │ │ │ │ │ │ │ Nullable(Bool │ │ │ │ │ │ │ │ │ │ │ │ │ ean), String, │ │ │ │ │ │ │ │ │ │ │ │ │ String))) │ ├─────────┼────────────────┼────────┼────────────────┼────────────────┼────────────────┼────────────────┼───────────────┼───────────────┼───────────────┼───────────────┼───────────────┤ │ 0 │ s3://warehouse │ 9241 │ 0 │ 75657674165904 │ 2 │ 0 │ 0 │ 2 │ 0 │ 0 │ [] │ │ │ /catalog_retur │ │ │ 11866 │ │ │ │ │ │ │ │ │ │ ns/metadata/fa │ │ │ │ │ │ │ │ │ │ │ │ │ 1ea4d5-a382-49 │ │ │ │ │ │ │ │ │ │ │ │ │ 7a-9f22-1acb9a │ │ │ │ │ │ │ │ │ │ │ │ │ 74a346-m0.avro │ │ │ │ │ │ │ │ │ │ │ ╰───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────╯ ICEBERG_SNAPSHOT:返回 Iceberg 表的快照元数据,包括数据更改、操作信息和摘要统计信息。 SELECT * FROM ICEBERG_SNAPSHOT('tpcds', 'catalog_returns'); ╭───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────╮ │ committed_at │ snapshot_id │ parent_id │ operation │ manifest_list │ summary │ ├────────────────────────────┼─────────────────────┼───────────┼───────────┼──────────────────────────────────────────────────────┼─────────────────────────────────────────────────────┤ │ 2025-03-12 23:18:26.626000 │ 7565767416590411866 │ 0 │ append │ s3://warehouse/catalog_returns/metadata/snap-7565767 │ {'spark.app.id':'local-1741821433430','added-data-f │ │ │ │ │ │ 416590411866-1-fa1ea4d5-a382-497a-9f22-1acb9a74a346. │ iles':'2','added-records':'144067','total-equality- │ │ │ │ │ │ avro │ deletes':'0','changed-partition-count':'1','total-r │ │ │ │ │ │ │ ecords':'144067','total-files-size':'7679811','tota │ │ │ │ │ │ │ l-data-files':'2','added-files-size':'7679811','tot │ │ │ │ │ │ │ al-delete-files':'0','total-position-deletes':'0'} │ ╰───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────╯ [新功能预览] 表函数 fuse_vacuum2() fuse_vacuum2() 表函数根据 data_retention_time_in_days 的设置,帮助用户清理 Fuse 表中过时的数据,回收存储空间并提升查询性能。 SET data_retention_time_in_days = 0; SELECT * FROM fuse_vacuum2('<database>', '<table>'); [新功能预览] Hilbert Clustering 优化 Databend 引入 基于范围的分区 来增强 Hilbert Clustering,使数据组织更加高效。它通过 对 Clustering Key 进行采样 、分配范围分区 ID 以及 计算 Hilbert 索引,从而实现更好的数据裁剪(pruning)和聚类,提高查询性能。 关于 Databend Databend 是一款开源、弹性、低成本,基于对象存储也可以做实时分析的新式湖仓。期待您的关注,一起探索云原生数仓解决方案,打造新一代开源 Data Cloud。 👨‍💻‍ Databend Cloud:databend.cn 📖 Databend 文档:docs.databend.com 💻 Wechat:Databend ✨ GitHub:github.com/databendlab...


优秀的个人博客,低调大师

Databend 产品月报(2025年2月)

很高兴为您带来 Databend 2025 年 2 月的最新更新、新功能和改进!我们希望这些增强功能对您有所帮助,并期待您的反馈。 从 MySQL 迁移到 Databend Databend 推荐使用 db-archiver 进行 MySQL 批量迁移,使用 Flink CDC 进行实时变更数据捕获(CDC)迁移。教程已更新: 使用 db-archiver 从 MySQL 迁移 使用 Flink CDC 从 MySQL 迁移 设置会话标签 现在,您可以为会话分配一个可选标签,从而更方便地在日志表中过滤具有指定标签的日志。例如,以下命令将当前会话的标签设置为 eric: SET SESSION query_tag = 'eric'; 随后,我们执行一个查询,并使用该标签从日志表中检索相应的日志记录: SHOW USERS; SELECT query_tag, query_text FROM system.query_log WHERE query_tag = 'eric' LIMIT 1; 返回结果中,您可以找到带有 eric 标签的查询记录: -[ RECORD 1 ]----------------------------------- query_tag: eric query_text: SHOW USERS 溢出数据存储 自托管 Databend 支持在内存使用超出可用限制时,将中间查询结果溢出到磁盘。现在,您可以配置溢出数据的存储位置,可选择本地磁盘存储或远程 S3 兼容存储桶。 以下示例将 Databend 配置为最多使用 1 TB 本地磁盘空间进行溢出操作,同时保留 40% 磁盘空间供系统使用: [spill] spill_local_disk_path = "/data1/databend/databend_spill" spill_local_disk_reserved_space_percentage = 40 spill_local_disk_max_bytes = 1099511627776 以下示例将 Databend 配置为使用 MinIO 作为 S3 兼容存储服务来进行溢出操作: [spill] [spill.storage] type = "s3" [spill.storage.s3] bucket = "databend" root = "admin" endpoint_url = "http://127.0.0.1:9900" access_key_id = "minioadmin" secret_access_key = "minioadmin" allow_insecure = true 使用 "FROM table" 获取所有列 Databend 扩展了 SQL 语法,允许查询直接以 FROM <table> 开头,而无需显式使用 SELECT *: FROM my_table; 等同于: SELECT * FROM my_table; 新增与优化的 SQL 命令 ATTACH TABLE:现在,您可以在附加表时指定选择的列。 ATTACH TABLE population_only (city, population) 's3://databend-doc/1/16/' CONNECTION = ( REGION='us-east-2', AWS_KEY_ID = '<your_aws_key_id>', AWS_SECRET_KEY = '<your_aws_secret_key>' ); 新教程:使用 ATTACH TABLE 链接表 DESC PROCEDURE:显示特定存储过程的详细信息。 DESC PROCEDURE sum_even_numbers(Uint8, Uint8); ┌────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────┐ │ Property │ Value │ ├───────────┼────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────┤ │ signature │ (start_val,end_val) │ │ returns │ (UInt8) │ │ language │ SQL │ │ body │ BEGIN\n LET sum := 0;\n FOR i IN start_val TO end_val DO\n IF i % 2 = 0 THEN\n sum := sum + i;\n END IF;\n END FOR;\n \n RETURN sum;\nEND; │ └────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────┘ 新增与优化的 SQL 函数 TIMESTAMP_DIFF:计算两个时间戳之间的差异,并将结果以 INTERVAL 格式返回。 SELECT TIMESTAMP_DIFF('2025-02-01'::TIMESTAMP, '2025-01-01'::TIMESTAMP); ┌──────────────────────────────────────────────────────────────────┐ │ timestamp_diff('2025-02-01'::TIMESTAMP, '2025-01-01'::TIMESTAMP) │ ├──────────────────────────────────────────────────────────────────┤ │ 744:00:00 │ └──────────────────────────────────────────────────────────────────┘ FUSE_TIME_TRAVEL_SIZE:计算表的历史数据(用于时间旅行)的存储大小。 -- Calculate historical data size for all tables in all databases SELECT ... FROM fuse_time_travel_size(); -- Calculate historical data size for all tables in a specified database SELECT ... FROM fuse_time_travel_size('<database_name>'); -- Calculate historical data size for a specified table in a specified database SELECT ... FROM fuse_time_travel_size('<database_name>', '<table_name>')); ARRAYS_ZIP:将多个数组合并为一个数组元组。 SELECT ARRAYS_ZIP([1, 2, 3], ['a', 'b', 'c']); ┌────────────────────────────────────────┐ │ arrays_zip([1, 2, 3], ['a', 'b', 'c']) │ ├────────────────────────────────────────┤ │ [(1,'a'),(2,'b'),(3,'c')] │ └────────────────────────────────────────┘ MAP_INSERT:返回一个新的 MAP,其中包含输入 MAP 和插入的新键值对(如果键已存在,则更新为新值)。 SELECT MAP_INSERT({'a':1,'b':2,'c':3}, 'd', 4); ┌─────────────────────────────────────────┐ │ map_insert({'a':1,'b':2,'c':3}, 'd', 4) │ ├─────────────────────────────────────────┤ │ {'a':1,'b':2,'c':3,'d':4} │ └─────────────────────────────────────────┘ SELECT MAP_INSERT({'a':1,'b':2,'c':3}, 'a', 5, true); ┌───────────────────────────────────────────────┐ │ map_insert({'a':1,'b':2,'c':3}, 'a', 5, TRUE) │ ├───────────────────────────────────────────────┤ │ {'a':5,'b':2,'c':3} │ └───────────────────────────────────────────────┘ MAP_PICK:返回一个新的 MAP,包含来自现有 MAP 的指定键值对。 SELECT MAP_PICK({'a':1,'b':2,'c':3}, 'a', 'c'); ┌─────────────────────────────────────────┐ │ map_pick({'a':1,'b':2,'c':3}, 'a', 'c') │ ├─────────────────────────────────────────┤ │ {'a':1,'c':3} │ └─────────────────────────────────────────┘ SELECT MAP_PICK({'a':1,'b':2,'c':3}, ['a', 'b']); ┌───────────────────────────────────────────┐ │ map_pick({'a':1,'b':2,'c':3}, ['a', 'b']) │ ├───────────────────────────────────────────┤ │ {'a':1,'b':2} │ └───────────────────────────────────────────┘ EXTRACT:现在,您可以从间隔值中提取组件,并新增对 EPOCH 作为可提取字段的支持。 SELECT NOW(), EXTRACT(DAY FROM NOW()), EXTRACT(DOY FROM NOW()), EXTRACT(EPOCH FROM NOW()); ┌────────────────────────────────────────────────────────────────────────────────────────────────────────────┐ │ now() │ EXTRACT(DAY FROM now()) │ EXTRACT(DOY FROM now()) │ EXTRACT(EPOCH FROM now()) │ ├────────────────────────────┼─────────────────────────┼─────────────────────────┼───────────────────────────┤ │ 2025-02-08 03:51:51.991167 │ 8 │ 39 │ 1738986711.991167 │ └────────────────────────────────────────────────────────────────────────────────────────────────────────────┘ SELECT EXTRACT(DAY FROM '1 day 2 hours 3 minutes 4 seconds'::INTERVAL); ┌─────────────────────────────────────────────────────────────────┐ │ EXTRACT(DAY FROM '1 day 2 hours 3 minutes 4 seconds'::INTERVAL) │ ├─────────────────────────────────────────────────────────────────┤ │ 1 │ └─────────────────────────────────────────────────────────────────┘ SUM:现在支持 INTERVAL 值。 -- Create a table with integer, double, and interval columns CREATE TABLE sum_example ( id INT, int_col INTEGER, double_col DOUBLE, interval_col INTERVAL ); -- Insert data INSERT INTO sum_example VALUES (1, 10, 15.5, INTERVAL '2 days'), (2, 20, 25.7, INTERVAL '3 days'), (3, NULL, 5.2, INTERVAL '1 day'), (4, 30, 40.1, INTERVAL '4 days'); -- Calculate the sum for each column SELECT SUM(int_col) AS total_integer, SUM(double_col) AS total_double, SUM(interval_col) AS total_interval FROM sum_example; -- NULL values are ignored. -- SUM(interval_col) returns 240:00:00 (10 days). ┌──────────────────────────────────────────────────────────┐ │ total_integer │ total_double │ total_interval │ ├─────────────────┼───────────────────┼────────────────────┤ │ 60 │ 86.5 │ 240:00:00 │ └──────────────────────────────────────────────────────────┘ DATE_TRUNC:现在支持 WEEK 作为精度。 SELECT DATE_TRUNC(MONTH, to_date('2022-07-07')), DATE_TRUNC(WEEK, to_date('2022-07-07')); ┌────────────────────────────────────────────────────────────────────────────────────┐ │ DATE_TRUNC(MONTH, to_date('2022-07-07')) │ DATE_TRUNC(WEEK, to_date('2022-07-07')) │ ├──────────────────────────────────────────┼─────────────────────────────────────────┤ │ 2022-07-01 │ 2022-07-04 │ └────────────────────────────────────────────────────────────────────────────────────┘ 关于 Databend Databend 是一款开源、弹性、低成本,基于对象存储也可以做实时分析的新式湖仓。期待您的关注,一起探索云原生数仓解决方案,打造新一代开源 Data Cloud。 👨‍💻‍ Databend Cloud:databend.cn 📖 Databend 文档:docs.databend.com 💻 Wechat:Databend ✨ GitHub:github.com/databendlab...

优秀的个人博客,低调大师

Databend 产品月报(2025年1月)

很高兴为您带来 Databend 2025 年 1 月的最新更新、新功能和改进!我们希望这些增强功能对您有所帮助,并期待您的反馈,祝您新春快乐! 本地计算集群 现在,您可以使用 SQL 命令管理本地计算集群,从而更轻松地在自托管的 Databend 环境中创建、扩展和提升查询性能。 CREATE WAREHOUSE my_warehouse ( ASSIGN 1 NODES FROM log_node, ASSIGN 2 NODES FROM infra_node ); 要详细了解相关概念和示例,请参阅 通过 SQL 管理本地查询计算集群。有关计算集群的相关命令,请参阅 计算集群相关命令。 全新 Python 驱动:databend-driver 我们推出了适用于 Databend 的全新 Python 驱动 databend-driver,支持同步和异步接口,与 Databend 的交互更加流畅。借助该驱动,您可以更高效地执行 SQL 查询和管理数据操作。 教程 :使用 databend-driver 集成 Databend Cloud 重要提醒 :此前的 Python 驱动 databend-py 已被弃用。 from databend_driver import BlockingDatabendClient Connecting to Databend Cloud with your credentials (replace PASSWORD, HOST, DATABASE, and WAREHOUSE_NAME) client = BlockingDatabendClient(f"databend://cloudapp:{PASSWORD}@{HOST}:443/{DATABASE}?warehouse={WAREHOUSE_NAME}") Get a cursor from the client to execute queries cursor = client.cursor() Drop the table if it exists cursor.execute('DROP TABLE IF EXISTS data') Create the table if it doesn't exist cursor.execute('CREATE TABLE IF NOT EXISTS data (x Int32, y String)') Insert data into the table cursor.execute("INSERT INTO data (x, y) VALUES (1, 'yy'), (2, 'xx')") Select all data from the table cursor.execute('SELECT * FROM data') Fetch all rows from the result rows = cursor.fetchall() Print the result for row in rows: print(row.values()) 从 MySQL 迁移至 Databend:使用 db-archiver Databend 推荐使用 db-archiver 迁移 MySQL 数据。db-archiver 是 Databend 开发的原生归档工具,提供开箱即用的解决方案,可高效地将数据从数据库或其他来源归档到 Databend。 db-archiver 支持通过 JSON 配置文件定义迁移的源和目标详细信息。有关完整的迁移教程,请参阅 Migrating from MySQL with db-archiver。 { // 将占位符替换为您的实际值: "sourceHost": "127.0.0.1", "sourcePort": 3306, "sourceUser": "root", "sourcePass": "root", "sourceDB": "mydb", "sourceTable": "my_table", "sourceQuery": "select * from mydb.my_table", "sourceSplitKey": "id", "sourceWhereCondition": "id < 100", "databendDSN": "https://cloudapp:{password}@{host}:443?warehouse={warehouse_name}", "databendTable": "{database}.my_table", "batchSize": 2, "batchMaxInterval": 30, "workers": 1, "copyPurge": false, "copyForce": false, "disableVariantCheck": false, "deleteAfterSync": false, "maxThread": 10 } 教程:使用 DBeaver 连接到 Databend DBeaver 从 24.3.1 版本开始支持使用内置驱动连接到 Databend。以下教程已更新: Connecting to Self-Hosted Databend using DBeaver Connecting to Databend Cloud using DBeaver 关于 Databend Databend 是一款开源、弹性、低成本,基于对象存储也可以做实时分析的新式数仓。期待您的关注,一起探索云原生数仓解决方案,打造新一代开源 Data Cloud。 👨‍💻‍ Databend Cloud:https://databend.cn 📖 Databend 文档:https://docs.databend.com 💻 Wechat:Databend ✨ GitHub:https://github.com/databendlabs/databend

优秀的个人博客,低调大师

Databend 产品月报(2024年12月)

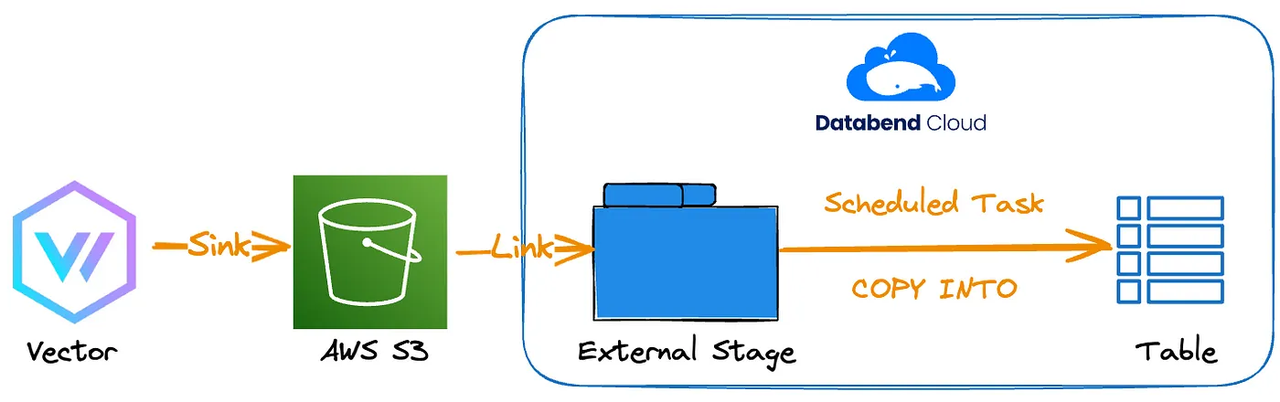
很高兴为您带来 Databend 2024 年 12 月的最新更新、新功能和改进!我们希望这些增强功能对您有所帮助,并期待您的反馈,祝您新年快乐! 临时表 您现在可以创建一个临时表,该临时表在会话结束时会自动删除。临时表仅在创建它的会话中可见,并在会话结束时自动删除,所有数据都会被清除。要创建临时表,请使用 CREATE TEMP TABLE 命令。 CREATE [ OR REPLACE ] { TEMPORARY | TEMP } TABLE [ IF NOT EXISTS ] [ <database_name>. ]<table_name> ... 新数据类型:INTERVAL INTERVAL 数据类型表示时间长度,允许精确操作和存储跨不同单位的时间间隔。 -- Create a table with one INTERVAL column CREATE OR REPLACE TABLE intervals (duration INTERVAL); -- Insert different types of INTERVAL data INSERT INTO intervals VALUES ('1 year 2 months ago'), -- Natural language format with 'ago' (negative interval) ('1 year 2 months'), -- Natural language format without 'ago' (positive interval) ('1000000'), -- Positive numeric value interpreted as microseconds ('-1000000'); -- Negative numeric value interpreted as microseconds -- Query the table to see the results SELECT * FROM intervals; ┌──────────────────────────┐ │ duration │ ├──────────────────────────┤ │ -1 year -2 months │ │ 1 year 2 months │ │ 0:00:01 │ │ -1 month -1 day -0:00:01 │ └──────────────────────────┘ 自定义聚合函数 现在您可以使用 Python 和 JavaScript 定义自己的聚合函数。 CREATE or REPLACE FUNCTION weighted_avg (INT, INT) STATE {sum INT, weight INT} RETURNS FLOAT LANGUAGE javascript AS $$ export function create_state() { return {sum: 0, weight: 0}; } export function accumulate(state, value, weight) { state.sum += value * weight; state.weight += weight; return state; } export function retract(state, value, weight) { state.sum -= value * weight; state.weight -= weight; return state; } export function merge(state1, state2) { state1.sum += state2.sum; state1.weight += state2.weight; return state1; } export function finish(state) { return state.sum / state.weight; } $$; 新教程:使用 Vector 自动加载 JSON 日志 在本教程中,我们模拟在本地生成日志,使用 Vector 收集日志,将其存储在 S3 中,并使用计划任务自动将其提取到 Databend Cloud 中。请单击此处访问完整教程。 增强对 Parquet 文件处理的支持 我们引入了一些新参数,以便在处理 Parquet 文件时提供更大的灵活性和精确性。 CASE_SENSITIVE参数 CASE_SENSITIVE参数用来决定所查询的Parquet文件中的列名是否区分大小写: CASE_SENSITIVE => false(默认): 列名不区分大小写。例如,b 和 B 被视为相同。 CASE_SENSITIVE => true:列名区分大小写,即只有完全匹配(包括大小写)才有效。例如,如果文件中的列名为 B,则查询 B 会成功,但如果列名为 b,则查询不会成功。 例如,如果在 Parquet 文件中有名为 MinTemp 的列,当 CASE_SENSITIVE 设置为 false 时,可以使用以下语句之一进行查询: SELECT MinTemp FROM '@mystage/weather.parquet'(CASE_SENSITIVE=>false); SELECT MINTEMP FROM '@mystage/weather.parquet'(CASE_SENSITIVE=>false); SELECT mintemp FROM '@mystage/weather.parquet'(CASE_SENSITIVE=>false); 当 CASE_SENSITIVE 设置为 true 时,必须使用文件中出现的准确列名: SELECT `MinTemp` FROM '@mystage/weather.parquet'(CASE_SENSITIVE=>true); 新增 COPY INTO 选项:COLUMN_MATCH_MODE COLUMN_MATCH_MODE 决定 COPY INTO 过程中列名匹配是区分大小写还是不区分大小写(默认)。有关 COPY INTO 选项的完整列表,请参阅 copyOptions。 二进制转换函数:TO_BINARY 和 TRY_TO_BINARY TO_BINARY 将支持的数据类型(包括字符串、变量、位图、几何图形和地理位置)转换为二进制表示(十六进制格式)。 SELECT TO_BINARY('Databend'); ┌───────────────────────┐ │ to_binary('Databend') │ ├───────────────────────┤ │ 4461746162656E64 │ └───────────────────────┘ SELECT TO_BINARY(PARSE_JSON('{"key":"value", "number":123}')) AS binary_variant; ┌──────────────────────────────────────────────────────────────────────────┐ │ binary_variant │ ├──────────────────────────────────────────────────────────────────────────┤ │ 40000002100000031000000610000005200000026B65796E756D62657276616C7565507B │ └──────────────────────────────────────────────────────────────────────────┘ SELECT TO_BINARY(TO_BITMAP('10,20,30')) AS binary_bitmap; ┌──────────────────────────────────────────────────────────────────────┐ │ binary_bitmap │ ├──────────────────────────────────────────────────────────────────────┤ │ 0100000000000000000000003A3000000100000000000200100000000A0014001E00 │ └──────────────────────────────────────────────────────────────────────┘ SELECT TO_BINARY(ST_GEOMETRYFROMWKT('SRID=4326;POINT(1.0 2.0)')) AS binary_geometry; ┌────────────────────────────────────────────────────┐ │ binary_geometry │ ├────────────────────────────────────────────────────┤ │ 0101000020E6100000000000000000F03F0000000000000040 │ └────────────────────────────────────────────────────┘ SELECT TO_BINARY(ST_GEOGRAPHYFROMEWKT('SRID=4326;POINT(-122.35 37.55)')) AS binary_geography; ┌────────────────────────────────────────────────────┐ │ binary_geography │ ├────────────────────────────────────────────────────┤ │ 0101000020E61000006666666666965EC06666666666C64240 │ └────────────────────────────────────────────────────┘ TRY_TO_BINARY 是 TO_BINARY 的增强版本,它将输入表达式转换为二进制值,如果转换失败则返回 NULL,而不是报错。 SELECT TRY_TO_BINARY(PARSE_JSON(NULL)) AS binary_variant_invalid_json; ┌─────────────────────────────┐ │ binary_variant_invalid_json │ ├─────────────────────────────┤ │ NULL │ └─────────────────────────────┘ 字符串函数:JARO_WINKLER JARO_WINKLER 计算两个字符串之间的 Jaro-Winkler 距离。它通常用于测量字符串之间的相似度,值范围从 0.0(完全不同)到 1.0(完全相同)。 SELECT JARO_WINKLER('databend', 'Databend') AS similarity; ┌────────────────────┐ │ similarity │ ├────────────────────┤ │ 0.9166666666666666 │ └────────────────────┘ SELECT JARO_WINKLER('databend', 'database') AS similarity; ┌────────────┐ │ similarity │ ├────────────┤ │ 0.9 │ └────────────┘ Databend 集成到 DBeaver 24.3.1 Databend 现已在 DBeaver 24.3.1 中获得官方支持,作为 Analytical 数据库的新连接类型: 私有云管控平台 Databend 新增私有云管理平台,实现对私有云部署的 Databend 节点状态的监控和管理。 关于 Databend Databend 是一款开源、弹性、低成本,基于对象存储也可以做实时分析的新式数仓。期待您的关注,一起探索云原生数仓解决方案,打造新一代开源 Data Cloud。 👨‍💻‍ Databend Cloud:databend.cn 📖 Databend 文档:docs.databend.cn/ 💻 Wechat:Databend ✨ GitHub:github.com/databendlab...

优秀的个人博客,低调大师

Databend 产品月报(2024年9月)

很高兴为您带来 Databend 2024 年 9 月的最新更新、新功能和改进!我们希望这些增强功能对您有所帮助,并期待您的反馈。 新集成方式:字典 您现在可以通过定义字典的结构并指定外部数据源来创建字典。Databend 的字典功能提供了一种高效的方式,可以直接在 Databend 中集成并查询来自支持的外部数据源(目前支持 MySQL 和 Redis)。通过充当内存中的键值存储,字典能够快速访问外部数据,而不需要复杂的数据管道或传统的 ETL 过程。 以下示例创建了一个引用 MySQL orders 表的字典。完整示例请参阅: https://docs.databend.cn/guides/query/dictionary CREATE DICTIONARY order_dict ( order_id INT, customer_name STRING, order_total INT ) PRIMARY KEY order_id SOURCE(MYSQL( host='mysql' port='3306' username='root' password='admin' db='dict' table='orders' )); 如果感兴趣,您可以跟随本教程进行实际操作体验:使用字典访问 MySQL 和 Redis。 SQL 变量 您现在可以使用 SQL 变量来存储和管理临时数据。在查询中使用变量时,您可以使用 $ 进行值替换,或使用 IDENTIFIER 访问数据库对象。有关更多信息,请参阅 SQL 变量。 您可以在 SQL 语句中通过 $ 符号或 getvariable() 函数引用变量的值。两种方法都支持动态替换,即在运行时将变量的值直接嵌入查询中。 -- Set a variable to use as a filter value SET VARIABLE threshold = 100; -- Use the variable in a query with $ SELECT * FROM sales WHERE amount > $threshold; -- Alternatively, use the getvariable() function SELECT * FROM sales WHERE amount > getvariable('threshold'); IDENTIFIER 关键字允许您动态引用存储在变量中的数据库对象名。请注意,使用 IDENTIFIER 访问对象的功能在 BendSQL 中尚未支持。 -- Create a table with sales data CREATE TABLE sales_data (region TEXT, sales_amount INT, month TEXT) AS SELECT 'North', 5000, 'January' UNION ALL SELECT 'South', 3000, 'January'; select * from sales_data; -- Set variables for the table name and column name SET VARIABLE table_name = 'sales_data'; SET VARIABLE column_name = 'sales_amount'; -- Use IDENTIFIER to dynamically reference the table and column in the query SELECT region, IDENTIFIER($column_name) FROM IDENTIFIER($table_name) WHERE IDENTIFIER($column_name) > 4000; 故障安全(Fail-Safe) Databend 中的故障安全机制旨在从对象存储中恢复丢失或意外删除的数据。目前,故障安全仅支持 S3 兼容的存储类型。有关故障安全的更多信息,请参阅故障安全。 CALL SYSTEM$FUSE_AMEND('<database_name>', '<table_name>'); 要使故障安全(Fail-Safe)生效,必须启用存储桶版本控制。请注意,启用版本控制之前创建的数据无法通过此方法恢复。 流提示 流提示允许您通过提示来指定各种流配置选项,从而控制流的处理方式。 SELECT ... FROM <stream_name> WITH (<hint1> = <value1>[, <hint2> = <value2>, ...]) 可用的提示选项: CONSUME : 指定此查询是否会消费流。默认为 False。 MAX_BATCH_SIZE: 定义从流中每批处理的最大行数。 有关这些提示和示例的更多信息,请参阅 WITH 流提示。 新增 FUSE 引擎选项 我们引入了一个新的 FUSE 引擎选项 data_retention_period_in_hours,允许您指定保留表数据的小时数。有关更多信息,请参阅 FUSE 引擎。 Databend Cloud 体验优化 我们给 Databend Cloud 带来了一些新功能,准备好迎接更棒的体验吧! TASK_HISTORY 表函数 我们引入了一个新的表函数 TASK_HISTORY,用于显示任务运行历史。 -- Retrieve all task history records SELECT * FROM TASK_HISTORY() order by scheduled_time; -- Retrieve the task history records where the scheduled time range starts at '2022-01-02T01:12:00-07:00' and ends at '2022-01-02T01:12:30-07:00'. SELECT * FROM TASK_HISTORY( SCHEDULED_TIME_RANGE_START=>TO_TIMESTAMP('2022-01-02T01:12:00-07:00'), SCHEDULED_TIME_RANGE_END=>TO_TIMESTAMP('2022-01-02T01:12:30-07:00')); 批量操作 您可以对计算集群执行批量操作,包括批量重启、批量暂停、批量恢复和批量删除。要进行批量操作,可以在计算集群列表中勾选所需操作的计算集群,然后点击省略号按钮选择所需的操作。 新教程 分析 AWS 账单:在本教程中,我们将指导您完成导入 AWS 账单数据并使用 SQL 进行成本分析的过程。您将学习如何将 AWS 账单数据加载到 Databend Cloud 中,查询以找出主要的成本驱动因素,并深入了解您的 AWS 使用情况。 从 Snowflake 迁移:在本教程中,我们将指导您完成将数据从 Snowflake 导出为 Parquet 格式并存储到 Amazon S3 存储桶的过程,然后将其加载到 Databend Cloud 中。 授予财务人员访问权限 为了便利财务团队的工作,同时确保数据安全,您可以在 Databend Cloud 中创建一个名为 billing 的角色。 CREATE ROLE billing; 该角色将专门为仅提供与账单相关的信息访问而定制。有关更多信息,请参阅授予财务人员访问权限。

优秀的个人博客,低调大师

Databend 产品月报(2024年8月)

很高兴为您带来 Databend 2024 年 8 月的最新更新、新功能和改进!我们希望这些增强功能对您有所帮助,并期待您的反馈。 Kafka Connect Sink Connector 插件 我们推出了一种将 Kafka 连接到 Databend 的新方式:databend-kafka-connect,这是一个 Kafka Connect sink connector 插件。该插件支持 Append Only 和 Upsert 两种写入模式,并能根据数据的 schema 自动在 Databend 中创建目标表。了解更多详情,请查看文档。 想亲身体验如何将 Kafka 消息加载到 Databend,请探索以下教程: 使用 bend-ingest-kafka 从 Kafka 加载数据:https://docs.databend.cn/tutorials/load/kafka-bend-ingest-kafka 使用 databend-kafka-connect 从 Kafka 加载数据:https://docs.databend.cn/tutorials/load/kafka-databend-kafka-connect 全文模糊搜索 全文搜索函数 MATCH 和 QUERY 现在可以在语法中包括以下选项,以支持模糊搜索: fuzziness: 允许在指定的 Levenshtein 距离内匹配关键字。 operator: 指定多个查询关键字如何组合。可以设置为 OR(默认)或 AND。OR 返回包含任何查询关键字的结果,而 AND 返回包含所有查询关键字的结果。 lenient: 控制在查询文本无效时是否报告错误。默认为 false。如果设置为 true,当查询文本无效时不会报告错误,结果集将为空。 以下是一些简单的例子: 使用模糊度 fuzziness=1 时,查询关键字 "box" 允许匹配像 "fox" 这样的单词,因为 "box" 和 "fox" 的 Levenshtein 距离为 1: SELECT id, score(), content FROM t WHERE match(content, 'box', 'fuzziness=1'); 使用 operator=AND 时,以下查询要求结果中同时包含 "action" 和 "works": SELECT id, score(), content FROM t WHERE query('content:action works', 'fuzziness=1;operator=AND'); 由于 fuzziness=1,它还会匹配像 "Actions" 和 "words" 这样的单词,因此会返回 "Actions speak louder than words"。 FUSE_STATISTIC 新增直方图信息 FUSE_STATISTIC 函数现在包括一个新的统计特性:直方图。这个新功能提供了有关每列数据分布的详细信息: bucket id: 桶的标识符。 min: 桶内的最小值。 max: 桶内的最大值。 ndv (number of distinct values) : 桶内唯一值的计数。 count: 桶内的总值数量。 以下是一个简单的例子: SELECT * FROM FUSE_STATISTIC('default', 'sample'); ┌───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────┐ │ column_name │ distinct_count │ histogram │ ├─────────────┼────────────────┼────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────┤ │ name │ 6 │ [bucket id: 0, min: "Alice", max: "Alice", ndv: 1.0, count: 1.0], [bucket id: 1, min: "Bob", max: "Bob", ndv: 1.0, count: 1.0], [bucket id: 2, min: "Charlie", max: "Charlie", ndv: 1.0, count: 1.0], [bucket id: 3, min: "Diana", max: "Diana", ndv: 1.0, count: 1.0], [bucket id: 4, min: "Eve", max: "Eve", ndv: 1.0, count: 1.0], [bucket id: 5, min: "Frank", max: "Frank", ndv: 1.0, count: 1.0] │ │ age │ 5 │ [bucket id: 0, min: "25", max: "25", ndv: 1.0, count: 1.0], [bucket id: 1, min: "28", max: "28", ndv: 1.0, count: 1.0], [bucket id: 2, min: "28", max: "28", ndv: 1.0, count: 1.0], [bucket id: 3, min: "30", max: "30", ndv: 1.0, count: 1.0], [bucket id: 4, min: "35", max: "35", ndv: 1.0, count: 1.0], [bucket id: 5, min: "40", max: "40", ndv: 1.0, count: 1.0] │ │ user_id │ 6 │ [bucket id: 0, min: "1", max: "1", ndv: 1.0, count: 1.0], [bucket id: 1, min: "2", max: "2", ndv: 1.0, count: 1.0], [bucket id: 2, min: "3", max: "3", ndv: 1.0, count: 1.0], [bucket id: 3, min: "4", max: "4", ndv: 1.0, count: 1.0], [bucket id: 4, min: "5", max: "5", ndv: 1.0, count: 1.0], [bucket id: 5, min: "6", max: "6", ndv: 1.0, count: 1.0] │ └───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────┘ Databend Cloud 体验优化 我们给 Databend Cloud 带来了一些新功能,准备好迎接更棒的体验吧! 您现在可以将工作区分享给您组织中的所有人或特定的个人。 支持对计算集群进行批量重启、批量挂起、批量恢复和批量删除操作。 新 SQL 函数 我们新增了一些SQL函数: JQ : 允许您对存储在 Variant 列中的 JSON 数据应用 jq 过滤器。 JSON_OBJECT_AGG : 将键值对转换为 JSON 对象。 JSON_ARRAY_AGG : 将值转换为 JSON 数组,同时跳过 NULL 值。 MONTHS_BETWEEN : 返回两个日期之间相隔的月份个数. 性能优化 了解我们最新的改进,这些提升使 Databend 更加高效、精确和可靠: 全局计划缓存: 引入了SQL执行计划缓存功能,通过缓存和重用查询计划,加速重复查询的处理,提升性能 十进制计算: 修复了十进制乘法问题,确保计算结果始终精确。 UDF 执行: 优化了 JavaScript 运行时,减少了延迟,提高了用户自定义函数的执行速度。 网络操作: 改进了对网络错误的处理,使 Databend 在分布式环境中更具韧性。 JOIN 性能: 提升了 JOIN 操作的效率,特别是在集群模式下,加快了查询处理速度,减少了复杂查询的延迟。

优秀的个人博客,低调大师

产品动态 | StreamNative 宣布开源 AWS SQS Connector

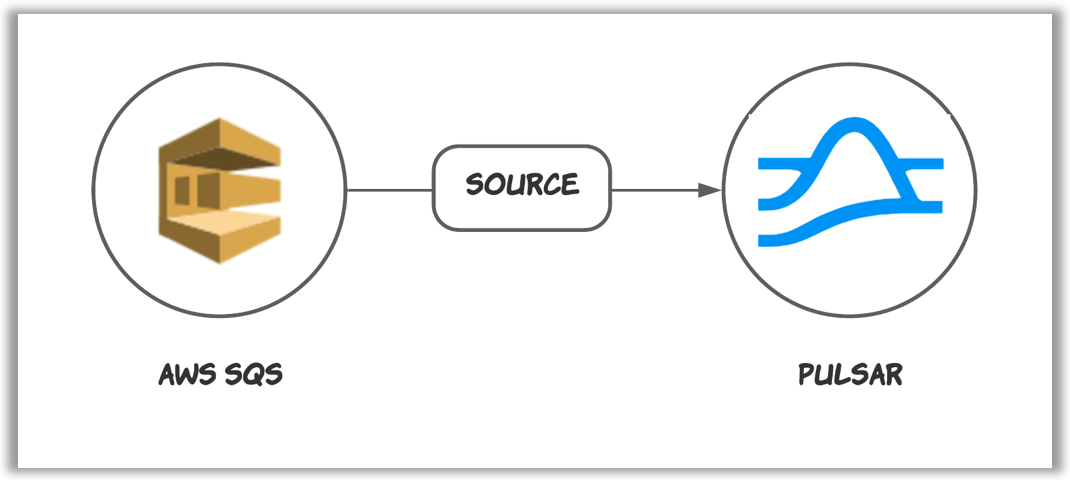
今天,我们很自豪地宣布 StreamNative 发布并开源首版AWS Simple Queue Service (SQS) connector[1]!通过 SQS connector,你能轻松地在 Pulsar 与 SQS 之间移动数据,并充分利用这两种消息系统的优势。这标志着 StreamNative 在提升 Pulsar 生态系统的多样性、完整性和生产力方面又向前跨越了一大步。 SQS connector 是什么? 众所周知,检验消息系统的重要指标之一是与周边生态的集成状况。与其它Pulsar connector[2]一样,SQS connector 是构建 Apache Pulsar 周边生态的重要组成部分。SQS connector 能够帮助你快速高效地在 Pulsar 和 SQS 之间移动数据,具有以下两类 connector: •SQS source connector – 将 SQS 的数据导入至 Pulsar。 •SQS sink connector – 将 Pulsar 的数据导出至 SQS。 为什么开发 SQS connector? 在当今云原生时代,Apache Pulsar 与AWS SQS[3]是构建分布式架构的重要组件和基础软件。 Pulsar 是下一代云原生分布式消息系统,具备强扩展性、高一致性和高弹性,有着非常广阔的应用前景。近年来,Pulsar 发展势如破竹,全球用户基数迅速增长,催生了更多集成流数据管道与事件驱动应用程序的需求。 SQS 是 Amazon 完全托管的消息队列服务,适用于分离和扩展微服务、分布式系统和无服务器应用程序,并支持动态弹性扩展。因为其操作简单、上手快速等特点,颇受用户青睐。 Pulsar 和 SQS 都拥有广泛的用户群体和强劲的开发支持,越来越多的用户都在使用这两种消息系统。同时,我们也收到了用户的需求,希望能在 Pulsar 与 SQS 之间移动数据,并充分利用这两种消息系统的优势。 SQS connector 有哪些优势? 为了使 Pulsar 与 SQS 拥有稳定的流式集成,SQS connector 具备诸多优势,包括但不限于: •易上手。无需编写任何代码,只需进行一些简单配置,便可通过 SQS connector 在 Pulsar 和 SQS 之间移动数据。简化的数据导入和导出过程能大幅提升企业的数据使用效率。•易扩展。根据不同的业务需求,可以选择在单机或集群上运行 SQS connector,助力企业构建实时数据管道。•可持续。SQS connector 简单的安装和部署过程,使企业能更专注和更高效地探索数据的商业价值。 如何参与? 此次,我们发布了 SQS connector 2.7.0,并构建了丰富的周边资源和活跃的开发社区。你可以通过以下任一方式参与该项目: •想上手试试?如需下载 SQS connector 2.7.0 和查阅用户指南(帮助你快速上手使用),点击这里查看[4]。•想解决问题?如有任何问题,你都可以在 SQS connector GitHub repo 中创建issue[5]、或发送至Pulsar mailing list[6]、或在Twitter[7]上留言、或加入Pulsar Slack[8]的 #connector-sqs 频道或加入 Pulsar 微信群进行讨论。无论哪种方式,Pulsar 资深专家都随时 standby。•想参与贡献?SQS connector 源码开放并托管在 GitHub 上。如需改进功能或修复 bug,欢迎提交 PR。 StreamNative 一直致力于为 Pulsar 构建丰富和完善的生态系统。与其它 Pulsar 集成和插件一样,SQS connector 也是StreamNative Hub[9]的重要组成部分。作为 Pulsar 的“活水源”,StreamNative 孜孜不倦多筑渠,引得潺潺活水来,竭尽全力为用户赋能,为企业增效,共同努力破局下一个云时代。 关于 StreamNative StreamNative 是一家开源基础软件公司,由 Apache 软件基金会顶级项目 Apache Pulsar 创始团队组建而成,围绕 Pulsar 打造下一代云原生批流融合数据平台。StreamNative 作为 Apache Pulsar 商业化公司,专注于开源生态和社区构建,致力于前沿技术领域的创新,创始团队成员曾就职于 Yahoo、Twitter、EMC 等知名大公司。 引用链接 [1]AWS Simple Queue Service (SQS) connector:https://github.com/streamnative/pulsar-io-sqs[2]Pulsar connector:http://pulsar.apache.org/docs/en/io-overview/[3]AWS SQS:https://aws.amazon.com/sqs/[4]SQS connector 文档:https://github.com/streamnative/pulsar-io-sqs/blob/master/README.md[5]反馈 SQS connector 问题:https://github.com/streamnative/pulsar-io-sqs/issues/new/choose[6]Pulsar mailing list:https://lists.apache.org/list.html?dev@pulsar.apache.org[7]StreamNative Twitter:https://twitter.com/streamnativeio[8]Pulsar Slack #connector-sqs 频道:https://apache-pulsar.slack.com/archives/C01NG4T1BU6[9]StreamNative Hub:https://streamnative.io/en/blog/tech/2020-05-26-intro-to-hub 点击“阅读原文”,立即试用 AWS SQS Connector! 本文分享自微信公众号 - StreamNative(StreamNative)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册