首页 文章 精选 留言 我的

精选列表

搜索[Java库],共10000篇文章
优秀的个人博客,低调大师

Python正则表达式re库的使用

指导思想:正则表达式只是一个工具,学会其中一种使用方法即可 1. ()和re.findall结合使用 ({}{})中第一个大括号替换为.则表示匹配所有字符,替换为[]则表示匹配中括号内限定的字符; 第二个大括号替换为*则表示匹配长度为>=0,替换为+则表示匹配长度为>=1,替换为空则表示匹配长度为1 (.*)表示匹配任意长度的所有字符 ([0-9]*)表示匹配任意长度的数字 ([0-9,a-z])表示匹配长度为1的数字和小写字母 re.findall函数需要传入2个参数,第1个参数是正则表达式,第2个参数是要进行搜索的源字符串。 re.findall函数返回结果的数据类型为列表,列表中的第1个元素的数据类型为元祖。 示例代码如下: import re if __name__ == "__main__": sourceStr = "11房5厅8卫" sourceStr2 = "a房b厅3卫" pattern_all = "(.*)房(.*)厅(.*)卫" pattern_number = "([0-9]*)房([0-9]*)厅([0-9]*)卫" pattern_numberAndLetter = "([0-9,a-z])房([0-9,a-z])厅([0-9,a-z])卫" print("正则表达式找出中间的字符:") result = re.findall(pattern_all, sourceStr) print(result,type(result),type(result[0])) print(re.findall(pattern_all,sourceStr2)) print("正则表达式找出中间的数字") print(re.findall(pattern_number,sourceStr)) print(re.findall(pattern_number,sourceStr2)) print("正则表达式找出中间的数字和字母") print(re.findall(pattern_numberAndLetter, sourceStr)) print(re.findall(pattern_numberAndLetter, sourceStr2)) 上面一段代码的运行结果如下: 正则表达式找出中间的字符: [('11', '5', '8')] <class 'list'> <class 'tuple'> [('a', 'b', '3')] 正则表达式找出中间的数字 [('11', '5', '8')] [] 正则表达式找出中间的数字和字母 [('1', '5', '8')] [('a', 'b', '3')] 2. 正则表达式中的元字符 \s 用于匹配单个空格符,包括tab键和换行符; \S 用于匹配除单个空格符之外的所有字符; \d 用于匹配从0到9的数字; \w 用于匹配字母,数字或下划线字符; \W 用于匹配所有与\w不匹配的字符; . 用于匹配除换行符之外的所有字符。 例如上一节中的([0-9]*)与([\d]*)作用相同 3. ()和re.search结合使用 re.search函数需要传入2个参数,第1个参数是正则表达式,第2个参数是要进行搜索的源字符串。 re.search函数返回结果的数据类型是sre.SRE_Match对象,span=(3,9)是匹配结果的索引,从索引3开始,不包括索引9。 把re.search函数返回结果赋值给result,通过result.group函数获取匹配结果,result.group函数需要传入1个参数,参数的数据类型为无符号整型,参数为0时,为正则表达式匹配到的长句内容;参数为1时,为正则表达式匹配到的第1个小括号中的内容;参数为2时,为正则表达式匹配到的第2个小括号中的内容,依此类推。 示例代码如下: import re if __name__ == "__main__": sourceStr = "户型:3室2厅2卫" pattern_all = "([\d]*)室(.)厅(.)卫" result = re.search(pattern_all,sourceStr) print(result) print(result.group(0)) print(result.group(1)) print(result.group(2)) print(result.group(3)) 上面一段代码的运行结果如下: <_sre.SRE_Match object; span=(3, 9), match='3室2厅2卫'> 3室2厅2卫 3 2 2 4 re.match的使用 re,match在实际应用中很少,不建议使用。 re.match能够匹配的前提是必须字符串索引0的位置能够匹配到。 import re if __name__ == "__main__": re1 = "hel." re2 = ".el" re3 = ".hel" re4 = "el" sourceStr = "hello" print(re.match(re1,sourceStr)) print(re.match(re2,sourceStr)) print(re.match(re3,sourceStr)) print(re.match(re3,sourceStr)) 上面一段代码的运行结果如下: <_sre.SRE_Match object; span=(0, 4), match='hell'> <_sre.SRE_Match object; span=(0, 3), match='hel'> None None
优秀的个人博客,低调大师

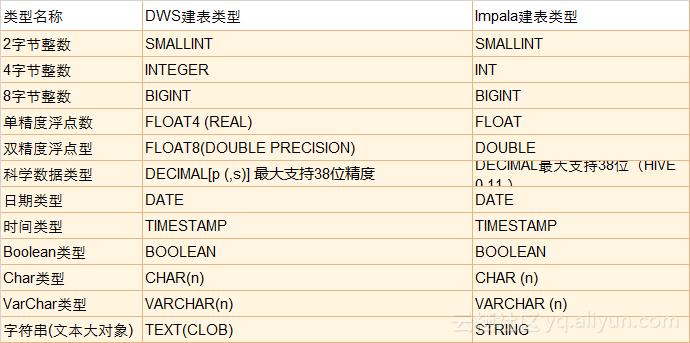
DWS和各异构数据库的差异对比

类型名称 DWS建表类型 Impala建表类型2字节整数 SMALLINT SMALLINT4字节整数 INTEGER INT8字节整数 BIGINT BIGINT单精度浮点数 FLOAT4 (REAL) FLOAT双精度浮点型 FLOAT8(DOUBLE PRECISION) DOUBLE科学数据类型 DECIMAL[p (,s)] 最大支持38位精度 DECIMAL最大支持38位(HIVE 0.11)日期类型 DATE DATE时间类型 TIMESTAMP TIMESTAMPBoolean类型 BOOLEAN BOOLEANChar类型 CHAR(n) CHAR (n)VarChar类型 VARCHAR(n) VARCHAR (n)字符串(文本大对象) TEXT(CLOB) STRING

优秀的个人博客,低调大师

其实它是个Python库

今天,谷歌联合Columbia University、Adobe(就是你们知道的那个Adobe)提出深度概率编程语言Edward,我就其发布Edward的专业论文,给大家介绍一下,这个秒天秒地秒空气的牛逼哄哄的新语言(框架)。 为什么开发Edward? 因为现在的概率编程语言啊, Too Young!Too Simple! 原文是这样的: Rather, most existing probabilistic programming languages treat the inference engine as a black box,abstracted away from the model. These cannot capture the recent advances in probabilistic inference that

优秀的个人博客,低调大师

标准模板库(STL)学习指南之set集合

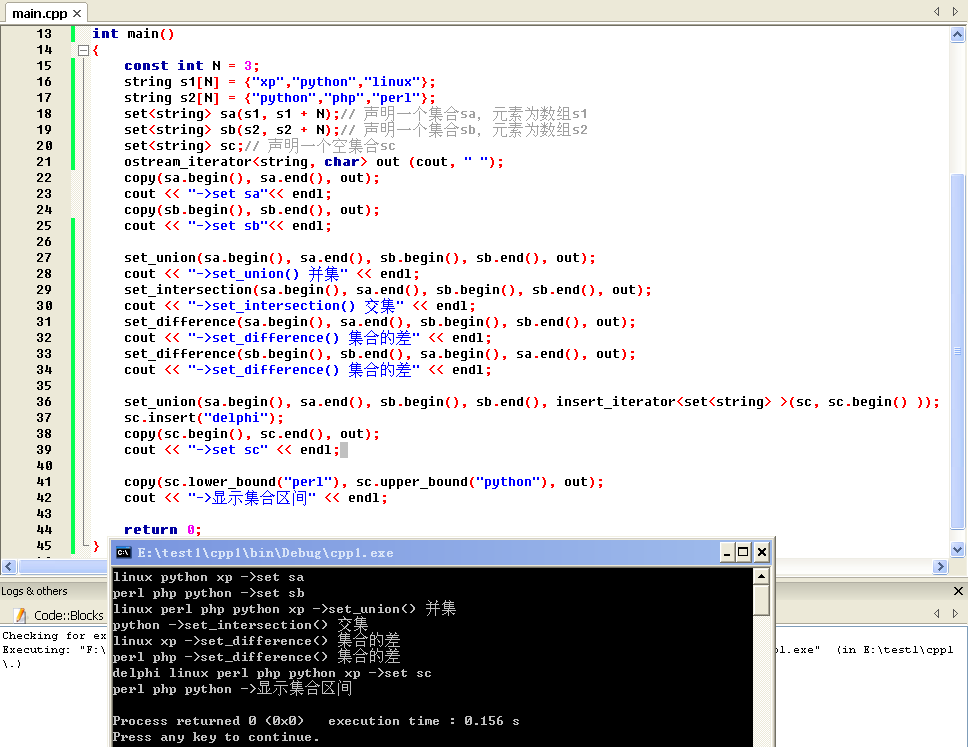
set是关联容器。其键值就是实值,实值就是键值,不可以有重复,所以我们不能通过set的迭代器来改变set的元素的值,set拥有和list相同的特性:当对他进行插入和删除操作的时候,操作之前的迭代器依然有效。当然删除了的那个就没效了。set的底层结构是RB-tree,所以是有序的。 stl中特别提供了一种针对set的操作的算法:交集set_intersection,并集set_union,差集set_difference。对称差集set_symeetric_difference,这些算法稍后会讲到。 一:set模板类的声明。 template < class key class =Traitsless<key> class Allocator=allocator<key> > class set。 其中个参数的意义如下: key:要放入set里的数据类型,可以是任何类型的数据。 Traits:这是一个仿函数(关于仿函数是什么,我后面的文章会讲到)。提供了具有比较功能的仿函数,来觉得元素在set里的排列的顺序,这是一个可选的参数,默认的是std::less<key>,如果要自己提供这个参数,那么必须要遵循此规则:具有两个参数,返回类型为bool。 Allocator:空间配置器,这个参数是可选的,默认的是std::allocator<key>. 二:set里的基本操作 我们可以通过下面的方法来实例化一个set对象 std::set<int> s;那个s这个对象里面存贮的元素是从小到大排序的,(因为用std::less作为比较工具。) 如果要想在s里面插入数据,可以用inset函数(set没用重载[]操作,因为set本生的值和索引是相同的) s.insert(3);s.insert(5)..... 因为set是集合,那么集合本身就要求是唯一性,所以如果要像set里面插入数据和以前的数据有重合,那么插入不成功。 可以通过下面的方法来遍历set里面的元素 1 2 3 4 5 std::set< int >::iterator it = s.begin(); while (it!=s.end()) { cout<<*it++<<endl; //迭代器依次后移,直到末尾。 } 如果要查找一个元素用find函数,it = s.find(3);这样it是指向3的那个元素的。可以通过rbegin,rend来逆向遍历 1 2 3 4 5 std::set< int >::reverse_iterator it = s.rbegin(); while (it!=s.rend()) { cout<<*it++<<endl; } 还有其他的一些操作在这就不一一列出了。 三:set向量的使用实例 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 #include <iostream> #include <string> #include <set> #include <algorithm> #include <iterator> using namespace std; /* 联合容器将值与关键字联合在一起,使用关键字来查找值, * 提供元素的快速访问,插入元素不能指定位置,容器自动处理插入位置 * STL 提供四种联合容器:set、multiset、map、multimap * set、multiset 存储一种元素,前者关键字不可重复,后者关键字可以重复。 * map、multimap 存储一对元素键与值,前者关键字不可重复,后者关键字可以重复。 */ int main() { const int N = 3; string s1[N] = { "xp" , "python" , "linux" }; string s2[N] = { "python" , "php" , "perl" }; set<string> sa(s1, s1 + N); // 声明一个集合sa,元素为数组s1 set<string> sb(s2, s2 + N); // 声明一个集合sb,元素为数组s2 set<string> sc; // 声明一个空集合sc ostream_iterator<string, char > out (cout, " " ); copy(sa.begin(), sa.end(), out); cout << "->set sa" << endl; copy(sb.begin(), sb.end(), out); cout << "->set sb" << endl; set_union(sa.begin(), sa.end(), sb.begin(), sb.end(), out); cout << "->set_union() 并集" << endl; set_intersection(sa.begin(), sa.end(), sb.begin(), sb.end(), out); cout << "->set_intersection() 交集" << endl; set_difference(sa.begin(), sa.end(), sb.begin(), sb.end(), out); cout << "->set_difference() 集合的差" << endl; set_difference(sb.begin(), sb.end(), sa.begin(), sa.end(), out); cout << "->set_difference() 集合的差" << endl; set_union(sa.begin(), sa.end(), sb.begin(), sb.end(), insert_iterator<set<string> >(sc, sc.begin() )); sc.insert( "delphi" ); copy(sc.begin(), sc.end(), out); cout << "->set sc" << endl; copy(sc.lower_bound( "perl" ), sc.upper_bound( "python" ), out); cout << "->显示集合区间" << endl; return 0; } 作者:ACShiryu出处:http://www.cnblogs.com/ACShiryu/若非注明,本博客文章均为原创,版权归作者和博客园共有,欢迎转载,但必须保留此段声明,且在文章页面明显位置给出原文链接,否则保留追究法律责任的权利。该文章也同步发布在我的新浪微博中-ACShiryu's weibo,欢迎收听。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册