首页 文章 精选 留言 我的

精选列表

搜索[webpack入门],共10000篇文章
优秀的个人博客,低调大师

Xamarin android SwipeRefreshLayout入门实例

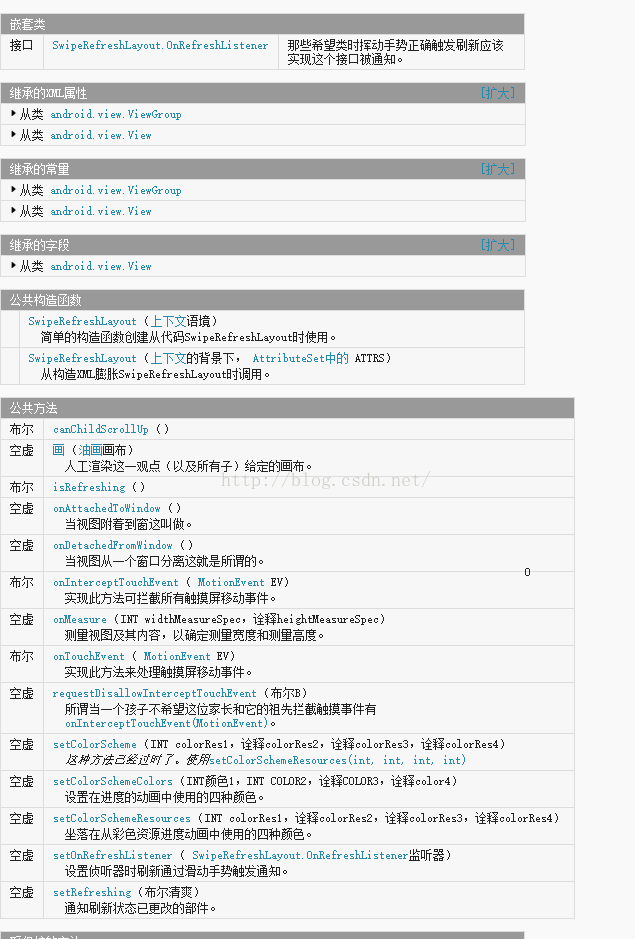
android SwipeRefreshLayout 是实现的效果就是上滑下拉刷新ListView 获取其他控件数据.基本上每个App都有这种效果。Google提供了一个官方的刷新控件SwipeRefreshLayout,当然你得引入V4兼容包哦还不错项目中也用到了。所以就演示一下这个控件怎么使用吧. 还是先看一下Android SwipeRefreshLayout的API吧 谷歌翻译是这么说的: 的SwipeRefreshLayout应该用于每当用户可以通过一个垂直扫掠姿态刷新的图的内容。每当完成刷新姿态刷卡被告知实例这种观点应该添加一个OnRefreshListener的活动。该SwipeRefreshLayout将通知每一个手势再次完成一次每个听者和;听者负责正确确定何时开始实际内容的刷新。如果侦听确定不应该有一个刷新,它必须调用setRefreshing(假)来取消刷新的任何可视指示。如果活动希望只显示进度动画,它应该调用setRefreshing(真)。要禁用的姿态和进步的动画,在视图上调用的setEnabled(假)。 这种布局应该由将被刷新为手势的结果,只能支持一个直接子视图的父。此视图也将作出手势的目标和将被迫以匹配的宽度,并在此布局提供的高度。该SwipeRefreshLayout不提供无障碍的事件;相反,必须提供一个菜单项,以允许内容的刷新无论使用该手势。 看一下 效果图: 具体代码如下,先看一下布局页:Main.axml <?xml version="1.0" encoding="utf-8"?> <LinearLayout xmlns:android="http://schemas.android.com/apk/res/android" android:orientation="vertical" android:layout_width="match_parent" android:layout_height="match_parent"> <android.support.v4.widget.SwipeRefreshLayout android:id="@+id/swipeRefreshLayout" android:layout_width="match_parent" android:layout_height="match_parent" > <ListView android:id="@+id/listView" android:layout_width="match_parent" android:layout_height="match_parent"> </ListView> </android.support.v4.widget.SwipeRefreshLayout> </LinearLayout>MainActivity.cs: using Android.App; using Android.Runtime; using Android.Widget; using Android.OS; using Android.Support.V4.Widget; namespace SwipeRefreshLayoutDemo { [Activity(Label = "SwipeRefreshLayoutDemo", MainLauncher = true, Icon = "@drawable/icon")] public class MainActivity : Activity { int count = 1; private SwipeRefreshLayout swipeRefreshLayout; private ListView listView; private ArrayAdapter<string> adapter; private JavaList<string> data= new JavaList<string>{"恩比德","拉塞尔","安东尼-戴维斯","西蒙斯"}; protected override void OnCreate(Bundle bundle) { base.OnCreate(bundle); SetContentView(Resource.Layout.Main); listView = (ListView)FindViewById(Resource.Id.listView); swipeRefreshLayout = FindViewById<SwipeRefreshLayout>(Resource.Id.swipeRefreshLayout); swipeRefreshLayout.Refresh += (s, e) => { data.Add("张林-布莱恩特"); adapter.NotifyDataSetChanged(); swipeRefreshLayout.SetColorScheme(Android.Resource.Color.HoloRedLight); swipeRefreshLayout.Refreshing=false; }; adapter = new ArrayAdapter<string>(this,Android.Resource.Layout.SimpleListItem1,data); listView.Adapter = adapter; } } } 示例非常简单,体验一下效果而已。也许有人很郁闷了,这个JavaList是什么玩意?如果用List的话,下拉刷新就没有效果。目前就到这儿,过两天去问问牛哥,看是怎么回事。 昨天晚上写的,今天下午来改一改。终于找到了原因,这个Android自带的适配器选项样式对于List可能是个bug,所以呢自己写一个Adapter就可以用List了 示例代码下载: http://download.csdn.net/detail/kebi007/9652257 作者:张林 原文地址:http://blog.csdn.net/kebi007/article/details/52801731 转载随意注明出处

优秀的个人博客,低调大师

推送 从入门到放弃

推送 推送简直就是一种轻量级的骚扰方式 自从有了推送,各个公司基本上都在使用推送,这确实是一个比较好的提醒方式,Android较iOS强的一个部分,也就是在于Android的Notification。Google教育我们利用好Android的通知模块,做更多友好的交互,可这句话,翻译成中文,不知不觉,就变成了在Notification中推送各种广告,而且仅仅就是一些广告,Notification各种牛逼的功能,完全不需要,这也违背了Google设计Notification的初衷。 更关键的是,现在随便找一款App,没有推送的真是凤毛麟角,更可恶的是,做外卖的App给我推送奥运新闻,一条新闻十几个App推送,以至于现在很多用户都非常反感各种推送广告,就我本人而言,基本上会禁用所有广告类的App的推送。 本人非常反感推送,借用王思聪的一句话,XXX App天天给我推送各种广告,还TM是自己做的推送,真是绝了。 推送方案 轮询 轮询是最简单的与服务器保持通信的方式,即循环向服务器通信。这个方案的特点就是通信由客户端主动发起,你需要自己实现轮询消息队列、频率等等参数,在功耗和效果间做权衡,类似于TCP的短连接。 SMS 这个其实就是借助短信来实现信息的展示,只不过把短信内容展示到了Notification中,这个方案,到达率确实高,毕竟短信是比较可靠、稳定的,但劣势也很明显,就是成本很高,而且在Android平台上,短信的权限比较开放,容易被劫持。 长连接 长连接和前面提到的短连接,都是基于Socket连接的方式,他们的区别在与,短连接是每次数据传输完毕后就断开连接,而长连接不会。所以,基于轮询的方式,每次都要进行链路的连接,性能消耗更大,基于长连接的方式,就是对这点的改进。应用一旦与服务器连接成功,并不会主动断开连接,后面的通信都基于这个通道。目前大部分的推送服务都是基于长连接的推送,在后台维护一个Service,维持应用与服务端之间的TCP长连接。 推送方案 iOS iOS这边使用系统统一的APNs,所有推送消息都由苹果的服务器进行下发,同时,也由系统进行统一展示和处理。 GCM 与iOS一样,Android同样有一套内置的推送方案,但很可惜的是,Google的服务在中国大陆无法使用,草了个蛋。 第三方推送服务 专业的第三方推送 极光 个推 友盟推送 手机ROM厂商推送 华为推送 小米推送 BAT级别的全家桶 阿里推送 信鸽推送 百度推送 关于第三方推送服务在各个App中的使用率,大家可以参考贾吉鑫的这篇文章: https://mp.weixin.qq.com/s?__biz=MzA5OTMxMjQzMw==&mid=2648112527&idx=1&sn=b23c1b5f3e32e343ad96d705bd4d63ff 第三方推送注意 这些推送服务大同小异,基本上一家使用了一个新功能,另外几家,也会很快推出这个功能,就例如之前比较火的,『共享推送通道进行App唤醒』这个技术,友盟、个推推出后,很快其它推送服务商就支持了,所以开发者并不需要担心哪一家推送功能比较强。 这里还需要说下现在的『推送唤醒』这样一个功能,简单的说,就是所有安装了A推送的App,只要有一个还活着,就可以把其它安装了A推送的App拉起来,从而提高推送的到达率。有些阿里系、百度系的App,被大家称作『全家桶』,实际上就是因为这个原因,这个方式,确实能在一定程度上提高推送到达率,但另一方面,也破坏了Android生态,增加了功耗,打乱了系统的清理策略。 另外,小米推送、华为推送,大家接入的原因可能很简单,就是他们的手机市场占有率比较高,接入他们自家的推送,可以在一定程度上提高到达率,但需要注意的是,推送分为透传和非透传两种方式,透传即我们自己App处理推送消息,而非透传,则是交给相应的PushSDK处理,对于小米推送、华为推送来说,只有采用非透传消息,到达率采用保证,而透传消息,与其它推送并没有什么区别,换句话说,小米手机、华为手机,只对非透传的推送消息做了可靠性保证,但非透传消息的展示格式非常固定、简单,且不能自定义,这是一个很大的问题,这点应该是很多开发者的误区。 最后,很多推送服务都需要在Application中进行初始化,同时,各种被唤醒策略,又会拉起Application,导致推送进程的重复,所以,这里经常需要对进程名进行过滤,非主进程,不进行初始化。 自建推送服务 基本都是基于AndroidPN、MQTT、XMPP、长连接这些方式去实现的,自己搭建Push平台服务,一个最大的问题就是服务端的架构设计,不仅成本高,而且效果不一定好,建议中小企业不要轻易尝试。 推送名词解释 RegistrationID\ClientID 一般来说,类似这类ID都是用于唯一标识应用\用户的,每个App在每台手机上都会生成一个唯一ID。 RegistrationID\ClientID生成规则 Android平台上因为国内存在大量山寨设备,所以很多设备的IMEI、Mac地址、AndroidID 都有可能为空或者错误,所以不能单独作为唯一标识,需要将这些进行组合起来使用。 对于应用卸载后RegistrationID的问题,很多PushSDK的策略是,生成一个DeviceID保存到本地存储,应用被卸载后如果被重新安装,如果检测到存储里的DeviceID还在的话,就判定是同一个设备,不重新生成RegistrationID。 AppKey\AppID 这些Key基本都是用于验证App的,每个包名对应一个加密的Key。 透传\非透传 非透传消息是指推送消息被PushSDK获取并处理,透传消息是指推送消息被PushSDK交给宿主应用处理,非透传消息通常只能设置一些固定的样式,比较简单,而透传消息,可以由App自定义处理,比较灵活。 推送数据基础 累计注册 通过应用使用的appid统计用户注册总量。 日在线用户 通过应用使用的appid统计当天的在线用户数。 活跃用户 通过应用使用的appid统计当天在推送平台激活过的用户总数。 在线下发率 在线消息下发数/总下发数。 回执率 消息回执数(去重)/消息在线下发数。 到达率 到达数/实际下发数。 百日内联网用户数(可推送用户数) 是指最近三个月内有登录过(设备与推送服务端建立长链接)的设备总数,即有效可下发的用户数。一般的推送服务端认为,设备在100天内没有登录请求,认为该设备已经失效,所以无需再次发送。 实际下发数 实际可推送设备数(在消息有效期内,有联网并推送进程正常的设备,即消息有效期内的在线下发数。消息有效期就是设置的离线时间)。 到达数 客户端SDK接收到消息的设备数(通过统计客户端SDK接收到消息后的回执获得)。 展示数 用自定义非透传消息在用户手机展示过的设备数。 点击数 点击通知栏消息的设备数。 推送数据分析 那么关于推送,大家实际上最关系的,就是『到达率』。那么这个到达率究竟怎么计算呢? 首先我们举个例子来说明上面的这些数据背后的实际意义,例如,我们有一款App,有100w的下载量,每个App启动后,都将上报给服务器一个唯一ID,所以,累计注册量就是100w,也称发送总量。 那么在服务端准备发送推送的时候,当前手机端推送进程还活着的,也就是说推送的长连接还健在的,就是在线设备,如果按天算,那么就叫日在线设备数,我们假设这个数字是60w。 OK,推送发出去后,客户端收到推送消息,并产生回执,代表完成了一次推送,假设这些完成推送的设备是55w,这个就是送达设备数。一般来说,只要设备在线,基本都能送达,所以这个数字和在线设备数非常接近,不接近的话,这个推送基本就有问题了,其中可能送不达的原因就在于网络切换等导致长连接断掉这类因素。 那么到这里,一般的推送服务商会使用送达设备数/在线设备数的方式来计算到达率,当然,前面我们也说了,这个比例一定是很高的,如果保持长连接的设备都不能收到推送,那一定是有问题了。 而一般的到达率,应该是送达设备数/可送达设备数,也就是百日内活跃的设备数,这样一除,这个比例一下子就小了很多,因为谁也不知道,这一百天内曾经活跃的用户,第二天是不是就已经把你卸载了。所以说,Android下统计推送的到达率一般都很低,而推送服务商宣传的到达率都很高,这其实就是一个偷换概念的问题,我们说的是一般的到达率,而服务商宣传的是在线到达率。 而且,这个到达率与iOS完全没有可比性,因为iOS统一通过APNs来进行推送,且无法获取到达回执,所以,iOS基本不存在到达率这一说法,如果有,几乎也是100%,完全没有意义,所以,如果哪一天有产品或者运营跟你说,为什么Android的到达率比iOS的到达率差这么多,请毫不客气的砸它一斤苹果。 Tag\Alias Tag Tag,或者叫标签,是用户的一种属性,在给某些用户设置某类标签后就可以针对推送。比如给喜欢『编程』的人打上『编程』的标签,就可以只给他们精准推送。 通常情况下,一个设备(在一个App里)可以设置多个标签。标签与别名类似,其对应关系也是保存在推送服务器侧的。 Alias Alias,或者叫别名,是对已经安装某应用的用户取个别名进行标识,在对该用户消息推送时,就可以用此别名来进行推送。设置了别名后,推送时服务器端指定别名即可。推送服务器端来把别名转化到设备ID来找到设备。 Tag和Alias他们的共同点在于,提供对用户的精确推送。 推送原理 目前大部分的第三方推送服务,都是基于长连接的推送方案,下面将对这个方式进行详细讲解。 NAT 首先,我们需要了解下一个网络基本知识——NAT,即网络地址转换(Network Address Translation,NAT),这是因为IP地址是有限的,手机无论是通过路由器还是数据网络,都有一个内网IP地址,同时,路由器上会维护一个外网IP地址,从而形成一个NAT路由表,即内网IP地址:端口,以及对应的外网IP地址:端口。这样通过一层层封装与解封装,就达到了内网与外网交换通信的方式。 NAT超时 由于NAT路由表的大小有效,所以一般路由都有NAT有效期,WIFI下,这个NAT有效期可能会比较长,而在数据流量下,运营商一般都会尽快更新NAT路由表,淘汰无效的设备,所以,在使用数据流量时,长连接经常容易断。 那么除了NAT路由表主动淘汰过期的设备之外,切换网络环境和DHCP服务器租期到期,这些情况都有可能导致NAT路由表改变,从而造成长连接中断。 心跳包 前面我们说了,现在的推送服务一般采用的是长连接的通信方式,而长连接会因为NAT路由表的更新而中断,所以,客户端会定时向服务端发送一个心跳包,来定期告知NAT路由表,我还活着,别杀我!这就是心跳包的作用——防止NAT路由表超时,同时检测连接是否被断开。 心跳包的心跳时间 既然心跳包的作用是防止NAT超时,那么就需要将心跳包的发送频率设置为小余NAT超时的检测频率,而WIFI和数据流量下,对于NAT路由表的超时时间又是不一样的,而且不同的网络运营商的超时时间,甚至都不一样,所以,一个比较好的方法就是根据设备当前网络环境,来动态的设置心跳时间。 注意,心跳包与轮询是不一样的,心跳包建立在长连接上,只要发送数据即可,而轮询每次都是一个完整的TCP连接。 心跳包谁来发 既然需要定时任务,那么就需要使用AlarmManager来作定时唤醒了,原因我之前的文章有讲过,是关于处理器唤醒的原因,这里就不赘述了,大家可以参考我之前的文章: http://mp.weixin.qq.com/s?__biz=MzAxNzMxNzk5OQ==&mid=2649484680&idx=1&sn=bd9086a95b769af8d8644cf681ce66ec#rd 进程保活 所谓进程保活,是指App希望尽可能的保证自己的App的推送进程能够存活在后台,以保证可以收到服务端的推送消息,因此,才出现了一大批关于进程保活的方式,例如NDK层的文件锁,fork子进程、前台服务、进程优先级等等方式,然而,这些东西,实际上,都不能完全保证手机的进程管理策略放过你,特别是Android 5.0以后的系统,Android对进程的管理更加严格,还有国内的这些ROM层的修改,ROM想要杀你这个进程,你怎么做也没有办法,哦,除了白名单。所以,不要再花心思去找什么进程保活的黑科技了,好好做好应用,提供用户的使用黏性,才是最佳的保活,而对于一些产品、运营所谓的『为什么微信、QQ都可以保活』这样的问题,我建议你回答它:『如果你能把产品做到微信、QQ那样的数量级,我也能让你活!』 推送整合方案 介于各种第三方推送与ROM推送的特点,我们目前采用的推送方案,名为『UniversalPushSDK』,即整合了多个不同的推送渠道,通过模板设计模式来进行整合,并向外暴露统一的接口,这种方式的好处在于UniversalPushSDK利用的各个不同推送特点,提高推送到达率,但是坏处在于,包的体积会大一些。例如,我们现在整合了『小米推送、极光推送、华为推送』,在系统启动的时候,判断当前系统,如果是小米系统,则启用『小米推送』,如果是华为手机,则启用『华为推送』,其它的Android设备,则启用『极光推送』,通过这种方式来设计我们自己的推送SDK,可以在一定程度上,利用好各个推送平台的特性。 那么如果利用这种方式来设计SDK给到不同的App接入,就需要能够将应用的推送Key做到动态配置,这也是我们遇到的最大的一个问题,解决方法大家可以参考我之前写的一篇文章: http://blog.csdn.net/eclipsexys/article/details/51283232 虽然我极力反对这种方案,我坚持认为,做好App,提升用户使用黏性,才是提升推送到达率的关键

优秀的个人博客,低调大师

docker基础入门之二

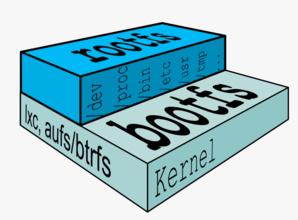
一、docker文件系统: linuxFS包括boot file system 和 root file system boot file system (bootfs),包含bootloader和kernel,在系统启动完成后,kernel滞留内存,bootfs解除挂载; root file system(rootfs),包括类似/bin,/usr, /lib等目录,这些和kernel无关,这也是不同linux发行版本的差异所在; Linux FS Linux FS in Docker 传统Linux启动时,将rootfs设置为readonly并检查完整性,然后设置成read-write Docker在启动container的时候,也是把rootfs设置为readonly,然后通过aufs把一个read-write的文件系统挂载到rootfs之上,并且把下层文件系统设置成readonly,这样构建一个完整的操作系统; 二、Layer FS 对于每层readonly的FS,在docker中成为image 对于顶上read-write的FS,成为container 对于readonly中内容的修改,采用的是COW的技术,把文件复制到read-write层并修改,实际用户看到的是当前container层中的文件,image中的文件是不受影响的; Image: 除了base image之外,每一层image都有一个parent image 没有parent image的镜像叫base image 基于cow的技术,image部分是不会被修改的,因此container可以共享image的FS,提高了存储效率; storage dirver 除了默认的aufs之外,docker通过对于storage的抽象,可以支持一些其他的storage driver; 例如:vfs, devicemapper, btrfs 修改docker启动时候的参数设置,增加——storage-driver = {storage plugin}在配置文件中; docker hub: docker官方提供的用来共享image的平台; 镜像命名和版本管理: base image是docker官方提供的基础镜像; 普通镜像的命名规范{namespace}/{repository name}:{tag} namespace是docker hub的用户名,实际是起namespace作用 repository,类似于github的项目,例如ubuntu, mysql等; tag,表示版本信息,例如cp/mysql:5.5, tag是可选的,默认值是latest 查找Image: docker search {repository name} #默认是在docker hub上进心搜索 获取Image: docker pull {image name} #如果不指定tag的话,会把该image的所有tags都会download下来; 上传Image: 1、docker login #登录到docker hub中 2、把container通过docker commit的命令转化成一个Image 3、通过docker tag来命名新生成的Image 4、docker push到docker hub中; 三、基本操作: 运行container: 运行一个container的本事就是开启一个具有独立namespace的进程 docker 通过run的命令来启动一个container 运行一个container必须要指定一个image作为初始化的文件系统; sudo docker run [OPTIONS] IMAGE[:TAG] [COMMANG][ARG....] Image: 对于不存在的Image,Docker会自动会Registry里面下载对于的Image,然后再运行container COMMAND: command标志的是container中实际运行的首进程; 如果Image里面包含了CMD的指令,那么在启动container的时候,不需要指定command,否则会使用指向command来覆盖Image的cmd 前台运行or后台运行: 默认的Container是在前台运行的,会绑定command进程的STDIN、STDOUT、STDERR到console上; 可以通过-d的选项让container运行在后台; 如果是前台运行,也可以通过指定-a {STDOUT、STDIN、STDERR}选择需要绑定的IO 前后台切换;通过attach命令可以重新attache一个后台运行的container 在后台运行的情况下,run命令会返回一下UUID,唯一标识container 可以通过docker ps来查看container的UUID和运行信息 可以通过指定——name的方式来指定container的名字,名字必须唯一 inspect: 通过docker inspect {Container ID}来获取container的更多的信息,包括网络、volume,实际在HOST上的进程ID等信息; Log: 通过Logs命令可以看到Container中的Command所指向进程的STDOUT、STDERR数据; 环境变量: 通过-e参数,可以在运行container的时候添加环境变量; Network架构: 在Host主机上的一个veth{id}的虚拟网卡和一个container里面的eth0网卡一一映射 Host上的bridge负责把数据流在不同的veth间转发,实现网络的IO bridge(docker0)使用RFC1918私有网络,给每一个container分配ip 网络设置: 通过——net参数来修改container的网络设置,默认是bridge的方式; --net host none表示关闭container的网络连接 host表示使用主机的网络栈,这个时候host主机不会创建veth虚拟网卡映射 container:{name|id}, 使用另外一个container的网络栈 端口映射: Docker通过采用端口映射的方式,允许把内部container的服务端口暴露到外部; 使用-p参数可以指定需要暴露的container的内部端口,在不指定特定的Host的对应端口的情况下,docker会自动分配(49000-49900)在一个Host上的端口与其映射; 使用-p参数,表示暴露所有在Image中通过expose指定的端口; volume绑定: 通过-v参数,可以把Host上的一个目录绑定到container中,允许container对其进行读写; docker run -v /home/test:/vagrant -t ubuntu ls -al /vagrant 容器间通信: 通过link参数,把container的端口信息暴露到另一个container中,实现container之间的通信; docker run --link redis:db -t ubuntu sh -c "export"

优秀的个人博客,低调大师

docker基础入门之一

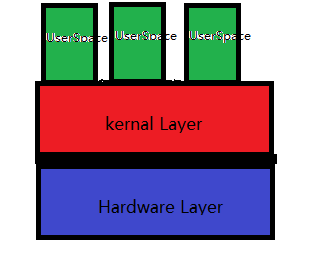
一、概述 1、传统虚拟化技术: 纯软件的虚拟化是通过对于硬件层的模拟从而实现允许运行多个操作系统; 硬件辅助虚拟化需要硬件层面对于虚拟化的支持,类似Intel-VT技术等,具有更高的运行效率; 解决方案: 商业版解决方案:VMware vSphere、 VMware Fusion 开源解决方案:KVM、Xen 2、system-level虚拟化(container虚拟机技术): 不需要模拟硬件层; 共享同一个HOST OS的Kernal user space instance = Container 解决方案: LXC: OpenVZ: Docker: Imctfy:google开源的容器虚拟实现 3、容器虚拟化和传统虚拟化的区别: 传统虚拟化 容器虚拟化 创建速度 很慢 非常快 性能影响 通过对于硬件层的模拟,增加了系统调用链路 的环节,有性能损耗 共享Kernel,几乎没有性能损耗 资源消耗 很大 很小,一台机器可以轻松创建多个 Container 操作系统覆盖 支持Linux、windows、Mac等 仅仅支持Kernal所支持的OS 4、container核心技术cgroups,namespace,chroot: CGroups 限制容器的资源使用; Linux内核提供的限制,记录和隔离进程组所使用的资源,由Google工程师提出,后来整合进kernel; 通过不同的子系统(blkio、cpu、cpuacct等)来实现对不听资源使用的控制和记录; Namespace机制,实现容器间的隔离; pid,容器有自己独立的进程表和1号进程 net,容器有自己独立的network info ipc,在ipc通信时候,需要加入额外信息来标识进程;(进程间通信) mnt,每个容器有自己唯一的目录挂载; utc,每个容器有独立的hostname和domain chroot,隔离根文件系统: 将host os的某个目录隔离成container的根目录; 二、进入Docker的世界: dotCloud是docker公司的前身,专注于PaaS的云计算平台;可能是支持最广泛的PaaS平台; 使用container的概念来解决应用stack部署的难题; 定义:什么是docker 开源的应用容器引擎,方便打包发布应用到容器中; Go语音领域比较大型的应用; docker实现: docker是container技术的实现,最早使用LXC作为container的引擎,最新版本的docker使用libcontainer替换了lxc; 采用aufs文件系统来管理Image和container 基于C/S架构的实现,Server端使用UnixSocket,也可以切换到TcpProtocol; aufs文件系统: 1、advanced multi layer unification filesystem //先进的多层的联合文件系统 2、可以实现把多个不同目录的内容合并在一起; 3、允许read-only和read-write目录并存; docker中的aufs: docker使用aufs来实现分层的文件系统的管理; 只读部分定义为Image,可写部分是container Image类似一个单链表系统,每个Image包含一个指向parent image的指针; 没有parent Image的image是base Image docker hub: 类似于Github服务,用来分发Image 大量标准的Image,例如Tutum/Ubuntu, Tutum/Mysql docker的优点: 构建标准化的应用运行的环境; 良好的RestAPI的实现; Container的实现,更少的资源的使用,创建速度快; docker的局限性: 基于Linux64的,不能在32bit的环境下运行; GuestOS只能是Linux Base 隔离性相对于KVM等虚拟化技术有所欠缺; 采用cgroup的resource control对于cpu的度量很困难; container随用户进程的停止而销毁; docker和LXC的区别: docker更专注于部署,而LXC专注于进程的隔离; docker有更好的api的方便对于docker容器的管理; dockerfile让image的创建变得容易; 通过docker hub方便image的分享; docker的未来: 网络 安全性 容器引擎

优秀的个人博客,低调大师

Spark(七) -- Scala快速入门

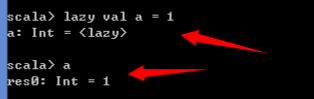
版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq1010885678/article/details/45830709 Scala作为Spark的开发语言,想要成为Spark高手,精通Scala是必须要走的一条路 然后一门语言并不是你想精通就能够精通的,更何况是Scala这种面向对象又面向函数的编程语言,个人觉得其学习的门槛会比C#,Java等面向对象语言要高 所以,这篇文章是建立在有一点编程语言知识的基础上的(如学过C#或者Java等),其实所有语言都是大同小异的,学会了一门语言在学其他的就不会像刚开始那么吃力了,因为它们很多概念都是相通的 本篇文章主要是介绍Scala本身的一些特性,以便以能够快速的上手开发,而对于真正要精通Scala,显然要付出的努力还要很多 安装Scala的开发环境就不具体介绍了,请自行百度之。IDE使用的是Eclipse For Scala,下载地址: Eclipse For Scala 本文大概从以下几个方面来介绍Scala: 声明变量的关键字 方法的定义格式 条件表达式 默认参数,带名参数和变长参数 lazy变量 数组 Map操作 元组 值函数 匿名函数 函数柯里化 高阶函数示例 List序列 case class和模式匹配 Scala中声明变量的关键字只有两种: val和var,分别表示常量和变量的声明(在Scala提倡中尽量使用val而不是var) 方法的定义格式: def 方法名(参数名:参数类型,…):返回值类型={方法体} 如: def add(x:Int,y:Int):Int={ x + y } 定义了一个参数为两个Int类型,返回值也为Int类型的方法add,返回x+y的值 相信已经有人注意到了,在Scala中,每个句子是不用以分号结束的(当然加上分号也没事),而且方法中不用return来返回,默认返回的是最后一行的值 当方法没有返回值时表现形式为: def add():Unit={...} 或者直接省略:Unit def add()={...} 在调用方法的时候,如果该方法没有参数,可以省略括号,如: add//加上括号也没事,如add() 条件表达式: 和其他语言的if/else唯一的却别就是,Scala的if/else是有返回值的 val x = 8 val res = if(x > 7) 1 else 0 如果x>7就返回1,否则返回0,赋值给res Scala中的while和do-while用法是和其他语言一样的,但是for的用法就不同了 for循环语句的格式为: for(i <- 表达式){ 循环体 } 例如: for(i <- 1 to 10){ println(i) } 上面代码中,1 to 10会产生1-10中的每个数,i会迭代循环这10个数,迭代一次执行一次循环体。 刚开始看肯定会很奇怪,<-这个符号是必须的,现在假设我们有一个arr数组,里面有1-10这10个数 首先用C#的循环方式为: for(int i = 0;i < arr.Length;i++) { Console.WriteLine(arr[i]); } //或者foreach方式 foreach(var i in arr) { Console.WriteLine(i); } 在对比一下Scala的for循环: for(i <- 0 to arr.length){ println(arr[i]) } //for同时也可以当foreach使用 for(i <- arr){ println(i) } 并且,在Scala中,for循环是可以添加if判断语句的,如: for(i <- 0 to 10 if i % 2 == 0){ println(i) } 上面代码的意思是,循环0-10,只打印出偶数 Scala的循环表达式中没有continue和break语句,但是可以通过一个Boolean变量和嵌套函数中return来实现 默认参数,带名参数和变长参数: 这几个概念很简单,通过几行实例代码基本可以了解 默认参数: def getName(name:String = "JChubby") = {...} 调用getName时如果没有传参数,则会使用默认的JChubby 带名参数: def showNum(x:Int,y:Int):Unit = {...} 调用该方法时,参数可以不按顺序,但是要执行参数名: showNum(y = 2,x = 4) 变长参数: def canChangeLength(x:Int*) = {...} 调用时: canChangeLength(1,2,3,4,...) lazy变量: 正常情况下使用val或者var声明变量时是直接分配内存空间使用的 当使用lazy关键字时,这个常/变量只有在使用的时候才会被分配内存 如在Scala命令行中输入下面的代码之后回车: lazy val a = 1 lazy(懒值)对应开销很大的初始化操作非常有用,如在读取一个很大的文件的时候,如果一开始并不马上使用,可以将其标记为lazy,直到文件真正使用的时候才分配内存空间 数组: Scala中分为两种: 定长数组:scala.collection.immutable.Array,一旦声明之后长度不可变 变长数组:scala.collection.mutable.ArrayBuffer,动态数组 定长数组使用: val arr = new Array[Int](3)//声明长度为3,类型为Int的Array数组(new可省略) //或者声明时直接赋值 //编译器会自动推断类型为Int val arr = Array(1,2,3) //通过下标访问数组的方式为()而不是[],请注意! val a = arr(0) 变长数组使用: val arrBuf = scala.collection.mutable.ArrayBuffer[Int]() //添加元素,相当于add arrBuf += 1 //也可以一次性添加多个 arrBuf += (1,2,3) //使用++=可以直接添加一个数组 arrBuf ++= Array(1,2,3) //在指定位置插入若干个元素,在0位置插入1,2,3 arrBuf.insert(0,1,2,3) //Scala中的函数除了通过.来调用之外也可以直接写成一下形式 arrBuf insert (0,1,2,3) //之前的1 to 10 其实就是调用了1.to(10)这个to方法 //移除指定位置的元素 arrBuf remove 0 //移除指定位置后的连续n个元素 arrBuf remove 0,3 //删除末尾的n个元素 arrBuf trimEnd 3 此外还有例如min,max等函数求最大最小等常用操作 Map操作: 和数组一样,Map同样也分为可变和不可变两种 不可变Map的使用: //声明一个Map,包含两个键值对,->表示键值对应的关系 val myMap = Map("JChubby" -> 22,"Looky" -> 21) 不可变的Map中,一旦声明之后,该Map不可添加不可删除不可修改,只能查看,查看方式与可变Map一致 可变Map的使用: val myMap = scala.collection.mutable.Map("JChubby" -> 22,"Looky" -> 21) //添加元素 myMap += ("abc" -> 12,"bcd" -> 13) //删除元素 myMap -= "abc" //修改元素 myMap("JChubby") = 10 //或者 myMap += ("JChubby" -> 10) //查找元素 myMap("JChubby") //或者使用getOrElse,该方法在取不到值的时候返回一个默认值,以免出现异常 myMap getOrElse ("JChubby",-1) //遍历,使用的是k,v格式来进行遍历 for((k,v) <- myMap){ println(k + ":" + v) } //如果只要遍历k或者v,可以使用_占位符 for((k,_) <- myMap){ println(k) } //获取所有的key myMap.keySet //获取所有的value myMap.values 元组: 元组其实就是一个集合,但是可以存放各种不同类型的数据 例如: val group = (1,2,"JChubby",3.0) //通过下标访问元组的格式为:元组名._下标 或者 元组名 _下标。如: group._0 group _0 //遍历元组格式为,productIterator为固定格式不可少 for(element <- group.productIterator){ ... } 值函数: Scala中可以将函数赋值给一个变量,这个变量就称为值函数 def add(x:Int,y:Int):Int = { x + y } //格式为方法名+空格+_ var res = add _ //之后可以将这个变量当做方法来用 res(1,2) 匿名函数: 顾名思义,没有名字的函数,定义格式如下: (参数名:参数类型,…) => 表达式 例如: (x:Int) => x + 3 可以将匿名函数赋值给一个常量 val func = (x:Int) => x + 3 //直接调用常量 func(7) 上面的用法其实和直接定义一个有名的函数是一样的,匿名函数主要是当做函数的参数来传递使用 例如scala.collection.mutable.ArrayBuffer的map方法,其参数要求是一个匿名函数 scala.collection.mutable.ArrayBuffer.map((x:Int) => x +3) 执行的结果是ArrayBuffer里面每个值都加3(map函数之后会介绍) 函数柯里化: 函数柯里化就是将原本有 很多参数 的函数,分成一个个只有 一个参数 的函数,每个函数的返回值都是 一个表达式 并且当做参数 传到下一个函数 例如: def mul(x:Int,y:Int) = x + y //调用方式为 mul(1,2) //柯里化后的函数为 def mul(x:Int)(y:Int) = x + y //调用当时为 mul(1)(2) //执行mul(1)时,返回的是1 + y,在将这个函数应用到2,得到 1 + 2 柯里化是闭包的典型体现,具体柯里化的概念请百度之~ 高阶函数示例: 数组的map函数 val arr = Array(1,2,3) arr.map(1 + _) _表示数组中的每个元素,执行的结果为每个元素+1 数组的filter函数 arr.filter(_ > 2) _ > 2会将数组中大于2的元素过滤出来 数组的reduce函数 arr.reduce(_ + _) reduce是迭代运算,将数组中两个元素先执行操作,把结果作为一个元素继续和下一个元素进行操作,执行结果为:1+2=3,3+3=9,也就是求和 List序列: List操作: val list = List(1,2,3) //获取头元素 list.head //获取除了头元素之外的其他元素 list.tail //新增元素 7::list //注意,::运算符是从右向左的 //获取前n个元素 list.take(n) //list的zip操作 val list1 = List(a,b,c) list.zip(list1) //得到的结果为List((1,a),(2,b),(3,c)),如果两个list的长度不同,以比较短的为基础 //flatten操作 val list2 = List(List(1,2),List(2,3),List(3,4)) list2.flatten //得到的结果为List(1,2,2,3,3,4),用于将嵌套List组合成一个新的List //flatmap操作 list2.flatmap(_.map(_ * 2)) //跟flatten相比,flatmap在组合之前,会先对每个子List进行map操作 case class和模式匹配: case class又称为样例类,和普通的类相比,样例类不用new就可以实例化,默认执行的是apply方法来构造对象 模式匹配: 和其他语言的switch功能差不多,但是Scala里面使用的是match 使用示例: val res = 1 res match{ case 0 => println(0) case 1 => println(1) case 2 => println(2) } 除了用法格式上略有不同,其余的基本类似,并且不需要使用break关键字 样例类和模式匹配结合使用: //定义抽象类Human abstract class Human //分别定义用例类Chinese,Japanese,American都继承自Human case class Chinese(name:String) extends Human case class Japanese(name:String) extends Human case class American(name:String) extends Human //定义模式匹配方法 def caseMatch(human:Human){ //human参数类型不同,做出不同处理,Chinese(_)表示只关心是不是Chinese而不关心叫什么名字 case Chinese(_) => println("Chinese") case Japanese(_) => println("Japanese") case American(_) => println("American") }


优秀的个人博客,低调大师

Hadoop入门 -- 简介,安装,示例

(1) Hadoop简介 Hadoop是Apache基金会旗下开源项目,是一款开源的可靠、可扩展的分布式计算软件平台。 Hadoop可以看做是实现分布式计算的一个框架。可利用其提供的函数接口进行简单编程,对数据进行分布式处理。 分布式处理系统关键是保证系统的高可靠性(一般分布式系统均使用廉价,配置不高的机器作为节点,所以单一的节点出现问题的几率较高),Hadoop利用软件在应用层发现与处理错误。 Hadoop实现分布式处理的思想主要体现在MapReduce框架上,MapReduce框架是Hadoop中的一个模块。 Hadoop作为处理分布式数据的平台,实现了HDFS(Hadoop Distributed File System)文件系统,用于分布式数据的存储。 (2) Hadoop安装 Hadoop一般在linux系统下使用,若在Windows系统下需模拟Unix系统来实现。 Hadoop一般使用Java函数接口,进行Java编程,也有C语言等接口可用。 最通用的就是linux+java。 Hadoop作为分布式处理系统,不仅可以应用在多台机器上,它也提供了伪分布式模式供单台机器使用。 安装Hadoop需要一些辅助环境与软件,首先是java环境,安装JDK,linux环境下安装JDK主要是配置环境变量,可参考相关教程。 示例: 在/usr下建立文件夹java,将jdk安装文件复制到该文件夹下,解压tar -xzvf jdk文件名,接着配置环境变量。 其次是安装SSH服务,一般选择OpenSSH,SSH用于分布式系统节点之间的联系(分布式系统要实现数据之间的分布式处理,需进行通信,SSH就是为了实现此所必须的)。 安装SSH使用,Ubuntu系统下示例: $ sudo apt-get install ssh $ sudo apt-get install rsync ssh安装后要设置ssh的免密码登陆,具体完成的操作是密钥的生成,在分布式环境中使用时要将密钥分发到各台机器上,以便相互无密码访问。 ssh无密码登陆的操作: $ ssh-keygen -t dsa -P '' -f ~/.ssh/id_dsa$ cat ~/.ssh/id_dsa.pub >> ~/.ssh/authorized_keys 第一句是生成无密码的密钥,第二句是将生成的密钥复制到密钥验证文件中,用于访问时加解密。 测试: $ ssh localhost 如果可以登陆到本地,即证明免密码登陆成功。 伪分布安装教程(用于自用试验性质) 1、下载软件包,将tar.gz软件包复制到安装目录(安装目录可以自己选择,一般选用/usr/local/下); 2、软件配置文件的配置,hadoop既然是分布式计算平台,就要规定它的数据节点,管理各子节点的机器,所以就要填一些网络地址,因为是伪分布模式,所以一般都是填写本地网络地址localhost。主要配置文件包括: conf/core-site.xml: <configuration> <property> <name>fs.default.name</name> <value>hdfs://localhost:9000</value> </property> </configuration> conf/hdfs-site.xml : <configuration> <property> <name>dfs.replication</name> <value>1</value> </property> </configuration> conf/mapred-site.xml : <configuration> <property> <name>mapred.job.tracker</name> <value>localhost:9001</value> </property> </configuration>此外还要配置JDK路径,供hadoop调用。 未完待续。。。

优秀的个人博客,低调大师

c# 语音功能入门

但是,这个方法本身并不知道你给的字符串是什么语言,所以需要我们它这个字符串用什么语言读出。SpVoiceClass 类的Voice 属性就是用来设置语种的,我们可以通过SpVoiceClass 的GetVoices方法得到所有的语种列表,然后在根据参数选择相应的语种,比如设置语种为汉语如下所示: private void SetChinaVoice() { voice.Voice = voice.GetVoices(string.Empty,string.Empty).Item(0) ; } 0表示是汉用,1234都表示英语,就是口音不同。 这样,我们就设置了语种,如果结合发音方法,我们就可以设计出一个只发汉语语音的方法 private void SpeakChina(string strSpeak) { SetChinaVoice() ; Speak(strSpeak) ; } 只发英语语音的方法也是类似的,上面程序里有。 对于一段中英文混合的语言,我们让程序读出混合语音的方法就是:编程把这段语言的中英文分开,对于 中文调用SpeakChina方法,英文调用SpeakEnglishi方法;至于怎样判断一个字符是英文还是中文,我采用的是判断 asc码的方法,具体的类方法是通过AnalyseSpeak实现的。 这样,对于一段中英文混合文字,我们只需把它作为参数传递给AnalyseSpeak就可以了,他能够完成中英文 的混合发音。 当然,对于发音的暂定、继续、停止等操作,上面也给出了简单的方法调用,很容易明白。 下面简单介绍一下中文语音识别的方法: 先把该语音识别的类源代码贴在下面,然后再做说明: 随 着.net技术深入人心,越来越多的程序员开始转到.net平台上进行开发。然而,在新发布的.net speech SDK里面并没有对中文语音进行支持,目前支持中文的Speech SDK最高版本为Windows平台下的SAPI 5.1(),本文介绍如何在.net平台下利用SAPI5.1开发中文语音应用程序。 -------------------------------------------------------------------------------- 目录: 1. SAPI.51 SDK浅析以及安装 2. 导入COM对象到.Net 3. 用C#开发中文TTS应用程序示例 4. 结论 5. 参考文献 -------------------------------------------------------------------------------- 1. SAPI.51 SDK浅析以及安装 SAPI SDK是微软公司免费提供的语音应用开发工具包,这个SDK中包含了语音应用设计接口(SAPI)、微软的连续语音识别引擎(MCSR)以及微软的语音合 成(TTS)引擎等等。目前的5.1版本一共可以支持3种语言的识别 (英语,汉语和日语)以及2种语言的合成(英语和汉语)。SAPI中还包括对于低层控制和高度适应性的直接语音管理、训练向导、事件、语法编译、资源、语 音识别(SR)管理以及TTS管理等强大的设计接口。其结构如图(1): 图(1) 语音引擎则通过DDI层(设备驱动接口)和SAPI(SpeechAPI)进行交互,应用程序通过API层和SAPI通信。通过使用这些API,用户可以快速开发在语音识别或语音合成方面应用程序。 SAPI5.1 SDK可以从微软网站下载:http://www.microsoft.com/speech/download/sdk51/ 需要安装程序的有Speech SDK 5.1(68M)和5.1 Language Pack (81.5M)。 -------------------------------------------------------------------------------- 2. 导入COM对象到.Net SAPI5.1 的基于Windows平台的,通过COM接口进行调用。在.Net平台下要应用SAPI5.1,我们可以利用.Net Framework自带的强大工具TlbImp.exe来把SAPI SDK的COM对象导入到.Net中。TlbImp.exe产生一个管制的包装类,管理客户端可以使用它。包装类管理实际的COM对象的参考数。当包装类 当作收集的垃圾时,包装类释放掉它包装的COM对象。当然,你也可以在VS.NET环境中通过从项目参考对话框选择COM对象,实现COM对象的导入,这 个过程也是通过TlbImp.exe来完成的。 下面演示如何导入SAPI的COM对象: D:\Program Files\Common Files\Microsoft Shared\Speech>Tlbimp sapi.dll /out: DotNetSpeech.dll 在 安转SDK以后,可以在D:\Program Files\Common Files\Microsoft Shared\Speech\目录下面找到SAPI.dll,这里面定义了SAPI的COM对象,用Tlbimp.exe工具将该dll转换成.net平 台下的Assembly---DotNetSpeech.dll,转换的过程会提示不少的警告(warning),但这部影响我们的开发,可以忽略。最 后,我们可以用ildasm查看DotnetSpeech.dll里面的对象。 -------------------------------------------------------------------------------- 3. 用C#开发中文TTS应用程序示例 下面通过一个实例来介绍如何利用C# 进行开发语音应用程序,开发环境为: 操作系统: Windows 2000 中文版+ SP3 .Net Framework: 1.0.3705(英文版) Visual Studio.Net 7.0.9466(英文版) 首 先,新建一个C#的Windows Application工程SpeechApp,在开发环境的右边的解决方案管理器(Solution Explorer)中,添加DotNetSpeech对象库。右键点击"Reference"(参考),选择"Add Reference"(添加参考),在弹出的文件选择对话框中找到刚才生成的DotNetSpeech.dll。 图(2) 打开Form1.cs代码文件,在代码开头添加名字空间(注意大小写)。 using DotNetSpeech; 这样就实现了SAPI SDK的导入,下面我们就可以开始编写应用代码了。本示例演示如何把文本通过喇叭朗读出来以及把文本转化成语音信号(Wave声音文件),程序界面如图(3): 以下为引用的内容: //朗读 private void buttonSynthesis_Click(object sender, System.EventArgs e) { try { SpeechVoiceSpeakFlags SpFlags = SpeechVoiceSpeakFlags.SVSFlagsAsync; SpVoice Voice = new SpVoice(); Voice.Speak(this.textBoxText.Text, SpFlags); } catch(Exception er) { MessageBox.Show("An Error Occured!","SpeechApp", MessageBoxButtons.OK, MessageBoxIcon.Error); } } //生成声音文件(Wav) private void buttonTTStoWave_Click(object sender, System.EventArgs e) { try { SpeechVoiceSpeakFlags SpFlags = SpeechVoiceSpeakFlags.SVSFlagsAsync; SpVoice Voice = new SpVoice(); SaveFileDialog sfd = new SaveFileDialog(); sfd.Filter = "All files (*.*)|*.*|wav files (*.wav)|*.wav"; sfd.Title = "Save to a wave file"; sfd.FilterIndex = 2; sfd.RestoreDirectory = true; if (sfd.ShowDialog()== DialogResult.OK) { SpeechStreamFileMode SpFileMode = SpeechStreamFileMode.SSFMCreateForWrite; SpFileStream SpFileStream = new SpFileStream(); SpFileStream.Open(sfd.FileName, SpFileMode, false); Voice.AudioOutputStream = SpFileStream; Voice.Speak(txtSpeakText.Text, SpFlags); Voice.WaitUntilDone(Timeout.Infinite); SpFileStream.Close(); } } catch(Exception er) { MessageBox.Show("An Error Occured!","SpeechApp", MessageBoxButtons.OK, MessageBoxIcon.Error); } } 接下来,还要去控制面板配置Speech SDK引擎当前所处理语言。打开"控制面板",打开"语音"配置项目,可以看到在这里我们可以指定当前可以对何种语言进行识别或者合成,还可以配置相关的硬件设备以及控制语速。 在"文字-语音转换"的"语音选择"组合框中选择简体中文(Microsoft Simplified Chinese)。这样就可以合成汉语文字了。 回到VS.Net,F5编译运行刚才的应用程序,在文本框里输入汉字,戴上耳机,点击"朗读"按钮,开始体验新一代的智能人机界面吧,呵呵 转自http://blog.csdn.net/rmb147/archive/2009/02/05/3864108.aspx

优秀的个人博客,低调大师

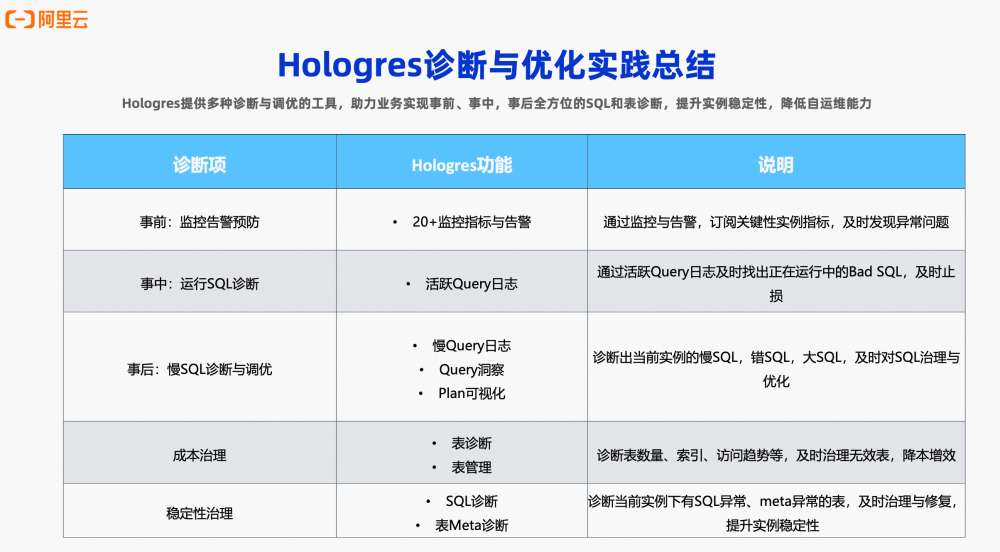
Hologres诊断与优化快速入门

作者:赵红梅 Hologres PD 摘要:在这次分享中,将向大家展示如何利用一系列诊断与调优工具,实现对 SQL 和数据库异常的全方位诊断,从而提升实例稳定性。 Hologres诊断与优化实践总结 我的介绍将分为五个部分:首先,在事前阶段,讲解如何利用监控指标实现实时监控和预防措施。其次,事中探讨团队如何通过活跃日志发现运行中的问题,并及时采取措施止损,以避免业务问题的恶化。接下来,在事后阶段介绍如何通过深入分析和结合可视化工具来诊断当前的性能瓶颈。此外展示如何通过表管理工具实现成本治理,以及如何利用特定的诊断工具来提升系统的稳定性。 内容大纲如下: Hologres 诊断与优化的实践 事前:通过监控指标实时监控实例异常 事中:通过活跃 SQL 日志快速定位长 SQL 事后:通过慢 Query 日志+Query 洞察诊断慢 Query 事后:通过慢 Query 日志+Query 洞察治理错 Query 稳定治理:SQL 诊断报告长期治理 SQL 稳定性治理:表 Meta 诊断报告治理 Meta 问题 成本治理 事前:实例实时监控 了解监控指标 首先事前团队需要预先审视业务,目的是提前发现并解决潜在问题,以防止问题在生产环境中恶化。建议采用监控指标并设置相应的告警机制来执行这一操作。Hologres 提供丰富的监控指标来帮助业务及时发现实例异常。访问管控台,选择相应的实例,进入监控信息页面,您将看到 Hologres 提供的大约五类监控指标,每一类都对应不同的业务属性。关于监控指标的详细使用见文档。 资源和Query类监控 资源与 Query 运行状况监控指标主要用于监控团队在实际操作中资源的利用率以及运行状况。包含CPU使用率、内存使用率等,可以实时监测到实例资源的使用。 CPU监控:以实例的CPU使用率为例,它反映了实例中 CPU 的整体使用情况。如果 CPU 使用率随着 Query 波动,这通常意味着 CPU 运行状况良好。然而,如果 CPU 使用率持续处于满载状态,这表明资源可能已经不足,此时需要团队及时优化实例中的 SQL 或对资源进行扩容。接下来是 Worker 节点的 CPU 使用率监控,它旨在报告每个 Worker 节点的 CPU 使用情况。从图表中可以看到,如果每个 Worker 的 CPU 使用率相对均匀,这通常表明运行状况是健康的。但是,如果某个 Worker 的 CPU 使用率达到 100%,而其他 Worker 的使用率很低,或者大部分 Worker 的 CPU 使用率都很高,唯独某个 Worker 的使用率偏低,这说明资源利用并不均衡。在这种情况下,团队需要检查是否存在数据倾斜问题,或者 Worker 节点的分布是否均匀。 内存监控:在内存相关的监控指标上,可以看到实例整体的内存使用情况,也能看到不同模块的内存使用,例如Query使用内存、meta内存等,方便业务对内存水位持续性监控和治理。 QPS和RPS指标:可以综合的反映实例的读写情况,但需要注意的是,实例能支撑的QPS和RPS与实例规格、Query复杂度等因素有关,建议根据实际情况进行压测 Query延迟:包括Query在每个阶段的延迟(Optimization 阶段、Start Query 阶段、Get next 阶段)可以根据阶段的耗时来评估Query的运行情况,并针对性优化。同时也提供Query的整体延迟和P99延迟,以综合反映实例中所有Query运行的延迟。但需要重点关注“本实例正在运行中 Query 最长的时长”,可以反映实例中是否出现运行时间较长的Query,及时结合holoweb-活跃Query找到该Query,并做治理,防止实例中资源长期打满,影响其他的任务运行。 失败Query:它主要监控实例在过去一段时间或实时中是否有失败的 Query。如果在某段时间内失败的 Query 数量增加,这可能表明实例出现异常,团队需要及时介入处理 I/O和存储类监控 IO:反映Query在运行过程中与底层存储的IO交互情况,不涉及网络的I/O,通过IO的吞吐情况,判断数据的处理。 存储:反映实例中真实的数据存储 流量和Framework 流量和Framework主要会反映Query运行过程中与网络等的交互情况。 Endpoint 流量:反映了不同网络的流量情况情况,包括公网、VBC 网以及经典网等,它记录了数据流入和流出的状况,流量的使用可以反馈带宽是否到达极限,从而影响数据写入或读取的速度。 Framework:反映shard多副本、以及实例副本的延迟,一般来说延迟在毫秒级都是正常,如果延迟较高,说明实例异常需要及时处理。请重点关注“FE replay 延迟(milliseconds)”指标,延迟已经累积到小时级别,表示实例中worker有卡住的情况,需要及时处理 Gateway:Gateway,作为计算组中的一个特殊组件,其主要职责是进行 SQL 分发和路由控制。因此,监控 Gateway 的 CPU、内存以及网络流量的使用情况,可以反映 Query 处理速度和规模,团队应定期检查这些资源的使用情况,以判断是否需要扩容。 Serverless和资源弹性 Serverless Computing:实时观测在serverless中运行的Query延迟、排队情况等,及时治理 Computing Resource:监控分时弹性的使用情况 Binlog和Analyze Auto Analyze:反映实例中每个DB内表的统计信息缺失情况,以判断auto analyze的准确率,及时手动更新表的统计信息 Binlog:主要是监控Binlog的使用情况,包括吞吐和wal sender连接数,从而判断消费Binlog是否出现瓶颈 监控告警最佳实践 如果要对监控指标告警,可以点击报警-报警设置,根据业务情况设置阈值告警。Holo推荐常用的监控指标告警如下: 监控CPU使用率:监控实例的CPU使用率和Worker节点CPU使用率,如果 CPU 使用率长时间保持在 100%,则表明资源严重不足,此时需要考虑扩容或优化团队运行的业务。其次,关注 Worker 节点的 CPU 使用率,这有助于观察资源是否被均匀利用。 监控Query延迟:通过监控Query延迟,可以实时监控是否有延迟上涨,以此判断实例负载情况 监控失败Query:通过失败Query可以监控到当前实例中任务运行情况,如果连续失败,可能存在实例异常,需要及时处理 监控“本实例/Serverless最长的Query运行时长”:可以了解当前是否有运行时间较长的Query,如果长时间运行,会导致资源占用,影响其他Query 事中:活跃 SQL 日志快速定位长 SQL 可以以通过活跃SQL日志快速定位运行中的长SQL。通过Holoweb>诊断与优化>活跃Query,查看到当前实例中正在运行的SQL,详细的信息包括运行时长、执行引擎等,如果CPU已经有长时间运行且不符合业务预期的,需要结合监控页面,看CPU是否已经被打满,然后在活跃Query界面点击取消,将该Query取消,以避免长期占用资源,同时CPU也会下降,说明问题止血成功。更多操作详情见文档 事后:慢Query日志诊断Query 优化慢Query 如果要对Query持续性的治理和优化,可以使用[慢Query日志](https://help.aliyun.com/zh/hologres/user-guide/query-and-analyze-slow-query-logs?spm=a2c4g.11186623.0.0.24994a5eQgWXyB" \l "concept-2069482)结合Query洞察功能: 第一步:前往holoweb>诊断优化>慢query日志查询当前实例的慢SQL列表,重点关注duration、engine type、cpu_time字段 第二步:对于运行时间较长、资源消耗较多的SQL,单击前往Query洞察分析,分析单个SQL性能,重点关注enginetype、readrows、readbytes 第三步:查看Query执行计划,重点关注算子:partitionselected、filter、time、rows,如下示例的plan,东从下往上看,Read Rows 已经处理了数亿量级的数据,从 274 个分区中扫描了60 个分区,比较多,同时也是读取的MC外表,因此建议优化方向是减少分区扫描或者将外表导入到内表,以提升性能 治理错Query 如果实例中监控到 Failed Query较多,可以通过慢Query日志结合Query洞察治理。方法如下: 第一步:监控指标观察FailedQueryQPS,观察到时间Query对应的时间段 第二步:前往holoweb>诊断优化>慢Query日志,图维度选择”失败Query“,并选择对应的时间段,查找错误的SQL 第三步:点击前往“query洞察分析”>错误信息,Query洞察会展示出详细报错,同时也会结合AI,给出详细的报错原因和解决方案,可以根据建议对SQL进行治理,提升实例的稳定性。 稳定性治理:SQL诊断长期治理 Hologres 在Holoweb提供一个 SQL 诊断报告,可以查看昨天以及过去的详细SQL运行,例如耗时占比、错误占比等,通过长期治理SQL,来提升实例稳定性。详细使用见文档。重点关注如下几个治理项: 错SQL治理:关注失败Query明细,可以查看某天的失败次数,典型失败Query,根据Query洞察中的错误信息和改进建议,治理错SQL,提升实例的成功率 长SQL治理:关注Query耗时占比趋势,可以分析出Query的耗时占比,重点关注耗时较长(超过10min)的query耗时占比,并通过Query洞察查看明细,治理慢SQL 应用治理:关注Query应用来源占比,可以分析出发起Query的应用来源,当出现异常时可以及时找到对应的应用。同时建议,尽量给每个应用都配置上应用来源application_name,不建议所有的Query都用统一的应用名,无法进一步排查问题 执行引擎治理:关注执行引擎的Query趋势,Hologres中有多个执行引擎(HQE、PQE、SQE等),其中HQE为自研引擎更高效,所以需要重点关注执行引擎为SQE、PQE的Query趋势,尽量减少PQE的Query,以此提升Query性能 稳定性治理:表Meta诊断Meta问题 meta诊断:当Hologres数据库中的元数据管理器(Storage Master)和FE节点保存的表元数据不一致时,会导致DDL操作报错或影响费用等。表Meta诊断功能,以检测当前实例中表元数据的一致性,并每周更新一次诊断结果,可以根据对应元数据问题的解决方案进行修复,以提高实例的可用性和稳定性。 Meta诊断是自动推送的异常问题,如果页面显示空白,则说明实例无meta问题,不需要治理。如果出现Meta异常,Hologres也提供一键修复的能力,单击一键修复,在业务低峰期执行修复SQL,以便修复meta问题,提升实例问题性,详细使用见文档。 成本治理:表索引诊断报告长期治理表 随着业务的持续迭代,团队实例中的表数量可能会迅速增加,导致管理困难,或者不清楚删除哪些不必要的表,以及表的索引使用情况等,为此,我们提供了一个标准的表索引诊断报告,以评估当前实例中表的使用情况。表索引诊断报告的项目较多,详细使用可以参考文档,Hologres比较建议对如下几项内容进行治理: 存储治理: 分区子表数和存储量:查看分区表的存储量,治理存储为0的表 存储为0的表:及时治理存储为0的表,防止占用meta内存 行存表治理: 没有设置主键:无法用上索引的能力,需要重新建表并设置主键 Distributionkey和clusteringkey不一致的行存表:不适用行存表点查场景,改成列存/行列共存 表字段数治理: 超过300列的列存表:列太多,性能开销大 超过300列的行列共存表:列太多,性能开销大 索引治理: 超过3列的clustering/segment/distributionkey:索引设置超过3列,会导致使用场景受限,无法很好的利用索引的能力 Binlog表治理: 开启Binlog的表:不建议列存表开启binlog,性能开销大 BinlogTTL大于7天:Binlog太多会导致占用过多的存储,关注表存储量,及时治理 通过表属性诊断,有助于深入分析团队实例中的表、索引以及字段数量,甚至包括表属性等情况,以便进一步优化管理表,以实现长期的成本治理目标

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册