首页 文章 精选 留言 我的

精选列表

搜索[webpack入门],共10000篇文章
优秀的个人博客,低调大师

C++ 从遗忘到入门

本文主要面向的是曾经学过、了解过C++的同学,旨在帮助这些同学唤醒C++的记忆,提升下自身的技术储备。如果之前完全没接触过C++,也可以整体了解下这门语言。 面向受众 本文主要面向的是曾经学过、了解过C++的同学,旨在帮助这些同学唤醒C++的记忆,提升下自身的技术储备。如果之前完全没接触过C++,也可以整体了解下这门语言。 C++是一种通用编程语言,它被广泛用于软件开发。C++以其强大的功能、高效的性能和灵活性而著称。以下是一些关键特点: 面向对象:C++支持面向对象编程(OOP)的四大特性:封装、继承、多态和抽象。通过类和对象,程序员能够创建模块化的代码,更容易地进行维护和扩展。 泛型编程:C++支持模板编程,允许编写与数据类型无关的代码。模板是实现泛型编程的关键工具,它们提高了代码的复用性。 直接内存管理:C++提供了对内存的直接操作能力,允许程序员手动管理内存分配和释放,这是C++的一个强大特性,也是需要谨慎使用的地方,因为不当的内存管理可能会导致资源泄露和其他问题。 性能:C++编写的程序通常有很高的执行效率,这是因为C++提供了与底层硬件直接对话的能力。这使得C++成为开发要求性能的系统软件(如操作系统、游戏引擎)的理想选择。 C语言兼容:大部分C语言程序可以在C++编译器上编译并运行。这一特性简化了从C到C++的过渡。 多编程范式支持:除了面向对象和泛型编程外,C++还支持过程式编程和函数式编程等范式,使其成为一个多样化的工具,能适应不同的编程需求。 C++语言的复杂劝退了很多人,诸如指针、虚函数、泛型等语言特性让C++变得特别复杂。事实也确实如此,不过C++的作者说过:“轻松地使用这种语言。不要觉得必须使用所有的特性,不要在第一次学习时就试图使用所有特性。” 本文主要内容是介绍现代C++(C++11及之后的版本)中的语法和特性,不会深入语法细节,每小节最后可能会列出一些相关的拓展知识点,感兴趣的同学可以自行了解。 语法基础 ▐类型 C++是静态编译语言,所有变量在声明时都要指定具体的变量类型,或者能让编译器推导出具体的变量类型(比如使用 auto、decltype 关键字的场景),类型检查不通过将导致编译期出错。 基础类型 C++的基础类型可以按照其所能表示的数据类型来分类。以下表格列出了C++的基础类型及其常见的大小和范围(请注意,实际的大小和范围可能根据平台和编译器的不同而有所变化): 类别 类型 大小(位) 备注 整形类型 short 至少 16 unsigned short 至少 16 int 至少 16 通常是 32 unsigned int 至少 16 long 至少 32 unsigned long 至少 32 long long 至少 64 C++11 新增 unsigned long long 至少 64 C++11 新增 定宽整数 (从 <cstdint> 导入) 8/16/32/64 int8_t, int16_t, int32_t, int64_t 等 无符号定宽整数 (从 <cstdint> 导入) 8/16/32/64 uint8_t, uint16_t, uint32_t, uint64_t 等 浮点数类型 float 32 单精度浮点数 double 64 双精度浮点数 long double 实现依赖 扩展精度浮点数,精度和大小由具体实现定义 字符类型 char 至少 8 可表示字符或小整数,有符号性由实现定义 signed char 8 明确的有符号字符类型 unsigned char 8 无符号字符类型 char16_t 16 C++11 新增,用于 UTF-16 字符 char32_t 32 C++11 新增,用于 UTF-32 字符 wchar_t 实现依赖 用于宽字符集 布尔类型 bool 实现依赖 表示布尔值 true 或 false 特殊类型 void N/A 表示无类型,用于函数返回值 nullptr_t 指针宽度(32/64) C++11 新增,表示空指针 nullptr 的类型 自动类型 auto N/A C++11 新增,允许编译器自动推导变量类型 指针和引用类型 指针类型 指针宽度(32/64) 例如 int* 表示整数指针 引用类型 一般和指针类型相同 例如 int& 表示整数引用 语法示例: int a; // 声明未初始化,使用前建议手动初始化char b = 'a';float c = 1.0f; // C++中默认小数是double类型,加上f可以指定为floatdouble d = 2.0;auto e = 20; // 编译器自动推导auto为 int 类型 基础类型隐式转换 编译器自动进行的类型转换,不需要程序员进行任何操作。这些转换通常在类型兼容的情况下发生,比如从小的整数类型转换到大的整数类型。下面是经常遇到的隐式类型转换: 安全的隐式转换: 整型提升:小的整型(如 char、short)会自动转换成较大的整型(如 int)。 算术转换:例如,当 int 和 double 混合运算时,int 会转换为 double。 存在隐患的隐式转换: 窄化转换:大的整数类型转换到小的整数类型,或者浮点数转换到整数,可能会造成数据丢失或截断。 指针转换:例如,将 void* 转换为具体类型的指针时,如果转换不正确,会导致未定义行为。 结构体(struct) 结构体是不同类型数据的集合,允许将数据组织成有意义的组合。 语法示例: // 结构体定义struct Person { std::string name; int age;}// 结构体初始化,Person person = {"Jim", 20}; Person person2; // 创建另一个实例person2 = person;// 将person中的值复制到person2中,默认是浅拷贝,在有指针的情况下有潜在风险枚举(enum) 枚举是一种用户定义的类型,它可以赋予一组整数值具有更易读的别名。 语法示例: enum Color { RED, GREEN, BLUE };// 使用Color myColor = RED; C++11引入了新的枚举类型 作用域枚举。 语法示例: enum class Color { RED, GREEN, BLUE};Color myColor = Color::RED; // 使用作用域解析运算符(::)访问枚举值 作用域枚举解决了传统枚举可能导致命名冲突的问题,并提供了更强的类型检查。 联合体(union) 联合体允许在相同的内存位置存储不同类型的数据,但一次只能使用其一。 语法示例: // 联合体的定义union Data { int intValue; float floatValue; char charValue;}// 联合体一次只能保存一种类型的数据,每次赋值都会覆盖内存中之前的值// 因此联合体一般是配合结构体来使用,下面是一个示例// 定义数据类型的枚举enum DataType { INT, FLOAT, CHAR};// 定义一个结构体,它包含一个联合体和一个枚举标签struct SafeUnion { // 标记当前联合体中存储的数据类型 DataType type; // 定义联合体 union { int intValue; float floatValue; char charValue; } data;};// 赋值操作SafeUnion su;su.type = FLOAT;su.data.floatValue = 1.0f;// 使用时,通过type判断类型然后访问联合体对应的成员变量switch(su.type) { case FLOAT: cout << su.data.floatValue << endl; break;} 类(class) 类是C++的核心特性,是面向对象的基础,允许将数据和操作这些数据的函数封装为一个对象。这里先只介绍定义。 语法示例: class Person {public: void doWork(); // 方法,类对外提供的一系列操作实例的函数private: std::string name; // 成员变量,封装到类中的属性,保存内部状态信息 int age;}; 列表初始化 现代C++提供了一种新的统一的变量初始化方式 - 列表初始化,推荐优先使用这种初始化方式,它能提供更加直观和统一的数据初始化方式。 列表初始化使用 {} 来初始化数据对象,包括基础类型、数组、结构体、类和容器等复杂的数据类型。语法示例: // 基础类型int a{0}; double b{3.14}; // 结构体struct MyStruct { int x; double y;};MyStruct s{1, 2.0};// 类class MyClass {public: MyClass(int a, double b) : a_(a), b_(b) {}private: int a_; double b_;};MyClass obj{5, 3.14}; // MyClass 必须有一个匹配这个参数列表的构造函数// 数组int arr[3]{1, 2, 3};// 上面介绍的都是现代C++推荐写法,省略 = // 下面的2种写法绝大多数情况下是等价的float arr[2]{1, 2}; // 写法1float arr[2] = {1, 2}; // 写法2// 编译器对这两种写法的处理是一致的,方法2并不会产生临时变量和拷贝赋值,包括类的声明 现代C++推荐优先使用列表初始化来初始化变量,因为这种方式不允许进行窄化转换这能避免一些问题的发生,示例: int a = 7.7; // 编译能通过,但是有warningint b = {1.0}; // 编译器拒绝通过,因为浮点到整形的转换会丢失精度 列表初始化支持参数列表小于数据对象的个数,这种情况下会默认进行其他变量的零初始化。 拓展: 零初始化 ▐数组 C++的数组是一个固定大小的序列容器,它可以存储特定类型的元素的集合。数组中的元素在内存中连续存储,这允许快速的随机访问,即可以直接通过索引访问任何元素,而无需遍历数组。 数组的声明 数组的声明形式如下: Typename arrayName[Size]; // 基本类型int arr[10];char charArr[30];// 复杂类型struct Point { int x; int y;}Point points[10]; 这里 Typename 是数组中元素的数据类型,arrayName 是数组的变量名,Size 是数组的元素个数,在这种声明形式下必须是整形的常量。 这里介绍的方式是数组的静态声明方式,即数组的元素个数在编译期间就能确定,数组占用的内存分配在栈内存中,实际开发中更多的情况可能是更具运行时的值确定数组的大小,这时需要动态的方式声明数组,后面会介绍。 数组的初始化 数组定义时如果未进行初始化,那么数组中的元素的值都是内存中残留的数据,而这些数据通常没有意义,直接使用会导致不可预知的问题。因此声明数组后需要对数组进行必要的初始化。 数组支持列表初始化语法: int arr[] = {1, 2, 3, 4, 5}; // 数组大小为5,编译器自动确定int arr[10] = {1, 2, 3}; // 数组前三项确定为1,2,3,其余被初始化为0int arr[10] = {0}; // 整个数组全部为0 数组的使用 数组中的元素可以通过索引来访问和修改,索引从0开始,第一元素索引是0,最后一个索引是Size-1。 int arr[10] = {}; // 零初始化arr[0] = 10; // 修改数组第一个元素值为10 数组在声明后(无论静态声明还是动态声明),数组的大小即固定,不可更改; 数组不提供任何内置的方法来获取其大小,通常需要额外保存数组的大小,或者使用特殊标记结束元素(C风格的字符串使用'\0'表示数组结束); 数组不提供边界检查,越界访问的代码是可以通过编译的(静态数组编译器会给出警告),可能导致很多潜在问题。 下面是越界访问的案例: int arr[10] = {0}; int a = arr[10]; // 最大的有效索引是9,这里出现越界,但编译器能顺利编译通过(有警告)// a中的值是不确定的,没有实际意义的,这里是读取,危害可能有限arr[10] = 99; // 可怕的是该语句也能通过编译,但这里进行了更加危险的操作,// 越界访问了一块内存并修改了其内容,这很可能导致程序崩溃 多维数组 二维数组 上面提到的数组存储的是一维的,即一系列同类型数据,但有时需要存储一个表格数据,需要区分行列,这时可以使用二维数组来存储。 Typename arrayName[Rows][Columns]; // Rows是行数, Columns是列数, 必须常量// 实际示例int arr[10][10]; // 定义了一个10*10的二维数组 下面是二维数组的初始化: // 完全初始化int matrix[2][3] = { {1, 2, 3}, {4, 5, 6}};// 部分初始化int matrix[2][3] = { {1, 2}, // 第一行的最后一个元素将被初始化为 0 {4} // 第二行的第二个和第三个元素将被初始化为 0};// 单行初始化int matrix[2][3] = {1, 2, 3}; // 只初始化第一行,其他行将默认初始化为0// 自动推断,和一维数组一样,编译器会根据数组推断二维数组第一维的大小int matrix[][3] = { {1, 2, 3}, {4, 5, 6}}; 多维数组 多维数据是和二维数组类似,在基础上再增加一维 Typename arrayName[Depth][Rows][Columns]; 当然可以推广这个概念,定义出四维、五维等等数组形式,这里不展开。 数组的替代 数组本身是一种常见的C++数据类型,使用范围很广,但是本身也存在局限性。因此为了提升开发效率,C++标准库中提供了更加灵活的数据容器供开发者使用: std::vector: 可变大小的数组。提供对元素的快速随机访问,并能高效地在尾部添加和删除元素。 std::list 双向链表。支持在任何位置快速插入和删除元素,但不支持快速随机访问。 std::deque: 双端队列。类似于std::vector,但提供在头部和尾部快速添加和删除元素的能力。 std::array (C++11): 固定大小的数组。提供对元素的快速随机访问,并且其大小在编译时确定。 std::forward_list (C++11): 单向链表。提供在任何位置快速插入和删除元素,但不支持快速随机访问。 std::stack: 栈容器适配器。提供后进先出(LIFO)的数据结构。 std::queue: 队列容器适配器。提供先进先出(FIFO)的数据结构。 std::priority_queue: 优先队列容器适配器。元素按优先级出队,通常使用堆数据结构实现。 std::set: 一个包含排序唯一元素的集合。基于红黑树实现。 std::multiset: 一个包含排序元素的集合,元素可以重复。基于红黑树实现。 std::unordered_set (C++11): 一个包含唯一元素的集合,但不排序。基于散列函数实现。 std::unordered_multiset (C++11): 一个包含元素的集合,元素可以重复,但不排序。基于散列函数实现。 ▐指针 在C++中,指针是一种基础数据类型,它存储了内存地址的值。通过指针,可以直接读取或修改相应内存地址处的数据。指针是C/C++强大功能的一个关键组成部分,允许直接操作内存,这在底层编程和系统编程中非常有用,但这一切能力的代价就是指针操作的 高风险 。 理解指针 下面是简单的整形变量和整形指针变量在内存中的示意图: 可以看出: a是一个整形,占用4个字节(一般int类型占用4字节),0xffffffffffffecdc是其首地址,内存中的值是2568,即代码中的赋值(具体的存储细节可以搜索 大端序、小端序) p是一个整形指针,占用8个字节(64位系统),0xffffffffffffece0是其首地址,内存中的值是a变量内存的首地址,即0xffffffffffffecdc。 通过示意图,可以知道指针本身是一种变量类型,和int、bool这些类型没有本质的区别,只不过其他类型的变量中存储的是数据,而指针类型变量中存储的内存地址。一旦理解了这个概念,那么指针的指针这一概念也不难理解,它本身是一个指针类型,其中存储的值是另一个指针的地址。 指针的定义 指针的定义语法: Typename * ptrName;// 指针定义风格,下面的声明都正确int *p; // C风格,旨在强调 (*p)是一个整形值int* p; // 经典C++风格,只在强调 p是一个整形指针类型(int*)// 集团推荐的风格,指针、引用都是居中,两边留空格int * p; // 指针int & a = xx; // 左值引用int && a = xx; // 右值引用 不论指针的类型是什么,指针本身的内存占用是相同的,64位系统占用8个字节。指针类型存储的是地址编号,本质上是整形,可以进行计算,但对地址的乘除法是没有意义的,加减法是有意义的,表示地址的偏移。 对指针进行 +1操作,指针将会偏移其指向的类型所占用的字节数(编译器根据指针的类型确定偏移的字节数),下面有个实际例子: int a = 123; // 假设 a 地址为 0xfffff100int * p = &a; // 此时 p 中存储的值为 0xfffff100p = p + 1; // 此时 p 中存储的值为 0xfffff104 (0xfffff100偏移4个字节,即int变量占用的大小) 指针初始化和访问 指针的赋值和访问语法如下: int a = 5;int * p = &a; // & 取地址运算符// * 用在指针这里是解引用运算符,可以获取指针指向的地址的值cout << *p << endl; // 输出 5int b = 10;p = &b; // 指针变量可以修改其指向地址cout << *p << endl; // 输出 10 常量指针 vs 指针常量 常量指针 常量指针指向一个常量值,不管指向的变量本身是否声明为常量都不能通过指针来修改指向的内容,但指针本身可以重新赋值指向新的地址。 int value = 5;const int * p = &value; // p是一个常量指针int const * q = &value; // 和上面的声明等价 *p = 10; // 非法,*p是常量不能修改int a = 6;p = &a; // 合法,p本身不是常量,可以重新赋值 常量指针在函数传参时非常有用,它可以限制函数内部通过指针非法地修改原始内容。 指针常量 指针常量表示指针本身是常量,必须在声明时初始化,之后不能指向其他地址,但可以通过指针修改指向的内容。 int value = 5;int * const p = &value; // p是常量*p = 6; // 合法int a = 7;p = &a; // 非法 要记住这两种声明的区别有个简单的方法:看 const 修饰是什么: const int * p :const修饰 *p,即 *p 是常量 int * const p :const修饰 p,即 p 是常量 指针与数组 指针和数组名的异同 在C++中,数组名在绝大多数场景下可以看做是指针,在这些场景下数组名和指向该数组首个元素的指针是等价的。 int arr[5] = {1, 2, 3, 4, 5};int * p1 = arr; // arr 被当做指向数组首元素的指针int * p2 = &arr[0]; // 取arr首个元素的地址// 这种情况下 p1 和 p2 是等价的if (p1 == P2) { // 检测会通过 cout << "p1,p2是等价的" << endl; cout << *p1 << endl; // 打印 1 cout << *p2 << endl; // 打印 1}// 使用指针访问数组// 指针方式cout << *(p1 + 1) << endl; // 访问数组第二个元素,这种方式符合指针的计算规则// 类似数组名的使用方式cout << p1[1] << endl;// p1虽然是指针,索引访问方式依然有效,本质是*(p1 + 1)的语法糖 指针和数组名有区别的地方: int arr[5] = {1, 2, 3, 4, 5};int * p1 = arr;cout << sizeof(arr) << endl; // 打印结果:20 cout << sizeof(p1) << endl; // 打印结果:8// sizeof(arr)为数组本身的大小,这里是 5个int占用20字节// sizeof(p1)为指针本身大小,64位系统中占用8个字节 此外 &取地址运算符对于 指针和数组名的处理也是不同的: cout << &arr << endl; // 0x16b98aa40cout << &arr + 1 << endl; // 0x16b98aa54cout << &arr[0] << endl; // 0x16b98aa40cout << &arr[0] + 1 << endl; // 0x16b98aa44// 可以看出 &arr 和 &arr[0] 的值是一样的,但是指针偏移1后// (&arr + 1) 在 &arr 的基础上偏移了20(0x14)个字节// (&arr[0] + 1) 在 &arr[0] 的基础上偏移了4个字节 对于数组名进行 & 取地址,得到的整个数组的地址,虽然值和首元素地址相同,但其指针类型是不同的。 &arr 得到的类型是 int (*)[5] ,这是一个指向包含5个整数数组的指针 &arr[0]得到的类型是 int *,这是一个整型指针 动态数组 前面介绍的数据都是静态数组,实际开发中,可能更希望更具实际需要动态申请指定长度的数组,这时就需要动态数组。因为标准库中提供了std::vector容器,提供了更加方便的动态数组解决方案,因此这里简单介绍下: int * arr = new int[10]; // new操作符在堆内存中申请10个int类型大小的连续空间,并返回首地址arr[0] = 1;arr[1] = 2;// ...delete[] arr; // new操作符申请的内存需要使用delete操作符释放,数组使用delete[] 多维数组的创建和释放比一维要复杂一些,下面是示例: // 二维数组的动态创建 & 释放int rows = 5; // 行数int cols = 3; // 列数// 动态创建二维数组int ** array = new int*[rows]; // 创建行指针for (int i = 0; i < rows; ++i) { array[i] = new int[cols]; // 为每行分配内存}// 初始化二维数组for (int i = 0; i < rows; ++i) { for (int j = 0; j < cols; ++j) { array[i][j] = i * cols + j; // 或者任何其他的赋值逻辑 }}// 使用二维数组,例如打印它for (int i = 0; i < rows; ++i) { for (int j = 0; j < cols; ++j) { std::cout << array[i][j] << ' '; } std::cout << std::endl;}// 动态释放二维数组for (int i = 0; i < rows; ++i) { delete[] array[i]; // 释放每行的内存}delete[] array; // 释放行指针数组的内存 数组和指针结合使用时会有一些容易出错的点: int * p[10]; // p是一个包含10个int变量的数组int (*p)[10]; // p是一个指向拥有10个int变量的数组的指针// * [] 两个运算符的优先级不同,[]的优先级更高// 第一个语句声明了 p[10], int * 是类型// 第二个语句有括号改变了优先级,因此 p 是一个指针,剩下的部分定义了类型// 下面函数指针也会有类似的定义int (*pf)(int, int); // pf是指向形如 int func(int, int) 的函数指针 函数 在 C++ 中,函数是一段执行特定任务的代码块,它具有一个名字,可以接受输入参数(也可以不接受),并可以返回一个值(也可以不返回,即返回类型为 void)。函数的主要目的是使代码更模块化、更易于管理,并且可以重用。 函数基础 C++的完整函数定义包括以下几个要素: 返回类型:函数可能返回的值的数据类型。如果函数不返回任何值,则使用关键字 void。 函数名:用于识别函数的唯一名称。 参数列表:括号内的变量列表,用于从调用者那里接收输入值。如果函数不接受任何参数,则参数列表为空。 函数体:花括号 {} 内包含的代码块,当函数被调用时将执行这些代码。 // 这是一个简单函数定义int add(int a, int b) { return a + b;}// 调用int sum = add(3, 7); // sum值为10 此外,函数定义时需要定义函数原型(也叫函数声明),函数原型告知编译器关于函数的名称、返回类型、参数,但是不提供函数体。一般函数原型都定义在头文件中,包含该头文件即可调用相关函数。 // 下面是一个函数原型的定义int draw(int, int); // 函数原型的参数列表可以省略参数名int draw(int width, int height);// 建议加上参数名,可以更直观的了解参数含义 参数传递 C++中函数的参数传递方式包含: 值传递 指针传递 引用传递(特指左值) 右值传递 传递方式 值传递 该传递方式中函数的实参的值被复制到形参中。函数操作的是实参的副本(拷贝)。 见下例: void swap(int a, int b) { int tmp = a; a = b; b = tmp;}int x = 5; int y = 7;swap(x, y); // x = 5 y = 7 调用swap(x, y)时,函数swap接受两个参数a(x的拷贝),b(y的拷贝),此时在函数中对ab的操作不会影响到外部的实参 x、y。 指针传递 在该传递方式中函数的实参的地址被传递给了形参,本质其实是指针类型的值传递。因为指针能操作其对应的地址的值,因此可以通过指针完成对实参的修改。 上面的swap函数并没有实际完成其命名的功能(交换两个变量的数值),这里利用指针传递改造,见下面代码: void swap(int * a, int * b) { int tmp = *a; *a = *b; *b = tmp;}int x = 5;int y = 7;swap(&x, &y); // x = 7 y = 5 对于需要传递数组参数的场景,指针传递是唯一的选择,数组传参的示例如下: int sum(int arr[], int size);// 定义1,这种定义的好处是清晰,调用者一看就知道传递数组指针int sum(int * arr, int size);// 定义2,这种定义更符合数组传参的本质// 特殊说明// 不管定义1还是定义2,通过参数传递数组指针后,数组指针(前面介绍过,即数组名)会退化为首个元素// 的地址指针,因此一定要通过size参数传递数组的大小给函数 引用传递(左值传递) 传递方式中形参成为实参的别名(引用),所以任何对形参的操作实际上都是在实参上进行的。引用就是别名。 编译器在底层可能会使用指针来实现引用,但会提供更严格的语义和更简单的语法。 引用的声明方式如下: int a = 5;int & ra = a; // ra的类型是 int&(引用),必须声明时立即初始化int b = 6;ra = b; // 非法,引用变量不支持重新赋值 依然以交换函数swap举例: void swap(int & a, int & b) { int tmp = a; a = b; b = tmp;}int x = 5;int y = 7;swap(x, y); // x = 7 y = 5 右值传递 右值传递同引用传递类似,是传递右值引用到函数内部的传递方式。主要被用来实现移动语义和完美转发。详细内容请自行搜索。在下面介绍类的移动语义的部分会有涉及右值。 左值(lvalue): 左值是指表达式结束后依然存在的持久性对象,可以出现在赋值语句的左边。 左值可以被取地址,即可以通过取地址运算符&获取其地址。 通常,变量、数组元素、引用、返回左值引用的函数等都是左值。 右值(rvalue): 右值是指表达式结束后不再存在的临时对象,不能出现在赋值语句的左边。 右值不能被取地址,即不能通过取地址运算符&获取其地址。 通常,字面量、临时对象、返回右值引用的函数等都是右值。 C++11引入了右值引用(rvalue reference)的概念,通过&&来声明一个右值引用。右值引用可以绑定到临时对象,从而支持移动语义和完美转发。移动语义允许将资源(如动态分配的内存)从一个对象“移动”到另一个对象,而不是进行昂贵的复制操作。完美转发允许将参数以原样传递给其他函数,避免不必要的拷贝。 总的来说,C++11中的左值和右值概念更加严格和明确,为语言引入了更多的灵活性和性能优化的可能性。 拓展: 纯右值 将亡值 泛左值 std::move 类型萃取 参数修改保护 对于使用指针传递方式和引用方式传递参数的函数,因为函数内部有修改外部变量数据的能力,因此使用不当可能出现问题。对于一个命名为 printInfo 函数大概率只会使用数据而不会修改数据,应该避免在之后的维护中出现修改参数的情况,这时可以通过 const 关键字来修饰函数的参数,达到禁止函数修改参数的目的。示例如下: // 下面指针传递示例void printInfo(int arr[], int size); // 内部可修改arrvoid printInfo(const int arr[], int size); // 内部不可修改arr// 下面是引用传递示例void printInfo(std::string& info); // 内部可以修改infovoid printInfo(const std::string& info); // 内部不可以修改info 传参方式选择原则 在函数定义时,选择合适的参数传递方式对于代码的性能和可读性至关重要。以下是一些常见的实践做法。 对于仅使用参数的值,并不会进行修改的函数而言,应尽量遵循下面的原则: 如果数据对象很小,如内置数据类型或者小型结构,这按值传递。 如果数据对象是数组,这使用指针,因为这是唯一的选择,并将指针声明为常量指针。 如果数据对象较大的结构,则使用常量指针或者const引用,可以节省复制结构所需要的时间和空间,提高程序的效率。 如果数据对象是类对象,则使用const引用。类设计的语义常常要求使用引用。这是C++增加引用的主要原因。因此传递类对参数的标准方式是按引用传递。 而对于需要通过参数修改原来变量值的函数,应遵循下面的原则: 如果数据对象是内置数据类型,则使用指针。 如果数据对象是数组,则只能使用指针。 如果数据对象是结构,则使用指针或者引用。 如果数据对象是类对象,则使用引用。 函数重载 函数重载是一种允许多个具有相同名称但参数列表不同的函数共存的特性。函数重载允许使用相同的函数名来执行不同的任务,只要它们的参数类型或数量不同即可。编译器通过查看函数的参数列表(也称之为函数签名)来区分重载的函数。 // 下面是一组重载函数,同样是计算两个数的和,针对不同类型提供了不同的定义int add(int a, int b) { // 版本1 return a + b;} float add(float a, float b) { // 版本2 return a + b;} double add(double a, double b) { // 版本3 return a + b;} add(1, 2); // 匹配版本1add(1.0f, 2.0f); // 匹配版本2add(1.0, 2.0); // 匹配版本3add(1.0f, 2.0) // 匹配 ???(匹配版本3,原因可以搜索 ”重载解析“) 重载规则 先介绍一个概念:函数签名。在C++中函数签名包含两个部分: 函数名称 参数列表:包括参数的类型、数量和顺序。注意一个参数是否使用引用并不能作为签名不同的依据。参数是否是 const 能作为不同的依据 函数重载遵循下面的原则: 函数签名必须不同 作用域必须相同:重载的函数必须处于同一个作用域,否则它们被视为不同作用域中的不相关函数。 最佳实践是尽量保持重载函数的明确性,避免产生容易混淆的重载集合。 一些注意点: // 下面两个版本的函数不算重载,因为两者调用时的表达式都是 add(x, y), 编译器无法区分int add(int a, int b);int add(int & a, int & b);// 下面两个版本算重载,编译器会根据实参是否是常量来匹配更合适的版本int add(const int a, const int b);int add(int a, int b); 拓展: 重载函数匹配规则 函数模板 函数模板的声明 C++ 中泛型编程的基础构建块。它们允许程序员编写与类型无关的代码,从而使得相同的函数逻辑可以应用于不同的数据类型。函数模板通过模板参数化来实现,在实例化时,编译器根据传递给模板的实际参数类型生成具体的函数实例。 对于在函数重载一节提到过的add函数,可以看到所有add函数的实现代码都是一样的,只是数据类型不一致。这里通过函数模板来实现同样的功能。 template <typename T>T add(T a, T b) { return a + b;}// 多类型的定义template <typename T1, typename T2>void funcName(T1 a, T2 b); 下面是一个实际示例: #include <iostream>using namespace std;// 函数原型template <typename T>T add(T a, T b); int main() { cout << add(1, 2) << endl; // 3 cout << add(1.0f, 2.1f) << endl; // 3.1 cout << add(1.0, 3.2) << endl; // 4.2 return 0;}template <typename T>T add(T a, T b) { return a + b;} 注意,编译器在编译时会根据调用的参数类型生成对应的实际函数,这个过程被称为模板的实例化,该示例中实际会生成3个版本的add函数,只是不可见而已。另外使用模板不会减小最终的可执行程序,因为最终程序中依然会包含多个版本的add函数实例。 重载的模板 依然以add函数举例,现在需要一个计算3个数据和的函数,并且也可能需要多种类型的版本,可以这么做: // 函数原型template <typename T>T add(T a, T b);template <class T> // 声明模板时 typename 和 class 等价T add(T a, T b, T c);// 函数定义略 模板的局限 考虑下面的模板: template <typename T1, typename T2>void funcName(T1 x, T2 y) { ... ?type? temp = x + y; ...} temp这行应该怎么声明呢?这个类型取决于 x + y 的结果,可能是int, double,甚至更加复杂。C++11为了解决这个问题提供了 decltype 关键字,可以这样使用: template <typename T1, typename T2>void funcName(T1 x, T2 y) { ... decltype(x + y) temp = x + y; ...} 关于 decltype 如何确定最终类型,可以自行搜索,这里不展开。 下面考虑另一个模板: template <typename T1, typename T2>?type?funcName(T1 x, T2 y) { ... return x + y;} 这里的返回值类型应该怎么声明?好像可以使用 decltype(x + y),但这里不行,因为这里还未定义x、y,编译器无法使用这种方式推断。C++11新增了新的语法返回类型后置解决该问题: // 正常函数声明int add(int a, int b);// 返回类型后置声明auto add(int a, int b) -> int;// 利用该语法可以这么声明上面的函数(推荐C+11中使用)template <typename T1, typename T2>auto funcName(T1 x, T2 y) -> decltype(x + y) { ... return x + y;}// C++14及以后得标准拓展了auto的类型推导能力auto funcName(T1 x, T2 y) { ... return x + y;} 更多拓展: 模板函数具体化、全特化 (Full Specialization) auto类型推导规则(区分C+11、C++14) decltype类型推导规则 模板元编程 回调函数 在复杂的应用程序中,回调函数是经常需要使用的技术。在C++中要实现回调函数有以下几种方式。 函数指针 函数名本身就是函数的指针。函数指针在定义时必须指明所指向函数的类型,包括返回类型和参数列表。 以下是函数指针的定义语法: // 返回类型 (*指针变量名)(参数列表);// 示例int add(int a, int b) { return a + b;}int (*pf)(int, int) = add; // 可以这么理解定义:因为(*pf)表示函数,那么pf就是函数的指针// 类似数组,函数指针也有两种使用方式cout << (*pf)(2, 3) << endl; // 5 指针使用方式cout << pf(2, 3) << endl; // 5 直接作为函数名使用// 函数指针的定义一般都不怎么直接,使用也不方面// 经典C++中可以使用typedef简化这个定义typedef int (*p_fun)(int, int); // 现在p_fun就是一种类型名称p_fun pAdd = add; // 精简很多// 现代C++提供了 using 语法让这个过程更加直观,推荐使用using p_fun = int (*)(int, int); // 可读性更强p_fun pAdd = add;// auto大杀器auto pAdd = add; // 懒人利器 知道怎么定义函数指针类型后,就可以定义支持回调函数的函数了,如下: #include <iostream>void callBack(int costTimeMs);void work(void (*pf)(int));int main() { work(callBack);}void callBack(int costTimeMs) { using namespace std; cout << "costTime:" << costTimeMs << endl; }void work(void (*pf)(int)) { std::cout << "do some work" << std::endl; // ... pf(123); // (*pf)(123) 也ok} std::function 上面介绍的函数指针在定义时不怎么直观,C++标准库中提供了std::function 容器来简化这个过程。其实现技术原理可以自行搜索。这里给出代码示例: #include <functional>#include <iostream>using namespace std;void callBack(int costTimeMs) { cout << "costTime:" << costTimeMs << endl; }void work(function<void(int)> callBack) { callBack(1234);}int main() { function<void(int)> func = callBack; work(func); return 0;} 更多方式 C++是面向对象的语言,回调的场景更多的涉及到对象。对此C++提供了 函数对象(Functors、成员函数指针和 std::bind 作为回调函数。这里先不展开。 ▐类(class) C++通过引入类支持了面向对象编程(OOP)。在 C++ 中,类是创建自定义数据类型的核心概念之一。类用于定义与特定类型相关的数据(成员变量)及操作这些数据的函数(成员函数)。通过类,可以实现面向对象编程(OOP)的基本原则,如封装、继承和多态。 关于C++类的知识非常多且复杂,这里介绍常用和重要的部分。 定义类 类是通过关键字 class 定义的,后跟类名和类体: class MyClass {public: // 公共成员,通常的对外提供的方法定义 void setMember(int member);private: // 私有成员,成员变量,仅供内部调用函数 int mMember; // 集团规范推荐,使用m前缀 void innerFunc(); // 函数一律小驼峰protected: // 受保护成员,成员变量,供子类调用函数}; 下面是类的实际定义: // person.hpp// C++一般使用 hpp 后缀的头文件,表明包含C++特性的代码(模板、引用、类等)// .h .hpp只是约定的做法,不是语法上的必要性// 类的定义一般放到头文件中,用来对外声明类// 类的头文件规范:类名小写 + '_'分割(如果有多个单词的case)// 如果类名:PersonInfo 对应头文件:person_info.hpp#ifndef PERSON_H#define PERSON_H#include <string>#include <iostream>// 声明 'Person' 类class Person {public: // 构造函数声明 Person(const std::string & name, int age); // 成员函数声明 void printInfo() const; // const成员函数,保证函数不会修改调用对象 // Setters 和 Getters 声明 void setName(const std::string & name); const std::string & getName() const; void setAge(int age); int getAge() const;private: // 成员变量 std::string mName; int mAge;};#endif // PERSON_H// person.cpp// 实现代码放到同名cpp文件中#include "person.hpp"// 构造函数定义Person::Person(const std::string & name, int age) : mName(name), mAge(age) {}// 成员函数定义void Person::printInfo() const { std::cout << "Name: " << mName << ", Age: " << mAge << std::endl;}// Setters 和 Getters 定义void Person::setName(const std::string & name) { mName = name;}const std::string & Person::getName() const { return mName;}void Person::setAge(int age) { mAge = age;}int Person::getAge() const { return mAge;} 拓展: const成员函数 访问控制 类成员的访问权限可以是 public、private 或 protected: Public(公共):公共成员可以在类的外部被访问。 Private(私有):私有成员只能在类的内部被访问。 Protected(受保护):受保护成员可以在类的内部以及其派生类中被访问。 构造函数 构造函数是一种特殊的成员函数,它在创建类实例时自动调用。 构造函数可以被重载,以提供不同的初始化方式。成员初始化列表提供了初始化成员变量的一种更高效的方式,对于类中的常量成员、引用成员来说,成员初始化列表是必须的: class MyClass {public: MyClass(int m1, int m2, int m3) : mM1(m1), mM2(m2), mM3(m3) {}private: int mM1; const int mM2; int & mM3;};// 类的初始化方式MyClass a1(1, 2, 3); // 传统构造函数MyClass a1 = MyClass(1, 2, 3); // 同上MyClass a2 = {1, 2, 3}; // 列表初始化,会匹配最合适的构造函数MyClass a3{1, 2, 3}; // 同上 拓展: explicit 关键字 析构函数 析构函数是类的一个特殊成员函数,它在类的对象生命周期结束时自动被调用以执行清理工作。主要用途是释放对象占用的资源,并执行一些必要的清理操作,例如释放动态分配的内存、关闭文件和数据库连接等。示例: class MyClass {public: MyClass() { // 构造函数分配资源或执行初始化 data = new int[10]; // 假设动态分配了内存 } ~MyClass() { // 析构函数释放资源 delete[] data; // 释放动态分配的内存 }private: int* data; // 指向动态分配的内存}; 自动调用析构函数的情况: 1.局部对象:当局部对象的作用域结束时,例如函数结束时,其中的局部对象会被销毁,调用析构函数。 2.动态分配的对象:当使用 delete 操作符删除一个动态分配的对象时,析构函数会被调用。 3.静态和全局对象:当程序结束时,所有的静态和全局对象会被销毁,调用析构函数。 4.临时对象:当临时对象的生命周期结束时,例如临时对象作为函数参数传递,或者在它们创建的表达式结束后,析构函数会被调用。 5.通过 std::unique_ptr 或 std::shared_ptr 管理的对象:当智能指针销毁或被重新赋值,造成引用计数降为零时,析构函数会被调用。 在 C++ 中,通常应用“资源获取即初始化”(RAII)原则来管理资源。RAII 建议在构造函数中获取资源,并在析构函数中释放资源。这样,资源的生命周期就与包含它的对象的生命周期绑定在一起,简化了资源管理并防止了资源泄漏。 当正确使用 RAII 原则时,通常不需要手动调用析构函数,因为 C++ 会确保在对象生命周期结束时自动调用析构函数。然而,如果你使用“裸”指针手动管理资源,就必须非常小心地确保每个分配的资源最终都被释放,否则可能会导致资源泄漏。智能指针(如 std::unique_ptr 和 std::shared_ptr)是现代 C++ 推荐的资源管理方式,它们可以自动管理资源的生命周期,从而避免直接手动管理资源的复杂性和危险。 运算符重载 类可以重载各种运算符,以提供类似于内建类型的行为: class MyClass {public: MyClass() : data(new int[10]) { } // 构造函数 ~MyClass() { delete[] data; } // 析构函数 // 拷贝赋值运算符 MyClass & operator=(const MyClass& other) { if (this != &other) { // 避免自赋值 std::copy(other.data, other.data + 10, data); } return *this; }private: int* data;};// 使用MyClass a;MyClass b = a; // 默认的赋值操作是浅拷贝,这里因为重载了 = 运算符,变成深拷贝// C++11开始可以删除默认的赋值操作符,从而防止因浅拷贝带来的风险class MyClass2 { // ... MyClass2 & operator=(const MyClass2 & other) = delete; // 禁用赋值操作符 // ...};MyClass2 a;MyClass2 b = a; // 非法,MyClass2的 = 运算符被禁用 一些注意事项: 运算符重载并不改变运算符的优先级、结合性或操作数个数。这些都是由语言规范定义的。 不要滥用运算符重载。重载的运算符应该和它的原始意图保持相关性,否则可能导致代码难以阅读和理解。 记得检查自赋值。特别是在重载赋值运算符时(如 operator=),要确保它能正确处理自赋值的情况。 为了保持一致性,考虑重载对应的复合赋值运算符。例如,如果你重载了 operator+,那么也应该重载 operator+=。 当重载某些运算符,如 ==,通常也需要重载相应的运算符,如 !=,以确保逻辑一致性。 某些运算符最好重载为非成员函数。像 << 和 >> 这类运算符,如果要用于输入输出流的话,通常作为非成员函数重载比较合适,因为它们的左操作数通常是流对象。 拓展: C++支持重载的运算符 转换函数(这个不算运算符重载,例:operator int()) 拷贝构造函数和拷贝赋值运算符 对象的赋值操作是常见的操作,应该尽量避免使用浅拷贝,因为这种方式存在潜在风向。为解决这个问题类可以定义专门的拷贝构造函数和拷贝赋值运算符,以控制对象如何被复制: #include <iostream>class MyClass {public: MyClass() : data(new int[10]) { } // 默认构造函数 ~MyClass() { delete[] data; } // 析构函数 // 拷贝构造函数 MyClass(const MyClass & other) : data(new int[10]) { std::copy(other.data, other.data + 10, data); std::cout << "copy init" << std::endl; } // 拷贝赋值运算符 MyClass & operator=(const MyClass & other) { if (this != &other) { // 避免自赋值 std::copy(other.data, other.data + 10, data); } std::cout << "copy =" << std::endl; return *this; }private: int* data;};int main() { MyClass a; MyClass b; MyClass c = a; c = b; return 0;}// 程序输出// copy init// copy = 拓展: 浅拷贝 深拷贝 移动构造函数和移动赋值运算符(C++11) 在 C++11 中引入了移动语义,允许从临时对象“移动”资源,而不是复制它们: #include <iostream>using namespace std;class BigMemoryPool { private: static const int POOL_SIZE = 4096; int* mPool; public: BigMemoryPool() : mPool(new int[POOL_SIZE]{0}) { cout << "call default init" << endl; } // 编译器会优化移动构造函数,正常情况可能不会被执行 // 可以添加编译选项 “-fno-elide-constructors” 关闭优化来观察效果 BigMemoryPool(BigMemoryPool && other) noexcept { mPool = other.mPool; other.mPool = nullptr; cout << "call move init" << endl; } BigMemoryPool & operator=(BigMemoryPool && other) noexcept { if (this != &other) { this->mPool = other.mPool; other.mPool = nullptr; } cout << "call op move" << endl; return *this; } void showPoolAddr() { cout << "pool addr:" << &(mPool[0]) << endl; } ~BigMemoryPool() { cout << "call destructor" << endl; }};BigMemoryPool makeBigMemoryPool() { BigMemoryPool x; // 调用默认构造函数 x.showPoolAddr(); return x; // 返回临时变量,属于右值}int main() { BigMemoryPool a(makeBigMemoryPool()); a.showPoolAddr(); a = makeBigMemoryPool(); a.showPoolAddr(); return 0;}// 输出内容call default initpool addr:0x152009600instance addr:0x16fdfeda0pool addr:0x152009600instance addr:0x16fdfeda0 // 编译器优化,这里a和x其实是同一个实例,因此不会触发移动构造call default initpool addr:0x15200e600 // 新的临时变量,堆内存重新分配instance addr:0x16fdfed88 // 临时变量对象地址call op move // 移动赋值call destructorpool addr:0x15200e600 // a的Pool指向的内存地址变成新临时对象分配的地址,完成转移instance addr:0x16fdfeda0 // a对象的地址没有变化call destructor 拓展: 返回值优化(RVO) 命名返回值优化(NRVO) C++11引入移动语义之前,类似的做法需要返回指针或者通过拷贝的方式来保存临时对象,前者会引入资源管理问题后者会有拷贝的性能损耗。 友元函数和友元类 友元函数 友元函数是定义在类外部的普通函数,它被某个类声明为其“友元”。这意味着友元函数可以访问该类的所有成员,包括私有和受保护的成员。友元函数不是类成员函数,也不受类的封装性约束。 友元函数的声明方式是在类的定义内部使用关键字 friend,后跟函数的原型,友元函数实现时不能加类名作用域限定: #include <iostream>// 声明 Vector2D 类class Vector2D {private: float x_; float y_;public: Vector2D(float x = 0.0f, float y = 0.0f) : x_(x), y_(y) {} // 友元函数声明,用于重载 + 操作符 friend Vector2D operator+(const Vector2D & a, const Vector2D & b); // 输出 Vector2D 对象的友元函数 friend std::ostream & operator<<(std::ostream & out, const Vector2D & v);};// 重载 + 操作符的友元函数定义Vector2D operator+(const Vector2D & a, const Vector2D & b) { return Vector2D(a.x_ + b.x_, a.y_ + b.y_);}// 重载 << 操作符的友元函数定义,用于输出 Vector2D 对象std::ostream & operator<<(std::ostream & out, const Vector2D & v) { out << "(" << v.x_ << ", " << v.y_ << ")"; return out;}int main() { Vector2D vec1(1.0, 2.0); Vector2D vec2(3.0, 4.0); Vector2D vec3; vec3 = vec1 + vec2; // 使用友元函数重载的 + 操作符 std::cout << "vec1: " << vec1 << std::endl; std::cout << "vec2: " << vec2 << std::endl; std::cout << "vec3: " << vec3 << std::endl; // 输出: vec3: (4, 6) return 0;} 友元类 友元类是一个允许特定类访问另一个类的私有和受保护成员的机制。在 C++ 中,通常情况下,一个类无法访问另一个类的私有(private)和受保护(protected)成员,即使它们需要彼此协作。友元类提供了一种方式,让你可以指定某些类之间有更紧密的关系,并允许它们访问对方的非公共接口。下面是示例: #include <iostream>class MyClass; // 前向声明// 声明一个类(FriendClass),该类将访问MyClass的私有和受保护成员class FriendClass {public: void accessMyClass(MyClass & obj);};// 声明主类(MyClass)class MyClass {private: int secret;public: MyClass(int val) : secret(val) {} // 声明FriendClass为MyClass的友元类 friend class FriendClass;};// FriendClass成员函数实现void FriendClass::accessMyClass(MyClass & obj) { // 可以访问MyClass的私有成员'secret' std::cout << "MyClass secret value is: " << obj.secret << std::endl;}int main() { MyClass obj(42); // 创建MyClass对象 FriendClass friendObj; // 创建FriendClass对象 friendObj.accessMyClass(obj); // 访问MyClass的私有成员 return 0;} 使用友元可能会破坏类的封装性和数据隐藏原则,因为它们允许外部函数或者类直接访问类的私有成员。因此,建议谨慎使用友元,只在确实需要时才使用,并寻找是否有其他设计替代方案。在设计类时,应尽可能通过公共成员函数或成员函数的重载来提供类的行为和操作,而将友元作为特定情况下的解决方案。 继承 类可以从其他类继承,从而获得基类的成员和行为: class Base { // 基类成员};class Derived : public Base { // 派生类成员}; C++继承方式有三种: 公有继承(public)最常见的继承类型。在公有继承中,基类的公有成员和保护成员在派生类中保持其原有的访问级别,而基类的私有成员在派生类中是不可访问的。 保护继承(protected)基类的公有成员和保护成员都成为派生类的保护成员。这意味着它们只能被派生类或其进一步的派生类中的成员函数访问。 私有继承(private)私有继承会将基类的公有成员和保护成员都变成派生类的私有成员。这意味着这些成员只能被派生类的成员函数访问,而不能被派生类的派生类访问。 C++是支持多重继承的,即可以从多个类派生一个类,但是通常建议谨慎使用,因为多重继承可能会引起一些复杂的问题。 拓展: 虚继承 多态 多态允许派生类重写基类的虚拟函数,使得通过基类引用或指针调用这些函数时可以执行派生类的版本: #include <iostream>class Base {public: void baseMethod() { std::cout << "Base method" << std::endl; } virtual void polymorphicMethod() { std::cout << "Base polymorphic method" << std::endl; } virtual ~Base() {} // 虚析构函数,用于多态};// 公有继承派生类class Derived : public Base {public: // 重写基类的虚函数 void polymorphicMethod() override { Base::polymorphicMethod(); // 可以通过添加限定域调用基类实现 std::cout << "Derived polymorphic method" << std::endl; }};int main() { Derived d; d.baseMethod(); // 调用基类的方法 d.polymorphicMethod(); // 调用派生类重写的方法 Base *b = &d; b->polymorphicMethod(); // 通过基类指针调用派生类的方法,体现多态 return 0;} 在类继承的场景中,基类的析构函数一般要声明为虚析构函数,这样才能保证在通过基类指针删除对象时,派生类的资源也能被正确的释放。 拓展: 虚函数表 动态绑定 抽象类和纯虚函数 如果一个类包含至少一个纯虚函数(以 = 0 结尾),则该类被认为是抽象类,不能直接实例化,只包含纯虚函数而没有成员变量的抽象类和Java中的接口(Interface)功能类似。 // Interface in C++class IShape {public: virtual void draw() const = 0; // 纯虚函数 virtual ~IShape() {} // 虚析构函数以确保派生类的析构函数被调用};class Circle : public IShape {public: void draw() const override { // 实现绘制圆形的代码 }};class Rectangle : public IShape {public: void draw() const override { // 实现绘制矩形的代码 }}; 模板类 C++模板类是一种强大的特性,它允许程序员编写泛型且可重用的代码。模板类可以用来定义在编译时可以指定类型参数的类,这意味着可以用相同的基本代码来处理不同的数据类型。可以这么说现代C++的很多功能强大的特性都和模板技术有关系下面是模板类的一般定义语法: template <typename T>class MyTemplateClass { const T& getValue();public: T myValue;}; 因为模板类的复杂性,这里不做展开。因为模板是一种强大的语言特性,C++中常见的模板类应用如下: 容器类 C++标准库中提供一系列的泛型容器,前面提到过的 vector、list、stack都是模板类实现的。 相关容器的用法可以搜索对应的文档。 智能指针 智能指针,同样是利用模板类技术实现的,它们提供了自动内存管理功能,可以帮助避免内存泄漏。 下面是现代C++提供的智能指针: std::unique_ptr:std::unique_ptr 是一个独有所有权的智能指针。它保证同一时间内只有一个智能指针实例可以拥有一个给定的对象。当 std::unique_ptr 被销毁时,它所拥有的对象也会被销毁。std::unique_ptr 通常用于对资源有独占所有权的情况,并且它是不可以被复制的,但可以被移动,以便所有权可以从一个 std::unique_ptr 转移到另一个。 std::shared_ptr:std::shared_ptr 实现了共享所有权的概念。它通过内部的引用计数机制来跟踪有多少个 std::shared_ptr 实例共享同一个对象。当最后一个这样的指针被销毁时,所拥有的对象将会被删除。std::shared_ptr 适用于多个拥有者需要管理同一个对象的生命周期的情况。 std::weak_ptr:std::weak_ptr 是一种非拥有(弱)引用的智能指针。它不会增加对象的引用计数,因此不会阻止所指向的对象被销毁。std::weak_ptr 主要用于解决 std::shared_ptr 之间可能出现的循环引用问题。通过 std::weak_ptr,你可以观察一个对象,但不会造成所有权关系。 // 简单示例// 定义智能指针// C++11语法std::unique_ptr<MyClass> my_unique_ptr(new MyClass());std::shared_ptr<MyClass> my_shared_ptr(new MyClass());// C++14提供了更安全更现代的方法auto my_unique_ptr = std::make_unique<MyClass>();auto my_shared_ptr = std::make_shared<MyClass>(); // 可以按照构造函数的定义传参// 调用类的方法和普通指针类似my_unique_ptr->func();my_shared_ptr->func();// 在需要传对象指针和引用的场景// 类指针类型void testFunc1(MyClass * p);testFunc1(my_unique_ptr.get()); // 通过get获取原始指针// 引用类型void testFunc2(MyClass & ref);testFunc2(*my_unique_ptr); // 通过*运算符获取对象的引用 函数对象 上面介绍函数回调时说过的 std::function也是模板类,它是一个泛型函数封装器,其实例可以存储、复制和调用任何可调用对象,如普通函数、Lambda 表达式、函数对象(functors)以及其他函数指针。下面是一些典型用法: // 封装函数void printHello() { std::cout << "Hello, World!" << std::endl;}std::function<void()> func = printHello;// 封装Lambda表达式std::function<int(int, int)> add = [](int a, int b) -> int { return a + b;};int sum = add(2, 3); // sum 的值为 5// 封装成员函数class MyClass {public: void memberFunction() const { std::cout << "Member function called." << std::endl; }};MyClass obj;std::function<void(const MyClass &)> f = &MyClass::memberFunction;f(obj); // 输出: Member function called.// 封装带有绑定参数的函数void printSum(int a, int b) { std::cout << "Sum: " << a + b << std::endl;}int main() { using namespace std::placeholders; // 对于 _1, _2, _3... // 绑定第二个参数为 10,并将第一个参数留作后面指定 std::function<void(int)> func = std::bind(printSum, _1, 10); func(5); // 输出: Sum: 15 return 0;} ¤ 拓展阅读 ¤ 3DXR技术| 终端技术| 音视频技术 服务端技术|技术质量|数据算法 本文分享自微信公众号 - 大淘宝技术(AlibabaMTT)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

CameraX 曝光补偿 API 入门指南

在移动端发展的过程中,相机设备对于推动移动设备创新起到了举足轻重的作用,而相机曝光则是能够拍摄出非凡品质照片的关键要素。在本文中,我将为大家详解移动端开发者在处理相机曝光时所遇到的挑战。之后我会为大家介绍新的 CameraX 曝光补偿 (Exposure Compensation) API 如何帮助开发者应对这些挑战,使快速拍摄高品质照片变得更加简单。最后,我将为大家展示如何在您的应用中使用该 API。 背景 在摄影中,曝光是决定最终相机所呈现图像的最重要因素之一,因此大多数摄影师都极力将曝光调至最佳。自动曝光 (AE) 模式在大多数常见拍摄场景下的效果都不错,比如自动快速拍照。然而在某些特定条件下,AE 模式会为了照片的整体质量而做出一些妥协,而这些妥协有时并不是您想要的。其中一个例子就是逆光,例如,在室内朝向窗户或者其它光源的位置拍摄,或者在室外拍摄,拍摄对象的后方刚好是太阳。在这些拍摄场景中,AE 模式会因为明亮的背景 (照片中高亮的区域) 而对照片进行适当曝光,但是处于黑暗前景中的主体就会变得过于昏暗或者成为剪影效果。图 1 展示的是在相同条件 (室内逆光) 下使用不同曝光进行拍摄的三张照片。 AE 对于照片的整体质量控制得很好,但是更高的曝光确实能够捕获到 Android 公仔的更多画面细节。 传统操作中,摄影师通过调整如下三个参数来达到满意的曝光: 光圈: 镜片的打开程度,它控制相机的进光量 快门速度: 照片曝光的持续时间 ISO (国际标准化组织): 相机感光元件对捕获光线的敏感程度 每个参数对于图像都有特殊的作用: 光圈可以调整景深效果,快门速度可以虚化运动的过程或者定格运动的瞬间,而更高的 ISO 会增加图像噪点。其中用到相当精准的数学计算,但是这些参数设置的不同组合可以获得相同的整体曝光效果,以及在这个过程中获得高水准的完美曝光数值。为了辅助补偿曝光,CameraX 实现了曝光补偿 API。 实现曝光补偿 API 曝光补偿 API 根据生成的自动曝光值,通过曝光补偿指数调整曝光补偿度。曝光补偿指数可以为正值 (用于提高照片亮度) 或者负值 (降低照片亮度)。它将整体曝光范围映射到补偿指数的取值区间,并将曝光总量映射到 EV 步长。相机设备内部会根据曝光指数改变曝光,减少控制其它参数的操作并且达到同一效果。 以图 1 为例,相机的默认配置无法为我们希望对焦的主体提供足够的亮度,所以我们可以使用正值指数的曝光补偿配置来获得两倍或者四倍的曝光,从而突出主体。通过改变曝光补偿指数,相机内部会控制快门速度、光圈和 ISO 以获得合适的曝光。 要获得补偿指数,CameraX 实现了以下内容: CameraControl::setExposureCompensationIndex,用于设置新的曝光补偿指数。 ExposureState 用于曝光补偿性能和当前配置,包括: 支持调整补偿 所支持的补偿范围 所支持的补偿步长 当前补偿指数值 我们来看看在 CameraX 应用中如何使用 API 来创建曝光合适的照片。 使用曝光补偿 API 要在应用中使用曝光补偿 API,您需要完成如下工作: 查询曝光补偿范围 设置新的曝光补偿指数 当 CameraX 确认后继续后续操作 查询曝光补偿指数的范围 曝光补偿值的范围依赖 相机设备的配置和硬件级别;应用可以通过 ExposureState 接口查询所支持的取值范围。 val camera = cameraProvider.bindToLifecycle( … ) valrange=camera.cameraInfo.exposureState.exposureCompensationRange 设置新的曝光补偿指数 如果照片显得较暗,在相机原本的修正曝光基础上设置一个正值的曝光补偿指数来提高亮度;同理,如果照片显得过亮,则设置一个负值。这可以通过 setExposureCompensationIndex() 来实现: interface CameraControl { fun setExposureCompensationIndex(value: Int): ListenableFuture<Int!> } 默认情况下,曝光补偿指数的值从 "0" 开始,新的指数值必须在相机设备所支持的范围内变化。否则 CameraX 会抛出 IllegalArgument 错误。请注意如果相机设备不支持曝光补偿调节,CameraX 所返回支持的取值范围是 [0,0]。 举个例子,下述代码中当用户点击了 UI 中的按钮会提高曝光补偿指数直到曝光指数达到所支持的最大值为止: var exposureIndex = 0 val camera = cameraProvider.bindToLifecycle( lifecycleOwner, getCameraSelector(), preview, imageCapture, ) evButton.setOnClickListener { val range = camera.cameraInfo.exposureState.exposureCompensationRange if (range.contains(exposureIndex + 1)) { camera.cameraControl.setExposureCompensationIndex(++exposureIndex) val ev = camera.cameraInfo.exposureState.exposureCompensationStep.toFloat() * exposureIndex Log.i("CameraXLog", "EV: $ev") } } setExposureCompensationIndex() 是 async 函数,每个相机只能响应一个未处理的请求。如果应用在之前的调用未被响应之前再次调用 setExposureCompensationIndex(),新的调用请求就会替代之前的请求,而之前的请求会被取消并抛出 OperationCanceledException。通常,新的指数值会被迅速启用,输出流的曝光会随着 绑定用例 变化。如果应用需要知道特定请求的准确执行时间和结果,可以在函数返回的 ListenableFuture<Int> 之上注册监听器。 关联补偿指数和曝光值 (EV) 曝光值 (EV) 是一个用于表示曝光补偿的光照度差异的度量单位。+1 EV 表示两倍光照,+2 EV 是四倍光照,依此类推。应用可以将相同的曝光值应用到各种相机,甚至不同的设备,来获得相似的曝光,但是应用不应该针对相同的目标效果直接使用相同的指数值,因为每个指数值是相机的专属值。 补偿 API 中,曝光值是通过如下公式进行计算的: 曝光值 (EV) = exposure_compensation_index * compensation_step 上述公式中提到的 compensation_step 是曝光值可被修改的最小单位。请注意 compensation_step 也依赖相机设备。应用可以通过 ExposureState 查询相机的 compensation_step,并且可以按照下面所示计算曝光值: val camera = cameraProvider.bindToLifecycle( … ) val exposureValue = camera.cameraInfo.exposureState.exposureCompensationStep.toFloat() * exposureIndex 例如: exposure_compensation_index 等于 6,compensation_step 等于 ⅓,那么曝光补偿计算为 +2 EV,也就是两倍的默认曝光值。 compensation_step 的 step_size 取值通常为 ⅓ 或者 ½,较少情况下,有些设备可能会支持 1 或者甚至 ¼。所能支持的最大曝光值一般是 2 EV 或者 3 EV。 CameraX 曝光补偿 API 的可用性 曝光补偿 API 是在 android.camera:camera-core:1.0.0-beta09 中首次以实验方式发布。 该 API 在版本 android.camera:camera-core:1.1.0-alpha06 中完成了实验阶段,成为正式版本 CameraX API 的一部分。 要获得最新的发布版本,请查阅 官方 CameraX 版本说明。 总结 在 GitHub 上可以找到 CameraX 曝光补偿的示例代码。结合 CameraX API 的其它部分,曝光补偿 API 可以帮助开发者实现富有创意的 Android 相机应用,并在移动应用的海洋中脱颖而出。如果您有兴趣了解更多关于 CameraX 的内容,请参阅 官方文档,如果希望能够持续获得 CameraX 的最新进展,可以加入 CameraX 讨论组。欢迎大家提出宝贵意见,可以在 CameraX 讨论组 中和我们交流,或者创建 CameraX issues 提交您遇到的问题。 相关阅读 setExposureCompensationIndex API ExposureState API CameraX 版本说明 Codelab: 上手使用 CameraX GitHub 示例 欢迎您 点击这里 向我们提交反馈,或分享您喜欢的内容、发现的问题。您的反馈对我们非常重要,感谢您的支持!

优秀的个人博客,低调大师

MySQL 不完全入门指南

由于 MySQL 的整个体系太过于庞大,文章的篇幅有限,不能够完全的覆盖所有的方面。所以我会尽可能的从更加贴进我们日常使用的方式来进行解释。 小白眼中的 MySQL 首先,对于我们来说,MySQL 是个啥?我们从一个最简单的例子来回顾一下。 这可能就是最开始大家认知中的 MySQL。那 MySQL 中是怎么处理这个查询语句的呢?换句话说,它是如何感知到这串字符串是一个查询语句的?它是如何感知到该去哪张表中取数据?它是如何感知到该如何取数据? 到目前为止,都不知道。接下来我们一步一补来进行解析。 连接池 首先,要去 MySQL 执行命令,肯定是需要连接上 MySQL 服务器的,就像我们通过「用户名」和「密码」登陆网站一样。所以,我们首先要认识的就是连接池。 这种池化技术的作用很明显,复用连接,避免频繁的销毁、创建线程所带来的开销。除此之外,在这一层还可以根据你的账号密码对用户的合法性、用户的权限进行校验。 每一个连接都对应一个线程,「服务器」 和 「MySQL」 都一样,服务器的一个线程从服务器的连接池中取出一个连接,发起查询语句。MySQL 服务器的线程从连接池中取出一个线程,继续后续的流程。 那么后面的流程是啥呢?当然是分析 SQL 语句了。 分析器 很明显,MySQL 肯定得知道这个 SQL 是不是个合法的 SQL 语句,以及 SQL 语句到底要干啥? 就好像有个哥们疯狂的敲你家门,门打开了,下一步是干嘛?肯定得问他是谁?来干嘛? 所以,下一步就是要将 SQL 进行解析。解析完成之后,我们就知道当前的 SQL 是否符合语法,它到底要干嘛,是要查询数据?还是要更新数据?还是要删除数据? 很简单,我们肉眼能能明显看出来一条 SQL 语句是要干嘛。但电脑不是人脑,我们得让电脑也能看懂这条 SQL 语句,才能帮我们去做后面的事。 知道了这个 SQL 语言要干嘛之后,是不是就可以开始执行操作了呢? 并不是 优化器 MySQL 除了要知道这条 SQL 要干嘛,在执行之前,还得决定怎么干,怎么干是最优解。 还是刚刚那个例子,隔壁的哥们敲开了你家的门,说哥们儿,我家里这停水了,想找你施(白)舍(漂) 24 瓶矿泉水。我们暂且不去讨论,他为什么需要 24 瓶矿泉水。 我们要讨论的是,我们要怎么把这 24 瓶矿泉水拿给他。因为你刚刚想起来,矿泉水在之前被你一顿操作全扔柜子了。 你是要每次拿个 4 瓶,跑 6 趟呢?还是找个箱子,把 24 瓶装满再搬出去给他。 这差不多就是优化器要做的事情,优化器会分析你的 SQL,找出最优解。 再举个正经的例子,假设 SELECT nameFROMstudentwhereid= 1 语句执行时,数据库里有 1W 条数据,此时有两种方案: 查出所有列的 name 值,然后再遍历对比,找到 id=1 的 name 值 直接找到 id=1 的数据,然后再取 name 的值 用屁股想想都知道应该选方案2. 找到了怎么做之后,接下来就需要落实到行动上了。所以,接下来执行器闪亮登场。 执行器 执行器会掉用底层存储引擎的接口,来真正的执行 SQL 语句,在这里的例子就是查询操作。 至此,MySQL 这个黑盒子已经被我们一步一步的揭开了面纱。但是在揭开最后一片面纱的时候,我们又发现了新的黑盒子。那就是存储引擎。 我们到目前为止,就只知道它的名字,至于其如何存储数据,如何查询数据,一概不知。 存储引擎 MySQL 的存储引擎有很多的种类,分别适用于不同的场景。大家可以这么理解,存储引擎就是一个执行数据操作的接口(Interface),而底层的具体实现有很多类。 InnoDB、MyISAM、Memory、CSV、Archive、Blackhole、Merge、Federated、Example 用的最广泛的,就是 InnoDB 了。打从 MySQL 5.5 之后,InnoDB 就是 MySQL 默认的存储引擎了。 所以,存储引擎其实并不是什么高大上的东西,跟什么大学拿去交作业的图书馆管理系统区别,就差了亿点而已。 或者,我再举个例子。我们往我们电脑上的文件中写入数据,此时由于 OS 的优化,数据并不会直接写入磁盘,因为 I/O 操作相当的昂贵。数据会先进入到 OS 的 Cache 中,由 OS 之后刷入磁盘。而 MySQL 在整个的逻辑结构上,跟计算机写文件差不多。 从上面的例子看出,存储引擎可以分为两部分: 内存 磁盘 所以,从宏观上来说,MySQL 就是把数据在缓存在内存中,鼓捣鼓捣,然后在某些时候刷入磁盘中去,就这么回事。 接下来,就让我们深入存储引擎 InnoDB 的底层原理中相当重要的一部分——内存架构。 简单来说,InnoDB 的内存由以下两部分组成: Buffer Pool Log Buffer 从上面画的图就能够看出,Buffer Pool 是 InnoDB 中非常重要的一部分,MySQL 之所以这么快其中一个重要的原因就是其数据都存在内存中,而这个内存就是 Buffer Pool。 Buffer Pool 一般来说,宿主机的 80% 的内存都会分配给 Buffer Pool。这个很好理解,内存越大,就能够存下更多的数据。这样一来更多的数据将可以直接在内存中读取,可以大大的提升操作效率。 那 Buffer Pool 中到底是如何存储数据的呢?如果其底层的数据存储不进行特殊的设计、优化,那么 InnoDB 在取数据的时候除了整个遍历之外,没有其他的捷径。而如果那样做,MySQL 也不会获得今天这样的地位。 页 如果我们能想象一下,InnoDB 会如何组织内存的数据。想象一下,图书馆的书是直接一本一本的摊在地上好找,还是按照类目、名称进行分类、放到对应的书架上、再进行编号好找?结论自然不言而喻。Buffer Pool 也采用了同样的数据整合措施。 InnoDB 将 Buffer Pool 分成了一张一张的页(Pages),同时还有个 Change Buffer(后面会详细讲,这里先知道就行)。分成一页一页的数据就能够提升查询效率吗?那这个页里面到底是个啥呢? 可以从上图看到,页和页之间,实际上是有关联的,他们通过双向链表进行连接,可以方便的从某一页跳到下一页。 那数据在页中具体是如何存储的呢? User Records 当然,光跳来跳去的并不能说明任何问题,我们还是揭开页(Pages)这个黑盒的面纱吧。 ! 可以看到,主要就分为 上一页指针 下一页指针 User Records 其余字段 为了方便理解,其余字段我后续会补充 上一页指针、下一页指针就不多赘述,就是一个指针。重点我们需要了解 User Records。 User Records 就是一行一行的数据**(Rows)最终存储的地方,其中,行与行之间形成了单向链表**。 看了这个单向链表不知道你有没有一个疑问。 我们知道,在聚簇索引中,Key 实际上会按照 Primary Key 的顺序来进行排列。那在 User Records 中也会这样吗?我们插入一条新的数据到 User Records 中时,是否也会按照 Primary Key 的顺序来对已有的数据重排序? 如果每次插入数据都需要对 User Records 中的数据进行重排序,那么 MySQL 的江湖地位将再次不保。 虽然在图中看起来是按照「主键」的顺序存储的,但实际上是按照数据的插入顺序来存储的,先到的数据会在前面,后到的数据会在后面,只是每个 User Records 数据的指针指向的不是物理上的下一个,而是逻辑上的下一个。 用图来表示,大概如下: 可以理解为数组和链表的区别。 看到这,那么问题来了,说好的不遍历呢?这不是打脸吗?因为从上图可以看出,我要找查找某个数据是否存在于当前的页(Pages)中,只能从头开始遍历这个单向链表。 就这?还敢号称高性能?当然,InnoDB 肯定不是这么搞的。这下就需要从「其余字段」中取出一部分字段了来解释了。 Infimum 和 Supremum 分别代表当前页(Pages)中的最大和最小的记录。 可以看到,有了 Infimum 和 Supremum,我们不需要再去遍历 User Records 就能够知道,要找的数据是否在当前的页中,大大的提升了效率。 但其实还是有问题,比如我需要查询的数据不在当前页中还好,那如果在呢?那是不是还是逃不了 O(N) 的链表遍历呢?算不算治标不治本? 这个时候,我们又需要从「其余字段」中抽一个概念出来了。 Page Directory 顾名思义,这玩意儿是个「目录」,可以看下图。 ! 可以看到,每隔一段记录就会在 Page Directory 中有个记录,这个记录是一个指向 User Records 中记录的一个指针。 不知道这个设计有没有让你想起跳表(Skip List)。那这个 Page Directory 中的目录拿来干嘛呢? 有了 Page Directory,就可以对一页中的数据进行类似于跳表的中的查询。在 Page Directory 中找到对应的「位置」之后,再根据指针跳到对应的 User Records 上的单链表,进行查询。如此一来就避免了遍历全部的数据。 上面提到的「位置」,其实有个专业的名词叫「槽位(Slots)」。每一个槽位的数据都是一个指向了 User Records 某条记录的指针。 当我们新增每条数据的时候,就会同步的对 Page Directory 中的槽位进行维护。InnoDB 规定每隔 6 条记录就会创建一个 Slot。 了解到这里之后,关于如何高效地在 MySQL 查询数据就已经了解的差不多了。 想了解「其余字段」还有哪些、以及「页」的完整面貌的,可以去看看我之前写的页的文章 MySQL 页完全指南——浅入深出页的原理,再次就不再赘述。 索引 了解完页之后,索引是什么就一目了然了。InnoDB 底层的存储使用的数据结构为 B+树,B树的变种。MySQL 中有两种索引,分别是聚簇索引和非聚簇索引,听着很高大上。 其实了解完「页」的底层原理,要区分它们就变成的很简单了。 聚簇索引的叶子结点上,存储的是「页」 **非聚簇索引(二级索引)**的叶子结点上,存储的是「主键ID」。很多时候,我们都需要通过非聚簇索引拿到主键,再根据这个主键去「聚簇索引」中拿完整的数据,这个过程还有一个很有意思的名字叫「回表」。 至于为什么底层数据结构要用 B+树 和 B树,大概是因为以下三点: B+树能够减少 I/O 的次数 查询效率更加的稳定 能够更好的支持范围查询 详细的原因可以参考之前写的 浅入浅出 MySQL 索引 更新数据 为什么下一步就是要看如何更新数据呢?因为上述的「页」的原理主要都是基于「查询」的前提在讲,看完了之后对查询的过程应该了然于胸了。接下来我们就来看看更新的时候会发生什么。 首先,如果我们插入了某条 id=100 的数据,然后再去更新的话,这条数据是一定的在 Buffer Pool 的。这句话看似是废话(我都写到数据库了那肯定存在啊) 那我换个说法,更新的时候,id=100 这条数据可能不在 Buffer Pool 中。为什么之前写入了 Buffer Pool,之后再来更新 Buffer Pool 中又没有呢? 答案是内存是有限的,我们不可能无限的向 Buffer Pool 中插入数据。熟悉 Redis 的知道,Redis 在运行时会有「过期策略」,有以下三种: 定时过期 惰性过期 定期过期 而 Buffer Pool 同样也是基于内存,同样也需要一个「过期策略」来清理掉一些不常被访问的数据,来为新的数据、热点数据腾出空间。 当然,这里的清理掉,并不是删除,而是将它们刷入磁盘 更新数据时,如果发现对应的数据不存在,就会将那个数据所在的页加载到 Buffer Pool 中来。注意,这里并不是只加载 id=100 这一行,而是其所在的一整「页」数据。 加载到 Buffer Pool 中之后,再对 Buffer Pool 中的数据进行更新。当然,这个情况对我们开发人员来说,是针对聚簇索引的。 还有另一种情况是针对「 非聚簇索引」 的。 Change Buffer 很简单,当我们更新了某些字段之后,假设这些字段是组成非聚簇索引的字段,就会涉及到非聚簇索引的更新,但不巧的是该非聚簇索引所在的页不在 Buffer Pool 中。按照之前的说法,需要将对应的页(Pages)加载到 Buffer Pool 中来。 但是这里有一个很大的问题,这个二级索引可能之后**根本不会被用到,**那这样一来,刚刚昂贵的 I/O 操作就被浪费掉了。积少成多,如果每次涉及到更新二级索引发现在 Buffer Pool 中不存在,都去做 I/O 操作,那也是一个相当大的开销。 所以,InnoDB 才设计了 Change Buffer。Change Buffer 就是专门用来存储当「非聚簇索引」所在的页不在 Buffer Pool 时的更改的。 换句话说,当对应的非聚簇索引被修改并且对应的页(Pages)不在 Buffer Pool 中时,会将其改动暂存在 Change Buffer,等到其对应的页被其他的请求加载进 Buffer Pool 时,就会将 Change Buffer 中暂存的数据 和 Buffer Pool 中的数据进行合并。 当然,Change Buffer 这个设计也不是没有缺点。当 Change Buffer 中有很多的数据时,全部合并到Buffer Pool可能会花上几个小时的时间,并且在合并的期间,磁盘的 I/O 操作会比较频繁,从而导致部分的CPU资源被占用,对 MySQL 整体的性能是有影响的。 那你可能会问,难道只有被缓存的页加载到了 Buffer Pool 才会触发合并操作吗?那要是它一直没有被加载进来,Change Buffer 不就被撑爆了?很显然,InnoDB 在设计的时候考虑到了这个点。除了对应的页加载,提交事务、服务停机、服务重启都会触发合并。 Adaptive Hash 自适应哈希索引(Adaptive Hash Index)是配合 Buffer Pool 工作的一个功能。自适应哈希索引使得MySQL的性能更加接近于内存服务器。 如果要启用自适应哈希索引,可以通过更改配置innodb_adaptive_hash_index来开启。如果不想启用,也可以在启动的时候,通过命令行参数--skip-innodb-adaptive-hash-index来关闭。 自适应哈希索引是根据索引 Key 的前缀来构建的,InnoDB 有自己的监控索引的机制,当其检测到为当前某个索引页建立哈希索引能够提升效率时,就会创建对应的哈希索引。如果某张表数据量很少,其数据全部都在 Buffer Pool 中,那么此时自适应哈希索引就会变成我们所熟悉的指针这样一个角色。 当然,创建、维护自适应哈希索引是会带来一定的开销的,但是比起其带来的性能上的提升,这点开销可以直接忽略不计。但是,是否要开启自适应哈希索引还是需要看具体的业务情况的,例如当我们的业务特征是有大量的并发 Join 查询,此时访问自适应哈希索引就会产生竞争。 并且如果业务还使用了 LIKE 或者 % 等通配符,根本就不会用到哈希索引,那么此时自适应哈希索引反而变成了系统的负担。 所以,为了尽可能的减少并发情况下带来的竞争,InnoDB 对自适应哈希索引进行了分区,每个索引都被绑定到了一个特定的分区,而每个分区都由单独的锁进行保护。 其实通俗点理解,就是降低了锁的粒度。分区的数量我们可以通过配置innodb_adaptive_hash_index_parts来改变,其可配置的区间范围为[8, 512]。 过期策略 上面提到,Buffer Pool 也会有自己的过期策略,定时的将不需要的数据刷回磁盘,为后续的请求腾出空间。那么,InnoDB 是怎么知道哪些数据是不需要的呢? 答案是 LRU 算法 LRU是**(L**east Recently Used)的简称,表示最近最少使用,Redis 的内存淘汰策略中也有用到 LRU。 但是 InnoDB 所采用的 LRU 算法和传统的 LRU 算法还不太一样,InnoDB 使用的是改良版的 LRU。那为啥要改良?这就需要了解原生 LRU 在 MySQL 有啥问题了。 在实际的业务场景下,很有可能会出现全表扫描的情况,如果数据量较大,那么很有可能会将之前 Buffer Pool 中缓存的热点数据全部换出。这样一来,热点数据被再次访问时,就需要执行 I/O 操作,而这样就会导致该段时间 MySQL 性能断崖式下跌。而这种情况还有个专门的名词,叫——缓冲池污染。 这也是为什么 InnoDB 要对 LRU 算法做优化。 优化之后的链表被分成了两个部分,分别是 New Sublist 和 Old Sublist,其分别占用了 Buffer Pool 的 3/4 和 1/4。 链表的前 3/4,也就是 New Sublist 存放的是访问较为频繁的页。而后 1/4 也就是 Old Sublist 则是反问的不那么频繁的页。Old Sublist中的数据,会在后续 Buffer Pool 剩余空间不足、或者有新的页加入时被移除掉。 了解了链表的整体构造和组成之后,我们就以新页被加入到链表为起点,把整体流程走一遍。首先,一个新页被放入到Buffer Pool之后,会被插入到链表中 New Sublist 和 Old Sublist 相交的位置,该位置叫MidPoint。 该链表存储的数据来源有两部分,分别是: MySQL 的预读线程预先加载的数据 用户的操作,例如 Query 查询 默认情况下,由用户操作影响而进入到 Buffer Pool 中的数据,会被立即放到链表的最前端,也就是 New Sublist 的 Head 部分。但如果是 MySQL 启动时预加载的数据,则会放入MidPoint中,如果这部分数据再次被用户访问过之后,才会放到链表的最前端。 这样一来,虽然这些页数据在链表中了,但是由于没有被访问过,就会被移动到后 1/4 的 Old Sublist中去,直到被清理掉。 Log Buffer Log Buffer 用来存储那些即将被刷入到磁盘文件中的日志,例如 Redo Log,该区域也是 InnoDB内存的重要组成部分。Log Buffer 的默认值为16M,如果我们需要进行调整的话,可以通过配置参数innodb_log_buffer_size来进行调整。 当 Log Buffer 如果较大,就可以存储更多的 Redo Log,这样一来在事务提交之前我们就不需要将 Redo Log 刷入磁盘,只需要丢到 Log Buffer 中去即可。因此较大的 Log Buffer 就可以更好的支持较大的事务运行;同理,如果有事务会大量的更新、插入或者删除行,那么适当的增大 Log Buffer 的大小,也可以有效的减少部分磁盘 I/O 操作。 至于 Log Buffer 中的数据刷入到磁盘的频率,则可以通过参数innodb_flush_log_at_trx_commit来决定。 本篇文章已放到我的 Github github.com/sh-blog 中,欢迎 Star。微信搜索关注【SH的全栈笔记】,回复【队列】获取MQ学习资料,包含基础概念解析和RocketMQ详细的源码解析,持续更新中。 如果你觉得这篇文章对你有帮助,还麻烦点个赞,关个注,分个享,留个言。

优秀的个人博客,低调大师

Redis入门|看这篇就够了!

2 --> Redis 是当今非常流行的基于 KV 结构的作为Cache 使用的 NoSQL数据库。 学习Redis最好的方法就是动手尝试,在介绍Redis核心内容之前,本篇文章主要先来介绍一下Redis的安装和使用,以及Redis的基础知识。 开始之前,分享给大家这套视频教程,在视频中能了解NoSQL是什么,NoSQL和关系型数据库的对比优缺点。掌握Redis是什么、能干什么、如何用;掌握Redis在Windows和Linux下的安装配置、五大数据类型、常用操作命令、Redis持久化、主从复制、事务控制以及用Jedis操作进行Java开发等技术点! 在线观看:https://www.bilibili.com/video/BV1Uz4y1X72A 资料下载:http://www.bjpowernode.com/javavideo/130.html Redis 介绍 Remote Dictionary Server(Redis)是一个开源的使用C 语言编写、支持网络、可基于内存亦可持久化的 Key-Value 数据库. Key 字符类型,其值(value)可以是字符串(String), 哈希(Map),列表(list), 集合(sets) 和有序集合(sorted sets)等类型,每种数据类型有自己的专属命令。所以它通常也被称为数据结构服务器。 Redis 的作者是 Antirez,来自意大利的西西里岛,现在居住在卡塔尼亚。目前供职于Pivotal 公司(Pivotal 是 Spring 框架的开发团队),Antirez 被称为 Redis 之父。 Redis的代码托管在GitHub上https://github.com/antirez/redis,开发十分活跃,代码量只有3万多行。 官网:https://redis.io/ 中文:http://www.redis.cn/ Window 上安装 Redis Windows 版本的 Redis 是 Microsoft 的开源部门提供的 Redis. 这个版本的 Redis 适合开发人员学习使用,生产环境中使用 Linux 系统上的 Redis (1) 下载 官网:https://redis.io/ windows 版本:https://github.com/MSOpenTech/redis/releases (2) 安装 下载的 Redis-x64-3.2.100.zip 解压后,放到某个目录(例如 d:\tools\),即可使用。目录结构: (3) 启动 1. Windows7 系统双击 redis-server.exe 启动 Redis 2. Windows 10 系统 有的机器双击 redis-server.exe 执行失败,找不到配置文件,可以采用以下执行方式: 在命令行(cmd)中按如下方式执行: D:\tools\Redis-x64-3.2.100>redis-server.exe redis.windows.conf 如图: (4) 关闭 按 ctrl+c 退出Redis 服务程序。 Linux 上安装 Redis (1) 安装 1. 上传 redis-4.0.13.tar.gz 到 linux 系统。使用 Xftp 工具 2. 解压 redis-4.0.13.tar.gz 到/usr/local 目录 3. 查看解压后的文件 切换目录 cd /usr/local 执行 ll 4. 安装 gcc 编译器 Redis 是使用 c 语言编写的。使用源文件安装方式,需要编译 c 源文件,会使用 gcc 编译器。 什么是 gcc ? gcc 是 GNU compiler collection 的缩写,它是 Linux 下一个编译器集合(相当于 javac ),是c 或 c++程序的编译器。 使用yum进行安装gcc 。执行命令:yum -y install gcc 在解压后的 Redis 目录下执行(cd /usr/local/redis-4.0.13) make 命令。 5. 编译 redis 源文件 1) 开始执行 make cd /usr/local/redis-4.0.13 再执行 make 如果 make 命令执行过程中出现错误: error: jemalloc/jemalloc.h: No such file or directory 解决方式执行 make MALLOC=libc 2)执行 make 成功的标志 3)查看make编译结果,cd src目录 cd src 在执行 ls (2) 启动 Redis redis 安装目录下 redis.conf 是重要的配置文件,包含 redis 服务器的配置信息。启动redis 需要指定配置文件路径。 启动方式: ①前台启动 ./redis-server redis.conf 配置文件路径 ②后台启动 ./redis-server redis.conf 配置文件路径 & 第①种 前台启动 启动 Redis 的服务器端:切换到 src 目录下执行redis-server 程序 或者使用全路径 redis 应用以前台的方式启动,不能退出当前窗口,退出窗口,应用终止。 在其他窗口查看redis 启动的进程 第②种 后台启动 src目录下执行 ./redis-server redis.conf配置文件路径 & 此时关闭窗口,查看redis进程,依然存在。 查看redis进程 (3) 关闭 Redis 关闭方式: ①使用 redis 客户端关闭,向服务器发出关闭命令 切换到 redis-4.0.13/src/ 目录,执行 ./redis-cli shutdown 推荐使用这种方式, redis 先完成数据操作,然后再关闭。 例如: ②kill pid 或者 kill -9 pid 这种不会考虑当前应用是否有数据正在执行操作,直接就关闭应用。先使用 ps -ef | grep redis 查出进程号,在使用 kill pid Redis 客户端 Redis 客户端是一个程序,通过网络连接到 Redis 服务器,在客户端软件中使用 Redis 可 以识别的命令,向 Redis 服务器发送命令,告诉 Redis 想要做什么。Redis 把处理结果显示在客户端界面上。通过 Redis 客户端和 Redis 服务器交互。 Redis 客户端发送命令,同时显示 Redis 服务器的处理结果在。 redis 命令行客户端: redis-cli(Redis Command Line Interface)是 Redis 自带的基于命令行的Redis 客户端,用于与服务端交互,我们可以使用该客户端来执行redis 的各种命令。 两种常用的连接方式: 1. 直接连接 redis (默认 ip127.0.0.1,端口 6379):./redis-cli 在 redis 安装目录/src,执行 ./redis-cli 此命令是连接本机 127.0.0.1 ,端口 6379 的 redis 2. 指定 IP 和端口连接 redis:./redis-cli -h 127.0.0.1 -p 6379 -h redis 主机 IP(可以指定任意的 redis 服务器) -p 端口号(不同的端口表示不同的redis 应用) 在 redis 安装目录/src,执行 ./redis-cli -h 127.0.0.1 -p 6379 例 1: redis 远程客户端 Redis Desktop Manager:C++ 编写,响应迅速,性能好。官网地址:https://redisdesktop.com/ 点击“DOWNLOAD” 1. 安装客户端软件 在 Windows 系统使用此工具,连接 Linux 上或 Windows 上的 Redis , 双击此exe 文件执行安装 安装后启动界面: 使用客户端连接 Linux 的 Redis 连接Linux的Reids之前需要修改Redis服务器的配置信息。 Redis服务器有安全保护措施,默认只有本机(安装Redis的那台机器)能够访问。配置信息存放在Redis安装目录下的redis.conf文件。修改此文件的两个设置。 远程连接redis需要修改redis主目录下的redis.conf配置文件: ①. bind ip 绑定ip此行注释 ②. protected-mode yes 保护模式改为 no 使用vim 命令修改redis.conf 文件,修改文件前备份此文件,执行 cp 命令 执行 vim redis.conf 3. 使用 redis.conf 启动 Redis 修改配置文件后,需要使用配置文件重新启动 Reids,默认不加载配置文件。先关闭已经启 动的 Redis ,使用以下命令启动 Redis 在 Redis 安装目录执行: ./redis-server ../redis.conf & 4. 关闭 Linux 系统的防火墙 linux 系统,命令行执行:systemctl stop firewalld 5. 配置 Redis Desktop Manamager(RDM),连接 Redis 在 RDM 的主窗口,点击左下的“Connect to Redis Server” 连接成功后: redis 编程客户端 Jedis redis 的 Java 编程客户端,Redis 官方首选推荐使用 Jedis,jedis 是一个很小但很健全的 redis 的 java 客户端。通过Jedis 可以像使用 Redis 命令行一样使用Redis。 jedis 完全兼容redis 2.8.x and 3.x.x Jedis 源码:https://github.com/xetorthio/jedis api 文档:http://xetorthio.github.io/jedis/ redis 的其他编程语言客户端: C 、C++ 、C# 、Erlang、Lua 、Objective-C、Perl 、PHP 、Python 、Ruby、Scala 、Go 等 40 多种语言都有连接redis 的编程客户端 Redis 基本操作命令 redis 默认为 16 个库 (在redis.conf 文件可配置,该文件很重要,后续很多操作都是这个配置文件) redis 默认自动使用 0 号库 (1) 沟通命令,查看状态 redis >ping 返回 PONG 解释:输入 ping,redis 给我们返回 PONG,表示 redis 服务运行正常 (2) 查看当前数据库中 key 的数目:dbsize 语法:dbsize 作用:返回当前数据库的 key 的数量。返回值:数字,key 的数量 例:先查索引 5 的 key 个数, 再查 0 库的 key 个数 (3) redis 默认使用 16 个库 Redis默认使用16个库,从0到15。 对数据库个数的修改,在redis.conf 文件中databases 16 (4) 切换库命令:select db 使用其他数据库,命令是 select index 例 1: select 5 (5) 删除当前库的数据:flushdb (6) redis 自带的客户端退出当前 redis 连接:exit 或 quit Redis 的Key 的操作命令 1. keys 语法:keys pattern 作用:查找所有符合模式 pattern 的 key. pattern 可以使用通配符。通配符: *:表示 0-多个字符,例如:keys * 查询所有的 key。 ?:表示单个字符,例如:wo?d , 匹配 word , wood 例 1:显示所有的 key 例 2:使用 *表示 0 或多个字符 例 3:使用?表示单个字符 2. exists 语法:exists key [key…] 作用:判断key 是否存在 返回值:整数,存在 key 返回 1,其他返回 0.使用多个 key,返回存在的key 的数量。 例 1:检查指定 key 是否存在 例 2:检查多个 key 3. expire 语法:expire key seconds 作用:设置key 的生存时间,超过时间,key 自动删除。单位是秒。返回值:设置成功返回数字 1,其他情况是 0 。 例 1:设置红灯的倒计时是 5 秒 4. ttl 语法:ttl key 作用:以秒为单位,返回 key 的剩余生存时间(ttl: time to live) 返回值: -1 :没有设置 key 的生存时间, key 永不过期。 -2:key 不存在 数字:key 的剩余时间,秒为单位 例 1:设置 redlight 的过期时间是 10,查看剩余时间 5. type 语法:type key 作用:查看key 所存储值的数据类型返回值:字符串表示的数据类型 none (key 不存在) string (字符串) list (列表) set (集合) zset (有序集) hash (哈希表) 例 1:查看存储字符串的 key:wood 例 2:查看不存在的key 6. del 语法:del key [key…] 作用:删除存在的key,不存在的key 忽略。返回值:数字,删除的 key 的数量。 例 1:删除指定的 key

优秀的个人博客,低调大师

每日一博 | WidgetKit 入门指北

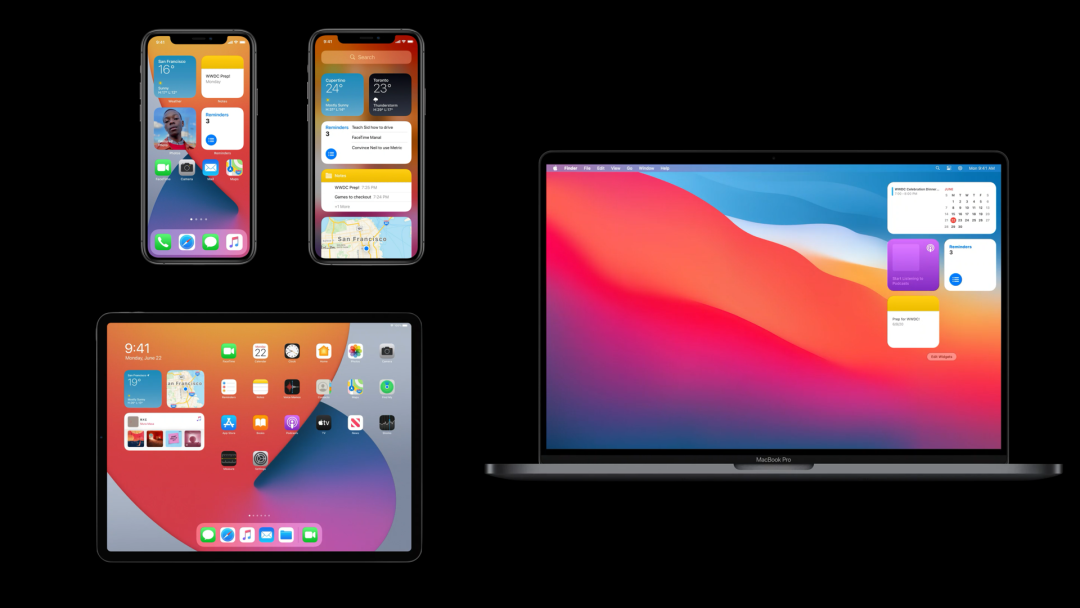
作者:zvving,iOS 开发者,现就职于字节跳动音乐团队 本主题基于 https://developer.apple.com/videos/play/wwdc2020/10028/ 梳理 概述 WidgetKit 是 WWDC20 备受关注的新特性,支持在 iOS、iPadOS 主屏幕,今日视图以及 macOS 通知栏展示动态信息和个性化内容。 众所周知,Apple 对 iOS 主屏幕的改进一直保持克制,这次引入 Widget 是一次巨大的改动。Widget 如何提供一致的跨平台体验?如何提供实时的个性化内容?如何引入 Widget 同时最大可能减少主屏幕的性能、电量开销?本文作为 WidgetKit 速览,带你快速了解这些内容。 优秀 Widget 的三要素 设计优秀的 Widget,包含如下三个要素 Glanceable 一目了然 Relevant 高相关性 Personalized 个性化 Glanceable 一目了然 Widgets are not mini-apps Widget 并不是(常驻桌面的)微型应用程序,这句话被反复提起。在一闪而过的快速切换应用的主屏幕里,设计交互复杂的应用界面并不能切合用户的需要。一目了然的内容才是用户关心的唯一要素 通过强大的 SwiftUI,你可以快速实现跨平台体验一致的 Widget,同时非常方便的支持 Dynamic Type、DarkMode 等系统特性,提供一目了然、快速响应的桌面体验。 Relevant 高相关性 一般用户每天进入主屏幕的次数超过 90 次,但停留的总时长不过几分钟。用户可不想在主屏幕见到枯燥的加载界面 WidgetKit 会在正确的时机显示即时的内容,避免每个 Widget 启动、加载、渲染的漫长过程。为了达成这一目标,WidgetKit 统一管理所有 Widget,支持预渲染、复用,并提供合适的更新策略,灵活可控的更新时机。 智能叠放 智能叠放是 Widget 与用户高相关性的又一体现。它是支持多个 Widget 叠放的智能组件。用户可以上下滑动手动切换,更巧妙的是:基于用户的使用场景以及开发者的配置,系统也会智能地为用户展示最需要的 Widget。 Personalized 个性化 在天气 widget 中,基于不同地理位置,语言、摄氏度单位,提供个性化的使用体验。同时支持三种尺寸,更小的尺寸展示核心内容,更大的尺寸则展示更多的相关信息,满足不同用户的需要。 快速开发一个 Widget 配置信息 Configuration Static configuration :静态配置,无用户配置项 Intent configuration :支持用户配置及用户意图推测功能(Intents Extension) SupportedFamilies Widget 支持 small、medium、large三种尺寸 ,建议开发者同时提供三种尺寸。 Placeholder UI Placeholder UI 是 Widget 加载中所显示的占位信息,它应该清晰的表达 Widget 所属类型。绝大多数场景下,用户不会看到 Placeholder UI ,只有在修改设备环境配置等个别场景下会碰到。 Widget 交互 Widgets are not mini-apps Widget UI 是无状态的,不支持滚动,不能展示视频和动态图像。 Widget 为用户提供一目了然的内容展示,在用户需要进一步查看或编辑的时候,通过轻点启动 app 完成顺畅的体验。 用户点击 Widget 中的特定专辑后,通过 Deep links,App 启动后快速展示对应专辑,方便用户的进一步操作。 注意:systemSmall 只支持一个 link ,systemMedium,systemLarge 支持多个 WidgetKit 执行原理 开发者通过 SwiftUI 构建 Views,定义 Timelines 为 Views 提供对应时间所需数据。数据变化时,通过 reload 更新数据。 WidgetKit 统一管理多个 Widgets:序列化 Widget Views 和 Timelines 数据,处理预渲染和复用,响应并处理 System reloads、App-driven reloads,为桌面、Widget Gallery 预览等场景提供高效、即时的 widget 体验。 值得一提的是:WidgetKit 会把 Timelines 所定义的 Entries 对应的 Views 结构信息缓存到磁盘,仅在需要的时候实时渲染特定的 View。这使得系统可以在极低电量开销下为众多 Widgets 处理 Timelines 信息。 Views Placeholder UI:(上文已经介绍)Widget 占位 UI Snapshot 以最快速度返回的视图。并非截图,而是真实体验。 大多数I情况下,timeline 第一条数据可以与 snapshot 相同,这样用户在 Widget Gallery 中看到内容和添加到设备时得到的东西相同。 Timelines Timeline 是一系列驱动 Views 的数据集合,WidgetKit 随着时间流逝加载对应的 Widget 数据,配合 Reload 策略灵活支持复杂业务场景的变化。 Reloads Reloads 分两类:System reloads,App-driven reloads。系统会综合判断,确定重新加载 widget 的最佳时间。 System reloads ReloadPolicy:配置 timeline 时定制 reload 策略 atEnd after(date: Date) never Widget 被查看越多,将更多的被 reload 设备环境变化也会触发 reload App-driven reloads 当应用在后台时,后台推送可以触发 reload;当应用在前台时,应用可以主动触发 reload。进而通过 reload 变更全部或特定 timeline entry。 请谨慎的对待 widget reload,仅当相关数据变化需要反映在 widget 中时才触发 relaod,避免无谓的重新加载。 对于后台加载需要网络数据可以通过 Background sessions 完成,相关的系统资源占用将计入 widget 开销,由 WidgetKit 管理对应 background reload 预算。 个性化并理解用户意图 Intents framework Intents framework 一直被应用在 SiriKit 和 Shortcuts,从现在开始 WidgetKit 也将借助 Intents framework 更好的理解用户意图。 驱动理解用户意图的智能堆栈 在智能堆栈小组件中,开发者通过每一个 TimelineEntryRelevance 可以告知 WidgetKit 用户在特定场景下相关性评分和持续时间。WidgetKit 综合评估不同 Widget 评分,分析用户意图,旋转堆栈到用户关心的 widget。 注意:widget 提供的所有 TimelineEntryRelevance 都会作为理解用户意图相关性的参考 Demo 配置 Widget 是很容易的,如下 SampleWidget 代码已经包含大部分 widget 初始配置: 静态 WidgetConfiguration 需要提供 Provider(),PlaceholderView(),entry -> SampleWidgetEntryView 闭包 Provider 中定义 snapshot,构建包含 Entry 集合的 Timeline 最后使用 SwiftUI 实现 PlaceholderView 和 SampleWidgetEntryView 即可 @mainpublicstructSampleWidget:Widget{privateletkind:String="SampleWidget"publicvarbody:someWidgetConfiguration{StaticConfiguration(kind:kind,provider:Provider(),placeholder:PlaceholderView()){entryinSampleWidgetEntryView(entry:entry)}.configurationDisplayName("MyWidget").description("Thisisanexamplewidget.")}}publicstructProvider:TimelineProvider{publicfuncsnapshot(withcontext:Context,completion:@escaping(SimpleEntry)->()){letentry=SimpleEntry(date:Date())completion(entry)}publicfunctimeline(withcontext:Context,completion:@escaping(Timeline<Entry>)->()){letentry=SimpleEntry(date:Date())lettimeline=Timeline(entries:[entry,entry],policy:.atEnd)completion(timeline)}} 总结 终于讲完了,为了理解上的完整性,本文做了很多扩展性的说明,感谢各位读者的耐心阅读;这是 Widget 系列的最后一篇,WidgetKit 的概念很棒,也非常好用!希望大家能真正读懂原理,创造更多优秀的 Widget! 推荐阅读 ✨ Apple Widget:下一个顶级流量入口? ✨ 为 Widgets 构建 SwiftUI 视图 《Widgets 边看边写》第一部分:冒险开始了 《Widgets 边看边写》第二部分:Timelines 的基本使用 《Widgets 边看边写》第三部分:Timelines的进阶使用 关注我们 我们是「老司机技术周报」,每周会发布一份关于 iOS 的周报,也会定期分享一些和 iOS 相关的技术。欢迎关注。 支持作者 这篇文章的内容来自于 《WWDC20 内参》。在这里给大家推荐一下这个专栏,专栏目前已经创作了 101 篇文章,只需要 29.9 元。点击【阅读原文】,就可以购买继续阅读 ~ WWDC 内参 系列是由老司机周报、知识小集合以及 SwiftGG 几个技术组织发起的。已经做了几年了,口碑一直不错。 主要是针对每年的 WWDC 的内容,做一次精选,并号召一群一线互联网的 iOS 开发者,结合自己的实际开发经验、苹果文档和视频内容做二次创作。 本文分享自微信公众号 - 老司机技术周报(LSJCoding)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

设计模式入门-简单工厂模式

前言 话说设计模式是我们面试中经常遇到的问题,但是开发中遇到的也不少。之前一直想学设计模式,然后总结写一些文章,但一直忙于其它事情,现在终于要学习设计模式,参考的书籍是《大话设计模式》,这本书写得通俗易懂,推荐大家都去看一下。 场景描述 借用书中示例问题,计算两个数的加、减、乘、除等其它运算,一般我们的思维是自上而下处理问题,也就造成了运算两个数就要经过多次判断。 场景示例 两个数之前的算法运算,如下面代码所示: package me.xueyao; /** * @author Simon.Xue * @date 2019-12-30 22:54 **/ public class OperationHello { public static void main(String[] args) { System.out.println(getResult("*", 1, 3)); } public static int getResult(String operationStr, int number1, int number2) { int result = 0; switch (operationStr) { case "+": result = number1 + number2; break; case "-": result = number1 - number2; break; case "*": result = number1 * number2; break; case "/": result = number1 / number2; break; } return result; } } 此处的代码要判断四次,但是如果再增加其它的运算,会在原来基础上又增加条件判断。以后,随着业务有扩展会不停添加判断条件。代码的耦合度会越来越高,如果修改某一处运算的问题,就造成线上业务不能访问相关运算的功能,必须要修改好问题,其它的运算功能才能使用。 解决办法 现在可以用到我们所说的简单工厂模式,首先,我们要想,加、减、乘、除运算都属于运算子类,所以我们创建一个运算父类Operation .class package me.xueyao; /** * @author Simon.Xue * @date 2019-12-30 22:18 **/ public abstract class Operation { private int number1; private int number2; public int getNumber1() { return number1; } public void setNumber1(int number1) { this.number1 = number1; } public int getNumber2() { return number2; } public void setNumber2(int number2) { this.number2 = number2; } public abstract int getResult(); } 加、减、乘、除四则运算,我们分别创建OperationAdd.class,OperationSub.class,OperationMul.class,OperationDiv.class四个子类分别继承运算父类Operation.class, 实现其中计算方法。 package me.xueyao; /** * @author Simon.Xue * @date 2019-12-30 22:22 **/ public class OperationAdd extends Operation { @Override public int getResult() { return getNumber1() + getNumber2(); } } package me.xueyao; /** * @author Simon.Xue * @date 2019-12-30 22:22 **/ public class OperationSub extends Operation { @Override public int getResult() { return getNumber1() - getNumber2(); } } package me.xueyao; /** * @author Simon.Xue * @date 2019-12-30 22:25 **/ public class OperationMul extends Operation { @Override public int getResult() { return getNumber1() * getNumber2(); } } package me.xueyao; /** * @author Simon.Xue * @date 2019-12-30 22:26 **/ public class OperationDiv extends Operation { @Override public int getResult() { return getNumber1() / getNumber2(); } } 当我们要使用运算方法时,只需要创建其对象,再执行计算方法,便可计算两个数的运算,但是现在又有一个问题,就是每种运算方式都要创建对象。都要暴露父类对象,我们可以创建一个工厂类,由工厂类来创建所需要的对象,如下代码如示 package me.xueyao; /** * @author Simon.Xue * @date 2019-12-30 22:30 **/ public class OperationFactory { public static Operation createOperation(String operationStr) { Operation operation = null; switch (operationStr) { case "+": operation = new OperationAdd(); break; case "-": operation = new OperationSub(); break; case "*": operation = new OperationMul(); break; case "/": operation = new OperationDiv(); break; } return operation; } } 总结 简单工厂模式,是设计模式中比较简单的一种模式,但是它每多出一种需求,就要创建一个类,总体来说用起来还不错。文章如有问题,请联系我。

优秀的个人博客,低调大师

Tablestore入门手册--表(Table)管理

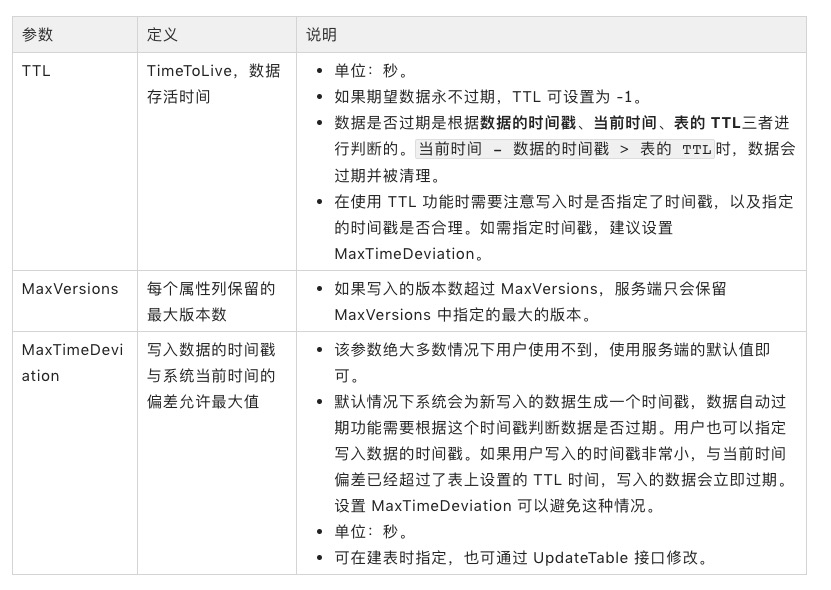
表管理接口概述 API 描述 createTable 创建表 deleteTable 删除表 listTable 列出实例下的所有表 updateTable 更新表(在表被创建之后,动态的更改表的配置或预留吞吐量) describeTable 获取表的详细信息 上述API操作是Tablestore最基础的API。官方提供了Java、Go、Node.js、Python、PHP、C#、C++语言的SDK。 createTable 创建表可以在控制台进行。在使用API进行创建的时候,需要指定表的配置信息和预留吞吐量等信息。 说明: 表格创建好后服务端有初始化时间,需要等待几秒钟才能对表进行读写,否则会出现异常 表限制 单个实例最多可以创建 64 张数据表 表名长度1-255 Bytes,需由[a-z, A-Z, 0-9]和下划线(_)组成。首字符必须是字母或下划线(_) 其它限制见: https://help.aliyun.com/document_detail/91524.html?spm=a2c4g.11186623.6.568.357f228382mAWN 参数说明 创建表的参数主要包括如下几部分: TableMeta: 表的结构信息,包含表的名称以及表的主键定义 TableOptions: 表的配置选项,用于配置TTL、MaxVersions等 ReservedThroughput:表的预留读写吞吐量设置 表结构 TableMeta 参数 定义 说明 TableName 表名 无 List 表的主键定义 1. 注意: 最多可设置 4 个主键,主键的配置及顺序一旦设置便不可修改。 2. 表格存储可包含多个主键列。主键列是有顺序的,与用户添加的顺序相同,例如, PRIMARY KEY (A, B, C) 与 PRIMARY KEY (A, C, B) 是不同的两个主键结构。表格存储会按照主键的大小为行排序,具体参见表格存储数据模型和查询操作。3. 第一列主键作为分片键。分片键相同的数据会存放在同一个分片内,所以相同分片键下最好不要超过 10 G 以上数据,否则会导致单分片过大,无法分裂。另外,数据的读/写访问最好在不同的分片键上均匀分布,有利于负载均衡。4. 属性列不需要定义。表格存储每行的数据列都可以不同,属性列的列名在写入时指定。 表配置 TableOptions 预留吞吐量 ReservedThroughtput ReservedThroughtput表的预留读/写吞吐量配置。 设置 ReservedThroughtput 后,表格存储按照您预留读/写吞吐量进行计费。 当 ReservedThroughtput 大于 0 时,表格存储会按照预留量和持续时间进行计费,超出预留的部分进行按量计费。更多信息参见计费,以免产生未期望的费用。 默认值为 0,即完全按量计费。 容量型实例的预留读/写吞吐量只能设置为 0,不允许预留。 Java代码示例 // 创建普通表(不使用索引等功能) public void createTable() { TableMeta tableMeta = new TableMeta(TABLE_NAME); // 为主表添加主键列。 tableMeta.addPrimaryKeyColumn(new PrimaryKeySchema("pk_1", PrimaryKeyType.STRING)); tableMeta.addPrimaryKeyColumn(new PrimaryKeySchema("pk_2", PrimaryKeyType.INTEGER)); tableMeta.addPrimaryKeyColumn(new PrimaryKeySchema("pk_3", PrimaryKeyType.BINARY)); // 设置该主键为自增列 tableMeta.addPrimaryKeyColumn(new PrimaryKeySchema("pk_4", PrimaryKeyType.INTEGER, PrimaryKeyOption.AUTO_INCREMENT)); // 数据的过期时间,单位秒, -1代表永不过期,例如设置过期时间为一年, 即为 365 * 24 * 3600。 int timeToLive = -1; // 保存的最大版本数,设置为3即代表每列上最多保存3个最新的版本。(如果使用索引,maxVersions只能等于1) int maxVersions = 3; TableOptions tableOptions = new TableOptions(timeToLive, maxVersions); CreateTableRequest request = new CreateTableRequest(tableMeta, tableOptions); // 设置读写预留值,容量型实例只能设置为0,高性能实例可以设置为非零值。 request.setReservedThroughput(new ReservedThroughput(new CapacityUnit(0, 0))); client.createTable(request); } 表设计相关技巧 分区键选择 表格存储Tablestore第一个主键是分区键,决定了数据分布式存储的位置。分区键的选择决定了数据是否均匀散列在不同的后端服务器上。散列是分布式数据库中常见的问题之一,数据的散列能够避免热点问题。因此在选择主键的时候,首先要选好分区键。其中比较常用的两种方式如下: 分区键可以选择业务上比较分散的Key放到第一列,如userID、DeviceId等。如果每个用户数据分布严重不均匀,则需要另外选择其它字段。 如果分区键不好设计,可以对想要当做分区键的值拼接MD5,这样能够保证数据散列。 更多的设计技巧见两篇表设计实践。 表设计的最佳实践 、表设计实践 数据生命周期TTL设计 数据生命周期(Time To Live,简称 TTL)是数据表的一个特性,即数据的存活时间,单位为秒。表格存储会在后台对超过存活时间的数据进行清理,以减少用户的数据存储空间,降低存储成本。 TTL特性能够实现数据过期自动删除,因此在很多场景能够用到,这些场景中随着时间的流逝数据的价值会降低,特别适合TTL。 舆情监控。如果用户只关心最近3个月的信息,因此超过3个月的数据可以自动删除。 物流轨迹。物流轨迹的记录信息在用户收到货物后就失去了其大部分的价值,因此可以设置1个月的TTL,来节省大量的存储费用。 系统日志。系统的运行日志大多数只有在系统出问题时候才会查看,而随着时间流逝,很早之前的系统日志也就失去了存在的价值,而这部分数据存储在数据库中会占用存储成本,设置合适的TTL能够自动将之前的数据删除。 TTL暂时仅支持主表,索引等还暂时不支持TTL特性。因此如果使用了二级索引或者多元索引,需要主表的TTL=-1,即永久不会失效,对于已经创建好表的用户,可以通过 UpdateTable 接口动态更改主表的 TTL。 Java 示例代码 public void updateTTL() { UpdateTableRequest request = new UpdateTableRequest(TABLE_NAME); int ttl = -1; request.setTableOptionsForUpdate(new TableOptions(ttl)); client.updateTable(request); } 主键自增 主键列自增功能是指若用户指定某一列主键为自增列,在其写入数据时,表格存储会自动为用户在这一列产生一个新的值,且这个值为同一个分区键下该列的最大值。 主键自增列的功能特性主要有生成数字ID且ID严格递增保证顺序,这个特性决定了许多场景能够使用。 如电商网站的商品 ID、大型网站的用户 ID等,这些场景中数值越大,表示该商品、用户越新。 如论坛帖子的 ID、聊天工具的消息 ID等消息保序的场景,这些场景需要严格保证消息递增,不然用户读取到的顺序就会乱序。举个例子,假如用户发朋友圈场景,用户在1点5分11.1秒时刻发送了一个朋友圈记录a,另一个用户在1点5分11.2秒发送了一个朋友圈记录b,则需要严格保证记录b的id比记录a的id大。主键自增在聊天系统IM中的应用见 Table Store主键列自增功能在IM系统中的应用 主键自增的一些限制: 表格存储支持多个主键,第一个主键为分区键,分区键不允许设置为自增列,其它任一主键都可以设置为自增列。 每张表最多只允许设置一个主键为自增列。 属性列不能设置为自增列。 仅支持在创建表的时候指定自增列,对于已存在的表不支持创建自增列。 Java示例代码 // 主键自增 创建主表 public void createTableWithPKAutoIncrement() { TableMeta tableMeta = new TableMeta(TABLE_NAME + "AUTO_INCREMENT"); tableMeta.addPrimaryKeyColumn(new PrimaryKeySchema("pk_1", PrimaryKeyType.STRING)); // 设置该主键为自增列 tableMeta.addPrimaryKeyColumn(new PrimaryKeySchema("pk_autoI_increment", PrimaryKeyType.INTEGER, PrimaryKeyOption.AUTO_INCREMENT)); tableMeta.addPrimaryKeyColumn(new PrimaryKeySchema("pk_3", PrimaryKeyType.INTEGER)); TableOptions tableOptions = new TableOptions(-1, 1); CreateTableRequest request = new CreateTableRequest(tableMeta, tableOptions); client.createTable(request); } // 自增列的数据插入 public void putRow(){ PrimaryKey primaryKey = PrimaryKeyBuilder.createPrimaryKeyBuilder() .addPrimaryKeyColumn("pk_1", PrimaryKeyValue.fromString("test1")) .addPrimaryKeyColumn("pk_auto_increment", PrimaryKeyValue.AUTO_INCREMENT) .addPrimaryKeyColumn("pk_3", PrimaryKeyValue.fromLong(100)) .build(); RowPutChange rowPutChange = new RowPutChange(TABLE_NAME , primaryKey); rowPutChange.addColumn("attr_1", ColumnValue.fromLong(100)); PutRowRequest request = new PutRowRequest(rowPutChange); client.putRow(request); } deleteTable 删除表,只需要指定表名字即可。 说明: 如果表中创建了多元索引,需要先删除多元索引才可以删除表。 Java代码示例 public void deleteTable() { DeleteTableRequest request = new DeleteTableRequest(TABLE_NAME); client.deleteTable(request); } listTable 该API能够列出当前实例下已创建的所有表的表名。 Java代码示例 public void listTable() { ListTableResponse response = client.listTable(); System.out.println("表的列表如下:"); for (String tableName : response.getTableNames()) { System.out.println(tableName); } } updateTable 该API能够动态的更改表的配置或预留吞吐量。可以只修改配置或只修改预留吞吐量,也可以一起修改。 说明: 该API调用频率有限制,为每 2分钟1次。 Java代码示例 public void updateTable() { UpdateTableRequest request = new UpdateTableRequest(TABLE_NAME); // 修改预留吞吐 request.setReservedThroughputForUpdate(new ReservedThroughput(new CapacityUnit(0, 0))); // 修改表的最大保留版本、TTL等 request.setTableOptionsForUpdate(new TableOptions(-1, 1)); client.updateTable(request); } describeTable 该API可以获得表的结构信息(TableMeta)、配置信息(TableOptions)和预留读/写吞吐量的情(ReservedThroughputDetails,包括调整时间)、表分区信息等, 如图所示。 Java代码示例 public void describeTable() { DescribeTableRequest request = new DescribeTableRequest(TABLE_NAME); DescribeTableResponse response = client.describeTable(request); TableMeta tableMeta = response.getTableMeta(); System.out.println("表的名称:" + tableMeta.getTableName()); System.out.println("表的主键:"); for (PrimaryKeySchema schema : tableMeta.getPrimaryKeyList()) { System.out.println("\t主键名字:" + schema.getName() + "\t主键类型:" + schema.getType() + "\t自增列:" + (schema.getOption() == null ? "false" : schema.getOption().equals(PrimaryKeyOption.AUTO_INCREMENT))); } System.out.println("预定义列信息:"); for (DefinedColumnSchema schema : tableMeta.getDefinedColumnsList()) { System.out.println("\t主键名字:" + schema.getName() + "\t主键类型:" + schema.getType()); } System.out.println("二级索引信息:"); for (IndexMeta meta : response.getIndexMeta()) { System.out.println("\t索引名字:" + meta.getIndexName()); System.out.println("\t\t索引类型:" + meta.getIndexType()); System.out.println("\t\t索引主键:" + meta.getPrimaryKeyList()); System.out.println("\t\t索引预定义列:" + meta.getDefinedColumnsList()); } TableOptions tableOptions = response.getTableOptions(); System.out.println("TableOptions:"); System.out.println("\t表的TTL:" + tableOptions.getTimeToLive()); System.out.println("\t表的MaxVersions:" + tableOptions.getMaxVersions()); ReservedThroughputDetails rtd = response.getReservedThroughputDetails(); System.out.println("预留吞吐量:"); System.out.println("\t读:" + rtd.getCapacityUnit().getReadCapacityUnit()); System.out.println("\t写:" + rtd.getCapacityUnit().getWriteCapacityUnit()); System.out.println("\t最近上调时间: " + new Date(rtd.getLastIncreaseTime() * 1000)); System.out.println("\t最近下调时间: " + new Date(rtd.getLastDecreaseTime() * 1000)); List<PrimaryKey> shardSplits = response.getShardSplits(); System.out.println("表分区信息:"); for (PrimaryKey primaryKey : shardSplits) { System.out.println("\t分裂点信息: " + primaryKey.getPrimaryKeyColumnsMap()); } } 专家服务 如有疑问或者需要更好的在线支持,欢迎加入钉钉群:“表格存储公开交流群”(群号:23307953)。群内提供免费的在线专家服务,欢迎扫码加入。

优秀的个人博客,低调大师

Python入门你要懂哪些?

前言 什么是计算机语言 计算机就是一台用来计算的机器,人让计算机干什么计算机就得干什么! 需要通过计算机的语言来控制计算机(也就是编程语言)! 计算机语言其实和人类的语言没有本质的区别,不同点就是交流的主体不同!计算机语言发展经历了三个阶段: 1). 机器语言 机器语言通过二进制编码来编写程序 执行效率好,编写起来太麻烦 2). 符号语言(汇编) 使用符号来代替机器码 编写程序时,不需要使用二进制, 而是直接编写符号 编写完成后,需要将符号转换为机器码,然后再由计算机执行符号转换为机器码的过程称为汇编 将机器码转换为符号的过程,称为反汇编 汇编语言一般只适用于某些硬件,兼容性比较差 3). 高级语言 高级语言的语法基本和现在英语语法类似,并且和硬件的关系没有那么紧密了。也就是说我们通过高级语言开发程序可以在不同的硬件系统中执行 并且高级语言学习起来也更加的容易,现在我们知道的语言基本都是高级语言 如:C、 C++、C#、Java、JavaScript、Python 等.. 编译型语言和解释型语言 计算机只能识别二进制编码(机器码),所以任何的语言在交由计算机执行时必须要先转换为机器码,也就是像 print('hello') 必须要转换为类似 1010101 这样的机器码。 根据转换时机的不同,语言分成了两大类: 1). 编译型语言 如:C语言 编译型语言,会在代码执行前将代码编译为机器码,然后将机器码交由计算机执行 执行过程:a(源码) --编译--> b(编译后的机器码) 特点: 执行速度特别快 跨平台性比较差 2). 解释型语言 如:Python JS Java 解释型语言,不会在执行前对代码进行编译,而是在执行的同时一边执行一边编译 执行过程:a(源码)--解释器--> 解释执行 特点: 执行速度比较慢 跨平台性比较好 下面我们切入正题,谈谈Python。 Python的介绍 Python是解释型语言。 Python(英国发音:/ˈpaɪθən/ 美国发音:/ˈpaɪθɑːn/),是一种广泛使用的高级编程语言,属于通用型编程语言,由吉多·范罗苏姆创造,第一版发布于1991年。可以视之为一种改良(加入一些其他编程语言的优点,如面向对象)的LISP。作为一种解释型语言,Python的设计哲学强调代码的可读性和简洁的语法(尤其是使用空格缩进划分代码块,而非使用大括号或者关键词)。相比于C++或Java,Python让开发者能够用更少的代码表达想法。不管是小型还是大型程序,该语言都试图让程序的结构清晰明了。 Python的用途: WEB应用 Facebook 豆瓣 爬虫程序 科学计算 自动化运维 大数据(数据清洗) 云计算 桌面软件/游戏 人工智能 Python开发环境搭建 开发环境搭建就是安装Python的解释器 Python的解释器分类: CPython(官方)用c语言编写的Python解释器 PyPy用Python语言编写的Python解释器 IronPython用.net编写的Python解释器 JPython用Java编写的Python解释器 步骤: 1.下载安装包 python-3.6.exe2.安装(傻瓜式安装, 默认选项..) 安装完成可以看到以下几个程序: 3.打开命令行窗口,输入python 出现如下内容Python的交互界面 当我们通过Windows命令行来输入Python,所进入到的界面就是Python的交互界面 结构: 版本和版权声明: Python 3.6.3 (tags/v3.6.3:2c5fed8, Oct 3 2017, 17:26:49) [MSC v.1900 32 bit (Intel)] on win32 Type "help", "copyright", "credits" or "license" for more information. 命令提示符: >>> 在命令提示符后可以直接输入Python的指令!输入完的指令将会被Python的解释器立即执行! 安装Python的同时,会自动安装一个Python的开发工具IDLE,通过IDLE也可以进入到交互模式。但是不同的是,在IDLE中可以通过TAB键来查看语句的提示。 IDLE实际上就是一个交互界面,但是他可以有一些简单的提示,并且可以将代码保存。 注意:交互模式只能你输入一行代码,它就是执行一行,所以他并不适用于我们日常的开发! 仅可以用来做一些日常的简单的测试! 我们一般会将Python代码编写到一个py文件中,然后通过python指令来执行文件中的代码。 Python和Sublime的整合 1.在Sublime中执行Python代码,按 ctrl + b 可以自动在Sublime内置的控制台中执行 这种执行方式,在某些版本的Sublime中对中文支持不好,并且不能使用input()函数。 2.使用SublimeREPL来运行python代码 如下图:选择SublimeREPL-> Python来执行Python代码但是这样很麻烦。为方便我们可以设置快捷键,按f5则自动执行当前的Python代码。 如下设置快捷键来执行python代码呢? 找到Preferences-->Key Bindings ,然后复制下面的内容到右边的中括号内。然后保存。 这样我们就可以按F5快捷键来自动执行当前的Python代码了。 { "keys": ["f5"], "caption": "SublimeREPL:Python","command": "run_existing_window_command", "args":{"id": "repl_python_run","file": "config/Python/Main.sublime-menu"}}, Python的几个基本概念 1.表达式 表达式就是一个类似于数学公式的东西 比如:10 + 5 8 - 4 表达式一般仅仅用了计算一些结果,不会对程序产生实质性的影响 如果在交互模式中输入一个表达式,解释器会自动将表达式的结果输出 2.语句 在程序中语句一般需要完成某种功能,比如打印信息、获取信息、为变量赋值比如: #Python学习交流QQ群:857662006 print() input() a = 10 语句的执行一般会对程序产生一定的影响 在交互模式中不一定会输出语句的执行结果 3.程序(program) 程序就是由一条一条的语句和一条一条的表达式构成的。 4.函数(function) 函数就是一种语句,函数专门用来完成特定的功能函数长的形如:xxx() 函数的分类: 1). 内置函数 由Python解释器提供的函数,可以在Python中直接使用 2). 自定义函数 由程序员自主的创建的函数 当我们需要完成某个功能时,就可以去调用内置函数,或者自定义函数 函数的两个要素: 1). 参数 ()中的内容就是函数的参数 函数中可以没有参数,也可以有多个参数,多个参数之间使用,隔开 2). 返回值 返回值是函数的返回结果,不是所有的函数都有返回值 Python的基本语法 在Python中严格区分大小写 Python中的每一行就是一条语句,每条语句以换行结束 Python中每一行语句不要过长(规范中建议每行不要超过80个字符) 一条语句可以分多行编写,多行编写时语句后边以结尾 Python是缩进严格的语言,所以在Python中不要随便写缩进 在Python中使用#来表示注释,#后的内容都属于注释,注释的内容将会被解释器所忽略 我们可以通过注释来对程序进行解释说明,一定要养成良好的编写注释的习惯注释要求简单明了,一般习惯上#后边会跟着一个空格 字面量和变量 字面量就是一个一个的值,比如:1,2,3,4,5,6,‘HELLO’ 字面量所表示的意思就是它的字面的值,在程序中可以直接使用字面量 变量(variable)变量可以用来保存字面量,并且变量中保存的字面量是不定的 变量本身没有任何意思,它会根据不同的字面量表示不同的意思 一般我们在开发时,很少直接使用字面量,都是将字面量保存到变量中,通过变量来引用字面量 数据类型 数据类型指的就是变量的值得类型,也就是可以为变量赋哪些值 在Python中,能够直接处理的数据类型有以下几种:整数、浮点数、字符串、布尔值、列表、元组、字典、集合。 以后我们详细介绍这几个数据类型。 对象(object) Python是一门面向对象的语言 一切皆对象! 程序运行当中,所有的数据都是存储到内存当中然后再运行的! 对象就是内存中专门用来存储指定数据的一块区域 对象实际上就是一个容器,专门用来存储数据 像我们之前学习的数值、字符串、布尔值、None都是对象 对象的结构 每个对象中都要保存三种数据 1). id(标识) id用来标识对象的唯一性,每一个对象都有唯一的id 对象的id就相当于人的身份证号一样 可以通过id()函数来查看对象的id id是由解析器生成的,在CPython中,id就是对象的内存地址 对象一旦创建,则它的id永远不能再改变 2). type(类型) 类型用来标识当前对象所属的类型 比如:int str float bool 类型决定了对象有哪些功能 通过type()函数来查看对象的类型 Python是一门强类型的语言,对象一旦创建类型便不能修改 3). value(值) 值就是对象中存储的具体的数据 对于有些对象值是可以改变的 对象分成两大类,可变对象 不可变对象 可变对象的值可以改变 不可变对象的值不能改变 变量和对象 对象并没有直接存储到变量中,在Python中变量更像是给对象起了一个别名 变量中存储的不是对象的值,而是对象的id(内存地址), 当我们使用变量时,实际上就是在通过对象id在查找对象 变量中保存的对象,只有在为变量重新赋值时才会改变 变量和变量之间是相互独立的,修改一个变量不会影响另一个变量 类型转换 所谓的类型转换,将一个类型的对象转换为其他对象 类型转换不是改变对象本身的类型,而是根据当前对象的值创建一个新对象 运算符(操作符) 运算符可以对一个值或多个值进行运算或各种操作 比如 + 、-、= 都属于运算符 运算符的分类: 1.算术运算符2.赋值运算符3.比较运算符(关系运算符)4.逻辑运算符5.条件运算符(三元运算符)

优秀的个人博客,低调大师

AI入门级算法常识

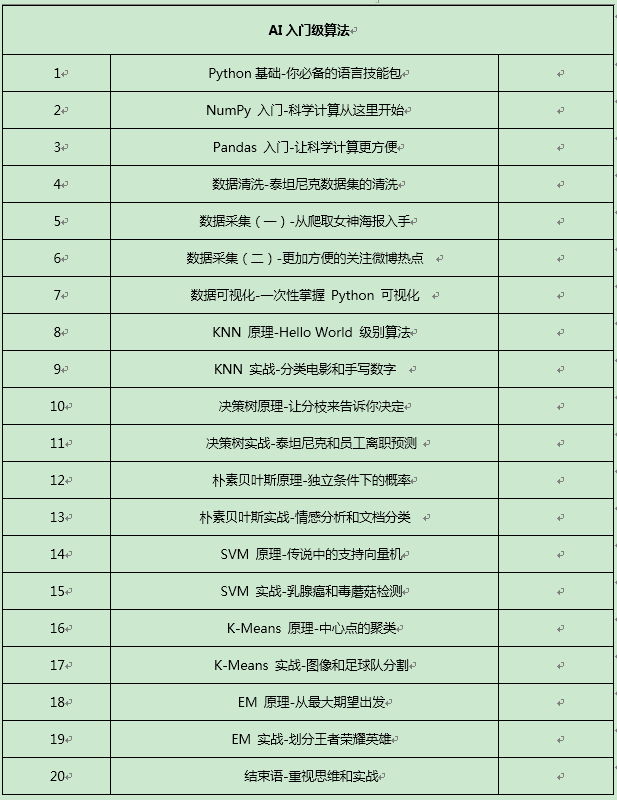
你好,我是周萝卜, 一名低调的挨踢工程师。 在每一个企业中,各个部门都会生产出一定的数据,目前,各类数据在企业生产经营中起着至关重要的作用。 数据已经成为了企业生产、经营,战略等等几乎所有的经营活动所依赖的,不可或缺的信息。 正确的数据分析可以帮助企业做出明智的业务经营决策,数据就犹如企业经营者的眼睛一样,通过数据可以反映出经营的问题,就犹如舵手依赖导航一样。 数据分析师是怎么练成的 其实,数据分析说白了,就是掌握数据,掌握规律,并加以应用的一门技术。那么这项技术具体又是怎样的呢,该如何来学习它呢,下面就一起来看看数据分析的三个组成部分。 数据采集:数据采集是我们的数据来源,只有当我们手中拥有足够的、可靠的数据之后,我们才有了分析数据的基础,数据采集可以通过网络爬虫,通过开源数据获取等途径来完成。 数据挖掘:数据挖掘部分,可以说是数据分析的核心部分,也是商业价值所在。我们通过分析手中的数据,来获得人、物等关系规律,从而指导我们的商业活动,达到一定的商业价值。 数据可视化:通过数据可视化,我们可以更加直观的观察到数据的组成、规律等,也能够更好的展示我们的分析结果。 从上面数据分析的三部分组成可以看出,一名优秀的数据分析师的工作包括:  数据采集:开源数据使用,网络爬虫,数据集成。 数据挖掘:数据处理,算法分析,数据预测。 数据可视化:数据分析结果呈现。 你只需要逐一击破这三个方面,那么就完全可以胜任一名数据分析师的工作。 1. 击破数据采集 对于数据采集,我们可以采用网络上的一些开源数据,但是这个局限性就是人家开源啥,你就只能用啥。如果我想分析王者荣耀的英雄呢,没有开源数据,此时自己动手,丰衣足食。我们可以抓取相关网站上的数据,那么 Python 爬虫就是做好的工具。我会带你一步步的完成网络爬虫从零到一的进阶,从而做到数据分析,不再过于依赖开源数据。 2. 击破数据挖掘 其实数据挖掘才是数据分析的核心,只有成功的挖掘出数据中隐藏的含义,我们数据分析的价值才有所体现。该如何挖掘呢,此时数据算法就要闪亮登场了。我会带你学习各种数据挖掘算法,从最简单的 KNN 分类算法到 EM 聚类算法,从算法原理到算法实战,一步步搞定数据挖掘。 3. 击破数据可视化 数据可视化是我们分析数据和展示分析成果的良好方式,直观的图表,要比枯燥的数字更加容易让人接受。我会带你完成多个可视化图表的制作,让你体会到数字的美丽与惊艳。 你能从专栏里面获得什么? 此专栏通过“基础篇”,“算法篇”两大模块,分别给你讲述数据分析所需要的基础知识和数据分析中的思路和流程,以及各种算法的原理及应用。 相信你通读完以上两个模块以后,会刷新你对于某些知识的认知。进而通过专栏的例子举一反三,从容应对未来工作中可能遇到的技术问题。 各个模块简介如下: 基础篇 此章节主要介绍 Python 基础语法以及两个数据分析常用库 NumPy 和 Pandas。再辅以数据清洗实战和 Python 爬虫实战,让你进一步加深理解,更快上手。 同时还会介绍10种 Python 数据可视化图表,同时使用 Matplotlib、Seaborn 及 pyecherts 来制作不同的可视化视图,让你充分体会不同工具之间的异同。 Python 作为当下最流行的语言,其在数据分析领域的表现也是非常惊艳的。Python 拥有众多的第三方库,可以方便的读写文本,获取数据,同时 NumPy 和 Pandas 都是业界一流的数据处理工具,给我们的数据处理提供了极大的方便。同时 Python 还拥有丰富的可视化模块,Matplotlib、Seaborn 和 Pyecharts 都是其中的佼佼者,是的我们的可视化工作也事半功倍。Python 还有众多的机器学习算法库,比如 scikit-learn,jieba 等,都是非常优秀且常用的模块。 以上所涉及的知识点,我都会在后面的章节中一一道来,勤奋的你,一定不会错过。 相信学习完本篇的内容,你一定会是一个基本掌握了 Python 基础知识,并能够根据自己对数据的要求,主动爬取网络上的资源,完成初始数据采集,同时还能够熟练使用 NumPy 和 Pandas 处理数据,清洗数据的工程师。并且还可以通过对数据的各种可视化操作,完成对数据的初步分析。 算法篇 算法是数据挖掘的灵魂,而数据挖掘则是数据分析的核心,所以学好算法,并能够灵活的运用,是每一个数据分析师的必备技能。 你一定听说过啤酒和尿布的故事,但是有想过为什么啤酒和尿布放在一起会相互刺进销量嘛?现在市面上有很多的情感分析系统,有没有考虑过其背后的原理?当你浏览购物网站时,为什么网站总时能精准的展示你所关心的物品,其中的核心在哪里? 如果你确实对以上的内容感兴趣,或者想了解其中的原理,那么不妨和我一起完成算法篇的内容。 此章节我会介绍6种数据分析常用算法,包括: 分类算法: KNN、决策树、SVM 和朴素贝叶斯聚类算法:K-Means 和 EM 每一个算法,我都会使用一节的篇幅来讲解算法原理,然后在下一节中通过一到两个实战例子来巩固知识。 可以让你了解到怎样才能给物品分类,如果才能做好预测。数据分析并不仅仅是数据的展示,探索数据背后的价值,才是数据分析的本质与意义所在。 相信学习完本篇内容后,你一定可以轻松的把王者荣耀中各个英雄分类,从而选出最适合自己的那一类。你也可以完成足球队的分档,看看心中的球队到底是什么水平。当然还有图像分割,乳腺癌检测,情感分析等多个实际例子等着你, 带你完成从理论到应用的完美转变。 需要什么基础才能完成以上内容? 完全是0基础就可以。只要你跟着我的节奏,踏实的完成基础篇的练习。即使你没有任何 Python 基础,只要通读完 Python、NumPy 和 Pandas 基础篇,并辅以简单的练习,你就一定可以完成后面内容的学习。 至于算法篇,同样不需要太多的数学知识,我会以通俗易懂的语言来向你展示一个不一样的算法世界。 总结 数据分析,探索数据中的价值。由于篇幅有限,无法涵盖所有的数据分析知识点,还请见谅。 但是希望你能够通过本专栏的学习,可以快速的积累经验,为你后面进入到数据分析的世界打下良好的基础。

优秀的个人博客,低调大师

Docker入门-docker compose的使用

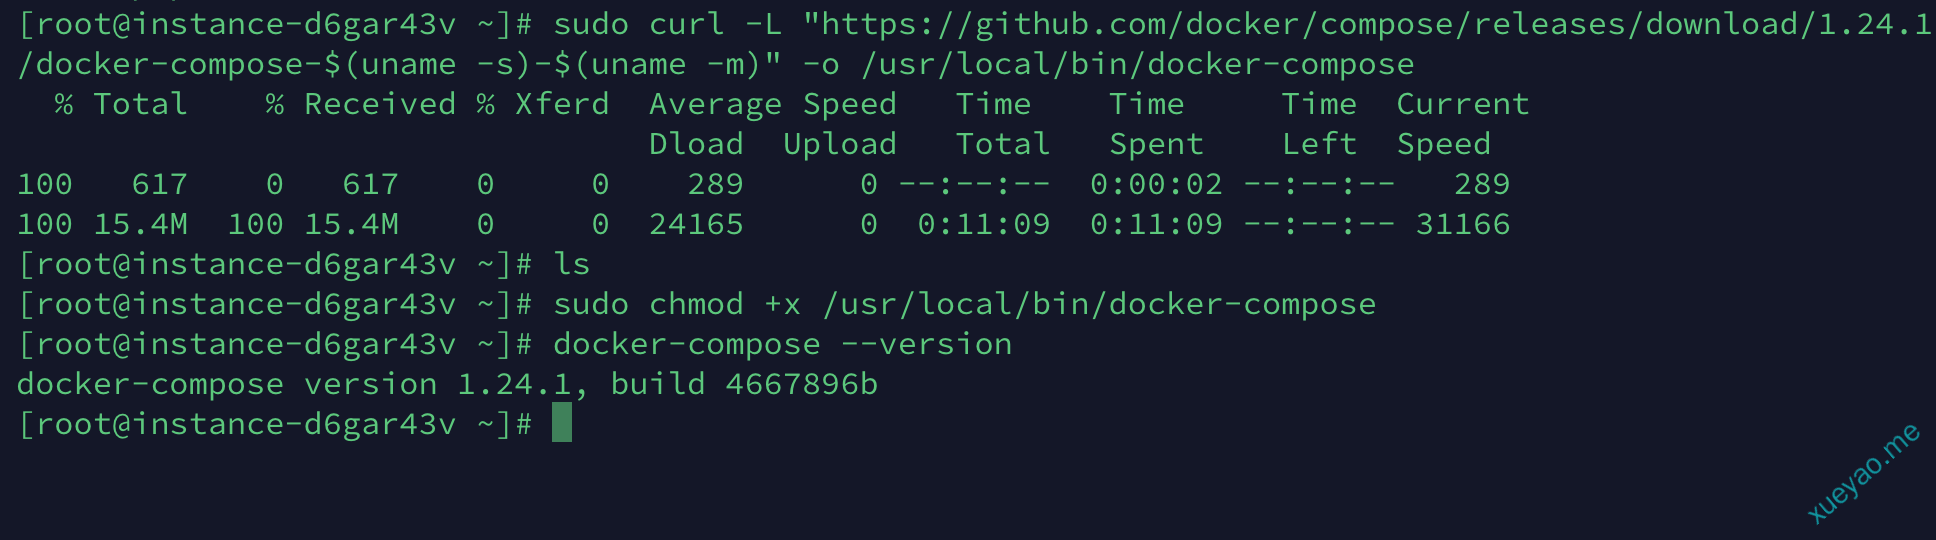
Compose简介 Compose项目是Docker官方的开源项目,负责实现对Docker容器集群的快速编排。其代码目前在https://github.com/docker/compose 上开源。 Compose定位是定义和运行多个Docker容器的应用,其前身是开源项目Fig。 通过前面内容的介绍,我们知道使用一个Dockerfile模板文件,可以让用户很方便的定义一个单独的应用容器。然而,在日常工作中,经常会碰到需要多个容器相互配合来完成某任务的情况。例如要实现一个Web项目,除了Web服务容器本身,往往还需要加上后端的数据库服务容器,甚至还包括负载均衡容器等。 Compose恰好满足了这样的需求。它允许用户通过一个单独的docker-compose.yml模板文件来定义一组相关联的应用容器为一个项目(project)。 Compose中有两个重要的概念: 服务(service):一个应用的容器,实际上可以包括若干运行相同镜像的容器实例。 项目(project):由一组关联的应用容器组成的一个完整业务单元。 Compose的默认管理对象是项目,通过子命令对项目中的一组容器进行便捷地生命周期管理。 Compose项目由Python编写,实现上调用了Docker服务提供的API来对容器进行管理。 安装和卸载 Compose支持Linux、macOS、Windows10三大平台。 Compose可以通过Python的包管理工具pip进行安装,也可以直接下载编译好的二进制文件使用,甚至能够直接在Docker容器中运行。 Docker for Mac、Docker for Windows自带docker-compose二进制文件,安装Docker之后可以直接使用。 docker-compose --version Linux系统需要单独使用二进制或者pip方式进行安装。 Linux安装docker-compose 二进制包 在Linux上的安装十分简单,从官方GitHub Release处直接下载编译好的二进制文件即可。例如,在Linux64位系统上直接下载对应的二进制包。 sudo curl -L "https://github.com/docker/compose/releases/download/1.24.1/docker-compose-$(uname -s)-$(uname -m)" -o /usr/local/bin/docker-compose sudo chmod +x /usr/local/bin/docker-compose #赋予可执行权限 PIP安装 如果您计算机的架构是ARM(例如,树莓派),建议使用pip安装。 sudo pip install -U docker-compose 使用 场景:最常见的项目是web网站,一般的web网站都会依赖第三方提供的服务(比如:DB和cache),我们拿dubbo-admin进行讲解(dubbo-admin依赖zookeeper)。 Compose构建dubbo-admin服务 从github上获取dubbo-admin的master分支源码 git clone -b master https://github.com/apache/incubator-dubbo-ops.git 修改admin中的application配置,把zookeeper地址改为zookeeper://zookeeper:2181 使用maven进行编译打包 mvn clean package -Dmaven.test.skip=true 在dubbo-admin目录下编写Dockerfile文件,内容为 # FROM,表示使用JDK8环境为基础镜像,如果镜像不是本地会从DockerHub进行下载 FROM openjdk:8-jdk-alpine # 作者 MAINTAINER Simon<xueyao.me@gmail.com> VOLUME /tmp # ADD,拷贝文件并且重命名 ADD ./target/dubbo-admin-0.0.1-SNAPSHOT.jar app.jar # ENTRYPOINT,为了缩短Tomcat启动时间,添加java.security.egd的系统属性指向/dev/urandom作为ENTRYPOINT ENTRYPOINT ["java", "-Djava.security.egd=file:/dev/./urandom","-jar","/app.jar"] 使用docker build -t dubbo-admin:1.0 .命令进行构建。 在项目根目录下编写docker-compose.yml文件,这个是Compose使用的主模板文件。 version: '3.4' services: zk_server: image: zookeeper:3.4 ports: - 2181:2181 dubbo-admin: image: dubbo-admin:1.0 links: - zk_server:zookeeper depends_on: - zk_server ports: - 7001:7001 在docker-compose.yml文件所在目录执行: docker-compose up 在浏览器中访问http://服务器ip:7001 进行验证,用户名密码为:root/root guest/guest Compose命令说明 命令对象与格式 执行docker-compose [COMMAND] --help或者docker-compose help [COMMAND]可以查看具体某个命令的使用格式。 docker-compose命令的基本的使用格式是: docker-compose [-f=<arg>...] [options] [COMMAND] [ARGS...] 命令选项 -f,--file FILE指定模板文件,默认为docker-compose.yml,可以多次指定。 -p,--project-name NAME指定项目名称,默认将使用所在目录名称作为项目名。 --x-networking使用Docker的可拔插网络后端特性 --x-network-driver DRIVER指定网络后端的驱动,默认为bridge --verbose输出更多调试信息。 -v,--version打印版本并退出。 build 格式为docker-compose build [options] [SERVICE...]。 构建(重新构建)项目中的服务容器。 可以随时在项目目录下运行docker-compose build来重新构建服务。 选项包括: * --force-rm 删除构建过程中的临时容器。 * --no-cache 构建镜像过程中不使用cache(将加长构建过程)。 * --pull 始终尝试通过pull来获取更新版本的镜像。 logs 格式为docker-compose logs [options] [SERVICE...]。 查看服务容器的输出。默认情况下,docker-compose将对不同的服务输出使用不同的颜色来区分。可以通过--no-color来关闭颜色。 port 格式为docker-compose port [options] SERVICE PRIVATE_PORT。 打印某个容器端口所映射的公共端口。 选项: --protocol=proto指定端口协议,tcp(默认值)或者udp。 --index=index如果同一服务存在多个容器,指定命令对象容器的序号(默认为1)。 ps 格式为docker-compose ps [options] [SERVICE...] 列出项目中目前的所有容器。 选项: -q只打印容器的ID信息。 pull 格式为docker-compose pull [options] [SERVICE...]。 拉取服务依赖的镜像。 选项: --ignore-pull-failures忽略拉取镜像过程中的错误。 restart 格式为docker-compose restart [options] [SERVICE...] 重启项目中的服务。 选项: -t,--timeout TIMEOUT指定重启前停止容器的超时(默认为10秒)。 rm 格式为docker-compose rm [options] [SERVICE...] 删除所有(停止状态的)服务容器。推荐先执行docker-compose stop命令来停止容器。 选项: -f,--force强制直接删除,包括非停止状态的容器。一般尽量不要使用该选项。 -v删除容器所挂载的数据卷。 run 格式为docker-compose run[options] [-p PORT...][-e KEY=VAL...] SERVICE [COMMAND] [ARGS...] 在指定服务上执行一个命令。例如: docker-compose run ubuntu ping docker.com scale 格式为docker-compose scal [options] [SERVICE=NUM...] 设置指定服务运行的容器个数。例如: docker-compose scale web=3 db=2 将启动3个容器运行web服务,2个容器运行db服务。 up 该命令十分强大,它将尝试自动完成包括构建镜像,(重新)创建服务,启动服务,并关联服务相关容器的一系列操作。链接的服务都将会被自动启动,除非已经处于运行状态。 选项: -d 在后台运行服务容器。 --no-color 不使用颜色来区分不同的服务的控制台输出。 --no-deps 不启动服务所链接的容器。 --force-recreate强制重新创建容器,不能与--no-recreate同时使用。 --no-recreate如果容器已经存在了,则不重新创建,不能与--force-recreate同时使用。 --no-build 不自动构建缺失的服务镜像。 -t,--timeout TIMEOUT停止容器时候的超时(默认为10秒)。 其它命令如下: 命令 说明 version 格式为docker-compose version,打印版本信息 config 验证Compose格式是否正确,若正确则显示配置,若格式错误显示错误原因。 exec 进入指定的容器 images 列出Compose文件中包含的镜像 down 停止up命令所启动的容器,并移除网络。 help 获得一个命令的帮助 kill 通过发送SIGKILL信号来强制停止服务容器 pause 格式为docker-compose pause [SERVICE...],暂停一个服务容器。 push 推送服务依赖的镜像到Docker镜像仓库 start 格式为docker-compose start[SERVICE...],启动已经存在的服务容器。 stop 停止已经存在的服务容器。 top 查看各个服务容器内运行的进程 unpause 格式为docker-compose unpause [SERVICE...],恢复处于暂停状态中的服务。 Compose模板文件 模板文件是使用Compose的核心,涉及到的指令关键字也比较多,大部分指令跟docker run 相关参数的含义都类似。 默认的模板文件名称为docker-compose.yml,格式为YAML格式。 注意每个服务都必须通过image指令指定镜像或build指令(需要Dockerfile)等来自动构建生成镜像。 如果使用build指令,在Dockerfile中设置的选项(例如:CMD,EXPOSE,VOLUME,ENV等)将会自动被获取,无需在docker-compose.yml中再次设置。下面介绍常用指令的用法。 version: '3' services: webapp: build: context: ./dir dockerfile: Dockerfile-alternate args: buildno: 1 build 指令Dockerfile所在文件夹的路径(可以是绝对路径,或者相对docker-compose.yml文件的路径)。 Compose将会利用它自动构建这个镜像,然后使用这个镜像。 使用context指令指定Dockerfile所在文件夹的路径 使用dockerfile指令指定Dockerfile文件名 使用arg指令指定构建镜像时的变量 command 覆盖容器启动后默认执行的命令。 command:echo "hello world" Container_name 指令容器名称。默认将会使用项目名称_服务名称_序号这样的格式。 container_name:docker-web-container configs 仅用于Swarm mode, 详细内容后页面swarm mode会进到。 deploy 仅用于Swarm mode,详细内容后面swarm mode会进到。 devices 指定设备映射关系。 devices: - "/dev/ttyUSB1:/ttyUSB0" depends_on 解决容器的依赖、启动先后的问题。 dns 自定义DNS服务器。可以是一个值,也可以是一个列表。 dns: 8.8.8.8 dns: - 8.8.8.8 - 114.114.114.114 environment 设置环境变量。你可以使用数组或字典两种格式。只给定名称的变量会自动获取运行Compose主机上对应变量的值,可以用来防止泄露不必要的数据。 environment: RACK_ENV: development SESSION_SECRET: environment: - RACK_ENV=development - SESSION_SECRET expose 显露端口,但不映射到宿主机,只被连接的服务访问。仅可以指定内部端口为参数 expose: - "3000" - "8000" extra_hosts 类似Docker中的--add-host参数,指定额外的host名称映射信息。会在启动后的服务容器中/etc/hosts文件中添加一条条目。8.8.8.8 googledns extra_hosts: - "googledns:8.8.8.8" healthcheck 通过命令容器是否健康运行。 healthcheck: test:["CMD","curl","-f","http://localhost"] interval:1m30s timeout:10s retries:3 image 指定为镜像名称或镜像ID。如果镜像在本地不存在,Compose将会尝试拉去这个镜像 image:session-web:latest lables 为容器添加Docker元数据(metadata)信息。例如可以为容器添加辅助说明信息。 labels: com.study.department:"devops department" com.study.release:"v1.0" links 连接到其他容器。注意:不推荐使用该指令。应该使用docker network,建立网络,而docker run --network来连接特定网络。或者使用version:'2'和更高版本的docker-compose.yml直接定义自定义网络并使用。 network_mode 设置网络模式。使用和docker run的--network参数一样的值。 network_mode:"bridge" network_mode:"host" network_mode:"none" networks 配置容器连接的网络。 version:"3" services: some-service: networks: - some-network networks: some-network: ports 暴露端口信息。使用宿主端口:容器端口(HOST:CONTAINER)格式,或者仅仅指定容器的端口(宿主将会随机选择端口)都可以。 ports: - "3000" - "8000:8000" volumes 数据卷所挂载路径设置,可以设置宿主机路径,同时支持相关路径。 volumes: - /var/lib/mysql - cache/:/tmp/cache - ~/configs:/etc/configs/:ro ulimits 指定容器的ulimits限制值。例如,指定最大进程数为65535,指定文件句柄数为20000(软限制,应用可以随时修改,不能超过硬限制)和40000(系统硬限制,只能root用户提高)。 ulimits: nproc: 65535 nofile: soft: 20000 hard: 40000 此外,还有包括domainname,entrypoint,hostname,ipc,mac_address,privileged,read_only,shm_size,restart,stdin_open,tty,user,working_dir等指令,基本跟docker run中对应参数的功能相同。 指定服务容器启动后执行的入口文件 entrypoint: /code/entrypoint.sh 指定容器中运行应用的用户名 user:nginx 指定容器中工作目录 working_dir: /code 指定容器中搜索域名、主机名、mac地址等 domainname:your_website.com hostname:test mac_address:08-00-27-00-0C-0A 允许容器中运行一些特权命令 privileged:true 指定容器退出后的重启策略为始终重启。在生产环境中推荐配置为always或者unless-stopped restart:alwarys 以只读模式挂载容器的root文件系统,意味着不能对容器内容进行修改 read_only:true 打开标准输入,可以接受外部输入 stdin_open:true 模拟一个伪终端 tty:true Compose模板文件支持动态读取主机的系统环境变量和当前目录下的.env文件中的变量。例如,下面的Compose文件将从运行它的环境中读取变量${MONGO_VERSION}的值,并写入执行的指令中。 version: "3" services: db: image: "mongo:${MONGO_VERSION}" 如果执行MONGO_VERSION=3.2 docker-compose up则会启动一个mongo:3.2镜像的容器。若当前目录存在.env文件,执行docker-compose命令时将从该文件中读取变量。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册