首页 文章 精选 留言 我的

精选列表

搜索[鸿蒙实践],共10000篇文章
优秀的个人博客,低调大师

官方总结鸿蒙应用开发常见问题与实现方法典型案例

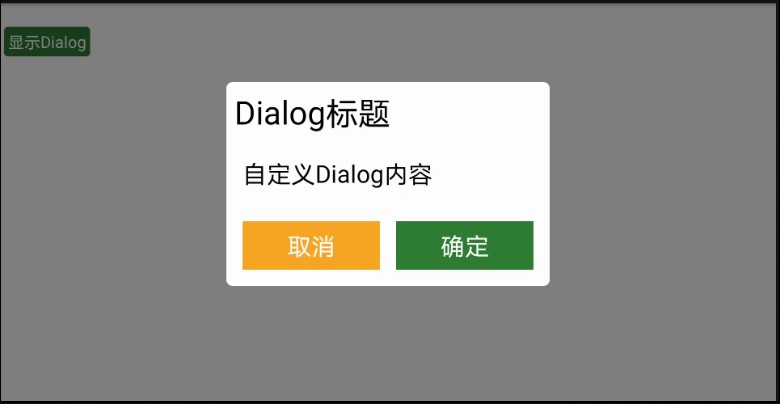
1自定义Dialog的布局 1.1 问题描述 如何实现自定义的Dialog? 1.2 实现方法 添加自定义Dialog代码 CommonDialog commonDialog = new CommonDialog(this); Component component = LayoutScatter.getInstance(getContext()) .parse(ResourceTable.Layout_dialog_custom_layout, null, true); commonDialog.setSize(800, 500); commonDialog.setContentCustomComponent(component); commonDialog.show(); 自定义Dialog的布局文件 <?xml version="1.0" encoding="utf-8"?> <DirectionalLayout xmlns:ohos="http://schemas.huawei.com/res/ohos" ohos:width="match_parent" ohos:height="match_content" ohos:padding="10vp" ohos:background_element="@graphic:grey" ohos:orientation="vertical"> <Text ohos:width="match_parent" ohos:height="match_content" ohos:text="Dialog标题" ohos:text_color="$color:Black" ohos:text_style="bold" ohos:text_size="40fp"/> <Text ohos:width="match_parent" ohos:height="match_parent" ohos:text="自定义Dialog内容" ohos:text_color="$color:Black" ohos:text_style="bold" ohos:weight="1" ohos:text_alignment="vertical_center" ohos:top_margin="30vp" ohos:bottom_margin="30vp" ohos:left_margin="10vp" ohos:right_margin="10vp" ohos:text_size="30fp"/> <DirectionalLayout ohos:height="match_content" ohos:width="match_parent" ohos:orientation="horizontal"> <Button ohos:width="match_parent" ohos:text="取消" ohos:text_size="30fp" ohos:padding="10vp" ohos:text_color="$color:White" ohos:weight="1" ohos:margin="10vp" ohos:background_element="$graphic:yellow" ohos:height="match_content"/> <Button ohos:width="match_parent" ohos:text="确定" ohos:text_size="30fp" ohos:weight="1" ohos:padding="10vp" ohos:text_color="$color:White" ohos:margin="10vp" ohos:background_element="$graphic:green" ohos:height="match_content"/> </DirectionalLayout> </DirectionalLayout> 1.3 实际效果 2 设置控件背景颜色 2.1 问题描述 在xml布局中设置控件ohos:background_element="$color:yellow"无效,目前背景颜色不支持以$color方式设置,只支持$graphic方式设置。 2.2 实现方法 方式1:xml中设置控件背景颜色使用$graphic <Button ohos:width="match_parent" ohos:text="控件按钮" ohos:text_size="30fp" ohos:padding="10vp" ohos:text_color="$color:White" ohos:background_element="$graphic:yellow" ohos:height="match_content"/> 资源文件graphic中yellow.xml代码如下: <?xml version="1.0" encoding="utf-8"?> <shape xmlns:ohos="http://schemas.huawei.com/res/ohos" ohos:shape="rectangle"> <solid ohos:color="#fff9a825"/> </shape> 方式2:纯代码设置控件颜色 DirectionalLayout.LayoutConfig config = new DirectionalLayout.LayoutConfig(DirectionalLayout.LayoutConfig.MATCH_CONTENT, DirectionalLayout.LayoutConfig.MATCH_CONTENT); config.setMargins(30, 10, 10, 10); ShapeElement element = new ShapeElement(); element.setRgbColor(new RgbColor(255, 111, 0)); Text text = new Text(this); text.setText("xml添加背景"); text.setTextColor(new Color(0xFFFFFFFF)); text.setTextSize(40); text.setPadding(30, 20, 30, 20); text.setTextAlignment(TextAlignment.CENTER); text.setBackground(element); text.setLayoutConfig(config); 2.3 实际效果 3 ScrollView嵌套DirectionalLayout进行滚动 3.1 问题描述 ScrollView嵌套DirectionalLayout如何进行滚动? 3.2 实现方法 使用xml布局,需要将ScrollView的高度设置成“match_parent”,ScrollView子布局的高度设置成“match_content” <?xml version="1.0" encoding="utf-8"?> <ScrollView xmlns:ohos="http://schemas.huawei.com/res/ohos" ohos:width="match_parent" ohos:height="match_parent" ohos:orientation="vertical"> <DirectionalLayout xmlns:ohos="http://schemas.huawei.com/res/ohos" ohos:width="match_parent" ohos:height="match_content" ohos:orientation="vertical"> ... </DirectionalLayout> </ScrollView> 使用代码添加,则需要给ScrollView和子布局设置LayoutConfig ComponentContainer.LayoutConfig scrollConfig = new ComponentContainer.LayoutConfig(DirectionalLayout.LayoutConfig.MATCH_PARENT, DirectionalLayout.LayoutConfig.MATCH_PARENT); scrollView.setLayoutConfig(scrollConfig); DirectionalLayout.LayoutConfig config = new DirectionalLayout.LayoutConfig(DirectionalLayout.LayoutConfig.MATCH_PARENT, DirectionalLayout.LayoutConfig.MATCH_CONTENT); myLayout.setLayoutConfig(config); ... scrollView.addComponent(myLayout); super.setUIContent(scrollView); 3.3 实际效果 4 加载和显示网络图片 4.1 问题描述 如何实现加载和显示网络图片? 4.2 实现方法 在config.json中添加网络权限 { "module": { "reqPermissions": [ { "name": "ohos.permission.INTERNET" } ] } } 获取并设置网络图片 String urlImage = "https://www.harmonyos.com/resource/image/community/20201009-164134eSpace.jpg"; HttpURLConnection connection = null; try { URL url = new URL(urlImage); URLConnection urlConnection = url.openConnection(); if (urlConnection instanceof HttpURLConnection) { connection = (HttpURLConnection) urlConnection; } if (connection != null) { connection.connect(); // 之后可进行url的其他操作 // 得到服务器返回过来的流对象 InputStream inputStream = urlConnection.getInputStream(); ImageSource imageSource = ImageSource.create(inputStream, new ImageSource.SourceOptions()); ImageSource.DecodingOptions decodingOptions = new ImageSource.DecodingOptions(); decodingOptions.desiredPixelFormat = PixelFormat.ARGB_8888; // 普通解码叠加旋转、缩放、裁剪 PixelMap pixelMap = imageSource.createPixelmap(decodingOptions); // 普通解码 getUITaskDispatcher().syncDispatch(() -> { Image image = new Image(HttpImageSlice.this); DirectionalLayout.LayoutConfig config = new DirectionalLayout.LayoutConfig(DirectionalLayout.LayoutConfig.MATCH_CONTENT, DirectionalLayout.LayoutConfig.MATCH_CONTENT); config.setMargins(10, 10, 10, 10); image.setLayoutConfig(config); image.setPixelMap(pixelMap); myLayout.addComponent(image); pixelMap.release(); }); } } catch (Exception e) { e.printStackTrace(); } 4.3 实际效果 5 ListContainer列表组件的使用 5.1 问题描述 ListContainer列表组件如何使用? 5.2 实现方法 在xml文件中声明组件 <?xml version="1.0" encoding="utf-8"?> <DirectionalLayout xmlns:ohos="http://schemas.huawei.com/res/ohos" ohos:width="match_parent" ohos:height="match_parent" ohos:orientation="vertical"> <ListContainer ohos:id="$+id:list_container" ohos:orientation="vertical" ohos:width="match_parent" ohos:height="match_parent"/> </DirectionalLayout> 获取 ListContainer 组件,并设置itemProvider private void initView() { mListContainer = (ListContainer) findComponentById(ResourceTable.Id_list_container); ListItemProvider listItemProvider = new ListItemProvider(); mListContainer.setItemProvider(listItemProvider); } 自定义 ListItemProvider 继承 RecycleItemProvider class ListItemProvider extends RecycleItemProvider { @Override public int getCount() { return data.size(); } @Override public long getItemId(int i) { return 0; } @Override public Component getComponent(int position, Component convertView, ComponentContainer componentContainer) { Component component = LayoutScatter.getInstance(getContext()) .parse(ResourceTable.Layout_layout_container_item, null, false); if (!(component instanceof ComponentContainer)) { return null; } ComponentContainer rootLayout = (ComponentContainer) component; Text rightText = (Text) rootLayout.findComponentById(ResourceTable.Id_content); rightText.setText(data.get(position)); return component; } } 5.3 实际效果 6 读取资源文件 6.1 问题描述 如何读取应用的资源文件? 6.2 实现方法 对于图片文件,建议放到base/media目录下,Image组件可以直接设置,方法如下。 Image image = (Image) findComponentById(ResourceTable.Id_component_image); image.setPixelMap(ResourceTable.Media_huawei); 对于rawfile文件的读写,请参考下面的方法: ohos.global.resource.ResourceManager resourceManager = getApplicationContext().getResourceManager(); ohos.global.resource.RawFileEntry rawFileEntry = resourceManager.getRawFileEntry("resources/rawfile/test.png"); RawFileDescriptor rawFileDescriptor = rawFileEntry.openRawFileDescriptor(); // 或者 Resource resource = rawFileEntry.openRawFile(); 6.3 实际效果 7 JS方法获取位置信息 7.1 问题描述 使用JS开发时,如何获取位置信息? 7.2 实现方法 导入获取位置模块,并调用getLocation方法获取位置信息 import geolocation from '@system.geolocation'; export default { data: { longitude: 0.0, latitude: 0.0 }, onInit() { this.getLocation(); }, getLocation() { var temp = this; geolocation.getLocation({ success: function(data) { console.info("get location success, longitude: " + data.longitude +", latitude: " + data.latitude); temp.longitude = data.longitude temp.latitude = data.latitude; }, fail: function(data, code) { console.error("get location failed, code: " + code + ", data: " + data); }, complete: function() { console.info("get location complete"); } }); } } 在config.json中增加获取位置信息的权限 "reqPermissions": [ { "name": "ohos.permission.LOCATION" } ], 7.3 实际效果 8 禁用手表中系统的左右滑动 8.1 问题描述 开发一个应用支持左右滑动的操作,但是在模拟器中右滑时,默认跳转到系统页面,并退出应用,如何禁用系统右滑? 8.2 实现方法 覆盖MainAbility中的onTouchEvent方法,实现如下 @Override protected boolean onTouchEvent(TouchEvent event) { super.onTouchEvent(event); return true; } 8.3 实际效果 9 Text控件中文字换行 9.1 问题描述 Text控件中文字目前不支持\n换行,如何进行换行? 9.2 实现方法 可以使用系统自动换行,保持两行文字长度一致,实现如下 <?xml version="1.0" encoding="utf-8"?> <DirectionalLayout xmlns:ohos="http://schemas.huawei.com/res/ohos" ohos:width="match_parent" ohos:height="match_parent" ohos:orientation="vertical"> <Text ohos:id="$+id:text" ohos:width="150vp" ohos:height="match_content" ohos:multiple_lines="true" ohos:max_text_lines="2" ohos:auto_font_size="true" ohos:text="目前车辆尊享服务已过期, 车主续费后才可继续使用"/> </DirectionalLayout> 9.3 实际效果 10 在一个布局xml中引入其他xml布局文件 10.1 问题描述 定义了一个公共的XML布局文件,如何在其他XML布局文件中引用这个公共的XML布局文件? 10.2 实现方法 可以通过include标签引用其他的XML布局文件,示例如下: <?xml version="1.0" encoding="utf-8"?> <include ohos:id="$+id:include_layout" ohos:layout="$layout:include_layout" ohos:width="match_parent" ohos:height="match_content"/> </DirectionalLayout> 10.3 实际效果 NA 11 自定义Swtich控件的颜色 11.1 问题描述 如何自定义Swtich控件的开关两个状态下的按钮颜色? 11.2 实现方法 在资源文件graphic文件下创建bg_element.xml和fg_element.xml,bg_element.xml文件内容如下 <?xml version="1.0" encoding="utf-8"?> <shape xmlns:ohos="http://schemas.huawei.com/res/ohos" ohos:shape="rectangle"> <corners ohos:radius="30"/> <solid ohos:color="#424242"/> </shape> fg_element.xml文件内容如下 <?xml version="1.0" encoding="utf-8"?> <shape xmlns:ohos="http://schemas.huawei.com/res/ohos" ohos:shape="oval"> <solid ohos:color="#D81B60"/> </shape> 代码实现自定义颜色: private void setupSwitch() { mSwitch = (Switch) findComponentById(ResourceTable.Id_switch_custom); Element elementBackground = ElementScatter.getInstance(this).parse(ResourceTable.Graphic_bg_element); mSwitch.setTrackElement(elementBackground); Element elementThumb = ElementScatter.getInstance(this).parse(ResourceTable.Graphic_fg_element); mSwitch.setThumbElement(elementThumb); mSwitch.setClickedListener(new Component.ClickedListener() { @Override public void onClick(Component component) { Log.i("switch: " + mSwitch.isChecked()); } }); } 11.3 实际效果 12 视频播放 12.1 问题描述 如何播放本地视频文件和网络视频? 12.2 实现方法 创建布局文件video_player_layout.xml,内容如下 <?xml version="1.0" encoding="utf-8"?> <DependentLayout xmlns:ohos="http://schemas.huawei.com/res/ohos" ohos:id="$+id:video_player_dl" ohos:width="match_parent" ohos:height="match_parent" ohos:orientation="vertical"> </DependentLayout> 定义下面的变量,内容如下: private static Player mPlayer; private SurfaceProvider mSurfaceProvider; private DependentLayout mLayout; 实现SurfaceOps.Callback接口,代码如下: class VideoSurfaceCallback implements SurfaceOps.Callback { @Override public void surfaceCreated(SurfaceOps surfaceOps) { Log.i("surfaceCreated() called."); if (mSurfaceProvider.getSurfaceOps().isPresent()) { Surface surface = mSurfaceProvider.getSurfaceOps().get().getSurface(); playUrl(surface); } } @Override public void surfaceChanged(SurfaceOps surfaceOps, int i, int i1, int i2) { Log.i("surfaceChanged() called."); } @Override public void surfaceDestroyed(SurfaceOps surfaceOps) { Log.i("surfaceDestroyed() called."); } } 实现Player.IplayerCallback接口,代码如下: private class VideoPlayerCallback implements Player.IPlayerCallback { @Override public void onPrepared() { Log.i("onPrepared"); } @Override public void onMessage(int i, int i1) { Log.i("onMessage"); } @Override public void onError(int i, int i1) { Log.i("onError: i=" + i + ", i1=" + i1); } @Override public void onResolutionChanged(int i, int i1) { Log.i("onResolutionChanged"); } @Override public void onPlayBackComplete() { Log.i("onPlayBackComplete"); if (mPlayer != null) { mPlayer.stop(); mPlayer = null; } } @Override public void onRewindToComplete() { Log.i("onRewindToComplete"); } @Override public void onBufferingChange(int i) { Log.i("onBufferingChange"); } @Override public void onNewTimedMetaData(Player.MediaTimedMetaData mediaTimedMetaData) { Log.i("onNewTimedMetaData"); } @Override public void onMediaTimeIncontinuity(Player.MediaTimeInfo mediaTimeInfo) { Log.i("onMediaTimeIncontinuity"); } } 实现播放本地文件的方法,其中test.mp4文件放到资源文件目录下,内容如下: private void playLocalFile(Surface surface) { try { RawFileDescriptor filDescriptor = getResourceManager().getRawFileEntry("resources/rawfile/test.mp4").openRawFileDescriptor(); Source source = new Source(filDescriptor.getFileDescriptor(),filDescriptor.getStartPosition(),filDescriptor.getFileSize()); mPlayer.setSource(source); mPlayer.setVideoSurface(surface); mPlayer.setPlayerCallback(new VideoPlayerCallback()); mPlayer.prepare(); mSurfaceProvider.setTop(0); mPlayer.play(); } catch (Exception e) { Log.e("playUrl Exception:" + e.getMessage()); } } 实现播放网络URL的方法,其中video url为视频资源URL,内容如下: private void playUrl(Surface surface) { try { Source source = new Source("video url"); mPlayer.setSource(source); mPlayer.setVideoSurface(surface); mPlayer.setPlayerCallback(new VideoPlayerCallback()); mPlayer.prepare(); mSurfaceProvider.setTop(0); mPlayer.play(); } catch (Exception e) { Log.e("playUrl Exception:" + e.getMessage()); } } 播放网络视频,需要申请网络使用权限,在config.json中增加如下内容: "reqPermissions": [ { "name": "ohos.permission.INTERNET" }, ] 12.3 实际效果 原文链接:https://developer.huawei.com/consumer/cn/forum/topic/0204410755673870341?fid=0101303901040230869 原作者:eva3w
优秀的个人博客,低调大师

鸿蒙开发快速入门之:Hi3861 开发板(2)环境搭建

这是Hi3861 开发板进行OpenHarmony 开发快速入门的第二篇,主要学习如何搭建环境。 硬件要求 Linux服务器 Windows工作台(主机电脑) Hi3861 WLAN模组 USB Type-C线(Windows工作台通过USB与Hi3861 WLAN模组连接) 各硬件连接关系如下图所示。 图 1硬件连线图 软件系统要求 表 1Hi3861 WLAN模組开发平台要求 硬件 软件 描述 备注 Linux编译服务器 操作系统 Ubuntu16.04及以上64位系统版本,Shell使用bash 开发人员可以在Windows工作台中进行程序开发,或者远程登录到Linux服务器进行程序开发。 Windows工作台 操作系统 Windows XP/Windows7/Windows10 Linux构建工具要求 Linux服务器通用环境配置需要的工具及其获取途径如下表所示。 表 2Linux服务器开发工具及获取途径 开发工具 用途 获取途径 交叉编译器gcc_riscv32 交叉编译工具 http://tools.harmonyos.com/mirrors/gcc_riscv32/7.3.0/linux/gcc_riscv32-linux-7.3.0.tar.gz Python3.7+ 编译构建工具 https://www.python.org/ftp/python/3.8.5/Python-3.8.5.tgz SCons3.0.4+ 编译构建工具 通过互联网获取 bash 命令处理器 通过互联网获取 build-essential 编译依赖的基础软件包 通过互联网获取 gn 产生ninja编译脚本 http://tools.harmonyos.com/mirrors/gn/1523/linux/gn.1523.tar ninja 执行ninja编译脚本 http://tools.harmonyos.com/mirrors/ninja/1.9.0/linux/ninja.1.9.0.tar Windows开发工具要求 表 3Windows工作台开发工具及获取途径 开发工具 用途 获取途径 Visual Studio Code 代码编辑工具。 https://code.visualstudio.com/ HUAWEI DevEco Device Tool IDE开发工具,支持WLAN模组的代码编写、远程编译、版本烧录、串口调试等功能。 说明: HUAWEI DevEco Device Tool是OpenHarmony面向智能设备开发者提供的一站式集成开发环境,支持OpenHarmony的组件按需定制,支持C/C++语言,以插件的形式部署在Visual Studio Code上。 https://device.harmonyos.com/cn/ide IPOP、PuTTY或其他超级终端(选其一) 远程连接Linux编译服务器,连接模组串口工具。 通过互联网获取(如:https://www.putty.org/) CH341SER.EXE USB转串口驱动。 http://www.wch.cn/search?q=ch340g&t=downloads 安装编译基础环境 连接Linux服务器 使用Windows远程登录Linux,以PUTTY工具为例: 打开PuTTY工具,输入Linux服务器IP地址,后点击“open”,打开连接。 图 2PuTTY界面示例图 弹框告警选择“是(Y)”。 弹出界面中输入账号并按回车键,继续输入密码并回车键。 图 3登录界面图 登录成功。 图 4登录成功界面 将Linux shell改为bash 查看shell是否为bash,在终端运行如下命令 ls -l /bin/sh 如果为显示为/bin/sh -> bash则为正常,否则请按以下方式修改: 方法一:在终端运行如下命令,然后选择 no。 sudo dpkg-reconfigure dash 方法二:先删除sh,再创建软链接。 rm -rf /bin/sh sudo ln -s /bin/bash /bin/sh 安装Python环境 打开Linux编译服务器终端。 输入命令“python3 --version”,查看Python版本号。需使用python3.7以上版本,否则请按以下步骤执行,以python3.8为例: 如果Ubuntu 版本为18,运行"sudo apt-get install python3.8" 如果Ubuntu 版本为16,请以下载包的方式安装python: python安装环境依赖(gcc, g++, make, zlib, libffi)请运行: "sudo apt-get install gcc && sudo apt-get install g++ && sudo apt-get install make && sudo apt-get install zlib* && sudo apt-get install libffi-dev " 获取python3.8.5安装包,将其放至linux服务器中,运行 : "tar -xvzf Python-3.8.5.tgz && cd Python-3.8.5 && sudo ./configure && make && sudo make install" 确定Python-3.8.5安装好后,运行"which python3.8",将回显路径链接到"/usr/bin/python",示例: "cd /usr/bin && rm python && ln -s /usr/local/bin/python3.8 python && python --version" 安装Python包管理工具,运行“sudo apt-get install python3-setuptools python3-pip -y”命令。(需root/sudo权限安装),升级pip3运行"sudo pip3 install --upgrade pip"。 或按官网方式安装Python包管理工具:下载"curlhttps://bootstrap.pypa.io/get-pip.py-o get-pip.py"后,再执行"python get-pip.py" 安装python模块setuptools,运行"pip3 install setuptools" 运行“sudo pip3 install kconfiglib”命令,安装GUI menuconfig工具,建议安装Kconfiglib 13.2.0+版本。(需root/sudo权限安装)。 或者按以下方法安装Kconfiglib 13.2.0+。 下载.whl文件(例如:kconfiglib-13.2.0-py2.py3-none-any.whl)。 下载路径:“https://pypi.org/project/kconfiglib#files” 运行“sudo pip3 install kconfiglib-xxx.whl”命令(例如:sudo pip3 install kconfiglib-13.2.0-py2.py3-none-any.whl),安装.whl文件(需root/sudo权限安装)。 可能会遇到错误:"subprocess.CalledProcessError: Command '('lsb_release', '-a')' returned non-zero exit status 1.",解决方法:"find / -name lsb_release",找到lsb_release位置并删除,如:"rm -rf /usr/bin/lsb_release" 安装pycryptodome。运行“sudo pip3 install pycryptodome”命令,或者按照以下方式安装: 说明: 安装升级文件签名依赖的Python组件包,包括:pycryptodome、six、ecdsa。 安装ecdsa依赖six,请按文档要求,先安装six,再安装ecdsa。 下载.whl文件(例如:pycryptodome-3.7.3-cp37-cp37m-manylinux1_x86_64.whl)。 下载路径:“https://pypi.org/project/pycryptodome/#files”。 运行“sudo pip3 install pycryptodome-xxx.whl”命令(例如:sudo pip3 install pycryptodome-3.7.3-cp37-cp37m-manylinux1_x86_64.whl),安装.whl文件(需root/sudo权限安装)。 安装完成后界面会提示“Successfully installed pycryptodome-3.7.3”。 安装six。运行"sudo pip3 install six --upgrade --ignore-installed six"或者按照以下方式安装: 下载.whl文件(例如:six-1.12.0-py2.py3-none-any.whl)。 下载路径:“https://pypi.org/project/six/#files” 运行“sudo pip3 install six-xxx.whl”命令(例如:sudo pip3 install six-1.12.0-py2.py3-none-any.whl),安装.whl文件(需root/sudo权限安装)。 安装完成后界面会提示“Successfully installed six-1.12.0”。 安装ecdsa。运行"sudo pip3 install ecdsa"或者按照以下方式安装: 下载.whl文件(例如:ecdsa-0.14.1-py2.py3-none-any.whl)。 下载路径:“https://pypi.org/project/ecdsa/#files” 运行“sudo pip3 install ecdsa-xxx.whl”命令(例如:sudo pip3 install ecdsa-0.14.1-py2.py3-none-any.whl),安装.whl文件(需root/sudo权限安装)。 安装完成后界面会提示“Successfully installed ecdsa-0.14.1”。 安装Scons 打开Linux编译服务器终端。 安装SCons安装包(需root/sudo权限安装)。 运行命令:“sudo apt-get install scons -y”。如果软件源中无法找到安装包,请按以下步骤处理: 下载源码包(下载路径:“https://scons.org/pages/download.html”,推荐SCons版本是3.0.4+)。 解压源码包到任意目录。 安装源码包:进入解压目录,运行命令“sudo python3 setup.py install”(需root/sudo权限安装),等待安装完毕。 输入命令“scons -v”,查看是否安装成功。如果安装成功,查询结果下图所示。 图 5SCons安装成功界面 安装编译工具环境 须知: 如果后续通过“HPM组件方式”或“HPM包管理器命令行工具方式”获取源码,不需要安装gn、ninja、gcc_riscv32编译工具。 (推荐)如果后续通过“镜像站点方式”或“代码仓库方式”获取源码,需要安装gn、ninja、gcc_riscv32编译工具。 安装gn、ninja、gcc_riscv32编译工具时,请确保编译工具的环境变量路径唯一。 安装gn 打开Linux编译服务器终端。 下载gn工具。 解压gn安装包至~/gn路径下:"tar -xvf gn.1523.tar -C ~/"。 设置环境变量:"vim ~/.bashrc", 新增:"export PATH=~/gn:$PATH"。 生效环境变量:"source ~/.bashrc"。 安装ninja 打开Linux编译服务器终端 下载ninja工具。 解压ninja安装包至~/ninja路径下:"tar -xvf ninja.1.9.0.tar -C ~/"。 设置环境变量:"vim ~/.bashrc", 新增:"export PATH=~/ninja:$PATH"。 生效环境变量:"source ~/.bashrc"。 安装gcc_riscv32(WLAN模组类编译工具链) 须知:Hi3861平台仅支持使用libgcc运行时库的静态链接,不建议开发者使用libgcc运行时库的动态链接,会导致商业分发时被GPL V3污染。 打开Linux编译服务器终端。 下载gcc_riscv32工具。 解压gcc_riscv32安装包至/opt/gcc_riscv32路径下:"tar -xvf gcc_riscv32-linux-7.3.0.tar.gz -C ~/"。 设置环境变量:"vim ~/.bashrc",新增:"export PATH=~/gcc_riscv32/bin:$PATH"。 生效环境变量:"source ~/.bashrc"。 Shell命令行中输入“riscv32-unknown-elf-gcc -v”,如果能正确显示编译器版本号,表明编译器安装成功。

优秀的个人博客,低调大师

《HarmonyOS 第一课之首席专家讲鸿蒙》重磅上线! 首席专家解码鸿蒙底层设计原理,赋能开发者迈向技术新高度

******************************************************************************************************************** ******************************************************************************************************************** ******************************************************************************************************************** ********************************************************************************************************************

优秀的个人博客,低调大师

HBase最佳实践

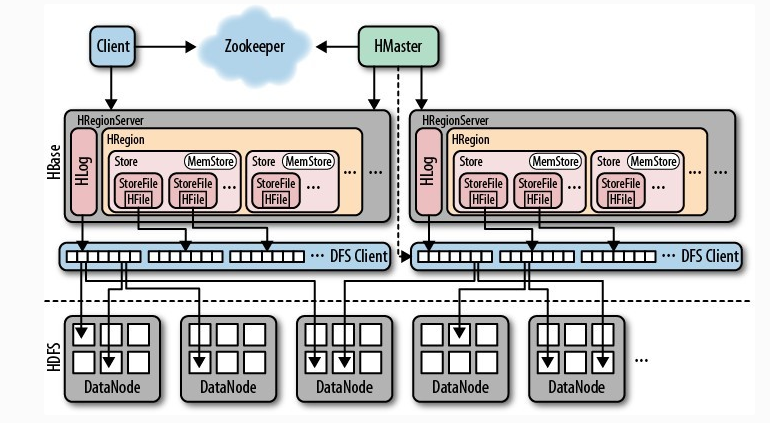
本文致力于从架构原理、集群部署、性能优化与使用技巧等方面,阐述在如何基于HBase构建 容纳大规模数据、支撑高并发、毫秒响应、稳定高效的OLTP实时系统 。 一、架构原理 1.1 基本架构 从上层往下可以看到HBase架构中的角色分配为: Client Zookeeper HMaster RegionServer HDFS Client Client是执行查询、写入等对HBase表数据进行增删改查的使用方,可以是使用HBase Client API编写的程序,也可以是其他开发好的HBase客户端应用。 Zookeeper 同HDFS一样,HBase使用Zookeeper作为集群协调与管理系统。 在HBase中其主要的功能与职责为: 存储整个集群HMaster与RegionServer的运行状态 实现HMaster的故障恢复与自动切换 为Client提供元数据表的存储信息 HMaster、RegionServer启动之后将会在Zookeeper上注册并创建节点(/hbasae/master 与 /hbase/rs/*),同时 Zookeeper 通过Heartbeat的心跳机制来维护与监控节点状态,一旦节点丢失心跳,则认为该节点宕机或者下线,将清除该节点在Zookeeper中的注册信息。 当Zookeeper中任一RegionServer节点状态发生变化时,HMaster都会收到通知,并作出相应处理,例如RegionServer宕机,HMaster重新分配Regions至其他RegionServer以保证集群整体可用性。 当HMaster宕机时(Zookeeper监测到心跳超时),Zookeeper中的 /hbasae/master 节点将会消失,同时Zookeeper通知其他备用HMaster节点,重新创建 /hbasae/master 并转化为active master。 协调过程示意图如下: 除了作为集群中的协调者,Zookeeper还为Client提供了 hbase:meta 表的存储信息。 客户端要访问HBase中的数据,只需要知道Zookeeper集群的连接信息,访问步骤如下: 客户端将从Zookeeper(/hbase/meta-region-server)获得 hbase:meta 表存储在哪个RegionServer,缓存该位置信息 查询该RegionServer上的 hbase:meta 表数据,查找要操作的 rowkey所在的Region存储在哪个RegionServer中,缓存该位置信息 在具体的RegionServer上根据rowkey检索该Region数据 可以看到,客户端操作数据过程并不需要HMaster的参与,通过Zookeeper间接访问RegionServer来操作数据。 第一次请求将会产生3次RPC,之后使用相同的rowkey时客户端将直接使用缓存下来的位置信息,直接访问RegionServer,直至缓存失效(Region失效、迁移等原因)。 通过Zookeeper的读写流程如下: hbase:meta 表 hbase:meta 表存储了集群中所有Region的位置信息。 表结构如下: Rowkey格式:tableName,regionStartKey,regionId 第一个region的regionStartKey为空 示例:ns1:testTable,,xxxxreigonid 只有一个列族info,包含三个列: regioninfo:RegionInfo的proto序列化格式,包含regionId,tableName,startKey,endKey,offline,split,replicaId等信息 server:RegionServer对应的server:port serverstartcode:RegionServer的启动时间戳 简单总结Zookeeper在HBase集群中的作用如下: 对于服务端,是实现集群协调与控制的重要依赖。 对于客户端,是查询与操作数据必不可少的一部分。 HMaster HBase整体架构中HMaster的功能与职责如下: 管理RegionServer,监听其状态,保证集群负载均衡且高可用。 管理Region,如新Region的分配、RegionServer宕机时该节点Region的分配与迁移 接收客户端的DDL操作,如创建与删除表、列簇等信息 权限控制 如我们前面所说的,HMaster 通过 Zookeeper 实现对集群中各个 RegionServer 的监控与管理,在 RegionServer 发生故障时可以发现节点宕机并转移 Region 至其他节点,以保证服务的可用性。 但是HBase的故障转移并不是无感知的,相反故障转移过程中,可能会直接影响到线上请求的稳定性,造成段时间内的大量延迟。 在分布式系统的 CAP定理 中(Consistency一致性、Availability可用性、Partition tolerance分区容错性),分布式数据库基本特性都会实现P,但是不同的数据库对于A和C各有取舍。如HBase选择了C,而通过Zookeeper这种方式来辅助实现A(虽然会有一定缺陷),而Cassandra选择了A,通过其他辅助措施实现了C,各有优劣。 对于HBase集群来说,HMaster是一个内部管理者,除了DDL操作并不对外(客户端)开放,因而HMaster的负载是比较低的。 造成HMaster压力大的情况可能是集群中存在多个(两个或者三个以上)HMaster,备用的Master会定期与Active Master通信以获取最新的状态信息,以保证故障切换时自身的数据状态是最新的,因而Active Master可能会收到大量来自备用Master的数据请求。 RegionServer RegionServer在HBase集群中的功能与职责: 根据HMaster的region分配请求,存放和管理Region 接受客户端的读写请求,检索与写入数据,产生大量IO 一个RegionServer中存储并管理者多个Region,是HBase集群中真正 存储数据、接受读写请求 的地方,是HBase架构中最核心、同时也是最复杂的部分。 RegionServer内部结构图如下: BlockCache BlockCache为RegionServer中的 读缓存,一个RegionServer共用一个BlockCache。 RegionServer处理客户端读请求的过程: 1. 在BlockCache中查询是否命中缓存 2. 缓存未命中则定位到存储该数据的Region 3. 检索Region Memstore中是否有所需要的数据 4. Memstore中未查得,则检索Hfiles 5. 任一过程查询成功则将数据返回给客户端并缓存至BlockCache BlockCache有两种实现方式,有不同的应用场景,各有优劣: On-Heap的LRUBlockCache 优点:直接中Java堆内内存获取,响应速度快 缺陷:容易受GC影响,响应延迟不稳定,特别是在堆内存巨大的情况下 适用于:写多读少型、小内存等场景 Off-Heap的BucketCache 优点:无GC影响,延迟稳定 缺陷:从堆外内存获取数据,性能略差于堆内内存 适用于:读多写少型、大内存等场景 我们将在「性能优化」一节中具体讨论如何判断应该使用哪种内存模式。 WAL 全称 Write Ahead Log ,是 RegionServer 中的预写日志。 所有写入数据默认情况下都会先写入WAL中,以保证RegionServer宕机重启之后可以通过WAL来恢复数据,一个RegionServer中共用一个WAL。 RegionServer的写流程如下: 1. 将数据写入WAL中 2. 根据TableName、Rowkey和ColumnFamily将数据写入对应的Memstore中 3. Memstore通过特定算法将内存中的数据刷写成Storefile写入磁盘,并标记WAL sequence值 4. Storefile定期合小文件 WAL会通过 日志滚动 的操作定期对日志文件进行清理(已写入HFile中的数据可以清除),对应HDFS上的存储路径为 /hbase/WALs/${HRegionServer_Name} 。 Region 一个Table由一个或者多个Region组成,一个Region中可以看成是Table按行切分且有序的数据块,每个Region都有自身的StartKey、EndKey。 一个Region由一个或者多个Store组成,每个Store存储该Table对应Region中一个列簇的数据,相同列簇的列存储在同一个Store中。 同一个Table的Region会分布在集群中不同的RegionServer上以实现读写请求的负载均衡。故,一个RegionServer中将会存储来自不同Table的N多个Region。 Store、Region与Table的关系可以表述如下:多个Store(列簇)组成Region,多个Region(行数据块)组成完整的Table。 其中,Store由Memstore(内存)、StoreFile(磁盘)两部分组成。 在RegionServer中,Memstore可以看成指定Table、Region、Store的写缓存(正如BlockCache小节中所述,Memstore还承载了一些读缓存的功能),以RowKey、Column Family、Column、Timestamp进行排序。如下图所示: 写请求到RegionServer之后并没有立刻写入磁盘中,而是先写入内存中的Memstore(内存中数据丢失问题可以通过回放WAL解决)以提升写入性能。 Region中的Memstore会根据特定算法将内存中的数据将会刷写到磁盘形成Storefile文件,因为数据在Memstore中为已排序,顺序写入磁盘性能高、速度快。 在这种 Log-Structured Merge Tree架构模式 下 随机写入 HBase拥有相当高的性能。 Memstore刷磁盘形成的StoreFile 以HFile格式存储HBase的KV数据 于HDFS之上。 HDFS HDFS为HBase提供底层存储系统,通过HDFS的高可用、高可靠等特性,保障了HBase的数据安全、容灾与备份。 1.2 写数据 与 Memstore Flush 对于客户端来说,将请求发送到需要写入的RegionServer中,等待RegionServer写入WAL、Memstore之后即返回写入成功的ack信号。 对于RegionServer来说,写入的数据还需要经过一系列的处理步骤。 首先我们知道Memstore是在内存中的,将数据放在内存中可以得到优异的读写性能,但是同样也会带来麻烦: 内存中的数据如何防止断电丢失 将数据存储于内存中的代价是高昂的,空间总是有限的 对于第一个问题,虽然可以通过WAL机制在重启的时候进行数据回放,但是对于第二个问题,则必须将内存中的数据持久化到磁盘中。 在不同情况下,RegionServer通过不同级别的刷写策略对Memstore中的数据进行持久化,根据触发刷写动作的时机以及影响范围,可以分为不同的几个级别: Memstore级别:Region中任意一个MemStore达到了 hbase.hregion.memstore.flush.size 控制的上限(默认128MB),会触发Memstore的flush。 Region级别:Region中Memstore大小之和达到了 hbase.hregion.memstore.block.multiplier hbase.hregion.memstore.flush.size 控制的上限(默认 2 128M = 256M),会触发Memstore的flush。 RegionServer级别:Region Server中所有Region的Memstore大小总和达到了 hbase.regionserver.global.memstore.upperLimit * hbase_heapsize 控制的上限(默认0.4,即RegionServer 40%的JVM内存),将会按Memstore由大到小进行flush,直至总体Memstore内存使用量低于 hbase.regionserver.global.memstore.lowerLimit * hbase_heapsize 控制的下限(默认0.38, 即RegionServer 38%的JVM内存)。 RegionServer中HLog数量达到上限:将会选取最早的 HLog对应的一个或多个Region进行flush(通过参数hbase.regionserver.maxlogs配置)。 HBase定期flush:确保Memstore不会长时间没有持久化,默认周期为1小时。为避免所有的MemStore在同一时间都进行flush导致的问题,定期的flush操作有20000左右的随机延时。 手动执行flush:用户可以通过shell命令 flush ‘tablename’或者flush ‘region name’分别对一个表或者一个Region进行flush。 Memstore刷写时会阻塞线上的请求响应,由此可以看到,不同级别的刷写对线上的请求会造成不同程度影响的延迟: 对于Memstore与Region级别的刷写,速度是比较快的,并不会对线上造成太大影响 对于RegionServer级别的刷写,将会阻塞发送到该RegionServer上的所有请求,直至Memstore刷写完毕,会产生较大影响 所以在Memstore的刷写方面,需要尽量避免出现RegionServer级别的刷写动作。 数据在经过Memstore刷写到磁盘时,对应的会写入WAL sequence的相关信息,已经持久化到磁盘的数据就没有必要通过WAL记录的必要。 RegionServer会根据这个sequence值对WAL日志进行滚动清理,防止WAL日志数量太多,RegionServer启动时加载太多数据信息。 同样,在Memstore的刷写策略中可以看到,为了防止WAL日志数量太多,达到指定阈值之后将会选择WAL记录中最早的一个或者多个Region进行刷写。 1.3 读数据 与 Bloom Filter 经过前文的了解,我们现在可以知道HBase中一条数据完整的读取操作流程中,Client会和Zookeeper、RegionServer等发生多次交互请求。 基于HBase的架构,一条数据可能存在RegionServer中的三个不同位置: 对于刚读取过的数据,将会被缓存到BlockCache中 对于刚写入的数据,其存在Memstore中 对于之前已经从Memstore刷写到磁盘的,其存在于HFiles中 RegionServer接收到的一条数据查询请求,只需要从以上三个地方检索到数据即可,在HBase中的检索顺序依次是:BlockCache -> Memstore -> HFiles。 其中,BlockCache、Memstore都是直接在内存中进行高性能的数据检索。 而HFiles则是真正存储在HDFS上的数据: 检索HFiles时会产生真实磁盘的IO操作 Memstore不停刷写的过程中,将会产生大量的HFile 如何在大量的HFile中快速找到所需要的数据呢? 为了提高检索HFiles的性能,HBase支持使用 Bloom Fliter 对HFiles进行快读定位。 Bloom Filter(布隆过滤器)是一种数据结构,常用于大规模数据查询场景,其能够快速判断一个元素一定不在集合中,或者可能在集合中。 Bloom Filter由 一个长度为m的位数组 和 k个哈希函数 组成。 其工作原理如下: 原始集合写入一个元素时,Bloom Filter同时将该元素 经过k个哈希函数映射成k个数字,并以这些数字为下标,将 位数组 中对应下标的元素标记为1 当需要判断一个元素是否存在于原始集合中,只需要将该元素经过同样的 k个哈希函数得到k个数字 取 位数组 中对应下标的元素,如果都为1,则表示元素可能存在 如果存在其中一个元素为0,则该元素不可能存在于原始集合中 因为哈希碰撞问题,不同的元素经过相同的哈希函数之后可能得到相同的值 对于集合外的一个元素,如果经过 k个函数得到的k个数字,对应位数组中的元素都为1,可能是该元素存在于集合中 也有可能是集合中的其他元素”碰巧“让这些下标对应的元素都标记为1,所以只能说其可能存在 对于集合中的不同元素,如果 经过k个函数得到的k个数字中,任意一个重复 位数组 中对应下标的元素会被覆盖,此时该下标的元素不能被删除(即归零) 删除可能会导致其他多个元素在Bloom Filter表示不“存在” 由此可见,Bloom Filter中: 位数组的长度m越大,误差率越小,而存储代价越大 哈希函数的个数k越多,误差率越小,而性能越低 HBase中支持使用以下两种Bloom Filter: ROW:基于 Rowkey 创建的Bloom Filter ROWCOL:基于 Rowkey+Column 创建的Bloom Filter 两者的区别仅仅是:是否使用列信息作为Bloom Filter的条件。 使用ROWCOL时,可以让指定列的查询更快,因为其通过Rowkey与列信息来过滤不存在数据的HFile,但是相应的,产生的Bloom Filter数据会更加庞大。 而只通过Rowkey进行检索的查询,即使指定了ROWCOL也不会有其他效果,因为没有携带列信息。 通过Bloom Filter(如果有的话)快速定位到当前的Rowkey数据存储于哪个HFile之后(或者不存在直接返回),通过HFile携带的 Data Block Index 等元数据信息可快速定位到具体的数据块起始位置,读取并返回(加载到缓存中)。 这就是Bloom Filter在HBase检索数据的应用场景: 高效判断key是否存在 高效定位key所在的HFile 当然,如果没有指定创建Bloom Filter,RegionServer将会花费比较多的力气一个个检索HFile来判断数据是否存在。 1.4 HFile存储格式 通过Bloom Filter快速定位到需要检索的数据所在的HFile之后的操作自然是从HFile中读出数据并返回。 据我们所知,HFile是HDFS上的文件(或大或小都有可能),现在HBase面临的一个问题就是如何在HFile中 快速检索获得指定数据? HBase随机查询的高性能很大程度上取决于底层HFile的存储格式,所以这个问题可以转化为 HFile的存储格式该如何设计,才能满足HBase 快速检索 的需求。 生成一个HFile Memstore内存中的数据在刷写到磁盘时,将会进行以下操作: 会先现在内存中创建 空的Data Block数据块 包含 预留的Header空间。而后,将Memstore中的KVs一个个顺序写满该Block(一般默认大小为64KB)。 如果指定了压缩或者加密算法,Block数据写满之后将会对整个数据区做相应的压缩或者加密处理。 随后在预留的Header区写入该Block的元数据信息,如 压缩前后大小、上一个block的offset、checksum 等。 内存中的准备工作完成之后,通过HFile Writer输出流将数据写入到HDFS中,形成磁盘中的Data Block。 为输出的Data Block生成一条索引数据,包括 {startkey、offset、size} 信息,该索引数据会被暂时记录在内存中的Block Index Chunk中。 至此,已经完成了第一个Data Block的写入工作,Memstore中的 KVs 数据将会按照这个过程不断进行 写入内存中的Data Block -> 输出到HDFS -> 生成索引数据保存到内存中的Block Index Chunk 流程。 值得一提的是,如果启用了Bloom Filter,那么 Bloom Filter Data(位图数据) 与 Bloom元数据(哈希函数与个数等) 将会和 KVs 数据一样被处理:写入内存中的Block -> 输出到HDFS Bloom Data Block -> 生成索引数据保存到相对应的内存区域中。 由此我们可以知道,HFile写入过程中,Data Block 和 Bloom Data Block 是交叉存在的。 随着输出的Data Block越来越多,内存中的索引数据Block Index Chunk也会越来越大。 达到一定大小之后(默认128KB)将会经过类似Data Block的输出流程写入到HDFS中,形成 Leaf Index Block (和Data Block一样,Leaf Index Block也有对应的Header区保留该Block的元数据信息)。 同样的,也会生成一条该 Leaf Index Block 对应的索引记录,保存在内存中的 Root Block Index Chunk。 Root Index -> Leaf Data Block -> Data Block 的索引关系类似 B+树 的结构。得益于多层索引,HBase可以在不读取整个文件的情况下查找数据。 随着内存中最后一个 Data Block、Leaf Index Block 写入到HDFS,形成 HFile 的 Scanned Block Section。 Root Block Index Chunk 也会从内存中写入HDFS,形成 HFile 的 Load-On-Open Section 的一部分。 至此,一个完整的HFile已经生成,如下图所示: 检索HFile 生成HFile之后该如何使用呢? HFile的索引数据(包括 Bloom Filter索引和数据索引信息)会在 Region Open 的时候被加载到读缓存中,之后数据检索经过以下过程: 所有的读请求,如果读缓存和Memstore中不存在,那么将会检索HFile索引 通过Bloom Filter索引(如果有设置Bloom Filter的话)检索Bloom Data以 快速定位HFile是否存在 所需数据 定位到数据可能存在的HFile之后,读取该HFile的 三层索引数据,检索数据是否存在 存在则根据索引中的 元数据 找到具体的 Data Block 读入内存,取出所需的KV数据 可以看到,在HFile的数据检索过程中,一次读请求只有 真正确认数据存在 且 需要读取硬盘数据的时候才会 执行硬盘查询操作。 同时,得益于 分层索引 与 分块存储,在Region Open加载索引数据的时候,再也不必和老版本(0.9甚至更早,HFile只有一层数据索引并且统一存储)一样加载所有索引数据到内存中导致启动缓慢甚至卡机等问题。 1.5 HFile Compaction Bloom Filter解决了如何在大量的HFile中快速定位数据所在的HFile文件,虽然有了Bloom Filter的帮助大大提升了检索效率,但是对于RegionServer来说 要检索的HFile数量并没有减少。 为了再次提高HFile的检索效率,同时避免大量小文件的产生造成性能低下,RegionServer会通过 Compaction机制 对HFile进行合并操作。 常见的Compaction触发方式有: Memstore Flush检测条件执行 RegionServer定期检查执行 用户手动触发执行 Minor Compaction Minor Compaction 只执行简单的文件合并操作,选取较小的HFiles,将其中的数据顺序写入新的HFile后,替换老的HFiles。 但是如何在众多HFiles中选择本次Minor Compaction要合并的文件却有不少讲究: 首先排除掉文件大小 大于 hbase.hstore.compaction.max.size 值的HFile 将HFiles按照 文件年龄排序(older to younger),并从older file开始选择 如果该文件大小 小于 hbase.hstore.compaction.min 则加入Minor Compaction中 如果该文件大小 小于 后续hbase.hstore.compaction.max 个HFile大小之和 * hbase.hstore.compaction.ratio,则将该文件加入Minor Compaction中 扫描过程中,如果需要合并的HFile文件数 达到 hbase.hstore.compaction.max(默认为10) 则开始合并过程 扫描结束后,如果需要合并的HFile的文件数 大于 hbase.hstore.compaction.min(默认为3) 则开始合并过程 通过 hbase.offpeak.start.hour、hbase.offpeak.end.hour 设置高峰、非高峰时期,使 hbase.hstore.compaction.ratio的值在不同时期灵活变化(高峰值1.2、非高峰值5) 可以看到,Minor Compaction不会合并过大的HFile,合并的HFile数量也有严格的限制,以避免产生太大的IO操作,Minor Compaction经常在Memstore Flush后触发,但不会对线上读写请求造成太大延迟影响。 Major Compaction 相对于Minor Compaction 只合并选择的一部分HFile合并、合并时只简单合并数据文件的特点,Major Compaction则将会把Store中的所有HFile合并成一个大文件,将会产生较大的IO操作。 同时将会清理三类无意义数据:被删除的数据、TTL过期数据、版本号超过设定版本号的数据,Region Split过程中产生的Reference文件也会在此时被清理。 Major Compaction定期执行的条件由以下两个参数控制: hbase.hregion.majorcompaction:默认7天 hbase.hregion.majorcompaction.jitter:默认为0.2 集群中各个RegionServer将会在 hbase.hregion.majorcompaction +- hbase.hregion.majorcompaction * hbase.hregion.majorcompaction.jitter 的区间浮动进行Major Compaction,以避免过多RegionServer同时进行,造成较大影响。 Major Compaction 执行时机触发之后,简单来说如果当前Store中HFile的最早更新时间早于某个时间值,就会执行Major Compaction,该时间值为 hbase.hregion.majorcompaction * hbase.hregion.majorcompaction.jitter 。 手动触发的情况下将会直接执行Compaction。 Compaction的优缺点 HBase通过Compaction机制使底层HFile文件数保持在一个稳定的范围,减少一次读请求产生的IO次数、文件Seek次数,确保HFiles文件检索效率,从而实现高效处理线上请求。 如果没有Compaction机制,随着Memstore刷写的数据越来越多,HFile文件数量将会持续上涨,一次读请求生产的IO操作、Seek文件的次数将会越来越多,反馈到线上就是读请求延迟越来越大。 然而,在Compaction执行过程中,不可避免的仍然会对线上造成影响。 对于Major Compaction来说,合并过程将会占用大量带宽、IO资源,此时线上的读延迟将会增大。 对于Minor Compaction来说,如果Memstore写入的数据量太多,刷写越来越频繁超出了HFile合并的速度 即使不停地在合并,但是HFile文件仍然越来越多,读延迟也会越来越大 HBase通过 hbase.hstore.blockingStoreFiles(默认7) 来控制Store中的HFile数量 超过配置值时,将会堵塞Memstore Flush阻塞flush操作 ,阻塞超时时间为 hbase.hstore.blockingWaitTime 阻塞Memstore Flush操作将会使Memstore的内存占用率越来越高,可能导致完全无法写入 简而言之,Compaction机制保证了HBase的读请求一直保持低延迟状态,但付出的代价是Compaction执行期间大量的读延迟毛刺和一定的写阻塞(写入量巨大的情况下)。 1.6 Region Split HBase通过 LSM-Tree架构提供了高性能的随机写,通过缓存、Bloom Filter、HFile与Compaction等机制提供了高性能的随机读。 至此,HBase已经具备了作为一个高性能读写数据库的基本条件。如果HBase仅仅到此为止的话,那么其也只是个在架构上和传统数据库有所区别的数据库而已,作为一个高性能读写的分布式数据库来说,其拥有近乎可以无限扩展的特性。 支持HBase进行自动扩展、负载均衡的是Region Split机制。 Split策略与触发条件 在HBase中,提供了多种Split策略,不同的策略触发条件各不相同。 如上图所示,不同版本中使用的默认策略在变化。 ConstantSizeRegionSplitPolicy 固定值策略,阈值默认大小 hbase.hregion.max.filesize 优点:简单实现 缺陷:考虑片面,小表不切分、大表切分成很多Region,线上使用弊端多 IncreasingToUpperBoundRegionSplitPolicy 非固定阈值 计算公式 min(R^2 * memstore.flush.size, region.split.size) R为Region所在的Table在当前RegionServer上Region的个数 最大大小 hbase.hregion.max.filesize 优点:自动适应大小表,对于Region个数多的阈值大,Region个数少的阈值小 缺陷:对于小表来说会产生很多小region SteppingSplitPolicy: 非固定阈值 如果Region个数为1,则阈值为 memstore.flush.size * 2 否则为 region.split.size 优点:对大小表更加友好,小表不会一直产生小Region 缺点:控制力度比较粗 可以看到,不同的切分策略其实只是在寻找切分Region时的阈值,不同的策略对阈值有不同的定义。 切分点 切分阈值确认完之后,首先要做的是寻找待切分Region的切分点。 HBase对Region的切分点定义如下: Region中最大的Store中,最大的HFile中心的block中,首个Rowkey 如果最大的HFile只有一个block,那么不切分(没有middle key) 得到切分点之后,核心的切分流程分为 prepare - execute - rollback 三个阶段。 prepare阶段 在内存中初始化两个子Region(HRegionInfo对象),准备进行切分操作。 execute阶段 execute阶段执行流程较为复杂,具体实施步骤为: RegionServer在Zookeeper上的 /hbase/region-in-transition 节点中标记该Region状态为SPLITTING。 HMaster监听到Zookeeper节点发生变化,在内存中修改此Region状态为RIT。 在该Region的存储路径下创建临时文件夹 .split 父Region close,flush所有数据到磁盘中,停止所有写入请求。 在父Region的 .split文件夹中生成两个子Region文件夹,并写入reference文件 reference是一个特殊的文件,体现在其文件名与文件内容上 文件名组成:${父Region对应切分点所在的HFile文件}.${父Region} 文件内容:[splitkey]切分点rowkey,[top?]true/false,true为top上半部分,false为bottom下半部分 根据reference文件名,可以快速找到对应的父Region、其中的HFile文件、HFile切分点,从而确认该子Region的数据范围 数据范围确认完毕之后进行正常的数据检索流程(此时仍然检索父Region的数据) 将子Region的目录拷贝到HBase根目录下,形成新的Region 父Regin通知修改 hbase:meta 表后下线,不再提供服务 此时并没有删除父Region数据,仅在表中标记split列、offline列为true,并记录两个子region 两个子Region上线服务 通知 hbase:meta 表标记两个子Region正式提供服务 rollback阶段 如果execute阶段出现异常,则执行rollback操作,保证Region切分整个过程是具备事务性、原子性的,要么切分成功、要么回到未切分的状态。 region切分是一个复杂的过程,涉及到父region切分、子region生成、region下线与上线、zk状态修改、元数据状态修改、master内存状态修改 等多个子步骤,回滚程序会根据当前进展到哪个子阶段清理对应的垃圾数据。 为了实现事务性,HBase设计了使用状态机(SplitTransaction类)来保存切分过程中的每个子步骤状态。这样一来一旦出现异常,系统可以根据当前所处的状态决定是否回滚,以及如何回滚。 但是目前实现中,中间状态是存储在内存中,因此一旦在切分过程中RegionServer宕机或者关闭,重启之后将无法恢复到切分前的状态。即Region切分处于中间状态的情况,也就是RIT。 由于Region切分的子阶段很多,不同阶段解决RIT的处理方式也不一样,需要通过hbck工具进行具体查看并分析解决方案。 好消息是HBase2.0之后提出了新的分布式事务框架Procedure V2,将会使用HLog存储事务中间状态,从而保证事务处理中宕机重启后可以进行回滚或者继续处理,从而减少RIT问题产生。 父Region清理 从以上过程中我们可以看到,Region的切分过程并不会父Region的数据到子Region中,只是在子Region中创建了reference文件,故Region切分过程是很快的。 只有进行Major Compaction时才会真正(顺便)将数据切分到子Region中,将HFile中的kv顺序读出、写入新的HFile文件。 RegionServer将会定期检查 hbase:meta 表中的split和offline为true的Region,对应的子Region是否存在reference文件,如果不存在则删除父Region数据。 负载均衡 Region切分完毕之后,RegionServer上将会存在更多的Region块,为了避免RegionServer热点,使请求负载均衡到集群各个节点上,HMaster将会把一个或者多个子Region移动到其他RegionServer上。 移动过程中,如果当前RegionServer繁忙,HMaster将只会修改Region的元数据信息至其他节点,而Region数据仍然保留在当前节点中,直至下一次Major Compaction时进行数据移动。 至此,我们已经揭开了HBase架构与原理的大部分神秘面纱,在后续做集群规划、性能优化与实际应用中,为什么这么调整以及为什么这么操作 都将一一映射到HBase的实现原理上。 如果你希望了解HBase的更多细节,可以参考《HBase权威指南》。 二、集群部署 经过冗长的理论初步了解过HBase架构与工作原理之后,搭建HBase集群是使用HBase的第一个步骤。 需要注意的是,HBase集群一旦部署使用,再想对其作出调整需要付出惨痛代价(线上环境中),所以如何部署HBase集群是使用的第一个关键步骤。 2.1 集群物理架构 硬件混合型+软件混合型集群 硬件混合型 指的是该集群机器配置参差不齐,混搭结构。 软件混合型 指的是该集群部署了一套类似CDH全家桶套餐。 如以下的集群状况: 集群规模:30 部署服务:HBase、Spark、Hive、Impala、Kafka、Zookeeper、Flume、HDFS、Yarn等 硬件情况:内存、CPU、磁盘等参差不齐,有高配有低配,混搭结构 这个集群不管是规模、还是服务部署方式相信都是很多都有公司的「标准」配置。 那么这样的集群有什么问题呢? 如果仅仅HBase是一个非「线上」的系统,或者充当一个历史冷数据存储的大数据库,这样的集群其实一点问题也没有,因为对其没有任何苛刻的性能要求。 但是如果希望HBase作为一个线上能够承载海量并发、实时响应的系统,这个集群随着使用时间的增加很快就会崩溃。 从 硬件混合型 来说,一直以来Hadoop都是以宣称能够用低廉、老旧的机器撑起一片天。 这确实是Hadoop的一个大优势,然而前提是作为离线系统使用。 离线系统的定义,即跑批的系统,如:Spark、Hive、MapReduce等,没有很强的时间要求,显著的吞吐量大,延迟高。 因为没有实时性要求,几台拖拉机跑着也没有问题,只要最后能出结果并且结果正确就OK。 那么在我们现在的场景中,对HBase的定义已经不是一个离线系统,而是一个实时系统。 对于一个硬性要求很高的实时系统来说,如果其中几台老机器拖了后腿也会引起线上响应的延迟。 统一高配硬件+软件混合型集群 既然硬件拖后腿,那么硬件升级自然是水到渠成。 现在我们有全新的高配硬件可以使用,参考如下: 集群规模:30 部署服务:HBase、Spark、Hive、Impala、Kafka、Zookeeper、Flume、HDFS、Yarn等 硬件情况:内存、CPU、磁盘统一高配置 这样的集群可能还会存在什么问题呢? 从 软件混合型 来说,离线任务最大的特点就是吞吐量特别高,瞬间读写的数据量可以把IO直接撑到10G/s,最主要的影响因素就是大型离线任务带动高IO将会影响HBase的响应性能。 如果仅止步于此,那么线上的表现仅仅为短暂延迟,真正令人窒息的操作是,如果离线任务再把CPU撑爆,RegionServer节点可能会直接宕机,造成严重的生产影响。 存在的另外一种情况是,离线任务大量读写磁盘、读写HDFS,导致HBase IO连接异常也会造成RegionServer异常(HBase日志反应HDFS connection timeout,HDFS日志反应IO Exception),造成线上故障。 根据观测,集群磁盘IO到4G以上、集群网络IO 8G以上、HDFS IO 5G以上任意符合一个条件,线上将会有延迟反应。 因为离线任务运行太过强势导致RegionServer宕机无法解决,那么能采取的策略只能是重新调整离线任务的执行使用资源、执行顺序等,限制离线计算能力来满足线上的需求。同时还要限制集群的CPU的使用率,可能出现某台机器CPU打满后整个机器假死致服务异常,造成线上故障。 软、硬件独立的HBase集群 简而言之,无论是硬件混合型还是软件混合型集群,其可能因为各种原因带来的延迟影响,对于一个高性能要求的HBase来说,都是无法忍受的。 所以在集群规划初始就应该考虑到种种情况,最好使用独立的集群部署HBase。 参考如下一组集群规模配置: 集群规模:15+5(RS+ZK) 部署服务:HBase、HDFS(另5台虚拟Zookeeper) 硬件情况:除虚拟机外,物理机统一高配置 虽然从可用节点上上来看比之前的参考配置少了一半,但是从集群部署模式上看,最大程度保证HBase的稳定性,从根本上分离了软硬件对HBase所带来的影响,将会拥有比之前两组集群配置 更稳定的响应和更高的性能。 其他硬件推荐 网卡:网卡是容易产生瓶颈的地方,有条件建议使用双万兆网卡 磁盘:没有特殊要求,空间越大越好,转速越高越好 内存:不需要大容量内存,建议32-128G(详见下文) CPU:CPU核数越多越好,HBase本身压缩数据、合并HFile等都需要CPU资源。 电源:建议双电源冗余 另外值得注意的是,Zookeeper节点建议设置5个节点,5个节点能保证Leader快速选举,并且最多可以允许2个节点宕机的情况下正常使用。 硬件上可以选择使用虚拟机,因为zk节点本身消耗资源并不大,不需要高配机器。但是5个虚拟节点不能在一个物理机上,防止物理机宕机影响所有zk节点。 2.2 安装与部署 以CDH集群为例安装HBase。 使用自动化脚本工具进行安装操作: # 获取安装脚本,上传相关安装软件包至服务器(JDK、MySQL、CM、CDH等) yum install -y git git clone https://github.com/chubbyjiang/cdh-deploy-robot.git cd cdh-deploy-robot # 编辑节点主机名 vi hosts # 修改安装配置项 vi deploy-robot.cnf # 执行 sh deploy-robot.sh install_all 安装脚本将会执行 配置SSH免密登录、安装软件、操作系统优化、Java等开发环境初始化、MySQL安装、CM服务安装、操作系统性能测试等过程。 脚本操作说明见:CDH集群自动化部署工具 。 等待cloudera-scm-server进程起来后,在浏览器输入 ip:7180 进入CM管理界面部署HDFS、HBase组件即可。 三、性能优化 HBase集群部署完毕运行起来之后,看起来一切顺利,但是所有东西都处于「初始状态」中。 我们需要根据软硬件环境,针对性地对HBase进行 调优设置,以确保其能够以最完美的状态运行在当前集群环境中,尽可能发挥硬件的优势。 为了方便后续配置项计算说明,假设我们可用的集群硬件状况如下: 总内存:256G 总硬盘:1.8T * 12 = 21.6T 可分配内存:256 * 0.75 = 192G HBase可用内存空间:192 * 0.8 = 153G(20%留给HDFS等其他进程) 可用硬盘空间:21.6T * 0.85 = 18.36T 3.1 Region规划 对于Region的大小,HBase官方文档推荐单个在10G-30G之间,单台RegionServer的数量控制在20-300之间(当然,这仅仅是参考值)。 Region过大过小都会有不良影响: 过大的Region 优点:迁移速度快、减少总RPC请求 缺点:compaction的时候资源消耗非常大、可能会有数据分散不均衡的问题 过小的Region 优点:集群负载平衡、HFile比较少compaction影响小 缺点:迁移或者balance效率低、频繁flush导致频繁的compaction、维护开销大 规划Region的大小与数量时可以参考以下算法: 0. 计算HBase可用磁盘空间(单台RegionServer) 1. 设置region最大与最小阈值,region的大小在此区间选择,如10-30G 2. 设置最佳region数(这是一个经验值),如单台RegionServer 200个 3. 从region最小值开始,计算 HBase可用磁盘空间 / (region_size * hdfs副本数) = region个数 4. 得到的region个数如果 > 200,则增大region_size(step可设置为5G),继续计算直至找到region个数最接近200的region_size大小 5. region大小建议不小于10G 当前可用磁盘空间为18T,选择的region大小范围为10-30G,最佳region个数为300。 那么最接近 最佳Region个数300的 region_size 值为30G。 得到以下配置项: hbase.hregion.max.filesize=30G 单节点最多可存储的Region个数约为300 3.2 内存规划 我们知道RegionServer中的BlockCache有两种实现方式: LRUBlockCache:On-Heap BucketCache:Off-Heap 这两种模式的详细说明可以参考 CDH官方文档。 为HBase选择合适的 内存模式 以及根据 内存模式 计算相关配置项是调优中的重要步骤。 首先我们可以根据可用内存大小来判断使用哪种内存模式。 先看 超小内存(假设8G以下) 和 超大内存(假设128G以上) 两种极端情况: 对于超小内存来说,即使可以使用BucketCache来利用堆外内存,但是使用堆外内存的主要目的是避免GC时不稳定的影响,堆外内存的效率是要比堆内内存低的。由于内存总体较小,即使读写缓存都在堆内内存中,GC时也不会造成太大影响,所以可以直接选择LRUBlockCache。 对于超大内存来说,在超大内存上使用LRUBlockCache将会出现我们所担忧的情况:GC时对线上造成很不稳定的延迟影响。这种场景下,应该尽量利用堆外内存作为读缓存,减小堆内内存的压力,所以可以直接选择BucketCache。 在两边的极端情况下,我们可以根据内存大小选择合适的内存模式,那么如果内存大小在合理、正常的范围内该如何选择呢? 此时我们应该主要关注业务应用的类型。 当业务主要为写多读少型应用时,写缓存利用率高,应该使用LRUBlockCache尽量提高堆内写缓存的使用率。 当业务主要为写少读多型应用时,读缓存利用率高(通常也意味着需要稳定的低延迟响应),应该使用BucketCache尽量提高堆外读缓存的使用率。 对于不明确或者多种类型混合的业务应用,建议使用BucketCache,保证读请求的稳定性同时,堆内写缓存效率并不会很低。 当前HBase可使用的内存高达153G,故将选择BucketCache的内存模型来配置HBase,该模式下能够最大化利用内存,减少GC影响,对线上的实时服务较为有利。 得到配置项: hbase.bucketcache.ioengine=offheap: 使用堆外缓存 确认使用的内存模式之后,接下来将通过计算确认 JavaHeap、对外读缓存、堆内写缓存、LRU元数据 等内存空间具体的大小。 内存与磁盘比 讨论具体配置之前,我们从 HBase集群规划 引入一个Disk / JavaHeap Ratio的概念来帮助我们设置内存相关的参数。 理论上我们假设 最优 情况下 硬盘维度下的Region个数 和 JavaHeap维度下的Region个数 相等。 相应的计算公式为: 硬盘容量维度下Region个数: DiskSize / (RegionSize * ReplicationFactor) JavaHeap维度下Region个数: JavaHeap * HeapFractionForMemstore / (MemstoreSize / 2 ) 其中: RegionSize:Region大小,配置项:hbase.hregion.max.filesize ReplicationFactor:HDFS的副本数,配置项:dfs.replication HeapFractionForMemstore:JavaHeap写缓存大小,即RegionServer内存中Memstore的总大小,配置项:hbase.regionserver.global.memstore.lowerLimit MemstoreSize:Memstore刷写大小,配置项:hbase.hregion.memstore.flush.size 现在我们已知条件 硬盘维度和JavaHeap维度相等,求 1 bytes的JavaHeap大小需要搭配多大的硬盘大小 。 已知: DiskSize / (RegionSize * ReplicationFactor) = JavaHeap * HeapFractionForMemstore / (MemstoreSize / 2 ) 求: DiskSize / JavaHeap 进行简单的交换运算可得: DiskSize / JavaHeap = RegionSize / MemstoreSize * ReplicationFactor * HeapFractionForMemstore * 2 以HBase的默认配置为例: RegionSize: 10G MemstoreSize: 128M ReplicationFactor: 3 HeapFractionForMemstore: 0.4 计算: 10G / 128M * 3 * 0.4 * 2 = 192 即理想状态下 RegionServer上 1 bytes的Java内存大小需要搭配192bytes的硬盘大小最合适。 套用到当前集群中,HBase可用内存为152G,在LRUBlockCache模式下,对应的硬盘空间需要为153G * 192 = 29T,这显然是比较不合理的。 在BucketCache模式下,当前 JavaHeap、HeapFractionForMemstore 等值还未确定,我们会根据这个 计算关系和已知条件 对可用内存进行规划和调整,以满足合理的 内存/磁盘比。 已知条件: 内存模式:BucketCache 可用内存大小:153G 可用硬盘大小:18T Region大小:30G ReplicationFactor:3 未知变量: JavaHeap MemstoreSize HeapFractionForMemstore 内存布局 在计算位置变量的具体值之前,我们有必要了解一下当前使用的内存模式中对应的内存布局。 BucketCache模式下,RegionServer的内存划分如下图: 简化版: 写缓存 从架构原理中我们知道,Memstore有4种级别的Flush,需要我们关注的是 Memstore、Region和RegionServer级别的刷写。 其中Memstore和Region级别的刷写并不会对线上造成太大影响,但是需要控制其阈值和刷写频次来进一步提高性能。 而RegionServer级别的刷写将会阻塞请求直至刷写完成,对线上影响巨大,需要尽量避免。 得到以下配置项: hbase.hregion.memstore.flush.size=256M: 控制的Memstore大小默认值为128M,太过频繁的刷写会导致IO繁忙,刷新队列阻塞等。设置太高也有坏处,可能会较为频繁的触发RegionServer级别的Flush,这里设置为256M。 hbase.hregion.memstore.block.multiplier=3: 控制的Region flush上限默认值为2,意味着一个Region中最大同时存储的Memstore大小为2 * MemstoreSize ,如果一个表的列族过多将频繁触发,该值视情况调整。 现在我们设置两个 经验值变量: RegionServer总内存中JavaHeap的占比=0.35 JavaHeap最大大小=56G:超出此值表示GC有风险 计算得JavaHeap的大小为 153 * 0.35 = 53.55 ,没有超出预期的最大JavaHeap。如果超过最大期望值,则使用最大期望值代替,得JavaHeap大小为53G。 现在JavaHeap、MemstoreSize已知,可以得到唯一的位置变量 HeapFractionForMemstore 的值为 0.48 。 得到以下配置项: RegionServer JavaHeap堆栈大小: 53G hbase.regionserver.global.memstore.upperLimit=0.58: 整个RS中Memstore最大比例,比lower大5-15% hbase.regionserver.global.memstore.lowerLimit=0.48: 整个RS中Memstore最小比例 写缓存大小为 53 * 0.48 = 25.44G 读缓存配置 当前内存信息如下: A 总可用内存:153G J JavaHeap大小:53G W 写缓存大小:25.44G R1 LRU缓存大小:? R2 BucketCache堆外缓存大小:153 - 53 = 100G 因为读缓存由 堆内的LRU元数据 与 堆外的数据缓存 组成,两部分占比一般为 1:9(经验值) 。 而对于总体的堆内内存,存在以下限制,如果超出此限制则应该调低比例: LRUBlockCache + MemStore < 80% * JVM_HEAP 即 LRUBlockCache + 25.44 < 53 * 0.8 可得R1的最大值为16.96G 总读缓存:R = R1 + R2 R1:R2 = 1:9 R1 = 11G < 16G R = 111G 配置堆外缓存涉及到的相关参数如下: hbase.bucketcache.size=111 * 1024M: 堆外缓存大小,单位为M hbase.bucketcache.percentage.in.combinedcache=0.9: 堆外读缓存所占比例,剩余为堆内元数据缓存大小 hfile.block.cache.size=0.15: 校验项,+upperLimit需要小于0.8 现在,我们再来计算 Disk / JavaHeap Ratio 的值,检查JavaHeap内存与磁盘的大小是否合理: RegionSize / MemstoreSize * ReplicationFactor * HeapFractionForMemstore * 2 30 * 1024 / 256 * 3 * 0.48 * 2 = 345.6 53G * 345.6 = 18T <= 18T 至此,已得到HBase中内存相关的重要参数: RegionServer JavaHeap堆栈大小: 53G hbase.hregion.max.filesize=30G hbase.bucketcache.ioengine=offheap hbase.hregion.memstore.flush.size=256M hbase.hregion.memstore.block.multiplier=3 hbase.regionserver.global.memstore.upperLimit=0.58 hbase.regionserver.global.memstore.lowerLimit=0.48 hbase.bucketcache.size=111 * 1024M hbase.bucketcache.percentage.in.combinedcache=0.9 hfile.block.cache.size=0.15 3.3 合并与切分 HFile合并 Compaction过程中,比较常见的优化措施是: Major Compaction 停止自动执行 增大其处理线程数 Minor Compaction 增加Memstore Flush大小 增加Region中最大同时存储的Memstore数量 配置项如下: # 关闭major compaction,定时在业务低谷执行,每周一次 hbase.hregion.majorcompaction=0 # 提高compaction的处理阈值 hbase.hstore.compactionThreshold=6 # 提高major compaction处理线程数 hbase.regionserver.thread.compaction.large=5 # 提高阻塞memstore flush的hfile文件数阈值 hbase.hstore.blockingStoreFiles=100 hbase.hregion.memstore.flush.size=256M hbase.hregion.memstore.block.multiplier=3: hbase.hstore.compaction.minhbase.hstore.compaction.max--> Major Compaction 脚本 关闭自动compaction之后手动执行脚本的代码示例: #!/bin/bash if [ $# -lt 1 ] then echo "Usage: <table key>" exit 1 fi TMP_FILE=tmp_tables TABLES_FILE=tables.txt key=$1 echo "list" | hbase shell > $TMP_FILE sleep 2 sed '1,6d' $TMP_FILE | tac | sed '1,2d' | tac | grep $key > $TABLES_FILE sleep 2 for table in $(cat $TABLES_FILE); do date=`date "+%Y%m%d %H:%M:%S"` echo "major_compact '$table'" | hbase shell echo "'$date' major_compact '$table'" >> /tmp/hbase-major-compact.log sleep 5 done rm -rf $TMP_FILE rm -rf $TABLES_FILE echo "" >> /tmp/hbase-major-compact.log Region切分 在架构原理中我们知道,Region多有种切分策略,在Region切分时将会有短暂时间内的Region下线无服务,Region切分完成之后的Major Compaction中,将会移动父Region的数据到子Region中,HMaster为了集群整体的负载均衡可能会将子Region分配到其他RegionServer节点。 从以上描述中可以看到,Region的切分行为其实是会对线上的服务请求带来一定影响的。 Region切分设置中,使用默认配置一般不会有太大问题,但是有没有 保证数据表负载均衡的情况下,Region不进行切分行为? 有一种解决方案是使用 预分区 + 固定值切分策略 可以一定程度上通过预估数据表数量以及Region个数,从而在一段时间内抑制Region不产生切分。 假设我们可以合理的预判到一个表的当前总数据量为150G,每日增量为1G,当前Region大小为30G。 那么我们建表的时候至少要设定 (150 + 1 * 360) / 30 = 17 个分区,如此一来一年内(360天)该表的数据增长都会落到17个Region中而不再切分。 当然对于一个不断增长的表,除非时间段设置的非常长,否则总有发生切分的一天。如果无限制的延长时间段则会在一开始就产生大量的空Region,这对HBase是极其不友好的,所以时间段是一个需要合理控制的阈值。 在hbase-site.xml中配置Region切分策略为ConstantSizeRegionSplitPolicy: hbase.regionserver.region.split.policy=org.apache.hadoop.hbase.regionserver.ConstantSizeRegionSplitPolicy 3.4 响应优化 HBase服务端 高并发情况下,如果HBase服务端处理线程数不够,应用层将会收到HBase服务端抛出的无法创建新线程的异常从而导致应用层线程阻塞。 可以释放调整HBase服务端配置以提升处理性能: # Master处理客户端请求最大线程数 hbase.master.handler.count=256 # RS处理客户端请求最大线程数,如果该值设置过大则会占用过多的内存,导致频繁的GC,或者出现OutOfMemory hbase.regionserver.handler.count=256 # 客户端缓存大小,默认为2M hbase.client.write.buffer=8M # scan缓存一次获取数据的条数,太大也会产生OOM hbase.client.scanner.caching=100 另外,以下两项中,默认设置下超时太久、重试次数太多,一旦应用层连接不上HBse服务端将会进行近乎无限的重试,长连接无法释放,新请求不断进来,从而导致线程堆积应用假死等,影响比较严重,可以适当减少: hbase.client.retries.number=3 hbase.rpc.timeout=10000 HDFS 适当增加处理线程等设置: dfs.datanode.handler.count=64 dfs.datanode.max.transfer.threads=12288 dfs.namenode.handler.count=256 dfs.namenode.service.handler.count=256 同时,对于HDFS的存储设置也可以做以下优化: # 可以配置多个,拥有多个元数据备份 dfs.name.dir # 配置多个磁盘与路径,提高并行读写能力 dfs.data.dir # dn同时处理文件的上限,默认为256,可以提高到8192 dfs.datanode.max.xcievers 应用层(客户端) 之前我们说到,HBase为了保证CP,在A的实现上做了一定的妥协,导致HBase出现故障并转移的过程中会有较大的影响。 对于应用服务层来说,保证服务的 稳定性 是最重要的,为了避免HBase可能产生的问题,应用层应该采用 读写分离 的模式来最大程度保证自身稳定性。 应用层读写分离 可靠的应用层应使用 读写分离 的模式提高响应效率与可用性: 读写应用应该分别属于 不同的服务实例 ,避免牵一发而动全身 对于写入服务,数据异步写入redis或者kafka队列,由下游消费者同步至HBase,响应性能十分优异 需要处理数据写入失败的事务处理与重写机制 对于读取服务,如果一个RS挂了,一次读请求经过若干重试和超时可能会持续几十秒甚至更久,由于和写入服务分离可以做到互不影响 最好使用缓存层来环节RS宕机问题,对于至关重要的数据先查缓存再查HBase(见下文) 在应用层的 代码 中,同样有需要注意的小TIPS: 如果在Spring中将HBaseAdmin配置为Bean加载,则需配置为懒加载,避免在启动时链接HMaster失败导致启动失败,从而无法进行一些降级操作。 scanner使用后及时关闭,避免浪费客户端和服务器的内存 查询时指定列簇或者指定要查询的列限定扫描范围 Put请求可以关闭WAL,但是优化不大 最后,可以适当调整一下 连接池 设置: # 配置文件加载为全局共享,可提升tps setInt(“hbase.hconnection.threads.max”, 512); setInt(“hbase.hconnection.threads.core”, 64); 3.5 使用缓存层 即使我们经过大量的准备、调优与设置,在真实使用场景中,随着HBase中承载的数据量越来越大、请求越来越多、并发越来越大,HBase不可避免的会有一些「毛刺」问题。 如果你现在已经通过HBase解决了大部分的线上数据存储与访问问题,但是有一小部分的数据需要提供最快速的响应、最低的延迟,由于HBase承载的东西太多,总是有延迟比较高的响应,此时需要怎么解决? 其实,对所有数据库软件来说都会存在这样的场景。于是,类似关系型数据库中的数据库拆分等策略也是可以应用到HBase上的。 或者是将最关键、最热点的数据使用 独立的HBase集群 来处理,或者是使用诸如 Redis等更高性能的缓存软件,其核心思想就是 将最关键的业务数据独立存储以提供最优质的服务,这个服务统称为缓存层。 3.6 其他配置 hbase-env.sh 的 HBase 客户端环境高级配置代码段 配置了G1垃圾回收器和其他相关属性: -XX:+UseG1GC -XX:InitiatingHeapOccupancyPercent=65 -XX:-ResizePLAB -XX:MaxGCPauseMillis=90 -XX:+UnlockDiagnosticVMOptions -XX:+G1SummarizeConcMark -XX:+ParallelRefProcEnabled -XX:G1HeapRegionSize=32m -XX:G1HeapWastePercent=20 -XX:ConcGCThreads=4 -XX:ParallelGCThreads=16 -XX:MaxTenuringThreshold=1 -XX:G1MixedGCCountTarget=64 -XX:+UnlockExperimentalVMOptions -XX:G1NewSizePercent=2 -XX:G1OldCSetRegionThresholdPercent=5 hbase-site.xml 的 RegionServer 高级配置代码段(安全阀) 手动split region配置 <property><name>hbase.regionserver.wal.codec</name><value>org.apache.hadoop.hbase.regionserver.wal.IndexedWALEditCodec</value></property><property><name>hbase.region.server.rpc.scheduler.factory.class</name><value>org.apache.hadoop.hbase.ipc.PhoenixRpcSchedulerFactory</value><description>Factory to create the Phoenix RPC Scheduler that uses separate queues for index and metadata updates</description></property><property><name>hbase.rpc.controllerfactory.class</name><value>org.apache.hadoop.hbase.ipc.controller.ServerRpcControllerFactory</value><description>Factory to create the Phoenix RPC Scheduler that uses separate queues for index and metadata updates</description></property><property><name>hbase.regionserver.thread.compaction.large</name><value>5</value></property><property><name>hbase.regionserver.region.split.policy</name><value>org.apache.hadoop.hbase.regionserver.ConstantSizeRegionSplitPolicy</value></property> 四、使用技巧 4.1 建表规约 Rowkey规范 如无特殊情况,长度应控制在64字节内。 充分分析业务需求后确认需要查询的维度字段。 get请求,则rowkey散列处理。 scan请求,rowkey前缀维度散列后,后续维度依照查询顺序或者权重拼接(视具体情况决定是否散列处理)。 各个字段都保持相同长度以支持左对齐的部分键扫描。 scan形式的数据表中,需要提前统计单个scan可扫描出的最大数量。 列簇规范 如无特殊情况,一个表中只有一个列簇,统一使用info命名。 如果需要1以上的列簇,则原则上一次请求的数据不可跨列簇存储,多不超过3个列簇。 示例:NAME =>'info' 压缩 统一使用SNAPPY压缩。 示例:COMPRESSION => 'SNAPPY' 版本 默认版本数为3,前期存储空间紧张的情况下设置为1。 示例:VERSIONS => 1 布隆过滤器 视情情况使用,主要针对get查询提高性能。 kv示例:BLOOMFILTER => 'ROW',根据rowkey中的信息生成布隆过滤器数据。 kv+col示例:BLOOMFILTER => 'ROWCOL',根据rowkey+列信息生成布隆过滤器,针对get+指定列名的查询,产生的过滤器文件会比ROW大。 预分区 预分区需要通过评估整体表数据量来确认,当前hbase集群region块大小为30G。 历史大增量小的数据:给定的预分区数足够支撑该表永远(或者相当长的时间内)不split,即更新的所有数据将进入已存在的region中,以减少split与compaction造成的影响。 历史小增量大的数据:预分区个数需满足历史数据等分存储,并支撑未来一段时间内(一个月以上)的增量数据。 预分区区间计算:属性相同的表中随机取出部分样本数据(rowkey维度字段)。将样本转换成rowkey之后排序,并以样本个数/预分区个数为步长,取预分区个数个rowkey组成预分区区间。 预分区代码示例: /** * hbase region预分区工具 * * @param filePath 样本文件路径 * @param numOfSPlits 预分区个数 **/ def rowkeySplitedArr(filePath: String, numOfSPlits: Int) = { val file = Source.fromFile(filePath).getLines() val res = file.map { line => val arr = line.split("_") val card = arr(0) val name = arr(1) MathUtil.MD5Encrypt32(card) + MathUtil.MD5Encrypt32(card) }.toList.sorted val count = res.length / numOfSPlits var str = "" for (i <- 0 until numOfSPlits) { str += s"\'${res(i * count)}\'," } println(str.substring(0, str.length - 1)) } 4.2 客户端使用 服务端配置完成之后,如何更好的使用HBase集群也需要花点心思测试与调整。 以Spark作为HBase读写客户端为例。 查询场景 批量查询 Spark有对应的API可以批量读取HBase数据,但是使用过程比较繁琐,这里安利一个小组件Spark DB Connector,批量读取HBase的代码可以这么简单: val rdd = sc.fromHBase[(String, String, String)]("mytable") .select("col1", "col2") .inColumnFamily("columnFamily") .withStartRow("startRow") .withEndRow("endRow") done! 实时查询 以流式计算为例,Spark Streaming中,我们要实时查询HBase只能通过HBase Client API(没有队友提供服务的情况下)。 那么HBase Connection每条数据创建一次肯定是不允许的,效率太低,对服务压力比较大,并且ZK的连接数会暴增影响服务。 比较可行的方案是每个批次创建一个链接(类似foreachPartiton中每个分区创建一个链接,分区中数据共享链接)。但是这种方案也会造成部分连接浪费、效率低下等。 如果可以做到一个Streaming中所有批次、所有数据始终复用一个连接池是最理想的状态。 Spark中提供了Broadcast这个重要工具可以帮我们实现这个想法,只要将创建的HBase Connection广播出去所有节点就都能复用,但是真实运行代码时你会发现HBase Connection是不可序列化的对象,无法广播。。。 其实利用scala的lazy关键字可以绕个弯子来实现: //实例化该对象,并广播使用 class HBaseSink(zhHost: String, confFile: String) extends Serializable { //延迟加载特性 lazy val connection = { val hbaseConf = HBaseConfiguration.create() hbaseConf.set(HConstants.ZOOKEEPER_QUORUM, zhHost) hbaseConf.addResource(confFile) val conn = ConnectionFactory.createConnection(hbaseConf) sys.addShutdownHook { conn.close() } conn } } 在Driver程序中实例化该对象并广播,在各个节点中取广播变量的value进行使用。 广播变量只在具体调用value的时候才会去创建对象并copy到各个节点,而这个时候被序列化的对象其实是外层的HBaseSink,当在各个节点上具体调用connection进行操作的时候,Connection才会被真正创建(在当前节点上),从而绕过了HBase Connection无法序列化的情况(同理也可以推导RedisSink、MySQLSink等)。 这样一来,一个Streaming Job将会使用同一个数据库连接池,在Structured Streaming中的foreachWrite也可以直接应用。 写入场景 批量写入 同理安利组件 rdd.toHBase("mytable") .insert("col1", "col2") .inColumnFamily("columnFamily") .save() 这里边其实对HBase Client的Put接口包装了一层,但是当线上有大量实时请求,同时线下又有大量数据需要更新时,直接这么写会对线上的服务造成冲击,具体表现可能为持续一段时间的短暂延迟,严重的甚至可能会把RS节点整挂。 大量写入的数据带来具体大GC开销,整个RS的活动都被阻塞了,当ZK来监测心跳时发现无响应就将该节点列入宕机名单,而GC完成后RS发现自己“被死亡”了,那么就干脆自杀,这就是HBase的“朱丽叶死亡”。 这种场景下,使用bulkload是最安全、快速的,唯一的缺点是带来的IO比较高。 大批量写入更新的操作,建议使用bulkload工具来实现。 实时写入 理同实时查询,可以使用创建的Connection做任何操作。 结束语 我们从HBase的架构原理出发,接触了HBase大部分的核心知识点。 理论基础决定上层建筑,有了对HBase的总体认知,在后续的集群部署、性能优化以及实际应用中都能够比较游刃有余。 知其然而之所以然,保持对技术原理的探索,不仅能学习到其中许多令人惊叹的设计与操作,最重要的是能够真正在业务应用中充分发挥其应有的性能。 ### 4.3 异常与故障排查hadoop fs -rmr /hbase/WALsrmr /hbase hbase.regionserver.executor.openregion.threads 100 yarn进程问题buffer/cache太多手动启动执行(补充环境信息)僵尸进程发现并处理-->

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册