首页 文章 精选 留言 我的

精选列表

搜索[文档解析],共10000篇文章
优秀的个人博客,低调大师

Apache Storm 官方文档 —— 命令行操作

本文介绍了 Storm 命令行客户端中的所有命令操作。如果想要了解怎样设置你的 Strom 客户端和远程集群的交互,请按照配置开发环境一文中的步骤操作。 Storm 中支持的命令包括: jar kill activate deactivate rebalance repl classpath localconfvalue remoteconfvalue nimbus supervisor ui drpc jar 语法:storm jar topology-jar-path class ... 使用指定的参数运行 main 方法(也就是打包好的拓扑 jar 包中的 main 方法)。Storm 所需要的 jar 包和配置信息都在类路径(classpath)中。这个运行过程已经配置好了,这样StormSubmitter就可以在提交拓扑的时候将topology-jar-path中的 jar 包上传到集群中。 kill 语法:storm kill topology-name [-w wait-time-secs] 杀死集群中正在运行的名为topology-name的拓扑。执行该操作后,Storm 首先会注销拓扑中的 spout,使得拓扑中的消息超时,这样当前的所有消息就会结束执行。随后,Storm 会将所有的 worker 关闭,并清除他们的状态。你可以使用-w参数来调整 Storm 在注销与关闭拓扑之间的间隔时间。 activate 语法:storm activate topology-name 激活运行指定拓扑的所有 spout。 deactivate 语法:storm deactivate topology-name 停止指定拓扑的所有 spout 的运行。 rebalance 语法:storm rebalance topology-name [-w wait-time-secs] 有些场景下需要对正在运行的拓扑的工作进程(worker)进行弹性扩展。例如,加入你有 10 个节点,每个节点上运行有 4 个 worker,现在由于各种原因你需要为集群添加 10 个新节点。这时你就会希望通过扩展正在运行的拓扑的 worker 来使得每个节点只运行两个 worker,降低集群的负载。实现这个目的的一种直接的办法是 kill 掉正在运行的拓扑,然后重新向集群提交。不过 Storm 提供了再平衡命令可以以一种更简单的方法实现目的。 再平衡首先会在一个超时时间内(这个时间是可以通过-w参数配置的)注销掉拓扑,然后在整个集群中重新分配 worker。接着拓扑就会自动回到之前的状态(也就是说之前处于注销状态的拓扑仍然会保持注销状态,而处于激活状态的拓扑则会返回激活状态)。 repl 语法:storm repl 打开一个带有类路径上的 jar 包和配置信息的 Clojure 的交互式解释器(REPL)。该命令主要用于调试。 classpath 语法:storm classpath 打印客户端执行命令时使用的类路径环境变量。 localconfvalue 语法:storm localconfvalue conf-name 打印出本地 Storm 配置中conf-name属性的值。这里的本地配置指的是~/.storm/storm.yaml和defaults.yaml两个配置文件综合后的配置信息。 remoteconfvalue 语法:storm remoteconfvalue conf-name 打印出集群配置中conf-name属性的值。这里的集群配置指的是$STORM-PATH/conf/storm.yaml和defaults.yaml两个配置文件综合后的配置信息。该命令必须在一个集群机器上执行。 nimbus 语法:storm nimbus 启动 nimbus 后台进程。该命令应该在daemontools或者monit这样的工具监控下执行。详细信息请参考配置 Storm 集群一文。 supervisor 语法:storm supervisor 启动 supervisor 后台进程。该命令应该在daemontools或者monit这样的工具监控下执行。详细信息请参考配置 Storm 集群一文。 ui 语法:storm ui 启动 UI 后台进程。UI 提供了一个访问 Storm 集群的 Web 接口,其中包含有运行中的拓扑的详细信息。该命令应该在daemontools或者monit这样的工具监控下执行。详细信息请参考配置 Storm 集群一文。 drpc 语法:storm drpc 启动 DRPC 后台进程。该命令应该在daemontools或者monit这样的工具监控下执行。详细信息请参考分布式 RPC一文。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Adopt Open JDK官方文档(五) Docker镜像

5.1 复制镜像 镜像可以从别的设备复制并导入本地的Docker仓库。 保存镜像的命令为: docker save -o <save image to path> <image name> 或者 docker save <image name> > <save image to path> 保存镜像示例 docker save -o base-image-openjdk9.tar neomatrix369/openjdk9-base-image:latest 或者 docker save neomatrix369/openjdk9-base-image:latest > openjdk9-base-image.tar 或者 docker save neomatrix369/openjdk9-base-image:latest | gzip > openjdk9-base-image.tar.gz openjdk9-base-image.tar 和 openjdk9-base-image.tar.gz 的镜像已默认保存至Docker仓库。 加载镜像的命令为 docker load -i <path to image tar file> 或者 docker load < <path to image tar file> 加载镜像示例 docker load -i openjdk9-base-image.tar 或者 docker load < openjdk9-base-image.tar 或者 docker load < gzip < openjdk9-base-image.tar.gz 5.2 创建镜像 提示:在之前的介绍章节中,已经给出了Docker在相关平台使用的介绍。 在Linux,MacOS,Windows平台创建OpenJDK9 docker镜像的详细步骤如下: Why not build #OpenJDK 9 using #Docker ? – Part 1 of 2 Why not build #OpenJDK 9 using #Docker ? – Part 2 of 2 5.3 检查镜像 提示:这一步针对的OpenJDK镜像,是已经创建好的或者从别处导入至本地的Docker仓库的。 不同的操作系统启动docker的方法也不相同,在Mac和Windows平台,通常通过命令boot2docker启动docker,Linux系统在启动时会自动加载。 在docker启动之后运行命令: $ docker images 会得到如下输出: REPOSITORY TAG IMAGE ID CREATED VIRTUAL SIZE neomatrix369/openjdk9 latest 5877e8efd939 4 days ago 5.82 GB neomatrix369/full-image-openjdk9 latest 32b0a686e93b 4 days ago 5.82 GB neomatrix369/base-image-openjdk9 latest ce63b2673e6a 4 days ago 781.7 MB phusion/baseimage latest 5a14c1498ff4 4 months ago 279.7 MB 继续执行如下命令: $ sudo docker run -it --name openjdk9 neomatrix369/openjdk9 /bin/bash 这一步是跳转到docker容器中执行bash shell命令 $ sudo docker run -it --name openjdk9 neomatrix369/openjdk9 java -version 这一步会运行java命令(需要事先配置好java环境变量,通过PATH或者JAVA_HOME可以找到java命令)获取如下信息: openjdk version "1.9.0-internal" OpenJDK Runtime Environment (build 1.9.0-internal-_2015_06_04_06_46-b00) OpenJDK 64-Bit Server VM (build 1.9.0-internal-_2015_06_04_06_46-b00, mixed mode) 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

APM开源产品Pinpoint——Hbase表设计文档

Pinpoint is an APM (Application Performance Management) tool for large-scale distributed systems written in Java. Modelled after Dapper, Pinpoint provides a solution to help analyze the overall structure of the system and how components within them are interconnected by tracing transactions across distributed applications. Git : https://github.com/naver/pinpoint image.png 架构 image.png 支持模块 JDK 6+ Tomcat 6/7/8, Jetty 8/9, JBoss EAP 6, Resin 3/4 Spring, Spring Boot Apache HTTP Client 3.x/4.x, JDK HttpConnector, GoogleHttpClient, OkHttpClient, NingAsyncHttpClient Thrift Client, Thrift Service, DUBBO PROVIDER, DUBBO CONSUMER MySQL, Oracle, MSSQL, CUBRID, DBCP, POSTGRESQL, MARIA Arcus, Memcached, Redis, CASSANDRA iBATIS, MyBatis gson, Jackson, Json Lib log4j, Logback Hbase表设计 序号 表名称 列簇 TTL 表说明 数据示例 备注 1 ApplicationIndex Agents 31536000 applicationIds 和 agentIds 注册信息 agentInfo.getApplicationName;agentInfo.getAgentId;agentInfo.getServiceType 2 HostApplicationMap M 5184000 applicationIds 和 agentIds 注册信息 host, bindApplicationName, bindServiceType to be removed - use ver2 instead. remove relevant code as well. 3 HostApplicationMap_Ver2 M 5184000 applicationIds 和 agentIds 注册信息 host, bindApplicationName, bindServiceType 4 AgentInfo Info 31536000 agent 的基础数据,如:ip, hostname agentversion, start time等 5 AgentStat S 5184000 agent的统计数据,如:cpuload, gc, heap等 6 AgentLifeCycle S 5184000 agent的生命周期数据 7 AgentEvent E 5184000 agent的不同event,如request for thread dump等 8 ApiMetaData Api 31536000 方法信息的元数据表 9 SqlMetaData Sql 15552000 SQL语句的元数据表 10 StringMetaData Str 15552000 字符串值的元数据表,如方法参数、异常名称等 11 ApplicationTraceIndex I 5184000 trace数据的索引表 12 Traces S 5184000 traced 处理信息 13 ApplicationMapStatisticsCaller C 5184000 用于存储各种代理之间的RPC统计表 to be removed - use ver2 instead. remove relevant code as well. 14 ApplicationMapStatisticsCallee C 5184000 15 ApplicationMapStatisticsSelf C 5184000 16 ApplicationMapStatisticsCaller_Ver2 C 5184000 用于存储各种代理之间的RPC统计表 17 ApplicationMapStatisticsCallee_Ver2 C 5184000 18 ApplicationMapStatisticsSelf_Ver2 C 5184000 初始化脚本 create'AgentInfo',{NAME=>'Info',TTL=>31536000} create'AgentStat',{NAME=>'S',TTL=>5184000},{SPLITS=>["\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x08\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x10\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x12\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x14\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x16\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x18\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'ApplicationIndex',{NAME=>'Agents',TTL=>31536000} create'AgentLifeCycle',{NAME=>'S',TTL=>5184000,},{SPLITS=>["\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x08\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x10\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x12\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x14\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x16\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x18\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'AgentEvent',{NAME=>'E',TTL=>5184000,},{SPLITS=>["\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x08\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x10\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x12\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x14\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x16\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x18\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'StringMetaData',{NAME=>'Str',TTL=>15552000},{SPLITS=>["\x01\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x03\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x05\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x07\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'ApiMetaData',{NAME=>'Api',TTL=>31536000},{SPLITS=>["\x01\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x03\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x05\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x07\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'SqlMetaData',{NAME=>'Sql',TTL=>15552000},{SPLITS=>["\x01\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x03\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x05\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x07\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'SqlMetaData_Ver2',{NAME=>'Sql',TTL=>15552000},{SPLITS=>["\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x08\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x10\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x12\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x14\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x16\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x18\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'Traces',{NAME=>'S',TTL=>5184000},{NAME=>'A',TTL=>5184000},{NAME=>'T',TTL=>5184000},{SPLITS=>["\x01\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x03\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x05\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x07\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x08\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x09\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0b\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0d\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0f\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x10\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x11\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x12\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x13\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x14\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x15\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x16\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x17\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x18\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x19\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1b\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1d\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1f\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x20\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x21\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x22\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x23\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x24\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x25\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x26\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x27\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x28\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x29\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x2a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x2b\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x2c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x2d\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x2e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x2f\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x30\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x31\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x32\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x33\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x34\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x35\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x36\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x37\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x38\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x39\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x3a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x3b\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x3c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x3d\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x3e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x3f\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'ApplicationTraceIndex',{NAME=>'I',TTL=>5184000},{SPLITS=>["\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x08\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x10\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x12\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x14\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x16\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x18\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'ApplicationMapStatisticsCaller',{NAME=>'C',TTL=>5184000,VERSION=>1} create'ApplicationMapStatisticsCallee',{NAME=>'C',TTL=>5184000,VERSION=>1},{NAME=>'D',TTL=>5184000,VERSION=>1} create'ApplicationMapStatisticsSelf',{NAME=>'C',TTL=>5184000,VERSION=>1} create'ApplicationMapStatisticsCaller_Ver2',{NAME=>'C',TTL=>5184000,VERSION=>1},{SPLITS=>["\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x08\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x10\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x12\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x14\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x16\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x18\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'ApplicationMapStatisticsCallee_Ver2',{NAME=>'C',TTL=>5184000,VERSION=>1},{SPLITS=>["\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x08\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x0e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x10\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x12\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x14\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x16\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x18\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1a\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1c\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x1e\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'ApplicationMapStatisticsSelf_Ver2',{NAME=>'C',TTL=>5184000,VERSION=>1},{SPLITS=>["\x01\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x03\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x04\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x05\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x06\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x07\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} create'HostApplicationMap',{NAME=>'M',TTL=>5184000,VERSION=>1} create'HostApplicationMap_Ver2',{NAME=>'M',TTL=>5184000,VERSION=>1},{SPLITS=>["\x01\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x02\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00","\x03\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00"]} list exit 欢迎关注 高广超的简书博客 与 收藏文章 !欢迎关注 头条号:互联网技术栈 ! 个人介绍: 高广超 :多年一线互联网研发与架构设计经验,擅长设计与落地高可用、高性能互联网架构。目前就职于美团网,负责核心业务研发工作。 本文首发在 高广超的简书博客 转载请注明! image.png

优秀的个人博客,低调大师

openGauss数据库源码解析系列文章——存储引擎源码解析(四)

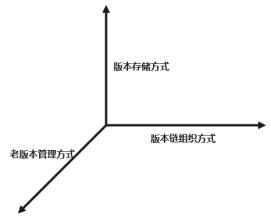
上一篇我们详细讲述“3. astore元组多版本机制”、“4.astore访存管理”及“5.astore空间管理和回收”相关内容。本篇我们将继续为小伙伴们带来“4.2.4 ustore”的详细介绍。 4.2.4 ustore ustore属于In-place Update更新模式,中文意思为:原地更新,是openGauss内核新增的一种存储模式。openGauss内核当前使用的行引擎采用的是Append Update(追加更新)模式,该模式在INSERT、DELETE、HOT UPDATE(页面内更新)的场景下有较好的表现。但对于非HOT UPDATE场景,垃圾回收不够高效。 In-place Update存储模式提供“原地更新”能力,主要思路是将最新版本的“有效数据”和历史版本的“垃圾数据”分离存储。将最新版本的“有效数据”存储在数据页面上,而单独开辟一段undo(回滚)空间,用于统一管理历史版本的“垃圾数据”,因此数据空间不会由于频繁更新而膨胀,垃圾回收效率更高。通过NUMA-aware的undo子系统设计,使得undo子系统在多核平台上高效扩展。同时通过对元组和数据页面结构的重新设计,减少存储空间的占用。采用多版本索引技术,解决索引膨胀问题,彻底去除autovacuum(垃圾清理线程)机制,提升存储空间的回收复用效率。 1. 整体框架及代码概览 数据库中数据处理的本质是在保证ACID的基础上支持尽量高的并发查询。这种状况下,并发控制、页面多版本控制以及页面存储结构相互耦合在一起,数据库存储引擎需要进行整体设计从而在高并发的状况下保证各个事务处理看到类似串行执行的效果。 在整个技术体系中多版本控制用来提升读写并发能力,按照多版本排列方式可以分为两类。 (1)Oldest to New,即版本按照从最老到最新的方式进行链接,当一个事务访问该元组时,先看到这个元组最老的版本,同时使用对应的可见性判断机制,看是否是自己可见的版本,如果不是则沿着版本链条继续往后看较新的版本是不是自己需要的。 (2)Newest to Old,即版本按照从最新到最老的方式进行连接,当一个事务访问该元组时,先看到这个元组最新的版本,同时使用对应的可见性判断机制,看是否是自己可见的版本,如果不是则沿着版本链条继续往后看较老的版本是不是自己需要的。 在上面的描述中又引出一个设计点,如何组织新老数据,有如下几种方式。 (1) 将新数据和老数据放在同样的页面内,即每个数据页内放置着各个元组的新老数据,在需要进行不可见数据版本回收的时候需要遍历所有的页面。 (2) 将最新数据和老数据分离存储,在实际的数据页面内放置最新版本数据,所有的老版本数据都集中存储,新版本数据通过一个指针指向老版本所在的数据区域,当进行不可见老版本数据回收的时候只要扫描老版本集中存放的位置即可。 当新老数据分别存储的时候又引出第三个设计点,在对同一个页面或者元组反复读取时,是否要还原对应的页面在数据缓冲区中,这个设计点有如下几种方式。 (1) 访问旧元组所在的页面时,还原该页面,并将该页面的旧版本放入数据缓冲区中,节省一定时间内其他线程多次访问该版本页面带来的合成开销。弊端是占用更大的内存空间,同时缓冲区淘汰管理在原始LRU(Least Recently Used,最近最少使用算法)基础上同时要考虑页面版本。这种方式对应PCR(Page Consistency Read,页面一致性读),其本质的设计理念是空间换时间。 (2) 访问元组时,沿着版本链还原该元组,直到找到自己对应的版本。这种方式对于短时间访问冲突不高的场景能够降低内存使用,但如果短时间内高频访问一个页面内的元组,则每次都会遍历版本链造成访问效率低下。这种方式对应RCR(Row Consistency Read,行一致性读)。 按照上面的描述,整个多版本控制设计分为三个维度,如图4-10、表4-15所示。 图4-10 多版本控制设计维度 表4-15 多版本控制设计维度 维度 备选 版本存储方式 集中存储、分离存储 版本链组织方式 Oldest to New、Newest to Old 老版本管理方式 1、RCR,2、PCR 当前openGauss在版本存储方式、版本链组织方式上的设计选择是集中存储 + Oldest to New,在清理数据旧版本时需要遍历所有的页面找到不可见的元组版本然后清除。商用及开源的常见数据库的多版本控制设计三维度选择如表4-16所示。 表4-16 当前数据库多版本控制设计选择 数据库 架构设计选择 版本存储方式 版本链组织方式 老版本管理方式 常见数据库 分离存储 Newest to Old PCR 集中存储 Oldest to New PCR 分离存储 Oldest to New PCR 不同的多版本控制设计都不能做到尽善尽美,都有些不足之处,相关的缺点如下。 (1)多核系统上扩展性较差,不支持多核处理器的NUMA感知; (2)依赖于Vacuum进行老版本回收,后台线程定期清理; (3)缺乏对索引多版本,全局索引、闪回等功能的支持; (4)PCR管理方式,内存管理开销较大。 openGauss的ustore存储模式最大程度结合各种设计的优势,在多版本管理上的架构设计采取的组合如表4-17所示。 表4-17 ustore在多版本管理上的架构设计 维度 架构设计选择 版本存储方式 分离存储 版本链组织方式 Newest to old 老版本管理方式 PbRCR(Page Based RCR,基于页面的行一致性读) 同时为了事务能够跨存储格式查询,并复用现有备份、恢复、升级等能力,openGauss定义如下的融合引擎架构设计原则。 (1) 一套并发控制系统。 (2) 一套系统表管理系统。 (3) 一套日志管理系统。 (4) 一套锁管理系统。 (5) 一套恢复系统。 ustore架构如图4-11所示。 ustore和astore共用事务管理、并发控制、缓冲区管理、检查点、故障恢复管理与介质管理器管理。ustore主要功能模块如表4-18所示。 表4-18 ustore主要功能模块 模块 说明 代码位置 ustore表存取管理 向上对接SQL引擎,提供对ustore表的行级查询、插入、删除、修改等操作接口,向下根据ustore表页间、页内结构,以及ustore表元组结构,完成对ustore表文件的遍历和增删改查操作 主要在“src/gausskernel/storage/access/ustore”目录(单表文件管理)下 ustore索引存取管理 向上对接SQL引擎,提供对索引表的行级查询、插入、删除等操作接口,向下根据索引表页间、页内结构,以及索引表元组结构,完成对指定索引键的查找和增删操作 抽象框架代码在“src/gausskernel/storage/access/ubtree”目录下 ustore表页面结构 包括ustore表元组在页面内的具体组织形式,在页面内插入元组操作、页面整理操作、页面初始化操作等 主要代码在“src/gausskernel/storage/access/ustore/knl_upage”目录中 ustore表元组结构 包括ustore表元组的结构、填充、解构、修改、字段查询、变形等操作 主要代码在“src/gausskernel/storage/access/ustore/knl_utuple.cpp”文件中 Undo记录结构 包括undo记录的结构、填充、编码、解码等操作 主要代码在“src/gausskernel/storage/access/ustore/undo”目录中 多版本索引 包括 ustore 专用多版本索引 ubtree 的页面结构、查询、修改、可见性检查、垃圾回收等模块 主要代码在“src/gausskernel/storage/access/ubtree”目录中 2. 页面元组结构 1) 元组结构 本节介绍行存储引擎ustore表的页面元组结构。 元组结构的定义如下: typedef struct UHeapDiskTupleData { ShortTransactionId xid; uint16 td_id : 8, locker_td_id : 8; uint16 flag; uint16 flag2; uint8 t_hoff; uint8 data[FLEXIBLE_ARRAY_MEMBER]; } UHeapDiskTupleData; 该结构体只是元组头部的定义,真正的元组内容跟在该结构体之后,距离元组头部起始处的偏移由t_hoff成员保存。上面元组头部结构体部分成员信息同时也构成了该元组的系统字段(字段序号小于0的那些字段)。对各个结构体成员的含义说明如下。 (1) flag,元组属性掩码。包含是否有空字段标记、是否有外部TOAST标记、是否有变长字段标记、指定的事务槽位是否已被重复使用标记,以及更新、删除、锁等标记。 (2) flag2,元组另一个属性掩码。包含元组中字段个数。 (3) t_hoff,元组数据距离元组头部结构体起始位置的偏移。 (4) data,字段的NULL值bitmap,每个字段对应一个bit位,因此是变长数组。 ustore元组头部比astore元组头部小一半,因此在相同大小的页面上,ustore可以放置更多的元组。 在内存中,上述元组结构体使用时被嵌入在一个更大的元组数据结构体中,除了保存元组内容的disk_tuple成员之外,其他的成员保存了该元组的一些其他系统信息,并构成了该元组剩余的一些系统字段内容,定义如下: typedef struct UHeapTupleData { uint32 disk_tuple_size; uint1 tupTableType = UHEAP_TUPLE; uint1 tupInfo; int2 t_bucketId; ItemPointerData ctid; Oid table_oid; TransactionId t_xid_base; TransactionId t_multi_base; UHeapDiskTupleData* disk_tuple; } UHeapTupleData; 该结构体几个主要成员的含义如下。 (1) disk_tuple_size,元组长度。 (2) ctid,元组所在页面号和页面内元组指针下标。 (3) table_oid,该元组属主表的OID。 常用的元组操作接口和说明如表4-19所示。 表4-19 常用的元组操作接口 函数名 操作含义 UHeapFormTuple 利用传入的、各个元组字段的值数组,生成一条完整的元组,一般用于插入操作 UHeapDeformTuple 利用传入的完整元组以及各个字段的类型定义,解构各个字段的值,生成值数组,一般用于更新前的准备工作 UHeapFreetuple 释放一条元组对应的内存空间 UHeapCopyTuple 复制一条完整的元组,包括元组头和元组内容 UHeapSlotGetAttr 获取一条元组中指定的用户或系统字段值 UHeapGetSysAttr 获取一条元组中指定的系统字段值 UHeapCopyHeapTuple 从ustore槽位构造一条astore元组 UHeapToHeap 将一条ustore元组转换为一条astore元组 HeapToUHeap 将一条astore元组转换为一条ustore元组 2) 页面结构 ustore与astore相同,在openGauss中也使用默认的8kB页面。其结构如图4-12所示。 图4-12 ustore引擎页面结构示意图 在一个页面中,页面头部分对应的UHeapPageHeaderData结构体存储了整个页面的重要元信息。UHeapPageHeaderData之后有一个共享的页内事务目录(Transaction Directory,TD),对应元组指针变长数组。元组指针变长数组的每个数组成员存储了页面中从后往前的、每个元组的起始偏移和元组长度。如图4-12所示,真正的元组内容从页面尾部开始插入,向页面头部扩展;相应地,TD插槽目录与记录每条元组的元组指针从页面头定长成员之后插入,往页面尾部扩展。这样整个页面中间就会形成一个空洞,以供后续插入的元组和元组指针使用。每一个ustore表里的一条具体元组都有一个全局唯一的逻辑地址(和astore表里的元组相同),它由元组所在的页面号和页面内元组指针数组下标组成。 页面头具体结构体定义如下: typedef struct UHeapPageHeaderData { PageXLogRecPtr pd_lsn; uint16 pd_checksum; uint16 pd_flags; uint16 pd_lower; uint16 pd_upper; uint16 pd_special; uint16 pd_pagesize_version; uint16 potential_freespace; uint16 td_count; TransactionId pd_prune_xid; TransactionId pd_xid_base; TransactionId pd_multi_base; uint32 reserved; } UHeapPageHeaderData; 其中各个成员的含义如下。 (1) pd_lsn:该页面最后一次修改操作对应的预写日志位置的下一位,用于检查点推进和保持恢复操作的幂等性。 (2) pd_checksum:页面的CRC校验值。 (3) pd_flags:页面标记位,用于保存各类页面相关的辅助信息,如页面是否有空闲的元组指针、页面是否已满等。 (4) pd_lower:页面中间空洞的起始位置,即当前已使用的元组指针数组的尾部。 (5) pd_upper:页面中间空洞的结束位置,即下一个可以插入元组的起始位置。 (6) pd_special:页面尾部特殊区域的起始位置。该特殊位置位于第一条元组记录和页面结尾之间,用于存储一些变长的页面级元信息,如索引的辅助信息等。 (7) pd_pagesize_version:页面的大小和版本号。 (8) potential_freespace:页面中已被删除和更新的元组的潜在空间。 (9) td_count:共享的页内事务信息描述插槽的数量。 (10) pd_prune_xid:页面清理辅助事务号(64位),通常为该页面内现存最老的删除或更新操作的事务号,用于判断是否要触发页面级空闲空间整理。 (11) pd_xid_base:该页面内所有元组的基准事务号(64位)。该页面所有元组实际生效的64位XID事务号由pd_xid_base(64位)和元组头部的XID成员(32位)相加得到。 (12) pd_multi_base:类似pd_xid_base。当对元组加锁时,会将持锁的事务号写入元组中,该64位事务号由pd_multi_base(64位)和元组头部的XID(32位)相加得到。 页面的主要管理接口如表4-20所示。 表4-20 页面管理接口函数 函数名 操作含义 UPageInit 初始化一个新的ustore页面 UPageAddItem 在页面中插入一条新的元组 UHeapPagePruneOptPage 页面空闲空间整理 为了节省每个元组存储空间,元组头部UHeapDiskTupleData采用32位元组XID的组合设计方式。64位的pd_xid_base和pd_multi_base储存在页面上,元组上储存32位的XID。页面上pd_xid_base和pd_multi_base也需要通过额外的逻辑进行维护:同一个页面中所有元组实际的64位XID,一定要在pd_xid_base和pd_xid_base+232之间,所以如果新写入的事务号和页面上现有任意一个元组的XID事务号差距已经超过232,那么需要尝试对现有元组进行基线移位操作,更新pd_xid_base和pd_multi_base。 3)事务目录 事务目录是一种常用的共享资源。它可以为数据页上的元组(tuple)链接相应的事务表(Transaction Table)及undo子系统中的undo页面。数据库中的每个表可以自定义事务目录的数量,并可以复用那些已完成事务占据的事务目录。 每个数据页默认会有4个事务目录。根据并发需求的不同,事务目录的数量可设置为2到128之间的任意值。在使用CREATE TABLE命令创建表时添加了一个新的选项INIT_TD以声明所需的事务目录数量: CREATE TABLE t1 ( c1 integer; c2 boolean; ) WITH (INIT_TD=16); 当需要为新事务目录留位置时,系统会先查找当前页面中是否有空事务目录。若无空事务目录,系统将遍历事务目录列表来寻找可以复用的条目。条目是否可以复用取决于与该条目关联的事务的状态。 通常可以复用那些与已冻结或已中止的事务关联的事务目录。 (1) 对于已经冻结的XID,并复用该事务目录。 对于astore而言,冻结的XID代表着事务在所有的会话中都已经不再活跃。 而在ustore中,仅当一个事务创建的所有的回滚记录都被丢弃后,或者说没有其他的Snapshot需要再观察该事务创建的元组历史版本(tuple version)时,才将该XID视为冻结。ustore中的undo回收进程会维护一个oldestXidInUndo变量,系统将通过比较XID与该变量来确定XID是否含有回滚记录。如果XID < oldestXidInUndo,代表所有该XID产生的回滚记录都已经被丢弃。 (2) 对于已中止的事务,在该事务被回滚后,系统才会复用相应的事务目录条目。 (3) 对于已提交的事务,系统将不会无效化回滚记录地址,这样可以保证undo链的完整性。 当没有事务目录可以复用时,事务目录将会自动扩容以容纳更多的条目。需注意的是,事务目录的后面跟随着元组指针区,在扩展时,首先需要将row pointer array向右挪动来腾出空间。扩展后,新的事务目录条目将会在先前的事务目录条目之后依序添加。设计上,允许事务目录的容量最多扩至页面大小的约25%,即约100个事务目录(在8kB大小的页面中,约20Bytes/事务目录)。目前,系统将以每次增加两个事务目录的方式逐步扩容,最多扩至128个事务目录。ustore暂不支持收缩事务目录空间。 在扩容时,可以增加的总条目数也取决于当前页面中的可用空间。有时,页面中的总剩余空间并不能支持事务目录的扩容。此时若当前操作为INSERT或MULTI-INSERT,事务将会索取一个新的页面来进行操作。若操作为UPDATE或DELETE,事务将等待10毫秒后重试获取事务目录。Lock timeout设置可以控制获取事务目录的最大等待时间。在多由短事务组成的工作负载中,等待是可以接受的。 PG stats会报告事务目录等待等信息,以方便监测系统及描述工作负载。 事务目录申请的过程(UHeapPageReserveTransactionSlot函数)如图4-13所示。 图4-13 事务目录申请处理流程 如果当前事务需要申请一个新的事务目录,且系统中不存在空的事务目录时,系统会遍历所有事务目录并寻找可复用的事务目录。 (1) 首先系统会遍历事务目录,寻找XID < oldestXidInUndo的事务目录。这些条目将被视为已冻结。 (2) 接着系统会遍历目标页面上的元组。 ① 系统把已删除的元组标记为死亡,其余的标记为闲置。 ② 如果系统发现元组还在活跃状态,且相应的TD条目存在于步骤(1)给出的冻结列表之中,系统会把该事务目录设置为UHEAPTUP_SLOT_FROZEN(冻结)。 ③ 设置为冻结之后,事务目录中的XID及Undo指针会被无效化。 (3) 如果上述的冻结操作并未产生可用的槽位,系统会遍历事务目录并寻找与已提交或已中止事务关联的条目。这些条目在满足一定条件的状况下可被复用。 (4) 遍历目标页面上的元组。 ① 如果系统发现元组关联的事务目录存在于步骤(3)给出的已提交列表中,系统就把该TD条目的flag设为UHEAP_INVALID_XACT_SLOT(无效)。 ② 此外,这些事务目录的XID被重设为无效XID。但为了维护undo链的完整,undo指针将被保留。 (5) 如果并未找到与已提交事务关联的事务目录,最后将寻找与已中止事务关联的事务目录。 (6) 遍历与已中止事务关联的事务目录:对于每个事务目录,沿着undo链执行相关的undo操作。 (7) 如果并未找到事务目录,扩展事务目录。 (8) 返回结果。 3. 回滚段设计与MVCC 1) 回滚段 旧版本数据会集中在回滚段的undo目录中,为了减少读写冲突,旧版本数据(回滚记录)采用追加写的方式写入数据目录的undo目录下。这样旧版本数据的读取和写入不会发生冲突,同一个事务的旧版本数据也会连续存放,便于进行回滚操作。为了减少并发写入时的竞争,undo目录空间被划分成多个逻辑区域(UndoZone,回滚段逻辑区域)。线程会在自己的逻辑区域上进行分配,与其他线程完全隔离,从而写入旧数据分配空间时就不会有额外的锁开销。UndoZone还可以按照CPU的NUMA核进行划分,每个线程会从当前的NUMA核上的UndoZone进行分配,进一步提升分配效率。在分配undo空间时会按照事务粒度进行记录,旧版本数据一旦确认没有事务进行访问,就会进行回收。 为了在回滚段的空间寻址,回滚记录使用8字节的指针来进行寻址,如图4-14所示。 图4-14 回滚记录寻址指针 其中各个字段的含义如下: (1) zoneId:占用20bit,表示逻辑区域的ID。 (2) blockId:占用31bit,表示块号,默认为8k。 (3) offset:占用13bit,表示块内偏移。 旧版本的数据采用回滚记录的格式存入回滚段中,其中回滚记录的格式如下所示: Class UndoRecord { … UndoRecordHeader whdr_; UndoRecordBlock wblk_; UndoRecordTransaction wtxn_; UndoRecordPayload wpay_; UndoRecordOldTd wtd_; UndoRecordPartition wpart_; UndoRecordTablespace wtspc_; StringInfoData rawdata_; } 其中,除了rawdata_代表了旧版本数据,其他成员均为结构体,下面对每个结构体分别进行说明。 whdr_成员由下面的结构组成: typedef struct { TransactionId xid; CommandId cid; Oid reloid; Oid relfilenode; uint8 utype; uint8 uinfo; } UndoRecordHeader; 各个字段的含义如下。 (1) xid:生成此回滚记录的事务ID,用于检查事务的可见性。“2)MVCC”小节有介绍。 (2) CID(Command ID,命令ID):生成此回滚记录的命令ID,用于判断可见性。 (3) reloid:relation对象的ID,回滚时需要。 (4) relfilenode:relfilenode对象的ID,回滚时需要。 (5) utype:操作类型,像UNDO_INSERT、UNDO_DELETE、UNDO_UPDATE等。 (6) uinfo:控制字段,用来判断后续的结构是否存在,用来减少回滚记录的占用空间。 wblk_成员由下面的结构组成: typedef struct { UndoRecPtr blkprev; BlockNumber blkno; OffsetNumber offset; } UndoRecordBlock; (1) blkprev:指向同一个block前一条回滚记录,用于回滚和事务可见性。“2)MVCC”小节有介绍。 (2) blkno:block number(块号)。 (3) Offset:修改的tuple在row pointer中的偏移。 wtxn_成员由下面的结构组成。 typedef struct { UndoRecPtr prevurp; } UndoRecordTransaction; prevurp:当一个事务的回滚记录跨越两个UndoZone时,后续的回滚记录使用此指针指向前一条回滚记录。 wpay_成员由下面的结构组成。 typedef struct { UndoRecordSize payloadlen; } payloadlen:rawdata_的长度。 wtd_成员由下面的结构组成。 typedef struct { TransactionId oldxactid; } UndoRecordOldTd; oldxactid:旧版本数据里事务目录的事务ID。 wpart_成员由下面的结构组成。 typedef struct { Oid partitionoid; } UndoRecordPartition; partitionoid:分区表的分区对象OID。 wtspc_成员由下面的结构组成。 typedef struct { Oid tablespace; } UndoRecordTablespace; tablespace:表空间的OID。 回滚段使用事务目录来记录每个事务分配的undo空间,便于事务回滚和回收。事务发生回滚时,会读取事务目录中记录的undo空间的起始位置,再读取undo空间中的回滚记录进行回滚操作,其中回滚记录中的字段如下: class TransactionSlot { TransactionId xactId_; UndoRecPtr startUndoPtr_;/*事务分配的undo空间开始*/ UndoRecPtr endUndoPtr_;/*事务分配的undo空间结束*/ uint8 info_;/*标记:如事务回滚状态*/ Oid dbId_;/*数据库对象ID*/ } (1) xactId:事务ID。 (2) startUndoPtr:事务分配的undo空间开始位置。 (3) endUndoPtr:事务分配的undo空间结束位置。 (4) info_:标记值,如事务回滚状态。 (5) dbId:数据库对象ID。 回滚段提供分配undo空间和更新事务目录的接口,主要接口如表4-21所示。 表4-21 回滚段主要接口 接口名 含义 AllocateUndoSpace 为回滚记录分配undo空间 UpdateTransactionSlot 更新事务目录 以ustore的删除操作为例,undo空间分配流程如下。 (1) UheapDelete作为ustore的删除接口,会调用UHeapPrepareUndoDelete函数准备回滚记录(undo record)。UHeapPrepareUndoDelete函数会填充回滚记录的各个字段(其中旧数据会设置到回滚记录的raw data字段上),再调用PrepareUndoRecord函数分配undo空间。PrepareUndoRecord函数调用“undo::AllocateUndoSpace”函数分配undo空间,再读取对应的回滚记录到缓冲池中。AllocateUndoSpace函数不仅会为回滚记录分配空间(使用“UndoZone::AllocateSpace”函数),如果是事务的第一条回滚记录,还会调用“UndoZone::AllocateSlotSpace”函数为事务目录分配空间。AllocateSpace函数会进行判断,如果回滚记录超过当前undo file的大小,就扩展当前的undo file,AllocateSlotSpace函数的逻辑类似。 (2) UheapDelete函数调用InsertPreparedUndo函数,将准备好的回滚记录追加写到缓冲池中的回滚段页面。 (3) UheapDelete函数调用UpdateTransactionSlot,记录下该事务分配的undo空间起始、事务ID、数据库ID。如果是事务的第一次更新,会从事务目录空间分配新的事务目录再进行更新。 undo空间需要回收回滚记录来保证undo空间不会无限膨胀,一旦事务id小于当前快照中最小的Xmin(oldestXmin),回滚记录中的旧版本数据就不会被访问,此时就可以对回滚记录进行回收。 如前述描述undo空间中的回滚记录按照事务ID递增的顺序存放在UndoZone中,回收的条件如下所示。 (1) 事务已经提交并且小于oldestXmin的undo空间可以回收。 (2) 事务发生回滚但已经完成回滚的undo空间可以回收。 图4-15 undo回收过程 如图4-15所示,UndoZone1中回收到小于oldestXmin的已提交事务16068,UndoZone2中回收到16050,UndoZone m回收到16056。而UndoZone n回收到事务16012,而事务16014待回滚但未发生回滚,因此UndoZone n回收事务id上限只到16014。其他zone的上限是oldestXmin,oldestXidInUndo会取所有undozone上的上限最小值,因此oldestXidInUndo等于16014。undo回收主要函数如表4-22所示。 表4-22 undo回收主要函数 函数名 操作含义 UndoRecycleMain 回收线程的入口函数,会在每个zone上调用RecycleUndoSpace函数 RecycleUndoSpace 按照前述条件回收undo空间,记录日志 2) MVCC ustore的可见性检查和astore类似,将快照CSN和元组删除和插入事务的CSN进行比较,判断元组是否可见。ustore和astore使用同一套事务管理机制和快照管理机制。 ustore和astore最大的区别在于astore会在页面上保留旧版本数据,而ustore在将旧版本数据放到回滚段统一存放。在需要获取旧版本数据时,astore可以直接从tuple的头部读取到元组的插入和删除的事务号(XID),来判断元组的可见性。但是ustore需要从回滚段里读取旧版本的事务信息,来判断旧版本是否可见。由于从回滚段中读取旧版本数据存在相对昂贵的开销,ustore通过一系列的优化手段来避免从回滚段中读取旧版本数据。 ustore在获取元组时,会先检查对应的事务目录。事务目录分成有效和无效两种。当事务目录是有效的,ustore直接就会得到元组上最新的事务。 如果事务目录被冻结(FROZEN),意味着元组已经在所有的事务中都会可见。如果事务目录中的事务id小于oldestXidInUndo,意味着元组已经足够旧在所有事务中都可见。同时会把事务目录置成冻结,来加速后续的查询。 如果元组被标记有一个无效事务目录,意味着修改元组的事务已经提交,并且比当前的事务目录中的事务旧。此时ustore会使用事务目录中的事务进行可见性判断。如果可见,意味着修改元组的事务更已经可见,就不需要从undo目录中再读取事务信息。 图4-16 元组查询过程 元组不可见的场景,ustore会从undo目录中读取回滚记录中的旧版本数据查找元组。例子如图4-16所示。查找tbl表中c1=1的数据项,从索引中读取到数据项位于block 1和offset 2,使用UHeapTupleFetch函数再从block 1中查询到元组,需要判断该元组的可见性。 (1) 从元组的TD读到ITL2,和astore类似,根据CSN的大小,判断TD2中的XID不可见,需要使用GetTupleFromUndo函数读取回滚记录。 (2) GetTupleFromUndo函数调用GetTupleFromUndoRecord函数读取回滚记录,使用InplaceSatisfyUndoRecord函数判断其中的block 1和offset 2是满足要求的元组。但是XID=1610可以判断出当前页面的tuple不可见,ustore继续查询更老的版本。由于旧元组的TD 1和当前的TD 2不一致,使用UHeapUpdateTDInfo从TD 2 undo链条进行切换,根据旧元组的TD 1找到当前的undo指针找到前一次修改。 (3) 再次读取到回滚记录,其中的block 1和offset 1并非要找的元组,ustore继续查询更老的版本,根据blkprev指针读取前一次修改。 (4) 读取到回滚记录,其中的block 1和offset 3并非要找的元组,ustore继续查询更老的版本,根据blkprev指针读取前一次修改。 (5) 读取到回滚记录,其中的block 1和offset 2是要求的元组,ustore判断可见性。根据CSN的大小,事务可见。因此前一次命中的元组可见,即(1, abc)可见,因此查找到元组的c2等于abc。 4. 多版本索引 在openGauss中实现了多版本索引ubtree,是专用于ustore的B-Tree索引变种,相比原有的B-Tree索引有如下差异点。 (1) 支持索引数据的多版本管理及可见性检查,能够自主鉴别旧版本元组并进行回收,同时索引层的可见性检查使得索引扫描(Index Scan)及仅索引扫描(Index Only Scan)性能有所提升。 (2) 在索引插入操作之外,增加了索引删除操作,用于对被删除或修改的元组对应的索引元组进行标记。 (3) 索引按照key + TID的顺序排列,索引列相同的元组按照对应元组的TID作为第二关键字进行排序。 (4) 添加新的可选页面分裂策略“insertpt”。 ubtree实现了索引访问接口所要求的全部接口,如表4-23所示: 表4-23 ubtree访问接口函数 接口名称 对应函数 接口含义 aminsert ubtinsert 插入一个索引元组 ambeginscan ubtbeginscan 开始一次索引扫描 amgettuple ubtgettuple 获取一个索引元组 amgetbitmap ubtgetbitmap 通过索引扫描获取所有元组 amrescan ubtrescan 重新开始一次索引扫描 amendscan ubtendscan 结束索引扫描 ammarkpos ubtmarkpos 标记一个扫描位置 amrestpos ubtrestpos 恢复到一个扫描位置 ammerge ubtmerge 合并多个索引 ambuild ubtbuild 建立一个索引 ambuildempty ubtbuildempty 建立一个空索引 ambulkdelete ubtbulkdelete 批量删除索引元组 amvacuumcleanup ubtvacuumcleanup 索引后置清理 amcanreturn ubtcanreturn 是否支持 Index Only Scan amcostestimate ubtcostestimate 索引扫描代价估计 amoptions ubtoptions 索引选项 此外,还实现了新增的的索引删除函数UBTreeDelete。 1) 索引页面组织 多版本索引层次结构与B-Tree索引基本相同,非叶子节点与B-Tree索引保持一致,仅页尾的Special字段有所不同。ubtree中的Special字段UBTPageOpaqueDataInternal如下所示: typedef struct UBTPageOpaqueDataInternal { …… /* 以上部分与BTPageOpaqueDataInternal一致 */ TransactionId last_delete_xid; /* 记录页面上最后一次删除事务的 XID */ TransactionId xid_base; /* 页面上的 xid-base */ int16 activeTupleCount; /* 页面上活跃元组计数 */ } UBTPageOpaqueDataInternal; typedef UBTPageOpaqueDataInternal* UBTPageOpaqueInternal; 其中last_delete_xid与activeTupleCount用于索引的自治式回收,会在ustore中的“6. 空间管理和回收”一节详细讲解。 通过xid_base字段,页面上的XID可以仅储存基于该xid_base的一个32位偏移(Offset),节省XID存储的空间开销。实际的XID为页面上的xid_base加上存储的XID(也就是偏移)得到。 多版本中的叶子页面的结构如图4-17所示。 图4-17 ubtree 叶子页面结构示意图 与astore堆页面中维护版本信息的方法类似,ubtree的叶子节点中每个索引元组尾部都附加了对应的xmin和xmax。由于索引只是用于加速搜索的结构,本身不与历史版本概念强相关,仅通过xmin和xmax来标识这个索引元组是从什么时候开始有效的,又是什么时候被删除的,而不像astore中堆元组一样会有指向旧版本元组的指针。 新插入的索引元组尾部用于存放xmin和xmax 空间在ubtinsert函数执行的过程中预留出来。预留的空间及xmin在索引元组插入时通过UBTreePageAddTuple函数中写入页面,而xmax在索引元组删除时通过UBTreeDeleteOnPage函数中写入页面。 在UBTreePagePruneOpt函数中,索引元组通过其xmin和xmax信息来判断该元组是否已经无效(Dead),进而进行独立的页面清理。该函数会尝试清除所有无效的元组,并进行相应的碎片整理。 索引扫描时会调用UBTreeFirst函数定位到第一个满足扫描条件的索引元组,然后调用UBTreeReadPage获取当前页面中符合索引扫描条件,且能够通过可见性检查的元组。可见性检查通过UBTreeVisibilityCheckXid函数及UBTreeVisibilityCheckCid函数处理,其基本逻辑与astore类似,通过xmin与xmax及当前的快照进行可见性判断。 在ubtree中,索引元组除了按照索引列有序排列之外,对于索引列相同的元组,还将其对应堆元组的TID作为第二关键字进行排序。其具体实现大致都集中在ubtbuild函数及ubtinsert函数调用的过程中,这中间对索引列相同的元组会按照TID来进行额外的比较。实现还借助了BTScanInsert结构体,该结构体定义如下: typedef struct BTScanInsertData { bool heapkeyspace; /* 标志索引是否额外按 TID 排序 */ bool anynullkeys; /* 标志待查找的索引元组是否有为 NULL的列 */ bool nextkey; /* 标志是否希望寻找第一个大于扫描条件的元组 */ bool pivotsearch; /* 标志是否希望查找 Pivot 元组 */ ItemPointer scantid; /* 用于作为排序依据的 TID */ int keysz; /* scankeys 数组的大小 */ ScanKeyData scankeys[INDEX_MAX_KEYS]; } BTScanInsertData; 在索引元组将TID作为第二关键字排序之后,用于划分搜索空间的非叶子节点元组及叶子节点的Hikey元组(统称Pivot元组)也需要携带对应的TID信息。这会使得Pivot元组占用空间增加,非叶子的扇出(fan out)降低。为了避免这一特性导致的扇出降低,若不需要比较TID即可区分两个叶子页面,则对应的Pivot原则中就不需要储存TID信息。类似地,Pivot元组中也可以去掉一些不需要进行比较的索引列,这一逻辑在UBTreeTruncate函数中进行处理。原则是当比较前几列就可以区分两个叶子页面时,Pivot元组中就不需要储存后续的列。 2) 索引操作 对于原有的B-Tree索引而言,主要有四类操作:索引创建、索引扫描、索引插入以及索引删除。下面将依次进行介绍。 (1) 索引创建。 索引创建操作由索引上的ubtbuild函数及ustore上的IndexBuildUHeapScan函数配合完成。IndexBuildUHeapScan函数负责扫描对应的ustore表,并取出每个元组的最新版本(遵循SnapshotNow的语义)以及其对应的xmin和xmax。若发现某个元组存在被就地更新的旧版本,则会将该索引标记为HotChainBroken。被标记为HotChainBroken的索引,会复用astore原有的逻辑,禁止隔离级别为可重复读(Read Repeatable)的老事务访问。ubtbuild函数会接收IndexBuildUHeapScan传过来的元组,将其按照索引列及TID排序后依次插入到索引页面中,并构建相应的元页面及上层页面。整个创建流程需要将所有页面都记录到XLOG中,并强制将存储管理中的内容刷到永久存储介质后才算成功结束。 (2) 索引扫描。 索引扫描与B-Tree索引基本一致,但是需要对索引元组进行可见性检查。没有通过可见性检查的索引元组不会被返回,通过可见性检查的元组仍需要在ustor 堆表上进行可见性检查,并找到正确的可见版本。在IndexOnlyScan场景中,通过可见性检查的元组即可直接返回,不需要再访问堆表。 不过索引进行可见性检查时,由于索引元组只存放了xmin和xmax而没有CID(对应“4.2.3 astore”节堆表元组中的t_cid字段)信息,如果发现了当前事务修改过的索引元组则不能正确地通过CID来判断其可见性。此时会将该元组视为可见,但会标记xs_recheck_itup,告知ustore的数据页面需要在取到对应的数据元组后,再次构建对应的索引元组并与返回的索引元组进行比较,来确认该索引元组是不是真正可见。相关逻辑在 UBTreeVisibilityCheckXid、UBTreeVisibilityCheckCid以及RecheckIndexTuple函数中进行处理。 (3) 索引插入。 索引元组需要存储对应的xmin和xmax版本信息,但其所占用的空间并不表现在IndexTupleSize中,而是对外部透明。索引插入的接口函数为ubtinsert,为了正确插入带有版本信息的元组,需要在执行插入前增加IndexTupleSize以预留用于储存版本信息的空间。真正将元组插入到页面的时候,会将版本信息所占用的空间大小从IndexTupleSize中去除。 在索引插入的过程中若页面空间不足,会首先调用UBTreePagePruneOpt函数尝试对已经无效的元组进行清理。若清理失败或清理成功后空间仍然不足,会进行索引页面分裂。索引页面分裂会在UBTreeInsertOnPage函数中进行。ubtree中存在两种分裂策略:default以及insertpt。其中default策略会将原页面上的内容均匀地分配到两个页面上,而insertpt会根据新插入元组的插入规律、插入位置及TID等信息选择合适的分裂点。 在ubtree需要申请新的页面时,并不会像原有的B-Tree索引一样调用_bt_getbuf通过FSM来查找可用页面。ubtree带有自治式的空间管理机制,通过UBtreeGetNewPage函数获取新页面。该自治式空间管理机制将在空间管理和回收部分介绍。 (4) 索引删除。 索引删除操作用于在堆元组被删除的同时,将对应的索引元组也标上对应的xmax。索引删除的流程与插入类似,通过二分查找定位到待删除元组的位置,并将xmax写入到对应的位置。需要注意的是,要删除的元组是索引列以及TID都匹配,且还未被写入xmax的那个元组,这部分逻辑在UBTreeFindDeleteLoc函数中处理。在最后会调用UBTreeDeleteOnPage函数为对应的索引元组写上xmax,更新页面上的last_delete_xid以及activeTupleCount,并在检测到activeTupleCount为0时将该页面放入潜在空页队列(Potential Empty Page Queue)中。关于潜在空页队列会在空间管理和回收部分介绍。 5. 存取管理 openGauss中的ustore表访存接口如表4-24所示。由于openGauss中ustore表只有一种页面和元组结构,因此在上述接口中,直接实现了底层的页面和元组操作流程。 表4-24 ustore表访存接口 函数名称 接口含义 heap_open 打开一个ustore表,得到表的相关元信息 heap_close 关闭一个ustore表,释放该表的加锁或引用 UHeapRescan 重新开始ustore表(顺序)扫描操作 UHeapGetNext (顺序)获取下一条元组 UHeapGetTupleFromPage UHeapGetNext内部实现,单页校验模式 UHeapScanGetTuple UHeapGetNext内部实现,单条校验模式 UHeapGetPage (顺序)获取并扫描下一个ustore表页面 UHeapInsert 在ustore表中插入一条元组 UHeapMultiInsert 在ustore表中批量插入多条元组 UHeapDelete 在ustore表中删除一条元组 UHeapUpdate 在ustore表中更新一条元组 UHeapLockTuple 在ustore表中对一条元组加锁 6. 空间管理和回收 不同于astore的空间管理和回收机制,ustore实现了自治式的空间管理机制。ustore里堆以及索引的空间分配和回收都在业务运行的过程中平稳地进行,不依赖中量级的VACUUM及AUTOVACUUM清理机制。 1) 自治式堆页面空间管理 ustore中堆页面的自治式空间管理,建立在与astore类似的轻量级堆页面清理机制的基础上。在执行DML及DQL操作的过程中,ustore都会进行堆数据页面清理,以取代VACUUM清理机制。UHeapPagePruneOptPage函数是页面清理的入口函数,会清理已经提交的被删除元组。 对于astore而言,复用数据元组的行指针前必须保证对应的索引元组已经被清理。这是为了防止通过索引元组访问已经被复用的行指针,导致取到错误的数据。在astore中需要通过VACUUM操作将这样的无效索引元组统一清除掉后才能复用行指针,这使得堆页面和索引页面的清理逻辑耦合在一起,也会导致间断性的大量I/O。在ustore中能高效地单独进行数据和索引页面的清理,因为带有版本信息的ubtree能够独立检测并过滤掉无效的索引元组,不会通过无效索引元组访问对应的数据表。 堆页面的空间管理机制复用openGauss中的FSM来管理UHeap中的可用空间。在UHeapPagePruneOptPage函数成功对页面进行清理后,会将其空闲空间刷新到对应的FSM页面中。为了避免每次页面清理都需要更新整个树状结构的FSM,从而带来额外的开销,引入了一个更新整个FSM的概率计算。考虑当前清理后的可用空间占预留可用空间(Reserved Free Space)阈值的百分比,计算得出清理一个页面后调用FreeSpaceMapVacuum函数的概率。也就是说,页面清理获得的可用空间越大,更新整个FSM的概率也就越大。 当数据元组被删除时,会在页面上记录对应的潜在空闲空间(Potential Free Space),该值用于估计页面上的空闲空间。在运行过程中,有多个场景会调用UHeapPagePruneOpt对页面尝试进行清理。DML语句执行过程中,INSERT、UPDATE以及DELETE操作都会拿到页面的写锁。如果发现空间不足,或者检测到潜在空闲空间到达某个阈值,会尝试对页面进行清理。DQL查询语句执行的过程中若检测到页面上潜在空闲空间到达阈值,也同样会尝试申请页面的写锁;如果拿到了页面的写锁,会尝试对页面进行清理。 存在可清理的元组,但一直不被访问的页面不能通过这一机制正确地清理。为了解决这一问题,引入了基于概率的清理方案。在RelationGetBufferForUTuple函数寻找新的可用空间时,若通过FSM发现没有足够的可用空间,在对物理文件进行扩展前,会“随机”选取一些页面进行清理。该机制并非完全随机选取,在多次尝试后选取的页面会覆盖到整个关系的全部页面。为了性能考虑,该过程中默认最多选取10个页面进行清理,该数量可以通过GUC参数max_search_length_for_prune进行设置。具体的页面选取数量通过DeadTupleRatio以及PruneSuccessRatio计算得出。其中DeadTupleRatio表示该表中无效元组的大致比例,该变量以统计信息的方式进行收集,在进行DML的过程中会进行更新;PruneSuccessRatio大致表示近几次尝试清理的成功率。 2) 自治式索引页面空间管理 索引页面的空间管理不依靠FSM数据结构,而是依靠特有的URQ(UBtree Recycle Queue)结构,简称为回收队列。索引回收队列单独储存在ubtree索引对应的.urq文件中,没有原有B-Tree索引的.fsm文件。索引回收队列相关代码在“ubtrecycle.cpp”文件中。涉及到的主要函数接口见表4-25。 表4-25 索引回收队列主要接口 函数名称 接口含义 UBTreeTryRecycleEmptyPage 尝试从潜在空页队列回收一个页面 UBTreeGetAvailablePage 获取有效页面(潜在空页或空闲页面) UBTreeRecordUsedPage 记录被成功使用的页面 UBTreeRecordEmptyPage 记录潜在的空页 UBTreeGetNewPage 获取新的可用页面 索引中的回收队列分为两部分,一部分是潜在空页队列(Potential Empty Page Queue),一部分是可用页面队列(Available Page Queue)。两个队列都是跨页面的循环队列,其中每个元素都会储存blkno以及XID。其中blkno表示该元素对应索引页面的block number;XID表示该页面在哪个时刻能够被回收或复用。这些元素在循环队列单个页内按照XID的顺序进行排序,以便于快速找到XID 小(最可能被回收或复用)的页面。其结构如图4-18所示。 图4-18 ubtree回收队列结构示意图 对于潜在空页队列而言,里面存放页内元组已经被全部删除但还没有全部无效的页面,其中的XID就标志页面中最后一个元组无效的可能时机。在系统整体的oldestXmin超过该XID后,该页面就有可能被从索引上删除,但也可能因为新插入元组或删除元组的事务中止而导致页面不能被删除。潜在空页队列中的页面在成功被删除后会被放入可用页面队列,并记录删除时最新事务的XID。 对于可用页面队列而言,里面存放已经被删除,可以或即将可以被复用的页面。其中XID就表示该页面可以被复用的时机。这样的页面复用时延是来自B-Tree索引页面删除时可能的并发访问导致的,可以参考nbtree文件夹下README 关于页面删除的部分。 在ubtree进行索引删除时,会更新页面上的last_delete_xid字段以及activeTupleCount字段。若更新后activeTupleCount变为0,会将该页面放入潜在空页队列,并将此时的last_delete_xid作为对应的可回收时间点。 在业务运行的过程中,索引会通过UBTreeTryRecycleEmptyPage函数不断尝试对潜在空页队列中的页面进行回收。在索引申请新的页面时,会通过UBTreeGetNewPage函数与可用页面队列交互,查找当前可用的空闲页面。当可用页面队列中没有可用页面时,一般会通过扩展索引物理文件的方式来获得新的页面。但也存在物理文件批量扩展,或扩展后还未来得及使用就出错退出的情况。此时在回收队列的元信息页面中保存了已正确追踪的页面数量,若该数量少于整个索引表的页面数量,会尝试去使用这一部分未追踪的页面,并更新已追踪的页面数量。 3) 中量级和重量级手动页面清理 与astore相同,ustore也提供VACUUM语句来让用户主动执行对某个ustore表及其上的索引进行中量级清理。其对外表现与astore一致,可参考astore的空间管理和回收内容。 在ustore中,中量级清理同样通过lazy_vacuum_rel函数进入,但不会调用lazy_scan_heap,而是调用LazyScanUHeap函数来进行数据页面的清理。在进行索引清理时,会调用lazy_vacuum_index接口及LazyVacuumHeap函数来清理索引文件和堆表文件,索引清理时会调用ubtbulkdelete函数。 重量级的VACUUM FULL也与astore一致,会清理无效数据并对数据空间和索引空间重新进行组织。重量级清理的对外接口是cluster_rel函数,本质上是重新对数据进行聚簇,清理过程中会阻塞对该表的所有操作。 介绍完“4.2.4 ustore”,下篇我们将详细介绍“4.2.5 行存储索引机制”相关内容,敬请期待!

优秀的个人博客,低调大师

openGauss数据库源码解析系列文章——存储引擎源码解析(三)

上一篇我们将详细介绍“4.2.3 astore”相关内容,本篇我们将讲述“3. astore元组多版本机制”、“4.astore访存管理”及“5.astore空间管理和回收”。 4.2.3 astore 3. astore元组多版本机制 openGauss行存储表支持多版本元组机制,即为同一条记录保留多个历史版本的物理元组以解决对同一条记录的读、写并发冲突(读事务和写事务工作在不同版本的物理元组上)。 astore存储格式为追加写优化设计,其多版本元组产生和存储方式如图4-5所示。当一个更新操作将v0版本元组更新为v1版本元组之后,如果v0版本元组所在页面仍然有空闲空间,则直接在该页面内插入更新后的v1版本元组,并将v0版本的元组指针指向v1版本的元组指针。在这个过程中,新版本元组以追加写的方式和被更新的老版本元组混合存放,这样可以减少更新操作的I/O开销。然而,需要指出的是,由于新、老版本元组是混合存放的,因此在清理老版本元组时需要的清理开销会比较大。因此,astore存储格式比较适合频繁插入、少量更新的业务场景。 图4-5 astore多版本元组产生和存储方式示意图 下面结合图4-6,介绍openGauss中行存储格式多版本元组的运行机制: 图4-6 行存储格式多版本元组运行机制示意图 (1) 首先事务号为10的事务插入一条值为value1的新记录。对应的页面修改为:在0号物理页面的第一个元组指针指向位置,插入一条“xmin”字段为10、“xmax”字段为0、“ctid”字段为(0,1)、“data”字段为value1的物理元组。该事务提交,将CSN从3推进到4,并且在CSN日志中对应事务号10的槽位处记下该CSN的值。 (2) 然后事务号为12的事务将上面这条记录的值从value1修改为value2。对应的页面修改为:在0号物理页面的第二个元组指针指向位置,插入另一条“xmin”字段为12、“xmax”字段为0、“ctid”字段为(0,2)、“data”为value2的物理元组。同时保留上面第一条插入的物理元组,但是将其“xmax”字段从0修改为12,将其“ctid”字段修改为(0,2),即新版本元组的物理位置。该事务提交,将CSN从7推进到8,并且在CSN日志中对应事务号12的槽位处记下该CSN的值。 (3) 最后事务号为15的事务将上面这条记录的值从value2又修改为value3,对应的页面修改为:(假设0号页面已满)在1号物理页面的第一个元组指针指向位置,插入一条“xmin”字段为15、“xmax”字段为0、“ctid”字段为(1,1)、“data”字段为value3的物理元组;同时,保留上面第1、第2条插入的物理元组,但是将第2条物理元组的“xmax”字段从0修改为15,将其“ctid”字段修改为(1,1),即最新版本元组的物理位置。该事务提交,将CSN从9推进到10,并且在CSN日志中对应事务号15的槽位处记下该CSN的值。 (4) 对于并发的读事务,其在查询执行开始时,会获取当前的全局CSN值作为查询的快照CSN。对于上面同一条记录的3个版本的物理元组来说,该读查询操作只能看到同时满足如下两个条件的这个物理元组版本。 元组“xmin”字段对应的CSN值小于等于读查询的快照CSN。 元组“xmax”字段为0,或者元组“xmax”字段对应的CSN值大于读查询的快照CSN。 比如,若并发读查询的快照CSN为8,那么这条查询将看到value2这条物理元组;若并发读查询的快照CSN为11,那么这条查询将看到value3这条物理元组。 对于不同的行存储子格式,上述多版本元组的格式和存储方式可能有所不同,但是可见性判断和并发控制方式都是如图4-6中所示的。通过上面介绍的元组可见性判断流程,可以发现:并发的读事务会根据自己的查询快照在同一个记录的多个历史版本元组中选择合适的那个来返回。并且即使是在可重复读的事务隔离级别下,只要使用相同的快照总可以筛选出相同的那个历史版本元组。在整个过程中读事务不阻塞任何对该记录的并发写操作(更新和删除)。 更详细的元组可见性判断流程将在第5章中详细介绍。 最后,对于astore行存储格式,更新一条记录的详细执行流程如图4-7所示,该图可以帮助读者更形象地理解多版本元组的产生流程,以及写、写并发下的处理逻辑。 图4-7 更新astore记录的执行流程示意图 4. astore访存管理 openGauss中的astore堆表访存接口如表4-13所示。 表4-13 astore堆表访存接口 接口名称 接口含义 对应的行存储统一访存接口 heap_open 打开一个表,得到表的相关元信息 无 heap_close 关闭一个表,释放该表的加锁或引用 无 heap_beginscan 初始化堆表(顺序)扫描操作 tableam_scan_begin heap_endscan 结束并释放堆表(顺序)扫描操作 tableam_scan_end heap_rescan 重新开始堆表(顺序)扫描操作 tableam_scan_rescan heap_getnext (顺序)获取下一条元组 tableam_scan_getnexttuple heap_markpos 记录当前扫描位置 tableam_scan_markpos heap_restrpos 重置扫描位置 tableam_scan_restrpos heapgettup_pagemode heap_getnext内部实现,单页校验模式 无 heapgettup heap_getnext内部实现,单条校验模式 无 heapgetpage (顺序)获取并扫描下一个堆表页面 tableam_scan_getpage heap_init_parallel_seqscan 初始化并行堆表(顺序)扫描操作 tableam_scan_init_parallel_seqscan heap_insert 在堆表中插入一条元组 tableam_tuple_insert heap_multi_insert 在堆表中批量插入多条元组 tableam_tuple_multi_insert heap_delete 在堆表中删除一条元组 tableam_tuple_delete heap_update 在堆表中更新一条元组 tableam_tuple_update heap_lock_tuple 在堆表中对一条元组加锁 tableam_tuple_lock heap_inplace_update 在堆表中(就地)更新一条元组 无 以astore堆表顺序扫描为例,执行流程如下。 (1) 调用heap_open接口打开待扫描的堆表,获取表的相关元信息,如表的行存储子格式为astore格式等。该步通常要获取AccessShare一级表锁,防止并发的DDL操作。 (2) 调用tableam_scan_begin接口,从g_tableam_routines数组中找到astore的初始化扫描接口,即heap_beginscan接口,完成初始化顺序扫描操作相关的结构体。 (3) 循环调用tableam_scan_getnexttuple接口,从g_tableam_routines数组中找到astore的扫描元组接口,即heap_getnext接口,顺序获取一条astore元组,直到完成全部扫描。顺序扫描时,每次先获取下一个页面,然后依次返回该页面上的每一条元组。这里提供了两种元组可见性的判断时机: a) heapgettup_pagemode。在第一次加载下一个页面时,加上页面共享锁,完成对页面上所有元组的可见性判断,然后将可见的元组位置保存起来,释放页面共享锁。后面每次直接从保存的可见性元组列表中返回下一条可见的元组,无须再对页面加共享,使用快照的查询,默认都使用该批量模式,因为元组的可见性在同一个快照中不会再发生变化。 b) heapgetpage。除了第一次加载下一个页面时需要批量校验元组可见性之外,在后面每一次返回该页面下一条元组时,都要重新对页面加共享锁,判断下一条元组的可见性。该模式的查询性能较批量模式要稍低,适用于对系统表的顺序扫描(系统表的可见性不参照查询快照,而是以实时的事务提交状态为准)。 (4) 调用tableam_scan_end接口,从g_tableam_routines数组中找到astore的扫描结束接口,即heap_endscan接口,结束顺序扫描操作,释放对应的扫描结构体。 (5) 调用heap_close接口,释放对表加的锁或引用计数。 5. astore空间管理和回收 openGauss中采用最大堆二叉树结构来记录和管理astore堆表页面的空闲空间,该最大堆二叉树结构按照页面粒度进行与存储介质的读写操作,并单独储存于专门的空闲空间位图文件中(free space map,简称FSM)。该FSM文件的结构如图4-8所示。 图4-8 astore FSM文件结构示意图 所有页面分为叶子节点页面和内部节点页面两种。两种页面的页面内部结构完全相同,区别在于:对于叶子节点页面,其页面中记录的二叉树的叶子节点对应堆/索引表页面的空闲空间程度;对于内部节点页面,其页面中记录的二叉树的叶子节点对应下层FSM页面的最大空闲空间程度。 使用FSM页面中的1个字节(即256档)来记录一个堆/索引页面的空闲空间程度。在FSM页面中不会记录任何堆/索引页面的页号信息,也不会记录任何根、子FSM节点页面的页号信息,这些信息主要通过以下的规则来计算得到: (1) 在一个FSM页面内部,二叉树节点按照从上到下、从左到右逐层排布,即:第一个字节为根节点的空闲程度,第二个字节为第一层内部节点最左边节点的空闲程度,依次类推。 (2) 所有FSM页面在物理存储上采用深度优先顺序,即某个FSM页面之前所有的物理页面包括:该FSM页面所在子树的所有上层节点,加上该FSM页面所有左侧子树。 (3)所有FSM叶子节点页面中的二叉树的叶子节点,对应堆/索引表页面的空闲空间程度,且根据从左到右的顺序,分别对应第1个、第2个、….、第n个堆/索引表物理页面。 (4)除了(3)中这些FSM节点之外,其他FSM父节点保存子节点(子树)中空闲空间的最大值。 根据上述算法,可以高效地查询出具有足够空闲空间的堆/索引页面的页面号,并将待插入的数据插入其中。 FSM模块主要的对外接口和含义如表4-14所示。 表4-14 FSM模块主要的对外接口 接口名称 接口含义 GetPageWithFreeSpace 获取空闲程度大于入参的堆/索引页面号 RecordAndGetPageWithFreeSpace 更新当前(不满足条件的)堆/索引页面的空闲空间程度,寻找新的空闲程度大于入参的堆/索引页面号 RecordPageWithFreeSpace 更新单个堆/索引页面的空闲空间程度 UpdateFreeSpaceMap 更新多个(批量插入的)堆/索引页面的空闲空间程度 FreeSpaceMapTruncateRel 删除所有储存大于某个堆/索引页面号空闲信息的FSM页面 FreeSpaceMapVacuum 修正所有FSM内部节点的空闲空间信息 此外,为了保证FSM信息的维护操作不会带来明显的开销,因此FSM的所有修改都是不记录日志的。同时,对于某个堆/索引页面对应的FSM信息,只在页面初始化和页面空闲空间整理(见本节后面介绍)两种场景下才会主动更新,除此之外,只有当新插入的数据发现该页面实际空间不足时才会被动更新该页面对应的FSM信息(也包括由于宕机导致的FSM页面损坏)。 空闲空间的管理难点在于空闲空间的回收。在openGauss中,对于astore存储格式,有3种回收空闲空间的方式,如图4-9所示。 图4-9 astore空闲空间回收机制示意图 1. 轻量级堆页面清理 当查询扫描到某个astore堆表页面时,会顺带尝试清理该页面上已经被删除的、足够老的元组(足够老是指在元组对于所有并发查询均为已经删除状态,具体参见事务处理章节)。由于只是顺带清理该页面内容,因此只能删除元组内容本身,元组指针还需要保留,以免在索引侧造成空引用或空指针(可参见4.2.5 行存储索引机制)。一个比较特殊的情况是HOT场景。HOT场景是指对于该表上所有的索引更新前后的索引键值均没有发生变化,因此对于更新后的元组只需要插入堆表元组而不需要新插入索引元组。对于同一个页面内一条HOT链上的多个元组,如果它们都足够老了,那么在清理时可以额外删除所有中间的元组指针,只保留第一个版本的元组指针,并将其重定向到第一个不用被清理的元组版本的元组指针。 轻量级堆页面清理的接口是heap_page_prune_opt函数,关键的数据结构是PruneState结构体,定义代码如下: typedef struct { TransactionId new_prune_xid; TransactionId latestRemovedXid; int nredirected; /* 待重定向的元组个数 */ int ndead; /* 待标记死亡的元组个数 */ int nunused; /* 待回收的元组个数 */ OffsetNumber redirected[MaxHeapTuplesPerPage * 2]; OffsetNumber nowdead[MaxHeapTuplesPerPage]; OffsetNumber nowunused[MaxHeapTuplesPerPage]; bool marked[MaxHeapTuplesPerPage + 1]; } PruneState; 其中,“new_prune_xid”字段用于记录页面上此次没有被清理的、但是已经被删除的元组的xmax,用于决定下次何时再次清理该页面;“latestRemovedXid”字段用于记录该页面上被清理的元组的最大的xmax,用于判断热备上回放页面整理时是否需要等待只读查询;nredirected、ndead、nunused、redirected、nowdead和nowunused分别记录该页面上待重定向的、待标记死亡的、待回收的元组。 2. 中量级堆页面和索引页面清理 openGauss提供VACUUM语句来让用户主动执行对某个astore表(或某个库中所有的astore表)及其上的索引进行中量级清理。中量级清理过程中,不阻塞相关表的查询和DML操作。由于在astore表中,新、老版本元组是混合存储的,因此,与顺带执行的轻量级清理相比,astore表的中量级清理需要进行全表顺序(或索引)扫描,才能识别出所有待清理的老版本元组。对于扫描出来的确认要清理的元组,会首先清理索引中的元组,然后再清理堆表中的元组,从而可以避免出现索引空指针的问题。 中量级清理的对外接口是lazy_vacuum_rel函数,内部逐层调用lazy_scan_rel、lazy_scan_heap和heap_page_prune(同轻量级清理)来扫描和暂存几类待清理的元组。当待清理的元组积攒到一定数量之后(受maintenance_work_mem内存上限控制),先后调用lazy_vacuum_index接口和lazy_vacuum_heap接口来分别清理索引文件和堆表文件。其中,与堆表页面将元组指针置为UNUSED不同,索引页面直接删除被清理的元组指针,并进行页面重整。 中量级清理的关键数据结构是LVRelStats结构体,定义代码如下: typedef struct LVRelStats { bool hasindex; /* 表上是否有索引 */ /* 统计信息 */ BlockNumber old_rel_pages; /* 之前的页面个数统计 */ BlockNumber rel_pages; /* 当前的页面个数统计 */ BlockNumber scanned_pages; /* 已经扫描的页面个数 */ double scanned_tuples; /* 已经扫描的元组个数 */ double old_rel_tuples; /* 之前的元组个数统计 */ double new_rel_tuples; /* 当前的元组个数统计 */ BlockNumber pages_removed; double tuples_deleted; BlockNumber nonempty_pages; /* 最后一个非空页面的页面号加1 */ /* 待清理的元组的行号信息(已排序) */ int num_dead_tuples; /* 当前待清理的元组个数 */ int max_dead_tuples; /* 单次最多可记录的待清理元组个数 */ ItemPointer dead_tuples; /* 待清理元组行号数组 */ int num_index_scans; TransactionId latestRemovedXid; bool lock_waiter_detected; BlockNumber* new_idx_pages; double* new_idx_tuples; bool* idx_estimated; Oid currVacuumPartOid; } LVRelStats; 其中hasindex表示该表是否有索引表,num_dead_tuples表示目前已经积攒的要清理的元组,dead_tuples是保存这些元组位置的TID数组,max_dead_tuples是根据maintenance_work_mem计算出来的单次允许积攒的最大待清理元组个数。 需要指出的是,如果在元组更新时就把老版本元组集中存储,那么清理时就无须全表扫描,只需要清理集中存储的老版本元组页面即可,这样可以有效降低清理过程带来的I/O开销,使得整体存储引擎的I/O开销和性能更平稳,这也是后续openGauss版本将支持的ustore行存储格式的设计出发点。 3. 重量级堆页面和索引页面清理 无论是轻量级清理,或是中量级清理,都只能局部清理astore页面中的死亡元组,无法真正实现对这些空闲空间的释放(被清理出的空间,仍然只能被该表使用)。因此,openGauss还提供了VACUUM FULL语句来让用户主动执行对某个astore表(或某个库中所有astore表)及其上的索引进行重量级清理。重量级清理将一个表中所有仍未死亡(但是可能已经被删除)的元组重新紧密插入到新的堆表文件中并在此基础上重新创建所有索引,从而实现对空闲空间的彻底回收。在重量级清理的主体流程中只允许用户执行只读查询操作,在重量级清理的提交流程中只读查询操作也会被阻塞。 为了尽可能提高重新创建的索引性能,如果用户堆表上有索引,那么上述全表扫描会采用索引扫描。 重量级清理的对外接口是cluster_rel函数,内部逐层调用rebuild_relation、copy_heap_data、tableam_relation_copy_for_cluster、heapam_relation_copy_for_cluster、copy_heap_data_internal、reform_and_rewrite_tuple、rewrite_heap_tuple。其中,“rewrite_heap_tuple”接口将每一条扫描的未死亡元组进行重构(去除被删除的字段)之后,插入到新的紧密排列的堆表中。在这个过程中,对原来多个元组之间的更新链关系采用两个哈希表来进行暂存。当一对更新元组的双方都扫描到之后,就进行新表的填充,并将更新后元组的新的TID(transaction ID,事务ID)保存到更新前的元组中。上述机制保证重量级清理过程中并发更新事务的执行机制不会受到破坏。 重量级清理的关键数据结构是RewriteStateData结构体,其定义代码如下: typedef struct RewriteStateData { Relation rs_old_rel; /* 源表 */ Relation rs_new_rel; /* 整理后的目标表 */ Page rs_buffer; /* 当前整理的源表页面 */ BlockNumber rs_blockno; /* 当前写入的目标表页面号 */ bool rs_buffer_valid; /* 当前缓冲区是否有效 */ bool rs_use_wal; /* 整理操作是否产生日志 */ TransactionId rs_oldest_xmin; /* 用于可见性判断的最老活跃事务号 */ TransactionId rs_freeze_xid; /* 用于元组冻结判断的事务号 */ MemoryContext rs_cxt; /* 哈希表内存上下文 */ HTAB *rs_unresolved_tups; /* 未匹配的更新前元组版本 */ HTAB *rs_old_new_tid_map; /* 未匹配的更新后元组版本 */ /* 元组压缩相关信息 */ PageCompress *rs_compressor; Page rs_cmprBuffer; HeapTuple *rs_tupBuf; Size rs_size; int rs_nTups; bool rs_doCmprFlag; /* 异步-同步读写相关 */ char *rs_buffers_queue; /* adio write queue */ char *rs_buffers_queue_ptr; /* adio write queue ptr */ BufferDesc *rs_buffers_handler; /* adio write buffer handler */ BufferDesc *rs_buffers_handler_ptr; /* adio write buffer handler ptr */ int rs_block_start; /* adio write start block id */ int rs_block_count; /* adio write block count */ } RewriteStateData; 其中,rs_old_rel是被清理的表,rs_new_rel是清理之后的表,rs_oldest_xmin是判断元组是否死亡的xid阈值,rs_freeze_xid是判断是否进行freeze操作的xid阈值。rs_unresolved_tups是保存一对更新元组中老元组的哈希表,rs_old_new_tid_map是保存一对更新元组中新元组的哈希表,这两个成员共同保证更新链信息不被丢失(在原表中更新后的元组的物理位置可能比更新前的元组的物理位置还要小)。 最后,重量级操作实际上是一种数据重聚簇操作,对于其他行存储子格式和cstore列存储格式同样适用,只是具体实现机制略有不同。 本期精彩内容将告一段落,下篇我们将详细介绍“4.2.4 ustore”相关内容,敬请期待!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册