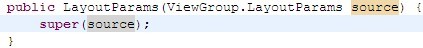首页 文章 精选 留言 我的

精选列表

搜索[文档解析],共10000篇文章
优秀的个人博客,低调大师

Redisson官方文档 - 10. 额外功能

10.1. 对Redis节点的操作 Redisson的NodesGroup对象提供了许些对Redis节点的操作。 NodesGroup nodesGroup = redisson.getNodesGroup(); nodesGroup.addConnectionListener(new ConnectionListener() { public void onConnect(InetSocketAddress addr) { // Redis节点连接成功 } public void onDisconnect(InetSocketAddress addr) { // Redis节点连接断开 } }); 也可以用来PING单个Redis节点或全部节点。 NodesGroup nodesGroup = redisson.getNodesGroup(); Collection<Node> allNodes = nodesGroup.getNodes(); for (Node n : allNodes) { n.ping(); } // 或者 nodesGroup.pingAll(); 10.2. 复杂多维对象结构和对象引用的支持 Redisson突破了Redis数据结构维度的限制,通过一个特殊引用对象的帮助,Redisson允许以任意的组合方式构建多维度的复杂对象结构,实现了对象之间的类似传统数据库里的关联关系。使用范例如下: RMap<RSet<RList>, RList<RMap>> map = redisson.getMap("myMap"); RSet<RList> set = redisson.getSet("mySet"); RList<RMap> list = redisson.getList("myList"); map.put(set, list); // 在特殊引用对象的帮助下,我们甚至可以构建一个循环引用,这是通过普通序列化方式实现不了的。 set.add(list); list.add(map); 可能您已经注意到了,在map包含的元素发生改变以后,我们无需再次“保存/持久”这些对象。因为map对象所记录的并不是序列化以后的值,而是元素对象的引用。这让Redisson提供的对象在使用方法上,与普通Java对象的使用方法一致。从而让Redis成为内存的一部分,而不仅仅是一个储存空间。 以上范例中,一共创建了三个Redis数据结构:一个Redis HASH,一个Redis SET和一个Redis LIST。 10.3. 命令的批量执行 多个连续命令可以通过RBatch对象在一次网络会话请求里合并发送,这样省去了产生多个请求消耗的时间和资源。这在Redis中叫做管道。 RBatch batch = redisson.createBatch(); batch.getMap("test").fastPutAsync("1", "2"); batch.getMap("test").fastPutAsync("2", "3"); batch.getMap("test").putAsync("2", "5"); batch.getAtomicLongAsync("counter").incrementAndGetAsync(); batch.getAtomicLongAsync("counter").incrementAndGetAsync(); // 原子化(事务)批量执行所有的命令 batch.atomic(); // 告知Redis不用返回结果(可以减少网络用量) batch.skipResult(); // 将写入操作同步到从节点 // 同步到2个从节点,等待时间为1秒钟 batch.syncSlaves(2, 1, TimeUnit.SECONDS) // 处理结果超时为2秒钟 batch.timeout(2, TimeUnit.SECONDS); // 命令重试等待间隔时间为2秒钟 batch.retryInterval(2, TimeUnit.SECONDS); // 命令重试次数,仅适用于未发送成功的命令 batch.retryAttempts(4); BatchResult res = batch.execute(); // 或者 Future<BatchResult> asyncRes = batch.executeAsync(); 在集群模式下,所有的命令会按各个槽所在的节点,筛选分配到各个节点并同时发送。每个节点返回的结果将会汇总到最终的结果列表里。 10.4. 脚本执行 redisson.getBucket("foo").set("bar"); String r = redisson.getScript().eval(Mode.READ_ONLY, "return redis.call('get', 'foo')", RScript.ReturnType.VALUE); // 通过预存的脚本进行同样的操作 RScript s = redisson.getScript(); // 首先将脚本保存到所有的Redis主节点 String res = s.scriptLoad("return redis.call('get', 'foo')"); // 返回值 res == 282297a0228f48cd3fc6a55de6316f31422f5d17 // 再通过SHA值调用脚本 Future<Object> r1 = redisson.getScript().evalShaAsync(Mode.READ_ONLY, "282297a0228f48cd3fc6a55de6316f31422f5d17", RScript.ReturnType.VALUE, Collections.emptyList()); 10.5. 底层Redis客户端 Redisson在底层采用了高性能异步非阻塞式Java客户端,它同时支持异步和同步两种通信模式。如果有哪些命令Redisson还没提供支持,也可以直接通过调用底层Redis客户端来实现。Redisson支持的命令在Redis命令和Redisson对象匹配列表里做了详细对比参照。 // 在使用多个客户端的情况下可以共享同一个EventLoopGroup EventLoopGroup group = new NioEventLoopGroup(); RedisClientConfig config = new RedisClientConfig(); config.setAddress("redis://localhost:6379") // 或者用rediss://使用加密连接 .setPassword("myPassword") .setDatabase(0) .setClientName("myClient") .setGroup(group); RedisClient client = RedisClient.create(config); RedisConnection conn = client.connect(); // 或 RFuture<RedisConnection> connFuture = client.connectAsync(); conn.sync(StringCodec.INSTANCE, RedisCommands.SET, "test", 0); // 或 conn.async(StringCodec.INSTANCE, RedisCommands.GET, "test"); conn.close() // 或 conn.closeAsync() client.shutdown(); // 或 client.shutdownAsync();

优秀的个人博客,低调大师

Ubuntu 14.04+Apache+PHP+MySQL+EduSoho[文档]

版权声明:转载请注明出处:http://blog.csdn.net/dajitui2024 https://blog.csdn.net/dajitui2024/article/details/79396611 参考原文:http://www.qiqiuyu.com/course/20/task/793/show注意: 本教程基于Ubuntu系统 14.04版本并且需要以root用户操作机器,请在确保您的环境是否符合以上两个条件之后,再进行后续的操作。切记:我们的edusoho访问目录是edusoho/web,只有在nginx或者Apache配置里面把根目录定位到web目录下,才不会出现奇怪的问题,否则就会出现图片不能显示或者文件无法上传的问题。 1、更新和升级系统 sudo apt-get update sudo apt-get upgrade 2、安装和配置apache 2.1、安装apache sudo apt-get install apache2 sudo apt-get install libapache2-mod-xsendfile 2.2、配置apache虚拟主机 apache说2.2的版本: 打开apache的配置文件httpd.conf 找到 #LoadModule rewrite_module modules/mod_rewrite.so 把前面#去掉。没有则添加,但必选独占一行,使apache支持 mod_rewrite 模块 apache说2.4的版本: 默认开启,在/etc/apache2/mods-available下存在rewrite.load 这个配置说明已启用 sudo a2enmod rewrite #启用rewrite模块 sudo a2enmod xsendfile #启用xsendfile模块 vi /etc/apache2/sites-enabled/edusoho.conf 将以下代码添加到虚拟主机配置中 <VirtualHost *:80> ServerName example.com ServerAlias www.example.com DocumentRoot /var/www/project/web <Directory /var/www/project/web> # enable the .htaccess rewrites AllowOverride All Require all granted </Directory> ErrorLog /var/log/apache2/project_error.log CustomLog /var/log/apache2/project_access.log combined </VirtualHost> 注意:apache2.2和2.4稍有不同,如果您是2.2,将<Directory>节点修改为: <Directory /var/www/project/web> # enable the .htaccess rewrites AllowOverride All Order allow,deny Allow from All </Directory> 注意: 1、将DocumentRoot、ServerName、伪静态路径修改为您安装系统的目录,保存修改。 2、rm /etc/apache2/sites-enabled/000-default -Rf 3、安装和配置PHP 3.1、安装PHP以及相关的插件 sudo apt-get install php5 php5-cli php5-curl php5-fpm php5-intl php5-mcrypt php5-mysqlnd php5-gd libapache2-mod-php5 3.2、修改PHP配置 #编辑php.ini , 将以下配置的值修改为1024M vi /etc/php5/apache2/php.ini memory_limit = 1024M post_max_size = 1024M upload_max_filesize = 1024M 重启Apache service apache2 restart 4、安装MySql和创建EduSoho数据库 apt-get install mysql-server 备注:安装过程中注意设定MySql的root密码,不设置默认为空,通常密码设置为root。 mysql -uroot -p 然后你需要输入MySQL数据库的root密码。 进入数据库命令行模式后,创建edusoho数据库,执行: CREATE DATABASE `edusoho` DEFAULT CHARACTER SET utf8 ; GRANT ALL PRIVILEGES ON `edusoho`.* TO 'esuser'@'localhost' IDENTIFIED BY 'edusoho'; quit; 注意:这里为edusoho数据库创建了一个用户名,用户名为:esuser,密码为edusoho,在后面安装的第三步需要用到,不建议直接填写root账户。 5、下载和解压EduSoho程序 mkdir /var/www cd /var/www wget http://download.edusoho.com/edusoho-VERSION.tar.gz (注:将VERSION替换为当前EduSoho最新版本号,可从官网www.edusoho.com查询获取) tar -zxvf edusoho-VERSION.tar.gz chown www-data:www-data edusoho/ -Rf 注:这里的下载地址可以在http://download.edusoho.com/中可以获取到,VERSION为下载来之后压缩包后面的版本号。 最后一步: 浏览器中打开:http://YOU_DOMAIN 安装,当然这里的YOU_DOMAIN是您的域名。

优秀的个人博客,低调大师

Android 中文 API 文档 (45) —— AbsoluteLayout.LayoutParams

正文 一、结构 public static classAbsoluteLayout.LayoutParamsextendsViewGroup.LayoutParams java.lang.Object android.view.ViewGroup.LayoutParams android.widget.AbsoluteLayout.LayoutParams 二、概述 每个子元素布局信息与绝对布局相关联。参见绝对布局属性中该类所支持的子视图属性列表。(译者注: AbsoluteLayout的这种“绝对”定位的布局方式和我们非常熟悉的Windows编程中的Left和Top设置UI元素的位置是基本一致的。) 三、字段 public int x 在View Group内部子元素中的X水平位置。 public int y 在View Group内部子元素中的Y垂直位置。 四、构造函数 public AbsoluteLayout.LayoutParams(int width, int height, int x, int y) 创建一个新的具有指定宽度、高度和位置的布局参数。 参数: widthMATCH_PARENT,WRAP_CONTENT或者固定大小的像素 heightMATCH_PARENT,WRAP_CONTENT或者固定大小的像素 x子元素的X位置 y子元素的Y位置 public AbsoluteLayout.LayoutParams(Context c, AttributeSet attrs) 创建一组新的布局参数,通过上下文提取的相关属性值设置。XML属性映射到这个布局参数设置如下: ·layout_x:子元素的X位置 ·layout_y:子元素的Y位置 ·所有来自ViewGroup.LayoutParams的XML属性 参数: c上下文环境. attrs从属性设置中提取布局参数值。 public AbsoluteLayout.LayoutParams(ViewGroup.LayoutParams source) (译者注:根据ViewGroup.LayoutParams实例化布局参数,从源码可以看出: 五、公共方法 public String debug (String output) 返回设置的布局参数的字符串表示形式。 参数 output用于内部表示的预置字符串 返回值 返回如下格式字符串:输出+ "ViewGroup.LayoutParams={ width=WIDTH, height=HEIGHT }" 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/582598,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android 中文 API 文档 (44) —— Chronometer.OnChronometerTickListener

正文 一、结构 public static interfaceChronometer.OnChronometerTickListener 二、概述 计时器递增的时候通知这个回调。 三、公共方法 public abstract voidonChronometerTick(Chronometer chronometer) 在计时器变化时通知。 参数 chronometer计时器对象。 本文转自over140 51CTO博客,原文链接:http://blog.51cto.com/over140/582600,如需转载请自行联系原作者

优秀的个人博客,低调大师

Rancher-k8s加速安装文档

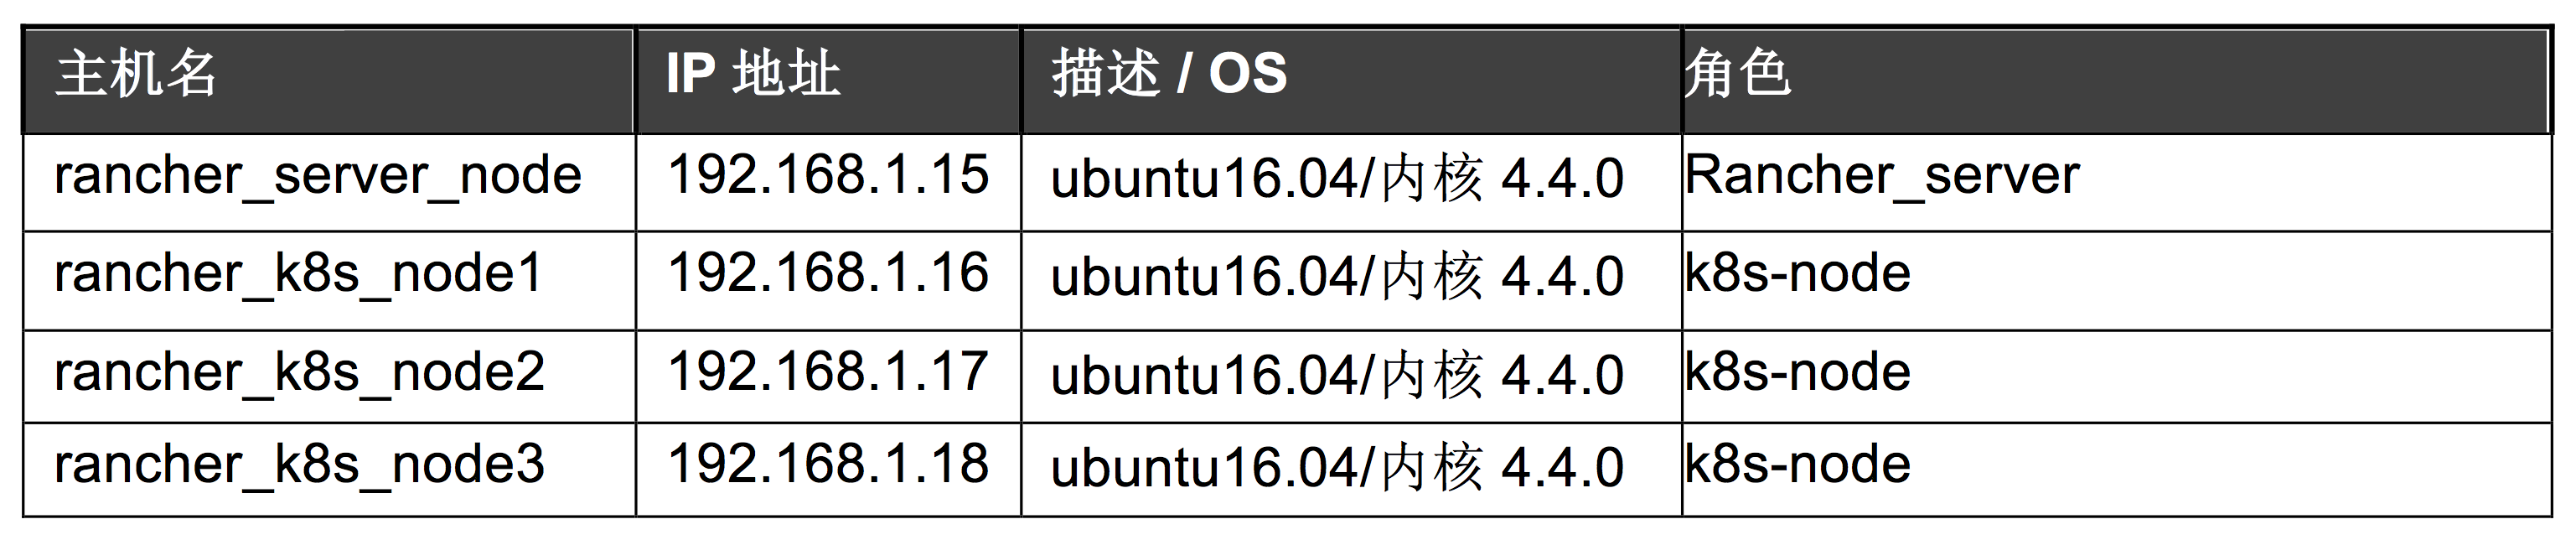
Kubernetes是一个强大的容器编排工具,帮助用户在可伸缩性系统上可靠部署和运行容器化应用。Rancher容器管理平台原生支持K8s,使用户可以简单轻松地部署K8s集群。 很多同学正常部署k8s环境后无法进入Dashboard,基础设施应用栈均无报错。但通过查看 基础架构|容器 发现并没有Dashboard相关的容器。 因为k8s在拉起相关服务(如Dashboard、内置DNS等服务)是通过应用商店里面的YML文件来定义的,YML文件中定义了相关的镜像名和版本。而Rancher部署的k8s应用栈属于k8s的基础框架,相关的镜像通过dockerhub/rancher 仓库拉取。 默认Rancher-catalog k8s YML中服务镜像都是从谷歌仓库拉取,在没有科学上网的情况下,国内环境几乎无法成功拉取镜像。 为了解决这一问题,优化中国区用户的使用体验,我们修改了http://git.oschina.net/rancher/rancher-catalog仓库中的YML文件,将相关的镜像也同步到国内仓库,通过替换默认商店地址来实现加速部署。 环境准备 整个演示环境由以下4台本地虚拟机组成,相关信息说明如下: 操作说明 具体演示操作说明如下: 第一步 1、直接运行Rancher_server: 1 Sudodockerrun-d--restartalways–namerancher_server-p 8080 : 8080 rancher/server:stable&&sudodockerlogs-francher-server 容器初始化完成后,通过主机IP:8080访问WEB。 2、添加变量启动Rancher_server: 1 2 3 Sudodockerrun-d--namerancher-server-p 8080 : 8080 --restart=unless-stopped-eDEFAULT_CATTLE_CATALOG_URL= '{"catalogs":{"library":{"url":"http://git.oschina.net/rancher/rancher-catalog.git","branch":"k8s-cn"}}}' \ rancher/server:stable&&sudodockerlogs-francher-server 变量的作用后面介绍。 第二步,Rancher基本配置: 因为Rancher修改过的设置参数无法同步到已创建的环境,所以在创建环境前要把相关设置配置好。比如,如果你想让Rancher默认去拉取私有仓库的镜像,需要配置registry.default= 参数等。 应用商店(Catalog)地址配置:在系统管理\系统设置中,找到应用商店。禁用Rancher 官方认证仓库并按照下图配置。 名称:library (全小写) 地址:https://git.oschina.net/rancher/rancher-catalog.git 分支: k8s-cn PS:回到最开始的启动命令,如果以第二种方式启动,这个地方就会被默认配置好。所以,根据自己的情况选择哪一种配置方式, 最后点击保存。 第三步,Kubernetes环境配置查看对比: 重启并进入WEB后,选择环境管理。如图: 在环境模板中,找到Kubernetes 模板,点击右边的编辑图标,接着点击编辑配置。 以下是Rancher-k8s的默认配置对比,图一为默认商店的参数,图二为自定义商店的参数。 这里只是查看参数不做相关修改。点击cancel返回模板编辑页面。 在这里,根据需要可以定制组件,比如可以把默认的ipsec网络改为vxlan网络等,这里不再叙述。 最后点保存或者cancle返回环境管理界面。 第四步,添加环境: 在环境管理界面中,点击页面上方的添加环境按钮: 填写环境名称,选择环境模板(Kubernetes),点击创建。创建后: PS:default环境由于没有添加host,会显示Unhealthy。 切换模板 等待添加主机 第五步,添加主机: 如上图,进入添加主机界面 指定用于注册这台主机的公网IP。如果留空,Rancher会自动检测IP注册。通常在主机有唯一公网IP 的情况下这是可以的。如果主机位于防火墙/NAT设备之后,或者主机同时也是运行rancher/server容器的主机时,则必须设置此IP。 以上这段话会在添加主机页面显示,这段话的意思就是:如果准备添加的节点有运行Rancher-server容器,那么在添加节点的时候就要输入节点可被直接访问的主机IP地址(如果做的Rancher-HA,那么每台运行Rancher-server的节点都要添加主机IP地址),如果不添加主机IP地址,那么在添加节点后获取到的地址很可能会是Rancher-server容器内部的私网地址,导致无法使各节点通信。所以需要注意一下! 本示例三个节点都没有运行rancher_server,所以直接复制生成的代码,在三个节点执行。 节点添加成功,应用栈创建完毕,正在启动服务: 镜像拉取中 到此为止,k8s就部署完成。 服务容器查看:点击基础架构|主机 对比基础设施中kubernetes 应用栈,可以发现有以下容器是不在应用栈中的: 这些应用是在k8s框架运行起来之后,再通过YML配置文件拉起的k8s服务,比如Dashboard服务 那些点击 kubernetes UI 提示服务不可达的。 可以先看看有没有此服务容器。 接下来在k8s中简单部署一个应用。 第六步,k8s应用部署: 进入k8s的Dashboard后,默认显示的是default 命名空间。 可以通过下拉箭头切换到kube-system命名空间,这里显示了CPU、内存使用率,以及一些系统组件的运行状况。 应用部署: 页面右上角点击create 按钮,进入部署配置界面,并简单做一写设置: 注:在service中,如果选择Internal, 将需要ingress功能,ingress类似于LB的功能,这个后续讲解。这里我们选择External 。 最后点击deploy .点击deploy后将会跳转到部署状态界面,如图: 部署完成后显示状态: 页面右侧点击service 可以看到部署的服务以及访问信息。 返回Rancher,进入基础设施 可以看到自动增加了一个kubernetes-loadbalancers 应用栈。 这个应用栈的信息是通过k8s传递到Rancher,所以在部署应用后,在Rancher中很容易找到服务访问点。 原文来源:Rancher Labs 本文转自 RancherLabs 51CTO博客,原文链接:http://blog.51cto.com/12462495/1946612

优秀的个人博客,低调大师

云数据恢复:文档是成功的关键

创建云上的数据恢复计划,很重要的一点是持续跟踪基础架构,DR需求和可能的故障转移持续时间。 公有云给IT部门提供了绝佳的机会来实现业务的持续性/灾难恢复计划,而无需花费巨资构建独享的数据中心。有了云数据恢复系统之后,云就可以用作基本数据的存储库或者甚至当主要系统出问题时运行应用之处。 当构建DR计划时,第一步是查看用来交付IT服务的应用,并且决定灾难发生时需要保护什么。这意味着创建需要运行的应用和服务的清单。很多企业已经转向虚拟化作为其核心服务器的部署模型;但是,仍然需要考虑物理服务器。完善的云数据恢复计划应该包括如下: 用来交付基础架构的物理和虚拟服务器。这些包括活动目录(AD)服务器,DNS/DNCP服务器和应用。 用来交付应用的物理服务器。为什么还在物理服务器上交付服务,这需要有好一点的理由;这可能包括扩展和性能要求,或者使用自定义硬件和操作系统。但是,云恢复服务可能能够帮助虚拟化其中一些组件。 用来交付应用的虚拟服务器。可能有几十台或者上百台虚拟机用来实现应用。每台都需要确认和记录、查看存储、内存和虚拟处理器需求。 最好提前确定基础架构服务器,因为当灾难发生时这些系统需要第一时间恢复服务。可以预配置在云上运行的AD、DNS和DNCP服务,并且和它们的内部实例同步,让DR流程更加容易,也能够更快实现。 要想让云上的DR能够成功工作,理解网络配置至关重要。这意味着需要花时间理解网络层的应用之间的相互依赖关系,包括安全和防火墙配置。云数据恢复相关的问题有: 是否有应用或者服务器互相之间有延迟依赖? 是否有East-West防火墙规则来管理站内流量? 面向客户的应用的外部带宽需求是什么? 确定云数据恢复需求 假定在灾难事件发生时,每个应用都需要立即恢复,这并不太实际。相反,应该基于一系列条件来区分应用的优先级,来决定需要多快,以及哪些同步系统和数据需要恢复运营。在决定恢复应用的服务等级时,可以使用一些标准来进行度量: 恢复时间目标。它衡量在应序备份并且运行之前可以容忍多长的下线时间;通常以分钟或者小时计量。比如,零RTO表示完全不能容忍掉线,而一小时的RTO意味着应用必须在DR发生的一小时内完成恢复。 恢复点目标。它衡量一旦应用再次运行时可以容忍丢失多少数据。零RPO意味着所有数据都必须恢复到灾难发生点,而24小时的RTO意味着恢复后数据或系统可以过时24小时。 服务级别目标。SLO衡量整体应用的恢复情况。比如,协议可能是在四小时内恢复90%的应用。越严格的SLO要求越多的基础架构支撑并且可能需要越多的人力才能达到,因此留有一定的灵活度有助于管理DR的费用。 SLO 允许区分数据和应用的优先级。比如,一个在线信用卡处理系统要求零RPO和非常低的RTO。期望这样的系统永远也不会丢失信息是合理的。另一种极端情 况是,负责报告的应用可能能够容忍24到48小时的数据过期时间,因为其数据是从其他应用里抽取出来的。其他系统大多数处在这两种极端情况之间。 建立正确的云数据恢复需求包括和应用程序的业务所有者沟通,因为他们了解其应用的重要程度。从经验上看,业务所有者会认为其所有应用都很重要——直到他们了解恢复所需的费用为止。因此可以告诉他们不同方案的费用评估。 服务级别的最后一点是:一些严格的需求,比如零PRO,基于云的DR是无法达成的,因为本地和云位置之间会有延时。需要将这些应用排除在基于云的DR之外,并且提供更多定制的DR产品。 DR服务会运行多久? 最后需要讨论的是,服务会在公有云上运行多久。做这样的决策依赖于发生的事件类型。并非所有灾难都会导致所有在线功能的崩溃。还会存在一些边缘事件类型,比如: 服务器丢失。要么是物理服务器,要么是虚拟服务器主机。虚拟服务器的丢失可能很严重,但也可能不严重,应用程序需要转而运行在DR模式。 多系统丢失。比如,如果共享存储阵列出问题的话,可能会失去多个应用。 数据中心丢失。在最坏的情况下,整个数据中心都丢失了,或者访问不了。所有服务都需要运行在DR模式下。 有时候,服务需要移动几个小时或者几天。当整个站点都丢失时,需求可能是运行DR服务几周或者几个月,直到重建了之前的设备。云恢复服务会为所使用的活动服务计费,因此在选择DR服务时这是很重要的考核点。 本文作者:崔婧雯编译 来源:51CTO

优秀的个人博客,低调大师

App开发架构指南(谷歌官方文档译文)

这篇文章面向的是已经掌握app开发基本知识,想知道如何开发健壮app的读者。 注:本指南假设读者对 Android Framework 已经很熟悉。如果你还是app开发的新手,请查看 Getting Started 系列教程,该教程涵盖了本指南的预备知识。 app开发者面临的常见问题 跟传统的桌面应用开发不同,Android app的架构要复杂得多。一个典型的Android app是由多个app组件构成的,包括activity,Fragment,service,content provider以及broadcast receiver。而传统的桌面应用往往在一个庞大的单一的进程中就完成了。 大多数的app组件都声明在app manifest中,Android OS用它来决定如何将你的app与设备整合形成统一的用户体验。虽然就如刚说的,桌面app只运行一个进程,但是一个优秀的Android app却需要更加灵活,因为用户操作在不同app之间,不断的切换流程和任务。 比如,当你要在自己最喜欢的社交网络app中分享一张照片的时候,你可以想象一下会发生什么。app触发一个camera intent,然后Android OS启动一个camera app来处理这一动作。此时用户已经离开了社交网络的app,但是用户的操作体验却是无缝对接的。而 camera app反过来也可能触发另一个intent,比如启动一个文件选择器,这可能会再次打开另一个app。最后用户回到社交网络app并分享照片。在这期间的任意时刻用户都可被电话打断,打完电话之后继续回来分享照片。 在Android中,这种app并行操作的行为是很常见的,因此你的app必须正确处理这些流程。还要记住移动设备的资源是有限的,因此任何时候操作系统都有可能杀死某些app,为新运行的app腾出空间。 总的来说就是,你的app组件可能是单独启动并且是无序的,而且在任何时候都有可能被系统或者用户销毁。因为app组件生命的短暂性以及生命周期的不可控制性,任何数据都不应该把存放在app组件中,同时app组件之间也不应该相互依赖。 通用的架构准则 如果app组件不能存放数据和状态,那么app还是可架构的吗? 最重要的一个原则就是尽量在app中做到separation of concerns(关注点分离)。常见的错误就是把所有代码都写在Activity或者Fragment中。任何跟UI和系统交互无关的事情都不应该放在这些类当中。尽可能让它们保持简单轻量可以避免很多生命周期方面的问题。别忘了能并不拥有这些类,它们只是连接app和操作系统的桥梁。根据用户的操作和其它因素,比如低内存,Android OS可能在任何时候销毁它们。为了提供可靠的用户体验,最好把对它们的依赖最小化。 第二个很重要的准则是用。之所以要持久化是基于两个原因:如果OS销毁app释放资源,用户数据不会丢失;当网络很差或者断网的时候app可以继续工作。Model是负责app数据处理的组件。它们不依赖于View或者app 组件(Activity,Fragment等),因此它们不会受那些组件的生命周期的影响。保持UI代码的简单,于业务逻辑分离可以让它更易管理。 app架构推荐 在这一小节中,我们将通过一个用例演示如何使用Architecture Component构建一个app。 注:没有一种适合所有场景的app编写方式。也就是说,这里推荐的架构适合作为大多数用户案例的开端。但是如果你已经有了一种好的架构,没有必要再去修改。 假设我们在创建一个显示用户简介的UI。用户信息取自我们自己的私有的后端REST API。 创建用户界面 UI由UserProfileFragment.java以及相应的布局文件user_profile_layout.xml组成。 要驱动UI,我们的data model需要持有两个数据元素。 User ID: 用户的身份识别。最好使用fragment argument来传递这个数据。如果OS杀死了你的进程,这个数据可以被保存下来,所以app再次启动的时候id仍是可用的。 User object: 一个持有用户信息数据的POJO对象。 我们将创建一个继承ViewModel类的UserProfileViewModel来保存这一信息。 一个ViewModel为特定的UI组件提供数据,比如fragment 或者 activity,并负责和数据处理的业务逻辑部分通信,比如调用其它组件加载数据或者转发用户的修改。ViewModel并不知道View的存在,也不会被configuration change影响。 现在我们有了三个文件。 user_profile.xml: 定义页面的UI UserProfileViewModel.java: 为UI准备数据的类 UserProfileFragment.java: 显示ViewModel中的数据与响应用户交互的控制器 下面我们开始实现(为简单起见,省略了布局文件): publicclassUserProfileViewModelextendsViewModel{ privateStringuserId; privateUseruser; publicvoidinit(StringuserId){ this.userId=userId; } publicUsergetUser(){ returnuser; } } publicclassUserProfileFragmentextendsLifecycleFragment{ privatestaticfinalStringUID_KEY="uid"; privateUserProfileViewModelviewModel; @Override publicvoidonActivityCreated(@NullableBundlesavedInstanceState){ super.onActivityCreated(savedInstanceState); StringuserId=getArguments().getString(UID_KEY); viewModel=ViewModelProviders.of(this).get(UserProfileViewModel.class); viewModel.init(userId); } @Override publicViewonCreateView(LayoutInflaterinflater, @NullableViewGroupcontainer,@NullableBundlesavedInstanceState){ returninflater.inflate(R.layout.user_profile,container,false); } } 注:上面的例子中继承的是LifecycleFragment而不是Fragment类。等Architecture Component中的lifecycles API稳定之后,Android Support Library中的Fragment类也将实现LifecycleOwner。 现在我们有了这些代码模块,如何连接它们呢?毕竟当ViewModel的user成员设置之后,我们还需要把它显示到界面上。这就要用到LiveData了。 LiveData是一个可观察的数据持有者。 无需明确在它与app组件之间创建依赖就可以观察LiveData对象的变化。LiveData还考虑了app组件(activities, fragments, services)的生命周期状态,做了防止对象泄漏的事情。 注:如果你已经在使用RxJava或者Agera这样的库,你可以继续使用它们,而不使用LiveData。但是使用它们的时候要确保正确的处理生命周期的问题,与之相关的LifecycleOwner stopped的时候数据流要停止,LifecycleOwner destroyed的时候数据流也要销毁。你也可以使用android.arch.lifecycle:reactivestreams让LiveData和其它的响应式数据流库一起使用(比如, RxJava2)。 现在我们把UserProfileViewModel中的User成员替换成LiveData,这样当数据发生变化的时候fragment就会接到通知。LiveData的妙处在于它是有生命周期意识的,当它不再被需要的时候会自动清理引用。 publicclassUserProfileViewModelextendsViewModel{ ... privateUseruser; privateLiveData<User>user; publicLiveData<User>getUser(){ returnuser; } } 现在我们修改UserProfileFragment,让它观察数据并更新UI。 @Override publicvoidonActivityCreated(@NullableBundlesavedInstanceState){ super.onActivityCreated(savedInstanceState); viewModel.getUser().observe(this,user->{ //updateUI }); } 每当User数据更新的时候 onChanged 回调将被触发,然后刷新UI。 如果你熟悉其它library的observable callback的用法,你会意识到我们不需要重写fragment的onStop()方法停止对数据的观察。因为LiveData是有生命周期意识的,也就是说除非fragment处于活动状态,否则callback不会触发。LiveData还可以在fragmentonDestroy()的时候自动移除observer。 对我们也没有做任何特殊的操作来处理 configuration changes(比如旋转屏幕)。ViewModel可以在configuration change的时候自动保存下来,一旦新的fragment进入生命周期,它将收到相同的ViewModel实例,并且携带当前数据的callback将立即被调用。这就是为什么ViewModel不应该直接引用任何View,它们游离在View的生命周期之外。参见ViewModel的生命周期。 获取数据 现在我们把ViewModel和fragment联系了起来,但是ViewModel该如何获取数据呢?在我们的例子中,假设后端提供一个REST API,我们使用Retrofit从后端提取数据。你也可以使用任何其它的library来达到相同的目的。 下面是和后端交互的retrofit Webservice: publicinterfaceWebservice{ /** *@GETdeclaresanHTTPGETrequest *@Path("user")annotationontheuserIdparametermarksitasa *replacementforthe{user}placeholderinthe@GETpath */ @GET("/users/{user}") Call<User>getUser(@Path("user")StringuserId); } ViewModel的一个简单的实现方式是直接调用Webservice获取数据,然后把它赋值给User对象。虽然这样可行,但是随着app的增大会变得难以维护。ViewModel的职责过多也违背了前面提到的关注点分离(separation of concerns)原则。另外,ViewModel的有效时间是和Activity和Fragment的生命周期绑定的,因此当它的生命周期结束便丢失所有数据是一种不好的用户体验。相反,我们的ViewModel将把这个工作代理给Repository模块。 Repository模块负责处理数据方面的操作。它们为app提供一个简洁的API。它们知道从哪里得到数据以及数据更新的时候调用什么API。你可以把它们看成是不同数据源(persistent model, web service, cache, 等等)之间的媒介。 下面的UserRepository类使用了WebService来获取用户数据。 publicclassUserRepository{ privateWebservicewebservice; //... publicLiveData<User>getUser(intuserId){ //Thisisnotanoptimalimplementation,we'llfixitbelow finalMutableLiveData<User>data=newMutableLiveData<>(); webservice.getUser(userId).enqueue(newCallback<User>(){ @Override publicvoidonResponse(Call<User>call,Response<User>response){ //errorcaseisleftoutforbrevity data.setValue(response.body()); } }); returndata; } } 虽然repository模块看起来没什么必要,但它其实演扮演着重要的角色;它把数据源从app中抽象出来。现在我们的ViewModel并不知道数据是由Webservice提供的,意味着有必要的话可以替换成其它的实现方式。 注:为简单起见我们省略了网络错误出现的情况。实现了暴露网络错误和加载状态的版本见下面的Addendum: exposing network status。 管理不同组件间的依赖: 前面的UserRepository类需要Webservice的实例才能完成它的工作。可以直接创建它就是了,但是为此我们还需要知道Webservice所依赖的东西才能构建它。这显著的增减了代码的复杂度和偶合度(比如,每个需要Webservice实例的类都需要知道如何用它的依赖去构建它)。另外,UserRepository很可能不是唯一需要Webservice的类。如果每个类都创建一个新的WebService,就变得很重了。 有两种模式可以解决这个问题: 依赖注入: 依赖注入允许类在无需构造依赖的情况下定义自己的依赖对象。在运行时由另一个类来负责提供这些依赖。在Android app中我们推荐使用谷歌的Dagger 2来实现依赖注入。Dagger 2 通过遍历依赖树自动构建对象,并提供编译时的依赖。 Service Locator:Service Locator 提供一个registry,类可以从这里得到它们的依赖而不是构建它们。相对依赖注入来说要简单些,所以如果你对依赖注入不熟悉,可以使用 Service Locator 。 这些模式允许你扩展自己的代码,因为它们提供了清晰的模式来管理依赖,而不是不断的重复代码。两者均支持替换成mock依赖来测试,这也是使用它们主要优势之一。 在这个例子中,我们将使用 Dagger 2 来管理依赖。 连接ViewModel和repository 现在我们修改UserProfileViewModel以使用repository。 publicclassUserProfileViewModelextendsViewModel{ privateLiveData<User>user; privateUserRepositoryuserRepo; @Inject//UserRepositoryparameterisprovidedbyDagger2 publicUserProfileViewModel(UserRepositoryuserRepo){ this.userRepo=userRepo; } publicvoidinit(StringuserId){ if(this.user!=null){ //ViewModeliscreatedperFragmentso //weknowtheuserIdwon'tchange return; } user=userRepo.getUser(userId); } publicLiveData<User>getUser(){ returnthis.user; } } 本文作者:佚名 来源:51CTO

优秀的个人博客,低调大师

akka文档(java)——akka的用例示例

我们看到akka正被许多大型组织所采用,已被广泛应用于投资与商业银行业务,零食与社交媒体,虚拟仿真,游戏与博彩,数据分析等等行业。任何需要高吞吐量和低延迟的系统都是使用akka的良好候选者。 这里有一些良好的关于akka用例的讨论以及在生产环境的使用评论。 下面是一些已将akka部署到生产环境的领域 事务处理(在线游戏,金融、银行,贸易,统计,博彩,社会化媒体,电信) 纵向扩展,横向扩展,容错/HA 后端服务 (任何行业,任何应用) REST服务, SOAP, Cometd, WebSockets等,充当信息枢纽/集成层纵向扩展 、横向扩展,容错/HA 并发/并行性(任何应用) 简单正确的使用与理解akka仅仅是将它的jar添加到你的JVM工程(使用Scala、Java、Groovy或JRuby) 虚拟仿真 主/从,计算风格,MapReduce等 批处理(任何行业) Camel与批量数据源整合,角色对工作负载分而治之 通讯枢纽(电信、网络媒体、移动媒体) 纵向扩展,横向扩展,容错/HA 游戏与博彩(MOM(消息中间件),网络游戏,博彩) 纵向扩展,横向扩展,容错/HA 商业智能/数据挖掘/通用运算 纵向扩展,横向扩展,容错/HA 复杂的事件流处理 纵向扩展,横向扩展,容错/HA 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— Ack 框架的实现

Storm 的acker使用哈希校验和来跟踪每个 tuple 树的完成情况:每个 tuple 在被发送出的时候,它的值会与校验和进行异或运算,然后在 tuple 被 ack 的时候这个值又会再次与校验和进行异或运算。这样,一旦所有的 tuple 都被成功 ack,校验和就会变为 0(随机生成的校验和为 0 的概率极小,可以忽略不计)。 你可以在wiki中了解更多关于可靠性机制的信息。 ackerexecute() Acker 实际上也是一个 bolt,它的execute 方法是定义在mk-acker-bolt中的。在一个新的 tuple 树生成的时候,spout 为每个 tuple 发送一个用于异或的固有 id,acker 会将这些 id 记录在它的挂起队列中。每次 executor ack 一个 tuple 的时候,acker 会接收到一个部分校验和,这个校验和是 tuple 自身的 id(将其从挂起队列中清除)和 executor 发送的每个下游 tuple 的 id(放入挂起队列中)的异或值。 这个过程是这样的: 在接收到 tick tuple 信号的时候,将 tuple 树的校验值向超时方向移动并且返回。同时,在 tuple 树中更新或者创建一个记录。 初始化阶段:使用指定的校验和值进行初始化,并且记录 spout 的 id; ack 阶段:将部分校验和与当前的校验和进行异或运算; fail 阶段:仅仅将 tuple 标记为 failed 状态。 接下来,将记录存入RotatingMap(重新设置超时计数值)并且继续以下过程: 如果总校验和为 0, 表明 tuple 树已经完成:将记录从挂起队列中移除,并通知 spout 处理成功; 如果 tuple 树失败了,也会有一种完成状态:将记录从挂起队列中移除,并通知 spout 处理失败。 最后,发送一个我们自己的 ack 信号。 挂起 tuples 与RotatingMap Acker 将挂起树存放在一个RotatingMap中。RotatingMap是一个在 Storm 中多处使用的简单工具,它主要用于高效地处理过程的超时。 RotatingMap 与 HashMap 类似,支持 O(1) 时间的 get 操作。 在 RotatingMap 内部有多个 HashMap(称为槽,buckets),每个 HashMap 都保存有一群会在同一时间超时的记录。我们称存在时间最长的 bucket 为死亡牢房(death row),而访问最多的 bucket 称为苗圃(nursery)。一个新的值在被.put()到 RotatingMap 中,它都会被重定位到 nursery 中,并且从其他的它之前可能在的 bucket 中移除(这是一种高效的重新设置延时时间的方法)。 在 RotatingMap 的所有者调用.rotate()方法的时候,RotatingMap 会将每个 bucket 向着超时的方向移动一步(一般 Storm 对象会在收到一个系统 tick 流 tuple 的时候调用 rotate 方法)。如果此时在前面所说的 death row bucket 中有 key-value 键值对,RotatingMap 会为每个 key-value 键值对触发一个回调函数(在构造器中定义的),让他们的所有者选择一个合适的操作(例如,将 tuple 标记为处理 转载自并发编程网 - ifeve.com 失败)。

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 分布式 RPC

分布式 RPC(DRPC)的设计目标是充分利用 Storm 的计算能力实现高密度的并行实时计算。Storm 接收若干个函数参数作为输入流,然后通过 DRPC 输出这些函数调用的结果。严格来说,DRPC 并不能算作是 Storm 的一个特性,因为它只是一种基于 Storm 原语 (Stream、Spout、Bolt、Topology) 实现的计算模式。虽然可以将 DRPC 从 Storm 中打包出来作为一个独立的库,但是与 Storm 集成在一起显然更有用。 概述 DRPC 是通过一个 DRPC 服务端(DRPC server)来实现分布式 RPC 功能的。DRPC server 负责接收 RPC 请求,并将该请求发送到 Storm 中运行的 Topology,等待接收 Topology 发送的处理结果,并将该结果返回给发送请求的客户端。因此,从客户端的角度来说,DPRC 与普通的 RPC 调用并没有什么区别。例如,以下是一个使用参数 “http://twitter.com”调用 “reach” 函数计算结果的例子: DRPCClient client = new DRPCClient("drpc-host", 3772); String result = client.execute("reach", "http://twitter.com"); 下图是 DRPC 的原理示意图。 客户端通过向 DRPC 服务器发送待执行函数的名称以及该函数的参数来获取处理结果。实现该函数的拓扑使用一个DRPCSpout从 DRPC 服务器中接收一个函数调用流。DRPC 服务器会为每个函数调用都标记了一个唯一的 id。随后拓扑会执行函数来计算结果,并在拓扑的最后使用一个名为ReturnResults的 bolt 连接到 DRPC 服务器,根据函数调用的 id 来将函数调用的结果返回。 定义 DRPC 拓扑 可以直接使用普通的拓扑构造方法来构造 DRPC 拓扑,如下所示: public static class ExclaimBolt extends BaseBasicBolt { public void execute(Tuple tuple, BasicOutputCollector collector) { String input = tuple.getString(1); collector.emit(new Values(tuple.getValue(0), input + "!")); } public void declareOutputFields(OutputFieldsDeclarer declarer) { declarer.declare(new Fields("id", "result")); } } public static void main(String[] args) throws Exception { TopologyBuilder builder = new TopologyBuilder(); // builder.setSpout(drpcSpout); // builder.setBolt(new ExclaimBolt(), 3); // submit(builder.createTopology()); } 本地模式 DRPC DRPC 可以在本地模式下运行。以下是使用本地模式构造拓扑的例子: LocalDRPC drpc = new LocalDRPC(); DRPCSpout spout = new DRPCSpout("exclamation", drpc); builder.setSpout("drpc", spout); builder.setBolt("exclaim", new ExclaimBolt(), 3) .shuffleGrouping("drpc"); builder.setBolt("return", new ReturnResults(), 3) .shuffleGrouping("exclaim"); LocalCluster cluster = new LocalCluster(); Config conf = new Config(); cluster.submitTopology("drpc-demo", conf, builder.createTopology()); // local mode 测试代码 System.out.println(drpc.execute("exclamation", "hello")); cluster.shutdown(); drpc.shutdown(); 在这种模式下,首先你会创建一个LocalDPRC对象,该对象会在进程中模拟一个 DRPC 服务器,其作用类似于LocalCluster在进程中模拟 Storm 集群的功能。在定义好拓扑的各个组件之后,就可以使用LocalCluster来提交拓扑。在本地模式下LocalDPRC对象不会绑定到任何一个实际的端口,所以需要通过向DRPCSpout传入参数的方式来关联到拓扑中。 在启动拓扑后,你可以使用execute方法来完成 DRPC 调用。 远程模式 DRPC 在一个实际的集群中使用 DRPC 有以下三个步骤: 配置并启动 DRPC 服务器; 在集群的各个服务器上配置 DRPC 服务器的地址; 将 DRPC 拓扑提交到集群运行。 可以像 Nimbus、Supervisor 那样使用storm命令来启动 DRPC 服务器(注意,此 server 的基本配置,如 nimbus,ZooKeeper 等参数应该与 Storm 集群其他机器相同): bin/storm drpc 接下来,你需要在集群的各个服务器上配置 DRPC 服务器的地址。这是为了让DRPCSpout了解从哪里获取函数调用的方法。可以通过编辑storm.yaml或者添加拓扑配置的方式实现配置。配置storm.yaml的方式类似于下面这样: drpc.servers: - "drpc1.foo.com" - "drpc2.foo.com" 最后,你可以像其他拓扑一样使用StormSubmitter来启动拓扑。 以下是使用远程模式构造拓扑的一个例子: TopologyBuilder builder = new TopologyBuilder(); DRPCSpout spout = new DRPCSpout("exclamation"); builder.setSpout("drpc", spout, 3); builder.setBolt("exclaim", new ExclamationBolt(), 3) .shuffleGrouping("drpc"); builder.setBolt("return", new ReturnResults(), 7) .shuffleGrouping("exclaim"); Config conf = new Config(); conf.setNumWorkers(2); StormSubmitter.submitTopology("drpc-demo", conf, builder.createTopology()); 更复杂的例子 请参考Trident 教程一文中计算指定 URL 的 Reach 数的例子。 转载自并发编程网 - ifeve.com
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册