首页 文章 精选 留言 我的

精选列表

搜索[面试],共5089篇文章
优秀的个人博客,低调大师

Python面试常用的高级用法,怎么动态创建类?

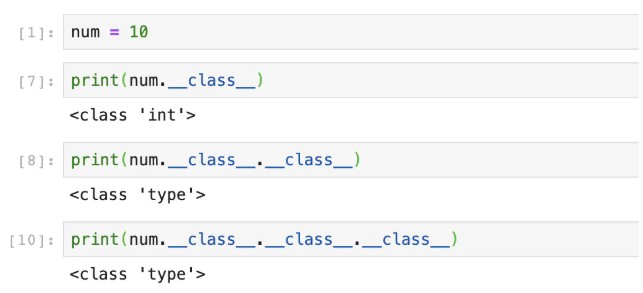
云栖号资讯:【点击查看更多行业资讯】在这里您可以找到不同行业的第一手的上云资讯,还在等什么,快来! 元类是Python当中的高级用法,如果你之前从来没见过这个术语或者是没听说过这个概念,这是非常正常的,因为一方面它的使用频率不高,另外一方面就是它相对不太容易理解。以至于很多Python开发者都理解得不是很深入,导致了市面上相关的资料也并不太多。我也是读了一些大牛的代码才开启了这扇新世界的大门。 一切都是对象 我们之前的时候曾经介绍过,在Python当中一切都是对象,注意,是一切都是对象。我们都知道对象是类实例化之后的结果,可以简单地将类和对象类比成模具和成品的关系。模具是类,而根据模具做出来的产品是对象。 这个比喻思想比较接近,但是不完美。因为实际当中一个模具可以做出多个产品,一个产品只有一个模具。但编程语言当中不同,由于类之间可以继承以及多继承,也就是说一个对象可以对应多个类。所以这个比喻不是特别合适,但是类和对象的关系是没错的。 但是这就有了一个问题,既然Python当中一切都是对象,那么是不是说类其实也是一个对象呢?也就是说一个模具其实也是另外一个模具的产品?同样,这个模具的模具其实也是另外一个模具的产品,那么我们一直追问下去会怎么样呢? 很简单,我们做个实验就知道了,我们可以用_class__关键字来查看一个变量的类型,那么我们反复调用就可以查看其中的关系了: 从上面的图中我们可以发现,num是int类型的变量。我们继续查看int这个类型的类型,得到了type类型。而当我们去查看type的类型的时候,会发现我们得到的还是一个type的类型。 所以我们可以明白了,type是Python中用来创建所有类的元类,是所有模具的模具。在Python当中,我们把一个类的类叫做元类(metaclass)。所以type就是Python当中内置的元类,我们也可以自己创建我们需要的元类。通过元类,我们创建的对象也是一个类,而不是一个实例。 动态创建类 理解了type是一切类基础之后,再来看动态类就简单了。动态类是动态语言最大的特性之一,作为典型的动态语言,Python自然也是支持类型的动态创建的。 在Python当中,创建动态类型的一种方式就是通过type关键字。说起来有些意想不到,type函数不是用来查询对象所属的类型的吗,怎么还可以创建类呢? 这其实是type的另外一种用法,作为元类来创建一个类。在这种用法,type函数接收3个参数,分别是类型的名称,父类的元组,以及一个字典。除了第一个参数之外,后面两个参数都可以为空。比如我们来看一个例子: 注意,type返回的结果是一个类,而不是一个实例。所以我们还可以通过它创建实例: 这样创建出来的是最简单的空类,它什么也没有,和下面的代码等价。 我们也可以在type的参数当中为这个类填充属性和方法: 这样我们就为Hello这个类创建了一个方法叫做hello,一个属性num等于3。我们可以来调用一下试试: 也就是说我们可以使用type来根据我们的需要自行定义类,只不过type既可以获取对象的类型又可以创建新的类,看起来可能觉得有些不太直观,但是其实这也是说得通的。我们在Python当中通过调用str创建一个string对象,通过int来创建一个integer对象,那么通过type则是创建一个类的对象。 实现继承 我们之前说了,当我们使用type来创建类的时候,还可以传入父类的元组从而实现类的继承。 比如我们再创建一个叫做World的类继承刚才通过type创建出来的Hello类,然后在为它加上额外的函数: 注意这里传入第二个参数是父类的元组,既然是元组,那么当元素只有一个的时候,需要加上逗号,表示这是一个元组。这样创建出来的类和我们通过class定义的静态类效果是一样的: 也就是说,我们可以先把函数实现,然后再根据任务的需要把这些函数组装成新的类。显然,这和传统的C++以及Java这些静态类型的语言相比,要灵活得多。 总结 我们固然可以通过type来创建动态创建类,但是从上面的使用过程也应该看得出来,这样使用起来并不太方便,并且很多进阶的功能很难实现。举个简单的例子,比如我们想要动态地为一个已有的类添加一些动态的方法,生成新的类。我们使用type就很难实现。type也的确不是Python元类的主要运用,metaclass才是王道。 当然,元类是一个非常高级的用法,以至于Python的创始人说99%的Python程序员并不需要用到它。所以如果你觉得理解起来非常费劲的话也没有关系,知道这么个概念就可以了。 【云栖号在线课堂】每天都有产品技术专家分享!课程地址:https://yqh.aliyun.com/live 立即加入社群,与专家面对面,及时了解课程最新动态!【云栖号在线课堂 社群】https://c.tb.cn/F3.Z8gvnK 原文发布时间:2020-06-05本文作者:承志本文来自:“掘金”,了解相关信息可以关注“掘金”

优秀的个人博客,低调大师

Android中高级面试题【理论知识】

1. ThreadLocal的理解 可以保证线程的安全。在多个线程共享相同的数据的时候,会为每个线程创建单独的副本,在单独的副本上进行数据的操作,不会对其它线程的数据产生影响,保证了线程安全。 2. HashMap HashSet HashTable的区别? 都是集合,底层都是Hash算法实现的。HashMap是Hashtable的替代品,这两个都是双列集合,而HashSet是单列集合。HashMap线程不安全、效率高、可以存储null键和null值;Hashtable线程安全,效率低,不可以存储null键和null值。 3. 如何让HashMap可以线程安全? HashMap 在并发执行 put 操作时会引起死循环,导致 CPU 利用率接近100%。因为多线程会导致 HashMap 的 Node 链表形成环形数据结构,一旦形成环形数据结构,Node 的 next 节点永远不为空,就会在获取 Node 时产生死循环。使用下面三种替换方式:HashtableConcurrentHashMapSynchronized Map 4. Android对HashMap做了优化后推出的新的容器类是什么? SparseArray它要比 HashMap 节省内存,某些情况下比HashMap性能更好,按照官方问答的解释,主要是因为SparseArray不需要对key和value进行auto-boxing(将原始类型封装为对象类型,比如把int类型封装成Integer类型),结构比HashMap简单(SparseArray内部主要使用两个一维数组来保存数据,一个用来存key,一个用来存value)不需要额外的额外的数据结构(主要是针对HashMap中的HashMapEntry而言的)。 5. Java多线程之间如何通信 等待唤醒机制 6. 线程池的实现机制 向线程池提交任务,会依次启动核心线程,如果提交的任务数超过了核心线程数,会将任务保存到阻塞队列中,如果阻塞队列也满了,且继续提交任务,则会创建新线程执行任务,直到任务数达到最大线程数。此时如果再提交任务的话会抛出异常或者直接丢弃任务。通过Executor.execute()无法得到返回值,通过ExecutorService.submit()可以得到返回值。 7. RxJava中map和flatmap操作符的区别及底层实现 Map返回的是结果集,flatmap返回的是包含结果集的Observable。Map只能一对一,flatmap可以一对多、多对多。RxJava是通过观察者模式实现的。 8. 对消息机制中Looper的理解 Looper在消息机制中扮演的角色是创造无限循环从Messagequeue中取得消息然后分发。 先领券再购买云产品》》 (不限新用户)云产品一折拼购直达地址》》aliyunp.com(阿里云拼团) (不限新老用户)阿里云双11优惠主会场直达地址》》aliyunh.com(阿里云优惠)! 9. 单例模式有哪些实现方式 饿汉模式(线程安全,调用效率高,但是不能延时加载)懒汉模式(线程安全,调用效率不高,但是能延时加载)双重检测锁模式(由于JVM底层模型原因,偶尔会出问题,不建议使用)静态内部类式(线程安全,调用效率高,可以延时加载)枚举类(线程安全,调用效率高,不能延时加载,可以天然的防止反射和反序列化调用) 10. 通过静态内部类实现单例模式有哪些优点 线程安全,调用效率高,可以延时加载 11. synchronized volatile关键字有什么区别?以及还有哪些同样功能的关键字 (1) volatile是变量修饰符,而synchronized则作用于一段代码或者方法。(2) volatile只是在线程内存和main memory(主内存)间同步某个变量的值;而synchronized通过锁定和解锁某个监视器同步所有变量的值。显然synchronized要比volatile消耗更多资源。const、final、lock 12. 界面卡顿的原因有哪些? UI线程(main)有耗时操作视图渲染时间过长,导致卡顿 13. 造成OOM/ANR 的原因? OOM: (1)不恰当地使用static关键字 (2)内部类对Activity的引用 (3)大量Bitmap的使用会导致程序包运行时的内存消耗变大 (4)游标Cursor对象用完应该及时关闭 (5)加载对象过大 (6)相应资源过多,来不及释放。ANR: (1)在5秒内没有响应输入的事件(IO操作耗时、数据库操作复杂耗时、主线程非主线程产生死锁等待、网络加载/图片操作耗时、硬件操作耗时) (2)BroadcastReceiver在10秒内没有执行完毕(Service binder数量达到上限、Service忙导致超时无响应) 14. Activity与Fragment生命周期有何联系 在创建的过程中,是Activity带领着Fragment,在销毁的过程中,是Fragment带领着Activity。这里写图片描述 15. Glide三级缓存 内存缓存,磁盘缓存、网络缓存(由于网络缓存严格来说不算是缓存的一种,故也称为二级缓存)。缓存的资源分为两种:原图(SOURCE)、处理图(RESULT)(默认)。内存缓存:默认开启的,可以通过调用skipMemoryCache(true)来设置跳过内存缓存,缓存最大空间:每个进程可用的最大内存*0.4。(低配手机0.33)磁盘缓存:分为四种:ALL(缓存原图)、NONE(什么都不缓存)、SOURCE(只缓存原图)、RESULT(之后处理图),通过diskCacheStrategy(DiskCacheStrategy.ALL)来设置,缓存大小250M。 16. MVC、MVP、MVVM的原理 (1) MVC,Model View Controller,是软件架构中最常见的一种框架,简单来说就是通过controller的控制去操作model层的数据,并且返回给view层展示。当用户发出事件的时候,view层会发送指令到controller层,接着controller去通知model层更新数据,model层更新完数据以后直接显示在view层上,这就是MVC的工作原理。这里写图片描述(2) MVP是MVC的演化。MVP的model层相对于MVC是一样的,而activity和fragment不再是controller层,而是纯粹的view层,所有关于用户事件的转发全部交由presenter层处理。presenter层充当了桥梁的作用,用于操作view层发出的事件传递到presenter层中,presenter层去操作model层,并且将数据返回给view层。这里写图片描述(3) MVVM和MVP的区别貌似不大,只不过是presenter层换成了viewmodel层,还有一点就是view层和viewmodel层是相互绑定的关系,这意味着当你更新viewmodel层的数据的时候,view层会相应的变动ui。这里写图片描述 17. 数据库的操作类型有哪些,如何导入外部数据库? (1) 增删改查(2) 将外部数据库放在项目的res/raw目录下。因为安卓系统下数据库要放在data/data/packagename/databases的目录下,然后要做的就是将外部数据库导入到该目录下,操作方法是通过FileInputStream读取外部数据库,再用FileOutputStrean把读取到的东西写入到该目录下。 18. 是否使用过 IntentService,作用是什么, AIDL 解决了什么问题? (1) IntentService继承自Service。由于Service运行在主线程,无法进行耗时操作。所以你需要在Service中开启一个子线程,并且在子线程中运行。为了简化这一操作,Android中提供了IntentService来进行这一处理。通过查看IntentService的源码可以看到,在onCreate中,我们开启了一个HandlerThread线程,之后获取HandlerThread线程中的Looper,并通过这个Looper创建了一个Handler。然后在onStart方法中通过这个Handler将intent与startId作为Message的参数进行发送到消息队列中,然后交由Handler中的handleMessage中进行处理。由于在onStart方法是在主线程内运行的,而Handler是通过工作者线程HandlerThread中的Looper创建的。所以也就是在主线程中发送消息,在工作者接收到消息后便可以进行一些耗时的操作。(2) 进程间通信 19. 是否使用过本地广播,和全局广播有什么差别? 本地广播的数据在本应用范围内传播,不用担心隐私数据泄露的问题。不用担心别的应用伪造广播,造成安全隐患。相比在系统内发送全局广播,它更高效。 20. Activity、 Window、 View 三者的差别, fragment 的特点? (1) Activity像一个工匠(控制单元),Window像窗户(承载模型),View像窗花(显示视图) LayoutInflater像剪刀,Xml配置像窗花图纸。(2) a. Fragment可以作为Activity界面的一部分组成出现; 可以在一个Activity中同时出现多个Fragment,并且一个Fragment也可以在多个Activity中使用; 在Activity运行过程中,可以添加、移除或者替换Fragment; Fragment可以响应自己的输入事件,并且有自己的生命周期,它们的生命周期会受宿主Activity的生命周期影响。 21. Handler、 Thread 和 HandlerThread 的差别 从Android中Thread(java.lang.Thread -> java.lang.Object)描述可以看出,Android的Thread没有对Java的Thread做任何封装,但是Android提供了一个继承自Thread的类HandlerThread(android.os.HandlerThread -> java.lang.Thread),这个类对Java的Thread做了很多便利Android系统的封装。android.os.Handler可以通过Looper对象实例化,并运行于另外的线程中,Android提供了让Handler运行于其它线程的线程实现,也是就HandlerThread。HandlerThread对象start后可以获得其Looper对象,并且使用这个Looper对象实例Handler。 22. 低版本 SDK 实现高版本 api 自己实现或使用注解@TargetApi annotation 23. launch mode 应用场景 (1) standard:标准的启动模式。 这里写图片描述(2) singleTop:单一顶部模式 如果Activity已经被开启,并且处于任务栈的栈顶,就不会创建新的Activity,而是复用这个已经开启的Activity。为了防止出现一些奇怪的用户体验,推荐使用单一顶部模式,整个任务栈可以有多个实例存在.应用场景:短信发送界面.这里写图片描述(3)singletask:单一任务栈 在整个任务栈里面只允许有一个当前Activity的实例存在如果要开启的Activity在任务栈中已经存在,直接复用这个已经存在的Activity,并且把这个Activity上面的所有的其他Activity给清空应用场景:如果一个Activity非常消耗内存和cpu资源,建议把这个Activity做成singletask的模式。浏览器的browserActivity这里写图片描述(4)singleinstance:单一实例. 整个手机操作系统只有一个实例存在,并且是运行在自己单独的任务栈里面.应用场景:通话界面的Activity这里写图片描述 24. touch 事件传递流程 事件处理包括三种情况,分别为:传递—-dispatchTouchEvent()函数、拦截——onInterceptTouchEvent()函数、消费—-onTouchEvent()函数和OnTouchListener。Android事件传递流程:(1) 事件都是从Activity.dispatchTouchEvent()开始传递(2) 事件由父View传递给子View,ViewGroup可以通过onInterceptTouchEvent()方法对事件拦截,停止其向子view传递(3) 如果事件从上往下传递过程中一直没有被停止,且最底层子View没有消费事件,事件会反向往上传递,这时父View(ViewGroup)可以进行消费,如果还是没有被消费的话,最后会到Activity的onTouchEvent()函数。(4) 如果View没有对ACTION_DOWN进行消费,之后的其他事件不会传递过来,也就是说ACTION_DOWN必须返回true,之后的事件才会传递进来(5) OnTouchListener优先于onTouchEvent()对事件进行消费 View不处理事件流程图View不处理事件流程图 View处理事件流程图View处理事件流程图 事件拦截事件拦截 25.Android性能优化 一、代码优化 1.使用AndroidLint分析结果进行相应优化2.不使用枚举及IOC框架,反射性能低3.常量加static4.静态方法5.减少不必要的对象、成员变量6.尽量使用线程池7.适当使用软引用和弱引用8.尽量使用静态内部类,避免潜在的内存泄露9.图片缓存,采用内存缓存LRUCache和硬盘缓存DiskLRUCache10.Bitmap优化,采用适当分辨率大小并及时回收 二、布局优化 避免OverDraw过渡绘制优化布局层级避免嵌套过多无用布局当我们在画布局的时候,如果能实现相同的功能,优先考虑相对布局,然后在考虑别的布局,不要用绝对布局。使用标签把复杂的界面需要抽取出来使用标签,因为它在优化UI结构时起到很重要的作用。目的是通过删减多余或者额外的层级,从而优化整个Android Layout的结构。核心功能就是减少冗余的层次从而达到优化UI的目的!ViewStub 是一个隐藏的,不占用内存空间的视图对象,它可以在运行时延迟加载布局资源文件。 三、ListView和GridView优化 1.采用ViewHolder复用convertView2.避免在getView中执行耗时操作3.列表在滑动状态时不加载图片4.开启硬件加速 26.Android内存泄漏 内存泄漏简单地说就是申请了一块内存空间,使用完毕后没有释放掉。它的一般表现方式是程序运行时间越长,占用内存越多,最终用尽全部内存,整个系统崩溃。由程序申请的一块内存,且没有任何一个指针指向它,那么这块内存就泄露了。可能的原因有:1.注册没取消造成内存泄露,如:广播2.静态变量持有Activity的引用3.单例模式持有Activity的引用4.查询数据库后没有关闭游标cursor5.构造Adapter时,没有使用 convertView 重用6.Bitmap对象不在使用时调用recycle()释放内存7.对象被生命周期长的对象引用,如activity被静态集合引用导致activity不能释放8.使用Handler造成的内存泄露 先领券再购买云产品》》 (不限新用户)云产品一折拼购直达地址》》aliyunp.com(阿里云拼团) (不限新老用户)阿里云双11优惠主会场直达地址》》aliyunh.com(阿里云优惠)!

优秀的个人博客,低调大师

2020 开春程序员面试必备!拿走不谢!

云栖号:https://yqh.aliyun.com第一手的上云资讯,不同行业精选的上云企业案例库,基于众多成功案例萃取而成的最佳实践,助力您上云决策! 软件技能在科技界很重要,如果你不会正确使用编程语言或平台,你可能得不到这份工作。 以下为译文: 软件技能在科技界很重要,如果你不会正确使用编程语言或平台,你可能得不到这份工作。 目前Indeed 人才招聘实验室跟踪调查了500多名技术人员,其中有哪些技能在美国最受欢迎? 以下是有关美国技术技能的新报告中所分析的结果。该调研团队由经济学家和研究人员组成,对Indeed.com网站在2014年至2019年的5年间发布的数百万个技术职位的招聘信息进行了研究,以发现软件技术公司最需要哪些技能。为了帮助你更好的发展职业生涯,以下是所有技术中最流行的五种编程语言和技能(倒序排列)。 JavaScript 作为前端的主要编程语言,JavaScript出现在14.5%的技术岗位招聘信息中。它不仅是一种广受欢迎的技能,也是使用最多的编程语言,69.7%的专业开发人员经常使用它编写代码。 该语言经历了不断的演变,特别是在库和框架方面。Angular是应用最广泛的,在2016年底击败了Ajax,在2018年中击败了jQuery。事实上,在过去五年中,jQuery的流行度下降了33%,Ajax下降了55%。 当然,并不是所有的技术都在下降。自2014年以来,js、Vue.js和Node.js都实现了强劲、稳定的增长。 Linux 在所有的技术岗位中,Linux占据了14.9%,这就不难理解为什么Linux是第四大最受欢迎的技术。人们每天访问的大多数网站和应用程序都是由Linux提供的(它在微软Azure上的表现甚至比Windows还要好)。 不仅作为最安全的操作系统,而且由于其开源开发模式,各个行业的公司都在寻找懂得Linux生态系统的技术专家,以节约各种产品和服务开发所需的时间和成本。 事实上,Linux开始在智能电视、无人机、冰箱、恒温控制器甚至超级计算机上寻找出路(世界上最快的电脑都是由Linux驱动的)。汽车制造商也看到了这种潜力。例如, Automotive Grade Linux (AGL)是一个开发联网汽车车载技术的开源项目,包括奥迪(Audi)、梅赛德斯-奔驰(Mercedes-Benz)、现代(Hyundai)和丰田(Toyota)。 Python 截至2019年9月,Python出现在18%的技术工作招聘信息中,使其成为榜单上第三受欢迎的技能。在招聘实验室调查的所有主要技术技能中,Python也是增长最快的。2014年,Python是排名第15的技能,但到2019年,它上升到第3名(增加了118%)。 数据科学家和相关角色(如数据工程师、数据分析师和机器学习工程师)在内的新工作组合,在一定程度上解释了这种增长。例如,自2013年12月以来,数据科学的工作岗位激增了256%。随着公司产生越来越多的数据,Python很可能会继续保持这种高速增长的轨迹,特别是因为Python多年来一直是数据科学家的最爱。 不仅仅是数据科学工作的兴起促使了Python的成功。软件工程师、全栈开发人员、QA工程师和其他一些角色越来越多地使用Python,是因为它的通用性、易用性和开发速度。在2019年,Python第一次超越Java成为第二大最受欢迎的语言(仅次于JavaScript)。 Java Java出现在21%的科技职位招聘中,使其成为第二大受欢迎的技能。Java不仅是Android移动开发的中流砥柱,而且在近25年的时间里一直是软件工程师的热门技能。因为它是一种“write once, run anywhere”(WORA)语言,所以它是跨平台的,允许公司在一个系统上开发Java代码,并在任何其他支持Java的机器上运行它。 因为它是为那些规模不断扩大的项目而设计的,所以大多数企业——包括Facebook、Netflix和airbnb等大公司以及初创公司——都使用它来构建从电子商务后端和机器学习环境到云应用甚至物联网技术的一切。由于它的通用性、丰富的工具生态系统和强大的社区,现在全世界有130亿支持Java的设备——这意味着对Java人才的需求还会持续。 SQL SQL是2019年最优秀的技能,在所有科技职位中占22%(仅比Java高出1%)。为什么呢?因为所有公司都依赖数据,需要组织、理解和可视化数据来做出重要的业务决策。SQL是最通用的数据库语言,支持Microsoft SQL Server、MySQL、PostgreSQL和SQLite等数据库引擎。 各种各样的技术人员都在使用它,从访问数据库编写程序的开发人员到设计数据库的工程师,再到数据科学家和分析师——他们将数千万(或数亿)行数据转化为商业价值信息。即使是非技术团队,比如市场和销售,也可以利用SQL来进行决策。 不过,尽管SQL占据了首位,但在过去五年里,SQL的份额实际上略有下降,部分原因可能是NoSQL等替代数据库查询工具的兴起。尽管如此,正如技术职位所描述的那样,SQL主导着市场,而且短期内似乎不会有任何变化。 编程语言和技术的兴衰变化 2019年雇主最看重的五种语言和技能不一定是增长最快的。科技从来都不是一成不变的,所以让我们来看看哪些技能正在经历最大的增长,哪些技能正在迅速失宠,这样你就可以在最新的趋势中保持领先。 通过学习以下发展最快的技术,在激烈的人才竞争中脱颖而出。你掌握了几种呢?在你的简历中突出它们,让雇主优先选择你。 Docker:在过去的五年里,Docker的发展轨迹令人印象深刻。2014年,在Indeed的工作岗位描述中几乎没有这种软件(因为第一个正式版本是在那年晚些时候发布的)。但在2019年,Docker增长了40多倍,雇主的需求实际上超过了求职者的兴趣。 IOT: IOT(物联网)技术在过去五年里增长了近2000%,这是由大量连接到互联网的物理设备推动的,包括智能家居、联网汽车、智能城市和可穿戴技术。 Ansible: 2014年,让应用程序和系统更容易部署的IT自动化平台只出现在0.1%的技术职位描述中,但现在达到2.8%——显著增长了近130%。 Kafka: Apache Kafka,一个建立实时流数据管道的开源平台,也经历了爆炸性的增长,在五年内增长了超过1200%。这反映了数据科学和与之相关的技术工作的迅速普及,如开发运营人员、数据科学家和全栈开发人员。 衰落最快的技能 随着新的技术、语言和标准进入主流,旧的技术、语言和标准被挤出了排行榜(甚至被淘汰)。考虑在2020年放弃这些技术。 Clojure:作为一种Lisp编程语言的经典,曾一度受到狂热的追捧,它的粉丝人数虽少,但热情高涨。它不是一种主流语言,由于其缺乏强大的库系统以及它需要更高的CPU占用率(这将增加使用和运营成本),因此对Clojure的需求自2014年以来下降了80%。 EJB:尽管Java是2019年最热门的技术之一,但EJB (Enterprise javabean的缩写)自2014年以来下降了73%。一种可能的解释是,其他现代的基于java的框架,比如Spring Boot(去年增长了58%)是开源的,使用起来更方便,资源消耗也更少。 Servlets: servlets是另一种基于java的技术,但很快就会成为一种遗留技术。为什么呢?使用servlets的开发人员必须编写大量程序代码来构建web应用程序,而其他框架,如Spring MVC,则使手工工作自动化,从而使构建web应用程序更快、更容易。 JSP: 与EJB和servlets的情况类似,随着构建动态web页面的新技术成熟和流行,JSP (JavaServer Pages)开始过时。JSP仅限于简单、固定的交互,但是像Angular、React和Vue.js这样的新JS框架提供了更丰富的web应用程序,其中包含大量用户交互。 你的技术能与时俱进吗? 在瞬息万变的科技世界里,无论是想找到一份新的科技工作还是投资未来的职业发展,保持你的技能与时俱进,都是至关重要的。但是,很难弄清楚什么技术是一时的流行,什么技术会持续下去,尤其是在新技术日益更新(旧的技术正在被淘汰)的情况下。 那么你该如何适应?学习所需的技能,而不是沉迷于昙花一现的狂热中。这五年的稳定(有时是爆炸性的)增长表明,一些像Python、Java或SQL语言或技能可能还会继续存在,至少在下一次打破排名之前是这样。 云栖号:https://yqh.aliyun.com第一手的上云资讯,不同行业精选的上云企业案例库,基于众多成功案例萃取而成的最佳实践,助力您上云决策! 原文发布时间:2020-1-17本文作者:CSDN App本文来自阿里云云栖号合作伙伴“CSDN”,了解相关信息可以关注“CSDN”

优秀的个人博客,低调大师

Android中高级面试题(理论知识)

1. ThreadLocal的理解 可以保证线程的安全。在多个线程共享相同的数据的时候,会为每个线程创建单独的副本,在单独的副本上进行数据的操作,不会对其它线程的数据产生影响,保证了线程安全。 2. HashMap HashSet HashTable的区别? 都是集合,底层都是Hash算法实现的。HashMap是Hashtable的替代品,这两个都是双列集合,而HashSet是单列集合。HashMap线程不安全、效率高、可以存储null键和null值;Hashtable线程安全,效率低,不可以存储null键和null值。 3. 如何让HashMap可以线程安全? HashMap 在并发执行 put 操作时会引起死循环,导致 CPU 利用率接近100%。因为多线程会导致 HashMap 的 Node 链表形成环形数据结构,一旦形成环形数据结构,Node 的 next 节点永远不为空,就会在获取 Node 时产生死循环。使用下面三种替换方式:HashtableConcurrentHashMapSynchronized Map 4. Android对HashMap做了优化后推出的新的容器类是什么? SparseArray它要比 HashMap 节省内存,某些情况下比HashMap性能更好,按照官方问答的解释,主要是因为SparseArray不需要对key和value进行auto-boxing(将原始类型封装为对象类型,比如把int类型封装成Integer类型),结构比HashMap简单(SparseArray内部主要使用两个一维数组来保存数据,一个用来存key,一个用来存value)不需要额外的额外的数据结构(主要是针对HashMap中的HashMapEntry而言的)。 5. Java多线程之间如何通信 等待唤醒机制 6. 线程池的实现机制 向线程池提交任务,会依次启动核心线程,如果提交的任务数超过了核心线程数,会将任务保存到阻塞队列中,如果阻塞队列也满了,且继续提交任务,则会创建新线程执行任务,直到任务数达到最大线程数。此时如果再提交任务的话会抛出异常或者直接丢弃任务。通过Executor.execute()无法得到返回值,通过ExecutorService.submit()可以得到返回值。 7. RxJava中map和flatmap操作符的区别及底层实现 Map返回的是结果集,flatmap返回的是包含结果集的Observable。Map只能一对一,flatmap可以一对多、多对多。RxJava是通过观察者模式实现的。 8. 对消息机制中Looper的理解 Looper在消息机制中扮演的角色是创造无限循环从Messagequeue中取得消息然后分发。 9. 单例模式有哪些实现方式 饿汉模式(线程安全,调用效率高,但是不能延时加载)懒汉模式(线程安全,调用效率不高,但是能延时加载)双重检测锁模式(由于JVM底层模型原因,偶尔会出问题,不建议使用)静态内部类式(线程安全,调用效率高,可以延时加载)枚举类(线程安全,调用效率高,不能延时加载,可以天然的防止反射和反序列化调用) 10. 通过静态内部类实现单例模式有哪些优点 线程安全,调用效率高,可以延时加载 11. synchronized volatile关键字有什么区别?以及还有哪些同样功能的关键字 (1) volatile是变量修饰符,而synchronized则作用于一段代码或者方法。(2) volatile只是在线程内存和main memory(主内存)间同步某个变量的值;而synchronized通过锁定和解锁某个监视器同步所有变量的值。显然synchronized要比volatile消耗更多资源。const、final、lock 12. 界面卡顿的原因有哪些? UI线程(main)有耗时操作视图渲染时间过长,导致卡顿 13. 造成OOM/ANR 的原因? OOM: (1)不恰当地使用static关键字 (2)内部类对Activity的引用 (3)大量Bitmap的使用会导致程序包运行时的内存消耗变大 (4)游标Cursor对象用完应该及时关闭 (5)加载对象过大 (6)相应资源过多,来不及释放。ANR: (1)在5秒内没有响应输入的事件(IO操作耗时、数据库操作复杂耗时、主线程非主线程产生死锁等待、网络加载/图片操作耗时、硬件操作耗时) (2)BroadcastReceiver在10秒内没有执行完毕(Service binder数量达到上限、Service忙导致超时无响应) 14. Activity与Fragment生命周期有何联系 在创建的过程中,是Activity带领着Fragment,在销毁的过程中,是Fragment带领着Activity。这里写图片描述 15. Glide三级缓存 内存缓存,磁盘缓存、网络缓存(由于网络缓存严格来说不算是缓存的一种,故也称为二级缓存)。缓存的资源分为两种:原图(SOURCE)、处理图(RESULT)(默认)。内存缓存:默认开启的,可以通过调用skipMemoryCache(true)来设置跳过内存缓存,缓存最大空间:每个进程可用的最大内存*0.4。(低配手机0.33)磁盘缓存:分为四种:ALL(缓存原图)、NONE(什么都不缓存)、SOURCE(只缓存原图)、RESULT(之后处理图),通过diskCacheStrategy(DiskCacheStrategy.ALL)来设置,缓存大小250M。 16. MVC、MVP、MVVM的原理 (1) MVC,Model View Controller,是软件架构中最常见的一种框架,简单来说就是通过controller的控制去操作model层的数据,并且返回给view层展示。当用户发出事件的时候,view层会发送指令到controller层,接着controller去通知model层更新数据,model层更新完数据以后直接显示在view层上,这就是MVC的工作原理。这里写图片描述(2) MVP是MVC的演化。MVP的model层相对于MVC是一样的,而activity和fragment不再是controller层,而是纯粹的view层,所有关于用户事件的转发全部交由presenter层处理。presenter层充当了桥梁的作用,用于操作view层发出的事件传递到presenter层中,presenter层去操作model层,并且将数据返回给view层。这里写图片描述(3) MVVM和MVP的区别貌似不大,只不过是presenter层换成了viewmodel层,还有一点就是view层和viewmodel层是相互绑定的关系,这意味着当你更新viewmodel层的数据的时候,view层会相应的变动ui。这里写图片描述 17. 数据库的操作类型有哪些,如何导入外部数据库? (1) 增删改查(2) 将外部数据库放在项目的res/raw目录下。因为安卓系统下数据库要放在data/data/packagename/databases的目录下,然后要做的就是将外部数据库导入到该目录下,操作方法是通过FileInputStream读取外部数据库,再用FileOutputStrean把读取到的东西写入到该目录下。 18. 是否使用过 IntentService,作用是什么, AIDL 解决了什么问题? (1) IntentService继承自Service。由于Service运行在主线程,无法进行耗时操作。所以你需要在Service中开启一个子线程,并且在子线程中运行。为了简化这一操作,Android中提供了IntentService来进行这一处理。通过查看IntentService的源码可以看到,在onCreate中,我们开启了一个HandlerThread线程,之后获取HandlerThread线程中的Looper,并通过这个Looper创建了一个Handler。然后在onStart方法中通过这个Handler将intent与startId作为Message的参数进行发送到消息队列中,然后交由Handler中的handleMessage中进行处理。由于在onStart方法是在主线程内运行的,而Handler是通过工作者线程HandlerThread中的Looper创建的。所以也就是在主线程中发送消息,在工作者接收到消息后便可以进行一些耗时的操作。(2) 进程间通信 19. 是否使用过本地广播,和全局广播有什么差别? 本地广播的数据在本应用范围内传播,不用担心隐私数据泄露的问题。不用担心别的应用伪造广播,造成安全隐患。相比在系统内发送全局广播,它更高效。 20. Activity、 Window、 View 三者的差别, fragment 的特点? (1) Activity像一个工匠(控制单元),Window像窗户(承载模型),View像窗花(显示视图) LayoutInflater像剪刀,Xml配置像窗花图纸。(2) a. Fragment可以作为Activity界面的一部分组成出现; 可以在一个Activity中同时出现多个Fragment,并且一个Fragment也可以在多个Activity中使用; 在Activity运行过程中,可以添加、移除或者替换Fragment; Fragment可以响应自己的输入事件,并且有自己的生命周期,它们的生命周期会受宿主Activity的生命周期影响。 21. Handler、 Thread 和 HandlerThread 的差别 从Android中Thread(java.lang.Thread -> java.lang.Object)描述可以看出,Android的Thread没有对Java的Thread做任何封装,但是Android提供了一个继承自Thread的类HandlerThread(android.os.HandlerThread -> java.lang.Thread),这个类对Java的Thread做了很多便利Android系统的封装。android.os.Handler可以通过Looper对象实例化,并运行于另外的线程中,Android提供了让Handler运行于其它线程的线程实现,也是就HandlerThread。HandlerThread对象start后可以获得其Looper对象,并且使用这个Looper对象实例Handler。 22. 低版本 SDK 实现高版本 api 自己实现或使用注解@TargetApi annotation 23. launch mode 应用场景 (1) standard:标准的启动模式。 这里写图片描述(2) singleTop:单一顶部模式 如果Activity已经被开启,并且处于任务栈的栈顶,就不会创建新的Activity,而是复用这个已经开启的Activity。为了防止出现一些奇怪的用户体验,推荐使用单一顶部模式,整个任务栈可以有多个实例存在.应用场景:短信发送界面.这里写图片描述(3)singletask:单一任务栈 在整个任务栈里面只允许有一个当前Activity的实例存在如果要开启的Activity在任务栈中已经存在,直接复用这个已经存在的Activity,并且把这个Activity上面的所有的其他Activity给清空应用场景:如果一个Activity非常消耗内存和cpu资源,建议把这个Activity做成singletask的模式。浏览器的browserActivity这里写图片描述(4)singleinstance:单一实例. 整个手机操作系统只有一个实例存在,并且是运行在自己单独的任务栈里面.应用场景:通话界面的Activity这里写图片描述 24. touch 事件传递流程 事件处理包括三种情况,分别为:传递—-dispatchTouchEvent()函数、拦截——onInterceptTouchEvent()函数、消费—-onTouchEvent()函数和OnTouchListener。Android事件传递流程:(1) 事件都是从Activity.dispatchTouchEvent()开始传递(2) 事件由父View传递给子View,ViewGroup可以通过onInterceptTouchEvent()方法对事件拦截,停止其向子view传递(3) 如果事件从上往下传递过程中一直没有被停止,且最底层子View没有消费事件,事件会反向往上传递,这时父View(ViewGroup)可以进行消费,如果还是没有被消费的话,最后会到Activity的onTouchEvent()函数。(4) 如果View没有对ACTION_DOWN进行消费,之后的其他事件不会传递过来,也就是说ACTION_DOWN必须返回true,之后的事件才会传递进来(5) OnTouchListener优先于onTouchEvent()对事件进行消费 View不处理事件流程图View不处理事件流程图 View处理事件流程图View处理事件流程图 事件拦截事件拦截 25.Android性能优化 一、代码优化 1.使用AndroidLint分析结果进行相应优化2.不使用枚举及IOC框架,反射性能低3.常量加static4.静态方法5.减少不必要的对象、成员变量6.尽量使用线程池7.适当使用软引用和弱引用8.尽量使用静态内部类,避免潜在的内存泄露9.图片缓存,采用内存缓存LRUCache和硬盘缓存DiskLRUCache10.Bitmap优化,采用适当分辨率大小并及时回收 二、布局优化 避免OverDraw过渡绘制优化布局层级避免嵌套过多无用布局当我们在画布局的时候,如果能实现相同的功能,优先考虑相对布局,然后在考虑别的布局,不要用绝对布局。使用标签把复杂的界面需要抽取出来使用标签,因为它在优化UI结构时起到很重要的作用。目的是通过删减多余或者额外的层级,从而优化整个Android Layout的结构。核心功能就是减少冗余的层次从而达到优化UI的目的!ViewStub 是一个隐藏的,不占用内存空间的视图对象,它可以在运行时延迟加载布局资源文件。 三、ListView和GridView优化 1.采用ViewHolder复用convertView2.避免在getView中执行耗时操作3.列表在滑动状态时不加载图片4.开启硬件加速 26.Android内存泄漏 内存泄漏简单地说就是申请了一块内存空间,使用完毕后没有释放掉。它的一般表现方式是程序运行时间越长,占用内存越多,最终用尽全部内存,整个系统崩溃。由程序申请的一块内存,且没有任何一个指针指向它,那么这块内存就泄露了。可能的原因有:1.注册没取消造成内存泄露,如:广播2.静态变量持有Activity的引用3.单例模式持有Activity的引用4.查询数据库后没有关闭游标cursor5.构造Adapter时,没有使用 convertView 重用6.Bitmap对象不在使用时调用recycle()释放内存7.对象被生命周期长的对象引用,如activity被静态集合引用导致activity不能释放8.使用Handler造成的内存泄露 原文地址:http://cloud.yundashi168.com/archives/964

优秀的个人博客,低调大师

面试题:如何设计一个权限系统?

点击关注CSDN:【程序员的梦想】,专注于Java,SpringBoot,SpringCloud,微服务,Docker以及前后端分离等全栈技术。 前言 权限管理是所有后台系统的都会涉及的一个重要组成部分,主要目的是对不同的人访问资源进行权限的控制,避免因权限控制缺失或操作不当引发的风险问题,如操作错误,隐私数据泄露等问题。目前在公司负责权限这块,所以对权限这块的设计比较熟悉,公司采用微服务架构,权限系统自然就独立出来了,其他业务系统包括商品中心,订单中心,用户中心,仓库系统,小程序,多个APP等十几个系统和终端 1.权限模型 迄今为止最为普及的权限设计模型是RBAC模型,基于角色的访问控制(Role-Based Access Control) 1.1 RBAC0模型 RBAC0模型如下: 这是权限最基础也是最核心的模型,它包括用户/角色/权限,其中用户和角色是多对多的关系,角色和权限也是多对多的关系。用户是发起操作的主体,按类型分可分为2B和2C用户,可以是后台管理系统的用户,可以是OA系统的内部员工,也可以是面向C端的用户,比如阿里云的用户。角色起到了桥梁的作用,连接了用户和权限的关系,每个角色可以关联多个权限,同时一个用户关联多个角色,那么这个用户就有了多个角色的多个权限。有人会问了为什么用户不直接关联权限呢?在用户基数小的系统,比如20个人的小系统,管理员可以直接把用户和权限关联,工作量并不大,选择一个用户勾选下需要的权限就完事了。但是在实际企业系统中,用户基数比较大,其中很多人的权限都是一样的,就是个普通访问权限,如果管理员给100人甚至更多授权,工作量巨大。这就引入了"角色(Role)"概念,一个角色可以与多个用户关联,管理员只需要把该角色赋予用户,那么用户就有了该角色下的所有权限,这样设计既提升了效率,也有很大的拓展性。权限是用户可以访问的资源,包括页面权限,操作权限,数据权限: 页面权限: 即用户登录系统可以看到的页面,由菜单来控制,菜单包括一级菜单和二级菜单,只要用户有一级和二级菜单的权限,那么用户就可以访问页面 操作权限: 即页面的功能按钮,包括查看,新增,修改,删除,审核等,用户点击删除按钮时,后台会校验用户角色下的所有权限是否包含该删除权限,如果是,就可以进行下一步操作,反之提示无权限。有的系统要求"可见即可操作",意思是如果页面上能够看到操作按钮,那么用户就可以操作,要实现此需求,这里就需要前端来配合,前端开发把用户的权限信息缓存,在页面判断用户是否包含此权限,如果有,就显示该按钮,如果没有,就隐藏该按钮。某种程度上提升了用户体验,但是在实际场景可自行选择是否需要这样做 数据权限: 数据权限就是用户在同一页面看到的数据是不同的,比如财务部只能看到其部门下的用户数据,采购部只看采购部的数据,在一些大型的公司,全国有很多城市和分公司,比如杭州用户登录系统只能看到杭州的数据,上海用户只能看到上海的数据,解决方案一般是把数据和具体的组织架构关联起来,举个例子,再给用户授权的时候,用户选择某个角色同时绑定组织如财务部或者合肥分公司,那么该用户就有了该角色下财务部或合肥分公司下的的数据权限。 以上是RBAC的核心设计及模型分析,此模型也叫做RBAC0,而基于核心概念之上,RBAC还提供了扩展模式。包括RBAC1,RBAC2,RBAC3模型。下面介绍这三种类型 1.2 RBAC1模型 此模型引入了角色继承(Hierarchical Role)概念,即角色具有上下级的关系,角色间的继承关系可分为一般继承关系和受限继承关系。一般继承关系仅要求角色继承关系是一个绝对偏序关系,允许角色间的多继承。而受限继承关系则进一步要求角色继承关系是一个树结构,实现角色间的单继承。这种设计可以给角色分组和分层,一定程度简化了权限管理工作。 1.3 RBAC2模型 基于核心模型的基础上,进行了角色的约束控制,RBAC2模型中添加了责任分离关系,其规定了权限被赋予角色时,或角色被赋予用户时,以及当用户在某一时刻激活一个角色时所应遵循的强制性规则。责任分离包括静态责任分离和动态责任分离。主要包括以下约束: 互斥角色: 同一用户只能分配到一组互斥角色集合中至多一个角色,支持责任分离的原则。互斥角色是指各自权限互相制约的两个角色。比如财务部有会计和审核员两个角色,他们是互斥角色,那么用户不能同时拥有这两个角色,体现了职责分离原则 基数约束: 一个角色被分配的用户数量受限;一个用户可拥有的角色数目受限;同样一个角色对应的访问权限数目也应受限,以控制高级权限在系统中的分配 先决条件角色: 即用户想获得某上级角色,必须先获得其下一级的角色 1.4 RBAC3模型 即最全面的权限管理,它是基于RBAC0,将RBAC1和RBAC2进行了整合 1.5 用户组 当平台用户基数增大,角色类型增多时,而且有一部分人具有相同的属性,比如财务部的所有员工,如果直接给用户分配角色,管理员的工作量就会很大,如果把相同属性的用户归类到某用户组,那么管理员直接给用户组分配角色,用户组里的每个用户即可拥有该角色,以后其他用户加入用户组后,即可自动获取用户组的所有角色,退出用户组,同时也撤销了用户组下的角色,无须管理员手动管理角色。根据用户组是否有上下级关系,可以分为有上下级的用户组和普通用户组: 具有上下级关系的用户组: 最典型的例子就是部门和职位,可能多数人没有把部门职位和用户组关联起来吧。当然用户组是可以拓展的,部门和职位常用于内部的管理系统,如果是面向C端的系统,比如淘宝网的商家,商家自身也有一套组织架构,比如采购部,销售部,客服部,后勤部等,有些人拥有客服权限,有些人拥有上架权限等等,所以用户组是可以拓展的 普通用户组: 即没有上下级关系,和组织架构,职位都没有关系,也就是说可以跨部门,跨职位,举个例子,某电商后台管理系统,有拼团活动管理角色,我们可以设置一个拼团用户组,该组可以包括研发部的后台开发人员,运营部的运营人员,采购部的人员等等。 每个公司都会涉及到到组织和职位,下面就重点介绍这两个。 1.5.1 组织 常见的组织架构如下图: 我们可以把组织与角色进行关联,用户加入组织后,就会自动获得该组织的全部角色,无须管理员手动授予,大大减少工作量,同时用户在调岗时,只需调整组织,角色即可批量调整。组织的另外一个作用是控制数据权限,把角色关联到组织,那么该角色只能看到该组织下的数据权限。 1.5.2 职位 假设财务部的职位如下图: 每个组织部门下都会有多个职位,比如财务部有总监,会计,出纳等职位,虽然都在同一部门,但是每个职位的权限是不同的,职位高的拥有更多的权限。总监拥有所有权限,会计和出纳拥有部分权限。特殊情况下,一个人可能身兼多职。 1.6 含有组织/职位/用户组的模型 根据以上场景,新的权限模型就可以设计出来了,如下图:根据系统的复杂度不同,其中的多对多关系和一对一关系可能会有变化, 在单系统且用户类型单一的情况下,用户和组织是一对一关系,组织和职位是一对多关系,用户和职位是一对一关系,组织和角色是一对一关系,职位和角色是一对一关系,用户和用户组是多对对关系,用户组和角色是一对一关系,当然这些关系也可以根据具体业务进行调整。模型设计并不是死的,如果小系统不需要用户组,这块是可以去掉的。 分布式系统且用户类型单一的情况下,到这里权限系统就会变得很复杂,这里就要引入了一个"系统"概念,此时系统架构是个分布式系统,权限系统独立出来,负责所有的系统的权限控制,其他业务系统比如商品中心,订单中心,用户中心,每个系统都有自己的角色和权限,那么权限系统就可以配置其他系统的角色和权限。 分布式系统且用户类型多个的情况下,比如淘宝网,它的用户类型包括内部用户,商家,普通用户,内部用户登录多个后台管理系统,商家登录商家中心,这些做权限控制,如果你作为架构师,该如何来设计呢?大神可以在评论区留言交流哦! 2.授权流程 授权即给用户授予角色,按流程可分为手动授权和审批授权。权限中心可同时配置这两种,可提高授权的灵活性。 手动授权: 管理员登录权限中心为用户授权,根据在哪个页面授权分为两种方式:给用户添加角色,给角色添加用户。给用户添加角色就是在用户管理页面,点击某个用户去授予角色,可以一次为用户添加多个角色;给角色添加用户就是在角色管理页面,点击某个角色,选择多个用户,实现了给批量用户授予角色的目的。 审批授权: 即用户申请某个职位角色,那么用户通过OA流程申请该角色,然后由上级审批,该用户即可拥有该角色,不需要系统管理员手动授予。 3.表结构 有了上述的权限模型,设计表结构就不难了,下面是多系统下的表结构,简单设计下,主要提供思路: 4.权限框架 Apache Shrio Spring Security 在项目中可以采用其中一种框架,它们的优缺点以及如何使用会在后面的文章中详细介绍. 5.结语 权限系统可以说是整个系统中最基础,同时也可以很复杂的,在实际项目中,会遇到多个系统,多个用户类型,多个使用场景,这就需要具体问题具体分析,但最核心的RBAC模型是不变的,我们可以在其基础上进行扩展来满足需求。最后,如果您觉得这篇文章对您有帮助,可以点个赞,谢谢支持! 关注微信公众号【程序员的梦想】,专注于Java,SpringBoot,SpringCloud,微服务,Docker以及前后端分离等全栈技术。
优秀的个人博客,低调大师

Andrioid中高级面试题目归纳整理

1. ThreadLocal的理解 可以保证线程的安全。在多个线程共享相同的数据的时候,会为每个线程创建单独的副本,在单独的副本上进行数据的操作,不会对其它线程的数据产生影响,保证了线程安全。 2. HashMap HashSet HashTable的区别? 都是集合,底层都是Hash算法实现的。HashMap是Hashtable的替代品,这两个都是双列集合,而HashSet是单列集合。HashMap线程不安全、效率高、可以存储null键和null值;Hashtable线程安全,效率低,不可以存储null键和null值。 3. 如何让HashMap可以线程安全? HashMap 在并发执行 put 操作时会引起死循环,导致 CPU 利用率接近100%。因为多线程会导致 HashMap 的 Node 链表形成环形数据结构,一旦形成环形数据结构,Node 的 next 节点永远不为空,就会在获取 Node 时产生死循环。使用下面三种替换方式:HashtableConcurrentHashMapSynchronized Map 4. Android对HashMap做了优化后推出的新的容器类是什么? SparseArray它要比 HashMap 节省内存,某些情况下比HashMap性能更好,按照官方问答的解释,主要是因为SparseArray不需要对key和value进行auto-boxing(将原始类型封装为对象类型,比如把int类型封装成Integer类型),结构比HashMap简单(SparseArray内部主要使用两个一维数组来保存数据,一个用来存key,一个用来存value)不需要额外的额外的数据结构(主要是针对HashMap中的HashMapEntry而言的)。 5. Java多线程之间如何通信 等待唤醒机制 6. 线程池的实现机制 向线程池提交任务,会依次启动核心线程,如果提交的任务数超过了核心线程数,会将任务保存到阻塞队列中,如果阻塞队列也满了,且继续提交任务,则会创建新线程执行任务,直到任务数达到最大线程数。此时如果再提交任务的话会抛出异常或者直接丢弃任务。通过Executor.execute()无法得到返回值,通过ExecutorService.submit()可以得到返回值。 7. RxJava中map和flatmap操作符的区别及底层实现 Map返回的是结果集,flatmap返回的是包含结果集的Observable。Map只能一对一,flatmap可以一对多、多对多。RxJava是通过观察者模式实现的。 8. 对消息机制中Looper的理解 Looper在消息机制中扮演的角色是创造无限循环从Messagequeue中取得消息然后分发。 9. 单例模式有哪些实现方式 饿汉模式(线程安全,调用效率高,但是不能延时加载)懒汉模式(线程安全,调用效率不高,但是能延时加载)双重检测锁模式(由于JVM底层模型原因,偶尔会出问题,不建议使用)静态内部类式(线程安全,调用效率高,可以延时加载)枚举类(线程安全,调用效率高,不能延时加载,可以天然的防止反射和反序列化调用) 10. 通过静态内部类实现单例模式有哪些优点 线程安全,调用效率高,可以延时加载 11. synchronized volatile关键字有什么区别?以及还有哪些同样功能的关键字 (1) volatile是变量修饰符,而synchronized则作用于一段代码或者方法。(2) volatile只是在线程内存和main memory(主内存)间同步某个变量的值;而synchronized通过锁定和解锁某个监视器同步所有变量的值。显然synchronized要比volatile消耗更多资源。const、final、lock 12. 界面卡顿的原因有哪些? UI线程(main)有耗时操作视图渲染时间过长,导致卡顿 13. 造成OOM/ANR 的原因? OOM: (1)不恰当地使用static关键字 (2)内部类对Activity的引用 (3)大量Bitmap的使用会导致程序包运行时的内存消耗变大 (4)游标Cursor对象用完应该及时关闭 (5)加载对象过大 (6)相应资源过多,来不及释放。ANR: (1)在5秒内没有响应输入的事件(IO操作耗时、数据库操作复杂耗时、主线程非主线程产生死锁等待、网络加载/图片操作耗时、硬件操作耗时) (2)BroadcastReceiver在10秒内没有执行完毕(Service binder数量达到上限、Service忙导致超时无响应) 14. Activity与Fragment生命周期有何联系 在创建的过程中,是Activity带领着Fragment,在销毁的过程中,是Fragment带领着Activity。这里写图片描述 15. Glide三级缓存 内存缓存,磁盘缓存、网络缓存(由于网络缓存严格来说不算是缓存的一种,故也称为二级缓存)。缓存的资源分为两种:原图(SOURCE)、处理图(RESULT)(默认)。内存缓存:默认开启的,可以通过调用skipMemoryCache(true)来设置跳过内存缓存,缓存最大空间:每个进程可用的最大内存*0.4。(低配手机0.33)磁盘缓存:分为四种:ALL(缓存原图)、NONE(什么都不缓存)、SOURCE(只缓存原图)、RESULT(之后处理图),通过diskCacheStrategy(DiskCacheStrategy.ALL)来设置,缓存大小250M。 16. MVC、MVP、MVVM的原理 (1) MVC,Model View Controller,是软件架构中最常见的一种框架,简单来说就是通过controller的控制去操作model层的数据,并且返回给view层展示。当用户发出事件的时候,view层会发送指令到controller层,接着controller去通知model层更新数据,model层更新完数据以后直接显示在view层上,这就是MVC的工作原理。这里写图片描述(2) MVP是MVC的演化。MVP的model层相对于MVC是一样的,而activity和fragment不再是controller层,而是纯粹的view层,所有关于用户事件的转发全部交由presenter层处理。presenter层充当了桥梁的作用,用于操作view层发出的事件传递到presenter层中,presenter层去操作model层,并且将数据返回给view层。这里写图片描述(3) MVVM和MVP的区别貌似不大,只不过是presenter层换成了viewmodel层,还有一点就是view层和viewmodel层是相互绑定的关系,这意味着当你更新viewmodel层的数据的时候,view层会相应的变动ui。这里写图片描述 17. 数据库的操作类型有哪些,如何导入外部数据库? (1) 增删改查(2) 将外部数据库放在项目的res/raw目录下。因为安卓系统下数据库要放在data/data/packagename/databases的目录下,然后要做的就是将外部数据库导入到该目录下,操作方法是通过FileInputStream读取外部数据库,再用FileOutputStrean把读取到的东西写入到该目录下。 18. 是否使用过 IntentService,作用是什么, AIDL 解决了什么问题? (1) IntentService继承自Service。由于Service运行在主线程,无法进行耗时操作。所以你需要在Service中开启一个子线程,并且在子线程中运行。为了简化这一操作,Android中提供了IntentService来进行这一处理。通过查看IntentService的源码可以看到,在onCreate中,我们开启了一个HandlerThread线程,之后获取HandlerThread线程中的Looper,并通过这个Looper创建了一个Handler。然后在onStart方法中通过这个Handler将intent与startId作为Message的参数进行发送到消息队列中,然后交由Handler中的handleMessage中进行处理。由于在onStart方法是在主线程内运行的,而Handler是通过工作者线程HandlerThread中的Looper创建的。所以也就是在主线程中发送消息,在工作者接收到消息后便可以进行一些耗时的操作。(2) 进程间通信 19. 是否使用过本地广播,和全局广播有什么差别? 本地广播的数据在本应用范围内传播,不用担心隐私数据泄露的问题。不用担心别的应用伪造广播,造成安全隐患。相比在系统内发送全局广播,它更高效。 20. Activity、 Window、 View 三者的差别, fragment 的特点? (1) Activity像一个工匠(控制单元),Window像窗户(承载模型),View像窗花(显示视图) LayoutInflater像剪刀,Xml配置像窗花图纸。(2) a. Fragment可以作为Activity界面的一部分组成出现; 可以在一个Activity中同时出现多个Fragment,并且一个Fragment也可以在多个Activity中使用; 在Activity运行过程中,可以添加、移除或者替换Fragment; Fragment可以响应自己的输入事件,并且有自己的生命周期,它们的生命周期会受宿主Activity的生命周期影响。 21. Handler、 Thread 和 HandlerThread 的差别 从Android中Thread(java.lang.Thread -> java.lang.Object)描述可以看出,Android的Thread没有对Java的Thread做任何封装,但是Android提供了一个继承自Thread的类HandlerThread(android.os.HandlerThread -> java.lang.Thread),这个类对Java的Thread做了很多便利Android系统的封装。android.os.Handler可以通过Looper对象实例化,并运行于另外的线程中,Android提供了让Handler运行于其它线程的线程实现,也是就HandlerThread。HandlerThread对象start后可以获得其Looper对象,并且使用这个Looper对象实例Handler。 22. 低版本 SDK 实现高版本 api 自己实现或使用注解@TargetApi annotation 23. launch mode 应用场景 (1) standard:标准的启动模式。 这里写图片描述(2) singleTop:单一顶部模式 如果Activity已经被开启,并且处于任务栈的栈顶,就不会创建新的Activity,而是复用这个已经开启的Activity。为了防止出现一些奇怪的用户体验,推荐使用单一顶部模式,整个任务栈可以有多个实例存在.应用场景:短信发送界面.这里写图片描述(3)singletask:单一任务栈 在整个任务栈里面只允许有一个当前Activity的实例存在如果要开启的Activity在任务栈中已经存在,直接复用这个已经存在的Activity,并且把这个Activity上面的所有的其他Activity给清空应用场景:如果一个Activity非常消耗内存和cpu资源,建议把这个Activity做成singletask的模式。浏览器的browserActivity这里写图片描述(4)singleinstance:单一实例. 整个手机操作系统只有一个实例存在,并且是运行在自己单独的任务栈里面.应用场景:通话界面的Activity这里写图片描述 24. touch 事件传递流程 事件处理包括三种情况,分别为:传递—-dispatchTouchEvent()函数、拦截——onInterceptTouchEvent()函数、消费—-onTouchEvent()函数和OnTouchListener。Android事件传递流程:(1) 事件都是从Activity.dispatchTouchEvent()开始传递(2) 事件由父View传递给子View,ViewGroup可以通过onInterceptTouchEvent()方法对事件拦截,停止其向子view传递(3) 如果事件从上往下传递过程中一直没有被停止,且最底层子View没有消费事件,事件会反向往上传递,这时父View(ViewGroup)可以进行消费,如果还是没有被消费的话,最后会到Activity的onTouchEvent()函数。(4) 如果View没有对ACTION_DOWN进行消费,之后的其他事件不会传递过来,也就是说ACTION_DOWN必须返回true,之后的事件才会传递进来(5) OnTouchListener优先于onTouchEvent()对事件进行消费 View不处理事件流程图View不处理事件流程图 View处理事件流程图View处理事件流程图 事件拦截事件拦截 25.Android性能优化 一、代码优化 1.使用AndroidLint分析结果进行相应优化2.不使用枚举及IOC框架,反射性能低3.常量加static4.静态方法5.减少不必要的对象、成员变量6.尽量使用线程池7.适当使用软引用和弱引用8.尽量使用静态内部类,避免潜在的内存泄露9.图片缓存,采用内存缓存LRUCache和硬盘缓存DiskLRUCache10.Bitmap优化,采用适当分辨率大小并及时回收 二、布局优化 避免OverDraw过渡绘制优化布局层级避免嵌套过多无用布局当我们在画布局的时候,如果能实现相同的功能,优先考虑相对布局,然后在考虑别的布局,不要用绝对布局。使用标签把复杂的界面需要抽取出来使用标签,因为它在优化UI结构时起到很重要的作用。目的是通过删减多余或者额外的层级,从而优化整个Android Layout的结构。核心功能就是减少冗余的层次从而达到优化UI的目的!ViewStub 是一个隐藏的,不占用内存空间的视图对象,它可以在运行时延迟加载布局资源文件。 三、ListView和GridView优化 1.采用ViewHolder复用convertView2.避免在getView中执行耗时操作3.列表在滑动状态时不加载图片4.开启硬件加速 26.Android内存泄漏 内存泄漏简单地说就是申请了一块内存空间,使用完毕后没有释放掉。它的一般表现方式是程序运行时间越长,占用内存越多,最终用尽全部内存,整个系统崩溃。由程序申请的一块内存,且没有任何一个指针指向它,那么这块内存就泄露了。可能的原因有:1.注册没取消造成内存泄露,如:广播2.静态变量持有Activity的引用3.单例模式持有Activity的引用4.查询数据库后没有关闭游标cursor5.构造Adapter时,没有使用 convertView 重用6.Bitmap对象不在使用时调用recycle()释放内存7.对象被生命周期长的对象引用,如activity被静态集合引用导致activity不能释放8.使用Handler造成的内存泄露 原文地址:http://cloud.yundashi168.com/archives/964

优秀的个人博客,低调大师

2019 DevOps 必备面试题——配置管理篇

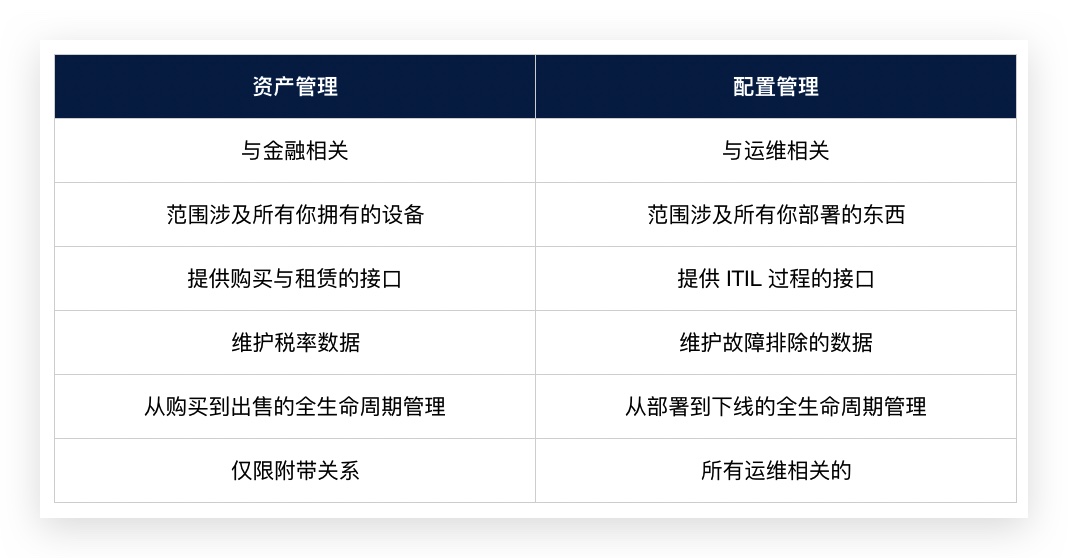
原文地址:https://medium.com/edureka/devops-interview-questions-e91a4e6ecbf3 原文作者:Saurabh Kulshrestha 翻译君:CODING 戴维奥普斯 现在让我们来看看您对配置管理的了解程度。 Q1、配置管理流程的目标是什么? 配置管理(CM)的目的是通过使开发或部署过程可控且可重复,来确保产品或系统在其整个生命周期中的完整性,从而创建更高质量的产品或系统。CM 流程允许有序管理系统信息和系统更改,以便: 调整能力 提高性能 提升可靠性或可维护性 延长寿命 降低成本 降低风险 及时纠正缺陷 Q2、IT 资产管理和配置管理有什么区别?IT 资产和配置有什么区别? 以下是资产管理和配置管理之间的一些差异: 接下来解释资产。它具有财务价值以及附加的折旧率。IT 资产只是它的一个子集。任何具有成本的组织都将其用于资产价值计算和税收计算中的相关收益归属于资产管理,此类项目称为资产。 另一方面,配置项可能有也可能没有分配给它的财务值,它不会有任何与之相关的折旧,因此它的生命不依赖于其财务价值,而是取决于该项目对该组织的过时时间。 现在,可以举例说明两者之间的相似性和差异:1)相似性:服务器 - 它既是资产又是配置项。2)差异:建筑 - 这是一种资产,但不是配置项。文档 - 它是配置项但不是资产 Q3、您对“基础设施即代码”有何看法?它如何适用于 DevOps 方法?它的目的是什么? 基础设施即代码(IAC)是一种 IT 基础架构,运维团队可以使用它来自动管理和通过代码进行配置,而不是通过手工的过程。 更快部署的公司也将基础设施视为软件:可以使用 DevOps 工具和流程管理的代码。利用这些工具,您可以更轻松、快速、安全、可靠地更改基础架构。 Q4、Puppet、Chef、SaltStack 和 Ansible 中哪一个您认为是最好的配置管理(CM)工具?为什么? 这取决于研发组织的需求,因此需要在所有这些工具上提到以下几点:Puppet 是最古老,最成熟的 CM 工具。Puppet 是一个基于 Ruby 的配置管理工具,虽然它有一些免费功能,但 Puppet 大部分很棒的内容仅在付费版本中可用。不需要大量额外功能的组织会发现 Puppet 很有用,但那些需要更多自定义的组织可能需要升级到付费版本。 Chef 是用 Ruby 编写的,因此可以由熟悉该语言的人进行定制。它还包括免费功能,如果需要,还可以从开源版本升级到企业级。最重要的是,它是一个非常灵活的产品。 Ansible 是一个非常安全的选项,因为它使用 Secure Shell。它是一个简单的工具,但除了配置管理之外,它还提供了许多其他服务。它非常容易学习,因此非常适合那些非专职 IT 但仍需要配置管理工具的人员。 SaltStack 是基于 python 的开源 CM 工具,适用于大型企业,但其学习曲线相当低。 Q5、什么是 Puppet? 它是一个配置管理工具,用于自动执行管理任务。Puppet 有一个 Master-Slave 架构,其中 Slave 必须首先向 Master 发送证书签名请求,Master 必须签署该证书才能在 Puppet Master 和 Puppet Slave 之间建立安全连接,如下图所示。Puppet Slave 向 Puppet Master 发送请求,然后 Puppet Master 向 Slave 推送配置。请参阅下图解释上述说明。 Q6、在客户端使用 Puppet Master 进行身份验证之前,需要对其证书进行签名和接受。您将如何自动完成这项任务? 最简单的方法是在 puppet.conf 中启用自动签名。请注意这是一个安全风险。如果您仍想这样做: 为您的 puppet master 建立防火墙 - 将端口 tcp / 8140 限制为您信任的网络。 为每个“信任区域”创建 puppet master,并且只在该 puppet master 清单中包含可信节点。 切勿使用完整的通配符,例如 * 。 Q7、描述通过 Puppet 自动化流程所取得的最重要的收益 对于这个答案,我建议您解释一下您过去使用 Puppet 的经历。可以参考以下示例:我使用 Puppet 自动配置和部署 Linux 和 Windows 机器。除了将处理时间从一周缩短到 10 分钟之外,我还使用了角色和配置文件模式,并在 README 中记录了每个模块的用途,以确保其他人可以使用 Git 更新模块。我写的模块仍然在使用,但是我的团队成员和社区成员对它们进行了改进。 Q8、您使用哪些开源或社区工具来使 Puppet 更强大? 在这里,您需要提及工具以及如何使用这些工具使 Puppet 更强大。以下是一个供您参考的示例:我们通过项目管理工具进行更改请求,通过内部流程管理请求,然后我们使用 Git 和 Puppet 的 Code Manager 应用程序来管理 Puppet 代码。此外,我们使用测试框架通过 Jenkins 中的持续集成流水线运行所有 Puppet 更改。 Q9、什么是 Puppet 清单? 首先定义清单。每个节点(或 Puppet Agent)都在 Puppet Master 中获得了用 Puppet 语言编写的配置细节。这些细节用 Puppet 可以理解的语言编写,称为 Manifest。它们由 Puppet 代码组成,其文件名使用 .pp 扩展名。 现在举个例子:您可以在 Puppet Master 中编写一个清单,用于创建文件并在连接到 Puppet Master 的所有 Puppet Agent(Slaves)上安装 apache。 Q10、什么是 Puppet 模块以及它与 Puppet Manifest 的不同之处? Puppet 模块是清单和数据(例如事实,文件和模板)的集合,它们具有特定的目录结构。模块对于组织 Puppet 代码很有用,因为它们允许您将代码拆分为多个清单。使用模块来组织几乎所有的 Puppet 清单是最佳实践。 Puppet 程序称为 Manifest,它由 Puppet 代码组成,其文件名使用 .pp 扩展名。 Q11、什么是 Puppet 的 Facter? 您应该回答 Facter 在 Puppet 中做了什么:“Facter 收集有关 Puppet Agent 的基本信息(事实),如硬件细节,网络设置,操作系统类型和版本,IP 地址,MAC 地址,SSH 密钥等等。这些 facts 随后会在 Puppet Master 的清单中作为变量提供。” Q12、什么是 Chef? 它是一个强大的自动化平台,可将基础架构转换为代码。Chef 是一个工具,您可以编写用于自动化流程的脚本,流程涵盖几乎与 IT 相关的任何事情。 Chef 的架构包括: Chef Server: Chef Server 是基础架构配置数据的中央存储。Chef Server 存储配置节点所需的数据并提供搜索功能,并允许您根据数据动态驱动节点配置。 Chef Node: Node 是使用 Chef-client 配置的任何主机。Chef-client 在您的节点上运行,与 Chef Server 联系以获取配置节点所需的信息。由于 Node 是运行 Chef-client 软件的机器,因此节点有时被称为“客户端”。 Chef Workstation: Chef Workstation 是您用来修改 cookbook 和其他配置数据的主机。 Q13、Chef 的资源是什么? 资源代表一个基础架构及其所需的状态,例如应安装的软件包,应运行的服务或应生成的文件。资源的功能包括以下几点: 描述配置项的所需状态。 声明将该项目置于所需状态所需的步骤。 指定资源类型,例如包,模板或服务。 根据需要列出其他详细信息(也称为资源属性)。 被分类为配方(recipes),来描述工作配置。 Q14、Chef 的 Recipe 是什么? Recipes 描述了特定配置或策略的资源集合,描述了配置系统部分所需的一切。Recipes 的功能: 安装和配置软件组件。 管理文件。 部署应用程序。 执行其他 recipe。 Q15、Cookbook 与 Recipe 有何不同? 可以简单地说,“Recipe 是一组资源,主要配置软件包或某些基础架构。Cookbook 将 recipe 和其他信息整合在一起,比单独使用 recipe 更易于管理。” 译者注:cookbook 类似于食谱集;recipe 类似于食谱。 Q16、如果未在 Chef 中指定 Resource 操作,会发生什么? 当您未指定资源的操作时,Chef 会使用默认操作。现在用一个例子解释一下,如下资源: file ‘C:UsersAdministratorchef-reposettings.ini’ do content ‘greeting=hello world’ end 与下面的资源相同: file ‘C:UsersAdministratorchef-reposettings.ini’ do action :create content ‘greeting=hello world’ end 因为:创建是文件资源的默认操作。 Q17、什么是 Ansible 模块? 模块被认为是 Ansible 的工作单元。每个模块大多是独立的,可以用标准的脚本语言编写,如 Python、Perl、Ruby、bash 等。模块的一个重要属性是幂等性,这意味着即使一个操作重复多次(例如从停电中恢复),它会始终将系统置于同一状态。 Q18、什么是 Ansible 的 playbooks? Playbooks 是 Ansible 的配置、部署和编排语言。他们可以描述您希望远程系统实施的策略,或者描述一般 IT 流程中的一系列步骤。Playbooks 设计为人类可读的,并以基本文本语言开发。在基础级别,可以使用 playbooks 来管理远程计算机的配置和部署。 Q19、如何查看所有 ansible_ 变量的列表? Ansible 默认收集有关所管理机器的“facts”,可以在 playbooks 和模板中访问这些“facts”。要查看计算机的所有可用“facts”的列表,可以将“设置”模块作为临时操作运行: Ansible -m setup hostname 这将打印出那个特定主机所有可用“facts”的目录。

优秀的个人博客,低调大师

8个有意思的JavaScript面试题

摘要: 神奇的JS系列。 作者:前端小智 原文:8个问题看你是否真的懂 JS Fundebug经授权转载,版权归原作者所有。 JavaScript 是一种有趣的语言,我们都喜欢它,因为它的性质。浏览器是JavaScript的主要运行的地方,两者在我们的服务中协同工作。JS有一些概念,人们往往会对它掉以轻心,有时可能会忽略不计。原型、闭包和事件循环等概念仍然是大多数JS开发人员绕道而行的晦涩领域之一。正如我们所知,无知是一件危险的事情,它可能会导致错误。 接下来,来看看几个问题,你也可以试试想想,然后作答。 问题1:浏览器控制台上会打印什么? var a = 10; function foo() { console.log(a); // ?? var a = 20; } foo(); 问题2:如果我们使用 let 或 const 代替 var,输出是否相同? var a = 10; function foo() { console.log(a); // ?? let a = 20; } foo(); 问题3:“newArray”中有哪些元素? var array = []; for (var i = 0; i < 3; i++) { array.push(() => i); } var newArray = array.map(el => el()); console.log(newArray); // ?? 问题4:如果我们在浏览器控制台中运行'foo'函数,是否会导致堆栈溢出错误? function foo() { setTimeout(foo, 0); // 是否存在堆栈溢出错误? } 问题5: 如果在控制台中运行以下函数,页面(选项卡)的 UI 是否仍然响应 function foo() { return Promise.resolve().then(foo); } 问题6: 我们能否以某种方式为下面的语句使用展开运算而不导致类型错误 var obj = { x: 1, y: 2, z: 3 }; [...obj]; // TypeError 问题7:运行以下代码片段时,控制台上会打印什么? var obj = { a: 1, b: 2 }; Object.setPrototypeOf(obj, { c: 3 }); Object.defineProperty(obj, "d", { value: 4, enumerable: false }); // what properties will be printed when we run the for-in loop? for (let prop in obj) { console.log(prop); } 问题8:xGetter() 会打印什么值? var x = 10; var foo = { x: 90, getX: function() { return this.x; } }; foo.getX(); // prints 90 var xGetter = foo.getX; xGetter(); // prints ?? 答案 现在,让我们从头到尾回答每个问题。我将给您一个简短的解释,同时试图揭开这些行为的神秘面纱,并提供一些参考资料。 问题1: undefined 使用var关键字声明的变量在JavaScript中会被提升,并在内存中分配值undefined。 但初始化恰发生在你给变量赋值的地方。 另外,var声明的变量是函数作用域的,而let和const是块作用域的。 所以,这就是这个过程的样子: var a = 10; // 全局使用域 function foo() { // var a 的声明将被提升到到函数的顶部。 // 比如:var a console.log(a); // 打印 undefined // 实际初始化值20只发生在这里 var a = 20; // local scope } 问题 2:ReferenceError:a undefined let和const声明可以让变量在其作用域上受限于它所使用的块、语句或表达式。与var不同的是,这些变量没有被提升,并且有一个所谓的暂时死区(TDZ)。试图访问TDZ中的这些变量将引发ReferenceError,因为只有在执行到达声明时才能访问它们。 var a = 10; // 全局使用域 function foo() { // TDZ 开始 // 创建了未初始化的'a' console.log(a); // ReferenceError // TDZ结束,'a'仅在此处初始化,值为20 let a = 20; } 下表概述了与JavaScript中使用的不同关键字声明的变量对应的提升行为和使用域: 问题 3: [3, 3, 3] 在for循环的头部声明带有var关键字的变量会为该变量创建单个绑定(存储空间)。 阅读更多关于闭包的信息。 让我们再看一次for循环。 // 误解作用域:认为存在块级作用域 var array = []; for (var i = 0; i < 3; i++) { // 三个箭头函数体中的每个`'i'`都指向相同的绑定, // 这就是为什么它们在循环结束时返回相同的值'3'。 array.push(() => i); } var newArray = array.map(el => el()); console.log(newArray); // [3, 3, 3] 如果使用 let 声明一个具有块级作用域的变量,则为每个循环迭代创建一个新的绑定。 // 使用ES6块级作用域 var array = []; for (let i = 0; i < 3; i++) { // 这一次,每个'i'指的是一个新的的绑定,并保留当前的值。 // 因此,每个箭头函数返回一个不同的值。 array.push(() => i); } var newArray = array.map(el => el()); console.log(newArray); // [0, 1, 2] 解决这个问题的另一种方法是使用闭包。 let array = []; for (var i = 0; i < 3; i++) { array[i] = (function(x) { return function() { return x; }; })(i); } const newArray = array.map(el => el()); console.log(newArray); // [0, 1, 2] 问题4 : 不会溢出 JavaScript并发模型基于“事件循环”。 当我们说“浏览器是 JS 的家”时我真正的意思是浏览器提供运行时环境来执行我们的JS代码。 浏览器的主要组件包括调用堆栈,事件循环,任务队列和Web API。 像setTimeout,setInterval和Promise这样的全局函数不是JavaScript的一部分,而是 Web API 的一部分。 JavaScript 环境的可视化形式如下所示: JS调用栈是后进先出(LIFO)的。引擎每次从堆栈中取出一个函数,然后从上到下依次运行代码。每当它遇到一些异步代码,如setTimeout,它就把它交给Web API(箭头1)。因此,每当事件被触发时,callback 都会被发送到任务队列(箭头2)。 事件循环(Event loop)不断地监视任务队列(Task Queue),并按它们排队的顺序一次处理一个回调。每当调用堆栈(call stack)为空时,Event loop获取回调并将其放入堆栈(stack )(箭头3)中进行处理。请记住,如果调用堆栈不是空的,则事件循环不会将任何回调推入堆栈。 现在,有了这些知识,让我们来回答前面提到的问题: 步骤 调用 foo()会将foo函数放入调用堆栈(call stack)。 在处理内部代码时,JS引擎遇到setTimeout。 然后将foo回调函数传递给WebAPIs(箭头1)并从函数返回,调用堆栈再次为空 计时器被设置为0,因此foo将被发送到任务队列(箭头2)。 由于调用堆栈是空的,事件循环将选择foo回调并将其推入调用堆栈进行处理。 进程再次重复,堆栈不会溢出。 运行示意图如下所示: 代码部署后可能存在的BUG没法实时知道,事后为了解决这些BUG,花了大量的时间进行log 调试,这边顺便给大家推荐一个好用的BUG监控工具 Fundebug。 问题5 : 不会响应 大多数时候,开发人员假设在事件循环图中只有一个任务队列。但事实并非如此,我们可以有多个任务队列。由浏览器选择其中的一个队列并在该队列中处理回调。 在底层来看,JavaScript中有宏任务和微任务。setTimeout回调是宏任务,而Promise回调是微任务。 主要的区别在于他们的执行方式。宏任务在单个循环周期中一次一个地推入堆栈,但是微任务队列总是在执行后返回到事件循环之前清空。因此,如果你以处理条目的速度向这个队列添加条目,那么你就永远在处理微任务。只有当微任务队列为空时,事件循环才会重新渲染页面、 现在,当你在控制台中运行以下代码段 function foo() { return Promise.resolve().then(foo); } 每次调用'foo'都会继续在微任务队列上添加另一个'foo'回调,因此事件循环无法继续处理其他事件(滚动,单击等),直到该队列完全清空为止。 因此,它会阻止渲染。 问题6 : 会导致TypeError错误 展开语法 和 for-of 语句遍历iterable对象定义要遍历的数据。Array 或Map 是具有默认迭代行为的内置迭代器。对象不是可迭代的,但是可以通过使用iterable和iterator协议使它们可迭代。 在Mozilla文档中,如果一个对象实现了@@iterator方法,那么它就是可迭代的,这意味着这个对象(或者它原型链上的一个对象)必须有一个带有@@iterator键的属性,这个键可以通过常量Symbol.iterator获得。 上述语句可能看起来有点冗长,但是下面的示例将更有意义: var obj = { x: 1, y: 2, z: 3 }; obj[Symbol.iterator] = function() { // iterator 是一个具有 next 方法的对象, // 它的返回至少有一个对象 // 两个属性:value&done。 // 返回一个 iterator 对象 return { next: function() { if (this._countDown === 3) { const lastValue = this._countDown; return { value: this._countDown, done: true }; } this._countDown = this._countDown + 1; return { value: this._countDown, done: false }; }, _countDown: 0 }; }; [...obj]; // 打印 [1, 2, 3] 还可以使用 generator 函数来定制对象的迭代行为: var obj = { x: 1, y: 2, z: 3 }; obj[Symbol.iterator] = function*() { yield 1; yield 2; yield 3; }; [...obj]; // 打印 [1, 2, 3] 问题7 : a, b, c for-in循环遍历对象本身的可枚举属性以及对象从其原型继承的属性。 可枚举属性是可以在for-in循环期间包含和访问的属性。 var obj = { a: 1, b: 2 }; var descriptor = Object.getOwnPropertyDescriptor(obj, "a"); console.log(descriptor.enumerable); // true console.log(descriptor); // { value: 1, writable: true, enumerable: true, configurable: true } 现在你已经掌握了这些知识,应该很容易理解为什么我们的代码要打印这些特定的属性 var obj = { a: 1, b: 2 }; //a,b 都是 enumerables 属性 // 将{c:3}设置为'obj'的原型,并且我们知道 // for-in 循环也迭代 obj 继承的属性 // 从它的原型,'c'也可以被访问。 Object.setPrototypeOf(obj, { c: 3 }); // 我们在'obj'中定义了另外一个属性'd',但是 // 将'enumerable'设置为false。 这意味着'd'将被忽略。 Object.defineProperty(obj, "d", { value: 4, enumerable: false }); for (let prop in obj) { console.log(prop); } // 打印 // a // b 问题8 : 10 在全局范围内初始化x时,它成为window对象的属性(不是严格的模式)。看看下面的代码: var x = 10; // global scope var foo = { x: 90, getX: function() { return this.x; } }; foo.getX(); // prints 90 let xGetter = foo.getX; xGetter(); // prints 10 咱们可以断言: window.x === 10; // true this 始终指向调用方法的对象。因此,在foo.getx()的例子中,它指向foo对象,返回90的值。而在xGetter()的情况下,this指向 window对象, 返回 window 中的x的值,即10。 要获取 foo.x的值,可以通过使用Function.prototype.bind将this的值绑定到foo对象来创建新函数。 let getFooX = foo.getX.bind(foo); getFooX(); // 90 就这样! 如果你的所有答案都正确,那么干漂亮。 咱们都是通过犯错来学习的。 这一切都是为了了解背后的“原因”。 代码部署后可能存在的BUG没法实时知道,事后为了解决这些BUG,花了大量的时间进行log 调试,这边顺便给大家推荐一个好用的BUG监控工具 Fundebug。 关于Fundebug Fundebug专注于JavaScript、微信小程序、微信小游戏、支付宝小程序、React Native、Node.js和Java线上应用实时BUG监控。 自从2016年双十一正式上线,Fundebug累计处理了10亿+错误事件,付费客户有阳光保险、核桃编程、荔枝FM、掌门1对1、微脉、青团社等众多品牌企业。欢迎大家免费试用!

优秀的个人博客,低调大师

突破Java面试(23-7) - Redis的哨兵架构

Github 1 Redis Sentinal机制 sentinal,中文名哨兵 哨兵是redis集群架构中非常重要的一个组件,主要功能如下 集群监控监控Redis master和slave进程的正常工作 消息通知如果某个Redis实例有故障,那么哨兵负责发送报警消息给管理员 故障转移若master node宕机,会自动转移到slave node上 配置中心若发生故障转移,通知client客户端新的master地址 哨兵本身也是分布式的,作为一个哨兵集群去运行,协同工作 故障转移时,判断一个master node是否宕机,需要大部分的哨兵都同意,涉及到了分布式选举问题 即使部分哨兵节点宕机,哨兵集群还是能正常工作的 目前采用的是sentinal 2版本,sentinal 2相对于sentinal 1来说,重写了很多代码,主要是让故障转移的机制和算法变得

优秀的个人博客,低调大师

搞定操作系统面试,看这篇就够了(二)

三、死锁 必要条件 image 互斥:每个资源要么已经分配给了一个进程,要么就是可用的。 占有和等待:已经得到了某个资源的进程可以再请求新的资源。 不可抢占:已经分配给一个进程的资源不能强制性地被抢占,它只能被占有它的进程显式地释放。 环路等待:有两个或者两个以上的进程组成一条环路,该环路中的每个进程都在等待下一个进程所占有的资源。 处理方法 主要有以下四种方法: 鸵鸟策略 死锁检测与死锁恢复 死锁预防 死锁避免 鸵鸟策略 把头埋在沙子里,假装根本没发生问题。 因为解决死锁问题的代价很高,因此鸵鸟策略这种不采取任务措施的方案会获得更高的性能。 当发生死锁时不会对用户造成多大影响,或发生死锁的概率很低,可以采用鸵鸟策略。 大多数操作系统,包括 Unix,Linux 和 Windows,处理死锁问题的办法仅仅是忽略它。 死锁检测与死锁恢复 不试图阻止死锁,而是当检测到死锁发生时,采取措施进行恢复。 1. 每种类型一个资源的死锁检测 image 上图为资源分配图,其中方框表示资源,圆圈表示进程。资源指向进程表示该资源已经分配给该进程,进程指向资源表示进程请求获取该资源。 图 a 可以抽取出环,如图 b,它满足了环路等待条件,因此会发生死锁。 每种类型一个资源的死锁检测算法是通过检测有向图是否存在环来实现,从一个节点出发进行深度优先搜索,对访问过的节点进行标记,如果访问了已经标记的节点,就表示有向图存在环,也就是检测到死锁的发生。 2. 每种类型多个资源的死锁检测 image 上图中,有三个进程四个资源,每个数据代表的含义如下: E 向量:资源总量 A 向量:资源剩余量 C 矩阵:每个进程所拥有的资源数量,每一行都代表一个进程拥有资源的数量 R 矩阵:每个进程请求的资源数量 进程 P1和 P2所请求的资源都得不到满足,只有进程 P3可以,让 P3执行,之后释放 P3拥有的资源,此时 A = (2 2 2 0)。P2可以执行,执行后释放 P2拥有的资源,A = (4 2 2 1) 。P1也可以执行。所有进程都可以顺利执行,没有死锁。 算法总结如下: 每个进程最开始时都不被标记,执行过程有可能被标记。当算法结束时,任何没有被标记的进程都是死锁进程。 寻找一个没有标记的进程 Pi,它所请求的资源小于等于 A。 如果找到了这样一个进程,那么将 C 矩阵的第 i 行向量加到 A 中,标记该进程,并转回 1。 如果没有这样一个进程,算法终止。 3. 死锁恢复 利用抢占恢复 利用回滚恢复 通过杀死进程恢复 死锁预防 在程序运行之前预防发生死锁。 1. 破坏互斥条件 例如假脱机打印机技术允许若干个进程同时输出,唯一真正请求物理打印机的进程是打印机守护进程。 2. 破坏占有和等待条件 一种实现方式是规定所有进程在开始执行前请求所需要的全部资源。 3. 破坏不可抢占条件 4. 破坏环路等待 给资源统一编号,进程只能按编号顺序来请求资源。 死锁避免 在程序运行时避免发生死锁。 1. 安全状态 image 图 a 的第二列 Has 表示已拥有的资源数,第三列 Max 表示总共需要的资源数,Free 表示还有可以使用的资源数。从图 a 开始出发,先让 B 拥有所需的所有资源(图 b),运行结束后释放 B,此时 Free 变为 5(图 c);接着以同样的方式运行 C 和 A,使得所有进程都能成功运行,因此可以称图 a 所示的状态时安全的。 定义:如果没有死锁发生,并且即使所有进程突然请求对资源的最大需求,也仍然存在某种调度次序能够使得每一个进程运行完毕,则称该状态是安全的。 安全状态的检测与死锁的检测类似,因为安全状态必须要求不能发生死锁。下面的银行家算法与死锁检测算法非常类似,可以结合着做参考对比。 2. 单个资源的银行家算法 一个小城镇的银行家,他向一群客户分别承诺了一定的贷款额度,算法要做的是判断对请求的满足是否会进入不安全状态,如果是,就拒绝请求;否则予以分配。 image 上图 c 为不安全状态,因此算法会拒绝之前的请求,从而避免进入图 c 中的状态。 3. 多个资源的银行家算法 image 上图中有五个进程,四个资源。左边的图表示已经分配的资源,右边的图表示还需要分配的资源。最右边的 E、P 以及 A 分别表示:总资源、已分配资源以及可用资源,注意这三个为向量,而不是具体数值,例如 A=(1020),表示 4 个资源分别还剩下 1/0/2/0。 检查一个状态是否安全的算法如下: 查找右边的矩阵是否存在一行小于等于向量 A。如果不存在这样的行,那么系统将会发生死锁,状态是不安全的。 假若找到这样一行,将该进程标记为终止,并将其已分配资源加到 A 中。 重复以上两步,直到所有进程都标记为终止,则状态时安全的。 如果一个状态不是安全的,需要拒绝进入这个状态。 推荐阅读:终于有人把 【移动开发】 从基础到实战的全套视频弄全了 四、内存管理 虚拟内存 虚拟内存的目的是为了让物理内存扩充成更大的逻辑内存,从而让程序获得更多的可用内存。 为了更好的管理内存,操作系统将内存抽象成地址空间。每个程序拥有自己的地址空间,这个地址空间被分割成多个块,每一块称为一页。这些页被映射到物理内存,但不需要映射到连续的物理内存,也不需要所有页都必须在物理内存中。当程序引用到不在物理内存中的页时,由硬件执行必要的映射,将缺失的部分装入物理内存并重新执行失败的指令。 从上面的描述中可以看出,虚拟内存允许程序不用将地址空间中的每一页都映射到物理内存,也就是说一个程序不需要全部调入内存就可以运行,这使得有限的内存运行大程序成为可能。例如有一台计算机可以产生 16 位地址,那么一个程序的地址空间范围是 0~64K。该计算机只有 32KB 的物理内存,虚拟内存技术允许该计算机运行一个 64K 大小的程序。 分页系统地址映射 内存管理单元(MMU)管理着地址空间和物理内存的转换,其中的页表(Page table)存储着页(程序地址空间)和页框(物理内存空间)的映射表。 一个虚拟地址分成两个部分,一部分存储页面号,一部分存储偏移量。 下图的页表存放着 16 个页,这 16 个页需要用 4 个比特位来进行索引定位。例如对于虚拟地址(0010 000000000100),前 4 位是存储页面号 2,读取表项内容为(110 1),页表项最后一位表示是否存在于内存中,1 表示存在。后 12 位存储偏移量。这个页对应的页框的地址为 (110 000000000100)。 页面置换算法 在程序运行过程中,如果要访问的页面不在内存中,就发生缺页中断从而将该页调入内存中。此时如果内存已无空闲空间,系统必须从内存中调出一个页面到磁盘对换区中来腾出空间。 页面置换算法和缓存淘汰策略类似,可以将内存看成磁盘的缓存。在缓存系统中,缓存的大小有限,当有新的缓存到达时,需要淘汰一部分已经存在的缓存,这样才有空间存放新的缓存数据。 页面置换算法的主要目标是使页面置换频率最低(也可以说缺页率最低)。 1. 最佳 OPT, Optimal replacement algorithm 所选择的被换出的页面将是最长时间内不再被访问,通常可以保证获得最低的缺页率。 是一种理论上的算法,因为无法知道一个页面多长时间不再被访问。 举例:一个系统为某进程分配了三个物理块,并有如下页面引用序列: 开始运行时,先将 7, 0, 1 三个页面装入内存。当进程要访问页面 2 时,产生缺页中断,会将页面 7 换出,因为页面 7 再次被访问的时间最长。 2. 最近最久未使用 LRU, Least Recently Used 虽然无法知道将来要使用的页面情况,但是可以知道过去使用页面的情况。LRU 将最近最久未使用的页面换出。 为了实现 LRU,需要在内存中维护一个所有页面的链表。当一个页面被访问时,将这个页面移到链表表头。这样就能保证链表表尾的页面是最近最久未访问的。 因为每次访问都需要更新链表,因此这种方式实现的 LRU 代价很高。 image 3. 最近未使用 NRU, Not Recently Used 每个页面都有两个状态位:R 与 M,当页面被访问时设置页面的 R=1,当页面被修改时设置 M=1。其中 R 位会定时被清零。可以将页面分成以下四类: R=0,M=0 R=0,M=1 R=1,M=0 R=1,M=1 当发生缺页中断时,NRU 算法随机地从类编号最小的非空类中挑选一个页面将它换出。 NRU 优先换出已经被修改的脏页面(R=0,M=1),而不是被频繁使用的干净页面(R=1,M=0)。 4. 先进先出 FIFO, First In First Out 选择换出的页面是最先进入的页面。 该算法会将那些经常被访问的页面也被换出,从而使缺页率升高。 5. 第二次机会算法 FIFO 算法可能会把经常使用的页面置换出去,为了避免这一问题,对该算法做一个简单的修改: 当页面被访问 (读或写) 时设置该页面的 R 位为 1。需要替换的时候,检查最老页面的 R 位。如果 R 位是 0,那么这个页面既老又没有被使用,可以立刻置换掉;如果是 1,就将 R 位清 0,并把该页面放到链表的尾端,修改它的装入时间使它就像刚装入的一样,然后继续从链表的头部开始搜索。 image 6. 时钟 Clock 第二次机会算法需要在链表中移动页面,降低了效率。时钟算法使用环形链表将页面连接起来,再使用一个指针指向最老的页面。 image 分段 虚拟内存采用的是分页技术,也就是将地址空间划分成固定大小的页,每一页再与内存进行映射。 下图为一个编译器在编译过程中建立的多个表,有 4 个表是动态增长的,如果使用分页系统的一维地址空间,动态增长的特点会导致覆盖问题的出现。 image 分段的做法是把每个表分成段,一个段构成一个独立的地址空间。每个段的长度可以不同,并且可以动态增长。 image 段页式 程序的地址空间划分成多个拥有独立地址空间的段,每个段上的地址空间划分成大小相同的页。这样既拥有分段系统的共享和保护,又拥有分页系统的虚拟内存功能。 分页与分段的比较 对程序员的透明性:分页透明,但是分段需要程序员显示划分每个段。 地址空间的维度:分页是一维地址空间,分段是二维的。 大小是否可以改变:页的大小不可变,段的大小可以动态改变。 出现的原因:分页主要用于实现虚拟内存,从而获得更大的地址空间;分段主要是为了使程序和数据可以被划分为逻辑上独立的地址空间并且有助于共享和保护。 五、设备管理 磁盘结构 盘面(Platter):一个磁盘有多个盘面; 磁道(Track):盘面上的圆形带状区域,一个盘面可以有多个磁道; 扇区(Track Sector):磁道上的一个弧段,一个磁道可以有多个扇区,它是最小的物理储存单位,目前主要有 512 bytes 与 4 K 两种大小; 磁头(Head):与盘面非常接近,能够将盘面上的磁场转换为电信号(读),或者将电信号转换为盘面的磁场(写); 制动手臂(Actuator arm):用于在磁道之间移动磁头; 主轴(Spindle):使整个盘面转动。 image 磁盘调度算法 读写一个磁盘块的时间的影响因素有: 旋转时间(主轴转动盘面,使得磁头移动到适当的扇区上) 寻道时间(制动手臂移动,使得磁头移动到适当的磁道上) 实际的数据传输时间 其中,寻道时间最长,因此磁盘调度的主要目标是使磁盘的平均寻道时间最短。 1. 先来先服务 FCFS, First Come First Served 按照磁盘请求的顺序进行调度。 优点是公平和简单。缺点也很明显,因为未对寻道做任何优化,使平均寻道时间可能较长。 2. 最短寻道时间优先 SSTF, Shortest Seek Time First 优先调度与当前磁头所在磁道距离最近的磁道。 虽然平均寻道时间比较低,但是不够公平。如果新到达的磁道请求总是比一个在等待的磁道请求近,那么在等待的磁道请求会一直等待下去,也就是出现饥饿现象。具体来说,两端的磁道请求更容易出现饥饿现象。 image 3. 电梯算法 SCAN 电梯总是保持一个方向运行,直到该方向没有请求为止,然后改变运行方向。 电梯算法(扫描算法)和电梯的运行过程类似,总是按一个方向来进行磁盘调度,直到该方向上没有未完成的磁盘请求,然后改变方向。 因为考虑了移动方向,因此所有的磁盘请求都会被满足,解决了 SSTF 的饥饿问题。 image 六、链接 编译系统 以下是一个 hello.c 程序: #include <stdio.h> int main() { printf("hello, world "); return 0; } 在 Unix 系统上,由编译器把源文件转换为目标文件。 gcc -o hello hello.c 这个过程大致如下: image 预处理阶段:处理以 # 开头的预处理命令; 编译阶段:翻译成汇编文件; 汇编阶段:将汇编文件翻译成可重定向目标文件; 链接阶段:将可重定向目标文件和 printf.o 等单独预编译好的目标文件进行合并,得到最终的可执行目标文件。 静态链接 静态链接器以一组可重定向目标文件为输入,生成一个完全链接的可执行目标文件作为输出。链接器主要完成以下两个任务: 符号解析:每个符号对应于一个函数、一个全局变量或一个静态变量,符号解析的目的是将每个符号引用与一个符号定义关联起来。 重定位:链接器通过把每个符号定义与一个内存位置关联起来,然后修改所有对这些符号的引用,使得它们指向这个内存位置。 目标文件 可执行目标文件:可以直接在内存中执行; 可重定向目标文件:可与其它可重定向目标文件在链接阶段合并,创建一个可执行目标文件; 共享目标文件:这是一种特殊的可重定向目标文件,可以在运行时被动态加载进内存并链接; 动态链接 静态库有以下两个问题: 当静态库更新时那么整个程序都要重新进行链接; 对于 printf 这种标准函数库,如果每个程序都要有代码,这会极大浪费资源。 共享库是为了解决静态库的这两个问题而设计的,在 Linux 系统中通常用 .so 后缀来表示,Windows 系统上它们被称为 DLL。它具有以下特点: 在给定的文件系统中一个库只有一个文件,所有引用该库的可执行目标文件都共享这个文件,它不会被复制到引用它的可执行文件中; 在内存中,一个共享库的 .text 节(已编译程序的机器代码)的一个副本可以被不同的正在运行的进程共享。

优秀的个人博客,低调大师

搞定操作系统面试,看这篇就够了(一)

一、概述 基本特征 1. 并发 并发是指宏观上在一段时间内能同时运行多个程序,而并行则指同一时刻能运行多个指令。 并行需要硬件支持,如多流水线、多核处理器或者分布式计算系统。 操作系统通过引入进程和线程,使得程序能够并发运行。 2. 共享 共享是指系统中的资源可以被多个并发进程共同使用。 有两种共享方式:互斥共享和同时共享。 互斥共享的资源称为临界资源,例如打印机等,在同一时间只允许一个进程访问,需要用同步机制来实现对临界资源的访问。 3. 虚拟 虚拟技术把一个物理实体转换为多个逻辑实体。 主要有两种虚拟技术:时分复用技术和空分复用技术。 多个进程能在同一个处理器上并发执行使用了时分复用技术,让每个进程轮流占有处理器,每次只执行一小个时间片并快速切换。 虚拟内存使用了空分复用技术,它将物理内存抽象为地址空间,每个进程都有各自的地址空间。地址空间的页被映射到物

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册