首页 文章 精选 留言 我的

精选列表

搜索[面试],共5090篇文章
优秀的个人博客,低调大师

Java并发编程75道面试题及答案

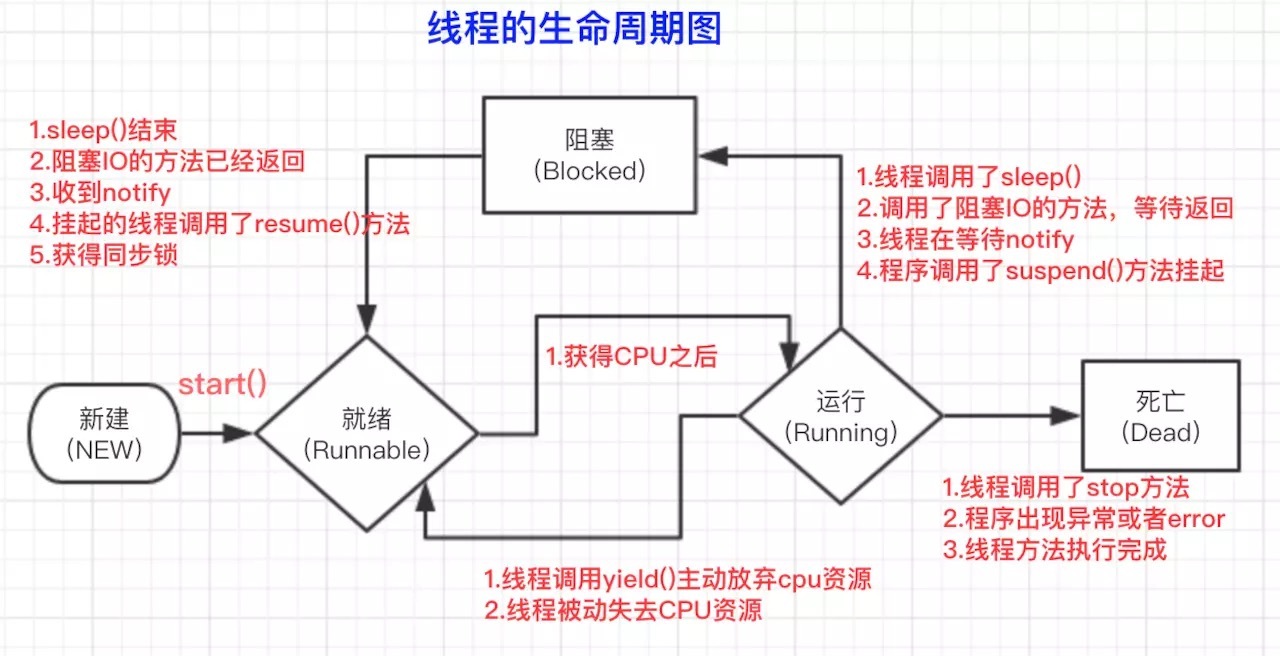
1、在java中守护线程和本地线程区别? java中的线程分为两种:守护线程(Daemon)和用户线程(User)。 任何线程都可以设置为守护线程和用户线程,通过方法Thread.setDaemon(bool on);true则把该线程设置为守护线程,反之则为用户线程。Thread.setDaemon()必须在Thread.start()之前调用,否则运行时会抛出异常。 两者的区别: 唯一的区别是判断虚拟机(JVM)何时离开,Daemon是为其他线程提供服务,如果全部的User Thread已经撤离,Daemon 没有可服务的线程,JVM撤离。也可以理解为守护线程是JVM自动创建的线程(但不一定),用户线程是程序创建的线程;比如JVM的垃圾回收线程是一个守护线程,当所有线程已经撤离,不再产生垃圾,守护线程自然就没事可干了,当垃圾回收线程是Java虚拟机上仅剩的线程时,Java虚拟机会自动离开。 扩展:Thread Dump打印出来的线程信息,含有daemon字样的线程即为守护进程,可能会有:服务守护进程、编译守护进程、windows下的监听Ctrl+break的守护进程、Finalizer守护进程、引用处理守护进程、GC守护进程。 2、线程与进程的区别? 进程是操作系统分配资源的最小单元,线程是操作系统调度的最小单元。 一个程序至少有一个进程,一个进程至少有一个线程。 3、什么是多线程中的上下文切换? 多线程会共同使用一组计算机上的CPU,而线程数大于给程序分配的CPU数量时,为了让各个线程都有执行的机会,就需要轮转使用CPU。不同的线程切换使用CPU发生的切换数据等就是上下文切换。 4、死锁与活锁的区别,死锁与饥饿的区别? 死锁:是指两个或两个以上的进程(或线程)在执行过程中,因争夺资源而造成的一种互相等待的现象,若无外力作用,它们都将无法推进下去。 产生死锁的必要条件: 1. 互斥条件:所谓互斥就是进程在某一时间内独占资源。 2. 请求与保持条件:一个进程因请求资源而阻塞时,对已获得的资源保持不放。 3. 不剥夺条件:进程已获得资源,在末使用完之前,不能强行剥夺。 4. 循环等待条件:若干进程之间形成一种头尾相接的循环等待资源关系。 活锁:任务或者执行者没有被阻塞,由于某些条件没有满足,导致一直重复尝试,失败,尝试,失败。 活锁和死锁的区别在于,处于活锁的实体是在不断的改变状态,所谓的“活”, 而处于死锁的实体表现为等待;活锁有可能自行解开,死锁则不能。 饥饿:一个或者多个线程因为种种原因无法获得所需要的资源,导致一直无法执行的状态。 Java中导致饥饿的原因: - 高优先级线程吞噬所有的低优先级线程的CPU时间。 - 线程被永久堵塞在一个等待进入同步块的状态,因为其他线程总是能在它之前持续地对该同步块进行访问。 - 线程在等待一个本身也处于永久等待完成的对象(比如调用这个对象的wait方法),因为其他线程总是被持续地获得唤醒。 5、Java中用到的线程调度算法是什么? 采用时间片轮转的方式。可以设置线程的优先级,会映射到下层的系统上面的优先级上,如非特别需要,尽量不要用,防止线程饥饿。 6、什么是线程组,为什么在Java中不推荐使用? ThreadGroup类,可以把线程归属到某一个线程组中,线程组中可以有线程对象,也可以有线程组,组中还可以有线程,这样的组织结构有点类似于树的形式。 为什么不推荐使用?因为使用有很多的安全隐患吧,没有具体追究,如果需要使用,推荐使用线程池。 7、为什么使用Executor框架? 每次执行任务创建线程 new Thread()比较消耗性能,创建一个线程是比较耗时、耗资源的。 调用 new Thread()创建的线程缺乏管理,被称为野线程,而且可以无限制的创建,线程之间的相互竞争会导致过多占用系统资源而导致系统瘫痪,还有线程之间的频繁交替也会消耗很多系统资源。 接使用new Thread() 启动的线程不利于扩展,比如定时执行、定期执行、定时定期执行、线程中断等都不便实现。 8、在Java中Executor和Executors的区别? Executors 工具类的不同方法按照我们的需求创建了不同的线程池,来满足业务的需求。 Executor 接口对象能执行我们的线程任务。 ExecutorService接口继承了Executor接口并进行了扩展,提供了更多的方法我们能获得任务执行的状态并且可以获取任务的返回值。 使用ThreadPoolExecutor 可以创建自定义线程池。 Future 表示异步计算的结果,他提供了检查计算是否完成的方法,以等待计算的完成,并可以使用get()方法获取计算的结果。 9、如何在Windows和Linux上查找哪个线程使用的CPU时间最长? 参考: http://daiguahub.com/2016/07/31/%E4%BD%BF%E7%94%A8jstack%E6%89%BE%E5%87%BA%E6%B6%88%E8%80%97CPU%E6%9C%80%E5%A4%9A%E7%9A%84%E7%BA%BF%E7%A8%8B%E4%BB%A3%E7%A0%81/ 10、什么是原子操作?在Java Concurrency API中有哪些原子类(atomic classes)? 原子操作(atomic operation)意为”不可被中断的一个或一系列操作” 。 处理器使用基于对缓存加锁或总线加锁的方式来实现多处理器之间的原子操作。 在Java中可以通过锁和循环CAS的方式来实现原子操作。 CAS操作——Compare & Set,或是 Compare & Swap,现在几乎所有的CPU指令都支持CAS的原子操作。 原子操作是指一个不受其他操作影响的操作任务单元。原子操作是在多线程环境下避免数据不一致必须的手段。 int++并不是一个原子操作,所以当一个线程读取它的值并加1时,另外一个线程有可能会读到之前的值,这就会引发错误。 为了解决这个问题,必须保证增加操作是原子的,在JDK1.5之前我们可以使用同步技术来做到这一点。到JDK1.5,java.util.concurrent.atomic包提供了int和long类型的原子包装类,它们可以自动的保证对于他们的操作是原子的并且不需要使用同步。 java.util.concurrent这个包里面提供了一组原子类。其基本的特性就是在多线程环境下,当有多个线程同时执行这些类的实例包含的方法时,具有排他性,即当某个线程进入方法,执行其中的指令时,不会被其他线程打断,而别的线程就像自旋锁一样,一直等到该方法执行完成,才由JVM从等待队列中选择一个另一个线程进入,这只是一种逻辑上的理解。 原子类:AtomicBoolean,AtomicInteger,AtomicLong,AtomicReference 原子数组:AtomicIntegerArray,AtomicLongArray,AtomicReferenceArray 原子属性更新器:AtomicLongFieldUpdater,AtomicIntegerFieldUpdater,AtomicReferenceFieldUpdater 解决ABA问题的原子类:AtomicMarkableReference(通过引入一个boolean来反映中间有没有变过),AtomicStampedReference(通过引入一个int来累加来反映中间有没有变过) 11、Java Concurrency API中的Lock接口(Lock interface)是什么?对比同步它有什么优势? Lock接口比同步方法和同步块提供了更具扩展性的锁操作。 他们允许更灵活的结构,可以具有完全不同的性质,并且可以支持多个相关类的条件对象。 它的优势有: 可以使锁更公平 可以使线程在等待锁的时候响应中断 可以让线程尝试获取锁,并在无法获取锁的时候立即返回或者等待一段时间 可以在不同的范围,以不同的顺序获取和释放锁 整体上来说Lock是synchronized的扩展版,Lock提供了无条件的、可轮询的(tryLock方法)、定时的(tryLock带参方法)、可中断的(lockInterruptibly)、可多条件队列的(newCondition方法)锁操作。另外Lock的实现类基本都支持非公平锁(默认)和公平锁,synchronized只支持非公平锁,当然,在大部分情况下,非公平锁是高效的选择。 12、什么是Executors框架? Executor框架是一个根据一组执行策略调用,调度,执行和控制的异步任务的框架。 无限制的创建线程会引起应用程序内存溢出。所以创建一个线程池是个更好的的解决方案,因为可以限制线程的数量并且可以回收再利用这些线程。利用Executors框架可以非常方便的创建一个线程池。 13、什么是阻塞队列?阻塞队列的实现原理是什么?如何使用阻塞队列来实现生产者-消费者模型? 阻塞队列(BlockingQueue)是一个支持两个附加操作的队列。 这两个附加的操作是:在队列为空时,获取元素的线程会等待队列变为非空。当队列满时,存储元素的线程会等待队列可用。 阻塞队列常用于生产者和消费者的场景,生产者是往队列里添加元素的线程,消费者是从队列里拿元素的线程。阻塞队列就是生产者存放元素的容器,而消费者也只从容器里拿元素。 JDK7提供了7个阻塞队列。分别是: ArrayBlockingQueue :一个由数组结构组成的有界阻塞队列。 LinkedBlockingQueue :一个由链表结构组成的有界阻塞队列。 PriorityBlockingQueue :一个支持优先级排序的无界阻塞队列。 DelayQueue:一个使用优先级队列实现的无界阻塞队列。 SynchronousQueue:一个不存储元素的阻塞队列。 LinkedTransferQueue:一个由链表结构组成的无界阻塞队列。 LinkedBlockingDeque:一个由链表结构组成的双向阻塞队列。 Java 5之前实现同步存取时,可以使用普通的一个集合,然后在使用线程的协作和线程同步可以实现生产者,消费者模式,主要的技术就是用好,wait ,notify,notifyAll,sychronized这些关键字。而在java 5之后,可以使用阻塞队列来实现,此方式大大简少了代码量,使得多线程编程更加容易,安全方面也有保障。 BlockingQueue接口是Queue的子接口,它的主要用途并不是作为容器,而是作为线程同步的的工具,因此他具有一个很明显的特性,当生产者线程试图向BlockingQueue放入元素时,如果队列已满,则线程被阻塞,当消费者线程试图从中取出一个元素时,如果队列为空,则该线程会被阻塞,正是因为它所具有这个特性,所以在程序中多个线程交替向BlockingQueue中放入元素,取出元素,它可以很好的控制线程之间的通信。 阻塞队列使用最经典的场景就是socket客户端数据的读取和解析,读取数据的线程不断将数据放入队列,然后解析线程不断从队列取数据解析。 14、什么是Callable和Future? Callable接口类似于Runnable,从名字就可以看出来了,但是Runnable不会返回结果,并且无法抛出返回结果的异常,而Callable功能更强大一些,被线程执行后,可以返回值,这个返回值可以被Future拿到,也就是说,Future可以拿到异步执行任务的返回值。 可以认为是带有回调的Runnable。 Future接口表示异步任务,是还没有完成的任务给出的未来结果。所以说Callable用于产生结果,Future用于获取结果。 15、什么是FutureTask?使用ExecutorService启动任务。 在Java并发程序中FutureTask表示一个可以取消的异步运算。它有启动和取消运算、查询运算是否完成和取回运算结果等方法。只有当运算完成的时候结果才能取回,如果运算尚未完成get方法将会阻塞。一个FutureTask对象可以对调用了Callable和Runnable的对象进行包装,由于FutureTask也是调用了Runnable接口所以它可以提交给Executor来执行。 16、什么是并发容器的实现? 何为同步容器:可以简单地理解为通过synchronized来实现同步的容器,如果有多个线程调用同步容器的方法,它们将会串行执行。比如Vector,Hashtable,以及Collections.synchronizedSet,synchronizedList等方法返回的容器。 可以通过查看Vector,Hashtable等这些同步容器的实现代码,可以看到这些容器实现线程安全的方式就是将它们的状态封装起来,并在需要同步的方法上加上关键字synchronized。 并发容器使用了与同步容器完全不同的加锁策略来提供更高的并发性和伸缩性,例如在ConcurrentHashMap中采用了一种粒度更细的加锁机制,可以称为分段锁,在这种锁机制下,允许任意数量的读线程并发地访问map,并且执行读操作的线程和写操作的线程也可以并发的访问map,同时允许一定数量的写操作线程并发地修改map,所以它可以在并发环境下实现更高的吞吐量。 17、多线程同步和互斥有几种实现方法,都是什么? 线程同步是指线程之间所具有的一种制约关系,一个线程的执行依赖另一个线程的消息,当它没有得到另一个线程的消息时应等待,直到消息到达时才被唤醒。 线程互斥是指对于共享的进程系统资源,在各单个线程访问时的排它性。当有若干个线程都要使用某一共享资源时,任何时刻最多只允许一个线程去使用,其它要使用该资源的线程必须等待,直到占用资源者释放该资源。线程互斥可以看成是一种特殊的线程同步。 线程间的同步方法大体可分为两类:用户模式和内核模式。顾名思义,内核模式就是指利用系统内核对象的单一性来进行同步,使用时需要切换内核态与用户态,而用户模式就是不需要切换到内核态,只在用户态完成操作。 用户模式下的方法有:原子操作(例如一个单一的全局变量),临界区。内核模式下的方法有:事件,信号量,互斥量。 18、什么是竞争条件?你怎样发现和解决竞争? 当多个进程都企图对共享数据进行某种处理,而最后的结果又取决于进程运行的顺序时,则我们认为这发生了竞争条件(race condition)。 19、你将如何使用thread dump?你将如何分析Thread dump? 新建状态(New) 用new语句创建的线程处于新建状态,此时它和其他Java对象一样,仅仅在堆区中被分配了内存。 就绪状态(Runnable) 当一个线程对象创建后,其他线程调用它的start()方法,该线程就进入就绪状态,Java虚拟机会为它创建方法调用栈和程序计数器。处于这个状态的线程位于可运行池中,等待获得CPU的使用权。 运行状态(Running) 处于这个状态的线程占用CPU,执行程序代码。只有处于就绪状态的线程才有机会转到运行状态。 阻塞状态(Blocked) 阻塞状态是指线程因为某些原因放弃CPU,暂时停止运行。当线程处于阻塞状态时,Java虚拟机不会给线程分配CPU。直到线程重新进入就绪状态,它才有机会转到运行状态。 阻塞状态可分为以下3种: 位于对象等待池中的阻塞状态(Blocked in object’s wait pool):当线程处于运行状态时,如果执行了某个对象的wait()方法,Java虚拟机就会把线程放到这个对象的等待池中,这涉及到“线程通信”的内容。 位于对象锁池中的阻塞状态(Blocked in object’s lock pool):当线程处于运行状态时,试图获得某个对象的同步锁时,如果该对象的同步锁已经被其他线程占用,Java虚拟机就会把这个线程放到这个对象的锁池中,这涉及到“线程同步”的内容。 其他阻塞状态(Otherwise Blocked):当前线程执行了sleep()方法,或者调用了其他线程的join()方法,或者发出了I/O请求时,就会进入这个状态。 死亡状态(Dead) 当线程退出run()方法时,就进入死亡状态,该线程结束生命周期。 我们运行之前的那个死锁代码SimpleDeadLock.java,然后尝试输出信息(/*这是注释,作者自己加的*/): /* 时间,jvm信息 */ 2017-11-01 17:36:28 Full thread dump Java HotSpot(TM) 64-Bit Server VM (25.144-b01 mixed mode): /* 线程名称:DestroyJavaVM 编号:#13 优先级:5 系统优先级:0 jvm内部线程id:0x0000000001c88800 对应系统线程id(NativeThread ID):0x1c18 线程状态: waiting on condition [0x0000000000000000] (等待某个条件) 线程详细状态:java.lang.Thread.State: RUNNABLE 及之后所有*/ "DestroyJavaVM" #13 prio=5 os_prio=0 tid=0x0000000001c88800 nid=0x1c18 waiting on condition [0x0000000000000000] java.lang.Thread.State: RUNNABLE "Thread-1" #12 prio=5 os_prio=0 tid=0x0000000018d49000 nid=0x17b8 waiting for monitor entry [0x0000000019d7f000] /* 线程状态:阻塞(在对象同步上) 代码位置:at com.leo.interview.SimpleDeadLock$B.run(SimpleDeadLock.java:56) 等待锁:0x00000000d629b4d8 已经获得锁:0x00000000d629b4e8*/ java.lang.Thread.State: BLOCKED (on object monitor) at com.leo.interview.SimpleDeadLock$B.run(SimpleDeadLock.java:56) - waiting to lock <0x00000000d629b4d8> (a java.lang.Object) - locked <0x00000000d629b4e8> (a java.lang.Object) "Thread-0" #11 prio=5 os_prio=0 tid=0x0000000018d44000 nid=0x1ebc waiting for monitor entry [0x000000001907f000] java.lang.Thread.State: BLOCKED (on object monitor) at com.leo.interview.SimpleDeadLock$A.run(SimpleDeadLock.java:34) - waiting to lock <0x00000000d629b4e8> (a java.lang.Object) - locked <0x00000000d629b4d8> (a java.lang.Object) "Service Thread" #10 daemon prio=9 os_prio=0 tid=0x0000000018ca5000 nid=0x1264 runnable [0x0000000000000000] java.lang.Thread.State: RUNNABLE "C1 CompilerThread2" #9 daemon prio=9 os_prio=2 tid=0x0000000018c46000 nid=0xb8c waiting on condition [0x0000000000000000] java.lang.Thread.State: RUNNABLE "C2 CompilerThread1" #8 daemon prio=9 os_prio=2 tid=0x0000000018be4800 nid=0x1db4 waiting on condition [0x0000000000000000] java.lang.Thread.State: RUNNABLE "C2 CompilerThread0" #7 daemon prio=9 os_prio=2 tid=0x0000000018be3800 nid=0x810 waiting on condition [0x0000000000000000] java.lang.Thread.State: RUNNABLE "Monitor Ctrl-Break" #6 daemon prio=5 os_prio=0 tid=0x0000000018bcc800 nid=0x1c24 runnable [0x00000000193ce000] java.lang.Thread.State: RUNNABLE at java.net.SocketInputStream.socketRead0(Native Method) at java.net.SocketInputStream.socketRead(SocketInputStream.java:116) at java.net.SocketInputStream.read(SocketInputStream.java:171) at java.net.SocketInputStream.read(SocketInputStream.java:141) at sun.nio.cs.StreamDecoder.readBytes(StreamDecoder.java:284) at sun.nio.cs.StreamDecoder.implRead(StreamDecoder.java:326) at sun.nio.cs.StreamDecoder.read(StreamDecoder.java:178) - locked <0x00000000d632b928> (a java.io.InputStreamReader) at java.io.InputStreamReader.read(InputStreamReader.java:184) at java.io.BufferedReader.fill(BufferedReader.java:161) at java.io.BufferedReader.readLine(BufferedReader.java:324) - locked <0x00000000d632b928> (a java.io.InputStreamReader) at java.io.BufferedReader.readLine(BufferedReader.java:389) at com.intellij.rt.execution.application.AppMainV2$1.run(AppMainV2.java:64) "Attach Listener" #5 daemon prio=5 os_prio=2 tid=0x0000000017781800 nid=0x524 runnable [0x0000000000000000] java.lang.Thread.State: RUNNABLE "Signal Dispatcher" #4 daemon prio=9 os_prio=2 tid=0x000000001778f800 nid=0x1b08 waiting on condition [0x0000000000000000] java.lang.Thread.State: RUNNABLE "Finalizer" #3 daemon prio=8 os_prio=1 tid=0x000000001776a800 nid=0xdac in Object.wait() [0x0000000018b6f000] java.lang.Thread.State: WAITING (on object monitor) at java.lang.Object.wait(Native Method) - waiting on <0x00000000d6108ec8> (a java.lang.ref.ReferenceQueue$Lock) at java.lang.ref.ReferenceQueue.remove(ReferenceQueue.java:143) - locked <0x00000000d6108ec8> (a java.lang.ref.ReferenceQueue$Lock) at java.lang.ref.ReferenceQueue.remove(ReferenceQueue.java:164) at java.lang.ref.Finalizer$FinalizerThread.run(Finalizer.java:209) "Reference Handler" #2 daemon prio=10 os_prio=2 tid=0x0000000017723800 nid=0x1670 in Object.wait() [0x00000000189ef000] java.lang.Thread.State: WAITING (on object monitor) at java.lang.Object.wait(Native Method) - waiting on <0x00000000d6106b68> (a java.lang.ref.Reference$Lock) at java.lang.Object.wait(Object.java:502) at java.lang.ref.Reference.tryHandlePending(Reference.java:191) - locked <0x00000000d6106b68> (a java.lang.ref.Reference$Lock) at java.lang.ref.Reference$ReferenceHandler.run(Reference.java:153) "VM Thread" os_prio=2 tid=0x000000001771b800 nid=0x604 runnable "GC task thread#0 (ParallelGC)" os_prio=0 tid=0x0000000001c9d800 nid=0x9f0 runnable "GC task thread#1 (ParallelGC)" os_prio=0 tid=0x0000000001c9f000 nid=0x154c runnable "GC task thread#2 (ParallelGC)" os_prio=0 tid=0x0000000001ca0800 nid=0xcd0 runnable "GC task thread#3 (ParallelGC)" os_prio=0 tid=0x0000000001ca2000 nid=0x1e58 runnable "VM Periodic Task Thread" os_prio=2 tid=0x0000000018c5a000 nid=0x1b58 waiting on condition JNI global references: 33 /* 此处可以看待死锁的相关信息! */ Found one Java-level deadlock: ============================= "Thread-1": waiting to lock monitor 0x0000000017729fc8 (object 0x00000000d629b4d8, a java.lang.Object), which is held by "Thread-0" "Thread-0": waiting to lock monitor 0x0000000017727738 (object 0x00000000d629b4e8, a java.lang.Object), which is held by "Thread-1" Java stack information for the threads listed above: =================================================== "Thread-1": at com.leo.interview.SimpleDeadLock$B.run(SimpleDeadLock.java:56) - waiting to lock <0x00000000d629b4d8> (a java.lang.Object) - locked <0x00000000d629b4e8> (a java.lang.Object) "Thread-0": at com.leo.interview.SimpleDeadLock$A.run(SimpleDeadLock.java:34) - waiting to lock <0x00000000d629b4e8> (a java.lang.Object) - locked <0x00000000d629b4d8> (a java.lang.Object) Found 1 deadlock. /* 内存使用状况,详情得看JVM方面的书 */ Heap PSYoungGen total 37888K, used 4590K [0x00000000d6100000, 0x00000000d8b00000, 0x0000000100000000) eden space 32768K, 14% used [0x00000000d6100000,0x00000000d657b968,0x00000000d8100000) from space 5120K, 0% used [0x00000000d8600000,0x00000000d8600000,0x00000000d8b00000) to space 5120K, 0% used [0x00000000d8100000,0x00000000d8100000,0x00000000d8600000) ParOldGen total 86016K, used 0K [0x0000000082200000, 0x0000000087600000, 0x00000000d6100000) object space 86016K, 0% used [0x0000000082200000,0x0000000082200000,0x0000000087600000) Metaspace used 3474K, capacity 4500K, committed 4864K, reserved 1056768K class space used 382K, capacity 388K, committed 512K, reserved 1048576K 20、为什么我们调用start()方法时会执行run()方法,为什么我们不能直接调用run()方法? 当你调用start()方法时你将创建新的线程,并且执行在run()方法里的代码。 但是如果你直接调用run()方法,它不会创建新的线程也不会执行调用线程的代码,只会把run方法当作普通方法去执行。 21、Java中你怎样唤醒一个阻塞的线程? 在Java发展史上曾经使用suspend()、resume()方法对于线程进行阻塞唤醒,但随之出现很多问题,比较典型的还是死锁问题。 解决方案可以使用以对象为目标的阻塞,即利用Object类的wait()和notify()方法实现线程阻塞。 首先,wait、notify方法是针对对象的,调用任意对象的wait()方法都将导致线程阻塞,阻塞的同时也将释放该对象的锁,相应地,调用任意对象的notify()方法则将随机解除该对象阻塞的线程,但它需要重新获取改对象的锁,直到获取成功才能往下执行;其次,wait、notify方法必须在synchronized块或方法中被调用,并且要保证同步块或方法的锁对象与调用wait、notify方法的对象是同一个,如此一来在调用wait之前当前线程就已经成功获取某对象的锁,执行wait阻塞后当前线程就将之前获取的对象锁释放。 22、在Java中CycliBarriar和CountdownLatch有什么区别? CyclicBarrier可以重复使用,而CountdownLatch不能重复使用。 Java的concurrent包里面的CountDownLatch其实可以把它看作一个计数器,只不过这个计数器的操作是原子操作,同时只能有一个线程去操作这个计数器,也就是同时只能有一个线程去减这个计数器里面的值。 你可以向CountDownLatch对象设置一个初始的数字作为计数值,任何调用这个对象上的await()方法都会阻塞,直到这个计数器的计数值被其他的线程减为0为止。 所以在当前计数到达零之前,await 方法会一直受阻塞。之后,会释放所有等待的线程,await的所有后续调用都将立即返回。这种现象只出现一次——计数无法被重置。如果需要重置计数,请考虑使用 CyclicBarrier。 CountDownLatch的一个非常典型的应用场景是:有一个任务想要往下执行,但必须要等到其他的任务执行完毕后才可以继续往下执行。假如我们这个想要继续往下执行的任务调用一个CountDownLatch对象的await()方法,其他的任务执行完自己的任务后调用同一个CountDownLatch对象上的countDown()方法,这个调用await()方法的任务将一直阻塞等待,直到这个CountDownLatch对象的计数值减到0为止。 CyclicBarrier一个同步辅助类,它允许一组线程互相等待,直到到达某个公共屏障点 (common barrier point)。在涉及一组固定大小的线程的程序中,这些线程必须不时地互相等待,此时 CyclicBarrier 很有用。因为该 barrier 在释放等待线程后可以重用,所以称它为循环 的 barrier。 23、什么是不可变对象,它对写并发应用有什么帮助? 不可变对象(Immutable Objects)即对象一旦被创建它的状态(对象的数据,也即对象属性值)就不能改变,反之即为可变对象(Mutable Objects)。 不可变对象的类即为不可变类(Immutable Class)。Java平台类库中包含许多不可变类,如String、基本类型的包装类、BigInteger和BigDecimal等。 不可变对象天生是线程安全的。它们的常量(域)是在构造函数中创建的。既然它们的状态无法修改,这些常量永远不会变。 不可变对象永远是线程安全的。 只有满足如下状态,一个对象才是不可变的; 它的状态不能在创建后再被修改; 所有域都是final类型;并且, 它被正确创建(创建期间没有发生this引用的逸出)。 24、什么是多线程中的上下文切换? 在上下文切换过程中,CPU会停止处理当前运行的程序,并保存当前程序运行的具体位置以便之后继续运行。从这个角度来看,上下文切换有点像我们同时阅读几本书,在来回切换书本的同时我们需要记住每本书当前读到的页码。在程序中,上下文切换过程中的“页码”信息是保存在进程控制块(PCB)中的。PCB还经常被称作“切换桢”(switchframe)。“页码”信息会一直保存到CPU的内存中,直到他们被再次使用。 上下文切换是存储和恢复CPU状态的过程,它使得线程执行能够从中断点恢复执行。上下文切换是多任务操作系统和多线程环境的基本特征。 25、Java中用到的线程调度算法是什么? 计算机通常只有一个CPU,在任意时刻只能执行一条机器指令,每个线程只有获得CPU的使用权才能执行指令.所谓多线程的并发运行,其实是指从宏观上看,各个线程轮流获得CPU的使用权,分别执行各自的任务.在运行池中,会有多个处于就绪状态的线程在等待CPU,JAVA虚拟机的一项任务就是负责线程的调度,线程调度是指按照特定机制为多个线程分配CPU的使用权. 有两种调度模型:分时调度模型和抢占式调度模型。 分时调度模型是指让所有的线程轮流获得cpu的使用权,并且平均分配每个线程占用的CPU的时间片这个也比较好理解。 java虚拟机采用抢占式调度模型,是指优先让可运行池中优先级高的线程占用CPU,如果可运行池中的线程优先级相同,那么就随机选择一个线程,使其占用CPU。处于运行状态的线程会一直运行,直至它不得不放弃CPU。 26、什么是线程组,为什么在Java中不推荐使用? 线程组和线程池是两个不同的概念,他们的作用完全不同,前者是为了方便线程的管理,后者是为了管理线程的生命周期,复用线程,减少创建销毁线程的开销。 27、为什么使用Executor框架比使用应用创建和管理线程好? 为什么要使用Executor线程池框架 1、每次执行任务创建线程 new Thread()比较消耗性能,创建一个线程是比较耗时、耗资源的。 2、调用 new Thread()创建的线程缺乏管理,被称为野线程,而且可以无限制的创建,线程之间的相互竞争会导致过多占用系统资源而导致系统瘫痪,还有线程之间的频繁交替也会消耗很多系统资源。 3、直接使用new Thread() 启动的线程不利于扩展,比如定时执行、定期执行、定时定期执行、线程中断等都不便实现。 使用Executor线程池框架的优点 1、能复用已存在并空闲的线程从而减少线程对象的创建从而减少了消亡线程的开销。 2、可有效控制最大并发线程数,提高系统资源使用率,同时避免过多资源竞争。 3、框架中已经有定时、定期、单线程、并发数控制等功能。 综上所述使用线程池框架Executor能更好的管理线程、提供系统资源使用率。 28、java中有几种方法可以实现一个线程? 继承 Thread 类 实现 Runnable 接口 实现 Callable 接口,需要实现的是 call() 方法 29、如何停止一个正在运行的线程? 使用共享变量的方式 在这种方式中,之所以引入共享变量,是因为该变量可以被多个执行相同任务的线程用来作为是否中断的信号,通知中断线程的执行。 使用interrupt方法终止线程 如果一个线程由于等待某些事件的发生而被阻塞,又该怎样停止该线程呢?这种情况经常会发生,比如当一个线程由于需要等候键盘输入而被阻塞,或者调用Thread.join()方法,或者Thread.sleep()方法,在网络中调用ServerSocket.accept()方法,或者调用了DatagramSocket.receive()方法时,都有可能导致线程阻塞,使线程处于处于不可运行状态时,即使主程序中将该线程的共享变量设置为true,但该线程此时根本无法检查循环标志,当然也就无法立即中断。这里我们给出的建议是,不要使用stop()方法,而是使用Thread提供的interrupt()方法,因为该方法虽然不会中断一个正在运行的线程,但是它可以使一个被阻塞的线程抛出一个中断异常,从而使线程提前结束阻塞状态,退出堵塞代码。 30、notify()和notifyAll()有什么区别? 当一个线程进入wait之后,就必须等其他线程notify/notifyall,使用notifyall,可以唤醒所有处于wait状态的线程,使其重新进入锁的争夺队列中,而notify只能唤醒一个。 如果没把握,建议notifyAll,防止notigy因为信号丢失而造成程序异常。 31、什么是Daemon线程?它有什么意义? 所谓后台(daemon)线程,是指在程序运行的时候在后台提供一种通用服务的线程,并且这个线程并不属于程序中不可或缺的部分。因此,当所有的非后台线程结束时,程序也就终止了,同时会杀死进程中的所有后台线程。反过来说, 只要有任何非后台线程还在运行,程序就不会终止。必须在线程启动之前调用setDaemon()方法,才能把它设置为后台线程。注意:后台进程在不执行finally子句的情况下就会终止其run()方法。 比如:JVM的垃圾回收线程就是Daemon线程,Finalizer也是守护线程。 32、java如何实现多线程之间的通讯和协作? 中断 和 共享变量 33、什么是可重入锁(ReentrantLock)? 举例来说明锁的可重入性 public class UnReentrant{ Lock lock = new Lock(); public void outer(){ lock.lock(); inner(); lock.unlock(); } public void inner(){ lock.lock(); //do something lock.unlock(); } } outer中调用了inner,outer先锁住了lock,这样inner就不能再获取lock。其实调用outer的线程已经获取了lock锁,但是不能在inner中重复利用已经获取的锁资源,这种锁即称之为 不可重入可重入就意味着:线程可以进入任何一个它已经拥有的锁所同步着的代码块。 synchronized、ReentrantLock都是可重入的锁,可重入锁相对来说简化了并发编程的开发。 34、当一个线程进入某个对象的一个synchronized的实例方法后,其它线程是否可进入此对象的其它方法? 如果其他方法没有synchronized的话,其他线程是可以进入的。 所以要开放一个线程安全的对象时,得保证每个方法都是线程安全的。 35、乐观锁和悲观锁的理解及如何实现,有哪些实现方式? 悲观锁:总是假设最坏的情况,每次去拿数据的时候都认为别人会修改,所以每次在拿数据的时候都会上锁,这样别人想拿这个数据就会阻塞直到它拿到锁。传统的关系型数据库里边就用到了很多这种锁机制,比如行锁,表锁等,读锁,写锁等,都是在做操作之前先上锁。再比如Java里面的同步原语synchronized关键字的实现也是悲观锁。 乐观锁:顾名思义,就是很乐观,每次去拿数据的时候都认为别人不会修改,所以不会上锁,但是在更新的时候会判断一下在此期间别人有没有去更新这个数据,可以使用版本号等机制。乐观锁适用于多读的应用类型,这样可以提高吞吐量,像数据库提供的类似于write_condition机制,其实都是提供的乐观锁。在Java中java.util.concurrent.atomic包下面的原子变量类就是使用了乐观锁的一种实现方式CAS实现的。 乐观锁的实现方式: 1、使用版本标识来确定读到的数据与提交时的数据是否一致。提交后修改版本标识,不一致时可以采取丢弃和再次尝试的策略。 2、java中的Compare and Swap即CAS ,当多个线程尝试使用CAS同时更新同一个变量时,只有其中一个线程能更新变量的值,而其它线程都失败,失败的线程并不会被挂起,而是被告知这次竞争中失败,并可以再次尝试。 CAS 操作中包含三个操作数 —— 需要读写的内存位置(V)、进行比较的预期原值(A)和拟写入的新值(B)。如果内存位置V的值与预期原值A相匹配,那么处理器会自动将该位置值更新为新值B。否则处理器不做任何操作。 CAS缺点: 1. ABA问题: 比如说一个线程one从内存位置V中取出A,这时候另一个线程two也从内存中取出A,并且two进行了一些操作变成了B,然后two又将V位置的数据变成A,这时候线程one进行CAS操作发现内存中仍然是A,然后one操作成功。尽管线程one的CAS操作成功,但可能存在潜藏的问题。从Java1.5开始JDK的atomic包里提供了一个类AtomicStampedReference来解决ABA问题。 2、循环时间长开销大: 对于资源竞争严重(线程冲突严重)的情况,CAS自旋的概率会比较大,从而浪费更多的CPU资源,效率低于synchronized。 3、只能保证一个共享变量的原子操作: 当对一个共享变量执行操作时,我们可以使用循环CAS的方式来保证原子操作,但是对多个共享变量操作时,循环CAS就无法保证操作的原子性,这个时候就可以用锁。 36、SynchronizedMap和ConcurrentHashMap有什么区别? SynchronizedMap一次锁住整张表来保证线程安全,所以每次只能有一个线程来访为map。 ConcurrentHashMap使用分段锁来保证在多线程下的性能。ConcurrentHashMap中则是一次锁住一个桶。ConcurrentHashMap默认将hash表分为16个桶,诸如get,put,remove等常用操作只锁当前需要用到的桶。这样,原来只能一个线程进入,现在却能同时有16个写线程执行,并发性能的提升是显而易见的。 另外ConcurrentHashMap使用了一种不同的迭代方式。在这种迭代方式中,当iterator被创建后集合再发生改变就不再是抛出ConcurrentModificationException,取而代之的是在改变时new新的数据从而不影响原有的数据 ,iterator完成后再将头指针替换为新的数据 ,这样iterator线程可以使用原来老的数据,而写线程也可以并发的完成改变。 37、CopyOnWriteArrayList可以用于什么应用场景? CopyOnWriteArrayList(免锁容器)的好处之一是当多个迭代器同时遍历和修改这个列表时,不会抛出ConcurrentModificationException。在CopyOnWriteArrayList中,写入将导致创建整个底层数组的副本,而源数组将保留在原地,使得复制的数组在被修改时,读取操作可以安全地执行。 1、由于写操作的时候,需要拷贝数组,会消耗内存,如果原数组的内容比较多的情况下,可能导致young gc或者full gc; 2、不能用于实时读的场景,像拷贝数组、新增元素都需要时间,所以调用一个set操作后,读取到数据可能还是旧的,虽然CopyOnWriteArrayList 能做到最终一致性,但是还是没法满足实时性要求; CopyOnWriteArrayList透露的思想 1、读写分离,读和写分开 2、最终一致性 3、使用另外开辟空间的思路,来解决并发冲突 38、什么叫线程安全?servlet是线程安全吗? 线程安全是编程中的术语,指某个函数、函数库在多线程环境中被调用时,能够正确地处理多个线程之间的共享变量,使程序功能正确完成。 Servlet不是线程安全的,servlet是单实例多线程的,当多个线程同时访问同一个方法,是不能保证共享变量的线程安全性的。 Struts2的action是多实例多线程的,是线程安全的,每个请求过来都会new一个新的action分配给这个请求,请求完成后销毁。 SpringMVC的Controller是线程安全的吗?不是的,和Servlet类似的处理流程。 Struts2好处是不用考虑线程安全问题;Servlet和SpringMVC需要考虑线程安全问题,但是性能可以提升不用处理太多的gc,可以使用ThreadLocal来处理多线程的问题。 39、volatile有什么用?能否用一句话说明下volatile的应用场景? volatile保证内存可见性和禁止指令重排。 volatile用于多线程环境下的单次操作(单次读或者单次写)。 40、为什么代码会重排序? 在执行程序时,为了提供性能,处理器和编译器常常会对指令进行重排序,但是不能随意重排序,不是你想怎么排序就怎么排序,它需要满足以下两个条件: 在单线程环境下不能改变程序运行的结果; 存在数据依赖关系的不允许重排序 需要注意的是:重排序不会影响单线程环境的执行结果,但是会破坏多线程的执行语义。 41、在java中wait和sleep方法的不同? 最大的不同是在等待时wait会释放锁,而sleep一直持有锁。Wait通常被用于线程间交互,sleep通常被用于暂停执行。 直接了解的深入一点吧: 在Java中线程的状态一共被分成6种: 初始态:NEW 创建一个Thread对象,但还未调用start()启动线程时,线程处于初始态。 运行态:RUNNABLE 在Java中,运行态包括就绪态 和 运行态。 就绪态 该状态下的线程已经获得执行所需的所有资源,只要CPU分配执行权就能运行。所有就绪态的线程存放在就绪队列中。 运行态 获得CPU执行权,正在执行的线程。由于一个CPU同一时刻只能执行一条线程,因此每个CPU每个时刻只有一条运行态的线程。 阻塞态 当一条正在执行的线程请求某一资源失败时,就会进入阻塞态。而在Java中,阻塞态专指请求锁失败时进入的状态。由一个阻塞队列存放所有阻塞态的线程。处于阻塞态的线程会不断请求资源,一旦请求成功,就会进入就绪队列,等待执行。PS:锁、IO、Socket等都资源。 等待态 当前线程中调用wait、join、park函数时,当前线程就会进入等待态。也有一个等待队列存放所有等待态的线程。线程处于等待态表示它需要等待其他线程的指示才能继续运行。进入等待态的线程会释放CPU执行权,并释放资源(如:锁) 超时等待态 当运行中的线程调用sleep(time)、wait、join、parkNanos、parkUntil时,就会进入该状态;它和等待态一样,并不是因为请求不到资源,而是主动进入,并且进入后需要其他线程唤醒;进入该状态后释放CPU执行权 和 占有的资源。与等待态的区别:到了超时时间后自动进入阻塞队列,开始竞争锁。 终止态 线程执行结束后的状态。 注意: wait()方法会释放CPU执行权 和 占有的锁。 sleep(long)方法仅释放CPU使用权,锁仍然占用;线程被放入超时等待队列,与yield相比,它会使线程较长时间得不到运行。 yield()方法仅释放CPU执行权,锁仍然占用,线程会被放入就绪队列,会在短时间内再次执行。 wait和notify必须配套使用,即必须使用同一把锁调用; wait和notify必须放在一个同步块中调用wait和notify的对象必须是他们所处同步块的锁对象。 42、用Java实现阻塞队列 参考java中的阻塞队列的内容吧,直接实现有点烦: http://www.infoq.com/cn/articles/java-blocking-queue 43、一个线程运行时发生异常会怎样? 如果异常没有被捕获该线程将会停止执行。Thread.UncaughtExceptionHandler是用于处理未捕获异常造成线程突然中断情况的一个内嵌接口。当一个未捕获异常将造成线程中断的时候JVM会使用Thread.getUncaughtExceptionHandler()来查询线程的UncaughtExceptionHandler并将线程和异常作为参数传递给handler的uncaughtException()方法进行处理。 44、如何在两个线程间共享数据? 在两个线程间共享变量即可实现共享。 一般来说,共享变量要求变量本身是线程安全的,然后在线程内使用的时候,如果有对共享变量的复合操作,那么也得保证复合操作的线程安全性。 45、Java中notify 和 notifyAll有什么区别? notify() 方法不能唤醒某个具体的线程,所以只有一个线程在等待的时候它才有用武之地。而notifyAll()唤醒所有线程并允许他们争夺锁确保了至少有一个线程能继续运行。 46、为什么wait, notify 和 notifyAll这些方法不在thread类里面? 一个很明显的原因是JAVA提供的锁是对象级的而不是线程级的,每个对象都有锁,通过线程获得。由于wait,notify和notifyAll都是锁级别的操作,所以把他们定义在Object类中因为锁属于对象。 47、什么是ThreadLocal变量? ThreadLocal是Java里一种特殊的变量。每个线程都有一个ThreadLocal就是每个线程都拥有了自己独立的一个变量,竞争条件被彻底消除了。它是为创建代价高昂的对象获取线程安全的好方法,比如你可以用ThreadLocal让SimpleDateFormat变成线程安全的,因为那个类创建代价高昂且每次调用都需要创建不同的实例所以不值得在局部范围使用它,如果为每个线程提供一个自己独有的变量拷贝,将大大提高效率。首先,通过复用减少了代价高昂的对象的创建个数。其次,你在没有使用高代价的同步或者不变性的情况下获得了线程安全。 48、Java中interrupted 和 isInterrupted方法的区别? interrupt interrupt方法用于中断线程。调用该方法的线程的状态为将被置为”中断”状态。 注意:线程中断仅仅是置线程的中断状态位,不会停止线程。需要用户自己去监视线程的状态为并做处理。支持线程中断的方法(也就是线程中断后会抛出interruptedException的方法)就是在监视线程的中断状态,一旦线程的中断状态被置为“中断状态”,就会抛出中断异常。 interrupted 查询当前线程的中断状态,并且清除原状态。如果一个线程被中断了,第一次调用interrupted则返回true,第二次和后面的就返回false了。 isInterrupted 仅仅是查询当前线程的中断状态 49、为什么wait和notify方法要在同步块中调用? Java API强制要求这样做,如果你不这么做,你的代码会抛出IllegalMonitorStateException异常。还有一个原因是为了避免wait和notify之间产生竞态条件。 50、为什么你应该在循环中检查等待条件? 处于等待状态的线程可能会收到错误警报和伪唤醒,如果不在循环中检查等待条件,程序就会在没有满足结束条件的情况下退出。 51、Java中的同步集合与并发集合有什么区别? 同步集合与并发集合都为多线程和并发提供了合适的线程安全的集合,不过并发集合的可扩展性更高。在Java1.5之前程序员们只有同步集合来用且在多线程并发的时候会导致争用,阻碍了系统的扩展性。Java5介绍了并发集合像ConcurrentHashMap,不仅提供线程安全还用锁分离和内部分区等现代技术提高了可扩展性。 52、什么是线程池? 为什么要使用它? 创建线程要花费昂贵的资源和时间,如果任务来了才创建线程那么响应时间会变长,而且一个进程能创建的线程数有限。为了避免这些问题,在程序启动的时候就创建若干线程来响应处理,它们被称为线程池,里面的线程叫工作线程。从JDK1.5开始,Java API提供了Executor框架让你可以创建不同的线程池。 53、怎么检测一个线程是否拥有锁? 在java.lang.Thread中有一个方法叫holdsLock(),它返回true如果当且仅当当前线程拥有某个具体对象的锁。 54、你如何在Java中获取线程堆栈? kill -3 [java pid] 不会在当前终端输出,它会输出到代码执行的或指定的地方去。比如,kill -3 tomcat pid, 输出堆栈到log目录下。 Jstack [java pid] 这个比较简单,在当前终端显示,也可以重定向到指定文件中。 -JvisualVM:Thread Dump 不做说明,打开JvisualVM后,都是界面操作,过程还是很简单的。 55、JVM中哪个参数是用来控制线程的栈堆栈小的? -Xss 每个线程的栈大小 56、Thread类中的yield方法有什么作用? 使当前线程从执行状态(运行状态)变为可执行态(就绪状态)。 当前线程到了就绪状态,那么接下来哪个线程会从就绪状态变成执行状态呢?可能是当前线程,也可能是其他线程,看系统的分配了。 57、Java中ConcurrentHashMap的并发度是什么? ConcurrentHashMap把实际map划分成若干部分来实现它的可扩展性和线程安全。这种划分是使用并发度获得的,它是ConcurrentHashMap类构造函数的一个可选参数,默认值为16,这样在多线程情况下就能避免争用。 在JDK8后,它摒弃了Segment(锁段)的概念,而是启用了一种全新的方式实现,利用CAS算法。同时加入了更多的辅助变量来提高并发度,具体内容还是查看源码吧。 58、Java中Semaphore是什么? Java中的Semaphore是一种新的同步类,它是一个计数信号。从概念上讲,从概念上讲,信号量维护了一个许可集合。如有必要,在许可可用前会阻塞每一个 acquire(),然后再获取该许可。每个 release()添加一个许可,从而可能释放一个正在阻塞的获取者。但是,不使用实际的许可对象,Semaphore只对可用许可的号码进行计数,并采取相应的行动。信号量常常用于多线程的代码中,比如数据库连接池。 59、Java线程池中submit() 和 execute()方法有什么区别? 两个方法都可以向线程池提交任务,execute()方法的返回类型是void,它定义在Executor接口中。 而submit()方法可以返回持有计算结果的Future对象,它定义在ExecutorService接口中,它扩展了Executor接口,其它线程池类像ThreadPoolExecutor和ScheduledThreadPoolExecutor都有这些方法。 60、什么是阻塞式方法? 阻塞式方法是指程序会一直等待该方法完成期间不做其他事情,ServerSocket的accept()方法就是一直等待客户端连接。这里的阻塞是指调用结果返回之前,当前线程会被挂起,直到得到结果之后才会返回。此外,还有异步和非阻塞式方法在任务完成前就返回。 61、Java中的ReadWriteLock是什么? 读写锁是用来提升并发程序性能的锁分离技术的成果。 62、volatile 变量和 atomic 变量有什么不同? Volatile变量可以确保先行关系,即写操作会发生在后续的读操作之前, 但它并不能保证原子性。例如用volatile修饰count变量那么 count++ 操作就不是原子性的。 而AtomicInteger类提供的atomic方法可以让这种操作具有原子性如getAndIncrement()方法会原子性的进行增量操作把当前值加一,其它数据类型和引用变量也可以进行相似操作。 63、可以直接调用Thread类的run ()方法么? 当然可以。但是如果我们调用了Thread的run()方法,它的行为就会和普通的方法一样,会在当前线程中执行。为了在新的线程中执行我们的代码,必须使用Thread.start()方法。 64、如何让正在运行的线程暂停一段时间? 我们可以使用Thread类的Sleep()方法让线程暂停一段时间。需要注意的是,这并不会让线程终止,一旦从休眠中唤醒线程,线程的状态将会被改变为Runnable,并且根据线程调度,它将得到执行。 65、你对线程优先级的理解是什么? 每一个线程都是有优先级的,一般来说,高优先级的线程在运行时会具有优先权,但这依赖于线程调度的实现,这个实现是和操作系统相关的(OS dependent)。我们可以定义线程的优先级,但是这并不能保证高优先级的线程会在低优先级的线程前执行。线程优先级是一个int变量(从1-10),1代表最低优先级,10代表最高优先级。 java的线程优先级调度会委托给操作系统去处理,所以与具体的操作系统优先级有关,如非特别需要,一般无需设置线程优先级。 66、什么是线程调度器(Thread Scheduler)和时间分片(Time Slicing )? 线程调度器是一个操作系统服务,它负责为Runnable状态的线程分配CPU时间。一旦我们创建一个线程并启动它,它的执行便依赖于线程调度器的实现。 同上一个问题,线程调度并不受到Java虚拟机控制,所以由应用程序来控制它是更好的选择(也就是说不要让你的程序依赖于线程的优先级)。 时间分片是指将可用的CPU时间分配给可用的Runnable线程的过程。分配CPU时间可以基于线程优先级或者线程等待的时间。 67、你如何确保main()方法所在的线程是Java 程序最后结束的线程? 我们可以使用Thread类的join()方法来确保所有程序创建的线程在main()方法退出前结束。 68、线程之间是如何通信的? 当线程间是可以共享资源时,线程间通信是协调它们的重要的手段。Object类中wait()\notify()\notifyAll()方法可以用于线程间通信关于资源的锁的状态。 69、为什么线程通信的方法wait(), notify()和notifyAll()被定义在Object 类里? Java的每个对象中都有一个锁(monitor,也可以成为监视器) 并且wait(),notify()等方法用于等待对象的锁或者通知其他线程对象的监视器可用。在Java的线程中并没有可供任何对象使用的锁和同步器。这就是为什么这些方法是Object类的一部分,这样Java的每一个类都有用于线程间通信的基本方法。 70、为什么wait(), notify()和notifyAll ()必须在同步方法或者同步块中被调用? 当一个线程需要调用对象的wait()方法的时候,这个线程必须拥有该对象的锁,接着它就会释放这个对象锁并进入等待状态直到其他线程调用这个对象上的notify()方法。同样的,当一个线程需要调用对象的notify()方法时,它会释放这个对象的锁,以便其他在等待的线程就可以得到这个对象锁。由于所有的这些方法都需要线程持有对象的锁,这样就只能通过同步来实现,所以他们只能在同步方法或者同步块中被调用。 71、为什么Thread类的sleep()和yield ()方法是静态的? Thread类的sleep()和yield()方法将在当前正在执行的线程上运行。所以在其他处于等待状态的线程上调用这些方法是没有意义的。这就是为什么这些方法是静态的。它们可以在当前正在执行的线程中工作,并避免程序员错误的认为可以在其他非运行线程调用这些方法。 72、如何确保线程安全? 在Java中可以有很多方法来保证线程安全——同步,使用原子类(atomic concurrent classes),实现并发锁,使用volatile关键字,使用不变类和线程安全类。 73、同步方法和同步块,哪个是更好的选择? 同步块是更好的选择,因为它不会锁住整个对象(当然你也可以让它锁住整个对象)。同步方法会锁住整个对象,哪怕这个类中有多个不相关联的同步块,这通常会导致他们停止执行并需要等待获得这个对象上的锁。 同步块更要符合开放调用的原则,只在需要锁住的代码块锁住相应的对象,这样从侧面来说也可以避免死锁。 74、如何创建守护线程? 使用Thread类的setDaemon(true)方法可以将线程设置为守护线程,需要注意的是,需要在调用start()方法前调用这个方法,否则会抛出IllegalThreadStateException异常。 75、什么是Java Timer 类?如何创建一个有特定时间间隔的任务? java.util.Timer是一个工具类,可以用于安排一个线程在未来的某个特定时间执行。Timer类可以用安排一次性任务或者周期任务。 java.util.TimerTask是一个实现了Runnable接口的抽象类,我们需要去继承这个类来创建我们自己的定时任务并使用Timer去安排它的执行。 目前有开源的Qurtz可以用来创建定时任务。 --------------------- 作者:乌枭 原文:https://blog.csdn.net/qq_34039315/article/details/78549311

优秀的个人博客,低调大师

面试请不要再问我Spring Cloud底层原理

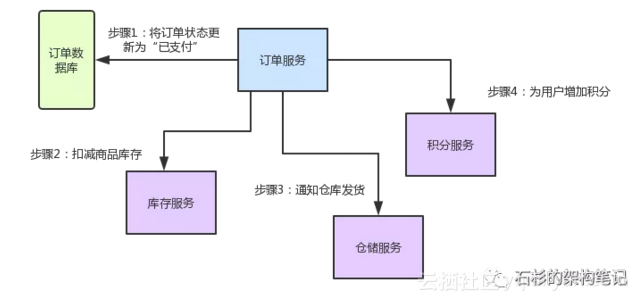
概述 毫无疑问,Spring Cloud是目前微服务架构领域的翘楚,无数的书籍博客都在讲解这个技术。不过大多数讲解还停留在对Spring Cloud功能使用的层面,其底层的很多原理,很多人可能并不知晓。因此本文将通过大量的手绘图,给大家谈谈Spring Cloud微服务架构的底层原理。实际上,Spring Cloud是一个全家桶式的技术栈,包含了很多组件。本文先从其最核心的几个组件入手,来剖析一下其底层的工作原理。也就是Eureka、Ribbon、Feign、Hystrix、Zuul这几个组件。 一、业务场景介绍 先来给大家说一个业务场景,假设咱们现在开发一个电商网站,要实现支付订单的功能,流程如下: 创建一个订单之后,如果用户立刻支付了这个订单,我们需要将订单状态更新为“已支付” 扣减相应的商品库存 通知仓储中心,进行发货 给用户的这次购物增加相应的积分 针对上述流程,我们需要有订单服务、库存服务、仓储服务、积分服务。整个流程的大体思路如下: 用户针对一个订单完成支付之后,就会去找订单服务,更新订单状态 订单服务调用库存服务,完成相应功能 订单服务调用仓储服务,完成相应功能 订单服务调用积分服务,完成相应功能 至此,整个支付订单的业务流程结束 下图这张图,清晰表明了各服务间的调用过程: 好!有了业务场景之后,咱们就一起来看看SpringCloud微服务架构中,这几个组件如何相互协作,各自发挥的作用以及其背后的原理。 二、Spring Cloud核心组件:Eureka 咱们来考虑第一个问题:订单服务想要调用库存服务、仓储服务,或者是积分服务,怎么调用? 订单服务压根儿就不知道人家库存服务在哪台机器上啊!他就算想要发起一个请求,都不知道发送给谁,有心无力! 这时候,就轮到Spring Cloud Eureka出场了。Eureka是微服务架构中的注册中心,专门负责服务的注册与发现。 咱们来看看下面的这张图,结合图来仔细剖析一下整个流程: 如上图所示,库存服务、仓储服务、积分服务中都有一个Eureka Client组件,这个组件专门负责将这个服务的信息注册到Eureka Server中。说白了,就是告诉Eureka Server,自己在哪台机器上,监听着哪个端口。而Eureka Server是一个注册中心,里面有一个注册表,保存了各服务所在的机器和端口号 订单服务里也有一个Eureka Client组件,这个Eureka Client组件会找Eureka Server问一下:库存服务在哪台机器啊?监听着哪个端口啊?仓储服务呢?积分服务呢?然后就可以把这些相关信息从Eureka Server的注册表中拉取到自己本地缓存起来。 这时如果订单服务想要调用库存服务,不就可以找自己本地的Eureka Client问一下库存服务在哪台机器?监听哪个端口吗?收到响应后,紧接着就可以发送一个请求过去,调用库存服务扣减库存的那个接口!同理,如果订单服务要调用仓储服务、积分服务,也是如法炮制。 总结一下: EurekaClient:负责将这个服务的信息注册到Eureka Server中 Eureka Server:注册中心,里面有一个注册表,保存了各个服务所在的机器和端口号 三、Spring Cloud核心组件:Feign 现在订单服务确实知道库存服务、积分服务、仓库服务在哪里了,同时也监听着哪些端口号了。但是新问题又来了:难道订单服务要自己写一大堆代码,跟其他服务建立网络连接,然后构造一个复杂的请求,接着发送请求过去,最后对返回的响应结果再写一大堆代码来处理吗? 这是上述流程翻译的代码片段,咱们一起来看看,体会一下这种绝望而无助的感受!!! 友情提示,前方高能: 看完上面那一大段代码,有没有感到后背发凉、一身冷汗?实际上你进行服务间调用时,如果每次都手写代码,代码量比上面那段要多至少几倍,所以这个事儿压根儿就不是地球人能干的。 既然如此,那怎么办呢?别急,Feign早已为我们提供好了优雅的解决方案。来看看如果用Feign的话,你的订单服务调用库存服务的代码会变成啥样? 看完上面的代码什么感觉?是不是感觉整个世界都干净了,又找到了活下去的勇气!没有底层的建立连接、构造请求、解析响应的代码,直接就是用注解定义一个 FeignClient接口,然后调用那个接口就可以了。人家Feign Client会在底层根据你的注解,跟你指定的服务建立连接、构造请求、发起靕求、获取响应、解析响应,等等。这一系列脏活累活,人家Feign全给你干了。 那么问题来了,Feign是如何做到这么神奇的呢?很简单,Feign的一个关键机制就是使用了动态代理。咱们一起来看看下面的图,结合图来分析: 首先,如果你对某个接口定义了@FeignClient注解,Feign就会针对这个接口创建一个动态代理 接着你要是调用那个接口,本质就是会调用Feign创建的动态代理,这是核心中的核心 Feign的动态代理会根据你在接口上的@RequestMapping等注解,来动态构造出你要请求的服务的地址 最后针对这个地址,发起请求、解析响应 四、Spring Cloud核心组件:Ribbon 说完了Feign,还没完。现在新的问题又来了,如果人家库存服务部署在了5台机器上,如下所示: 192.168.169:9000 192.168.170:9000 192.168.171:9000 192.168.172:9000 192.168.173:9000 这下麻烦了!人家Feign怎么知道该请求哪台机器呢? 这时Spring CloudRibbon就派上用场了。Ribbon就是专门解决这个问题的。它的作用是负载均衡,会帮你在每次请求时选择一台机器,均匀的把请求分发到各个机器上 Ribbon的负载均衡默认使用的最经典的RoundRobin轮询算法。这是啥?简单来说,就是如果订单服务对库存服务发起10次请求,那就先让你请求第1台机器、然后是第2台机器、第3台机器、第4台机器、第5台机器,接着再来—个循环,第1台机器、第2台机器。。。以此类推。 此外,Ribbon是和Feign以及Eureka紧密协作,完成工作的,具体如下: 首先Ribbon会从Eureka Client里获取到对应的服务注册表,也就知道了所有的服务都部署在了哪些机器上,在监听哪些端口号。 然后Ribbon就可以使用默认的RoundRobin算法,从中选择一台机器 Feign就会针对这台机器,构造并发起请求。 对上述整个过程,再来一张图,帮助大家更深刻的理解: 五、Spring Cloud核心组件:Hystrix 在微服务架构里,一个系统会有很多的服务。以本文的业务场景为例:订单服务在一个业务流程里需要调用三个服务。现在假设订单服务自己最多只有100个线程可以处理请求,然后呢,积分服务不幸的挂了,每次订单服务调用积分服务的时候,都会卡住几秒钟,然后抛出—个超时异常。 咱们一起来分析一下,这样会导致什么问题? 如果系统处于高并发的场景下,大量请求涌过来的时候,订单服务的100个线程都会卡在请求积分服务这块。导致订单服务没有一个线程可以处理请求 然后就会导致别人请求订单服务的时候,发现订单服务也挂了,不响应任何请求了 上面这个,就是微服务架构中恐怖的服务雪崩问题,如下图所示: 如上图,这么多服务互相调用,要是不做任何保护的话,某一个服务挂了,就会引起连锁反应,导致别的服务也挂。比如积分服务挂了,会导致订单服务的线程全部卡在请求积分服务这里,没有一个线程可以工作,瞬间导致订单服务也挂了,别人请求订单服务全部会卡住,无法响应。 但是我们思考一下,就算积分服务挂了,订单服务也可以不用挂啊!为什么? 我们结合业务来看:支付订单的时候,只要把库存扣减了,然后通知仓库发货就OK了 如果积分服务挂了,大不了等他恢复之后,慢慢人肉手工恢复数据!为啥一定要因为一个积分服务挂了,就直接导致订单服务也挂了呢?不可以接受! 现在问题分析完了,如何解决? 这时就轮到Hystrix闪亮登场了。Hystrix是隔离、熔断以及降级的一个框架。啥意思呢?说白了,Hystrix会搞很多个小小的线程池,比如订单服务请求库存服务是一个线程池,请求仓储服务是一个线程池,请求积分服务是一个线程池。每个线程池里的线程就仅仅用于请求那个服务。 打个比方:现在很不幸,积分服务挂了,会咋样? 当然会导致订单服务里的那个用来调用积分服务的线程都卡死不能工作了啊!但是由于订单服务调用库存服务、仓储服务的这两个线程池都是正常工作的,所以这两个服务不会受到任何影响。 这个时候如果别人请求订单服务,订单服务还是可以正常调用库存服务扣减库存,调用仓储服务通知发货。只不过调用积分服务的时候,每次都会报错。但是如果积分服务都挂了,每次调用都要去卡住几秒钟干啥呢?有意义吗?当然没有!所以我们直接对积分服务熔断不就得了,比如在5分钟内请求积分服务直接就返回了,不要去走网络请求卡住几秒钟,这个过程,就是所谓的熔断! 那人家又说,兄弟,积分服务挂了你就熔断,好歹你干点儿什么啊!别啥都不干就直接返回啊?没问题,咱们就来个降级:每次调用积分服务,你就在数据库里记录一条消息,说给某某用户增加了多少积分,因为积分服务挂了,导致没增加成功!这样等积分服务恢复了,你可以根据这些记录手工加一下积分。这个过程,就是所谓的降级。 为帮助大家更直观的理解,接下来用一张图,梳理一下Hystrix隔离、熔断和降级的全流程: 六、Spring Cloud核心组件:Zuul 说完了Hystrix,接着给大家说说最后一个组件:Zuul,也就是微服务网关。这个组件是负责网络路由的。不懂网络路由?行,那我给你说说,如果没有Zuul的日常工作会怎样? 假设你后台部署了几百个服务,现在有个前端兄弟,人家请求是直接从浏览器那儿发过来的。打个比方:人家要请求一下库存服务,你难道还让人家记着这服务的名字叫做inventory-service?部署在5台机器上?就算人家肯记住这一个,你后台可有几百个服务的名称和地址呢?难不成人家请求一个,就得记住一个?你要这样玩儿,那真是友谊的小船,说翻就翻! 上面这种情况,压根儿是不现实的。所以一般微服务架构中都必然会设计一个网关在里面,像android、ios、pc前端、微信小程序、H5等等,不用去关心后端有几百个服务,就知道有一个网关,所有请求都往网关走,网关会根据请求中的一些特征,将请求转发给后端的各个服务。 而且有一个网关之后,还有很多好处,比如可以做统一的降级、限流、认证授权、安全,等等。 七、总结: 最后再来总结一下,上述几个SpringCloud核心组件,在微服务架构中,分别扮演的角色: Eureka:各个服务启动时,EurekaClient都会将服务注册到EurekaServer,并且EurekaClient还可以反过来从EurekaServer拉取注册表,从而知道其他服务在哪里 Ribbon:服务间发起请求的时候,基于Ribbon做负载均衡,从一个服务的多台机器中选择一台 Feign:基于Feign的动态代理机制,根据注解和选择的机器,拼接请求URL地址,发起请求 Hystrix:发起请求是通过Hystrix的线程池来走的,不同的服务走不同的线程池,实现了不同服务调用的隔离,避免了服务雪崩的问题 Zuul:如果前端、移动端要调用后端系统,统一从Zuul网关进入,由Zuul网关转发请求给对应的服务 以上就是我们通过一个电商业务场景,阐述了SpringCloud微服务架构几个核心组件的底层原理。 文字总结还不够直观?没问题!我们将Spring Cloud的5个核心组件通过一张图串联起来,再来直观的感受一下其底层的架构原理: 如有收获,请帮忙转发,您的鼓励是作者最大的动力,谢谢! 原文发布时间为:2018-11-12 本文作者:中华石杉 本文来自云栖社区合作伙伴“猿天地”,了解相关信息可以关注“猿天地”。

优秀的个人博客,低调大师

速来围观老田的蚂蚁金服Java面试经历!

电话一面 1、自我介绍、自己做的项目和技术领域 2、项目中的监控:那个监控指标常见的哪些? 3、微服务涉及到的技术以及需要注意的问题有哪些? 4、注册中心你了解了哪些? 5、consul 的可靠性你了解吗? 6、consul 的机制你有没有具体深入过?有没有和其他的注册中心对比过? 7、项目用 Spring 比较多,有没有了解 Spring 的原理?AOP 和 IOC 的原理 8、Spring Boot除了自动配置,相比传统的 Spring 有什么其他的区别? 9、Spring Cloud 有了解多少? 10、Spring Bean 的生命周期 11、HashMap 和 hashTable 区别? 12、Object 的 hashcode 方法重写了,equals 方法要不要改? 13、Hashmap 线程不安全的出现场景 14、线上服务 CPU 很高该怎么做?有哪些措施可以找到问题 15、JDK 中有哪几个线程池?顺带把线程池讲了个遍 16、SQL 优化的常见方法有哪些 17、SQL 索引的顺序,字段的顺序 18、查看 SQL 是不是使用了索引?(有什么工具) 19、TCP 和 UDP 的区别?TCP 数据传输过程中怎么做到可靠的? 20、说下你知道的排序算法吧 21、查找一个数组的中位数? 22、你有什么问题想问我的吗? 电话二面(85 分钟) 1、自我介绍、工作经历、技术栈 2、项目中你学到了什么技术?(把三项目具体描述了很久) 3、微服务划分的粒度 4、微服务的高可用怎么保证的? 5、常用的负载均衡,该怎么用,你能说下吗? 6、网关能够为后端服务带来哪些好处? 7、Spring Bean 的生命周期 8、xml 中配置的 init、destroy 方法怎么可以做到调用具体的方法? 9、反射的机制 10、Object 类中的方法 11、hashcode 和 equals 方法常用地方 12、对象比较是否相同 13、hashmap put 方法存放的时候怎么判断是否是重复的 14、Object toString 方法常用的地方,为什么要重写该方法 15、Set 和 List 区别? 16、ArrayList 和 LinkedList 区别 17、如果存取相同的数据,ArrayList 和 LinkedList 谁占用空间更大? 18、Set 存的顺序是有序的吗? 19、常见 Set 的实现有哪些? 20、TreeSet 对存入对数据有什么要求呢? 21、HashSet 的底层实现呢 22、TreeSet 底层源码有看过吗? 23、HashSet 是不是线程安全的?为什么不是线程安全的? 24、Java 中有哪些线程安全的 Map? 25、Concurrenthashmap 是怎么做到线程安全的? 26、HashTable 你了解过吗? 27、如何保证线程安全问题? 28、synchronized、lock 29、volatile 的原子性问题?为什么 i++ 这种不支持原子性?从计算机原理的设计来讲下不能保证原子性的原因 30、happens before 原理 31、cas 操作 32、lock 和 synchronized 的区别? 33、公平锁和非公平锁 34、Java 读写锁 35、读写锁设计主要解决什么问题? 36、你项目除了写 Java 代码,还有前端代码,那你知道前端有哪些框架吗? 37、MySQL 分页查询语句 38、MySQL 事务特性和隔离级别 39、不可重复读会出现在什么场景? 40、sql having 的使用场景 41、前端浏览器地址的一个 http 请求到后端整个流程是怎么样?能够说下吗? 42、http 默认端口,https 默认端口 43、DNS 你知道是干嘛的吗? 44、你们开发用的 ide 是啥?你能说下 idea 的常用几个快捷键吧? 45、代码版本管理你们用的是啥? 46、git rebase 和 merge 有什么区别? 47、你们公司加班多吗? 48、后面一起聊 high 了,之间扯了些蛋,哈哈哈 欢迎工作一到五年的Java工程师朋友们加入Java填坑之路:860113481 群内提供免费的Java架构学习资料(里面有高可用、高并发、高性能及分布式、Jvm性能调优、Spring源码,MyBatis,Netty,Redis,Kafka,Mysql,Zookeeper,Tomcat,Docker,Dubbo,Nginx等多个知识点的架构资料)合理利用自己每一分每一秒的时间来学习提升自己,不要再用"没有时间“来掩饰自己思想上的懒惰!趁年轻,使劲拼,给未来的自己一个交代!

优秀的个人博客,低调大师

最新一期Spring Boot 面试题

问题一 什么是Spring Boot? 多年来,随着新功能的增加,spring变得越来越复杂。只需访问 https://spring.io/projects 页面,我们就会看到可以在我们的应用程序中使用的所有Spring项目的不同功能。如果必须启动一个新的Spring项目,我们必须添加构建路径或添加Maven依赖关系,配置应用程序服务器,添加spring配置。因此,开始一个新的spring项目需要很多努力,因为我们现在必须从头开始做所有事情。 Spring Boot是解决这个问题的方法。Spring Boot已经建立在现有spring框架之上。使用spring启动,我们避免了之前我们必须做的所有样板代码和配置。因此,Spring Boot可以帮助我们以最少的工作量,更加健壮地使用现有的Spring功能。 问题二 Spring Boot有哪些优点? Spring Boot的优点有: 减少开发,测试时间和努力。 使用JavaConfig有助于避免使用XML。 避免大量的Maven导入和各种版本冲突。 提供意见发展方法。 通过提供默认值快速开始开发。 没有单独的Web服务器需要。这意味着你不再需要启动Tomcat,Glassfish或其他任何东西。 需要更少的配置 因为没有web.xml文件。只需添加用@ Configuration注释的类,然后添加用@Bean注释的方法,Spring将自动加载对象并像以前一样对其进行管理。您甚至可以将@Autowired添加到bean方法中,以使Spring自动装入需要的依赖关系中。 基于环境的配置使用这些属性,您可以将您正在使用的环境传递到应用程序:-Dspring.profiles.active = {enviornment}。在加载主应用程序属性文件后,Spring将在(application{environment} .properties)中加载后续的应用程序属性文件。 问题三 什么是JavaConfig? Spring JavaConfig是Spring社区的产品,它提供了配置Spring IoC容器的纯Java方法。因此它有助于避免使用XML配置。使用JavaConfig的优点在于: 面向对象的配置。由于配置被定义为JavaConfig中的类,因此用户可以充分利用Java中的面向对象功能。一个配置类可以继承另一个,重写它的@Bean方法等。 减少或消除XML配置。基于依赖注入原则的外化配置的好处已被证明。但是,许多开发人员不希望在XML和Java之间来回切换。JavaConfig为开发人员提供了一种纯Java方法来配置与XML配置概念相似的Spring容器。从技术角度来讲,只使用JavaConfig配置类来配置容器是可行的,但实际上很多人认为将JavaConfig与XML混合匹配是理想的。 类型安全和重构友好。JavaConfig提供了一种类型安全的方法来配置Spring容器。由于Java 5.0对泛型的支持,现在可以按类型而不是按名称检索bean,不需要任何强制转换或基于字符串的查找。 问题四 如何重新加载Spring Boot上的更改,而无需重新启动服务器? 这可以使用DEV工具来实现。通过这种依赖关系,您可以节省任何更改,嵌入式tomcat将重新启动。Spring Boot有一个开发工具(DevTools)模块,它有助于提高开发人员的生产力。Java开发人员面临的一个主要挑战是将文件更改自动部署到服务器并自动重启服务器。开发人员可以重新加载Spring Boot上的更改,而无需重新启动服务器。这将消除每次手动部署更改的需要。Spring Boot在发布它的第一个版本时没有这个功能。这是开发人员最需要的功能。DevTools模块完全满足开发人员的需求。该模块将在生产环境中被禁用。它还提供H2数据库控制台以更好地测试应用程序。 org.springframework.boot spring-boot-devtools true 问题五 Spring Boot中的监视器是什么? Spring boot actuator是spring启动框架中的重要功能之一。Spring boot监视器可帮助您访问生产环境中正在运行的应用程序的当前状态。有几个指标必须在生产环境中进行检查和监控。即使一些外部应用程序可能正在使用这些服务来向相关人员触发警报消息。监视器模块公开了一组可直接作为HTTP URL访问的REST端点来检查状态。 问题六 如何在Spring Boot中禁用Actuator端点安全性? 默认情况下,所有敏感的HTTP端点都是安全的,只有具有ACTUATOR角色的用户才能访问它们。安全性是使用标准的HttpServletRequest.isUserInRole方法实施的。 我们可以使用 management.security.enabled = false 来禁用安全性。只有在执行机构端点在防火墙后访问时,才建议禁用安全性。 问题七 如何在自定义端口上运行Spring Boot应用程序? 为了在自定义端口上运行Spring Boot应用程序,您可以在application.properties中指定端口。 server.port = 8090 问题八 什么是YAML? YAML是一种人类可读的数据序列化语言。它通常用于配置文件。 与属性文件相比,如果我们想要在配置文件中添加复杂的属性,YAML文件就更加结构化,而且更少混淆。可以看出YAML具有分层配置数据。 问题九 如何实现Spring Boot应用程序的安全性? 为了实现Spring Boot的安全性,我们使用 spring-boot-starter-security依赖项,并且必须添加安全配置。它只需要很少的代码。配置类将必须扩展WebSecurityConfigurerAdapter并覆盖其方法。 问题十 如何集成Spring Boot和ActiveMQ? 对于集成Spring Boot和ActiveMQ,我们使用 spring-boot-starter-activemq 依赖关系。 它只需要很少的配置,并且不需要样板代码。 问题十一 如何使用Spring Boot实现分页和排序? 使用Spring Boot实现分页非常简单。使用Spring Data-JPA可以实现将可分页的 org.springframework.data.domain.Pageable 传递给存储库方法。 问题十二 什么是Swagger?你用Spring Boot实现了它吗? Swagger广泛用于可视化API,使用Swagger UI为前端开发人员提供在线沙箱。Swagger是用于生成RESTful Web服务的可视化表示的工具,规范和完整框架实现。它使文档能够以与服务器相同的速度更新。当通过Swagger正确定义时,消费者可以使用最少量的实现逻辑来理解远程服务并与其进行交互。因此,Swagger消除了调用服务时的猜测。 问题十三 什么是Spring Profiles? Spring Profiles允许用户根据配置文件(dev,test,prod等)来注册bean。因此,当应用程序在开发中运行时,只有某些bean可以加载,而在PRODUCTION中,某些其他bean可以加载。假设我们的要求是Swagger文档仅适用于QA环境,并且禁用所有其他文档。这可以使用配置文件来完成。Spring Boot使得使用配置文件非常简单。 问题十四 什么是Spring Batch? Spring Boot Batch提供可重用的函数,这些函数在处理大量记录时非常重要,包括日志/跟踪,事务管理,作业处理统计信息,作业重新启动,跳过和资源管理。它还提供了更先进的技术服务和功能,通过优化和分区技术,可以实现极高批量和高性能批处理作业。简单以及复杂的大批量批处理作业可以高度可扩展的方式利用框架处理重要大量的信息。 问题十五 什么是FreeMarker模板? FreeMarker是一个基于Java的模板引擎,最初专注于使用MVC软件架构进行动态网页生成。使用Freemarker的主要优点是表示层和业务层的完全分离。程序员可以处理应用程序代码,而设计人员可以处理html页面设计。最后使用freemarker可以将这些结合起来,给出最终的输出页面。 问题十六 如何使用Spring Boot实现异常处理? Spring提供了一种使用ControllerAdvice处理异常的非常有用的方法。 我们通过实现一个ControlerAdvice类,来处理控制器类抛出的所有异常。 问题十七 您使用了哪些starter maven依赖项? 使用了下面的一些依赖项 spring-boot-starter-activemq spring-boot-starter-security spring-boot-starter-web 这有助于增加更少的依赖关系,并减少版本的冲突。 问题十八 什么是CSRF攻击? CSRF代表跨站请求伪造。这是一种攻击,迫使最终用户在当前通过身份验证的Web应用程序上执行不需要的操作。CSRF攻击专门针对状态改变请求,而不是数据窃取,因为攻击者无法查看对伪造请求的响应。 问题十九 什么是WebSockets? WebSocket是一种计算机通信协议,通过单个TCP连接提供全双工通信信道。 WebSocket是双向的 -使用WebSocket客户端或服务器可以发起消息发送。 WebSocket是全双工的 -客户端和服务器通信是相互独立的。 单个TCP连接 -初始连接使用HTTP,然后将此连接升级到基于套接字的连接。然后这个单一连接用于所有未来的通信 Light -与http相比,WebSocket消息数据交换要轻得多。 问题二十 什么是AOP? 在软件开发过程中,跨越应用程序多个点的功能称为交叉问题。这些交叉问题与应用程序的主要业务逻辑不同。因此,将这些横切关注与业务逻辑分开是面向方面编程(AOP)的地方。 问题二十一 什么是Apache Kafka? Apache Kafka是一个分布式发布 - 订阅消息系统。它是一个可扩展的,容错的发布 - 订阅消息系统,它使我们能够构建分布式应用程序。这是一个Apache顶级项目。Kafka适合离线和在线消息消费。 问题二十二 我们如何监视所有Spring Boot微服务? Spring Boot提供监视器端点以监控各个微服务的度量。这些端点对于获取有关应用程序的信息(如它们是否已启动)以及它们的组件(如数据库等)是否正常运行很有帮助。但是,使用监视器的一个主要缺点或困难是,我们必须单独打开应用程序的知识点以了解其状态或健康状况。想象一下涉及50个应用程序的微服务,管理员将不得不击中所有50个应用程序的执行终端。

优秀的个人博客,低调大师

面试java基础(真的很实用,点个赞呗!)

J2SE 基础 八种基本数据类型的大小,以及他们的封装类。 八种基本数据类型,int ,double ,long ,float, short,byte,character,boolean 对应的封装类型是:Integer ,Double ,Long ,Float, Short,Byte,Character,Boolean Switch能否用string做参数? 在Java 5以前,switch(expr)中,expr只能是byte、short、char、int。从Java 5开始,Java中引入了枚举类型,expr也可以是enum类型,从Java 7开始,expr还可以是字符串(String),但是长整型(long)在目前所有的版本中都是不可以的。 equals与==的区别。 http://www.importnew.com/6804.html ==与equals的主要区别是:==常用于比较原生类型,而equals()方法用于检查对象的相等性。另一个不同的点是:如果==和equals()用于比较对象,当两个引用地址相同,==返回true。而equals()可以返回true或者false主要取决于重写实现。最常见的一个例子,字符串的比较,不同情况==和equals()返回不同的结果。equals()方法最重要的一点是,能够根据业务要求去重写,按照自定义规则去判断两个对象是否相等。重写equals()方法的时候,要注意一下hashCode是否会因为对象的属性改变而改变,否则在使用散列集合储存该对象的时候会碰到坑!!理解equals()方法的存在是很重要的。 使用==比较有两种情况: 比较基础数据类型(Java中基础数据类型包括八中:short,int,long,float,double,char,byte,boolen):这种情况下,==比较的是他们的值是否相等。 引用间的比较:在这种情况下,==比较的是他们在内存中的地址,也就是说,除非引用指向的是同一个new出来的对象,此时他们使用`==`去比较得到true,否则,得到false。 使用equals进行比较: equals追根溯源,是Object类中的一个方法,在该类中,equals的实现也仅仅只是比较两个对象的内存地址是否相等,但在一些子类中,如:String、Integer 等,该方法将被重写。 以String类为例子说明eqauls与==的区别: 在开始这个例子之前,同学们需要知道JVM处理String的一些特性。Java的虚拟机在内存中开辟出一块单独的区域,用来存储字符串对象,这块内存区域被称为字符串缓冲池。当使用String a = "abc"这样的语句进行定义一个引用的时候,首先会在字符串缓冲池中查找是否已经相同的对象,如果存在,那么就直接将这个对象的引用返回给a,如果不存在,则需要新建一个值为"abc"的对象,再将新的引用返回a。String a = new String("abc");这样的语句明确告诉JVM想要产生一个新的String对象,并且值为"abc",于是就在堆内存中的某一个小角落开辟了一个新的String对象。 - `==`在比较引用的情况下,会去比较两个引用的内存地址是否相等。 ``` String str1 = "abc"; String str2 = "abc"; System.out.println(str1 == str2); System.out.println(str1.equals(str2)); String str2 = new String("abc"); System.out.println(str1 == str2); System.out.println(str1.equals(str2)); ``` 以上代码将会输出 true true false true **第一个true:**因为在str2赋值之前,str1的赋值操作就已经在内存中创建了一个值为"abc"的对象了,然后str2将会与str1指向相同的地址。 **第二个true:**因为`String`已经重写了`equals`方法:为了方便大家阅读我贴出来,并且在注释用进行分析: ``` public boolean equals(Object anObject) { //如果比较的对象与自身内存地址相等的话 //就说明他两指向的是同一个对象 //所以此时equals的返回值跟==的结果是一样的。 if (this == anObject) { return true; } //当比较的对象与自身的内存地址不相等,并且 //比较的对象是String类型的时候 //将会执行这个分支 if (anObject instanceof String) { String anotherString = (String)anObject; int n = value.length; if (n == anotherString.value.length) { char v1[] = value; char v2[] = anotherString.value; int i = 0; //在这里循环遍历两个String中的char while (n-- != 0) { //只要有一个不相等,那么就会返回false if (v1[i] != v2[i]) return false; i++; } return true; } } return false; } ``` 进行以上分析之后,就不难理解第一段代码中的实例程序输出了。 Object有哪些公用方法? http://www.cnblogs.com/yumo/p/4908315.html 1.clone方法 保护方法,实现对象的浅复制,只有实现了Cloneable接口才可以调用该方法,否则抛出CloneNotSupportedException异常。 主要是JAVA里除了8种基本类型传参数是值传递,其他的类对象传参数都是引用传递,我们有时候不希望在方法里讲参数改变,这是就需要在类中复写clone方法。 2.getClass方法 final方法,获得运行时类型。 3.toString方法 该方法用得比较多,一般子类都有覆盖。 4.finalize方法 该方法用于释放资源。因为无法确定该方法什么时候被调用,很少使用。 5.equals方法 该方法是非常重要的一个方法。一般equals和==是不一样的,但是在Object中两者是一样的。子类一般都要重写这个方法。 6.hashCode方法 该方法用于哈希查找,可以减少在查找中使用equals的次数,重写了equals方法一般都要重写hashCode方法。这个方法在一些具有哈希功能的Collection中用到。 一般必须满足obj1.equals(obj2)==true。可以推出obj1.hashCode()==obj2.hashCode(),但是hashCode相等不一定就满足equals。不过为了提高效率,应该尽量使上面两个条件接近等价。 如果不重写hashCode(),在HashSet中添加两个equals的对象,会将两个对象都加入进去。 7.wait方法 wait方法就是使当前线程等待该对象的锁,当前线程必须是该对象的拥有者,也就是具有该对象的锁。wait()方法一直等待,直到获得锁或者被中断。wait(long timeout)设定一个超时间隔,如果在规定时间内没有获得锁就返回。 调用该方法后当前线程进入睡眠状态,直到以下事件发生。 (1)其他线程调用了该对象的notify方法。 (2)其他线程调用了该对象的notifyAll方法。 (3)其他线程调用了interrupt中断该线程。 (4)时间间隔到了。 此时该线程就可以被调度了,如果是被中断的话就抛出一个InterruptedException异常。 8.notify方法 该方法唤醒在该对象上等待的某个线程。 9.notifyAll方法 该方法唤醒在该对象上等待的所有线程。 Java的四种引用,强弱软虚,用到的场景。 JDK1.2之前只有强引用,其他几种引用都是在JDK1.2之后引入的. 强引用(Strong Reference) 最常用的引用类型,如Object obj = new Object(); 。只要强引用存在则GC时则必定不被回收。 软引用(Soft Reference) 用于描述还有用但非必须的对象,当堆将发生OOM(Out Of Memory)时则会回收软引用所指向的内存空间,若回收后依然空间不足才会抛出OOM。一般用于实现内存敏感的高速缓存。 当真正对象被标记finalizable以及的finalize()方法调用之后并且内存已经清理, 那么如果SoftReference object还存在就被加入到它的 ReferenceQueue.只有前面几步完成后,Soft Reference和Weak Reference的get方法才会返回null 弱引用(Weak Reference) 发生GC时必定回收弱引用指向的内存空间。 和软引用加入队列的时机相同 虚引用(Phantom Reference) 又称为幽灵引用或幻影引用,虚引用既不会影响对象的生命周期,也无法通过虚引用来获取对象实例,仅用于在发生GC时接收一个系统通知。 当一个对象的finalize方法已经被调用了之后,这个对象的幽灵引用会被加入到队列中。通过检查该队列里面的内容就知道一个对象是不是已经准备要被回收了. 虚引用和软引用和弱引用都不同,它会在内存没有清理的时候被加入引用队列.虚引用的建立必须要传入引用队列,其他可以没有 Hashcode的作用。 http://c610367182.iteye.com/blog/1930676 以Java.lang.Object来理解,JVM每new一个Object,它都会将这个Object丢到一个Hash哈希表中去,这样的话,下次做Object的比较或者取这个对象的时候,它会根据对象的hashcode再从Hash表中取这个对象。这样做的目的是提高取对象的效率。具体过程是这样: new Object(),JVM根据这个对象的Hashcode值,放入到对应的Hash表对应的Key上,如果不同的对象确产生了相同的hash值,也就是发生了Hash key相同导致冲突的情况,那么就在这个Hash key的地方产生一个链表,将所有产生相同hashcode的对象放到这个单链表上去,串在一起。 比较两个对象的时候,首先根据他们的hashcode去hash表中找他的对象,当两个对象的hashcode相同,那么就是说他们这两个对象放在Hash表中的同一个key上,那么他们一定在这个key上的链表上。那么此时就只能根据Object的equal方法来比较这个对象是否equal。当两个对象的hashcode不同的话,肯定他们不能equal. String、StringBuffer与StringBuilder的区别。 Java 平台提供了两种类型的字符串:String和StringBuffer / StringBuilder,它们可以储存和操作字符串。其中String是只读字符串,也就意味着String引用的字符串内容是不能被改变的。而StringBuffer和StringBulder类表示的字符串对象可以直接进行修改。StringBuilder是JDK1.5引入的,它和StringBuffer的方法完全相同,区别在于它是单线程环境下使用的,因为它的所有方面都没有被synchronized修饰,因此它的效率也比StringBuffer略高。 try catch finally,try里有return,finally还执行么? 会执行,在方法 返回调用者前执行。Java允许在finally中改变返回值的做法是不好的,因为如果存在finally代码块,try中的return语句不会立马返回调用者,而是纪录下返回值待finally代码块执行完毕之后再向调用者返回其值,然后如果在finally中修改了返回值,这会对程序造成很大的困扰,C#中就从语法规定不能做这样的事。 Excption与Error区别 Error表示系统级的错误和程序不必处理的异常,是恢复不是不可能但很困难的情况下的一种严重问题;比如内存溢出,不可能指望程序能处理这样的状况;Exception表示需要捕捉或者需要程序进行处理的异常,是一种设计或实现问题;也就是说,它表示如果程序运行正常,从不会发生的情况。 Excption与Error包结构。OOM你遇到过哪些情况,SOF你遇到过哪些情况。 http://www.cnblogs.com/yumo/p/4909617.html Java异常架构图 image Throwable Throwable是 Java 语言中所有错误或异常的超类。 Throwable包含两个子类: Error 和 Exception 。它们通常用于指示发生了异常情况。 Throwable包含了其线程创建时线程执行堆栈的快照,它提供了printStackTrace()等接口用于获取堆栈跟踪数据等信息。 Exception Exception及其子类是 Throwable 的一种形式,它指出了合理的应用程序想要捕获的条件。 RuntimeException RuntimeException是那些可能在 Java 虚拟机正常运行期间抛出的异常的超类。 编译器不会检查RuntimeException异常。 例如,除数为零时,抛出ArithmeticException异常。RuntimeException是ArithmeticException的超类。当代码发生除数为零的情况时,倘若既"没有通过throws声明抛出ArithmeticException异常",也"没有通过try...catch...处理该异常",也能通过编译。这就是我们所说的"编译器不会检查RuntimeException异常"! 如果代码会产生RuntimeException异常,则需要通过修改代码进行避免。 例如,若会发生除数为零的情况,则需要通过代码避免该情况的发生! Error 和Exception一样, Error也是Throwable的子类。 它用于指示合理的应用程序不应该试图捕获的严重问题,大多数这样的错误都是异常条件。 和RuntimeException一样, 编译器也不会检查Error。 Java将可抛出(Throwable)的结构分为三种类型: 被检查的异常(Checked Exception),运行时异常(RuntimeException)和错误(Error)。 (01) 运行时异常 定义 : RuntimeException及其子类都被称为运行时异常。 特点 : Java编译器不会检查它。 也就是说,当程序中可能出现这类异常时,倘若既"没有通过throws声明抛出它",也"没有用try-catch语句捕获它",还是会编译通过。例如,除数为零时产生的ArithmeticException异常,数组越界时产生的IndexOutOfBoundsException异常,fail-fail机制产生的ConcurrentModificationException异常等,都属于运行时异常。 虽然Java编译器不会检查运行时异常,但是我们也可以通过throws进行声明抛出,也可以通过try-catch对它进行捕获处理。 如果产生运行时异常,则需要通过修改代码来进行避免。 例如,若会发生除数为零的情况,则需要通过代码避免该情况的发生! (02) 被检查的异常 定义 : Exception类本身,以及Exception的子类中除了"运行时异常"之外的其它子类都属于被检查异常。 特点 : Java编译器会检查它。 此类异常,要么通过throws进行声明抛出,要么通过try-catch进行捕获处理,否则不能通过编译。例如,CloneNotSupportedException就属于被检查异常。当通过clone()接口去克隆一个对象,而该对象对应的类没有实现Cloneable接口,就会抛出CloneNotSupportedException异常。 被检查异常通常都是可以恢复的。 (03) 错误 定义 : Error类及其子类。 特点 : 和运行时异常一样,编译器也不会对错误进行检查。 当资源不足、约束失败、或是其它程序无法继续运行的条件发生时,就产生错误。程序本身无法修复这些错误的。例如,VirtualMachineError就属于错误。 按照Java惯例,我们是不应该是实现任何新的Error子类的! 对于上面的3种结构,我们在抛出异常或错误时,到底该哪一种?《Effective Java》中给出的建议是: 对于可以恢复的条件使用被检查异常,对于程序错误使用运行时异常。 OOM: OutOfMemoryError异常 除了程序计数器外,虚拟机内存的其他几个运行时区域都有发生OutOfMemoryError(OOM)异常的可能, Java Heap 溢出 一般的异常信息:java.lang.OutOfMemoryError:Java heap spacess java堆用于存储对象实例,我们只要不断的创建对象,并且保证GC Roots到对象之间有可达路径来避免垃圾回收机制清除这些对象,就会在对象数量达到最大堆容量限制后产生内存溢出异常。 出现这种异常,一般手段是先通过内存映像分析工具(如Eclipse Memory Analyzer)对dump出来的堆转存快照进行分析,重点是确认内存中的对象是否是必要的,先分清是因为内存泄漏(Memory Leak)还是内存溢出(Memory Overflow)。 如果是内存泄漏,可进一步通过工具查看泄漏对象到GC Roots的引用链。于是就能找到泄漏对象时通过怎样的路径与GC Roots相关联并导致垃圾收集器无法自动回收。 如果不存在泄漏,那就应该检查虚拟机的参数(-Xmx与-Xms)的设置是否适当。 虚拟机栈和本地方法栈溢出 如果线程请求的栈深度大于虚拟机所允许的最大深度,将抛出StackOverflowError异常。 如果虚拟机在扩展栈时无法申请到足够的内存空间,则抛出OutOfMemoryError异常 这里需要注意当栈的大小越大可分配的线程数就越少。 运行时常量池溢出 异常信息:java.lang.OutOfMemoryError:PermGen space 如果要向运行时常量池中添加内容,最简单的做法就是使用String.intern()这个Native方法。该方法的作用是:如果池中已经包含一个等于此String的字符串,则返回代表池中这个字符串的String对象;否则,将此String对象包含的字符串添加到常量池中,并且返回此String对象的引用。由于常量池分配在方法区内,我们可以通过-XX:PermSize和-XX:MaxPermSize限制方法区的大小,从而间接限制其中常量池的容量。 方法区溢出 方法区用于存放Class的相关信息,如类名、访问修饰符、常量池、字段描述、方法描述等。 异常信息:java.lang.OutOfMemoryError:PermGen space 方法区溢出也是一种常见的内存溢出异常,一个类如果要被垃圾收集器回收,判定条件是很苛刻的。在经常动态生成大量Class的应用中,要特别注意这点。 Java面向对象的三个特征与含义。 继承:继承是从已有类得到继承信息创建新类的过程。提供继承信息的类被称为父类(超类、基类);得到继承信息的类被称为子类(派生类)。继承让变化中的软件系统有了一定的延续性,同时继承也是封装程序中可变因素的重要手段。 封装:通常认为封装是把数据和操作数据的方法绑定起来,对数据的访问只能通过已定义的接口。面向对象的本质就是将现实世界描绘成一系列完全自治、封闭的对象。我们在类中编写的方法就是对实现细节的一种封装;我们编写一个类就是对数据和数据操作的封装。可以说,封装就是隐藏一切可隐藏的东西,只向外界提供最简单的编程接口(可以想想普通洗衣机和全自动洗衣机的差别,明显全自动洗衣机封装更好因此操作起来更简单;我们现在使用的智能手机也是封装得足够好的,因为几个按键就搞定了所有的事情)。 多态:多态性是指允许不同子类型的对象对同一消息作出不同的响应。简单的说就是用同样的对象引用调用同样的方法但是做了不同的事情。多态性分为编译时的多态性和运行时的多态性。如果将对象的方法视为对象向外界提供的服务,那么运行时的多态性可以解释为:当A系统访问B系统提供的服务时,B系统有多种提供服务的方式,但一切对A系统来说都是透明的(就像电动剃须刀是A系统,它的供电系统是B系统,B系统可以使用电池供电或者用交流电,甚至还有可能是太阳能,A系统只会通过B类对象调用供电的方法,但并不知道供电系统的底层实现是什么,究竟通过何种方式获得了动力)。方法重载(overload)实现的是编译时的多态性(也称为前绑定),而方法重写(override)实现的是运行时的多态性(也称为后绑定)。运行时的多态是面向对象最精髓的东西,要实现多态需要做两件事:1. 方法重写(子类继承父类并重写父类中已有的或抽象的方法);2. 对象造型(用父类型引用引用子类型对象,这样同样的引用调用同样的方法就会根据子类对象的不同而表现出不同的行为)。 Override和Overload的含义与区别。 Overload:顾名思义,就是Over(重新)——load(加载),所以中文名称是重载。它可以表现类的多态性,可以是函数里面可以有相同的函数名但是参数名、类型不能相同;或者说可以改变参数、类型但是函数名字依然不变。 Override:就是ride(重写)的意思,在子类继承父类的时候子类中可以定义某方法与其父类有相同的名称和参数,当子类在调用这一函数时自动调用子类的方法,而父类相当于被覆盖(重写)了。 方法的重写Overriding和重载Overloading是Java多态性的不同表现。重写Overriding是父类与子类之间多态性的一种表现,重载Overloading是一个类中多态性的一种表现。如果在子类中定义某方法与其父类有相同的名称和参数,我们说该方法被重写 (Overriding)。子类的对象使用这个方法时,将调用子类中的定义,对它而言,父类中的定义如同被“屏蔽”了。如果在一个类中定义了多个同名的方法,它们或有不同的参数个数或有不同的参数类型,则称为方法的重载(Overloading)。Overloaded的方法是可以改变返回值的类型。 Interface与abstract类的区别。 抽象类和接口都不能够实例化,但可以定义抽象类和接口类型的引用。一个类如果继承了某个抽象类或者实现了某个接口都需要对其中的抽象方法全部进行实现,否则该类仍然需要被声明为抽象类。接口比抽象类更加抽象,因为抽象类中可以定义构造器,可以有抽象方法和具体方法,而接口中不能定义构造器而且其中的方法全部都是抽象方法。抽象类中的成员可以是private、默认、protected、public的,而接口中的成员全都是public的。抽象类中可以定义成员变量,而接口中定义的成员变量实际上都是常量。有抽象方法的类必须被声明为抽象类,而抽象类未必要有抽象方法。 Static class 与non static class的区别。 内部静态类不需要有指向外部类的引用。但非静态内部类需要持有对外部类的引用。非静态内部类能够访问外部类的静态和非静态成员。静态类不能访问外部类的非静态成员。他只能访问外部类的静态成员。一个非静态内部类不能脱离外部类实体被创建,一个非静态内部类可以访问外部类的数据和方法,因为他就在外部类里面。 java多态的实现原理。 http://blog.csdn.net/zzzhangzhun/article/details/51095075 当JVM执行Java字节码时,类型信息会存储在方法区中,为了优化对象的调用方法的速度,方法区的类型信息会增加一个指针,该指针指向一个记录该类方法的方法表,方法表中的每一个项都是对应方法的指针。 方法区:方法区和JAVA堆一样,是各个线程共享的内存区域,用于存储已被虚拟机加载的类信息、常量、静态变量、即时编译器编译后的代码等数据。 运行时常量池:它是方法区的一部分,Class文件中除了有类的版本、方法、字段等描述信息外,还有一项信息是常量池,用于存放编译器生成的各种符号引用,这部分信息在类加载时进入方法区的运行时常量池中。 方法区的内存回收目标是针对常量池的回收及对类型的卸载。 方法表的构造 由于java的单继承机制,一个类只能继承一个父类,而所有的类又都继承Object类,方法表中最先存放的是Object的方法,接下来是父类的方法,最后是该类本身的方法。如果子类改写了父类的方法,那么子类和父类的那些同名的方法共享一个方法表项。 由于这样的特性,使得方法表的偏移量总是固定的,例如,对于任何类来说,其方法表的equals方法的偏移量总是一个定值,所有继承父类的子类的方法表中,其父类所定义的方法的偏移量也总是一个定值。 实例 假设Class A是Class B的子类,并且A改写了B的方法的method(),那么B来说,method方法的指针指向B的method方法入口;对于A来说,A的方法表的method项指向自身的method而非父类的。 流程:调用方法时,虚拟机通过对象引用得到方法区中类型信息的方法表的指针入口,查询类的方法表 ,根据实例方法的符号引用解析出该方法在方法表的偏移量,子类对象声明为父类类型时,形式上调用的是父类的方法,此时虚拟机会从实际的方法表中找到方法地址,从而定位到实际类的方法。 注:所有引用为父类,但方法区的类型信息中存放的是子类的信息,所以调用的是子类的方法表。 foreach与正常for循环效率对比。 http://904510742.iteye.com/blog/2118331 直接for循环效率最高,其次是迭代器和 ForEach操作。 作为语法糖,其实 ForEach 编译成 字节码之后,使用的是迭代器实现的,反编译后,testForEach方法如下: public static void testForEach(List list) { for (Iterator iterator = list.iterator(); iterator.hasNext();) { Object t = iterator.next(); Object obj = t; } } 可以看到,只比迭代器遍历多了生成中间变量这一步,因为性能也略微下降了一些。 反射机制 JAVA反射机制是在运行状态中, 对于任意一个类, 都能够知道这个类的所有属性和方法; 对于任意一个对象, 都能够调用它的任意一个方法和属性; 这种动态获取的信息以及动态调用对象的方法的功能称为java语言的反射机制. 主要作用有三: 运行时取得类的方法和字段的相关信息。 创建某个类的新实例(.newInstance()) 取得字段引用直接获取和设置对象字段,无论访问修饰符是什么。 用处如下: 观察或操作应用程序的运行时行为。 调试或测试程序,因为可以直接访问方法、构造函数和成员字段。 通过名字调用不知道的方法并使用该信息来创建对象和调用方法。 String类内部实现,能否改变String对象内容 String源码分析 http://blog.csdn.net/zhangjg_blog/article/details/18319521 try catch 块,try里有return,finally也有return,如何执行 http://qing0991.blog.51cto.com/1640542/1387200 泛型的优缺点 优点: 使用泛型类型可以最大限度地重用代码、保护类型的安全以及提高性能。 泛型最常见的用途是创建集合类。 缺点: 在性能上不如数组快。 泛型常用特点,List<String>能否转为List<Object> 能,但是利用类都继承自Object,所以使用是每次调用里面的函数都要通过强制转换还原回原来的类,这样既不安全,运行速度也慢。 解析XML的几种方式的原理与特点:DOM、SAX、PULL。 http://www.cnblogs.com/HaroldTihan/p/4316397.html Java与C++对比。 http://developer.51cto.com/art/201106/270422.htm Java1.7与1.8新特性。 http://blog.chinaunix.net/uid-29618857-id-4416835.html JNI的使用。 http://landerlyoung.github.io/blog/2014/10/16/java-zhong-jnide-shi-yong/ 集合 ArrayList、LinkedList、Vector的底层实现和区别 从同步性来看,ArrayList和LinkedList是不同步的,而Vector是的。所以线程安全的话,可以使用ArrayList或LinkedList,可以节省为同步而耗费的开销。但在多线程下,有时候就不得不使用Vector了。当然,也可以通过一些办法包装ArrayList、LinkedList,使我们也达到同步,但效率可能会有所降低。 从内部实现机制来讲ArrayList和Vector都是使用Object的数组形式来存储的。当你向这两种类型中增加元素的时候,如果元素的数目超出了内部数组目前的长度它们都需要扩展内部数组的长度,Vector缺省情况下自动增长原来一倍的数组长度,ArrayList是原来的50%,所以最后你获得的这个集合所占的空间总是比你实际需要的要大。如果你要在集合中保存大量的数据,那么使用Vector有一些优势,因为你可以通过设置集合的初始化大小来避免不必要的资源开销。 ArrayList和Vector中,从指定的位置(用index)检索一个对象,或在集合的末尾插入、删除一个对象的时间是一样的,可表示为O(1)。但是,如果在集合的其他位置增加或者删除元素那么花费的时间会呈线性增长O(n-i),其中n代表集合中元素的个数,i代表元素增加或移除元素的索引位置,因为在进行上述操作的时候集合中第i和第i个元素之后的所有元素都要执行(n-i)个对象的位移操作。LinkedList底层是由双向循环链表实现的,LinkedList在插入、删除集合中任何位置的元素所花费的时间都是一样的O(1),但它在索引一个元素的时候比较慢,为O(i),其中i是索引的位置,如果只是查找特定位置的元素或只在集合的末端增加、移除元素,那么使用Vector或ArrayList都可以。如果是对其它指定位置的插入、删除操作,最好选择LinkedList。 HashMap和HashTable的底层实现和区别,两者和ConcurrentHashMap的区别。 http://blog.csdn.net/xuefeng0707/article/details/40834595 HashTable线程安全则是依靠方法简单粗暴的sychronized修饰,HashMap则没有相关的线程安全问题考虑。。 在以前的版本貌似ConcurrentHashMap引入了一个“分段锁”的概念,具体可以理解为把一个大的Map拆分成N个小的HashTable,根据key.hashCode()来决定把key放到哪个HashTable中。在ConcurrentHashMap中,就是把Map分成了N个Segment,put和get的时候,都是现根据key.hashCode()算出放到哪个Segment中。 通过把整个Map分为N个Segment(类似HashTable),可以提供相同的线程安全,但是效率提升N倍。 HashMap的hashcode的作用?什么时候需要重写?如何解决哈希冲突?查找的时候流程是如何? 从源码分析HashMap Arraylist和HashMap如何扩容?负载因子有什么作用?如何保证读写进程安全? http://m.blog.csdn.net/article/details?id=48956087 http://hovertree.com/h/bjaf/2jdr60li.htm ArrayList 本身不是线程安全的。 所以正确的做法是去用 java.util.concurrent 里的 CopyOnWriteArrayList 或者某个同步的 Queue 类。 HashMap实现不是同步的。如果多个线程同时访问一个哈希映射,而其中至少一个线程从结构上修改了该映射,则它必须 保持外部同步。(结构上的修改是指添加或删除一个或多个映射关系的任何操作;仅改变与实例已经包含的键关联的值不是结构上的修改。)这一般通过对自然封装该映射的对象进行同步操作来完成。如果不存在这样的对象,则应该使用 Collections.synchronizedMap 方法来“包装”该映射。最好在创建时完成这一操作,以防止对映射进行意外的非同步访问. TreeMap、HashMap、LinkedHashMap的底层实现区别。 http://blog.csdn.net/lolashe/article/details/20806319 Collection包结构,与Collections的区别。 Collection是一个接口,它是Set、List等容器的父接口;Collections是一个工具类,提供了一系列的静态方法来辅助容器操作,这些方法包括对容器的搜索、排序、线程安全化等等。 Set、List之间的区别是什么? http://developer.51cto.com/art/201309/410205_all.htm Map、Set、List、Queue、Stack的特点与用法。 http://www.cnblogs.com/yumo/p/4908718.html Collection 是对象集合, Collection 有两个子接口 List 和 Set List 可以通过下标 (1,2..) 来取得值,值可以重复 而 Set 只能通过游标来取值,并且值是不能重复的 ArrayList , Vector , LinkedList 是 List 的实现类 ArrayList 是线程不安全的, Vector 是线程安全的,这两个类底层都是由数组实现的 LinkedList 是线程不安全的,底层是由链表实现的 Map 是键值对集合 HashTable 和 HashMap 是 Map 的实现类 HashTable 是线程安全的,不能存储 null 值 HashMap 不是线程安全的,可以存储 null 值 Stack类:继承自Vector,实现一个后进先出的栈。提供了几个基本方法,push、pop、peak、empty、search等。 Queue接口:提供了几个基本方法,offer、poll、peek等。已知实现类有LinkedList、PriorityQueue等。

资源下载

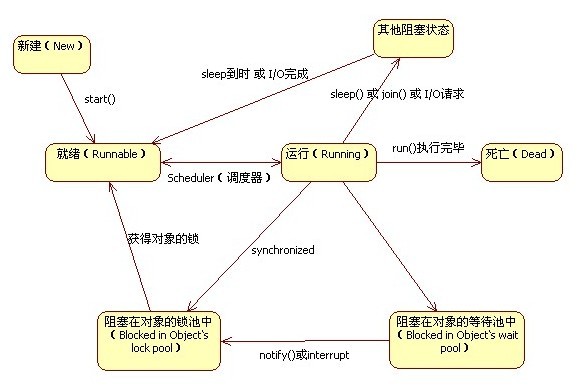
更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册