首页 文章 精选 留言 我的

精选列表

搜索[面试],共5090篇文章
优秀的个人博客,低调大师

春季最新最全面 JAVA 面试题 附答案

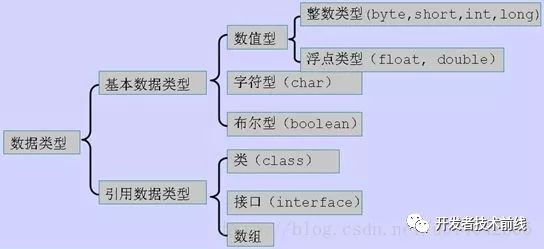
包含的重点内容: JAVA基础 JVM 知识 开源框架知识 操作系统 多线程 TCP 与 HTTP 架构设计与分布式 算法 数据库知识 消息队列 Redis,Memcached 搜索 JAVA基础 JAVA中的几种基本类型,各占用多少字节? image 下图单位是bit,非字节 1B=8bit image String能被继承吗?为什么? 不可以,因为String类有final修饰符,而final修饰的类是不能被继承的,实现细节不允许改变。平常我们定义的String str=”a”;其实和String str=new String(“a”)还是有差异的。 前者默认调用的是String.valueOf来返回String实例对象,至于调用哪个则取决于你的赋值,比如String num=1,调用的是 public static String valueOf(int i) { return Integer.toString(i); } 后者则是调用如下部分: public String(String original) { this.value = original.value; this.hash = original.hash; } 最后我们的变量都存储在一个char数组中 private final char value[]; String, Stringbuffer, StringBuilder 的区别。 String 字符串常量(final修饰,不可被继承),String是常量,当创建之后即不能更改。(可以通过StringBuffer和StringBuilder创建String对象(常用的两个字符串操作类)。) StringBuffer 字符串变量(线程安全),其也是final类别的,不允许被继承,其中的绝大多数方法都进行了同步处理,包括常用的Append方法也做了同步处理(synchronized修饰)。其自jdk1.0起就已经出现。其toString方法会进行对象缓存,以减少元素复制开销。 public synchronized String toString() { if (toStringCache == null) { toStringCache = Arrays.copyOfRange(value, 0, count); } return new String(toStringCache, true); } StringBuilder 字符串变量(非线程安全)其自jdk1.5起开始出现。与StringBuffer一样都继承和实现了同样的接口和类,方法除了没使用synch修饰以外基本一致,不同之处在于最后toString的时候,会直接返回一个新对象。 public String toString() { // Create a copy, don’t share the array return new String(value, 0, count); } ArrayList 和 LinkedList 有什么区别。 ArrayList和LinkedList都实现了List接口,有以下的不同点: 1、ArrayList是基于索引的数据接口,它的底层是数组。它可以以O(1)时间复杂度对元素进行随机访问。与此对应,LinkedList是以元素列表的形式存储它的数据,每一个元素都和它的前一个和后一个元素链接在一起,在这种情况下,查找某个元素的时间复杂度是O(n)。 2、相对于ArrayList,LinkedList的插入,添加,删除操作速度更快,因为当元素被添加到集合任意位置的时候,不需要像数组那样重新计算大小或者是更新索引。 3、LinkedList比ArrayList更占内存,因为LinkedList为每一个节点存储了两个引用,一个指向前一个元素,一个指向下一个元素。 讲讲类的实例化顺序,比如父类静态数据,构造函数,字段,子类静态数据,构造函数,字段,当 new 的时候, 他们的执行顺序。 此题考察的是类加载器实例化时进行的操作步骤(加载–>连接->初始化)。 父类静态代变量、 父类静态代码块、 子类静态变量、 子类静态代码块、 父类非静态变量(父类实例成员变量)、 父类构造函数、 子类非静态变量(子类实例成员变量)、 子类构造函数。 测试demo:http://blog.csdn.net/u014042066/article/details/77574956 参阅我的博客《深入理解类加载》:http://blog.csdn.net/u014042066/article/details/77394480 用过哪些 Map 类,都有什么区别,HashMap 是线程安全的吗,并发下使用的 Map 是什么,他们内部原理分别是什么,比如存储方式, hashcode,扩容, 默认容量等。 hashMap是线程不安全的,HashMap是数组+链表+红黑树(JDK1.8增加了红黑树部分)实现的,采用哈希表来存储的, 参照该链接:https://zhuanlan.zhihu.com/p/21673805 JAVA8 的 ConcurrentHashMap 为什么放弃了分段锁,有什么问题吗,如果你来设计,你如何设计。 参照:https://yq.aliyun.com/articles/36781 有没有有顺序的 Map 实现类, 如果有, 他们是怎么保证有序的。 TreeMap和LinkedHashMap是有序的(TreeMap默认升序,LinkedHashMap则记录了插入顺序)。 参照:http://uule.iteye.com/blog/1522291 抽象类和接口的区别,类可以继承多个类么,接口可以继承多个接口么,类可以实现多个接口么。 1、抽象类和接口都不能直接实例化,如果要实例化,抽象类变量必须指向实现所有抽象方法的子类对象,接口变量必须指向实现所有接口方法的类对象。 2、抽象类要被子类继承,接口要被类实现。 3、接口只能做方法申明,抽象类中可以做方法申明,也可以做方法实现 4、接口里定义的变量只能是公共的静态的常量,抽象类中的变量是普通变量。 5、抽象类里的抽象方法必须全部被子类所实现,如果子类不能全部实现父类抽象方法,那么该子类只能是抽象类。同样,一个实现接口的时候,如不能全部实现接口方法,那么该类也只能为抽象类。 6、抽象方法只能申明,不能实现。abstract void abc();不能写成abstract void abc(){}。 7、抽象类里可以没有抽象方法 8、如果一个类里有抽象方法,那么这个类只能是抽象类 9、抽象方法要被实现,所以不能是静态的,也不能是私有的。 10、接口可继承接口,并可多继承接口,但类只能单根继承。 继承和聚合的区别在哪。 继承指的是一个类(称为子类、子接口)继承另外的一个类(称为父类、父接口)的功能,并可以增加它自己的新功能的能力,继承是类与类或者接口与接口之间最常见的关系;在Java中此类关系通过关键字extends明确标识,在设计时一般没有争议性; image.png 聚合是关联关系的一种特例,他体现的是整体与部分、拥有的关系,即has-a的关系,此时整体与部分之间是可分离的,他们可以具有各自的生命周期,部分可以属于多个整体对象,也可以为多个整体对象共享;比如计算机与CPU、公司与员工的关系等;表现在代码层面,和关联关系是一致的,只能从语义级别来区分; image.png 参考:http://www.cnblogs.com/jiqing9006/p/5915023.html 讲讲你理解的 nio和 bio 的区别是啥,谈谈 reactor 模型。 IO是面向流的,NIO是面向缓冲区的 参考:https://zhuanlan.zhihu.com/p/23488863http://developer.51cto.com/art/201103/252367.htmhttp://www.jianshu.com/p/3f703d3d804c 反射的原理,反射创建类实例的三种方式是什么 参照:http://www.jianshu.com/p/3ea4a6b57f87?amp http://blog.csdn.net/yongjian1092/article/details/7364451 反射中,Class.forName 和 ClassLoader 区别。 https://my.oschina.net/gpzhang/blog/486743 描述动态代理的几种实现方式,分别说出相应的优缺点。 Jdk cglib jdk底层是利用反射机制,需要基于接口方式,这是由于 Proxy.newProxyInstance(target.getClass().getClassLoader(), target.getClass().getInterfaces(), this); Cglib则是基于asm框架,实现了无反射机制进行代理,利用空间来换取了时间,代理效率高于jdkhttp://lrd.ele.me/2017/01/09/dynamic_proxy/ 动态代理与 cglib 实现的区别 同上(基于invocationHandler和methodInterceptor) 为什么 CGlib 方式可以对接口实现代理。 同上 final 的用途****类、变量、方法 http://www.importnew.com/7553.html 写出三种单例模式实现。 懒汉式单例,饿汉式单例,双重检查等 参考:https://my.oschina.net/dyyweb/blog/609021 如何在父类中为子类自动完成所有的 hashcode 和 equals 实现?这么做有何优劣。 同时复写hashcode和equals方法,优势可以添加自定义逻辑,且不必调用超类的实现。 参照:http://java-min.iteye.com/blog/1416727 请结合 OO 设计理念,谈谈访问修饰符 public、private、protected、default 在应用设计中的作用。 访问修饰符,主要标示修饰块的作用域,方便隔离防护 image.png public: Java语言中访问限制最宽的修饰符,一般称之为“公共的”。被其修饰的类、属性以及方法不 仅可以跨类访问,而且允许跨包(package)访问。 private: Java语言中对访问权限限制的最窄的修饰符,一般称之为“私有的”。被其修饰的类、属性以 及方法只能被该类的对象访问,其子类不能访问,更不能允许跨包访问。 protect: 介于public 和 private 之间的一种访问修饰符,一般称之为“保护形”。被其修饰的类、 属性以及方法只能被类本身的方法及子类访问,即使子类在不同的包中也可以访问。 default:即不加任何访问修饰符,通常称为“默认访问模式“。该模式下,只允许在同一个包中进行访 问。 深拷贝和浅拷贝区别。 http://www.oschina.net/translate/java-copy-shallow-vs-deep-in-which-you-will-swim 数组和链表数据结构描述,各自的时间复杂度 http://blog.csdn.net/snow_wu/article/details/53172721 error 和 exception 的区别,CheckedException,RuntimeException 的区别 http://blog.csdn.net/woshixuye/article/details/8230407 请列出 5 个运行时异常。 同上 在自己的代码中,如果创建一个 java.lang.String 对象,这个对象是否可以被类加载器加载?为什么 类加载无须等到“首次使用该类”时加载,jvm允许预加载某些类。。。。http://www.cnblogs.com/jasonstorm/p/5663864.html 说一说你对 java.lang.Object 对象中 hashCode 和 equals 方法的理解。在什么场景下需要重新实现这两个方法。 参考上边试题 在 jdk1.5 中,引入了泛型,泛型的存在是用来解决什么问题。 泛型的本质是参数化类型,也就是说所操作的数据类型被指定为一个参数,泛型的好处是在编译的时候检查类型安全,并且所有的强制转换都是自动和隐式的,以提高代码的重用率http://baike.baidu.com/item/java%E6%B3%9B%E5%9E%8B 这样的 a.hashcode() 有什么用,与 a.equals(b)有什么关系。 hashcode hashcode()方法提供了对象的hashCode值,是一个native方法,返回的默认值与System.identityHashCode(obj)一致。 通常这个值是对象头部的一部分二进制位组成的数字,具有一定的标识对象的意义存在,但绝不定于地址。 作用是:用一个数字来标识对象。比如在HashMap、HashSet等类似的集合类中,如果用某个对象本身作为Key,即要基于这个对象实现Hash的写入和查找,那么对象本身如何实现这个呢?就是基于hashcode这样一个数字来完成的,只有数字才能完成计算和对比操作。 **hashcode是否唯一 ** hashcode只能说是标识对象,在hash算法中可以将对象相对离散开,这样就可以在查找数据的时候根据这个key快速缩小数据的范围,但hashcode不一定是唯一的,所以hash算法中定位到具体的链表后,需要循环链表,然后通过equals方法来对比Key是否是一样的。 **equals与hashcode的关系 ** equals相等两个对象,则hashcode一定要相等。但是hashcode相等的两个对象不一定equals相等。https://segmentfault.com/a/1190000004520827 有没有可能 2 个不相等的对象有相同的 hashcode。 有 Java 中的 HashSet 内部是如何工作的。 底层是基于hashmap实现的http://wiki.jikexueyuan.com/project/java-collection/hashset.html **什么是序列化,怎么序列化,为什么序列化,反序列化会遇到什么问题,如何解决。 **http://www.importnew.com/17964.html JVM 知识 什么情况****下会发生栈内存溢出。 如果线程请求的栈深度大于虚拟机所允许的深度,将抛出StackOverflowError异常。 如果虚拟机在动态扩展栈时无法申请到足够的内存空间,则抛出OutOfMemoryError异常。 参照:http://wiki.jikexueyuan.com/project/java-vm/storage.html JVM 的内存结构,Eden 和 Survivor 比例。 image eden 和 survior 是按8比1分配的http://blog.csdn.net/lojze_ly/article/details/49456255 jvm 中一次完整的 GC 流程是怎样的,对象如何晋升到老年代,说说你知道的几种主要的jvm 参数。 对象诞生即新生代->eden,在进行minor gc过程中,如果依旧存活,移动到from,变成Survivor,进行标记代数,如此检查一定次数后,晋升为老年代,http://www.cnblogs.com/redcreen/archive/2011/05/04/2037056.htmlhttp://ifeve.com/useful-jvm-flags/https://wangkang007.gitbooks.io/jvm/content/jvmcan_shu_xiang_jie.html 你知道哪几种垃圾收集器,各自的优缺点,重点讲下 cms,包括原理,流程,优缺点 Serial、parNew、ParallelScavenge、SerialOld、ParallelOld、CMS、G1https://wangkang007.gitbooks.io/jvm/content/chapter1.html 垃圾回收算法的实现原理。 http://www.importnew.com/13493.html 当出现了内存溢出,你怎么排错。 首先分析是什么类型的内存溢出,对应的调整参数或者优化代码。https://wangkang007.gitbooks.io/jvm/content/4jvmdiao_you.html JVM 内存模型的相关知识了解多少,比如重排序,内存屏障,happen-before,主内存,工作内存等。 内存屏障:为了保障执行顺序和可见性的一条cpu指令 重排序:为了提高性能,编译器和处理器会对执行进行重拍 happen-before:操作间执行的顺序关系。有些操作先发生。 主内存:共享变量存储的区域即是主内存 工作内存:每个线程copy的本地内存,存储了该线程以读/写共享变量的副本http://ifeve.com/java-memory-model-1/http://www.jianshu.com/p/d3fda02d4caehttp://blog.csdn.net/kenzyq/article/details/50918457 简单说说你了解的类加载器。 类加载器的分类(bootstrap,ext,app,curstom),类加载的流程(load-link-init)http://blog.csdn.net/gjanyanlig/article/details/6818655/ 讲讲 JAVA 的反射机制。 Java程序在运行状态可以动态的获取类的所有属性和方法,并实例化该类,调用方法的功能http://baike.baidu.com/link?url=C7p1PeLa3ploAgkfAOK-4XHE8HzQuOAB7K5GPcK_zpbAa_Aw-nO3997K1oir8N–1_wxXZfOThFrEcA0LjVP6wNOwidVTkLBzKlQVK6JvXYvVNhDWV9yF-NIOebtg1hwsnagsjUhOE2wxmiup20RRa#7 你们线上应用的 JVM 参数有哪些。 -server Xms6000M -Xmx6000M -Xmn500M -XX:PermSize=500M -XX:MaxPermSize=500M -XX:SurvivorRatio=65536 -XX:MaxTenuringThreshold=0 -Xnoclassgc -XX:+DisableExplicitGC -XX:+UseParNewGC -XX:+UseConcMarkSweepGC -XX:+UseCMSCompactAtFullCollection -XX:CMSFullGCsBeforeCompaction=0 -XX:+CMSClassUnloadingEnabled -XX:-CMSParallelRemarkEnabled -XX:CMSInitiatingOccupancyFraction=90 -XX:SoftRefLRUPolicyMSPerMB=0 -XX:+PrintClassHistogram -XX:+PrintGCDetails -XX:+PrintGCTimeStamps -XX:+PrintHeapAtGC -Xloggc:log/gc.log g1 和 cms 区别,吞吐量优先和响应优先的垃圾收集器选择。 Cms是以获取最短回收停顿时间为目标的收集器。基于标记-清除算法实现。比较占用cpu资源,切易造成碎片。 G1是面向服务端的垃圾收集器,是jdk9默认的收集器,基于标记-整理算法实现。可利用多核、多cpu,保留分代,实现可预测停顿,可控。http://blog.csdn.net/linhu007/article/details/48897597 请解释如下 jvm 参数的含义: -server -Xms512m -Xmx512m -Xss1024K -XX:PermSize=256m -XX:MaxPermSize=512m -XX:MaxTenuringThreshold=20 XX:CMSInitiatingOccupancyFraction=80 -XX:+UseCMSInitiatingOccupancyOnly。 Server模式启动 最小堆内存512m 最大512m 每个线程栈空间1m 永久代256 最大永久代256 最大转为老年代检查次数20 Cms回收开启时机:内存占用80% 命令JVM不基于运行时收集的数据来启动CMS垃圾收集周期 开源框架知识 简单讲讲 tomcat 结构,以及其类加载器流程。 Server- –多个service Container级别的:–>engine–》host–>context Listenter Connector Logging、Naming、Session、JMX等等 image 通过WebappClassLoader 加载classhttp://www.ibm.com/developerworks/cn/java/j-lo-tomcat1/http://blog.csdn.net/dc_726/article/details/11873343http://www.cnblogs.com/xing901022/p/4574961.htmlhttp://www.jianshu.com/p/62ec977996df tomcat 如何调优,涉及哪些参数。 硬件上选择,操作系统选择,版本选择,jdk选择,配置jvm参数,配置connector的线程数量,开启gzip压缩,trimSpaces,集群等http://blog.csdn.net/lifetragedy/article/details/7708724 讲讲 Spring 加载流程。 通过listener入口,核心是在AbstractApplicationContext的refresh方法,在此处进行装载bean工厂,bean,创建bean实例,拦截器,后置处理器等。https://www.ibm.com/developerworks/cn/java/j-lo-spring-principle/ 讲讲 Spring 事务的传播属性。 七种传播属性。 事务传播行为 所谓事务的传播行为是指,如果在开始当前事务之前,一个事务上下文已经存在,此时有若干选项可以指定一个事务性方法的执行行为。在TransactionDefinition定义中包括了如下几个表示传播行为的常量: TransactionDefinition.PROPAGATION_REQUIRED:如果当前存在事务,则加入该事务;如果当前没有事务,则创建一个新的事务。 TransactionDefinition.PROPAGATION_REQUIRES_NEW:创建一个新的事务,如果当前存在事务,则把当前事务挂起。 TransactionDefinition.PROPAGATION_SUPPORTS:如果当前存在事务,则加入该事务;如果当前没有事务,则以非事务的方式继续运行。 TransactionDefinition.PROPAGATION_NOT_SUPPORTED:以非事务方式运行,如果当前存在事务,则把当前事务挂起。 TransactionDefinition.PROPAGATION_NEVER:以非事务方式运行,如果当前存在事务,则抛出异常。 TransactionDefinition.PROPAGATION_MANDATORY:如果当前存在事务,则加入该事务;如果当前没有事务,则抛出异常。 TransactionDefinition.PROPAGATION_NESTED:如果当前存在事务,则创建一个事务作为当前事务的嵌套事务来运行;如果当前没有事务,则该取值等价于TransactionDefinition.PROPAGATION_REQUIRED。https://www.ibm.com/developerworks/cn/education/opensource/os-cn-spring-trans/ Spring 如何管理事务的。 编程式和声明式 同上 Spring 怎么配置事务(具体说出一些关键的 xml 元素)。 说说你对 Spring 的理解,非单例注入的原理?它的生命周期?循环注入的原理, aop 的实现原理,说说 aop 中的几个术语,它们是怎么相互工作的。 核心组件:bean,context,core,单例注入是通过单例beanFactory进行创建,生命周期是在创建的时候通过接口实现开启,循环注入是通过后置处理器,aop其实就是通过反射进行动态代理,pointcut,advice等。 Aop相关:http://blog.csdn.net/csh624366188/article/details/7651702/ Springmvc 中 DispatcherServlet 初始化过程。 入口是web.xml中配置的ds,ds继承了HttpServletBean,FrameworkServlet,通过其中的init方法进行初始化装载bean和实例,initServletBean是实际完成上下文工作和bean初始化的方法。http://www.mamicode.com/info-detail-512105.html 操作系统 Linux 系统下你关注过哪些内核参数,说说你知道的。 image.png Tcp/ip io cpu memory net.ipv4.tcp_syncookies = 1 启用syncookies net.ipv4.tcp_max_syn_backlog = 8192 SYN队列长度 net.ipv4.tcp_synack_retries=2 SYN ACK重试次数 net.ipv4.tcp_fin_timeout = 30 主动关闭方FIN-WAIT-2超时时间 net.ipv4.tcp_keepalive_time = 1200 TCP发送keepalive消息的频度 net.ipv4.tcp_tw_reuse = 1 开启TIME-WAIT重用 net.ipv4.tcp_tw_recycle = 1 开启TIME-WAIT快速回收 net.ipv4.ip_local_port_range = 1024 65000 向外连接的端口范围 net.ipv4.tcp_max_tw_buckets = 5000 最大TIME-WAIT数量,超过立即清除 net.ipv4.tcp_syn_retries = 2 SYN重试次数 echo “fs.file-max=65535” >> /etc/sysctl.conf sysctl -p http://www.haiyun.me/category/system/ Linux 下 IO 模型有几种,各自的含义是什么。 阻塞式io,非阻塞io,io复用模型,信号驱动io模型,异步io模型。https://yq.aliyun.com/articles/46404https://yq.aliyun.com/articles/46402 epoll 和 poll 有什么区别。 select的本质是采用32个整数的32位,即3232= 1024来标识,fd值为1-1024。当fd的值超过1024限制时,就必须修改FD_SETSIZE的大小。这个时候就可以标识32max值范围的fd。 对于单进程多线程,每个线程处理多个fd的情况,select是不适合的。 1.所有的线程均是从1-32*max进行扫描,每个线程处理的均是一段fd值,这样做有点浪费 2.1024上限问题,一个处理多个用户的进程,fd值远远大于1024 所以这个时候应该采用poll, poll传递的是数组头指针和该数组的长度,只要数组的长度不是很长,性能还是很不错的,因为poll一次在内核中申请4K(一个页的大小来存放fd),尽量控制在4K以内 epoll还是poll的一种优化,返回后不需要对所有的fd进行遍历,在内核中维持了fd的列表。select和poll是将这个内核列表维持在用户态,然后传递到内核中。但是只有在2.6的内核才支持。 epoll更适合于处理大量的fd ,且活跃fd不是很多的情况,毕竟fd较多还是一个串行的操作https://yq.aliyun.com/articles/10525 平时用到哪些 Linux 命令。 Ls,find,tar,tail,cp,rm,vi,grep,ps,pkill等等https://yq.aliyun.com/articles/69417?spm=5176.100240.searchblog.18.Zrbh9R 用一行命令查看文件的最后五行。 Tail -n 5 filename 用一行命令输出正在运行的 java 进程。 ps -ef|grep Java 介绍下你理解的操作系统中线程切换过程。 控制权的转换,根据优先级切换上下文(用户,寄存器,系统)http://www.cnblogs.com/kkshaq/p/4544426.html 进程和线程的区别。 Linux 实现并没有区分这两个概念(进程和线程) 1. 进程:程序的一次执行 2. 线程:CPU的基本调度单位 一个进程可以包含多个线程。 http://www.ruanyifeng.com/blog/2013/04/processes_and_threads.html 多线程 多线程的几种实现方式,什么是线程安全。 实现runable接口,继承thread类。http://ifeve.com/java-multi-threading-concurrency-interview-questions-with-answers/ volatile 的原理,作用,能代替锁么。 Volatile利用内存栅栏机制来保持变量的一致性。不能代替锁,其只具备数据可见性一致性,不具备原子性。http://blog.csdn.net/gongzi2311/article/details/20715185 画一个线程的生命周期状态图。 新建,可运行,运行中, 睡眠,阻塞,等待,死亡。 image.png http://ifeve.com/thread-status sleep 和 wait 的区别。 Sleep是休眠线程,wait是等待,sleep是thread的静态方法,wait则是object的方法。 Sleep依旧持有锁,并在指定时间自动唤醒。wait则释放锁。http://www.jianshu.com/p/4ec3f4b3903d Lock 与 Synchronized 的区别。 首先两者都保持了并发场景下的原子性和可见性,区别则是synchronized的释放锁机制是交由其自身控制,且互斥性在某些场景下不符合逻辑,无法进行干预,不可人为中断等。 而lock常用的则有ReentrantLock和readwritelock两者,添加了类似锁投票、定时锁等候和可中断锁等候的一些特性。此外,它还提供了在激烈争用情况下更佳的性能。http://blog.csdn.net/vking_wang/article/details/9952063 synchronized 的原理是什么,解释以下名词:重排序,自旋锁,偏向锁,轻量级锁,可重入锁,公平锁,非公平锁,乐观锁,悲观锁。 Synchronized底层是通过监视器的enter和exit实现https://my.oschina.net/cnarthurs/blog/847801http://blog.csdn.net/a314773862/article/details/54095819 用过哪些原子类,他们的原理是什么。 AtomicInteger; AtomicLong; AtomicReference; AtomicBoolean;基于CAS原语实现 ,比较并交换、加载链接/条件存储,最坏的情况下是旋转锁https://www.ibm.com/developerworks/cn/java/j-jtp11234/index.htmlhttp://www.jmatrix.org/java/848.html 用过线程池吗,newCache 和 newFixed 有什么区别,他们的原理简单概括下,构造函数的各个参数的含义是什么,比如 coreSize,maxsize 等 newSingleThreadExecutor返回以个包含单线程的Executor,将多个任务交给此Exector时,这个线程处理完一个任务后接着处理下一个任务,若该线程出现异常,将会有一个新的线程来替代。 newFixedThreadPool返回一个包含指定数目线程的线程池,如果任务数量多于线程数目,那么没有没有执行的任务必须等待,直到有任务完成为止。 newCachedThreadPool根据用户的任务数创建相应的线程来处理,该线程池不会对线程数目加以限制,完全依赖于JVM能创建线程的数量,可能引起内存不足。 底层是基于ThreadPoolExecutor实现,借助reentrantlock保证并发。 coreSize核心线程数,maxsize最大线程数。http://ifeve.com/java-threadpoolexecutor/ 线程池的关闭方式有几种,各自的区别是什么。 Shutdown shutdownNow tryTerminate 清空工作队列,终止线程池中各个线程,销毁线程池http://blog.csdn.net/xxcupid/article/details/51993235 假如有一个第三方接口,有很多个线程去调用获取数据,现在规定每秒钟最多有 10 个线程同时调用它,如何做到。 ScheduledThreadPoolExecutor 设置定时,进行调度。 public ScheduledThreadPoolExecutor(int corePoolSize, ThreadFactory threadFactory) { super(corePoolSize, Integer.MAX_VALUE, 0, TimeUnit.NANOSECONDS, new DelayedWorkQueue(), threadFactory); } http://ifeve.com/java-scheduledthreadpoolexecutor/ spring 的 controller 是单例还是多例,怎么保证并发的安全。 单例 通过单例工厂 DefaultSingletonBeanRegistry实现单例 通过保AsyncTaskExecutor持安全 用三个线程按顺序循环打印 abc 三个字母,比如 abcabcabc。 public static void main(String[] args) { final String str=”abc”; ExecutorService executorService= Executors.newFixedThreadPool(3); executorService.execute(new Runnable() { @Override public void run() { System.out.println(“1”+str); } }); executorService.execute(new Runnable() { @Override public void run() { System.out.println(“2”+str); } }); executorService.execute(new Runnable() { @Override public void run() { System.out.println(“2”+str); } }); } ThreadLocal 用过么,用途是什么,原理是什么,用的时候要注意什么。 Threadlocal底层是通过threadlocalMap进行存储键值 每个ThreadLocal类创建一个Map,然后用线程的ID作为Map的key,实例对象作为Map的value,这样就能达到各个线程的值隔离的效果。 ThreadLocal的作用是提供线程内的局部变量,这种变量在线程的生命周期内起作用,减少同一个线程内多个函数或者组件之间一些公共变量的传递的复杂度。 **谁设置谁负责移除 **http://qifuguang.me/2015/09/02/[Java%E5%B9%B6%E5%8F%91%E5%8C%85%E5%AD%A6%E4%B9%A0%E4%B8%83]%E8%A7%A3%E5%AF%86ThreadLocal/ 如果让你实现一个并发安全的链表,你会怎么做。 Collections.synchronizedList() ConcurrentLinkedQueuehttp://blog.csdn.net/xingjiarong/article/details/48046751 有哪些无锁数据结构,他们实现的原理是什么。 LockFree,CAS 基于jdk提供的原子类原语实现,例如AtomicReferencehttp://blog.csdn.net/b_h_l/article/details/8704480 讲讲 java 同步机制的 wait 和 notify。 首先这两个方法只能在同步代码块中调用,wait会释放掉对象锁,等待notify唤醒。http://blog.csdn.net/ithomer/article/details/7685594 多线程如果线程挂住了怎么办。 根据具体情况(sleep,wait,join等),酌情选择notifyAll,notify进行线程唤醒。http://blog.chinaunix.net/uid-122937-id-215913.html countdowlatch 和 cyclicbarrier 的内部原理和用法,以及相互之间的差别。 CountDownLatch是一个同步辅助类,在完成一组正在其他线程中执行的操作之前,它运行一个或者多个线程一直处于等待状态。 CyclicBarrier要做的事情是,让一组线程到达一个屏障(也可以叫同步点)时被阻塞,直到最后一个线程到达屏障时,屏障才会开门,所有被屏障拦截的线程才会继续运行。 CyclicBarrier初始化的时候,设置一个屏障数。线程调用await()方法的时候,这个线程就会被阻塞,当调用await()的线程数量到达屏障数的时候,主线程就会取消所有被阻塞线程的状态。 前者是递减,不可循环,后者是递加,可循环用 countdowlatch 基于abq cb基于ReentrantLock Conditionhttp://www.jianshu.com/p/a101ae9797e3http://blog.csdn.net/tolcf/article/details/50925145 使用 synchronized 修饰静态方法和非静态方法有什么区别。 对象锁和类锁https://yq.aliyun.com/articles/24226 简述 ConcurrentLinkedQueue LinkedBlockingQueue 的用处和不同之处。 LinkedBlockingQueue 是一个基于单向链表的、范围任意的(其实是有界的)、FIFO 阻塞队列。ConcurrentLinkedQueue是一个基于链接节点的无界线程安全队列,它采用先进先出的规则对节点进行排序,当我们添加一个元素的时候,它会添加到队列的尾部,当我们获取一个元素时,它会返回队列头部的元素。它采用了“wait-free”算法来实现,该算法在Michael & Scott算法上进行了一些修改, Michael & Scott算法的详细信息可以参见参考资料一。http://ifeve.com/concurrentlinkedqueue/http://ifeve.com/juc-linkedblockingqueue/http://blog.csdn.net/xiaohulunb/article/details/38932923 导致线程死锁的原因?怎么解除线程死锁。 死锁问题是多线程特有的问题,它可以被认为是线程间切换消耗系统性能的一种极端情况。在死锁时,线程间相互等待资源,而又不释放自身的资源,导致无穷无尽的等待,其结果是系统任务永远无法执行完成。死锁问题是在多线程开发中应该坚决避免和杜绝的问题。 **一般来说,要出现死锁问题需要满足以下条件: ** 1. 互斥条件:一个资源每次只能被一个线程使用。 2. 请求与保持条件:一个进程因请求资源而阻塞时,对已获得的资源保持不放。 3. 不剥夺条件:进程已获得的资源,在未使用完之前,不能强行剥夺。 4. 循环等待条件:若干进程之间形成一种头尾相接的循环等待资源关系。 只要破坏死锁 4 个必要条件之一中的任何一个,死锁问题就能被解决。https://www.ibm.com/developerworks/cn/java/j-lo-deadlock/ 调非常多个线程(可能是不同机器),相互之间需要等待协,才能完成某种工作,问怎么设计这种协调方案。 此问题的本质是保持顺序执行。可以使用executors TCP 与 HTTP http1.0 和 http1.1 有什么区别。 HTTP 1.0主要有以下几点变化: 请求和相应可以由于多行首部字段构成 响应对象前面添加了一个响应状态行 响应对象不局限于超文本 服务器与客户端之间的连接在每次请求之后都会关闭 实现了Expires等传输内容的缓存控制 内容编码Accept-Encoding、字符集Accept-Charset等协商内容的支持 这时候开始有了请求及返回首部的概念,开始传输不限于文本(其他二进制内容) HTTP 1.1加入了很多重要的性能优化:持久连接、分块编码传输、字节范围请求、增强的缓存机制、传输编码及请求管道。http://imweb.io/topic/554c5879718ba1240cc1dd8a TCP 三次握手和四次挥手的流程,为什么断开连接要 4 次,如果握手只有两次,会出现什么。 第一次握手(SYN=1, seq=x): 客户端发送一个 TCP 的 SYN 标志位置1的包,指明客户端打算连接的服务器的端口,以及初始序号 X,保存在包头的序列号(Sequence Number)字段里。 发送完毕后,客户端进入 SYN_SEND 状态。 第二次握手(SYN=1, ACK=1, seq=y, ACKnum=x+1): 服务器发回确认包(ACK)应答。即 SYN 标志位和 ACK 标志位均为1。服务器端选择自己 ISN 序列号,放到 Seq 域里,同时将确认序号(Acknowledgement Number)设置为客户的 ISN 加1,即X+1。 发送完毕后,服务器端进入 SYN_RCVD 状态。 第三次握手(ACK=1,ACKnum=y+1) 客户端再次发送确认包(ACK),SYN 标志位为0,ACK 标志位为1,并且把服务器发来 ACK 的序号字段+1,放在确定字段中发送给对方,并且在数据段放写ISN的+1 发送完毕后,客户端进入 ESTABLISHED 状态,当服务器端接收到这个包时,也进入 ESTABLISHED 状态,TCP 握手结束。 第一次挥手(FIN=1,seq=x) 假设客户端想要关闭连接,客户端发送一个 FIN 标志位置为1的包,表示自己已经没有数据可以发送了,但是仍然可以接受数据。 发送完毕后,客户端进入 FIN_WAIT_1 状态。 第二次挥手(ACK=1,ACKnum=x+1) 服务器端确认客户端的 FIN 包,发送一个确认包,表明自己接受到了客户端关闭连接的请求,但还没有准备好关闭连接。 发送完毕后,服务器端进入 CLOSE_WAIT 状态,客户端接收到这个确认包之后,进入 FIN_WAIT_2 状态,等待服务器端关闭连接。 第三次挥手(FIN=1,seq=y) 服务器端准备好关闭连接时,向客户端发送结束连接请求,FIN 置为1。 发送完毕后,服务器端进入 LAST_ACK 状态,等待来自客户端的最后一个ACK。 第四次挥手(ACK=1,ACKnum=y+1) 客户端接收到来自服务器端的关闭请求,发送一个确认包,并进入 TIME_WAIT状态,等待可能出现的要求重传的 ACK 包。 服务器端接收到这个确认包之后,关闭连接,进入 CLOSED 状态。 客户端等待了某个固定时间(两个最大段生命周期,2MSL,2 Maximum Segment Lifetime)之后,没有收到服务器端的 ACK ,认为服务器端已经正常关闭连接,于是自己也关闭连接,进入 CLOSED 状态。 两次后会重传直到超时。如果多了会有大量半链接阻塞队列。https://segmentfault.com/a/1190000006885287https://hit-alibaba.github.io/interview/basic/network/TCP.html TIME_WAIT 和 CLOSE_WAIT 的区别。 TIME_WAIT状态就是用来重发可能丢失的ACK报文。 TIME_WAIT 表示主动关闭,CLOSE_WAIT 表示被动关闭。 说说你知道的几种 HTTP 响应码,比如 200, 302, 404。 1xx:信息,请求收到,继续处理 2xx:成功,行为被成功地接受、理解和采纳 3xx:重定向,为了完成请求,必须进一步执行的动作 4xx:客户端错误,请求包含语法错误或者请求无法实现 5xx:服务器错误,服务器不能实现一种明显无效的请求 200 ok 一切正常 302 Moved Temporatily 文件临时移出 404 not foundhttps://my.oschina.net/gavinjin/blog/42856 当你用浏览器打开一个链接的时候,计算机做了哪些工作步骤。 Dns解析–>端口分析–>tcp请求–>服务器处理请求–>服务器响应–>浏览器解析—>链接关闭 TCP/IP 如何保证可靠性,说说 TCP 头的结构。 使用序号,对收到的TCP报文段进行排序以及检测重复的数据;使用校验和来检测报文段的错误;使用确认和计时器来检测和纠正丢包或延时。//TCP头部,总长度20字节 typedef struct _tcp_hdr { unsigned short src_port; //源端口号 unsigned short dst_port; //目的端口号 unsigned int seq_no; //序列号 unsigned int ack_no; //确认号 if LITTLE_ENDIAN unsigned char reserved_1:4; //保留6位中的4位首部长度 unsigned char thl:4; //tcp头部长度 unsigned char flag:6; //6位标志 unsigned char reseverd_2:2; //保留6位中的2位 else unsigned char thl:4; //tcp头部长度 unsigned char reserved_1:4; //保留6位中的4位首部长度 unsigned char reseverd_2:2; //保留6位中的2位 unsigned char flag:6; //6位标志 endif unsigned short wnd_size; //16位窗口大小 unsigned short chk_sum; //16位TCP检验和 unsigned short urgt_p; //16为紧急指针 }tcp_hdr; https://zh.bywiki.com/zh-hans/%E4%BC%A0%E8%BE%93%E6%8E%A7%E5%88%B6%E5%8D%8F%E8%AE%AE 如何避免浏览器缓存。 无法被浏览器缓存的请求: HTTP信息头中包含Cache-Control:no-cache,pragma:no-cache,或Cache-Control:max-age=0等告诉浏览器不用缓存的请求 需要根据Cookie,认证信息等决定输入内容的动态请求是不能被缓存的 经过HTTPS安全加密的请求(有人也经过测试发现,ie其实在头部加入Cache-Control:max-age信息,firefox在头部加入Cache-Control:Public之后,能够对HTTPS的资源进行缓存,参考《HTTPS的七个误解》) POST请求无法被缓存 HTTP响应头中不包含Last-Modified/Etag,也不包含Cache-Control/Expires的请求无法被缓存http://www.alloyteam.com/2012/03/web-cache-2-browser-cache/ 简述 Http 请求 get 和 post 的区别以及数据包格式。 image.png image.png http://www.w3school.com.cn/tags/html_ref_httpmethods.asphttp://www.360doc.com/content/12/0612/14/8093902_217673378.shtml 简述 HTTP 请求的报文格式。 参考上面 HTTPS 的加密方式是什么,讲讲整个加密解密流程。 加密方式是tls/ssl,底层是通过对称算法,非对称,hash算法实现 客户端发起HTTPS请求 –》2. 服务端的配置 –》 3. 传送证书 —》4. 客户端解析证书 5. 传送加密信息 6. 服务段解密信息 7. 传输加密后的信息 8. 客户端解密信息http://www.cnblogs.com/zhuqil/archive/2012/07/23/2604572.html 架构设计与分布式 常见的缓存策略有哪些,你们项目中用到了什么缓存系统,如何设计的。 Cdn缓存,redis缓存,ehcache缓存等 Cdn 图片资源 js等, redis一主一从 echcache缓存数据 用 java 自己实现一个 LRU。 final int cacheSize = 100; Map 分布式集群下如何做到唯一序列号。 Redis生成,mongodb的objectId,zk生成http://www.cnblogs.com/haoxinyue/p/5208136.html 设计一个秒杀系统,30 分钟没付款就自动关闭交易。 分流 – 限流–异步–公平性(只能参加一次)–用户体验(第几位,多少分钟,一抢完) 容错处理 Redis 队列 mysql 30分钟关闭 可以借助redis的发布订阅机制 在失效时进行后续操作,其他mq也可以http://www.infoq.com/cn/articles/yhd-11-11-queuing-system-design 如何使用 redis 和 zookeeper 实现分布式锁?有什么区别优缺点,分别适用什么场景。 首先分布式锁实现常见的有数据库锁(表记录),缓存锁,基于zk(临时有序节点可以实现的)的三种 Redis适用于对性能要求特别高的场景。redis可以每秒执行10w次,内网延迟不超过1ms 缺点是数据存放于内存,宕机后锁丢失。 锁无法释放?使用Zookeeper可以有效的解决锁无法释放的问题,因为在创建锁的时候,客户端会在ZK中创建一个临时节点,一旦客户端获取到锁之后突然挂掉(Session连接断开),那么这个临时节点就会自动删除掉。其他客户端就可以再次获得锁。 非阻塞锁?使用Zookeeper可以实现阻塞的锁,客户端可以通过在ZK中创建顺序节点,并且在节点上绑定监听器,一旦节点有变化,Zookeeper会通知客户端,客户端可以检查自己创建的节点是不是当前所有节点中序号最小的,如果是,那么自己就获取到锁,便可以执行业务逻辑了。 不可重入?使用Zookeeper也可以有效的解决不可重入的问题,客户端在创建节点的时候,把当前客户端的主机信息和线程信息直接写入到节点中,下次想要获取锁的时候和当前最小的节点中的数据比对一下就可以了。如果和自己的信息一样,那么自己直接获取到锁,如果不一样就再创建一个临时的顺序节点,参与排队。 单点问题?使用Zookeeper可以有效的解决单点问题,ZK是集群部署的,只要集群中有半数以上的机器存活,就可以对外提供服务。 http://www.hollischuang.com/archives/1716 如果有人恶意创建非法连接,怎么解决。 可以使用filter过滤处理 分布式事务的原理,优缺点,如何使用分布式事务。 Two Phase commit协议 优点是可以管理多机事务,拥有无线扩展性 确定是易用性难,承担延时风险 JTA,atomiks等https://yq.aliyun.com/webinar/join/185?spm=5176.8067841.0.0.RL4GDa 什么是一致性 hash。 一致性hash是一种分布式hash实现算法。满足平衡性 单调性 分散性 和负载。http://blog.csdn.net/cywosp/article/details/23397179/ 什么是 restful,讲讲你理解的 restful。 REST 指的是一组架构约束条件和原则。满足这些约束条件和原则的应用程序或设计就是 RESTful。http://baike.baidu.com/link?url=fTSAdL-EyYvTp9z7mZsCOdS3kbs4VKKAnpBLg3WS_1Z4cmLMp3S-zrjcy5wakLTO5AIoPTopWVkG-IenloPKxq 如何设计建立和保持 100w 的长连接。 服务器内核调优(tcp,文件数),客户端调优,框架选择(netty) 如何防止缓存雪崩。 缓存雪崩可能是因为数据未加载到缓存中,或者缓存同一时间大面积的失效,从而导致所有请求都去查数据库,导致数据库CPU和内存负载过高,甚至宕机。 **解决思路: ** 1,采用加锁计数,或者使用合理的队列数量来避免缓存失效时对数据库造成太大的压力。这种办法虽然能缓解数据库的压力,但是同时又降低了系统的吞吐量。 2,分析用户行为,尽量让失效时间点均匀分布。避免缓存雪崩的出现。 3,如果是因为某台缓存服务器宕机,可以考虑做主备,比如:redis主备,但是双缓存涉及到更新事务的问题,update可能读到脏数据,需要好好解决。 http://www.cnblogs.com/jinjiangongzuoshi/archive/2016/03/03/5240280.html 解释什么是 MESI 协议(缓存一致性)。 MESI是四种缓存段状态的首字母缩写,任何多核系统中的缓存段都处于这四种状态之一。我将以相反的顺序逐个讲解,因为这个顺序更合理: 失效(Invalid)缓存段,要么已经不在缓存中,要么它的内容已经过时。为了达到缓存的目的,这种状态的段将会被忽略。一旦缓存段被标记为失效,那效果就等同于它从来没被加载到缓存中。共享(Shared)缓存段,它是和主内存内容保持一致的一份拷贝,在这种状态下的缓存段只能被读取,不能被写入。多组缓存可以同时拥有针对同一内存地址的共享缓存段,这就是名称的由来。独占(Exclusive)缓存段,和S状态一样,也是和主内存内容保持一致的一份拷贝。区别在于,如果一个处理器持有了某个E状态的缓存段,那其他处理器就不能同时持有它,所以叫“独占”。这意味着,如果其他处理器原本也持有同一缓存段,那么它会马上变成“失效”状态。已修改(Modified)缓存段,属于脏段,它们已经被所属的处理器修改了。如果一个段处于已修改状态,那么它在其他处理器缓存中的拷贝马上会变成失效状态,这个规律和E状态一样。此外,已修改缓存段如果被丢弃或标记为失效,那么先要把它的内容回写到内存中——这和回写模式下常规的脏段处理方式一样。 说说你知道的几种 HASH 算法,简单的也可以。 哈希(Hash)算法,即散列函数。 它是一种单向密码体制,即它是一个从明文到密文的不可逆的映射,只有加密过程,没有解密过程。 同时,哈希函数可以将任意长度的输入经过变化以后得到固定长度的输出 MD4 MD5 SHAhttp://blog.jobbole.com/106733/ 什么是 paxos 算法。 Paxos算法是莱斯利·兰伯特(Leslie Lamport,就是 LaTeX 中的”La”,此人现在在微软研究院)于1990年提出的一种基于消息传递的一致性算法。 http://baike.baidu.com/item/Paxos%20%E7%AE%97%E6%B3%95 什么是 zab 协议。 ZAB 是 Zookeeper 原子广播协议的简称 整个ZAB协议主要包括消息广播和崩溃恢复两个过程,进一步可以分为三个阶段,分别是: **发现 Discovery 同步 Synchronization 广播 Broadcast ** 组成ZAB协议的每一个分布式进程,都会循环执行这三个阶段,将这样一个循环称为一个主进程周期。https://zzzvvvxxxd.github.io/2016/08/09/ZAB/ 一个在线文档系统,文档可以被编辑,如何防止多人同时对同一份文档进行编辑更新。 点击编辑的时候,利用redis进行加锁setNX完了之后 expire 一下 也可以用版本号进行控制 线上系统突然变得异常缓慢,你如何查找问题。 逐级排查(网络,磁盘,内存,cpu),数据库,日志,中间件等也可通过监控工具排查。 说说你平时用到的设计模式。 单例, 代理,模板,策略,命令http://www.jianshu.com/p/bdf65e4afbb0 Dubbo 的原理,数据怎么流转的,怎么实现集群,负载均衡,服务注册和发现。重试转发,快速失败的策略是怎样的。 Dubbo[]是一个分布式服务框架,致力于提供高性能和透明化的RPC远程服务调用方案,以及SOA服务治理方案。 Cluster 实现集群 在集群负载均衡时,Dubbo提供了多种均衡策略,缺省为random随机调用。 Random LoadBalance:随机,按权重比率设置随机概率。 RoundRobin LoadBalance:轮循,按公约后的权重比率设置轮循比率。 LeastActive LoadBalance:最少活跃调用数,相同活跃数的随机,活跃数指调用前后计数差。使慢的提供者收到更少请求,因为越慢的提供者的调用前后计数差会越大。 ConsistentHash LoadBalance:一致性Hash,相同参数的请求总是发到同一提供者。当某一台提供者挂时,原本发往该提供者的请求,基于虚拟节点,平摊到其它提供者,不会引起剧烈变动。 快速失败,只发起一次调用,失败立即报错。 https://my.oschina.net/u/1378920/blog/693374 一次 RPC 请求的流程是什么。 1)服务消费方(client)调用以本地调用方式调用服务; 2)client stub接收到调用后负责将方法、参数等组装成能够进行网络传输的消息体; 3)client stub找到服务地址,并将消息发送到服务端; 4)server stub收到消息后进行解码; 5)server stub根据解码结果调用本地的服务; 6)本地服务执行并将结果返回给server stub; 7)server stub将返回结果打包成消息并发送至消费方; 8)client stub接收到消息,并进行解码; 9)服务消费方得到最终结果。 异步模式的用途和意义。 异步模式使用与服务器多核,并发严重的场景 可提高服务吞吐量大,不容易受到冲击,可以采用并发策略,提高响应时间 **缓存数据过期后的更新如何设计。 ** 失效:应用程序先从cache取数据,没有得到,则从数据库中取数据,成功后,放到缓存中。 命中:应用程序从cache中取数据,取到后返回。 更新:先把数据存到数据库中,成功后,再让缓存失效。 编程中自己都怎么考虑一些设计原则的,比如开闭原则,以及在工作中的应用。 开闭原则(Open Close Principle) 一个软件实体如类、模块和函数应该对扩展开放,对修改关闭。 里氏代换原则(Liskov Substitution Principle) 子类型必须能够替换掉它们的父类型。 依赖倒转原则(Dependence Inversion Principle) 高层模块不应该依赖低层模块,二者都应该依赖其抽象;抽象不应该依赖细节;细节应该依赖抽象。即针对接口编程,不要针对实现编程 接口隔离原则(Interface Segregation Principle) 建立单一接口,不要建立庞大臃肿的接口,尽量细化接口,接口中的方法尽量少 组合/聚合复用原则 说要尽量的使用合成和聚合,而不是继承关系达到复用的目的 迪米特法则(Law Of Demeter) 迪米特法则其根本思想,是强调了类之间的松耦合,类之间的耦合越弱,越有利于复用,一个处在弱耦合的类被修改,不会对有关系的类造成影响,也就是说,信息的隐藏促进了软件的复用。 单一职责原则(Single Responsibility Principle) 一个类只负责一项职责,应该仅有一个引起它变化的原因http://www.banzg.com/archives/225.html 设计一个社交网站中的“私信”功能,要求高并发、可扩展等等。 画一下架构图。 **MVC 模式,即常见的 MVC 框架。 ** SSM SSH SSI等 聊了下曾经参与设计的服务器架构。应用服务器怎么监控性能,各种方式的区别。如何设计一套高并发支付方案,架构如何设计。如何实现负载均衡,有哪些算法可以实现。Zookeeper 的用途,选举的原理是什么。Mybatis 的底层实现原理。请思考一个方案,设计一个可以控制缓存总体大小的自动适应的本地缓存。请思考一个方案,实现分布式环境下的 countDownLatch。后台系统怎么防止请求重复提交。可以通过token值进行防止重复提交,存放到redis中,在表单初始化的时候隐藏在表单中,添加的时候在移除。判断这个状态即可防止重复提交。 如何看待缓存的使用(本地缓存,集中式缓存),简述本地缓存和集中式缓存和优缺点。本地缓存在并发使用时的注意事项。描述一个服务从发布到被消费的详细过程。讲讲你理解的服务治理。如何做到接口的幂等性。 算法题 10 亿个数字里里面找最小的 10 个。有 1 亿个数字,其中有 2 个是重复的,快速找到它,时间和空间要最优。2 亿个随机生成的无序整数,找出中间大小的值。给一个不知道长度的(可能很大)输入字符串,设计一种方案,将重复的字符排重。遍历二叉树。有 3n+1 个数字,其中 3n 个中是重复的,只有 1 个是不重复的,怎么找出来。写一个字符串反转函数。常用的排序算法,快排,归并、冒泡。 快排的最优时间复杂度,最差复杂度。冒泡排序的优化方案。二分查找的时间复杂度,优势。一个已经构建好的 TreeSet,怎么完成倒排序。什么是 B+树,B-树,列出实际的使用场景。 数据库知识 数据库隔离级别有哪些,各自的含义是什么,MYSQL 默认的隔离级别是是什么。 ·未提交读(Read Uncommitted):允许脏读,也就是可能读取到其他会话中未提交事务修改的数据 ·提交读(Read Committed):只能读取到已经提交的数据。Oracle等多数数据库默认都是该级别 (不重复读) ·可重复读(Repeated Read):可重复读。在同一个事务内的查询都是事务开始时刻一致的,InnoDB默认级别。在SQL标准中,该隔离级别消除了不可重复读,但是还存在幻象读 ·串行读(Serializable):完全串行化的读,每次读都需要获得表级共享锁,读写相互都会阻塞 MYSQL默认是RepeatedRead级别 MYSQL 有哪些存储引擎,各自优缺点。 MyISAM: 拥有较高的插入,查询速度,但不支持事务 InnoDB :5.5版本后Mysql的默认数据库,事务型数据库的首选引擎,支持ACID事务,支持行级锁定 BDB: 源自Berkeley DB,事务型数据库的另一种选择,支持COMMIT和ROLLBACK等其他事务特性 Memory :所有数据置于内存的存储引擎,拥有极高的插入,更新和查询效率。但是会占用和数据量成正比的内存空间。并且其内容会在Mysql重新启动时丢失 Merge :将一定数量的MyISAM表联合而成一个整体,在超大规模数据存储时很有用 Archive :非常适合存储大量的独立的,作为历史记录的数据。因为它们不经常被读取。Archive拥有高效的插入速度,但其对查询的支持相对较差 Federated: 将不同的Mysql服务器联合起来,逻辑上组成一个完整的数据库。非常适合分布式应用 Cluster/NDB :高冗余的存储引擎,用多台数据机器联合提供服务以提高整体性能和安全性。适合数据量大,安全和性能要求高的应用 CSV: 逻辑上由逗号分割数据的存储引擎。它会在数据库子目录里为每个数据表创建一个.CSV文件。这是一种普通文本文件,每个数据行占用一个文本行。CSV存储引擎不支持索引。 BlackHole :黑洞引擎,写入的任何数据都会消失,一般用于记录binlog做复制的中继 另外,Mysql的存储引擎接口定义良好。有兴趣的开发者通过阅读文档编写自己的存储引擎。http://baike.baidu.com/item/%E5%AD%98%E5%82%A8%E5%BC%95%E6%93%8E 高并发下,如何做到安全的修改同一行数据。 使用悲观锁 悲观锁本质是当前只有一个线程执行操作,结束了唤醒其他线程进行处理。 也可以缓存队列中锁定主键。 乐观锁和悲观锁是什么,INNODB 的行级锁有哪 2 种,解释其含义。 乐观锁是设定每次修改都不会冲突,只在提交的时候去检查,悲观锁设定每次修改都会冲突,持有排他锁。 行级锁分为共享锁和排他锁两种 共享锁又称读锁 排他锁又称写锁http://www.jianshu.com/p/f40ec03fd0e8 SQL 优化的一般步骤是什么,怎么看执行计划,如何理解其中各个字段的含义。 查看慢日志(show [session|gobal] status ),定位慢查询,查看慢查询执行计划 根据执行计划确认优化方案 Explain sql select_type:表示select类型。常见的取值有SIMPLE(简单表,即不使用连接或者子查询)、PRIMARY(主查询,即外层的查询)、UNION(union中的第二个或者后面的查询语句)、SUBQUERY(子查询中的第一个SELECT)等。 talbe:输出结果集的表。 type:表的连接类型。性能由高到底:system(表中仅有一行)、const(表中最多有一个匹配行)、eq_ref、ref、ref_null、index_merge、unique_subquery、index_subquery、range、idnex等 possible_keys:查询时,可能使用的索引 key:实际使用的索引 key_len:索引字段的长度 rows:扫描行的数量 Extra:执行情况的说明和描述http://blog.csdn.net/hsd2012/article/details/51106285 数据库会死锁吗,举一个死锁的例子,mysql 怎么解决死锁。 产生死锁的原因主要是: (1)系统资源不足。 (2) 进程运行推进的顺序不合适。 (3)资源分配不当等。 如果系统资源充足,进程的资源请求都能够得到满足,死锁出现的可能性就很低,否则就会因争夺有限的资源而陷入死锁。其次,进程运行推进顺序与速度不同,也可能产生死锁。 产生死锁的四个必要条件: (1) 互斥条件:一个资源每次只能被一个进程使用。 (2) 请求与保持条件:一个进程因请求资源而阻塞时,对已获得的资源保持不放。 (3) 不剥夺条件:进程已获得的资源,在末使用完之前,不能强行剥夺。 (4) 循环等待条件:若干进程之间形成一种头尾相接的循环等待资源关系。 这四个条件是死锁的必要条件,只要系统发生死锁,这些条件必然成立,而只要上述条件之一不满足,就不会发生死锁。这里提供两个解决数据库死锁的方法: 1)重启数据库(谁用谁知道) 2)杀掉抢资源的进程: 先查哪些进程在抢资源:SELECT * FROM INFORMATION_SCHEMA.INNODB_TRX; 杀掉它们:Kill trx_mysql_thread_id; MYsql 的索引原理,索引的类型有哪些,如何创建合理的索引,索引如何优化。 索引是通过复杂的算法,提高数据查询性能的手段。从磁盘io到内存io的转变 普通索引,主键,唯一,单列/多列索引建索引的几大原则 1.最左前缀匹配原则,非常重要的原则,mysql会一直向右匹配直到遇到范围查询(>、<、between、like)就停止匹配,比如a = 1 and b = 2 and c > 3 and d = 4 如果建立(a,b,c,d)顺序的索引,d是用不到索引的,如果建立(a,b,d,c)的索引则都可以用到,a,b,d的顺序可以任意调整。 2.=和in可以乱序,比如a = 1 and b = 2 and c = 3 建立(a,b,c)索引可以任意顺序,mysql的查询优化器会帮你优化成索引可以识别的形式 3.尽量选择区分度高的列作为索引,区分度的公式是count(distinct col)/count(*),表示字段不重复的比例,比例越大我们扫描的记录数越少,唯一键的区分度是1,而一些状态、性别字段可能在大数据面前区分度就是0,那可能有人会问,这个比例有什么经验值吗?使用场景不同,这个值也很难确定,一般需要join的字段我们都要求是0.1以上,即平均1条扫描10条记录 4.索引列不能参与计算,保持列“干净”,比如from_unixtime(create_time) = ’2014-05-29’就不能使用到索引,原因很简单,b+树中存的都是数据表中的字段值,但进行检索时,需要把所有元素都应用函数才能比较,显然成本太大。所以语句应该写成create_time = unix_timestamp(’2014-05-29’); 5.尽量的扩展索引,不要新建索引。比如表中已经有a的索引,现在要加(a,b)的索引,那么只需要修改原来的索引即可 http://tech.meituan.com/mysql-index.htmlhttp://www.cnblogs.com/cq-home/p/3482101.html 聚集索引和非聚集索引的区别。 “聚簇”就是索引和记录紧密在一起。 非聚簇索引 索引文件和数据文件分开存放,索引文件的叶子页只保存了主键值,要定位记录还要去查找相应的数据块。 数据库中 BTREE 和 B+tree 区别。 B+是btree的变种,本质都是btree,btree+与B-Tree相比,B+Tree有以下不同点: 每个节点的指针上限为2d而不是2d+1。 内节点不存储data,只存储key;叶子节点不存储指针。 http://lcbk.net/9602.html **Btree 怎么分裂的,什么时候分裂,为什么是平衡的。 ** Key 超过1024才分裂B树为甚会分裂? 因为随着数据的增多,一个结点的key满了,为了保持B树的特性,就会产生分裂,就向红黑树和AVL树为了保持树的性质需要进行旋转一样! ACID 是什么。 A,atomic,原子性,要么都提交,要么都失败,不能一部分成功,一部分失败。 C,consistent,一致性,事物开始及结束后,数据的一致性约束没有被破坏 I,isolation,隔离性,并发事物间相互不影响,互不干扰。 D,durability,持久性,已经提交的事物对数据库所做的更新必须永久保存。即便发生崩溃,也不能被回滚或数据丢失。 Mysql 怎么优化 table scan 的。 避免在where子句中对字段进行is null判断 应尽量避免在where 子句中使用!=或<>操作符,否则将引擎放弃使用索引而进行全表扫描。 避免在where 子句中使用or 来连接条件 in 和not in 也要慎用 Like查询(非左开头) 使用NUM=@num参数这种 where 子句中对字段进行表达式操作num/2=XX 在where子句中对字段进行函数操作 如何写 sql 能够有效的使用到复合索引。 由于复合索引的组合索引,类似多个木板拼接在一起,如果中间断了就无法用了,所以要能用到复合索引,首先开头(第一列)要用上,比如index(a,b) 这种,我们可以select table tname where a=XX 用到第一列索引 如果想用第二列 可以 and b=XX 或者and b like‘TTT%’ mysql 中 in 和 exists 区别。 mysql中的in语句是把外表和内表作hash 连接,而exists语句是对外表作loop循环,每次loop循环再对内表进行查询。一直大家都认为exists比in语句的效率要高,这种说法其实是不准确的。这个是要区分环境的。 如果查询的两个表大小相当,那么用in和exists差别不大。 如果两个表中一个较小,一个是大表,则子查询表大的用exists,子查询表小的用in: not in 和not exists如果查询语句使用了not in 那么内外表都进行全表扫描,没有用到索引;而not extsts 的子查询依然能用到表上的索引。所以无论那个表大,用not exists都比not in要快。 1.EXISTS只返回TRUE或FALSE,不会返回UNKNOWN。 2.IN当遇到包含NULL的情况,那么就会返回UNKNOWN。 数据库自增主键可能的问题。 在分库分表时可能会生成重复主键 利用自增比例达到唯一 自增1 2,3 等https://yq.aliyun.com/articles/38438 消息队列 用过哪些 MQ,和其他 mq 比较有什么优缺点,MQ 的连接是线程安全的吗,你们公司的MQ 服务架构怎样的。 根据实际情况说明 我们公司用activeMQ 因为业务比较简单 只有转码功能,而amq比较简单 如果是分布式的建议用kafkahttp://blog.csdn.net/sunxinhere/article/details/7968886 MQ 系统的数据如何保证不丢失。 基本都是对数据进行持久化,多盘存储 rabbitmq 如何实现集群高可用。 集群是保证服务可靠性的一种方式,同时可以通过水平扩展以提升消息吞吐能力。RabbitMQ是用分布式程序设计语言erlang开发的,所以天生就支持集群。接下来,将介绍RabbitMQ分布式消息处理方式、集群模式、节点类型,并动手搭建一个高可用集群环境,最后通过java程序来验证集群的高可用性。 三种分布式消息处理方式 RabbitMQ分布式的消息处理方式有以下三种: 1、Clustering:不支持跨网段,各节点需运行同版本的Erlang和RabbitMQ, 应用于同网段局域网。 2、Federation:允许单台服务器上的Exchange或Queue接收发布到另一台服务器上Exchange或Queue的消息, 应用于广域网,。 3、Shovel:与Federation类似,但工作在更低层次。 RabbitMQ对网络延迟很敏感,在LAN环境建议使用clustering方式;在WAN环境中,则使用Federation或Shovel。我们平时说的RabbitMQ集群,说的就是clustering方式,它是RabbitMQ内嵌的一种消息处理方式,而Federation或Shovel则是以plugin形式存在。https://my.oschina.net/jiaoyanli/blog/822011https://www.ibm.com/developerworks/cn/opensource/os-cn-RabbitMQ/ Redis,Memcached redis 的 list 结构相关的操作。 LPUSH LPUSHX RPUSH RPUSHX LPOP RPOP BLPOP BRPOP LLEN LRANGEhttps://redis.readthedocs.io/en/2.4/list.html Redis 的数据结构都有哪些。 字符串(strings):存储整数(比如计数器)和字符串(废话。。),有些公司也用来存储json/pb等序列化数据,并不推荐,浪费内存 哈希表(hashes):存储配置,对象(比如用户、商品),优点是可以存取部分key,对于经常变化的或者部分key要求atom操作的适合 列表(lists):可以用来存最新用户动态,时间轴,优点是有序,确定是元素可重复,不去重 集合(sets):无序,唯一,对于要求严格唯一性的可以使用 有序集合(sorted sets):集合的有序版,很好用,对于排名之类的复杂场景可以考虑https://redis.readthedocs.io/en/2.4/list.html Redis 的使用要注意什么,讲讲持久化方式,内存设置,集群的应用和优劣势,淘汰策略等。 持久化方式:RDB时间点快照 AOF记录服务器执行的所有写操作命令,并在服务器启动时,通过重新执行这些命令来还原数据集。 内存设置 maxmemory used_memory 虚拟内存: vm-enabled yes **3.0采用Cluster方式, ** Redis集群相对单机在功能上存在一些限制, 需要开发人员提前了解, 在使用时做好规避。 限制如下: 1) key批量操作支持有限。 如mset、 mget, 目前只支持具有相同slot值的 ke y执 行批量操作。 对于映射为不同slot值的key由于执行mget、 mget等操作可 能存在于多个节点上因此不被支持。 2) key事务操作支持有限。 同理只支持多key在同一节点上的事务操 作, 当多个key分布在不同的节点上时无法使用事务功能。 3) key作为数据分区的最小粒度, 因此不能将一个大的键值对象如 ha sh、 list等映射到不同的节点。 4) 不支持多数据库空间。 单机下的Redis可以支持16个数据库, 集群模 式下只能使用一个数据库空间, 即db0。 5) 复制结构只支持一层, 从节点只能复制主节点, 不支持嵌套树状复 制结构。 Redis Cluster是Redis的分布式解决方案, 在3.0版本正式推出, 有效地解 决了Redis分布式方面的需求。 当遇到单机内存、 并发、 流量等瓶颈时, 可 以采用Cluster架构方案达到负载均衡的目的。 之前, ** Redis分布式方案一般 有两种: ** ·客户端分区方案, 优点是分区逻辑可控, 缺点是需要自己处理数据路 由、 高可用、 故障转移等问题。 ·代理方案, 优点是简化客户端分布式逻辑和升级维护便利, 缺点是加 重架构部署复杂度和性能损耗。 现在官方为我们提供了专有的集群方案: Redis Cluster, 它非常优雅地 解决了Redis集群方面的问题, 因此理解应用好Redis Cluster将极大地解放我 们使用分布式Redis的工作量, 同时它也是学习分布式存储的绝佳案例。 LRU(近期最少使用算法)TTL(超时算法) 去除ttl最大的键值http://wiki.jikexueyuan.com/project/redis/data-elimination-mechanism.htmlhttp://www.infoq.com/cn/articles/tq-redis-memory-usage-optimization-storagehttp://www.redis.cn/topics/cluster-tutorial.html redis2 和 redis3 的区别,redis3 内部通讯机制。 集群方式的区别,3采用Cluster,2采用客户端分区方案和代理方案 通信过程说明: 1) 集群中的每个节点都会单独开辟一个TCP通道, 用于节点之间彼此 通信, 通信端口号在基础端口上加10000。 2) 每个节点在固定周期内通过特定规则选择几个节点发送ping消息。 3) 接收到ping消息的节点用pong消息作为响应。 当前 redis 集群有哪些玩法,各自优缺点,场景。 当缓存使用 持久化使用 Memcache 的原理,哪些数据适合放在缓存中。 基于libevent的事件处理 内置内存存储方式SLab Allocation机制 并不单一的数据删除机制 基于客户端的分布式系统 变化频繁,具有不稳定性的数据,不需要实时入库, (比如用户在线 状态、在线人数..) 门户网站的新闻等,觉得页面静态化仍不能满足要求,可以放入 到memcache中.(配合jquey的ajax请求) redis 和 memcached 的内存管理的区别。 Memcached默认使用Slab Allocation机制管理内存,其主要思想是按照预先规定的大小,将分配的内存分割成特定长度的块以存储相应长度的key-value数据记录,以完全解决内存碎片问题。 Redis的内存管理主要通过源码中zmalloc.h和zmalloc.c两个文件来实现的。 在Redis中,并不是所有的数据都一直存储在内存中的。这是和Memcached相比一个最大的区别。http://lib.csdn.net/article/redis/55323 Redis 的并发竞争问题如何解决,了解 Redis 事务的 CAS 操作吗。 Redis为单进程单线程模式,采用队列模式将并发访问变为串行访问。Redis本身没有锁的概念,Redis对于多个客户端连接并不存在竞争,但是在Jedis客户端对Redis进行并发访问时会发生连接超时、数据转换错误、阻塞、客户端关闭连接等问题,这些问题均是由于客户端连接混乱造成。对此有2种解决方法: 1.客户端角度,为保证每个客户端间正常有序与Redis进行通信,对连接进行池化,同时对客户端读写Redis操作采用内部锁synchronized。 2.服务器角度,利用setnx实现锁。 MULTI,EXEC,DISCARD,WATCH 四个命令是 Redis 事务的四个基础命令。其中: MULTI,告诉 Redis 服务器开启一个事务。注意,只是开启,而不是执行 EXEC,告诉 Redis 开始执行事务 DISCARD,告诉 Redis 取消事务 WATCH,监视某一个键值对,它的作用是在事务执行之前如果监视的键值被修改,事务会被取消。 可以利用watch实现cas乐观锁http://wiki.jikexueyuan.com/project/redis/transaction-mechanism.htmlhttp://www.jianshu.com/p/d777eb9f27df Redis 的选举算法和流程是怎样的 Raft采用心跳机制触发Leader选举。系统启动后,全部节点初始化为Follower,term为0.节点如果收到了RequestVote或者AppendEntries,就会保持自己的Follower身份。如果一段时间内没收到AppendEntries消息直到选举超时,说明在该节点的超时时间内还没发现Leader,Follower就会转换成Candidate,自己开始竞选Leader。一旦转化为Candidate,该节点立即开始下面几件事情: 1、增加自己的term。 2、启动一个新的定时器。 3、给自己投一票。 4、向所有其他节点发送RequestVote,并等待其他节点的回复。 如果在这过程中收到了其他节点发送的AppendEntries,就说明已经有Leader产生,自己就转换成Follower,选举结束。 如果在计时器超时前,节点收到多数节点的同意投票,就转换成Leader。同时向所有其他节点发送AppendEntries,告知自己成为了Leader。 每个节点在一个term内只能投一票,采取先到先得的策略,Candidate前面说到已经投给了自己,Follower会投给第一个收到RequestVote的节点。每个Follower有一个计时器,在计时器超时时仍然没有接受到来自Leader的心跳RPC, 则自己转换为Candidate, 开始请求投票,就是上面的的竞选Leader步骤。 如果多个Candidate发起投票,每个Candidate都没拿到多数的投票(Split Vote),那么就会等到计时器超时后重新成为Candidate,重复前面竞选Leader步骤。 Raft协议的定时器采取随机超时时间,这是选举Leader的关键。每个节点定时器的超时时间随机设置,随机选取配置时间的1倍到2倍之间。由于随机配置,所以各个Follower同时转成Candidate的时间一般不一样,在同一个term内,先转为Candidate的节点会先发起投票,从而获得多数票。多个节点同时转换为Candidate的可能性很小。即使几个Candidate同时发起投票,在该term内有几个节点获得一样高的票数,只是这个term无法选出Leader。由于各个节点定时器的超时时间随机生成,那么最先进入下一个term的节点,将更有机会成为Leader。连续多次发生在一个term内节点获得一样高票数在理论上几率很小,实际上可以认为完全不可能发生。一般1-2个term类,Leader就会被选出来。 Sentinel的选举流程 Sentinel集群正常运行的时候每个节点epoch相同,当需要故障转移的时候会在集群中选出Leader执行故障转移操作。Sentinel采用了Raft协议实现了Sentinel间选举Leader的算法,不过也不完全跟论文描述的步骤一致。Sentinel集群运行过程中故障转移完成,所有Sentinel又会恢复平等。Leader仅仅是故障转移操作出现的角色。 选举流程 1、某个Sentinel认定master客观下线的节点后,该Sentinel会先看看自己有没有投过票,如果自己已经投过票给其他Sentinel了,在2倍故障转移的超时时间自己就不会成为Leader。相当于它是一个Follower。 2、如果该Sentinel还没投过票,那么它就成为Candidate。 3、和Raft协议描述的一样,成为Candidate,Sentinel需要完成几件事情 1)更新故障转移状态为start 2)当前epoch加1,相当于进入一个新term,在Sentinel中epoch就是Raft协议中的term。 3)更新自己的超时时间为当前时间随机加上一段时间,随机时间为1s内的随机毫秒数。 4)向其他节点发送is-master-down-by-addr命令请求投票。命令会带上自己的epoch。 5)给自己投一票,在Sentinel中,投票的方式是把自己master结构体里的leader和leader_epoch改成投给的Sentinel和它的epoch。 4、其他Sentinel会收到Candidate的is-master-down-by-addr命令。如果Sentinel当前epoch和Candidate传给他的epoch一样,说明他已经把自己master结构体里的leader和leader_epoch改成其他Candidate,相当于把票投给了其他Candidate。投过票给别的Sentinel后,在当前epoch内自己就只能成为Follower。 5、Candidate会不断的统计自己的票数,直到他发现认同他成为Leader的票数超过一半而且超过它配置的quorum(quorum可以参考《redis sentinel设计与实现》)。Sentinel比Raft协议增加了quorum,这样一个Sentinel能否当选Leader还取决于它配置的quorum。 6、如果在一个选举时间内,Candidate没有获得超过一半且超过它配置的quorum的票数,自己的这次选举就失败了。 7、如果在一个epoch内,没有一个Candidate获得更多的票数。那么等待超过2倍故障转移的超时时间后,Candidate增加epoch重新投票。 8、如果某个Candidate获得超过一半且超过它配置的quorum的票数,那么它就成为了Leader。 9、与Raft协议不同,Leader并不会把自己成为Leader的消息发给其他Sentinel。其他Sentinel等待Leader从slave选出master后,检测到新的master正常工作后,就会去掉客观下线的标识,从而不需要进入故障转移流程。http://weizijun.cn/2015/04/30/Raft%E5%8D%8F%E8%AE%AE%E5%AE%9E%E6%88%98%E4%B9%8BRedis%20Sentinel%E7%9A%84%E9%80%89%E4%B8%BELeader%E6%BA%90%E7%A0%81%E8%A7%A3%E6%9E%90/ redis 的持久化的机制,aof 和 rdb 的区别。 RDB 定时快照方式(snapshot): 定时备份,可能会丢失数据 AOF 基于语句追加方式 只追加写操作 AOF 持久化和 RDB 持久化的最主要区别在于,前者记录了数据的变更,而后者是保存了数据本身 redis 的集群怎么同步的数据的。 redis replication redis-migrate-tool等方式 搜索 elasticsearch 了解多少,说说你们公司 es 的集群架构,索引数据大小,分片有多少,以及一些调优手段。elasticsearch 的倒排索引是什么。 ElasticSearch(简称ES)是一个分布式、Restful的搜索及分析服务器,设计用于分布式计算;能够达到实时搜索,稳定,可靠,快速。和Apache Solr一样,它也是基于Lucence的索引服务器,而ElasticSearch对比Solr的优点在于: 轻量级:安装启动方便,下载文件之后一条命令就可以启动。 Schema free:可以向服务器提交任意结构的JSON对象,Solr中使用schema.xml指定了索引结构。 多索引文件支持:使用不同的index参数就能创建另一个索引文件,Solr中需要另行配置。 分布式:Solr Cloud的配置比较复杂 倒排索引是实现“单词-文档矩阵”的一种具体存储形式,通过倒排索引,可以根据单词快速获取包含这个单词的文档列表。倒排索引主要由两个部分组成:“单词词典”和“倒排文件”。 elasticsearch 索引数据多了怎么办,如何调优,部署。 使用bulk API 初次索引的时候,把 replica 设置为 0 增大 threadpool.index.queue_size 增大 indices.memory.index_buffer_size 增大 index.translog.flush_threshold_ops 增大 index.translog.sync_interval 增大 index.engine.robin.refresh_intervalhttp://www.jianshu.com/p/5eeeeb4375d4 lucence 内部结构是什么 索引(Index): 在Lucene中一个索引是放在一个文件夹中的。 如上图,同一文件夹中的所有的文件构成一个Lucene索引。段(Segment): 一个索引可以包含多个段,段与段之间是独立的,添加新文档可以生成新的段,不同的段可以合并。 如上图,具有相同前缀文件的属同一个段,图中共三个段 “_0” 和 “_1”和“_2”。 segments.gen和segments_X是段的元数据文件,也即它们保存了段的属性信息。文档(Document): 文档是我们建索引的基本单位,不同的文档是保存在不同的段中的,一个段可以包含多篇文档。 新添加的文档是单独保存在一个新生成的段中,随着段的合并,不同的文档合并到同一个段中。域(Field): 一篇文档包含不同类型的信息,可以分开索引,比如标题,时间,正文,作者等,都可以保存在不同的域里。 不同域的索引方式可以不同,在真正解析域的存储的时候,我们会详细解读。词(Term): 词是索引的最小单位,是经过词法分析和语言处理后的字符串。

优秀的个人博客,低调大师

java面试- 深入理解JVM(七)——Class文件结构

什么是JVM的“无关性”? Java具有平台无关性,也就是任何操作系统都能运行Java代码。之所以能实现这一点,是因为Java运行在虚拟机之上,不同的操作系统都拥有各自的Java虚拟机,因此Java能实现“一次编写,处处运行”。 而JVM不仅具有平台无关性,还具有语言无关性。平台无关性是指不同操作系统都有各自的JVM,而语言无关性是指Java虚拟机能运行除Java以外的代码! 这听起来非常惊人,但JVM对能运行的语言是有严格要求的。首先来了解下Java代码的运行过程。 Java源代码首先需要使用Javac编译器编译成class文件,然后启动JVM执行class文件,从而程序开始运行。也就是JVM只认识class文件,它并不管何种语言生成了class文件,只要class文件符合JVM的规范就能运行。因此目前已经有Scala、JRuby、Jython等语言能够在JVM上运行。它们有各自的语法规则,不过它们的编译器都能将各自的源码编译成符合JVM规范的class文件,从而能够借助JVM运行它们。 纵观Class文件结构 class文件是二进制文件,它的内容具有严格的规范,文件中没有任何空格,全是连续的0/1。class文件中的所有内容被分为两种类型:无符号数 和 表。- 无符号数它表示class文件中的值,这些值没有任何类型,但有不同的长度。根据这些值长度的不同分为:u1、u2、u4、u8,分别代表1字节的无符号数、2字节的无符号数、4字节的无符号数、8字节的无符号数。- 表class文件中所有数据(即无符号数)要么单独存在,要么由多个无符号数组成二维表。即class文件中的数据要么是单个值,要么是二维表。 class文件的组织结构 魔数 本文件的版本信息 常量池 访问标志 类索引 父类索引 接口索引集合 字段表集合 方法表集合 Class文件的构成1:魔数 class文件的头4个字节称为魔数,用来表示这个class文件的类型。 魔数的作用就相当于文件后缀名,只不过后缀名容易被修改,不安全,因此在class文件中标示文件类型比较合适。 class文件的魔数是用16进制表示的“CAFEBABE”,非常具有浪漫主义色彩,谁说程序员的情商都很低! Class文件的构成2:版本信息 紧接着魔数的4个字节是版本号。它表示本class中使用的是哪个版本的JDK。 在高版本的JVM上能够运行低版本的class文件,但在低版本的JVM上无法运行高版本的class文件,即使该class文件中没有用到任何高版本JDK的特性也无法运行! Class文件的构成3:常量池 1. 什么是常量池? 紧接着版本号之后的就是常量池。常量池中存放两种类型的常量: 字面值常量字面值常量即我们在程序中定义的字符串、被final修饰的值。 符号引用符号引用就是我们定义的各种名字: 类和接口的全限定名 字段的名字 和 描述符 方法的名字 和 描述符 2. 常量池的特点 常量池长度不固定常量池的大小是不固定的,因此常量池开头放置一个u2类型的无符号数,用来存储当前常量池的容量。JVM根据这个值就知道常量池的头尾来。注:这个值是从1开始的,若为5表示池中有4个常量。 常量池中的常量由而为表来表示常量池开头有个常量池容量计数器,接下来就全是一个个常量了,只不过常量都是由一张张二维表构成,除了记录常量的值以外,还记录当前常量的相关信息。 常量池是class文件的资源仓库 常量池是与本class中其它部分关联最多的部分 常量池是class文件中空间占用最大的部分之一 3. 常量池中常量的类型 刚才介绍了,常量池中的常量大体上分为:字面值常量 和 符号引用。在此基础上,根据常量的数据类型不同,又可以被细分为14种常量类型。这14种常量类型都有各自的二维表示结构。每种常量类型的头1个字节都是tag,用于表示当前常量属于14种类型中的哪一个。 以CONSTANT_Class_info常量为例,它的二维表示结构如下:CONSTANT_Class_info表: 类型 名称 数量 u1 tag 1 u2 name_index 1 tag表示当前常量的类型(当前常量为CONSTANT_Class_info,因此tag的值应为7,表示一个类或接口的全限定名);name_index表示这个类或接口全限定名的位置。它的值表示指向常量池的第几个常量。它会指向一个CONSTANT_Utf8_info类型的常量,它的二维表结构如下:CONSTANT_Utf8_info表: 类型 名称 数量 u1 tag 1 u2 length 1 u1 bytes length CONSTANT_Utf8_info表示字符串常量;tag表示当前常量的类型,这里应该是1;length表示这个字符串的长度;bytes为这个字符串的内容(采用缩略的UTF8编码) 问:为什么Java中定义的类、变量名字必须小于64K?类、接口、变量等名字都属于符号引用,它们都存储在常量池中。而不管哪种符号引用,它们的名字都由CONSTANT_Utf8_info类型的常量表示,这种类型的常量使用u2存储字符串的长度。由于2字节最多能表示65535个数,因此这些名字的最大长度最多只能是64K。 问:什么是UTF-8编码?什么是缩略UTF-8编码?前者每个字符使用3个字节表示,而后者把128个ASKII码用1字节表示,某些字符用2字节表示,某些字符用3字节表示。 Class文件的构成4:访问标志 在常量池之后是2字节的访问标志。访问标志是用来表示这个class文件是类还是接口、是否被public修饰、是否被abstract修饰、是否被final修饰等。由于这些标志都由是/否表示,因此可以用0/1表示。访问标志为2字节,可以表示16位标志,但JVM目前只定义了8种,未定义的直接写0. Class文件的构成5:类索引、父类索引、接口索引集合 类索引、父类索引、接口索引集合是用来表示当前class文件所表示类的名字、父类名字、接口们的名字。它们按照顺序依次排列,类索引和父类索引各自使用一个u2类型的无符号常量,这个常量指向CONSTANT_Class_info类型的常量,该常量的bytes字段记录了本类、父类的全限定名。由于一个类的接口可能有好多个,因此需要用一个集合来表示接口索引,它在类索引和父类索引之后。这个集合头两个字节表示接口索引集合的长度,接下来就是接口的名字索引。 Class文件的构成6:字段表的集合 1. 什么是字段表集合? 接下来是字段表的集合。字段表集合用于存储本类所涉及到的成员变量,包括实例变量和类变量,但不包括方法中的局部变量。每一个字段表只表示一个成员变量,本类中所有的成员变量构成了字段表集合。 2. 字段表结构的定义 类型 名称 数量 u2 access_flags 1 u2 name_index 1 u2 descriptor_index 1 u2 attributes_count 1 attribute_info attributes attributes_count access_flags字段的访问标志。在Java中,每个成员变量都有一系列的修饰符,和上述class文件的访问标志的作用一样,只不过成员变量的访问标志与类的访问标志稍有区别。 name_index本字段名字的索引。指向一个CONSTANT_Class_info类型的常量,这里面存储了本字段的名字等信息。 descriptor_index描述符。用于描述本字段在Java中的数据类型等信息(下面详细介绍) attributes_count属性表集合的长度。 attributes属性表集合。到descriptor_index为止是字段表的固定信息,光有上述信息可能无法完整地描述一个字段,因此用属性表集合来存放额外的信息,比如一个字段的值。(下面会详细介绍) 3. 什么是描述符? 成员变量(包括静态成员变量和实例变量) 和 方法都有各自的描述符。对于字段而言,描述符用于描述字段的数据类型;对于方法而言,描述符用于描述字段的数据类型、参数列表、返回值。 在描述符中,基本数据类型用大写字母表示,对象类型用“L对象类型的全限定名”表示,数组用“[数组类型的全限定名”表示。描述方法时,将参数根据上述规则放在()中,()右侧按照上述方法放置返回值。而且,参数之间无需任何符号。 4. 字段表集合的注意点 一个class文件的字段表集合中不能出现从父类/接口继承而来字段; 一个class文件的字段表集合中可能会出现程序猿没有定义的字段如编译器会自动地在内部类的class文件的字段表集合中添加外部类对象的成员变量,供内部类访问外部类。 Java中只要两个字段名字相同就无法通过编译。但在JVM规范中,允许两个字段的名字相同但描述符不同的情况,并且认为它们是两个不同的字段。 Class文件的构成7:方法表的集合 在class文件中,所有的方法以二维表的形式存储,每张表来表示一个函数,一个类中的所有方法构成方法表的集合。方法表的结构和字段表的结构一致,只不过访问标志和属性表集合的可选项有所不同。 类型 名称 数量 u2 access_flags 1 u2 name_index 1 u2 descriptor_index 1 u2 attributes_count 1 attribute_info attributes attributes_count 方法表的属性表集合中有一张Code属性表,用于存储当前方法经编译器编译过后的字节码指令。 方法表集合的注意点 如果本class没有重写父类的方法,那么本class文件的方法表集合中是不会出现父类/父接口的方法表; 本class的方法表集合可能出现程序猿没有定义的方法编译器在编译时会在class文件的方法表集合中加入类构造器和实例构造器。 重载一个方法需要有相同的简单名称和不同的特征签名。JVM的特征签名和Java的特征签名有所不同: Java特征签名:方法参数在常量池中的字段符号引用的集合 JVM特征签名:方法参数+返回值 Class文件的构成8:属性表的集合

优秀的个人博客,低调大师

java面试-深入理解JVM(一)——JVM内存模型

JVM内存模型 Java虚拟机(Java Virtual Machine=JVM)的内存空间分为五个部分,分别是:1. 程序计数器2. Java虚拟机栈3. 本地方法栈4. 堆5. 方法区。 下面对这五个区域展开深入的介绍。 1. 程序计数器 1.1. 什么是程序计数器? 程序计数器是一块较小的内存空间,可以把它看作当前线程正在执行的字节码的行号指示器。也就是说,程序计数器里面记录的是当前线程正在执行的那一条字节码指令的地址。注:但是,如果当前线程正在执行的是一个本地方法,那么此时程序计数器为空。 1.2. 程序计数器的作用 程序计数器有两个作用: 字节码解释器通过改变程序计数器来依次读取指令,从而实现代码的流程控制,如:顺序执行、选择、循环、异常处理。 在多线程的情况下,程序计数器用于记录当前线程执行的位置,从而当线程被切换回来的时候能够知道该线程上次运行到哪儿了。 1.3. 程序计数器的特点 是一块较小的存储空间 线程私有。每条线程都有一个程序计数器。 是唯一一个不会出现OutOfMemoryError的内存区域。 生命周期随着线程的创建而创建,随着线程的结束而死亡。 2. Java虚拟机栈(JVM Stack) 2.1. 什么是Java虚拟机栈? Java虚拟机栈是描述Java方法运行过程的内存模型。Java虚拟机栈会为每一个即将运行的Java方法创建一块叫做“栈帧”的区域,这块区域用于存储该方法在运行过程中所需要的一些信息,这些信息包括: 局部变量表存放基本数据类型变量、引用类型的变量、returnAddress类型的变量。 操作数栈 动态链接 方法出口信息 等 当一个方法即将被运行时,Java虚拟机栈首先会在Java虚拟机栈中为该方法创建一块“栈帧”,栈帧中包含局部变量表、操作数栈、动态链接、方法出口信息等。当方法在运行过程中需要创建局部变量时,就将局部变量的值存入栈帧的局部变量表中。当这个方法执行完毕后,这个方法所对应的栈帧将会出栈,并释放内存空间。 注意:人们常说,Java的内存空间分为“栈”和“堆”,栈中存放局部变量,堆中存放对象。这句话不完全正确!这里的“堆”可以这么理解,但这里的“栈”只代表了Java虚拟机栈中的局部变量表部分。真正的Java虚拟机栈是由一个个栈帧组成,而每个栈帧中都拥有:局部变量表、操作数栈、动态链接、方法出口信息。 2.2. Java虚拟机栈的特点 局部变量表的创建是在方法被执行的时候,随着栈帧的创建而创建。而且,局部变量表的大小在编译时期就确定下来了,在创建的时候只需分配事先规定好的大小即可。此外,在方法运行的过程中局部变量表的大小是不会发生改变的。 Java虚拟机栈会出现两种异常:StackOverFlowError和OutOfMemoryError。a) StackOverFlowError:若Java虚拟机栈的内存大小不允许动态扩展,那么当线程请求栈的深度超过当前Java虚拟机栈的最大深度的时候,就抛出StackOverFlowError异常。b) OutOfMemoryError:若Java虚拟机栈的内存大小允许动态扩展,且当线程请求栈时内存用完了,无法再动态扩展了,此时抛出OutOfMemoryError异常。 Java虚拟机栈也是线程私有的,每个线程都有各自的Java虚拟机栈,而且随着线程的创建而创建,随着线程的死亡而死亡。 注:StackOverFlowError和OutOfMemoryError的异同?StackOverFlowError表示当前线程申请的栈超过了事先定好的栈的最大深度,但内存空间可能还有很多。而OutOfMemoryError是指当线程申请栈时发现栈已经满了,而且内存也全都用光了。 3. 本地方法栈 3.1. 什么是本地方法栈? 本地方法栈和Java虚拟机栈实现的功能类似,只不过本地方法区是本地方法运行的内存模型。 本地方法被执行的时候,在本地方法栈也会创建一个栈帧,用于存放该本地方法的局部变量表、操作数栈、动态链接、出口信息。 方法执行完毕后相应的栈帧也会出栈并释放内存空间。 也会抛出StackOverFlowError和OutOfMemoryError异常。 4. 堆 4.1. 什么是堆? 堆是用来存放对象的内存空间。几乎所有的对象都存储在堆中。 4.2. 堆的特点 线程共享整个Java虚拟机只有一个堆,所有的线程都访问同一个堆。而程序计数器、Java虚拟机栈、本地方法栈都是一个线程对应一个的。 在虚拟机启动时创建 垃圾回收的主要场所。 可以进一步细分为:新生代、老年代。新生代又可被分为:Eden、From Survior、To Survior。不同的区域存放具有不同生命周期的对象。这样可以根据不同的区域使用不同的垃圾回收算法,从而更具有针对性,从而更高效。 堆的大小既可以固定也可以扩展,但主流的虚拟机堆的大小是可扩展的,因此当线程请求分配内存,但堆已满,且内存已满无法再扩展时,就抛出OutOfMemoryError。 5. 方法区 5.1. 什么是方法区? Java虚拟机规范中定义方法区是堆的一个逻辑部分。方法区中存放已经被虚拟机加载的类信息、常量、静态变量、即时编译器编译后的代码等。 5.2. 方法区的特点 线程共享方法区是堆的一个逻辑部分,因此和堆一样,都是线程共享的。整个虚拟机中只有一个方法区。 永久代方法区中的信息一般需要长期存在,而且它又是堆的逻辑分区,因此用堆的划分方法,我们把方法区称为老年代。 内存回收效率低方法区中的信息一般需要长期存在,回收一遍内存之后可能只有少量信息无效。对方法区的内存回收的主要目标是:对常量池的回收 和 对类型的卸载。 Java虚拟机规范对方法区的要求比较宽松。和堆一样,允许固定大小,也允许可扩展的大小,还允许不实现垃圾回收。 5.3. 什么是运行时常量池? 方法区中存放三种数据:类信息、常量、静态变量、即时编译器编译后的代码。其中常量存储在运行时常量池中。 我们一般在一个类中通过public static final来声明一个常量。这个类被编译后便生成Class文件,这个类的所有信息都存储在这个class文件中。 当这个类被Java虚拟机加载后,class文件中的常量就存放在方法区的运行时常量池中。而且在运行期间,可以向常量池中添加新的常量。如:String类的intern()方法就能在运行期间向常量池中添加字符串常量。 当运行时常量池中的某些常量没有被对象引用,同时也没有被变量引用,那么就需要垃圾收集器回收。 6. 直接内存 直接内存是除Java虚拟机之外的内存,但也有可能被Java使用。 在NIO中引入了一种基于通道和缓冲的IO方式。它可以通过调用本地方法直接分配Java虚拟机之外的内存,然后通过一个存储在Java堆中的DirectByteBuffer对象直接操作该内存,而无需先将外面内存中的数据复制到堆中再操作,从而提升了数据操作的效率。 直接内存的大小不受Java虚拟机控制,但既然是内存,当内存不足时就会抛出OOM异常。 综上所述 Java虚拟机的内存模型中一共有两个“栈”,分别是:Java虚拟机栈和本地方法栈。两个“栈”的功能类似,都是方法运行过程的内存模型。并且两个“栈”内部构造相同,都是线程私有。只不过Java虚拟机栈描述的是Java方法运行过程的内存模型,而本地方法栈是描述Java本地方法运行过程的内存模型。 Java虚拟机的内存模型中一共有两个“堆”,一个是原本的堆,一个是方法区。方法区本质上是属于堆的一个逻辑部分。堆中存放对象,方法区中存放类信息、常量、静态变量、即时编译器编译的代码。 堆是Java虚拟机中最大的一块内存区域,也是垃圾收集器主要的工作区域。 程序计数器、Java虚拟机栈、本地方法栈是线程私有的,即每个线程都拥有各自的程序计数器、Java虚拟机栈、本地方法区。并且他们的生命周期和所属的线程一样。而堆、方法区是线程共享的,在Java虚拟机中只有一个堆、一个方法栈。并在JVM启动的时候就创建,JVM停止才销毁。

优秀的个人博客,低调大师

java面试-Java并发编程(六)——线程间的通信

多条线程之间有时需要数据交互,下面介绍五种线程间数据交互的方式,他们的使用场景各有不同。 1. volatile、synchronized关键字 PS:关于volatile的详细介绍请移步至:Java并发编程的艺术(三)——volatile 1.1 如何实现通信? 这两种方式都采用了同步机制实现多条线程间的数据通信。与其说是“通信”,倒不如说是“共享变量”来的恰当。当一个共享变量被volatile修饰 或 被同步块包裹后,他们的读写操作都会直接操作共享内存,从而各个线程都能看到共享变量最新的值,也就是实现了内存的可见性。 1.2 特点 这种方式本质上是“共享数据”,而非“传递数据”;只是从结果来看,数据好像是从写线程传递到了读线程; 这种通信方式无法指定特定的接收线程。当数据被修改后究竟哪条线程最先访问到,这由操作系统随机决定。 总的来说,这种方式并不是真正意义上的“通信”,而是“共享”。 1.3 使用场景 这种方式能“传递”变量。当需要传递一些公用的变量时就可以使用这种方式。如:传递boolean flag,用于表示状态、传递一个存储所有任务的队列等。 1.4 例子 用这种方式实现线程的开关控制。 // 用于控制线程当前的执行状态 private volatile boolean running = false; // 开启一条线程 Thread thread = new Thread(new Runnable(){ void run(){ // 开关 while(!running){ Thread.sleep(1000); } // 执行线程任务 doSometing(); } }).start(); // 开始执行 public void start(){ running = true; } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 2. 等待/通知机制 2.1 如何实现? 等待/通知机制的实现由Java完成,我们只需调用Object类的几个方法即可。 wait():将当前线程的状态改为“等待态”,加入等待队列,释放锁;直到当前线程发生中断或调用了notify方法,这条线程才会被从等待队列转移到同步队列,此时可以开始竞争锁。 wait(long):和wait()功能一样,只不过多了个超时动作。一旦超时,就会继续执行wait之后的代码,它不会抛超时异常! notify():将等待队列中的一条线程转移到同步队列中去。 notifyAll():将等待队列中的所有线程都转移到同步队列中去。 2.2 注意点 以上方法都必须放在同步块中; 并且以上方法都只能由所处同步块的锁对象调用; 锁对象A.notify()/notifyAll()只能唤醒由锁对象A wait的线程; 调用notify/notifyAll函数后仅仅是将线程从等待队列转移到阻塞队列,只有当该线程竞争到锁后,才能从wait方法中返回,继续执行接下来的代码; 2.3 QA 为什么wait必须放在同步块中调用?因为等待/通知机制需要和共享状态变量配合使用,一般是先检查状态,若状态为true则执行wait,即包含“先检查后执行”,因此需要把这一过程加锁,确保其原子执行。举个例子: // 共享的状态变量 boolean flag = false; // 线程1 Thread t1 = new Thread(new Runnable(){ public void run(){ while(!flag){ wait(); } } }).start(); // 线程2 Thread t2 = new Thread(new Runnable(){ public void run(){ flag = true; notifyAll(); } }).start(); 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 上述例子thread1未加同步。当thread1执行到while那行后,判断其状态为true,此时若发生上下文切换,线程2开始执行,并一口气执行完了;此时flag已经是true,然而thread1继续执行,遇到wait后便进入等待态;但此时已经没有线程能唤醒它了,因此就一直等待下去。 为什么notify需要加锁?且必须和wait使用同一把锁?首先,加锁是为了保证共享变量的内存可见性,让它发生修改后能直接写入共享内存,好让wait所处的线程立即看见。其次,和wait使用同一把锁是为了确保wait、notify之间的互斥,即:同一时刻,只能有其中一条线程执行。 为什么必须使用同步块的锁对象调用wait函数?首先,由于wait会释放锁,因此通过锁对象调用wait就是告诉wait释放哪个锁。其次,告诉线程,你是在哪个锁对象上等待的,只有当该锁对象调用notify时你才能被唤醒。 为什么必须使用同步块的锁对象调用notify函数?告诉notify,只唤醒在该锁对象上等待的线程。 2.4 代码实现 等待/通知机制用于实现生产者和消费者模式。 生产者 synchronized(锁A){ flag = true;// 或者:list.add(xx); 锁A.notify(); } 1 2 3 4 消费者 synchronized(锁A){ // 不满足条件 while(!flag){ // 或者:list.isEmpty() 锁A.wait(); } // doSometing…… } 1 2 3 4 5 6 7 8 2.5 超时等待模式 在之前的生产者-消费者模式中,如果生产者没有发出通知,那么消费者将永远等待下去。为了避免这种情况,我们可以给消费者增加超时等待功能。该功能依托于wait(long)方法,只需在wait前的检查条件中增加超时标识位,实现如下: public void get(long mills){ synchronized( list ){ // 不加超时功能 if ( mills <= 0 ) { while( list.isEmpty() ){ list.wait(); } } // 添加超时功能 else { boolean isTimeout = false; while(list.isEmpty() && isTimeout){ list.wait(mills); isTimeout = true; } // doSometing…… } } } 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 3. 管道流 3.1 作用 管道流用于在两个线程之间进行字节流或字符流的传递。 3.2 特点 管道流的实现依靠PipedOutputStream、PipedInputStream、PipedWriter、PipedReader。分别对应字节流和字符流。 他们与IO流的区别是:IO流是在硬盘、内存、Socket之间流动,而管道流仅在内存中的两条线程间流动。 3.3 实现 步骤如下:1. 在一条线程中分别创建输入流和输出流;2. 将输入流和输出流连接起来;3. 将输入流和输出流分别传递给两条线程;4. 调用read和write方法就可以实现线程间通信。 // 创建输入流与输出流对象 PipedWriter out = new PipedWriter(); PipedReader in = new PipedReader(); // 连接输入输出流 out.connect(in); // 创建写线程 class WriteThread extends Thread{ private PipedWriter out; public WriteThread(PipedWriter out){ this.out = out; } public void run(){ out.write("hello concurrent world!"); } } // 创建读线程 class ReaderThread extends Thread{ private PipedReader in; public ReaderThread(PipedReader in){ this.in = in; } public void run(){ in.read(); } } // 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 4. join 4.1 作用 join能将并发执行的多条线程串行执行; join函数属于Thread类,通过一个thread对象调用。当在线程B中执行threadA.join()时,线程B将会被阻塞(底层调用wait方法),等到threadA线程运行结束后才会返回join方法。 被等待的那条线程可能会执行很长时间,因此join函数会抛出InterruptedException。当调用threadA.interrupt()后,join函数就会抛出该异常。 4.2 实现 public static void main(String[] args){ // 开启一条线程 Thread t = new Thread(new Runnable(){ public void run(){ // doSometing } }).start(); // 调用join,等待t线程执行完毕 try{ t.join(); }catch(InterruptedException e){ // 中断处理…… } }

优秀的个人博客,低调大师

春节跳槽最新Java面试题及答案整理

今天大部分码农同学已经上班了吧,最近也是跳槽人才流动的高峰期,拿了年终奖,找找更好的机会。 小编也面了几家公司了,回来整理下面经分享给大家做个参考。有很多,暂时先分享20道,后续更多会陆续整理分享出来。 1.Mybatis与Ibatis的区别 2.Http1与Http2的区别 3.SpringMVC的执行流程 4.JVM内存溢出具体指哪些内存区域?都会抛出什么异常? 5.谈谈对AJAX的理解 6.谈谈对事务的理解 7.String能被继承吗?为什么? 8.谈谈继承和聚合 9.什么是深拷贝和浅拷贝? 10.说说常见的几个运行时异常 11.JDK引入泛型是解决什么问题的? 12.谈谈hashCode与equals之间的关系 13.谈谈反射机制 14.常用的JVM设置参数都有哪些? 15.Spring Boot是什么? 16.谈谈Spring事物传播特性 17.Spring有哪几种事物管理机制? 18.ACID是指什么? 19.谈谈Mysql中的Btree和B+Tree算法 20.谈谈Mysql中in和exists的应用场景 关注下方公众号回复"答案"获取以上全部答案。

优秀的个人博客,低调大师

2017年经典运维面试题28例

1、Linux如何挂载windows下的共享目录? mount.cifs //IP地址/server /mnt/server -o user=administrator,password=123456 linux 下的server需要自己手动建一个 后面的user与pass 是windows主机的账号和密码 注意空格 和逗号。 2、如何查看http的并发请求数与其TCP连接状态? netstat -n | awk ‘/^tcp/ {++b[$NF]}’ END {for(a in b) print a,b[a]}’ 还有ulimit -n 查看linux系统打开最大的文件描述符,这里默认1024,不修改这里web服务器修改再大也没用。若要用就修改很几个办法,这里说其中一个: 修改/etc/security/limits.conf * soft nofile 10240 * hard nofile 10240 重启后生效 3、如何用tcpdump嗅探80端口的访问看看谁最高? tcpdump -i eth0 -tnn dst port 80 -c 1000 | awk -F”.” ‘{print $1″.”$2″.”$3″.”$4″.”}’ | sort |uniq -c | sort -nr | head-5 4、如何查看/var/log目录下的文件数? ls /var/log/ -1R | grep “-” | wc -l 5、如何查看Linux系统每个ip的连接数? netstat -n | awk ‘/^tcp/ {print $5}’ | awk -F: ‘{print $1}’ | sort | uniq -c | sort -rn 6、shell下生成32位随机密码 cat /dev/urandom | head -1 | md5sum | head -c 32 >> /pass 7、统计出apache的access.log中访问量最多的5个ip cat access.log | awk ‘{print $1}’ | sort | uniq -c | sort -n -r | head -5 8、如何查看二进制文件的内容? 我们一般通过hexdump命令 来查看二进制文件的内容。 hexdump -C XXX(文件名) -C是参数 不同的参数有不同的意义 -C 是比较规范的 十六进制和ASCII码显示 -c 是单字节字符显示 -b 单字节八进制显示 -o 是双字节八进制显示 -d 是双字节十进制显示 -x 是双字节十六进制显示 9、ps aux 中的VSZ代表什么意思,RSS代表什么意思? VSZ:虚拟内存集,进程占用的虚拟内存空间 RSS:物理内存集,进程战用实际物理内存空间 10、如何检测并修复/dev/hda5? fsck用来检查和维护不一致的文件系统。若系统掉电或磁盘发生问题,可利用fsck命令对文件系统进行检查 11、介绍下Linux系统的开机启动顺序 加载BIOS–>读取MBR–>Boot Loader–>加载内核–>用户层init一句inittab文件来设定系统运行的等级(一般3或者 5,3是多用户命令行,5是界面)–>init进程执行rc.syninit–>启动内核模块–>执行不同级别运行的脚本程序–>执行/etc/rc.d/rc.local(本地运行服务)–>执行/bin/login,就可以登录了。 12、符号链接与硬链接的区别 我们可以把符号链接,也就是软连接 当做是 windows系统里的 快捷方式。 硬链接 就好像是 又复制了一份,举例说明: ln 3.txt 4.txt 这是硬链接,相当于复制,不可以跨分区,但修改3,4会跟着变,若删除3,4不受任何影响。 ln -s 3.txt 4.txt 这是软连接,相当于快捷方式。修改4,3也会跟着变,若删除3,4就坏掉了。不可以用了。 13、保存当前磁盘分区的分区表 dd 命令是以个强大的命令,在复制的同时进行转换 dd if=/dev/sda of=./mbr.txt bs=1 count=512 14、如何在文本里面进行复制、粘贴,删除行,删除全部,按行查找和按字母查找? 以下操作全部在命令行状态操作,不要在编辑状态操作。 在文本里 移动到想要复制的行 按yy 想复制到哪就移动到哪,然后按P 就黏贴了 删除行 移动到改行 按dd 删除全部 dG 这里注意G一定要大写 按行查找 :90 这样就是找到第90行 按字母查找 /path 这样就是 找到path这个单词所在的位置,文本里可能存在多个,多次查找会显示在不同的位置。 15、手动安装grub grub-install /dev/sda 16、修改内核参数 vi /etc/sysctl.conf 这里修改参数 sysctl -p 刷新后可用 17、在1-39内取随机数 expr $[RANDOM%39] +1 RANDOM随机数 %39取余数范围0-38 18、限制apache每秒新建连接数为1,峰值为3 每秒新建连接数 一般都是由防火墙来做,apache本身好像无法设置每秒新建连接数,只能设置最大连接: iptables -A INPUT -d 172.16.100.1 -p tcp –dport 80 -m limit –limit 1/second -j ACCEPT 19、FTP的主动模式和被动模式 FTP协议有两种工作方式:PORT方式和PASV方式,中文意思为主动式和被动式。 PORT(主动)方式的连接过程是:客户端向服务器的FTP端口(默认是21)发送连接请 求,服务器接受连接,建立一条命令链路。当需要传送数据时,客户端在命令链路上用PORT 命令告诉服务器:“我打开了XX端口,你过来连接我”。于是服务器从20端口向客户端的 XX端口发送连接请求,建立一条数据链路来传送数据。 PASV(被动)方式的连接过程是:客户端向服务器的FTP端口(默认是21)发送连接请 求,服务器接受连接,建立一条命令链路。当需要传送数据时,服务器在命令链路上用PASV 命令告诉客户端:“我打开了XX端口,你过来连接我”。于是客户端向服务器的XX端口 发送连接请求,建立一条数据链路来传送数据。 从上面可以看出,两种方式的命令链路连接方法是一样的,而数据链路的建立方法就完 全不同。 20、显示/etc/inittab中以#开头,且后面跟了一个或者多个空白字符,而后又跟了任意非空白字符的行 grep “^#\{1,\}[^]” /etc/inittab 21、显示/etc/inittab中包含了:一个数字:(即两个冒号中间一个数字)的行 grep “\:[0-9]\{1\}:” /etc/inittab 22、怎么把脚本添加到系统服务里,即用service来调用? 在脚本里加入 #!/bin/bash # chkconfig: 345 85 15 # description: httpd 然后保存 chkconfig httpd –add 创建系统服务 现在就可以使用service 来 start or restart 23、写一个脚本,实现批量添加20个用户 用户名为user01-20,密码为user后面跟5个随机字符 #!/bin/bash #description: useradd for i in `seq -f”%02g” 1 20`;do useradd user$i echo “user$i-`echo $RANDOM|md5sum|cut -c 1-5`”|passwd –stdinuser$i >/dev/null 2>&1 done 24、写一个脚本,实现判断192.168.1.0/24网络里,当前在线的IP有哪些,能ping通则认为在线 #!/bin/bash for ip in `seq 1 255` do ping -c 1 192.168.1.$ip > /dev/null 2>&1 if [ $? -eq 0 ]; then echo 192.168.1.$ip UP else echo 192.168.1.$ip DOWN fi }& done wait 25、写一个脚本,判断一个指定的脚本是否是语法错误 如果有错误,则提醒用户键入Q或者q无视错误并退出其它任何键可以通过vim打开这个指定的脚本 [root@localhost tmp]# cat checksh.sh #!/bin/bash read -p “please input check script-> ” file if [ -f $file ]; then sh -n $file > /dev/null 2>&1 if [ $? -ne 0 ]; then read -p “You input $file syntax error,[Type q to exit or Type vim to edit]” answer case $answer in q | Q) exit 0 ;; vim ) vim $file ;; *) exit 0 ;; esac fi else echo “$file not exist” exit 1 fi 26、写一个脚本,要求如何: 创建一个函数,能接受两个参数: 1)第一个参数为URL,即可下载的文件;第二个参数为目录,即下载后保存的位置; 2)如果用户给的目录不存在,则提示用户是否创建;如果创建就继续执行,否则,函数返回一个51的错误值给调用脚本; 3)如果给的目录存在,则下载文件;下载命令执行结束后测试文件下载成功与否;如果成功,则返回0给调用脚本,否则,返回52给调用脚本; [root@localhost tmp]# cat downfile.sh #!/bin/bash url=$1 dir=$2 download() { cd $dir >> /dev/null 2>&1 if [ $? -ne 0 ];then read -p “$dir No such file or directory,create?(y/n)” answer if [ “$answer” == “y” ];then mkdir -p $dir cd $dir wget $url 1> /dev/null 2>&1 else return “51” fi fi if [ $? -ne 0 ]; then return “52” fi } download $url $dir echo $? 27、写一个脚本,详细需求如下: 1、创建一个函数 可以接受一个磁盘设备路径(如/dev/sdb)作为参数;在真正开始后面步骤之前提醒用户有危险,并让用户选择是否继续;而后将此磁盘设备上的所有分区清空(提示,使用命令dd if=/dev/zero of=/dev/sdb bs=512 count=1实现,注意其中的设备路径不要写错了; 如果此步骤失败,返回67给主程序; 接着在此磁盘设备上创建两个主分区,一个大小为100M,一个大小为1G;如果此步骤失败,返回68给主程序; 格式化此两分区,文件系统类型为ext3;如果此步骤失败,返回69给主程序; 如果上述过程都正常,返回0给主程序; 2、调用此函数 并通过接收函数执行的返回值来判断其执行情况,并将信息显示出来; local Darray=(`ls /dev/sd[a-z]`) for i in ${Darray};do [[ “$i” == “$1” ]] && Sd=$i &&break done else return66 fi #当匹配成功,进入选择,告诉用户,是否继续,输错的话进入无限循环,当用户选择Y,则清空目标分区,且跳出while循环 while :;do read -p “Warning!!!This operation will clean $Sd data.Next=y,Quit=n [y|n]:” Choice case $Choice in y) dd if=/dev/zero of=$Sd bs=512 count=1 &> /dev/null &&break || return 67 ;; n) exit 88 ;; *) echo “Invalid choice,please choice again.” ;; esac done #使用echo传递给fdisk进行分区,如果此命令失败,则跳转出去,错误值68,需要注意的是,有时候这个返回值很诡异,笔者之前成功与否都是返回的1,后来重启之后,就好了,如果慎重的话,可以对创建的分区,进行判断,不过就需要使用其他工具截取相关字段了,虽有些小麻烦,但无大碍 echo-e “n\np\n1\n\n+100M\nn\np\n2\n\n+1024M\nw\n”|fdisk /dev/sdb&> /dev/null || || return 68 #格式化之前,让内核重新读取磁盘分区表,值得注意的是,有的系统版本,使用partprobe无效,譬如笔者的环境是rhel5.8,而rhel6.0以后,这个命令就很危险了,而使用partx -a /dev/sdb则效果更好…此项需慎重,如果格式化失败,则告知把失败的分区定义成变量,且跳出函数,并带出错误值69 `partprobe` Part=`fdisk -l /dev/$Sd|tail -2|cut -d” ” -f1` for M in ${Part};do mke2fs -j $M &> /dev/null && ErrorPart=$M &&return 69 done return 0 } #下面代码,调用函数,接收函数返回值,根据返回值进行判断哪里出错。 Disk_Mod $1 Res=$? [ $Res-eq 0 ] && exit 0 [ $Res-eq 66 ] && echo “Error! Invalid input.” [ $Res-eq 67 ] && echo “Error! Command -> dd fdisk mke2fs 28、如何让history命令显示具体时间? HISTTIMEFORMAT=”%Y-%m-%d %H:%M:%S” export HISTTIMEFORMAT 重新开机后会还原,可以写/etc/profile 原文来自: http://www.yunweipai.com/archives/18798.html

优秀的个人博客,低调大师

常用linux面试笔试题及参考答案

一.填空题: 1. 在Linux系统中,以文件方式访问设备 . 2. Linux内核引导时,从文件/etc/fstab中读取要加载的文件系统. 3. Linux文件系统中每个文件用i节点来标识. 4. 全部磁盘块由四个部分组成,分别为引导块 、专用块 、 i节点表块 和数据存储块. 5. 链接分为:硬链接 和 符号链接. 6. 超级块包含了i节点表 和 空闲块表等重要的文件系统信息. 7. 某文件的权限为:d-rw-_r--_r--,用数值形式表示该权限,则该八进制数为:644,该文件属性是目录. 8. 前台起动的进程使用Ctrl c终止. 9. 静态路由设定后,若网络拓扑结构发生变化,需由系统管理员修改路由的设置. 10. 网络管理的重要任务是:控制 和 监控. 11. 安装Linux系统对硬盘分区时,有两种分区类型:文件系统分区 和 交换分区. 13. 编写的Shell程序运行前赋予该脚本文件执行权限. 14. 系统管理的任务之一是能够在分布式环境中实现对程序和数据的安全保护、备份、恢复和更新. 15. 系统交换分区是作为系统虚拟存储器的一块区域. 16. 内核分为进程管理系统 、 内存管理系统 、 I/O管理系统 和文件管理系统等四个子系统. 17. 内核配置是系统管理员在改变系统配置硬件时要进行的重要操作. 18. 在安装Linux系统中,使用netconfig程序对网络进行配置,该安装程序会一步步提示用户输入主机名、域名、域名服务器、IP地址、网关地址 和 子网掩码等必要信息. 19. 唯一标识每一个用户的是用户 ID 和用户名. 20 .RIP协议是最为普遍的一种内部协议,一般称为动态路由信息协议. 21. 在Linux系统中所有内容都被表示为文件,组织文件的各种方法称为文件系统. 22. DHCP可以实现动态 IP 地址分配. 23. 系统网络管理员的管理对象是服务器、 用户 和服务器的进程 以及系统的各种资源. 24. 网络管理通常由监测、传输和管理三部分组成,其中管理部分是整个网络管理的中心. 25. 当想删除本系统用不上的 设备驱动程序 时编译内核,当内核不支持系统上的 设备驱动程序 时,对内核 升级 . 26 Ping命令可以测试网络中本机系统是否能到达 一台远程主机 ,常常用于测试网络的 连通性 . 27. vi编辑器具有两种工作模式: 命令模式 和 输入模式 . 28. 可以用ls &ndash;al命令来观察文件的权限,每个文件的权限都用10位表示,并分为四段,其中第一段占 1 位,表示 文件类型 ,第二段占3位,表示 文件所有者 对该文件的权限. 29. 进程与程序的区别在于其动态性,动态的产生和终止,从产生到终止进程可以具有的基本状态为: 运行态 、 就绪态 和 等待态(阻塞态) . 30. DNS实际上是分布在internet上的主机信息的数据库,其作用是实现 IP地址和主机名 之间的转换. 31. Apache是实现WWW服务器功能的应用程序,即通常所说的"浏览web服务器",在服务器端 为用户提供浏览 web服务 的就是apache应用程序. 32. 在Linux系统上做备份可以有两种类型:系统备份 和 用户备份 .其中前者是指对 操作系统 的备份,后者是指对 应用程序和用户文件的备份. 33. CD-ROM标准的文件系统类型是 iso9660 . 34. 当lilo.conf配置完毕后,使之生效,应运行的命令及参数是 lilo . 35. 在使用ls命令时,用八进制形式显示非打印字符应使用参数 -b . 36. Linux使用支持Windows 9.x/2000长文件名的文件系统的类型是 vfat . 37. 设定限制用户使用磁盘空间的命令是 quota . 38 在Linux系统中,用来存放系统所需要的配置文件和子目录的目录是 /etc . 39. 硬连接只能建立对 文件 链接.符号链接可以跨不同文件系统创建. 40. 套接字文件的属性位是 s . 41. 结束后台进程的命令是 kill . 42. 进程的运行有两种方式,即 独立运行和使用父进程运行 . 43. Links分为 硬链接和符号链接 . 44. 在超级用户下显示Linux系统中正在运行的全部进程,应使用的命令及参数是 ps -aux . 45. 管道文件的属性位是 p . 46. 将前一个命令的标准输出作为后一个命令的标准输入,称之为 管道 . 47. 为脚本程序指定执行权的命令及参数是 chmod a x filename . 48. 进行远程登录的命令是 telnet . 49. 欲发送10个分组报文测试与主机abc.tuu.edu.cn的连通性,应使用的命令和参数是: ping abc.tuu.edu.cn &ndash;c 10 . 50. DNS服务器的进程命名为named,当其启动时,自动装载 /etc目录下的 named.conf 文件中定义的DNS分区数据库文件. 51. Apache服务器进程配置文件是 httpd.conf .52.在 Linux系统中,压缩文件后生成后缀为.gz文件的命令是 gzip . 53. 在用vi编辑文件时,将文件内容存入test.txt文件中,应在命令模式下键入 :w test.txt . 54 可以在标准输出上显示整年日历的命令及参数是 cal -y . 55. 在shell编程时,使用方括号表示测试条件的规则是:方括号两边有 空格 . 56. 检查已安装的文件系统/dev/had5是否正常,若检查有错,则自动修复,其命令及参数是 fsck &ndash;a /dev/had5 . 57. 在Windows9.x环境下共享Unix/Linux中的用户目录的一个工具是 Samba服务器 . 58. 系统管理员的职责是进行系统资源管理、系统性能管理、设备管理、安全管理和 系统性能监测 . 59 在Linux系统中,测试DNS服务器是否能够正确解析域名的的客户端命令,使用命令 nslookup . 60. 在Linux系统下,第二个IDE通道的硬盘(从盘)被标识为 hdb . 61. 当系统管理员需升级内核版本和改变系统硬件配置时,应 重新编译内核 . 62. 如果只是要修改系统的IP地址,应修改 /etc/rc.d/rc.inet1 配置文件. 63. 当LAN内没有条件建立DNS服务器,但又想让局域网内的用户可以使用计算机名互相访问时,应配置 /etc/hosts 文件. 64. 在vi编辑环境下,使用 Esc键 进行模式转换. 65. Slackware Linux 9.0通常使用 ext3 文件系统,系统的全部磁盘块由 四 部分组成. 66. 将/home/stud1/wang目录做归档压缩,压缩后生成wang.tar.gz文件,并将此文件保存到/home目录下,实现此任务的tar命令格式 tar zcvf /home/wang.tar.gz /home/stud1/wang . 67. 管道就是将前一个命令的 标准输出 作为后一个命令的 标准输入 . 68. 在使用手工的方法配置网络时,可通过修改 /etc/HOSTNAME 文件来改变主机名,若要配置该计算机的域名解析客户端,需配置 /etc/resolv.conf 文件. 69. 启动进程有手动启动和调度启动两种方法,其中调度启动常用的命令为 at 、 batch 和 crontab . 70. test.bns.com.cn的域名是 bns.com.cn ,如果要配置一域名服务器,应在 named.conf 文件中定义DNS数据库的工作目录. 71. Sendmail邮件系统使用的两个主要协议是: SMTP 和 POP ,前者用来发送邮件,后者用来接收邮件. 72. DHCP是动态主机配置协议的简称,其作用是:为网络中的主机分配IP地址 . 73. 目前代理服务器使用的软件包有很多种,教材中使用的是 squid . 74. rm命令可删除文件或目录,其主要差别就是是否使用递归开关 -r或-R . 75. mv 命令可以移动文件和目录,还可以为文件和目录重新命名. 76. 路由选择协议(RIP)的跳数表示到达目的地之前通过的 网关 数,RIP接受的最长距离是 15跳 . 77. ping命令用于测试网络的连通性,ping命令通过 ICMP 协议(internet控制信息协议)来实现. 78. nfs 协议用于实现Unix(/linux)主机之间的文件系统共享. 79. 在Linux操作系统中,设备都是通过特殊的 文件 来访问. 80. shell不仅是 用户命令的解释器 ,它同时也是一种功能强大的编程语言. bash是Linux的缺省shell. 81. 用 〉;〉; 符号将输出重定向内容附加在原文的后面. 82. 增加一个用户的命令是:adduser 或useradd . 83 进行字符串查找,使用grep命令. 84. 使用 * 每次匹配若干个字符. 85. /sbin 目录用来存放系统管理员使用的管理程序. 二.单项选择题: 1. 下面的网络协议中,面向连接的的协议是: A . A 传输控制协议 B 用户数据报协议 C 网际协议 D 网际控制报文协议 2. 在/etc/fstab文件中指定的文件系统加载参数中, D 参数一般用于CD-ROM等移动设备. A defaults B sw C rw和ro D noauto 3. Linux文件权限一共10位长度,分成四段,第三段表示的内容是 C . A 文件类型 B 文件所有者的权限 C 文件所有者所在组的权限 D 其他用户的权限 4. 终止一个前台进程可能用到的命令和操作 B . A kill B 〈CTRL〉; C C shut down D halt 5.在使用mkdir命令创建新的目录时,在其父目录不存在时先创建父目录的选项是 D . A -m B -d C -f D -p 6. 下面关于i节点描述错误的是 A.(inode是一种数据结构,vfs中描述文件的相关参数??) A i节点和文件是一一对应的 B i节点能描述文件占用的块数 C i节点描述了文件大小和指向数据块的指针 D 通过i节点实现文件的逻辑结构和物理结构的转换 7. 一个文件名字为rr.Z,可以用来解压缩的命令是: D . A tar B gzip C compress D uncompress 8. 具有很多C语言的功能,又称过滤器的是 C . A csh B tcsh C awk (awk详解) D sed 9. 一台主机要实现通过局域网与另一个局域网通信,需要做的工作是 C .A 配置域名服务器 B 定义一条本机指向所在网络的路由 C 定义一条本机指向所在网络网关的路由 D 定义一条本机指向目标网络网关的路由 10. 建立动态路由需要用到的文件有 D . A /etc/hosts B /etc/HOSTNAME C /etc/resolv.conf D /etc/gateways 11. 局域网的网络地址192.168.1.0/24,局域网络连接其它网络的网关地址是192.168.1.1.主机192.168.1.20访问172.16.1.0/24网络时,其路由设置正确的是 B . A route add &ndash;net 192.168.1.0 gw 192.168.1.1 netmask 255.255.255.0 metric 1 B route add &ndash;net 172.16.1.0 gw 192.168.1.1 netmask 255.255.255.255 metric 1 C route add &ndash;net 172.16.1.0 gw 172.16.1.1 netmask 255.255.255.0 metric 1 D route add default 192.168.1.0 netmask 172.168.1.1 metric 1 12. 下列提法中,不属于ifconfig命令作用范围的是 D . A 配置本地回环地址 B 配置网卡的IP地址 C 激活网络适配器 D 加载网卡到内核中 13. 下列关于链接描述,错误的是 B . A 硬链接就是让链接文件的i节点号指向被链接文件的i节点 B 硬链接和符号连接都是产生一个新的i节点 C 链接分为硬链接和符号链接 D 硬连接不能链接目录文件 14. 在局域网络内的某台主机用ping命令测试网络连接时发现网络内部的主机都可以连同,而不能与公网连通,问题可能是 C. A 主机IP设置有误 B 没有设置连接局域网的网关 C 局域网的网关或主机的网关设置有误 D 局域网DNS服务器设置有误 15. 下列文件中,包含了主机名到IP地址的映射关系的文件是: B . A /etc/HOSTNAME B /etc/hosts C /etc/resolv.conf D /etc/networks 16. 不需要编译内核的情况是 D . A 删除系统不用的设备驱动程序时 B 升级内核时 C 添加新硬件时 D 将网卡激活 17. 在shell中变量的赋值有四种方法,其中,采用name=12的方法称 A . A 直接赋值 B使用read命令 C 使用命令行参数 D使用命令的输出 18. D 命令可以从文本文件的每一行中截取指定内容的数据. A cp B dd C fmt D cut 19. 下列不是Linux系统进程类型的是 D . A 交互进程 B 批处理进程 C 守护进程 D 就绪进程(进程状态) 20.配置Apache 1.3.19服务器需要修改的配置文件为___A______ A httpd.conf B access.conf C srm.conf D named.conf 21. 内核不包括的子系统是 D . A 进程管理系统 B 内存管理系统 C I/O管理系统 D硬件管理系统 22. 在日常管理中,通常CPU会影响系统性能的情况是: A . A CPU已满负荷地运转 B CPU的运行效率为30% C CPU的运行效率为50% D CPU的运行效率为80% 23. 若一台计算机的内存为128MB,则交换分区的大小通常是 C . A 64MB B 128MB C 256MB D 512MB 24. 在安装Linux的过程中的第五步是让用户选择安装方式,如果用户希望安装部分组件(软件程序),并在选择好后让系统自动安装,应该选择的选项是 D . A full B expert C newbie D menu 25. Linux有三个查看文件的命令,若希望在查看文件内容过程中可以用光标上下移动来查看文件内容,应使用 C 命令. A cat B more C less D menu 26. 下列信息是某系统用ps &ndash;ef命令列出的正在运行的进程, D 进程是运行Internet超级服务器,它负责监听Internet sockets上的连接,并调用合适的服务器来处理接收的信息. A root 1 4.0 0.0 344 204? S 17:09 0:00 init B root 2 0.0 0.1 2916 1520? S 17:09 0:00 /sbin/getty C root 3 0.0 0.2 1364 632? S 17:09 0:00 /usr/sbin/syslogd D root 4 0.0 1344 1204? S 17:09 0:10 /usr/sbin/inetd 27.在TCP/IP模型中,应用层包含了所有的高层协议,在下列的一些应用协议中, B 是能够实现本地与远程主机之间的文件传输工作. A telnet B FTP C SNMP D NFS 28.当我们与某远程网络连接不上时,就需要跟踪路由查看,以便了解在网络的什么位置出现了问题,满足该目的的命令是 C . A ping B ifconfig C traceroute D netstat 29.对名为fido的文件用chmod 551 fido 进行了修改,则它的许可权是 D . A -rwxr-xr-x B -rwxr--r-- C -r--r--r-- D -r-xr-x-x 30. 在i节点表中的磁盘地址表中,若一个文件的长度是从磁盘地址表的第1块到第11块,则该文件共占有 B 块号. A 256 B 266 C 11 D 256&times;10 (??)31. 用ls &ndash;al 命令列出下面的文件列表, D 文件是符号连接文件. A -rw-rw-rw- 2 hel-s users 56 Sep 09 11:05 hello B -rwxrwxrwx 2 hel-s users 56 Sep 09 11:05 goodbey C drwxr--r-- 1 hel users 1024 Sep 10 08:10 zhangD lrwxr--r-- 1 hel users 2024 Sep 12 08:12 cheng 32. DNS域名系统主要负责主机名和 A 之间的解析. A IP地址 B MAC地址 C 网络地址 D 主机别名 33. WWW服务器是在Internet上使用最为广泛,它采用的是 B 结构. A 服务器/工作站 B B/S C 集中式 D 分布式 34.Linux系统通过 C 命令给其他用户发消息. A less B mesg y C write D echo to[ 注:mesg [y|n] 所有使用者 决定是否允许其他人传讯息到自己的终端机介面 ] 35.NFS是 C 系统. A 文件 B 磁盘 C 网络文件 D 操作 36. B 命令可以在Linux的安全系统中完成文件向磁带备份的工作. A cp B tr C dir D cpio[注:如果用 echo $PATH 或者 echo $LD_LIBRARY_PATH 等类似的命令来显示路径信息的话,我们看到的将会是一大堆用冒号连接在一起的路径, tr 命令可以把这些冒号转换为回车,这样,这些路径就具有很好的可读性了: echo $PATH | tr &quot;:&quot; &quot;&#92;n&quot;] 37.Linux文件系统的文件都按其作用分门别类地放在相关的目录中,对于外部设备文件,一般应将其放在 C 目录中. A /bin B /etc C /dev D /lib 38.在重新启动Linux系统的同时把内存中的信息写入硬盘,应使用 D 命令实现. A # reboot B # halt C # reboot D # shutdown &ndash;r now 39.网络管理具备以下几大功能:配置管理、 A 、性能管理、安全管理和计费管理等. A 故障管理 B 日常备份管理 C 升级管理 D 发送邮件 40.关于代理服务器的论述,正确的是 A . A 使用internet上已有的公开代理服务器,只需配置客户端. B 代理服务器只能代理客户端http的请求. C 设置好的代理服务器可以被网络上任何主机使用. D 使用代理服务器的客户端没有自己的ip地址. 41.关闭linux系统(不重新启动)可使用命令 B . A Ctrl Alt Del B halt C shutdown -r now D reboot 42.实现从IP地址到以太网MAC地址转换的命令为: C . A ping B ifconfig C arp D traceroute 43.在vi编辑器中的命令模式下,键入 B 可在光标当前所在行下添加一新行. A 〈a〉; B 〈o〉; C 〈I〉; D A 44.在vi编辑器中的命令模式下,删除当前光标处的字符使用 A 命令. A 〈x〉; B 〈d〉;〈w〉; C 〈D〉; D 〈d〉;〈d〉; 45.在vi编辑器中的命令模式下,重复上一次对编辑的文本进行的操作,可使用 C 命令. A 上箭头 B 下箭头 C 〈.〉; D 〈*〉; 46.用命令ls -al显示出文件ff的描述如下所示,由此可知文件ff的类型为 A . -rwxr-xr-- 1 root root 599 Cec 10 17:12 ff A 普通文件 B 硬链接 C 目录 D 符号链接 47.删除文件命令为: D . A mkdir B rmdir C mv D rm 48.在下列的名称中,不属于DNS服务器类型的是:____C_____ A Primary Master Server B Secondary Master Server C samba D Cache_only Server 49.网络管理员对WWW服务器进行访问、控制存取和运行等控制,这些控制可在 A 文件中体现. A httpd.conf B lilo.conf C inetd.conf D resolv.conf 50.邮件转发代理也称邮件转发服务器,它可以使用SMTP协议,也可以使用 C 协议. A FTP B TCP C UUCP D POP 51.启动samba服务器进程,可以有两种方式:独立启动方式和父进程启动方式,其中前者是在 C 文件中以独立进程方式启动. A /usr/sbin/smbd B /usr/sbin/nmbd Crc.sambaD /etc/inetd.conf 52.DHCP是动态主机配置协议的简称,其作用是可以使网络管理员通过一台服务器来管理一个网络系统,自动地为一个网络中的主机分配___D______地址. A 网络 B MAC C TCP D IP 53.为了保证在启动服务器时自动启动DHCP进程,应将 A文件中的dhcpd=no改为dhcpd=yes. Arc.inet1B lilo.conf C inetd.conf D httpd.conf[注: 英文原义:RC中文释义:含有程序(应用程序甚至操作系统)启动指令的脚本文件注解:这一文件在操作系统启动时会自动执行,它含有要运行的指令(命令或其它脚本)列表.] 54.对文件进行归档的命令为 D . A dd B cpio C gzip D tar 55.改变文件所有者的命令为 C . A chmod B touch C chown D cat 56.在给定文件中查找与设定条件相符字符串的命令为: A . A grep B gzip C find D sort 57.建立一个新文件可以使用的命令为 D . A chmod B more C cp Dtouch(指令改变档案的时间记录.) 58.在下列命令中,不能显示文本文件内容的命令是: D . A more B less C tail D join 59.在使用匿名登录ftp时,用户名为 B . A users B anonymous C root D guest 60.在实际操作中,想了解命令logname 的用法,可以键入 D 得到帮助. A logname --man B logname/? C help logname D logname --help 61.如果LILO被安装在MBR,使用 A 命令即可卸载LILO. A lilo &ndash;u B lilo &ndash;c C lilo &ndash;v D lilo -V 62.当用命令ls &ndash;al查看文件和目录时,欲观看卷过屏幕的内容,应使用组合键 D . A Shift Home B Ctrl PgUp C Alt PgDn D Shift PgUp 63.mc是UNIX风格操作系统的 C . A 文件编辑器/程序编译器 B 配置网络的窗口工具 C 目录浏览器/文件管理器 D Samba服务器管理工具 64.i节点是一个 D 长的表,表中包含了文件的相关信息.A 8字节 B 16字节 C 32字节 D 64字节 65.文件权限读、写、执行的三种标志符号依次是 A . A rwx B xrw C rdx D srw 66.Linux 文件名的长度不得超过 C 个字符. A 64 B 128 C 256 D 512 67.进程有三种状态: C . A 准备态、执行态和退出态 B 精确态、模糊态和随机态 C 运行态、就绪态和等待态 D 手工态、自动态和自由态 68. 从后台启动进程,应在命令的结尾加上符号 A . A &amp; B @ C # D $ 69. B 不是邮件系统的组成部分. A 用户代理B 代理服务器C 传输代理 D 投递代理 70.在Shell脚本中,用来读取文件内各个域的内容并将其赋值给Shell变量的命令是 D . A fold B join C tr D read 71.crontab文件由六个域组成,每个域之间用空格分割,其排列如下: B . A MIN HOUR DAY MONTH YEAR COMMAND B MIN HOUR DAY MONTH DAYOFWEEK COMMAND C COMMAND HOUR DAY MONTH DAYOFWEEK D COMMAND YEAR MONTH DAY HOUR MINcrontab命令:实现程序定时运行 72.用ftp进行文件传输时,有两种模式: C . A Word和binary B .txt和Word Document C ASCII和binary D ASCII和Rich Text Format 73.某文件的组外成员的权限为只读;所有者有全部权限;组内的权限为读与写,则该文件的权限为 D . A 467 B 674 C 476 D 764 74.在DNS系统测试时,设named进程号是53,命令 D 通知进程重读配置文件. A kill &ndash;USR2 53 B kill &ndash;USR1 53 C kill -INT 63 D kill &ndash;HUP 53 75.Apache服务器默认的接听连接端口号是 C . A 1024 B 800 C 80 (http)D 8 76.PHP和MySQL的联合使用解决了 C . A 在Proxy上处理数据库的访问问题 B 在WWW服务器上处理黑客的非法访问问题 C 在WWW服务器上处理数据库的访问问题 D 在Sendmail邮件系统上处理数据库的访问问题 77.OpenSSL是一个 A . A 加密软件 B 邮件系统 C 数据库管理系统 D 嵌入式脚本编程语言 78.Samba服务器的配置文件是 D . A httpd.conf B inetd.conf C rc.samba D smb.conf 79.关于DNS服务器,叙述正确的是 D . A DNS服务器配置不需要配置客户端 B 建立某个分区的DNS服务器时只需要建立一个主DNS服务器 C 主DNS服务器需要启动named进程,而辅DNS服务器不需要 D DNS服务器的root.cache文件包含了根名字服务器的有关信息 80.退出交互模式的shell,应键入 C . A 〈Esc〉; B ^q C exit D quit 81.将Windows C:盘(hda1)安装在Linux文件系统的/winsys目录下,命令是 B . Aroot@l04.edu.cn:~#mountdev/had1 /winsys Broot@l04.edu.cn:~#mount/dev/had1 /winsys Croot@l04.edu.cn:~#mount/dev/had1 winsys Droot@l04.edu.cn:~#mountdev/had1 winsys 82.设超级用户root当前所在目录为:/usr/local,键入cd命令后,用户当前所在目录为 B . A /home B /root C /home/root D /usr/local 83.字符设备文件类型的标志是 B . A p B c C s D l 84.将光盘CD-ROM(hdc)安装到文件系统的/mnt/cdrom目录下的命令是 C . A mount /mnt/cdrom B mount /mnt/cdrom /dev/hdc C mount /dev/hdc /mnt/cdromD mount /dev/hdc 85.将光盘/dev/hdc卸载的命令是 C . A umount /dev/hdc B unmount /dev/hdc C umount /mnt/cdrom /dev/hdc D unmount /mnt/cdrom /dev/hdc 86.在/home/stud1/wang目录下有一文件file,使用 D 可实现在后台执行命令,此命令将file文件中的内容输出到file.copy文件中. A cat file 〉;file.copy B cat 〉;file.copy C cat file file.copy &amp; D cat file 〉;file.copy &amp; 87.在DNS配置文件中,用于表示某主机别名的是: B . A NS B CNAME C NAME D CN 88.可以完成主机名与IP地址的正向解析和反向解析任务的命令是: A . AnslookupB arp C ifconfig D dnslook 89.下列变量名中有效的shell变量名是: C . A -2-time B _2$3 C trust_no_1 D 2004file 90.qmail是 B . A 收取邮件的协议 B 邮件服务器的一种 C 发送邮件的协议 D 邮件队列 92.已知某用户stud1,其用户目录为/home/stud1.分页显示当前目录下的所有文件的文件或目录名、用户组、用户、文件大小、文件或目录权限、文件创建时间等信息的命令是 D . A more ls &ndash;al B more &ndash;al ls C more 〈 ls &ndash;al D ls &ndash;al | more 93.关于进程调度命令, B 是不正确的.at--定期执行程序的调度命令 A 当日晚11点执行clear命令,使用at命令:at 23:00 today clearB 每年1月1日早上6点执行date命令,使用at命令:at 6am Jan 1 date C 每日晚11点执行date命令,crontab文件中应为:0 23 * * * date D 每小时执行一次clear命令,crontab文件中应为:0 */1 * * * clear 94.系统中有用户user1和user2,同属于users组.在user1用户目录下有一文件file1,它拥有644的权限,如果user2用户想修改user1用户目录下的file1文件,应拥有 B 权限. A 744 B 664 C 646 D 746 95.如果想配置一台匿名ftp服务器,应修改 C 文件. A /etc/gateway B /etc/ftpservers C /etc/ftpusers D /etc/inetd.conf 96.Samba服务器的进程由B 两部分组成 . A named和sendmail Bsmbd和nmbdC bootp和dhcpd D httpd和squid 97.要配置NFS服务器,在服务器端主要配置 C 文件. A /etc/rc.d/rc.inet1 B /etc/rc.d/rc.MC /etc/exportsD /etc/rc.d/rc.S 98.为保证在启动服务器时自动启动DHCP进程,应对 B 文件进行编辑. A /etc/rc.d/rc.inet2B /etc/rc.d/rc.inet1C /etc/dhcpd.conf D /etc/rc.d/rc.S 99.在配置代理服务器时,若设置代理服务器的工作缓存为64MB,配置行应为 D . A cache 64MB B cache_dir ufs /usr/local/squid/cache 10000 16 256 C cache_ mgr 64MB Dcache_ mem 64MB 100.安全管理涉及的问题包括保证网络管理工作可靠进行的安全问题和保护网络用户及网络管理对象问题. C 属于安全管理的内容. A 配置设备的工作参数 B 收集与网络性能有关的数据 C 控制和维护访问权限 D 监测故障 101.以下命令对中,正确的是: B . A ls和sl B cat和tac C more和erom D exit和tixecat是显示文件夹的命令,这个大家都知道,tac是cat的倒写,意思也和它是相反的.cat是从第一行显示到一行,而tac是从一行显示到第一行,而rev 则是从一个字符显示到第一个字符 102. B 命令是在vi编辑器中执行存盘退出. A :q B ZZ C :q! D :WQ 103.下列关于/etc/fstab文件描述,正确的是 D . A fstab文件只能描述属于linux的文件系统 B CD_ROM和软盘是自动加载的 C fstab文件中描述的文件系统不能被卸载 D 启动时按fstab文件描述内容加载文件系统 104.通过文件名存取文件时,文件系统内部的操作过程是通过 C . A 文件在目录中查找文件数据存取位置.B 文件名直接找到文件的数据,进行存取操作. C 文件名在目录中查找对应的I节点,通过I节点存取文件数据. D 文件名在中查找对应的超级块,在超级块查找对应i节点,通过i节点存取文件数据 105.Linux将存储设备和输入/输出设备均看做文件来操作, C 不是以文件的形式出现. A 目录 B 软链接 C i节点表 D 网络适配器 106.关于i节点和超级块,下列论述不正确的是 B . A i节点是一个长度固定的表 B 超级块在文件系统的个数是唯一的 C i节点包含了描述一个文件所必需的全部信息 D 超级块记录了i节点表和空闲块表信息在磁盘中存放的位置 107. D 设备是字符设备. A hdc B fd0 C hda1 D tty1(A,B,C为块设备) 108. B 目录存放着Linux的源代码. A /etc B /usr/src C /usr D /home 109.关于文件系统的安装和卸载,下面描述正确的是 A . A 如果光盘未经卸载,光驱是打不开的 B 安装文件系统的安装点只能是/mnt下 C 不管光驱中是否有光盘,系统都可以安装CD-ROM设备 D mount /dev/fd0 /floppy 此命令中目录/floppy是自动生成的 110. B 不是进程和程序的区别. A 程序是一组有序的静态指令,进程是一次程序的执行过程 B 程序只能在前台运行,而进程可以在前台或后台运行 C 程序可以长期保存,进程是暂时的 D 程序没有状态,而进程是有状态的 111.文件exer1的访问权限为rw-r--r--,现要增加所有用户的执行权限和同组用户的写权限,下列命令正确的是 A . A chmod a x g w exer1B chmod 765 exer1 C chmod o x exer1 D chmod g w exer1 112.有关归档和压缩命令,下面描述正确的是 C . A 用uncompress命令解压缩由compress命令生成的后缀为.zip的压缩文件 B unzip命令和gzip命令可以解压缩相同类型的文件 C tar归档且压缩的文件可以由gzip命令解压缩 D tar命令归档后的文件也是一种压缩文件 113.不是shell具有的功能和特点的是 C . A 管道 B 输入输出重定向 C 执行后台进程 D 处理程序命令 114.下列对shell变量FRUIT操作,正确的是: C . A 为变量赋值:$FRUIT=apple B 显示变量的值:fruit=apple C 显示变量的值:echo $FRUIT D 判断变量是否有值:[ -f "$FRUIT" ] 三.简答题: 1.简述Linux文件系统通过i节点把文件的逻辑结构和物理结构转换的工作过程. 参考答案: Linux通过i节点表将文件的逻辑结构和物理结构进行转换. i 节点是一个64字节长的表,表中包含了文件的相关信息,其中有文件的大小、文件所有者、文件的存取许可方式以及文件的类型等重要信息.在i节点表中最重要 的内容是磁盘地址表.在磁盘地址表中有13个块号,文件将以块号在磁盘地址表中出现的顺序依次读取相应的块.Linux文件系统通过把i节点和文件名进行 连接,当需要读取该文件时,文件系统在当前目录表中查找该文件名对应的项,由此得到该文件相对应的i节点号,通过该i节点的磁盘地址表把分散存放的文件物 理块连接成文件的逻辑结构.2.简述进程的启动、终止的方式以及如何进行进程的查看. 参考答案: 在Linux中启动一个进程有手工启动和调度启动两种方式: (1)手工启动 用户在输入端发出命令,直接启动一个进程的启动方式.可以分为: ①前台启动:直接在SHELL中输入命令进行启动. ②后台启动:启动一个目前并不紧急的进程,如打印进程. (2)调度启动 系统管理员根据系统资源和进程占用资源的情况,事先进行调度安排,指定任务运行的时间和场合,到时候系统会自动完成该任务. 经常使用的进程调度命令为:at、batch、crontab. 3. 简述DNS进行域名解析的过程. 参考答案: ,客户端发出DNS请求翻译IP地址或主机名.DNS服务器在收到客户机的请求后: (1)检查DNS服务器的缓存,若查到请求的地址或名字,即向客户机发出应答信息; (2)若没有查到,则在数据库中查找,若查到请求的地址或名字,即向客户机发出应答信息; (3)若没有查到,则将请求发给根域DNS服务器,并依序从根域查找顶级域,由顶级查找二级域,二级域查找三级,直至找到要解析的地址或名字,即向客户机所在网络的DNS服务器发出应答信息,DNS服务器收到应答后现在缓存中存储,然后,将解析结果发给客户机. (4)若没有找到,则返回错误信息.4.系统管理员的职责包括那些?管理的对象是什么? 参考答案: 系统管理员的职责是进行系统资源管理、设备管理、系统性能管理、安全管理和系统性能监测.管理的对象是服务器、用户、服务器的进程及系统的各种资源等. 5.简述安装Slackware Linux系统的过程. 参考答案: (1)对硬盘重新分区. (2)启动Linux系统(用光盘、软盘等). (3)建立Linux主分区和交换分区.(4)用setup命令安装Linux系统. (5)格式化Linux主分区和交换分区(6)安装Linux软件包 (7)安装完毕,建立从硬盘启动Linux系统的LILO启动程序,或者制作一张启动Linux系统的软盘.重新启动Linux系统. 6.什么是静态路由,其特点是什么?什么是动态路由,其特点是什么? 参考答案: 静态路由是由系统管理员设计与构建的路由表规定的路由.适用于网关数量有限的场合,且网络拓朴结构不经常变化的网络.其缺点是不能动态地适用网络状况的变化,当网络状况变化后由网络管理员修改路由表. 动态路由是由路由选择协议而动态构建的,路由协议之间通过交换各自所拥有的路由信息实时更新路由表的内容.动态路由可以自动学习网络的拓朴结构,并更新路由表.其缺点是路由广播更新信息将占据大量的网络带宽. 87.进程的查看和调度分别使用什么命令? 参考答案: 进程查看的命令是ps和top. 进程调度的命令有at,crontab,batch,kill. 8.当文件系统受到破坏时,如何检查和修复系统? 参考答案: 成功修复文件系统的前提是要有两个以上的主文件系统,并保证在修复之前卸载将被修复的文件系统. 使用命令fsck对受到破坏的文件系统进行修复.fsck检查文件系统分为5步,每一步检查系统不同部分的连接特性并对上一步进行验证和修改.在执行 fsck命令时,检查从超级块开始,然后是分配的磁盘块、路径名、目录的连接性、链接数目以及空闲块链表、i-node. 9.解释i节点在文件系统中的作用. 参考答案: 在linux文件系统中,是以块为单位存储信息的,为了找到某一个文件在存储空间中存放的位置,用i节点对一个文件进行索引.I节点包含了描述一个文件所的全部信息.i节点是文件系统管理的一个数据结构. 10.什么是符号链接,什么是硬链接?符号链接与硬链接的区别是什么? 参考答案: 链接分硬链接和符号链接. 符号链接可以建立对于文件和目录的链接.符号链接可以跨文件系统,即可以跨磁盘分区.符号链接的文件类型位是l,链接文件具有新的i节点. 硬链接不可以跨文件系统.它只能建立对文件的链接,硬链接的文件类型位是-,且硬链接文件的i节点同被链接文件的i节点相同. 11.在对linux系统分区进行格式化时需要对磁盘簇(或i节点密度)的大小进行选择,请说明选择的原则. 参考答案: 磁盘簇(或i节点密度)是文件系统调度文件的基本单元.磁盘簇的大小,直接影响系统调度磁盘空间效率.当磁盘分区较大时,磁盘簇也应选得大些;当分区较小时,磁盘簇应选得小些.通常使用经验值. 12.简述网络文件系统NFS,并说明其作用. 参考答案: 网络文件系统是应用层的一种应用服务,它主要应用于Linux和Linux系统、Linux和Unix系统之间的文件或目录的共享.对于用户而言可以通过 NFS方便的访问远地的文件系统,使之成为本地文件系统的一部分.采用NFS之后省去了登录的过程,方便了用户访问系统资源.13.某/etc /fstab文件中的某行如下: /dev/had5 /mnt/dosdata msdos defaults,usrquota 1 2 请解释其含义. 参考答案: (1)第一列:将被加载的文件系统名;(2)第二列:该文件系统的安装点; (3)第三列:文件系统的类型;(4)第四列:设置参数; (5)第五列:供备份程序确定上次备份距现在的天数; (6)第六列:在系统引导时检测文件系统的顺序. 14.Apache服务器的配置文件httpd.conf中有很多内容,请解释如下配置项: (1)MaxKeepAliveRequests 200 (2)UserDir public_html 3)DefaultType text/plain (4)AddLanguare en.en (5)DocumentRoot"/usr/local/httpd/htdocs" (6)AddType application/x-httpd-php.php.php.php4 参考答案: (1)允许每次连接的最大请求数目,此为200;(2)设定用户放置网页的目录; (3)设置服务器对于不认识的文件类型的预设格式; (4)设置可传送语言的文件给浏览器;(5)该目录为Apache放置网页的地方; (6)服务器选择使用php4. 15.某Linux主机的/etc/rc.d/rc.inet1文件中有如下语句,请修正错误,并解释其内容. /etc/rc.d/rc.inet1: &hellip;&hellip; ROUTE add &ndash;net default gw 192.168.0.101 netmask 255.255.0.0 metric 1 ROUTE add &ndash;net 192.168.1.0 gw 192.168.0.250 netmask 255.255.0.0 metric 1 参考答案: 修正错误: (1)ROUTE应改为小写:route;(2)netmask 255.255.0.0应改为:netmask 255.255.255.0; (3)缺省路由的子网掩码应改为:netmask 0.0.0.0; (4)缺省路由在设定,否则其后的路由将无效. 解释内容: (1)route:建立静态路由表的命令;(2)add:增加一条新路由; (3)-net 192.168.1.0:到达一个目标网络的网络地址; (4)default:建立一条缺省路由;(5)gw 192.168.0.101:网关地址; (6)metric 1:到达目标网络经过的路由器数(跳数).16.试解释apache服务器以下配置的含义: (1)port 1080 (2)UserDir userdoc (3)DocumentRoot "/home/htdocs" (4)〈Directory /home/htdocs/inside〉; Options Indexes FollowSymLinks AllowOverride None Order deny,allow deny from all allow from 192.168.1.5 〈/Directory〉; (5)Server Type Standlone Apache服务器配置行含义如下: (1)将apache服务器的端口号设定为1080; (2)设定用户网页目录为userdoc; (3)设定apache服务器的网页根目录:/home/htdocs; (4)在此apache服务器上设定一个目录/home/htdocs/inside,且此目录只允许IP地址为192.168.1.5的主机访问; (5)定义apache服务器以独立进程的方式运行. 17.简述使用ftp进行文件传输时的两种登录方式?它们的区别是什么?常用的ftp文件传输命令是什么? 参考答案: (1)ftp有两种登录方式:匿名登录和授权登录.使用匿名登录时,用户名为:anonymous,密码为:任何合法email地址;使用授权登录时,用户名为用户在远程系统中的用户帐号,密码为用户在远程系统中的用户密码. 区别:使用匿名登录只能访问ftp目录下的资源,默认配置下只能下载;而授权登录访问的权限大于匿名登录,且上载、下载均可. (2)ftp文件传输有两种文件传输模式:ASCII模式和binary模式.ASCII模式用来传输文本文件,其他文件的传输使用binary模式. (3)常用的ftp文件传输命令为:bin、asc、put、get、mput、mget、prompt、bye

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册