首页 文章 精选 留言 我的

精选列表

搜索[面试],共5088篇文章
优秀的个人博客,低调大师

9个常用的Shell脚本,面试也常问!

1、Dos 攻击防范(自动屏蔽攻击 IP) #!/bin/bash DATE=$(date+%d/%b/%Y:%H:%M) LOG_FILE=/usr/local/nginx/logs/demo2.access.log ABNORMAL_IP=$(tail-n5000$LOG_FILE|grep$DATE|awk'{a[$1]++}END{for(iina)if(a[i]>10)printi}') forIPin$ABNORMAL_IP;do if[$(iptables-vnL|grep-c"$IP")-eq0];then iptables-IINPUT-s$IP-jDROP echo"$(date+'%F_%T')$IP">>/tmp/drop_ip.log fi done 2、Linux 系统发送告警脚本 #yuminstallmailx #vi/etc/mail.rc setfrom=baojingtongzhi@163.comsmtp=smtp.163.com setsmtp-auth-user=baojingtongzhi@163.comsmtp-auth-password=123456 setsmtp-auth=login 3、MySQL 数据库备份单循环 #!/bin/bash DATE=$(date+%F_%H-%M-%S) HOST=localhost USER=backup PASS=123.com BACKUP_DIR=/data/db_backup DB_LIST=$(mysql-h$HOST-u$USER-p$PASS-s-e"showdatabases;"2>/dev/null|egrep-v"Database|information_schema|mysql|performance_schema|sys") forDBin$DB_LIST;do BACKUP_NAME=$BACKUP_DIR/${DB}_${DATE}.sql if!mysqldump-h$HOST-u$USER-p$PASS-B$DB>$BACKUP_NAME2>/dev/null;then echo"$BACKUP_NAME备份失败!" fi done 4、MySQL 数据库备份多循环 #!/bin/bash DATE=$(date+%F_%H-%M-%S) HOST=localhost USER=backup PASS=123.com BACKUP_DIR=/data/db_backup DB_LIST=$(mysql-h$HOST-u$USER-p$PASS-s-e"showdatabases;"2>/dev/null|egrep-v"Database|information_schema|mysql|performance_schema|sys") forDBin$DB_LIST;do BACKUP_DB_DIR=$BACKUP_DIR/${DB}_${DATE} [!-d$BACKUP_DB_DIR]&&mkdir-p$BACKUP_DB_DIR&>/dev/null TABLE_LIST=$(mysql-h$HOST-u$USER-p$PASS-s-e"use$DB;showtables;"2>/dev/null) forTABLEin$TABLE_LIST;do BACKUP_NAME=$BACKUP_DB_DIR/${TABLE}.sql if!mysqldump-h$HOST-u$USER-p$PASS$DB$TABLE>$BACKUP_NAME2>/dev/null;then echo"$BACKUP_NAME备份失败!" fi done done 5、Nginx 访问访问日志按天切割 #!/bin/bash LOG_DIR=/usr/local/nginx/logs YESTERDAY_TIME=$(date-d"yesterday"+%F) LOG_MONTH_DIR=$LOG_DIR/$(date+"%Y-%m") LOG_FILE_LIST="default.access.log" forLOG_FILEin$LOG_FILE_LIST;do [!-d$LOG_MONTH_DIR]&&mkdir-p$LOG_MONTH_DIR mv$LOG_DIR/$LOG_FILE$LOG_MONTH_DIR/${LOG_FILE}_${YESTERDAY_TIME} done kill-USR1$(cat/var/run/nginx.pid) 6、Nginx 访问日志分析脚本 #!/bin/bash #日志格式:$remote_addr-$remote_user[$time_local]"$request"$status$body_bytes_sent"$http_referer""$http_user_agent""$http_x_forwarded_for" LOG_FILE=$1 echo"统计访问最多的10个IP" awk'{a[$1]++}END{print"UV:",length(a);for(vina)printv,a[v]}'$LOG_FILE|sort-k2-nr|head-10 echo"----------------------" echo"统计时间段访问最多的IP" awk'$4>="[01/Dec/2018:13:20:25"&&$4<="[27/Nov/2018:16:20:49"{a[$1]++}END{for(vina)printv,a[v]}'$LOG_FILE|sort-k2-nr|head-10 echo"----------------------" echo"统计访问最多的10个页面" awk'{a[$7]++}END{print"PV:",length(a);for(vina){if(a[v]>10)printv,a[v]}}'$LOG_FILE|sort-k2-nr echo"----------------------" echo"统计访问页面状态码数量" awk'{a[$7""$9]++}END{for(vina){if(a[v]>5)printv,a[v]}}' 7、查看网卡实时流量脚本 #!/bin/bash NIC=$1 echo-e"In------Out" whiletrue;do OLD_IN=$(awk'$0~"'$NIC'"{print$2}'/proc/net/dev) OLD_OUT=$(awk'$0~"'$NIC'"{print$10}'/proc/net/dev) sleep1 NEW_IN=$(awk'$0~"'$NIC'"{print$2}'/proc/net/dev) NEW_OUT=$(awk'$0~"'$NIC'"{print$10}'/proc/net/dev) IN=$(printf"%.1f%s""$((($NEW_IN-$OLD_IN)/1024))""KB/s") OUT=$(printf"%.1f%s""$((($NEW_OUT-$OLD_OUT)/1024))""KB/s") echo"$IN$OUT" sleep1 done 8、服务器系统配置初始化脚本 #/bin/bash #设置时区并同步时间 ln-s/usr/share/zoneinfo/Asia/Shanghai/etc/localtime if!crontab-l|grepntpdate&>/dev/null;then (echo"*1***ntpdatetime.windows.com>/dev/null2>&1";crontab-l)|crontab fi #禁用selinux sed-i'/SELINUX/{s/permissive/disabled/}'/etc/selinux/config #关闭防火墙 ifegrep"7.[0-9]"/etc/redhat-release&>/dev/null;then systemctlstopfirewalld systemctldisablefirewalld elifegrep"6.[0-9]"/etc/redhat-release&>/dev/null;then serviceiptablesstop chkconfigiptablesoff fi #历史命令显示操作时间 if!grepHISTTIMEFORMAT/etc/bashrc;then echo'exportHISTTIMEFORMAT="%F%T`whoami`"'>>/etc/bashrc fi #SSH超时时间 if!grep"TMOUT=600"/etc/profile&>/dev/null;then echo"exportTMOUT=600">>/etc/profile fi #禁止root远程登录 sed-i's/#PermitRootLoginyes/PermitRootLoginno/'/etc/ssh/sshd_config #禁止定时任务向发送邮件 sed-i's/^MAILTO=root/MAILTO=""/'/etc/crontab #设置最大打开文件数 if!grep"*softnofile65535"/etc/security/limits.conf&>/dev/null;then cat>>/etc/security/limits.conf<<EOF *softnofile65535 *hardnofile65535 EOF fi #系统内核优化 cat>>/etc/sysctl.conf<<EOF net.ipv4.tcp_syncookies=1 net.ipv4.tcp_max_tw_buckets=20480 net.ipv4.tcp_max_syn_backlog=20480 net.core.netdev_max_backlog=262144 net.ipv4.tcp_fin_timeout=20 EOF #减少SWAP使用 echo"0">/proc/sys/vm/swappiness #安装系统性能分析工具及其他 yuminstallgccmakeautoconfvimsysstatnet-toolsiostatif 9、监控 100 台服务器磁盘利用率脚本 #!/bin/bash HOST_INFO=host.info forIPin$(awk'/^[^#]/{print$1}'$HOST_INFO);do USER=$(awk-vip=$IP'ip==$1{print$2}'$HOST_INFO) PORT=$(awk-vip=$IP'ip==$1{print$3}'$HOST_INFO) TMP_FILE=/tmp/disk.tmp ssh-p$PORT$USER@$IP'df-h'>$TMP_FILE USE_RATE_LIST=$(awk'BEGIN{OFS="="}/^\/dev/{print$NF,int($5)}'$TMP_FILE) forUSE_RATEin$USE_RATE_LIST;do PART_NAME=${USE_RATE%=*} USE_RATE=${USE_RATE#*=} if[$USE_RATE-ge80];then echo"Warning:$PART_NAMEPartitionusage$USE_RATE%!" fi done done

优秀的个人博客,低调大师

面试官常问的HTTP知识点

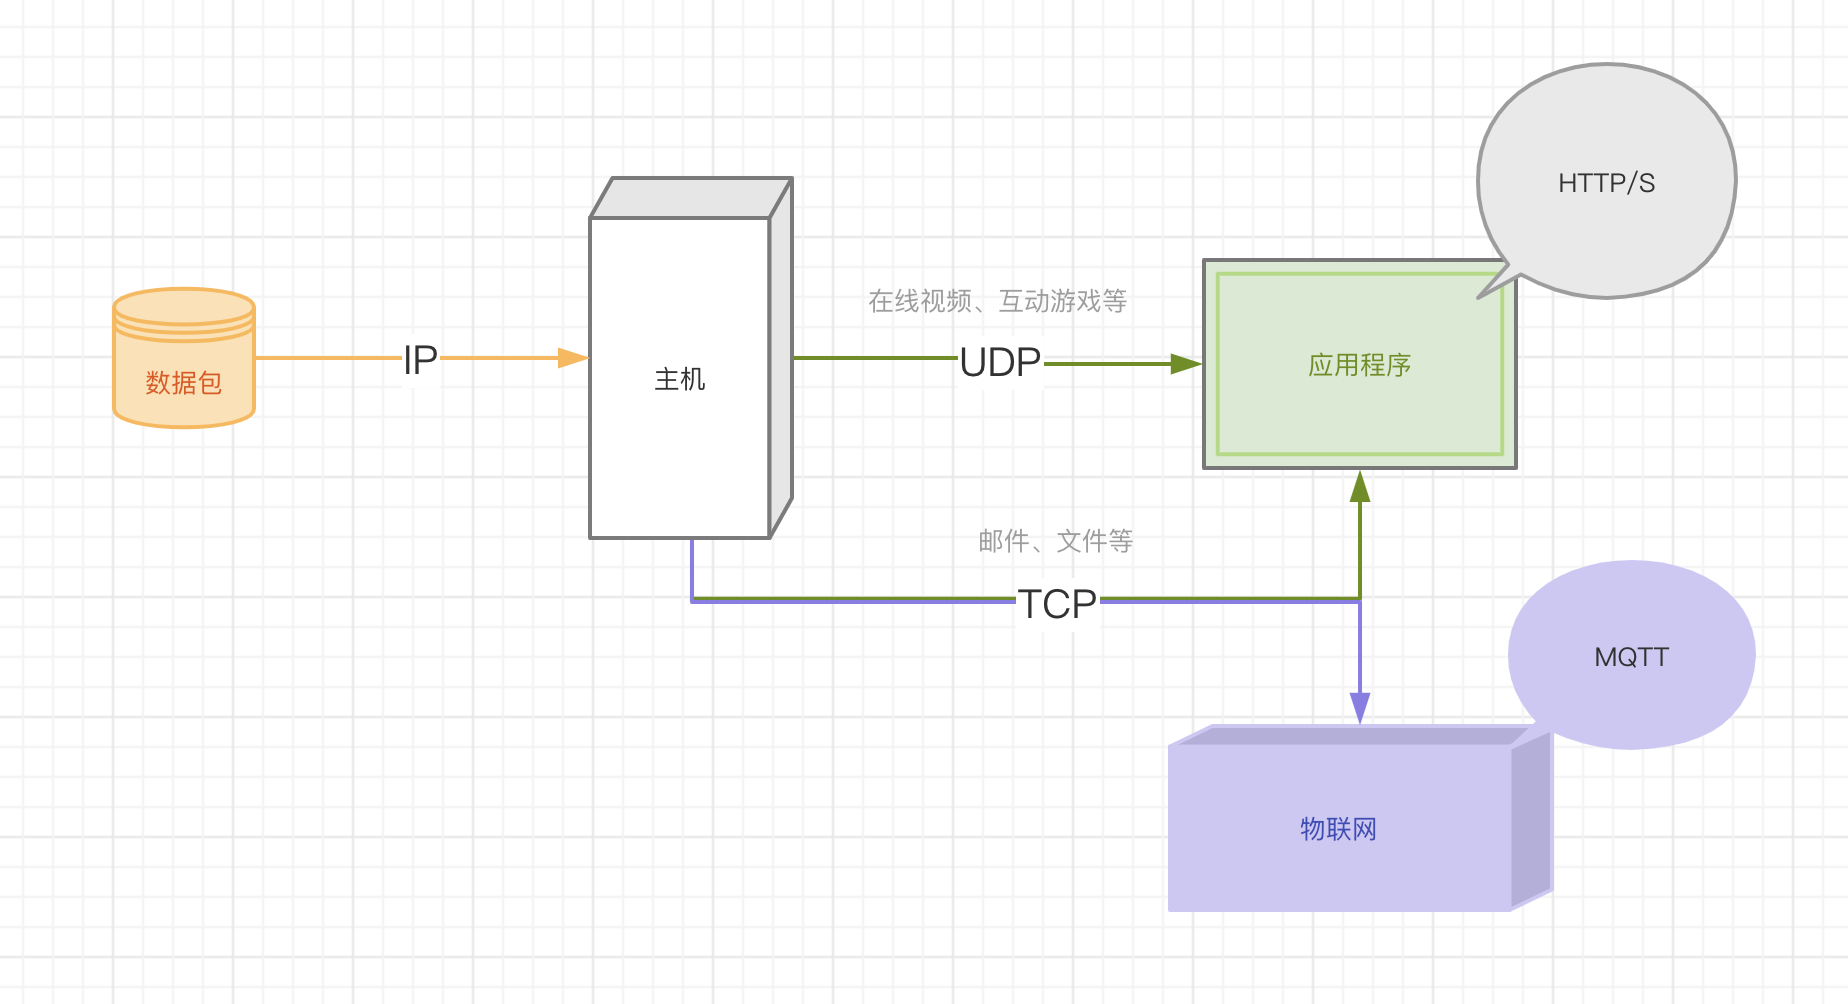
互联网中的数据是通过数据包来传输的,IP通过DNS查询IP地址进而把数据包送达目的主机,UDP接过数据包,通过端口号把数据包送往具体的应用,而使用TCP可保证数据的完整性 当传输层TCP/IP协议将数据传输到网络上时,浏览器可通过HTTP协议进行文本传输,物联网可通过MQTT协议进行交互 一、UDP UDP传输非常快,适合在线视频、互动游戏这类强交互的场景 对于数据可靠性有要求的场景则不太适合,它有个大缺点:不能保证数据可靠性 不提供重发机制,直接丢弃当前的包 发送之后不售后,无法确认是否到达目的地 无法还原数据包成完整的文件 但它的兄弟TCP可以代劳 二、TCP TCP是一种面向连接的、可靠的、基于字节流的传输层通信协议。解决了丢失数据包的问题,并且提供了组装数据包的能力。这不得不感谢发送端不仅给它提供了源端口号和目标端口号,还提供了序列号,引入了数据包排列机制 1、连接过程 1.1、建立连接 TCP是面向连接的,在数据通信之前就做好两端的准备工作,在客户端和服务端通过三个数据包来确认连接的建立 一开始,客户端和服务端都处于 close状态,接着服务端主动监听某个端口,处于listen状态 客户端生成初始序列号client_isn置于TCP首部的序列号中,同时更改SYN标志为1向服务器发起连接,之后处于SYN-SENT状态 服务端收到SYN报文同样生成初始序列号server_isn置于TCP首部的序列号中,并将客户端序列号+1置于TCP首部的确认应答号中,同时更改SYN和ACK标志为1,发送SYN + ACK报文并更改状态为SYN_RCVD 客户端收到SYN + ACK报文,将服务端序列号+1填入确认应答号并回复ACK应答报文变更状态为established 服务器收到应答后也进入established状态 只有第三次握手可以携带数据,前面两次是不可携带数据的 1.2、为什么三次握手? 通过三次握手能防止历史连接的建立,能减少双方不必要的资源开销,能帮助双方同步初始化序列号 两次握手无法仿制历史连接的建立,会造成双方资源的浪费,也无法可靠的同步双方序列号 四次握手:三次握手就已经理论上最少可靠连接建立,因此不需要使用更多的通信次数 2、传输数据 TCP是可靠的,接收端必须对每个数据包进行确认操作,即重发机制 当发送端发送了一个数据包之后,在规定时间内没有接收到反馈的确认信息,则判断数据包丢失,触发重发机制 TCP是基于字节流的,接收端可通过TCP提供的序号进行排序,进而保证数据的完整性,即排列机制 3、断开过程 3.1、断开连接 客户端主动关闭连接,发送FIN报文,即更改FIN标志为1同时进入FIN_WAIT_1状态 服务端收到报文后发出ACK应答报文,接着进入CLOSED_WAIT状态 客户端收到报文后,进入FIN_WAIT_2状态 服务器处理完成后发出FIN报文,并进入LAST_ACK状态 客户端收到报文后发出ACK应答报文,接着进入TIME_WAIT状态 服务器收到ACK应答报文后完成连接关闭 客户端 等待两倍报文最大生存时间(MSL)后 自动进入close状态,完成连接关闭 主动关闭连接的,才有TIME_WAIT状态 3.2、为什么四次挥手? 关闭连接时,客户端向服务端发送FIN时,仅代表客户端不再发送数据但能接收数据 服务端接收到FIN时,回复一个ACK,仅代表收到报文,但服务器可能还有数据需要处理和发送,确保不再发送数据时才发送FIN给到客户端表示同意现在关闭连接 三、HTTP HTTP 协议以 ASCII 码传输,构建于 TCP/IP 协议之上的应用层协议,默认端口号是 80,它是无连接无状态的超文本传输协议 1、HTTP 报文 1.1、请求报文 规范把 HTTP 请求分为三个部分:请求行、请求头 和 消息主体 [method] [url] [version] [headers] [body] HTTP 中的GET、POST、PUT、DELETE对应着资源的查、增、改、删4个操作 1.1.1、GET 只读操作,是安全且幂等的 安全:请求方法不会破坏服务器上的资源 幂等:多次执行相同的操作,结果都是相同的 1.1.2、POST 读写操作,是不安全且不幂等的 1.1.3、PUT 不同于POST,PUT是幂等的 1.1.4、OPTIONS 用以从服务器获取更多信息 1.2、响应报文 同样HTTP响应分为三个部分:状态行、响应头 和 响应正文 [version] [status code] [status msg] [headers] [body] 常见的状态码有 状态码 状态描述 备注 206 Partial Content 范围响应,主体包含所请求的数据区间<br/>断点续传时通过 Range 指定区间 301 Moved Permanently 请求永久重定向 302 Moved Temporarily 请求临时重定向 304 Not Modified 未修改,使用缓存文件(协商缓存) 400 Bad Request 客户端请求有语法错误 401 Unauthorized 请求未经授权(同WWW-Authenticate一起使用)<br/>在后续请求中携带 Authorization用于验证用户代理身份的凭证 403 Forbidden 服务器拒绝提供服务,通常在响应正文给出原因 404 Not Found 请求资源不存在 500 Internal Server Error 服务器发生不可预期的错误 503 Service Unavailable 服务器当前无法处理请求,需等待服务器恢复正常 2、HTTP 演变 版本 核心诉求 新增特性 HTTP/1.0 支持多种类型的文件下载 引入请求头、响应头、状态码 HTTP/1.1 提高对带宽的利用率 1、持久连接(每个域名最多同时维护 6 个 TCP 持久连接) 2、使用 CDN 实现域名分片机制 3、提供虚拟主机的支持(Host 字段) 4、增加缓存策略 5、安全机制(CORS) HTTP/2.0 提升网络速度 1、多路复用 2、设置请求的优先级 3、服务器推送 4、头部压缩 5、二进制格式 HTTP/3.0 构建高效网络 1、甩掉TCP、TLS 的包袱,使用UDP协议 2、QUIC协议 HTTPS 构建安全HTTP 引入SSL 、混合加密、摘要算法 、数字证书 2.1、持久连接 HTTP/1.1 中增加了持久连接的方法,即在一个 TCP 连接上可以传输多个 HTTP 请求,只要浏览器或者服务器没有明确断开连接,那么该 TCP 连接会一直保持,提升了整体 HTTP 的请求时长。目前浏览器中对于同一个域名,默认允许同时建立 6 个 TCP 持久连接 Connection: Keep-Alive; // HTTP/1.1默认使用持久连接,如需关闭,请求头Connection设置为close Keep-Alive: timeout=5, max=100; // HTTP 长连接不可能一直保持,timeout=5 表示这个TCP通道可以保持5秒,max=100,表示这个长连接最多接收100次请求就断开 2.2、使用 CDN 实现域名分片机制 2.3、提供虚拟主机的支持 Host表示当前的域名地址,服务器可以根据不同的 Host 值做不同的处理 Host: <host>:<port>; // host: 服务器的域名(用于虚拟主机) port: 服务器监听的 TCP 端口号 2.4、缓存策略 2.5、安全机制 2.5.1、会话跟踪 HTTP是无状态协议,即浏览器对于事务的处理没有记忆能力,可通过Cookie和JWT机制来进行会话跟踪 Cookie机制 服务端第一次收到请求时创建session对象生成对应的sessionID,将其放进Set-Cookie发送给客户端,下一次访问时,客户端携带sessionID请求服务端,服务端可通过sessionID识别用户信息 Cookie 的过期时间、域、路径、有效期、适用站点都可以根据需要来指定 功能 属性 例子 补充说明 定义 Cookie 的生命周期 Expires <br/> Max-Age Set-Cookie: key=value; Expires=Wed, 21 Oct 2022 07:28:00 GMT 设定的日期和时间只与客户端相关,会话期 Cookie 仅在会话期内有效 限制访问 Cookie HttpOnly<br/>Secure Set-Cookie: key=value; Secure; HttpOnly HttpOnly:仅作用于服务器<br/>Secure仅适用于 HTTPS 协议加密过的请求 Cookie 的作用域 Domain<br/>Path Set-Cookie:Domain=mozilla.org;Path=/docs Domain 指定了哪些主机可以接受 Cookie<br/>Path 指定了主机下的哪些路径可以接受 Cookie SameSite None<br/>Strict<br/>Lax Set-Cookie: key=value; SameSite=Strict None:浏览器会在同站请求、跨站请求下继续发送 cookies(旧版本浏览器默认选项)<br/>Strict:浏览器将只在访问相同站点时发送 cookie<br/>Lax:与 Strict 类似,但用户从外部站点导航至URL时除外(新版本浏览器默认选项) JWT机制 (JSON Web Token) Cookies 只适用于单节点的域 或 节点的子域,若通过第三个节点访问会被禁止。而JWT机制则支持跨域认证,可通过多个节点进行用户认证 服务端第一次收到请求时,进行认证后生成一个 Token(签名后的JSON 对象)发送给客户端。客户端可将收到的jwt存储在Cookie或localStorage上,之后每次与服务端通信都携带上,可通过Cookie自动发送,但这种方式不能跨域,比较推荐通过 POST 请求的数据体 或 Authorization进行传递 注意喔,JWT 的 Cookie 信息存储在客户端,即服务端是无状态的 2.5.2、跨源资源共享(CORS) 规范要求那些可能产生副作用的请求,浏览器必须首先使用OPTIONS方法发起一个预检请求,从而获知服务端是否允许跨域请求。服务器确认允许后才发起实际的HTTP请求。在预检请求的返回中,服务端可通知客户端是否需要携带身份凭证 简单请求 若请求满足下述所有条件,则称之为简单请求,它不会触发预检请求 1、使用GET、HEAD和POST请求方法 2、Content-Type的值仅限于text/plain、multipart/form-data和application/x-www-form-urlencoded 3、请求中没有注册任何事件监听器,没有使用 ReadableStream 对象 // 附带身份凭证的简单请求 withCredentials:true; // 向服务器发送 Cookies Access-Control-Allow-Credentials: true; // 服务端允许附带身份凭证 复杂请求 响应头 例子 说明 Access-Control-Allow-Origin Access-Control-Allow-Origin: <origin>/* Vary: Origin origin:指定允许访问该资源的URI<br/>若指定了具体的域名,则Vary的值必须包含Origin,表明服务端按URI返回对应内容 Access-Control-Expose-Headers Access-Control-Expose-Headers: X-My-Custom-Header 服务器把允许浏览器访问的头放入白名单 Access-Control-Allow-Credentials Access-Control-Allow-Credentials: true 指定了credentials:true时是否允许浏览器读取 response 的内容<br/>在预检请求的响应时,指定实际的请求是否可以使用 credentials Access-Control-Max-Age Access-Control-Max-Age: 86400 预检请求的结果在多少秒内有效 Access-Control-Allow-Methods Access-Control-Allow-Methods: <method>[, <method>]* 预检请求的响应,指明了实际请求所允许使用的 HTTP 方法 Access-Control-Allow-Headers Access-Control-Allow-Headers: <field-name>[, <field-name>]* 预检请求的响应,指明了实际请求中允许携带的首部字段 2.6、支持动态生成内容 服务器会将数据分割成若干个任意大小的数据块,每个数据块发送时会附上上个数据块的长度,最后使用一个零长度的块作为发送数据完成的标志,因此对于下载请求来说,是没有办法实现进度的 Transfer-Encoding: gzip, chunked; // 分块:chunked 压缩算法:compress、deflate、gzip 2.7、多路复用 一个域名只使用一个TCP长连接来传输数据,这样整个页面资源的下载过程只需要一次慢启动,避免了多个 TCP 连接竞争带宽的问题。移除了串行请求,顺应的解决了队头阻塞问题 2.8、设置请求的优先级 每个数据流都标记着独一无二的编号,客户端可以指定数据流的优先级 2.9、服务器推送 服务端主动向客户端发送消息,即:当用户请求一个 HTML 页面之后,服务器知道该 HTML 页面会引用几个重要的 JavaScript 文件和 CSS 文件,那么在接收到 HTML 请求之后,附带将要使用的 CSS 文件和 JavaScript 文件一并发送给浏览器,这样当浏览器解析完 HTML 文件之后,就能直接拿到需要的 CSS 文件和 JavaScript 文件,大大提升了页面首次渲染速度 2.10、头部压缩 HTTP/2.0引入HPACK算法:在客户端和服务器同时维护一张头信息表,所有字段都会存入这个表生成一个索引号,相同字段只发送对应的索引号,即:同时发出多个请求,请求头一样或相似,则协议会将重复部分消除 2.11、二进制格式 HTTP/2.0 全面采用二进制格式,头信息和数据体都是二进制,统称为「帧」提高了数据传输的效率 2.12、QUIC协议 实现了类似 TCP 的流量控制、传输可靠性的功能 集成了 TLS 加密功能,减少了握手所花费的 RTT 个数 实现了 HTTP/2 中的多路复用功能 不同于 TCP,QUIC 实现了在同一物理连接上可以有多个独立的逻辑数据流,实现了数据流的单独传输,避免了 TCP 中队头阻塞的问题 实现了快速握手功能,基于 UDP 的 QUIC 可使用 0-RTT|1-RTT 来建立连接 3、HTTPS HTTPS在HTTP和TCP之间加了一层用于加解密的SSL/TLS协议,通过信息加密、校验机制 和 身份证书 保证通信的安全性 客户端 发送 对称加密套件列表、非对称加密套件列表 和 客户端随机数 给到服务端 服务端 保存 客户端随机数 和 私钥,回复 选中的对称加密套件、非对称加密套件 和 服务端随机数 以及 数字证书 客户端向 CA机构验证数字证书,证实服务端身份并获取公钥 客户端利用两端的随机数计算出pre-master,并用获取到的公钥进行加密,发送加密后的pre-master 服务端拿出私钥进行解密,得到pre-master 服务端和客户端使用这三组随机数生成会话密钥,并返回确认消息 之后使用对称加密进行通讯 3.1、混合加密 HTTPS通过非对称加密交换「会话密钥」后续通信使用对称加密,这是由于 非对称加密使用两个密钥:公钥和私钥,公钥可保存在CA机构同时保存私钥。可以安全的进行密钥交换,但速度慢 对称加密只使用一个密钥,无法做到安全的密钥交换,但速度快 3.2、摘要算法 摘要算法通过生成唯一的指纹,用于校验数据的完整性。客户端在进行通信前会通过摘要算法得出明文的指纹,请求时将指纹和明文一并加密,服务端收到密文后进行解密,比对携带的指纹和当前计算的指纹是否一致,一致则说明数据完整 3.3、数字证书 权威机构CA签发认证的数字证书【包含了公钥、组织信息、CA信息、有效时间、证书序列号、CA生成的数字签名等】这些信息是明文的,同时可向浏览器证明服务器的身份 四、MQTT MQTT是基于二进制消息的发布/订阅编程模式的消息协议,非常适合需要低功耗和网络带宽有限的IoT场景 设备连接 设备通过MQTT协议连接到物联网云服务,进而可以进行设备管理及数据管理 消息类型 MQTT拥有14种不同的消息类型,比如CONNECT表示客户端连接到MQTT代理,CONNACK表示连接确认 主题 MQTT提供了主题对消息进行分类,消息是一个UTF-8的字符串,通过类似正则的规则进行匹配分类,比如:+可以过滤一个层级,*可以过滤任意级别的层级(必须在主题最后) 服务质量 MQTT提供级别0、级别1和级别2三种服务质量 服务质量 消息可靠性 解释 级别0 尽力而为 不提供重发 级别1 至少一次 提供重发,并发可能造成重复消息 级别2 恰好一次 不丢失不重复,但增加延时减少并发

优秀的个人博客,低调大师

5 分钟搞懂面试官必问 React 题

说说对 React Hooks 的理解?解决了什么问题? 一、是什么 Hook是 React 16.8 的新增特性。它可以让你在不编写class的情况下使用state以及其他的React特性 至于为什么引入hook,官方给出的动机是解决长时间使用和维护react过程中常遇到的问题,例如: 难以重用和共享组件中的与状态相关的逻辑 逻辑复杂的组件难以开发与维护,当我们的组件需要处理多个互不相关的 local state 时,每个生命周期函数中可能会包含着各种互不相关的逻辑在里面 类组件中的this增加学习成本,类组件在基于现有工具的优化上存在些许问题 由于业务变动,函数组件不得不改为类组件等等 在以前,函数组件也被称为无状态的组件,只负责渲染的一些工作 因此,现在的函数组件也可以是有状态的组件,内部也可以维护自身的状态以及做一些逻辑方面的处理 二、有哪些 上面讲到,Hooks让我们的函数组件拥有了类组件的特性,例如组件内的状态、生命周期 最常见的hooks有如下: useState useEffect 其他 useState 首先给出一个例子,如下: import React, { useState } from 'react'; function Example() { // 声明一个叫 "count" 的 state 变量 const [count, setCount] = useState(0); return ( <div> <p>You clicked {count} times</p > <button onClick={() => setCount(count + 1)}> Click me </button> </div> ); } 复制代码 在函数组件中通过useState实现函数内部维护state,参数为state默认的值,返回值是一个数组,第一个值为当前的state,第二个值为更新state的函数 该函数组件等价于的类组件如下: class Example extends React.Component { constructor(props) { super(props); this.state = { count: 0 }; } render() { return ( <div> <p>You clicked {this.state.count} times</p > <button onClick={() => this.setState({ count: this.state.count + 1 })}> Click me </button> </div> ); } } 复制代码 从上述两种代码分析,可以看出两者区别: state声明方式:在函数组件中通过 useState 直接获取,类组件通过constructor 构造函数中设置 state读取方式:在函数组件中直接使用变量,类组件通过this.state.count的方式获取 state更新方式:在函数组件中通过 setCount 更新,类组件通过this.setState() 总的来讲,useState 使用起来更为简洁,减少了this指向不明确的情况 useEffect useEffect可以让我们在函数组件中进行一些带有副作用的操作 同样给出一个计时器示例: class Example extends React.Component { constructor(props) { super(props); this.state = { count: 0 }; } componentDidMount() { document.title = `You clicked ${this.state.count} times`; } componentDidUpdate() { document.title = `You clicked ${this.state.count} times`; } render() { return ( <div> <p>You clicked {this.state.count} times</p > <button onClick={() => this.setState({ count: this.state.count + 1 })}> Click me </button> </div> ); } } 复制代码 从上面可以看见,组件在加载和更新阶段都执行同样操作 而如果使用useEffect后,则能够将相同的逻辑抽离出来,这是类组件不具备的方法 对应的useEffect示例如下: import React, { useState, useEffect } from 'react'; function Example() { const [count, setCount] = useState(0); useEffect(() => { document.title = `You clicked ${count} times`; }); return ( <div> <p>You clicked {count} times</p > <button onClick={() => setCount(count + 1)}> Click me </button> </div> ); } 复制代码 useEffect第一个参数接受一个回调函数,默认情况下,useEffect会在第一次渲染和更新之后都会执行,相当于在componentDidMount和componentDidUpdate两个生命周期函数中执行回调 如果某些特定值在两次重渲染之间没有发生变化,你可以跳过对 effect 的调用,这时候只需要传入第二个参数,如下: useEffect(() => { document.title = `You clicked ${count} times`; }, [count]); // 仅在 count 更改时更新 复制代码 上述传入第二个参数后,如果count的值是5,而且我们的组件重渲染的时候count还是等于5,React 将对前一次渲染的[5]和后一次渲染的[5]进行比较,如果是相等则跳过effects执行 回调函数中可以返回一个清除函数,这是effect可选的清除机制,相当于类组件中componentwillUnmount生命周期函数,可做一些清除副作用的操作,如下: useEffect(() => { function handleStatusChange(status) { setIsOnline(status.isOnline); } ChatAPI.subscribeToFriendStatus(props.friend.id, handleStatusChange); return () => { ChatAPI.unsubscribeFromFriendStatus(props.friend.id, handleStatusChange); }; }); 复制代码 所以,useEffect相当于componentDidMount,componentDidUpdate和componentWillUnmount这三个生命周期函数的组合 其它 hooks 在组件通信过程中可以使用useContext,refs学习中我们也用到了useRef获取DOM结构...... 还有很多额外的hooks,如: useReducer useCallback useMemo useRef 三、解决什么 通过对上面的初步认识,可以看到hooks能够更容易解决状态相关的重用的问题: 每调用useHook一次都会生成一份独立的状态 通过自定义hook能够更好的封装我们的功能 编写hooks为函数式编程,每个功能都包裹在函数中,整体风格更清爽,更优雅 hooks的出现,使函数组件的功能得到了扩充,拥有了类组件相似的功能,在我们日常使用中,使用hooks能够解决大多数问题,并且还拥有代码复用机制,因此优先考虑hooks 结语 创作不易,如果对大家有所帮助,希望大家点赞支持,有什么问题也可以在评论区里讨论😄~ 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star: http://github.crmeb.net/u/defu 不胜感激 ! 来自 “开源独尊 ” ,链接: https://ym.baisou.ltd/post/852.html

优秀的个人博客,低调大师

前端面试常考题:JS垃圾回收机制

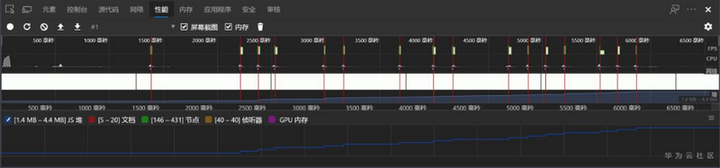
摘要:众所周知,应用程序在运行过程中需要占用一定的内存空间,且在运行过后就必须将不再用到的内存释放掉,否则就会出现下图中内存的占用持续升高的情况,一方面会影响程序的运行速度,另一方面严重的话则会导致整个程序的崩溃。 众所周知,应用程序在运行过程中需要占用一定的内存空间,且在运行过后就必须将不再用到的内存释放掉,否则就会出现下图中内存的占用持续升高的情况,一方面会影响程序的运行速度,另一方面严重的话则会导致整个程序的崩溃。 JavaScript中的内存管理 内存:由可读写单元组成,表示一片可操作空间; 管理:人为的去操作一片空间的申请、使用和释放; 内存管理:开发者主动申请空间、使用空间、释放空间; 管理流程:申请-使用-释放 部分语言需要(例如C语言)需要手动去释放内存,但是会很麻烦,所以很多语言,例如JAVA都会提供自动的内存管理机制,称为“垃圾回收机制”,JavaScript语言中也提供了垃圾回收机制(Garbage Collecation),简称GC机制。 全停顿(Stop The World ) 在介绍垃圾回收算法之前,我们先了解一下「全停顿」。垃圾回收算法在执行前,需要将应用逻辑暂停,执行完垃圾回收后再执行应用逻辑,这种行为称为 「全停顿」(Stop The World)。例如,如果一次GC需要50ms,应用逻辑就会暂停50ms。 全停顿的目的,是为了解决应用逻辑与垃圾回收器看到的情况不一致的问题。 举个例子,在自助餐厅吃饭,高高兴兴地取完食物回来时,结果发现自己餐具被服务员收走了。这里,服务员好比垃圾回收器,餐具就像是分配的对象,我们就是应用逻辑。在我们看来,只是将餐具临时放在桌上,但是服务员看来觉得你已经不需要使用了,因此就收走了。你与服务员对于同一个事物看到的情况是不一致,导致服务员做了与我们不期望的事情。因此,为避免应用逻辑与垃圾回收器看到的情况不一致,垃圾回收算法在执行时,需要停止应用逻辑。 JavaScript中的垃圾回收 JavaScript中会被判定为垃圾的情形如下: 对象不再被引用; 对象不能从根上访问到; GC算法 常见的GC算法如下: 引用计数 标记清除 标记整理 分代回收 引用计数 早期的浏览器最常使用的垃圾回收方法叫做"引用计数"(reference counting):语言引擎有一张"引用表",保存了内存里面所有的资源(通常是各种值)的引用次数。如果一个值的引用次数是0,就表示这个值不再用到了,因此可以将这块内存释放。 const user1 = {age: 11} const user2 = {age: 22} const user3 = {age: 33} const userList = [user1.age, user2.age, user3.age] 上面这段代码,当执行过一遍过后,user1、user2、user3都是被userList引用的,所以它们的引用计数不为零,就不会被回收 function fn() { const num1 = 1 const num2 = 2 } fn() 上面代码中fn函数执行完毕,num1、num2都是局部变量,执行过后,它们的引用计数就都为零,所有这样的代码就会被当做“垃圾”,进行回收。 引用计数算法有一个比较大的问题:循环引用 function objGroup(obj1, obj2) { obj1.next = obj2 obj2.prev = obj1 return { o1: obj1, o2: obj2, } } let obj = objGroup({name: 'obj1'}, {name: 'obj2'}) console.log(obj) 上面的这个例子中,obj1和obj2通过各自的属性相互引用,所有它们的引用计数都不为零,这样就不会被垃圾回收机制回收,造成内存浪费。 引用计数算法其实还有一个比较大的缺点,就是我们需要单独拿出一片空间去维护每个变量的引用计数,这对于比较大的程序,空间开销还是比较大的。 引用计数算法优点: 引用计数为零时,发现垃圾立即回收; 最大限度减少程序暂停; 引用计数算法缺点: 无法回收循环引用的对象; 空间开销比较大; 标记清除(Mark-Sweep) 核心思想:分标记和清除两个阶段完成。 遍历所有对象找标记活动对象; 遍历所有对象清除没有标记对象; 回收相应的空间。 标记清除算法的优点是:对比引用计数算法,标记清除算法最大的优点是能够回收循环引用的对象,它也是v8引擎使用最多的算法。 标记清除算法的缺点是: 上图我们可以看到,红色区域是一个根对象,就是一个全局变量,会被标记;而蓝色区域就是没有被标记的对象,会被回收机制回收。这时就会出现一个问题,表面上蓝色区域被回收了三个空间,但是这三个空间是不连续的,当我们有一个需要三个空间的对象,那么我们刚刚被回收的空间是不能被分配的,这就是“空间碎片化”。 标记整理(Mark-Compact) 为了解决内存碎片化的问题,提高对内存的利用,引入了标记整理算法。 标记整理可以看做是标记清除的增强。标记阶段的操作和标记清除一致。 清除阶段会先执行整理,移动对象位置,将存活的对象移动到一边,然后再清理端边界外的内存。 标记整理的缺点是:移动对象位置,不会立即回收对象,回收的效率比较慢。 增量标记(Incremental Marking) 为了减少全停顿的时间,V8对标记进行了优化,将一次停顿进行的标记过程,分成了很多小步。每执行完一小步就让应用逻辑执行一会儿,这样交替多次后完成标记。 长时间的GC,会导致应用暂停和无响应,将会导致糟糕的用户体验。从2011年起,v8就将「全暂停」标记换成了增量标记。改进后的标记方式,最大停顿时间减少到原来的1/6。 v8引擎垃圾回收策略 采用分代回收的思想; 内存分为新生代、老生代; 针对不同对象采用不同算法: (1)新生代:对象的存活时间较短。新生对象或只经过一次垃圾回收的对象。 (2)老生代:对象存活时间较长。经历过一次或多次垃圾回收的对象。 V8堆的空间等于新生代空间加上老生代空间。且针对不同的操作系统对空间做了内存的限制。 针对浏览器来说,这样的内存是足够使用的。限制内存的原因: 针对浏览器的GC机制,经过不断的测试,如果内存再设置大一点,GC回收的时间就会达到用户的感知,会造成感知上的卡顿。 回收新生代对象 回收新生代对象主要采用复制算法(Scavenge 算法)加标记整理算法。而Scavenge 算法的具体实现,主要采用了Cheney算法。 Cheney算法将内存分为两个等大空间,使用空间为From,空闲空间为To。 检查From空间内的存活对象,若对象存活,检查对象是否符合晋升条件,若符合条件则晋升到老生代,否则将对象从From空间复制到To空间。若对象不存活,则释放不存活对象的空间。完成复制后,将From空间与To空间进行角色翻转。 对象晋升机制 一轮GC还存活的新生代需要晋升。 当对象从From空间复制到To空间时,若To空间使用超过 25%,则对象直接晋升到老生代中。设置为25%的比例的原因是,当完成Scavenge回收后,To空间将翻转成From空间,继续进行对象内存的分配。若占比过大,将影响后续内存分配。 回收老生代对象 回收老生代对象主要采用标记清除、标记整理、增量标记算法,主要使用标记清除算法,只有在内存分配不足时,采用标记整理算法。 首先使用标记清除完成垃圾空间的回收; 采用标记整理进行空间优化; 采用增量标记进行效率优化; 新生代和老生代回收对比 新生代由于占用空间比较少,采用空间换时间机制。 老生代区域空间比较大,不太适合大量的复制算法和标记整理,所以最常用的是标记清除算法,为了就是让全停顿的时间尽量减少。 内存泄漏识别方法 我们先写一段比较消耗内存的代码: <button class="btn">点击</button> <script> const btn = document.querySelector('.btn') const arrList = [] btn.onclick = function() { for(let i = 0; i < 100000; i++) { const p = document.createElement('p') // p.innerHTML = '我是一个p元素' document.body.appendChild(p) } arrList.push(new Array(1000000).join('x')) } </script> 使用浏览器的Performance来监控内存变化 点击录制,然后我们操作们感觉消耗性能的操作,操作完成之后,点击stop停止录制。 然后我们看一看是那些地方引起了内存的泄漏,我们只需要关注内存即可。 可以看到内存在短时间消耗的比较快,下降的小凹槽,就是浏览器在进行垃圾回收。 性能优化 1.避免使用全局变量 全局变量会挂载在window下; 全局变量至少有一个引用计数; 全局变量存活更久,持续占用内存; 在明确数据作用域的情况下,尽量使用局部变量; 2.减少判断层级 function doSomething(part, chapter) { const parts = ['ES2016', '工程化', 'Vue', 'React', 'Node'] if (part) { if (parts.includes(part)) { console.log('属于当前课程') if (chapter > 5) { console.log('您需要提供 VIP 身份') } } } else { console.log('请确认模块信息') } } doSomething('Vue', 6) // 减少判断层级 function doSomething(part, chapter) { const parts = ['ES2016', '工程化', 'Vue', 'React', 'Node'] if (!part) { console.log('请确认模块信息') return } if (!parts.includes(part)) return console.log('属于当前课程') if (chapter > 5) { console.log('您需要提供 VIP 身份') } } doSomething('Vue', 6) 3.减少数据读取次数 对于频繁使用的数据,我们要对数据进行缓存。 <div id="skip" class="skip"></div> <script> var oBox = document.getElementById('skip') // function hasEle (ele, cls) { // return ele.className === cls // } function hasEle (ele, cls) { const className = ele.className return className === cls } console.log(hasEle(oBox, 'skip')) </script> 4.减少循环体中的活动 var test = () => { var i var arr = ['Hello World!', 25, '岂曰无衣,与子同袍'] for(i = 0; i < arr.length; i++) { console.log(arr[i]) } } // 优化后,将arr.length单独提出,防止每次循环都获取一次 var test = () => { var i var arr = ['Hello World!', 25, '岂曰无衣,与子同袍'] var len = arr.length for(i = 0; i < len; i++) { console.log(arr[i]) } } 5.事件绑定优化 <ul class="ul"> <li>Hello World!</li> <li>25</li> <li>岂曰无衣,与子同袍</li> </ul> <script> var list = document.querySelectorAll('li') function showTxt(ev) { console.log(ev.target.innerHTML) } for (item of list) { item.onclick = showTxt } // 优化后 function showTxt(ev) { var target = ev.target if (target.nodeName.toLowerCase() === 'li') { console.log(ev.target.innerHTML) } } var ul = document.querySelector('.ul') ul.addEventListener('click', showTxt) </script> 6.避开闭包陷阱 <button class="btn">点击</button> <script> function foo() { let el = document.querySelector('.btn') el.onclick = function() { console.log(el.className) } } foo() // 优化后 function foo1() { let el = document.querySelector('.btn') el.onclick = function() { console.log(el.className) } el = null // 将el置为 null 防止闭包中的引用使得不能被回收 } foo1() </script> 本文分享自华为云社区《Vue进阶(幺陆玖):JS垃圾回收机制》,原文作者:SHQ5785 。 点击关注,第一时间了解华为云新鲜技术~

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册